


103
社区成员
 发帖
 与我相关
 我的任务

 分享
| 这个作业属于哪个课程 | 2501_CS_SE_FZU |
|---|---|
| 这个作业要求在哪里 | 软件工程实践——大模型评测作业 |
| 这个作业的目标 | 调研、评测 |
| 其他参考文献 | 构建之法 |
阿里百炼是阿里巴巴集团推出的一站式大模型服务平台。它的核心定位是降低大模型应用的门槛,为企业和开发者提供一个集成了模型、工具、算力和服务的“模型应用工厂”,让用户能够像在工厂流水线上一样,高效、便捷地构建、调试和部署大模型应用。
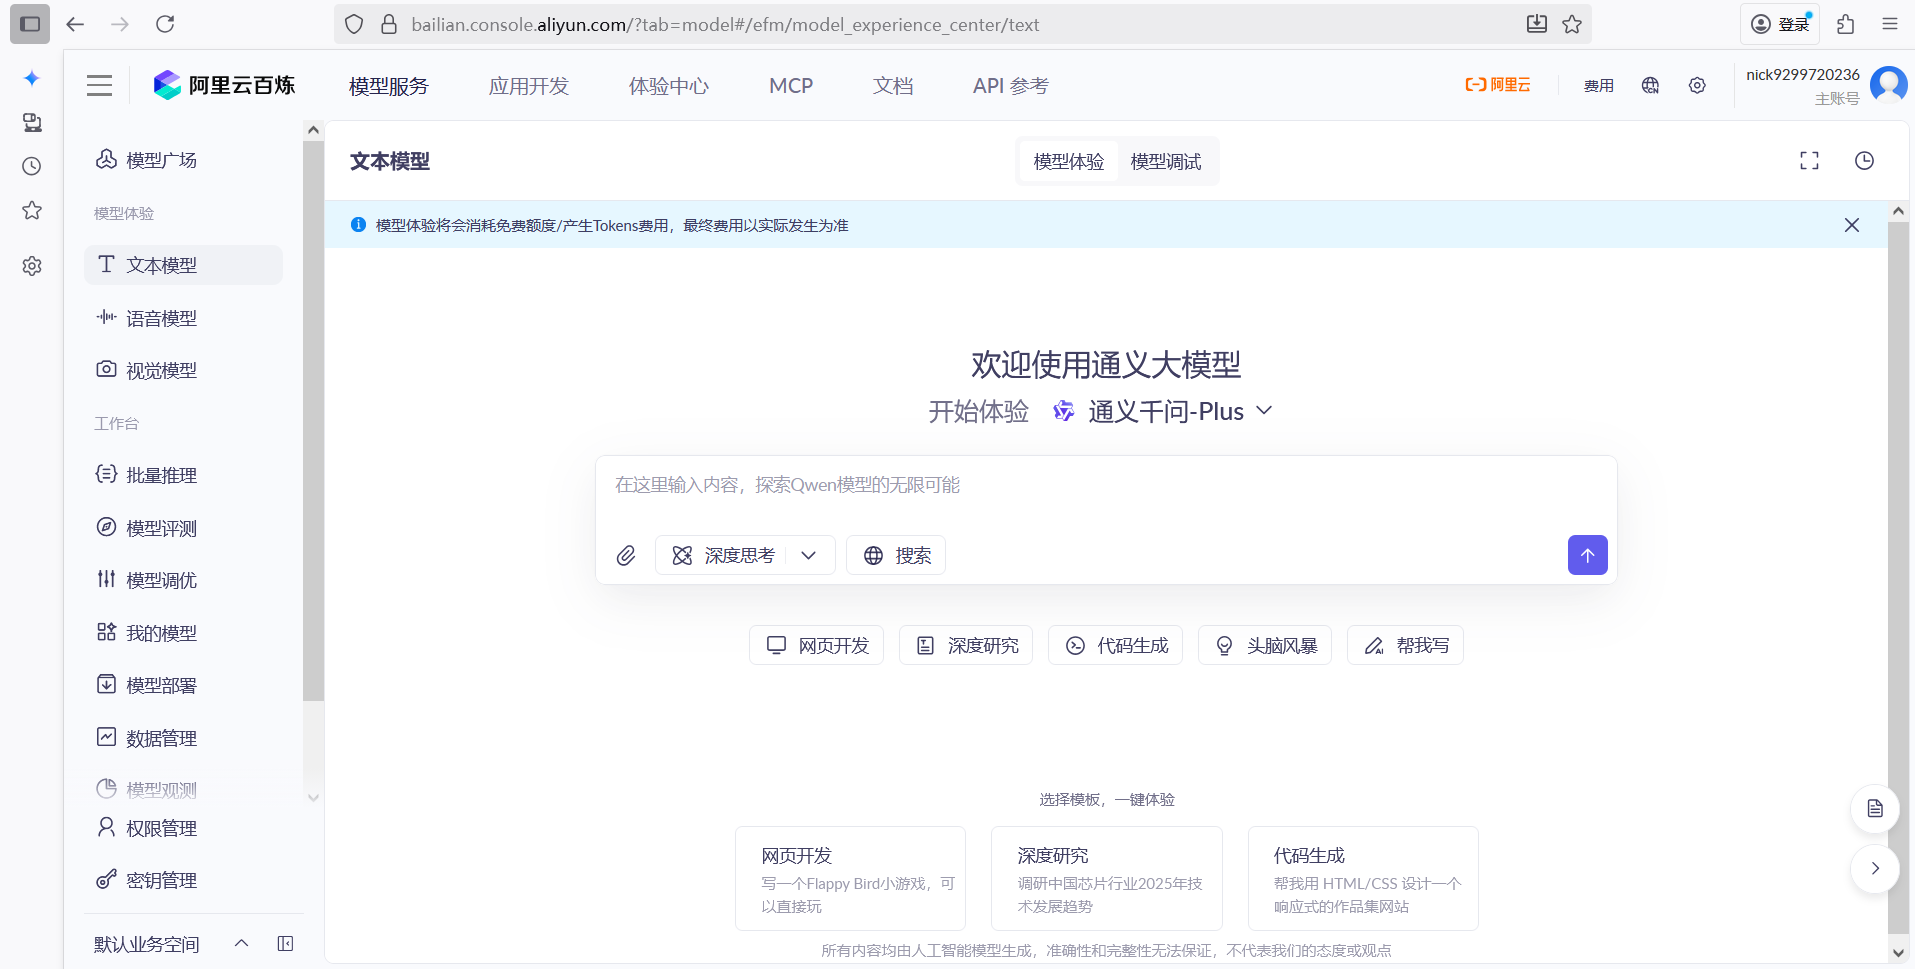
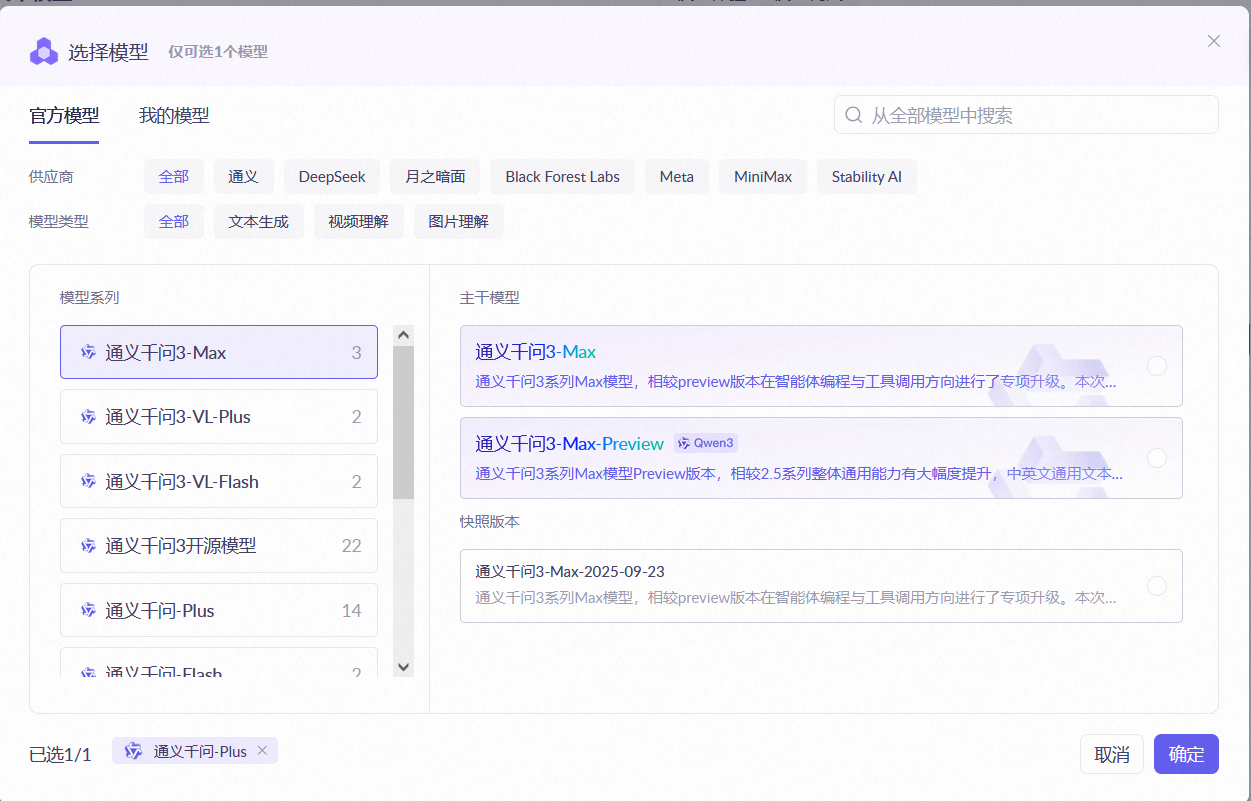
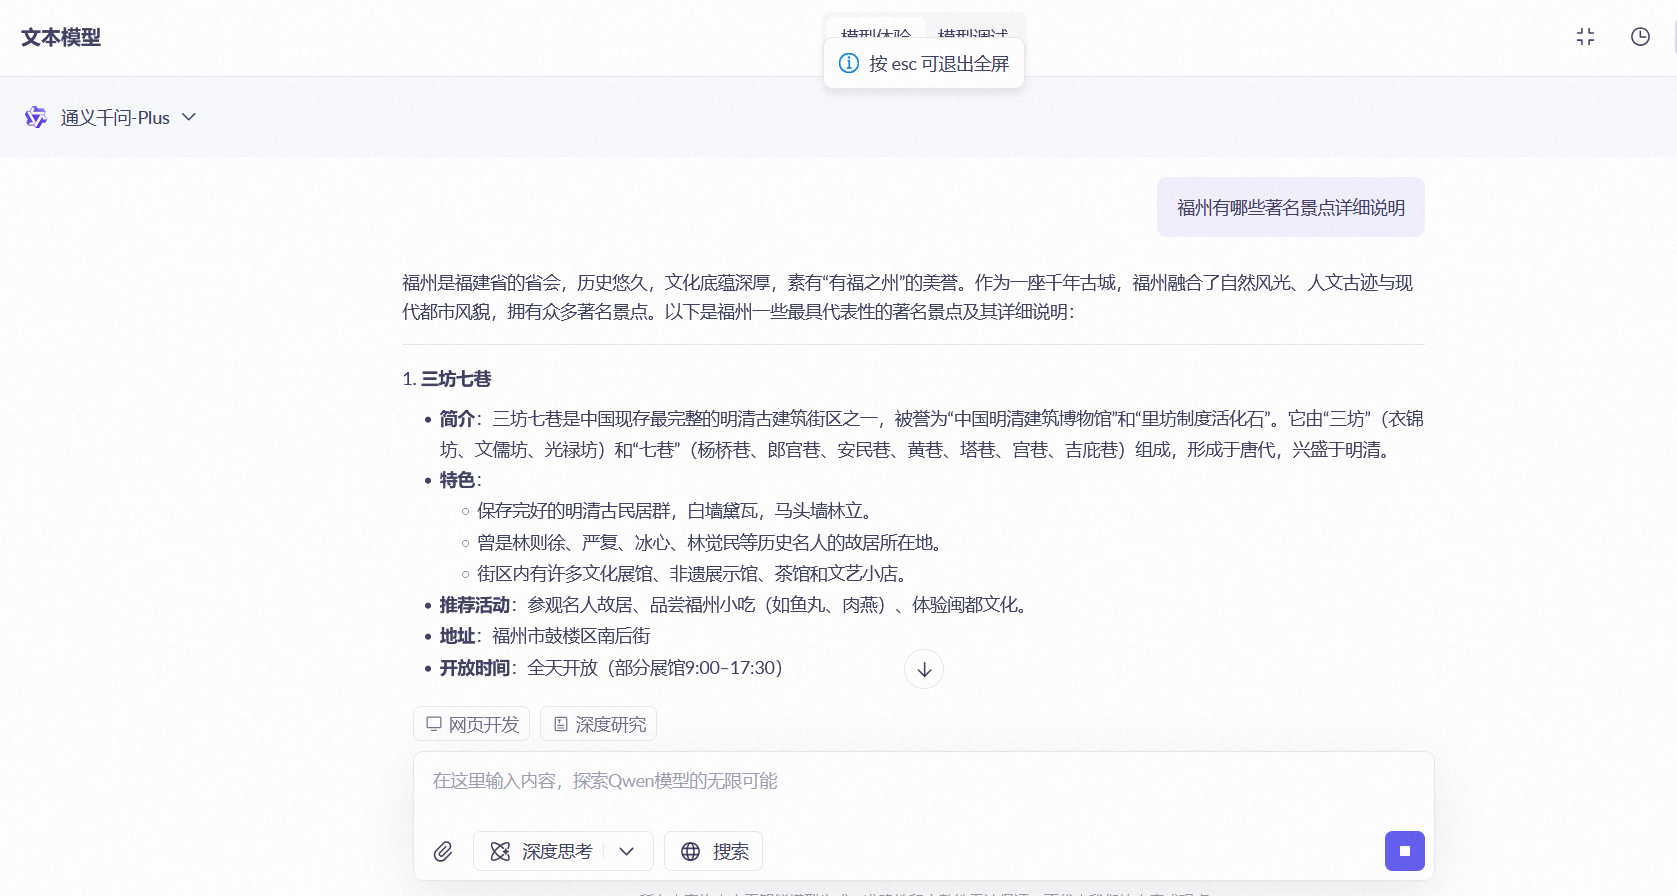
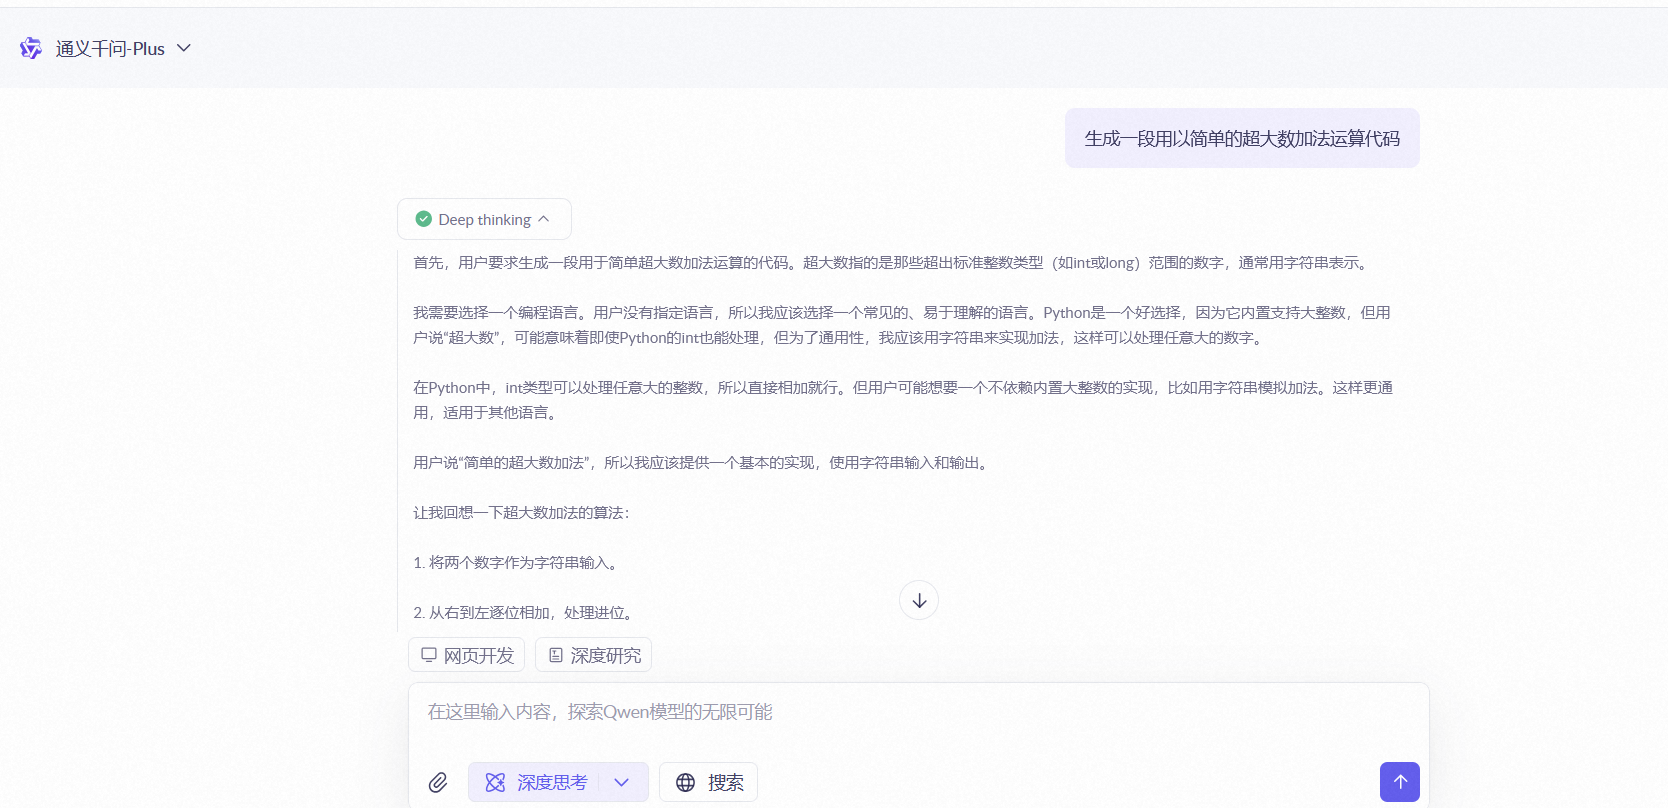
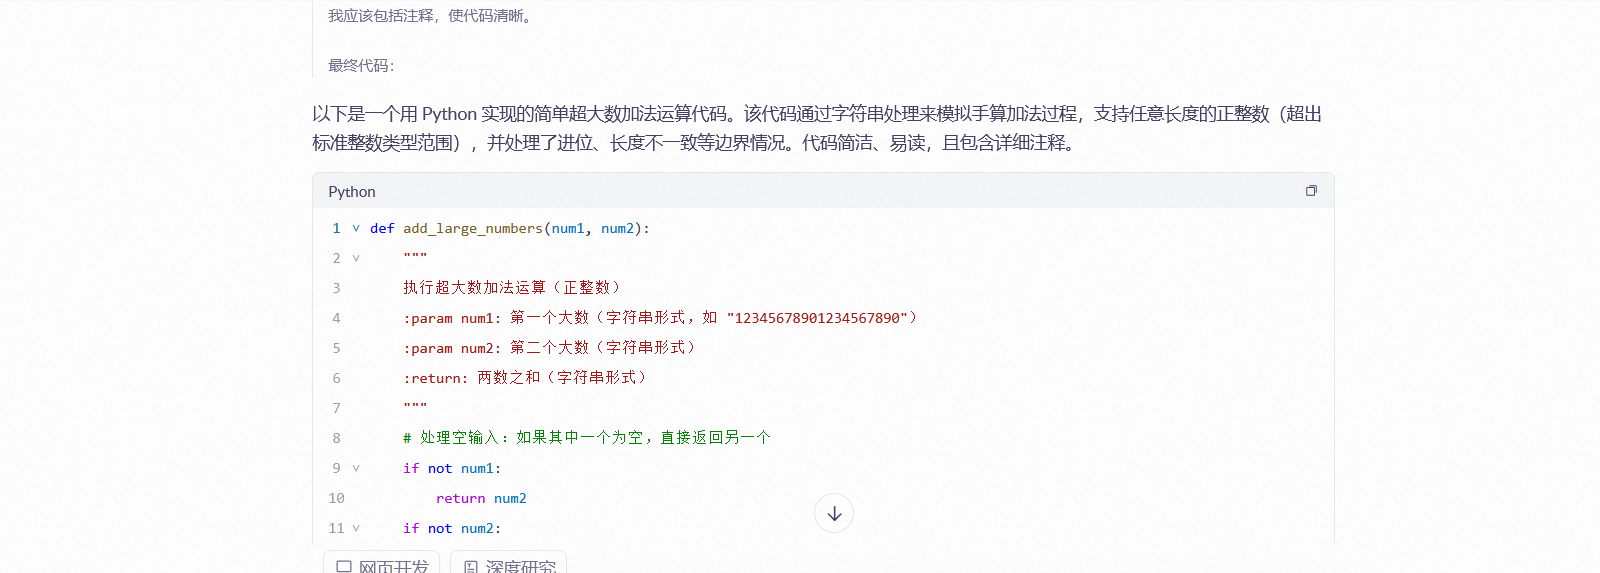
开发广场
有多中应用模板供选择,让用户更快开发
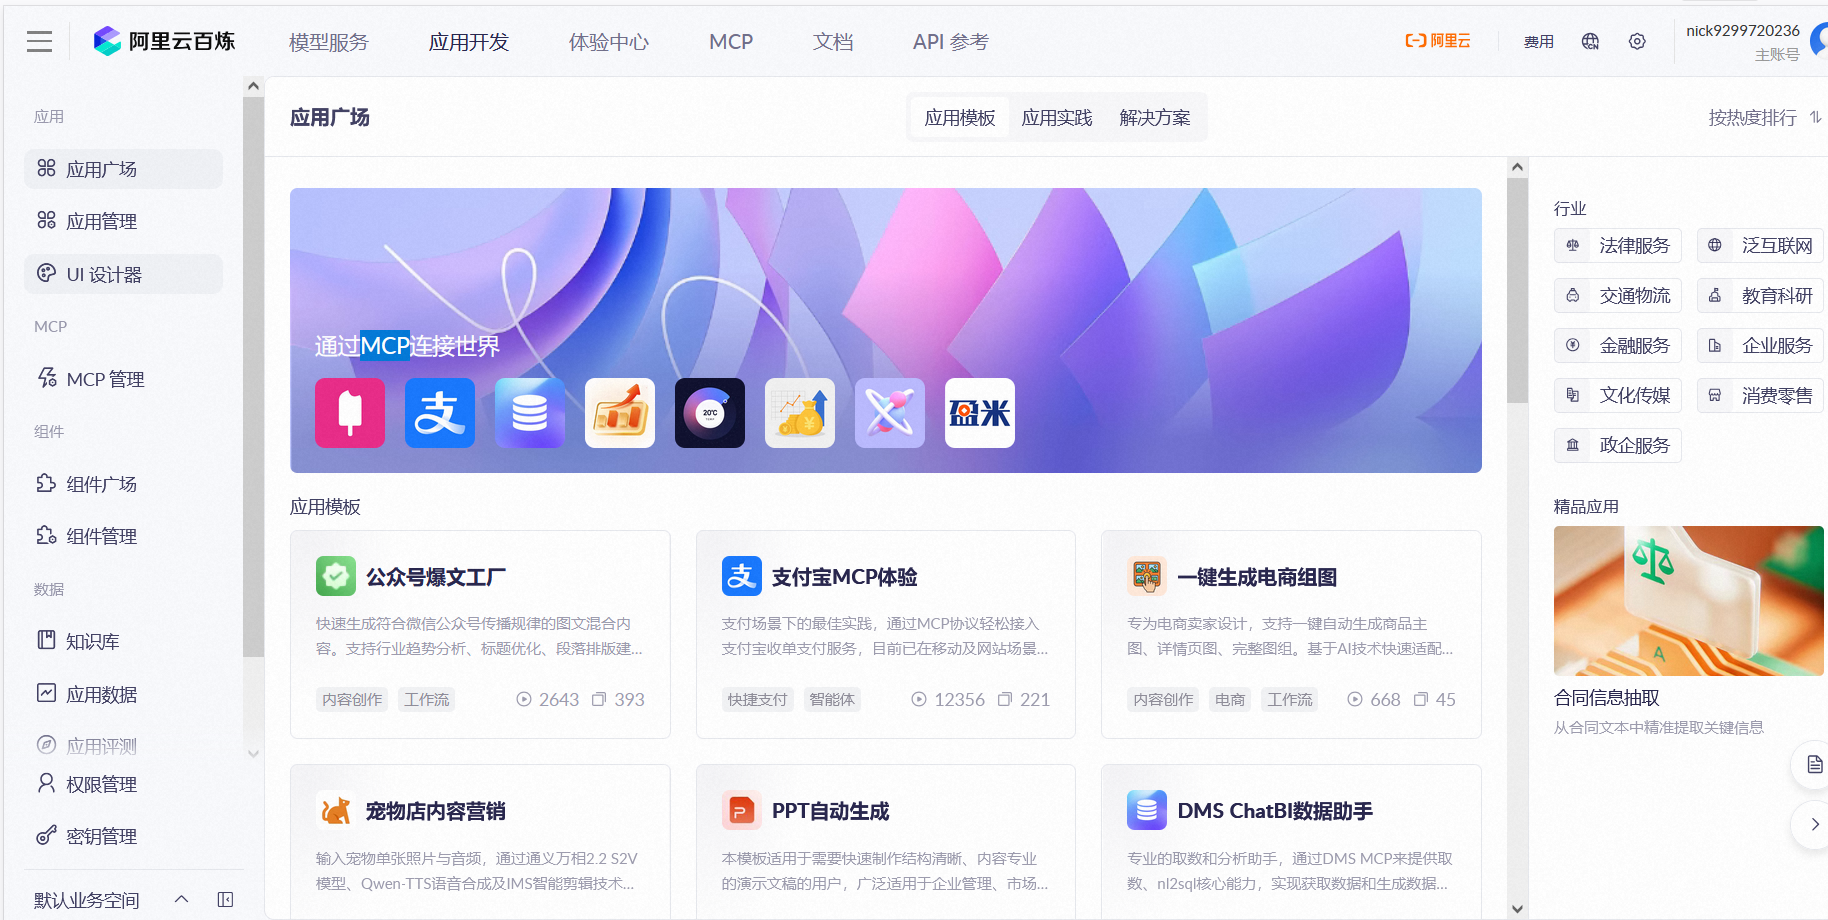
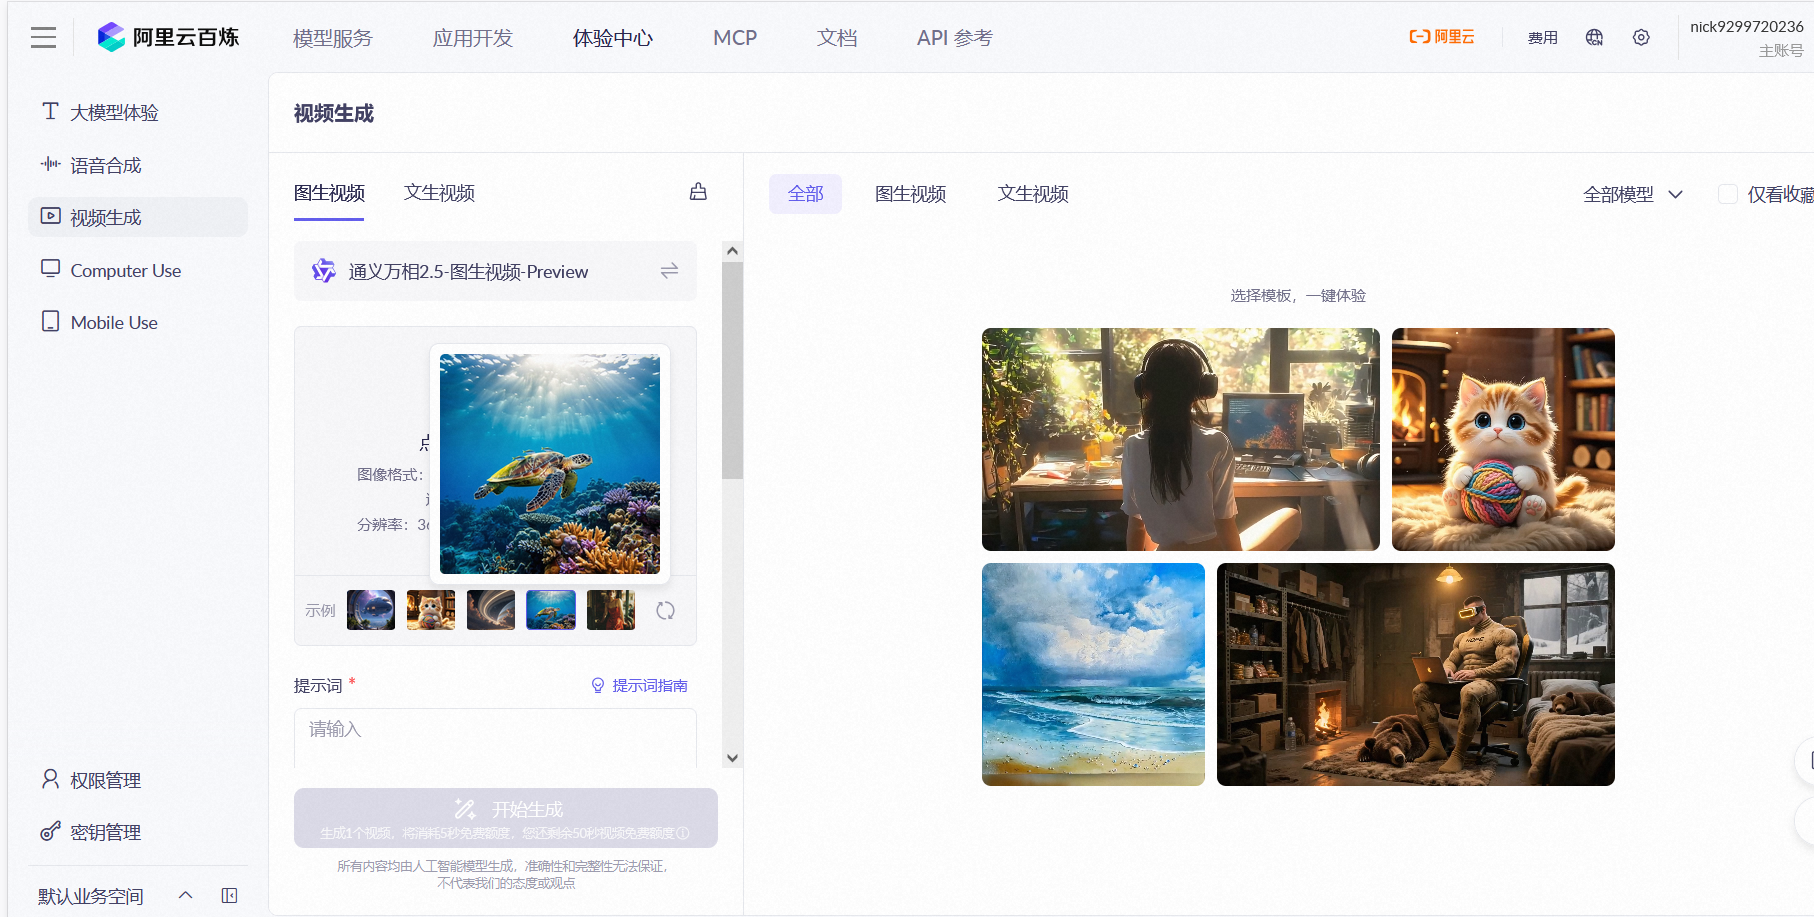
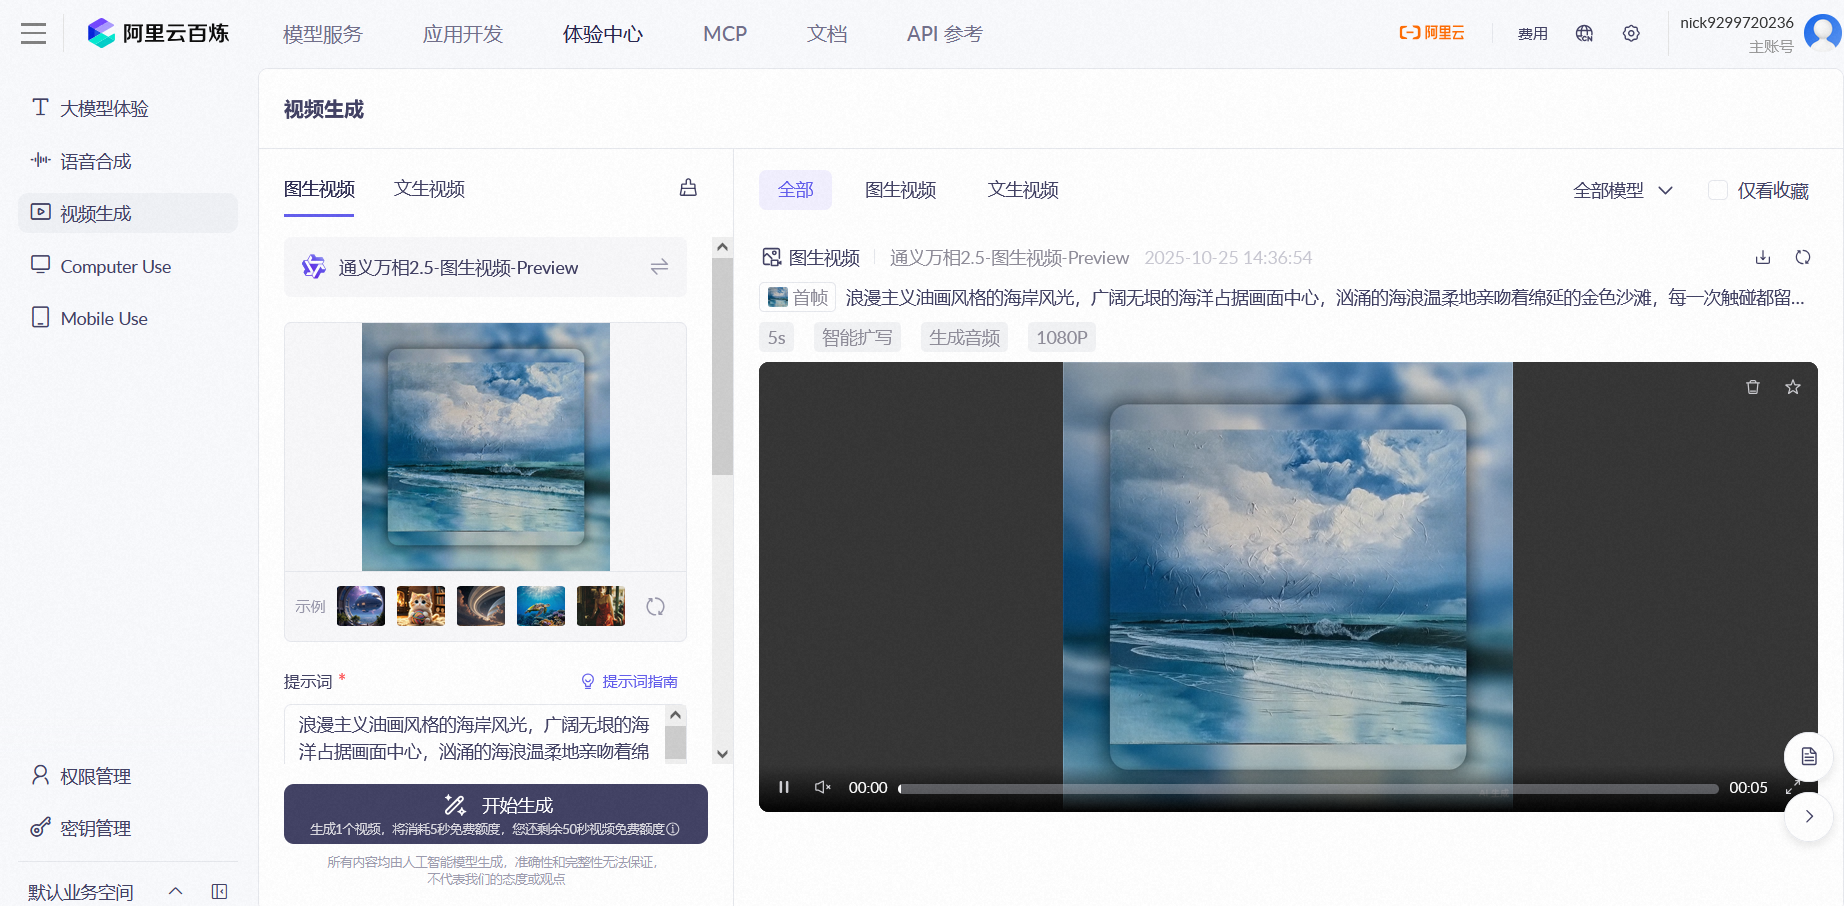
视频生成
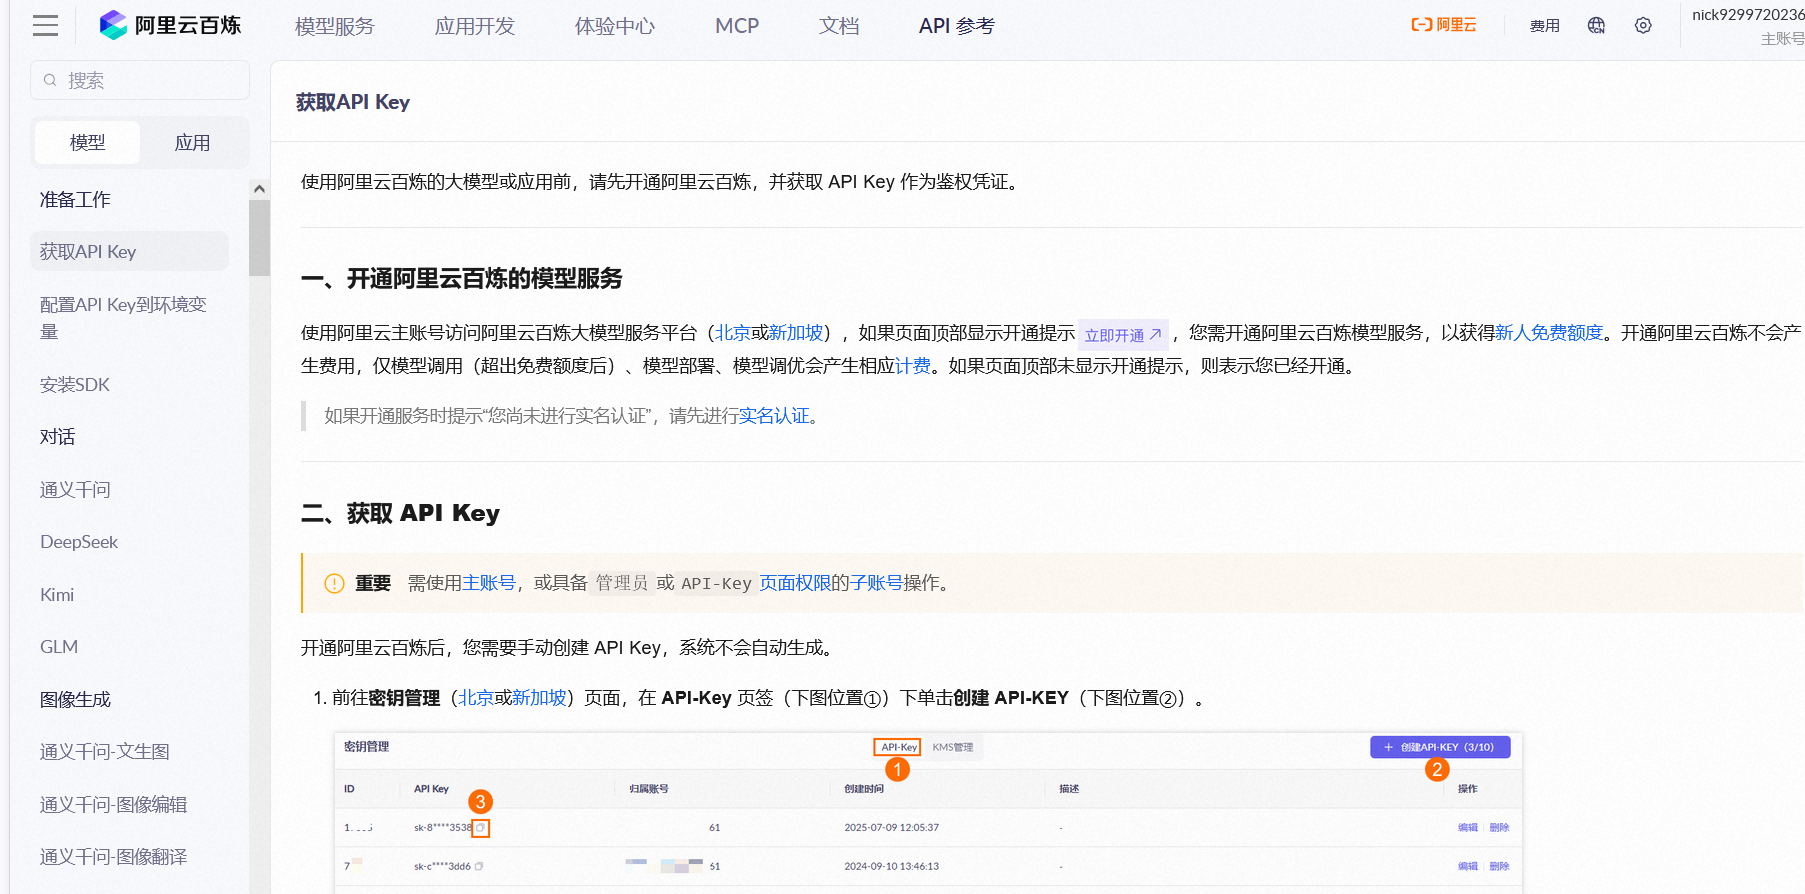
技术门槛极大降低,赋能传统开发者
提供了从模型选择、数据微调、应用编排到最终部署的全链路可视化、低代码操作。开发者无需深入理解分布式训练、模型量化等复杂技术,也能构建出功能强大的AI应用。打破了AI应用是“算法专家专利”的壁垒,使广大的Web开发者和企业IT团队成为大模型应用的主力军。
“模型超市”选择丰富,避免供应商锁定
集成了阿里自研的通义千问系列、以及ChatGLM、Baichuan、LLaMA等众多国内外优秀开源模型。用户可以在一个平台内横向对比不同模型的效果和成本,轻松切换,无需对接多个供应商。为企业提供了灵活性和议价能力,降低了因依赖单一模型厂商带来的风险。
与企业现有生态无缝集成,开箱即用
深度集成阿里云体系,如OSS对象存储(存放训练数据)、VPC私有网络(保障数据安全)、日志服务SLS等。对于已是阿里云用户的企业来说,迁移和集成成本极低。提供了真正的“企业级”解决方案,在安全性、稳定性和合规性上更有保障,尤其受到对数据安全要求高的金融、政企客户的青睐。
RAG知识库功能强大,落地性强
其检索增强生成功能设计得非常成熟,支持多种格式文档上传、自动切片、向量化检索。这是将通用大模型转化为企业专属“专家”的核心功能,效果显著。
直接解决了大模型“幻觉”和企业知识“最后一公里”的问题,让模型能基于准确、最新的私有知识回答问题,实用性极高。
成本效益与弹性伸缩
按使用量(Tokens、算力时长)付费的模式,无需承担高昂的GPU硬件采购和维护成本。云原生的弹性伸缩能力可以轻松应对业务高峰。
特别适合初创公司和业务波动较大的应用场景,实现了“用多少付多少”,极大优化了现金流。
学习曲线依然存在,新手引导待加强
尽管是“低代码”,但平台涉及的概念依然很多,如“工作空间”、“微调超参”、“RAG召回策略”等。对于完全没有AI背景的用户,初始的学习成本仍然不低,平台的新手引导和教学文案有待优化。
模型存在轻微“延迟”
平台接入的第三方开源模型版本更新有时会稍慢于社区最快速度。对于追求绝对最新模型特性的前沿开发者来说,可能会感觉“慢半拍”。
定制化深度与灵活性受限
为了追求易用性,平台在底层框架和训练流程上做了大量封装。这对于想要进行极度个性化底层优化(如修改模型架构、使用特殊训练技巧)的资深AI团队来说,可能会感到“束手束脚”。
成本控制的复杂性
虽然按量付费节省了硬件成本,但如果管理不当,月度账单可能超出预期。平台在成本预警和资源使用分析上还可以做得更直观。
市场竞争激烈,同质化初显
国内云厂商(如百度智能云千帆、腾讯云TI平台、火山引擎方舟)都推出了类似的一站式平台,核心功能矩阵高度同质化。
1.提供清晰明确的新手指导与学习路线
2.提供更直观的成本管理与监控
3.增强模型的透明度和可比性
4.加强一下图片识别的准确性
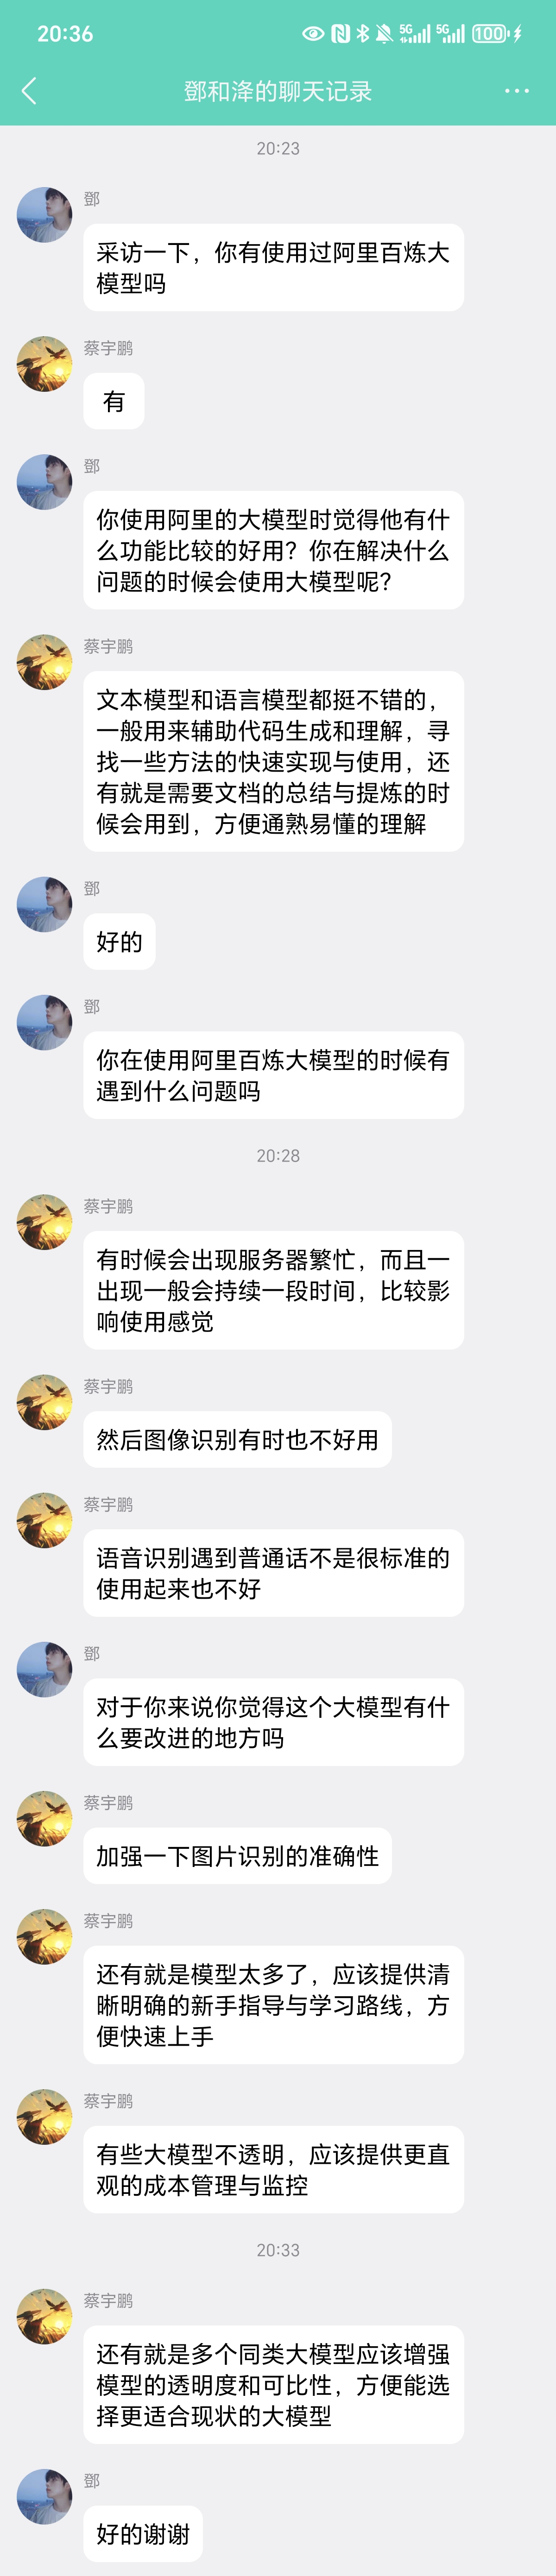
采访对象背景:来自福州大学软件工程2023级的蔡宇鹏
为什么选取这个同学? 原因:平时经常使用ai工具来进行更深刻的理解问题
Ta的需求:写写文档,看看代码等
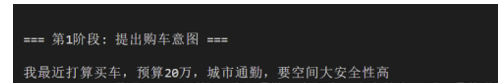
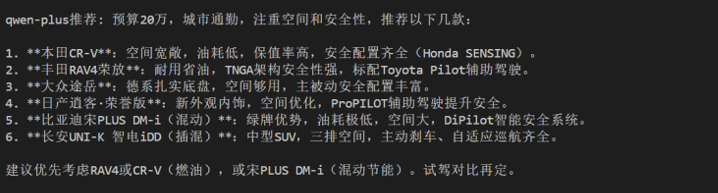
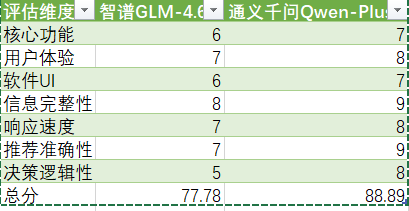
| 评估维度 | 维度描述 | 通义千问Qwen-Plus |
|---|---|---|
| 核心功能 | 文本理解、内容生成、对话交互等基础AI能力 | 7 |
| 用户体验 | 交互流程自然度、响应及时性、使用便捷性 | 8 |
| 软件UI | 界面设计美观度、操作逻辑清晰度 | 7 |
| 信息完整性 | 回答内容的全面性、信息覆盖广度 | 9 |
| 响应速度 | 问题处理速度、回复延迟表现 | 8 |
| 推荐准确性 | 建议和推荐内容的相关性与精准度 | 9 |
| 决策逻辑性 | 推理过程的合理性、结论的可靠性 | 8 |
| 总体得分 | 88.89分 |
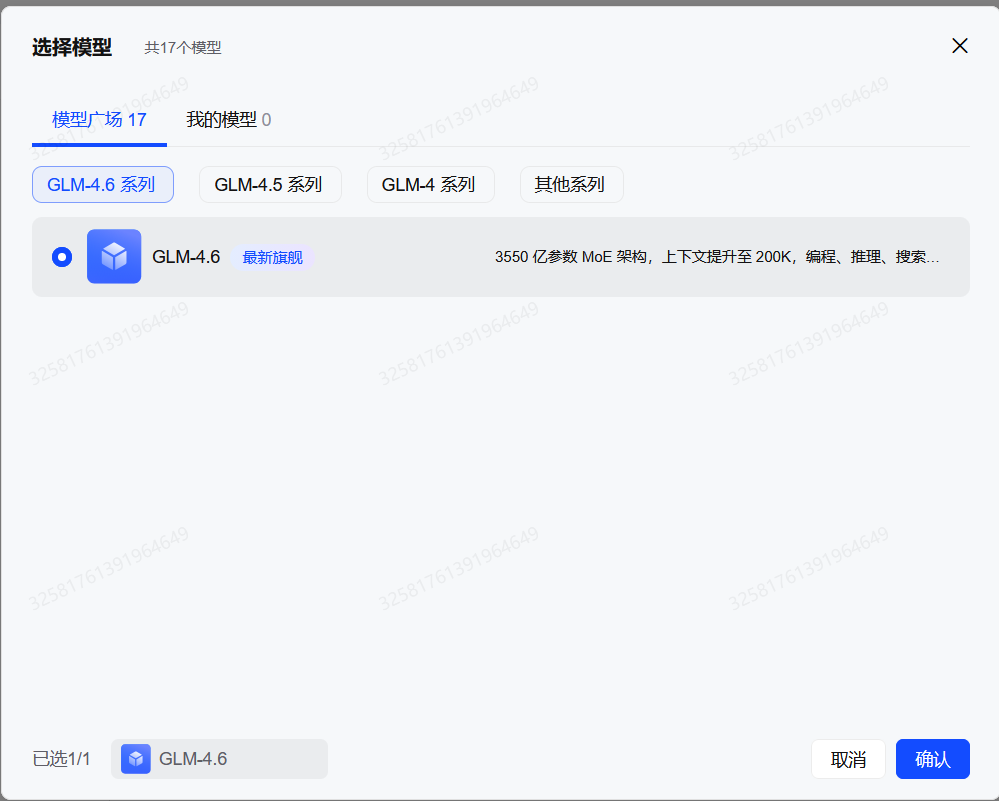
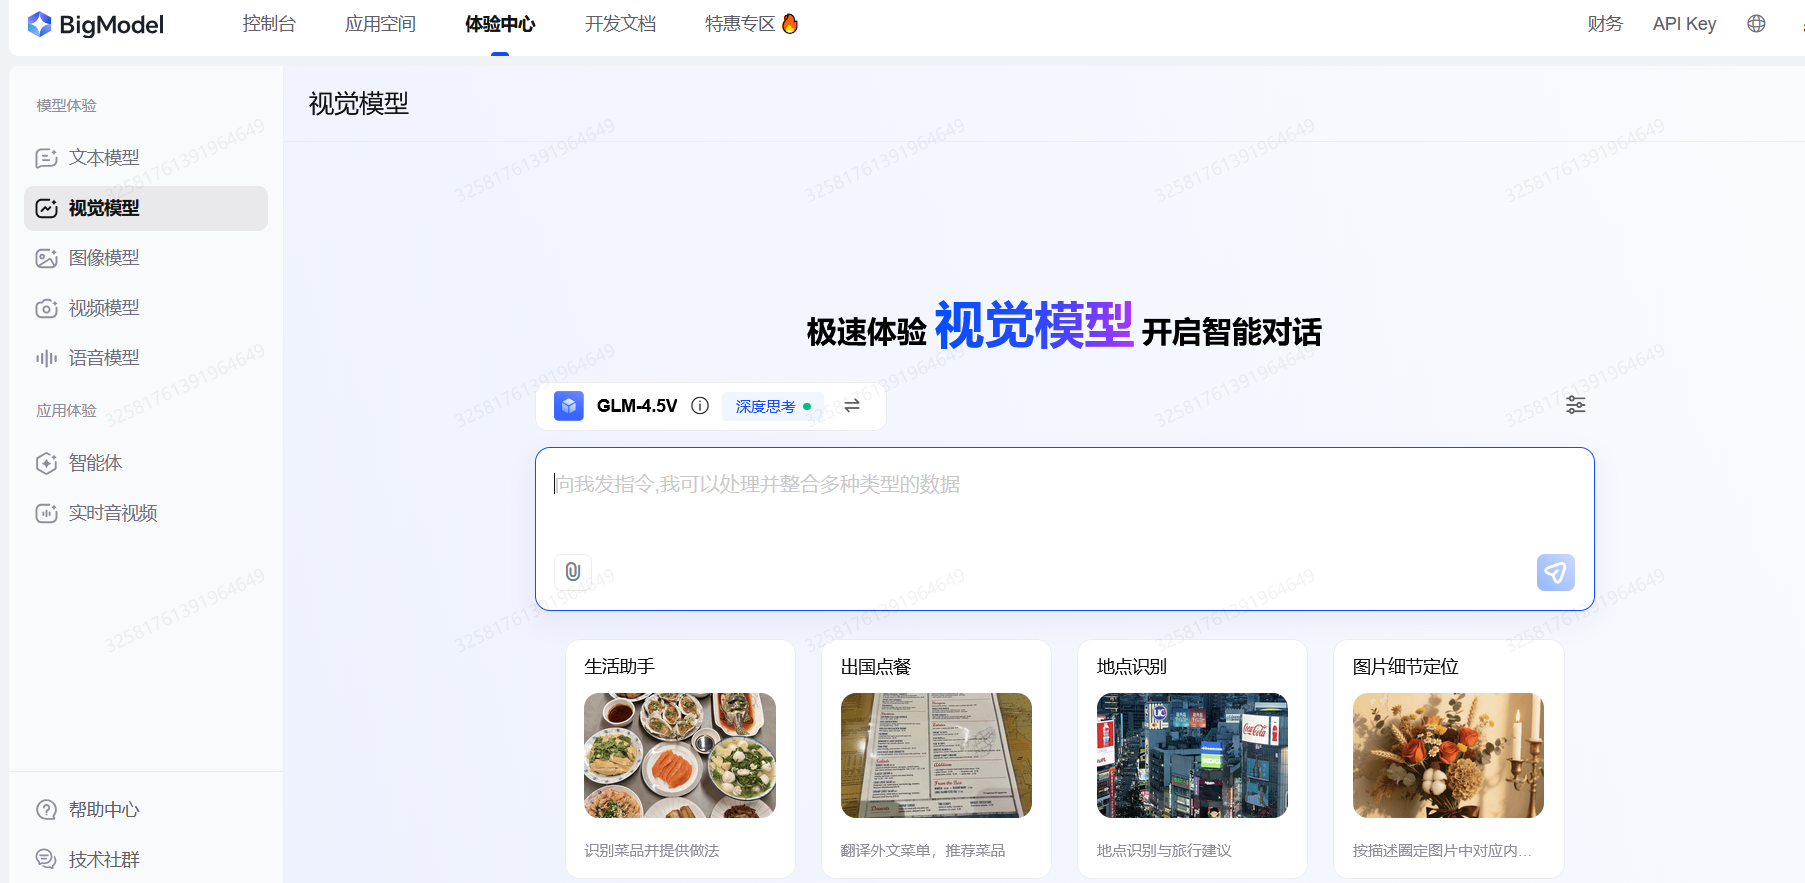
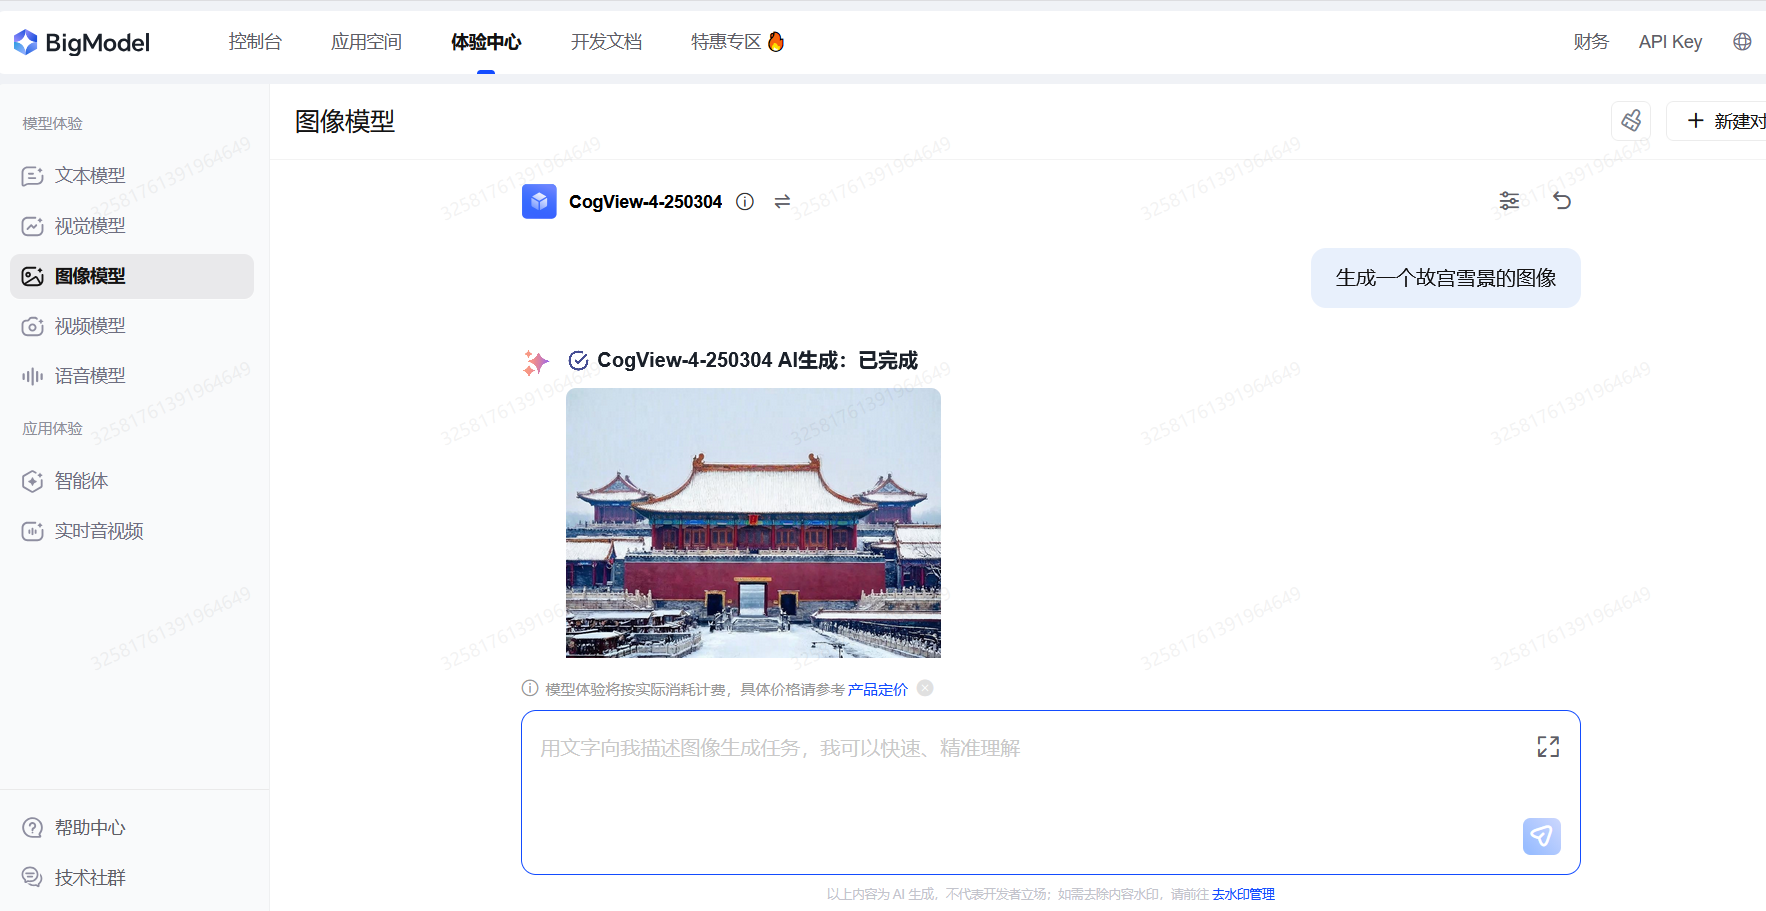
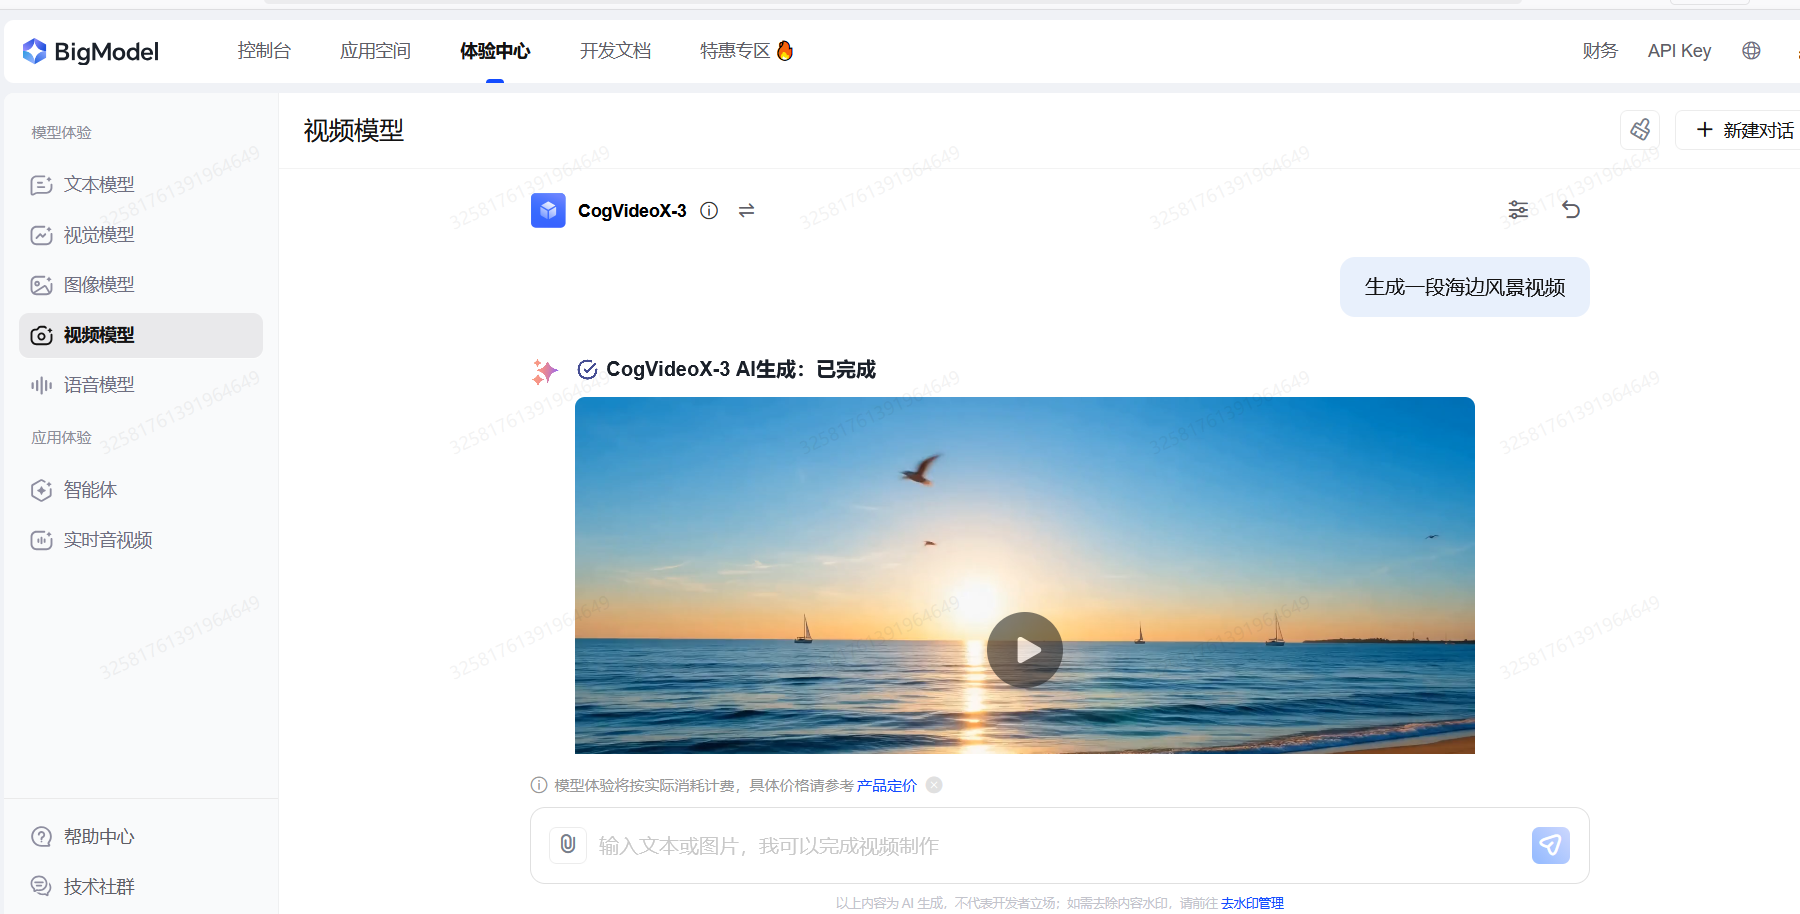
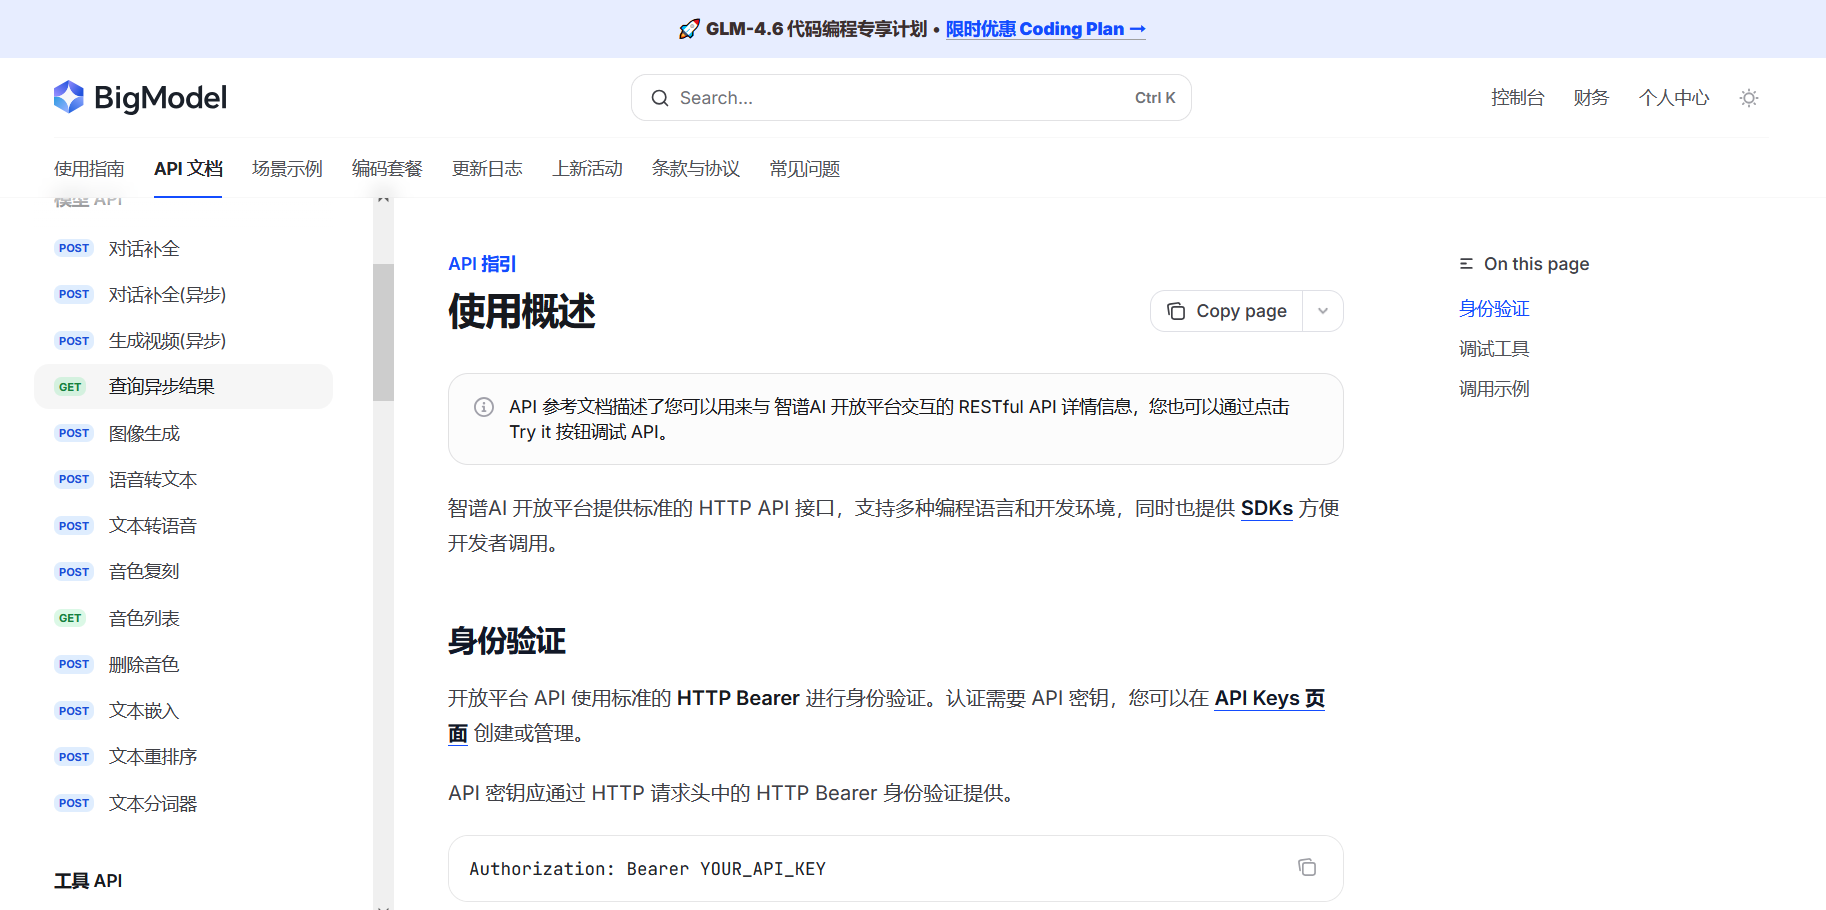
智普AI是清华系顶尖AI公司,推出性能卓越的GLM大模型系列。其核心产品GLM-4支持复杂推理、多模态交互和长文本处理,为企业和开发者提供强大的通用人工智能解决方案。
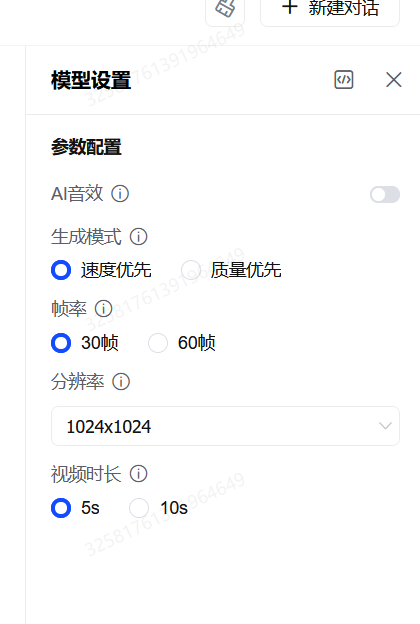
智普ai提供了许多的模型供选择
1.学术背景雄厚,技术扎实
背靠清华大学KEG实验室,团队学术底蕴深厚,模型架构创新(如GLM统一框架)。
2.模型性能卓越,推理能力强
GLM-4在复杂推理、数学计算和代码生成等核心能力上已逼近国际一流水平,中文理解尤其出色。
3.开源策略激进,生态友好
开源了从轻量到大规模的完整模型系列(如GLM-3、ChatGLM),极大降低了开发者和企业的使用与研究门槛。
4.长文本处理能力强
支持128K甚至更长的上下文窗口,在长文档摘要、知识库问答等场景优势明显。
1.多模态能力相对滞后
与GPT-4V、Gemini等国际顶尖模型相比,其图像识别、生成等多模态能力发布稍晚,生态成熟度有待提升。
2.商业化与生态规模有待追赶
相较于百度、阿里等大厂,其云服务、开发者生态和行业解决方案的完善度和市场占有率仍需时间积累。
3.API服务与工具有待完善
部分开发者反馈其API服务的稳定性、文档易用性及配套调试工具相比成熟平台仍有优化空间。
1.优化API与开发工具链
2.优化其官方Web聊天界面的用户体验,支持对话分享、会话文件夹管理、自定义指令等常用功能。
3.尽快发布并完善图像、语音等多模态模型的API,并降低使用门槛。
4.联合生态伙伴,推出针对金融、编程、教育、医疗等垂直领域的精调模型或开箱即用的解决方案。
5.提供更灵活的计费方式
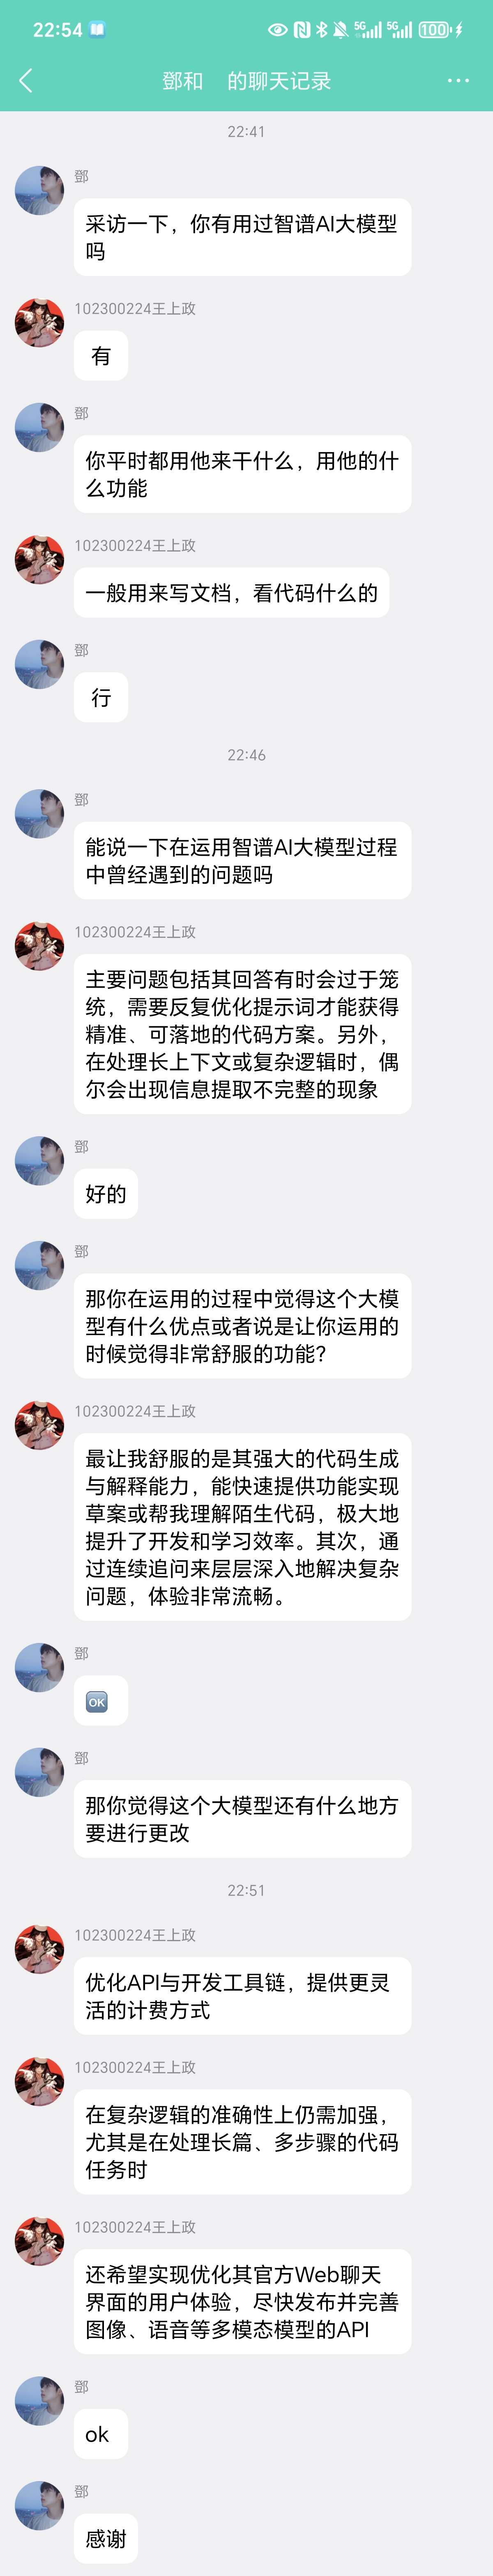
采访对象背景:来自福州大学软件工程2023级的王上政
为什么选取这个同学? 原因:平时经常使用ai工具来进行更深刻的理解问题
Ta的需求:写写文档,看看代码等
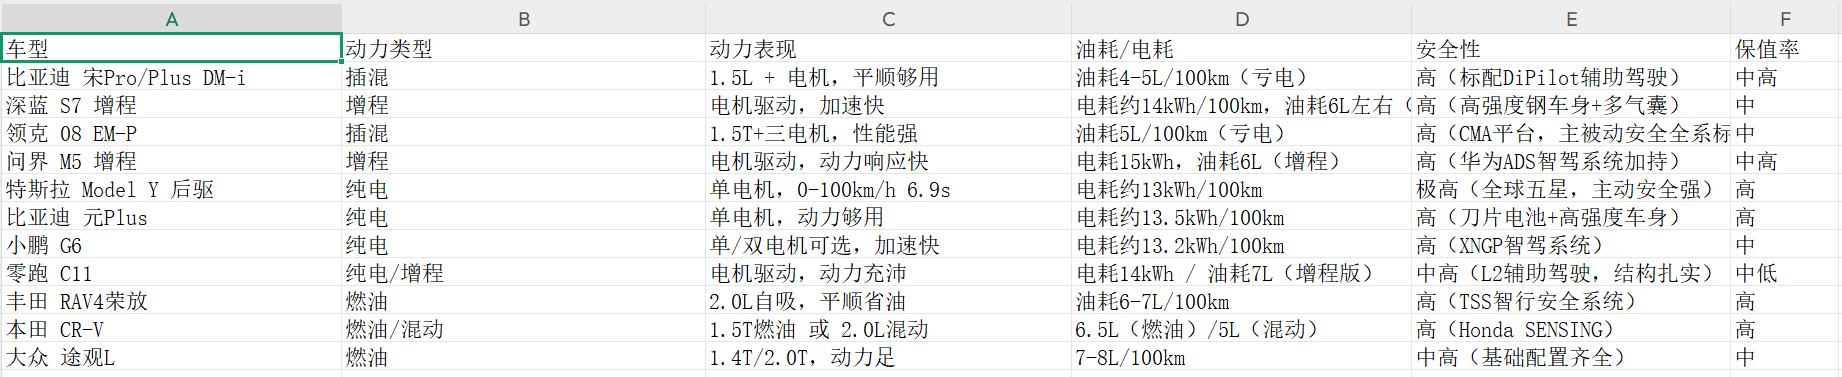
| 评估维度 | 维度描述 | 智谱GLM-4评分 |
|---|---|---|
| 核心功能 | 文本理解、内容生成、对话交互等基础AI能力 | 6 |
| 用户体验 | 交互流程自然度、响应及时性、使用便捷性 | 7 |
| 软件UI | 界面设计美观度、操作逻辑清晰度 | 6 |
| 信息完整性 | 回答内容的全面性、信息覆盖广度 | 8 |
| 响应速度 | 问题处理速度、回复延迟表现 | 7 |
| 推荐准确性 | 建议和推荐内容的相关性与精准度 | 7 |
| 决策逻辑性 | 推理过程的合理性、结论的可靠性 | 5 |
| 总体得分 | 77.78分 |
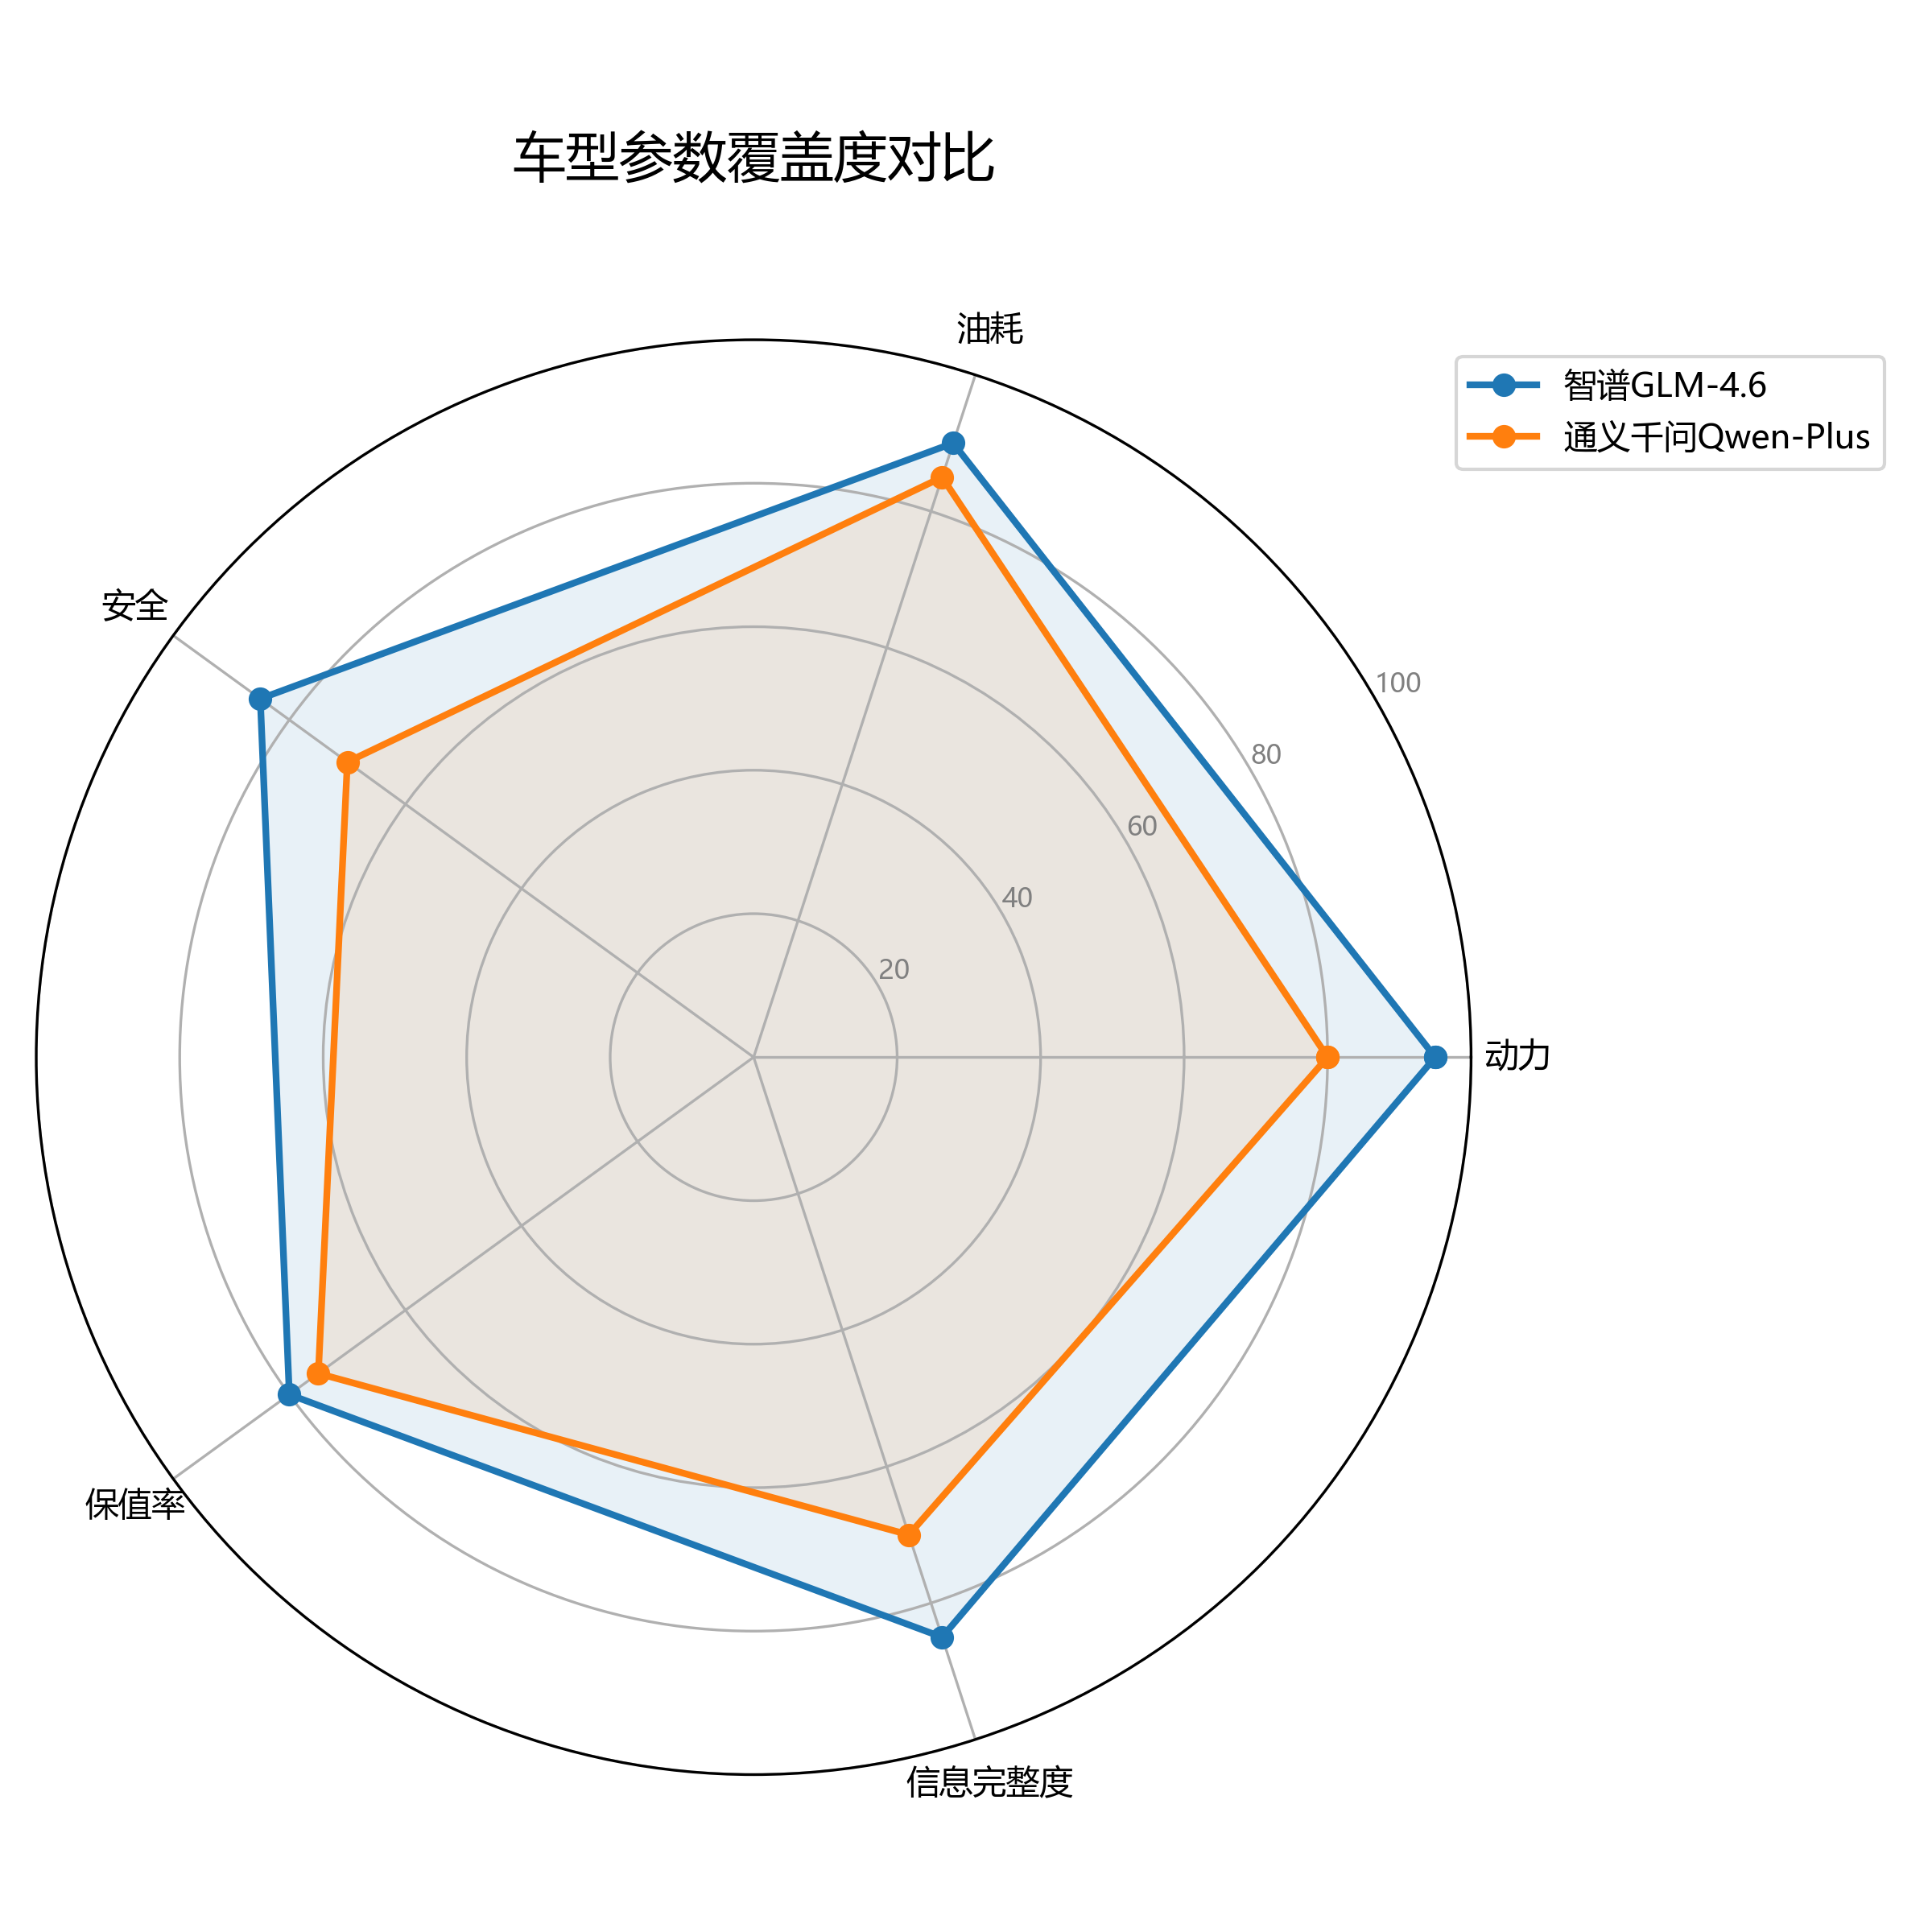
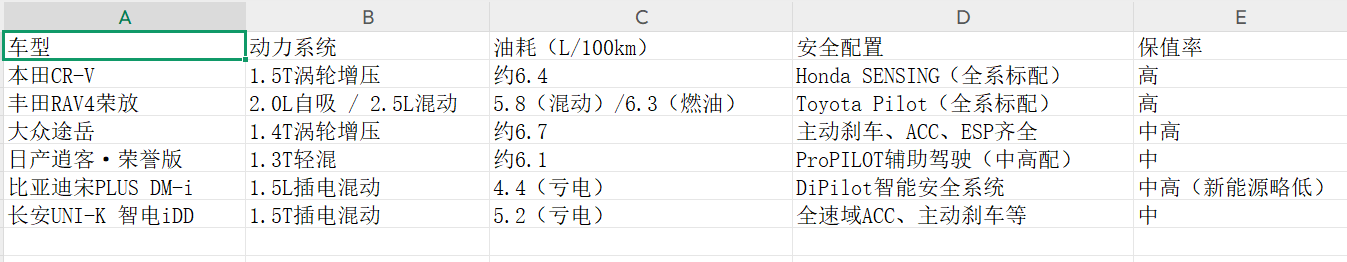
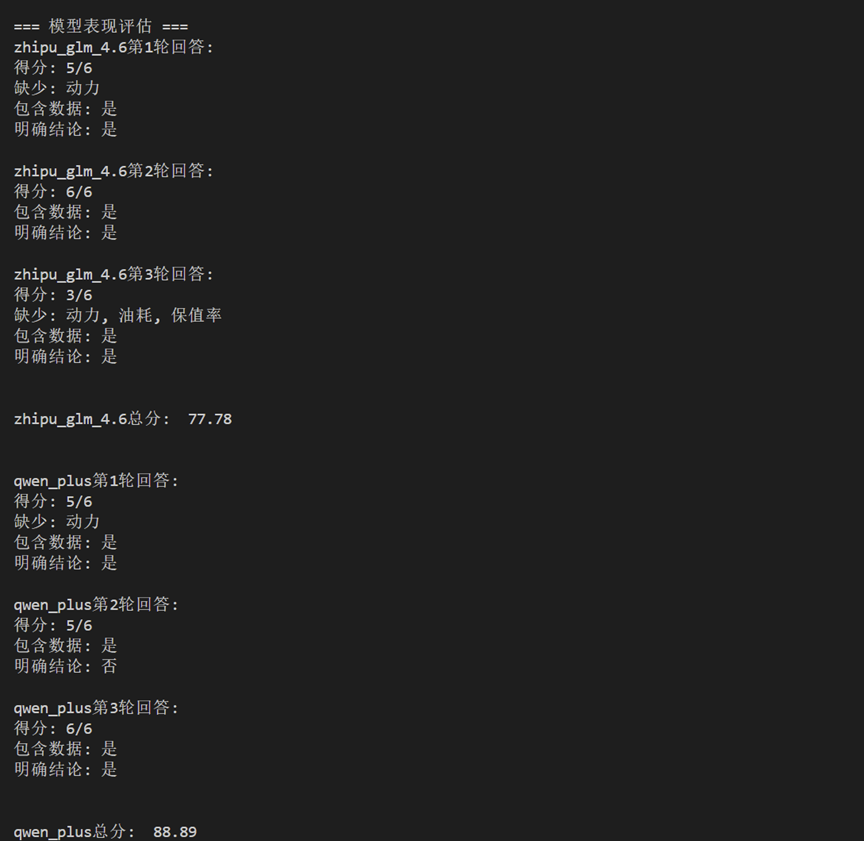
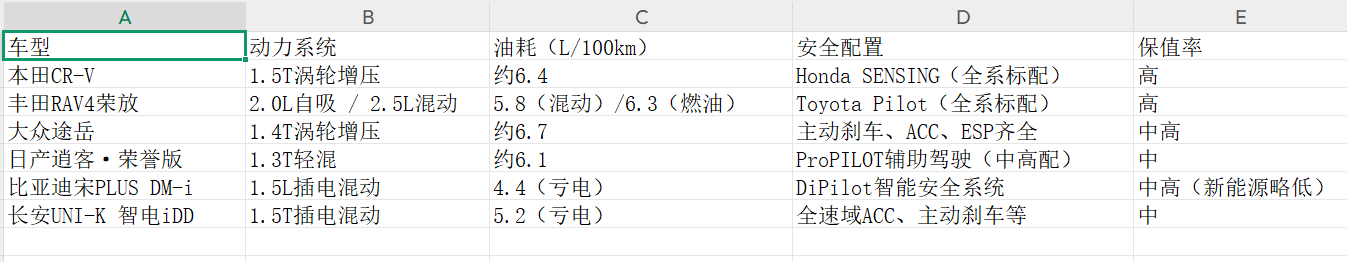
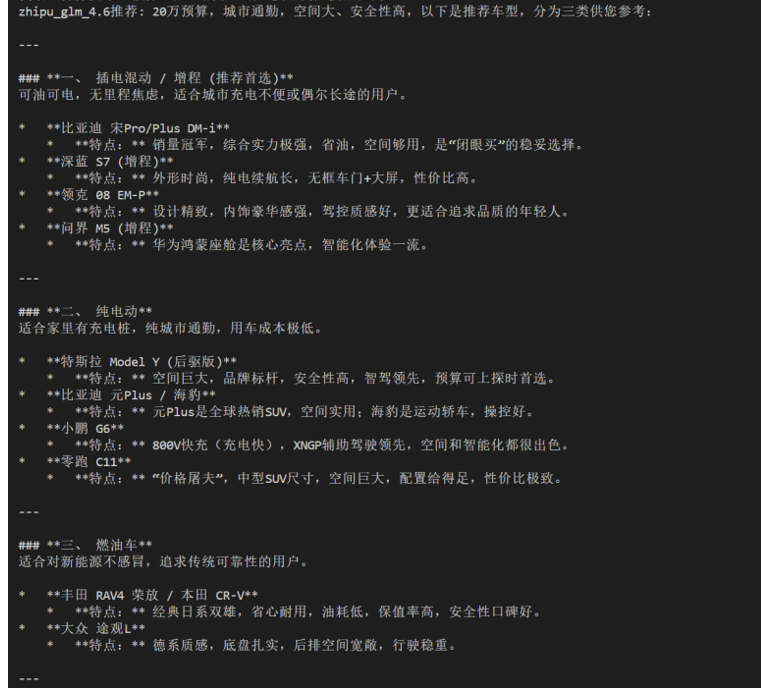
结合了图表与前期的分析来对智谱GLM-4.6与通义千问Qwen-Plus两个大数据模型在本次车型推荐任务中的表现。从“车型参数覆盖度对比”的雷达图中可以得出,GLM-4.6模型在油耗、安全、保值率及信息完整度方面都显著优于Qwen-Plus模型,特别是在信息完整度这一方面上达到85%,而Qwen-Plus只有70%;但是在动力系统参数呈现上两者几乎一样。这说明了GLM-4.6模型有更强的数据整合能力,可以提供更全面的参数支撑。
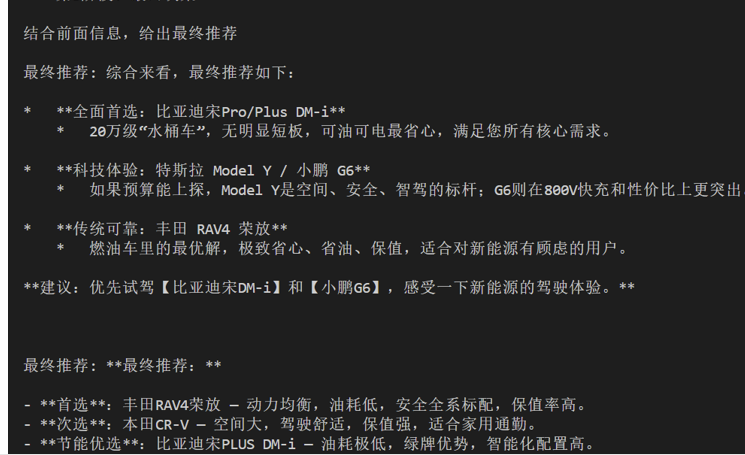
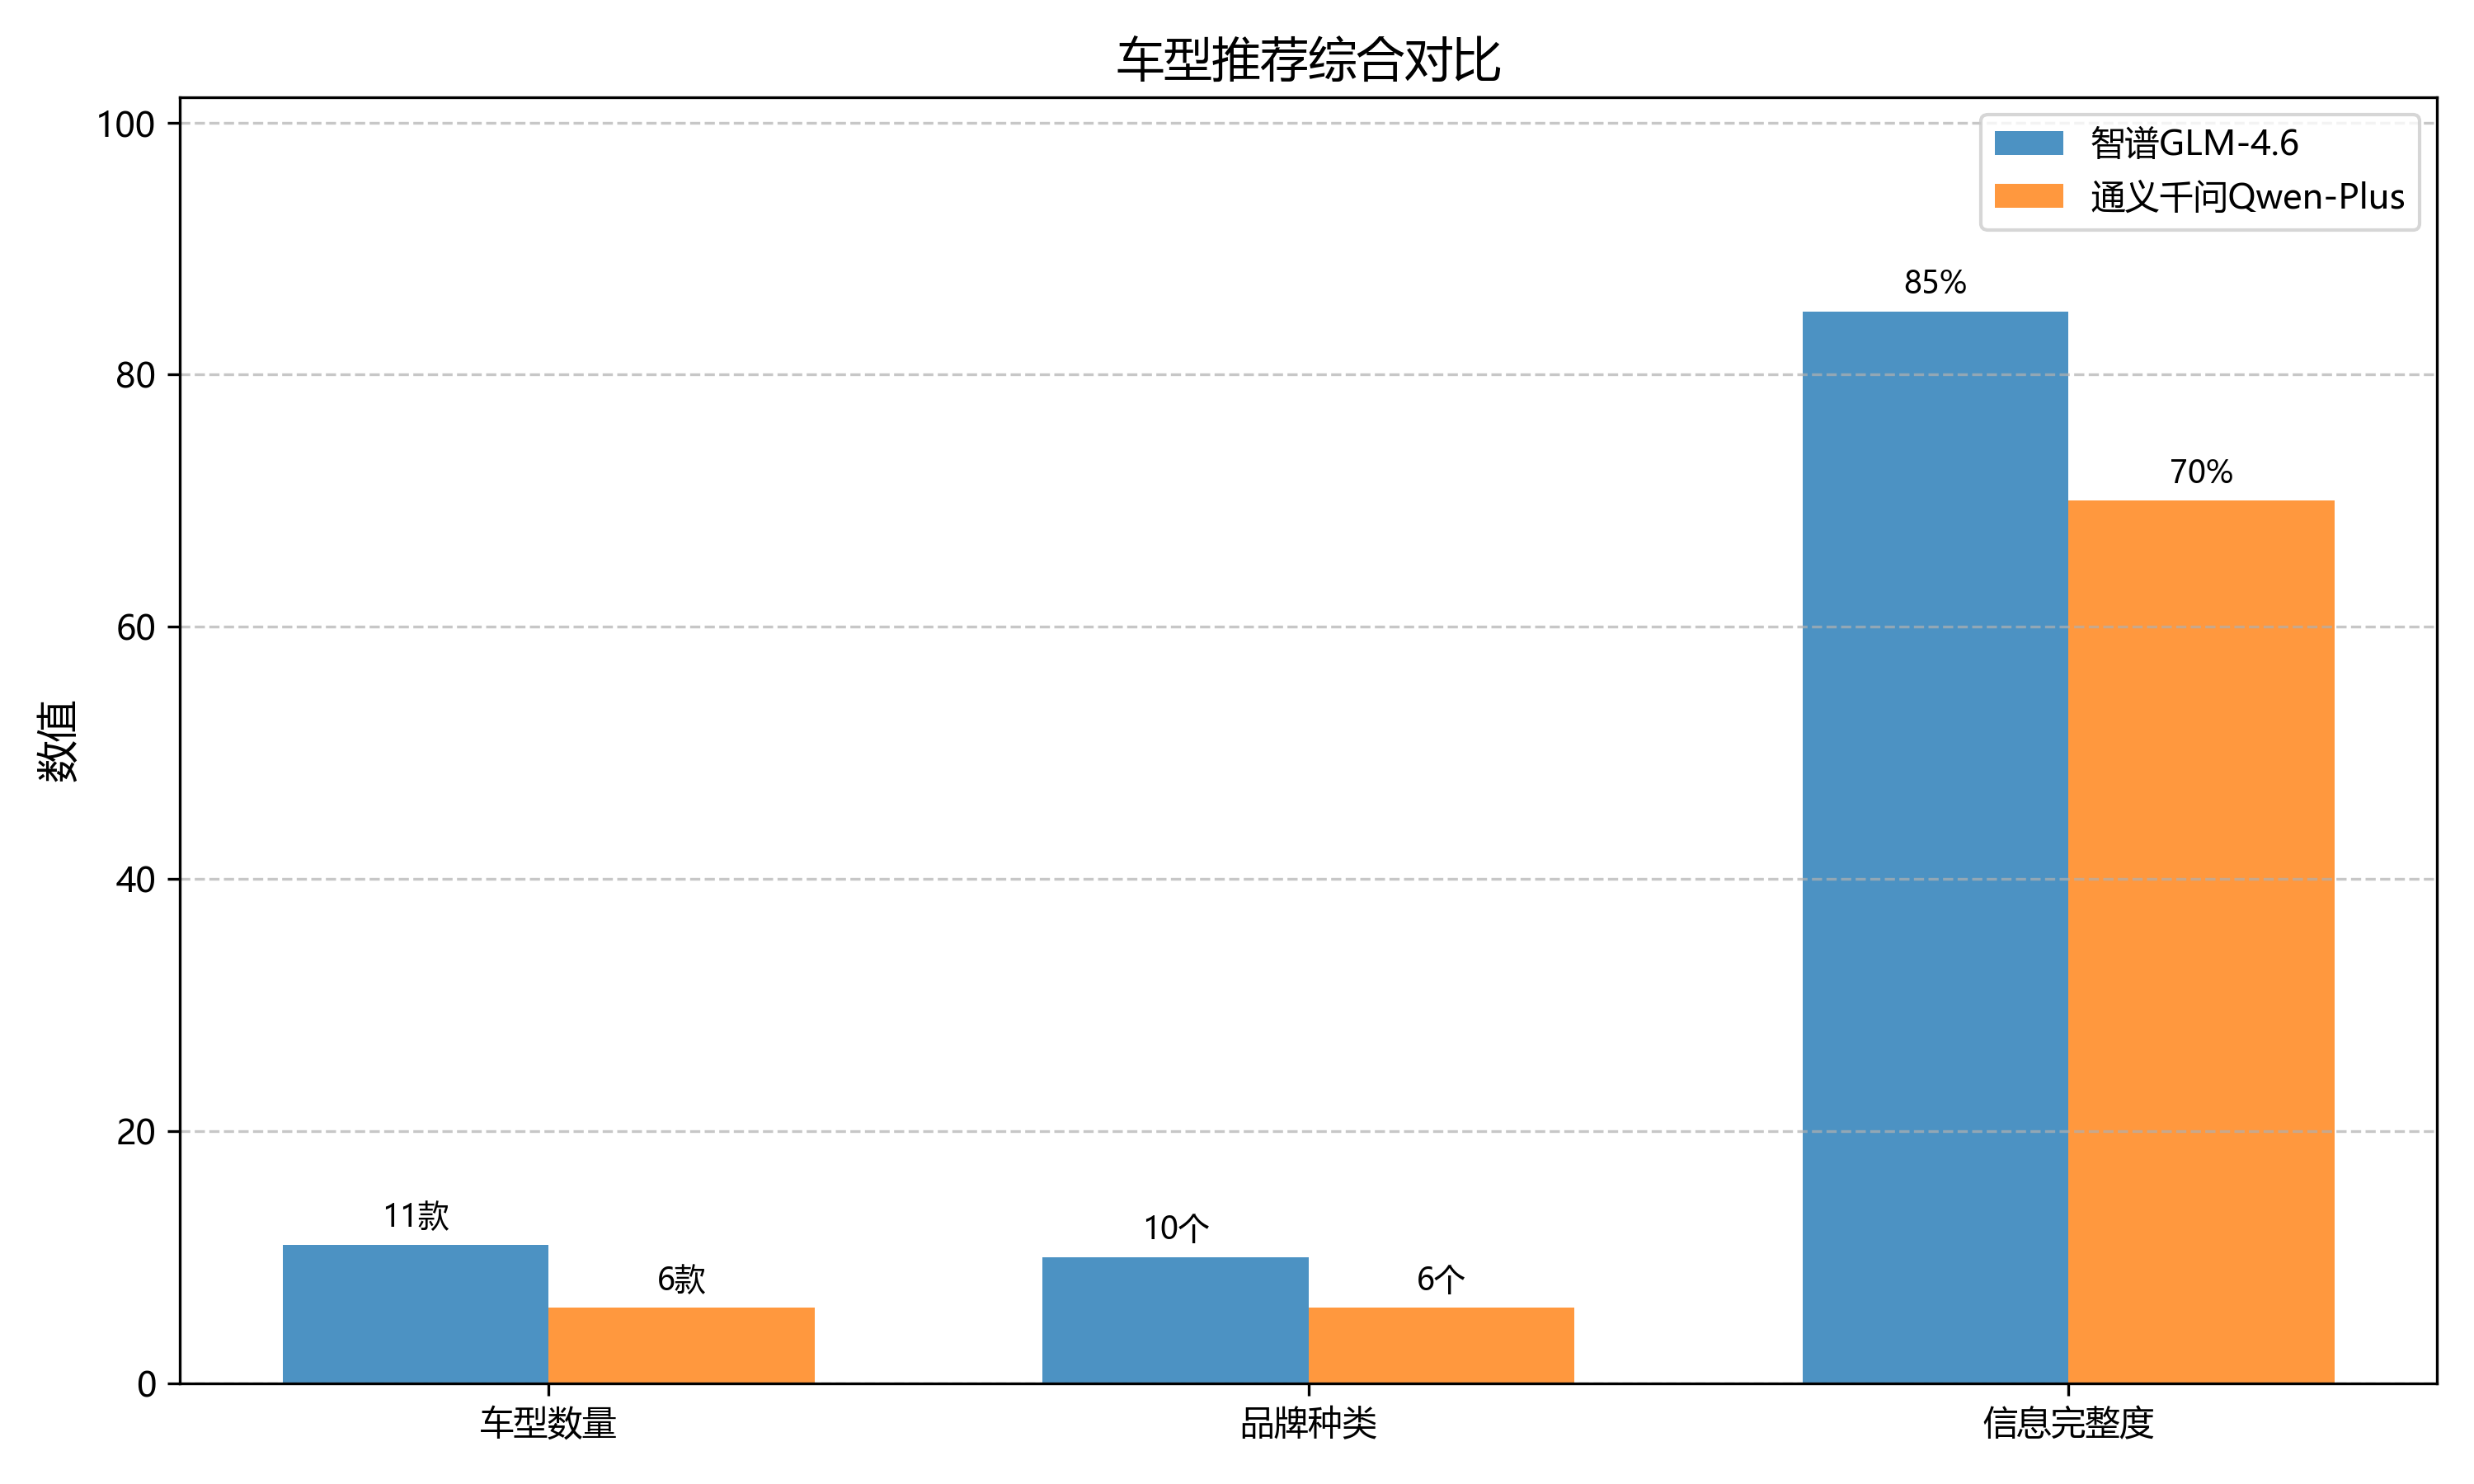
而在“车型推荐综合对比”柱状图之中,GLM-4.6模型推荐11款车型、涵盖l10个品牌,可见其极强的信息广度;而Qwen-Plus模型却仅推荐6款、6个品牌,数量虽少但是聚焦性更强。即使GLM-4.6在信息完整性上领先,但是推荐数量庞大的内容可能会导致用户选择困难,缺乏决策引导。相比之下,Qwen-Plus模型虽更注重推荐质量与实用性的方面胜出。
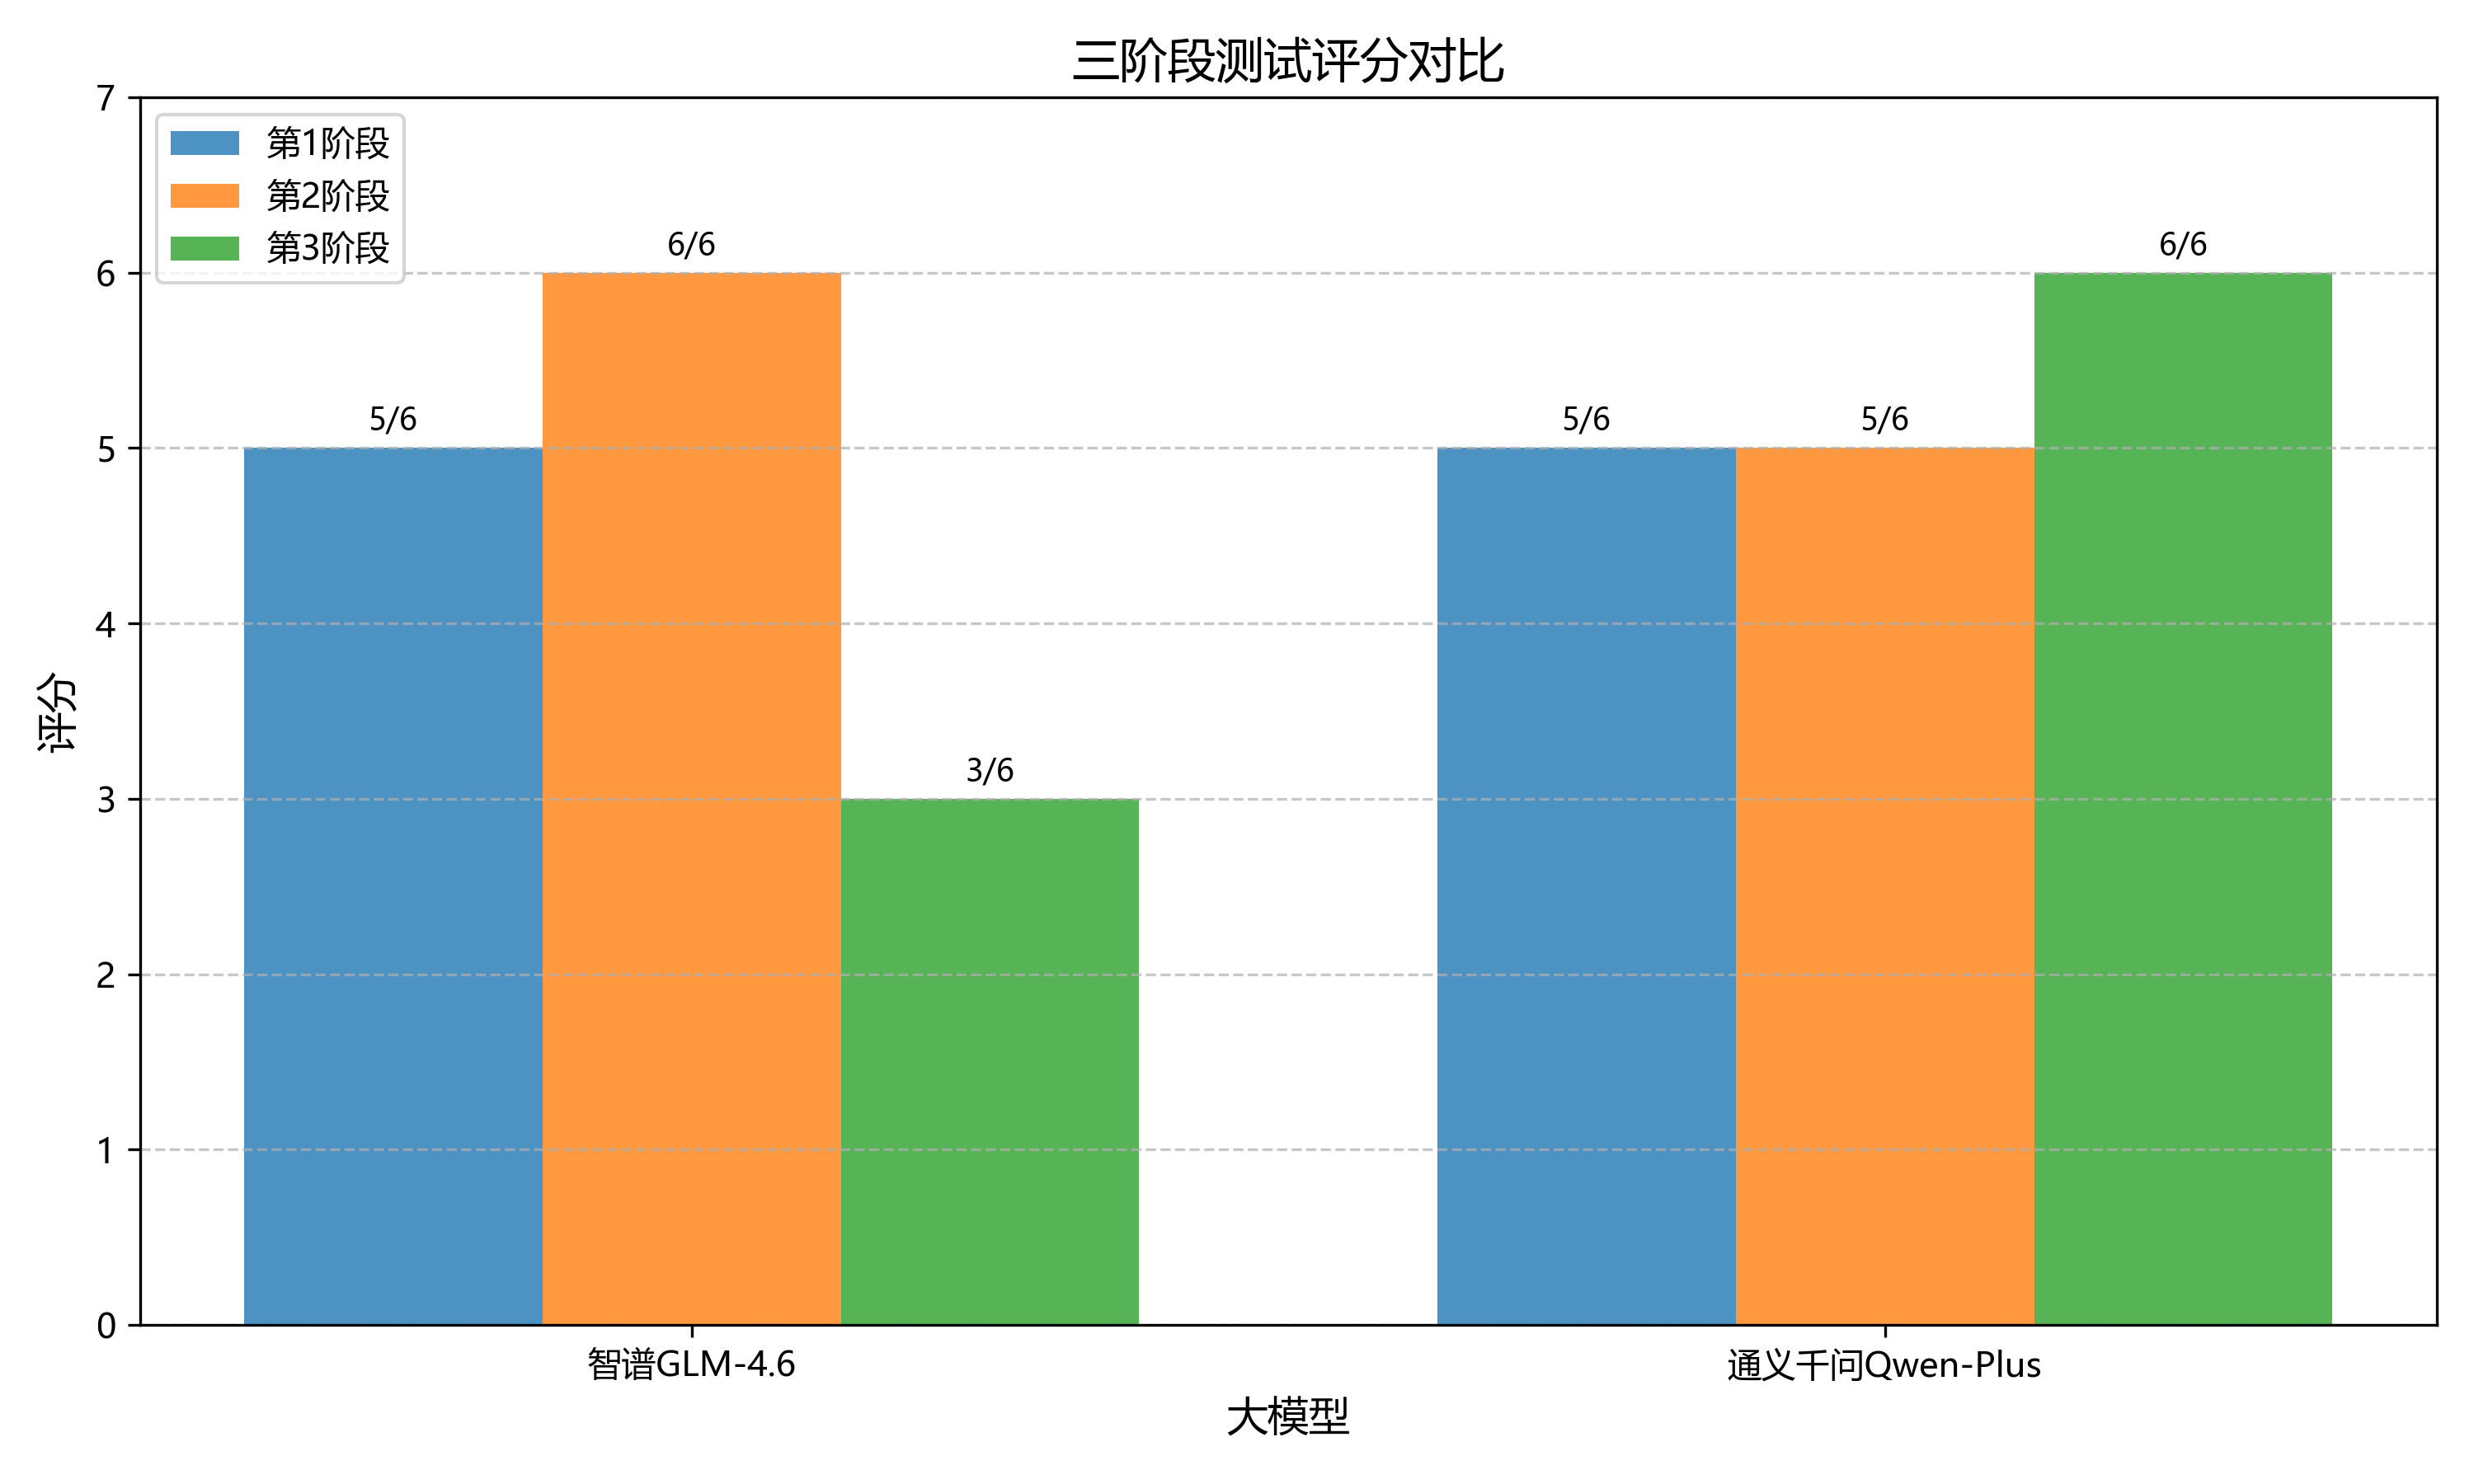
三阶段测试评分进一步揭示差异:第一阶段(需求理解)二者均为5/6,第二阶段(参数对比)GLM-4.6以6/6领先,体现其在技术细节处理上的优势;但是第三阶段(最终推荐)中,GLM-4.6仅仅只有3/6,远远低于Qwen-Plus模型的6/6。这说明该模型的虽能输出丰富信息,但没有Qwen-Plus模型的逻辑推理与个性化建议能力,难以形成有效决策支持。
综上所述,通义千问Qwen-Plus会更适合购车推荐场景。它在关键决策阶段表现出色,推荐精准、逻辑清晰、能够贴近用户实际需求,适合普通消费者来快速筛选合适车型。而GLM-4.6虽信息全面、覆盖广泛,但存在着“重数据、轻决策”的问题,更适合部分专业用户来进行横向比对。所以,在真实的购车场景中,Qwen-Plus模型凭有更高的推荐准确性和用户体验,是更优的选择。
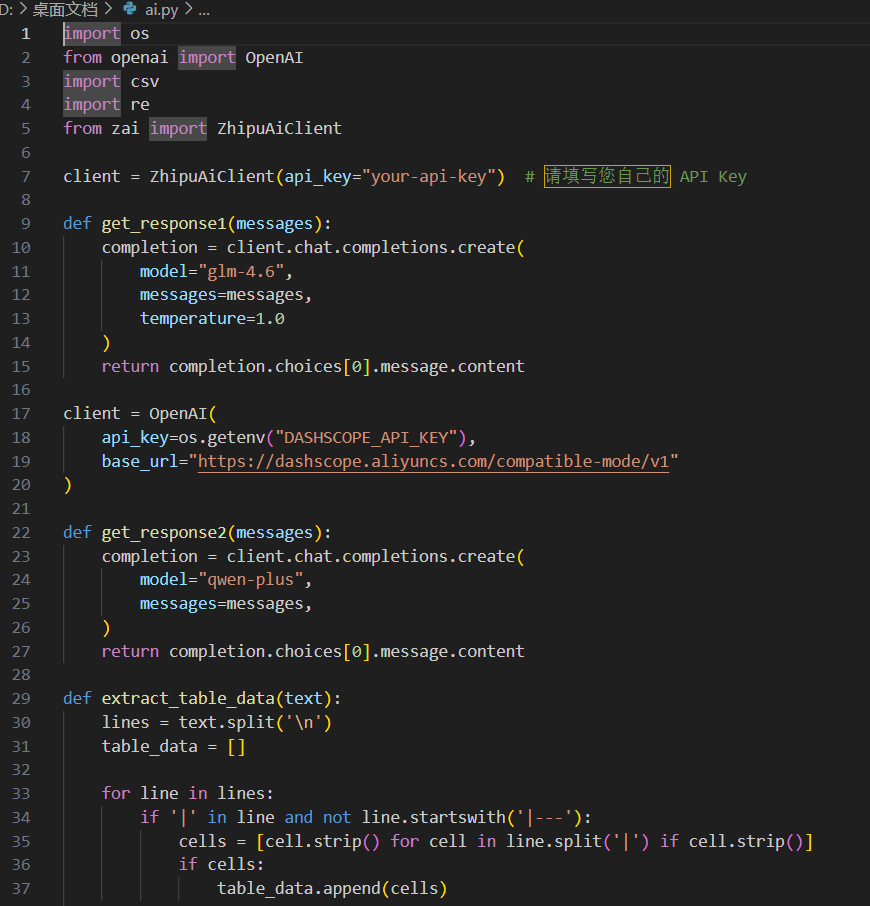
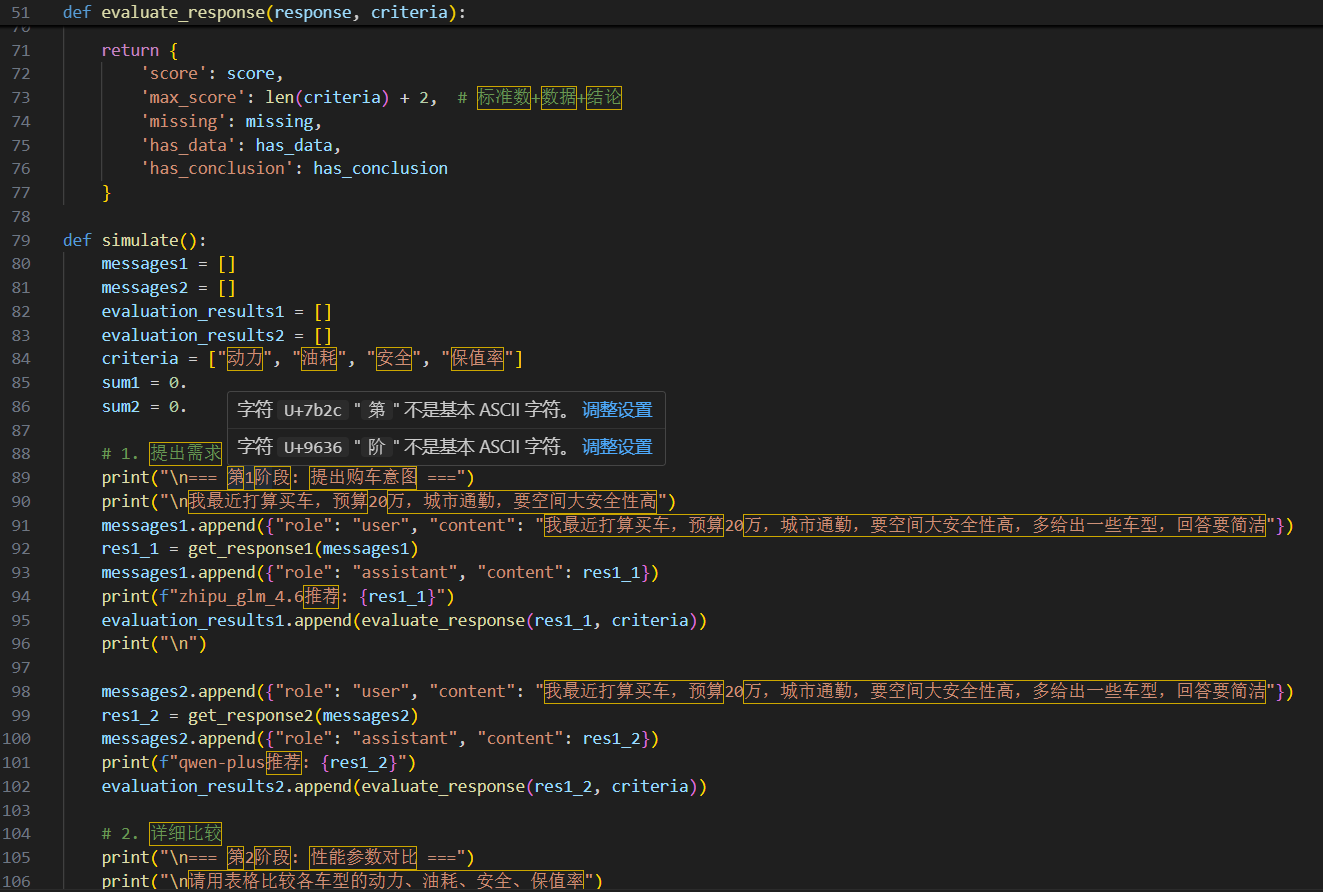
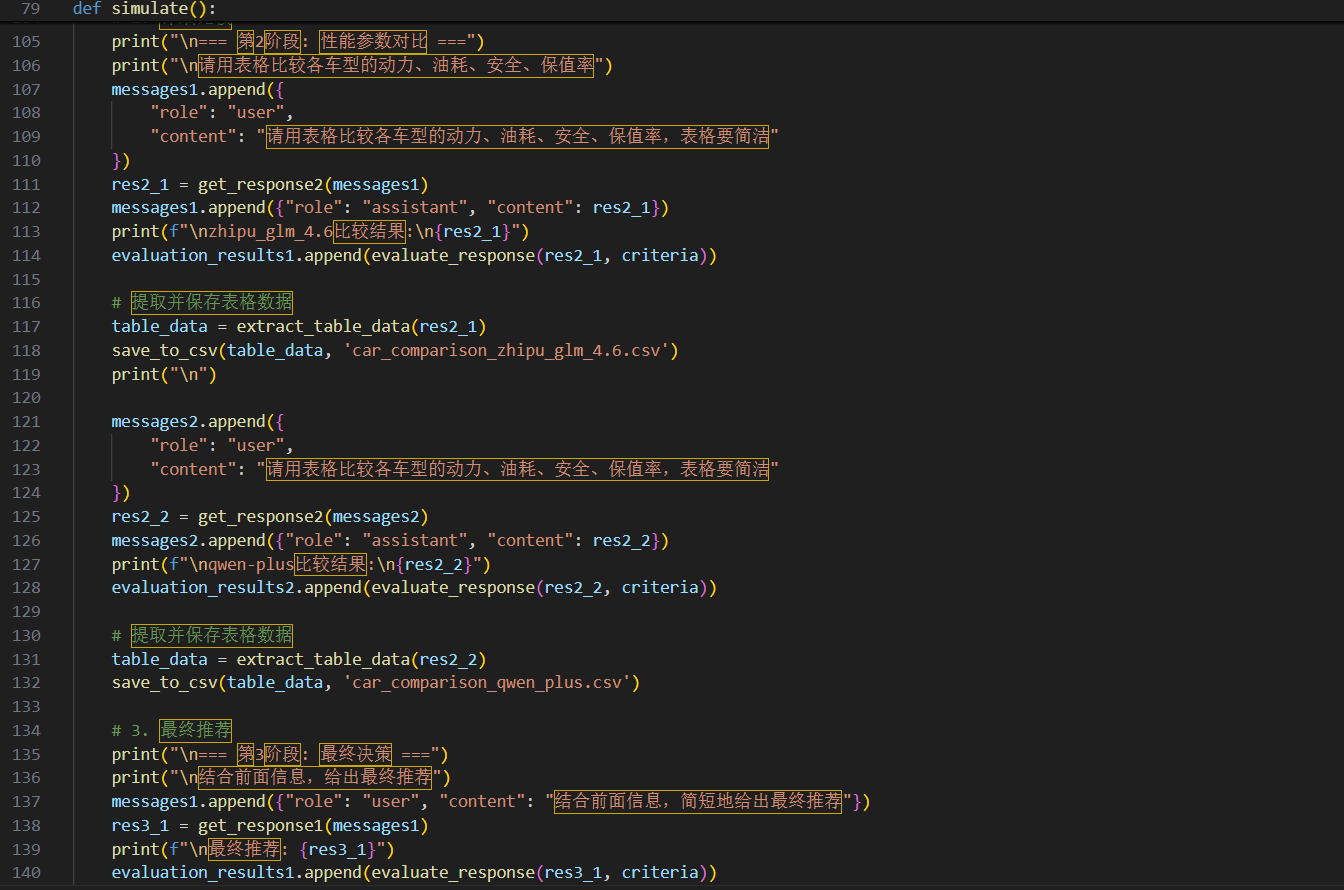
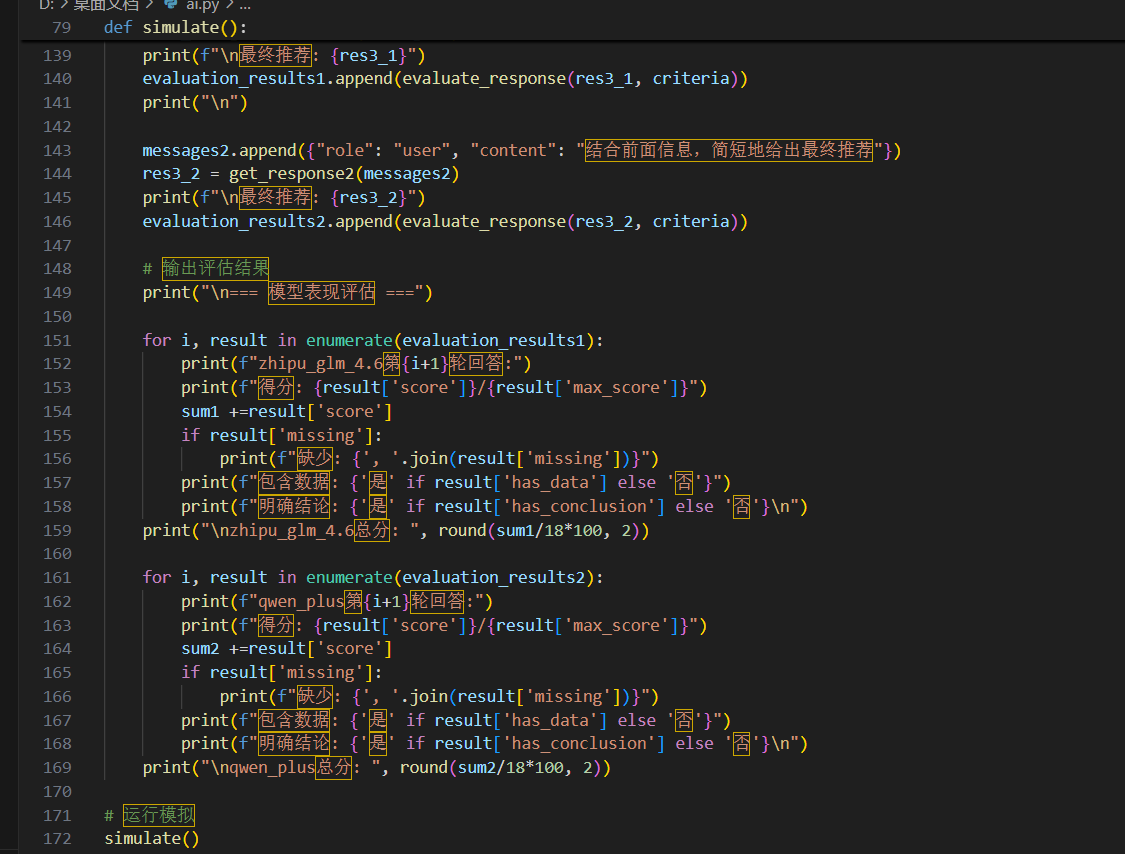
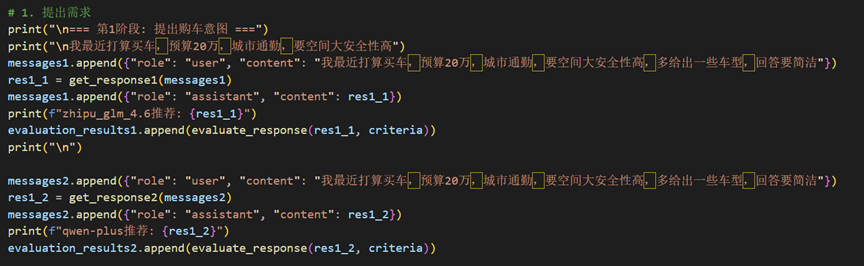
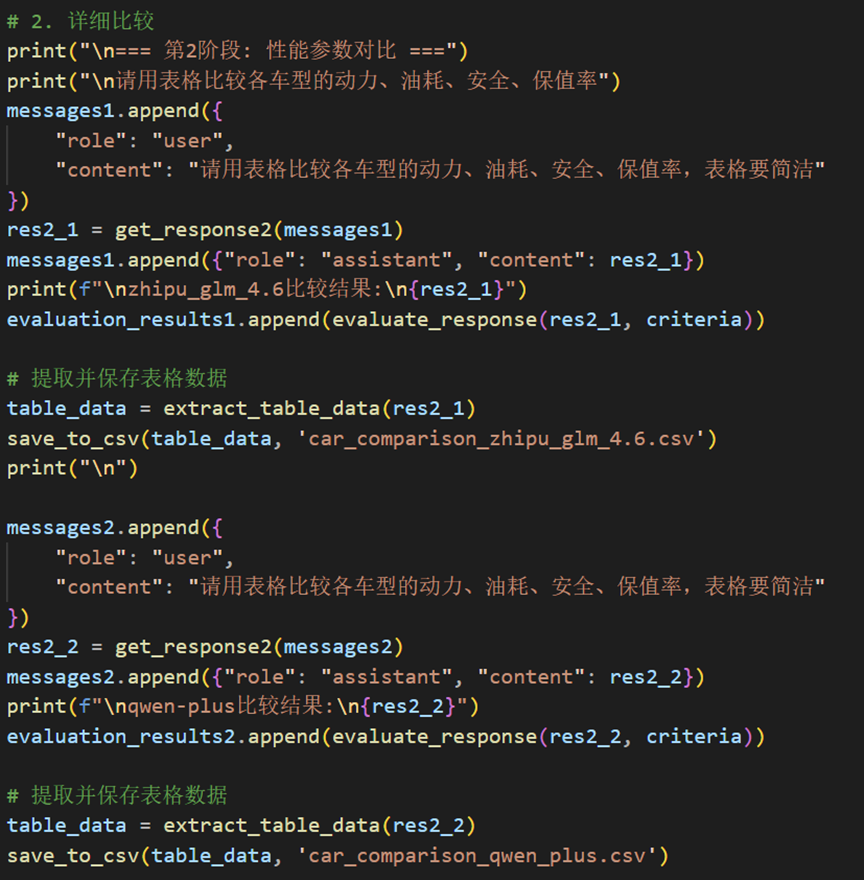
本系统的核心“程序”,是用于调用、解析和对比通义千问 (Qwen) 和 DeepSeek 这两个大模型的“粘合剂”与“裁判员”。
API 调度与并发控制算法:
本系统接收到一个测试用例(Prompt),需要将其同时发送给通义千问和DeepSeek的API端点。这需要并发处理算法(如异步I/O、线程池)来保证两个模型能近乎同时开始处理,以便公平地比较响应速度。
系统还包括API的重试与熔断算法,以处理某个模型(如Qwen)暂时超时或返回错误(如503)时的容错逻辑。
对话上下文管理算法:
[{role: 'user', ...}, {role: 'assistant', ...}])进行拼接,确保模型理解上下文。响应解析与信息抽取算法:
自动化评估与评分算法:
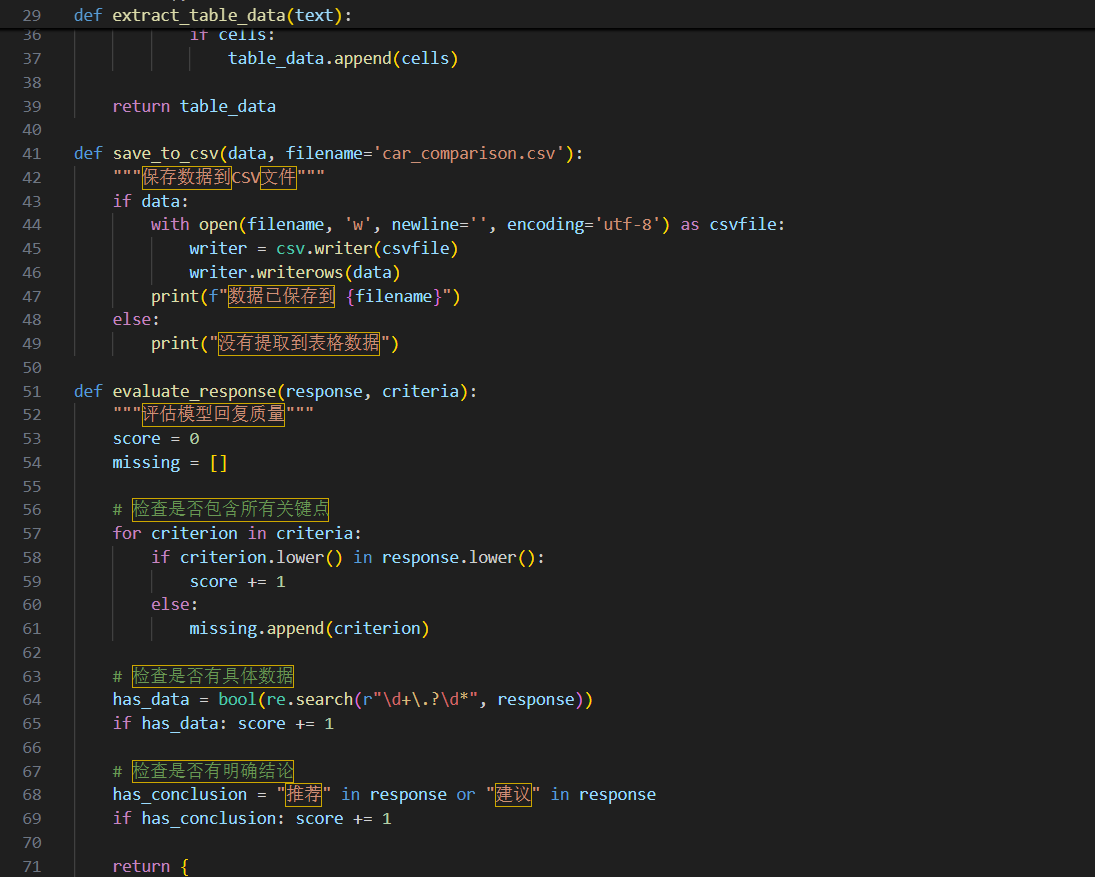
系统如何判断“好”与“坏”?这依赖于评估算法。
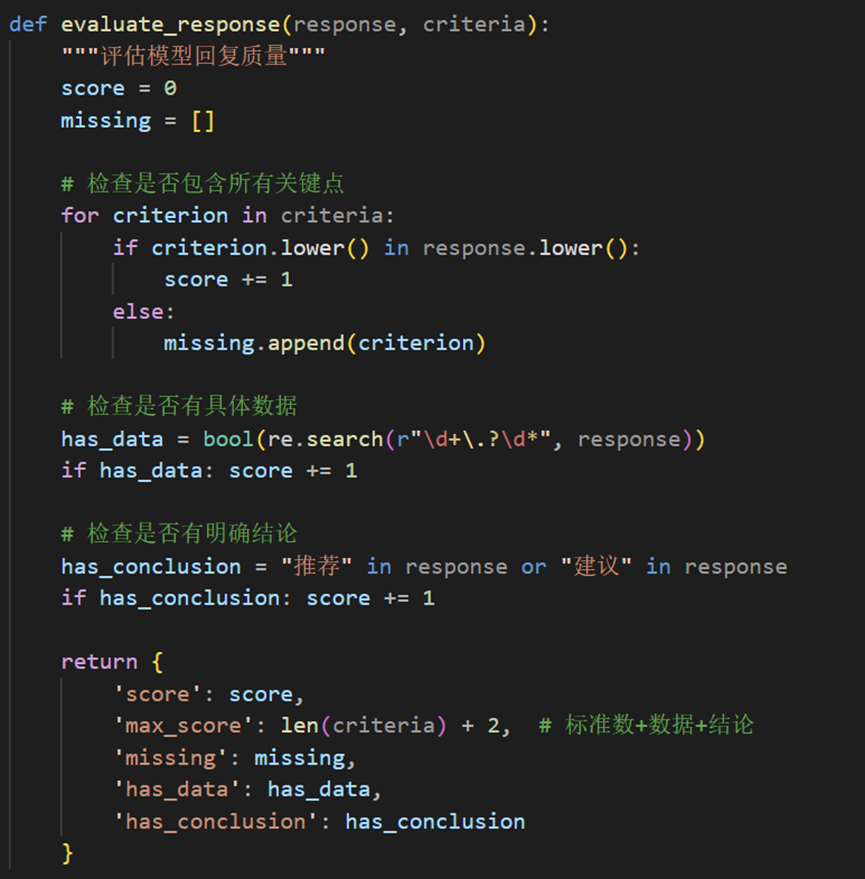
客观评估: 通过关键词匹配(如“是否提到了‘安全性’?”)、信息完整度(“是否列出了3个车型?”)来自动打分。
主观评估:(如果实现了)可能涉及更复杂的语义相似度算法,将模型的回答与一个“黄金标准答案”进行比对,计算其语义得分。
模型配置 (ModelConfig):
结构: 字典 (Dictionary / Map) 或 哈希表。
作用: Config = {'qwen': {'api_key': 'sk-xxx', 'endpoint': '...'}, 'deepseek': {'api_key': 'sk-yyy', 'endpoint': '...'}}。用于存储和管理不同模型的认证信息和API地址。
测试用例 (PromptCase):
结构: 对象 (Object) 或 结构体 (Struct)。
作用: 存储一个标准化的测试任务,例如 { 'id': 'case-001', 'scenario': '购车咨询', 'prompt': '预算20万,推荐SUV', 'expected_keywords': ['SUV', '安全', '空间'] }。
对话历史 (ConversationHistory):
结构: 嵌套的字典或列表,如 History['qwen'] = [...] 和 History['deepseek'] = [...]。
作用: 分别存储与两个模型的多轮交互记录,是对话管理算法的数据基础。
评测结果矩阵 (ResultMatrix):
结构: 二维数组或嵌套字典。
作用: 存储对比结果,例如 Result['case-001']['qwen']['response_time'] = 1.8s,Result['case-001']['deepseek']['response_time'] = 1.5s,以及解析后提取的数据和得分。
要让这个对比“程序”变得健壮、可维护、可扩展,就必须引入软件工程。
模型抽象层 (Model Abstraction Layer):
ModelService.get_response(model_name, prompt),而不需要关心Qwen和DeepSeek的API参数有何不同。这就是“高内聚、低耦合”的体现。API网关/Facade服务:
日志与监控服务:
缓存服务 (Caching):
API文档: 清晰的文档,说明如何调用本系统的对比API、如何传入参数、返回的对比结果JSON格式是怎样的。
README.md: 详细的项目说明,指导新加入的开发者如何配置通义千问和DeepSeek的API Key、如何运行测试、如何添加一个新的模型(如ChatGLM)到对比池中。
版本控制 (Git): 使用Git进行代码管理。例如,feature/add-deepseek-parser 这样的分支命名,通过Pull Request (PR) 和Code Review(代码审查)机制来保证解析算法的质量。
自动化测试 (CI): 建立持续集成流水线。每当有人提交代码时,自动运行单元测试(如“测试Qwen的解析器是否正常工作”)和集成测试(“真实调用一次DeepSeek的API看是否能通”)。
本系统虽然是“测试系统”,但它本身就是一个极具潜力的“软件企业”雏形。
B2B - SaaS 订阅:
B2B - 私有化部署与咨询:
B2C - “模型竞技场”网站 (Freemium):
中立性与客观性: 我们的核心价值在于“中立”。我们不生产模型,我们只是模型的“评测机构”。相比于阿里云(推广Qwen)或DeepSeek(推广自己),用户更相信我们给出的第三方对比报告。
领域专精 (Domain-Specific): 我们的竞争优势不在于模型本身,而在于我们为特定领域(如购车、医疗、法律)积累的“黄金测试集”和“高精度解析算法”。这是我们的核心技术壁垒。
易用性与自动化: 相比于复杂的开源评测框架,我们的系统提供一站式UI界面,让不懂技术的业务人员也能轻松完成模型评估,极大降低了企业引入AI的决策门槛。
成本控制: 通过缓存和精确的API用量统计,我们能帮企业清晰地看到“使用Qwen处理1000个客服工单需要5元,而DeepSeek需要4.5元”,提供了直观的成本决策依据。
(参考知识点:《构建之法》第8章功能的定位和优先级;第9章项目经理)
作为这个“AI模型对比平台”的新任项目经理,面对市场上其他评测工具和模型厂商自带的竞技场,我的目标是将其从一个“对比工具”升级为企业决策的“自动化QA(质量保障)中心”。
首先市场有多大?
其次直接的用户有多少?
潜在的用户又有多少?
我要在当前模型对比的基础上,设计一个名为“自动化QA流水线 (Automated QA Pipeline)” 的新功能。
N (Need - 需求)
用户痛点: 当前的对比(包括我们的系统)大多停留在“感觉”层面(这个回答更流畅、那个回答更详细)。企业真正的痛点是:“AI是否在胡说八道(幻觉)?”、“AI的回答是否符合我们公司的最新规定?”
市场空白: 开发者可以手动测试Qwen和DeepSeek,但无法规模化、自动化地测试它们在企业私有知识上的准确性。
A (Approach - 做法)
知识库接入: 允许企业用户上传自己的私有知识库(例如,最新的产品价格表CSV、公司规章制度PDF、内部技术文档库)。
“Ground Truth”生成: 系统利用RAG(检索增强生成)技术,先根据用户知识库生成一批“问题-标准答案”对(Ground Truth)。
自动化QA执行: 系统定期(例如每天晚上)自动运行这些问题,去轰炸Qwen和DeepSeek的API。
事实一致性校验: 这是核心算法。系统自动对比Qwen和DeepSeek的回答与“标准答案”的事实一致性,并输出“幻觉率”、“事实错误率”等关键QA指标。
B (Benefit - 好处)
对用户:
节省人力: 将过去需要10个人工测试一周的工作,缩短为系统自动运行1小时。
保障质量: 提供了客观、可量化的数据,帮助企业在Qwen和DeepSeek之间做出基于事实而非感觉的选择。
安全感: 解决了企业最怕的“AI幻觉”和“合规风险”问题。
为什么用户会用你的产品?(创新点):
C (Competitors - 竞争)
模型厂商(阿里、DeepSeek): 他们是运动员,我们是裁判。他们无法中立地评测自己。
其他评测平台(如LangSmith, Superwise): 它们通常是“开发者工具”,功能强大但使用复杂,需要写很多代码。
我们的优势: 我们提供UI驱动的、面向非技术人员的“一键式QA”服务。产品经理和运营人员也能轻松配置和查看QA报告,这是我们胜出的关键。
D (Delivery - 交付)
MVP(最小可行产品): 砍掉所有复杂功能,只做一个核心流程:允许用户上传一个CSV文件作为知识库 -> 用户输入一个问题 -> 系统同时展示Qwen和DeepSeek的回答,并在旁边高亮显示“回答中的哪些事实与CSV中的内容不符”。
第二阶段: 实现自动化批量测试和“QA报告”仪表盘。
GTM(推向市场): 针对已经在使用Qwen和DeepSeek API的中小型企业进行精准营销,宣传口号:“在AI对你的客户撒谎之前,先用我们的系统抓住它。”
| 学号 | 分工内容 | 贡献度 |
|---|---|---|
| 102300208 | 博客撰写、调研分析 | 12.5% |
| 102300209 | ppt制作 | 12.5% |
| 102300224 | 大模型测试 | 12.5% |
| 102300222 | 分析、大模型测试 | 12.5% |
| 102300120 | 汇报 | 12.5% |
| 102300116 | 大模型测试 | 12.5% |
| 102300113 | 测试结果汇总和图表制作 | 12.5% |
| 102300129 | 评测结论与主观体验分析 | 12.5% |


