

 2501_CS_SE_FZU

团队作业β冲刺——day2
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
| 这个作业属于哪个课程 | https://bbs.csdn.net/forums/2501_CS_SE_FZU |
|---|---|
| 这个作业要求在哪里 | 团队作业β冲刺 |
| 这个作业的目标 | 记录冲刺阶段每一天的进程 |
| 其他参考文献 | 暂无 |
目录
- SCRUM部分
- 1、站立式会议
- 2、各成员进展总结
- 3、代码签入记录
- 4、测试截图
- PM部分
- 5、项目燃尽图
- 6、运行截图
- 7、工作量总结
- 任务量统计(按时间估算)
- 任务量变化
SCRUM部分
1、站立式会议
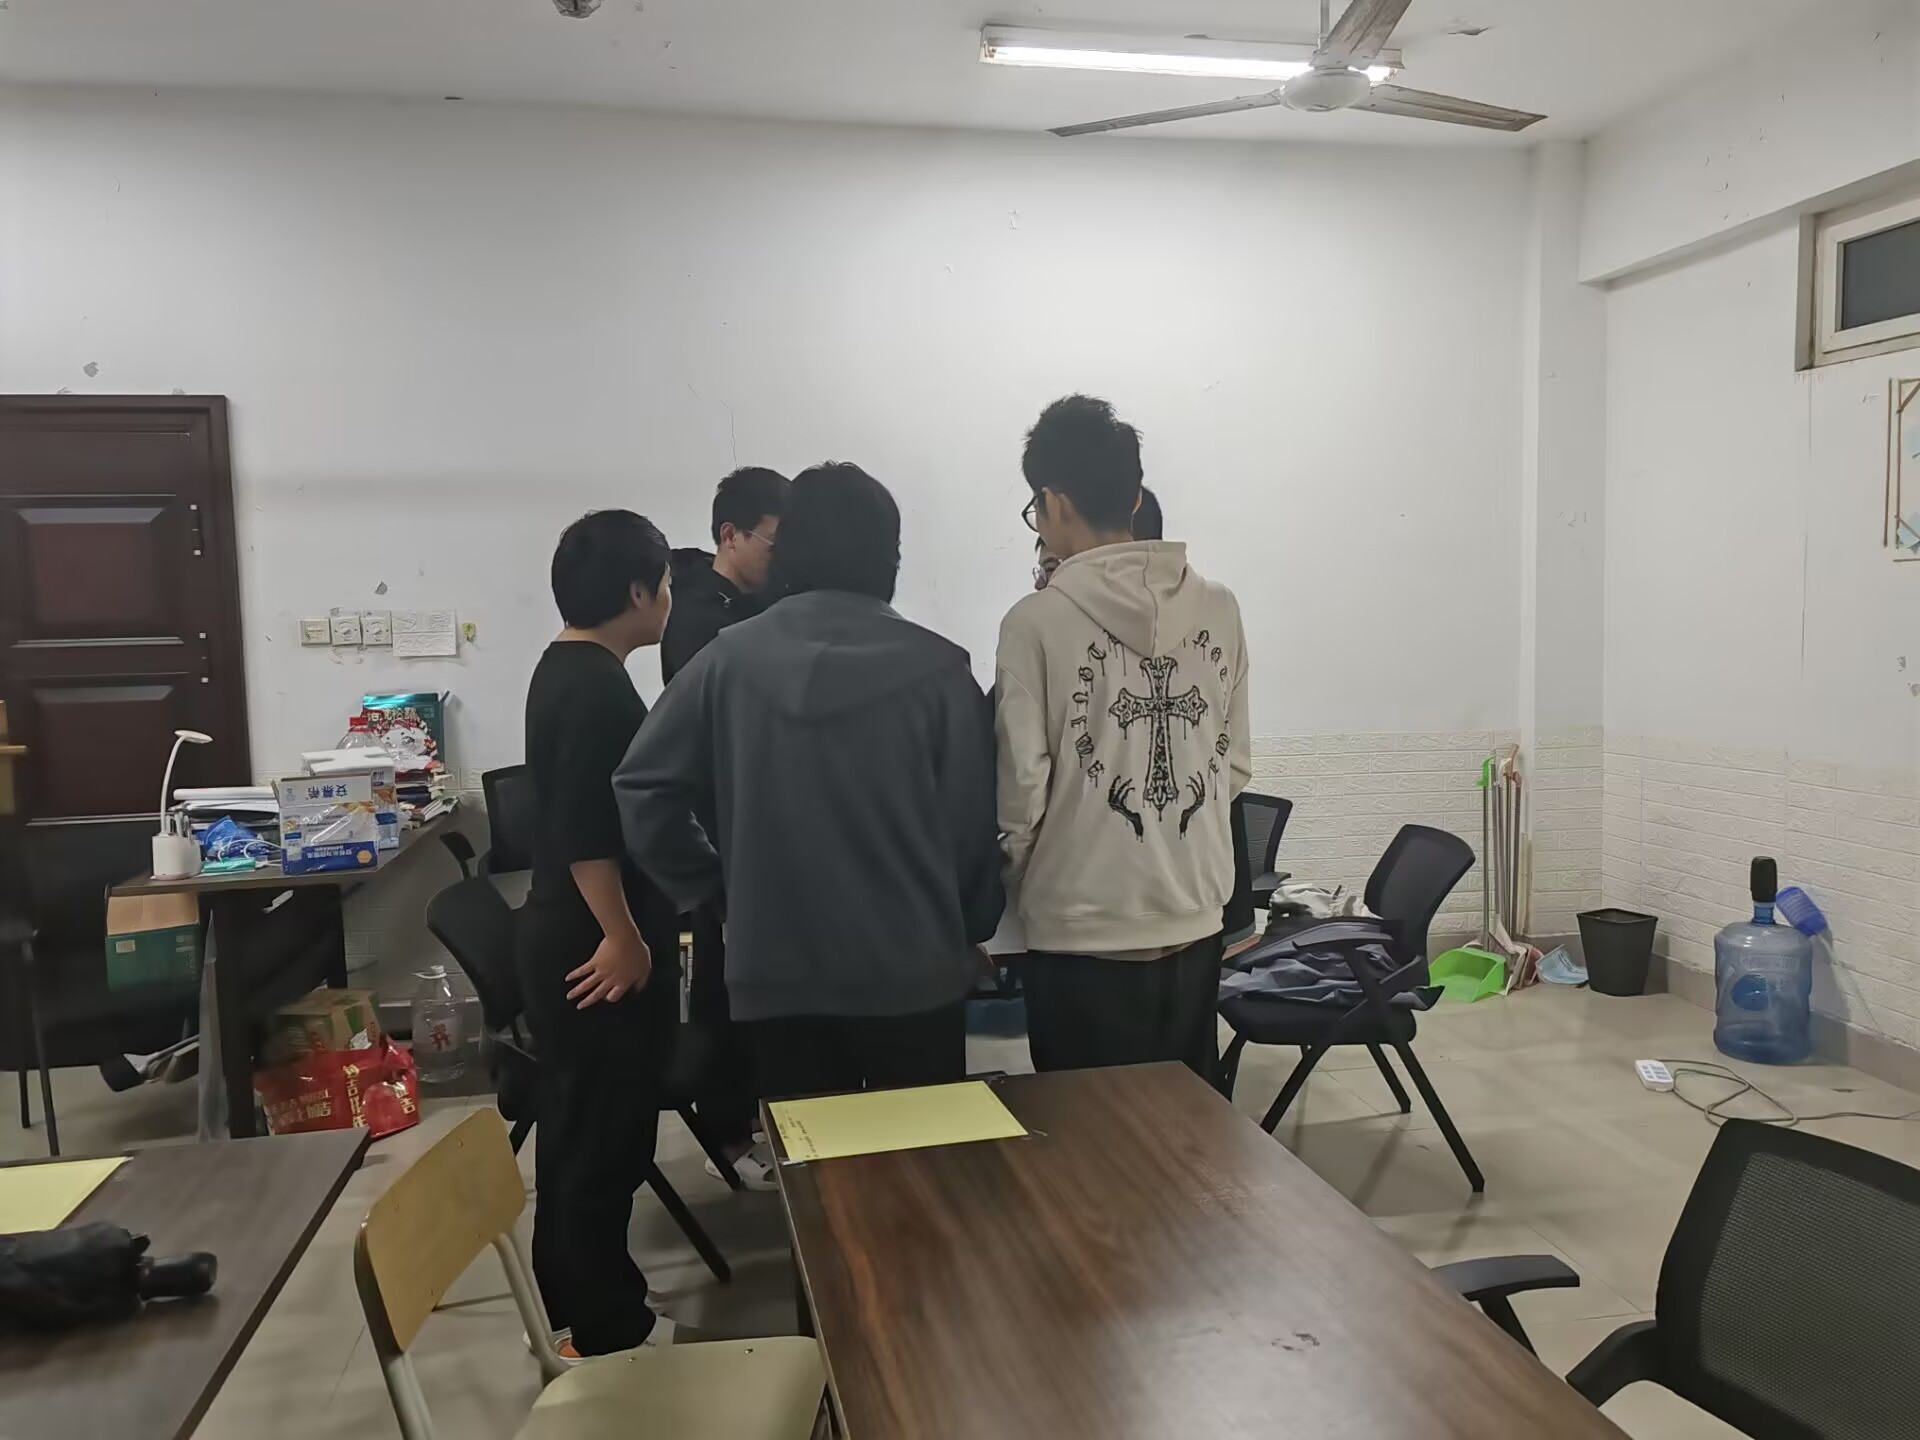
会议内容概要:
协调任务进度以及任务量变化事宜,分配任务以及进行任务进程相关事项讨论。
2、各成员进展总结
| 学号姓名 | 任务进展 | 存在困难/问题 | 明日安排 | 心得体会 |
|---|---|---|---|---|
| 102300113叶佳康 | 完善单选题功能逻辑,与后端同学对接 | 暂无 | 根据文档连接接口 | 文档是好东西 |
| 102300423骆泽权 | 创建文章基础类,创建controller,service,mapper接口 | 无 | 继续对接 | 无 |
| 102300120覃俊源 | 排行榜优化 | 无 | 继续优化 | 无 |
| 102300129柯振宇 | 学习测试相关技术 | 暂无 | 为后续的后端测试做准备 | 暂无 |
| 102300208蔡少钦 | 完成对更新用户数据的前后端对接 | 无 | 继续对接 | 无 |
| 102300209蔡宇鹏 | 题目按种类,和错题重做,详情和用户头像base64所有接口补充完整,数据库修正 | 暂无 | 与前端同学一起改bug,修正接口 | 无 |
| 102300222苏忠朝 | 历年真题所有接口补充完整,数据库修正 | 暂无 | 与前端同学一起改bug,补充缺少的接口 | 无 |
| 102300224王上政 | 实现登录,将用户信息存到本地,打开首页、排行榜-我的成绩和我的自动更新 | 暂无 | 续前后端对接,优化界面 | 暂无 |
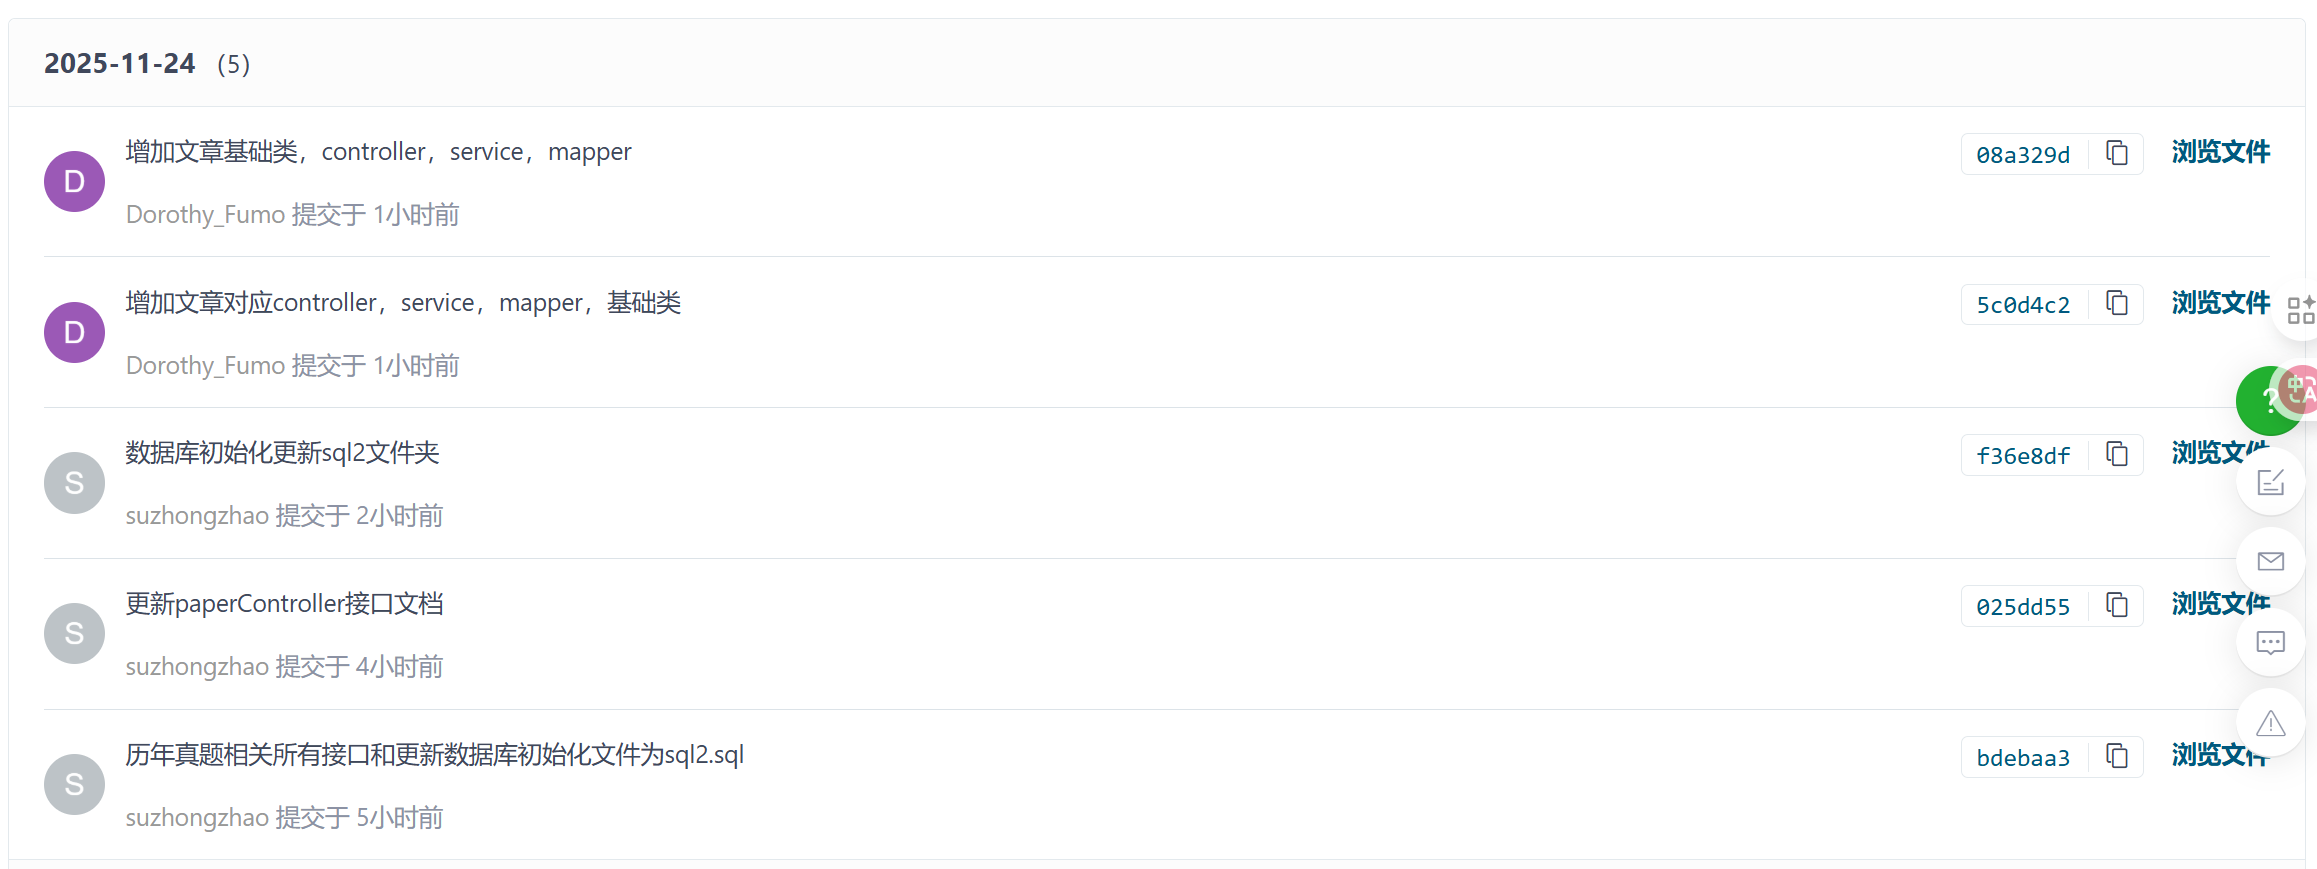
3、代码签入记录
前端阶段任务两天完成,当日暂无代码签入
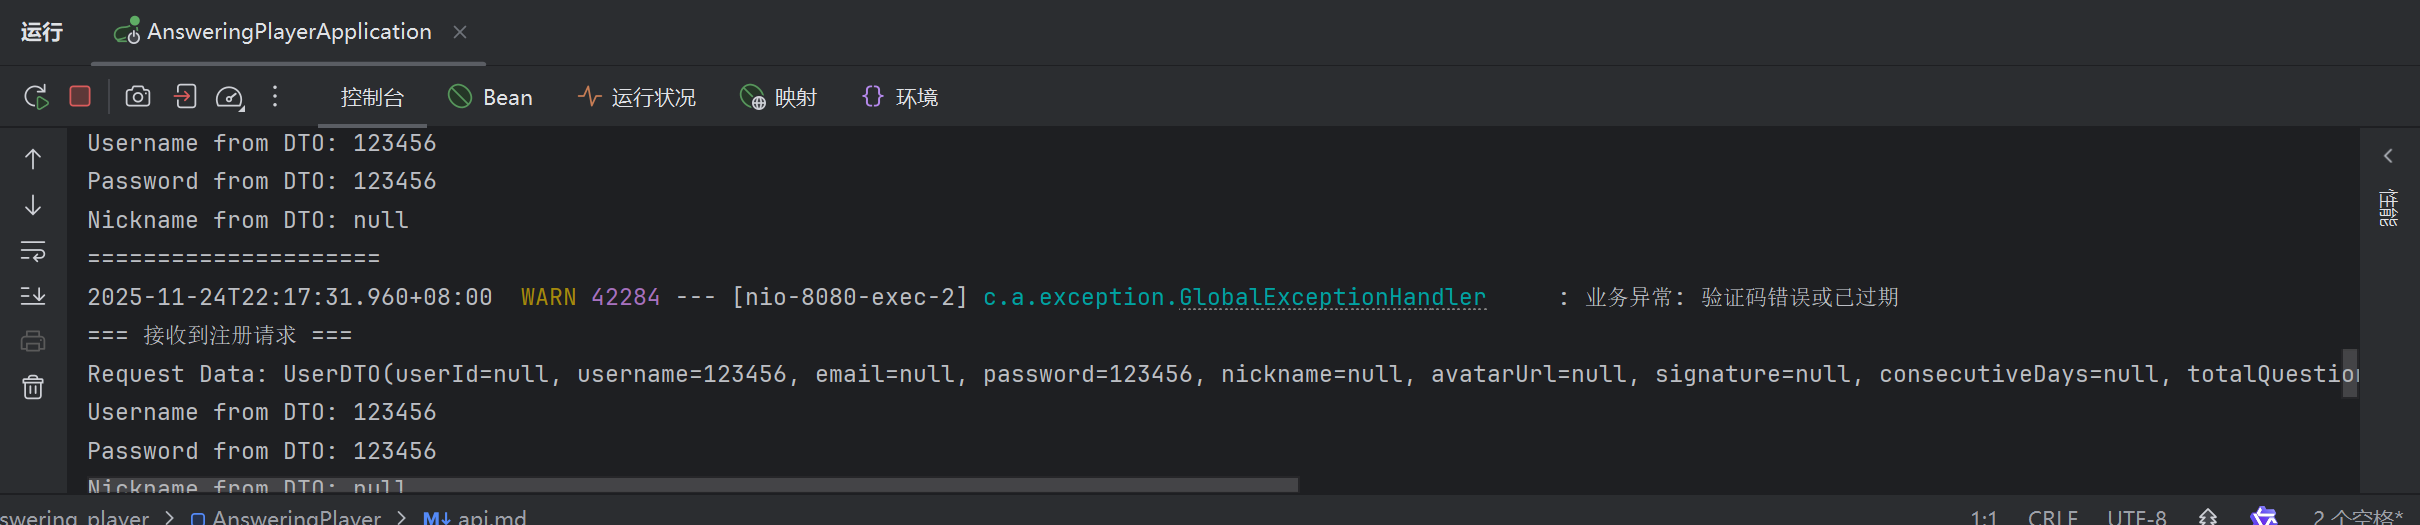
4、测试截图
PM部分
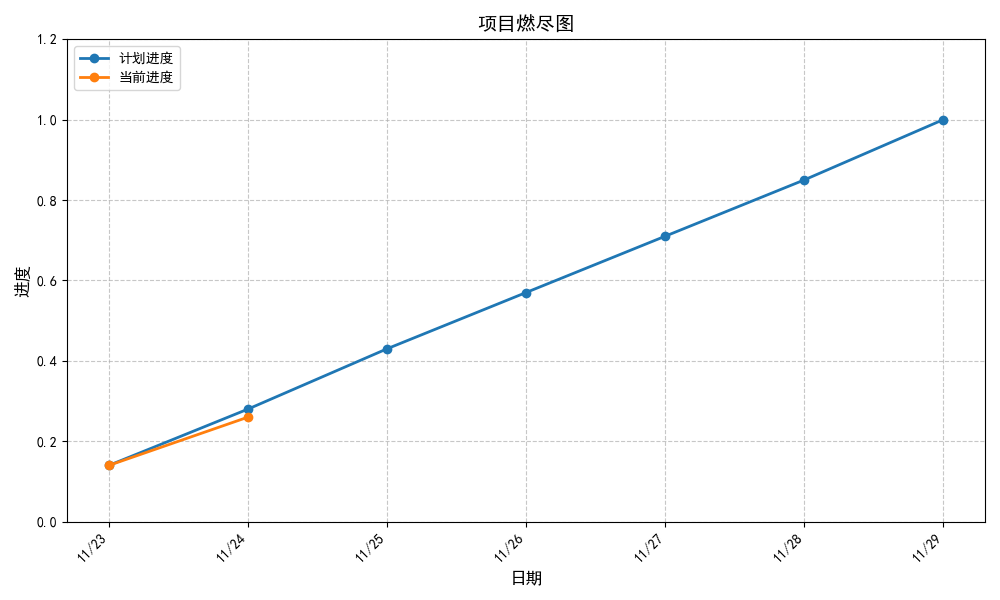
5、项目燃尽图
6、运行截图
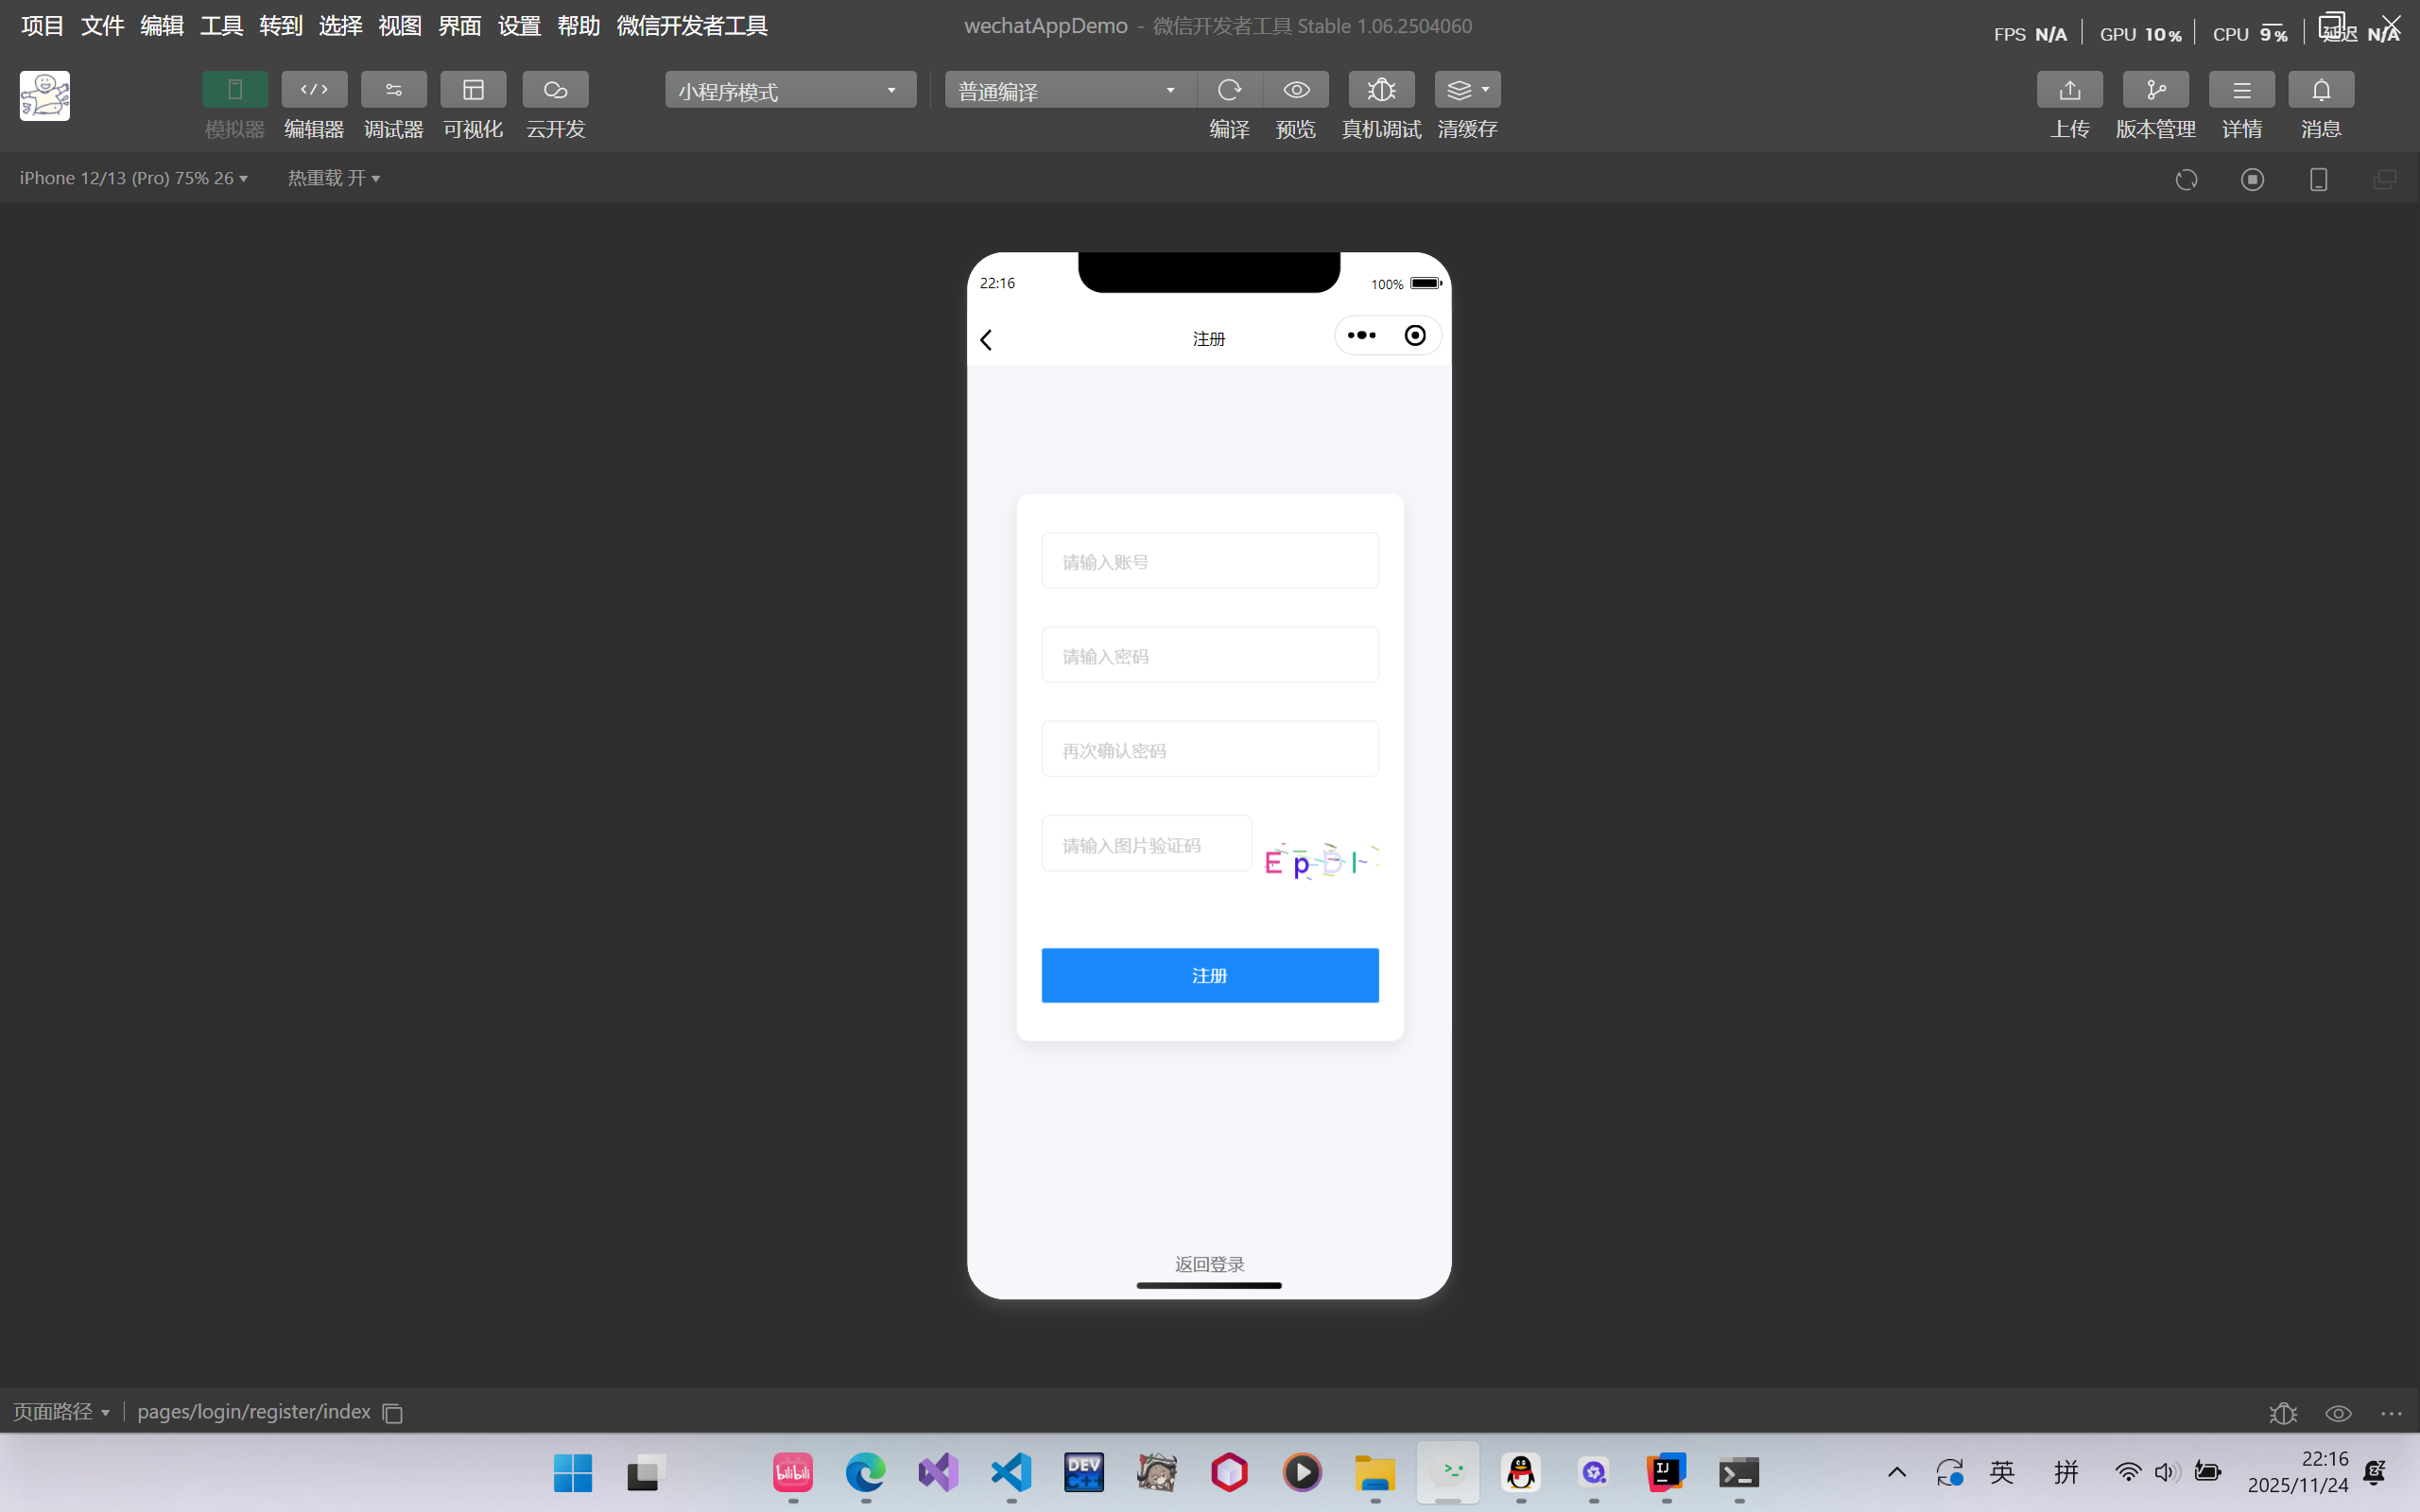
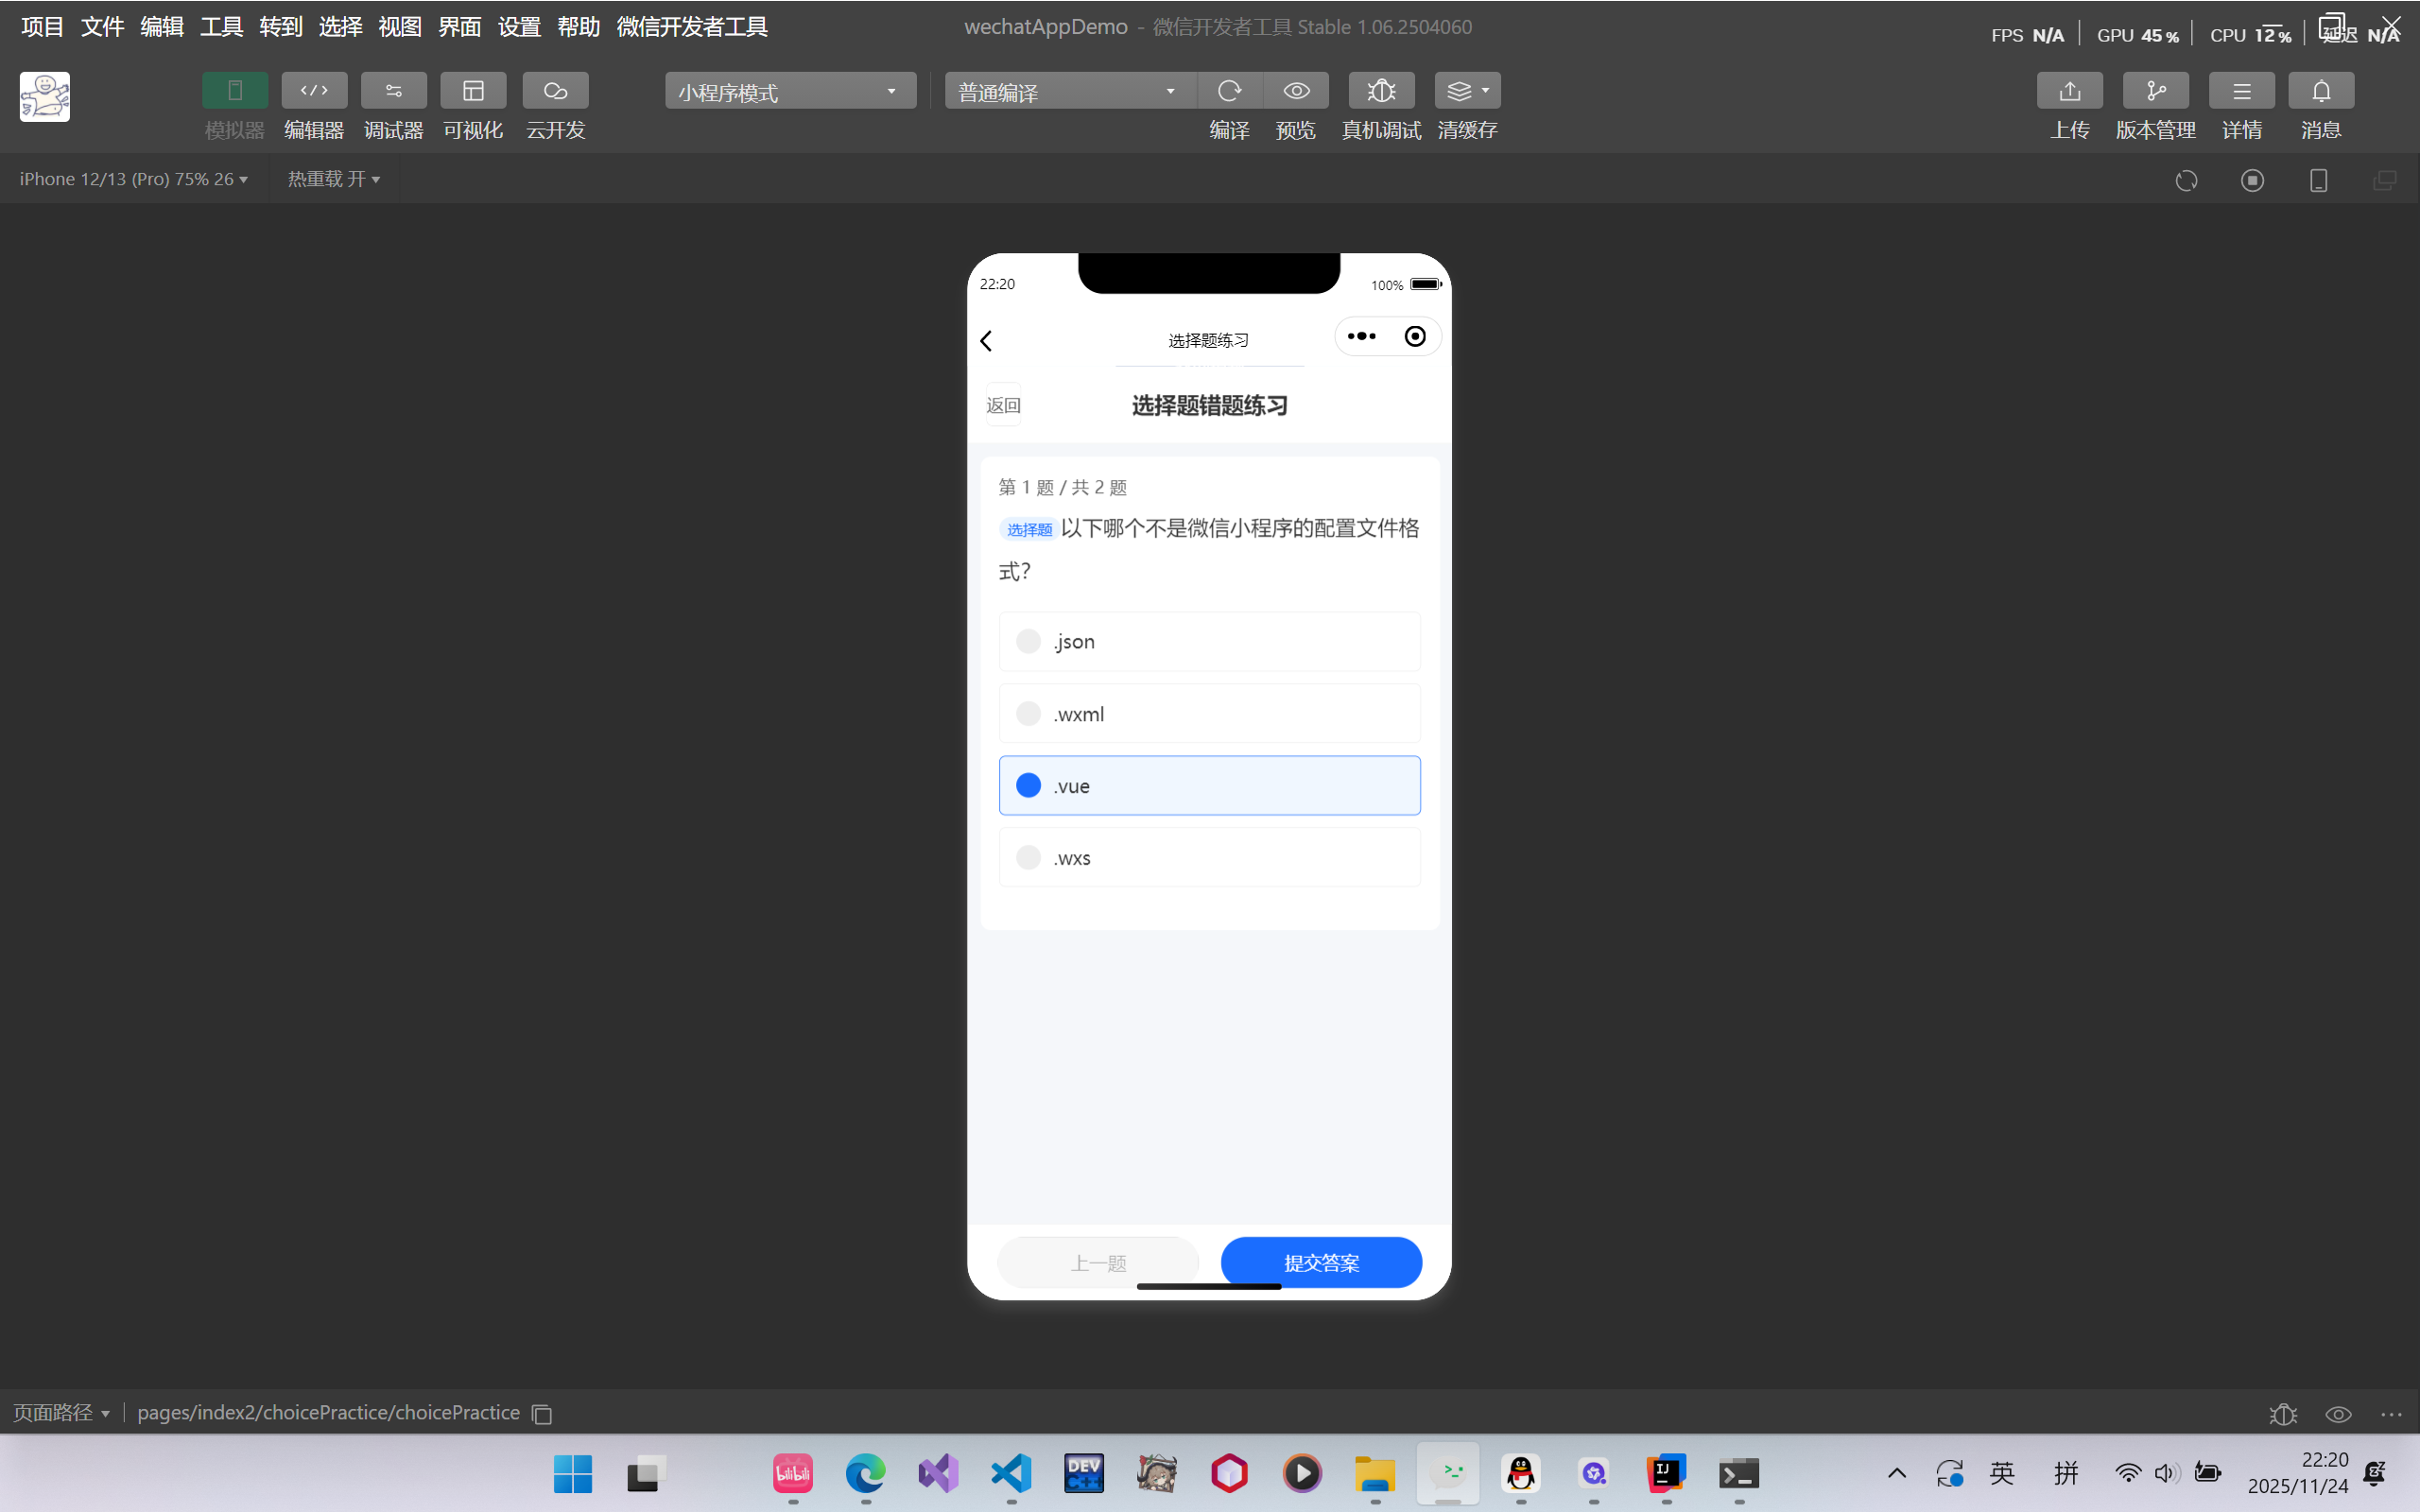
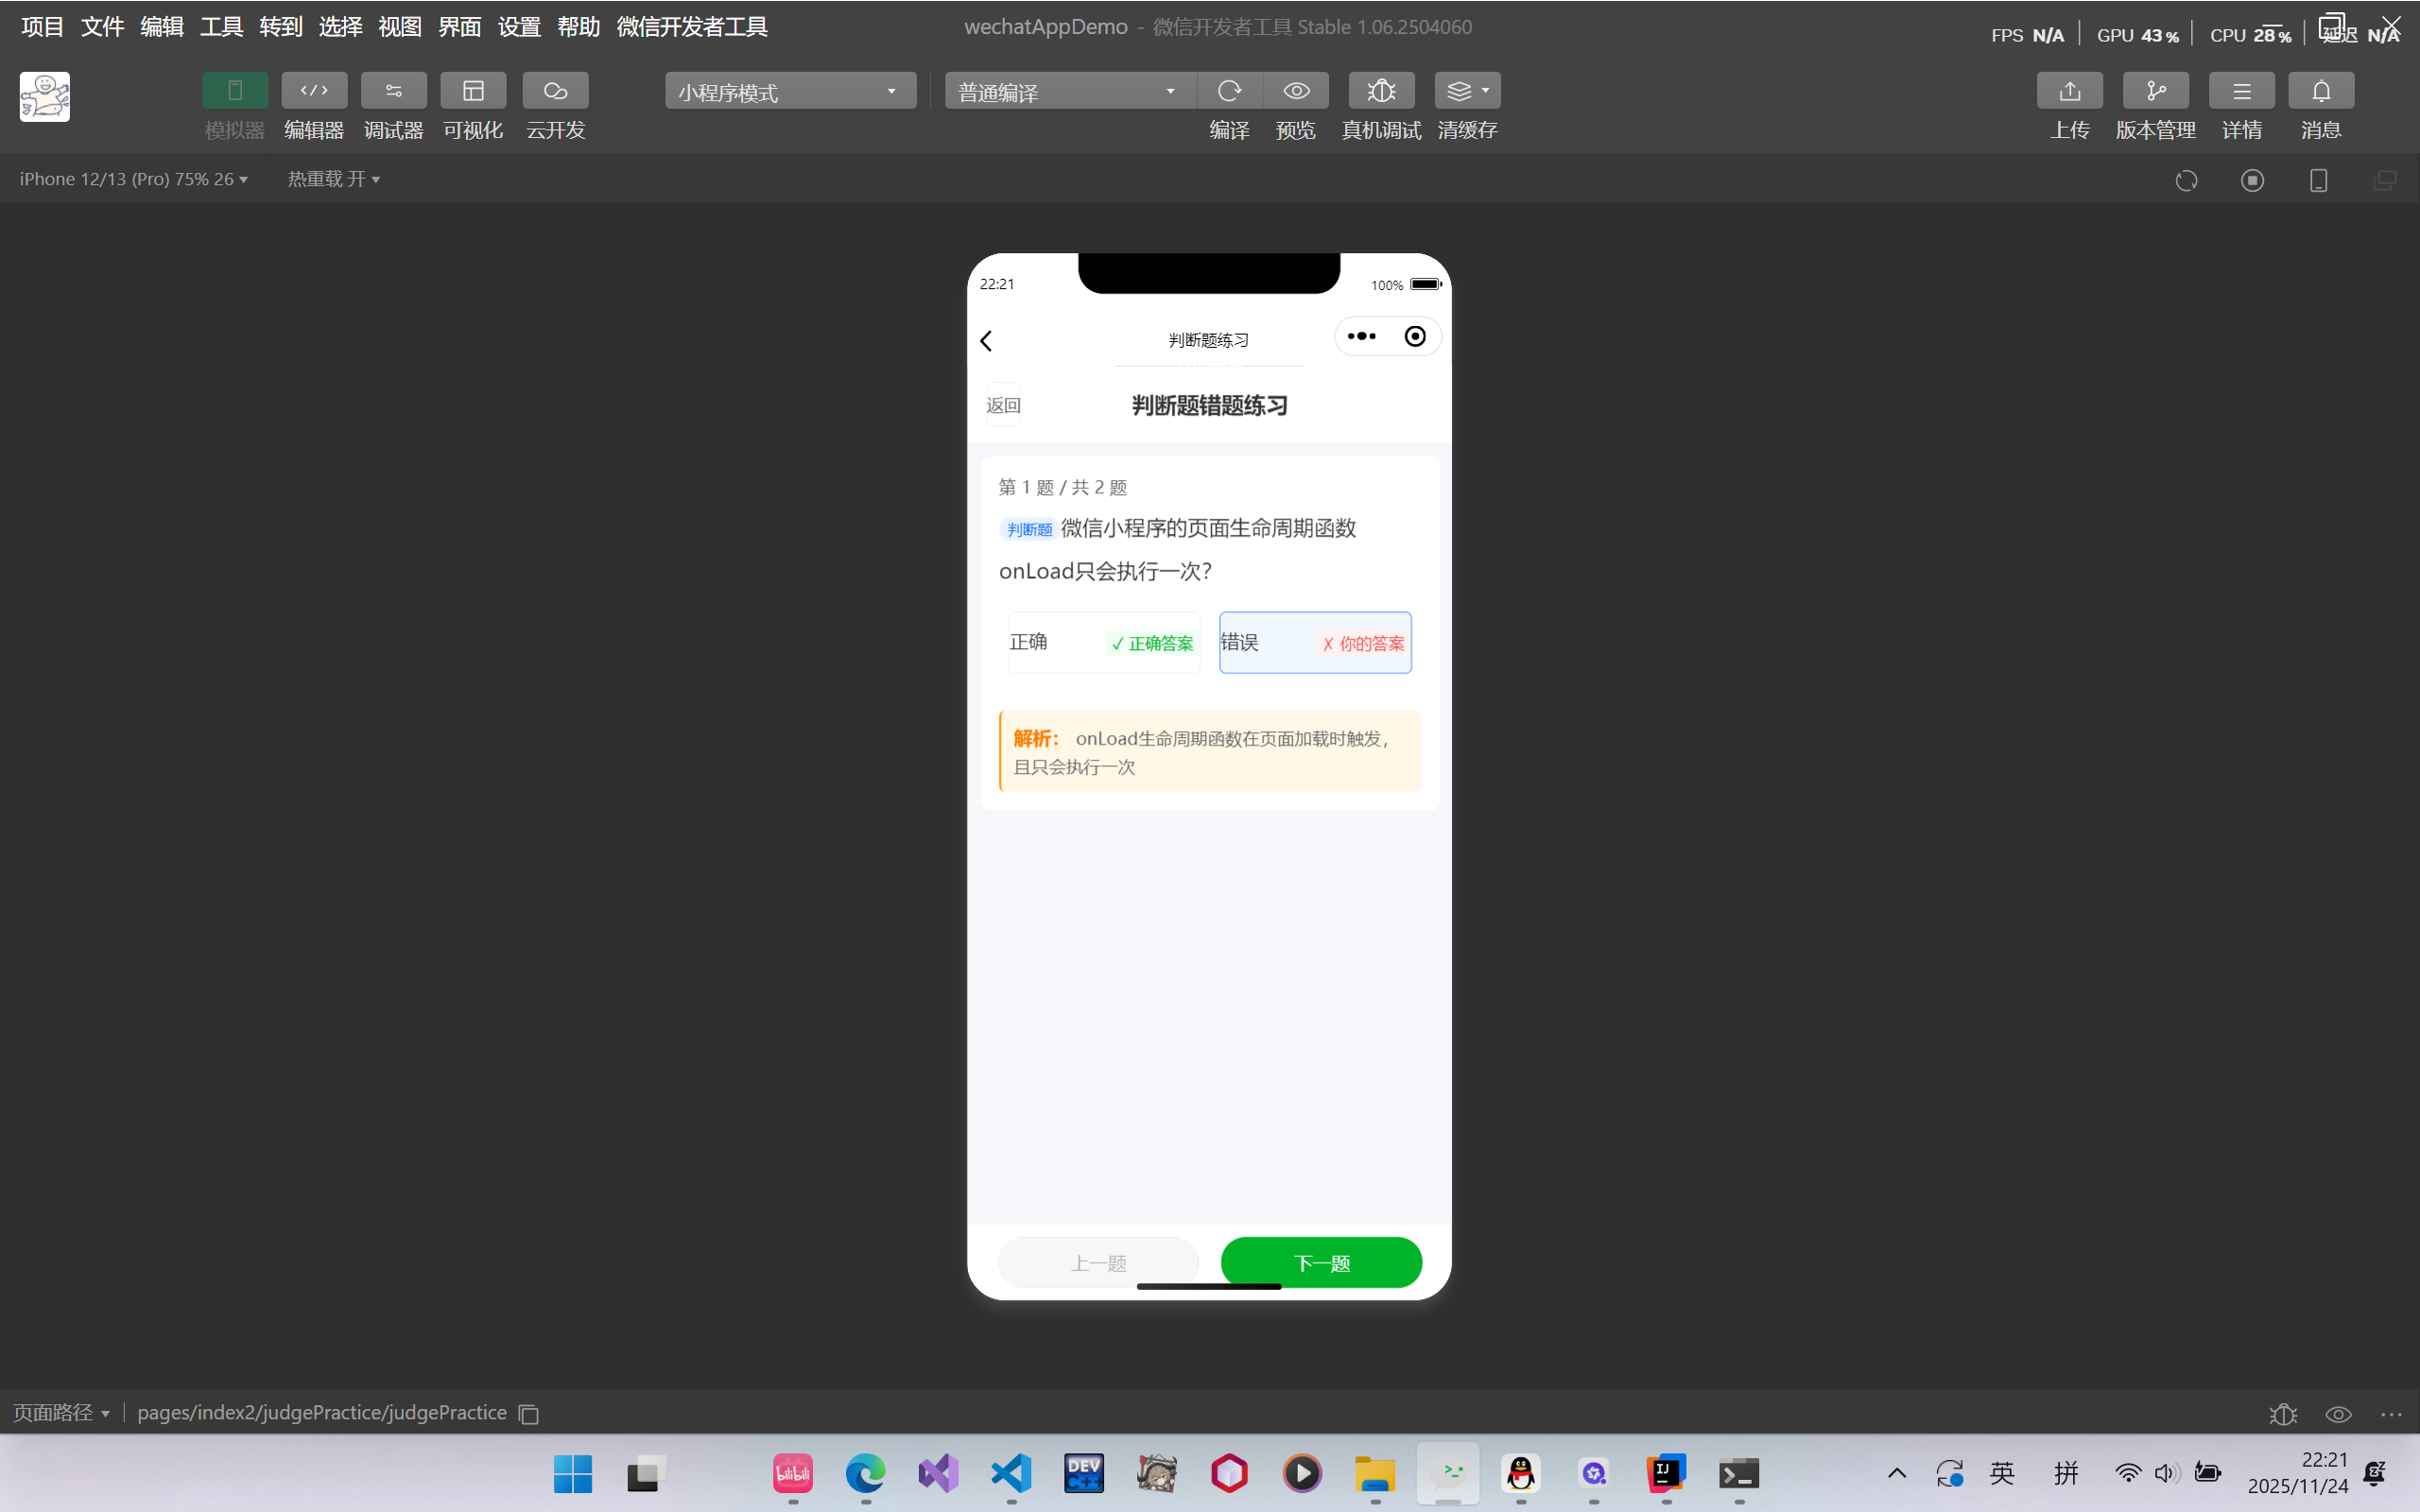
7、工作量总结
任务量统计(按时间估算)
| 项目 | 工时估算 | 说明 |
|---|---|---|
| 预期总任务量 | 176工时 | 按7天×8人×3小时/天计算 + 新增工作量 |
| 已完成工作量 | 44工时 | 第二天完成(8人×2.5小时,课程较多,没有多余空闲时间) |
| 剩余工作量 | 132工时 | 剩余5天需要完成 |
任务量变化
| 新增工作量来源 | 工作量增加预估 |
|---|---|
| 技术栈学习成本 | +4工时 |
| 需求细节调整 | +2工时 |
| 代码规范统一 | +2工时 |
相关推荐
PPO在动态定价中的工业级落地:从原理到毫秒级服务
动态定价是一种典型的序列决策问题,本质是面向高维、非平稳环境的在线强化学习任务。其核心挑战在于平衡探索与稳定性、实时性与鲁棒性、业务目标与算法目标。PPO(近端策略优化)凭借裁剪代理目标函数和信任域约束机制,在保证策略更新安全性的前提下支持持续在线优化,成为工业界首选算法。相比DQN难以处理连续动作空间、SAC过度鼓励危险探索等局限,PPO天然适配定价场景对‘输不起、等不及、改不了’的严苛要求。本文结合真实本地生活平台实践,详解如何将PPO嵌入状态工程、奖励建模、分布式训练与gRPC服务全链路,实现司机履约
【信息科学与工程学】【广告科学】第四十四篇 广告平台投放和广告计费类算法01
全行业的中国企业广告投放模型总表。行业分类依据《国民经济行业分类》(GB/T 4754—2017)的门类/大类 ,产品层参考"主营产品统计代码"行业—产品映射 ,平台算法以巨量引擎、腾讯广告等官方文档为硬支撑 ,合规部分严格对齐《互联网广告管理办法》以及2026年市场监管部门最新合规提示 。编号类型(门类)行业(大类)企业及产品内容列表投放模型投放平台投放人群欲望激发维度面向人群模式(地域/文化/年龄/角色)001A 农林牧渔01 农业北大荒/中粮:五常大米、面粉、食用油、杂粮品牌曝光 + 电商转化双轨(C
非科班转行数据科学的18个月真实进阶路径
数据科学不是调包拼凑,而是数学直觉、工程能力与业务语感三位一体的实践学科。从线性回归的几何直观到PCA的降维本质,从手写SVD实现到特征工程中的缺失值归因,其核心在于建立‘问题—原理—代码—业务’的闭环认知。尤其对非科班学习者,跳过黑箱操作、直击梯度下降的三维动态过程、在真实销售数据中验证统计显著性,才能跨越Kaggle幻觉与生产环境的鸿沟。本文聚焦Data Science落地所需的肌肉记忆构建,涵盖数学筑基、工程锚定、业务翻译三大阶段,助力零基础者扎实迈入企业级数据岗位。
时间序列过拟合诊断与防御:从Sevilla FC舆情预测实战出发
时间序列建模中的过拟合,本质是模型将时间戳伪因果、局部噪声或单点异常误判为普适规律,导致在训练集上表现优异却在真实预测中严重失准。其核心成因在于时间依赖性放大记忆偏差、窗口与周期失配、特征过度精细化及验证策略违背时序因果。技术价值在于提升模型鲁棒性、泛化能力与业务可解释性,支撑体育舆情、电商销量、电力负荷等强周期+弱突变场景的稳定决策。本文基于Sevilla FC欧联杯舆情预测真实案例,系统拆解数据层噪声注入与时间掩码、特征层可行动性设计与滞后差分、模型层非对称损失与异构集成等抗过拟合实践方法。
RAG不是模块而是智能体:自建陷阱与商用选型指南
RAG(检索增强生成)作为当前企业AI落地的关键技术,其本质并非简单的‘检索+大模型’拼接,而是一个强耦合、高敏感、需持续演进的智能体系统。理解其底层原理——如向量检索延迟对实时性的影响、知识库更新一致性对准确性的制约——是规避失败的前提。技术价值在于 bridging 业务知识与LLM生成能力,支撑智能客服、合规核保、销售助手等场景。但自建常因低估知识治理复杂度与检索-生成闭环成本而陷入运维泥潭。本文聚焦RAG架构设计、向量检索延迟优化与提示词工程协同等核心挑战,提供可落地的商用评估框架与自建生存红线。




