

 全栈攻防局

HTML meta charset 出现乱码?数据变成问号?编码端和解码端是两回事
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
HTML meta charset 出现乱码?数据变成问号?编码端和解码端是两回事
问题引入:
我们写HTML时,<head>的第一行就是<meta charset = "UTF-8" >,你真的理解它解决了什么问题吗?
原因分析:
首先,我们要对编码和解码有一个简单的但最起码的认知:
编码 = 把你的数据放进箱子里。
放错箱子 → 东西损坏 → 不可逆
↓ ↓ ↓
用错编码方式 数据存储错误,当场变成问号 数据直接废掉,无法再弥补
解码 = 打开箱子取出数据。
用错钥匙 → 打不开箱子 → 换正确的钥匙
↓ ↓ ↓
用错解码方式 导致数据错乱,出现乱码 数据被成功解读
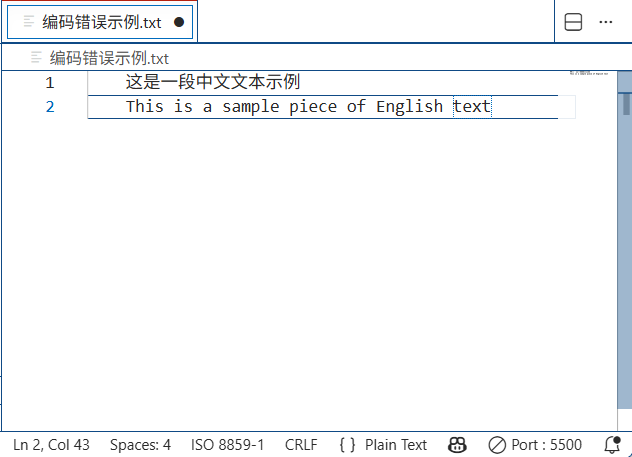
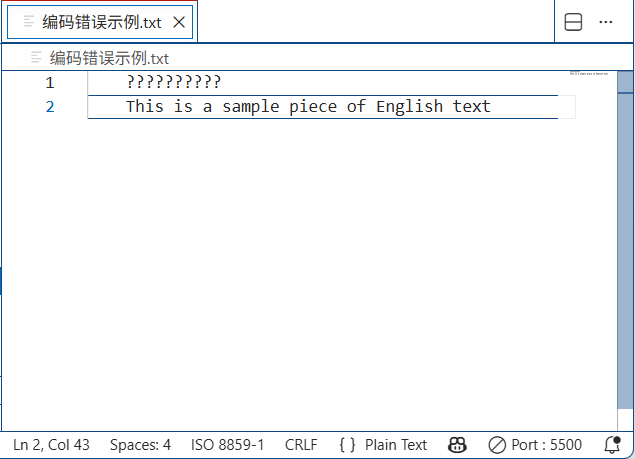
> 编码错误的示例
用 ISO-8859-1 编码保存前
用 ISO-8859-1 编码保存之后
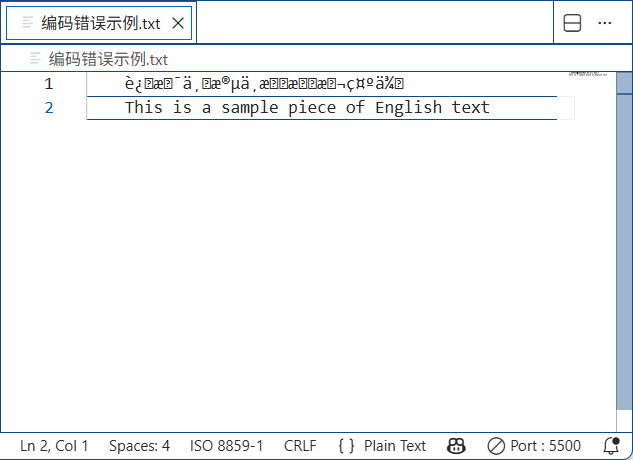
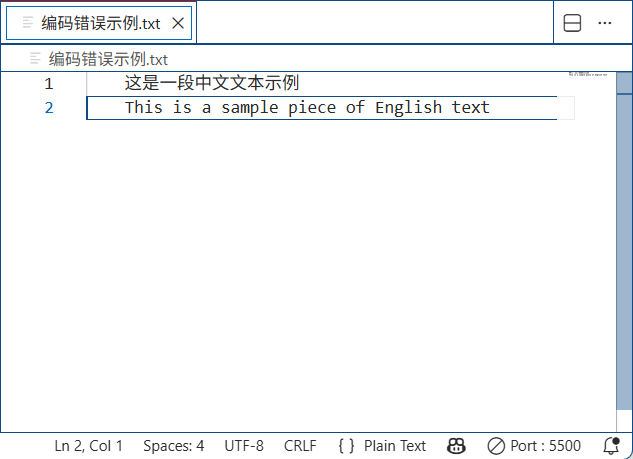
> 解码错误的示例
用 ISO-8859-1 解码的结果
用 UTF-8 解码的结果
解决方案:
> 编码错误的解决办法
重写
编码错误导致的数据损坏是不可逆的,只能把问号全部删掉,然后重新写一遍,最后用正确的编码方式保存。
> 解码错误的解决办法
切换正确的解码方式
解码错误不会对数据本身造成损坏,所以解码错误是可逆的,只需切换正确的解码方式重新解码即可。
相关推荐
Python网络爬虫出现乱码问题的解决方法
关于爬虫乱码有很多各式各样的问题,这里不仅是中文乱码,编码转换、还包括一些如日文、韩文 、俄文、藏文之类的乱码处理,因为解决方式是一致的,故在此统一说明。 网络爬虫出现乱码的原因 源网页编码和爬取下来后的编码格式不一致。 如源网页为gbk编码的字节流,而我们抓取下后程序直接使用utf-8进行编码并输出到存储文件中,这必然会引起乱码 即当源网页编码和抓取下来后程序直接使用处理编码一致时,则不会出现乱码; 此时再进行统一的字符编码也就不会出现乱码了 注意区分 源网编码A、 程序直接使用的编码B、 统一转换字符的编码C。 乱码的解决方法 确定源网页的编码A,编码A往往在网页中的
java中form以post、get方式提交数据中文乱码问题总结
主要介绍了java中form以post、get方式提交数据中文乱码问题总结,需要的朋友可以参考下
utf-8编码引起js输出中文乱码的解决办法
utf-8编码引起[removed]ln输出中文乱码的解决办法
JSP乱码处理
自己总结的JSP中页面出现乱码的解决方法,很全很详细,希望对初学者有用
PHP统一页面编码避免乱码问题
页面编码统一 MySQL数据库编码、html页面编码、PHP或html文件本身编码要全部一致。 1、MySQL数据库编码: 建立数据库时指定编码(如gbk_chinese_ci),建立数据表、建立字段、插入数据时不要指定编码,会自动继承数据库的编码。 数据库连接时,也有编码,可以在连接完数据库后,执行mysql_query(‘SET NAMES gbk’);//将gbk换成你的编码,如utf8。 2、html页面的编码,指的是这一行的设置: 复制代码 代码如下: <meta http-equiv=”Content-Type” content=”text/html; charset=gbk”




