


102
社区成员
 发帖
 与我相关
 我的任务

 分享
| 项目 | 内容 |
|---|---|
| 这个作业属于哪个课程 | 202601福大-软件工程实践-W班 |
| 学号-姓名 | 102400320_林明阳 |
| 这个作业要求在哪里 | 顶会热词统计作业要求 |
| 这个作业的目标 | 使用 AI 结对完成需求分析、墨刀原型、Web 编码、测试、部署和过程反思,分析 CVPR、ICCV、ECCV 的专业研究方向变化 |
| 其他参考文献 | DBLP Search API、《构建之法》第 3、4、8 章、课程附录 14 论文清单 |
| 类型 | 访问地址 | 检查结果 |
|---|---|---|
| CodeArts 项目代码仓库 | 102400320-2 | 已检查,仓库页面可访问 |
| CodeArts 代码规范 | codestyle.md | 已检查,代码规范文件位于仓库根目录 |
| 项目部署网站 | https://hotwords.43-128-25-27.sslip.io/ | 已检查,HTTPS 返回 200 |
| 墨刀原型在线链接 | 顶会热词统计平台-102400320-分享 | 已检查,分享页面可访问 |
项目部署服务器公网 IP 也可以直接访问:http://43.128.25.27/。
部署平台说明:本项目实际部署在腾讯云服务器上;CodeArts 用于代码仓库和提交记录管理。当前
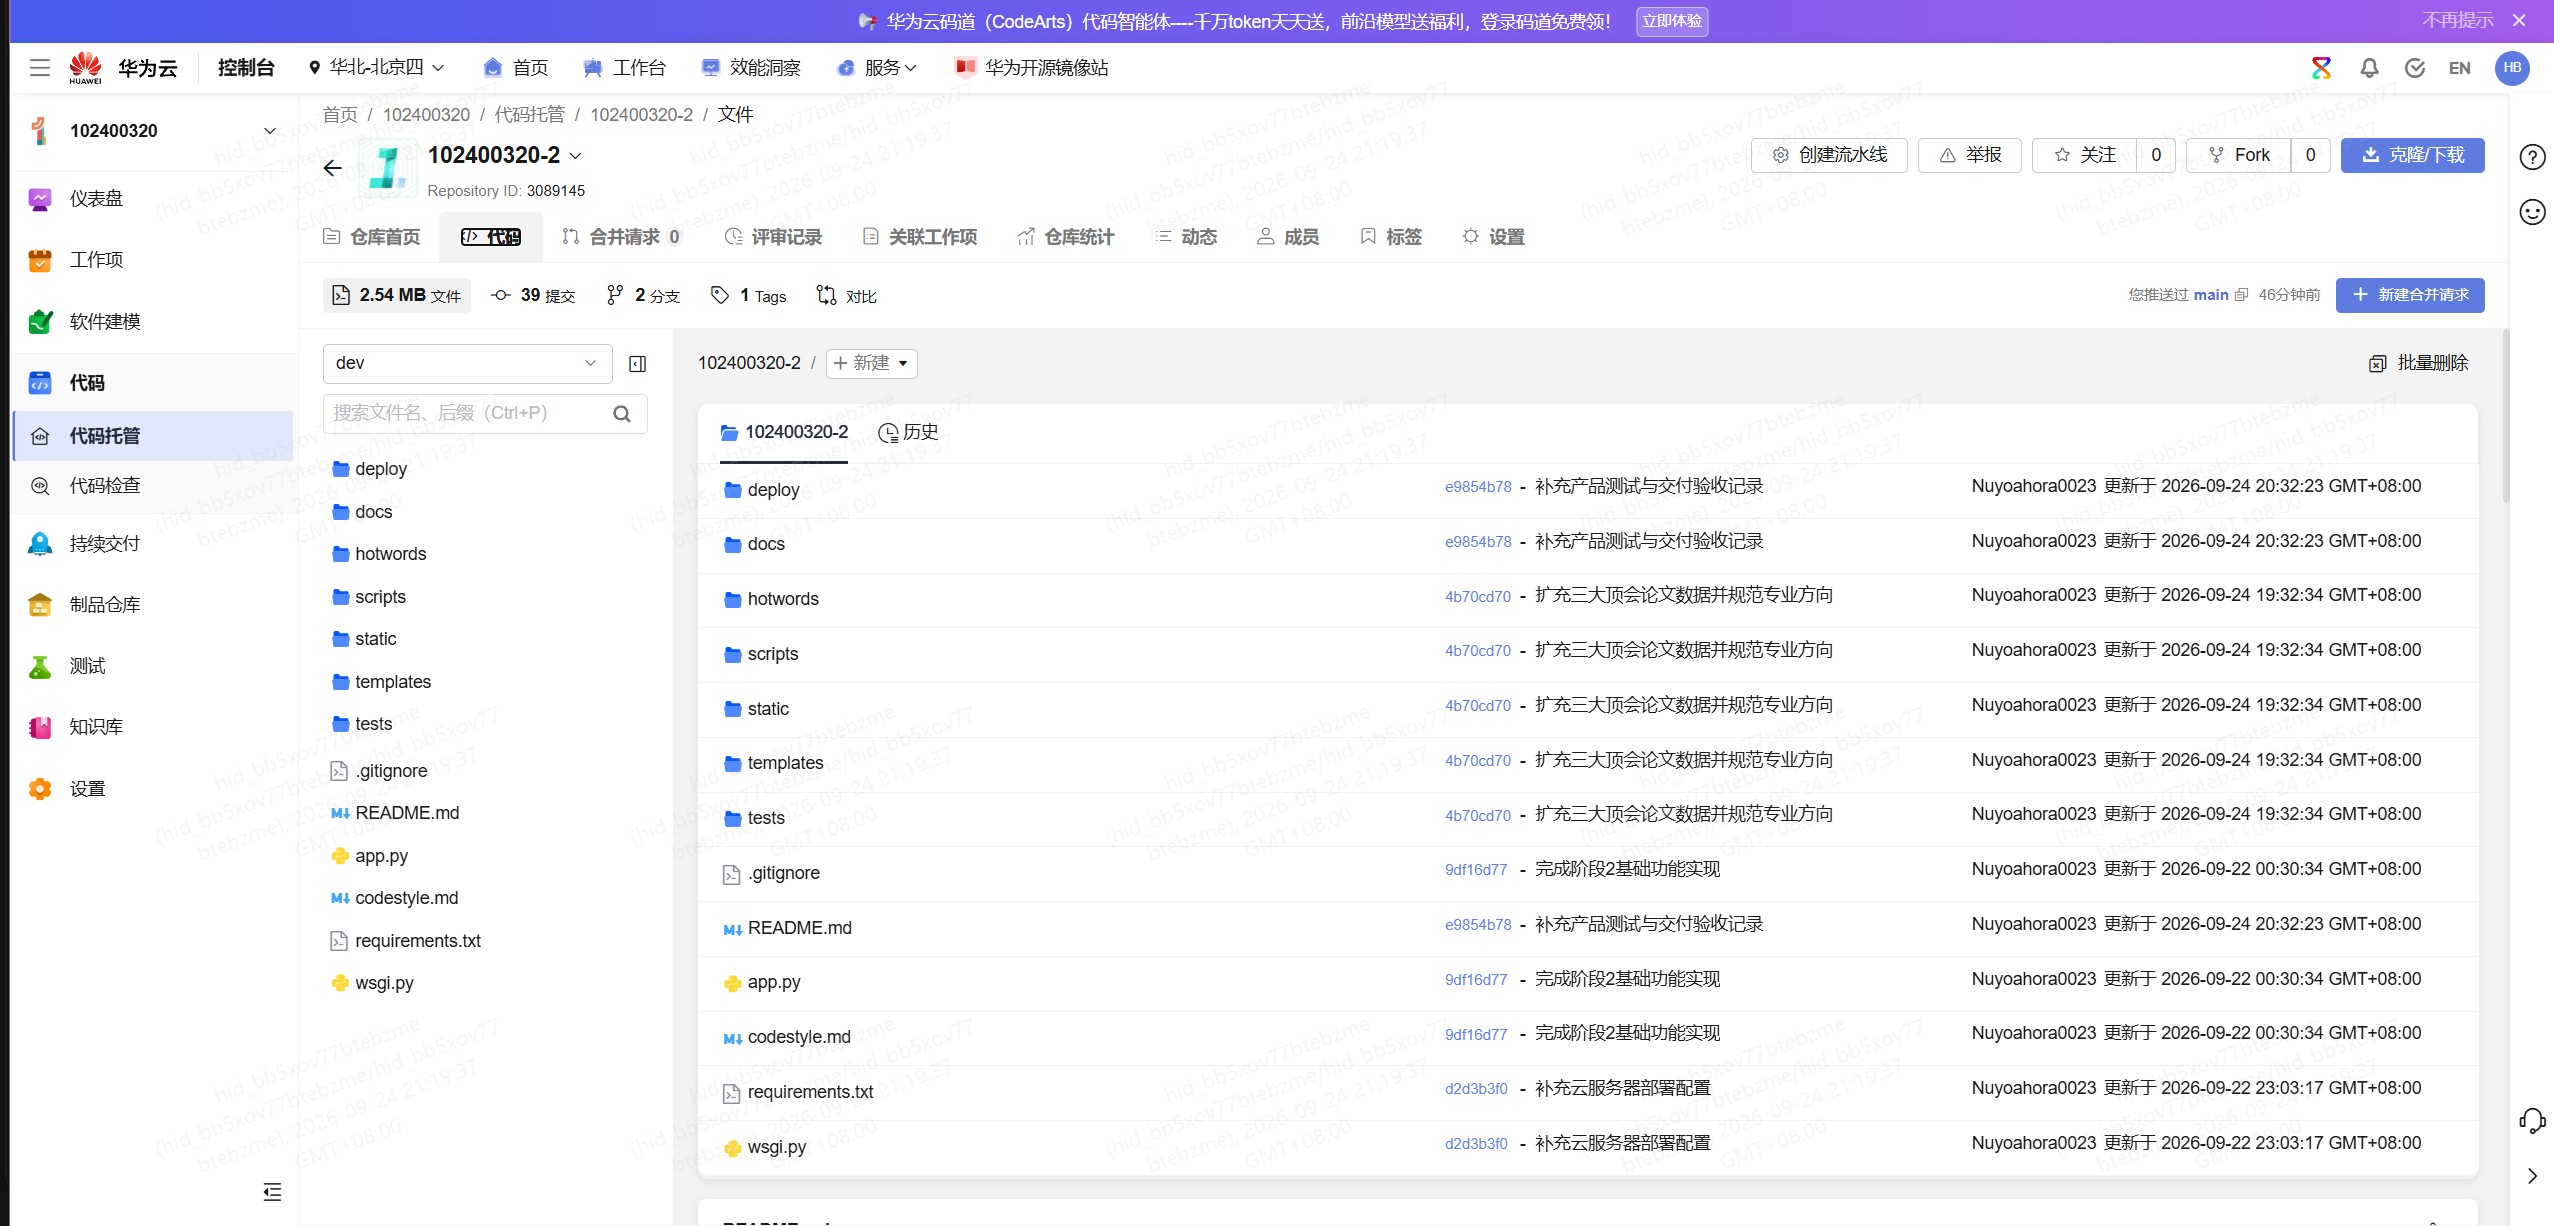
dev、远程main已同步到e9854b7,共 39 次提交,并保留v1.0.0标签。
本项目使用的 AI 编程助手是 ChatGPT / Codex(GPT-5 系列)。
主要用途如下:
AI 输出只作为候选方案和结对讨论材料。最终页面划分、数据口径、异常处理、代码修改、测试结果和部署检查均由我审核、修改并验证。
本项目面向对计算机视觉研究方向感兴趣的初学者、需要整理论文数据的研究者以及负责检查课程作业的助教,设计并实现一个“顶会热词统计平台”。
系统以 CVPR、ICCV、ECCV 三大计算机视觉顶会为范围,使用附录 14 论文清单作为标题、会议和年份的主要来源,再通过 DBLP 等公开接口,在本地没有结果且数据源可访问时补充摘要和原文链接。系统不承诺稳定爬取所有会议官网,也不把自动提取的关键词冒充成论文官方关键词。
平台目前包含六个独立页面:
已验证的当前数据规模为:
这里的热度表示清洗后的系统提取方向在论文中的出现频次或论文覆盖数,不等同于严格的学术影响力、引用量或研究质量评价。
| 页面 | 页面职责 |
|---|---|
| 数据总览 | 展示论文总数、会议分布、年份覆盖、Top 10 摘要和最近导入记录 |
| 论文导入 | 区分单篇查询与批量导入,提供文件预览、字段校验、重复论文提示和结果反馈 |
| 论文列表管理 | 提供搜索、筛选、论文详情、编辑、删除和无结果后的条件远程检索 |
| 热门方向与关键词图谱 | 展示 Top 10 专业研究方向、关键词关系和关键词关联论文 |
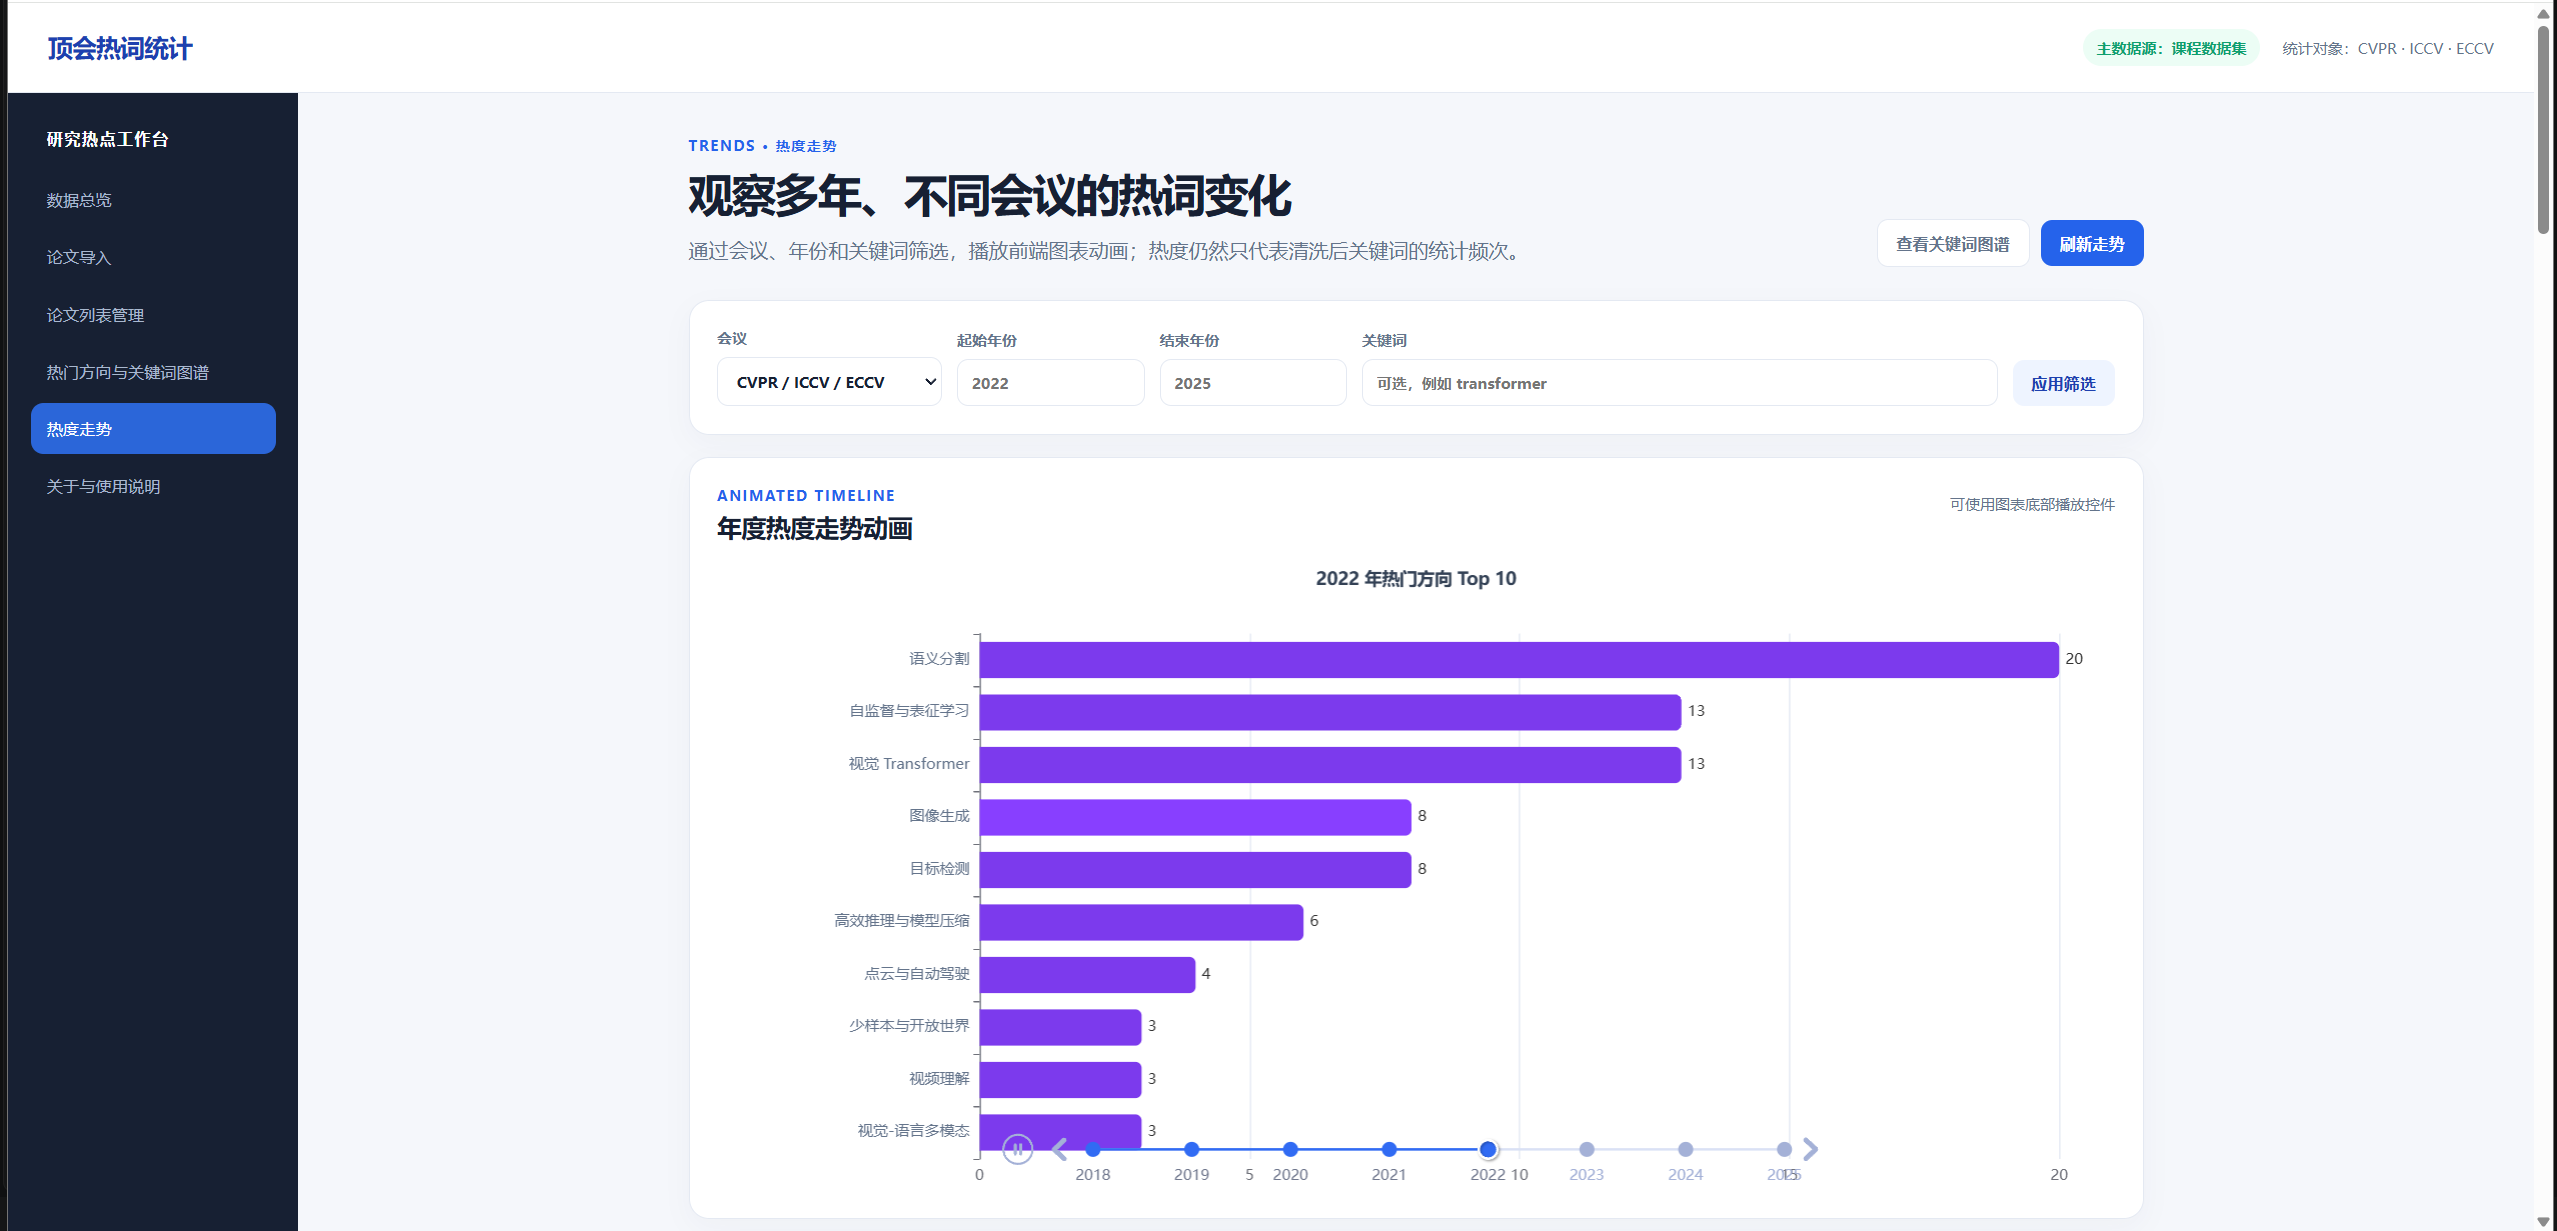
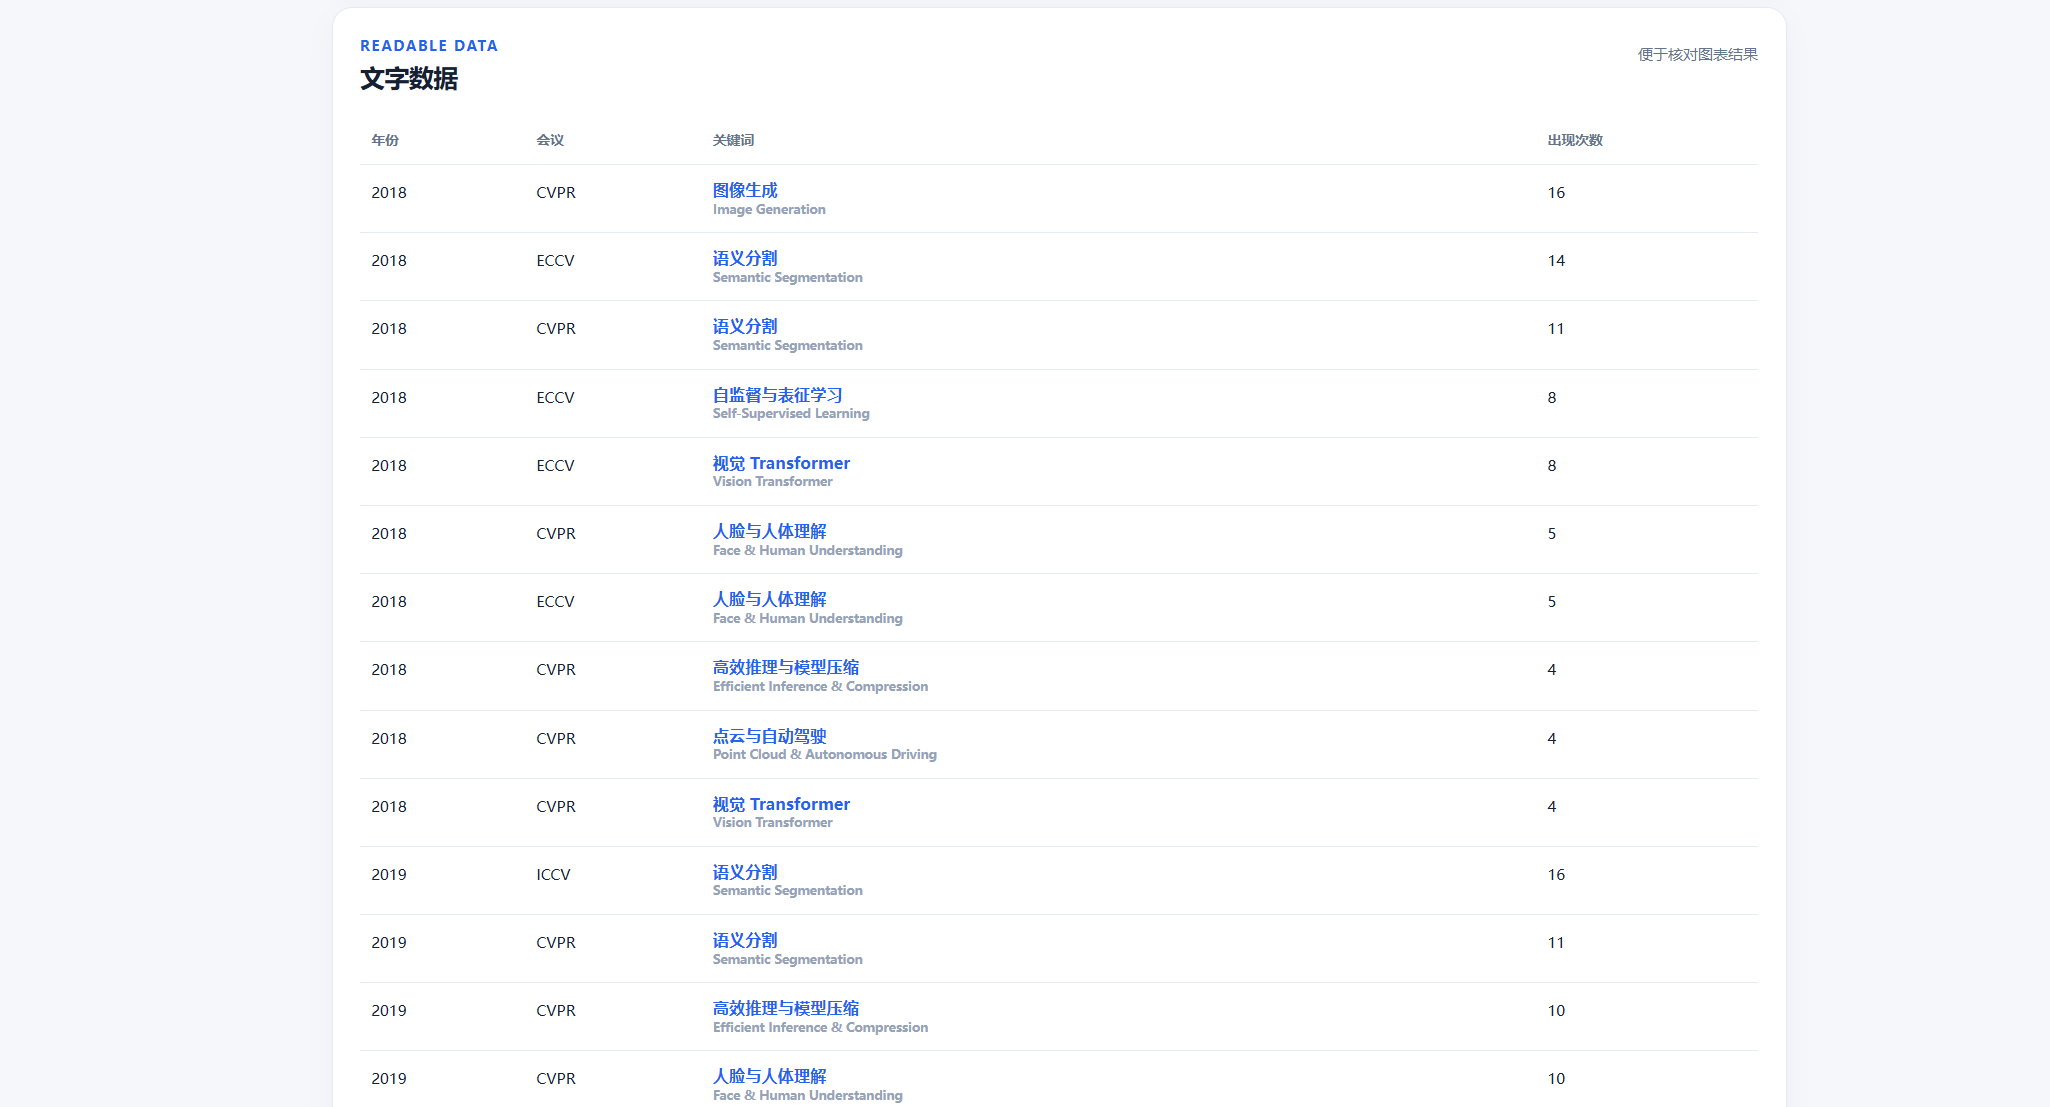
| 热度走势 | 按会议、年份和关键词筛选,以图表动画展示多年变化,并同步展示文字数据 |
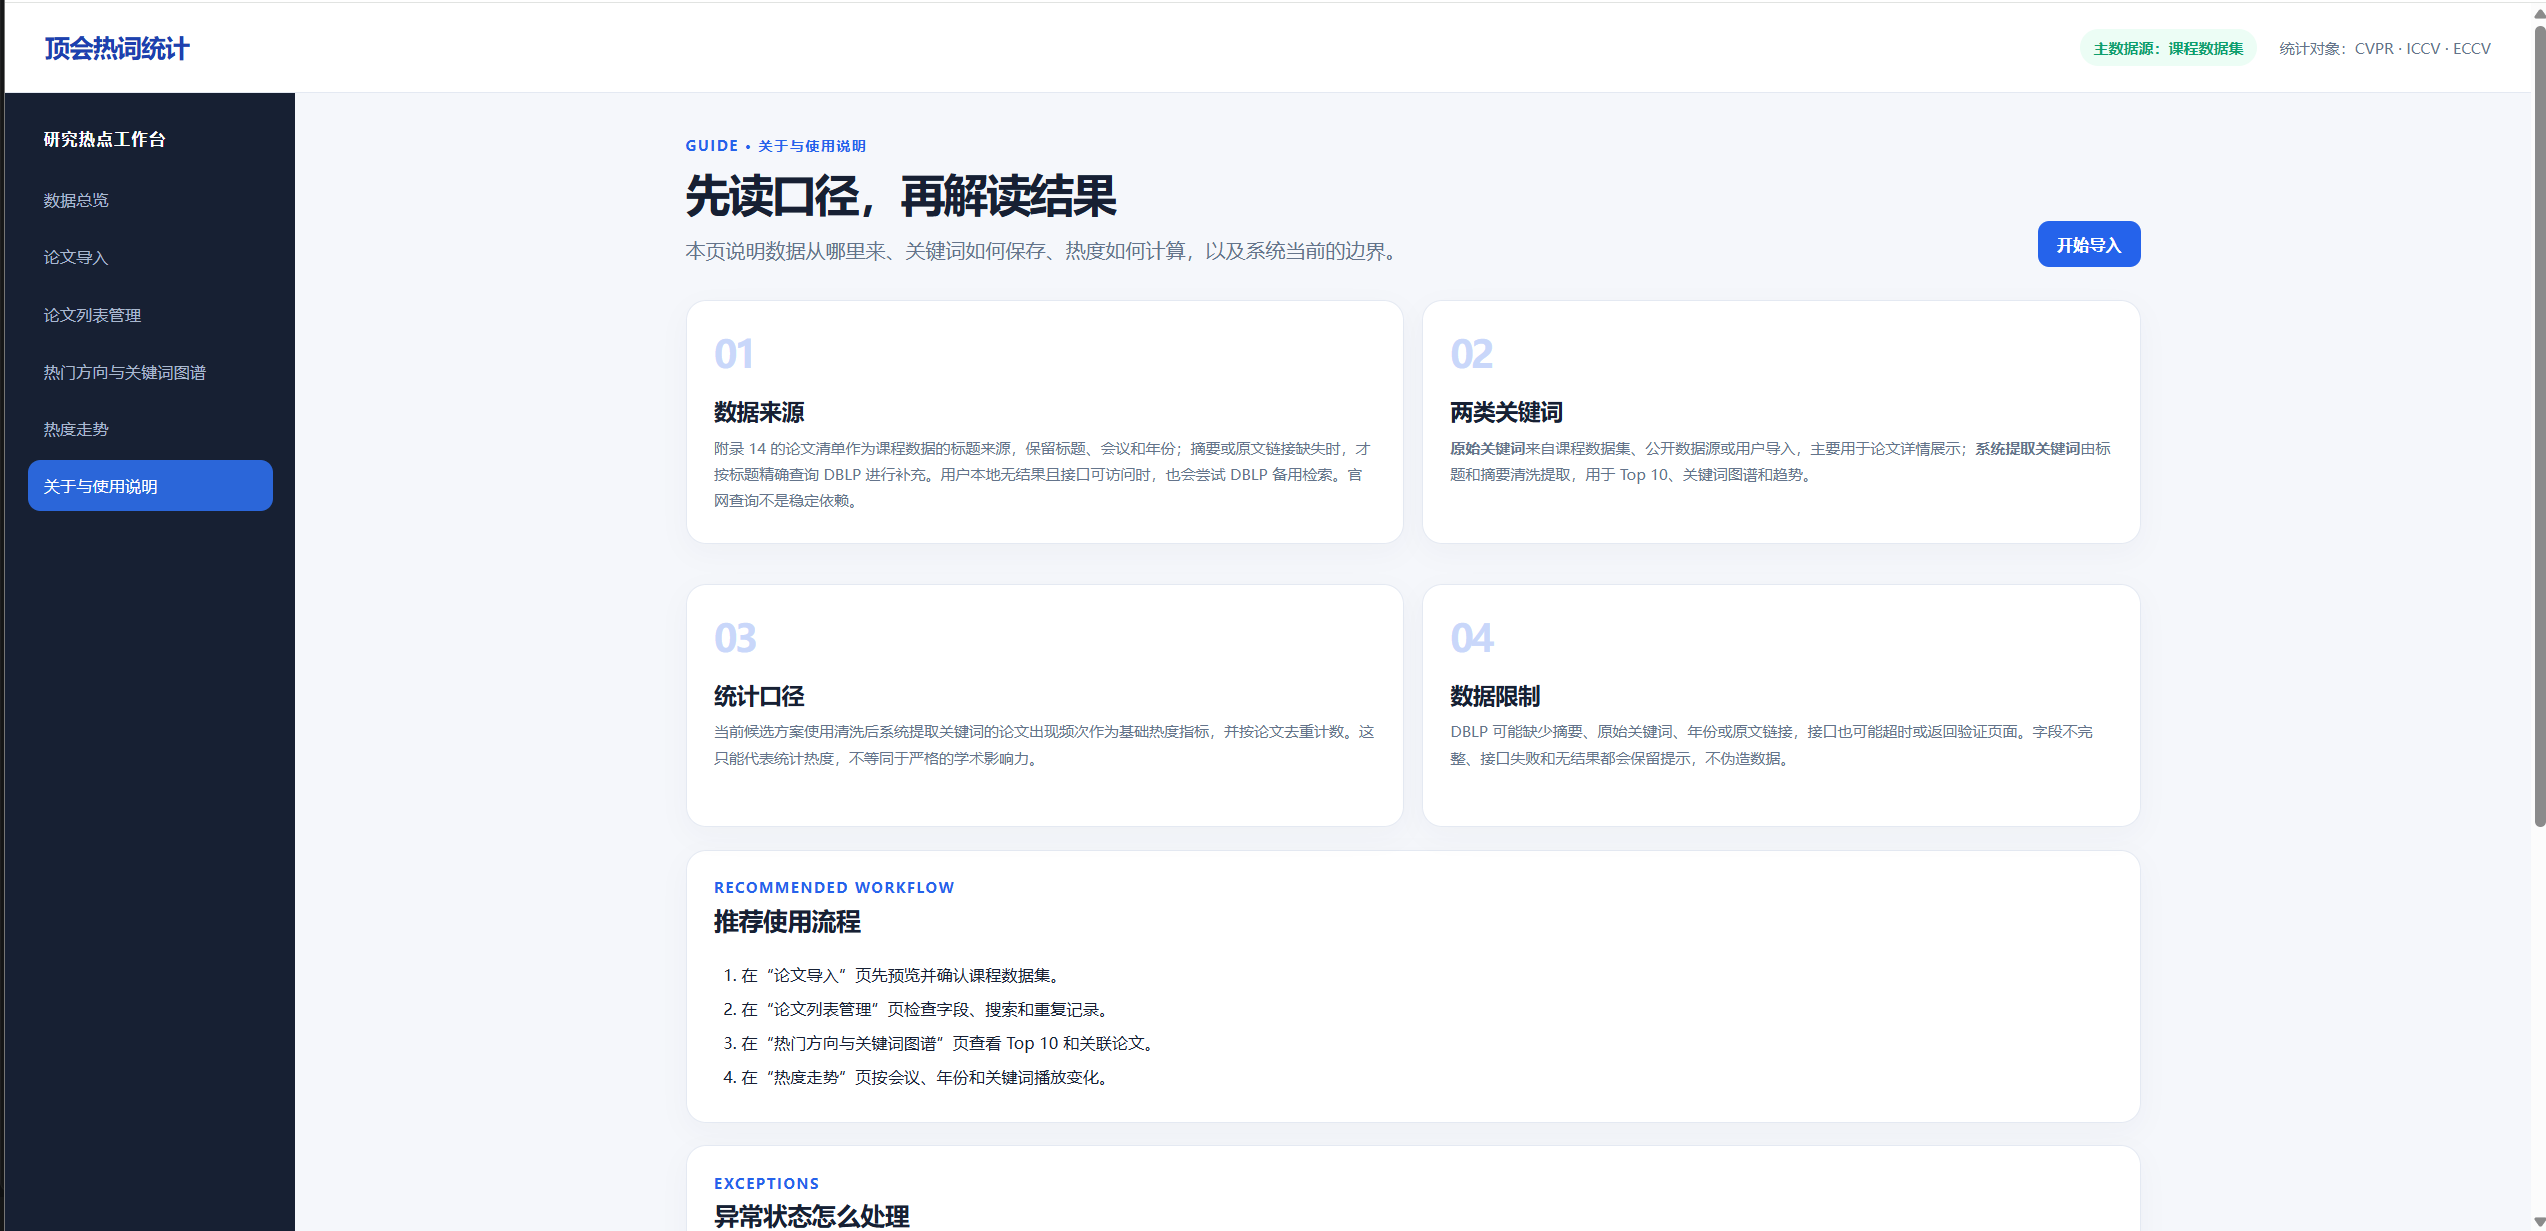
| 关于与使用说明 | 说明数据来源、原始关键词、系统提取关键词、统计口径和数据限制 |
本次没有把登录、收藏、复杂个性化推荐、微服务拆分、全文 PDF 下载、引用网络分析和商业化权限系统列为必须功能。这些可以作为后续扩展,不影响本次基础功能验收。
以下表格沿用本次作业过程中确认的分钟记录。实际耗时用于课程实践复盘,不把时间记录解释为系统功能完成的证明。
| 阶段 | 预计耗时(分钟) | 实际耗时(分钟) | 偏差 |
|---|---|---|---|
| 计划与需求分析 | 130 | 195 | +65 |
| 原型与交互设计 | 190 | 312 | +122 |
| 数据库和 API 设计 | 130 | 183 | +53 |
| 代码规范与设计评审 | 60 | 108 | +48 |
| 后端编码 | 380 | 605 | +225 |
| 前端编码 | 380 | 650 | +270 |
| 测试与缺陷修复 | 190 | 312 | +122 |
| 文档与截图 | 240 | 432 | +192 |
| Git 提交与发布 | 100 | 180 | +80 |
| 合计 | 1800 | 2977 | +1177 |
本节中的“已确认”是项目约束;“候选建议”是结合需求分析得到的可执行方案,不表示所有扩展已经实现。
痛点:
使用场景:
小刚在数据总览页查看论文规模和会议分布,在热门方向页查看“视频理解、扩散模型、视觉-语言、多模态、视觉 Transformer、自监督学习”等专业方向,再点击关键词查看相关论文,最后在热度走势页观察某个方向在不同会议和年份中的变化。
痛点:
使用场景:
研究者在论文导入页上传课程数据或输入单篇题目,先预览字段和重复项,再确认导入;之后在论文列表管理页按会议和年份筛选,打开详情查看摘要、原始关键词、系统提取方向和原文链接。
附录14标题清单
        |
        v
本地清洗、去重、字段校验
        |
        v
SQLite 论文库
        |
        +--> 本地精确/模糊查询
        |        |
        |        +--> 有结果:展示论文详情
        |        |
        |        +--> 无结果:数据源可访问时尝试 DBLP
        |                         |
        |                         +--> 成功:提示来源并允许保存
        |                         +--> 失败:说明失败原因,不伪装成功
        |
        v
系统提取专业方向
        |
        +--> Top 10 方向
        +--> 关键词图谱
        +--> 多会议多年趋势动画
| 替代方案 | 能解决什么 | 局限 | 本项目的差异化 |
|---|---|---|---|
| CVF 或会议官网 | 查看论文标题、摘要和原文 | 更适合逐篇浏览,不直接提供课程作业要求的导入、维护、Top 10 和趋势整合 | 将课程数据、论文管理和统计分析组合起来 |
| DBLP | 公开检索论文元数据 | 不保证所有论文都有完整摘要、关键词或原文链接 | 只在本地无结果时条件查询,并显示失败和字段不完整 |
| Google Scholar、Semantic Scholar | 搜索论文和引用信息 | 数据范围、接口限制和统计口径不完全受本项目控制 | 项目范围固定为三大顶会,结果可解释、可复现 |
| VOSviewer、CiteSpace | 适合复杂文献计量分析 | 使用门槛较高,不是面向初学者的六页 Web 平台 | 用较少操作展示 Top 10、图谱和趋势 |
| 只做静态页面的课程项目 | 能展示界面 | 常缺少真实导入、异常状态和可操作查询 | 以可操作验收为中心,保留真实数据链路和失败提示 |
本项目不是要替代专业文献计量软件,而是针对课程需求,强调“数据来源透明、功能链路完整、初学者能看懂、助教能验收”。
| 编号 | 必须功能 |
|---|---|
| F1 | 单篇论文查询 |
| F2 | 批量导入论文列表,先预览后确认 |
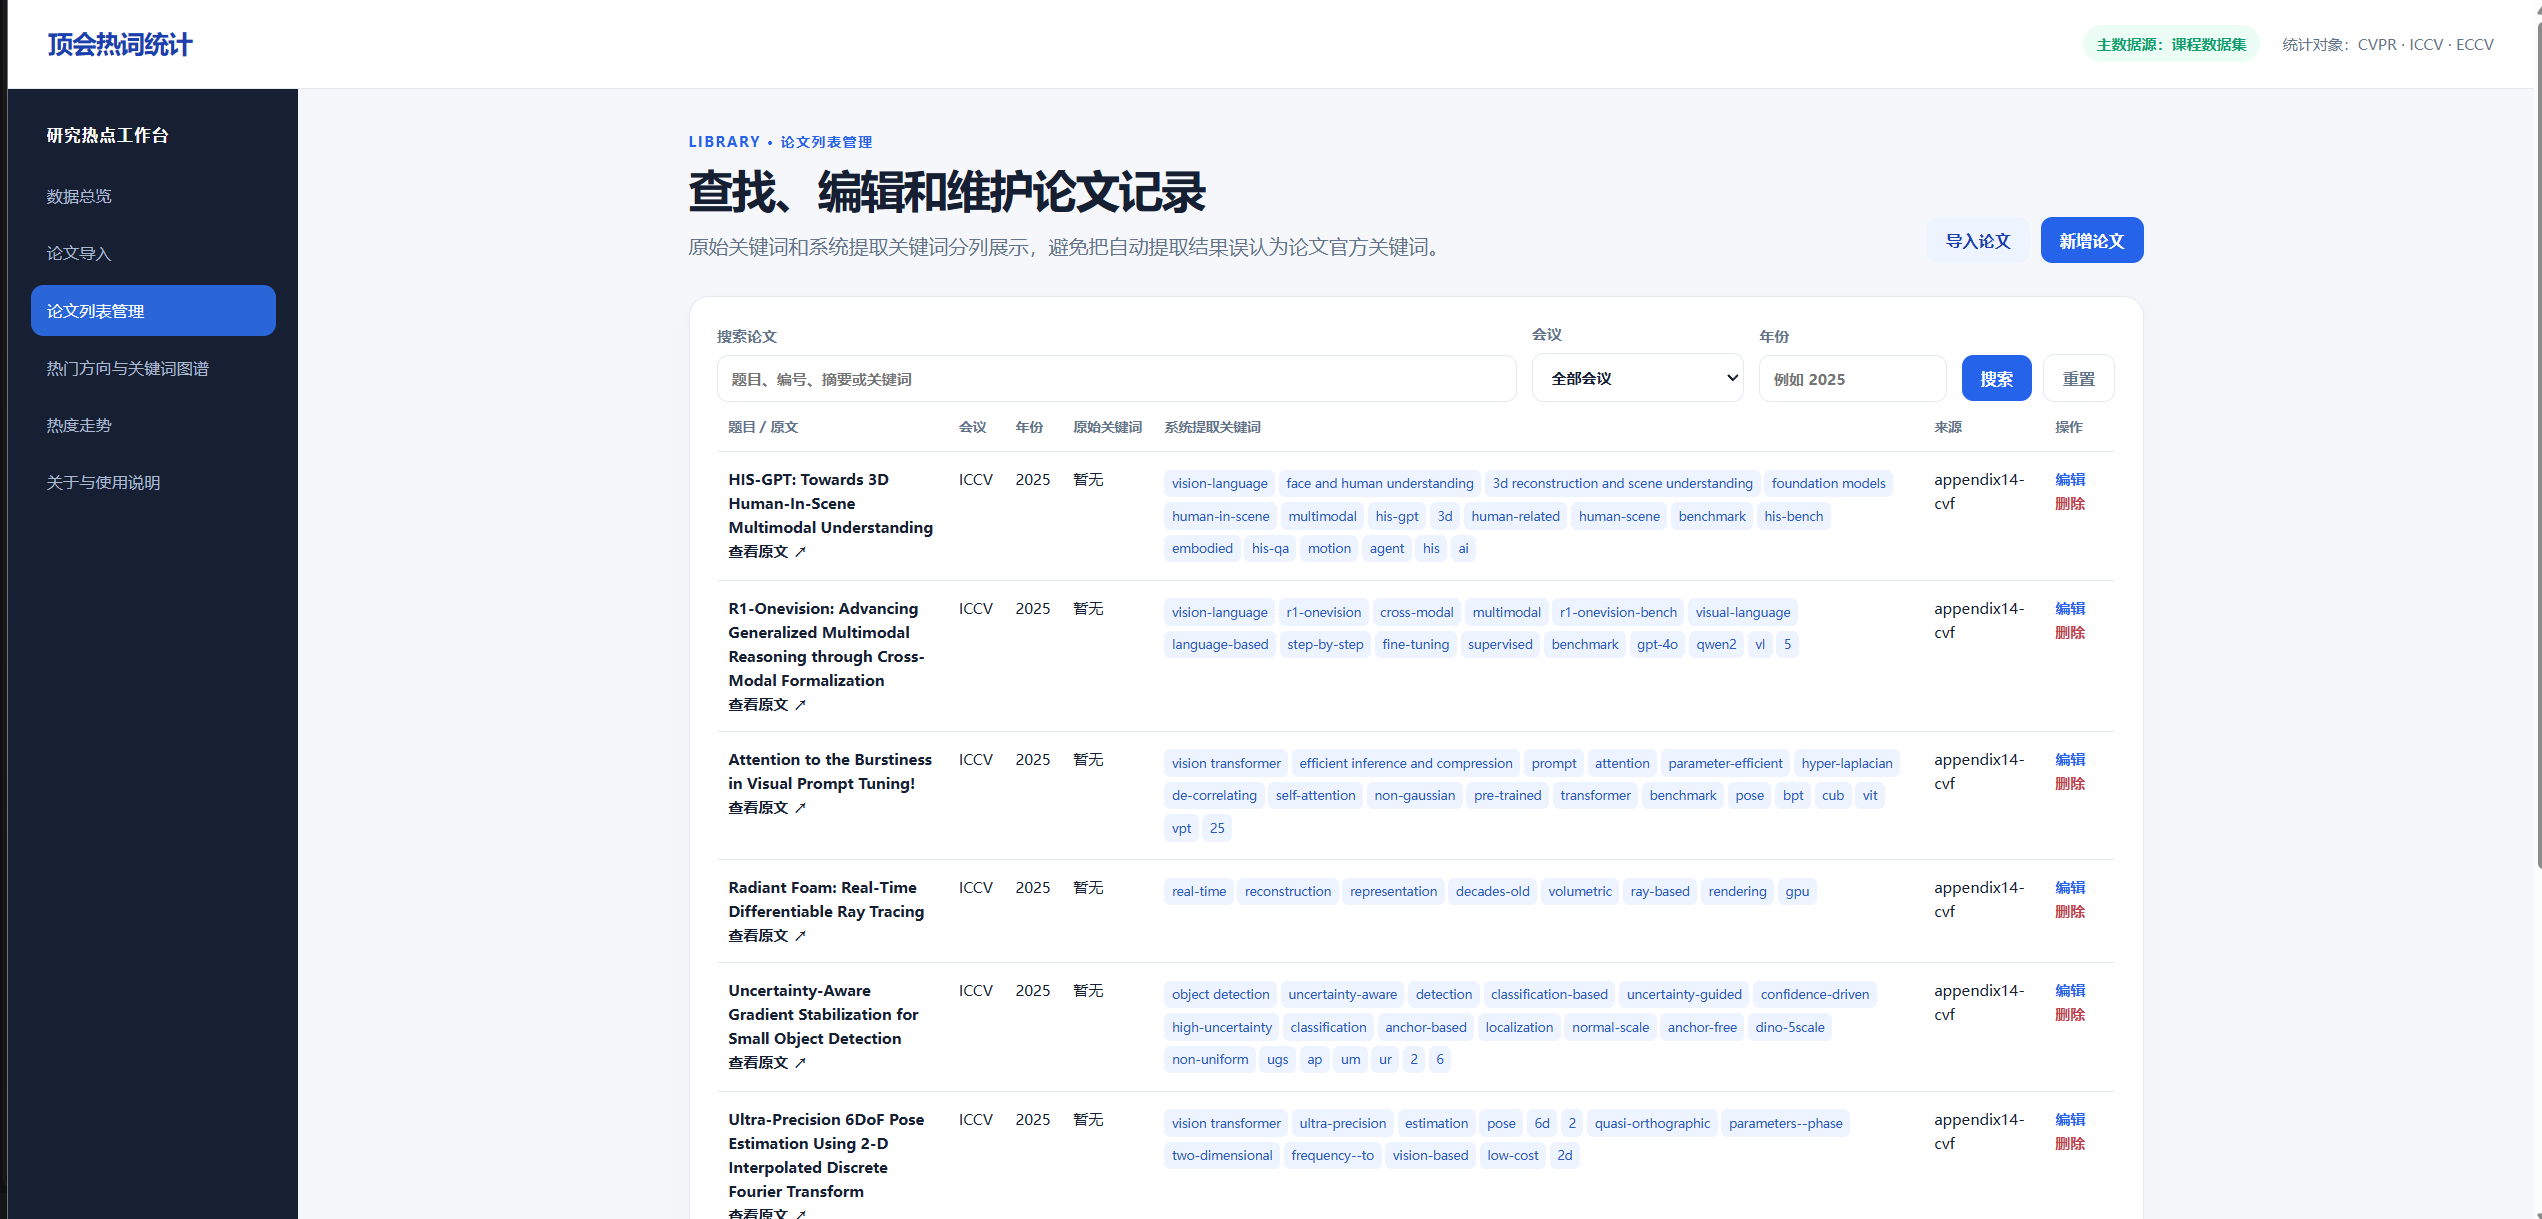
| F3 | 标题、摘要、原始关键词、系统提取方向、原文链接展示 |
| F4 | 论文新增、修改、删除和查询 |
| F5 | 精确查询、模糊查询和无结果时的条件远程检索 |
| F6 | Top 10 专业研究方向统计 |
| F7 | 关键词图谱,点击关键词显示关联论文 |
| F8 | CVPR、ICCV、ECCV 多年份热度走势和前端动画 |
| F9 | 空数据、加载、网络失败、重复论文、字段校验失败、无搜索结果、图表加载失败提示 |
| F10 | 六个独立页面和清晰跳转 |
| F11 | CodeArts 提交记录、自动化测试和腾讯云部署 |
| 功能 | 操作步骤 | 成功判断 |
|---|---|---|
| 单篇查询 | 打开“论文导入”,输入一个已有论文标题并查询 | 返回标题、会议、年份、摘要、原始关键词、系统提取方向和原文链接 |
| 单篇无结果 | 输入本地不存在的题目 | 页面明确显示“本地无结果”,只有数据源可访问时才出现远程查询入口 |
| 远程失败 | 让备用数据源不可访问或等待超时 | 显示“远程查询失败/超时”,给出“重试”和“返回本地查询”,不显示伪造论文 |
| 批量预览 | 选择包含合法行、缺字段行和重复行的文件 | 先显示预览、合法数、错误数、重复数,未点击确认前数据库数量不变 |
| 批量成功 | 在预览页点击确认导入 | 只写入合法且不重复的记录,显示成功数和失败数 |
| 字段校验 | 提交空标题、非法年份或不支持会议 | 阻止提交并在对应字段下方显示错误原因 |
| 重复论文 | 导入与已有记录标题和会议年份相同的论文 | 标记为重复,默认不重复写入,并说明可跳过或返回修改 |
| 列表搜索 | 在管理页输入完整题目搜索 | 只返回匹配论文,并能打开详情 |
| 模糊搜索 | 输入编号、关键词或部分标题 | 返回包含查询词的记录 |
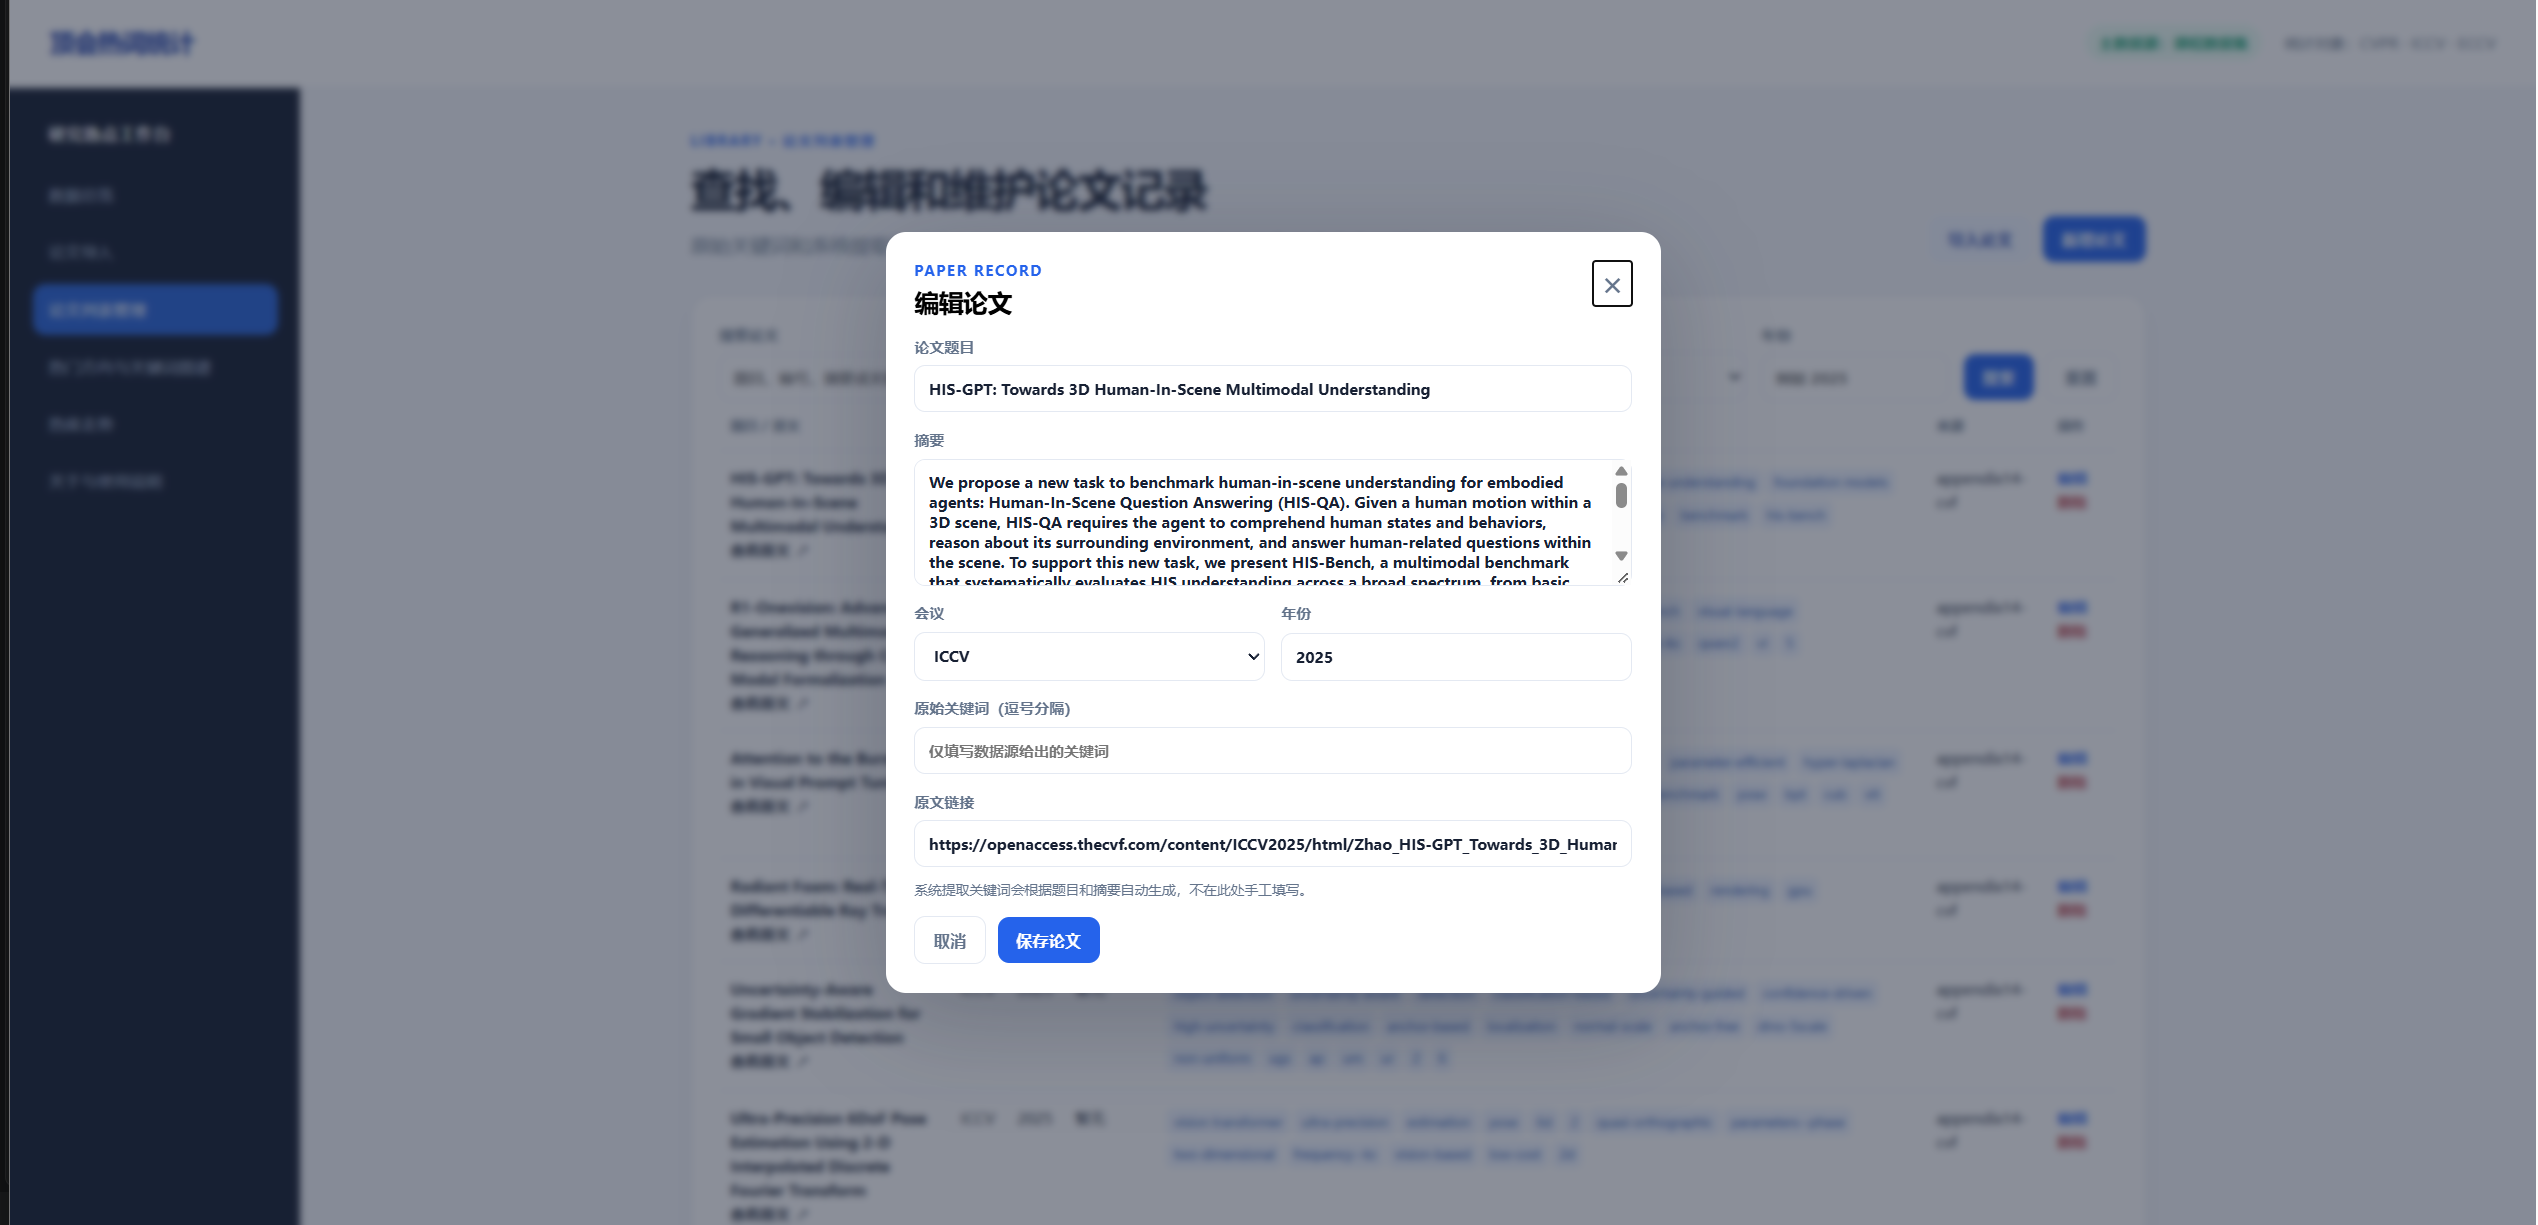
| 编辑 | 点击编辑,修改摘要后提交 | 显示明确确认步骤,确认后列表显示新摘要 |
| 删除 | 点击删除 | 先显示包含论文标题的确认框,取消不删除,确认后刷新列表并提示成功 |
| Top 10 | 打开热门方向页 | 显示 10 个专业方向的中文名、英文名、论文数和占比 |
| 图谱 | 点击图谱中的一个方向节点 | 节点高亮,并在下方或右侧显示相关论文 |
| 图谱防重叠 | 调整窗口或刷新页面 | 主要节点和标签可辨识,不出现所有标签重叠在一个圆内 |
| 趋势筛选 | 在热度走势页选择会议、年份范围和专业方向 | 图表和文字数据同步更新 |
| 趋势动画 | 点击播放或重播 | 时间轴按年份推进,能比较 CVPR、ICCV、ECCV 的变化 |
| 空数据 | 清空或使用无数据数据源进入页面 | 显示空状态说明和“去导入论文”按钮,不显示空白图表 |
| 加载状态 | 首次进入或点击刷新 | 显示加载提示,加载完成后替换为统计内容 |
| 图表失败 | 让分析接口返回错误 | 保留页面标题和筛选条件,显示“图表加载失败”和“重新加载”按钮 |
| 原文链接 | 在列表中点击“查看原文” | 浏览器直接打开记录中的真实公开论文地址,而不是跳转到 example.com |
| 移动端 | 手机访问部署链接并依次打开六页 | 导航可折叠,表格可横向滚动,按钮和文字不被裁切 |
| 部署 | 使用外网打开部署 URL | 首页返回 200,六个页面和核心 API 可访问 |
| 代码提交 | 查看 CodeArts 提交记录 | 能看到按功能划分的多次中文提交记录,并能定位对应代码变更 |
| 测试 | 在项目环境执行测试命令 | 输出 31 passed 或不低于当前测试数量的通过结果 |
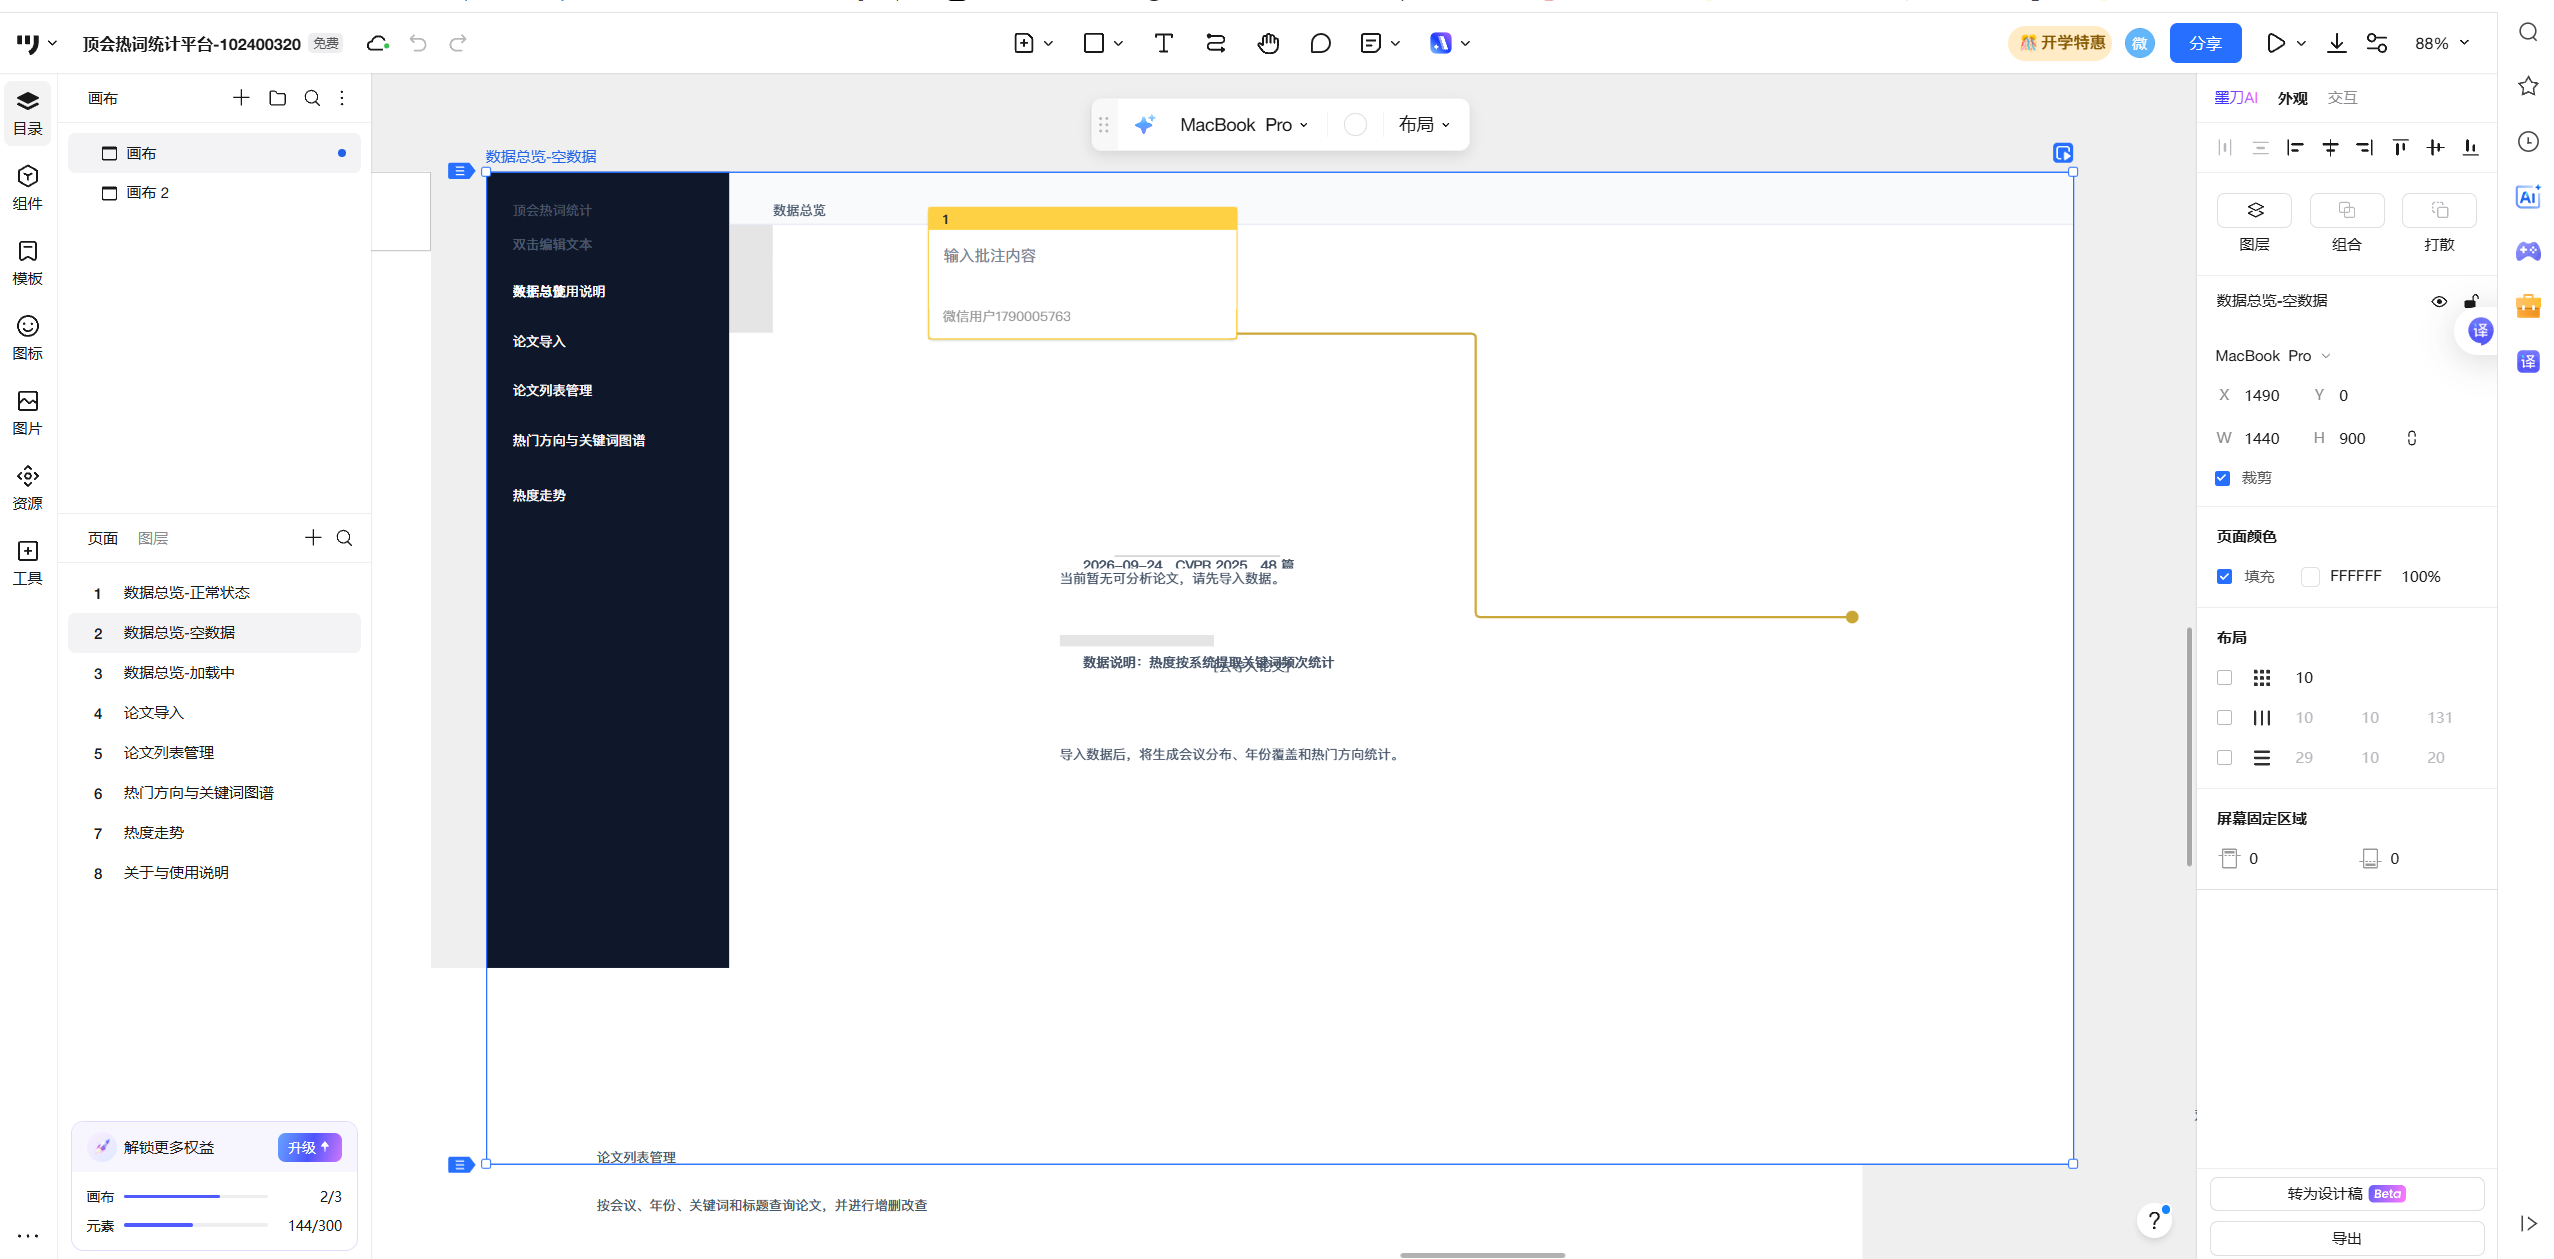
原型使用墨刀手工绘制,没有使用原型工具生成代码。
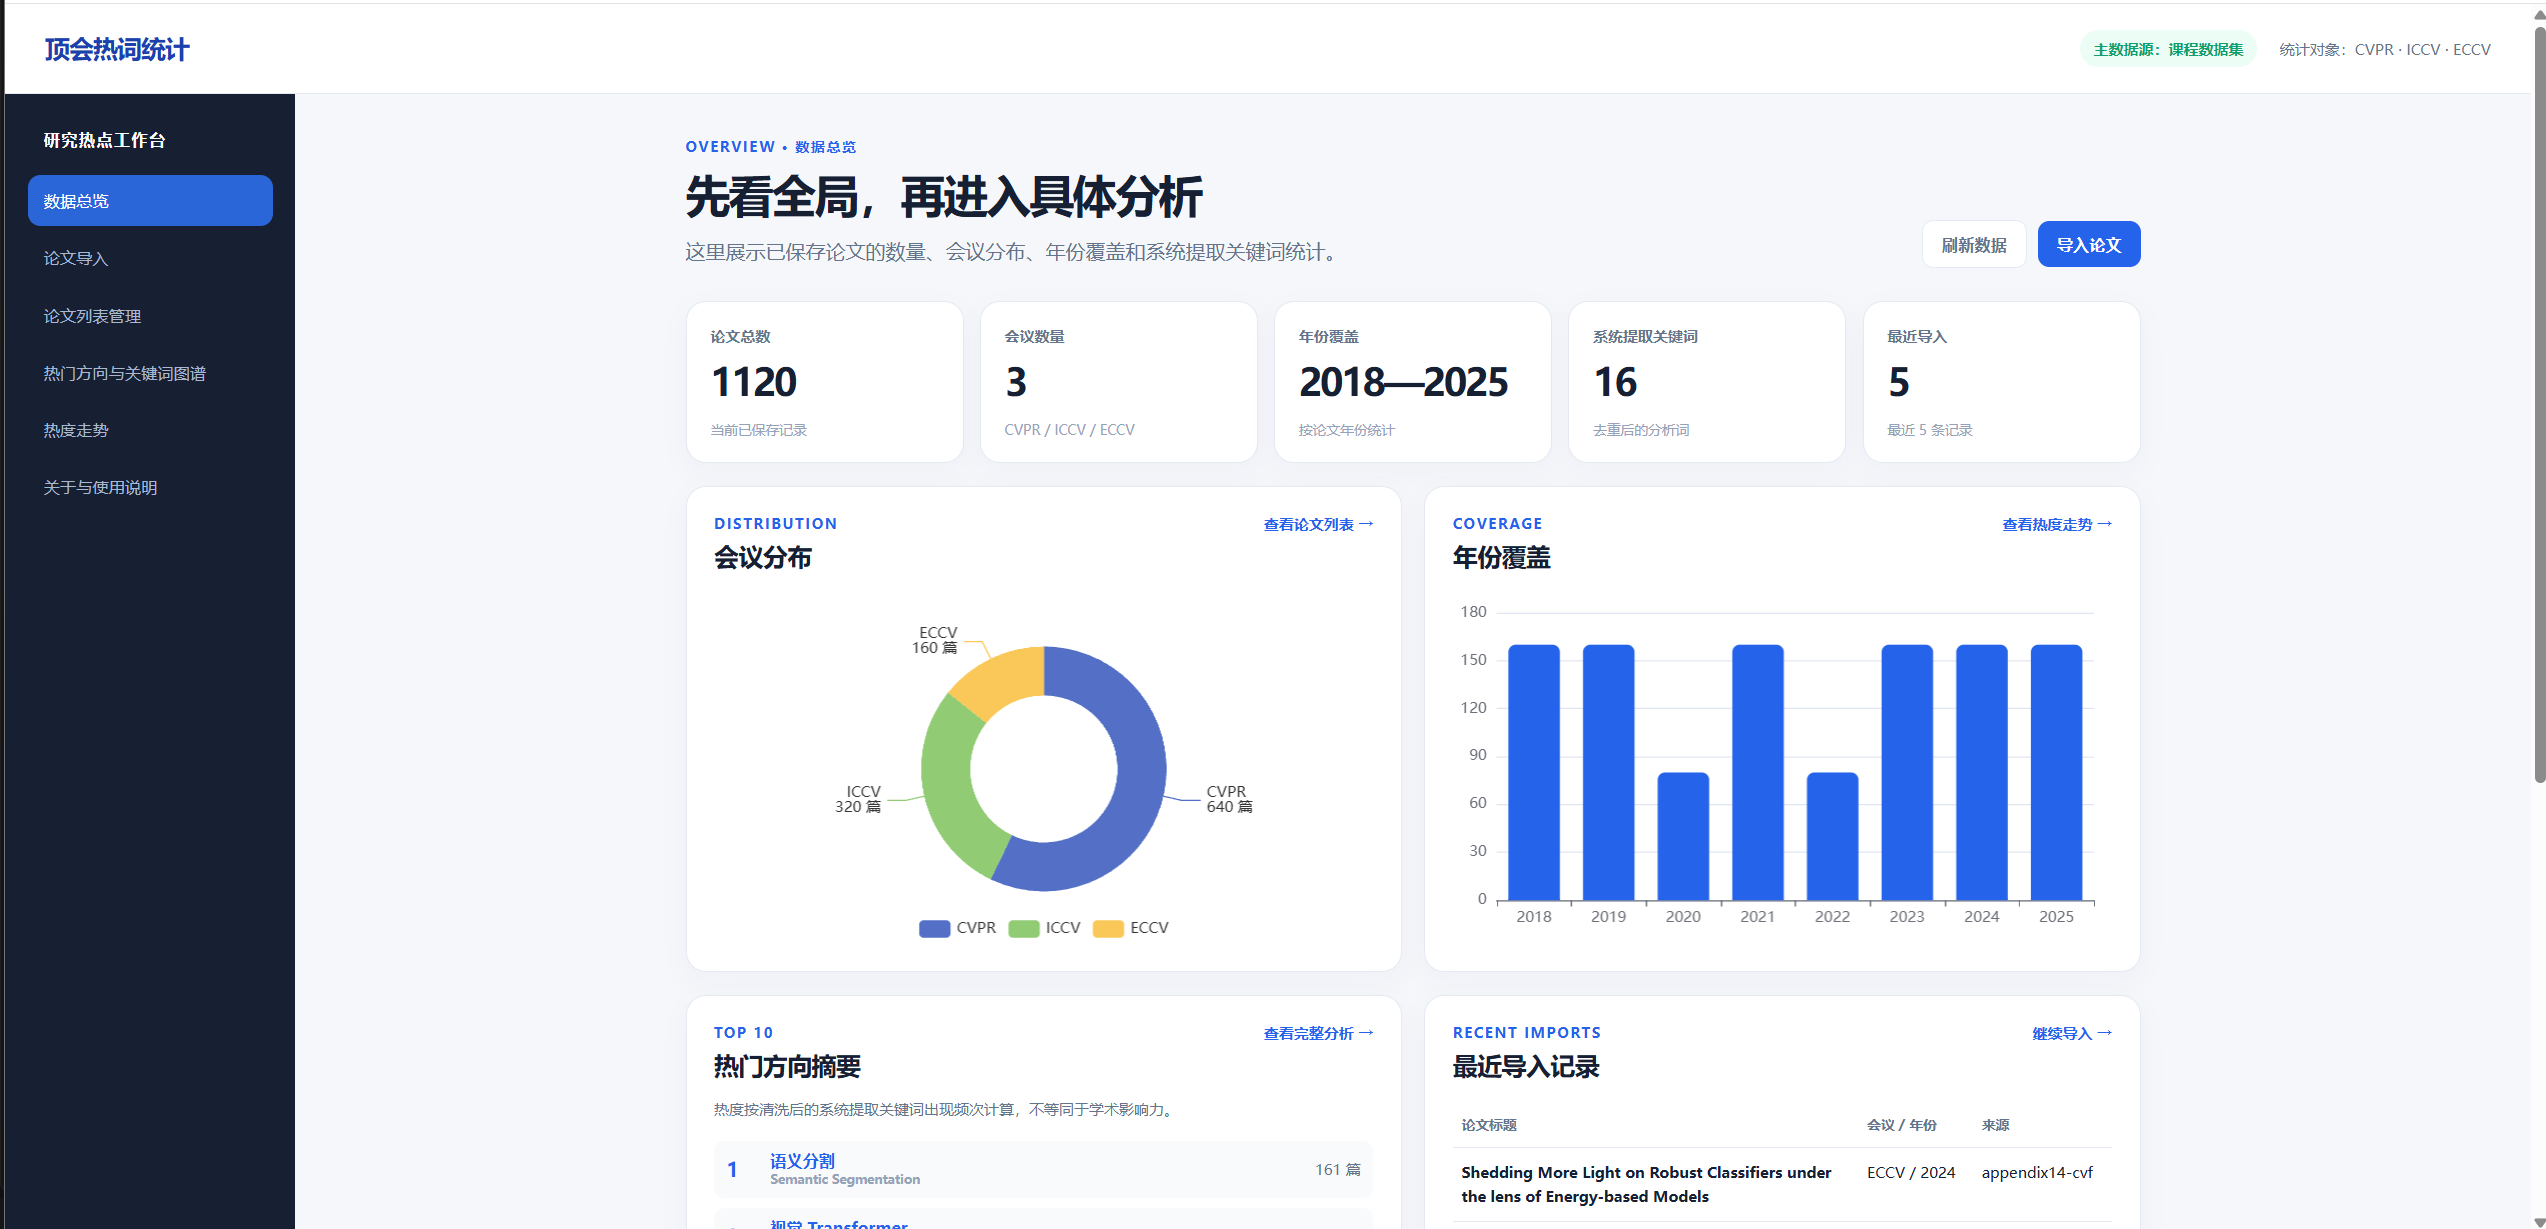
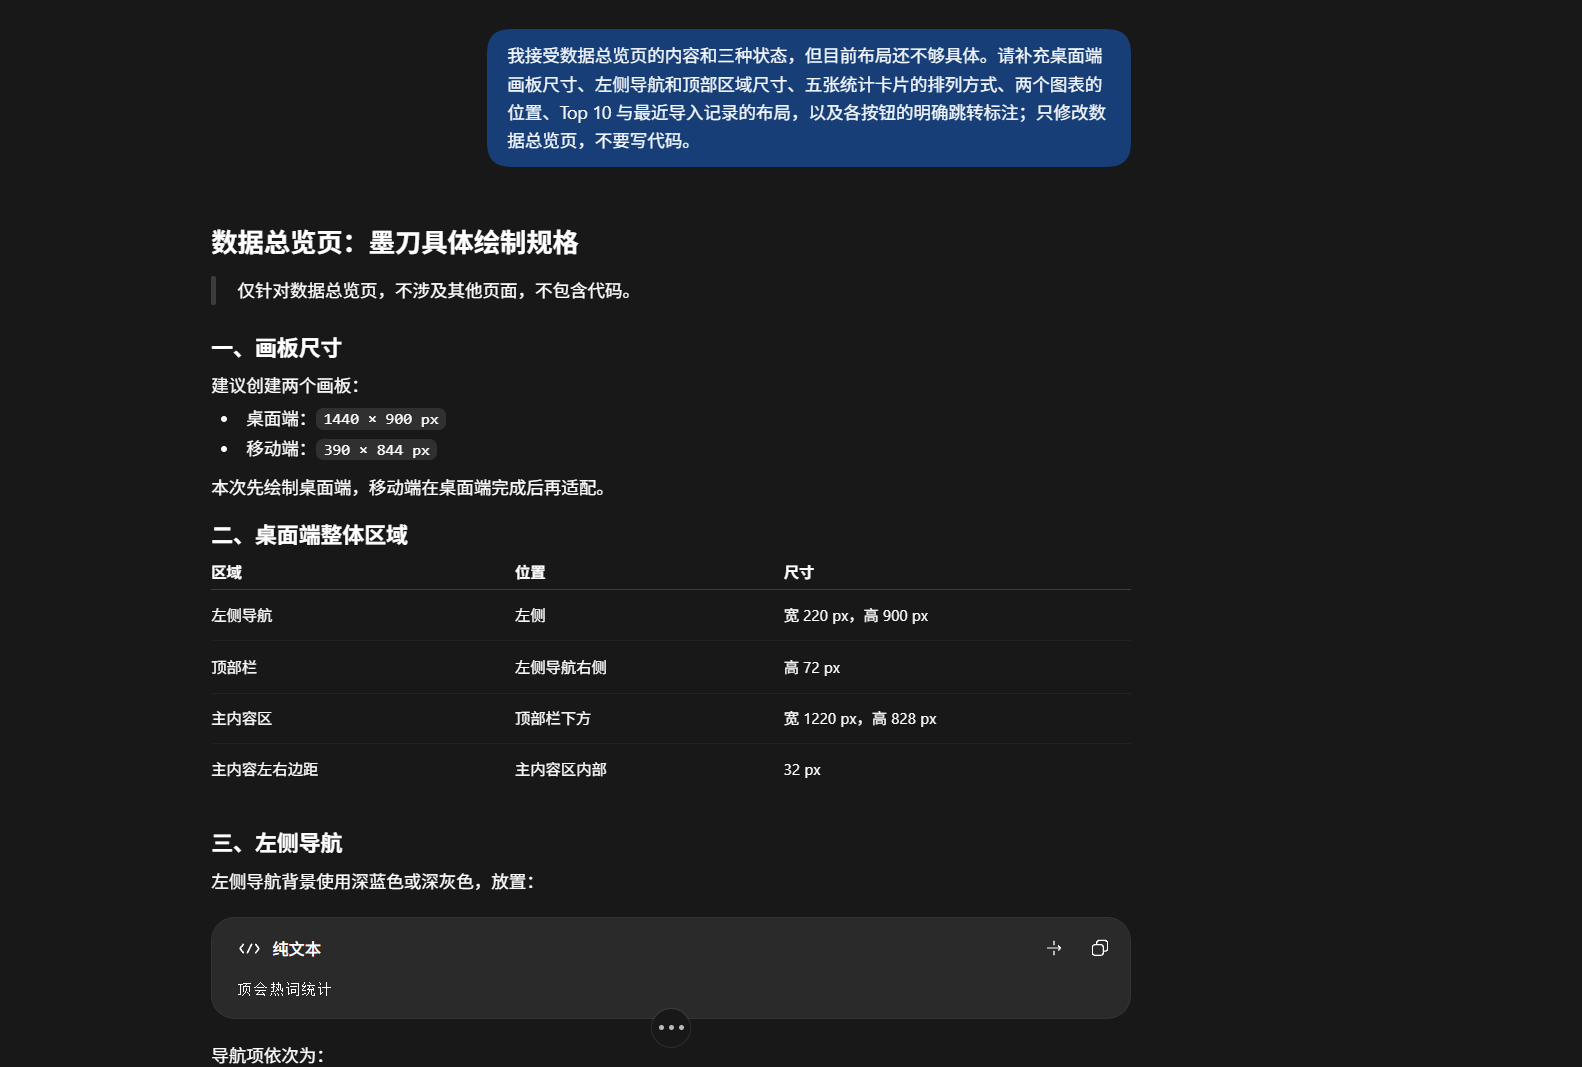
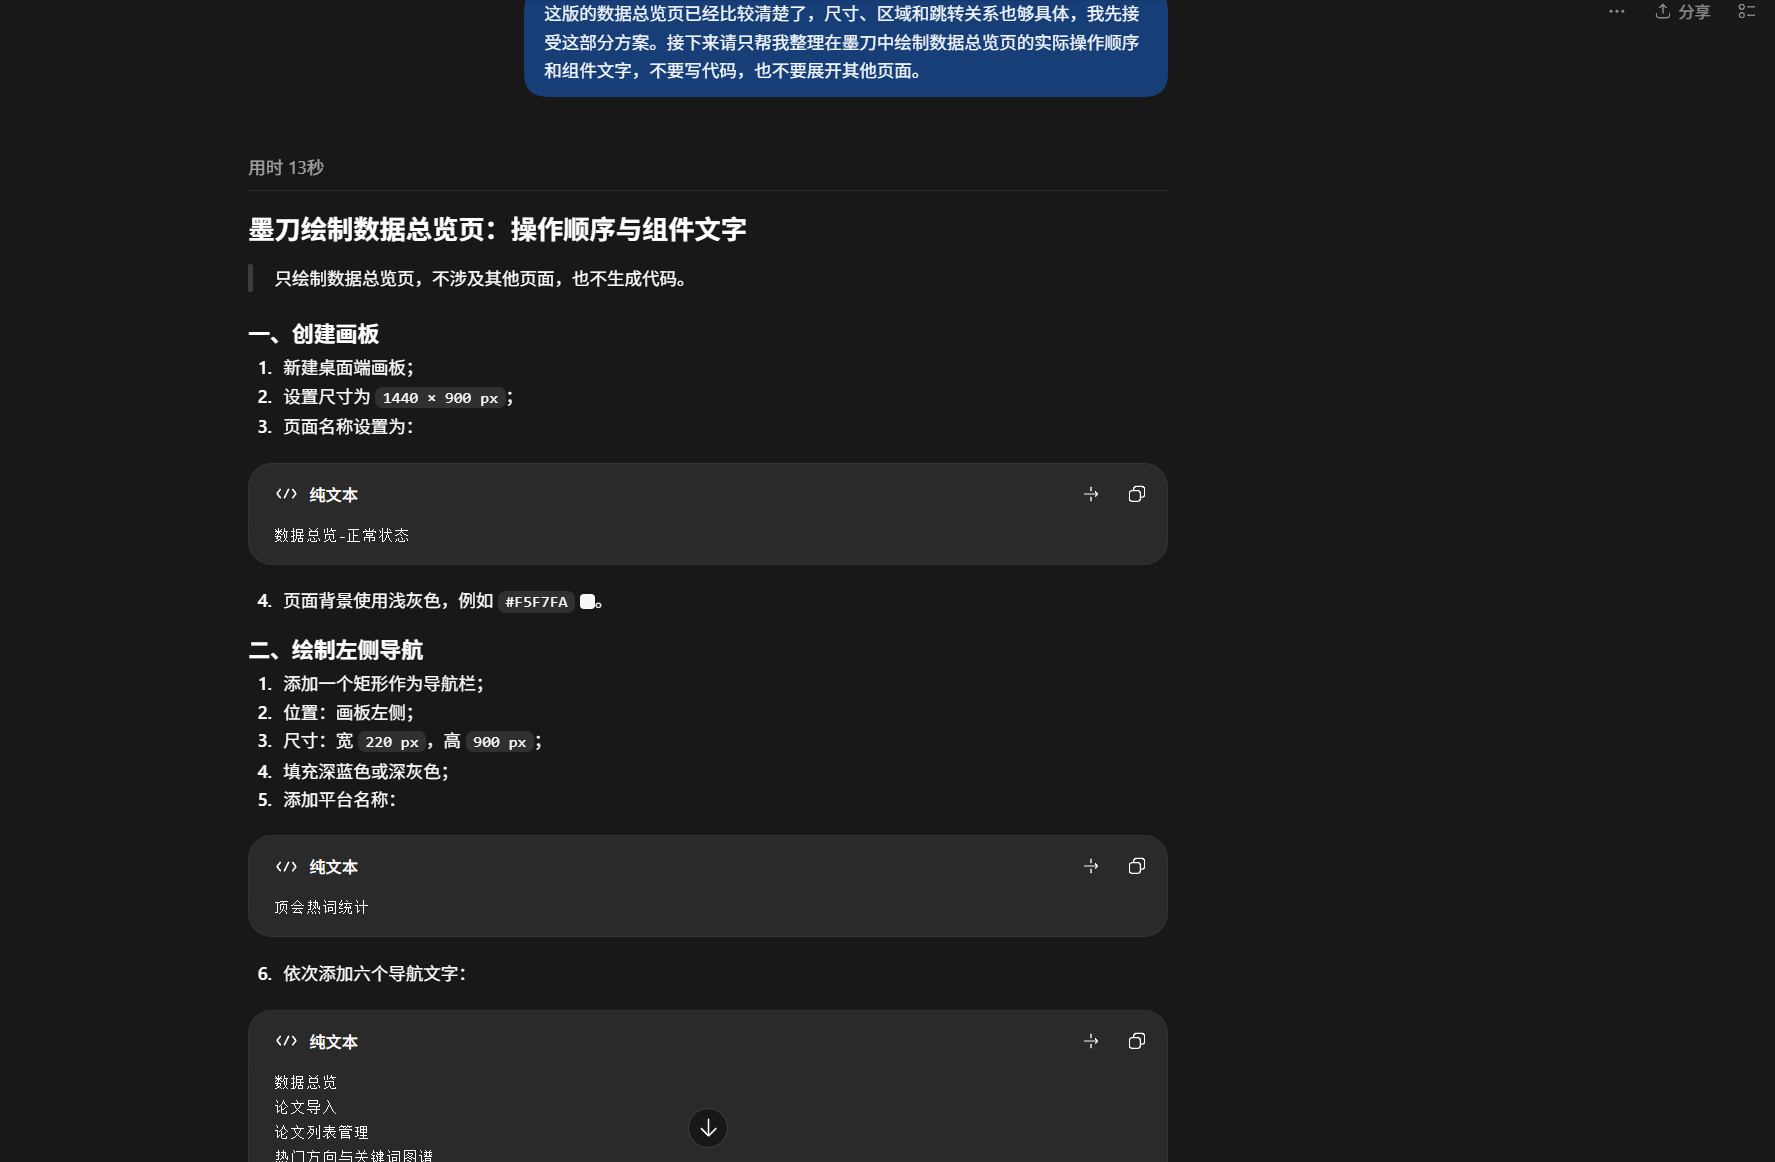
展示五张统计卡片:论文总数、会议数量、年份覆盖、系统提取方向数量、最近导入数量;下方放会议分布图、年份覆盖图、Top 10 摘要和最近导入记录。
按钮跳转:
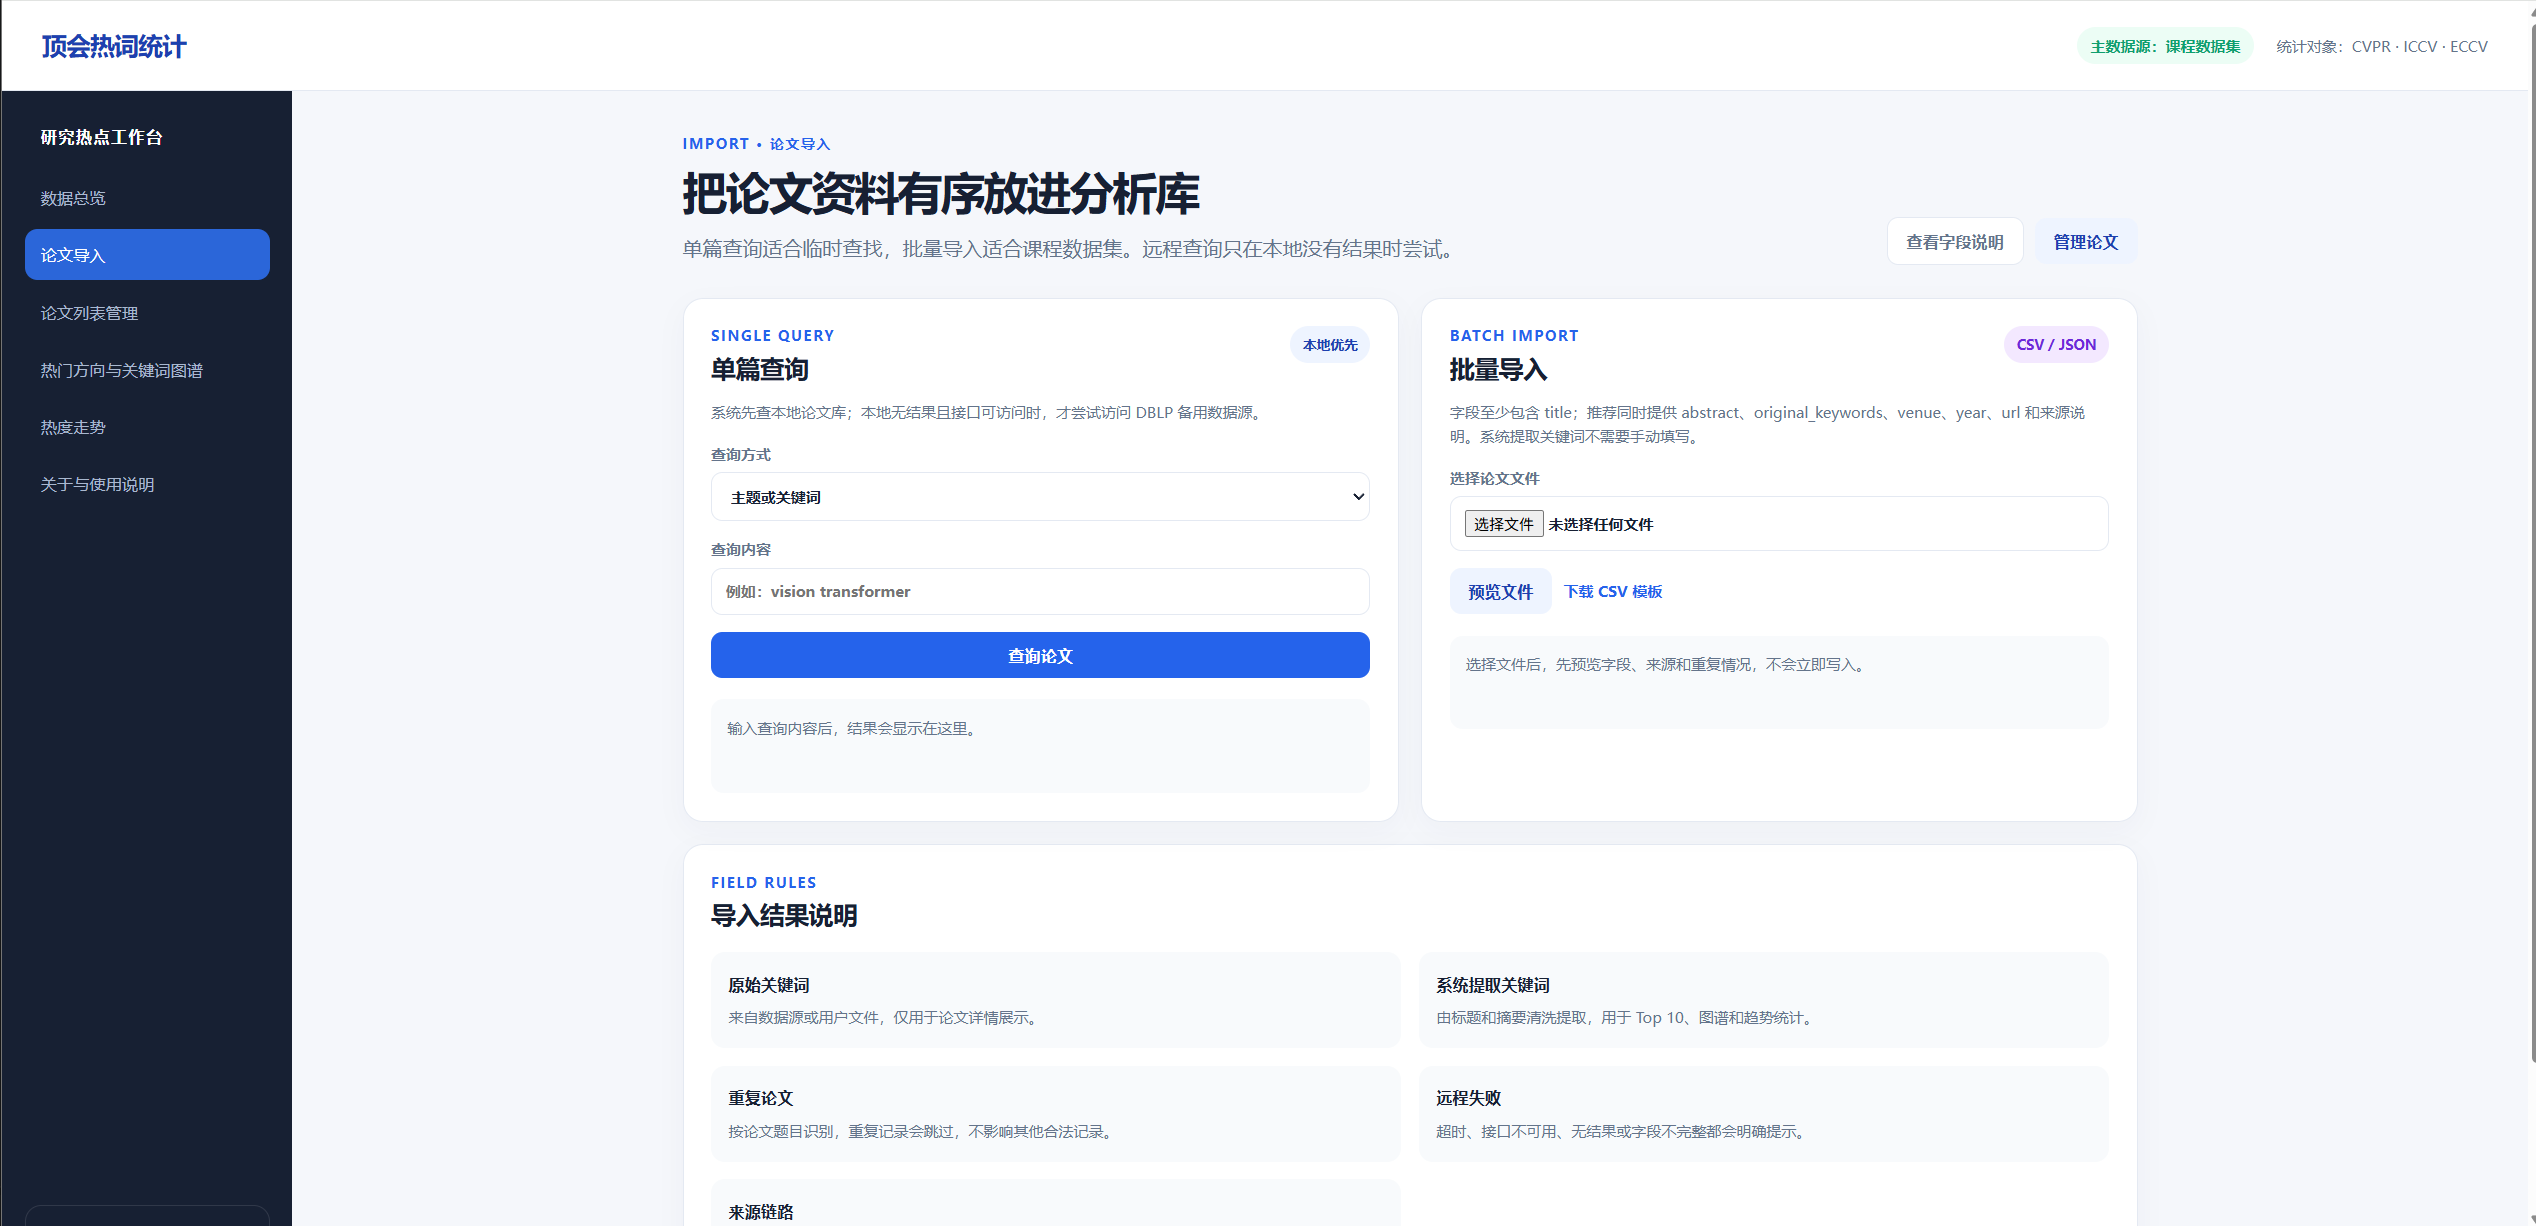
页面上半部分是“单篇查询”,下半部分是“批量导入”。批量导入必须先显示文件名、字段预览、合法数、错误数和重复数,再由用户确认。
状态包括:输入为空、查询中、查询成功、本地无结果、远程成功、远程失败、文件格式错误、字段错误、重复论文、部分成功和全部失败。
分为搜索区、筛选区、列表区和操作区。列表中同时显示“原始关键词”和“系统提取方向”,并提供详情、编辑、删除和查看原文。
编辑流程为:点击编辑 -> 打开表单 -> 修改 -> 点击“保存修改” -> 显示修改确认 -> 确认后刷新列表。删除流程为:点击删除 -> 显示论文标题和风险提示 -> 点击“确认删除”或“取消”。
上方是 Top 10 专业方向表格,中部是关键词图谱,下方或右侧是关联论文列表。点击节点后只刷新关联论文,不跳转到热度走势。
只保留会议筛选、年份筛选、专业方向筛选、播放、暂停、重播按钮、动态图表和文字统计。页面不放论文导入、删除和编辑操作。
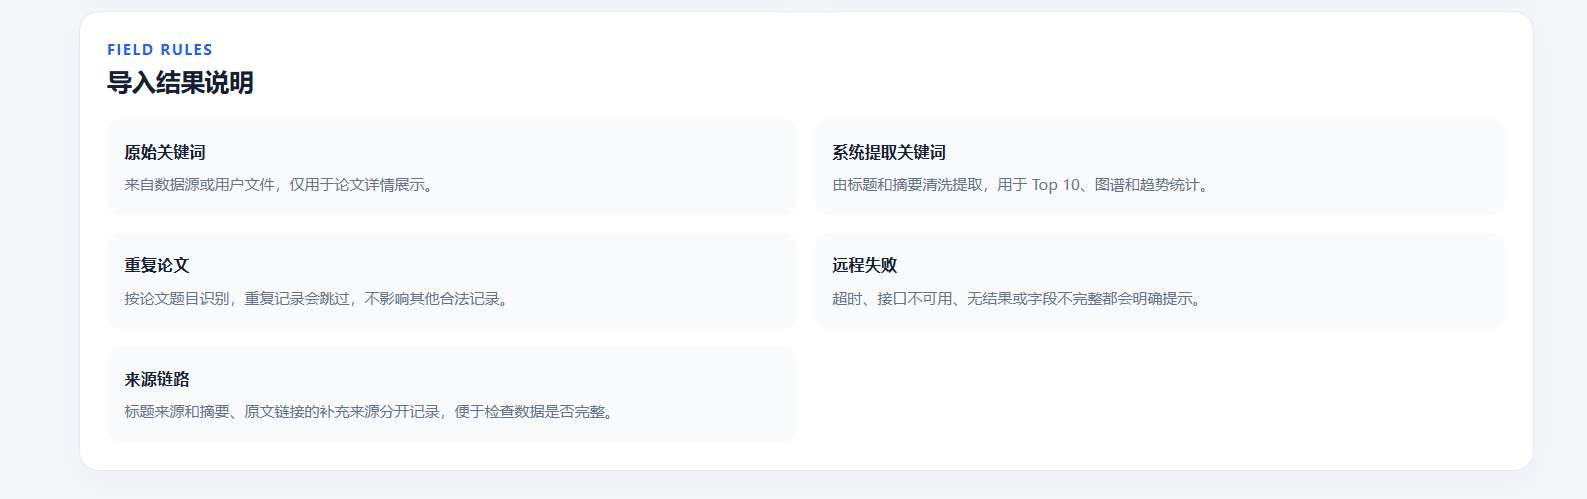
单独说明课程数据集、DBLP 备用检索、原始关键词、系统提取方向、热度统计口径、异常状态和数据限制。
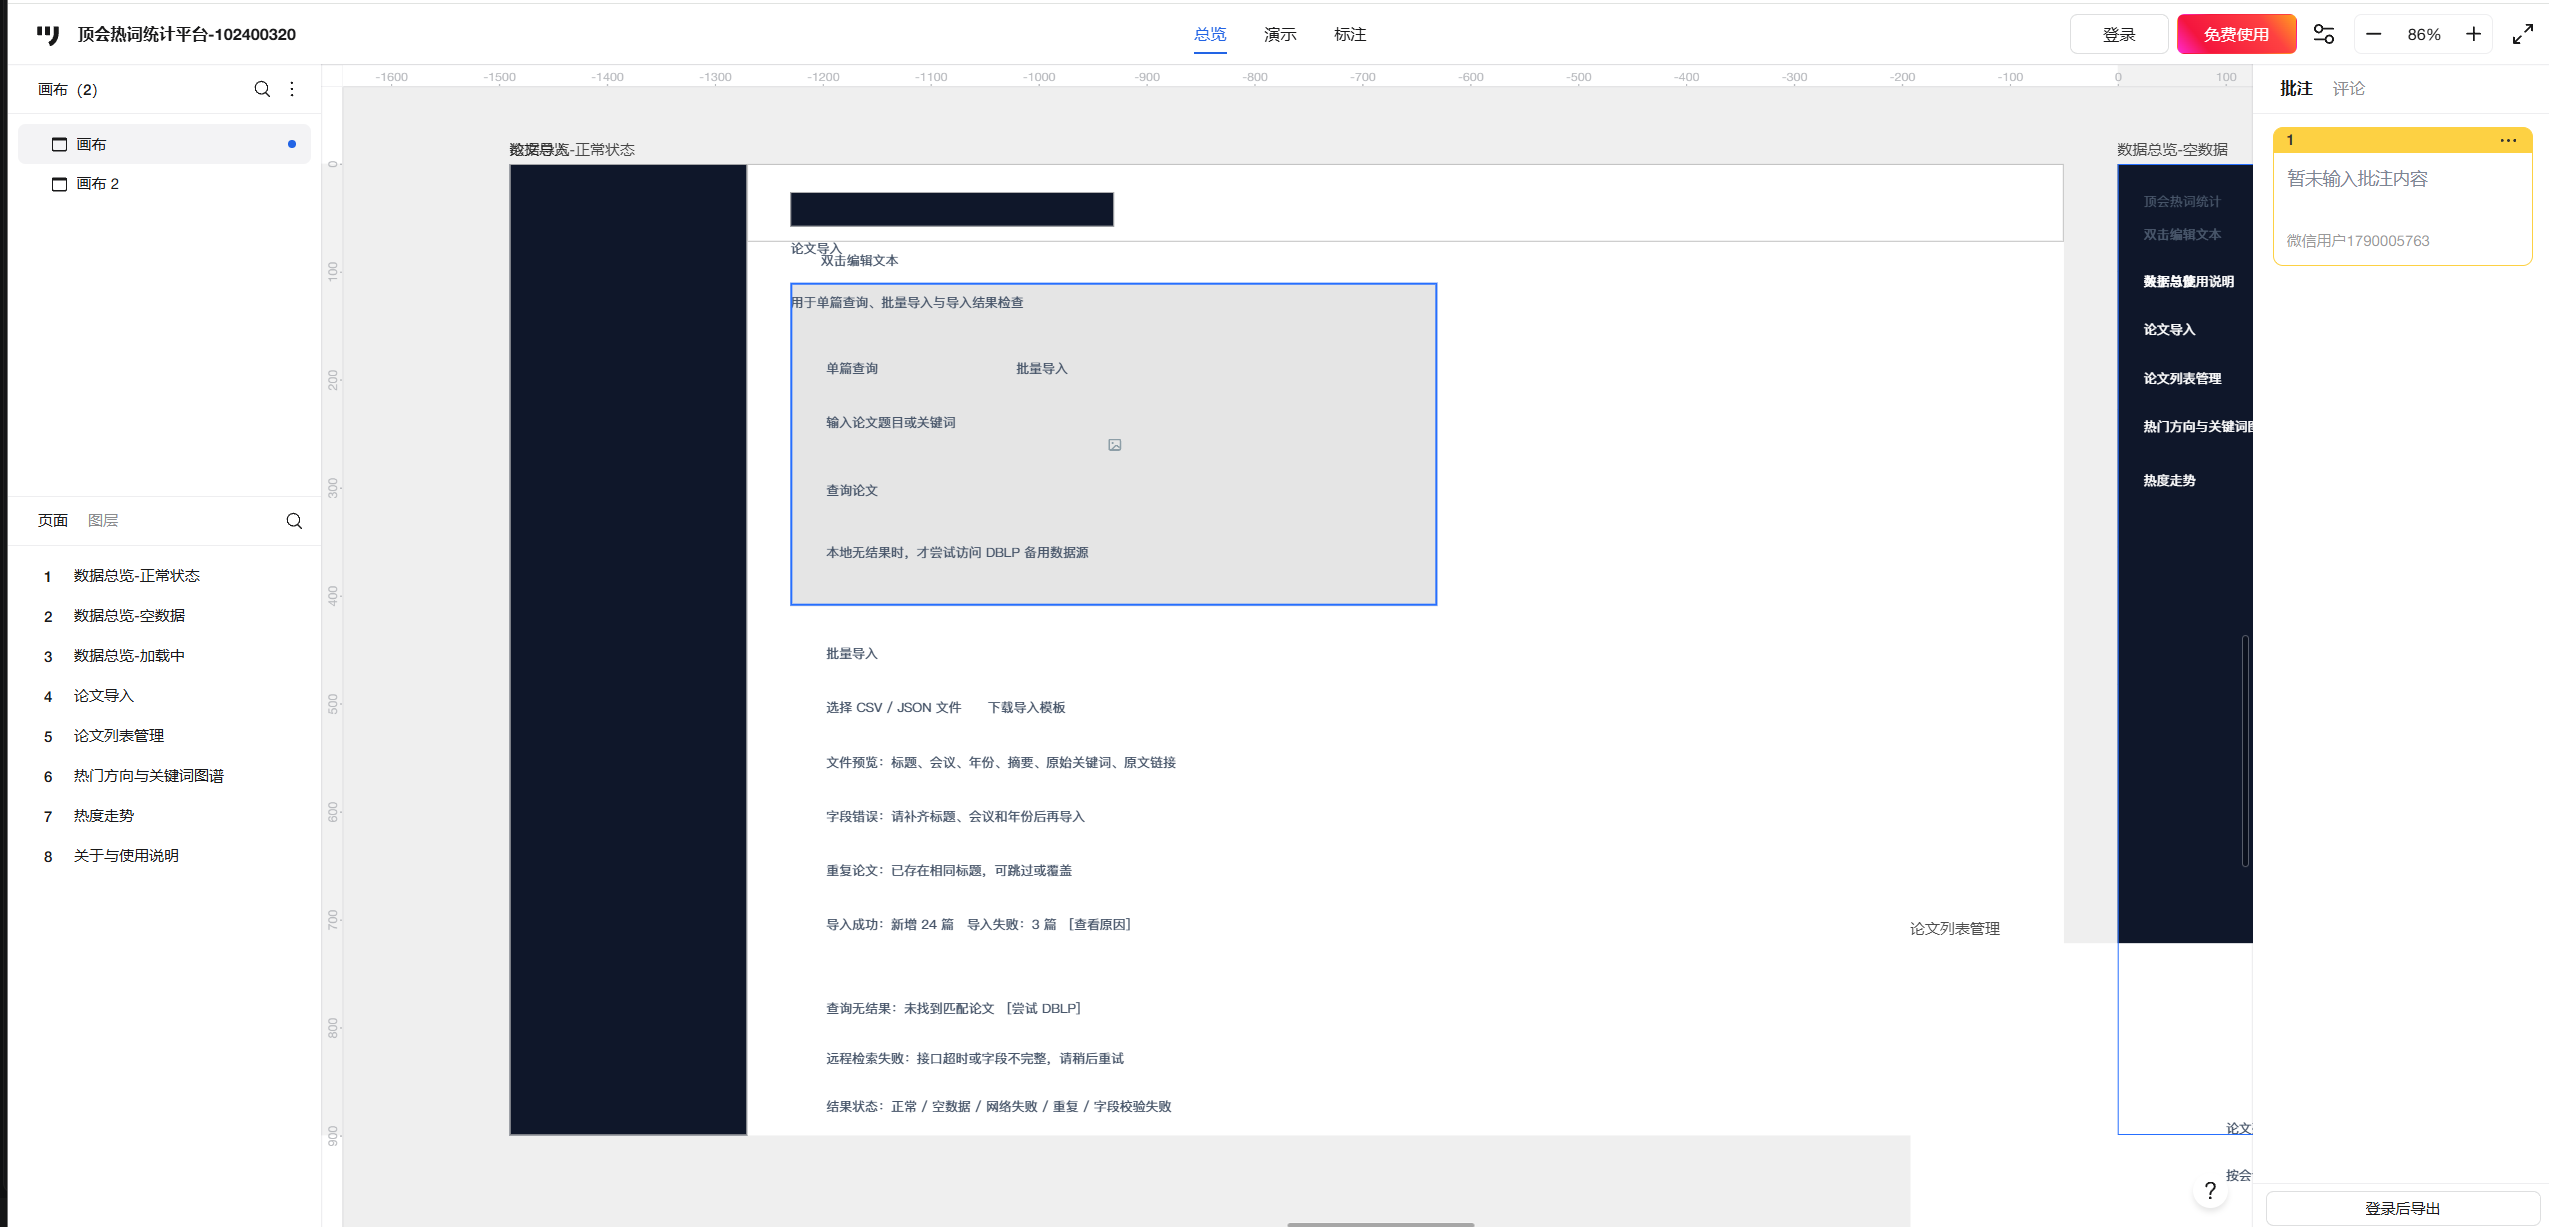
墨刀六个页面在同一画板中的整体布局
数据总览页的卡片、图表、Top 10 摘要和最近导入区域。
浏览器
  |
  v
HTML / CSS / JavaScript / ECharts
  |
  v
Flask 路由与 JSON API
  |
  +--> 论文导入、列表管理、详情接口
  +--> 统计、Top 10、图谱、趋势接口
  +--> DBLP 条件远程检索
  |
  v
SQLite
  |
  +--> papers
  +--> import_records
  +--> keyword statistics
部署结构:
公网 HTTPS
    |
    v
Caddy 反向代理
    |
    v
Gunicorn(127.0.0.1:8001)
    |
    v
Flask 应用
    |
    v
SQLite 数据库
| 字段 | 含义 |
|---|---|
| title | 论文标题 |
| abstract | 摘要,可能为空 |
| venue | 会议,限定 CVPR、ICCV、ECCV |
| year | 发表年份 |
| original_keywords | 数据源提供的原始关键词,若有则保留 |
| extracted_keywords | 系统从标题、摘要中提取的专业方向 |
| url | 原文或公开论文页面链接 |
| source | 数据来源,例如附录14或 DBLP |
| title_source | 标题来源说明 |
| created_at | 导入时间 |
展示论文总数、会议分布、年份覆盖、Top 10 摘要和最近导入记录。
展示文件名、字段列、合法记录数、错误记录数和重复记录数,说明确认前不会直接写入。
展示批量导入完成后的成功数、跳过数、失败数,以及“查看论文列表”按钮。
展示标题为空、年份不合法或会议不支持时的字段级错误提示。
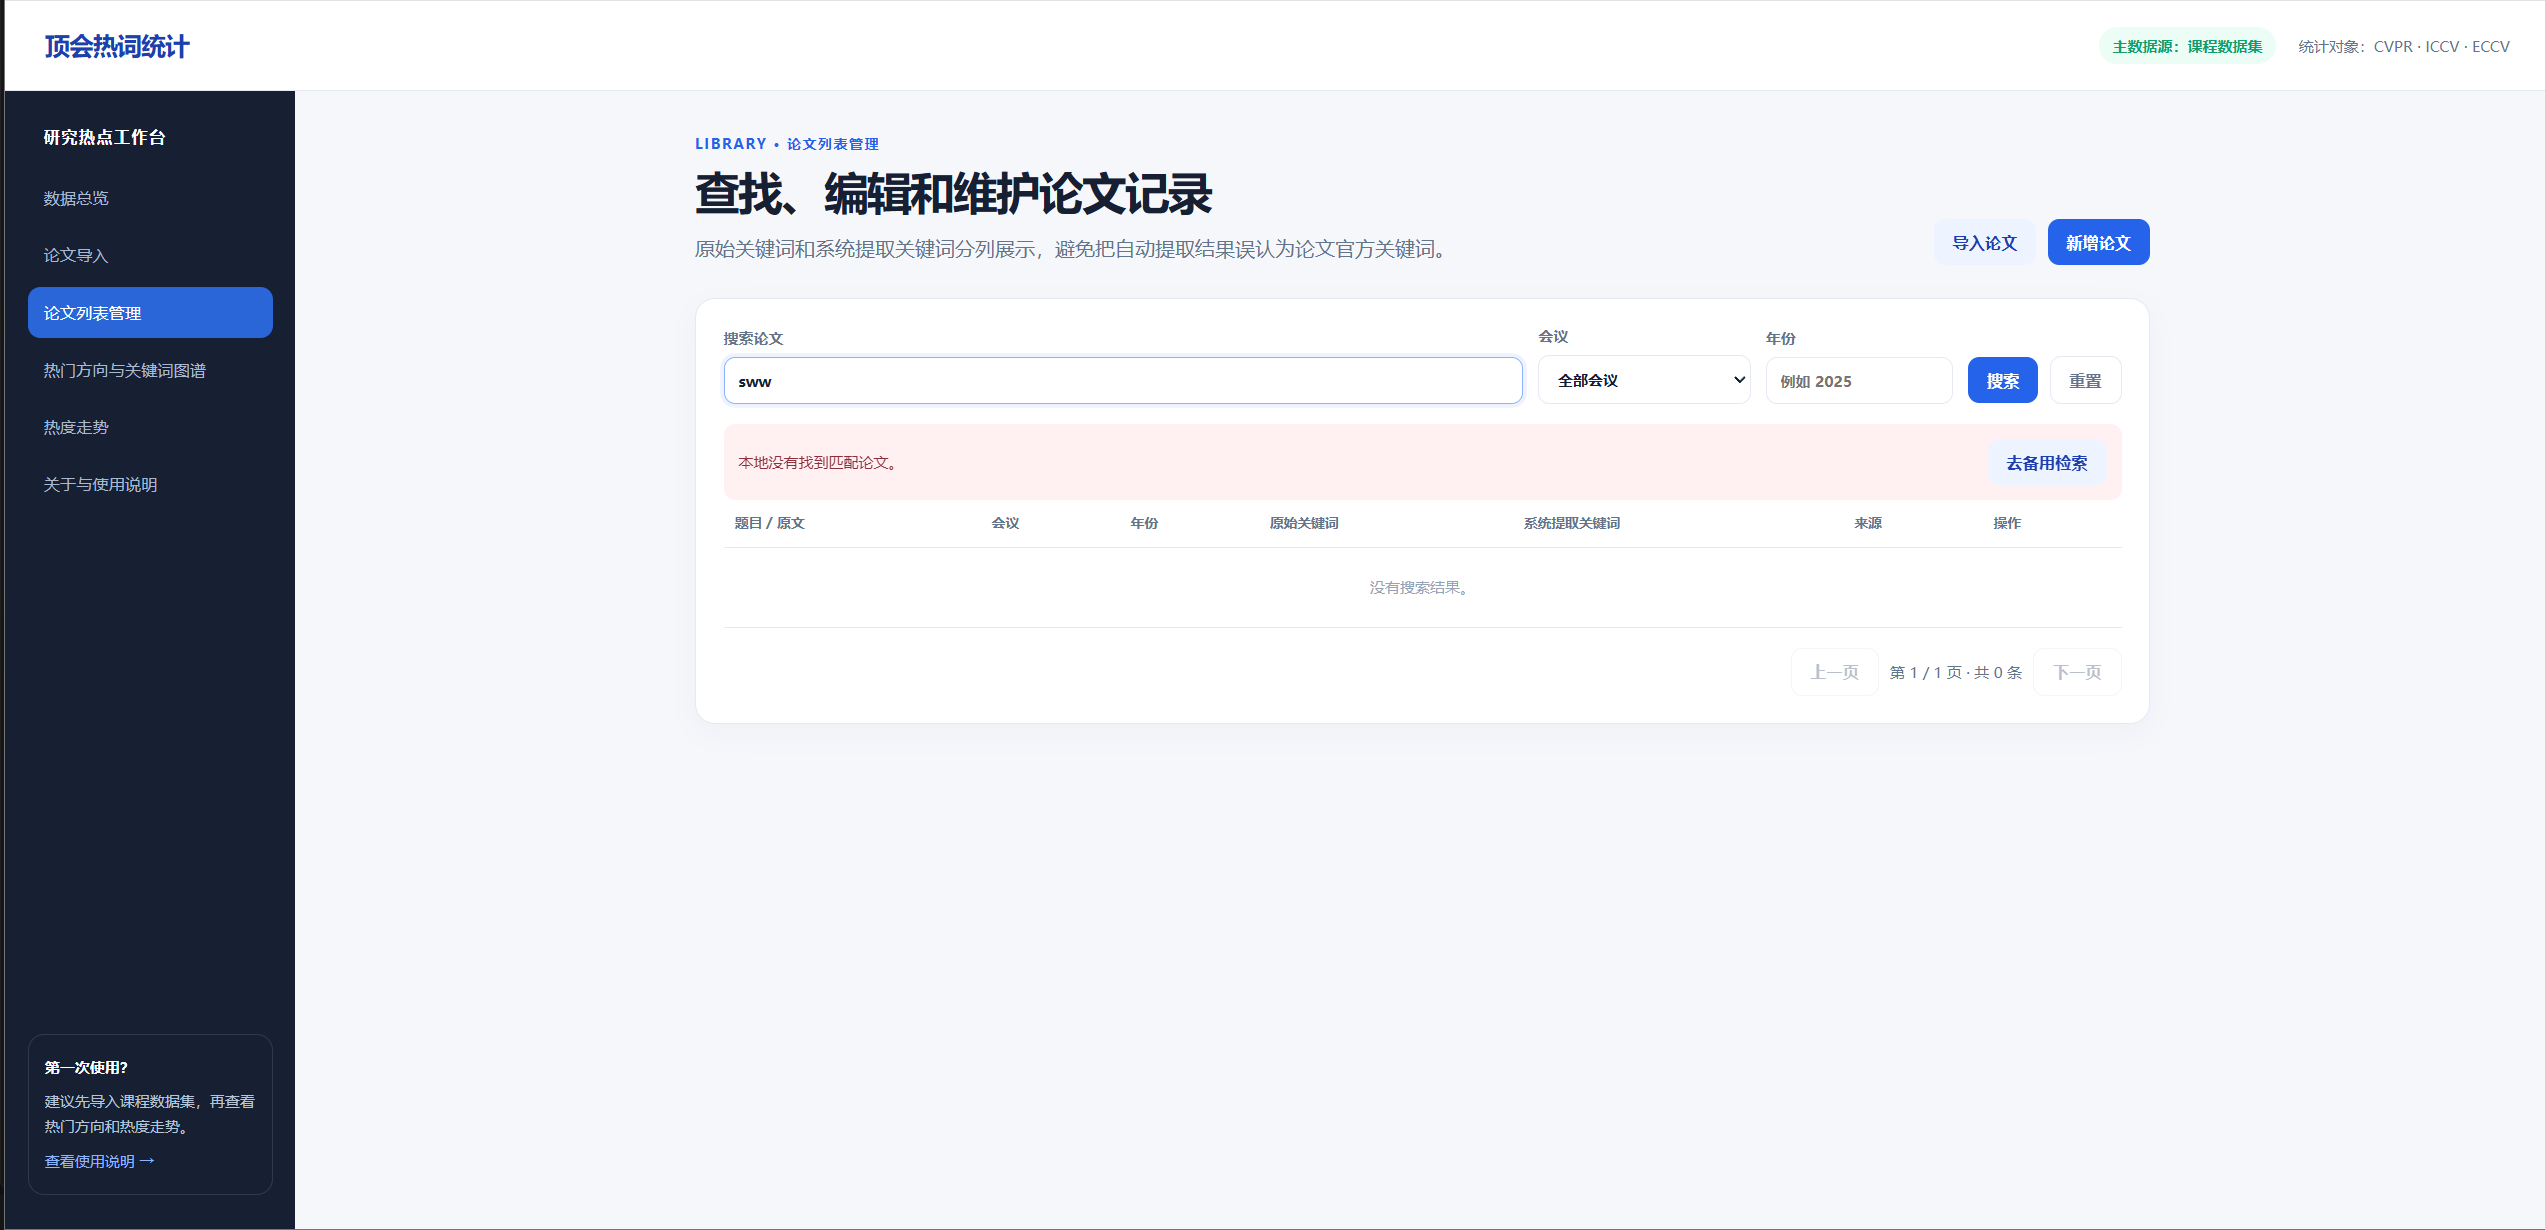
展示搜索区、会议筛选、年份筛选、原始关键词、系统提取方向和操作按钮。
展示编辑表单、保存修改确认,或包含论文标题的删除确认框。
展示摘要、原始关键词、系统提取方向、来源字段和“查看原文”按钮。点击按钮后应打开真实公开论文地址。
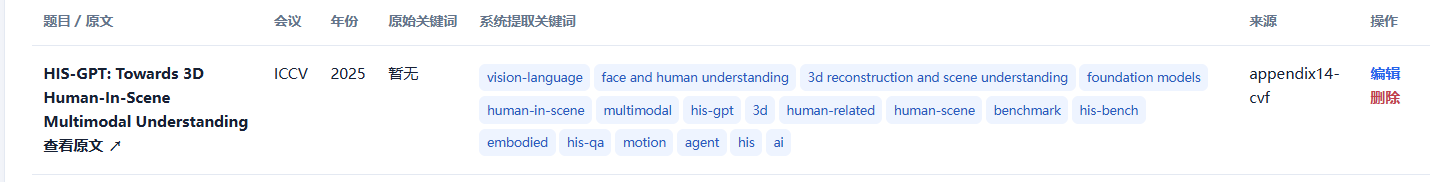
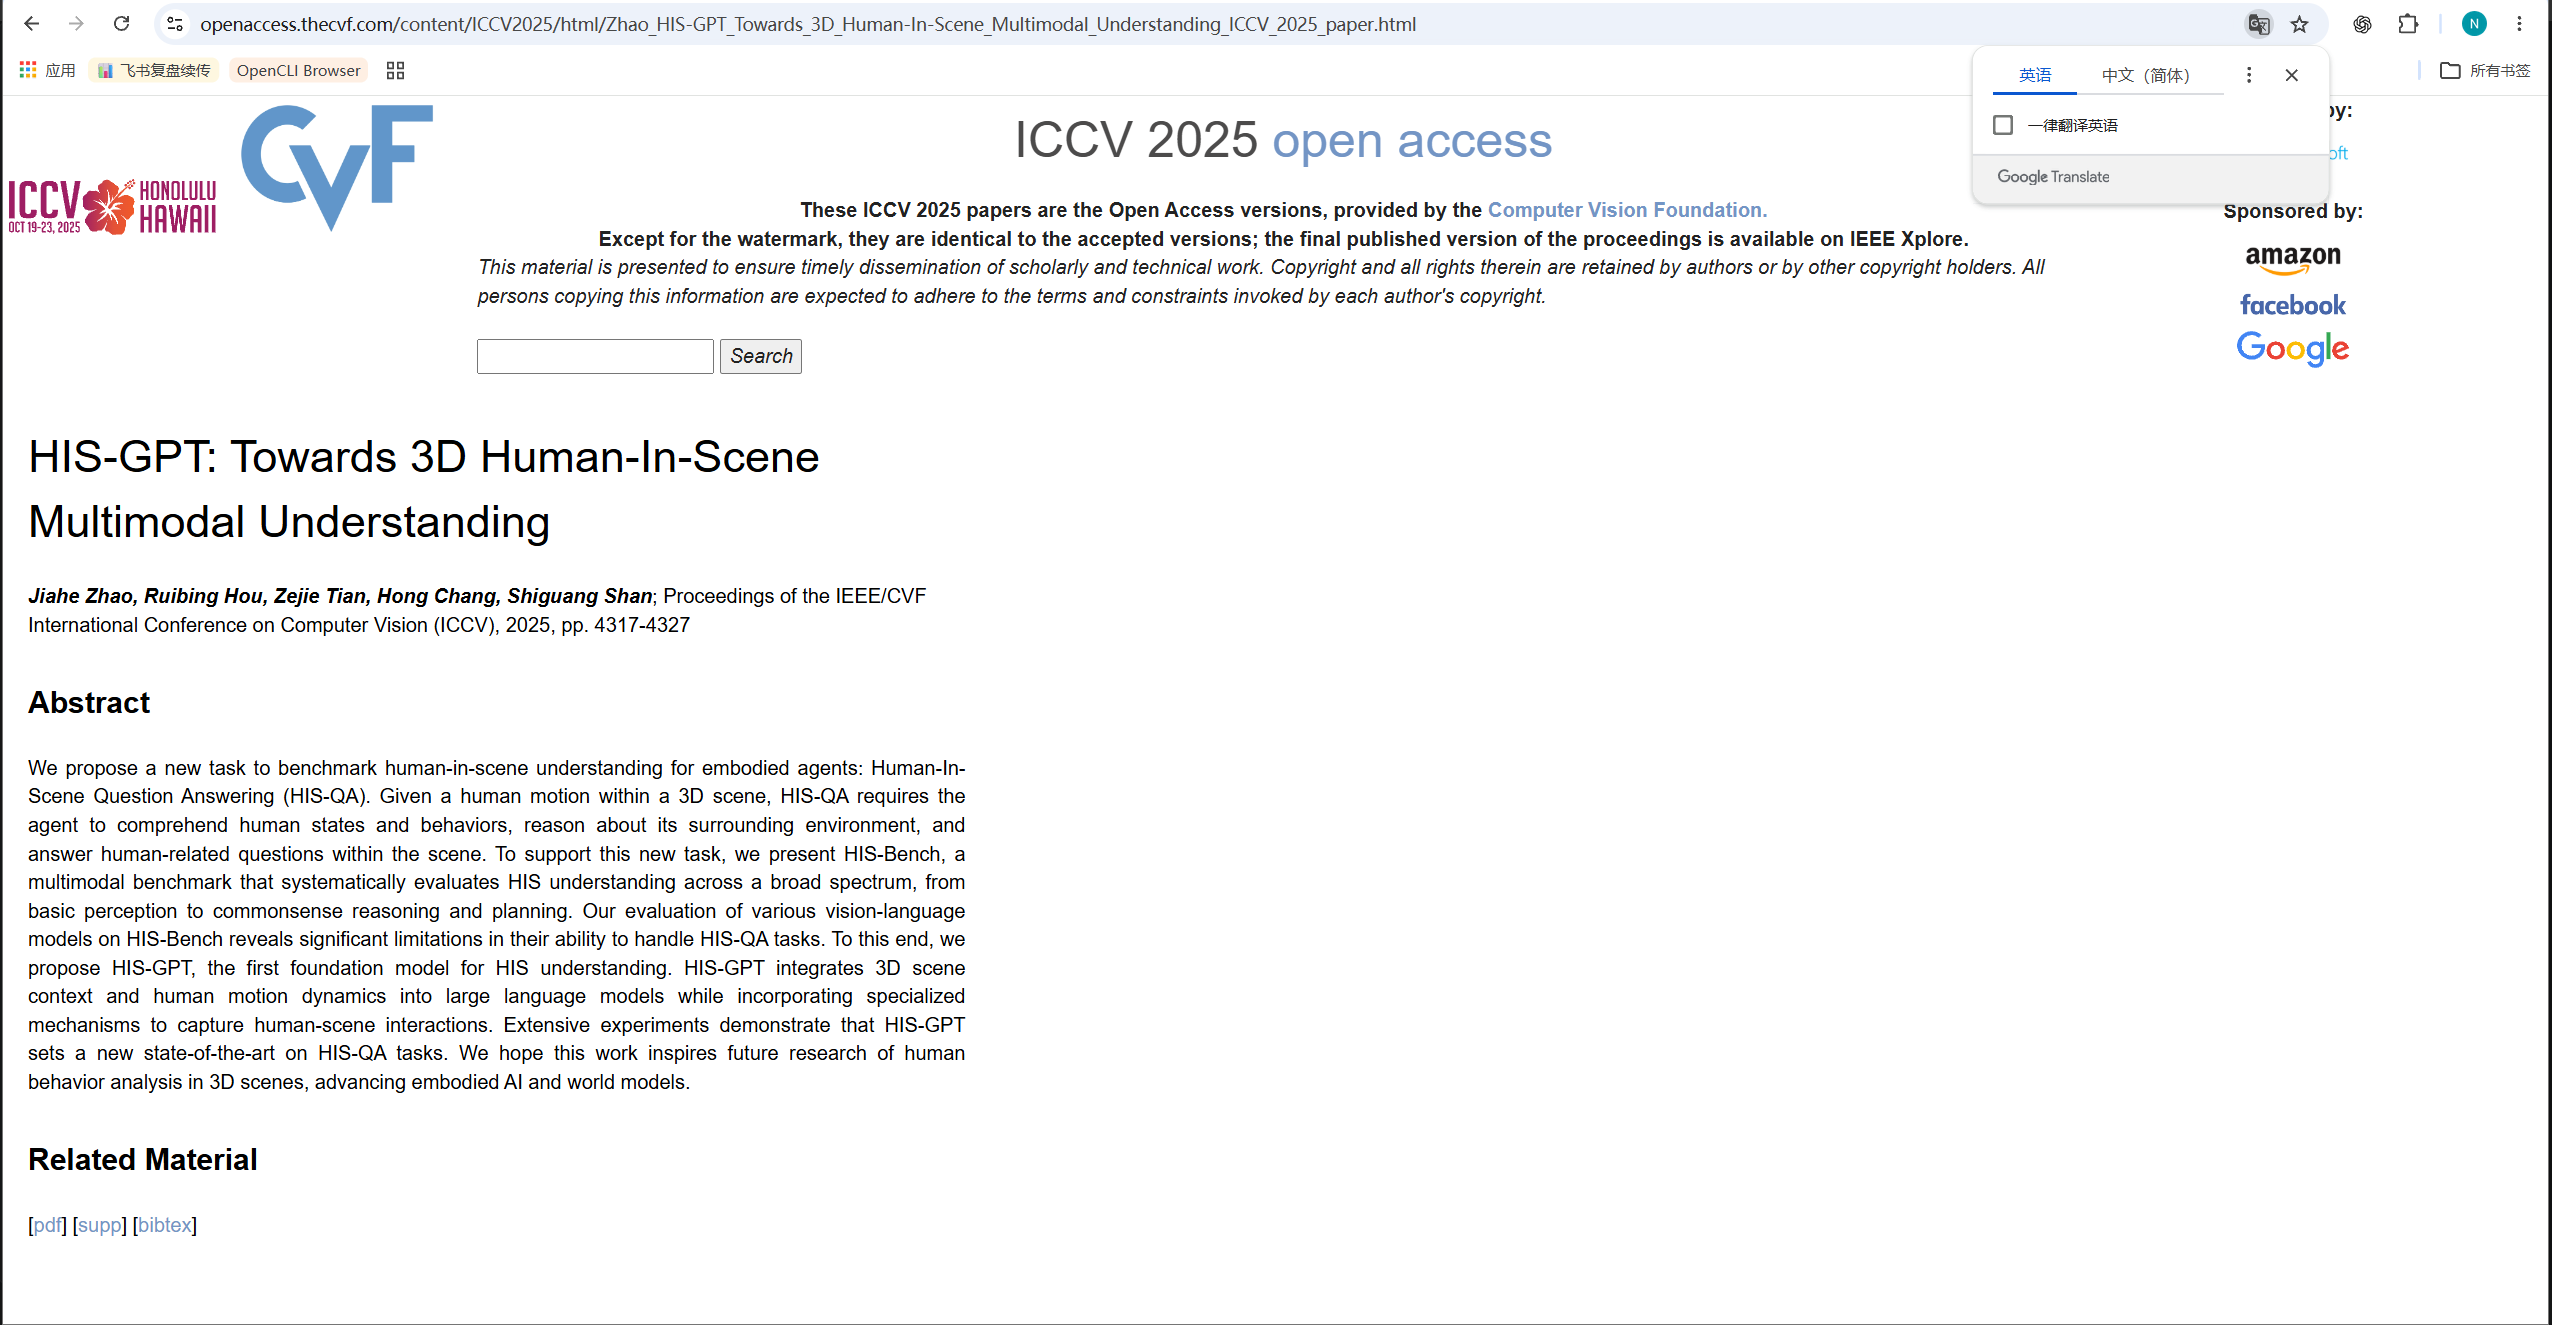
展示方向中文名、英文名、论文数、占比、增长信息和“查看相关论文”。
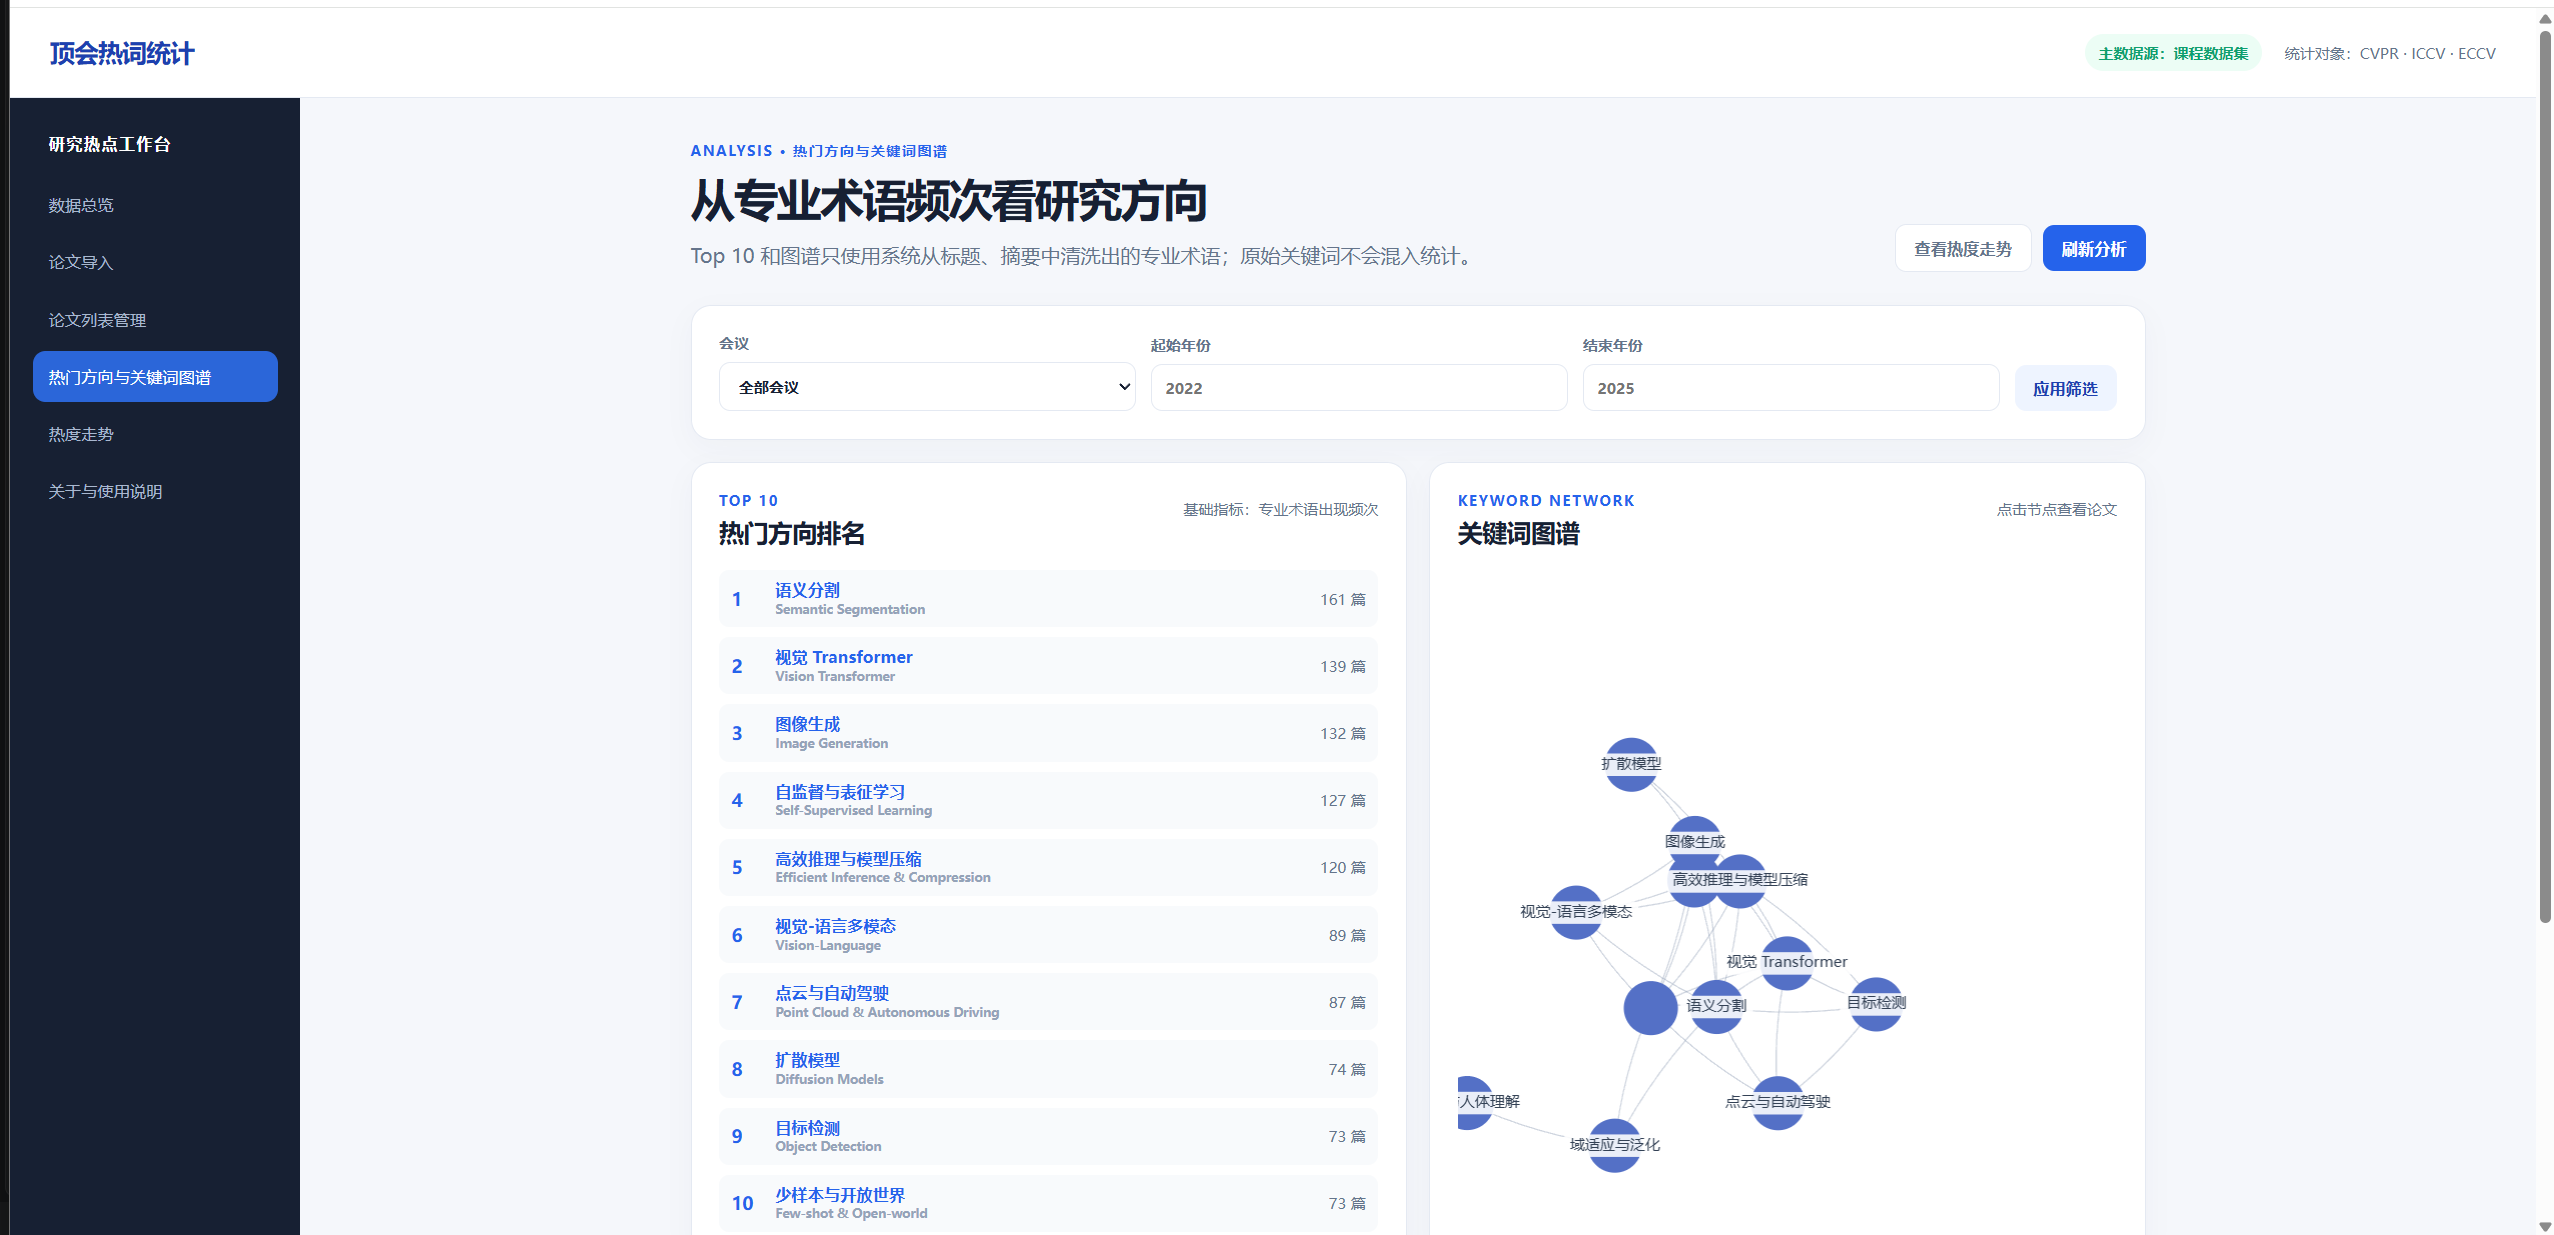
展示节点间距、节点标签和点击某个专业方向后的关联论文列表,重点证明标签没有全部重叠。
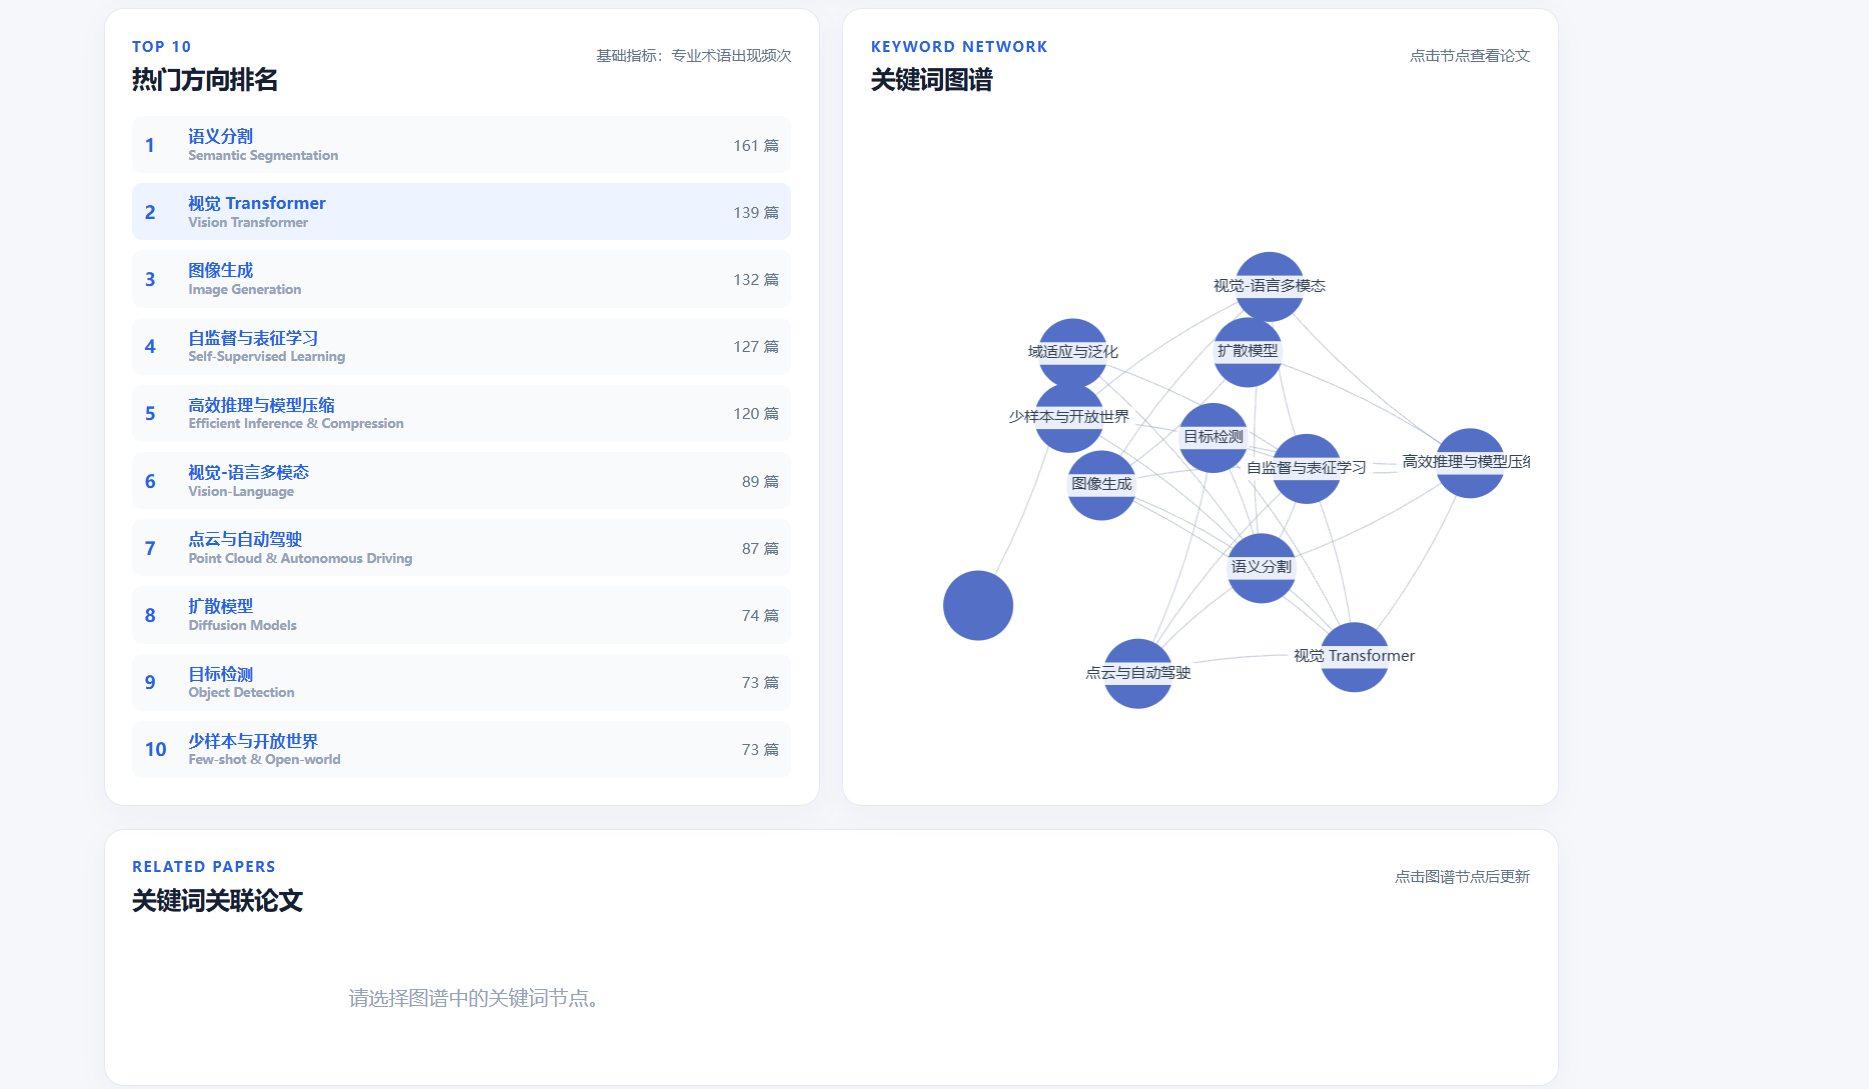
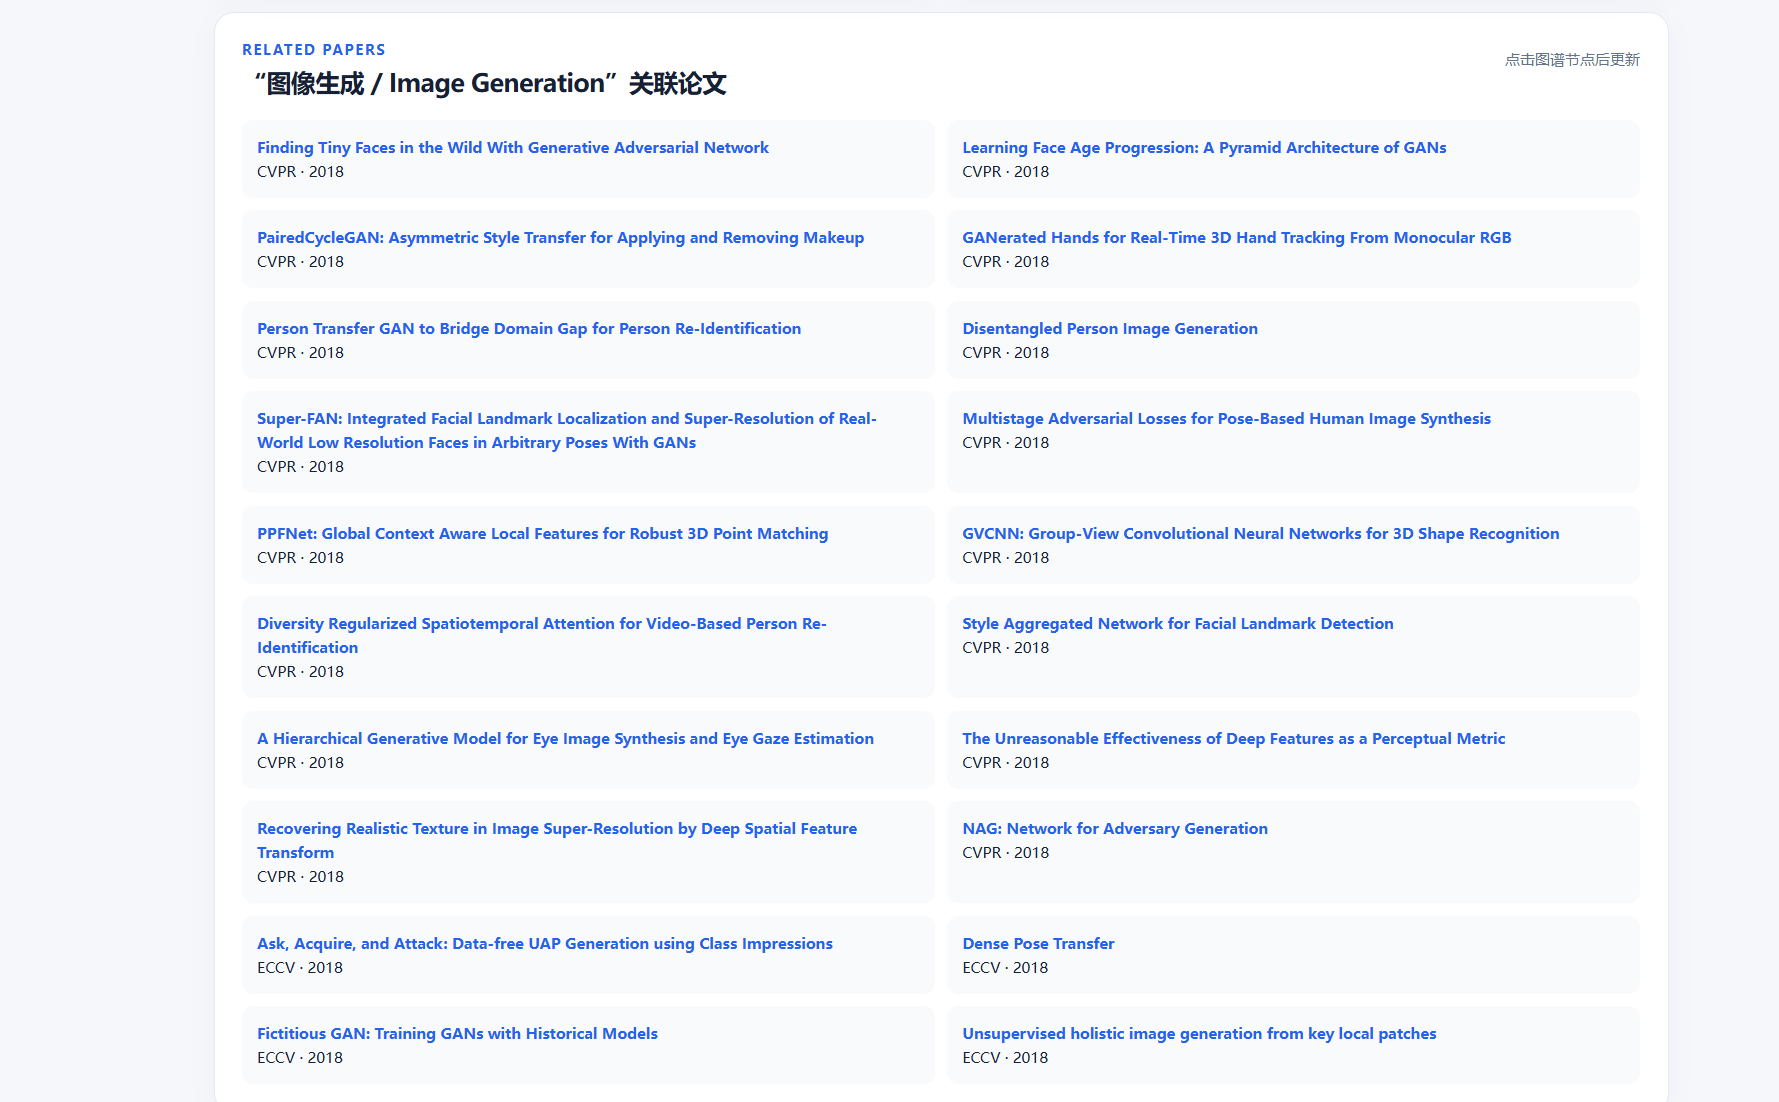
点击“图像生成”的关键词节点的结果如下
展示会议、年份和专业方向筛选,以及按年份推进的动态图表和文字数据。
展示课程数据集、DBLP 备用检索、原始关键词、系统提取方向和统计限制。
展示空数据提示、加载动画、统计数据加载失败和“重新加载”按钮。
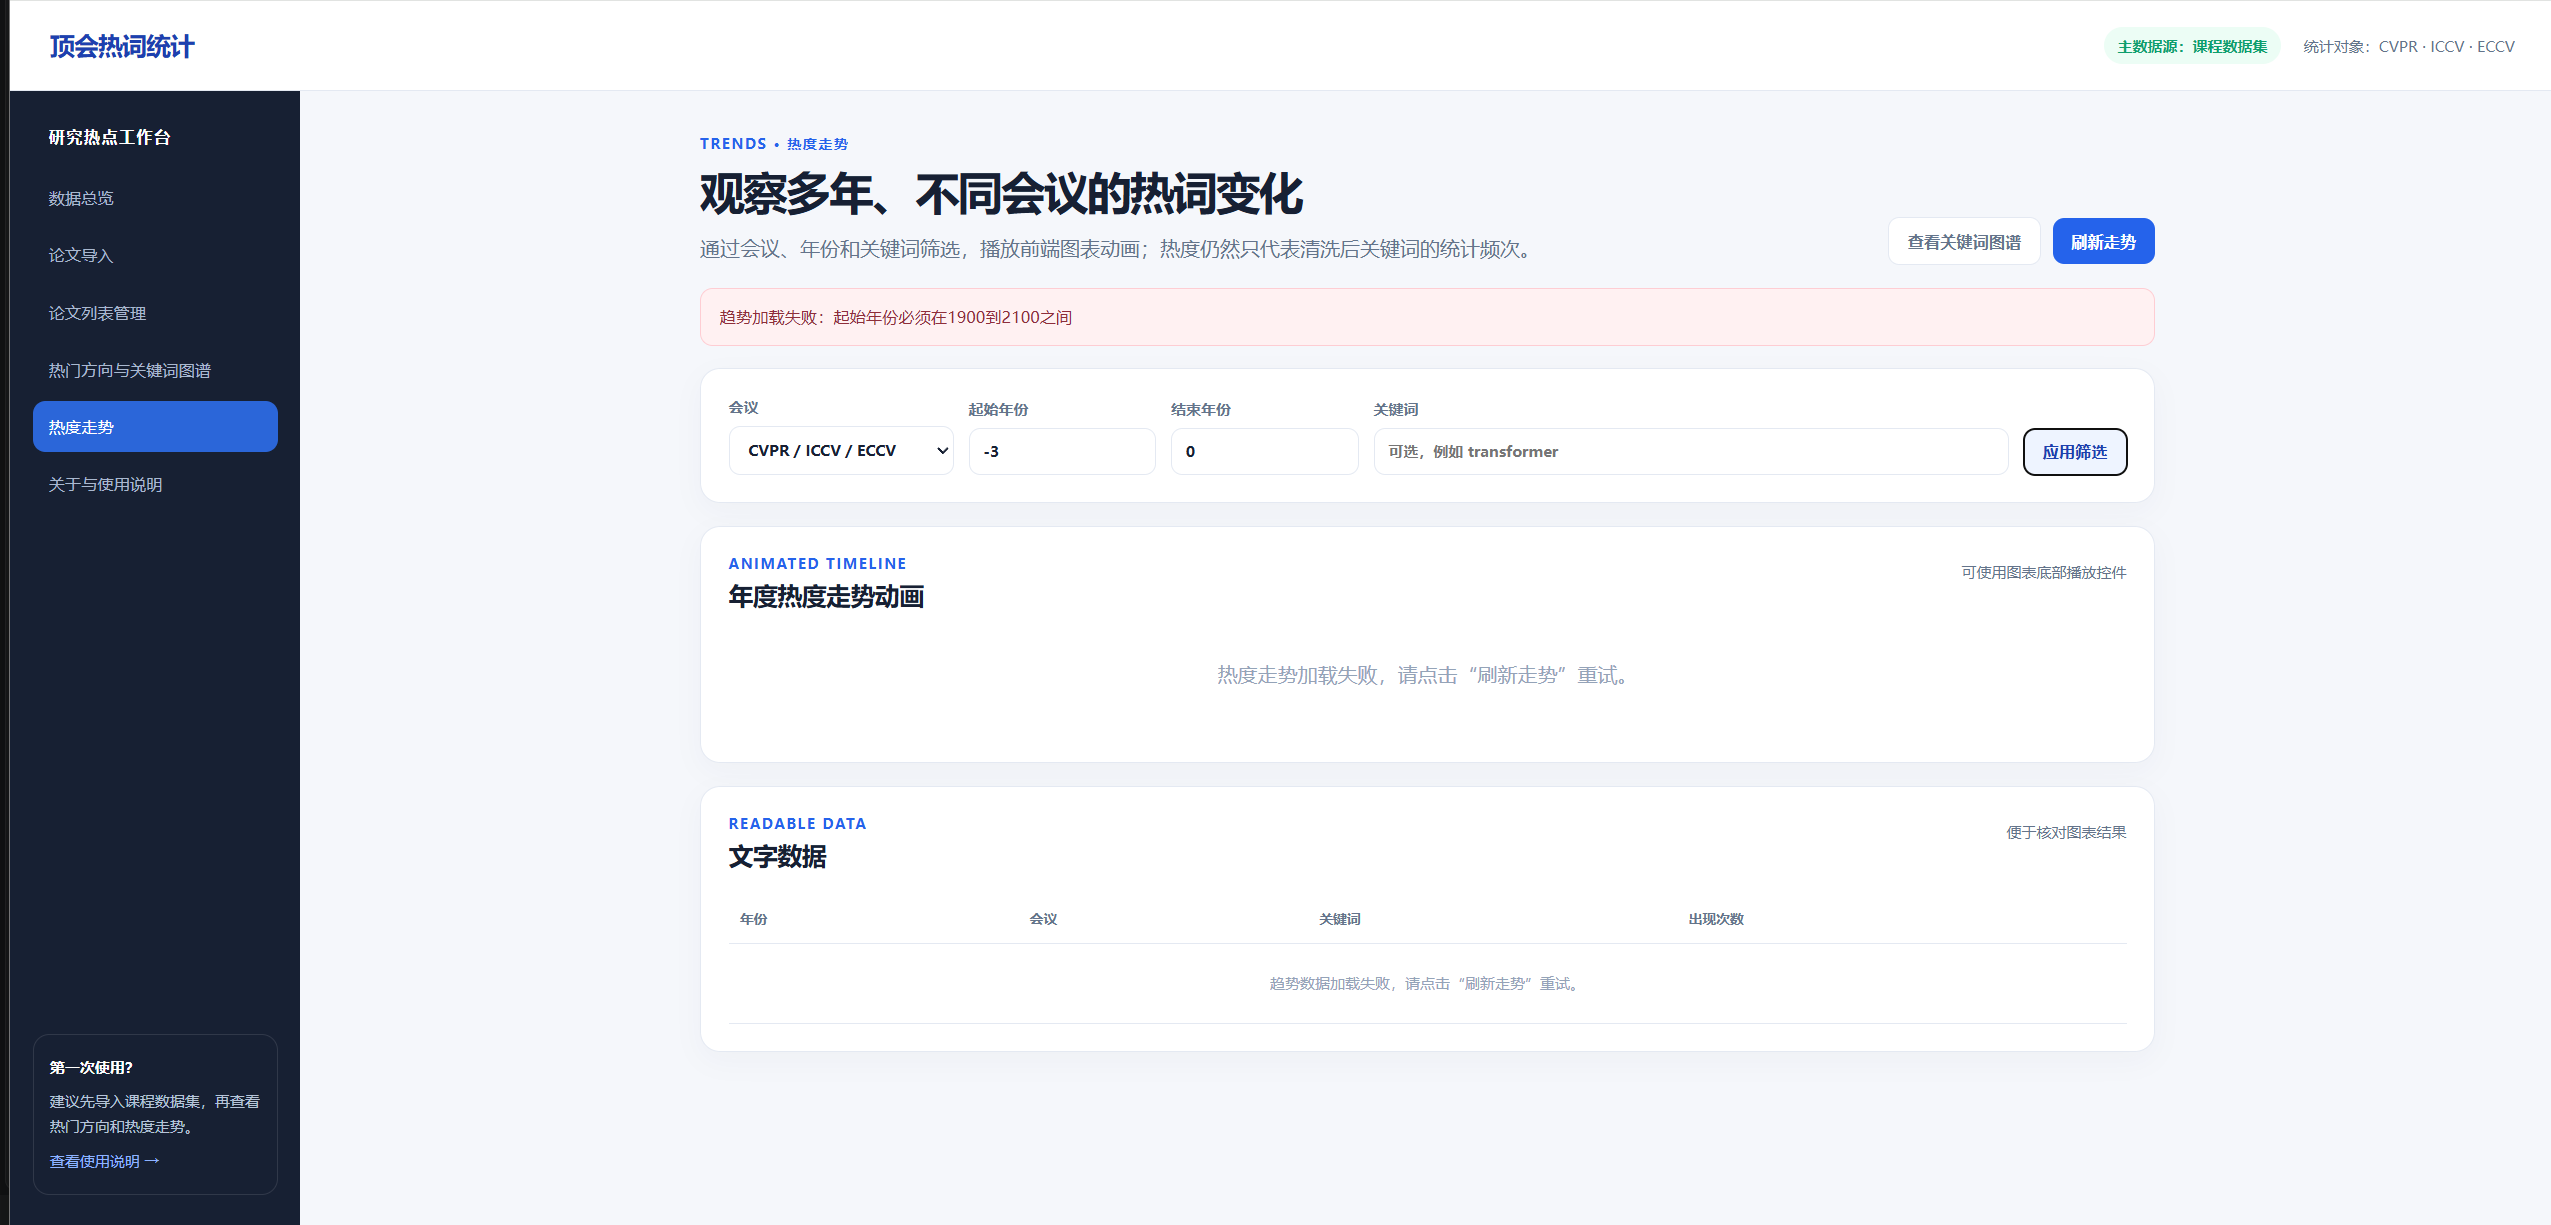
展示测试结果 31 passed 或当前实际测试结果,以及公网页面地址。
我的协作方式不是把整道题一次性交给 AI,而是把任务拆成需求分析、原型评审、数据处理、功能实现、测试修复和文档整理几个阶段。每个阶段都先提出约束,再检查 AI 输出,最后用页面操作、测试命令或公网接口验证。
AI 更像一个可以快速提出候选方案的搭档;我负责决定哪些内容符合题目、哪些内容需要删减,以及哪些代码必须通过测试后才能保留。
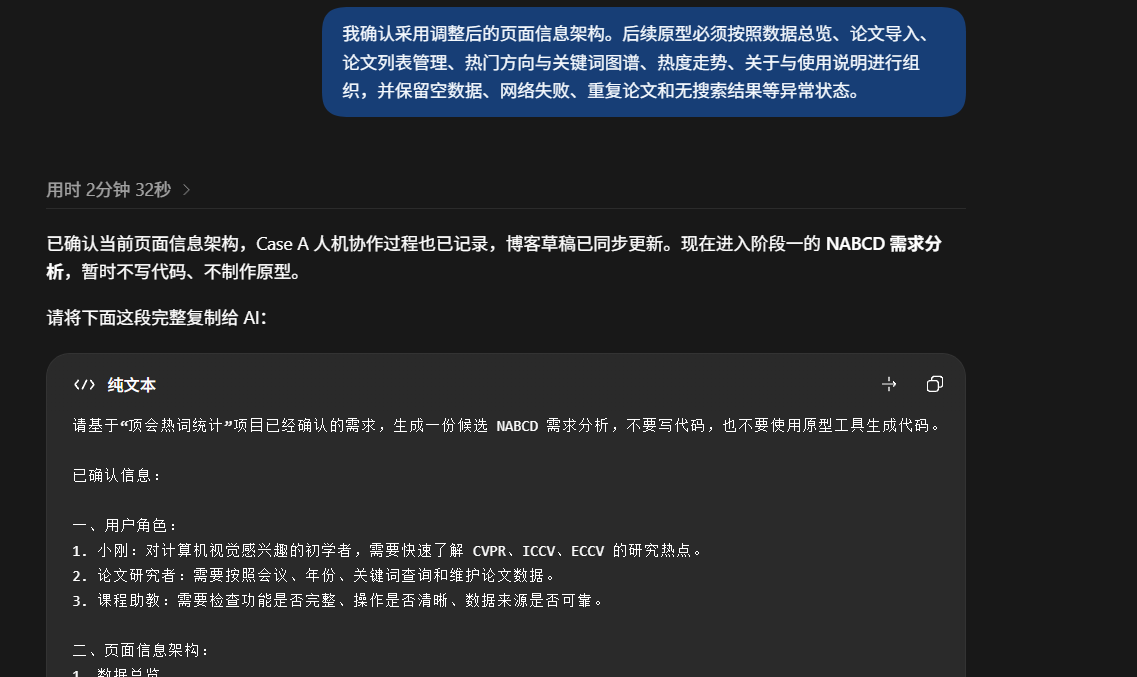
请根据“顶会热词统计”作业要求,从小刚和论文研究者两个角色分析用户痛点、使用场景、必须功能、可选功能、数据来源风险和验收标准。请先提出候选方案,不直接写代码,也不要使用原型工具生成代码。
AI 按两个角色整理了用户痛点、使用场景、功能优先级和验收方向,建议设置数据总览、导入、论文管理、分析、趋势和说明等页面。
这一轮没有直接产生代码,而是形成了墨刀手工原型的页面职责、状态设计和跳转关系。后续页面设计均以这版收紧后的需求为准。
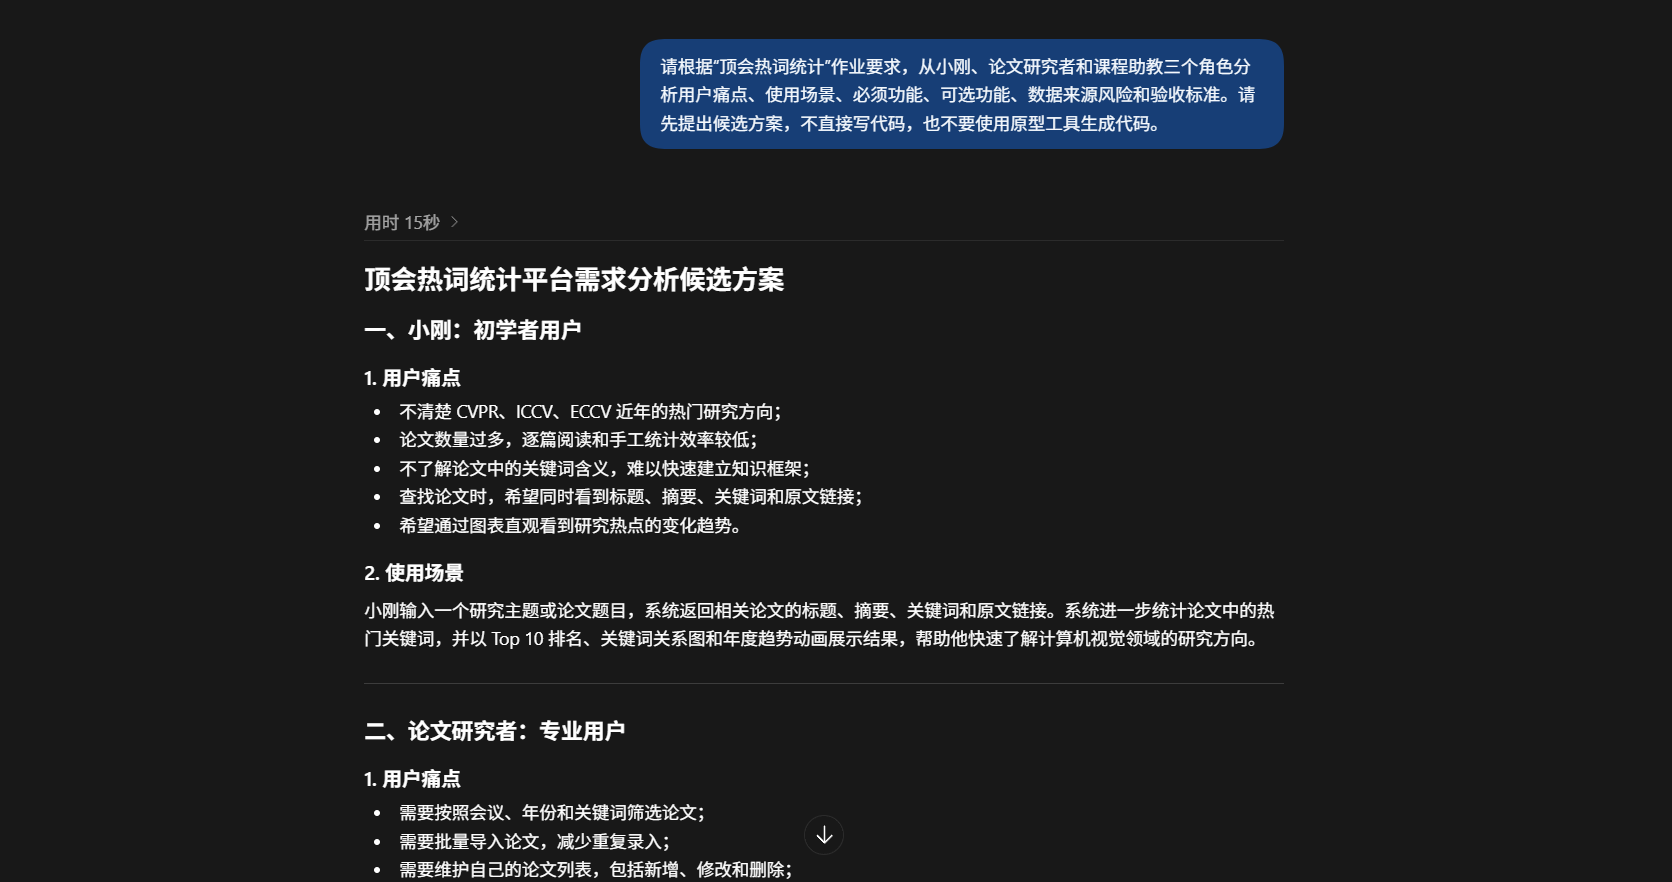
需求分析提示词截图。
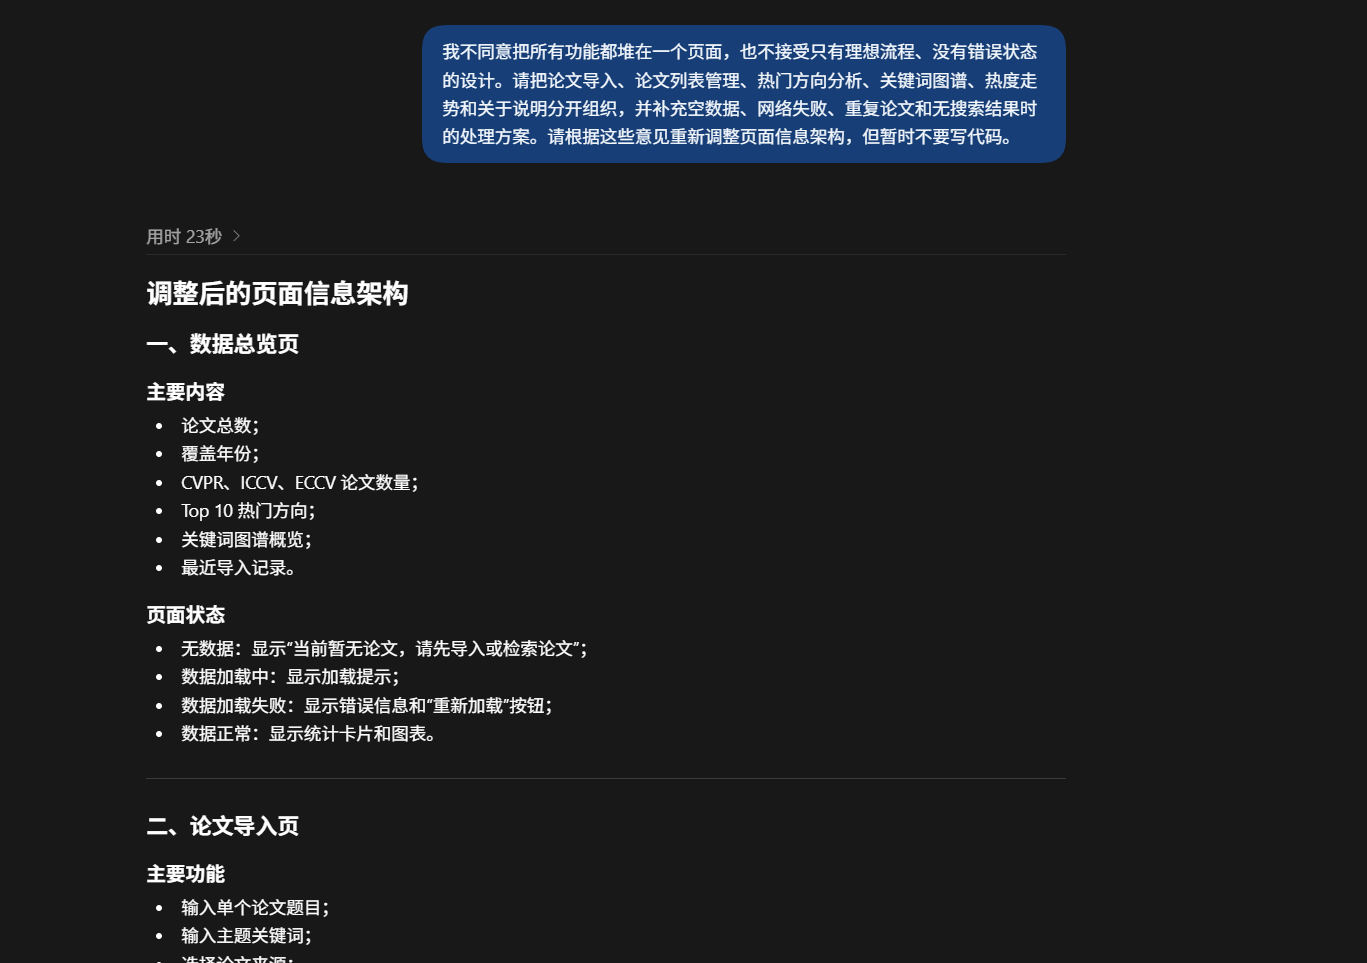
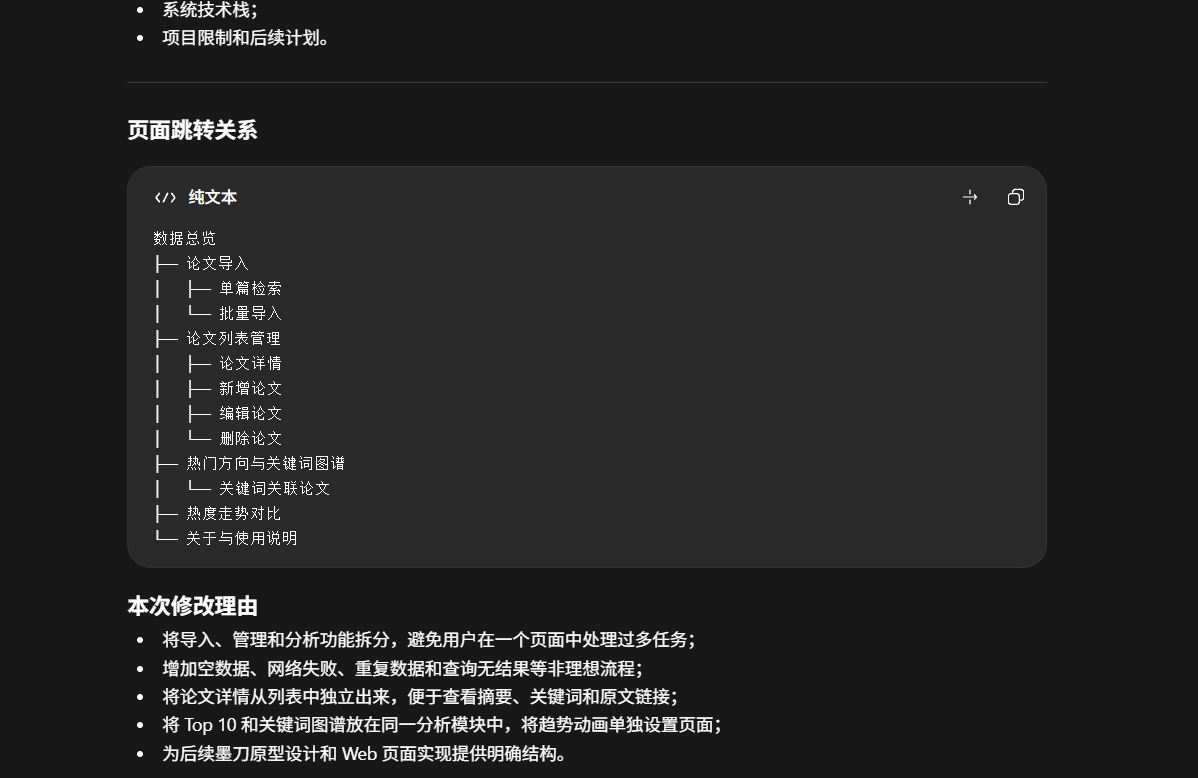
我对单页堆叠方案的否定和页面架构修改截图。
请把已经确认的六页面需求落实为 Flask + SQLite 的最小可解释实现:批量导入必须先预览再写入;原始关键词和系统提取关键词分开保存;Top 10、关键词图谱和趋势只能使用系统提取关键词;DBLP 只在本地无结果时尝试。请先说明接口和测试点,不要把失败的远程查询伪装成成功。
AI 建议将导入预览和确认写入分成两个动作,将论文字段、来源和两类关键词分开存储,并为统计接口增加明确的失败返回。
专业方向 Top 10、图谱和趋势动画截图。
点“查看原文”不能直接打开真实论文网址;热词中出现普通英文词;关键词图谱的节点和标签全部重叠。请定位问题并修复,同时保留失败状态提示,不要用 example.com 这类演示地址。
AI 分析了原文链接字段、前端点击行为、关键词清洗和图谱布局几个位置,建议先检查数据源和接口返回,再检查前端按钮是否使用了真实 URL,最后增加专业词过滤和图谱布局约束。
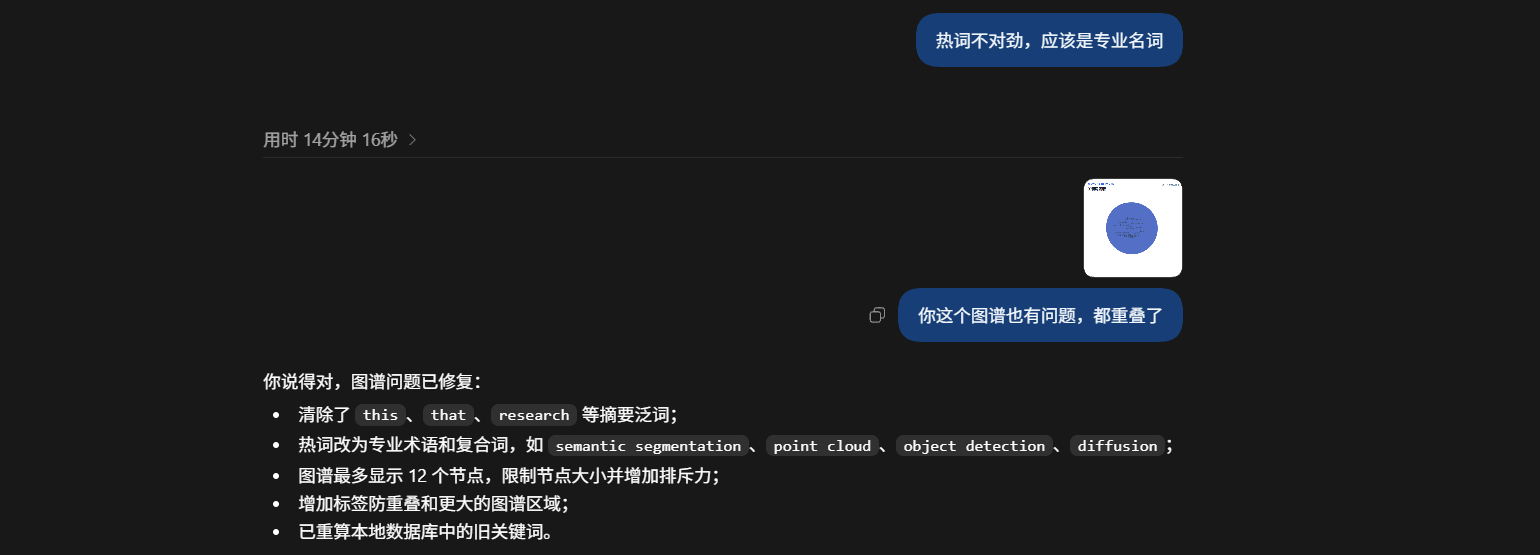
发现原文链接、专业热词和图谱重叠问题的调试截图。
以下代码用于说明关键思路,展示的是项目中与数据源、关键词分析、异常处理和前端交互有关的核心片段。为控制文章篇幅,重复的样式、模板和简单 CRUD 代码用省略号表示;个别局部变量为了便于阅读做了整理,接口路径按当前仓库版本书写,完整实现以 CodeArts 仓库为准,目标是展示约 300 行左右的关键代码。
# hotwords/sources.py
from __future__ import annotations

import json
from urllib.parse import quote
from urllib.request import Request, urlopen

SUPPORTED_VENUES = {"CVPR", "ICCV", "ECCV"}


class SourceError(RuntimeError):
    """公开数据源不可用、超时或返回内容不完整时使用。"""


def _read_json(url: str, timeout: float = 8.0) -> dict:
    request = Request(
        url,
        headers={
            "Accept": "application/json",
            "User-Agent": "top-conference-hotwords-course-project/1.0",
        },
    )
    try:
        with urlopen(request, timeout=timeout) as response:
            body = response.read().decode("utf-8")
    except Exception as exc:
        raise SourceError(f"公开数据源请求失败:{exc}") from exc

    try:
        return json.loads(body)
    except json.JSONDecodeError as exc:
        raise SourceError("公开数据源返回的内容不是合法 JSON") from exc


def fetch_dblp(title: str) -> dict | None:
    """仅在本地无结果时被调用,找不到时返回 None。"""
    if not title.strip():
        return None

    url = (
        "https://dblp.org/search/publ/api"
        f"?q={quote(title)}&format=json&h=10"
    )
    payload = _read_json(url)
    hits = payload.get("result", {}).get("hits", {}).get("hit", [])

    for item in hits:
        info = item.get("info", {})
        venue = str(info.get("venue", "")).upper()
        if not any(name in venue for name in SUPPORTED_VENUES):
            continue

        result = {
            "title": info.get("title", ""),
            "abstract": info.get("abstract", ""),
            "url": info.get("ee", ""),
            "source": "DBLP",
        }
        if not result["title"] or not result["url"]:
            raise SourceError("DBLP 返回记录字段不完整")
        return result

    return None
这段代码的重点是:远程查询不是默认路径;只在本地没有结果时调用;接口失败、JSON 错误和字段不完整都会转成可解释的错误。
# hotwords/analyzer.py
from collections import Counter
import re

STOP_WORDS = {
    "the", "and", "for", "with", "from", "that", "this",
    "data", "show", "however", "which", "both", "novel",
}

PROFESSIONAL_TOPICS = {
    "video understanding": "视频理解",
    "diffusion models": "扩散模型",
    "vision-language": "视觉-语言多模态",
    "vision transformer": "视觉 Transformer",
    "self-supervised learning": "自监督与表征学习",
    "image generation": "图像生成",
    "semantic segmentation": "语义分割",
    "object detection": "目标检测",
    "3d vision": "三维视觉",
    "efficient inference and compression": "高效推理与模型压缩",
}


def normalize_text(value: str) -> str:
    value = value.lower().replace("_", " ")
    return re.sub(r"\s+", " ", value).strip()


def extract_professional_topics(title: str, abstract: str) -> list[str]:
    text = normalize_text(f"{title} {abstract}")
    found = []
    for english_name in PROFESSIONAL_TOPICS:
        if english_name in text:
            found.append(english_name)
    return sorted(set(found))


def count_topics(papers: list[dict]) -> list[dict]:
    counts = Counter()
    paper_total = len(papers)

    for paper in papers:
        topics = paper.get("extracted_keywords", [])
        for topic in set(topics):
            counts[topic] += 1

    result = []
    for rank, (topic, count) in enumerate(
        counts.most_common(10), start=1
    ):
        result.append(
            {
                "rank": rank,
                "topic": topic,
                "name_zh": PROFESSIONAL_TOPICS.get(topic, topic),
                "paper_count": count,
                "share": round(count / paper_total * 100, 2)
                if paper_total else 0,
            }
        )
    return result
这段代码把普通高频词过滤在专业方向集合之外,并用“覆盖论文数”计数。set(topics) 保证一篇论文在同一方向只统计一次。
def build_keyword_graph(papers: list[dict]) -> dict:
    node_counts = Counter()
    edge_counts = Counter()

    for paper in papers:
        topics = sorted(set(paper.get("extracted_keywords", [])))
        for topic in topics:
            node_counts[topic] += 1
        for index, left in enumerate(topics):
            for right in topics[index + 1:]:
                edge_counts[(left, right)] += 1

    nodes = []
    for topic, count in node_counts.most_common(12):
        nodes.append(
            {
                "id": topic,
                "name": PROFESSIONAL_TOPICS.get(topic, topic),
                "value": count,
                "symbolSize": 26 + min(count, 80) * 0.45,
            }
        )

    links = [
        {"source": left, "target": right, "value": count}
        for (left, right), count in edge_counts.most_common(24)
    ]

    return {"nodes": nodes, "links": links}


def trend_series(
    papers: list[dict],
    venues: list[str],
    years: list[int],
    topic: str,
) -> list[dict]:
    result = []
    for year in years:
        row = {"year": year}
        for venue in venues:
            row[venue] = sum(
                1
                for paper in papers
                if paper.get("year") == year
                and paper.get("venue") == venue
                and topic in set(paper.get("extracted_keywords", []))
            )
        result.append(row)
    return result
图谱使用共现关系,不是把所有关键词都画成一个大圆。前端还会对节点间距、布局和标签位置进行约束,避免用户看到重叠文字。趋势接口按会议和年份返回数字,前端用 ECharts 时间轴动画展示。
# hotwords/__init__.py(核心逻辑节选)
@app.get("/api/papers")
def list_papers():
    query = request.args.get("q", "").strip()
    venue = request.args.get("venue", "").strip()
    year = request.args.get("year", "").strip()

    try:
        items = repository.search(
            query=query,
            venue=venue,
            year=int(year) if year else None,
        )
    except ValueError:
        return jsonify({
            "ok": False,
            "message": "年份必须是数字",
        }), 400

    return jsonify({
        "ok": True,
        "items": items,
        "total": len(items),
    })


@app.post("/api/papers/import/preview")
def preview_import():
    upload = request.files.get("file")
    if upload is None or not upload.filename:
        return jsonify({
            "ok": False,
            "message": "请选择论文文件",
        }), 400

    preview = importer.preview(upload)
    return jsonify({
        "ok": True,
        "valid_count": preview.valid_count,
        "duplicate_count": preview.duplicate_count,
        "error_count": preview.error_count,
        "rows": preview.rows,
    })


@app.post("/api/papers/import")
def confirm_import():
    payload = request.get_json(silent=True) or {}
    token = payload.get("preview_token", "")
    if not token:
        return jsonify({
            "ok": False,
            "message": "请先完成文件预览",
        }), 400

    try:
        result = importer.confirm(token)
    except DuplicateError as exc:
        return jsonify({
            "ok": False,
            "message": str(exc),
        }), 409
    except ValidationError as exc:
        return jsonify({
            "ok": False,
            "message": str(exc),
        }), 400

    return jsonify({"ok": True, "result": result})
当前仓库还提供 /api/papers/fetch 和 /api/papers/lookup 作为远程检索入口;接口把输入错误、远程失败、重复错误和字段校验错误返回成不同状态,前端可以据此显示不同文案,而不是全部显示“操作失败”。
function openPaperSource(url) {
  if (!url) {
    showToast("该论文暂未返回可访问的原文链接");
    return;
  }

  const target = String(url).trim();
  if (!/^https?:\/\//i.test(target)) {
    showToast("原文链接格式异常,请先检查论文来源");
    return;
  }

  window.open(target, "_blank", "noopener,noreferrer");
}


async function loadTrend() {
  setLoading("#trend-panel", "正在加载趋势数据……");

  const params = new URLSearchParams({
    venue: getValue("#venue-filter"),
    year_from: getValue("#year-from"),
    year_to: getValue("#year-to"),
    topic: getValue("#topic-filter"),
  });

  try {
    const response = await fetch("/api/analysis/trends?" + params);
    if (!response.ok) {
      throw new Error("HTTP " + response.status);
    }

    const payload = await response.json();
    if (!payload.ok) {
      throw new Error(payload.message || "趋势数据加载失败");
    }

    renderTrendChart(payload.series);
    renderTrendTable(payload.series);
  } catch (error) {
    showError(
      "#trend-panel",
      "趋势数据加载失败,请检查网络后重试",
      loadTrend,
    );
  }
}


function renderTrendChart(series) {
  const chart = echarts.init(
    document.querySelector("#trend-chart"),
  );

  chart.setOption({
    timeline: {
      axisType: "category",
      autoPlay: false,
      playInterval: 1200,
      data: series.map(item => item.year),
    },
    options: series.map(item => ({
      title: { text: item.year + " 年专业方向热度" },
      xAxis: {
        type: "category",
        data: ["CVPR", "ICCV", "ECCV"],
      },
      yAxis: { type: "value" },
      series: [{
        type: "bar",
        data: [item.CVPR, item.ICCV, item.ECCV],
      }],
    })),
  });
}
这里把“打开真实 URL”和“展示趋势动画”分开处理。原文地址缺失或格式错误时不打开空白页;趋势加载失败时保留重试按钮。
在项目环境中执行:
python -m pytest -q
当前验证结果:
31 passed in 5.54s
测试覆盖了论文查询、导入预览、重复处理、原文链接、统计接口、图谱、趋势和部分异常状态。
项目在 CodeArts 的 dev 分支进行开发,当前可核验的提交数量为 39 个,远程 main 与 dev 已同步到提交 e9854b7,并保留 v1.0.0 标签。
提交按功能阶段拆分,示例包括:
每次提交前先完成对应功能、编译或启动检查,再提交代码;没有把所有功能一次性提交。
部署结构为:
已验证接口:
人机结对和传统两人结对都需要:
本项目中,我先提出需求约束,AI 给出候选结构;我再指出“不能所有功能堆在一个页面”“不能把普通英文词当热词”“不能把 DBLP 失败写成成功”,这种往返和传统结对中的驾驶员、观察员协作比较接近。
AI 适合作为高响应速度的方案讨论者、代码草稿助手和测试清单生成器,但不适合替代需求判断、数据核验和最终验收。
这次协作中,AI 最有价值的地方是帮助我把一个较宽泛的“统计热词平台”收紧为六页、可操作、可验收的系统;最需要警惕的地方是它可能默认理想网络、理想数据和理想用户流程。因此我把“提出建议”和“证明完成”分开:前者可以让 AI 加快,后者必须由代码、测试、截图和公网访问共同证明。
