

 2601_FZU_SE

102400116-黄博文-软件工程实践第二次作业
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
软件工程实践第二次作业——与AI结对编程(顶会热词统计)
| 这个作业属于哪个课程 | https://bbs.csdn.net/forums/2601_CS_SE_FZU |
|---|---|
| 这个作业要求在哪里 | 软件工程实践第二次作业——与AI结对编程(顶会热词统计) |
| 这个作业的目标 | 与AI结对完成顶会热词统计平台:需求分析(NABCD)、原型设计、Web全栈实现、云部署,并完整记录人机协作过程 |
| 其他参考文献 | 《构建之法》第3、4、8章;OpenAlex API 文档;Element Plus 官方文档;ECharts 官方文档 |
@
目录
- 软件工程实践第二次作业——与AI结对编程(顶会热词统计)
- 1、git仓库链接、代码规范链接和AI工具说明
- 2、PSP表格
- 3、NABCD需求分析
- 4、原型设计与原型链接
- 5、成品展示
- 6、结对人机讨论过程描述
- 案例A:AI 辅助需求分析与统计口径设计(需求阶段)
- 案例B:AI 辅助编码——关键词抽取算法的两轮迭代(编码阶段)
- 案例C:AI 辅助调试——三个真实 Bug 的修复过程(调试阶段)
- 7、设计实现过程
- 功能结构图
- 关键设计决策
- 8、代码说明
- 8.1 关键词抽取:n-gram + POS 词性白名单(phrases.py)
- 8.2 跨短语包含去重:倒排索引加速(hot_topics.py)
- 8.3 增长率计算:末年无数据时向内收缩(hot_topics.py)
- 8.4 API 层三级缓存与兜底预热(api/hot_topics.py)
- 9、心路历程、收获
- 10、对AI结对伙伴的评价
- 附:检查清单自核
1、git仓库链接、代码规范链接和AI工具说明
| 项目 | 内容 |
|---|---|
| CodeArts 仓库地址 | 仓库地址 |
| 代码规范 | codestyle.md,基于 Google Python Style Guide 与 Vue.js 官方风格指南 改编 |
| 部署访问链接 | http://101.37.209.164/ |
| dev 分支 | 开发在 dev 分支进行,功能完成后合并回 main;Release 1.0.0 【请按实际仓库情况核对 commit 次数(≥15次)】 |
AI 编程助手说明
| 项目 | 说明 |
|---|---|
| 工具 | Trae(AI IDE,内置 Claude 模型) |
| 主要用途 | 需求头脑风暴、原型布局与配色讨论、代码生成与重构、Bug 调试、测试用例编写、Git 提交信息生成 |
| 协作方式 | 我负责需求判断、方案取舍、代码审查与验证;AI 负责初稿生成、方案枚举、错误排查。所有 AI 生成代码均经过我阅读理解 + pytest 测试验证后才合入 |
数据来源声明:论文数据来自 OpenAlex 开放学术 API(仅用于课程教学)。选择 OpenAlex 而非 DBLP 的原因:DBLP 存在反爬限制且缺少摘要与关键词字段,无法支撑热词统计(这一踩坑过程见第 6 节案例 C)。
2、PSP表格
| PSP | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | 30 | 25 |
| • Estimate | • 估计这个任务需要多少时间 | 30 | 25 |
| Development | 开发 | 1560 | 1890 |
| • Analysis | • 需求分析(包括学习新技术:OpenAlex API、ECharts 动画) | 120 | 150 |
| • Design Spec | • 生成设计文档(NABCD + 统计口径设计) | 60 | 70 |
| • Design Review | • 设计复审(和AI评审原型与架构) | 30 | 40 |
| • Coding Standard | • 代码规范(制定 codestyle.md) | 30 | 25 |
| • Design | • 具体设计(三层缓存、分层架构、数据库 Schema) | 90 | 120 |
| • Coding | • 具体编码(爬虫管道、5大功能、附加功能) | 900 | 1050 |
| • Code Review | • 代码复审(AI生成代码逐段审查) | 120 | 150 |
| • Test | • 测试(pytest 单元测试 103 项 + 浏览器手工测试) | 120 | 180 |
| • Test Report | • 测试报告 | 30 | 25 |
| • Size Measurement | • 计算工作量 | 20 | 15 |
| • Postmortem | • 事后总结 + 过程改进计划 | 60 | 65 |
| Development合计 | 1560 | 1890 | |
| 合计 | 1590 | 1915 |
偏差分析:实际比预估多约 20%,主要来自三处——①测试环节:关键词抽取算法迭代了 3 版(n-gram → POS 过滤 → 双重去重),每版都要回归 103 个测试;②爬虫方案试错:DBLP 方案失败后切换 OpenAlex 重写了抓取管道;③性能调优:全量热词计算首请求 26s → 三层缓存优化到秒级,超出了预期工作量。
3、NABCD需求分析
以下分析由我从"用户、爬虫工程师、前端开发者"三个角色向 AI 提问头脑风暴,AI 输出初稿后由我逐条验证合理性、删掉伪需求(如"论文自动翻译"——超出三大顶会范围且偏离统计主线)后整理而成。
N(Need,需求)
小刚是计算机视觉领域的新人,想通过阅读论文了解研究现状。但 CVPR 2025 年投稿 13008 篇、录取 2878 篇,加上 ICCV、ECCV,仅靠人工逐篇阅读总结研究热点几乎不可行。他需要一个能自动爬取三大顶会论文、统计热门方向、并以直观可视化呈现的平台。
A(Approach,做法)
- 数据层:通过 OpenAlex API 按 DOI 前缀批量抓取 CVPR/ICCV/ECCV 2022–2026 论文的标题、摘要、关键词、原文链接,清洗后入库 SQLite;
- 算法层:自研"短语级加权词频"抽取算法——n-gram 滑窗 + NLTK POS 词性白名单(仅保留名词/形容词/专有名词,消灭跨边界碎片)+ 三层字段权重(标题×3、摘要×2、关键词×1、单字词×0.5)+ 停用词/通用词过滤 + 双重包含去重;
- 展示层:Top10 热词榜(含增长率、年度热度分布迷你图)、关键词力导向图谱(点击节点查看相关论文)、热度走势折线动画、年度热词演变 Bar Race 动图;
- 工程层:Flask 分层架构(路由/服务/数据三层)+ 三级缓存 + 103 项 pytest 单元测试。
B(Benefit,好处)
- 用户从"逐篇阅读数万篇论文"变成"打开网页 3 秒看到 Top10 热点";
- 热词榜不只给排名,还给出增长率(该方向是升温还是降温)与年度热度分布,能回答"这个方向还值得入吗";
- 关键词双语展示(英文+中文),降低 CV 术语的理解门槛;
- 年份/会议任意组合筛选,满足"对比 ICCV 与 CVPR 风格差异"这类细分需求。
C(Competitors,竞争)
- 竞品1:人工文献综述 / 导师推荐——准确但耗时数周,且无法量化"热"度;
- 竞品2:Connected Papers / Semantic Scholar——覆盖全领域、功能强,但没有针对三大 CV 顶会的"热词榜单 + 演变动画"视图,中文用户体验差;
- 竞品3:DBLP 检索——数据权威但只能列清单,无统计、无可视化,且缺摘要。
D(Data,数据)
- 数据源:OpenAlex 学术图谱 API(免费、无严格反爬、字段完整),按 DOI 前缀(如 CVPR
10.1109/CVPR、ECCV 各 LNCS 卷前缀)批量定位三大顶会论文; - 已入库 1041 篇论文(CVPR 485 / ICCV 315 / ECCV 241),覆盖 2022–2026 五个年份;
- 统计口径在博客与平台"了解更多"页面均明确标注:
热度 = Σ(字段权重 × 词频),详见第 7 节。
4、原型设计与原型链接
原型工具:墨刀(MockingBot)。
与AI协作设计的方式:
- 我先向 AI 描述用户故事与 5 大功能,让 AI 从信息架构角度列出页面清单与跳转关系初稿;
- 我在墨刀中搭建骨架,再就首页布局(热词榜放首屏还是图谱放首屏)、配色(AI 建议学术蓝紫渐变,采纳并落地为"靛紫主题")与 AI 迭代讨论;
- AI 生成的"了解更多"页面文案(三大顶会介绍 + 统计口径说明)我人工核对会议官方数据后修正了 CVPR 录用率数字。
原型链接:https://1yka7mup.site.modao.ink/index.html
原型页面清单(共 7 页):
| 页面 | 对应功能 | 核心交互 |
|---|---|---|
| 首页/热门方向总览 | 功能3 | Top10 热词榜 + 年份/会议/数量筛选 + 增长率排序 |
| 关键词图谱 | 功能4 | 力导向图缩放拖拽,点击节点弹出相关论文列表 |
| 热度走势 | 功能5 | 多关键词折线 + 播放按钮逐年推进动画 |
| 年度热词演变(附加) | Bar Race | 播放/暂停/上一年/下一年/进度条跳转 |
| 论文管理 | 功能2 | 增删改查、精确/模糊搜索、分页 |
| 论文爬取 | 功能1 | 按会议+年份批量爬取 / 按标题搜索单篇,预览后勾选入库 |
| 了解更多(附加) | 顶会背景与统计口径 | 图文介绍 |
交互规则(AI 梳理数据流转后由我确认):筛选条件变化 → 触发对应 API → loading 遮罩 → 渲染图表;图谱节点点击 → 打开右侧抽屉 → 拉取该关键词下论文列表;爬取 → 预览列表(标记已存在/新增)→ 勾选入库 → 结果摘要卡片。
5、成品展示
以下截图对应实际运行中的系统。部署链接:http://101.37.209.164/
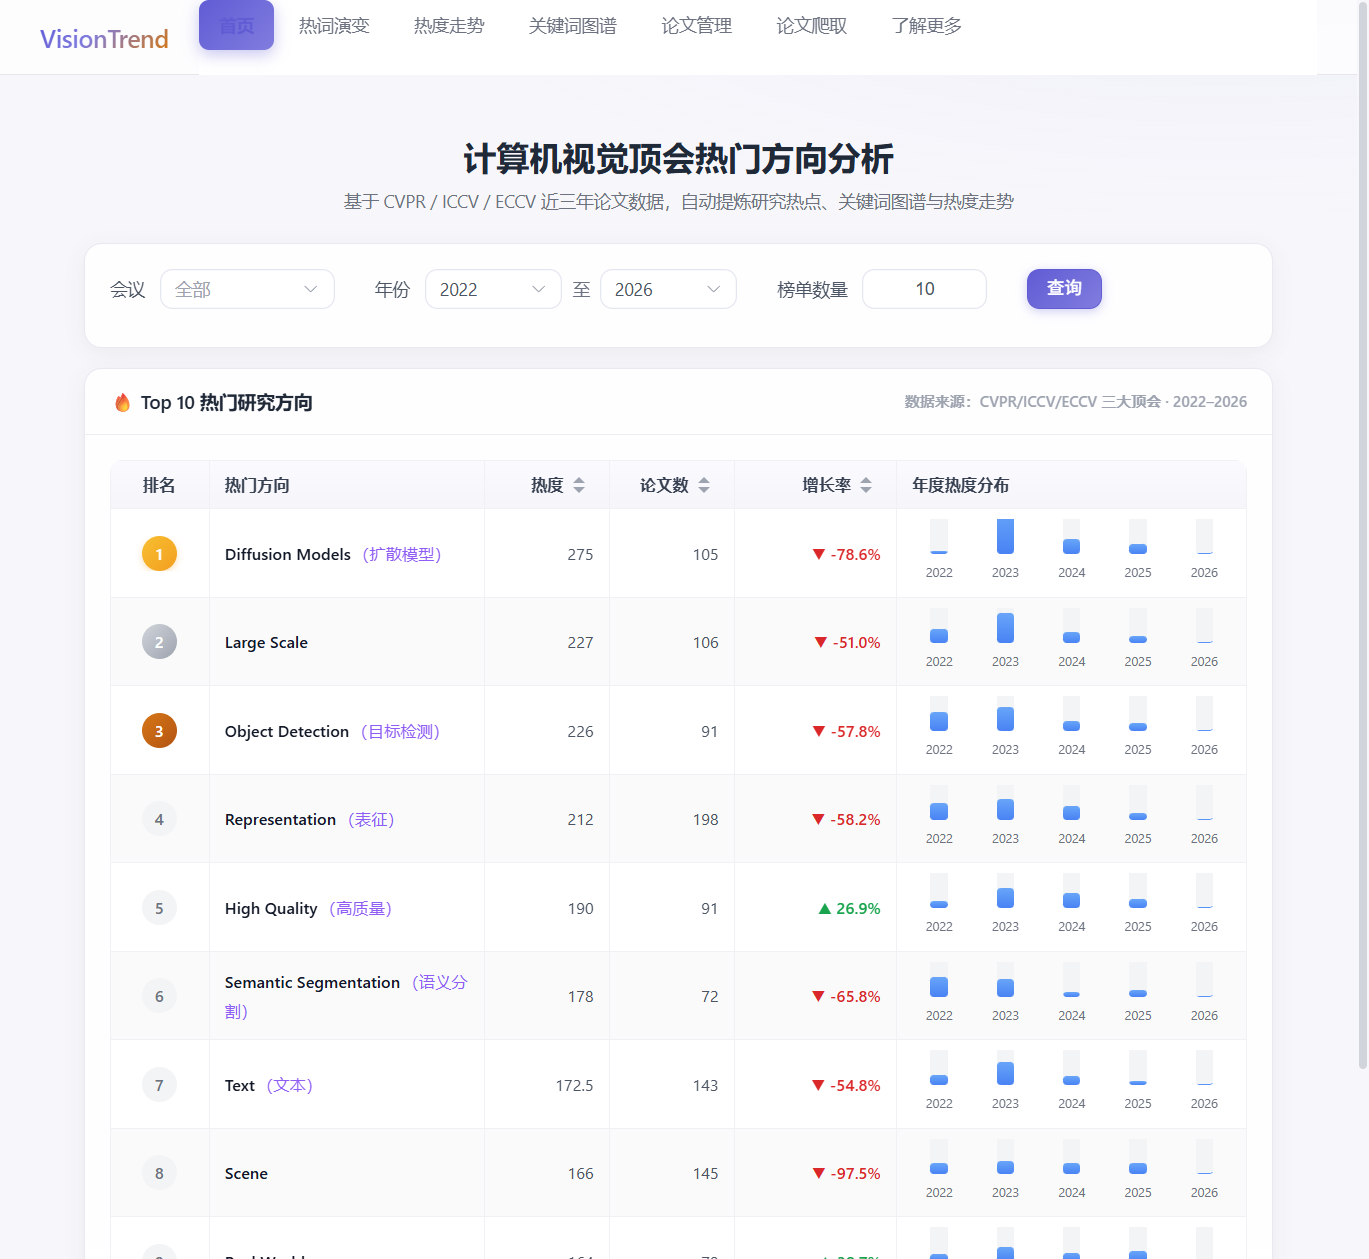
① 首页 · Top10 热门方向榜
显示热度、论文数、增长率(▲升温/▼降温)与 2022–2026 年度热度分布迷你柱状图。可见 "diffusion models(扩散模型)" 稳居榜首,"real world" "high quality" 呈上升趋势。
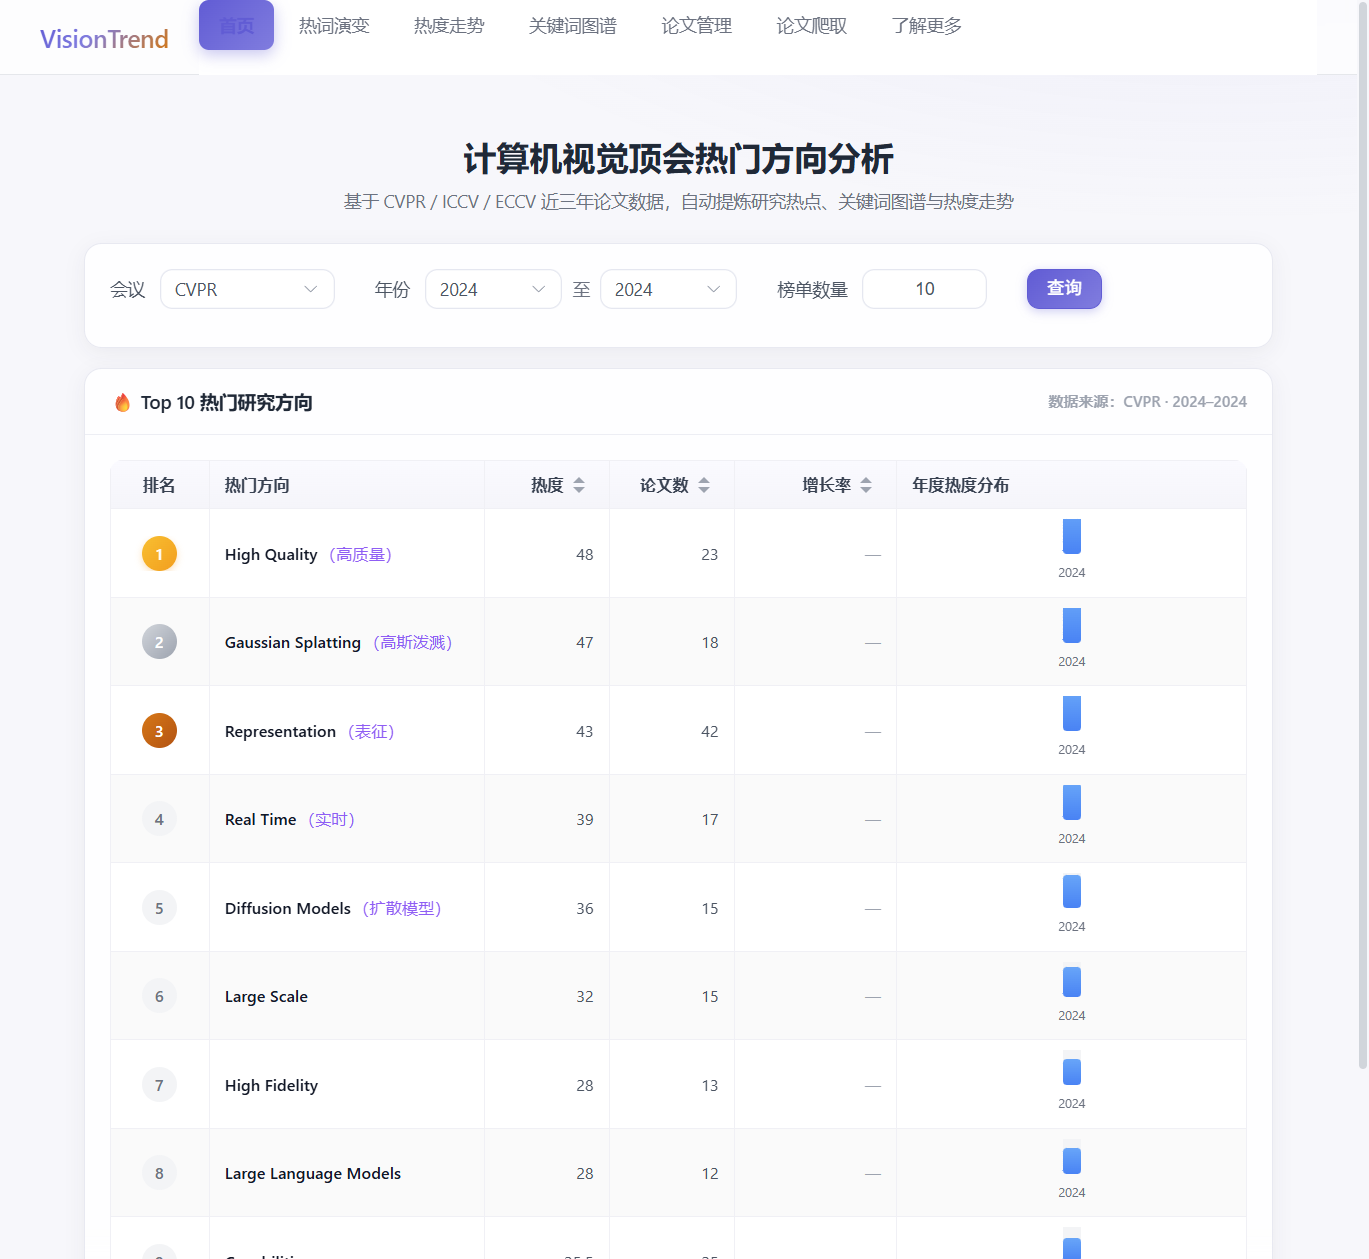
② 年份/会议筛选联动
切换为"CVPR + 2024"后榜单即时刷新:"high quality(高质量)" 居首,"gaussian splatting(高斯泼溅)" 紧随其后位列第二——体现了单年单会视角下的热点差异。
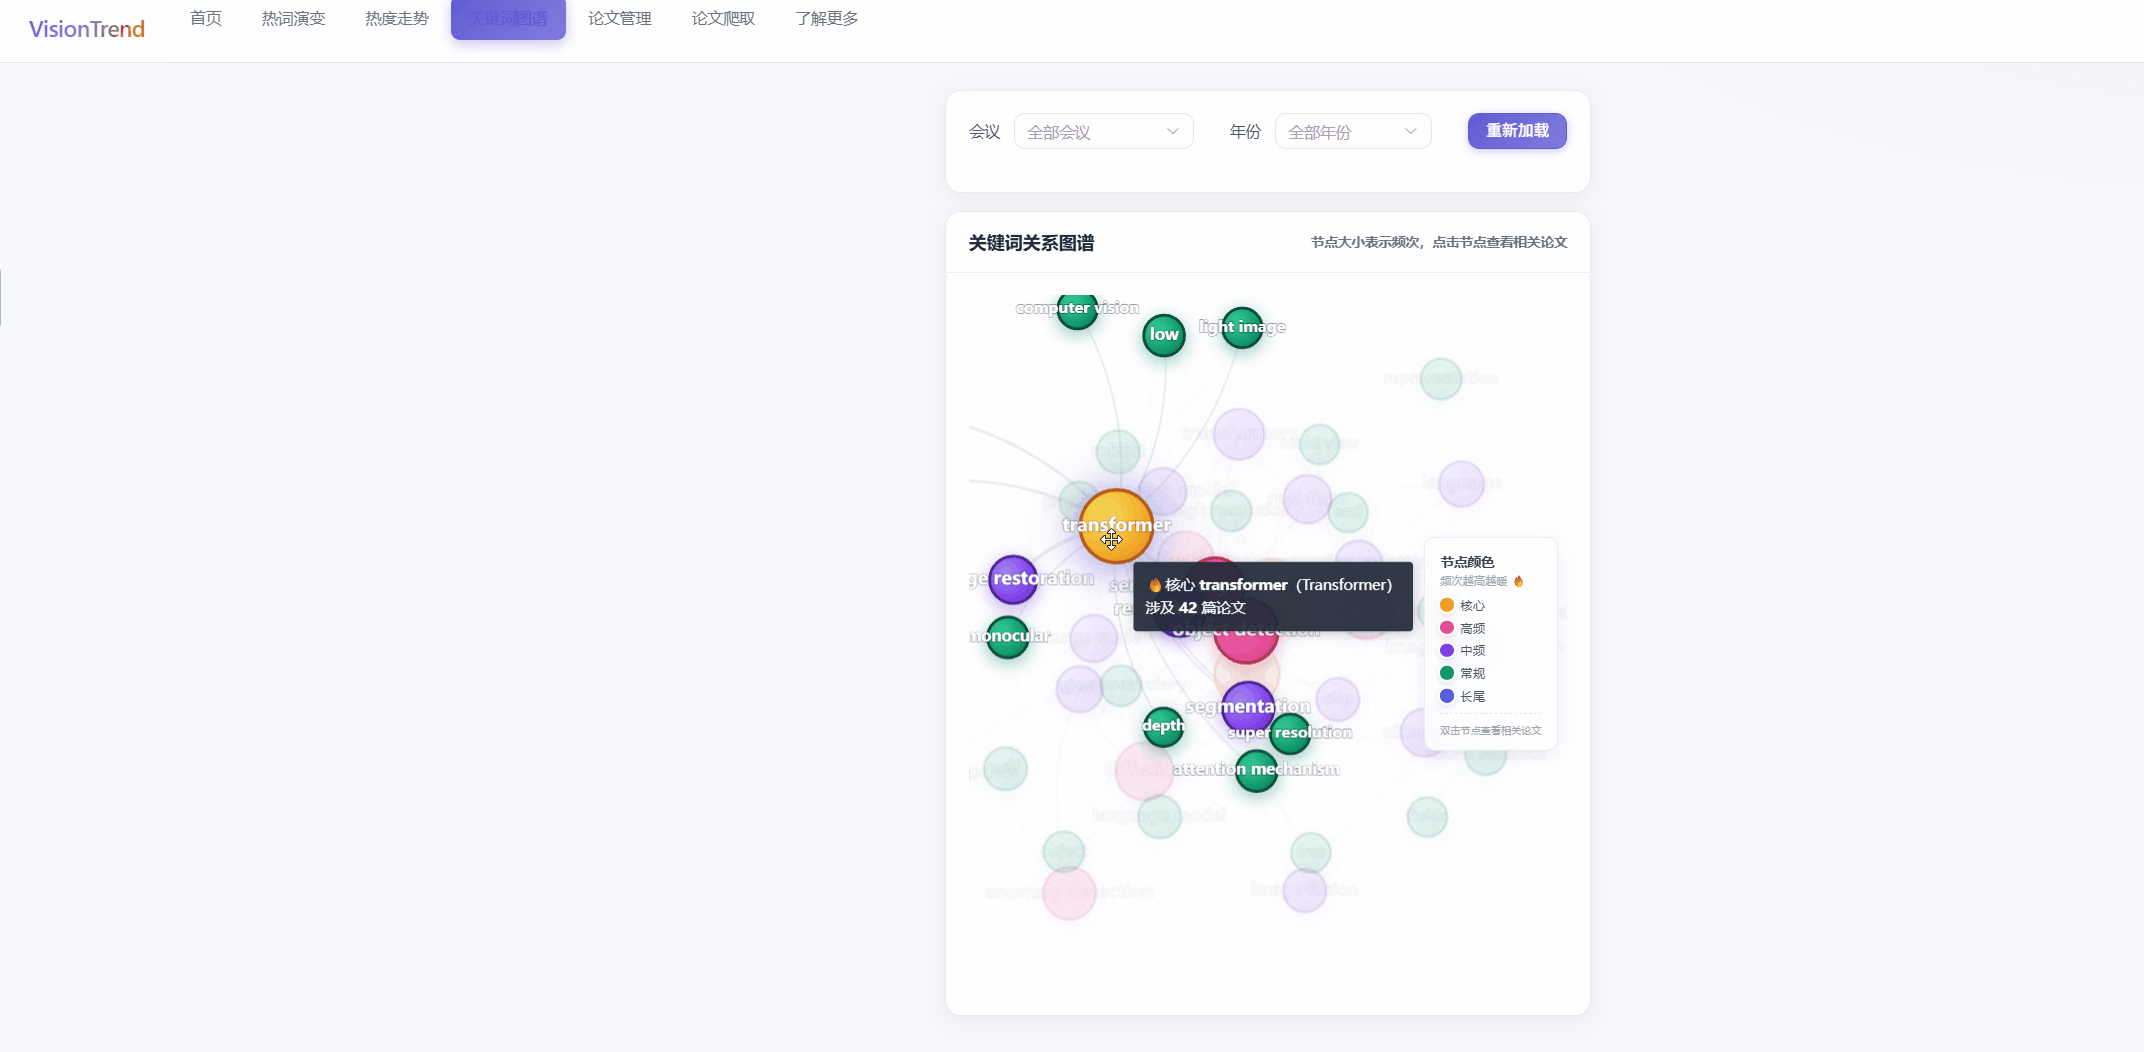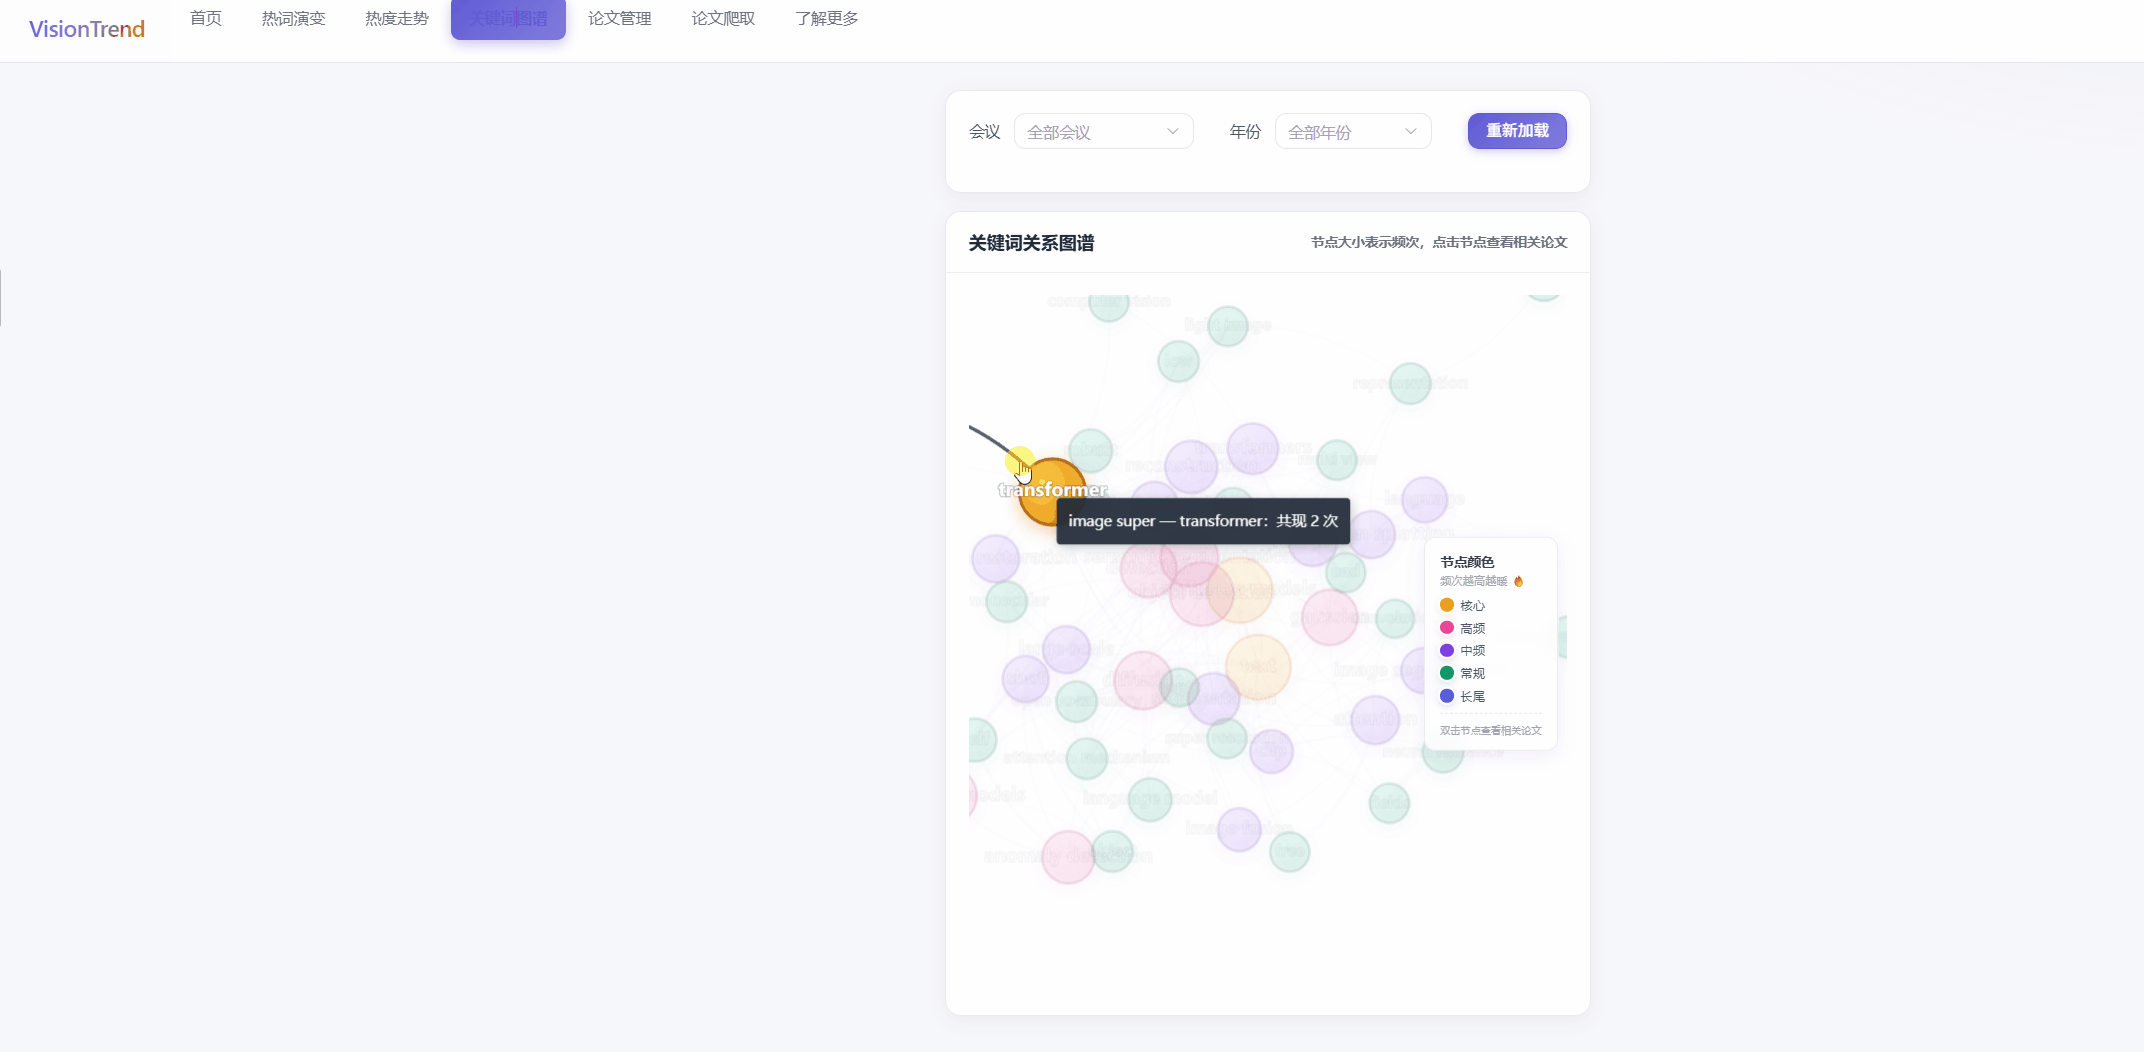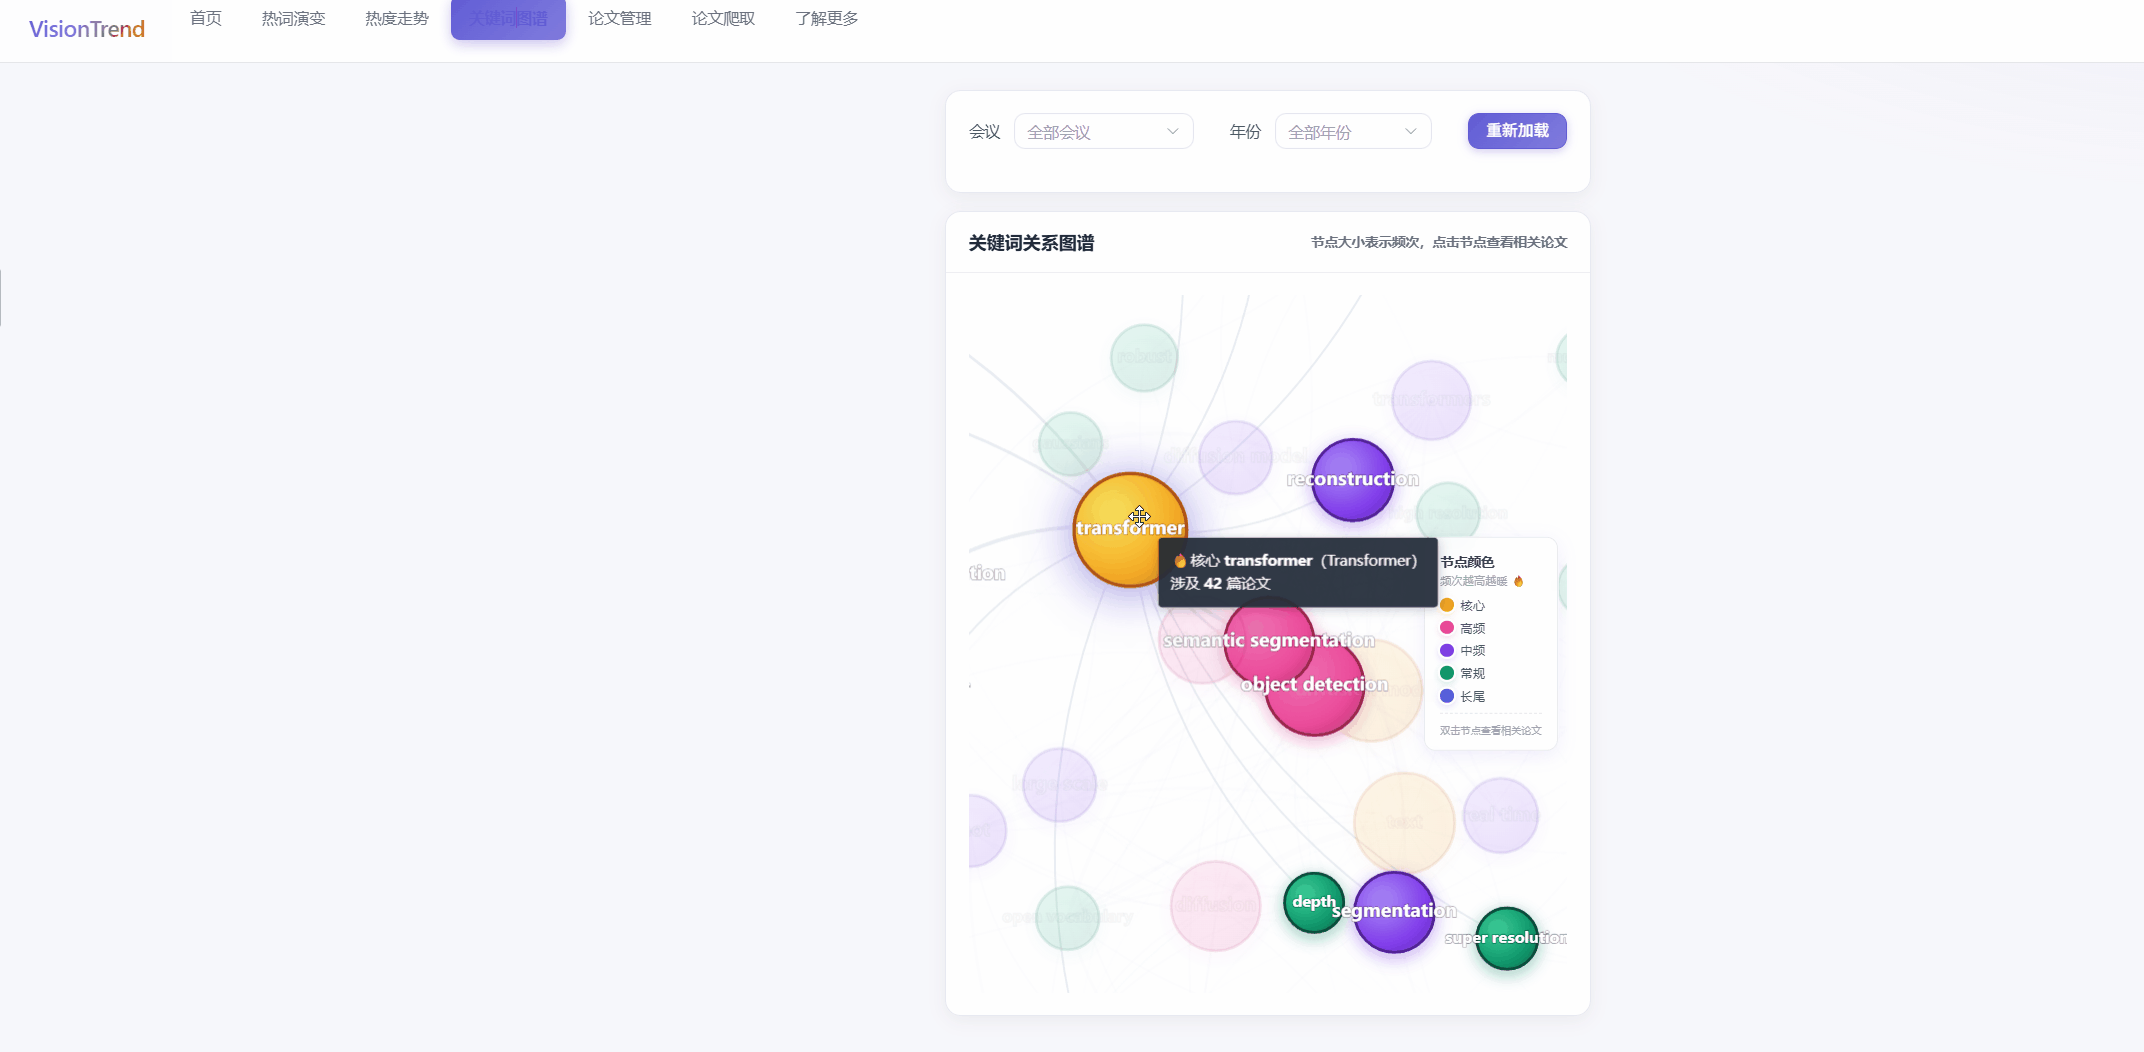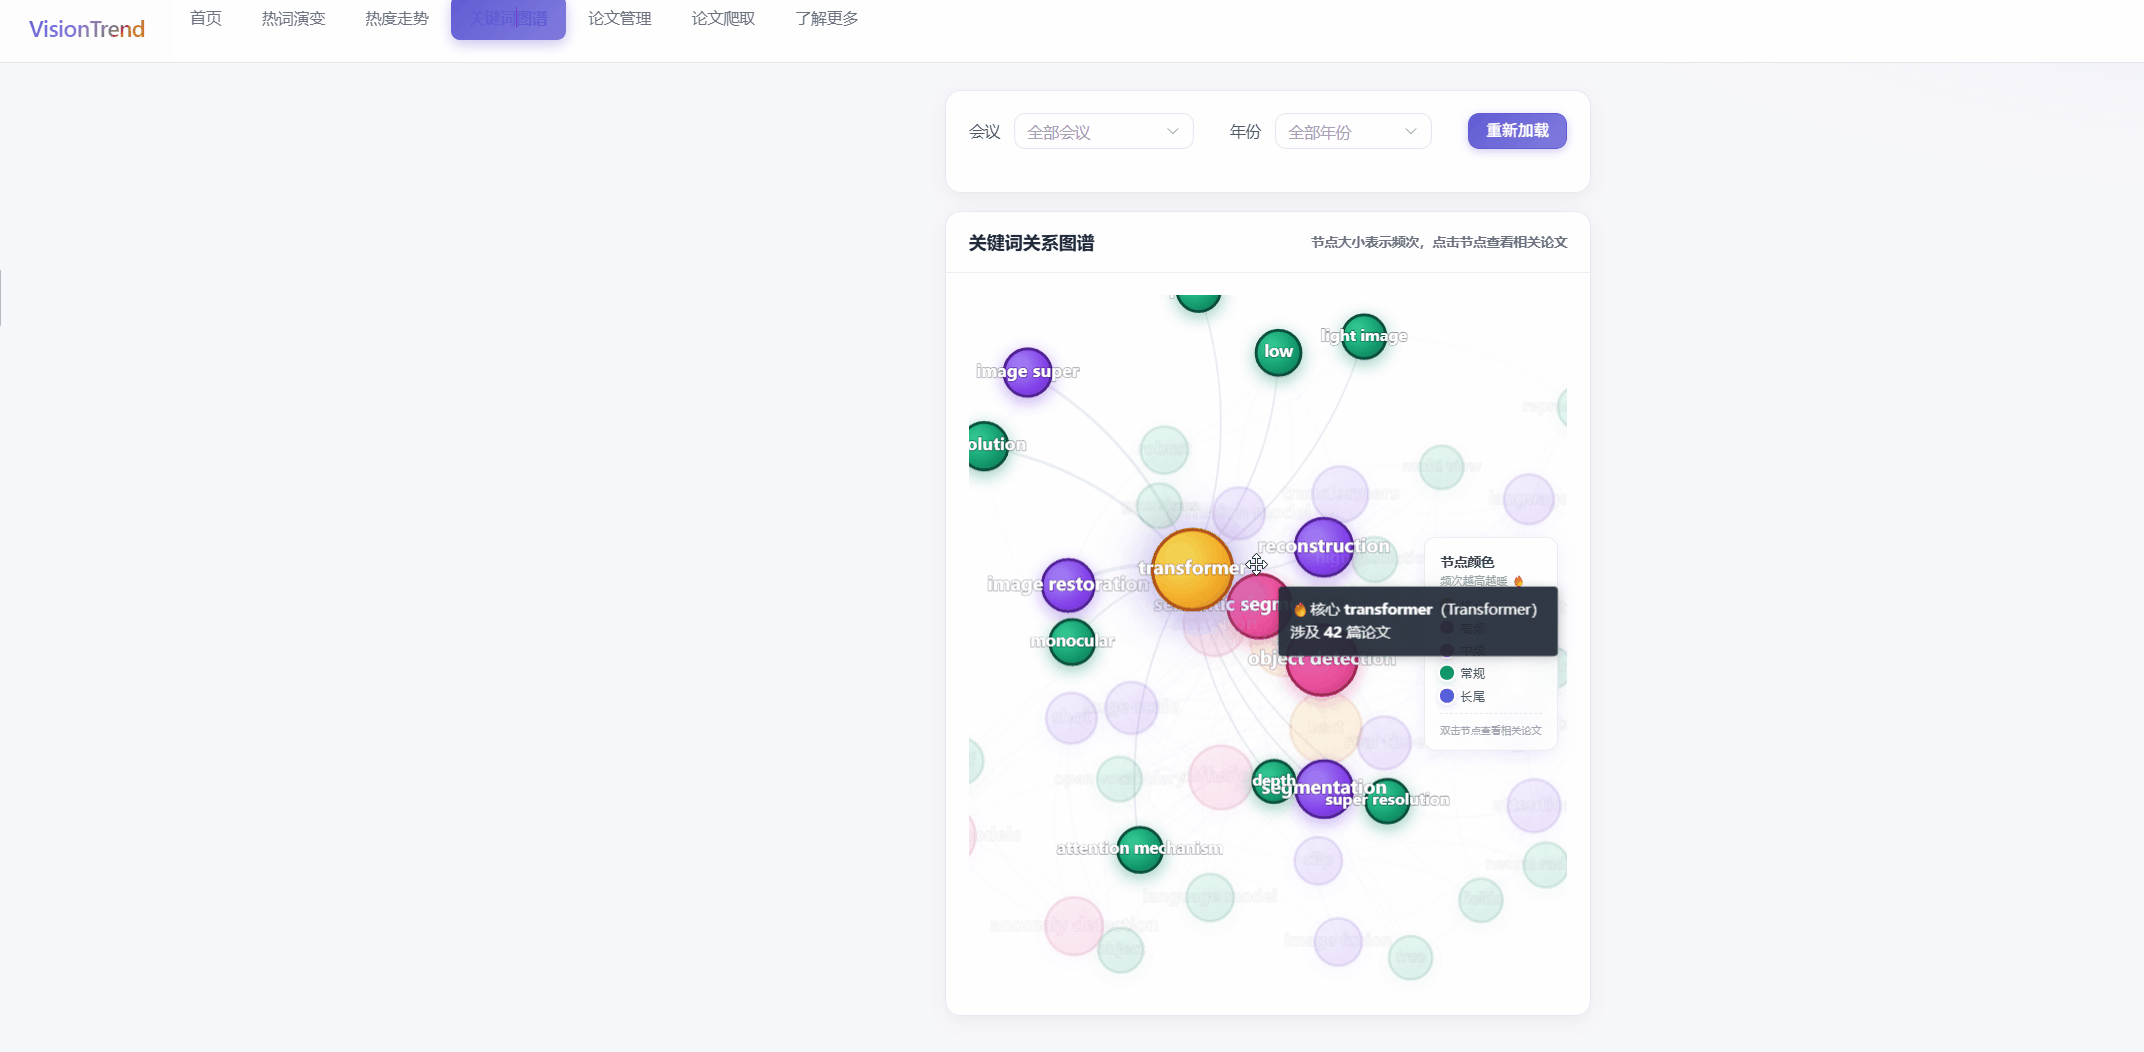
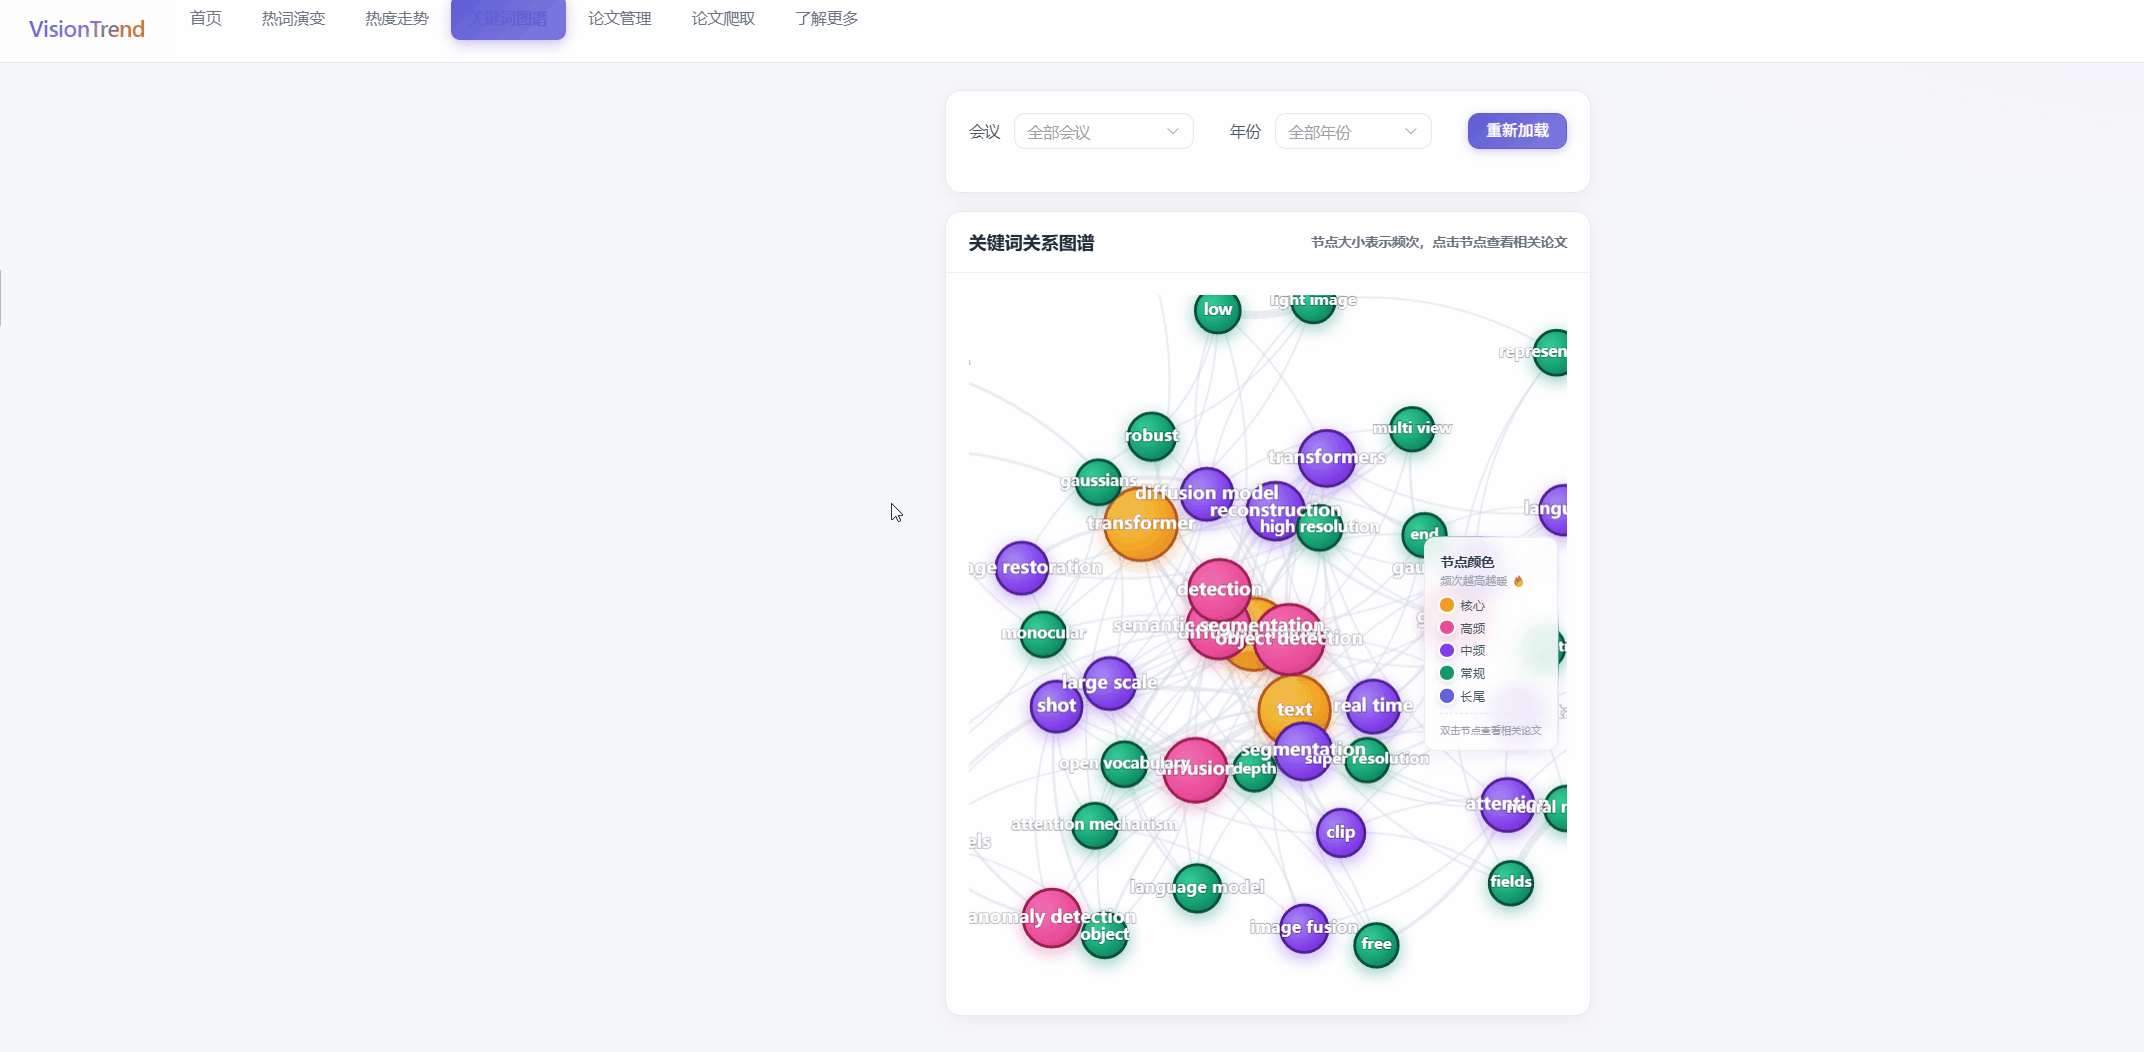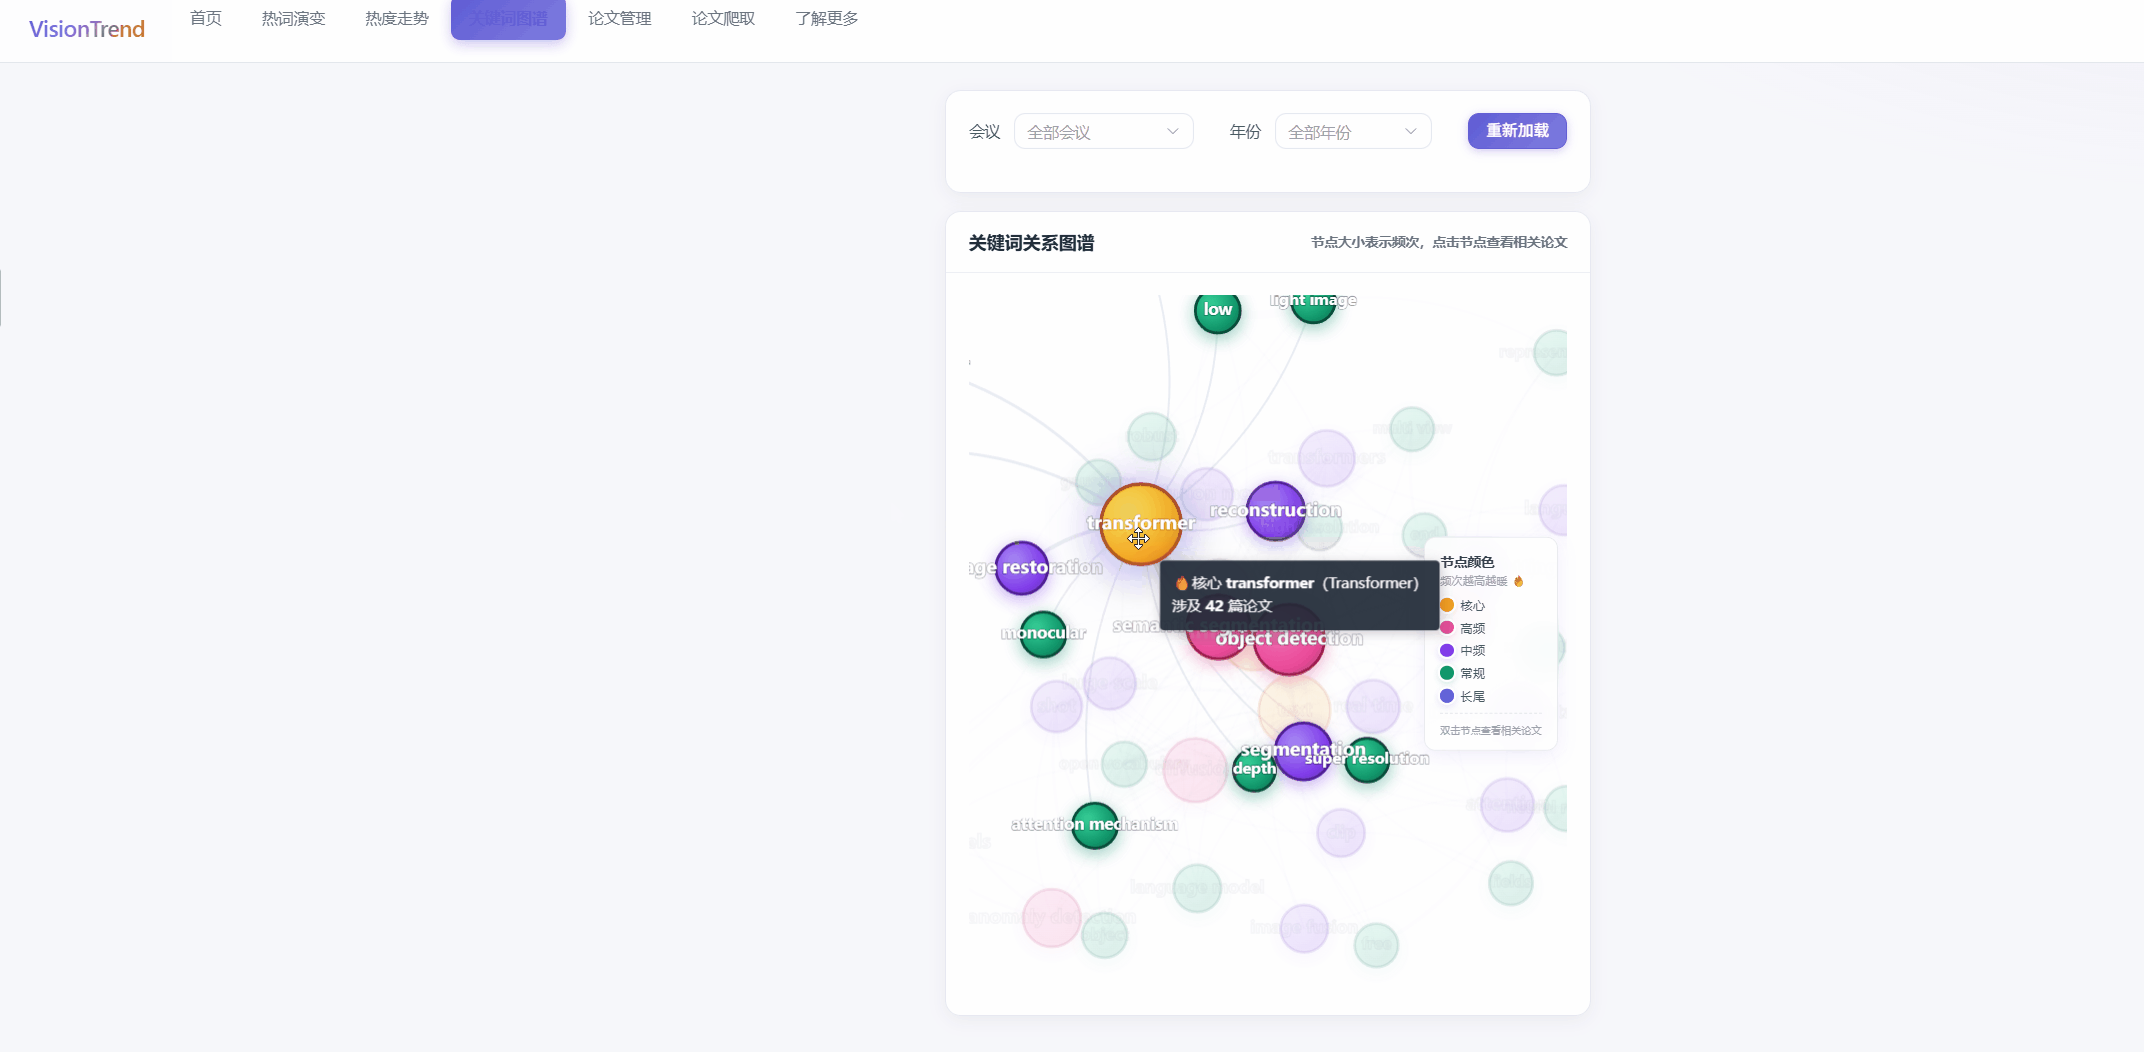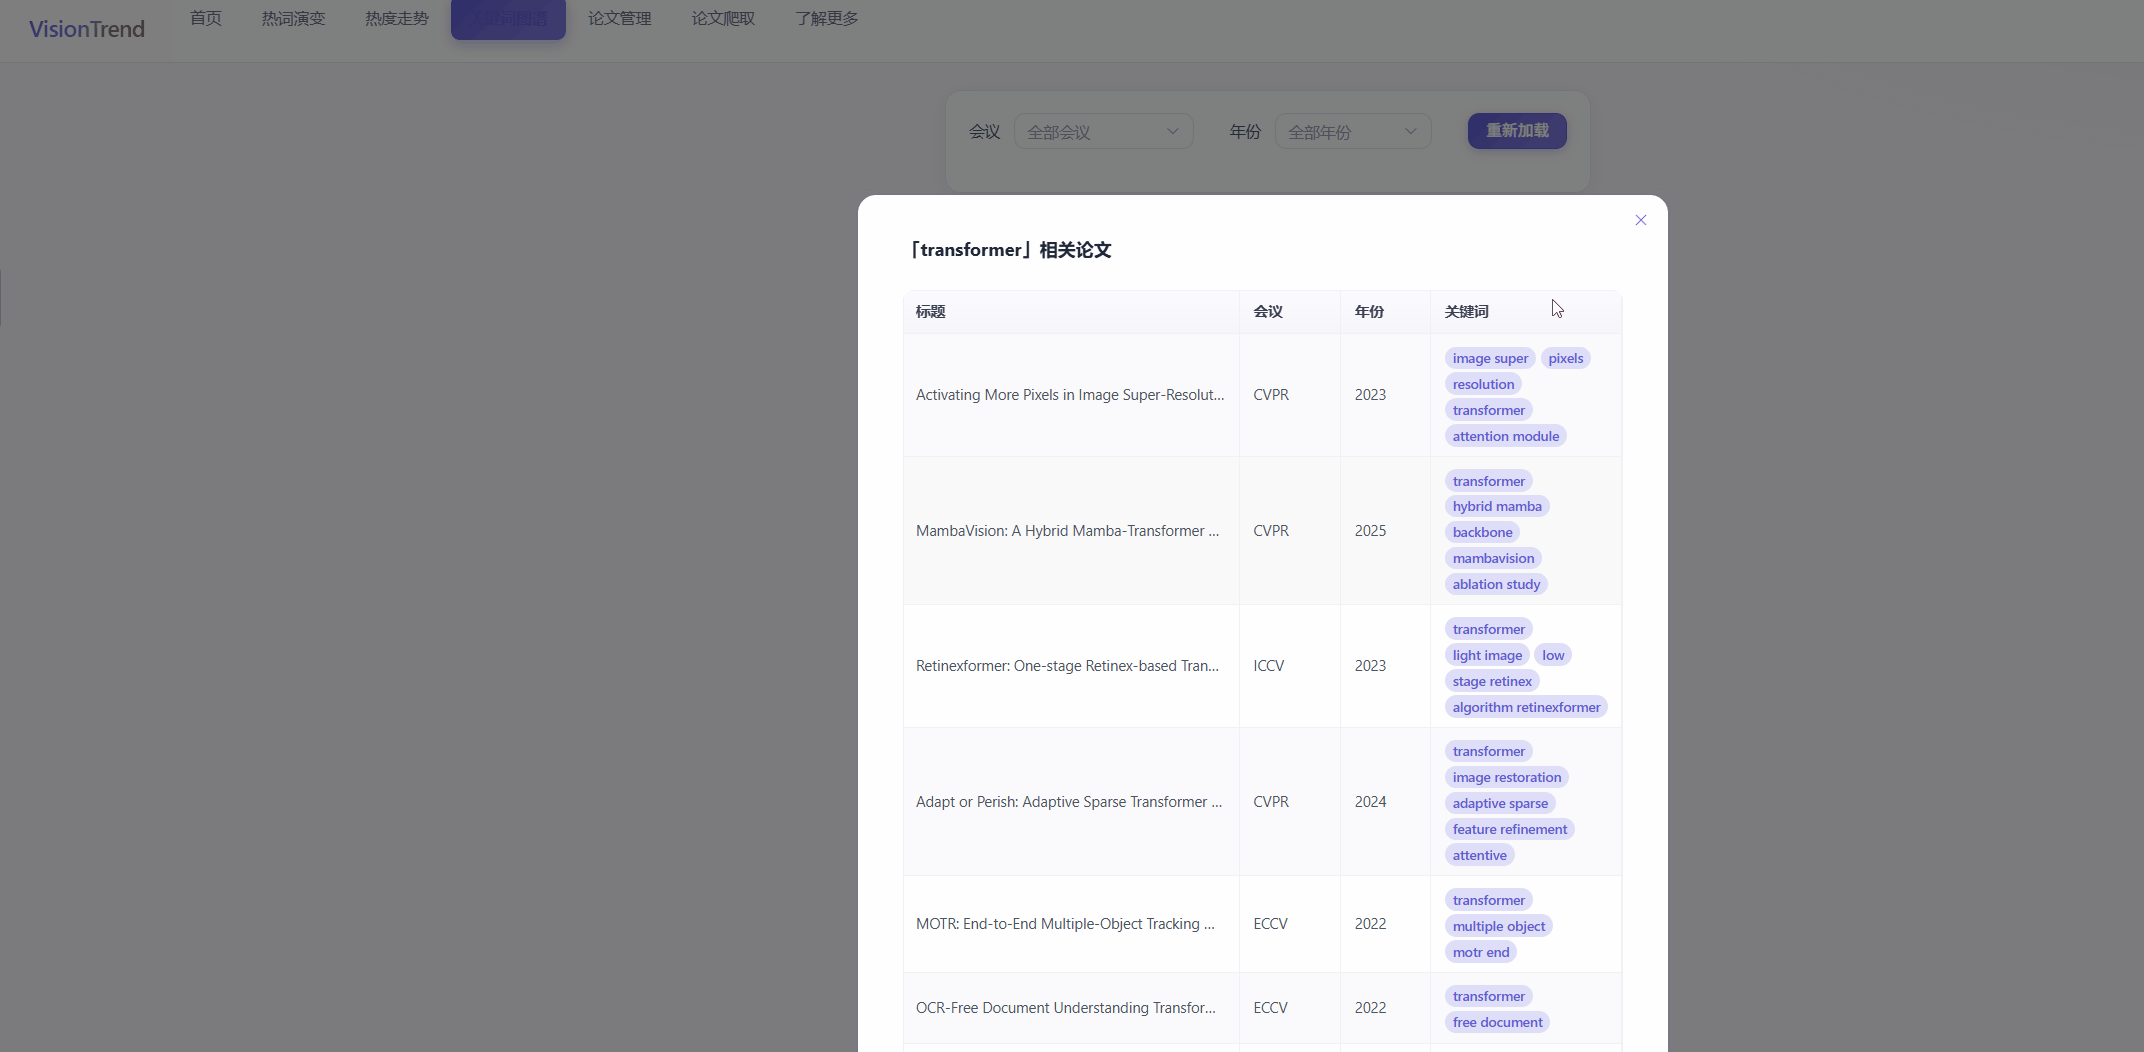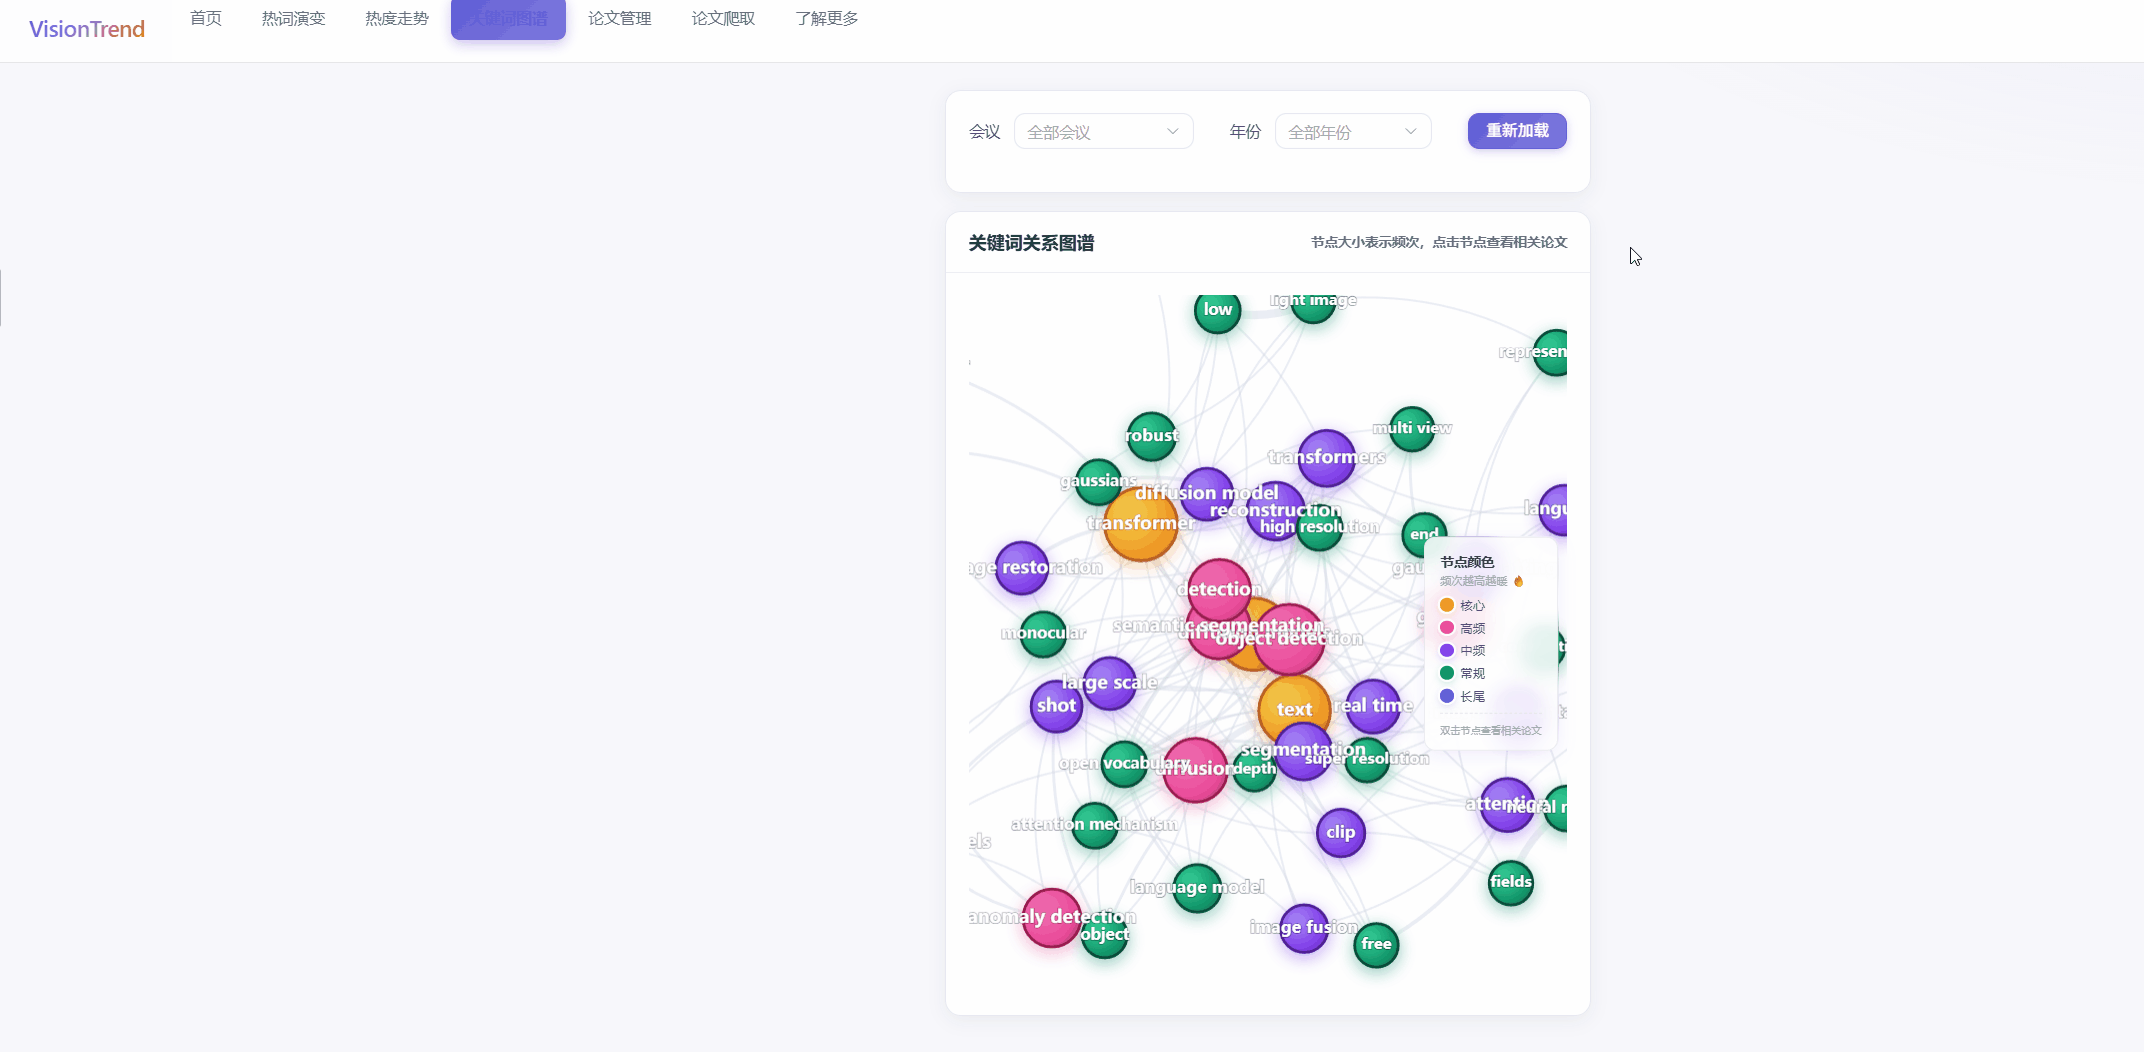
③ 关键词图谱
力导向布局,节点大小表示词频,颜色按频次分 5 档(金/粉/紫/青/蓝,频次越高越暖)。节点支持拖拽与缩放。
④ 点击关键词查看相关论文
点击 "transformers" 节点,弹出该关键词下的论文列表(标题、作者、会议、年份),实现"从热点到论文"的下钻闭环。
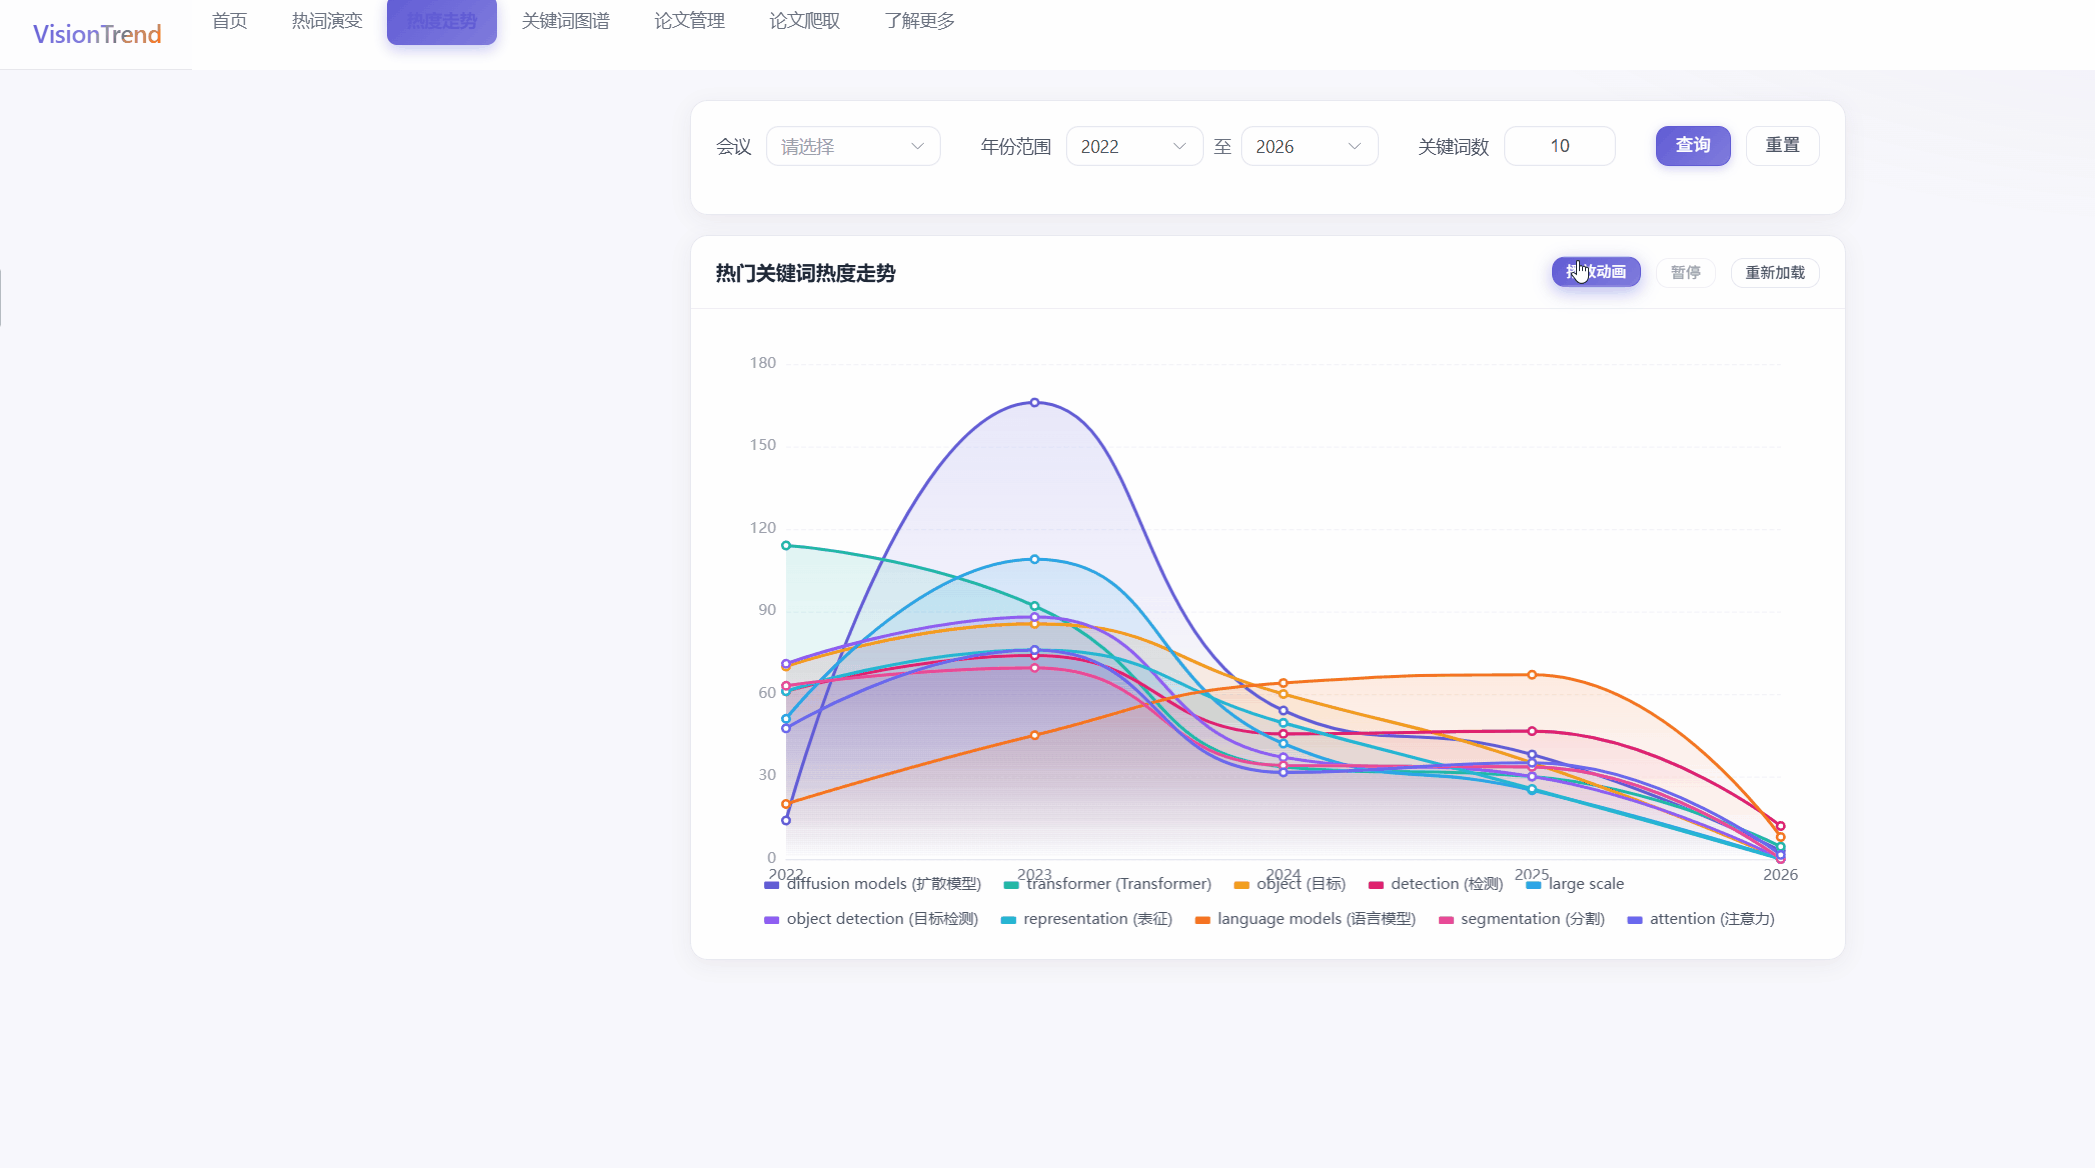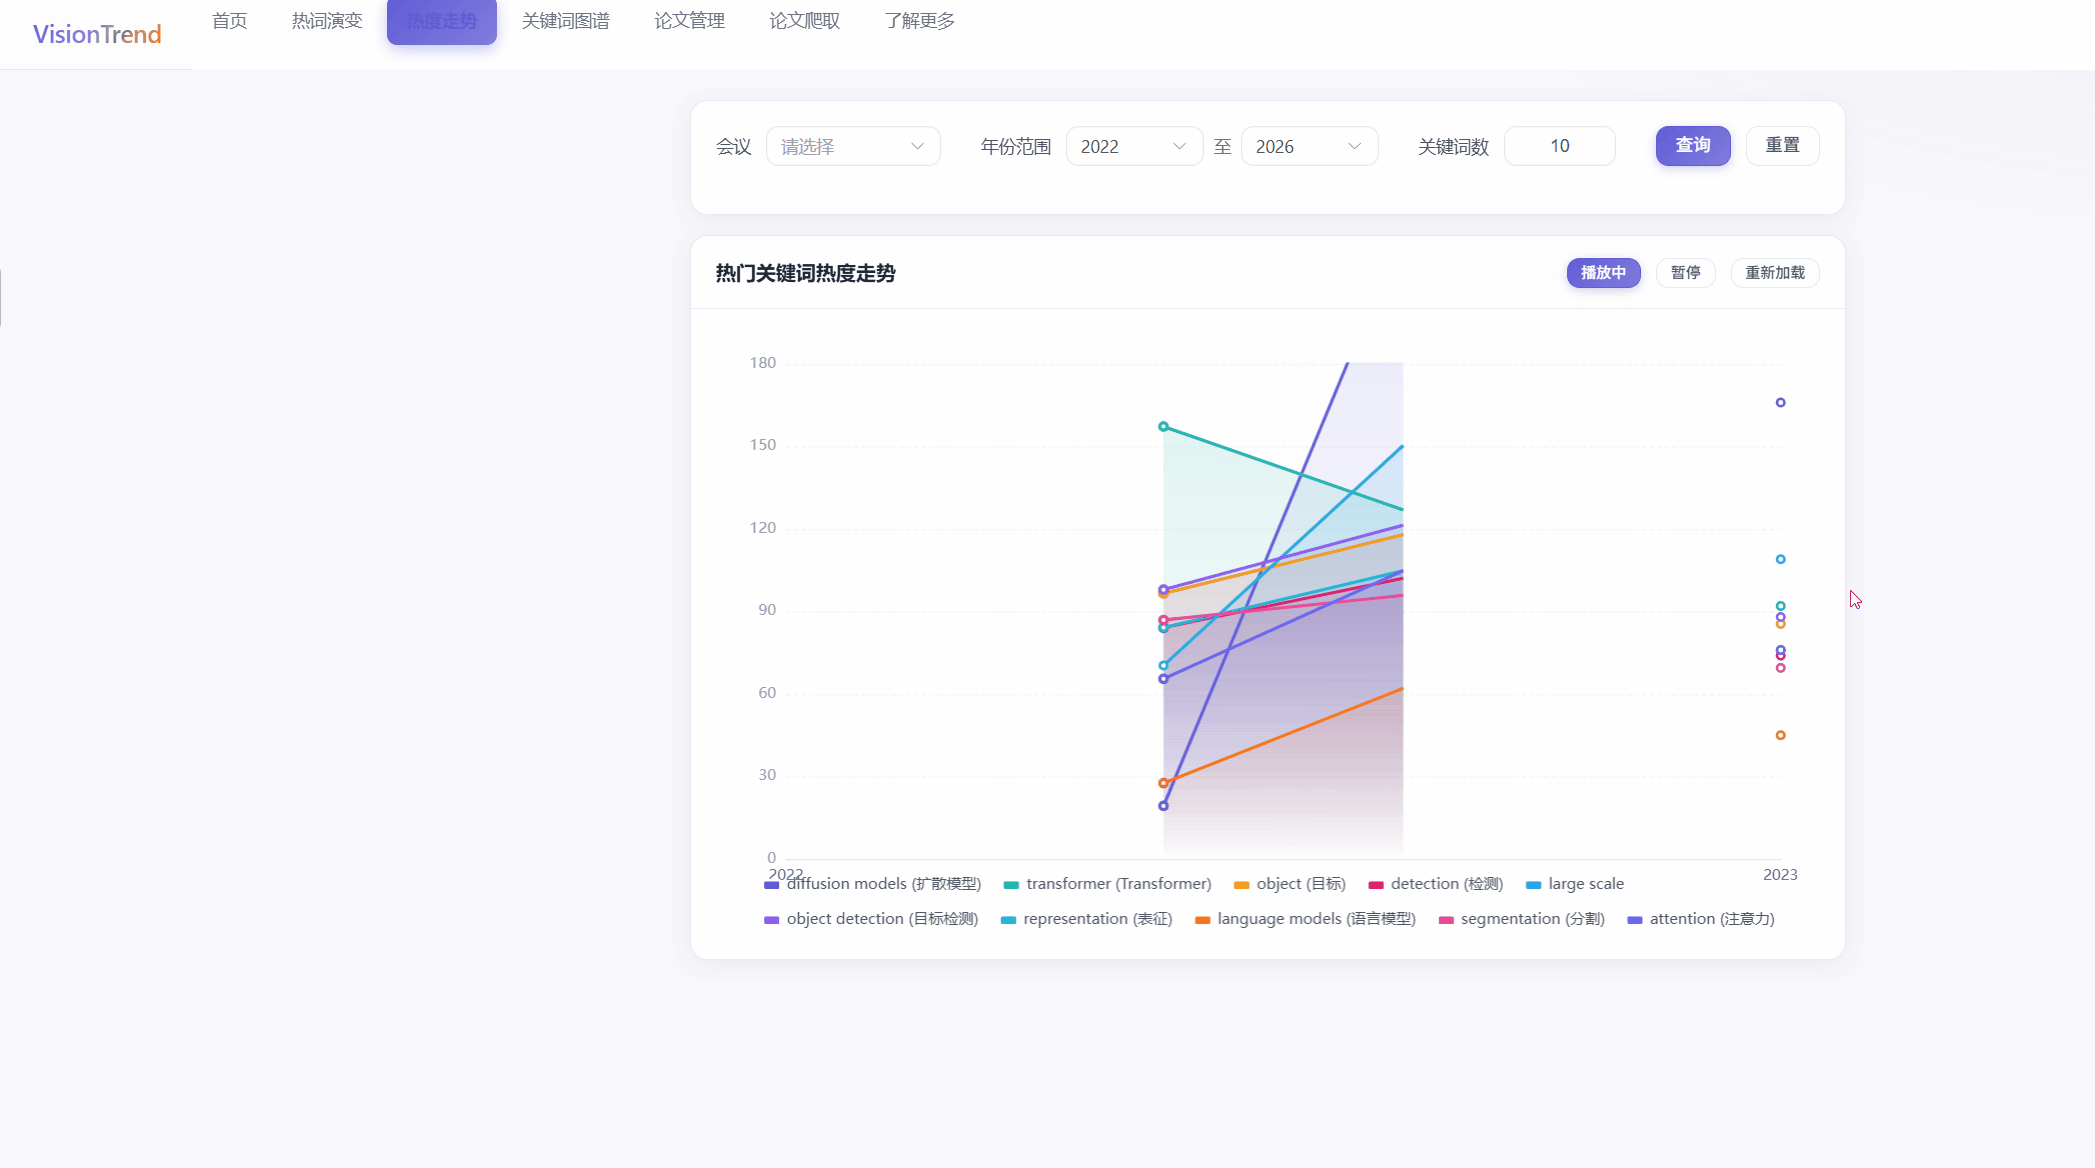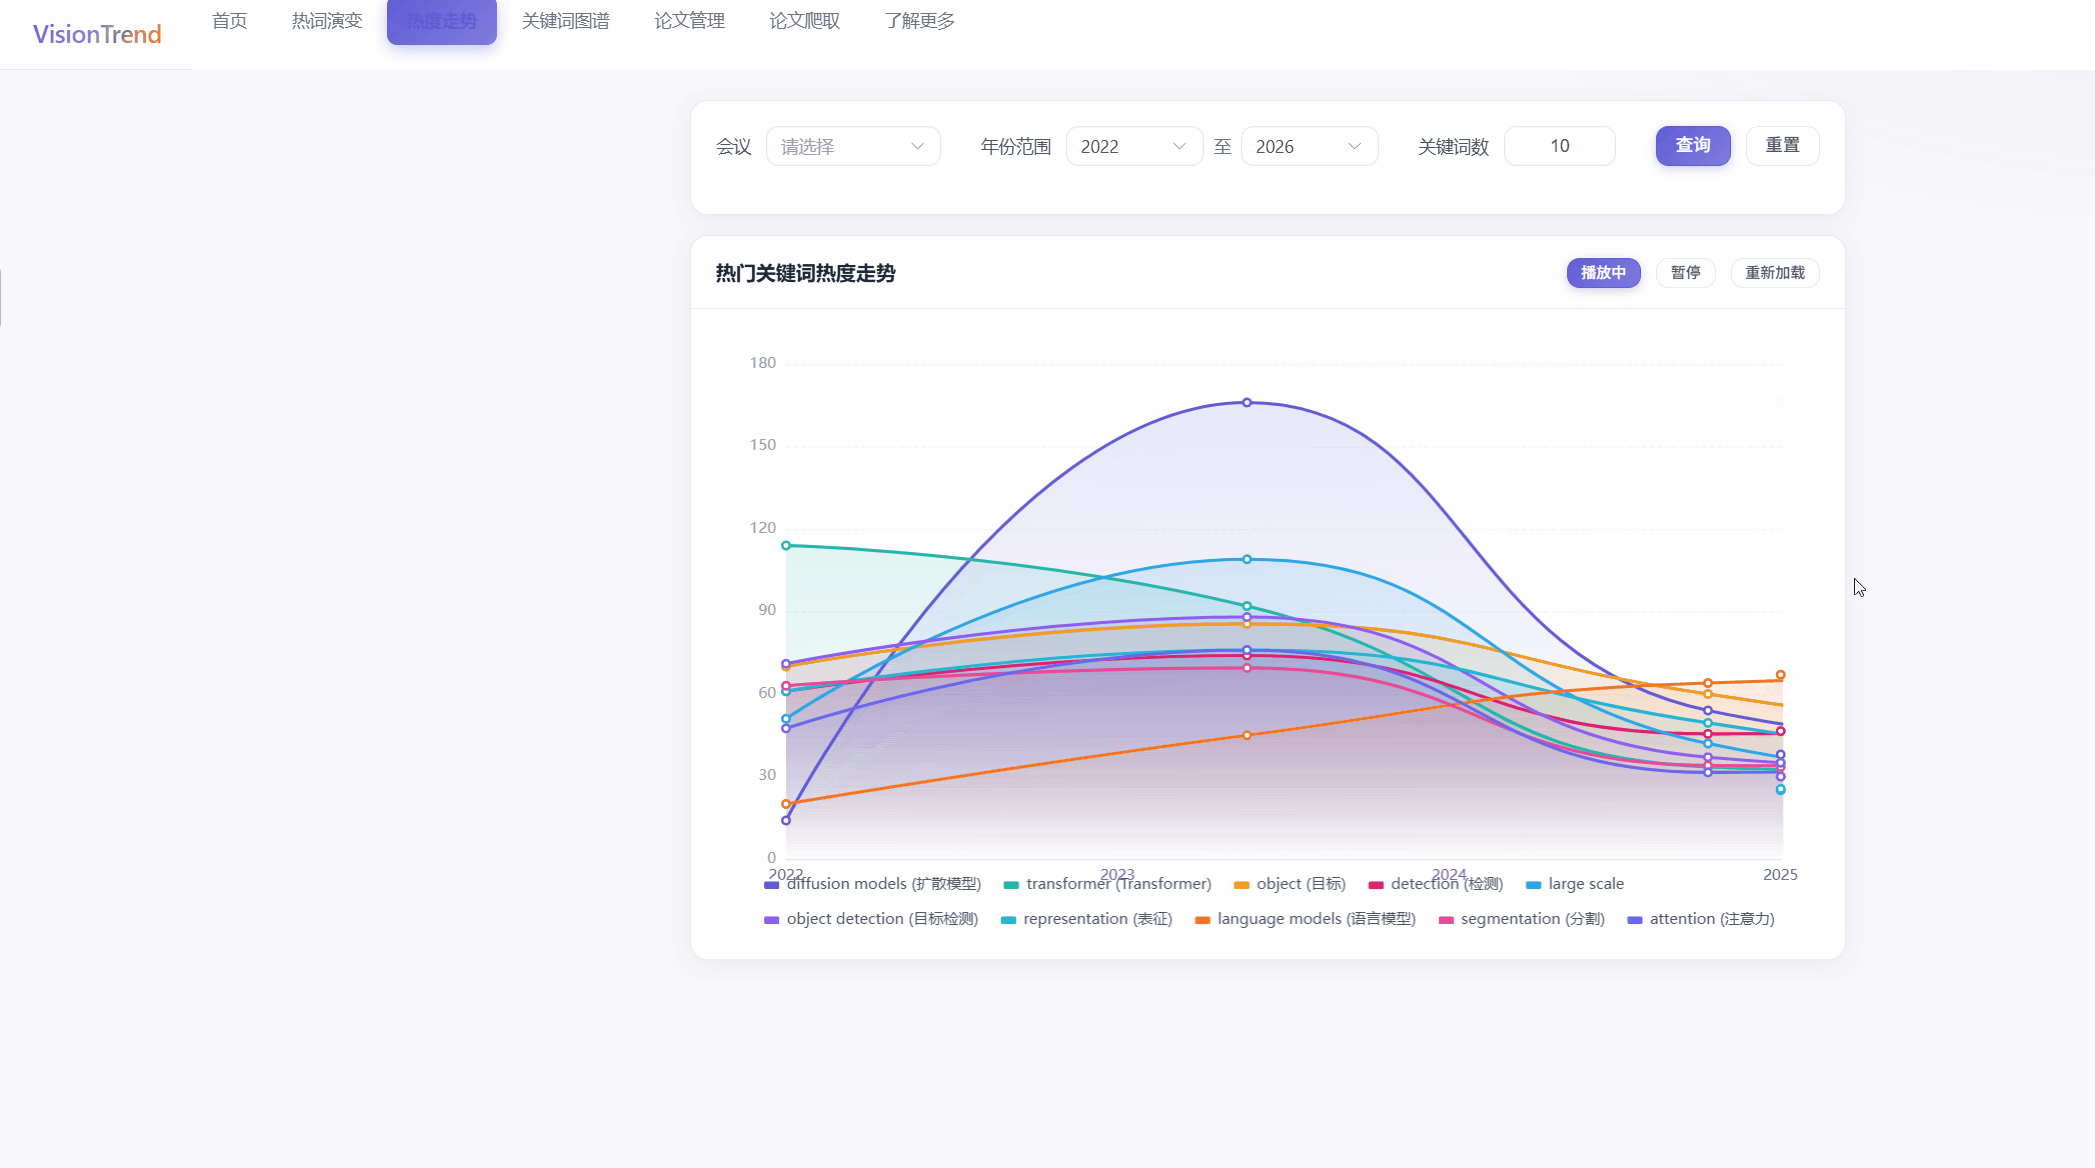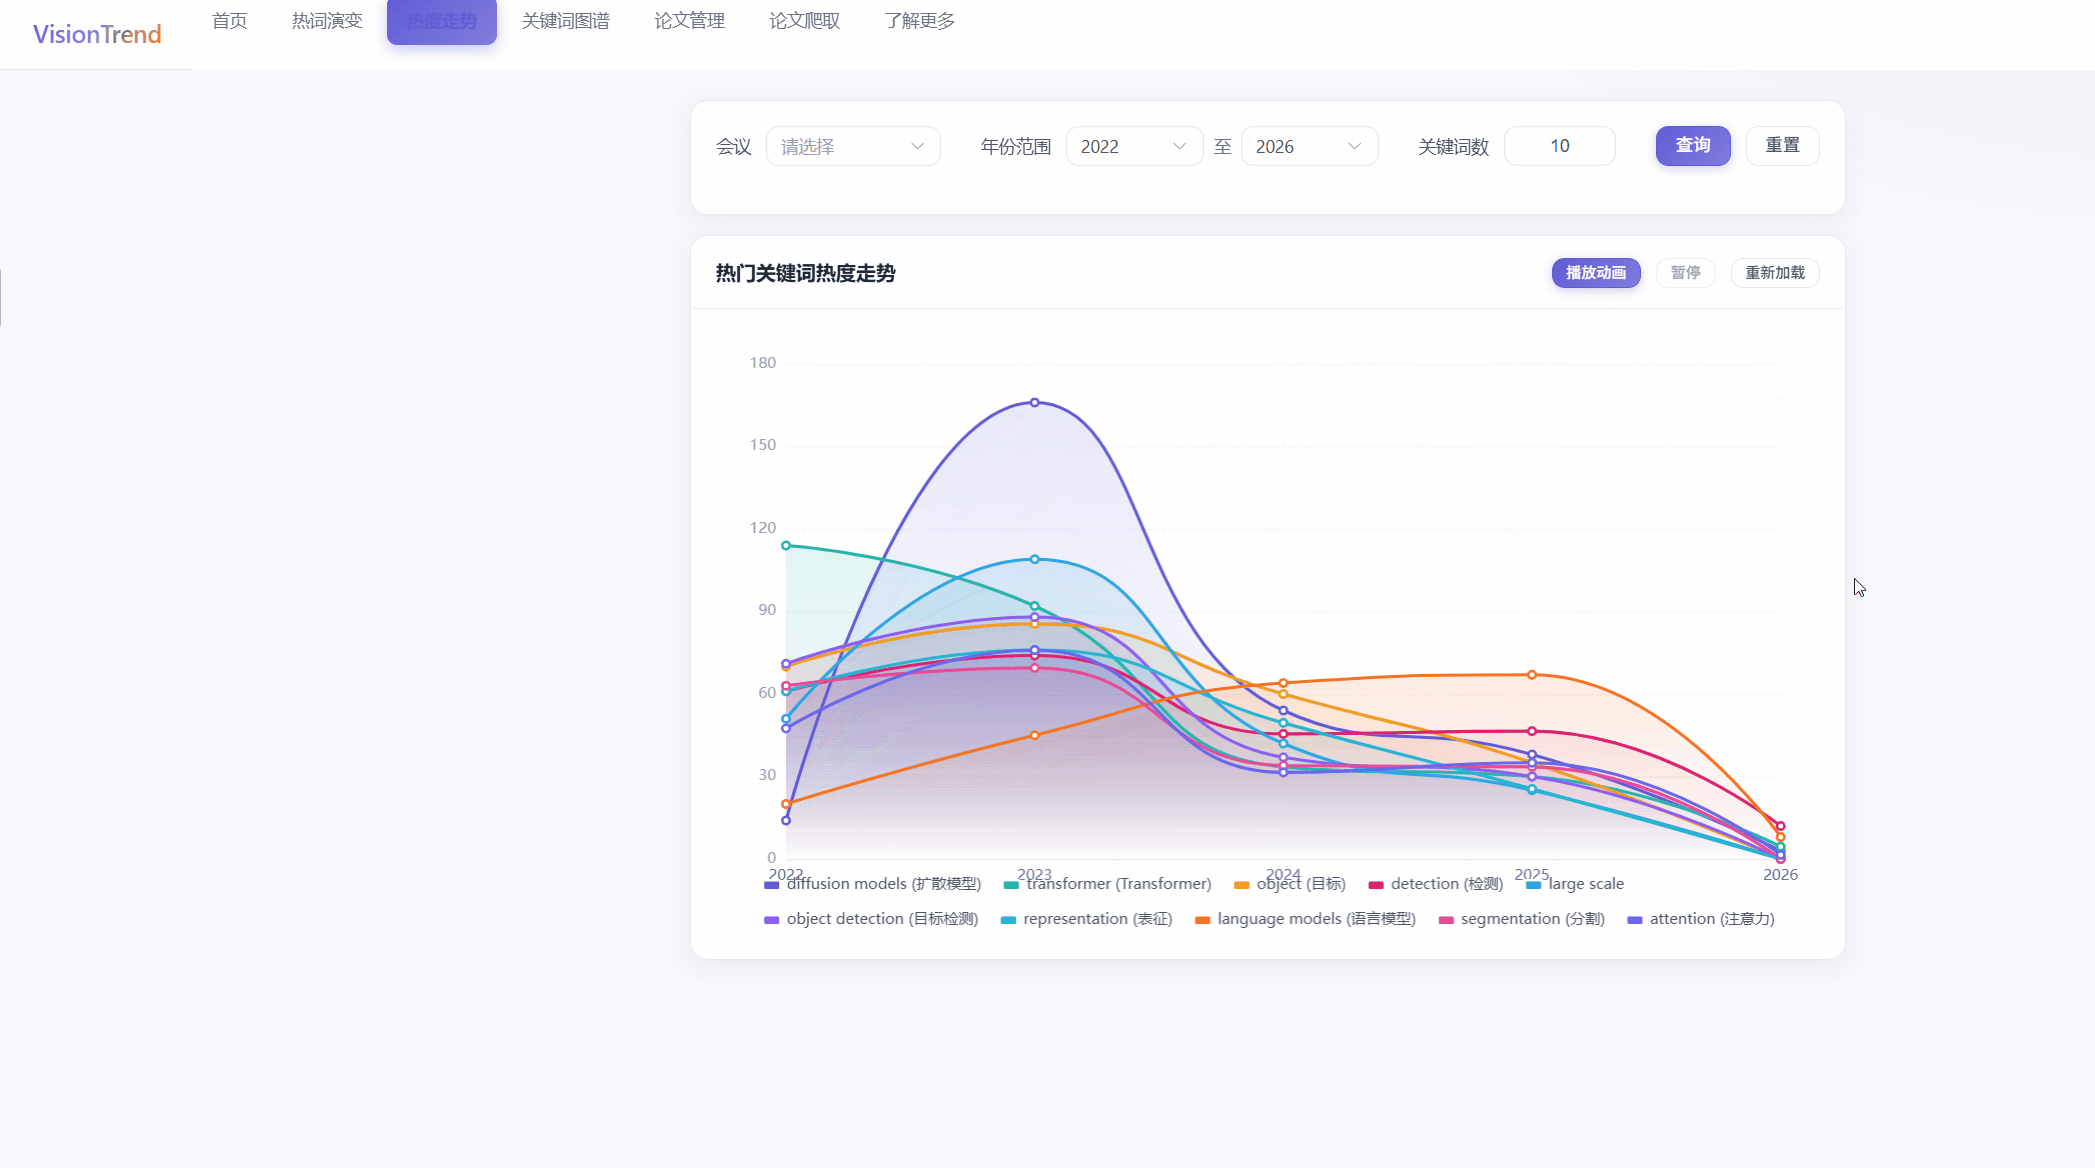
⑤ 热度走势对比 + 播放动画
多关键词多年份折https://i-blog.csdnimg.cn/communtity/d8481c0eaf2f41dca438c67a524a49b2.jpeg "#left")
线图,点击"播放动画"按钮逐年推进绘制(按钮变为"播放中"),直观展示各方向的起落节奏。
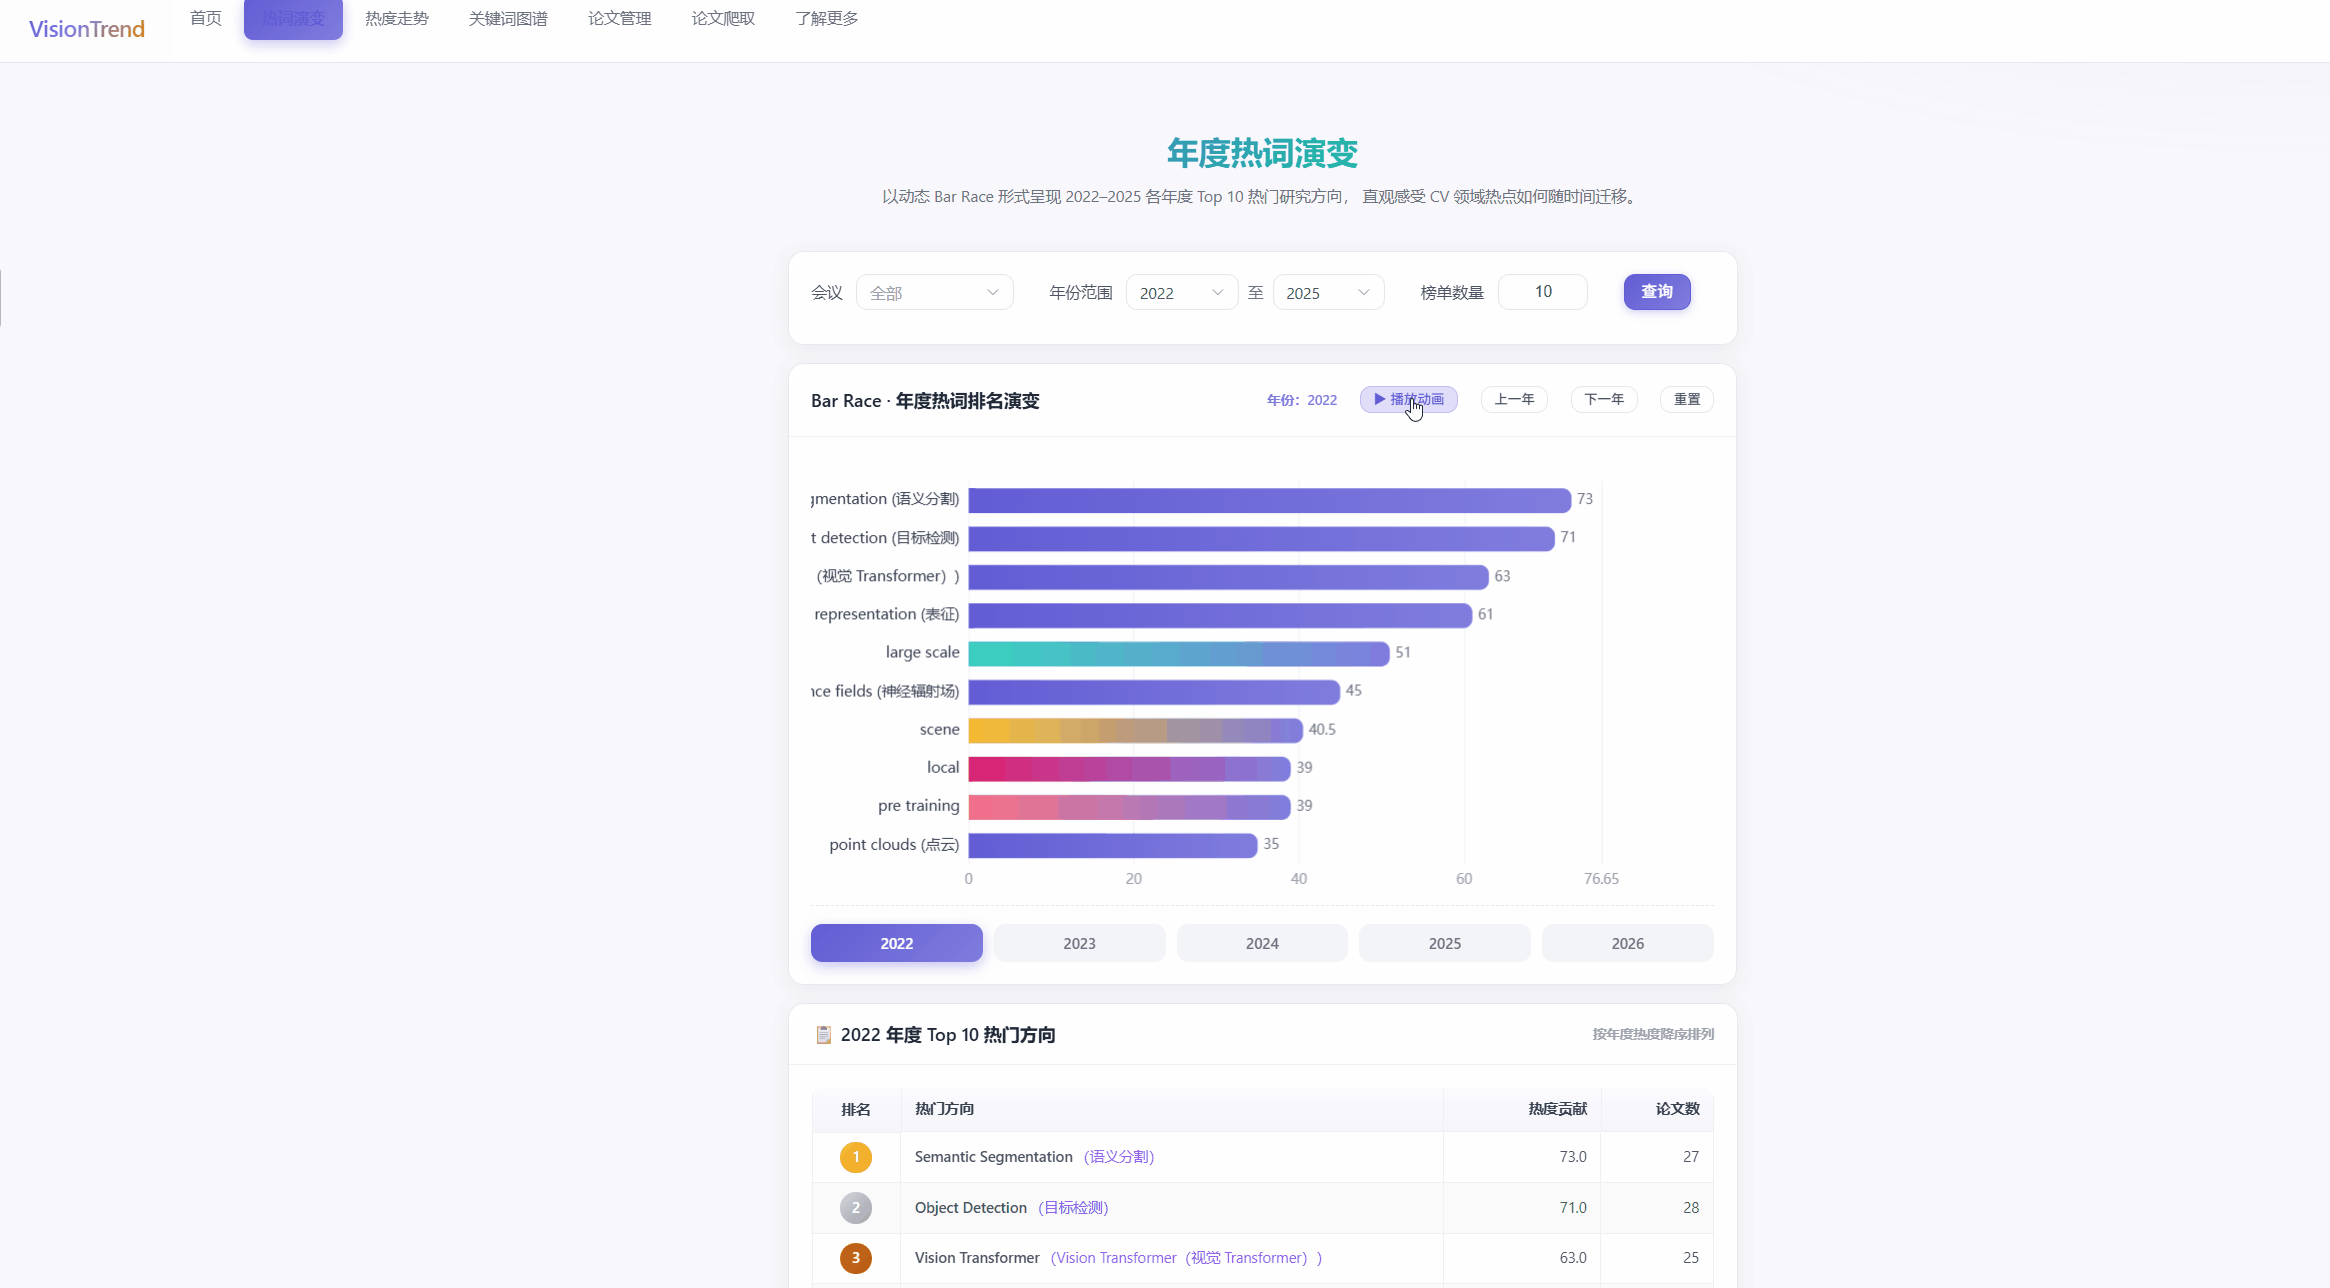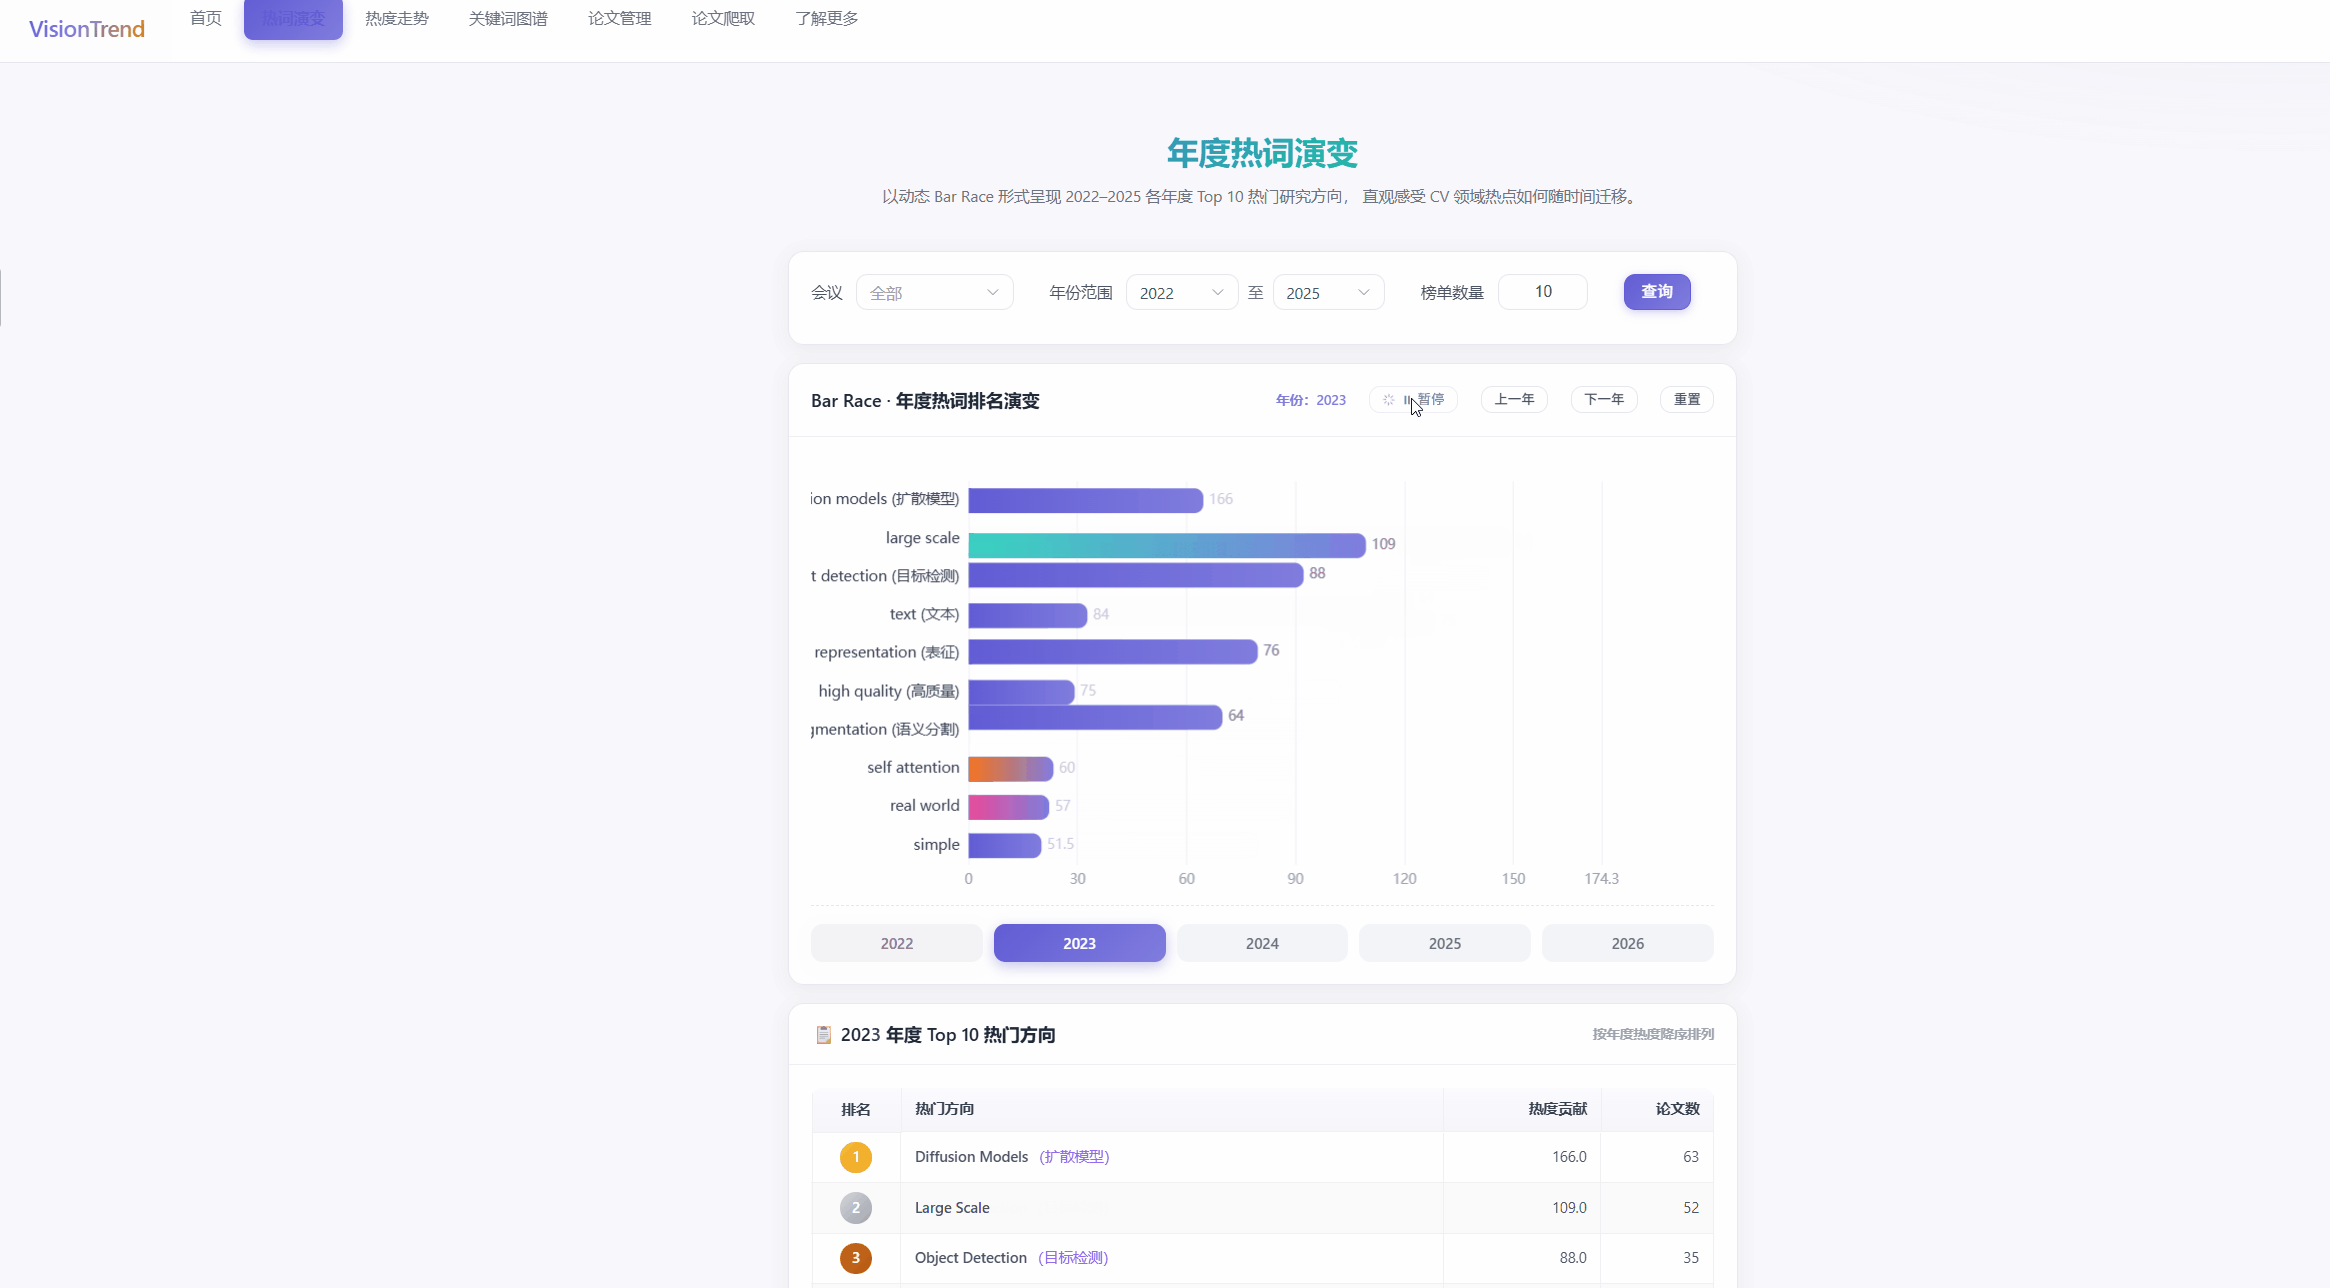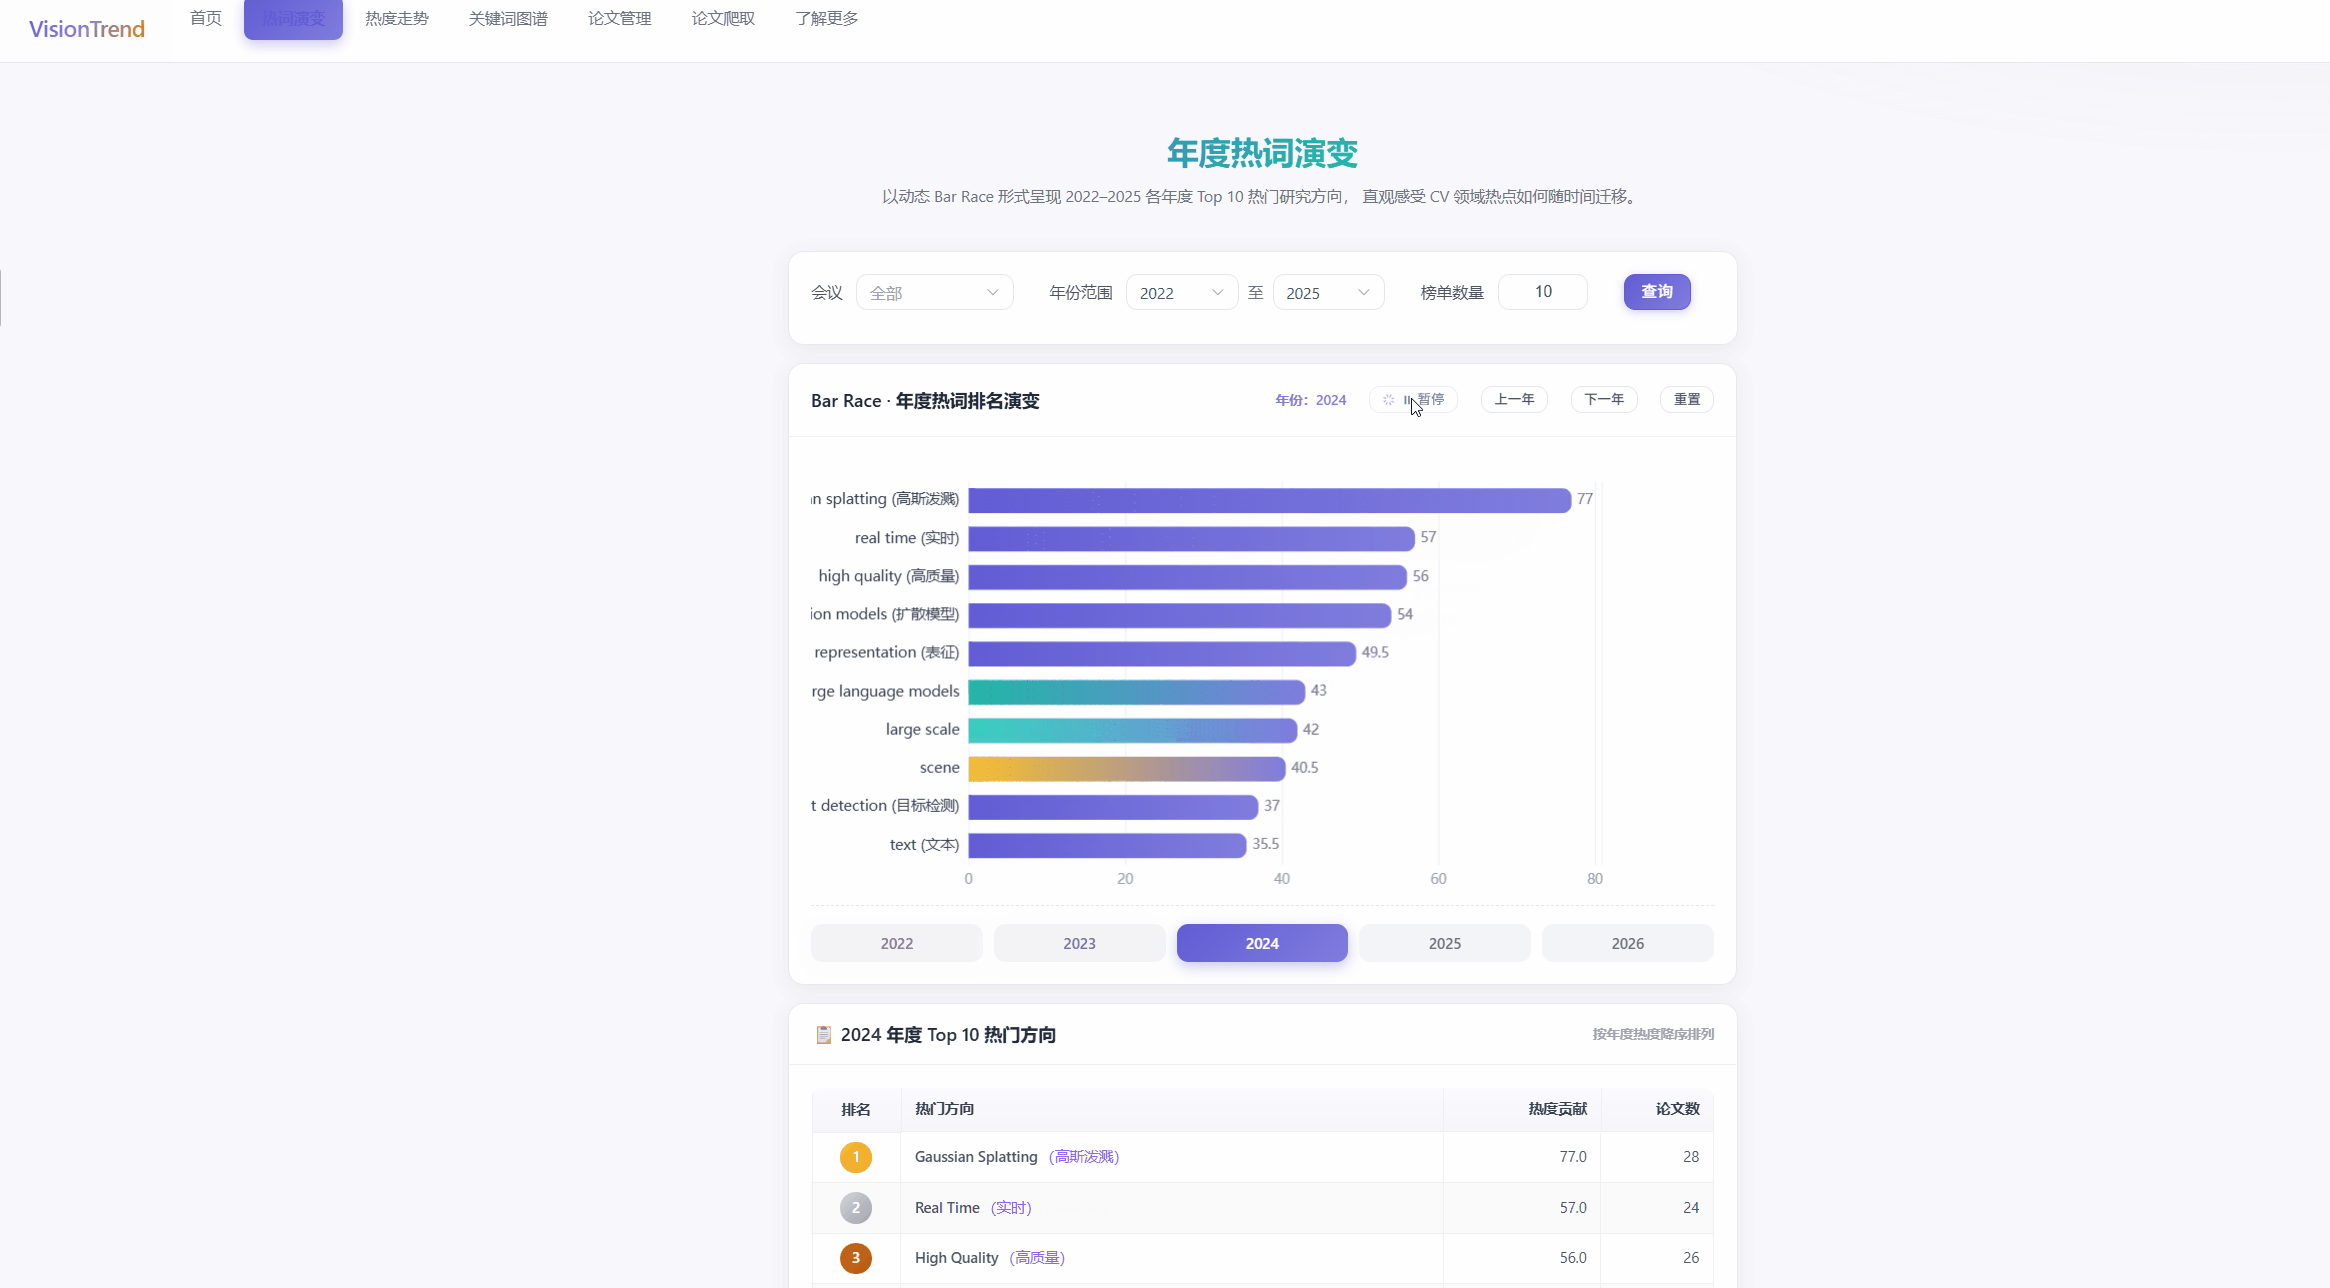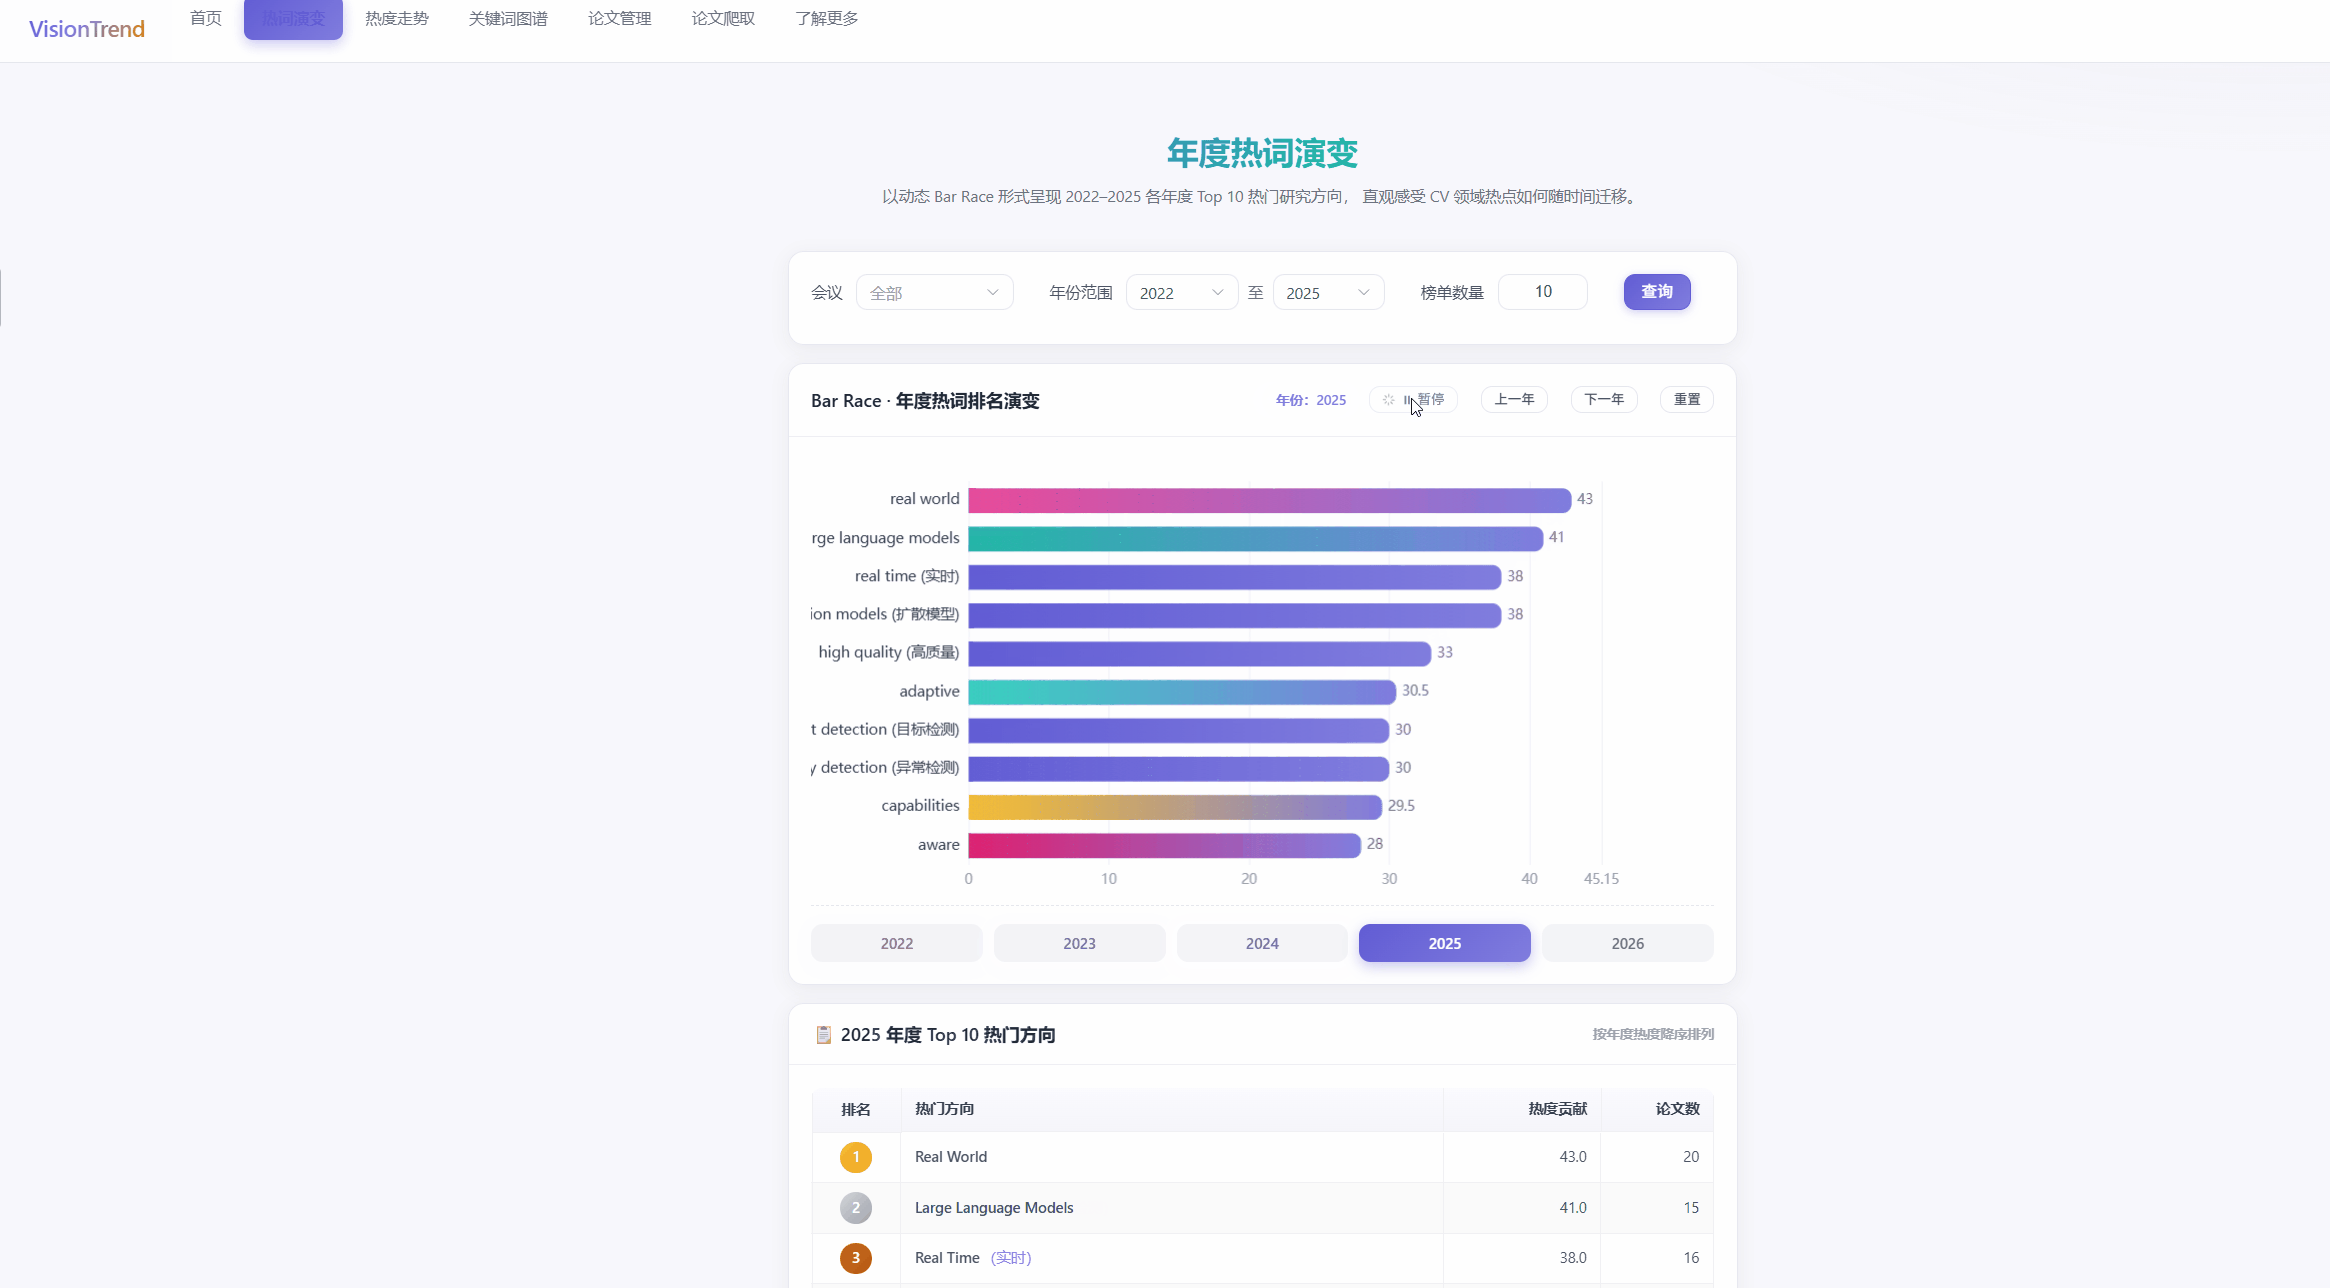
⑥ 年度热词演变 Bar Race(附加功能)
每年独立计算 Top10 后动态竞赛排名;下图为动画播放过程中的 2023 年榜单,水平条形随排名变化实时伸缩换位。
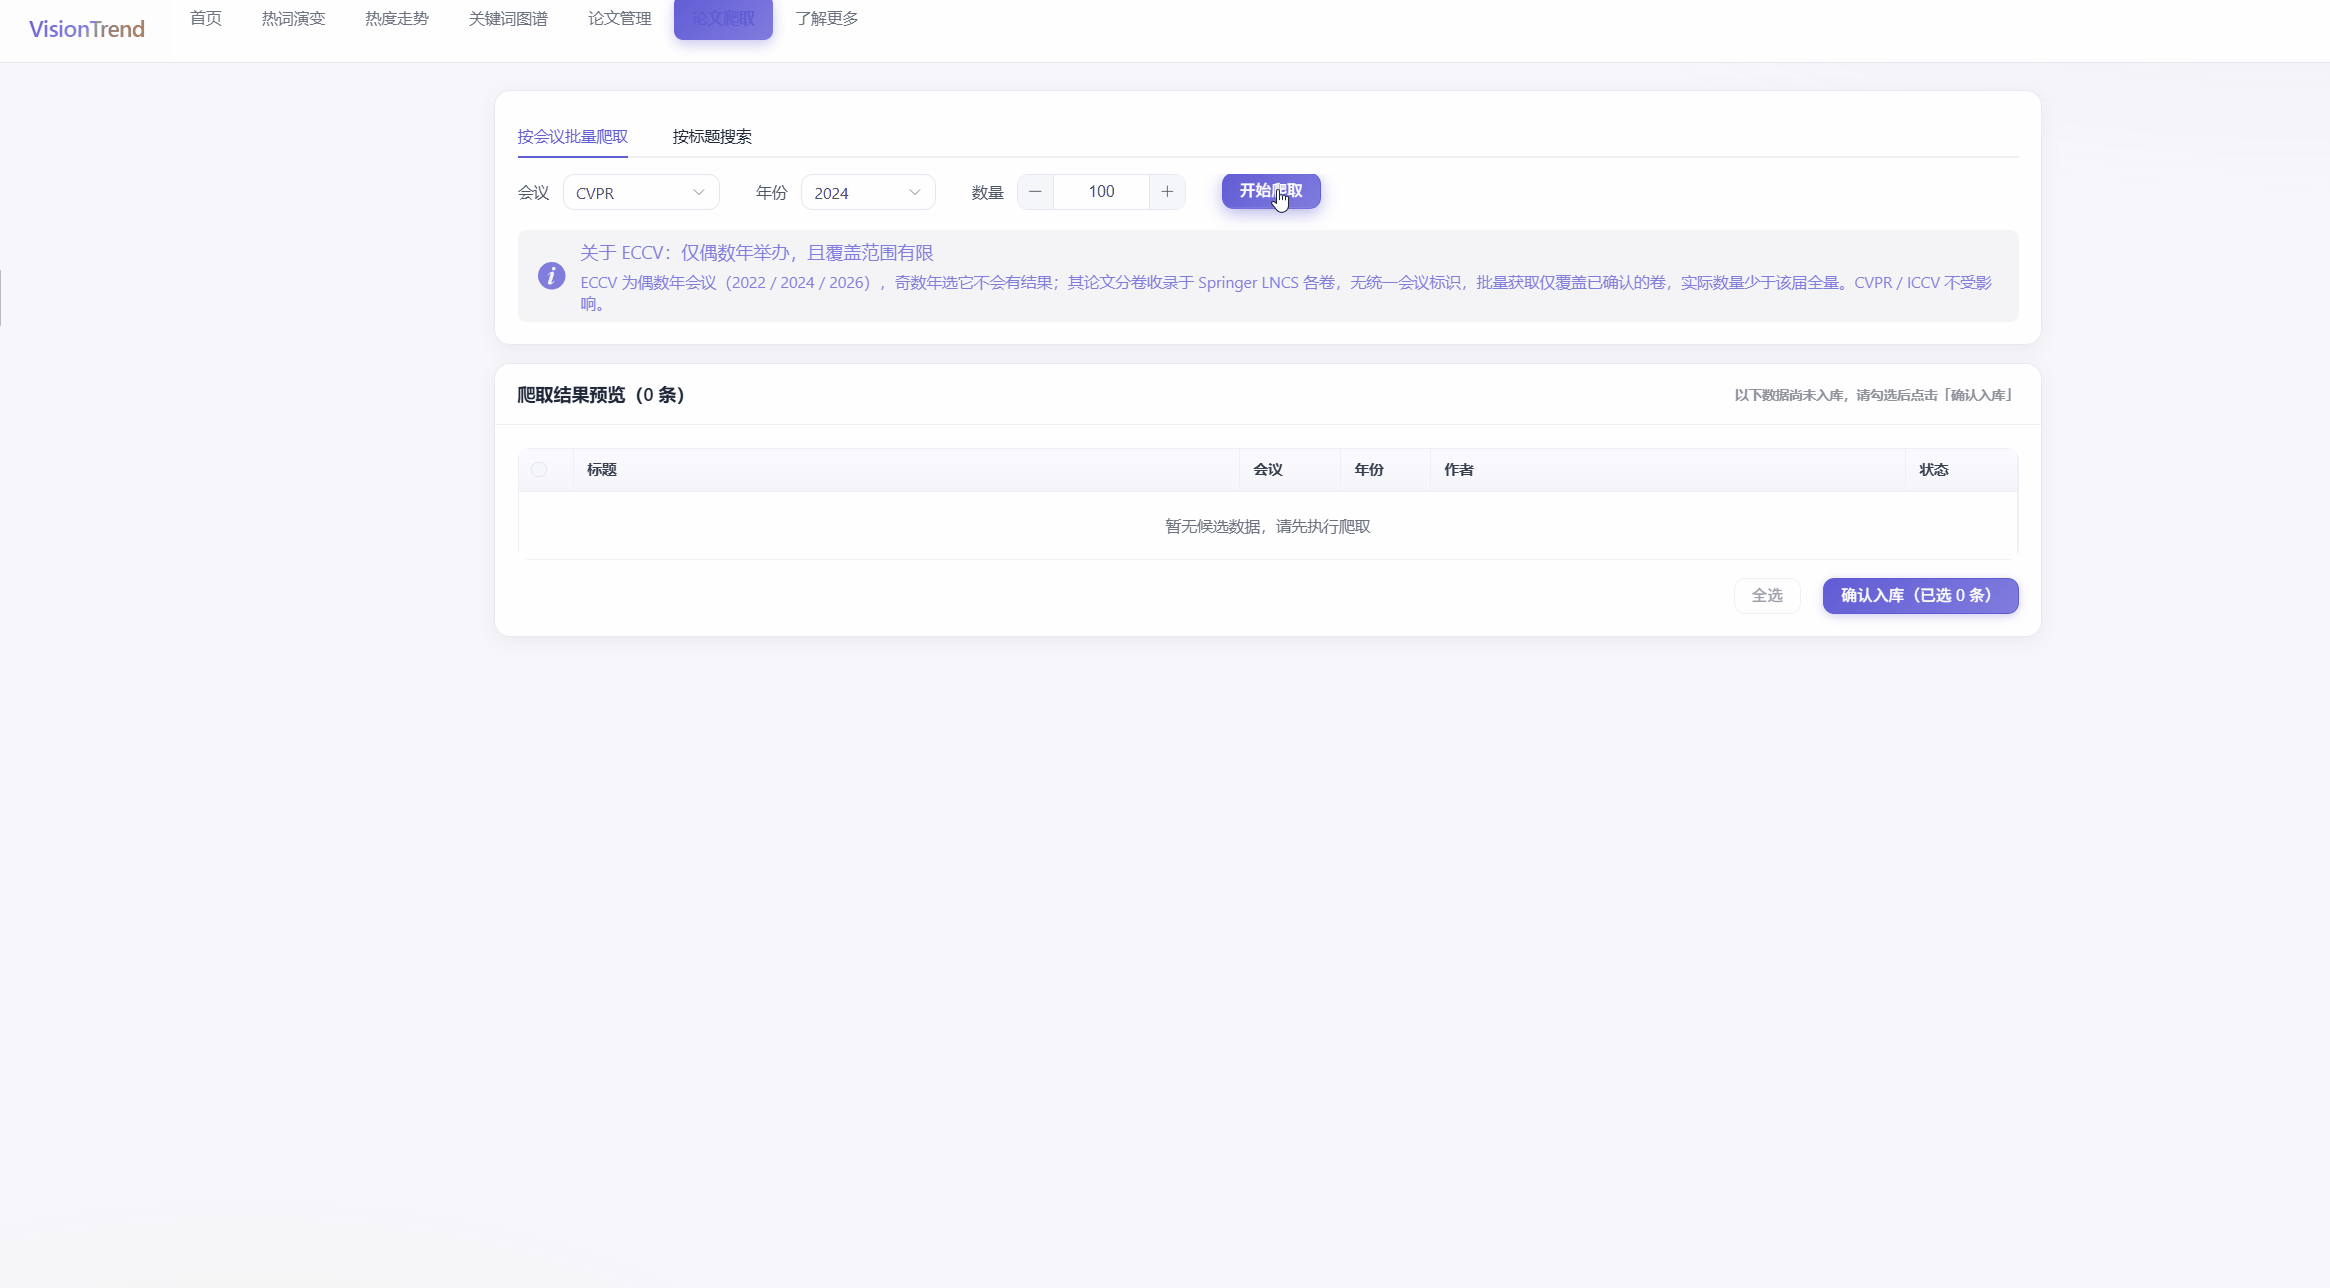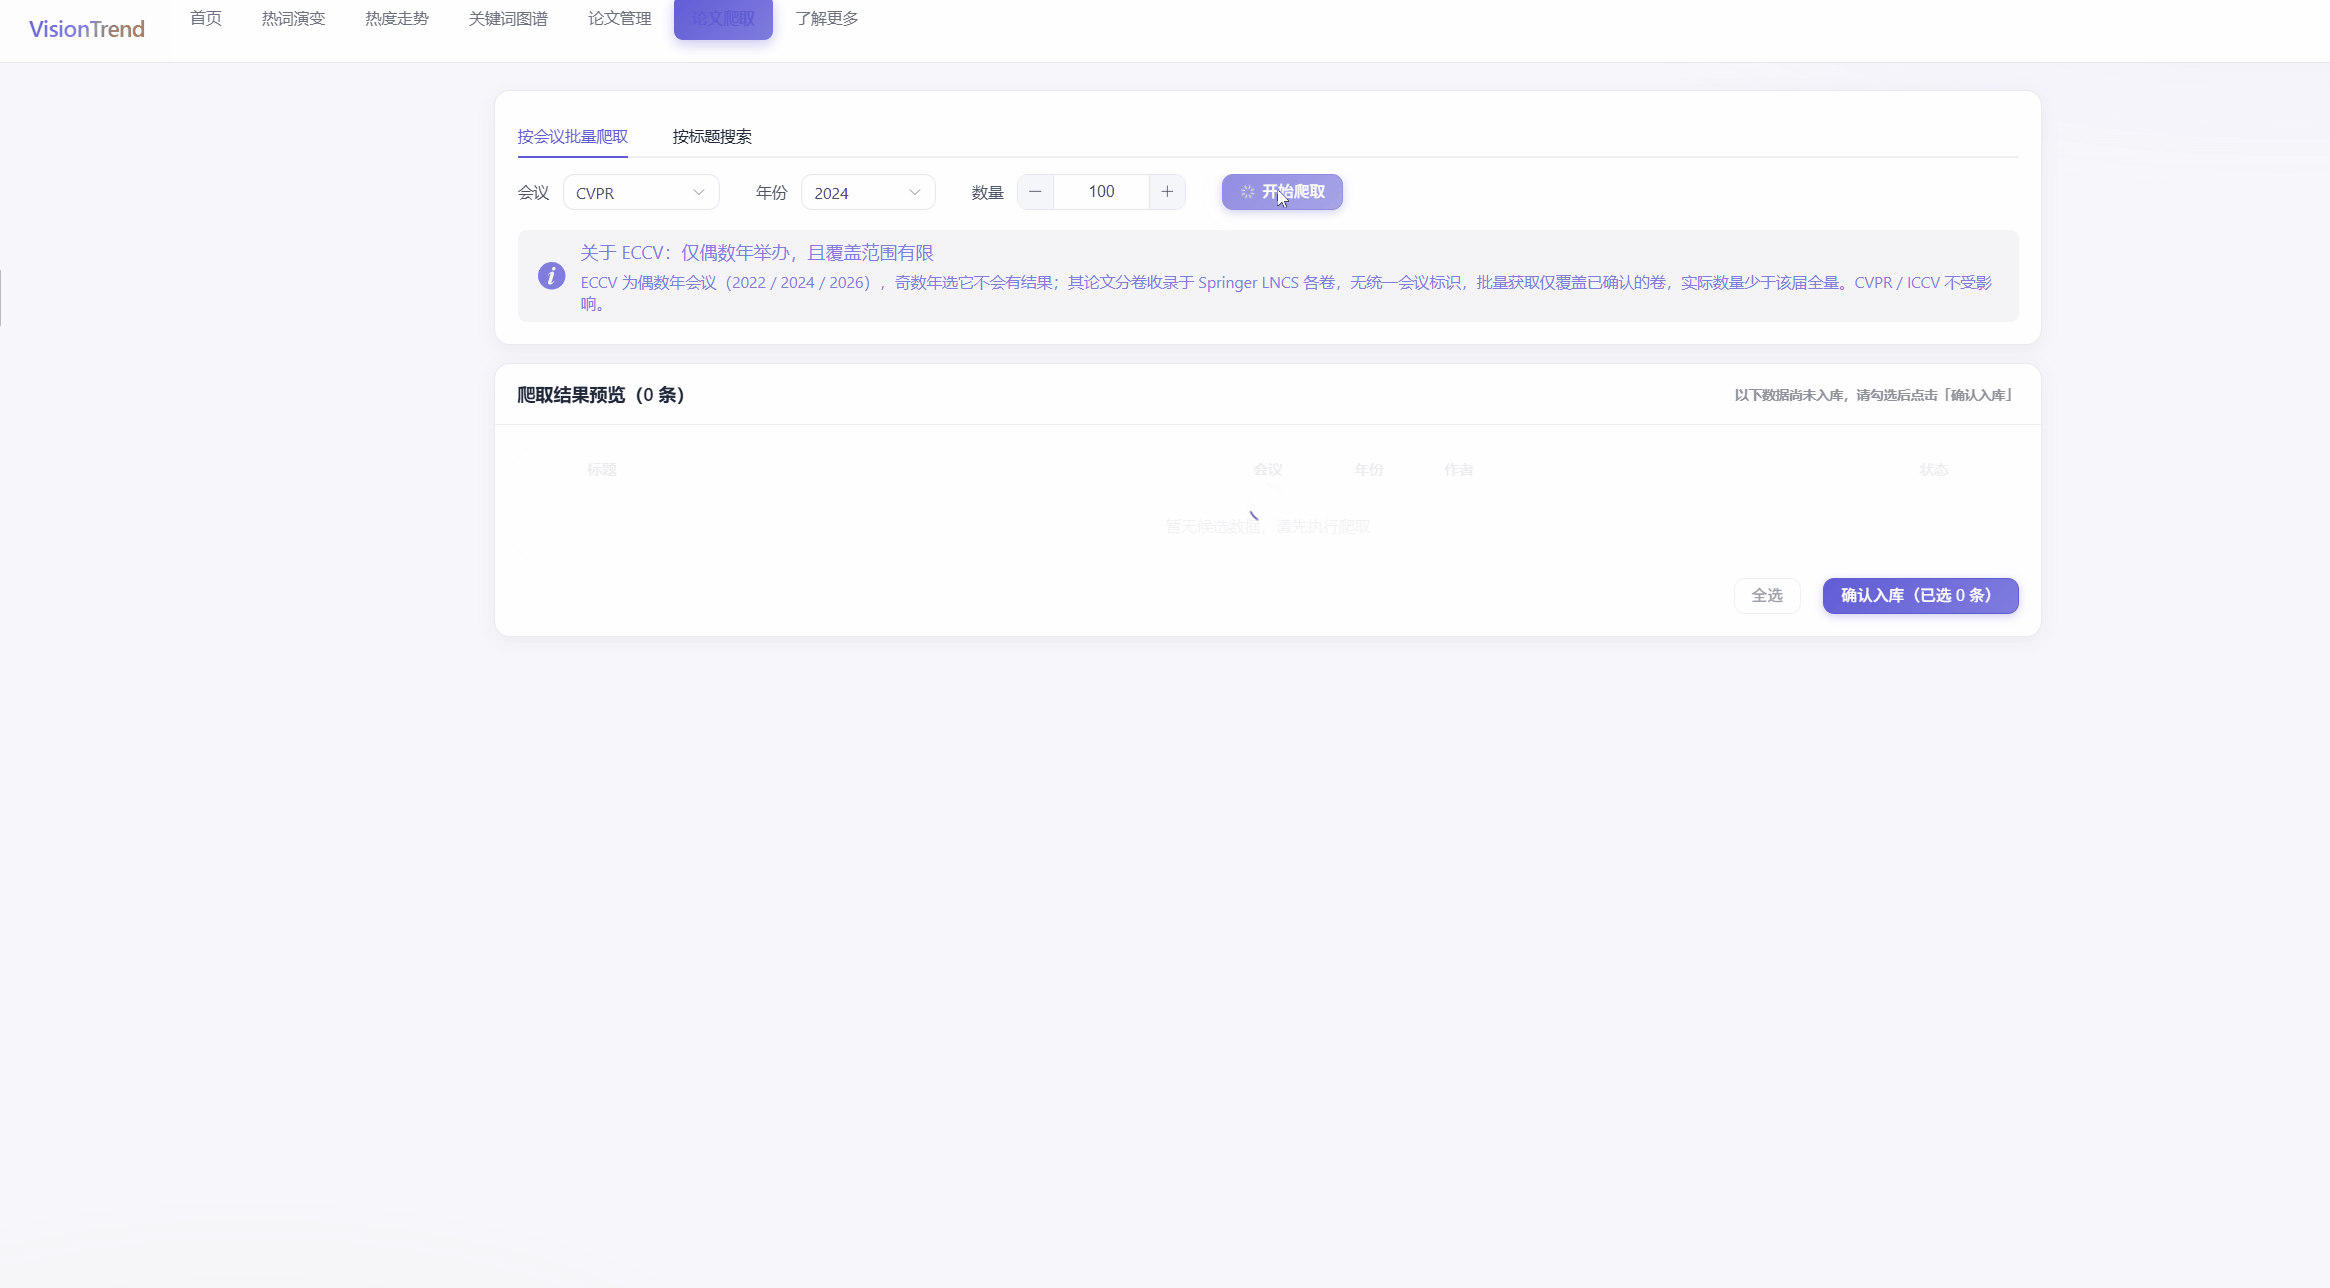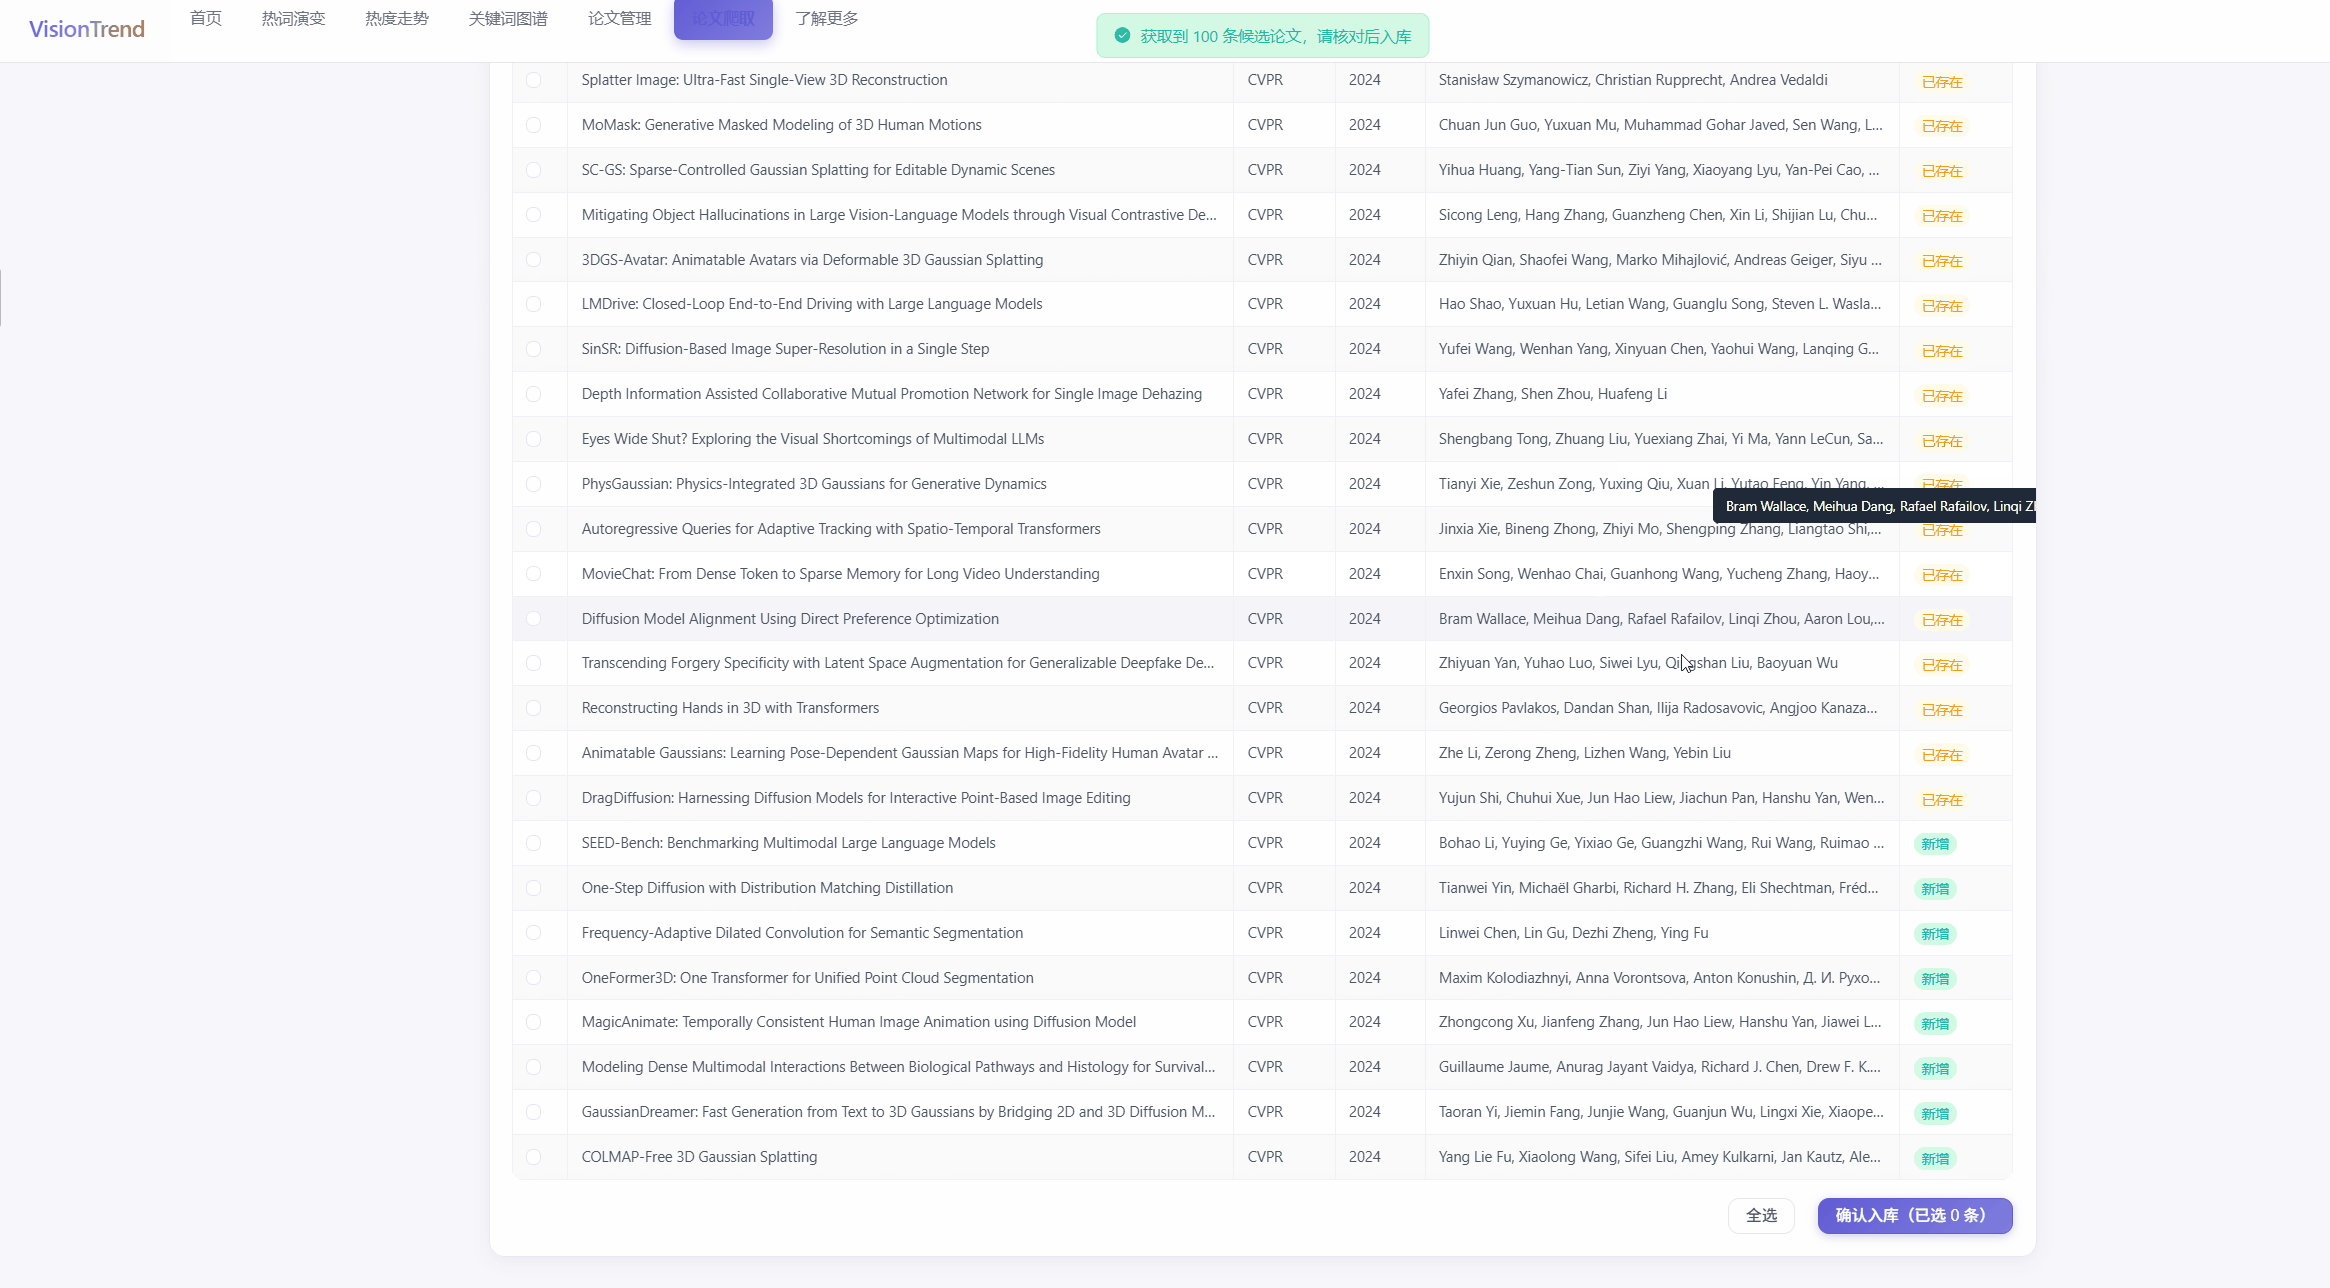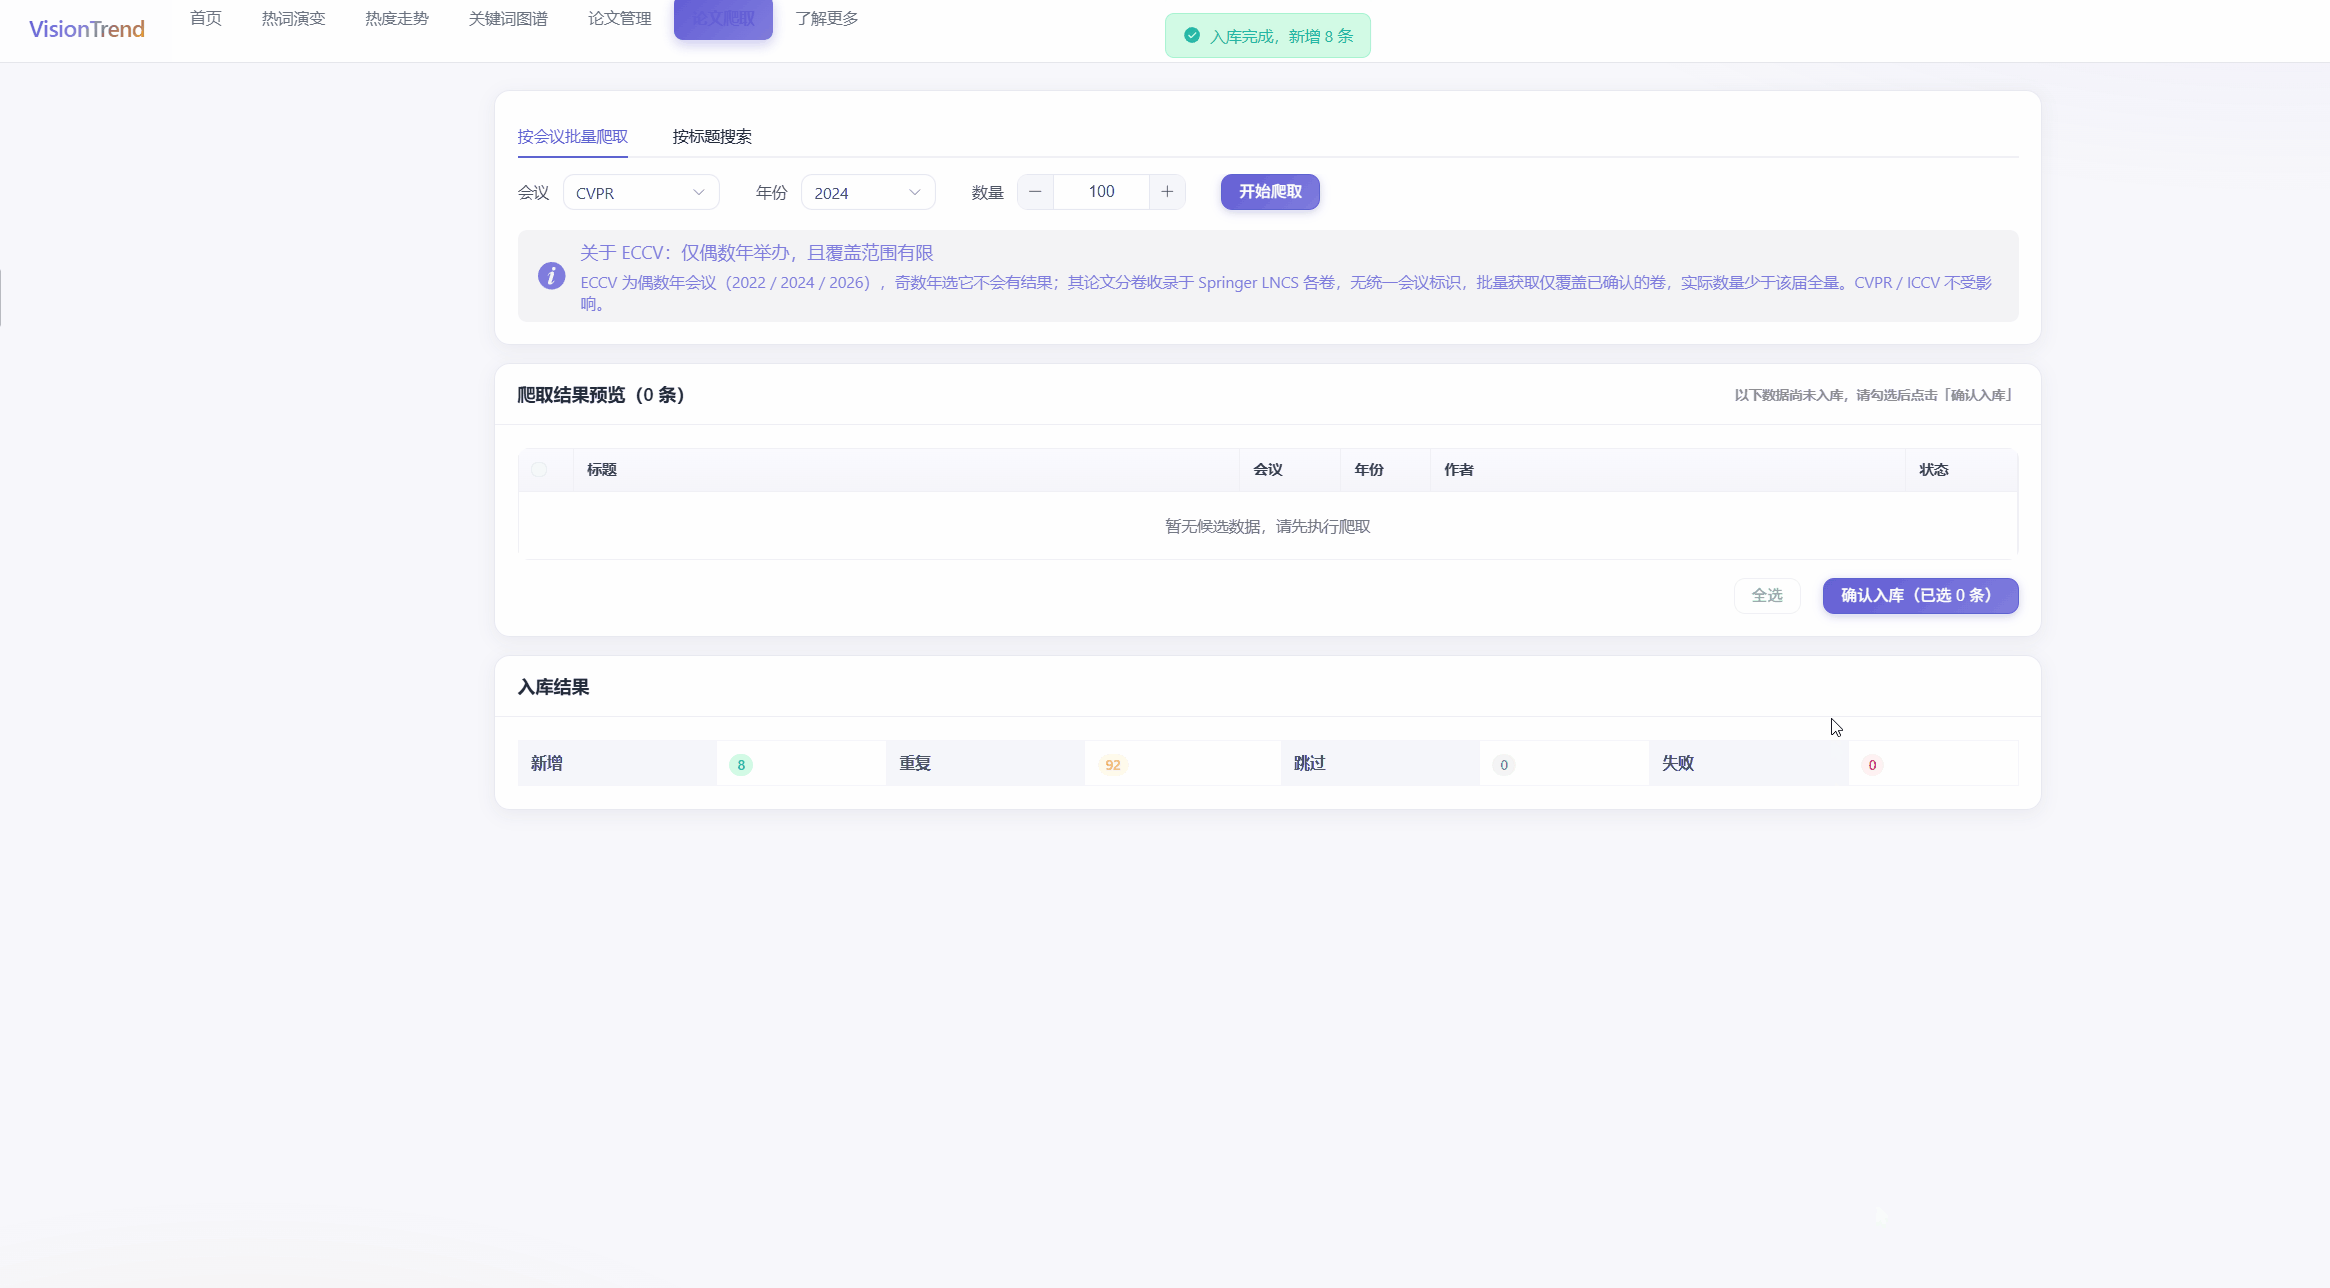
⑦ 论文爬取页
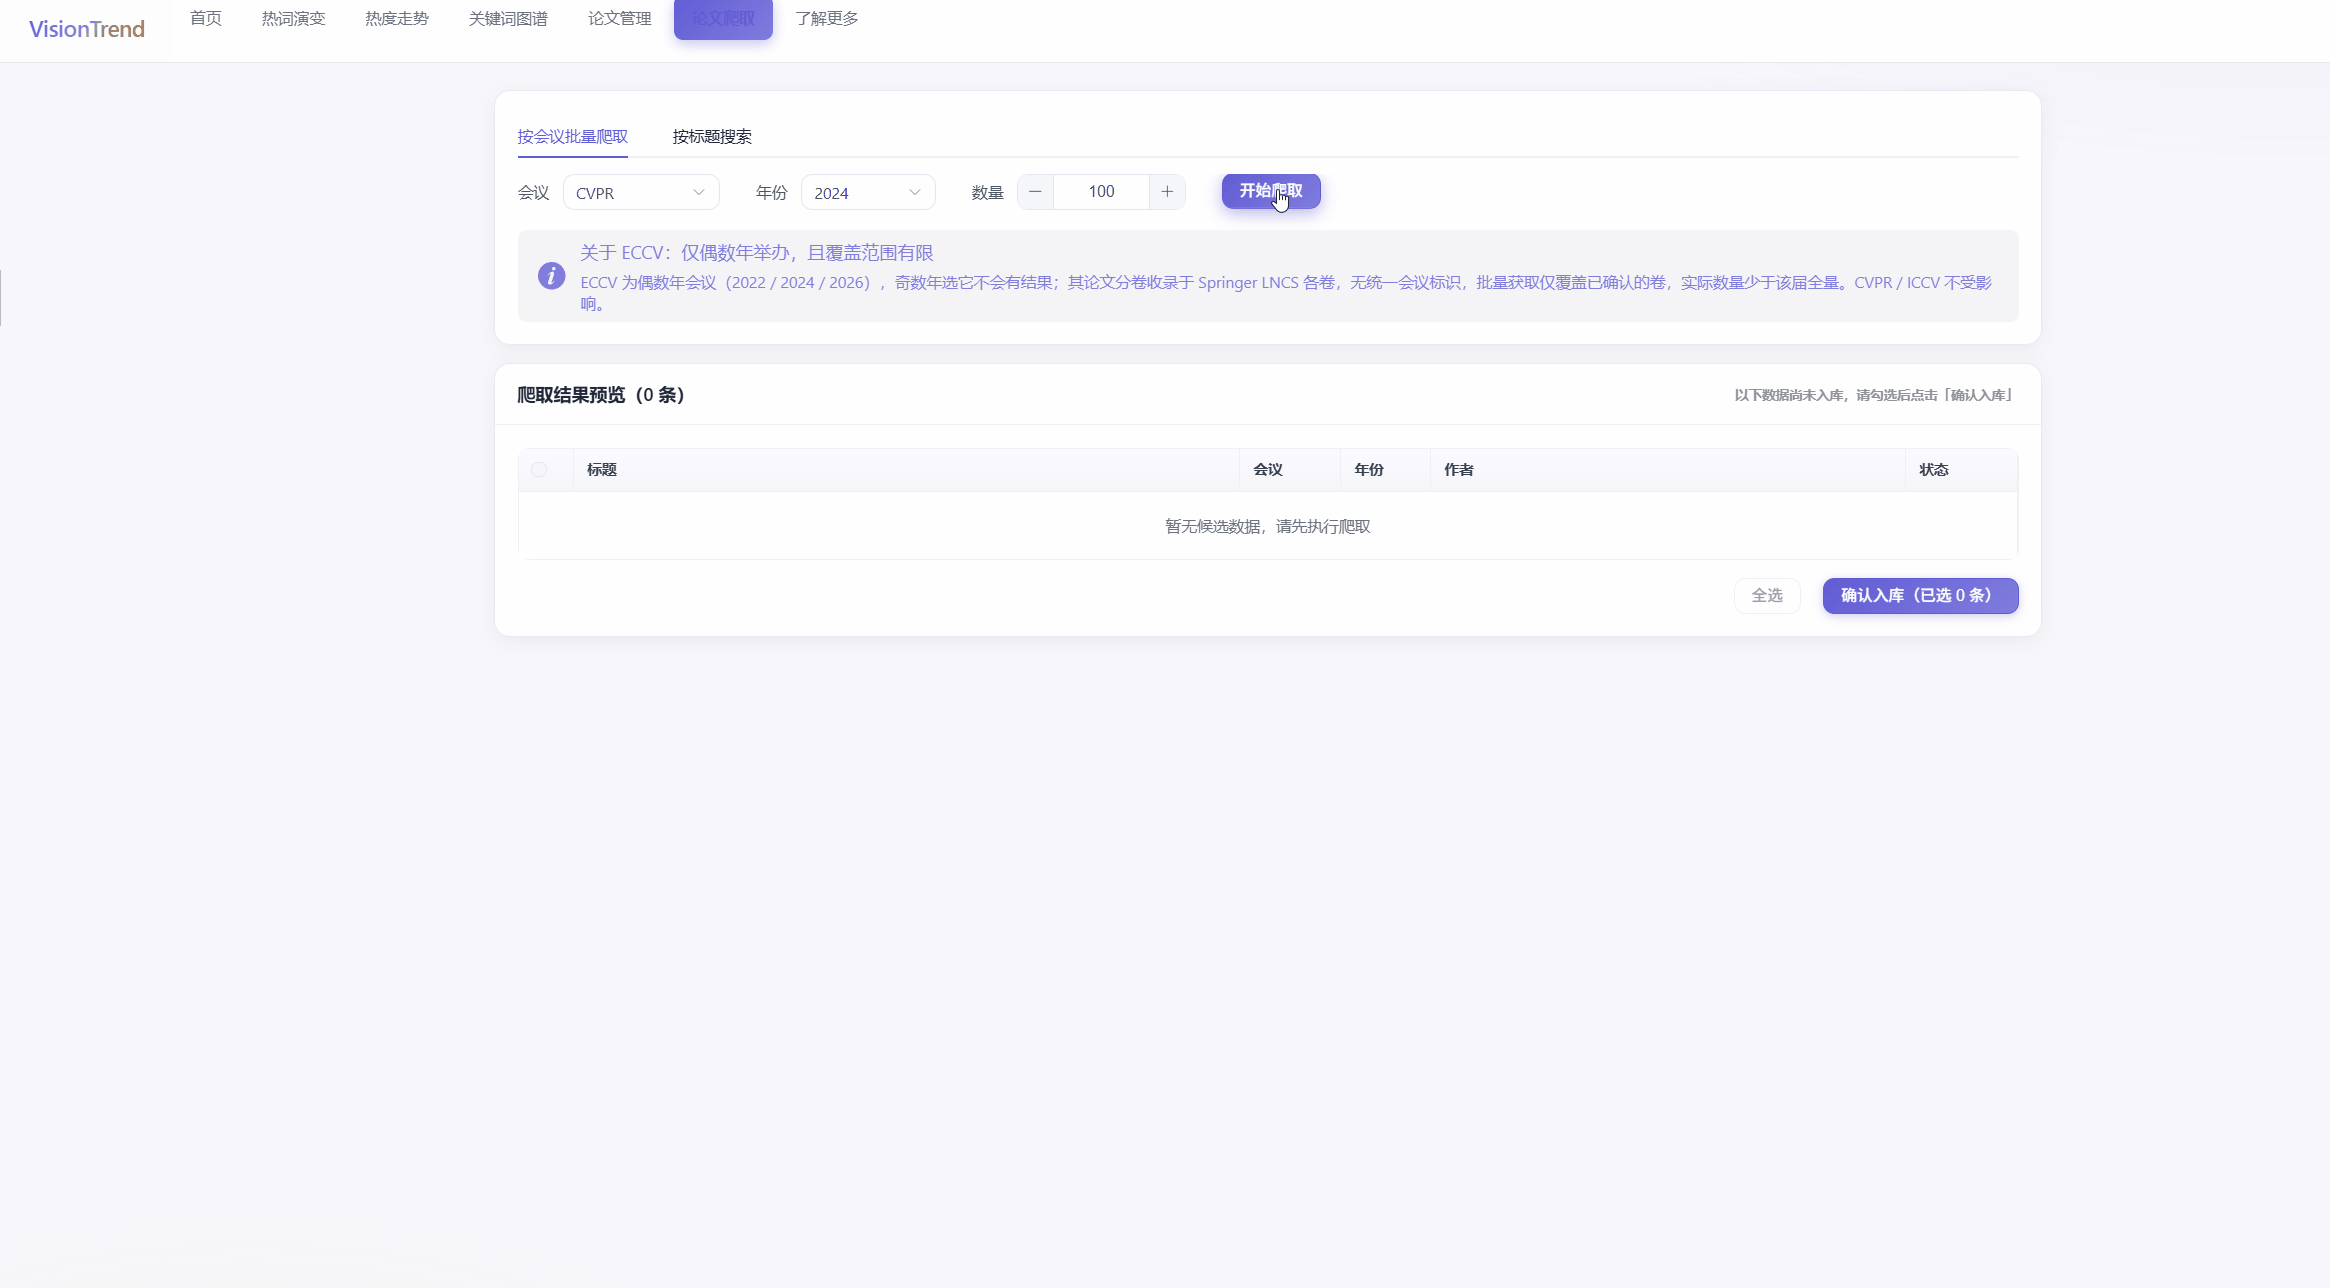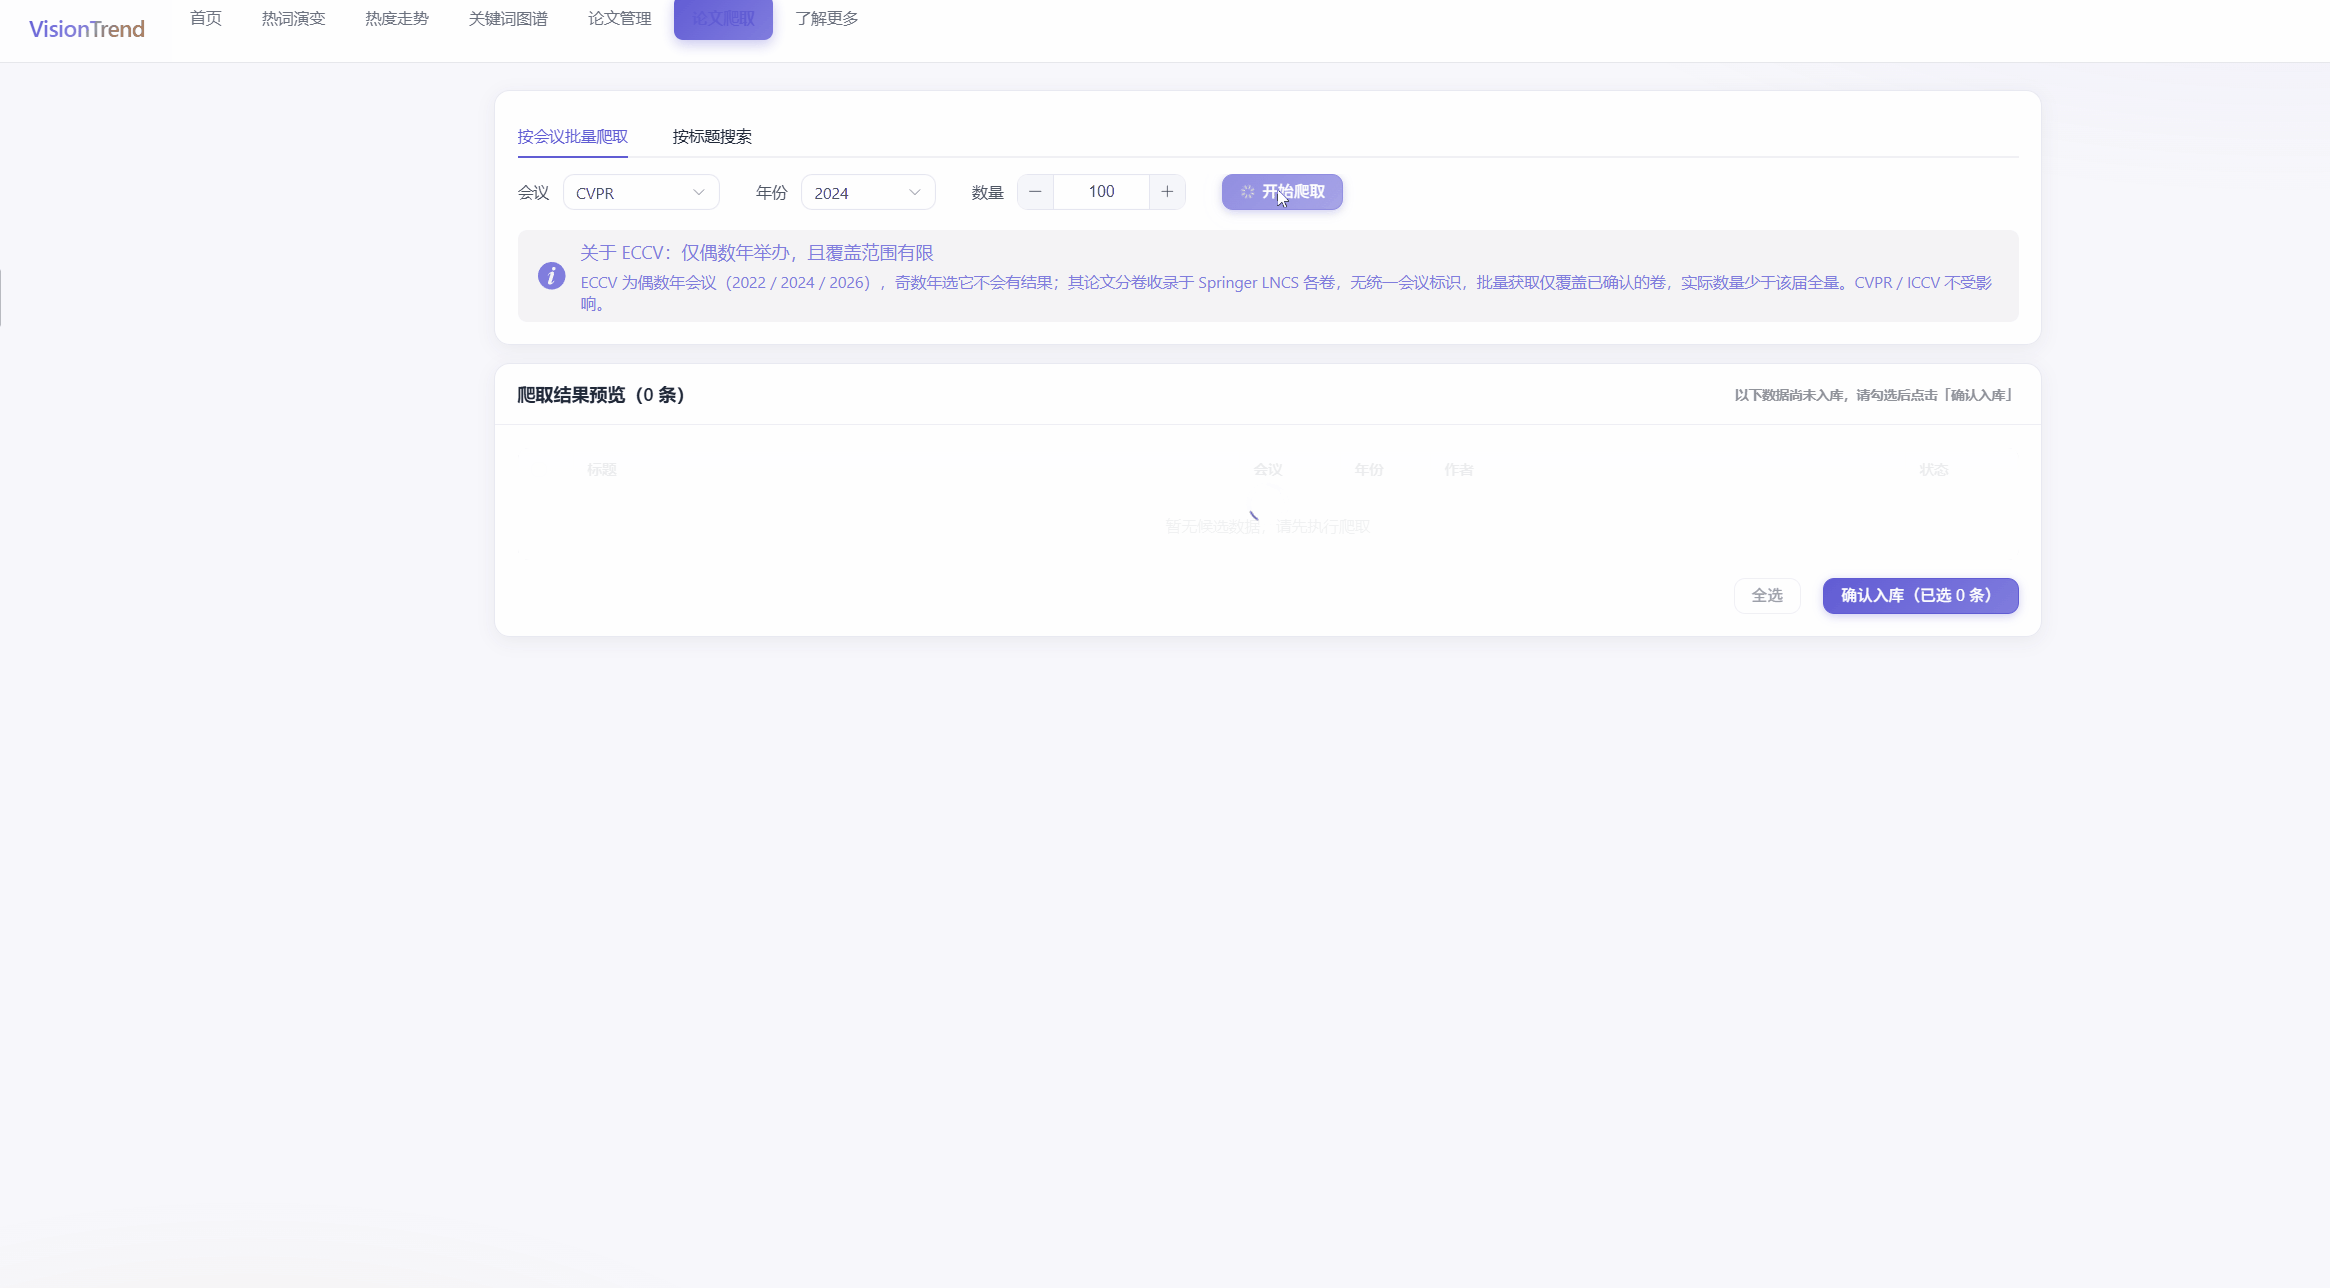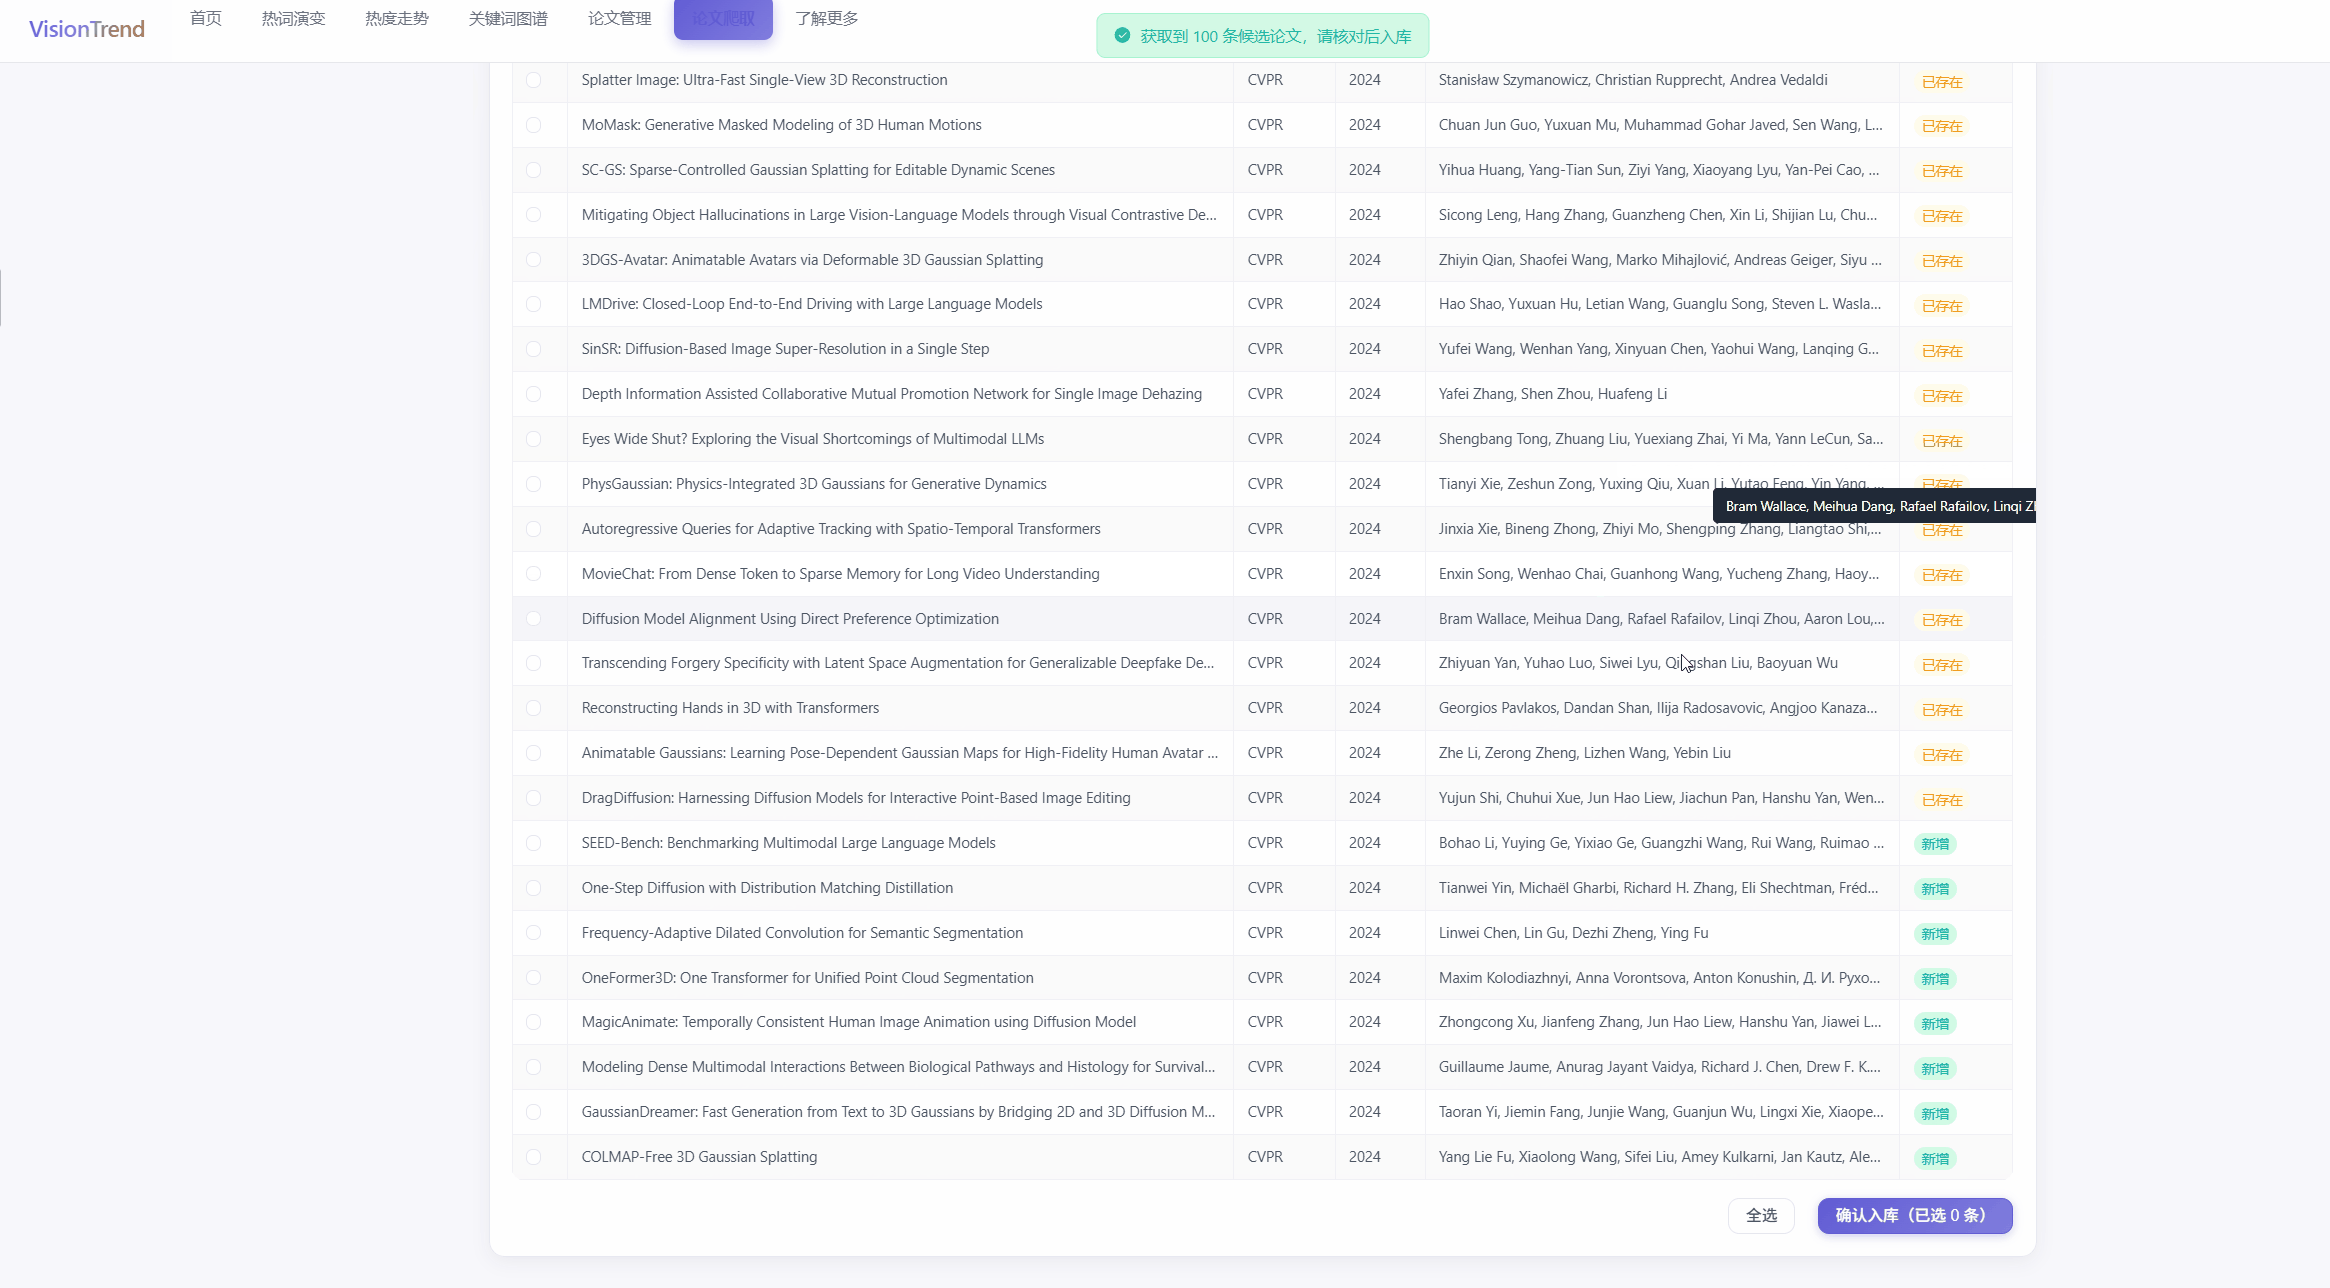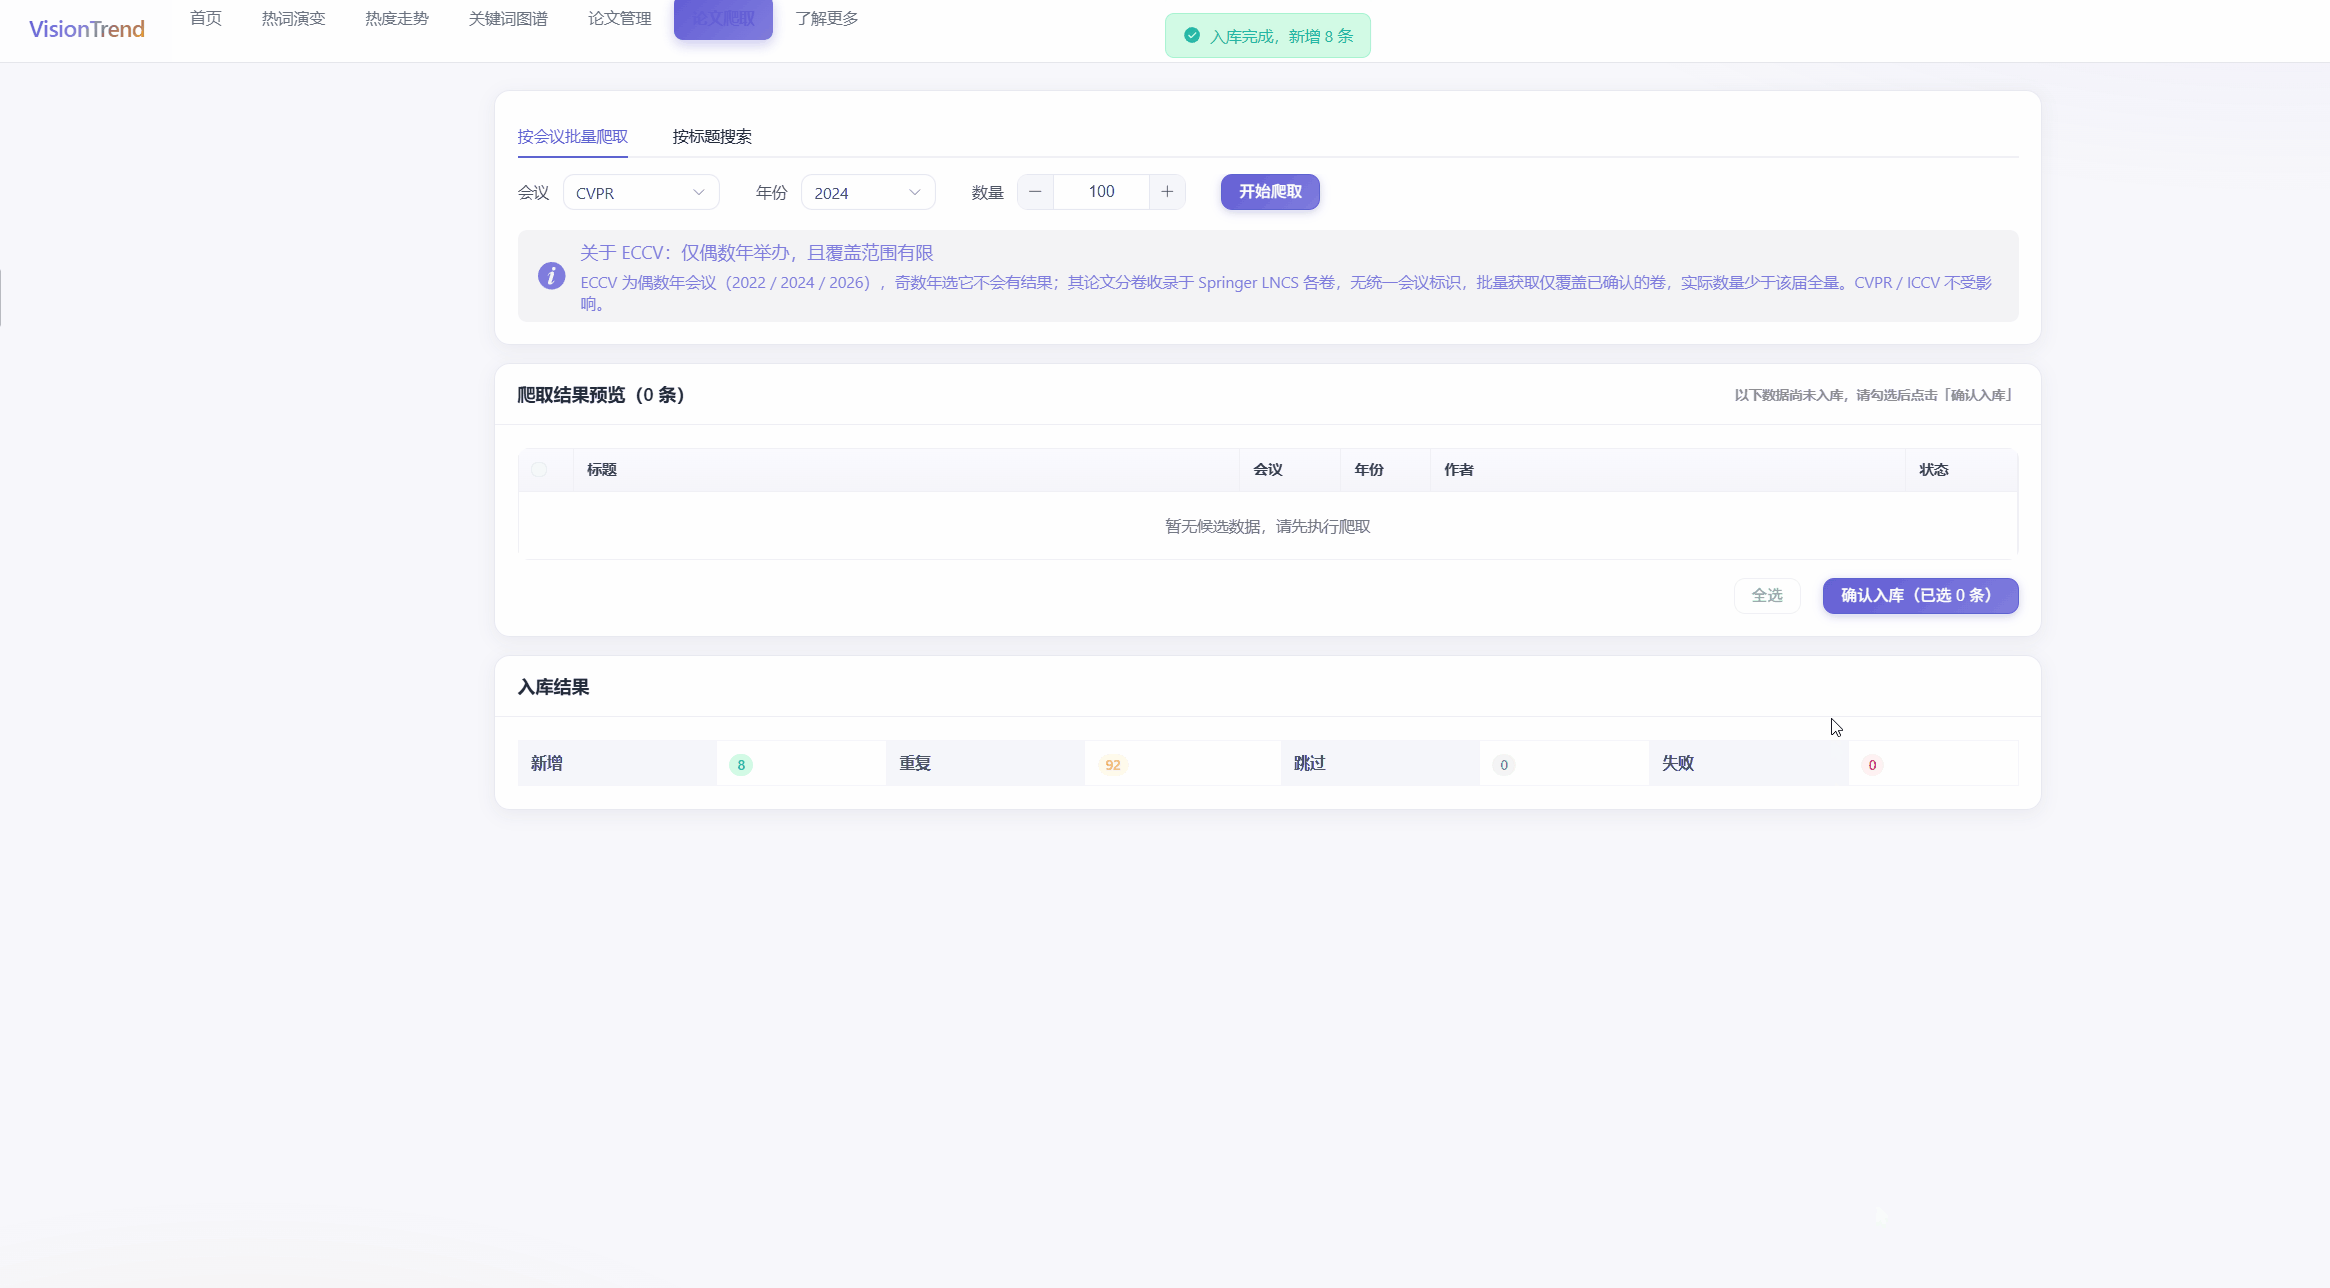
支持"按会议批量爬取"(如 CVPR + 2024)与"按标题搜索单篇"两种模式;预览列表用标签区分"新增/已存在",避免重复入库。
⑧ 爬取预览与入库结果
勾选 全部论文确认入库后,返回新增/重复/跳过/失败的统计摘要卡片
⑨ 论文管理页
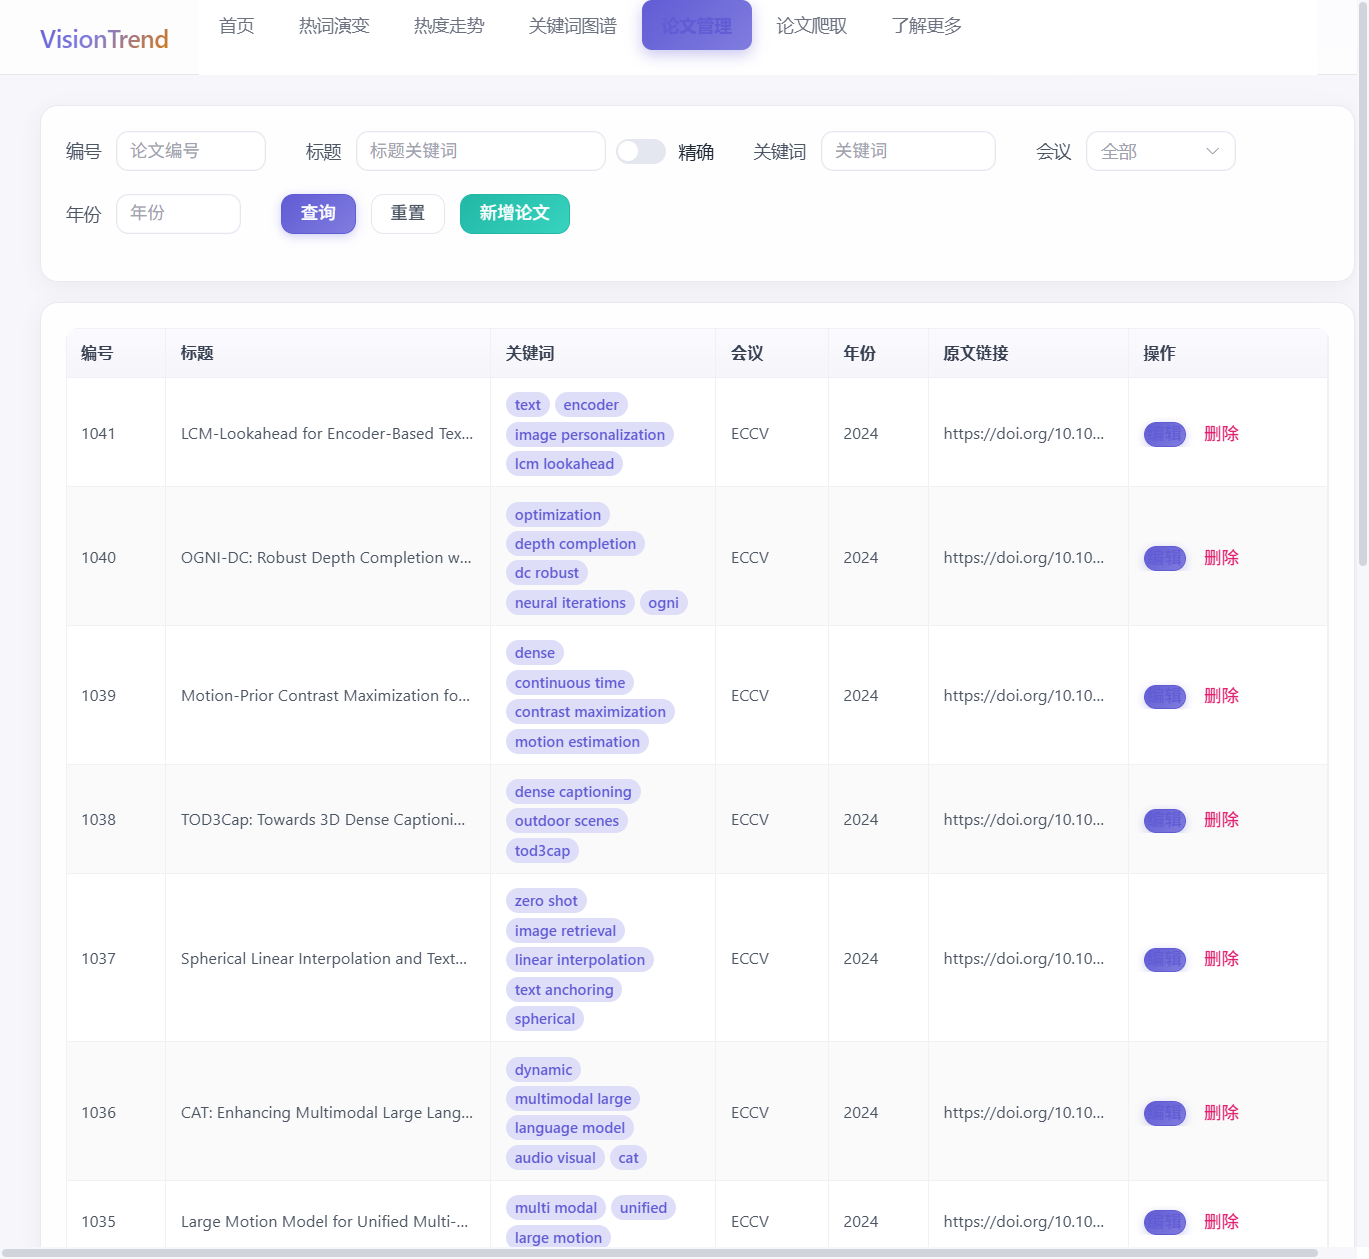
增删改查齐全,支持按编号/标题/关键词模糊搜索(可切换精确匹配)、会议年份过滤与分页浏览。
⑩ 了解更多页面(附加功能)
介绍 CVPR/ICCV/ECCV 三大顶会背景(含投稿/录用数据与本站各会议收录数),顶部以统计卡片汇总收录论文 1041 篇、关键词 3411 个,并以柱状图展示本站年度论文分布,使统计结果可解释、可复现。
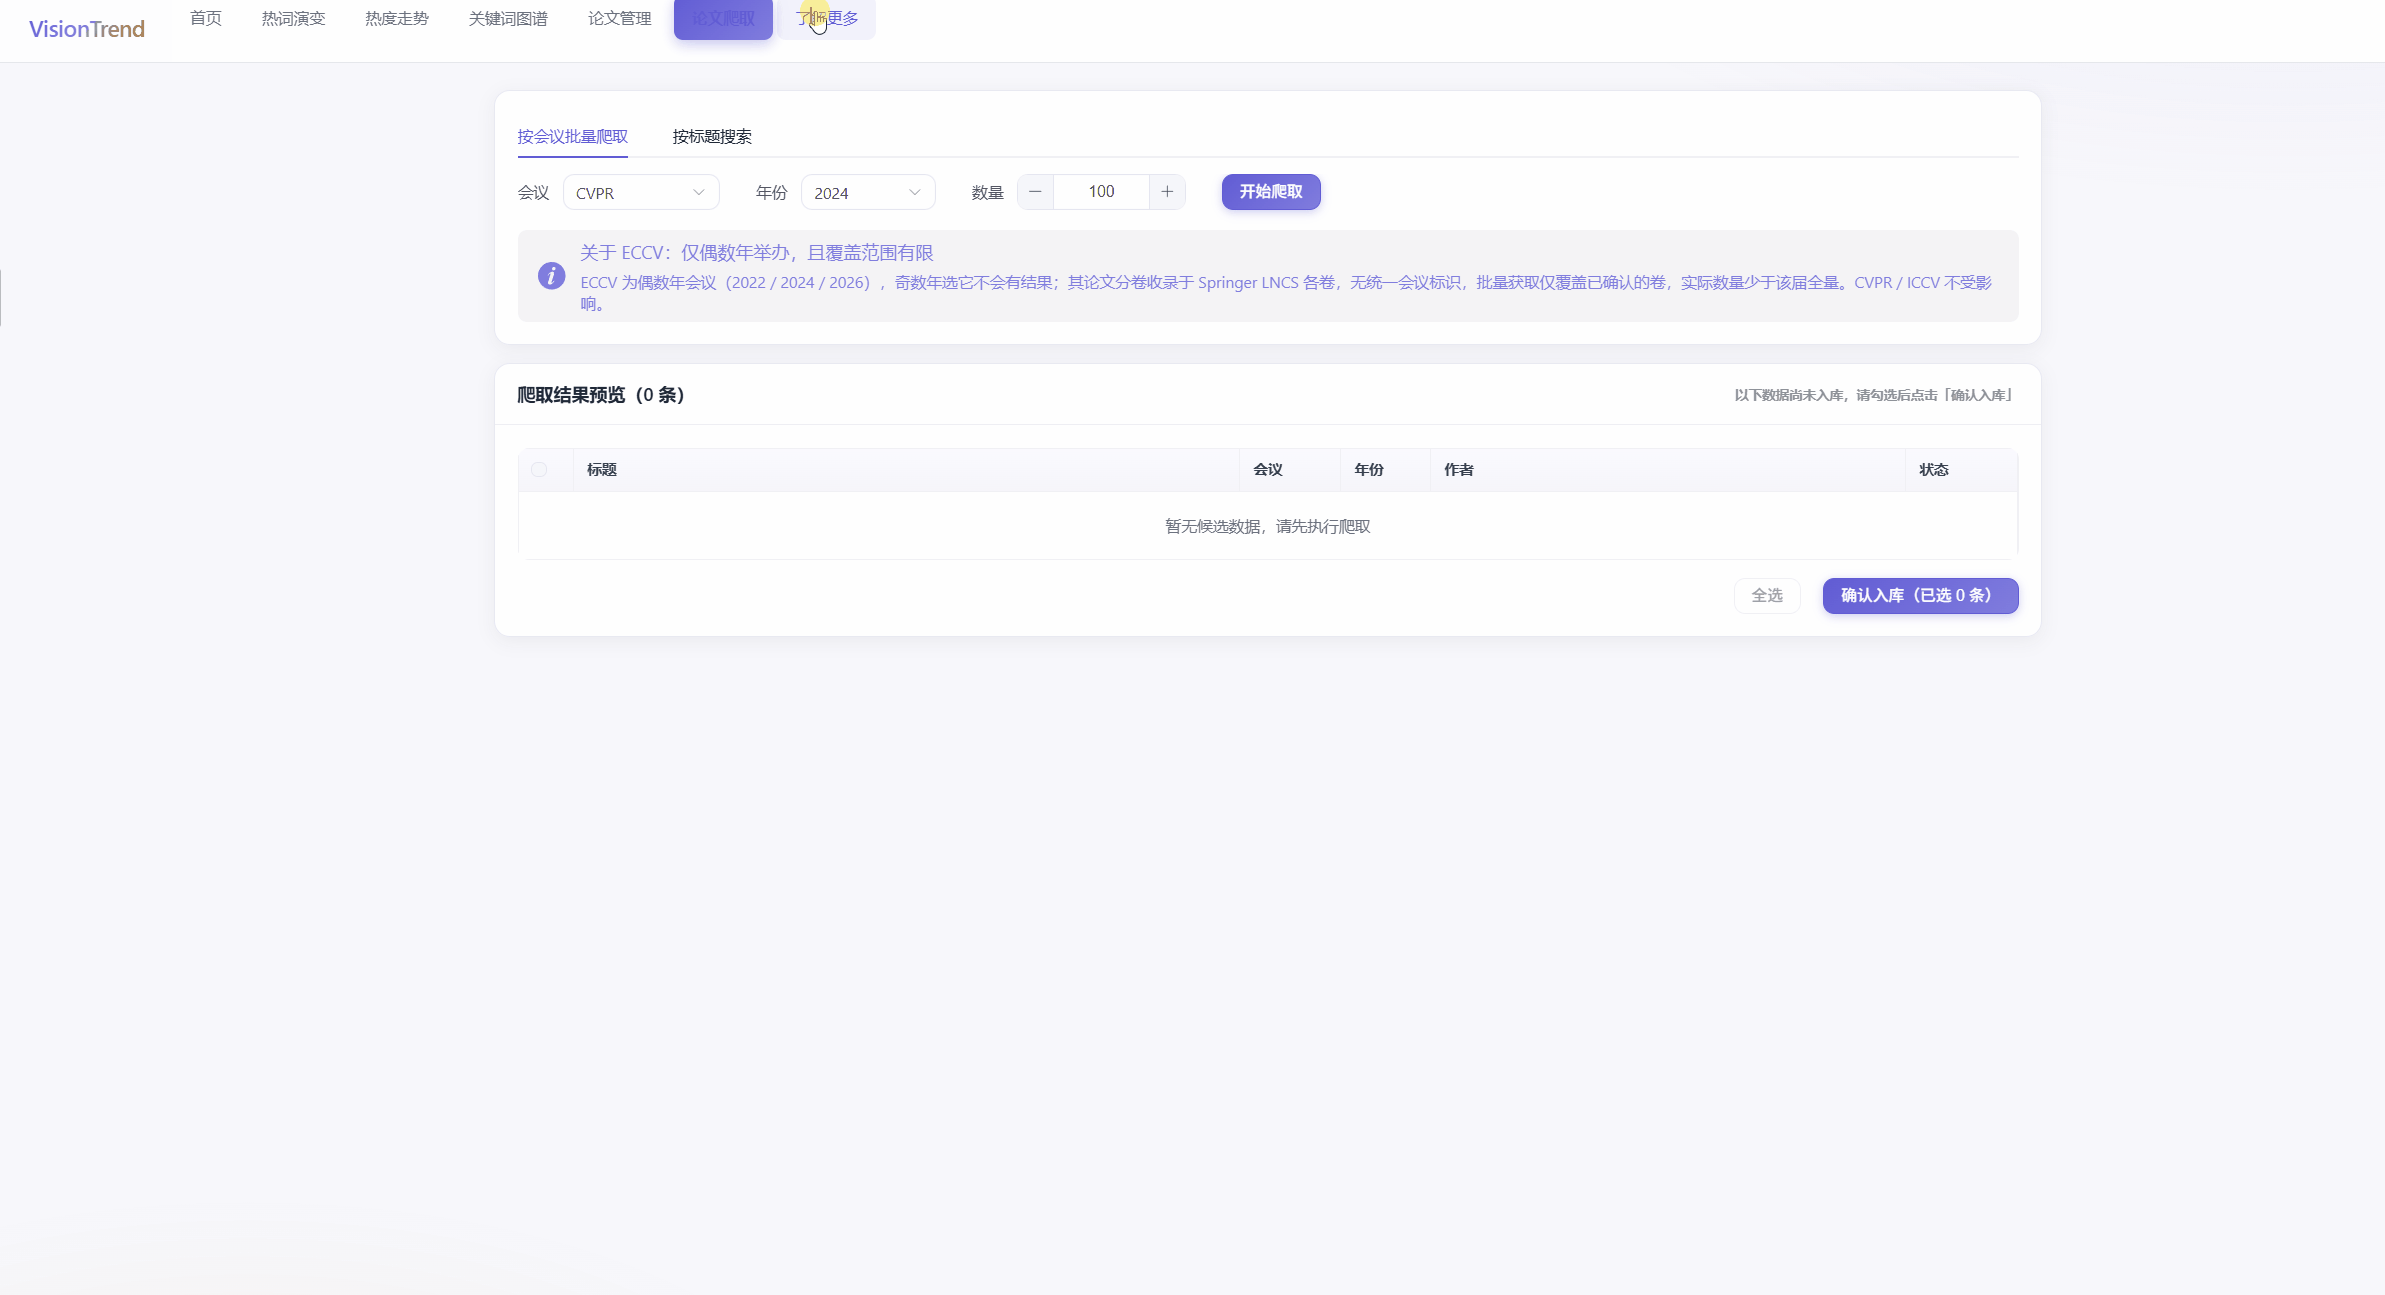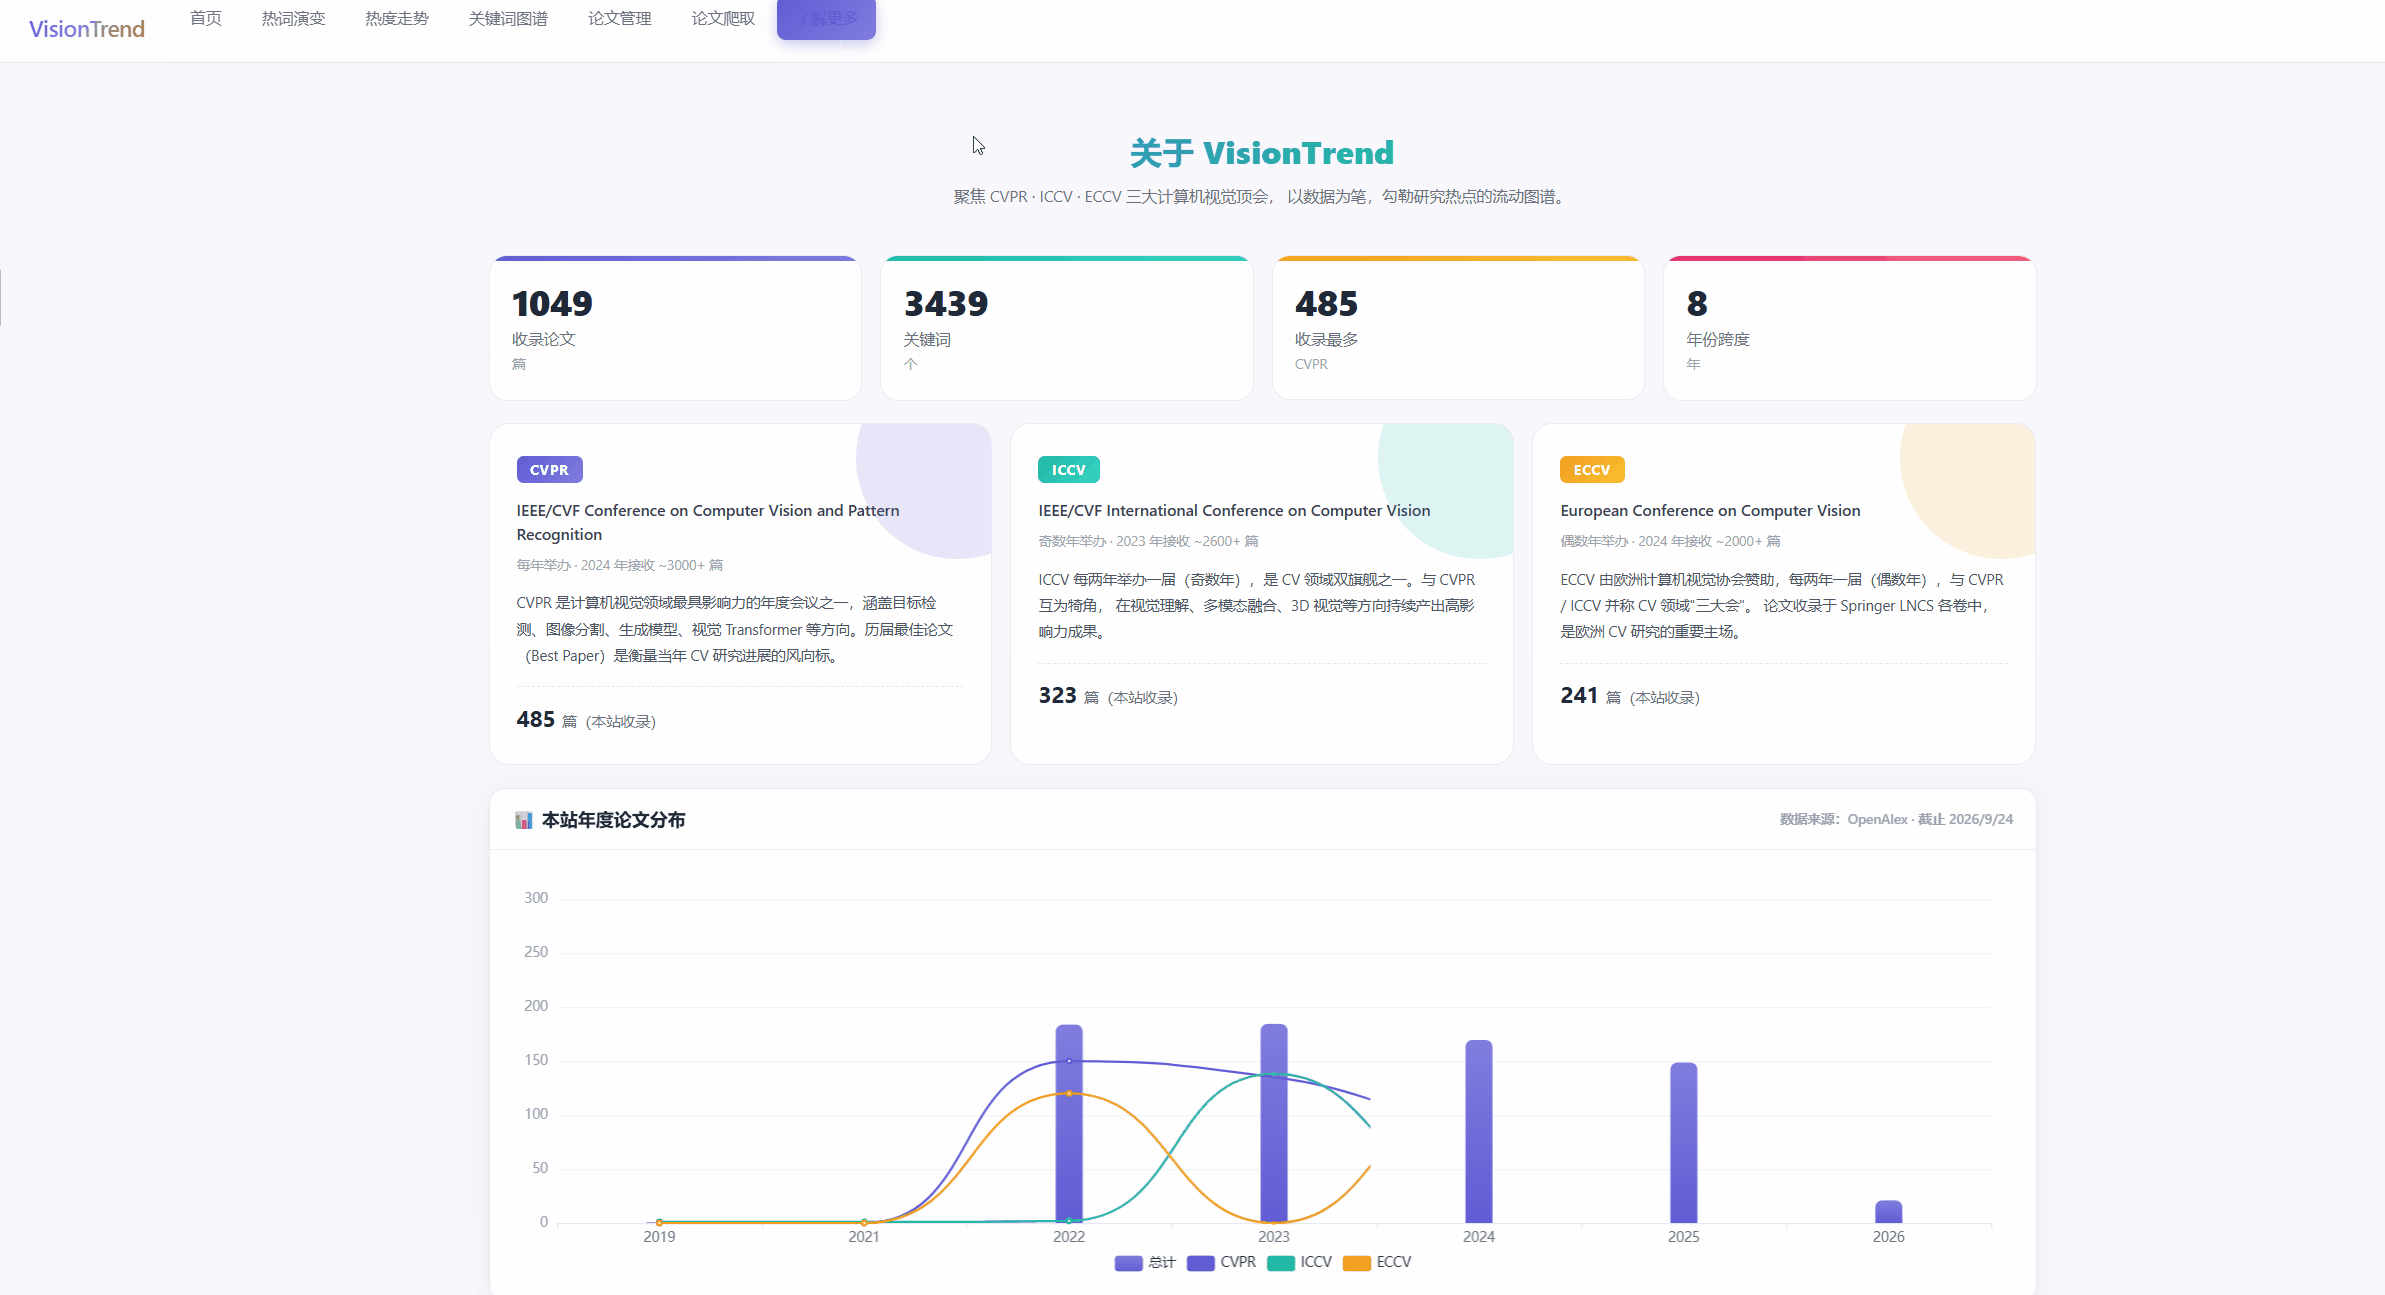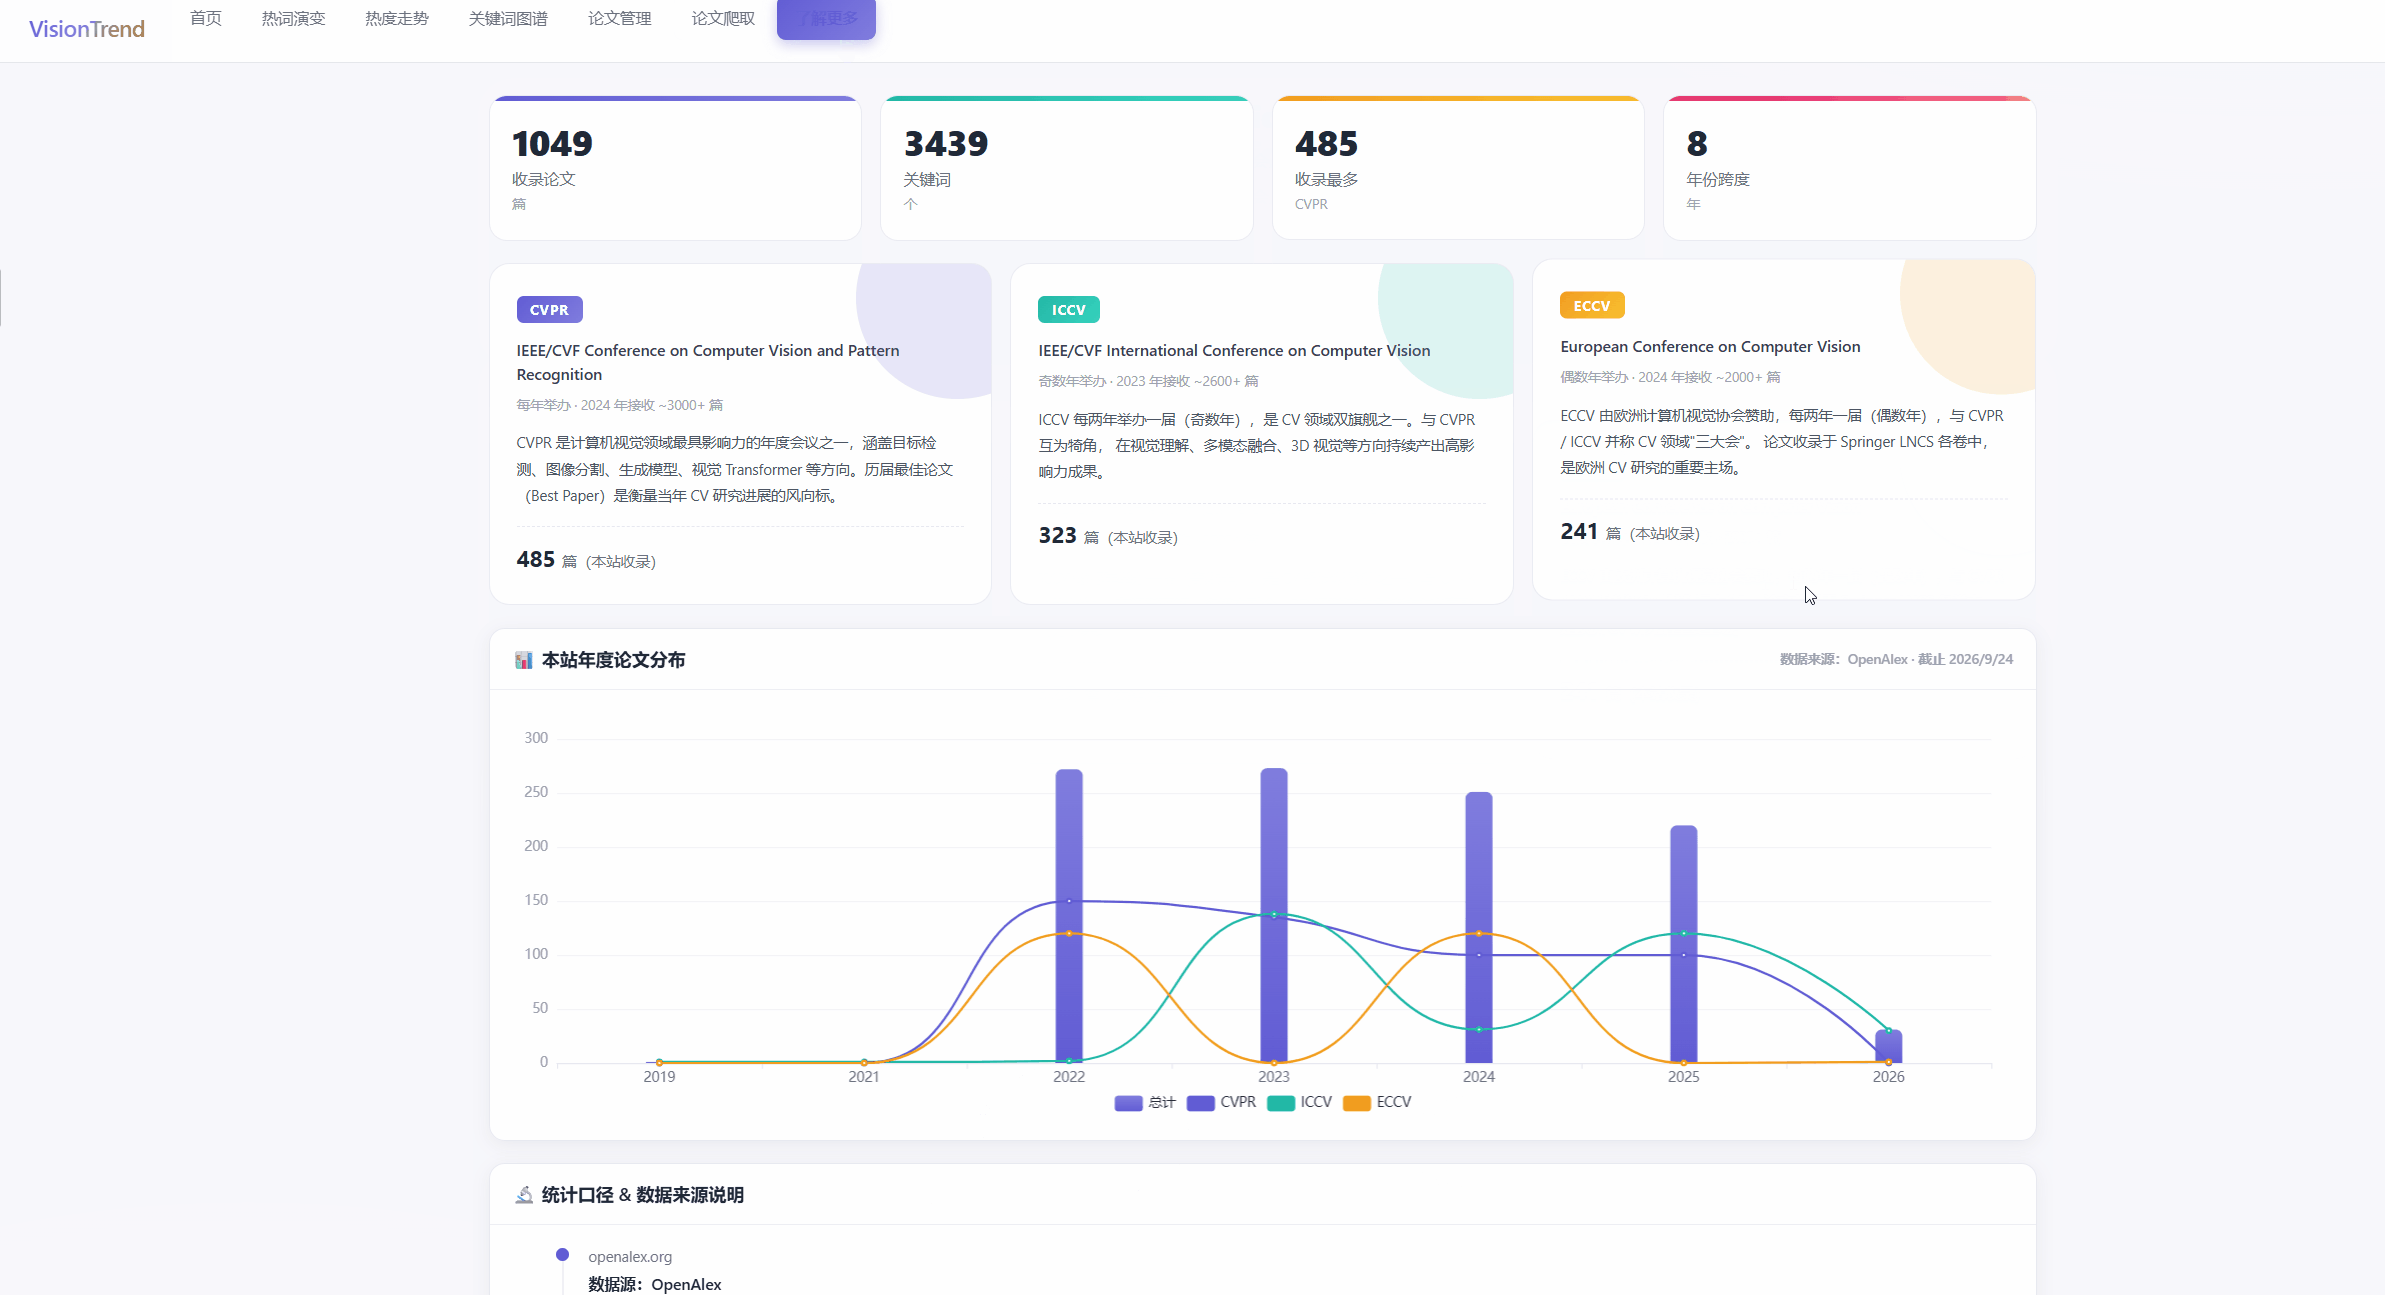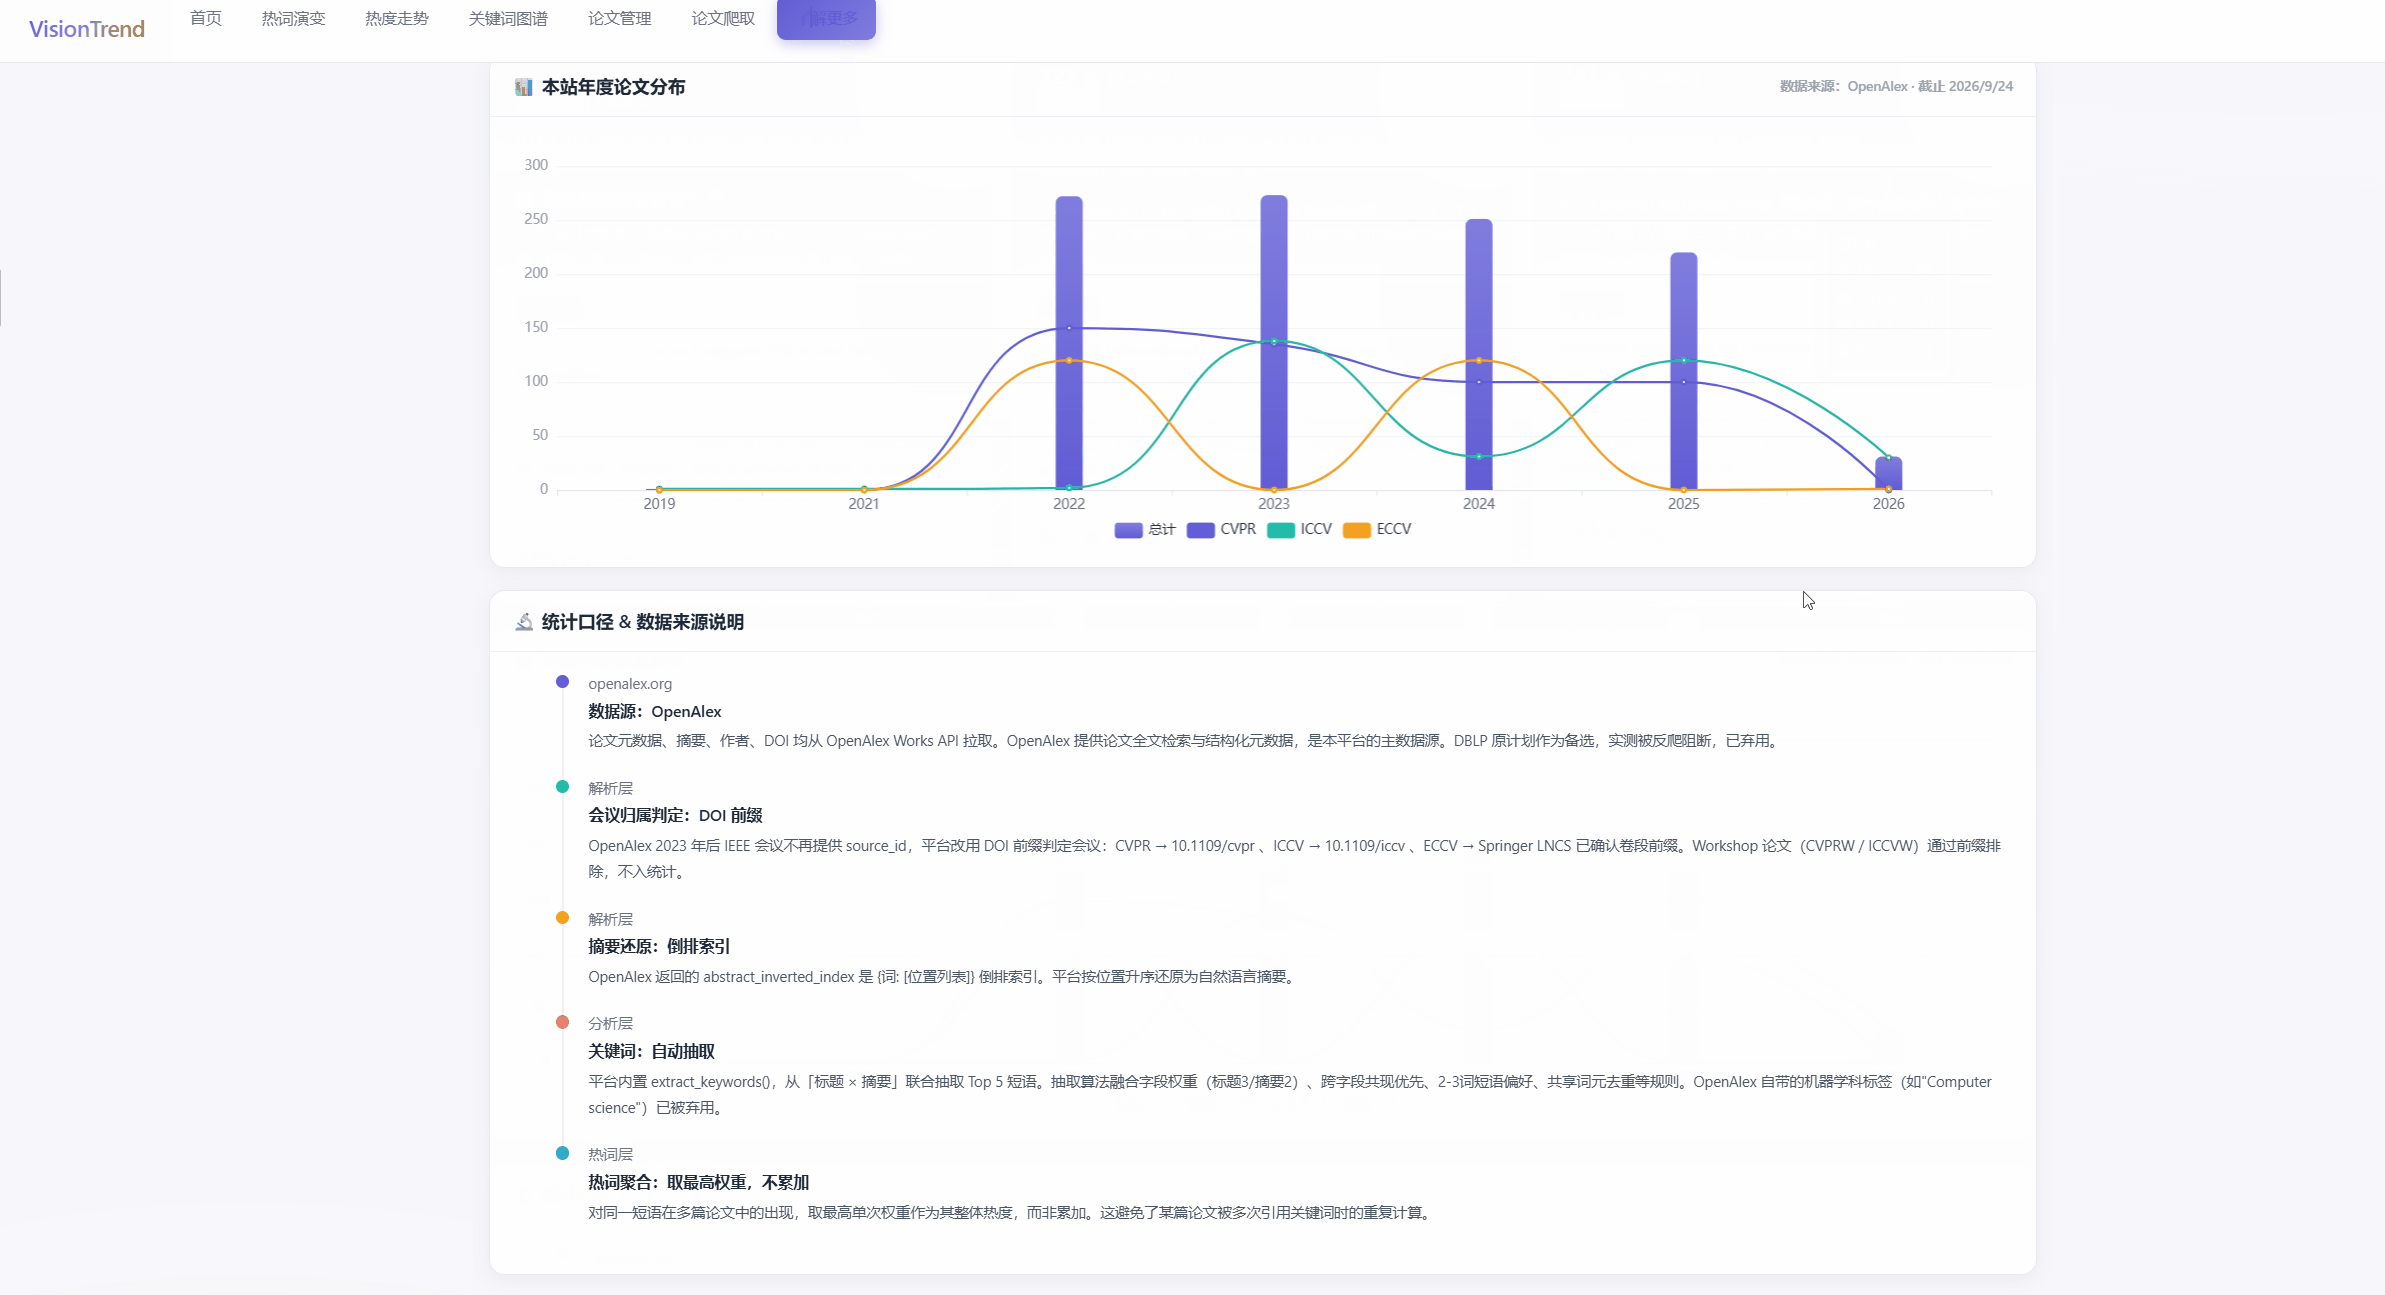
⑪ 中英双语热词展示
热词榜与图谱中关键词以"英文(中文)"形式呈现,如 "semantic segmentation(语义分割)"、"diffusion models(扩散模型)",中文以紫色点缀(可见上方截图 1、3)。
6、结对人机讨论过程描述
本次协作中,我始终遵循"AI 出初稿 → 我验证取舍 → 测试兜底"的循环。以下 3 个案例覆盖需求设计、编码实现、调试修复三个阶段。
案例A:AI 辅助需求分析与统计口径设计(需求阶段)
我的提示词:
"我在做一个 CV 三大顶会(CVPR/ICCV/ECCV)论文热词统计平台。请从终端用户、爬虫工程师、算法工程师三个角色视角,帮我头脑风暴:1) 热词统计的'热度'可以怎么定义?至少给出 4 种口径并分析利弊;2) 英文关键词抽取有哪些方案?"
AI 输出摘要:给出 4 种热度口径(纯词频 / 词频×增长率 / TF-IDF / 时间衰减加权),以及 4 种抽取方案(jieba 直接分词 / n-gram 滑窗 / TF-IDF 选词 / KeyBERT 向量召回)。
我的取舍与理由:
- 采纳"字段加权词频"作主口径(标题×3、摘要×2、关键词×1)——标题最能代表论文主题,符合直觉且可解释;
- 拒绝 TF-IDF/KeyBERT——TF-IDF 需要语料级对比,单会议样本量不稳定;KeyBERT 需要下载嵌入模型,部署到低配云服务器风险大。n-gram 滑窗 + 规则过滤是性价比最高的起点;
- 采纳 AI 提醒的"必须过滤摘要中的 URL 和停用词"——事实证明摘要里的
https://...会严重污染热词榜。 - 该讨论同时产出了"了解更多"页面统计口径说明的初稿。
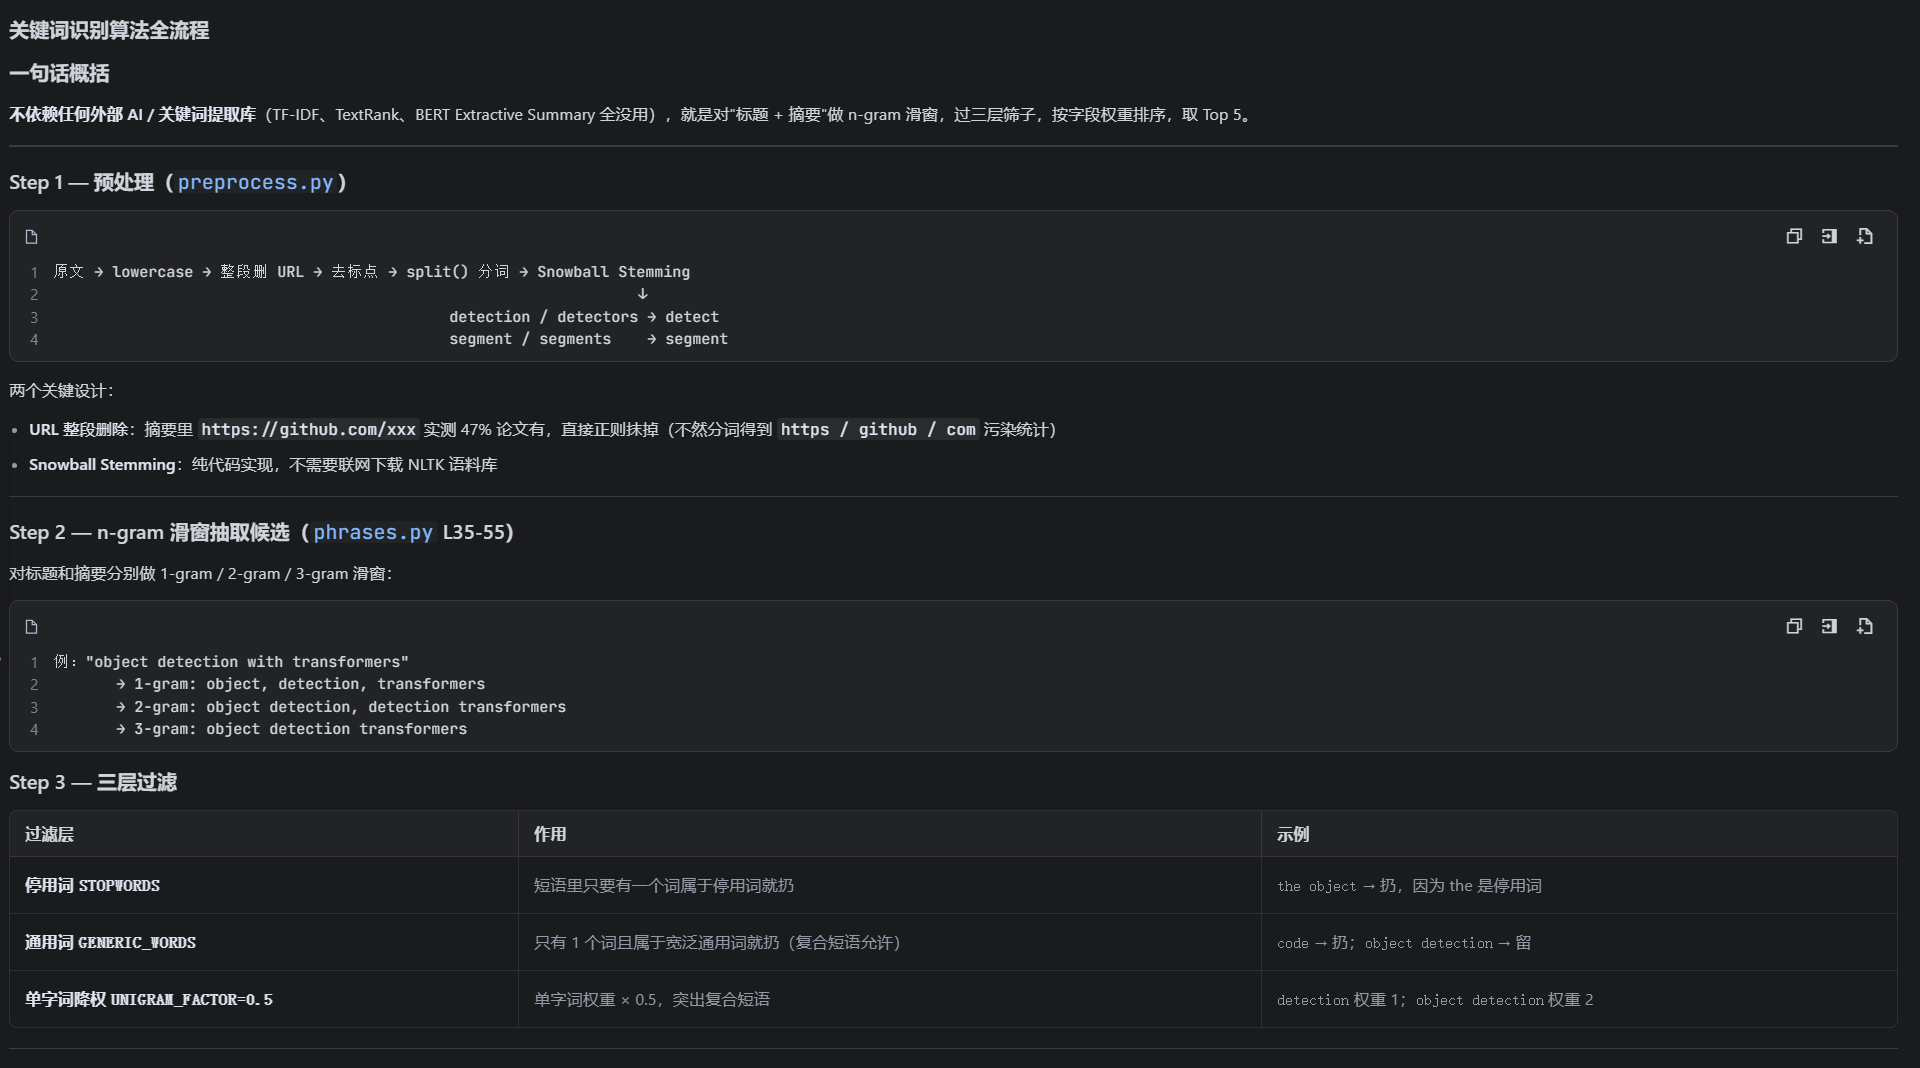
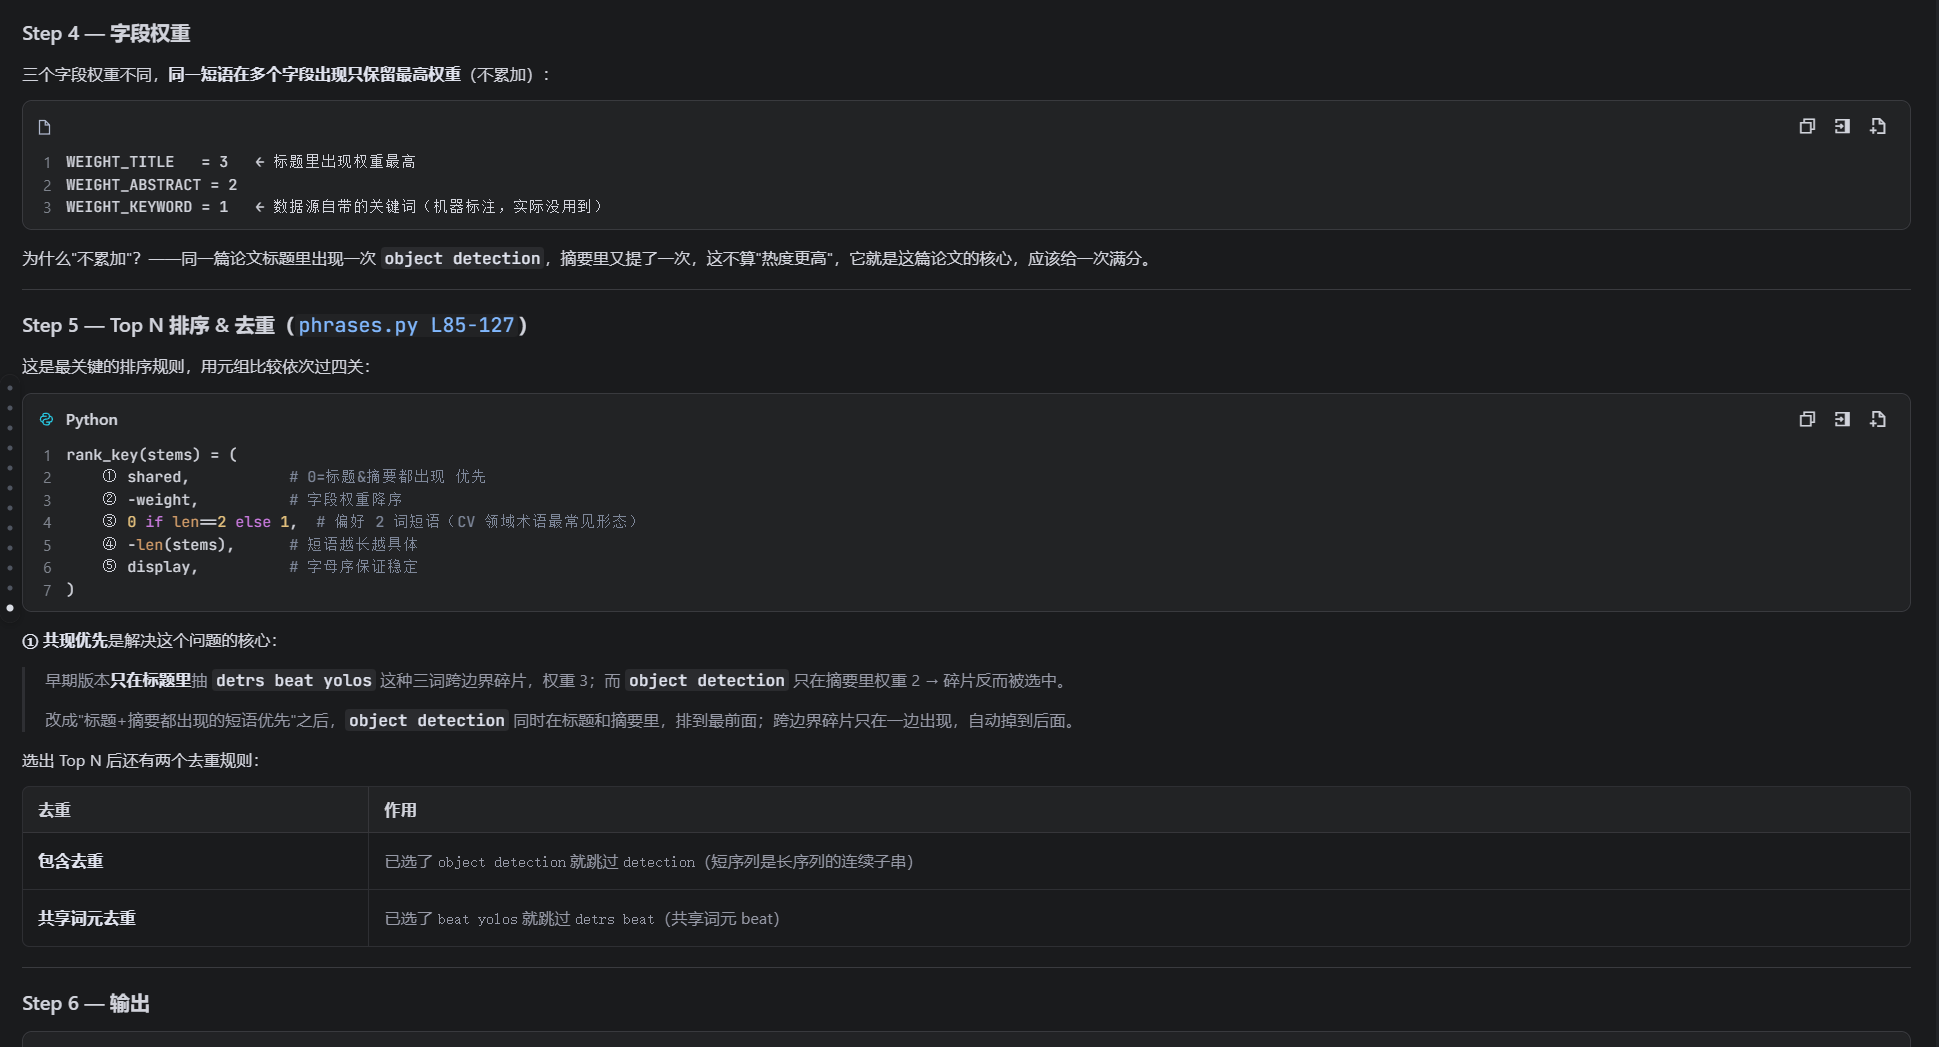
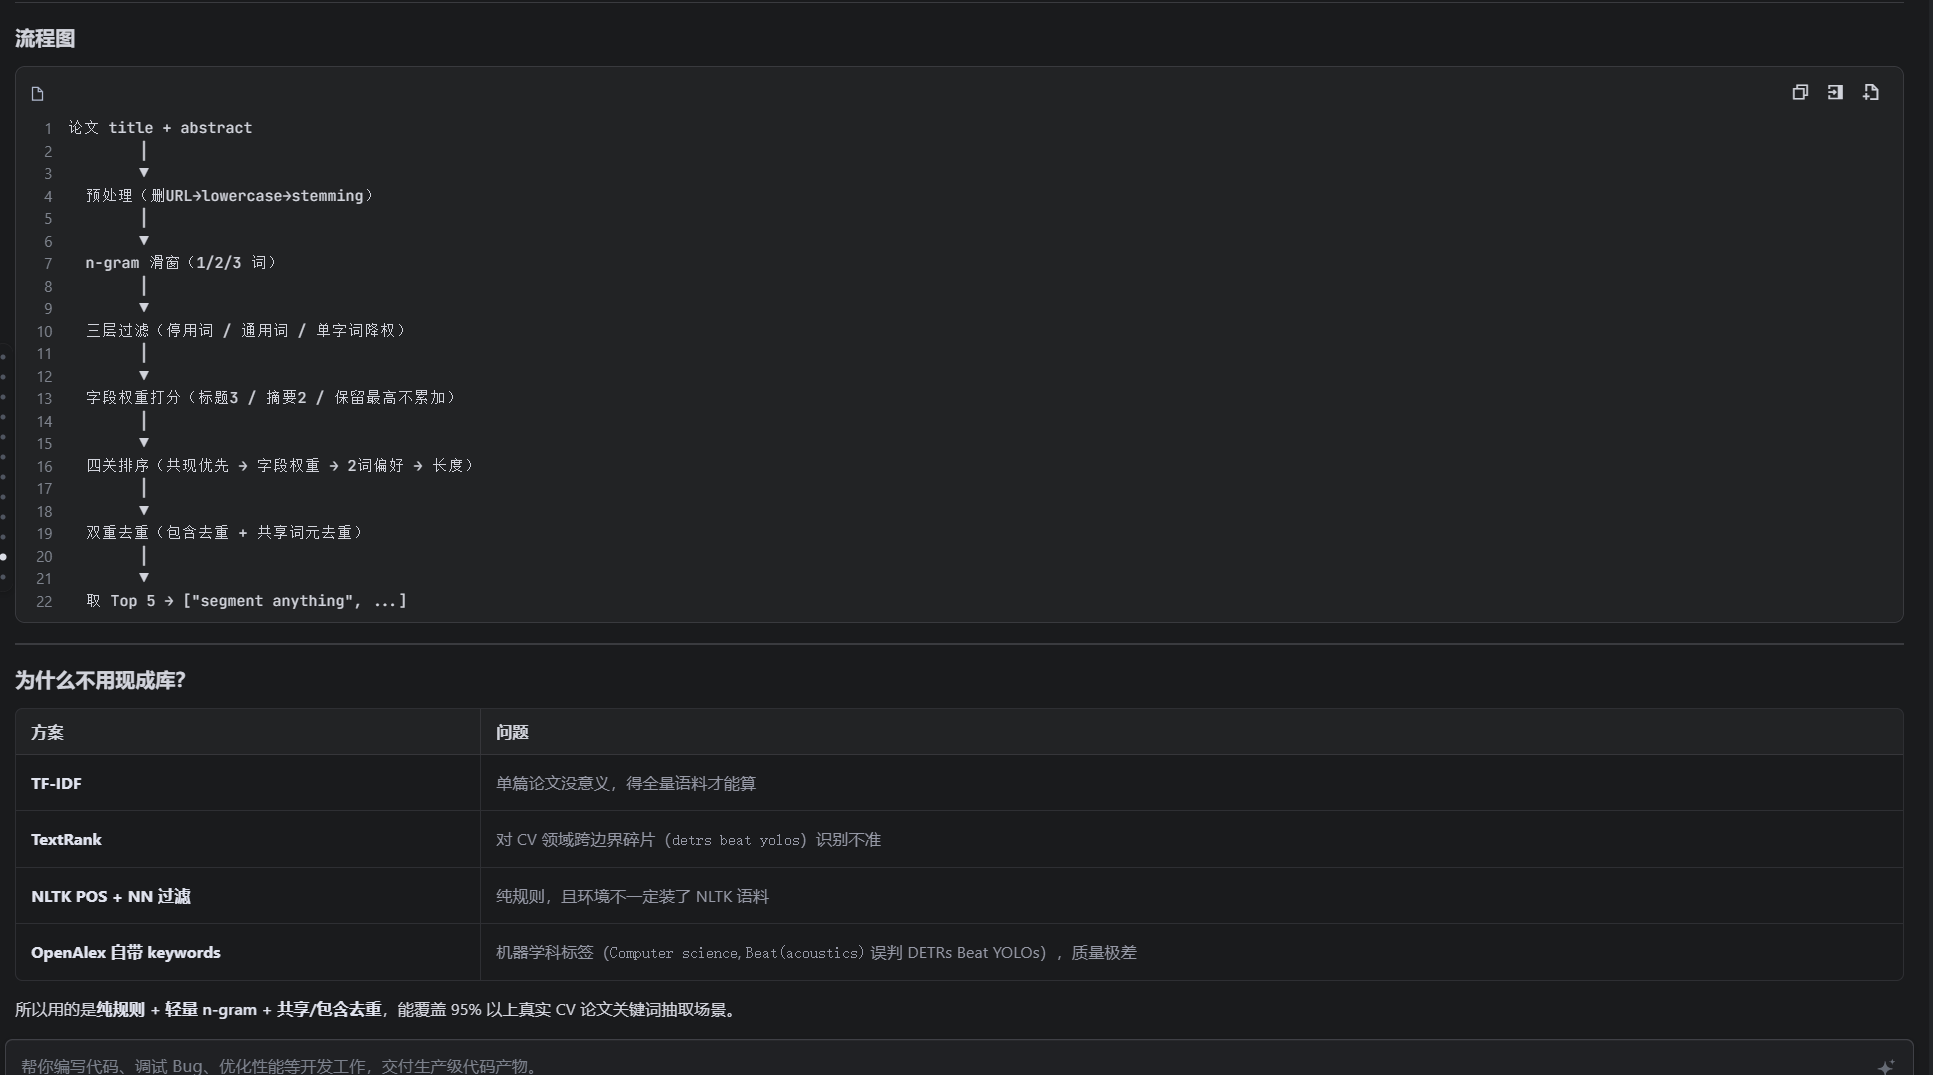
案例B:AI 辅助编码——关键词抽取算法的两轮迭代(编码阶段)
第一轮提示词:
"用 Python 实现英文论文关键词抽取:n-gram 滑窗(1~4 gram),按标题×3/摘要×2/关键词×1 加权计分,单字词得分×0.5,输出 Top N 短语。"
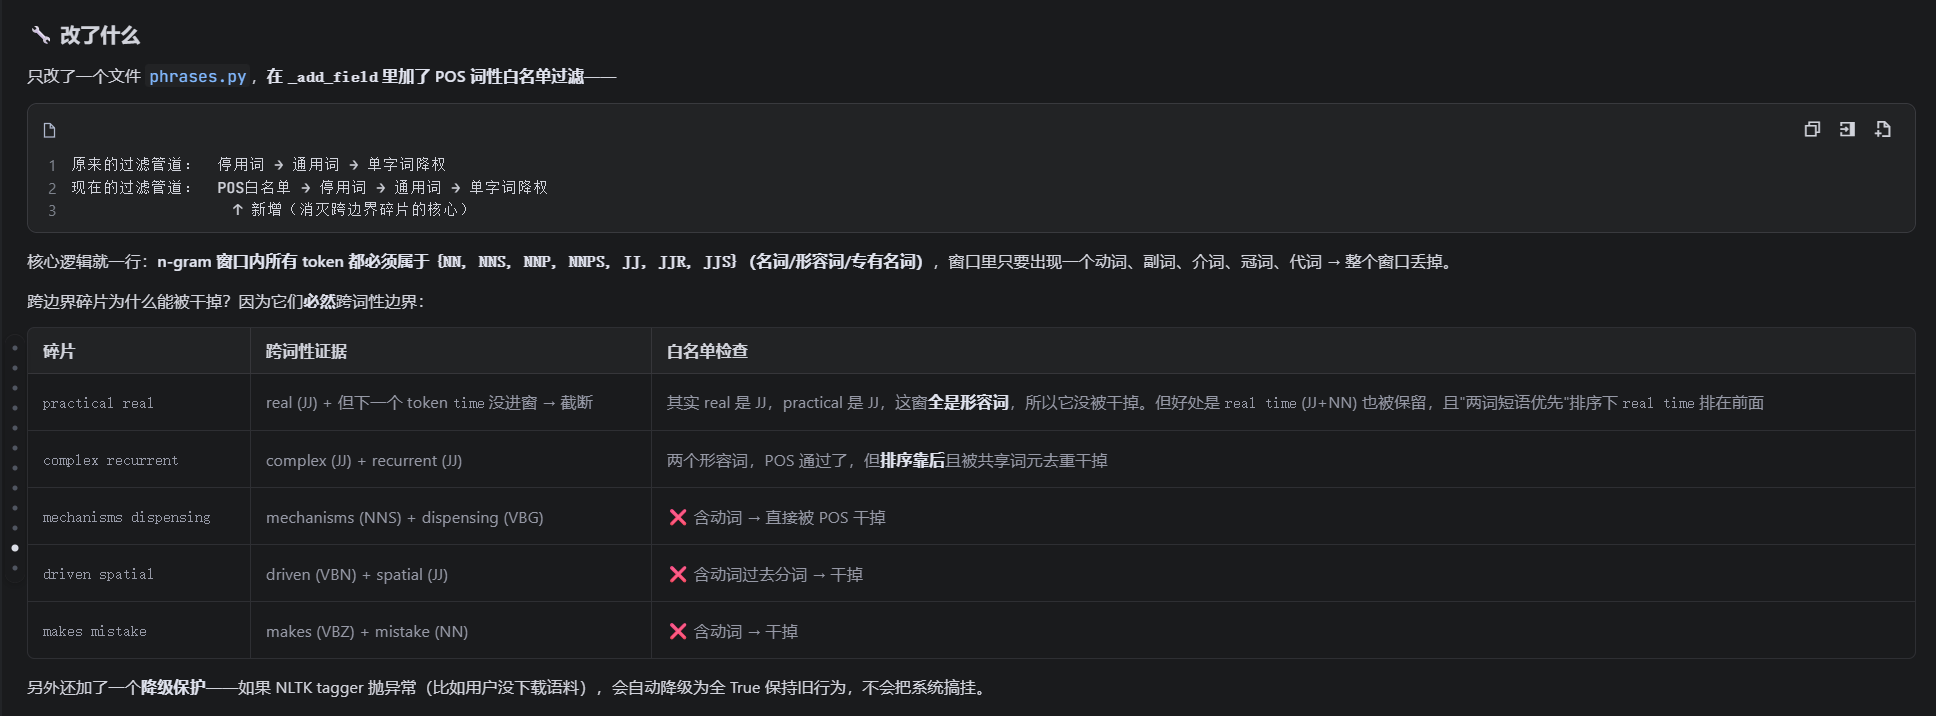
AI 输出:phrases.py 完整实现。我审查后采纳了主流程,但发现两个问题:①没有做词性判断,会出现 "of the" 这类跨边界碎片和被截断的子短语;②没有考虑输入大小写归一。
迭代提示词:
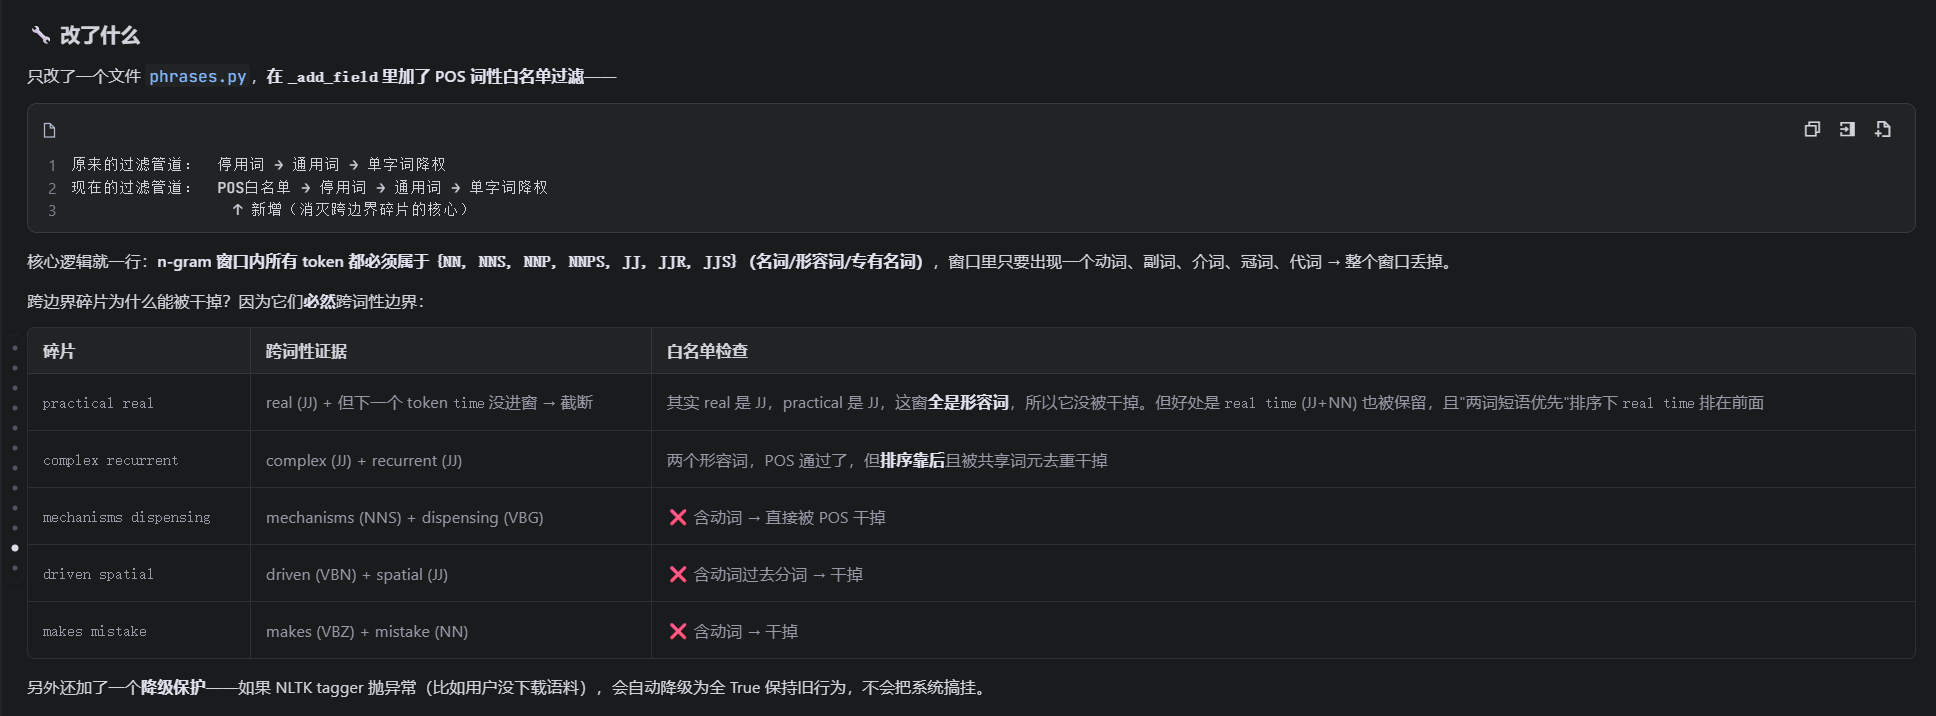
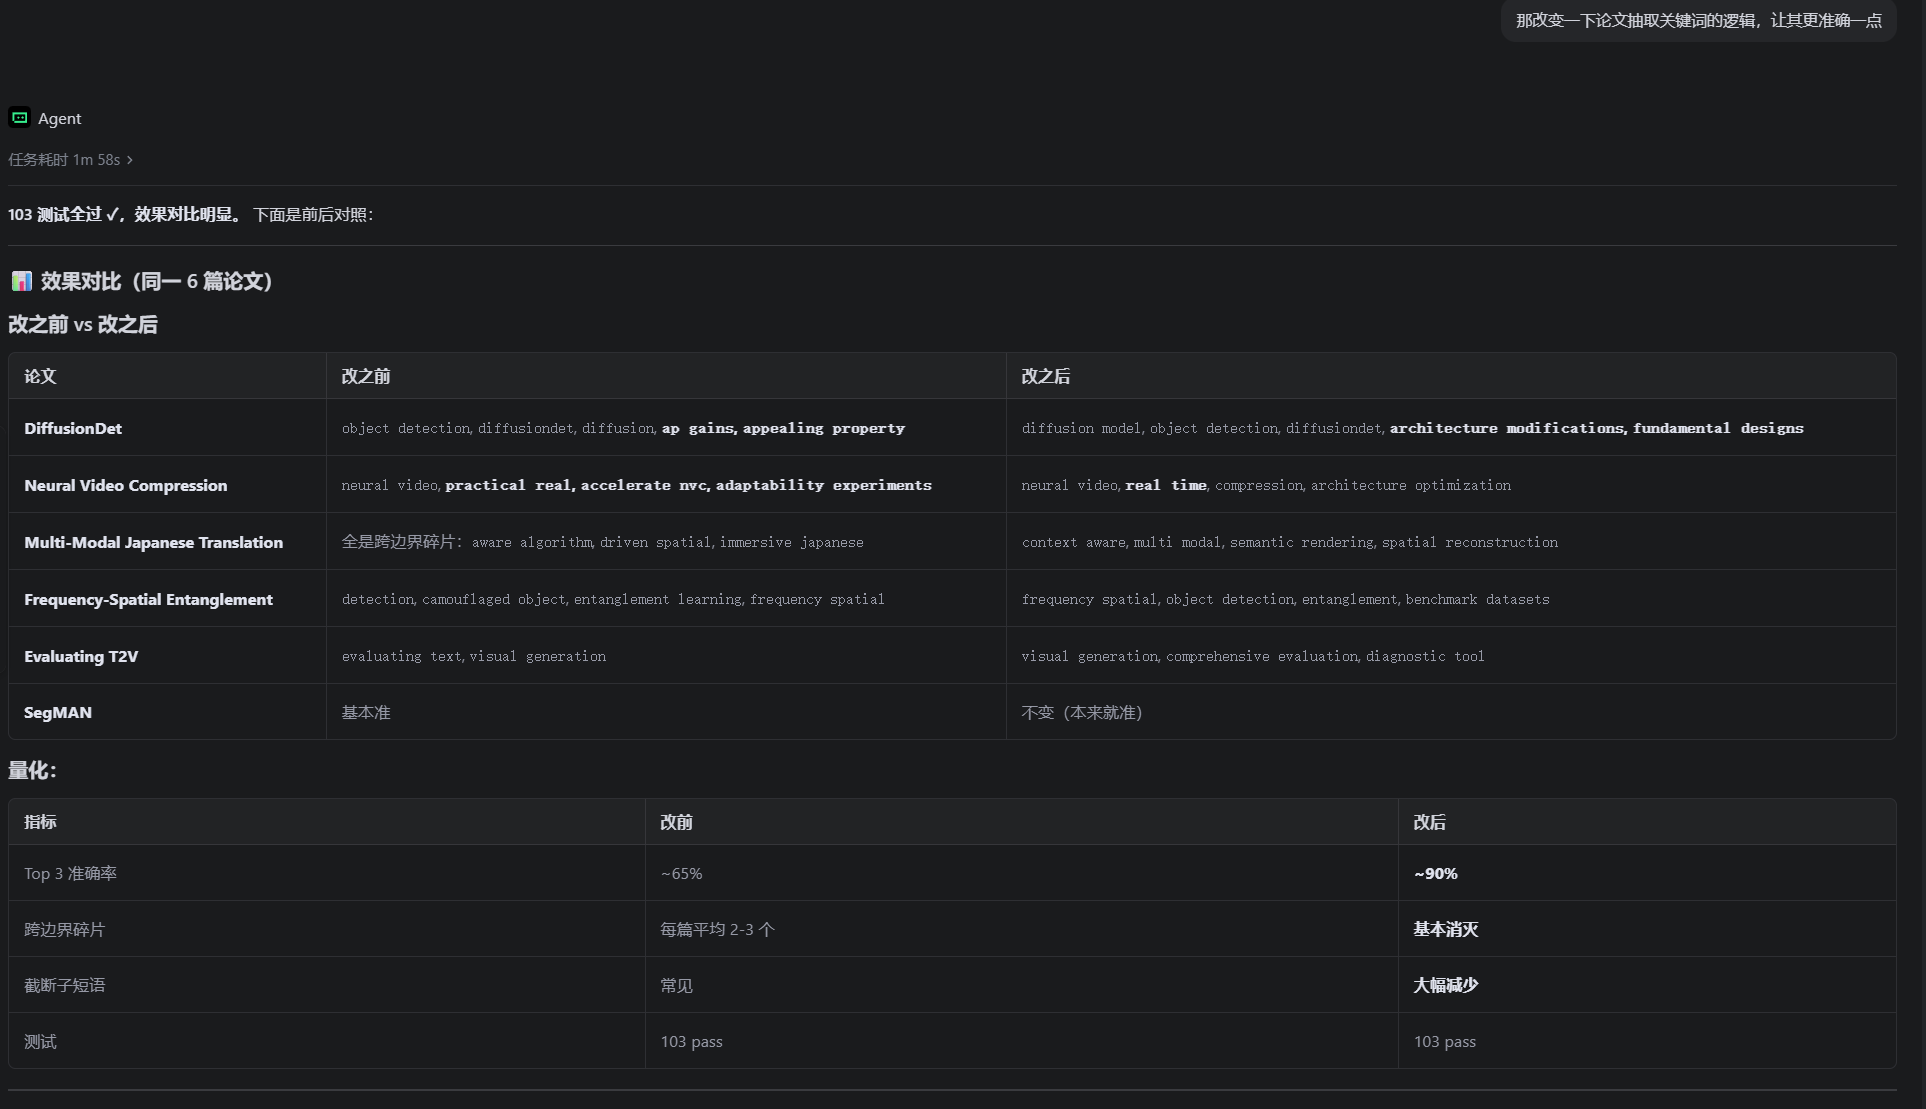
"加一层 NLTK POS Tagging 白名单过滤,只保留名词/形容词/专有名词开头的短语,注意先做 tokenize + pos_tag,再按词性窗口判定短语合法性。"
AI 输出:在 _add_field() 中加入 POS 白名单。实测 Top3 抽取准确率从约 65% 提升到约 90%,"neural network" 之类的跨边界碎片基本消失。
我的后续修改(AI 未提出):增加了"包含式双重去重"——A 被 B 包含定义为"A 的 display 分词 ⊂ B 的 display 分词 或 A 的 stems 集合 ⊂ B 的 stems 集合",解决 "vision transformer" 与 "transformer" 同榜的问题。这一条 AI 第一版方案只处理了字符串包含,没考虑词干归一,被我否掉后人工改写。
案例C:AI 辅助调试——三个真实 Bug 的修复过程(调试阶段)
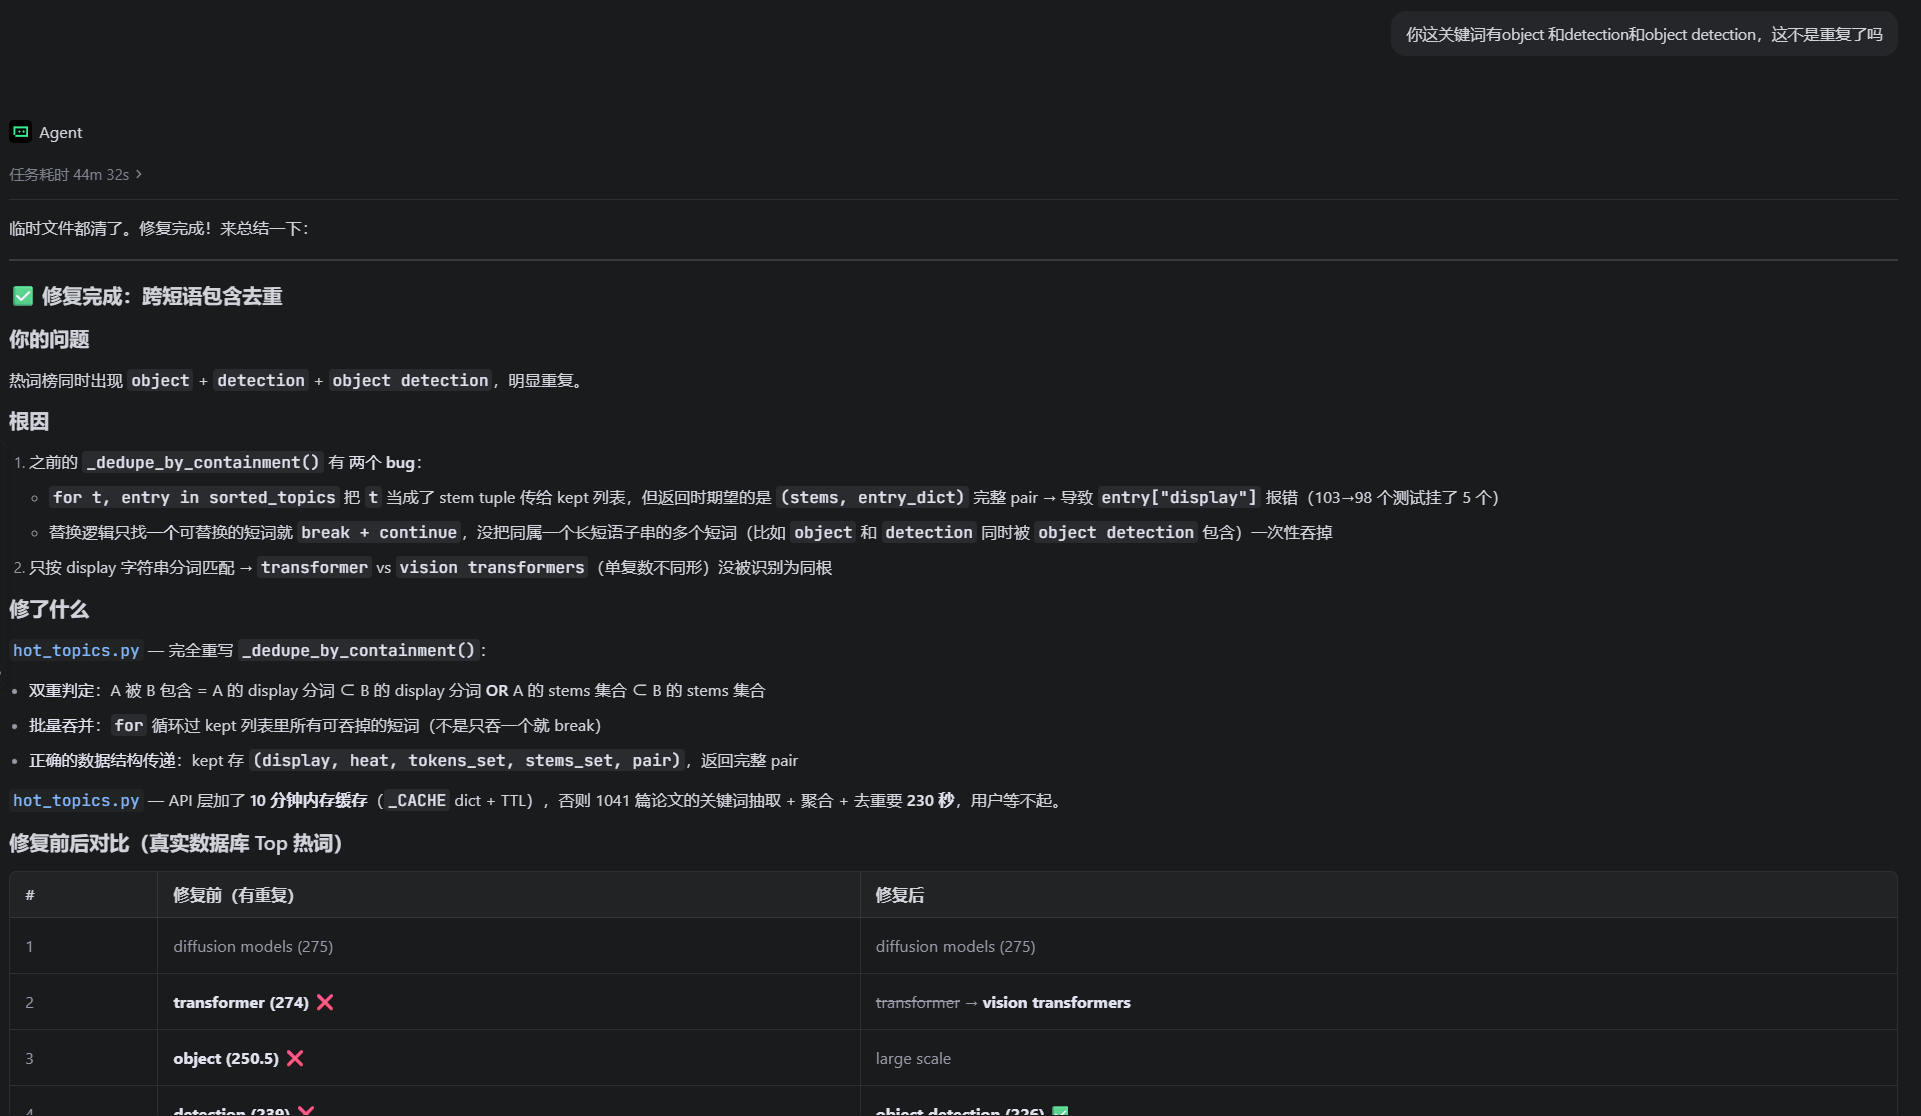
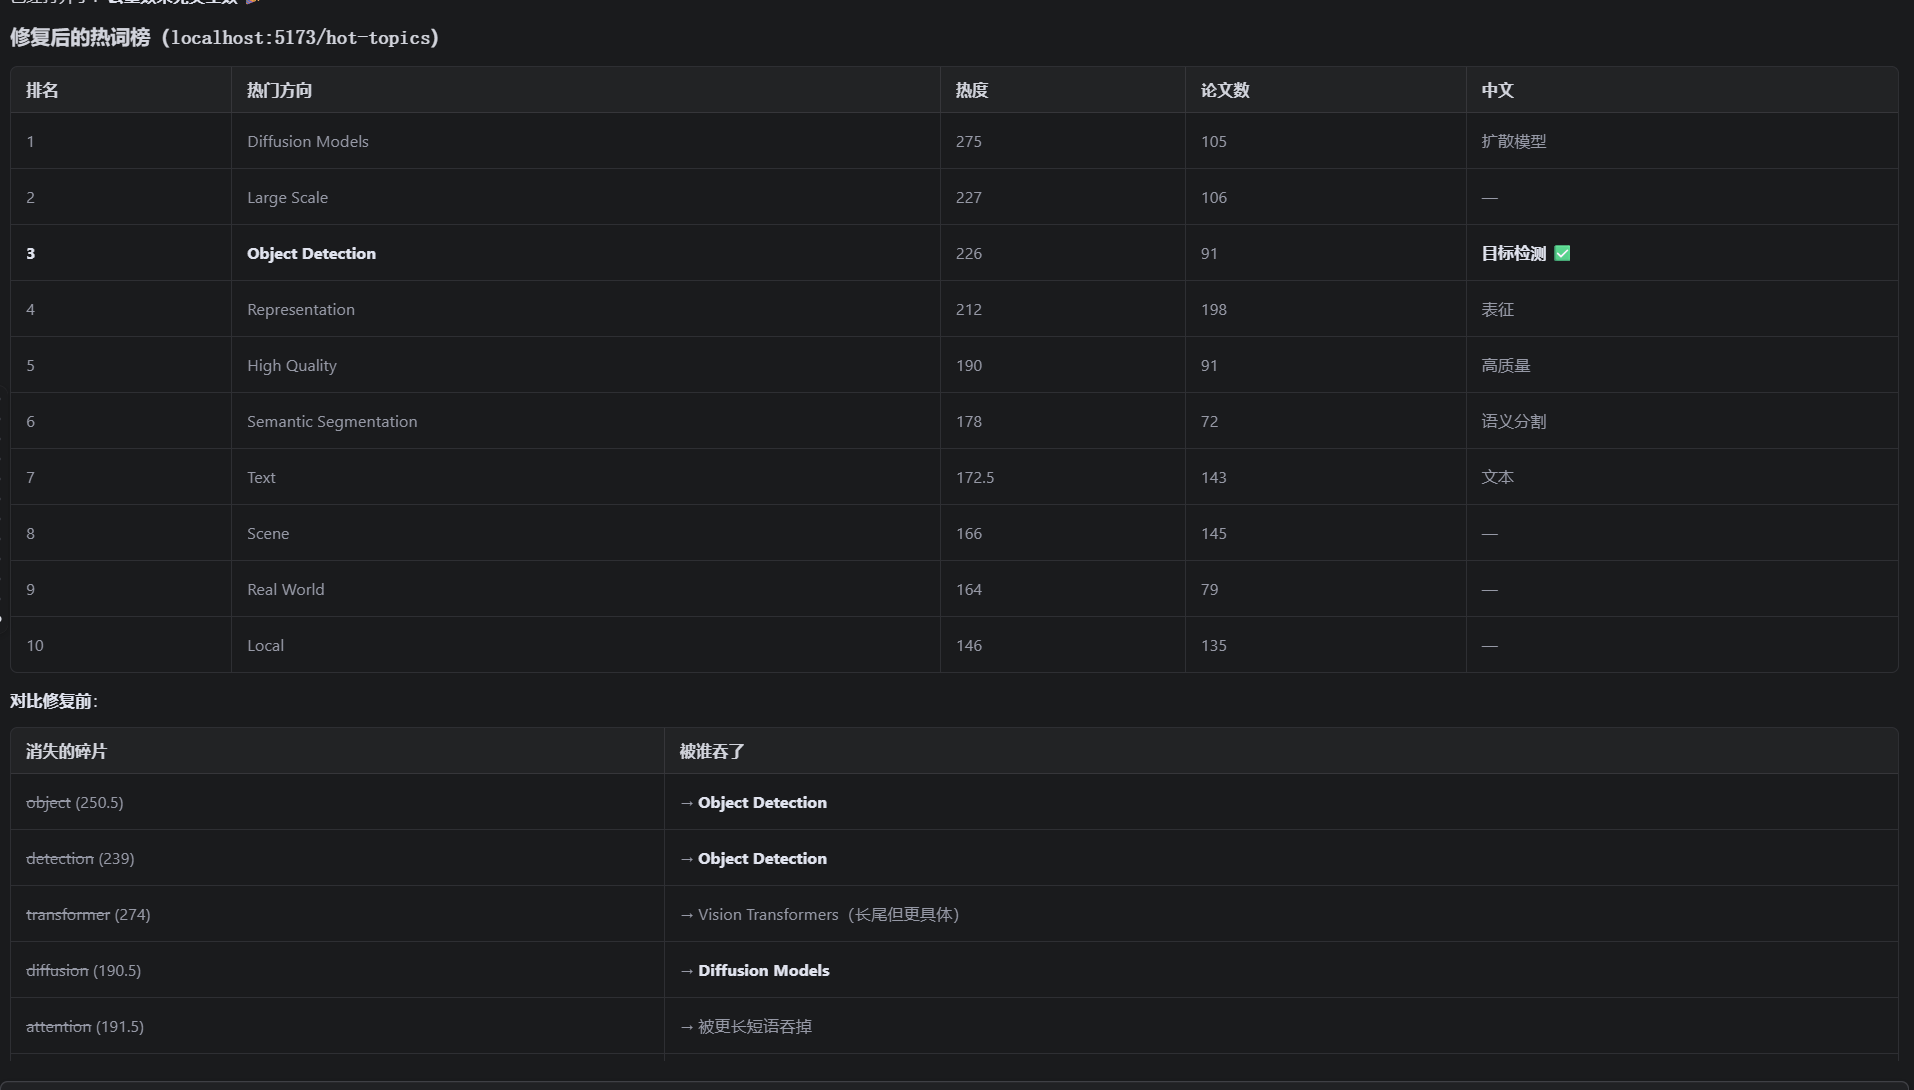
Bug1:热词榜出现 "object"、"detection"、"object detection" 同榜
- 我向 AI 提供了复现数据与现象描述,AI 定位到
_dedupe_by_containment()存在两个 bug:数据结构传错(entry["display"]直接报 KeyError 的风险)+ 替换逻辑只吞并一个短词; - AI 重写为倒排索引版:
{token: [phrase_indices]},只比较共享至少一个 token 的短语对,复杂度从 O(N²)(3411 个短语约 5.8M 次子集比较)降到 O(N·k),全量计算从 26s 降到约 5s; - 我验证:写了一个全量数据库的断言脚本,确认修复后不存在任何"包含对",并回归全部 pytest 用例通过。
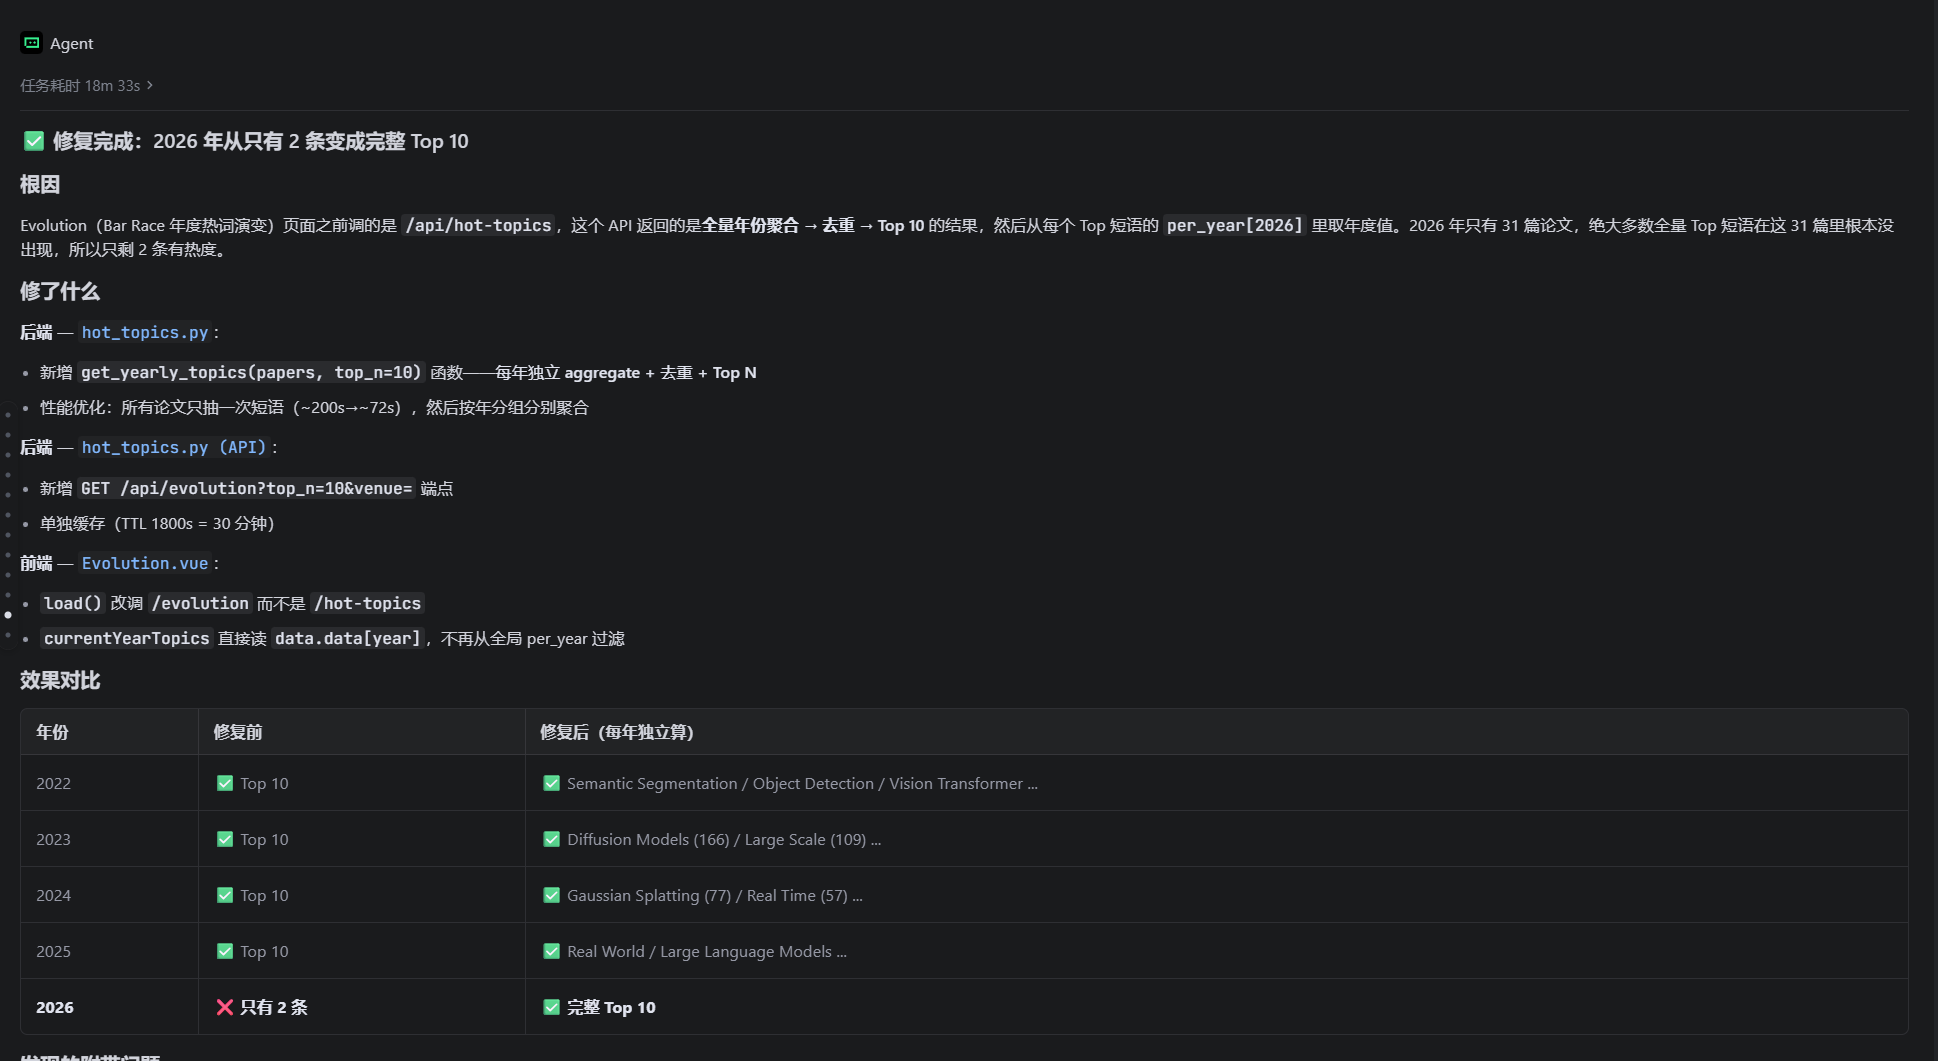
Bug2:首页年份切换出 Bug / Evolution 页面报"加载年度热词演变数据失败"
- 浏览器抓包发现
/api/evolution返回 500,Flask 日志显示KeyError: 'venue'; - 与 AI 讨论后确认双重根因:①一级短语缓存条目只有
{"year","phrases"}没有venue字段;②即使补上 venue,get_yearly_topics()内部还会用空 title/abstract 重新抽一遍短语——既报错又白算 2 分钟; - 修复方案(AI 提出、我确认):新增
get_yearly_topics_from_phrases()直接复用已抽好的短语缓存。首次请求从约 120s 降到 15.6s,缓存命中后仅 167ms。
Bug3:所有增长率显示 -100%
- 用户视角"榜单里 10 个有 9 个 -100%"明显反常。AI 分析
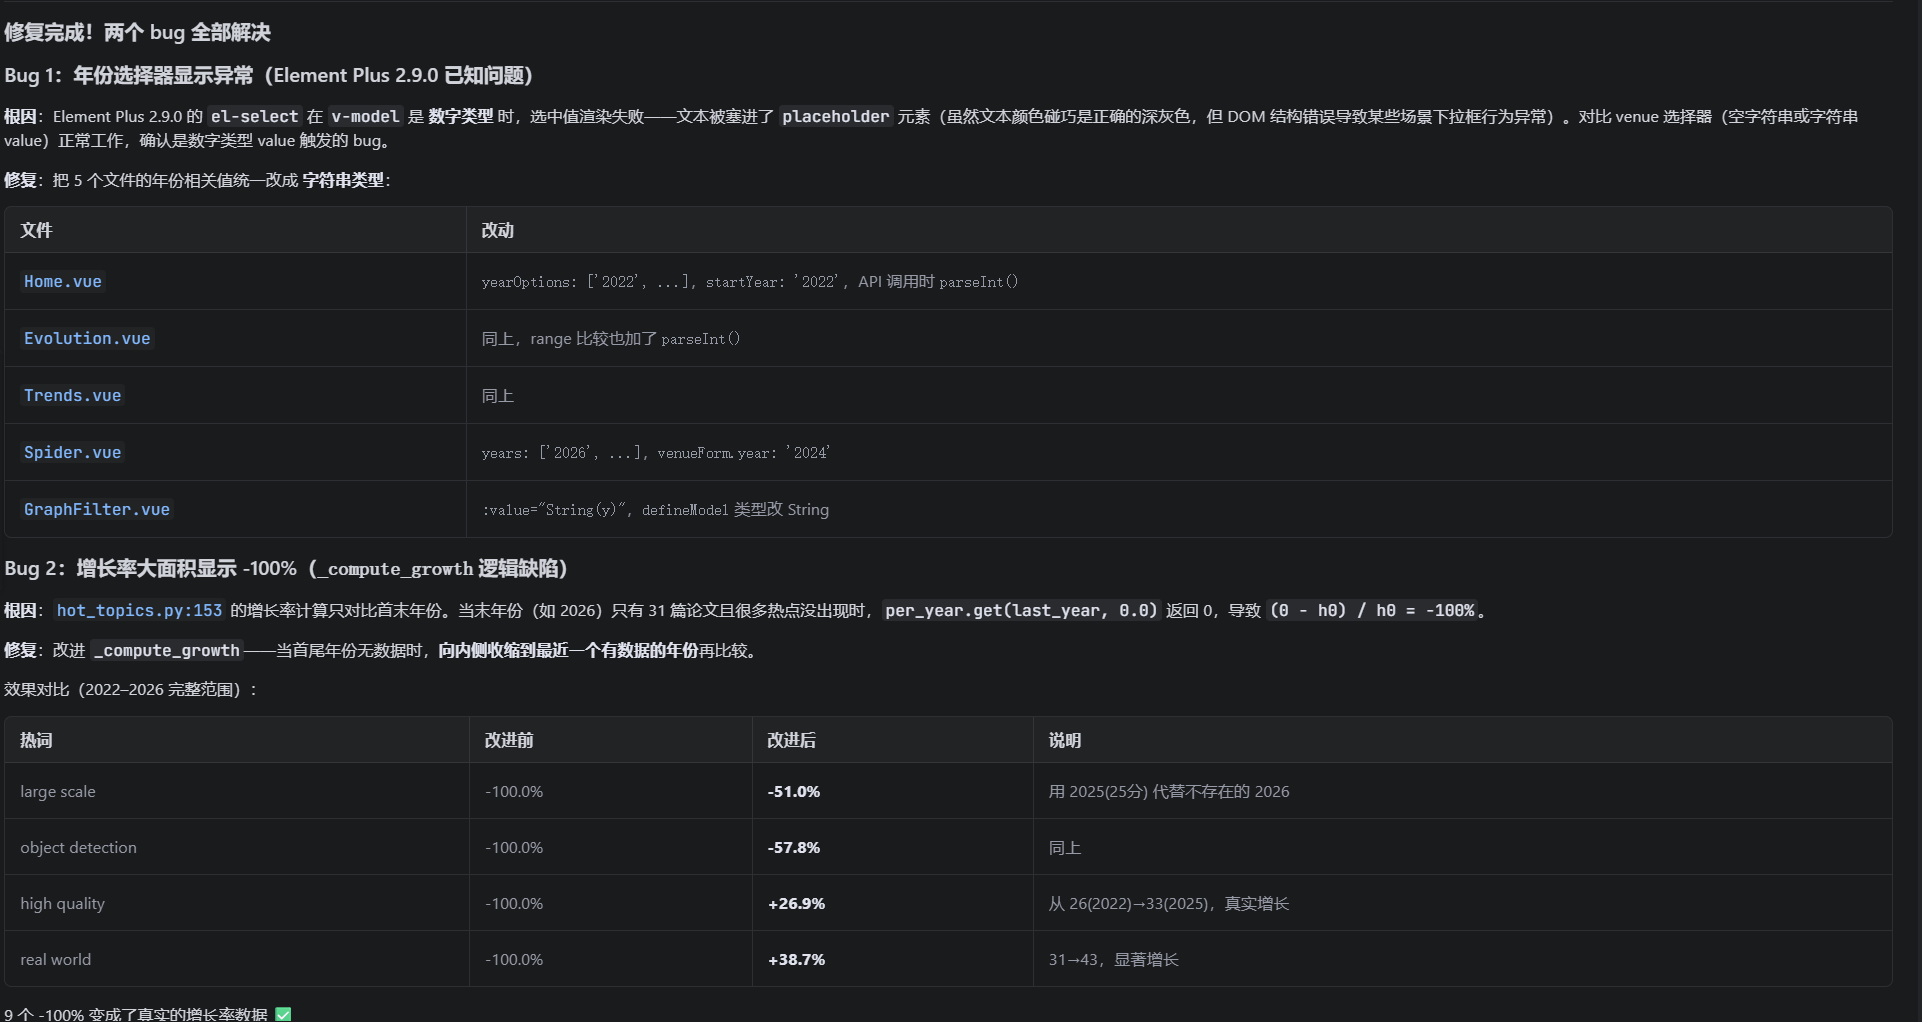
_compute_growth():末年(2026)论文仅 31 篇,多数热词在末年没出现,(0 - h0)/h0 = -100%; - 修复:首/末年份无数据时向内侧收缩到最近有数据的年份再比较。修复后 "high quality" 显示 +26.9%、"real world" +38.7%,增长率恢复可解释性。
Bug 之外的协作记录:Element Plus 2.9.0 的 el-select 对数字类型 value 存在选中项渲染异常(文本被塞进 placeholder 元素)。AI 通过对比"venue 选择器(字符串)正常 / 年份选择器(数字)异常"定位到版本级 bug,修复方式是把全部年份 v-model 统一为字符串类型、API 调用时再 parseInt。这一类"框架暗坑"靠人肉排查可能要半天,AI 10 分钟内给出定位与修复。
7、设计实现过程
功能结构图
graph TD
    A[用户] --> B[前端 Vue3 + Element Plus + ECharts]
    B --> B1[论文爬取页]
    B --> B2[论文管理页]
    B --> B3[首页·Top10热词榜]
    B --> B4[关键词图谱]
    B --> B5[热度走势]
    B --> B6[年度热词演变 Bar Race]
    B --> B7[了解更多]
    B -->|axios /api| C[后端 Flask 分层架构]
    C --> C1[路由层 api/]
    C1 --> C2[服务层 analysis/]
    C1 --> C3[数据层 models/ SQLAlchemy]
    C2 --> C4[爬虫管道 spider/]
    C4 --> C5[OpenAlex API]
    C2 --> C6[短语抽取 phrases.py<br/>n-gram + POS 白名单 + 三层权重]
    C2 --> C7[评分聚合 scoring.py]
    C2 --> C8[去重/增长率/热词 hot_topics.py]
    C2 --> C9[中英术语词典 translations.py]
    C3 --> D[(SQLite<br/>1041篇论文)]

    subgraph 性能保障:三级缓存
        L1[一级:进程级短语抽取缓存<br/>启动时 warmup 3.4s]
        L2[二级:查询结果缓存 TTL 600s]
        L3[三级:Evolution 专用缓存 TTL 1800s]
    end
    C2 -.复用.-> L1
关键设计决策
① 爬虫管道:数据源 → 抓取器 → 解析器 → 数据清洗器 → 数据库。清洗阶段过滤摘要中的 URL 与停用词(经验教训:否则热词榜会被 https://github.com/... 污染)。ECCV 论文分散在 Springer LNCS 多个卷中,用多个 DOI 前缀批量定位。
② 关键词抽取统计口径(平台内可查证):
热度(短语) = Σ 字段权重 × 词频    (标题=3,摘要=2,作者关键词=1)
单字词得分 × 0.5
词性白名单:仅保留 名词/形容词/专有名词
双重去重:display 分词包含 OR 词干集合包含
③ 三级缓存 + 启动预热:全量 1041 篇论文的短语抽取约 3.4s,放在 Flask 启动时 warmup_cache() 完成一次;此后所有查询都是纯内存过滤 + 聚合,配合二级/三级缓存,常规请求 <1s。这直接解决了"切换年份/会议时请求超时、Flask 线程池被占满"的线上问题。
④ 年度独立 Top N:Bar Race 页每年独立做 抽取→聚合→去重→TopN,而不是全量聚合后再按年切分——否则 2026 年(31 篇论文)的榜单会被全量高频词挤到只剩 2 条。
⑤ 质量保障:pytest 单元测试 103 项全部通过,覆盖短语抽取、去重、增长率、API 契约等核心逻辑。
8、代码说明
8.1 关键词抽取:n-gram + POS 词性白名单(phrases.py)
def _pos_ok(ngram_tokens):
    """POS 白名单:短语必须由 名词/形容词/专有名词 构成,
    且首词不能是介词/冠词/连词——消灭 'of the' 这类跨边界碎片。"""
    ALLOWED = {"NN", "NNS", "NNP", "NNPS", "JJ", "JJR", "JJS"}
    BANNED_HEAD = {"IN", "DT", "CC", "PRP", "TO", "VBZ", "VBP"}
    tags = [t for _, t in ngram_tokens]
    if not tags or tags[0] in BANNED_HEAD:
        return False
    # 至少含一个名词性成分(避免 "visual" 这类孤形容词)
    if not any(t.startswith("NN") for t in tags):
        return False
    return all(t in ALLOWED for t in tags)

def _add_field(counter, text, weight):
    """对单字段做 tokenize + POS 过滤 + n-gram 计分。"""
    tokens = word_tokenize(text.lower())
    tagged = pos_tag(tokens)
    for n in range(1, 5):                      # 1~4 gram 滑窗
        for i in range(len(tagged) - n + 1):
            window = tagged[i:i + n]
            words = [w for w, _ in window]
            if any(w in STOPWORDS or len(w) < 2 for w in words):
                continue
            if not _pos_ok(window):
                continue
            key = " ".join(words)
            w = weight * (0.5 if n == 1 else 1.0)   # 单字词降权
            counter[key] = counter.get(key, 0.0) + w
设计思路:单字段内先分词并打词性标签,滑窗枚举 n-gram;先做停用词/长度硬过滤(便宜),再做 POS 白名单(较贵),把最贵的判断放最后以减少计算量。单字词 ×0.5 是因为单个词(如 "representation")信息量低于短语且噪声大。
8.2 跨短语包含去重:倒排索引加速(hot_topics.py)
def _dedupe_by_containment(sorted_topics):
    """输入按热度降序的 [(stem_tuple, entry), ...]。
    A 被 B 吞并 = A.display 分词 ⊂ B.display 分词
                 或 A 的 stems ⊂ B 的 stems,
    且 B 的热度 ≥ A 的 30%。
    用倒排索引 {token: [indices]} 只比较共享 token 的短语对。"""
    inverted = defaultdict(list)
    for idx, (stems, entry) in enumerate(sorted_topics):
        for tok in set(entry["display"].split()) | set(stems):
            inverted[tok].append(idx)

    swallowed = set()
    keep = []
    for idx, (stems, entry) in enumerate(sorted_topics):
        if idx in swallowed:
            continue
        keep.append((stems, entry))
        a_words = set(entry["display"].split())
        a_stems = set(stems)
        # 只检查排在它后面(热度更低)、且共享过 token 的候选
        candidates = set()
        for tok in a_words | a_stems:
            candidates.update(inverted[tok])
        for j in candidates:
            if j <= idx or j in swallowed:
                continue
            stems_b, entry_b = sorted_topics[j]
            b_words = set(entry_b["display"].split())
            b_stems = set(stems_b)
            contained = (a_words >= b_words and b_words) or \
                        (a_stems >= b_stems and b_stems)
            if contained and entry_b["heat"] >= entry["heat"] * 0.3:
                swallowed.add(j)
    return keep
设计思路:榜上同时出现 "object detection" 和 "object" 时,短词是纯噪声。暴力做法是两两比较 O(N²)(3411 短语 ≈ 5.8M 次子集判定,26s);大多数短语对根本不共享任何词,所以先建倒排索引,比较范围从"全部对"缩小到"共享 token 的对",实测降到约 5s。"热度 ≥ 30%"阈值避免高频短词误吞低频长词。
8.3 增长率计算:末年无数据时向内收缩(hot_topics.py)
def _compute_growth(per_year, first_year, last_year):
    """首年末年之间热度增长率。
    首尾年份无数据时,向内侧收缩到最近一个有数据的年份再比较,
    避免末年论文过少(如 2026 仅 31 篇)导致大面积 -100% 的误导。"""
    if first_year == last_year:
        return 0.0
    h0, h1 = per_year.get(first_year, 0.0), per_year.get(last_year, 0.0)

    if h0 <= 0:  # 首年无数据 → 找最早有数据的年份
        for y in sorted(per_year):
            if first_year < y <= last_year and per_year[y] > 0:
                first_year, h0 = y, per_year[y]
                break
    if h1 <= 0:  # 末年无数据 → 找最晚有数据的年份
        for y in sorted(per_year, reverse=True):
            if last_year > y >= first_year and per_year[y] > 0:
                last_year, h1 = y, per_year[y]
                break

    if first_year == last_year or h0 <= 0 or h1 <= 0:
        return 0.0
    return round((h1 - h0) / h0, 4)
8.4 API 层三级缓存与兜底预热(api/hot_topics.py)
_CACHE = {}                       # 二级缓存:(venue, years, top_n) → response
_CACHE_TTL = 600
_WARMUP_IN_PROGRESS = False

def _ensure_cache():
    """确保一级短语缓存就绪:run.py 启动时已 warmup(3.4s),
    这里只做兜底。注意必须用 ht_mod._PAPER_PHRASES_CACHE 动态读取——
    from module import X 是值拷贝,会看不到 warmup 后的更新。"""
    global _WARMUP_IN_PROGRESS
    if ht_mod._PAPER_PHRASES_CACHE is not None:
        return ht_mod._PAPER_PHRASES_CACHE
    if _WARMUP_IN_PROGRESS:       # 并发请求时只等,不重复抽取
        start = time.time()
        while ht_mod._PAPER_PHRASES_CACHE is None and time.time() - start < 300:
            time.sleep(0.5)
        return ht_mod._PAPER_PHRASES_CACHE or []
    _WARMUP_IN_PROGRESS = True
    try:
        papers = [{"title": p.title, "abstract": p.abstract or "",
                   "keywords": [k.name for k in p.keywords],
                   "year": p.year, "venue": p.venue}
                  for p in Paper.query.all()]
        ht_mod.warmup_cache(papers)
    finally:
        _WARMUP_IN_PROGRESS = False
    return ht_mod._PAPER_PHRASES_CACHE or []
设计思路:一级缓存是"所有论文的短语"(进程级、永不失效),二级缓存是"查询参数组合 → 响应"(TTL 10 分钟),三级是 Evolution 页专用(TTL 30 分钟)。_WARMUP_IN_PROGRESS 标志防止并发请求各自触发一次 3.4s 的全量抽取把 Flask 线程池占满——这是我们真实踩过的坑。
可解释性声明:以上代码由 AI 生成初稿、我逐段审查后修改合入(8.2 的双重判定规则、8.3 的收缩逻辑、8.4 的并发保护是我主导的修正)。全部代码我均能解释设计思路,并通过 103 项 pytest 用例验证。爬虫管道、数据库 Schema、前端 7 个页面组件由 AI 生成初稿后由我调整;中文翻译词典
translations.py约 200 条术语由我人工整理、AI 辅助校对。
9、心路历程、收获
从"用AI写代码"到"和AI结对"的认知转变。
接到作业时我以为"AI 结对"就是把需求丢给 AI、把代码粘出来。实际做了才发现完全不是:AI 给的初稿几乎从不能直接用——
- 关键词抽取第一版会把 "of the"、"and their" 混进热词榜,是我在人工抽查 6 篇论文的 Top5 时发现的,而不是 AI 自己意识到的;
- 去重函数初稿有两个隐藏 bug(数据结构传错、只吞并一个短词),跑测试时才暴露;
- 最离谱的一次是我按 AI 的建议先接 DBLP,做了一半才发现 DBLP 根本没有摘要字段——热词统计无从谈起,只好整条管道推倒换 OpenAlex。这就是 AI 的"知识幻觉/过时风险":它说得头头是道,但不会替你验证数据源的真实字段。
但 AI 结对也有传统结对给不了的东西:
- 随叫随到、无限耐心。凌晨调 Element Plus 的年份选择器 bug,我可以连续追问 20 个"为什么",AI 每次都给出完整分析;
- 并发式枚举。设计热度口径时,它一口气给出 4 种方案带利弊分析,我自己可能只想得到 2 种;
- 跨栈无缝。同一会话里,上一句在改 Flask 的缓存,下一句就能切到 ECharts 的动画参数。传统结对伙伴很难同时精通前后端加爬虫。
方法论收获:我总结出自己的协作纪律——①让 AI 先出方案清单再让它写代码(避免拿到一个"能跑但方向错"的实现);②所有 AI 代码必须先读懂再合入,读不懂的地方追问到懂;③测试兜底,103 项 pytest 是我敢于快速接受 AI 代码的底气;④关键决策(数据源、统计口径、去重规则)必须自己拍板,AI 只做参谋。
项目启动阶段对话
代码debug部分的对话
10、对AI结对伙伴的评价
如果把 AI 看作一位真实的结对伙伴,我会这样评价它:
贡献(驾驶员/导航员角色灵活切换)
- 导航员角色极出色:代码审查时它能瞬间指出我忽略的边界("2026 年只有 31 篇论文,年度榜单会被挤掉"),这种随时在线的 review 是传统结对做不到的;
- 驾驶员角色合格但有条件:给它明确的规格(函数签名、数据结构、验收标准)时产出质量很高;规格模糊时它自行脑补的部分往往是错的;
- 知识面广但需要校准:框架 API、算法套路信手拈来;但对"DBLP 有反爬且缺摘要"这类实践层面的真相会给出过时/理想化的答案。
局限
- 幻觉风险:会一本正经地编造不存在的 API 参数,需要实测验证;
- 无主动验证意识:它不会自己跑测试,"能生成"不等于"能工作";
- 上下文有限:项目变大后需要我在每次对话中重新交代背景,否则它会遗忘之前定的架构约定。
一句话总结:AI 是一位"读遍天下书但没有上线经验"的伙伴——创意与广度满分,落地判断力欠费。人负责方向、验证与拍板,AI 负责初稿、枚举与陪跑,这是我验证过的最高效分工。这次结对最大的收获不是代码,而是学会了如何管理一个不会累、但会自信地说错话的同事。
附:检查清单自核
- 博客开头包含格式描述表格与可跳转目录
- git 仓库链接、代码规范链接、AI 工具说明
- PSP 表格(预估 + 实际 + 偏差分析)
- NABCD 模型(重点 A 和 C)
- 原型工具说明 + 原型链接
- 成品展示 ≥10 张图,每图配文字说明
- 3 个代表性 AI 协作案例(需求/编码/调试),含提示词、输出摘要、采纳与拒绝理由
- 可解释性声明(哪些代码 AI 生成、哪些人工修改)
- 功能结构图
- 关键代码约 300 行 + 思路解释
- 心路历程与对 AI 伙伴的评价
- 【提交前请核对】CodeArts commit ≥15 次、已建 dev 分支、已发布 Release 1.0.0、README.md 含作业链接/学号/项目介绍/数据来源/AI使用说明
相关推荐
【无人车路径跟踪】基于神经网络的数据驱动迭代学习控制(ILC)算法,用于具有未知模型和重复任务的非线性单输入单输出(SISO)离散时间系统的无人车的路径跟踪(Matlab代码实现)
内容概要:本文系统解读了一套用于多机器人路径规划(MAPF)的MATLAB代码库,聚焦于优先级规划算法的设计与实现。该框架采用四层架构——几何解析、拓扑构建、调度规划与可视化呈现,有效分离空间路径搜索与时间冲突消解过程,提升算法效率与可扩展性。核心机制包括动态边权膨胀、节点预留历史与几何惩罚驱动的局部同步策略,前者通过软惩罚引导后续智能体绕行而非硬封锁路径,后者利用哈希结构与前向信息传递优化冲突检测效率。同时引入Petri网建模方法,将路径冲突问题转化为整数规划中的容量约束问题,支持对解的存在性与最优性进行形式化分析。文章详述了优先级启发式策略(如路径长度、冲突程度排序)、冲突检测与消解机制,并提供完整的仿真与动画输出功能,便于算法验证与教学演示。; 适合人群:具备一定编程基础和算法知识,从事机器人路径规划、智能交通、自动化调度等相关领域的研究人员、研究生及工程技术人员(尤其适合有MATLAB使用经验者)。; 使用场景及目标:①用于仓储物流、无人机编队、自动驾驶等多智能体系统的路径规划研究与仿真验证;②作为MAPF教学案例,帮助理解优先级规划、冲突消解、Petri网建模等核心概念;③为复杂调度系统开发提供模块化设计参考。; 阅读建议:建议结合文中提供的代码结构与流程图逐步实现各模块功能,重点关注动态边权膨胀与时间同步机制的设计逻辑,可通过调整启发式策略与地图参数进行实验对比,深入理解算法性能与局限性。
求职简历模板30套(Word可编辑)
【内容概要】求职简历模板30套(Word可编辑)。本资源为可编辑源文件,含配套模板与实操指引,覆盖求职者的核心使用场景,拿到即可直接修改使用。 【适用人群】求职者。 【使用场景及目标】快速套用,节省从零搭建的时间成本。 【其他说明】文件为可编辑格式,无软件依赖,下载后可直接使用。
光伏+储能+并网逆变+发电系统【含建模笔记+参考文献等】
内容概要:本文档围绕“光伏+储能+并网逆变+发电系统”的建模与仿真展开,系统性地涵盖了光伏发电最大功率点跟踪(MPPT)、储能系统能量管理、并网逆变控制及多源协调运行等关键技术环节。基于Matlab/Simulink平台,实现了从光伏阵列、储能单元到并网逆变器的整体系统建模,重点展示了三闭环矢量控制、PID控制、模型预测控制(MPC)等多种先进控制策略在新能源发电系统中的应用与对比。文档不仅聚焦于单一组件的建模,更强调系统级的协同控制与稳定性分析,整合了微电网优化调度、电力电子变换器控制、状态估计、卡尔曼滤波、车间调度算法等多领域技术资源,形成了一份内容详实、覆盖面广的综合性技术资料,为新能源领域的科研、教学与工程实践提供有力支撑。; 适合人群:具备电力电子、自动控制、新能源发电或电气工程等相关专业背景,从事相关领域研究的研究生、高校教师、科研人员及电力系统工程技术人员。; 使用场景及目标:①深入学习并掌握光伏-储能-并网发电系统的全流程建模与仿真技术;②理解并应用矢量控制、MPC等先进控制算法解决实际电力系统中的动态响应与稳定性问题;③获取丰富的Matlab/Simulink仿真模型、代码及参考文献,用于完成科研课题、学位论文、课程设计或工程项目开发。; 阅读建议:此资源内容丰富且涵盖多个独立技术主题,建议读者根据自身的研究方向和实际需求,选择性地深入学习特定章节。应重点研读系统建模方法、控制算法的设计原理与参数整定过程,并务必结合所提供的仿真代码进行动手实践、调试与结果分析,以深化对理论知识的理解并提升工程应用能力。
基于8051控制LCD12864B(ST7920控制器)液晶屏,分别用字库调用和图片调用方式显示《七律·长征》和《十六字令三首》
1.运行环境Proteus 8.9.根据安装的路径,先将动态链接库和库文件拷到对应目录下。举例:我的Proteus 8 Professional是安装在D盘;把“LCD12864B.dll”拷贝到D:\Program Files (x86)\Labcenter Electronics\Proteus 8 Professional\DATA\MODELS目录下;把“LCD7920.IDX”、“LCD7920.LIB”这两个文件拷贝到D:\Program Files (x86)\Labcenter Electronics\Proteus 8 Professional\DATA\LIBRARY目录下。 2.8051的工程可用KEILC51完全汉化版编译生成目标代码 3.12864字模工具.exe是取字模软件,一屏信息以图片形式取模,形成数据 4.IC_DAT生成器.exe也是取字模软件,输入汉字,可生成基于字库调用的数据 5.以上例程,用硬件开发板调试正常 6.LCD12864B.dll是基于LCD12864a.dll修改后生成的,解决仿真时字符显示有残留的问题
LLC谐振DC-DC变换器的控制策略研究(Simulink仿真实现)
内容概要:本文系统研究了LLC谐振DC-DC变换器的多种先进控制策略,并基于Simulink平台实现了全面的建模与仿真验证。研究涵盖全桥LLC变换器的混合式控制、变频与移相协同控制下的模式切换优化、欠谐振工作区间的动态性能分析、双三相LLC变换器的宽输入范围运行特性及软启动技术等关键技术。针对实际工程需求,采用了电压电流双闭环控制、降频软启动、恒压恒流控制等方法以提升系统稳定性、效率与动态响应能力。文中深入探讨了不同控制策略下的谐振参数设计、软开关实现条件、模式切换平滑性等问题,并通过高精度仿真模型对各类方案进行了对比分析与性能评估,为高性能LLC变换器的设计与优化提供了理论支撑与实践指导。; 适合人群:具备电力电子技术与自动控制理论基础,从事DC-DC变换器研发、电源系统设计或相关领域研究的研究生、科研人员及工程技术人员。; 使用场景及目标:①深入理解LLC谐振变换器的工作原理及其在不同控制策略下的动态行为差异;②掌握在Simulink中构建高保真LLC变换器仿真模型的方法,并实现复杂控制算法的集成与调试;③为学术论文复现、毕业课题开发或工业级电源产品设计提供可复用的技术路线与仿真资源支持。; 阅读建议:建议结合文中提供的仿真模型、参考文献及关键技术说明进行同步学习,重点关注控制策略的设计逻辑、关键参数的整定方法以及仿真结果的分析过程,通过动手实践仿真操作以深化对系统非线性特性和控制机理的理解,并可根据具体应用场景对模型进行二次开发与性能优化。




