


101
社区成员
 发帖
 与我相关
 我的任务
 分享
| 项目 | 内容 |
|---|---|
| 这个作业属于哪个课程 | 202601 福大-软件工程实践-W班 |
| 学号-姓名 | 102400325—邱宁华 |
| 这个作业要求在哪里 | 软件工程实践第二次作业——与 AI 结对编程(顶会热词统计) |
| 这个作业的目标 | 运用 NABCD 分析用户需求;使用 AI 结对完成论文采集、管理、热词分析与趋势可视化;通过 Git 版本控制和云端部署形成可验证交付 |
| 其他参考文献 | 《构建之法》第 3、4、8 章;Google JavaScript Style Guide;Google HTML/CSS Style Guide;CVF Open Access;ECVA |
https://codehub-cn-south-1.devcloud.huaweicloud.com/538373125b434b55873faa4c8494ac8b/102400325.gitcodestyle.md,位于仓库根目录http://49.232.19.164:8080/api/papers/count项目简述:CV TrendAtlas 面向刚接触计算机视觉的初学者,把"查找论文—阅读摘要—观察热词—比较趋势—回到原文"连接起来。项目采用 Java 17 + Spring Boot 4.1.1 + MySQL 8.0 + 原生 HTML/CSS/JavaScript + ECharts,数据来源以 CVF Open Access 与 ECVA 官方目录为主。当前云端种子文库覆盖 CVPR 2022—2025 四个会议年度,共 20 篇论文(用于演示部署效果)。
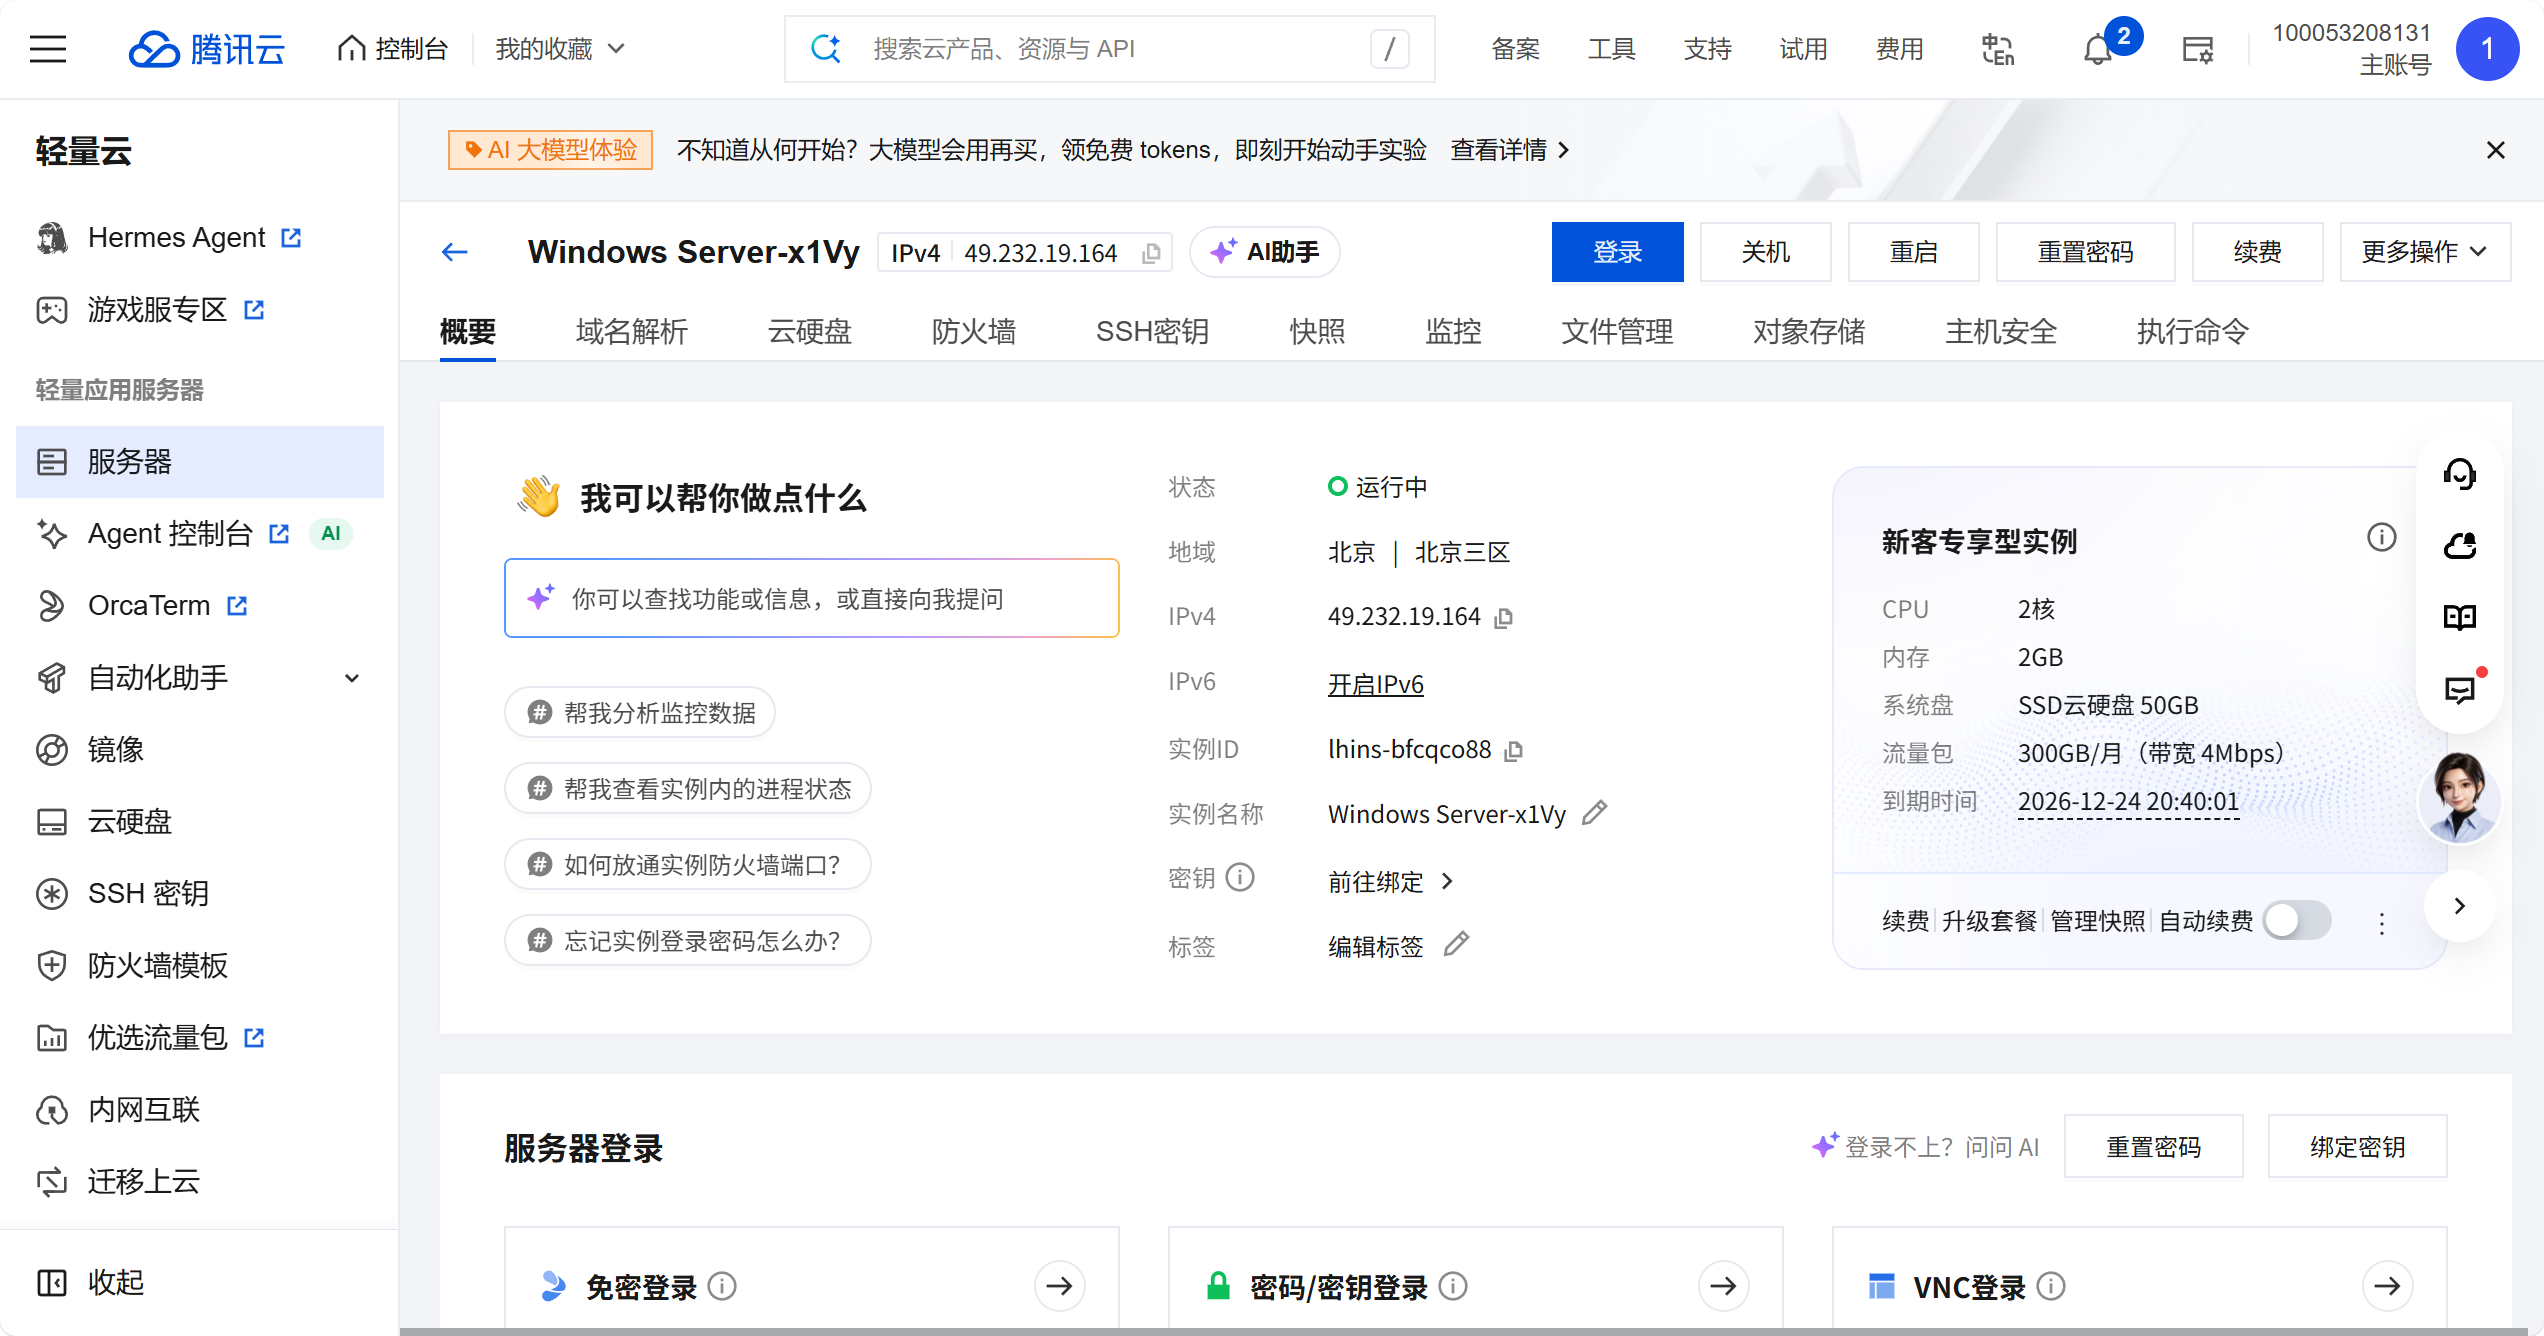
源码地址与运行地址职责不同:CodeArts 保存版本,腾讯云轻量应用服务器提供在线访问。
| 项目 | 说明 |
|---|---|
| 主要 AI 工具 | 通义灵码(Qoder CN,DeepSeek-V4-Pro 模型) |
| 工具版本或会话说明 | IDEA 插件版通义灵码,具体版本以实际会话界面为准 |
| AI 的主要工作 | 需求拆解、Spring Boot 项目结构、爬虫与接口初稿、统计逻辑、前端页面、错误定位、文档整理 |
| 我的主要工作 | 提出需求、选择技术方案、组织项目结构、编写和修改代码、运行并验证程序、审查 AI 生成代码、对最终交付负责 |
| 责任边界 | 通义灵码主要提供代码建议与问题分析,我负责理解、筛选、修改和验证。所有 AI 输出均结合实际源码、运行结果和测试结果进行判断 |
可解释性声明:
本项目使用了 AI 辅助生成和修改的代码,包括项目骨架、页面结构、爬虫、REST 接口、统计逻辑和前端图表配置。不能把这些内容描述为完全由我独立手写。本文按模块说明实现思路;我需要能够解释数据从哪里来、如何入库、怎样统计、哪里可能失败,以及每项修改解决了什么问题。
记录口径说明:下表为回顾估算,不是完整计时日志,仅用于讨论时间分配。
| PSP | Personal Software Process Stages | 预估耗时/分钟 | 实际耗时/分钟(回顾估算) |
|---|---|---|---|
| Planning | 计划小计 | 45 | 45 |
| · Estimate | · 估计任务与整理工作区 | 45 | 45 |
| Development | 开发小计 | 1200 | 1560 |
| · Analysis | · 需求分析、学习技术、与 AI 讨论 | 150 | 180 |
| · Design Spec | · 设计文档、页面与数据结构 | 90 | 100 |
| · Design Review | · 设计复审与交互规则检查 | 45 | 60 |
| · Coding Standard | · 编码规范与工程约定 | 30 | 40 |
| · Design | · 前端页面与交互设计 | 180 | 240 |
| · Coding | · Spring Boot 后端、爬虫、前端页面与图表编码 | 420 | 540 |
| · Code Review | · 人工与 AI 代码复审 | 105 | 140 |
| · Test | · 测试、修复、提交与部署验证 | 180 | 260 |
| Reporting | 报告小计 | 210 | 280 |
| · Test Report | · 测试报告与功能截图 | 60 | 90 |
| · Size Measurement | · 工作量与提交记录统计 | 30 | 35 |
| · Postmortem & Process Improvement Plan | · 博客整理、复盘与改进计划 | 120 | 155 |
| 合计 | 计划+开发+报告 | 1455 | 1885 |
实际投入比预估增加约 30%,主要差异集中在三处:
环境配置比预期复杂。IDEA 运行配置、JDK 版本、Maven 镜像、Lombok 注解处理器、MySQL 连接、IDEA 静态资源构建,每一步都出现过报错。尤其是"IDEA 找不到 chrome"这个报错,查了很久才定位到是运行配置问题。
真实爬虫比模拟数据复杂。CVF 列表页 URL 必须带 ?day=all 才返回论文链接,ECVA 页面结构和 CVF 不完全一致,还要处理缓存、超时、重试和摘要缺失。
云端部署比本地复杂。SSH 密码、防火墙、系统重装、JDK 版本兼容、Maven 首次编译缓慢,都需要单独排时间。
下次我会在每轮工作开始时记录时间,把"编码"、"等待网络"、"调试"、"环境配置"分开统计。
题目中的小刚对计算机视觉感兴趣,但不知道从哪里开始阅读。对他而言,问题不是论文不够多,而是缺少一条从总体认识走向具体阅读的路径。
核心问题可以归纳为:
| 用户 | 使用场景 | 需要完成的任务 |
|---|---|---|
| 计算机视觉初学者 | 第一次了解领域 | 从 Top 10 和主题图谱进入具体论文 |
| 课程学习者 | 整理某一会议、某一年度的资料 | 搜索、筛选、维护论文 |
| 研究方向探索者 | 对比同一主题在不同会议中的表现 | 查看年度篇数、样本占比与原文依据 |
第一步,把数据来源做实。
初始数据从 CVF Open Access 和 ECVA 官方目录采集,再访问论文详情页面获取作者、摘要及 PDF 链接。每条记录保存来源和抓取时间。爬虫没有获取到合格摘要时记录失败,不用模拟论文补齐数量。
第二步,统一论文的存储和操作。
采用 Java Spring Boot 提供 REST API,MySQL 8.0 作为持久化数据库。论文新增、修改、删除和导入都经过统一的 PaperService 校验,前端重新读取数据库后再展示结果,避免不同页面维护各自的论文副本。
第三步,让统计结果能够返回原始论文。
系统基于标题和摘要匹配明确的主题规则,按包含某主题的论文数生成榜单。用户点击关键词或趋势数据点后,进入带有对应条件的论文文库,可以继续核查摘要与原文。
第四步,把比较口径写在页面上。
趋势既支持篇数,也支持"主题匹配数/该会议该年度样本数"的占比。ICCV 偶数年和 ECCV 奇数年不被当成零热度;未举办或未收录的年份使用断点及文字说明。
第五步,以测试控制范围。
实际程序由 Spring Boot、原生 HTML/CSS/JavaScript 与 ECharts 实现。接口经过实际运行验证,数据来源可追溯到官方页面。
技术选择考虑了我的学习基础:原生前端便于直接理解 DOM、事件与数据处理,Spring Boot + MySQL 是企业级 Web 开发的主流组合。当前数据量约千篇,前端读取后筛选便于实现;如果规模继续增长,应改为后端分页、查询索引与独立统计接口。
用户可以沿着"方向—年份与会议—论文—官方来源"的路径完成初步探索,减少在不同页面之间手工整理信息的操作。明确的来源和统计说明帮助用户判断结果是否适合自己的问题。
这些是功能带来的预期收益,并没有经过正式用户实验验证。因此本文不使用"效率提高某个百分比"等缺乏测量依据的结论。
| 替代方案 | 已有优势 | 与本题场景的差异 | 本项目的选择 |
|---|---|---|---|
| CVF / ECVA 官方目录 | 来源直接,原文链接可追溯 | 按会议阅读方便,跨年度主题比较还需整理 | 保留官方来源,增加统一主题统计与跳转 |
| DBLP | 书目信息组织成熟,适合检索和文献定位 | 摘要覆盖与本题所需的热词可视化并非同一任务 | 作为可扩展书目检索来源,不声称替代它 |
| Google Scholar | 覆盖广,检索能力强 | 面向广泛学术搜索,难以直接控制本课程样本口径 | 聚焦三大顶会与可解释样本分析 |
| 表格工具+手工整理 | 自由度高,上手直接 | 重复导入、去重、主题关联与更新需要人工维护 | 将常用流程封装到一个可操作网页中 |
本项目的优势是范围清晰、统计规则公开、分析结果能够回到论文,不是数据覆盖量超过成熟学术平台。它也存在不足:样本有限、词典规则需要维护、没有引文网络分析、尚未开展正式用户研究。
本项目的技术栈选择 Java 17 + Spring Boot + MySQL,属于企业级 Web 开发的主流组合,便于后续扩展和部署。前端采用原生 HTML/CSS/JavaScript + ECharts,避免引入复杂构建工具,降低课程作业的部署难度。
通过 CodeArts 交付源代码与版本记录,通过腾讯云服务器提供在线访问入口,通过博客集中呈现功能、实现、测试和人机协作。演示时优先使用一条完整路径:在首页选择某个主题,查看相关论文,进入趋势比较,再回到指定会议年度的论文列表。
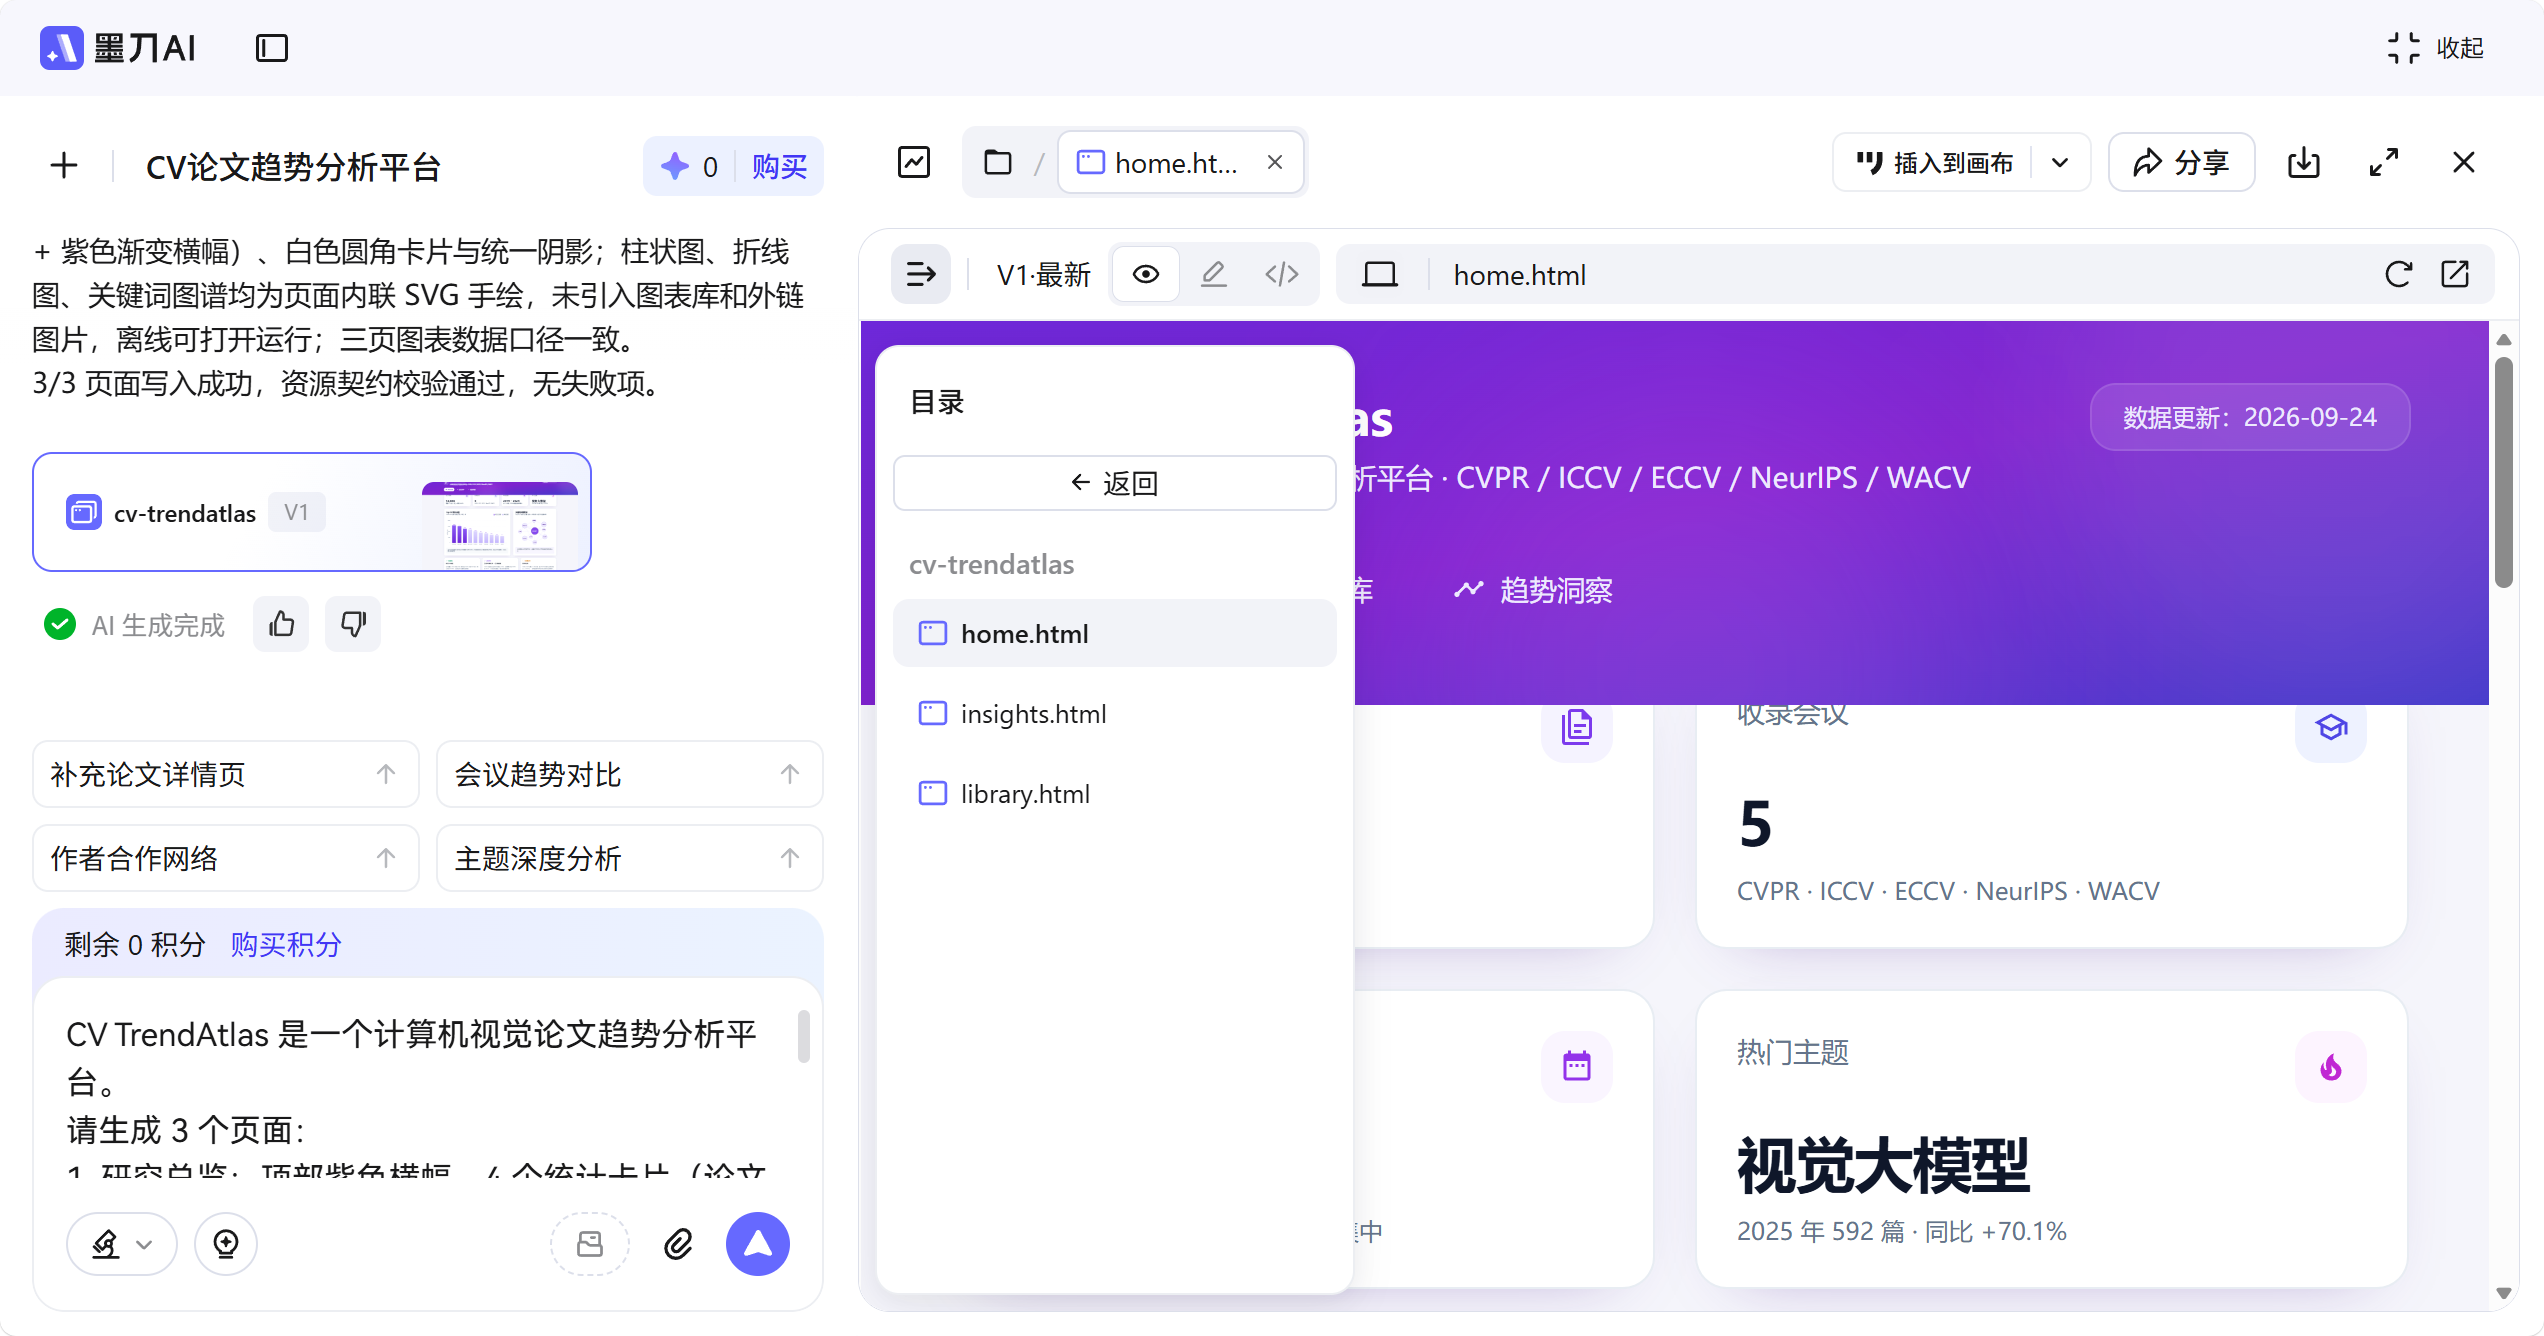
我将主要页面组织为:研究总览、论文文库、趋势洞察。论文详情使用弹窗承载,让用户查看摘要后仍能回到原来的列表。首页负责提供方向入口,列表负责精细检索,趋势页负责比较。
| 页面或状态 | 主要内容 | 关键交互规则 |
|---|---|---|
| 研究总览 | 统计卡片、Top 10、主题气泡 | 点击主题进入该主题论文 |
| 论文文库 | 搜索、筛选、详情弹窗 | 精确查询匹配完整题目;模糊查询覆盖题目、作者、关键词 |
| 论文详情 | 作者、摘要、主题、原文与来源 | 弹窗关闭后保留列表;外部链接另开页面 |
| 趋势洞察 | 主题、会议、年度走势、明细表 | 图表与明细采用一致条件 |
我希望界面先回答"看什么",再回答"怎么筛选",所以首页不堆放全部输入控件。浅色背景配合一个紫色主色突出关键操作,图表同时保留文字标签,避免只靠颜色传递信息。
原型阶段的人机讨论重点是信息层级、操作反馈和页面联动。AI 给出布局候选,我需要检查是否符合小刚的实际使用路径。
以下截图来自实际运行的项目,部署在腾讯云轻量应用服务器上,公网地址 http://49.232.19.164:8080/%E3%80%82
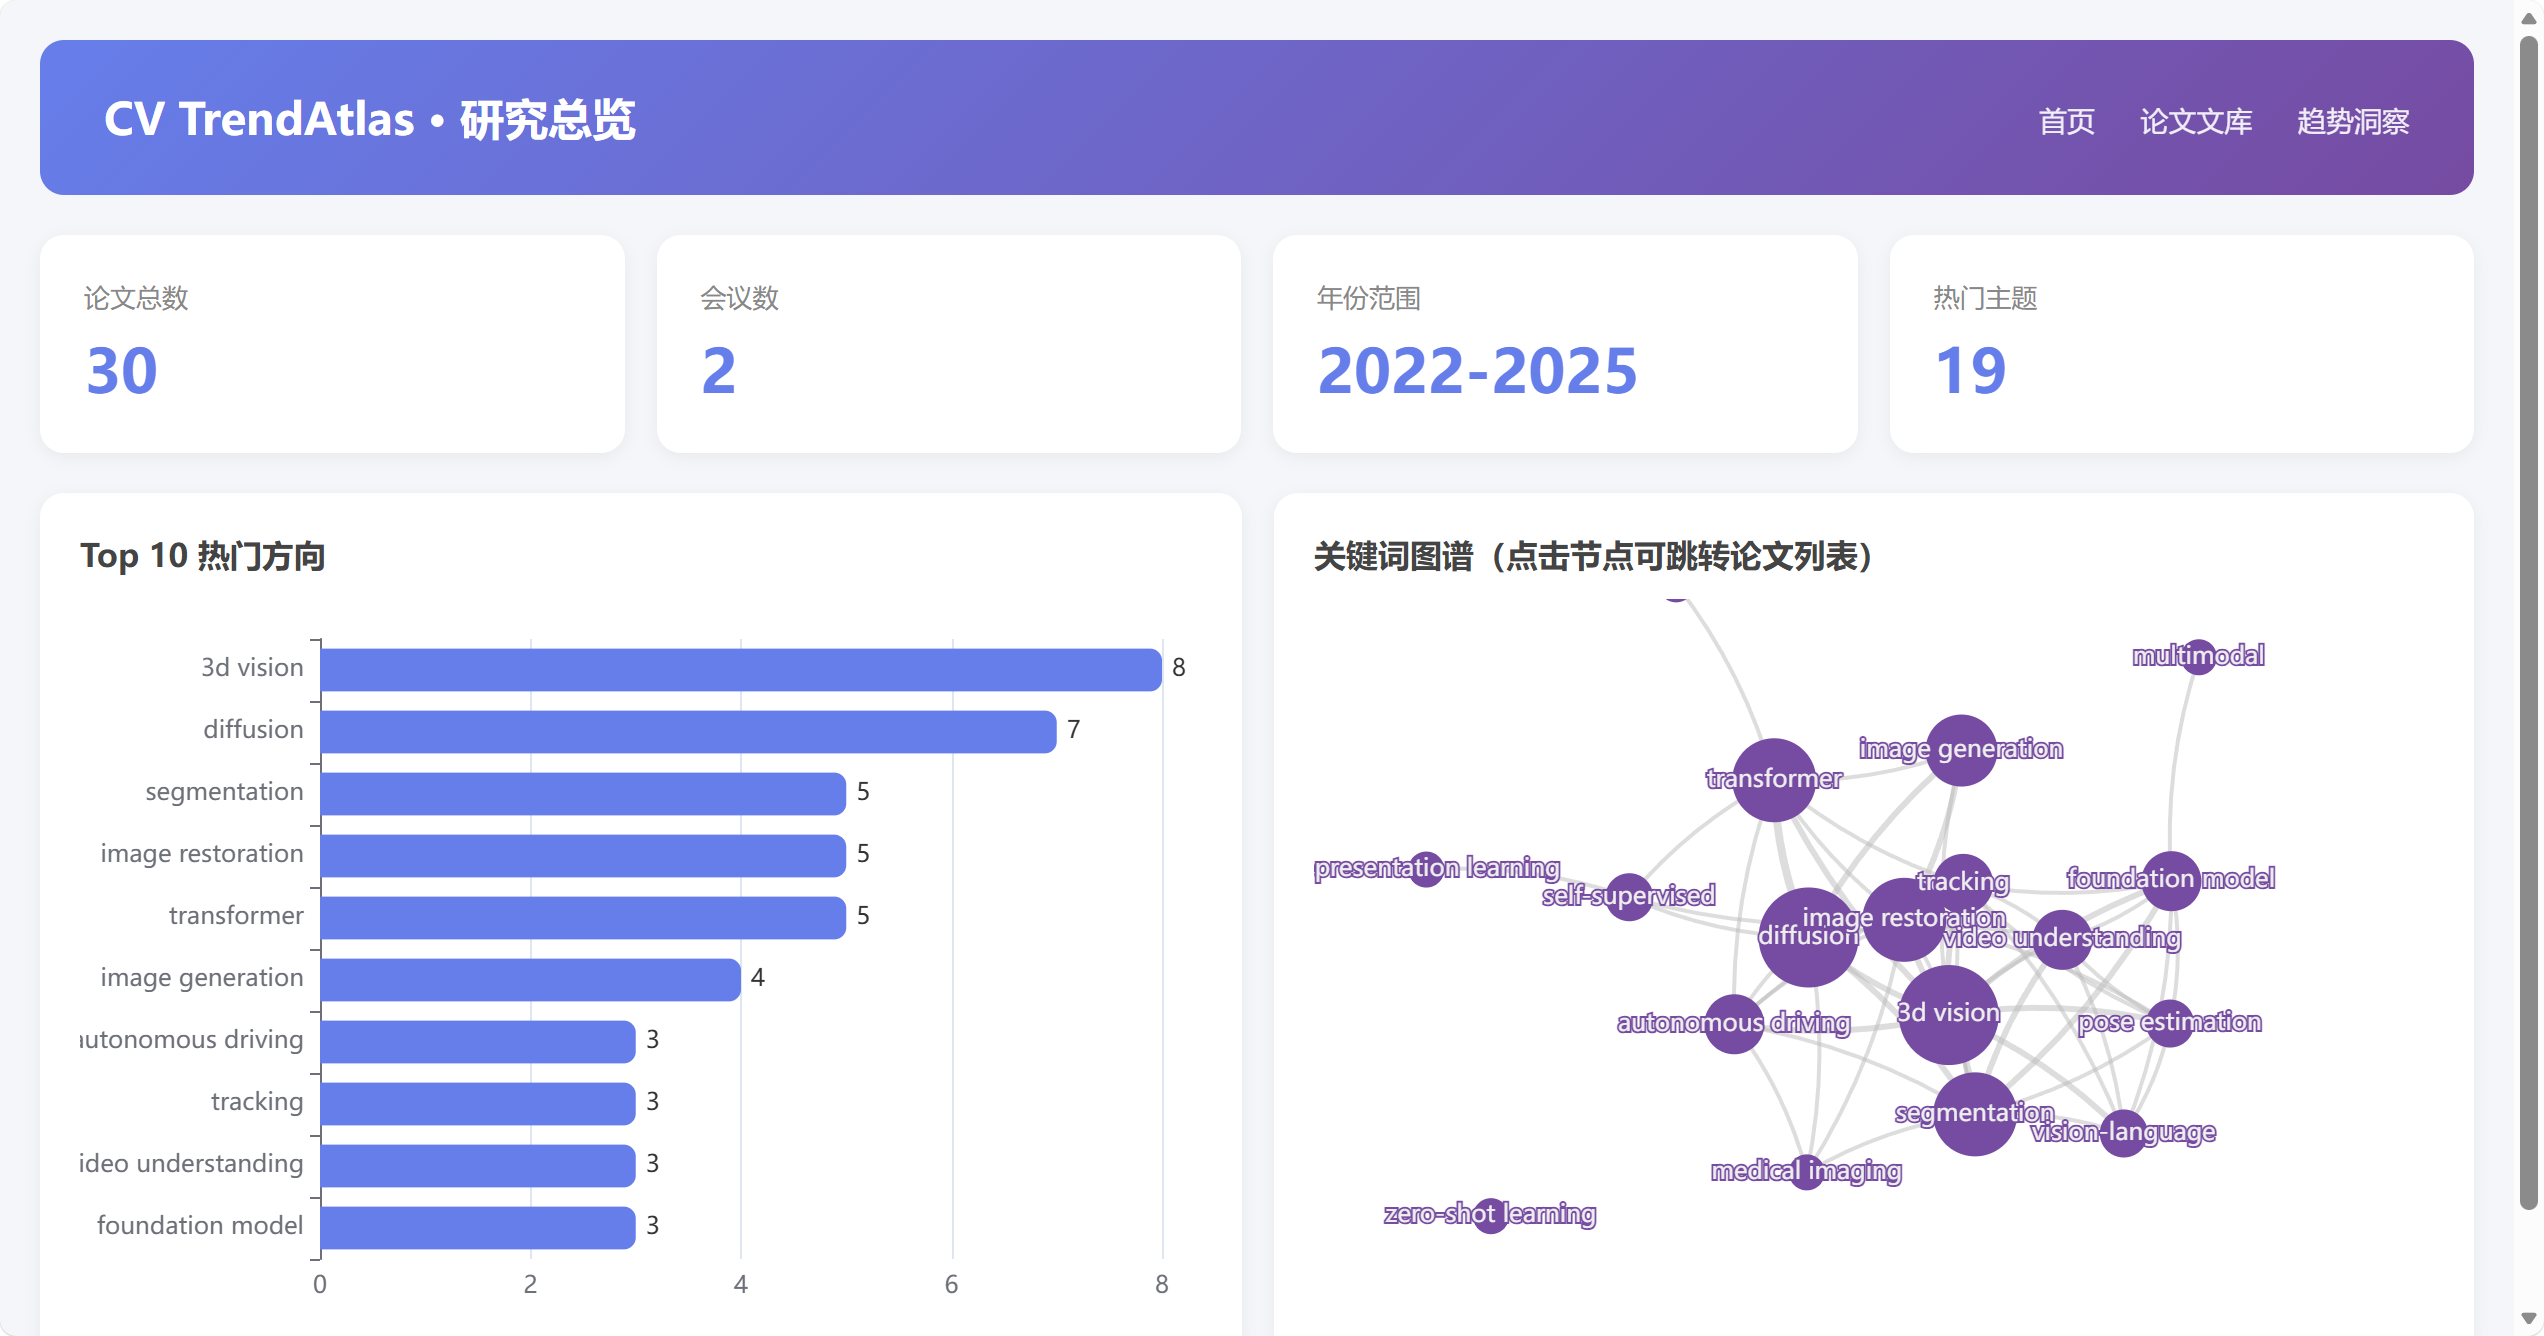
首页汇总论文总数、会议数、年份范围、热门主题数,并展示 Top 10 主题柱状图和关键词图谱。当前服务器数据库包含 20 篇 CVPR 论文,覆盖 2022—2025 年。
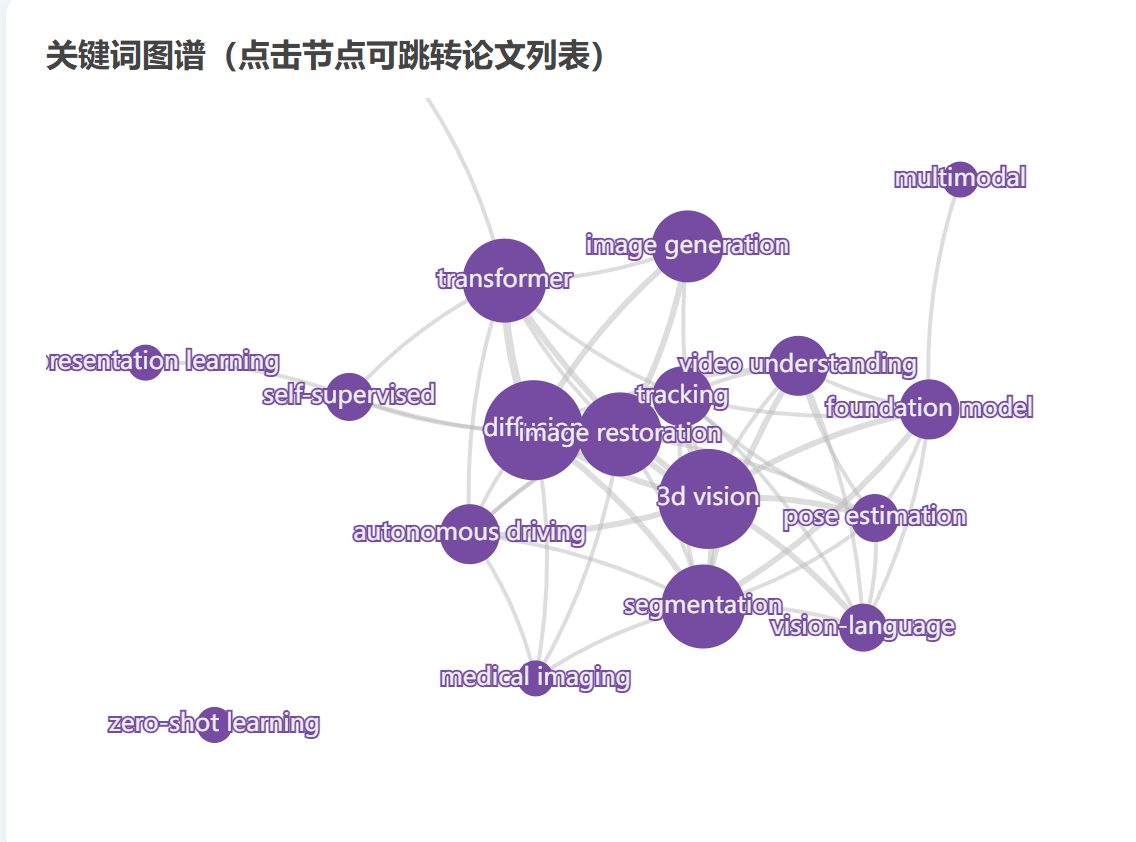
ECharts 力导向图展示主题节点和共现关系,节点大小表示该主题的论文数,连线粗细表示共现次数。点击节点可跳转到论文文库并自动筛选。
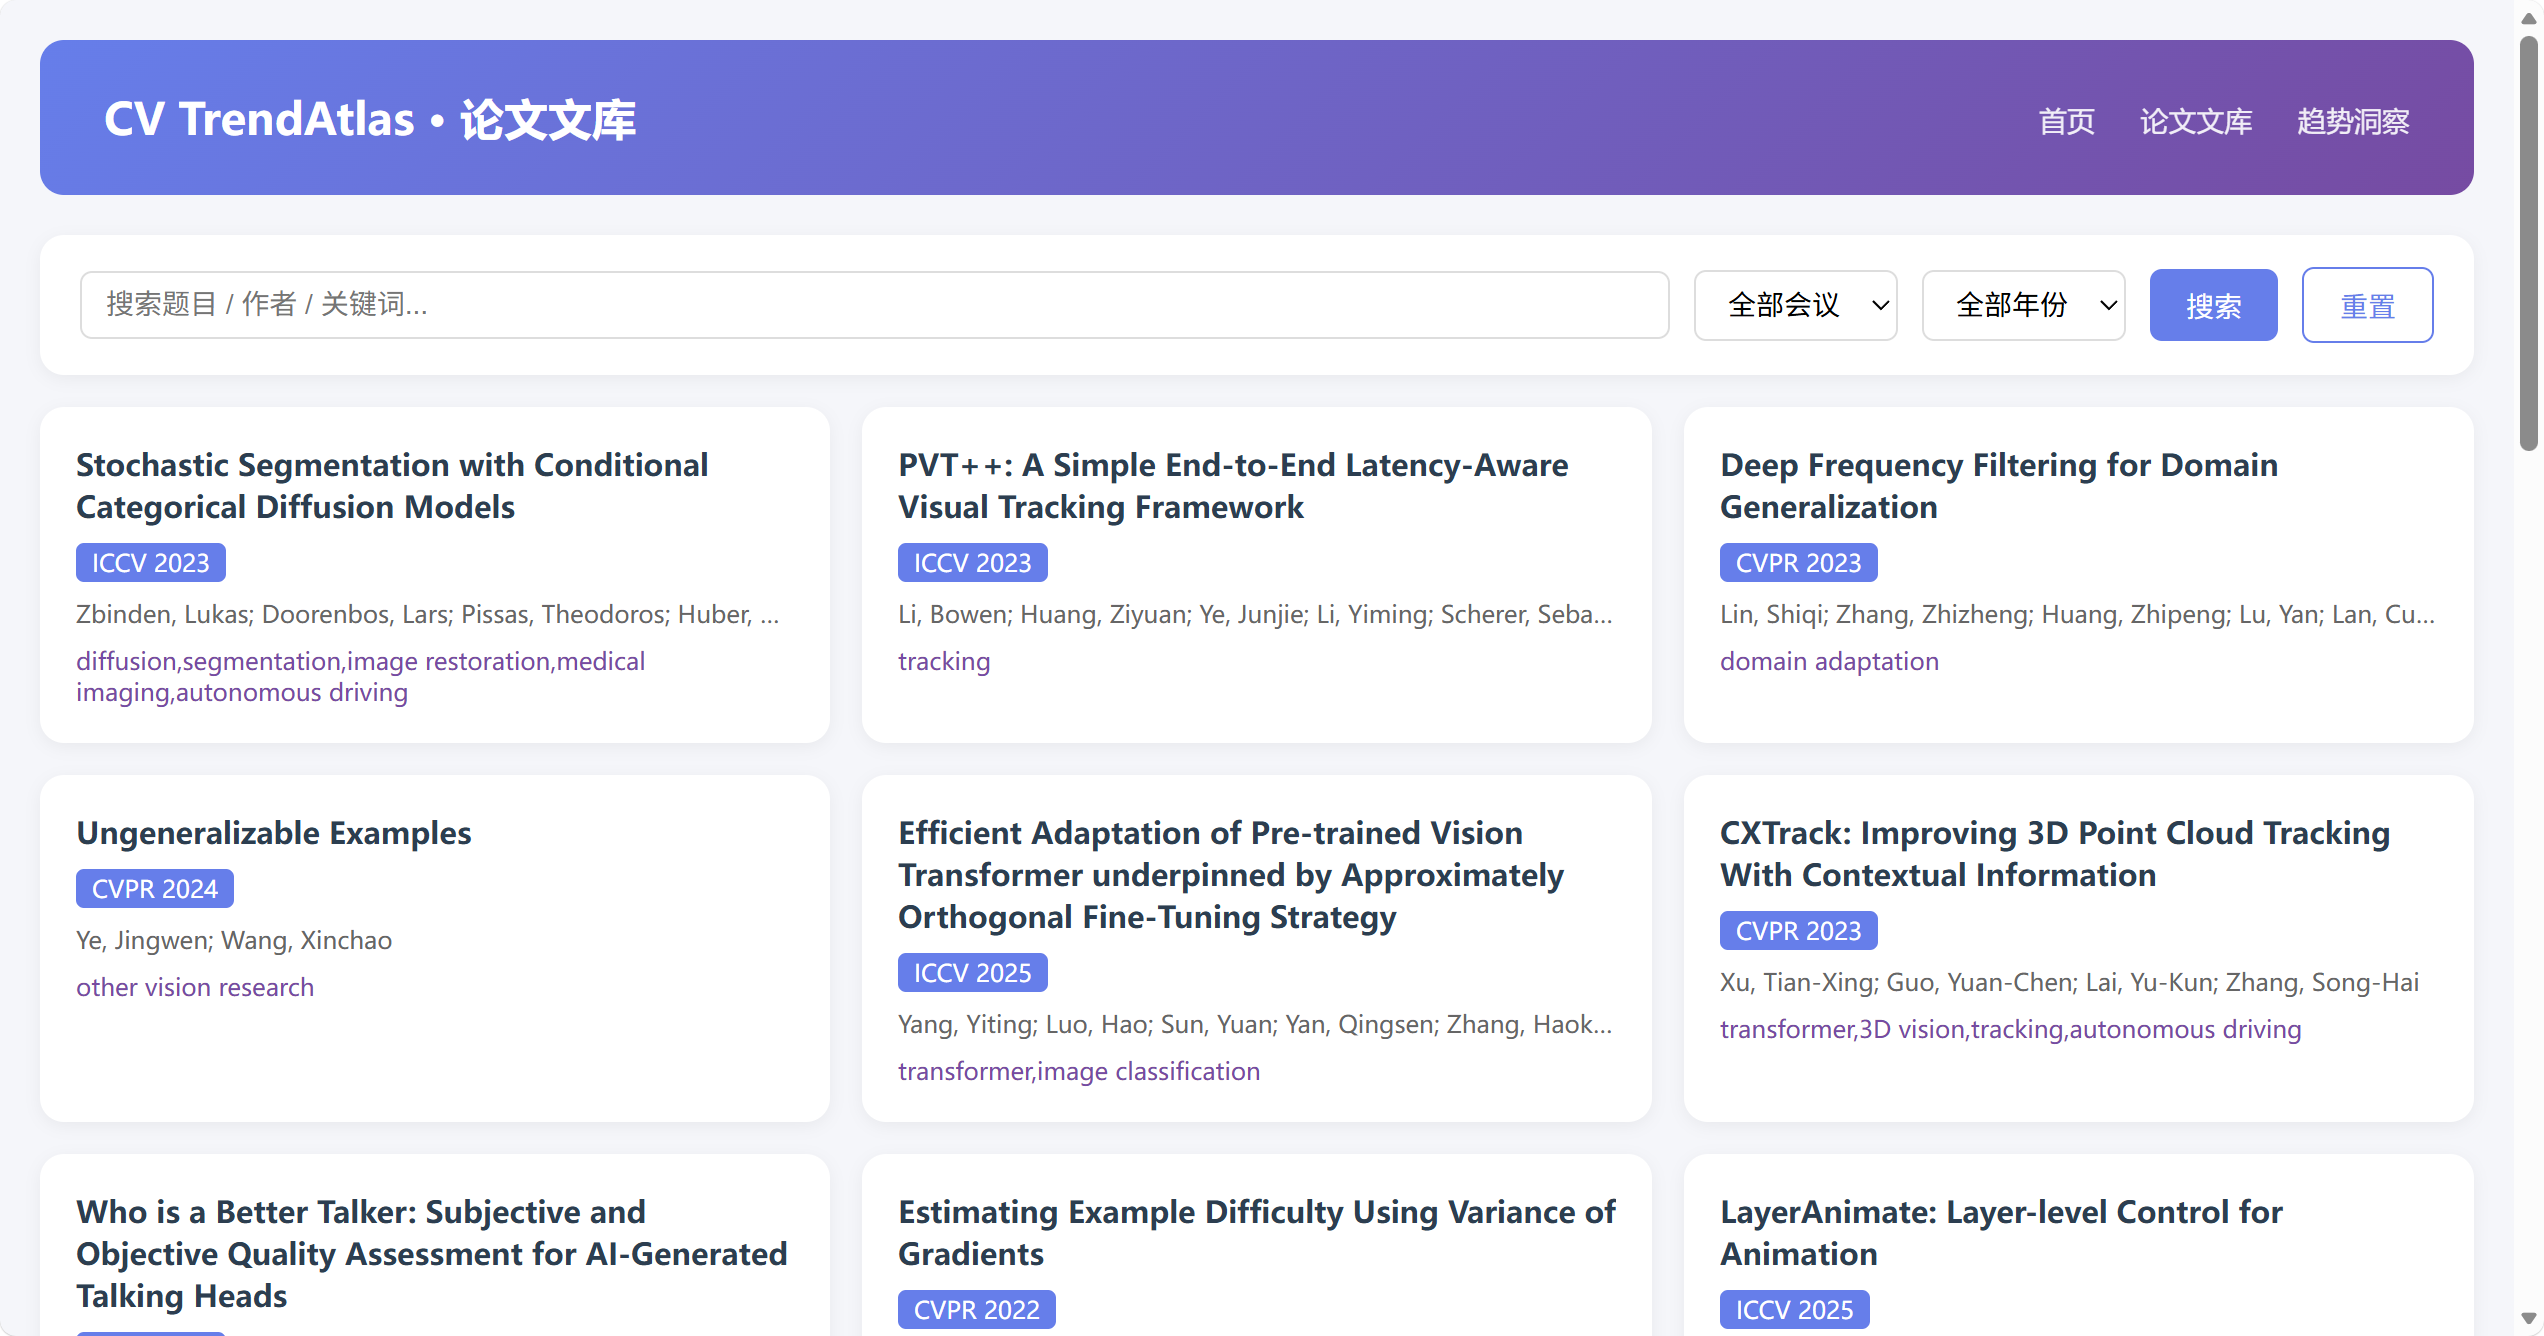
论文文库支持按题目、作者、关键词模糊搜索,支持按会议和年份筛选。
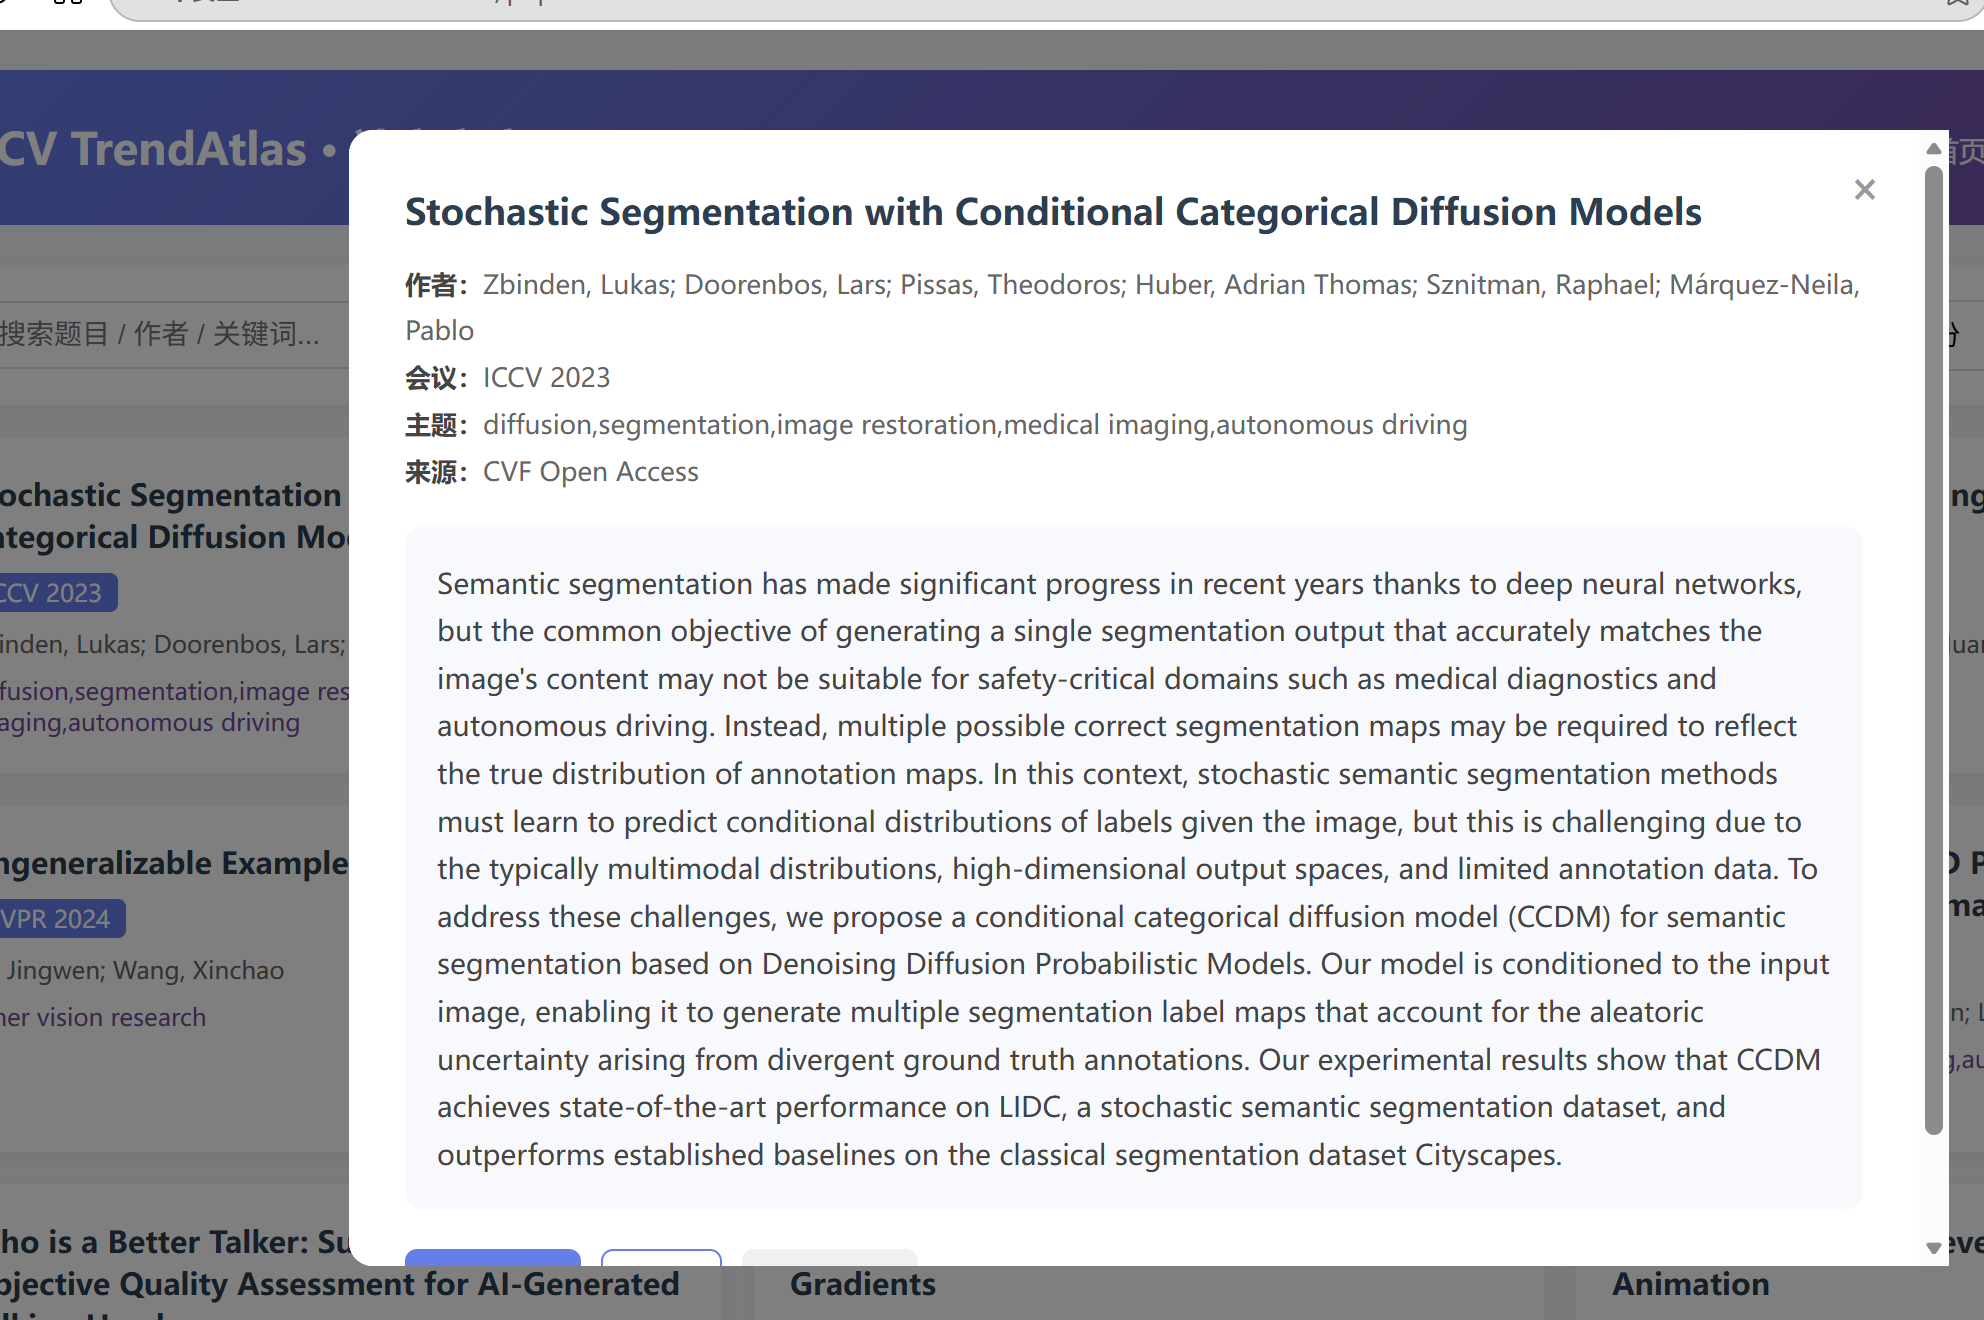
详情显示作者、原文摘要、主题标签、来源,并提供官方页面和 PDF 链接。
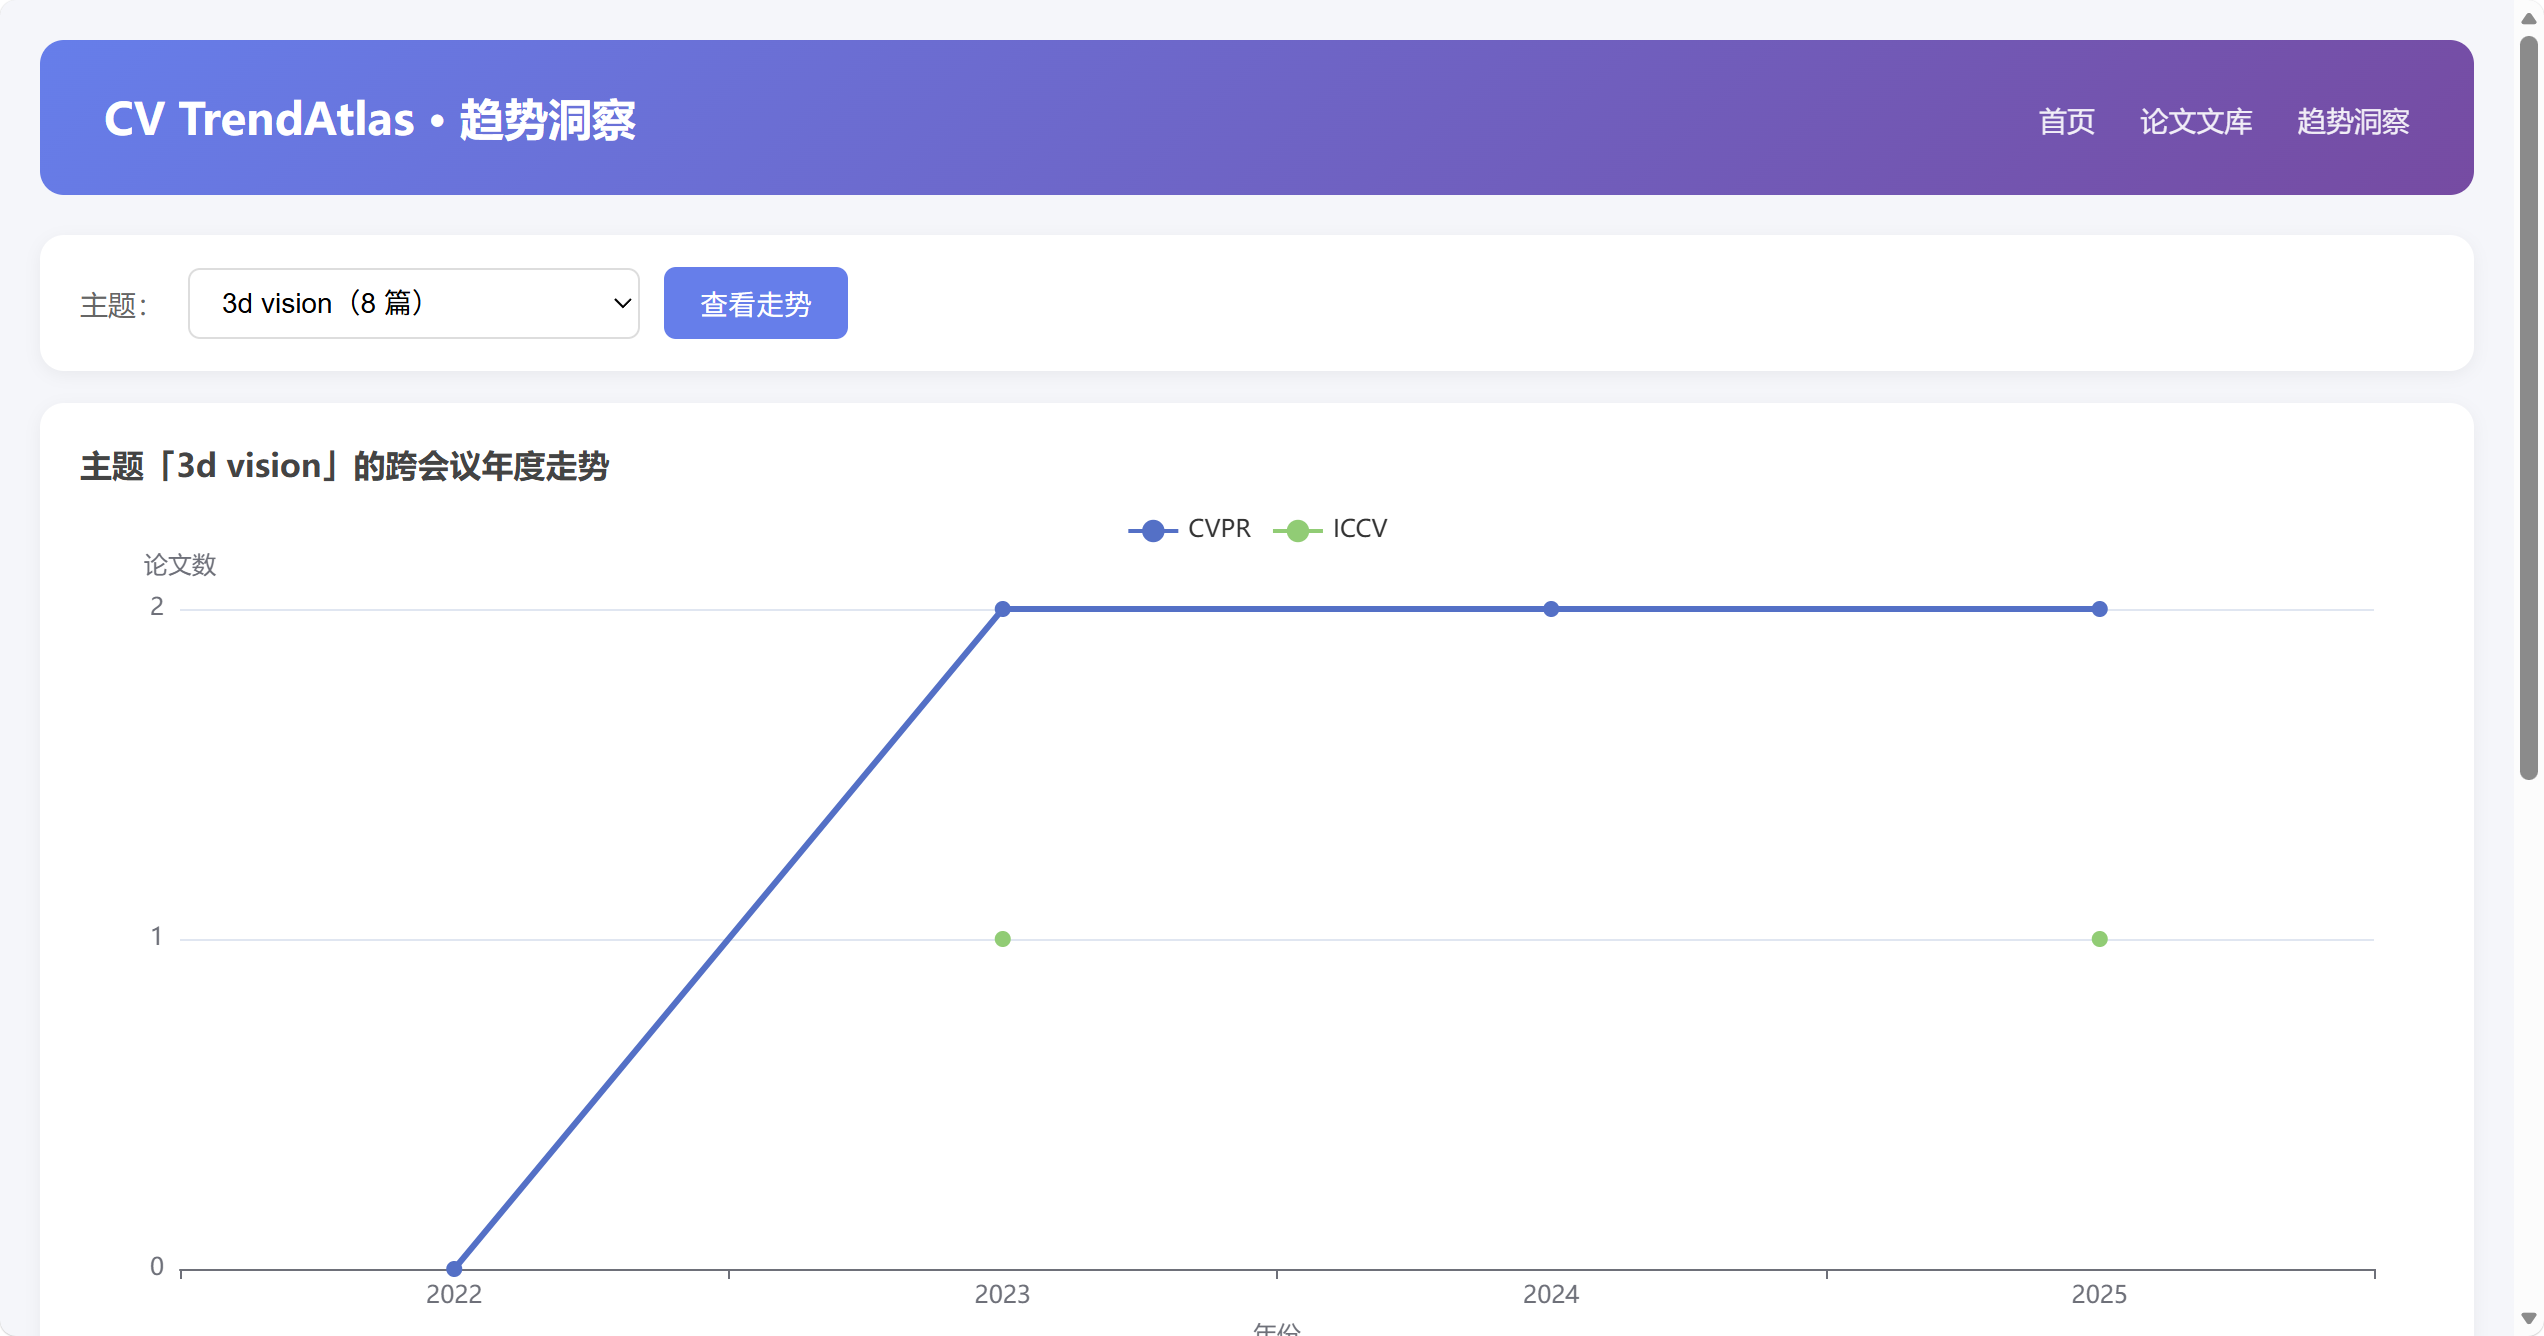
展示指定主题在 CVPR、ICCV、ECCV 各年度的论文数变化。因为服务器数据目前只有 CVPR,图上仅显示 CVPR 一条线。
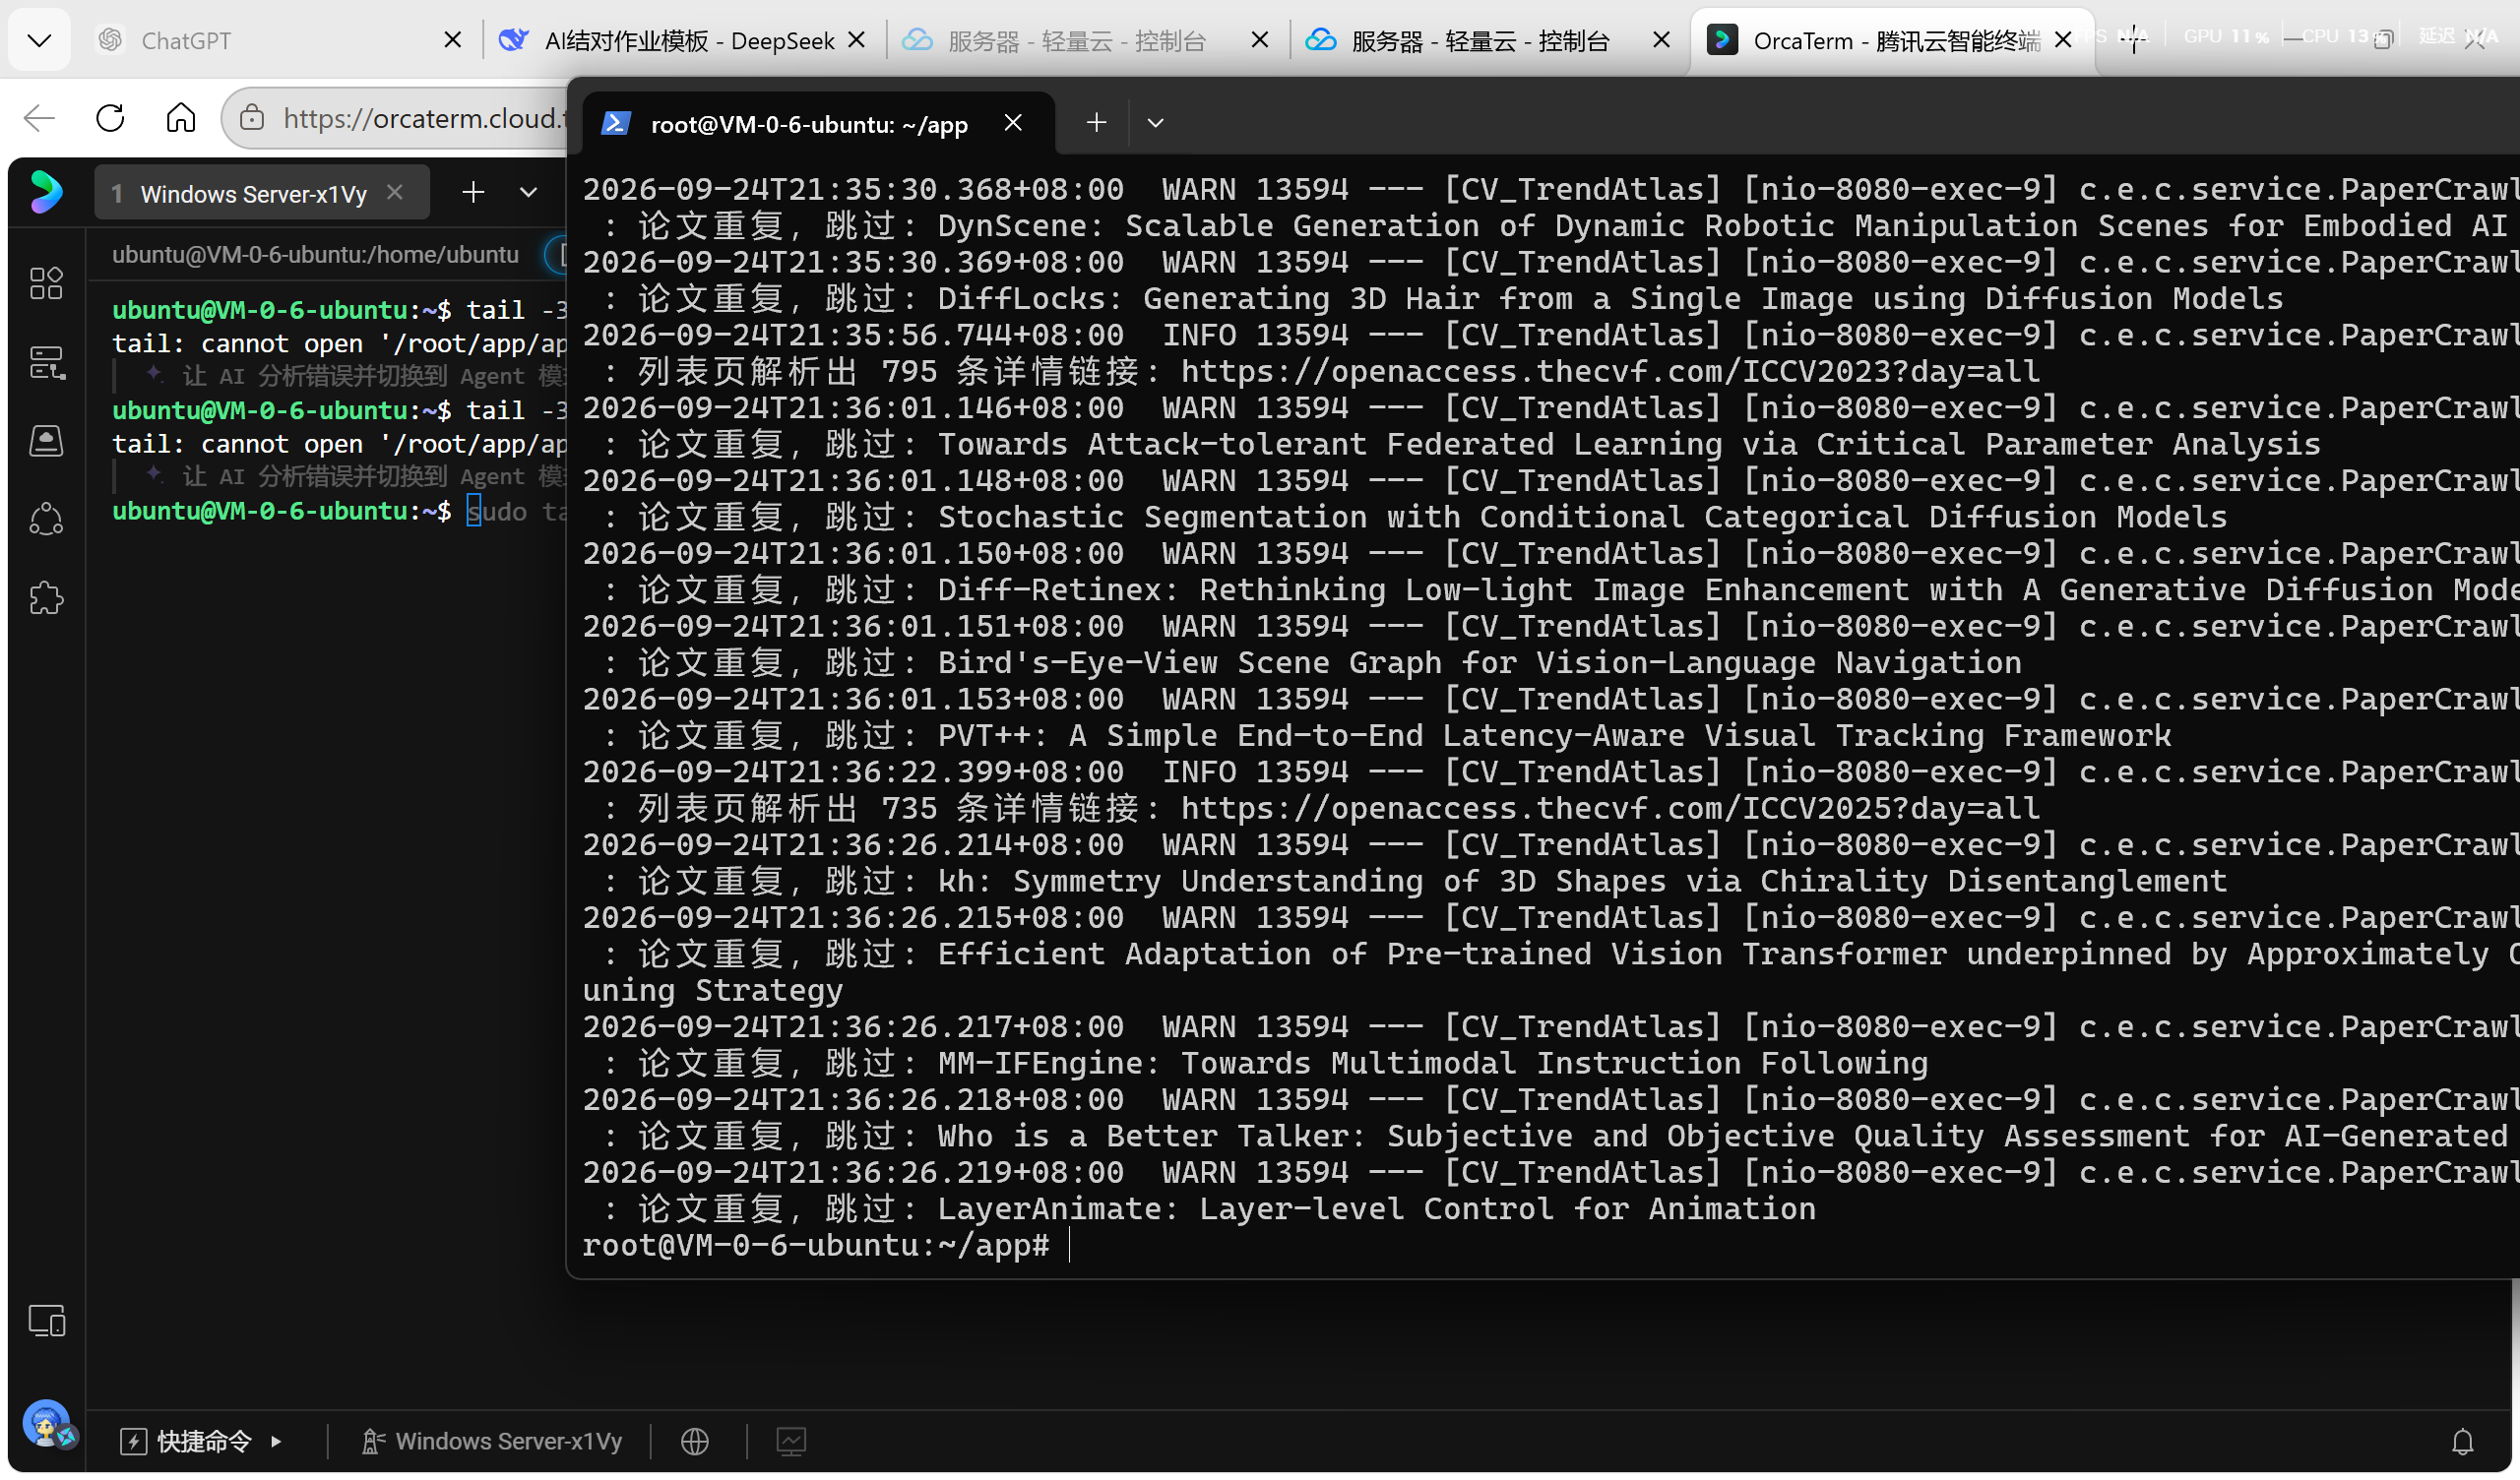
服务器上 java -jar 启动 Spring Boot,Tomcat 监听 8080 端口,HikariPool 成功连接 MySQL。
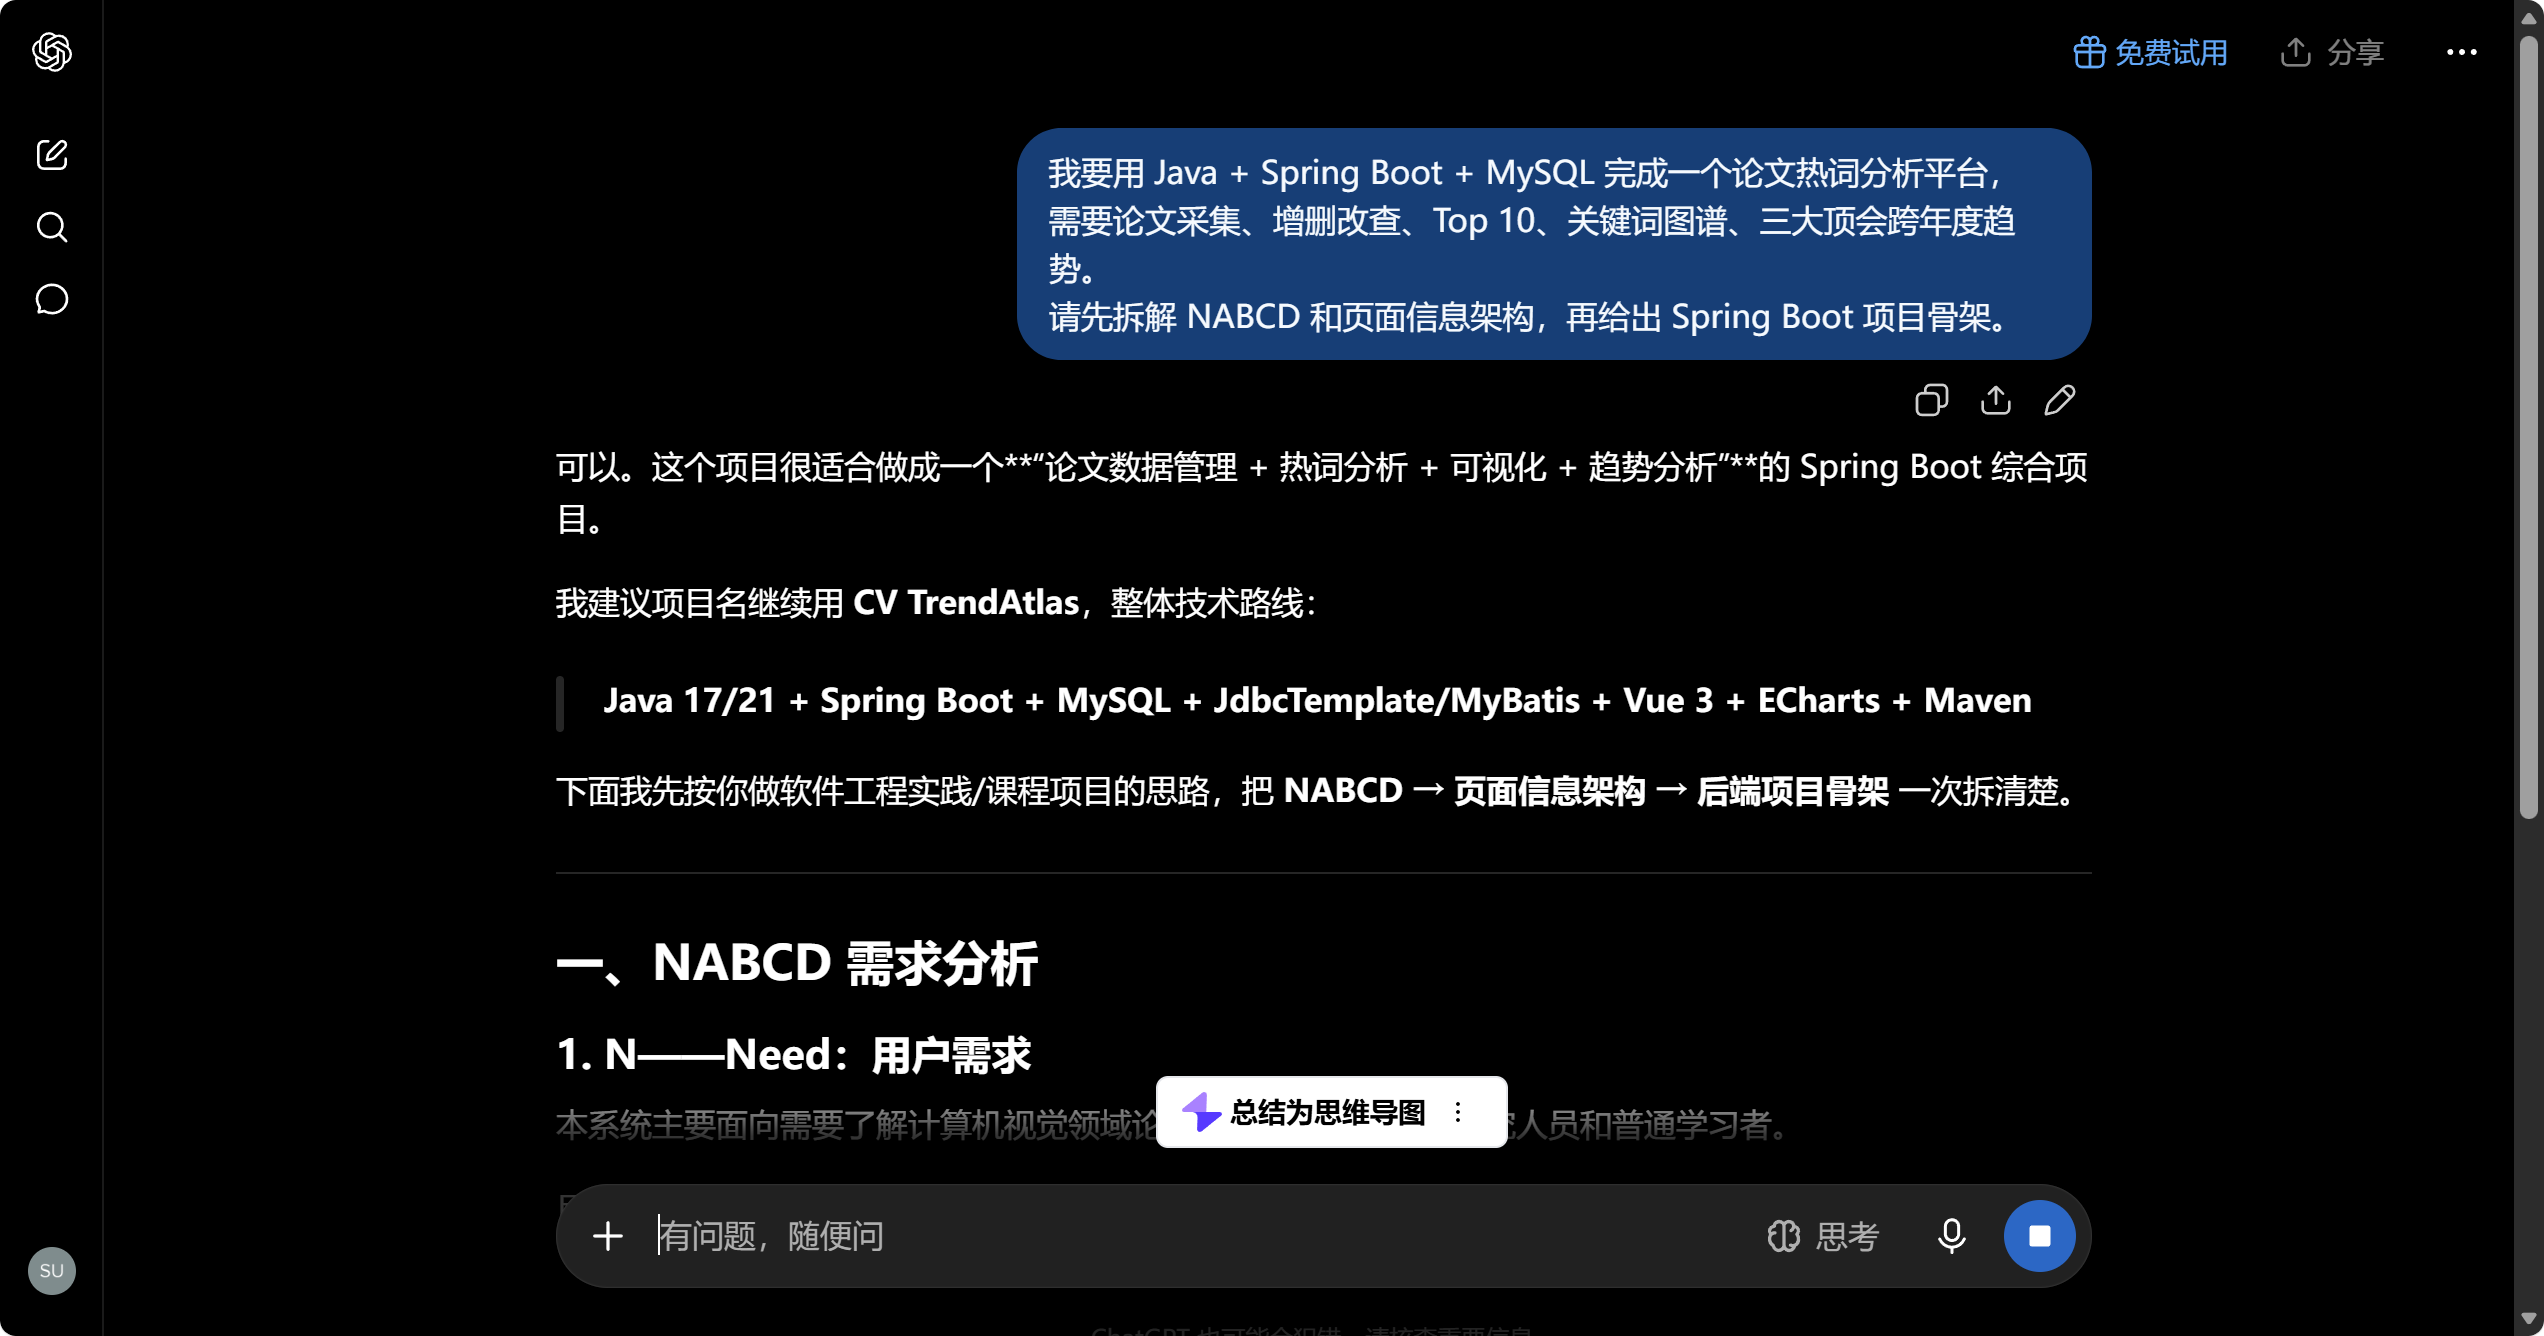
说明:以下按需求与原型、编码、调试三个案例整理。提示词为便于复盘而重述的完整版本,不冒充逐字聊天记录。
第一轮提示词:
我要用 Java + Spring Boot + MySQL 完成一个论文热词分析平台,
需要论文采集、增删改查、Top 10、关键词图谱、三大顶会跨年度趋势。
请先拆解 NABCD 和页面信息架构,再给出 Spring Boot 项目骨架。
AI 输出摘要: AI 拆解了 NABCD,给出 3 个页面的信息架构建议,并生成了 Spring Boot 4.1.1 的 pom.xml 和基本目录结构。
我的追问与调整:
我已有 Java 和数据库基础,但 Spring Boot 和云部署还不熟练。
请压缩技术范围,只保留 Spring Boot + MySQL + 原生 HTML/CSS/JS + ECharts,
不要引入 Spring Data JPA,改用 JdbcTemplate。
采纳与调整:
没有采用的方向:
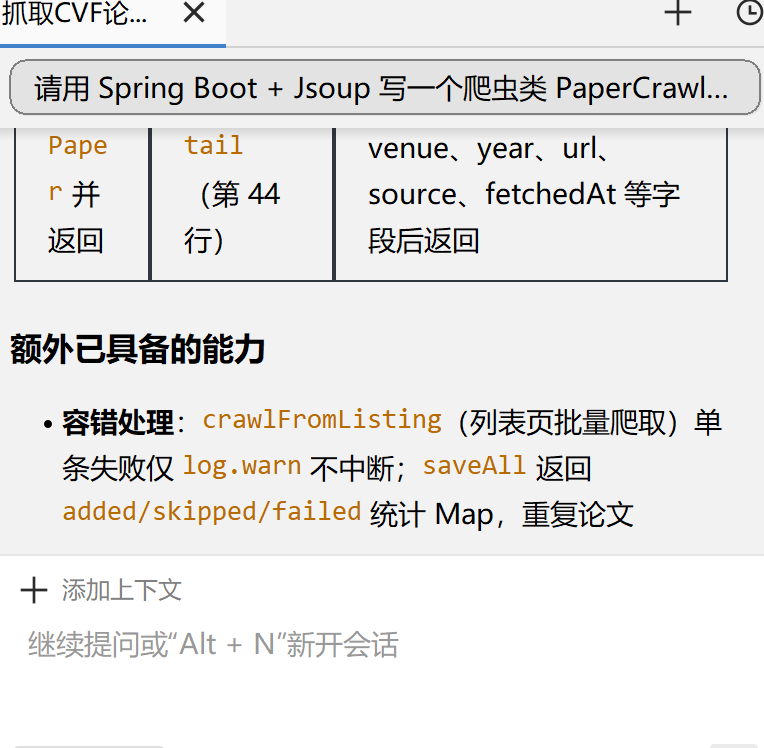
AI 对话截图:
问题现象: 调用 /api/papers/crawl-test 返回:
{"added":0,"skipped":0,"failed":0}
第一轮提示词:
爬虫返回 0 篇论文,检查一下 URL 和选择器是否正确。
目标页面:https://openaccess.thecvf.com/CVPR2024
AI 分析: 指出 CVF 列表页需要带 ?day=all 参数才返回论文列表,且列表项是 <dt class="ptitle"><a href="..."> 结构。
我的验证: 在 PowerShell 里执行
curl.exe -s "https://openaccess.thecvf.com/CVPR2024?day=all" | Select-String "content/CVPR2024/html"
返回大量论文链接,证实 AI 的判断。
第二轮提示词:
确认了 URL 是 CVPR2024?day=all。
请把 PaperCrawlerService 里的列表页选择器
从 a[href] 改成 dt.ptitle > a[href],
并且保证 href 里含 /html/ 且以 .html 结尾。
最终修改:
for (Element a : doc.select("dt.ptitle > a[href]")) {
    String href = a.attr("href");
    String lowerHref = href.toLowerCase();
    if (lowerHref.contains("/html/") && lowerHref.endsWith(".html")) {
        detailUrls.add(resolve(listingUrl, href));
    }
}
验证结果: 重新运行后返回
{"added":5,"skipped":0,"failed":0}
成功抓取 5 篇 CVPR 2024 论文入库。
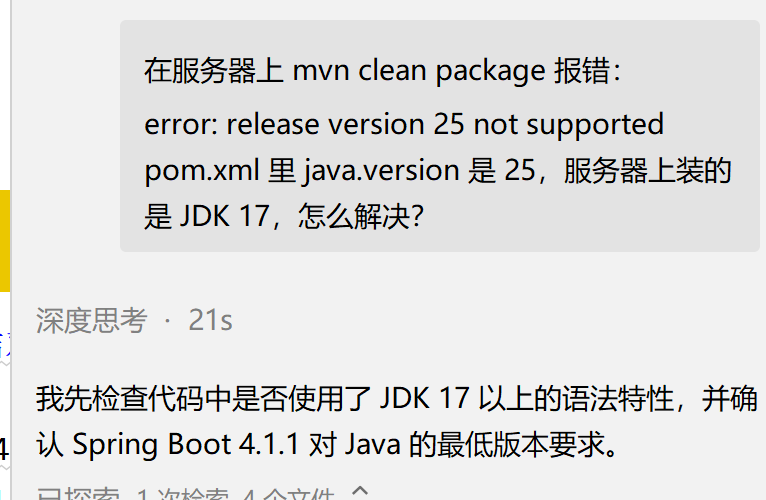
AI 对话截图:
问题依据: 在腾讯云服务器上 mvn clean package 报错:
[ERROR] Fatal error compiling: error: release version 25 not supported
第一轮提示词:
Maven 编译报错 release version 25 not supported,
pom.xml 里 java.version 是 25,
服务器上装的是 JDK 17,怎么解决?
AI 建议: 两个方案。
pom.xml 的 java.version 改成 17我的选择: 方案二。JDK 25 在 Ubuntu 22.04 上安装要额外配置源,不如用系统自带的 JDK 17 稳定。
执行的修改:
sed -i 's|<java.version>25</java.version>|<java.version>17</java.version>|' pom.xml
验证结果: 重新编译后 BUILD SUCCESS,jar 成功生成在 target/CV_TrendAtlas-0.0.1-SNAPSHOT.jar。
没有采用的简化方式: 不把 mvn 编译命令搞成"跳过编译直接下载 jar",也不把本地打包好的 jar 直接传上去(因为后续可能需要服务器重新编译)。
AI 对话截图:
这三个案例共同采用"给出上下文—缩小问题—提出候选方案—检查代码—验证结果"的方式。相比一次让 AI 生成整个项目,分轮讨论更容易明确某段代码到底解决什么问题,也更容易拒绝与现有数据或需求不一致的建议。
协作记录的价值不在于展示很多聊天,而在于保留关键判断:我为什么追问,哪条建议被修改,依据是什么,验证是否支持结论。
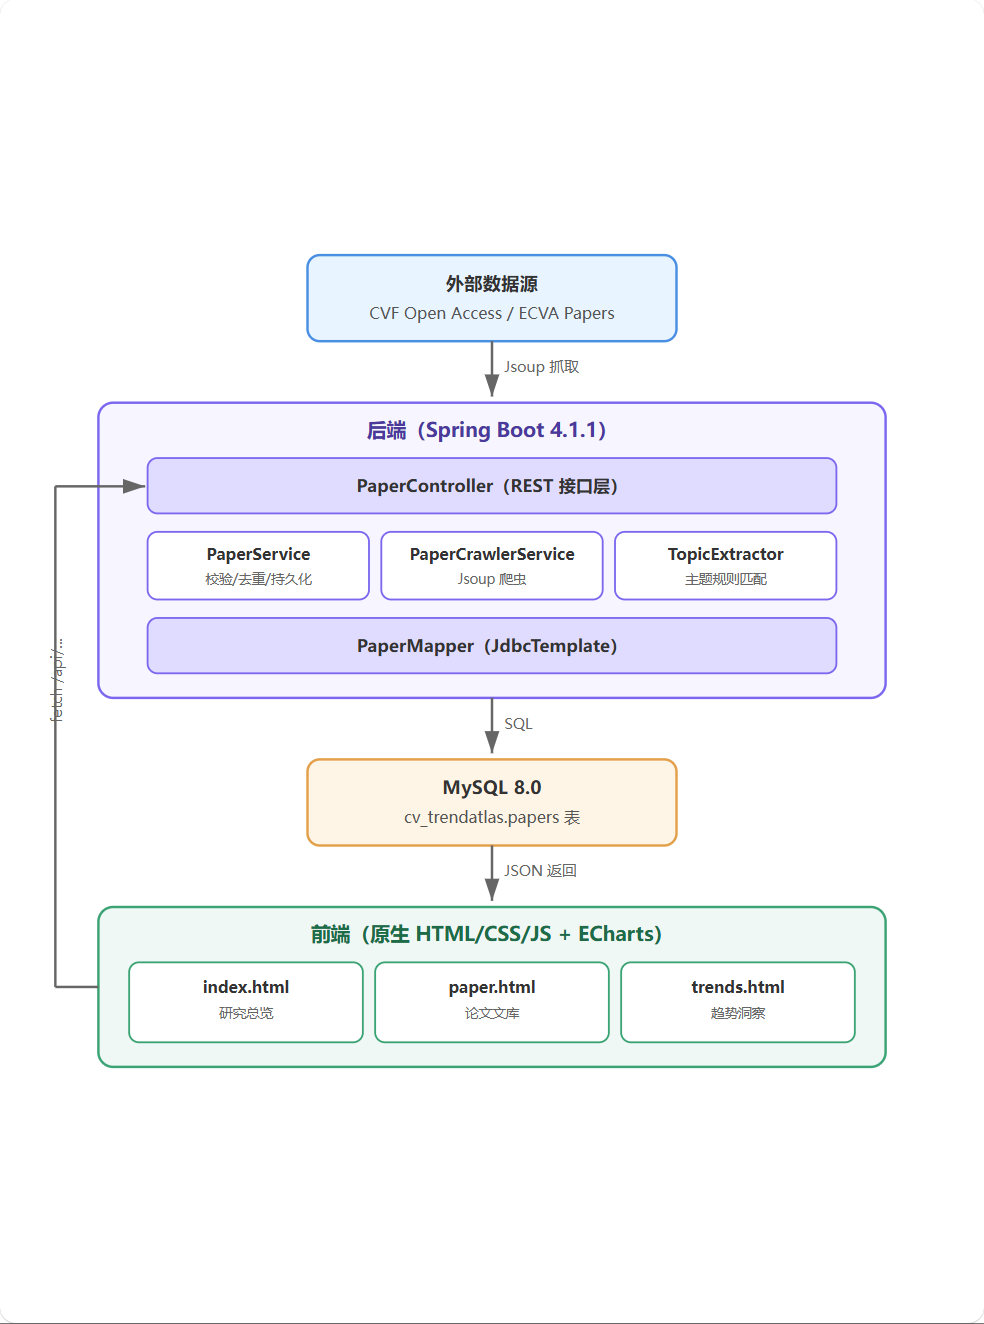
系统由三层组成:
PaperCrawlerService 从 CVF/ECVA 官方目录抓取论文列表和详情页,TopicExtractor 基于标题+摘要的主题规则抽取标签。PaperController 提供 REST 接口,PaperService 负责业务校验和去重,PaperMapper 用 JdbcTemplate 操作 MySQL。index.html(研究总览)、paper.html(论文文库)、trends.html(趋势洞察),用原生 fetch 调接口,用 ECharts 画图。CV_TrendAtlas/
├── src/main/java/com/example/cv_trendatlas/
│ ├── controller/
│ │ └── PaperController.java
│ ├── entity/
│ │ └── Paper.java
│ ├── mapper/
│ │ └── PaperMapper.java
│ ├── service/
│ │ ├── PaperService.java
│ │ ├── PaperCrawlerService.java
│ │ └── TopicExtractor.java
│ └── CvTrendAtlasApplication.java
├── src/main/resources/
│ ├── static/
│ │ ├── index.html
│ │ ├── paper.html
│ │ └── trends.html
│ └── application.properties
├── pom.xml
├── README.md
└── codestyle.md
| 会议 | 年份 | 已收录篇数(云端) |
|---|---|---|
| CVPR | 2022 | 5 |
| CVPR | 2023 | 5 |
| CVPR | 2024 | 5 |
| CVPR | 2025 | 5 |
| 合计 | 4 个会议年度 | 20 |
云端部署时使用 crawl-batch?limitPerEdition=5 抓取小批量数据用于演示。本地开发环境的数据量更大。
清洗包括 HTML 标签移除、实体解码、空白归一化、相对链接补全、题目规范化去重、会议和年份校验。数据库以标准化题目建立唯一约束(title_key),避免重复题目重复入库;这一方法简单明确,但也可能把极少数同名论文合并。
当前采用可解释的主题规则,未使用 TF-IDF、TextRank 或大模型语义分类。算法把标题和摘要拼接后转为小写,匹配明确主题规则;未匹配的论文标为 other vision research,该类不参加热门方向榜单。
对主题 k、会议 v、年份 y,定义:
主题篇数 N(k, v, y)
= 同时属于会议 v、年份 y,且主题集合包含 k 的论文数量

样本占比 S(k, v, y)
= N(k, v, y) / 该会议该年度已收录论文总数 × 100%
每篇论文在同一主题下只计一次,不因摘要中重复出现该词而增加权重;一篇论文可以命中多个主题。图谱展示的是主题节点和共现连线,共现统计方式是:若两篇论文的 keywords 都包含 A、B,则 A-B 连线计数加 1。
精确查询采用忽略大小写的完整题目匹配;模糊查询将题目、作者、关键词、摘要组成文本进行包含匹配。会议、年份、主题筛选在同一条过滤链上组合。
JSON/CSV 导入先逐条验证,再在事务中写入;空题目、不合法会议、错误年度与危险 URL 协议会被拒绝。当前系统适合课程演示,尚不是多用户生产服务。
@Repository
public class PaperMapper {

    private static final String SELECT_COLUMNS =
            "id, title, title_key, authors, venue, year, `abstract`, keywords, url, pdf_url, source, fetched_at";

    private final JdbcTemplate jdbcTemplate;

    public PaperMapper(JdbcTemplate jdbcTemplate) {
        this.jdbcTemplate = jdbcTemplate;
    }

    private static final RowMapper<Paper> ROW_MAPPER = (rs, rowNum) -> {
        Paper paper = new Paper();
        paper.setId(rs.getString("id"));
        paper.setTitle(rs.getString("title"));
        paper.setTitleKey(rs.getString("title_key"));
        paper.setAuthors(rs.getString("authors"));
        paper.setVenue(rs.getString("venue"));
        paper.setYear(rs.getObject("year", Integer.class));
        paper.setAbstractText(rs.getString("abstract"));
        paper.setKeywords(rs.getString("keywords"));
        paper.setUrl(rs.getString("url"));
        paper.setPdfUrl(rs.getString("pdf_url"));
        paper.setSource(rs.getString("source"));
        Timestamp fetchedAt = rs.getTimestamp("fetched_at");
        paper.setFetchedAt(fetchedAt != null ? fetchedAt.toLocalDateTime() : null);
        return paper;
    };

    public int insert(Paper paper) {
        String sql = "INSERT INTO papers (" + SELECT_COLUMNS + ") VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?)";
        return jdbcTemplate.update(sql,
                paper.getId(), paper.getTitle(), paper.getTitleKey(),
                paper.getAuthors(), paper.getVenue(), paper.getYear(),
                paper.getAbstractText(), paper.getKeywords(),
                paper.getUrl(), paper.getPdfUrl(),
                paper.getSource(), paper.getFetchedAt());
    }

    public Optional<Paper> findByTitleKey(String titleKey) {
        String sql = "SELECT " + SELECT_COLUMNS + " FROM papers WHERE title_key = ?";
        return jdbcTemplate.query(sql, ROW_MAPPER, titleKey).stream().findFirst();
    }
}
设计思路: 用 SELECT_COLUMNS 常量避免重复列名;abstract 是 MySQL 关键字,SQL 中用反引号 `abstract` 引用;RowMapper 集中处理 snake_case 到 camelCase 的映射。SQL 一律使用参数化查询,防止注入。
public List<Paper> crawlFromListing(String listingUrl, String venue, int year, int limit) {
    Document doc = Jsoup.connect(listingUrl)
            .userAgent(USER_AGENT)
            .timeout(TIMEOUT_MILLIS)
            .get();

    Set<String> detailUrls = new LinkedHashSet<>();
    // CVF 列表页结构:<dt class="ptitle"><a href="/content/CVPR2024/html/xxx.html">
    for (Element a : doc.select("dt.ptitle > a[href]")) {
        String href = a.attr("href");
        String lowerHref = href.toLowerCase();
        if (lowerHref.contains("/html/") && lowerHref.endsWith(".html")) {
            detailUrls.add(resolve(listingUrl, href));
        }
    }

    log.info("列表页解析出 {} 条详情链接: {}", detailUrls.size(), listingUrl);

    List<Paper> papers = new ArrayList<>();
    for (String detailUrl : detailUrls) {
        if (papers.size() >= limit) break;
        try {
            papers.add(crawlDetail(detailUrl, venue, year));
        } catch (Exception e) {
            log.warn("抓取详情页失败: {}", detailUrl, e);
        }
    }
    return papers;
}
设计思路: 先用 dt.ptitle > a[href] 精确选择器抓取列表链接,LinkedHashSet 去重;逐条访问详情页,单个失败只 log.warn 不中断,保证批量抓取的鲁棒性。
public Paper save(Paper paper) {
    validate(paper);
    String titleKey = buildTitleKey(paper.getTitle());
    paper.setTitleKey(titleKey);
    if (paperMapper.findByTitleKey(titleKey).isPresent()) {
        throw new IllegalStateException("论文已存在,titleKey: " + titleKey);
    }
    if (paper.getId() == null || paper.getId().isBlank()) {
        paper.setId(UUID.randomUUID().toString().replace("-", ""));
    }
    if (paper.getFetchedAt() == null) {
        paper.setFetchedAt(LocalDateTime.now());
    }
    if (paper.getKeywords() == null || paper.getKeywords().isBlank()) {
        List<String> topics = topicExtractor.extractTopics(
                paper.getTitle(),
                paper.getAbstractText() == null ? "" : paper.getAbstractText());
        paper.setKeywords(String.join(",", topics));
    }
    paperMapper.insert(paper);
    return paper;
}

private String buildTitleKey(String title) {
    return title.trim().toLowerCase().replaceAll("\\s+", " ");
}
设计思路: titleKey 是规范化后的题目(去空格、转小写),数据库有 UNIQUE 约束,防止重复入库。keywords 为空时自动调用 TopicExtractor 抽取主题。
@Component
public class TopicExtractor {

    private static final Map<String, Pattern> TOPIC_RULES = new LinkedHashMap<>();

    static {
        TOPIC_RULES.put("diffusion", Pattern.compile("diffusion", Pattern.CASE_INSENSITIVE));
        TOPIC_RULES.put("vision-language", Pattern.compile("vision.language|visual.language", Pattern.CASE_INSENSITIVE));
        TOPIC_RULES.put("transformer", Pattern.compile("transformer", Pattern.CASE_INSENSITIVE));
        TOPIC_RULES.put("segmentation", Pattern.compile("segment", Pattern.CASE_INSENSITIVE));
        TOPIC_RULES.put("3d vision", Pattern.compile("\\b3d\\b|point cloud", Pattern.CASE_INSENSITIVE));
        TOPIC_RULES.put("image restoration", Pattern.compile("denois|deblur|super.resolution", Pattern.CASE_INSENSITIVE));
        // ... 其他规则
    }

    public List<String> extractTopics(String title, String abstractText) {
        String text = (title + " " + abstractText).toLowerCase();
        List<String> topics = new ArrayList<>();
        for (Map.Entry<String, Pattern> e : TOPIC_RULES.entrySet()) {
            if (e.getValue().matcher(text).find()) {
                topics.add(e.getKey());
            }
        }
        return topics.isEmpty() ? List.of("other vision research") : topics;
    }
}
设计思路: 规则用 Pattern 预编译,LinkedHashMap 保证主题顺序稳定;没匹配任何主题的论文归入 other vision research,不参与 Top 10 统计。
本地开发阶段通过 PowerShell 的 curl.exe 和浏览器对接口做了验证:
| 验证内容 | 接口 | 结果 |
|---|---|---|
| 论文总数 | GET /api/papers/count | 返回 {"count":20} |
| 论文列表 | GET /api/papers | 返回 JSON 数组 |
| Top 10 | GET /api/papers/top10 | 返回 10 个主题及数量 |
| 关键词图谱 | GET /api/papers/topic-graph | 返回 nodes 和 links |
| 趋势走势 | GET /api/papers/trend?topic=diffusion | 返回各会议年度数据 |
| 批量抓取 | POST /api/papers/crawl-batch | 返回新增/跳过/失败统计 |
| 主题抽取 | POST /api/papers/extract-topics | 返回更新条数 |
本地 dev 分支共有 10 次提交,master 分支通过 Fast-forward 合并了 dev 的全部提交,并发布了 tag 1.0.0。
| 提交 | 主要变化 |
|---|---|
| a10eab2 | 添加 pom.xml 和项目基础配置 |
| f0200bd | 添加 PaperService 业务逻辑层 |
| 074b555 | 完成趋势洞察功能 |
| 6807c50 | 完成论文文库页面 paper.html |
| a53ab36 | 添加论文实体类并完善前后端功能 |
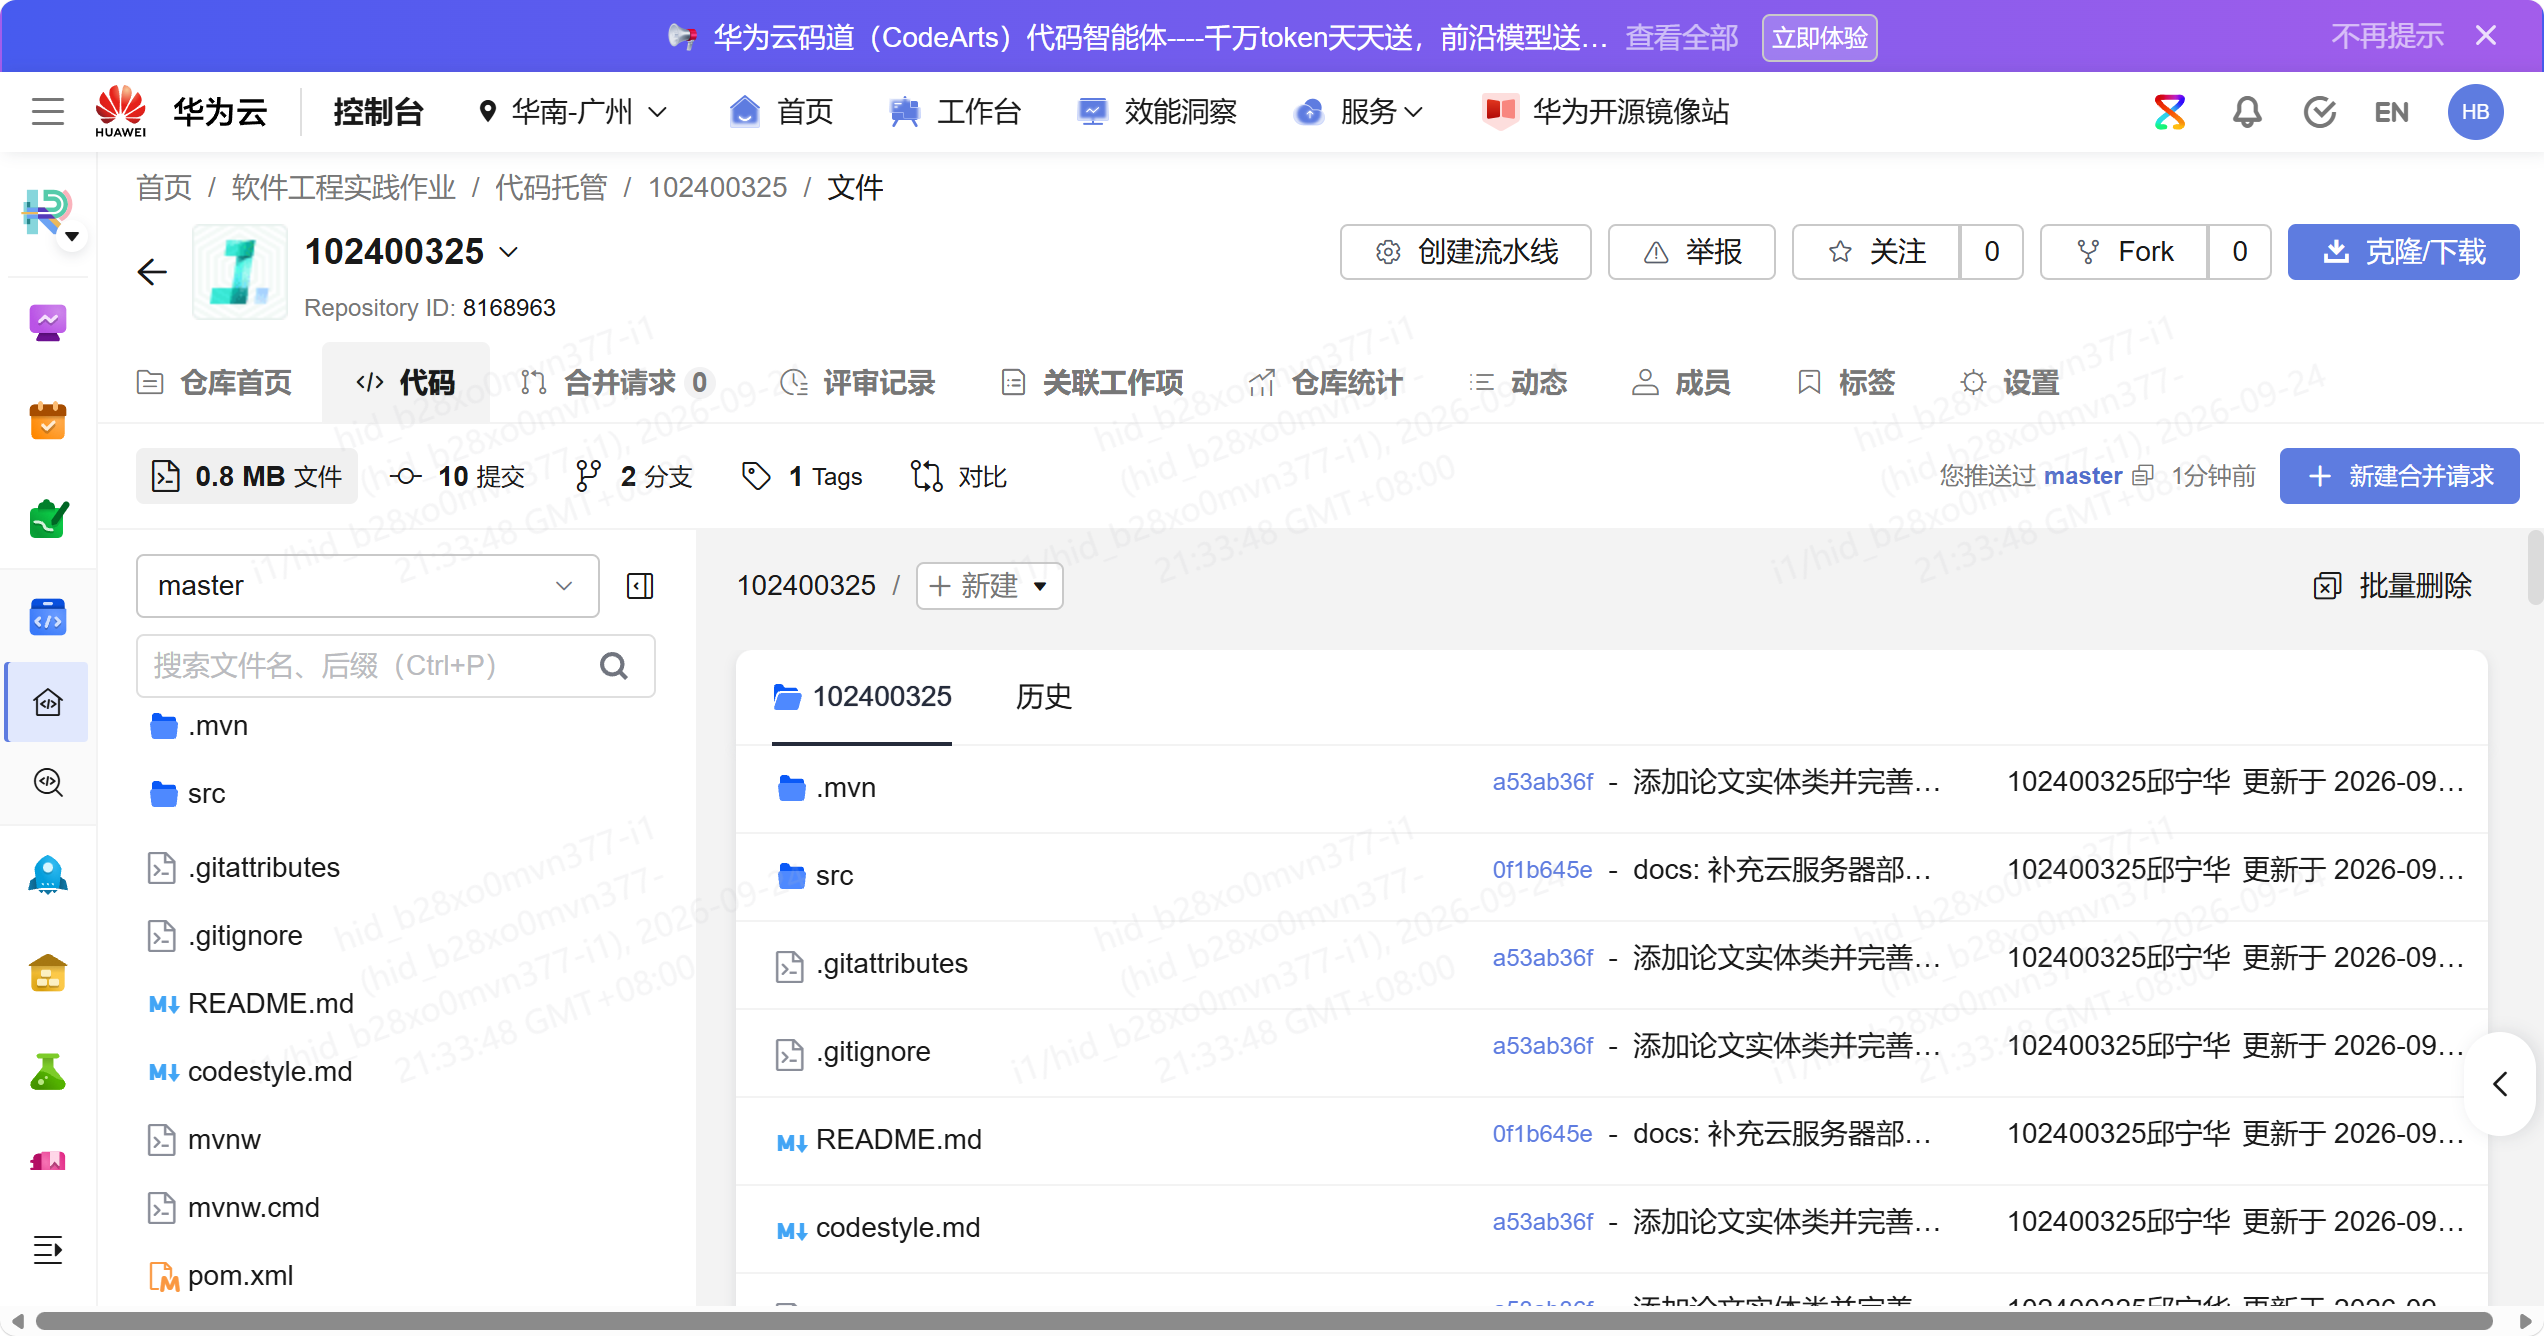
分支和发布状态:
master 和 dev 都已推送到 CodeArts 远程仓库1.0.0 已创建并推送,可在 CodeArts 的标签页查看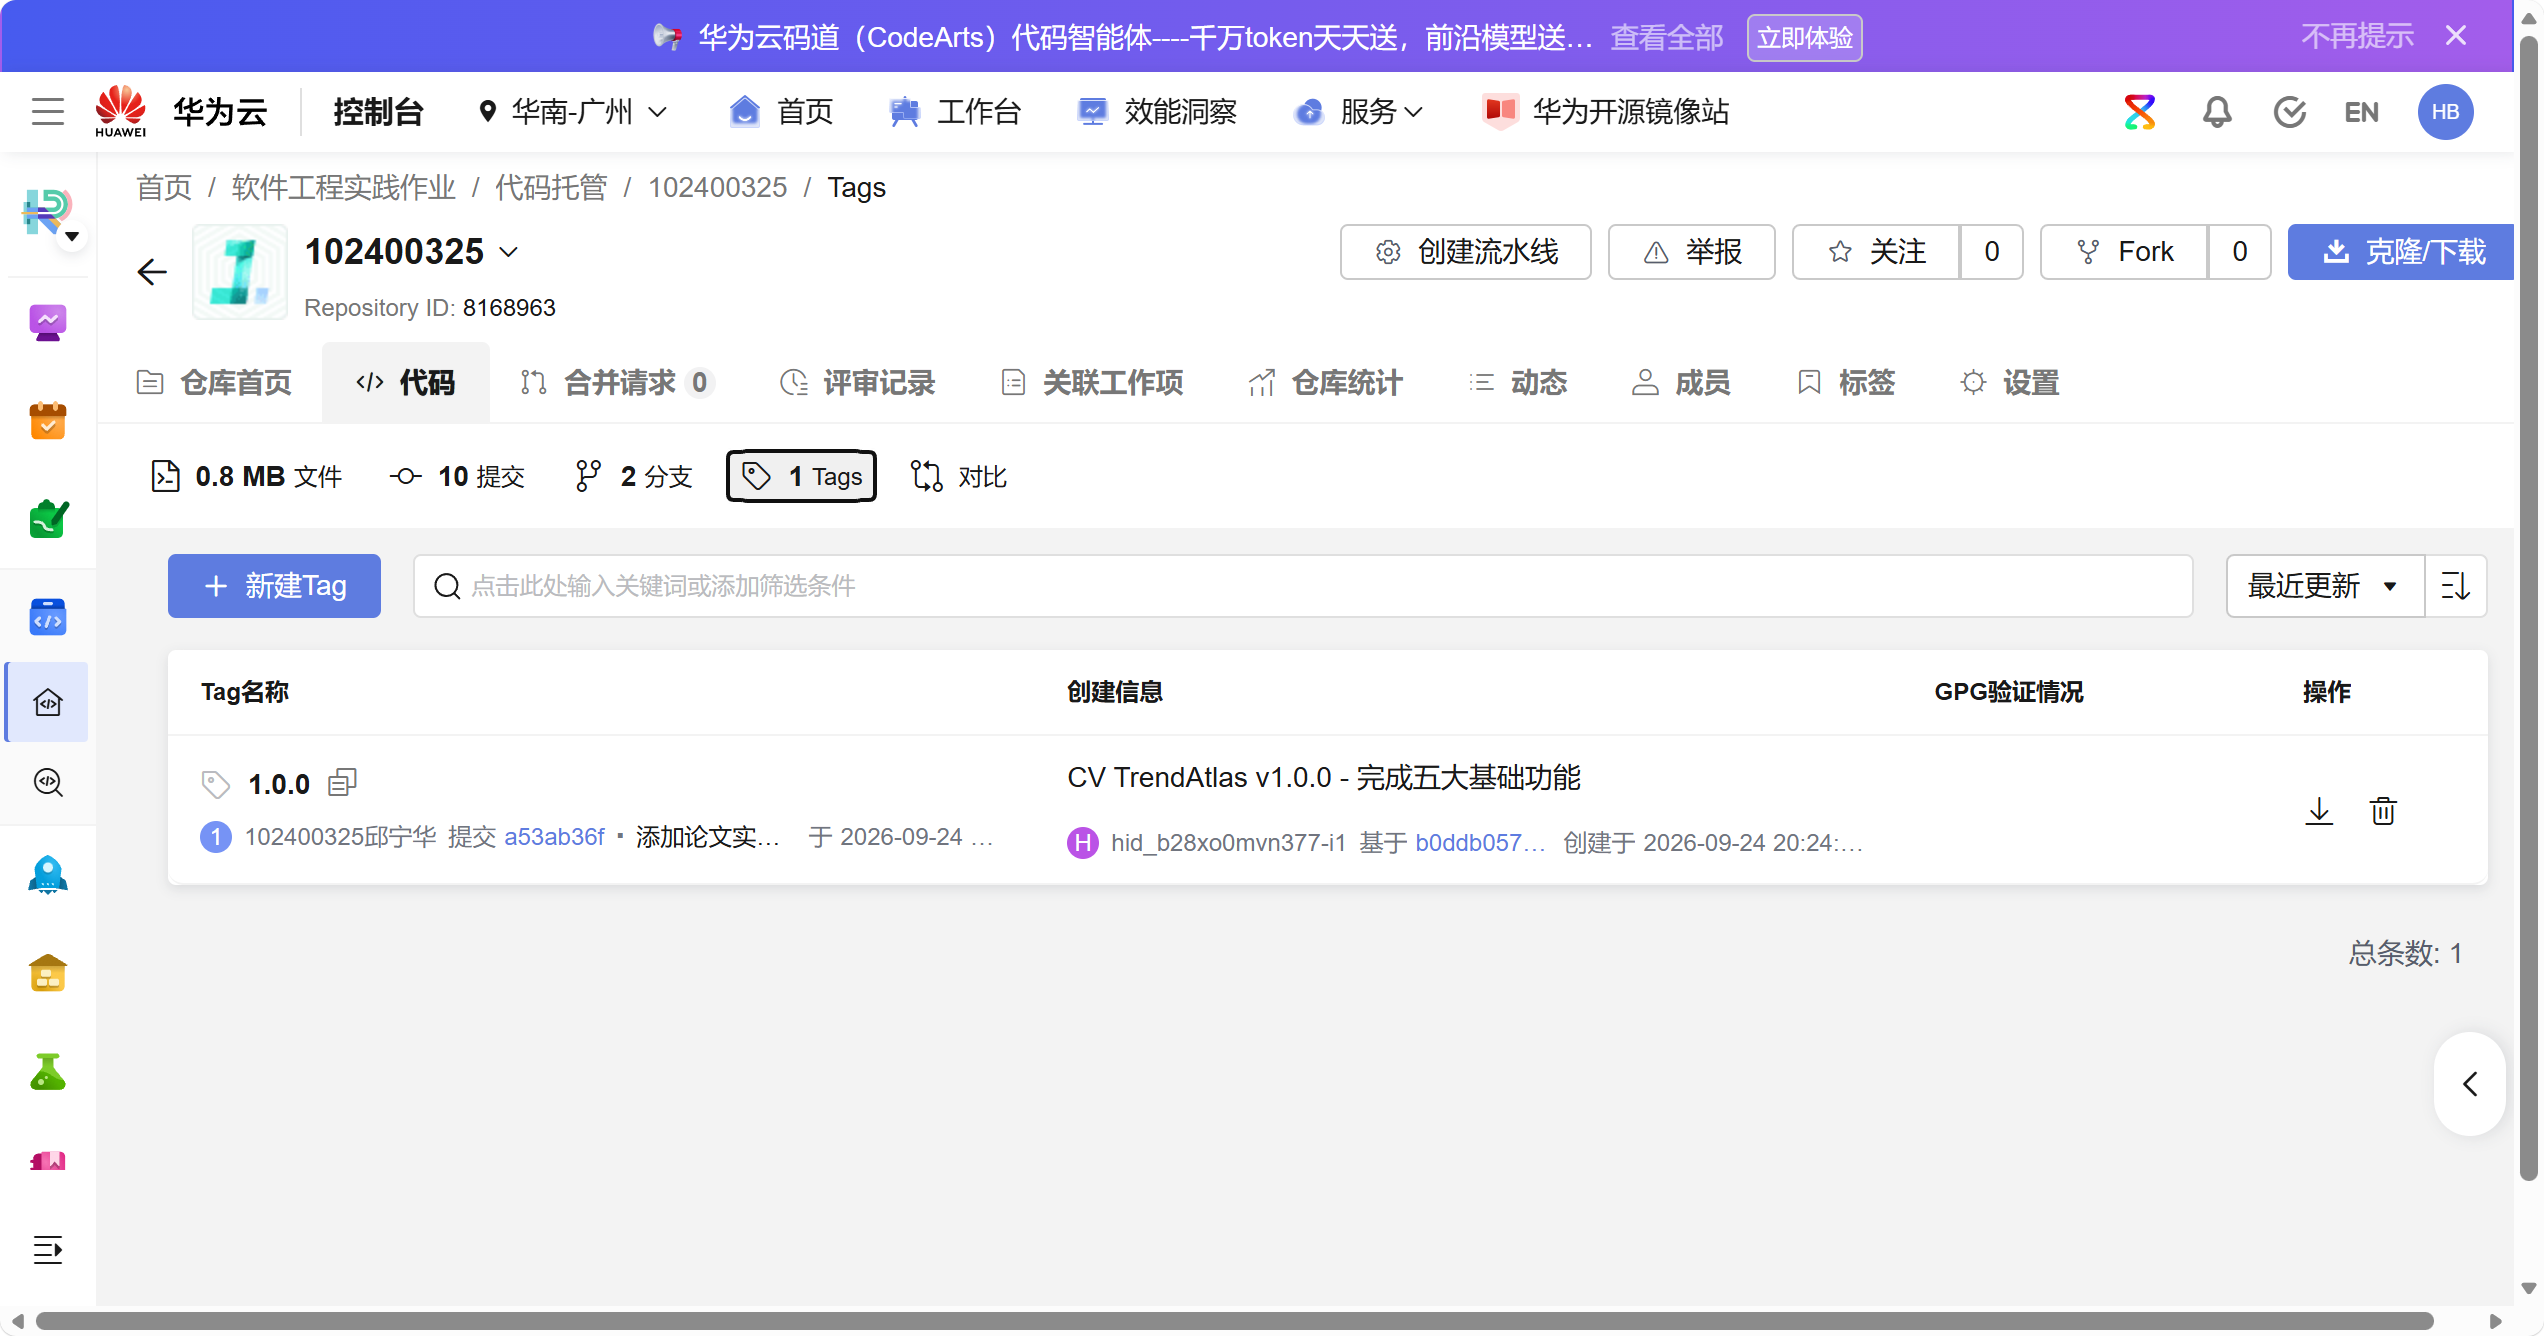
本地运行:
git clone https://codehub-cn-south-1.devcloud.huaweicloud.com/538373125b434b55873faa4c8494ac8b/102400325.git
cd 102400325
mvn clean package -DskipTests
java -jar target/CV_TrendAtlas-0.0.1-SNAPSHOT.jar
浏览器访问 http://localhost:8080/。
云端部署(腾讯云轻量应用服务器,Ubuntu 22.04):
# 1. 安装环境
apt update
apt install openjdk-17-jdk mysql-server git maven -y

# 2. 配置 MySQL
mysql -u root -p
# CREATE DATABASE cv_trendatlas ...;
# CREATE TABLE papers (...);

# 3. 克隆代码
cd /root && git clone <仓库 HTTPS 地址> app && cd app

# 4. 修改配置
# 编辑 src/main/resources/application.properties 里的数据库密码
# 修改 pom.xml 的 java.version 为 17

# 5. 编译并运行
mvn clean package -DskipTests
nohup java -jar target/CV_TrendAtlas-0.0.1-SNAPSHOT.jar --server.port=8080 > app.log 2>&1 &
实际云端入口: http://49.232.19.164:8080/
说明: 因华为云 ECS 按需计费成本较高,本项目实际部署在腾讯云轻量应用服务器上。项目代码本身平台无关,部署流程与华为云 ECS 完全相同:安装 JDK + MySQL、克隆代码、mvn package、nohup java -jar 后台运行。
这次作业从零开始搭建一个完整的 Spring Boot Web 项目,过程比预想的复杂。
一开始我以为"写个网页展示论文统计"很简单,但真正做起来才发现,光是让项目跑起来就踩了不少坑:JDK 版本、Maven 镜像、Lombok 注解处理器、MySQL 连接配置、IDEA 的运行配置……每一步都可能卡住。尤其是有一次 IDEA 一直弹出"找不到 chrome"的报错,查了半天才发现是运行配置绑定了错误的浏览器路径,而不是代码问题。
数据这一块也让我重新认识了"持久化"。最初我把数据写在前端 JS 里,后来发现刷新就没了;改用数据库后,又要处理连接池、字符编码、唯一约束这些细节。
AI 在这个过程中帮了很多忙,但也不是万能的。比如爬虫代码,AI 一开始给我的 URL 是 CVPR2024,实际验证后发现必须是 CVPR2024?day=all 才返回论文列表。再比如 Java 25 在服务器上不兼容,AI 提出了两种方案,我需要自己判断哪种更稳。这让我意识到:AI 能给出方案,但判断方案对不对、能不能用,还是得靠自己动手验证。
部署到云服务器的过程也是一波三折。SSH 密码、防火墙、系统重装、JDK 版本、Maven 编译……每解决一个问题,都让我更理解"从代码到能访问"这件事有多少环节。最后看到浏览器能打开 http://49.232.19.164:8080/,看到首页的统计卡片显示数字,那一刻挺有成就感的。
最大的收获不是学会了某个框架,而是养成了一种工作习惯:写代码之前先讲清需求,写完代码一定要实际运行验证,遇到问题先看日志再下结论。
结合《构建之法》第 4 章对结对协作的讨论,我把人机结对理解为需要不断切换"提出方案"和"审查方案"的过程。AI 可以承担代码初稿与备选思路,我必须检查它是否符合任务。
| 维度 | 人人结对 | 人机结对中的体会 |
|---|---|---|
| 反馈与分工 | 双方可交流背景、承担协作任务 | AI 反馈快,但需要主动补充上下文和约束 |
| 审查作用 | 同伴可依据经验发现问题 | AI 擅长列出检查方向,但建议需要运行与资料验证 |
| 知识边界 | 能通过讨论表达不熟悉的领域 | AI 可能以确定语气给出不适用的 API 或部署建议 |
| 责任与理解 | 团队成员共同承担工程责任 | AI 不替我承担提交责任;最终仍需我理解、核实和交付 |
| 过程证据 | 任务分工、评审和提交可追踪 | 还应保留 Prompt、追问、采纳理由和修复结果 |
贡献:
局限:
总体评价:
它是一位高效的候选方案提供者和辅助审查者,但不是最终验收人。今后我会继续使用 AI,同时坚持让每个重要结论能够落到可检查的文件、数据或运行结果上。
本项目已完成作业要求的 5 个基础功能。后续可扩展的方向:

