

 2601_FZU_SE

软件工程实践第二次作业
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
软件工程第二次实践作业
| 这个作业属于哪个课程 | 2601_FZU_SE |
|---|---|
| 这个作业要求在哪里 | 软件工程实践第二次作业 |
| 这个作业的目标 | 开发并部署一个 CV 顶会论文趋势分析平台,完成爬取、管理、热门分析、关键词图谱、热度动图五大功能,并与 AI 结对协作完成全部文档与原型交付。 |
| 其他参考文献 | 邹欣.《构建之法》(第 3 版)第 3、8 章;jieba 分词:github.com/fxsjy/jieba |
目录
- 软件工程第二次实践作业
- 目录
- 1.仓库链接&代码规范链接&AI工具说明
- 1.1 仓库链接:
- 1.3 AI工具说明:
- 2.PSP表格
- 2.1阶段一:需求理解与原型设计
- 2.1阶段二:编程实现与部署
- 2.3总计
- 2.4偏差原因分析
- 3.NABCD需求分析
- 3.1N — Need(需求)
- 核心痛点
- N1.需求分层(六类用户)
- N2.课程约束
- N3.市场空白
- 3.2A — Approach(方案:如何解决问题)
- A1. 总体定位
- A2. 三个设计反转
- A3. 数据方案(DBLP 为主源)
- A4. 关键词与热度统计方案
- A5. 功能与原型页面映射
- A6. 技术方案
- A7. AI 协作流程
- A8. 迭代路线
- 3.3B — Benefit(收益)
- 3.4C — Competition(竞争:对手是谁、如何竞争、有何优势)
- C1. 竞争总判断(客观)
- C2. 四个竞品逐个分析
- 1. arXiv
- 2. Connected Papers
- 3. Papers with Code
- 4. 机器之心 / 极市等中文年度盘点文
- C3. 竞争策略总结
- C4. 相对整个竞品集的优势清单
- C5. 客观风险(不回避)
- 3.5D — Delivery(交付与部署)
- D1. 两阶段交付物总表
- D2. 部署方案(CodeArts,最高优先级风险项)
- D4. 博客内容清单
- 4.原型设计与原型链接
- 4.1原型开发工具声明
- 4.2 AI 协作设计
- 1.布局与视觉的高保真初稿(AI 生成,人重构)
- 2.交互与动图的 AI 辅助实现(AI 建议,人配置)
- 4.3 最终结果展示&介绍:
- 热门总览页面(主页面)
- 热度走势页面
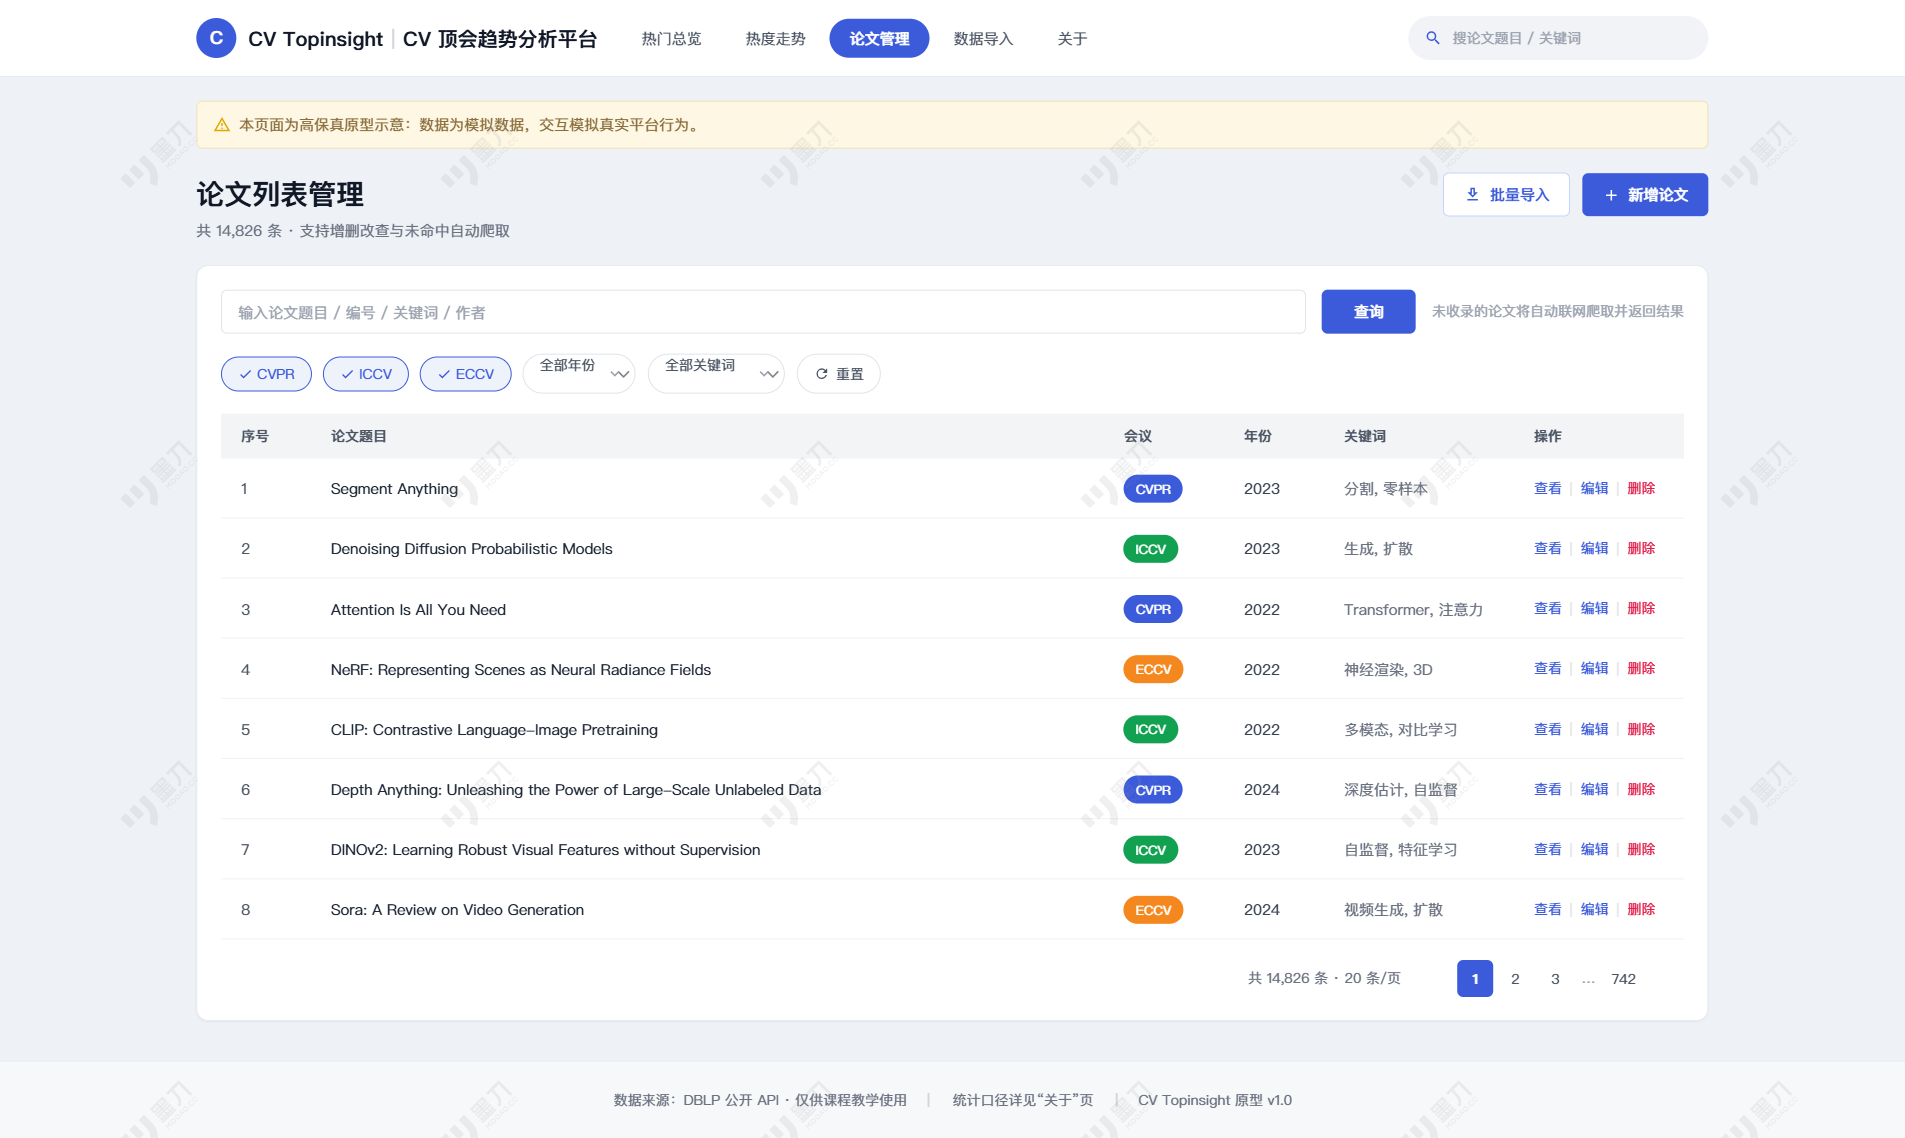
- 论文管理页面
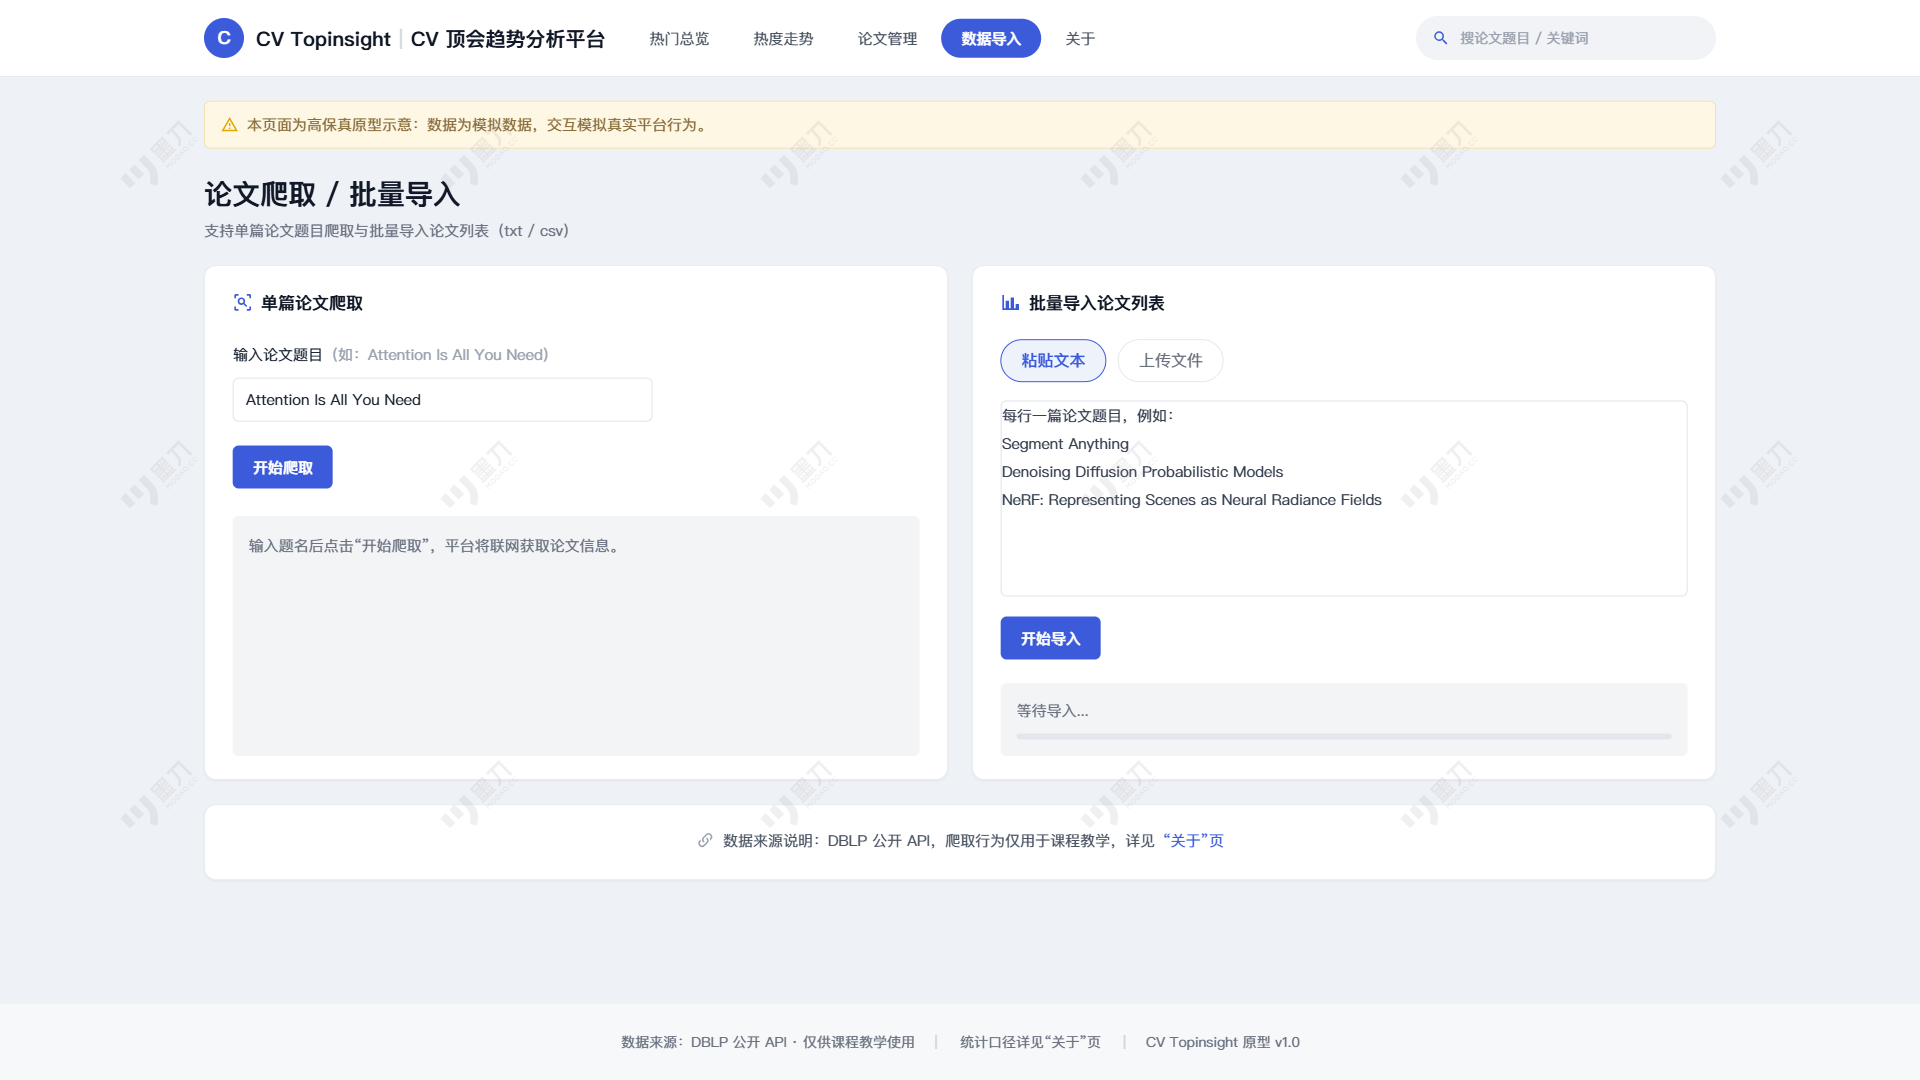
- 数据导入页面
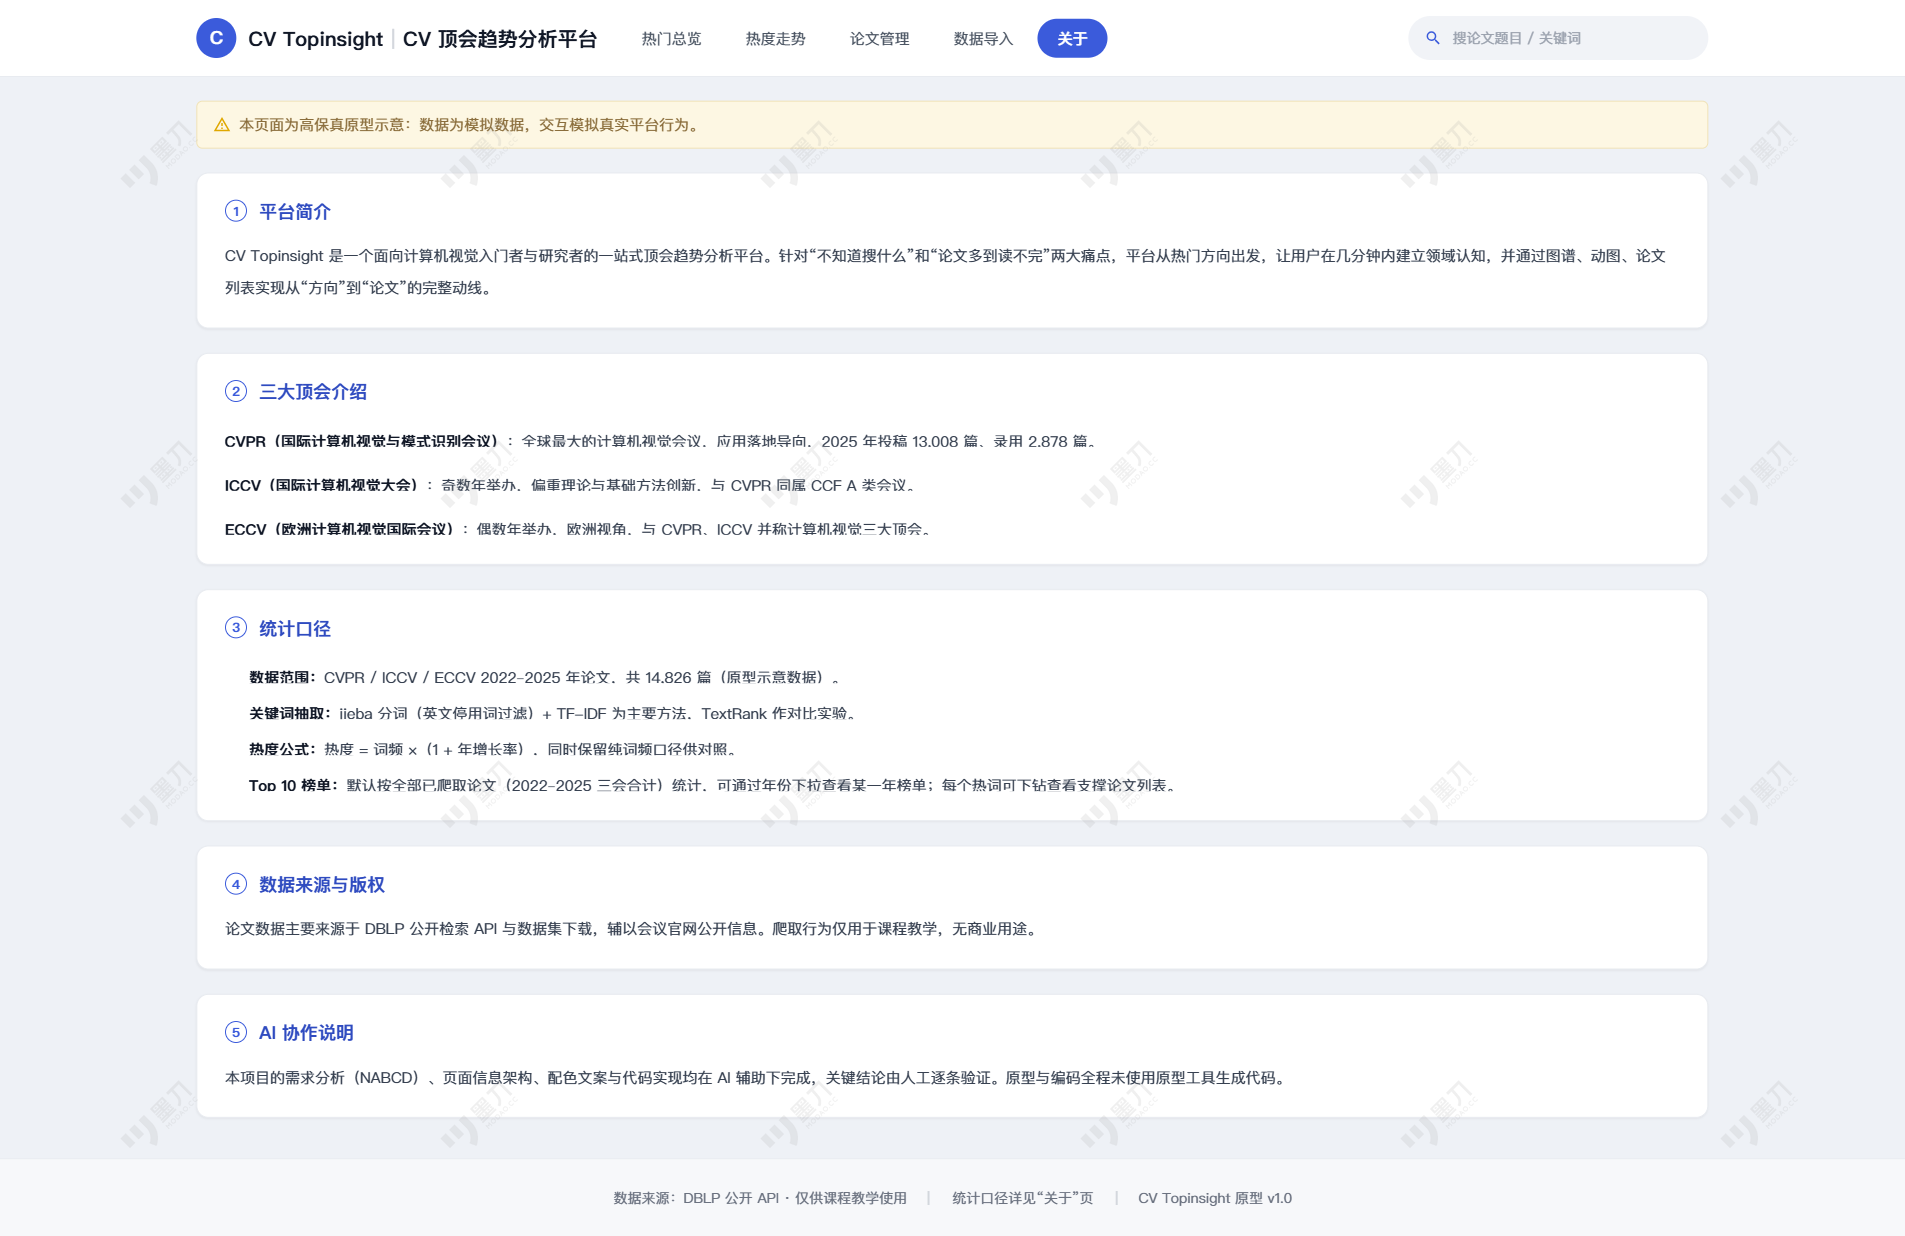
- 关于页面
- 5.成品展示
- 6.结对(人机)讨论过程描述
- 6.1协作记录总览
- 6.2三个代表性案例
- 案例 1:需求分析与原型设计
- 案例 2:数据源真实情况由 AI 主动发现,人拍板技术路线
- 案例 3:限流应对与部署路径
- 6.3可解释性声明
- 7.设计实现过程
- 7.1设计实现过程
- 阶段一:需求与原型(AI 结对起点)
- NABCD 分析
- 原型设计
- 阶段二前半:数据管道
- 仓库与规范
- 表结构设计
- 清洗入库
- 阶段二后半:功能实现(数据依赖决定顺序)
- 功能1/2 后端
- 功能3 统计
- 功能4/5 前端
- 隔年会议修正
- 收尾:部署与交付
- CodeArts 部署
- Git 收口
- 关键决策记录表
- 7.2功能结构图
- 8.代码说明
- 8.1数据管道(fetcher/dblp.py)—— DBLP 检索 API 分页 + front matter 过滤
- 8.2 关键词抽取(services/keywords.py)—— 词形还原 + 加权
- 8.3 统计引擎(services/stats.py)—— TF-IDF + 热度 + Top10
- 8.4 数据访问(repository.py)—— 组合筛选查询
- 8.5统计接口(api/stats.py)
- 8.6 前端数据层(api/index.js)
- 8.7 竞速动图(views/TrendView.vue)—— 线性插值 + realtimeSort
- 9.心路历程、收获
- 10.对AI结对伙伴的评价
1.仓库链接&代码规范链接&AI工具说明
1.1 仓库链接:
1.3 AI工具说明:
- 核心工具:
opencode(AI 代码助手 / 结对编程终端) - 底层模型:
DeepSeek V4 Pro - 协作模式:AI 负责快速生成初稿、提供方案思路、代码实现与查错;人工负责需求验证、方案定夺、代码审查与最终测试。
2.PSP表格
规则:预估列在动手前填写;实际列在全部工作完成后填写;
偏差 = 实际 - 预估;偏差原因逐条分析,不虚构。
2.1阶段一:需求理解与原型设计
| 子任务 | 预估(h) | 实际(h) | 偏差(h) |
|---|---|---|---|
| 阅读《构建之法》第 3、8 章 | 2 | 2 | 0 |
| 与 AI 头脑风暴(角色/竞品/优先级) | 2 | 3 | 1 |
| NABCD 人工验证与定稿 | 4 | 4 | 0 |
| 学习原型工具(墨刀) | 3 | 3 | 0 |
| 与 AI 讨论页面信息架构/配色/文案 | 3 | 2 | -1 |
| 五页高保真原型设计 | 5 | 8 | 3 |
| 原型发布分享链接 + 阶段一博客 | 2 | 2 | 0 |
| 阶段一小计 | 21 | 24 | 3 |
2.1阶段二:编程实现与部署
| 子任务 | 预估(h) | 实际(h) | 偏差(h) |
|---|---|---|---|
| 仓库初始化与文档基线(README/.gitignore/codestyle/AGENTS.md) | 1 | 1 | 0 |
| 数据管道:DBLP bibtex 下载 + arXiv 补摘要 | 5 | 12 | 7 |
| 关键词抽取(jieba + 停用词 + 词形还原 + 噪音词表) | 4 | 4 | 0 |
| 热度统计与 Top10(TF-IDF + 热度公式) | 4 | 4 | 0 |
| 功能1、2 后端接口(爬取/导入/增删改查/未命中兜底) | 6 | 5 | -1 |
| Vue3 前端初始化(对照原型重写,路由 + 全局布局) | 4 | 2 | -2 |
| 热门总览页(Top10 + 图谱 + 下钻) | 5 | 4 | -1 |
| 热度走势页(连续插值动图 + 三会分面 + 单词走势) | 5 | 3 | -2 |
| 论文管理页 + 数据导入页联调 | 3 | 3 | 0 |
| 详情页 + 关于页 | 3 | 2 | -1 |
| 测试(fixtures + pytest + 口径验证) | 3 | 4 | 1 |
| Bug 修复(表结构 abstract_flag、动图溢出、隔年会议) | 2 | 3 | 1 |
| CodeArts 部署(ECS + gunicorn + 公网访问) | 2 | 2 | 0 |
| Git 操作(dev 分支、15+ commit、merge main、tag v1.0.0、Release) | 2 | 2 | 0 |
| 博客收尾 | 3 | 4 | 1 |
| 阶段二小计 | 52 | 55 | 3 |
2.3总计
| 阶段 | 预估(h) | 实际(h) | 偏差(h) |
|---|---|---|---|
| 合计 | 72 | 78 | 6 |
2.4偏差原因分析
偏差最大任务
| 任务 | 原因分析 |
|---|---|
| 数据管道:DBLP bibtex 下载 + arXiv 补摘要 | 本地 dblp.org bibtex 下载不稳定 ,改用ECS,选择「先跑完再补失败卷宗」的策略。 |
3.NABCD需求分析
说明:本文档为阶段一需求分析成果,与 AI 协作完成初稿,经人工逐条验证后定稿。
3.1N — Need(需求)
核心痛点
CV 入门者(小刚)面前有两道墙:
- **"不知道搜什么"**:不会构造英文检索式、不掌握专业术语(想不到 "object detection");
- **"搜到了也读不完"**:CVPR 2025 投稿 13,008 篇、录用 2,878 篇,三大顶会年合计近万篇,逐篇总结热点在人力上不可行。
N1.需求分层(六类用户)
| 用户 | 核心需求 | 刚性 |
|---|---|---|
| 入门爱好者(小刚) | 零门槛建立方向认知,从热词一路下钻到论文 | 定义产品主线 |
| 本科生 | 批量导入、自动补全元数据、综述查漏 | 高频一次性 |
| 研究生 | 选题热度依据、热词可回查、列表长期管理 | 最高频 |
| 教师/研究员 | 立项依据图表、统计口径可引用 | 低频高价值 |
| 算法工程师 | 判断技术窗口期、图表进汇报 | 中频 |
| 自媒体 | 现成年度榜单与动图素材 | 低频高传播 |
N2.课程约束
- 数据范围:CVPR / ICCV / ECCV 近若干年(2022 年至今,约 1.2–1.5 万篇);
- 功能 1–5 为必做项:论文爬取、列表管理、热门方向分析、关键词图谱、热度走势对比(动图);
- 原型必须包含指定五页:首页/热门总览、热度走势对比页、论文列表管理页、论文爬取/导入页、详情或关于页;
N3.市场空白
现有工具全部假设用户已经知道要搜什么;没有产品服务"从兴趣出发、零检索能力"的入门用户,也没有"会议 × 年份 × 热词"的动态对比视角。
3.2A — Approach(方案:如何解决问题)
A1. 总体定位
不做"CV 版 Google Scholar",做"从热词进入的 CV 顶会趋势分析平台"。
数据靠聚合不靠对抗爬虫;差异化押在入口形态与呈现方式上。
A2. 三个设计反转
- 入口反转:竞品首页都是搜索框 → 我们首页是热门 Top 10 + 动图竞速。用户从"看"开始,全程不需要任何检索能力;
- 结构反转:Connected Papers 是"论文 → 论文"图 → 我们做"关键词 → 关键词 → 论文"图,先建立方向认知,再落到具体论文;
- 形态反转:静态榜单 → 动图竞速;盘点文 → 可交互下钻。每个热词都能点开看"由哪些论文统计而来"。
A3. 数据方案(DBLP 为主源)
- 主源:DBLP 公开检索 API + 数据集下载。
- 理由:
- 作业明确推荐,合规且注明来源即可用于教学;
- 自带"会议 → 论文"归属关系,直接解决最大数据坑(会议归属),CVPR/ICCV/ECCV 分年切片天然可靠;
- 省去 arXiv 方案中"额外做会议映射"的一整步工程。
- 补充源:会议官网或老师提供的数据集做交叉校验与补漏;Semantic Scholar API 可选补引用数据。
- 清洗入库:题名/作者去重、年份归一、字段结构化,持久化到 SQLite(作业推荐嵌入式数据库,部署到 CodeArts 无服务端依赖、跨平台兼容)。
- 覆盖目标:三会 2022–2025,约 1.2–1.5 万篇。
A4. 关键词与热度统计方案
- 抽取:jieba 分词(英文按停用词过滤)→ TF-IDF 为主,基础词频法做 baseline,TextRank 作为对比实验;
- 热度口径:默认
热度 = 词频 × (1 + 年增长率),同时保留纯词频口径;两种口径使教师/工程师引用时有据可依; - 人工校准:维护 CV 噪音词表(method / propose / image / results),人工抽检 50 篇验证关键词质量。
A5. 功能与原型页面映射
| 原型页面 | 承载功能 | 角色服务重点 |
|---|---|---|
| 首页 / 热门方向总览 | 功能3(Top 10)+ 功能4(图谱入口)+ 小刚引导路径 | 小刚、自媒体 |
| 热度走势对比页 | 功能5(动图,三会 × 多年) | 研究生、教师、工程师 |
| 论文列表管理页 | 功能2(增删改查、精确/模糊查询、未命中自动爬取) | 本科生、研究生 |
| 论文爬取 / 导入页 | 功能1(单篇输入 + 批量导入 txt/csv) | 本科生 |
| 详情 / 关于页 | 论文摘要/关键词/原文链接 + "了解更多"(三会背景与统计口径) | 全部角色 |
A6. 技术方案
- 主栈:Vue/React + Flask(或 Spring Boot),前后端分离;
- 动图:ECharts timeline 柱状图竞速(bar chart race),前端动态渲染 → 录屏导出 GIF 嵌入博客;年度间采用线性插值实现连续生长动画(插值仅用于演示连续性,年份端点值为真实统计值);
- 持久化:SQLite,环境无关、可直接随项目部署到 CodeArts;
- 保底方案:若后端遇阻,退回"纯前端 + storage/内嵌数据";
- 红线:绝不使用原型工具生成代码。
A7. AI 协作流程
- 阶段一:AI 做头脑风暴初稿(角色视角、竞品、优先级、NABCD 框架、页面信息架构与配色文案建议)→ 人工逐条判断与验证(验收标准、数据口径、零分红线由人拍板)→ 关键对话截图存档入博客;
- 阶段二:AI 辅助编码(接口设计、SQL、ECharts 配置、排错)→ 人负责功能验收与部署上线;
- 协作原则:AI 负责发散与草稿,人负责收敛与裁决;博客中如实记录 AI 输出中"被采纳 / 被否定"的部分及理由。
A8. 迭代路线
- 阶段一(原型设计期):完成 NABCD、五页高保真原型、发布分享链接、PSP 预估表——设计先行,原型即需求文档;
- 阶段二(编码实现期):P0 功能1+2(保底)→ P1 功能3 → P1/P2 功能4 → P2 功能5→ 部署 CodeArts → 博客收尾;
- P3 扩展加分项:年度 Top 10 榜单演变、CSV/图表导出、"了解更多"科普页、首页引导标签——每做一个都在博客详细描述。
3.3B — Benefit(收益)
| 对象 | 可感知收益 |
|---|---|
| 小刚 | 无需检索能力,3 分钟从"电影灵感"走到"看懂领域结构" |
| 本科生 | 批量导入自动补全元数据;图谱发现综述遗漏方向 |
| 研究生 | 热词可回查支撑论文,趋势数据敢写进论文 |
| 教师/工程师 | 动图截帧进 PPT,口径页保证数据经得起追问 |
| 自媒体 | 现成年度榜单 + 动图 + 口径说明,直接出内容 |
技术红利:数据管道一次建成后,每年新会议发布只需重跑清洗与统计即可刷新全部榜单/图谱/动图,维护成本趋近于零。
3.4C — Competition(竞争:对手是谁、如何竞争、有何优势)
C1. 竞争总判断(客观)
竞品全部免费、背后是巨头或头部媒体,正面对抗没有胜算;但所有竞品共享同一个盲区假设——**"用户已经知道要搜什么"。我们的策略是错位竞争 + 借力**:不抢它们的战场,做它们入口之前的"那一层"。
C2. 四个竞品逐个分析
1. arXiv
- 强项:预印本当周上线、时效最早;API 免费无 key、限流宽松、按 cs.CV 批量拉取;元数据字段统一规范,清洗成本低。
- 对我们的错位:首页即搜索框,要求英文检索式(小刚做不到);无会议归属字段(给不了"会议 × 年份"对比);无 keywords 字段。
- 竞争策略:不当对手,也不做首选管道。本方案改走 DBLP 主源,会议归属一步到位;arXiv 仅作摘要补全的备选源。
- 胜负手:它作为通用预印本库不可能为"中文 CV 入门者"改产品形态,我们没有它的历史包袱。
2. Connected Papers
- 强项:图谱质量标杆(共引 + 文本相似度,"相关论文"准确率公认第一梯队);"节点点击 → 侧栏论文卡片"的交互范式成熟,照抄即安全;力导向布局与配色可直接参考。
- 对我们的错位:入口强制要求输入一篇英文种子论文(小刚一篇都没读过,进不去);是"论文图"而非"关键词图",解决不了"领域有哪些方向";无时间维度,看不到方向兴衰。
- 竞争策略:结构反向。它回答"这篇论文还有什么相关论文",我们回答"这个领域有哪些方向、各自兴衰如何";它在我们的下游,交互范式我们直接借鉴。
- 胜负手:用户先在我们这建立方向认知;多数入门场景里,我们的"热词 → 论文列表"一步到位,用户根本不需要再打开它。
3. Papers with Code
- 强项:业界唯一 task 级论文索引(按任务层级组织);每个 benchmark 的 SOTA 排行是研究者查"当前最高精度"的首选;趋势曲线视觉形式成熟。
- 对我们的错位:要求用户知道 task 名(小刚想不到 "3D Object Detection");task 分类靠人工维护、成本极高,课程规模无法复制;无中文、无会议 × 年份切片。
- 竞争策略:维度错开。它回答"哪个模型最强",我们回答"哪些方向在涨"。不做 task 分类,借鉴它的趋势曲线视觉,数据源换成我们自建的"关键词 × 会议 × 年份"统计。
- 胜负手:它对研究者是刚需、对入门者是死路;且它不提供会议维度,研究生做三会对比时我们独占此切片。
4. 机器之心 / 极市等中文年度盘点文
- 强项:中文叙事、可读性极高,是小刚最可能已经接触过的入口;每篇盘点的高阅读量证明"Top 10 热词"内容有真实需求;榜单经编辑人工筛选,解读深度超过自动统计。
- 对我们的错位:静态、一年一篇,只能看别人选好的结论;不可下钻(看到热词点不开支撑论文);不能自定义查询、不能按会议筛选、数据不可导出。
- 竞争策略:**做它的"可交互升级版"**——它产出内容,我们产出工具:动图竞速替代静态图;任意词可查五年 × 三会曲线;热词可下钻;口径透明可引用。
- 胜负手:它不是工具,不会开放自定义查询;自媒体反而会成为我们的分发渠道——来平台取榜单和动图素材,等于帮我们传播。
C3. 竞争策略总结
- 错位:四竞品分别占据"检索 / 论文图 / task 榜 / 盘点文"四块阵地,我们占据它们都没有的第五块——**"会议 × 年份 × 热词"趋势分析**,并用动图做呈现差异;
- 借力:DBLP 当数据管道,Connected Papers 与 Papers with Code 当交互与视觉参考,机器之心当需求验证与叙事模板——真正的竞争关系只存在于最后一块;
- 收缩:三不做——不做论文搜索引擎、不做 task 分类、不做重算法主题模型;资源压在竞品空白的两个点上(关键词图谱入口、动图对比)。
C4. 相对整个竞品集的优势清单
| 优势 | 对应竞品缺口 |
|---|---|
| 唯一"零输入"入口(热词榜 + 图谱 + 动图,不需检索式) | arXiv/PwC/CP 全部要求先输入 |
| 唯一"会议 × 年份 × 热词"切片视角 | arXiv 无会议字段、PwC 无会议维度、盘点文无自定义 |
| 唯一动图竞速呈现 | 全部竞品均为静态图表 |
| 唯一可回查的统计口径 | 盘点文人工选词无口径,学者不敢引用 |
| 唯一中文 + 入门科普路径 | 前三家全英文,盘点文不可交互 |
C5. 客观风险(不回避)
- 竞品全免费、无商业壁垒——但本项目是课程作业,竞品分析的目的是论证设计合理性而非真实商业对抗;
- 用户成长后会流向 arXiv/PwC——平台定位为"入门导航 + 趋势分析",不试图替代检索;研究生/教师因"会议切片 + 口径可引用"仍有留存理由;
- 机器之心若推出交互版,优势会被追平——其编辑模式与工具模式的组织成本不同,短期内概率低,不构成验收风险。
3.5D — Delivery(交付与部署)
D1. 两阶段交付物总表
| 阶段 | 必交物 | 载体 |
|---|---|---|
| 阶段一:需求理解与原型设计 | ① NABCD 完整模型(含与 AI 协作的关键对话截图)② 五页高保真原型(首页/热门总览、动图页、列表管理页、爬取/导入页、详情/关于页)③ 原型分享链接 ④ PSP 表(预估列) | 博客 |
| 阶段二:编程实现与部署 | ① 功能 1–5 全部实现 ② CodeArts 云服务器部署链接③ 数据入库结果与统计口径说明 ④ 动图效果展示(GIF)⑤ PSP 表(实际列 + 偏差分析)⑥ 扩展功能说明(若有) | 博客 + 云服务器 |
D2. 部署方案(CodeArts,最高优先级风险项)
- 技术选型就为部署服务:SQLite 嵌入式数据库,无独立数据库服务 → 应用随代码整体打包部署,环境依赖最小;
- 部署路径:本地完成全部功能测试 → 打包部署到 CodeArts 云服务器 → 配置公网访问 → 在服务器上跑通一遍"小刚完整动线"冒烟测试 → 链接贴博客;
- 平台兼容性:不依赖特定本机环境,数据库路径、API 地址全部走配置文件。
D4. 博客内容清单
- NABCD 模型 + AI 协作关键对话截图(含"AI 建议了什么、人否决/采纳了什么及理由");
- 数据来源与获取方式注明(DBLP API/数据集、会议官网、老师数据集,爬取仅用于教学);
- 统计口径说明(词频、TF-IDF、热度公式
热度 = 词频 × (1 + 年增长率),逐条解释); - 动图效果展示(GIF 嵌入);
- 原型分享链接;
- PSP 表格:预估列(动手前)→ 实际列(完成后)→ 偏差原因分析;
- 扩展功能详细描述(每做一个写一段);
- 《构建之法》第 3、8 章 NABCD 阅读成果体现。
4.原型设计与原型链接
4.1原型开发工具声明
本项目原型设计采用了 墨刀 (Modao) 作为专用原型设计工具。
所有页面均是在墨刀中通过拖拽组件、调整图层并设置交互完成的,符合课程“必须使用专用原型设计工具(如Axure、墨刀、Figma等)”的要求。
4.2 AI 协作设计
1.布局与视觉的高保真初稿(AI 生成,人重构)
- AI 做了什么:让 AI 生成了一套包含 CSS/Tailwind 样式的 HTML 代码,作为视觉初稿。
- 我做了什么:将 HTML 导入墨刀,打散原有图层,在墨刀中手动重绘页面布局。利用 AI 生成的配色建议(#3B5BDB 主色调)和文案,在墨刀内构建出符合“热门总览”、“论文管理”等五页要求的高保真页面。
- 佐证材料(以主页面为例):
AI生成: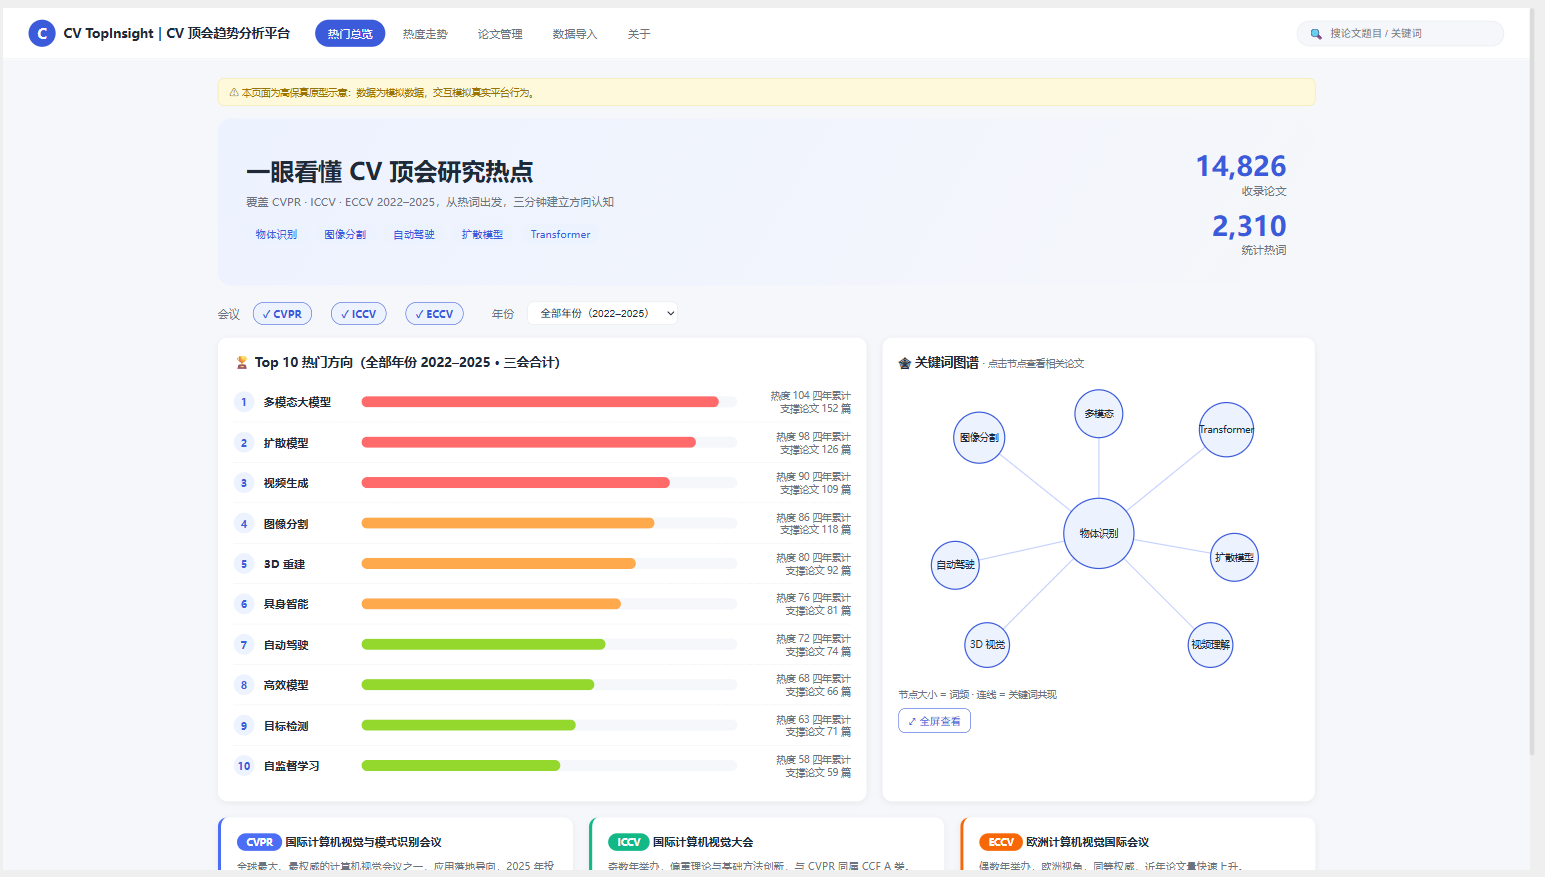
重构后:
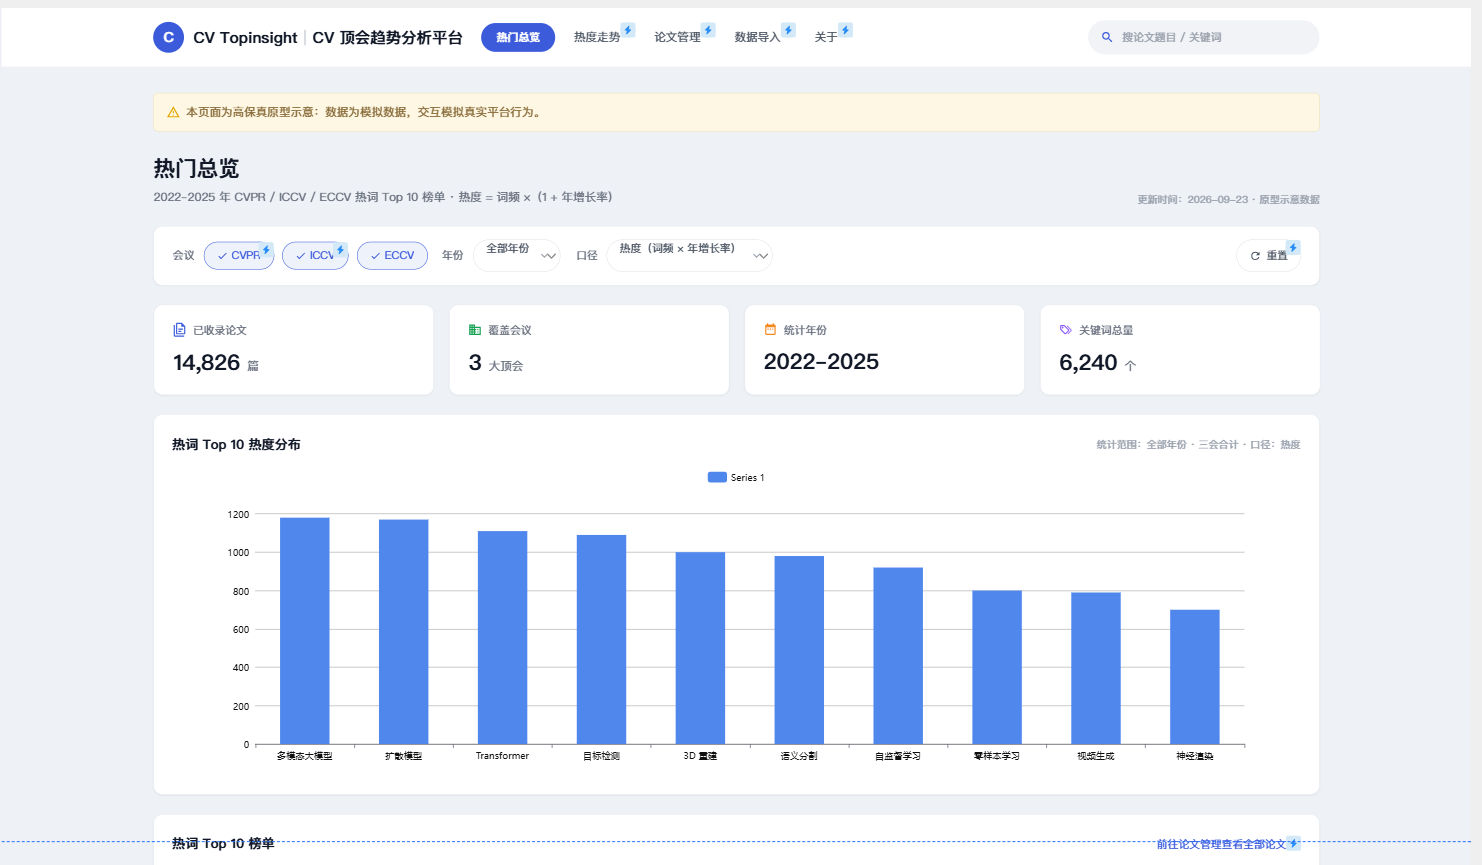
2.交互与动图的 AI 辅助实现(AI 建议,人配置)
- AI 做了什么:在墨刀中设置“热度走势对比页”的动图时,我们与 AI 讨论了墨刀“动态组件”和“定时器”的逻辑原理。
- 我做了什么:根据 AI 的建议,在墨刀内手动创建了“2022-2025”的四个组件状态,并自己配置了切换的交互动作,但是墨刀上的效果没有html生成的网页的动图效果好,只能点一下切换一年。
- 佐证材料:
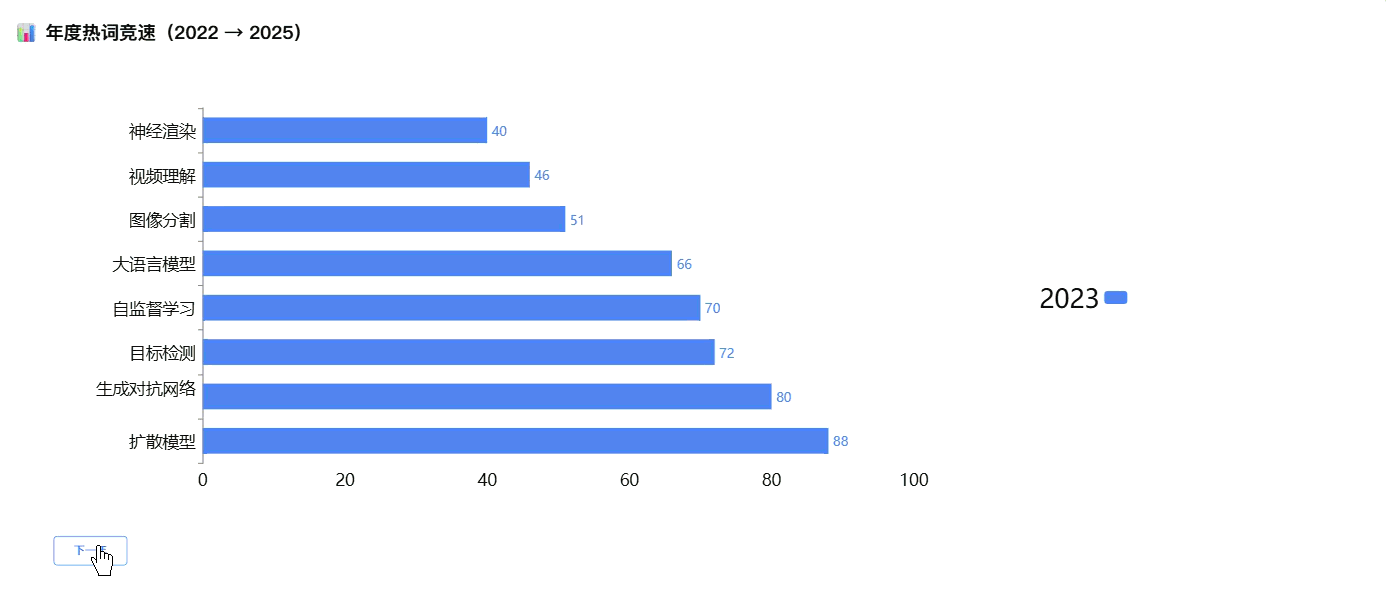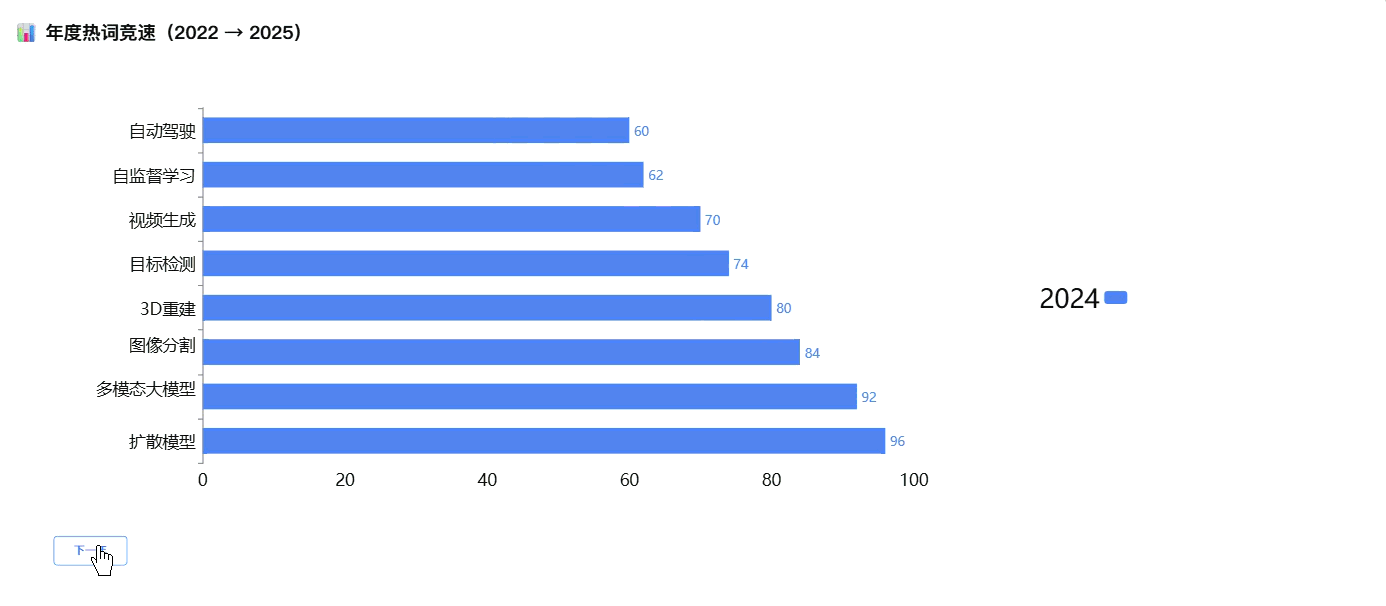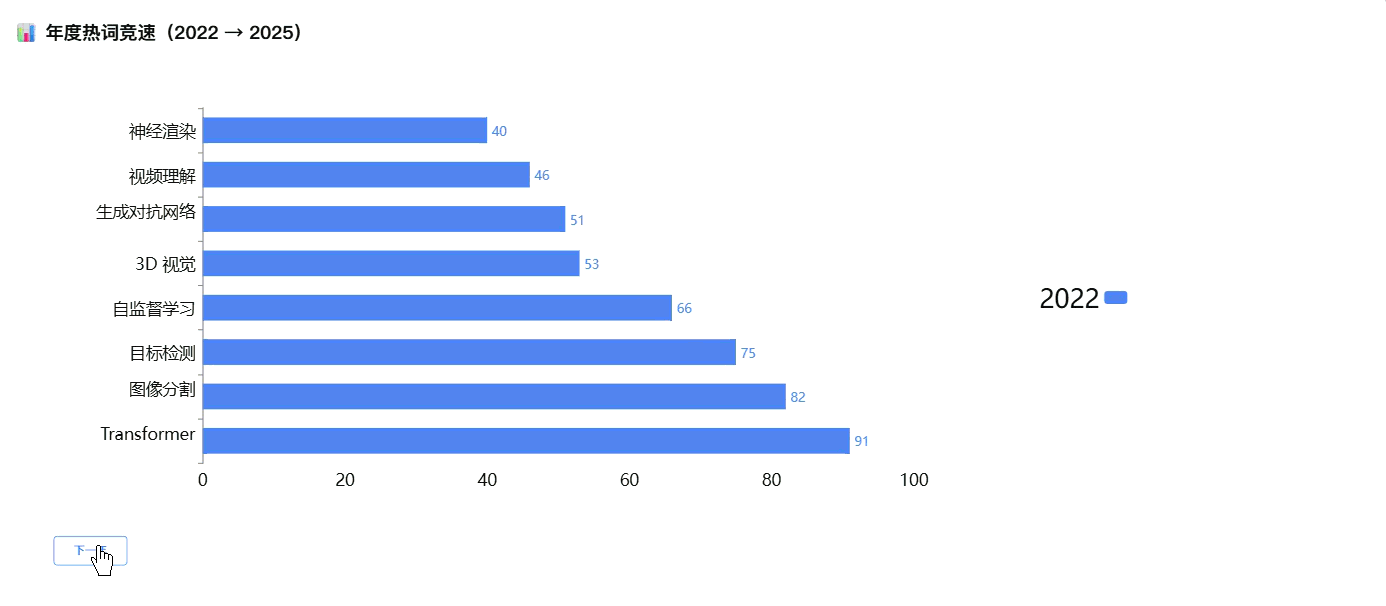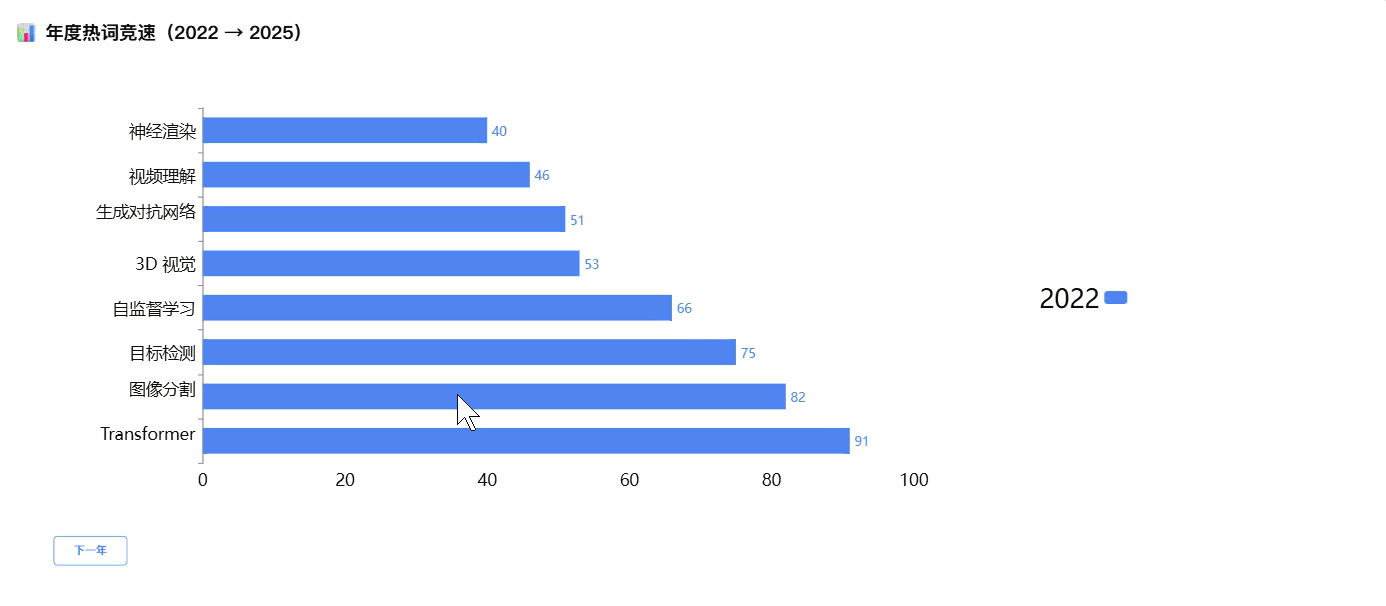
4.3 最终结果展示&介绍:
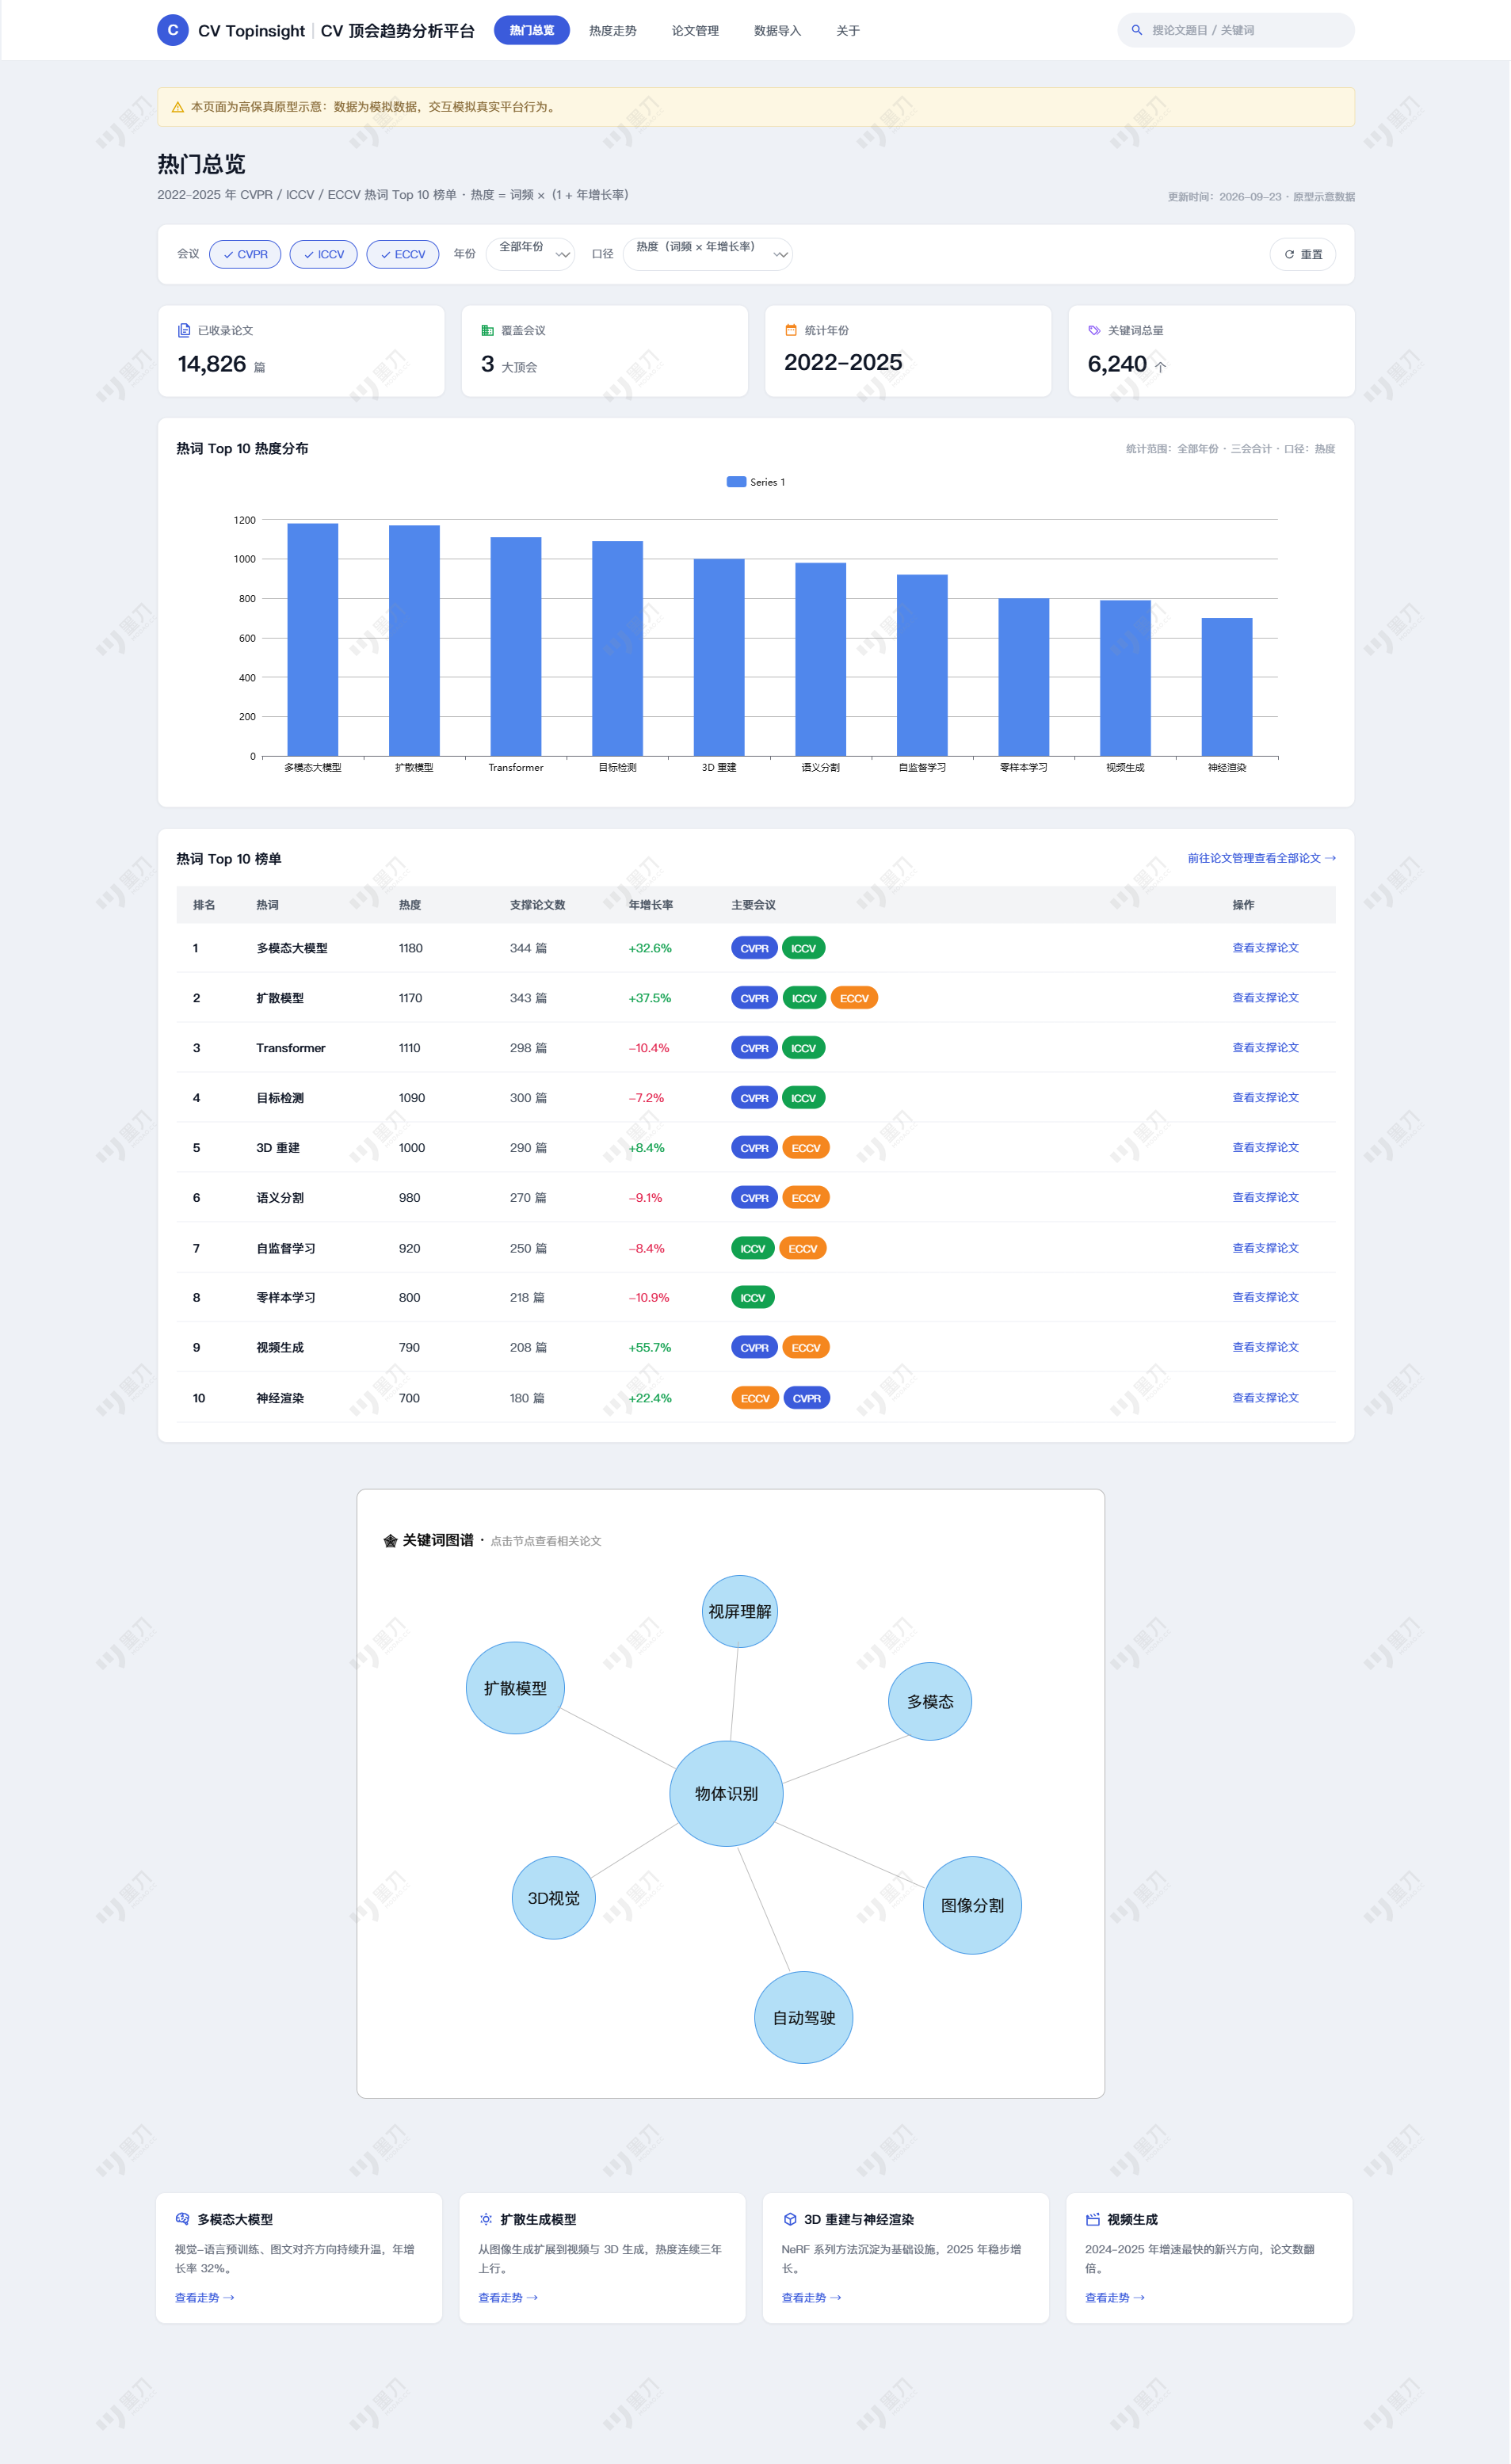
热门总览页面(主页面)
核心内容:平台核心数据的综合仪表盘。
- 数据筛选区:支持按会议(CVPR/ICCV/ECCV)、年份、口径(热度/论文量)进行全局筛选。
- 核心指标卡片:展示收录论文总数(14,826 篇)、覆盖会议数、统计年份、关键词总量。
- 热词 Top 10 分布图:柱状图展示 Top 10 热词的热度分布情况。
- 热词 Top 10 榜单:表格形式展示排名、热词、热度、支撑论文数、年增长率、主要会议及跳转操作的链接。
- 关键词图谱:以“物体识别”为中心的关联词网络图,直观展示词与词之间的关联。
- 趋势方向卡片:底部提供多模态大模型、扩散模型、3D 重建、视频生成等热门方向的简要解读及查看走势入口。
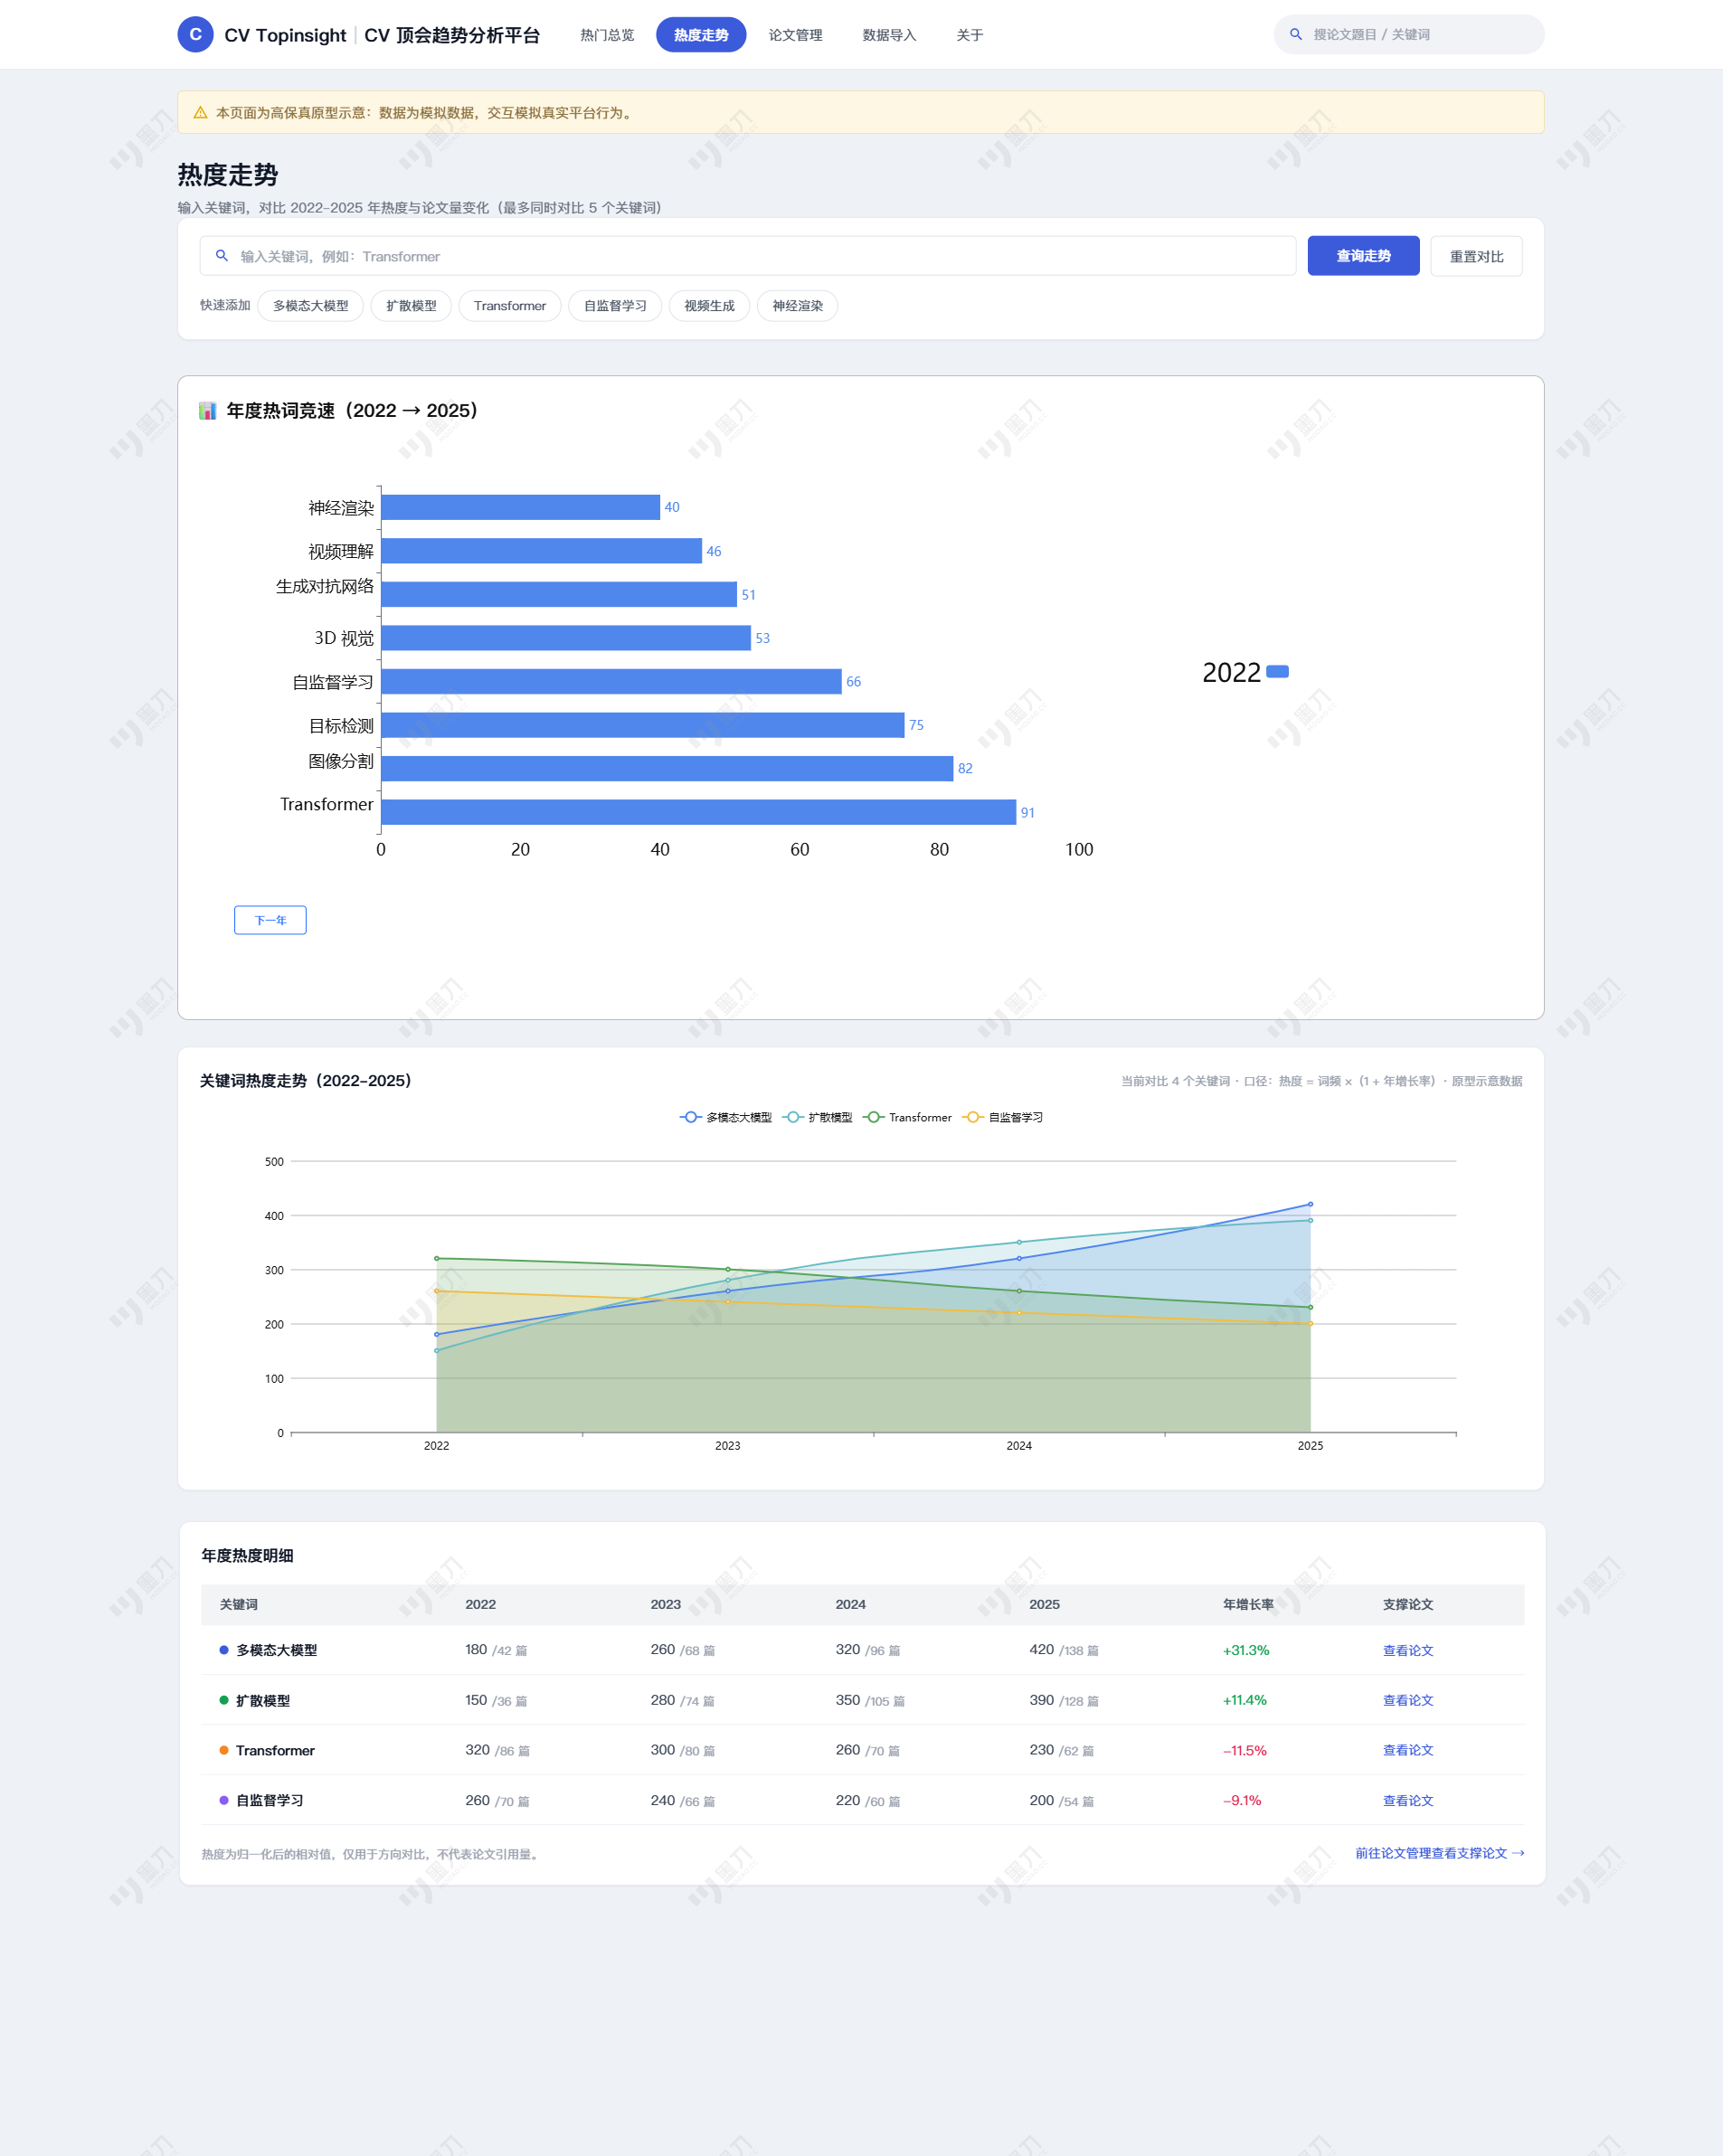
热度走势页面
- 核心内容:针对特定关键词进行时间维度的趋势分析。*
- 搜索与快捷添加:输入关键词(最多对比 5 个)进行查询,并提供热门词汇的“快速添加”按钮。
- 年度热词竞速图:水平条形图展示某年份下各关键词的热度排名,左下角提供“下一年”切换按钮。
- 关键词热度走势图:多折线图直观对比多个关键词在 2022-2025 年间的热度变化。
- 年度热度明细表:表格展示各关键词在各年度的热度及支撑论文数,并计算年增长率,附带查看支撑论文的快捷入口。
论文管理页面
- 核心内容:论文数据的增删改查(CRUD)管理中心。*
- 搜索与筛选区:支持输入题目、编号、关键词、作者进行模糊查询,并支持按会议、年份、关键词过滤。
- 操作按钮:包含“批量导入”和“新增论文”功能。
- 论文列表表格:显示序号、论文题目、会议(带彩色标签)、年份、关键词,以及“查看”、“编辑”、“删除”操作按钮。
- 分页组件:展示总数据量(14,826 条),支持切换页码(1-742 页)和修改每页显示条数。
数据导入页面
- 核心内容:论文数据的增量获取工具。*
- 单篇论文爬取:输入单篇论文题目(如 Attention Is All You Need),点击“开始爬取”,系统将联网获取该论文信息。
- 批量导入论文列表:支持“粘贴文本”或“上传文件”(txt/csv)的方式批量导入论文题目。页面包含示例格式提示、开始导入按钮以及导入进度条。
关于页面
核心内容:平台背景与规则说明。
该页面包含五个主要板块:
- 平台简介:说明定位(面向计算机视觉入门者/研究者的一站式分析平台)及核心痛点解决思路。
- 三大顶会介绍:简要科普 CVPR、ICCV、ECCV 三大会议的特点。
- 统计口径:明确数据范围(2022-2025年)、关键词抽取方法(TF-IDF/TextRank)、热度公式及 Top 10 榜单规则。
- 数据来源与版权:声明数据来源于 DBLP 公开 API,仅供教学,无商业用途。
- AI 协作说明:披露项目在需求分析、UI 设计及代码实现中的 AI 辅助占比。
5.成品展示
具体项目结果此处以视频方式展示:
[video(video-4Nc1AorT-1790264275245)(type-csdn)(url-https://live.csdn.net/v/embed/545927)(image-https://i-blog.csdnimg.cn/direct/c97e1a95f09047188216d44f3bffd13f.png)(title-9%E6%9C%8824%E6%97%A5)]
6.结对(人机)讨论过程描述
结对伙伴:OpenCode(主要)+ deepseek v4pro(需求分析辅助)
协作原则:AI 负责发散与初稿,人负责验证、裁决与兜底;AI 输出未经人工验证不进入定稿。
6.1协作记录总览
| 阶段 | 关键提示词(摘要) | AI 输出 | 采纳/拒绝及理由 |
|---|---|---|---|
| 需求分析 | "从不同角色视角列出潜在用户、竞品分析、功能优先级" | 六类用户、四竞品表、P0–P3 优先级 | 采纳 80%;**拒绝"做登录注册"(需求未要求且违背零门槛定位);修正"Top10 按年切片"**为按需求原文"分析已爬取论文"的全量聚合 |
| 竞品取舍 | "保留 4 个竞品且强项详细" | arXiv/CP/PwC/盘点文四表 | 采纳;DBLP、Semantic Scholar 降级为数据供应商不列竞品 |
| 原型设计 | "生成初始版的HTML 原型" | 单文件六页原型 | 采纳;运行后人工发现 3 个缺陷(年份不可选、动图跳帧、柱子溢出),逐条回传修正 |
| 数据源 | "用 DBLP bibtex 批量建库" | fetcher.pipeline | 拒绝并降级:本地网络拉不动,AI 声称"云上可通"未被采信,先小规模验证;最终改老师数据集(附录14)为主源 |
| 表结构 | "创建 papers 表" | 骨架版无 abstract_flag | 人工检查发现缺字段,补 ALTER 修正(AI 初版缺陷被纠正) |
| 动图 | "实现连续生长竞速图" | 写死像素宽度 | 发现溢出 Bug,人工定位原因后改为容器宽度动态计算 |
| 部署 | "密钥登录步骤" | 给出控制台流程 | 采纳;实际界面无对应入口,人工换用密码/VNC 路径 |
6.2三个代表性案例
案例 1:需求分析与原型设计
提示词:让 AI 按 NABCD 框架输出潜在用户、场景、竞品、优先级。
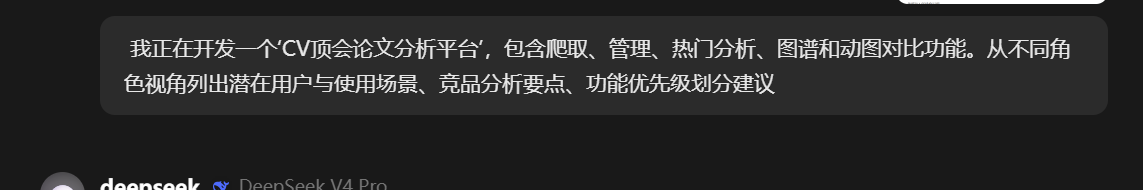
输出:六类用户画像、六竞品错位分析、三个设计反转(入口/结构/形态)。
人工修改:剔除课程老师角色;修正功能3 统计口径;竞品从 6 个收敛为 4 个并把 DBLP 改称数据供应商;页面补"论文详情页"使动线完整。
理由:AI 发散广但不懂作业验收细节,口径类结论必须回对需求原文。
案例 2:数据源真实情况由 AI 主动发现,人拍板技术路线
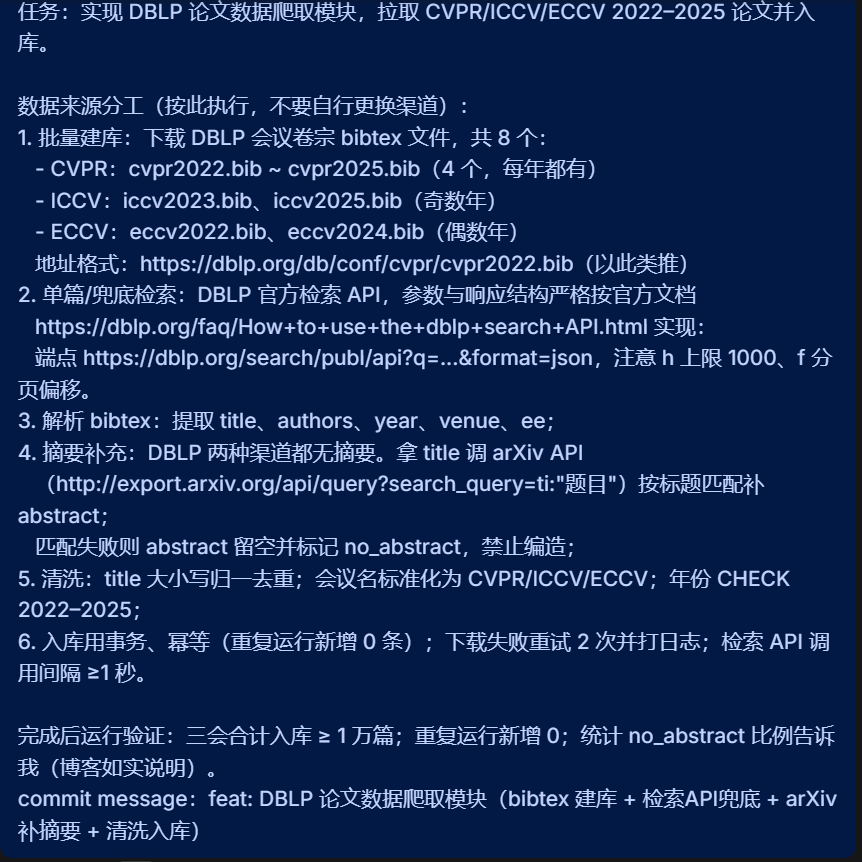
提示词:
输出:
AI 提问/探查:按你给的 dblp.org/db/conf/cvpr/cvpr2022.bib 去拉数据时,AI 主动抓包探测,发现三件事:① DBLP 全站启用了 Anubis 反爬(proof-of-work 挑战);② 你给的 .bib URL 已失效(404);③ ECCV 在 DBLP 里是分卷的(eccv2022-1 ~ eccv2022-39),不是单个卷宗。
AI 输出:逆向出 Anubis 的 fast 算法(SHA-256 工作量证明,找 nonce 使 hash 前 2 字节为 0),并给出三个候选拉取方案(bibtex 端点分页 / 检索 API / 会议 HTML 解析)。人工修改:确认采用「bibtex 端点分页」;AI 据此实现 Anubis 绕过、discover_volumes 分卷发现、parse_bibtex 解析。数据链路从「照搬旧 URL」修正为「真实可用的检索端点」,这是整个数据管道能跑通的前提。
案例 3:限流应对与部署路径
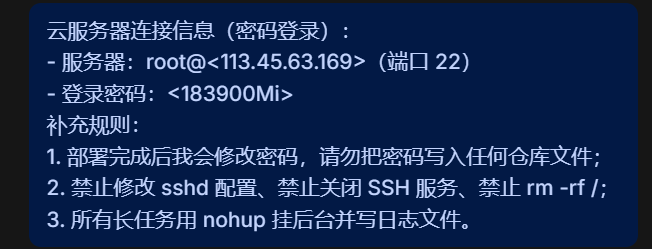
现象:本机 IP 被 DBLP 深度限流(大量 429/连接重置)
我的决策:建议改用ECS;提供云服务器信息,选择「先跑完再补失败卷宗」的策略。

6.3可解释性声明
- AI 生成:NABCD/竞品/原型的初稿、Flask 接口骨架、爬取与统计 pipeline 主体、Vue 组件初版、ECharts 配置。
- 人工编写/修改:表结构修正(abstract_flag)、统计口径定稿、停用词表维护、动图响应式修复、部署与 Git 操作、全部验收验证。
- 能解释:每段 AI 代码均经人工逐行审阅并知其设计思路(如插值动画的帧率选择、幂等入库的事务设计),无未理解代码。
7.设计实现过程
7.1设计实现过程
阶段一:需求与原型(AI 结对起点)
NABCD 分析
- 过程:用 AI 从六类角色(入门者小刚、本科生、研究生、教师、工程师、自媒体)头脑风暴,产出使用场景与竞品分析(arXiv、Connected Papers、Papers with Code、中文盘点文),人工逐条验证后定稿。
- 核心结论:差异化 = "零输入入口 + 会议×年份×热词切片 + 动图呈现"。
原型设计
- 过程:先由 AI 生成 HTML 初稿快速验证交互(发现"柱子溢出""年份不可选"等问题),再在墨刀通过拖拽复刻大致相似的五页 + 详情页共六页,发布分享链接。
- 定稿三原则:入口从"看"开始、图谱从关键词出发、动图连续生长。
阶段二前半:数据管道
仓库与规范
-
main存文档基线,dev开发;.gitignore忽略*.db/node_modules/dist。 -
codestyle.md标注来源 PEP 8 + Google Style。 - 新增
AGENTS.md固化数据链路、业务口径、协作红线(AI 每新会话自动读取,防跑偏)。
表结构设计
- 设计
papers(abstract 可空)、conferences、paper_conference、keywords、paper_keyword(weight 字段供 TF-IDF)。 - 骨架版漏了
abstract_flag——导入数据前人工检查发现,补ALTER TABLE ADD COLUMN修正。
清洗入库
- 只保留三会 2022–2025(含隔年约束)、title 去重、会议标准化、事务批量写、幂等设计支持断点续跑。
- 无摘要者标
no_abstract(统计仍纳入,仅标题抽词)。
阶段二后半:功能实现(数据依赖决定顺序)
功能1/2 后端
- 单篇爬取(本地查→DBLP→arXiv 三段链路)、批量导入(三类计数返回)、增删改查 + 未命中兜底(5 秒超时,save=true 才入库)。
- 先在独立
test.db验证,避开与全量导入的生产库冲突。
功能3 统计
-
jieba+ 停用词 + 词形还原 → 标题×3/摘要×1 加权 → TF-IDF → 热度公式。 - Top 30 高频词人工抽检后删噪音词(
method/propose等)回填词表——案例 B 素材。 - Top10 默认全量聚合,年份下拉为可选筛选(按需求原文"分析已爬取的论文"定口径)。
功能4/5 前端
- Vue 3 按原型重写(非照搬,遵守红线)。
- 图谱用共现矩阵力导向图;动图用 ECharts 柱状竞速 + 年粒度线性插值实现连续生长。
- 初版 AI 写死像素宽度导致窄窗口溢出,人工诊断后改为容器宽度动态计算 +
overflow:hidden+ resize 重绘(案例 C 主素材)。
隔年会议修正
- ICCV 2022/2024 与 ECCV 2023/2025 不出柱,接口同步过滤,图例标注"当年无会议"。
收尾:部署与交付
CodeArts 部署
- ECS 密钥/密码登录 → 环境探测(Python 版本/磁盘)→ 依赖安装 → 建库。
- 全量导入用
nohup挂后台写日志(合盖断网不影响)。 -
npm run build后由 Flask 托管 →gunicorn起服务 → 公网访问冒烟测试。
Git 收口
-
dev开发(21 次 commit)→ merge 到main→ tagv1.0.0→ 创建 Release。 - PSP 实际列回填 + 偏差分析(数据源切换、AI 返工、Vue 重写为三大偏差来源)。
关键决策记录表
| 决策点 | 初方案 | 最终定稿 | 原因 |
|---|---|---|---|
| 数据源 | DBLP bibtex 批量 | 老师数据集(附录14)+ DBLP API 兜底 | 本地网络拉不动,AI 初方案验证失败 |
| 摘要 | 无 | arXiv 补 + no_abstract 标记 | DBLP 无摘要字段,禁止伪造 |
| 前端 | 复用原型 HTML | Vue 3 重写 | 作业推荐框架 + 规避"盲抄 AI 代码"红线 |
| Top10 口径 | 按年切片 | 全量聚合 + 年份下拉可选 | 需求原文"分析已爬取的论文" |
| 动图 | 逐年跳帧 | 年粒度 + 线性插值连续生长 | 演示要求连续增长;口径如实标注 |
| 登录注册 | 考虑 | 不做 | 需求未要求;登录墙违背小刚零门槛定位 |
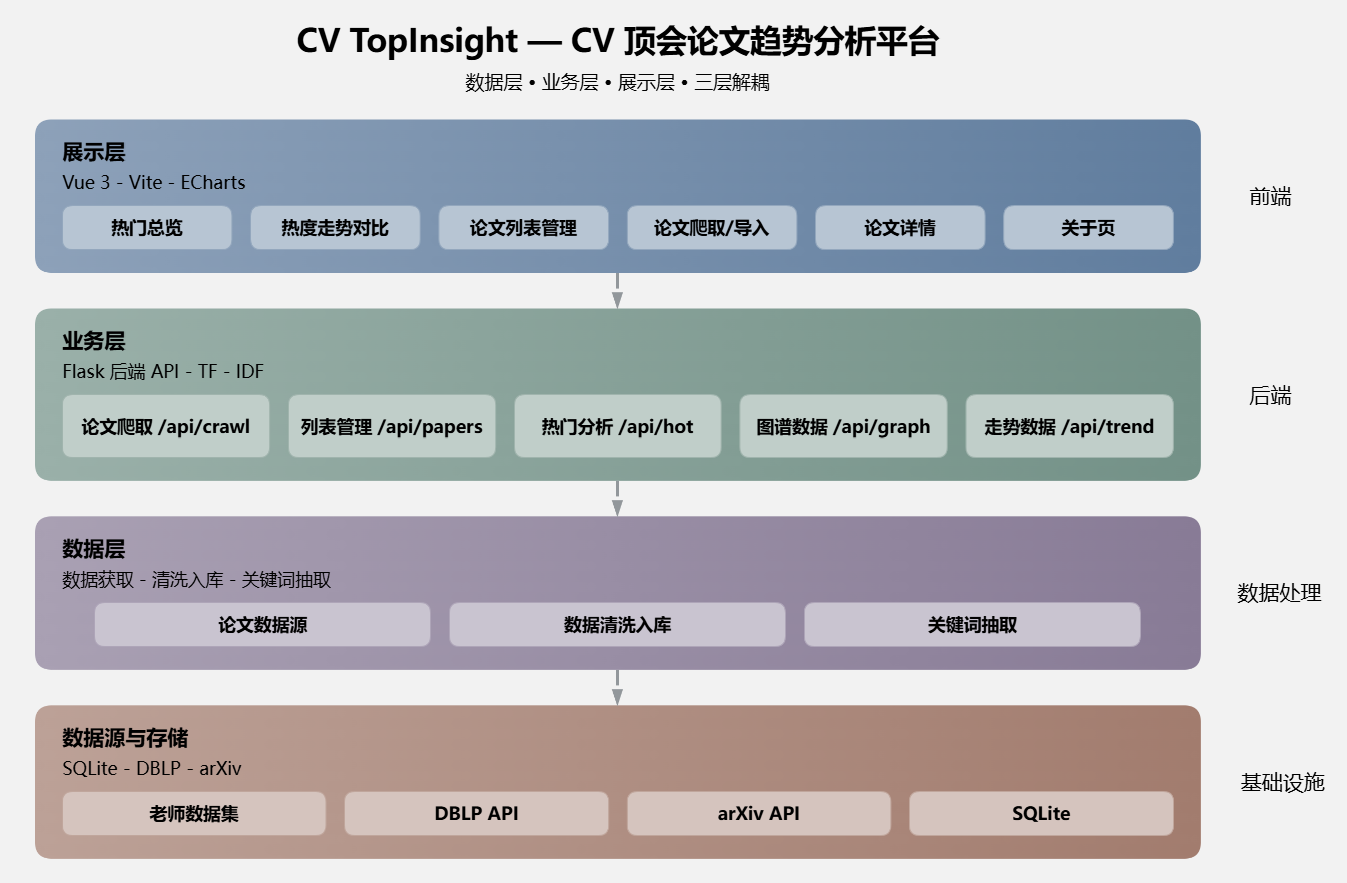
7.2功能结构图
8.代码说明
8.1数据管道(fetcher/dblp.py)—— DBLP 检索 API 分页 + front matter 过滤
_PROC_KEYWORDS = (
    "conference on computer vision and pattern recognition",
    "international conference on computer vision",
    "european conference on computer vision",
    "proceedings",
)

def is_proceedings(title):
    text = (title or "").lower()
    return any(k in text for k in _PROC_KEYWORDS)

def fetch_volume(session, conf, volume_slug):
    query = f"toc:db/conf/{conf.lower()}/{volume_slug}.bht:"
    papers, offset = [], 0
    while True:
        resp = session.get_dblp(_SEARCH_API, params={
            "q": query, "h": "1000", "format": "json", "f": str(offset)}, timeout=120)
        hits = resp.json()["result"]["hits"]
        total = int(hits.get("@total", 0))
        hit_list = hits.get("hit") or []
        if isinstance(hit_list, dict):
            hit_list = [hit_list]
        for hit in hit_list:
            info = hit.get("info", {})
            title = info.get("title")
            if is_proceedings(title):
                continue
            papers.append({"title": title, "year": info.get("year"),
                           "venue": info.get("venue"),
                           "ee": info.get("ee") or info.get("url")})
        offset += len(hit_list)
        if not hit_list or offset >= total:
            break
    return papers
8.2 关键词抽取(services/keywords.py)—— 词形还原 + 加权
def lemmatize(word):
    if word.endswith("ies") and len(word) > 4: return word[:-3] + "y"
    if word.endswith("ing") and len(word) > 5: return word[:-3]
    if word.endswith("ed") and len(word) > 4: return word[:-2]
    if word.endswith("s") and not word.endswith("ss") and len(word) > 3: return word[:-1]
    return word

def extract_keywords(title, abstract=None, abstract_flag="ok"):
    weights = {}
    for word in tokenize(title):
        w = lemmatize(word)
        if w in STOP_WORDS or len(w) < 2: continue
        weights[w] = weights.get(w, 0) + 3
    if abstract_flag != "no_abstract" and abstract:
        for word in tokenize(abstract):
            w = lemmatize(word)
            if w in STOP_WORDS or len(w) < 2: continue
            weights[w] = weights.get(w, 0) + 1
    return weights
8.3 统计引擎(services/stats.py)—— TF-IDF + 热度 + Top10
def compute_hotness(freq, prev_freq):
    growth = (freq - prev_freq) / prev_freq if prev_freq > 0 else 0.0
    return freq * (1.0 + growth)

def compute_tfidf(weighted_by_paper):
    n = len(weighted_by_paper)
    tf, df = {}, {}
    for paper in weighted_by_paper:
        for word, weight in paper.items():
            tf[word] = tf.get(word, 0) + weight
            df[word] = df.get(word, 0) + 1
    return {w: tf[w] * (math.log(n / df[w]) + 1.0) for w in tf}

def top_keywords(weighted_by_paper, paper_ids, k=10, scorer=None):
    freq, doc_ids = {}, {}
    for pid, paper in zip(paper_ids, weighted_by_paper):
        for word, weight in paper.items():
            freq[word] = freq.get(word, 0) + weight
            doc_ids.setdefault(word, []).append(pid)
    def score_of(w):
        return scorer(w, freq[w], doc_ids[w]) if scorer else freq[w]
    words = sorted(freq, key=lambda w: (-score_of(w), w))
    return [{"word": w, "score": score_of(w), "freq": freq[w],
             "paper_ids": sorted(doc_ids[w])} for w in words[:k]]
8.4 数据访问(repository.py)—— 组合筛选查询
def search(self, conference=None, year=None, keyword=None, query=None,
           exact=False, page=1, page_size=20):
    where, params = [], []
    if conference:
        where.append("c.name = ?"); params.append(normalize_conf(conference))
    if year is not None:
        where.append("p.year = ?"); params.append(year)
    if keyword:
        where.append("p.keywords_text LIKE ?"); params.append(f"%{keyword}%")
    if query:
        if exact:
            where.append("p.title = ? COLLATE NOCASE"); params.append(query.strip())
        else:
            where.append("(p.title LIKE ? OR p.keywords_text LIKE ? OR CAST(p.id AS TEXT) = ?)")
            params.extend([f"%{query}%", f"%{query}%", query.strip()])
    base = ("FROM papers p LEFT JOIN paper_conference pc ON p.id = pc.paper_id "
            "LEFT JOIN conferences c ON pc.conference_id = c.id " +
            ("WHERE " + " AND ".join(where) if where else ""))
    total = conn.execute(f"SELECT COUNT(*) {base}", params).fetchone()[0]
    rows = conn.execute(f"SELECT p.*, c.name AS conference {base} "
                        "ORDER BY p.id LIMIT ? OFFSET ?",
                        params + [page_size, (page - 1) * page_size]).fetchall()
    return total, [dict(r) for r in rows]
8.5统计接口(api/stats.py)
@bp.get("/hot")
def hot():
    year = _parse_year(request.args.get("year"))
    conf = request.args.get("conf", "all")
    method = request.args.get("method", "freq")
    if year is None or method not in ("tfidf", "freq"):
        return fail(CODE_BAD_REQUEST, "参数非法")
    return ok(compute_top(_db(), year=year, conf=conf, method=method))

@bp.get("/graph")
def graph():
    return ok(compute_graph(_db(), year=_parse_year(request.args.get("year")),
                            conf=request.args.get("conf", "all")))

@bp.get("/trend")
def trend():
    keyword = (request.args.get("keyword") or "").strip()
    if not keyword:
        return fail(CODE_BAD_REQUEST, "缺少 keyword")
    return ok(compute_trend(_db(), keyword))
8.6 前端数据层(api/index.js)
const USE_MOCK = import.meta.env.VITE_USE_MOCK !== 'false'

export function fetchHot({ year = 'all', conf = 'all', method = 'freq' } = {}) {
  if (!USE_MOCK) return httpGet('/hot', { year, conf, method })
  return ok({ method, total_papers: 14826, no_abstract_count: 2310, top: mockData.HOT_TOP })
}
8.7 竞速动图(views/TrendView.vue)—— 线性插值 + realtimeSort
function renderRaceFrame() {
  const y1 = YEARS[raceSeg], y2 = YEARS[raceSeg + 1], p = Math.min(1, raceP)
  const vals = raceValues()
  const frame = allRaceWords()
    .map(w => ({ name: w, value: vals[w][raceSeg] + (vals[w][raceSeg + 1] - vals[w][raceSeg]) * p }))
    .filter(it => it.value >= 1).sort((a, b) => b.value - a.value)
  const names = frame.map(it => it.name)
  const data = frame.map(it => ({ value: Math.round(it.value),
    itemStyle: { color: CONF_COLORS[confOf(it.name, p)] } }))
  raceChart.setOption({
    yAxis: { type: 'category', data: names, inverse: true },
    animationDurationUpdate: 80, animationEasingUpdate: 'linear',
    series: [{ type: 'bar', realtimeSort: true, data }],
  })
}
raceTimer = setInterval(() => { raceP += 0.05; /* 80ms×20=1.6s/年 */ }, 80)
9.心路历程、收获
《构建之法》第4章讲两人合作:结对编程有"驾驶员"与"领航员",代码复审保证质量。这次"人机结对"让我体会到:AI 是不知疲倦的驾驶员,而我必须永远做领航员与复审者。
心路上,最深的教训是不能轻信 AI。它曾把数据源 URL 说得言之凿凿,执行后才发现本地根本拉不通;表结构缺字段、动图溢出,都是它初版代码的坑。三次返工让我明白:AI 的"自信"不等于正确,它的答案必须先验证再用——这正对应第4章"代码复审"的价值。
收获有三:
- 学会写高质量提示词,用 AGENTS.md 把需求、口径、红线固化,AI 才不跑偏;
- "发现问题并纠正 AI"本身就是最重要的能力,案例 C 的价值远超让 AI 写对一段代码;
- 可解释性声明倒逼我读懂每一行 AI 代码。
10.对AI结对伙伴的评价
评价伙伴:优点明显——发散快、出稿快、代码规范、能讲设计思路;局限同样明显——会幻觉、无责任感、不会主动质疑错误需求。它像一位能力很强但需要严管的实习生:给清规格就高效,撒手不管就翻车。
相关推荐
PairProject:W班软件工程实践结对第二次作业仓库
结对第二次作业-顶会热词统计的实现 为了不遗漏作业内容,这里有一个清单检查表方便同学们快速检阅。 fork仓库,和伙伴商讨如何通过github协作/代码规范等 编程实现 功能一,操作爬取的论文列表 功能二,爬取结果分析展示 功能三,爬取论文信息(附加功能,实现有附加分) 其他附加功能 部署 发布发布版本,发起拉取请求 撰写博客,在预先之前提交一份博客 包含作业描述和目录 核对评分标准 上一次结对作业中,大家都和小伙伴完成了原型的设计,那么现在再联合小伙伴动手实现原型中的部分功能吧。采用网络技术来实现原型中的功能。 一,作业内容 1.基础功能 功能1:对已爬取的论文列表进行操作 可对论文列表进行删除; 可对论文列表进行查询详细信息(支持模糊查询,查询结果的展示,排序等功能可自行设计); 功能2:分析已爬取到的论文信息,提取top10个热门领域或热门研究方向 形成如关键字图谱之类直观的查看方式
软件工程第二次作业 计算机学院
软件工程第二次作业 计算机学院
2024年机器人软件工程学课程作业项目仓库_包含四次作业任务_第一次作业使用OpenCV实现图片显示功能_第二次作业开发简易聊天程序_第三次作业构建消息发布订阅系统_期末大作业完成.zip
2024年机器人软件工程学课程作业项目仓库_包含四次作业任务_第一次作业使用OpenCV实现图片显示功能_第二次作业开发简易聊天程序_第三次作业构建消息发布订阅系统_期末大作业完成.zip
第二次作业.zip
第二次作业.zip
2024年机器人软件工程学课程作业项目仓库-包含四次作业任务-第一次作业使用OpenCV实现图片显示功能-第二次作业开发简易聊天程序-第三次作业构建消息发布订阅系统-期末大作业完成.zip
搜索引擎2024年机器人软件工程学课程作业项目仓库_包含四次作业任务_第一次作业使用OpenCV实现图片显示功能_第二次作业开发简易聊天程序_第三次作业构建消息发布订阅系统_期末大作业完成.zip




