


88
社区成员
 发帖
 与我相关
 我的任务
 分享
| 这个作业属于哪个课程 | 福州大学软件工程实践课程社区 |
|---|---|
| 这个作业要求在哪里 | 作业要求 |
| 这个作业的目标 | 与 AI 结对完成 NABCD、专用工具原型、Web 编码、真实数据处理、测试、Git 协作和华为云部署 |
| 其他参考文献 | 《构建之法》第 3、4、8 章;Google JavaScript/HTML/CSS Style Guide;MDN;CVF Open Access;ECVA;Semantic Scholar API |
102400105AI 主要用于拆解要求、NABCD 头脑风暴、信息架构和文案建议、代码初稿、自动测试、Bug 定位、部署步骤和文档整理。我负责提出并持续修改需求、操作墨刀、决定页面结构与审美、检查数据来源、指出 AI 方案的问题、验收功能和完成云平台操作。正式网站代码独立编写,没有使用墨刀生成代码。
本项目代码规范参考 Google JavaScript Style Guide、Google HTML/CSS Style Guide 和 MDN,并针对纯前端项目约定了职责拆分、命名、输入转义、异步错误处理与测试要求。
| PSP 阶段 | 具体任务 | 预计(分钟) | 实际(分钟) | 偏差原因摘要 |
|---|---|---|---|---|
| Planning | 估计整个作业所需时间 | 30 | 20 | AI 辅助拆分任务后较快形成计划 |
| Analysis | 阅读并拆解作业要求 | 60 | 60 | 与预估基本一致 |
| Analysis | 学习 NABCD 模型 | 60 | 50 | AI 辅助解释模型关系 |
| Analysis | 与 AI 讨论用户、场景和需求 | 90 | 180 | 多轮纠正用户范围、搜索入口与论文库结构 |
| Design Spec | 整理完整 NABCD | 120 | 45 | 前期记录较完整,定稿以归纳核验为主 |
| Design | 学习墨刀 | 120 | 120 | 学习图层、组件、浮层和交互 |
| Design | 页面结构与交互流程 | 120 | 90 | 在 AI 初稿上进行人工决策 |
| Design | 制作并修改完整原型 | 300 | 360 | 导入后仍需转为可编辑并重做交互 |
| Design Review | 原型一致性检查 | 60 | 120 | 发现重复入口、搜索输入和按钮无效等问题 |
| Coding Standard | 制定代码规范 | 60 | 20 | 基于主流规范整理项目约定 |
| Coding | 数据获取与处理 | 240 | 90 | AI 辅助脚本,人工核验来源与数量 |
| Coding | 增删改查与检索 | 240 | 120 | 完成分组、预览、排序、联网补全与持久化 |
| Coding | Top 10 与关键词图谱 | 240 | 90 | 复用统一的纯数据函数 |
| Coding | 多年多会议动态趋势 | 240 | 90 | 完成占比趋势和可播放年度动画 |
| Code Review | 代码检查与解释 | 120 | 60 | 检查数据、转义、错误提示与函数职责 |
| Test | 测试、调试和修改 | 240 | 120 | 13 项单元/数据测试及浏览器流程检查 |
| Reporting | 华为云部署与验证 | 180 | 75 | 安全组、Nginx、上传和公网验证 |
| Reporting | 截图、GIF 和结果整理 | 120 | 75 | 整理 21 张成品图及原型/部署证据 |
| Reporting | 博客撰写和检查 | 300 | 120 | 包含图片上传、排版、链接检查和本人复核 |
| Reporting | 事后总结 | 60 | 60 | 发布前完成最终复盘 |
| 合计 | 3120 | 1965 | 约 32 小时 45 分钟 |
主要偏差是编码比预计快,而需求讨论、原型制作和复审比预计慢。AI 能快速生成结构和测试,但无法替代产品判断;墨刀导入后的图层、浮层坐标和交互连接也比想象中耗时。下一次我会从第一天开始使用计时器,并先冻结页面清单、数据口径和验收标准。
目标用户不是已经熟练使用论文网站的研究人员,而是对计算机视觉感兴趣、甚至从未打开过顶会论文网站的本科生。他们不知道 CVPR、ICCV、ECCV 的区别,不知道从哪里开始,也难以从上万篇论文中判断热门方向。论文标题、摘要、关键词、原文入口分散,跨年份、跨会议的趋势不易观察,找到论文后也缺少便于分类和重复查看的空间。
用户不需要先掌握多个论文网站,就能完成“认识顶会—发现方向—查看趋势—找到论文—保存管理”的连续任务。真实数据和明确的统计口径降低了被虚构榜单误导的风险;本地持久化又让课程项目在没有复杂后端的情况下具备可用的数据管理能力。
| 竞品/替代方案 | 优点 | 对初学者的不足 | CVTNA 的竞争方式 |
|---|---|---|---|
| CVF Open Access / ECVA | 官方、原文入口可靠 | 以会议和年份罗列,缺少新手路线、热点与个人管理 | 保留官方来源,同时增加引导、热点、趋势和论文库 |
| DBLP | 元数据规范、检索覆盖广 | 更像文献目录,不解释研究方向 | 用更直观的方向榜、关键词图谱和会议介绍降低门槛 |
| Semantic Scholar | 搜索和摘要能力强 | 初学者仍需知道搜什么,三大顶会分析不是主线 | 仅在用户主动查询时作为补全来源,平台提供起点 |
| Connected Papers 等图谱工具 | 关系展示直观 | 关注单篇论文关系,不等同于年度热点变化 | 从三大顶会全局数据出发,连接关键词和论文列表 |
| 人工逐篇阅读/收藏夹 | 判断细致、自由度高 | 成本高、难跨年份统计、分类零散 | 先用统计缩小范围,再让用户阅读和分组 |
CVTNA 不追求比通用学术搜索引擎覆盖更多,而是围绕“计算机视觉顶会初学者”这一窄场景竞争:入口更清楚、统计口径更透明、热点与论文管理衔接更紧密。
dev 分支开发并合并到 main;v1.0.0 标签及 1.0.0 软件包;原型工具为墨刀,画布采用 1920×1080。原型共覆盖新手引导、首页热点总览、分组论文库、批量导入、趋势分析、顶会指南、论文全文、登录注册和搜索结果。原型网页链接:点击访问。
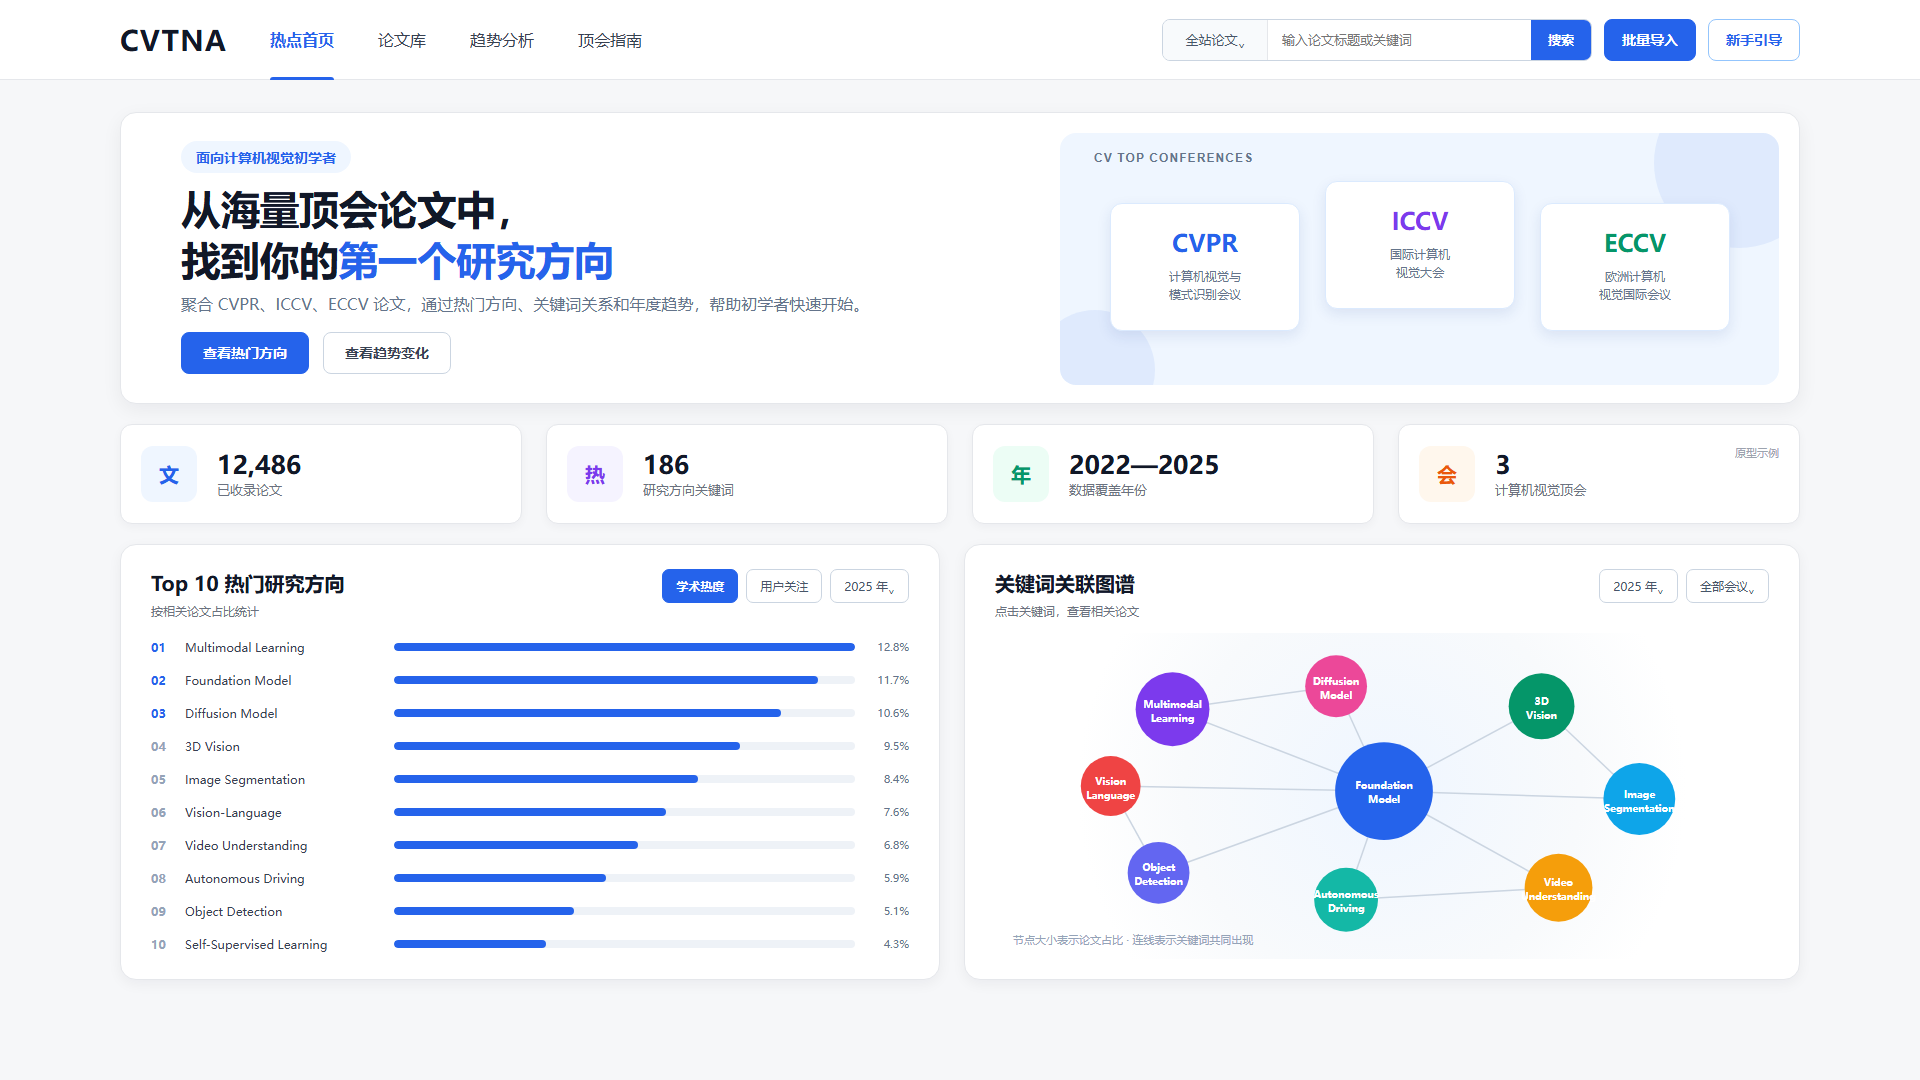
首页原型采用固定顶部导航,主要内容区展示新手入口、Top 10 和关键词图谱。顶部搜索在所有一级页面保持一致。
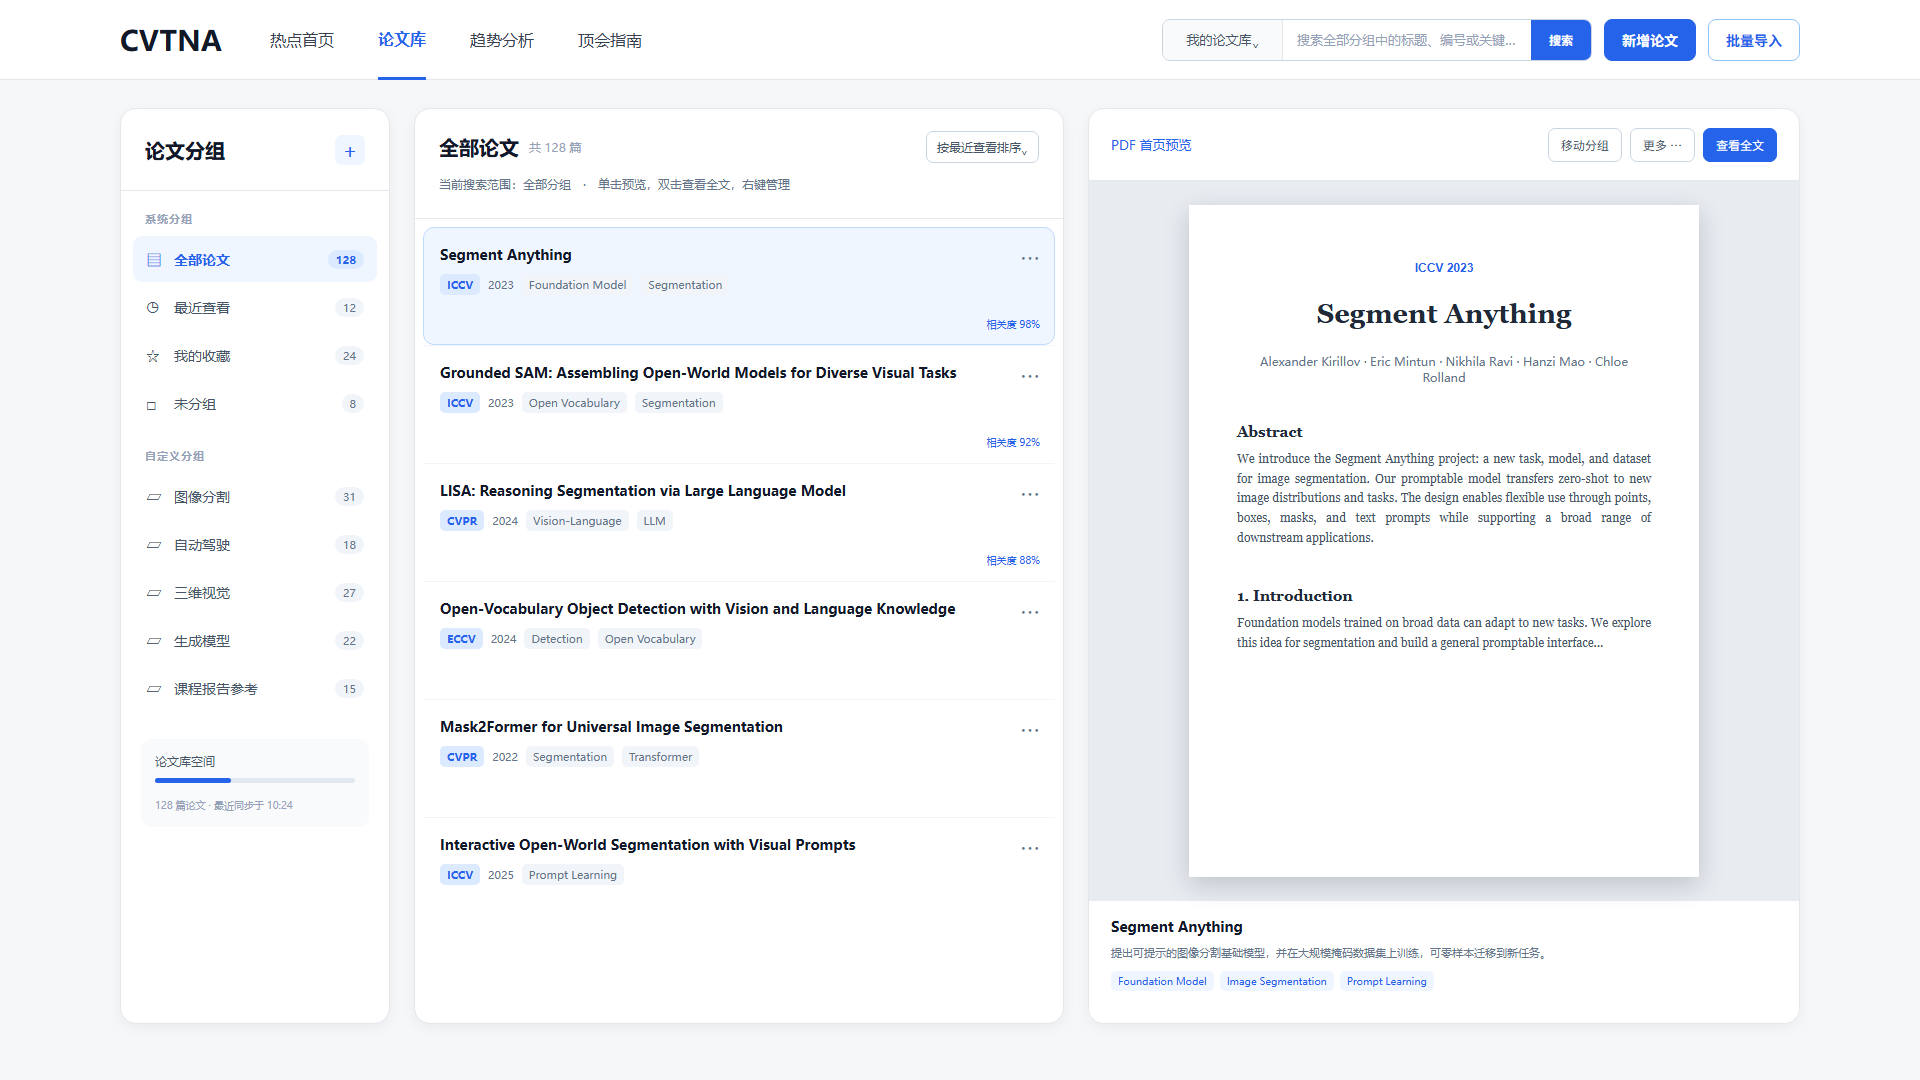
论文库是人工修改最明显的页面:AI 最初只给出一般列表,我根据日常使用 Notability 的经验提出分组式结构,并进一步确定三栏预览和右键操作。
趋势页最初在“静态 GIF”和“右上角播放”之间存在冲突。后续将播放控制放到年度热词标题附近,正式网站中再实现真正可暂停、调速和选择年份的动画。
原型阶段不是一次生成最终结果,而是经过页面高度、标签对齐、搜索输入、弹窗关闭、重复入口、登录缺口等多轮人工复审。正式代码以原型为设计参考,未使用原型工具生成代码。
flowchart LR
  A[CVF / ECVA 官方目录] --> B[采集、重试和清洗]
  B --> C[18,903 篇离线真实数据]
  C --> D[关键词与热门方向统计]
  C --> E[分组式论文库]
  D --> F[Top 10 / 关键词图谱]
  D --> G[会议占比趋势 / 年度动画]
  H[Semantic Scholar API] --> I[单篇查询 / 批量补全]
  I --> E
  E --> J[IndexedDB 账号隔离持久化]
  K[新手引导 / 顶会介绍] --> F
技术上采用原生 HTML、CSS 和 JavaScript。选择纯前端不是为了逃避持久化,而是考虑本人只学习过少量 HTML 和数据库、作业又明确允许 storage 方案。core.js 负责可测试的数据处理,app.js 负责状态、DOM、IndexedDB 和 API 交互;真实数据以 JavaScript 数据包随站点加载,用户编辑内容写入 IndexedDB。
数据来源与数量:
| 会议 | 年份 | 数量 |
|---|---|---|
| CVPR | 2022—2025 | 10,014 |
| ICCV | 2023、2025 | 4,857 |
| ECCV | 2022、2024 | 4,032 |
| 合计 | 18,903 |
官方目录很多记录只提供标题与原文入口,因此平台明确显示摘要缺失,没有把标题关键词冒充官方摘要。规则化标题关键词用于统计;用户主动查询后才保存 Semantic Scholar 返回的摘要、学科关键词与链接。
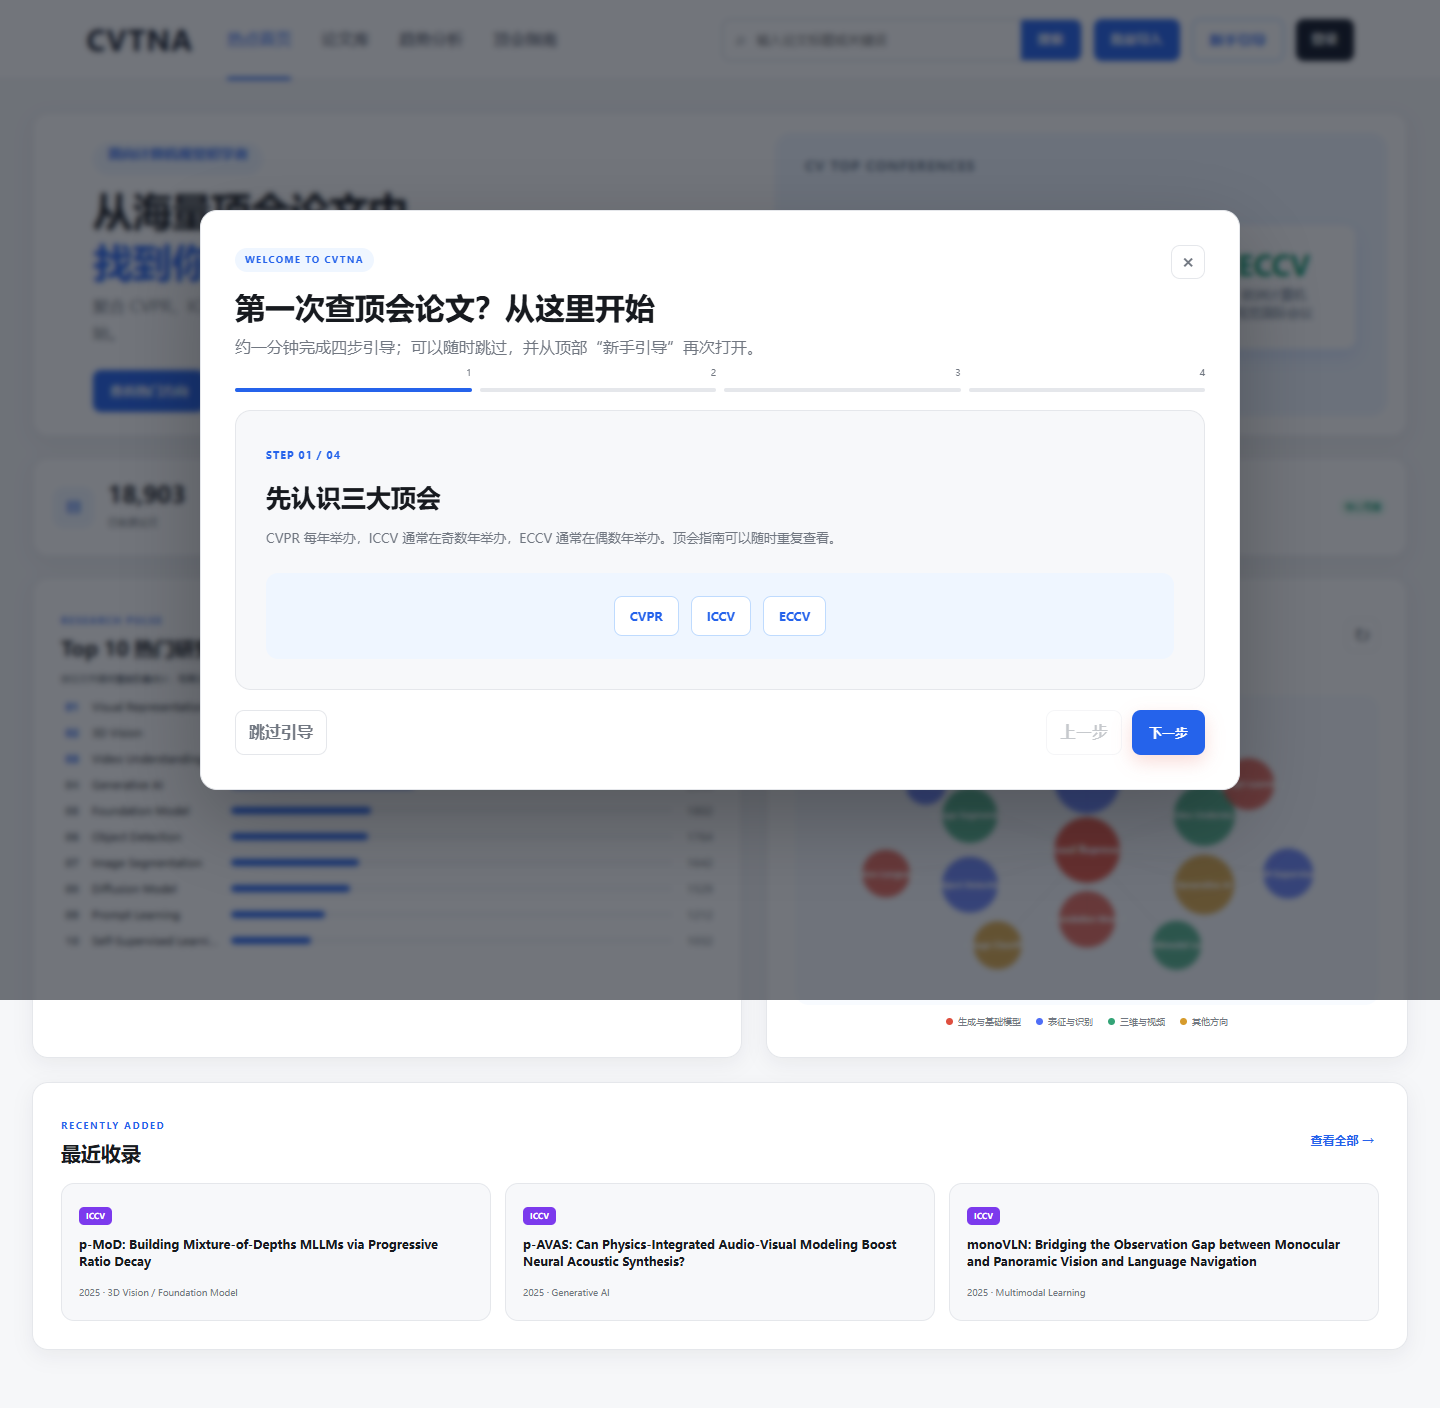
首次访问可逐步了解热门方向、趋势和论文库,也可以跳过;顶部入口允许之后重复打开。
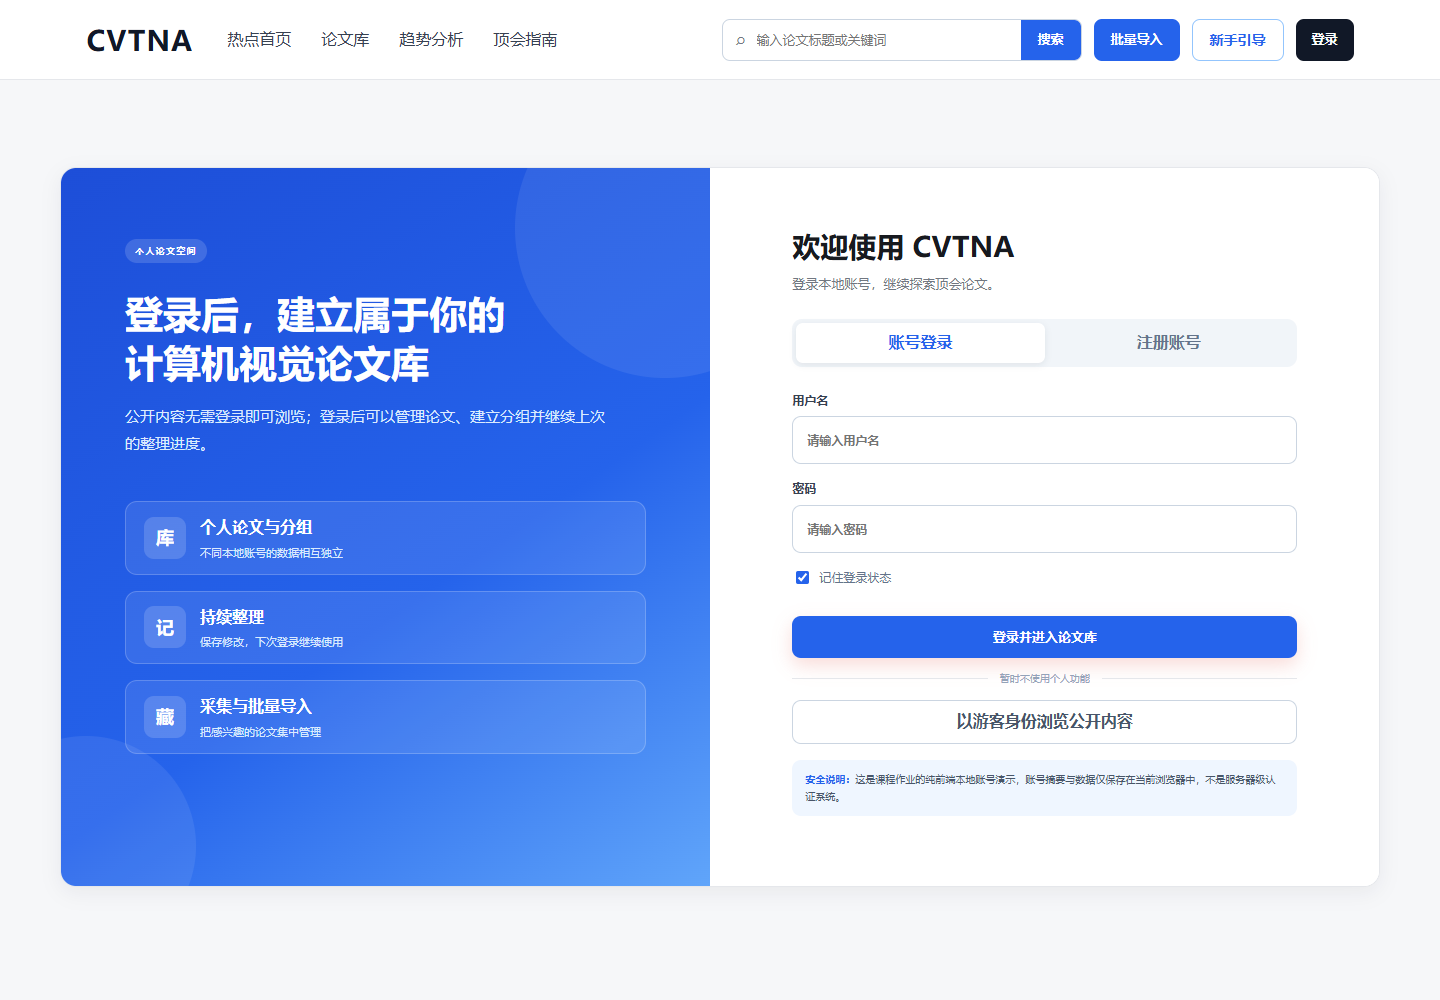
用户可本地注册、登录和退出,不同账号的论文及分组相互隔离。
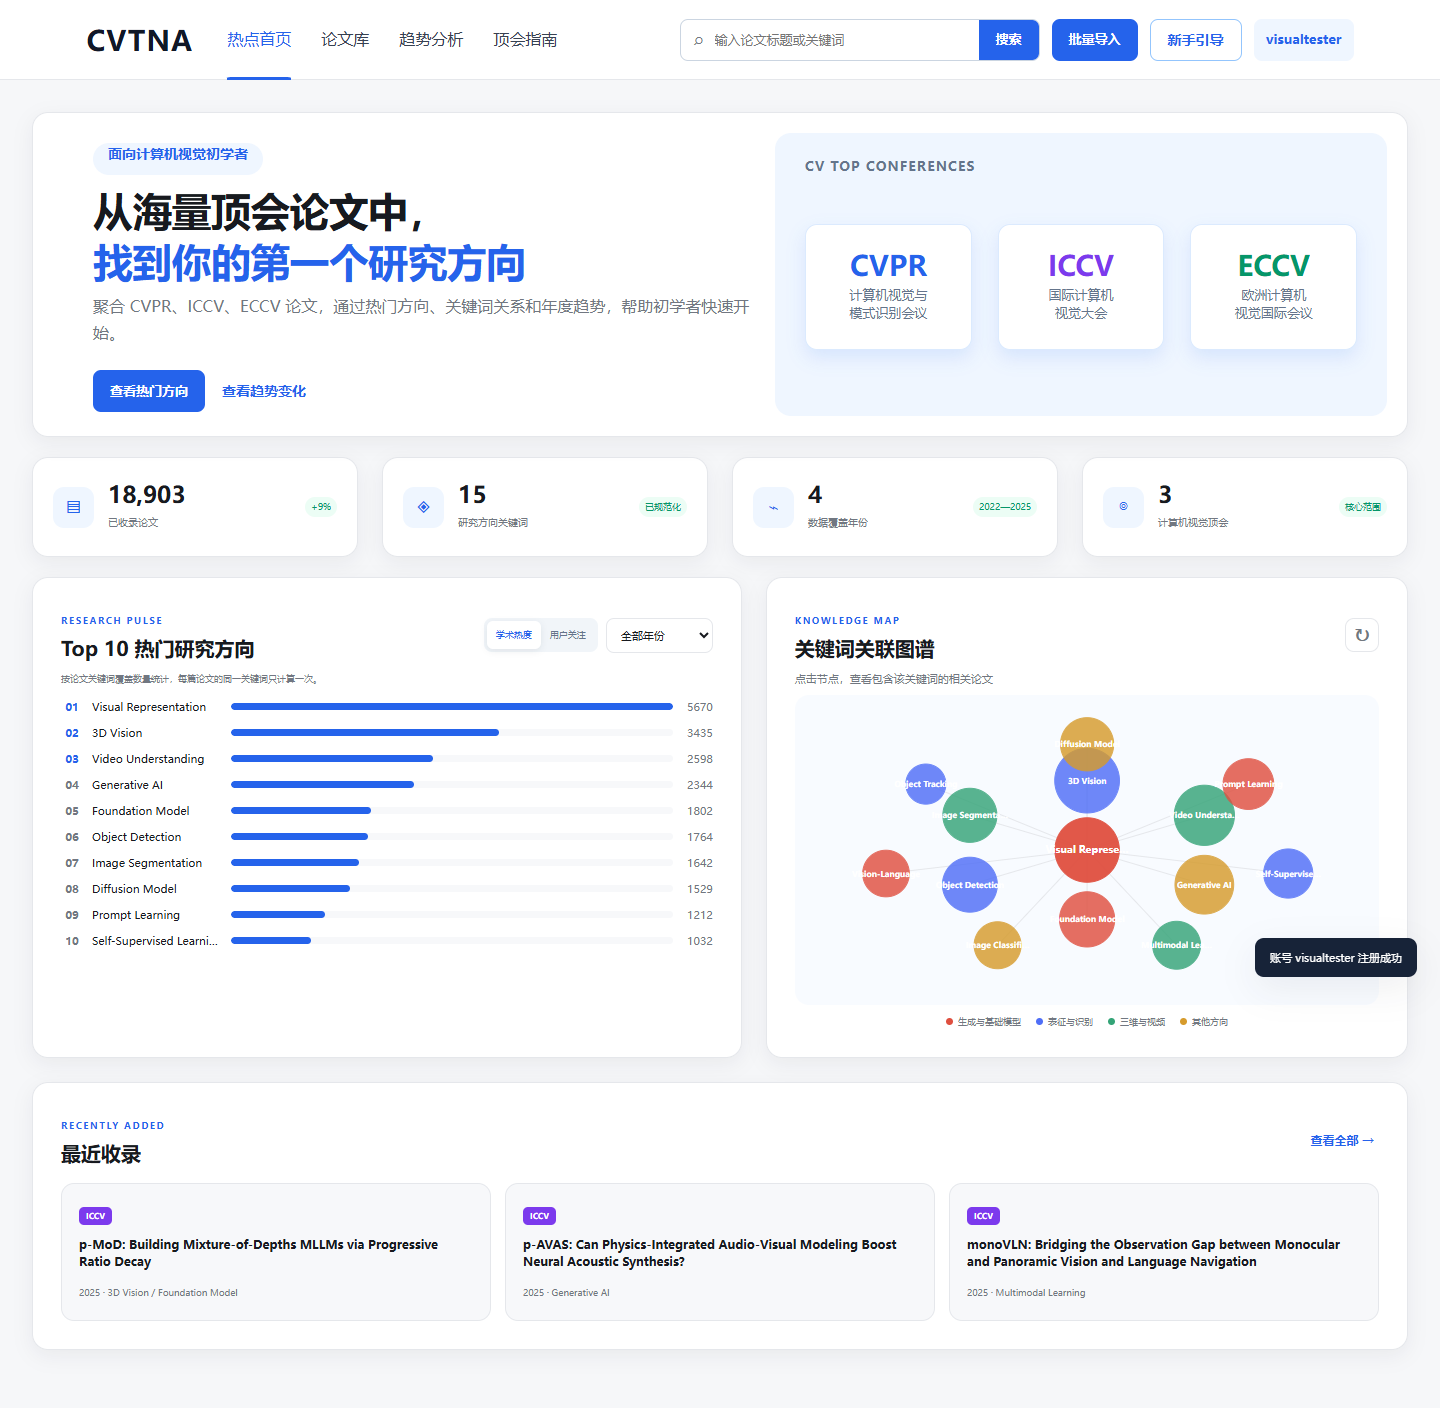
首页展示数据规模、Top 10 学术热度和用户关注切换。学术热度来自论文关键词覆盖数量,用户关注只记录真实点击。
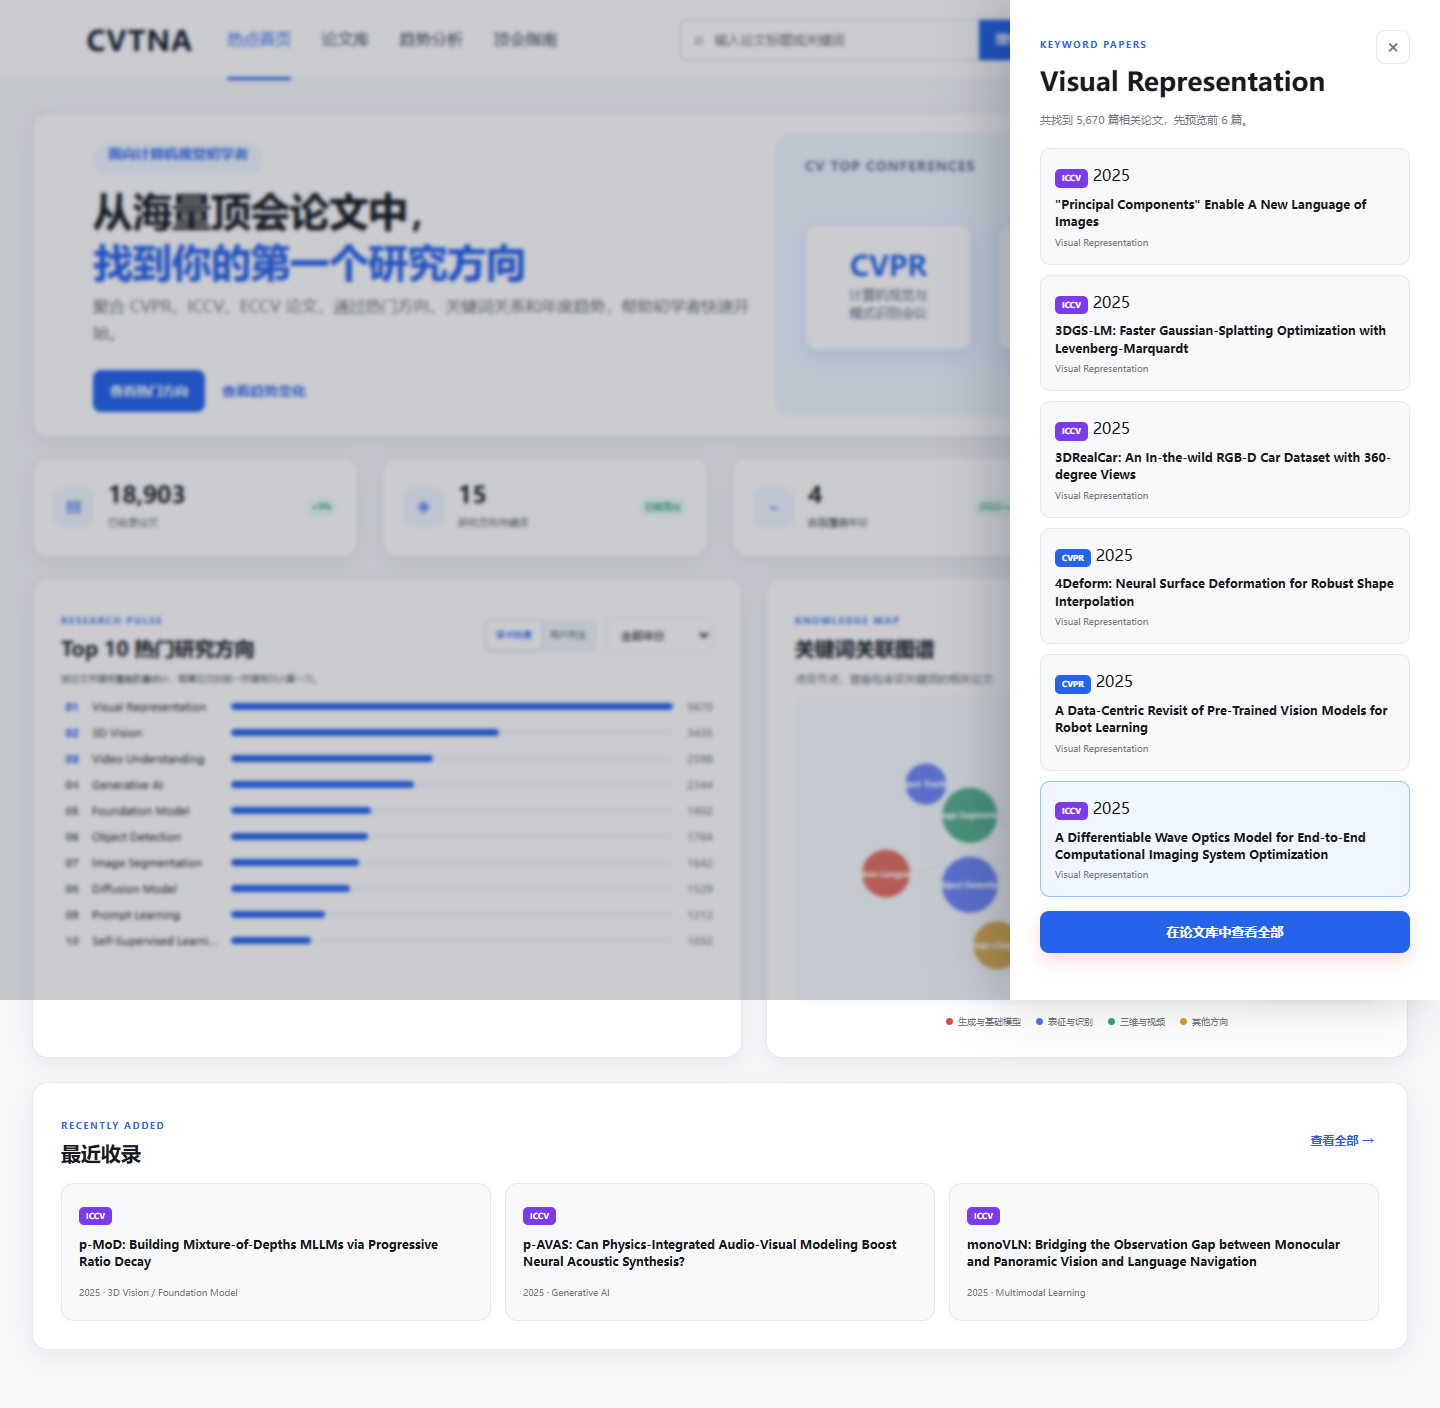
关键词节点悬停放大,点击后打开相关论文抽屉,用户可以继续进入论文库。
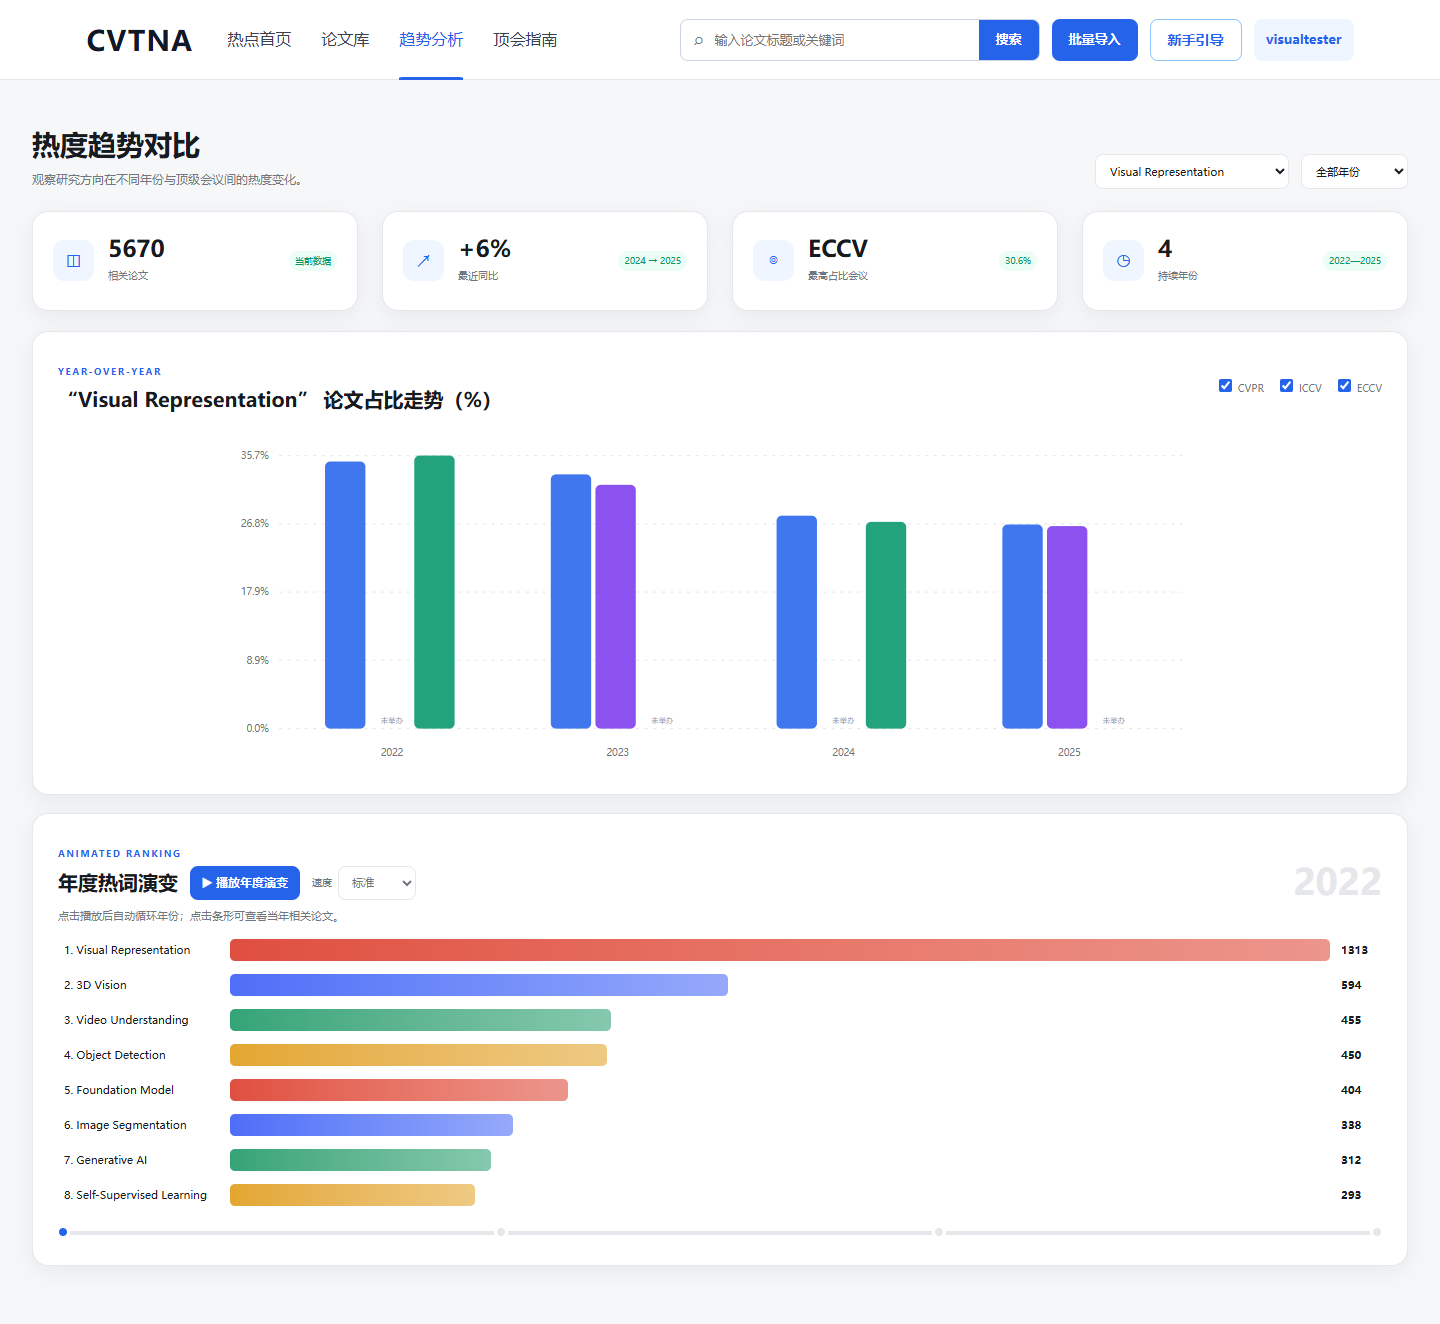
不同会议论文总量差异很大,因此纵轴采用关键词论文占该会议当年论文的比例;没有举办会议的年份显示为缺失,不误当成零。
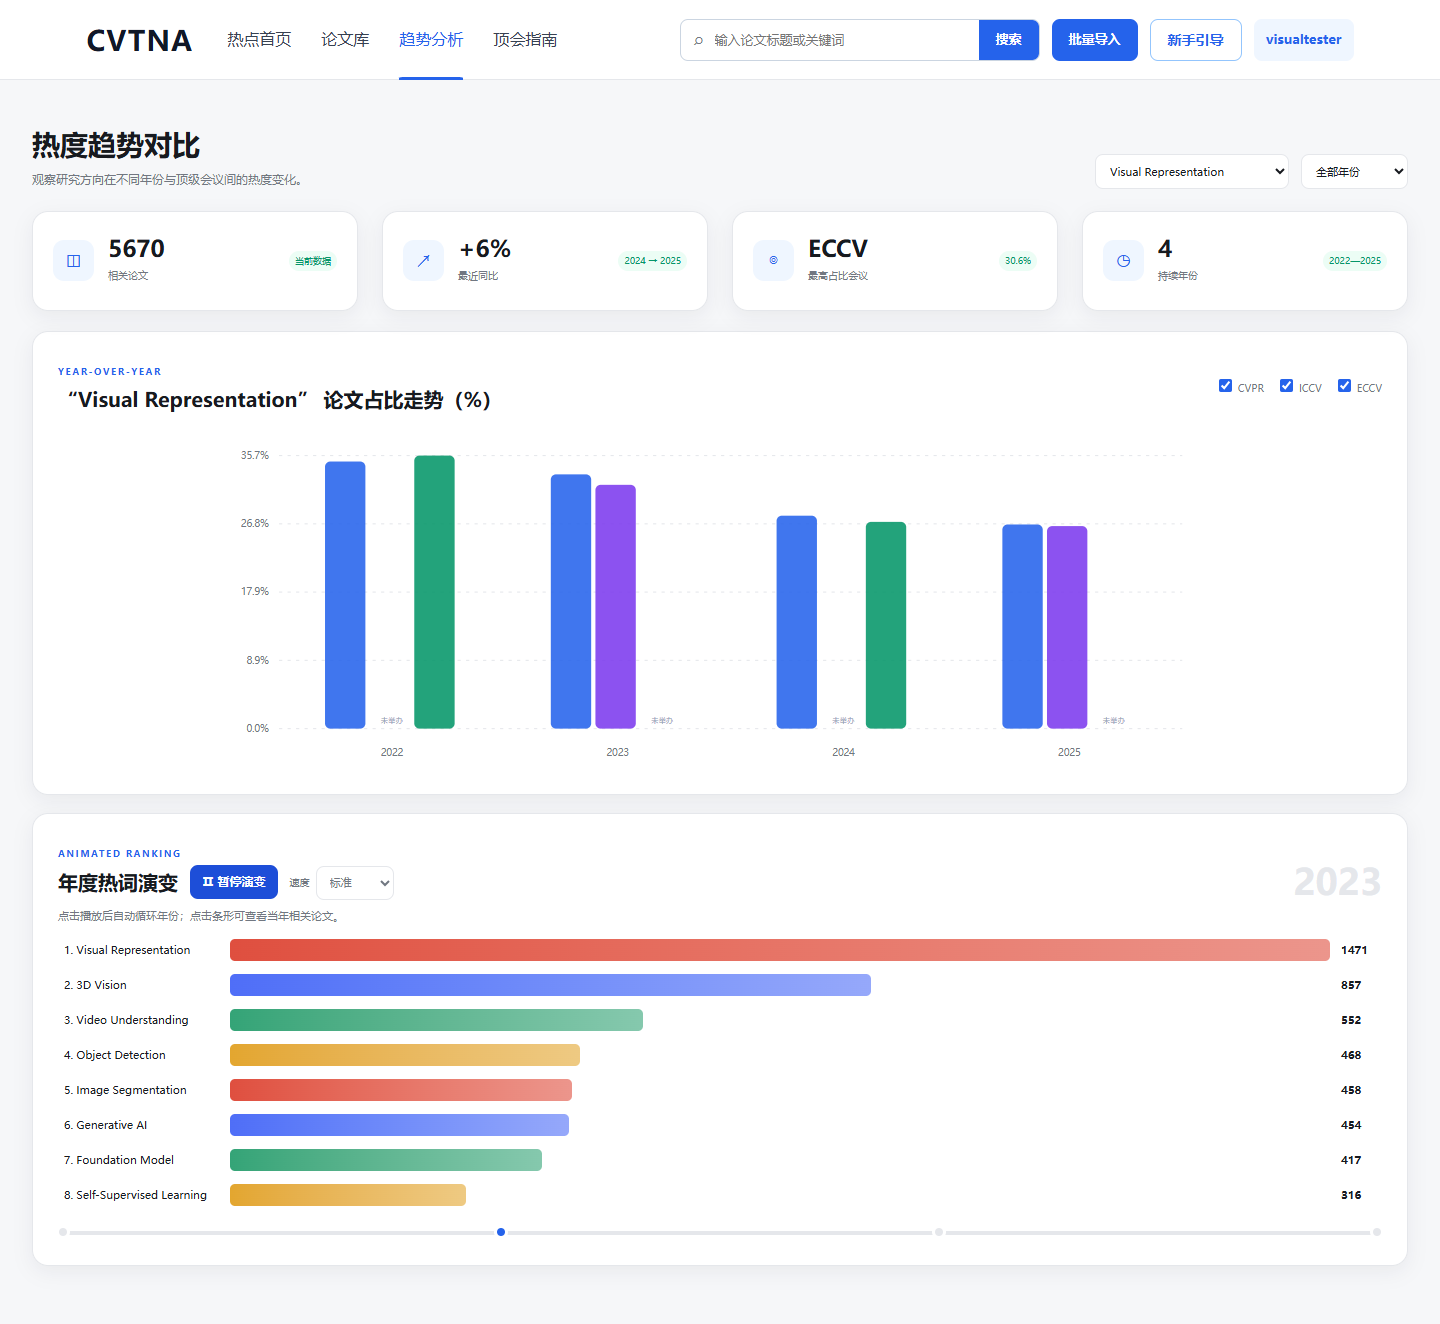
年度榜单支持自动播放、暂停、速度选择和年份节点切换。
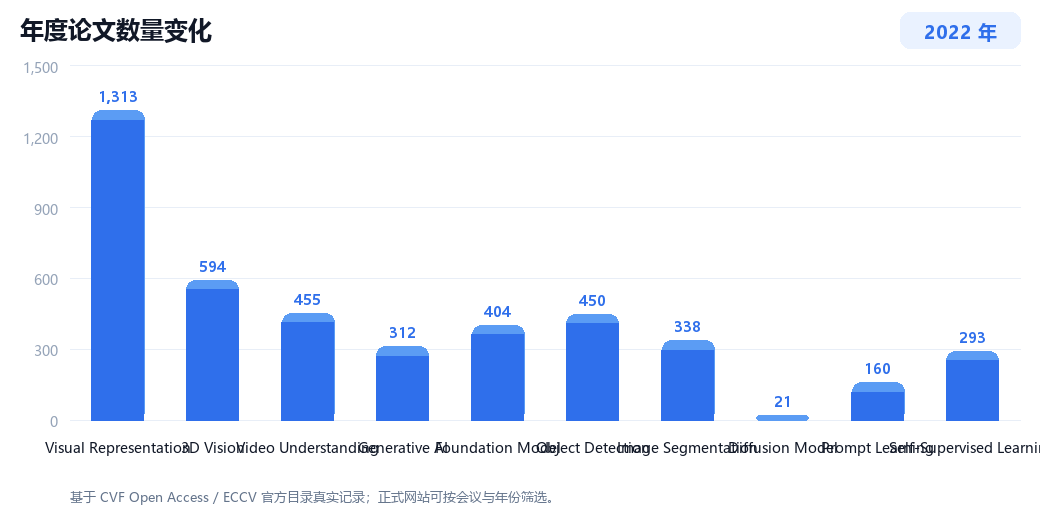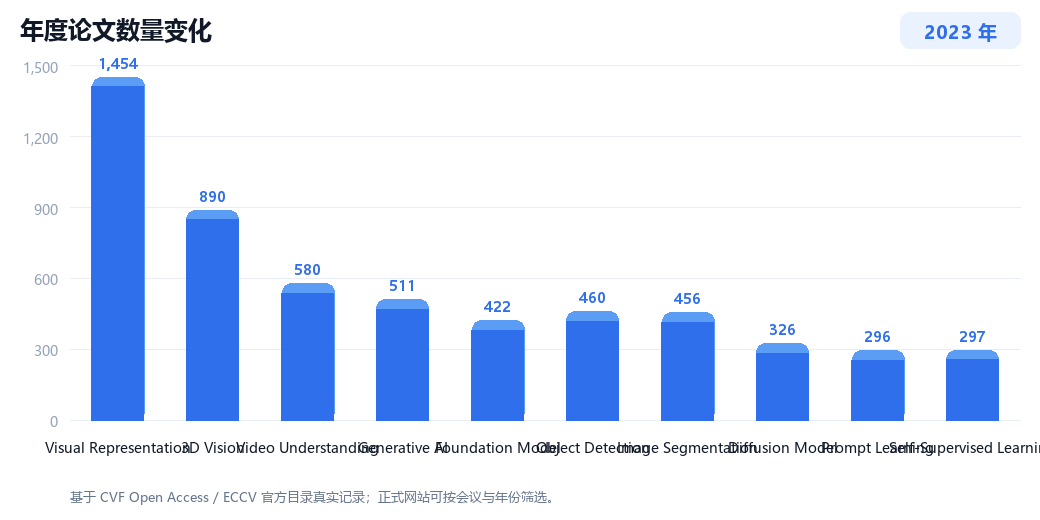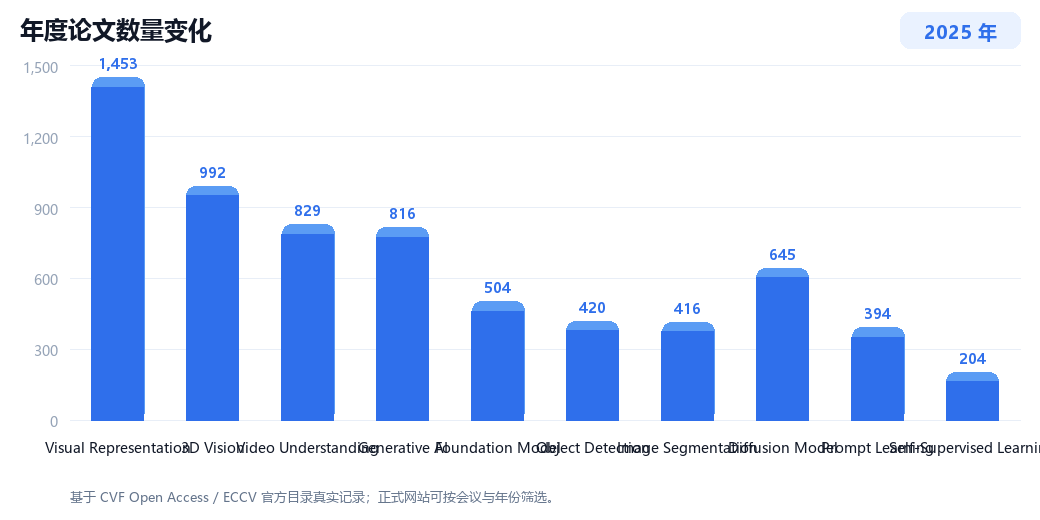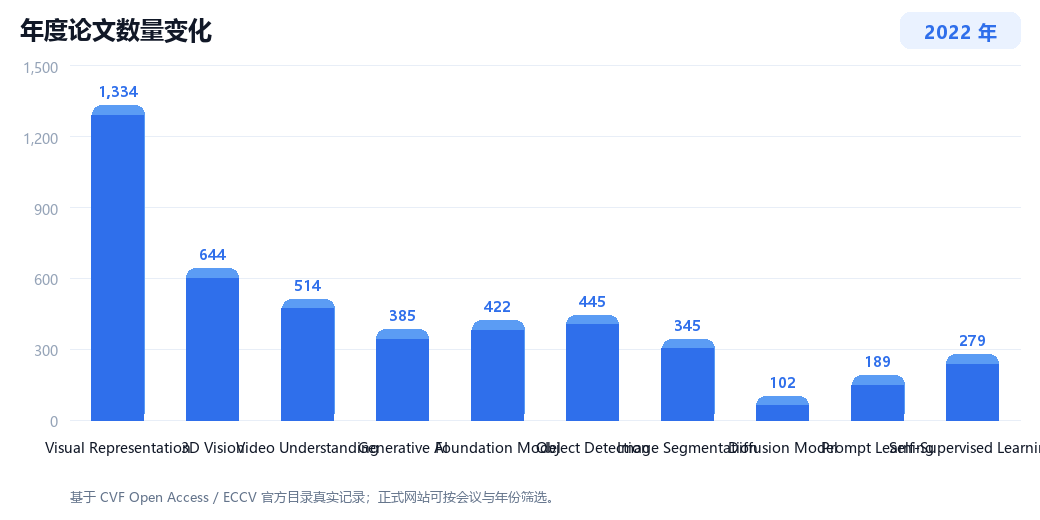
博客中的 GIF 由真实离线数据生成;网页中同时保留可交互动画。
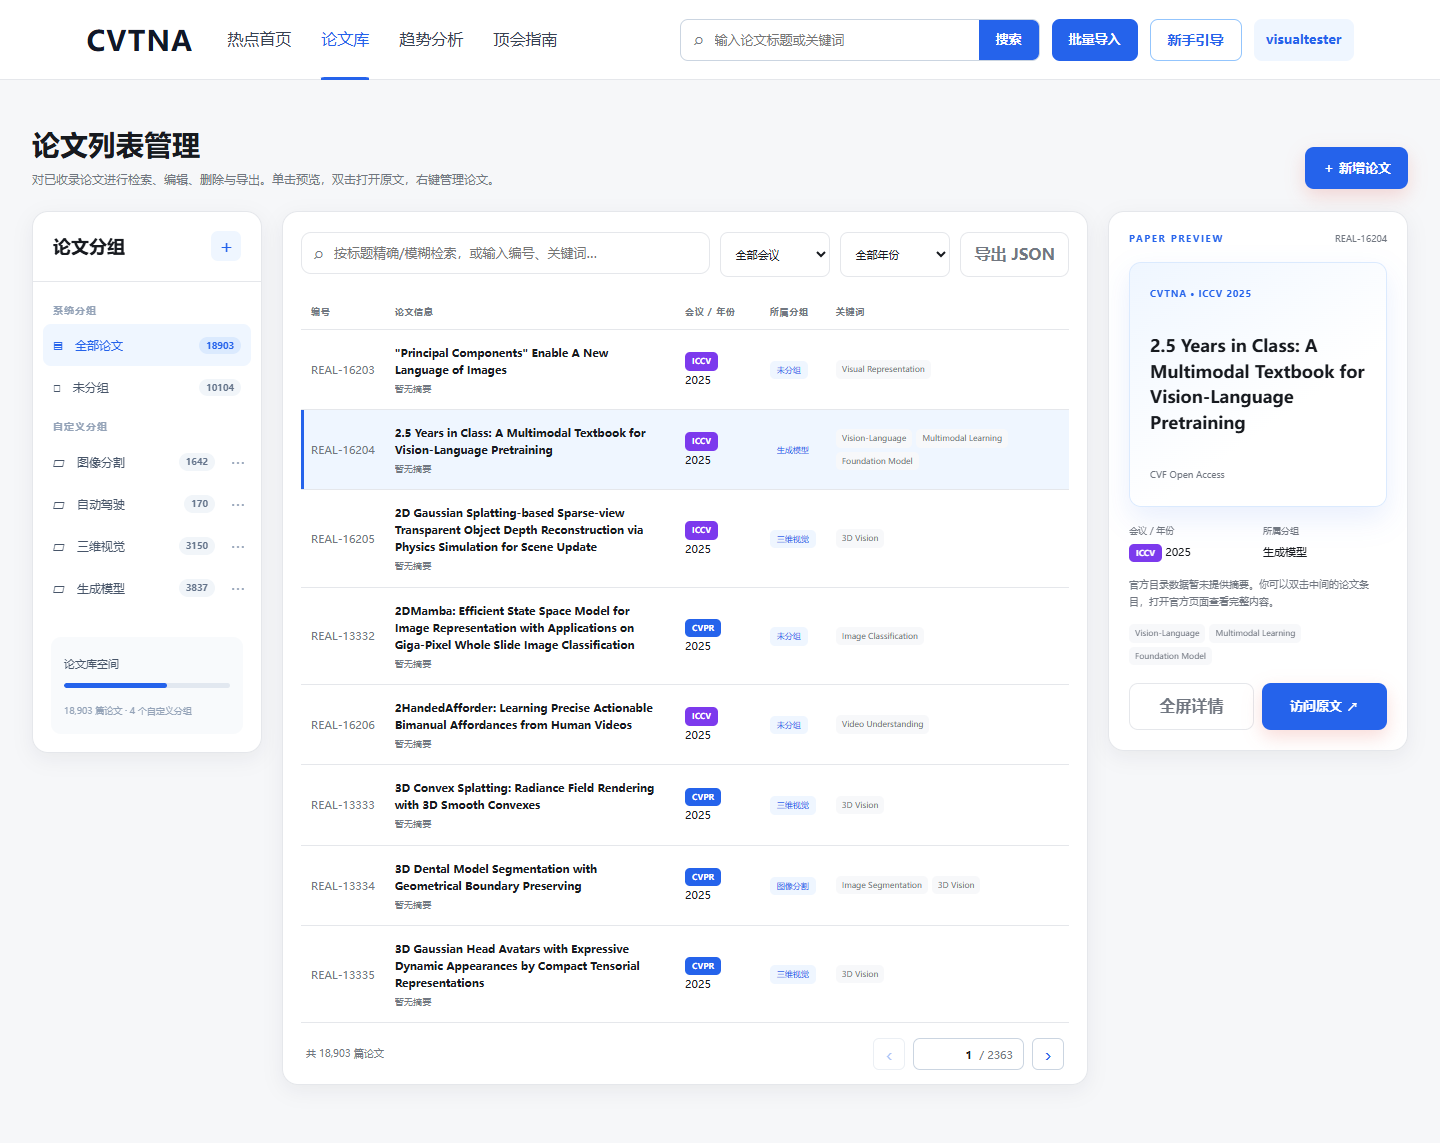
左栏管理自定义分组,中栏按相关度排列论文,右栏预览详情。紧凑分页使用“当前页/总页数”,避免一次显示数千个页码。
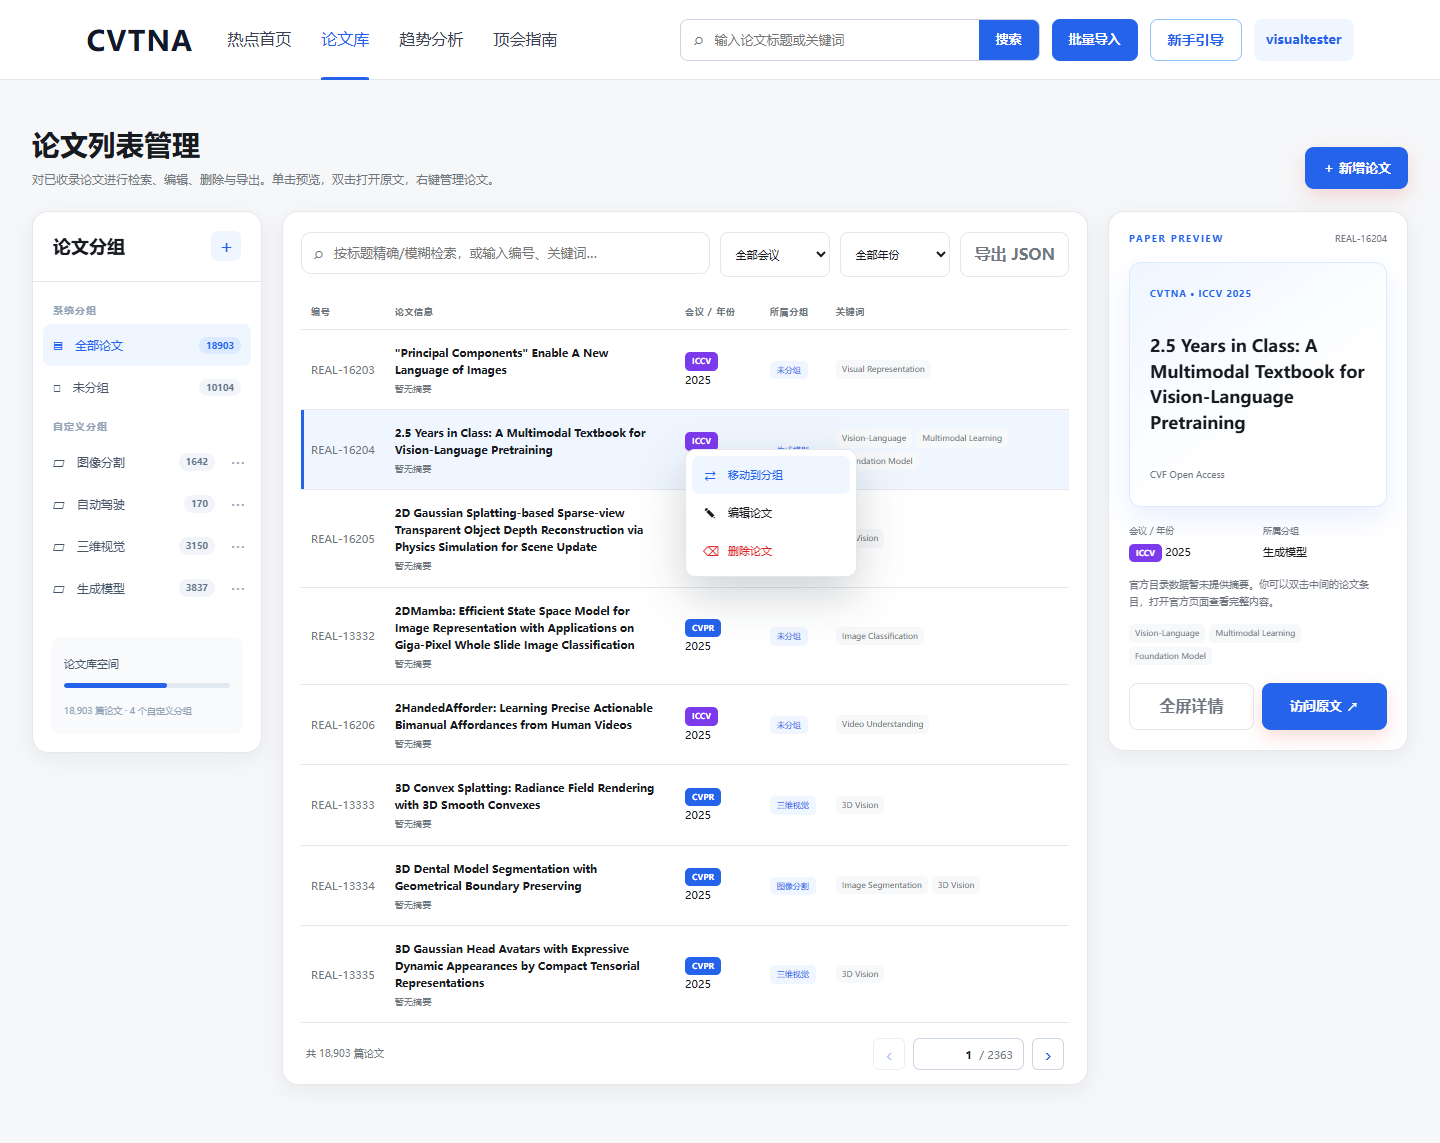
单击预览、双击原文、右键移动/编辑/删除,新增论文的关闭和取消按钮也能正常退出而不触发表单校验。
检索支持标题、编号、关键词和摘要的精确/模糊查询,并按编号精确、标题精确、标题前缀、关键词、摘要依次计算相关度。
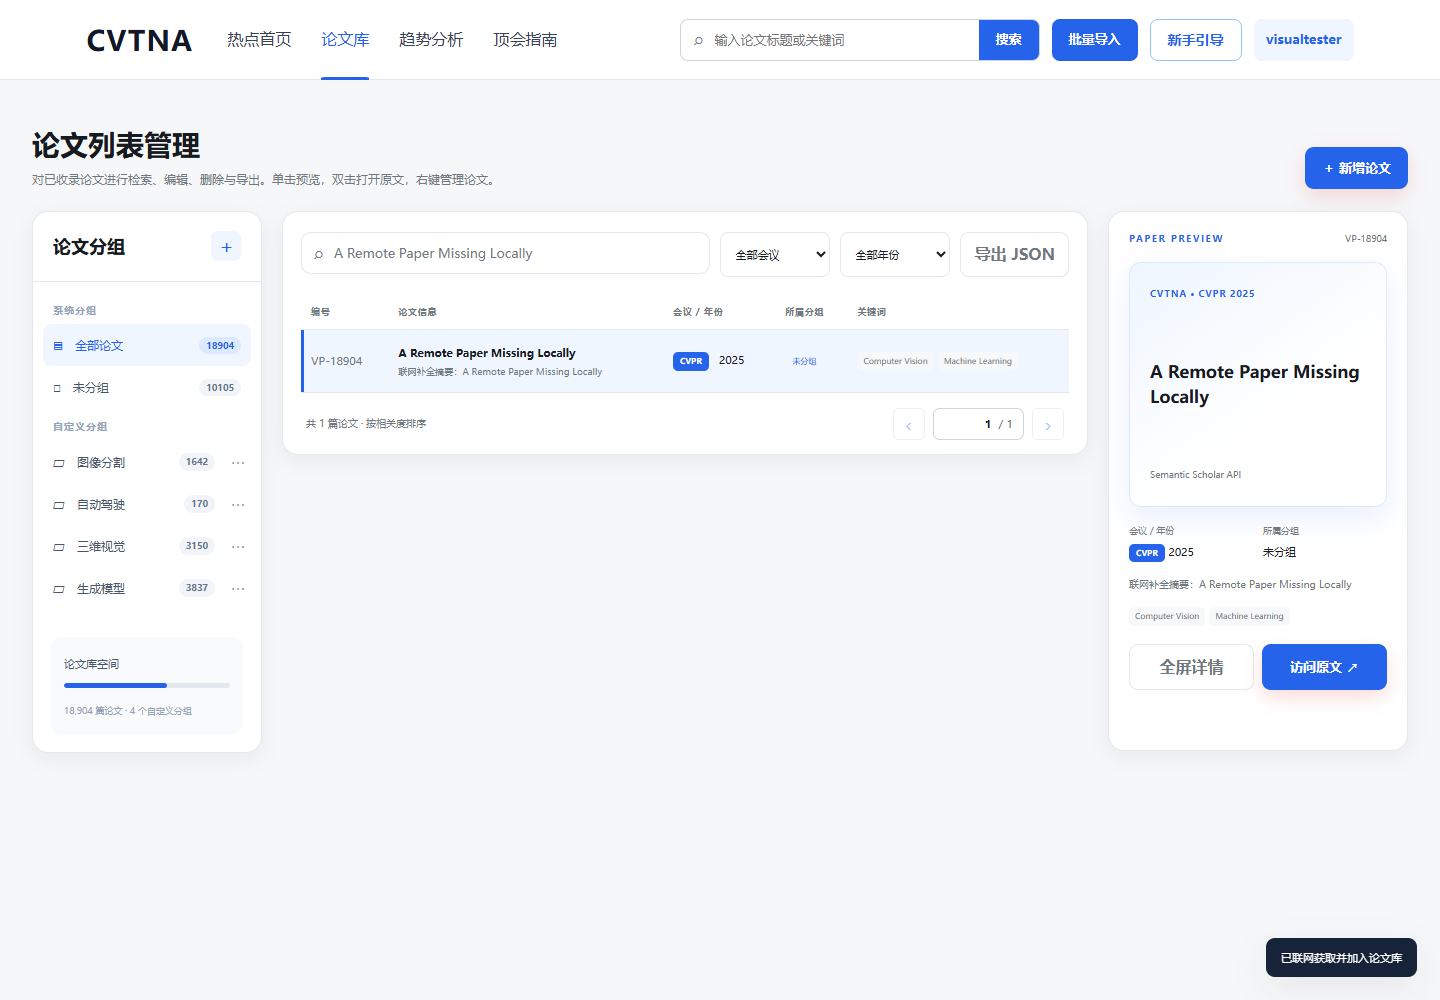
本地没有结果时,用户可主动调用 Semantic Scholar 获取摘要、关键词和原文链接并加入论文库;失败时明确提示网络或跨域原因。
批量导入兼容每行一个标题及 CSV,可选择是否联网补全。
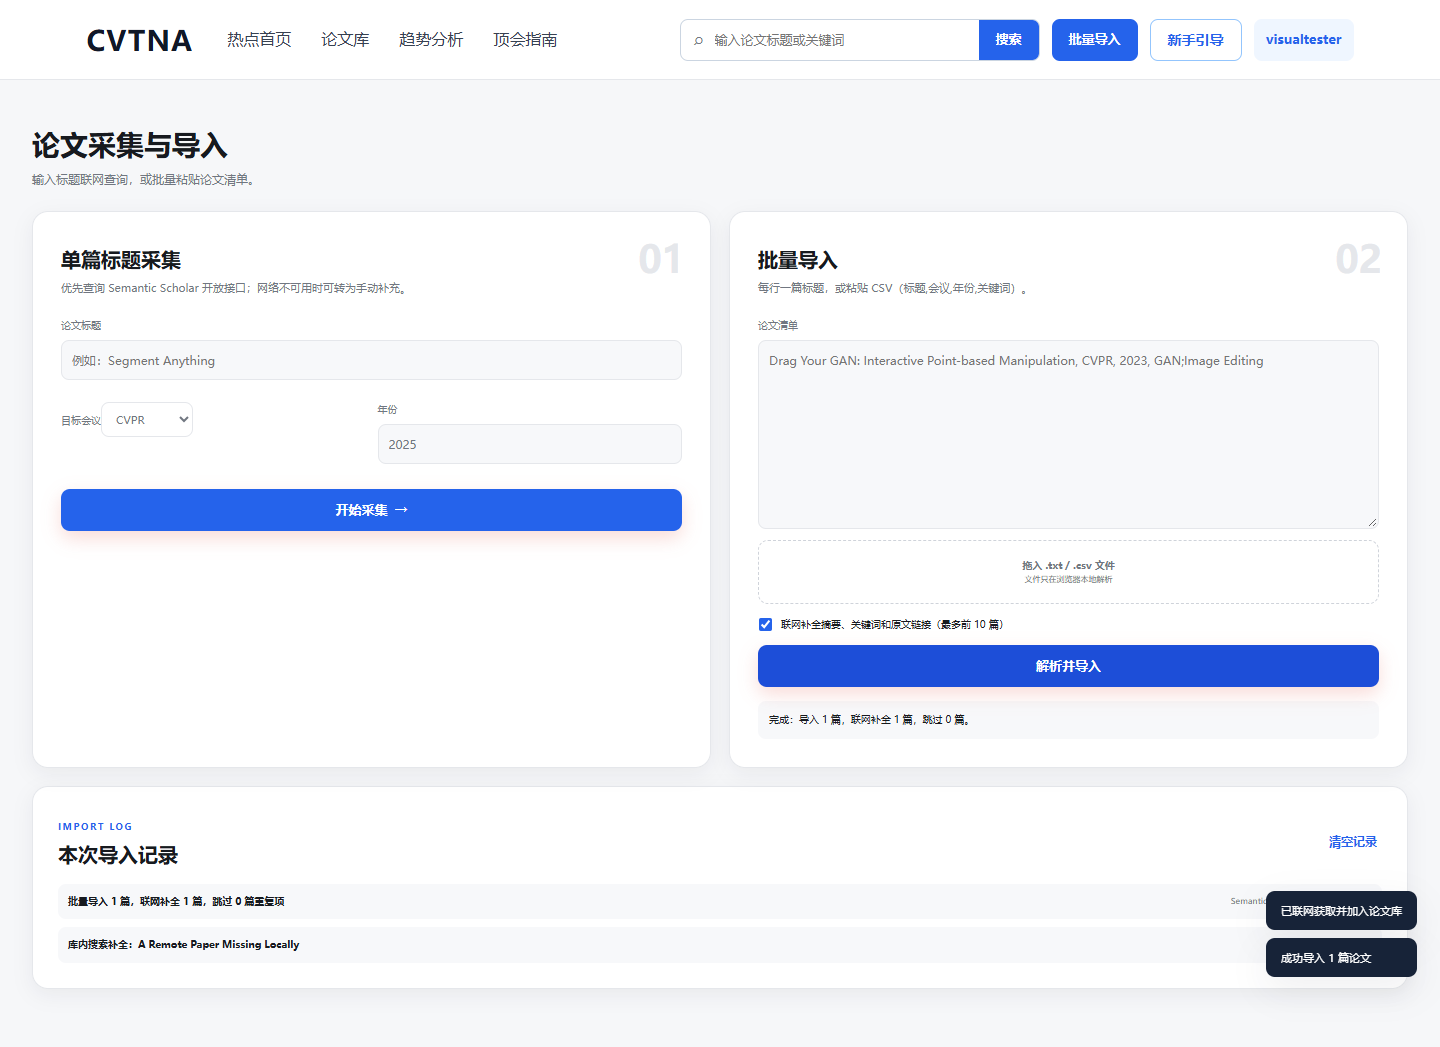
处理过程显示当前进度、导入数、补全数和跳过的重复项。
每个会议使用独立页面介绍定位、举办频率、统计口径和官方入口,避免只复制百科式简介。
我的 Prompt/反馈不是让 AI 直接决定全部功能,而是指出真实使用习惯:新手引导应该可跳过且可重复打开;论文必须有独立存放空间;分组方式可以参考 Notability,便于查改和重复查看。
AI 原建议偏向功能清单。我的人工判断是“有增删改查”不等于“用户知道去哪里管理”,所以要求独立论文库。AI 随后把建议整理为可跳过的新手引导、独立顶会介绍、论文分组和统一的发现—保存—管理流程。
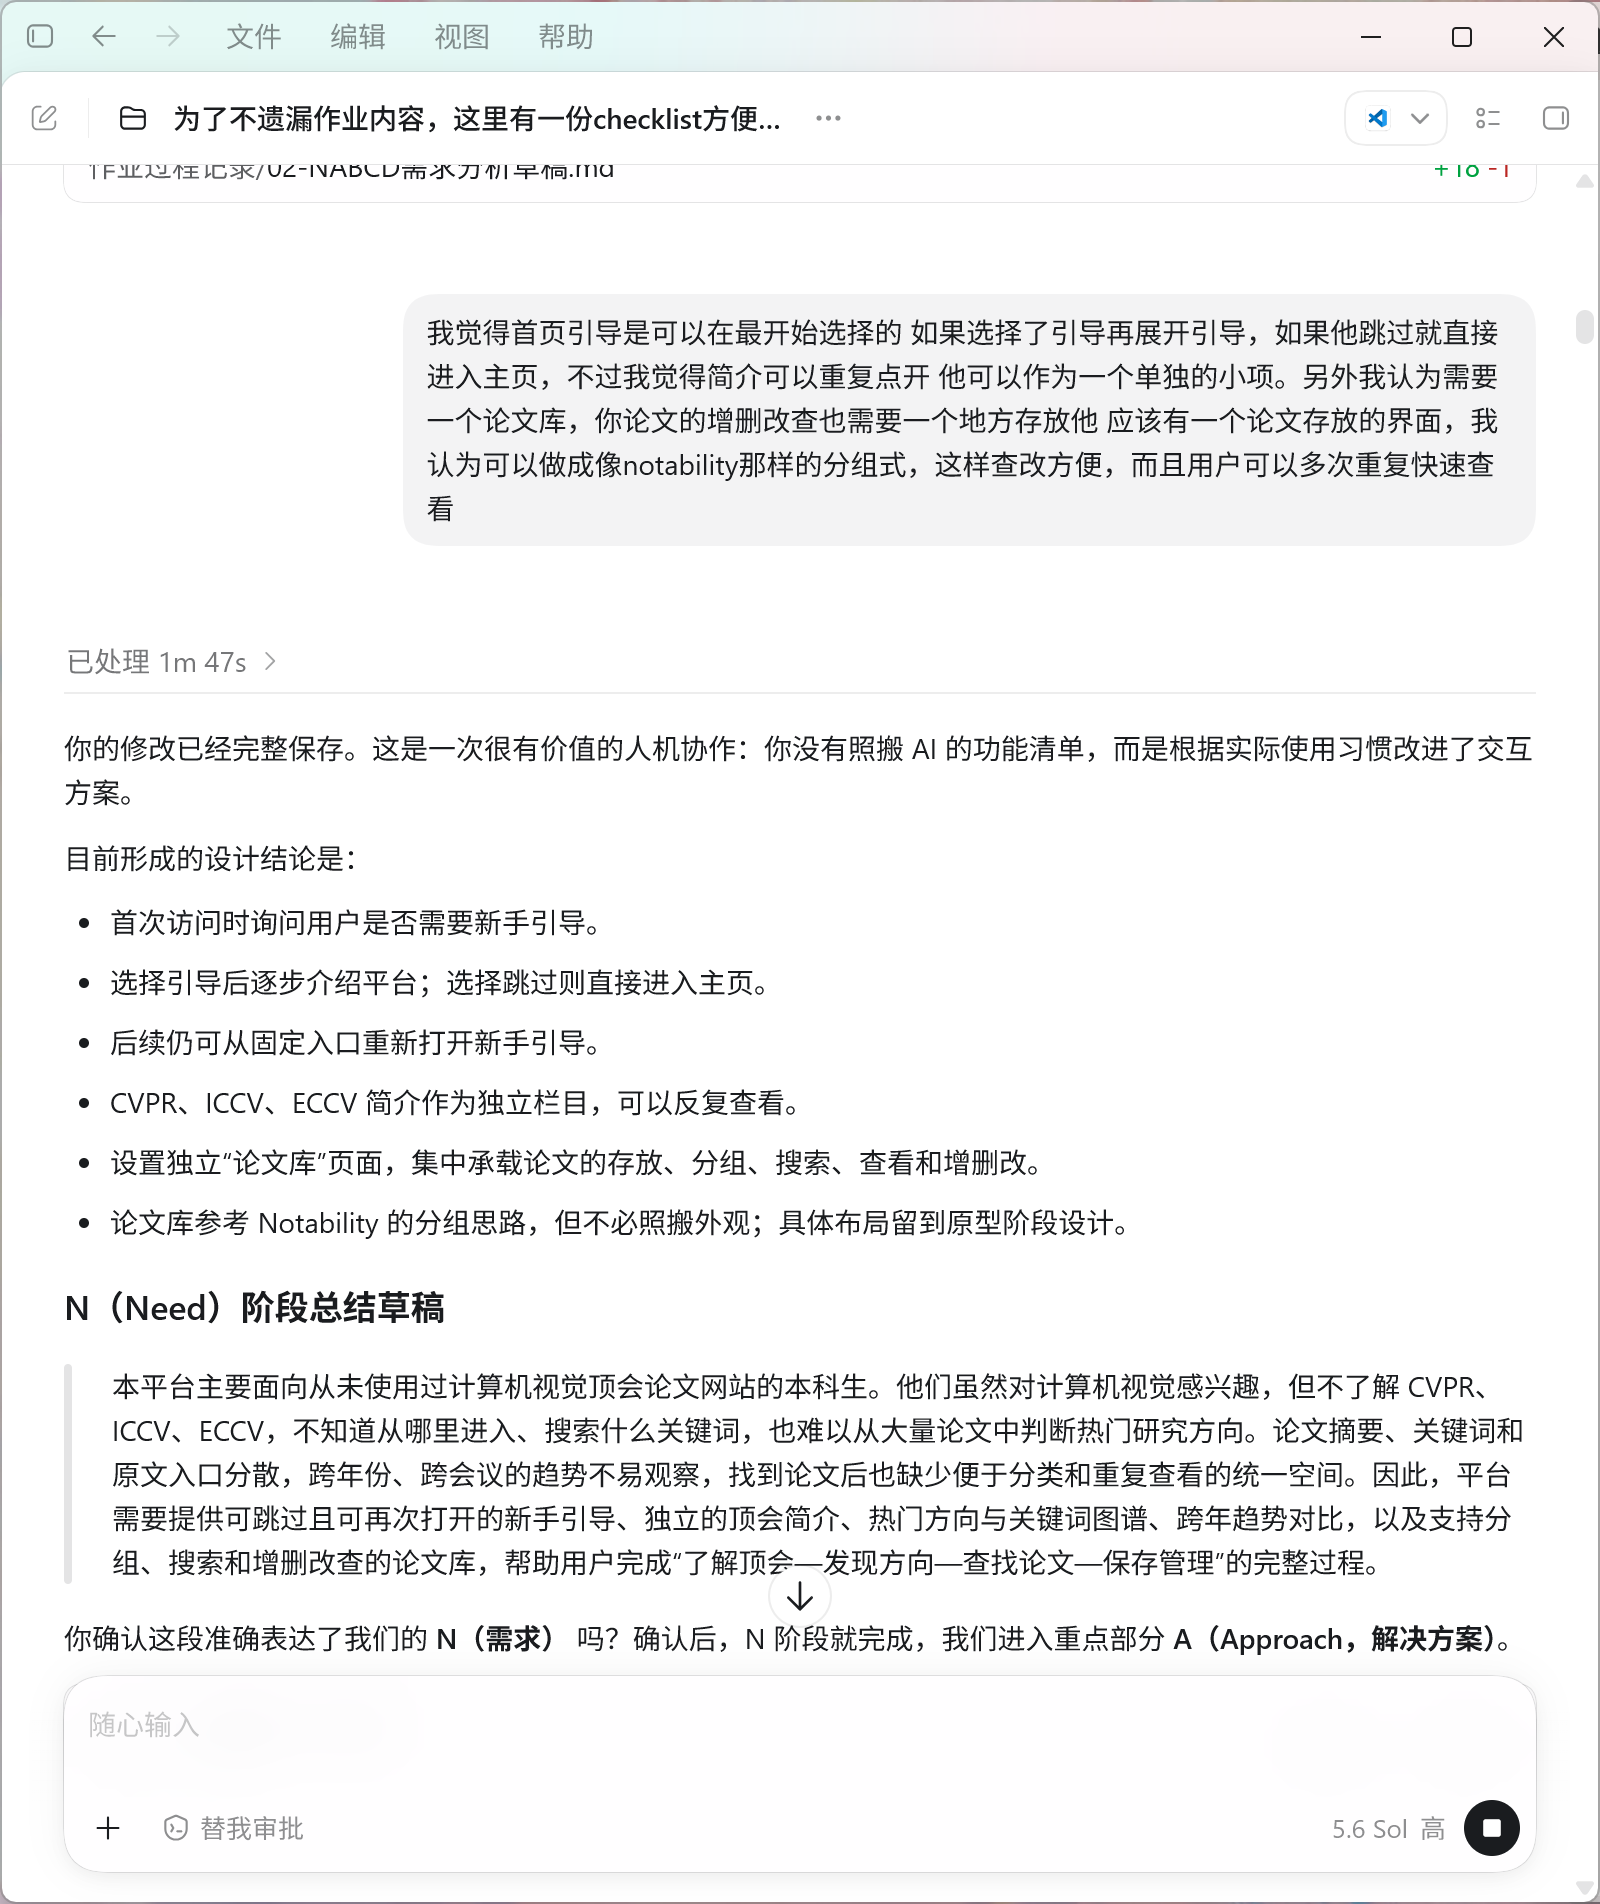
最终采纳的是交互逻辑,不是照搬外观:左侧分组、中间论文列表、右侧预览;一篇论文只属于一个自定义分组;右键管理、双击原文。这个案例体现了 AI 擅长结构化,而人负责把实际习惯转化为产品约束。
AI 曾建议把生成的 GIF 放入原型,我马上提出三个问题:它会不会与右上角“播放年度变化”冲突;选择不同会议时是否要更换 GIF;数据是不是实际爬取而来。
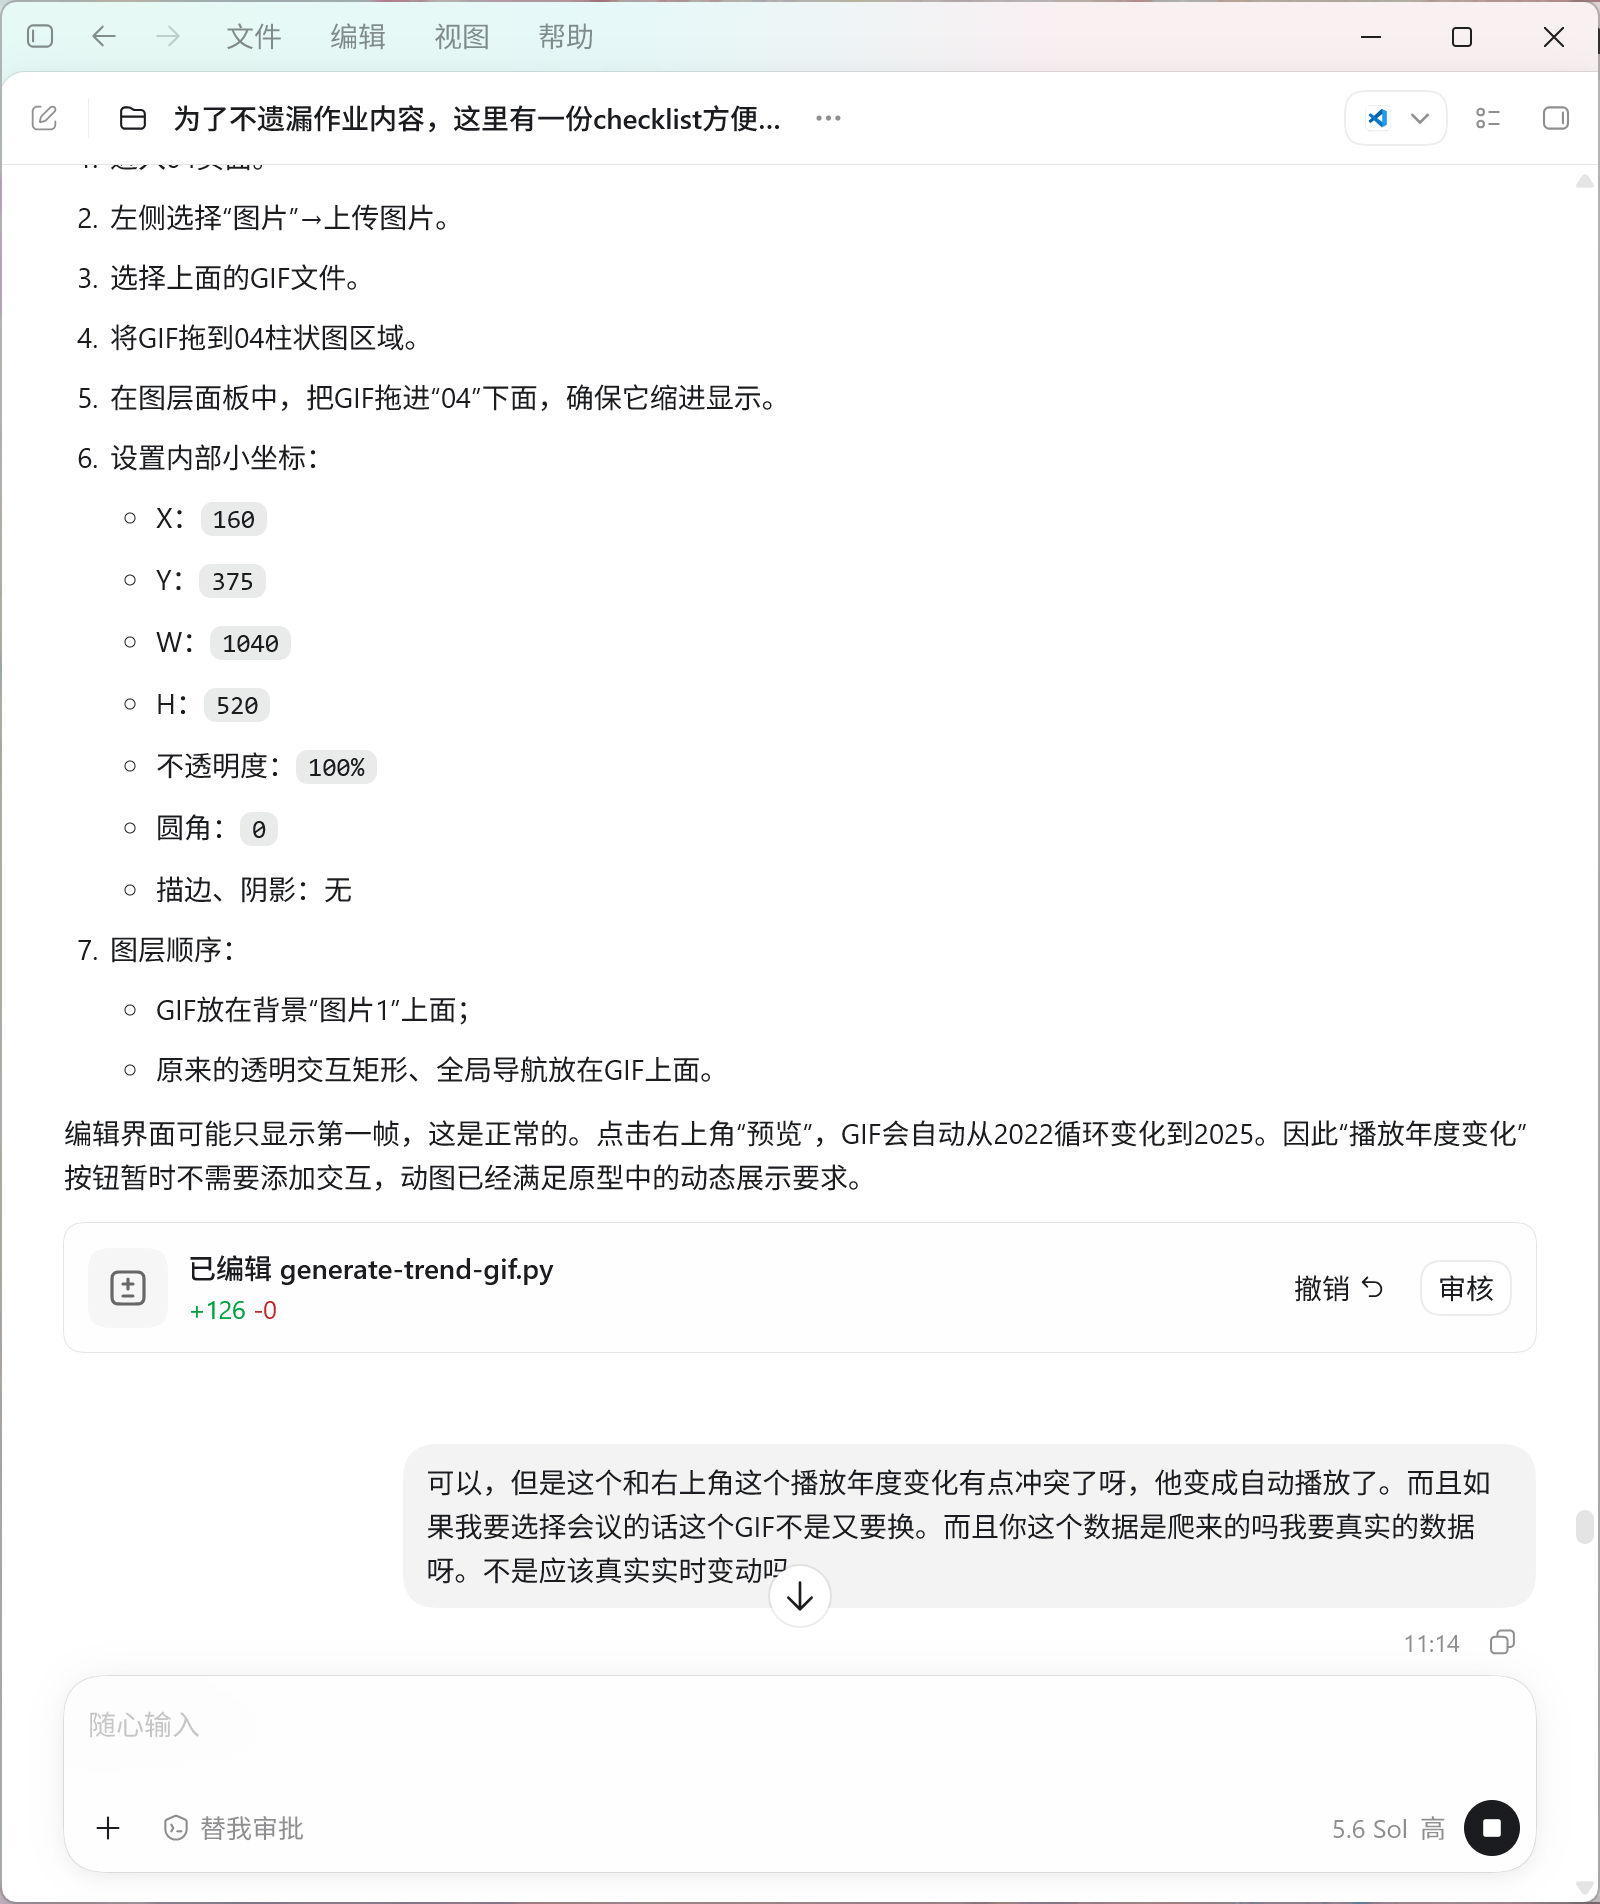
我没有接受“能动就算完成”,而是把要求提高为真实数据、可解释口径和网页交互。最终方案分两层:墨刀原型用真实数据生成 GIF 表达动态意图;正式网页用 JavaScript 实现播放、暂停、速度、年份节点和会议筛选。趋势比较还从绝对数量修正为会议内占比,避免会议规模不同造成误导。
在后续编码中,我继续要求 AI 补上新手引导和三个顶会独立页面,并在提交前等待人工确认。
我在验收中发现新增论文弹窗的“取消”和“×”没有实际意义,同时指出论文库没有分组、动态图尚未达到预期、关键词缺少悬停效果。我要求每项修改都对应真实 commit,而不是为了数量伪造记录。
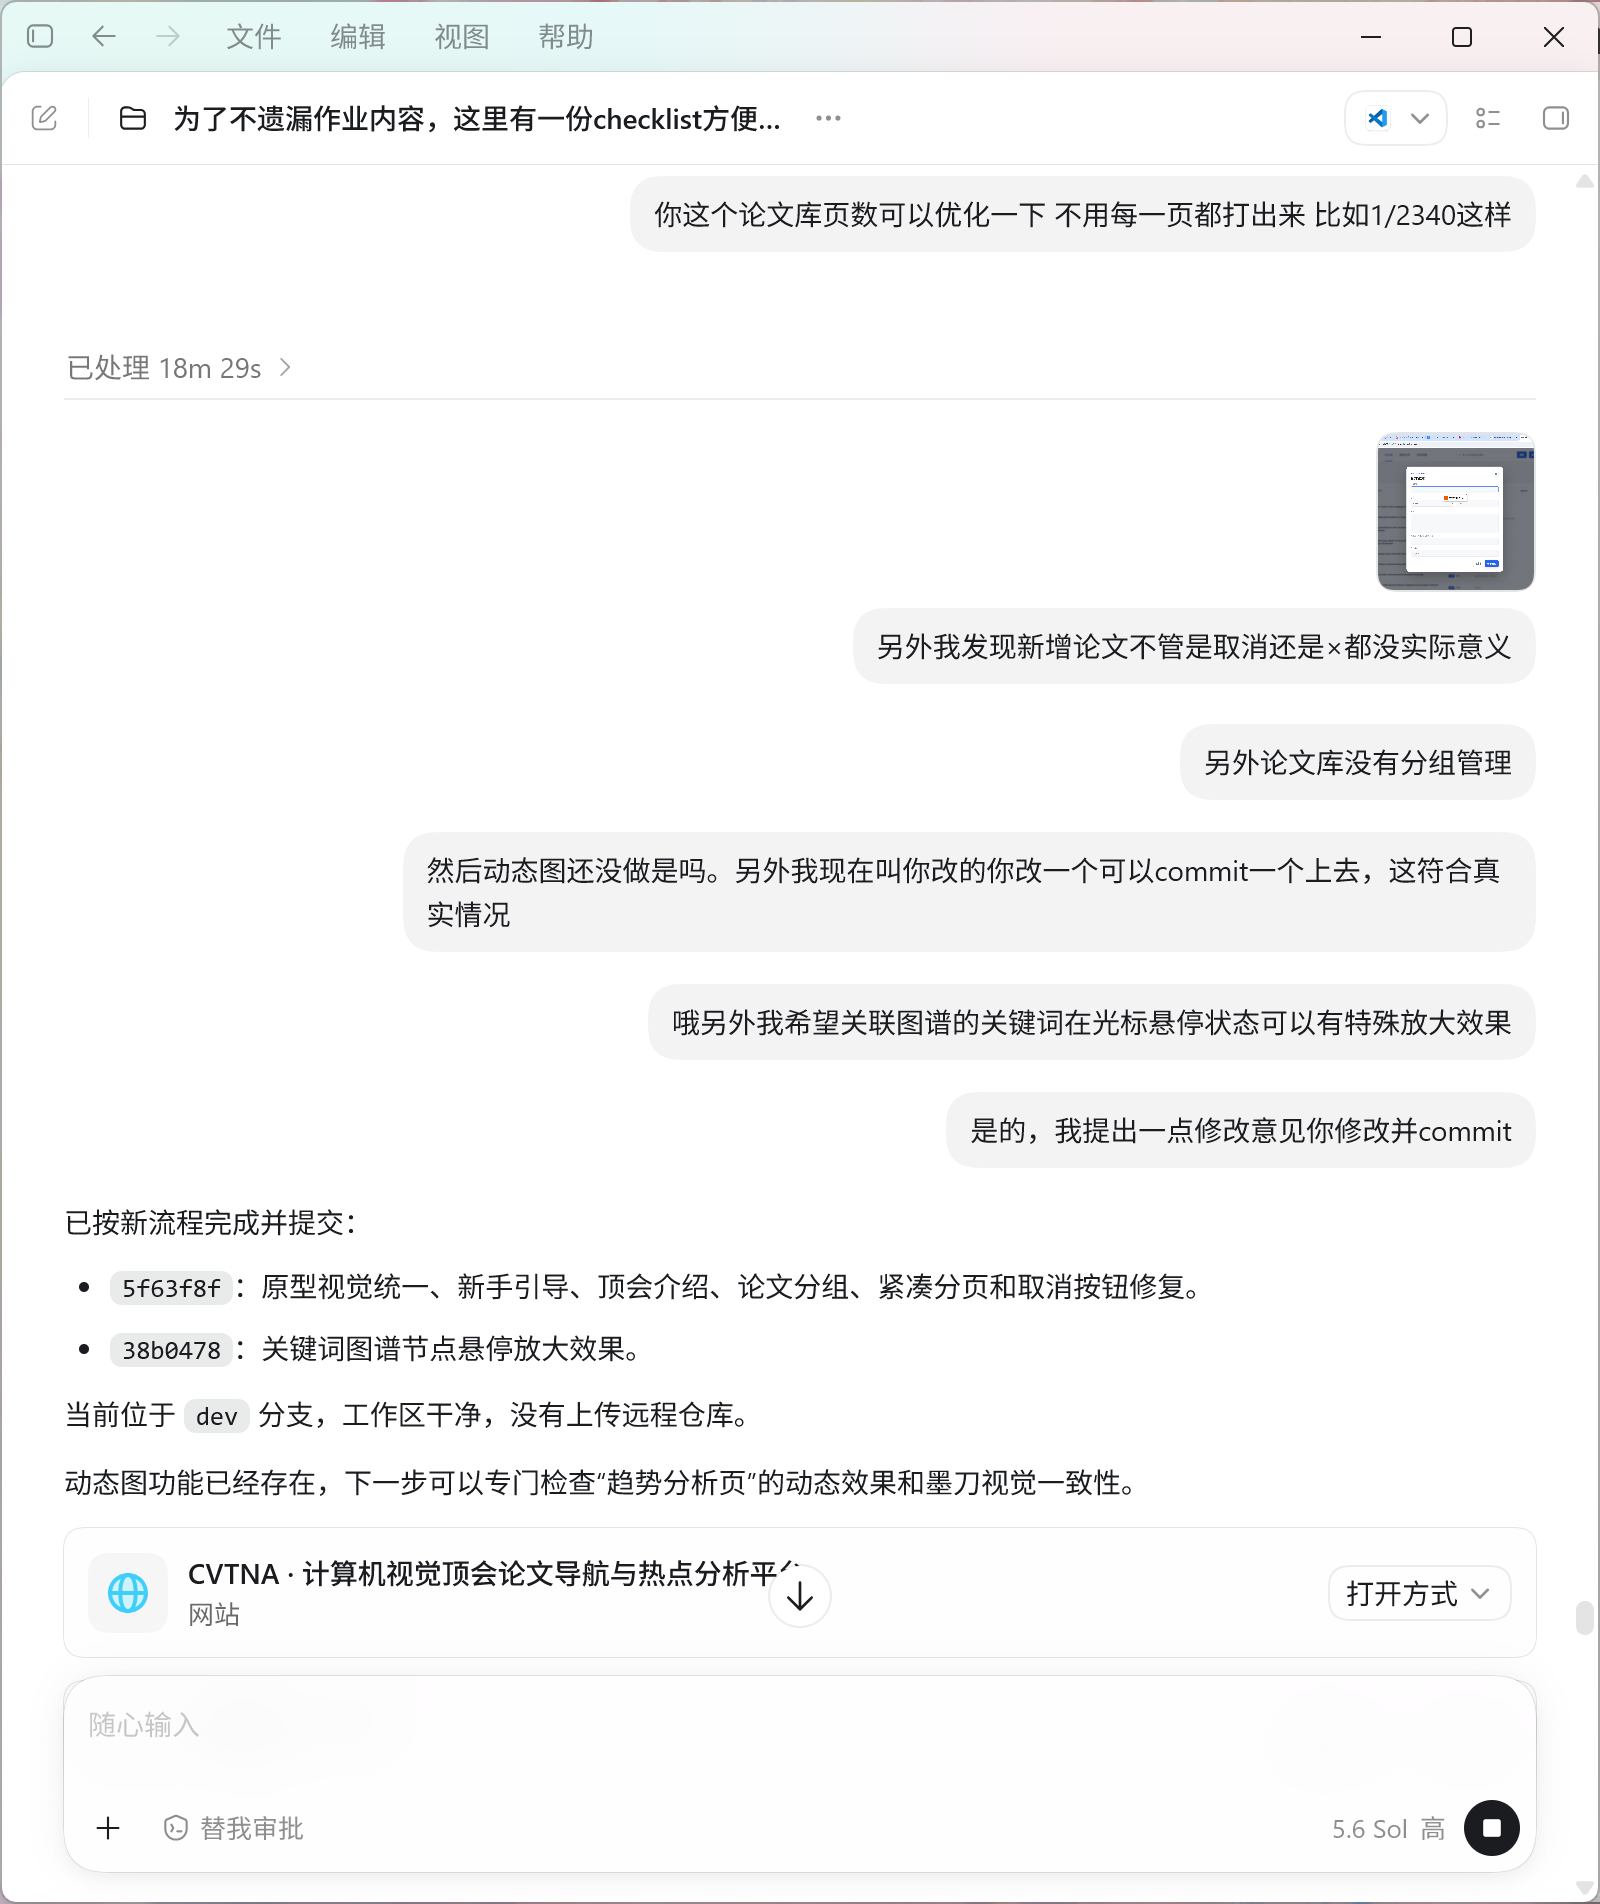
AI 修改了关闭逻辑、论文分组和紧凑分页,并加入关键词悬停放大;之后又增加自动化浏览器检查,确保“×”和“取消”均可关闭弹窗而不触发 required 表单校验。这个过程说明 AI 代码必须由人实际点击验证,测试也需要覆盖用户真正遇到的问题。
以下选择约 300 行关键逻辑进行说明;完整代码见仓库。代码按照“采集—纯数据处理—持久化与联网补全”分层。
scripts/collect-real-papers.py 对网络请求设置重试,分别解析 CVF 与 ECVA 官方目录。extract_keywords 使用公开、可检查的规则从标题提取方向标签;如果没有匹配则归入 Visual Representation。官方没有摘要时保存空字符串,不制造摘要。
def fetch(url: str) -> str:
    last_error = None
    for attempt in range(1, 4):
        try:
            request = Request(url, headers={
                "User-Agent": USER_AGENT,
                "Accept-Encoding": "identity",
                "Connection": "close",
            })
            with urlopen(request, timeout=120) as response:
                return response.read().decode("utf-8", errors="replace")
        except (IncompleteRead, TimeoutError, OSError) as error:
            last_error = error
            print(f"  retry {attempt}/3 after incomplete response")
            time.sleep(2 * attempt)
    raise RuntimeError(f"Unable to fetch {url}: {last_error}")

TOPIC_RULES = [
    ("Autonomous Driving", r"autonomous|self.driving|driving scene|vehicle trajectory"),
    ("Video Understanding", r"video|temporal action|motion|egocentric"),
    ("Image Segmentation", r"segment|segmentation|mask|matting"),
    ("Object Detection", r"detect|detection|localization|open.world object"),
    ("Vision-Language", r"vision.language|visual language|language.image|caption|grounding|text.image"),
    ("Multimodal Learning", r"multimodal|multi.modal|cross.modal|vision and language"),
    ("Diffusion Model", r"diffusion|score.based|denoising diffusion"),
    ("Generative AI", r"generative|generation|synthesis|gan|image editing|inpainting"),
    ("3D Vision", r"\b3d\b|three dimensional|neural radiance|nerf|stereo|depth|point cloud|view synthesis|gaussian splatting"),
    ("Foundation Model", r"foundation model|large language|llm|pretrain|pre.training|vision transformer|transformer"),
    ("Self-Supervised Learning", r"self.supervised|unsupervised|masked autoencoder|contrastive learning"),
    ("Image Classification", r"classif|recognition|visual categor"),
    ("Object Tracking", r"tracking|tracker"),
    ("Prompt Learning", r"prompt|few.shot|zero.shot|open.vocabulary"),
]

def extract_keywords(title: str) -> list[str]:
    lowered = title.lower()
    keywords = [label for label, pattern in TOPIC_RULES if re.search(pattern, lowered)]
    if not keywords:
        keywords.append("Visual Representation")
    return keywords[:5]

def collect_cvf(conference: str, years: list[int]) -> list[dict]:
    papers = []
    base = "https://openaccess.thecvf.com"
    for year in years:
        url = f"{base}/{conference}{year}?day=all"
        parser = CVFTitleParser()
        parser.feed(fetch(url))
        seen = set()
        for index, (title, href) in enumerate(parser.rows, start=1):
            if title in seen:
                continue
            seen.add(title)
            papers.append({
                "id": f"REAL-{conference}-{year}-{index:04d}",
                "title": title,
                "conference": conference,
                "year": year,
                "keywords": extract_keywords(title),
                "abstract": "",
                "url": urljoin(base, href),
                "source": "CVF Open Access",
            })
        time.sleep(0.6)
    return papers

def collect_eccv(years: list[int]) -> list[dict]:
    url = "https://www.ecva.net/papers.php"
    parser = ECCVTitleParser()
    parser.feed(fetch(url))
    papers = []
    seen = set()
    for title, href in parser.rows:
        match = re.search(r"eccv_(20(?:22|24))", href, re.I)
        if not match:
            continue
        year = int(match.group(1))
        if year not in years or title in seen:
            continue
        seen.add(title)
        papers.append({
            "id": f"REAL-ECCV-{year}-{len(seen):04d}",
            "title": title,
            "conference": "ECCV",
            "year": year,
            "keywords": extract_keywords(title),
            "abstract": "",
            "url": urljoin("https://www.ecva.net/", href),
            "source": "ECCV official proceedings",
        })
    return papers
core.js 不操作 DOM,便于用 Node 直接测试。检索按字段设置不同权重;趋势使用关键词论文数除以会议当年论文总数,未举办年份返回 null。
function normalizeKeywords(value) {
const input = Array.isArray(value) ? value : String(value || '').split(/[;,,;|]/);
return [...new Set(input.map(item => String(item).trim()).filter(Boolean))];
}
function sanitizePaper(paper, fallbackId) {
return {
id: String(paper.id || fallbackId || '').trim(),
title: String(paper.title || '').trim(),
conference: String(paper.conference || 'CVPR').trim().toUpperCase(),
year: Number.parseInt(paper.year, 10) || new Date().getFullYear(),
keywords: normalizeKeywords(paper.keywords),
abstract: String(paper.abstract || '').trim(),
url: String(paper.url || '').trim(),
source: String(paper.source || '').trim(),
group: String(paper.group || '').trim()
};
}
function searchPapers(papers, query, conference, year) {
const needle = String(query || '').trim().toLocaleLowerCase();
const matches = papers.filter(paper =>
(!needle || paperRelevance(paper, needle) > 0) &&
(!conference || paper.conference === conference) &&
(!year || paper.year === Number(year))
);
if (!needle) return matches;
return matches.sort((a, b) =>
paperRelevance(b, needle) - paperRelevance(a, needle) ||
b.year - a.year || a.title.localeCompare(b.title)
);
}
function paperRelevance(paper, query) {
const needle = String(query || '').trim().toLocaleLowerCase();
if (!needle) return 0;
const title = String(paper.title || '').toLocaleLowerCase();
const id = String(paper.id || '').toLocaleLowerCase();
const abstract = String(paper.abstract || '').toLocaleLowerCase();
const keywords = normalizeKeywords(paper.keywords).map(keyword => keyword.toLocaleLowerCase());
if (id === needle) return 1100;
if (title === needle) return 1000;
if (title.startsWith(needle)) return 850;
if (title.includes(needle)) return 700;
if (keywords.includes(needle)) return 600;
if (keywords.some(keyword => keyword.startsWith(needle))) return 550;
if (keywords.some(keyword => keyword.includes(needle))) return 500;
if (id.includes(needle)) return 350;
if (abstract.includes(needle)) return 200;
return 0;
}
function keywordCounts(papers, options) {
const settings = options || {};
const counts = new Map();
papers.forEach(paper => {
if (settings.year && paper.year !== Number(settings.year)) return;
if (settings.conference && paper.conference !== settings.conference) return;
normalizeKeywords(paper.keywords).forEach(keyword =>
counts.set(keyword, (counts.get(keyword) || 0) + 1)
);
});
return [...counts.entries()]
.map(([keyword, count]) => ({ keyword, count }))
.sort((a, b) => b.count - a.count || a.keyword.localeCompare(b.keyword));
}
function trendShareSeries(papers, keyword, years, conferences) {
const selectedYears = years || [...new Set(papers.map(p => p.year))].sort();
const selectedConferences = conferences || VALID_CONFERENCES;
return selectedConferences.map(conference => ({
conference,
values: selectedYears.map(year => {
const conferencePapers = papers.filter(p =>
p.year === year && p.conference === conference
);
if (!conferencePapers.length) return null;
const matches = conferencePapers.filter(p =>
normalizeKeywords(p.keywords).includes(keyword)
).length;
return Number((matches / conferencePapers.length * 100).toFixed(2));
})
}));
}
function parseBatch(text, defaults) {
const fallback = defaults || {};
return String(text || '').split(/\r?\n/)
.map(line => line.trim()).filter(Boolean).map(line => {
const cells = line.split(',').map(cell => cell.trim());
const title = cells.shift() || '';
let conference = String(cells[0] || fallback.conference || 'CVPR').toUpperCase();
if (!VALID_CONFERENCES.includes(conference)) {
conference = fallback.conference || 'CVPR';
} else cells.shift();
let year = Number.parseInt(cells[0], 10);
if (Number.isFinite(year)) cells.shift();
else year = Number(fallback.year) || new Date().getFullYear();
return sanitizePaper({ title, conference, year, keywords: cells.join(',') });
}).filter(paper => paper.title);
}
function escapeHtml(value) {
return String(value == null ? '' : value).replace(/[&<>'"]/g, char => ({
'&': '&', '<': '<', '>': '>', "'": ''', '"': '"'
}[char]));
}
论文数据量较大,不适合全部写入 localStorage。应用使用 IndexedDB,并把用户名加入 key,使不同本地账号互不覆盖;读取失败时只警告,不让主要页面崩溃。
function openPaperStore() {
  return new Promise((resolve, reject) => {
    if (!window.indexedDB) {
      reject(new Error('IndexedDB unavailable'));
      return;
    }
    let request;
    try {
      request = indexedDB.open('cvtna-local-data', 1);
    } catch (error) {
      reject(error);
      return;
    }
    request.onupgradeneeded = () => request.result.createObjectStore('papers');
    request.onsuccess = () => resolve(request.result);
    request.onerror = () => reject(request.error || new Error('IndexedDB open failed'));
  });
}

async function savePaperStore(papers) {
  try {
    const db = await openPaperStore();
    await new Promise((resolve, reject) => {
      const transaction = db.transaction('papers', 'readwrite');
      transaction.objectStore('papers').put(papers, paperStoreKey());
      transaction.oncomplete = resolve;
      transaction.onerror = () => reject(transaction.error);
    });
    db.close();
  } catch (error) {
    console.warn('Local paper persistence unavailable:', error);
  }
}

async function hydratePapers() {
  try {
    const db = await openPaperStore();
    const saved = await new Promise((resolve, reject) => {
      const request = db.transaction('papers', 'readonly')
        .objectStore('papers').get(paperStoreKey());
      request.onsuccess = () => resolve(request.result);
      request.onerror = () => reject(request.error);
    });
    db.close();
    if (Array.isArray(saved) && saved.length) {
      state.papers = saved.map(p => Core.sanitizePaper(p));
      route();
    }
  } catch (error) {
    console.warn('Local paper hydration unavailable:', error);
  }
}
每次 API 请求使用 AbortController 设置 6 秒超时。批量导入最多联网补全前 10 篇,避免无节制调用接口;一旦网络失败,后续记录退回本地解析。界面不会把失败写成成功。
async function querySemanticScholar(title, conference = 'CVPR', year = new Date().getFullYear()) {
  const controller = new AbortController();
  const timeout = setTimeout(() => controller.abort(), 6000);
  try {
    const endpoint = `https://api.semanticscholar.org/graph/v1/paper/search?query=${encodeURIComponent(title)}&limit=1&fields=title,abstract,url,year,fieldsOfStudy`;
    const response = await fetch(endpoint, { signal: controller.signal });
    if (!response.ok) throw new Error(`HTTP ${response.status}`);
    const data = await response.json();
    const hit = data.data?.[0];
    if (!hit) throw new Error('未找到匹配结果');
    return Core.sanitizePaper({
      title: hit.title || title,
      conference,
      year: hit.year || year,
      abstract: hit.abstract || '',
      url: hit.url || '',
      keywords: hit.fieldsOfStudy || [],
      source: 'Semantic Scholar API'
    });
  } finally {
    clearTimeout(timeout);
  }
}

async function importBatch() {
  if (!requireLogin()) return;
  const input = $('#batch-input');
  const parsed = Core.parseBatch(input.value, {
    conference: 'CVPR',
    year: new Date().getFullYear()
  });
  if (!parsed.length) {
    toast('没有识别到有效标题', 'error');
    return;
  }
  const button = $('#batch-import');
  const status = $('#batch-status');
  const shouldEnrich = $('#batch-enrich').checked;
  button.disabled = true;
  status.hidden = false;
  let added = 0;
  let skipped = 0;
  let enriched = 0;
  let networkAvailable = shouldEnrich;
  try {
    for (let index = 0; index < parsed.length; index++) {
      let item = parsed[index];
      if (state.papers.some(p => p.title.toLowerCase() === item.title.toLowerCase())) {
        skipped++;
        continue;
      }
      status.textContent = `正在处理 ${index + 1} / ${parsed.length}:${item.title}`;
      if (networkAvailable && enriched < 10) {
        try {
          const remote = await querySemanticScholar(item.title, item.conference, item.year);
          item = Core.sanitizePaper({
            ...item,
            title: remote.title,
            year: remote.year,
            abstract: remote.abstract,
            url: remote.url,
            keywords: remote.keywords.length ? remote.keywords : item.keywords,
            source: remote.source
          });
          enriched++;
        } catch {
          networkAvailable = false;
        }
      }
      item.id = Core.nextId(state.papers);
      state.papers.push(item);
      added++;
    }
    persist();
    addLog(
      `批量导入 ${added} 篇,联网补全 ${enriched} 篇,跳过 ${skipped} 篇重复项`,
      enriched ? 'Semantic Scholar + 本地解析' : '本地解析'
    );
    input.value = '';
    status.textContent = `完成:导入 ${added} 篇,联网补全 ${enriched} 篇,跳过 ${skipped} 篇。`;
    toast(`成功导入 ${added} 篇论文`);
  } finally {
    button.disabled = false;
  }
}
Node 测试共 13 项,全部通过,覆盖关键词规范化、检索和相关度、Top 统计、趋势占比、批量解析、编号、HTML 转义、分组清洗以及真实数据的数量、会议和来源完整性。浏览器自动化覆盖新手引导、登录、关键词抽屉、动画、论文预览、右键菜单、联网补全、弹窗关闭和主要页面,捕获浏览器错误 0 条。
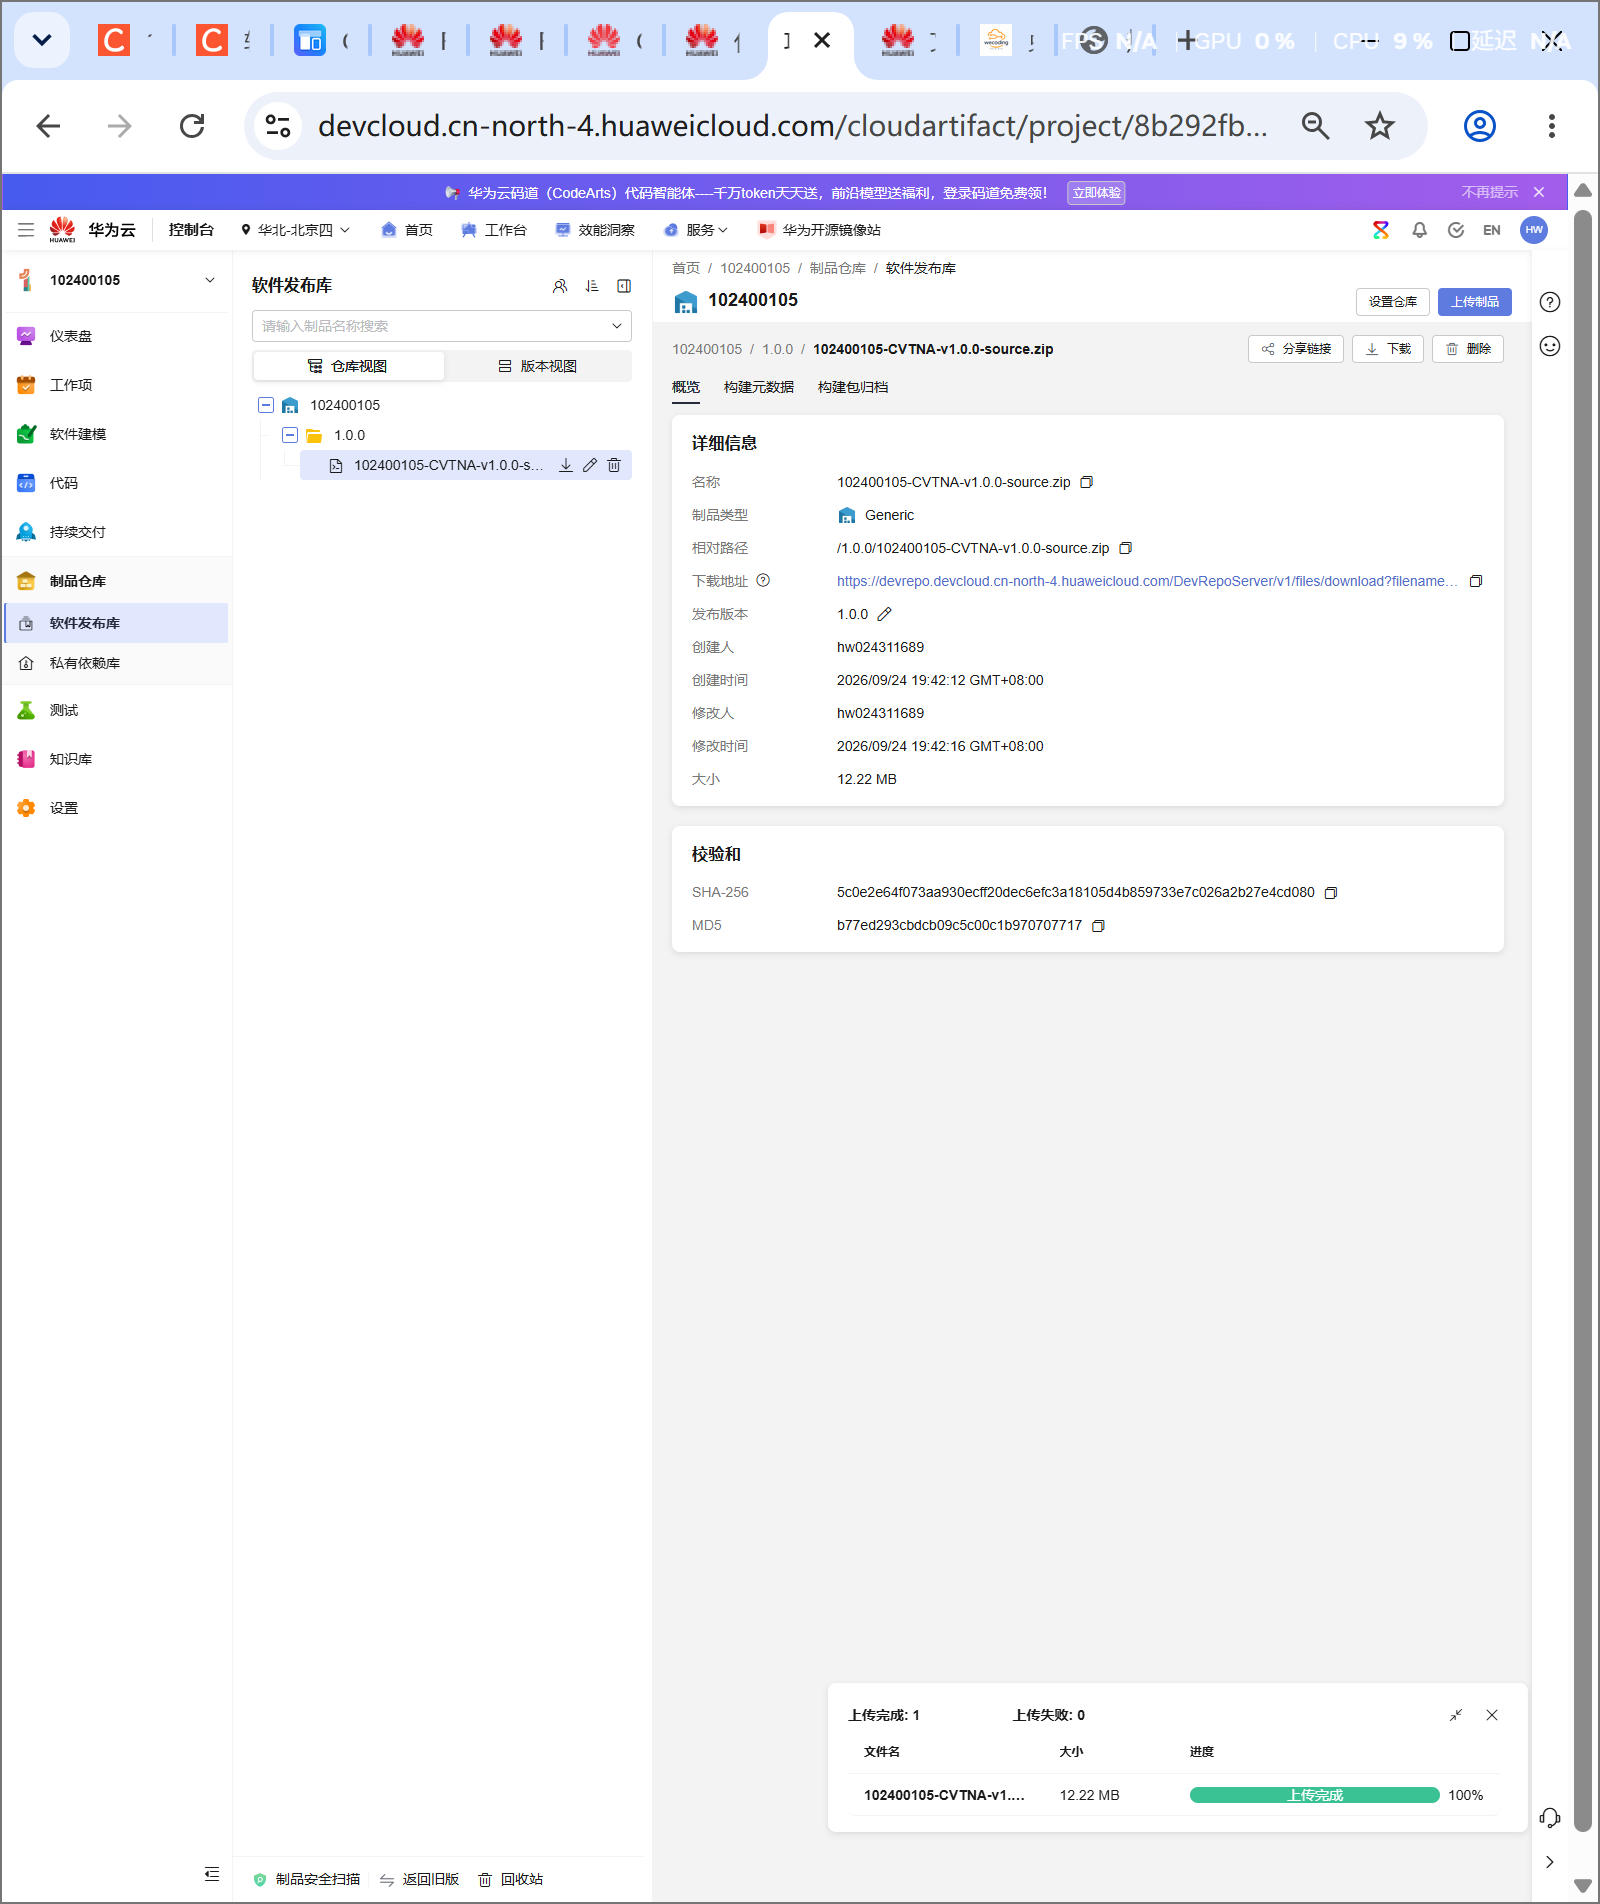
dev 分支进行开发,完成后合并到 main;main 当前包含 42 次真实提交;v1.0.0 Git 标签;102400105-CVTNA-v1.0.0-source.zip,发布版本为 1.0.0。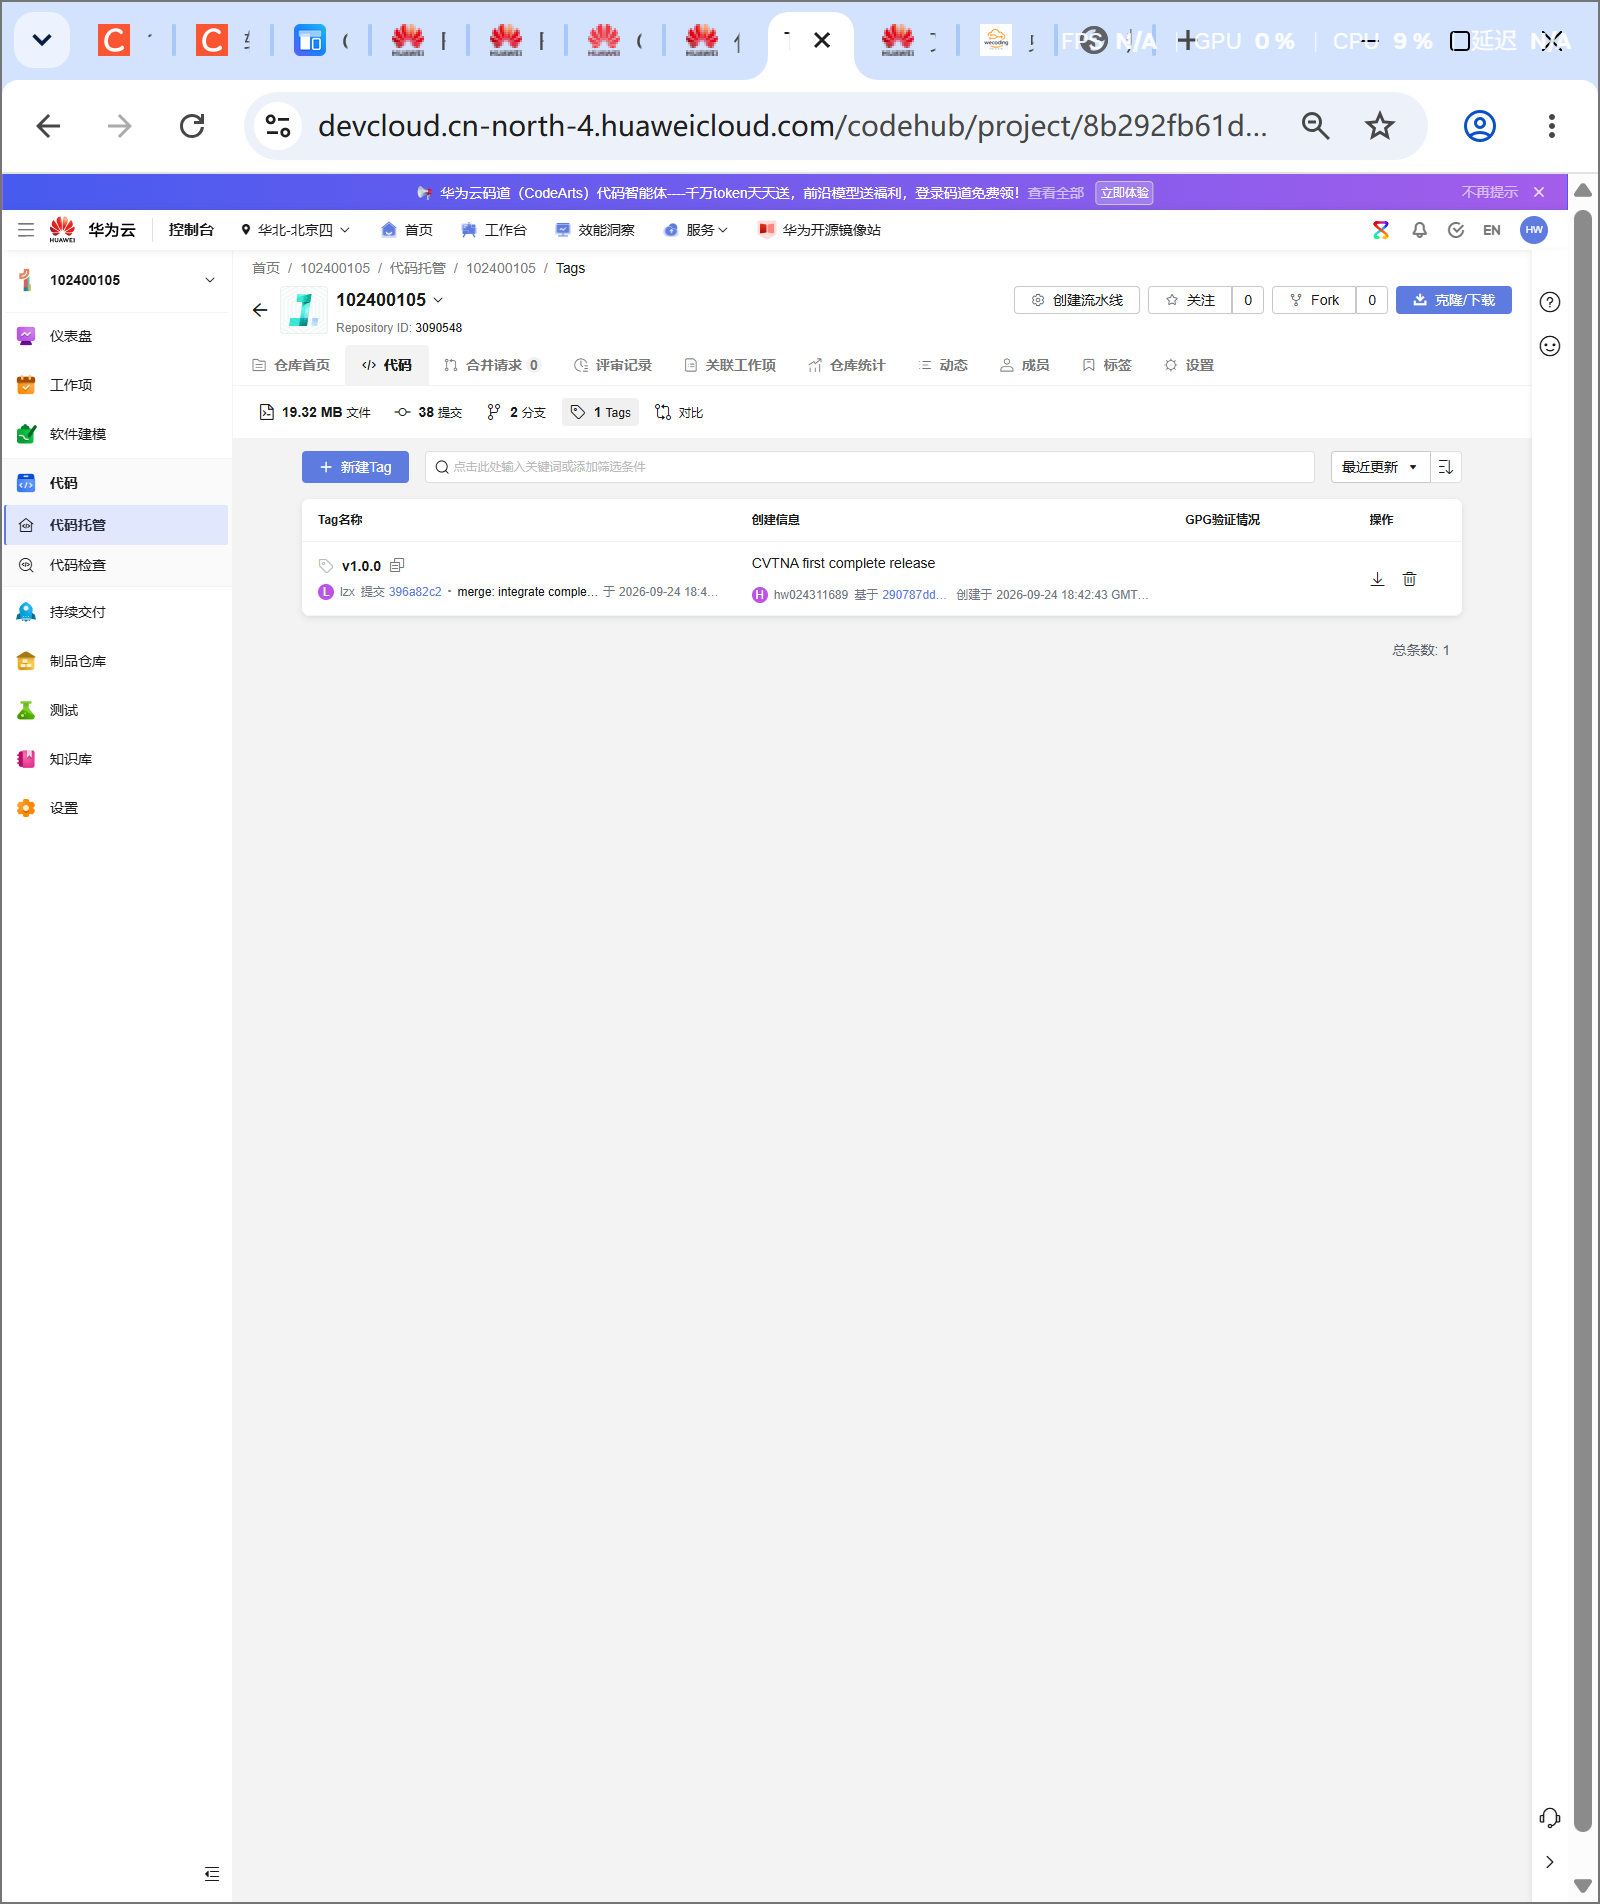
服务器为华为云 Flexus 应用服务器 L,Ubuntu 24.04,Nginx 1.24.0,网站目录为 /var/www/cvtna。安全组对公网开放 TCP 80;部署时使用的 SSH 22 端口在完成后关闭。公网首页和 data/real-papers.js 均返回 HTTP 200,其中真实数据文件响应长度为 6,857,871 字节。
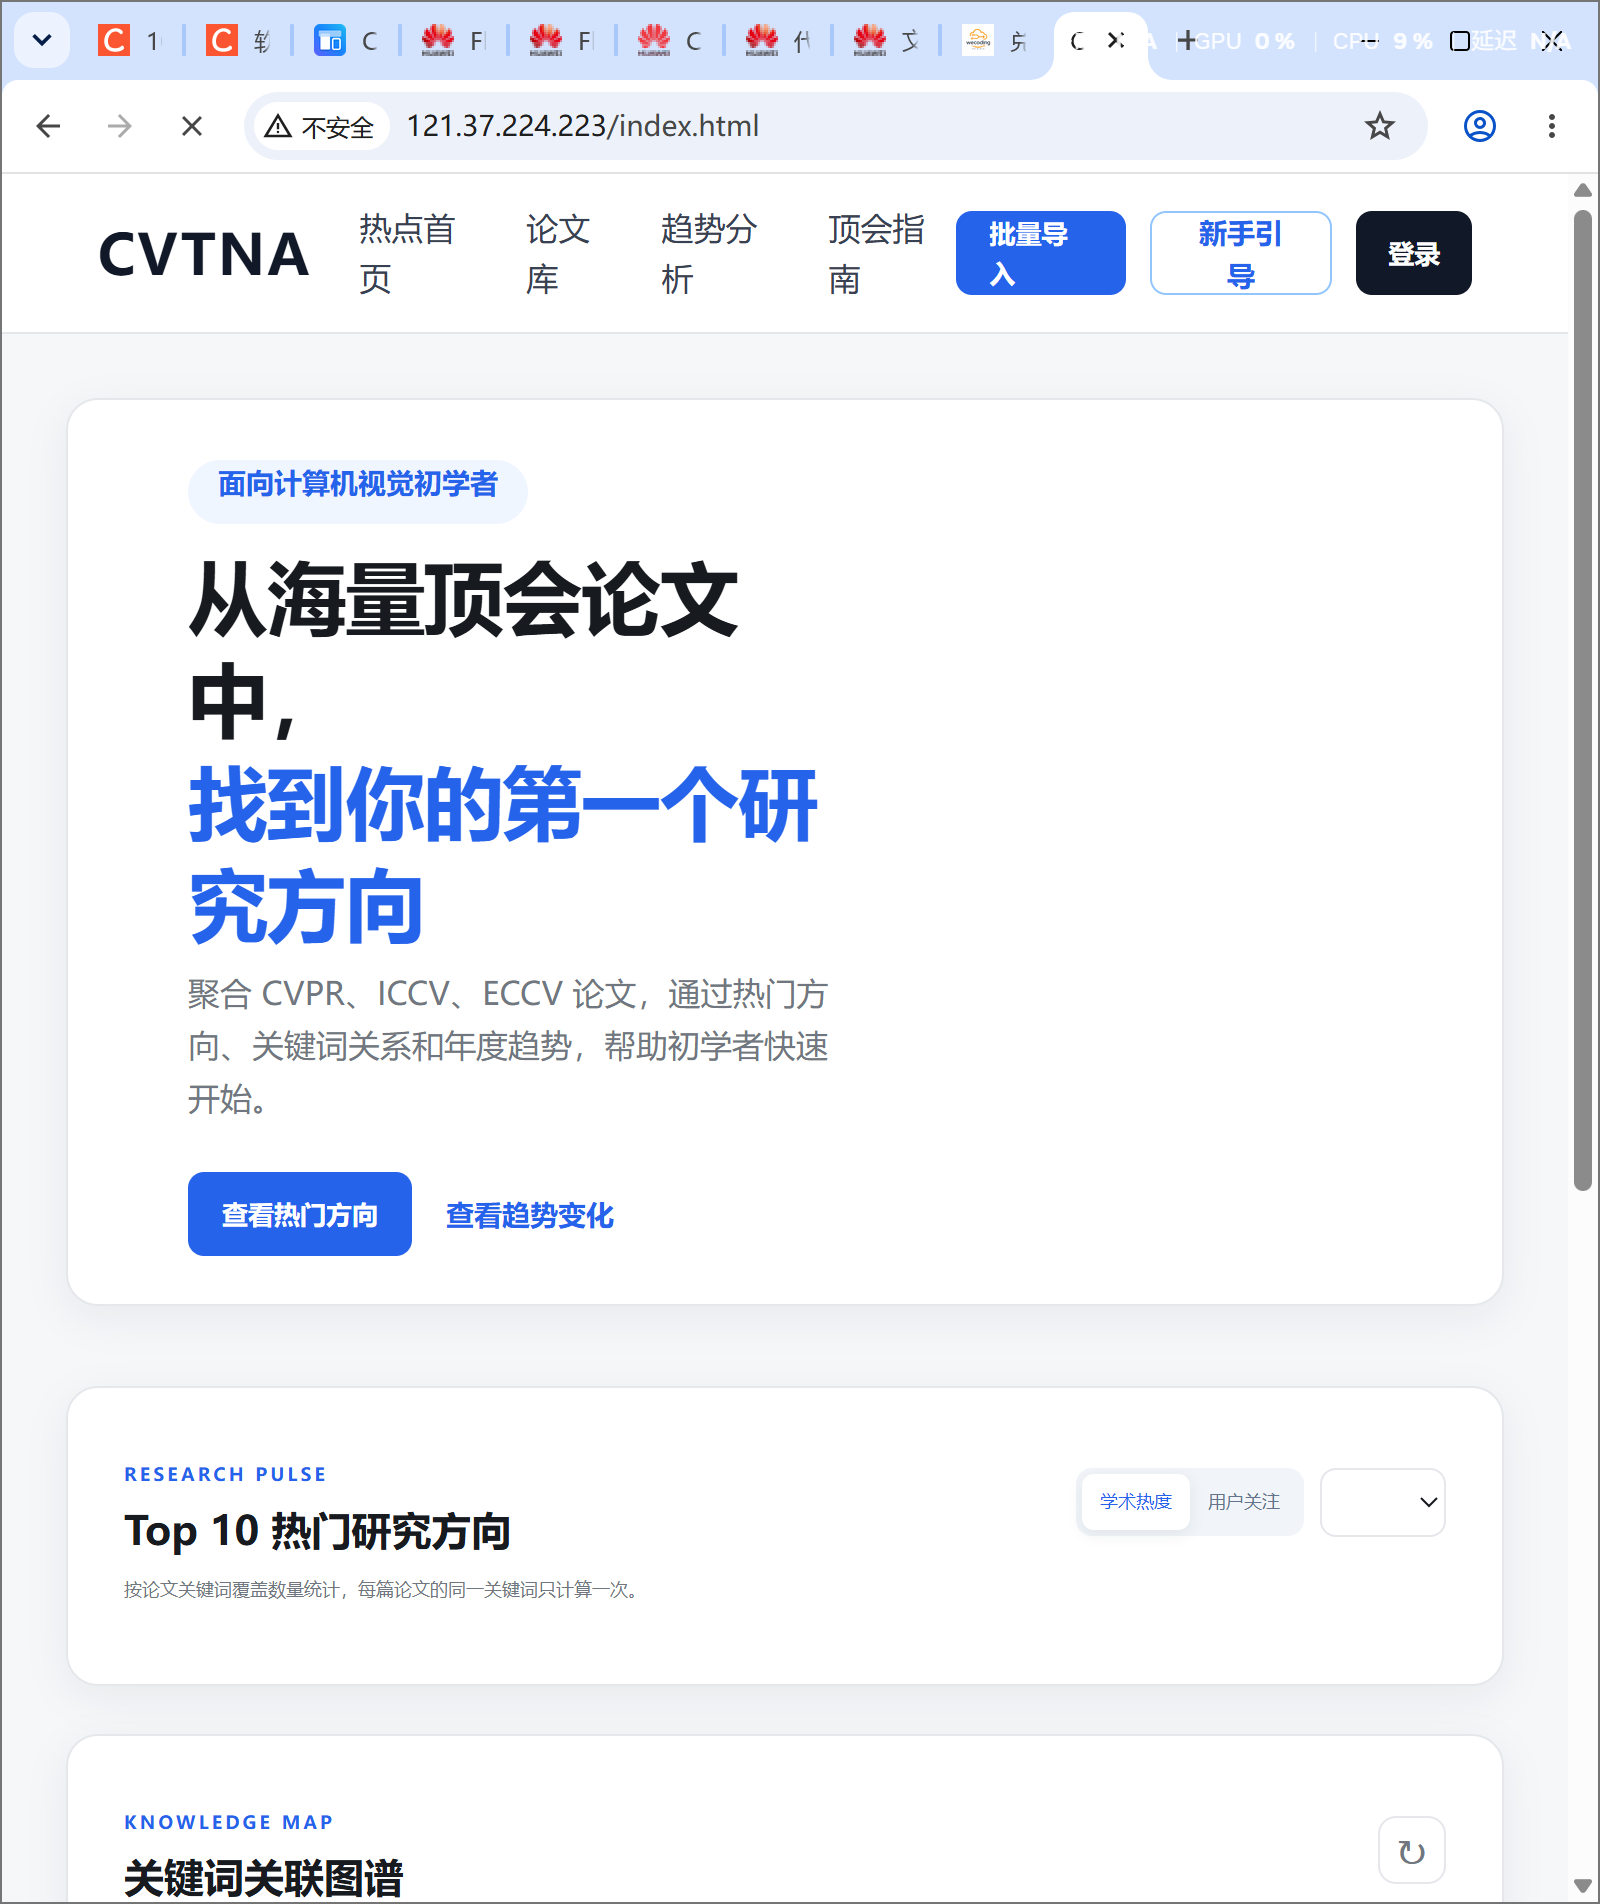
访问地址:http://121.37.224.223/。当前未配置域名证书,因此浏览器显示 HTTP“不安全”是预期现象,不影响课程访问。
这次作业最初让我压力很大。我只学过 C、C++、Java、少量 HTML 和数据库,对 Flask、ECharts、墨刀和服务器部署都不熟悉。一开始我也容易把目标理解为“让 AI 帮我把平台做出来”,后来重新阅读要求才意识到,真正被考察的是人如何参与判断、检查和修正,而不只是最后有没有一个网页。
原型阶段让我感受最深。AI 能快速列出页面和功能,但它不知道我平时为什么觉得 Notability 的分组好用,也不会自动发现页面左右留白、按钮位置和搜索入口是否符合我的使用习惯。我一次次提出“这里太挤”“这个入口重复”“用户在其他页面也要搜索”“取消按钮没有意义”,最终产品才逐渐从功能清单变成可以连续使用的流程。
编码阶段我学到,真实数据和“看起来像真的”完全不同。我多次追问数据是不是爬来的、动画是不是实时根据选择变化,也拒绝把模拟点击写成点击率。最后平台把官方离线目录、规则化关键词和用户主动联网补全分开说明,这比做一个数字更漂亮但无法解释的图表更重要。
部署阶段则让我第一次完整接触安全组、SSH、Nginx、网站目录和公网验证。看到自己的页面通过公网 IP 打开时,我才真正理解“本地能运行”与“交付给别人访问”之间还有一条完整链路。
如果再做一次,我会从第一天就计时,先冻结信息架构和数据口径,再开始高保真原型;我也会更早编写测试,而不是等功能很多以后再补。AI 可以显著提高速度,但越快越需要人明确验收标准。
与传统人人结对相比,AI 的优势是随时可用、响应快、能同时辅助需求、代码、测试和文档,也不会因为我反复询问基础问题而失去耐心。它很适合生成初稿、解释陌生概念、把分散反馈整理成结构,并帮助我快速尝试不同方案。
局限也很明显。AI 会在上下文不完整时过早进入编码,会给出尺寸或操作步骤却不一定完全适配当前软件界面,也可能把“动图”“实时数据”“点击率”等词按最省事的方式理解。它生成的测试本身也可能写错,联网能力和界面控制能力有限,并且不会替我承担提交结果的责任。数据来源、安全端口、代码是否能运行、按钮是否真的有效,都必须由人验证。
因此,我把这次协作理解为:AI 是速度很快、知识面很广但需要持续审查的结对伙伴;人负责目标、价值判断、真实性和最终责任。高质量人机协作不是“一句话生成作业”,而是提出要求、检查结果、发现问题、修改 Prompt、运行验证并留下真实过程证据。


