


88
社区成员
 发帖
 与我相关
 我的任务

 分享
| 这个作业属于哪个课程 | 福州大学2026年01学期-软件工程实践 |
|---|---|
| 这个作业要求在哪里 | 软件工程实践第二次作业——与 AI 结对编程(顶会热词统计) |
| 这个作业的目标 | 与 AI 结对完成需求分析、专用工具原型设计、Web 编程实现、测试和部署;实现顶会论文获取、管理、热点分析与可视化;记录人工审查、修改和验证 AI 输出的过程 |
| 学号 / 姓名 | 102400402/关欣 |
| 其他参考文献 | 《构建之法》第 3、4、8 章;Vue、Express、ECharts 官方文档;CVF、ECVA、DBLP 公开资源 |
本项目名为 Vision Insight,面向希望了解计算机视觉研究方向的学生和论文阅读者。平台聚合 CVPR、ICCV、ECCV 的论文信息,将论文获取、列表维护、热门方向统计、关键词共现图谱和多年趋势放在同一个 Web 应用中。
用户可以先从 Top 10 了解方向,再点击关键词查看相关论文,进入详情页阅读摘要,最后通过原文链接继续阅读;已有论文标题的用户则可以直接检索或批量导入。
| 工具 | 版本 / 模型 | 使用阶段与用途 |
|---|---|---|
| 墨刀 AI | / | 原型布局、配色、文案和交互讨论 |
| OpenCode | DeepSeek V4.1 Flash | 需求讨论、代码初稿、调试修改 |
| OpenCode | GPT-6 Astra | 对照作业要求检查文档、源码、辅助初稿写作 |
项目在 codestyle.md 中整理了代码规范,主要参考 Vue 官方风格指南、Airbnb JavaScript Style Guide、Google HTML/CSS 和 JavaScript 规范。
项目采用 ES Module、Vue Composition API 和 <script setup>;前后端分别按组件、视图、接口、路由和业务服务组织;数据库用户输入使用参数绑定;提交信息使用 feat:、fix:、docs:、style: 等前缀。
PSP 用于比较任务的预估投入和实际投入。本项目按需求、原型、编码、审查、测试和报告拆分任务,并将“与 AI 讨论”归入实际发生的对应阶段,避免单独重复累加。
记录依据:事前计划记录、计时记录、开发日志和会话时间记录。
| PSP | Personal Software Process Stages / 工作内容 | 预估耗时(分钟) | 实际耗时(分钟) | 偏差(实际-预估) |
|---|---|---|---|---|
| Planning | 计划(分类项,不重复计时) | — | — | — |
| • Estimate | 阅读作业、拆分任务、记录事前预估 | 40 | 25 | −15 |
| Development | 开发(分类项,不重复计时) | — | — | — |
| • Analysis | 需求理解、数据源调研、技术和原型工具学习、AI 头脑风暴 | 120 | 60 | −60 |
| • Design Spec | NABCD、功能结构、接口和统计口径设计 | 90 | 60 | −30 |
| • Design Review | 人工复核 AI 需求建议、页面结构与交互 | 45 | 30 | −15 |
| • Coding Standard | 制定并检查代码规范 | 25 | 15 | −10 |
| • Design | 原型页面、布局配色、弹窗跳转、原型发布 | 90 | 45 | −45 |
| • Coding | 前后端、爬虫、数据处理、图表和部署配置实现 | 480 | 360 | −120 |
| • Code Review | 阅读 AI 生成代码、检查接口与统计逻辑 | 80 | 60 | −20 |
| • Test | 功能测试、前后端联调、Bug 修复、部署验证 | 120 | 80 | −40 |
| Reporting | 报告(分类项,不重复计时) | — | — | — |
| • Test Report | 整理验收记录、截图、GIF 和问题说明 | 80 | 60 | −20 |
| • Size Measurement | 统计有效提交、模块与交付成果 | 25 | 20 | −5 |
| • Postmortem & Process Improvement Plan | 撰写博客、分析偏差、个人总结与 AI 评价 | 160 | 135 | −25 |
| 合计 | 仅累加实际计时的子项 | 1355 | 950 | −405 |
AI 在需求梳理、原型初稿和代码编写上提速明显,实际比预估少了 405 分钟(约 −30%)。
虽然真实数据源拖慢了节奏:DBLP 反爬、CVF 早期年份需逐日合并、ECVA 链接清洗,但是AI的辅助确实在Coding和Test阶段带来了效率的提高。
小刚的困难并非无法打开论文网站,而是缺乏从大量论文中建立研究方向认识的方法。会议论文分散在不同年份、不同网站的列表中,单篇检索只能回答“这篇论文是什么”,很难直接回答“哪些方向更热门”“相关方向如何联系”“应该从哪些论文开始阅读”。
由点及面,我思考了四种不同类型的用户的问题与对应可能的需求,并由此规划了对应系统功能的设计:
| 角色 | 典型问题 | 候选需求 | 对应功能 |
|---|---|---|---|
| 计算机视觉初学者 | 不知道领域中有哪些方向,也不知道先读什么 | 首页展示热门方向,点击后看到论文和摘要 | Top 10、图谱、论文详情 |
| 选题学生 | 想判断一个方向近几年是否值得继续了解 | 按年份和会议查看论文数量变化 | 热度趋势、会议年份筛选 |
| 研究生 / 读书小组成员 | 手上已有标题清单,希望减少重复查找 | 批量补充元数据,维护论文列表 | 批量导入、增删改查 |
| 教师 / 助教 | 需要判断统计结果是否可信、功能是否完成 | 提供来源、统计口径、原文链接和操作记录 | 关于页、文档、演示与验收 |
因此,平台需要同时支持两条路径:
核心需求可拆成四类:
Vision Insight 以论文数据为基础串联「获取—整理—分析—阅读」:
数据获取:输入单个标题、批量标题或选择会议年份后先查本地、无结果再访问公开数据源,经标题规范化、元数据清洗与研究方向打标后写入 SQLite,再由 Top 10 榜单、共现图谱与多年趋势呈现,点击关键词即可到相关论文、论文详情与原文链接。
数据整理:批量按会议年份抓取 CVF Open Access 与 ECVA 论文集并补充摘要,单篇则并行查询 DBLP、Crossref、Semantic Scholar、OpenAlex 与 arXiv 后按来源优先级合并结果。
数据分析:关键词用领域词表加正则将标题与摘要映射到 13 类研究方向,热度以关联论文数量计且同篇同词只计一次,图谱则连接同一论文中共同出现的关键词
页面组织与交互:页面采用左侧导航加分页面布局,把总览、获取、管理、热门方向、趋势与详情分开,并用关键词和论文链接串联各页,减少用户手动切换负担。
技术上,以 Vue3 + Element Plus + ECharts 实现单页前端,Express + SQLite 作为数据与接口层,用多源爬虫按会议年份抓取并清洗论文、抽取关键词入库,再通过统计接口驱动 Top10、共现图谱与多年趋势可视化,形成"爬取—存储—分析—展示"的闭环。
| 替代方案 | 优势 | 劣势 | 本平台的对策设计 |
|---|---|---|---|
| CVF Open Access / ECVA 官方论文集 | 会议来源明确,论文页和原文易于核对 | 用户通常需要自行整理、分类与统计;并且官网前端不够人性化 | 在官方来源基础上增加统一管理、方向统计和可视化 |
| DBLP | 书目信息组织规范,适合标题、作者、会议检索 | 摘要和方向分析需结合其他来源处理 | 将书目匹配与摘要获取、领域标签连接起来 |
| Semantic Scholar 等学术检索服务 | 覆盖广、检索和论文关联能力丰富 | 用户需要进行定向会议检索时,无法获得准确信息和对应论文 | 为课程场景提供范围集中、计算方法可见的界面 |
| 表格或自写分析脚本 | 灵活,可自行控制字段和公式 | 数据整理与后处理需要手工维护,极大耗费用户精力 | 将常用步骤包装成可重复操作的 Web 流程 |
| 直接向通用 AI 询问热门方向 | 交互方便,适合入门解释和头脑风暴 | AI可能存在幻觉,并且调研时不全面 | 以实际入库论文支撑榜单,再由用户回到原文 |
| 询问师兄师姐/老师 | 能快速获取大量领域相关知识,简单易懂 | 带有较强主观性,并且需要更多时间精力成本 | 客观图表对照反映具体趋势,展现领域实际情况 |
差异化策略:
现阶段局限性: 数据覆盖和更新能力弱于成熟学术服务;关键词词表只有 13 类;部分论文摘要缺失;当前缺少完善的质量评估和后台采集任务管理。项目优势主要体现在课程需求的一体化实现,不等于检索质量优于大型平台。
本项目采用“开箱即用”的 Web 服务模式进行交付,用户无需配置本地环境,直接通过公网链接即可访问使用。
最终交付的完整产物包括:在线 Web 系统、CodeArts 源码仓库、原型网页、README 文档、代码规范、Release 发行版以及本篇博客。
在展示与触达方面,博客将结合系统截图与GIF,清晰演示从“浏览热门方向”、“批量导入文献”到“对比热度趋势”的完整系统操作路径,以此向读者与目标用户直观传递平台的核心价值。
在原型设计上,使用了原型设计工具墨刀进行初版原型设计。首先根据自己的设计逻辑,与 AI 进行交互并给出设计相关的建议,汇总为Prompt 之后输入到墨刀AI中生成初版原型。根据初版原型,再进一步进行手动设计微调,最终得到五个界面的原型。以下阐述设计逻辑与人机交互过程:
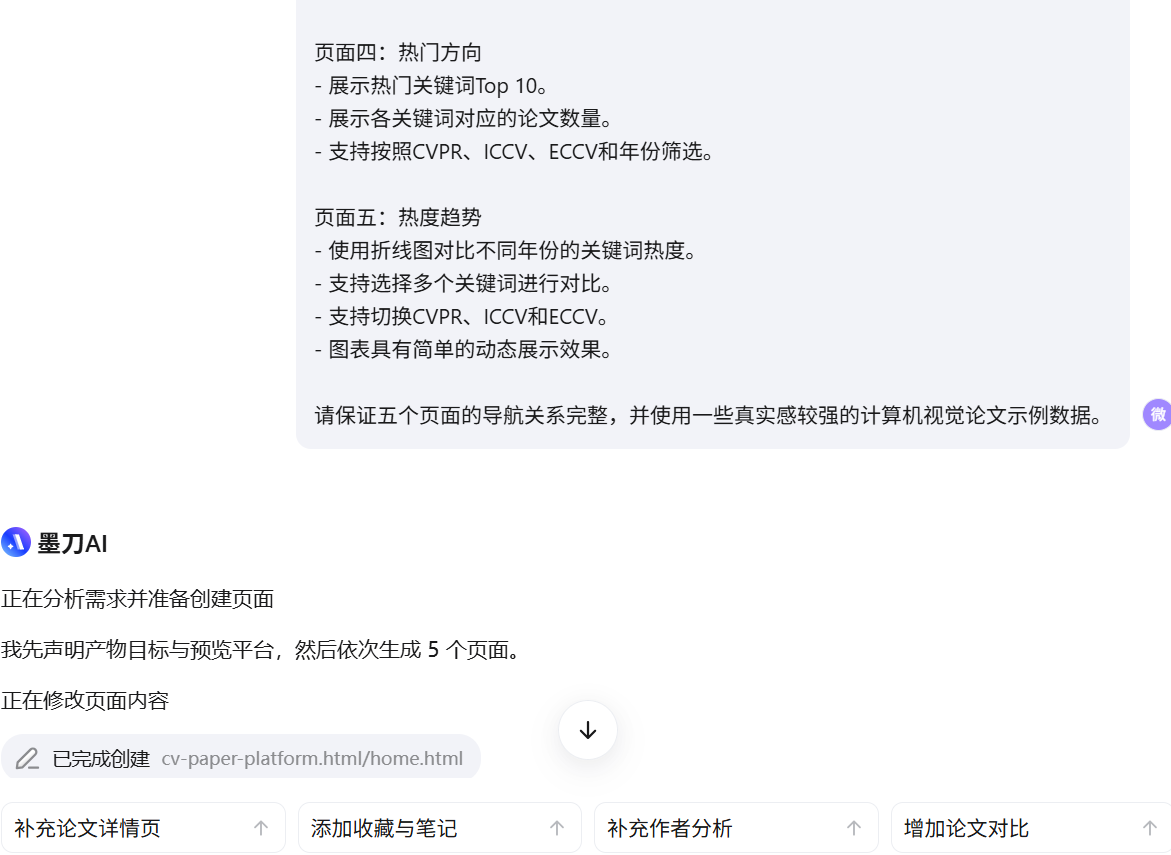
图 1|与墨刀 AI 进行初版原型交互。
生成的五页原型截图如下:
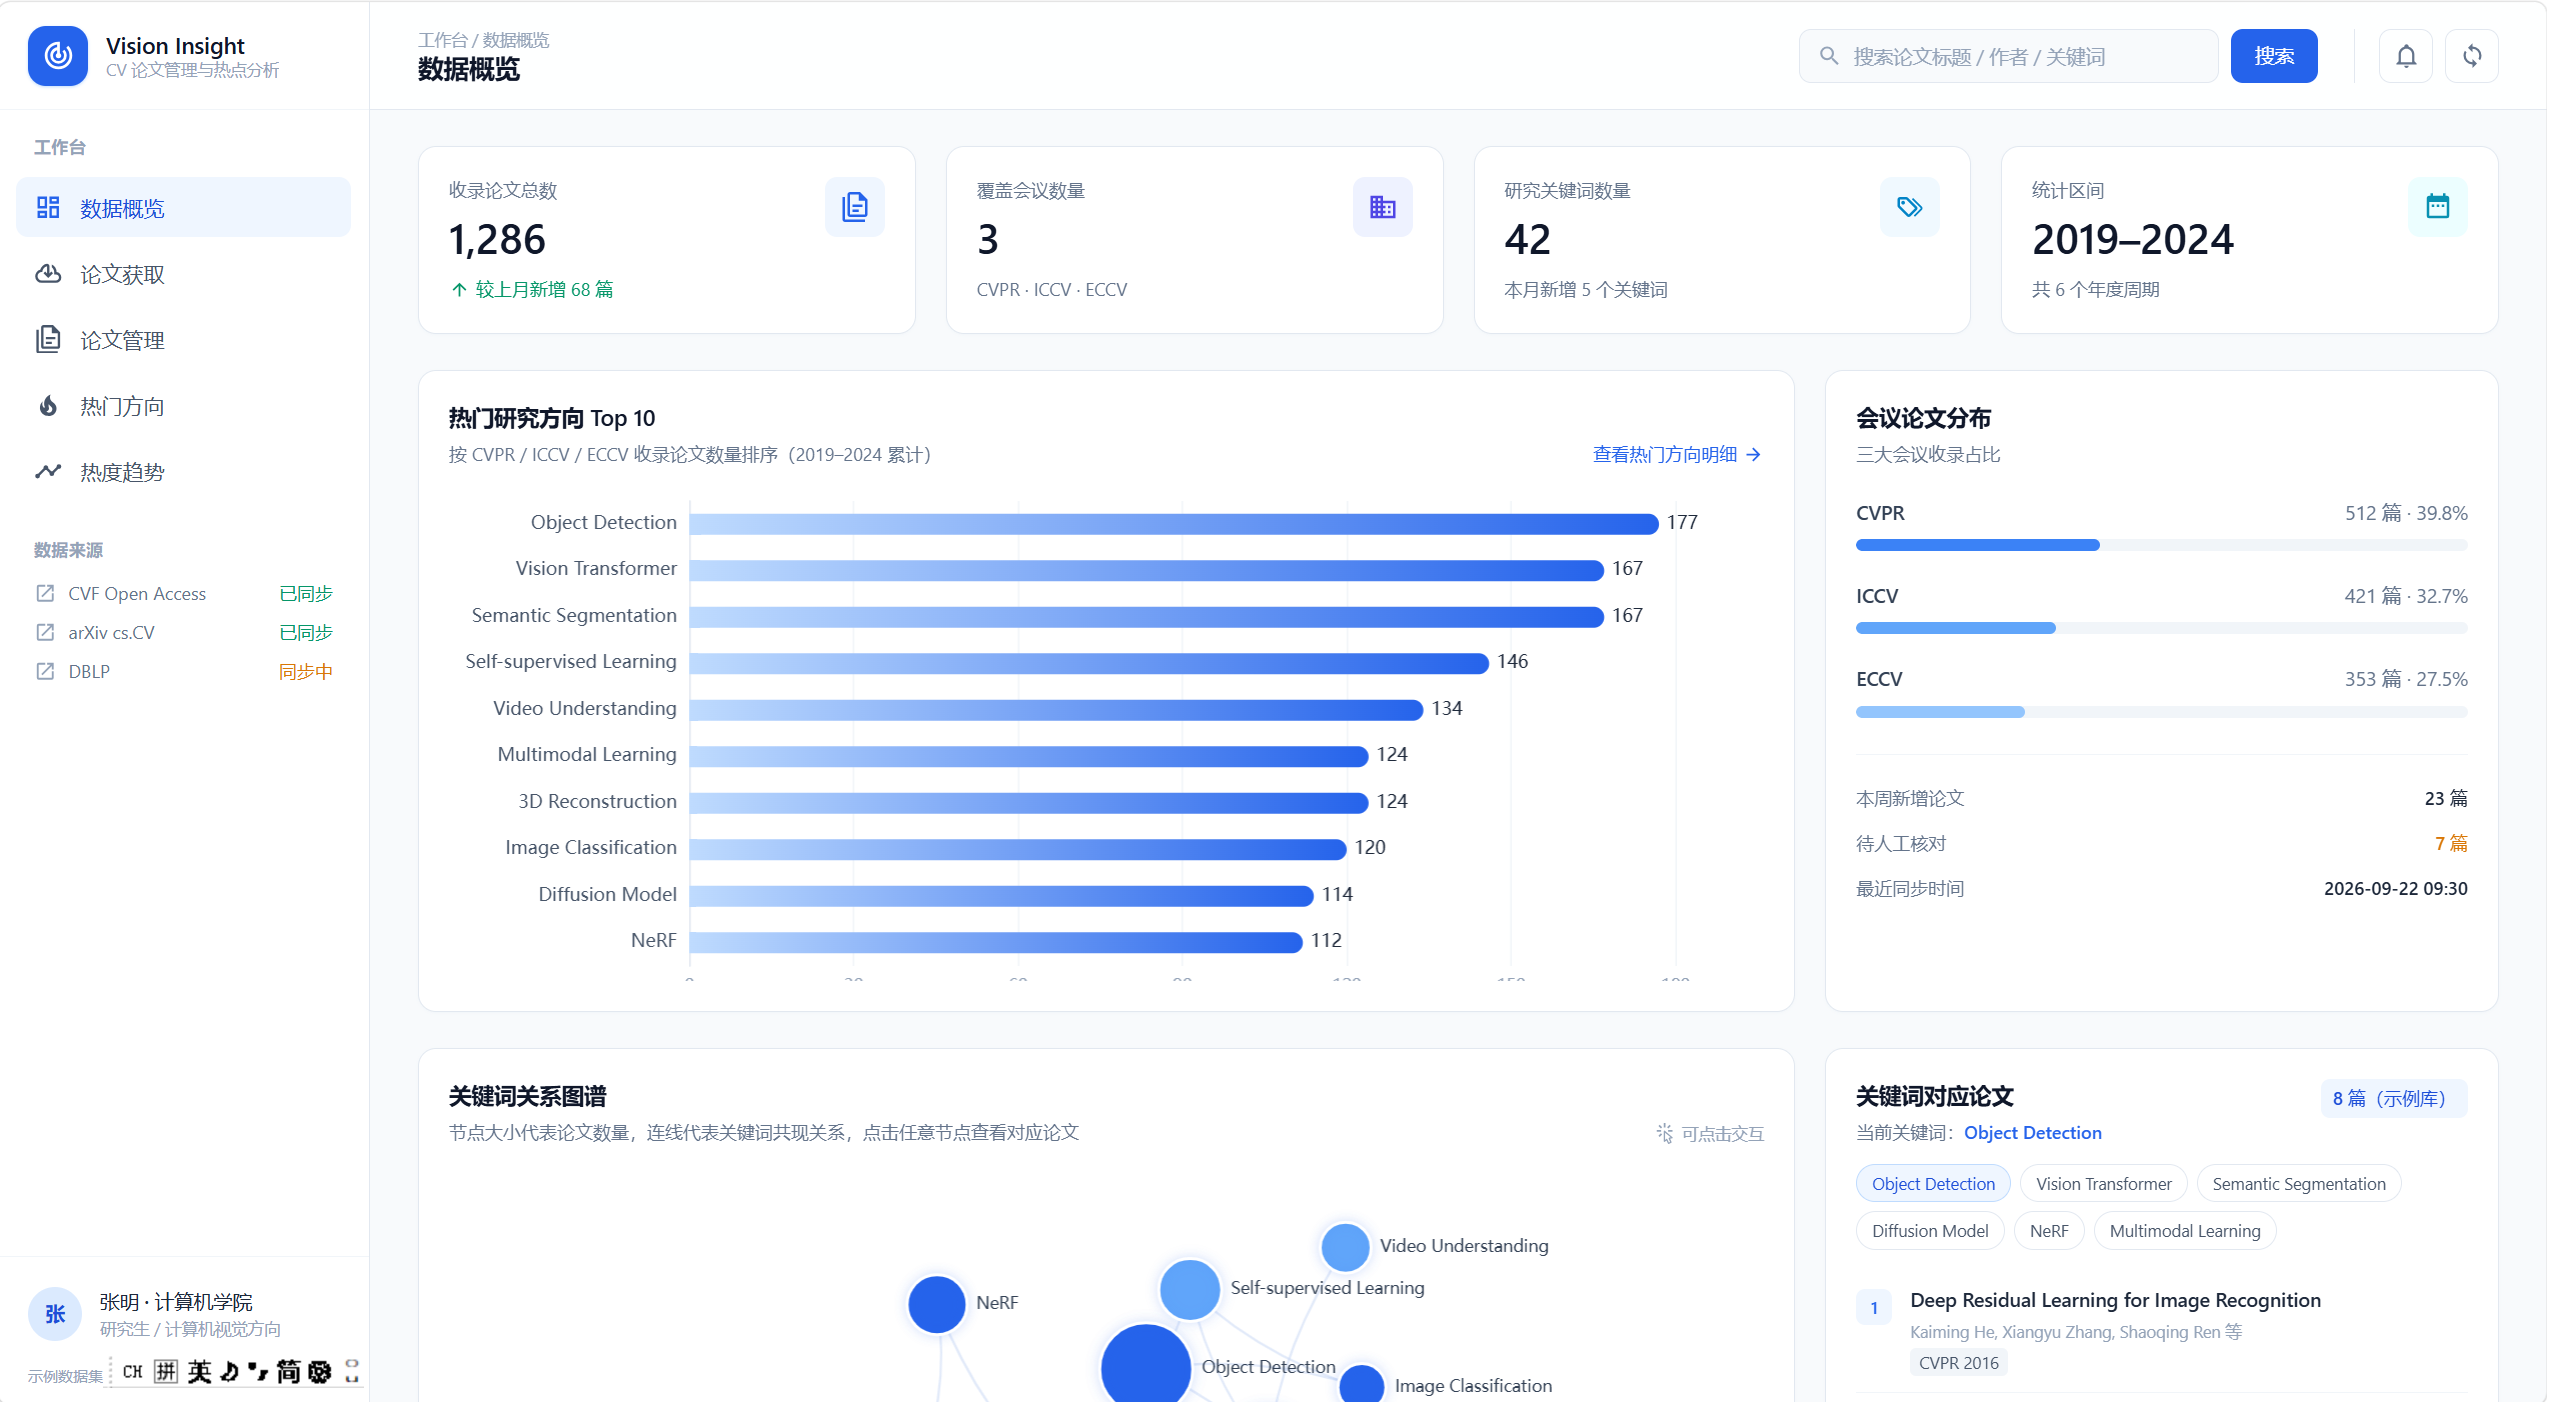
图 2|原型首页数据概览:总量、Top 10、图谱、相关论文入口。
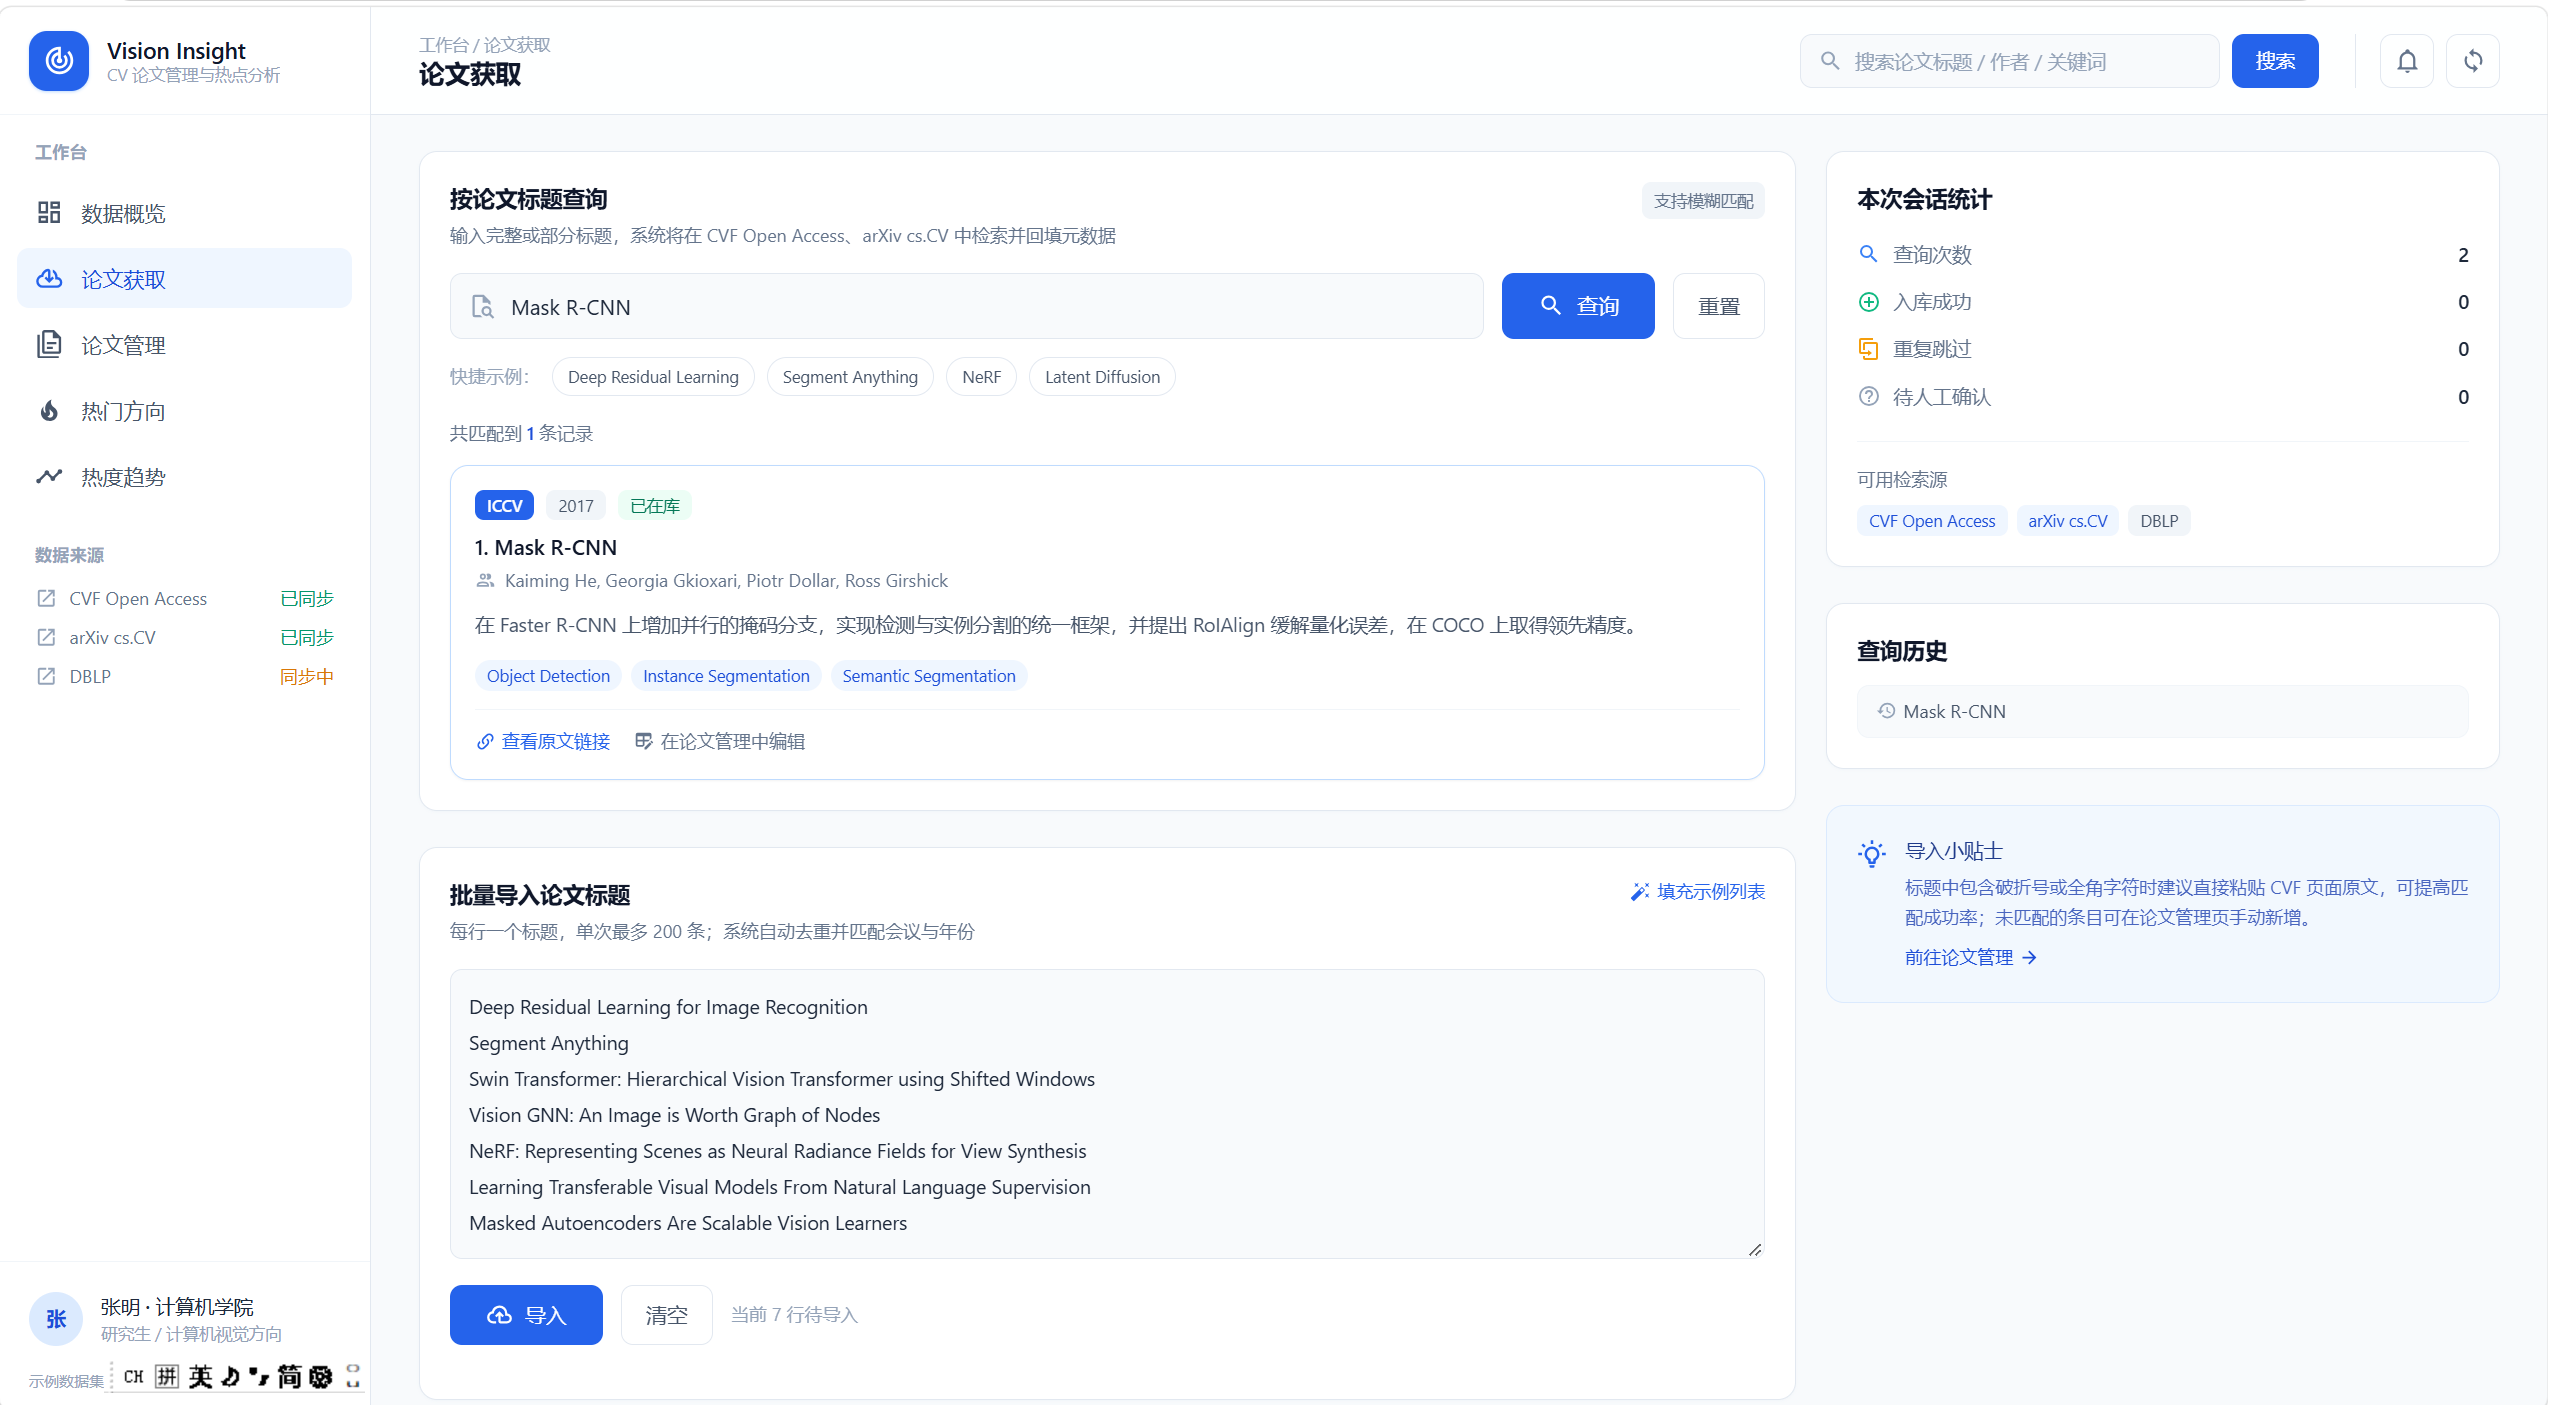
图 3|原型论文获取页面:单篇标题、批量标题、结果状态。
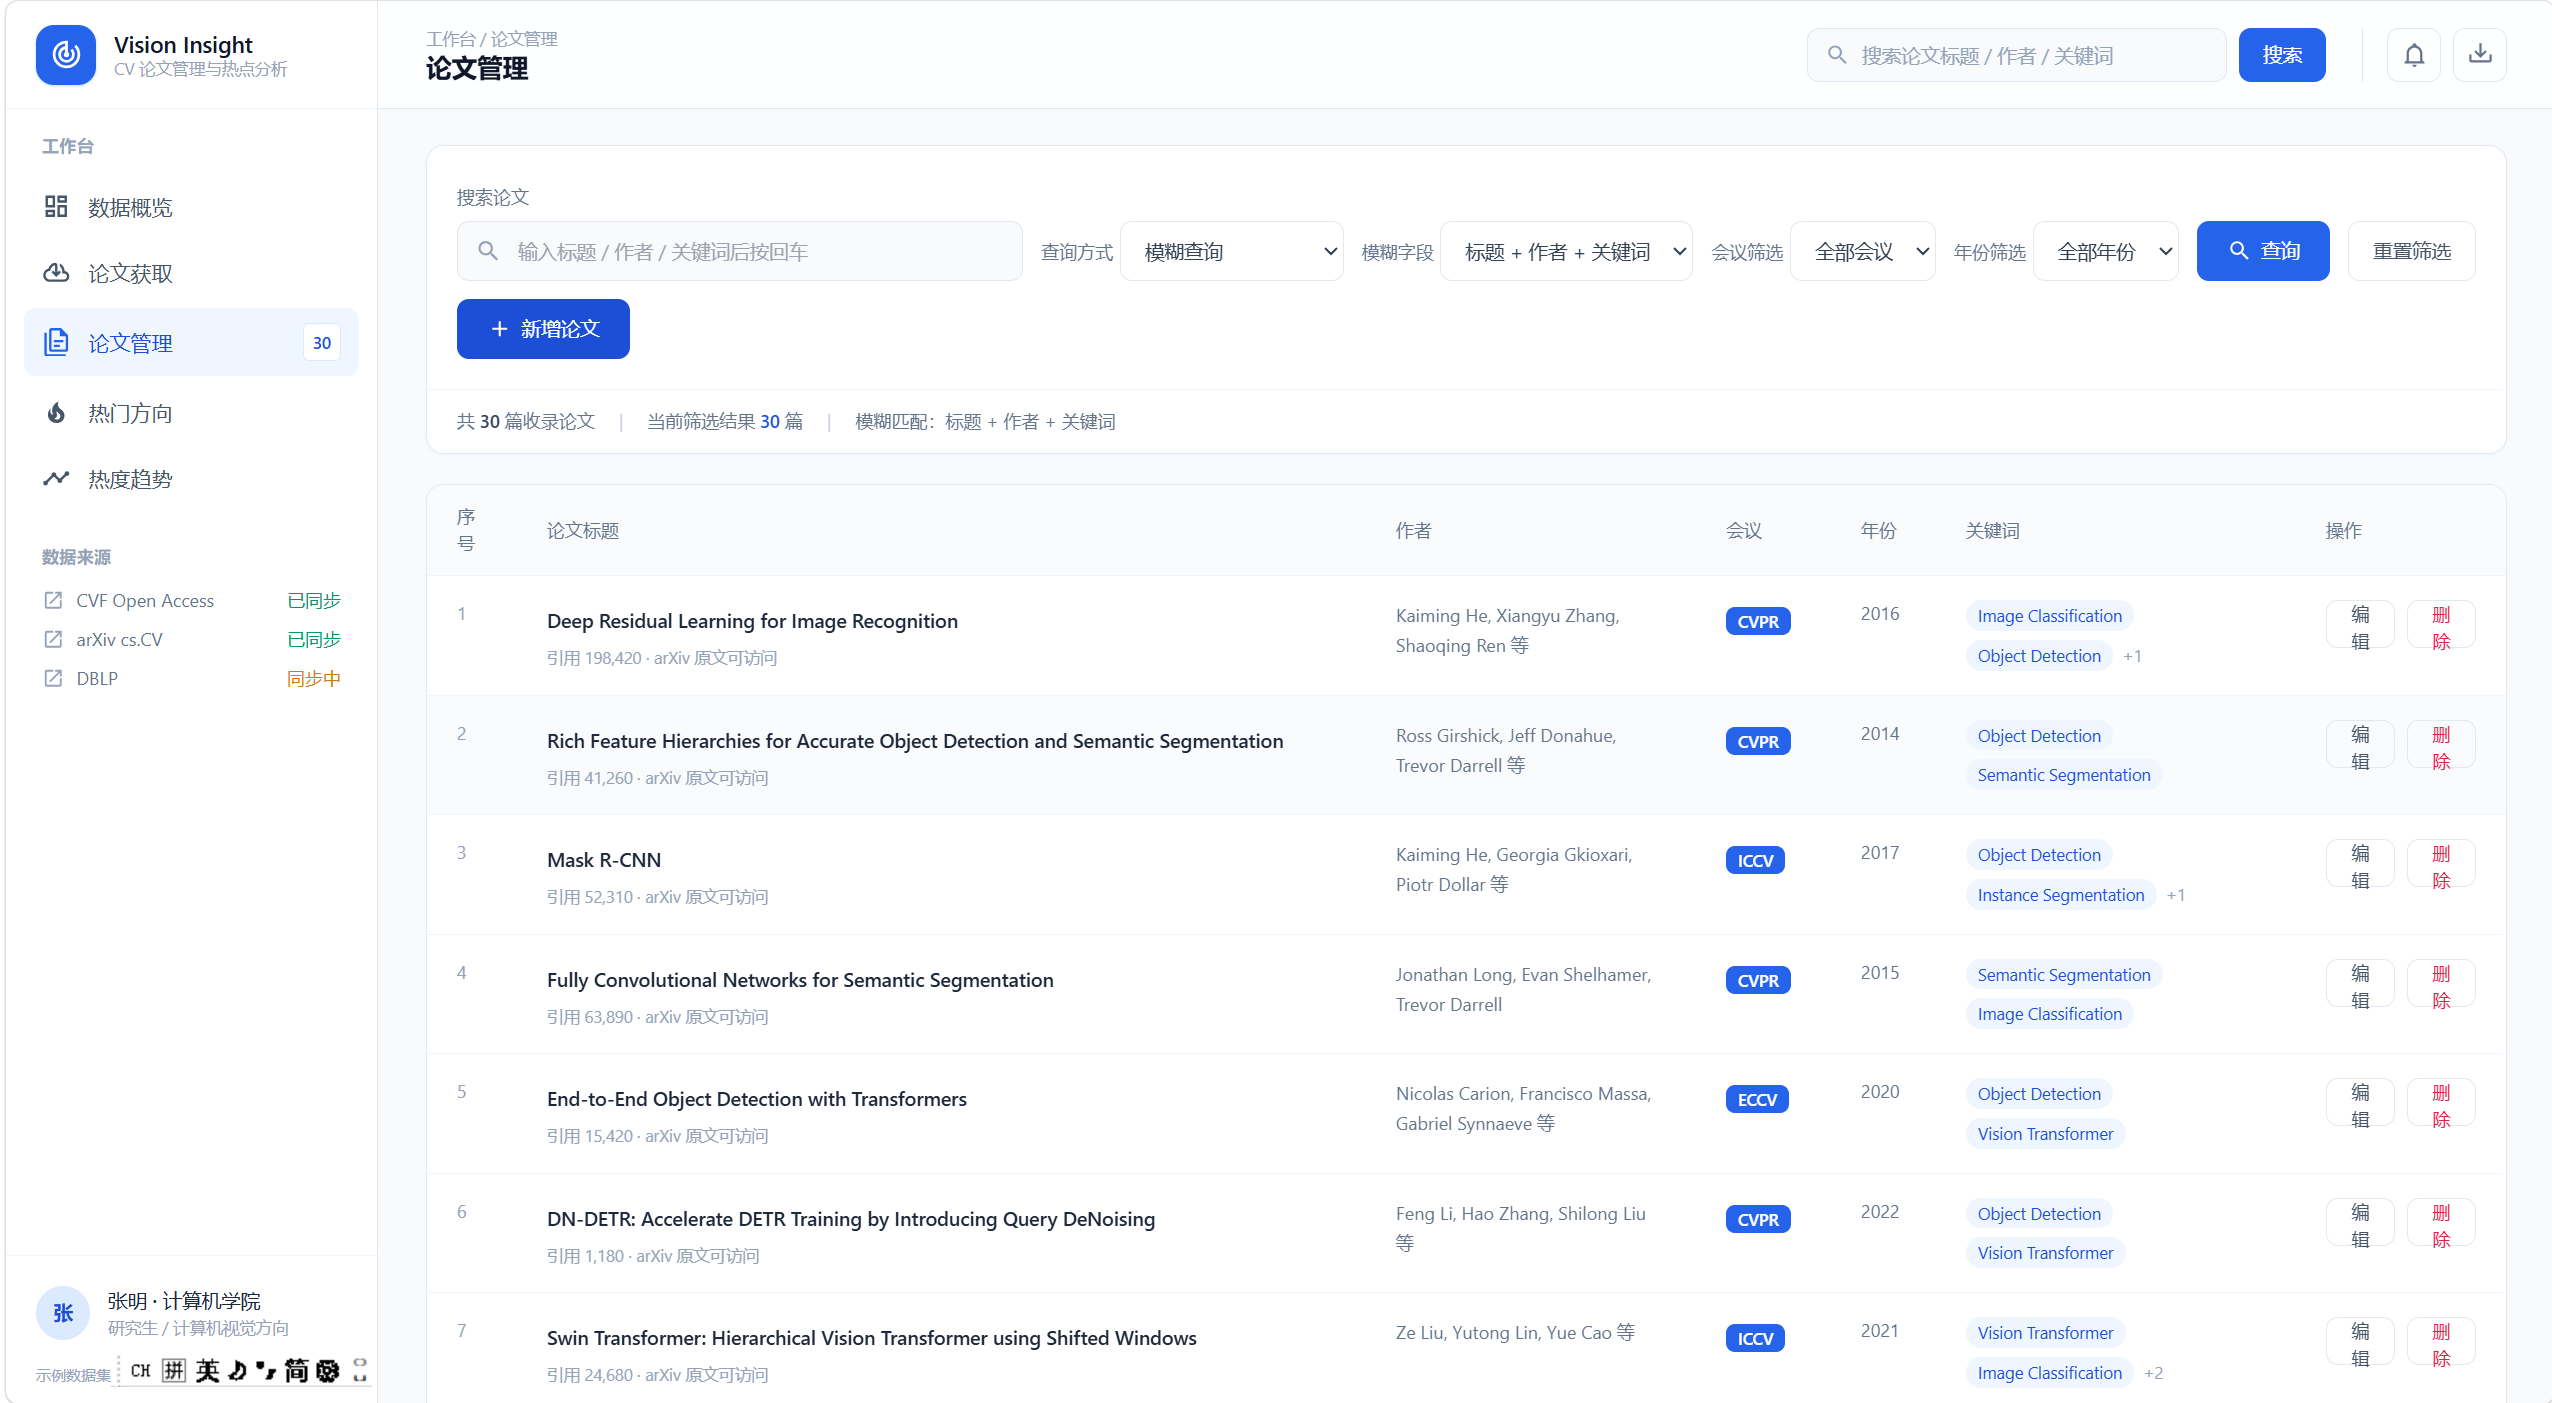
图 4|原型论文管理页面:查询、分页、编辑弹窗、删除确认。
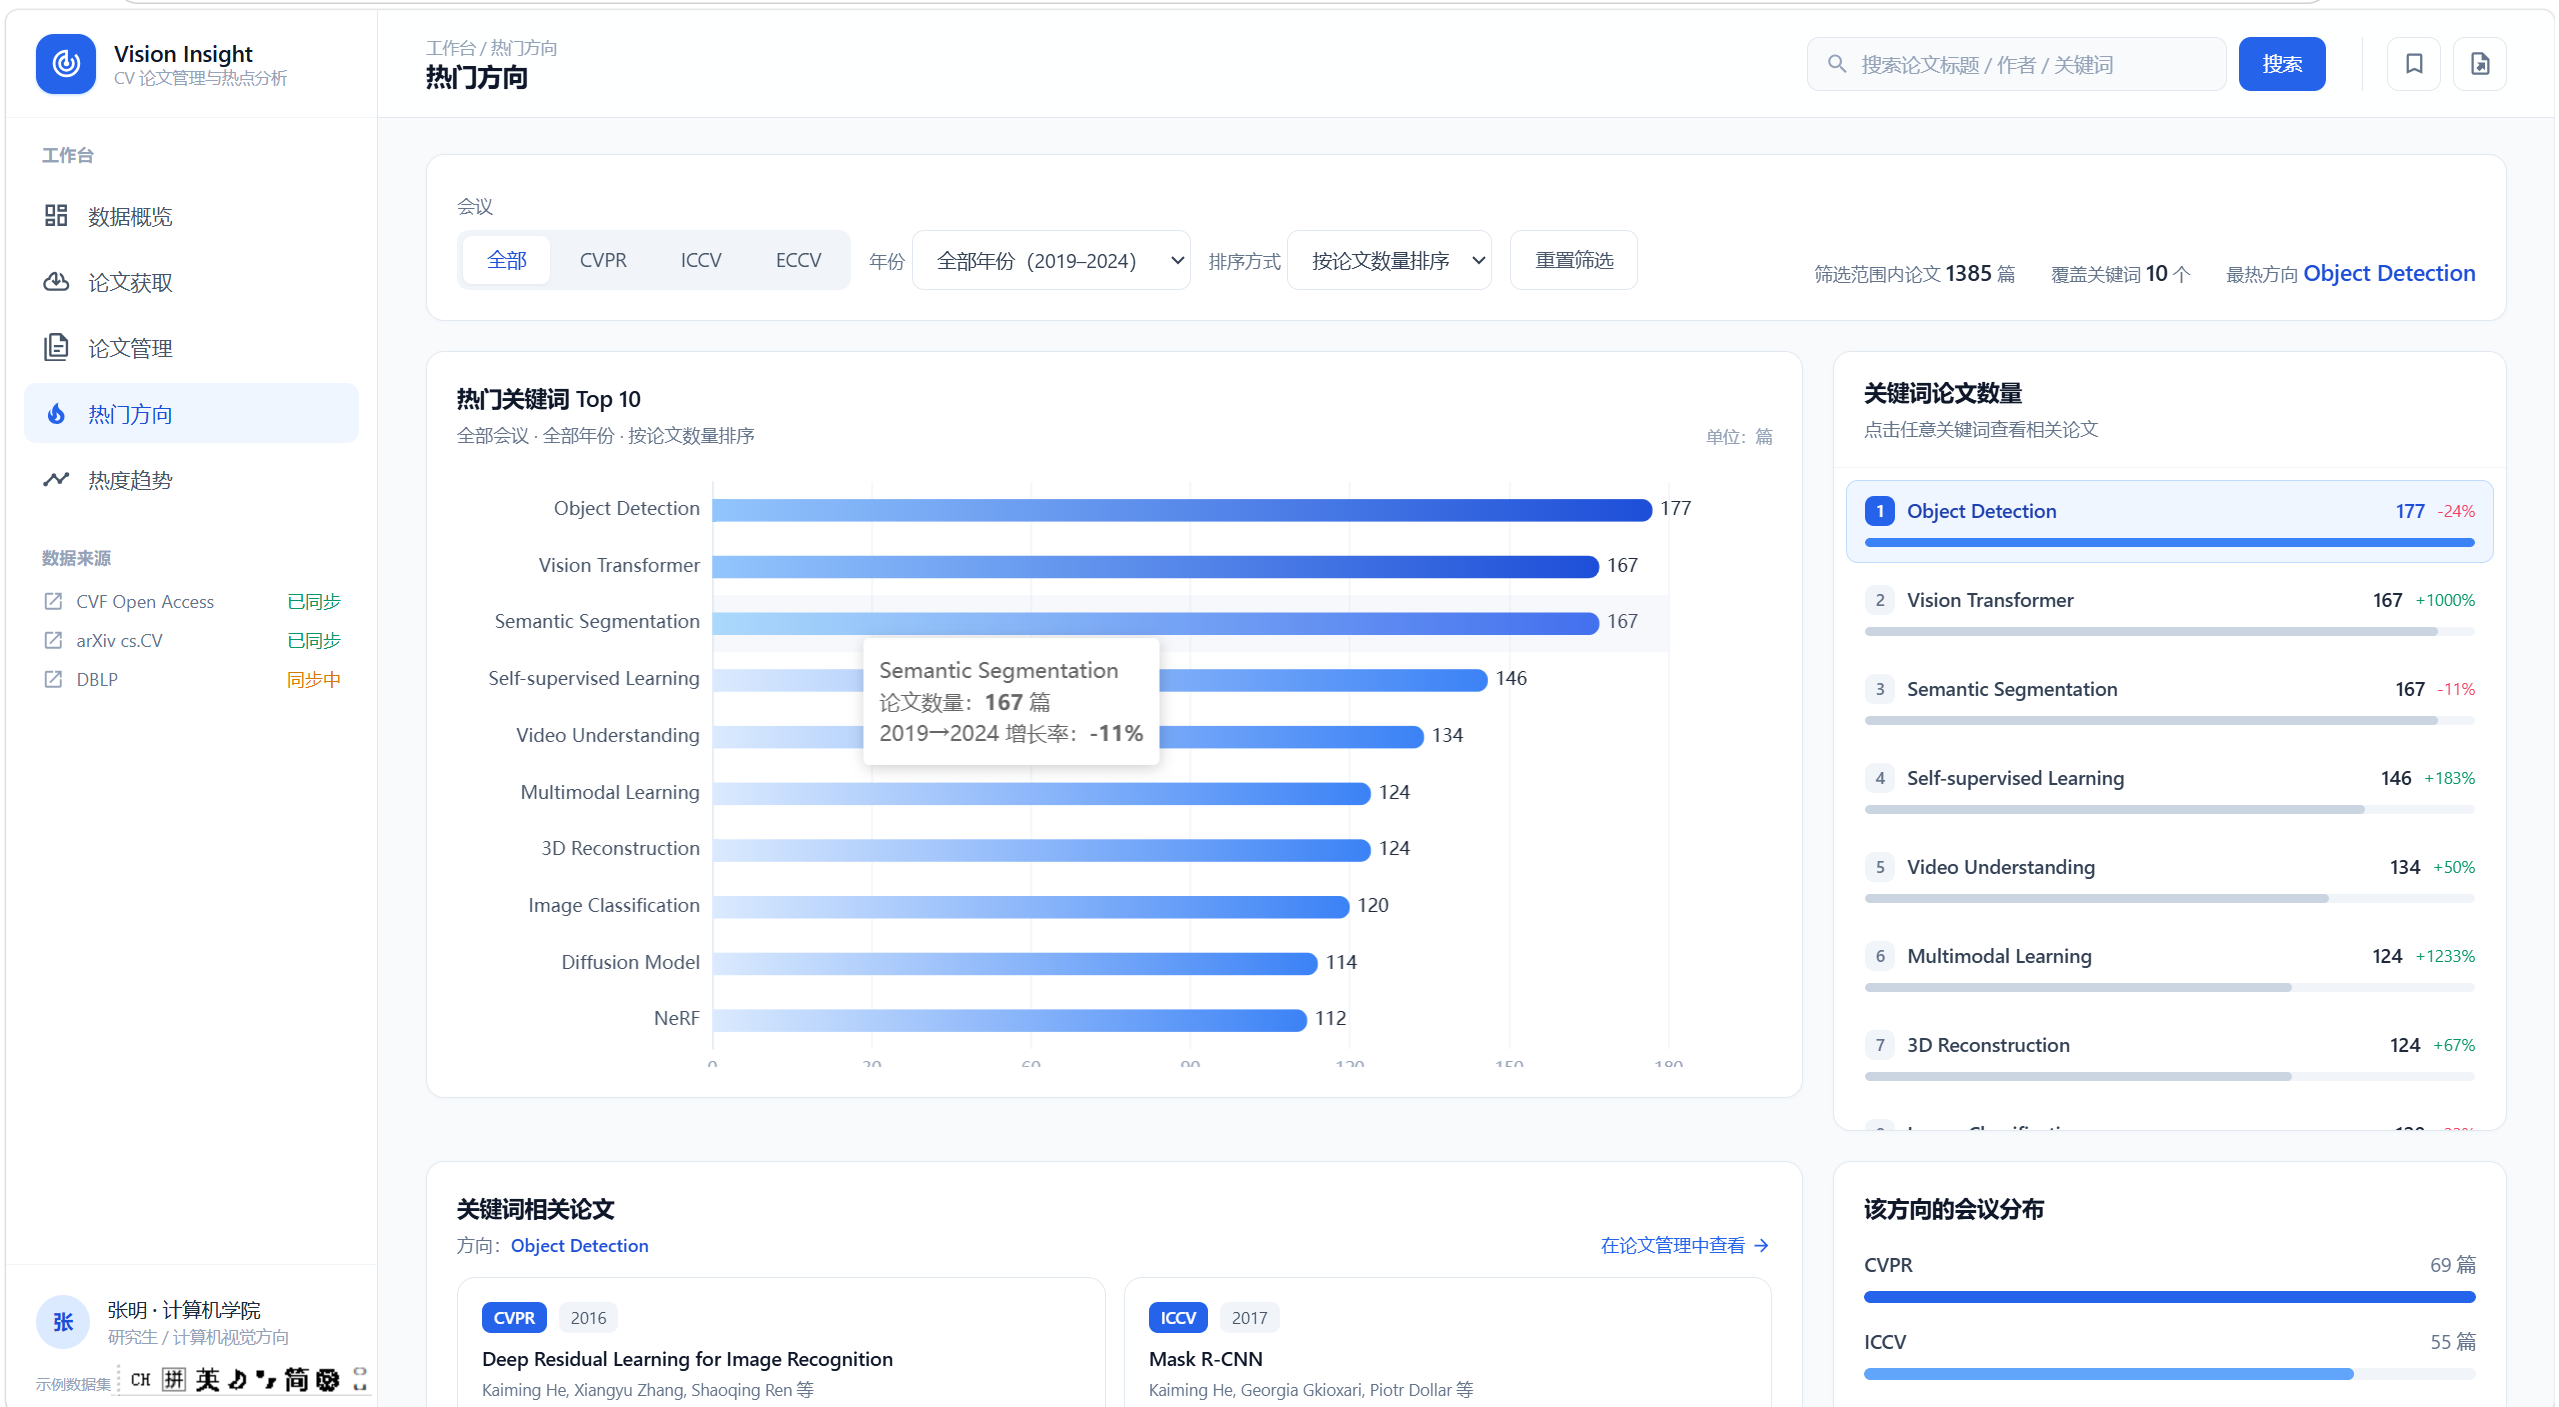
图 5|原型论文热门方向界面:方向排名、相关论文、趋势入口。
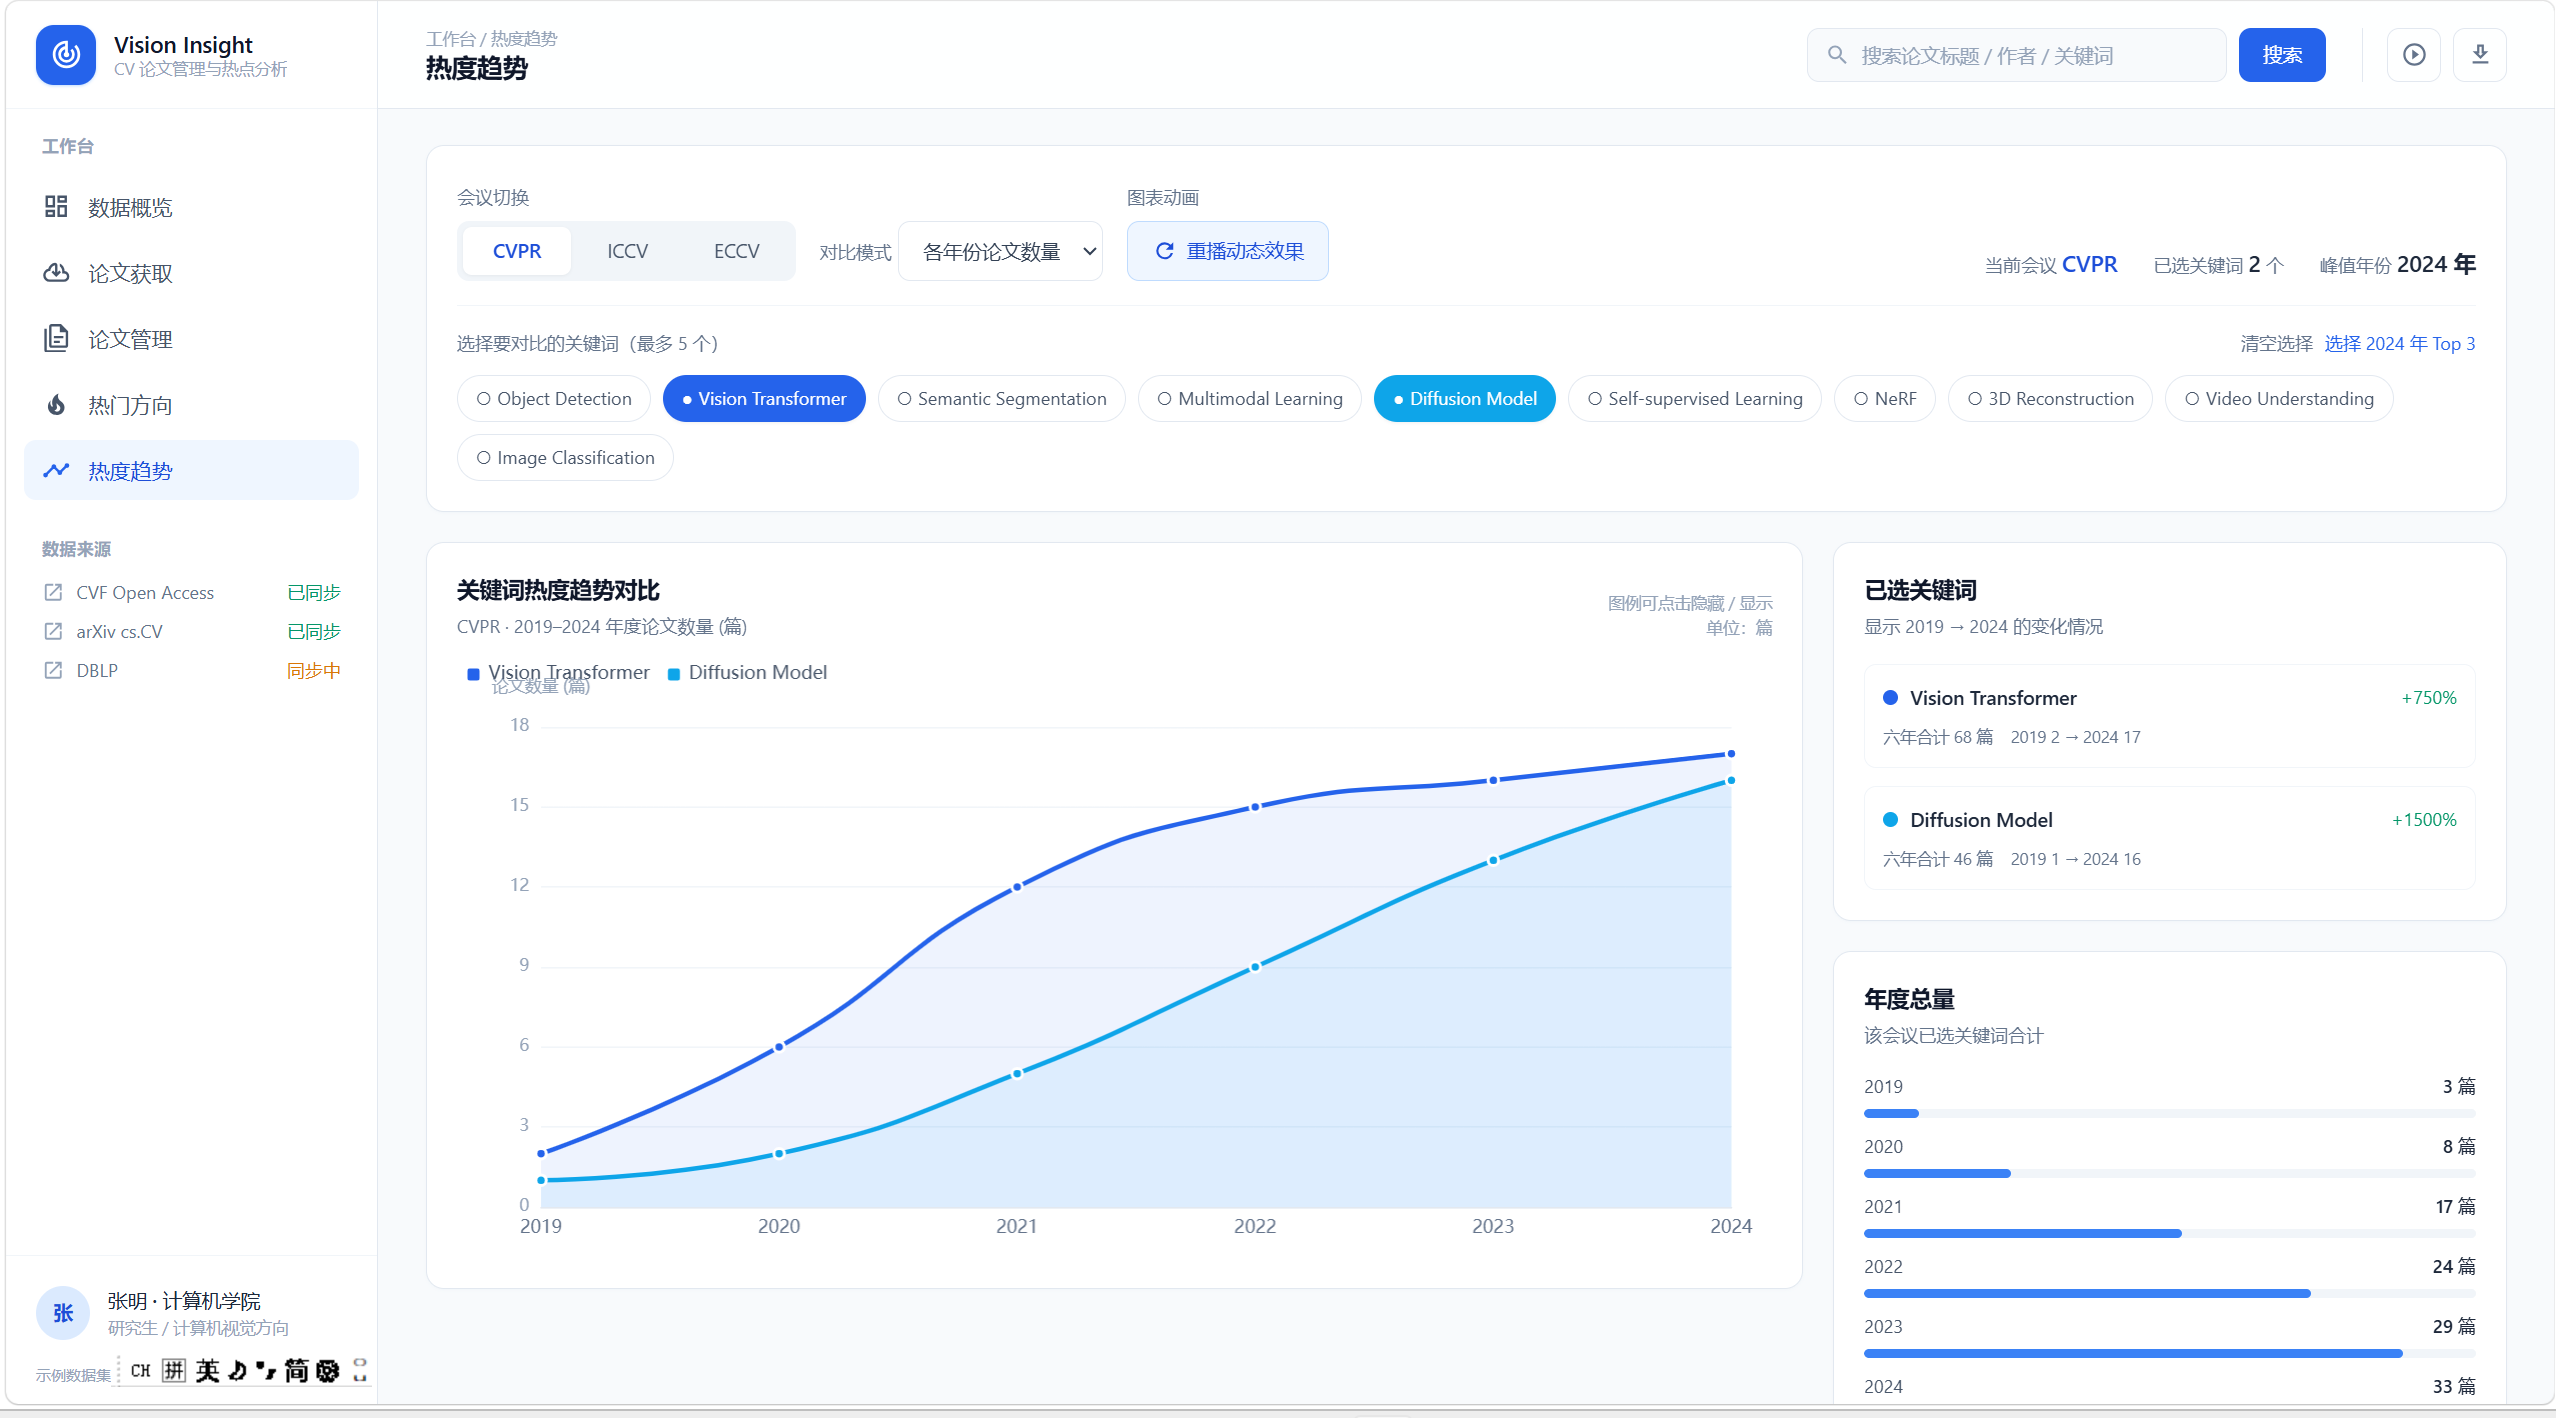
图 6|原型热度趋势界面:会议切换、关键词选择、趋势动画。
| 起点 | 终点 | 设计目的 |
|---|---|---|
| 点击左侧导航 | 进入对应模块,突出当前页 | 减少用户寻找功能的成本 |
| 点击关键词 | 展示对应论文或聚焦关联方向 | 将统计结果关联到论文证据 |
| 点击新增 / 编辑 | 打开表单;保存后刷新列表 | 在同一上下文中维护数据 |
| 点击删除 | 弹出确认,确认后删除 | 降低误操作风险 |
| 切换查询与筛选条件 | 更新当前论文列表 | 避免展示与条件不一致的结果 |
| 改变会议或关键词 | 更新图表与说明 | 保持图形和统计范围一致 |
| 层次 | 技术 | 选择理由 |
|---|---|---|
| 页面与组件 | Vue 3、Element Plus | 组件化实现表格、表单、弹窗和布局 |
| 路由与状态 | Vue Router、Pinia | 组织七个视图和论文管理状态 |
| 可视化 | ECharts | 支持柱状图、折线图、力导向图和交互事件 |
| 构建 | Vite | 开发代理和生产构建流程较简洁 |
| 服务端 | Node.js、Express | 与前端使用同一语言,便于接口开发与调试 |
| 持久化 | SQLite、node:sqlite | 不需独立数据库服务,适合本项目规模 |
| 网络与解析 | Fetch、fast-xml-parser、HTML 解析规则 | 处理 JSON、arXiv XML 和官方论文列表 |
| 运行管理 | Ubuntu、systemd | 保持后端进程常驻,统一记录运行日志 |
应用使用跨平台的 Web 与 Node.js 技术;systemd 属于当前 Linux 部署方式,本地开发通过 npm 命令启动。后端依赖支持 node:sqlite 的 Node 版本,复现时应优先使用项目已经验证的 Node 22.22.2 或兼容版本。
平台由六个主要功能组成,结构及联系如下图所示:
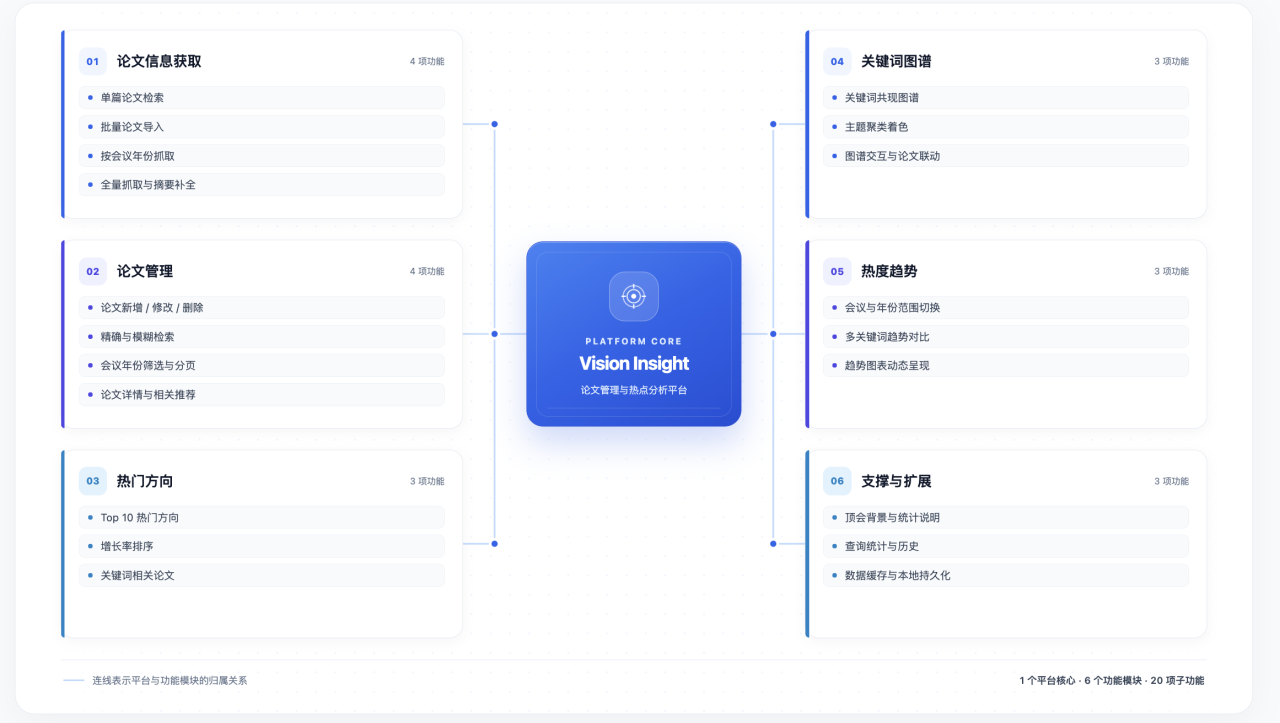
图 7|平台功能结构图。
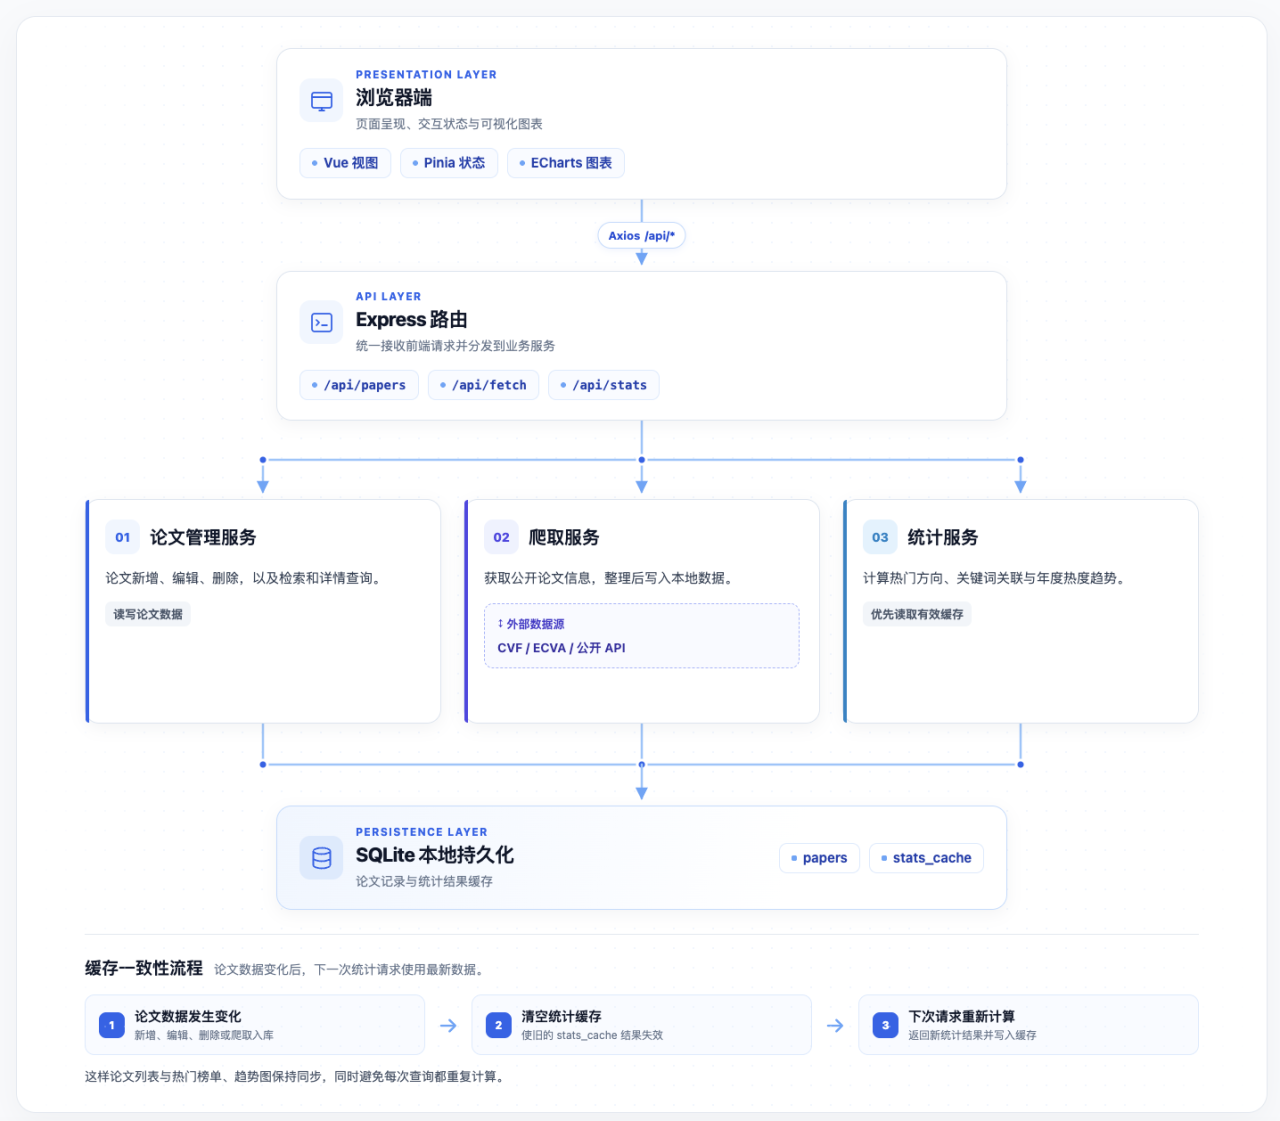
图 8|平台系统架构与数据流。
| 表 | 主要字段 | 用途 |
|---|---|---|
papers | id、title、title_norm、authors、venue、year、keywords、link、abstract、source、时间字段 | 保存论文元数据;title_norm 有唯一约束;关键词以 JSON 文本保存 |
stats_cache | key、payload、updated_at | 保存聚合接口结果,减少重复计算 |
| 问题 | 分析与处理 |
|---|---|
| 单一元数据来源不稳定 | 增加 Crossref、Semantic Scholar、OpenAlex 等来源,结合 arXiv 返回信息 |
| 关键词标签与图谱点击不能加载论文 | 前端补齐 statsApi.keyword 方法,对齐后端接口 |
CVF 部分年份不能用统一 day=all 获取 | 解析或配置会议日期,逐日抓取并合并去重 |
| 图谱连线密集、标签拥挤 | 裁剪共现边、分簇着色、点击聚焦子图 |
| 少量异常年份影响增长率 | 按年份论文数阈值选择统计跨度 |
| 频繁访问统计接口重复计算 | 增加 SQLite 缓存,写入后统一失效 |
| 来源 | 当前用途 |
|---|---|
| CVF Open Access | CVPR、ICCV 按届论文列表和详情摘要 |
| ECVA | ECCV 论文列表和详情摘要 |
| DBLP | 标题匹配、会议、年份及作者信息 |
| Crossref | 单篇元数据匹配的补充来源 |
| Semantic Scholar | 单篇会议元数据匹配的补充来源 |
| OpenAlex | 单篇元数据匹配的补充来源 |
| arXiv | 标题检索、摘要、作者和链接;辅助解析会议信息 |
搭建平台时使用爬虫爬取了 2017-2026 年的 CVPR,ECCV,ICCV 的论文数据(其中 ECCV,ICCV 分别为偶数年与奇数年两年举办一届,故论文规模与 CVPR 有较大差异),下表展示了论文数据概览:
| 指标 | 数值 |
|---|---|
| 论文总量 | 32,154 |
| CVPR | 18,457 |
| ICCV | 7,536 |
| ECCV | 6,161 |
| 关键词种类 | 13 |
| 数据库年份最小值—最大值 | 2017—2026 |
对于爬虫爬取的论文数据,进行如下步骤对数据进行清洗加工:
title_norm 使用唯一约束防止重复插入。当前规则标签包括目标检测、视觉 Transformer、语义分割、多模态学习、扩散模型、自监督学习、NeRF、三维重建、视频理解、图像分类、图像生成、零样本学习和动作识别。
程序将标题和摘要拼接后匹配规则。例如:包含 neural radiance 或 radiance field 的文本可被归为 NeRF;包含 vision-language 或 image-text 的文本可被归为多模态学习。
项目中所有涉及热度、关系、增长率的计算统一如下表:
H(k, v, y) = 指定会议 v、年份 y 中,关键词集合含 k 的论文数
每篇论文对同一个关键词最多贡献一次;同一论文可以对多个关键词贡献计数。
C(a, b) = 同时含关键词 a 与 b 的论文数
图谱节点大小反映方向论文数,边权反映共现次数;前端再进行可读性裁剪。
G = (末年论文数 - 首年论文数) / 首年论文数 × 100%
当前排名服务会过滤论文数过少的年份,再取首末年;当首年为零而末年大于零时,代码返回 100。
P(k, v, y) = H(k, v, y) / 该会议该年份收录论文总数 × 100%
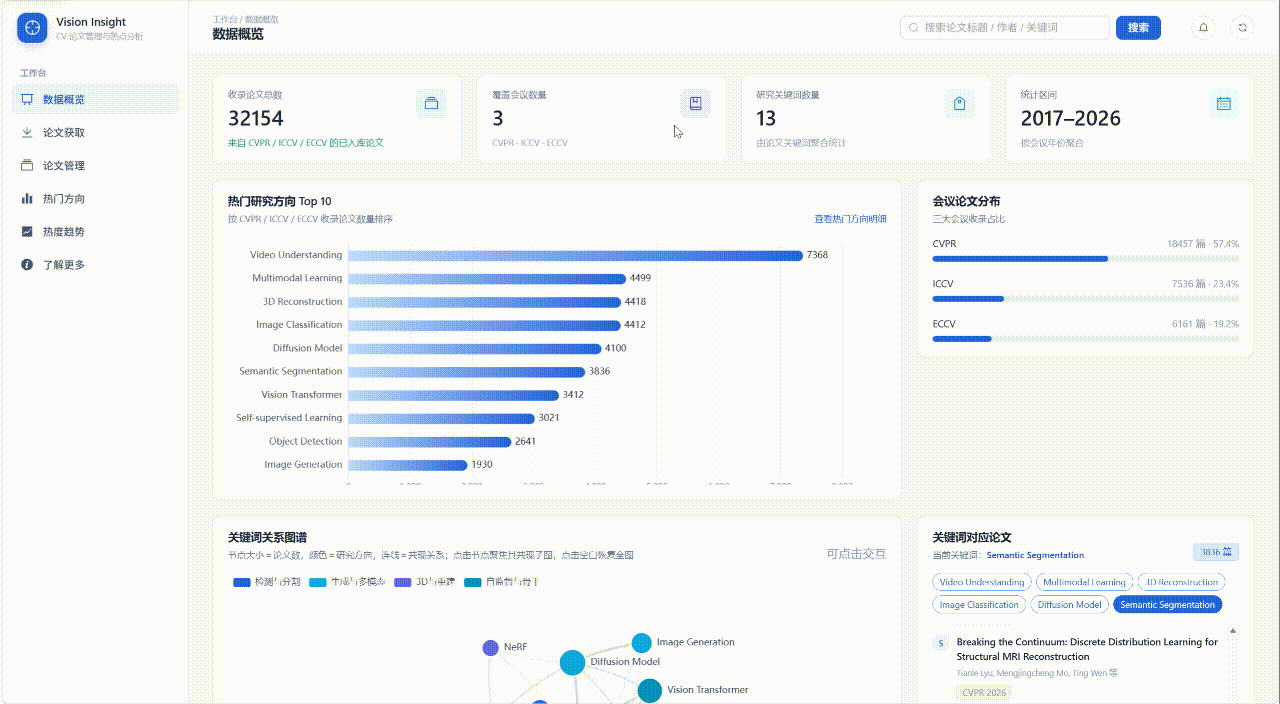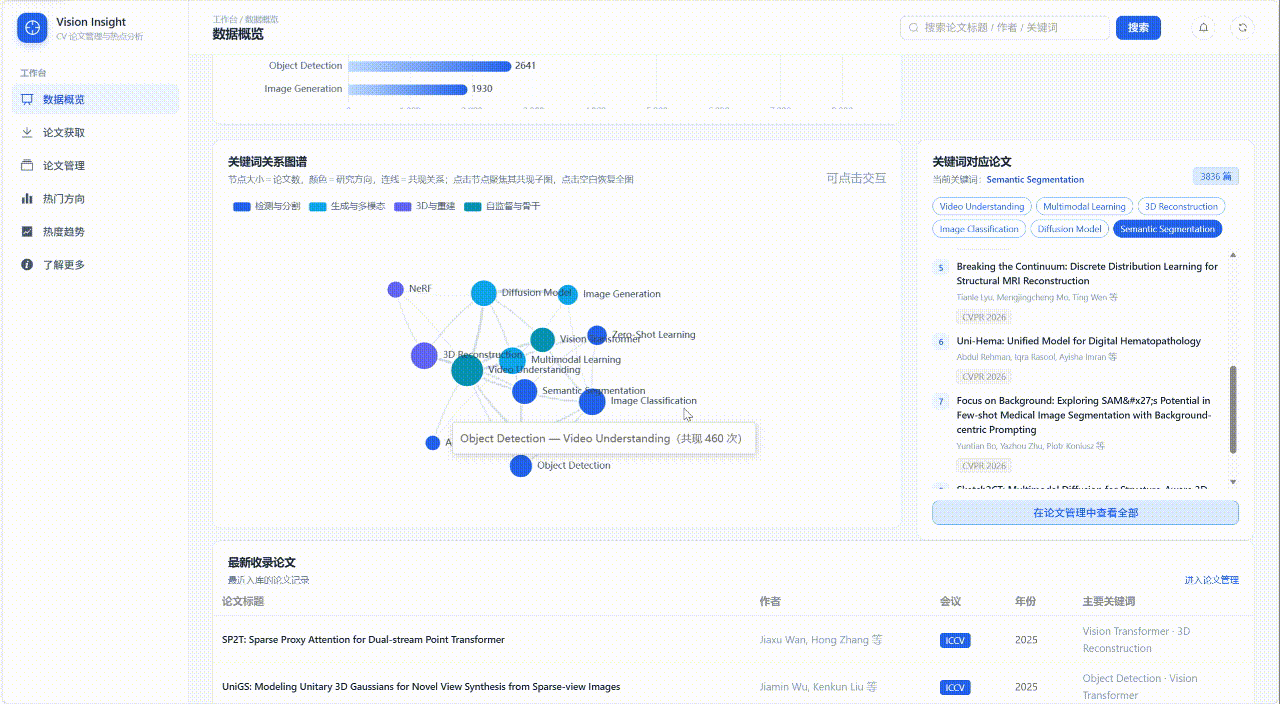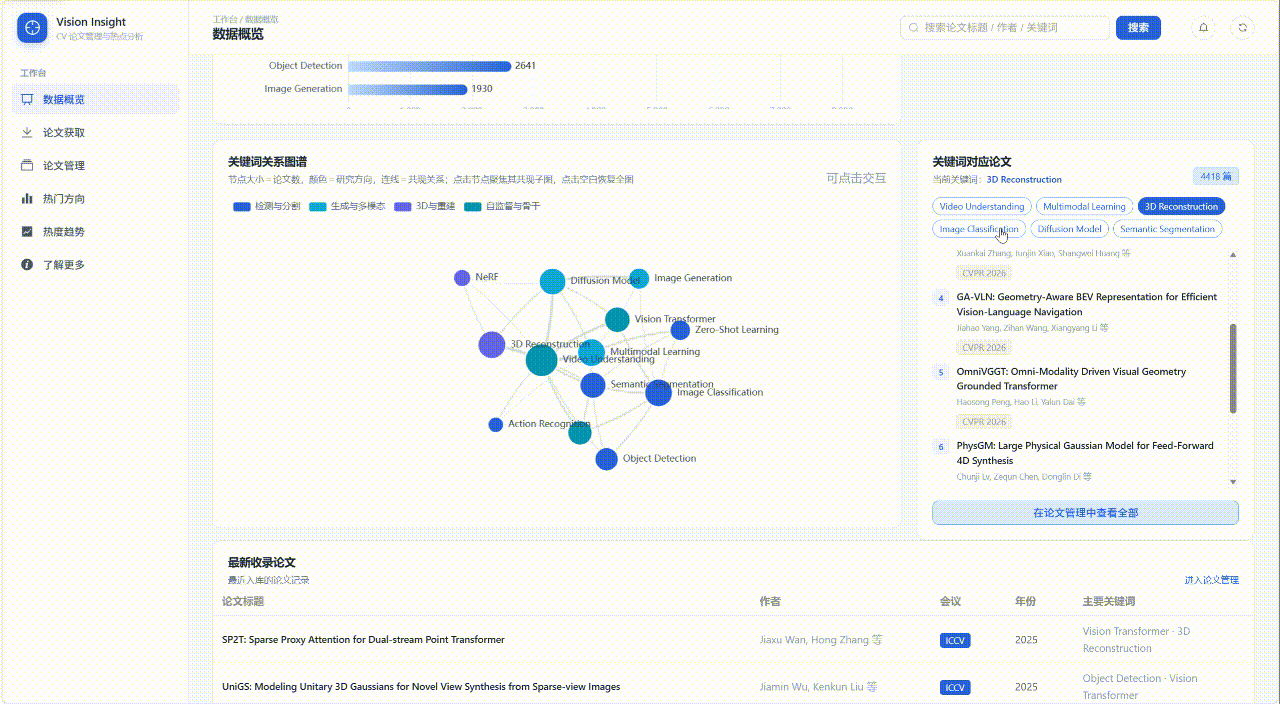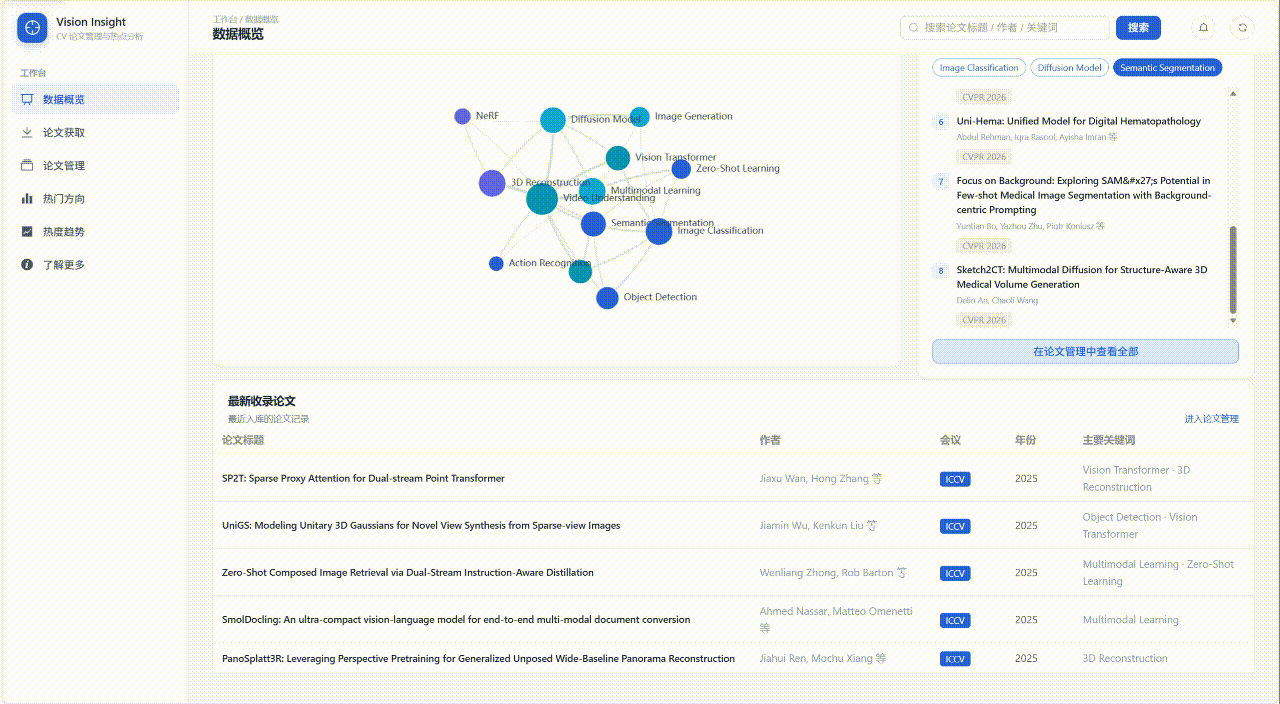
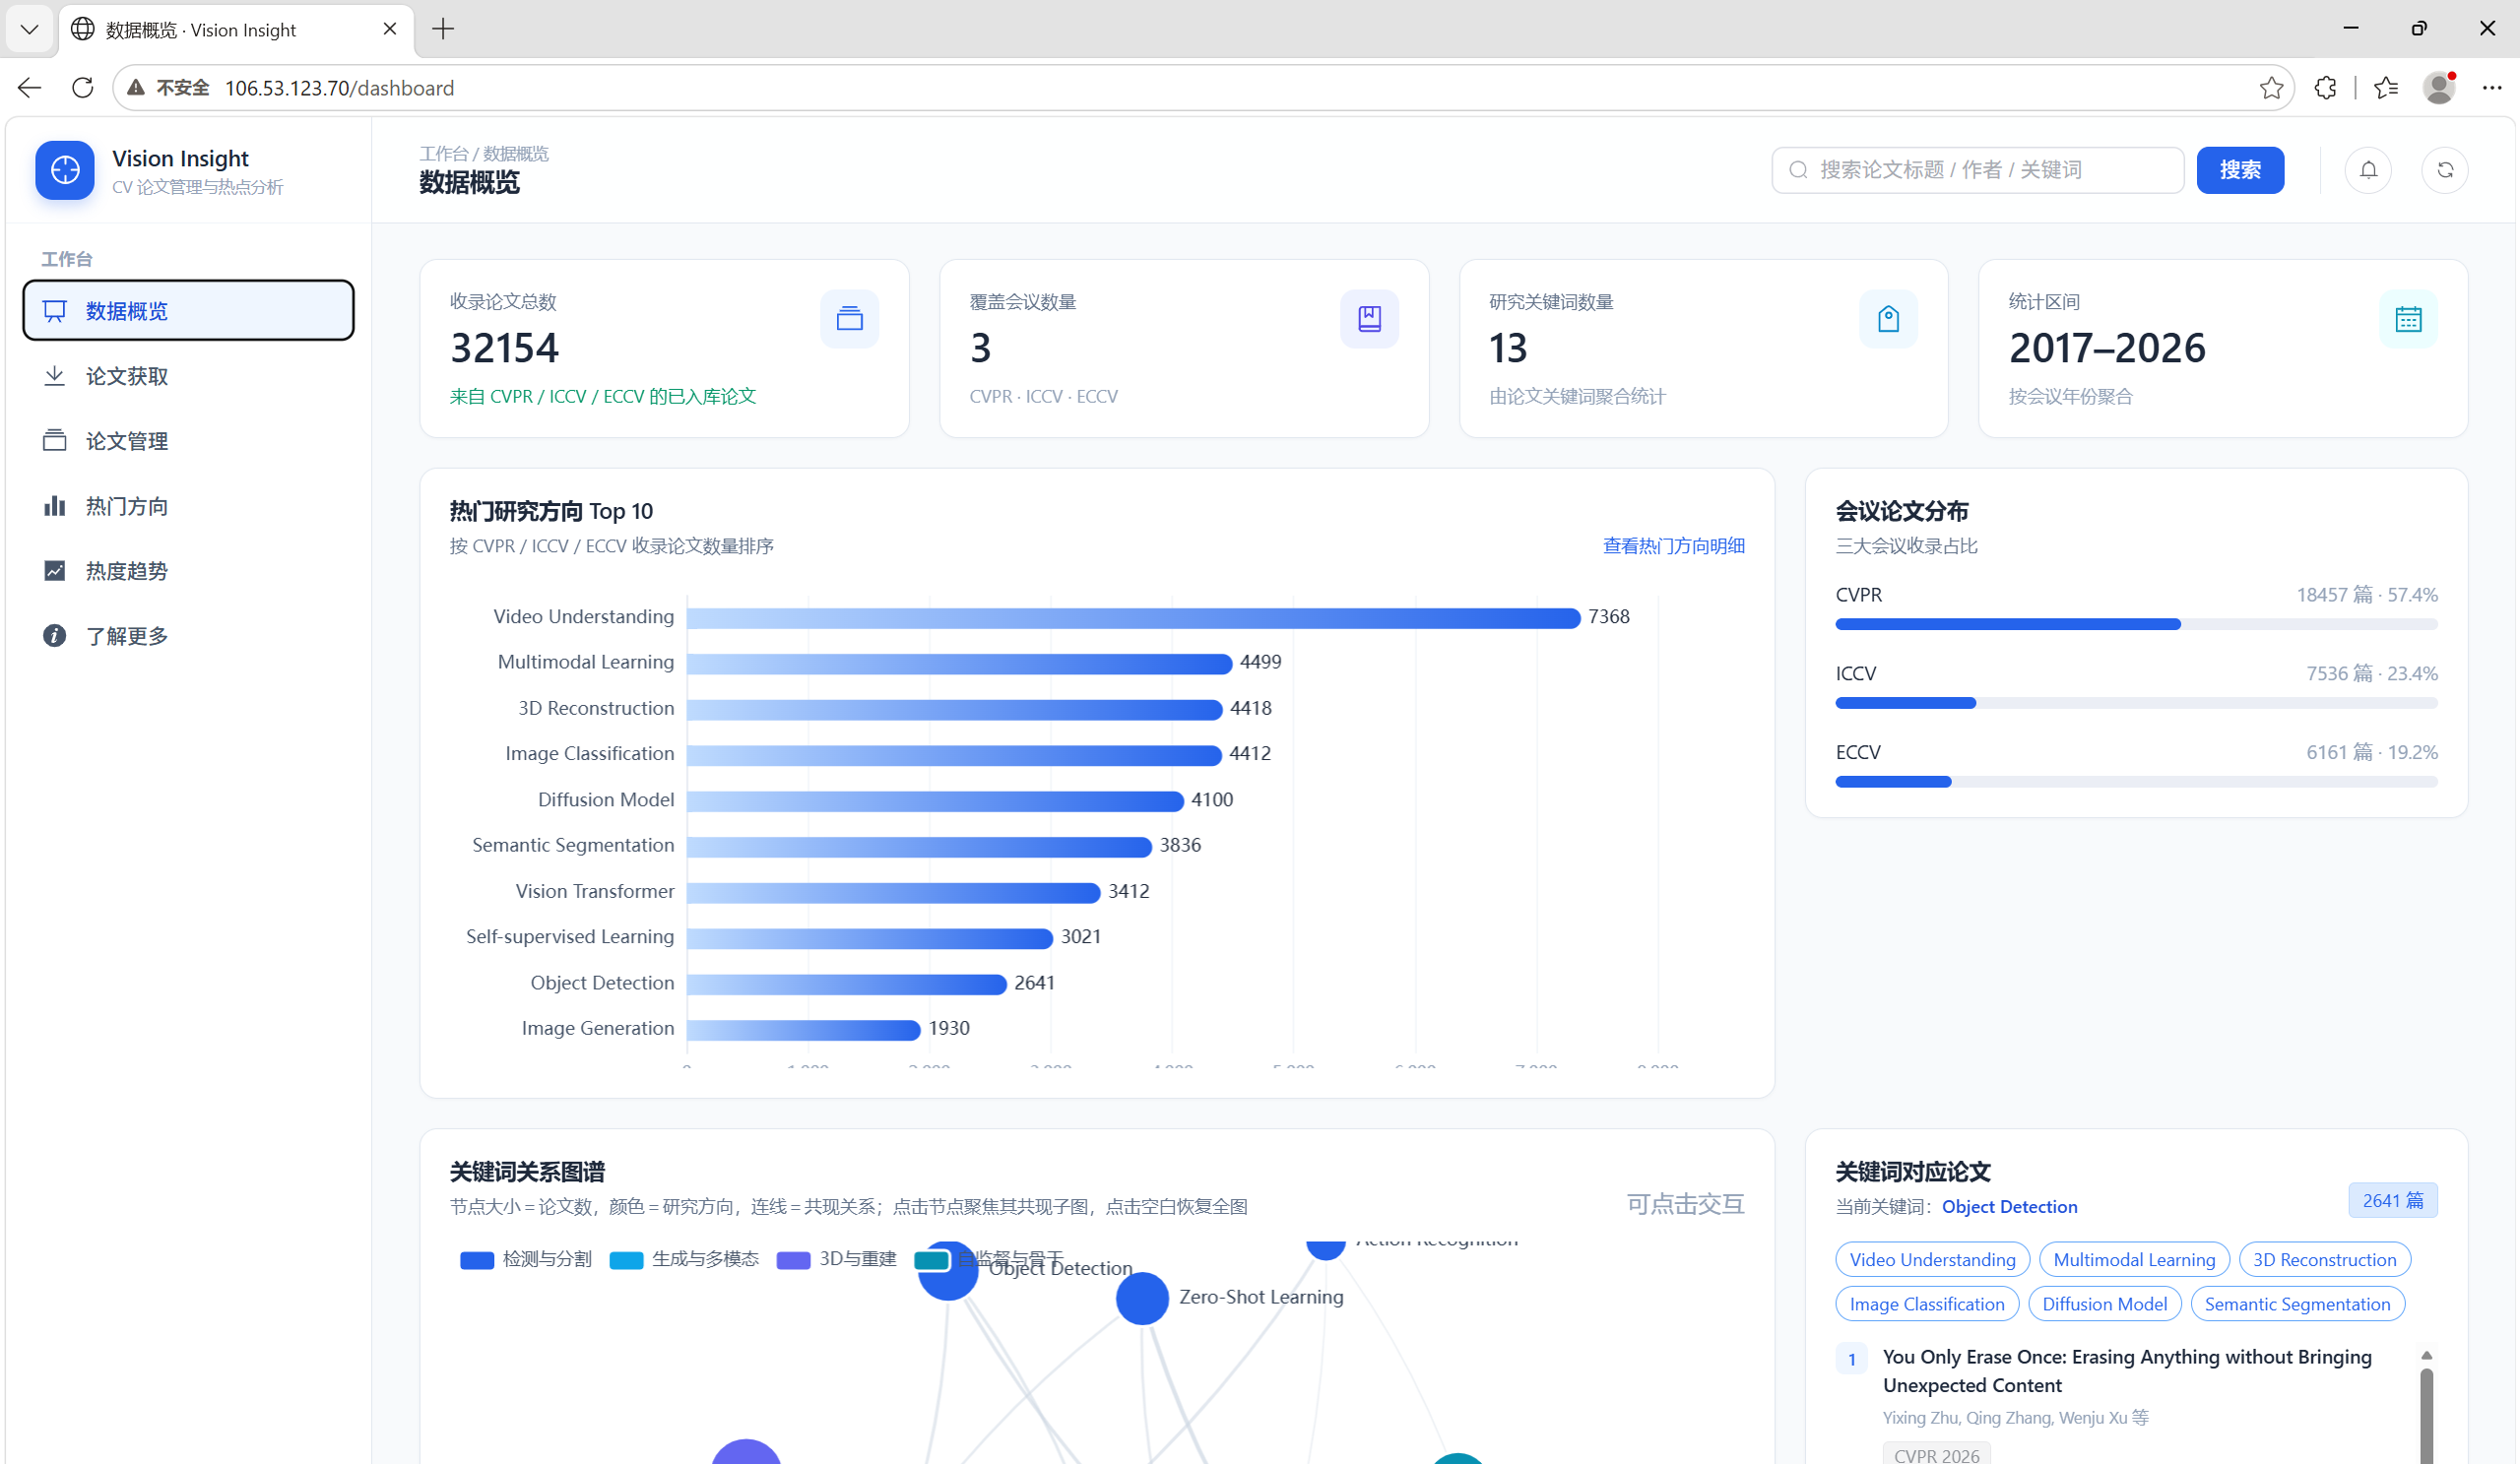
图 9|平台首页整体:数据概览页,包含侧边导航、指标卡、榜单和图谱。
平台首页集中展示论文总量、会议分布和热门方向。用户可以从整体数据认识平台覆盖范围,再选择感兴趣的研究方向继续阅读。
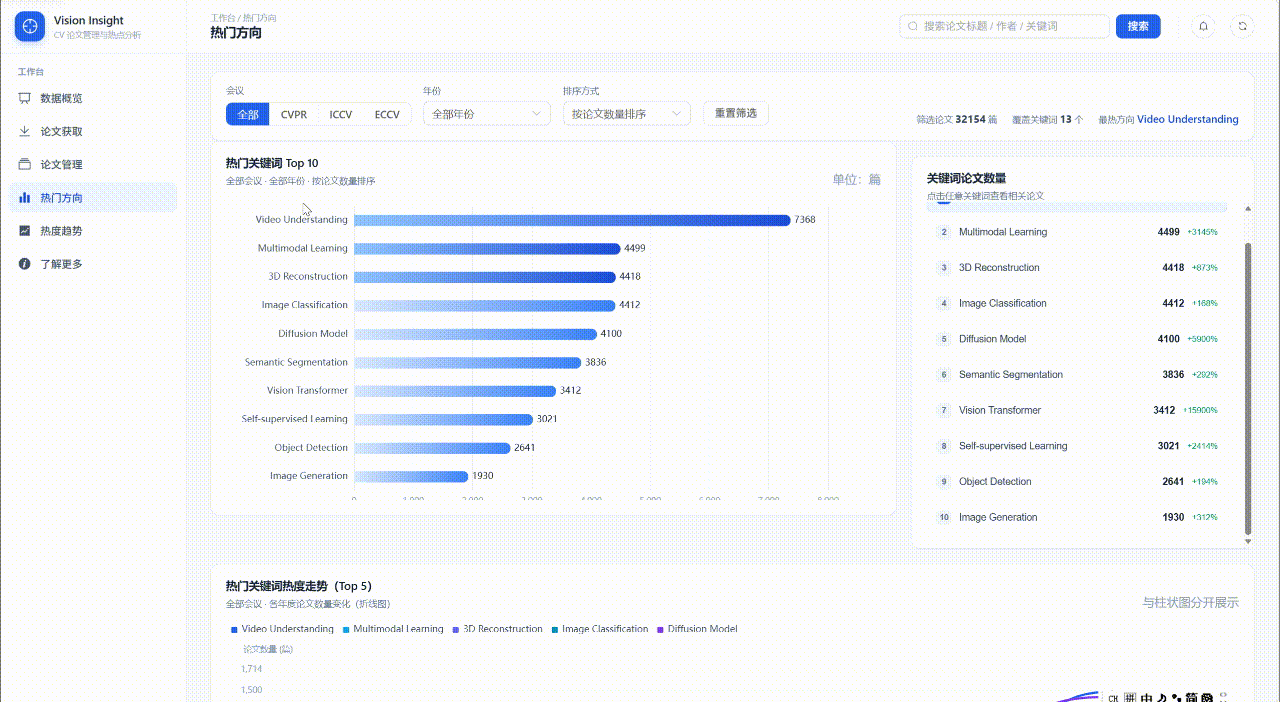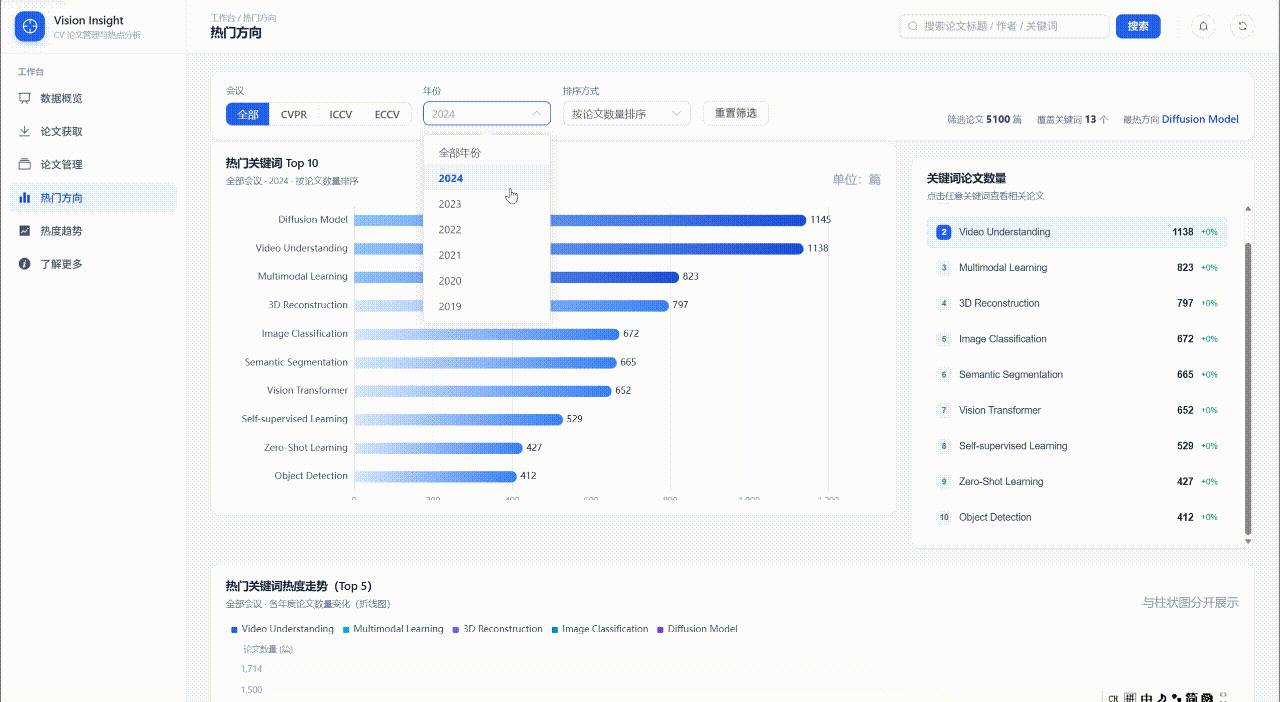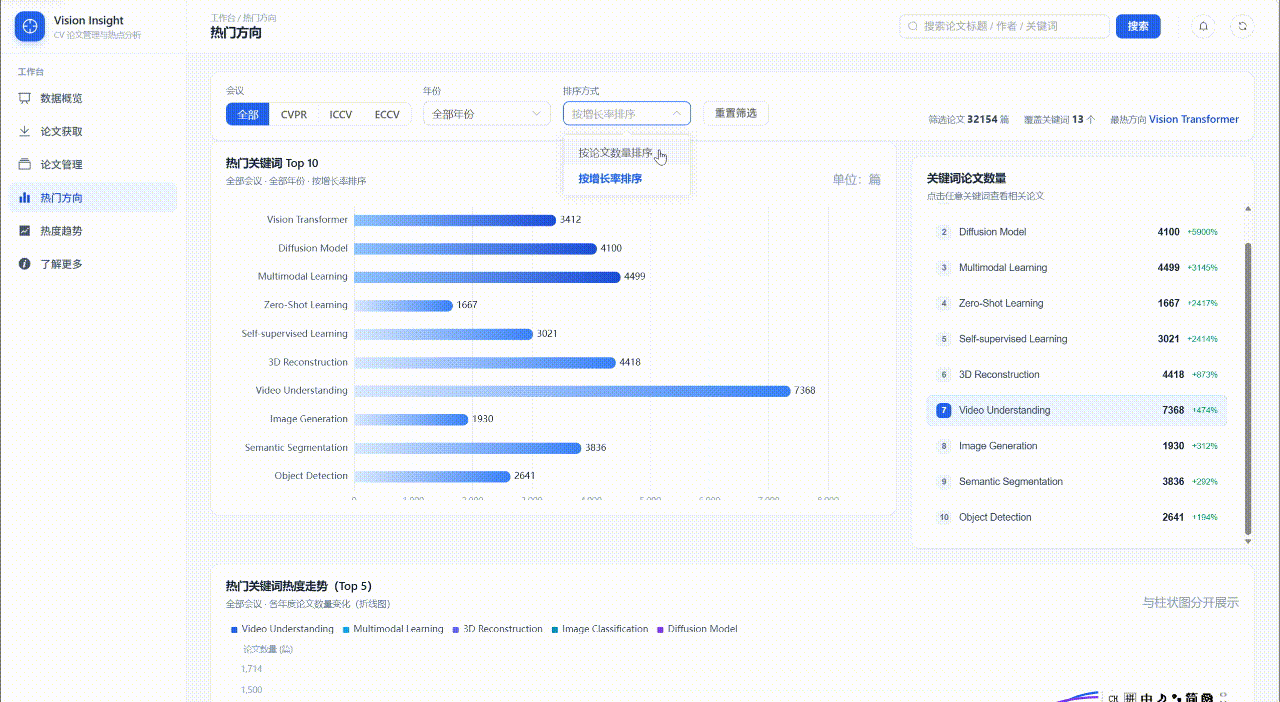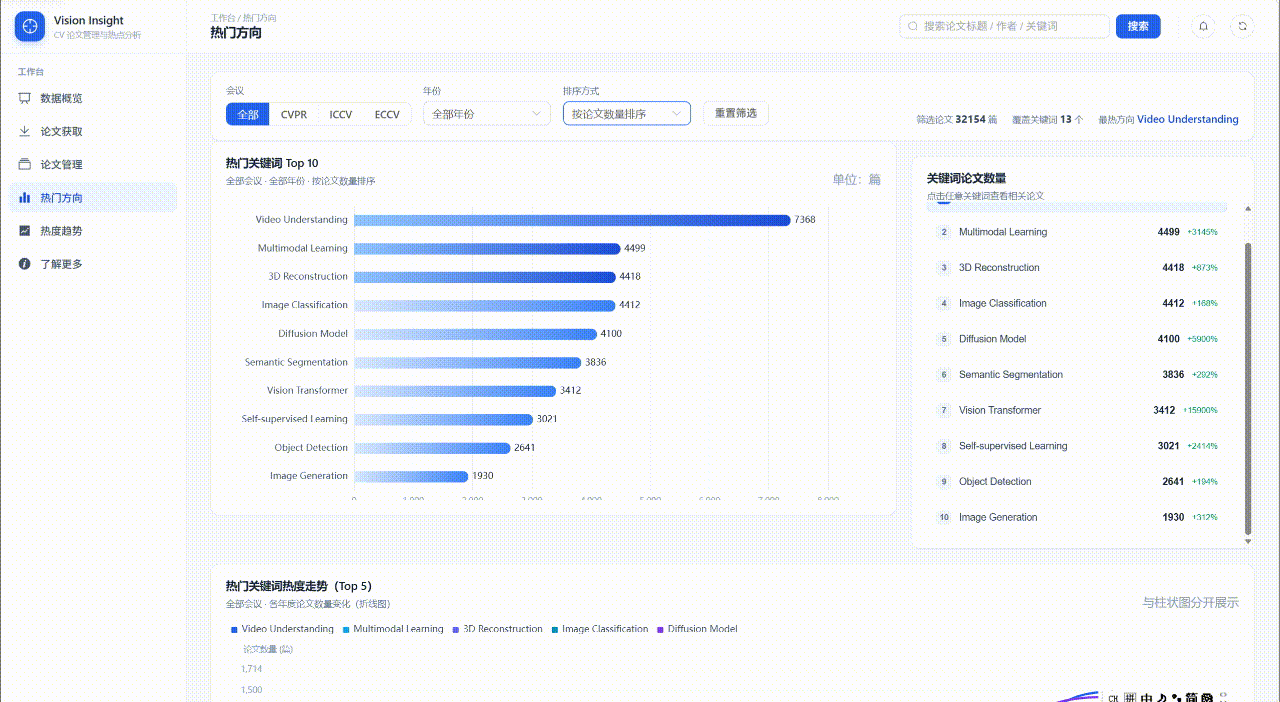
图 10|热门方向页的榜单及对应柱状图。
榜单按当前统计范围内的关联论文数展示热门研究方向。
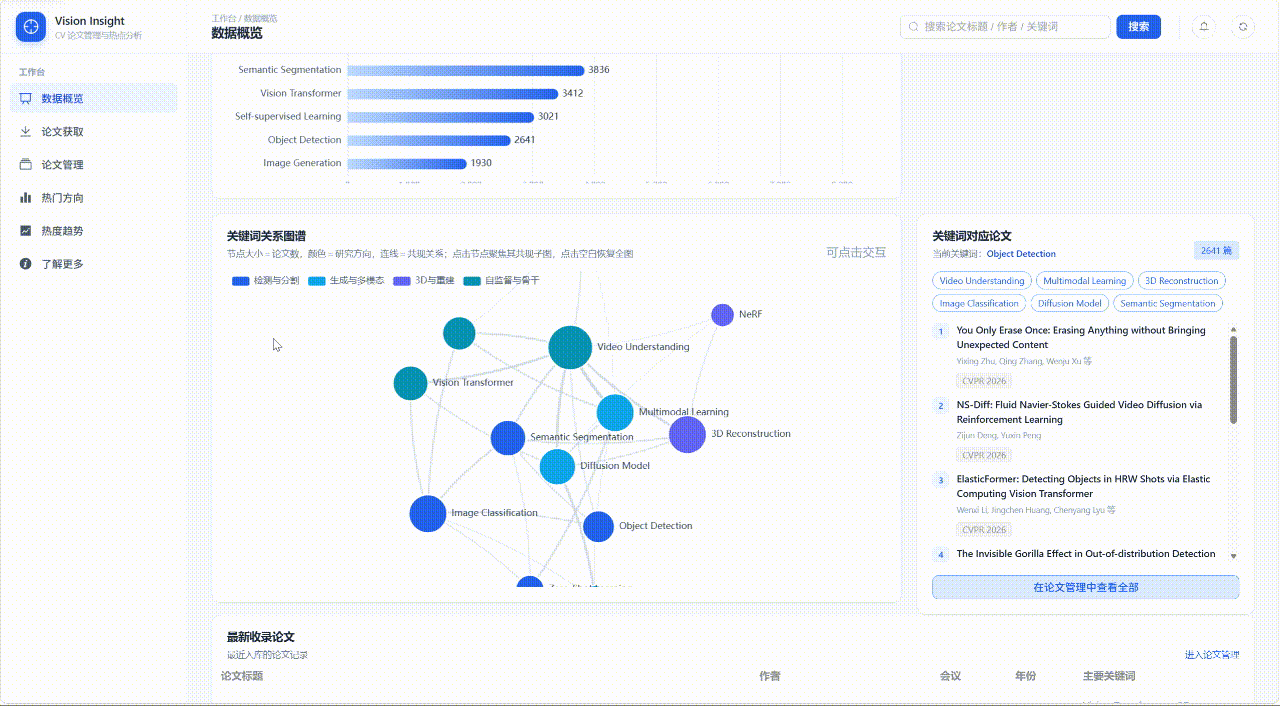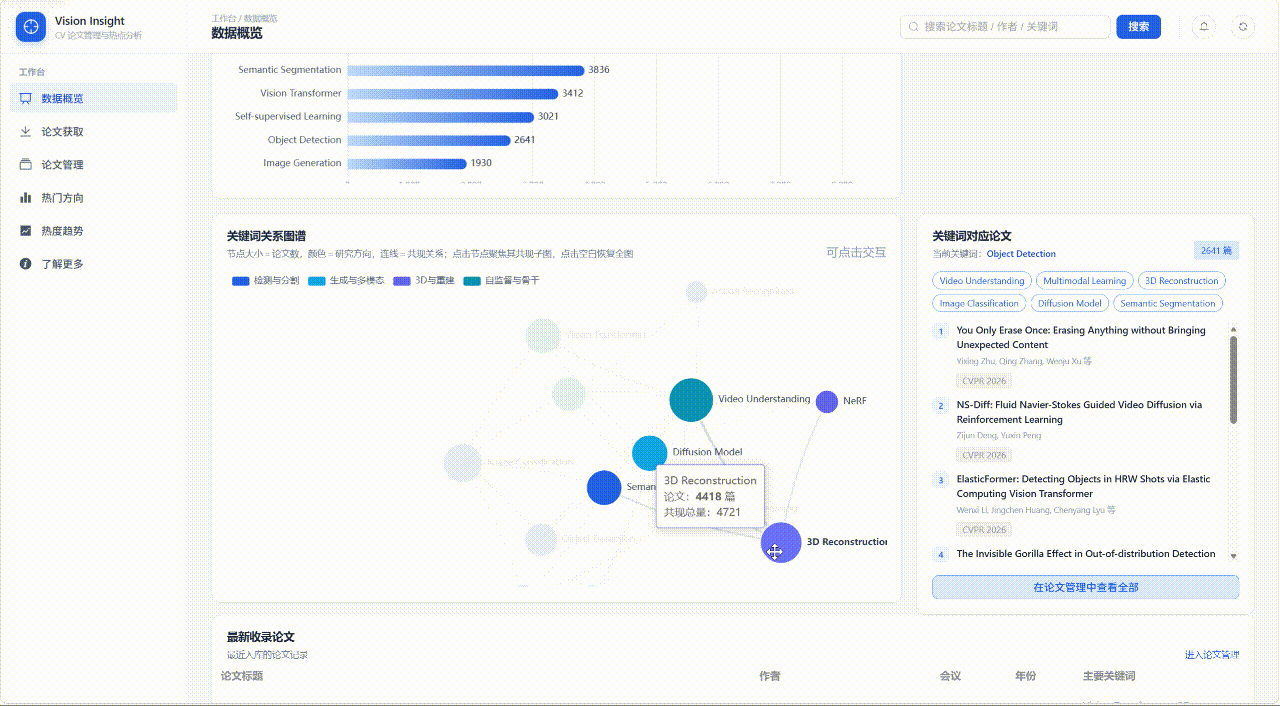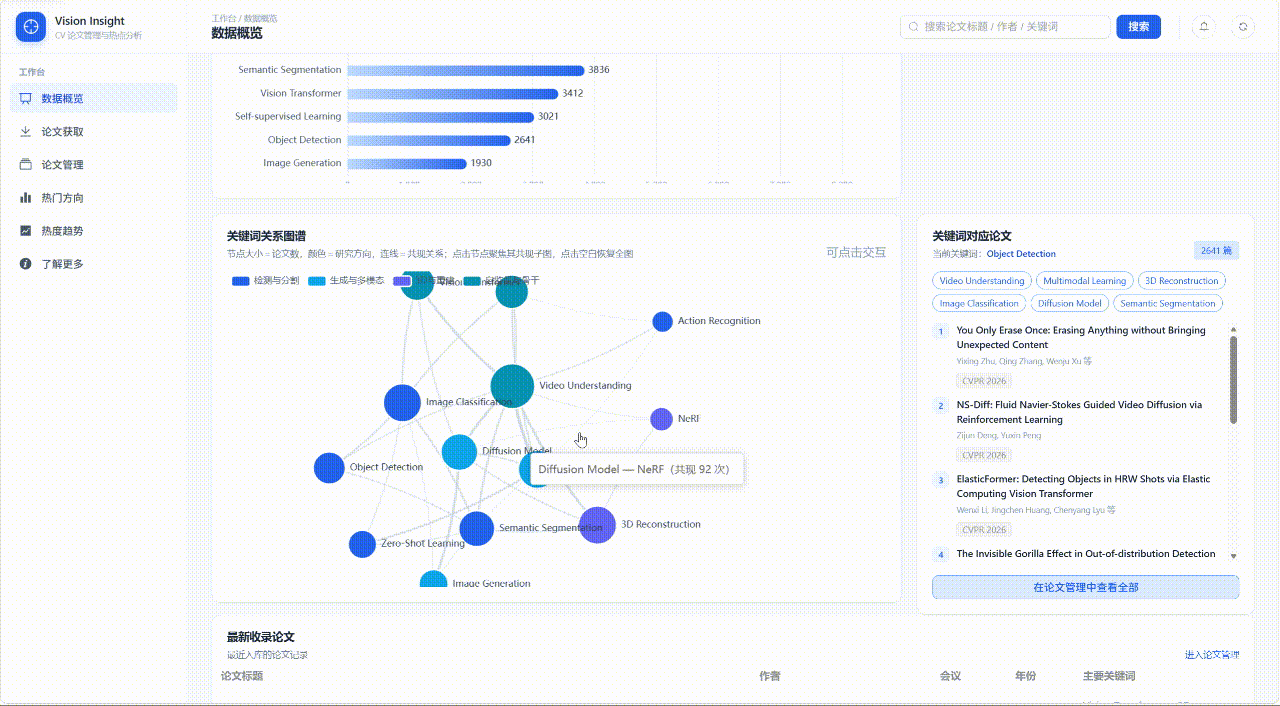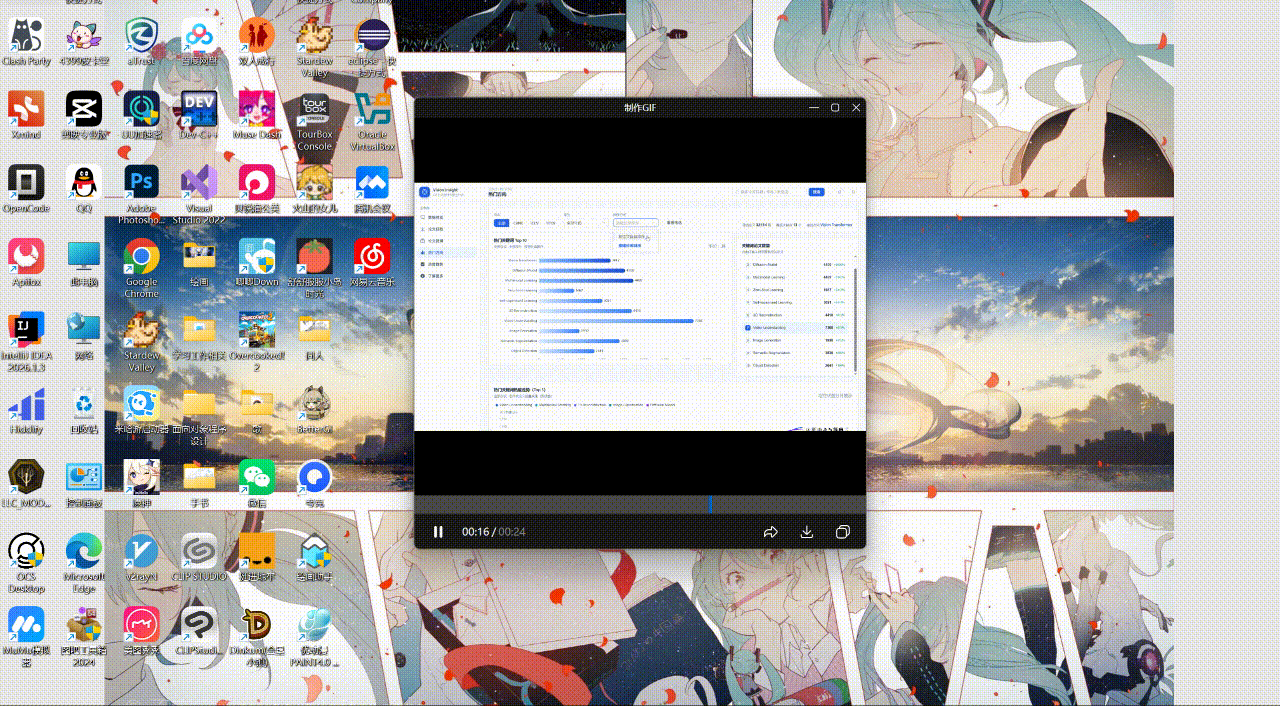
图 11|关键词共现图谱。
节点表示研究方向,节点大小反映关联论文数量,连线表示同一论文中出现的方向组合。图谱通过边裁剪和分类着色减少信息拥挤。
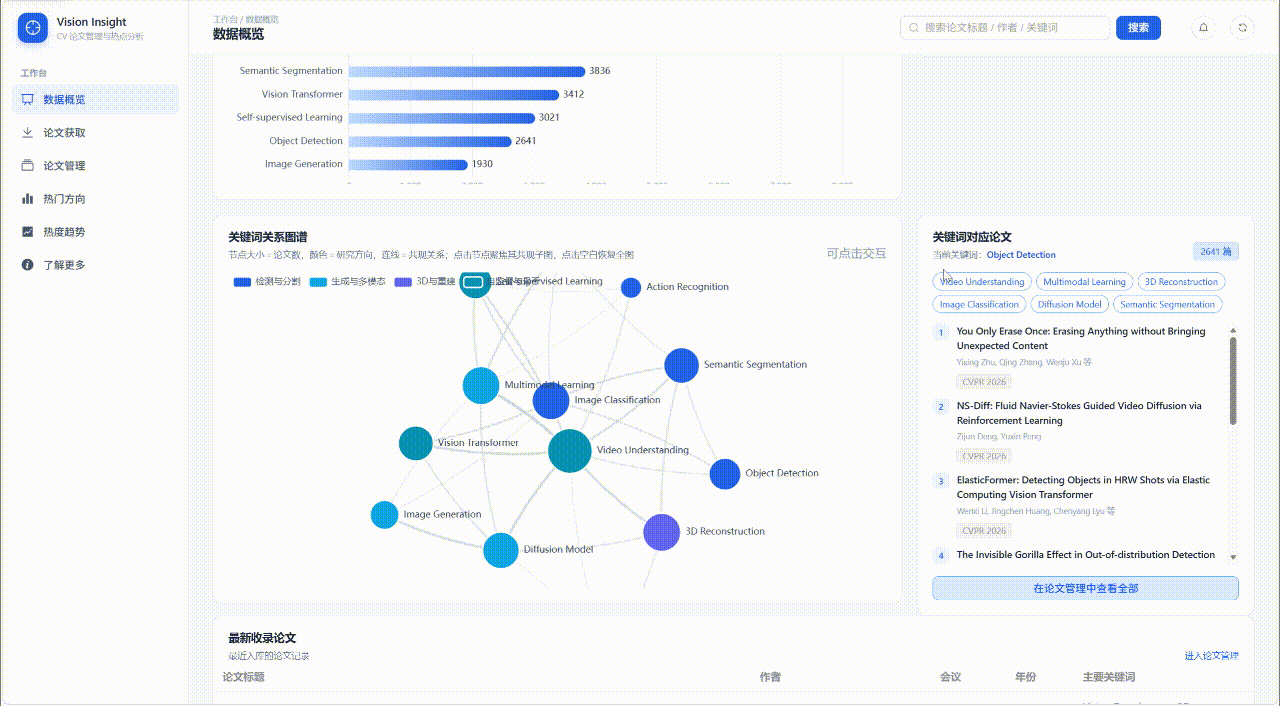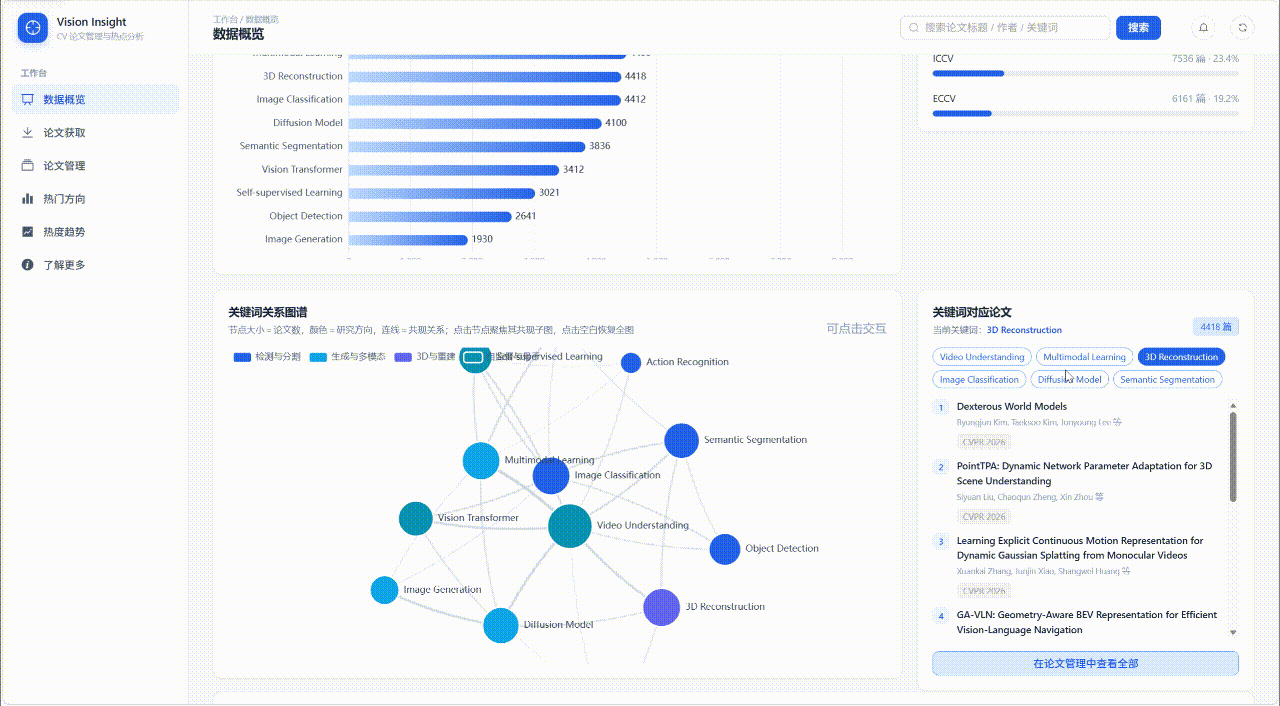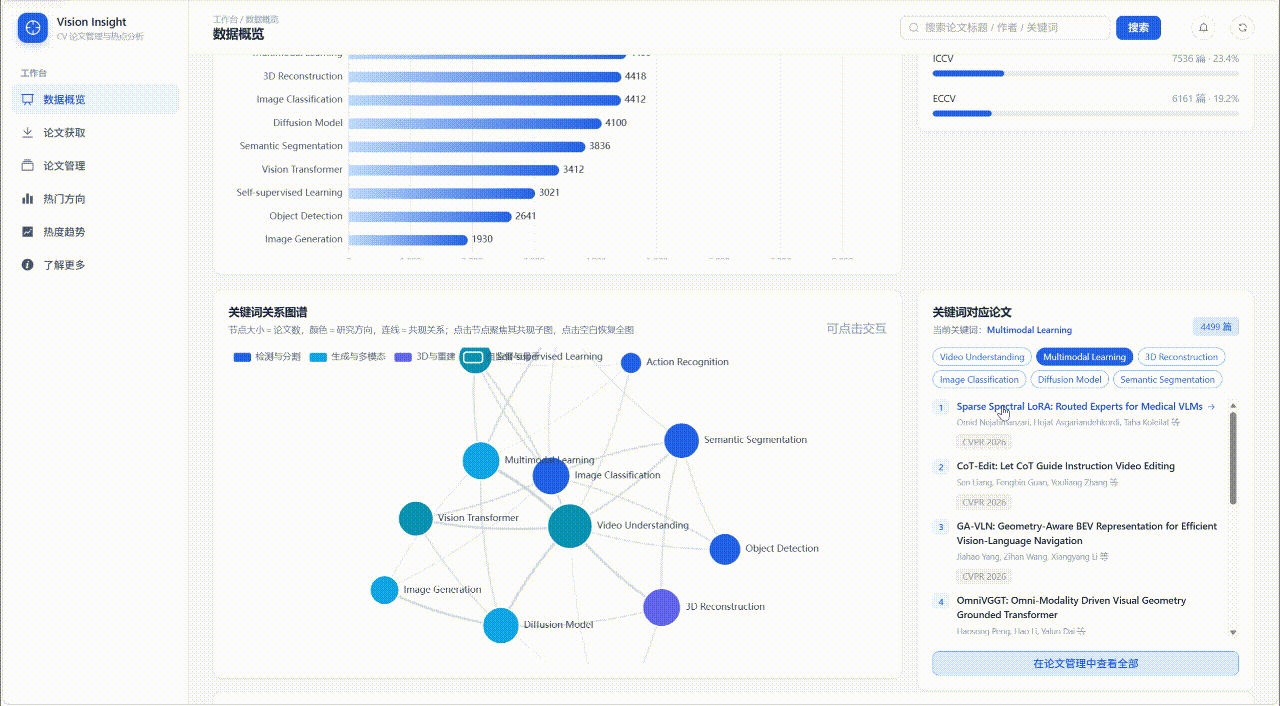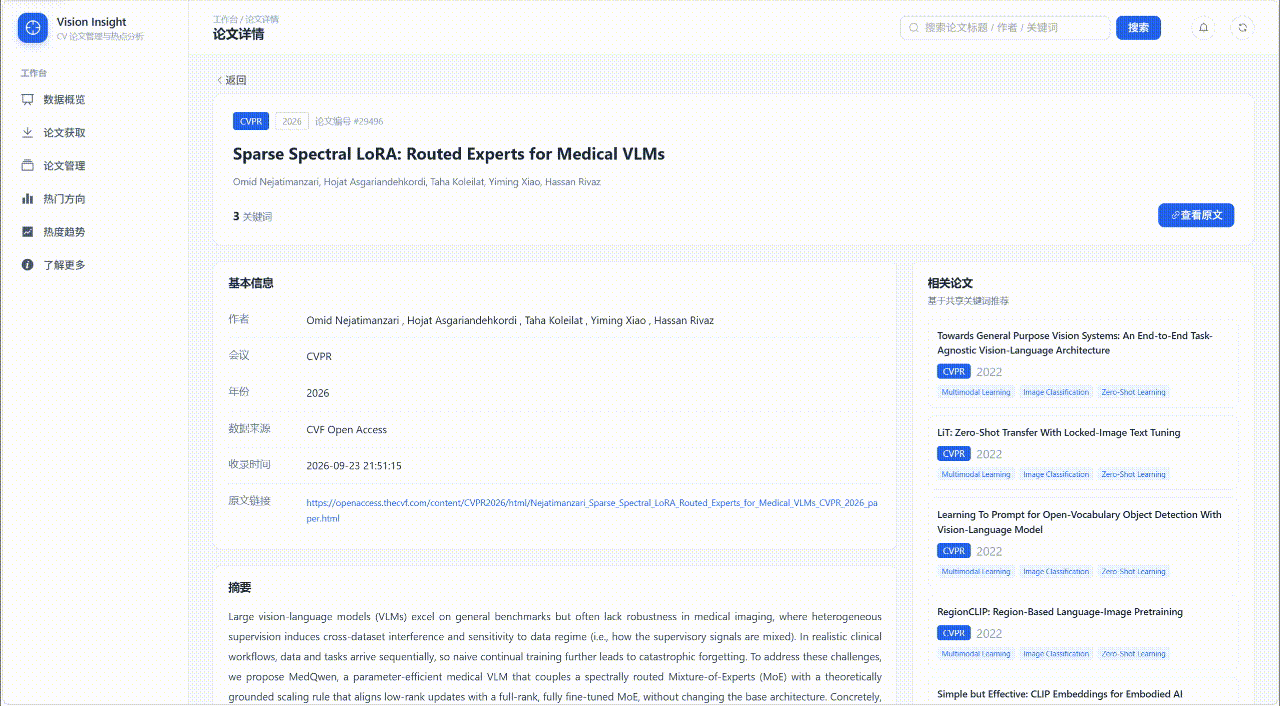
图 12|点击关键词后的论文展示。
点击关键词后,系统加载该方向对应的论文。用户可以从抽象的方向名称进入具体阅读材料,形成“看热点—找论文”的连续操作。
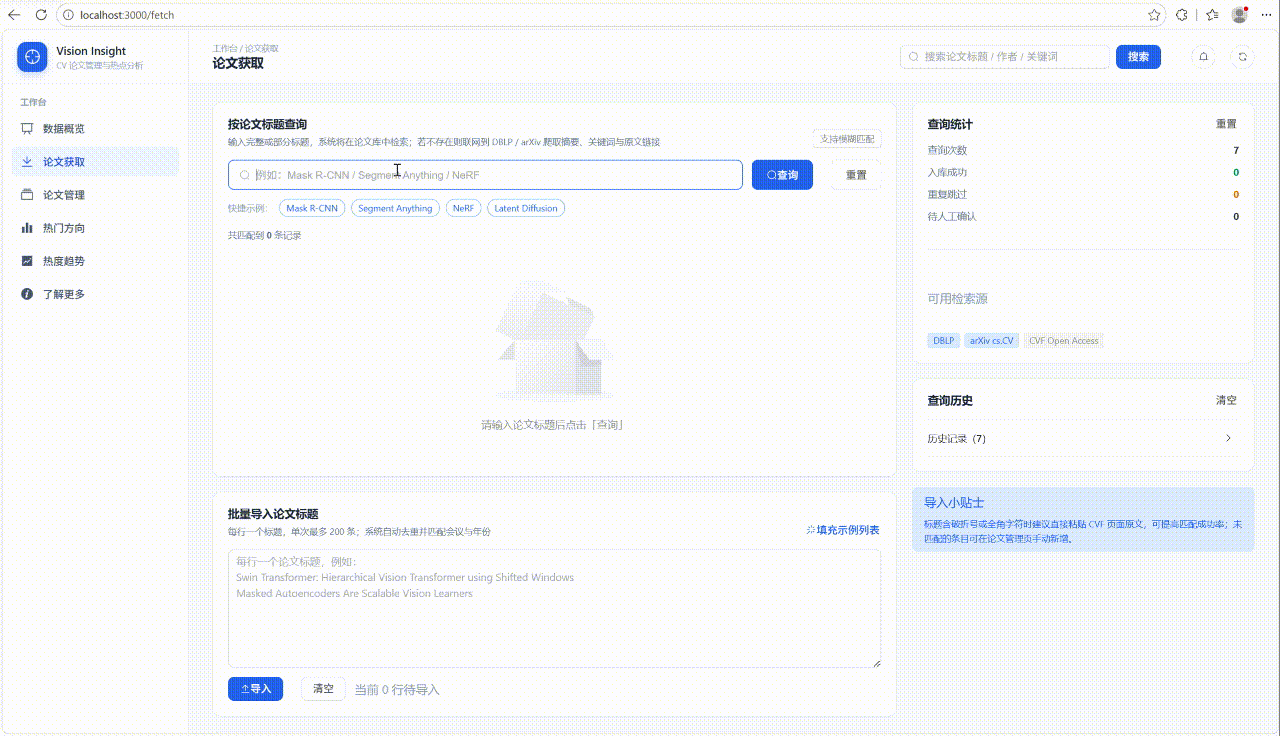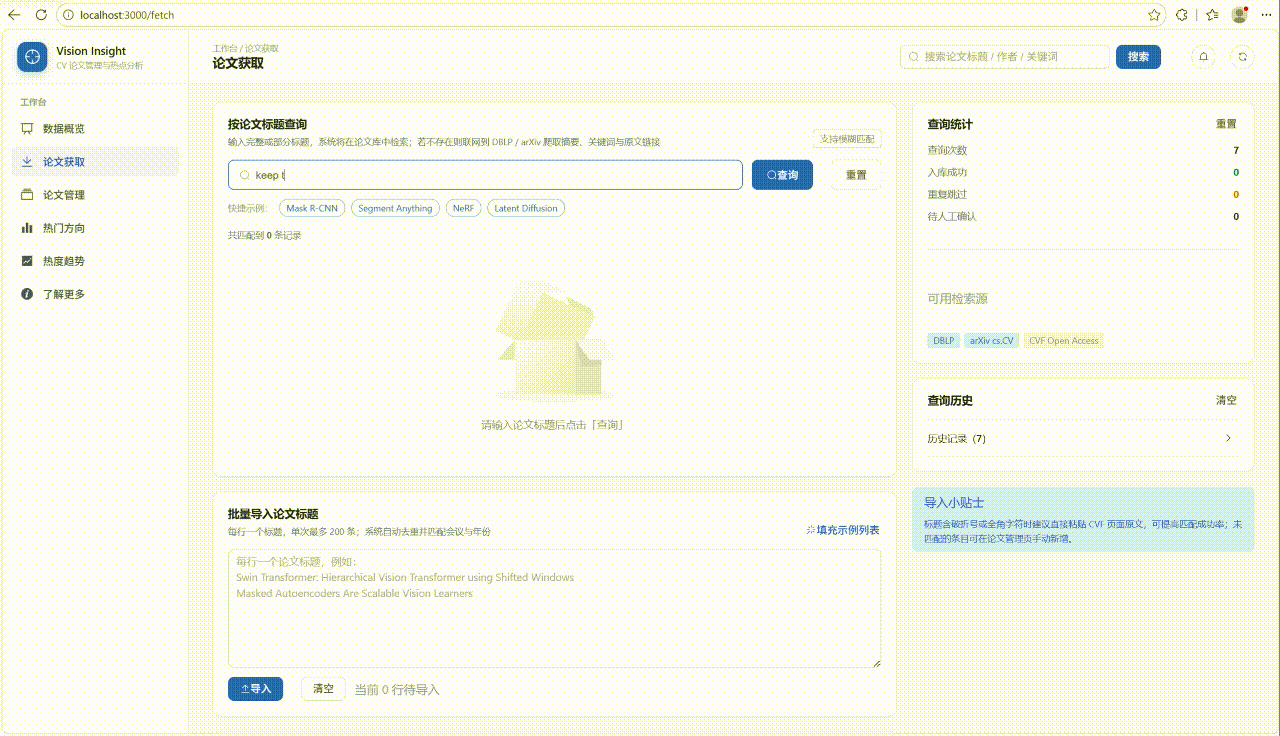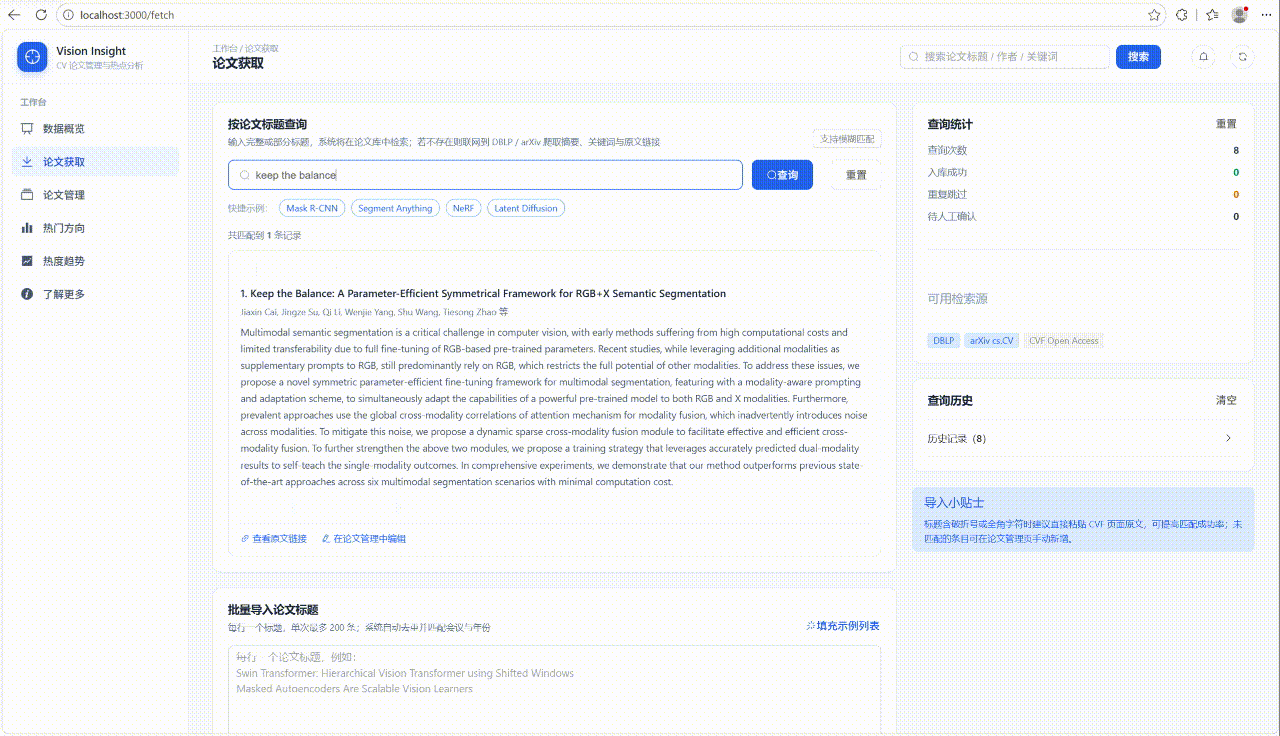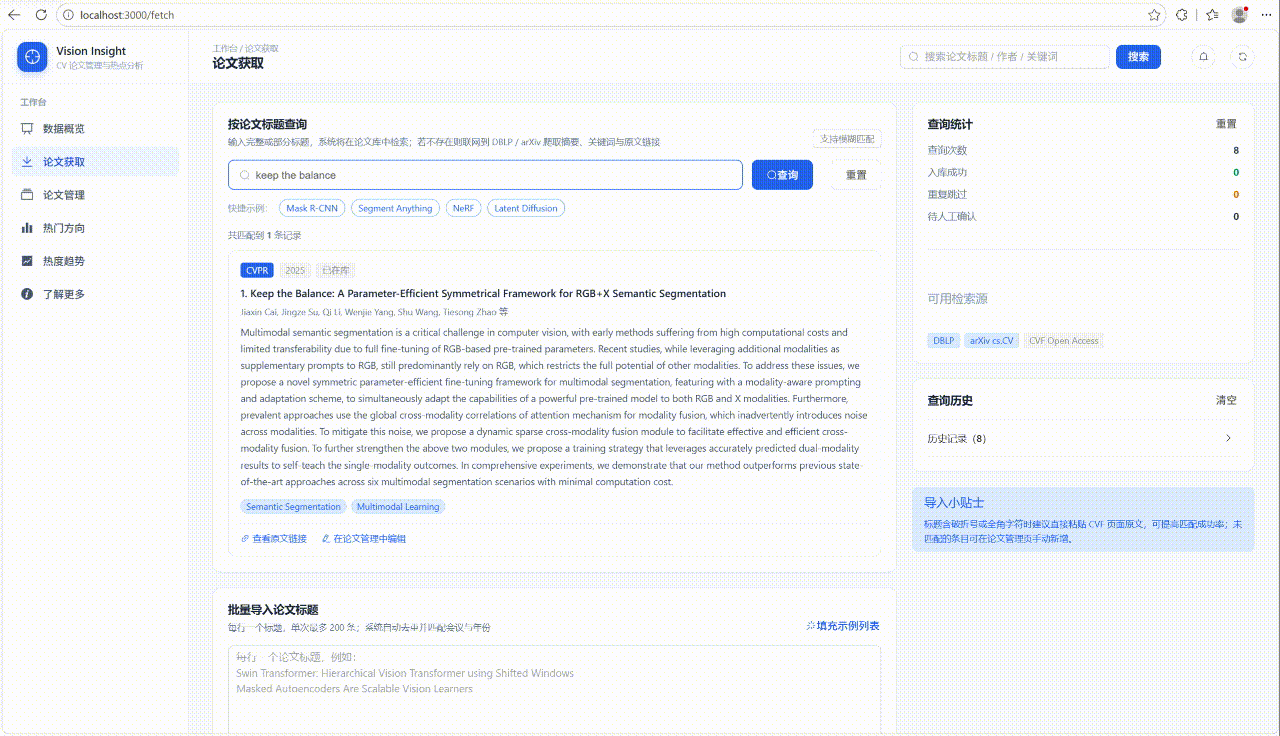
图 13|单篇标题查询。
系统先检索本地论文库;若没有匹配结果,则调用公开数据源尝试获取论文元数据。
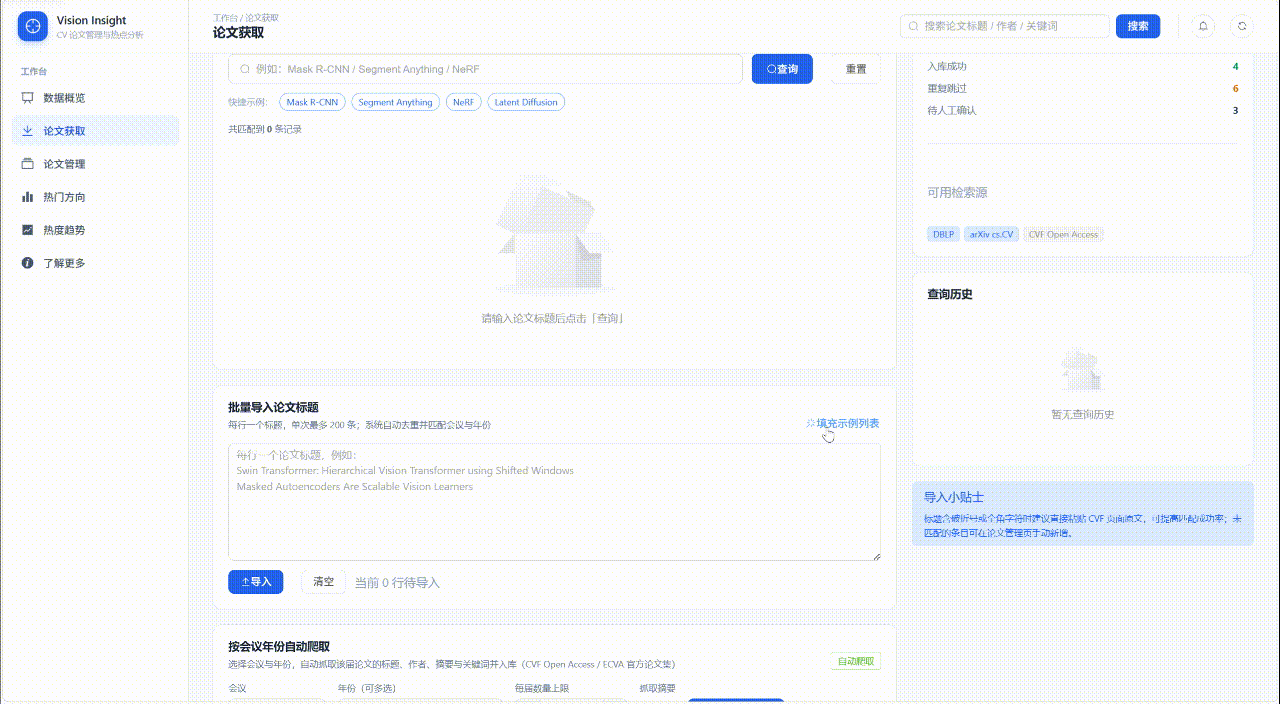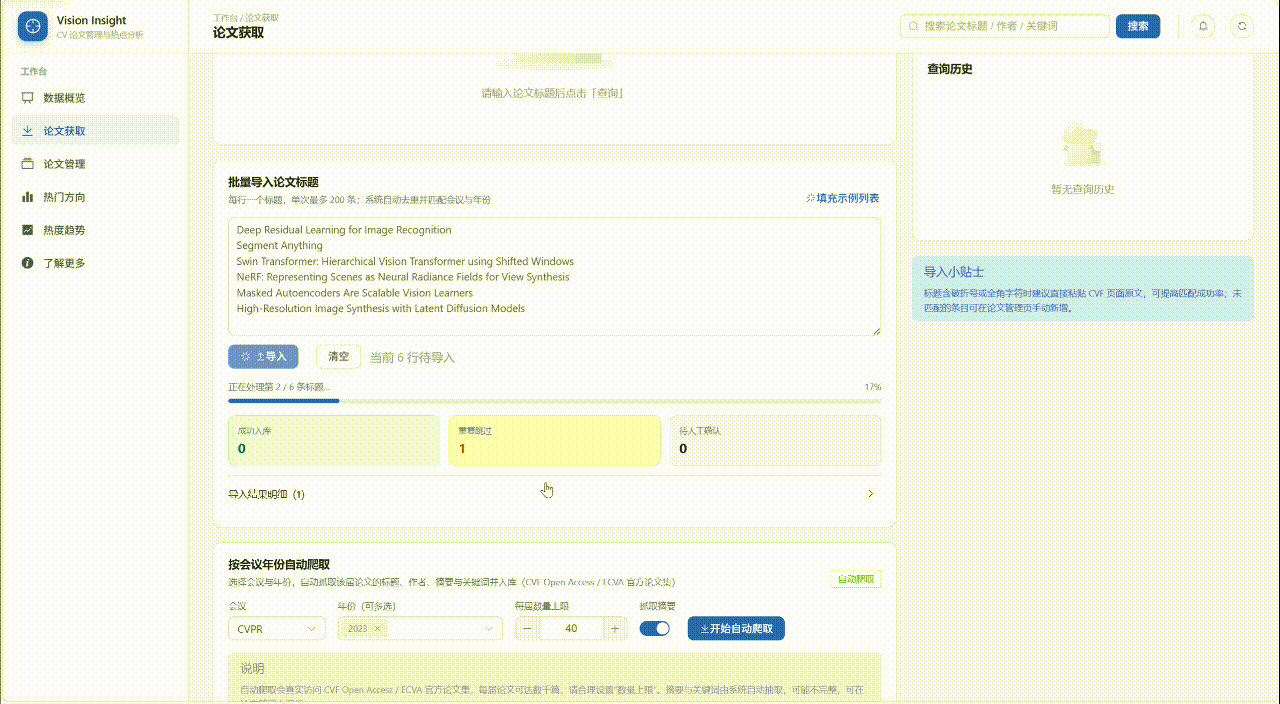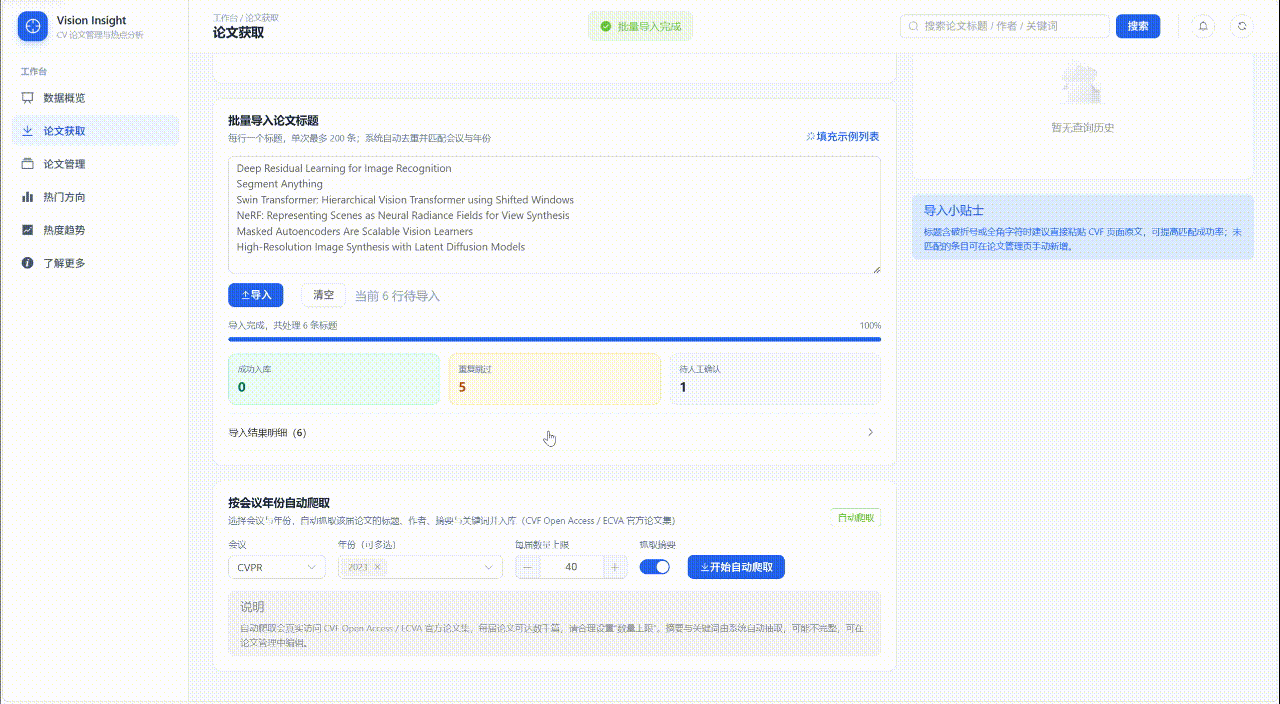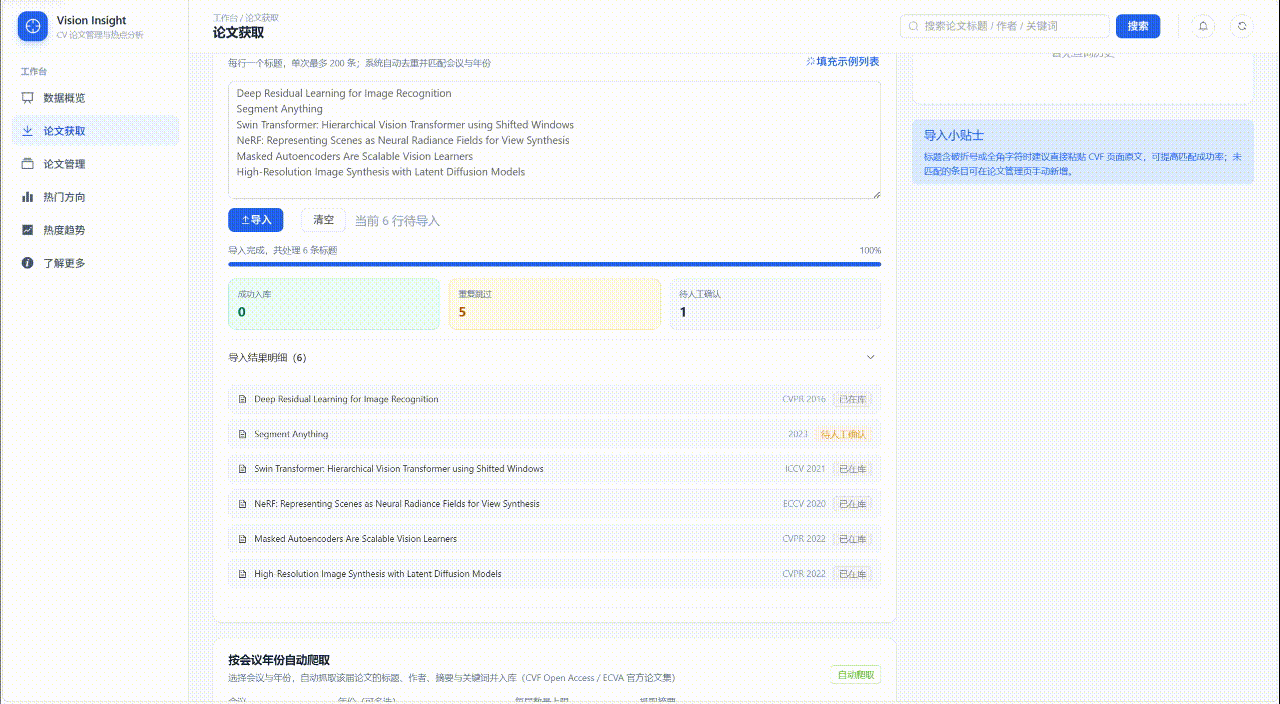
图 14|批量导入过程。
批量导入采用每行一个标题的形式,前端逐条处理并更新进度。用户可以查看哪些论文新增入库、哪些已经存在、哪些需要进一步确认。
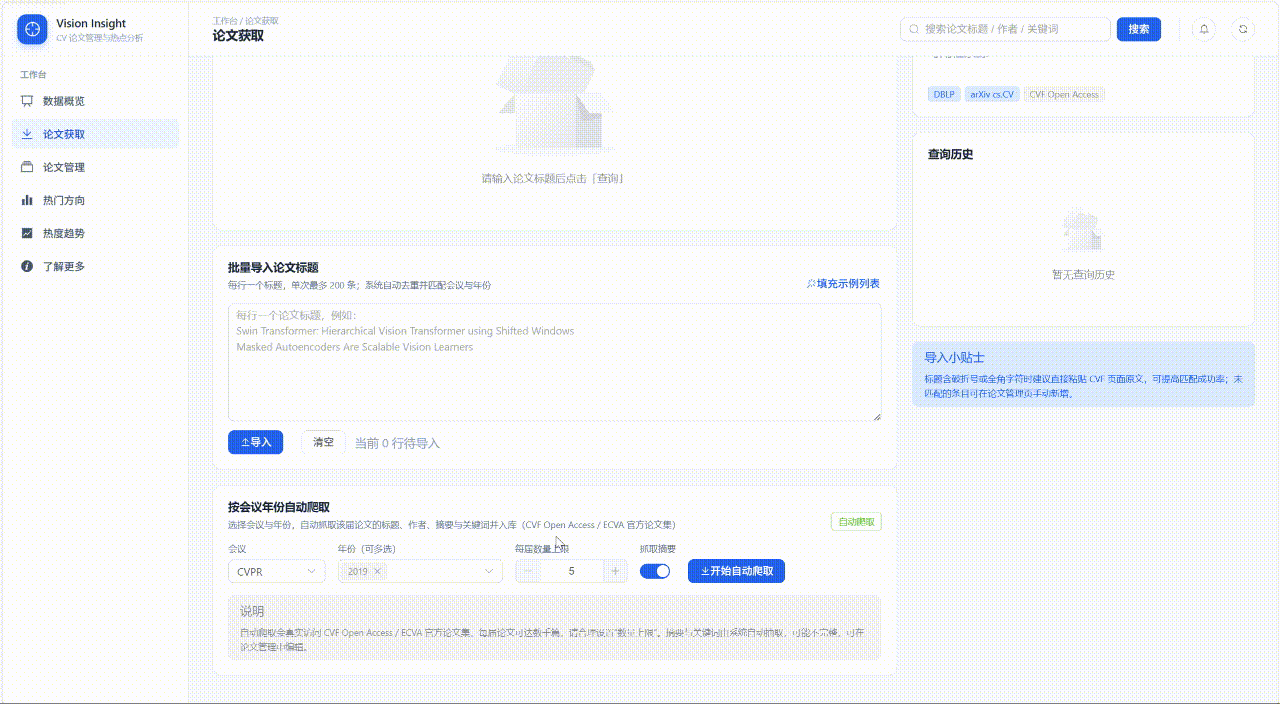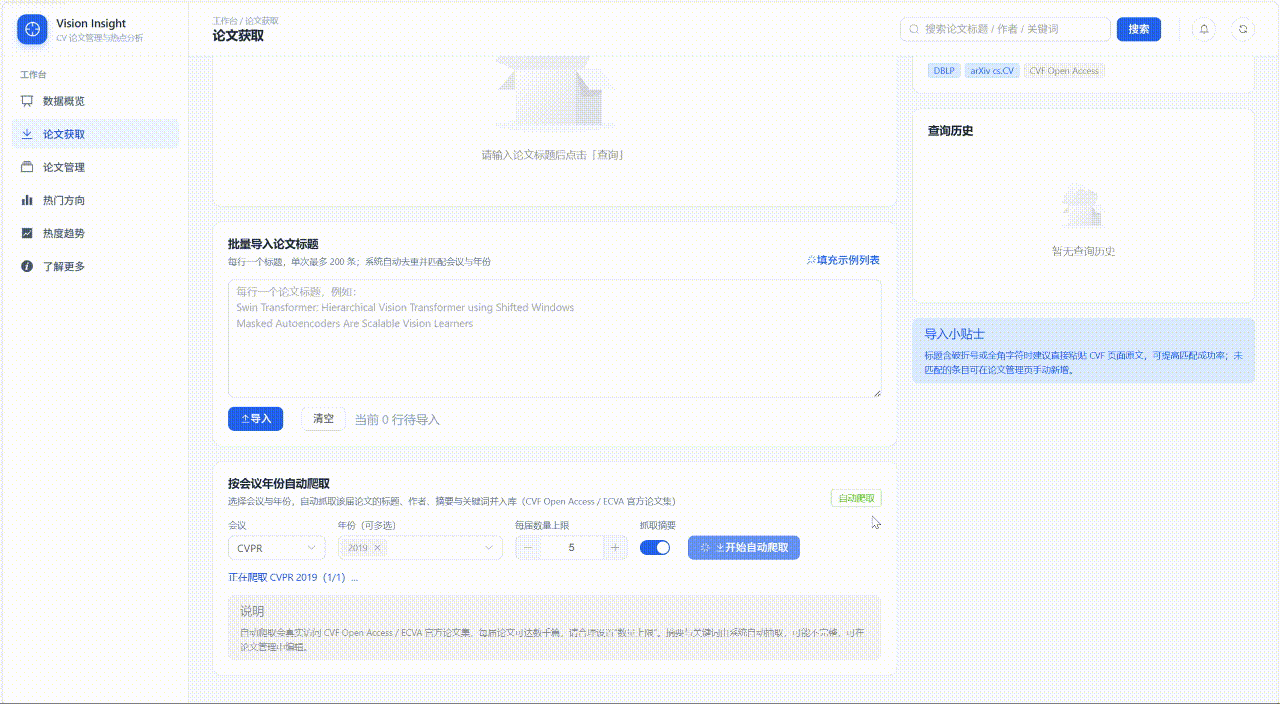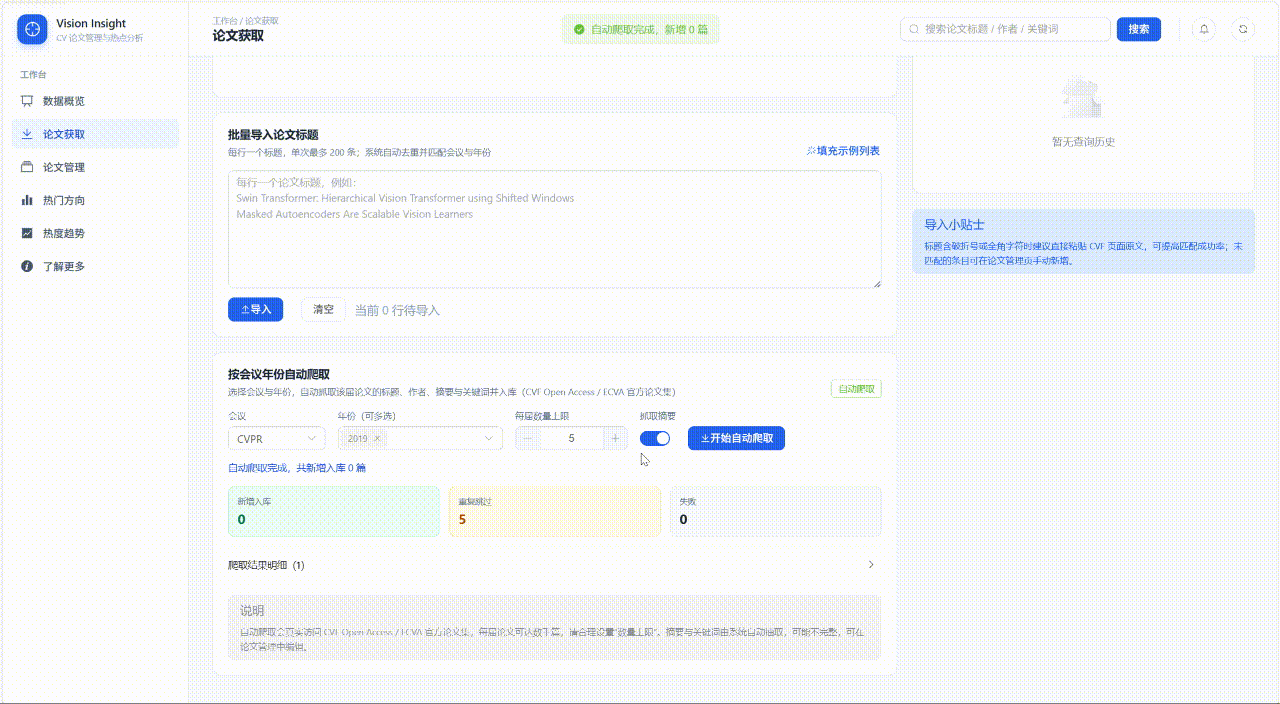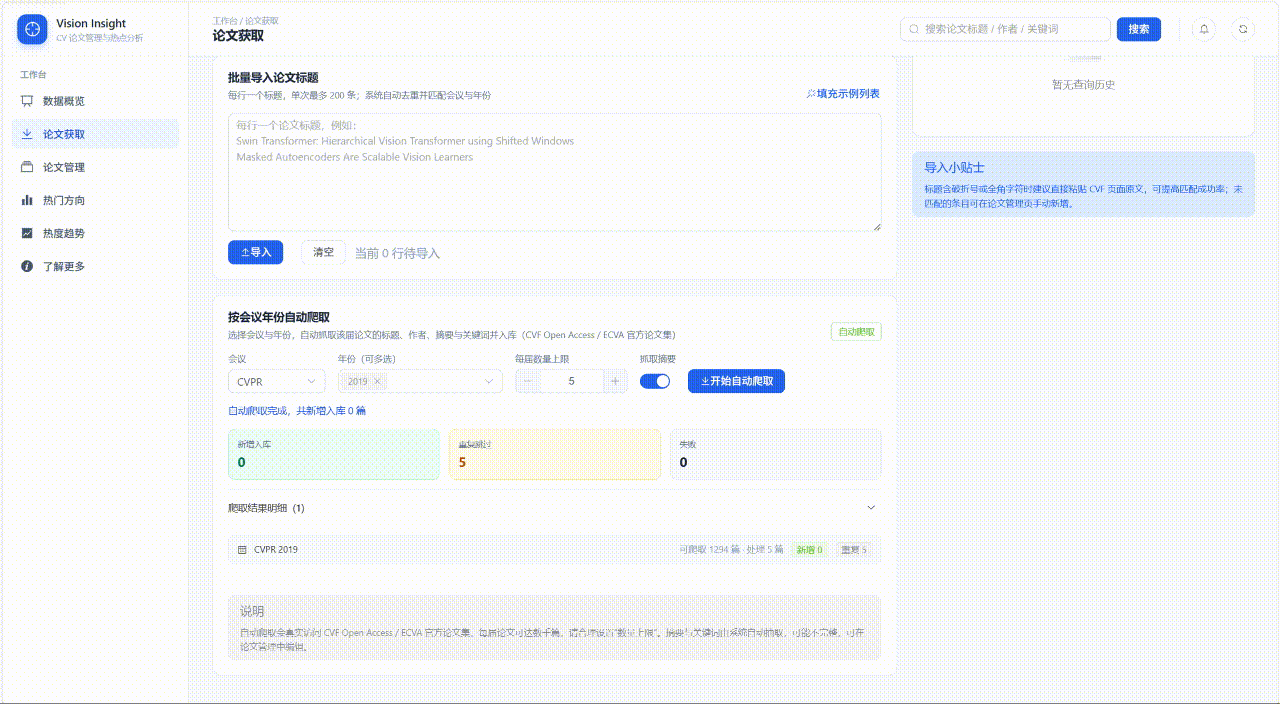
图 15|按会议年份自动爬取。
该功能适合按届建立论文库。当前页面提供有数量上限的抓取入口;全量获取由后端脚本完成,避免把页面有限抓取写成已抓取整届。
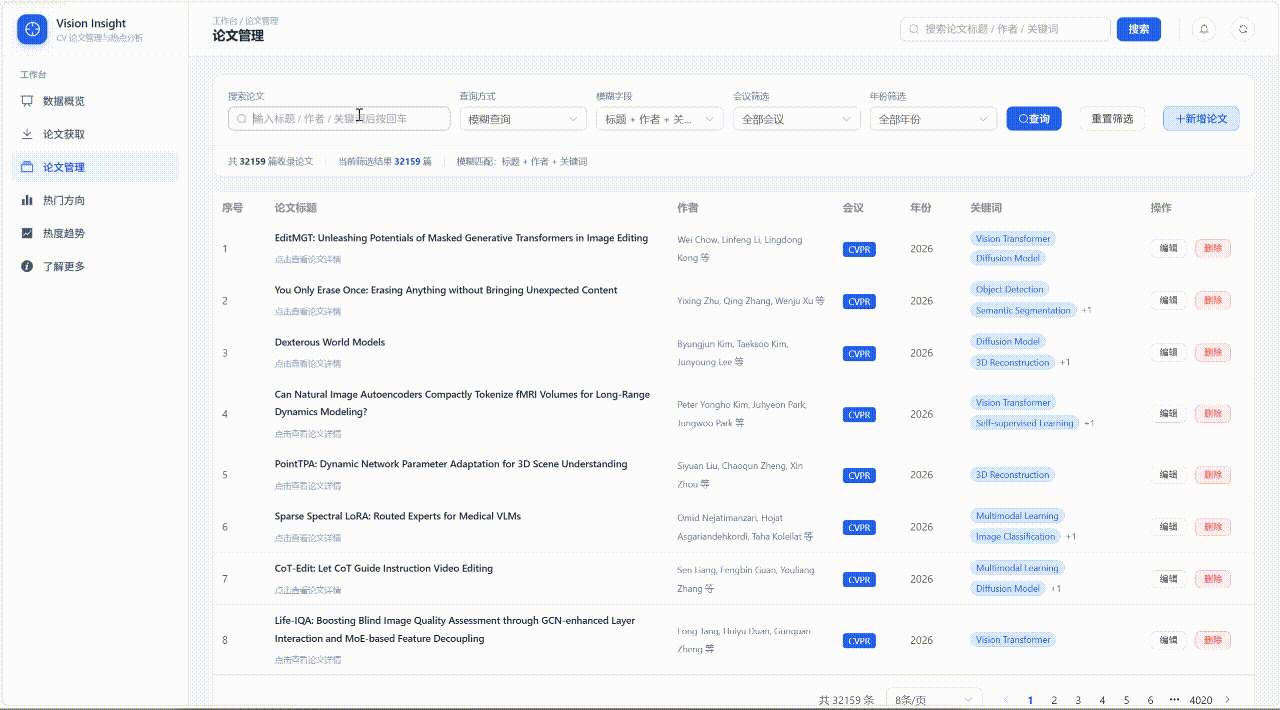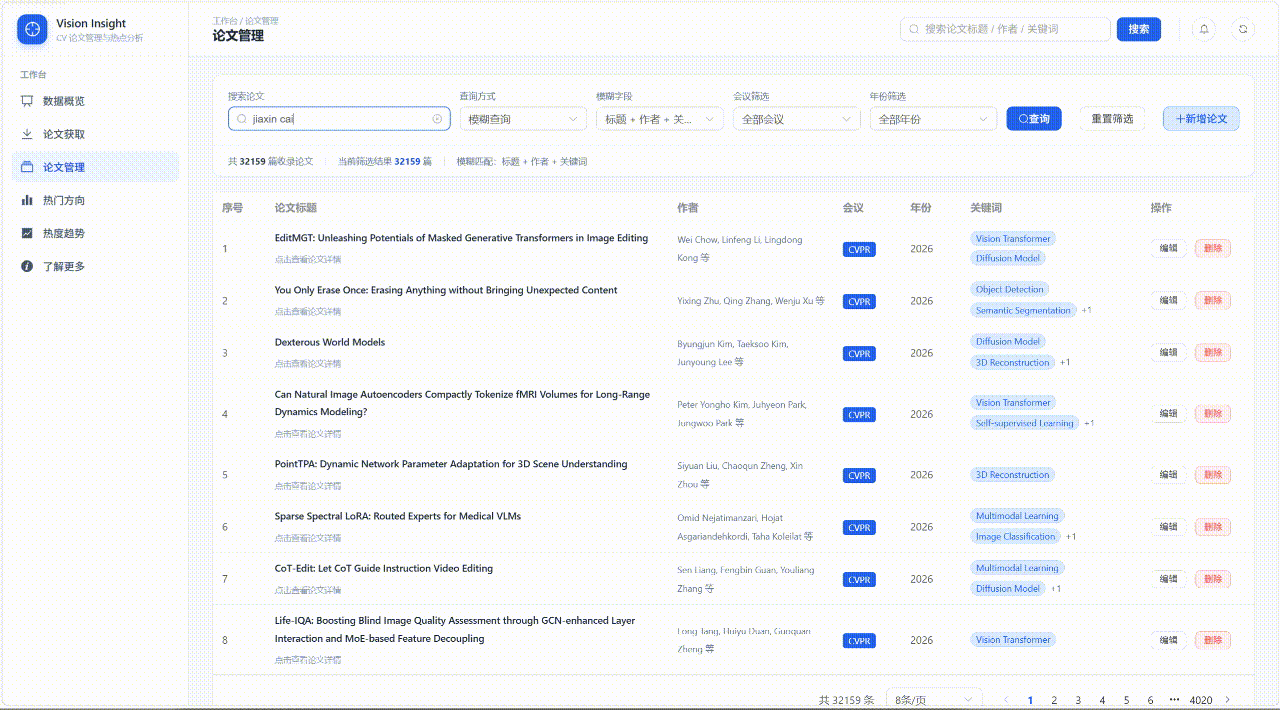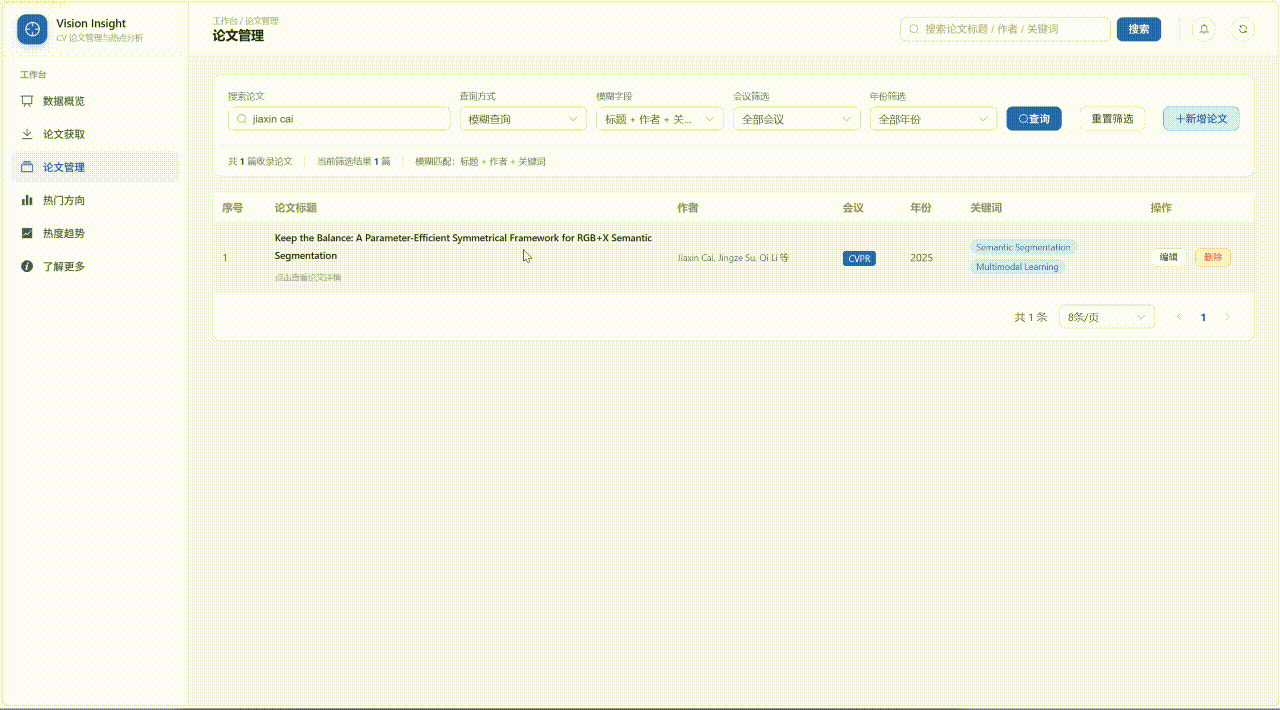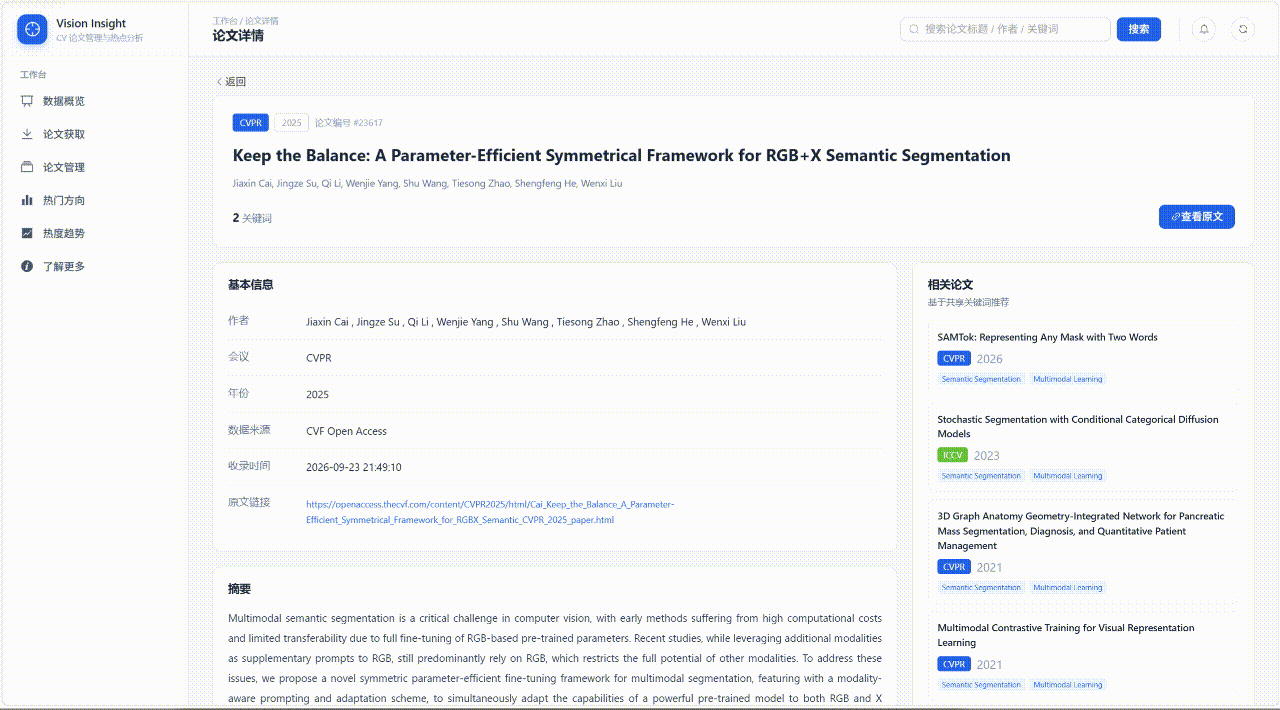
图 16|论文列表与组合筛选。
列表支持标题精确匹配,以及标题、作者、关键词模糊匹配,可结合会议、年份和分页筛选。当前版本尚未支持按稳定论文编号检索。
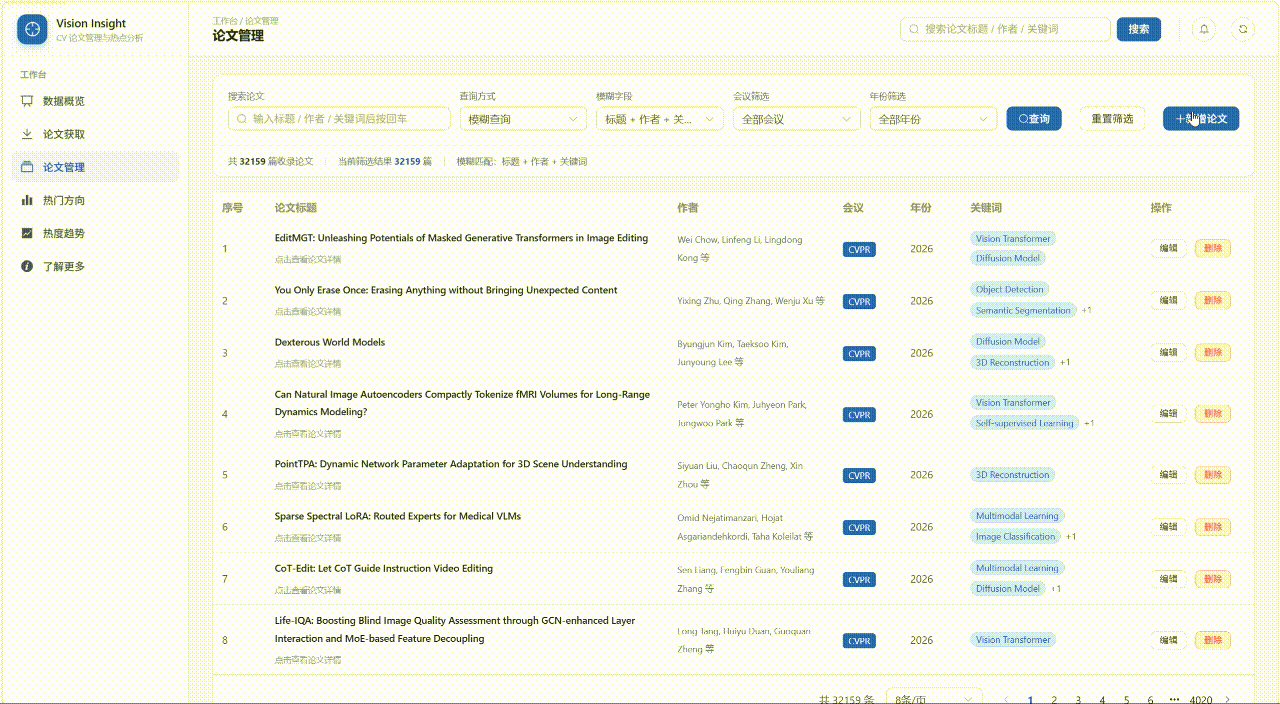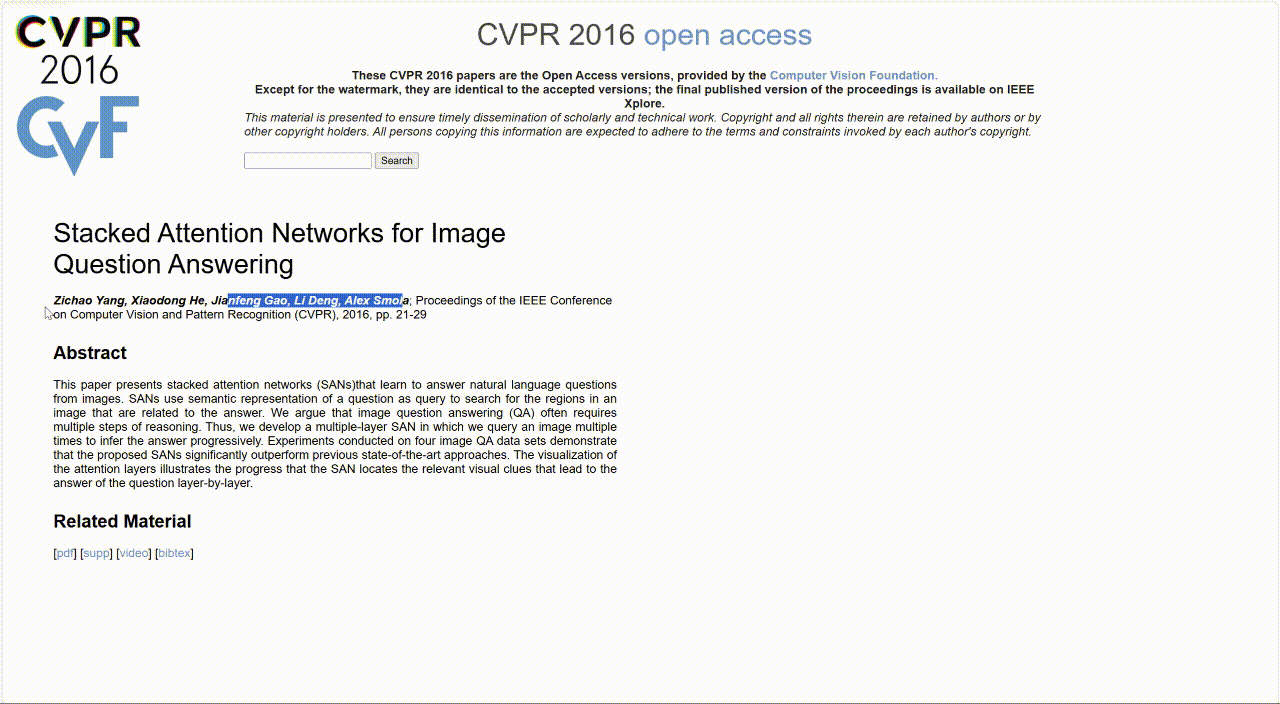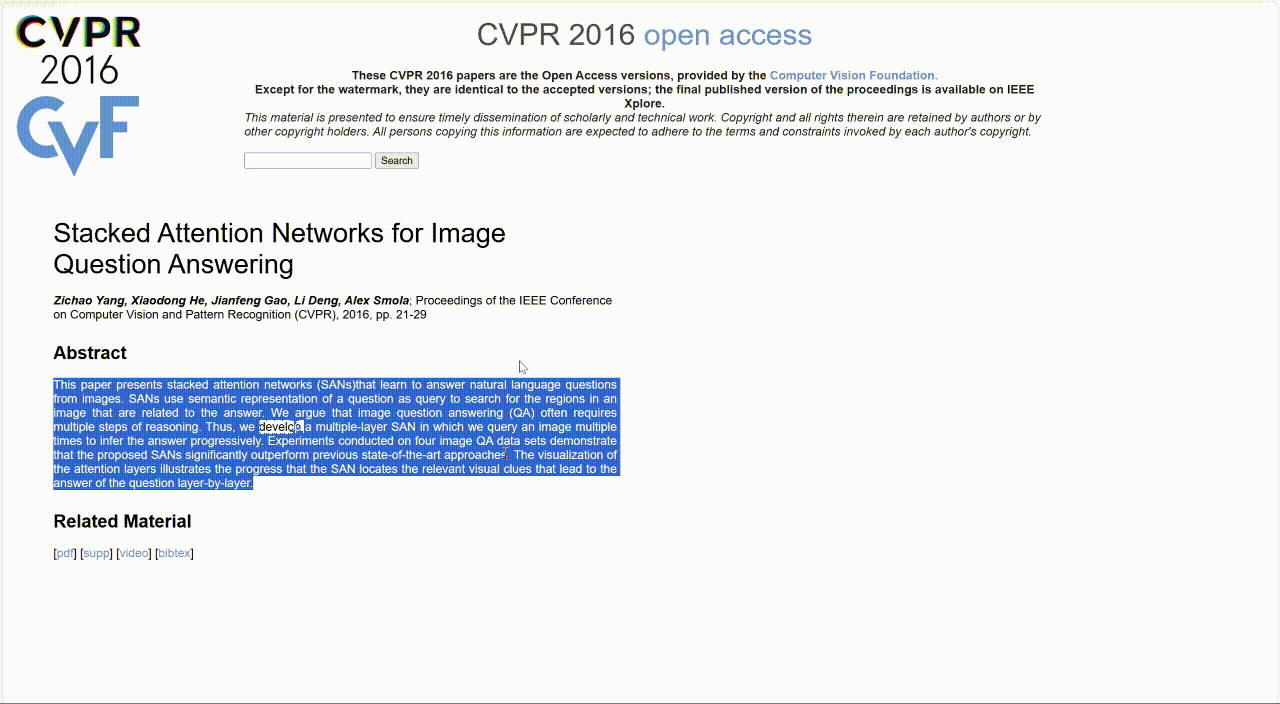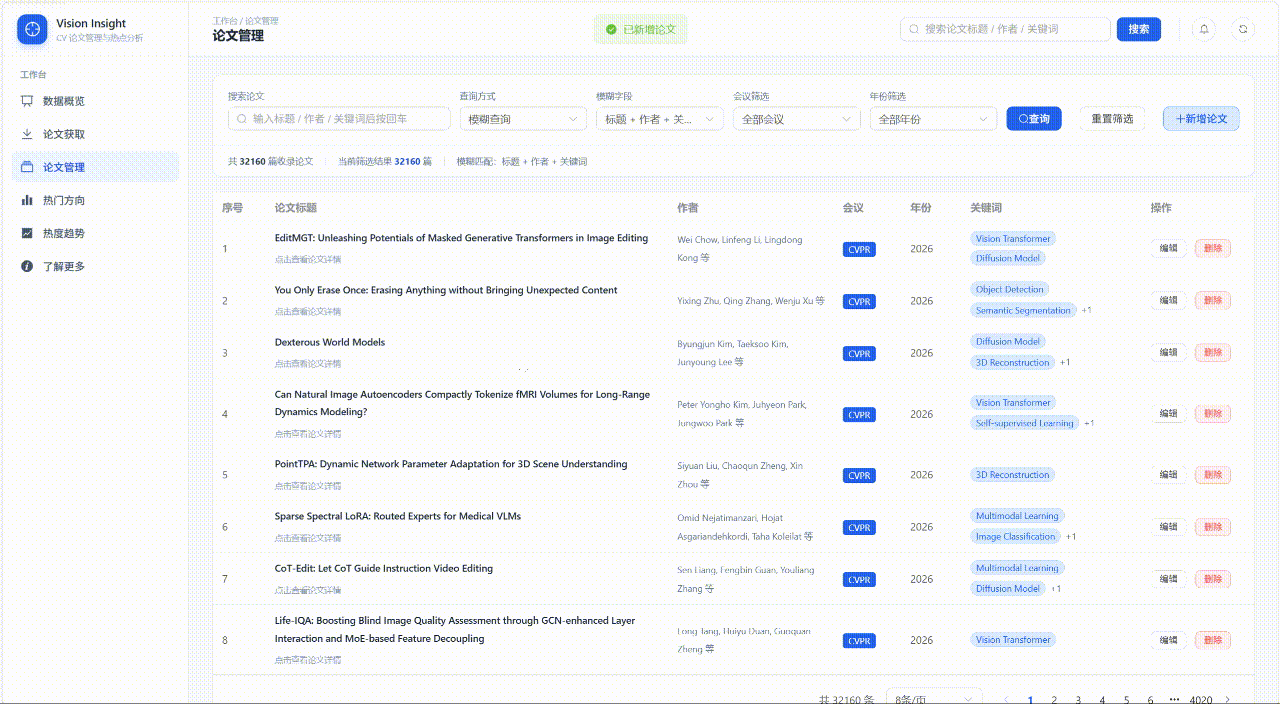
图 17|新增论文。
用户可以手动补充论文标题、会议、年份、关键词、摘要与链接。保存后论文进入数据库,后续统计请求重新计算。
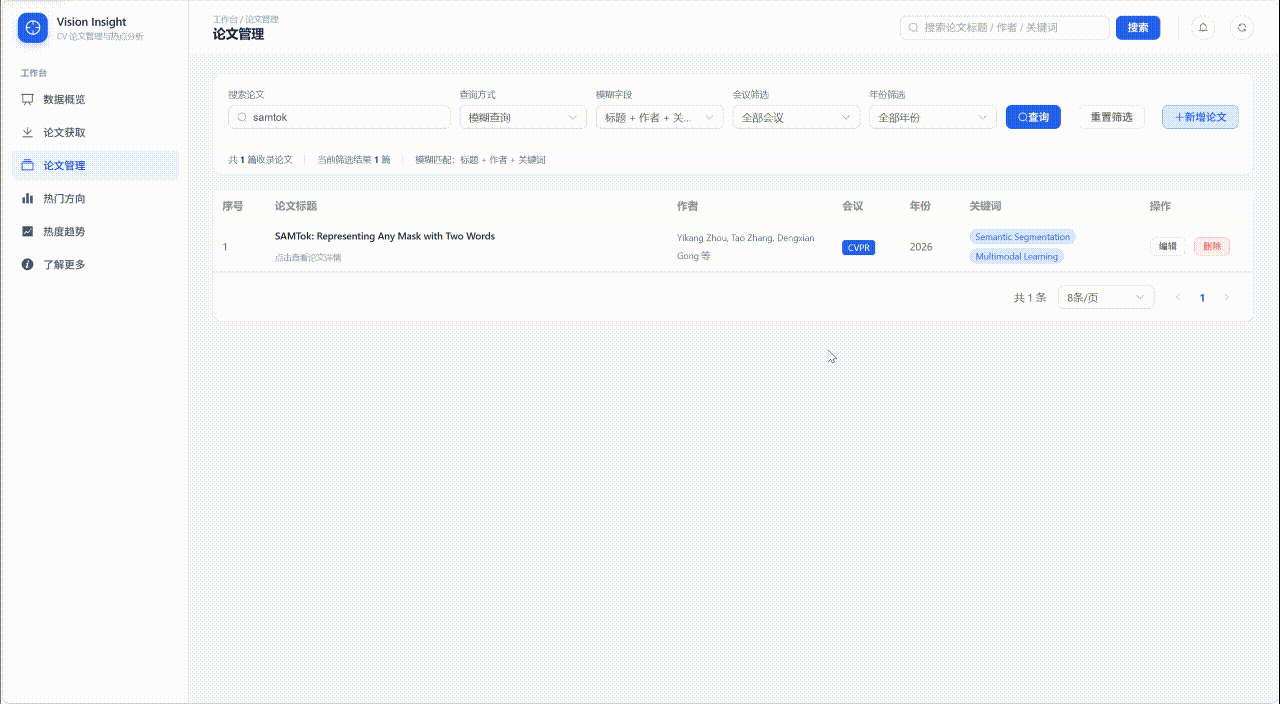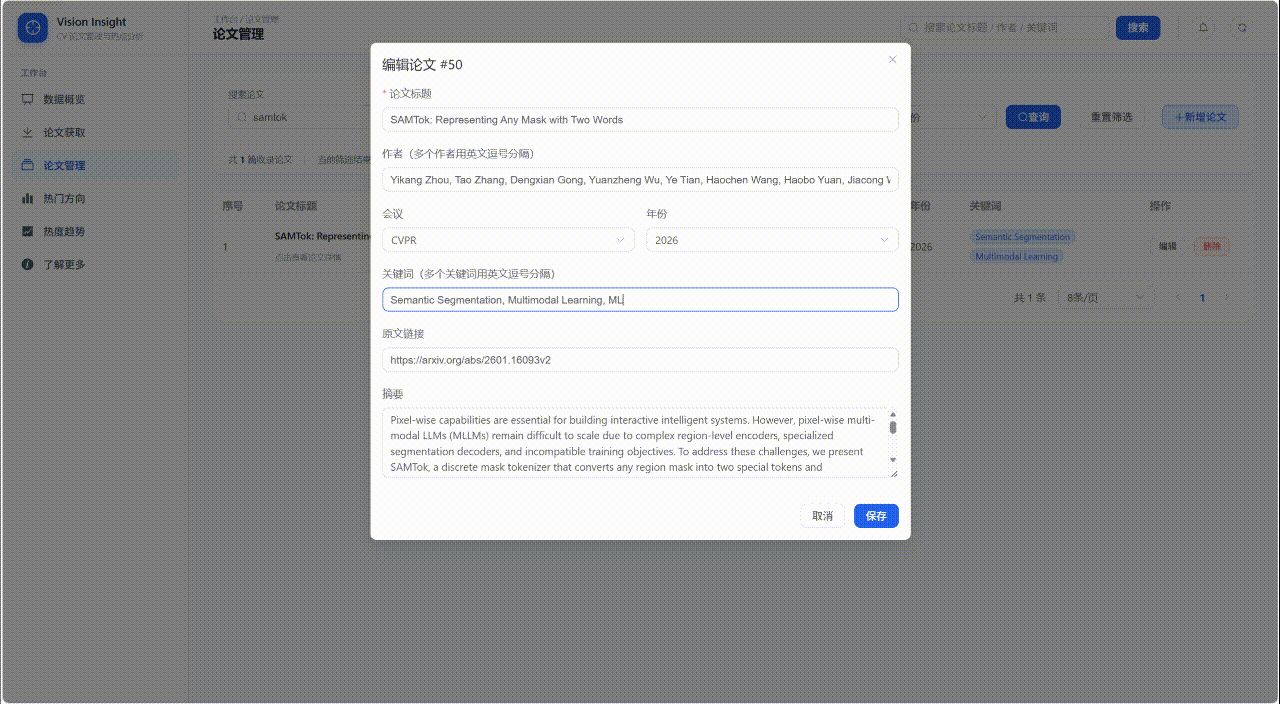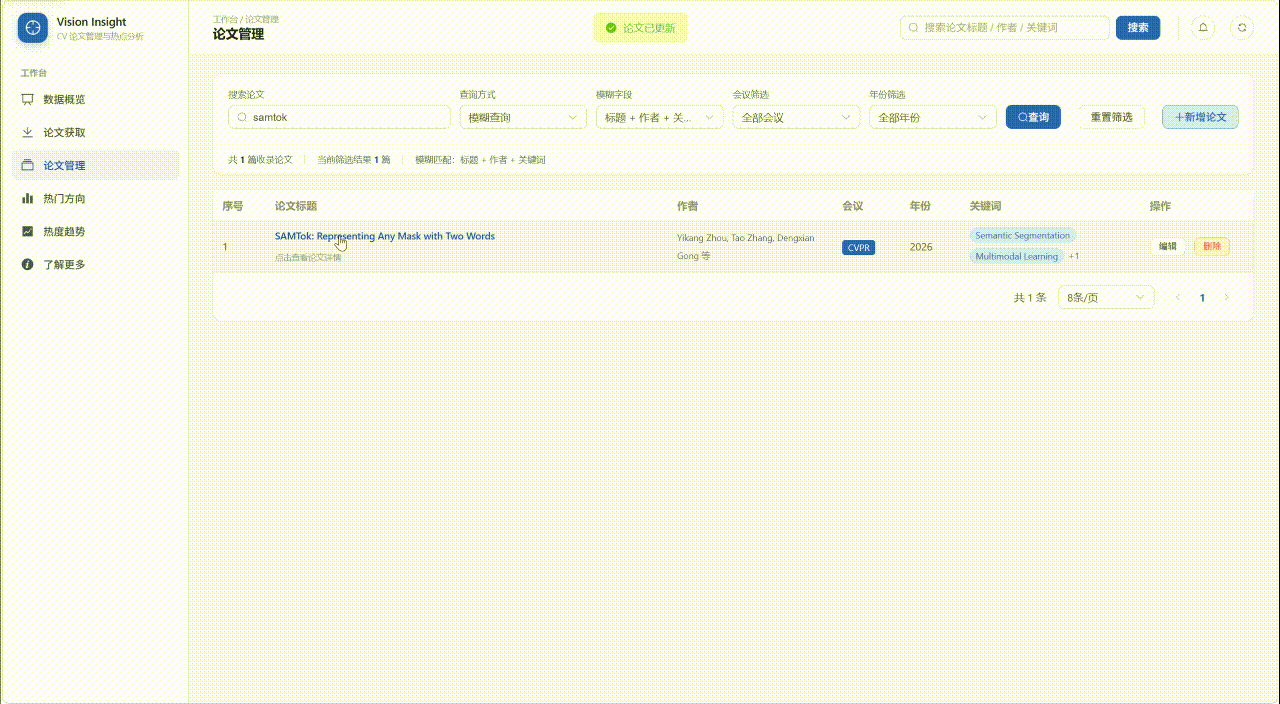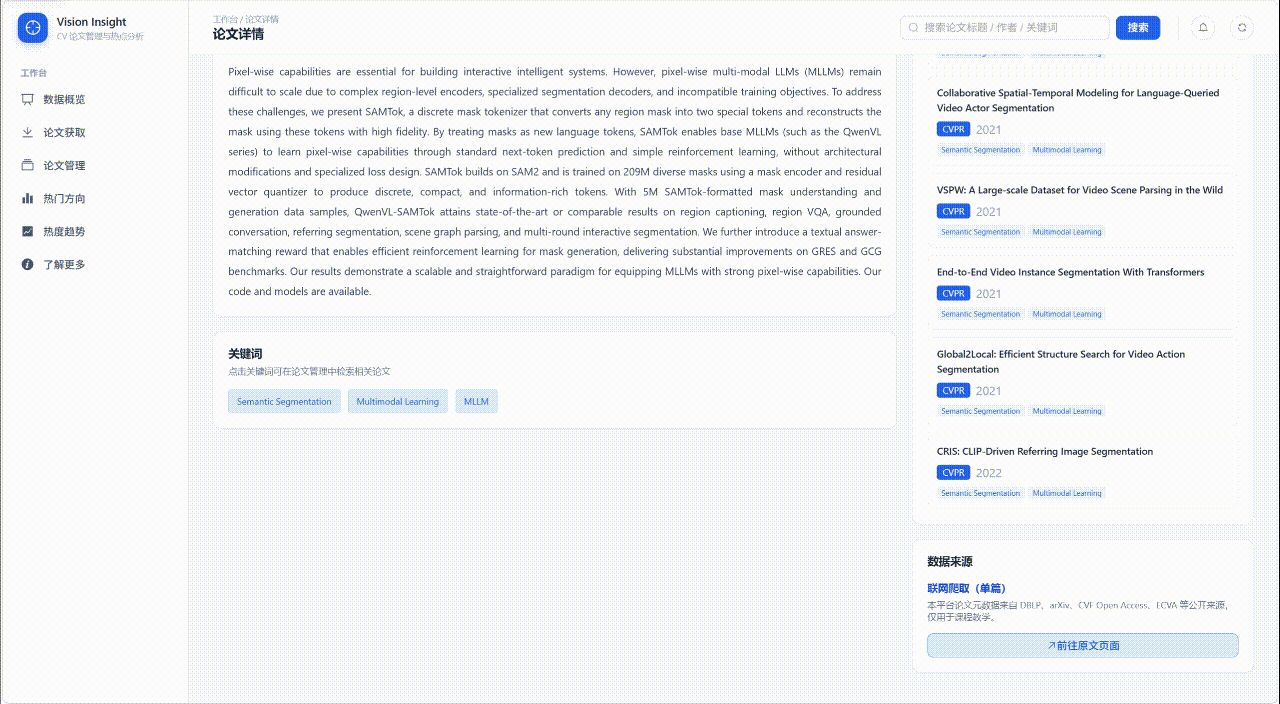
图 18|修改论文信息。
编辑功能用于修正元数据和补充缺失内容。演示时应说明修改字段及保存后的结果,而不是只展示打开的弹窗。
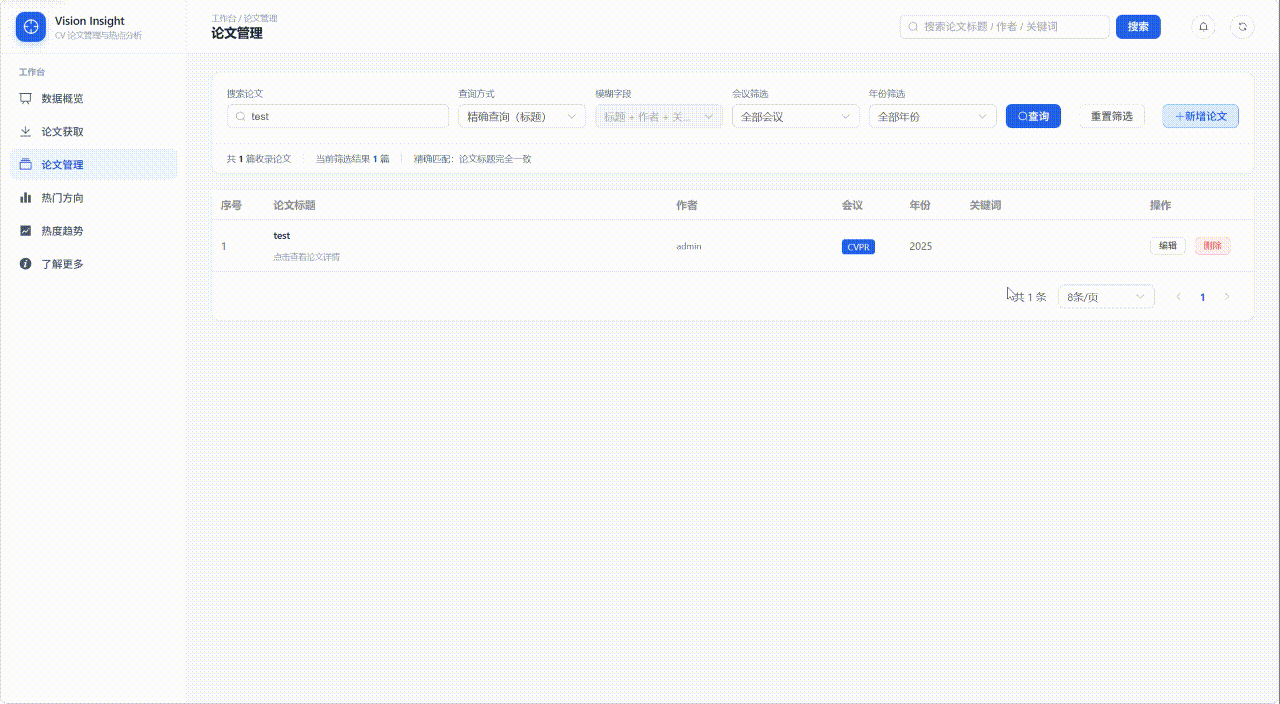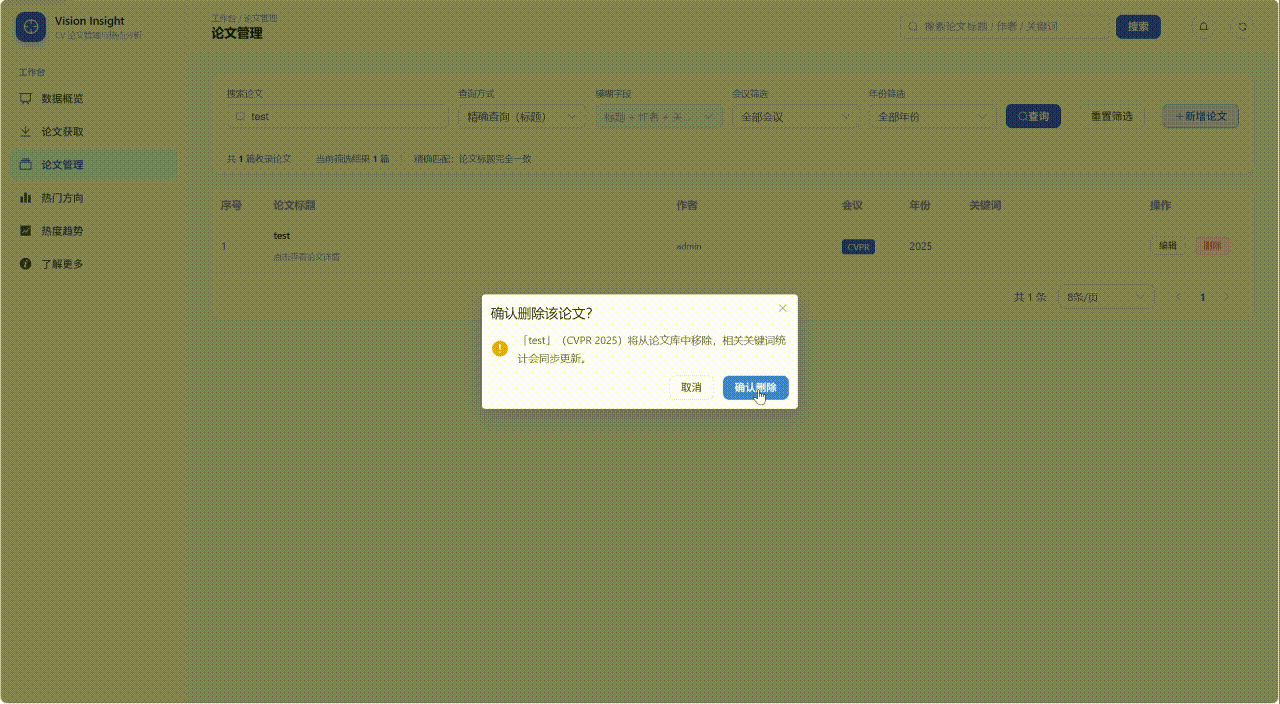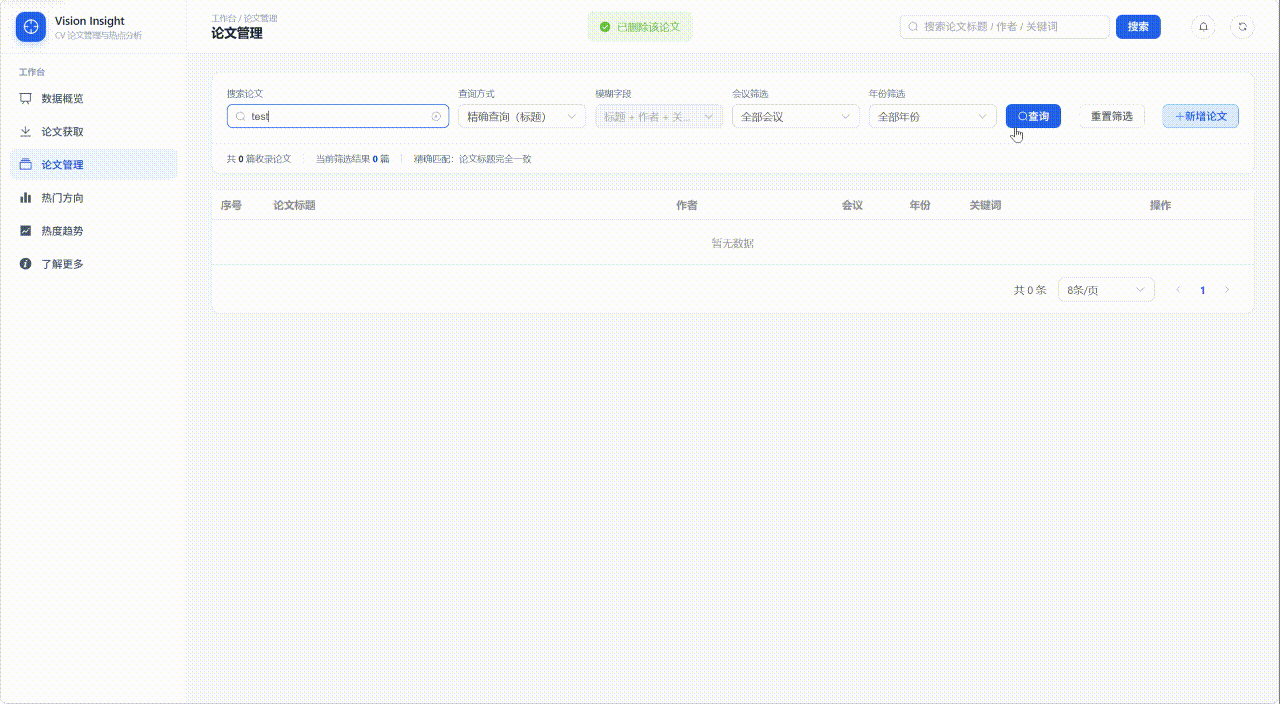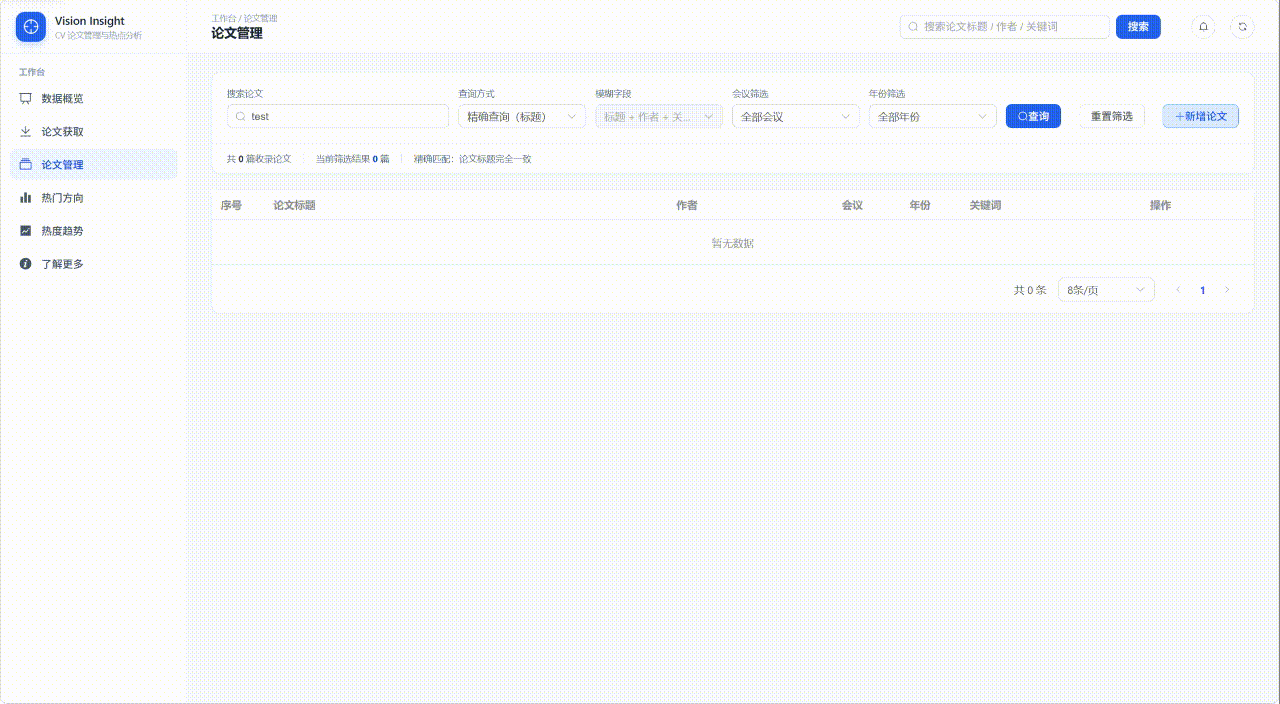
图 19|删除确认。
删除前显示确认信息,确认后刷新列表。
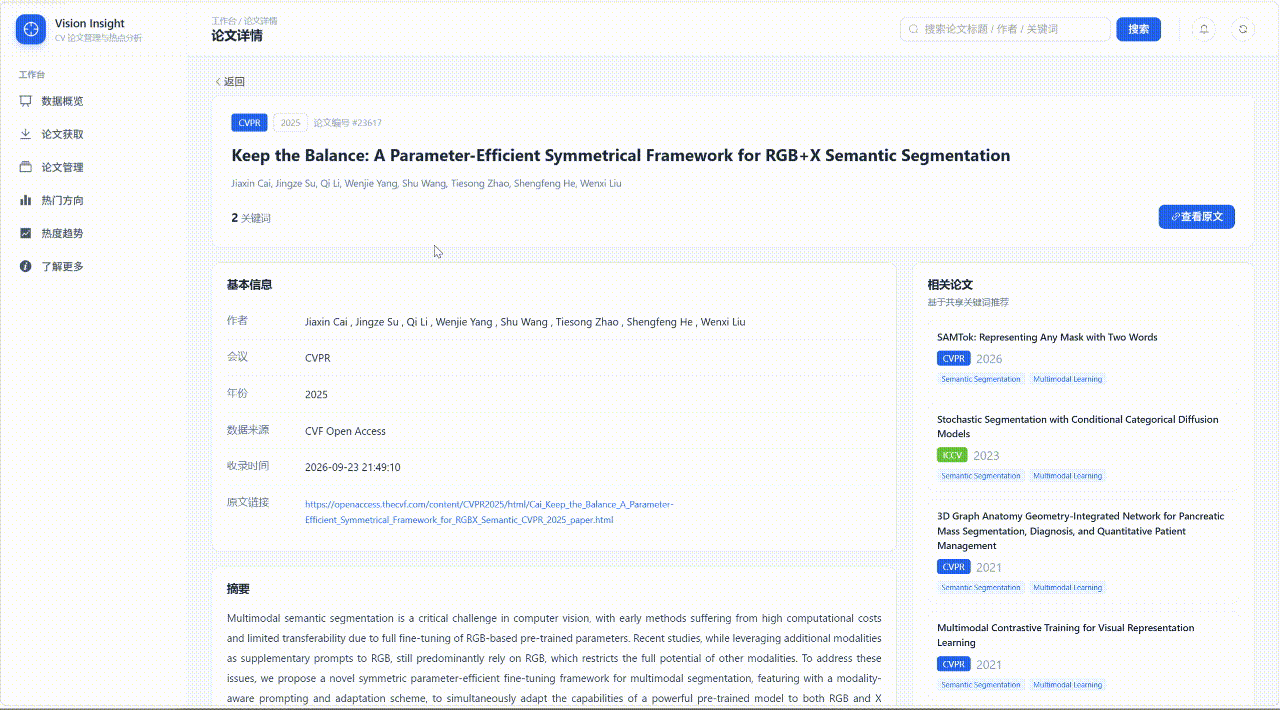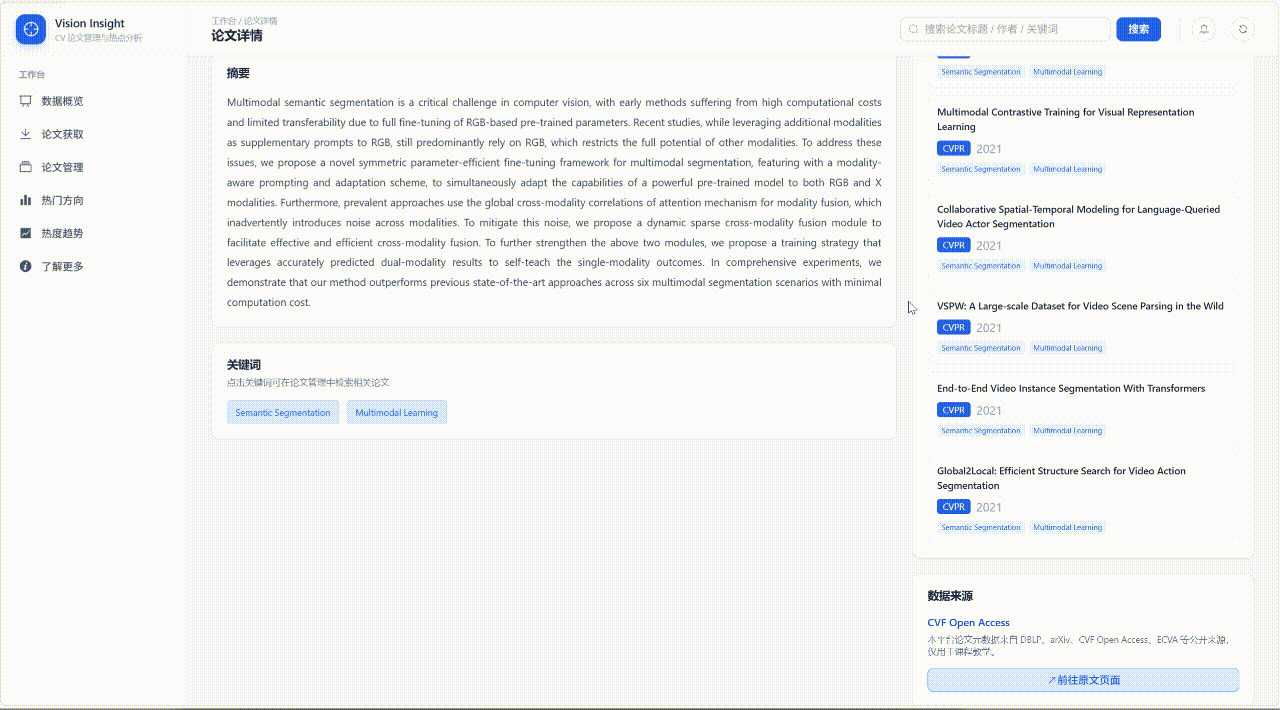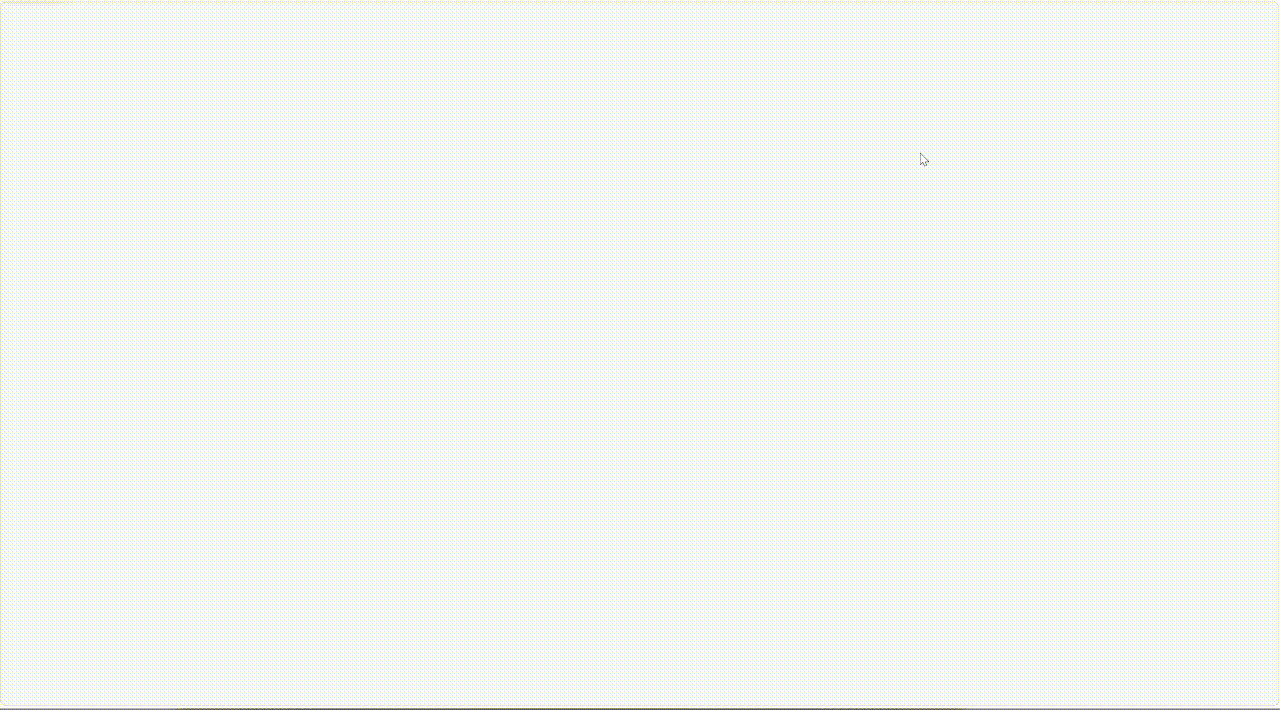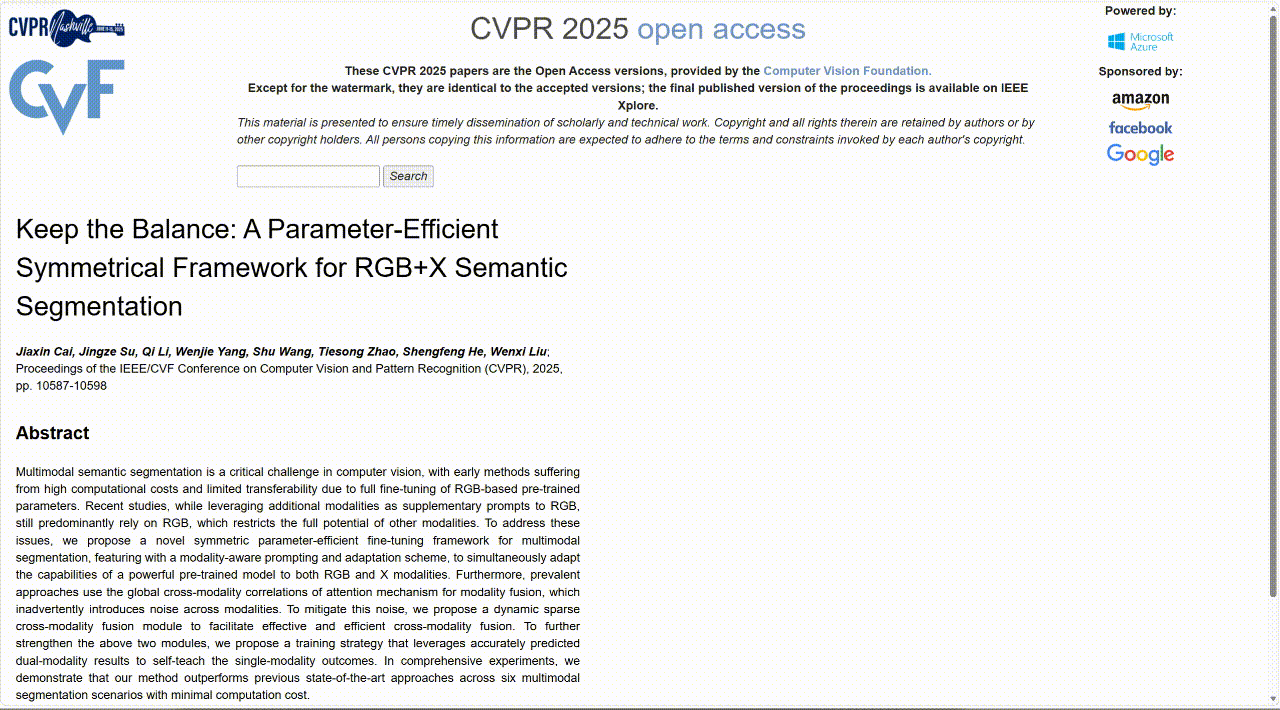
图 20|论文详情与相关论文。
详情页集中呈现论文阅读所需信息,并基于共享关键词推荐相关论文。推荐依据是标签重合,属于轻量关联推荐,不是语义相似度模型。
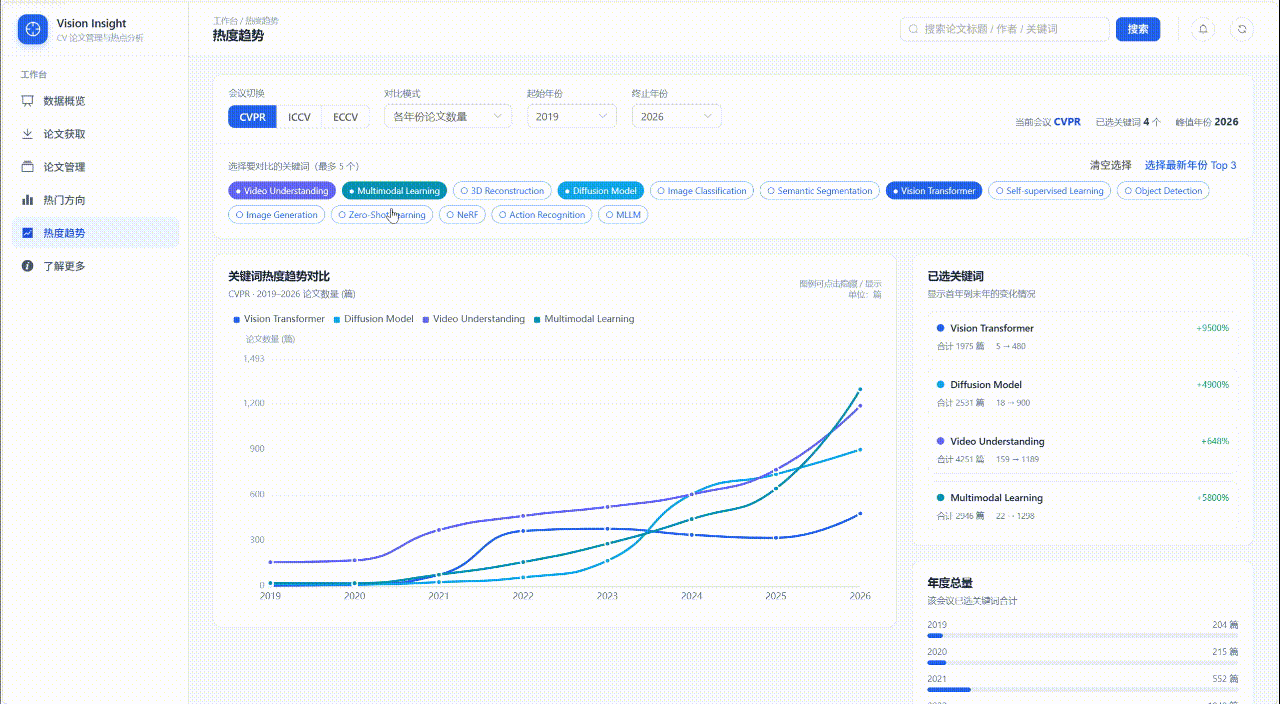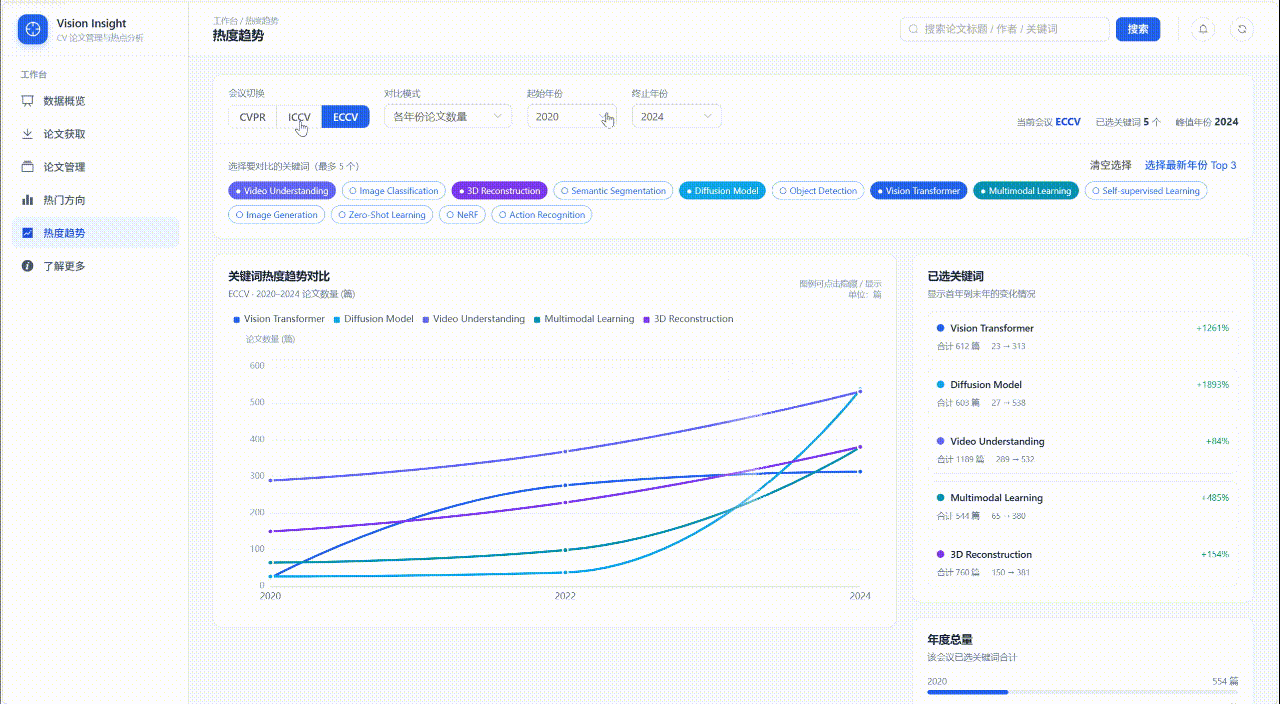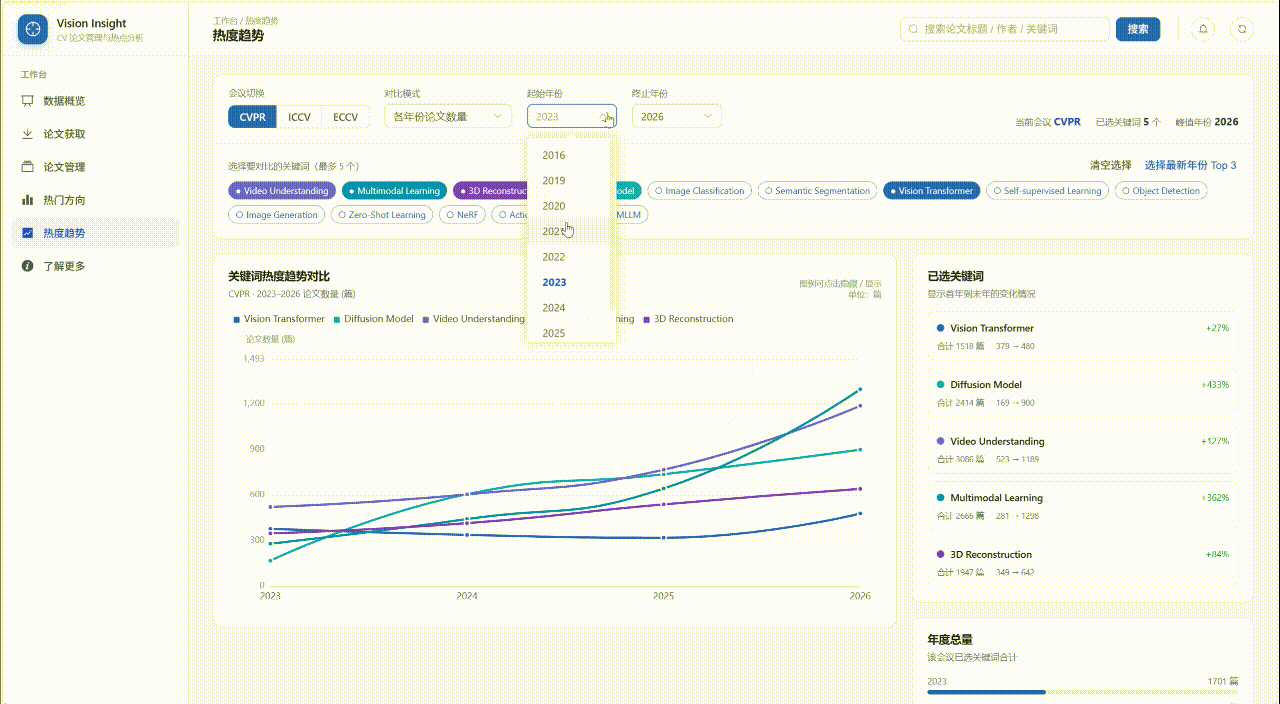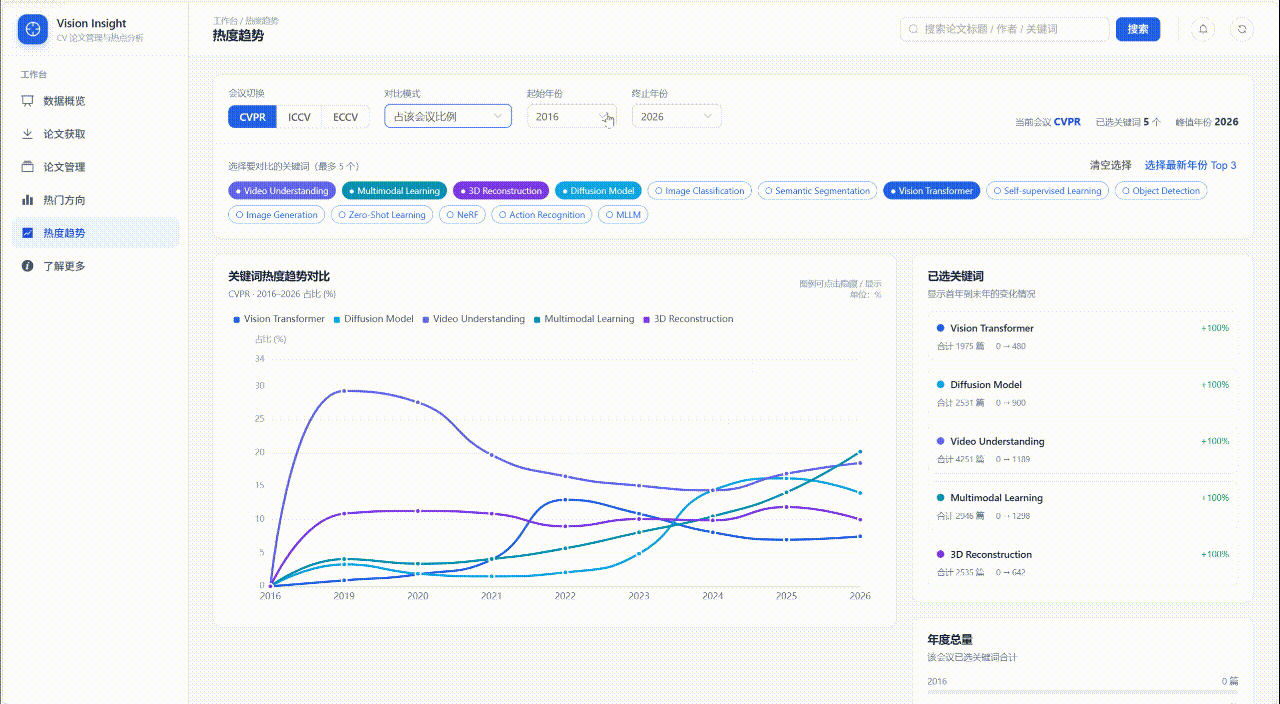
图 21|多年份、多关键词趋势。
趋势页允许选择会议和年份范围,比较不同关键词的关联论文数量变化。当前一次展示一个会议,可切换 CVPR、ICCV、ECCV。
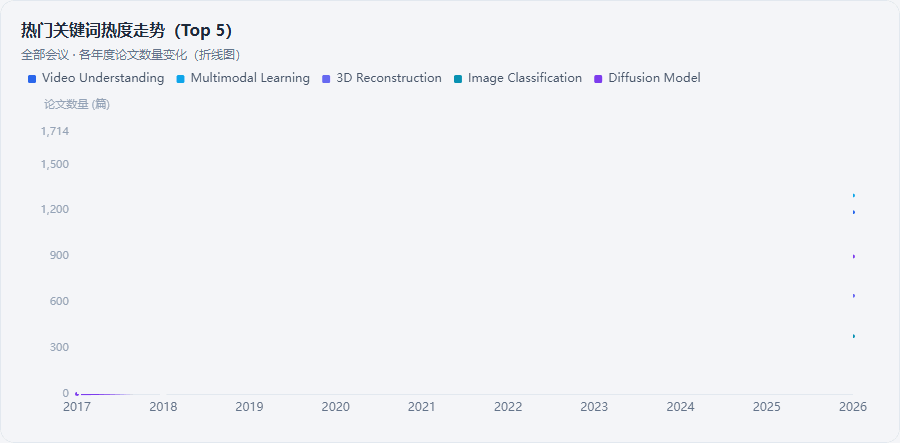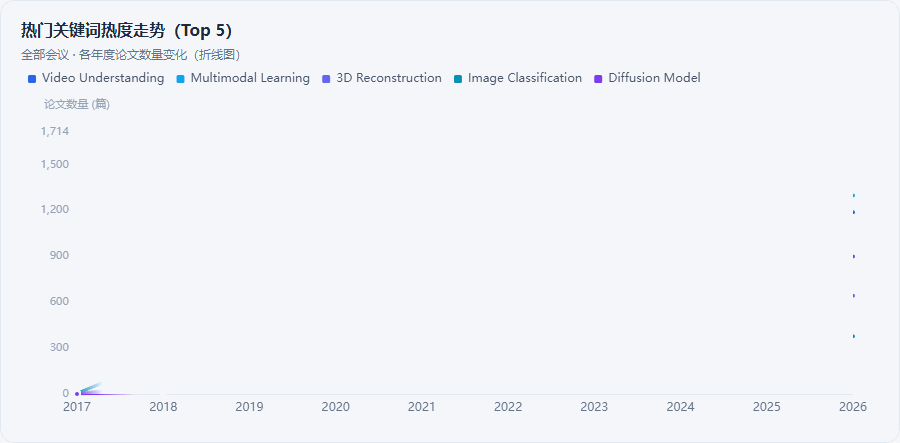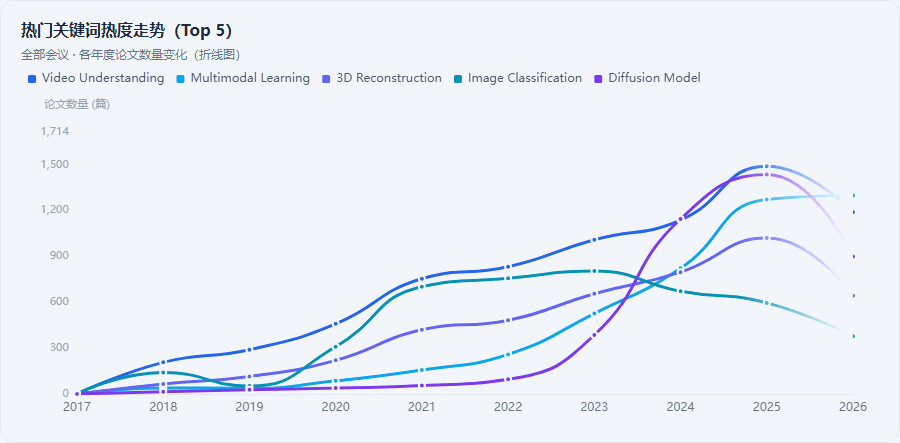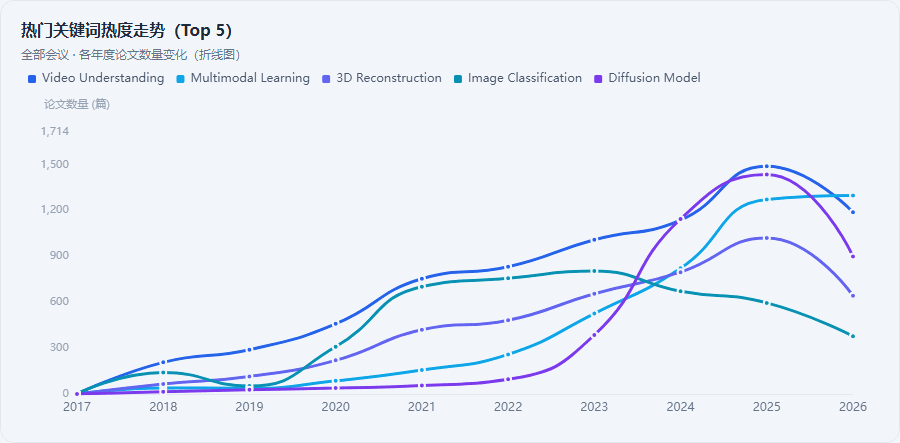
图 22|折线渐显动画。
动画通过渐变遮罩逐步显示已绘制的折线,帮助读者沿年份顺序观察变化。它是前端呈现动画,不改变统计值;博客通过录屏导出的 GIF 展示效果。
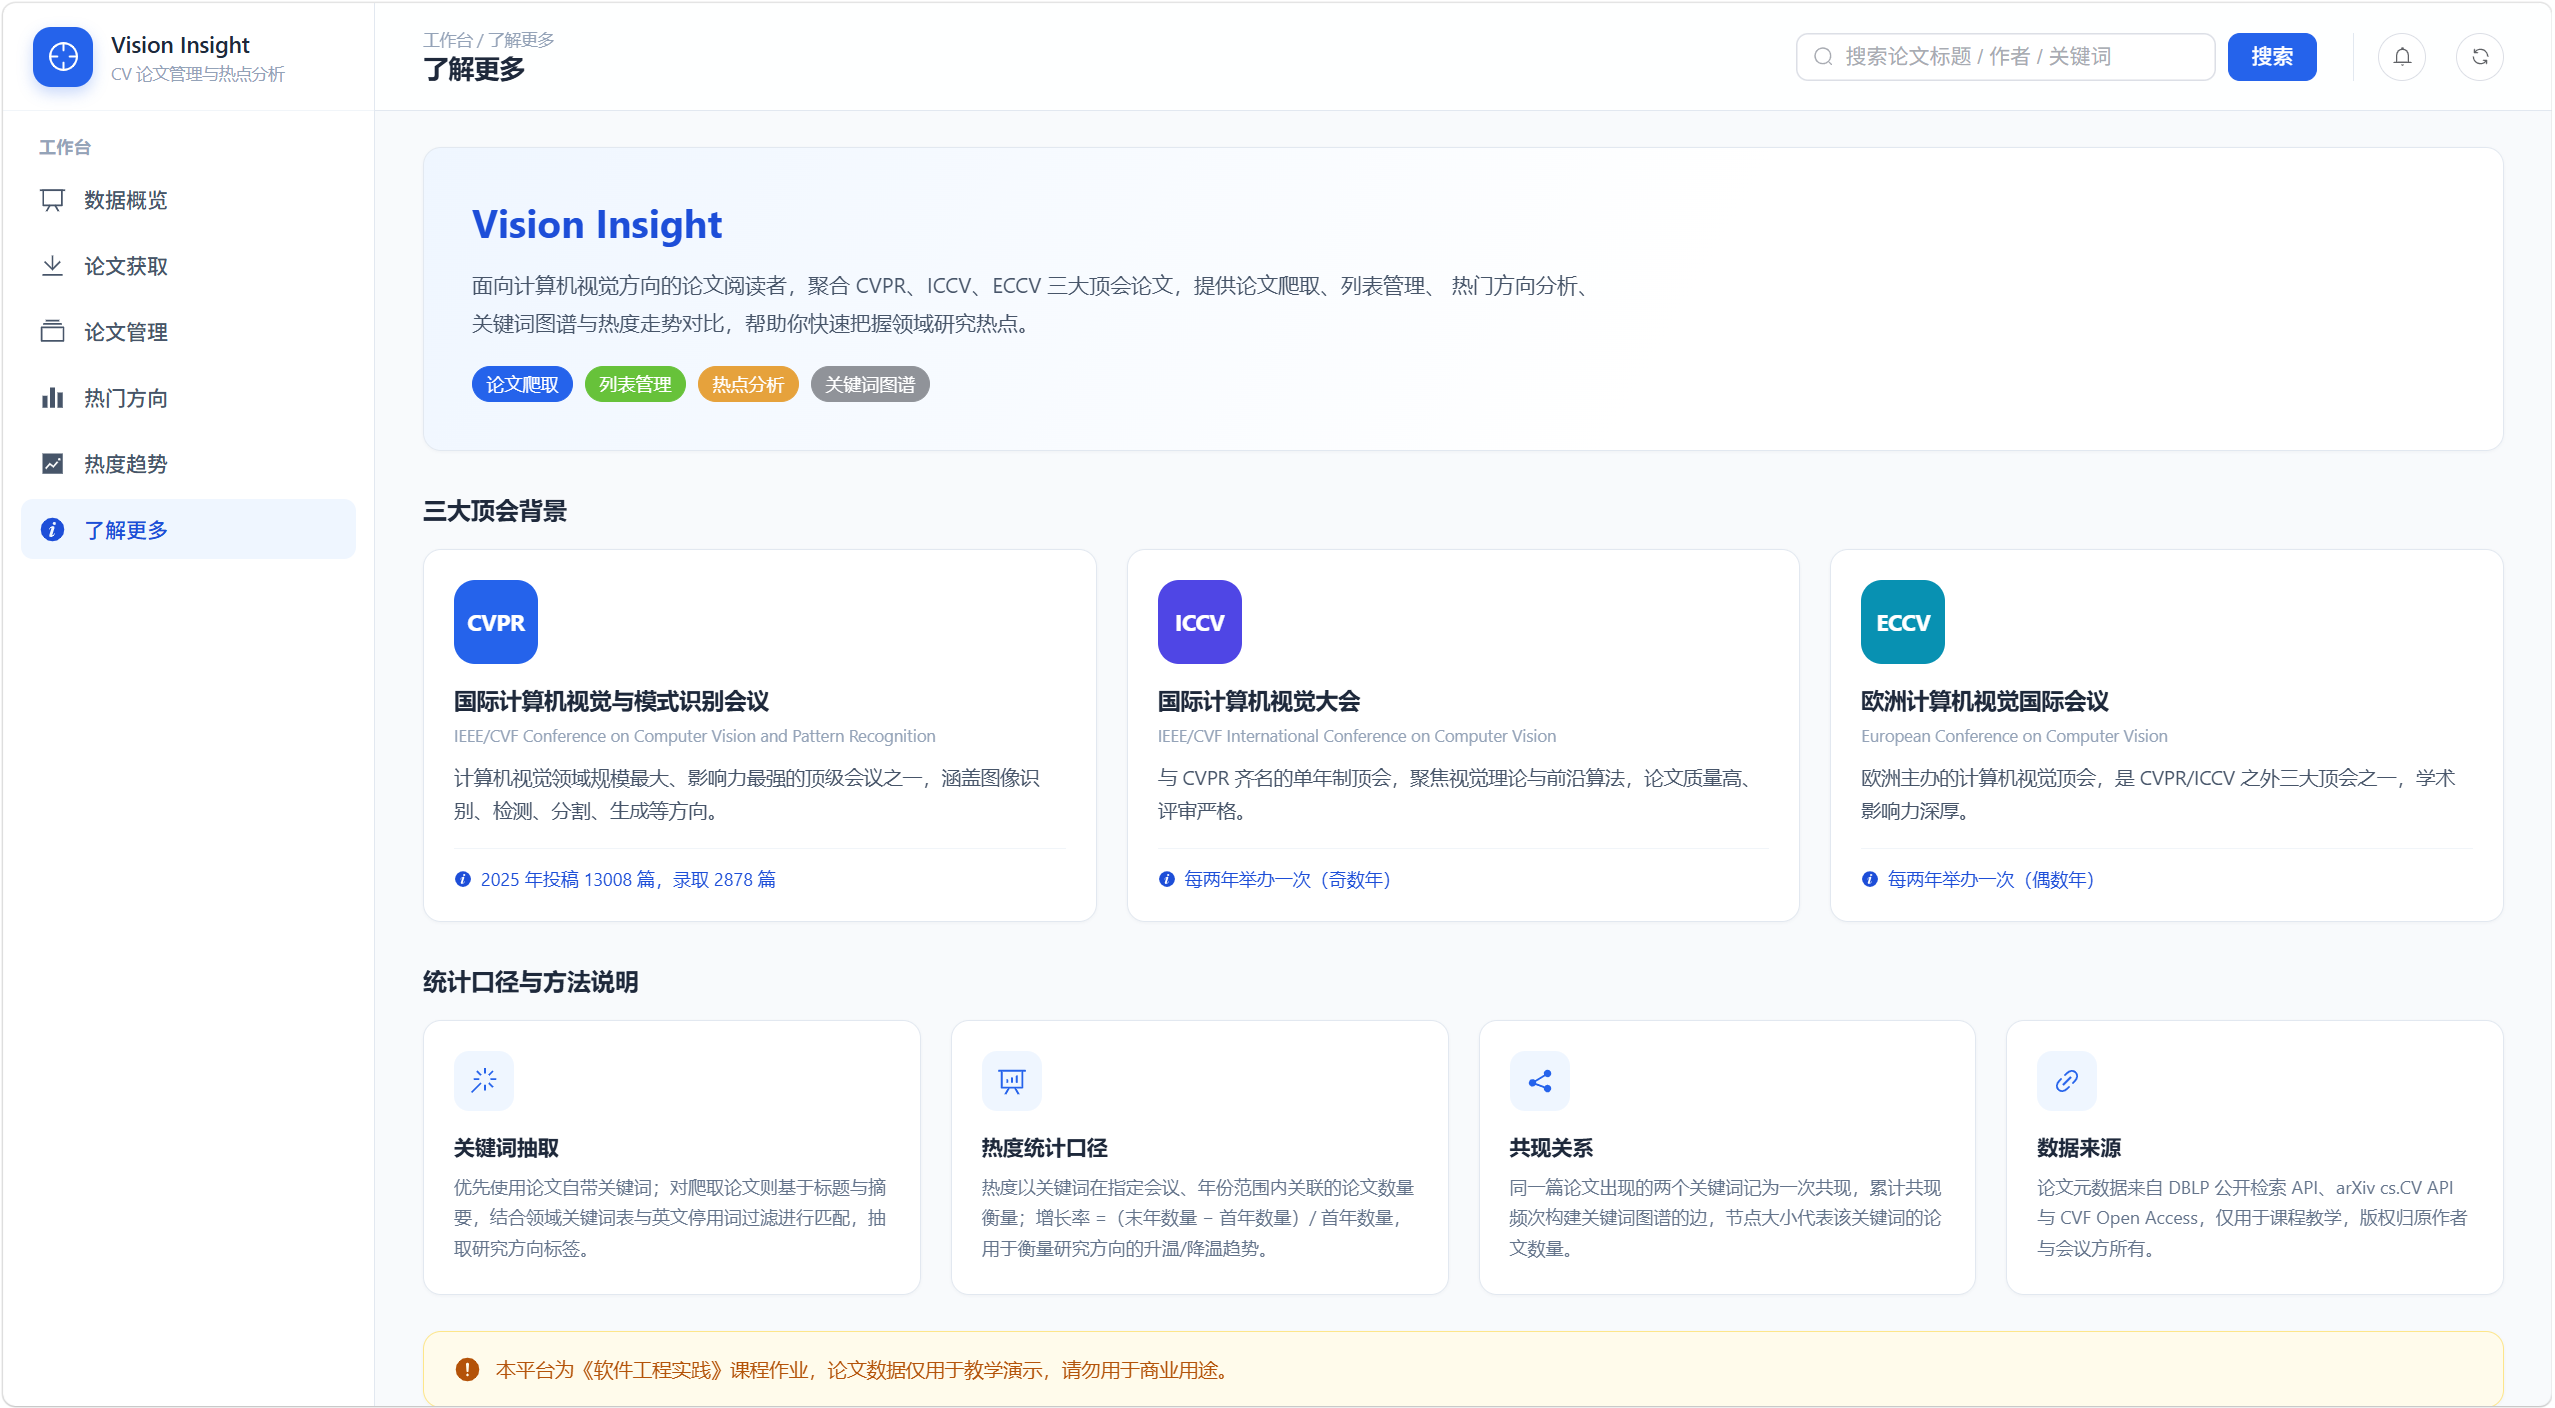
图 23|了解更多。
关于页介绍三大会议背景、关键词抽取、热度统计和共现关系,让初次使用者理解数据范围与图表含义。
为了真实还原与 AI 的结对编程过程,我挑选了三个具有代表性的开发案例。每个案例按照“问题背景 ➔ 原始 Prompt ➔ AI 输出 ➔ 人工判断 ➔ 迭代修改 ➔ 验证结果”的链路进行复盘。展示过程不仅包含最终的生成结果,还附带了保留关键上下文的真实对话截图,所有技术细节与修改依据均可与 Git 提交记录相互印证。
目标: 将五项功能要求转化为初学者可以理解的页面结构与操作流程。
第一轮 Prompt 原文:
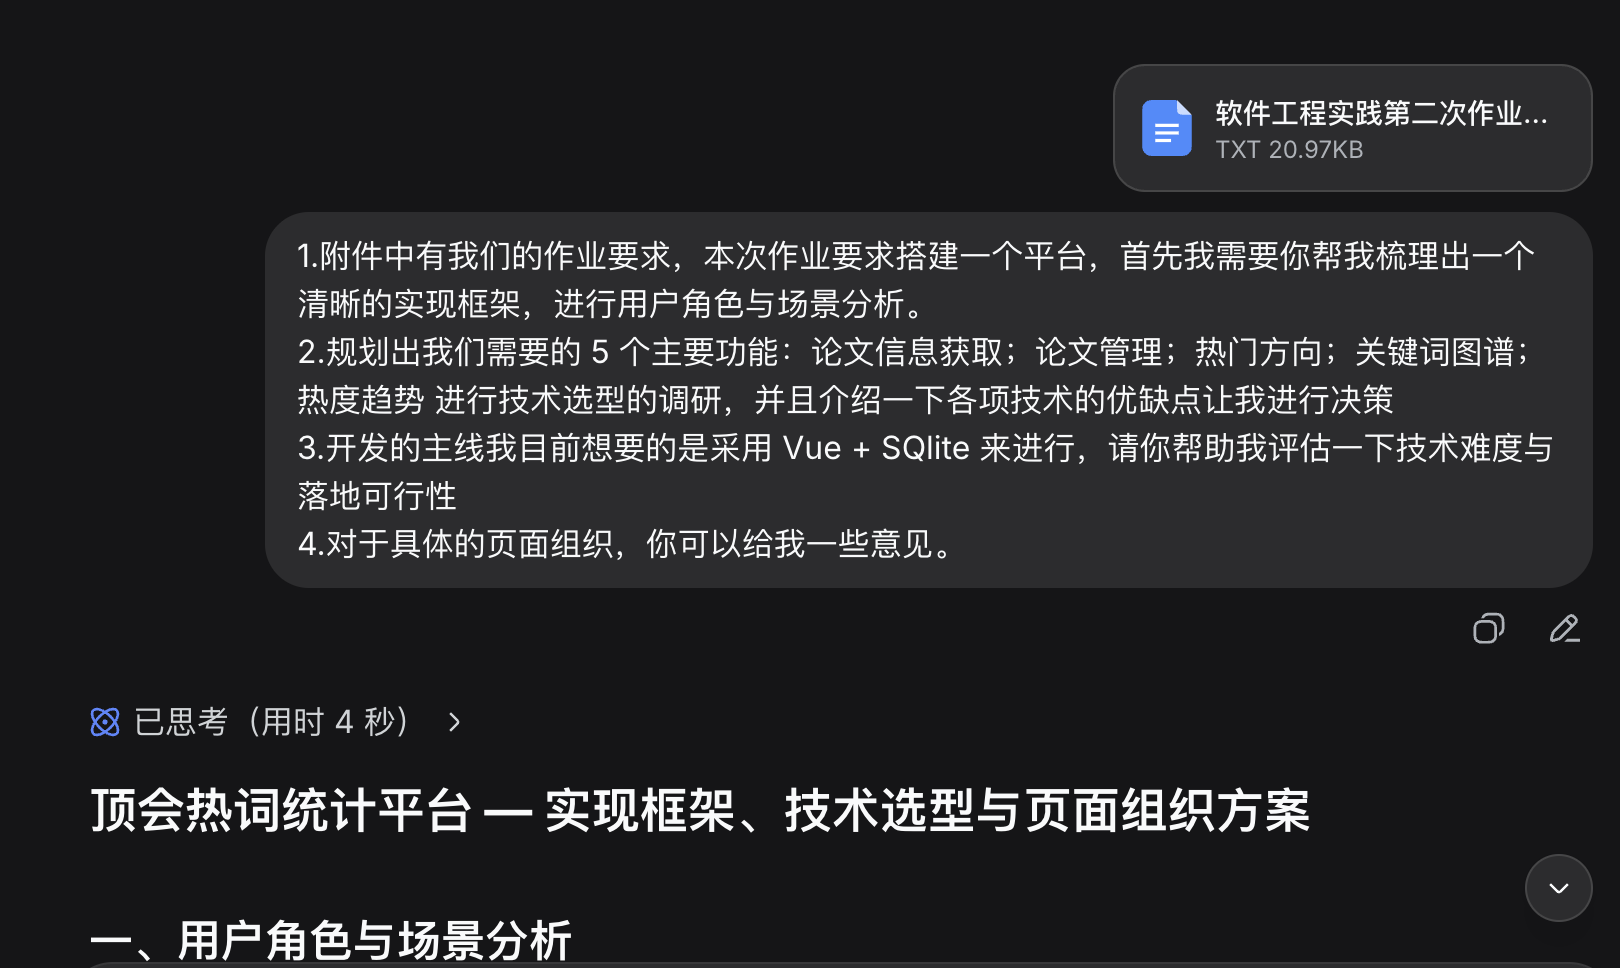
AI 输出摘要:
五大功能技术选型建议
论文信息获取:推荐 DBLP API 获取元数据,会议官网补充摘要;备选 Semantic Scholar API。
论文列表管理:SQLite + REST API,支持精确/模糊查询,查不到时触发联网爬取。
Top 10热门方向:推荐 TF-IDF + 停用词过滤,备选 TextRank / KeyBERT;热度 = 词频 × 年份增长率。
关键词图谱:推荐 ECharts 力导向图,点击节点展示相关论文。
热度走势动图:推荐 ECharts 动态排序柱状图 + gif.js 导出,备选录屏导出。
人工判断与修改:
| AI 建议 | 意见 | 本人理由 |
|---|---|---|
| DBLP API 获取元数据 | 拒绝 | DBLP官网有反爬虫机制,较难绕过,尽量使用备用方案 |
| SQLite + REST API | 采纳 | SQLite 轻量零配置、单文件持久化;REST API 解耦前后端、便于跨平台调用和云部署。 |
第二轮 Prompt 原文:
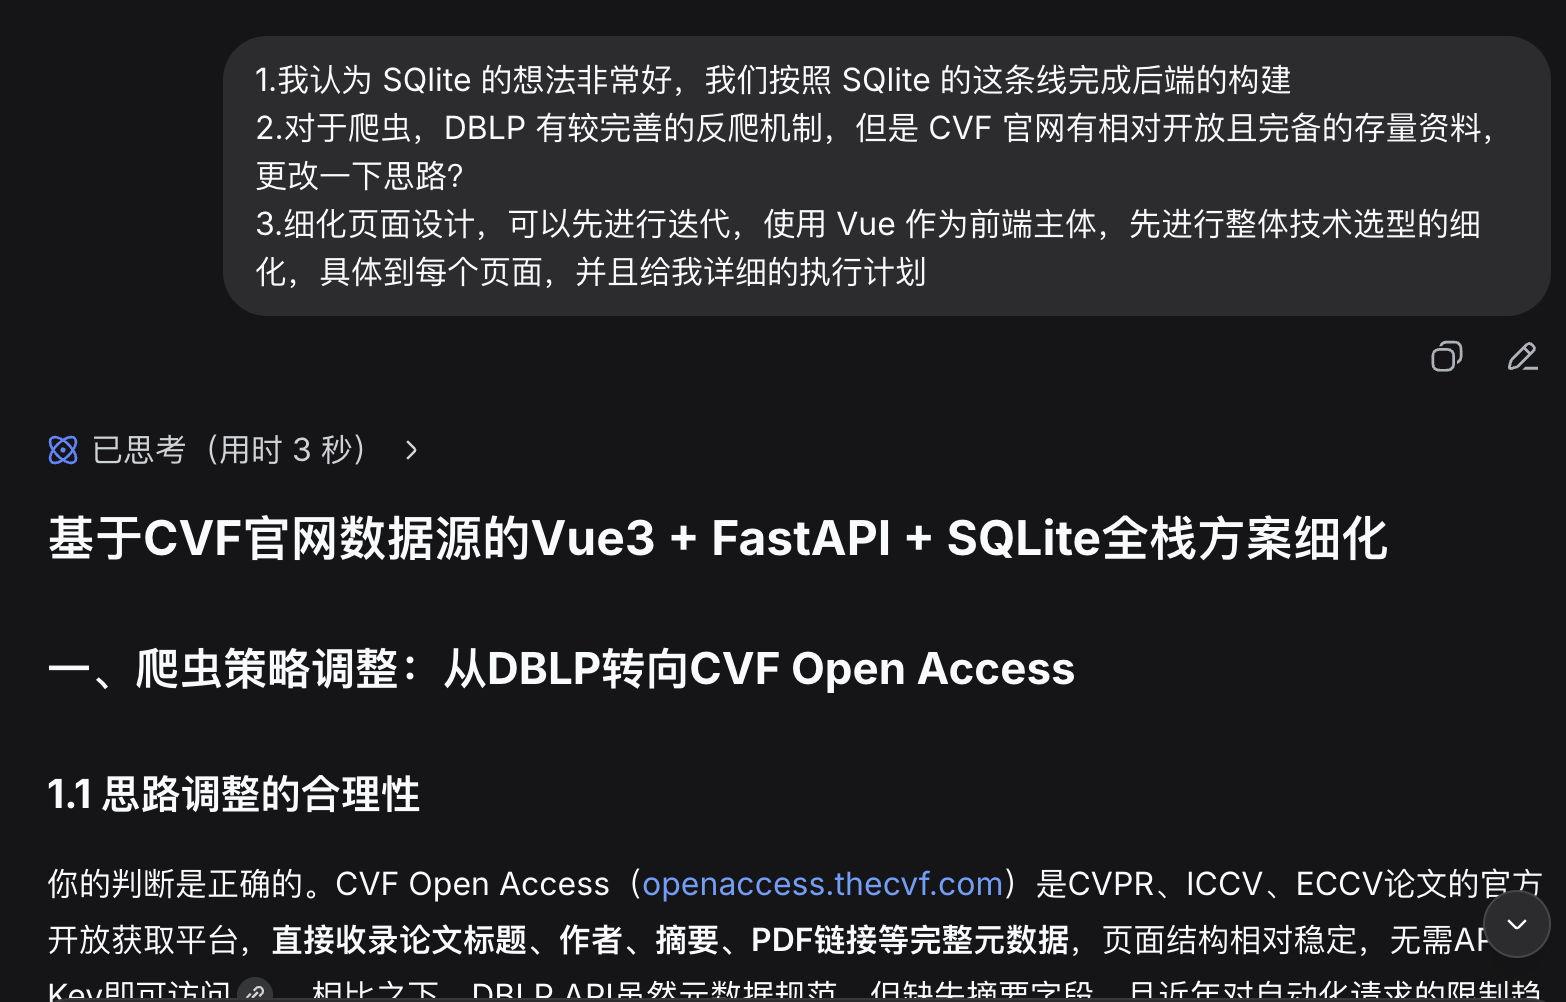
最终成果: 进行了项目的整体选型和调研,确定了以Vue3 + Element Plus + ECharts + Express + SQLite为主线的项目开发。
技术背景: 图谱后端按同篇论文中的关键词组合统计共现,前端使用 ECharts 力导向图展示。关键词较密集时,直接展示全部连线容易导致标签重叠、难以阅读。
相关代码: backend/src/services/stats.js、frontend/src/views/DashboardView.vue;提交 6170112 记录了“边裁剪+标签防重叠、主题聚类着色、点击聚焦共现子图”的优化。
第一轮 Prompt 原文:
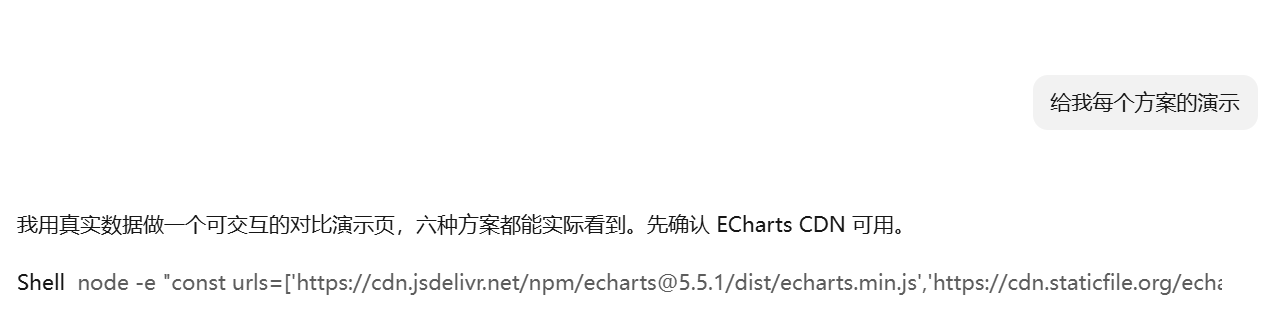
AI 输出摘要:
方案 A:边裁剪 + 标签防重叠(改动最小,收益最大,推荐)
方案 B:Ego 聚焦子图(交互最佳)
方案 C:换布局(治中心堆叠)
方案 D:共现热力图(信息密度最高,最不"冗杂")
方案 E:主题聚类着色 + 分组
方案 F:气泡图替代网络图(另辟视角)
第二轮 Prompt 原文与迭代结果:
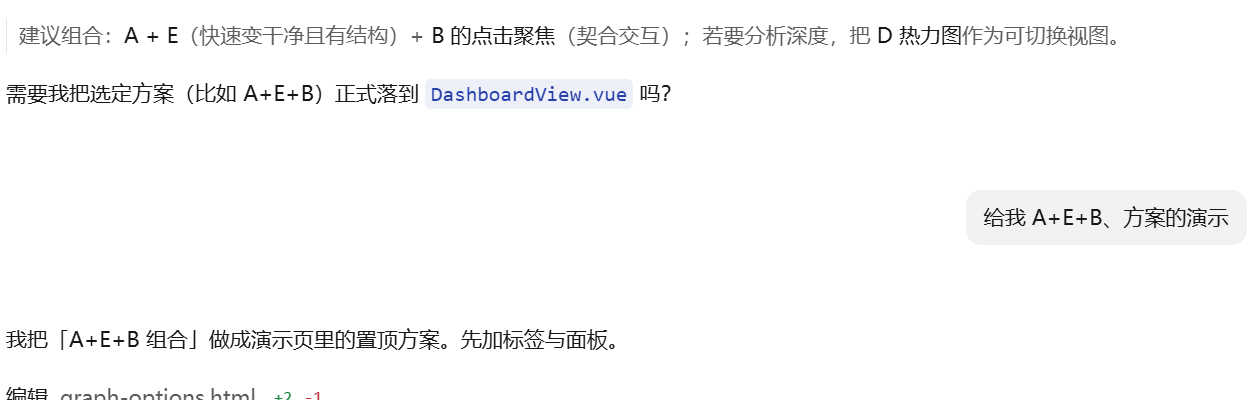
AI 输出摘要:
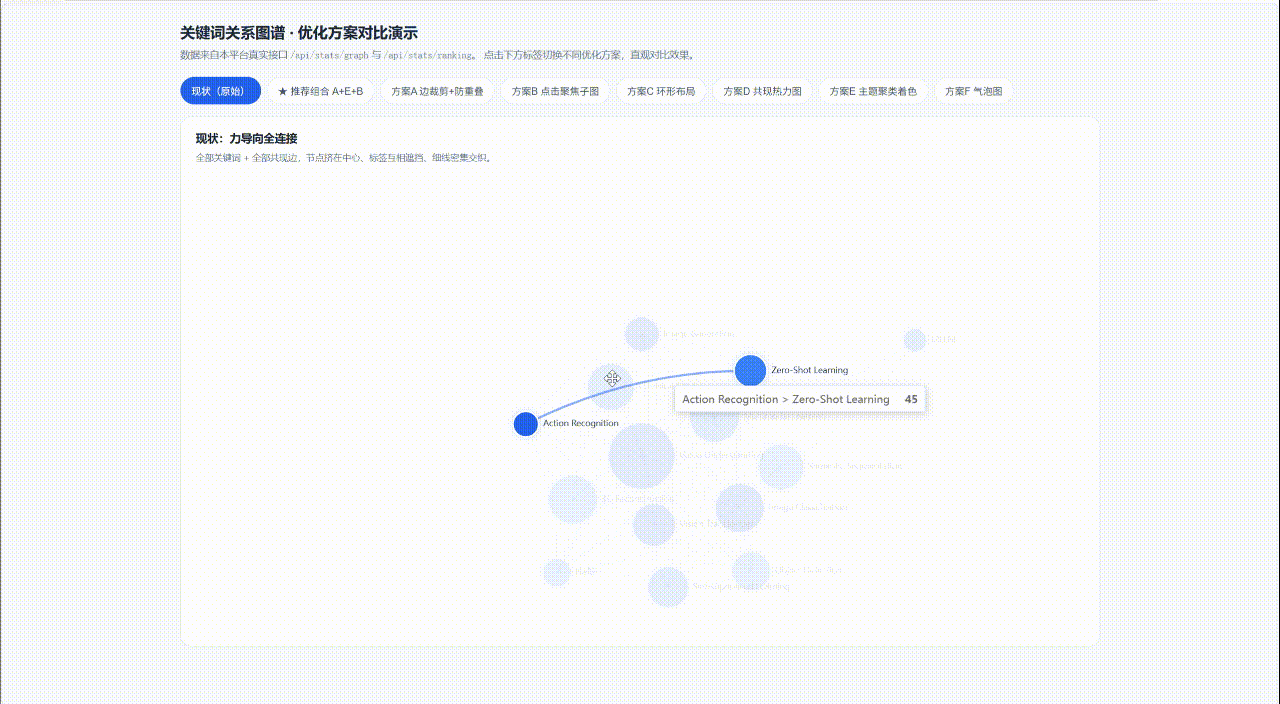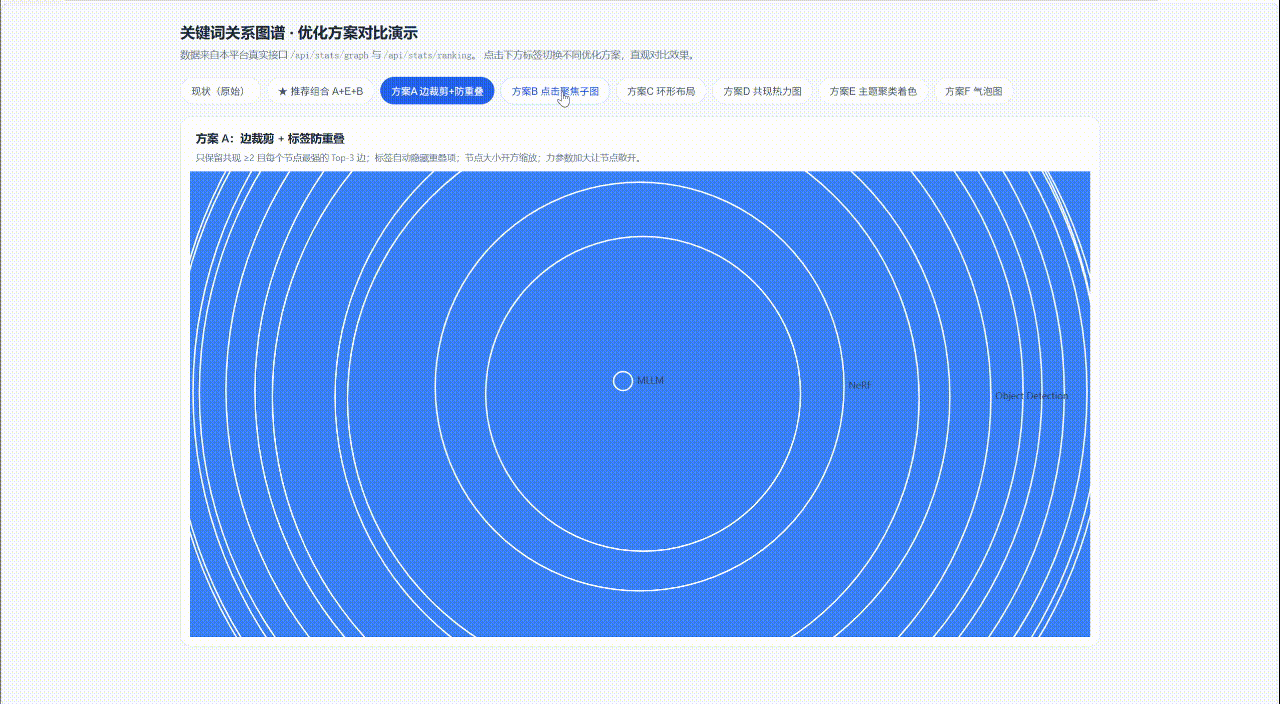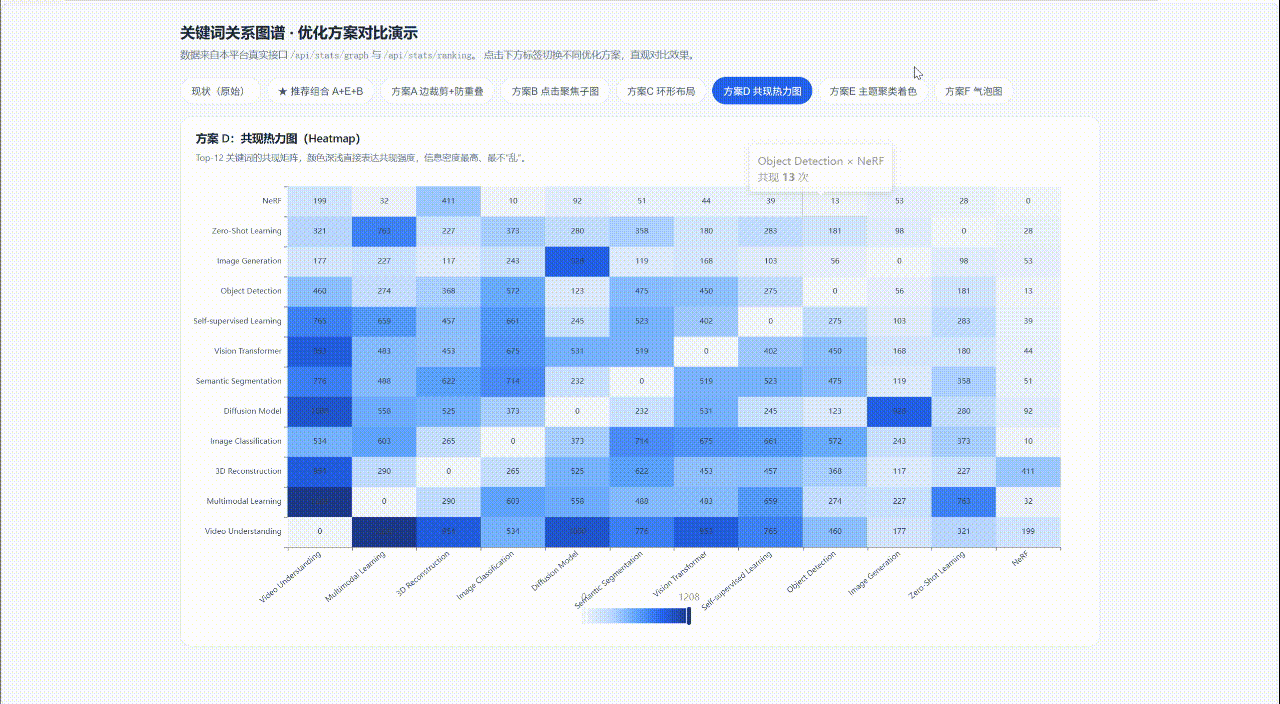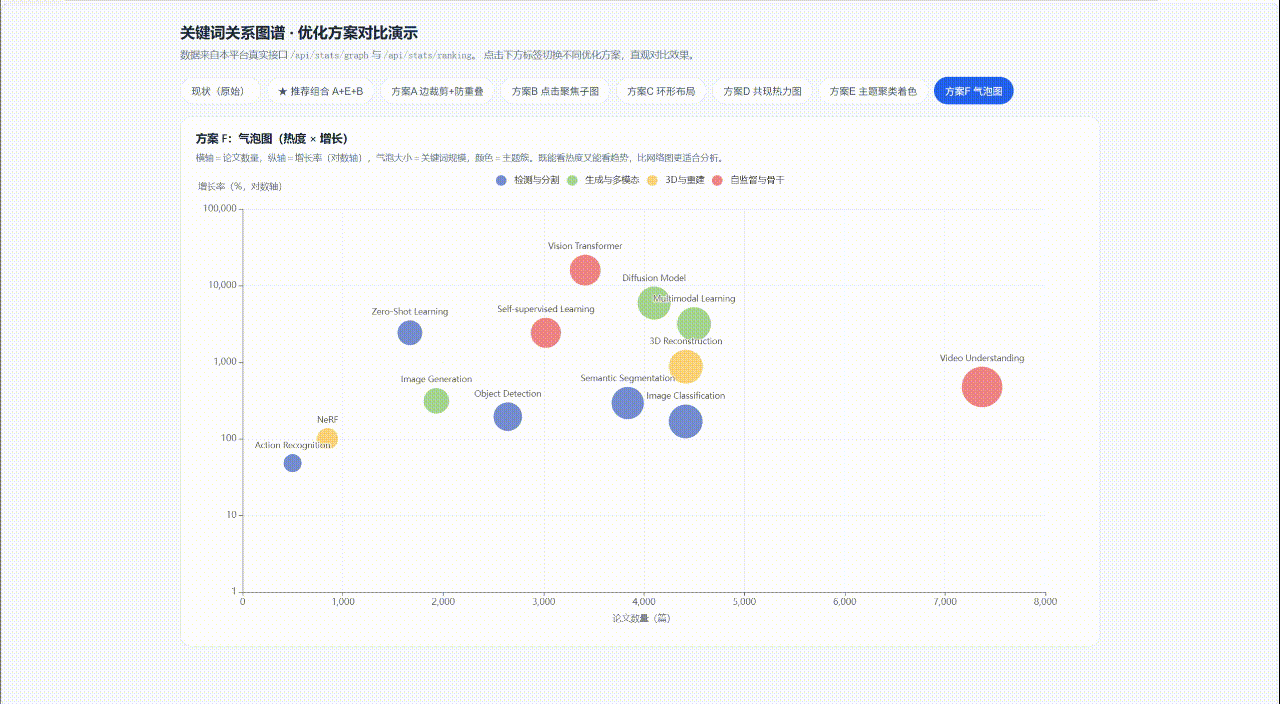
人工判断与修改:
最终采用了A+E+B方案作为关键词图谱实现可读性优化,简洁易读的同时能够直观清晰地了解关键词热度以及不同关键词之间的联系。
问题现象: Git 修复记录显示,关键词标签与图谱点击曾无法加载论文。
相关代码: 页面调用 statsApi.keyword 获取关键词详情,但前端 API 封装缺少对应方法。提交 47187a1 补齐该方法,使调用路径与后端 /api/stats/keyword 对齐。
原始 Prompt:
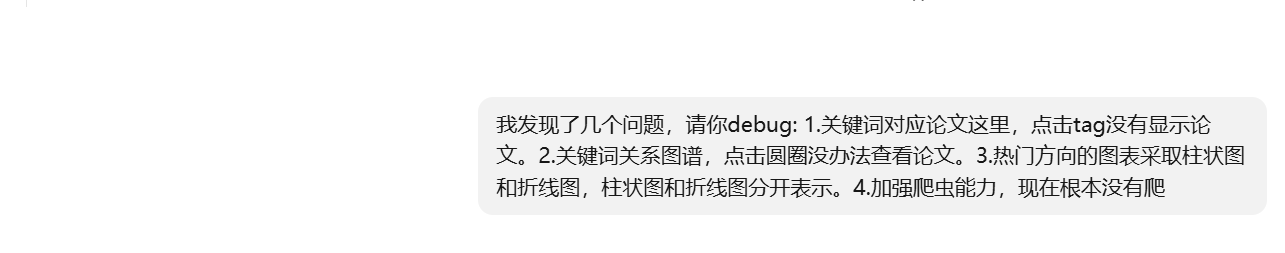
AI 输出摘要:
关键词标签 / 图谱点击无反应的根因是:frontend/src/api/index.js 里根本没定义 statsApi.keyword,Dashboard 的标签点击和图谱节点点击都调用它 → 直接抛 is not a function,后端的 /api/stats/keyword 一直是好的(实测 Vision Transformer → 15 篇)。 修复:补上该方法 frontend/src/api/index.js:35。
修复后的核心方法:
keyword(name, params = {}) {
  return request.get('/stats/keyword', { params: { name, ...params } })
}
该方法统一封装关键词参数和筛选条件。页面不再自行拼接接口地址,便于保持调用一致。
第二轮追问与修复后验证:修复后,在首页点击 NeRF 关键词,确认发出了 /api/stats/keyword 请求,页面加载了对应论文,控制台不再出现 statsApi.keyword is not a function。
以下代码摘自源码,覆盖关键词抽取、多源爬取、查询、热点统计、图谱和缓存等关键路径。
来源:backend/src/services/crawler.js。
思路: 预先定义统一标签及其匹配表达式,将不同写法映射到稳定的研究方向名。每条规则最多加入一次标签,便于后续按论文数计数。
const KEYWORD_RULES = [
  { name: 'Object Detection', pattern: /object detection|detr|yolo|faster r-?cnn|detector/i },
  { name: 'Vision Transformer', pattern: /vision transformer|\bvit\b|swin|deit|transformer/i },
  { name: 'Semantic Segmentation', pattern: /semantic segmentation|segmentation|segment anything|\bseg\b/i },
  { name: 'Multimodal Learning', pattern: /multimodal|vision-language|clip|image-text|vqa|visual question/i },
  { name: 'Diffusion Model', pattern: /diffusion|denoising|stable diffusion|text-to-image/i },
  { name: 'Self-supervised Learning', pattern: /self-supervised|contrastive|masked autoencoder|moco|simclr|dino/i },
  { name: 'NeRF', pattern: /nerf|neural radiance|radiance field/i },
  { name: '3D Reconstruction', pattern: /3d reconstruction|gaussian splatting|point cloud|depth estimation|multi-?view/i },
  { name: 'Video Understanding', pattern: /video|action recognition|temporal|tracking/i },
  { name: 'Image Classification', pattern: /image classification|imagenet|classifier|classification/i },
  { name: 'Image Generation', pattern: /image generation|\bgan\b|generative adversarial|image synthesis/i },
  { name: 'Zero-Shot Learning', pattern: /zero-?shot|open-?vocabulary/i },
  { name: 'Action Recognition', pattern: /action recognition|human action/i }
]

export function extractKeywords(text) {
  const result = []
  for (const rule of KEYWORD_RULES) {
    if (rule.pattern.test(text)) result.push(rule.name)
  }
  return result
}
该方法的关键限制是词表覆盖和规则精度。例如一般的 transformer 不一定专指视觉 Transformer,后续可以通过人工样本标注评估误差,再细化匹配条件。
来源:backend/src/services/crawler.js。
思路: 多个来源并行查询,使用 Promise.allSettled 保留成功结果,避免某一个来源失败导致整个检索中断。会议元数据优先选择 DBLP 等匹配结果,摘要主要由 arXiv 补充。
export async function crawlPaper(title) {
  const results = await Promise.allSettled([
    searchDblp(title),
    searchCrossref(title),
    searchSemanticScholar(title),
    searchOpenAlex(title),
    searchArxiv(title)
  ])
  const at = (i) => (results[i].status === 'fulfilled' ? results[i].value : null)
  const [dblp, crossref, semanticscholar, openalex, arxiv] = [at(0), at(1), at(2), at(3), at(4)]

  const venueSource = dblp || crossref || semanticscholar || openalex || null
  if (!venueSource && !arxiv) return null

  const keywords = arxiv?.keywords?.length
    ? arxiv.keywords
    : extractKeywords(`${title} ${arxiv?.abstract || ''}`)

  return {
    title: venueSource?.title || arxiv?.title || cleanup(title),
    authors: venueSource?.authors || arxiv?.authors || '',
    venue: venueSource?.venue || arxiv?.venue || '',
    year: venueSource?.year || arxiv?.year || null,
    link: arxiv?.link || venueSource?.link || '',
    abstract: arxiv?.abstract || '',
    keywords,
    citations: 0,
    source: venueSource?.source || 'arxiv',
    matched: Boolean(venueSource?.venue || arxiv?.venue)
  }
}
matched 用于判断是否识别到目标会议。
来源:backend/src/routes/fetch.js。
思路: 把单个标题处理封装为统一流程,使单篇和批量入口返回一致的状态。先查本地避免重复抓取,再联网匹配,最后入库。
async function processTitle(rawTitle) {
  const title = String(rawTitle || '').trim()
  if (title.length < 3) return { title, status: 'invalid' }

  const existing = findByTitle(title)
  if (existing) return { title, status: 'dup', paper: existing }

  let crawled = null
  try {
    crawled = await crawlPaper(title)
  } catch {
    crawled = null
  }
  if (!crawled) return { title, status: 'miss' }

  if (!crawled.matched) return { title, status: 'miss', paper: crawled }

  try {
    const paper = createPaper({ ...crawled, source: 'crawl' })
    return { title, status: 'ok', paper }
  } catch {
    const dup = findByTitle(title)
    if (dup) return { title, status: 'dup', paper: dup }
    return { title, status: 'miss', paper: crawled }
  }
}
这里能够解释为什么结果区分为成功、重复、未匹配和无效输入。
来源:backend/src/services/papers.js。
思路: 根据前端条件组合受控 SQL 片段,用户数据通过占位符传入;查询总数与分页内容使用同一组筛选条件。
export function listPapers(params = {}) {
  const mode = params.mode || 'fuzzy'
  const field = params.field || 'all'
  const q = (params.q || '').trim()
  const venue = params.venue || ''
  const year = params.year || ''
  const keyword = params.keyword || ''

  const where = []
  const args = []

  if (venue) {
    where.push('venue = ?')
    args.push(venue)
  }
  if (year) {
    where.push('year = ?')
    args.push(Number(year))
  }
  if (keyword) {
    where.push('LOWER(keywords) LIKE ?')
    args.push(`%"${String(keyword).toLowerCase()}"%`)
  }
  if (q) {
    if (mode === 'exact') {
      where.push('title_norm = ?')
      args.push(normalizeTitle(q))
    } else {
      const like = `%${q.toLowerCase()}%`
      if (field === 'title') {
        where.push('LOWER(title) LIKE ?')
        args.push(like)
      } else if (field === 'authors') {
        where.push('LOWER(authors) LIKE ?')
        args.push(like)
      } else if (field === 'keywords') {
        where.push('LOWER(keywords) LIKE ?')
        args.push(like)
      } else {
        where.push('(LOWER(title) LIKE ? OR LOWER(authors) LIKE ? OR LOWER(keywords) LIKE ?)')
        args.push(like, like, like)
      }
    }
  }

  const whereSql = where.length ? `WHERE ${where.join(' AND ')}` : ''
  const total = db.prepare(`SELECT COUNT(*) AS n FROM papers ${whereSql}`).get(...args).n

  const page = Math.max(1, Number(params.page) || 1)
  const pageSize = Math.min(PAGE_SIZE_MAX, Math.max(1, Number(params.pageSize) || 8))
  const offset = (page - 1) * pageSize

  const rows = db
    .prepare(`SELECT * FROM papers ${whereSql} ORDER BY year DESC, id DESC LIMIT ? OFFSET ?`)
    .all(...args, pageSize, offset)

  return { items: rows.map(toPaper), total, page, pageSize }
}
精确匹配针对规范化标题,因此忽略大小写和多余空白。
来源:backend/src/services/stats.js。
思路: 先按会议和年份筛选论文,再维护“关键词 → 各年论文数”的映射。Set 保证同一论文中的重复标签不会重复加分。
export function ranking(params = {}) {
  const rows = loadRows(params)
  const counter = new Map()
  const yearTotals = new Map()

  rows.forEach((row) => {
    if (row.year) yearTotals.set(row.year, (yearTotals.get(row.year) || 0) + 1)
    for (const keyword of new Set(row.keywords)) {
      if (!counter.has(keyword)) counter.set(keyword, new Map())
      const byYear = counter.get(keyword)
      byYear.set(row.year, (byYear.get(row.year) || 0) + 1)
    }
  })

  const yearList = [...yearTotals.keys()].sort((a, b) => a - b)
  const threshold = Math.max(3, Math.floor(rows.length * 0.002))
  const validYears = yearList.filter((year) => (yearTotals.get(year) || 0) >= threshold)
  const span = validYears.length ? validYears : yearList
  const first = span[0]
  const last = span[span.length - 1]

  const list = [...counter.entries()].map(([name, byYear]) => {
    const value = [...byYear.values()].reduce((a, b) => a + b, 0)
    const f = byYear.get(first) || 0
    const l = byYear.get(last) || 0
    const growth = f === 0 ? (l > 0 ? 100 : 0) : Math.round(((l - f) / f) * 100)
    return { name, value, growth }
  })

  if (params.sort === 'growth') list.sort((a, b) => b.growth - a.growth)
  else list.sort((a, b) => b.value - a.value)

  return list
}
后端返回有序结果,前端截取前十展示。
来源:backend/src/services/stats.js。
思路: 为所有关键词建立统一年份轴,形成前端可直接绘制的计数数组。统一年份轴避免不同曲线的数据索引错位。
export function trend(params = {}) {
  const rows = loadRows(params)
  const years = [...new Set(rows.map((r) => r.year).filter(Boolean))].sort((a, b) => a - b)
  const map = new Map()

  rows.forEach((row) => {
    for (const keyword of new Set(row.keywords)) {
      if (!map.has(keyword)) map.set(keyword, { name: keyword, data: years.map(() => 0) })
      if (row.year) {
        const idx = years.indexOf(row.year)
        if (idx > -1) map.get(keyword).data[idx] += 1
      }
    }
  })

  const keywords = [...map.values()].map((item) => ({
    ...item,
    total: item.data.reduce((a, b) => a + b, 0)
  }))
  keywords.sort((a, b) => b.total - a.total)

  return { years, keywords }
}
来源:backend/src/services/stats.js。
思路: 每篇论文对关键词做去重后两两组合,排序形成无向边唯一键,累计共同出现的论文数。
export function graph(params = {}, limit = 15) {
  const rows = loadRows(params)
  const freq = new Map()
  const pairs = new Map()

  rows.forEach((row) => {
    const kws = [...new Set(row.keywords)]
    kws.forEach((k) => freq.set(k, (freq.get(k) || 0) + 1))
    for (let i = 0; i < kws.length; i += 1) {
      for (let j = i + 1; j < kws.length; j += 1) {
        const key = [kws[i], kws[j]].sort().join('||')
        pairs.set(key, (pairs.get(key) || 0) + 1)
      }
    }
  })

  const nodes = [...freq.entries()]
    .sort((a, b) => b[1] - a[1])
    .slice(0, limit)
    .map(([name, value]) => ({ name, size: value }))
  const names = new Set(nodes.map((n) => n.name))
  const links = [...pairs.entries()]
    .map(([key, value]) => {
      const [source, target] = key.split('||')
      return { source, target, value }
    })
    .filter((l) => names.has(l.source) && names.has(l.target))

  return { nodes, links }
}
边 (a, b) 和 (b, a) 应当表示同一关系,排序避免重复计数。只保留已选节点之间的边,保证前端收到的数据可直接组成图谱。
来源:backend/src/services/cache.js。
思路: 用缓存键保存聚合结果,论文发生变化后删除旧缓存。查询命中时直接返回,未命中时计算并持久化。
export function getCached(key) {
  const row = db.prepare('SELECT payload FROM stats_cache WHERE key = ?').get(key)
  if (!row) return null
  try {
    return JSON.parse(row.payload)
  } catch {
    return null
  }
}

export function setCached(key, value) {
  db.prepare(`
    INSERT INTO stats_cache (key, payload, updated_at)
    VALUES (?, ?, datetime('now', 'localtime'))
    ON CONFLICT(key) DO UPDATE SET payload = excluded.payload, updated_at = datetime('now', 'localtime')
  `).run(key, JSON.stringify(value))
}

export function cacheStats(key, compute) {
  const cached = getCached(key)
  if (cached !== null) return cached
  const value = compute()
  setCached(key, value)
  return value
}

export function clearStatsCache() {
  db.prepare('DELETE FROM stats_cache').run()
}
来源:frontend/src/utils/lineReveal.js 和 components/charts/BaseChart.vue。
折线先按固定坐标完整绘制,再在绘图区覆盖与背景同色的渐变矩形,通过 requestAnimationFrame 推进透明区域边界,让曲线从左向右逐渐显现。动画结束后移除遮罩,恢复完整图表交互。图表组件负责初始化、响应尺寸变化和销毁实例,避免页面切换后遗留图表资源。
export function revealLine(chart, grid, duration = 1800) {
  if (!chart) return
  const width = chart.getWidth()
  const height = chart.getHeight()
  const left = grid?.left ?? 56
  const right = grid?.right ?? 28
  const top = grid?.top ?? 46
  const bottom = grid?.bottom ?? 34
  const plotWidth = Math.max(1, width - left - right)
  const plotHeight = Math.max(1, height - top - bottom)

  const start = performance.now()
  const easeInOut = (t) => (t < 0.5 ? 4 * t * t * t : 1 - Math.pow(-2 * t + 2, 3) / 2)

  const frame = (now) => {
    const t = Math.min(1, (now - start) / duration)
    const p = easeInOut(t)
    const edge = EDGE_START + p * (EDGE_END - EDGE_START)
    chart.setOption({
      graphic: [
        {
          id: 'vi-wipe',
          type: 'rect',
          left,
          top,
          shape: { width: plotWidth, height: plotHeight },
          style: { fill: maskFill(edge) },
          silent: true,
          z: 100
        }
      ]
    })
    if (t < 1) {
      requestAnimationFrame(frame)
    } else {
      requestAnimationFrame(() => chart.setOption({ graphic: [] }, { replaceMerge: ['graphic'] }))
    }
  }
  requestAnimationFrame(frame)
}
片段中的 EDGE_START、EDGE_END 和 maskFill 定义在同一源文件中:边界从绘图区左侧之外推进到右侧之外,maskFill 根据边界构造透明到背景色的渐变。silent: true 避免遮罩接管鼠标交互。
为确保 Release 版本的可用性,本项目围绕数据、功能与体验三个维度进行了多轮回归验证。以下为核心验收结论:
| 测试维度 | 核心验证场景 | 验收结论 |
|---|---|---|
| 接口与数据一致性 | 服务端健康检查、真实数据快照加载、热点与图谱聚合 API 返回规范 | 接口调用均返回 code: 0,ECharts 数据绑定成功。 |
| 核心业务流转联调 | 论文的单篇/批量爬取入库 ➔ 列表组合检索 ➔ 增删改查 ➔ 数据重算 | 业务闭环跑通,新增/删除论文后,统计大盘的缓存能正确刷新。 |
| 视觉与交互容错 | 图表渐显动画性能、节点密集时的图谱渲染、查询不存在的乱码数据 | 动效流畅不卡顿,空数据与边界条件均有合理的无数据状态兜底。 |
测试总结:
经前端 npm run build 生产环境打包与后端实际部署联调,前端大文件分块正常,首屏加载符合预期。系统的核心“获取—管理—分析”路径已稳定可用,可支撑后续的灰度试用与迭代。
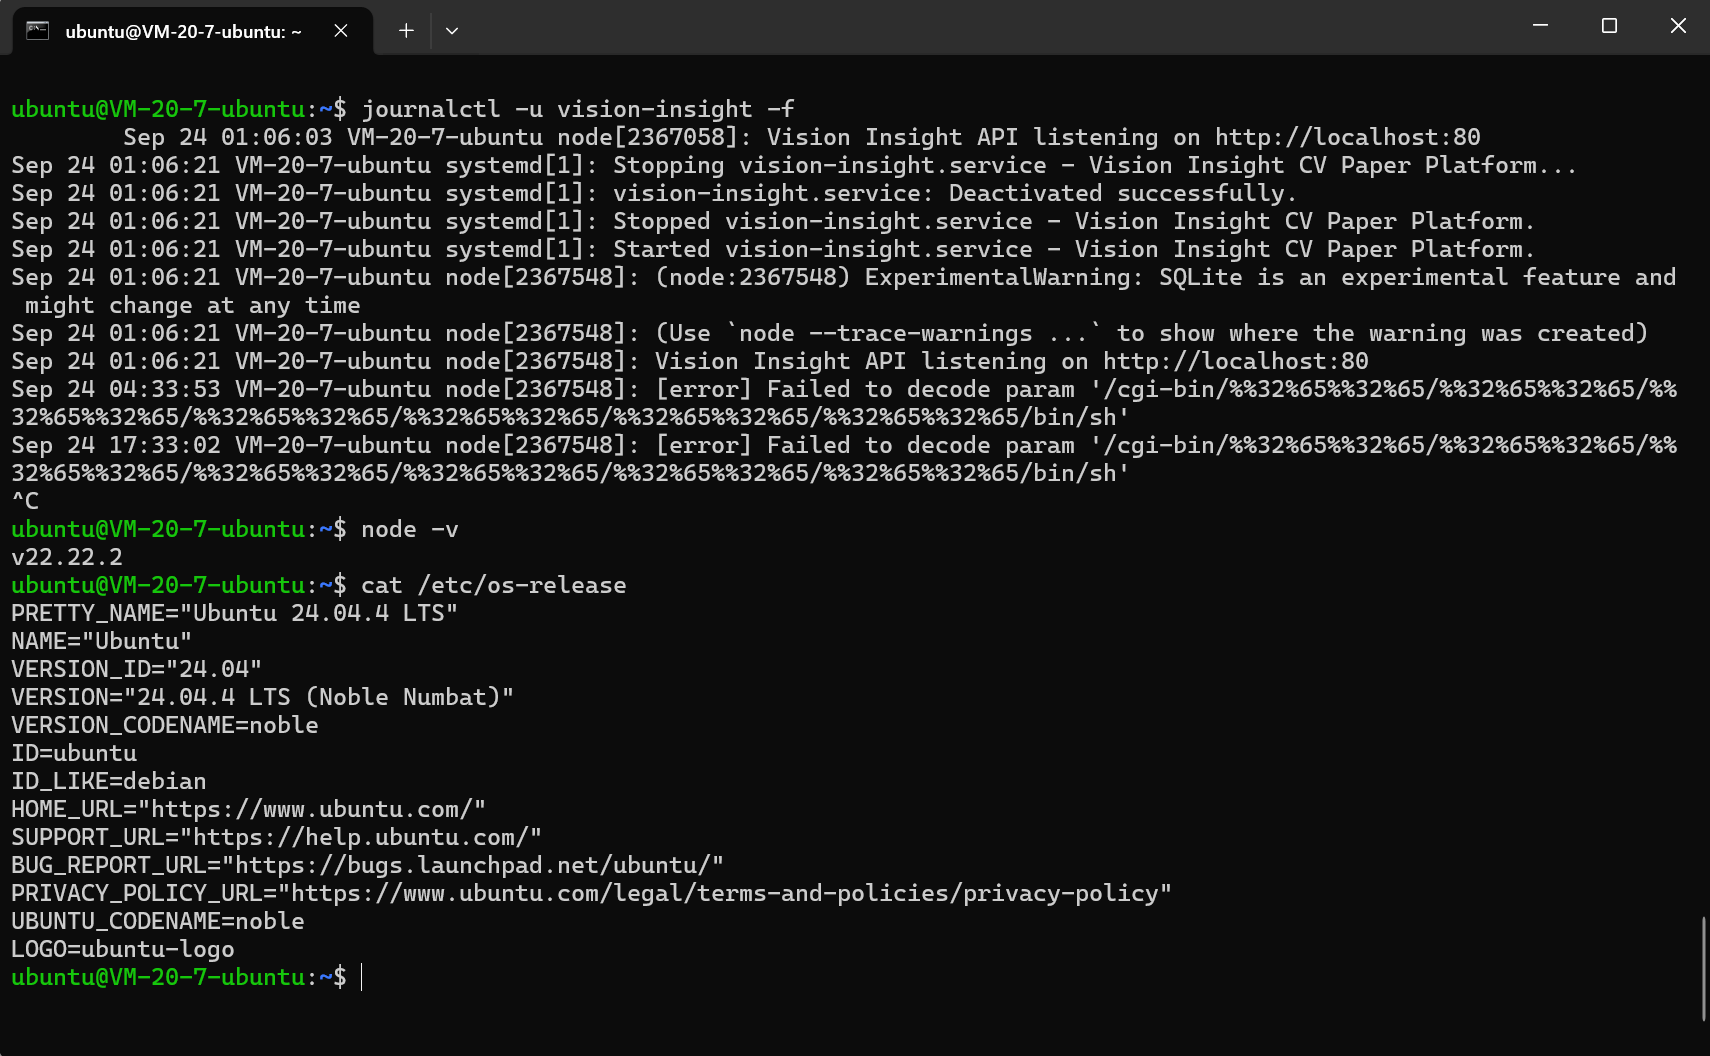
本项目已部署至云服务器(Ubuntu 24.04, Node.js 22.22.2),通过 systemd 进行守护进程管理,保证服务高可用。后端通过 Express 代理前端的 dist 静态产物并提供 /api 接口,实现了前后端同域名的简洁部署架构。
部署与启动的核心指令如下:
# 在项目根目录构建前端
npm ci --prefix frontend
npm run build --prefix frontend

# 安装后端依赖;普通启动默认端口见 server.js 配置
npm ci --prefix backend
npm start --prefix backend

# 当前服务器的服务状态与日志
sudo systemctl status vision-insight
journalctl -u vision-insight -f
生产服务的端口、工作目录和启动命令由实际 systemd 配置决定。数据库位于 backend/data/vision-insight.db,被 .gitignore 忽略,因此仅克隆仓库不会获得线上 3.2 万篇数据。迁移或复现需通过数据库备份或爬取脚本准备数据。
# 按项目脚本获取数据
npm run crawl:full --prefix backend
npm run crawl:enrich --prefix backend
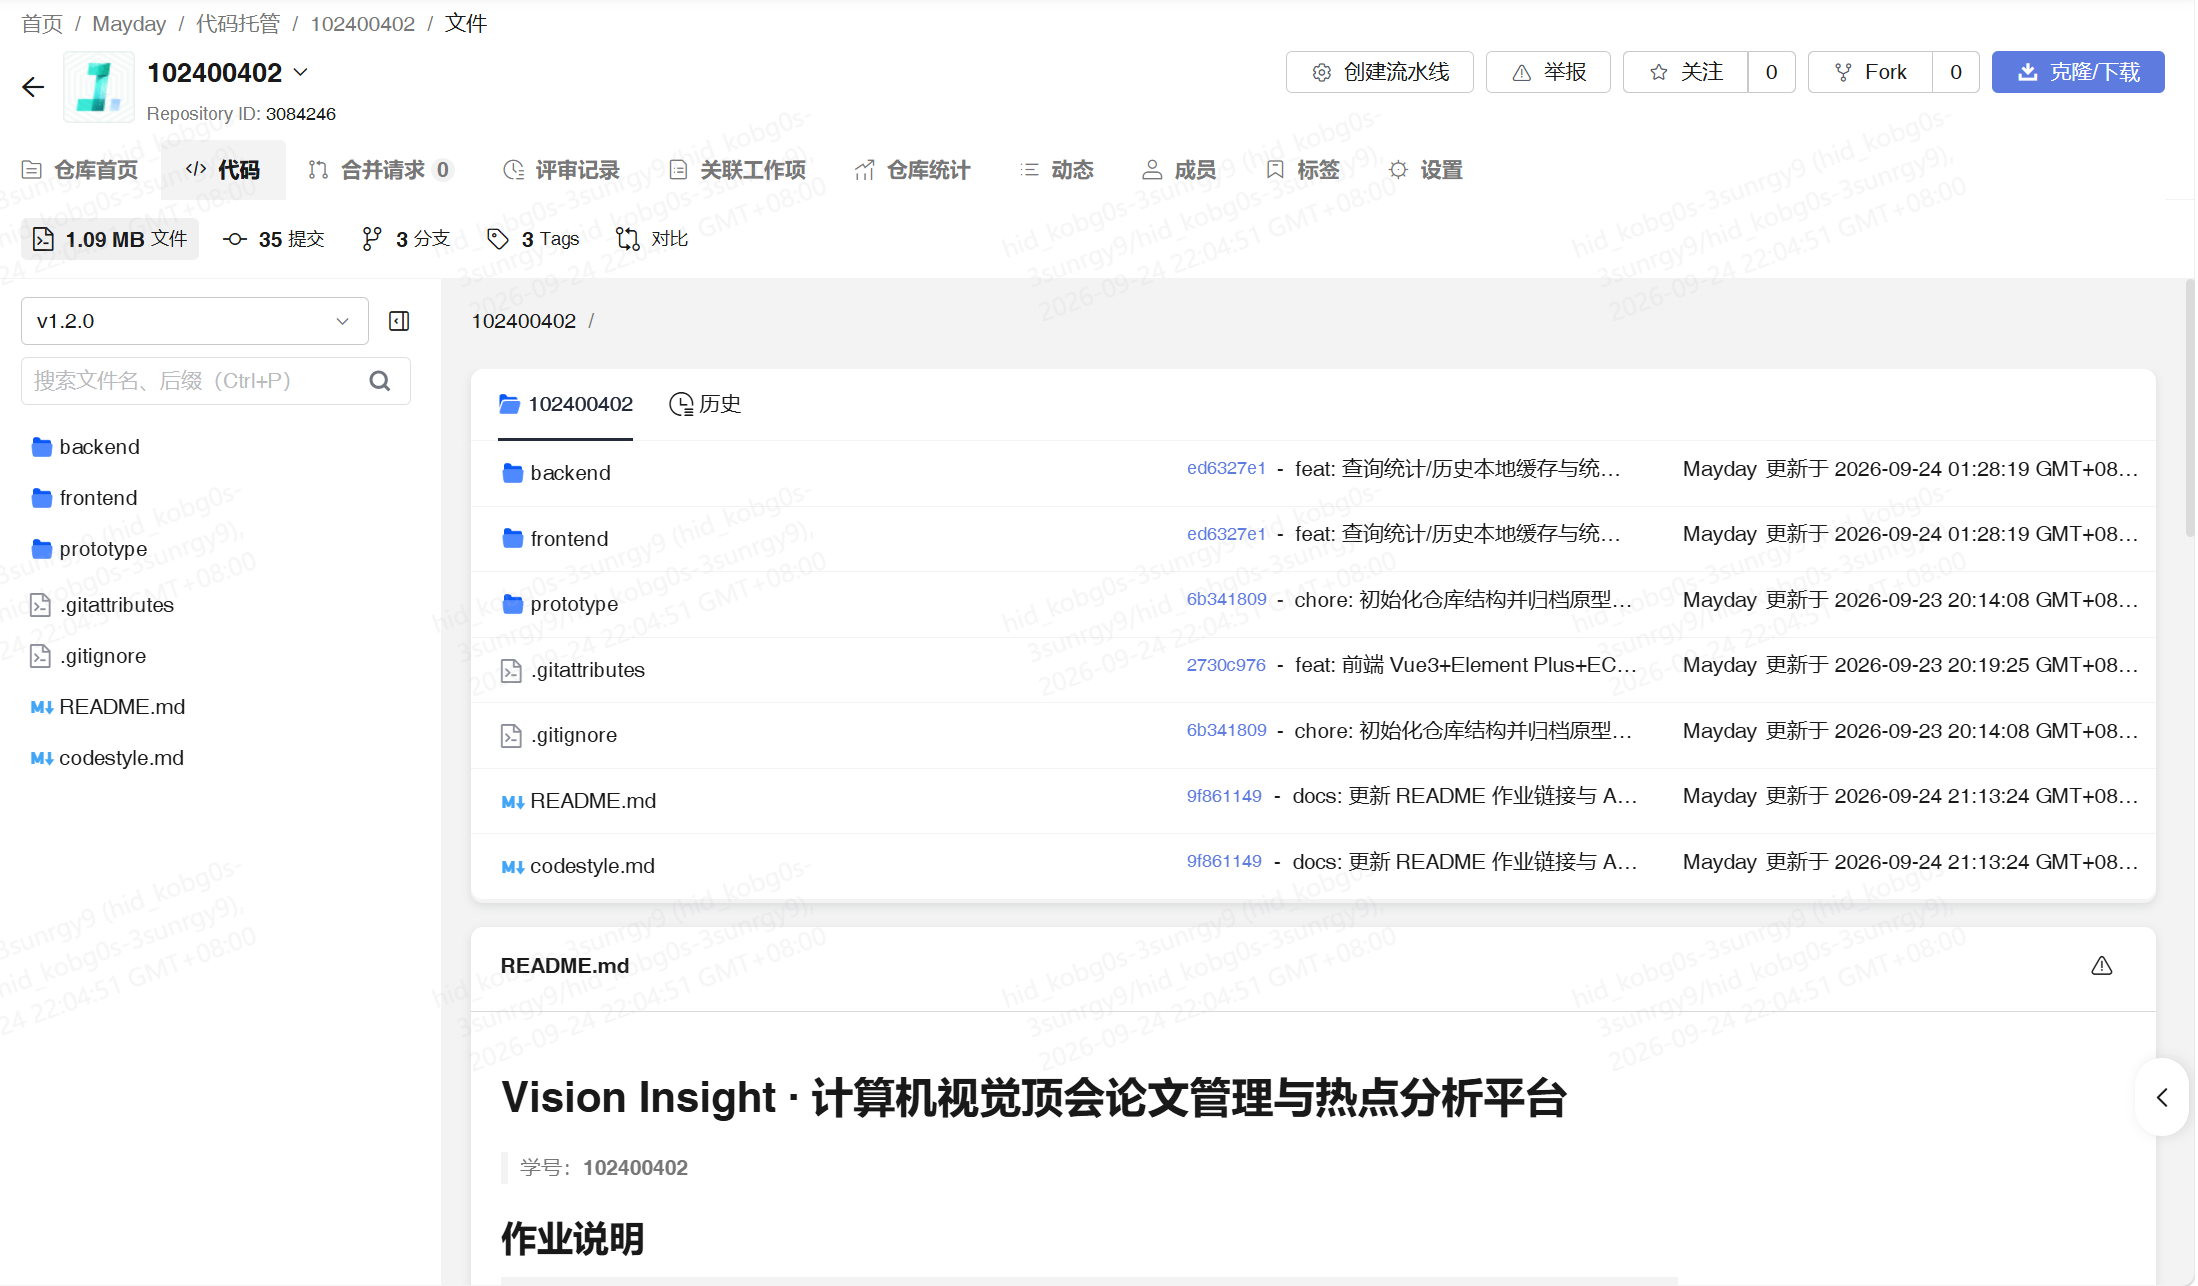
在整个开发周期内,严格遵循 Git 分支管理与代码规范。核心迭代均在 dev 分支完成,最终交付前已合入 main 主分支并打上版本标签。
下表为核心迭代路径摘要:
| 阶段 | 代表commit | 迭代内容 |
|---|---|---|
| 基础建设 | 8d2a9d7 / 2730c97 | 前后端项目初始化、Express/SQLite CRUD 跑通、Vue 统一布局建立 |
| 抓取增强 | 1140515 / dd8ab3f | 突破单源限制,实现按届爬取、摘要补全与年份回退机制 |
| 业务优化 | 47187a1 / cbc8355 | 修复关键详情接口漏缺,上线论文详情页与联动分析闭环 |
| 性能与体验 | 6170112 / ed6327e | ECharts 图谱聚类优化、趋势渐显动画上线、引入查询历史与统计缓存 |
发版记录:
dev ➔ main 合并。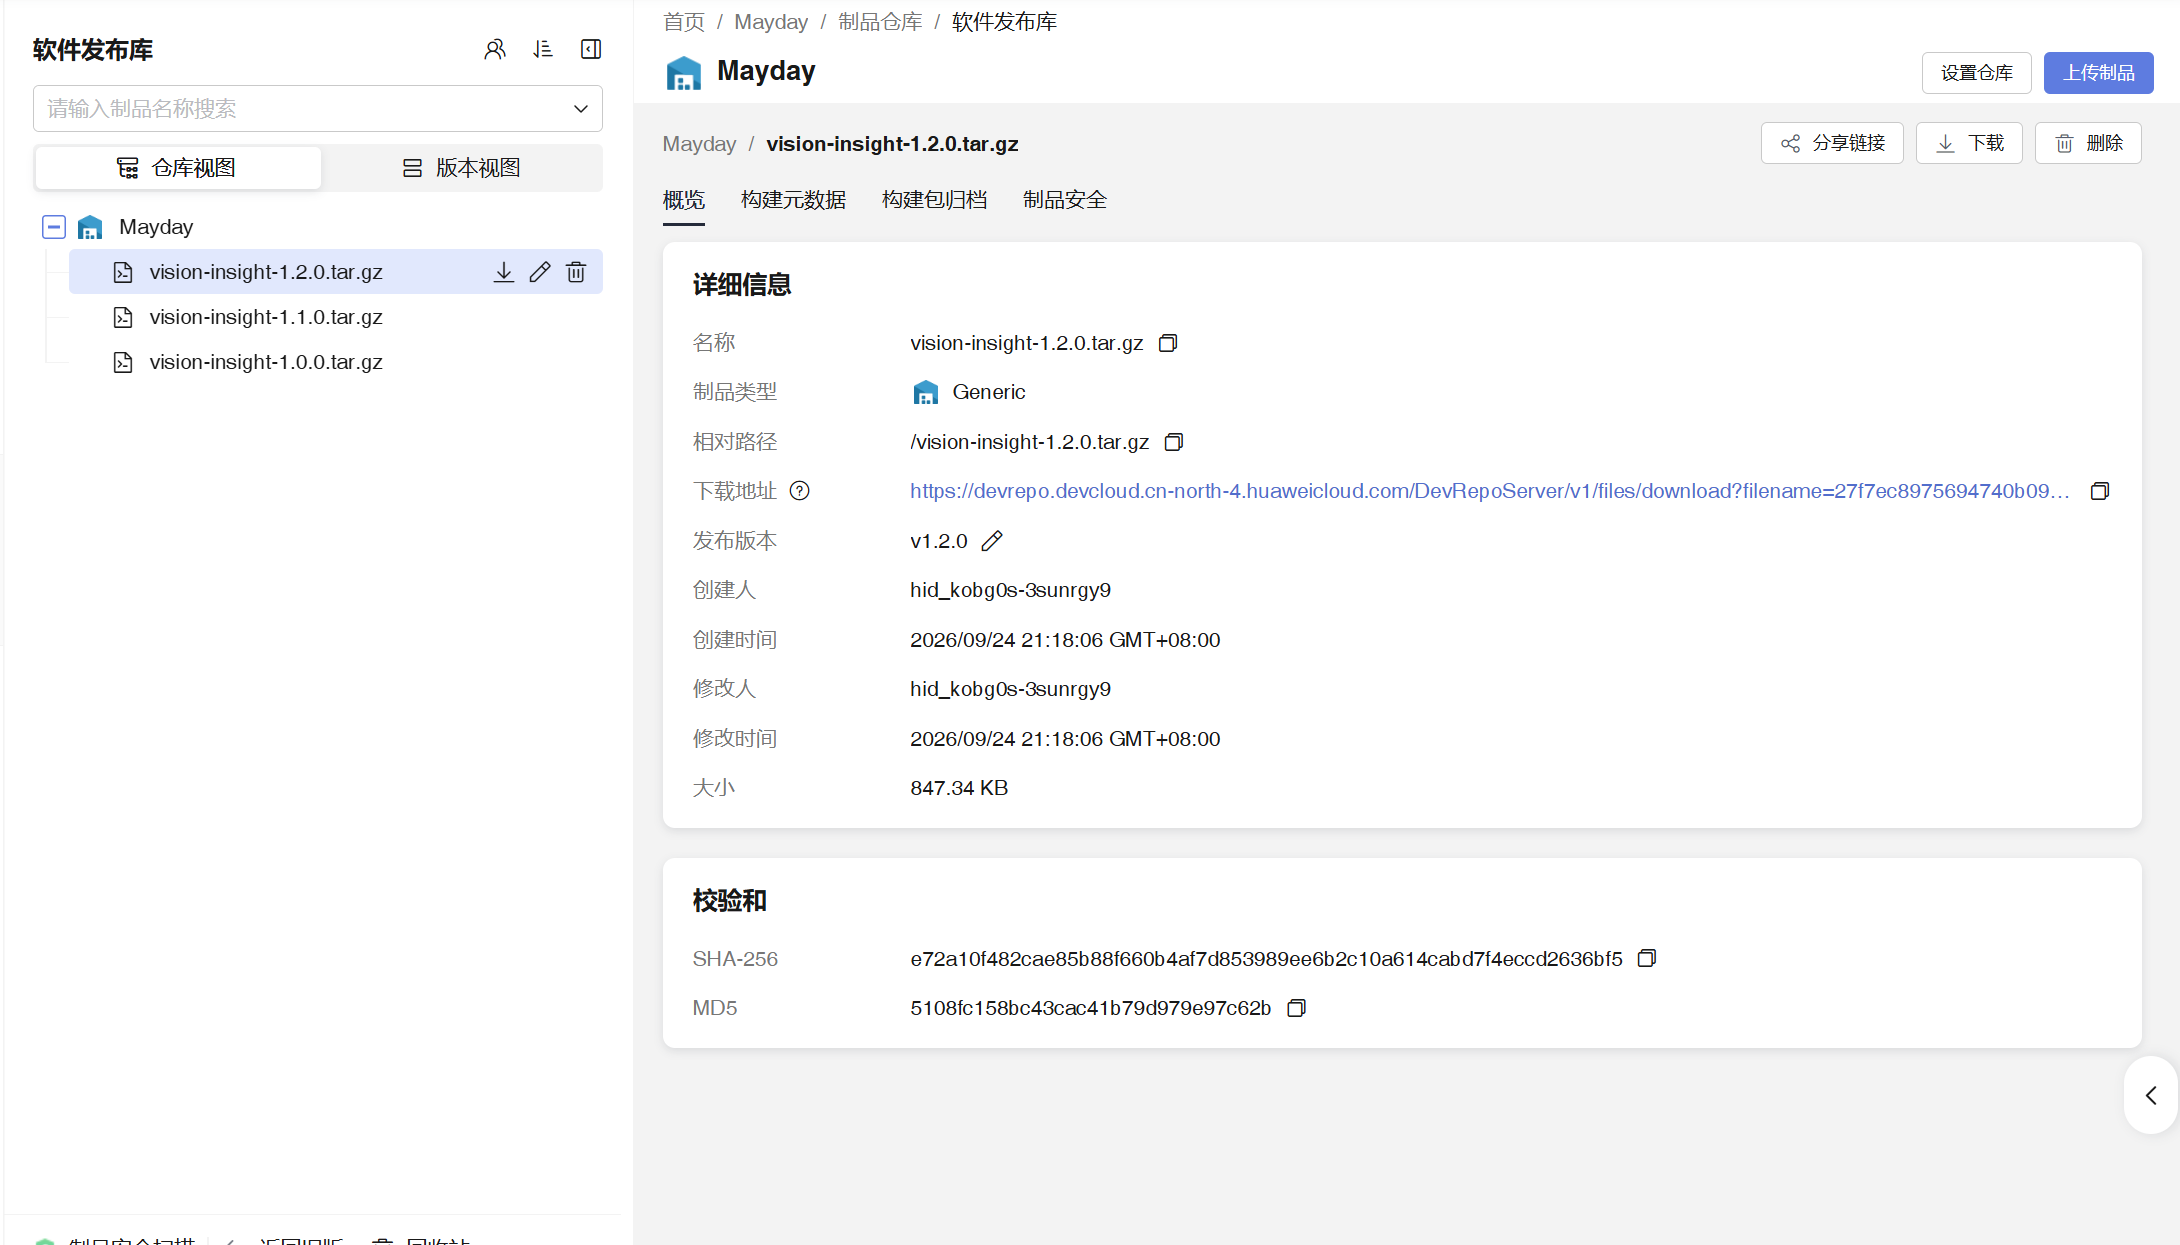
| 功能 | 实现内容 | 用户价值 |
|---|---|---|
| 了解更多 | 三大会议介绍与统计方法说明 | 降低初学者理解成本 |
| 按会议年份获取 | 选择会议与年份抓取,并有全量脚本 | 减少手工整理标题清单 |
| 论文详情与相关论文 | 摘要、链接、关键词和基于共享标签的推荐 | 连续阅读和进一步探索 |
| 查询历史与计数 | localStorage 保存近期查询和获取统计 | 便于重复查询和回顾 |
| 图谱可读性优化 | 裁剪边、主题着色、点击聚焦 | 更容易观察关联方向 |
| 统计缓存 | 聚合结果持久化,数据变化后失效 | 减少重复计算 |
一开始,我以为“热词统计”仅仅是算个词频、排个序这么简单。但在精读《构建之法》第 3、8 章并完成 NABCD 分析后,我意识到用户小刚面临的真正痛点并非缺乏词频数据,而是面对海量文献时“不知道该看什么、从哪看起”的迷茫。
因此,我在设计上将用户行为拆分为“探索”与“目标检索”两条路径:想初步了解领域的初学者,可以通过首页榜单和图谱逐层下钻;已有特定文献清单的研究者,则可直达单篇或批量检索。这种以用户为中心的视角促使我做出了真实的工程取舍:放弃了最初“把所有数据全堆在首页”的简陋想法,转而设计了分工明确的六大页面,决定先将五项基础功能做扎实,再去考量附加项。AI 虽能轻易列出长串的功能清单,但究竟哪些功能是真正贴合具体科研场景的,还是得靠开发者自己的判断。
这次开发让我深刻体会到了“构造原型”与“实际实现”之间的巨大鸿沟。在测试关键词图谱时,点击节点毫无反应,我最初以为是 ECharts 配置有误,排查后却发现后端接口一切正常,纯粹是前端封装层漏写了方法。这让我认识到,功能验收必须沿着“点击交互 ➔ 发起请求 ➔ 数据返回 ➔ 重绘渲染”的链路验证。
此外,在计算方向热度增长率时,个别早期年份因收录论文仅有一两篇,导致增长率计算出现极端异常。在引入阈值过滤掉离群年份后,我领悟到:脱离了严谨统计口径的数字毫无意义。如今,无论是多源爬取
crawlPaper复杂的优先级合并逻辑,还是统计缓存“写入即失效”的底层机制,我都能在代码层面给出一定的技术解释。
复盘本次 PSP 数据,AI 在需求框架梳理、原型初步搭建以及样板代码生成上帮我节省了大量精力,让核心编码时间从预估的 480 分钟锐减至 360 分钟。然而,意料之外的返工几乎全部来自真实的外部数据环境——DBLP 的反爬虫策略、CVF 早期年份列表需逐日抓取合并、ECVA 不规范链接的深度清洗,这些“脏数据”的处理占用了大量联调时间。
这次项目实战给我留下的最大教训是:切忌在未经连通性验证的“地基”上盲目铺设业务。如果重来一次,我会优先用“一个会议 + 一个年份 + 10 篇论文”跑通全链路的demo,再扩大抓取范围,并将数据源可达性、接口契约和统计口径列为动工前的必查项。整体来看,实际耗时比预估缩减了约 30%,这个数据印证了我对人机结对编程的最终理解:把繁复枯燥的重复劳动放心地交给 AI,而将最核心的业务逻辑判断与真机环境验证,牢牢握在自己手中。
结合《构建之法》第 4 章关于结对编程的讨论,可以从分工、沟通和审查理解本项目的人机协作:
| 维度 | 共同点 | 人机结对中需要特别处理的地方 |
|---|---|---|
| 目标与分工 | 都需要明确任务和验收标准 | AI 能快速产出,但需求边界和最终责任由人确认 |
| 沟通 | 都需要说明背景、约束与问题 | Prompt 必须提供当前代码、真实错误和期望行为 |
| 审查 | 都应检查实现是否正确、清晰 | AI 可能生成能运行但不符合业务含义的代码 |
| 知识互补 | 都能提供不同思路和方案 | AI 对外部接口与平台现状可能过时,需要实测 |
| 迭代 | 都依赖反馈和验证 | 不能以 AI 的“已完成”总结代替实际验收 |
从本项目的技术内容看,AI 适合帮助拆分模块、搭建组件和接口初稿、解释错误、比较可视化方案以及整理文档。其价值体现在减少从零开始的重复劳动,让人有更多时间检查需求与结果。
同时,AI 的输出需要持续核实:外部数据源可能变化,自动总结可能夸大完成范围,统计公式即使可执行也未必符合指标名称。本次交付审查中发现的编号检索与占比分母问题,说明“有对应页面”并不足以证明满足要求。
涉及数据操作、服务配置和部署命令时,也需要本人理解执行范围和结果。AI 可以辅助解释和检查,但不能替代对真实环境的判断。
本次作业的构建是和 Agent(Opencode)一同构建的,在具体实现方面使用了 DeepSeek v4.1 Flash 模型,模型的速度极快,在写具体功能的时候等待时间短,开销低,正反馈很强。但问题是 bug 也层出不穷。所以在项目后期审计的时候引入更强的 GPT-6 Astra 模型,但该模型在极其昂贵的同时思考链极长,虽然debug效果不错但用户体验一般,并且在进行辅助写作的时候写的文字防御性偏强,和正规的技术文档差距相当大,文档最后还是需要靠人类进行撰写,这也体现了当下模型的局限性。
本项目采用“人工主导设计与决策,AI 辅助分析与编码实现”的开发方式。AI 结对助手(Opencode,分别使用 DeepSeek 与 GPT 模型)并不是独立完成项目,而是作为结对开发工具参与需求分析、技术方案讨论、代码实现、测试补充和问题排查。所有 AI 输出均经过人工判断、检查和实际运行验证后才决定是否保留。
为明确人工与 AI 在项目中的职责边界,现对主要代码与设计工作说明如下。
| 工作部分 | 完成方式 | 人工完成或修改的内容 | AI 辅助内容 |
|---|---|---|---|
| 系统整体架构 | 人工主导 | 确定前后端分离结构,以及「API → Service → 数据访问 → SQLite」的分层方式,明确各模块职责边界 | 提供候选架构方案供比较与取舍 |
| 数据模型与论文 CRUD | 人工 + AI | 确定论文字段、标题规范化规则、精确/模糊查询边界、会议年份筛选与分页格式 | 按最终规则实现 Service、API 与前端表单 |
| 数据源与爬取策略 | 人工决策 + AI 辅助实现 | 比较后决定「CVF/ECVA 按会议年份抓取」为主、DBLP/Crossref/Semantic Scholar/OpenAlex/arXiv 多源兜底为补充,并确定来源优先级 | 实现各数据源解析器、逐日回退与重试逻辑 |
| 关键词抽取与研究方向分类 | 人工主导规则 + AI 辅助实现 | 确定 13 类研究方向词表、别名归一方式、标题+摘要匹配、同篇同词只计一次等口径 | 整理规则并实现抽取与匹配代码 |
| 关键词图谱 | 人工提出统计与交互要求 + AI 辅助实现 | 确定节点=关键词论文数、边=共现次数等统计含义,并根据真实页面效果决定边裁剪、聚类着色与点击聚焦方案 | 实现后端图数据与 ECharts 参数调整 |
| 热度趋势与统计口径 | 人工设计口径 + AI 辅助实现 | 确定增长率按有效年份区间计算、忽略论文量过少的离群年份、占比分母按当年全部关键词计等规则 | 实现趋势统计、渐显播放逻辑与前端交互 |
| 论文详情与相似推荐 | 人工确定目标与展示方式 + AI 辅助实现 | 确定推荐仅基于本地论文库、排除当前论文、按共享关键词排序并展示共同关键词 | 实现相关论文接口与前端推荐列表 |
| 性能与缓存 | 人工决策 + AI 辅助实现 | 决定统计结果做云端缓存并在数据写入后失效,关键词接口限量返回以避免超大响应 | 实现缓存服务、失效逻辑与接口体积优化 |
| 前端 Bug 修复(关键词点击/图谱无响应) | 人工主导定位与修复方案 | 根据现象沿「点击 → 请求 → 返回 → 渲染」判断根因是前端缺少关键词接口方法,要求补全接口而非临时绕过,并以真实点击完成验收 | 协助定位调用链并补全接口方法 |
| 数据获取异常(DBLP 反爬、CVF 年份页面、ECVA 链接) | 人工分析问题 + AI 辅助修改 | 判断需采用多源兜底、按会期逐日合并、链接清洗等处理方向,而非放宽匹配条件 | 修改解析逻辑并补充重试与回退 |
| 页面视觉与交互 | 人工 | 根据原型和真实页面效果决定布局、导航、筛选、折叠面板与详情排版是否保留 | 提供原型初稿与页面实现初版 |
| 测试与发布验收 | 人工 | 检查真实页面、真实 API、统计结果与云端部署效果,并决定是否接受修改、发布新版本 | 辅助执行构建、接口自测、截图/GIF 生成与发布包打包 |
总体而言,AI 承担的是“减少从零开始的重复劳动”,而需求边界、统计口径、真实环境验证与最终验收始终由本人负责。

