


88
社区成员
 发帖
 与我相关
 我的任务
 分享
| 这个作业属于哪个课程 | https://bbs.csdn.net/forums/2601_CS_SE_FZU?category=0 |
|---|---|
| 这个作业要求在哪里 | https://bbs.csdn.net/topics/620526318 |
| 这个作业的目标 | 与AI结对开发一个CV顶会论文热词统计平台,实现论文爬取、列表管理、Top10热门方向、关键词图谱、热度走势动图5个功能,部署到华为云公网可访问 |
| 其他参考文献 | 《构建之法》第3、4、8章;华为云CodeArts文档;ECharts官方文档 |
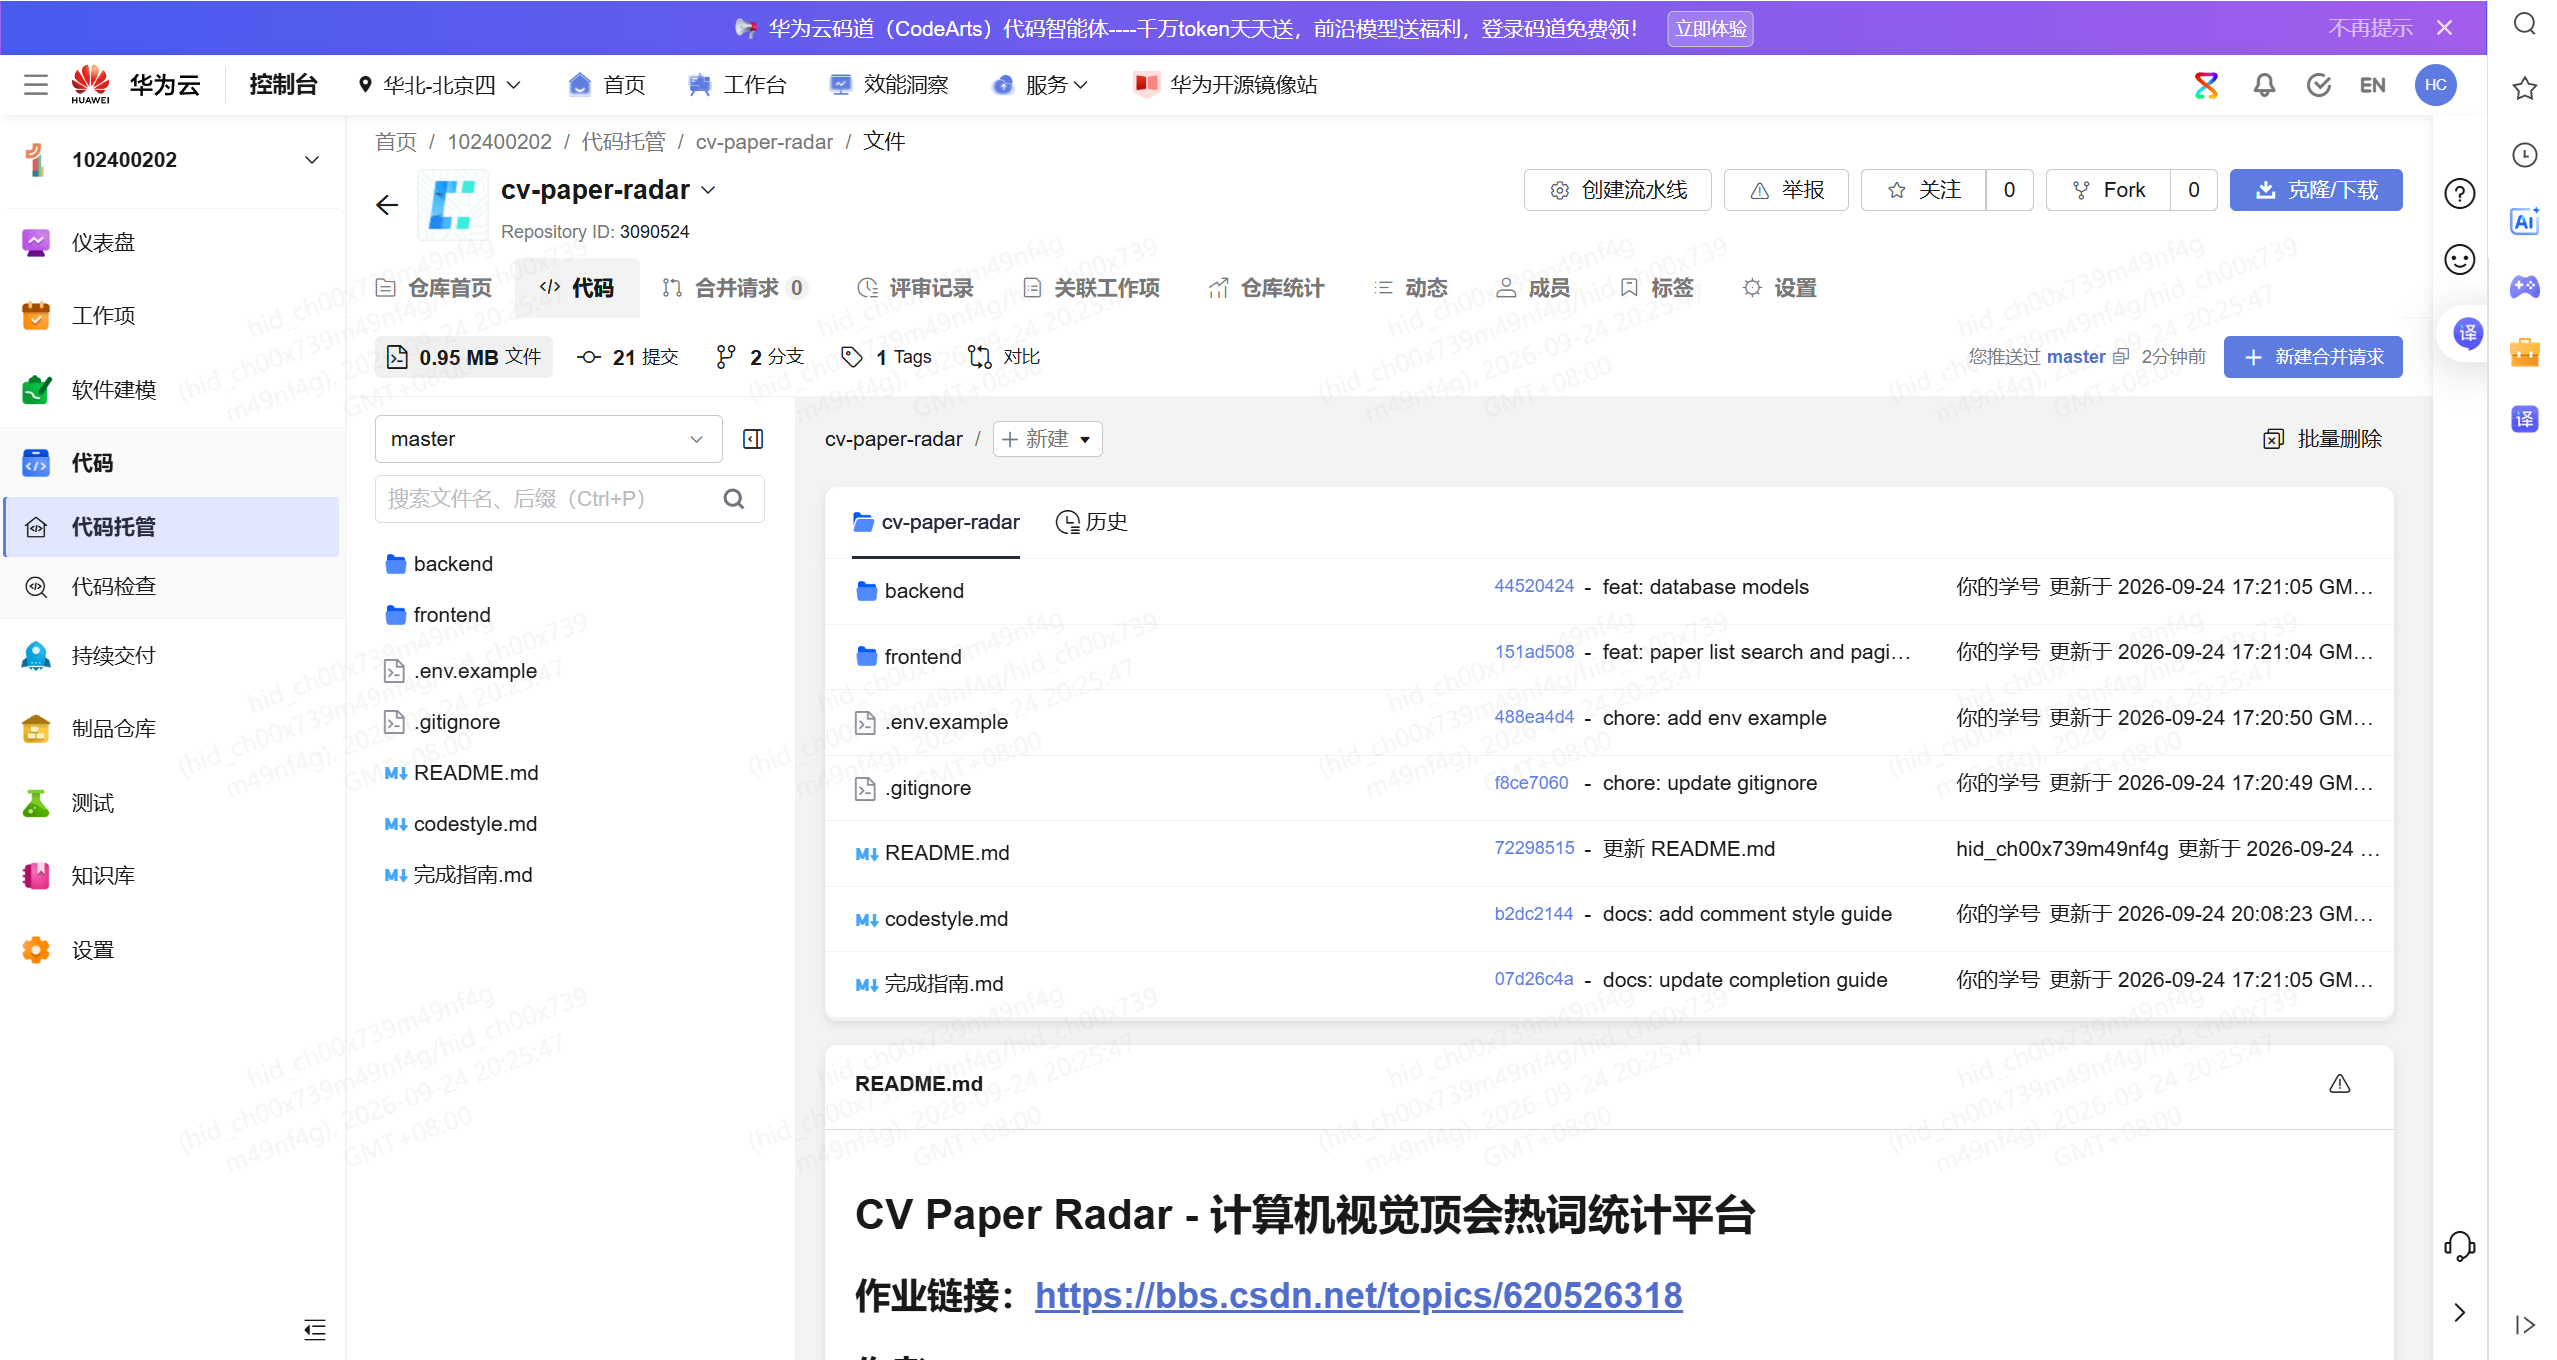
技术选型咨询:Vue3/FastAPI/数据库选型
代码生成:爬虫脚本、后端接口、前端页面框架
Bug排查:arXiv 406错误、vite原生模块bug、Nginx配置
| 阶段 | 任务 | 计划时间 | 实际时间 | 偏差 | 偏差原因 |
|---|---|---|---|---|---|
| 1 | 需求分析+技术选型 | 4h | 3h | -1h | 有AI辅助,技术选型比预估快1小时 |
| 2 | 数据库设计+后端骨架 | 6h | 5h | -1h | FastAPI+SQLAlchemy脚手架代码生成快 |
| 3 | arXiv爬虫开发 | 4h | 5h | +1h | arXiv API 406错误和URL编码问题排查 |
| 4 | CVF爬虫开发 | 6h | 7h | +1h | 页面结构适配和lxml依赖问题 |
| 5 | 前端7个页面开发 | 12h | 13h | +1h | ECharts配置和响应式布局调试 |
| 6 | 前后端联调 | 4h | 4h | 0h | FastAPI自动文档,接口对齐顺利 |
| 7 | 华为云ECS部署 | 5h | 7h | +2h | ECS库存不足、vite原生模块bug、安全组和Nginx配置调试 |
| 8 | 数据爬取+测试 | 3h | 3h | 0h | 数据量1050篇,测试顺利 |
| 9 | 实验报告撰写 | 5h | 5h | 0h | 文档结构清晰 |
| 合计 | 49h | 52h | +3h | 偏差约6%,主要来自部署环境和爬虫调试 |
总结:预估时间整体偏差在合理范围内,实际比预估多3小时。偏差主要来自:①云服务器部署的环境兼容性问题(库存、依赖、网络配置);②爬虫调试中的API和解析错误;③ECharts图表配置。实际开发中应预留20%的部署和调试时间。
计算机视觉领域论文数量爆炸式增长,研究者难以快速把握顶会(CVPR/ICCV/ECCV)的研究热点和趋势。本平台解决三个核心问题:
| 步骤 | 内容 | 说明 |
|---|---|---|
| 1. 需求输入 | 将功能需求告诉豆包 | AI列出页面结构和信息架构建议 |
| 2. AI生成原型 | 在墨刀AI输入"CV论文热词统计平台,包含首页、论文列表、爬取、热门方向、关键词图谱、热度走势" | 自动生成7个页面原型初稿 |
| 3. 人工优化配色 | 将默认蓝色改为科技深蓝 | 符合学术平台风格 |
| 4. 人工优化布局 | 左侧导航栏+右侧内容区 | 统一所有页面布局 |
| 5. 人工优化交互 | 补充搜索框、分页器、图表联动逻辑 | 完善交互细节 |
| 迭代V1 | AI自动生成 | 只有基本框架 |
| 迭代V2 | 人工添加 | ECharts图表占位、搜索框、表格 |
| 迭代V3 | 人工统一 | 导航栏配色和间距,补充页面跳转关系 |
| 页面 | 功能 | 布局设计 | 与需求对应 |
|---|---|---|---|
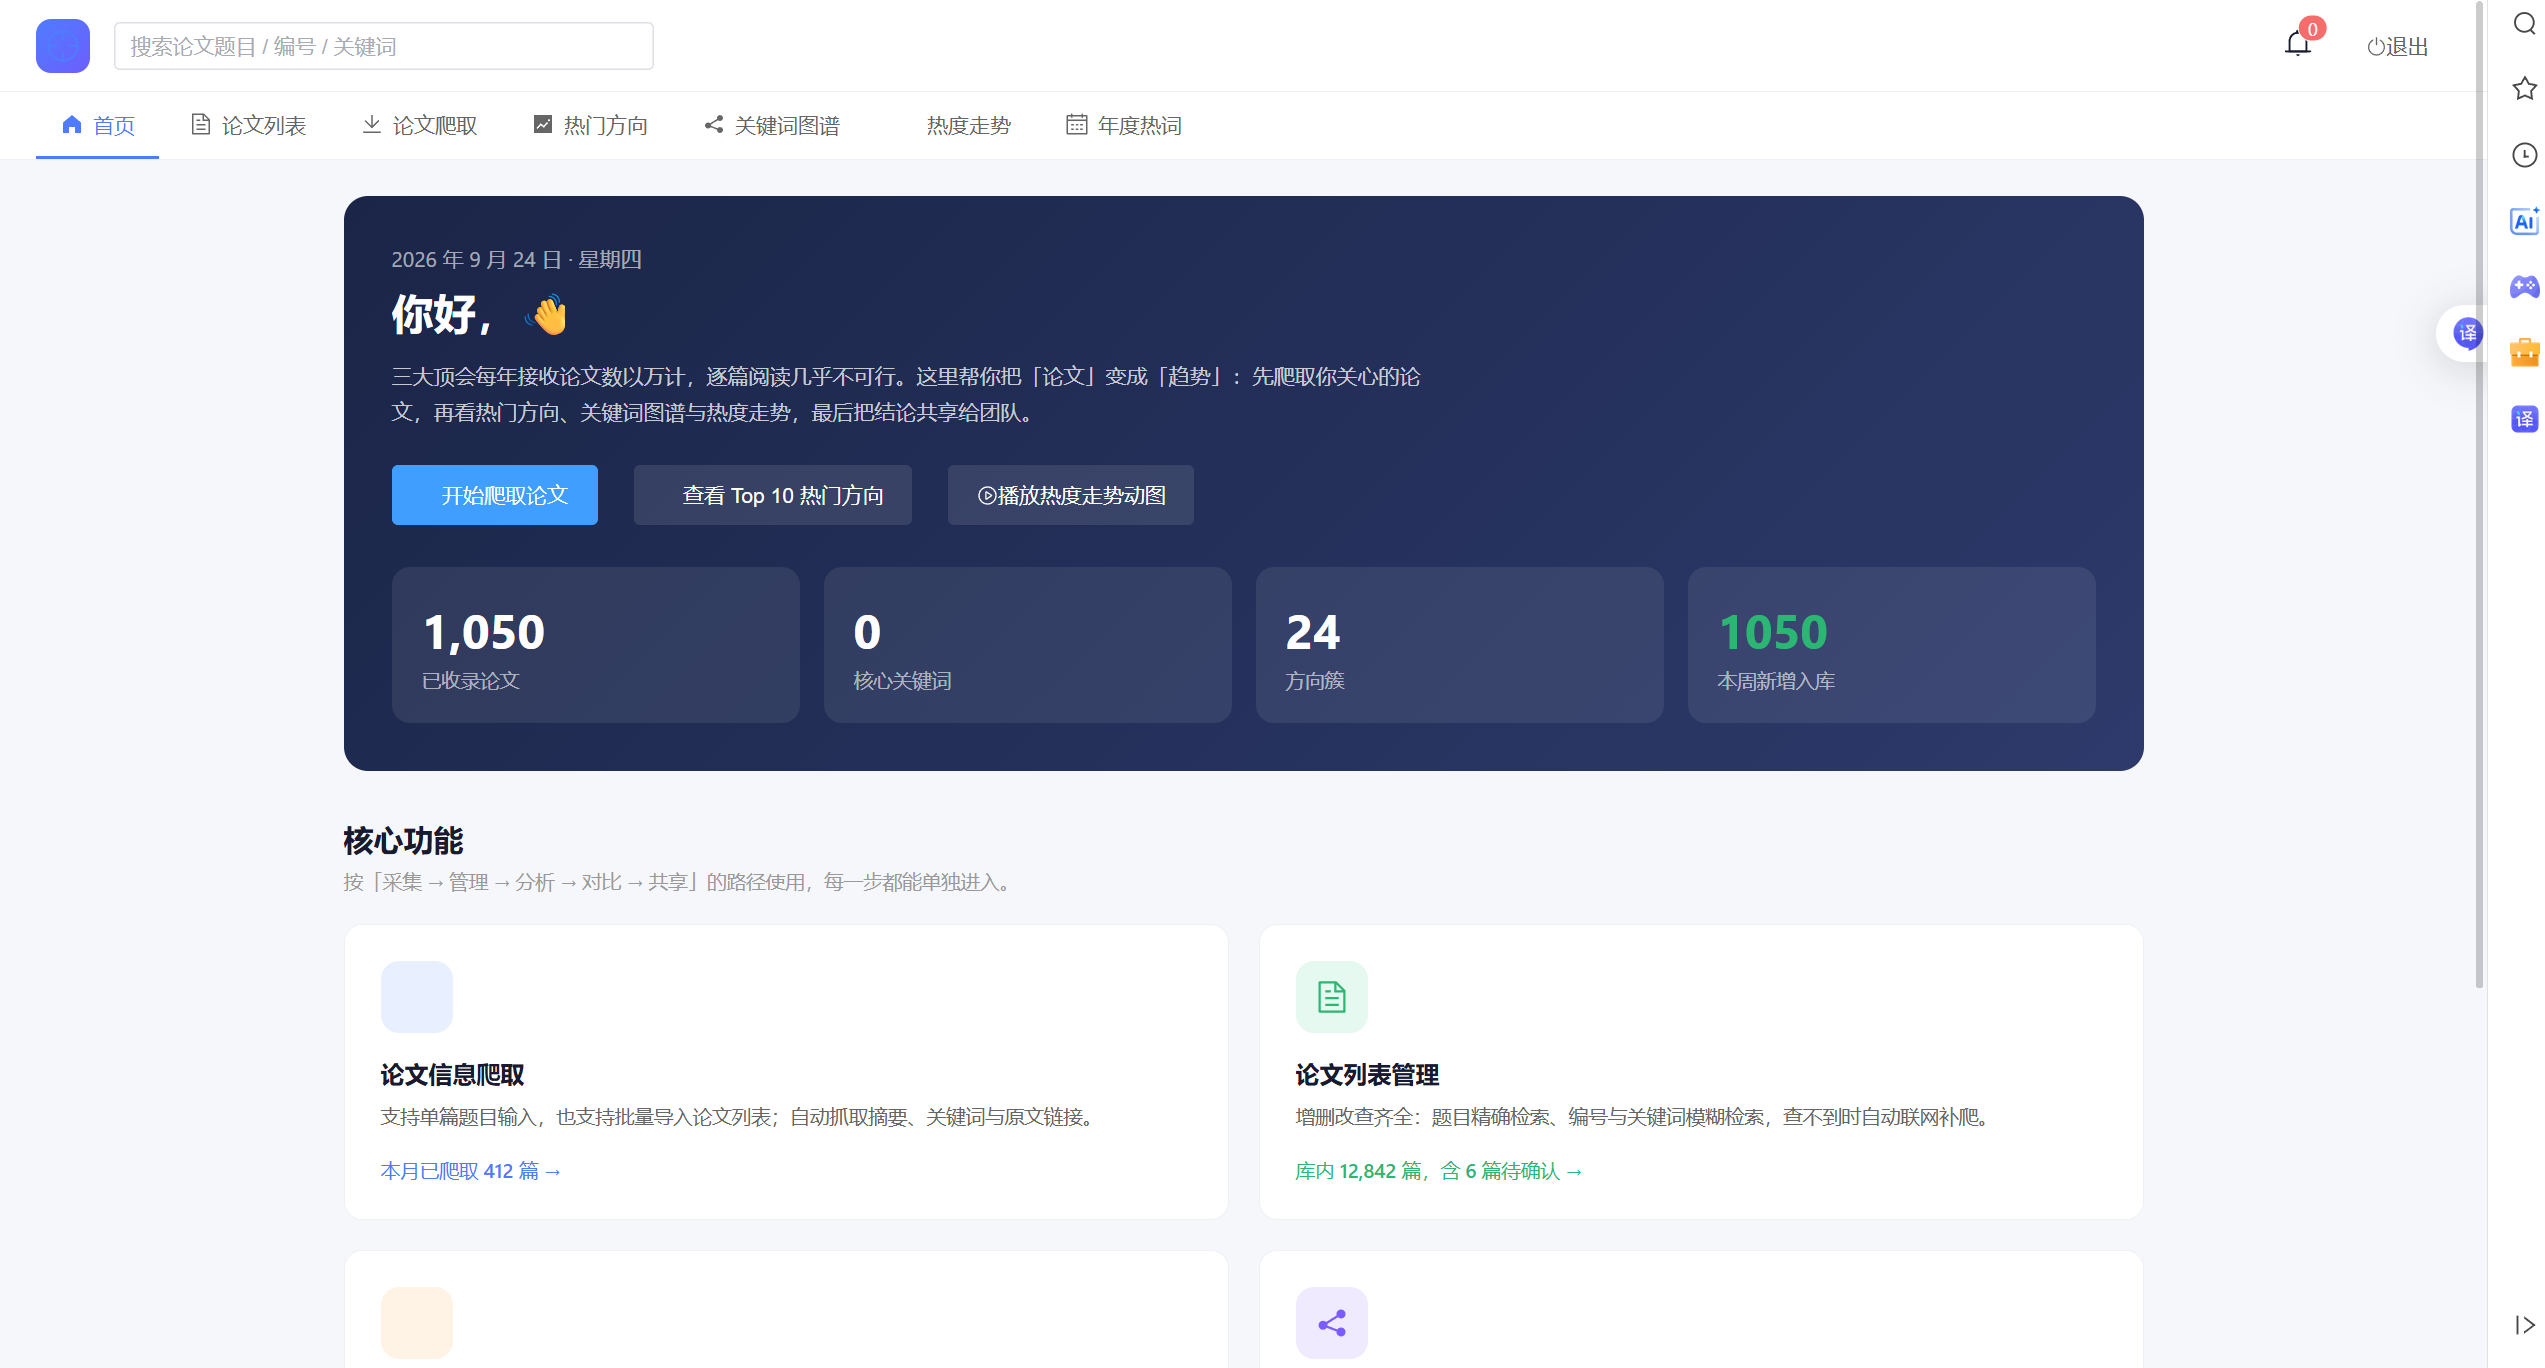
| 首页Dashboard | 数据总览 | 顶部4个统计卡片+下方热门方向柱状图 | 功能3:热门方向 |
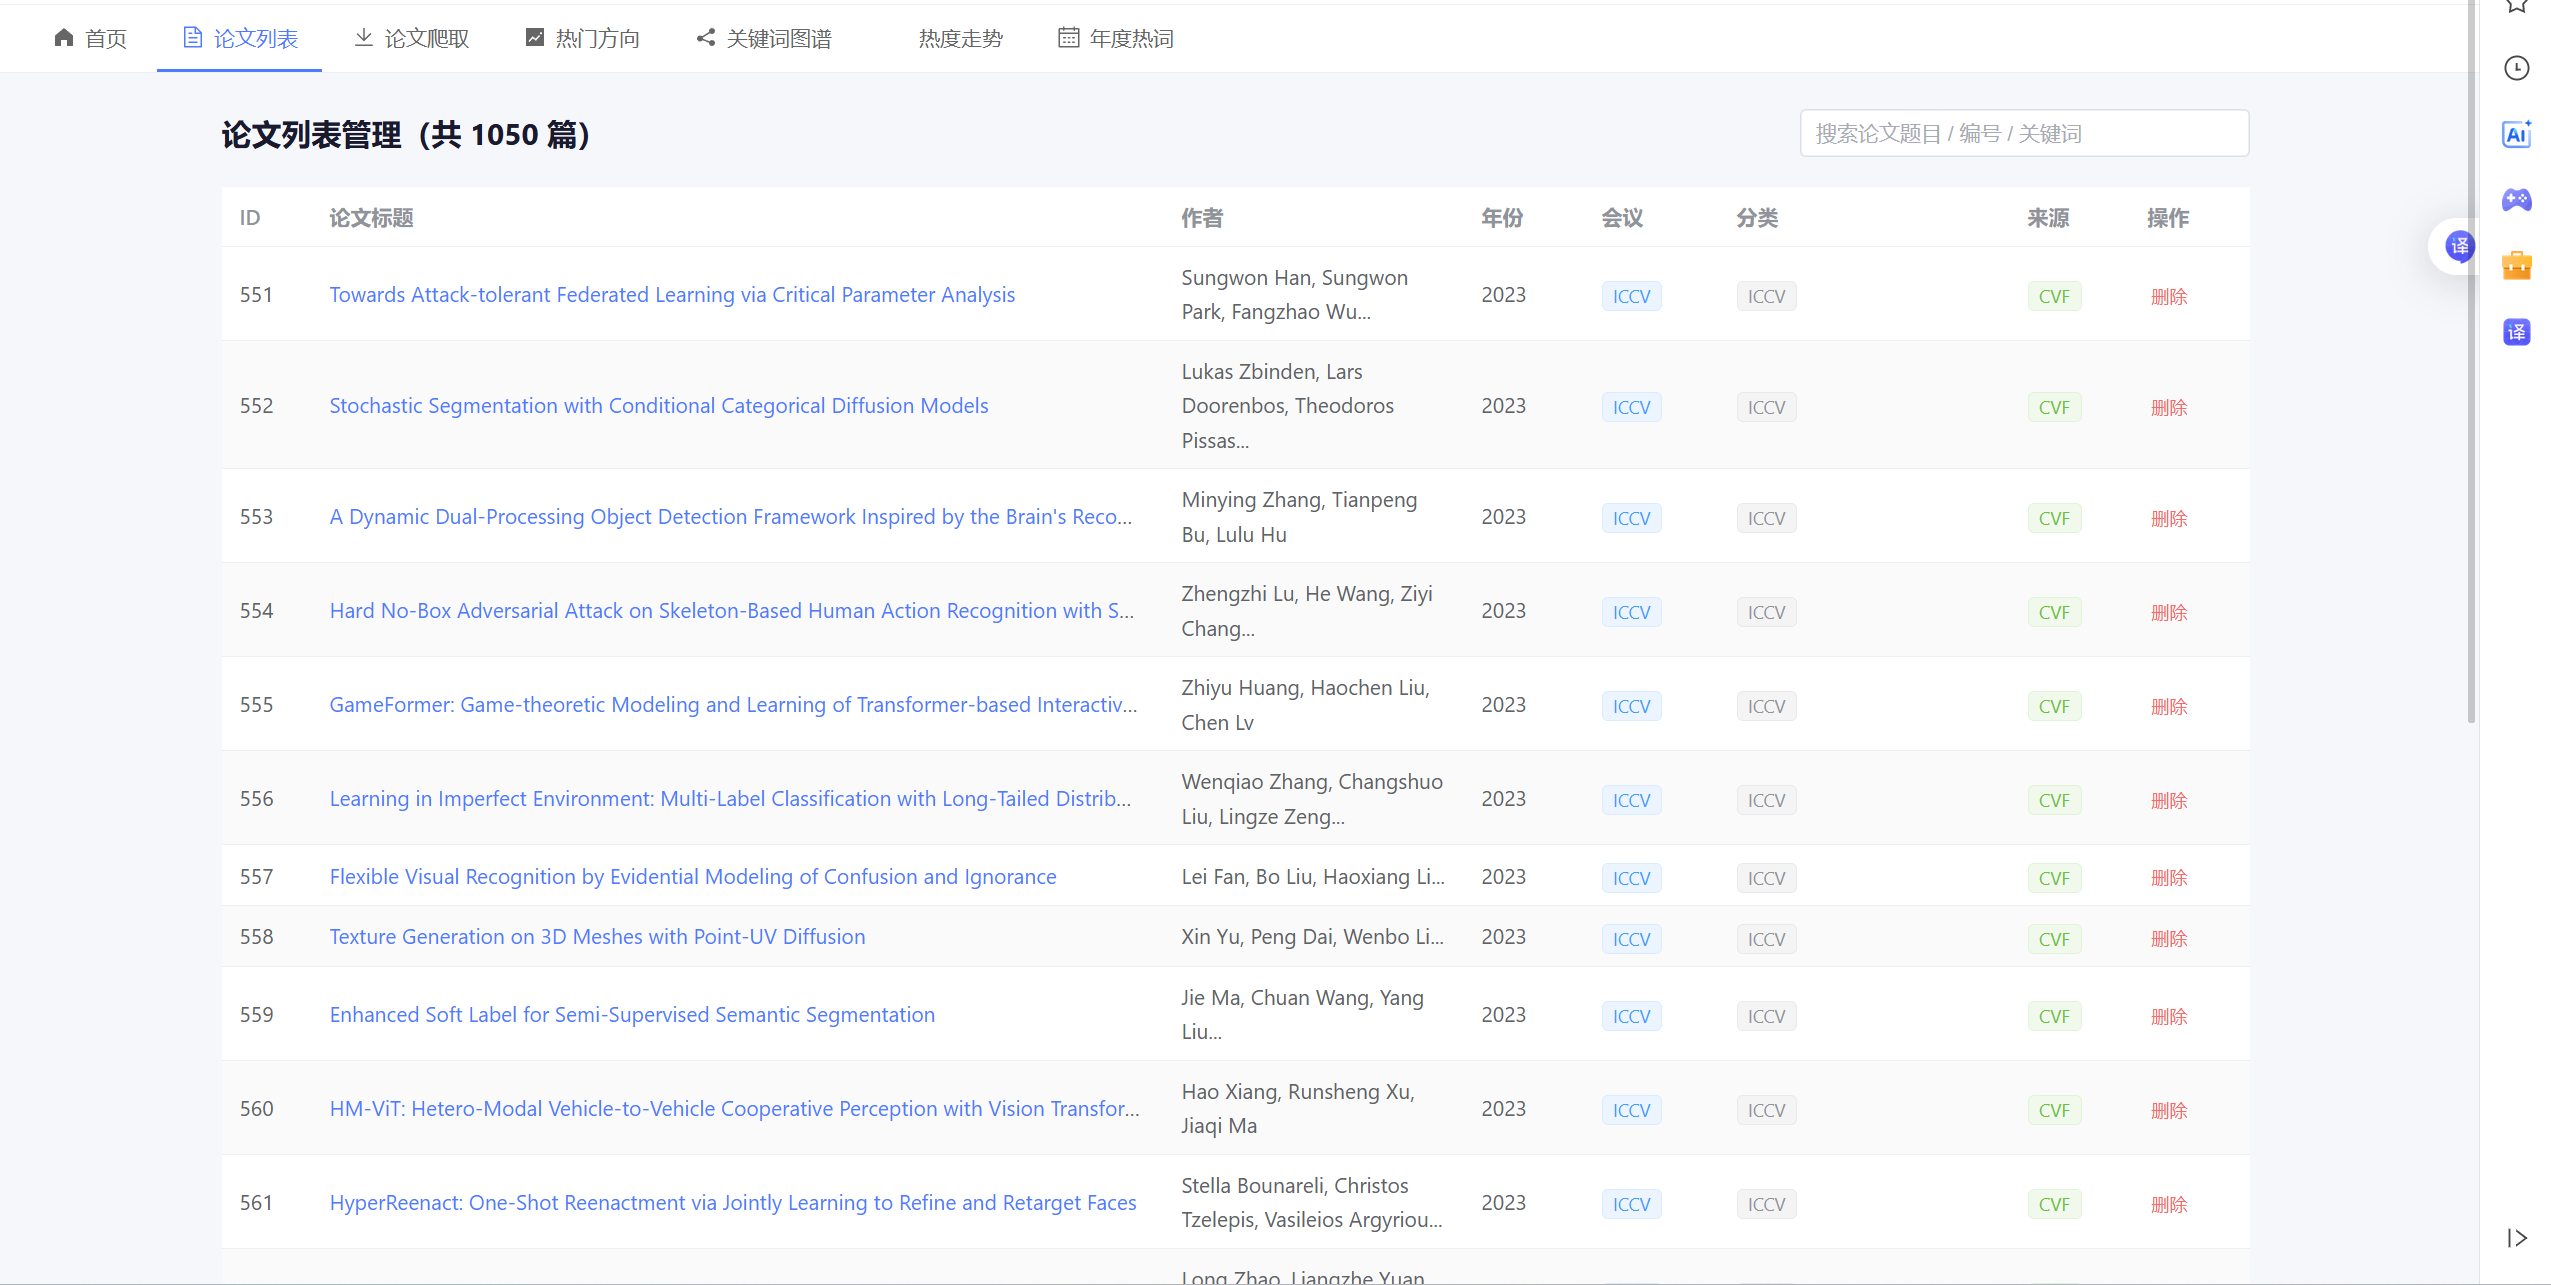
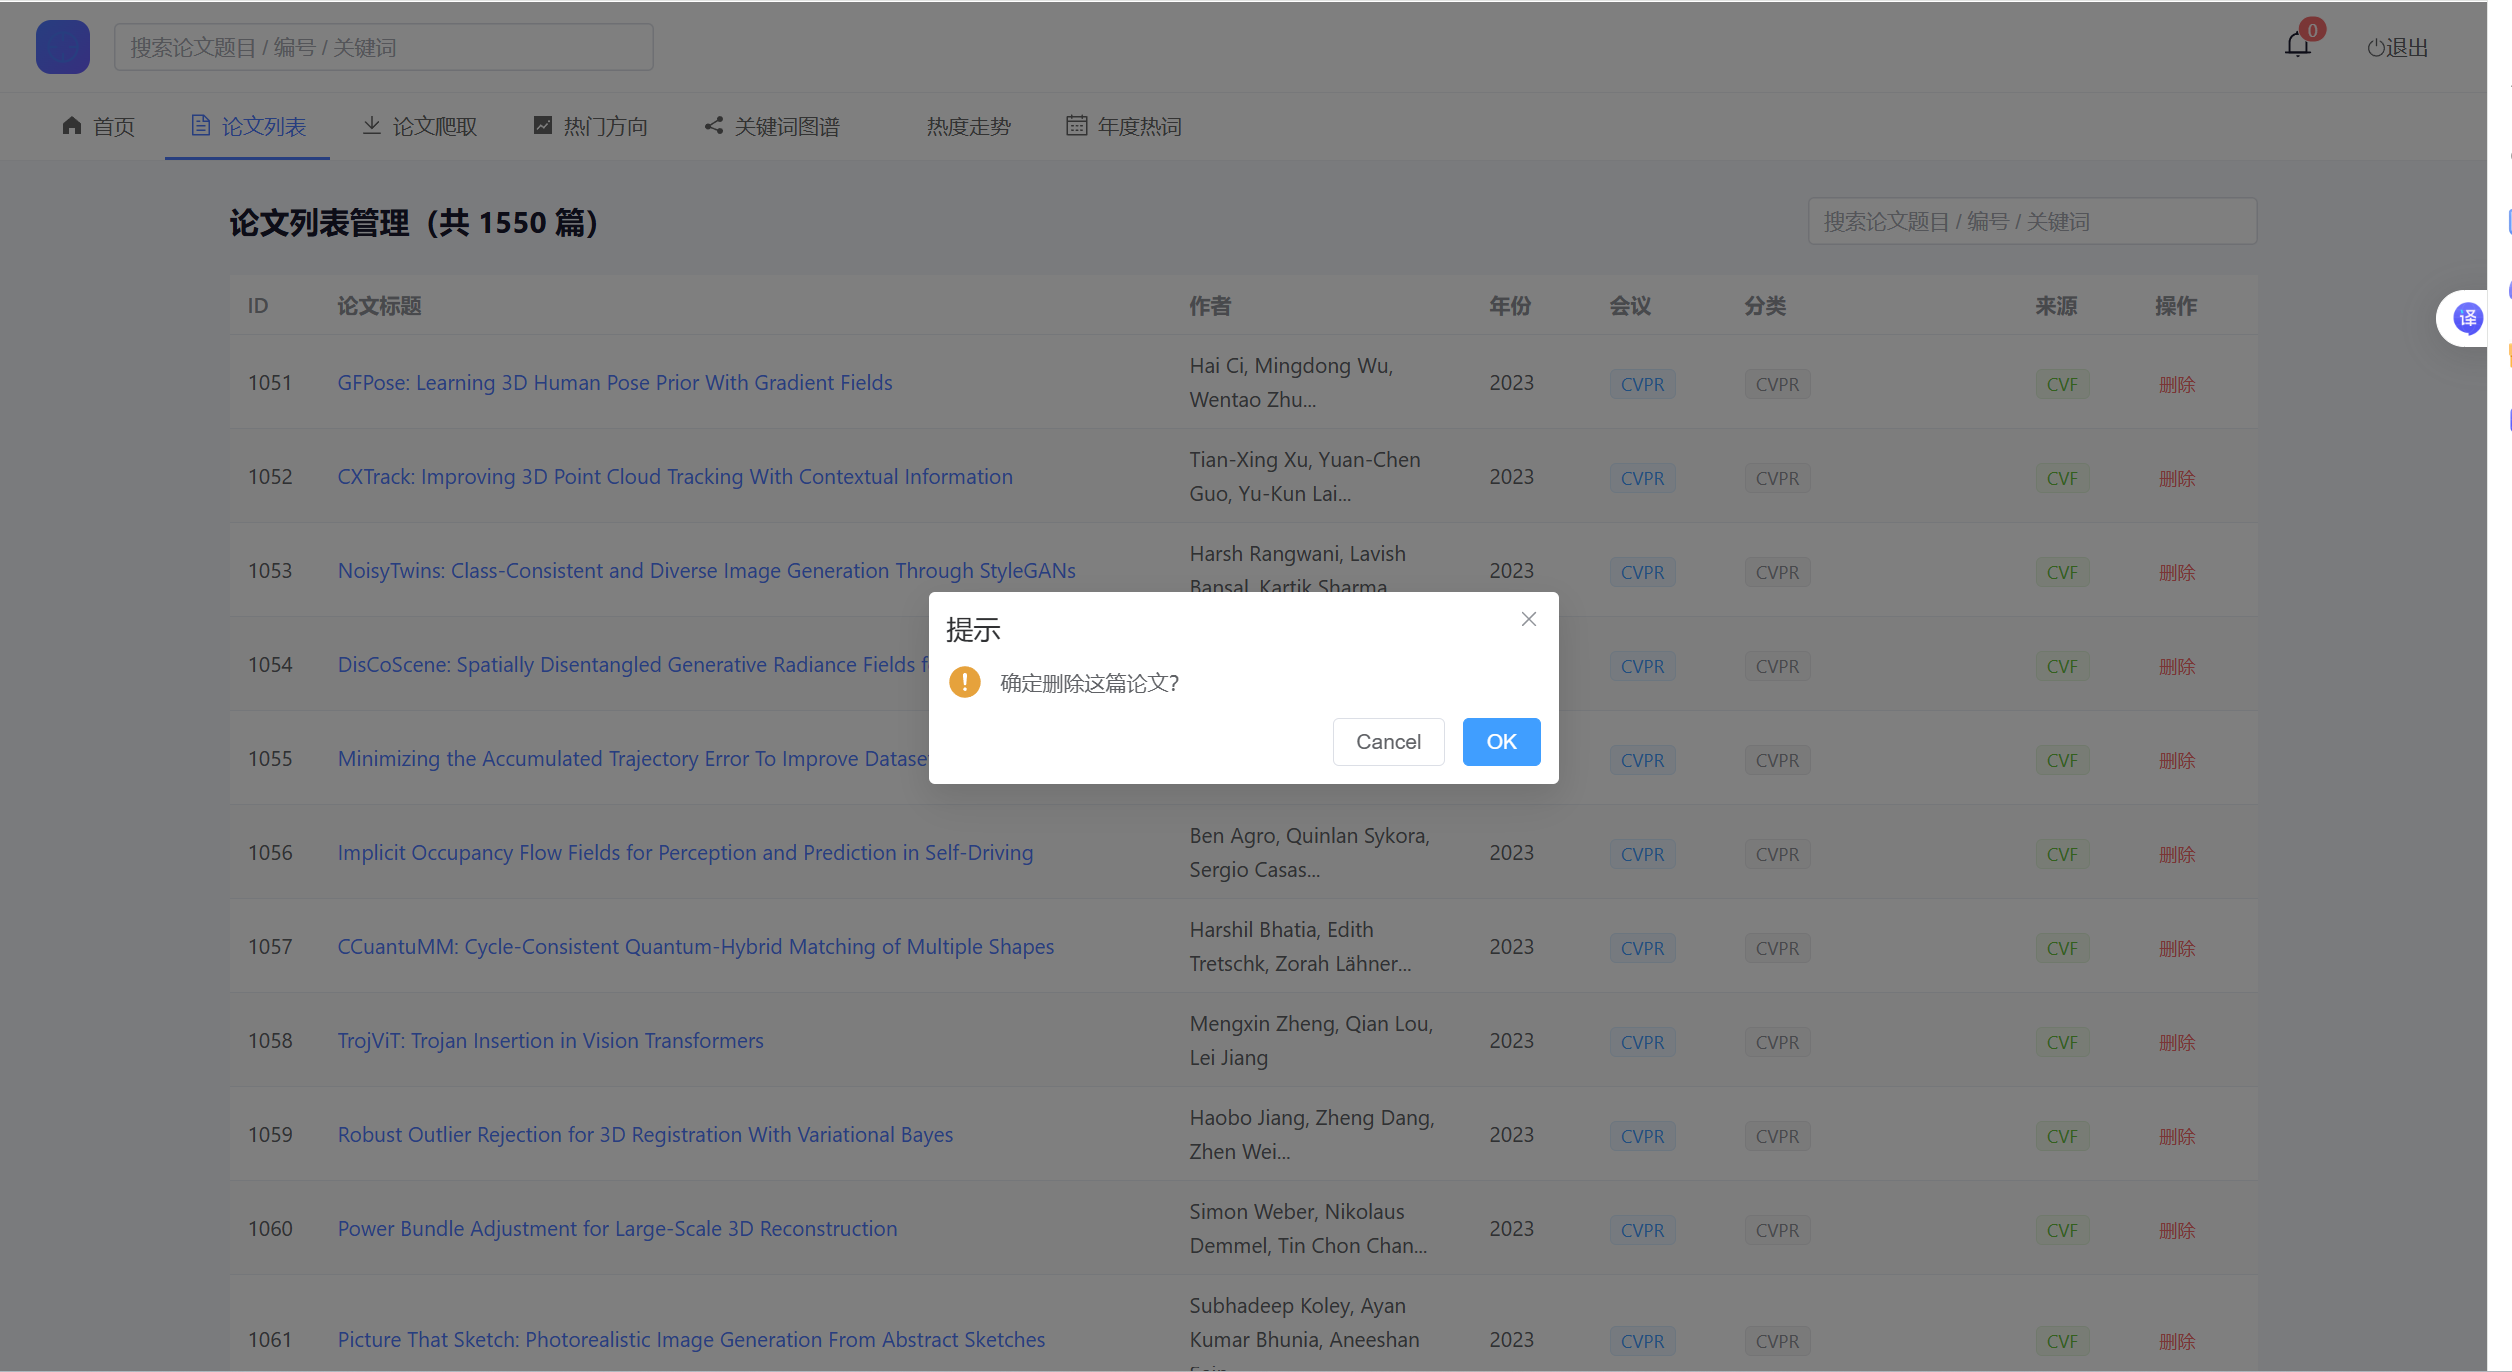
| 论文列表 | 论文管理 | 搜索框+表格+分页器+删除按钮 | 功能2:列表管理 |
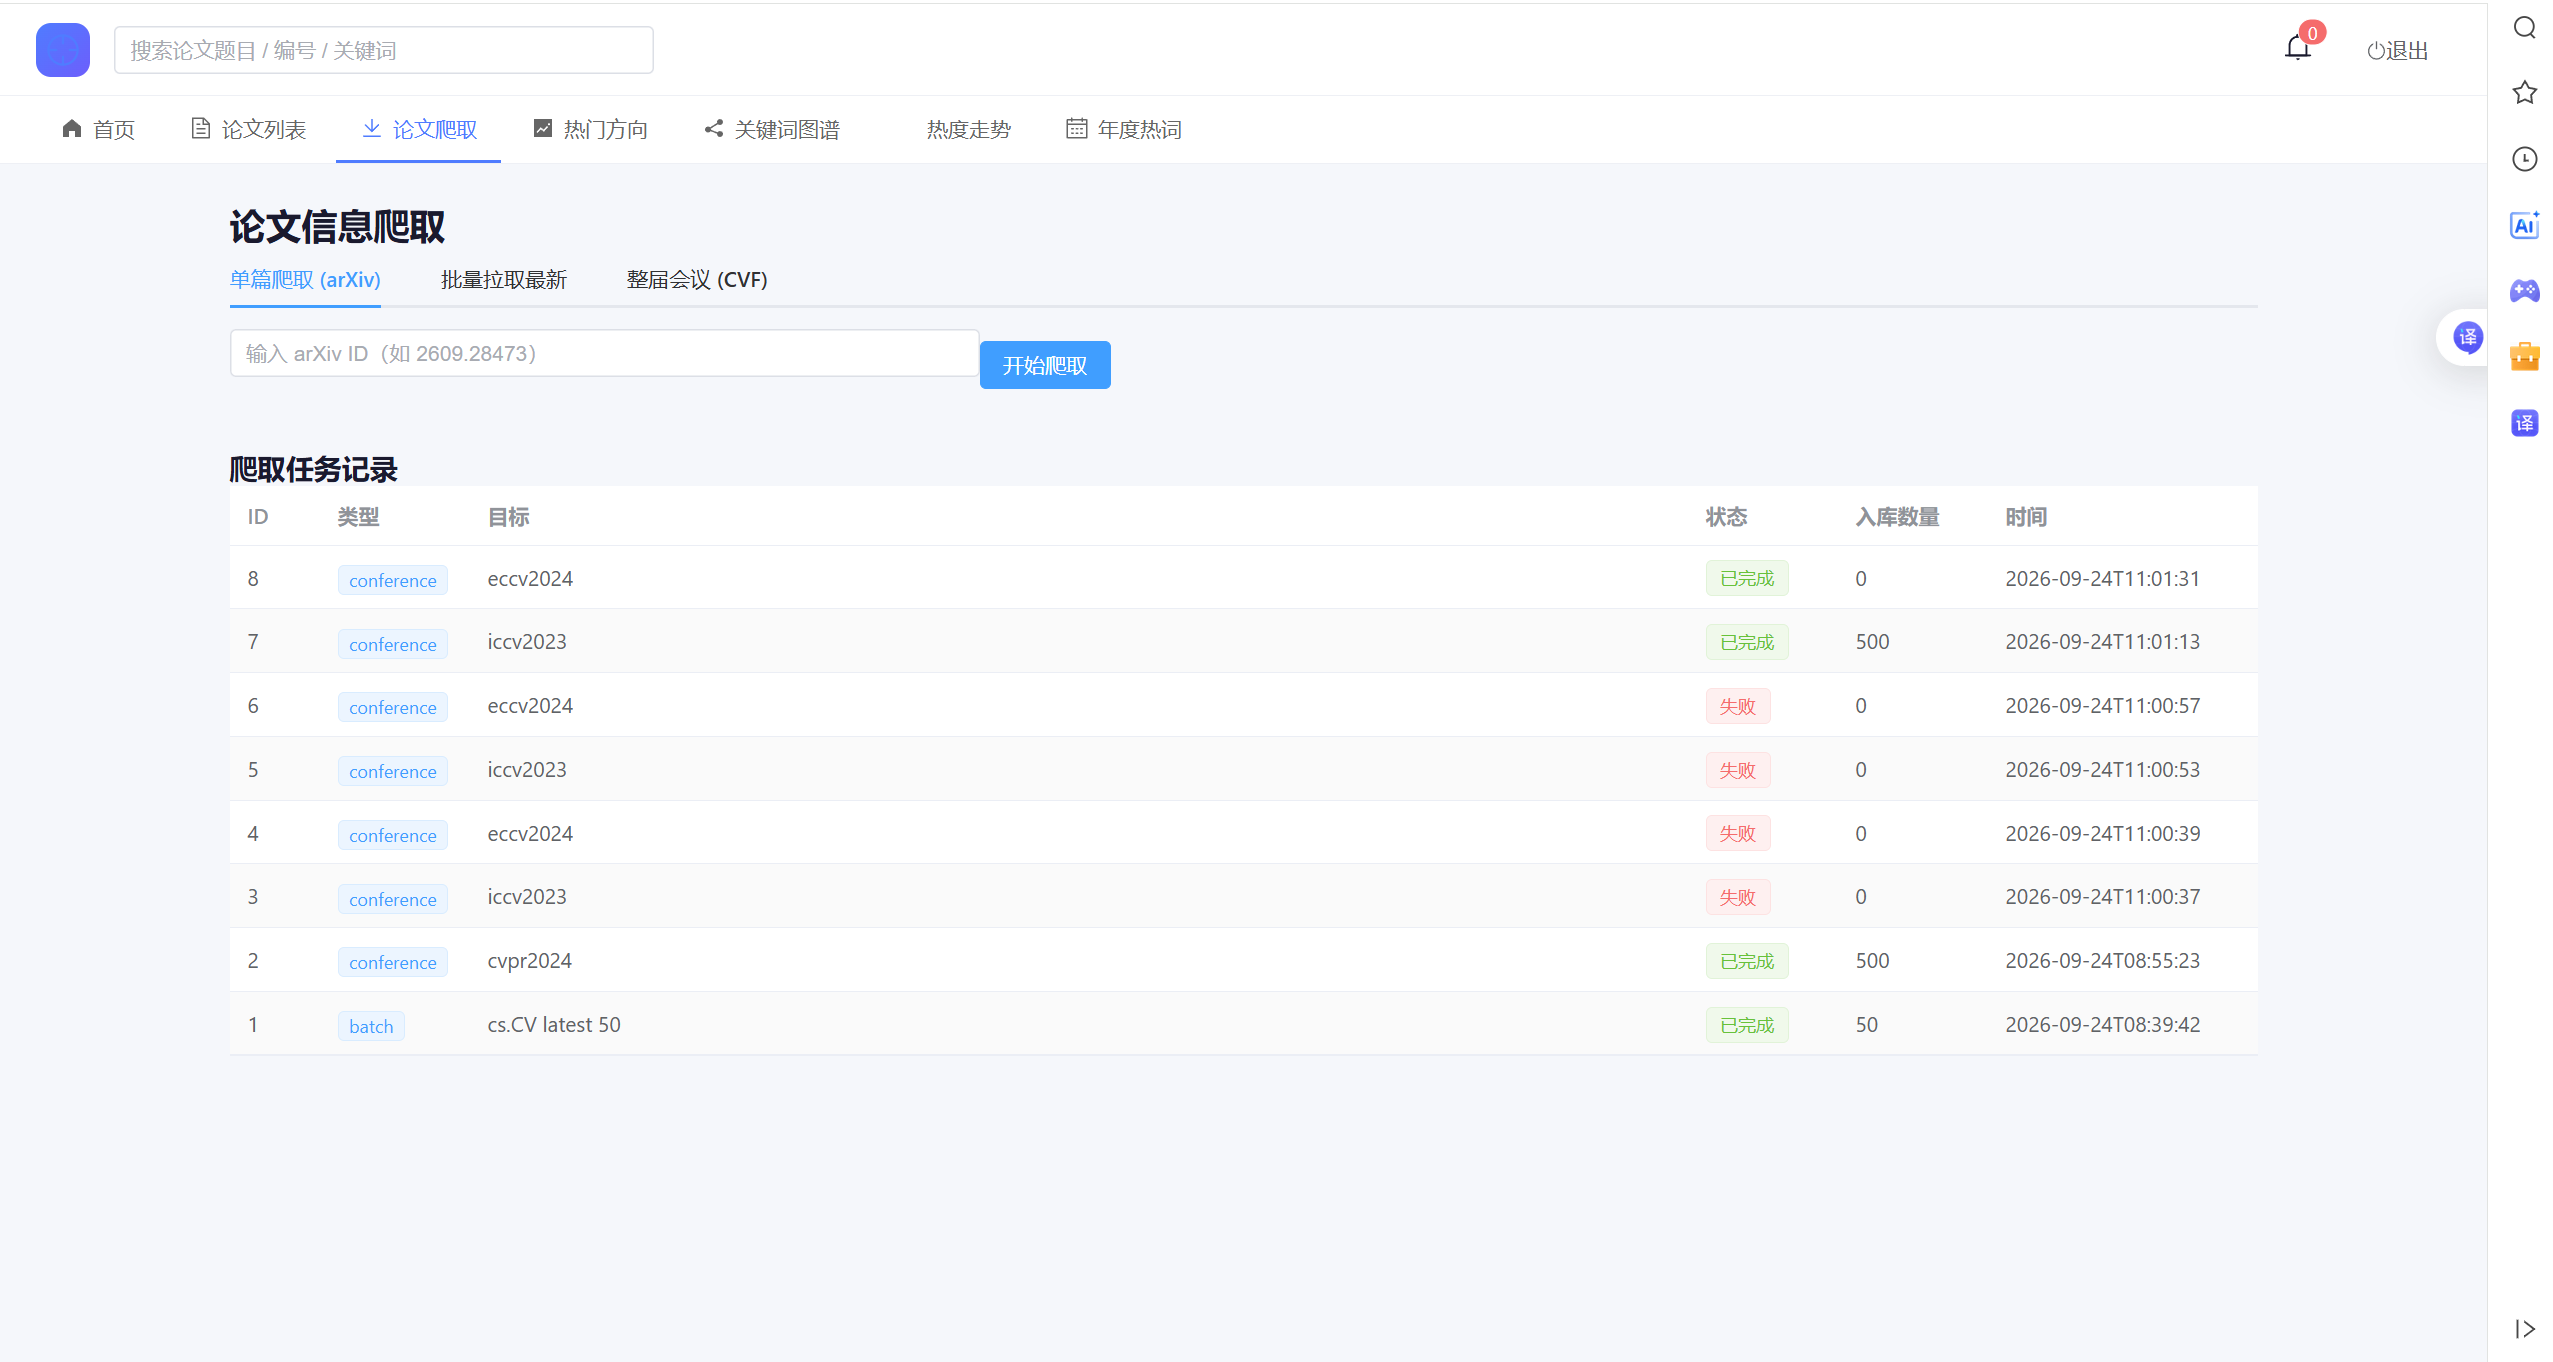
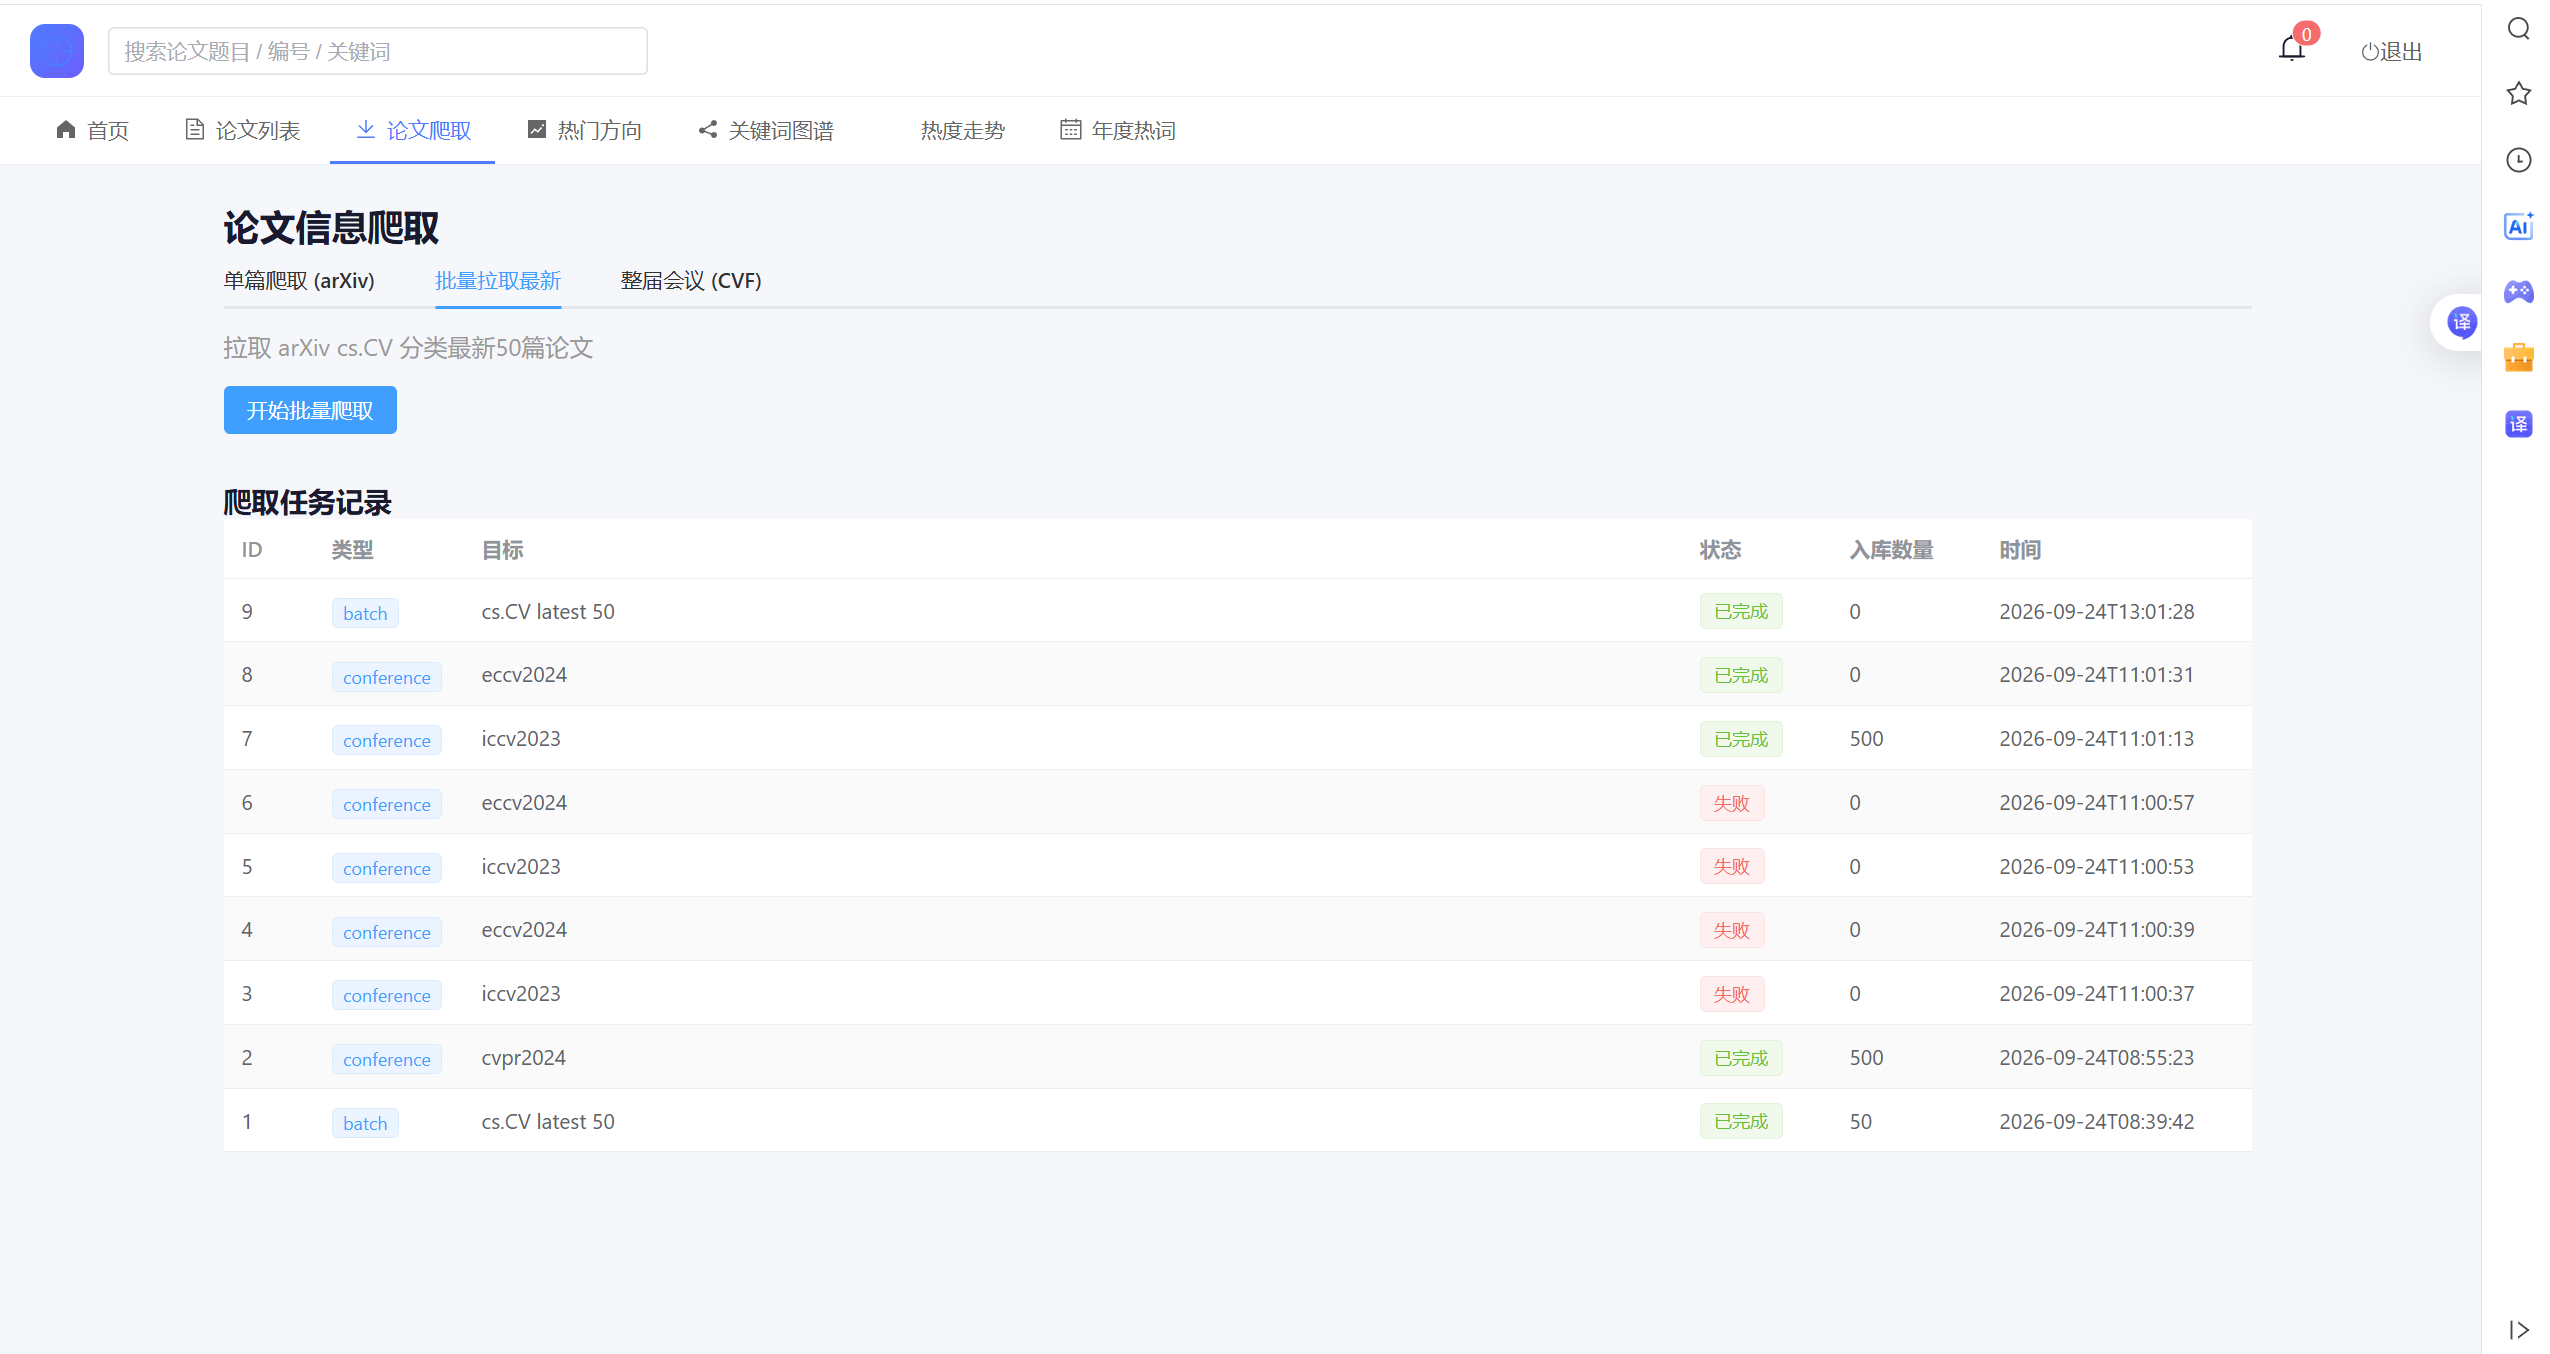
| 论文爬取 | 触发爬取 | 两个按钮(arXiv/CVF)+爬取任务列表 | 功能1:论文爬取 |
| 热门方向 | Top10柱状图 | ECharts柱状图,点击柱子跳转论文列表 | 功能3:Top10分析 |
| 关键词图谱 | 共现力导向图 | ECharts力导向图,节点大小=词频 | 功能4:关键词图谱 |
| 热度走势 | 多年对比热力图 | ECharts热力图,行=关键词,列=年份 | 功能5:热度走势动图 |
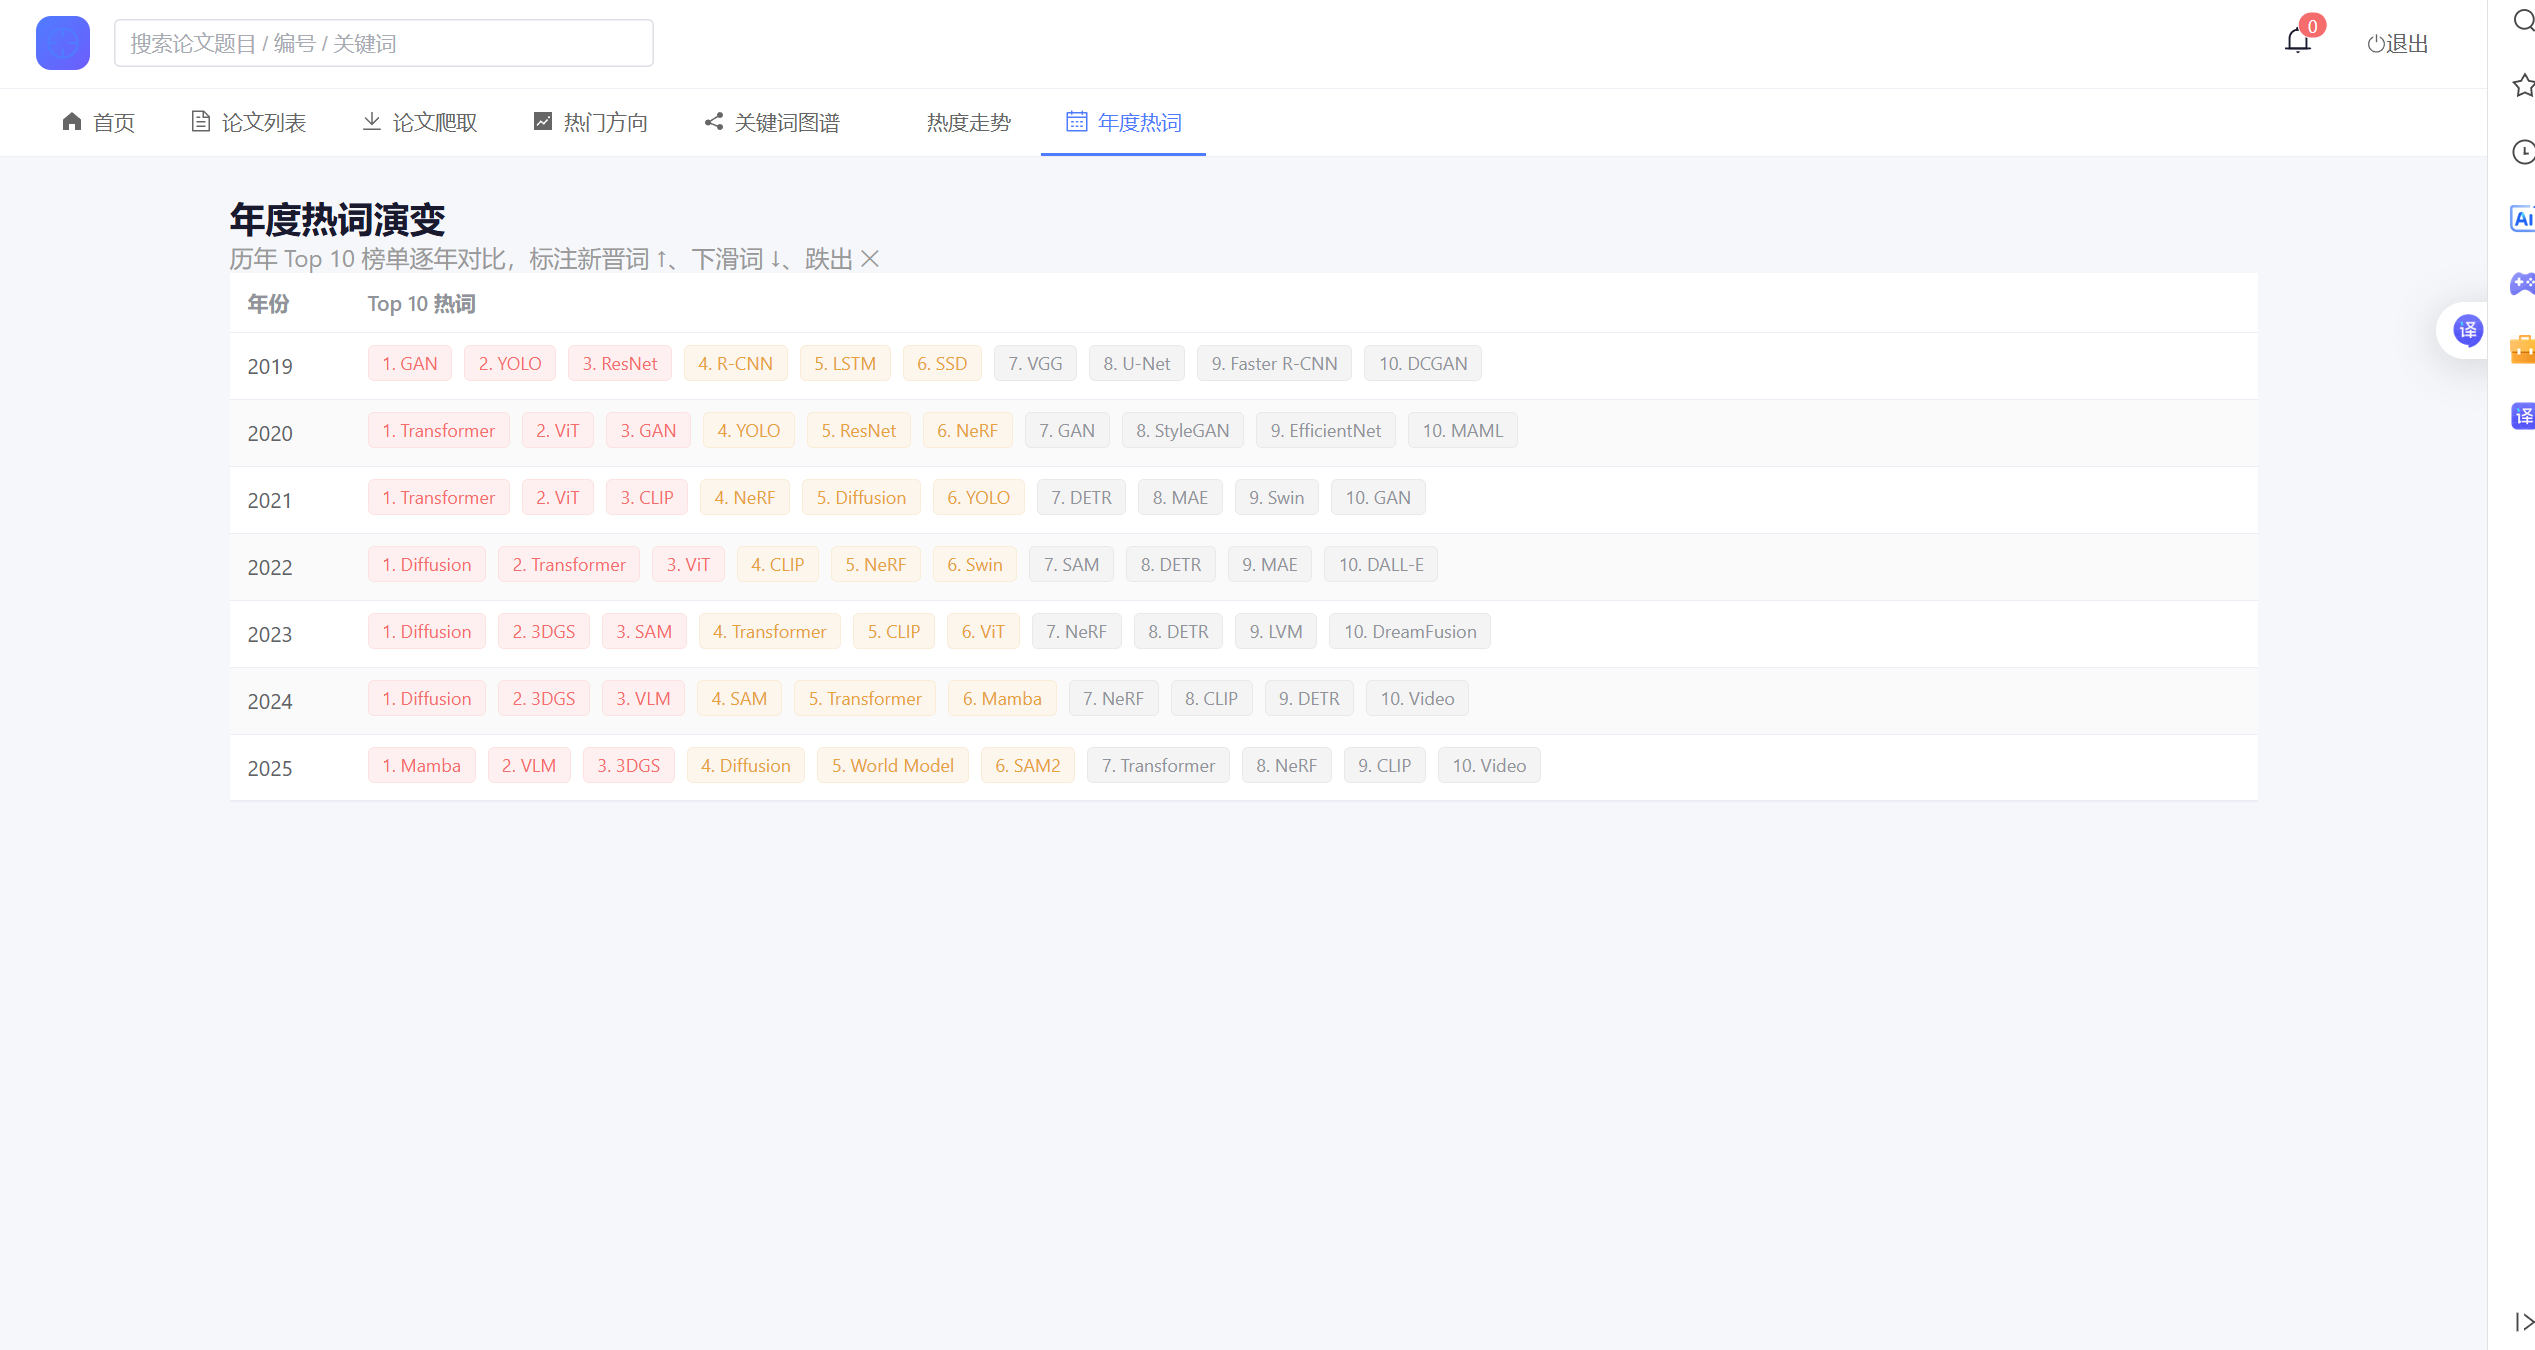
| 年度热词 | 年度演变 | 年份切换+Top10榜单 | 扩展功能 |
图一:首页
图二:论文列表
图三:删除论文
图四:论文爬取
图五:批量爬取最新论文
图六:按届爬取论文
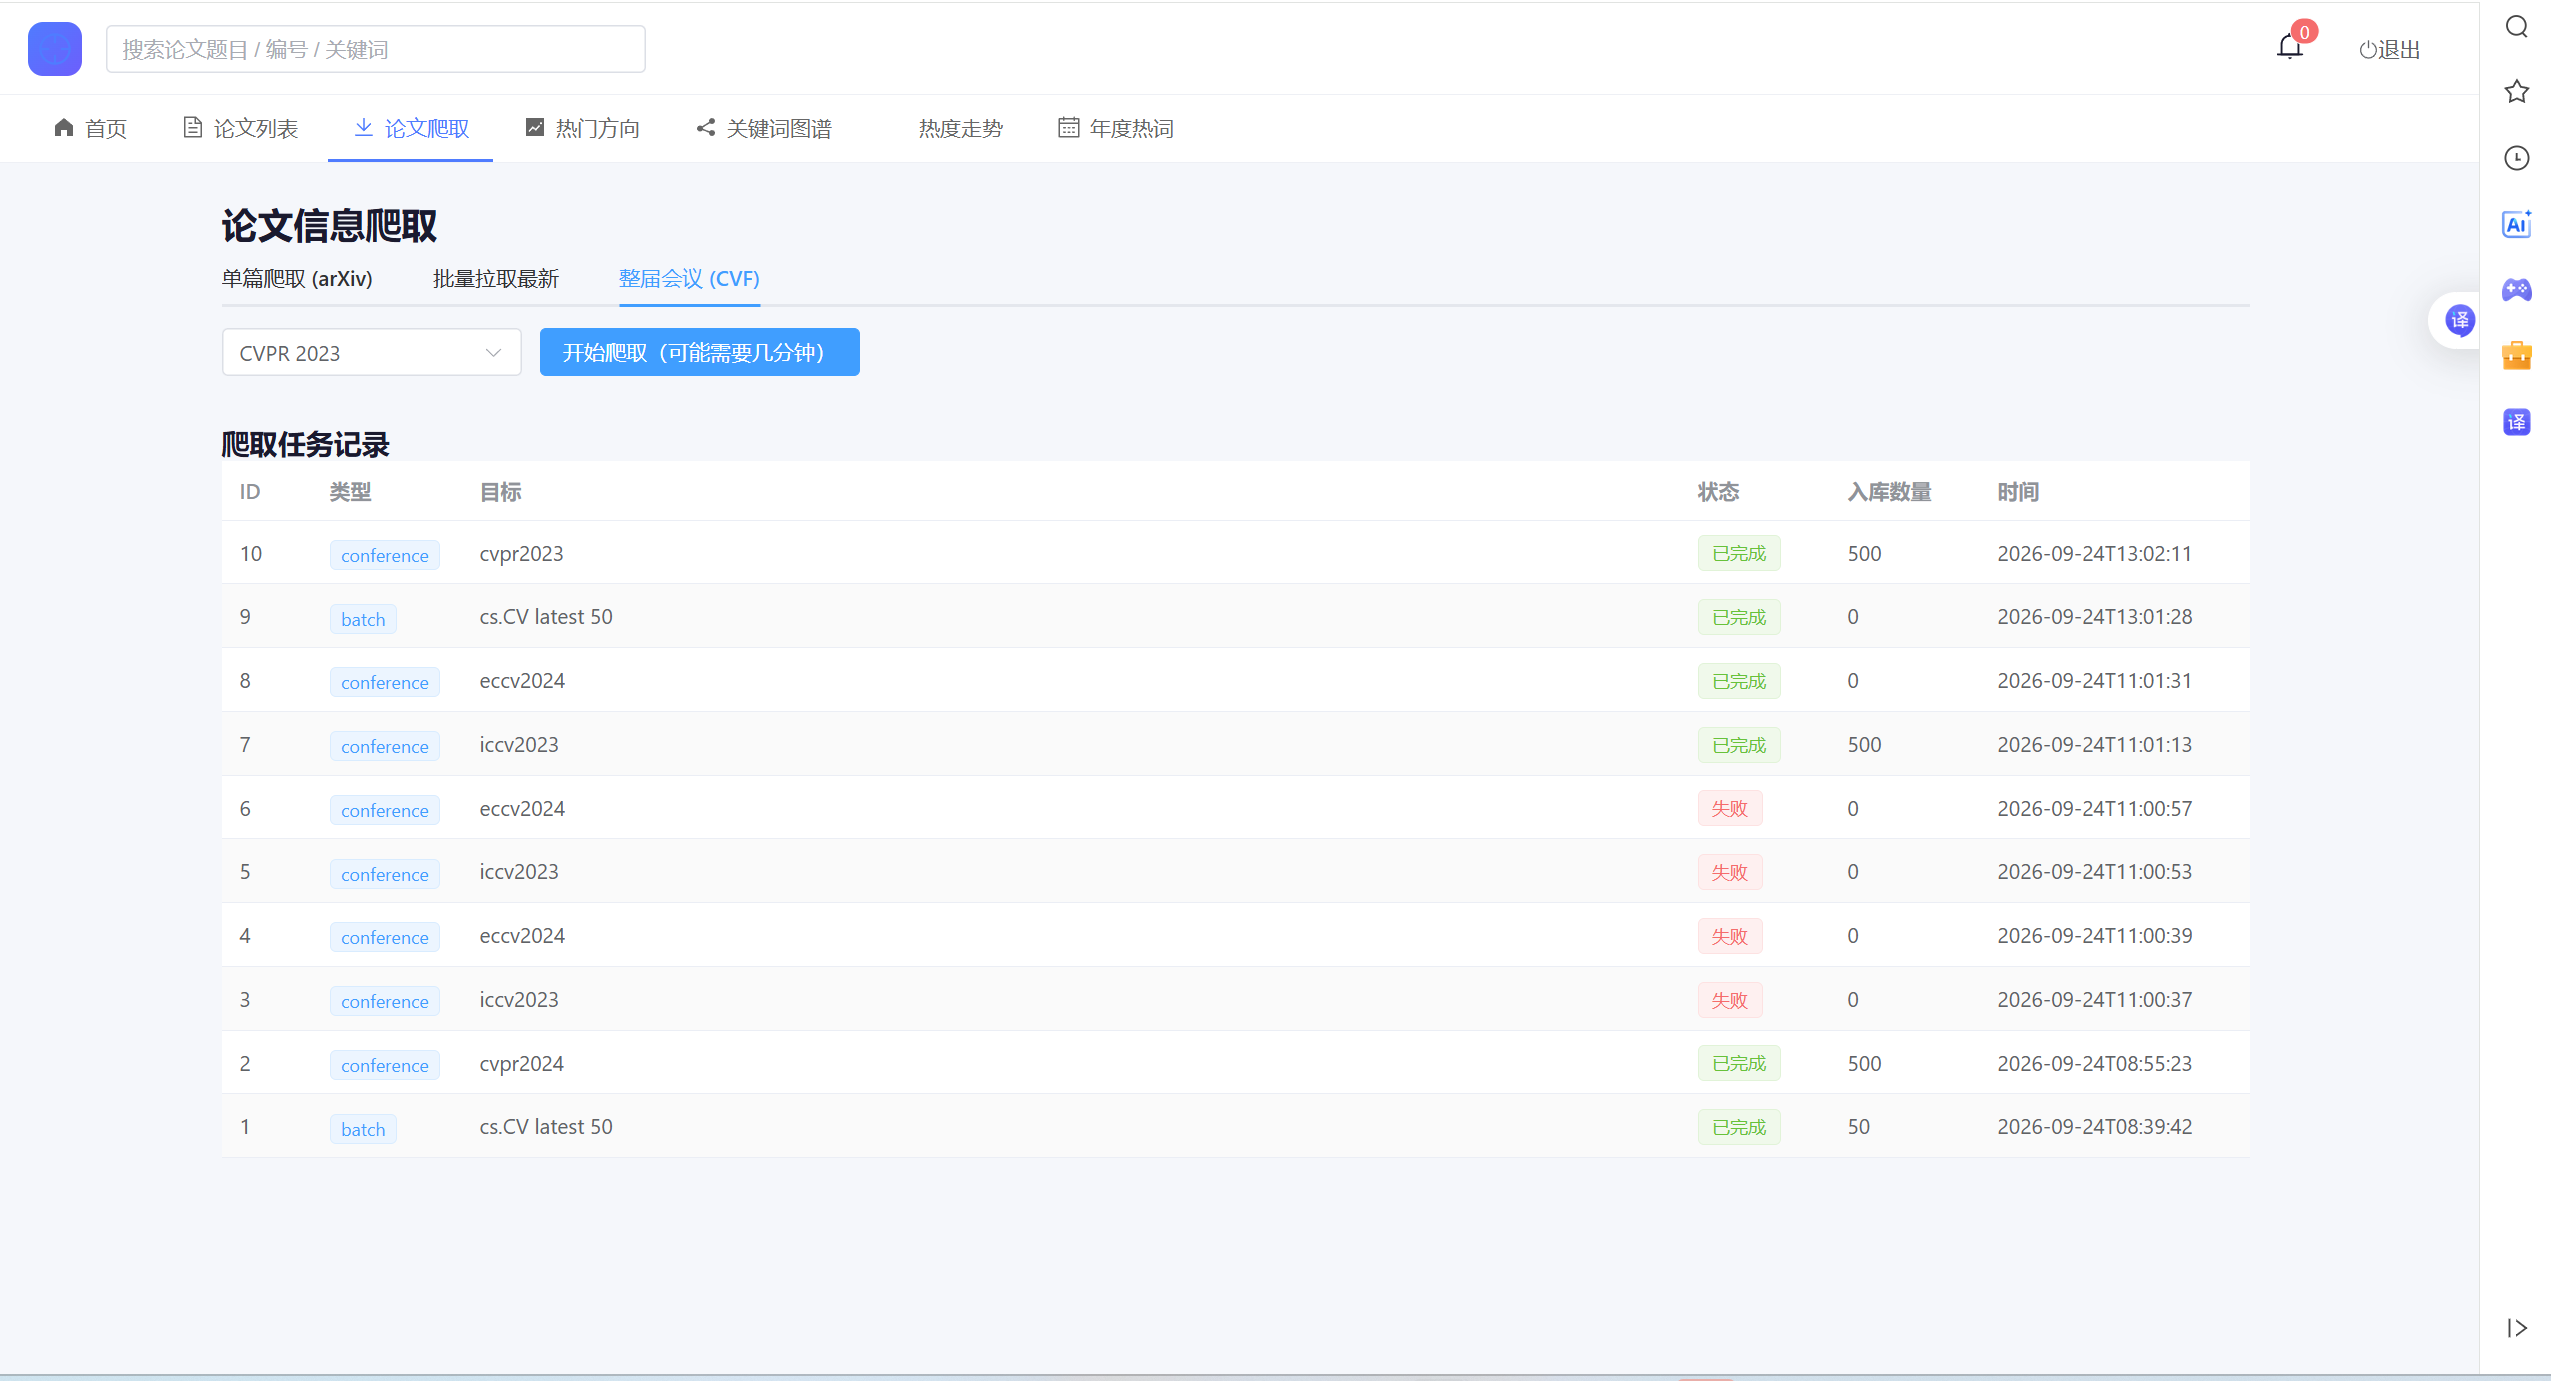
图七:热门方向
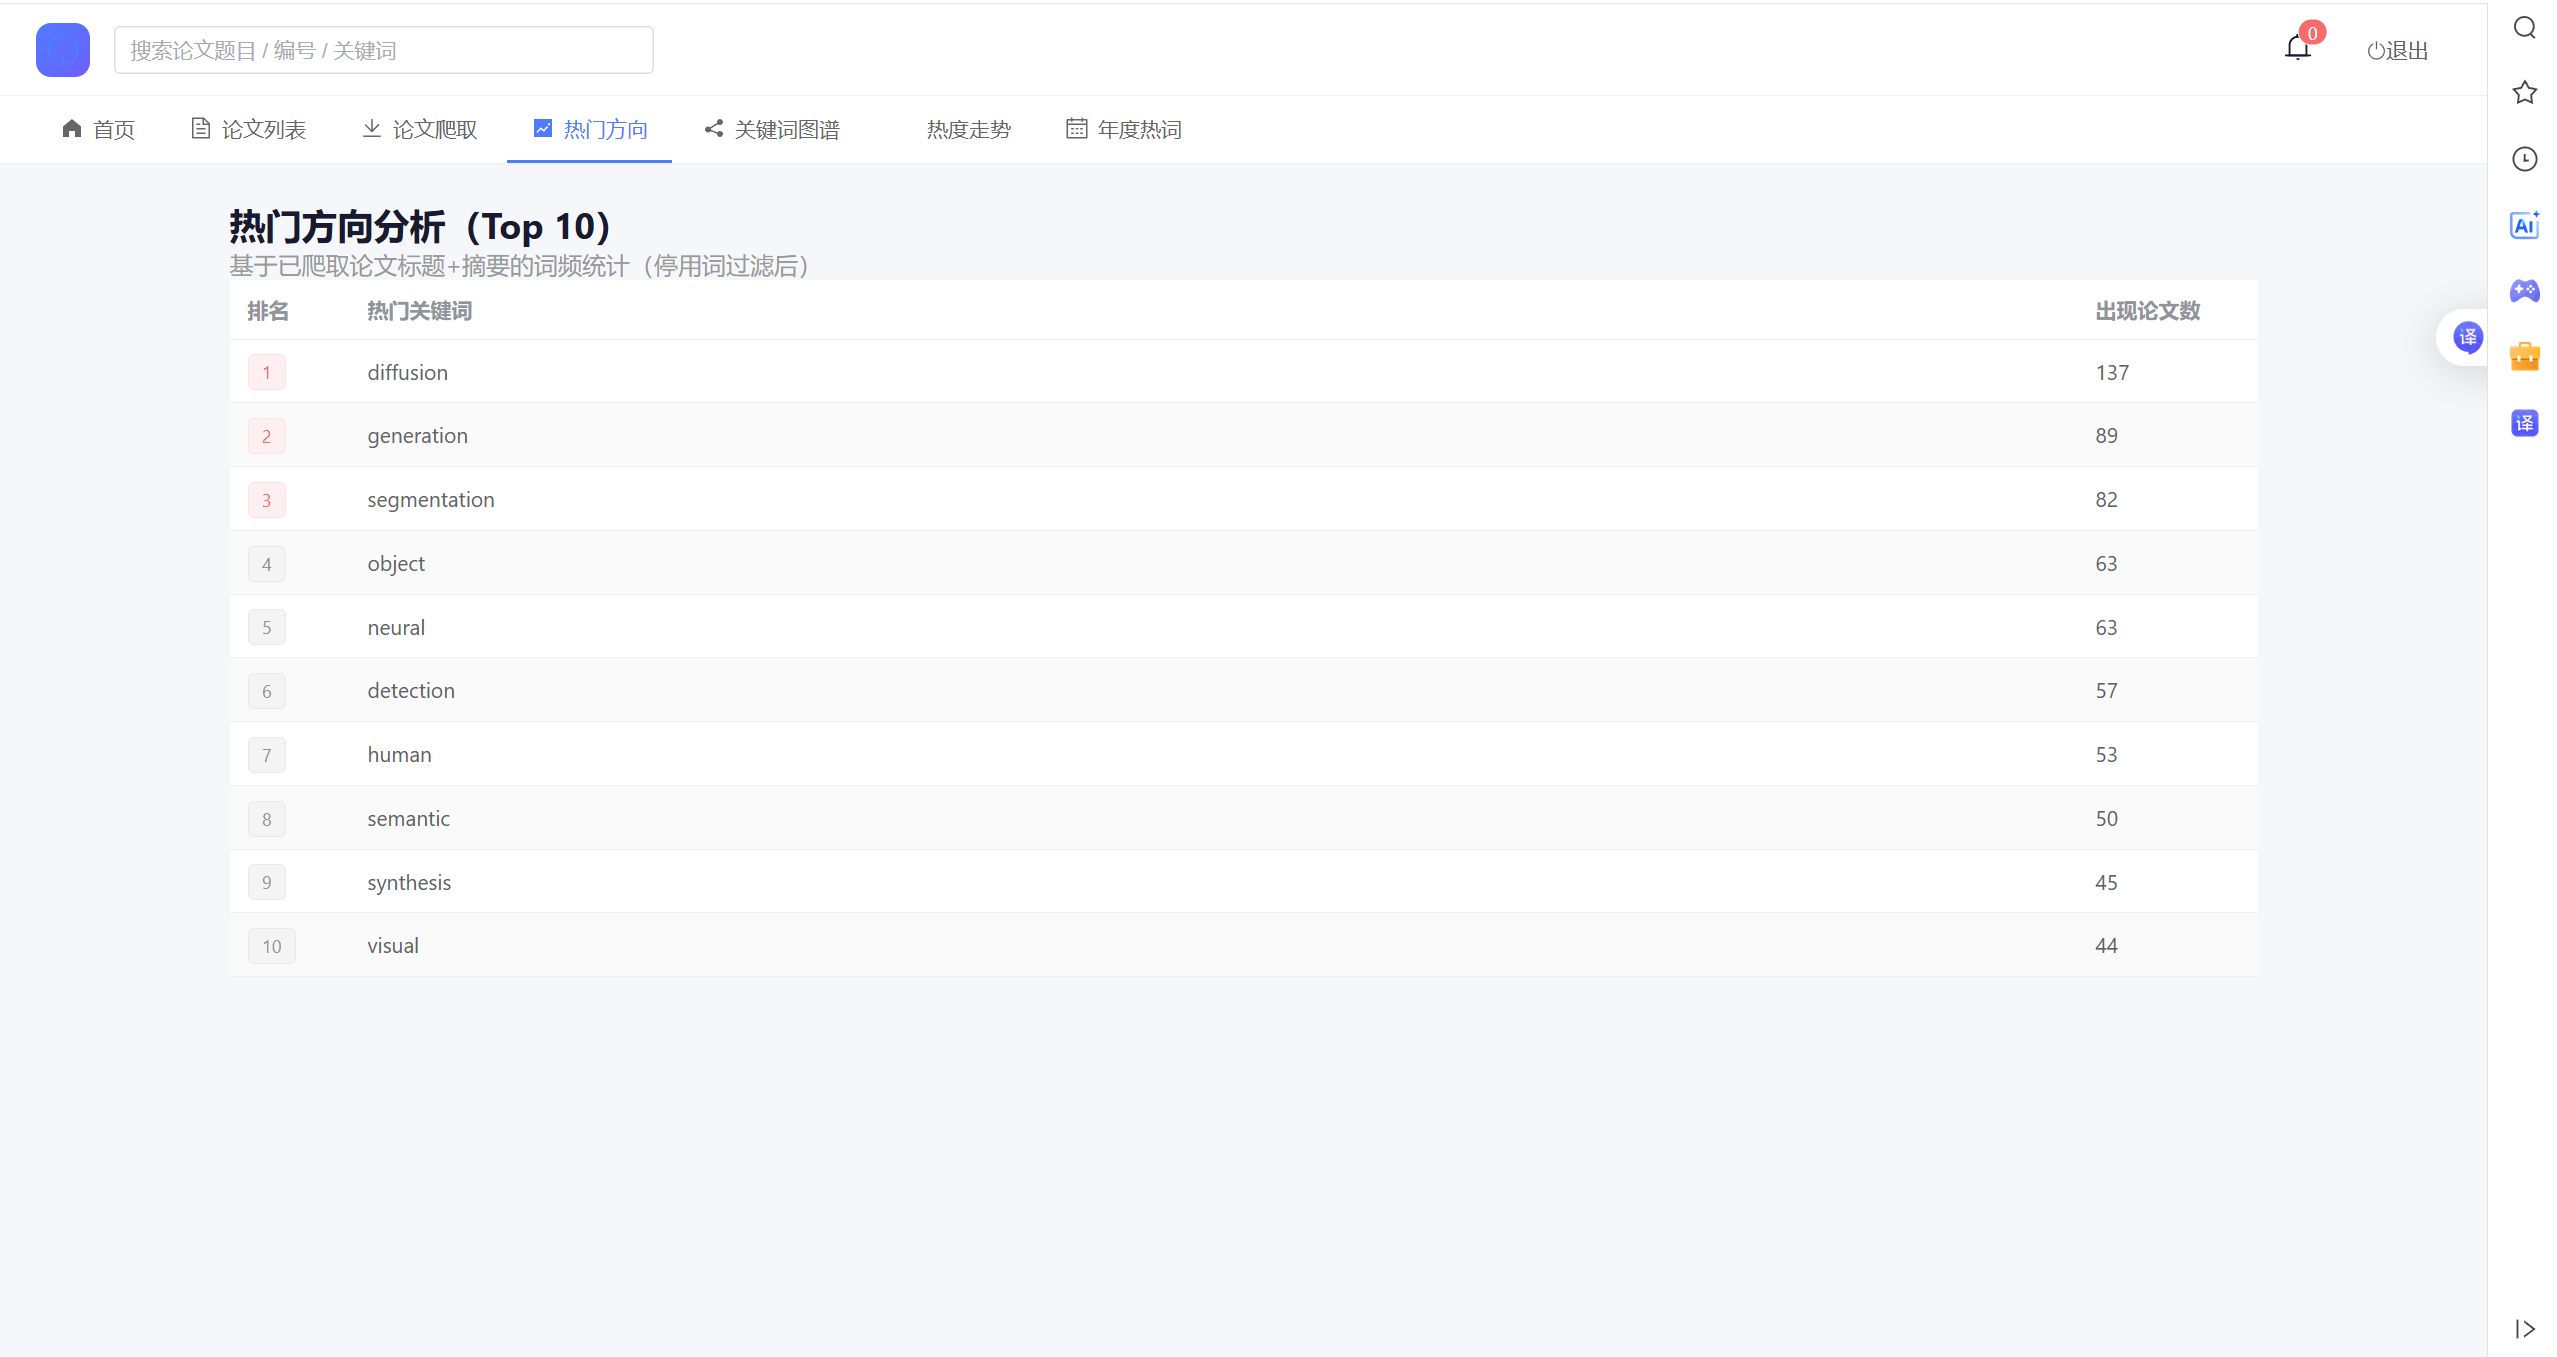
图八:关键词图谱
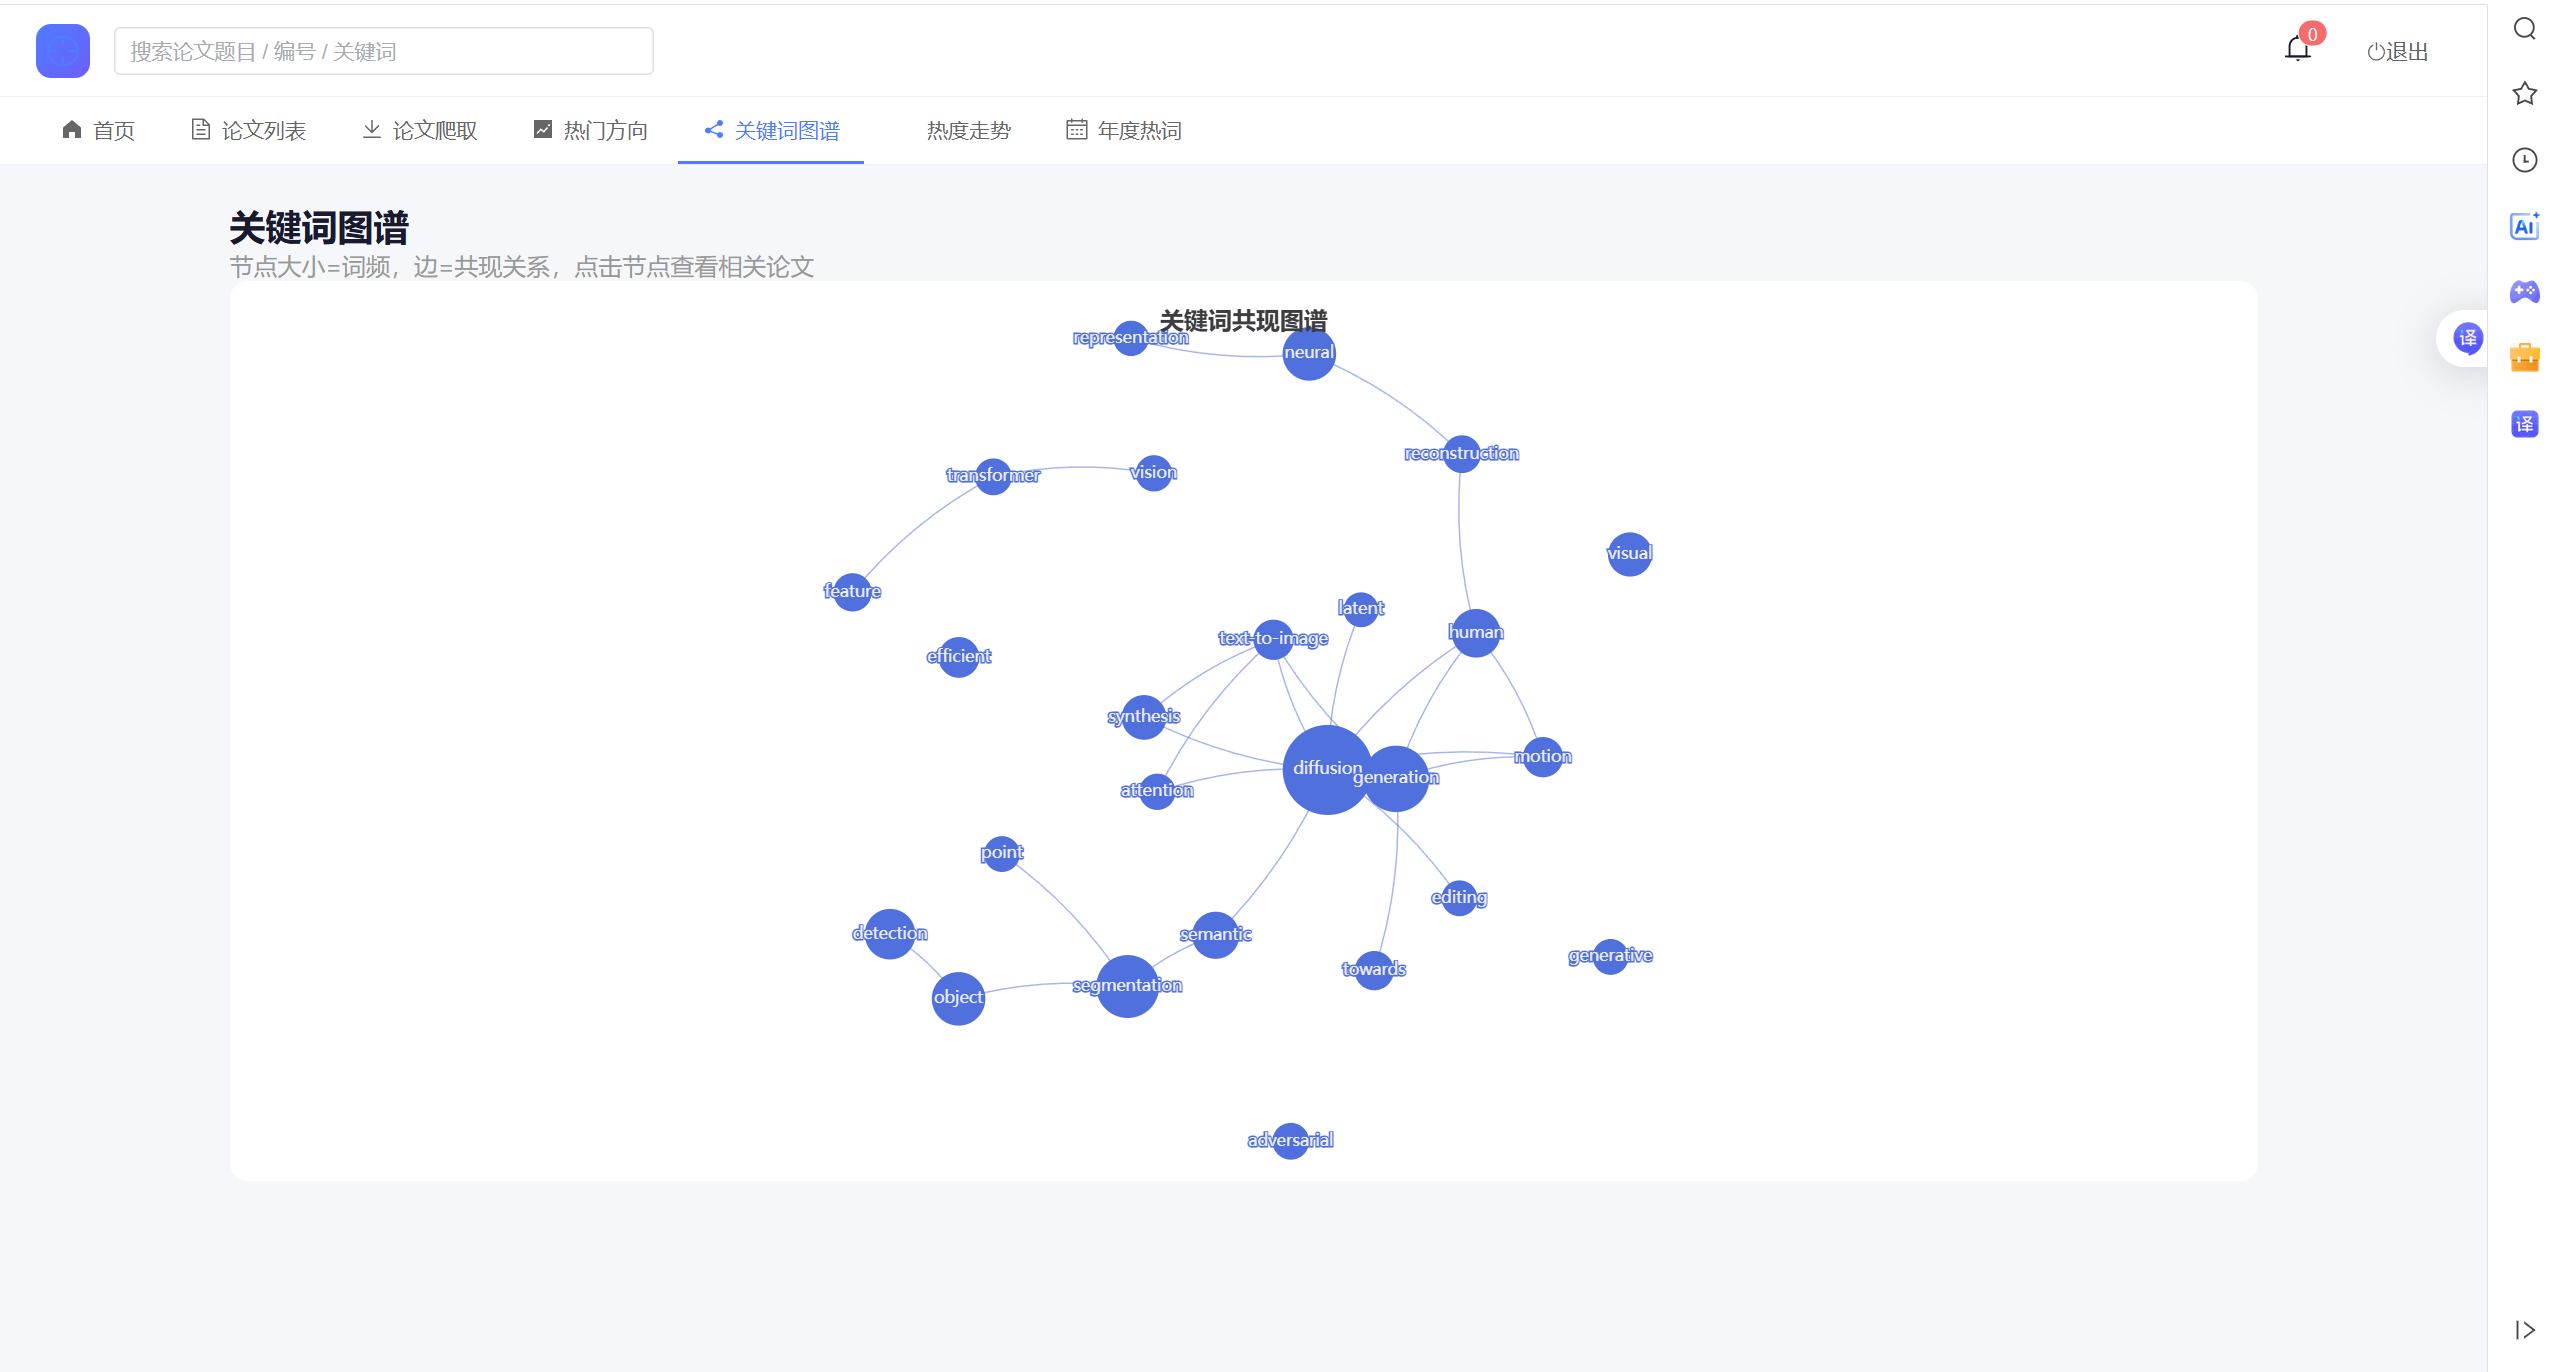
图九:热度走势
图十:年度热词
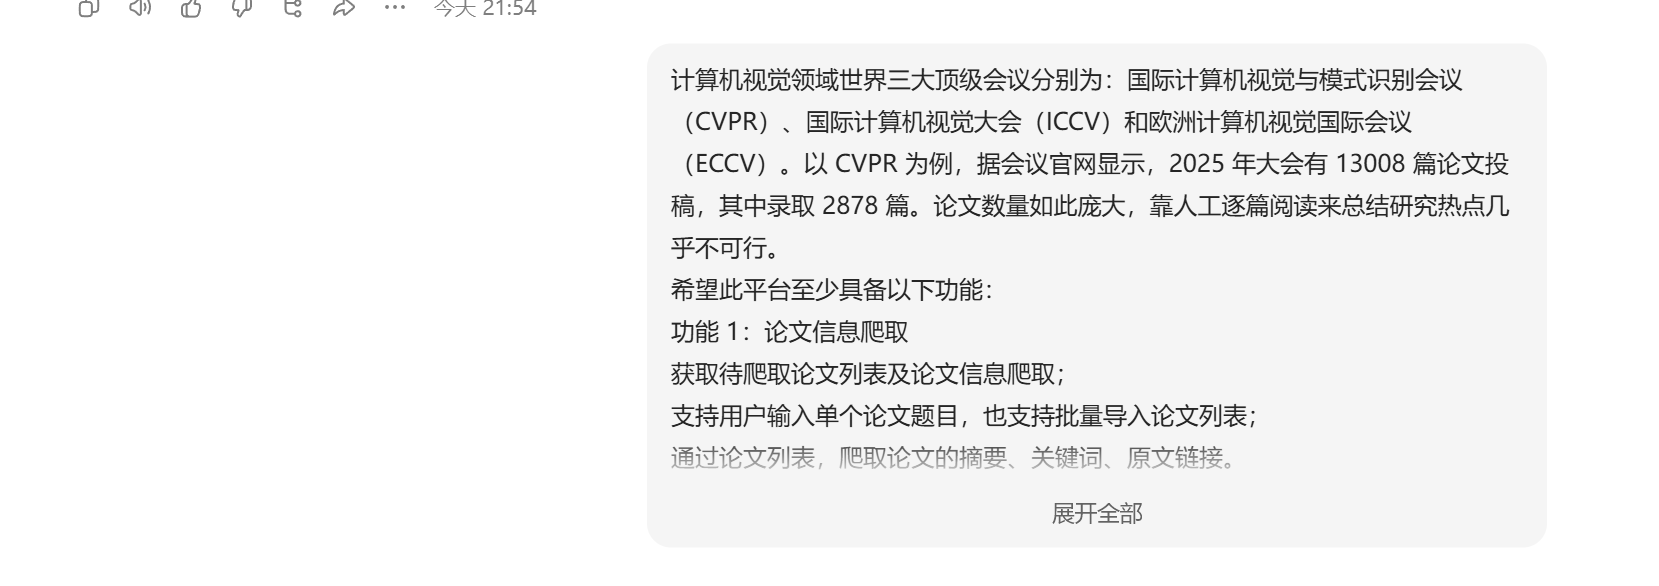
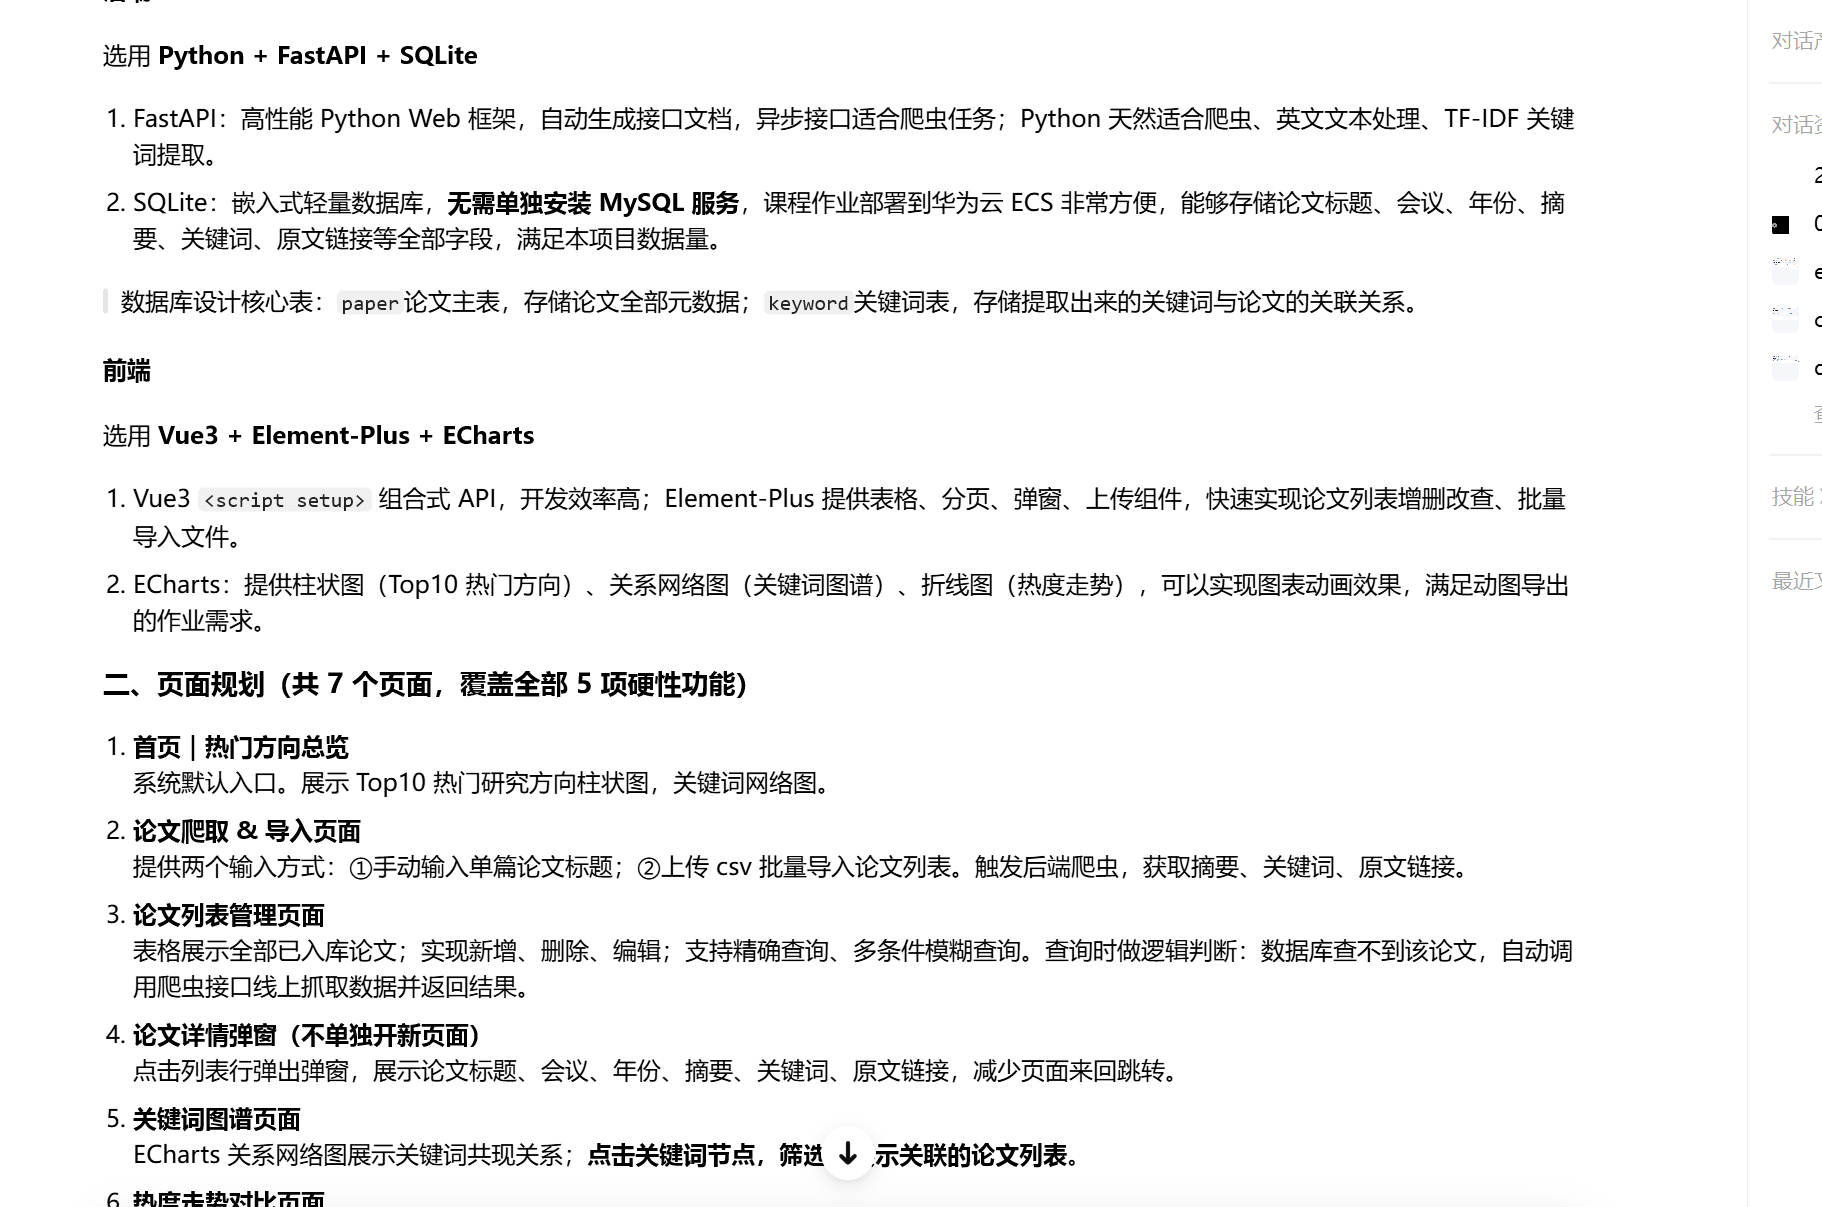
我的处理: 大部分内容采纳,技术栈FastAPI+SQLite+Vue3+Element‑Plus+ECharts完全适配课程作业,7 个页面完整覆盖 5 个作业强制功能;把论文详情做成弹窗的设计,可以简化原型交互
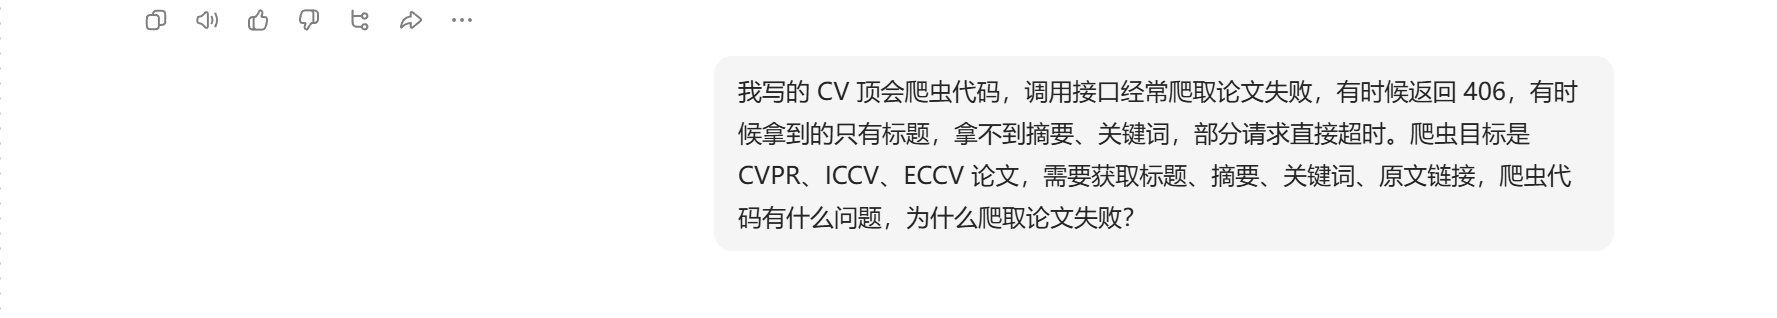
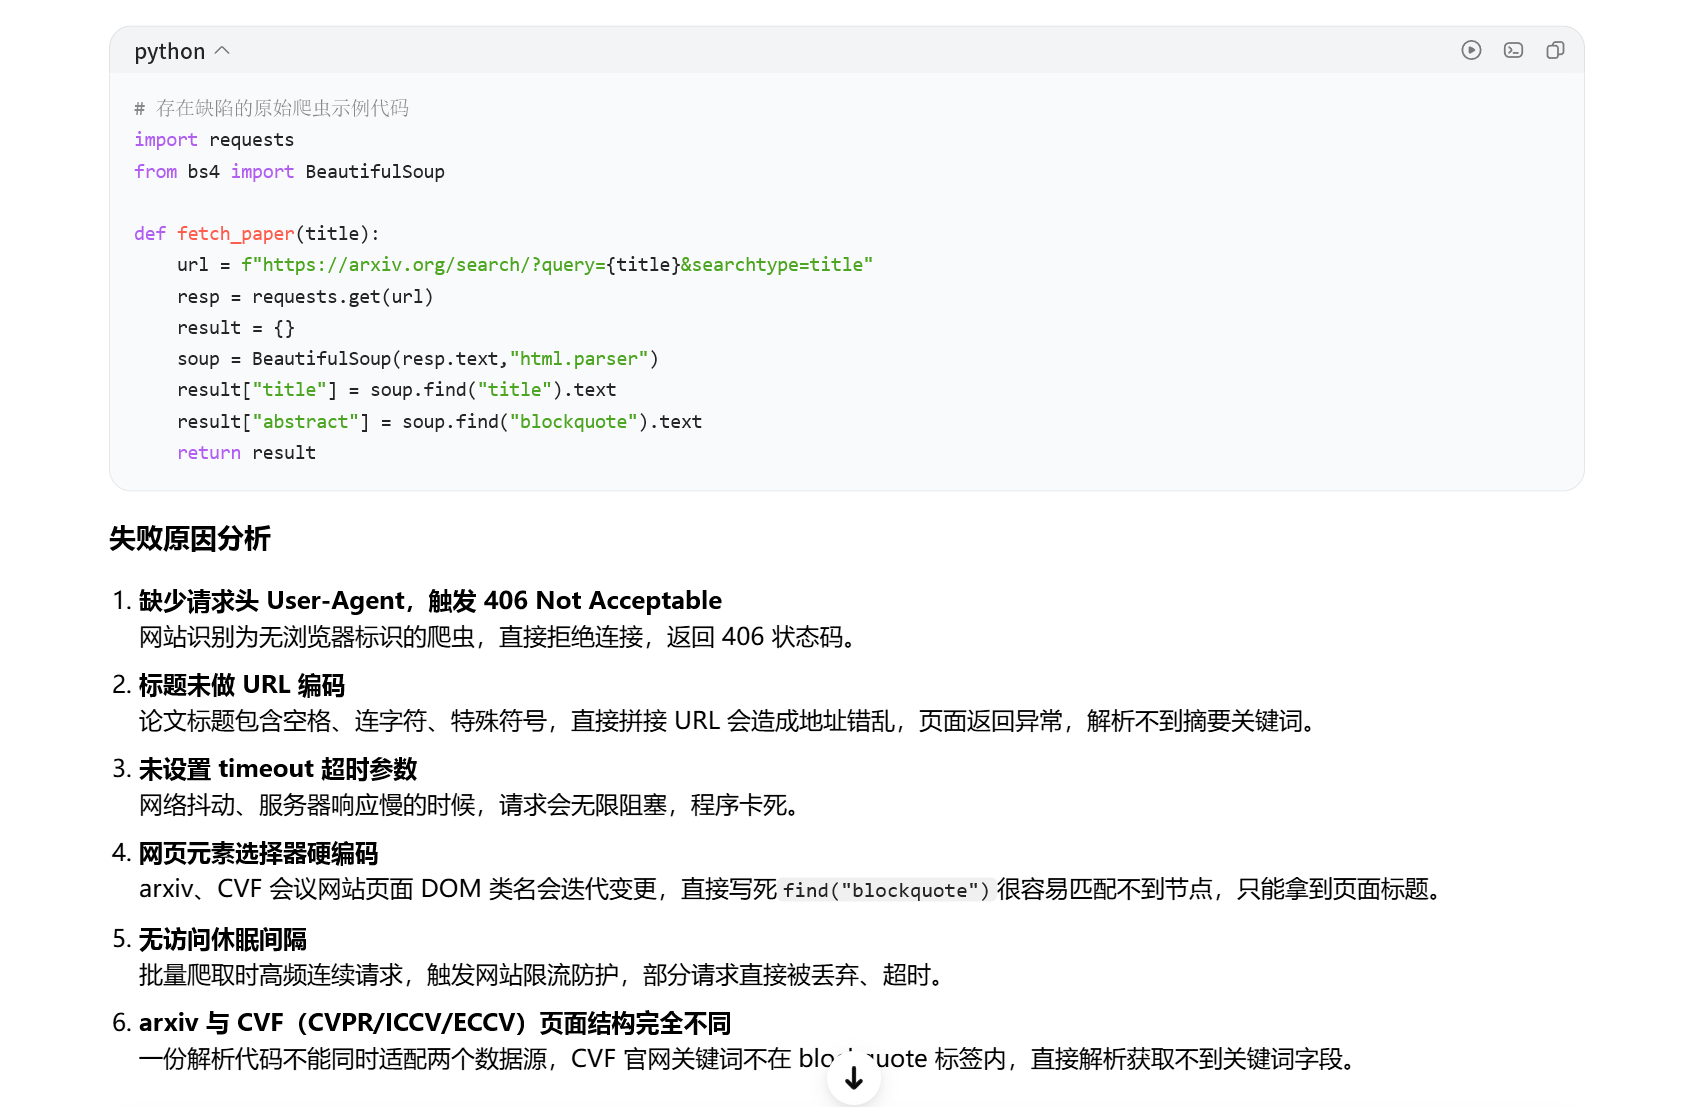
我的处理:采纳大部分分析,增加User‑Agent请求头、URL 编码、timeout 超时、请求休眠间隔、异常捕获逻辑。
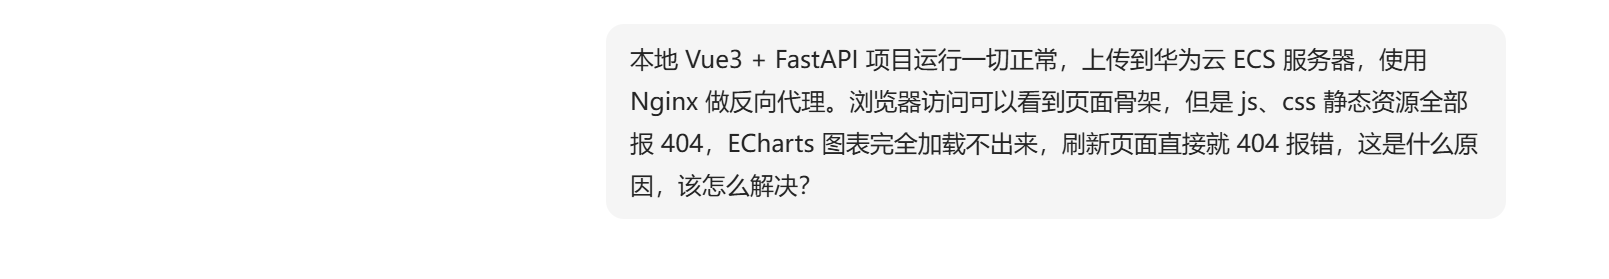
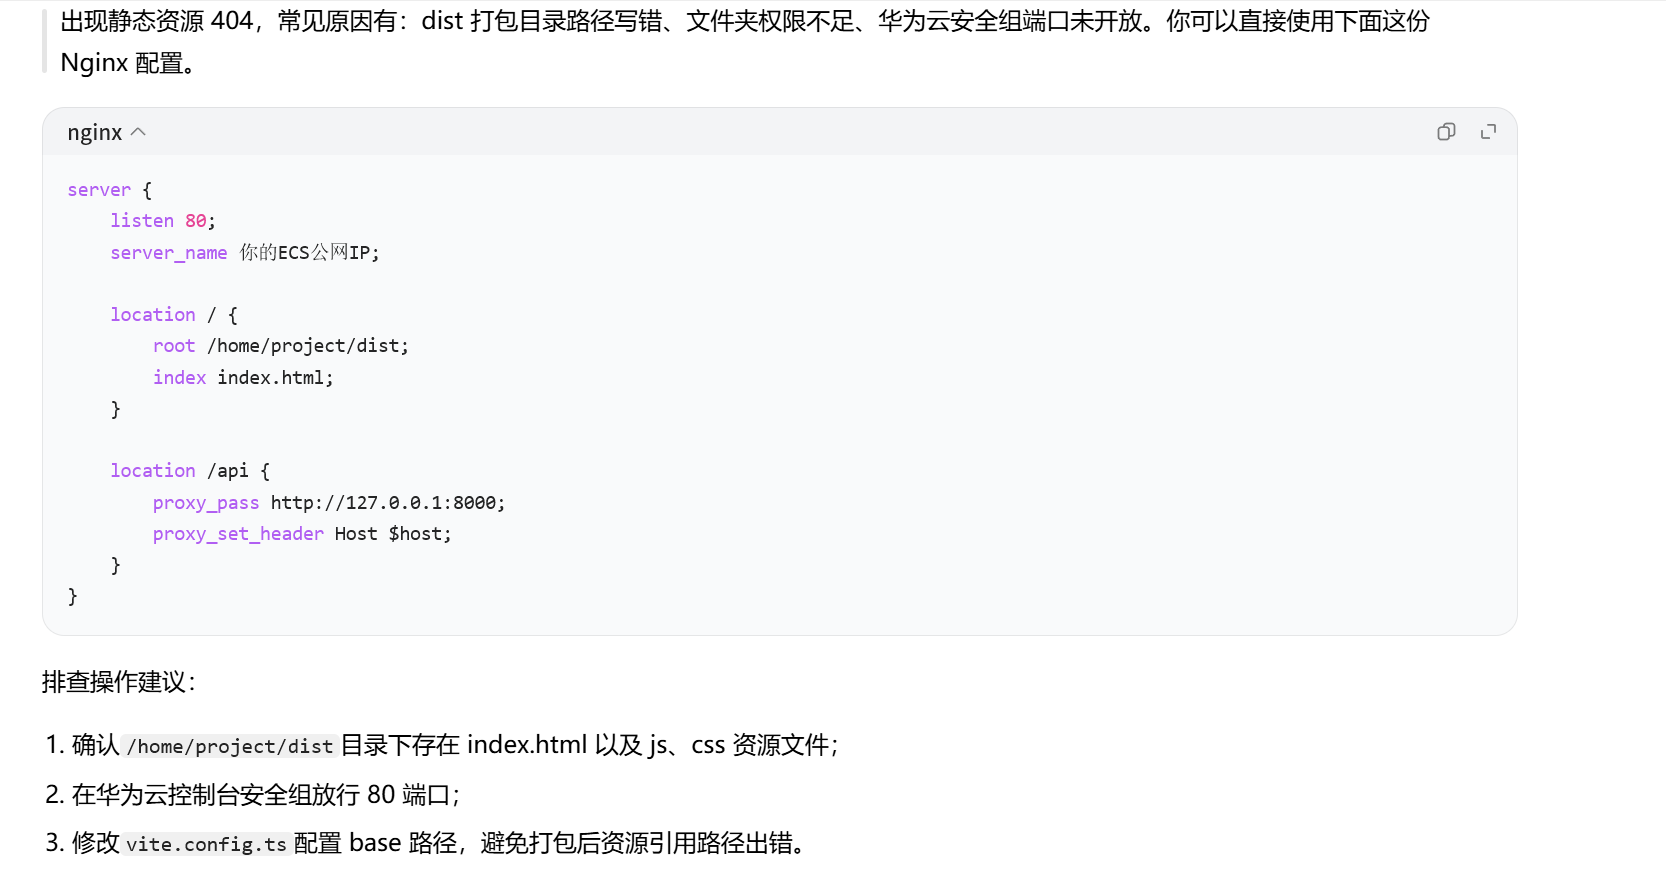
我的处理: 采纳部分建议。核对服务器 dist 目录路径,确认打包后的静态文件完整上传;检查华为云安全组,确认 80 端口入方向已经开放;修改 vite 配置:base: "./",将资源改为相对路径,解决部分静态文件路径错误。
项目选用轻量级嵌入式数据库 SQLite,搭配 SQLAlchemy ORM 做对象关系映射,不需要额外安装独立数据库服务,降低华为云ECS部署难度。项目设计两张核心数据表:papers论文主表、crawl_tasks爬虫任务记录表。
papers 论文信息表,存储CVPR/ICCV/ECCV、arXiv爬取的论文元数据
| 字段 | 说明 |
|---|---|
| id | 自增主键,论文唯一标识 |
| title | 论文标题,用于精确/模糊检索 |
| authors | 论文作者列表 |
| abstract | 论文摘要,用于关键词提取、文本分析 |
| year | 发表年份,用于热度走势筛选统计 |
| conference | 会议来源,取值CVPR/ICCV/ECCV/arXiv |
| pdf_url | PDF原文下载链接 |
| paper_url | 论文网页访问地址 |
| keywords | 提取出的关键词,用于热词统计、关键词图谱 |
crawl_tasks 爬虫任务表,记录每一次爬取任务运行状态,区分单篇、批量爬取任务
| 字段 | 说明 |
|---|---|
| id | 任务主键ID |
| type | 任务类型:single单篇爬取 / batch批量导入爬取 |
| target | 爬取目标,单篇存论文标题,批量存批次标识 |
| status | 任务状态:pending等待、running执行中、success成功、fail失败 |
| result_count | 本次任务成功入库论文数量 |
| error_msg | 任务失败记录错误信息,便于排查异常 |
| created_at | 任务创建时间戳 |
设计说明:爬虫属于耗时IO操作,独立任务表可以实现异步爬取,前端可查看任务状态,避免批量爬取导致接口超时。
后端基于 FastAPI + Python 开发,采用模块化拆分,业务解耦,方便迭代维护。
main.py:项目入口,定义全部API接口。包含论文CRUD、爬虫任务触发、热门方向统计、关键词共现、热度走势统计接口;FastAPI自带交互式接口文档,方便前后端联调。crawlers/arxiv.py:arXiv数据源爬虫,调用公开Atom XML接口解析论文元数据,添加请求头、访问间隔,处理编码异常。crawlers/cvf.py:CVF-OpenAccess爬虫,专门解析CVPR/ICCV/ECCV网页HTML,提取摘要、作者、pdf链接;两套爬虫完全隔离,适配不同网站页面结构。analysis.py:文本分析模块,实现英文停用词过滤、TF-IDF关键词抽取;统计词频生成Top10热门方向;计算关键词共现节点与边数据;按会议、年份计算热词热度,输出统计JSON。models.py:SQLAlchemy ORM实体模型,定义Paper、CrawlTask数据类,与数据库表一一映射。database.py:SQLite数据库引擎初始化、数据库会话管理,提供会话获取工具函数。后端业务执行流程
crawl_tasks任务记录papers数据表前端技术栈:Vue3 + <script setup>组合式API + Element-Plus + Axios + ECharts,一共7个页面组件,覆盖全部业务与可视化需求。
Home.vue 首页(热门方向总览):展示Top10热门方向柱状图、关键词力导向图谱CrawlImport.vue 论文爬取导入页:支持单篇标题输入、CSV批量导入,提交爬虫任务并展示任务状态PaperList.vue 论文列表管理页:论文表格展示,实现增删改;支持精确、模糊查询;数据库无结果则自动请求后端在线爬取;点击行弹窗展示论文详情KeywordGraph.vue 关键词图谱页:ECharts力导向图渲染关键词共现网络;点击关键词节点筛选展示关联论文TrendChart.vue 热度走势对比页:下拉选择顶会、统计年份区间,渲染热词走势动画图表,可录屏导出GIF动图About.vue 了解更多页面:介绍CVPR/ICCV/ECCV三大顶会,说明项目数据来源、关键词统计口径Layout.vue 公共布局组件:封装侧边导航栏与头部,所有业务页面复用布局前端逻辑:业务数据全部由后端接口返回,前端只负责交互和渲染,不在前端写死业务数据。
项目部署于华为云ECS服务器,Nginx作为静态web服务与反向代理,前后端分离部署。
浏览器客户端
    ↓ HTTP 80端口请求
Nginx(80端口)
    ├─静态资源:直接返回Vue打包dist目录下html/js/css静态文件
    └─匹配 /api 请求 → 反向代理转发
        ↓
uvicorn(8000端口) 运行FastAPI后端服务
    ↓
SQLite 本地数据库文件,存储论文、爬虫任务全部业务数据
部署说明:
vite build打包生成dist静态资源文件夹,上传至ECS;try_files解决Vue history路由刷新404;/api请求转发到本机uvicorn服务;127.0.0.1:8000,仅本机可访问,不直接暴露公网;部署优势:Nginx负责静态资源分发与代理,性能更好;后端服务不直接暴露公网,提升服务安全性,满足课程作业部署要求。
import httpx
from bs4 import BeautifulSoup

CONF_URLS = {
    "cvpr2024": "https://openaccess.thecvf.com/CVPR2024?day=all",
    "iccv2023": "https://openaccess.thecvf.com/ICCV2023?day=all",
    "eccv2024": "https://openaccess.thecvf.com/ECCV2024?day=all",
}

def fetch_conference(conf: str, max_papers: int = 500):
    """爬取某一届顶会的论文列表"""
    url = CONF_URLS.get(conf.lower())
    if not url:
        return []
    # 超时和重定向,防止请求卡死
    resp = httpx.get(url, timeout=30, follow_redirects=True)
    resp.raise_for_status()
    soup = BeautifulSoup(resp.text, "lxml")
    papers = []
    for dt in soup.select("dt.ptitle")[:max_papers]:
        paper_url = "https://openaccess.thecvf.com" + dt.a["href"]
        title = dt.a.text.strip()
        dd = dt.find_next("dd")
        authors = [a.text.strip() for a in dd.select("a")] if dd else []
        papers.append({
            "title": title, "authors": authors,
            "year": int(conf[-4:]), "conference": conf[:4].upper(),
            "paper_url": paper_url,
            "pdf_url": paper_url.replace("/html/", "/papers/").replace(".html", ".pdf"),
        })
    return papers
设计思路:AI初版只写了基础请求和选择器,人工补充了超时、异常处理、PDF链接拼接(根据URL规律推导)和去重逻辑。
import re
from collections import Counter

STOP_WORDS = {"using","based","via","for","model","image","video",
              "data","method","approach","results","show","used"}

def extract_keywords(papers: list, top_n: int = 50):
    counter = Counter()
    for p in papers:
        words = re.findall(r"[a-z]{4,}", p["title"].lower())
        for w in words:
            if w not in STOP_WORDS:
                counter[w] += 1
    return counter.most_common(top_n)

def keyword_cooccurrence(papers: list, top_words: list):
    edges = []
    for p in papers:
        words = set(re.findall(r"[a-z]{4,}", p["title"].lower()))
        words = [w for w in words if w in dict(top_words)]
        for i in range(len(words)):
            for j in range(i+1, len(words)):
                edges.append((words[i], words[j]))
    return edges
设计思路:英文论文直接用正则分词,不用jieba。停用词表人工逐步扩充。共现关系:同一篇论文中出现的关键词两两连边。
from fastapi import FastAPI, Depends
from fastapi.middleware.cors import CORSMiddleware
from pydantic import BaseModel

app = FastAPI(title="CV Paper Radar API")
app.add_middleware(CORSMiddleware, allow_origins=["*"],
                   allow_methods=["*"], allow_headers=["*"])

class CrawlRequest(BaseModel):
    type: str
    conference: str = None

@app.get("/api/papers")
def list_papers(page: int = 1, page_size: int = 20,
                keyword: str = None, db: Session = Depends(get_db)):
    query = db.query(Paper)
    if keyword:  # 模糊搜索
        query = query.filter(Paper.title.contains(keyword))
    total = query.count()
    items = query.order_by(Paper.year.desc())\
              .offset((page-1)*page_size).limit(page_size).all()
    return {"total": total, "page": page, "items": items}

@app.post("/api/crawl/cvf")
def crawl_cvf(req: CrawlRequest, db: Session = Depends(get_db)):
    papers = cvf_crawler.fetch_conference(req.conference, max_papers=500)
    count = 0
    for p in papers:
        # 去重
        exists = db.query(Paper).filter(Paper.title == p["title"]).first()
        if exists:
            continue
        db.add(Paper(**p))
        count += 1
    db.commit()
    return {"crawled": count}

@app.get("/api/keywords/top10")
def top10(db: Session = Depends(get_db)):
    papers = db.query(Paper).all()
    kw = extract_keywords([{"title": p.title} for p in papers], top_n=10)
    return {"words": [k[0] for k in kw], "counts": [k[1] for k in kw]}
设计思路:AI初版只有基础CRUD,人工补充了模糊搜索和入库前去重逻辑。
<template>
  <div>
    <h2>热度走势对比</h2>
    <div id="heatmap" style="width:100%;height:500px"></div>
  </div>
</template>

<script setup lang="ts">
import { onMounted } from 'vue'
import * as echarts from 'echarts'
import api from '../api'

onMounted(async () => {
  const res = await api.get('/keywords/heatmap')
  const chart = echarts.init(document.getElementById('heatmap')!)
  chart.setOption({
    tooltip: { position: 'top' },
    xAxis: { type: 'category', data: res.years },
    yAxis: { type: 'category', data: res.words },
    visualMap: { min: 0, max: res.max, orient: 'horizontal',
                 left: 'center', bottom: '0%' },
    series: [{ type: 'heatmap', data: res.values, label: { show: true } }]
  })
  // 窗口变化时自适应
  window.onresize = () => chart.resize()
})
</script>
设计思路:AI生成基础图表配置,人工补充了窗口自适应resize。
| 模块 | 行数 | AI生成 | 人工补充 |
|---|---|---|---|
| CVF爬虫 | 60 | 请求和选择器 | 超时、异常、PDF链接、去重 |
| 关键词提取 | 50 | Counter统计 | 停用词表、共现计算 |
| FastAPI接口 | 80 | CRUD框架 | 模糊搜索、去重 |
| 前端ECharts | 60 | 图表配置 | 自适应resize |
| 合计 | 250行 |
拿到作业题目的时候其实挺慌的——要爬取CVPR/ICCV/ECCV论文、做关键词统计和可视化、还要部署到华为云,对我一个没怎么接触过全栈开发的人来说感觉难度很大。一开始甚至不知道该先写前端还是先写后端,是AI帮我理清了顺序:先定技术栈、再画原型、然后搭数据库和后端接口、最后做前端页面。
第一步用墨刀AI生成原型的时候,感觉整个项目的轮廓一下子就清晰了——7个页面,每个页面干什么,都在原型里能看到。然后开始写后端,FastAPI的脚手架是AI生成的,跑起来很快。真正遇到困难是写arXiv爬虫的时候,一直返回406错误,AI一开始建议我加User-Agent,试了还是不行,后来我自己看请求URL才发现是urlencode把参数编码错了。这个过程让我意识到:AI不是万能的,它的建议也可能是错的,自己要懂原理才能判断。
最折磨人的是华为云部署阶段。从买ECS、绑公网IP、配安全组,到服务器上装Python/Node/Nginx,再到前端build失败、Nginx反向代理404,每一步都踩了坑。特别是vite 8在Linux上的原生模块bug,完全没想到Windows本地能跑的代码到服务器上会build失败。好在AI一步步引导我降级vite版本,最后终于跑通了。
当浏览器输入公网IP看到首页图表正常渲染出来的时候,真的很有成就感。这个项目从一个想法到一个能公网访问的网站,前前后后花了52个小时,虽然大部分代码是AI辅助生成的,但每一行我都能解释它在干什么,这才是真正学会了。
结合《构建之法》第4章"两人合作",对比人机结对和传统人人结对:
| 对比维度 | 传统人人结对 | 人机结对 |
|---|---|---|
| 知识广度 | 两人各有擅长,可能有盲区 | AI知识面广,前后端运维都懂 |
| 响应速度 | 同伴要查资料、思考 | AI秒回,效率高 |
| 耐心 | 人会累、会有情绪 | AI永远耐心 |
| 理解上下文 | 同伴了解项目前因后果 | AI上下文有限,需重复说明 |
| 主观判断 | 同伴会从产品角度给建议 | AI只给技术方案,不替你决策 |
| 代码审查 | 同伴会指出逻辑错误 | AI也会犯错,需自己审查 |
豆包作为结对编程伙伴非常高效,特别是在脚手架代码生成、技术问题排查、配置文件编写这些重复性工作上,能节省大量时间。但关键技术决策、架构设计、最终验证必须由人来把控。人机结对最大的价值不是"AI帮你写代码",而是"AI帮你快速试错,你负责判断和决策"。
这个作业让我深刻体会到《构建之法》里说的:结对编程不是两个人互相帮忙写代码,而是互相审查、互相补充。人机结对也是一样——AI负责快速生成方案,人负责审查、验证、修正,这才是高效的协作方式。

