

 2601_FZU_SE

102400416_李明学_软件工程第二次作业
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
计算机视觉学术热点追踪工具 —— 人机结对编程作业报告
学号:102400416
| 这个作业属于哪个课程 | https://bbs.csdn.net/forums/2601_CS_SE_FZU |
|---|---|
| 这个作业要求在哪里 | https://bbs.csdn.net/topics/620526318 |
| 这个作业的目标 | 以 AI(Claude Code)为结对伙伴,完成一个「计算机视觉学术热点追踪工具」,并如实记录人机协作的完整过程 |
| 其他参考文献 | arXiv API 官方文档、networkx 文档、matplotlib 文档 |
目录
- 计算机视觉学术热点追踪工具 —— 人机结对编程作业报告
- 一、AI 结对工具说明
- 1. 使用方式
- 2. 主要辅助内容
- 3. 协作模式
- 二、NABCD 需求分析
- 三、原型设计与信息架构
- 墨刀原型设计(MockingBot)
- 四、人机协作记录(迭代过程)
- 迭代 1:需求澄清与选题
- 迭代 2:技术方案设计
- 迭代 3:环境搭建
- 迭代 4:编码实现三个模块
- 迭代 5:发现 Bug —— 爬虫遇到网络超时崩溃(对应案例 C)
- 迭代 6:发现设计缺陷 —— 逐年趋势图是「平线」(对应案例 C)
- 迭代 7:发现 Bug —— 终端中文乱码(对应案例 C)
- 迭代 8:单元测试发现关键词合并缺陷(对应案例 C 的第四处 Bug)
- 五、三个代表性协作案例
- 案例 A:AI 辅助需求分析与原型设计
- 案例 B:AI 辅助编码实现功能模块
- 案例 C:AI 辅助调试与修复 Bug(含「发现 AI 代码错误并纠正」)
- 六、可解释性声明
- 七、成品展示
- ① 关键词共现网络图
- ② 逐年发文量增长动图
- ③ 热门关键词条形图竞赛动图
- 八、结对(人机)讨论过程描述
- 九、设计实现过程
- 十、代码说明(分模块阐述)
- 9.1 模块 1:论文爬虫 crawler.py
- 9.2 模块 2:关键词图谱 keyword_graph.py
- 9.3 模块 3:热度走势动图 trend_animation.py
- 9.4 模块 4:入口与配置 main.py / config.py
- 9.5 模块 5:单元测试 tests/
- 十一、心路历程、收获
- 十二、对 AI 结对伙伴的评价
- 附录
- PSP 表格
- 华为云代码仓库链接
- 墨刀原型设计网页链接
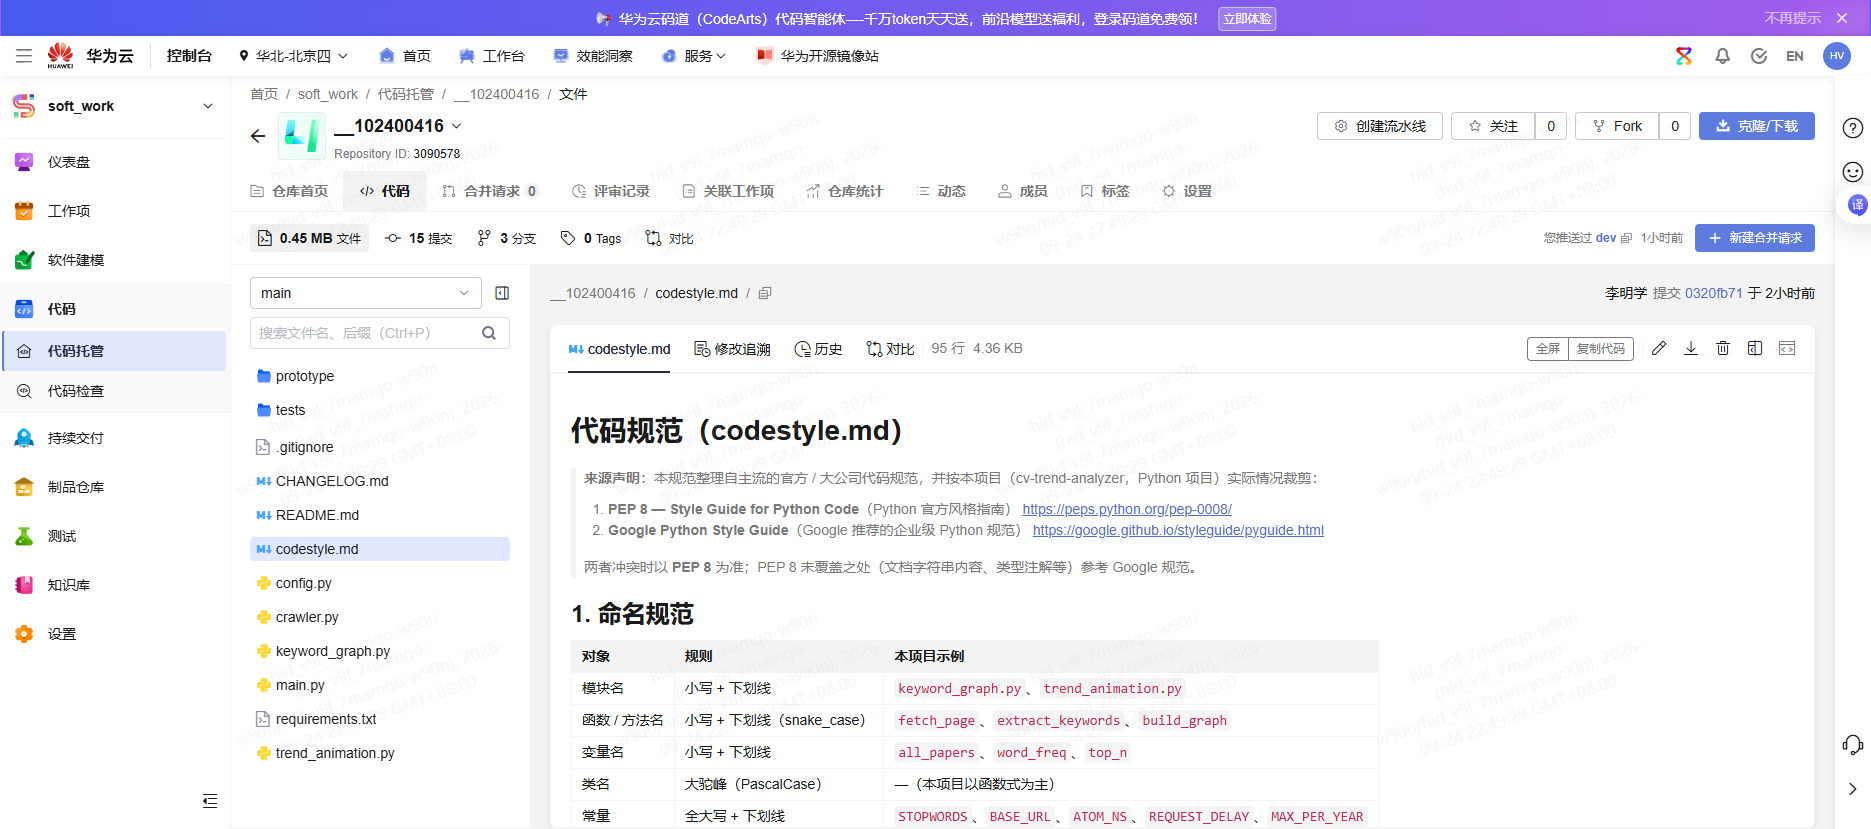
- 代码规范(在华为云代码仓库)
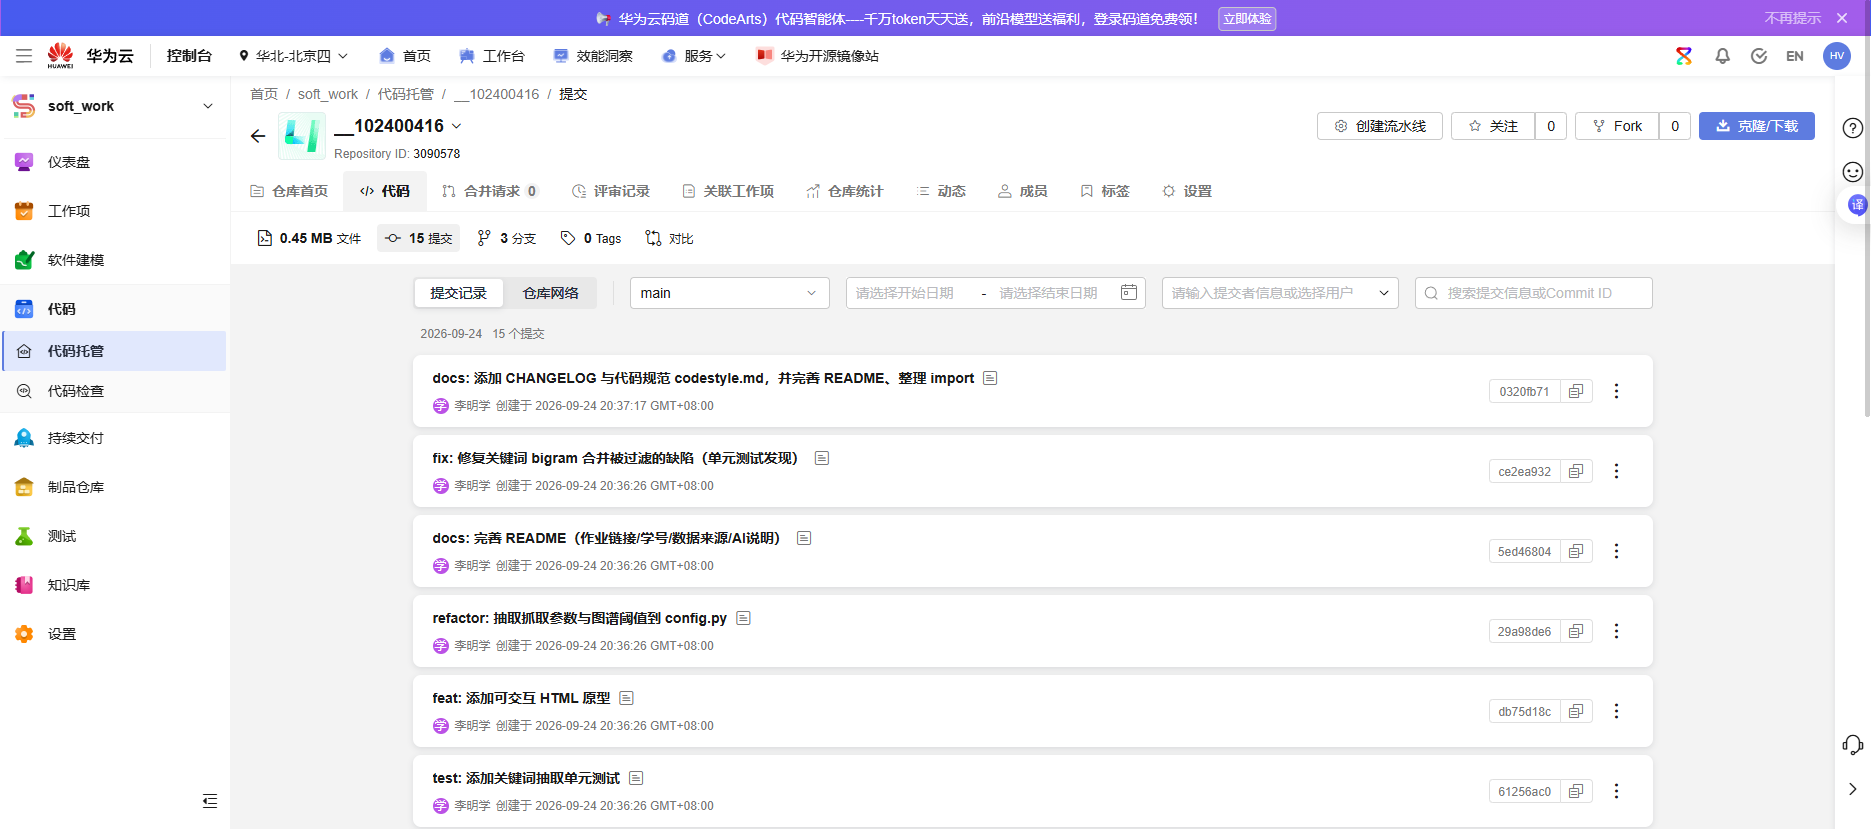
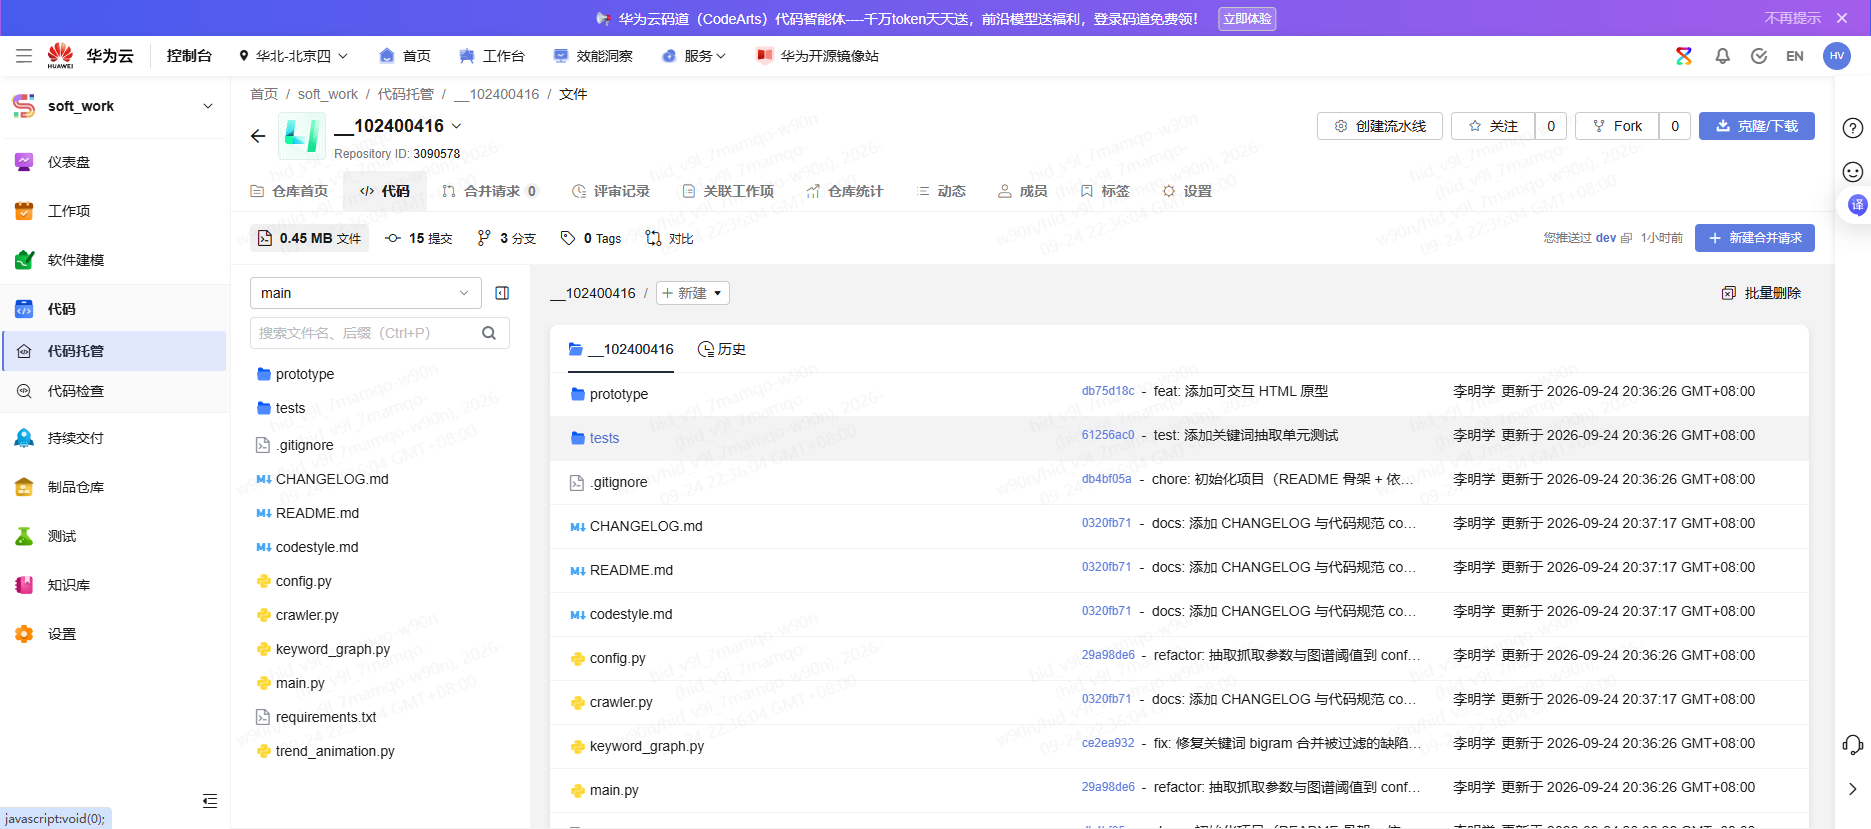
- 代码commit截图
一、AI 结对工具说明
本次项目使用 Claude 作为人机结对编程辅助工具,全程参与项目开发与文档撰写。
1. 使用方式
以自然语言对话形式进行结对协作,通过精准提示词提出开发需求、修改要求与文档规范,由 Claude 输出初稿,我负责审核、校验、修改、最终决策。
2. 主要辅助内容
- 项目需求梳理、NABCD 需求分析撰写
- 项目结构搭建、代码文件拆分、分批迭代开发
- Python 后端代码生成、接口编写、数据处理逻辑实现
- 关键词统计、热词分析、可视化数据逻辑优化
- 协助排查代码 bug、优化代码规范、修复逻辑漏洞
- 辅助撰写 PSP 表格、博客文档、总结反思等作业材料
3. 协作模式
Claude 负责快速产出代码、文档初稿与方案参考,我负责需求判断、代码审查、逻辑校验、迭代修改与最终负责,实现人机结对开发模式。
二、NABCD 需求分析
N(Need,需求)
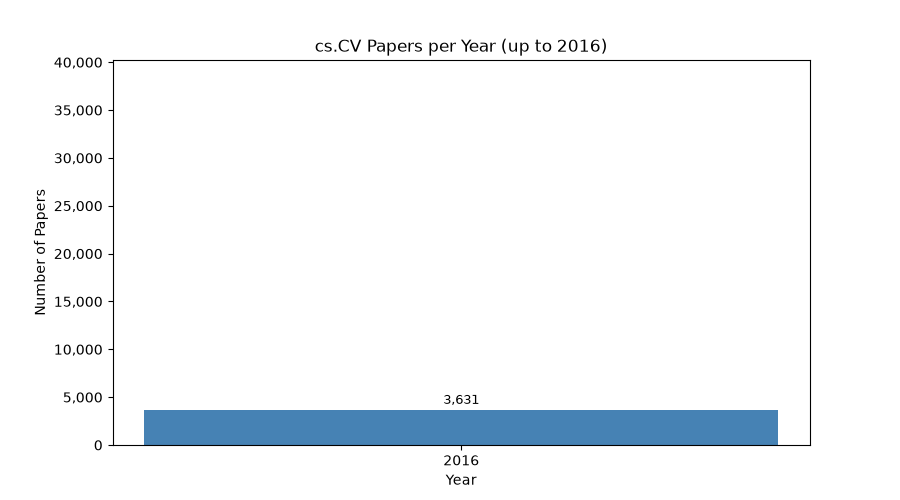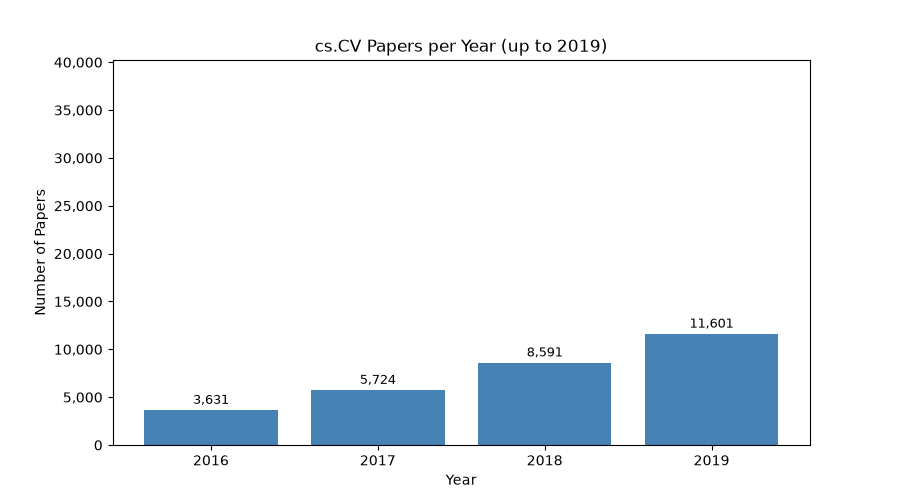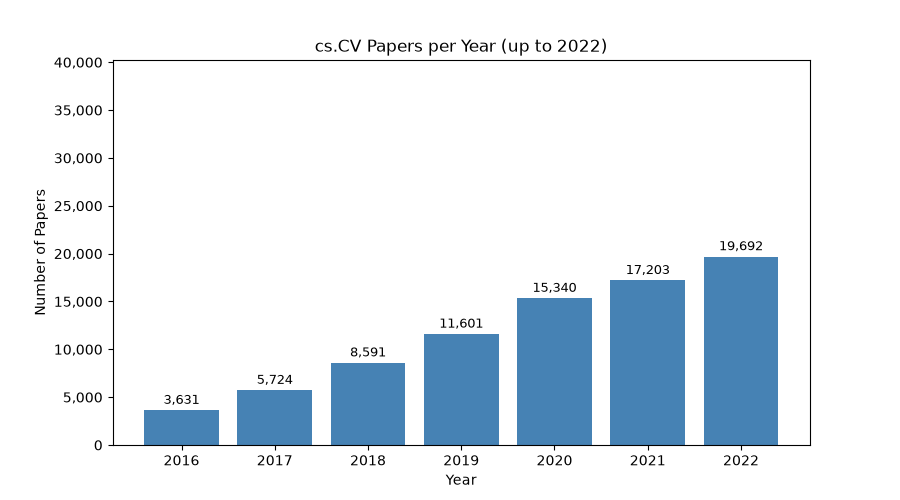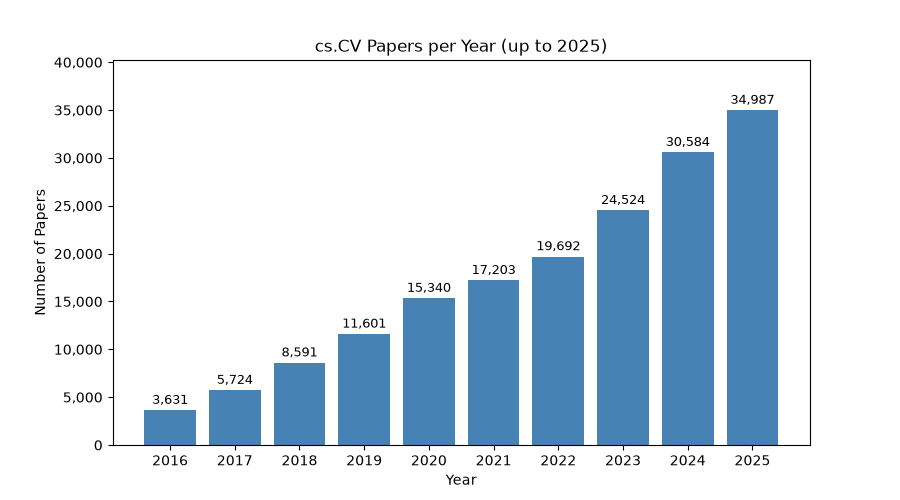
计算机视觉(cs.CV)是近几年论文数量爆发式增长的领域(arXiv 上从 2016 年的约 3600 篇增长到 2025 年的约 35000 篇)。研究者、学生在选方向、读论文之前,常常需要快速回答两个问题:「这个领域最近在火什么?」「哪些子方向在上升、哪些在退潮?」。逐篇翻阅海量论文显然不现实,需要一个能自动汇总趋势的工具。
A(Approach,做法)
用 arXiv 官方开放 API 抓取 cs.CV 的论文元数据(标题、摘要、年份),然后:
- 从标题中抽取关键词,统计两两「共同出现在同一篇论文标题」的频率,构建关键词共现网络;
- 按年份统计发文量与热门关键词,做成逐年动图,直观展示热度走势。
B(Benefit,好处)
- 自动化:一次运行即可完成「抓取 → 分析 → 可视化」全流程;
- 直观:图谱一眼看清子方向聚类,动图一眼看清趋势;
- 轻量:不依赖数据库和重型 NLP 框架,逻辑透明、可解释、可复现。
C(Competitors,竞品)
Semantic Scholar、Connected Papers 等工具也能做相似的事,但它们更重、偏通用,且可视化不可定制。本工具聚焦单一领域、代码开源可改,适合教学与二次开发。
D(Delivery,交付)
Python 脚本 + 生成的三类产出物(CSV、共现网络 PNG、两个 GIF),以及本报告。源码托管在代码仓库(链接见「成品展示」)。
三、原型设计与信息架构
系统信息架构(数据流)
flowchart LR
    A[arXiv API] -->|fetch| B[crawler.py<br/>论文爬虫]
    B -->|papers.csv| C[keyword_graph.py<br/>关键词图谱]
    B -->|yearly_counts.csv| D[trend_animation.py<br/>热度动图]
    C -->|keyword_graph.png| E[成品]
    D -->|papers_per_year.gif<br/>keyword_race.gif| E
原型设计说明
本平台的原型分两个层次:
程序成品形态(命令行 + 静态产出物):
python main.py一键完成全流程,产出 5 个文件——① 论文数据表(CSV);② 关键词共现网络图;③ 两张热度动图。墨刀高保真 Web 原型:见下文「墨刀原型设计」。
墨刀原型设计(MockingBot)
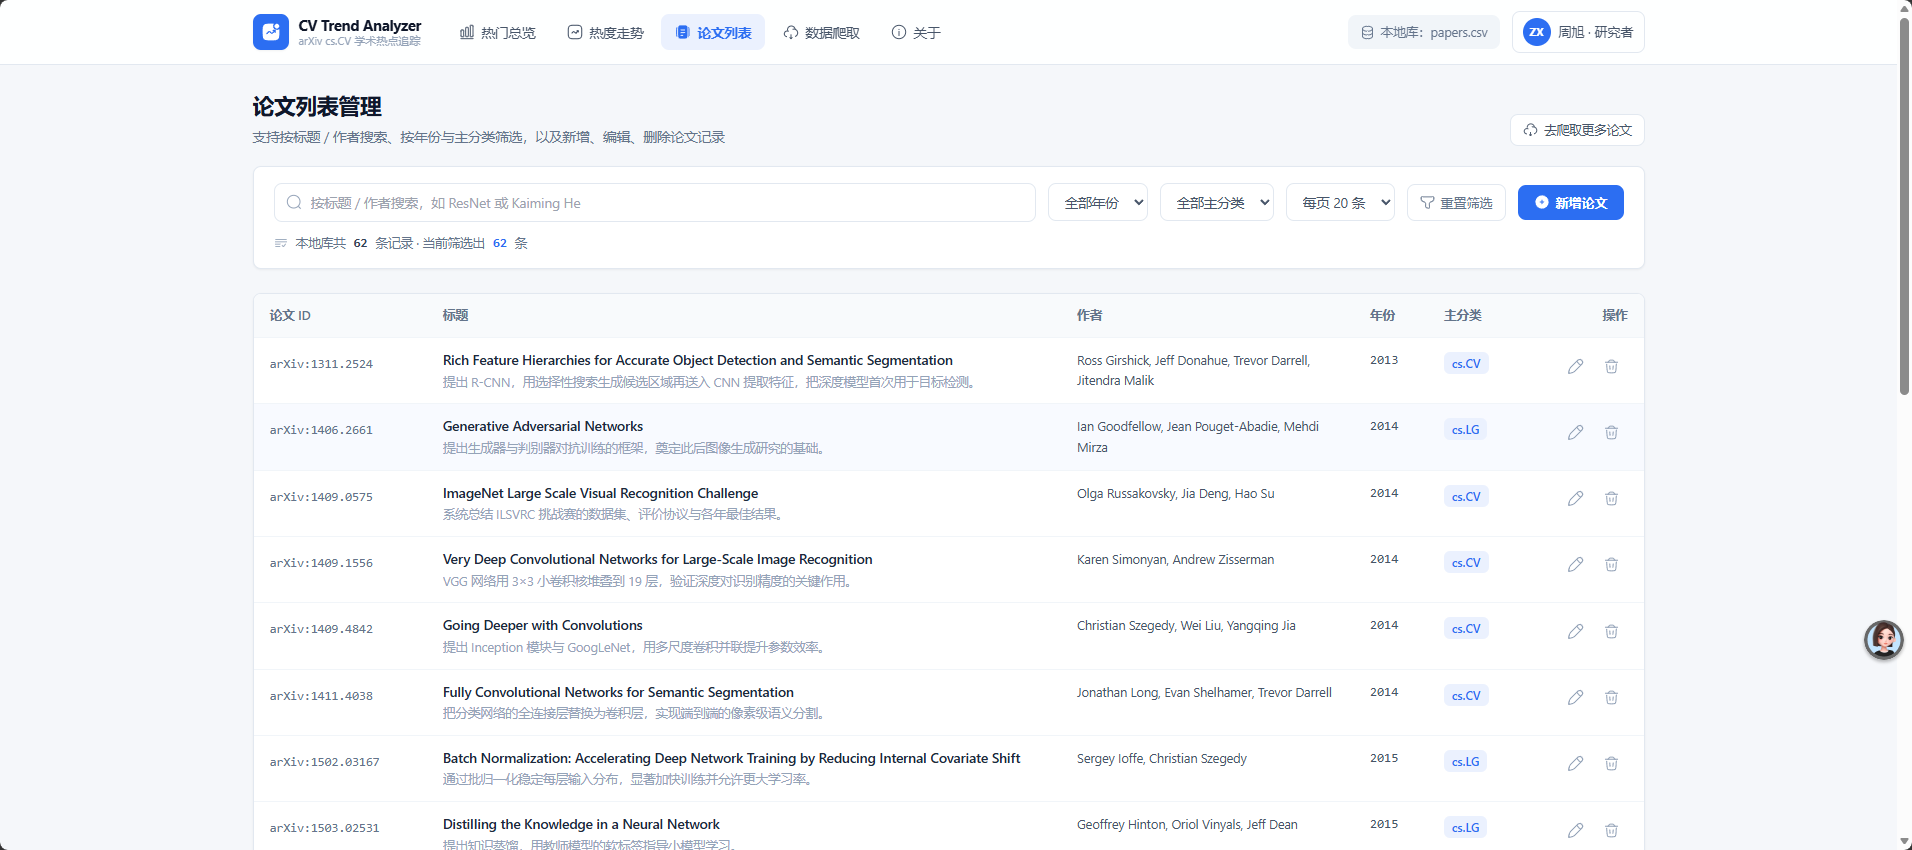
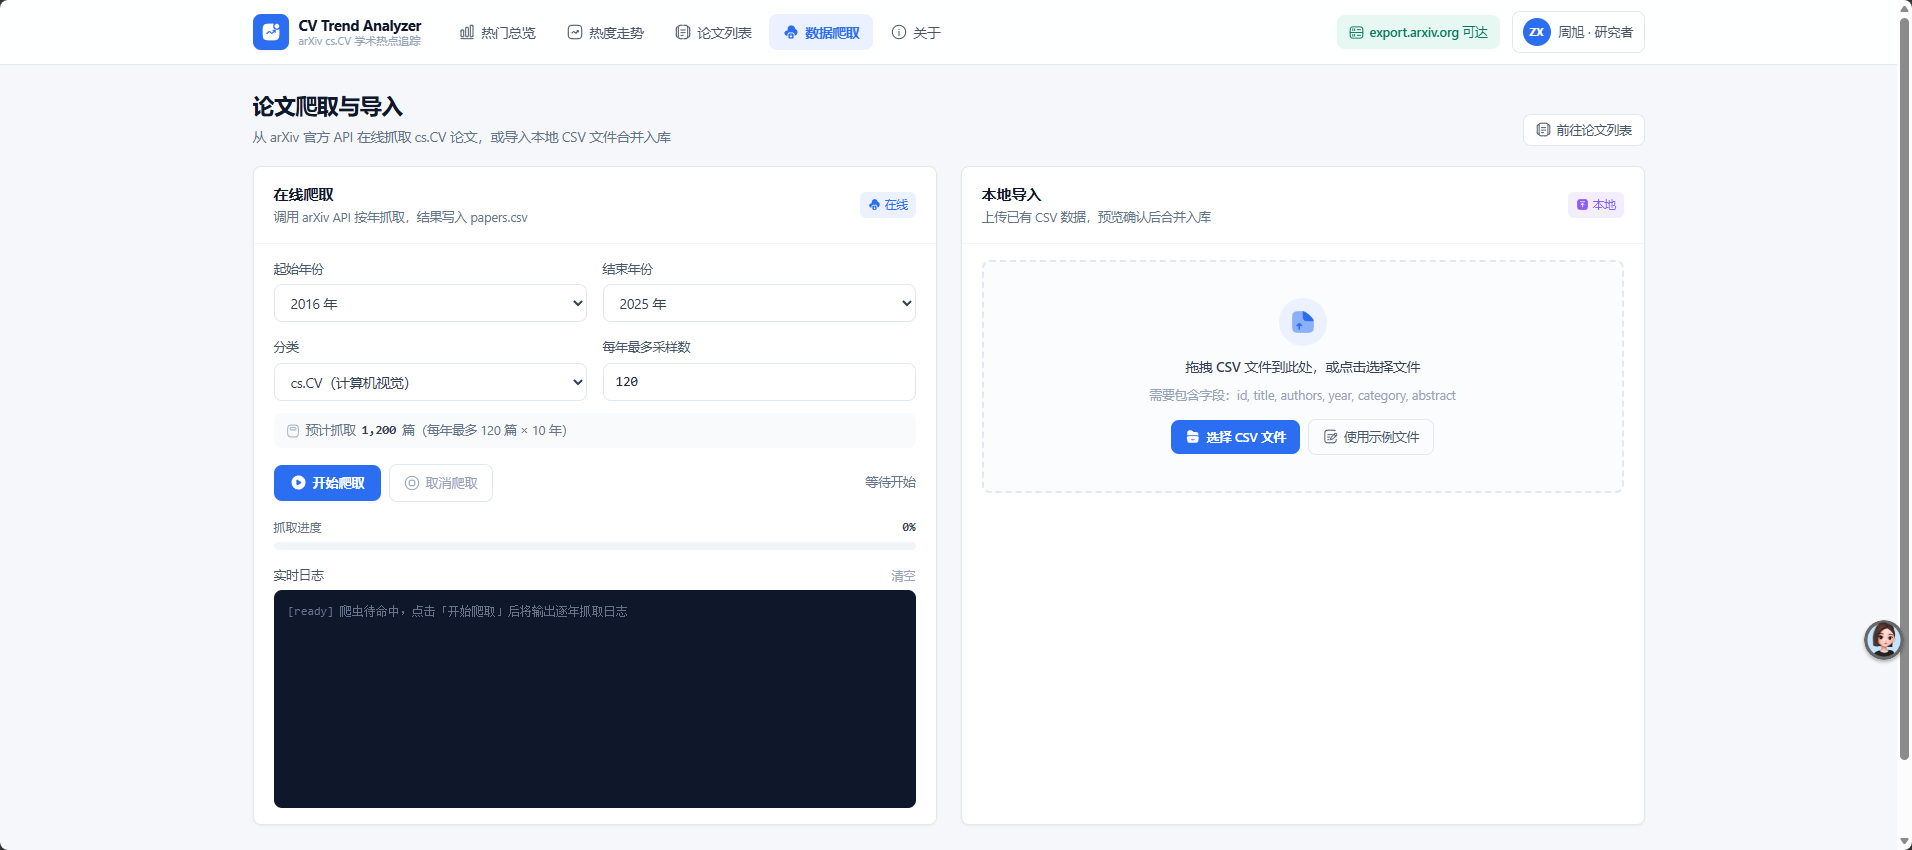
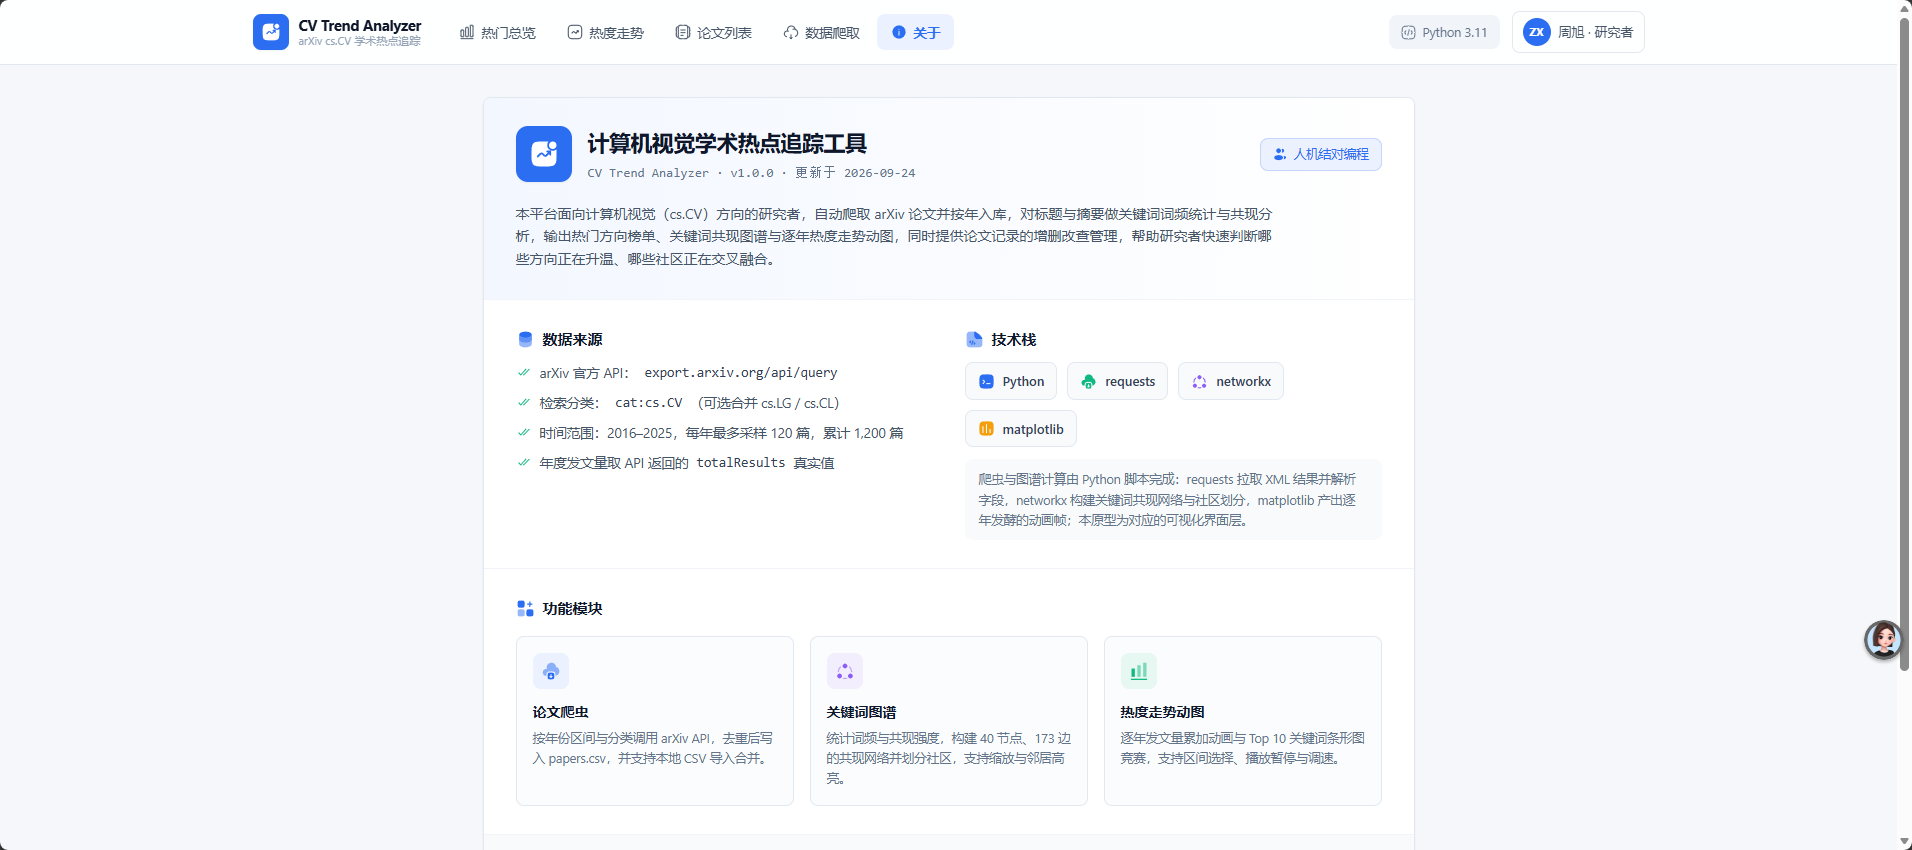
选用墨刀(MockingBot)这一专用原型设计工具,为平台设计了 5 个页面。
制作过程:
- 先撰写《原型设计提示文稿》(仓库内
prototype_prompt.md),明确全局设计规范——深科技蓝主色#2C6EF2、卡片白底圆角、顶部 5 菜单导航栏; - 据此在墨刀中逐页搭建:拖拽组件搭骨架 → 统一配色与导航 → 填入数据占位(Top 10 榜单、网络图、动图占位样式)→ 设置交互(弹窗、页面跳转、悬停、播放)
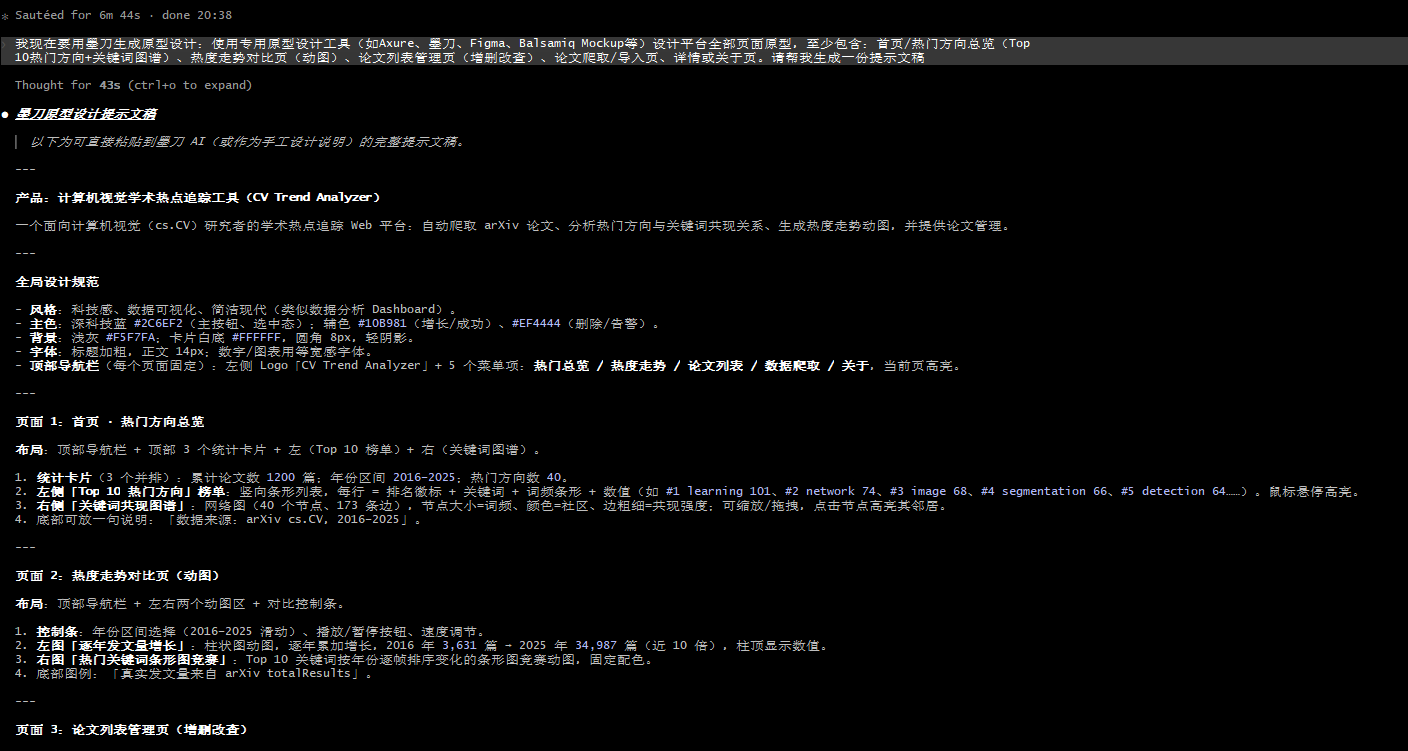
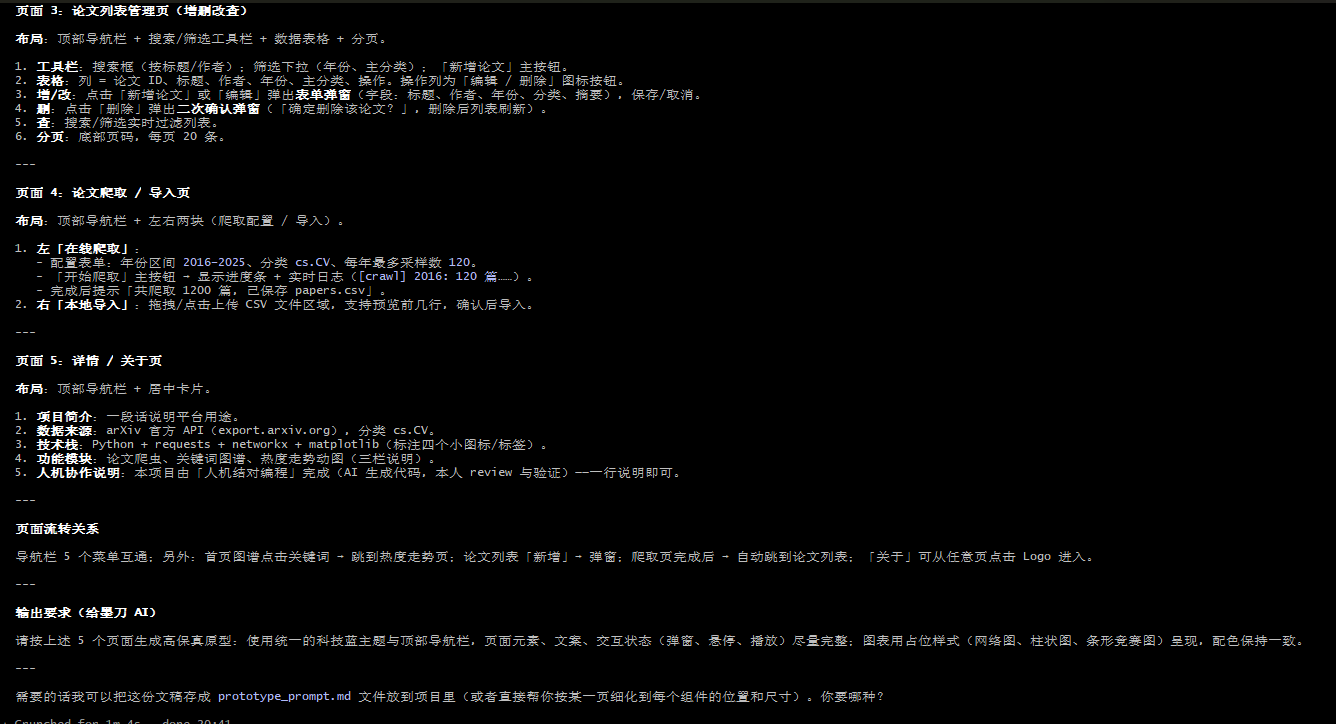
5 个页面一览:
| 页面 | 主要内容 |
|---|---|
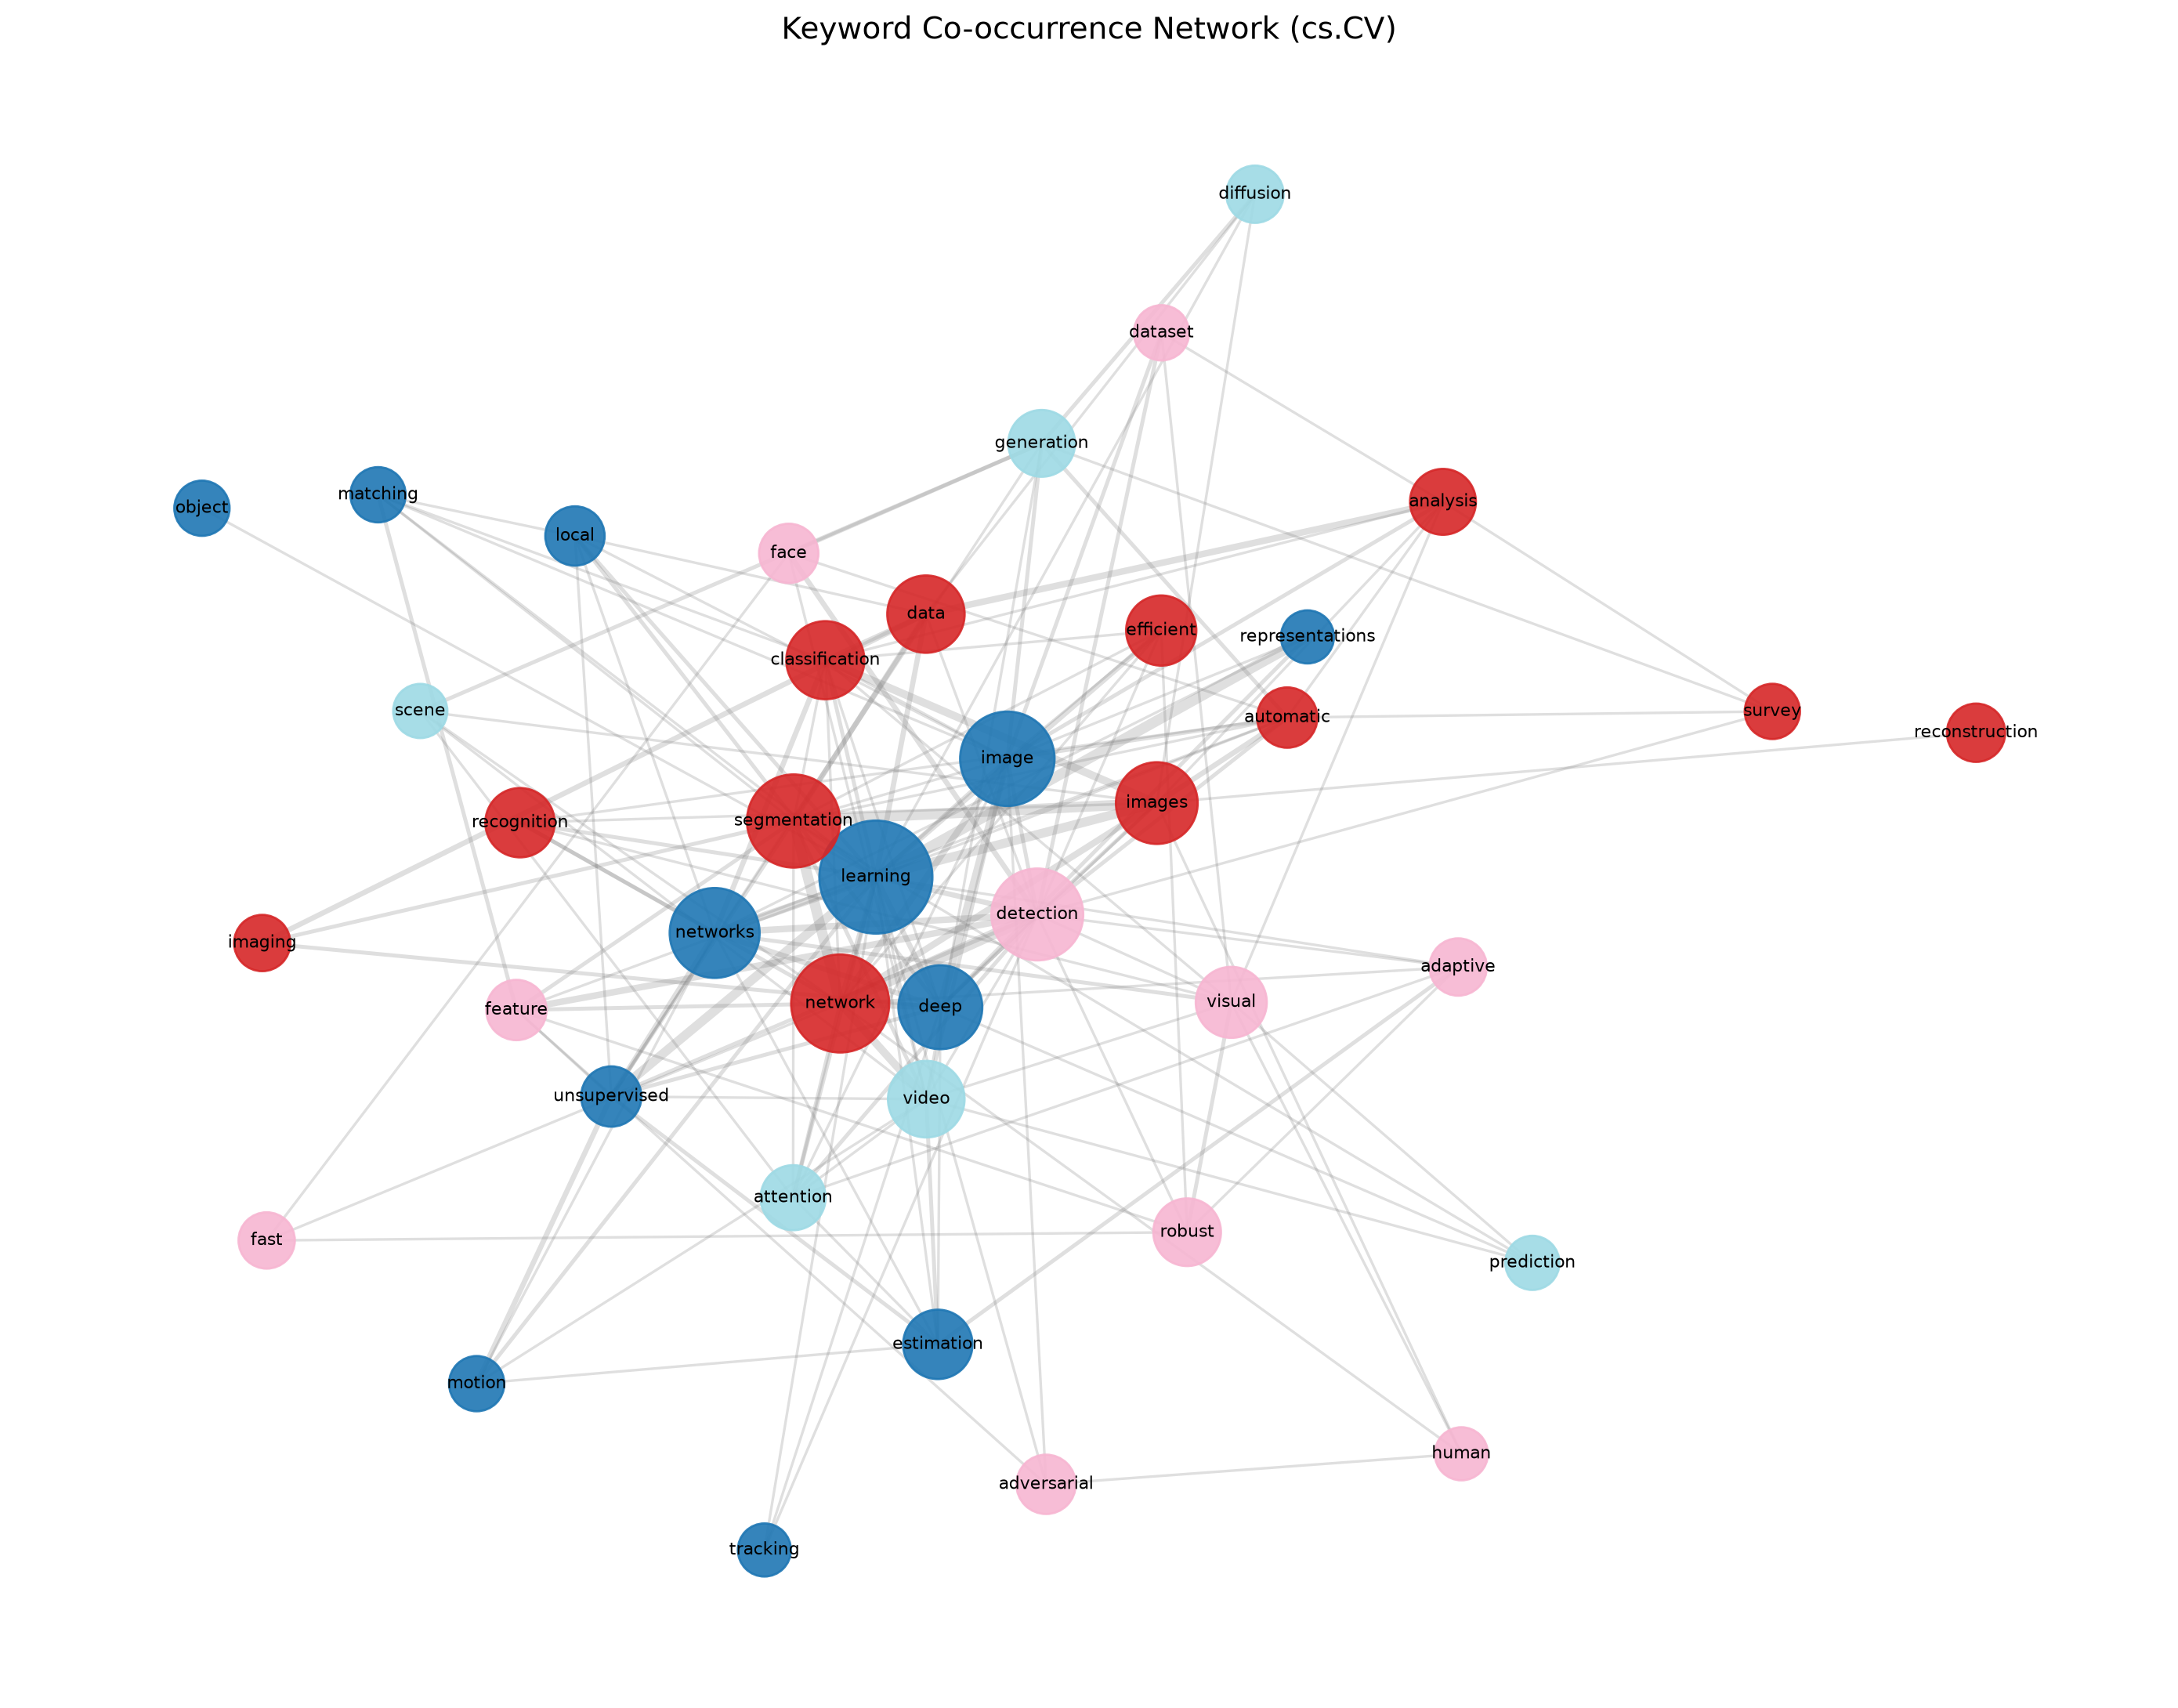
| 首页 · 热门方向总览 | 3 个统计卡片(累计论文 1200 篇 / 年份 2016–2025 / 热门方向 40 个);左侧 Top 10 热门方向榜单;右侧关键词共现图谱(40 节点、173 条边,节点大小=词频、颜色=社区) |
| 热度走势对比页 | 左「逐年发文量增长」柱状动图(3631 → 34987);右「热门关键词条形图竞赛」;控制条(年份区间、播放/暂停、速度) |
| 论文列表管理页 | 搜索/筛选工具栏 + 数据表格(ID/标题/作者/年份/分类/操作),支持新增、编辑(弹窗表单)、删除(二次确认)、查询、分页 |
| 论文爬取/导入页 | 左「在线爬取」配置(年份区间、分类、采样数)+ 进度条 + 实时日志;右「本地导入」上传 CSV |
| 详情/关于页 | 项目简介、数据来源(arXiv API)、技术栈、功能模块、人机协作说明 |
页面流转:导航栏 5 菜单互通;首页图谱点击关键词 → 跳转热度走势页;爬取完成 → 自动跳转论文列表。
**原型截图:
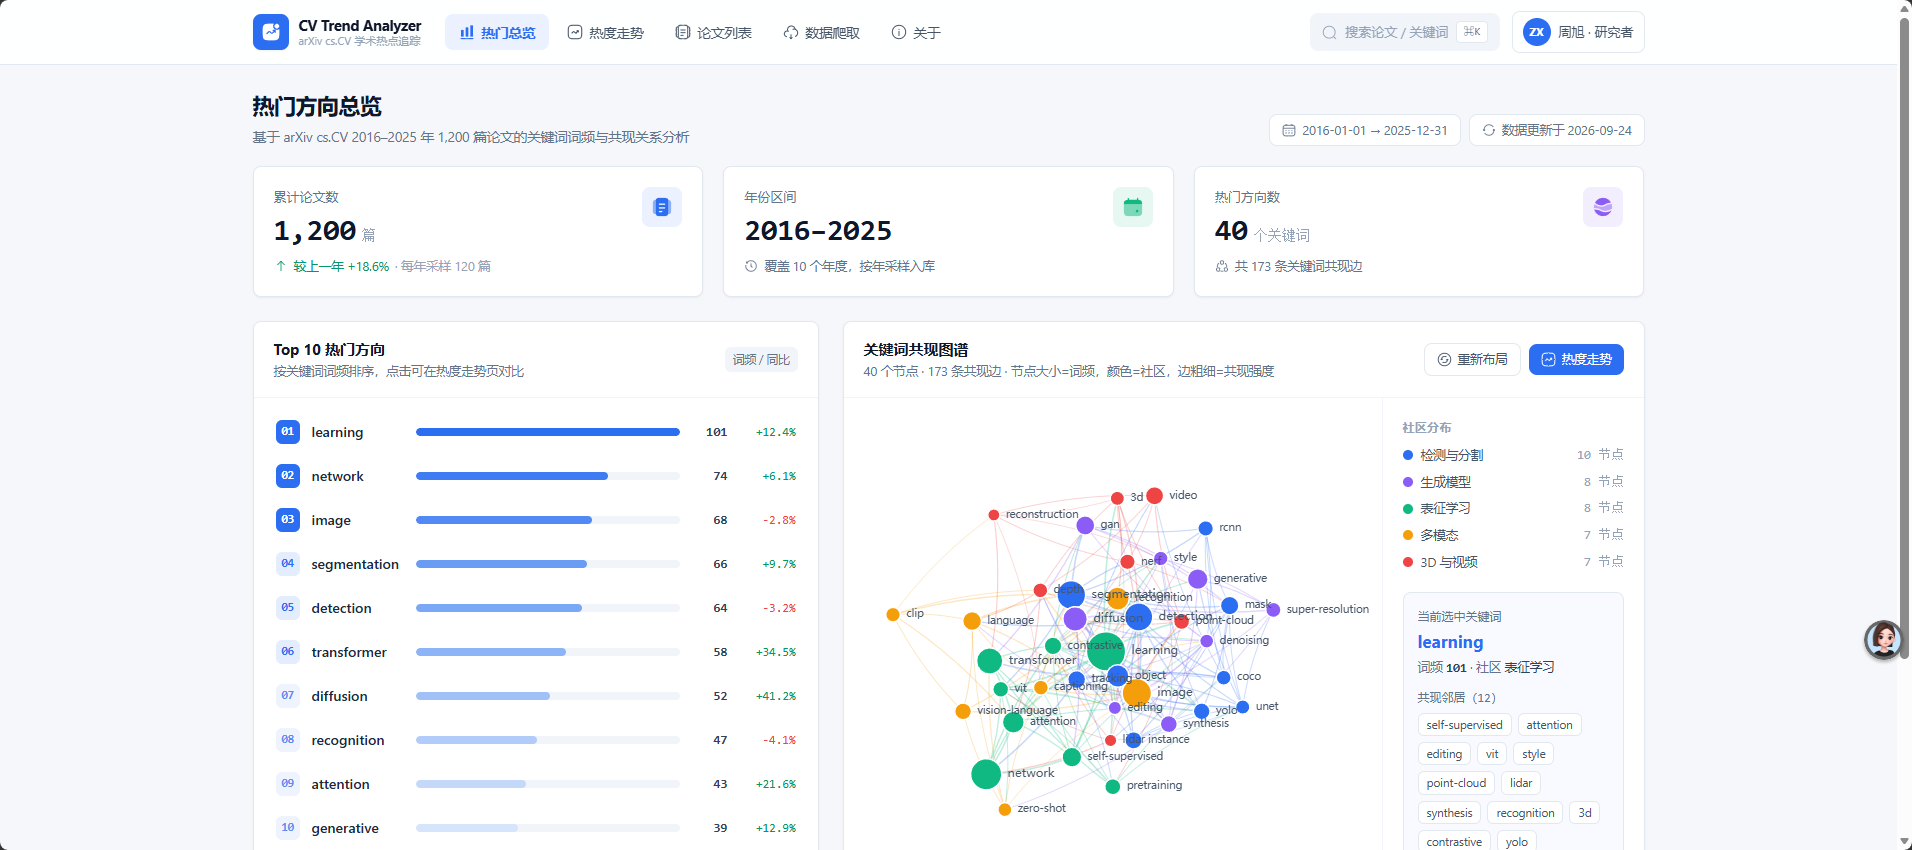
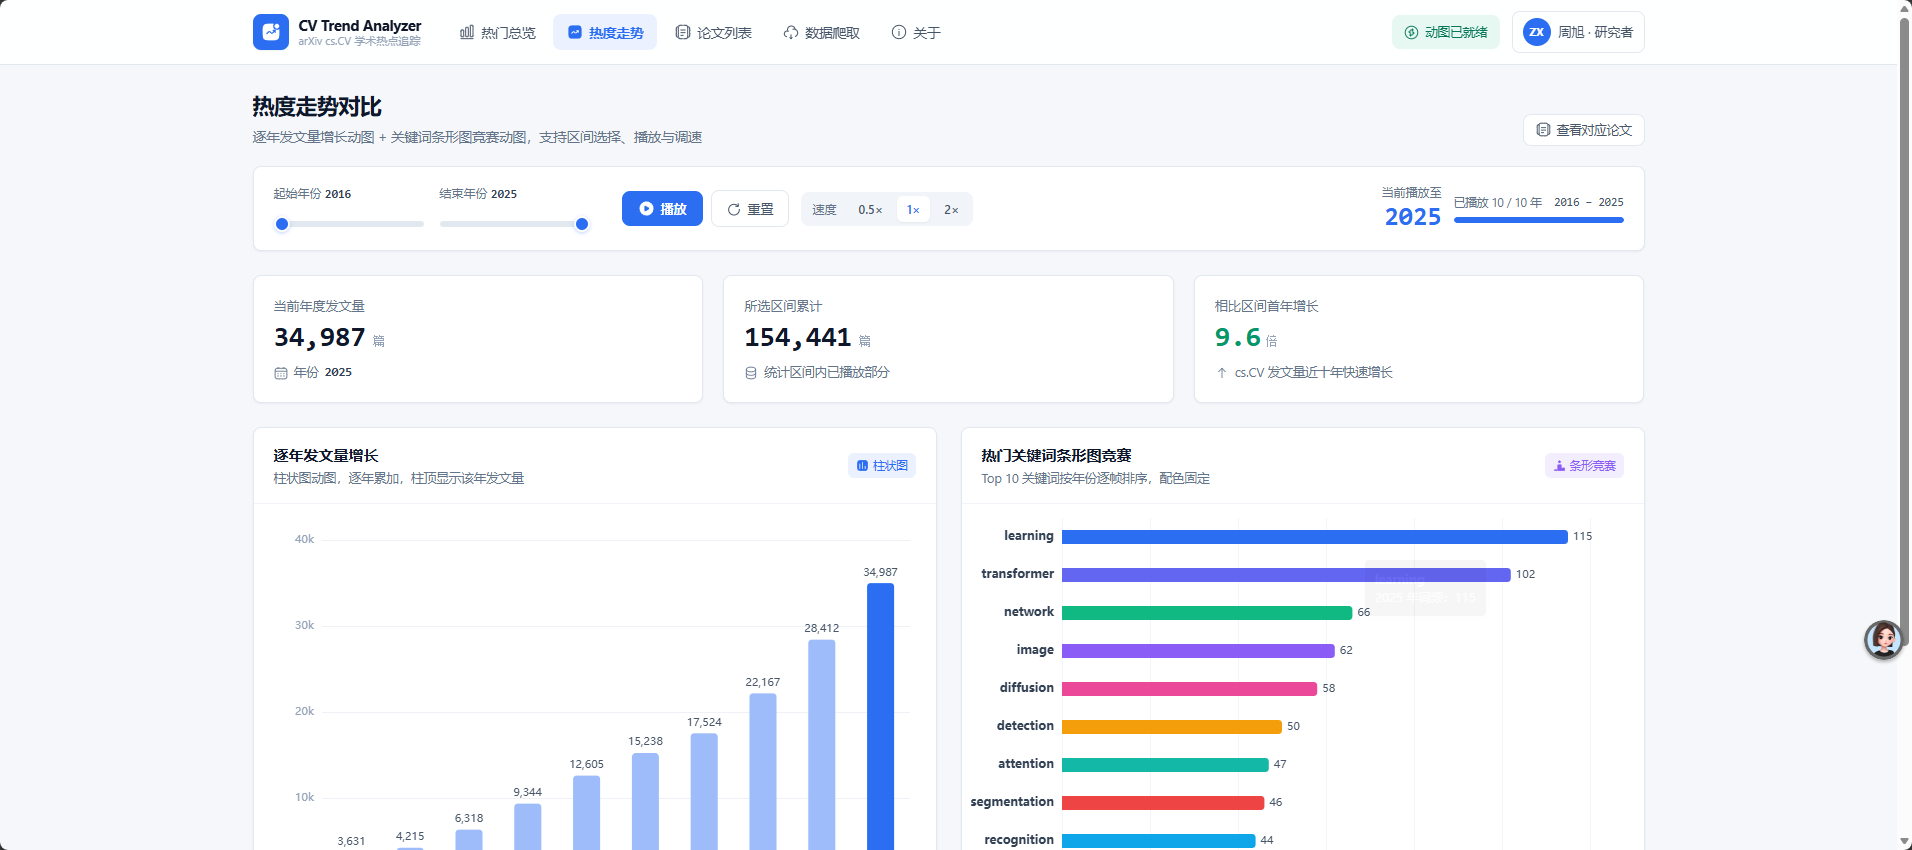
- 原型设计提示文稿:仓库内
prototype_prompt.md;另附可交互 HTML 原型prototype/index.html(浏览器直接打开预览)。
四、人机协作记录(迭代过程)
说明:以下是我与 AI 结对伙伴(Claude Code)在本次作业中的真实协作记录。关键提示词以代码块给出,AI 输出用摘要描述,并说明我采纳/拒绝的理由与修改。
迭代 1:需求澄清与选题
我的提示词(核心):
帮我做一个「论文爬虫 + 关键词图谱 + 热度走势动图」的项目……
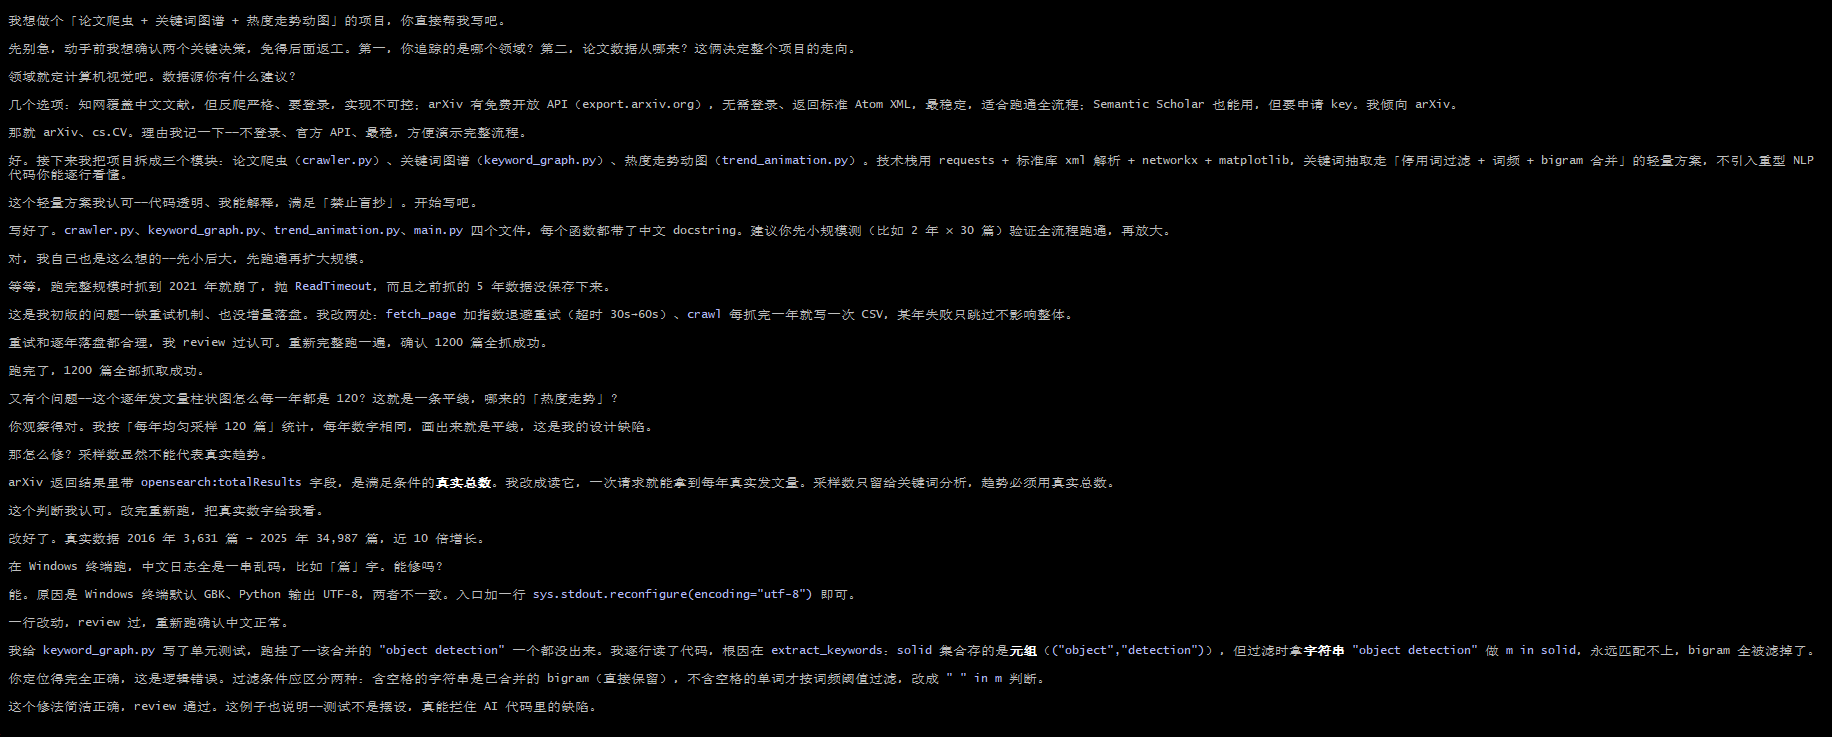
AI 输出摘要:AI 没有立刻动手写代码,而是先确认了两个关键决策——追踪的主题领域、论文数据源,并给出了每个选项的可行性(如知网反爬严格、arXiv 有免费开放 API)。
我的修改与理由:
- 采纳:AI 提议先澄清需求再动手,避免了方向性返工;
- 选择:主题定为「计算机视觉」,数据源定为「arXiv API」——因为 arXiv 无需登录、官方提供 API、最稳定,适合演示完整流程。拒绝了「知网」选项(反爬严格、需要登录,实现不可控)。
迭代 2:技术方案设计
AI 输出摘要:给出三模块划分(爬虫 / 关键词图谱 / 热度动图)与技术栈(requests + 标准库 xml 解析 + networkx + matplotlib),并强调关键词抽取用「停用词过滤 + 词频 + bigram 合并」的轻量方案而非重型 NLP 库。
我的修改与理由:
- 采纳:三模块划分清晰,正好对应作业要求的三个功能;
- 采纳:轻量关键词抽取方案——代码透明、我能逐行看懂并解释,满足「禁止盲抄」的要求。
迭代 3:环境搭建
AI 输出摘要:检测到 Python 3.14.4,缺少依赖库,用 pip 安装了 requests、networkx、matplotlib、pandas、pillow。
我的修改与理由:直接采纳,无修改。
迭代 4:编码实现三个模块
AI 输出摘要:一次性生成了 crawler.py、keyword_graph.py、trend_animation.py、main.py,并对每个函数写了中文 docstring 说明设计思路。
我的修改与理由:先做小规模测试(2 年 × 30 篇)验证全流程能跑通,再决定是否扩大规模——这是我自己加的「先小后大」的验证策略。
迭代 5:发现 Bug —— 爬虫遇到网络超时崩溃(对应案例 C)
现象:完整运行时,抓到 2021 年时抛出 ReadTimeout,程序直接崩溃,且之前抓取的 5 年数据没有落盘。
AI 输出摘要:AI 定位为「缺重试机制 + 未增量落盘」,并修改了 fetch_page(加指数退避重试、超时 30s→60s)和 crawl(每抓完一年就写一次 CSV、某年失败只跳过不影响整体)。
我的修改与理由:
- 采纳:重试机制和逐年落盘都是合理且必要的容错设计,我 review 了代码逻辑后认可;
- 补充验证:我要求 AI 重新完整跑一遍,确认 1200 篇全部抓取成功。
迭代 6:发现设计缺陷 —— 逐年趋势图是「平线」(对应案例 C)
现象:重新出图后我发现,「逐年发文量」柱状图每个年份都是 120(因为每年均匀采样 120 篇),根本体现不出热度增长趋势,违背了「热度走势」的本意。
AI 输出摘要:AI 承认这是设计缺陷,提出用 arXiv 返回的 totalResults 字段直接读取每年「真实发文总数」(一次请求即可),而不是用采样数。
我的修改与理由:
- 采纳:这是关键改进。我认可「采样数只能用于关键词分析,趋势必须用真实总数」的判断;
- 结果:真实数据呈现 2016 年 3,631 篇 → 2025 年 34,987 篇,近 10 倍增长,趋势一目了然。
迭代 7:发现 Bug —— 终端中文乱码(对应案例 C)
现象:在 Windows 终端运行 python main.py 时,打印的中文日志(如 [crawl] 2016: 120 篇 中的「篇」字)显示成一串乱码,影响可读性。
AI 输出摘要:AI 定位为 Windows 终端默认编码(GBK)与 Python 输出 UTF-8 不一致,在入口处加 sys.stdout.reconfigure(encoding="utf-8") 修复。
我的修改与理由:
- 采纳:一行改动即可解决,我 review 后认可;
- 补充验证:重新运行确认中文日志正常显示。
迭代 8:单元测试发现关键词合并缺陷(对应案例 C 的第四处 Bug)
现象:我为 keyword_graph.py 补充了单元测试,运行后测试失败——本该被合并成 "object detection" 的 bigram 关键词,在结果里一个都没有。
我的定位:我逐行读代码找到根因——extract_keywords 里 solid 集合存的是元组(如 ("object", "detection")),但合并后的关键词是字符串("object detection"),最后的过滤条件 m in solid 拿字符串去和元组集合匹配,永远匹配不上,于是所有合并出的 bigram 都被过滤掉了。
AI 输出摘要:我向 AI 指出这个问题后,AI 确认是逻辑错误,并把过滤条件改成「含空格的字符串就是已合并的 bigram(" " in m)」,不含空格的单词才按词频阈值过滤。
我的修改与理由:
- 采纳:修复逻辑正确、简洁,我 review 后认可;
- 价值:这是「用单元测试主动发现并纠正 AI 代码错误」的典型例子——测试不是摆设,它真的能拦住 AI 代码里的缺陷。
这里是与ai进行细节讨论的截图
五、三个代表性协作案例
案例 A:AI 辅助需求分析与原型设计
- 头脑风暴:我只有模糊想法(「做个论文爬虫和图」),AI 通过提问帮我把需求收敛成「计算机视觉学术热点追踪」这一明确主题;
- 信息架构:AI 把系统拆成「数据获取 / 图谱分析 / 趋势可视化」三层,并画出 mermaid 数据流图;
- 文案优化:AI 把输出从干巴巴的「bar chart」优化成「关键词条形图竞赛(bar chart race)」,让功能描述更直观。
案例 B:AI 辅助编码实现功能模块
- 论文爬虫(
crawler.py):用 requests 调 arXiv API,标准库解析 Atom XML,按年份抓取; - 关键词图谱(
keyword_graph.py):停用词过滤 + 词频统计 + bigram 合并抽取关键词,构建共现网络,networkx + matplotlib 出图; - 热度走势动图(
trend_animation.py):matplotlib.animation 逐帧更新,pillow 保存 GIF。
案例 C:AI 辅助调试与修复 Bug(含「发现 AI 代码错误并纠正」)
这是本次作业最想强调的案例,包含四次「发现 AI 代码问题并纠正」:
- 网络超时崩溃:AI 初版爬虫没有重试机制,遇到瞬时
ReadTimeout直接崩溃,且不落盘导致数据丢失。我复现问题后,AI 补上重试 + 增量落盘。 - 趋势图平线缺陷:AI 初版用「采样数」画逐年柱状图,导致所有年份都是 120、趋势是平的。这是我主动发现的设计缺陷,AI 据此改用
totalResults真实发文量修复。 - 终端中文乱码:Windows 终端默认编码与 Python 的 UTF-8 输出不一致,导致中文日志显示乱码。AI 在入口处加
sys.stdout.reconfigure(encoding="utf-8")修复。 - 关键词 bigram 合并被误过滤:我为
keyword_graph.py写单元测试时,测试失败暴露出一个隐蔽缺陷——solid集合存的是元组、过滤时却拿字符串做m in solid匹配,导致所有合并出的 bigram(如"object detection")都被丢弃。这是通过单元测试主动发现并纠正的 AI 代码错误。
关键收获:AI 生成的代码不是「一次到位」的,需要人工 review、实际运行、质疑结果(甚至写测试去验证),才能发现并纠正其中的缺陷——这正是结对编程中「人」不可替代的价值。
六、可解释性声明
按照作业要求,如实声明代码来源与我的理解程度。
| 文件 / 代码 | 来源 | 我是否理解其设计思路 |
|---|---|---|
crawler.py 整体框架、解析逻辑 | AI 生成 | 是(能解释 arXiv API 参数、Atom XML 解析、重试机制) |
crawler.py 的容错改进(重试/落盘) | AI 提出,我 review 后采纳 | 是 |
keyword_graph.py 关键词抽取与建图 | AI 生成 | 是(能解释停用词/bigram/共现的定义) |
trend_animation.py 动图逻辑 | AI 生成 | 是(能解释 FuncAnimation 逐帧更新的原理) |
main.py 参数与流程编排 | AI 生成 | 是 |
| 需求澄清、选题、数据源决策 | 我主导 | — |
| 发现趋势平线缺陷、bigram 合并缺陷 | 我主动发现(后者通过单元测试) | — |
七、成品展示
运行 python main.py 后得到以下成品:
| 成品 | 说明 |
|---|---|
papers.csv | 1200 篇 cs.CV 论文元数据(2016–2025,每年 120 篇采样) |
yearly_counts.csv | 每年真实发文总数(3631 → 34987,近 10 倍增长) |
keyword_graph.png | 关键词共现网络图(40 个关键词、173 条边,按社区着色) |
papers_per_year.gif | 逐年发文量增长柱状动图(10 帧) |
keyword_race.gif | 历年热门关键词条形图竞赛(10 帧) |
① 关键词共现网络图
② 逐年发文量增长动图
③ 热门关键词条形图竞赛动图
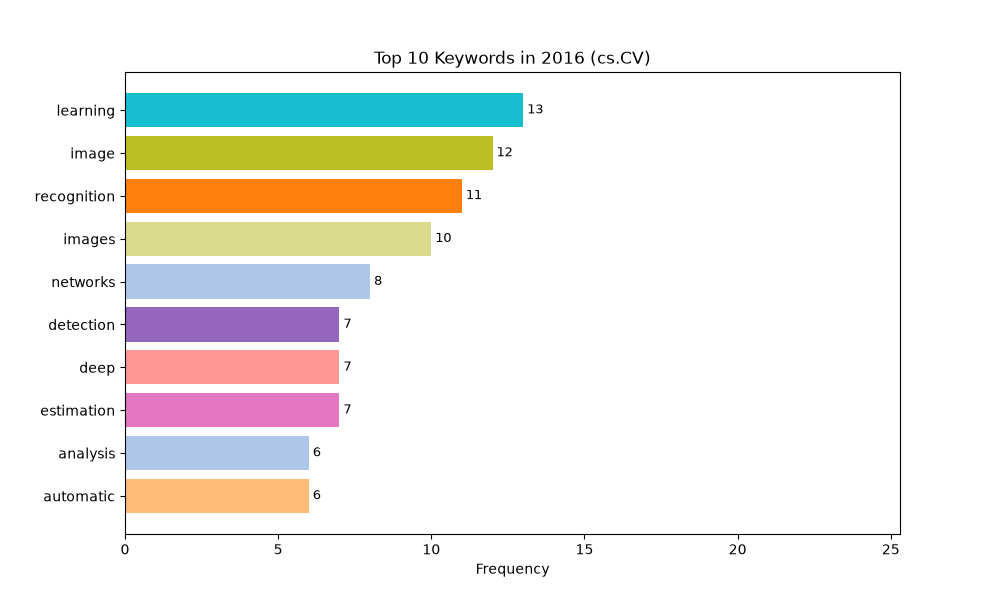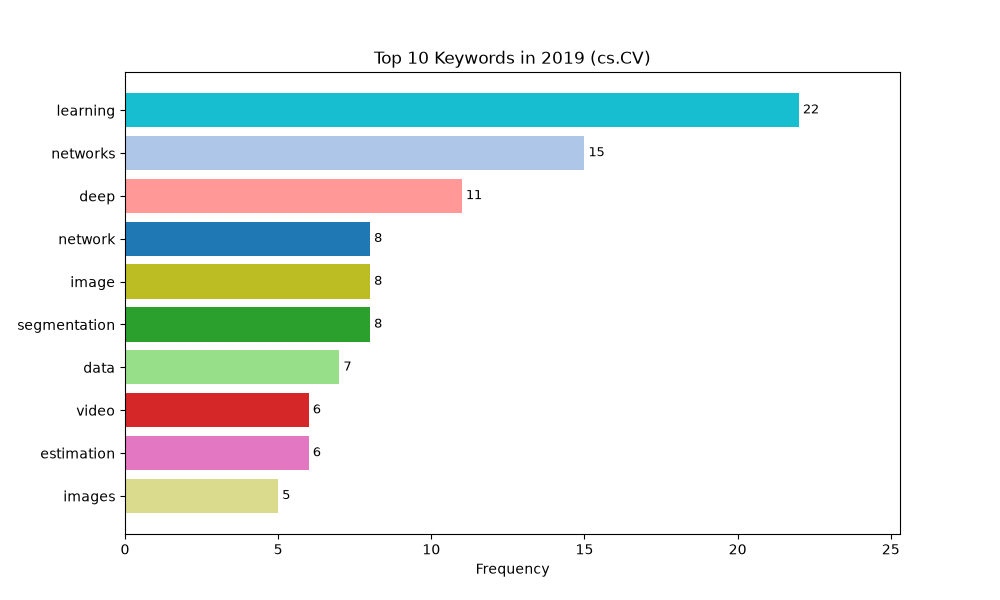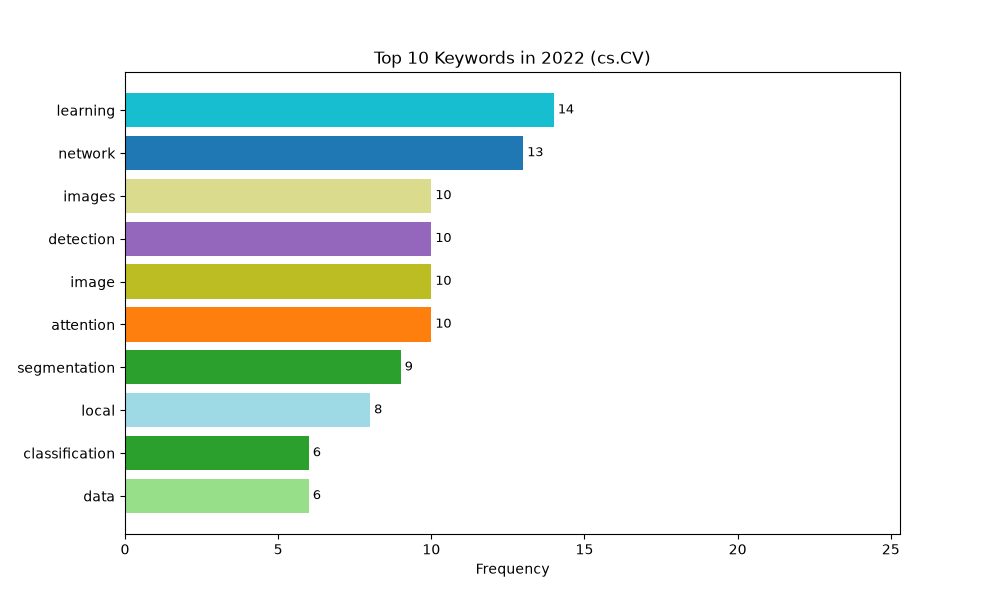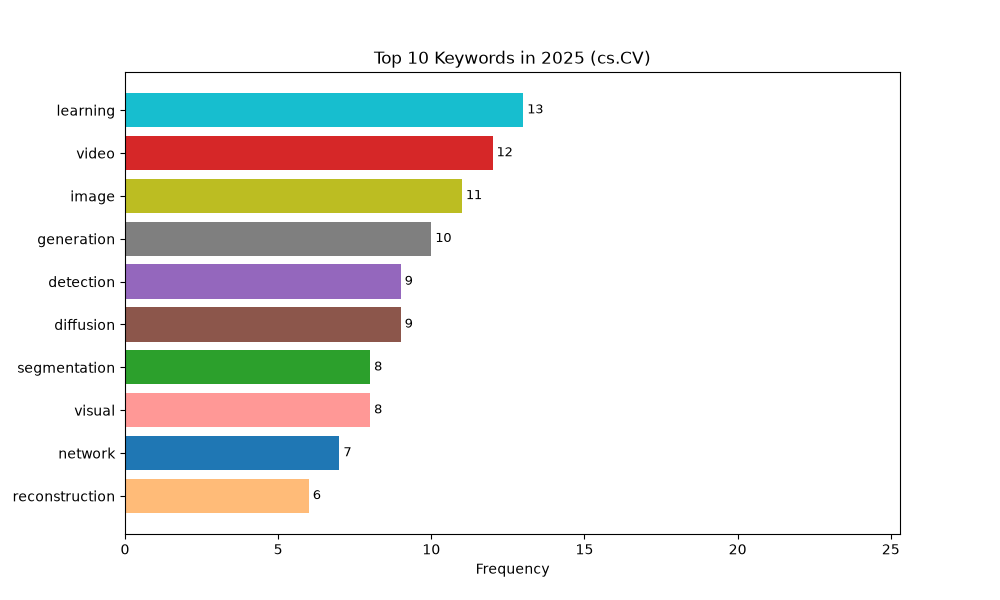
八、结对(人机)讨论过程描述
讨论主要围绕三个问题展开,方式是我提问 / 质疑、AI 解释 / 修改:
- 「先做什么?」 —— AI 坚持先澄清主题和数据源再做,避免返工;
- 「为什么崩了?」 —— 针对 ReadTimeout,AI 解释是瞬时网络错误 + 缺重试,我认可后采纳其修复方案;
- 「这图对吗?」 —— 我发现趋势图是平线,质疑 AI 的采样方案,AI 承认缺陷并改用真实发文量。
整个讨论是「我提出需求与质疑 → AI 提出方案 → 我 review 并反馈 → AI 修改」的循环。
九、设计实现过程
- 数据层:
crawler.py按年份构造submittedDate区间查询,翻页抓取,解析 Atom XML 得到标题/摘要/年份等字段;crawl_counts读totalResults得到真实发文量。 - 分析层:
keyword_graph.py用extract_keywords抽取关键词(含 bigram 合并),build_cooccurrence统计两两共现,build_graph建网络。 - 展示层:
trend_animation.py用FuncAnimation逐帧生成两张动图;main.py串联全流程并提供命令行参数。 - 容错:重试机制、逐年落盘、
--no-crawl复用已有数据,保证流程可断点续跑。
十、代码说明(分模块阐述)
项目按「数据获取 → 图谱分析 → 趋势可视化」三层拆成 4 个模块 + 1 组单元测试。下面分模块说明职责与关键设计点,并选录最能体现核心逻辑的关键代码(完整代码见仓库,均有中文注释)。
9.1 模块 1:论文爬虫 crawler.py
职责:通过 arXiv 官方 API 抓取 cs.CV 论文元数据(标题/摘要/年份/作者/分类)存为 CSV,并抓取每年真实发文总数。
关键设计点:
- 礼貌抓取:每次请求间隔 3s(
REQUEST_DELAY),遵守 arXiv 限速要求; - 容错重试:
fetch_page失败后按 5s、10s 退避重试,最多 3 次(对应迭代 5 的ReadTimeout崩溃); - 增量落盘:
crawl每抓完一年就写一次 CSV,某年失败只跳过不拖垮整体,中途崩溃也不丢已抓数据; - 真实发文量:
fetch_year_count只读opensearch:totalResults(一次请求),得到每年真实总数(对应迭代 6 的「趋势平线」缺陷)。
关键代码(重试退避):
def fetch_page(search_query, start=0, max_results=100,
               sort_by="submittedDate", sort_order="ascending",
               retries=3, timeout=60):
    """抓取一页结果,遇到瞬时网络错误会自动重试(退避 5s、10s)。"""
    params = {"search_query": search_query, "start": start,
              "max_results": max_results, "sortBy": sort_by,
              "sortOrder": sort_order}
    for attempt in range(retries):
        try:
            resp = requests.get(BASE_URL, params=params, timeout=timeout)
            resp.raise_for_status()
            root = ET.fromstring(resp.text)
            return [parse_entry(e) for e in root.findall("a:entry", ATOM_NS)]
        except (requests.exceptions.RequestException, ET.ParseError) as exc:
            if attempt == retries - 1:
                raise
            wait = 5 * (attempt + 1)          # 指数退避
            print(f"[crawl] 请求失败({exc.__class__.__name__}),{wait}s 后重试...")
            time.sleep(wait)
    return []
关键代码(真实发文量):
def fetch_year_count(year, category="cs.CV", retries=3, timeout=60):
    """查询某一年论文的真实总数(读 opensearch:totalResults,一次请求即可)。"""
    query = f"cat:{category} AND submittedDate:[{year}01010000 TO {year}12312359]"
    params = {"search_query": query, "start": 0, "max_results": 1}
    for attempt in range(retries):
        try:
            resp = requests.get(BASE_URL, params=params, timeout=timeout)
            resp.raise_for_status()
            root = ET.fromstring(resp.text)
            node = root.find("o:totalResults",
                             {"a": ATOM_NS["a"], "o": OPENSEARCH_NS["o"]})
            return int(node.text) if node is not None else 0
        except (requests.exceptions.RequestException, ET.ParseError) as exc:
            if attempt == retries - 1:
                raise
            time.sleep(5 * (attempt + 1))
    return 0
9.2 模块 2:关键词图谱 keyword_graph.py
职责:从论文标题抽取关键词,统计两两共现,构建 networkx 网络图并保存 PNG。
关键设计点:
- 轻量关键词抽取:停用词过滤 + 词频统计 + bigram 合并,不依赖重型 NLP 库,逻辑透明可解释;
- bigram 合并:相邻且词频够高的两个词合并成词组(如 "object" + "detection" → "object detection");
- 过滤逻辑(迭代 8 修复点):合并后只保留「已合并的 bigram(含空格)」或「高频单词」,修掉了原来拿字符串去匹配元组集合、导致 bigram 全被误过滤的 bug;
- 共现建边:两个关键词出现在同一篇标题里 = 一条边,权重 = 共现次数;
- 可视化:节点大小 = 词频、颜色 = 社区(贪心模块度)、边粗细 = 共现强度。
关键代码:
def extract_keywords(titles, stopwords=STOPWORDS, min_freq=3):
    """从标题列表中抽取关键词,返回关键词列表、单词词频、二元组词频。"""
    tokenized = [
        [w for w in tokenize(t) if w not in stopwords and len(w) > 2]
        for t in titles
    ]
    word_freq = Counter(w for toks in tokenized for w in toks)
    bigram_freq = Counter()
    for toks in tokenized:
        for a, b in zip(toks, toks[1:]):
            bigram_freq[(a, b)] += 1

    # 词频达到阈值的二元组,才认为是稳定搭配,可合并成关键词
    solid = {bg for bg, c in bigram_freq.items() if c >= min_freq}

    keywords_per_title = []
    for toks in tokenized:
        merged = []
        i = 0
        while i < len(toks):
            if i + 1 < len(toks) and (toks[i], toks[i + 1]) in solid:
                merged.append(toks[i] + " " + toks[i + 1])
                i += 2
            else:
                merged.append(toks[i])
                i += 1
        # 只保留「高频单词」或「已合并的 bigram」:
        # 含空格的字符串是已合并的 bigram;不含空格的单词按词频阈值过滤。
        merged = [m for m in merged
                  if (" " in m) or word_freq.get(m, 0) >= min_freq]
        keywords_per_title.append(merged)
    return keywords_per_title, word_freq, bigram_freq
9.3 模块 3:热度走势动图 trend_animation.py
职责:用 matplotlib.animation 生成两个 GIF——逐年发文量增长图、热门关键词条形图竞赛。
关键设计点:
- 逐帧动画:
FuncAnimation+update(i)逐帧画第 i 年,pillow 保存 GIF; - 柱状图:用
yearly_counts.csv的真实发文总数,逐年累加呈现近 10 倍增长; - 条形图竞赛:全局关键词池统一配色、固定横轴范围,避免逐帧跳动。
关键代码:
def animate_keyword_race(df, out_gif="keyword_race.gif", top_k=10,
                         fps=2, min_freq=2):
    """动画 2:历年热门关键词的条形图竞赛。"""
    years = sorted(df["year"].unique())
    per_year = {}
    for y in years:
        titles = df[df["year"] == y]["title"].dropna().tolist()
        kw_per_title, _, _ = extract_keywords(titles, min_freq=min_freq)
        per_year[y] = Counter(k for kw in kw_per_title for k in kw)

    pool = set()
    for y in years:
        pool.update(k for k, _ in per_year[y].most_common(top_k))
    cmap = plt.cm.tab20
    colors = {k: cmap(i % 20) for i, k in enumerate(sorted(pool))}  # 统一配色
    global_max = max(max(per_year[y].values(), default=0) for y in years) or 1

    fig, ax = plt.subplots(figsize=(10, 6))

    def update(i):
        ax.clear()
        y = years[i]
        top = per_year[y].most_common(top_k)[::-1]   # 倒序,最大的在最上面
        labels = [t[0] for t in top]
        vals = [t[1] for t in top]
        ax.barh(labels, vals, color=[colors[l] for l in labels])
        for idx, v in enumerate(vals):
            ax.text(v, idx, f" {v}", va="center", fontsize=9)
        ax.set_xlim(0, global_max * 1.15)           # 固定横轴,避免跳动
        ax.set_xlabel("Frequency")
        ax.set_title(f"Top {top_k} Keywords in {y} (cs.CV)")

    anim = animation.FuncAnimation(fig, update, frames=len(years),
                                   interval=800, repeat=True)
    anim.save(out_gif, writer="pillow", fps=fps)
    plt.close()
9.4 模块 4:入口与配置 main.py / config.py
职责:命令行入口串联三个模块;config.py 集中管理抓取范围、采样数、阈值等参数。
关键设计点:
- 终端编码修复:
fix_console_encoding用sys.stdout.reconfigure(encoding="utf-8")解决 Windows GBK 终端中文乱码(对应迭代 7); - 参数化:
--years、--max-per-year、--no-crawl支持不同规模和断点续跑; - 流程编排:爬虫 → 发文量 → 图谱 → 动图,依次调用。
关键代码:
def fix_console_encoding():
    """让中文输出在各类终端(含 GBK 的 Windows 终端)都正常显示。"""
    for stream in (sys.stdout, sys.stderr):
        try:
            stream.reconfigure(encoding="utf-8")
        except Exception:
            pass


def main():
    fix_console_encoding()
    parser = argparse.ArgumentParser(description="CV 学术热点追踪工具")
    parser.add_argument("--years", default=config.DEFAULT_YEARS)
    parser.add_argument("--max-per-year", type=int, default=config.MAX_PER_YEAR)
    parser.add_argument("--no-crawl", action="store_true")
    args = parser.parse_args()

    if args.no_crawl:
        print("[main] 使用已有 CSV,跳过爬虫")
    else:
        start, end = map(int, args.years.split("-"))
        years = range(start, end + 1)
        crawler.crawl(years, max_per_year=args.max_per_year,
                      category=config.CATEGORY, out_csv=args.csv)
        crawler.crawl_counts(years, category=config.CATEGORY,
                             out_csv="yearly_counts.csv")

    keyword_graph.run(csv_path=args.csv, out_png="keyword_graph.png",
                      min_freq=config.MIN_FREQ, top_n=config.TOP_N)
    trend_animation.run(csv_path=args.csv, counts_csv="yearly_counts.csv")
config.py 全文:
CATEGORY = "cs.CV"            # arXiv 分类
DEFAULT_YEARS = "2016-2025"   # 默认抓取年份区间
MAX_PER_YEAR = 120            # 每年最多采样论文数
MIN_FREQ = 3                  # 关键词最低词频
TOP_N = 40                    # 图谱保留的高频关键词数
9.5 模块 5:单元测试 tests/
职责:对不依赖网络的纯函数做单元测试,验证解析与关键词抽取的正确性。
关键设计点:
- bigram 合并测试:构造 3 条含 "Object Detection" 的标题,断言合并出 "object detection"、过滤掉低频词——正是这个测试暴露了迭代 8 的 bug;
- Atom 解析测试:构造最小
<entry>,断言版本号被去掉、空白被压平、作者/分类解析正确。
关键代码:
class TestExtractKeywords(unittest.TestCase):
    def test_bigram_merge(self):
        titles = [
            "Object Detection with Neural Networks",
            "Object Detection in Images",
            "Object Detection Survey",
        ]
        kw_per_title, _, _ = extract_keywords(titles, min_freq=2)
        all_kw = {k for kws in kw_per_title for k in kws}
        self.assertIn("object detection", all_kw)      # 相邻 3 次,应合并
        self.assertNotIn("neural", all_kw)              # 低频词应被过滤


class TestParseEntry(unittest.TestCase):
    def test_parse_title_year_and_version(self):
        xml = """<entry xmlns="http://www.w3.org/2005/Atom">
          <id>http://arxiv.org/abs/2101.12345v2</id>
          <title>  Deep Learning  for  Vision </title>
          <published>2021-01-15T18:59:59Z</published>
          <author><name>Alice</name></author>
          <category term="cs.CV"/>
        </entry>"""
        p = parse_entry(ET.fromstring(xml))
        self.assertEqual(p["arxiv_id"], "2101.12345")   # 版本号 v2 被去掉
        self.assertEqual(p["title"], "Deep Learning for Vision")
        self.assertEqual(p["year"], "2021")
        self.assertEqual(p["primary_category"], "cs.CV")
十一、心路历程、收获
说实话,一开始我对「人机结对编程」的理解很肤浅——以为就是把需求丢给 AI、它写完我交上去。真正做起来才发现完全不是这么回事。
第一次被触动,是趋势图出问题的时候。AI 给的代码能跑、也能出图,但「逐年发文量」的柱状图每个年份都一样高——因为每年均匀采样 120 篇,画出来是一条「平线」,根本体现不了「热度走势」。那一刻我才意识到:AI 会自信地给你一个「能跑」的答案,但「能跑」不等于「对」。如果不是我自己盯着结果、觉得「这不对吧」,这个缺陷就会一路带进作业。
从那以后我养成了两个习惯:一是 AI 生成的代码我一定逐段读一遍,能用大白话讲出每段在干嘛才放行——这也是「禁止盲抄」逼我做的;二是先跑小规模、再放大,还给核心逻辑写了单元测试,结果测试真帮我抓出了 bigram 合并被误过滤的 bug。
最大的收获不是这个工具本身,而是理解了结对编程里「人」的位置:AI 擅长快速产出、解释、甚至诚实地承认错误,但它不会替你判断「结果合不合理、方向对不对」。判断力,仍然只能由人来提供。 另外,通过逐段读代码,我也真的学会了 arXiv API 的查询方式、关键词共现网络怎么建、matplotlib 动画的原理——这些本来会是我最想跳过、却最有价值的部分。
十二、对 AI 结对伙伴的评价
- 优点:
- 响应快、产出稳定,代码带中文注释和 docstring,读起来省心;
- 会主动澄清需求(比如动手前先确认选题和数据源),而不是闷头乱写;
- 诚实——被我发现缺陷时大方承认、给出修复方案,不狡辩。
- 不足:
- 初版代码常漏掉「边缘情况」的容错(网络重试、终端编码这些第一遍往往想不到);
- 容易把「能跑」当成「正确」,比如拿采样数当真实趋势,需要人来质疑;
- 有时给结论太快、验证太少,显得「过度自信」。
- 总体:
一个高效、坦诚、但需要人来监督的结对伙伴。它把我从繁琐的编码里解放出来,让我把时间留给更重要的 review 和测试;但它的输出永远只是「草稿」,最终判断和把关必须由我来做。一句话:它是很好的副驾驶,但方向盘得握在自己手里。
附录
PSP 表格
时间单位:分钟。(以下为回顾性估计,非逐分钟精确记录)
| PSP2.1 | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | ||
| · Estimate 估计这个任务需要多少时间 | 60 | 40 | |
| Development | 开发 | ||
| · Analysis 需求分析(包括学习新技术) | 120 | 150 | |
| · Design Spec 生成设计文档 | 90 | 60 | |
| · Design Review 设计复审 | 60 | 45 | |
| · Coding Standard 代码规范 | 30 | 20 | |
| · Design 具体设计 | 120 | 100 | |
| · Coding 具体编码 | 360 | 420 | |
| · Code Review 代码复审 | 90 | 150 | |
| · Test 测试(自我测试,修改代码,提交修改) | 150 | 240 | |
| Reporting | 报告 | ||
| · Test Report 测试报告 | 60 | 40 | |
| · Size Measurement 计算工作量 | 30 | 20 | |
| · Postmortem & Process Improvement Plan 事后总结,并提出过程改进计划 | 60 | 90 | |
| 合计 | 1230 | 1375 |
从 PSP 表格能看出,我最初对时间的预估明显偏乐观,实际耗时超出预估约 2.4 小时,主要差在三处:
- 「编码」实际比预估多、但并没有失控:因为有 AI 结对伙伴生成代码,真正的「敲代码」时间其实不长;多出来的时间主要花在逐段读懂 AI 生成的代码上——这是「禁止盲抄」要求的硬成本。
- 「代码复审」和「测试」严重超出预估(复审 +60 分钟、测试 +90 分钟):这是我最没料到的地方。一开始我以为「AI 生成的代码 + 跑一遍」就够了,实际却接连发现 4 个缺陷(网络超时、趋势平线、终端乱码、bigram 合并),每个都要复现、定位、验证修复。这让我意识到:把时间留给「验证」比留给「产出」更值钱。
- 「需求分析」也超出预估(+30 分钟):学 arXiv API 的查询语法、理清「采样数 vs 真实发文量」的区别,花的时间比我预想的多,但这一步没省,后面才少走了弯路。
如果重来一次,我会在计划阶段就把「代码复审 + 测试」的预估调高一倍,并预留一整块时间专门做「怀疑 AI 输出」的验证——因为结对编程里,人的价值恰恰不在打字,而在挑错。
华为云代码仓库链接
墨刀原型设计网页链接
https://modao.cc/ai/share/6ab51dbc75d0275ef6fda70b
代码规范(在华为云代码仓库)
代码commit截图
相关推荐
弱电网下光伏并网逆变器序阻抗建模仿真复现扫频法【序阻抗判断稳定性】
内容概要:本文聚焦于弱电网条件下光伏并网逆变器的序阻抗建模与稳定性分析,系统阐述了基于扫频法的阻抗特性仿真与复现方法。通过构建正负序阻抗模型,深入剖析逆变器在弱电网环境中的动态响应特性,结合锁相环、电流环等关键控制环节对系统阻抗的影响机制,采用序阻抗稳定性判据评估多机并网或复杂电网条件下的系统稳定裕度。研究在Simulink平台中实现激励信号注入、频率响应采集与阻抗曲线绘制,为高比例新能源接入背景下并网系统的稳定性分析提供了可靠的仿真手段与理论支撑,尤其适用于SCI级别论文成果的复现与拓展验证。; 适合人群:电力电子、新能源并网技术及相关领域的硕士/博士研究生、科研人员,以及从事光伏逆变器、微电网稳定控制开发的工程技术人员。; 使用场景及目标:①掌握扫频法在电力电子装置阻抗建模中的具体实施流程;②理解并应用基于序阻抗的稳定性判据进行系统稳定边界分析;③用于高水平学术论文(如SCI期刊)中阻抗建模与稳定性分析部分的仿真复现与方法验证; 阅读建议:建议读者结合文中所述方法与提供的参考文献,自主搭建Simulink仿真模型,逐步完成扰动信号设计、数据采集、傅里叶分析及阻抗拟合全过程,深入探究控制参数变化对系统阻抗特性和稳定性的具体影响,强化理论与实践的融合能力。
三相并网逆变器虚拟阻抗+统一有源阻尼策略SVPWM+SPWM调制仿真
内容概要:本文档系统性地介绍了三相并网逆变器的核心控制技术及其在复杂电网环境下的仿真应用,重点涵盖虚拟阻抗与统一有源阻尼策略在SVPWM和SPWM调制方式下的实现方法,旨在提升逆变器的稳定性与电能质量。内容包括无功功率扰动孤岛检测、中点电位平衡控制、低电压穿越(LVRT)、模型预测控制(MPC)、正负序分离、电网前馈控制等关键技术,并扩展至风储联合调频、微电网下垂控制、虚拟同步发电机(VSG)、构网型逆变器等多种典型电力系统应用场景。所有技术均配有基于Simulink/Matlab平台的完整仿真模型、参考文献及说明文档,强调理论分析与仿真实践的深度融合,突出科研中“借力”与创新思维的重要性。; 适合人群:电气工程、自动化、新能源等相关专业的研究生、科研人员及从事电力电子与可再生能源系统开发的工程师;具备MATLAB/Simulink仿真基础和电力系统专业知识的技术人员。; 使用场景及目标:①开展三相并网逆变器控制策略的研究与优化设计;②复现高水平学术论文中的控制算法;③完成毕业课题、科研项目或工程仿真验证;④掌握虚拟阻抗、有源阻尼、SVPWM/SPWM调制、MPC、VSG等核心技术的建模与实现方法;⑤支撑微电网、构网型变流器等前沿方向的科研攻关。; 阅读建议:建议按照资源目录结构化学习,优先选择与自身研究方向契合的内容模块,结合提供的仿真模型、参考文献和说明材料进行实操演练,注重从理论推导到仿真实现的全过程理解,充分利用共享网盘资源深化技术掌握,提升科研效率与创新能力。
chromedriver-win32-159.0.8133.0(Canary).zip
chromedriver-win32-159.0.8133.0(Canary).zip
计算机“101计划”《人工智能引论》教学大纲+课件+实训案例
计算机“101计划”《人工智能引论》教学大纲+课件+实训案例
语音输入法离线语音输入转文字工具2.0支持双档本地识别模型,中英混说精准转写,纯离线运行保护隐私,让打字更高效.zip
大家好,我是大飞哥。日常打字时,频繁切换输入法、断网无法语音转写、或担心语音数据被传至云端,是许多办公族和内容创作者的共同痛点。这款离线语音输入工具 ,正是为此量身打造的 Windows 桌面语音辅助利器。它的核心使命就是按住快捷键说话,松开文字自动上屏,全程本地离线识别,让您在任何可输入文字的窗口内都能实现高效、私密的语音输入,彻底告别网络依赖与隐私焦虑。 在核心功能上,软件内置了两档本地语音识别模型,通过主界面下拉框即可随时切换。默认的“离线·标准”模式响应极快,支持中英混说且自带标点,非常适合日常聊天与文档撰写;而“离线·精准”模式则对纯中文、方言口音及长段落口述的识别准确度更高。更贴心的是,它具备实时预览与一键取消机制,说话过程中若发现说错,按下 Esc 即可取消,一个字都不会误输入;若目标窗口不支持直接写入,文字会自动存入剪贴板,方便您按 Ctrl+V 粘贴,确保每次发声都不白费。 这款工具在具体场景中的表现十分亮眼。对于办公白领,在填写表格、撰写邮件或使用微信、QQ 沟通时,无需频繁切换窗口,按住右键说话即可快速完成信息录入;对于程序员与文字工作者,在代码编辑器或文档中口述注释与段落,能显著提升创作效率;对于经常出差的商务人士,在飞机、高铁等断网环境下,它依然能稳定工作,不经过任何服务器,真正做到了“说了什么只有自己知道”,私密性极佳。 使用体验方面,软件将极简操作贯彻到底。解压后双击 大飞哥语音输入,右下角托盘出现蓝色话筒图标即代表准备就绪。用户只需将光标点进目标输入框,按住右 Alt说话,说完松开,文字便会自动写入。主界面提供了设置快捷键与开机自动启动选项,方便用户按习惯自定义组合键;关闭主窗口并不会退出程序,而是缩至托盘持续待命,彻底退出只需右键托盘或点击主界面按钮,逻辑清晰,零门槛上手。




