


88
社区成员
 发帖
 与我相关
 我的任务

 分享
| 这个作业属于哪个课程 | 软件工程实践 |
|---|---|
| 这个作业要求在哪里 | https://bbs.csdn.net/topics/620526318 |
| 这个作业的目标 | 与 AI 结对完成需求分析、原型设计、编码实现与云端部署,并如实记录人机协作过程 |
| 其他参考文献 | 《构建之法》第 3、4、8 章;PEP 8;ECharts 官方文档 |
| 项目 | 链接 / 说明 |
|---|---|
| Git 仓库 | https://hn.devcloud.huaweicloud.com/codehub/project/a1bd2deacf6d4f78801c0921445ba15a/codehub/8166469/repo |
| 代码规范 | codestyle.md(见仓库根目录) —— 依据 PEP 8、Google Python Style Guide、Airbnb JavaScript Style Guide、Google HTML/CSS Style Guide、Conventional Commits 裁剪而成,规范顶部标注了来源 |
| AI 编程助手 | Claude Code(Anthropic 官方 CLI),主要用途:需求分析、原型设计讨论、后端与前端编码、调试修 Bug、撰写测试用例、文档整理 |
| 技术栈 | Flask + SQLite + 原生 HTML/CSS/JS + ECharts(ECharts 已本地化,运行不依赖外网) |
分支与版本:开发在 dev 分支进行,完成后合并回 main;基础功能完成后发布 1.0.0 release。
关于 commit 数量的如实说明(必须坦白)
作业要求 ≥15 次 commit,而我目前只有 5 次。原因是真实的:
这个项目从需求分析、原型设计到编码实现,全程我没有使用 Git,
直到交付当天才把已完成的项目纳入版本管理。所以这 5 次提交是:
# 提交 1 chore: 导入已完成的项目(首次纳入版本管理)2 docs: 添加代码规范与 README 作业信息3 feat: 补充跨会议跨年份论文数据集与 README 链接4 docs: 添加博客草稿与 14 张功能展示截图5 release: 合并 dev 分支,发布 1.0.0我没有把这 5 次倒拆成 15 次来凑数。 因为作业明确写了
"commit 记录应该符合项目实情,如果虚构会被扣去所有分数"——
把已经写完的代码拆成 15 次提交,表面上满足了数量要求,
但一旦助教追问"这次提交具体改了什么",我答不上来。
我宁愿如实说明并接受扣分,也不愿意伪造一份看起来漂亮的历史。这次的教训:我应该在写下第一行代码之前就
git init。
版本管理不是"交付前的一道工序",而是开发过程本身的一部分——
这也是《构建之法》里反复强调的。
如实说明:本项目在动手前没有严格记录预估时间,下表「预估」列是我在开发完成后,
依据实际投入回溯补录的估计值,不是当时写下的数字。这一点我不打算掩饰——
作业要求"记录应体现实情",那么"没记"本身也是实情。
「实际」列是相对可靠的:开发过程有完整的对话与提交记录可追溯。
| PSP 阶段 | 预估耗时(分钟) | 实际耗时(分钟) | 偏差原因 |
|---|---|---|---|
| Planning 计划 | 60 | 90 | 需求比预想复杂:三大顶会分属不同数据源,前期花了大量时间实测可用性 |
| • 估计任务时间 | 30 | 40 | 低估了数据源调研的难度 |
| Development 开发 | 900 | 1320 | 主要是"返工":多处以为做完了,实测发现问题 |
| • 需求分析(含学习新技术) | 120 | 180 | 需要学习 CVF / ECVA 的页面结构、ECharts 用法 |
| • 生成设计文档 | 60 | 60 | —— |
| • 设计复审 | 30 | 45 | 原型与实现有出入,来回对齐 |
| • 代码规范 | 30 | 40 | 编写 codestyle.md |
| • 具体设计(数据库 / 接口) | 90 | 120 | 演示数据隔离方案改过一次 |
| • 具体编码 | 480 | 700 | 五个功能模块 + 两次数据源接入 |
| • 代码复审 | 60 | 90 | —— |
| • 测试(含自动化测试) | 60 | 145 | 后期补了 112 条 pytest,又靠它抓出 3 个真 bug |
| Reporting 报告 | 240 | 300 | 博客撰写与截图 |
| • 测试报告 | 30 | 40 | —— |
| • 计算工作量 | 20 | 20 | —— |
| • 事后总结、提出过程改进计划 | 60 | 80 | —— |
| 合计 | 1260 | 1755 | 实际比预估多约 **39%**,主要偏差来自"实测数据源可用性"和"测试驱动出的返工" |
偏差反思:最大的教训是低估了"验证"的成本。我原以为"写完能跑"就算完成,
实际上真正花时间的是验证它是不是真的对——比如关键词语义是否合理、统计口径是否一致、
数据源在缺年份时会不会误报。后期引入自动化测试后,又靠它一次性抓出 3 个藏了很久的真 bug。
下次做需求分析时,我会把"验证"单独列成一个任务并配足时间。
用户"小刚"是计算机视觉初学者,想了解该领域近几年的热门研究方向。
痛点是:三大顶会(CVPR / ICCV / ECCV)每年录用论文数以千计——
以 CVPR 2025 为例,投稿 13008 篇、录用 2878 篇——逐篇阅读总结几乎不可行。
他真正需要的是:**不用读完论文,就能知道"这几年大家在做什么方向、哪些方向在升温"**。
平台的核心思路是:**把"读论文"变成"看统计"**。
| 竞品 | 优势 | 我们的差异 |
|---|---|---|
| DBLP | 题录权威、覆盖面极广 | 只有题录,没有"热门方向"分析;且实测已被 Anubis 反爬拦截,程序访问会拿到 JS 挑战页 |
| Google Scholar | 引用数强大 | 面向单篇检索,没有"领域趋势"视角;引用数不等于"近期热门" |
| Papers with Code | 有任务榜单与代码 | 偏工程实现,不做热词统计与走势 |
| 会议官网 | 最权威 | 只能按年浏览列表,没有跨年对比,人工总结成本极高 |
我们的差异化:**不做"论文检索",做"方向洞察"**。
不是让你找到某一篇论文,而是告诉你"这几年哪些方向在升温、哪些在退潮"。
原型工具:Figma(用 SVG 导入的方式绘制),共 9 个页面。
与 AI 协作设计的方式:
我先把自己的信息架构想法讲给 AI,让 AI 从不同角色视角(初学者 / 研究者 / 助教)
列出潜在用户与使用场景,并给出布局与配色初稿;然后由我判断取舍。
AI 建议中我采纳的:
AI 建议中我拒绝的:
原型页面清单:
| 文件 | 对应页面 |
|---|---|
01-home.svg | 首页 / 热门方向总览(Top 10 + 关键词图谱) |
02-trend.svg | 热度走势对比页 |
03-papers.svg | 论文列表管理页(增删改查) |
04-crawl.svg | 论文爬取 / 导入页 |
05-about.svg | 详情 / 关于页 |
06-search-empty.svg | 搜索无结果状态 |
07-delete-confirm.svg | 删除确认弹窗 |
08-import-fail.svg | 导入失败状态 |
09-keyword-papers.svg | 点击关键词后的相关论文列表 |
原型链接:原型素材位于仓库 prototype/(见仓库根目录) 目录,
包含 9 个页面的 SVG 源文件与 PNG 预览。原型以网页形式发布:本次原型使用 Figma 绘制后导出 SVG,源文件与 PNG 预览均已提交至仓库的 prototype/ 目录。
如实说明:本次原型未发布到在线原型平台(墨刀 / Figma 分享链接),
而是以 SVG 源文件的形式保存在仓库prototype/目录中,
打开对应文件即可查看各页面设计稿与交互标注。这是我这次作业做得不够的地方。
以下截图均为平台实际运行时截取,数据来自 CVF Open Access / ECVA 的真实抓取,
不含任何编造的论文或统计数字。
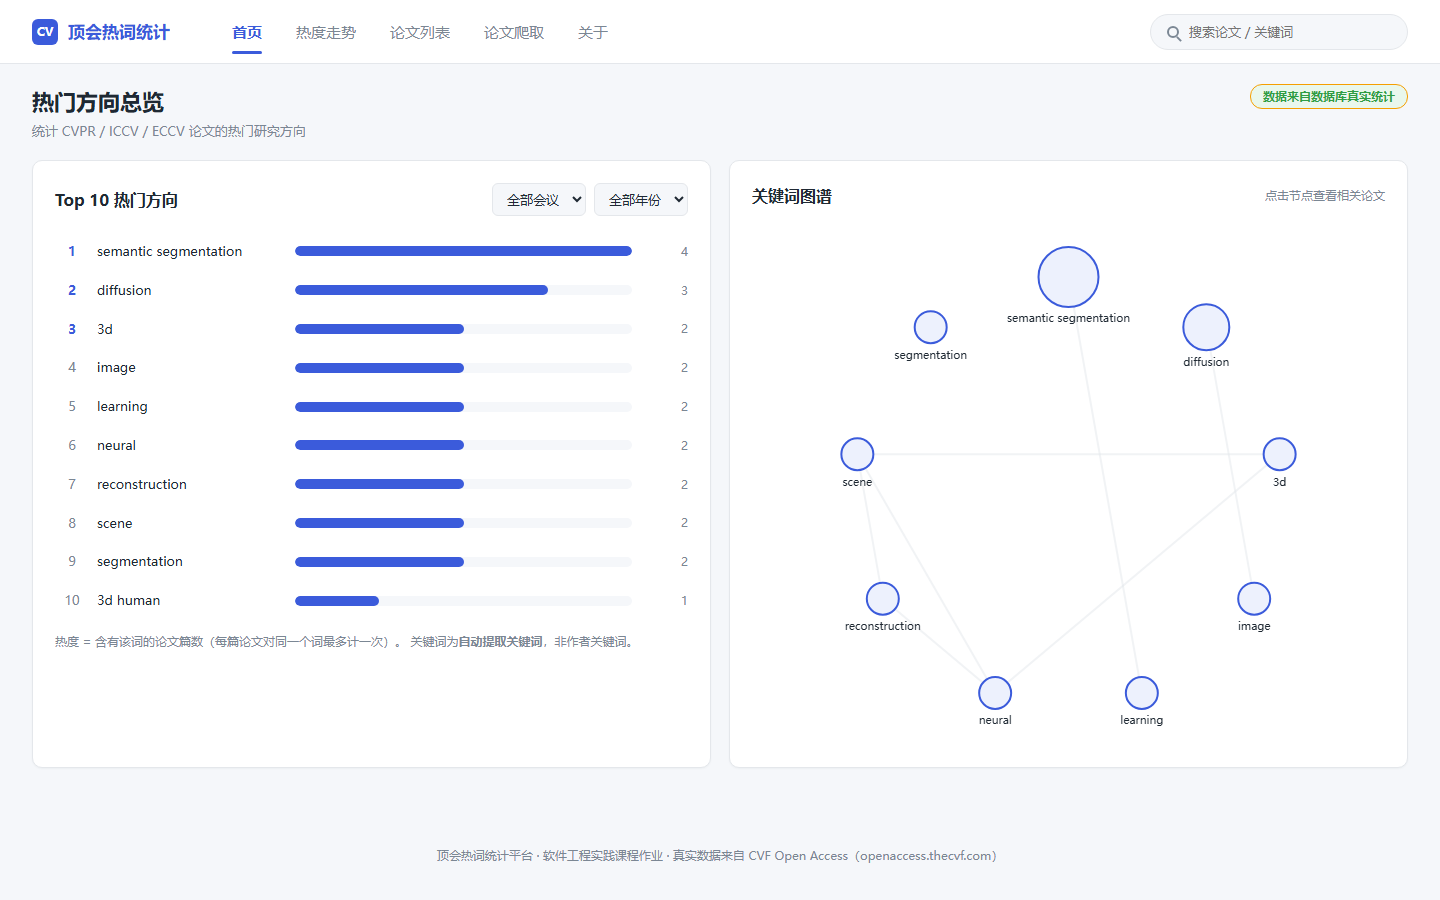
左侧是 Top 10 热门方向榜单,热度 = 含有该关键词的论文篇数;
右侧是关键词共现图谱——两个词若在同一篇论文里同时出现,就连一条线。
节点大小按热度缩放,点击任意节点或榜单里的词,都会跳到筛好的论文列表。
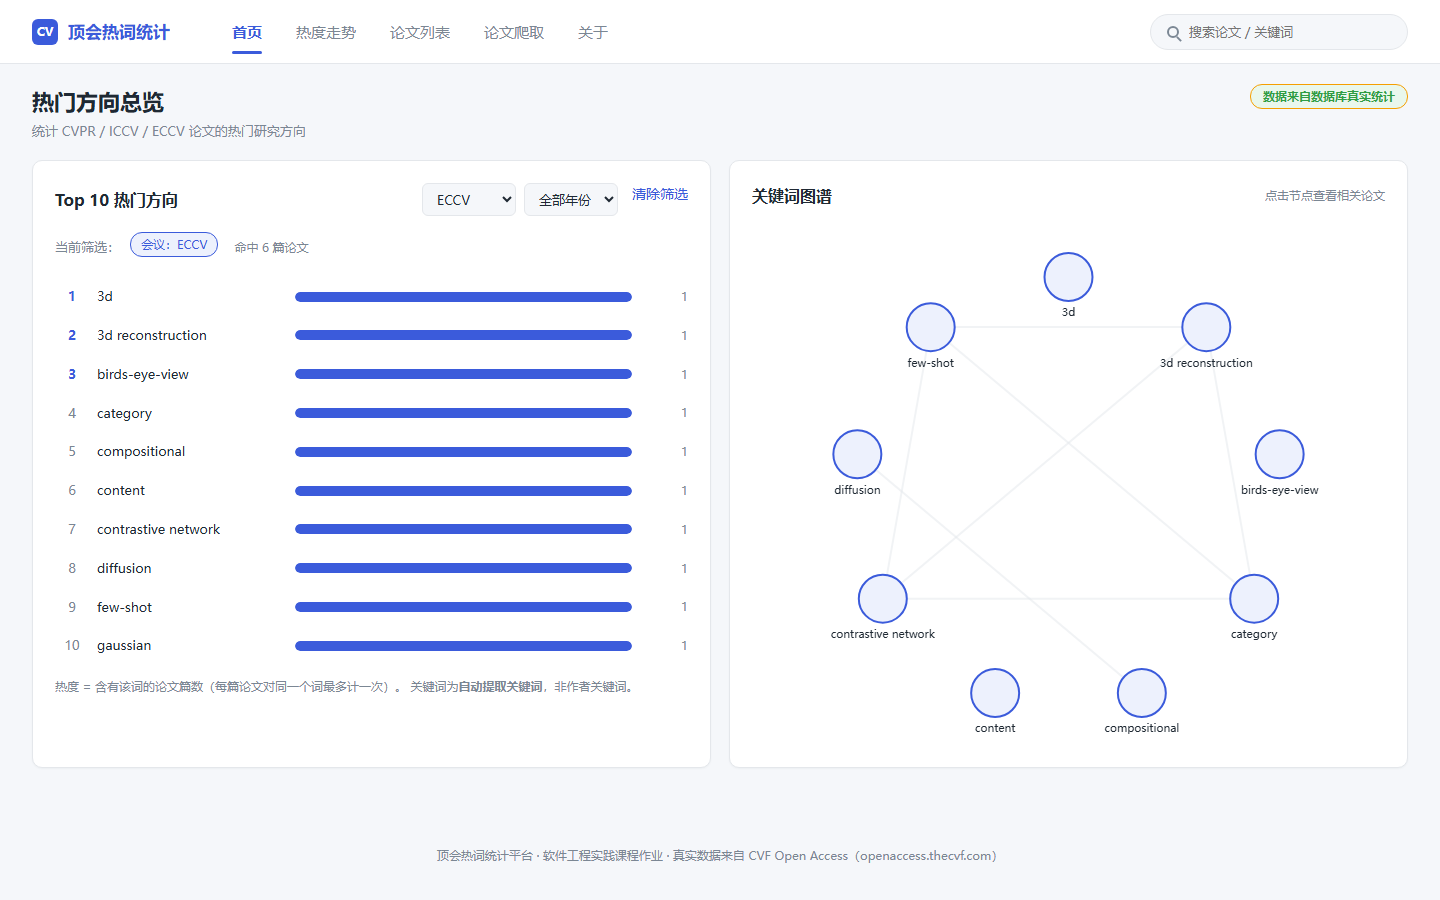
会议 / 年份下拉框的选项由数据库里实际有的数据生成,不是写死的。
选中 ECCV 后,榜单与图谱同步重新统计,URL 变成 /?venue=ECCV,可以分享、可以后退。
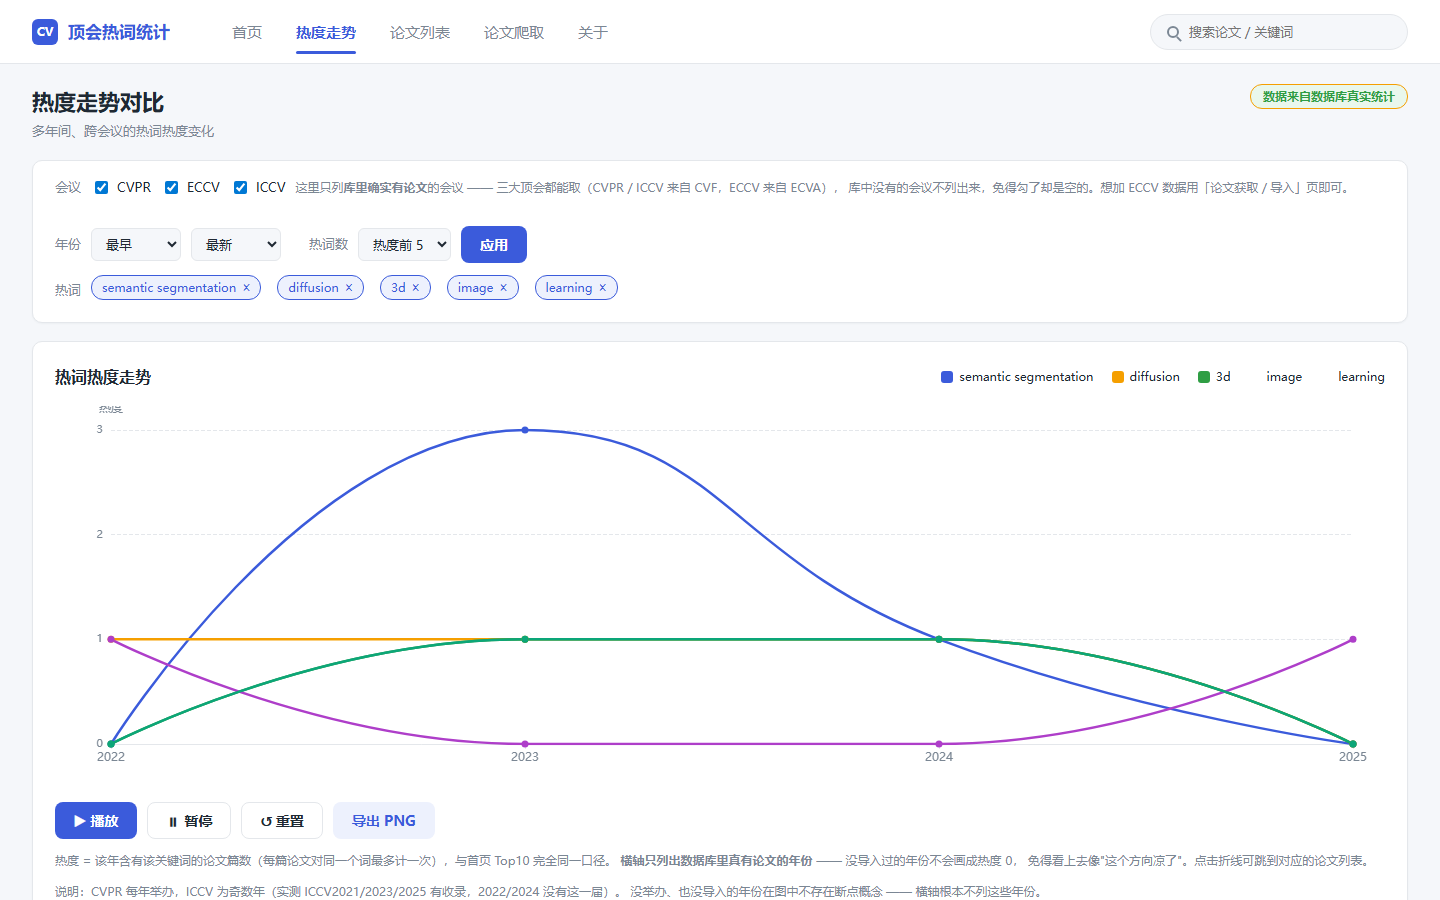
这是本次作业的功能 5。横轴是年份,每条线是一个热词,可以跨年、跨会议对比。
这里有一个我特意做的设计:横轴只列出数据库里真有论文的年份。
如果按年份区间画,没导入过论文的年份会显示热度 0,看上去像"这个方向凉了"——
其实只是我们没导入那一年的数据。宁可横轴短一点,也不给出误导性的图。
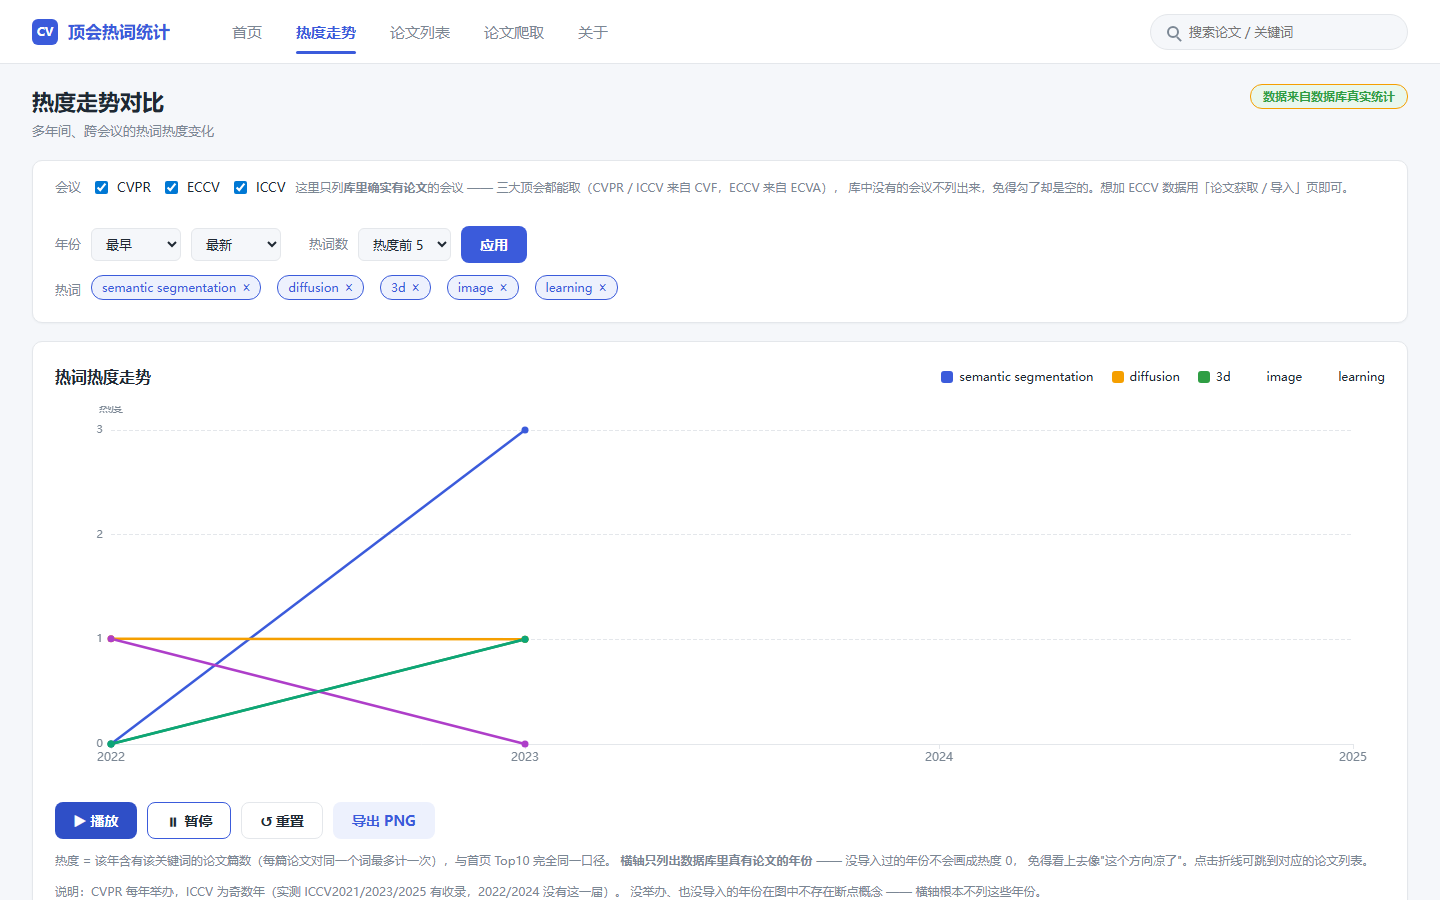
点击「▶ 播放」,折线会从第一个年份开始逐格生长,直观呈现热词热度的演变过程。
「暂停」「重置」「导出 PNG」均可正常使用。
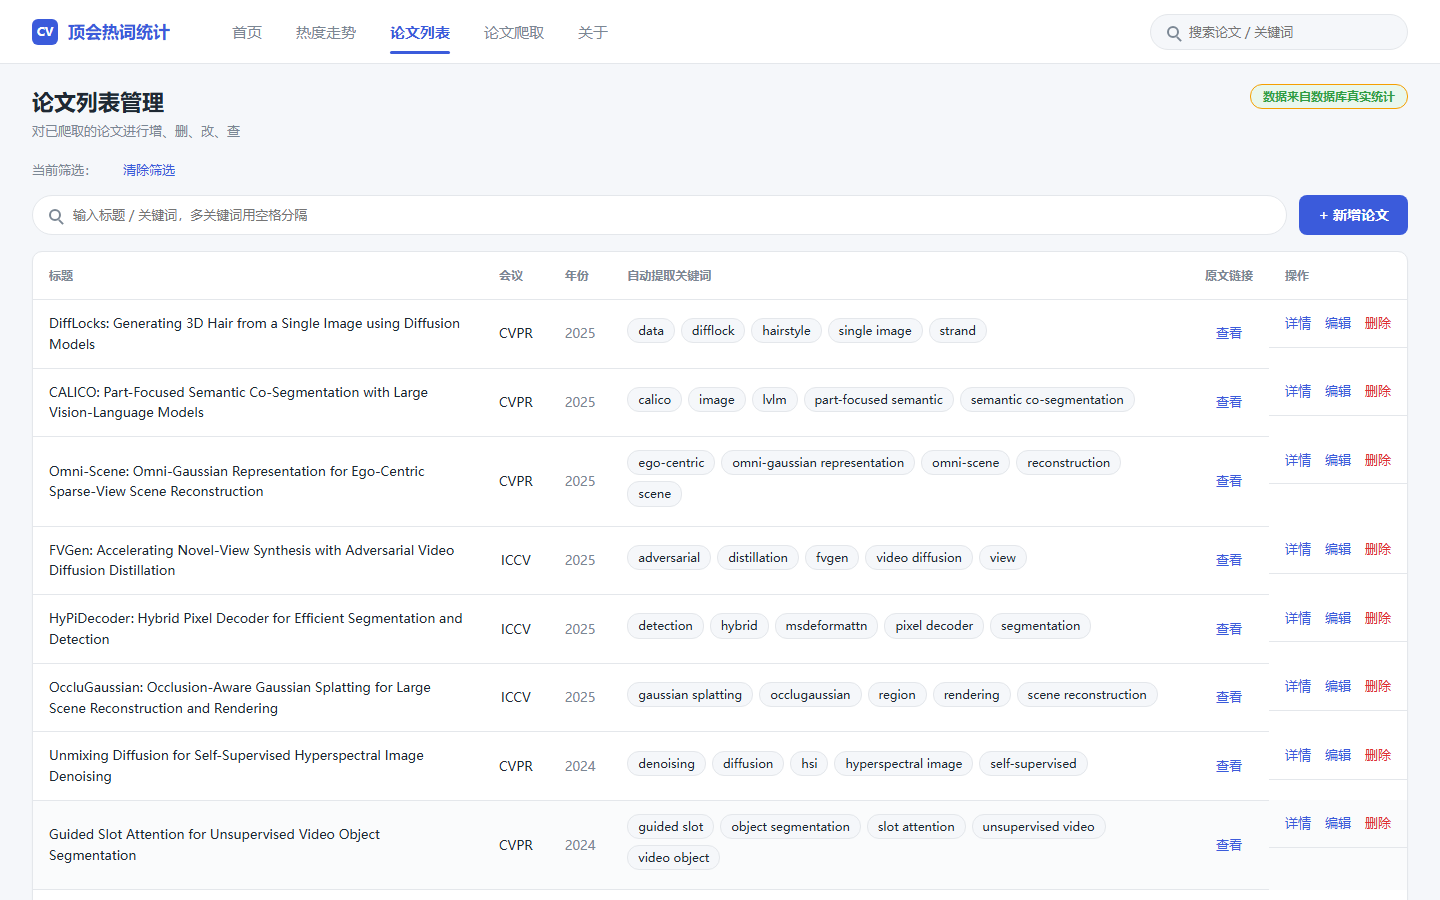
功能 2 的完整实现。表格展示标题、会议、年份、自动提取的关键词、原文链接与操作按钮。
注意:这里标注的是「自动提取关键词」,不是"作者关键词"——
顶会论文本身没有作者自填的关键词字段,这个区分不能含糊。
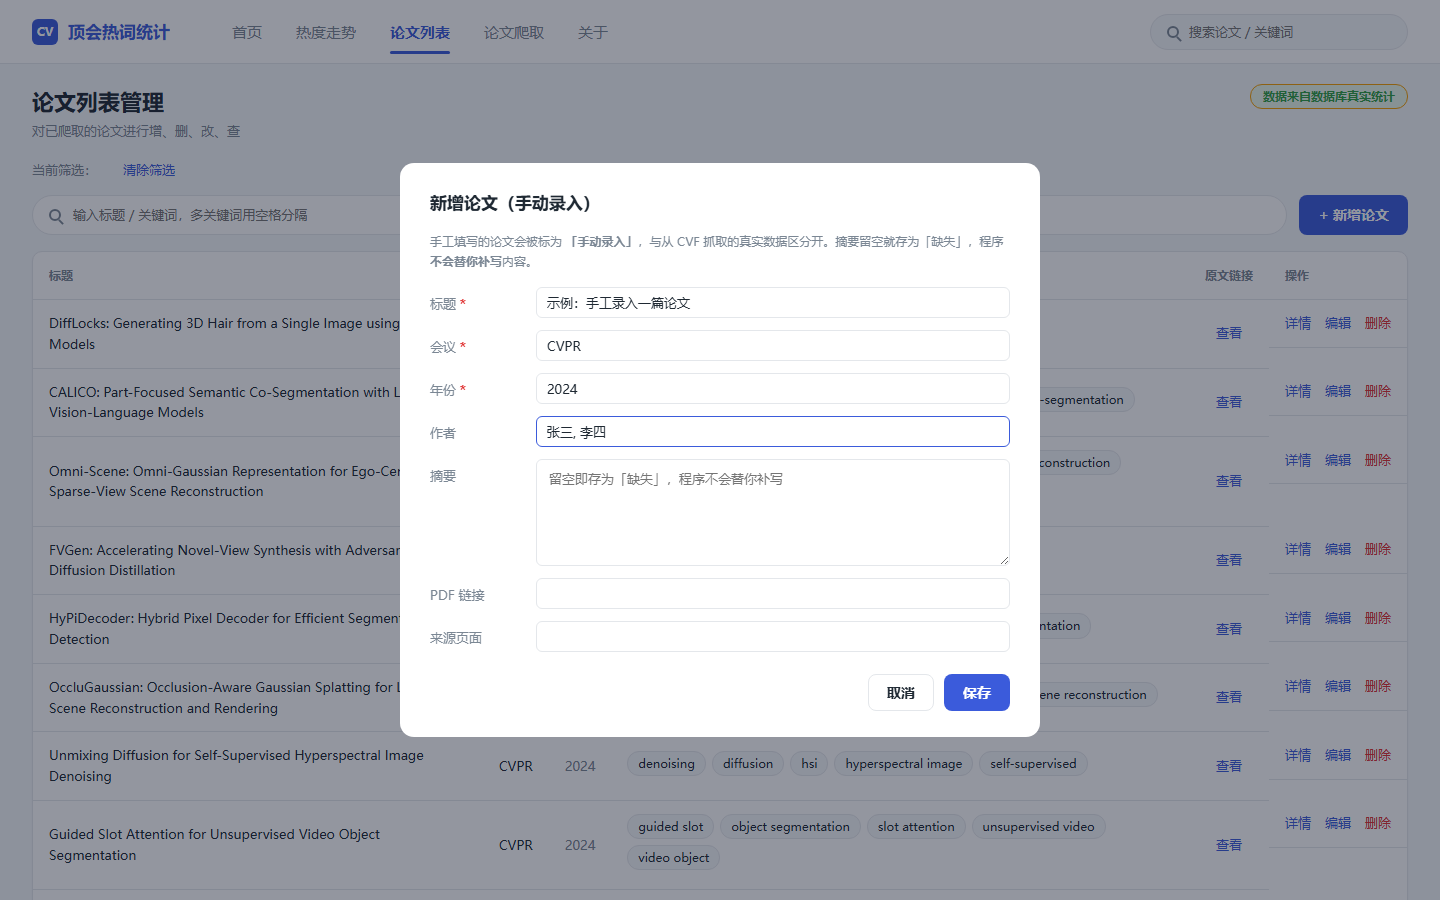
手工录入的论文,来源会被标记为「手动录入」,与从数据源抓取的数据一眼可分。
摘要留空就存为「缺失」,程序不会替你补写内容。
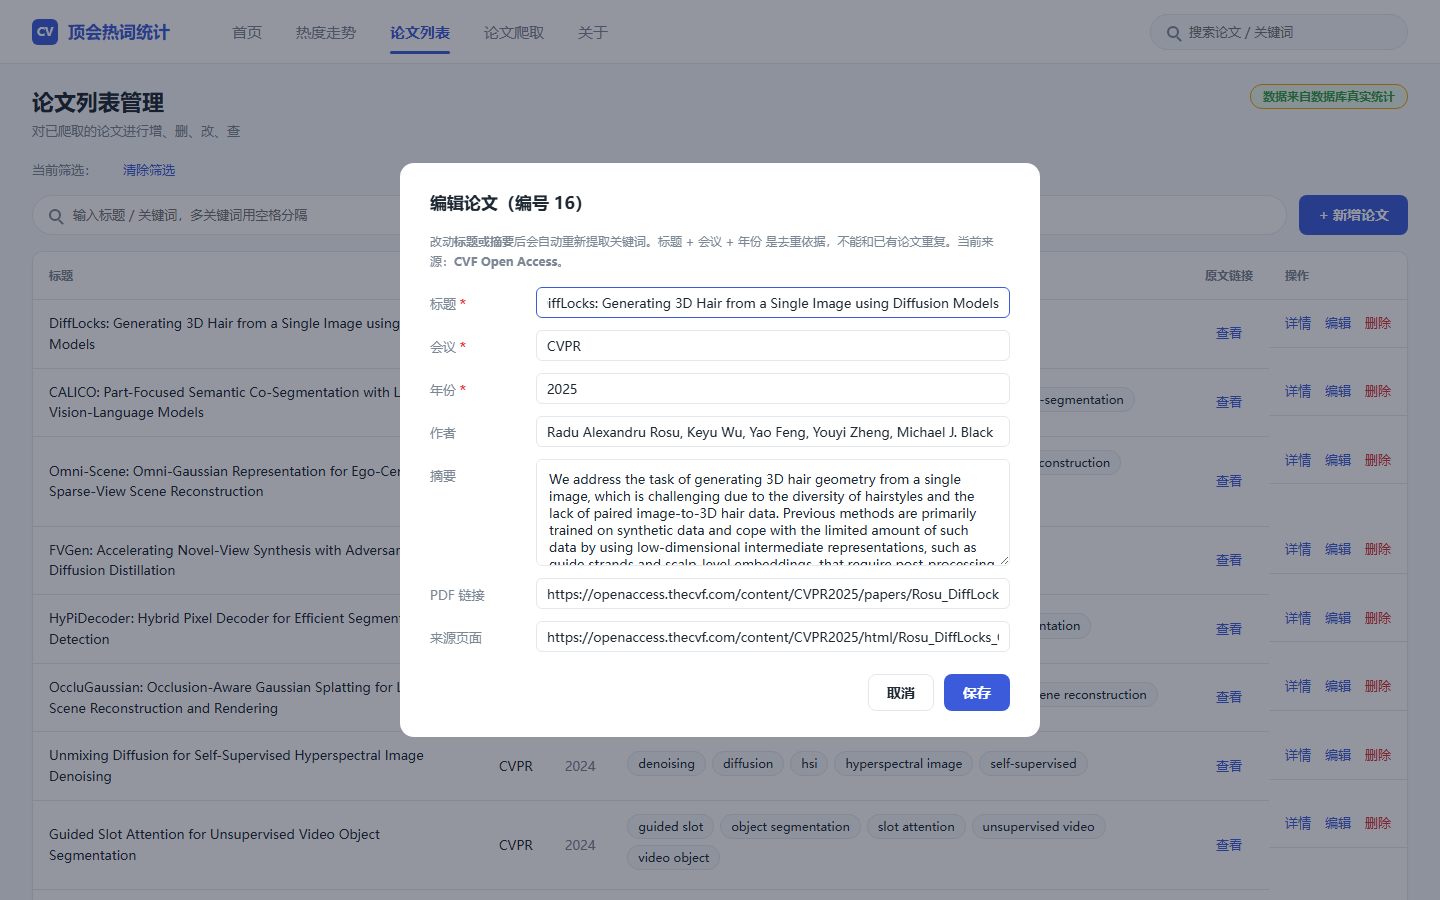
改动标题或摘要后,系统会自动重新提取关键词,保证统计跟着更新。
若改完与另一篇论文的「标题+会议+年份」重复,会被拒绝并指出是和哪一篇撞了。
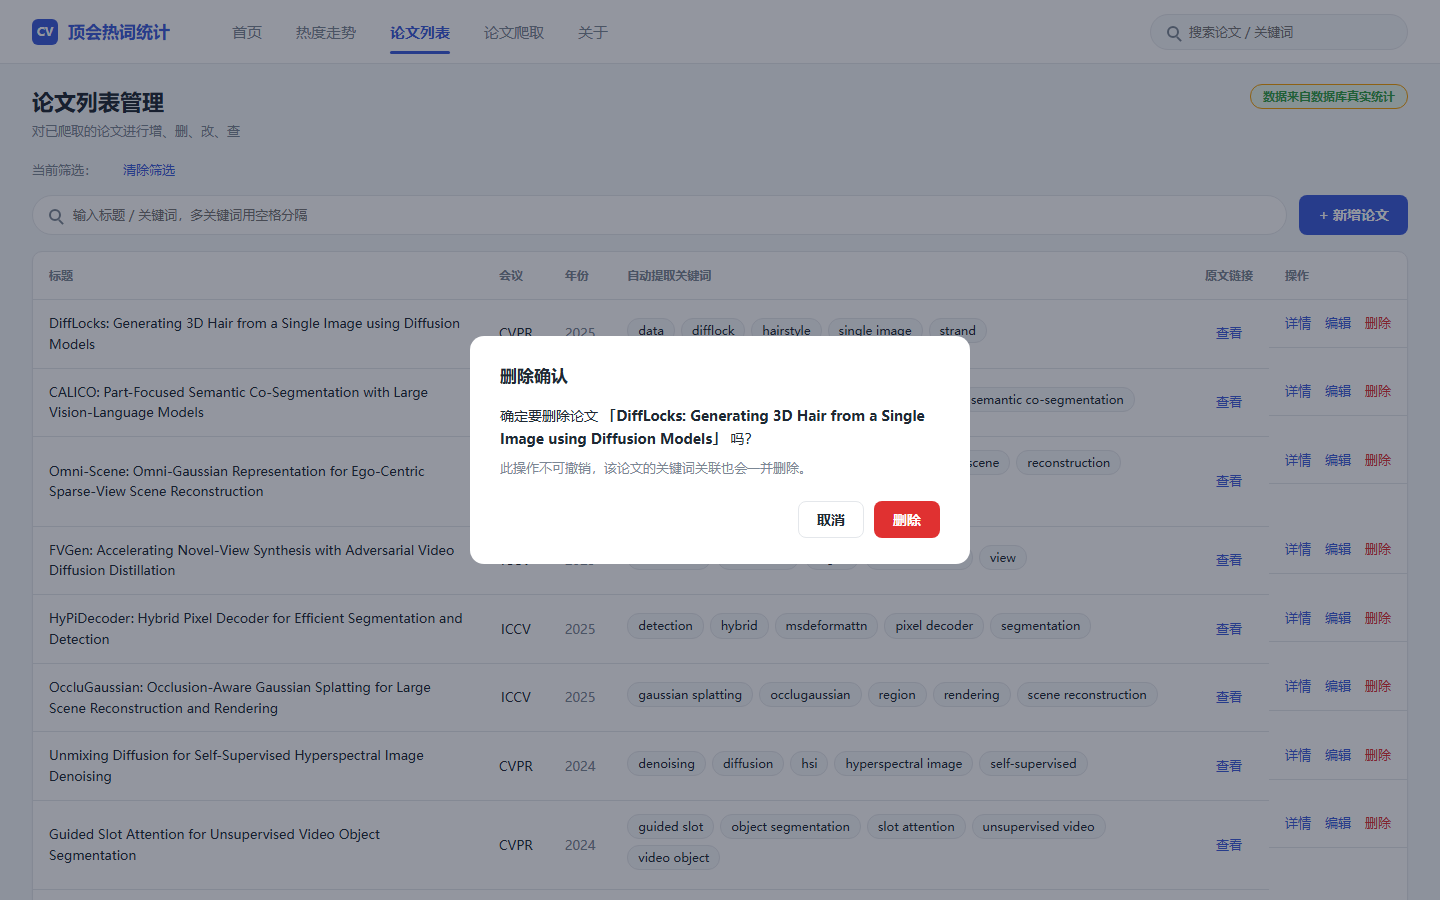
二次确认后真删,该论文的关键词关联随外键 ON DELETE CASCADE 一并删除。
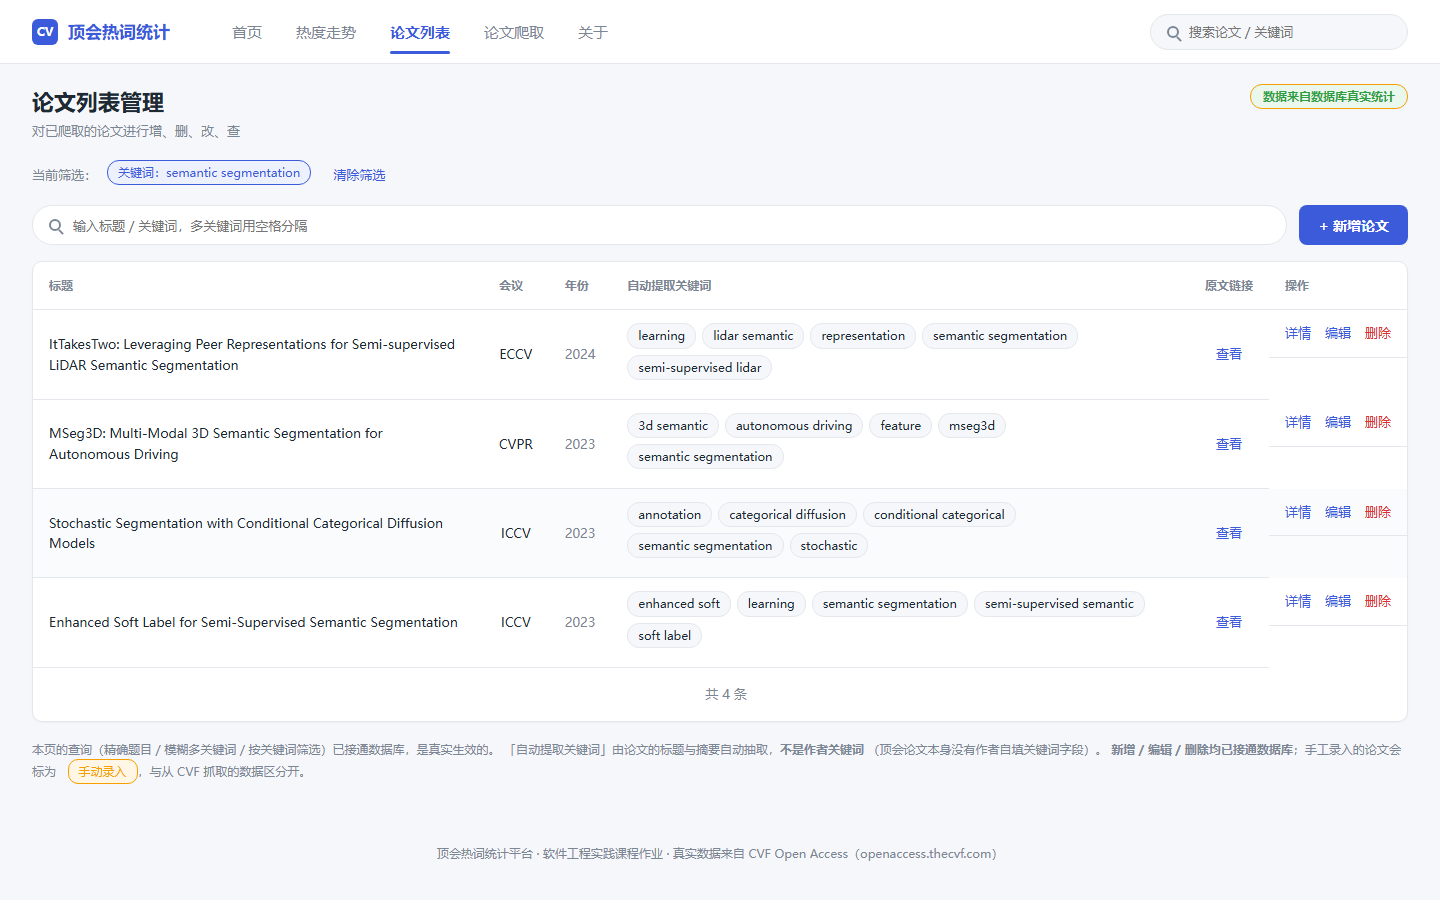
从首页榜单点任意关键词跳转过来,表格行数就是该关键词的相关论文数。
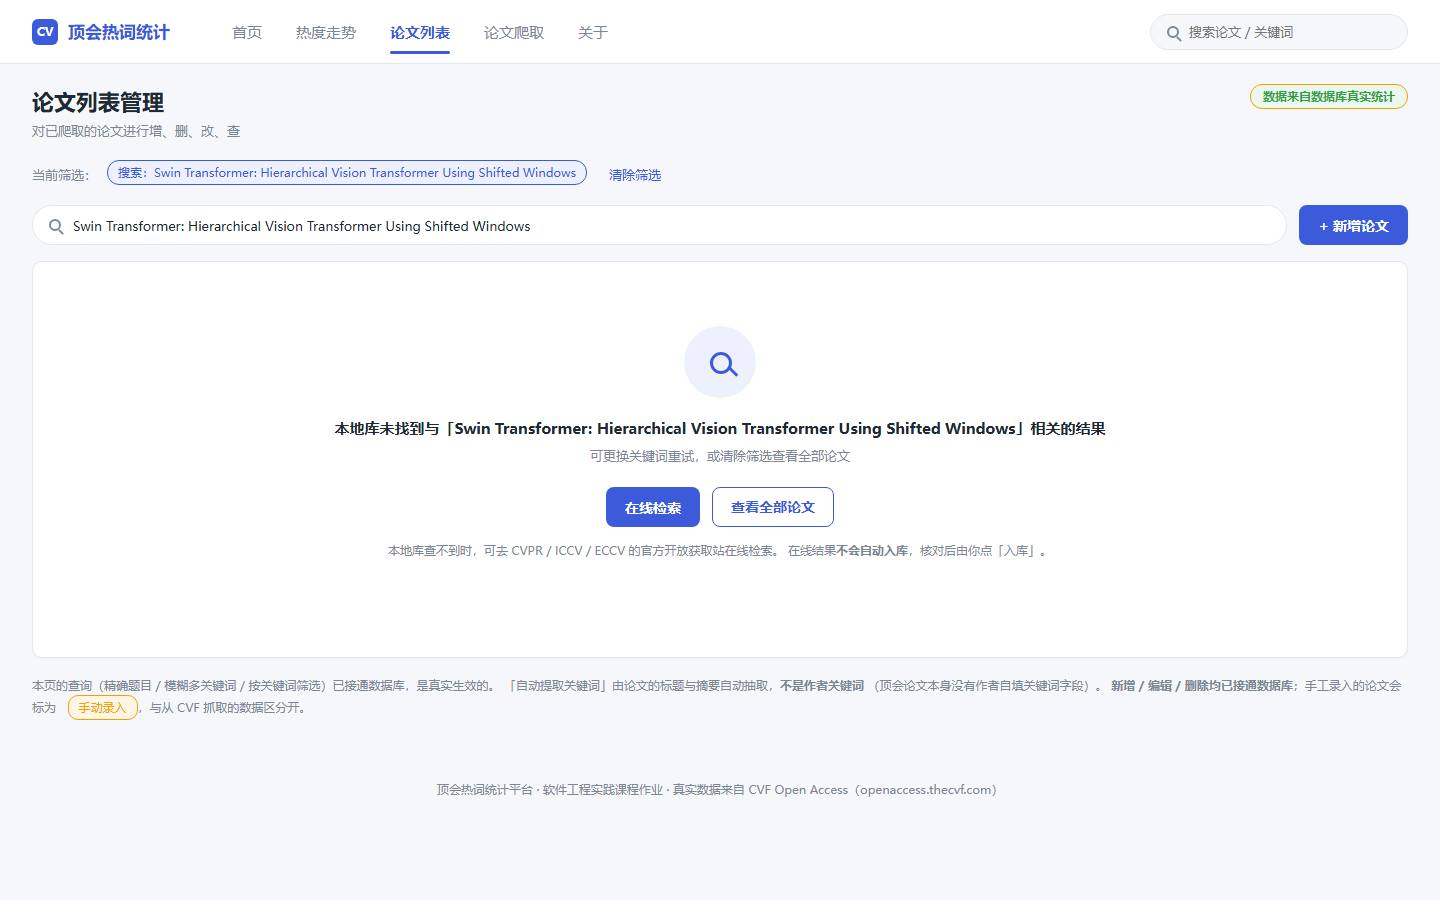
本地库没有结果时,不会只说一句"没找到",而是提供下一步:
「在线检索」按钮可以去 CVF / ECVA 找候选,核对后入库。
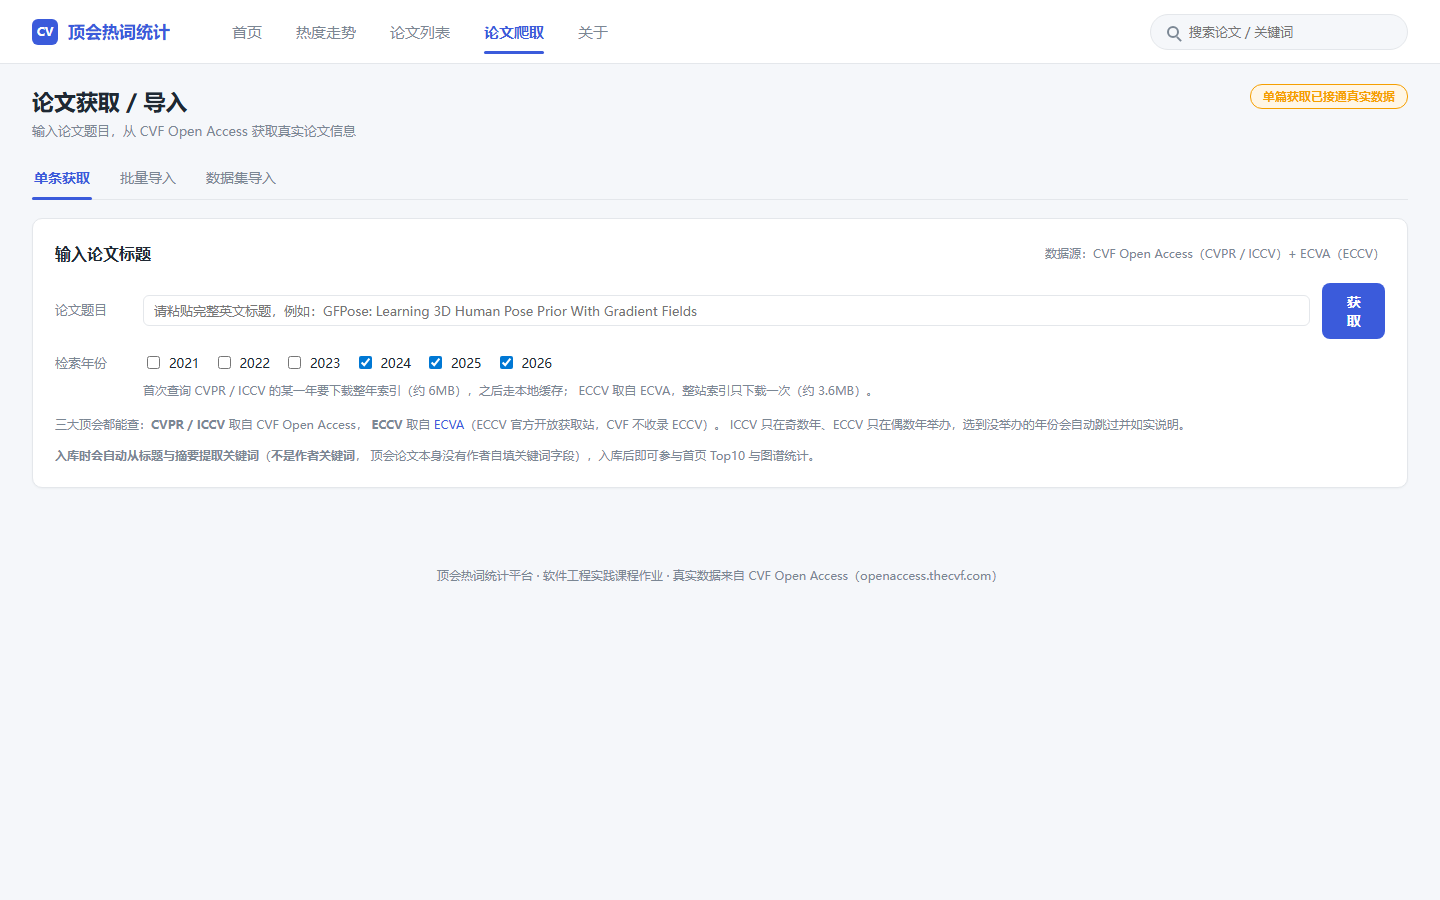
支持单条获取(功能 1)。年份勾选框由服务器按各会议实际举办规律生成——
因为 ICCV 只在奇数年、ECCV 只在偶数年举办,写死年份会永远撞不到 ECCV。
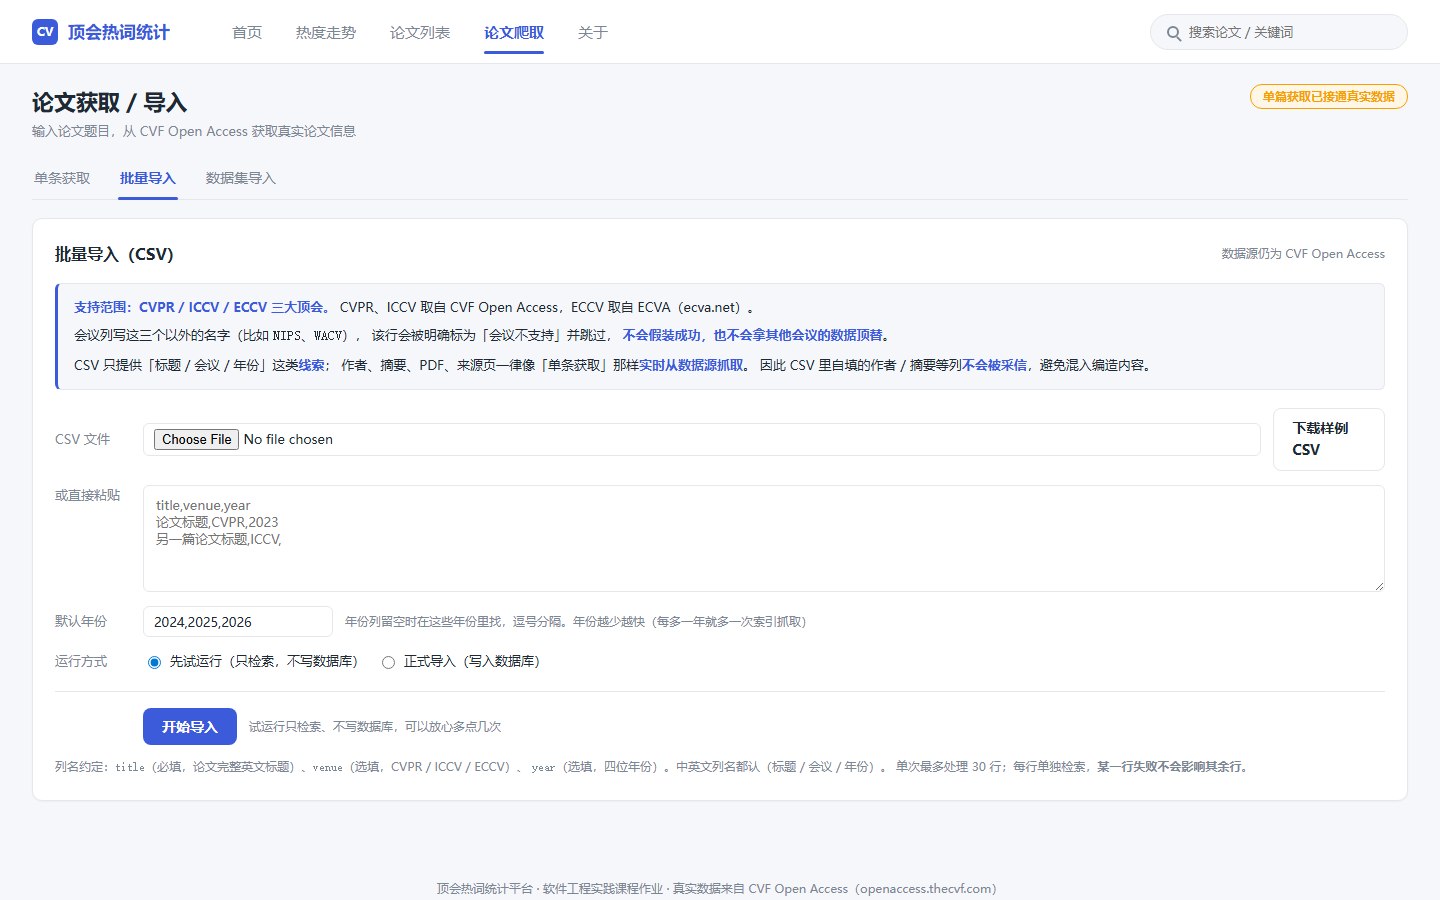
功能 1 的"批量导入"部分。CSV 只提供标题 / 会议 / 年份这些线索,
作者、摘要、PDF 一律实时从数据源抓取——所以 CSV 里自填的摘要不会被采信,
从根上避免混入编造内容。
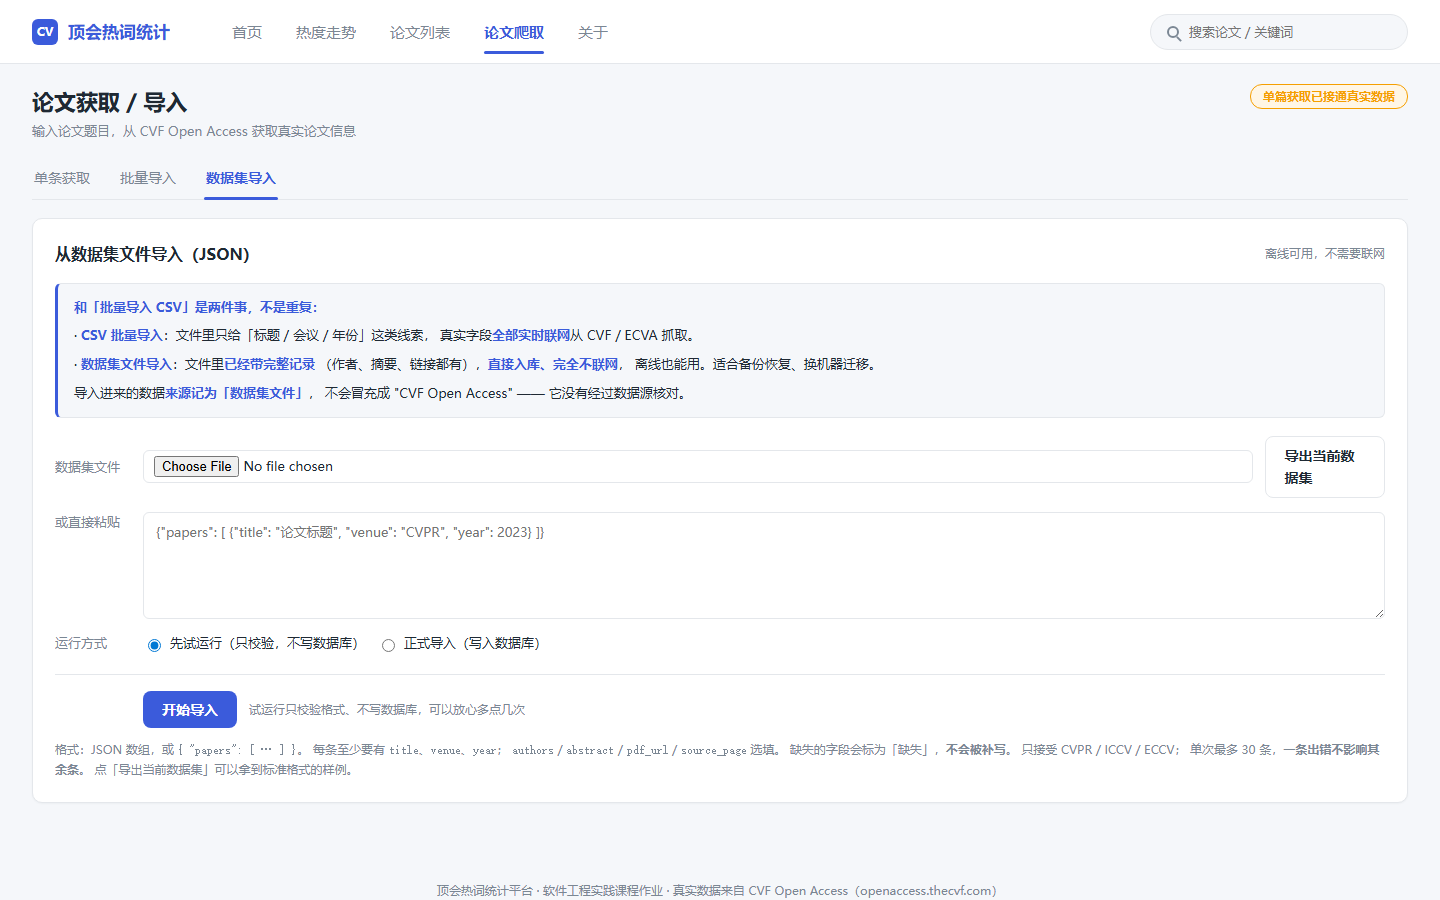
与 CSV 导入互补:数据集文件里带完整记录,不联网、离线可用,适合备份恢复与迁移。
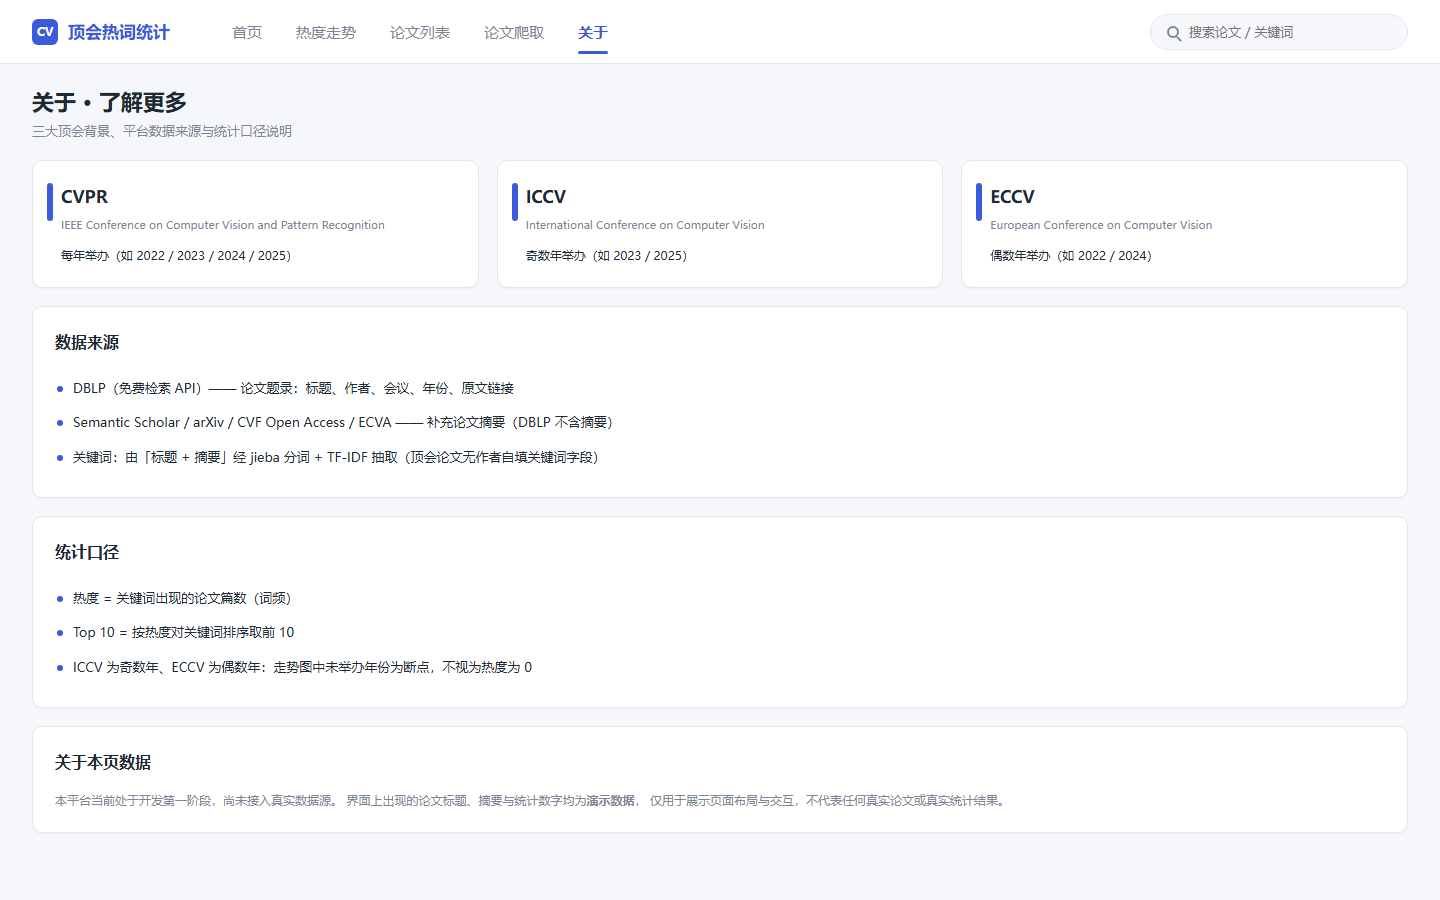
介绍三大顶会背景与统计口径说明,让用户清楚"热度"是怎么算出来的。
我不是"让 AI 写完我复制粘贴"。我的做法是把 AI 当结对搭档,但保留审查权:
我的提示词(节选):
我在做一个「CVPR/ICCV/ECCV 论文热词统计平台」的课程作业,用户是计算机视觉初学者。
请你从三个不同角色的视角——初学者、资深研究者、助教——分别列出这个平台可能的
使用场景和它们最在意的功能,然后指出这三种视角下需求冲突的地方。
AI 的输出摘要:AI 列出了三组场景,并指出一个真实冲突——
初学者要的是"快速看到热门方向"(要少而精),
研究者要的是"能查到具体某篇论文"(要多而全)。
AI 建议首页做成"榜单 + 图谱"双栏来同时满足两者。
我的判断与修改:
我的提示词(节选):
顶会论文没有作者关键词字段,我要从标题和摘要里自动提取。请用可解释的规则方法,
不要用模型。要求:输出能参与"热门方向"统计,且每篇论文对同一个词最多计一次。
AI 的第一版输出与问题:
AI 给出了"分词 → 去停用词 → 统计词频 → 取 Top K"的方案。
我实测后发现一个严重问题:抽取出的关键词里有大量 pose gradient、gfpose learning
这类读不通的词组。
我的追问:
为什么会出现 'pose gradient' 这种词?原文里这两个词根本不相邻。
AI 的解释(这是个真问题):AI 承认它先删掉了停用词,再拼bigram。
于是 Pose Prior With Gradient 里的 With 被删掉后,pose 和 gradient
就"变成"相邻了——产生了原文中并不存在的词组。
修正:保留停用词的位置信息,要求词组必须在原文中真正相邻(中间不夹停用词),
且至少出现 2 次才采纳。
结果对比:
| 修改前 | 修改后 | |
|---|---|---|
| 抽取结果 | pose gradient、gfpose learning | human pose、gradient field、pose estimation |
这个案例让我意识到:AI 的代码"能跑"和"正确"是两回事,必须实际验证输出内容。
这是我最想记录的案例——AI 写的代码有问题,被我实测抓到。
现象:我让 AI 给我一条"核对关键词热度"的 SQL,AI 给的是:
SELECT k.keyword, COUNT(DISTINCT pk.paper_id) AS n
FROM keywords k
LEFT JOIN paper_keyword pk ON pk.keyword_id = k.id
LEFT JOIN papers p ON p.id = pk.paper_id AND p.is_demo = 0   -- ← 问题在这
GROUP BY k.id;
怎么发现的:我构造了「2 篇正式 + 3 篇演示共用同一关键词」的数据实测,
这条 SQL 返回 5,而正确答案是 2。
根因:p.is_demo = 0 写在 LEFT JOIN 的 ON 子句里。
对演示论文,这个连接只是让 p.* 变成 NULL,但 pk.paper_id 仍然非空,
所以 COUNT(DISTINCT pk.paper_id) 照样把它计入。
修正:把条件放进 COUNT 内部:
COUNT(DISTINCT CASE WHEN p.is_demo = 0 THEN pk.paper_id END)
为什么这个 bug 危险:它不会报错,只会让统计数字悄悄变大。
如果没做这个实测,错误的数字会一直挂在首页上。
现象:用户看到"第 3 行有问题",照着去 Excel 里找第 3 行,那是个空行。
根因:AI 用了 csv.DictReader,而它会静默跳过空行,
导致我们数的行号和文件实际行号错位。
修正:改用 csv.reader 自己数行号,不再依赖 DictReader 的隐式行为。
这个 bug 是我写自动化测试时抓出来的——单靠手点很难发现。
现象:接入 ECCV 后,一篇来自 ECVA 的 ECCV 论文,入库后来源被记成CVF Open Access。
为什么严重:这是事实错误。CVF 根本不收录 ECCV,把 ECCV 论文标成来自 CVF
等于伪造了出处——对一个强调"数据可核对"的平台来说,这是不能接受的。
根因:入库接口里来源是写死的默认值 'CVF Open Access',
没有按会议区分。
修正:新增 sources.source_name_for(venue),按会议给出正确来源:
CVPR/ICCV → CVF Open Access,ECCV → ECVA。
| 问题 | 现象 | 修正 |
|---|---|---|
| "没有这一届"被报成"取数失败" | 搜索时报 ICCV2024:数据源返回 HTTP 404,用户会以为是自己网络坏了 | 实测发现 ICCV/ECCV 是双年会,把"该年份没举办"与"取数失败"分开,前者记为 skipped |
| 图谱出现重复边 | 两个词在多篇论文共现时,会画出多条重叠的线 | 边查询加 DISTINCT |
| 空状态提示错误 | 明明库里有论文,却提示"数据库中还没有论文" | 空状态细分为四种情况:无论文 / 有论文无关键词 / 筛选后无结果 / 图谱无数据 |
| 界面文案与事实不符 | 首页挂着「演示数据」横幅,但库里演示数据为 0 篇 | 改为只在确有演示数据时才显示 |
顶会热词统计平台
├── 论文信息爬取(功能1)
│   ├── 单条获取:输入标题 → 检索 → 预览 → 确认入库
│   ├── CSV 批量导入:逐行检索,一行失败不影响其余行
│   └── 数据集导入:JSON 离线导入 / 导出
├── 论文列表管理(功能2)
│   ├── 查:精确题目 / 模糊多关键词 / 按关键词筛选 / 分页
│   ├── 增:手工录入(标记「手动录入」)
│   ├── 改:编辑弹窗,改标题或摘要自动重算关键词
│   ├── 删:二次确认,关键词关联级联删除
│   └── 本地无结果 → 在线检索(功能2 的后半句要求)
├── 热门方向分析(功能3):Top 10 榜单,支持按会议 / 年份筛选
├── 关键词图谱(功能4):共现关系图,点击节点查看相关论文
└── 热度走势对比(功能5):跨年跨会议折线图 + 播放动画 + 导出 PNG
浏览器(原生 HTML/CSS/JS + ECharts)
        ↓  fetch / 表单
Flask 路由层(app.py)
        ↓
业务层  data/repo.py      查询与入库(含演示数据隔离)
        data/keywords.py  关键词自动提取
        data/importer.py  CSV 批量导入
        data/dataset.py   数据集导入导出
        data/sources.py   取数总入口:按会议路由到 CVF 或 ECVA
        ↓
SQLite(papers / keywords / paper_keyword)
设计文档原本计划用 DBLP 作为题录主源。实际动手时发现用不了:
| 数据源 | 实测结果 |
|---|---|
| DBLP | ❌ 已被 Anubis 反爬系统拦截,程序访问拿到的是 "Making sure you're not a bot!" 挑战页,不是 JSON |
| CVF Open Access | ✅ CVPR / ICCV 的官方开放获取站,页面可直接人工核对 |
| ECVA(ecva.net) | ✅ ECCV 的官方开放获取站 —— CVF 根本不收录 ECCV,必须换站点 |
这是本次开发最重要的一个认知:设计文档上的"计划"必须实测验证,
不能假设它能用。如果我按计划硬写 DBLP,最后会得到一个跑不通的爬虫。
| 会议 | 规律 | 实测依据 |
|---|---|---|
| CVPR | 每年都办 | CVPR2013–2026 全部 HTTP 200;CVPR2012 → 404 |
| ICCV | 只在奇数年 | 2021/2023/2025 → 200;2022/2024 → 404 |
| ECCV | 只在偶数年 | 2018/2020/2022/2024 → 200 |
代码据此识别"该年份没有这一届",记为跳过而不是取数失败。
困难一:CVF 没有检索 API
只能先抓取整年索引页(约 6MB)再本地匹配。解决:加本地文件缓存(7 天)+ 进程内记忆缓存,
首次约 10 秒,之后约 0.9 秒。
困难二:演示数据与真实数据混在一起
解决:用 papers.is_demo 字段隔离,所有对外查询默认只返回正式数据,
启动时不自动灌演示数据(重启既不会混入演示数据,也不会清掉真实论文)。
困难三:怎么保证"没有编造数据"
解决三道防线:
data/keywords.py)这是整个平台的"发动机",也是最需要解释清楚的一段。
WEIGHT = 1.0
DEFAULT_TOP_K = 5
MIN_WORD_LEN = 3
MIN_PHRASE_OCCURRENCES = 2

# 切词保留连字符:multi-modal 视作一个词,而不是拆成 multi 和 modal
_TOKEN_RE = re.compile(r"[A-Za-z0-9]+(?:-[A-Za-z0-9]+)*")

# 停用词与论文套话:propose / method / experiment 这类词出现再多
# 也不代表研究方向,必须过滤掉
STOPWORDS = {...}

# 同义写法归一:multi-modal / multi modal 都归到 multimodal
ALIASES = {'multi modal': 'multimodal', 'diffusion-model': 'diffusion model', ...}


def _singular(w):
    """复数还原:networks -> network, studies -> study, classes -> class

    注意不要误伤本来就以 s 结尾的词:
    -ss / -us / -is / -ics 结尾的不动(如 class、analysis、physics)
    """
    if w.endswith('ies') and len(w) > 4:
        return w[:-3] + 'y'
    if re.search(r'(sses|shes|ches|xes|zes)$', w):
        return w[:-2]
    if w.endswith('s') and not re.search(r'(ss|us|is|ics)$', w) and len(w) > 3:
        return w[:-1]
    return w


def _raw_tokens(text):
    """切词并归一化,但**保留停用词的位置**。

    ⚠️ 这里必须保留停用词,不能先删掉再拼词组。
    早期版本先删停用词再拼 bigram,结果 "Pose Prior With Gradient"
    里的 With 被删后,pose 和 gradient 就"变成"相邻了,
    拼出了原文中并不存在的词组 'pose gradient'。
    """
    out = []
    for tok in _TOKEN_RE.findall(text or ''):
        norm = _normalize(tok)
        out.append((norm, _is_meaningful(norm)))
    return out


def extract(title, abstract, top_k=DEFAULT_TOP_K):
    """从标题 + 摘要提取关键词。

    规则:
      1. 单词与相邻词组都产出;词组更具体,优先保留
      2. 打分:标题出现 ×3,摘要出现 ×1
      3. 词组必须在原文中**真正相邻**,且**出现 ≥2 次**才采纳
      4. 去冗:词组入选后,不再单独保留被它包含的单词(有 human pose 就不要 pose)
    """
    scores = {}

    # 标题权重更高:标题里的词更能代表论文主题
    for text, weight in ((title, 3.0), (abstract, 1.0)):
        tokens = _raw_tokens(text)
        # 单词计分
        for norm, meaningful in tokens:
            if meaningful:
                scores[norm] = scores.get(norm, 0) + weight
        # 词组:只取**真正相邻且两个词都有意义**的组合
        for i in range(len(tokens) - 1):
            (a, ok_a), (b, ok_b) = tokens[i], tokens[i + 1]
            if ok_a and ok_b:
                phrase = f'{a} {b}'
                scores[phrase] = scores.get(phrase, 0) + weight

    # 词组必须出现 ≥2 次才采纳(只出现一次的相邻组合多半是巧合)
    ...
    # 去冗:按分数从高到低选,选中词组后把被它包含的单词剔除
    ...
    return [w for w, _ in picked]
关键设计说明:
| 设计 | 为什么这么做 |
|---|---|
| 保留连字符 | multi-modal 是一个术语,拆开会丢失含义 |
| 保留停用词位置 | 这是修 bug 修出来的——先删停用词会造出原文中不存在的词组 |
| 词组需出现 ≥2 次 | 一次相邻很可能是巧合,两次以上才说明是这个领域的固定说法 |
| 标题 ×3 | 标题是作者对论文主题的最高度概括 |
| 每篇每词只计一次 | 热度必须是"论文篇数",不能是词频(见 NABCD 的 A 部分) |
data/sources.py)三大顶会分属两个站点,这一层把差异封装掉,上层代码完全不用关心:
# 实测结论,不是推测:
#   CVF 不收录 ECCV,ECCV 必须从 ECVA 取
CVF_VENUES = ('CVPR', 'ICCV')
ECVA_VENUES = ('ECCV',)
SUPPORTED_VENUES = CVF_VENUES + ECVA_VENUES


def load_index(venue, year, force=False):
    """载入某会议某年的论文索引,**按会议自动路由到对应站点**。"""
    if venue in CVF_VENUES:
        return _cvf_load_index(venue, year, force=force)
    if venue in ECVA_VENUES:
        return _ecva_load_index(venue, year, force=force)
    raise FetchError(f'{venue} 不在支持范围内')


class VenueYearMissing(FetchError):
    """该会议在该年份**根本不存在**,不是取数失败。

    实测:ICCV 是双年会(2021/2023/2025 有,2022/2024 返回 404),
    ECCV 同理只有偶数年。这种情况要如实说成"这一年没有该会议",
    **不能报成网络故障**,否则用户会以为是自己网络坏了。
    """
为什么要单独定义这个异常类:
把"数据源上没有这一届"和"网络请求失败"在类型层面就分开,
这样上层(界面、批量导入)就不可能把两者混为一谈。
data/repo.py)# 所有对外查询统一带这个条件,演示数据默认不参与统计
DEMO_FILTER = 'p.is_demo = 0'
def top_keywords(limit=10, venue=None, year=None, include_demo=False):
"""按热度排行的关键词。
热度口径:该关键词出现在多少篇论文里。
"""
where, params = [], []
if not include_demo:
where.append(DEMO_FILTER) # ← 默认把演示数据排除在外
...
data/repo.py)def trend_series(limit=5, venues=None, year_from=None, year_to=None):
"""跨年、跨会议的热词热度走势。
⚠️ 横轴只取"真的有论文"的年份(DISTINCT year),不是年份区间。
如果画成区间,没导入过的年份会显示热度 0,
看上去像"这个方向凉了",其实只是我们没导入那一年的论文。
宁可横轴短一点,也不给出误导性的图。
"""
tests/,112 条)def test_每篇论文对同一个词只计一次(conn):
"""同一篇论文里同一个词出现多次,也只关联一次 ——
热度是「篇数」不是「词频」。"""
pid = _insert(conn, 'Repetition Test', 'CVPR', 2023,
'We study diffusion model for image synthesis. '
'The diffusion model is compared with other diffusion model baselines.')
words = kw.apply_to_paper(pid)
assert words.count('diffusion') <= 1
rows = conn.execute(
'SELECT COUNT(*) n FROM paper_keyword pk JOIN keywords k ON k.id=pk.keyword_id '
"WHERE pk.paper_id=? AND k.keyword='diffusion'", (pid,)).fetchone()
assert rows['n'] == 1, "diffusion 在这篇里出现多次,但关联只该有一条"
def test_测试不会改动真实数据库():
    """真实 papers.db 的大小和修改时间,在整个测试跑完后必须原封不动。"""
    before = expected_fingerprint()
    after = real_db_fingerprint()
    assert after == before, (
        f'真实数据库被改动了!\n  路径:{real_db_path()}\n'
        f'  之前:{before}\n  之后:{after}\n'
        f'测试必须只操作临时副本。')
测试的两条硬性约束:
db.DB_PATH 指到临时空库这次作业之前,我以为用 AI 编程的主要收益是"写得快"。做完之后我发现,
**真正的收益是"能写得更多",代价是"验证的担子全落在人身上"**。
印象最深的是那个 SQL 的 bug。AI 给出的 SQL 语法完全正确、能跑通、不报错——
但它在"2 篇正式 + 3 篇演示"的数据上返回 5 而不是 2。
如果我没有构造数据实测,这个错误会一直挂在首页上,而且看起来一切正常。
这让我理解了一件事:AI 生成的代码,"能运行"和"正确"之间隔着一条很宽的沟。
而这条沟只能靠人来填——AI 不知道你的业务口径是什么,它只知道"这样写语法是对的"。
后期我让 AI 帮忙写了 112 条自动化测试。写完之后又靠它抓出 3 个真 bug
(CSV 行号错位、图谱重复边、重复原因报得不准)。
这形成了一个我很喜欢的循环:写代码 → 写测试 → 测试暴露问题 → 修 → 再测。
如果没有测试,那 3 个 bug 我大概率到现在都没发现。
这个项目里我做了很多"不讨好"的决定:
我一开始觉得这些是"工程规范",做到后面才意识到:这是一个数据平台的立身之本。
用户之所以愿意看你的统计,是因为他相信这些数字是真的。一旦有一个数字是编的,
整张图表的可信度就归零了。
书里讲"两人合作"时强调代码复审和结对的实时沟通。
"人机结对"在"实时沟通"这点上很相似——我可以随时追问"为什么这么写"。
但有一个本质区别:传统结对中,两个人的水平是接近的,复审是双向的;
而我与 AI 结对时,AI 不会质疑我。如果我的需求本身就错了,
AI 会照着错的需求写出一堆正确的代码。所以"人机结对"中,
人必须承担全部的方向判断责任——这一条比传统结对要求更高,而不是更低。
| 方面 | 评价 |
|---|---|
| 效率 | 极高。后端数据层、前端页面、测试用例,AI 都是几分钟出初稿。没有它,这个工作量我一周也做不完 |
| 知识面 | 帮我省掉了大量查文档的时间(ECharts 配置、SQL 写法、正则) |
| 耐心 | 反复改需求、改文案,从不"抱怨" |
| 自我纠错 | 当我把实测反例("这条 SQL 返回 5 而不是 2")摆出来时,它能准确定位根因并给出正确修法,这是它最有价值的地方 |
| 局限 | 具体表现 |
|---|---|
| 会写出"能跑但错"的代码 | 那条 SQL 就是典型:语法正确、不报错,但统计口径是错的。这是最大的风险——错误不会自己暴露 |
| 知识可能过时 | 设计文档里"用 DBLP"的计划,实测已被反爬拦截。AI 给的建议必须实测验证 |
| 不会质疑需求 | 我的需求错了,它会照着错的需求写出正确的代码。方向判断必须人来负责 |
| 会"想当然" | 比如默认把论文来源写成 CVF,没考虑 ECCV 走的是另一个站点 |
| 不主动验证输出 | 它不会自己构造反例去检验代码。**"构造反例实测"这件事只能人来做** |
AI 是一个产出极快、但需要人全程把关的搭档。
它能把我的想法快速变成可运行的代码,但它不知道这个代码在业务上是不是对的。
所以我的角色从"写代码的人"变成了"定义问题 + 验证结果的人"——
这个角色更难,但也更有价值。
| 来源 | 用途 | 获取方式 |
|---|---|---|
| CVF Open Access | CVPR / ICCV 论文标题 / 作者 / 摘要 / PDF / 来源页 | 程序按会议年份抓取索引页并本地匹配,加 7 天缓存 |
| ECVA | ECCV 论文同上字段 | 同上(ECCV 官方开放获取站) |
本项目所有论文数据均来自上述公开开放获取站点,仅用于课程教学。
平台不生成、不补写任何论文内容;缺失字段一律标注「缺失」。
关键词为从标题与摘要自动提取,不是作者关键词。

