101
社区成员
 发帖
 与我相关
 我的任务

 分享
| 项目 | 内容 |
|---|---|
| 课程 | 202601 福大软件工程实践 W 班 |
| 学号—姓名 | 182400336—赵子龙 |
| 作业要求 | 第二次作业:与 AI 结对编程 |
| 作业目标 | 与 AI 结对完成需求分析、原型、编码、测试、部署和版本发布,构建可运行的 CV 顶会论文热词分析平台。 |
| 项目 | 链接 |
|---|---|
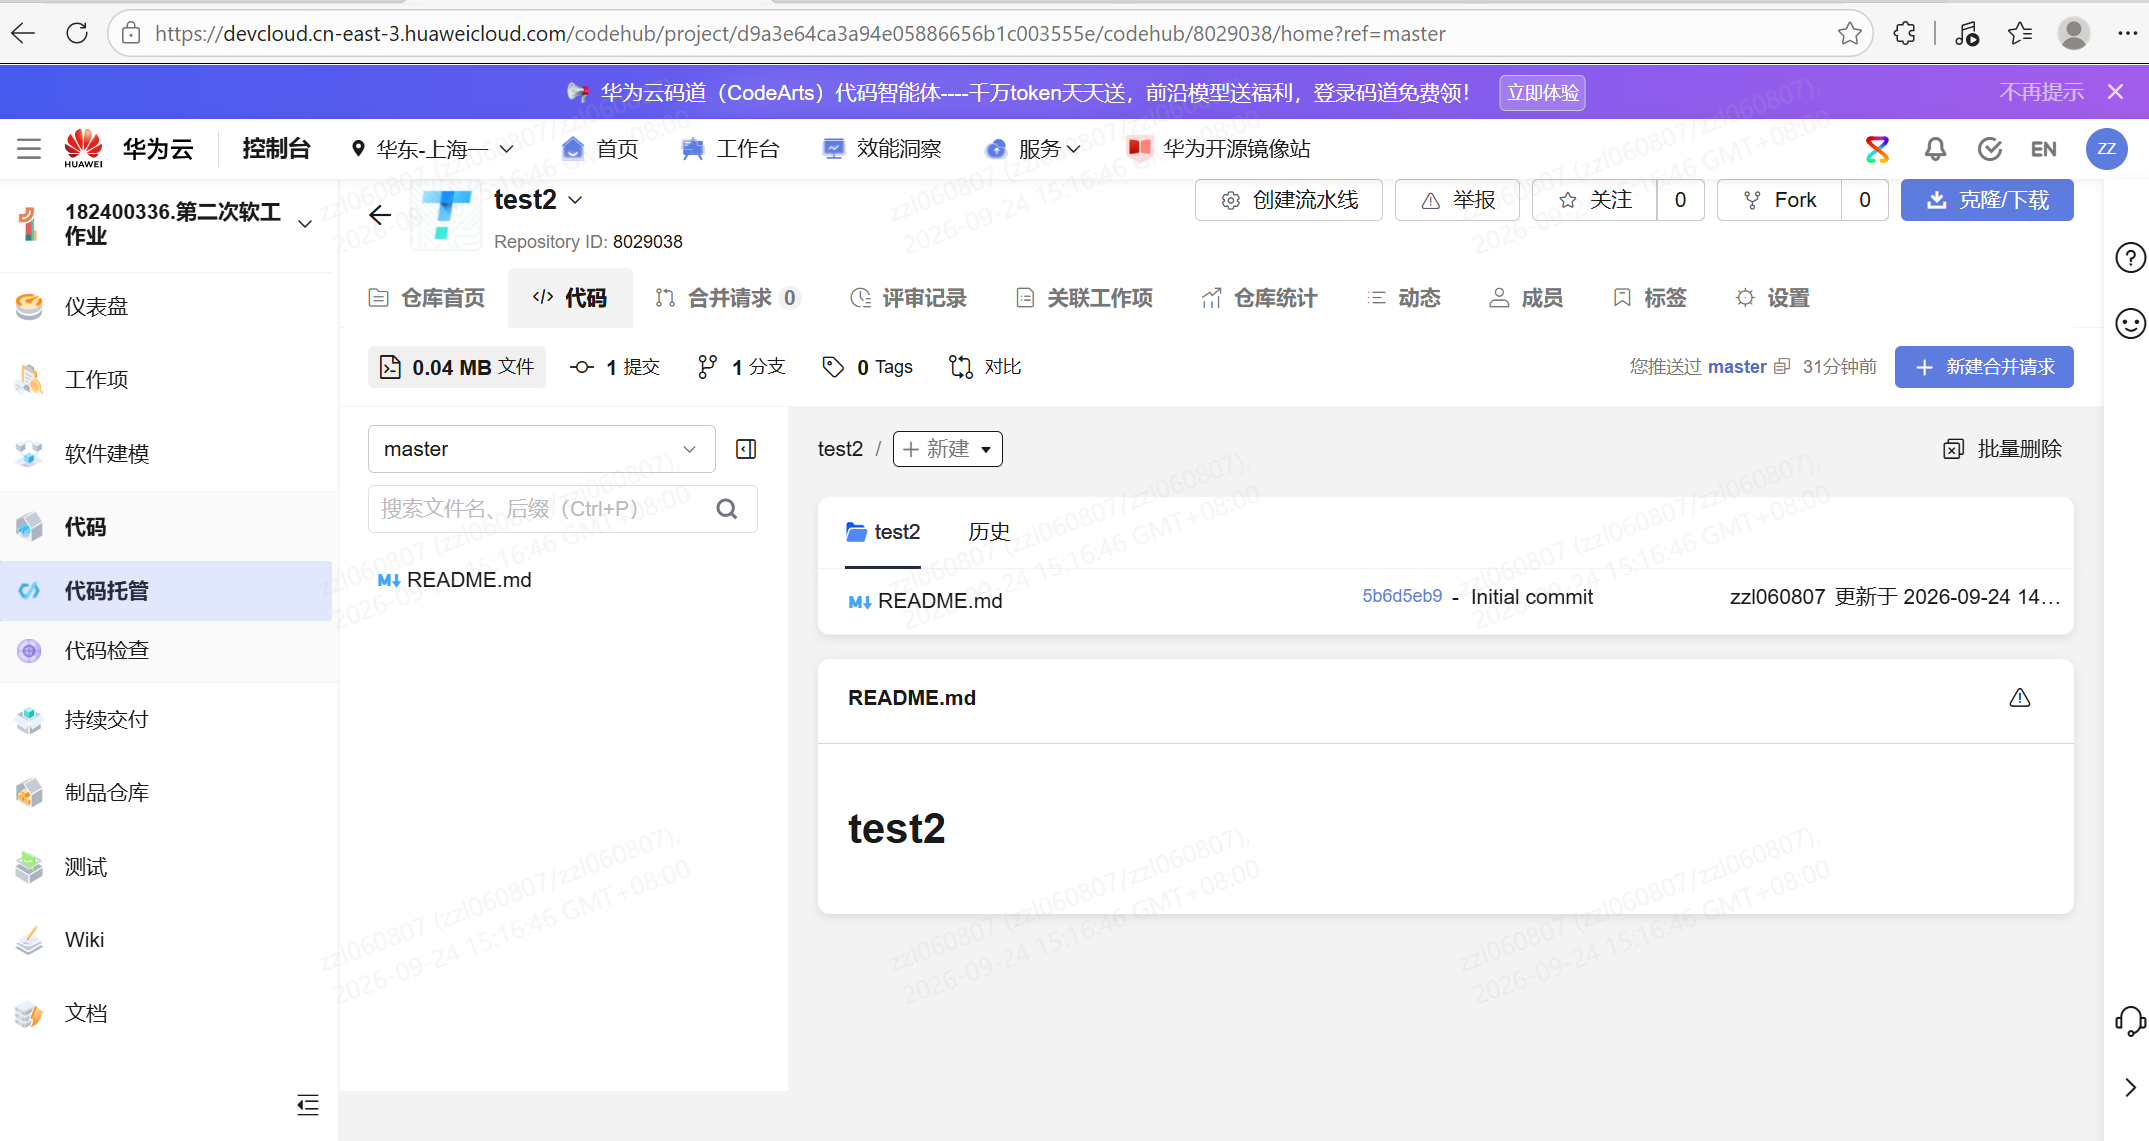
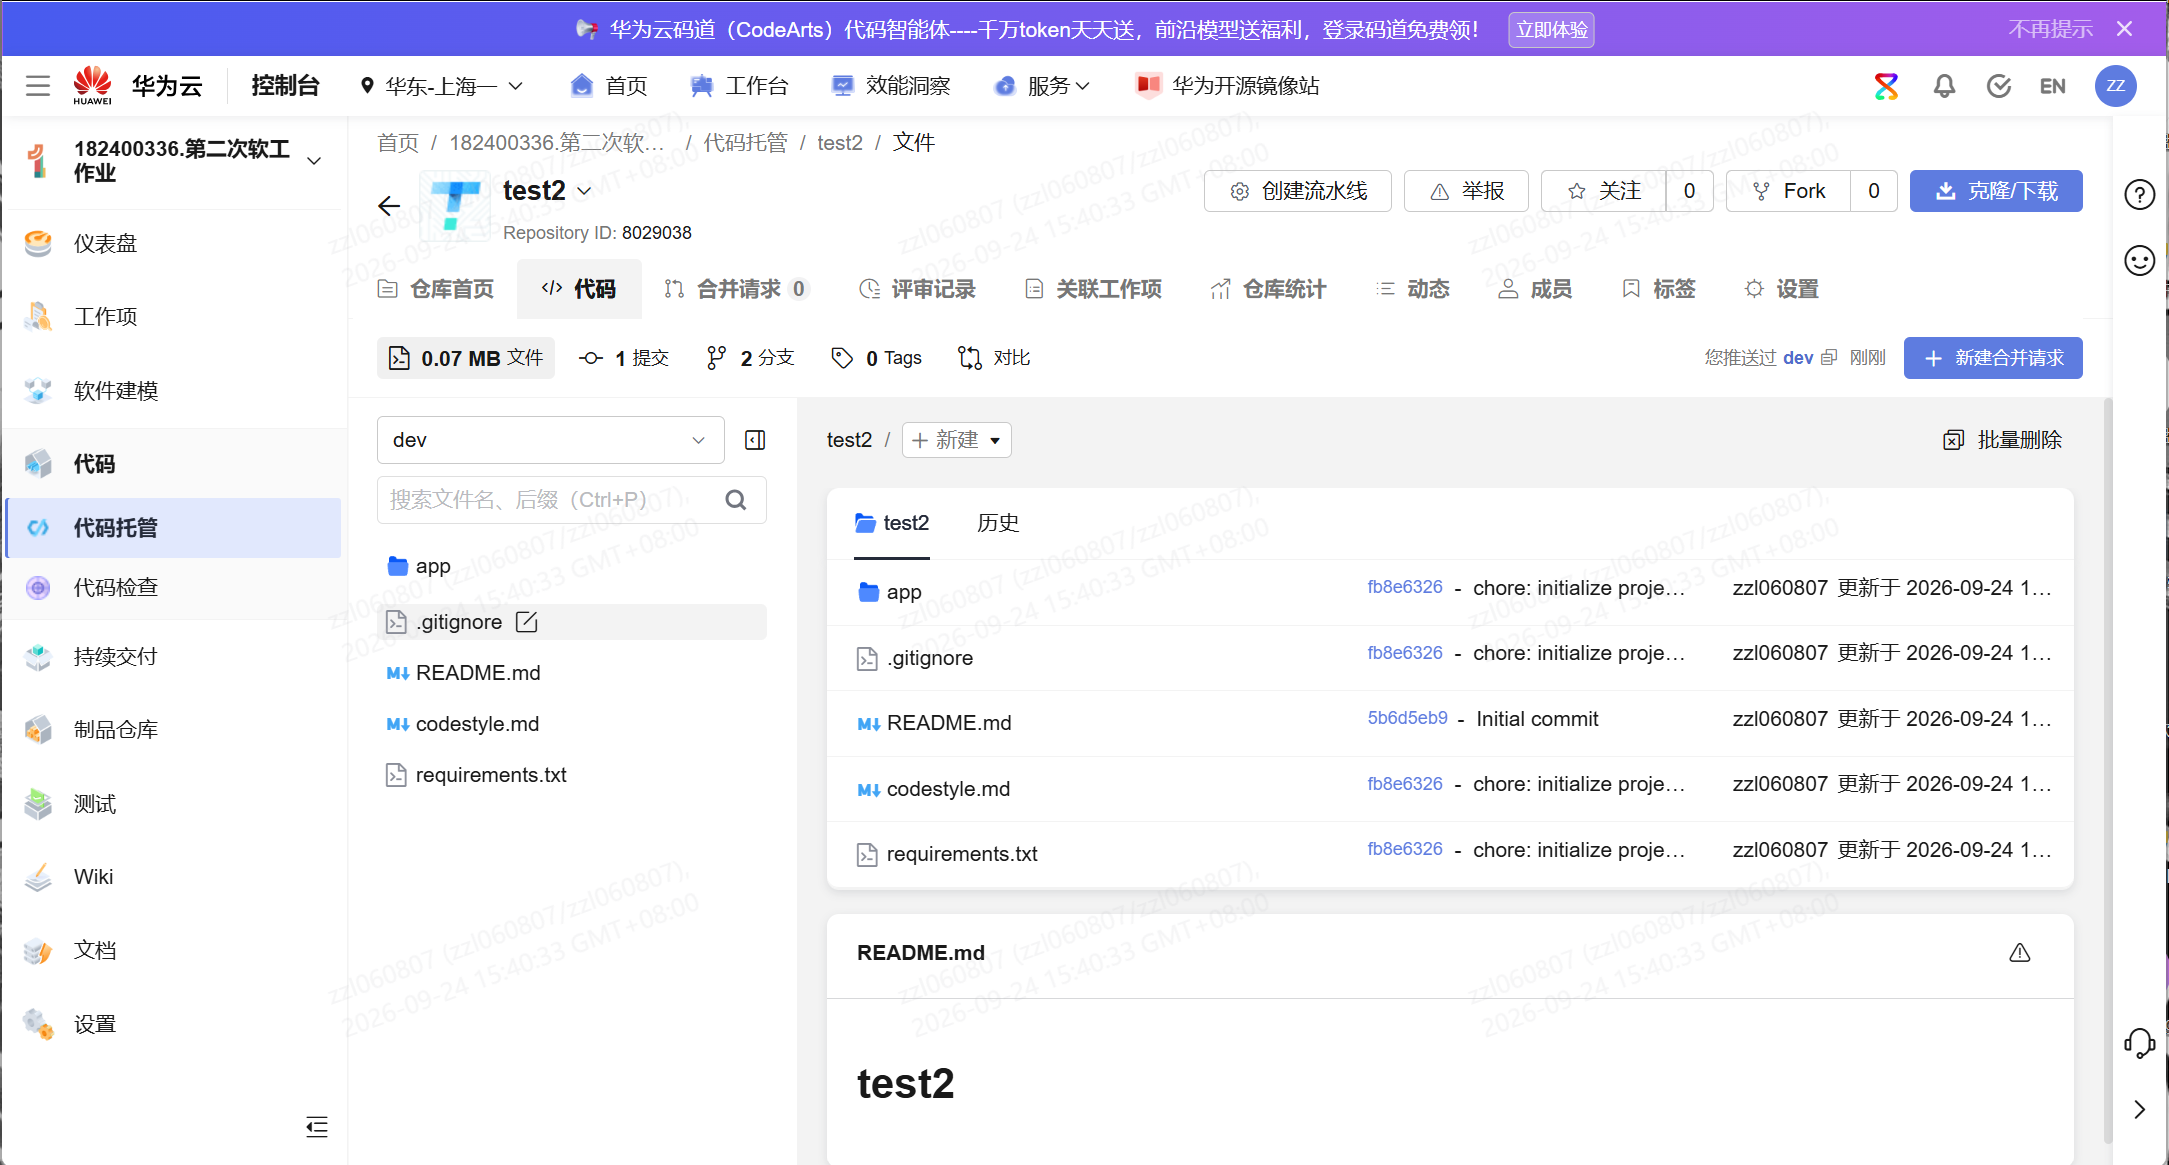
| CodeArts 仓库 | test2 |
| 代码规范 | codestyle.md |
| 墨刀原型 | 交互原型 |
| 公网网站 | https://60.204.200.151/ |
| v1.0.0 标签 | CodeArts v1.0.0 |
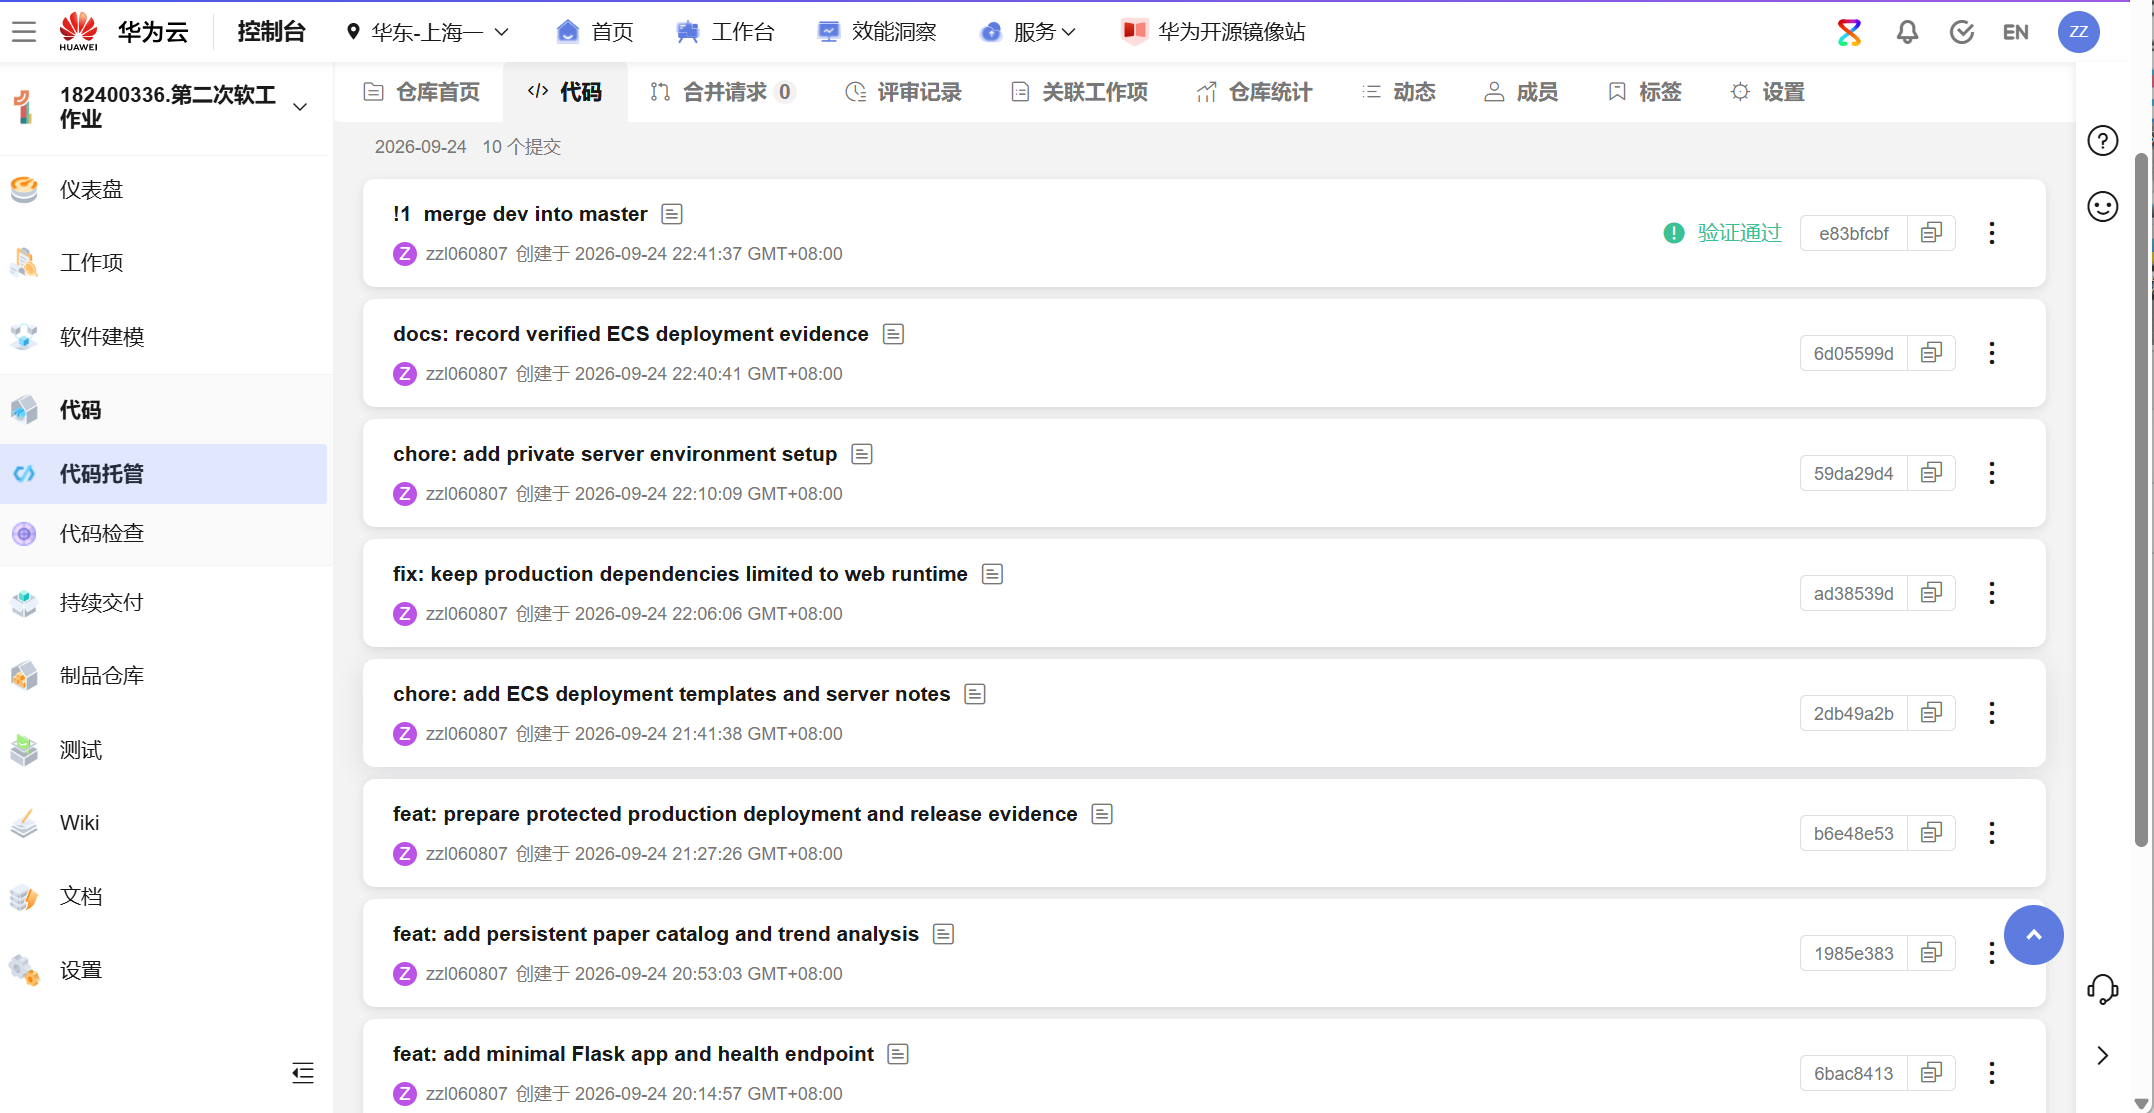
| 合并请求 | dev 合并到 master |
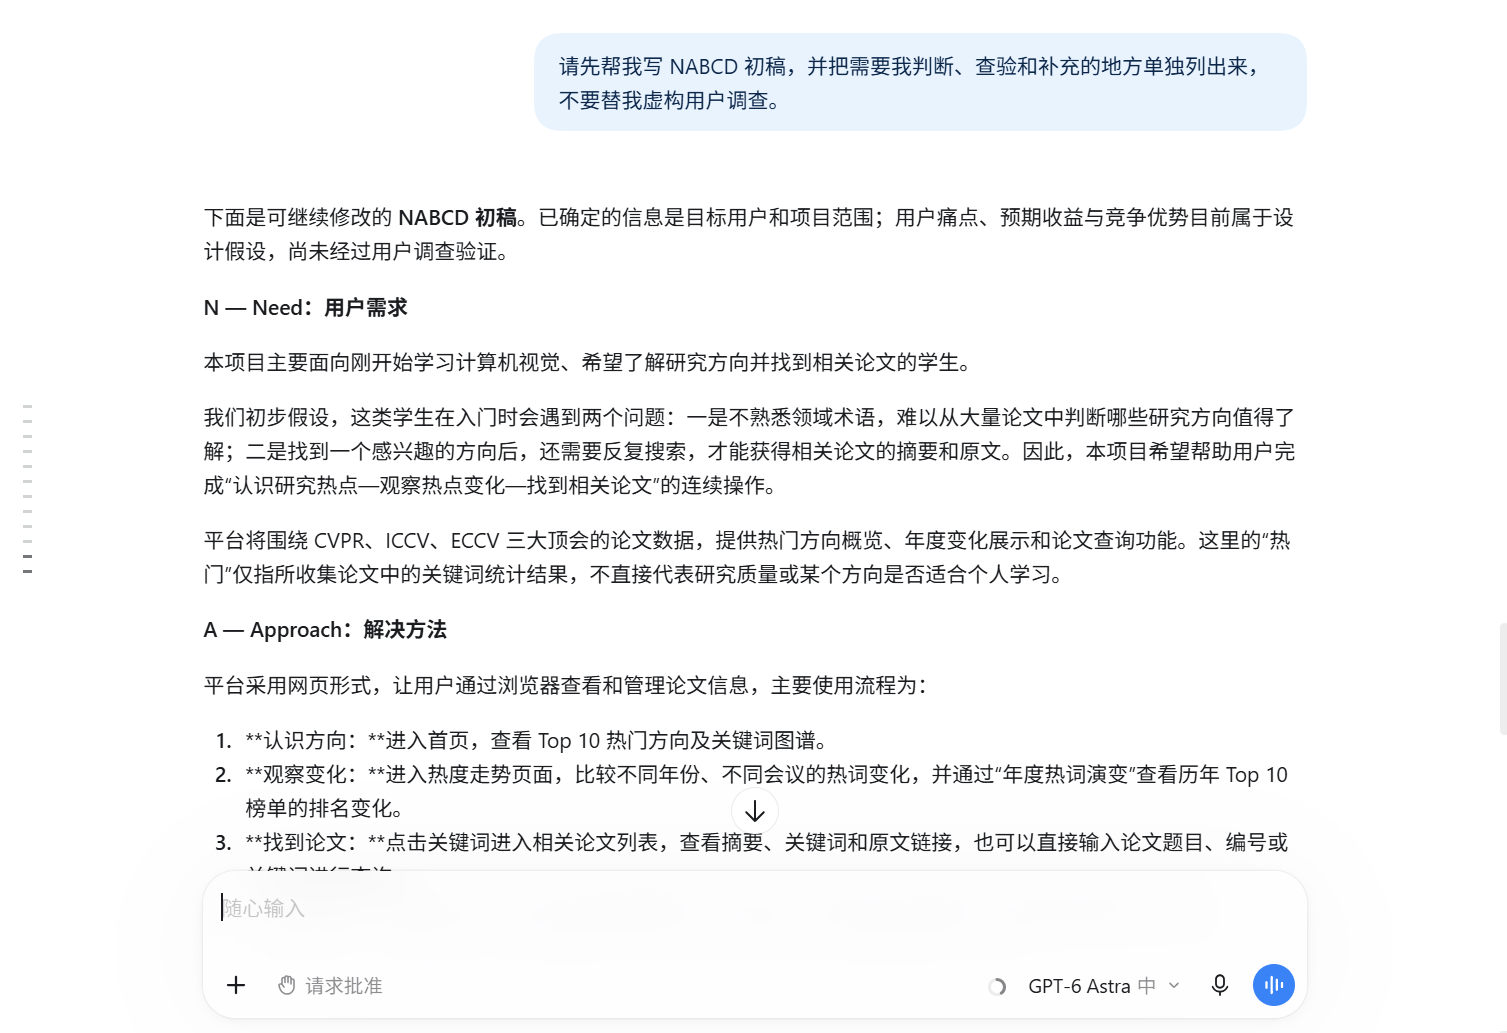
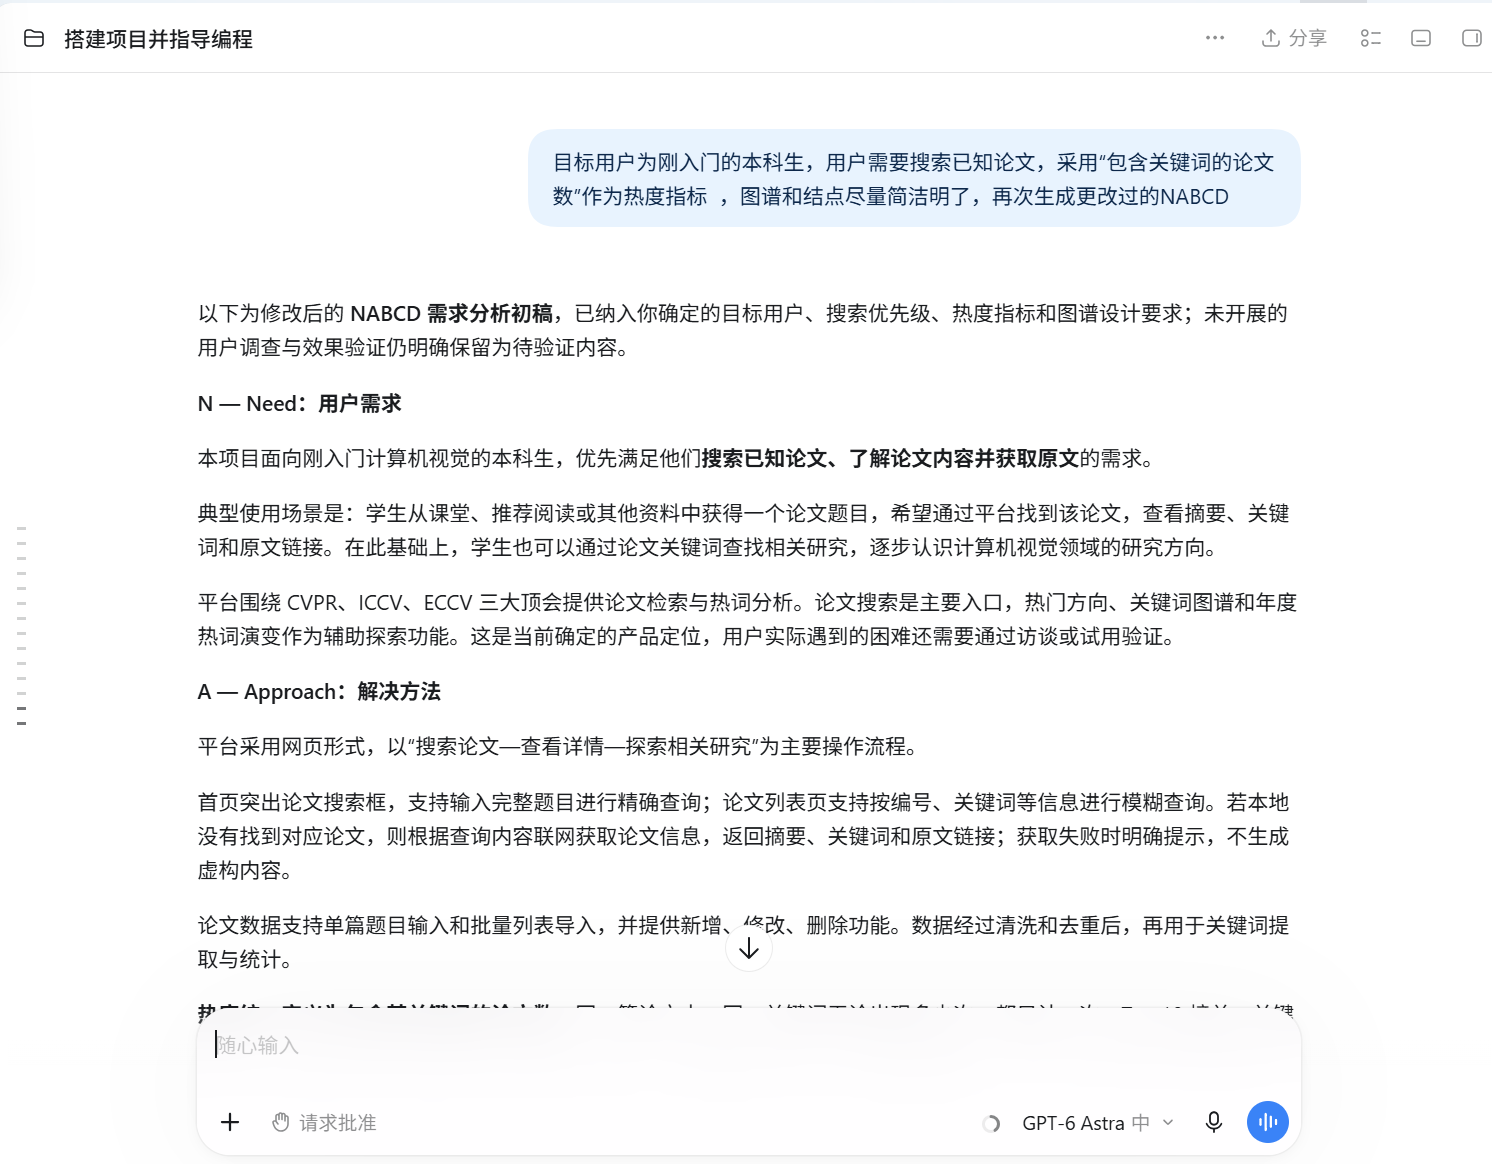
本次主要使用 Codex。AI 负责拆分任务、生成和修改代码、分析测试及部署输出、整理博客结构;我负责确定范围、登录平台、运行命令、核对真实页面并决定最终实现。
以下时间根据本次开发过程回填,单位为分钟,休息和自动下载等待不计入有效工作时间。
| 阶段 | 预估 | 实际 | 偏差原因 |
|---|---|---|---|
| 计划与阅读要求 | 40 | 55 | 对照多个案例 |
| 环境准备 | 60 | 85 | 排查 CodeArts 凭据和服务器环境 |
| NABCD 与原型 | 100 | 125 | 七个页面及交互较多 |
| 数据库与论文管理 | 150 | 175 | 增删改查和校验联调 |
| 联网获取与批量导入 | 160 | 205 | 需核对题名、会议和年份 |
| Top 10、图谱、走势 | 150 | 180 | 统一统计口径 |
| 测试与修复 | 100 | 145 | 处理 SQL 通配符和依赖问题 |
| 云部署与发布 | 120 | 190 | CentOS 7 环境较旧并配置 HTTPS |
| 截图、GIF、博客 | 100 | 135 | 核对证据与最终页面 |
| 合计 | 980 | 1295 | 比预估多 315 分钟 |
本项目面向希望快速了解计算机视觉研究热点的学生、课程教师和初学者。CVPR、ICCV、ECCV 每年收录大量论文,直接逐篇阅读成本较高;普通搜索只能返回论文列表,难以回答“某个会议和年份最常出现哪些关键词”“两个关键词是否经常共同出现”“某个方向近几年是上升还是下降”等问题。
用户主要有五类需求:
系统采用 Flask、SQLite 和服务分层实现一个满足作业要求的最小完整闭环。
与仅展示静态词云或论文列表相比,本项目提供了从“论文来源”到“关键词统计”再到“相关论文反查”的完整链路。
| 对比对象 | 优点 | 局限 | 本项目的差异 |
|---|---|---|---|
| Google Scholar | 覆盖广、引用检索强 | 热词统计和共现分析不是核心功能 | 聚焦三大 CV 顶会,提供 Top 10、图谱和走势 |
| OpenAlex | 开放 API、元数据丰富 | 候选结果仍需核对,界面不针对课程场景 | 对标题、会议、年份进行二次校验后入库 |
| CVF / ECVA | 官方论文页面可靠 | 以浏览和下载论文为主,缺少统一趋势视图 | 保留官方来源链接,同时形成统一数据库 |
| 普通词云工具 | 生成快、视觉直观 | 缺少论文详情、年份维度和结果追溯 | 每个关键词可反查论文,并提供年度统计口径 |
| 同类课程作品 | 展示形式可能更丰富 | 部分只使用静态样例或来源说明不清 | 完成真实联网导入、持久化、自动测试与公网部署 |
本项目不追求替代大型学术搜索引擎,而是强调“小而完整、数据可核对、统计可解释、结果可复现”。当前样本数量有限,因此页面明确声明结果只代表已收录数据,不能据此断言整个领域的真实热点。
项目采用多种可验证成果进行交付:
推广方式以课程班级社区和仓库链接为主。验收时可按“打开公网首页→查询论文→查看详情→真实导入→查看图谱→播放走势→检查仓库版本”的顺序体验。后续若继续扩展,可增加更多会议年份、改进关键词抽取算法和完善普通用户权限,但本次交付优先保证作业要求内的功能真实可用。
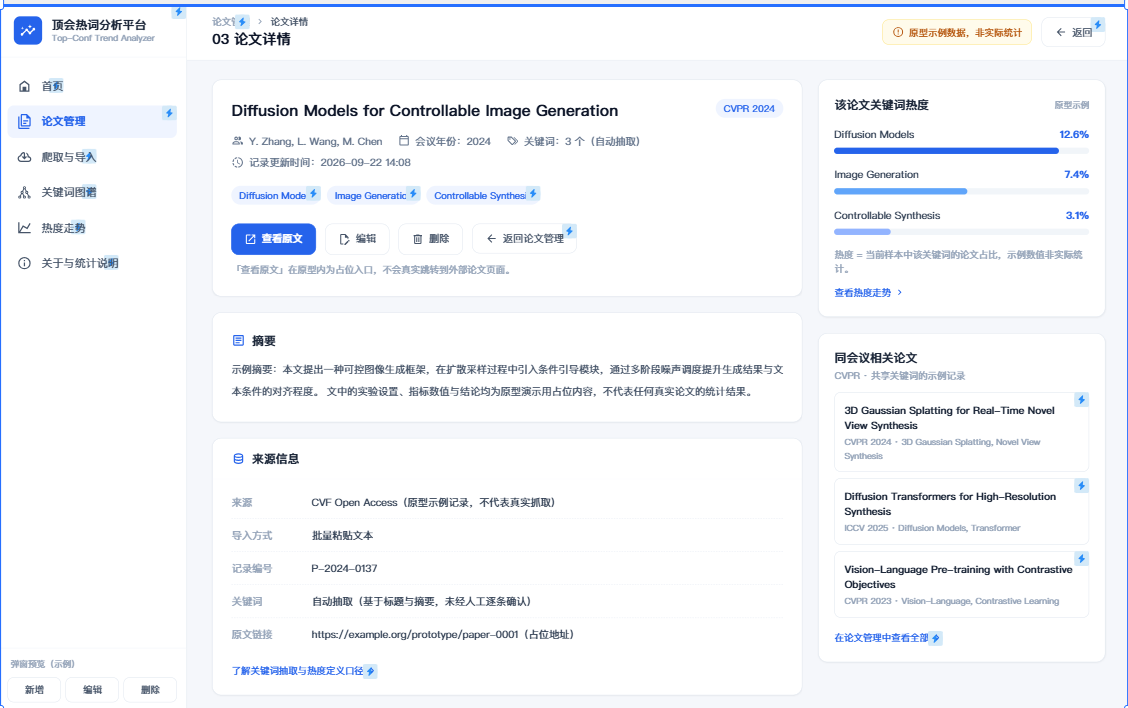
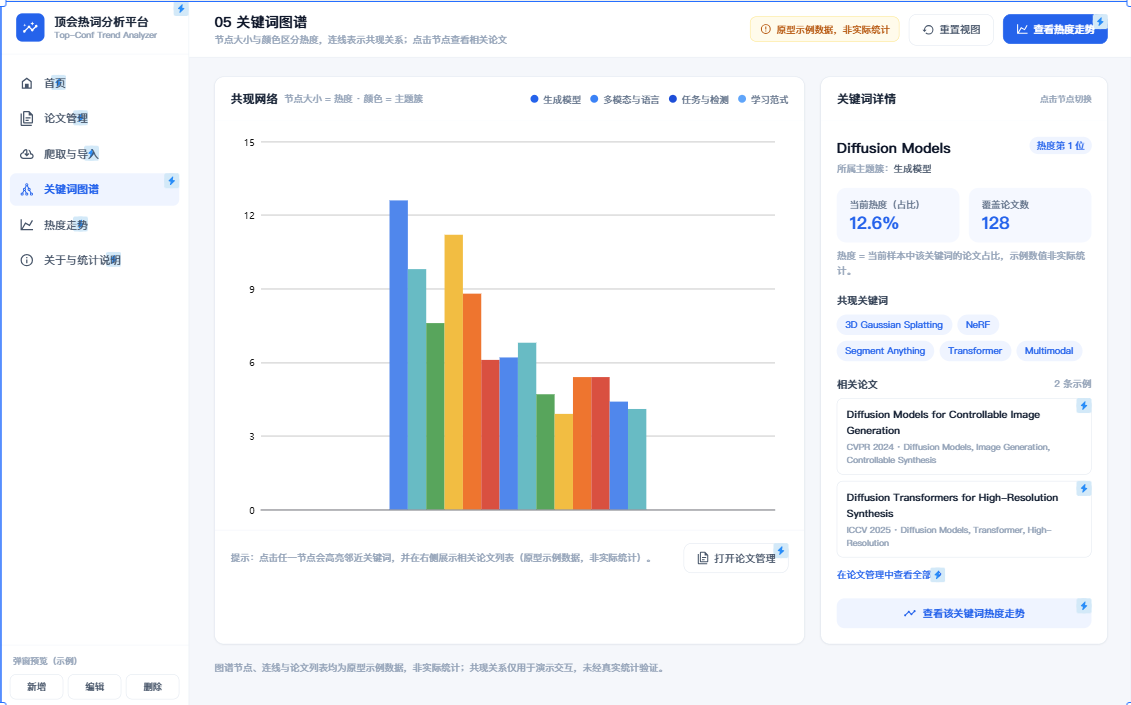
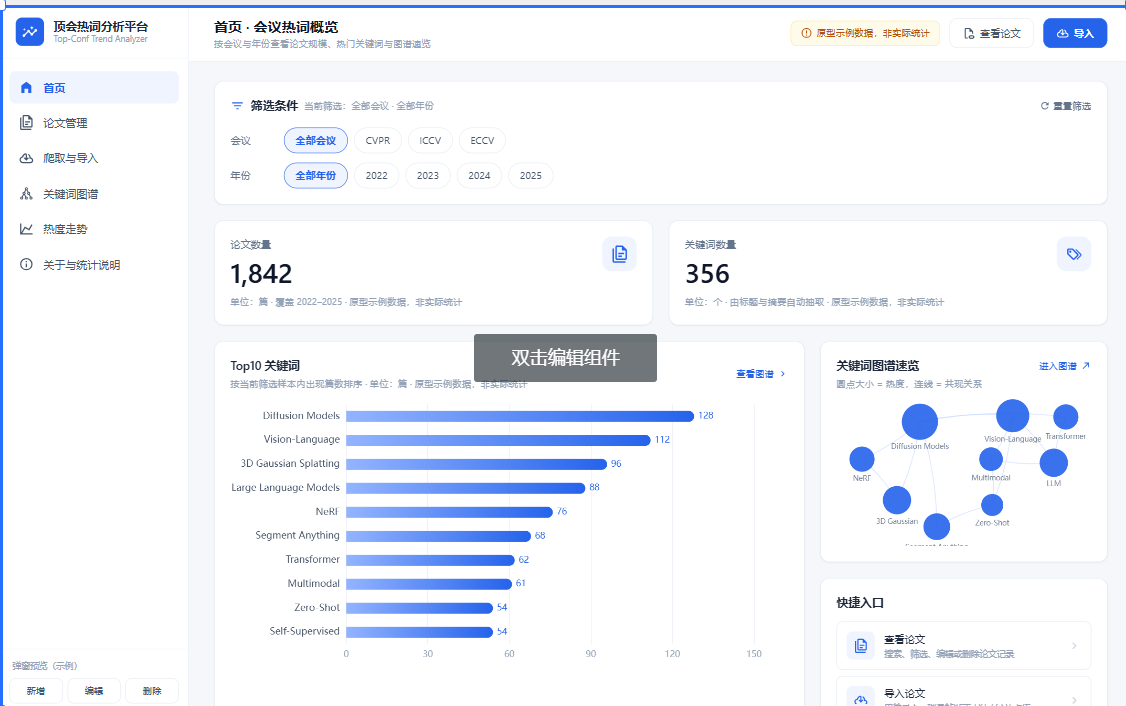
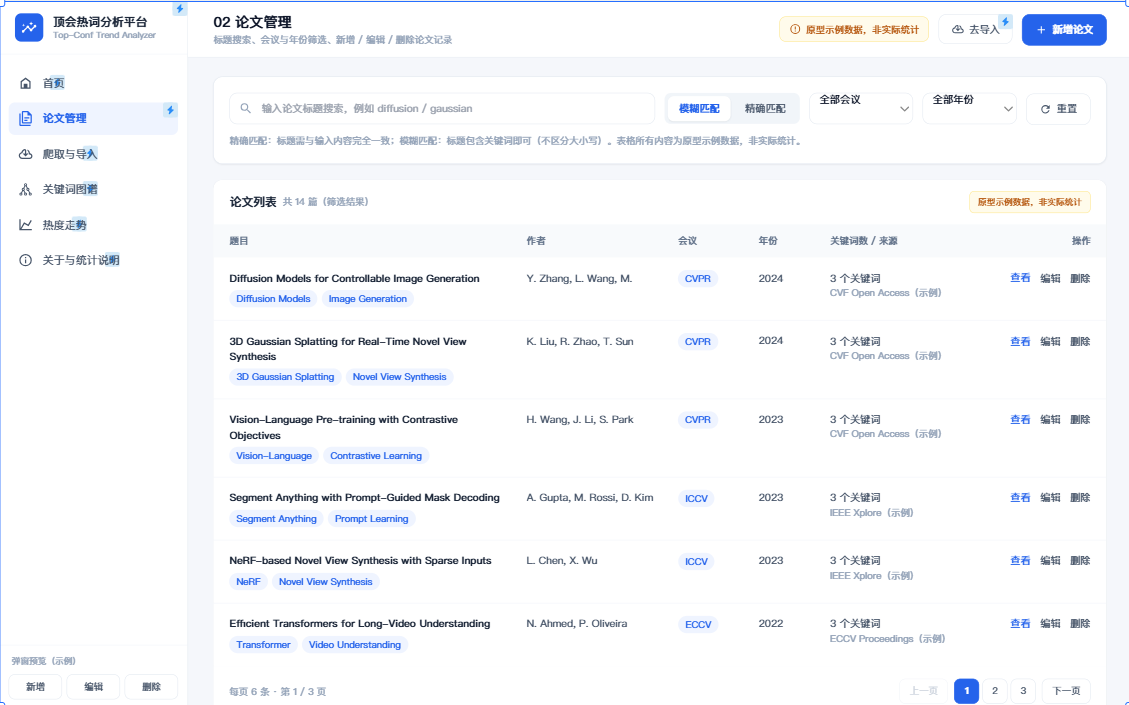
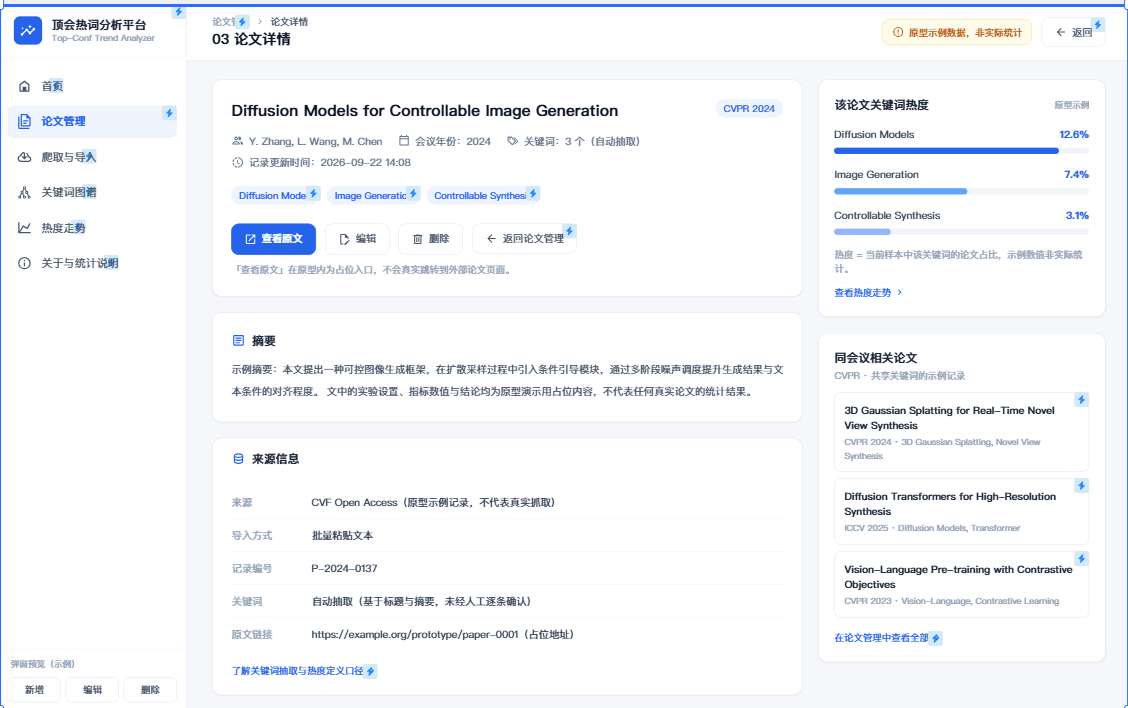
原型统一采用浅灰背景、白色卡片和蓝色主色,共设计首页、论文管理、论文详情、爬取与导入、关键词图谱、热度走势、关于与统计说明七个页面,连接导航、详情、新增、编辑、删除确认、导入结果和趋势播放等主要交互。
原型截图已保存在“顶会热词统计作业/原型截图”,分享链接见上表。
功能结构:论文管理(列表、详情、增删改查)→ 数据导入(单篇、逐行、TXT、去重)→ 数据分析(Top 10、共现图谱、年度趋势)→ 运维接口(/api/health、/api/version)。
技术链路:浏览器 → Nginx(HTTPS) → Gunicorn → Flask → SQLite;联网获取服务访问 OpenAlex、CVF 和 ECVA。
统计口径:关键词论文数是筛选范围内包含该词的不同论文数量;占比为关键词论文数除以当前范围已收录论文总数。图谱节点大小表示论文数,连线权重表示共同出现次数。趋势按“关键词×会议×年份”聚合,并区分“未举办”“未收录”和“已收录但命中 0 篇”。每篇论文内同一关键词只计算一次。
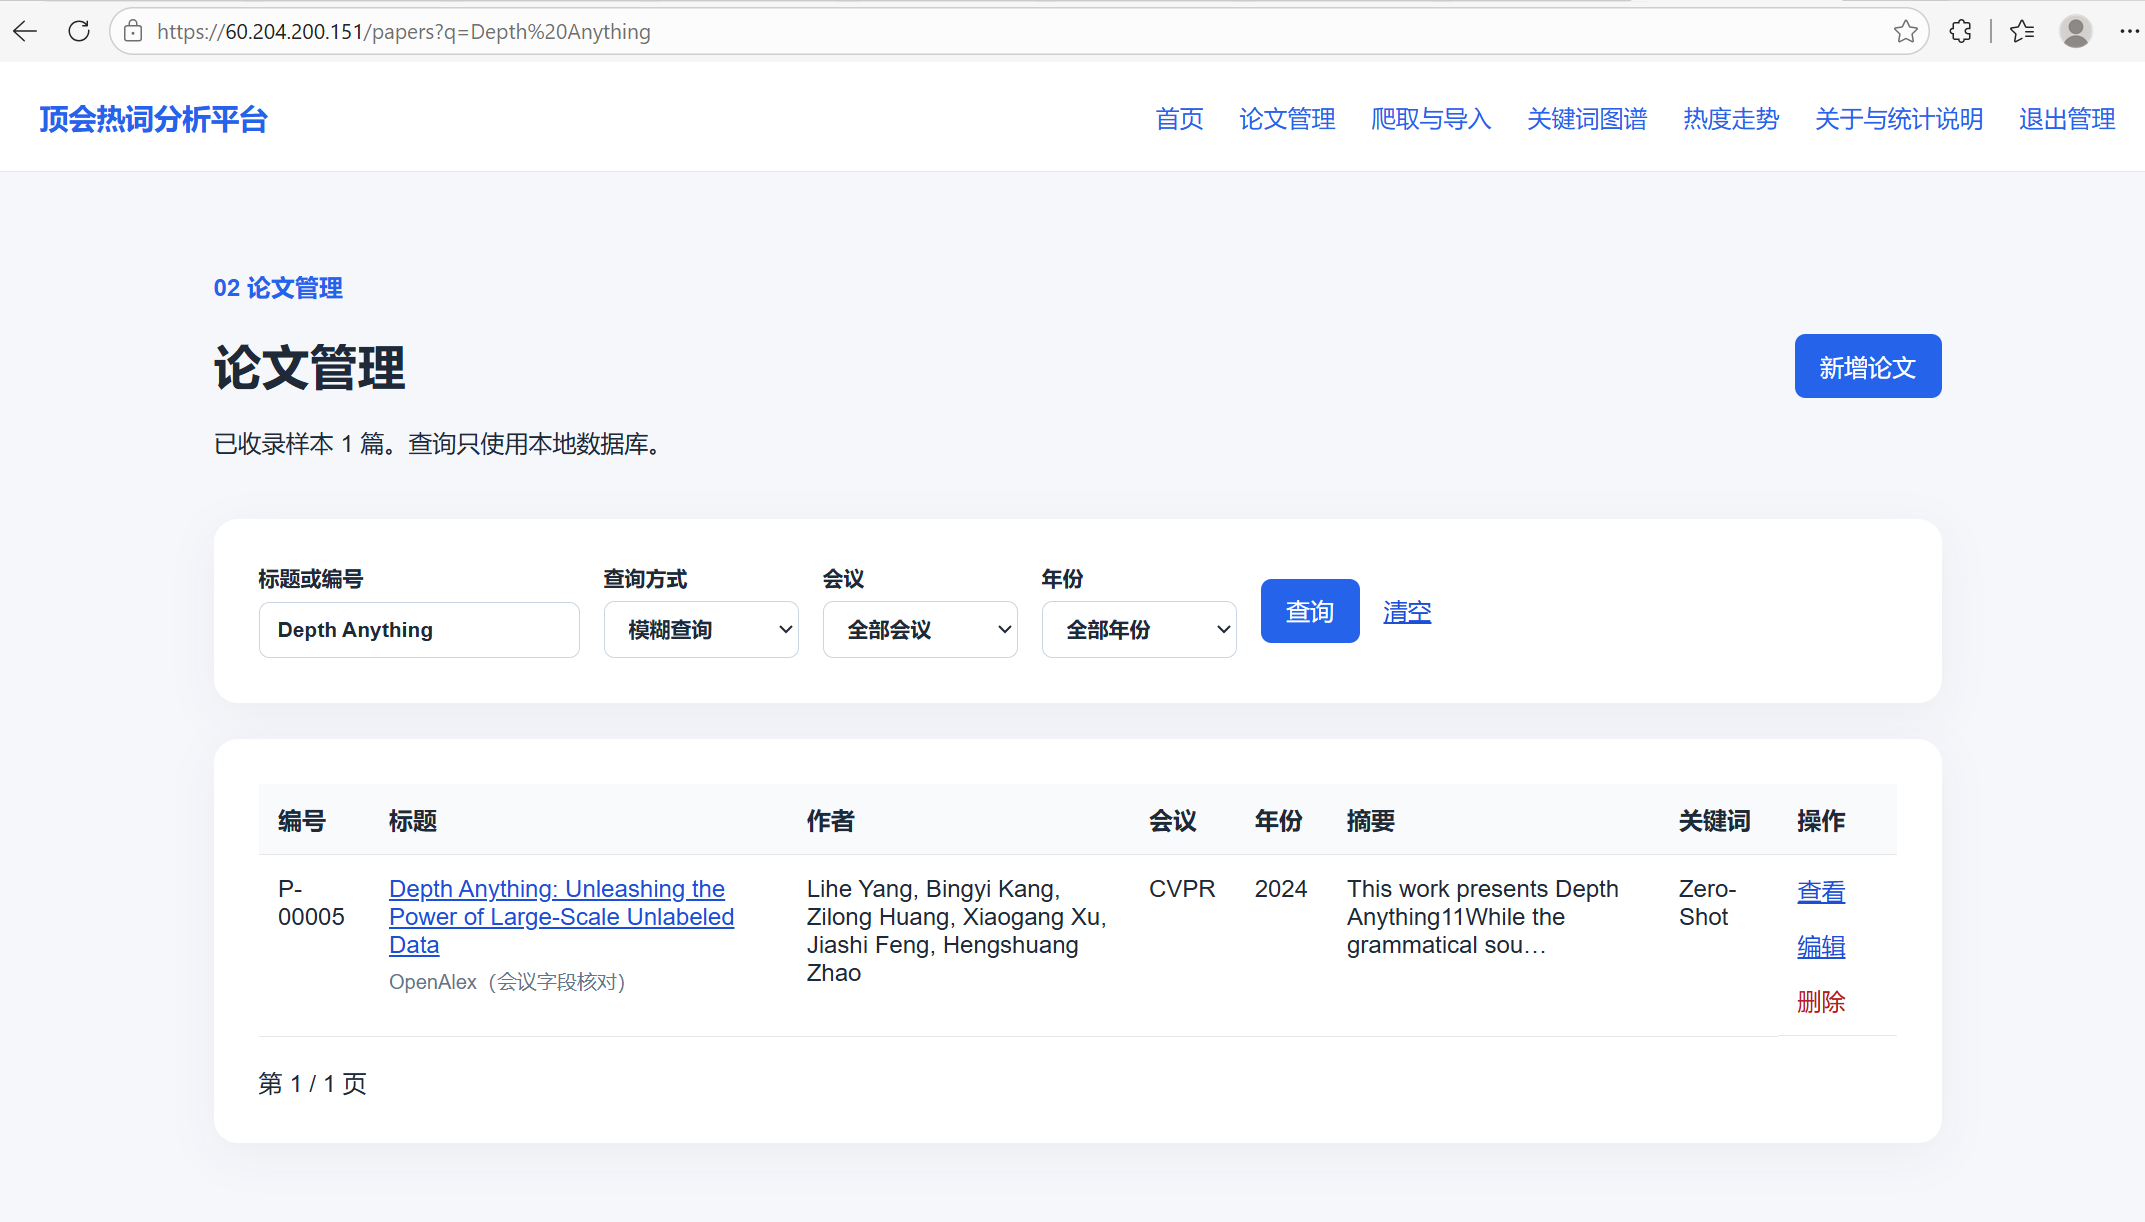
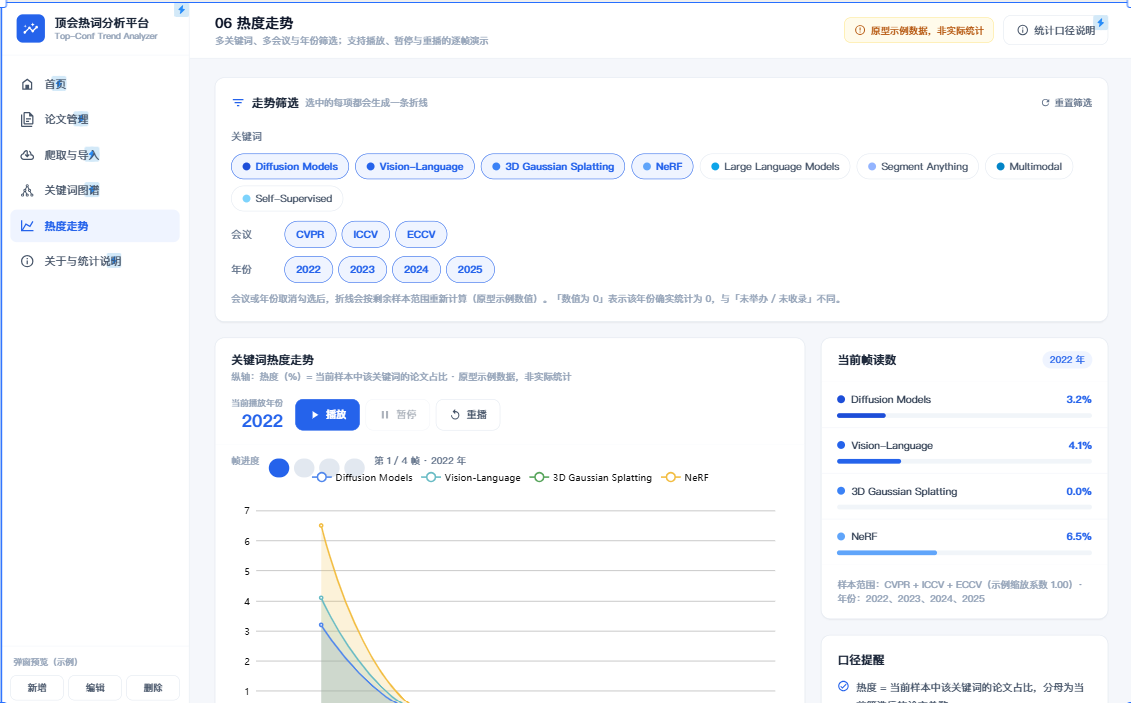
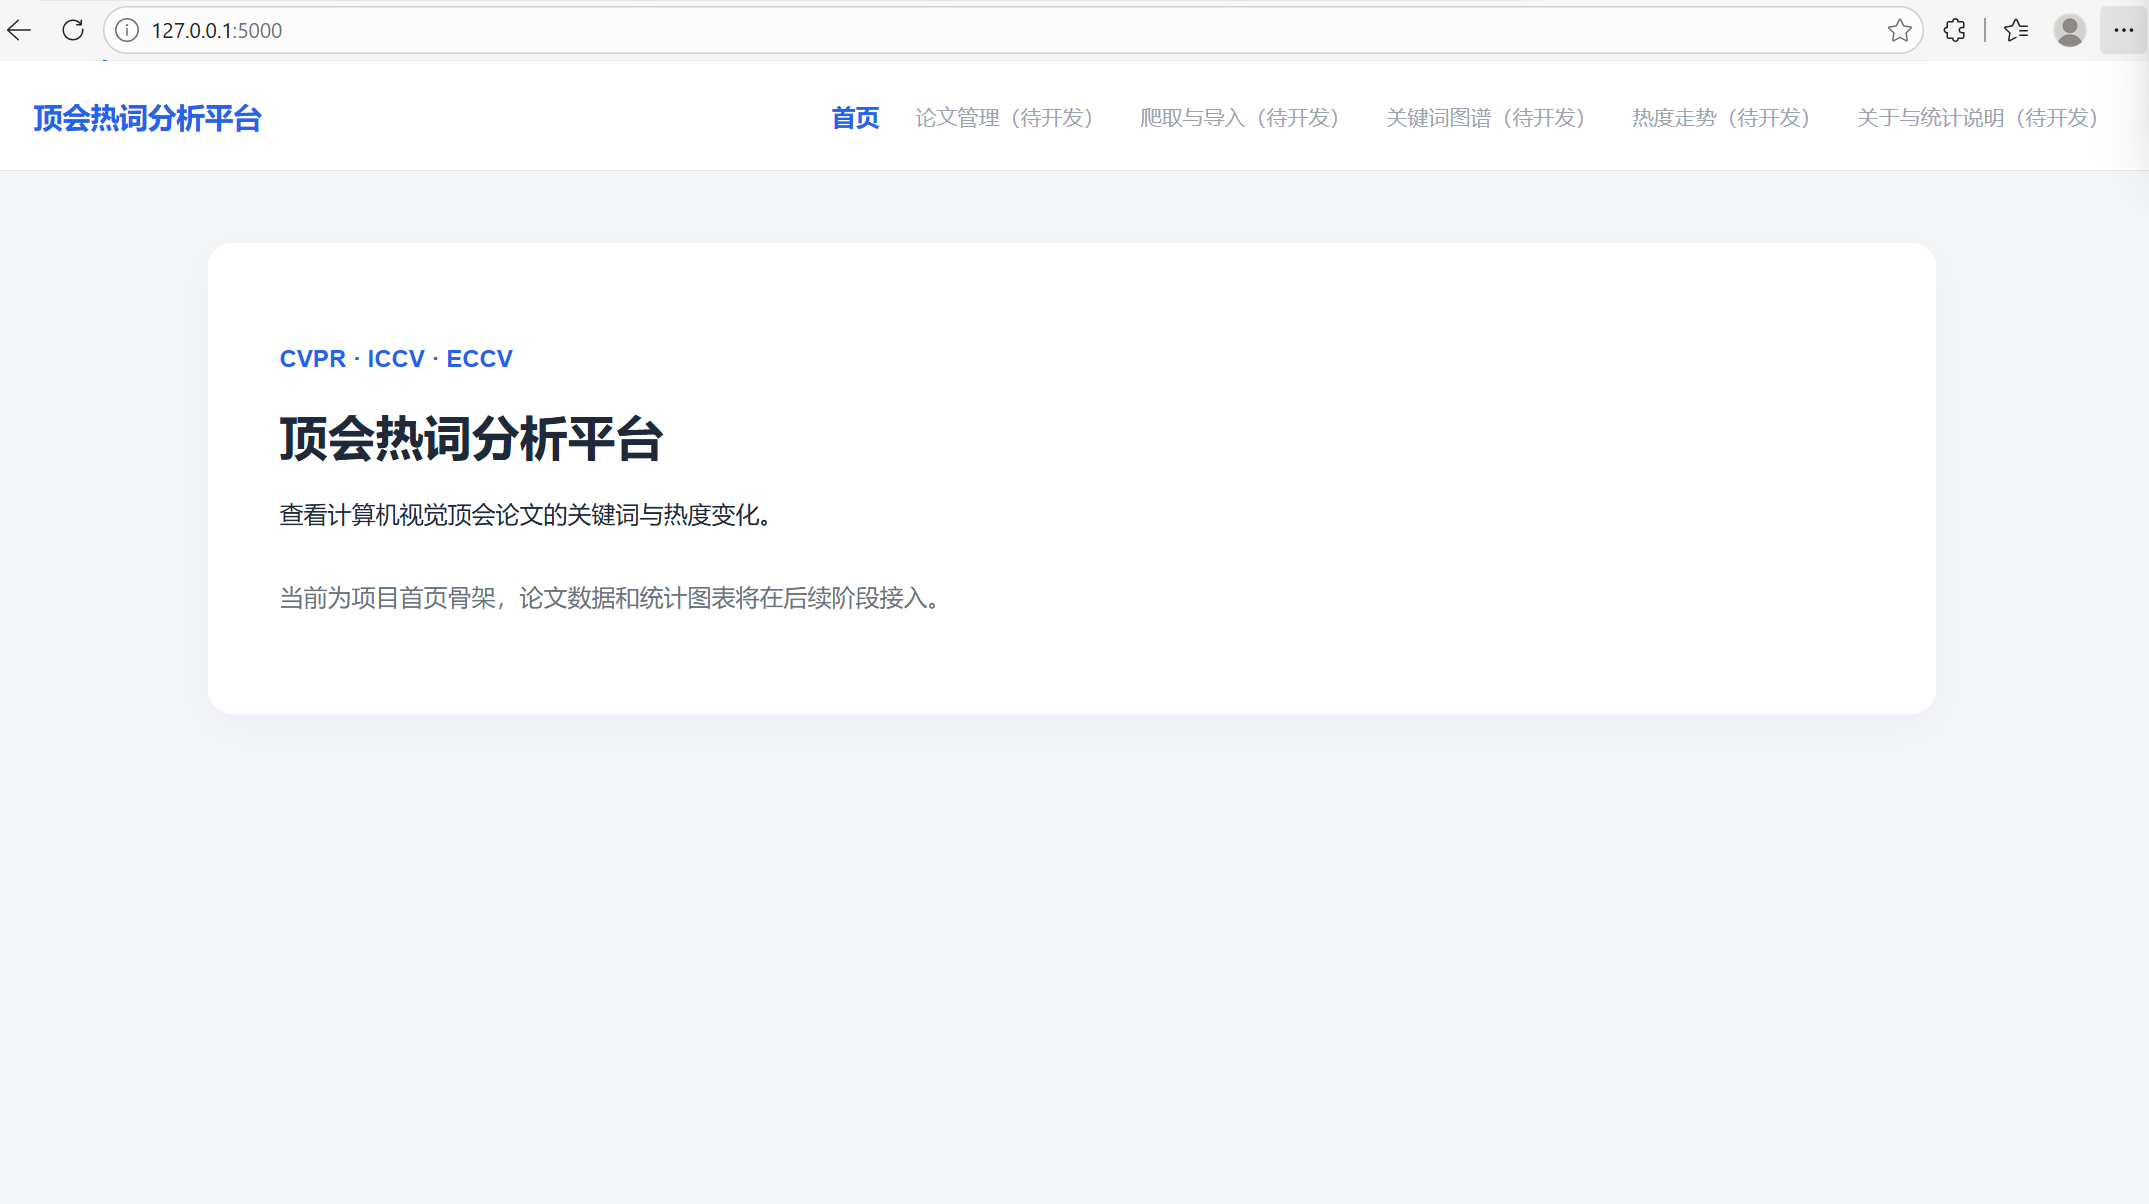
公网首页可按会议和年份显示样本数及 Top 10;论文管理支持分页、详情、精确标题以及标题片段、编号、关键词模糊查询;导入页支持单篇和批量处理;图谱节点可下钻到相关论文;走势页支持播放、暂停、重播。
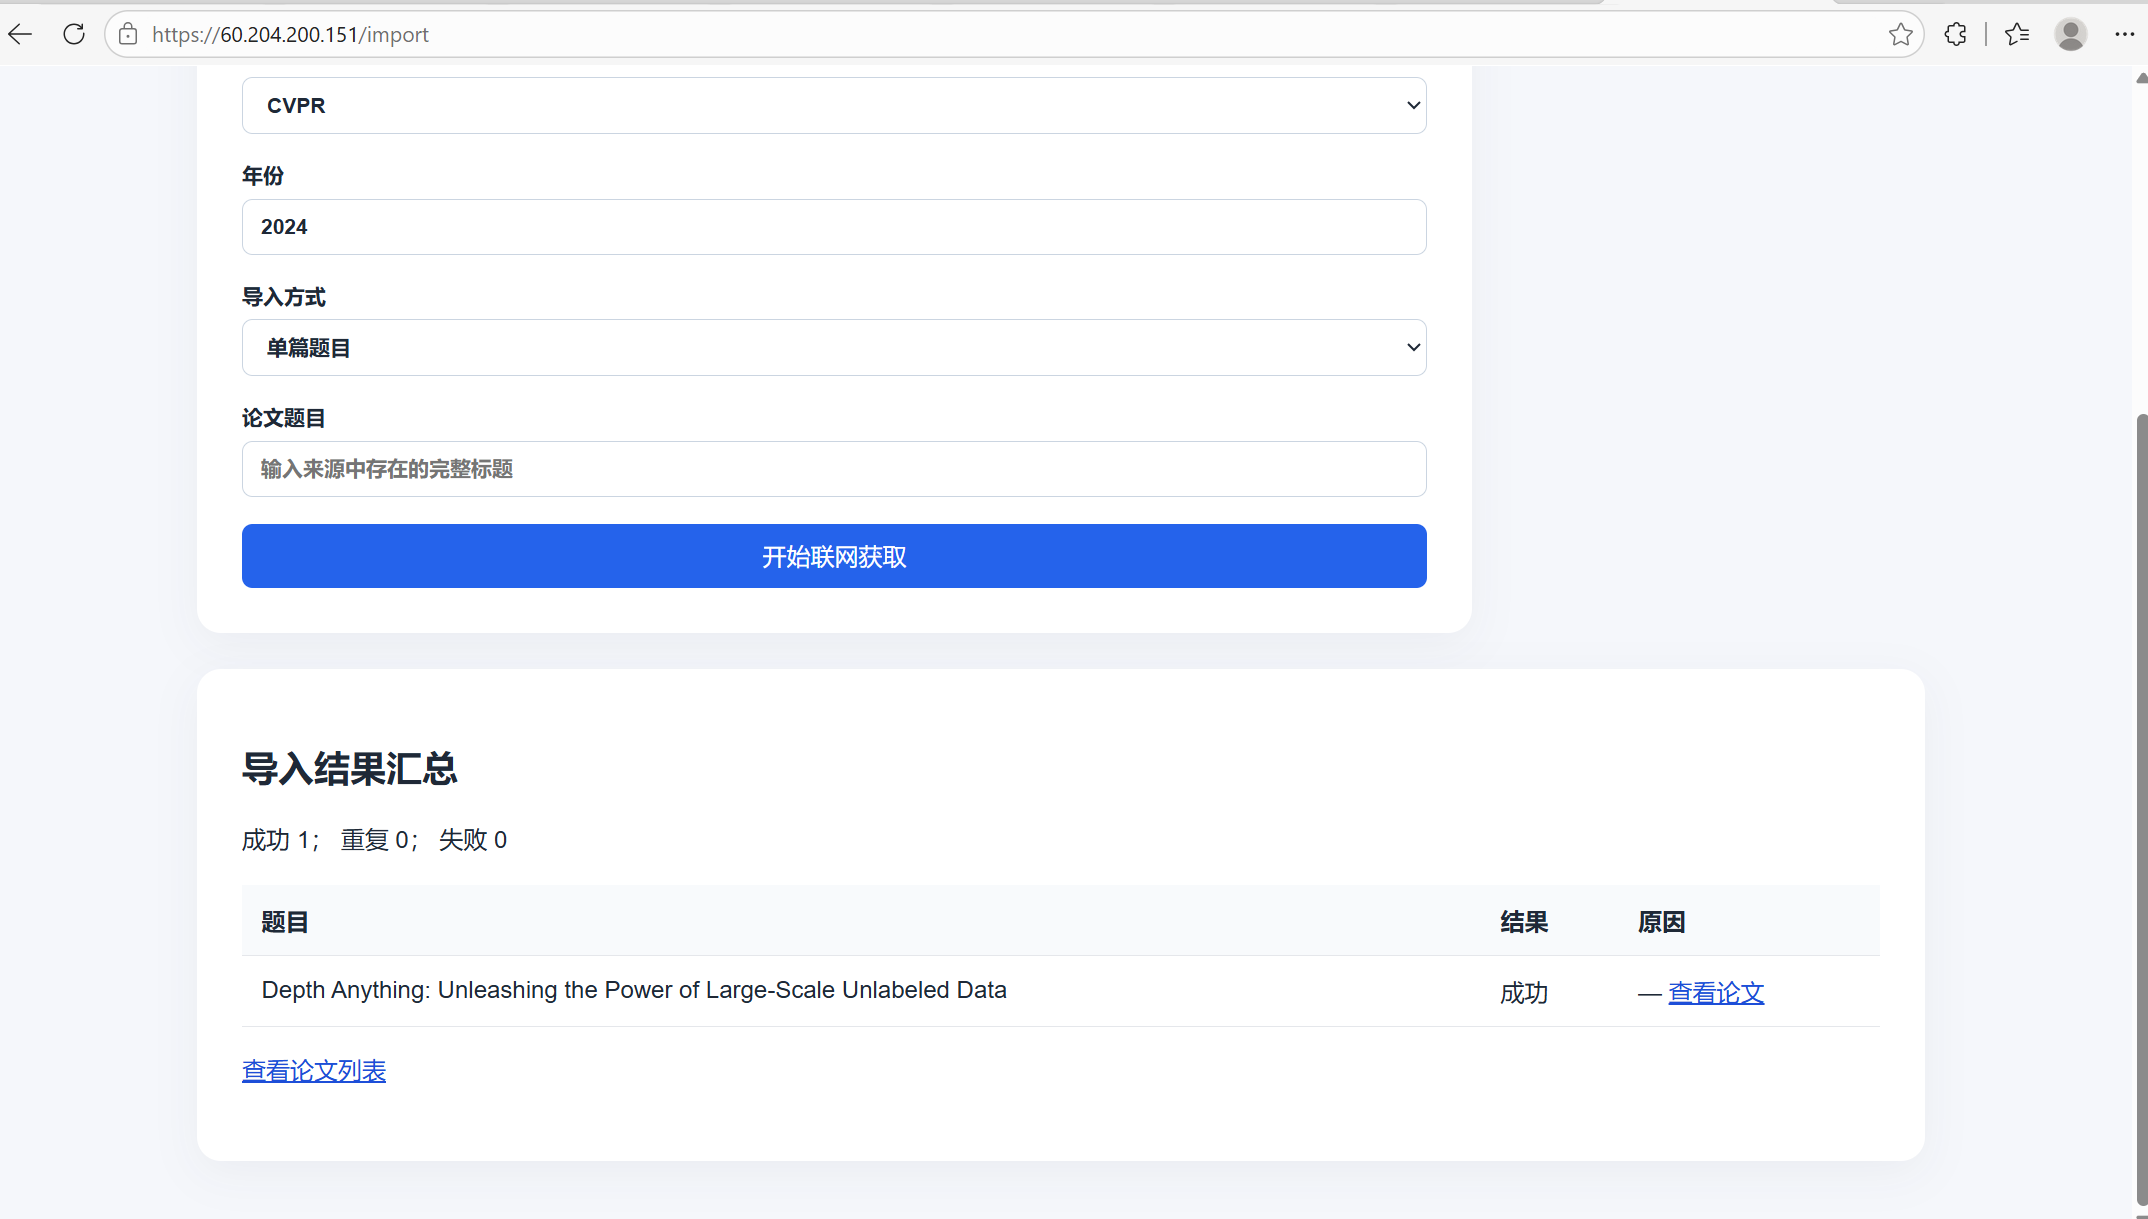
真实导入时选择 CVPR 2024,输入 Depth Anything: Unleashing the Power of Large-Scale Unlabeled Data,系统严格核对后显示“成功 1、重复 0、失败 0”。服务重启后再次查询,该论文仍然存在。
本地和华为云 ECS 均运行 7 项自动测试,结果为 Ran 7 tests、OK。测试覆盖页面和健康接口、CRUD 持久化、输入校验和去重、精确/模糊查询、手算统计、混合批量导入、在线标题校验和生产写操作保护。
| 验收项 | 实际结果 |
|---|---|
| 首页、列表、图谱、趋势、说明 | HTTP 200 |
| /api/health | status=ok |
| 单篇真实导入 | 成功 1、重复 0、失败 0 |
| 服务重启后查询 | 数据仍在 |
| HTTPS | 浏览器正常打开,无证书警告 |
真实调试案例:查询 % 时,SQL LIKE 把它当成通配符,错误匹配全部论文。修复时转义通配符,并限制只有纯数字查询词才搜索数字编号。重新测试后 % 返回 0 条,普通标题、编号和关键词查询仍正确。
服务器为华为云 ECS,CentOS 7.6、1 vCPU、约 1 GB 内存。应用使用独立 Python 3.11,Gunicorn 监听本机端口,Nginx 提供 HTTPS 反向代理,systemd 负责常驻运行。Let's Encrypt 公网 IP 证书已签发,并配置自动续期。
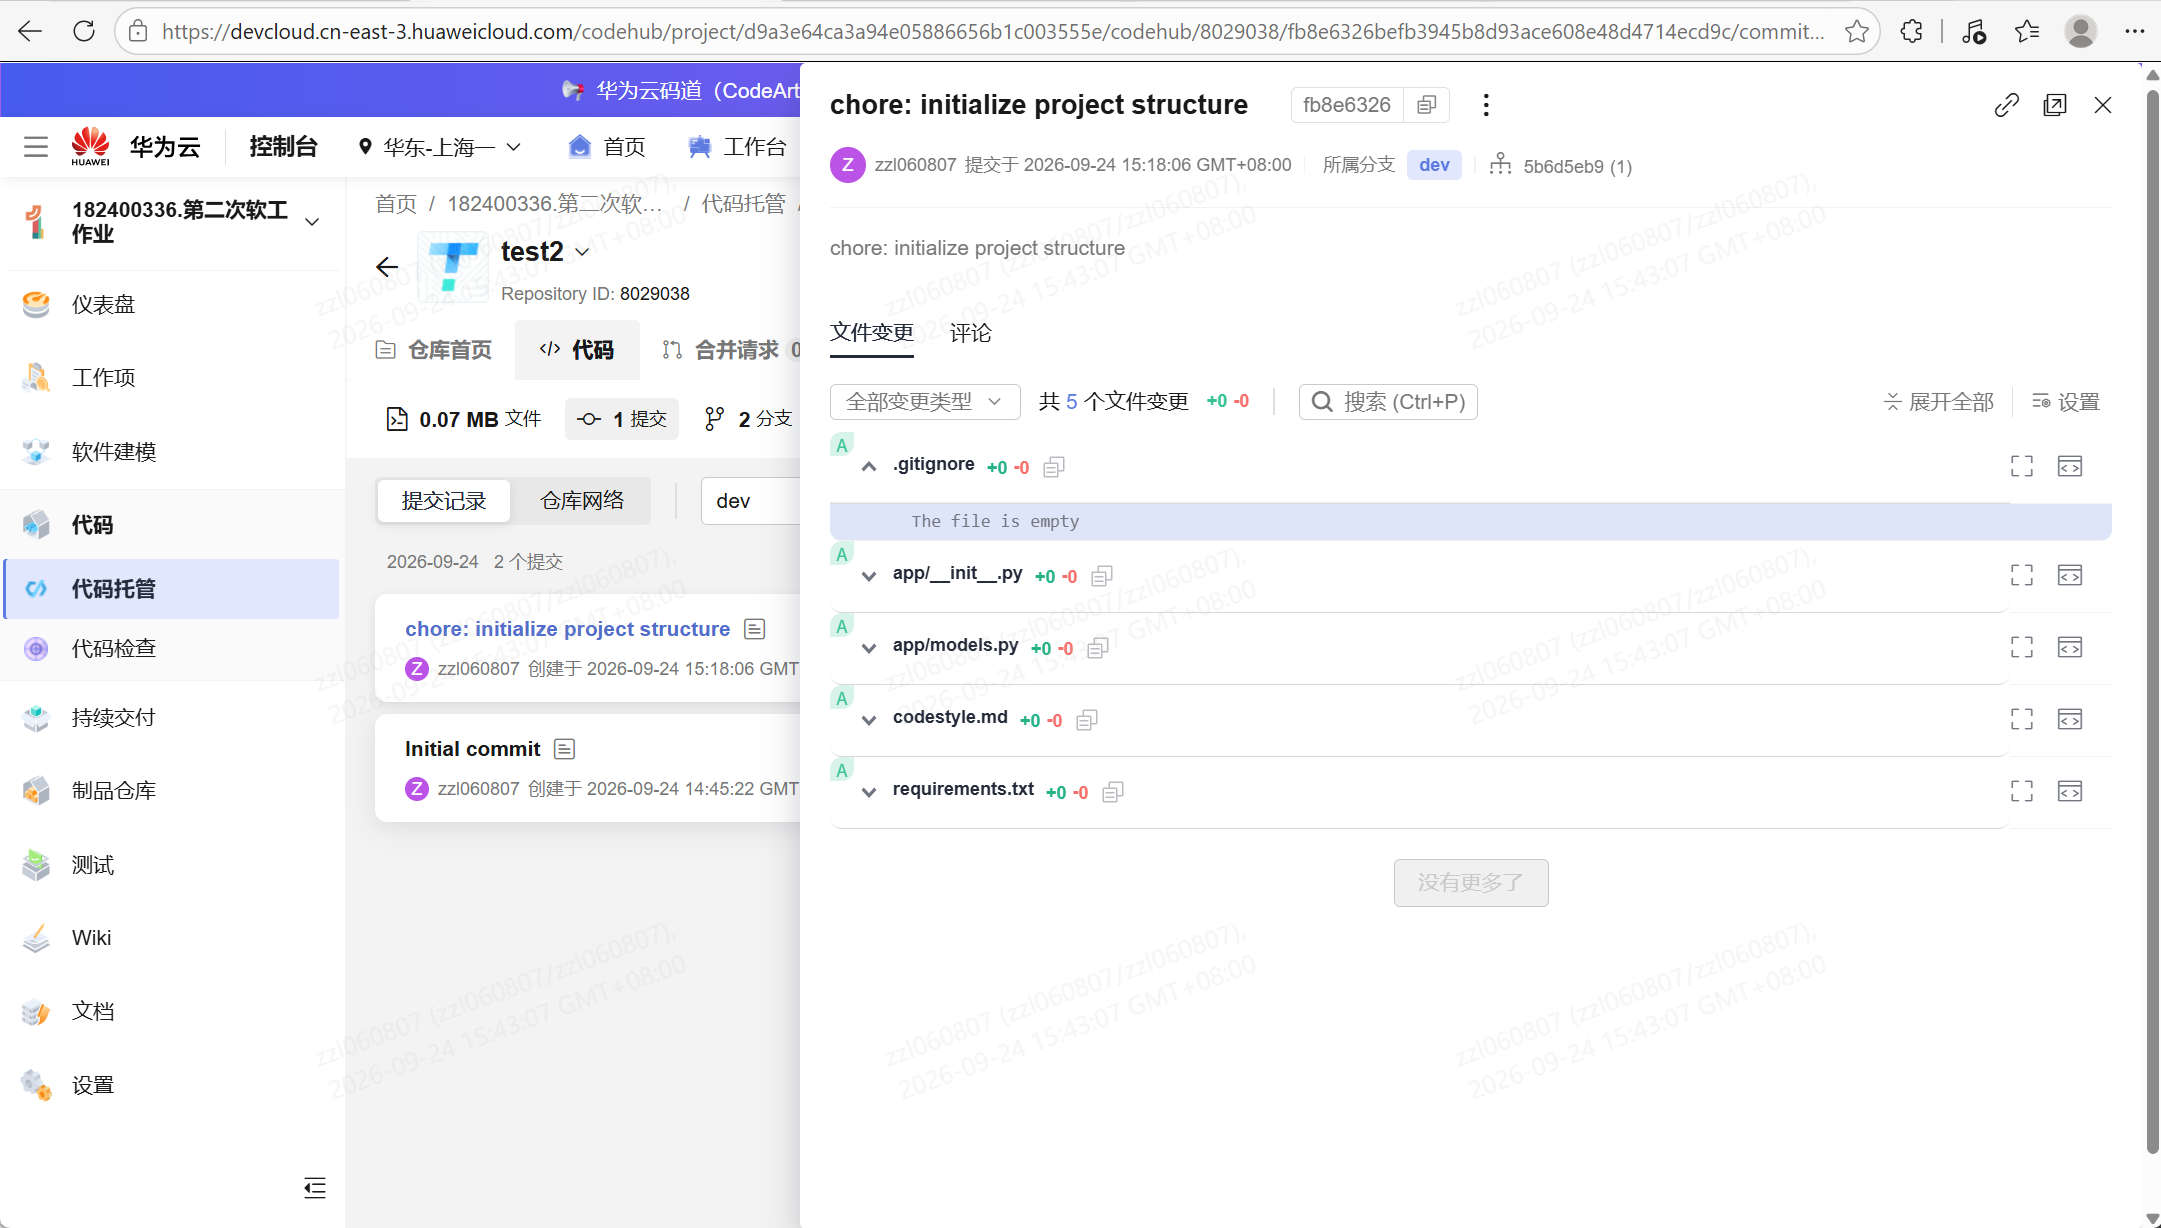
代码已由 dev 通过合并请求 !1 合并到 master,v1.0.0 标签已推送。发布包 topconftrend-v1.0.0.zip 已生成,SHA-256:02f3f7010180a9170dd4ca6365aec501ca6079cf988afffda98906c491dda45c。服务器最终切换到 v1.0.0 前仍需执行一次工作区状态检查,因此本文不把“标签已发布”误写成“服务器已完成最终切换”。
第一轮要求 AI 根据作业要求和已提交案例生成完整步骤。AI 按仓库、PSP、NABCD、原型、编码、测试、部署和博客拆分,并给出完成标志。我检查后要求以满足作业为准,删去过度复杂功能。最终形成从项目骨架到 v1.0.0 的可验证流程。
最初目标是输入标题后自动获取论文。我检查后指出不能直接拿接口第一条候选冒充目标论文。第二轮改为先规范化并精确比较标题,再核对会议和年份;无法确认时必须失败并说明原因。四篇官方样本和 Depth Anything 均验证成功,不存在的题目会明确失败。
CentOS 7 默认 Python 3.6,最初没有 Git 和 Nginx;完整依赖中的 Pillow 编译失败。我和 AI 根据错误确认生产服务无需 Pillow,拆分 requirements-prod.txt,并使用独立 Python 3.11,不覆盖系统 Python。最终依赖安装成功、7 项测试通过、服务 active、公网 HTTPS 正常。
关键模块:app/models.py 负责建表、CRUD、分页和搜索;app/services/fetch.py 负责题名、会议、年份核对;keywords.py 负责规则抽取;analysis.py 负责 Top 10、图谱和走势;routes/web.py 负责页面、导入、登录、CSRF 和 API;templates/trend.html 负责动画控制。完整代码以仓库 v1.0.0 为准。
最开始我认为真实抓取最难,实际最耗时间的是把应用部署到旧版 CentOS。AI 最大的帮助是把复杂任务拆成小步骤并根据真实输出排错;AI 输出也必须人工核查,例如生产依赖最初包含不必要的 Pillow。如果重做,我会更早确认服务器环境,并在每完成一个功能时立即保存截图和计时记录。
| 模块 | AI 的工作 | 我的工作 | 验证方式 |
|---|---|---|---|
| 需求 | 提取任务、生成步骤 | 确认范围和取舍 | 对照作业要求 |
| 原型 | 给出布局建议 | 制作和调整 | 分享链接逐页点击 |
| 编码 | 生成和修改实现 | 运行、审查、反馈 | 自动测试和页面操作 |
| 部署 | 生成适配命令 | 云终端逐条执行 | 服务状态、HTTPS、公网访问 |
| 博客 | 整理初稿 | 核对事实并最终发布 | 逐项打开链接和证据 |
本项目关键词由规则法自动抽取,并非论文作者关键词;统计只覆盖已收录样本,不能概括整个领域。所有账号登录、密码输入、最终发布和功能取舍均由本人完成或确认。
app/
├─ __init__.py              # Flask 应用工厂和环境配置
├─ models.py                # SQLite 建表、CRUD、搜索和分页
├─ routes/web.py            # 页面路由、导入、登录和 API
├─ services/
│  ├─ fetch.py              # 真实来源查询及论文身份核对
│  ├─ keywords.py           # 关键词规范化与自动抽取
│  └─ analysis.py           # Top 10、图谱和趋势聚合
├─ templates/               # 首页、论文、导入、图谱、走势等模板
└─ static/style.css         # 统一页面样式
scripts/                    # 样本导入、GIF 导出、服务器环境脚本
tests/test_workflow.py      # 端到端工作流自动测试
deploy/                     # systemd、Nginx 和证书续期配置示例
docs/                       # PSP、测试报告、部署说明和验收截图
这种结构将页面路由、数据访问、联网来源和统计逻辑分开,便于测试和后续修改。运行时数据库、虚拟环境、密码和缓存均通过 .gitignore 排除,不进入仓库和发布包。
| 数据对象 | 主要字段 | 用途 |
|---|---|---|
| 论文 Paper | 编号、标题、作者、会议、年份、摘要、链接、来源 | 保存论文基本信息并支持查询 |
| 关键词 Keyword | 规范化名称 | 合并大小写及明确变体 |
| 论文关键词关系 | paper_id、keyword_id、来源类型 | 支持统计和反向查询 |
| 抓取日志 FetchLog | 输入题目、状态、原因、时间 | 记录成功、重复和失败原因 |
论文与关键词是多对多关系。一篇论文可以对应多个关键词,一个关键词也可以出现在多篇论文中。删除论文后关联数据同步处理,统计服务每次从数据库重新聚合,因此不会继续计算已删除记录。
用户输入论文题目
  ↓
规范化标题并检查本地重复
  ↓
按会议选择 OpenAlex / CVF / ECVA 来源
  ↓
比较规范化标题 → 核对会议 → 核对年份
  ↓
无法确认:返回失败原因并记录日志
确认成功:保存原始字段 → 自动抽取关键词 → 建立关联
  ↓
重新计算 Top 10、共现图谱和年度走势
批量导入只是重复执行这一单篇流程,每一行都有独立结果,所以某一篇失败不会导致整批回滚。
| 作业要求 | 本项目实现 | 验证方式 |
|---|---|---|
| CodeArts 代码托管 | dev 开发、MR 合并 master、v1.0.0 标签 | 打开仓库、合并请求和标签页 |
| 原型设计 | 墨刀七页面可点击原型 | 打开分享链接并逐页点击 |
| 论文基本操作 | 列表、详情、新增、编辑、删除、分页 | 操作后刷新并重新打开 |
| 精确与模糊查询 | 完整标题精确匹配;标题片段、编号、关键词模糊匹配 | 使用不同查询词比较结果 |
| 联网获取 | 标题、会议、年份严格核对后入库 | 导入 Depth Anything |
| 批量处理 | TXT 或逐行输入,逐条去重和失败说明 | 使用正常、重复、不存在、空行混合文件 |
| 热词 Top 10 | 按会议和年份聚合已收录论文 | 与三篇手工样本计算结果比较 |
| 关键词图谱 | 关键词节点、共现边、节点下钻论文 | 点击节点检查相关论文 |
| 年度走势动画 | 播放、暂停、重播及年度状态区分 | 播放一轮并保存 GIF |
| 云端部署 | 华为云 ECS、HTTPS、systemd 常驻 | 外部浏览器访问并重启服务 |
| 测试与调试 | 7 项自动测试及 SQL LIKE 真实案例 | 测试输出、修复前后结果 |
| 编号 | 操作 | 预期结果 | 实际结果 | 状态 |
|---|---|---|---|---|
| T01 | 打开首页、列表、详情、图谱、走势和健康接口 | 页面和接口正常返回 | 全部 HTTP 200 | 通过 |
| T02 | 新增论文后刷新并重建应用 | 新记录仍在 | SQLite 中持续存在 | 通过 |
| T03 | 修改测试论文摘要并重新打开详情 | 显示修改后的摘要 | 与输入一致 | 通过 |
| T04 | 删除专用测试记录并刷新 | 记录不再出现 | 查询结果为空 | 通过 |
| T05 | 提交空标题、无效年份、重复标题 | 拒绝保存并给出提示 | 均被拒绝 | 通过 |
| T06 | 查询完整标题、标题片段、编号、关键词和 % | 只返回符合规则的记录 | 修复后均符合 | 通过 |
| T07 | 三篇手工数据统计 | 目标检测 2、Transformer 2、图像分割 1 | 系统结果一致 | 通过 |
| T08 | 批量输入成功、重复、失败和空行 | 分别显示结果并忽略空行 | 与预期一致 | 通过 |
| T09 | 真实查询 CVPR、ICCV、ECCV 样本 | 核对身份后返回 | 官方样本验证成功 | 通过 |
| T10 | 生产模式匿名写入和缺少表单令牌 | 拒绝写操作 | 自动测试通过 | 通过 |
| T11 | 公网真实导入后重启服务 | 新论文仍能查询 | Depth Anything 仍存在 | 通过 |
问题发生在模糊搜索中:用户输入百分号 % 时,SQLite LIKE 会把它解释为任意长度通配符,原实现因此返回全部论文。排查时先用独立测试数据库稳定复现,再检查生成的 SQL 条件,确认问题不在页面而在查询转义。修复方案是对 %、_ 和转义符进行处理,并且只在查询词全部为数字时匹配数字编号。最后增加回归测试,既验证 % 返回 0 条,也验证普通标题、编号和关键词仍能查询。这个案例体现了“复现—定位—最小修改—回归验证”的调试流程。
| 项目 | 最终情况 |
|---|---|
| 云平台 | 华为云 ECS |
| 系统 | CentOS Linux 7.6.1810 |
| 配置 | 1 vCPU、约 1 GB 内存 |
| Python | 独立 CPython 3.11 环境 |
| Web 服务 | Gunicorn + Nginx |
| 数据 | SQLite,独立持久化目录 |
| 进程管理 | systemd 开机启动与重启 |
| 公网访问 | https://60.204.200.151/ |
| HTTPS | Let's Encrypt IP 证书并配置续期定时器 |
| 测试 | 7 项通过、0 项失败 |
| 仓库版本 | master 已合并,v1.0.0 已推送 |
发布包 topconftrend-v1.0.0.zip 不包含数据库、密码、私钥、缓存或虚拟环境,可以根据 README 安装依赖并运行测试。SHA-256 校验值为 02f3f7010180a9170dd4ca6365aec501ca6079cf988afffda98906c491dda45c,用于确认下载文件未发生变化。
5,与AI 交流记录
6.寻找成功,成果展示