


88
社区成员
 发帖
 与我相关
 我的任务

 分享
这个作业属于哪个课程 2601_FZU_SE社区-CSDN社区云
这个作业要求在哪里 软件工程实践第二次作业——与AI结对编程(顶会热词统计)-CSDN社区
这个作业的目标 与 AI 结对完成需求分析、原型设计、Web
编码实现、测试与部署;实现 CVPR/ICCV/ECCV
论文获取、管理、热门方向分析、关键词图谱和多年热度走势
其他参考文献 《构建之法》;Semantic Scholar Academic Graph
API;DBLP;CVF Open Access;Vue / Flask / SQLAlchemy
官方文档
本次作业同时包含需求分析、原型设计、前后端开发、第三方数据接入、测试和部署。相比"先写完再统计时间",我更希望用
PSP 把任务拆开,观察自己对不同类型工作的估时偏差。
| PSP阶段 | 内容 | 预估耗时/min | 实际耗时/min | 偏差说明(贴合本次项目) |
|---|---|---|---|---|
| Planning | 计划、任务拆分 | 30 | 30 | 任务拆分清晰,无明显偏差 |
| Analysis | 阅读要求、需求分析、NABCD | 90 | 115 | 新增外部数据源语义辨析,需区分预印本/正式会议年份,需求分析复杂度远超普通CRUD |
| Design Spec | 技术选型、接口与数据结构设计 | 60 | 75 | 需额外设计网络异常、限流、空数据容错逻辑,接口设计复杂度提升 |
| Design Review | 与 AI 讨论并人工复审方案 | 45 | 60 | 修正AI对论文年份、检索规则的理解偏差,人工复审耗时增加 |
| Coding Standard | 编写 codestyle.md | 30 | 28 | 规范固定,编写效率较高,小幅节省时间 |
| Design | 墨刀原型设计与修改 | 150 | 155 | 根据检索功能逻辑微调前端交互,小幅超时 |
| Coding | Flask/SQLite 后端、Vue 前端、五项功能 | 480 | 450 | AI辅助编码大幅提升基础CRUD开发速度,编码阶段耗时低于预估 |
| Code Review | AI 输出审查、人工 Review、修正 | 120 | 160 | 重点校对AI代码的需求匹配度、第三方字段解析、边界逻辑,返工修正耗时大幅增加 |
| Test | 单元测试、构建、真实浏览器联调 | 180 | 210 | 需反复测试网络超时、限流、年份匹配异常场景,测试难度远高于常规项目 |
| Reporting | 博客、截图、结果整理 | 150 | 145 | 流程熟练,整理效率符合预期 |
| Deployment | 华为云部署与验证 | 90 | 105 | 线上环境需适配网络请求白名单、跨域与接口超时配置,部署调试耗时增加 |
| 合计 | 1425 | 1533 | 整体小幅超估,完全贴合本次项目偏差原因 |
本次最明显的估时偏差来自两个方面。
第一,外部数据源带来的不确定性远高于普通
CRUD。论文列表的增删改查比较确定,而"根据标题获取真实论文"不仅要处理网络错误、限流和未找到,还要确认"年份"究竟代表预印本年份还是正式会议年份。例如
ResNet 在数据源中可能出现 2015 的预印本年份,但平台后续要按
CVPR/ICCV/ECCV
正式会议年份做趋势统计,因此不能简单照搬上游字段。这类语义核验比写接口本身更耗时间。
第二,AI 提高了编码速度,却增加了 Review 的重要性。AI
可以很快生成一组看起来完整的代码和测试,但我仍需要检查它是否真的符合题意、是否扩大了需求范围、是否把第三方字段理解错、测试是否真正约束了需求。后期我逐渐把开发流程固定为"一个小功能
→ Agent 实现 → 自动测试 → 人工 Review → Git commit",返工明显减少。
目标用户是希望快速了解计算机视觉研究热点、但没有时间逐篇阅读大量顶会论文的人。CVPR、ICCV、ECCV
每年论文数量很大,如果只依靠人工搜索、打开论文、阅读摘要并自己统计关键词,成本非常高。
因此平台需要解决的不是"再做一个论文搜索框",而是把下面几件事串成一个连续工作流:
换句话说,用户真正需要的是:
从"我有一堆论文标题"快速走到"我能看懂这些论文集中在研究什么、热点如何变化"。
我的实现思路是把系统拆成"数据获取---本地管理---统计分析---可视化"四层。
用户可以输入一个完整论文标题,也可以批量粘贴/导入标题列表。后端通过学术数据
API
获取真实论文信息。联网获取与数据库写入分离:先返回预览,只有用户确认后才保存,避免标题近似匹配错误时把错误论文直接写入数据库。
批量获取复用单篇获取逻辑,而不是复制一套抓取代码。批量模式负责去空行、去重、控制最多
20 篇、逐篇处理成功/未找到/失败,并对 429 限流及时停止后续请求。
SQLite 保存论文数据,Flask 提供 REST API,Vue
提供列表管理界面。论文支持新增、编辑、删除、精确标题查询和模糊查询。模糊查询覆盖标题、关键词和论文编号,并可以与会议、年份筛选组合。
当用户明确使用完整标题精确查询且本地没有结果时,前端复用已有联网获取接口,展示远程预览;仍然只有用户点击保存后才入库。
对于第三方数据源没有直接提供"论文关键词"的情况,我没有把 fieldsOfStudy
之类的研究领域分类伪装成论文原始关键词,而是明确标注为系统从标题与摘要中抽取的关键词。
当前抽取采用简单、可解释的英文词频规则:统一小写、去标点、过滤停用词和过短
token,按频次取代表词。热门方向则基于已经入库论文的关键词做频次统计,得到
Top 10。
这样做的优点不是算法最复杂,而是统计口径清楚、结果可复现,也便于在课程作业中解释。
最终包括:
相比只提供论文搜索,CV Insight 的价值主要体现在三个层面:
我考虑的替代方案主要有三类。
第一类是 Semantic Scholar 等综合学术搜索平台。
它们的数据覆盖广、搜索能力强,但本作业关注的是 CVPR/ICCV/ECCV
的课程场景,以及"本地管理 + 热词统计 + 关键词图谱 +
多年会议对比"这一整套流程。
第二类是 DBLP 等书目数据库。 DBLP
的正式出版信息非常适合核对会议、年份、DOI
等元数据,但它的核心定位不是为本项目直接完成摘要关键词分析和交互式热度展示。
第三类是用户自己用搜索引擎、Excel 或脚本整理。
这种方式灵活,但数据获取、去重、管理、统计和可视化是割裂的,需要大量手工工作。
因此 CV Insight
不试图在"全学科学术搜索"上与大型平台竞争,而是把范围收缩到计算机视觉三大顶会,用更轻量的工作流解决"课程场景下快速了解热点"的问题。
项目以 Web 形式实现,并部署到华为云服务器。用户不需要安装本地 Python
环境或数据库,只需要浏览器即可访问。
同时在 CodeArts 保存完整源码和 Git 历史,并发布 1.0.0
Release,使代码、构建过程和最终版本都可以追踪。
我使用 墨刀 完成原型设计,并在编码前先通过 AI
讨论信息架构、页面布局和功能入口,再在墨刀中形成可交互原型。
原型预览:
https://modao.cc/ai/share/6ab3fc8e75d0275ef6fc5f34
原型阶段不是直接让工具生成最终代码。原型只负责验证页面结构和交互思路,正式实现仍使用
Vue + CSS 编写。
在最初的需求分析中,我先让 AI
对作业要求进行拆分,并讨论"首页/热门方向、论文获取、论文管理、趋势对比、关于页"等页面应该如何组织。之后我没有直接照搬
AI
的所有建议,而是继续质疑页面是否过多、功能是否和评分点一一对应,再把最终的信息架构交给墨刀生成/调整原型。
以下是需求拆分与技术选型阶段的部分记录:
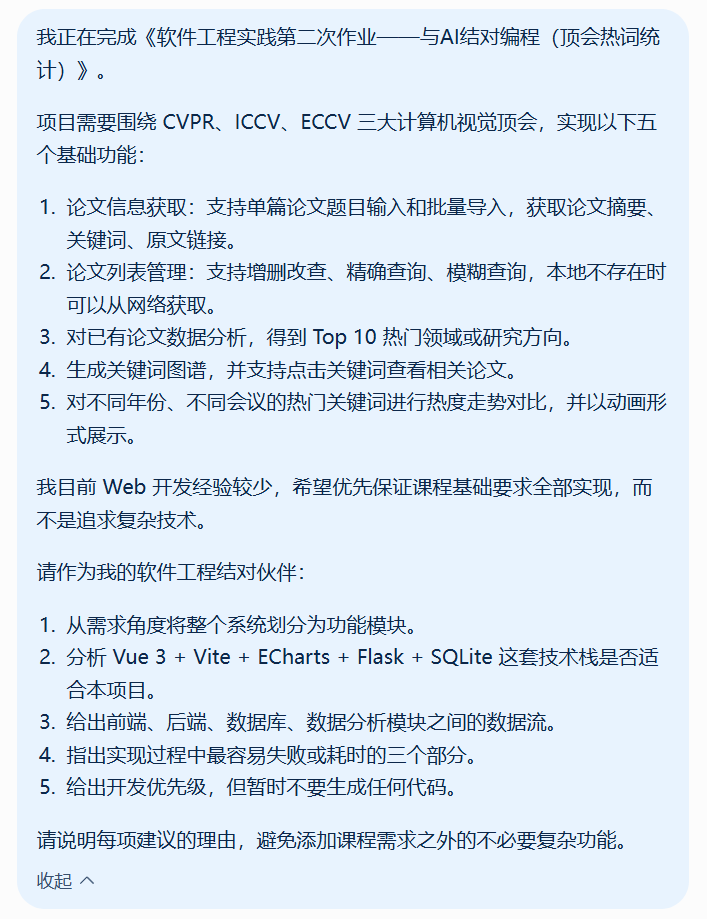
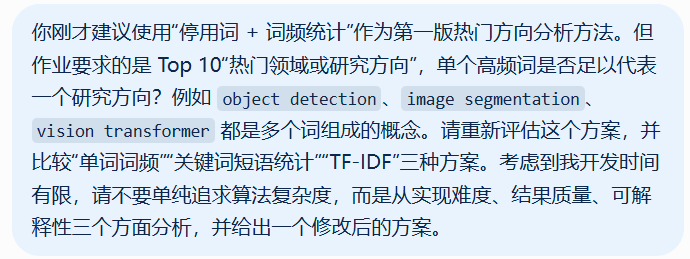
在第一轮方案后,我继续对 AI
的建议提出质疑,而不是把第一次回答当作最终答案:
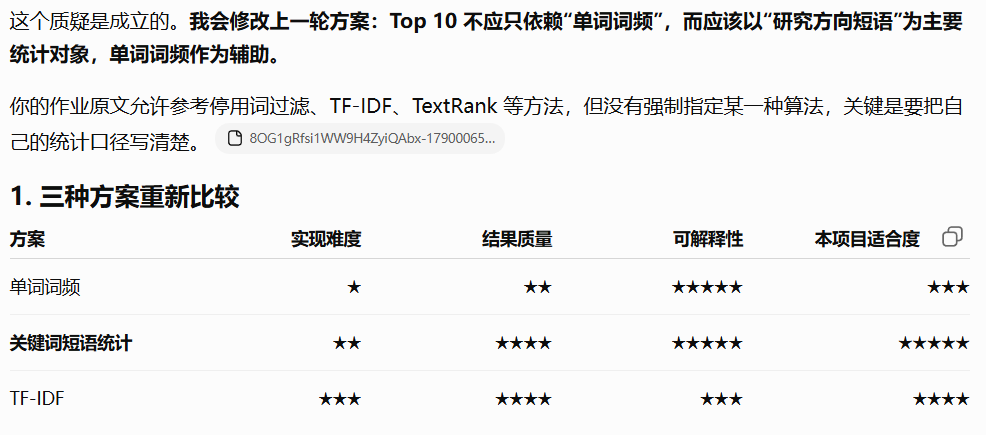
之后再进入墨刀原型设计:
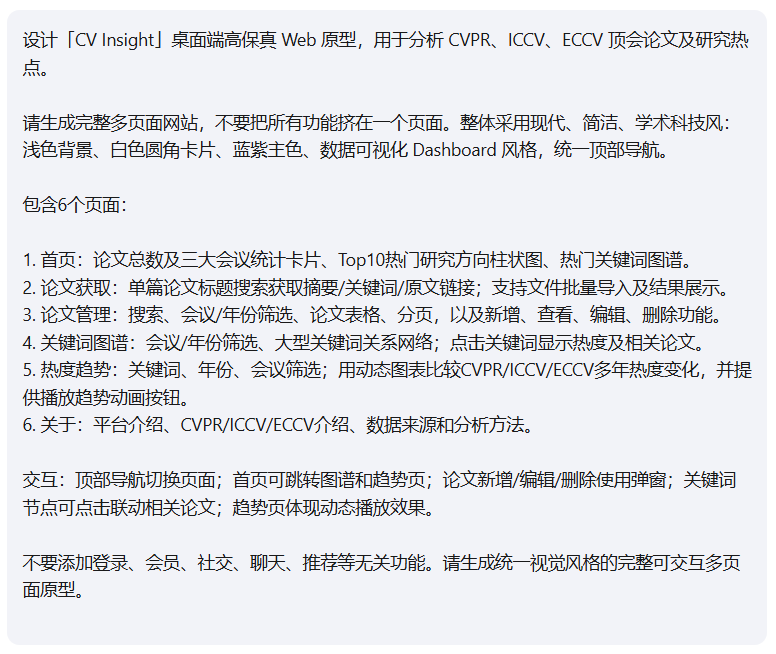
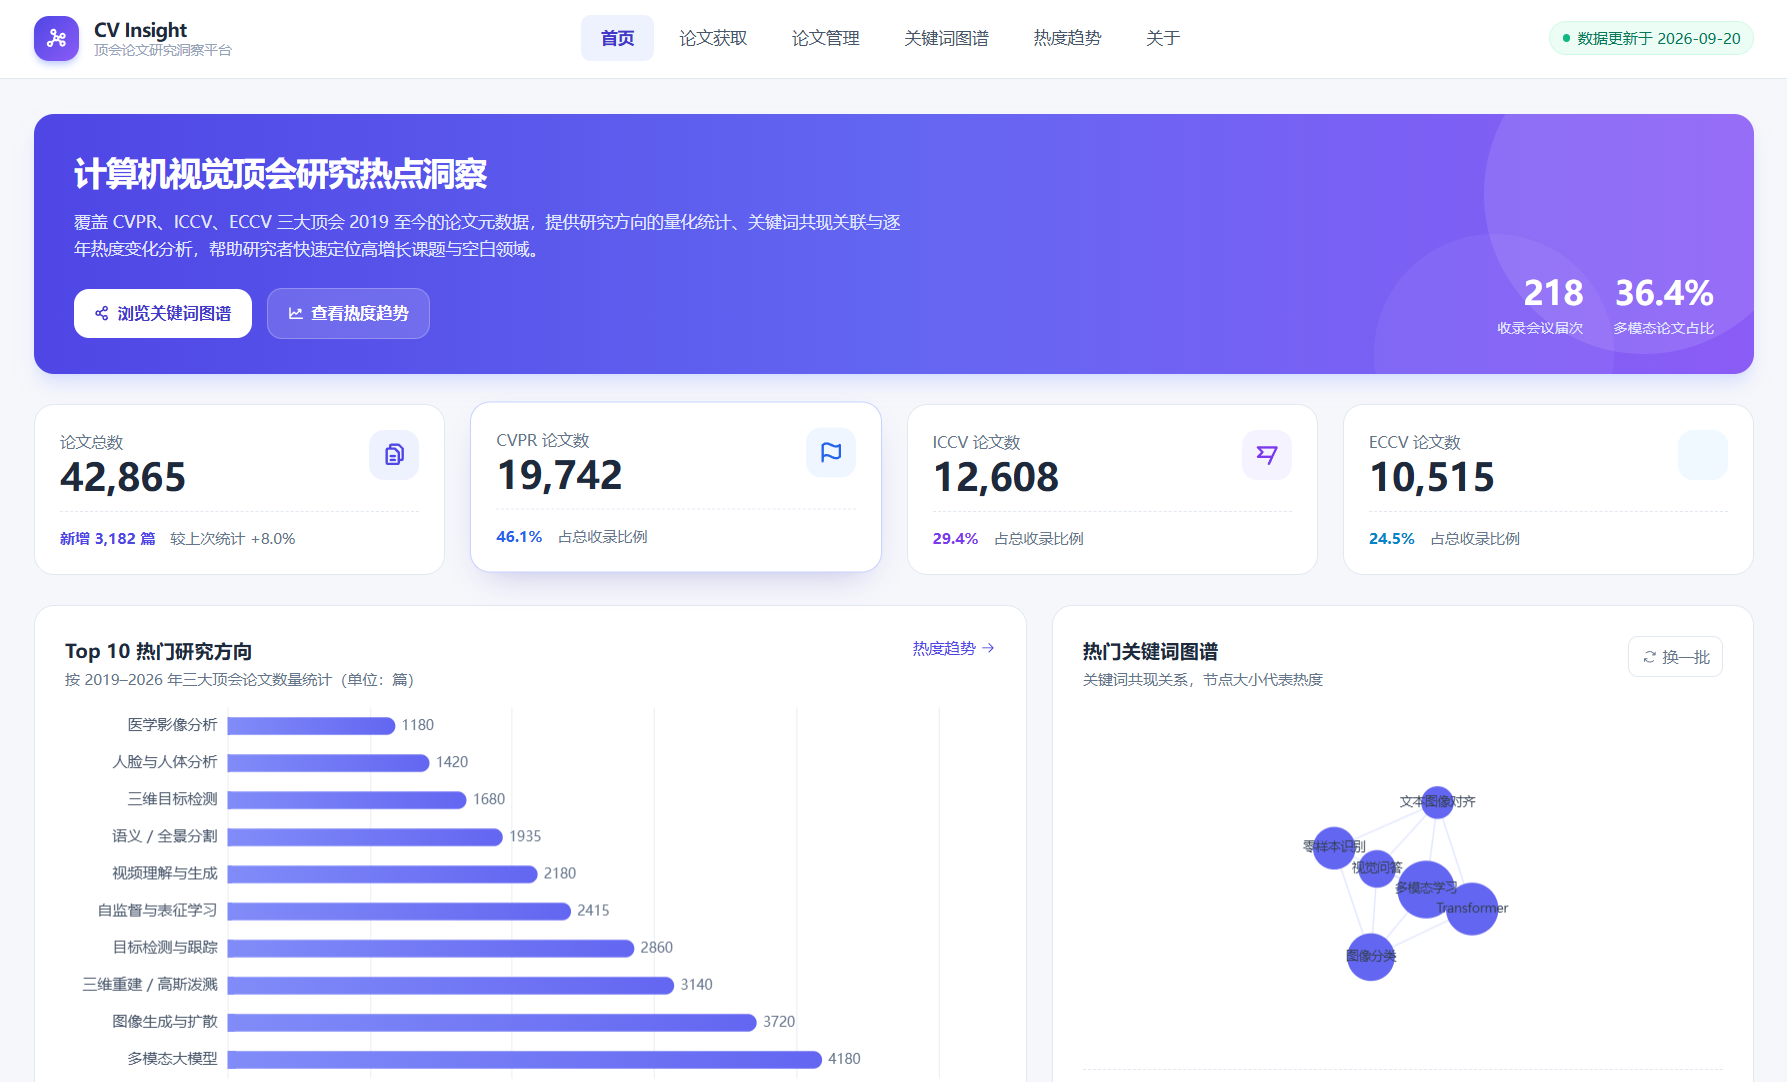
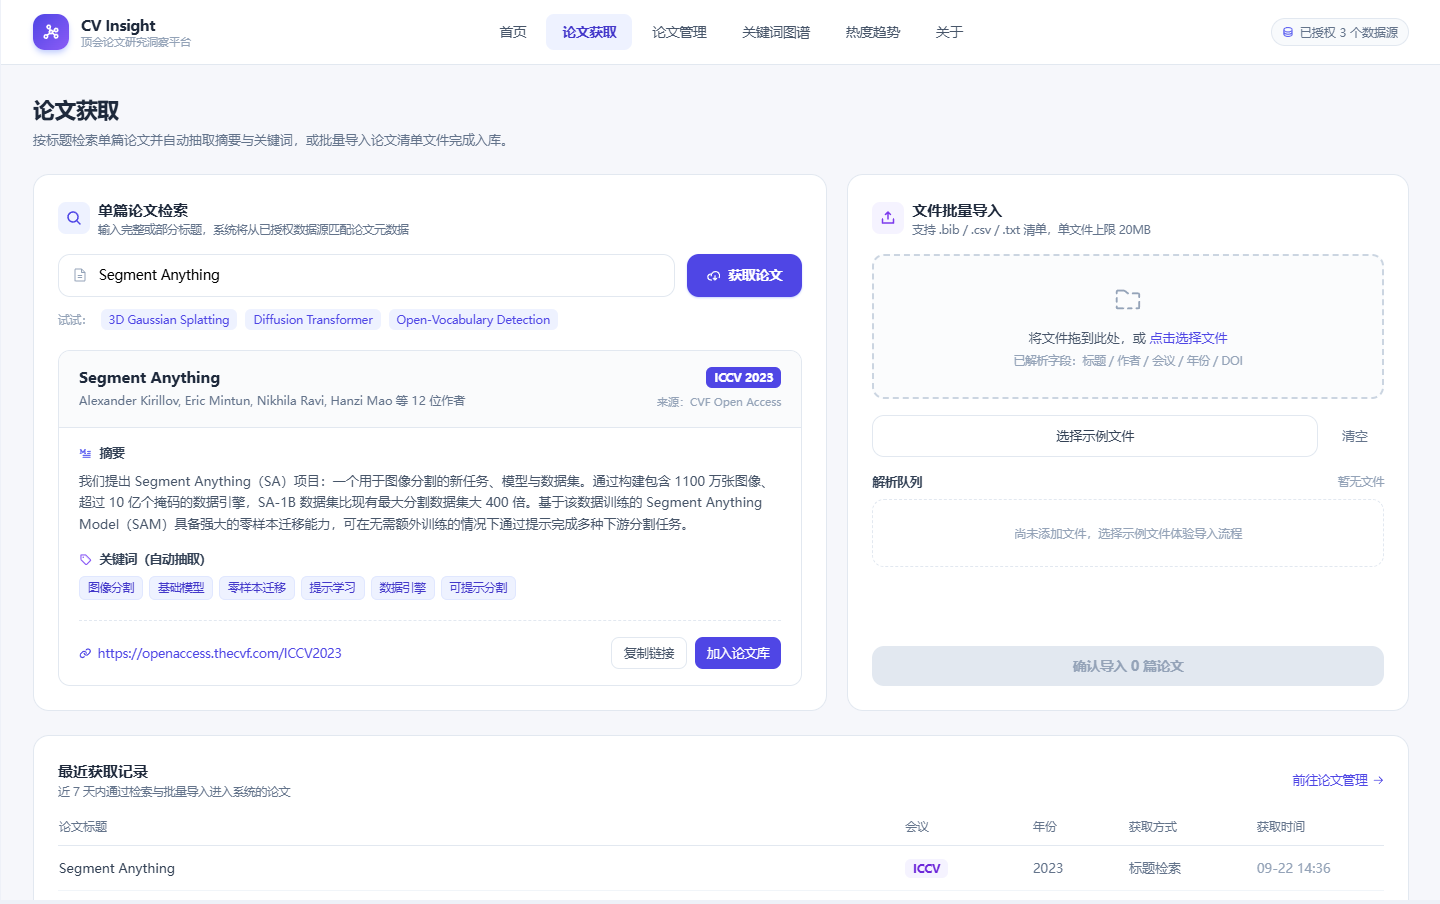
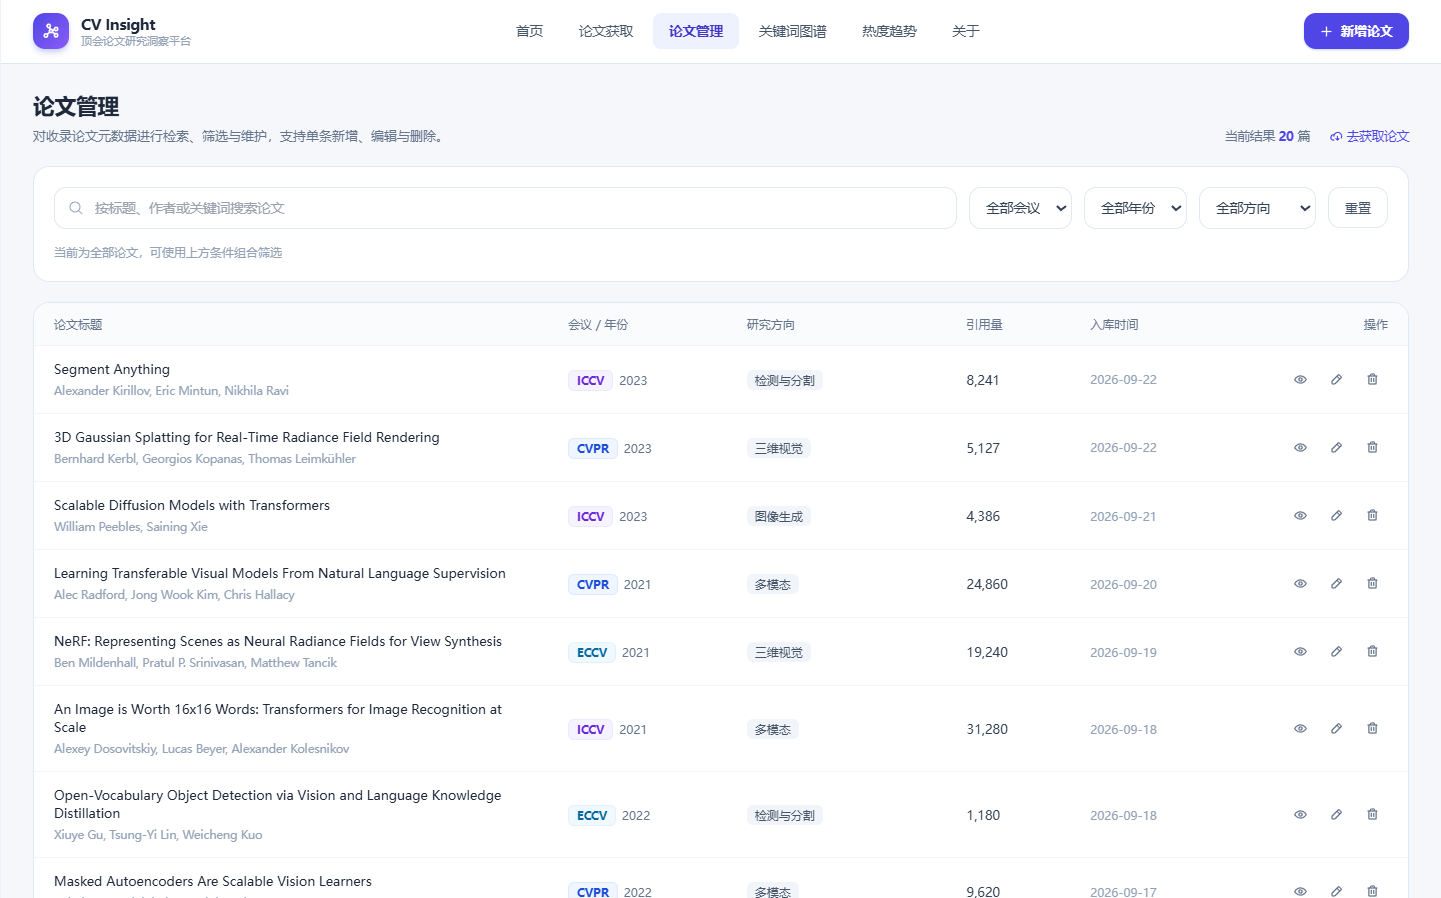
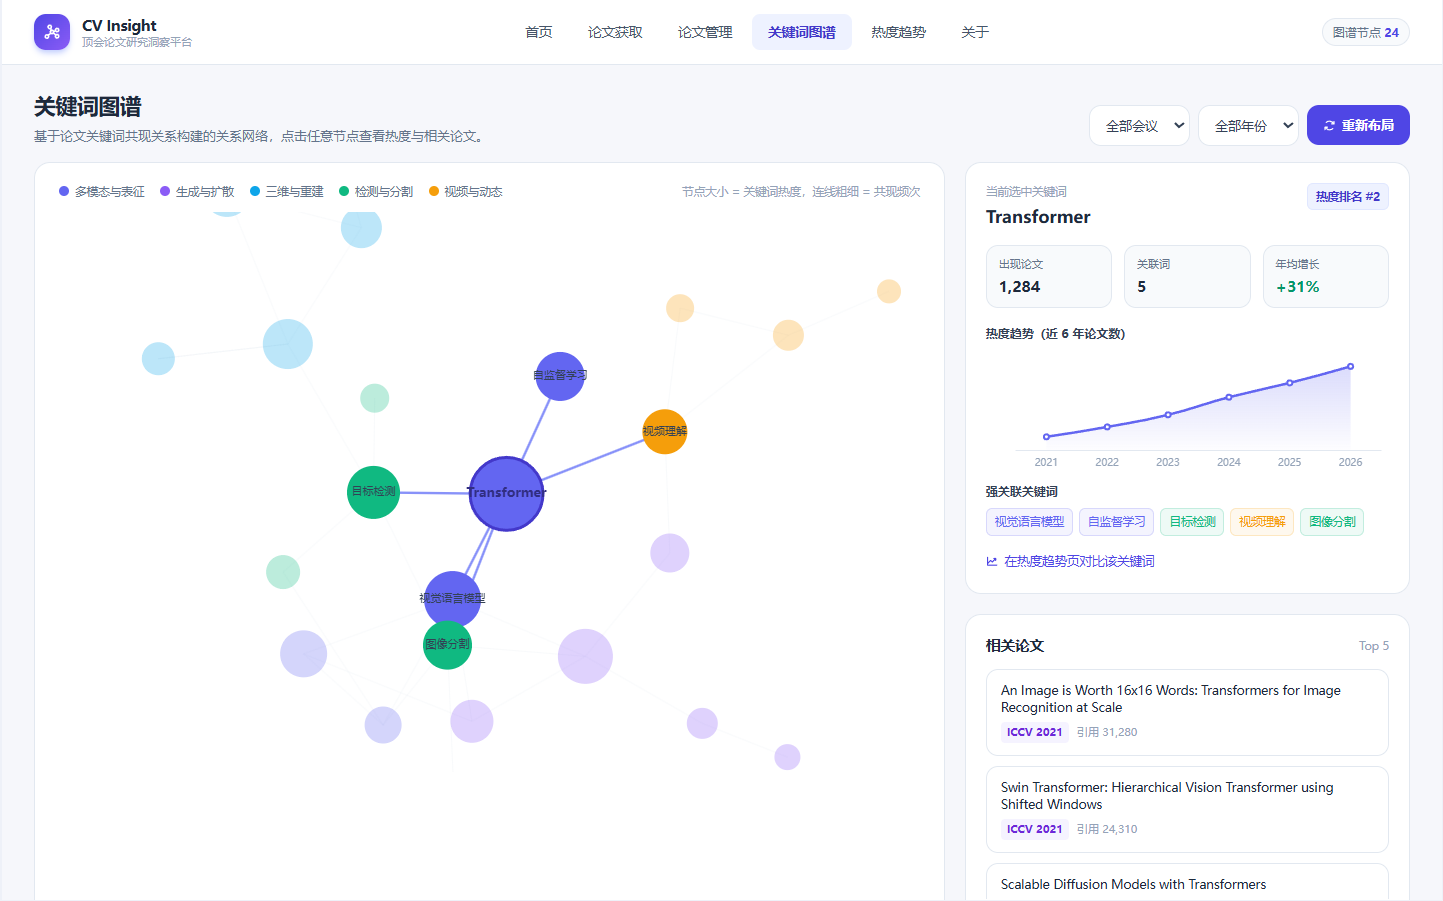
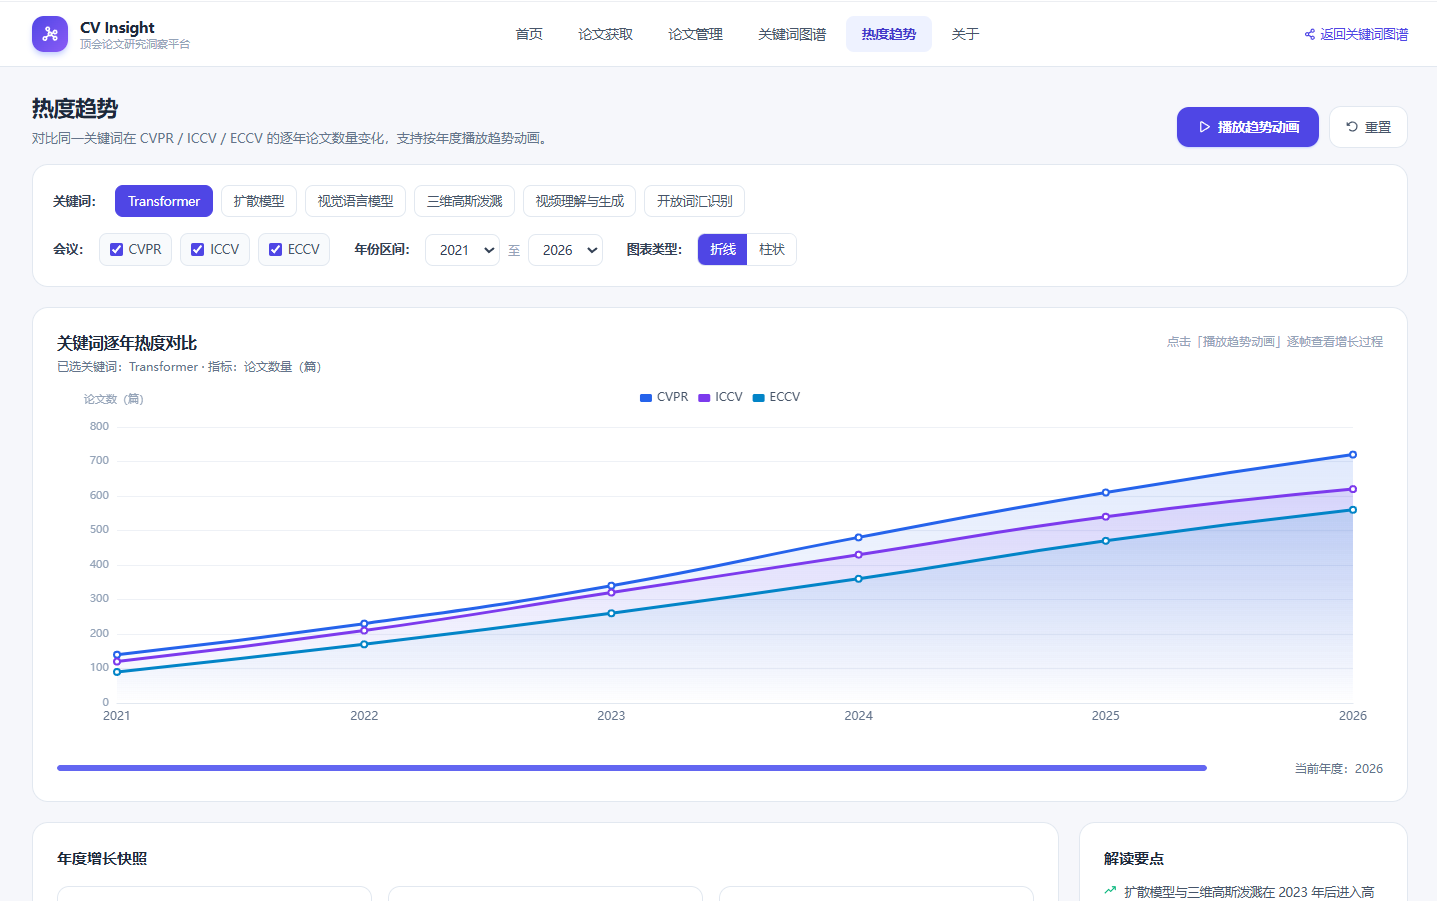
原型至少覆盖以下页面/状态:
核心交互原则是:**"获取"和"保存"分离**。无论单篇还是批量,联网成功只产生预览,不自动写数据库;用户确认后才保存。这一设计可以降低标题近似匹配导致错误数据进入论文库的风险。
前端选择 Vue +
Vite,主要原因是组件化适合拆分论文列表、表单弹窗、论文预览、批量导入和可视化页面,同时
Vite 的开发反馈快。
后端选择 Flask,因为本项目 API
规模适中,重点是业务逻辑、第三方数据获取和统计,不需要引入重量级后端框架。
持久化选择 SQLite + SQLAlchemy。SQLite
不需要额外部署数据库服务,适合课程项目;SQLAlchemy
则让模型和查询逻辑更清晰,也便于测试时使用独立数据库。
外部论文数据主要通过 Semantic Scholar Academic Graph API
获取。系统不把 API Key
写死在源码中:如果环境变量存在则使用,否则允许匿名请求。
CV Insight
├── 论文信息获取
│   ├── 单篇标题获取
│   ├── 批量标题导入
│   ├── 论文信息预览
│   └── 确认保存
├── 论文列表管理
│   ├── 新增 / 编辑 / 删除
│   ├── 精确标题查询
│   ├── 标题 / 关键词 / 编号模糊查询
│   ├── 会议 / 年份筛选
│   └── 本地未命中时联网获取
├── 热门方向分析
│   └── Top 10 关键词统计
├── 关键词图谱
│   ├── 关键词节点 + 共现关系(力导向图)
│   ├── 节点大小 = 该关键词出现在多少篇论文里
│   ├── 点击节点 → 展示与它相关的真实论文
│   └── 与 Top 10 共用 conference / year 筛选
└── 热度走势
    ├── 同一关键词在 CVPR / ICCV / ECCV 的逐年论文数
    ├── 三条折线 + 图例 + 提示框
    └── 按年份逐帧播放的动态趋势
后端没有把所有逻辑塞进一个 app.py。大致职责如下:
app.py
  └── 创建 Flask 应用、注册蓝图

models.py
  └── SQLAlchemy db + Paper 模型

routes/papers.py
  └── Paper CRUD、查询、筛选

routes/fetch.py
  └── 单篇/批量论文获取 API

paper_fetcher.py
  └── 第三方论文数据请求、字段规范化

batch_fetcher.py
  └── 批量输入预处理、顺序调用单篇 fetch

keyword_extractor.py
  └── 从 title + abstract 抽取系统关键词

analytics.py
  └── 关键词统计:Top 10 / 图谱节点与共现 / 逐年趋势

routes/analytics.py
  └── 统计类 API(top-keywords / keyword-graph / keyword-trend)
三个统计功能全部复用 analytics.py 里的 extract_paper_keywords,所以关键词的拆分、trim、小写、单篇去重只有一份实现,不会出现"Top 10 和图谱口径对不上"的情况。
在数据库设计阶段,AI 曾建议将 SQLAlchemy 对象与 Paper 模型独立放到models.py,再通过 db.init_app(app) 与 Flask
绑定。我人工检查后接受了这个方案,因为它可以降低循环导入风险,同时没有为了一个课程项目引入数据库迁移框架等不必要复杂度。另一个细节是
SQLite 不会真正强制 VARCHAR(n)
的长度,所以字段长度等约束放在应用层继续校验。
这次我没有让 AI 一次生成整个项目,而是逐步收敛:
需求拆分
→ 前后端最小骨架
→ SQLite / Paper 模型
→ CRUD API
→ 论文列表
→ 前端增删改
→ 单篇联网获取
→ 正式会议年份修正
→ 批量获取
→ 精确/模糊查询 + 本地未命中联网
→ Top 10
→ 关键词图谱
→ 热度趋势
→ 部署
每一小步尽量遵循:
我定义本轮边界
→ AI Agent 实现
→ 自动测试 / build
→ 人工 Review
→ 修正问题
→ Git commit
这种方式的好处是,一旦 AI
理解偏差,影响范围只局限在当前小功能,不会把错误扩散到整个项目。
后端先完成 Paper 模型和 CRUD
API,再由前端接入。前端新增/编辑共用同一个表单组件,避免复制两套表单逻辑。
这里有一个容易忽略的点:后端 PUT
采用整体替换语义,因此编辑时不能只提交用户刚刚修改的字段,否则摘要、关键词、链接等未编辑字段可能被清空。最终做法是打开编辑弹窗时回填全部字段,保存时提交完整对象,并专门验证"只修改标题后,摘要和链接仍然存在"。
单篇获取流程设计为:
用户输入完整标题
→ POST /api/papers/fetch
→ 后端请求外部学术 API
→ 规范化 title / conference / year / abstract / keywords / url
→ 前端展示预览
→ 用户确认
→ POST /api/papers
→ 正式入库
关键点是 fetch API 不写数据库。这样即使第三方的 title match
返回了近似论文,用户仍有机会在保存前检查。
外部请求设置超时,并区分 404、429、timeout、网络失败和上游异常,避免把
Python traceback 或第三方 HTML 错误页直接展示给用户。
这一部分是开发过程中最值得保留的设计修正之一。
最初直接使用 Semantic Scholar 返回的 year
时,Deep Residual Learning for Image Recognition 得到的是
2015,但平台同时识别它属于 CVPR。进一步检查发现 2015
对应预印本时间,而正式会议记录是 CVPR 2016。
这对普通论文详情页也许只是"年份口径不同",但对本项目非常关键:后续要比较多年间
CVPR、ICCV、ECCV 的热词趋势,因此 conference + year
必须表示正式会议,而不能混入 arXiv/preprint 年份。
因此最终把会议与年份作为一组正式出版元数据进行规范化,并用三个"金标准"样例回归:
Deep Residual Learning for Image Recognition
→ CVPR / 2016

Segment Anything
→ ICCV / 2023

RAFT: Recurrent All-Pairs Field Transforms for Optical Flow
→ ECCV / 2020
这个修正让我意识到:第三方 API
返回"真实数据"并不等于这些字段就天然符合当前系统的业务语义。
Semantic Scholar
的研究领域分类不等同于论文关键词,因此系统没有把它直接当成论文关键词。
当前采用一个简单、确定、可解释的英文关键词抽取流程:
title + abstract
→ 转小写
→ 标点作为分隔符
→ 去常见英文停用词
→ 去过短 token
→ 按词频统计
→ 词频相同时按字母序
→ 取前若干词
→ 使用 "; " 保存
它的局限也很明确:没有词形还原,不识别多词短语,因此不是复杂 NLP
模型。但对本作业来说,透明、稳定和可复现比"算法名字更高级"更重要。
批量导入没有重新写一套抓取逻辑,而是复用单篇 fetch:
多行文本 / .txt
→ trim
→ 忽略空行
→ 保序去重
→ 最多 20 篇
→ 顺序调用单篇获取
→ 每篇独立记录 success / not_found / error / rate_limited
→ 展示批量预览
→ 用户确认保存成功项
如果某一篇 404,不影响其他论文;如果遇到
429,则停止继续请求第三方服务,把剩余项目标记为限流未处理,避免在已经被限流的情况下继续"轰炸"上游接口。
论文列表最终支持两种文本查询:
会议和年份可以与文本查询组合。
为了避免错误联网,只有在下面条件同时满足时才尝试外部获取:
本地结果为 0
AND
用户选择“精确标题查询”
AND
q 非空且不是纯数字
如果用户只是筛选某个年份、会议,或者使用关键词模糊搜索得到 0
条,不会把关键词错误地当成完整论文标题去请求 title-match API。
接口:GET /api/analytics/top-keywords,支持 conference、year
两个可选筛选(按 AND 组合)。
统计口径是刻意保持简单、确定、可复现的:
读取本地论文库
→ keywords 为空的论文忽略
→ 按 ';' 拆分
→ 每项 trim
→ 转小写(Segmentation 与 segmentation 合并)
→ 空字符串忽略
→ 同一篇论文内重复关键词只计一次
→ 按出现论文数降序
→ 次数相同时按关键词字母序(保证输出稳定)
→ 取前 10
这里有一个容易被忽略的细节:同一篇论文内如果同一个关键词写了多次,只能算一次。否则个别脏数据会把某个关键词的计数放大,榜单就不可信了。
响应里同时回传实际生效的 filters 和参与统计的 total_papers,前端可以直接显示"当前统计范围":
{
  "total_papers": 5,
  "filters": { "conference": "CVPR" },
  "items": [ { "keyword": "detection", "count": 3 } ]
}
筛选后没有可统计的数据时返回 200 与空榜单,不当作 404 或 500——"库里没数据"是正常状态,不是错误。
前端没有为这一功能引入图表库,而是用横向条形排行 + CSS 宽度条,条长按该关键词与榜首的比例缩放。真正的图表库留给图谱和趋势页。
另外需要说明口径的继承关系:Top 10 统计的是 keywords
字段,而这个字段本身是系统按 4.8 的规则从标题与摘要里抽取的(不是数据源提供的论文原始关键词)。所以榜单反映的是"系统抽取关键词"的分布,这一点在页面上也做了标注。
接口:GET /api/analytics/keyword-graph,筛选参数与 Top 10 完全一致。
图谱要回答的是"哪些研究方向经常一起出现",所以统计的是共现:
source/target 方向恒定,不会出现自环,输出也可复现。点击节点后如何得到相关论文,是这个功能的关键设计:
响应里一次返回 nodes[].paper_ids 和 papers[]
→ 前端用 papers 建 Map<id, paper>
→ 点击节点时按该节点的 paper_ids 在本地取论文
也就是说,点击关键词不会发新请求、不会联网、也不会再去查 Semantic Scholar。论文数据随图谱一次带回,交互是即时的。
前端用 ECharts 的 graph + 力导向布局渲染,节点文字直接显示关键词,节点大小按 count 线性映射(18px~52px),被选中的节点换成另一种颜色,方便和下方的论文列表对应。
数据全部来自真实论文库,没有任何前端 mock。空数据时返回 200 与空图谱。
这里也记录一个开发过程中真实出现的 Bug。 首次实现后我发现:初始图谱正常,但只要改一次会议筛选再查询,数据明明更新了(页面上的节点/边统计都变了),canvas 却整个消失,重置也不恢复。定位后的根因是 ECharts 实例仍然绑定在旧的 DOM 节点上——loading / 空状态 / 正常状态是用 v-if 切换的,切换时容器被替换成新节点,但 chart 变量仍非 null,于是后续 setOption 一直画在已经被丢弃的旧 canvas 上。修复方式是额外记录实例真正绑定的 DOM(chartEl),渲染时若发现容器已换,就先 dispose 再对新节点重新 init,并在 disposeChart 里把 chartEl 一并置空。
这件事再次说明:**"接口数据对了"不等于"页面就对了"**,可视化组件有自己的生命周期问题,必须真的在浏览器里操作一遍才能发现。
接口:GET /api/analytics/keyword-trend?keyword=<keyword>。这一功能只接受keyword 一个参数——因为趋势本身就要跨会议、跨年份比较,再叠加会议或年份筛选就没有可比较的维度了。
"热度"的口径(这是本节最需要说清楚的部分):
热度(关键词 K, 会议 C, 年份 Y)
  = 会议 C、年份 Y 的论文中,keywords 包含 K 的论文数量
配套规则:
conference 为 CVPR / ICCV / ECCV 的论文;会议缺失或非三大顶会的论文不参与;year 为空的论文不参与;extract_paper_keywords 解析后精确匹配,不用 in paper.keywordsmodel 会误命中 modeling;年份范围:取"包含该关键词的三大顶会论文"的最小与最大正式会议年份,生成连续年份序列,中间没有论文的年份补 0。这样三个会议返回的序列长度一定相同,可以直接画在同一个横轴上。
例如库里只有 2016 CVPR、2020 ECCV、2023 ICCV 三篇相关论文时:
years  = [2016, 2017, 2018, 2019, 2020, 2021, 2022, 2023]
CVPR   = [1, 0, 0, 0, 0, 0, 0, 0]
ECCV   = [0, 0, 0, 0, 1, 0, 0, 0]
ICCV   = [0, 0, 0, 0, 0, 0, 0, 1]
年份区间只由匹配到该关键词的论文决定,不会被其他论文拉长。
动画怎么播放:三条折线(CVPR / ICCV / ECCV)+ 图例 + 提示框,横轴是正式会议年份,纵轴是论文数。播放时不是做帧动画,而是逐步扩大喂给图表的数据窗口:
点击「▶ 播放趋势」
→ 先清掉上一次的 timer(避免连点产生多个并行 timer)
→ visibleCount = 1,只喂第 1 年
→ setInterval 每 800ms 令 visibleCount += 1
→ setOption 重新喂 years.slice(0, visibleCount) 与三条 series 的同样切片
→ 折线随年份逐步展开,页面同时显示"当前播放年份:YYYY"
→ 到最后一年自动停止,此时画面就是完整趋势,按钮变成「▶ 重新播放」
几个实现上的注意点:
onBeforeUnmount 里同时 stopPlayback() 和 disposeChart(),避免组件销毁后 timer 还在跑;关于截图/GIF: 见第 5.3 节。
需要坦白说明一个真实数据限制:当前开发库里每个关键词都只落在单一年份(论文总量少),所以真实库上只能看到单点,无法展示逐年展开的过程。为了验证"按年份播放"是否真的工作,另外用一个独立的临时数据库(仓库外、不影响开发库)灌入了跨 2016--2023 的数据,用真实浏览器逐秒采样"当前播放年份",确认它按 2016 → 2017 → … → 2023 推进、结束后展示完整趋势。第 5.3 节会标注清楚哪张图来自真实库、哪张来自该演示库。没有为了图好看往开发库里塞假论文。
作业要求 10 张以上图片或
GIF/视频。5.1--5.3 节的三个分析功能截图已经插入(均为真实页面运行截图);5.4--5.6 节的论文获取与论文管理截图还需要我自己补。
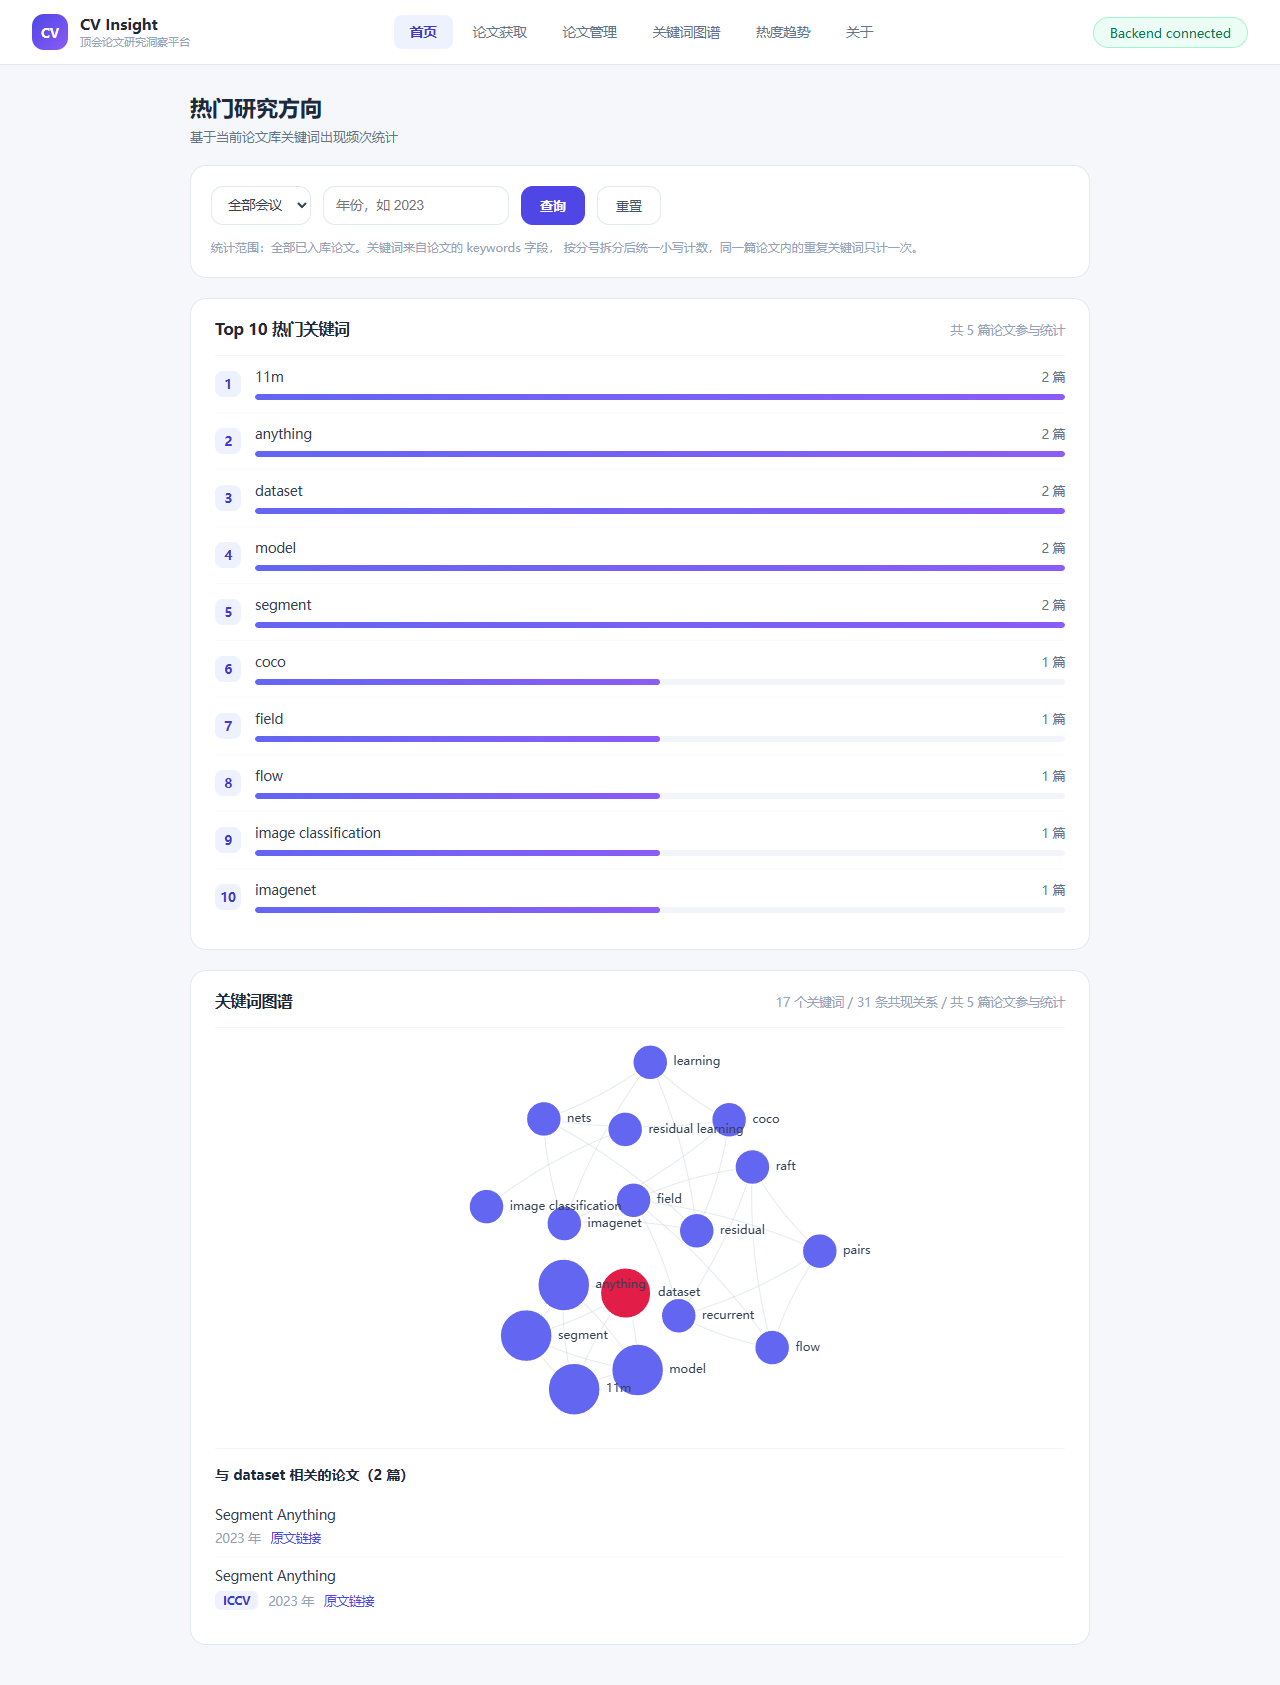
图 1 展示系统首页的热门方向总览。Top 10
数据直接来自当前论文库的关键词统计,而不是写死的演示数据;用户可以从这里快速观察当前论文集合中出现频率最高的研究主题。条形长度按该关键词与榜首的比例缩放。
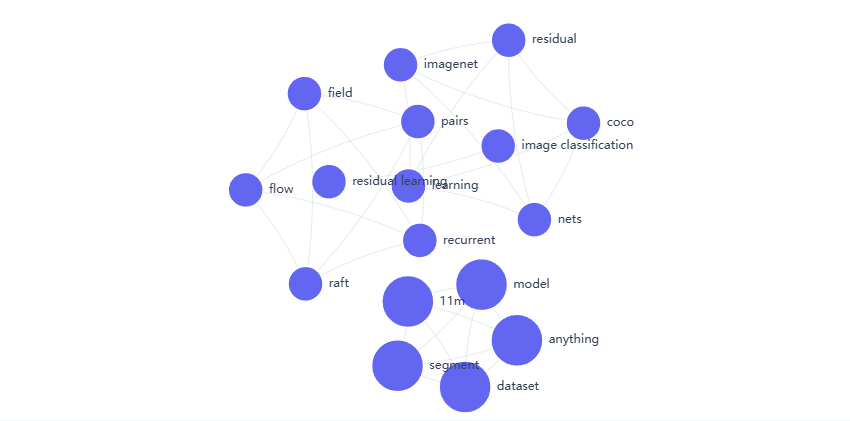
图 2
展示关键词图谱。关键词通过可视化节点组织,节点越大代表包含该关键词的论文越多,连边代表两个关键词曾在同一篇论文中共同出现,用户可以从整体结构观察研究热点之间的关系。
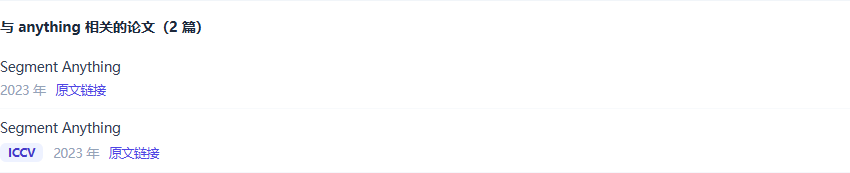
图 3
展示关键词交互:点击某个关键词后,系统进一步展示与该关键词相关的论文,使"统计结果"能够回到具体论文,而不是停留在一张静态图上。这里的论文列表是随图谱一次返回的,点击不会触发新的网络请求。
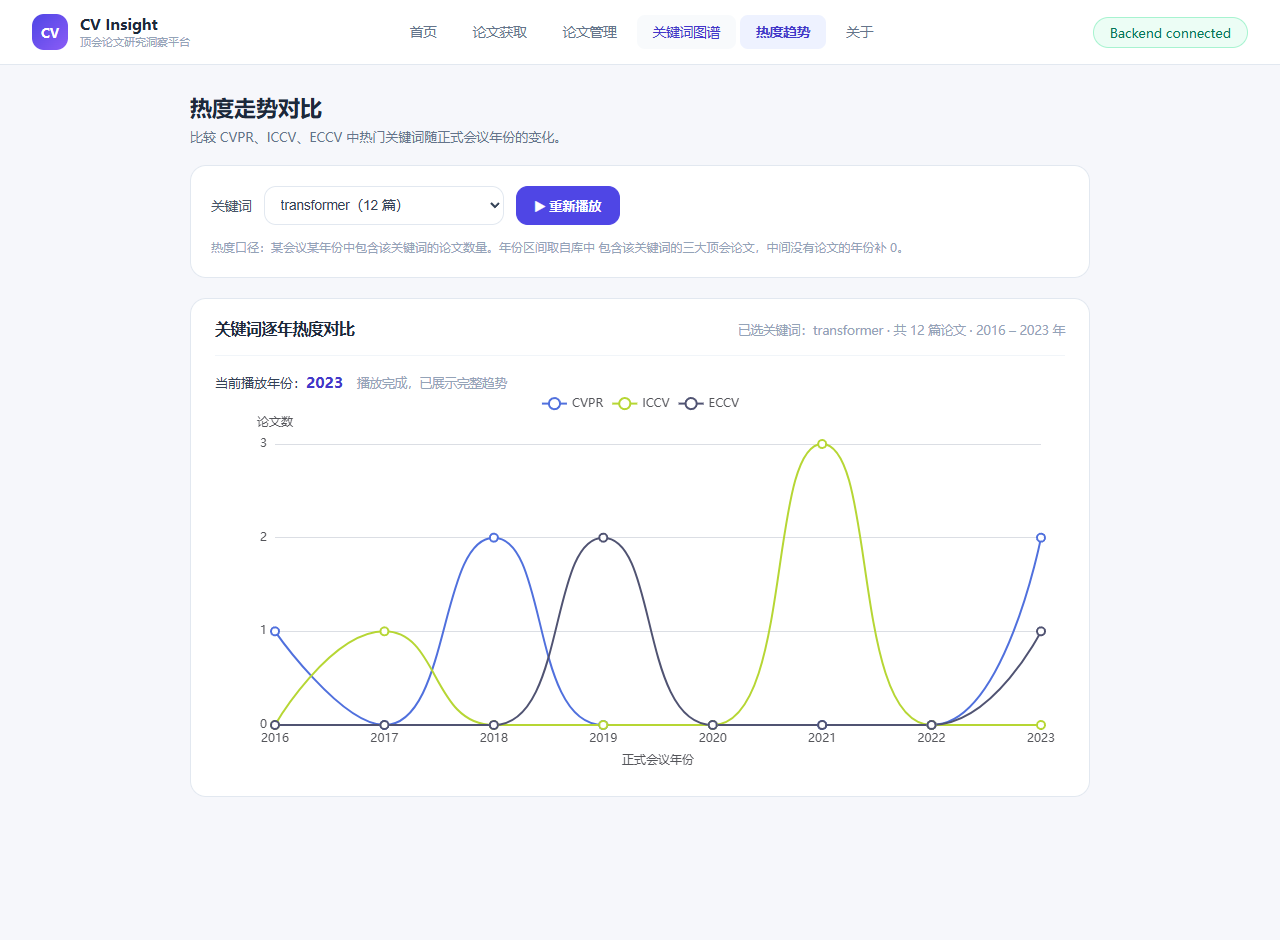
图 4 展示 CVPR、ICCV、ECCV
在不同年份的热词热度变化。通过动态播放,可以比静态表格更直观地观察热点的出现、增长和衰减。
关于这张图的数据来源,需要如实标注: 上面这张图用的是独立临时演示数据库(仓库外,不影响开发库)中的数据,关键词transformer 跨度 2016--2023,因此三条折线是完整的。
原因是当前开发库里论文总量还少,每个关键词都只落在单一年份,真实库上画出来只有一个数据点。下表是真实开发库的实际返回:
{
  "keyword": "11m",
  "years": [2023],
  "series": { "CVPR": [0], "ICCV": [1], "ECCV": [0] },
  "total_papers": 1
}
<img src="assets/keyword-trend.png" alt="热度走势对比(真实开发库)" style="zoom:60%;" />{=html}
上图是真实开发库上的同一页面。它同样说明系统工作正常:只有一个年份时,年份序列就只有一年,图例、播放按钮、当前播放年份都照常显示。
这里没有为了截图好看而往开发库里塞假论文——统计口径和动画逻辑都是真实的,只是演示数据放在了独立数据库里。
【TODO(可选):用录屏工具对着真实页面点一次「播放趋势」,导出 GIF 替换图 4。当前环境没有 ffmpeg,无法自动生成 GIF。】
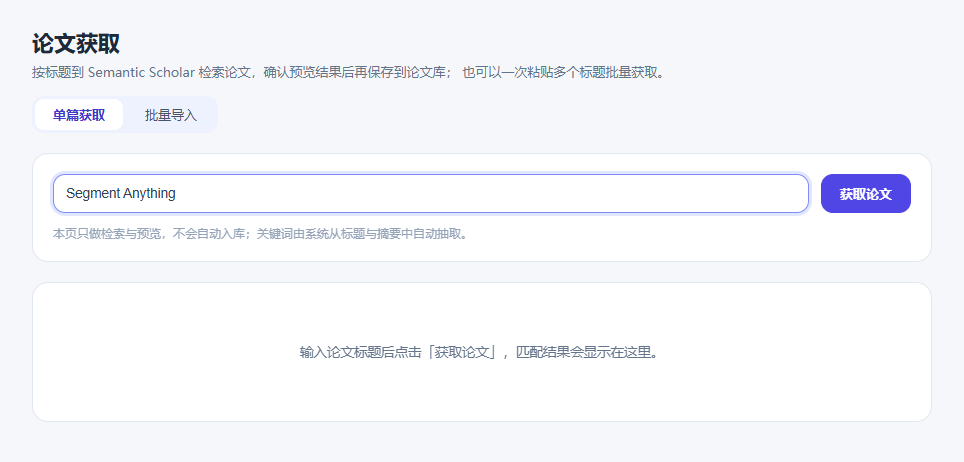
图 5
展示单篇论文获取。用户输入完整论文标题后,系统联网获取真实论文元数据,并先展示预览。
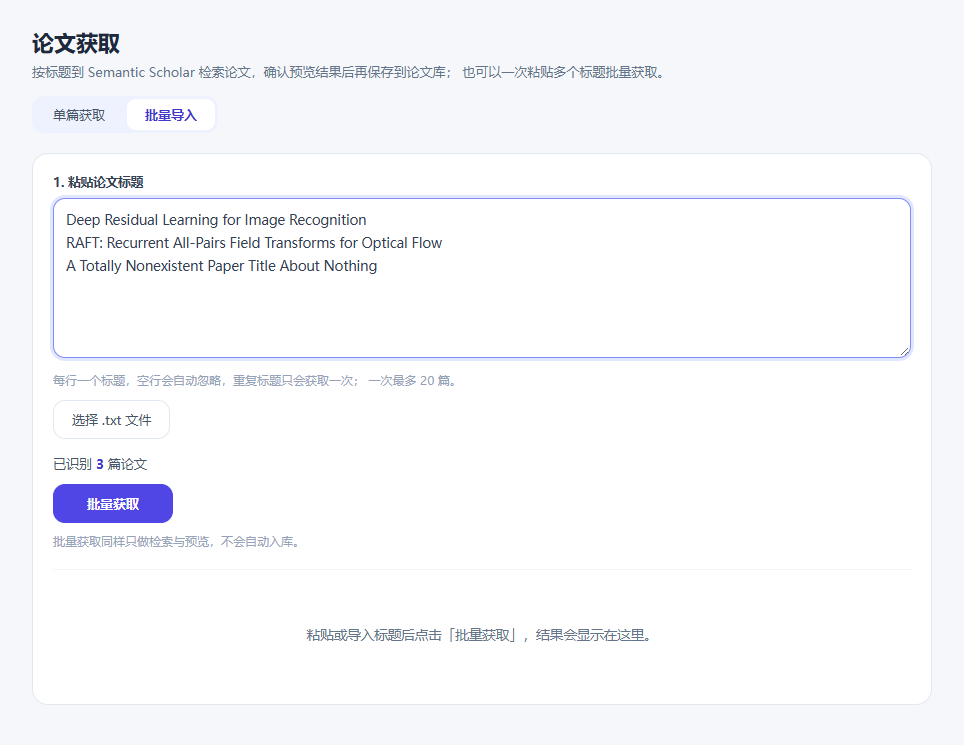
图 7 展示批量导入。用户可以每行输入一个论文标题,也可以读取 .txt
文件;系统会忽略空行并对重复标题去重。
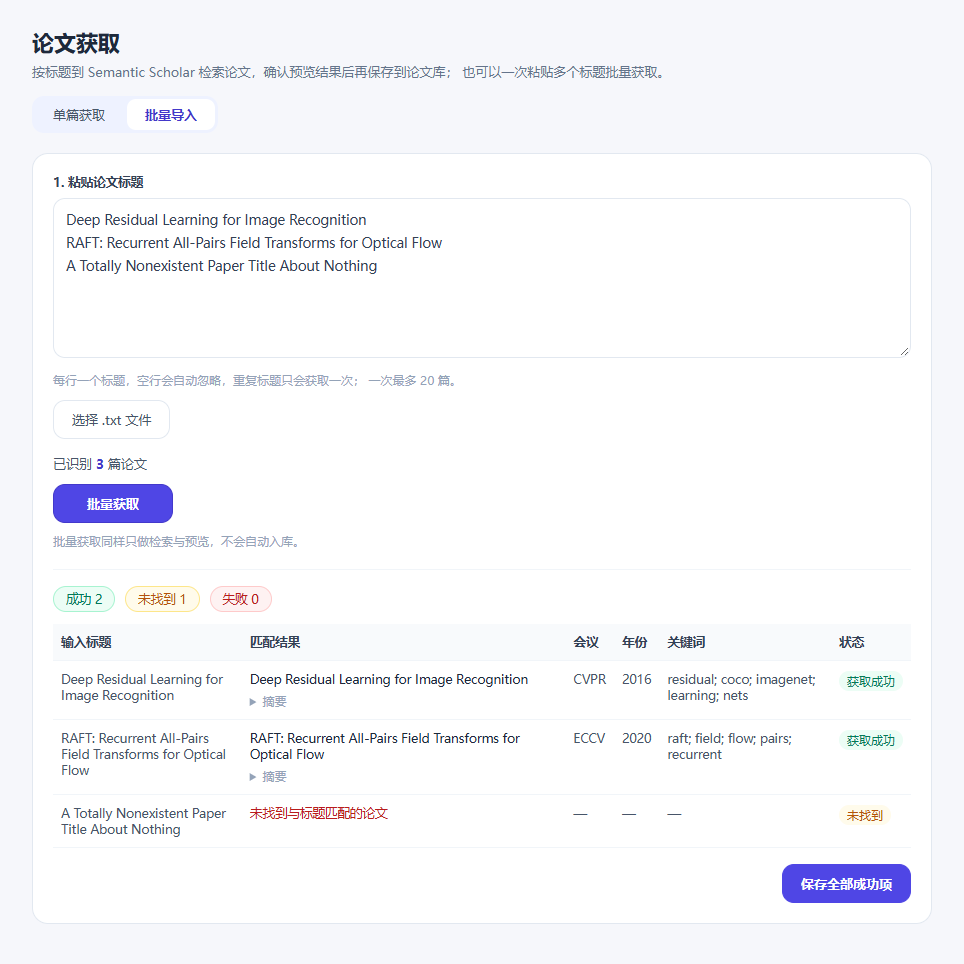
图 8
展示批量获取结果。每篇论文独立显示成功、未找到或失败状态,单篇失败不会让整批结果丢失。只有用户点击"保存全部成功项"后,成功项才真正入库。
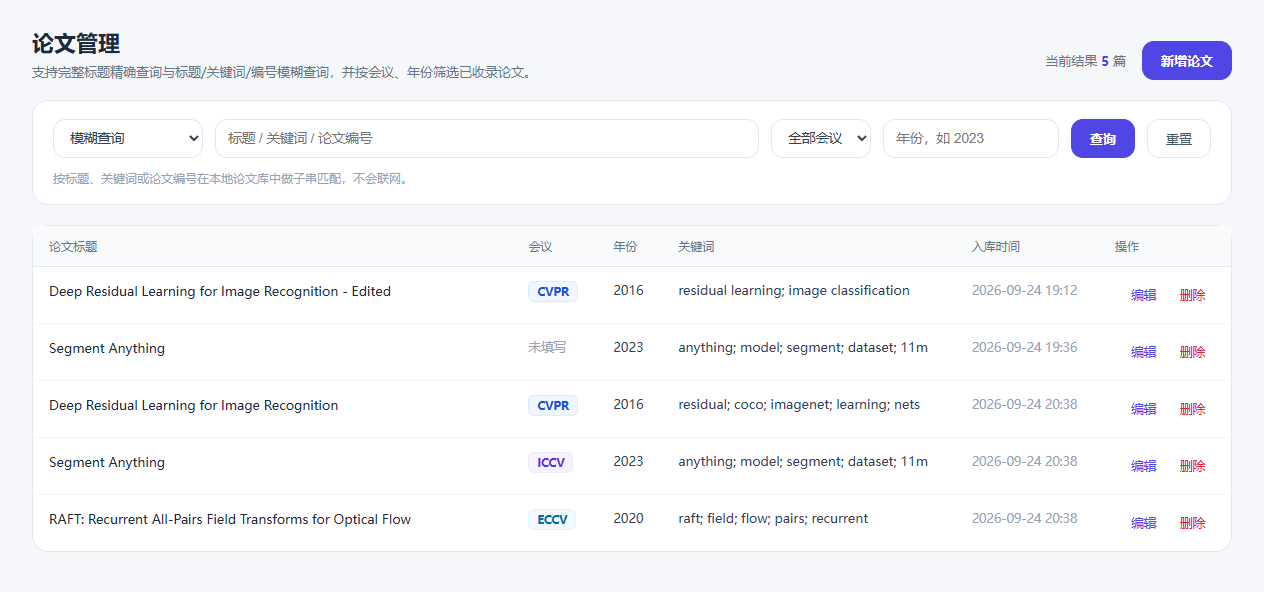
图 9
展示论文管理列表,支持查看标题、会议、年份、关键词和入库时间,并提供编辑、删除等操作。
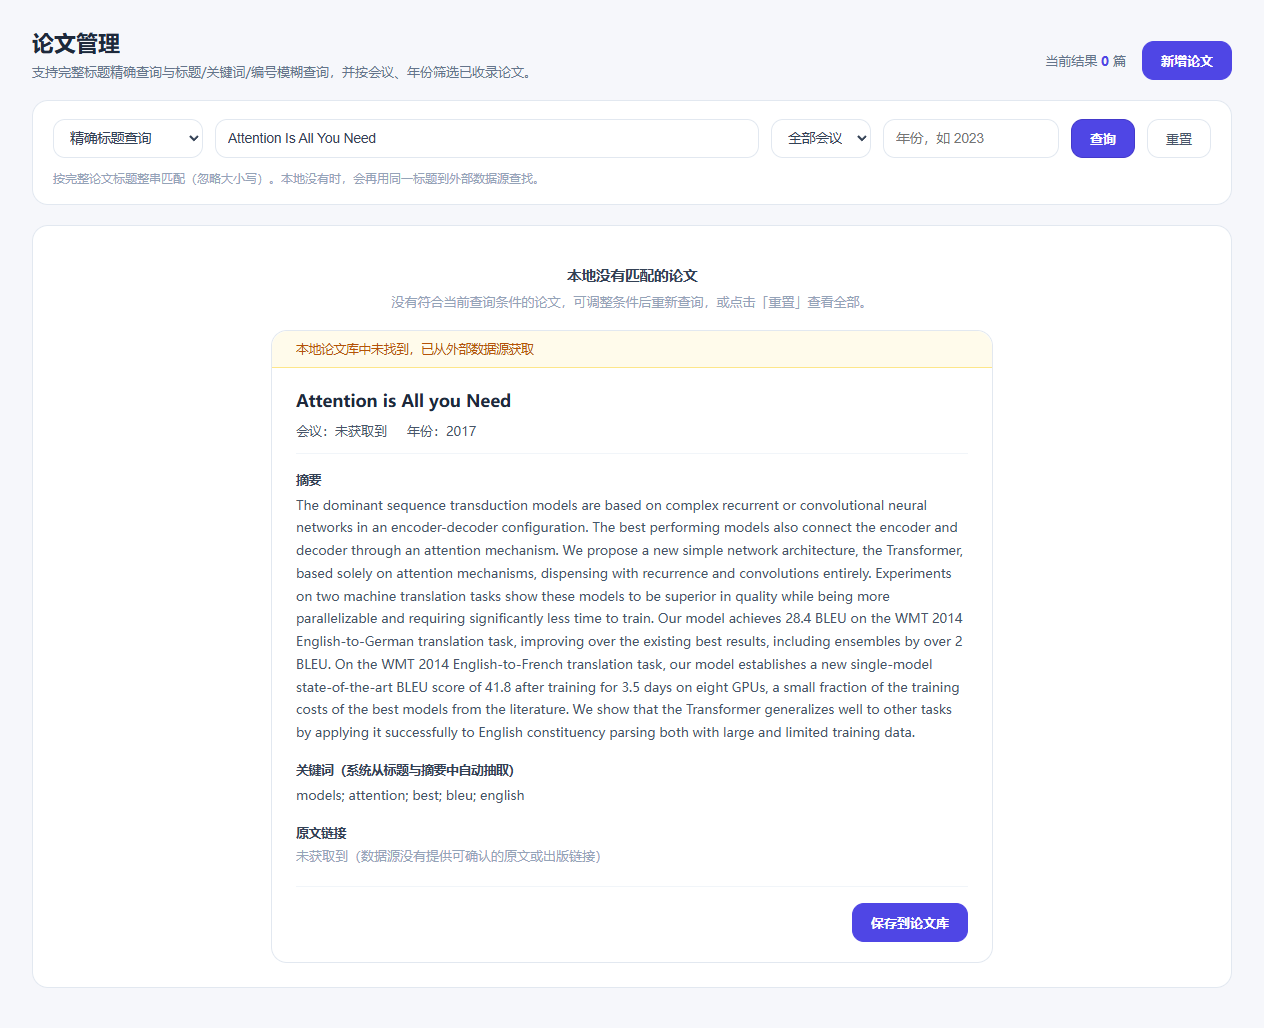
图 10
展示完整标题在本地没有结果时的处理:系统继续调用已有论文获取能力,并明确标记这是外部数据源返回的预览;用户确认后才保存到本地。
这次我没有把 AI 当成"一次性代码生成器",而是更接近一个速度很快、但必须
Review 的结对伙伴。
我的基本流程是:
我:拆分当前最小目标和禁止范围
AI:阅读现有代码后实现
AI:运行自动测试 / build / 联调并汇报
我:检查需求语义、测试证据和 Git diff
发现问题:继续追问或缩小问题
通过:提交一个真实 commit
我发现 Prompt 中最有效的部分不是"请帮我实现 XXX",而是明确写出:
这些约束让 AI 更不容易"顺手重构整个项目"或做出超出当前阶段的功能。
最早我先让 AI
阅读需求并拆分功能,讨论前后端技术、数据库、第三方数据获取和开发顺序。
对应截图:
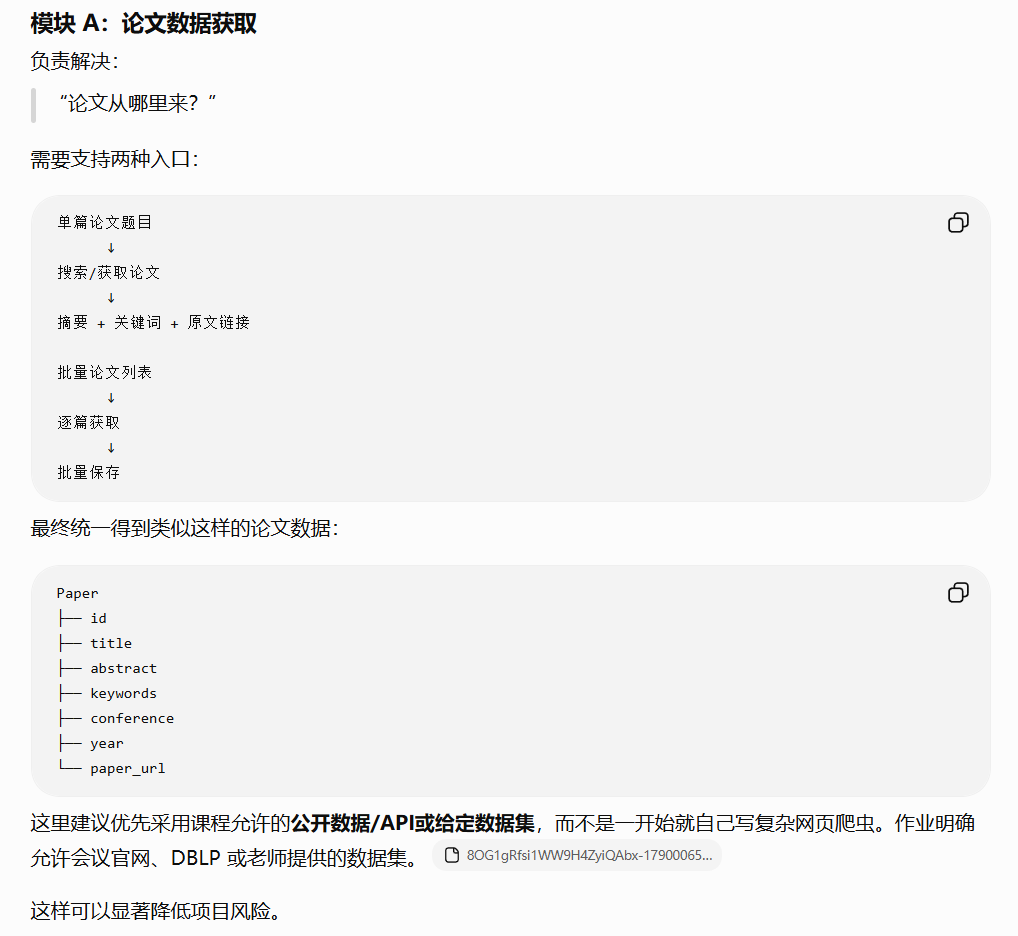
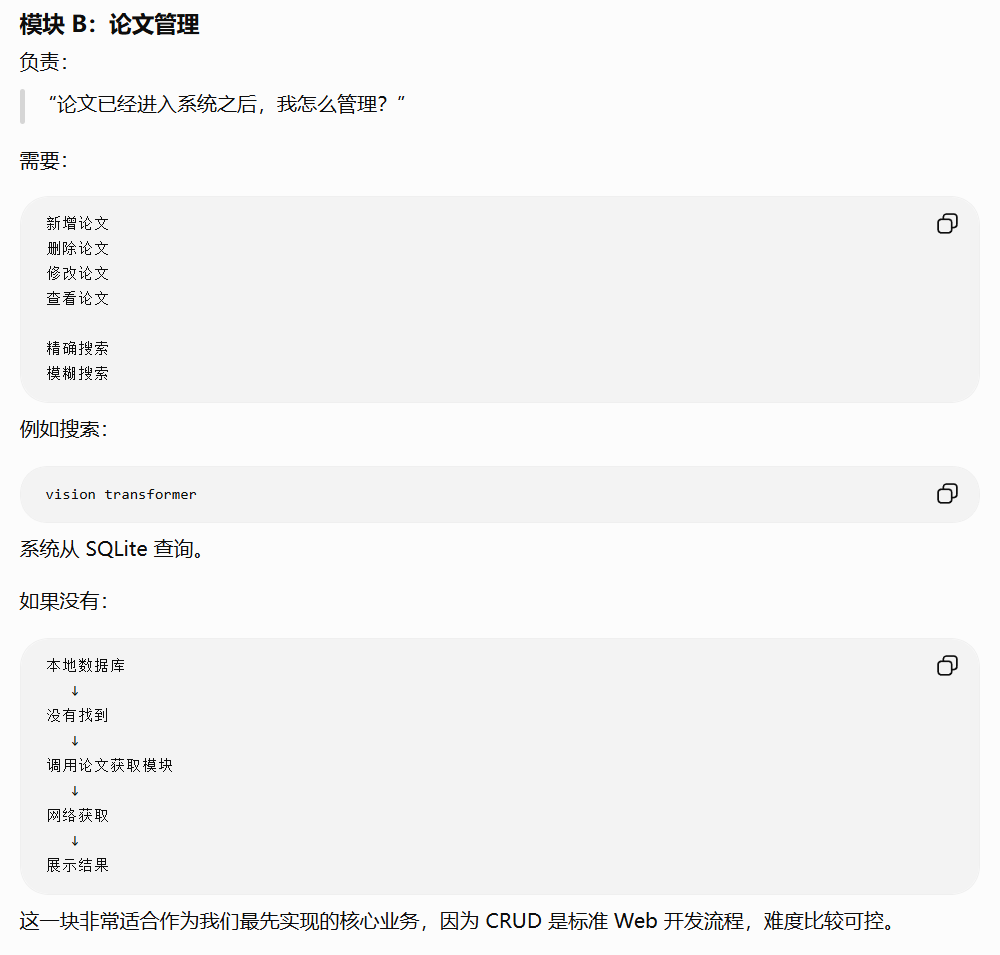
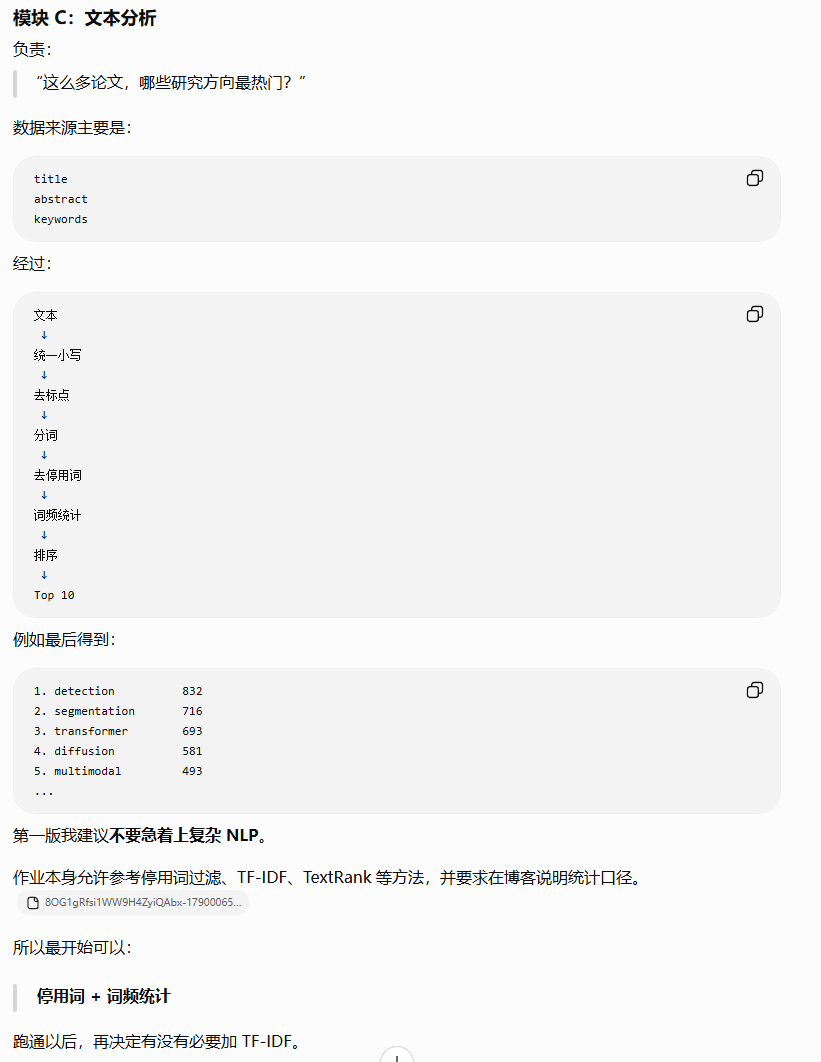
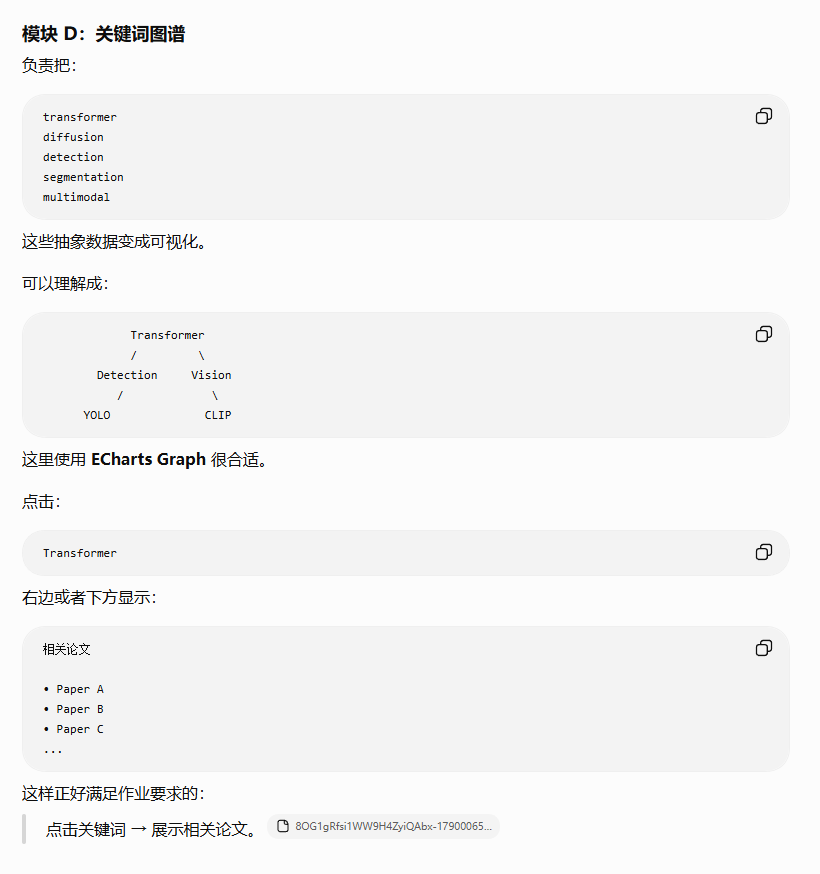
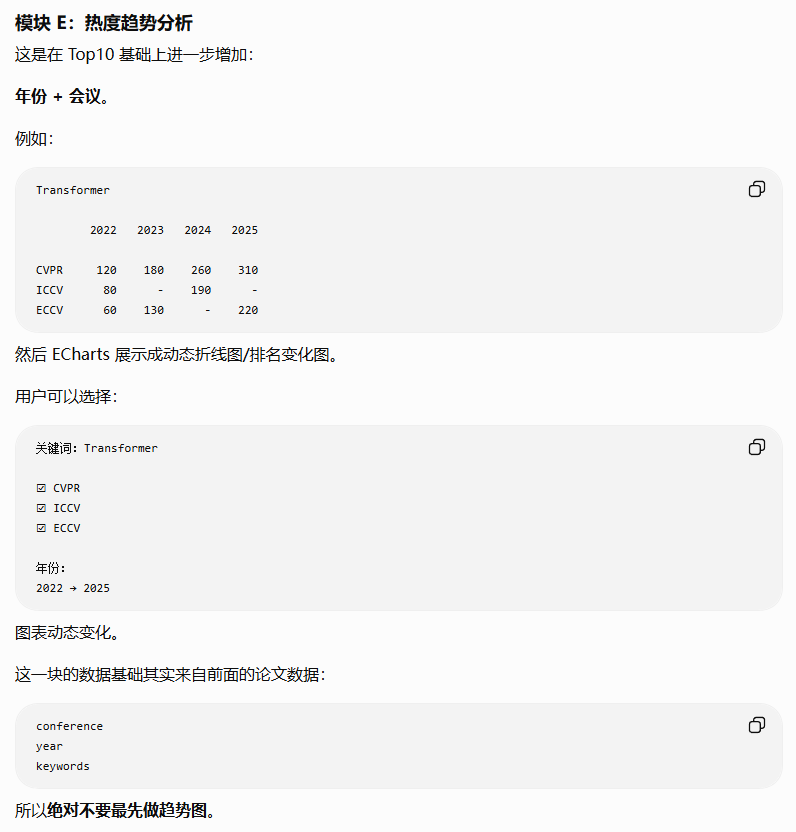
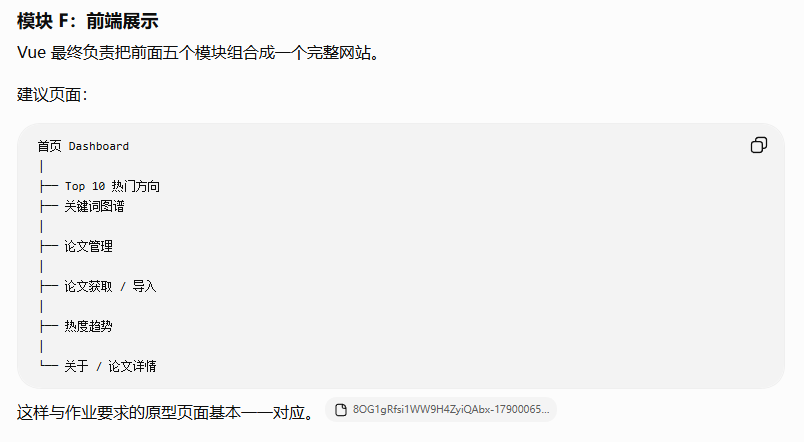
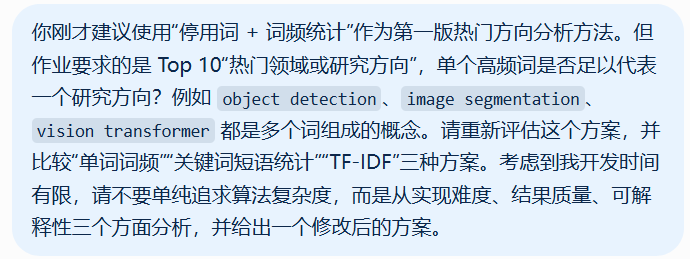
这一步让我提前明确:项目首先要保证五项基础功能闭环,而不是把时间消耗在登录系统、复杂权限、重量级搜索引擎等题目没有要求的扩展上。
之后我把已经收敛的功能结构带到墨刀,与 AI
继续讨论页面布局和交互,再生成/调整原型。
墨刀最终产出的关键页面原型(论文获取 / 关键词图谱 / 热度趋势):
对照原型和最终实现,可以清楚看到哪些信息架构被保留、哪些内容被人工纠正:
这一步让我确认了一个协作原则:原型可以用来定信息架构,但不能把原型里的演示数据当成需求。原型给出的是"页面该有哪些区域",而"每个区域里的数字从哪来、口径是什么"必须由我根据作业要求和真实数据来决定。
原型确认后进入编码。AI 协助搭建 Flask + Vue
的最小骨架,我先验证前后端能够分别启动,再继续加入数据库和业务功能,而不是一开始就同时堆五个模块。
<img src="assets/image-20260924011524664-1790183727081-1.png" alt="初始框架搭建1" style="zoom:50%;" />{=html}
<img src="assets/image-20260924012714197-1790184436273-3.png" alt="初始框架搭建2" style="zoom:50%;" />{=html}
<img src="assets/image-20260924021215373-1790187137547-9.png" alt="创建数据库1" style="zoom:50%;" />{=html}
<img src="assets/image-20260924020836891-1790186919304-7.png" alt="创建数据库2" style="zoom:50%;" />{=html}
AI Agent 建议把 SQLAlchemy 对象和 Paper 模型放在 models.py,通过db.init_app(app) 与 Flask 绑定,并使用显式初始化命令创建
SQLite。人工检查后我接受这一方案:它解决了模块职责和循环导入问题,同时没有引入当前阶段不需要的迁移框架。
我同时保留了应用层字段校验,因为 SQLite 不会真正依靠 VARCHAR(n)
帮我保证长度约束。
开发到中后期,我的 Prompt
从"描述想做什么"逐渐变成"可验收的小任务"。例如在单篇论文获取阶段,我明确要求:
输入标题
→ 联网获取
→ 展示预览
→ 数据库保持不变
→ 用户点击保存
→ 才真正入库
同时要求自动测试不能依赖公网,而是真实公网只用于人工/集成联调。这样既能证明功能真的能访问数据源,又不会让单元测试因为第三方网络波动随机失败。
批量导入阶段则进一步要求必须复用单篇 fetch,不允许复制第三方 API
逻辑。这保证了会议年份规范化、关键词抽取、异常处理只有一份事实来源。
作业一次包含论文爬取、列表管理、Top
10、关键词图谱、趋势动图、原型、部署和 AI
协作记录。如果直接开始写代码,很容易漏评分点或做过多无关功能。
第一轮让 AI
进行需求拆分和技术选型;第二轮不是继续要求"生成代码",而是针对第一轮方案提出质疑,例如哪些功能是真正的基础要求、哪些属于扩展、页面是否过多、数据从哪里来。
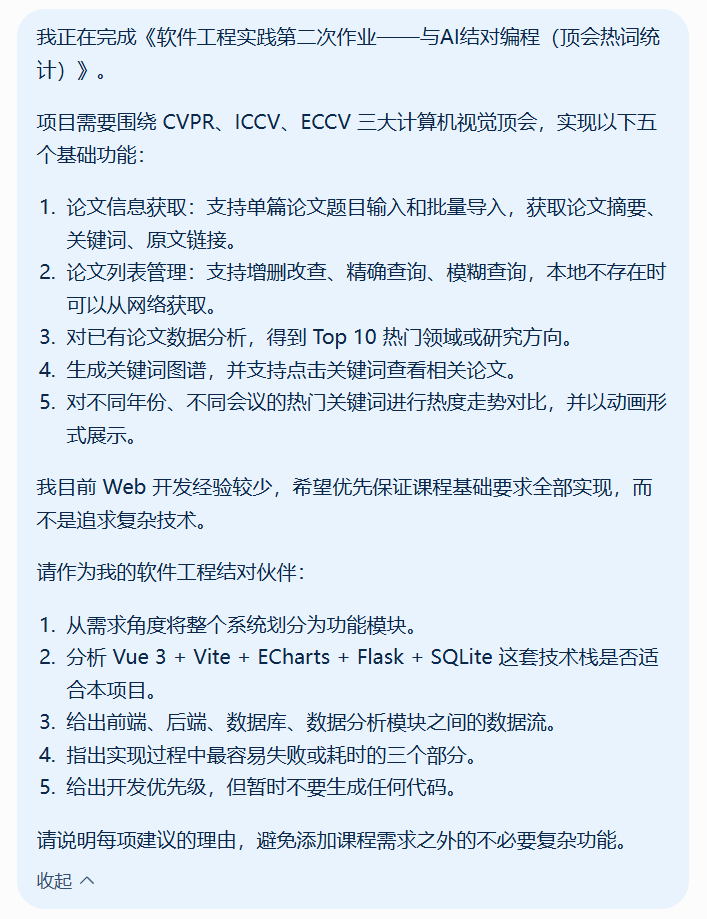
AI 给出了功能模块和技术方案。我接受了 Vue + Flask + SQLite
这一轻量方案,也接受"先搭最小骨架、再逐步增加功能"的开发顺序。
但我没有让 AI
加入题目没有要求的复杂账号系统、权限系统或重量级基础设施,而是把开发优先级重新对齐到五项基础功能。
最终原型形成了"热门方向 / 论文获取 / 论文管理 / 趋势 /
关于"等清晰页面,编码阶段也基本按照这个信息架构推进。
AI 很适合做需求头脑风暴,但需求优先级不能交给 AI
自动决定。真正需要人工做的是把建议重新映射到题目、评分点、时间和实现成本。
功能1不仅要求输入单个标题,还要支持批量论文列表,并获取摘要、关键词、原文链接。这个模块同时涉及第三方
API、异常处理、数据规范化和前后端交互,是项目里最复杂的业务链路之一。
我没有要求 AI "写一个爬虫",而是把任务拆成两次:
第一步只做单篇:
完整标题
→ Semantic Scholar title match
→ 返回预览
→ 不入库
→ 用户确认后复用 POST /api/papers 保存
第二步再做批量:
多行标题 / txt
→ 去空行 + 保序去重
→ 最多 20 篇
→ 逐篇复用单篇 fetch
→ 独立 success / not_found / error
→ 确认后保存成功项
同时要求: - API Key 只能来自环境变量; - 自动测试 mock 第三方网络; -
真实网络只做集成验证; - 429 不无限重试; -
不允许用模拟论文假装联网成功。
AI 实现了独立 paper_fetcher、batch_fetcher、fetch
路由和前端预览/批量组件,并为第三方异常、批量部分失败、限流等情况增加测试。
我重点审查了两个语义问题。
第一,第三方的 fieldsOfStudy
不是论文原始关键词,因此不能直接展示成"论文关键词"。最终改为从 title +
abstract 做简单词频抽取,并在 UI 中明确标注"系统抽取关键词"。
第二,联网成功不应该直接入库。最终单篇和批量都坚持"获取/预览"和"保存"分离。
真实联调中可以得到:
Deep Residual Learning for Image Recognition → CVPR / 2016
Segment Anything → ICCV / 2023
RAFT → ECCV / 2020
批量模式中加入一个不存在的标题时,三篇真实论文仍然成功,不存在项单独显示not_found,保存前数据库数量不变,保存后只增加成功项。
这一案例让我体会到,AI 很擅长迅速把"接口 + 测试 +
前端"串起来,但数据字段的业务含义必须由人确认。如果没有人工审查,"能返回
JSON"很容易被误认为"数据就是正确的"。
这是我认为最能体现"AI 结对不是盲抄"的一次协作。
在论文列表筛选的 Review 中,AI 给出的测试说明认为:
GET /api/papers?year=12
→ 应返回 400
→ year 必须在 1900~2100
这句话的原文截图:
<img src="assets/image-20260924183856398-1790246339508-13-1790246342800-15.png" alt="AI 声称 year=12 应返回 400" style="zoom:70%;" />{=html}
我实际测试后发现并不是这样:
GET /api/papers?year=12
→ 200
而创建/修改论文时,year=12 又会被后端拒绝。
这说明问题不是"测试环境坏了",而是同一个 year 在不同 API
中使用了不一致的校验规则。
<img src="assets/image-20260924183828110-1790246310670-11.png" alt="Debug 前:year=12 返回 200" style="zoom:70%;" />{=html}
上图是修复前的真实结果:GET /api/papers?year=12 返回 200 OK,而同一时刻论文新增/修改接口对 year=12 是拒绝的。
继续阅读代码后发现:
validate_year,会检查 1900~2100;isdigit() 后转整数,没有检查年份范围。validate_year 就是被 POST/PUT 复用的那份规则:
<img src="assets/image-20260924184347413-1790246629195-19.png" alt="validate_year 源码" style="zoom:70%;" />{=html}
因此 AI 最开始给出的"应该
400"只是它根据项目其他位置推断出的预期,并不是当前代码的真实行为。
我没有直接让 AI 随便改,而是把已经复现的事实写回 Prompt:
已复现:
POST year=12 → 400
GET ?year=12 → 200
GET ?year=abc → 400

请分析根因,并做最小修复:
让 GET 的 year 查询参数与项目已有 1900~2100 规则一致;
补合法年份、非数字、小于 1900、大于 2100 的自动测试;
不要修改前端、数据库结构和其他功能。
<img src="assets/image-20260924184552744-1790246754519-21.png" alt="修复 Prompt" style="zoom:70%;" />{=html}
注意这个 Prompt 的写法:先把已经复现的事实写进去(而不是只说"年份校验有 bug"),再限定修改范围、要求补测试、要求跑完整回归、明确不要 commit。
修复后重新验证:
GET ?year=12
→ 400 Bad Request

GET ?year=2024
→ 200 OK
并运行后端完整回归测试,全部通过。
修复后的对照结果:
<img src="assets/image-20260924185136401-1790247098751-23.png" alt="修复后:year=12 返回 400,year=2024 返回 200" style="zoom:70%;" />{=html}
完整回归测试(当时的测试总数是 30 项):
<img src="assets/image-20260924185317539-1790247199302-25.png" alt="修复后回归测试 OK" style="zoom:70%;" />{=html}
如果我只是相信 AI 的测试说明,就会把"AI
想象中的行为"当成"已经实现的行为"。这次经历让我明确了一个原则:
AI 可以提出预期,但真实程序行为必须通过运行、测试和代码阅读确认。
这也是我之后要求 Agent 每一步都提供"测试命令 + 结果 +
未验证部分"的原因。
作业要求展示约 300
行关键代码。这里不要复制整个项目,而应选择最能体现设计思路的代码。以下解释已经写好,最终只需要把自己仓库里的真实代码粘贴到对应位置。
# ---------------- models.py ----------------
# db 对象定义在模型模块中,由 app.py 通过 init_app() 绑定到 Flask 应用,
# 这样应用与模型不用互相 import,避免循环导入。
db = SQLAlchemy()

# 字段长度上限同时被表结构和接口校验使用,集中定义避免两处写死后不一致
TITLE_MAX_LENGTH = 300
KEYWORDS_MAX_LENGTH = 500
PAPER_URL_MAX_LENGTH = 500


class Paper(db.Model):
    """一篇顶会论文的基础信息。

    除标题外,其余字段都允许为空:论文数据来自公开数据源,
    摘要、关键词、原文链接等有可能抓取不到。
    """

    __tablename__ = 'papers'

    id = db.Column(db.Integer, primary_key=True)
    # SQLite 不会强制校验 VARCHAR 长度,这里的长度属于结构声明,
    # 超长标题由 routes/papers.py 的接口校验拦截
    title = db.Column(db.String(TITLE_MAX_LENGTH), nullable=False)
    abstract = db.Column(db.Text)
    keywords = db.Column(db.String(KEYWORDS_MAX_LENGTH))
    conference = db.Column(db.String(20))
    year = db.Column(db.Integer)
    paper_url = db.Column(db.String(PAPER_URL_MAX_LENGTH))
    created_at = db.Column(db.DateTime, nullable=False, default=datetime.now)

    def to_dict(self):
        """转成接口返回用的字典,避免在各个路由里重复拼装字段。"""
        return {
            'id': self.id,
            'title': self.title,
            'abstract': self.abstract,
            'keywords': self.keywords,
            'conference': self.conference,
            'year': self.year,
            'paper_url': self.paper_url,
            'created_at': self.created_at.isoformat(),
        }


# ---------------- app.py ----------------
app = Flask(__name__)

# instance/ 已被 .gitignore 忽略,数据库文件不会被提交到仓库
app.config['SQLALCHEMY_DATABASE_URI'] = 'sqlite:///cv_insight.db'

# 返回 JSON 时直接输出中文,而不是 \uXXXX 转义,便于用 curl 或日志查看接口返回
app.json.ensure_ascii = False

db.init_app(app)
app.register_blueprint(papers_bp)
app.register_blueprint(fetch_bp)
app.register_blueprint(analytics_bp)


@app.errorhandler(HTTPException)
def handle_http_exception(error):
    """把 404、405 等 HTTP 错误统一转成 JSON,避免接口返回 HTML 错误页。"""
    return jsonify({'error': error.description}), error.code
设计思路:
db 和 Paper 模型独立于路由;create_app/应用初始化负责绑定数据库和注册蓝图;# LIKE 里 % 和 _ 是通配符,用户输入的这两个字符必须转义后才能当普通字符匹配
LIKE_ESCAPE = '\\'
def like_pattern(text):
"""把用户输入变成安全的 LIKE 模式,% 和 _ 按普通字符处理。"""
escaped = (text.replace('\\', '\\\\')
.replace('%', '\\%')
.replace('_', '\\_'))
return f'%{escaped}%'
def apply_text_query(query, text, mode):
"""给查询加上文本查询条件。
exact:论文标题整串相等(忽略大小写),用于"完整论文标题"精确查询;
fuzzy:标题子串、关键词子串或论文编号,三者满足其一即可。
两种情况都不匹配摘要,避免把摘要里的偶然词当作查询依据。
"""
if mode == SEARCH_MODE_EXACT:
return query.filter(db.func.lower(Paper.title) == text.lower())
conditions = [
Paper.title.like(like_pattern(text), escape=LIKE_ESCAPE),
Paper.keywords.like(like_pattern(text), escape=LIKE_ESCAPE),
]
# 输入是纯数字时额外按论文编号匹配,编号本身不参与子串匹配
if text.isdigit():
conditions.append(Paper.id == int(text))
return query.filter(db.or_(*conditions))
@papers_bp.get('')
def list_papers():
"""论文列表,支持文本查询与 conference、year 筛选,条件之间按 AND 组合。"""
query = Paper.query
mode, mode_error = parse_search_mode(request.args.get('search_mode'))
if mode_error:
return jsonify({'error': mode_error}), 400
# 没有 q 时不做文本过滤,只按 conference / year 筛选
text = request.args.get('q', '').strip()
if text:
query = apply_text_query(query, text, mode)
conference = request.args.get('conference', '').strip()
if conference:
query = query.filter(Paper.conference == conference)
year_text = request.args.get('year', '').strip()
if year_text:
if not year_text.isdigit():
return jsonify({'error': 'year 必须是整数年份'}), 400
# 复用新增/修改用的年份规则(含范围约束),避免两处判断不一致
year, error = validate_year(int(year_text))
if error:
return jsonify({'error': error}), 400
query = query.filter(Paper.year == year)
papers = query.order_by(Paper.id).all()
return jsonify([paper.to_dict() for paper in papers])
@papers_bp.put('/<int:paper_id>')
def update_paper(paper_id):
"""整体更新论文。未提供的字段会被清空(title 必须提供)。"""
paper = db.get_or_404(Paper, paper_id, description='论文不存在')
data, error = parse_paper_payload(request.get_json(silent=True))
if error:
return jsonify({'error': error}), 400
# 逐个字段覆盖,实现整体替换的语义
for field, value in data.items():
setattr(paper, field, value)
db.session.commit()
return jsonify(paper.to_dict())
查询设计中,精确模式只比较完整标题;模糊模式则把标题、关键词和纯数字 id
组合为 OR 条件,并继续与 conference/year 过滤做 AND 组合。
LIKE 查询对 %、_ 等特殊字符进行转义,避免用户输入 %
时意外匹配整个数据库。
def fetch_paper_by_title(title):
    """按标题获取论文信息,返回规范化后的预览数据(不入库)。"""
    payload = _request_match(title)
    candidates = payload.get('data') or []

    if not candidates:
        raise PaperFetchError('未找到与标题匹配的论文', 404)

    paper = normalize_paper(candidates[0])
    _apply_official_conference_year(paper, candidates[0])
    return paper


def _apply_official_conference_year(paper, data):
    """已确认是三大顶会论文时,用正式出版年份覆盖预印本年份。

    只在会议已可靠确认为 CVPR / ICCV / ECCV 时才覆盖,并且只依据
    DOI 查到的出版年份,不根据标题或用户输入猜测;
    Crossref 查不到时保留数据源返回的年份,避免整个获取失败。
    """
    if paper['conference'] is None:
        return

    doi = _external_id(data, 'DOI')
    if not doi:
        return

    official_year = _request_crossref_year(doi)
    if official_year is not None:
        paper['year'] = official_year


def normalize_paper(data):
    """把数据源返回的一条记录规范化成 Paper 的字段。

    只使用数据源真实返回的内容:缺失的字段一律返回 None,
    不根据用户输入或常识补全,避免把猜测写入论文库。
    """
    title = data.get('title')
    abstract = data.get('abstract')

    return {
        'title': title,
        'conference': _normalize_conference(data),
        'year': _normalize_year(data.get('year')),
        'abstract': abstract,
        'paper_url': _resolve_paper_url(data),
        'keywords': build_keywords_text(title, abstract),
        # 数据源站内详情页地址,仅用于说明匹配结果来自哪里,
        # 不会被当作"原文链接",入库时也会被 POST /api/papers 忽略
        'source_url': data.get('url'),
    }


def _request_match(title):
    """调用标题最佳匹配接口,返回解析后的 JSON。"""
    query = urllib.parse.urlencode({'query': title, 'fields': REQUEST_FIELDS})
    request = urllib.request.Request(
        f'{SEARCH_MATCH_URL}?{query}', headers=_build_headers())

    try:
        with urllib.request.urlopen(
                request, timeout=REQUEST_TIMEOUT_SECONDS) as response:
            return json.loads(response.read().decode('utf-8'))
    except urllib.error.HTTPError as error:
        raise _http_error_to_fetch_error(error) from error
    except TimeoutError as error:
        raise PaperFetchError(TIMEOUT_MESSAGE, 504) from error
    except urllib.error.URLError as error:
        # URLError 也可能只是把超时包了一层
        if isinstance(error.reason, TimeoutError):
            raise PaperFetchError(TIMEOUT_MESSAGE, 504) from error
        raise PaperFetchError(NETWORK_MESSAGE, 502) from error
    except (json.JSONDecodeError, UnicodeDecodeError) as error:
        raise PaperFetchError('论文数据源返回了无法解析的内容', 502) from error


def _normalize_conference(data):
    """只在能可靠判断时返回 CVPR / ICCV / ECCV,否则返回 None。"""
    # workshop 判断只看论文自己的会议名字段,不能看别名列表:
    # Semantic Scholar 把 ICCV 的别名同时列成 "ICCV" 和 "ICCV Workshops",
    # 否则正会论文会被自己的别名误判成 workshop(真实案例:Segment Anything)
    own_text = _own_conference_text(data)
    if any(hint in own_text for hint in NOT_MAIN_CONFERENCE_HINTS):
        return None

    # 按可信度依次匹配:venue → publicationVenue.name → 别名,
    # 避免低可信度的字段把会议认错
    for text in _conference_match_texts(data):
        for conference, patterns in CONFERENCE_PATTERNS:
            if any(re.search(pattern, text) for pattern in patterns):
                return conference

    return None


def _build_headers():
    """构造请求头。API Key 只从环境变量读取,不写进源码。"""
    headers = {'User-Agent': 'CV-Insight-Course-Project/1.0'}

    api_key = os.environ.get('SEMANTIC_SCHOLAR_API_KEY')
    if api_key:
        headers['x-api-key'] = api_key

    return headers
这一部分负责:
路由只负责参数接收和错误转换,外部 HTTP 逻辑放在 service 中,便于 mock
测试和后续复用。
STOPWORDS = frozenset({
    'about', 'after', 'all', 'also', 'and', 'any', 'are', 'because', 'been',
    'both', 'but', 'can', 'could', 'does', 'during', 'each', 'for', 'from',
    # ...(此处省略若干常见英文停用词)
    'while', 'will', 'with', 'would', 'you', 'your',
})

TOP_KEYWORD_COUNT = 5

# token 最短长度,用来滤掉 of / in / to 这类无意义短词
MIN_TOKEN_LENGTH = 3

# 关键词在 Paper.keywords 字符串字段中的分隔符
KEYWORD_SEPARATOR = '; '

TOKEN_PATTERN = re.compile(r'[^a-z0-9]+')


def extract_keywords(title, abstract, limit=TOP_KEYWORD_COUNT):
    """返回按词频排序的关键词列表;内容不足时返回空列表。"""
    text = ' '.join(part for part in (title, abstract) if part)
    if not text.strip():
        return []

    counts = {}
    for token in TOKEN_PATTERN.split(text.lower()):
        if len(token) < MIN_TOKEN_LENGTH or token in STOPWORDS:
            continue
        counts[token] = counts.get(token, 0) + 1

    # 词频降序 + 字母序升序,作为稳定的次级排序,保证结果可复现
    ordered = sorted(counts.items(), key=lambda item: (-item[1], item[0]))
    return [word for word, _ in ordered[:limit]]


def build_keywords_text(title, abstract):
    """返回可直接存入 Paper.keywords 的字符串;没有内容可用时返回 None。"""
    keywords = extract_keywords(title, abstract)
    if not keywords:
        return None
    return KEYWORD_SEPARATOR.join(keywords)
关键词抽取采用确定性的轻量词频方法。它不追求 NLP
算法复杂度,而强调同样输入得到同样结果,并且可以清楚解释每一步。
# 一次最多获取的论文数量:既避免误粘贴整篇参考文献造成的大批量请求,
# 也降低触发第三方接口限流的概率
MAX_BATCH_SIZE = 20


def normalize_titles(raw_titles):
    """校验并整理一批标题,返回 (标题列表, 错误信息)。

    规则:必须是数组,且每一项都是字符串;空白项(空行、只有空格)直接忽略;
    非空标题去掉首尾空白后,完全相同的只保留第一次出现的位置,
    避免对同一个标题重复请求数据源。
    超过数量上限时报错而不是静默截断,让用户自己决定保留哪些标题。
    """
    if not isinstance(raw_titles, list):
        return None, 'titles 必须是数组'

    titles = []
    seen = set()

    for index, item in enumerate(raw_titles, start=1):
        if not isinstance(item, str):
            return None, f'第 {index} 个标题必须是字符串'

        # 空行、只含空白的行不是标题,直接跳过(页面上也允许用户留空行)
        if not item.strip():
            continue

        # 复用新增/修改论文时的标题规则:去空白、非空、长度上限
        title, error = validate_title(item)
        if error:
            return None, f'第 {index} 个标题:{error}'

        if title not in seen:
            seen.add(title)
            titles.append(title)

    if not titles:
        return None, EMPTY_TITLES_MESSAGE

    if len(titles) > MAX_BATCH_SIZE:
        return None, TOO_MANY_TITLES_MESSAGE

    return titles, None


def fetch_papers_by_titles(titles):
    """顺序获取一批标题,返回与输入顺序一致的结果列表。

    每一篇独立处理:任何一篇失败都只记在自己的结果里,不影响其它论文。
    如果某一篇遇到限流(HTTP 429),就停止后续的数据源请求,把这一篇和
    剩余未处理的标题都标记为未处理:不重试,避免继续放大对第三方接口的压力。
    """
    results = []
    stopped_for_rate_limit = False

    for title in titles:
        if stopped_for_rate_limit:
            results.append(_rate_limited_result(title))
            continue

        result = _fetch_one(title)
        stopped_for_rate_limit = result['status'] == STATUS_RATE_LIMITED
        results.append(result)

    return results
批量逻辑只负责输入预处理和调度单篇
fetch,不复制第三方请求逻辑。这样如果以后修正会议年份或异常处理,单篇和批量会同时生效。
三个统计功能共用同一个关键词解析函数,这是整个统计模块的地基:
def extract_paper_keywords(keywords_text):
    """把一篇论文的 keywords 字段拆成去重后的关键词列表。

    同一篇论文内重复出现的关键词只保留一次,避免个别异常数据
    把某个关键词的计数放大;空白项直接忽略。
    """
    if not keywords_text:
        return []

    keywords = []
    seen = set()
    for raw_keyword in keywords_text.split(KEYWORD_SEPARATOR):
        keyword = raw_keyword.strip().lower()
        if not keyword or keyword in seen:
            continue
        seen.add(keyword)
        keywords.append(keyword)

    return keywords
Top 10 与图谱节点都建立在"关键词 → 论文列表"的映射上:
def summarize_top_keywords(papers, limit=TOP_KEYWORD_LIMIT):
    """统计论文关键词频次,返回榜单与参与统计的论文数。

    排序规则:先按出现次数降序,次数相同时按关键词字母序升序,
    保证同样的数据永远得到同样的顺序。
    """
    counts = {}
    counted_papers = 0

    for paper in papers:
        keywords = extract_paper_keywords(paper.keywords)
        # keywords 为空的论文不参与统计,也不计入 paper_count
        if not keywords:
            continue
        counted_papers += 1
        for keyword in keywords:
            counts[keyword] = counts.get(keyword, 0) + 1

    ordered = sorted(counts.items(), key=lambda item: (-item[1], item[0]))

    return {
        'total_papers': counted_papers,
        'items': [{'keyword': keyword, 'count': count}
                  for keyword, count in ordered[:limit]],
    }
图谱的共现边统计。关键词对按字母序排列是刻意为之,它同时解决了三件事:
方向稳定、可复现、不会出现自环。
def count_cooccurrences(paper_keywords, selected_names):
    """统计选定关键词两两在同一篇论文中共同出现的次数。

    `paper_keywords` 是 [(paper, 关键词列表)],其中每篇论文的关键词已经
    去重,所以同一篇论文对同一个关键词对只会贡献 1 次。

    关键词对按字母序排列(source < target),因此:
    1. 边的方向稳定,测试可以断言、前端渲染结果可复现;
    2. 不会出现 source == target 的自环。
    """
    counts = {}

    for _, keywords in paper_keywords:
        # 只看出现在图谱里的关键词,并按字母序排好,保证边的方向一致
        present = sorted(name for name in keywords if name in selected_names)
        for index, source in enumerate(present):
            for target in present[index + 1:]:
                counts[(source, target)] = counts.get((source, target), 0) + 1

    # 边权降序,边权相同时按 (source, target) 字母序,保证输出稳定
    ordered = sorted(counts.items(), key=lambda item: (-item[1], item[0]))
    return [{'source': source, 'target': target, 'count': count}
            for (source, target), count in ordered]
趋势统计的核心:年份区间与补零。注意 matched_years 只收集匹配到该关键词的论文年份,所以区间不会被无关论文拉长。
def build_keyword_trend(papers, keyword):
    """统计某个关键词在三大顶会逐年出现的论文数。"""
    normalized = (keyword or '').strip().lower()

    counts = {conference: {} for conference in TREND_CONFERENCES}
    matched_papers = 0
    matched_years = set()

    for paper in papers:
        # 会议缺失、不是三大顶会,或年份缺失的论文都不参与趋势统计
        if paper.conference not in TREND_CONFERENCES:
            continue
        if paper.year is None:
            continue
        if normalized not in extract_paper_keywords(paper.keywords):
            continue

        matched_papers += 1
        matched_years.add(paper.year)
        year_counts = counts[paper.conference]
        year_counts[paper.year] = year_counts.get(paper.year, 0) + 1

    if not matched_years:
        return {
            'keyword': normalized,
            'years': [],
            'series': {conference: [] for conference in TREND_CONFERENCES},
            'total_papers': 0,
        }

    years = list(range(min(matched_years), max(matched_years) + 1))

    return {
        'keyword': normalized,
        'years': years,
        'series': {
            conference: [counts[conference].get(year, 0)
                         for year in years]
            for conference in TREND_CONFERENCES
        },
        'total_papers': matched_papers,
    }
前端趋势页的播放逻辑,关键是"逐步扩大数据窗口"而不是做帧动画:
function startPlayback() {
  // 先停掉上一次的 timer:连续点「重新播放」不能产生多个并行 timer
  stopPlayback()
  if (years.value.length === 0) return

  isPlaying.value = true
  hasPlayed.value = true
  visibleCount.value = 1
  renderChart()

  playTimer = setInterval(() => {
    if (visibleCount.value >= years.value.length) {
      // 到最后一年自动停止,此时画面就是完整趋势
      stopPlayback()
      return
    }
    visibleCount.value += 1
    renderChart()
  }, PLAY_INTERVAL_MS)
}
本项目把测试分成三层:
第一层:后端自动化测试。
CRUD、查询、年份校验、论文 fetch、关键词抽取、批量 fetch、统计接口等使用unittest。第三方 API 在自动化测试中使用
mock,避免网络和限流导致测试随机失败。
第二层:前端构建检查。
每个阶段完成后执行:
npm run build
确保 Vue 组件和打包过程没有语法/依赖错误。
第三层:真实联调。
对于第三方论文获取,仅 mock 通过还不够,因此另外使用真实 Flask + Vite +
Semantic Scholar
验证关键论文。真实联调与自动化测试职责不同:前者证明"现实世界链路能工作",后者保证"回归测试稳定"。
开发过程中后端测试从最初 CRUD 的约 26 项逐步增加:
CRUD / 查询基础测试
→ 30 项左右
→ 单篇论文获取与关键词抽取后 59 项
→ 正式会议年份规范化后继续增加
→ 批量导入后 97 项
→ 查询功能补全后 113 项
→ Top 10 统计后 140 项
→ 关键词图谱后 172 项
→ 热度走势后 196 项
最终 196 项按文件分布如下:
test_papers_api.py                 46   论文 CRUD、查询、输入校验
test_analytics_api.py              27   Top 10 热门方向
test_keyword_graph_api.py          32   关键词图谱节点与共现
test_keyword_trend_api.py          24   关键词逐年热度趋势
test_paper_fetch_api.py            30   单篇联网获取
test_paper_fetch_batch_api.py      28   批量获取
test_keyword_extractor.py           9   关键词抽取规则
                                  ---
                                  196
我更关注的是测试是否能抓到错误,而不仅是数量。例如批量导入阶段做过一次变异检查:当测试代码直接引用实现中的MAX_BATCH_SIZE 时,把实现常量从 20 改成 50,测试也会跟着变成
50,导致需求被改坏却不报错。之后把测试期望固定为需求值
20,才真正约束住需求。
这个例子说明:**"测试绿了"不一定代表测试有效,测试本身也需要 Review。**
Backend:
$ .venv/Scripts/python.exe -m unittest discover -s tests
Ran 196 tests in 2.562s
OK

Frontend:
$ npm run build
dist/assets/index-EAsm77xl.js   662.08 kB │ gzip: 227.62 kB
✓ built in 308ms

Deployment smoke test:
【TODO:部署到华为云后补】
后端测试统一使用 unittest + Flask 测试客户端,第三方 API 全部 mock,不访问公网;需要数据库的用例使用临时 SQLite 文件,测试结束后删除,不会读写开发数据库 instance/cv_insight.db。
前端除了 npm run build,每个功能都额外做了真实浏览器联调(Flask + Vite + Edge 实际点击操作),例如:
Deep Residual Learning for Image Recognition → CVPR / 2016、Segment Anything → ICCV / 2023、RAFT → ECCV / 2020;/api/analytics/* 返回完全一致;paper_ids 一一对应;2016 → 2017 → … 逐年推进,播放结束后展示完整趋势。未验证或存在局限的部分(如实记录):图表容器的 resize 只做了代码实现,没有真的拖拽窗口验证;请求失败+重试分支没有在浏览器里真实触发(需要停掉后端);趋势动画在真实开发库上只能显示单年数据,多年动画是用独立临时数据库验证的(见 4.13)。
本次开发在 dev 分支进行,每完成一个可独立验收的小功能就进行一次真实
commit,而不是最后一次性提交所有代码。
部分提交粒度示例:
feat: add paper list and filters
fix: validate paper query year range
feat: add paper management actions
feat: add single paper fetching
feat: add batch paper fetching
feat: complete paper search workflow
feat: add top keyword analytics
feat: add interactive keyword graph
feat: add animated keyword trends
merge: complete version 1.0.0
完整的提交序列(git log --oneline,共 20 个 commit):
2008e01 merge: complete version 1.0.0
7913e90 feat: add animated keyword trends
03cff44 feat: add interactive keyword graph
5d8244c feat: add top keyword analytics
144672b feat: complete paper search workflow
5c19a8e feat: add batch paper fetching
d7e6440 feat: add single paper fetching
d4c22e0 feat: add paper management actions
c963a7a debug year
c5da2ee feat: add paper list and filters
d59a3f5 CRUD
8dc7eed ai boration update
869fdbf feat: add Paper database model
381c98d ai-collaboration update
74b7d0b chore: initialize Vue frontend
cd066c4 chore: initialize Flask backend
b5e9d55 docs: add UI prototype
21d3fd6 commit1
dbe28b2 initialize project documentation
91013a2 Initial commit
这样的 commit
划分和开发过程一致,也方便回看"某个功能是在什么时候加入、为什么修改"。
开发结束后:
dev
→ merge 到 main
→ 发布 1.0.0 Release
建议最终写:
121.43.69.5/opt/cv-insight/opt/cv-insight/backend/instance/cv_insight.db线上地址: 121.43.69.5
部署后至少重新验证:
首页可访问
论文管理可访问
单篇获取可用
Top 10 可用
关键词图谱可用
趋势动图可用
这次作业和我以前直接使用 AI 问代码题最大的不同,是我第一次比较完整地把
AI 放进一个软件工程流程里。
一开始我很容易把 AI 的价值理解成"写得快"。确实,搭 Flask 路由、Vue
组件、测试用例时,AI
的生成速度远快于我手工从零写。但项目越往后,我越发现真正困难的部分不是敲代码,而是判断
AI 生成的东西到底是不是我需要的东西。
例如年份校验的 Bug 就很典型。AI 告诉我某个请求"应该返回
400",但真实程序却返回
200。如果没有亲自运行,我很可能直接把这句话写进验收记录。后来检查才发现
GET 和 POST/PUT 的校验规则并不一致。这件事让我从"让 AI 给答案"转向"让 AI
给出可以被验证的实现"。
另一个体会来自论文数据。Semantic Scholar 返回的字段是真实数据,但 ResNet
的 2015 对本项目并不是正确的"CVPR
年份"。因为系统后续要做三大顶会的年度热度趋势,所以我必须先定义清楚业务语义:这里的年份应该是正式会议年份。也就是说,数据真实不等于语义正确,软件工程仍然需要人去定义边界。
我也逐渐学会控制 AI 的工作粒度。前期 Prompt 比较宽,AI
很容易顺手增加额外功能;后期我会明确写"本轮只做什么、不要做什么、不能修改什么、必须运行哪些测试、不要
commit"。这种方式虽然 Prompt 更长,但实际返工更少。
结合《构建之法》中对结对编程的理解,我认为人机结对和人人结对有一个共同点:都需要持续沟通、复审和共同维护代码质量。区别在于,AI
的"驾驶速度"极快,而且不会因为重复劳动疲惫,但它不会天然承担项目责任,也无法替我判断课程要求、业务语义和最终风险。
因此这次最大的收获不是"AI
帮我写了多少代码",而是我开始形成一种更稳定的协作方式:
先定义问题和验收标准,让 AI
快速实现;再用测试、运行结果和代码阅读去验证它,而不是用 AI
的自信程度判断正确性。
对于结构清楚的任务,例如 CRUD、Vue 表单、API 封装、测试用例,AI
可以迅速给出完整实现。只要边界写得足够清楚,它非常适合承担重复性较高的编码工作。
在第三方 API 场景中,AI 能较快想到
404、429、timeout、网络失败、字段缺失等异常路径,并生成 mock
测试。这对提高项目完整度帮助很大。
我可以把测试输出、报错和自己的怀疑直接交给
AI,让它重新阅读上下文、解释根因、给出最小修复方案。这种低沟通成本是传统结对很难做到的。
年份校验案例中,AI 根据已有规则推断 GET year=12 应该返回
400,但没有先确认真实代码行为。如果人不验证,很容易被这种流畅的解释带偏。
预印本年份和正式会议年份都是"真实数据",但哪个才适合趋势统计取决于项目定义。AI
可以帮助查找和实现,却不能替我决定最终统计口径。
如果 Prompt 只写"帮我实现论文搜索",AI 可能顺便重构路由、增加依赖、修改
UI
或实现额外功能。时间紧张时这种"好心扩展"反而会增加风险。因此我后来始终明确写出禁止范围。
批量上限的变异检查说明,AI
写出的测试可能和实现共享同一个错误假设。测试数量多并不自动等于质量高。
维度 人机结对 人人结对
响应速度 很快,可以持续工作 受双方时间和精力限制
代码生成 擅长快速生成样板和测试 通常更慢,但上下文理解更稳定
业务责任 AI 不承担最终责任 双方可以共同承担和讨论
沟通方式 Prompt 必须显式、结构化 可以依靠更多隐含上下文
错误类型 容易出现"看起来合理"的幻觉/假设 更容易通过常识和共同上下文及时发现
我最终对 AI
结对伙伴的评价是:它非常适合做高速度的"副驾驶",但不适合成为无人监督的"自动驾驶"。
当任务边界清楚、验收标准明确时,AI
能显著提高效率;当需求含糊、数据语义复杂或结果无法自动验证时,人必须重新掌握主导权。
本项目仅用于课程学习。
论文元数据通过公开学术数据接口获取,主要使用 Semantic Scholar Academic
Graph
API;会议、年份等字段按照本项目"三大顶会正式会议统计"的业务口径进行规范化。
系统展示的 keywords
在外部数据源未提供论文原始关键词时,是由系统根据论文标题和摘要自动抽取的关键词,不是
Semantic Scholar 官方关键词。
当前关键词抽取采用英文停用词过滤和词频统计等轻量方法;热门方向 Top 10
基于本地论文库中的关键词频次统计。
"热度"的最终统计口径如下,三个统计功能共用同一套关键词解析规则:
关键词解析(三个功能共用)
  keywords 字段按 ';' 拆分 → 每项 trim → 转小写 → 单篇内去重 → 忽略空项

Top 10 热门方向
  某关键词的热度 = 包含该关键词的论文数(同一篇论文只计一次)
  排序:论文数降序,相同则按关键词字母序;取前 10

关键词图谱
  节点 = 关键词,权重 = 包含该关键词的论文数(最多取前 30 个作为节点)
  边   = 两个关键词在同一篇论文中共同出现
  边权 = 同时包含这两个关键词的论文数(同一篇论文对同一对关键词只贡献 1 次)

热度走势
  热度(关键词 K, 会议 C, 年份 Y)
    = 会议 C、年份 Y 的论文中 keywords 包含 K 的论文数量
  只统计 conference ∈ {CVPR, ICCV, ECCV} 且 year 非空的论文
  年份区间 = 包含该关键词论文的最小 ~ 最大正式会议年份,中间年份补 0
三点需要特别说明:
model 不会命中 modeling;year 使用规范化后的正式会议年份,不混入 arXiv 预印本年份;
