


87
社区成员
 发帖
 与我相关
 我的任务

 分享
顶会热词统计系统——与AI结对编程实践
| 项目 | 内容 |
|---|---|
| 这个作业属于哪个课程 | https://bbs.csdn.net/forums/2601_CS_SE_FZU |
| 这个作业要求在哪里 | https://bbs.csdn.net/topics/620526318 |
| 这个作业的目标 | 运用NABCD模型完成需求分析,与AI进行结对编程,完成计算机视觉顶会论文数据处理、热门方向分析、关键词图谱、热度走势等功能,并完成原型设计、编码实现、测试和云端部署 |
| 学号 | 102400335 |
| 姓名 | 郑栋兴 |
| AI 编程助手 | ChatGPT |
| 其他参考文献 | 《构建之法》、CVPR、ICCV、ECCV相关公开论文数据、DBLP公开数据、ECharts相关文档 |
以下链接将在项目完成后补充。
随着计算机视觉领域的发展,CVPR、ICCV、ECCV 等会议每年都会产生大量论文。对于刚开始学习计算机视觉的学生而言,仅仅浏览论文标题很难快速判断当前领域的研究热点。
因此,本项目设计并实现了一个项目名为CV Insight的顶会论文热词统计系统,希望通过论文信息管理、热门关键词统计、关键词关系图以及多年热度趋势等方式,将大量论文信息转换为更加直观的研究方向信息。
本项目主要围绕以下三个计算机视觉会议展开:
目前系统已经实现:
本系统主要面向以下用户:
① 计算机视觉初学者
刚接触计算机视觉时,很难快速了解当前领域有哪些热门研究方向。
② 软件工程课程学生
需要通过论文数据完成研究方向分析,同时希望通过一个简单的网页进行论文数据管理。
③ 论文阅读者
面对大量论文时,希望能够根据关键词快速筛选相关论文,并观察某一研究方向近年来的发展情况。
因此,系统需要解决的核心问题是:
如何从大量计算机视觉顶会论文中快速找到热门方向,并进一步定位到具体论文?
针对上述需求,我将系统设计为几个相互关联的功能模块。
论文管理
通过论文列表统一管理论文数据,实现:
新增
删除
修改
查看
搜索
数据导入*
支持 CSV 批量导入,CSV 文件可以包含:
title
conference
year
keywords
abstract
url
热门方向分析
系统对论文关键词进行统计,并根据关键词出现次数生成 Top 10 热门关键词。
关键词图谱
系统根据论文之间共享关键词的情况建立关键词关系,并以图谱形式展示。
点击关键词后,可以进一步查看与该关键词相关的论文。
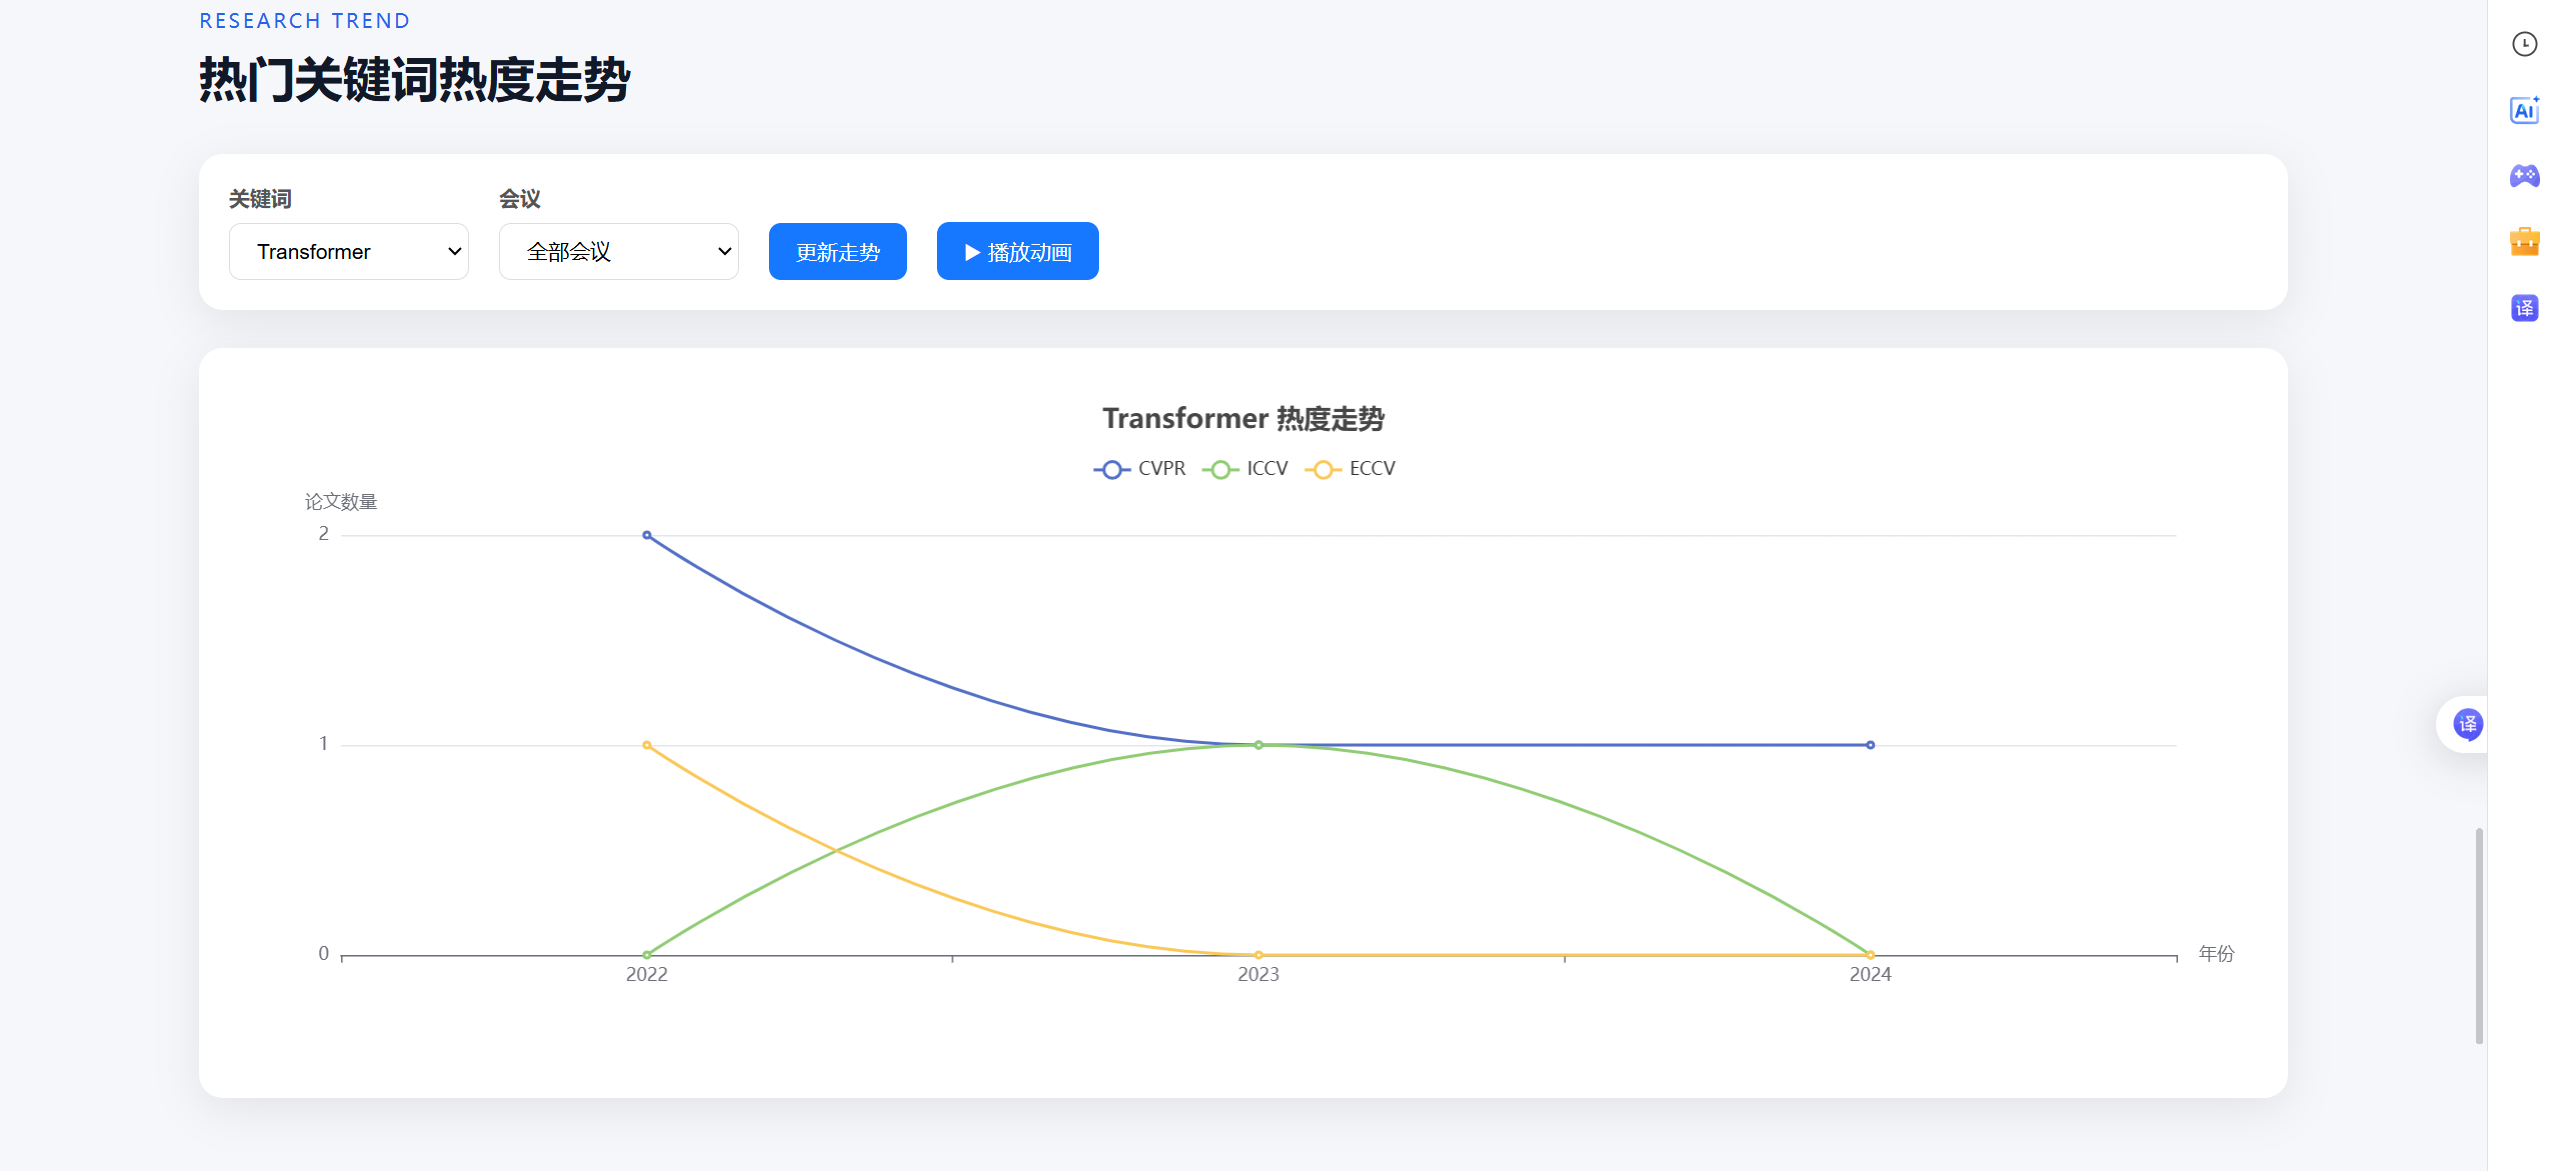
热度走势
用户可以选择关键词以及会议范围,观察不同年份的关键词热度变化。
本系统主要具有以下作用:
降低论文信息整理成本
将论文信息集中到统一平台,减少重复整理工作。
提高研究方向发现效率
通过 Top 10 热门关键词,可以快速了解当前数据范围内出现频率较高的研究关键词。
增强论文之间的联系
关键词图谱将原本分散的论文关键词联系起来,可以从一个关键词继续寻找相关论文。
直观看到趋势变化
通过趋势图可以更加直观地观察关键词在不同年份中的变化。
| 方案 | 优点 | 局限 |
|---|---|---|
| 会议官方网站 | 数据来源直接 | 主要提供论文信息,分析功能有限 |
| DBLP | 论文检索方便 | 缺少针对本作业的可视化分析 |
| Excel 等表格工具 | 数据处理灵活 | 需要人工整理,交互性较弱 |
| 通用搜索引擎 | 搜索范围广 | 缺少针对 CVPR/ICCV/ECCV 的统一分析 |
| 本系统 | 集中管理、关键词分析、图谱、趋势 | 当前数据规模和在线数据获取能力仍有限 |
本系统并不是为了取代专业论文数据库,而是针对本次课程作业,将:
论文管理 + 关键词统计 + 可视化分析
集中到一个简单的网页系统中。
最终项目计划通过以下方式交付:
在正式编码之前,根据作业要求对系统的信息架构进行了拆分。
最终页面主要分为:
首页(热门方向 Top10・系统功能介绍)
论文管理(论文搜索・论文列表・新增・编辑・删除・详情)
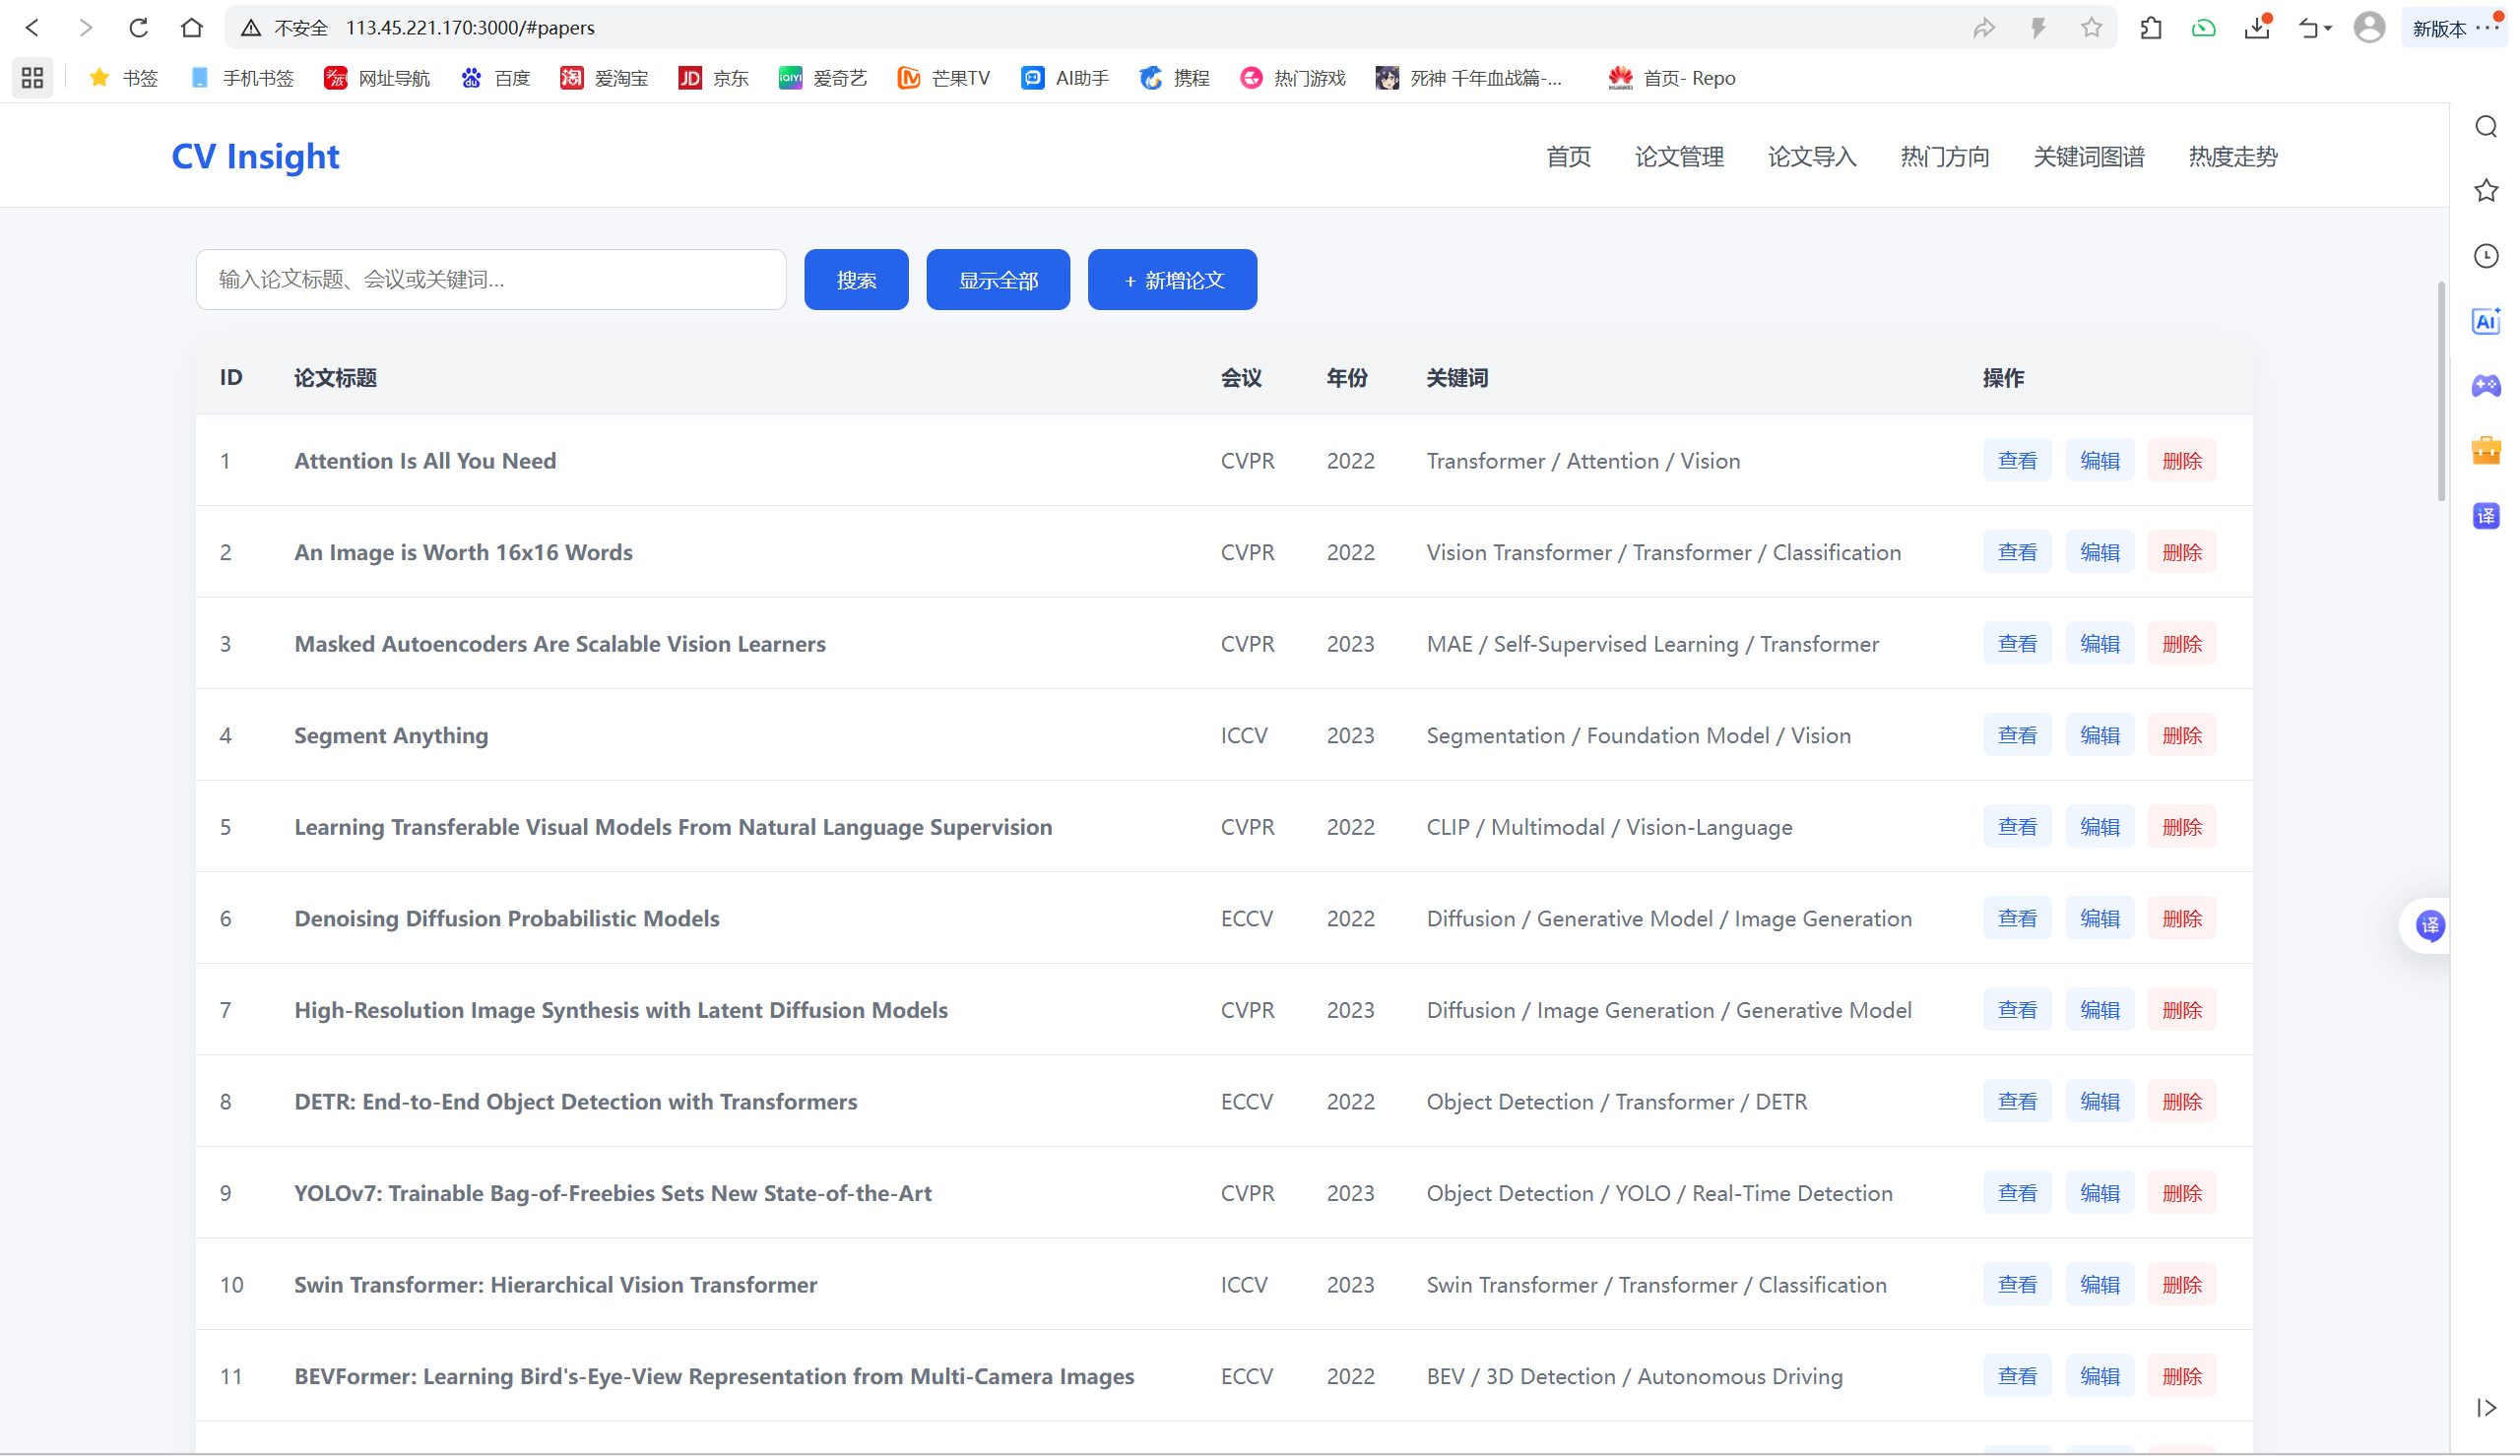
论文导入(在线查询・CSV 批量导入)
热门方向(Top10 热门关键词)
关键词图谱(关键词 → 相关论文)
热度走势(关键词选择・会议选择・年度趋势动画)
目前系统已经完成以下主要页面:
首页
展示系统整体功能和热门研究方向。
论文管理
用于查看、搜索和管理论文。
论文导入
提供在线论文查询入口和 CSV 批量导入功能。
热门方向
展示当前论文数据中的 Top 10 热门关键词。
关键词图谱
将关键词之间的关系进行可视化。
热度走势
通过折线图和动画展示关键词在不同年份中的变化。
以下为原型展示图:
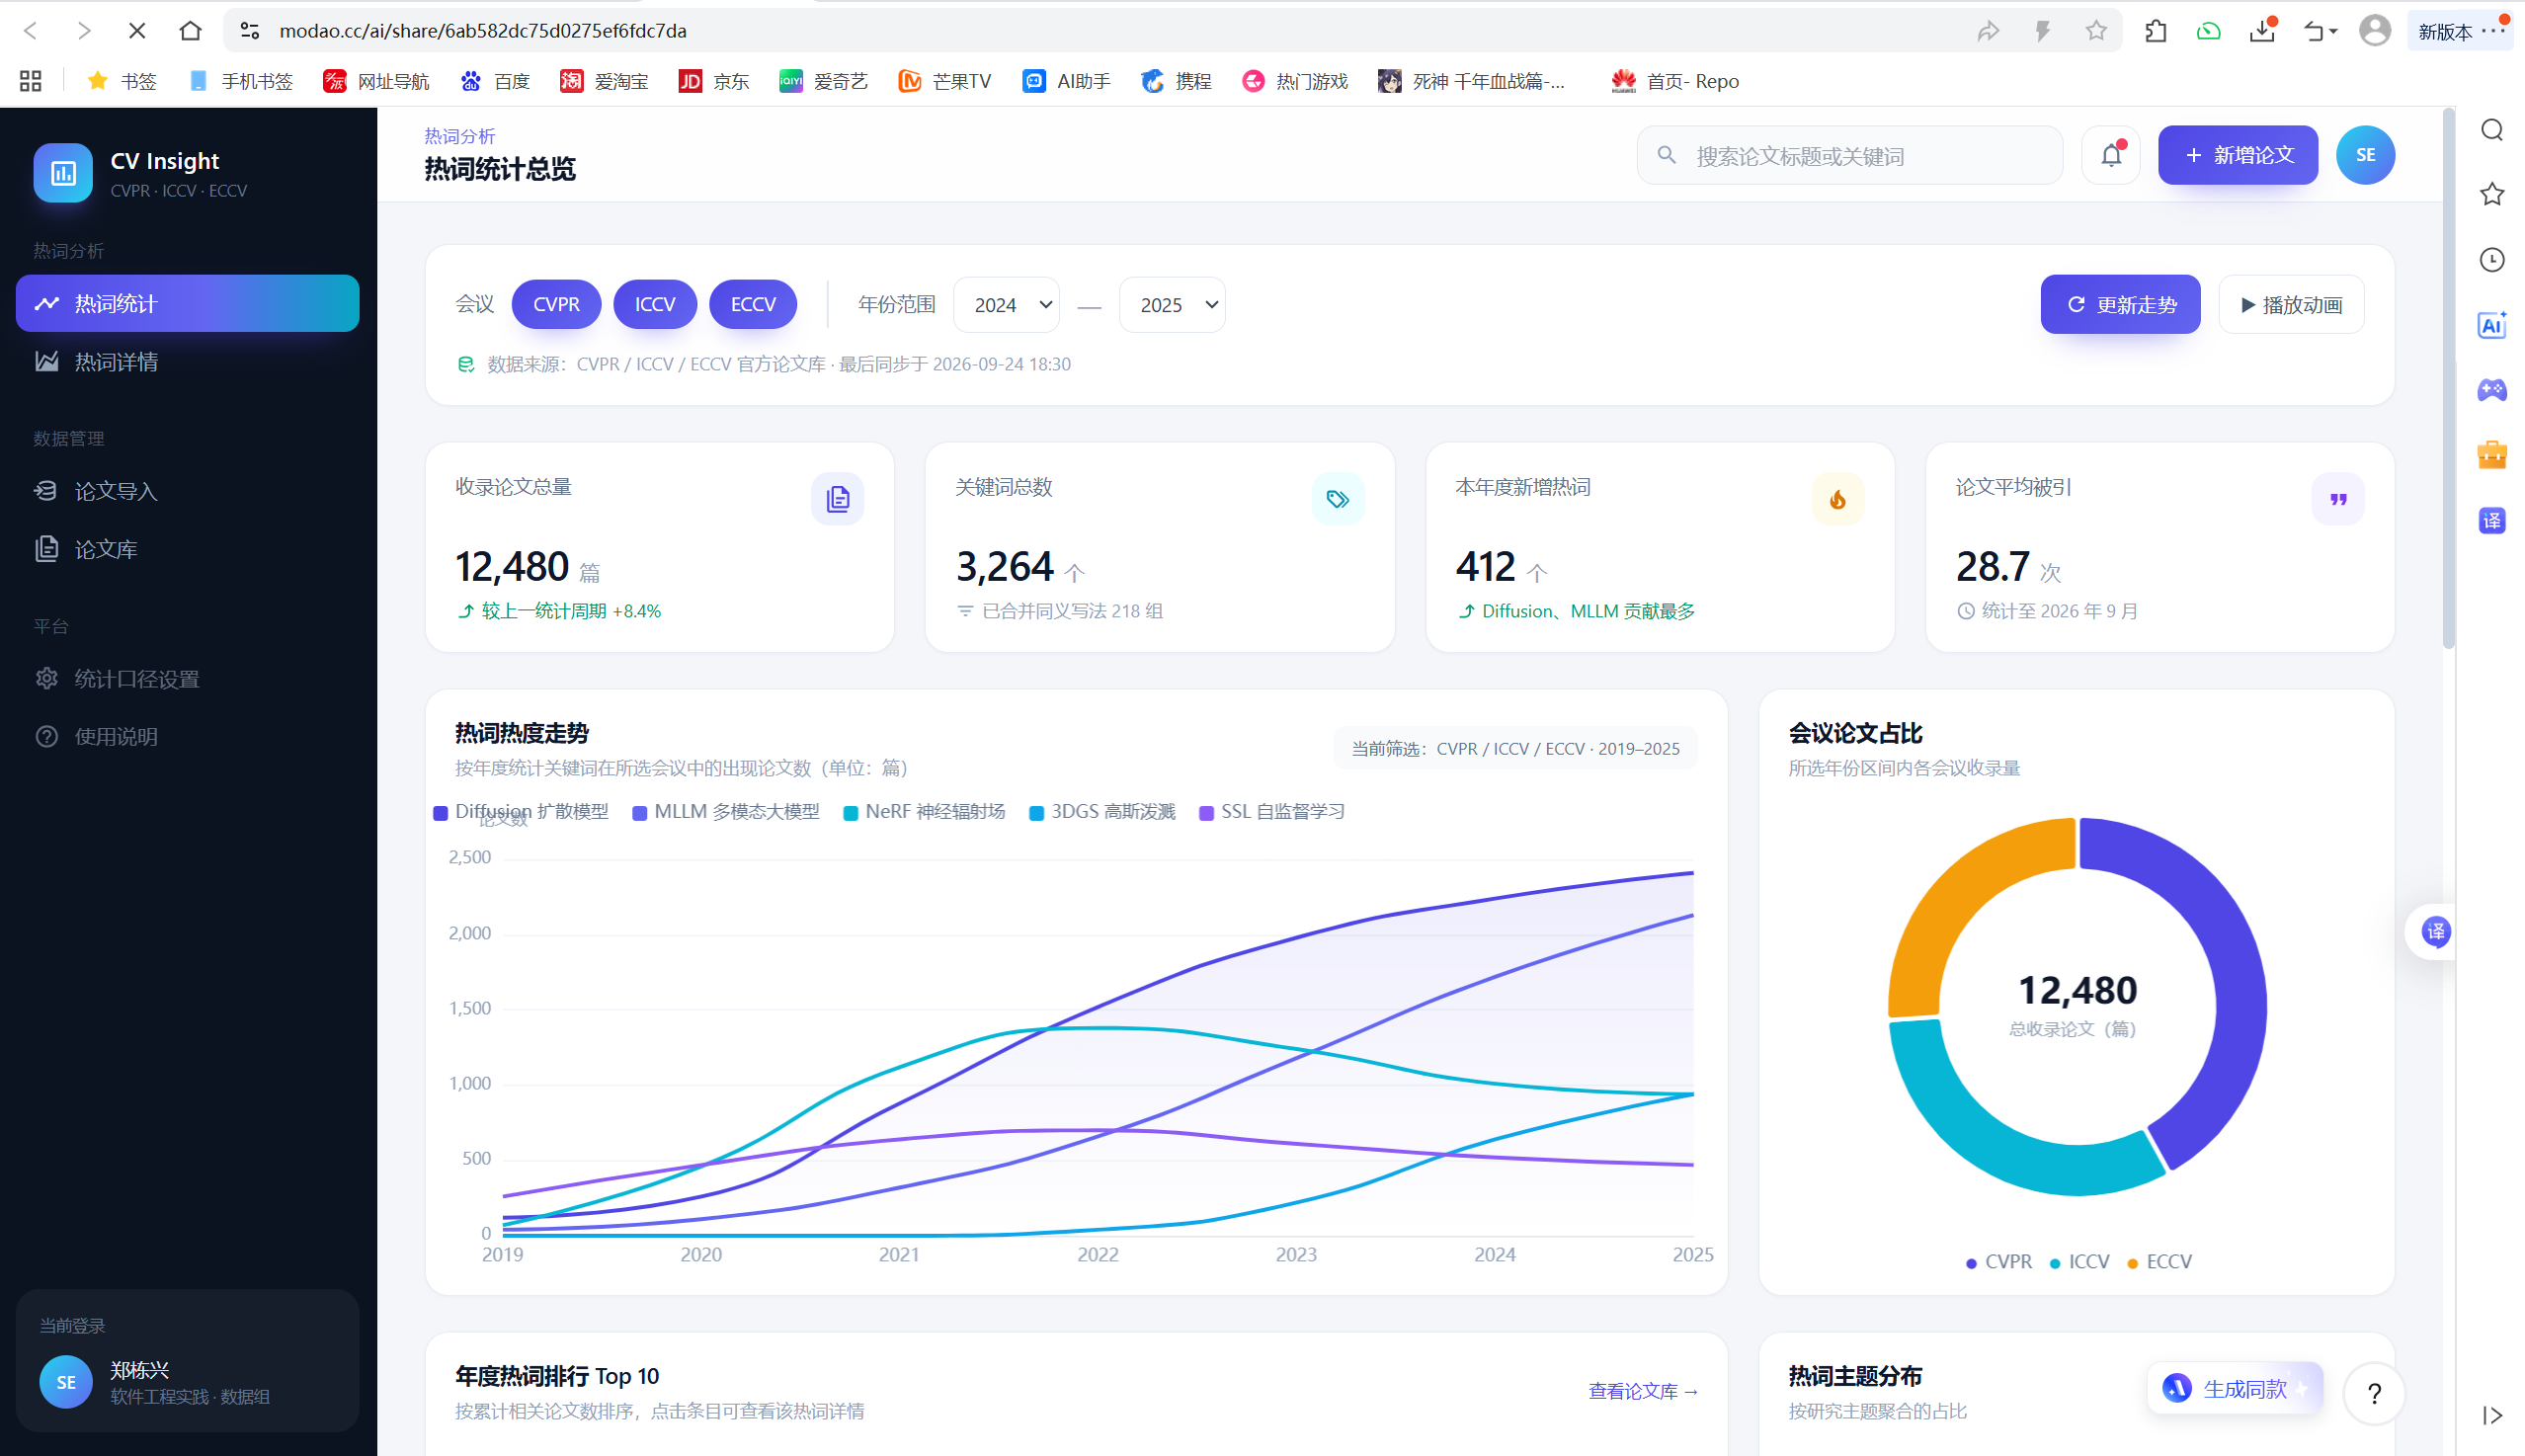
首页负责展示系统整体结构,并提供主要功能入口。
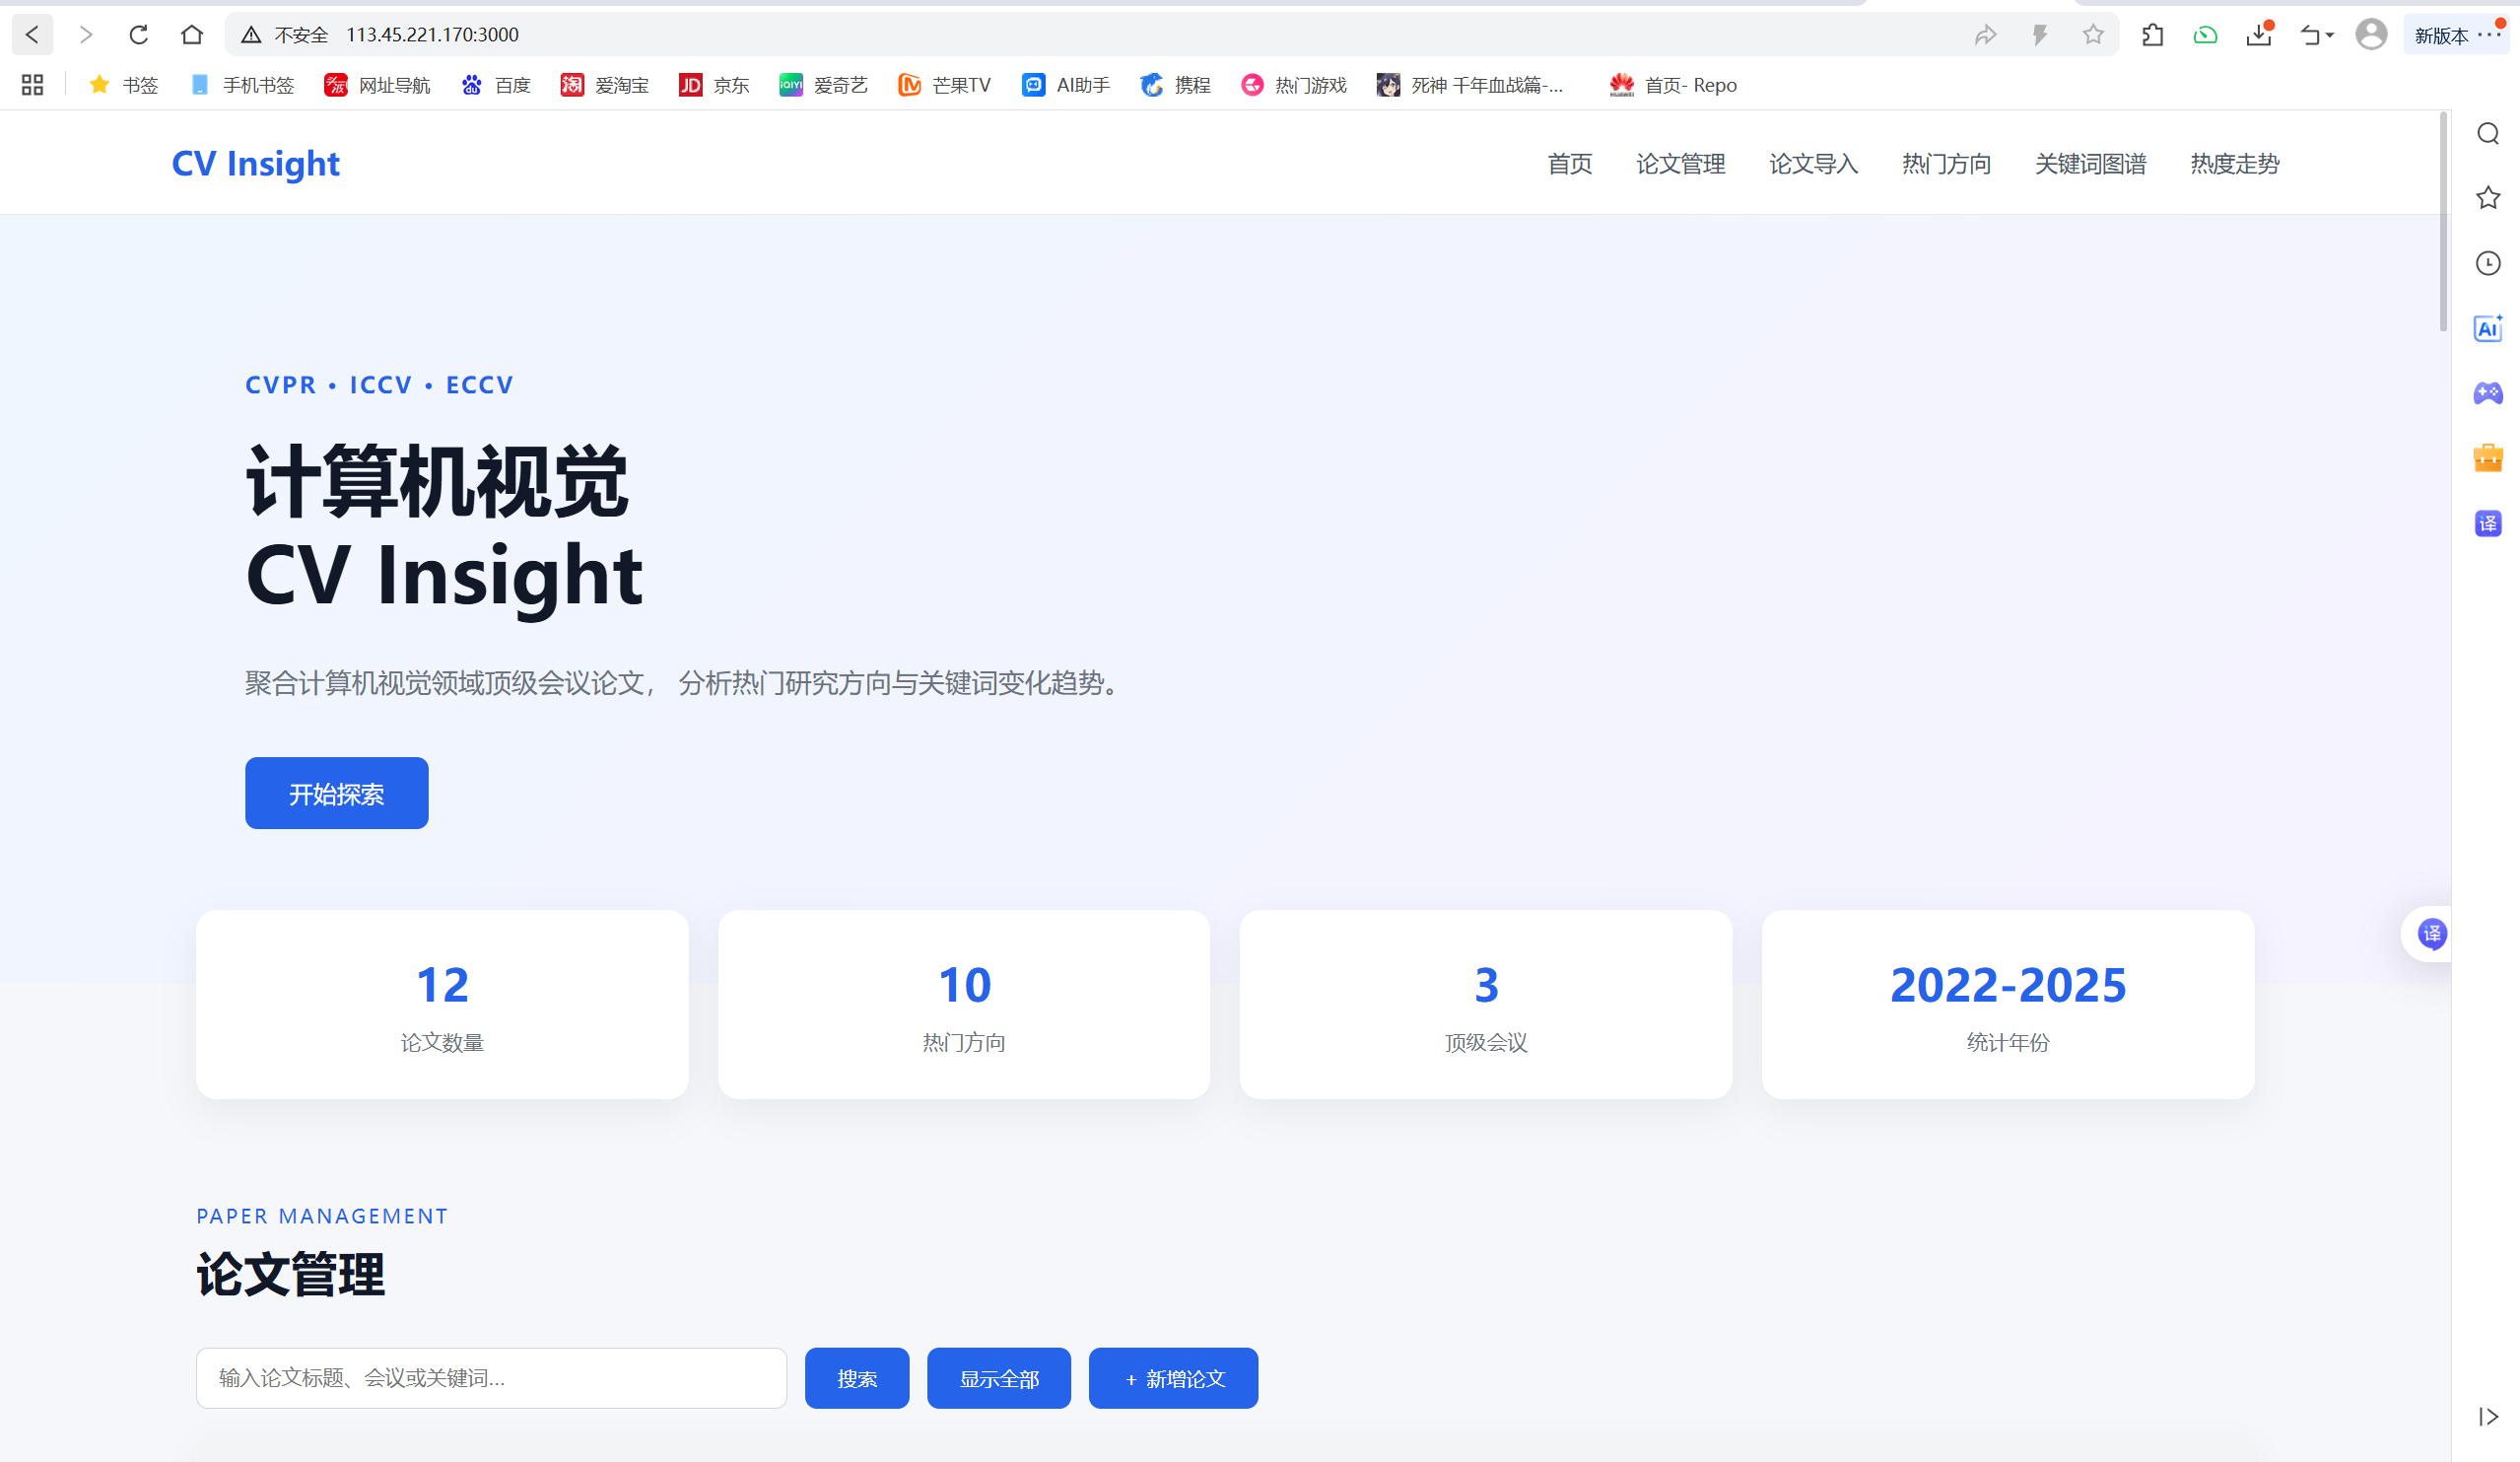
论文管理页面是整个系统的数据基础。
页面展示:
系统支持多种搜索方式。
首先可以根据论文 ID 进行精确查询。
其次可以根据完整论文标题进行精确查询。
如果没有找到精确结果,还可以根据:
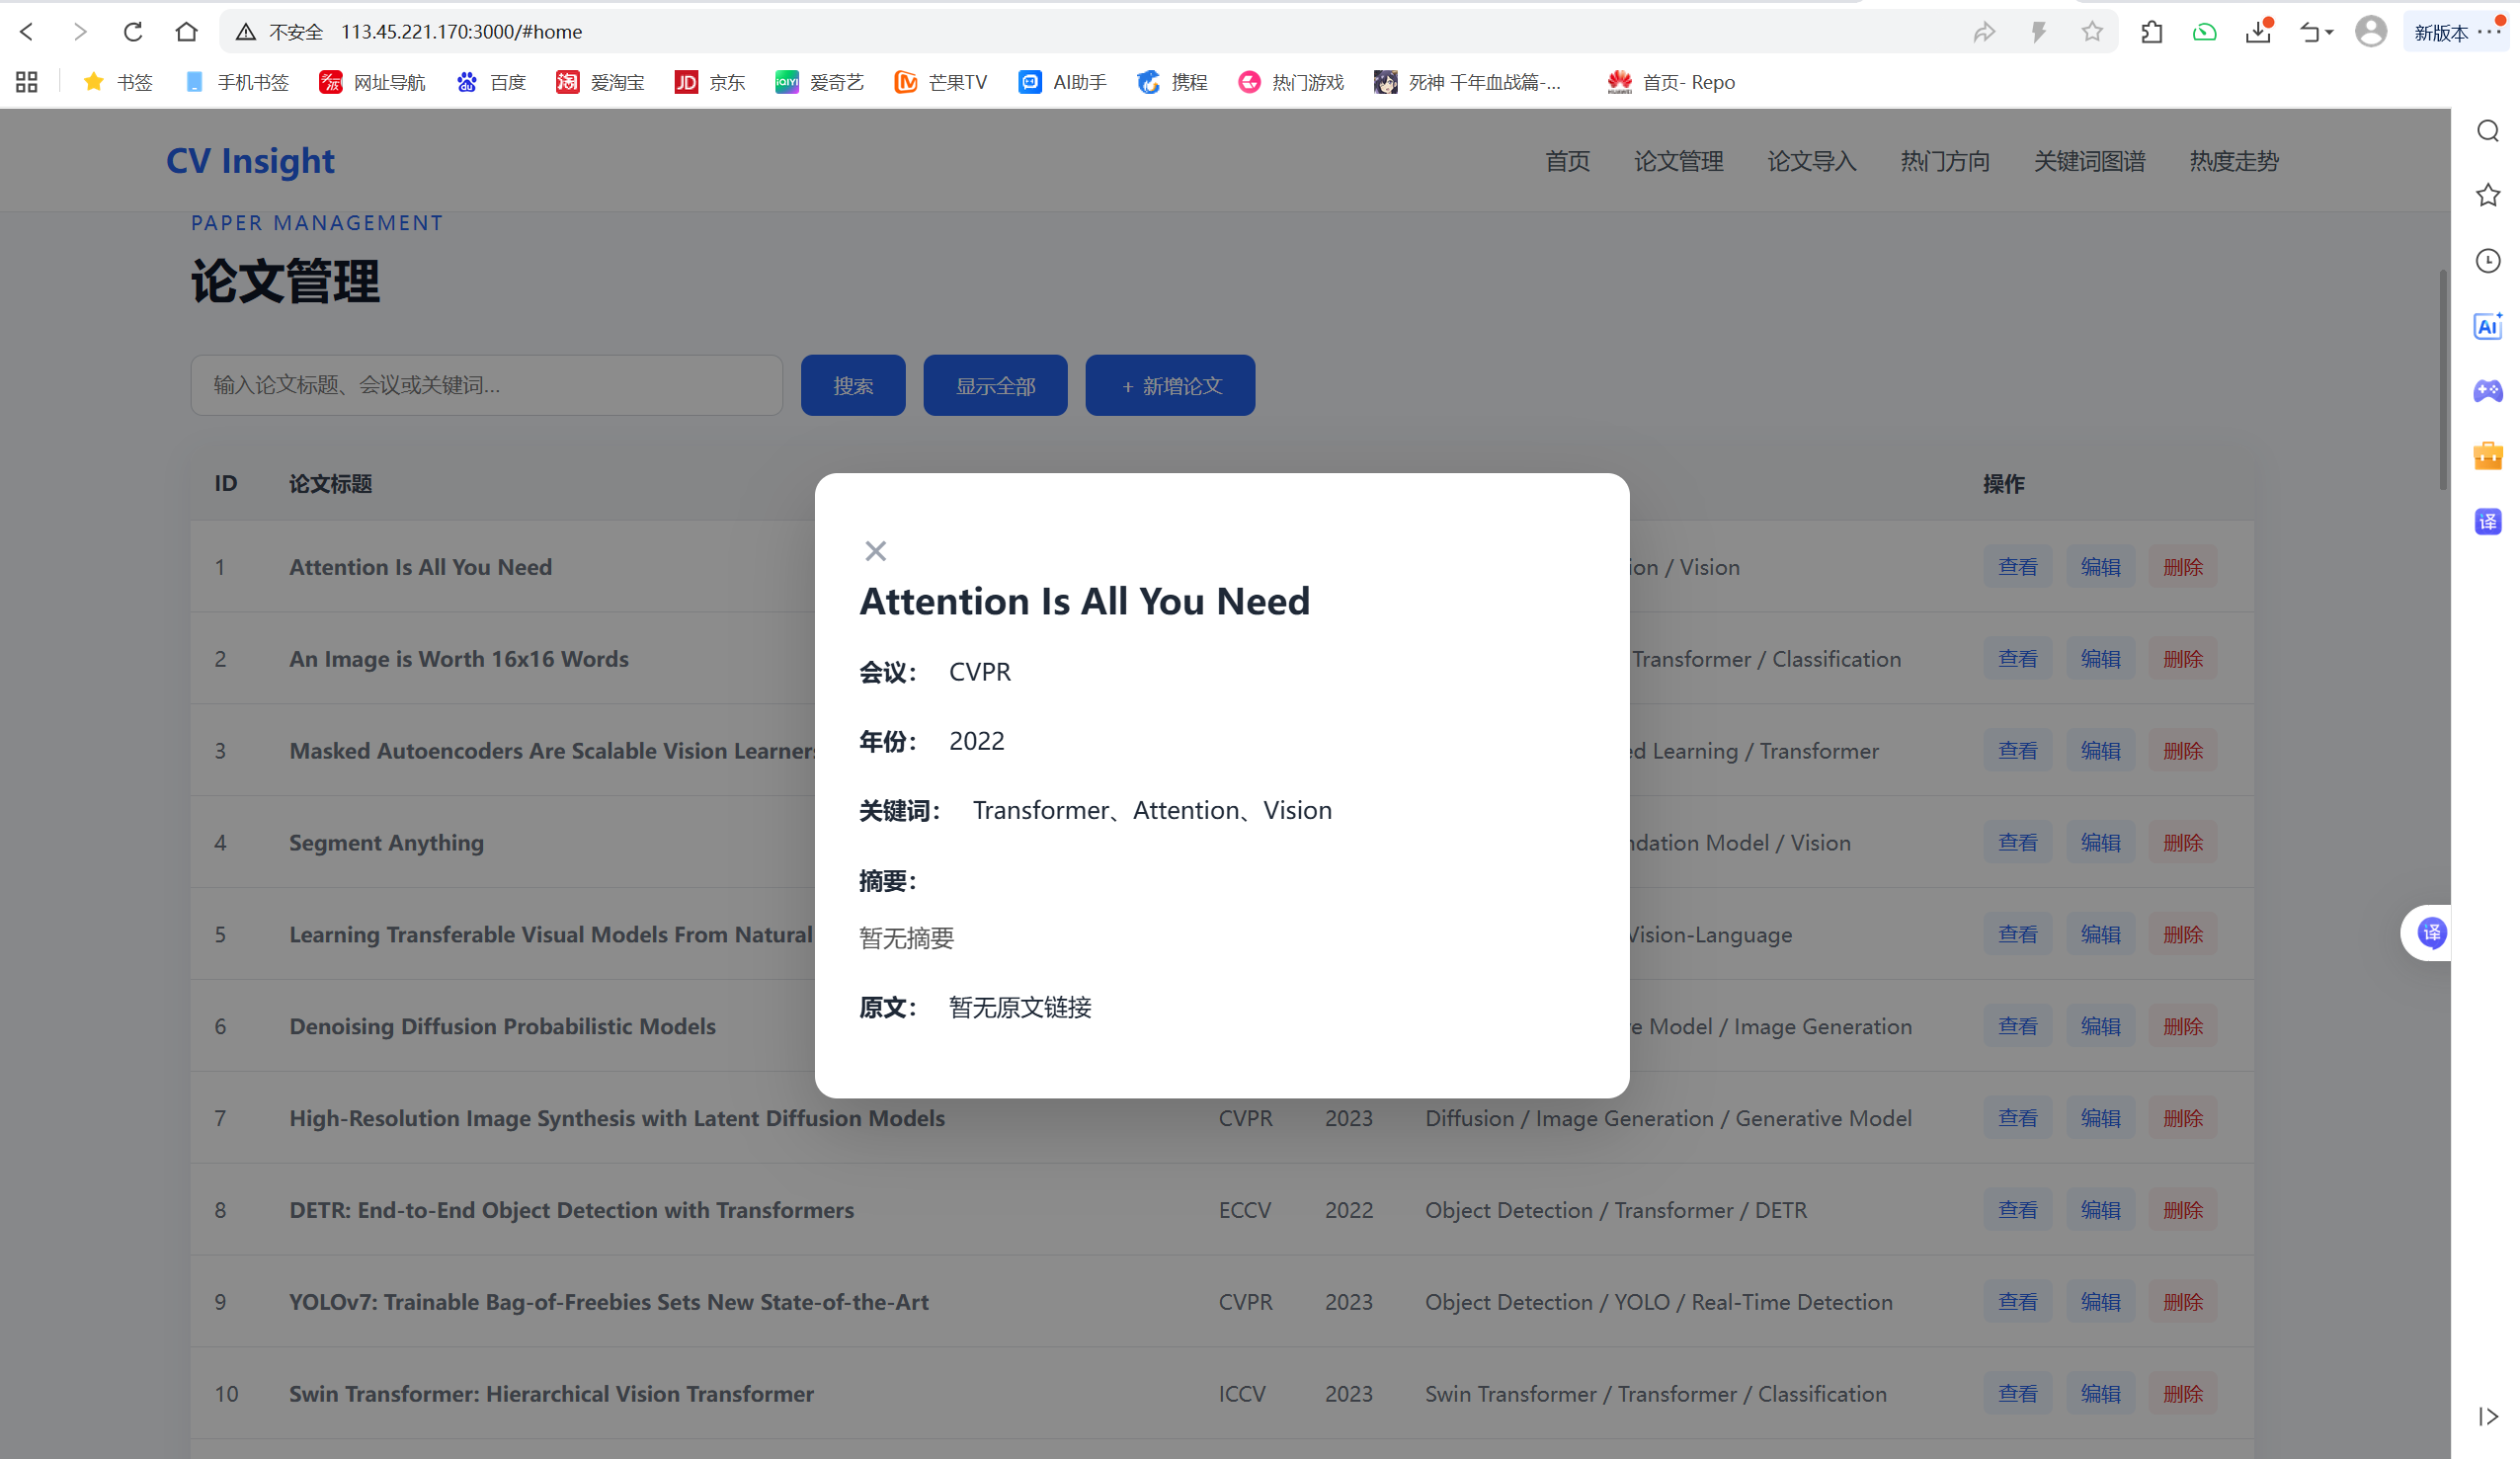
点击论文的“查看”按钮,可以打开论文详情窗口。
详情包括:
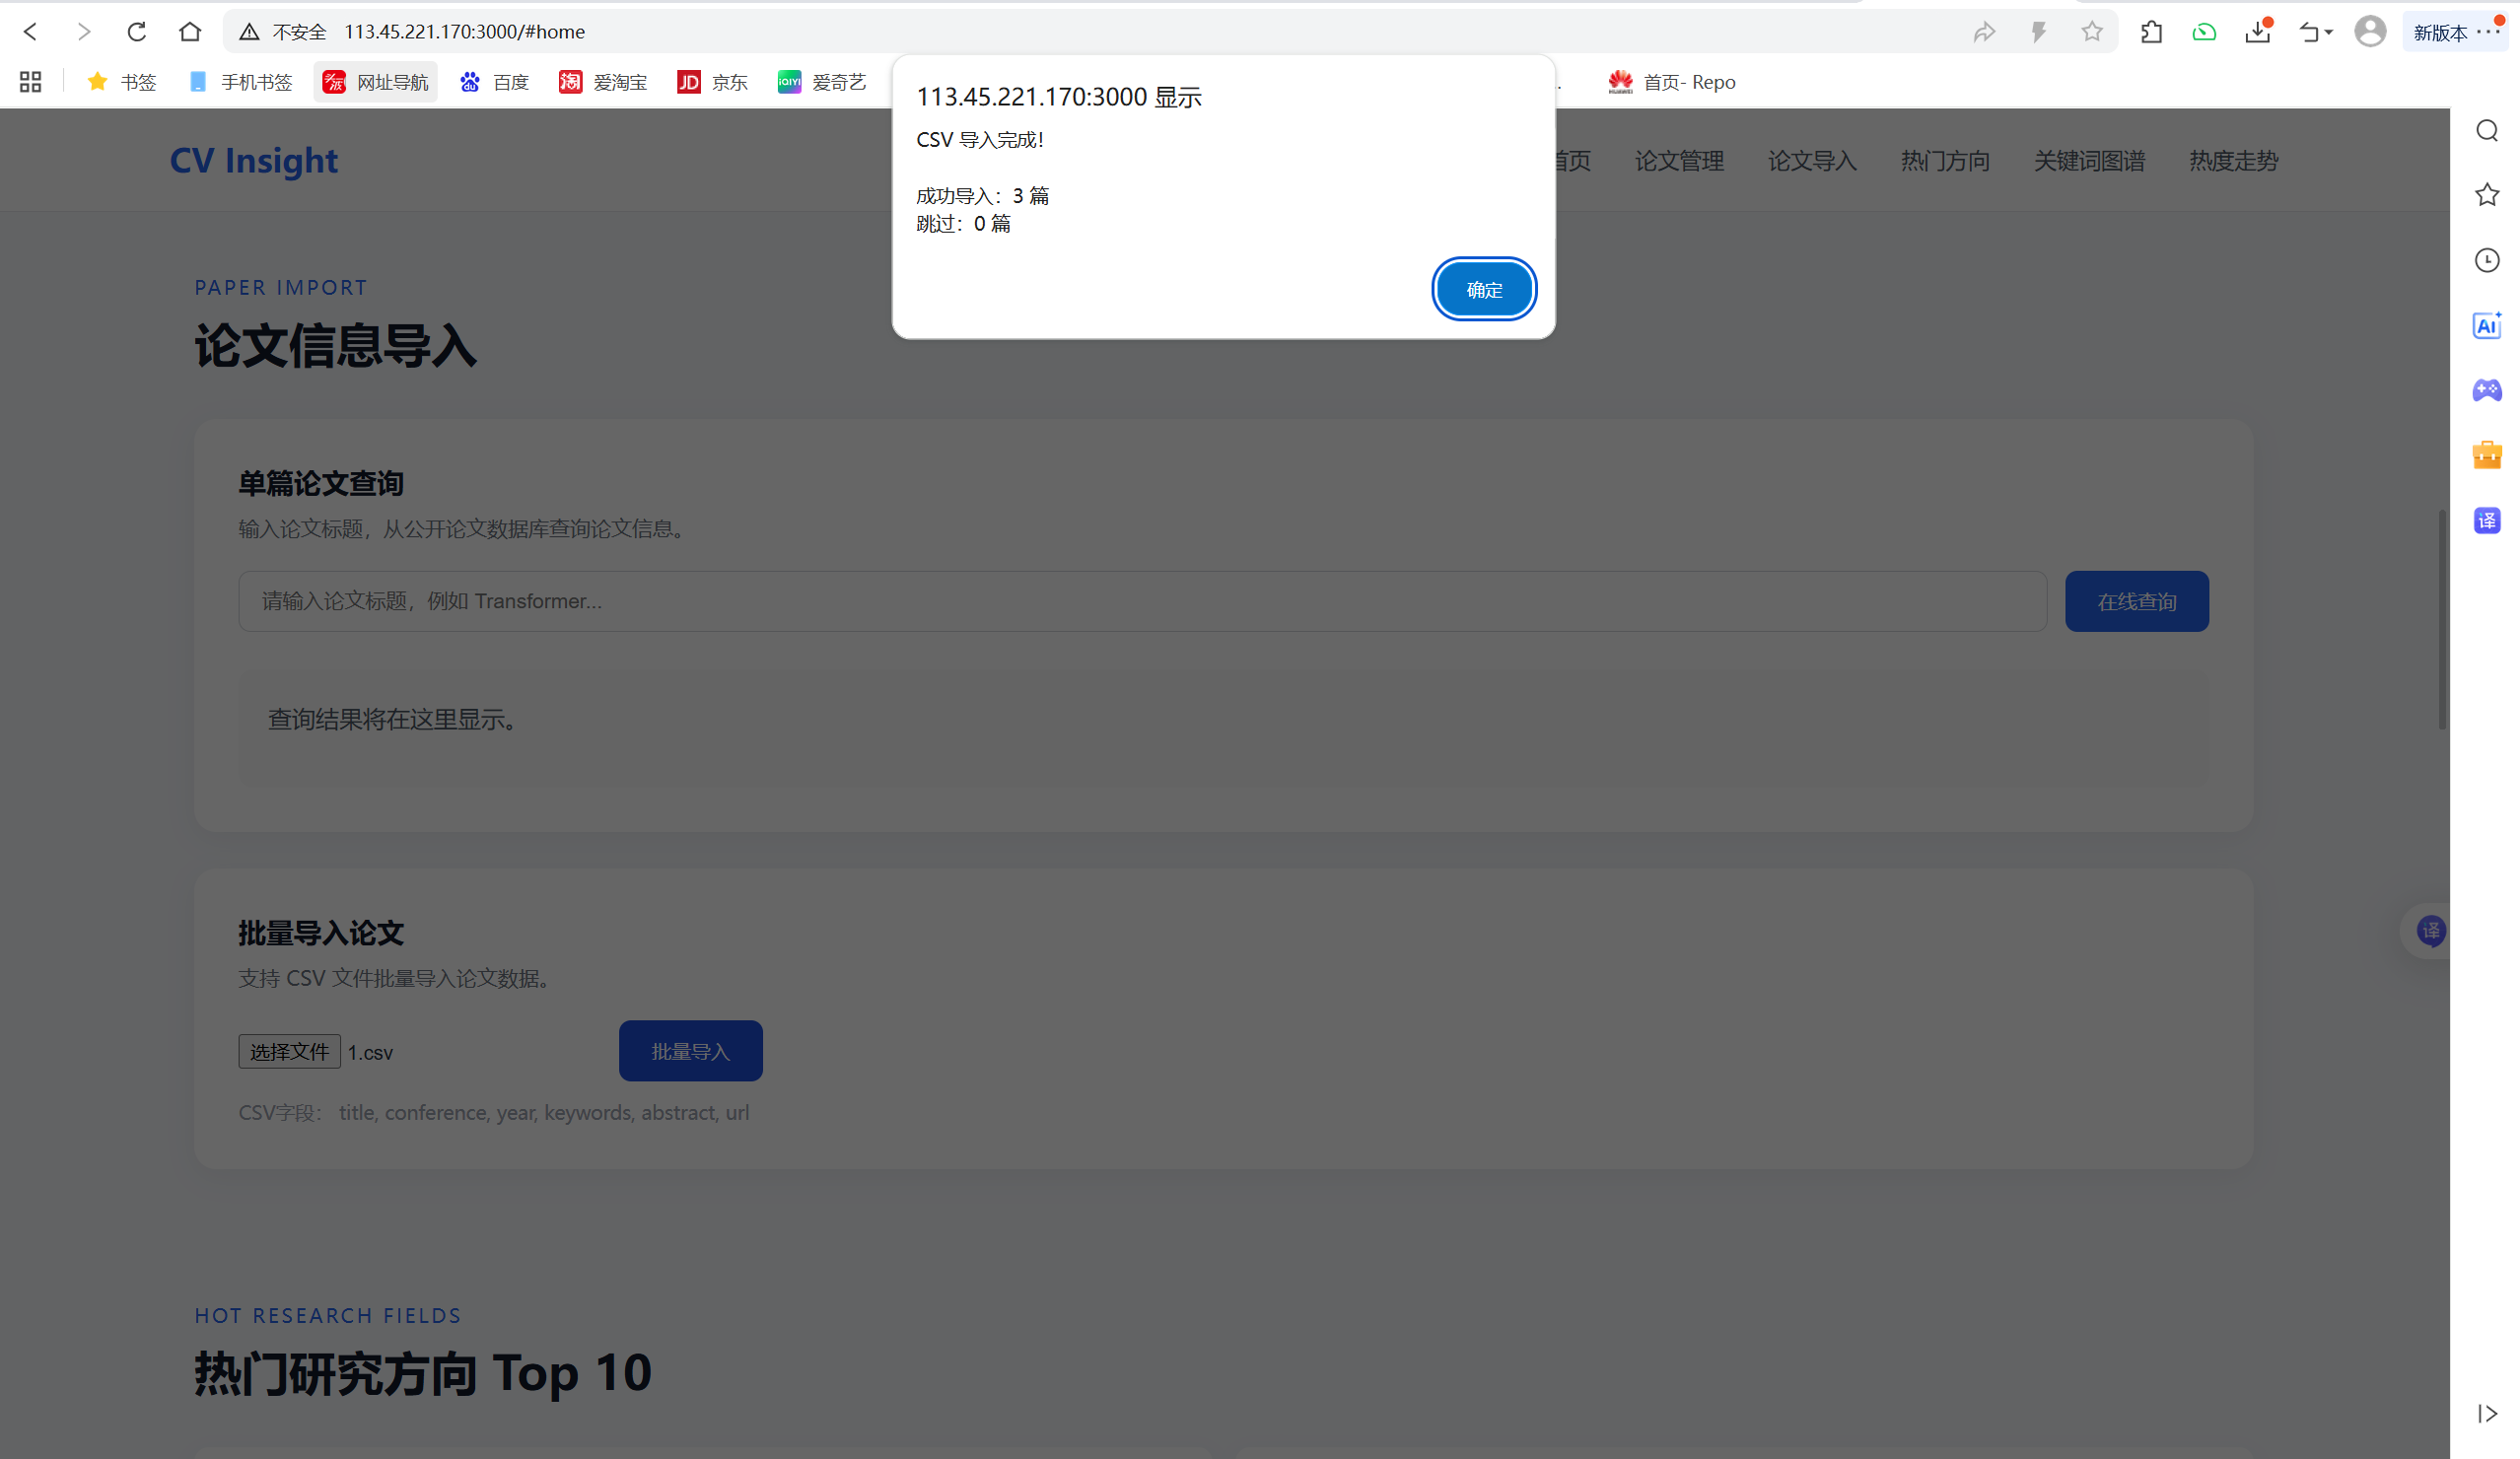
为了避免逐条添加论文,本系统增加了 CSV 批量导入功能。
CSV 文件支持:
title,conference,year,keywords,abstract,url
系统会自动:
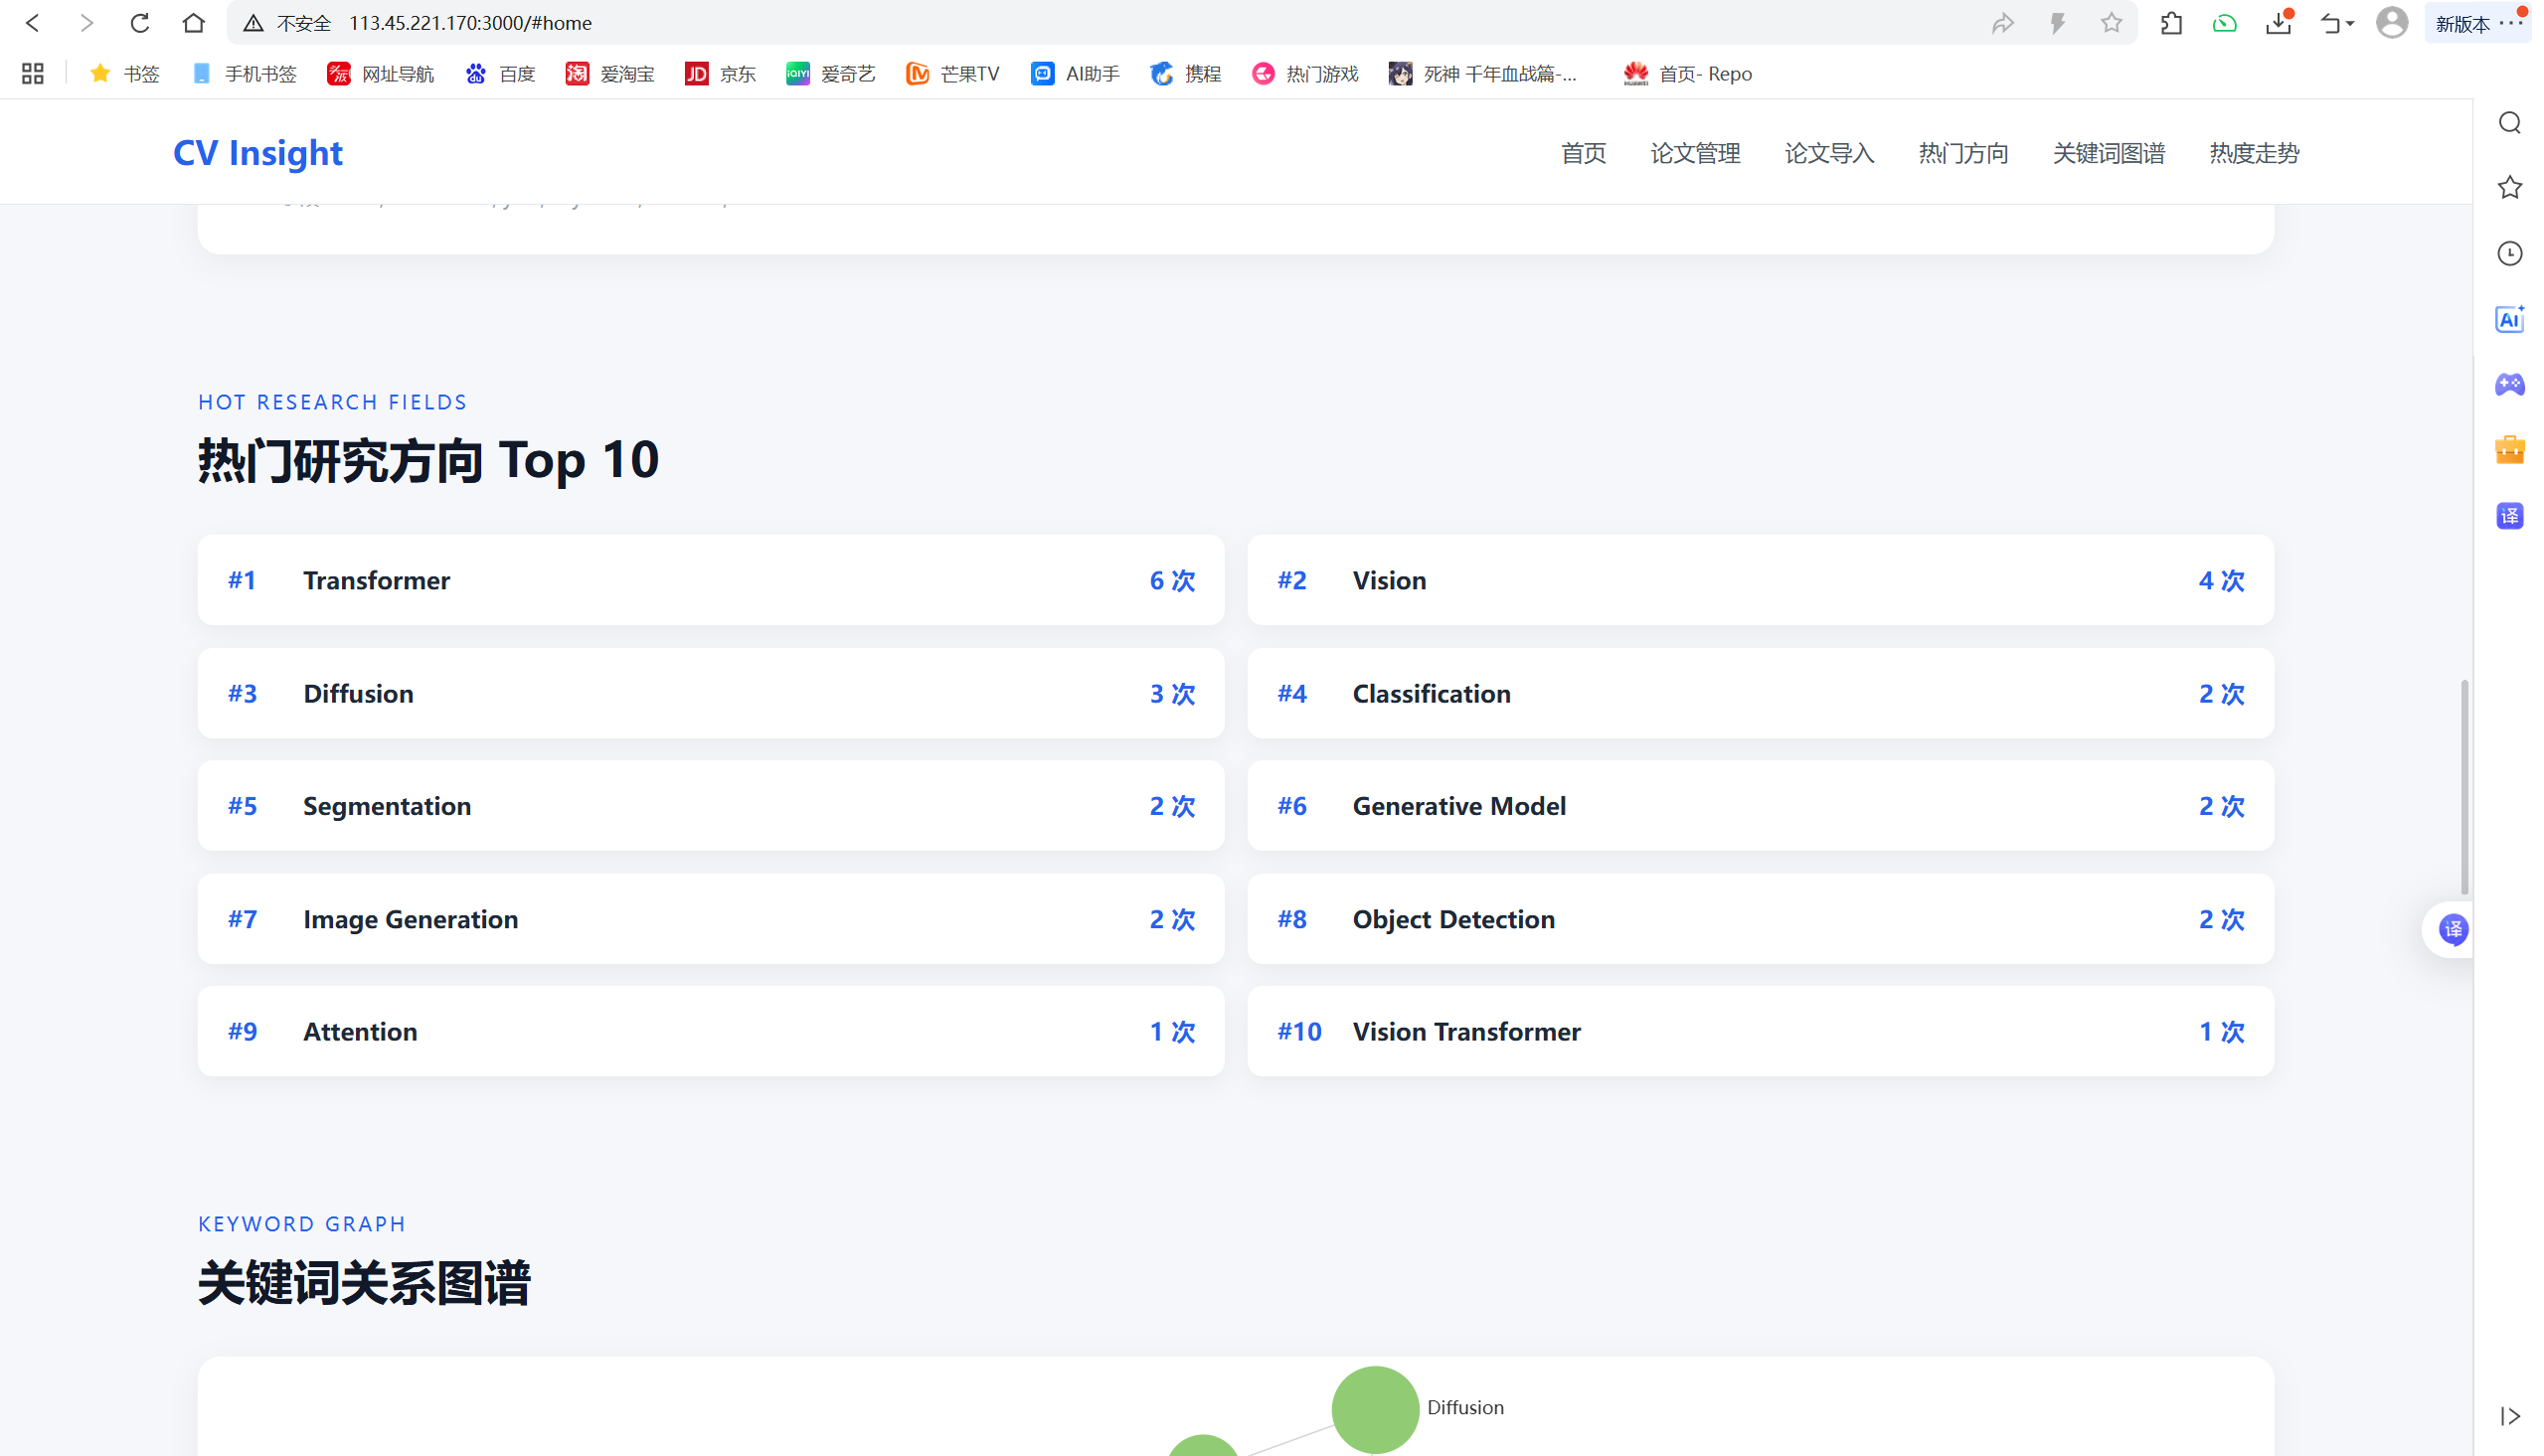
系统会统计论文关键词出现次数,并生成 Top 10 热门关键词。
该功能可以帮助用户快速了解当前论文数据中的高频研究方向。
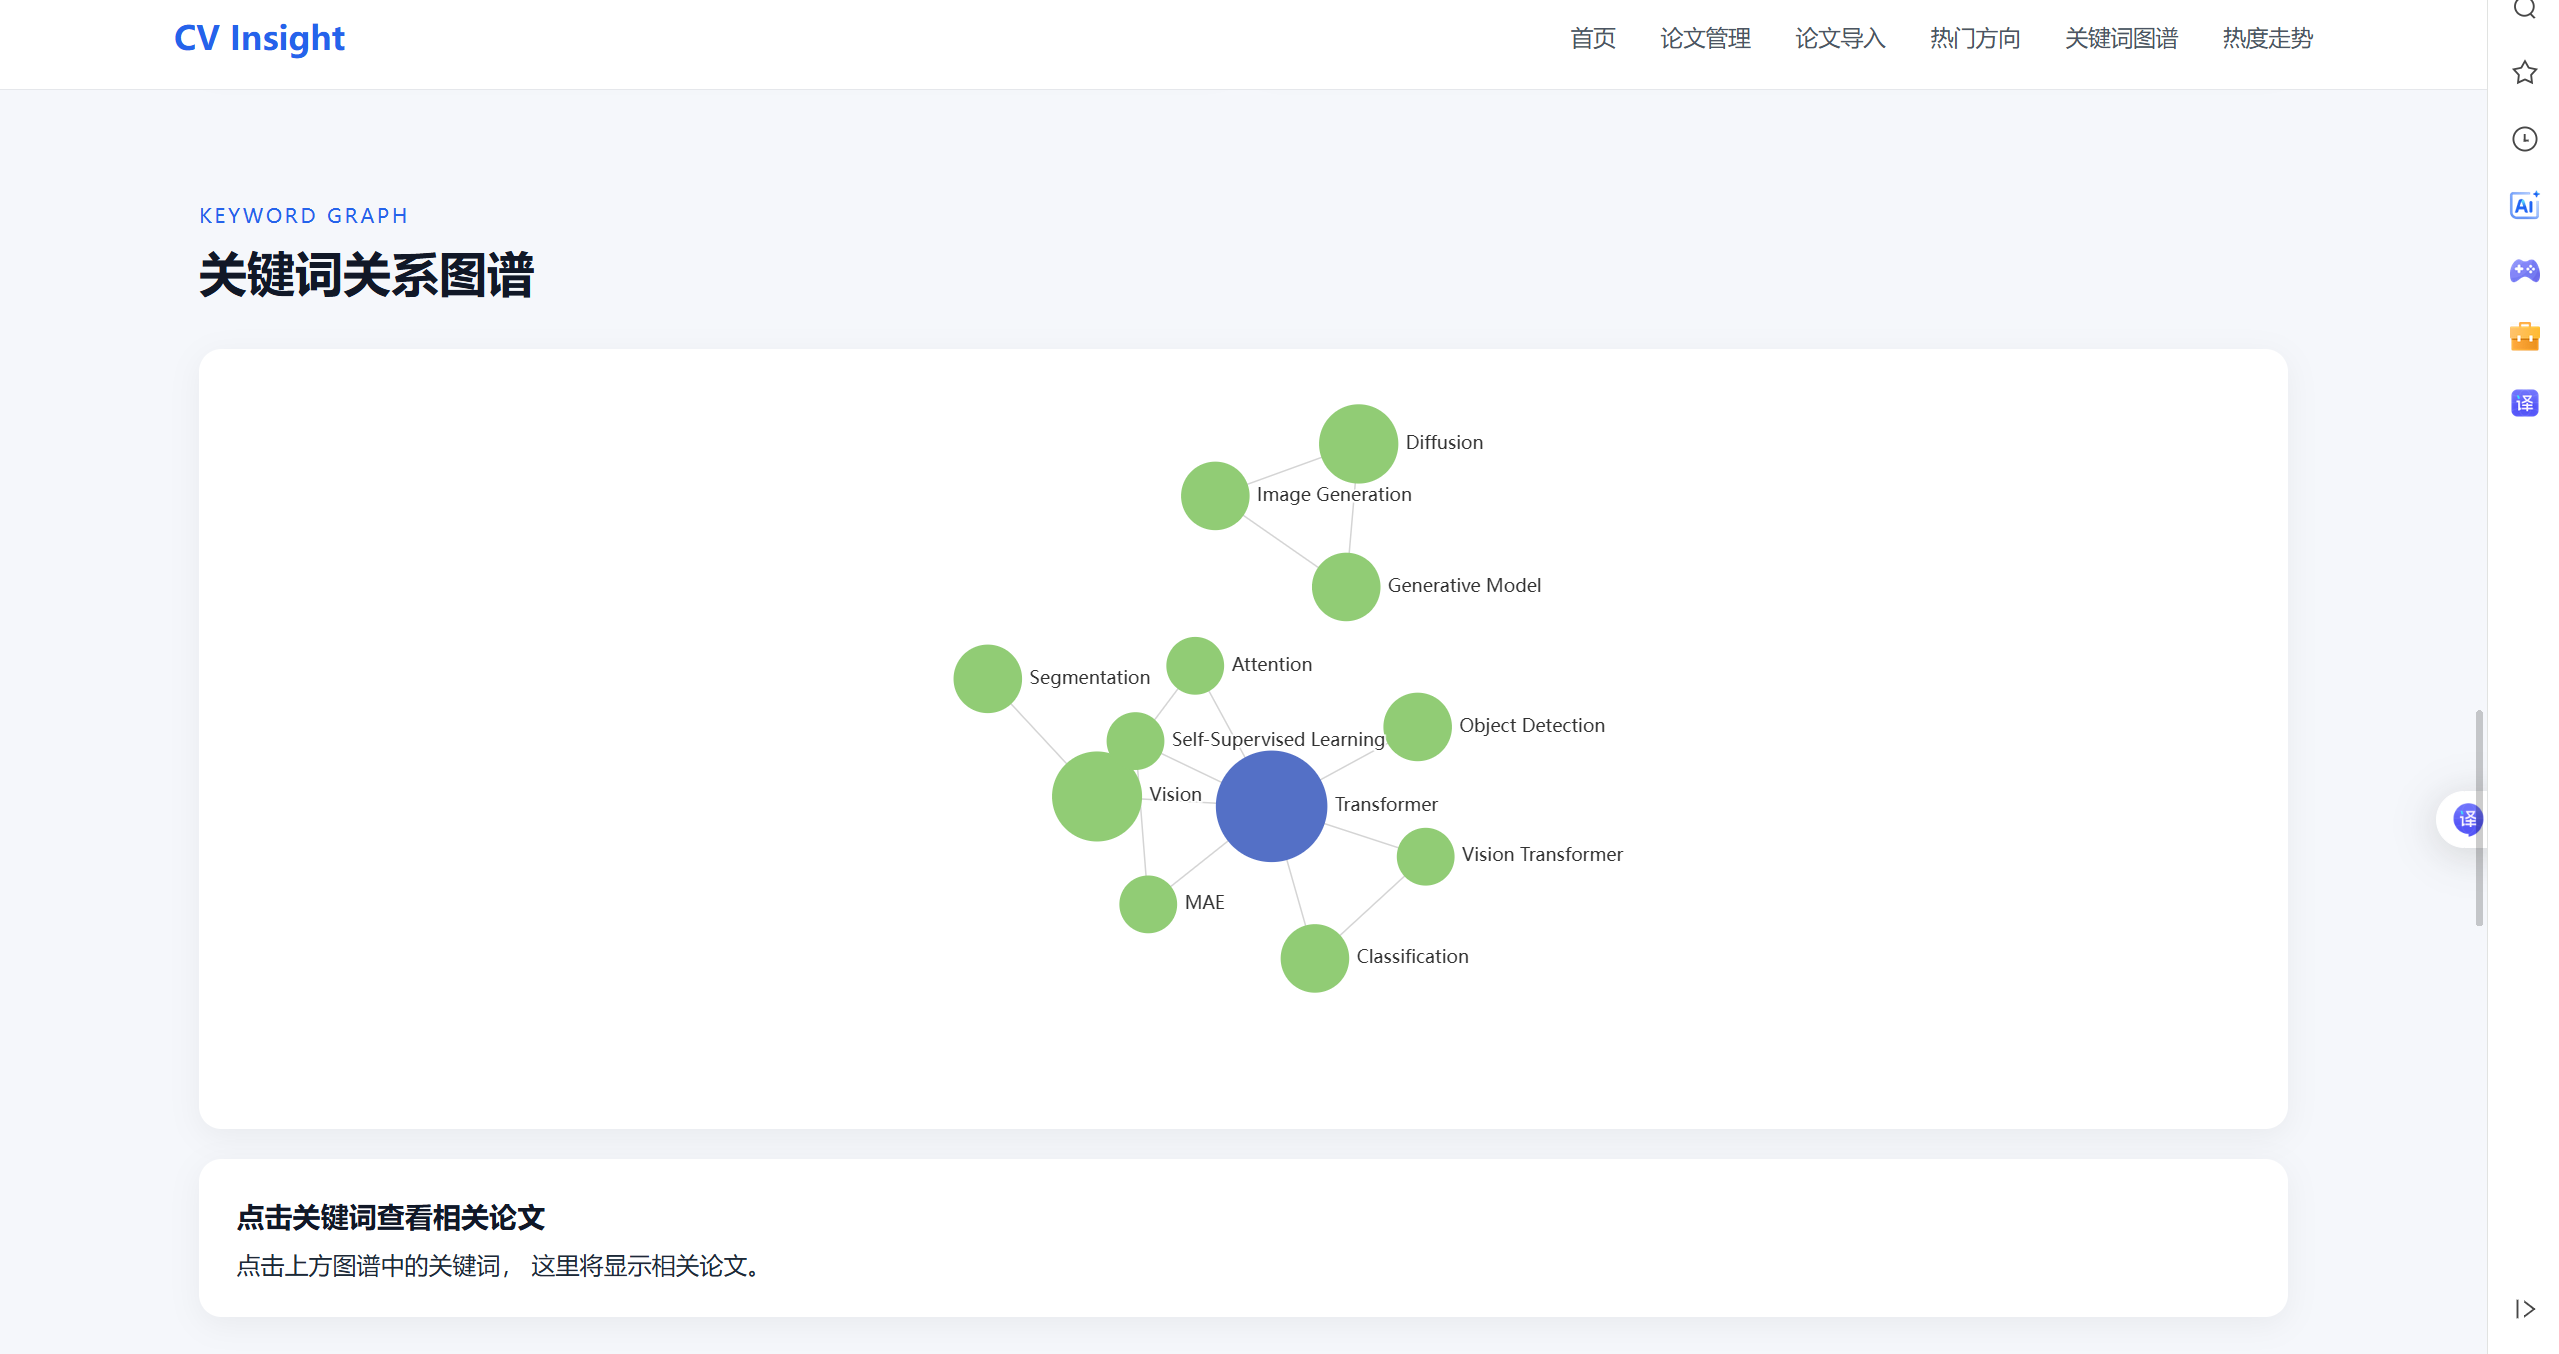
关键词图谱用于展示不同关键词之间的联系。
当多个论文共同包含某些关键词时,这些关键词之间会产生关联。
用户可以点击关键词,系统进一步展示相关论文。
这一功能将:
关键词 → 论文
建立起来,使用户能够从一个研究方向继续寻找具体论文。
热度走势页面支持选择:
最终博客计划至少展示以下截图:
| 编号 | 展示内容 |
|---|---|
| 1 | 系统首页 |
| 2 | 论文管理 |
| 3 | 论文搜索 |
| 4 | 论文新增 |
| 5 | 论文编辑 |
| 6 | 论文详情 |
| 7 | CSV 批量导入 |
| 8 | Top10 热门关键词 |
| 9 | 关键词图谱 |
| 10 | 热度走势 |
| 11 | 云服务器运行效果 |
本项目的数据主要通过以下方式进入系统。
CSV 数据
系统支持用户通过 CSV 文件批量导入论文数据。
CSV 可以包含:
title
conference
year
keywords
abstract
url
DBLP
项目在线查询功能设计中使用 DBLP 的论文检索接口获取论文基础信息。
在实际开发过程中,直接从浏览器调用 DBLP 接口时遇到了 CORS 跨域限制,因此后续设计了 Node.js 后端代理方案。
测试数据
开发阶段使用部分测试论文数据,用于验证:
系统中的一条论文数据主要包含:
{
id: 1,
title: "论文标题",
conference: "CVPR",
year: 2023,
keywords: [
"Transformer",
"Vision"
],
abstract: "论文摘要",
url: "论文链接"
}
当前系统使用浏览器 LocalStorage 保存论文数据。
保存数据时: papers 数组 → JSON.stringify () → LocalStorage
页面重新打开后: LocalStorage → JSON.parse () → papers 数组
因此,在当前浏览器环境下,论文数据不会因为刷新页面而立即丢失。
批量导入论文时,系统会根据论文标题进行重复检查。
如果发现论文标题已经存在,则跳过该论文。
这样可以避免重复导入同一篇论文。
当前版本主要采用论文数据中的关键词进行统计。
如果导入数据没有提供关键词,则系统会根据论文标题进行简单关键词提取。
后续如果扩大真实论文数据规模,可以进一步引入更系统的关键词提取方法。
本次作业最大的特点不是单纯“让 AI 写代码”,而是尝试把 AI 当作一个可以不断沟通、修改和审查的结对伙伴。
实际开发过程中采用:
提出需求 → AI 给出方案 → 人工检查 → 实际运行 → 发现问题 → 把错误信息反馈给 AI → 修改方案 → 再次运行
这种方式比直接要求 AI 一次性生成整个项目更加可靠。
在项目开始阶段,我首先将老师的作业要求交给 AI,让 AI 帮助拆分系统功能。
AI 根据作业要求将系统拆分为:
并将功能逐步实现,而不是一次性开发所有模块。
在编码阶段,我将已有的 HTML 和 JavaScript 代码逐步提供给 AI,让 AI 在现有项目基础上修改。
例如:
目前页面已经有 CSV 文件选择框和批量导入按钮,请在不修改其他功能的情况下,实现 CSV 解析,并将 title、conference、year、keywords、abstract、url 导入现有 papers 数组。
AI 给出了 CSV 解析代码。
在实际测试过程中,又发现 CSV 文件可能存在:
CSV 文件 → FileReader → 去除 BOM → 逐行解析 → 解析 CSV 字段 → 检查 title → 检查重复 → 生成 ID → 加入 papers → 保存 LocalStorage → 刷新页面
最终经过实际测试后可以正常工作。
在论文搜索功能开发过程中,希望搜索同时支持:
输入关键词 → 是否为空?(非空则继续)→ ID 精确查询 → 标题精确查询 → 标题 / 会议 / 关键词模糊查询 → 找到?
这样同时满足了精确查询和模糊查询的要求。
这是本次开发过程中比较典型的一次调试。
最初直接在浏览器中调用:
https://dblp.org/search/publ/api
但是浏览器控制台出现:
Access to fetch ... has been blocked by CORS policy
我将完整的控制台错误信息提供给 AI。
AI 判断这是浏览器同源策略导致的跨域问题。
之后尝试讨论不同的解决方式,最终采用:
浏览器 → localhost:3000 → Node.js 服务器 → DBLP API
由 Node.js 后端向 DBLP 发起请求,再将结果返回给前端。
这一过程让我认识到:
AI 可以很快提出解决方案,但真正决定方案是否可用的仍然是实际运行和人工验证。
CV Insight
项目采用原生 HTML、CSS 和 JavaScript 实现。
主要文件:
index.html
style.css
app.js
papers.js
index.html
负责:
系统核心数据流如下:
CSV / 测试数据 / 在线数据 → papers 数组 → LocalStorage 保存 → 论文管理 / Top10 / 图谱 → 趋势
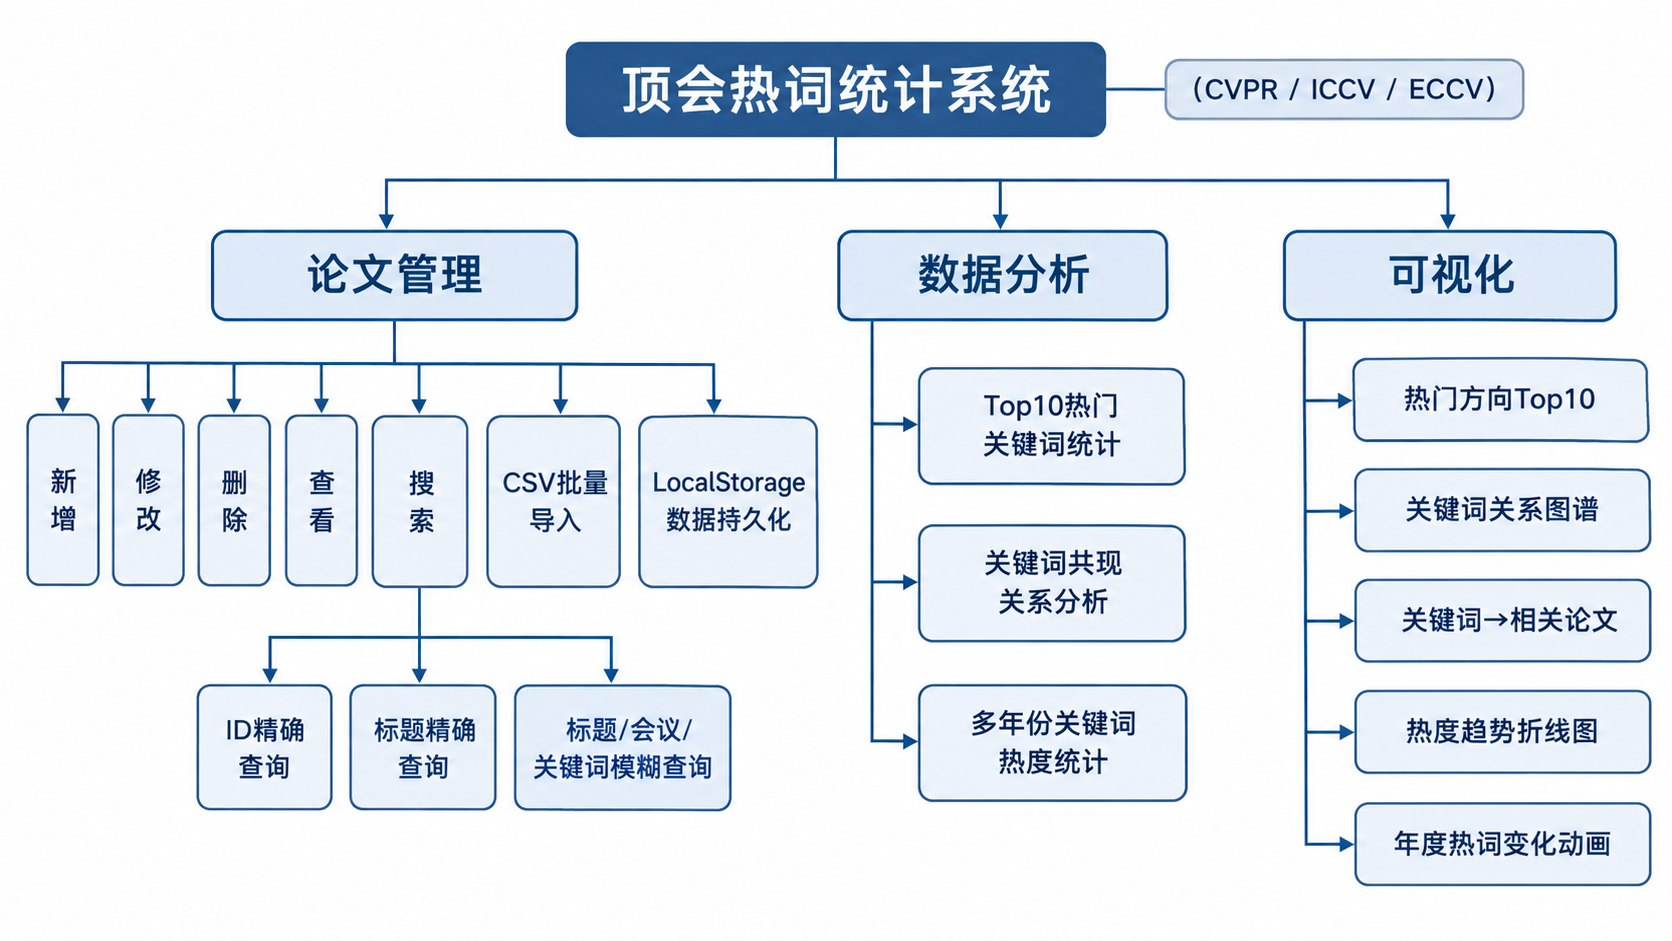
功能结构图如下:
为了避免刷新网页后论文数据丢失,增加了 LocalStorage。
const STORAGE_KEY = "cv_papers";
function loadPapers() {
const savedData = localStorage.getItem(STORAGE_KEY);
if (savedData) {
try {
const savedPapers = JSON.parse(savedData);
if (Array.isArray(savedPapers)) {
papers = savedPapers;
}
} catch (error) {
console.error("读取本地论文数据失败:", error);
}
}
}
function savePapers() {
localStorage.setItem(
STORAGE_KEY,
JSON.stringify(papers)
);
}
核心思想:
将 JavaScript 数组转换成 JSON 字符串保存,读取时再转换回数组。
搜索功能按照优先级依次进行:
function searchPapers() {
const input = document.getElementById("searchInput");
const keyword = input.value.trim().toLowerCase();
if (!keyword) {
displayPapers(papers);
return;
}
const idResult = papers.filter(paper =>
String(paper.id).toLowerCase() === keyword
);
if (idResult.length > 0) {
displayPapers(idResult);
return;
}
const exactResult = papers.filter(paper =>
paper.title &&
paper.title.trim().toLowerCase() === keyword
);
if (exactResult.length > 0) {
displayPapers(exactResult);
return;
}
const fuzzyResult = papers.filter(paper => {
const title = paper.title
? paper.title.toLowerCase()
: "";
const conference = paper.conference
? paper.conference.toLowerCase()
: "";
const keywords = Array.isArray(paper.keywords)
? paper.keywords.join(" ").toLowerCase()
: "";
return title.includes(keyword) ||
conference.includes(keyword) ||
keywords.includes(keyword);
});
displayPapers(fuzzyResult);
}
该功能实现了:
CSV 导入的核心过程:
读取文件 → 解析表头 → 寻找 title 字段 → 逐行读取 → 检查重复 → 解析关键词 → 生成 ID → 加入论文数组 → 保存
同时处理了 UTF-8 BOM 和 CSV 引号等情况。
系统遍历所有论文关键词,对关键词出现次数进行统计。
const keywordCount = {};
papers.forEach(paper => {
if (!Array.isArray(paper.keywords)) {
return;
}
paper.keywords.forEach(keyword => {
if (!keywordCount[keyword]) {
keywordCount[keyword] = 0;
}
keywordCount[keyword]++;
});
});
最后将结果排序并取前十名。
关键词图谱首先统计关键词之间的共现关系。
例如一篇论文同时包含:
Transformer
Vision
Classification
那么这些关键词之间存在关联。
通过这种方式,可以将论文数据转换成:
关键词节点 + 关键词关系
再通过前端进行可视化展示。
点击关键词后,再从论文数组中筛选包含该关键词的论文。
趋势图根据:
年份+会议+关键词
进行筛选。
例如用户选择:
关键词:Transformer
会议:CVPR
系统统计不同年份 Transformer 在 CVPR 数据中的出现情况,并生成折线图。
进行会议范围筛选。
本次项目采用:
dev ——merge —— main
开发阶段主要在 dev 分支进行。
基本功能开发完成并经过测试后,再将 dev 合并到 main。
根据作业要求,最终仓库需要至少 15 次真实 commit。
计划根据实际开发过程形成:
| 序号 | Commit 内容 |
|---|---|
| 1 | docs: 添加 README.md 项目说明 |
| 2 | docs: 添加 codestyle.md 代码规范 |
| 3 | chore: 添加 .gitignore 忽略配置文件 |
| 4 | feat: 添加平台页面结构 index.html |
| 5 | feat: 添加页面样式 style.css |
| 6 | feat: 添加论文示例数据 papers.js |
| 7 | feat: 添加核心业务逻辑 app.js |
| 8 | feat: 添加 DBLP 在线查询后端代理 server.js |
| 9 | feat: 增强 server.js 在线查询健壮性 |
| 10 | feat: server.js 增加前端静态页面托管,支持单进程部署 |
| 11 | build: 添加云端部署 Dockerfile 配置 |
| 12 | docs: 添加部署说明 DEPLOY |
| 13 | docs: README 补充原型与部署链接章节 |
| 14 | feat: 平台更名 CV Insight,更新页面与后端 |
| 15 | docs: 完善 README 项目介绍与 AI 使用说明 |
最终以 CodeArts 中真实产生的 Commit 记录为准。
基本功能开发完成并经过测试后,创建:
Release 1.0.0
后续如果继续增加功能,可以发布新的版本。
项目单独编写:
codestyle.md
代码规范主要参考主流官方规范,并在文件顶部注明来源。
项目主要涉及:
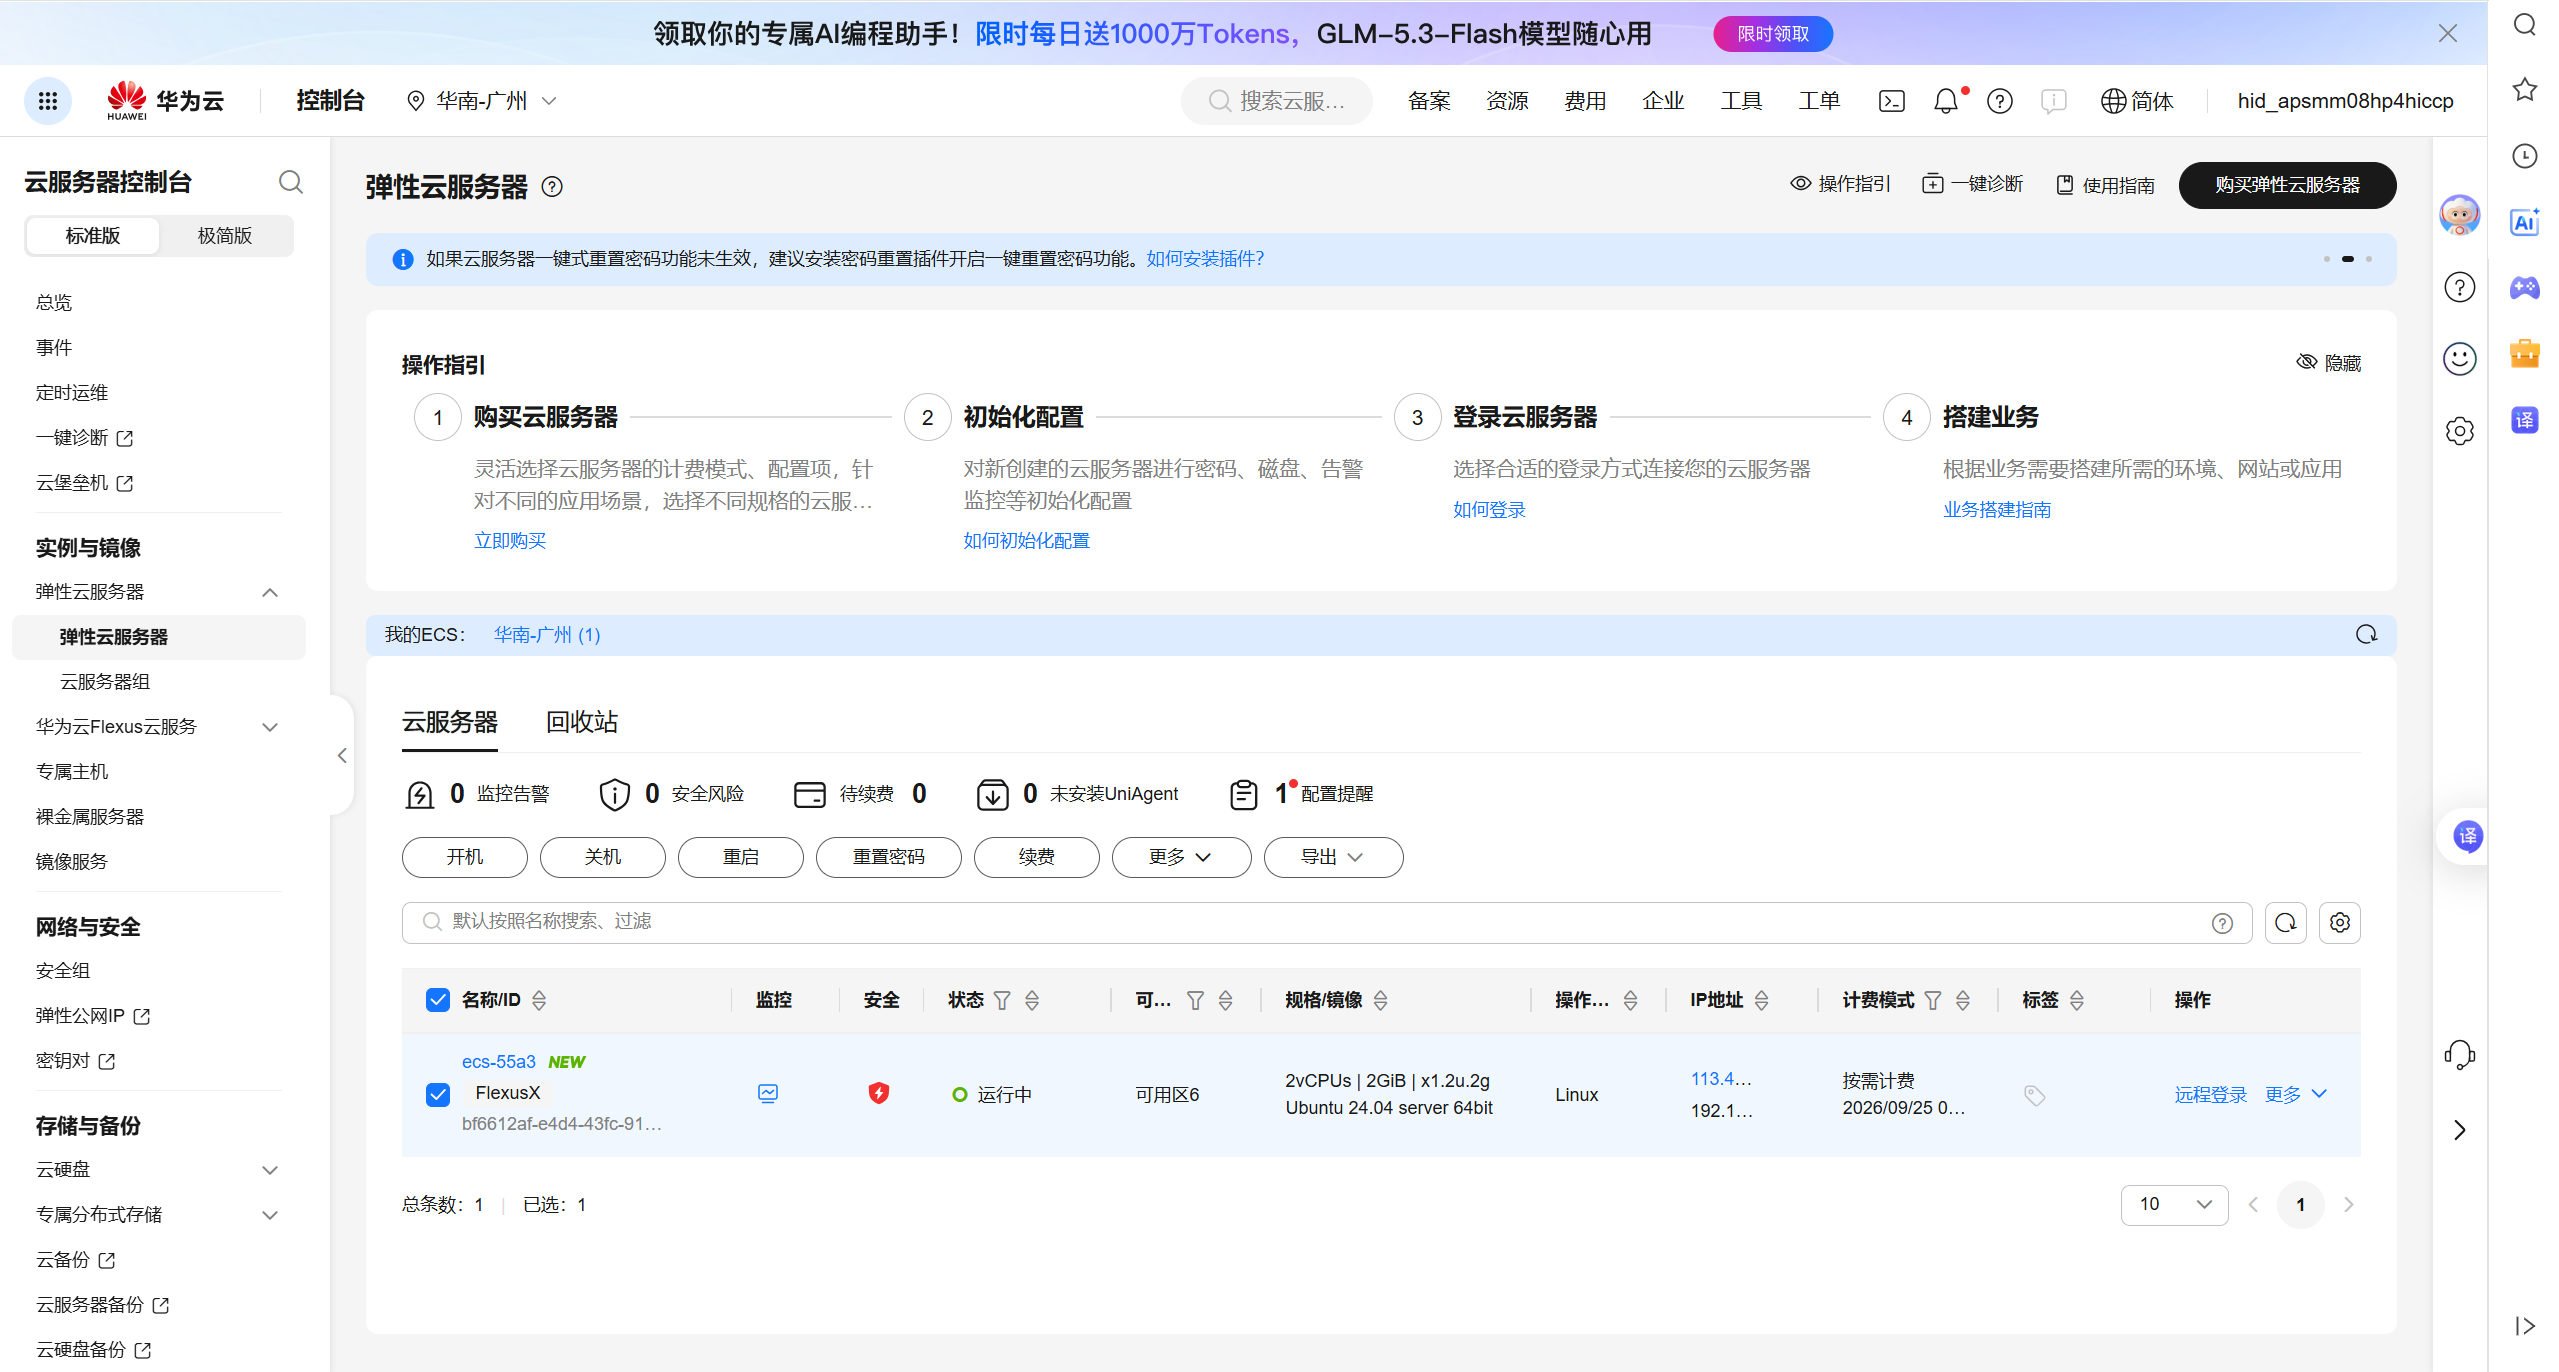
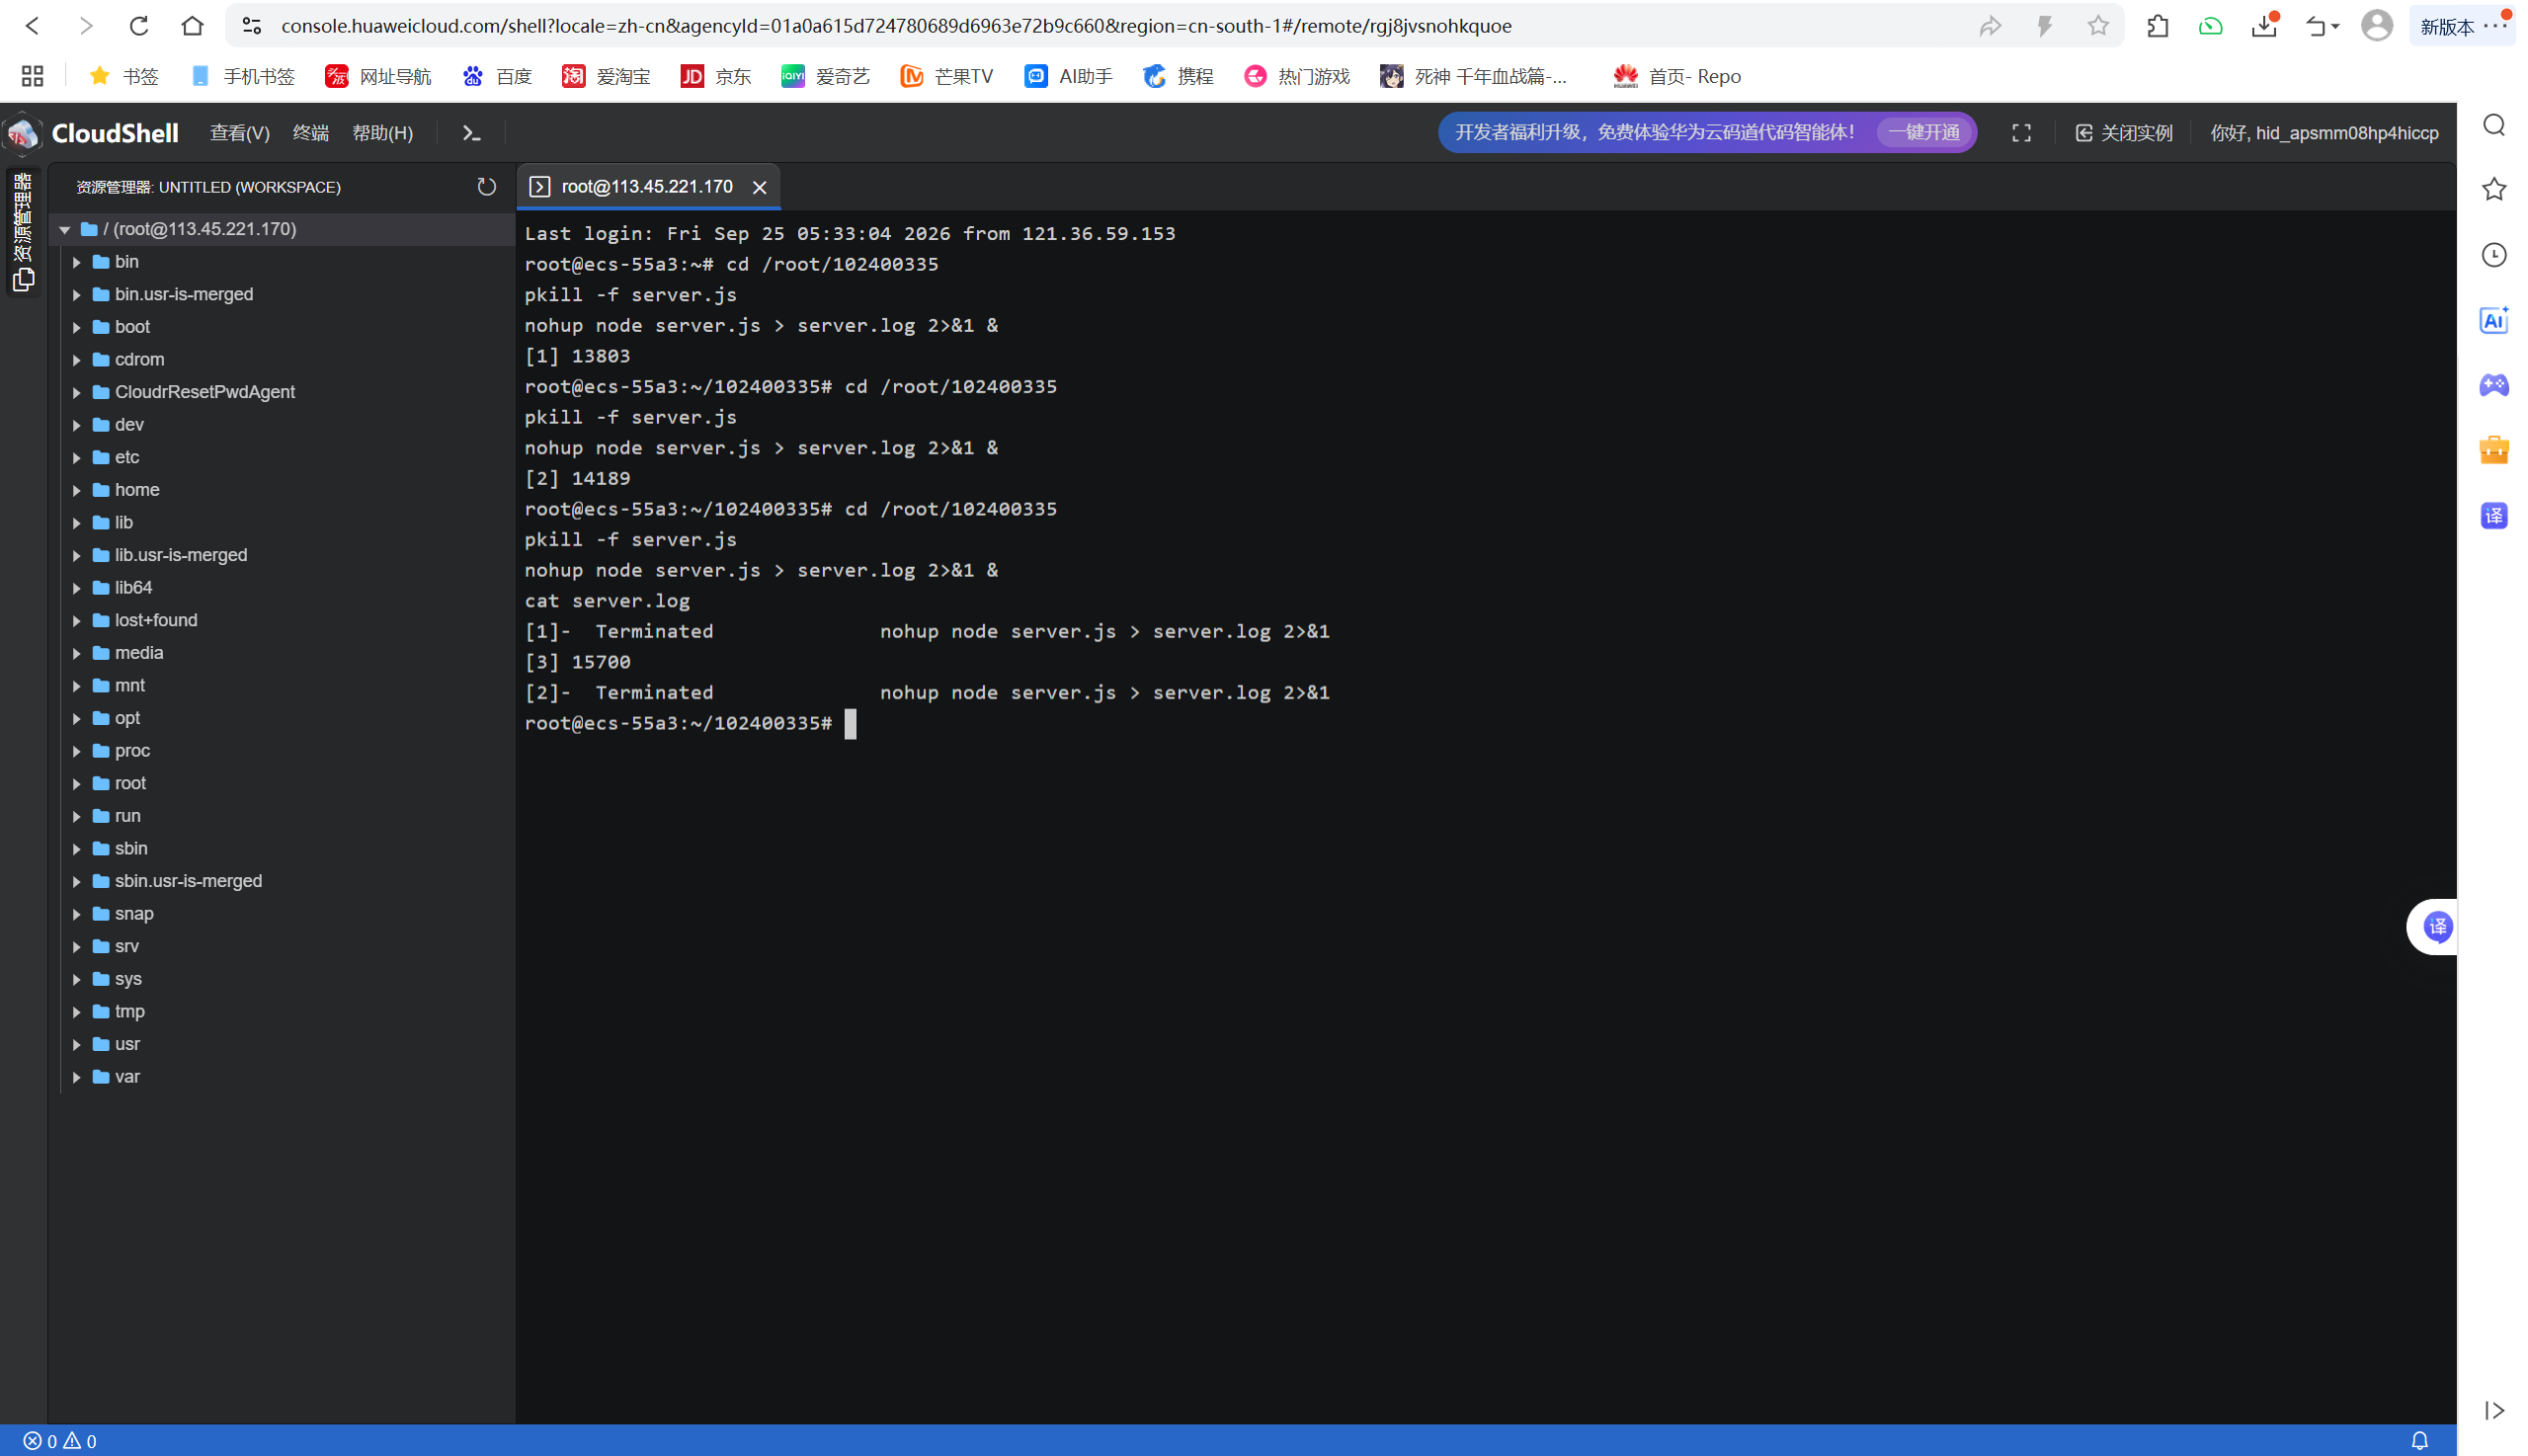
本项目最终计划部署到华为云服务器。
部署结构:
用户浏览器 → 华为云服务器 → Web 服务 → 项目页面 → Node.js 后端
| PSP 阶段 | 工作内容 | 预估时间/min | 实际时间/min | 偏差/min |
|---|---|---|---|---|
| Planning | 项目计划与任务拆分 | 30 | 40 | +10 |
| Analysis | 需求分析 | 60 | 80 | +20 |
| Design | 页面及系统设计 | 90 | 100 | +10 |
| Coding | HTML/CSS/JS 开发 | 300 | 360 | +60 |
| Testing | 功能测试 | 120 | 100 | -20 |
| Debugging | Bug 调试 | 120 | 140 | +20 |
| Documentation | README、博客等 | 120 | 150 | +30 |
| Deployment | 云服务器部署 | 120 | 180 | +60 |
| 总计 | 960 | 1150 | +190 |
偏差分析
本项目使用 AI 进行辅助开发,因此编码阶段部分工作的完成速度比完全独立开发更快。
但是,AI 提高编码速度的同时,也增加了人工检查成本。
例如:
这次作业与之前单独写程序的体验比较不同。
以前遇到问题时,通常需要自己搜索资料、阅读文档,然后尝试修改代码。
这次更多采用:
我提出问题 → AI 提供方案 → 我实际运行 → 把错误反馈给 AI → 再修改
这种循环。
最开始认为 AI 可以直接把整个项目写出来,但实际开发后发现并不是这样。
例如 CSV 导入功能,表面上只是读取文件并按照逗号拆分,但实际测试之后还会涉及:
① 反馈速度快
遇到代码问题时,可以立即询问。
② 能够提供多个解决思路
例如遇到 DBLP CORS 问题时,可以讨论:
AI 生成的代码并不意味着一定正确。
实际开发中的典型问题就是 DBLP 在线查询。
最开始直接在前端调用接口时出现:
Access to fetch ... has been blocked by CORS policy
这说明:
AI 给出的代码必须通过真实运行环境验证。
此外,如果 AI 没有完整理解当前项目结构,直接进行大范围修改,也可能导致原本正常的功能出现问题。
因此,在本项目中逐渐采用:
小范围修改,立即测试,确认正常后再继续。
本次项目从一个简单的“顶会热词统计”需求开始,逐步实现了:
在这个过程中,我对 AI 结对编程有了更加具体的认识。
AI 更像是一名可以随时讨论问题的编程伙伴,但最终的需求理解、代码审查、测试验证以及项目责任仍然需要由开发者自己承担。
因此,本次作业最大的收获并不是:
“AI 帮我写了多少代码”
而是:
“我学会了如何提出问题、验证答案、发现错误,并让 AI 根据真实结果继续参与开发。”

