


88
社区成员
 发帖
 与我相关
 我的任务

 分享
| 这个作业属于哪个课程 | https://bbs.csdn.net/forums/2601_CS_SE_FZU?spm=1001.2014.3001.6685 |
|---|---|
| 这个作业要求在哪里 | https://bbs.csdn.net/topics/620526318 |
| 这个作业的目标 | 与 AI 结对完成需求分析、原型设计、编码实现与云部署,做一个可验证的 CVPR/ICCV/ECCV 顶会热词统计平台 |
| 其他参考文献 | 《构建之法》第 3、4、8 章;Node.js / React / ECharts 官方文档;CVF Open Access、ECVA 官网 |
dev 分支进行、基础功能完成后合并 master,并打了 v1.0.0 标签。GET /api/health 实测返回 {"status":"ok"})| 工具 | 模型 | 主要用途 |
|---|---|---|
| Codex | —(初始化会话) | 工程骨架、pnpm workspace、文档与验收表初始化 |
| DeepSeek Harness(命令行代理框架,主会话+子代理并行) | deepseek-v4.1-flash | 数据源实测、API 全量实现(论文 CRUD/抓取/统计)、Figma 原型程序化生成、前端五页、真实数据采集 |
| ZCode(命令行,含子智能体调度) | GLM-5.3-flash | 会话恢复与核验、缺陷修复与回归、测试重写、外网验收、部署收尾 |
| ego-browser / playwright | 浏览器自动化 | 人工式目检、原型 Present 模式验证、重复性截图与导出脚本 |
这一节先讲清楚本项目能在一个晚上保持质量的工程手段,后面代码说明会反复用到它们:
.mise.toml + .node-version 双文件锁定 Node 24.18.1 / pnpm 11.18.0,mise exec 后所有机器(本机、CI、部署服务器)版本一致,engines 告警归零。部署服务器装的就是同版本 Node 24.18.1。packages/contracts 同时被 API 与前端引用,导出 CONFERENCES、isHeldIn、全部 DTO 与 KEYWORD_METHOD_VERSION;根脚本在 dev/build/typecheck 前自动先构建它。接口改动只改一处,前后端同时被类型检查约束。pnpm check = typecheck → lint → test → build 四步全绿才算完成;测试独立成 tests/ 包(API 用 supertest,Web 用 jsdom + React Testing Library),与生产代码物理隔离,共 36 个测试。实际耗时按三次真实 AI 协作会话的记录归属统计(会话日志可核对),博客提交前可根据自己的计时微调。
| PSP | 阶段/任务 | 预估(分钟) | 实际(分钟) |
|---|---|---|---|
| Planning | 计划:作业阅读、需求拆解、估计 | 35 | 20 |
| Analysis | 需求分析:NABCD、竞品核查 | 40 | 45 |
| Design Spec | 架构、数据与 API 设计 | 35 | 30 |
| Design Review | 设计复审(人工复核 AI 方案) | 20 | 15 |
| Coding Standard | 代码规范制定 | 10 | 15 |
| Design | 学习工具与五页原型(Figma 两版) | 75 | 160 |
| Coding | 数据库/爬取/清洗 | 90 | 95 |
| Coding | 统计 API/图谱/趋势 | 70 | 70 |
| Coding | 五页前端与联动 | 75 | 90 |
| Code Review | 人工检查 AI 代码 | 25 | 30 |
| Test | 功能/浏览器/边界测试 | 40 | 55 |
| Reporting | 云部署/验收 | 40 | 45 |
| Reporting | 博客/截图/总结 | 40 | 60 |
| 合计 | 595 | 710 |
偏差分析(最大的三项):
react-router-dom 在 tests 包解析失败的问题,重写了 4 条旧断言并新增 API client 错误码测试。主要用户是想快速了解计算机视觉研究方向的学生(作业场景中的"小刚")。CVPR 一年录取近 3000 篇论文,靠人工逐篇阅读总结热点不可行。他的核心诉求是:先看方向、再看证据、再读原文——从"哪些方向热"下钻到"哪些论文支撑这个结论",并能比较不同会议、不同年份的变化。次要用户是助教/研究生:需要核查某个趋势的数据来源与统计口径,确认它是不是"编出来的"。
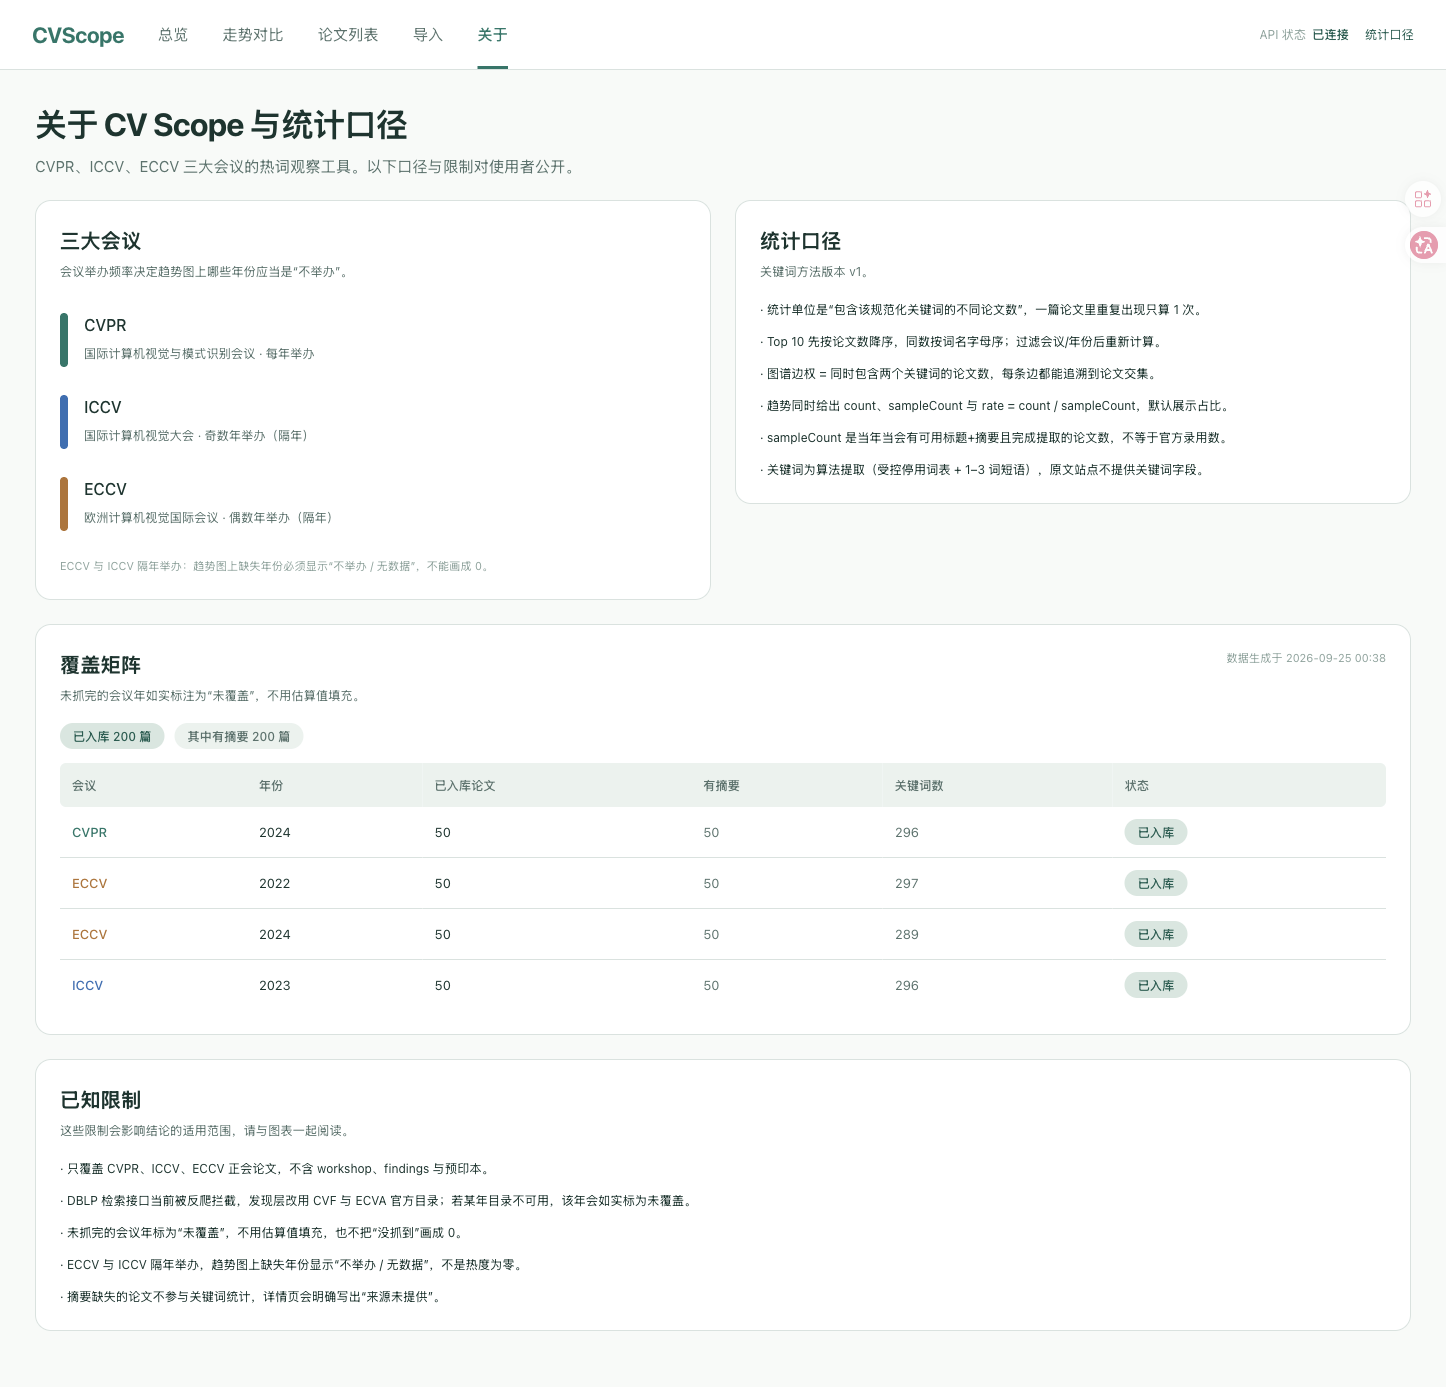
robots.txt: Disallow: /),且 DBLP 官方 FAQ 明确不提供摘要。因此发现层改用 CVF Open Access(CVPR/ICCV)与 ECVA(ECCV)官方目录:目录缓存 8903 条(CVPR 2024 共 2715 条、ICCV 2023 共 2156 条、ECCV 2022/2024 共 1645/2387 条),论文页再抓摘要与原文链接。extracted**:子句切段防伪短语 → 停用词/学术泛词过滤 → 1–3 词短语打分(题名命中按词数加权 + 摘要频次 + 短语长度奖励)→ 贪心选择互不包含。方法版本号进库,改规则可整库重算。null 并显示"不举办",未采集的年份显示"无数据"——两者都不画成 0。用户 2 分钟内可以从一个热词找到支撑论文(实测路径:总览点词 → 列表 → 详情/原文);批量导入把逐篇打开网页的时间压缩成一次粘贴;公开覆盖矩阵让跨会议比较可解释、可信任。
| 替代方式 | 核查结论(2026-09-24 实测) | 差异 |
|---|---|---|
| 会议官网 / CVF / ECVA | 权威论文入口,逐届可浏览,但没有跨年三会的热词聚合视图 | 我们补的就是聚合与下钻 |
| DBLP | 检索 API 被反爬拦截(Anubis 挑战页),且官方 FAQ 说明不提供摘要 | 只能做书目,做不了摘要/关键词层 |
| 人工 Excel / 脚本 | 灵活但无界面、难共享、口径易漂移 | 我们把口径写进代码并版本化(v1) |
竞争策略:不追求取代学术搜索引擎,而是把范围收窄到三大顶会,做"热词 → 论文证据"的真实闭环,并公开覆盖率与缺失情况——数据上绝不冒充全量。
原型用专用工具(Figma)制作并发布网页链接;正式产品部署在云服务器(本作业部署在阿里云 ECS · 杭州,源码与版本管理在华为云 CodeArts);博客提供可访问链接、数据来源、动画截图与 AI 协作记录。
第一版 → 第二版的修复(AI 协作案例 A 的人工复核部分):
| 现象 | 根因 | 修复 |
|---|---|---|
| 中文普遍溢出 | 用"字符数×常数"估宽,中文全角宽度≈字号 | 改为 measure() 先量文本真实宽度再定尺寸 |
| 图谱只见连线、气泡不可见 | 节点缺颜色字段 | 补充颜色并重排为力导向式布局 |
| 折线整体比数据点高约 16px | 误判 Figma rotation 旋转锚点 | 改用 relativeTransform 显式仿射变换 |
| 详情摘要压住关键词标题 | resize(w,10) 后读到的是换行前高度 | 改为 resize(w, t.height) 按真实高度推进 |
原型关键帧(12 张导出图之一,与最终实现对照):
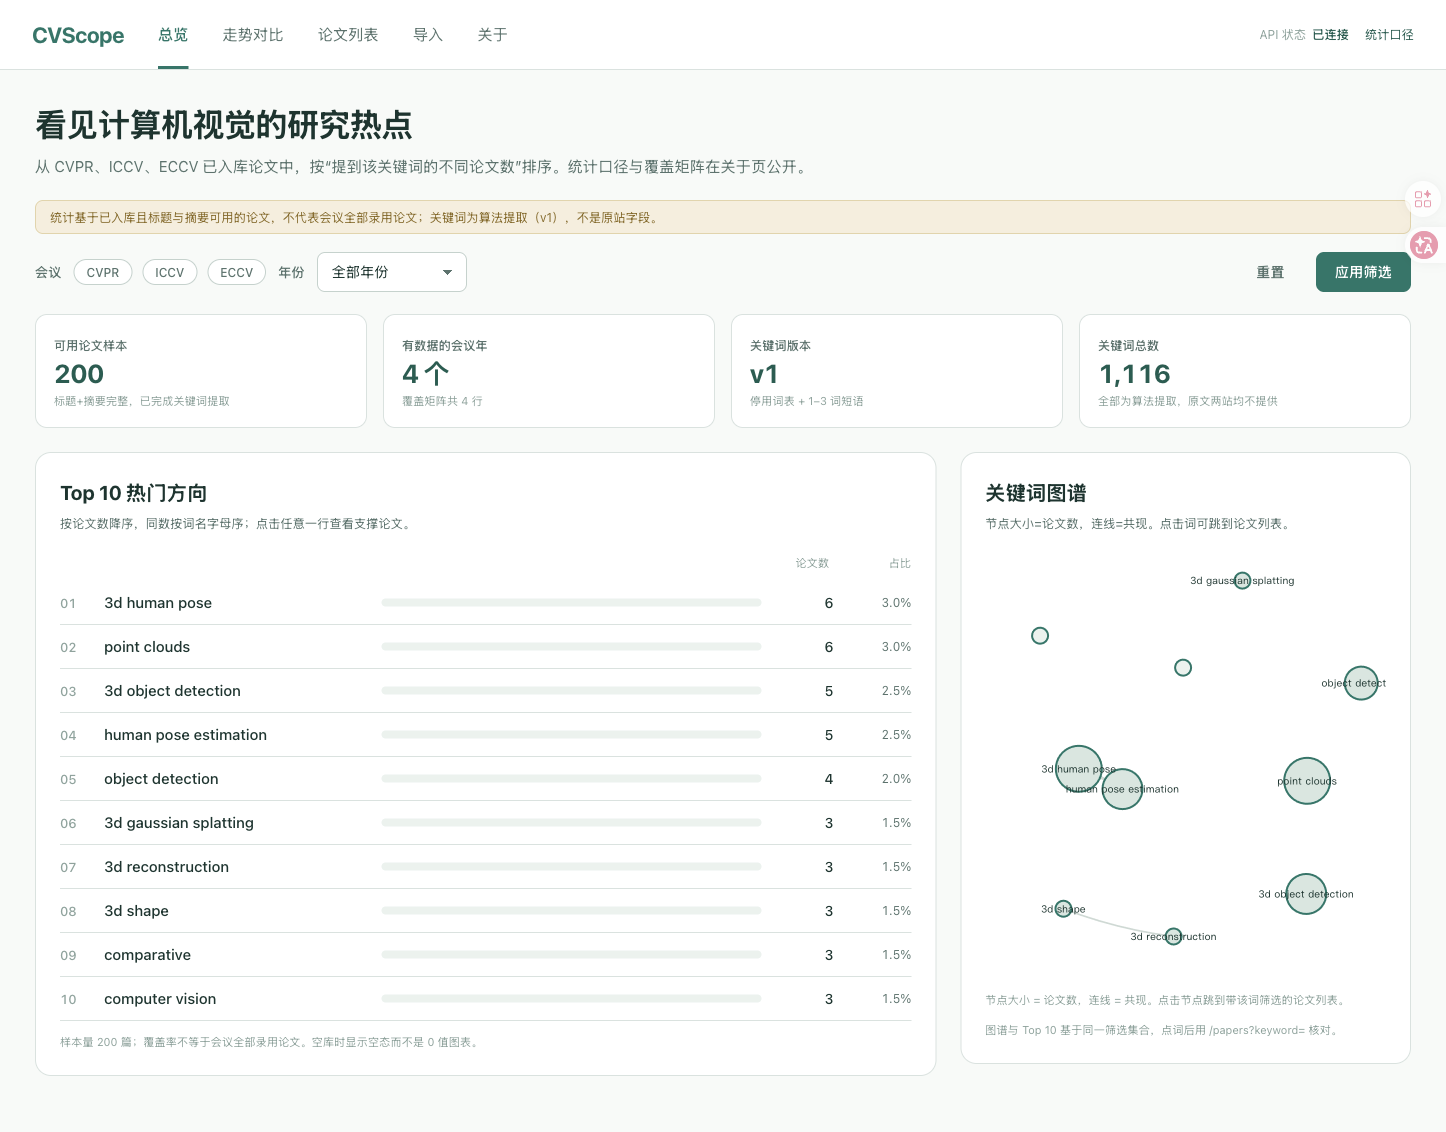
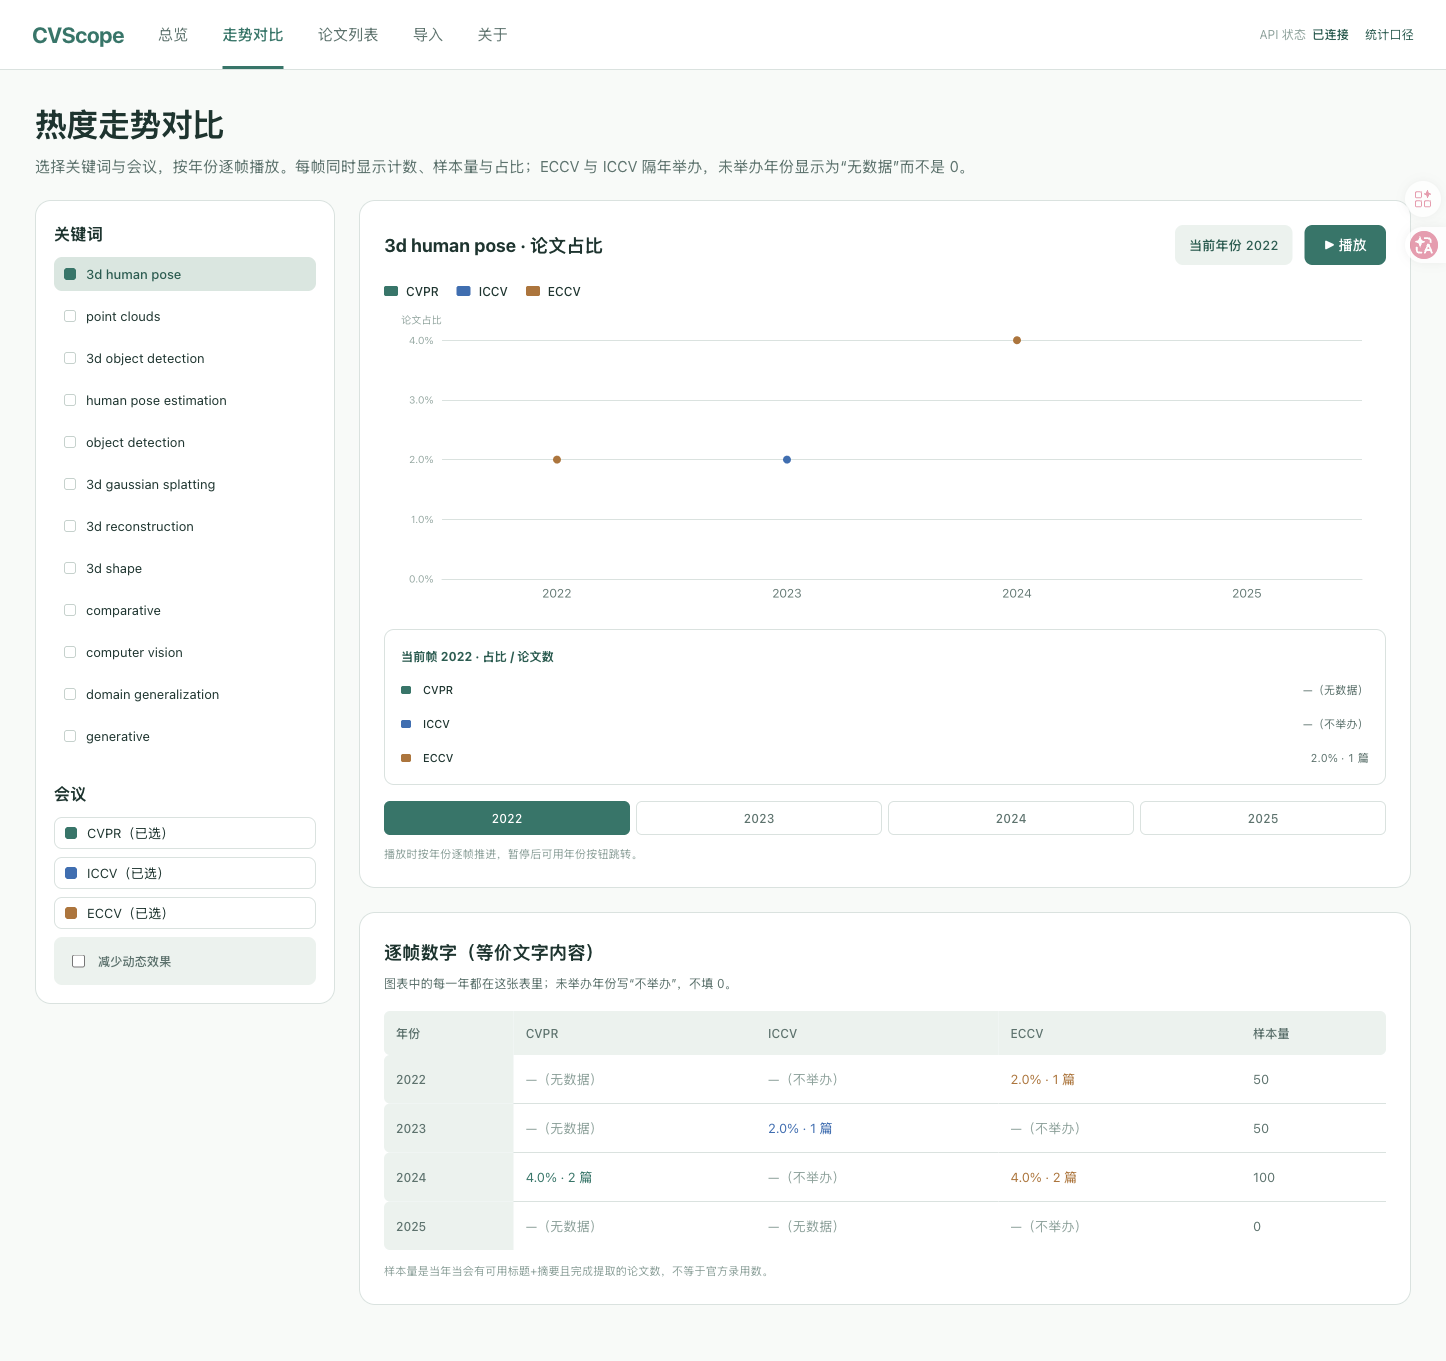
注意:原型由专用原型工具制作并发布;
apps/里的正式实现是独立手写代码,没有导入任何原型工具生成的代码。
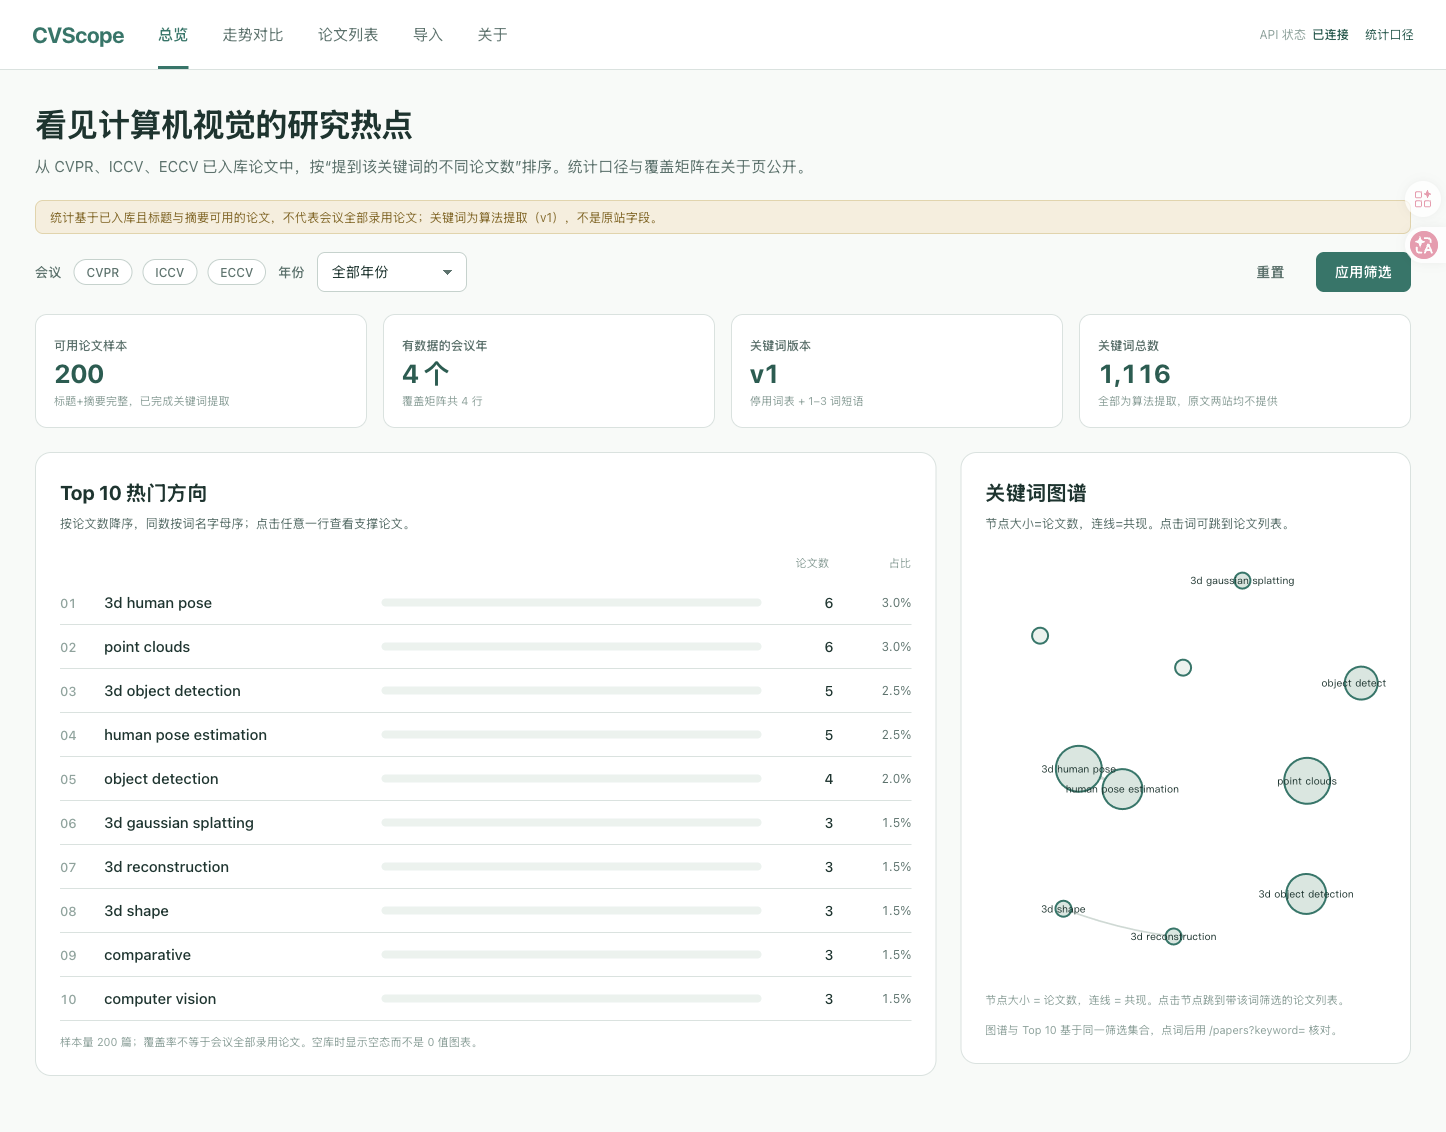
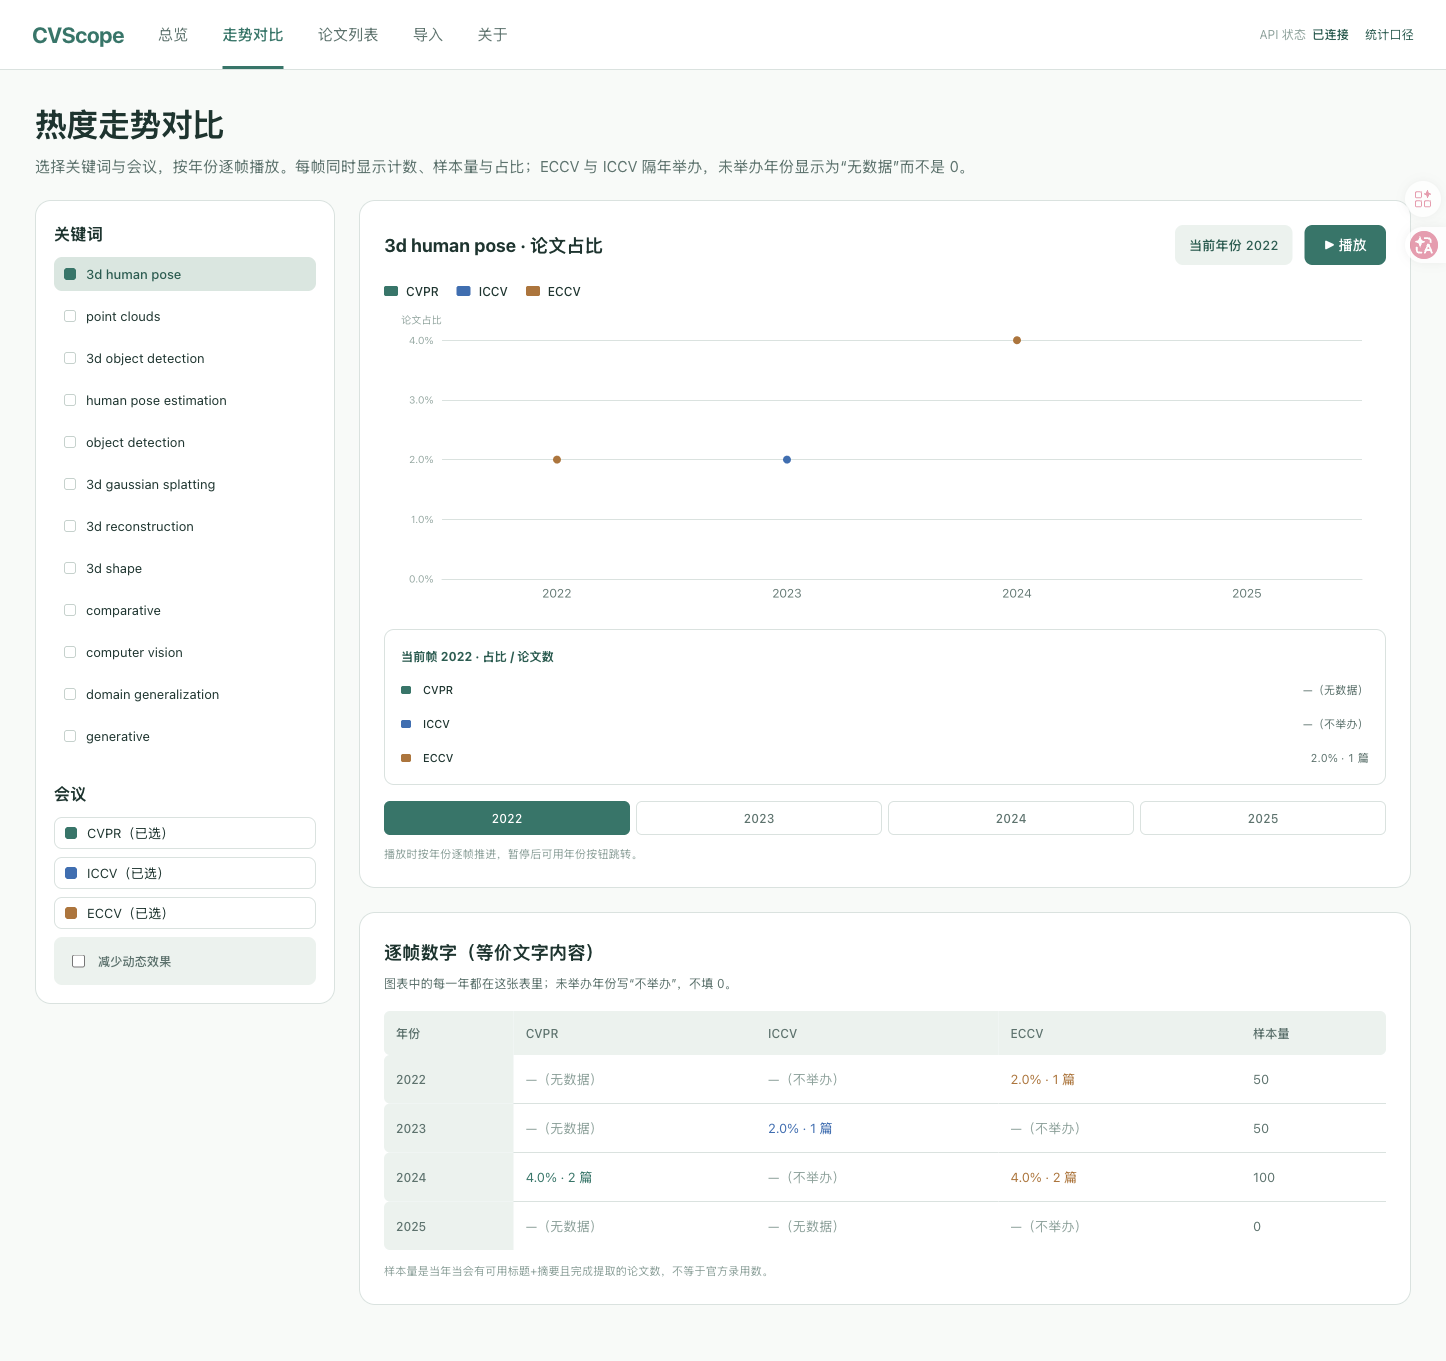
以下截图全部来自部署后的线上站点 http://116.62.81.154/ (浏览器实测)。
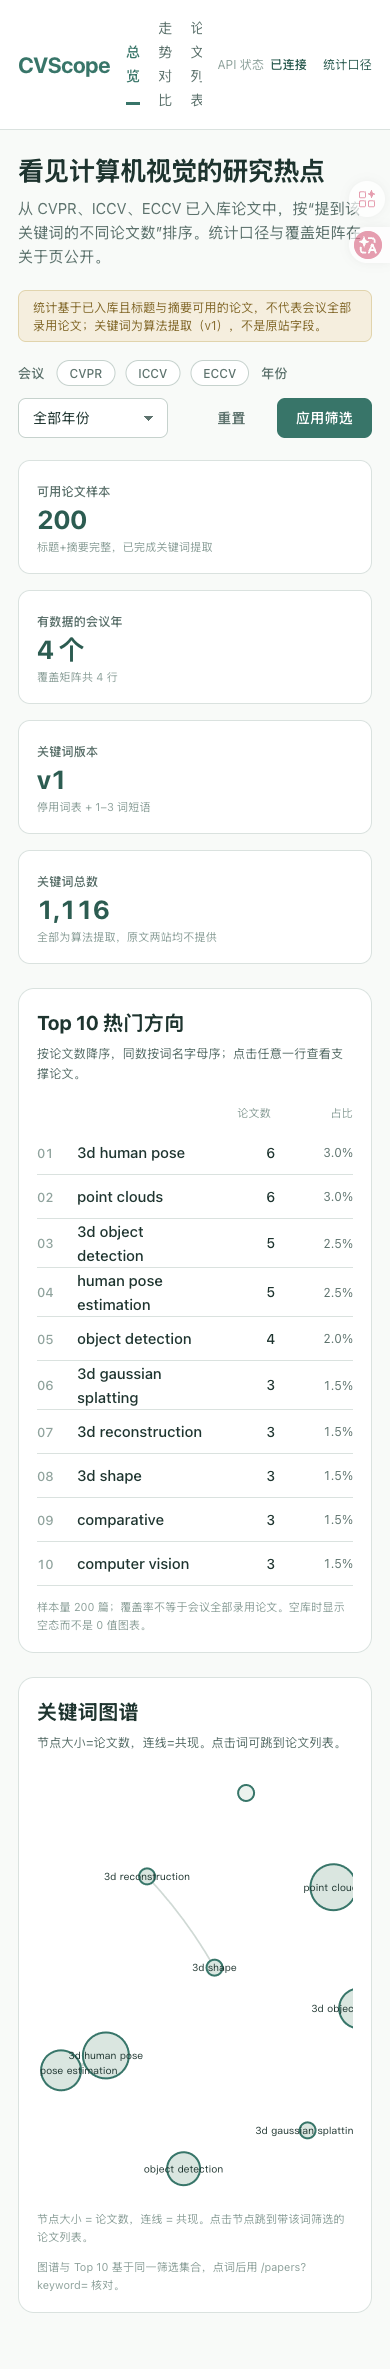
进入首页即看到数据范围(样本数、会议年、关键词版本、关键词总数四张统计卡)、Top 10 热门方向榜单(计数/占比/条形)与关键词图谱(节点大小=论文数、连线=共现)。点击任一行或节点会跳到带关键词筛选的论文列表。
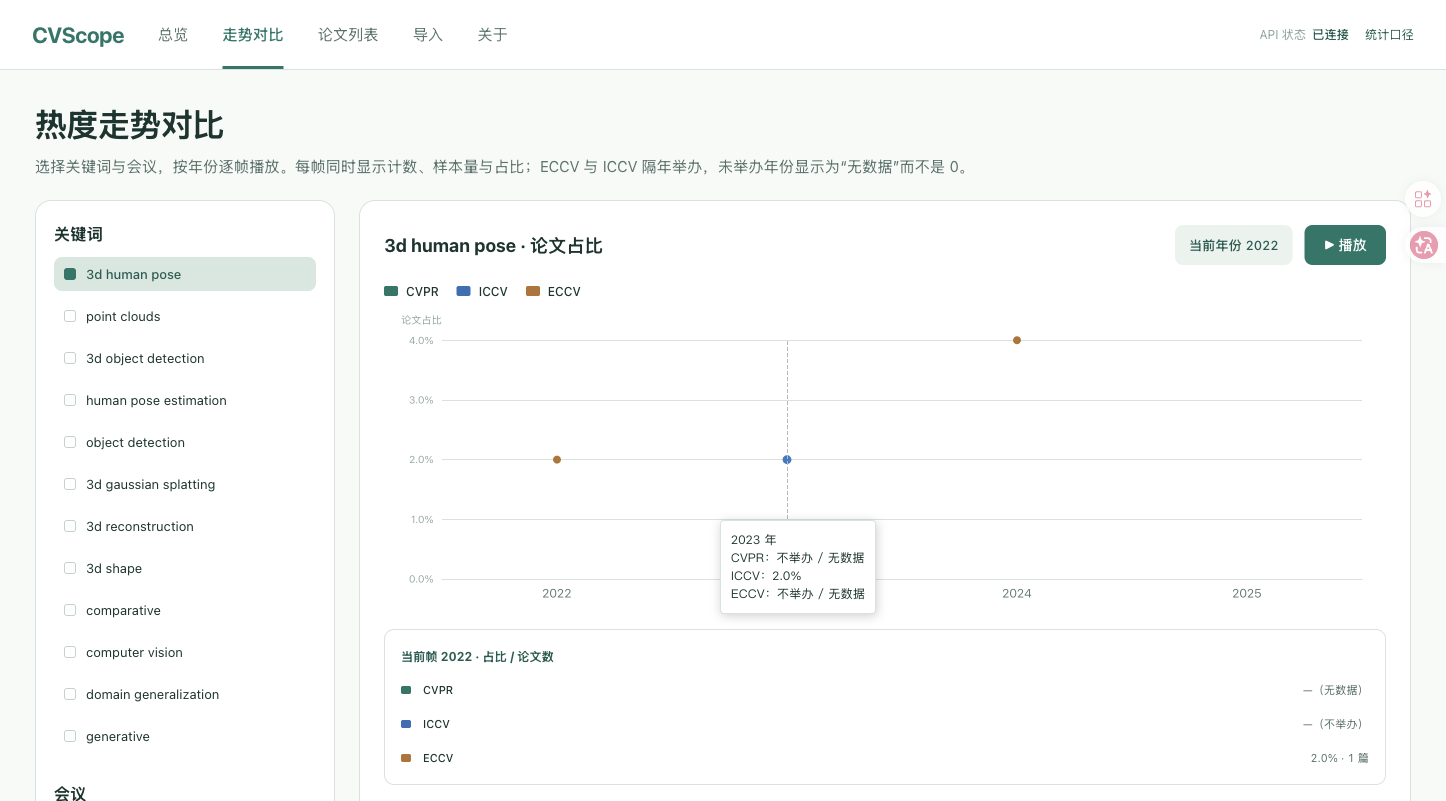
走势页按年份逐帧播放三大会议的热度折线:有播放/暂停、速度控制、"减少动态效果"开关、当前帧读数卡(每会显示"占比 · N 篇",不举办显示"—(不举办)"),下方提供等价的逐帧数字表格(无障碍与键盘可达)。
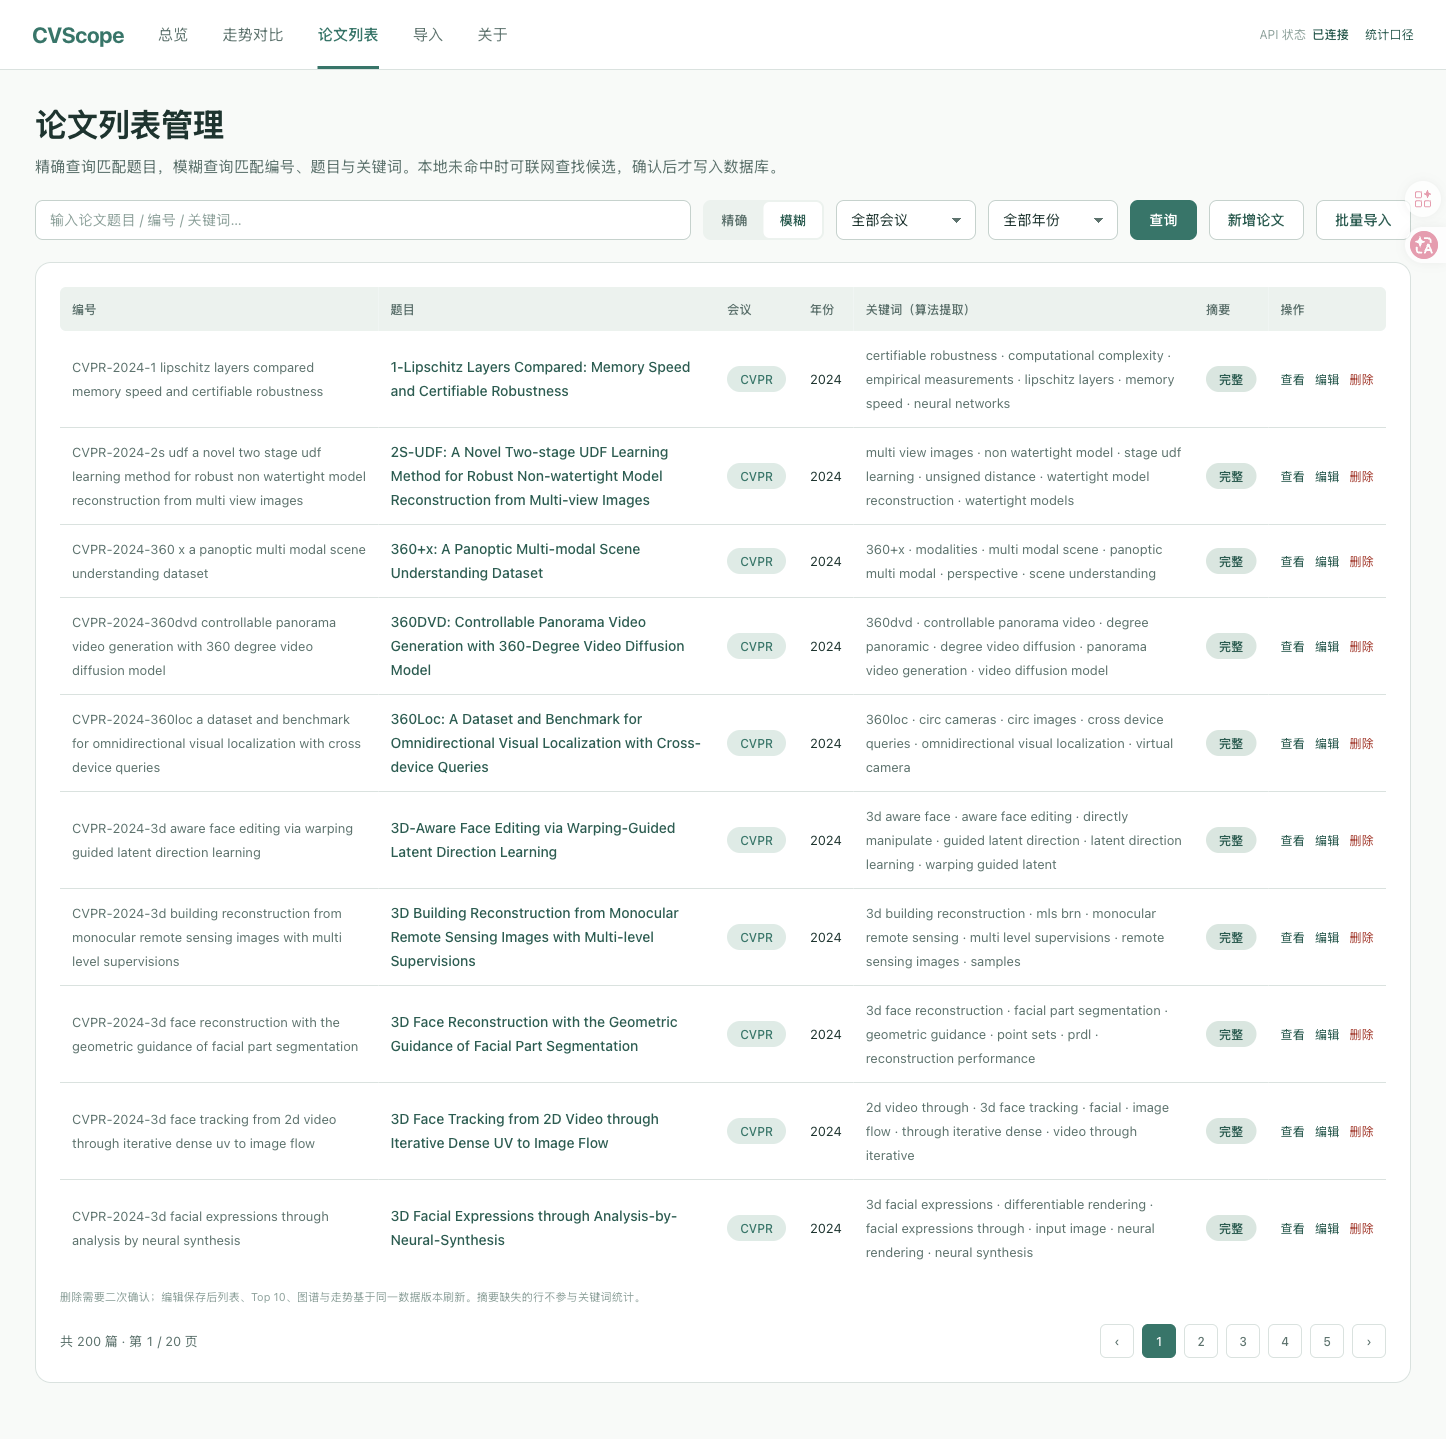
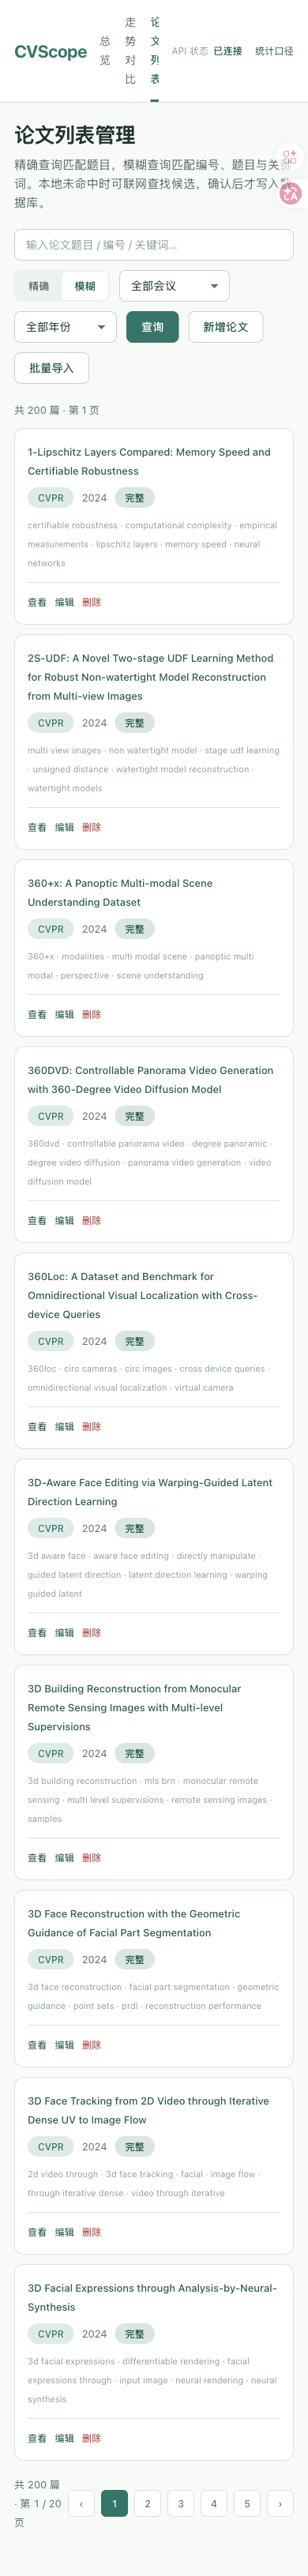
搜索框支持精确查询(题目正规化后全等)与模糊查询(编号/题目/关键词),可按会议、年份过滤;表格支持分页(每页 10 条)、行内"查看/编辑/删除",删除有二次确认弹窗;移动端自动切换为卡片布局。
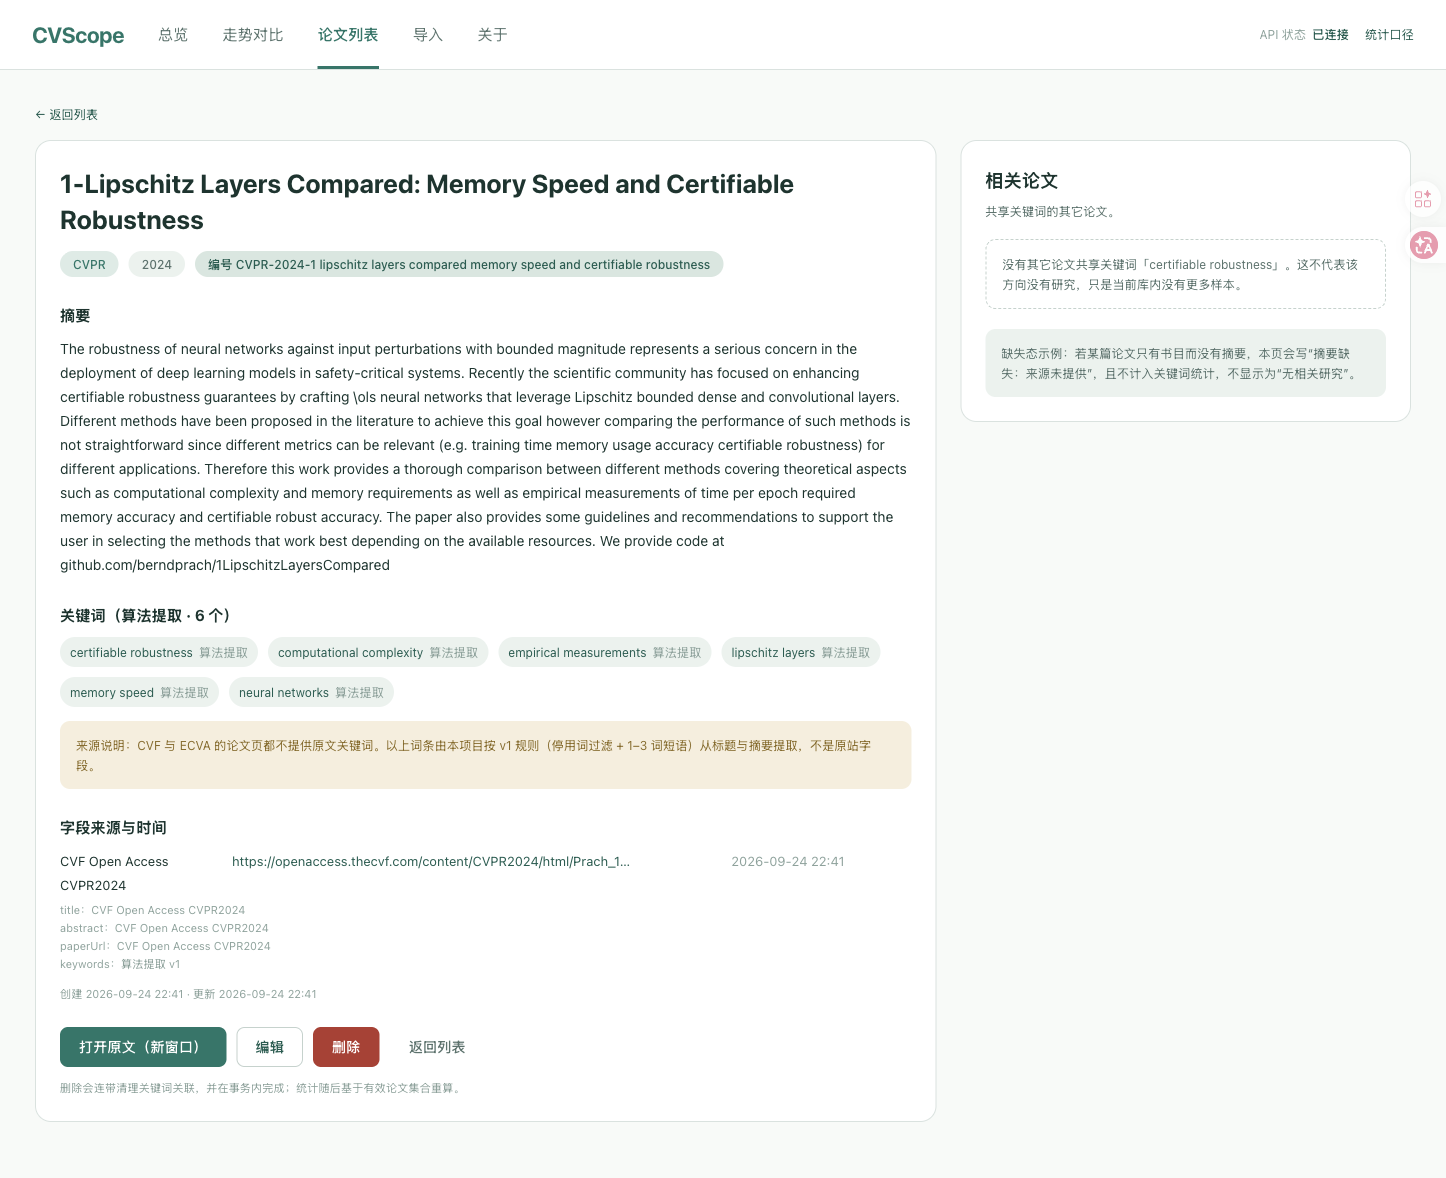
详情页展示摘要、关键词(带来源标签:原文关键词 / 算法提取 / 手工录入)、字段来源与抓取时间(sourceName/sourceUrl/fetchedAt)、相关论文;点击可直接打开原文。
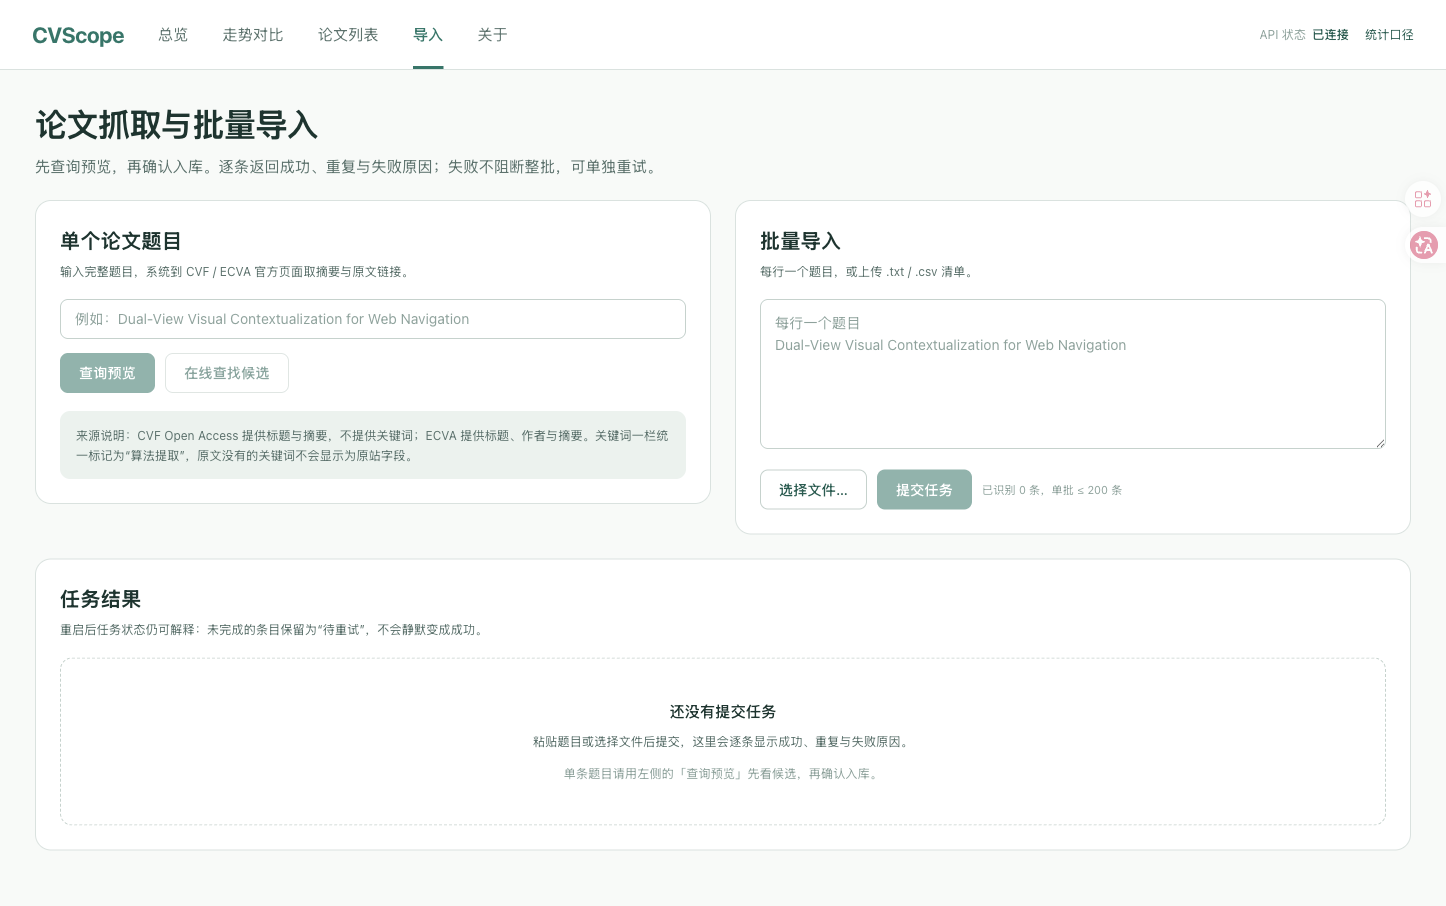
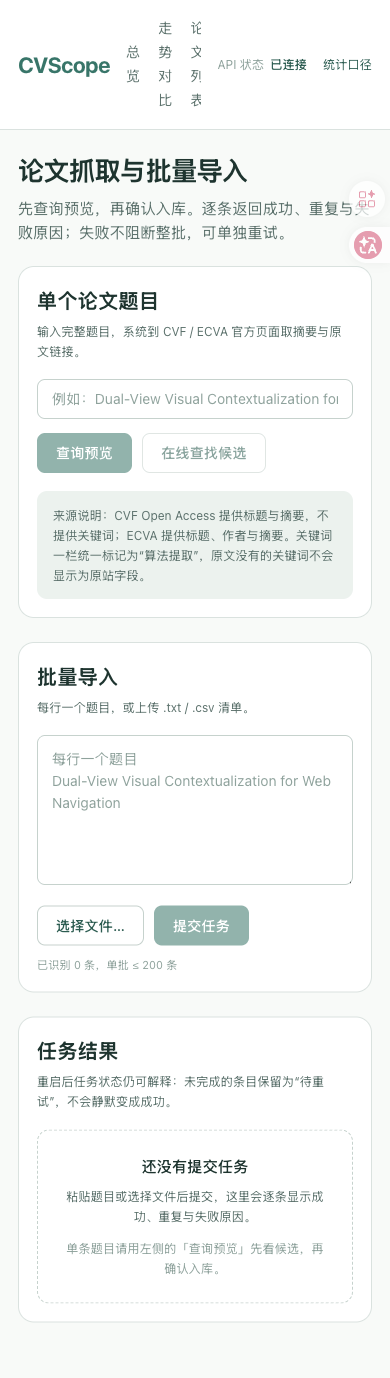
单个题目支持"查询预览 / 在线查找候选"——本地未命中时联网查询官方目录返回候选,用户确认后才入库;批量导入支持文本粘贴与 .txt/.csv 文件,单批 ≤200 条,任务按 1.5s 轮询返回逐条成功/重复/失败结果,失败可重试。
公开覆盖矩阵(真实数字:四会议年 × 50 篇抽样、200 篇全部含摘要)、统计口径 6 条规则、三大会议背景与已知限制——把"数据可信度"做成产品的一部分。
≤760px 断点下导航横向滚动、统计卡单列、论文列表变卡片布局,全部功能可操作。
curl http://116.62.81.154/api/health → {"status":"ok"}/api/papers 数据完整读回(SQLite 持久化在 /var/lib/cvscope/,由 systemd 管理 cvscope-api 服务,Nginx 同源反向代理 80 端口)。本项目由 DeepSeek Harness(deepseek-v4.1-flash)+ ZCode(GLM-5.3-flash)双 AI 结对完成,全程保留会话记录,以下三个案例均给出真实 Prompt/输出截图。
协作方式:我先让 AI 通读作业与已有代码库,冻结接口契约(packages/contracts),再授权它通过浏览器自动化直接操作 Figma(类似 MCP 的工具调用),程序化生成设计系统与五页原型;原型定了交互与信息架构,再照稿手写实现。
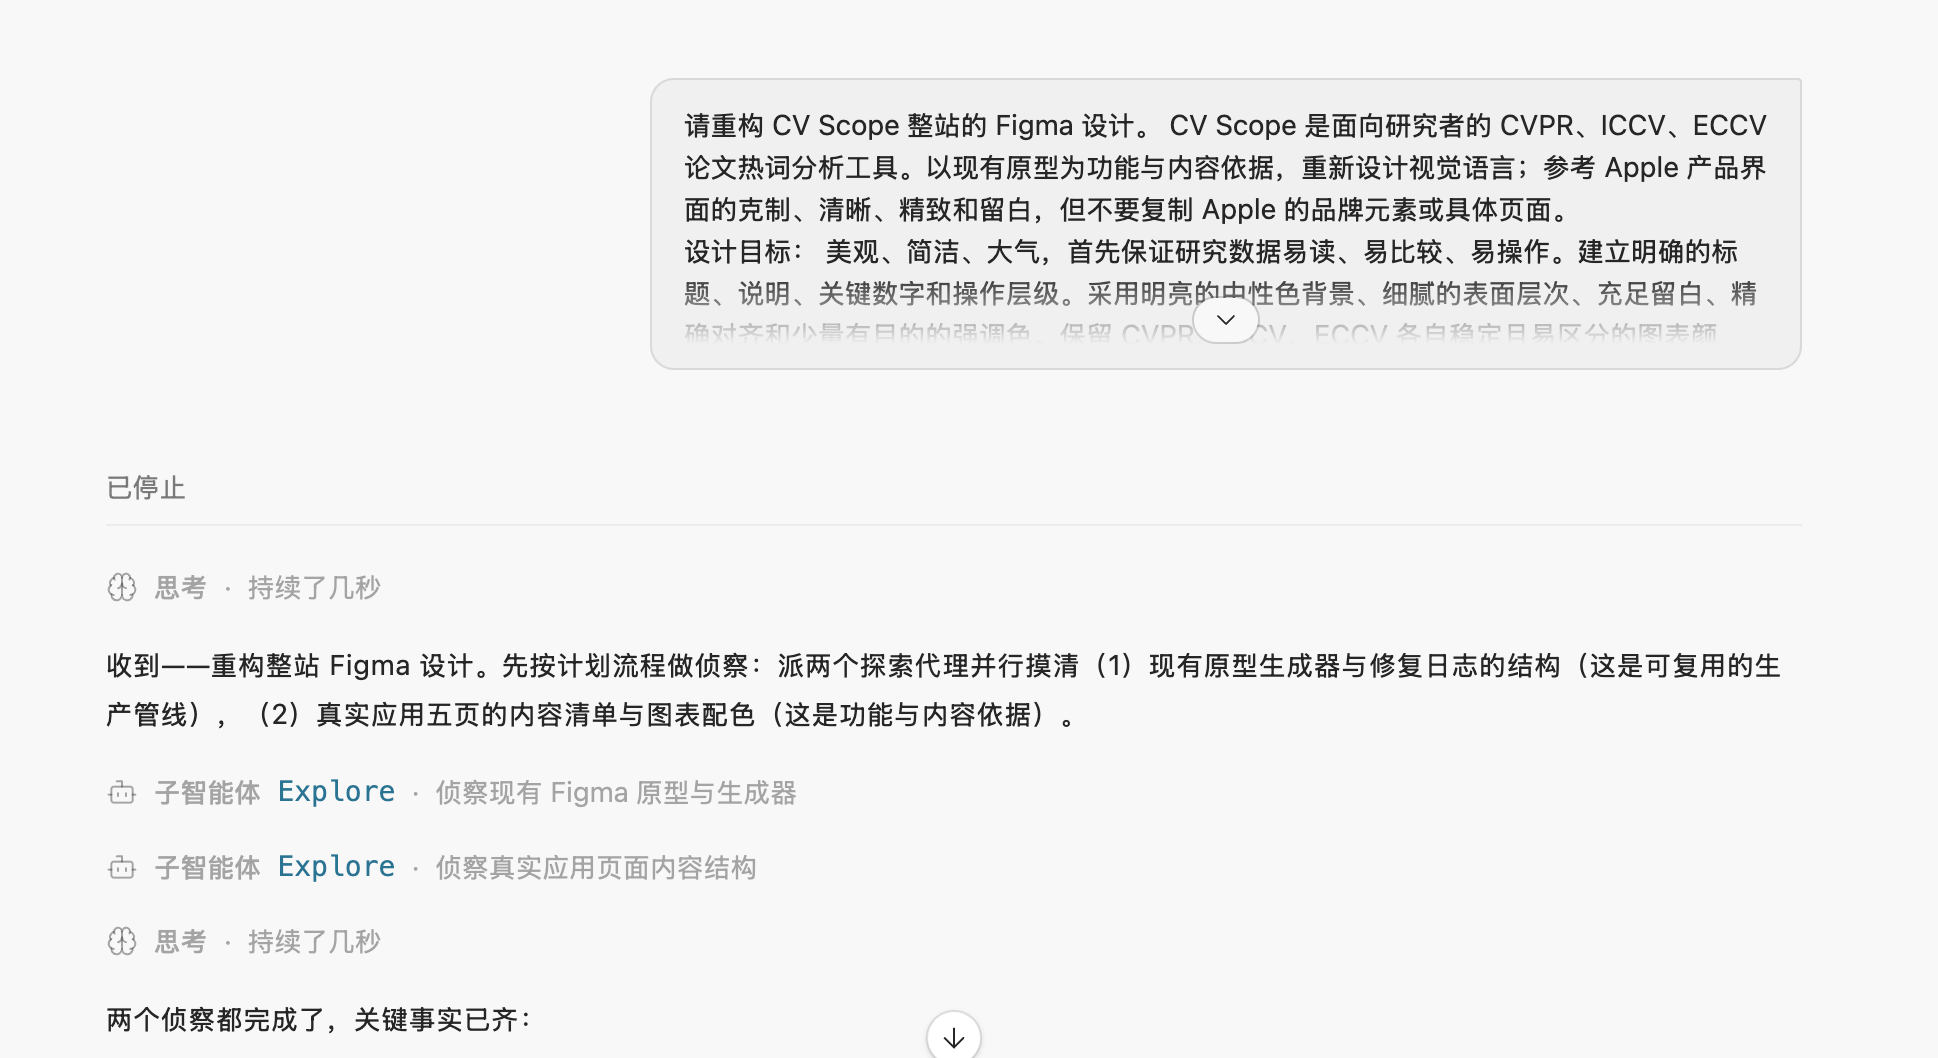
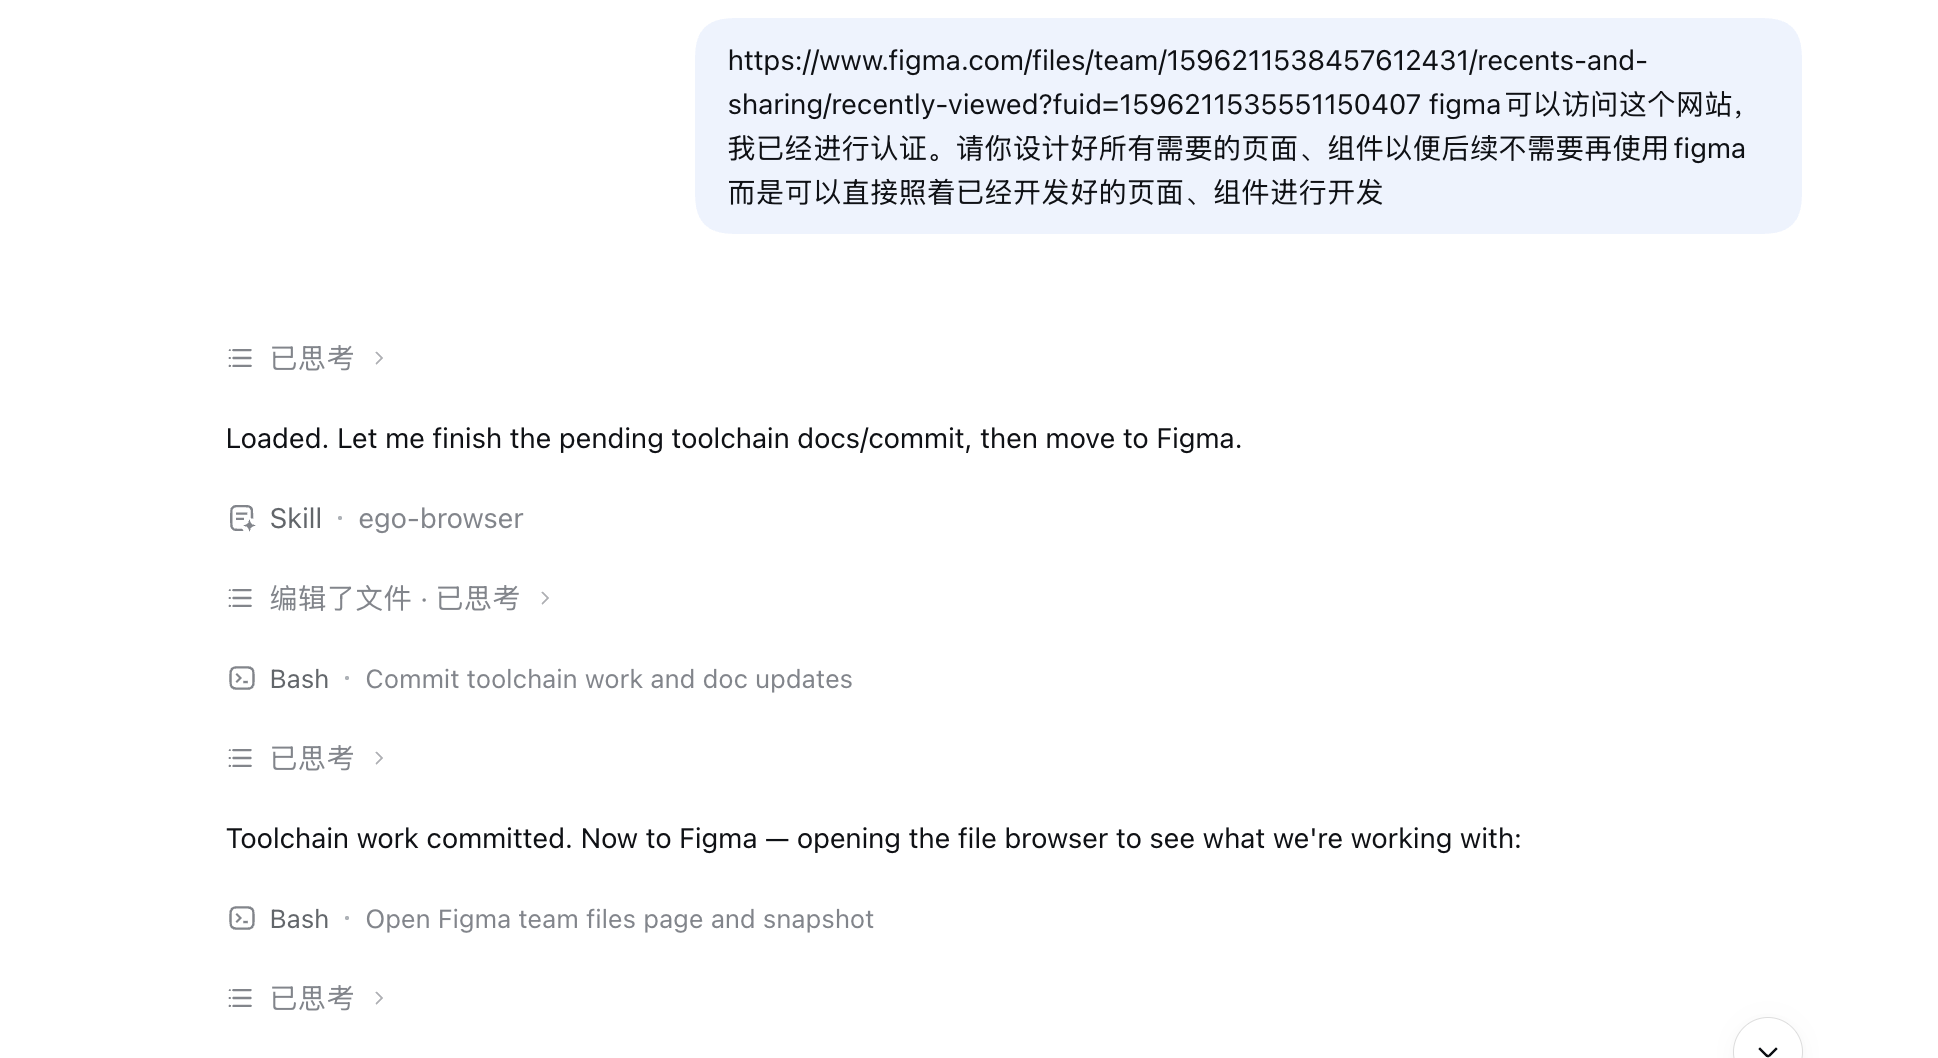
采纳:AI 提出的"发现层改用 CVF/ECVA 官方目录、关键词标注算法提取"(因 DBLP 被反爬拦截且无摘要)经我用 curl 逐条实测后采纳;脚本程序化生成设计系统 + 热区接线的方案被采纳并复用两版。
拒绝/修改:AI 最初用"字符数×常数"估文本宽度,中文全角普遍溢出——我要求改为先测量再排版;Figma API 的三处用法错误(textAlignHorizontal 枚举大小写、OVERLAY 必须顶层 Frame、reaction 参数限制)在人工复核中修正。
协作方式:主会话冻结契约后并行开工——主线程做 API(Express + node:sqlite + 抓取解析),同时派一个前端子代理按 Figma 导出帧实现五页。前端产出了统一 API client(错误码映射/Abort/INVALID_RESPONSE 兜底)、路由级懒加载(ECharts 不进首屏包)、走势逐帧读数卡等。
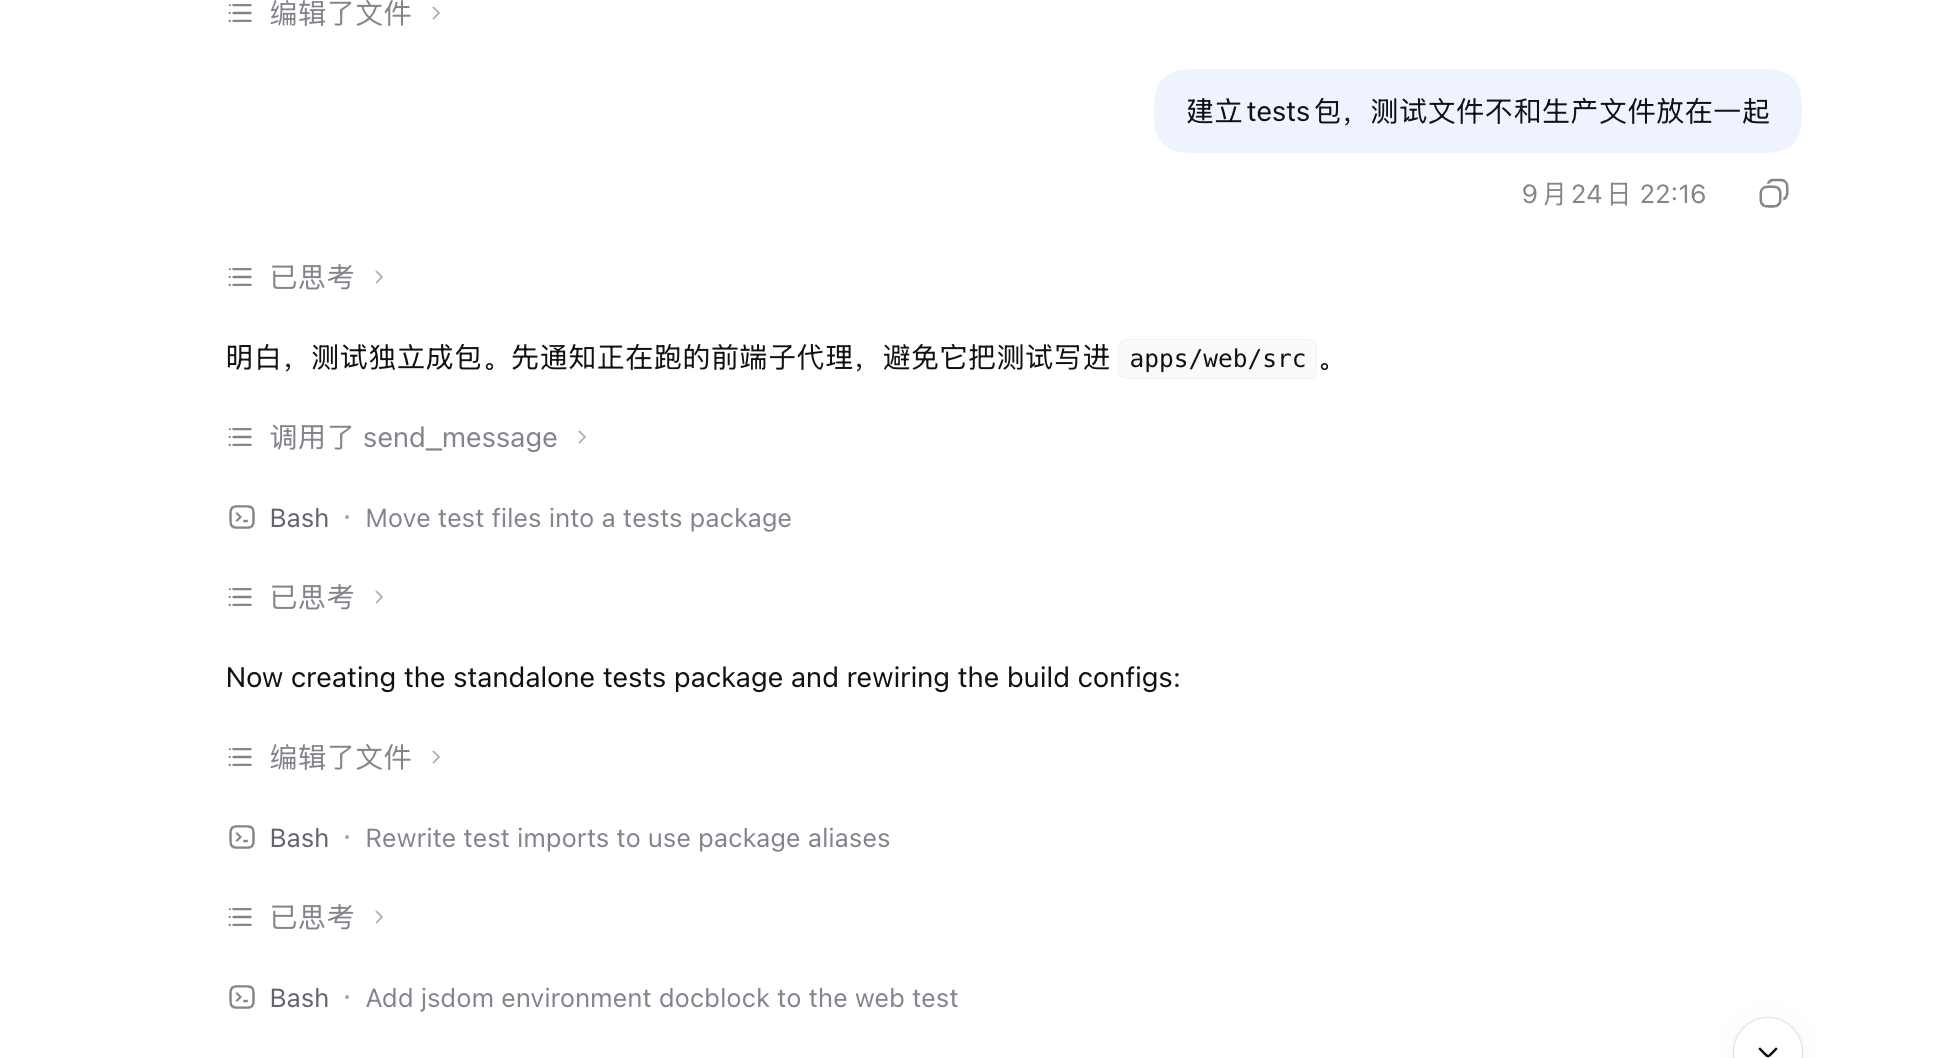
人工核验:typecheck/lint 过后逐条修掉 9 个 React Compiler 警告;发现前端 graph 请求传 limit 而服务端契约是 nodeLimit/edgeLimit 的类型漂移,改为正确参数——这正是"契约包 + 双端类型检查"要防的问题,AI 仍会犯,必须靠检查门兜住。
Bug 1(会话中断留下的脏行):DeepSeek Harness 会话在 replaceKeywords 中断时误删了一行 DELETE FROM paper_keywords WHERE paper_id = ?。恢复现场时用 git diff 定位:编辑论文传 keywords 时旧关键词只增不删。修复后做真实回归:创建 → PATCH 换关键词 → 确认旧词被替换 → 删除 → 404,全链路通过。
Bug 2(测试包依赖解析):测试独立成包后 tests/ 里解析不到 react-router-dom。AI 的分析是正确的:pnpm 不做依赖提升,依赖只存在于 apps/web/node_modules,从 tests/ 出发解析不到;按此结论给 tests 包补依赖、用路由型 mock 重写 4 条测试并新增 client 错误码测试,36 个测试全绿。
Bug 3(关键词质量):真实数据入 200 篇后,Top 10 里出现 benchmark、data、simple 这类泛词,还有跨标点拼出的伪短语("compared memory speed")。修复方案:n-gram 不跨子句标点、弱名词只允许参与短语、题名修辞性词(simple/worth/closer look 等)进泛词表;随后跑重算脚本(先自动备份 DB)重建全部关键词,复测 Top 10 全部变为真实研究方向(3d human pose / point clouds / 3d object detection…)。
curl 实测、浏览器逐页操作、36 个自动化测试、外网验收),博客中每个数字都来自实测或真实会话记录,没有编造。flowchart LR
U[浏览器 React 19 + Vite 8] -->|同源 /api| P[Nginx 反向代理]
P --> A[Express 5 API]
P --> S[静态产物 dist]
A --> D[(SQLite node:sqlite\n迁移/WAL/备份)]
A --> I[抓取与清洗 ingestion]
I --> C1[CVF 目录 CVPR/ICCV]
I --> C2[ECVA 目录 ECCV]
I -.被反爬拦截.-> DBLP[DBLP 书目]
A --> K[关键词抽取 v1 + 统计]
K --> D
apps/web React 19 / apps/api Express 5 / packages/contracts 共享类型);数据库用 Node 24 内置 node:sqlite(免原生编译,部署友好);图表 ECharts(按路由懒加载,首屏不载图表库)。127.0.0.1:3000),Nginx 把 /api/ 反代到 API、其余路径到静态产物并做 SPA 回退;SQLite 置于 /var/lib/cvscope/ 持久目录。| 会议年 | 官方目录条数 | 已入库 | 含摘要 |
|---|---|---|---|
| CVPR 2024 | 2715 | 50(抽样) | 50 |
| ICCV 2023 | 2156 | 50(抽样) | 50 |
| ECCV 2022 | 1645 | 50(抽样) | 50 |
| ECCV 2024 | 2387 | 50(抽样) | 50 |
canonical_key = 会议+年份+正规化题名 保证重复导入幂等。held=false 输出 null(断线显示"不举办"),未采集年份 rate 为空(显示"无数据")——绝不把缺失画成 0。| 问题 | 原因 | 解决方式 |
|---|---|---|
| DBLP 全站被 Anubis 拦截 | 反爬 + robots 全站禁抓 | 不绕过;发现层改走 CVF/ECVA 官方目录,博客与关于页如实说明 |
| 编辑论文关键词只增不删 | 会话中断误删 DELETE 行 | git diff 定位恢复 + 真实链路回归(增→改→删→404) |
| tests 包解析不到 react-router-dom | pnpm 不做依赖提升 | tests 包补开发依赖 + 测试统一走别名引用源码 |
| Top 10 出现 benchmark/data 等泛词 | 抽取器初版无弱名词过滤 | v1 修订(子句切段/弱名词/泛词/题名加权)+ 全库重算(重算前自动备份 DB) |
服务器 apt install nginx 找不到包 | Ubuntu 源列表过期 | apt-get update 后安装成功 |
以下均为仓库中的真实代码(节选),按调用链组织:契约 → 存储 → 抽取 → 统计 → 错误处理 → 前端。
前端图表与后端统计共用这一份真值,避免"前后端各自判断 ECCV 奇数年"的类型漂移:
export const CONFERENCE_CADENCE: Record<Conference, 'annual' | 'odd' | 'even'> = {
  CVPR: 'annual',
  ICCV: 'odd',
  ECCV: 'even',
};

export function isHeldIn(conference: Conference, year: number): boolean {
  const cadence = CONFERENCE_CADENCE[conference];
  if (cadence === 'annual') return true;
  return cadence === 'odd' ? year % 2 === 1 : year % 2 === 0;
}
SQLite 表结构在迁移里集中管理,重复迁移不破坏数据;会议字段用 CHECK 约束而不是靠前端自觉:
CREATE TABLE papers (
  id INTEGER PRIMARY KEY AUTOINCREMENT,
  canonical_key TEXT NOT NULL UNIQUE,
  title TEXT NOT NULL,
  normalized_title TEXT NOT NULL,
  conference TEXT NOT NULL CHECK (conference IN ('CVPR','ICCV','ECCV')),
  year INTEGER NOT NULL,
  abstract TEXT,
  paper_url TEXT,
  ...
);
设计思路:先切段、再组短语、按信息量打分、贪心去重。题名命中的短语按词数放大,避免高频弱词 "diffusion" 挤掉更具体的 "diffusion models";单字泛名词(model/image/data)不单独成词但可参与短语:
const scored: Candidate[] = [];
for (const candidate of candidates.values()) {
  const words = candidate.text.split(' ');
  const inTitle = titleSpans.has(candidate.text);
  const lengthBonus = words.length === 2 ? 1.5 : words.length === 3 ? 1 : 0;
  // 题名命中的短语比单词更有信息量,按词数放大,避免 "diffusion" 挤掉 "diffusion models"
  const score = (inTitle ? 4 * words.length : 0) + Math.min(candidate.score, 4) + lengthBonus;
  if (words.length === 1) {
    if (WEAK_UNIGRAM.has(candidate.text)) continue; // 单字泛名词不当关键词
    if (!inTitle && candidate.score < 2) continue; // 只在摘要里出现一次的单词太弱
  }
  scored.push({ ...candidate, score });
}

scored.sort((a, b) => b.score - a.score || b.text.length - a.text.length || a.text.localeCompare(b.text));

const chosen: Candidate[] = [];
for (const candidate of scored) {
  if (chosen.length >= limit) break;
  // 不重叠:避免同时输出 "diffusion" 与 "diffusion models"
  const overlaps = chosen.some((picked) => candidate.text.includes(picked.text) || picked.text.includes(candidate.text));
  if (overlaps) continue;
  chosen.push(candidate);
}
这是案例 C 修复的方法:先清空旧关联再写新集合,并清理不再被引用的词,保证统计不被旧词污染;重复词在一篇内只算一次:
replaceKeywords(paperId: number, keywords: KeywordInput[]): void {
  // 先清空旧关联再写新集合,否则编辑传 keywords 时旧词只增不删
  this.db.prepare('DELETE FROM paper_keywords WHERE paper_id = ?').run(paperId);
  const seen = new Set<string>();
  for (const keyword of keywords) {
    const normalized = normalizeKeyword(keyword.label);
    if (!normalized || seen.has(normalized)) continue; // 一篇里重复出现的词只算一次
    seen.add(normalized);
    const keywordId = existing?.id ?? insertKeyword(normalized, keyword.label);
    this.db
      .prepare('INSERT OR REPLACE INTO paper_keywords (paper_id, keyword_id, origin, weight) VALUES (?, ?, ?, ?)')
      .run(paperId, keywordId, keyword.origin, keyword.weight ?? 1);
  }
}
"不举办"与"没采到数据"是两种不同的缺失,都不能画成 0——这是本产品统计可信度的底线:
const held = isHeldIn(conference, year);
if (!held) {
  // 不举办:缺失值,不能画成 0
  points.push({ year, conference, held: false, count: null, sampleCount: null, rate: null });
  continue;
}
// …统计该会议年的样本量与命中论文数后:
points.push({
  year, conference, held: true,
  count: hit.total,
  sampleCount: sample.total,
  rate: sample.total > 0 ? hit.total / sample.total : null,
});
所有业务错误都是 {error:{code,message}},内部堆栈绝不返回给客户端:
export function sendError(response: Response, error: unknown): void {
  if (error instanceof ApiError) {
    response.status(error.status).json({ error: { code: error.code, message: error.message } });
    return;
  }
  // 不把内部堆栈返回给客户端
  console.error('[api] unexpected error', error);
  response.status(500).json({ error: { code: 'INTERNAL', message: '服务内部错误' } });
}
全站唯一的 HTTP 入口,网络层失败、非 JSON 响应、服务端错误体、用户取消四类情况都有明确归宿:
async function request<T>(path: string, options: RequestOptions = {}): Promise<T> {
  const url = `${API_PREFIX}${path}${buildQuery(options.query)}`;
  let response: Response;
  try {
    response = await fetch(url, { method: options.method ?? 'GET', signal: options.signal, /* … */ });
  } catch (cause) {
    if (isAbortError(cause)) throw new ApiError('ABORTED', CODE_TO_MESSAGE.ABORTED, 0);
    throw new ApiError('NETWORK', CODE_TO_MESSAGE.NETWORK, 0);
  }
  // …读取文本并 JSON.parse,非 JSON 兜底 INVALID_RESPONSE…
  if (!response.ok) throw toApiError(response.status, payload);
  if (payload === null) throw new ApiError('INVALID_RESPONSE', CODE_TO_MESSAGE.INVALID_RESPONSE, response.status);
  return payload as T;
}
export function normalizeKeyword(label: string): string {
  return label
    .normalize('NFKC')
    .toLowerCase()
    .replace(/[^a-z0-9\u4e00-\u9fff+#.]+/g, ' ')
    .trim()
    .replace(/\s+/g, ' ');
}
这次结对作业和我以往写课程作业最大的不同:写代码的时间变短了,"审查 AI"的时间变长了。三次真实会话里,AI 在几分钟内给出的 API 骨架、解析器和前端页面,我过去要写一整天;但 AI 也会把接口参数写漂移(limit vs nodeLimit/edgeLimit)、会留下被截断的半成品代码、会在真实数据上暴露抽取规则的漏洞——如果照单全收,这些问题全部会流到演示现场才爆发。
我最后的做法是把"人的位置"固定在四件事上:冻结契约(接口先于实现,双 AI 并行也不漂)、跑真实数据(Top 10 一出现泛词立刻暴露抽取器问题)、外网验收(部署后用无痕浏览器逐页走查)、只提交真实的东西(22 个 commit 每个都能讲清楚做了什么)。AI 给的是初稿和速度,判断与责任仍然是人的——这也正是《构建之法》第 4 章里结对编程"驾驶员-领航员"关系的AI版:AI 是不知疲倦的驾驶员,但我必须始终坐在领航员的位置上。
最大的教训是一次时间管理:低估了"真实数据闭环"的复杂度(数据源被拦截、目录解析、抽样限速),导致最后压缩交付。PSP 表 595→710 的偏差说明:预估必须给"返工"和"环境踩坑"留出 20% 余量,这个 19% 的偏差本身就是本次作业教给我的最贵一课。
deepseek-v4.1-flash(DeepSeek Harness):产出密度极高,且子代理并行编排(主会话做 API、子代理照 Figma 写前端)真实地压缩了关键路径。局限也很典型:中断恢复时会留下半成品(正是案例 C 的 Bug 1 来源),对"估宽度"这类看似简单的操作会给出系统性错误方案,需要人工给出"先测量再排版"的硬约束。它最大的优点是在被指出后能给出准确的根因分析——pnpm 依赖提升、Figma API 锚点语义,都一次讲透。
GLM-5.3-flash(ZCode):擅长"接手烂摊子":从会话日志恢复现场、只读侦察并行铺开、把恢复出的缺陷逐个修复并做实景回归;在收尾核验阶段用双端截图与 curl 逐条对验收,把"文档说了"和"系统真的会"区分开。不足是它同样不能代替人的判断:比如它明确提出"不能伪造提交时间戳",最终是我确认了这个决定——AI 能把风险讲清楚,但守规矩的最终决定仍是人的责任。
与传统人人结对的异同:AI 结对没有情绪、没有时区、随叫随到,产出速度极快;但它不会主动质疑需求,也会自信地写错——所以"持续 Code Review + 真实测试门"必须由人搭好。人人结对的价值在相互提醒与共同担责,AI 结对里"担责"完全落在人这边,因此人的审查纪律比传统结对更重要,而不是更不重要。
dev 分支与 v1.0.0 标签已推送
