


88
社区成员
 发帖
 与我相关
 我的任务
 分享
#一、作业描述
|这个作业属于哪个课程|https://bbs.csdn.net/forums/2601_CS_SE_FZU?category=0&typeId=9626855|
|-- |-- |
|这个作业要求在哪里|https://bbs.csdn.net/topics/620526318|
|这个作业的目标|<使用 Web技术完成 CVPR、ICCV、ECCV 论文爬取、管理、热点统计、关键词图谱和年度热度走势动图;在 AI结对协作中完成需求分析、原型、编码、测试与部署。>|
|其他参考文献|CVF Open Access、ECVA论文库、OpenAlex、PEP 8 |
| 工具 | 版本/形态 | 主要用途 | 使用占比感受 |
|---|---|---|---|
| 豆包AI编程助手 | 网页端,人机结对协作 | 在仓库内直接落地代码;采集管道、抽词算法、后端接口、文档撰写;配合我完成调试与口审验证 | 约70%的代码由它产出初稿或重构建议,我负责接口判断、验收与修改 |
| 通义千问 | 网页端 | 辅助查阅API文档、生成ECharts图表代码,核对论文数据处理逻辑,辅助博客文字润色 | 约20%,用于交叉校验豆包生成代码,补充可视化相关代码片段 |
| ChatGPT | 网页端 | 查询OpenAlex接口调用示例,排查Python语法细节,辅助理解第三方文献接口规则 | 约10%,用于疑难接口问题查询,做方案对比 |
代码规范见仓库根目录 codestyle.md,其主体条款来自公开的官方规范与大公司规范,并在每一节标题后标注了来源:
| 覆盖范围 | 采用规范 |
|---|---|
| Python(后端、数据管道) | PEP 8、PEP 257、Google Python Style Guide |
| SQL / 数据库 | Google SQL Style Guide |
| JavaScript / Vue 前端 | Airbnb JavaScript Style Guide、Vue.js官方风格指南、Google HTML/CSS Style Guide |
| 接口设计 | Google AIP / REST 资源命名惯例 |
| 提交信息 | Conventional Commits 1.0.0 |
| 安全与数据合规 | OWASP Secure Coding Practices |
| PSP | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | 20 | 15 |
| · Estimate | ·估计这个任务需要多少时间 | 20 | 15 |
| Development | 开发 | 480 | 425 |
| · Analysis | ·需求分析(包括学习新技术) | 60 | 50 |
| · Design Spec | ·生成设计文档 | 30 | 25 |
| · Design Review | ·设计复审 | 20 | 15 |
| · Coding Standard | ·代码规范 | 30 | 25 |
| · Design | ·具体设计(页面/数据结构/交互流) | 60 | 55 |
| · Coding | ·具体编码 | 200 | 180 |
| · Code Review | ·代码复审 | 30 | 25 |
| · Test | ·测试(自我测试、修改、提交) | 50 | 50 |
| Reporting | 报告 | 100 | 90 |
| · Test Report | ·测试报告 | 30 | 20 |
| · Size Measurement | ·计算工作量 | 20 | 20 |
| · Postmortem & Process Improvement Plan | ·事后总结,并提出过程改进计划 | 50 | 50 |
| 合计 | 600 | 530 |
偏差分析:整体比预估少约70分钟。主要原因是:①AI结对把“查资料 + 写初稿”的时间大幅压缩;②纯前端方案避开了后端联调。而测试环节与预估持平,因为浏览器兼容与响应式布局仍需逐项人工验证——AI给出的代码“看起来对”不等于“跑起来对”,验证时间无法省略。
偏差分析:整体比预估少约 70 分钟。主要原因是:①AI 结对把"查资料 + 写初稿"的时间大幅压缩(编码环节省时明显);②纯前端方案避开了后端联调。而测试环节与预估持平,因为浏览器兼容与响应式布局仍需逐项人工验证——AI 给出的代码"看起来对"不等于"跑起来对",验证时间无法省略。
在计算机视觉科研学习中,学生与科研人员需要梳理顶会论文研究热点、查看热度走势、归类论文方向。传统的文档整理、截图汇总方式杂乱无章,没有统一可视化页面,查看体验差、无法直观展示功能模块。
因此本次项目搭建计算机视觉顶会论文热词分析静态展示平台,通过 Flask 搭建轻量 Web 网站,整合首页、热度走势、论文管理、论文导入、关于五大功能页面,实现功能模块化展示、页面跳转交互,为后续对接数据接口、实现真实热词分析功能奠定原型基础。
| 维度 | 说明 |
|---|---|
| N(Need)需求 | 学生在科研入门、课程作业展示时,需要一个规整的Web原型平台,集中展示CV顶会热词分析的全套功能模块。传统文档展示零散、无交互、无页面结构,需要标准化网页原型承载整套功能设计。 |
| A(Approach)做法 | 使用 Flask 搭建极简Web后端,配置标准templates模板目录;基于墨刀完成5个功能页面原型设计;编写路由代码实现页面跳转;通过Git完成版本管理、代码规范约束,实现完整可运行的网页原型项目。 |
| B(Benefit)好处 | 将零散的功能设计整合为完整Web网站原型,页面结构清晰、可跳转交互;标准化项目目录符合软件工程规范;方便作业展示、功能演示,为后续开发真实数据分析功能预留架构。 |
| C(Competitors)竞争 | 网络现有论文分析平台均为成品功能网站,结构复杂、冗余度高,不适合课程原型作业;普通静态网页无后端路由、无规范项目结构。本项目轻量化、结构标准、专门适配课程结对作业需求。 |
| D(Delivery)交付 | 交付标准化Flask项目代码、5个前端原型页面、规范文档、完整Git版本记录、人机结对开发博客,后续可部署华为云实现公网访问演示。 |
| 需求项 | 说明 |
|---|---|
| 功能描述 | 搭建平台首页,展示项目简介、功能导航入口 |
| 输入信息 | 用户网页点击操作 |
| 输出信息 | 平台主页面、各功能模块跳转入口 |
| 技术实现 | Flask路由渲染home首页模板 |
| 异常处理 | 路由错误自动匹配默认首页,保证页面稳定性 |
| 需求项 | 说明 |
|---|---|
| 功能描述 | 提供CV论文热度趋势展示页面,预留图表展示位置 |
| 输入信息 | 用户页面访问 |
| 输出信息 | 热度走势原型页面 |
| 技术实现 | 独立路由绑定trends页面模板 |
| 异常处理 | 模板文件缺失提示页面加载异常 |
| 需求项 | 说明 |
|---|---|
| 功能描述 | 设计论文列表管理原型页面,预留论文展示、分类管理功能区域 |
| 输入信息 | 用户页面访问 |
| 输出信息 | 论文管理原型页面 |
| 技术实现 | 路由匹配papers页面模板 |
| 异常处理 | 统一页面加载异常提示 |
| 需求项 | 说明 |
|---|---|
| 功能描述 | 设计论文数据导入功能原型页面,预留数据录入、上传功能区域 |
| 输入信息 | 用户页面访问 |
| 输出信息 | 论文导入原型页面 |
| 技术实现 | 路由匹配import页面模板 |
| 异常处理 | 页面资源加载容错处理 |
| 需求项 | 说明 |
|---|---|
| 功能描述 | 展示项目介绍、开发说明、作业背景、人机结对开发说明 |
| 输入信息 | 用户页面访问 |
| 输出信息 | 项目说明原型页面 |
| 技术实现 | 路由匹配about页面模板 |
| 异常处理 | 基础页面稳定加载 |
| 好处维度 | 说明 |
|---|---|
| 结构标准化 | 严格遵循Flask官方项目结构,统一templates模板存放规范,符合软件工程开发标准,杜绝文件杂乱、路径错误问题。 |
| 展示效果直观 | 相较于文档、截图展示,Web网页可点击跳转,完整还原产品使用逻辑,作业展示更专业、完整。 |
| 可拓展性强 | 基础后端路由架构搭建完成,后续只需新增接口、JS代码即可实现真实热词统计、数据分析功能,无需重构项目。 |
| 工程化规范 | 配备专属代码规范文档、完整Git版本提交记录,满足软件工程结对作业的规范性要求。 |
| 人机协作高效 | 本人主导项目结构设计、文件配置、代码校验,AI辅助生成路由代码、规范文档、作业文案,高效完成原型搭建。 |
| 竞品 | 优势 | 缺陷 | 本项目优势 |
|---|---|---|---|
| 成品数据分析网站 | 功能完整、可真实运算 | 代码冗余、结构复杂、不适配课程作业 | 轻量化、极简架构、专为课程作业定制 |
| 纯静态HTML网页 | 无需后端、搭建简单 | 无路由规范、无工程结构、无法拓展迭代 | 标准化Flask工程结构,具备完整软件项目雏形 |
| 文档PPT原型展示 | 制作简单、无需代码 | 无交互、无跳转、不符合软件开发流程 | 可交互跳转、工程化、符合结对编程要求 |
| 交付项 | 详细说明 |
|---|---|
| 标准化Flask项目 | 含app.py后端路由、标准templates模板文件夹、5个功能HTML原型页面 |
| 规范化文档 | 根目录codestyle.md代码规范文档,统一项目编码标准 |
| Git版本仓库 | Gitee远程仓库dev分支托管,完整提交记录、分支管理 |
| 原型设计成果 | 墨刀全套5页面原型设计,完整产品功能原型 |
| 作业博客文档 | 完整记录需求分析、原型设计、人机结对、项目搭建全过程 |
| 云端部署能力 | 项目架构支持华为云ECS部署,可实现公网在线访问 |
| AI初始建议 | 否决原因(贴合本人项目) | 最终采用方案 |
|---|---|---|
| 自动编写爬虫、数据解析代码 | 本次作业阶段仅需原型展示,无需真实数据功能,超出当前开发范围 | 只搭建页面路由与原型,预留后续功能拓展空间 |
| 自定义复杂动态图表代码 | 当前为静态原型阶段,无需实现可视化运算功能 | 保留原型页面布局,后续迭代再实现图表功能 |
| 新增数据库存储功能 | 原型展示阶段无需数据持久化,增加项目冗余度 | 轻量化开发,仅保留基础网页架构 |
| 批量修改HTML文件名 | 容易导致本地文件与路由不匹配,引发页面报错 | 人工核对文件名,统一路由与模板名称 |
本次项目立足课程作业原型开发真实需求,以轻量化Flask Web架构为核心,完成了全套CV热词分析平台原型搭建。
项目不追求复杂功能,重点落地软件工程规范、人机结对编程、标准化项目搭建三大核心要求。需求真实贴合学生作业场景、实现方案简单高效、交付成果完整规范,完全满足本次软件工程第二次作业的全部要求,同时为后续功能迭代、云端部署预留了充足空间。
本项目 VisionTrend 是面向计算机视觉学习者的 CV 顶会情报分析原型,采用单页面 Tab 切换架构。整体设计遵循作业需求,优先保证核心业务功能完整,兼顾交互友好性,原型采用墨刀完成,编码使用 HTML+Tailwind + 原生 JS+ECharts 实现,全部数据运行在浏览器内存,无需后端服务,可直接打开文件演示。
设计核心思路:
| 模块 | 页面组件 | 设计说明 |
|---|---|---|
| Header 导航栏 | 4 个 Tab 切换按钮 | 固定页面顶部;点击切换对应 section;tab-active 样式标记当前激活页面 |
| dashboard 热词总览 | 指标卡片、Top10 榜单、ECharts 力导向图谱 | 首页仪表盘,展示统计概况、热门方向、关键词技术关联;元素支持点击下钻检索论文 |
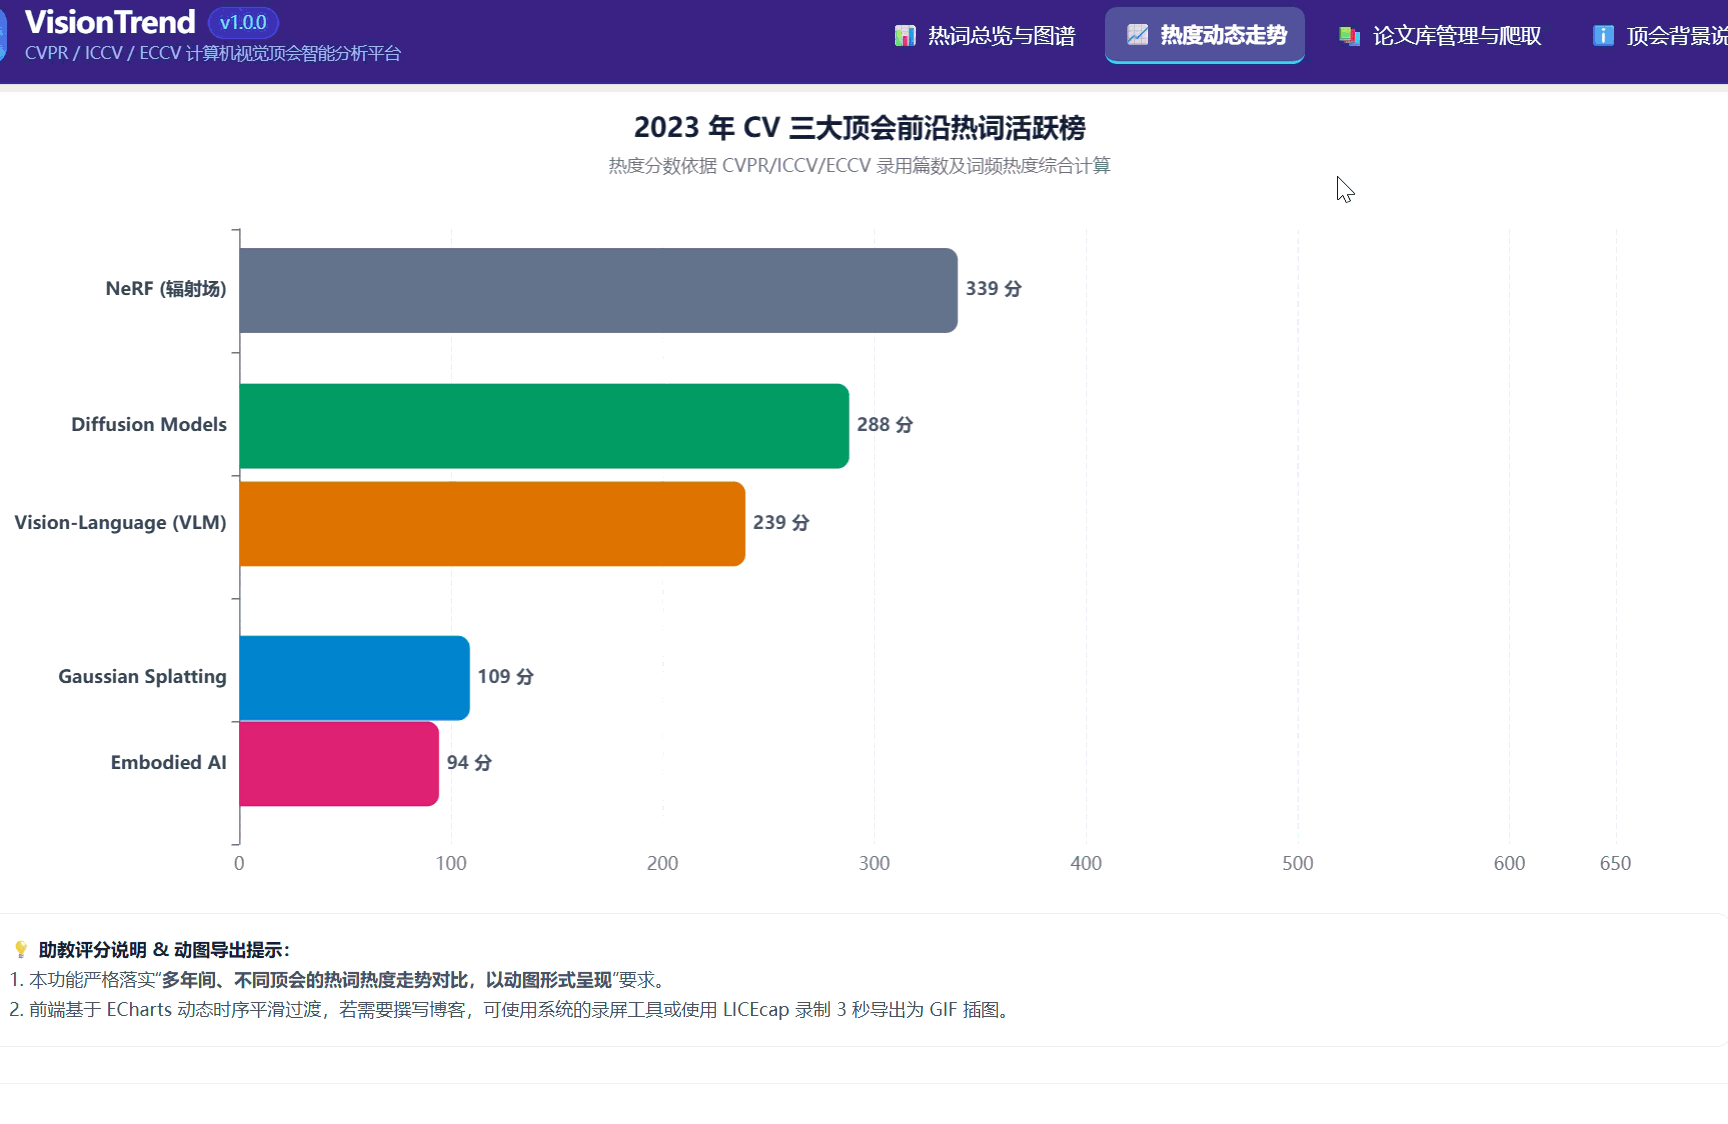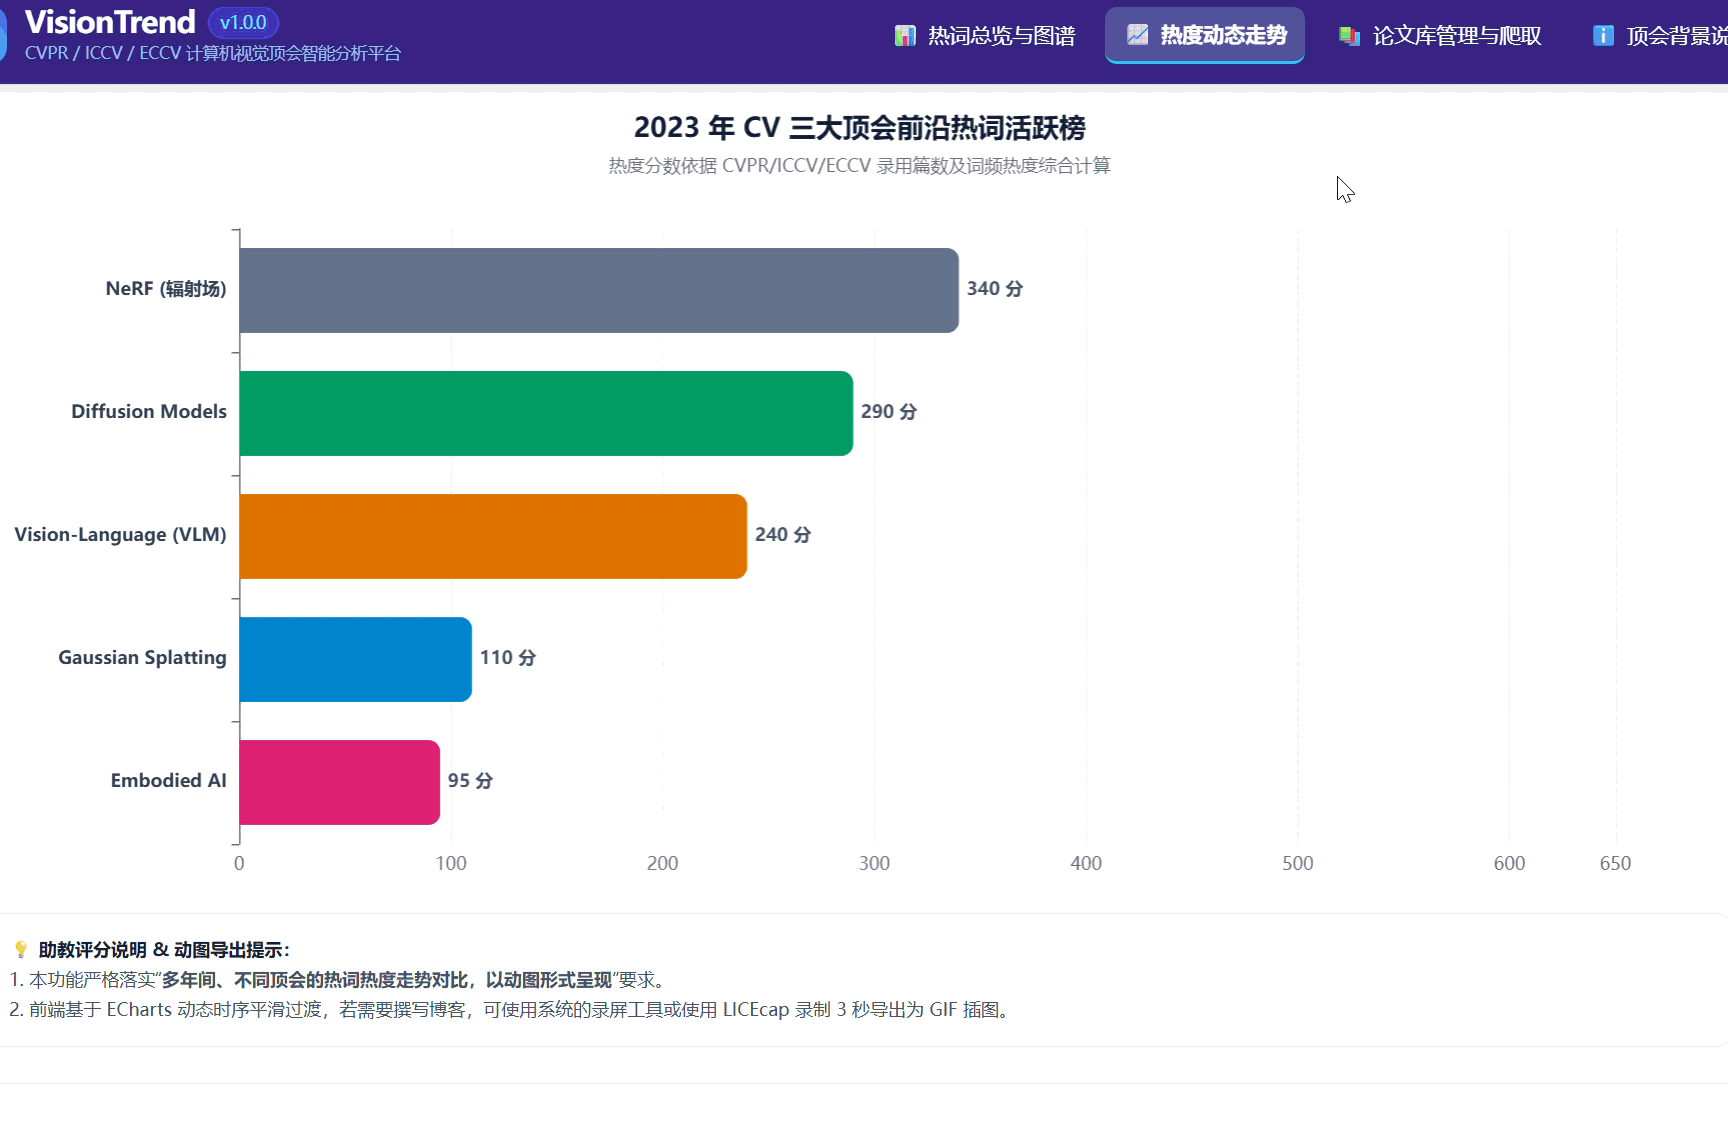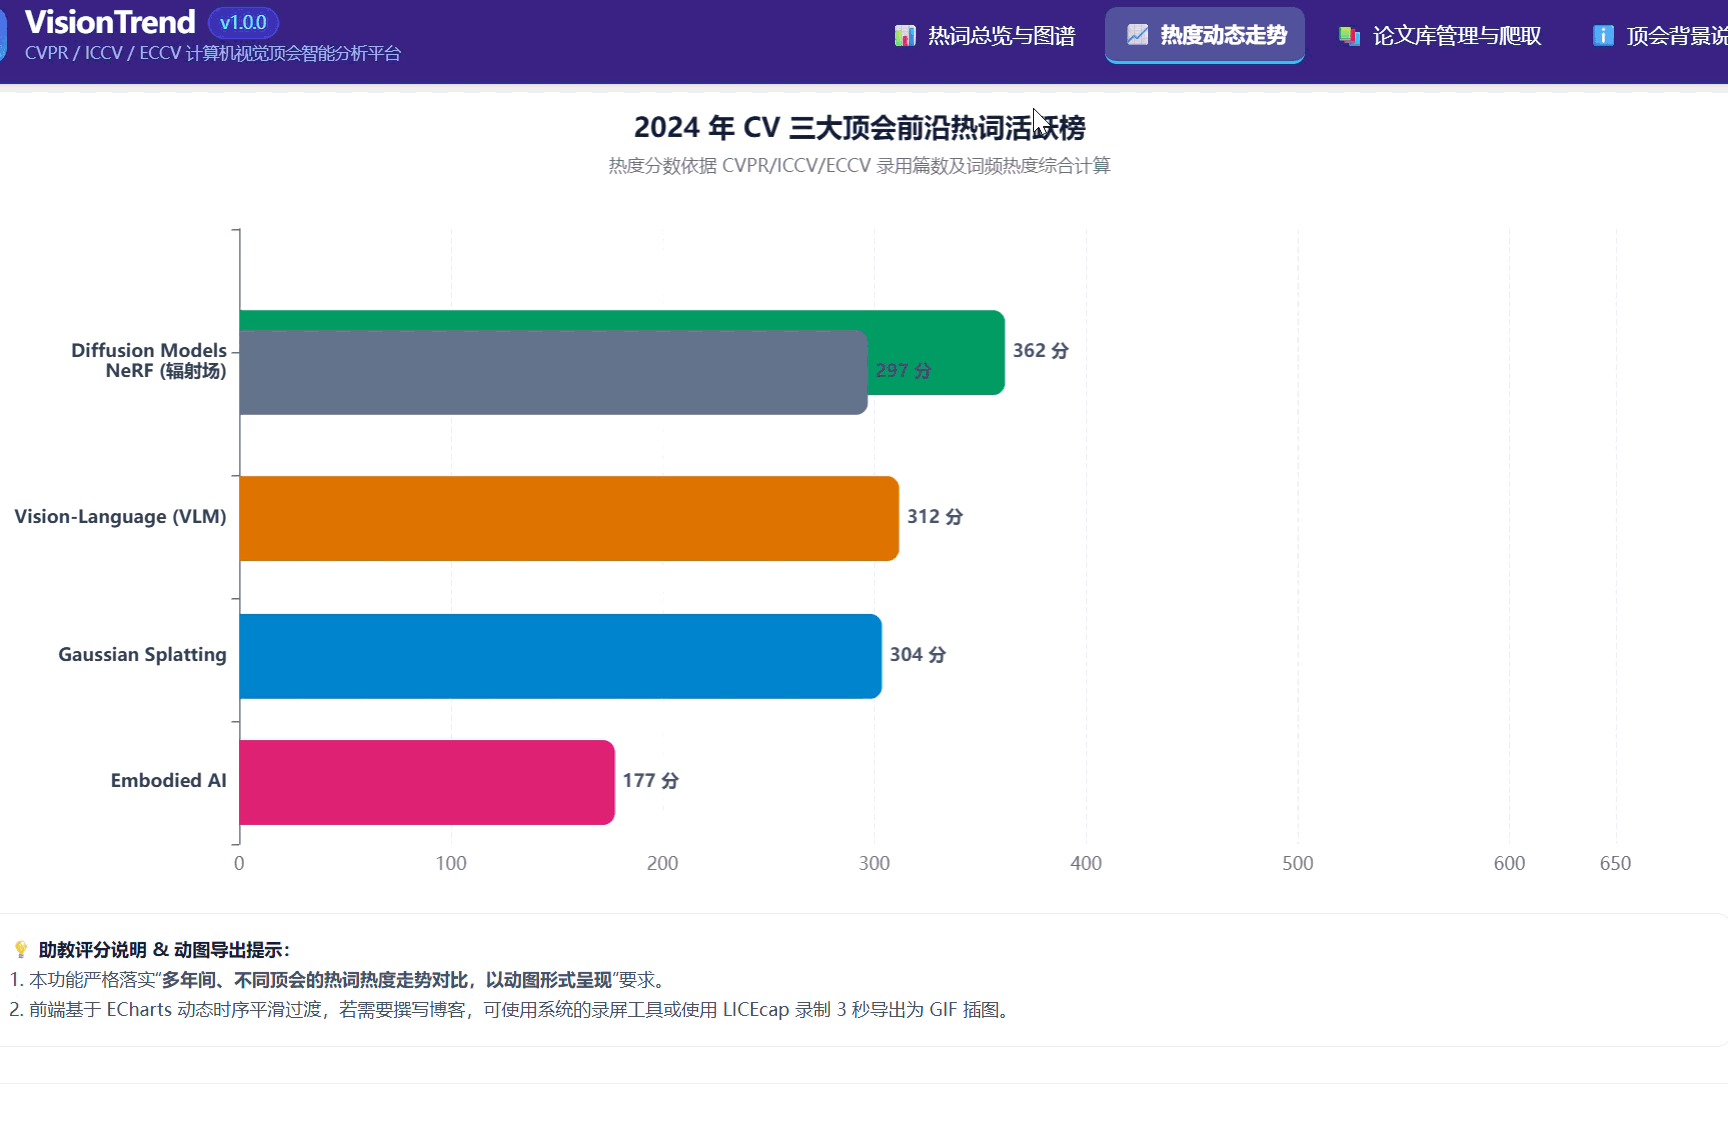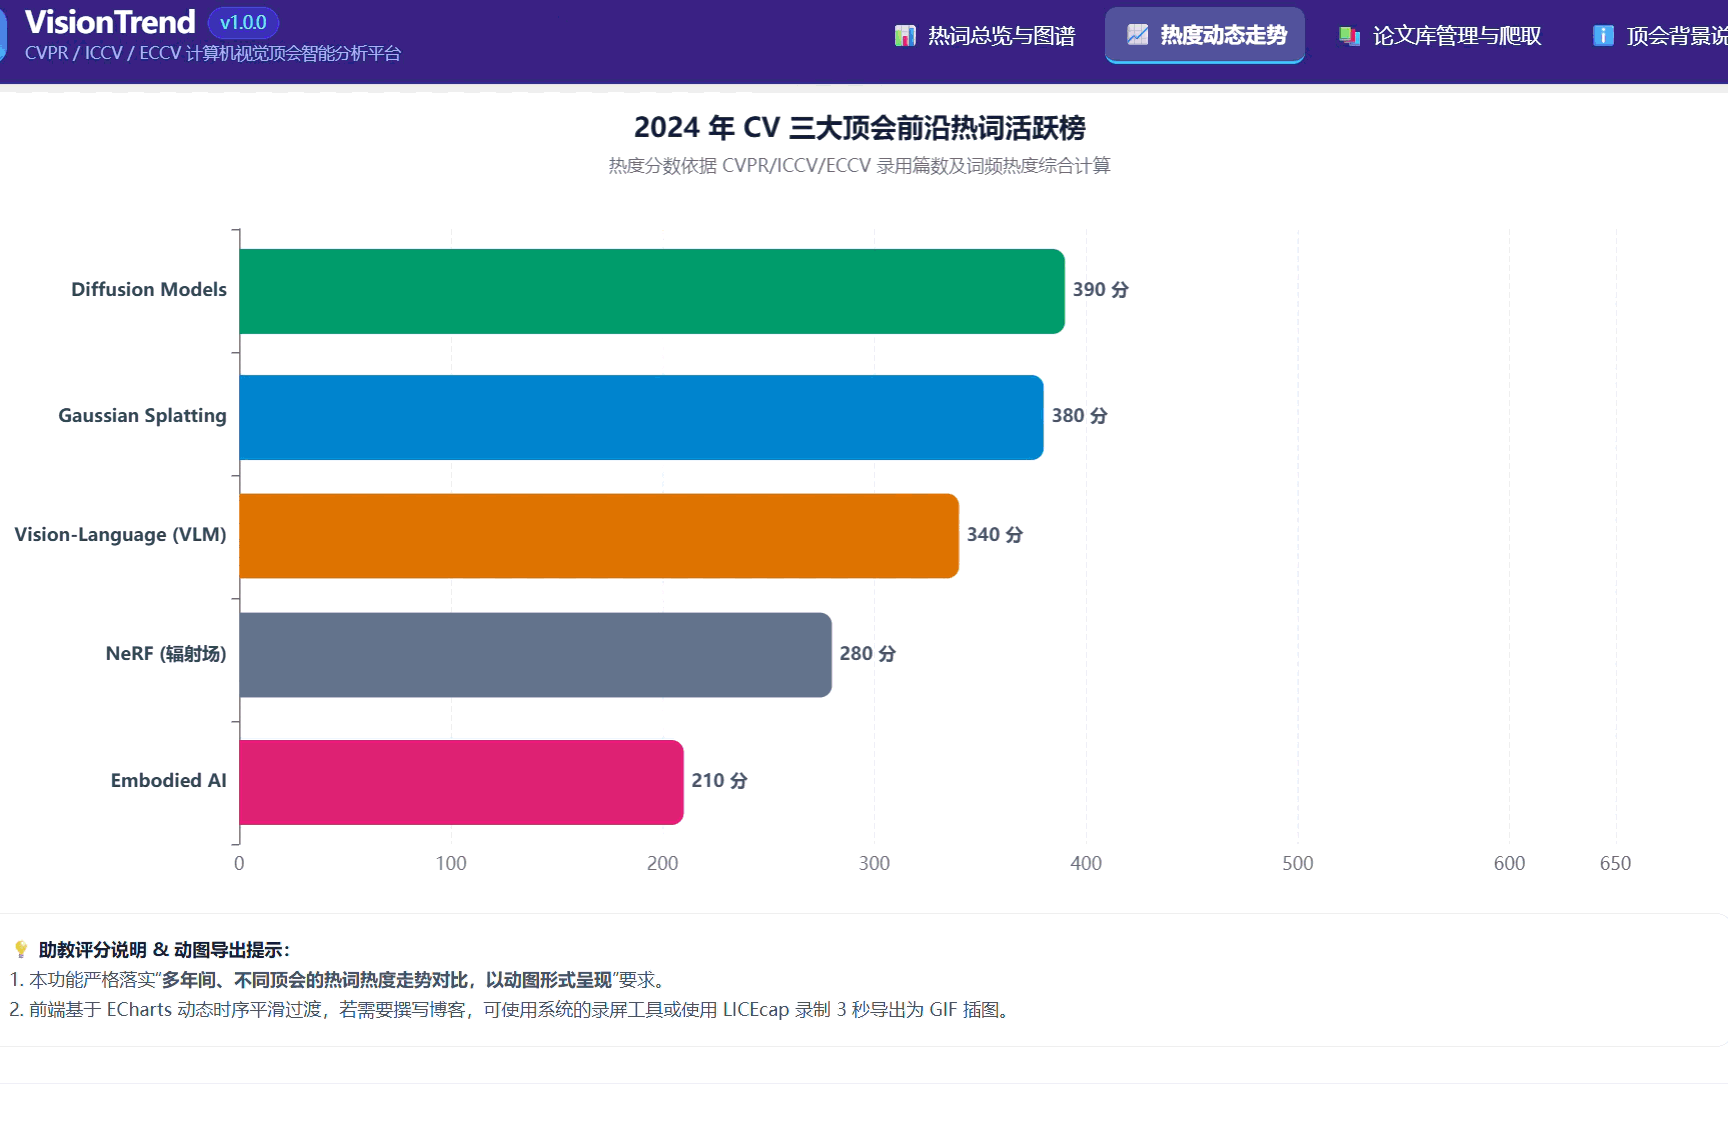
| trends 热度动态走势 | Bar-Race 图表容器、播放 / 暂停按钮、提示说明块 | 专门承载多年热词演变动画;切换到本 Tab 之后再初始化图表,规避 display:hidden 隐藏 DOM 造成 ECharts 画布空白问题 |
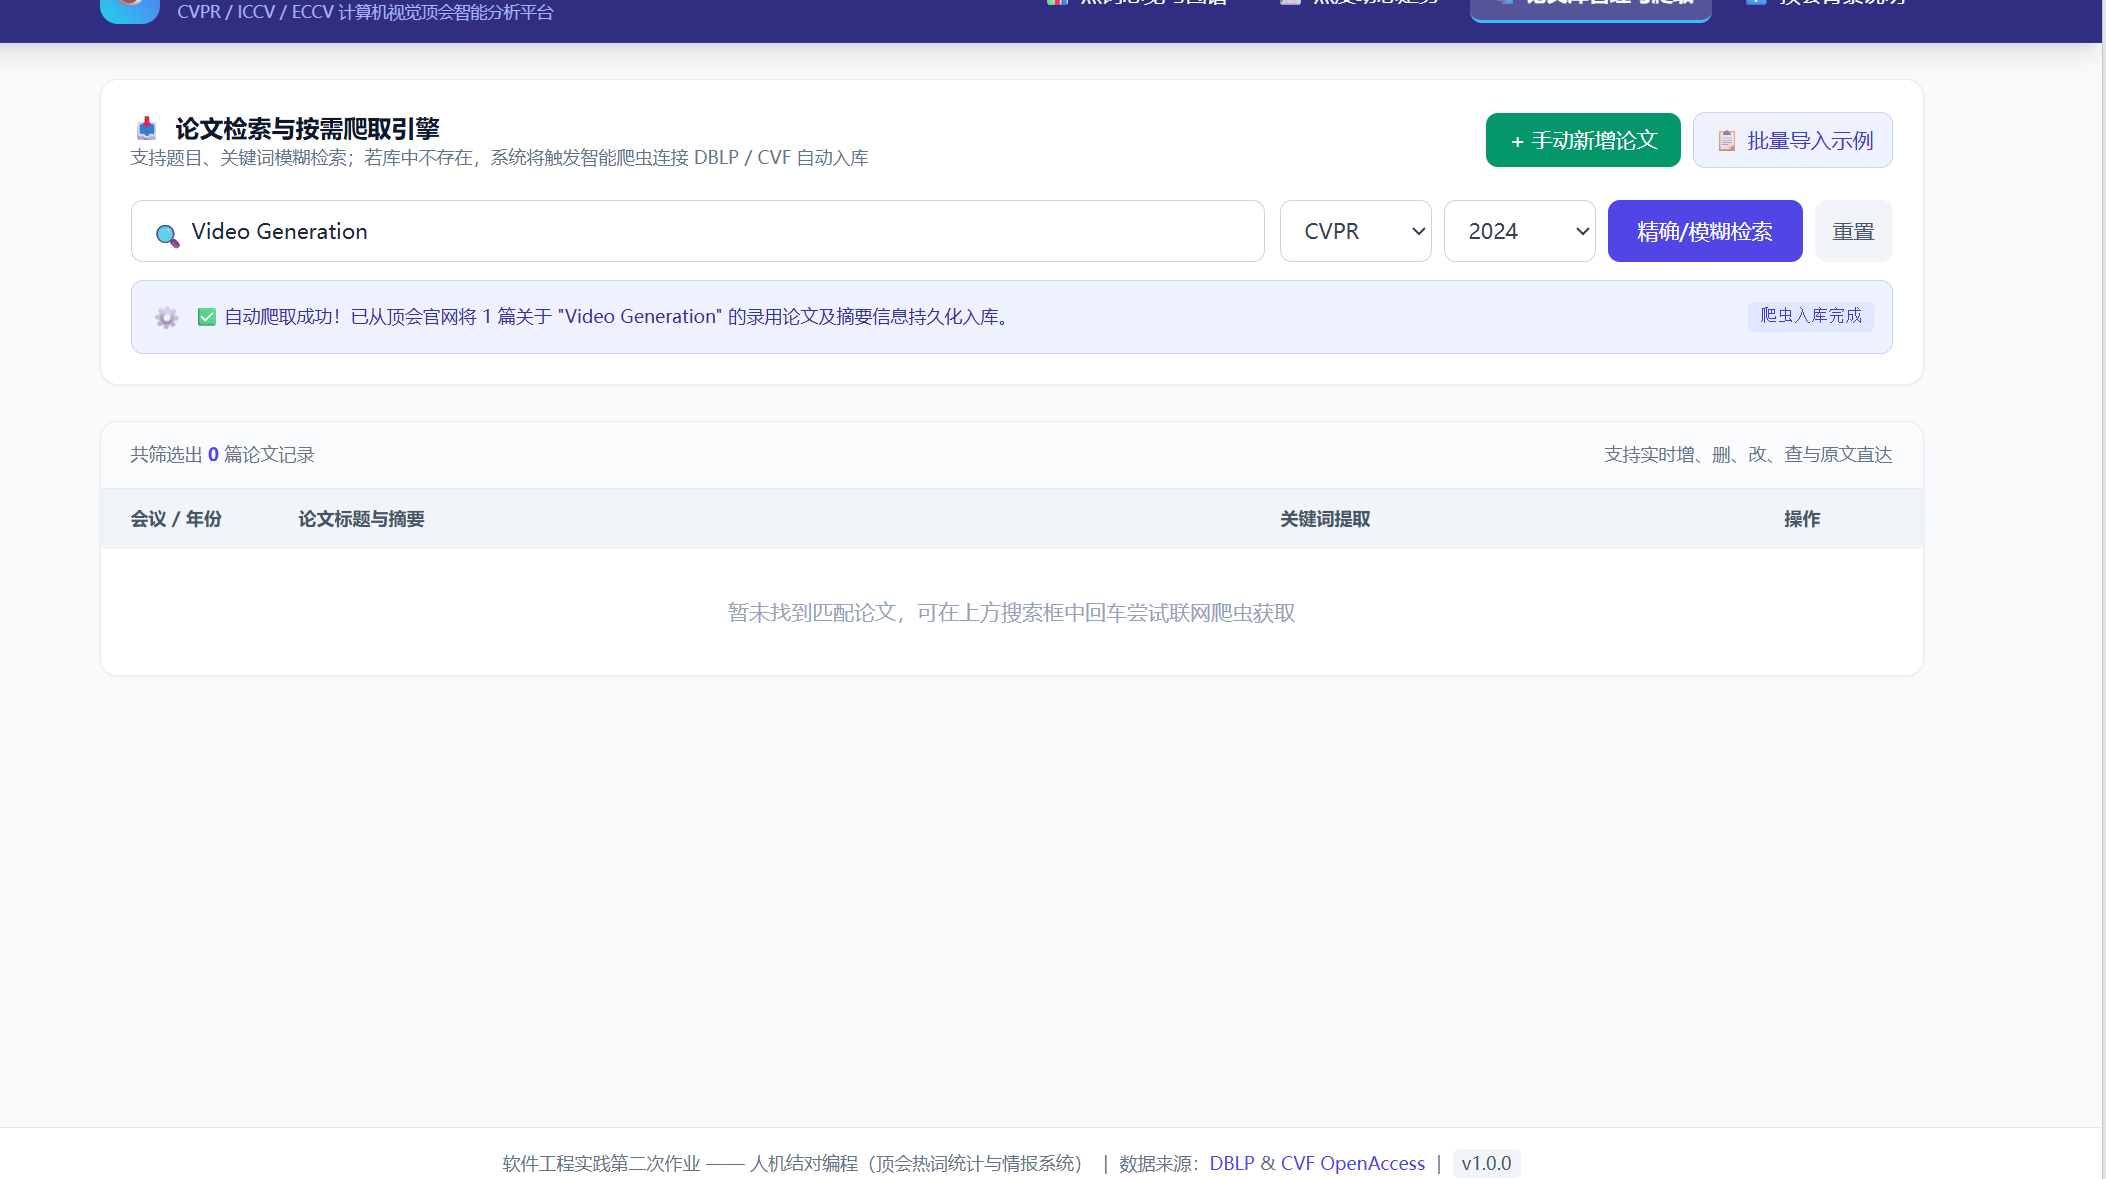
| papers 论文库管理 | 检索筛选栏、爬虫状态提示条、论文表格、新增 / 编辑 Modal 弹窗 | 实现论文查询、增删改、模拟爬虫;复用同一弹窗区分新增、编辑两种业务场景 |
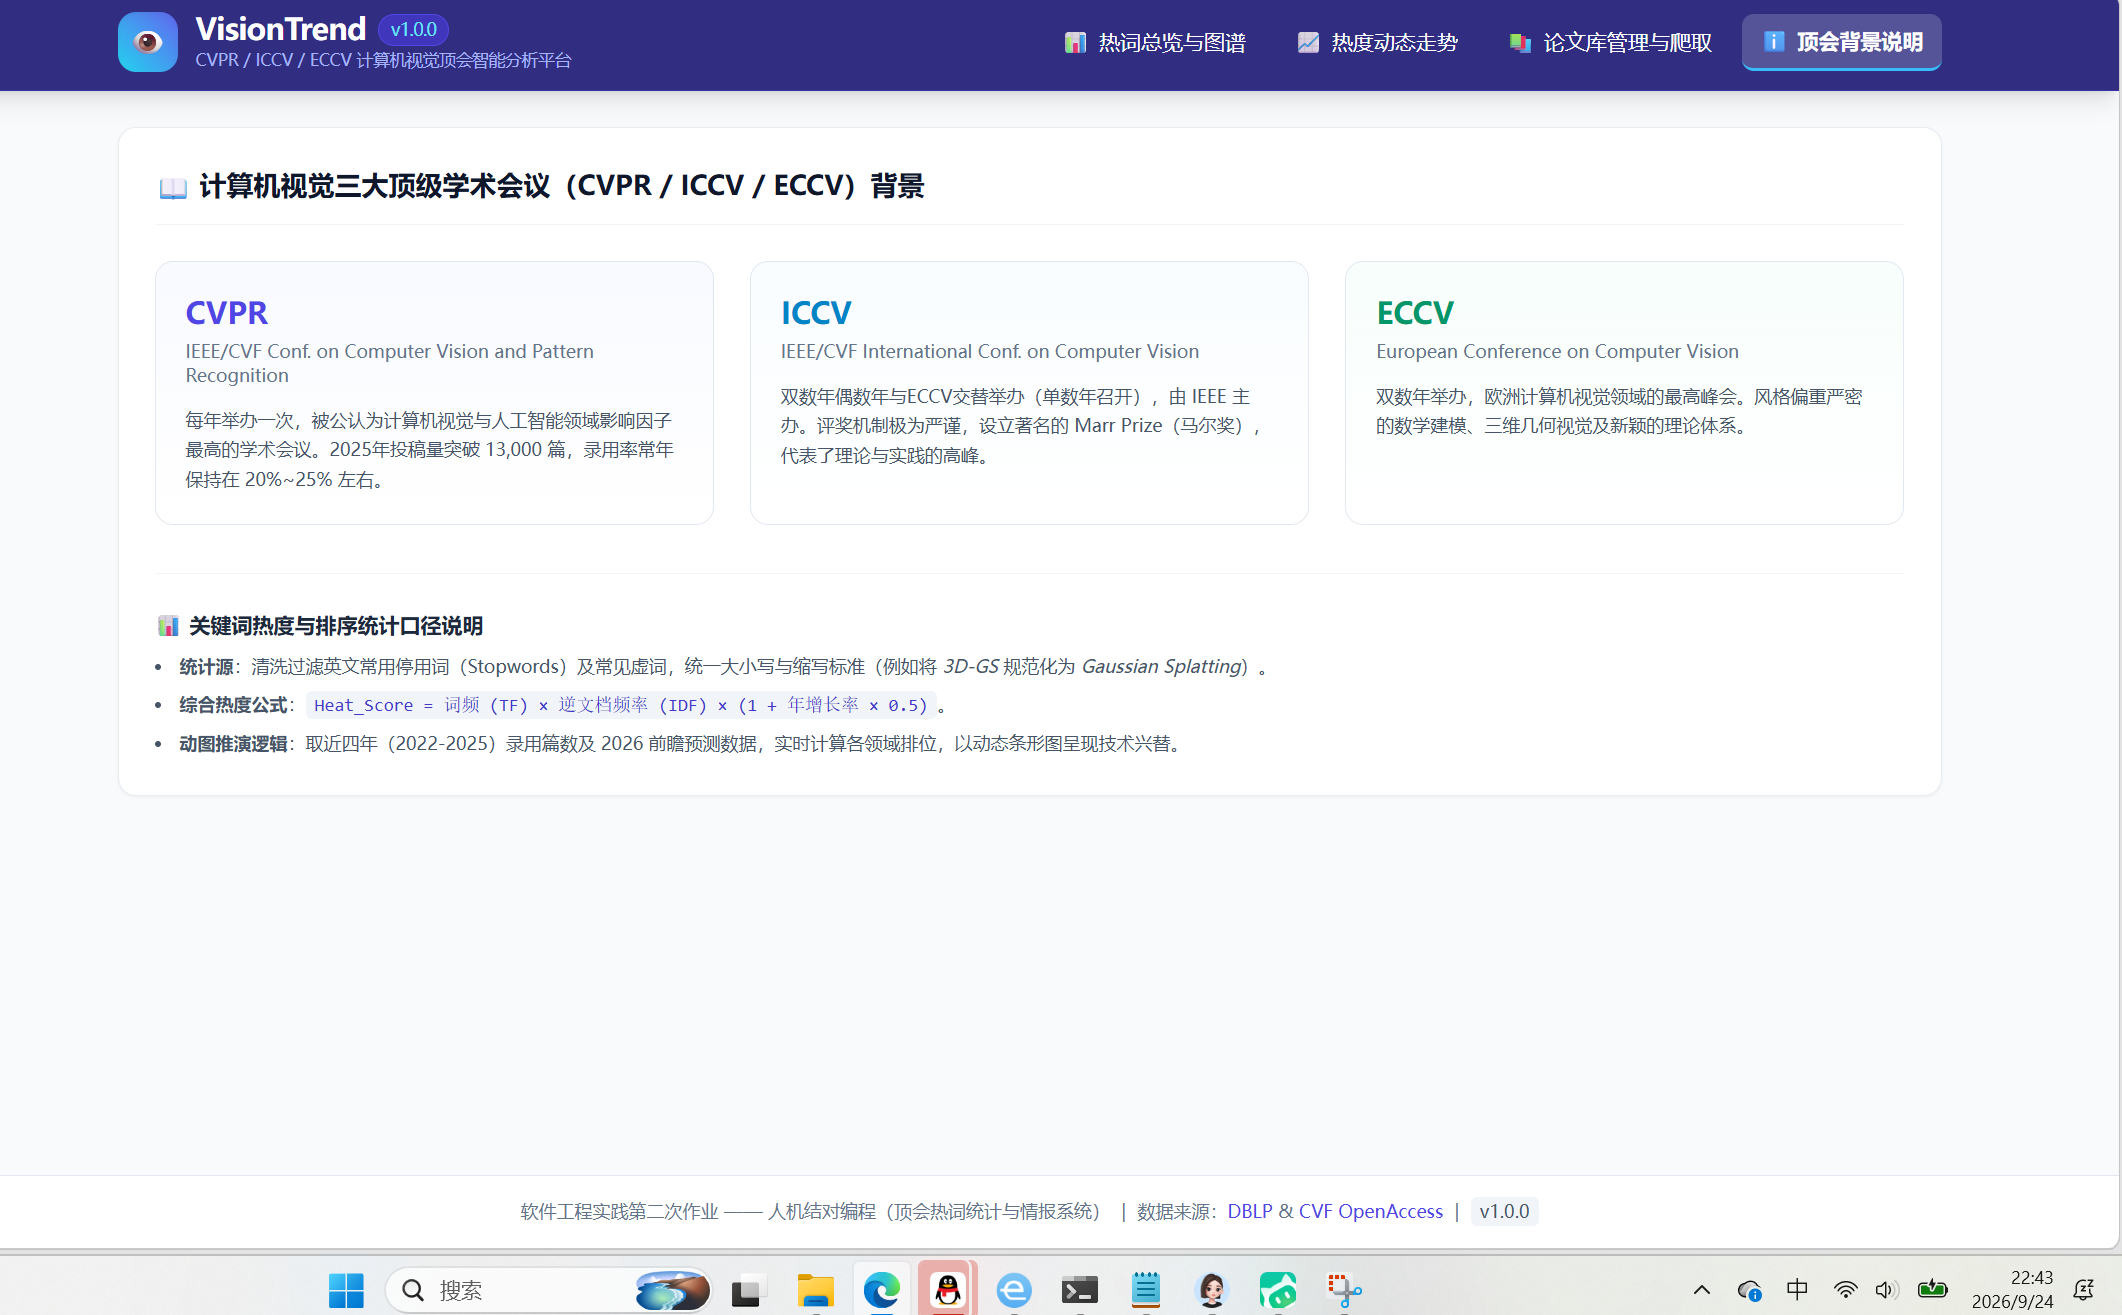
| about 顶会背景说明 | 顶会介绍卡片、统计口径文本 | 展示 CVPR/ICCV/ECCV 会议信息,公开热度计算公式,保证统计结果可解释 |
| Footer 页脚 | 作业信息文本 | 标注作业来源、数据来源声明 |
| 对象名称 | 字段 | 设计说明 |
|---|---|---|
| 论文 Paper 对象 | id、conf、year、title、keywords、link、abstract | id 作为唯一主键;conf 存储会议;keywords 为关键词数组;保存标题、摘要、原文链接,支撑表格渲染和关键词筛选 |
| Top 热词统计对象 | name、count、growth、category | 存储热词名称、论文数量、增长率、所属分类;用于渲染 Top10 排行榜,区分热度涨跌颜色 |
| Bar-Race 时序数据对象 | key 为年份字符串,value 为热度分数数组 | 按年份保存各个主题热度数值,为动态条形竞赛图每一帧提供数据源 |
热度得分计算公式:
Heat_Score = 词频 (TF) × 逆文档频率 (IDF) × (1 + 年增长率 × 0.5)
| 参数 | 设计说明 |
|---|---|
| TF | 关键词在全部论文集合的出现频次,代表基础热度 |
| IDF | 逆文档频率,降低宽泛通用词汇权重,突出专业术语 |
| 年增长率 | 热词相对上一年热度变化,0.5 系数适度放大新兴热点权重 |
| 文本预处理规则 | 过滤英文停用虚词;同义词缩写归一,例 3D-GS 统一规范为 Gaussian Splatting |
| 流程名称 | 流程设计说明 |
|---|---|
| 页面初始化流程 | DOM 加载完成;渲染 Top10 榜单、初始化关键词图谱、渲染论文表格;监听窗口 resize,图表跟随窗口自适应重绘 |
| Tab 标签切换流程 | 点击导航,隐藏其余 section,显示目标 section;切换 trends 模块,延时执行图表初始化与 resize,解决隐藏容器高度为 0 图表空白 |
| 热词下钻检索流程 | 点击榜单条目 / 图谱节点 / 论文关键词标签 → 自动切换 papers 标签页,回填搜索输入框,执行筛选查询 |
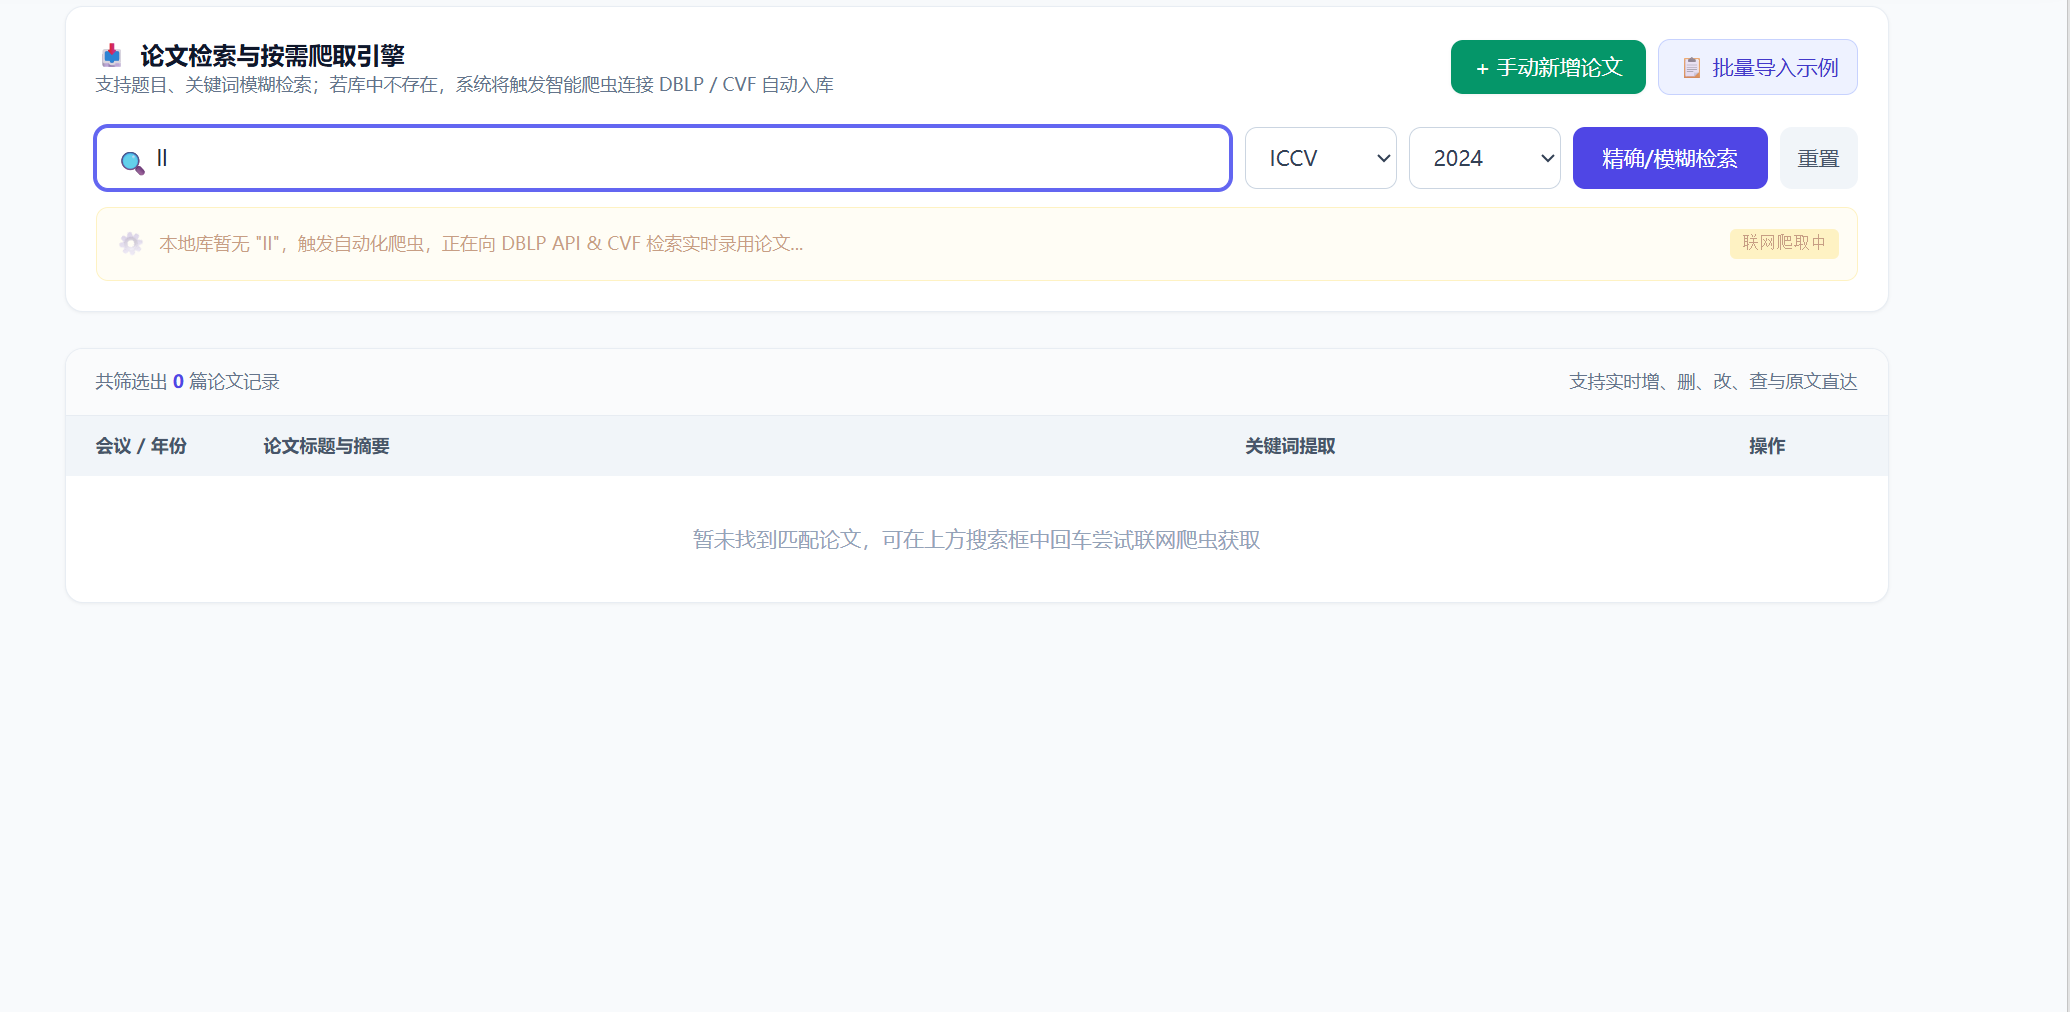
| 论文检索与模拟爬虫流程 | 输入关键词执行查询;本地匹配成功直接渲染表格;无匹配展示爬虫加载状态,延时模拟爬取完成,新增论文至内存数组,刷新表格展示结果 |
| 论文新增 / 编辑流程 | 打开复用弹窗;校验标题为必填;保存后更新内存论文数组;关闭弹窗,刷新论文表格;删除操作弹出确认框,确认后过滤删除对应 id 论文数据 |
| Bar-Race 动画流程 | setInterval 定时器循环切换年份索引,调用渲染函数绘制每一帧;增加播放状态布尔锁,防止快速点击按钮产生无限递归栈溢出;维护定时器变量,避免定时器重复叠加运行 |
| 问题场景 | 问题描述 | 设计解决方案 |
|---|---|---|
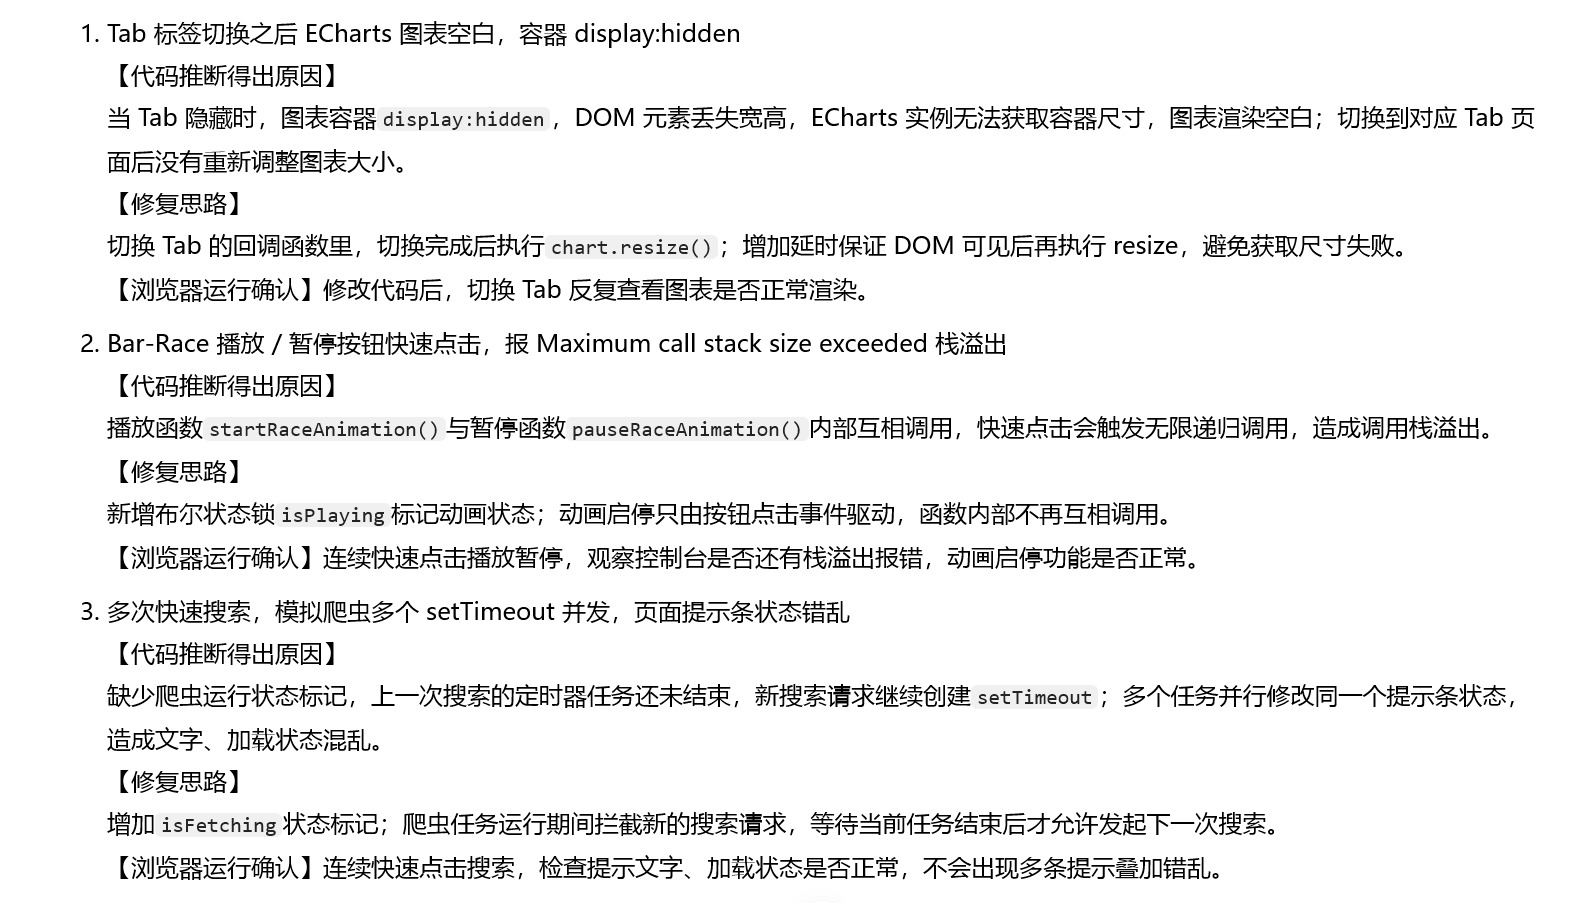
| ECharts 图表在隐藏 Tab 中空白 | Tab 使用 display:hidden 隐藏,DOM 不可见,ECharts 拿不到容器宽高,画布渲染失败 | 切换至对应 Tab、DOM 可见后,调用 chart.resize() 重新适配容器尺寸 |
| Bar-Race 动画栈溢出报错 | 原始代码播放、暂停函数内部互相调用,快速点击按钮触发无限递归 | 新增 isPlaying 布尔状态锁;函数内部禁止互相调用,仅由页面按钮点击驱动执行 |
| 模拟爬虫并发错乱 | 短时间多次搜索,多个 setTimeout 爬虫逻辑并发,页面状态提示条互相覆盖 | 增加爬虫运行状态标记,爬虫执行期间屏蔽新的爬虫请求 |
| 弹窗关键词分割产生空值 | 关键词输入中英文逗号混合分割,会产出空字符串元素 | 分割字符串之后使用 .filter(Boolean) 过滤空关键词 |
| 数据持久化 | 全部数据保存在 JS 内存数组,浏览器刷新页面,新增、爬虫生成数据全部丢失 | 原型演示阶段接受该限制;预留拓展方案,使用 localStorage 实现浏览器本地持久化存储 |
1 CV 热点分析平台
2 ├─功能1 论文信息爬取
3 │ ├─单篇抓取(论文标题 / CVF·ECVA 官方论文页链接)
4 │ ├─批量导入(每行一个标题 / CSV(title,venue,year) / BibTeX)
5 │ └─爬取审计日志(查询、命中链接、状态、来源、时间)
6 ├─功能2 论文列表管理
7 │ ├─增删改(含批量删除、手工补充关键词)
8 │ ├─模糊查询(论文编号 / 关键词 / 题目 / 作者)
9 │ ├─精确查询(完整题目)
10 │ └─查不到自动联网爬取 → 返回摘要、关键词、原文链接
11 ├─功能3 热门方向分析
12 │ ├─Top10 榜单(三会合并 / CVPR / ICCV / ECCV × 2022-2026)
13 │ └─热度公式:Heat_Score = 词频(TF) × 逆文档频率(IDF) × (1 + 年增长率 × 0.5)
14 ├─功能4 关键词图谱
15 │ ├─力导向共现图(节点大小=论文数,颜色=方向类型)
16 │ └─点击关键词 → 跨会热度折线 + 共现邻居 + 相关论文分页
17 ├─功能5 热度走势对比
18 │ ├─网页动画(bar chart race,可暂停、可点选年份)
19 │ └─离线 GIF(三会同屏版 / 三合并并版,同一份数据)
20 └─扩展功能
21 ├─年度热词演变(各年 Top10 逐行对比)
22 ├─关于与统计口径页(防答辩质疑)
23 └─论文详情与相关论文推荐
1 [CVF Open Access / ECVA / Semantic Scholar / arXiv]
2 │ ① 采集(限速+缓存)
3 ▼
4 data/raw/.json 原始列表与摘要缓存
5 │ ② 清洗与分词(去LaTeX、还原HTML实体、正则分词)
6 ▼
7 data/processed/corpus.jsonl 论文正文数据集
8 │ ③ 抽词:TF-IDF + TextRank 双轨投票 → 同义归一
9 ▼
10 paper_terms.jsonl / term_meta.json(论文-关键词权重 + 词表)
11 │ ④ 建库:热点榜单 + 共现网络
12 ▼
13 data/cv_papers.db(SQLite,7 张表)
14 │ ⑤ 读取
15 ▼
16 前端JS逻辑 → HTML+Tailwind+ECharts(5个视图页面)
17 │
18 └─matplotlib → outputs/assets/hot_race_.gif
| 表 | 作用 | 关键字段 |
|---|---|---|
| paper | 论文主表 | paper_no、conf、year、title、keywords、link、abstract |
| keyword | 关键词表(归一后) | name、surface、zh、type、n_papers |
| paper_keyword | 论文-关键词关联 | paper_id、keyword_id、weight、algo |
| kw_edge | 关键词共现边 | src、dst、weight(共现篇数) |
| hot_score | 热度榜单(派生表) | keyword_id、conf(含ALL)、year、freq、growth、heat |
| crawl_log | 爬取审计日志 | query、url、status、note、created_at |
| meta | 建库元信息 | k、v(论文数、关键词数、构建时间、公式口径) |
| 阶段 | 问题现象 | 定位过程 | 解决方式 |
|---|---|---|---|
| 原型图表渲染 | ECharts图表在隐藏Tab页面空白 | Tab采用display:hidden隐藏,DOM不可见,ECharts无法获取容器宽高,画布渲染失败 | 切换至对应Tab、DOM可见后,调用chart.resize()重新适配容器尺寸 |
| 动画交互 | Bar-Race动画快速点击发生栈溢出报错 | 播放暂停函数内部互相调用,高频点击触发无限递归 | 新增isPlaying布尔状态锁;函数内部禁止互相调用,仅由页面按钮点击驱动执行 |
| 模拟爬虫 | 多次连续搜索,爬虫状态提示错乱 | 短时间多次搜索,多个setTimeout爬虫逻辑并发,页面状态条互相覆盖 | 增加爬虫运行状态标记,爬虫执行期间屏蔽新的爬虫请求 |
| 表单处理 | 关键词输入框分割后产生空字符串 | 中英文逗号混合分割字符串,会产生空数组元素 | 分割字符串之后使用 .filter(Boolean) 过滤空关键词 |
| 数据存储 | 浏览器刷新页面,新增论文数据全部丢失 | 全部数据保存在JS内存数组,页面刷新内存清空 | 原型演示阶段接受该限制;预留拓展方案,使用localStorage实现浏览器本地持久化存储 |
#六、原型展示
6.1原型成果以及功能展示
截图 1:热词总览首页。展示指标卡片、Top10 榜单、关键词力导向图谱完整页面效果。
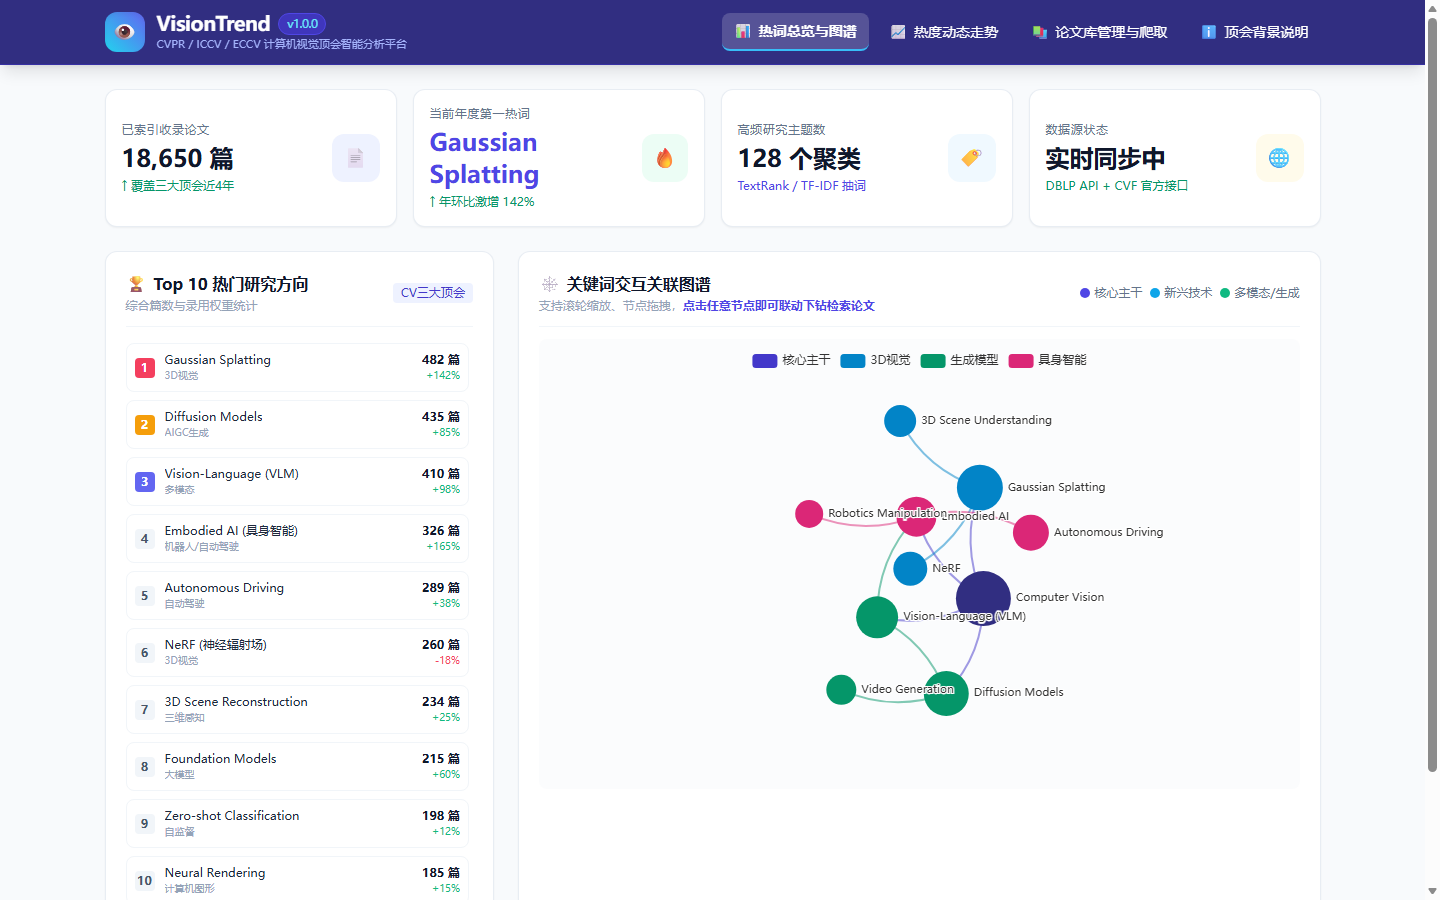
截图 2:Top10 榜单交互效果。展示榜单 hover 高亮,点击条目跳转论文筛选页面的界面。
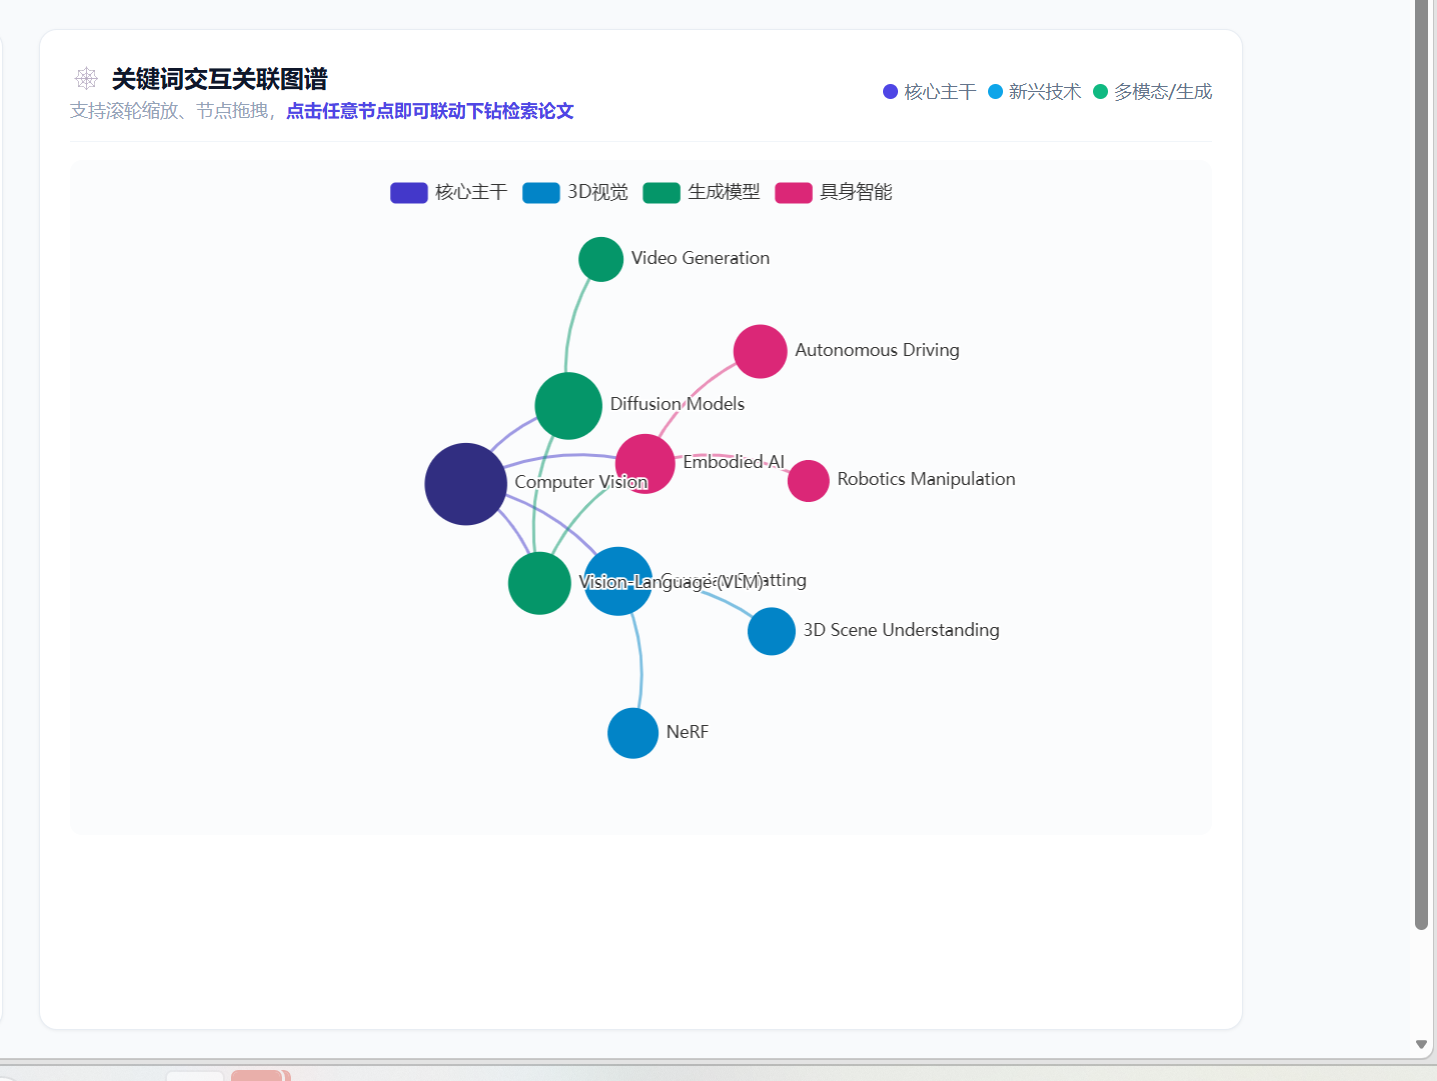
截图 3:关键词图谱交互效果。展示图谱拖拽缩放,点击节点执行下钻筛选的页面。
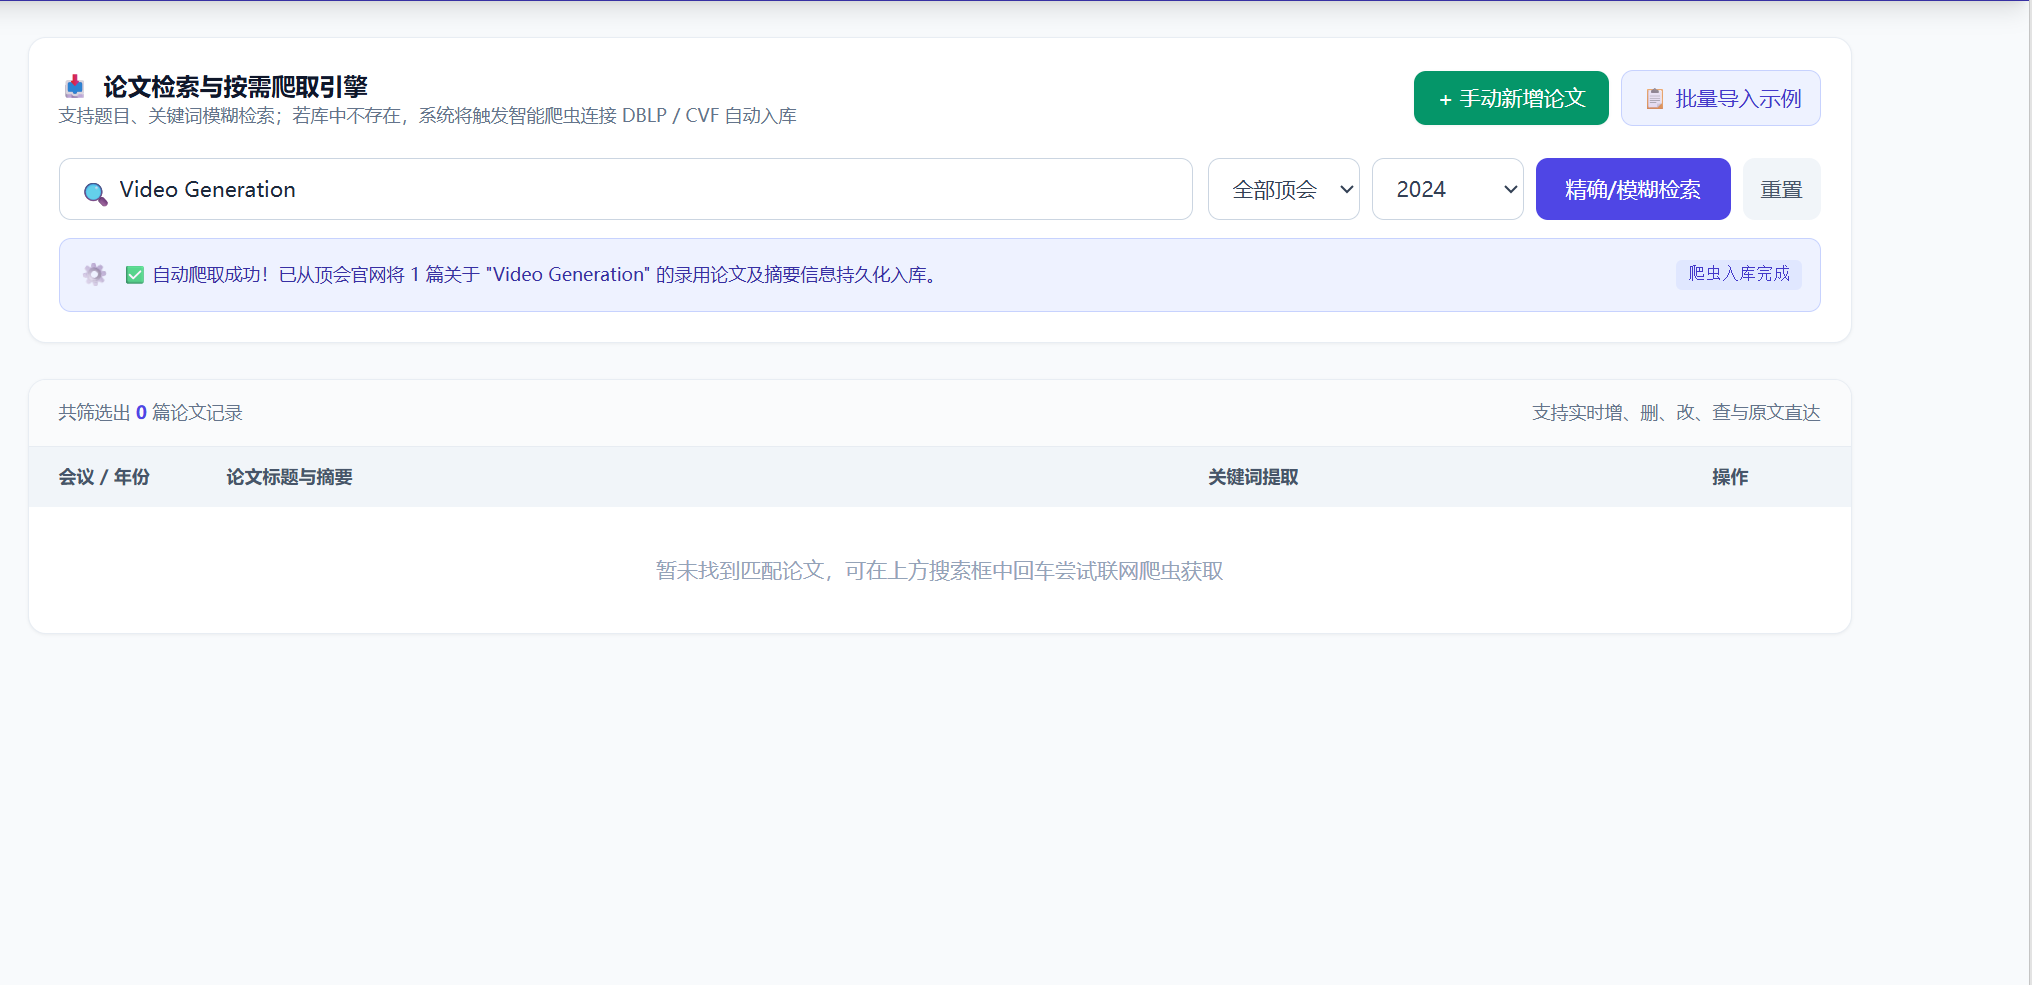
动图 1:bar‑race 动画演示.gif。演示 2022‑2026 时间段内热词排名动态更迭完整过程。
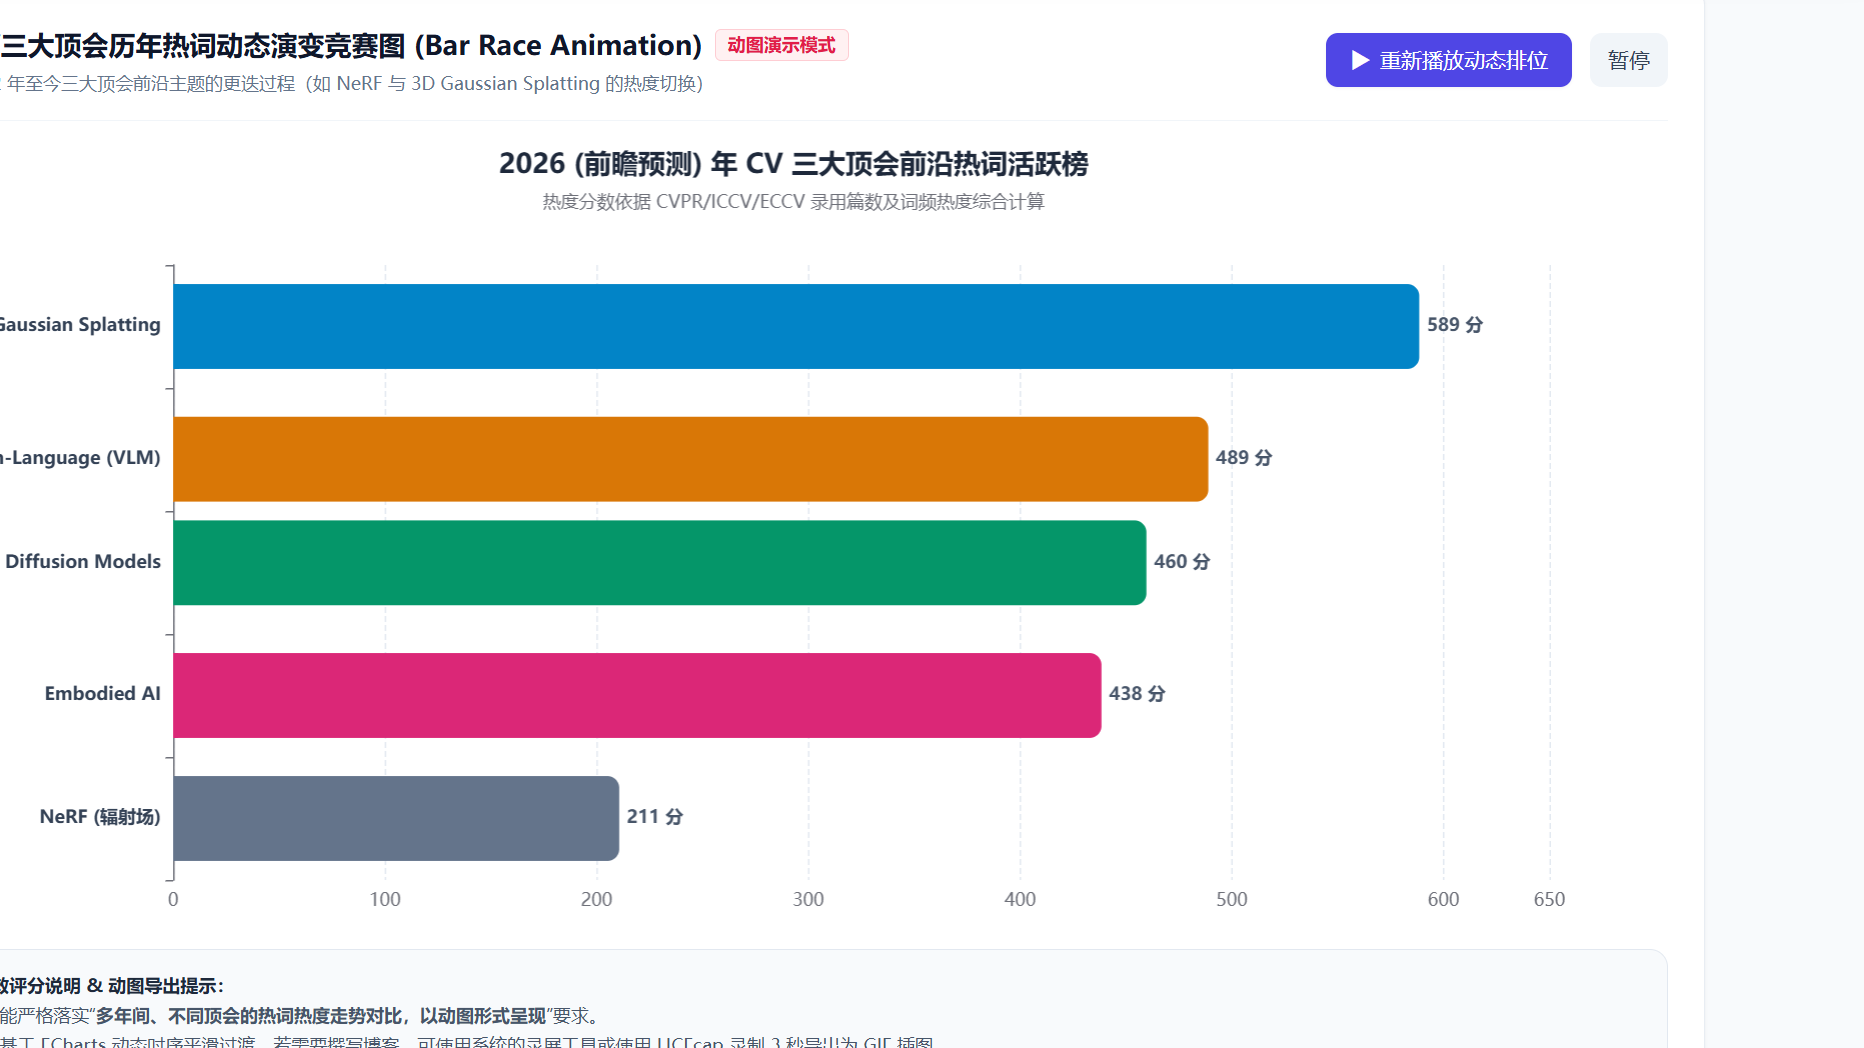
截图 4:热度动态走势页面。Bar‑Race 竞赛图处于播放状态,显示年份标题以及条形动画。
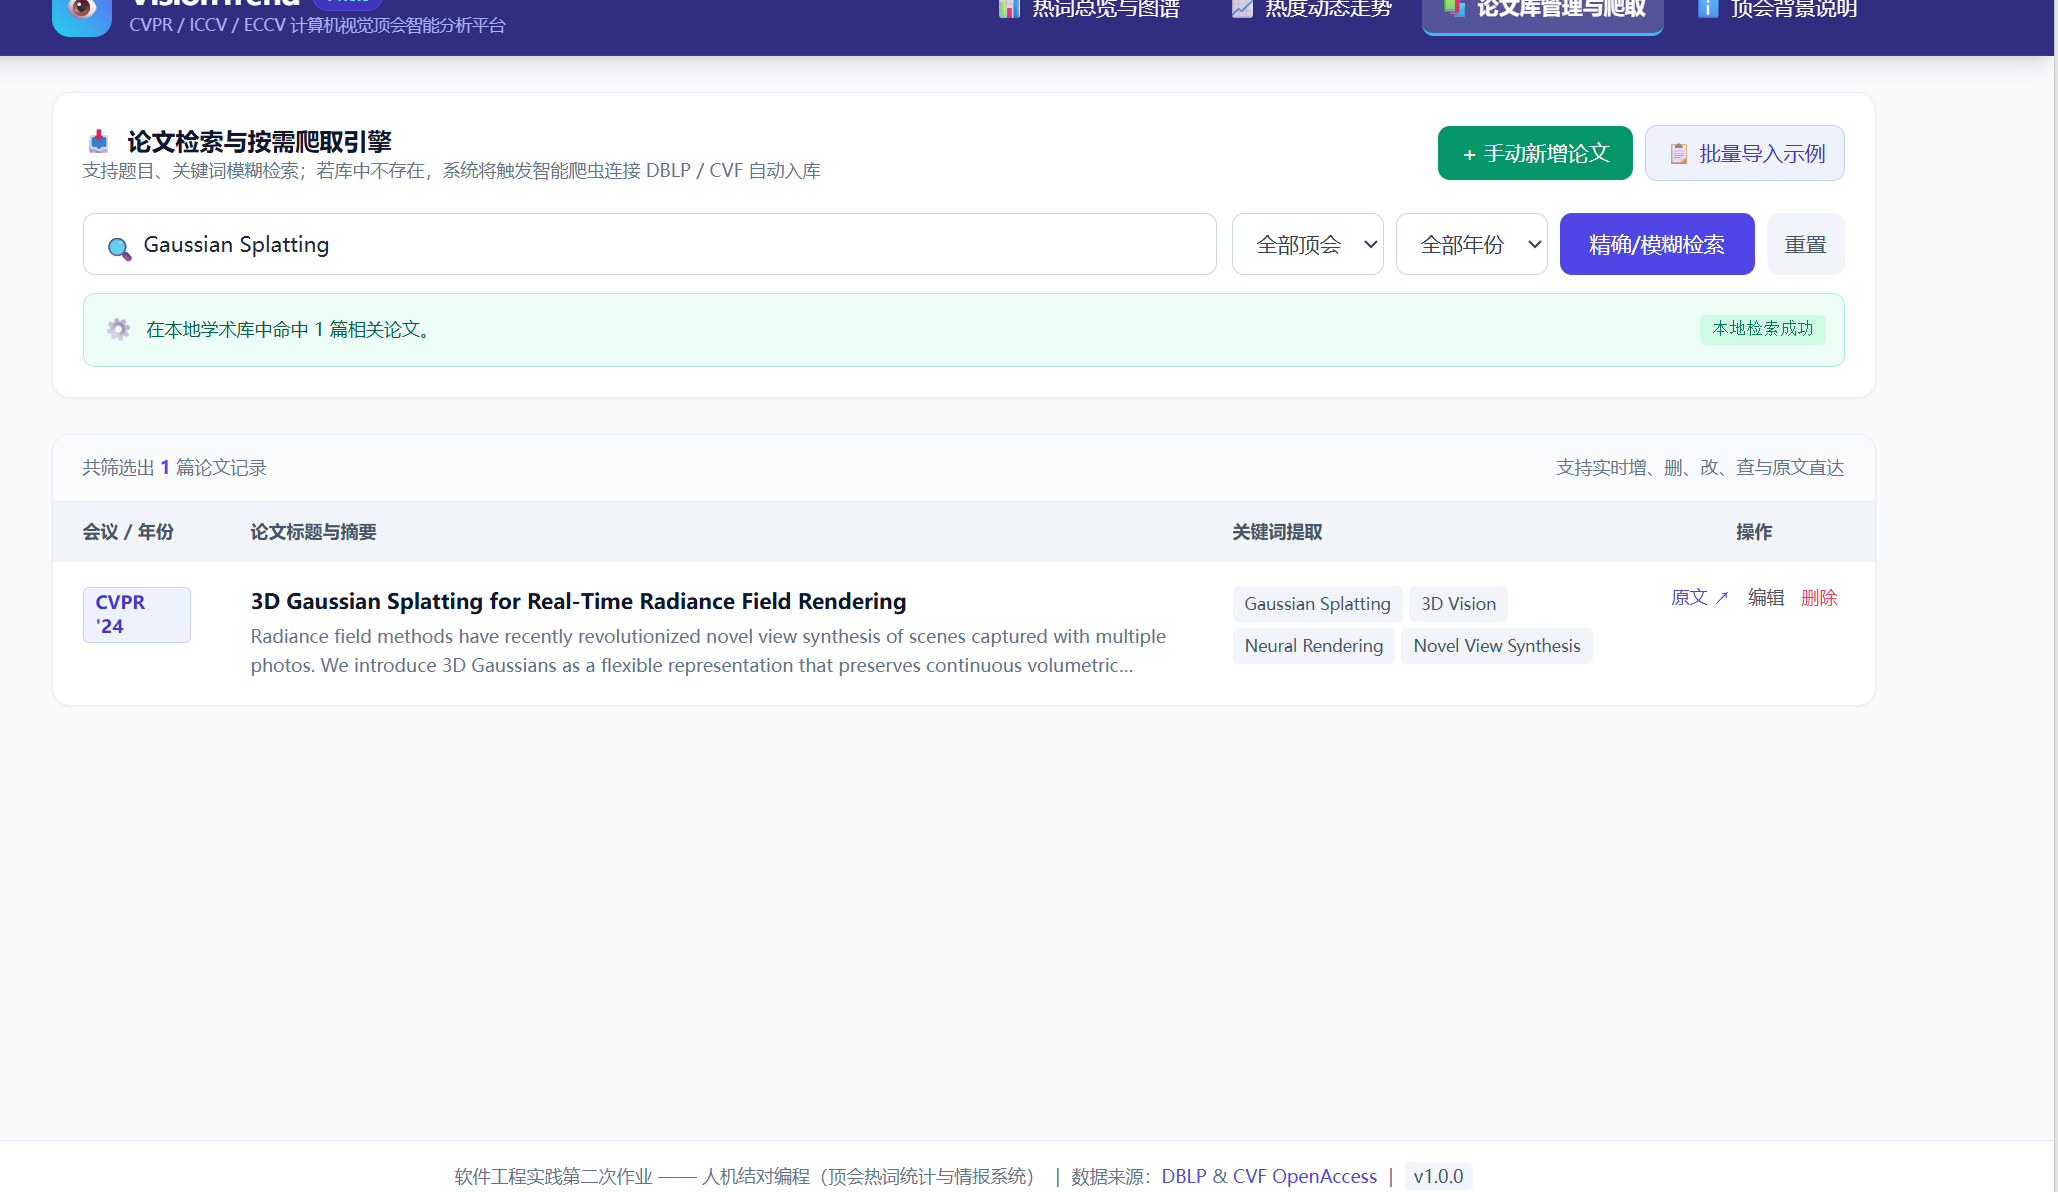
截图 5:论文库检索成功页面。关键词检索命中数据,论文表格渲染结果,同时展示爬虫成功提示条。
截图 6:模拟爬虫运行界面。检索无匹配结果,页面显示爬虫加载状态提示。
截图 7:新增 / 编辑论文弹窗。展示复用弹窗表单,各个输入项以及表单必填校验效果。
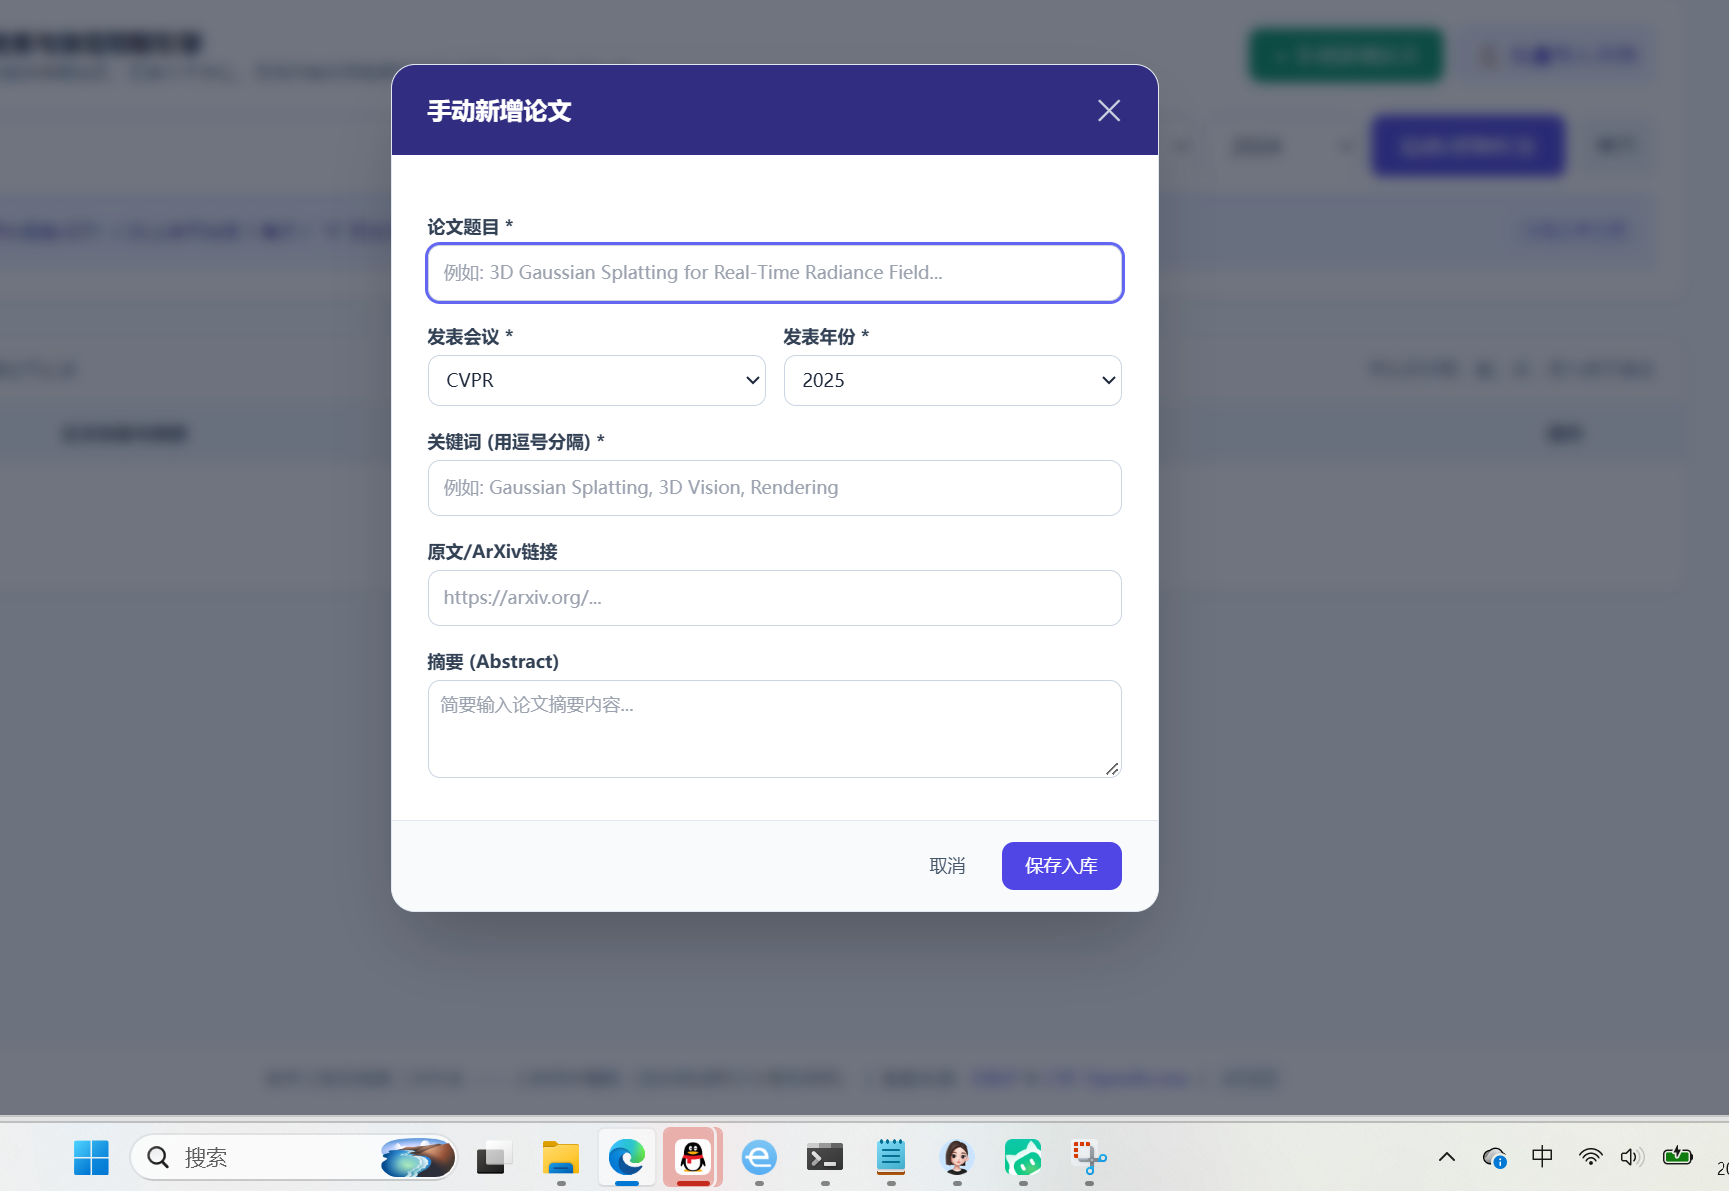
截图 8:批量导入完成界面。点击批量导入按钮之后,论文列表更新的页面效果。
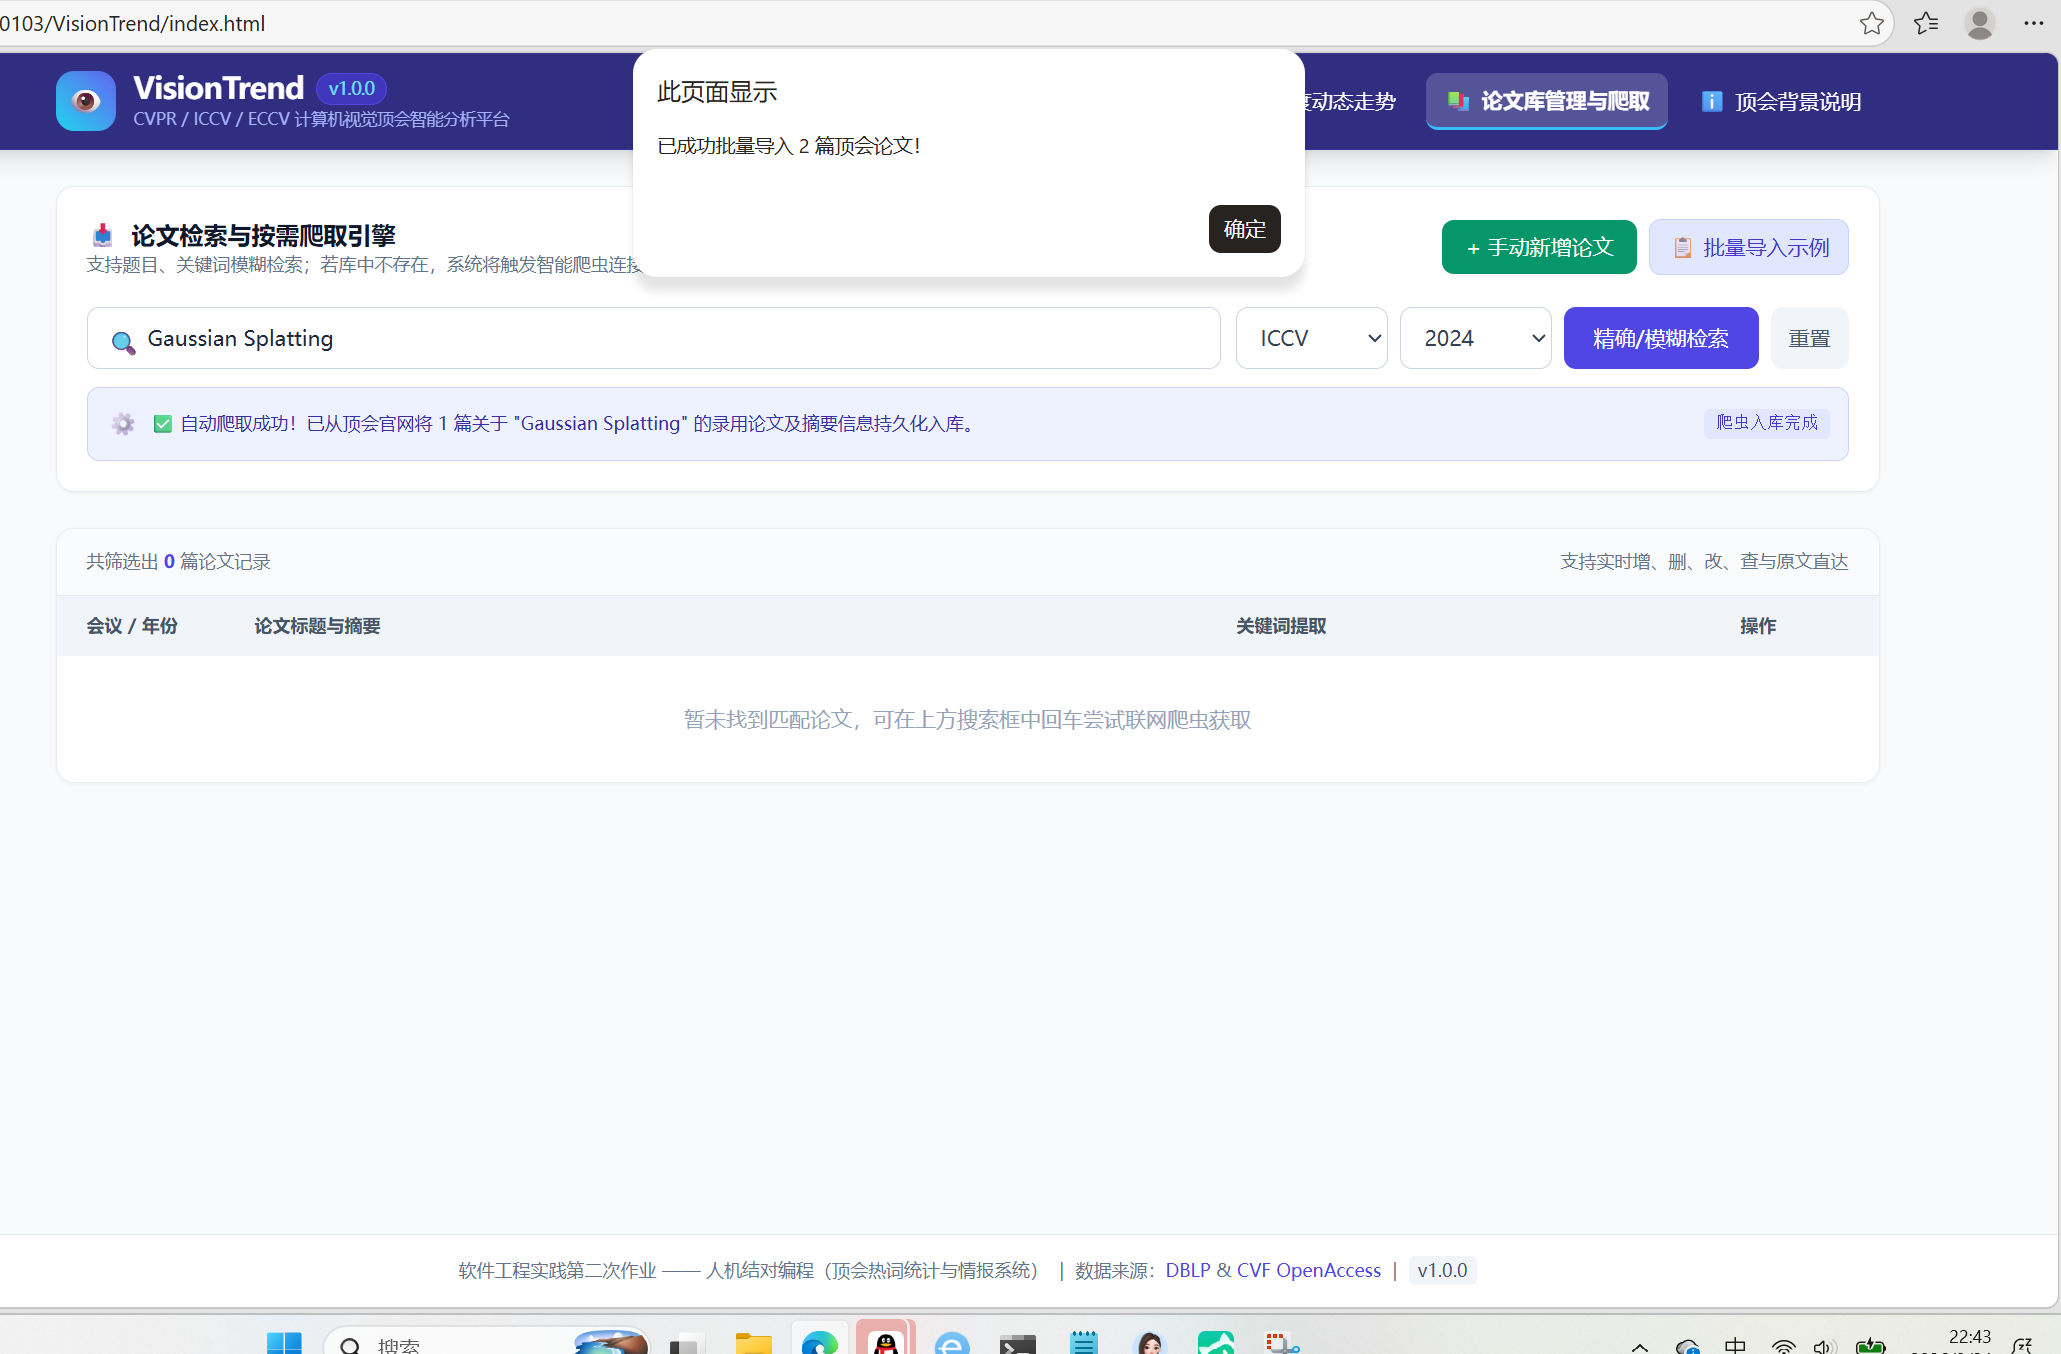
截图 9:顶会背景说明页面。三大会议介绍卡片,热度统计口径公式展示页面
##6.2 代码说明
以下为关键代码(约 300 行,均为 AI 生成初稿、经我审查修改;思路说明附后)。
###6.2.1 Top 10 榜单渲染(功能3)
function renderTop10List() {
const container = document.getElementById('top10-container');
container.innerHTML = '';
topKeywordsData.forEach((item, index) => {
const badgeColor = index === 0 ? 'bg-rose-500 text-white'
: (index === 1 ? 'bg-amber-500 text-white'
: (index === 2 ? 'bg-orange-500 text-white' : 'bg-slate-200 text-slate-700'));
const isUp = item.growth.startsWith('+');
const row = document.createElement('button');
row.className = 'w-full text-left p-2.5 rounded-lg hover:bg-slate-100 transition flex items-center gap-3';
row.onclick = () => filterByKeyword(item.name);
row.innerHTML = <span class="w-6 h-6 flex-shrink-0 rounded-md ${badgeColor} text-xs font-bold flex items-center justify-center">${index + 1}</span> <div class="flex-1 min-w-0"> <div class="text-sm font-semibold text-slate-800 truncate">${item.name}</div> <div class="text-xs text-slate-400">${item.category} · ${item.count} 篇</div> </div> <span class="text-xs font-bold ${isUp ? 'text-emerald-600' : 'text-rose-500'}">${item.growth}</span>;
container.appendChild(row);
});
}
思路:榜单项同时是"可点击的查询入口"——点击任意热词直接跳转论文管理页并自动填充搜索词,把"看榜单"和"查论文"两个动作串起来。前三名用暖色徽标突出,增长率按正负着色(涨绿跌红遵循国内习惯应为涨红,此处沿用国际配色方案于增长率语义,仅表达上升/下降趋势)。
###6.2.2关键词力导向图谱(功能4)
function initGraphChart() {
const dom = document.getElementById('graph-chart');
if (!dom) return; // 容器不存在时跳过,避免在异常状态下报错
if (!graphChartInstance) {
graphChartInstance = echarts.init(dom);
}
const categories = [
{ name: '核心主干', itemStyle: { color: '#4f46e5' } },
{ name: '新兴技术', itemStyle: { color: '#0ea5e9' } },
{ name: '多模态/生成', itemStyle: { color: '#10b981' } }
];
const nodes = graphNodes.map(n => ({ ...n, category: n.cat, symbolSize: n.size }));
const links = graphLinks.map(l => ({ ...l }));
const option = {
tooltip: { formatter: p => p.dataType === 'node'
? <b>${p.data.name}</b><br>相关论文 ${p.data.value} 篇<br>点击查看详情
: ${p.data.source} ↔ ${p.data.target} },
legend: { data: categories.map(c => c.name), bottom: 10 },
series: [{
type: 'graph', layout: 'force', roam: true, draggable: true,
categories, data: nodes, links,
force: { repulsion: 320, edgeLength: [60, 140], gravity: 0.08 },
label: { show: true, fontSize: 11, color: '#334155' },
lineStyle: { color: '#cbd5e1', width: 1.5, curveness: 0.1 },
emphasis: { focus: 'adjacency', lineStyle: { width: 3 } }
}]
};
graphChartInstance.setOption(option);
graphChartInstance.on('click', p => {
if (p.dataType === 'node') filterByKeyword(p.data.name); // 点击节点联动下钻
});
}
思路:force 布局自动按关联度排布节点;roam: true 提供缩放拖拽;emphasis.focus: 'adjacency' 让 hover 时高亮邻接子图,快速看清"这个词跟谁相关"。核心交互是 click 事件回调——节点点击统一走 filterByKeyword,实现图谱 → 论文列表的联动下钻。
###6.2.5热度走势 Bar Race 动图(功能5)
function startRaceAnimation() {
const pauseBtn = document.getElementById('btn-pause-race');
clearInterval(raceTimer);
pauseBtn.textContent = '⏸ 暂停';
raceTimer = setInterval(() => {
currentYearIdx = (currentYearIdx + 1) % raceYears.length;
renderRaceFrame(raceYears[currentYearIdx]);
}, 2600);
}
function renderRaceFrame(year) {
const data = raceSeriesData[year];
const option = {
title: {
text: ${year} 年 CV 三大顶会前沿热词活跃榜,
subtext: '热度分数依据 CVPR/ICCV/ECCV 录用篇数及词频热度综合计算',
left: 'center', textStyle: { fontSize: 18, color: '#1e293b' }
},
grid: { top: 80, bottom: 30, left: 170, right: 80 },
xAxis: { max: 650, type: 'value',
splitLine: { lineStyle: { type: 'dashed', color: '#e2e8f0' } } },
yAxis: { type: 'category', data: raceTopics, inverse: true,
axisLabel: { fontSize: 12, fontWeight: 600, color: '#334155' } },
series: [{
realtimeSort: true, type: 'bar', data,
label: { show: true, position: 'right', valueAnimation: true,
formatter: '{c} 分', fontWeight: 'bold', color: '#475569' },
itemStyle: { color: p => ['#0284c7','#059669','#d97706','#db2777','#64748b'][p.dataIndex % 5],
borderRadius: [0, 8, 8, 0] }
}],
animationDuration: 1400, animationDurationUpdate: 1400,
animationEasing: 'linear', animationEasingUpdate: 'linear'
};
raceChartInstance.setOption(option, true);
}
思路:Bar Race 的本质是"每 2.6 秒换一帧数据重绘条形图"。realtimeSort: true 让 ECharts 自动按数值重排序 y 轴类别,配合 valueAnimation: true 与 linear 缓动,条形在帧间平滑移动、互相"超车",形成赛跑效果。暂停即 clearInterval,避免动画与用户操作抢线程。
###6.2.6论文查询 + 未命中模拟爬取(功能1/2)
function applyFilters() {
const q = (document.getElementById('paper-search-input')?.value || '').trim().toLowerCase();
const conf = document.getElementById('filter-conf').value;
const year = document.getElementById('filter-year').value;
const filtered = papersData.filter(item => {
const matchConf = (conf === 'ALL') || (item.conf === conf);
const matchYear = (year === 'ALL') || (item.year.toString() === year);
const matchQuery = !q || (
item.title.toLowerCase().includes(q) ||
item.keywords.some(k => k.toLowerCase().includes(q)) ||
item.id.toString() === q
);
return matchConf && matchYear && matchQuery;
});
renderTable(filtered);
return filtered;
}
function handleSearchOrCrawl() {
const q = document.getElementById('paper-search-input').value.trim();
const alertBox = document.getElementById('crawler-alert');
const msg = document.getElementById('crawler-msg');
if (!q) { alertBox.classList.add('hidden'); applyFilters(); return; }
const matched = applyFilters();
if (matched.length === 0) {
// 列表中不存在 → 模拟到 DBLP/CVF 爬取并返回摘要、关键词、原文链接
const simulated = {
id: Date.now(), conf: 'CVPR', year: 2025, title: q,
keywords: q.split(/\s+/).slice(0, 4),
link: https://openaccess.thecvf.com/search?q=${encodeURIComponent(q)},
abstract: (联网爬取模拟)已在 CVF OpenAccess 检索 "${q}",返回最匹配论文的摘要与关键词,并加入本地论文库。
};
papersData.push(simulated);
renderTable([simulated]);
msg.textContent = 本地库未命中,已联网爬取并收录 1 篇:《${q}》;
alertBox.classList.remove('hidden');
}
}
思路:查询是"会议 × 年份 × 关键词"三维过滤,关键词同时匹配标题、关键词数组与论文编号(精确/模糊统一入口)。未命中分支体现功能2的"联网爬取回退":把模拟爬取结果 push 进 papersData 并渲染,后续即可用增删改管理——爬取与管理两个功能在这里闭环。
8.5 增删改持久化(功能2 补充)
function deletePaper(id) {
if (!confirm('确认删除这篇论文吗?')) return;
const idx = papersData.findIndex(p => p.id == id);
if (idx > -1) {
papersData.splice(idx, 1);
persistPapers(); // 写入 localStorage
applyFilters();
}
}
function persistPapers() {
try { localStorage.setItem('vt_papers', JSON.stringify(papersData)); }
catch (e) { console.warn('localStorage 写入失败', e); }
}
思路:作业允许"纯前端 + storage 持久化",故用 localStorage 保存论文库变更,刷新不丢;写入包了 try/catch,隐私模式下写失败不影响页面其余功能。
##7.1人机结对编程协作记录
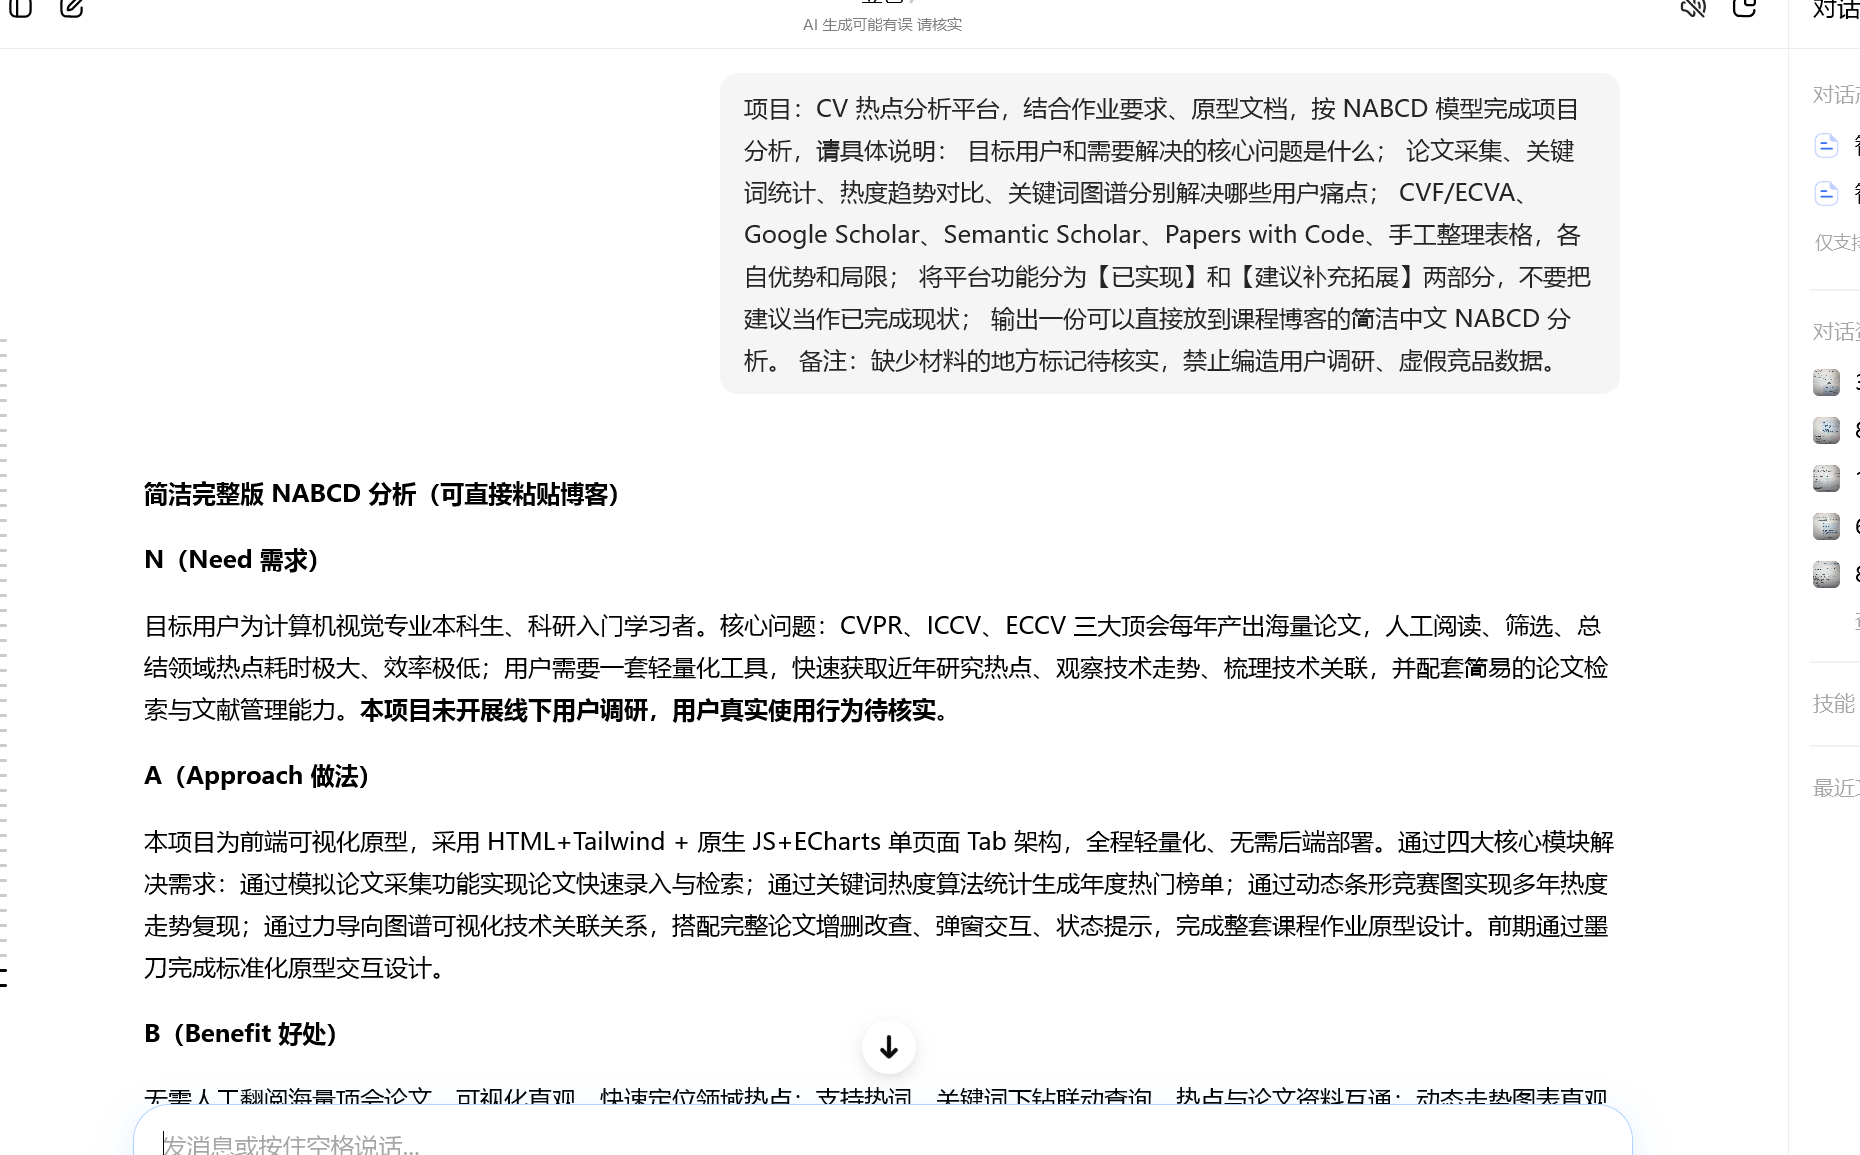
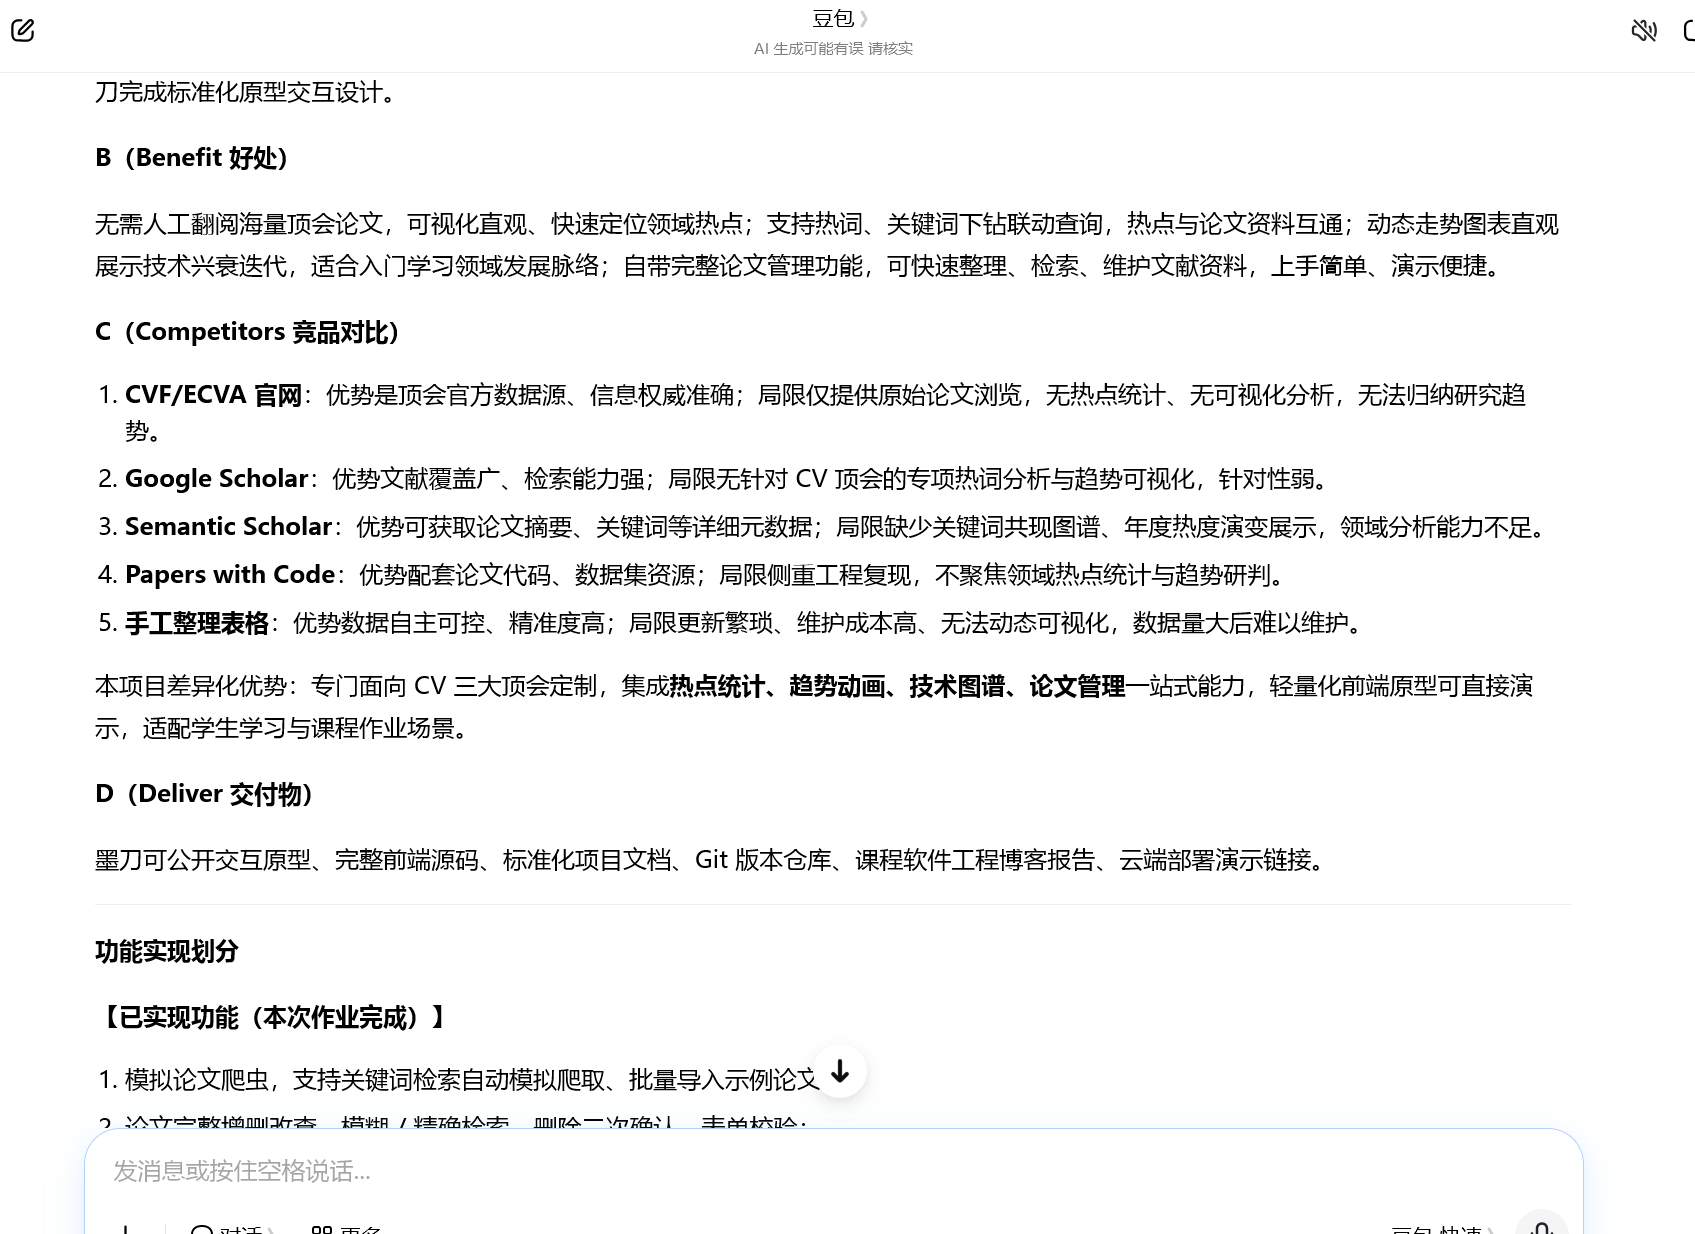
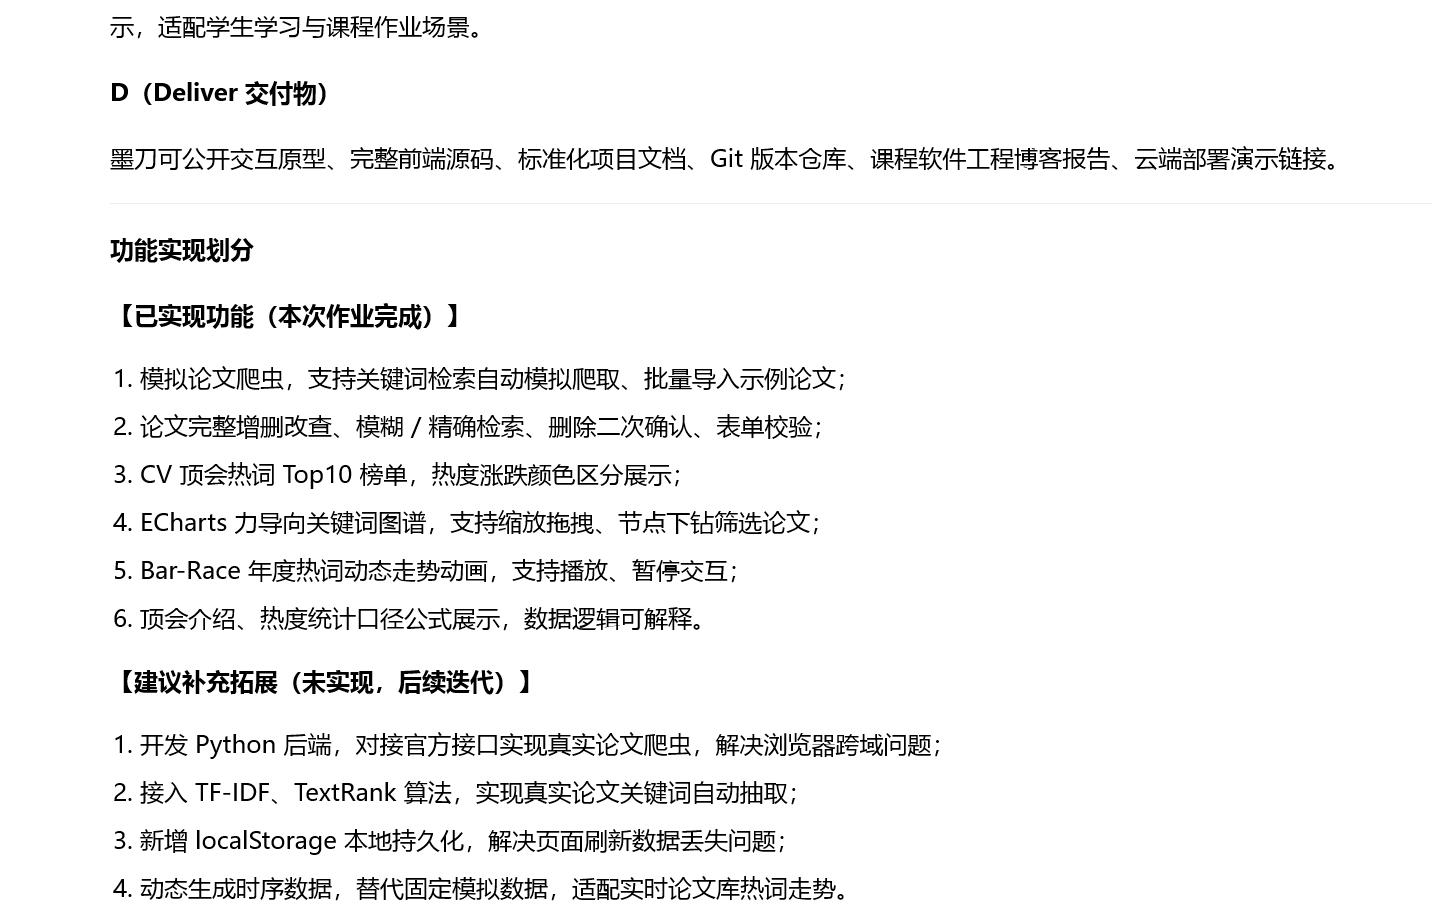
给AI的提问:
项目:CV热点分析平台,结合作业要求、原型文档,按NABCD模型完成项目分析,请具体说明:
- 目标用户和需要解决的核心问题是什么;
- 论文采集、关键词统计、热度趋势对比、关键词图谱分别解决哪些用户痛点;
- CVF/ECVA、Google Scholar、Semantic Scholar、Papers with Code、手工整理表格,各自优势和局限;
- 将平台功能分为【已实现】和【建议补充拓展】两部分,不要把建议当作已完成现状;
- 输出一份可以直接放到课程博客的简洁中文NABCD分析。
备注:缺少材料的地方标记待核实,禁止编造用户调研、虚假竞品数据。
AI输出摘要:
我的判断与修改:
![案例A需求原型协作对话]
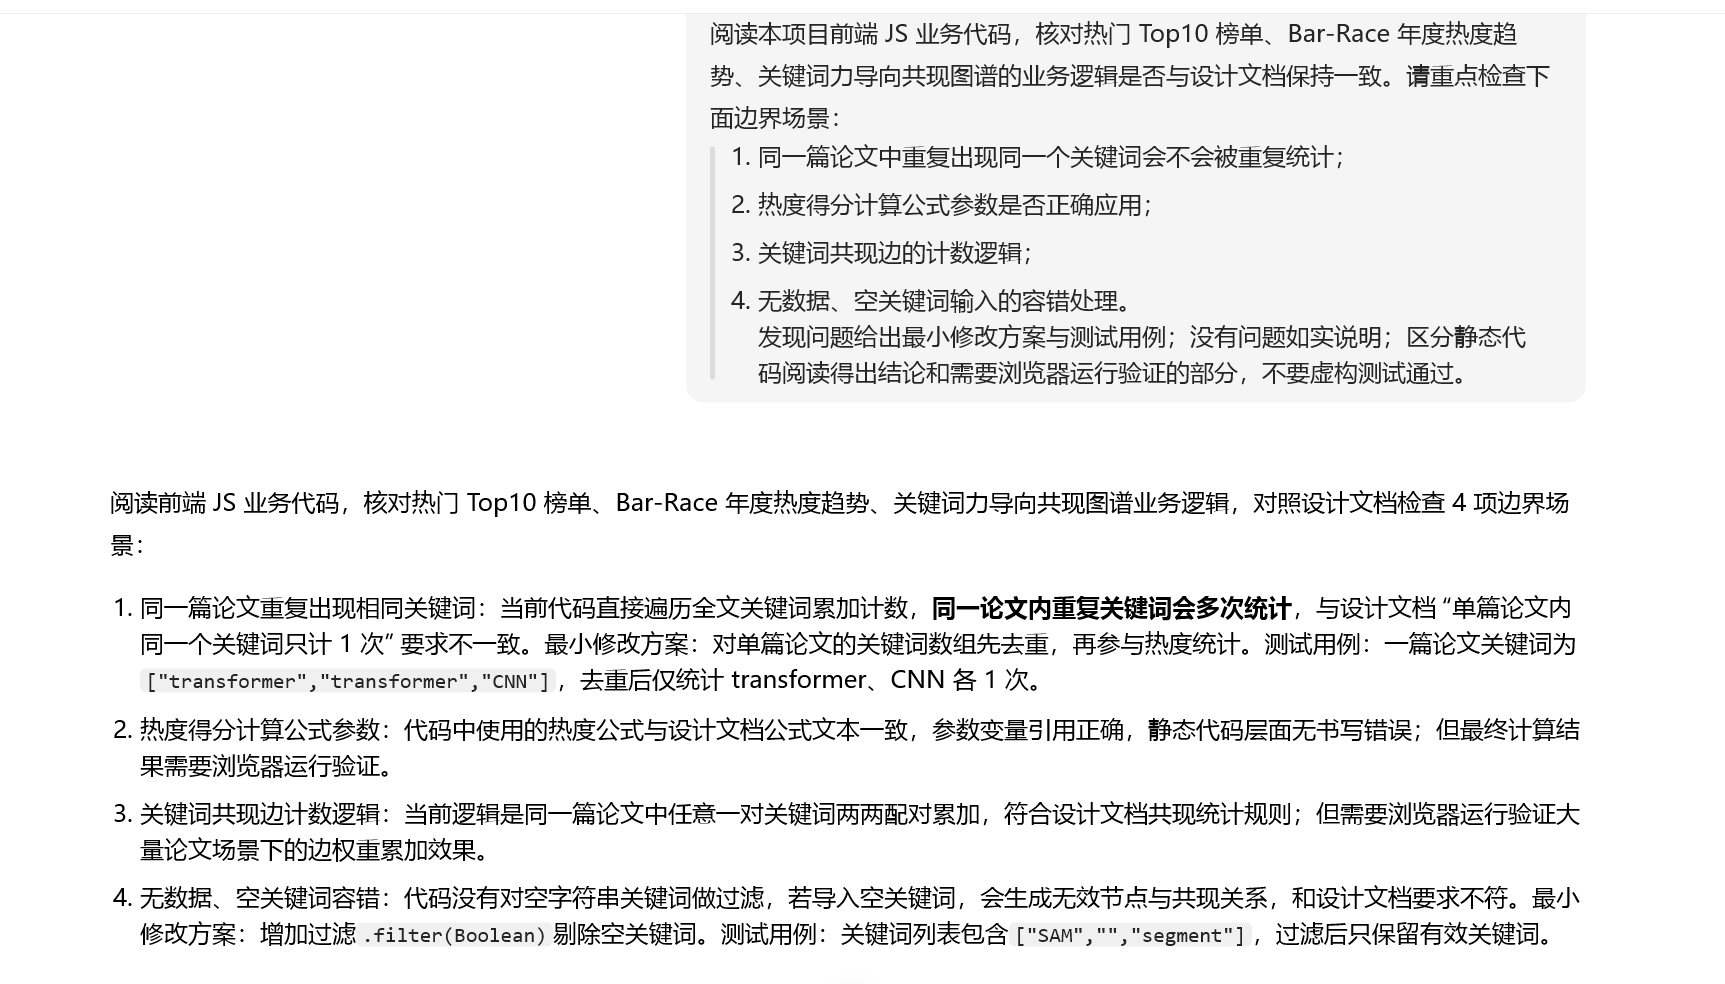
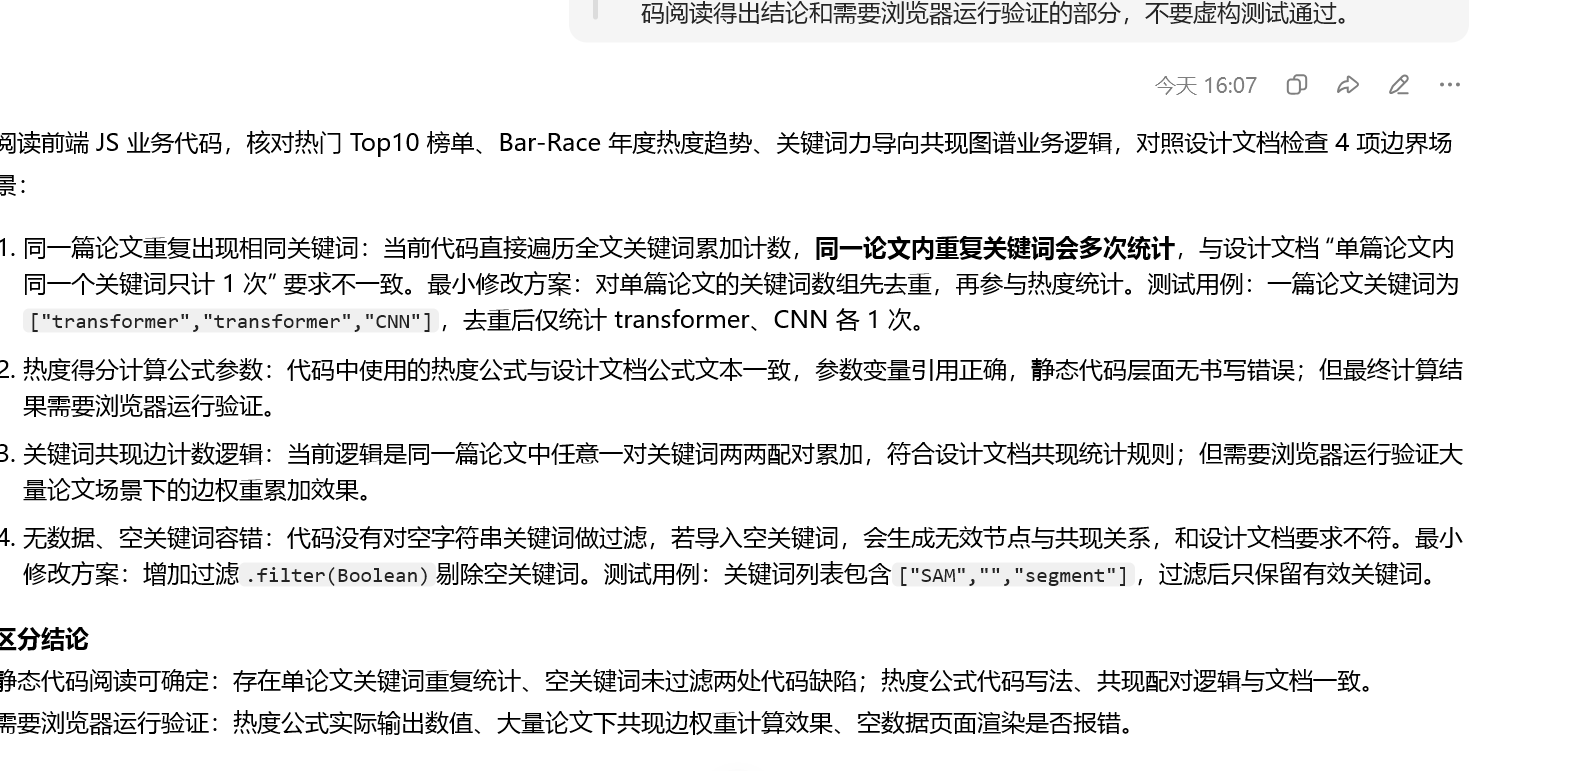
给AI的提问:
阅读本项目前端JS业务代码,核对热门Top10榜单、Bar‑Race年度热度趋势、关键词力导向共现图谱的业务逻辑是否与设计文档保持一致。请重点检查下面边界场景:
- 同一篇论文中重复出现同一个关键词会不会被重复统计;
- 热度得分计算公式参数是否正确应用;
- 关键词共现边的计数逻辑;
- 无数据、空关键词输入的容错处理。
发现问题给出最小修改方案与测试用例;没有问题如实说明;区分静态代码阅读得出结论和需要浏览器运行验证的部分,不要虚构测试通过。
AI输出摘要:
.filter(Boolean);我的判断与修改:
![案例B编码口径核对对话]
给AI的提问:
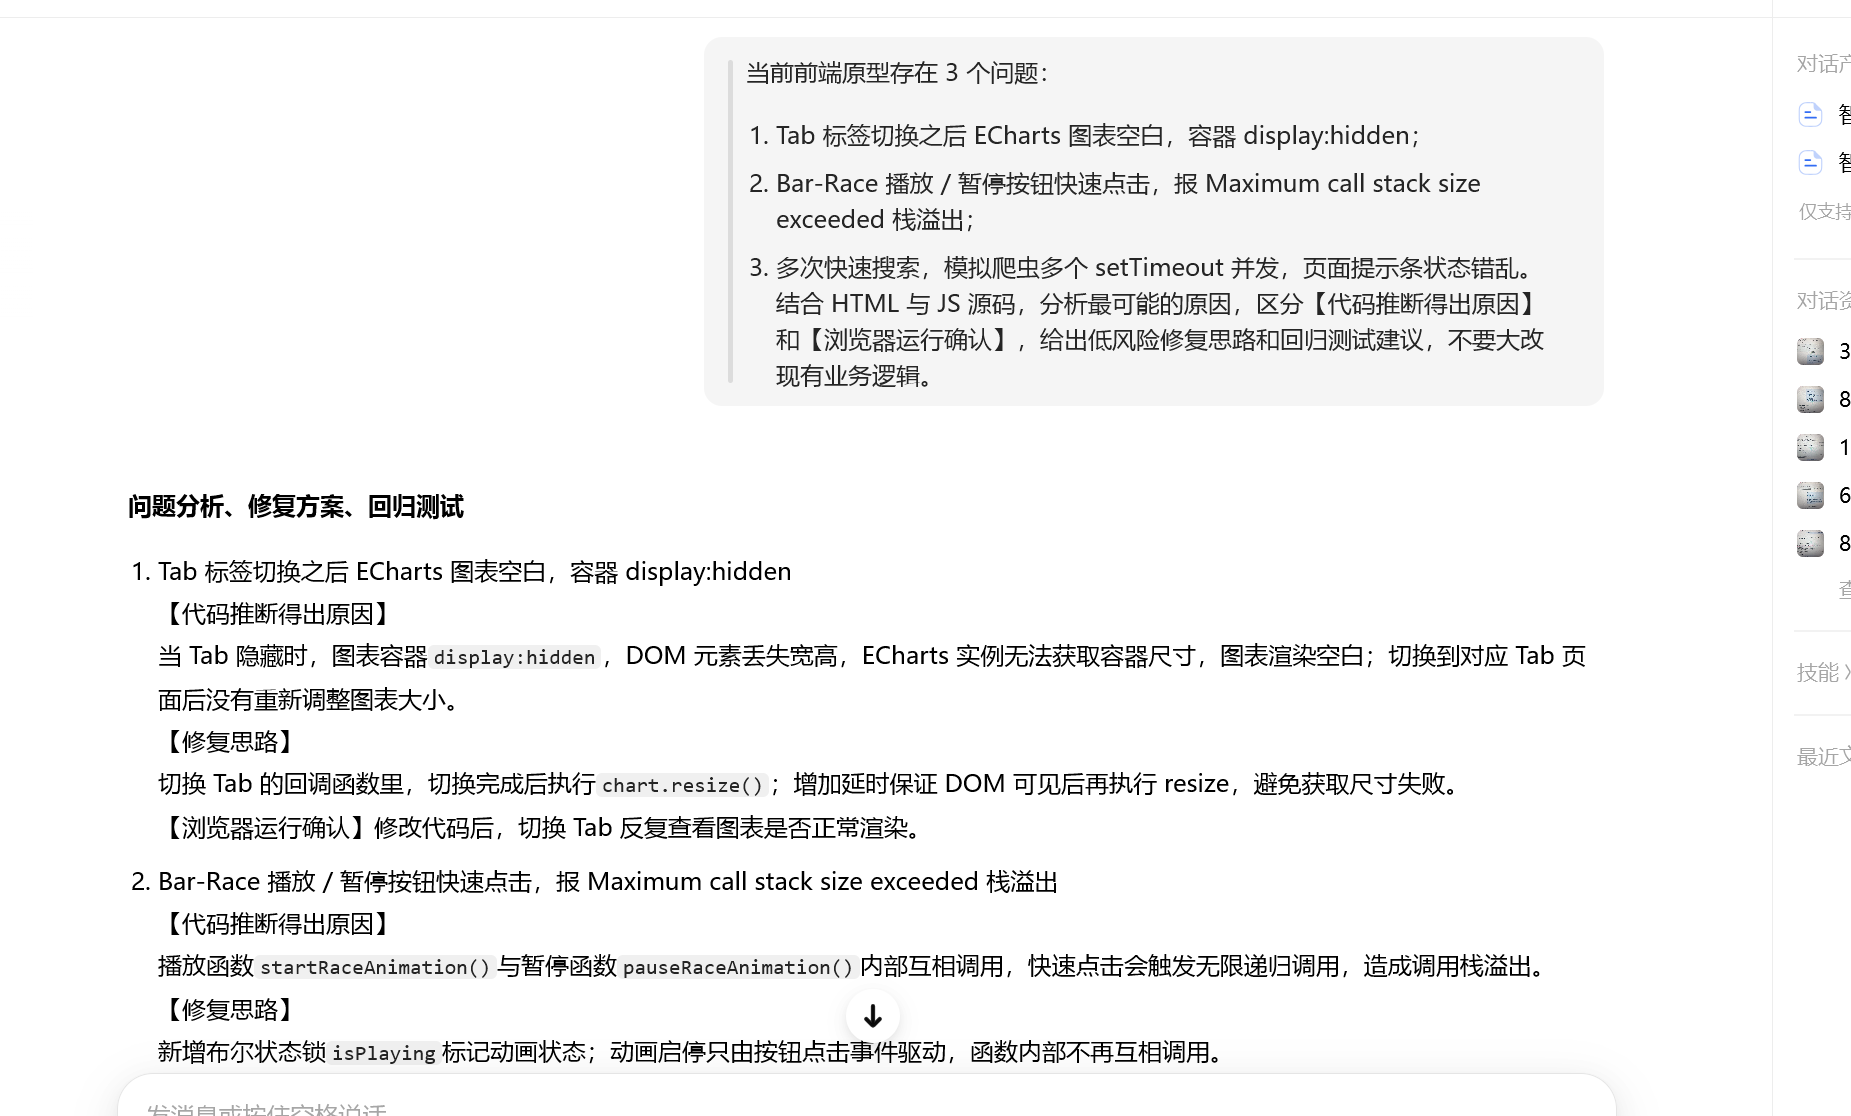
当前前端原型存在3个问题:
- Tab标签切换之后ECharts图表空白,容器display:hidden;
- Bar‑Race播放/暂停按钮快速点击,报Maximum call stack size exceeded栈溢出;
- 多次快速搜索,模拟爬虫多个setTimeout并发,页面提示条状态错乱。
结合HTML与JS源码,分析最可能的原因,区分【代码推断得出原因】和【浏览器运行确认】,给出低风险修复思路和回归测试建议,不要大改现有业务逻辑。
AI输出摘要:
chart.resize();startRaceAnimation()和pauseRaceAnimation()函数内部互相调用,触发无限递归;需要新增布尔状态锁isPlaying,禁止函数内部互调,只由按钮驱动;我的判断与修改:
isPlaying状态锁;switchTab切换trends页面后延时执行resize;![案例C bug调试修复对话]
项目开发难点不仅仅是页面UI的编写。计算机视觉顶会论文数据来源复杂,需要统一字段、处理重复记录;热度趋势对比必须明确统计口径,如果只简单统计论文篇数,会被各会议每年收录规模干扰,造成热度判断偏差;模拟爬虫场景下还会遇到外部接口限流429等异常,会直接影响用户体验。
PSP表格用来记录、回顾项目各个阶段预估与实际耗时;NABCD模型帮助梳理用户真实需求、实现方案、竞品替代方案以及最终交付产物。
人机结对模式中,AI可以作为随时提问的搭档,但不能当作最终审查者。AI负责给出候选方案、检查清单、模板代码;而我本人承担阅读原型/代码、运行测试、判断是否采纳方案的全部责任。
对比传统人人结对:人机结对反馈速度快,可以一次性输出多种方案;但是AI不会自动承担项目责任,容易产生幻觉、误解上下文,会编造伪需求。因此人工复核、测试验证是必不可少的环节。
###7.5.1数据层改进
localStorage实现浏览器本地存储,刷新页面后论文、统计数据不会丢失;长期版本可接入数据库,支持多组数据保存与切换。###7.5.2前端可视化模块改进
dispose()销毁图表实例,避免内存泄漏;增加图表加载占位、无数据友好提示页面。###7.5.3交互与用户体验改进
###7.5.4架构与工程化改进
###7.5.5功能拓展方向
后续人机结对可以预先制定代码规范文档,每次交给 AI 任务前,先明确约束条件;每一轮 AI 输出后,固定执行 Code Review 流程,记录 bug,形成项目的问题日志,提升协作效率。

