


101
社区成员
 发帖
 与我相关
 我的任务

 分享
VisionPulse 是一个面向计算机视觉初学者的顶会趋势探索与个人论文库分析平台,覆盖 CVPR、ICCV、ECCV,提供论文检索与导入、论文管理、热门方向分析、关键词图谱和热度趋势对比等功能。
| 这个作业属于哪个课程 | 2026 年软件工程实践班级 |
|---|---|
| 学号-姓名 | 102400215-胡加乘 |
| 这个作业要求在哪里 | 软件工程实践第二次作业 |
| 这个作业的目标 | 完成人机结对开发,掌握需求分析、原型设计、前后端实现、Git 协作与云服务器部署 |
| 其他参考文献 | 《构建之法》、DBLP API 文档、React、Vite、Gin、ECharts 等官方文档 |
目前项目的整体开发流程已经基本完成,云服务器仍在进行正式数据初始化。网站前端与后端服务均已部署,页面可以正常访问,后端健康检查接口也能够正常返回运行状态。
项目采用 React、TypeScript 和 Vite 构建前端,使用 Go 与 Gin 实现后端服务,并以 SQLite 保存论文及分析数据。生产环境通过 Docker Compose 部署,由同一个服务同时提供前端静态资源和后端 API。
本项目主要使用 Codex 作为 AI 编程助手,开发过程中使用过 GPT-5.6 Sol 和 GPT-5.6 Terra 模型。AI 主要用于协助需求讨论、技术方案比较、roadmap 与 ticket 拆分、代码实现、自动化测试、部署脚本编写和错误排查。
AI 实际承担了项目中较多的编码工作,但需求边界、原型取舍、技术选型、代码验收和服务器操作由我决定或完成。AI 生成的代码在保留前均经过阅读、测试和实际运行验证;无法解释、与项目约束冲突或没有通过验证的内容不会直接进入最终项目。详细的提示词、迭代过程及采纳或拒绝理由见第八章。
由于项目开始时没有逐项使用计时工具,本表中的实际耗时根据 Git 提交记录、AI 对话记录、原型设计过程和部署记录进行回溯整理。时间包含需求分析、原型、编码、测试和部署,但不包含等待云端数据下载与导入完成的机器运行时间。
| PSP | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | ||
| · Estimate | · 估计这个任务需要多少时间 | 60 | 90 |
| Development | 开发 | ||
| · Analysis | · 需求分析(包括学习新技术) | 300 | 420 |
| · Design Spec | · 生成设计文档 | 300 | 480 |
| · Design Review | · 设计复审 | 120 | 180 |
| · Coding Standard | · 代码规范(为目前的开发制定合适的规范) | 90 | 120 |
| · Design | · 具体设计 | 480 | 600 |
| · Coding | · 具体编码 | 1800 | 2400 |
| · Code Review | · 代码复审 | 300 | 420 |
| · Test | · 测试(自我测试、修改代码、提交修改) | 600 | 900 |
| Reporting | 报告 | ||
| · Test Report | · 测试报告 | 120 | 180 |
| · Size Measurement | · 计算工作量 | 60 | 90 |
| · Postmortem & Process Improvement Plan | · 事后总结,并提出过程改进计划 | 180 | 240 |
| 合计 | 4410 | 6120 |
计算机视觉领域每年都会在 CVPR、ICCV、ECCV 等顶级会议中发表大量论文。初学者面对数量庞大的论文时,往往不知道应该从什么方向入手,也很难依靠人工完成论文整理和趋势分析。因此,我采用 NABCD 模型,从用户需求、解决方案、用户收益、竞争分析和项目交付五个方面分析 VisionPulse 的产品定位。
VisionPulse 的主要用户是希望了解计算机视觉研究现状,但尚未建立完整专业知识和论文阅读体系的初学者。此外,平台也面向需要准备课程报告或文献综述的学生、正在选择研究方向的学生,以及已经拥有论文清单、希望进一步整理和分析的用户。
这些用户面临的主要问题包括:不了解近年来的热门研究方向;不熟悉专业术语,不知道应该使用哪些关键词检索;找到论文后仍需手工整理标题、摘要、关键词和原文链接;难以比较不同年份、不同会议的研究趋势;普通论文收藏工具只能保存论文,不能回答“我收集的这些论文主要关注什么”。
针对这些问题,平台需要提供以下能力:
因此,VisionPulse 的需求定位并不是一个单纯的论文搜索网站或静态图表页面,而是连接以下三个环节:
发现热门方向 → 获取和管理论文 → 分析个人论文集
平台采用“全局趋势 + 个人分析”的双模式。全局趋势基于平台预先收集的三大顶会论文数据,为新用户展示整体 Top 10 热门方向、关键词关系、年度变化和代表论文;个人分析则以用户自己检索、导入和维护的论文为数据范围,生成个人 Top 10、关键词图谱、趋势和研究覆盖差距。全局分析负责提供入门入口和参考,个人分析负责形成有针对性的结论。
平台设计了两条主要使用路径:
小白探索路径:全局热门方向 → 方向详情 → 代表论文 → 个人论文库 → 个人分析

主动研究路径:标题、关键词或批量清单 → 候选论文 → 人工确认 → 个人论文库 → 个人分析
论文获取支持完整标题、研究方向和批量论文列表三种输入方式。查询时先检查个人论文库,本地不存在时再请求公开学术数据源。系统不会将查询结果直接写入论文库,而是生成候选论文列表,由用户检查标题、作者、年份、会议等信息并勾选需要的论文。这样可以避免相似标题和模糊关键词造成的错误导入,同时保留用户的判断权。
论文关键词分为来源关键词、系统提取关键词和用户编辑关键词。数据源提供的关键词优先保留;数据缺失时,系统根据标题和摘要提取关键词;用户还可以手工修改结果。分析时,系统会清理文本、去除停用词、统一缩写和同义表达,再结合论文覆盖规模和年度变化计算研究方向热度。
平台提供三种主要分析视图:Top 10 用于回答“目前哪些方向最热门”;关键词图谱用于展示研究主题之间的共现关系;年度与会议趋势用于比较研究方向在不同年份以及 CVPR、ICCV、ECCV 中的变化。每项统计都能够追溯到贡献论文,动态图也同时提供暂停、年份定位和精确数值,避免只追求动画效果而影响数据阅读。
在基础功能之外,平台还设计了“研究覆盖差距”:通过比较全局研究方向和个人论文库的方向分布,指出全局热门但个人关注较少的方向,以及个人特别关注但全局相对小众的方向。这一功能将全局分析和个人分析连接起来。
VisionPulse 首先降低了计算机视觉的入门成本。用户不需要预先知道完整论文题目或专业术语,可以直接从全局热门方向、关键词图谱和代表论文开始探索,逐步形成对领域的整体认识。
其次,平台降低了资料整理成本。论文的检索、信息补全、去重、保存和统计在同一套流程中完成,相比手工将资料复制到 Excel 或 Notion,可以减少大量重复操作。用户还可以在论文库中继续编辑关键词,使系统分析与自己的理解相结合。
更重要的是,平台将普通的论文收藏转化为可以持续更新的个人研究画像。用户能够看到自己的论文主要集中在哪些方向、哪些关键词经常共同出现、关注方向如何随年份变化,以及个人收藏与领域整体热点之间有什么差异。
平台的分析结果具有可解释性。用户可以从 Top 10、图谱节点和趋势数据返回对应论文,了解结论由哪些数据形成,而不是只能看到无法验证的词云或排行榜。项目的核心收益可以概括为:
将领域整体热点与用户自己的论文分析结合起来,让初学者既能获得方向指引,也能逐步形成属于自己的、可以追溯和验证的研究认识。
目前已有多种学术检索或论文管理工具,但它们解决的问题与 VisionPulse 并不完全相同:
| 竞品或替代方案 | 主要优势 | 在本项目场景中的不足 |
|---|---|---|
| Google Scholar | 覆盖面广,检索和引用信息成熟 | 主要解决论文查找,不直接分析三大顶会研究方向 |
| DBLP | 计算机领域书目信息规范、来源可靠 | 更偏向论文目录,趋势和个人分析能力有限 |
| Semantic Scholar | 语义检索和相关论文推荐能力较强 | 面向通用学术搜索,个人论文集热点不是核心功能 |
| Papers with Code | 论文、代码、任务和榜单关联紧密 | 更适合查找任务与 SOTA,不突出跨会议的方向演变 |
| Connected Papers | 论文关系图直观,适合扩展阅读 | 主要表达相似或引用关系,不分析个人热词和年度走势 |
| Zotero、Excel、Notion | 收藏和整理方式灵活 | 信息补全、统计和绘图需要较多手工操作 |
| 直接询问生成式 AI | 使用方便,能够快速解释概念 | 回答可能缺少完整数据支撑,存在遗漏和幻觉风险 |
VisionPulse 不试图在论文数量、引用数据和通用搜索算法上与大型学术平台竞争,而是聚焦 CVPR、ICCV、ECCV 三大计算机视觉顶会,把已有论文数据整理为初学者能够理解的研究趋势。
项目的主要差异在于:个人论文库不是普通收藏夹,论文的增删改会直接影响个人 Top 10、关键词图谱和趋势;用户可以同时查看全局结果与个人结果,并通过研究覆盖差距发现遗漏方向;每个统计结论都能回到具体论文和关键词来源;系统负责提供候选项和分析建议,但将最终判断权保留给用户。
当然,课程项目也存在明确的能力边界:平台无法保证覆盖所有论文;自动提取的关键词可能受到数据缺失和术语歧义影响;热度只表示当前数据与算法下的关注程度,不代表论文质量或未来价值;个人论文数量较少时,分析结果只能作为阅读参考。
项目采用“先体验,再导入”的交付思路。新用户进入平台后不会面对空白页面,而是可以立即看到三大顶会的全局 Top 10、关键词图谱和趋势数据。用户可以从感兴趣的方向查看代表论文,再通过标题搜索、方向搜索或批量导入建立个人论文库,最后生成个人分析和研究画像。
课程阶段的主要交付物包括:
main 分支和完整提交记录;在课程展示之外,平台也可以提供给需要完成文献综述、课程报告或选择研究方向的学生试用。后续可持续补充三大顶会的新年份数据,更新术语映射和停用词表,优化关键词提取,并增加分析结果导出功能。
Delivery 的核心原则是:即使用户还没有建立个人论文库,也应当能够通过全局数据立即理解平台用途;当用户开始积累论文后,系统再逐步提供更有针对性的个人分析。
本项目使用 Figma 完成高保真交互原型设计,主要按照 1440px 桌面端页面进行布局。原型阶段的目标不是简单绘制几张静态页面,而是提前确定系统的信息架构、核心功能入口和主要操作流程,并通过页面跳转、候选论文选择、详情查看等交互验证设计是否合理。
原型主要面向刚接触计算机视觉的用户,因此整体设计遵循“先看到结果,再逐步深入”的思路。首页直接展示全局热门方向和关键词图谱,避免新用户在没有个人论文时面对空白页面;当用户对某个方向产生兴趣后,可以继续查看相关论文、将论文加入个人论文库,并生成个人分析结果。
在视觉设计上,系统采用白色与浅灰色作为主要背景,以蓝紫色作为品牌色和交互强调色。页面中的数据卡片、论文列表和图表保持统一的圆角、间距和文字层级,使用户能够快速区分页面标题、统计结果和可操作区域。顶部导航在所有页面中保持一致,包含首页、热度走势、论文库、爬取/导入、我的分析和关于六个主要入口。
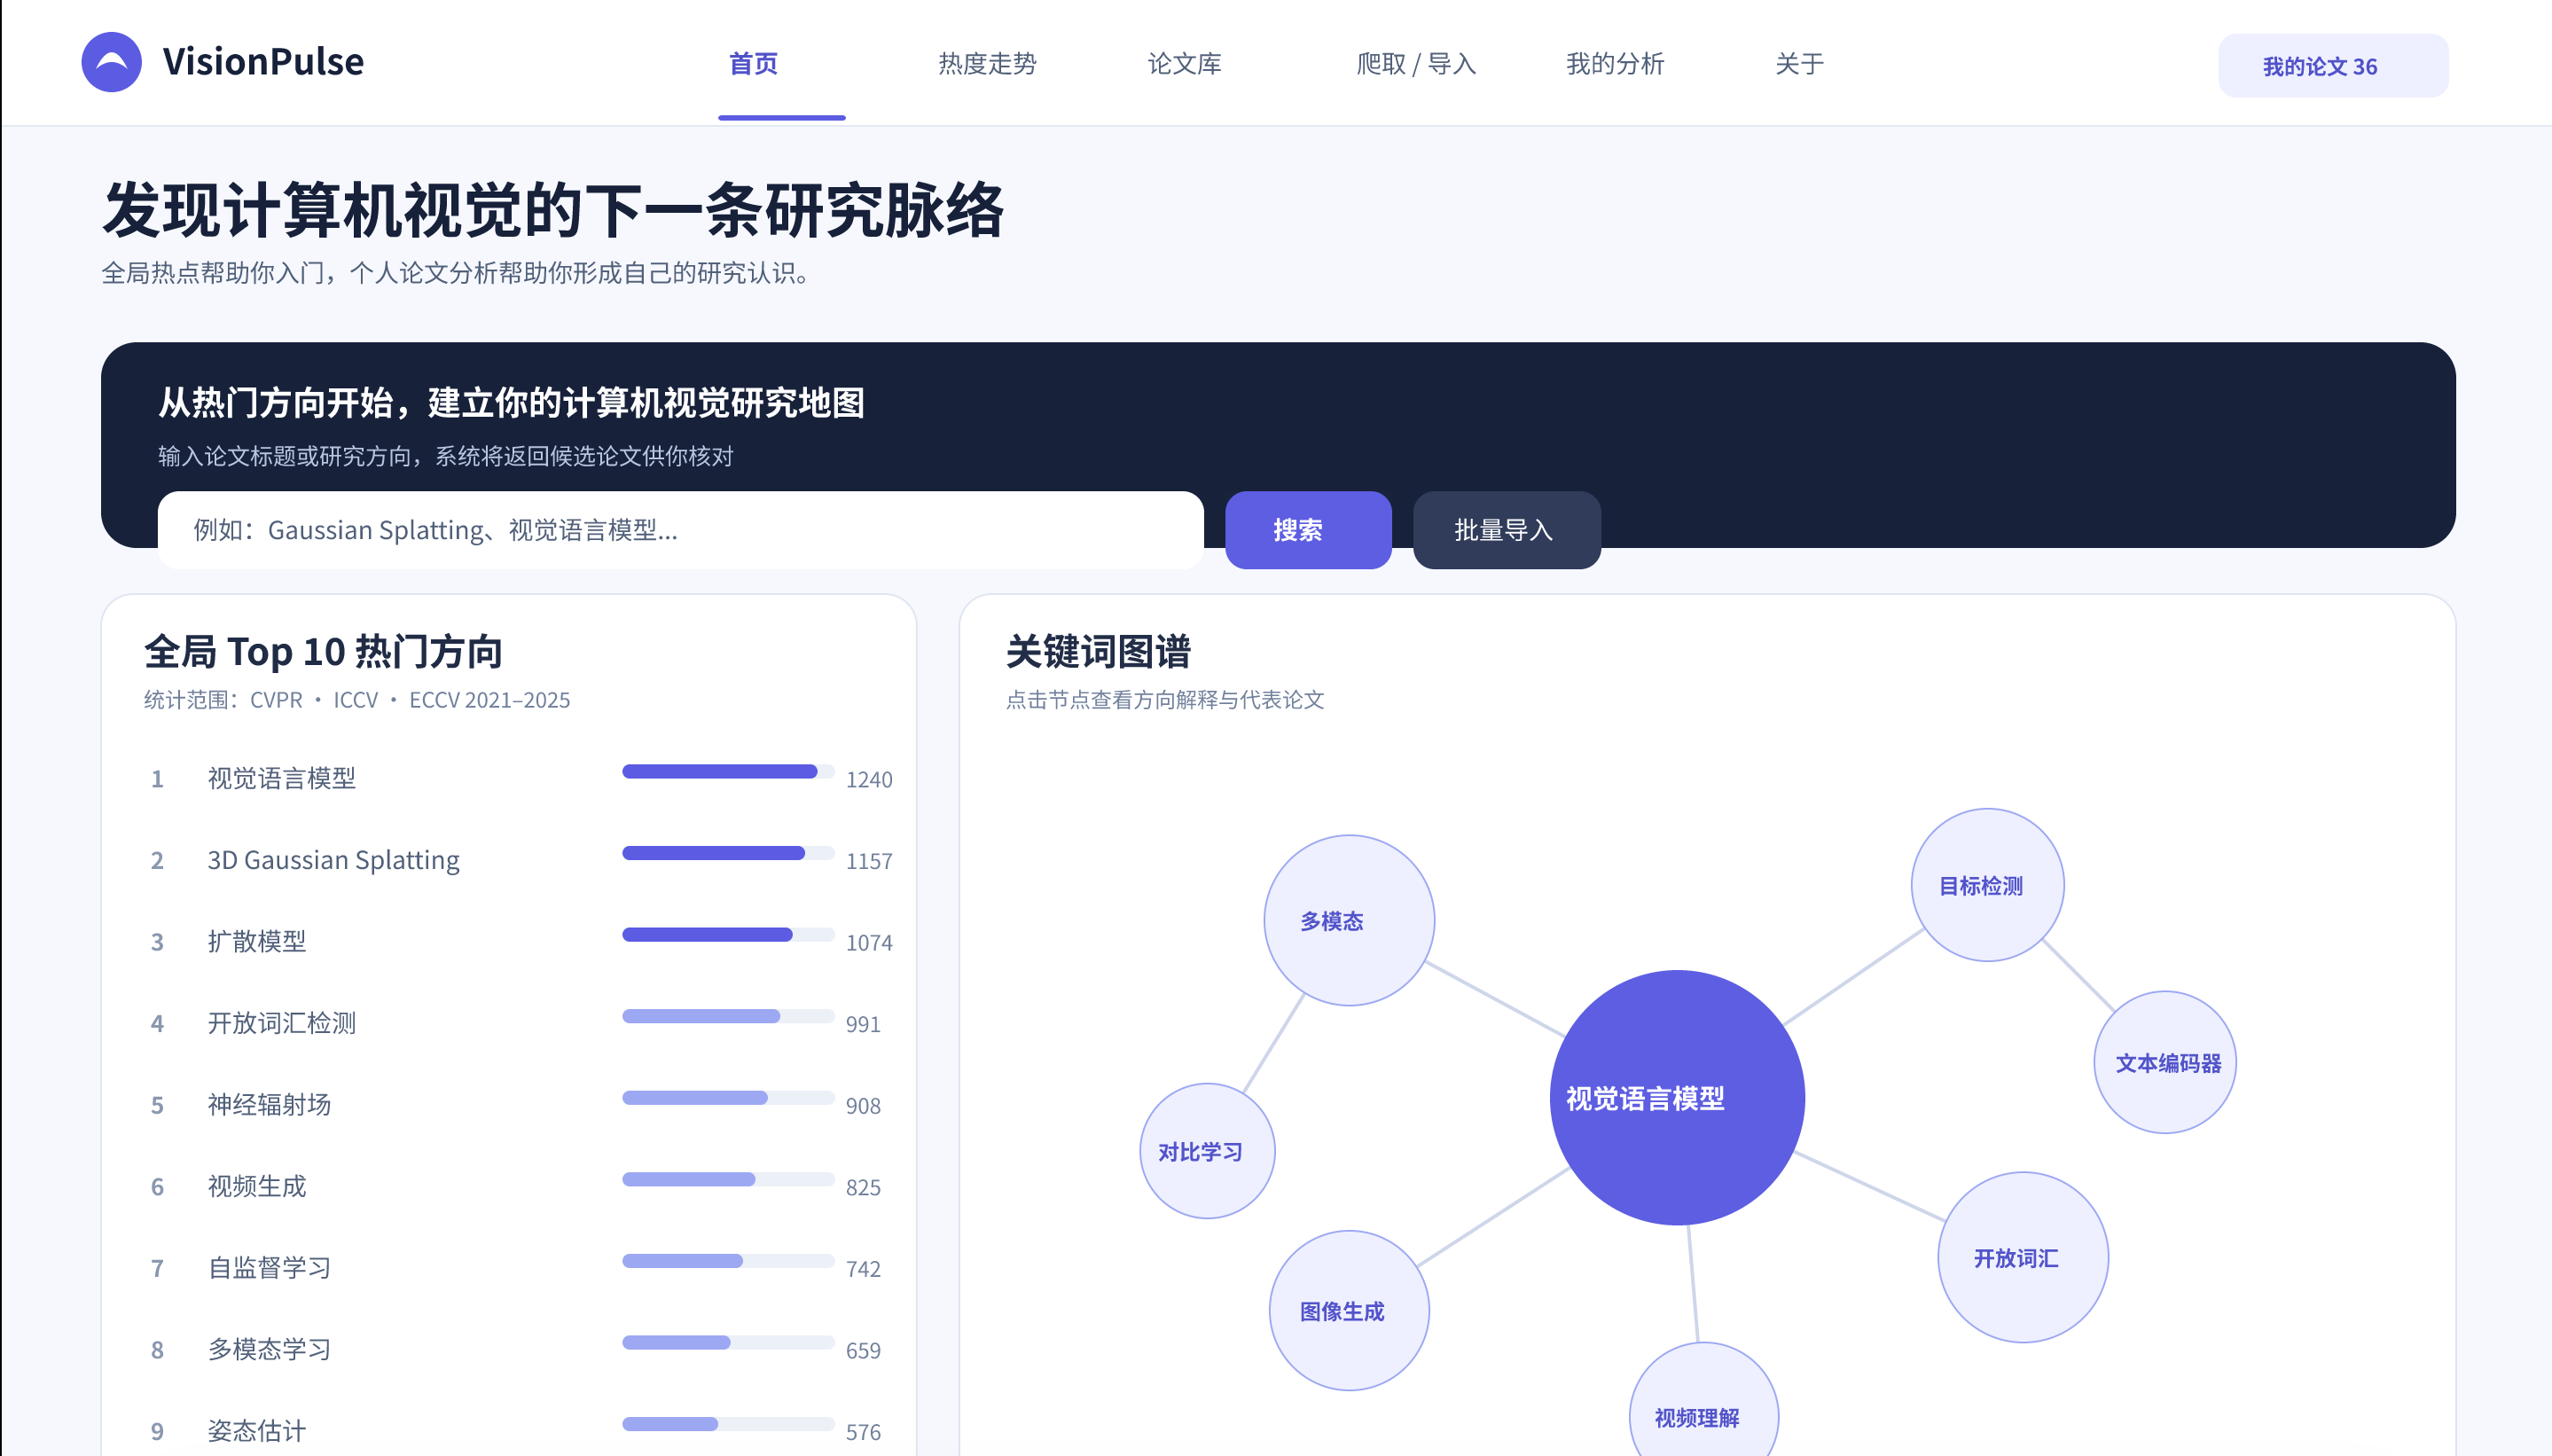
首页将全局 Top 10 和关键词图谱放在主要区域。用户可以从热门方向开始探索,也可以直接输入论文标题或研究方向。热门方向、图谱节点和代表论文之间相互关联,点击后可以继续查看对应论文及趋势。
论文获取页面分为“标题检索”“方向探索”和“批量导入”三个标签,分别对应已知论文名称、探索研究方向和已有论文清单三种使用场景。查询完成后,系统展示候选论文而不是自动保存,由用户核对会议、年份和匹配信息后进行勾选,减少错误论文进入个人库的概率。
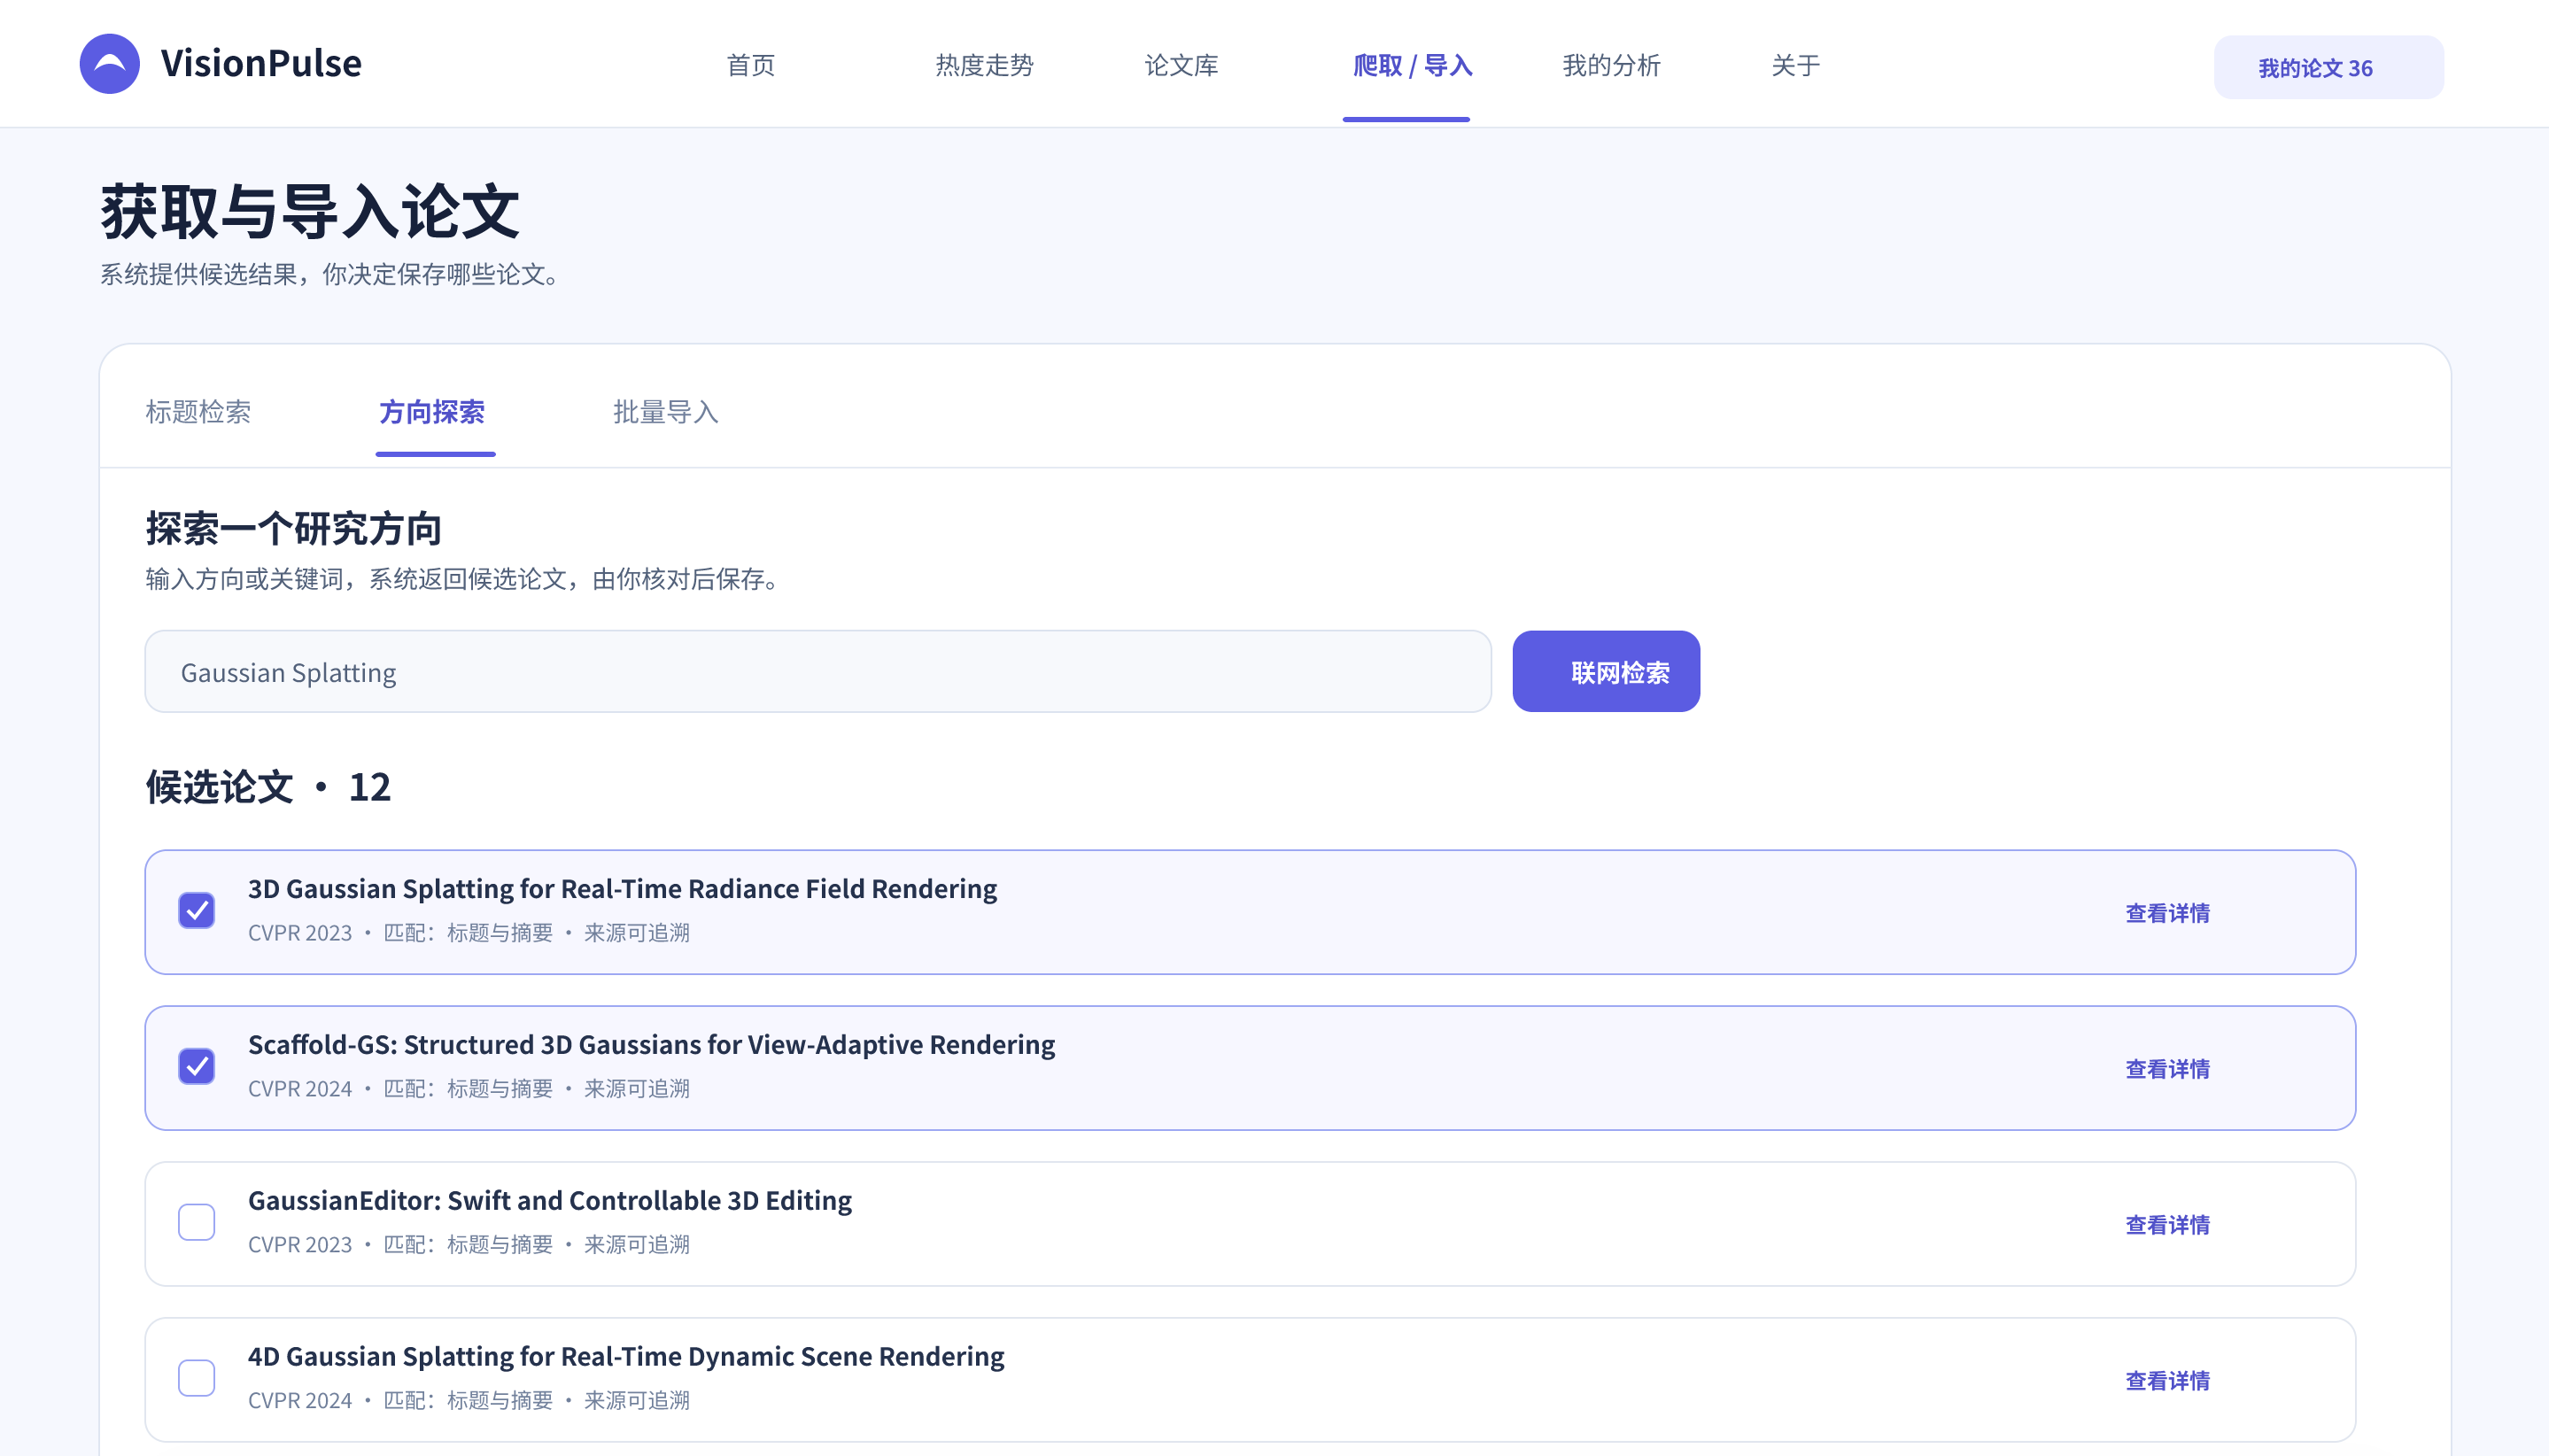
候选列表通过复选框显示当前选择状态,并提供详情入口。选中的论文使用边框和浅色背景突出显示,使用户能够在最终保存前再次确认。
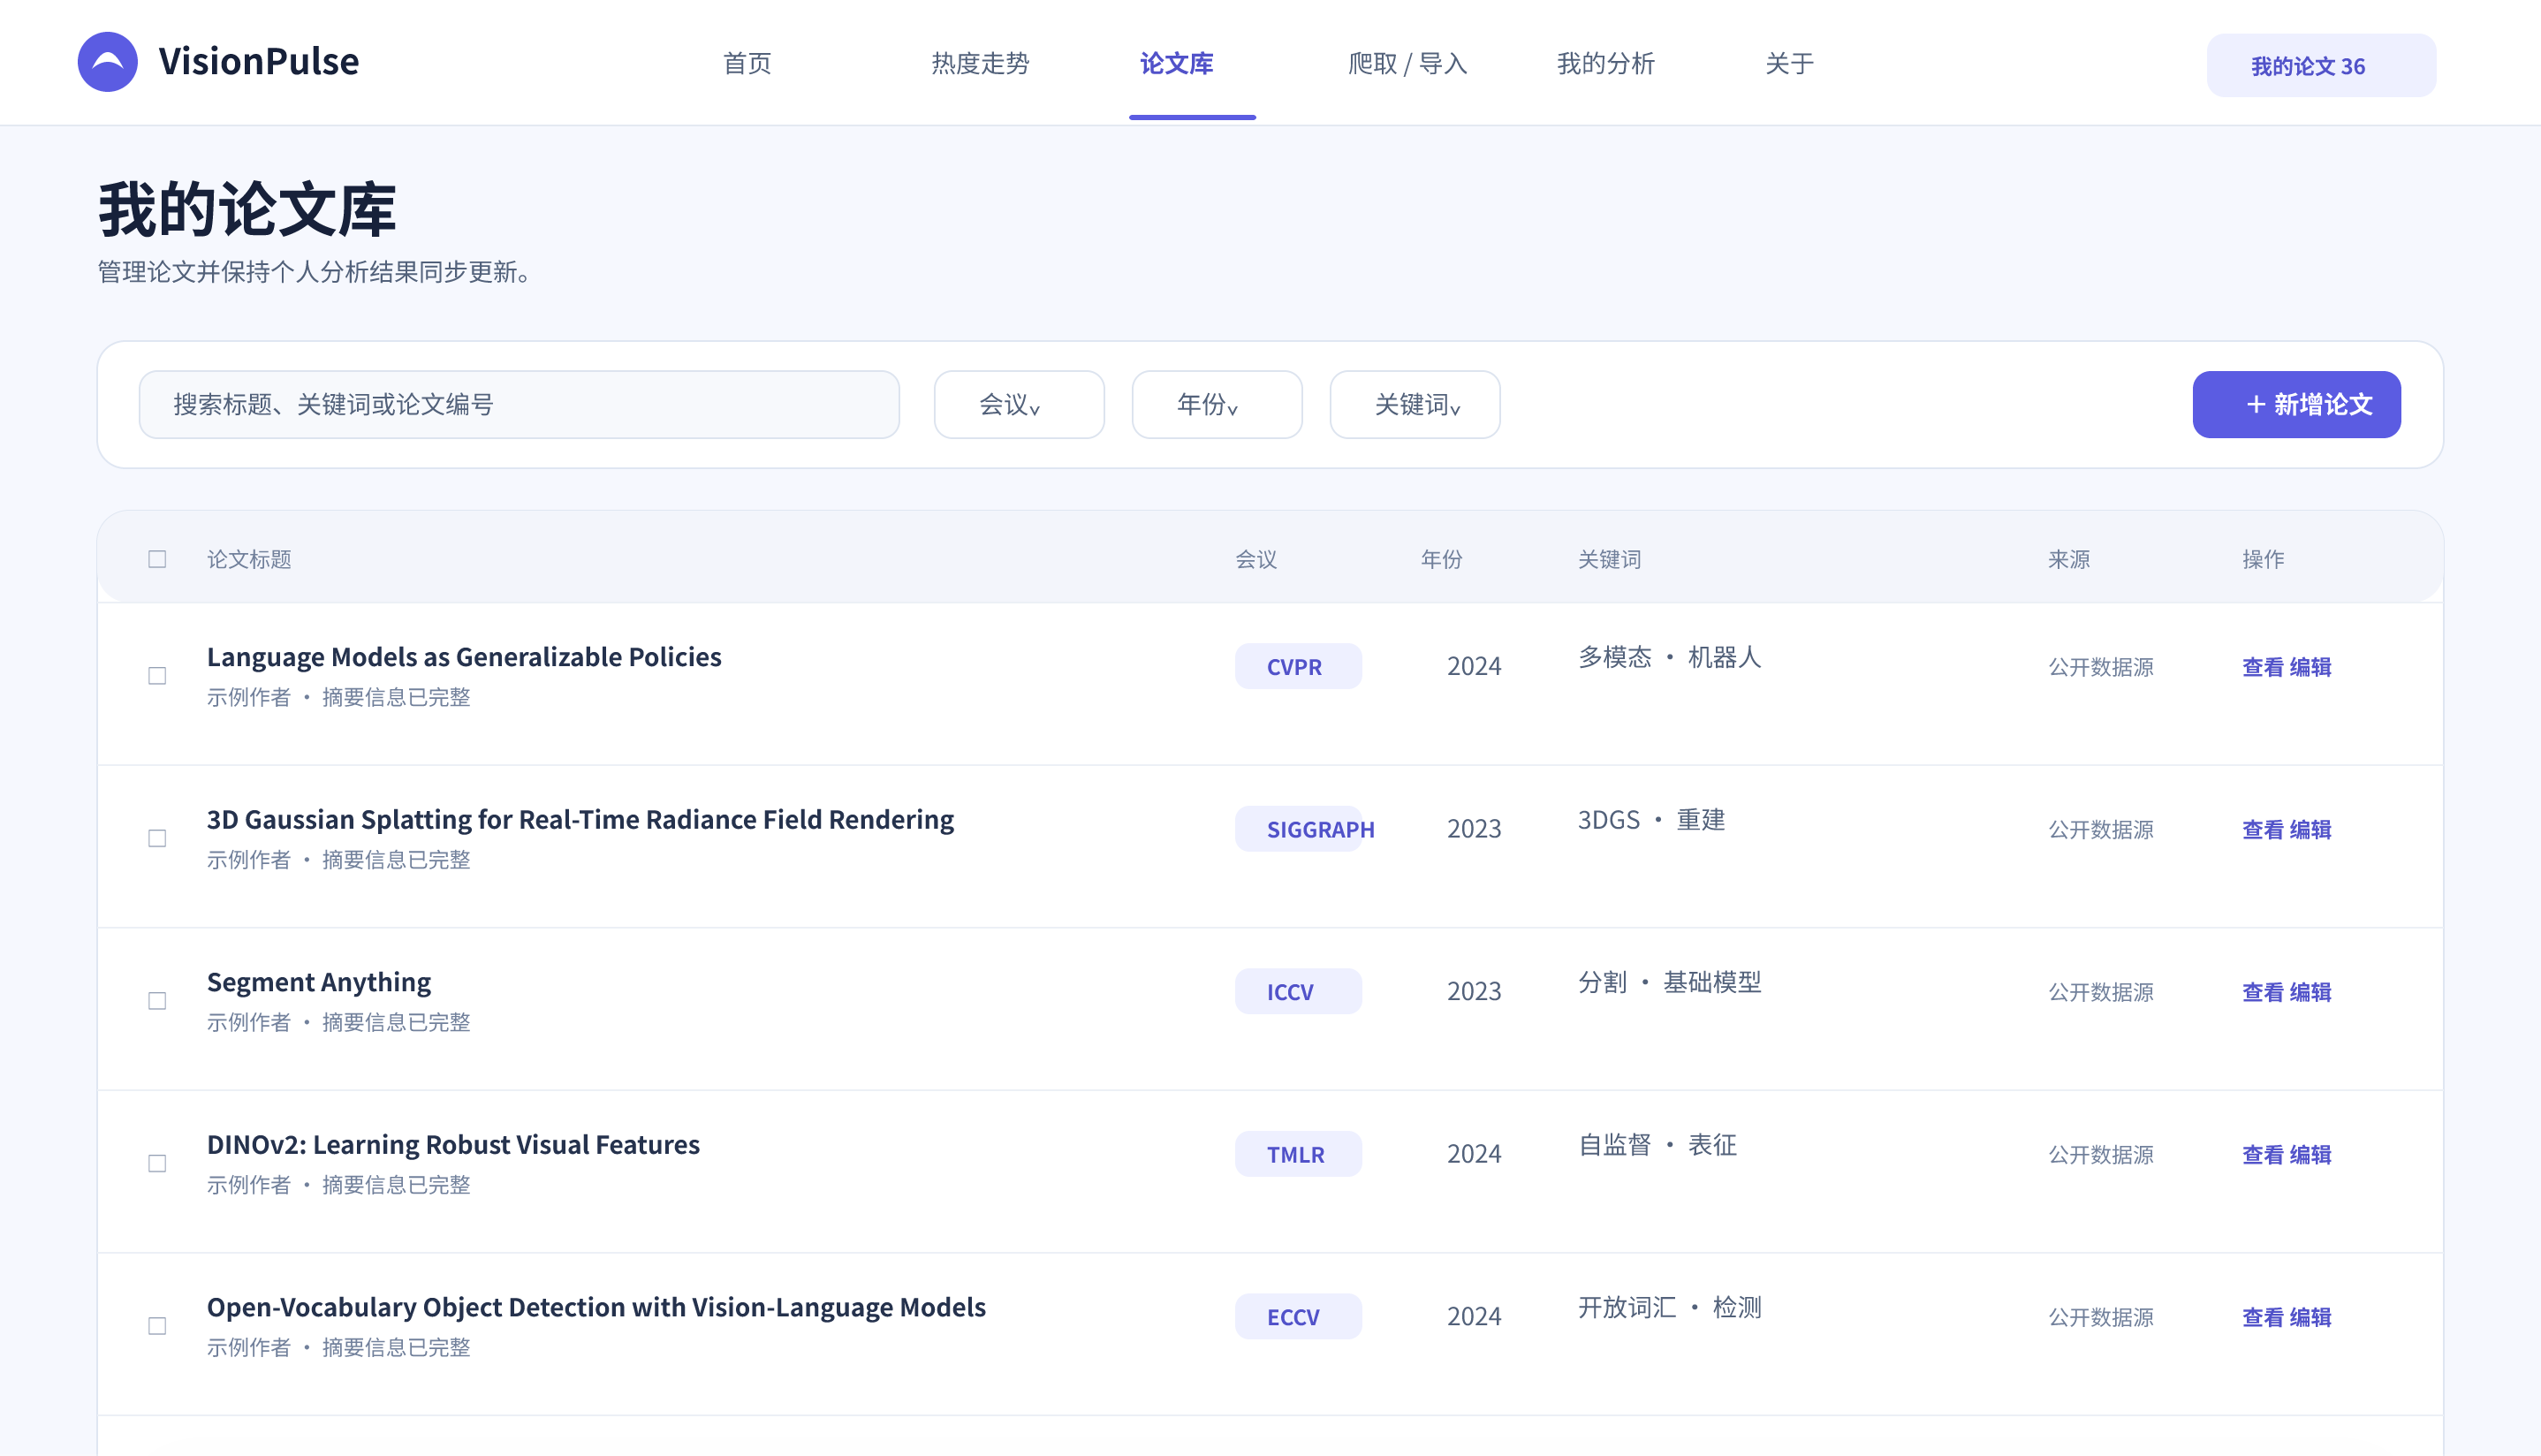
论文库采用“筛选栏 + 数据表格”的布局。用户可以通过标题、关键词或论文编号搜索,并按照会议、年份和关键词进行筛选。列表集中展示论文标题、会议、年份、关键词和数据来源,同时提供查看和编辑入口。新增、编辑或删除论文后,个人分析结果会随论文库数据同步更新。
“我的分析”用于把个人论文库转化为研究画像。页面首先展示论文总数、覆盖方向、时间跨度和主要会议等概览信息,然后展示个人 Top 10、关键词图谱、年度趋势和研究覆盖差距。研究覆盖差距会比较全局排名与个人排名,帮助用户发现个人论文库中关注较少的热门方向。
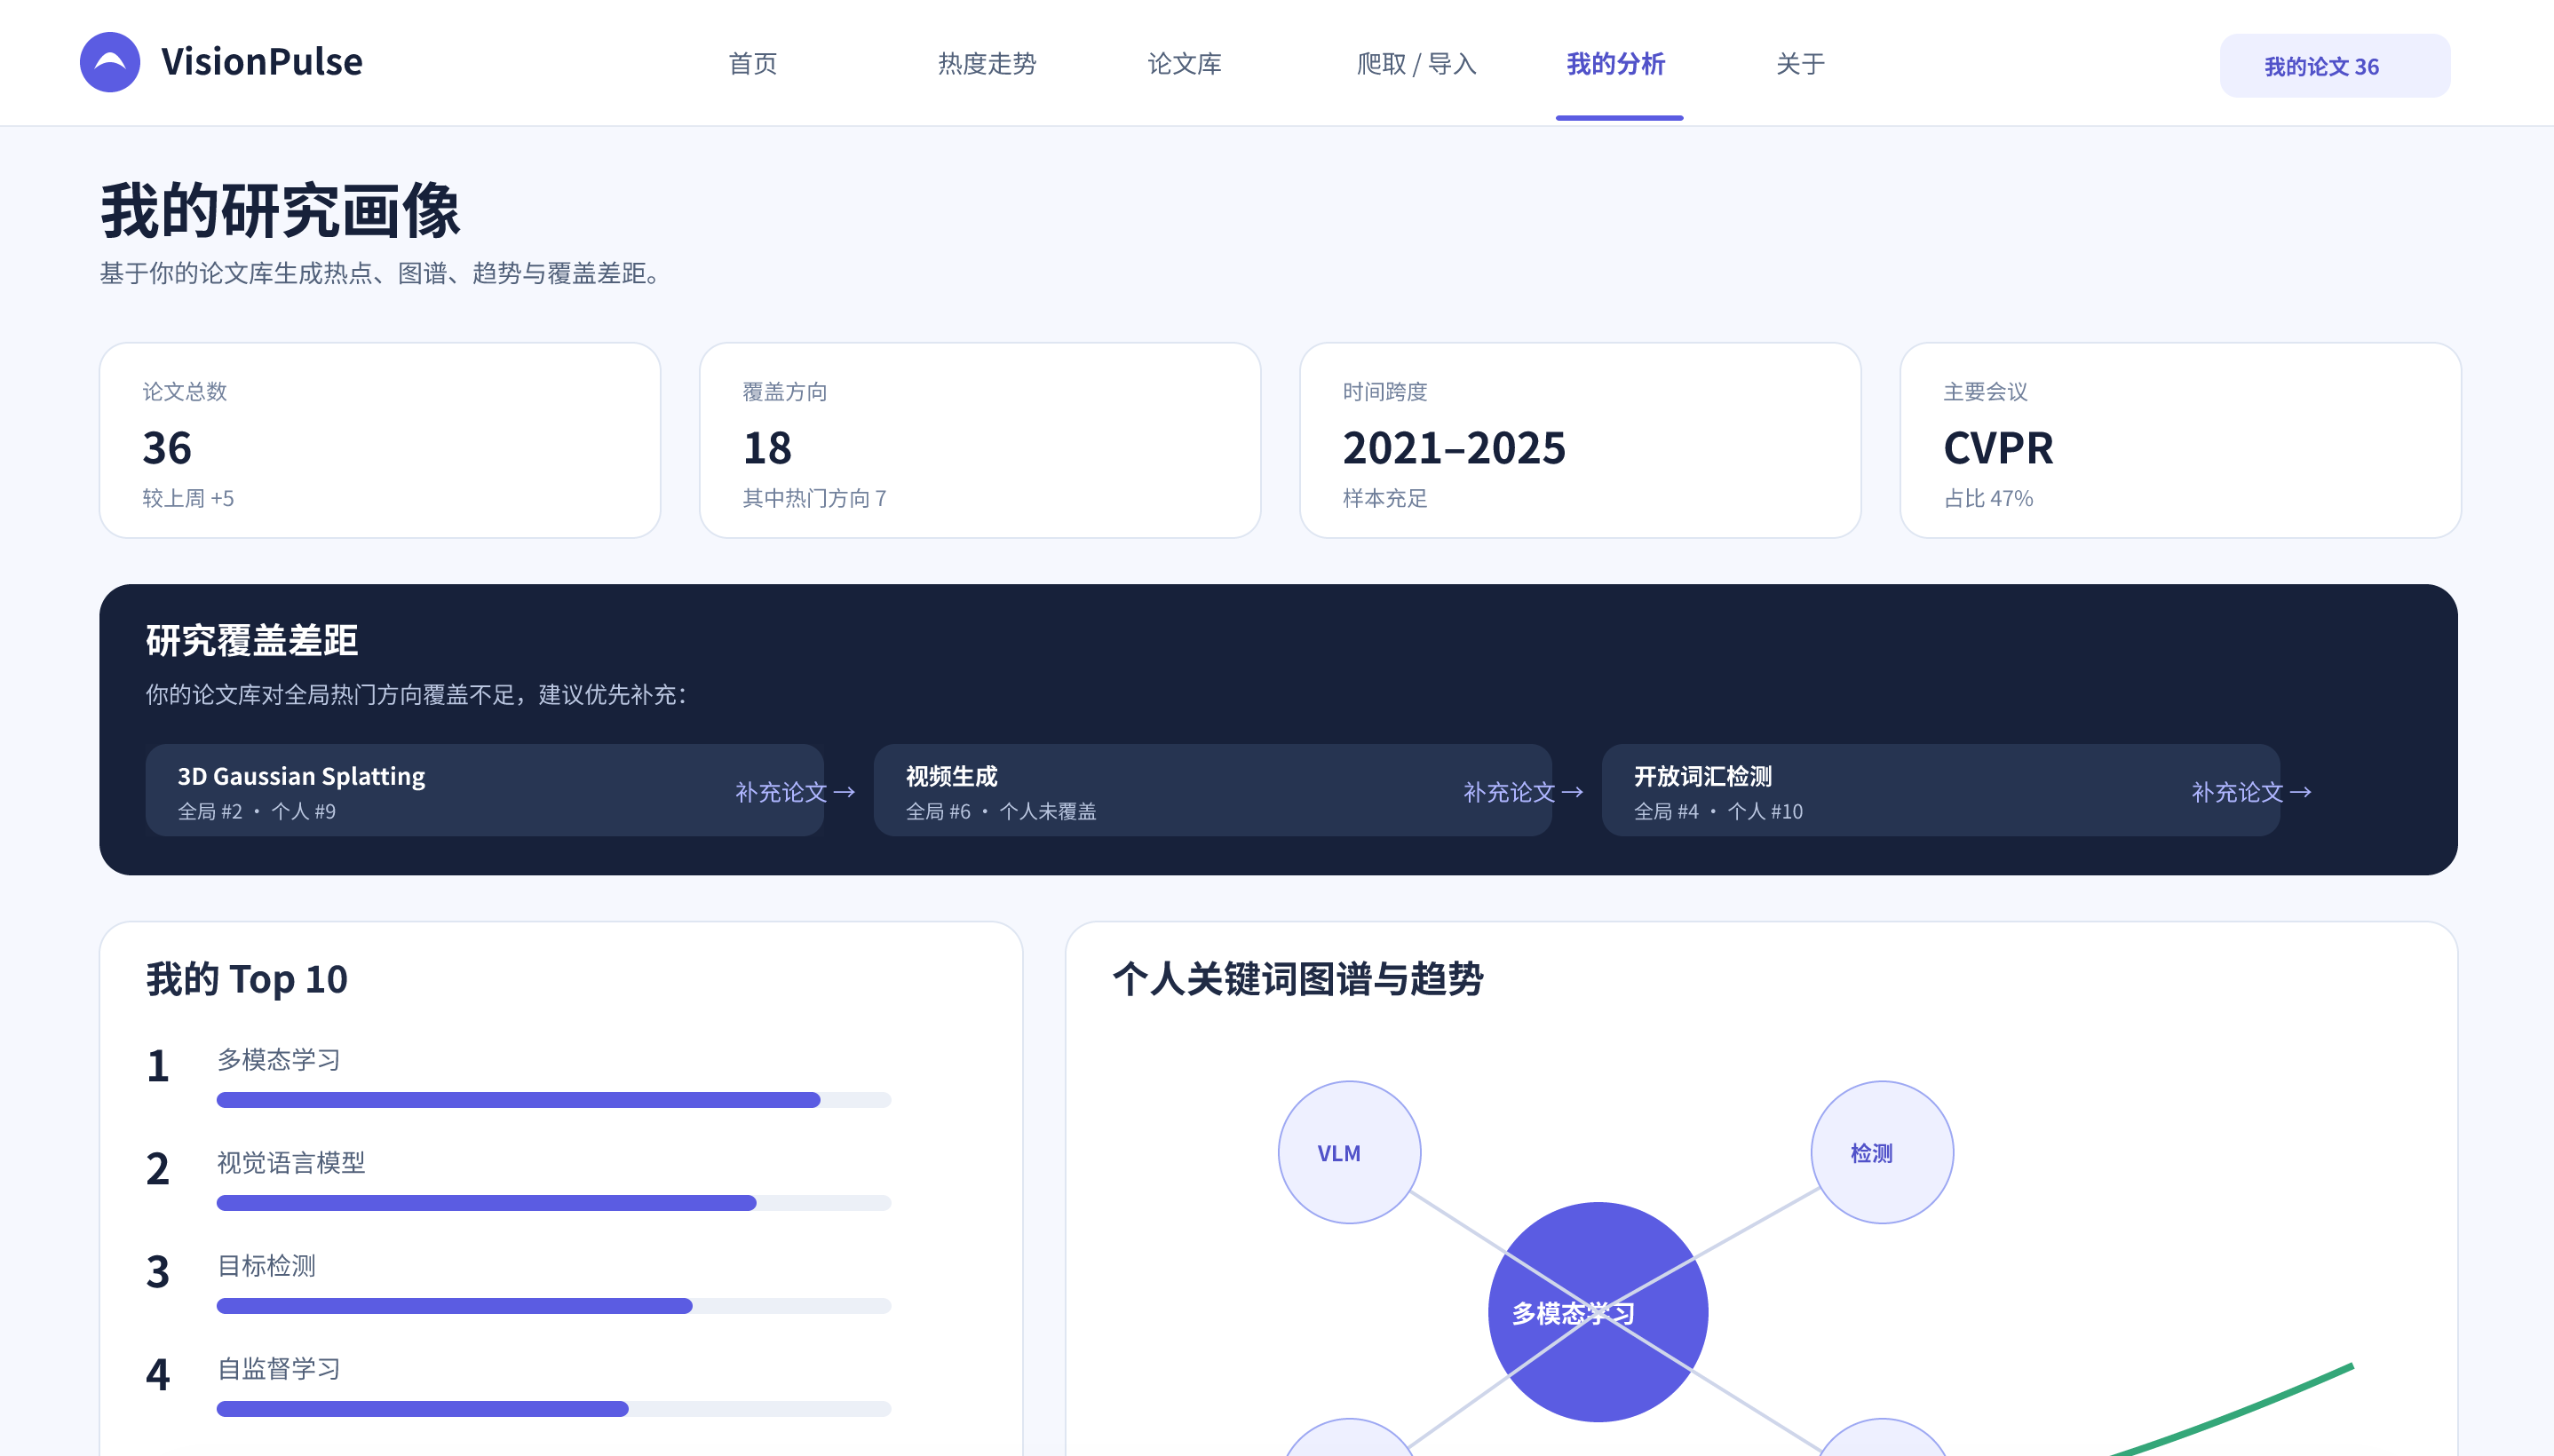
原型重点打通了两条主要使用流程:
小白探索流程:
首页热门方向 → 查看方向与代表论文 → 选择论文 → 加入个人论文库 → 查看个人分析

主动研究流程:
标题检索 / 方向探索 / 批量导入 → 查看候选论文 → 勾选并确认 → 管理论文 → 查看分析变化
除页面跳转外,原型还设计了论文详情、查询联动、候选论文选择、删除确认、批量导入部分失败和个人样本不足等状态。热度走势页面支持播放、暂停和年份定位,使动态展示不会影响用户读取具体数值。
在原型设计阶段,我使用 AI 协助梳理用户路径、页面信息层级和异常状态,并根据讨论结果形成初步的信息架构。AI 给出的方案主要用于补充容易遗漏的场景,例如新用户无数据、批量导入部分失败、个人样本不足和全局数据与个人数据混淆等问题。
最终的页面布局、视觉风格、信息优先级和交互取舍由我在 Figma 中完成和调整。例如,首页没有设计成空白搜索页,而是优先展示全局热门方向;搜索结果不会自动加入论文库,而是要求用户选择候选论文;“我的分析”页面将研究覆盖差距放在较靠前的位置,以突出全局趋势与个人论文分析之间的联系。
项目采用前后端分离的 Web 架构。前端负责页面展示、用户交互和数据可视化,后端负责论文检索、数据管理、分析计算和持久化。
| 层次 | 主要技术 | 用途 |
|---|---|---|
| 前端框架 | React 19、TypeScript | 使用组件化方式实现页面,并通过类型检查减少接口数据错误 |
| 构建工具 | Vite | 提供本地开发服务器和生产环境构建 |
| UI 组件 | Ant Design | 实现表格、表单、按钮、弹窗和状态提示等通用组件 |
| 数据可视化 | ECharts | 绘制 Top 10、关键词关系图和年度趋势图 |
| 前端路由 | React Router | 管理首页、趋势、论文库、导入和个人分析等页面 |
| 后端语言 | Go 1.23 | 实现业务逻辑、数据处理和分析服务 |
| Web 框架 | Gin | 提供 REST API、请求校验和统一响应处理 |
| 数据库 | SQLite | 保存全局论文集、个人论文库、关键词和数据版本信息 |
| 数据来源 | DBLP、Semantic Scholar | 获取论文书目信息、摘要及其他补充数据 |
| 测试工具 | Vitest、Go Test、Playwright | 分别完成前端、后端和端到端测试 |
| 部署方式 | Docker、Docker Compose | 统一构建和运行环境,并管理数据持久化与健康检查 |
SQLite 不需要额外部署数据库服务,比较适合当前单机课程项目。Go 编译后的程序可以同时提供 API 和前端静态文件,使生产环境只需运行一个应用容器,从而降低部署复杂度。
系统主要由前端应用、HTTP API、业务服务、数据访问层和外部学术数据源组成:
浏览器
  │
  ▼
React + TypeScript 前端
  ├── 首页与全局热门方向
  ├── 热度走势
  ├── 论文库
  ├── 爬取与导入
  └── 我的分析
  │ REST API
  ▼
Go + Gin 后端
  ├── httpapi:路由、参数校验与响应处理
  ├── search:DBLP 在线论文检索
  ├── importing:候选论文和确认导入
  ├── pipeline:论文清洗、数据集采集与导入
  ├── analysis:热门方向、图谱和趋势计算
  └── storage:SQLite 数据访问
  │                         │
  ▼                         ▼
SQLite 数据库          DBLP / Semantic Scholar
前端通过 /api/v1 下的接口与后端通信。开发环境中由 Vite 将 API 请求代理到 Go 服务;生产环境中,Go 服务同时提供前端构建产物和 API,用户只需要访问同一个公网地址。
用户可以按照论文标题或研究方向进行检索,也可以一次粘贴多条论文标题进行批量导入。系统先生成临时候选结果,用户确认勾选后才会写入个人论文库,避免模糊搜索结果被直接保存。联网查询失败时,系统会尝试使用本地预置论文数据,并在响应中标明数据来源。
论文库提供新增、编辑、删除、分页、精确查询和模糊查询,并支持按照会议、年份和关键词筛选。论文整体更新和删除使用修订号进行检查,减少多个请求之间发生数据覆盖的风险。
分析模块会处理论文标题、摘要和关键词,通过文本清洗、停用词过滤、n-gram、TF-IDF 和术语归一化得到研究方向。在此基础上生成全局或个人 Top 10、关键词共现图和年度会议趋势。每项结果都保存对应的追溯信息,使用户能够从图表返回形成该结果的具体论文。
数据集工具负责采集和导入 CVPR、ICCV、ECCV 论文。采集过程支持请求限速、失败重试和断点续传;数据发布前会验证会议和年份的完整性。只有通过校验的数据版本才会成为系统当前使用的全局论文集,避免中断或不完整数据影响线上分析。
系统使用 SQLite 保存数据,主要包括全局论文、个人论文、关键词、候选导入记录和数据集版本。全局论文集用于生成整个领域的分析结果,个人论文库用于生成用户自己的研究画像,两类数据在接口和页面上保持明确区分。
个人论文发生新增、修改或删除后,个人分析的修订号也会变化。旧分析结果的追溯请求会被识别为过期,从而避免用户根据已经变化的数据得到错误结论。
项目使用 Go Test 测试后端存储、接口、数据管道和分析逻辑,使用 Vitest 测试前端组件,并通过 Playwright 验证“检索论文—确认导入—管理论文—查看分析”等完整流程。端到端测试使用固定数据,不依赖外部学术服务,以保证测试可以重复执行。
生产环境通过 Docker Compose 部署。Go 程序在同一个容器中提供前端静态资源和后端接口,SQLite 数据目录映射到宿主机进行持久化,同时配置健康检查、自动重启和日志轮转。该结构所需服务较少,便于在云服务器上更新、备份和恢复。
目前 VisionPulse 已经部署到云服务器,可以通过 http://101.43.121.125/ 访问。下面按照实际使用流程展示系统的主要功能。
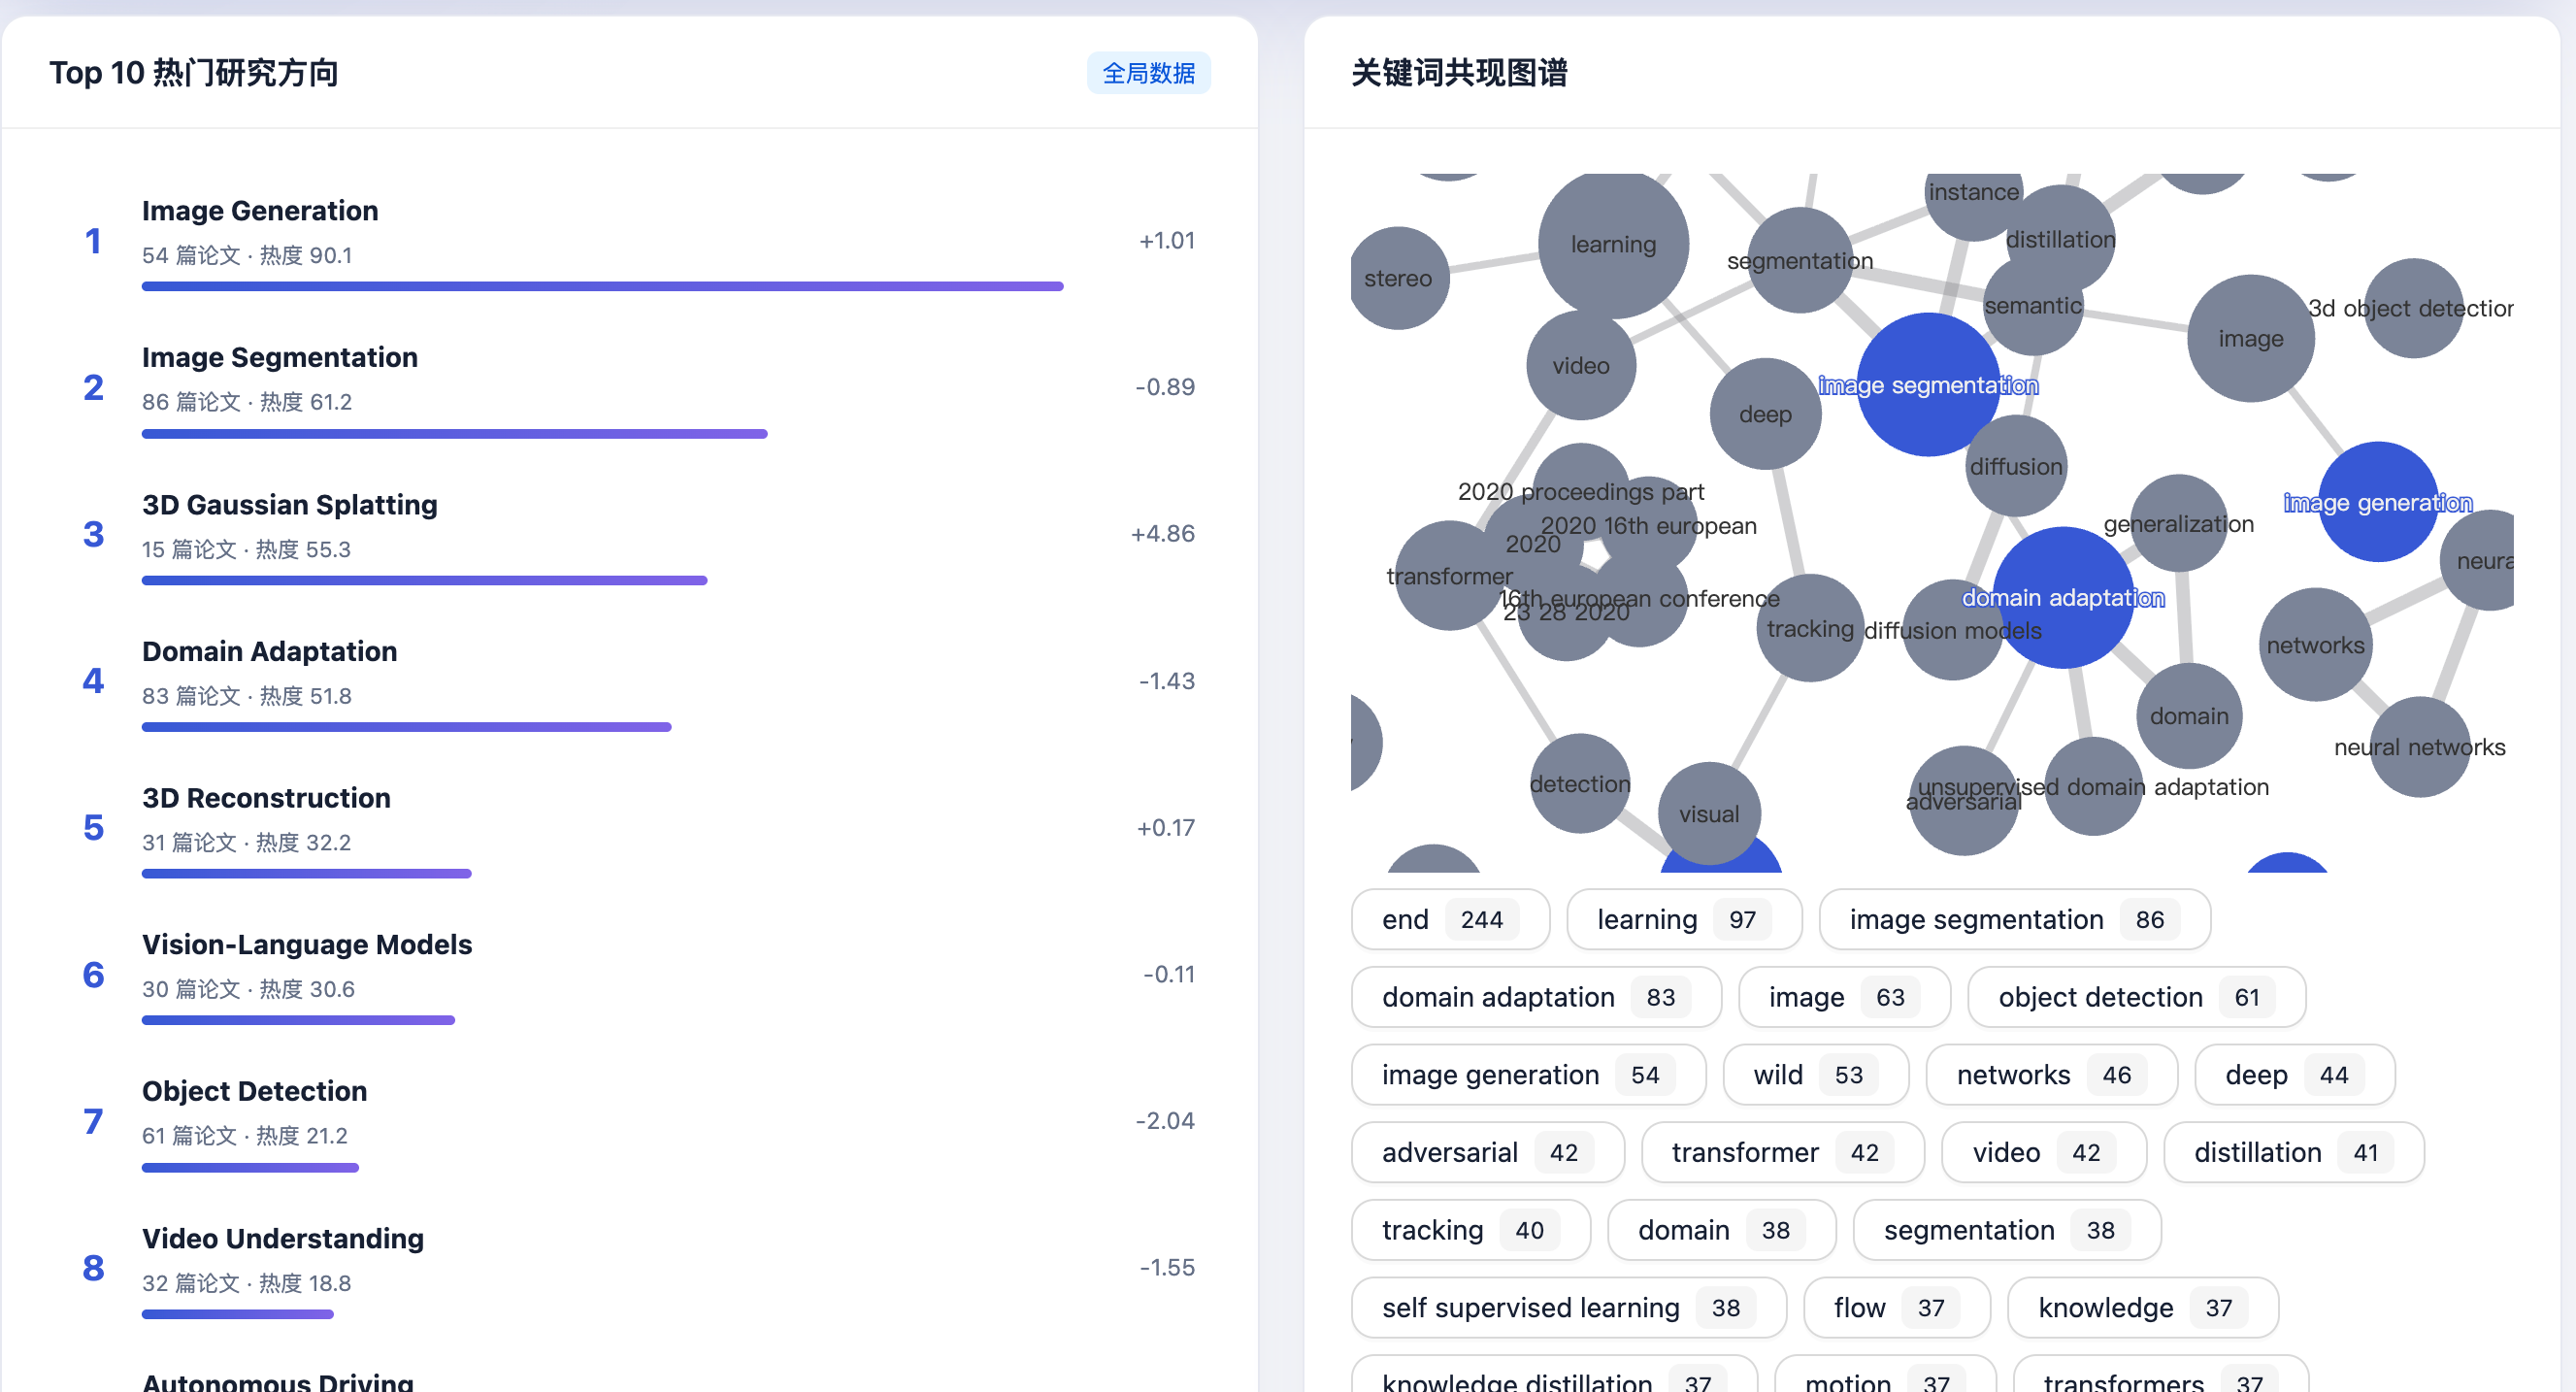
首页展示全局论文数据分析结果,左侧为 Top 10 热门研究方向,右侧为关键词共现图谱。Top 10 不仅显示研究方向排名,还会显示相关论文数量、热度分数和近期变化;关键词图谱则根据关键词在论文中的共同出现关系生成节点和连线。
用户点击某个研究方向或关键词后,可以进一步查看对该结果有贡献的论文。这样既能够快速观察计算机视觉领域的主要热点,也能够从统计结果返回原始论文,避免图表与数据来源脱节。
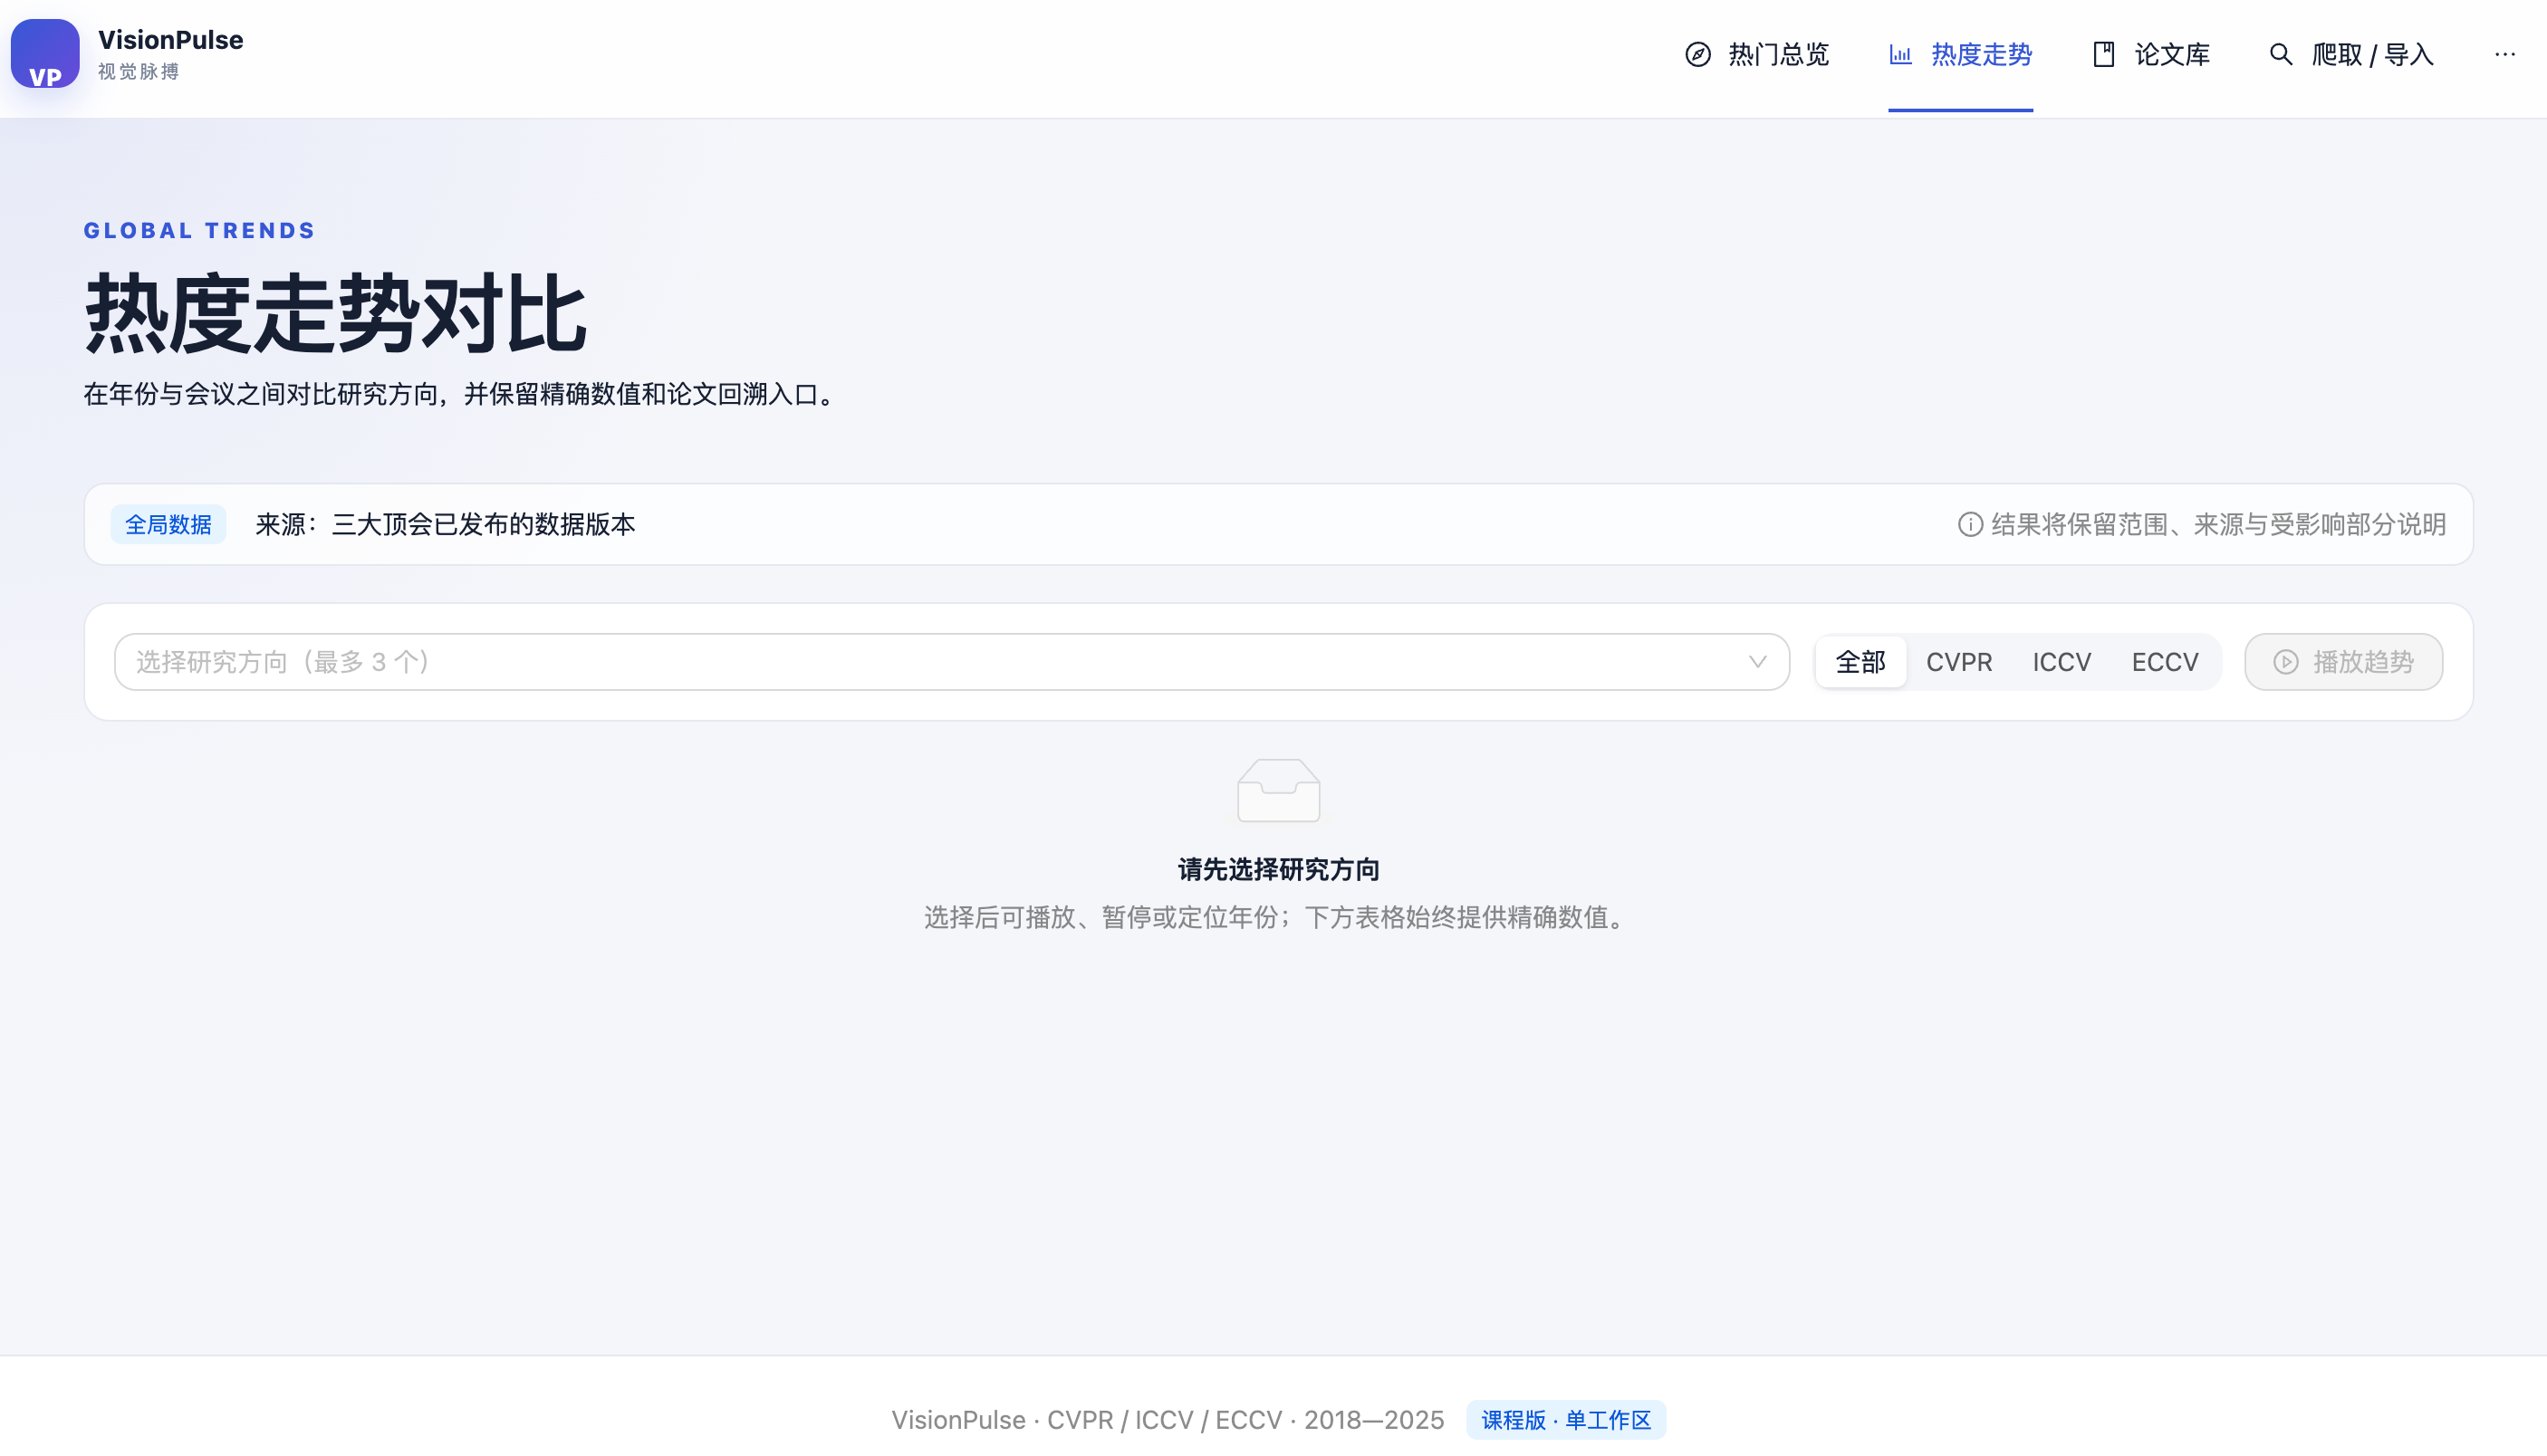
热度走势页面用于比较研究方向在不同年份和不同会议中的变化。初次进入页面时,系统提示用户选择研究方向,并明确标注当前结果来自三大顶会已发布的数据版本。
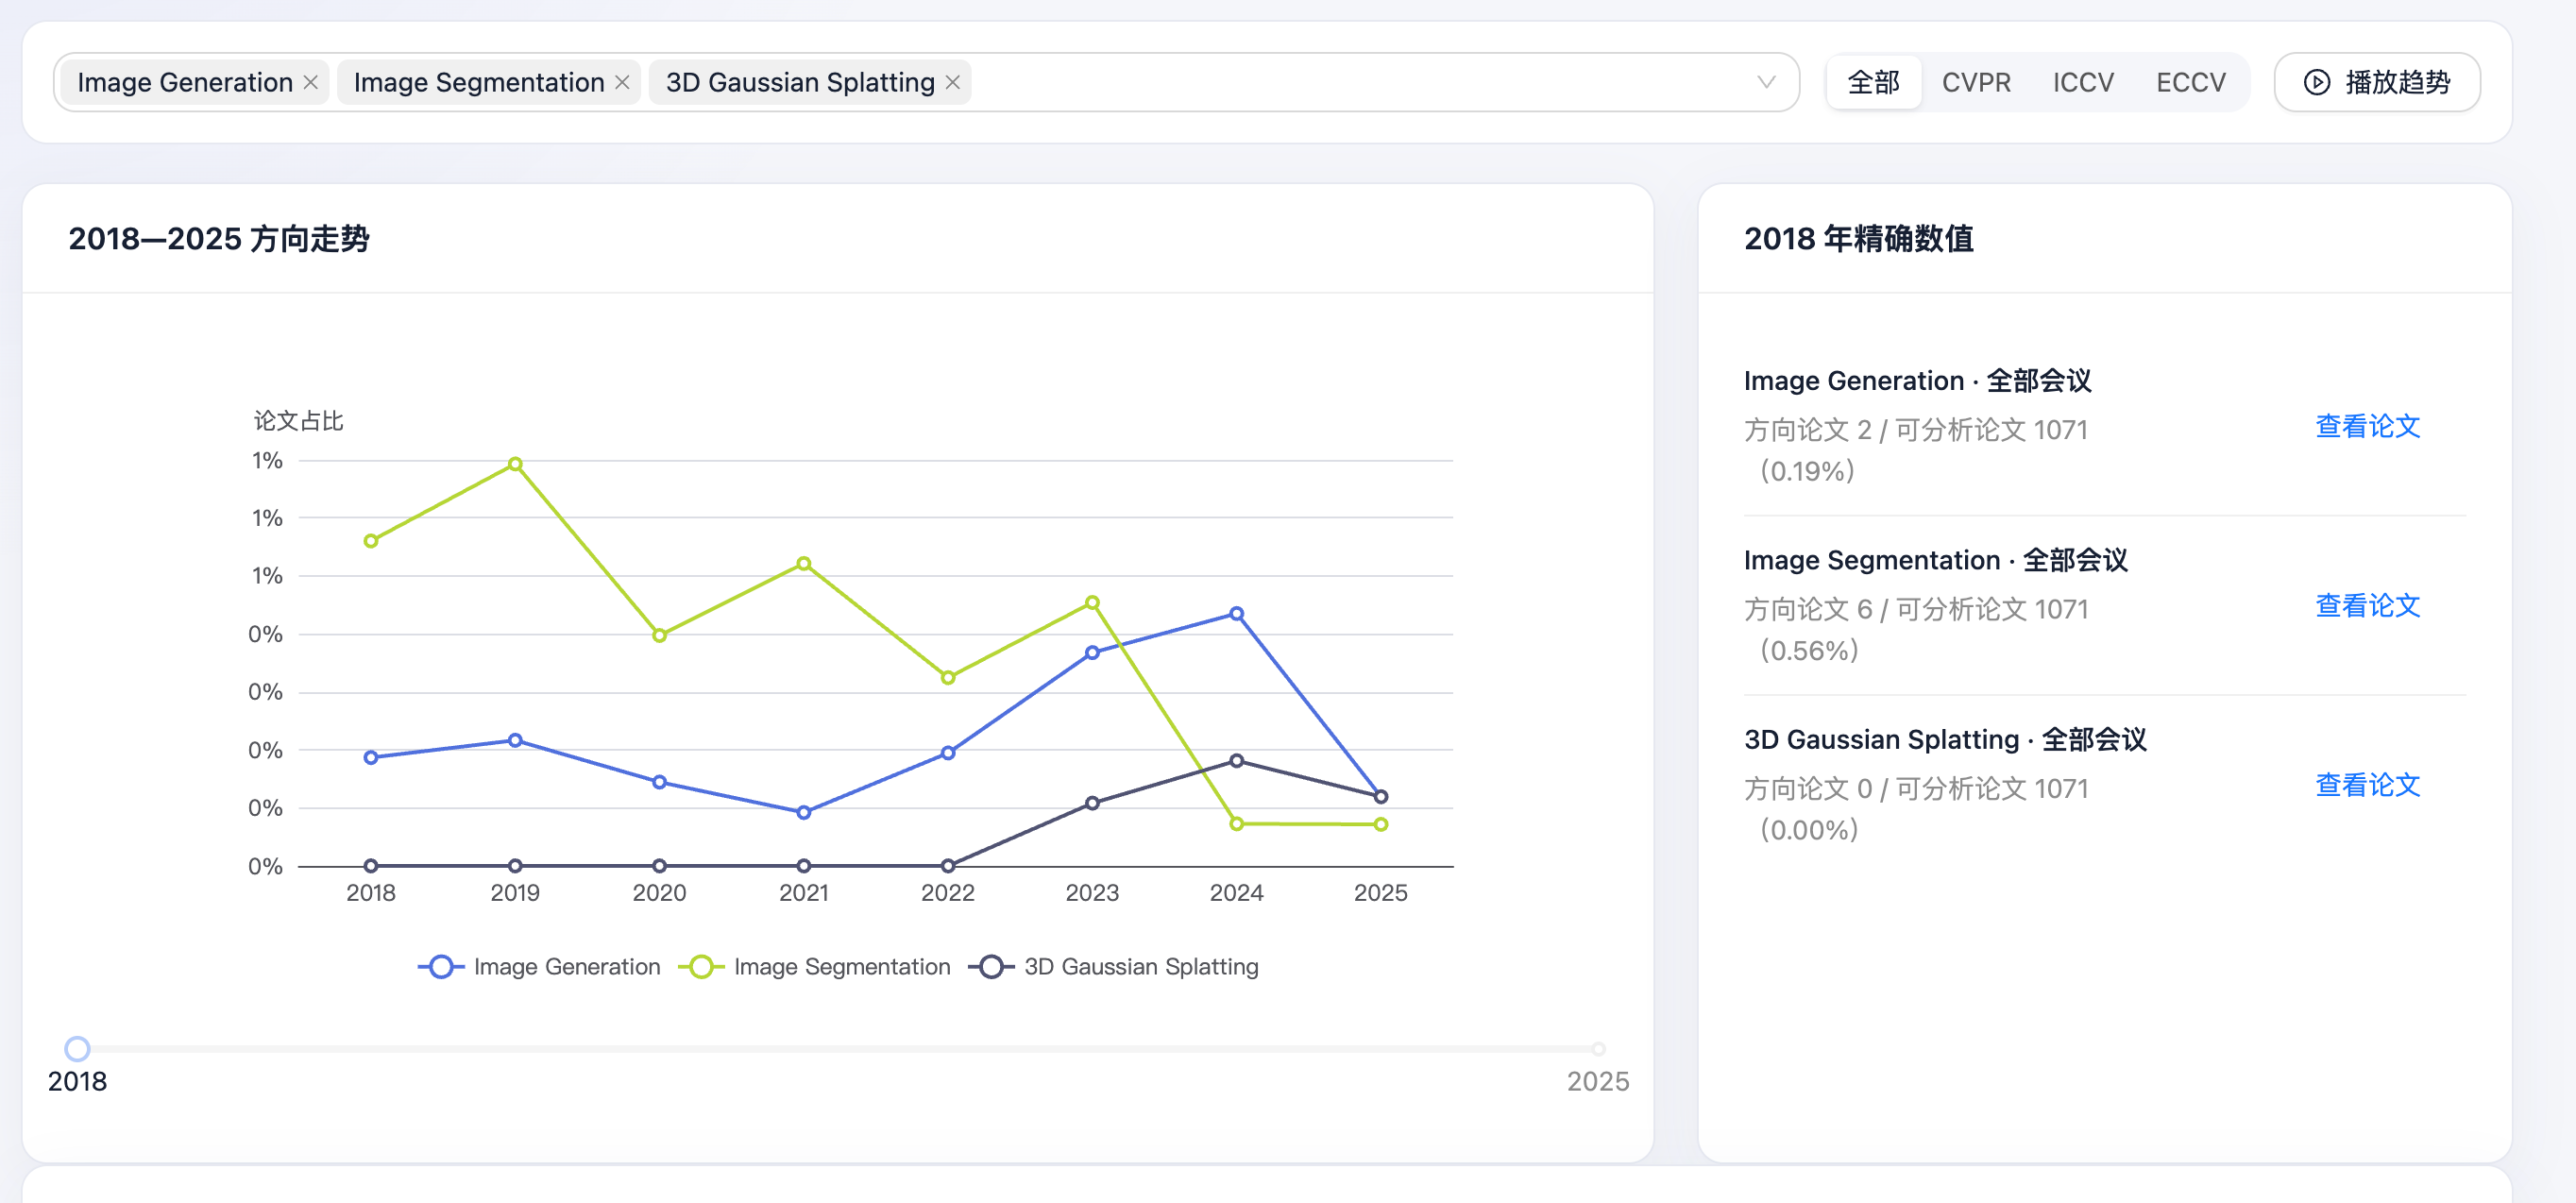
系统最多支持同时选择三个研究方向,通过不同颜色的折线进行对比。用户还可以切换全部会议、CVPR、ICCV 或 ECCV,观察同一方向在不同会议中的变化。当前数据范围为 2018—2025 年,横轴表示年份,纵轴使用方向论文占当年可分析论文的比例,使不同年份的数据规模具有可比性。
截图中同时选择了 Image Generation、Image Segmentation 和 3D Gaussian Splatting 三个方向。右侧面板会给出当前年份的精确论文数量、可分析论文总数和占比,并提供“查看论文”入口。页面还支持播放趋势和拖动年份进度条,便于动态观察热点变化,同时保留精确数值用于比较。
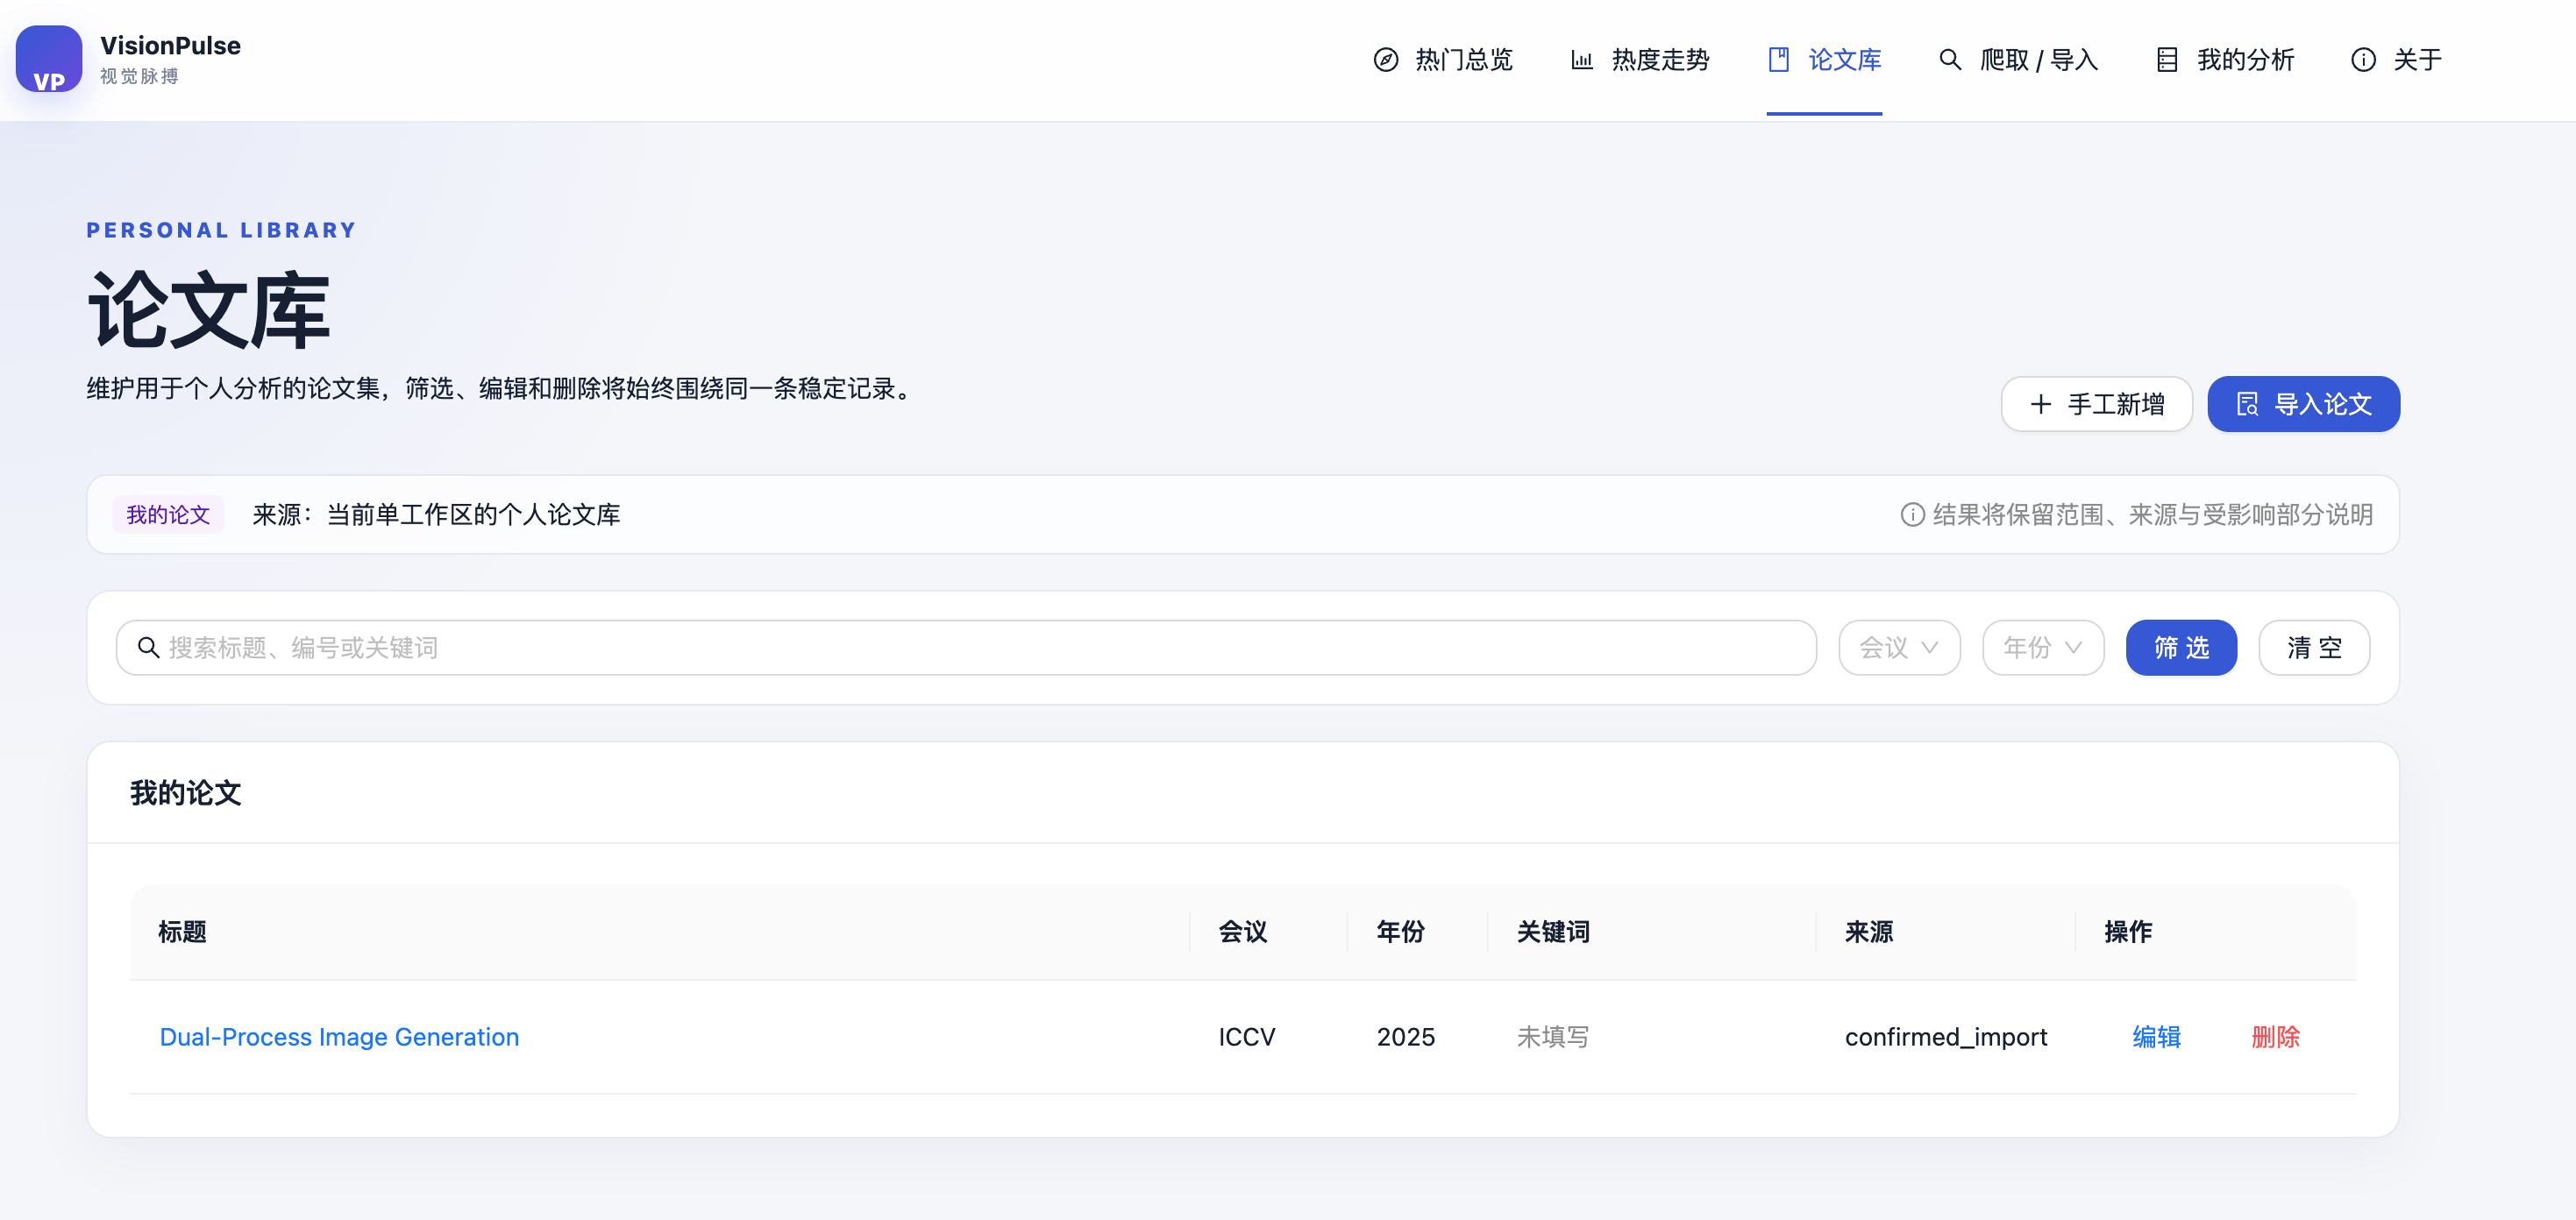
论文库保存用户已经确认导入或手工新增的论文,是个人分析的数据基础。列表显示论文标题、会议、年份、关键词、来源和可执行操作。用户可以按标题、编号或关键词搜索,也可以按照会议和年份组合筛选。
每篇论文均支持编辑和删除。编辑论文信息或关键词后,个人分析会基于最新修订重新计算。页面右上角提供“手工新增”和“导入论文”两个入口,其中“导入论文”会跳转到爬取/导入页面,继续完成在线检索或批量导入。
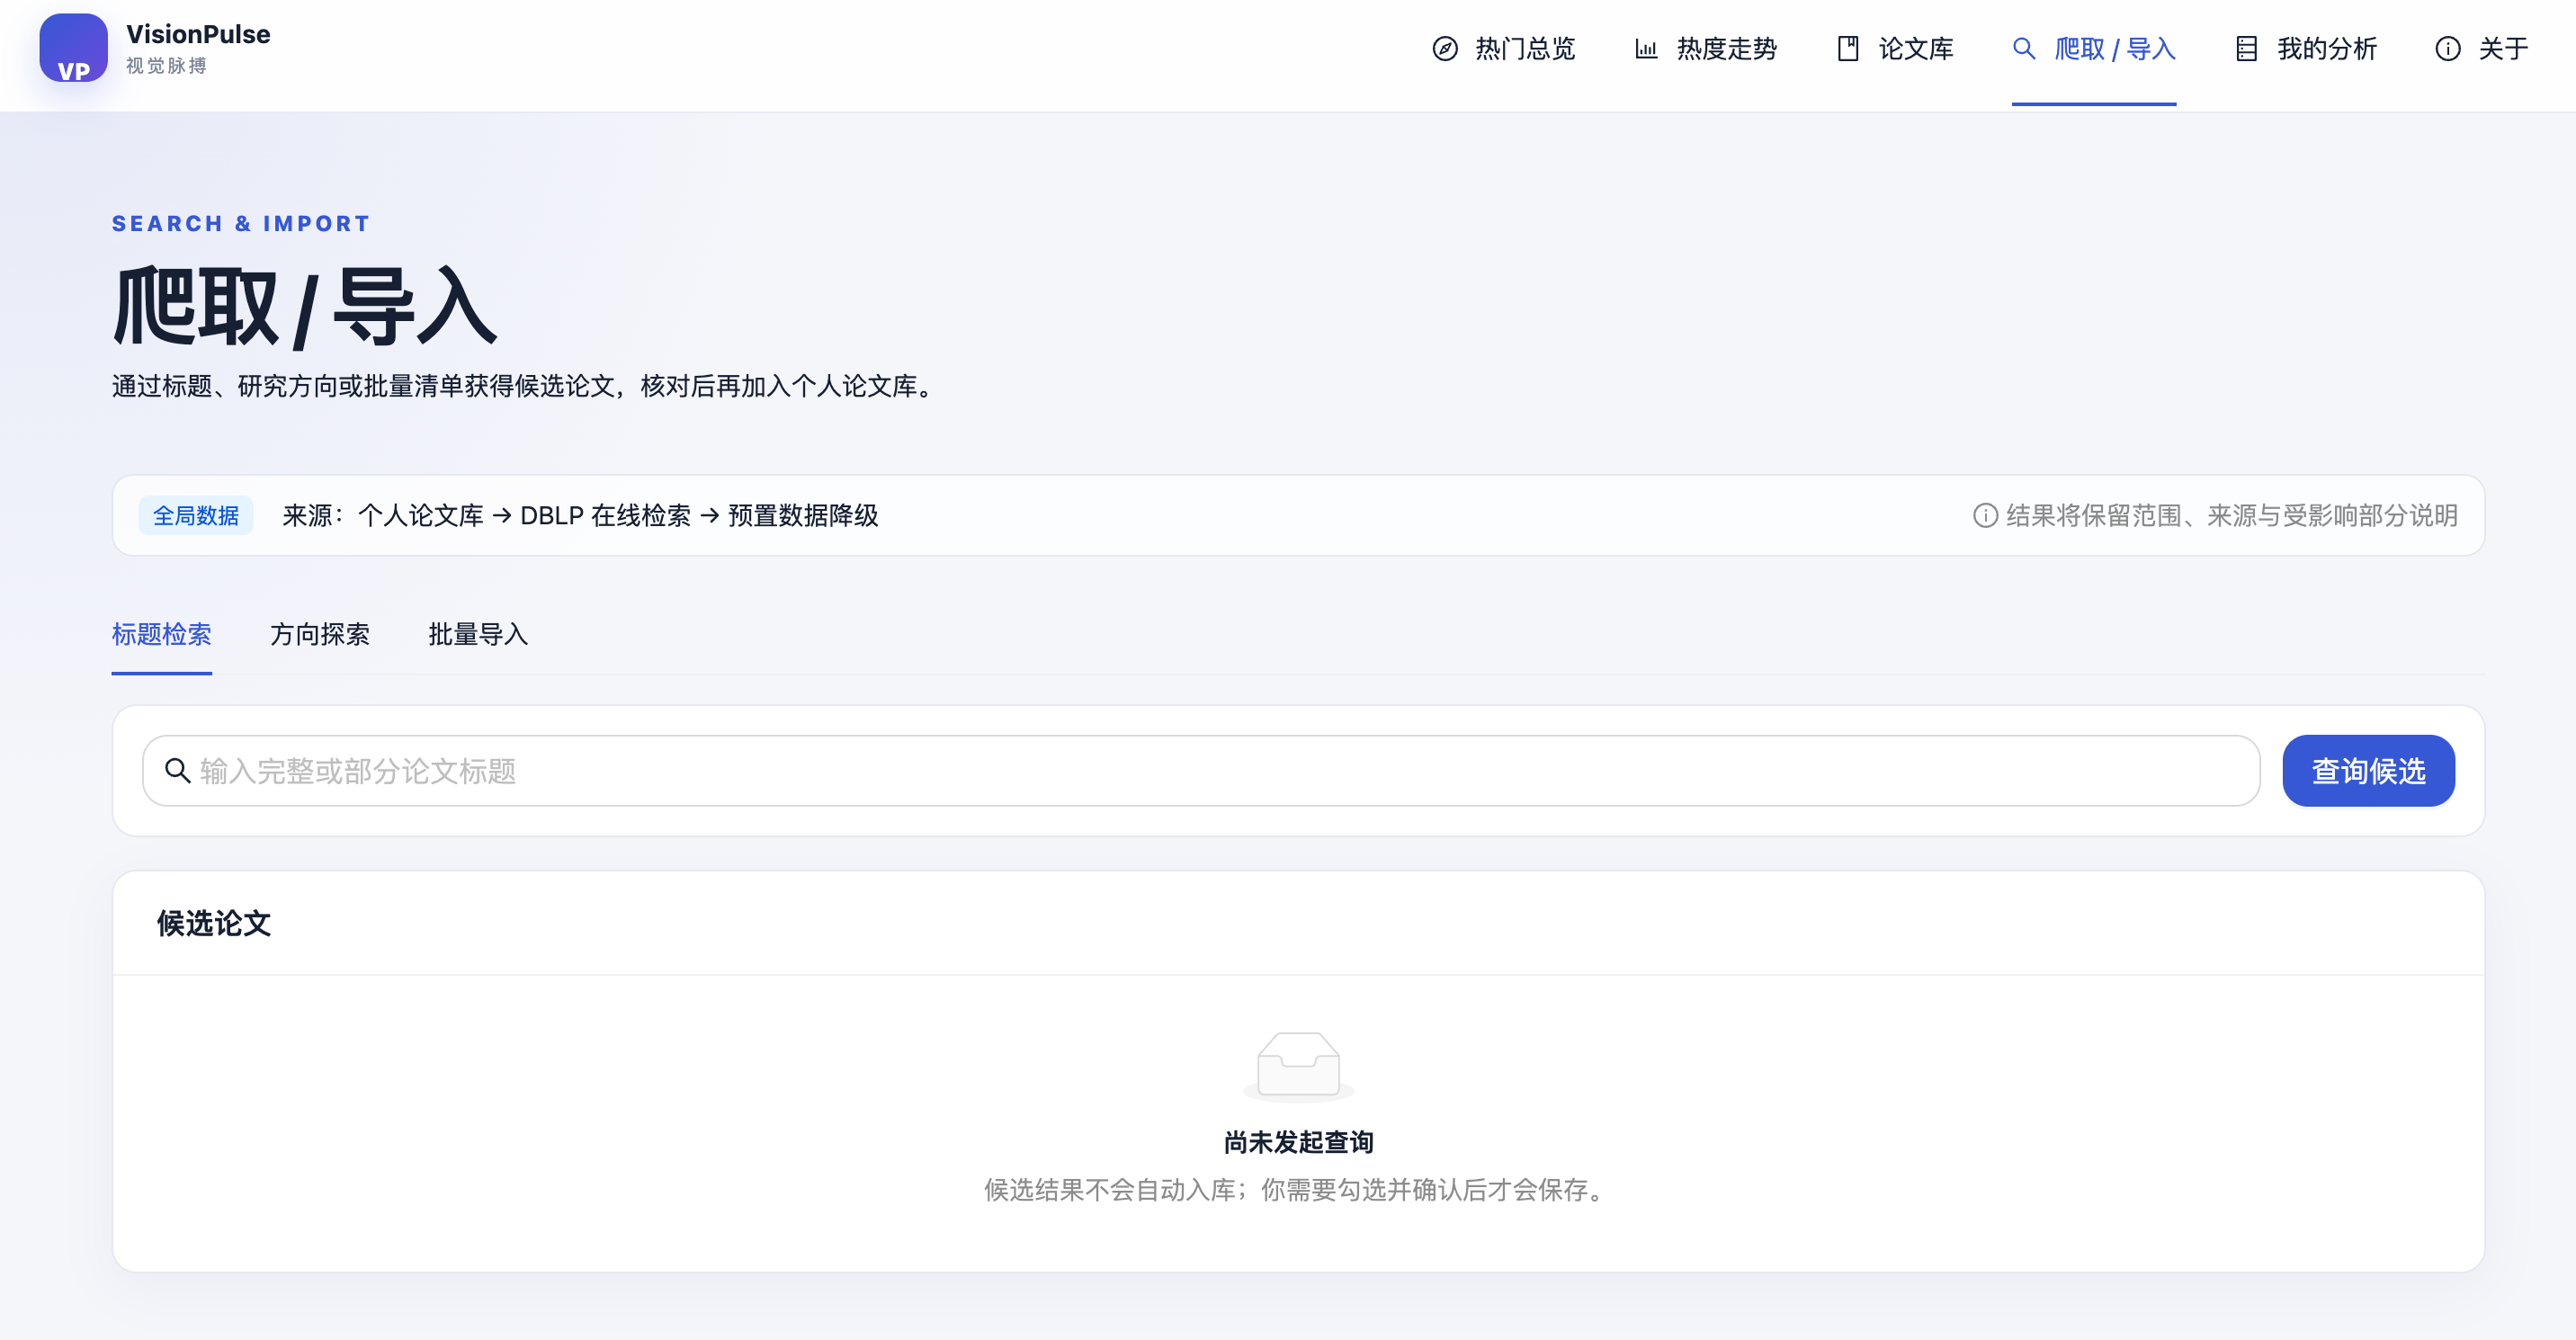
爬取/导入页面提供三种论文获取方式:
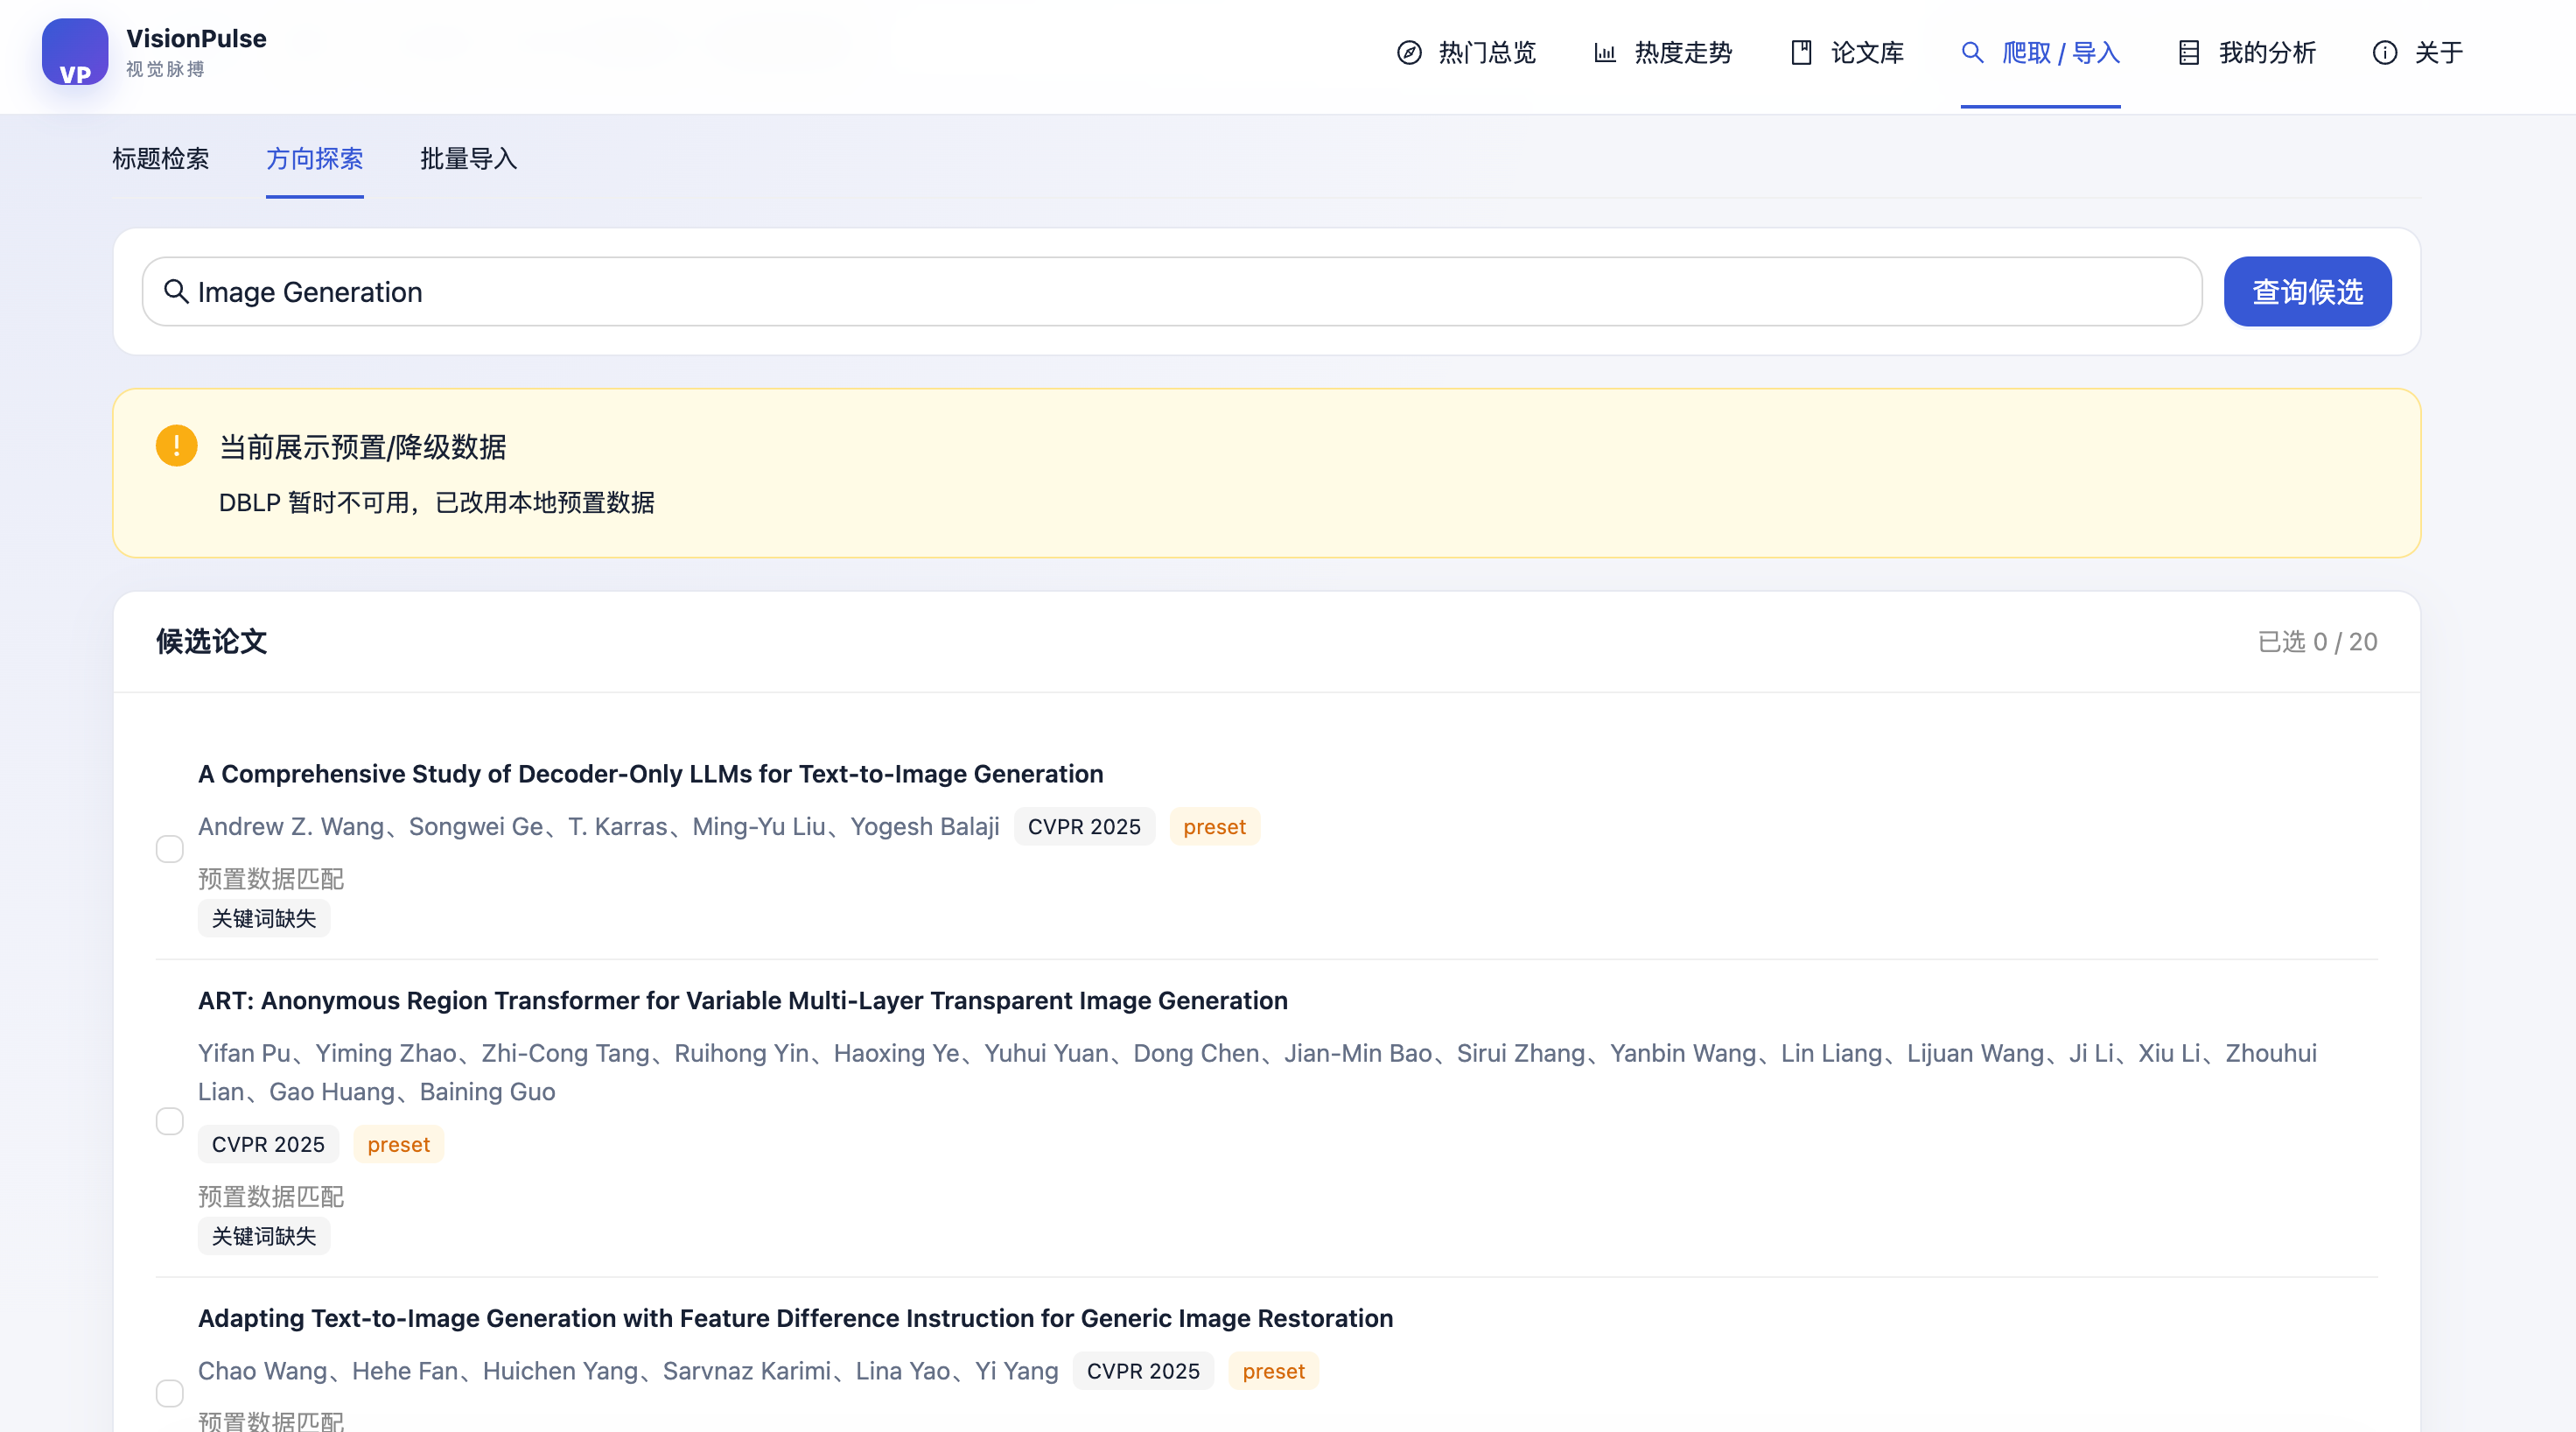
系统的数据查询顺序为“个人论文库 → DBLP 在线检索 → 本地预置数据”。正常情况下优先通过 DBLP 获取公开书目信息;当 DBLP 暂时不可用、超时或受到访问限制时,系统会自动降级到本地预置数据。页面会显示黄色提示,并给候选论文添加 preset 标记,避免将预置结果冒充实时联网数据。
无论使用哪一种检索方式,查询结果都只会形成候选论文,不会自动写入个人论文库。用户需要查看标题、作者、会议、年份和数据来源,勾选确认后才会保存。批量导入同样采用“预览—确认”两阶段流程,并分别反馈成功、失败和重复数量。
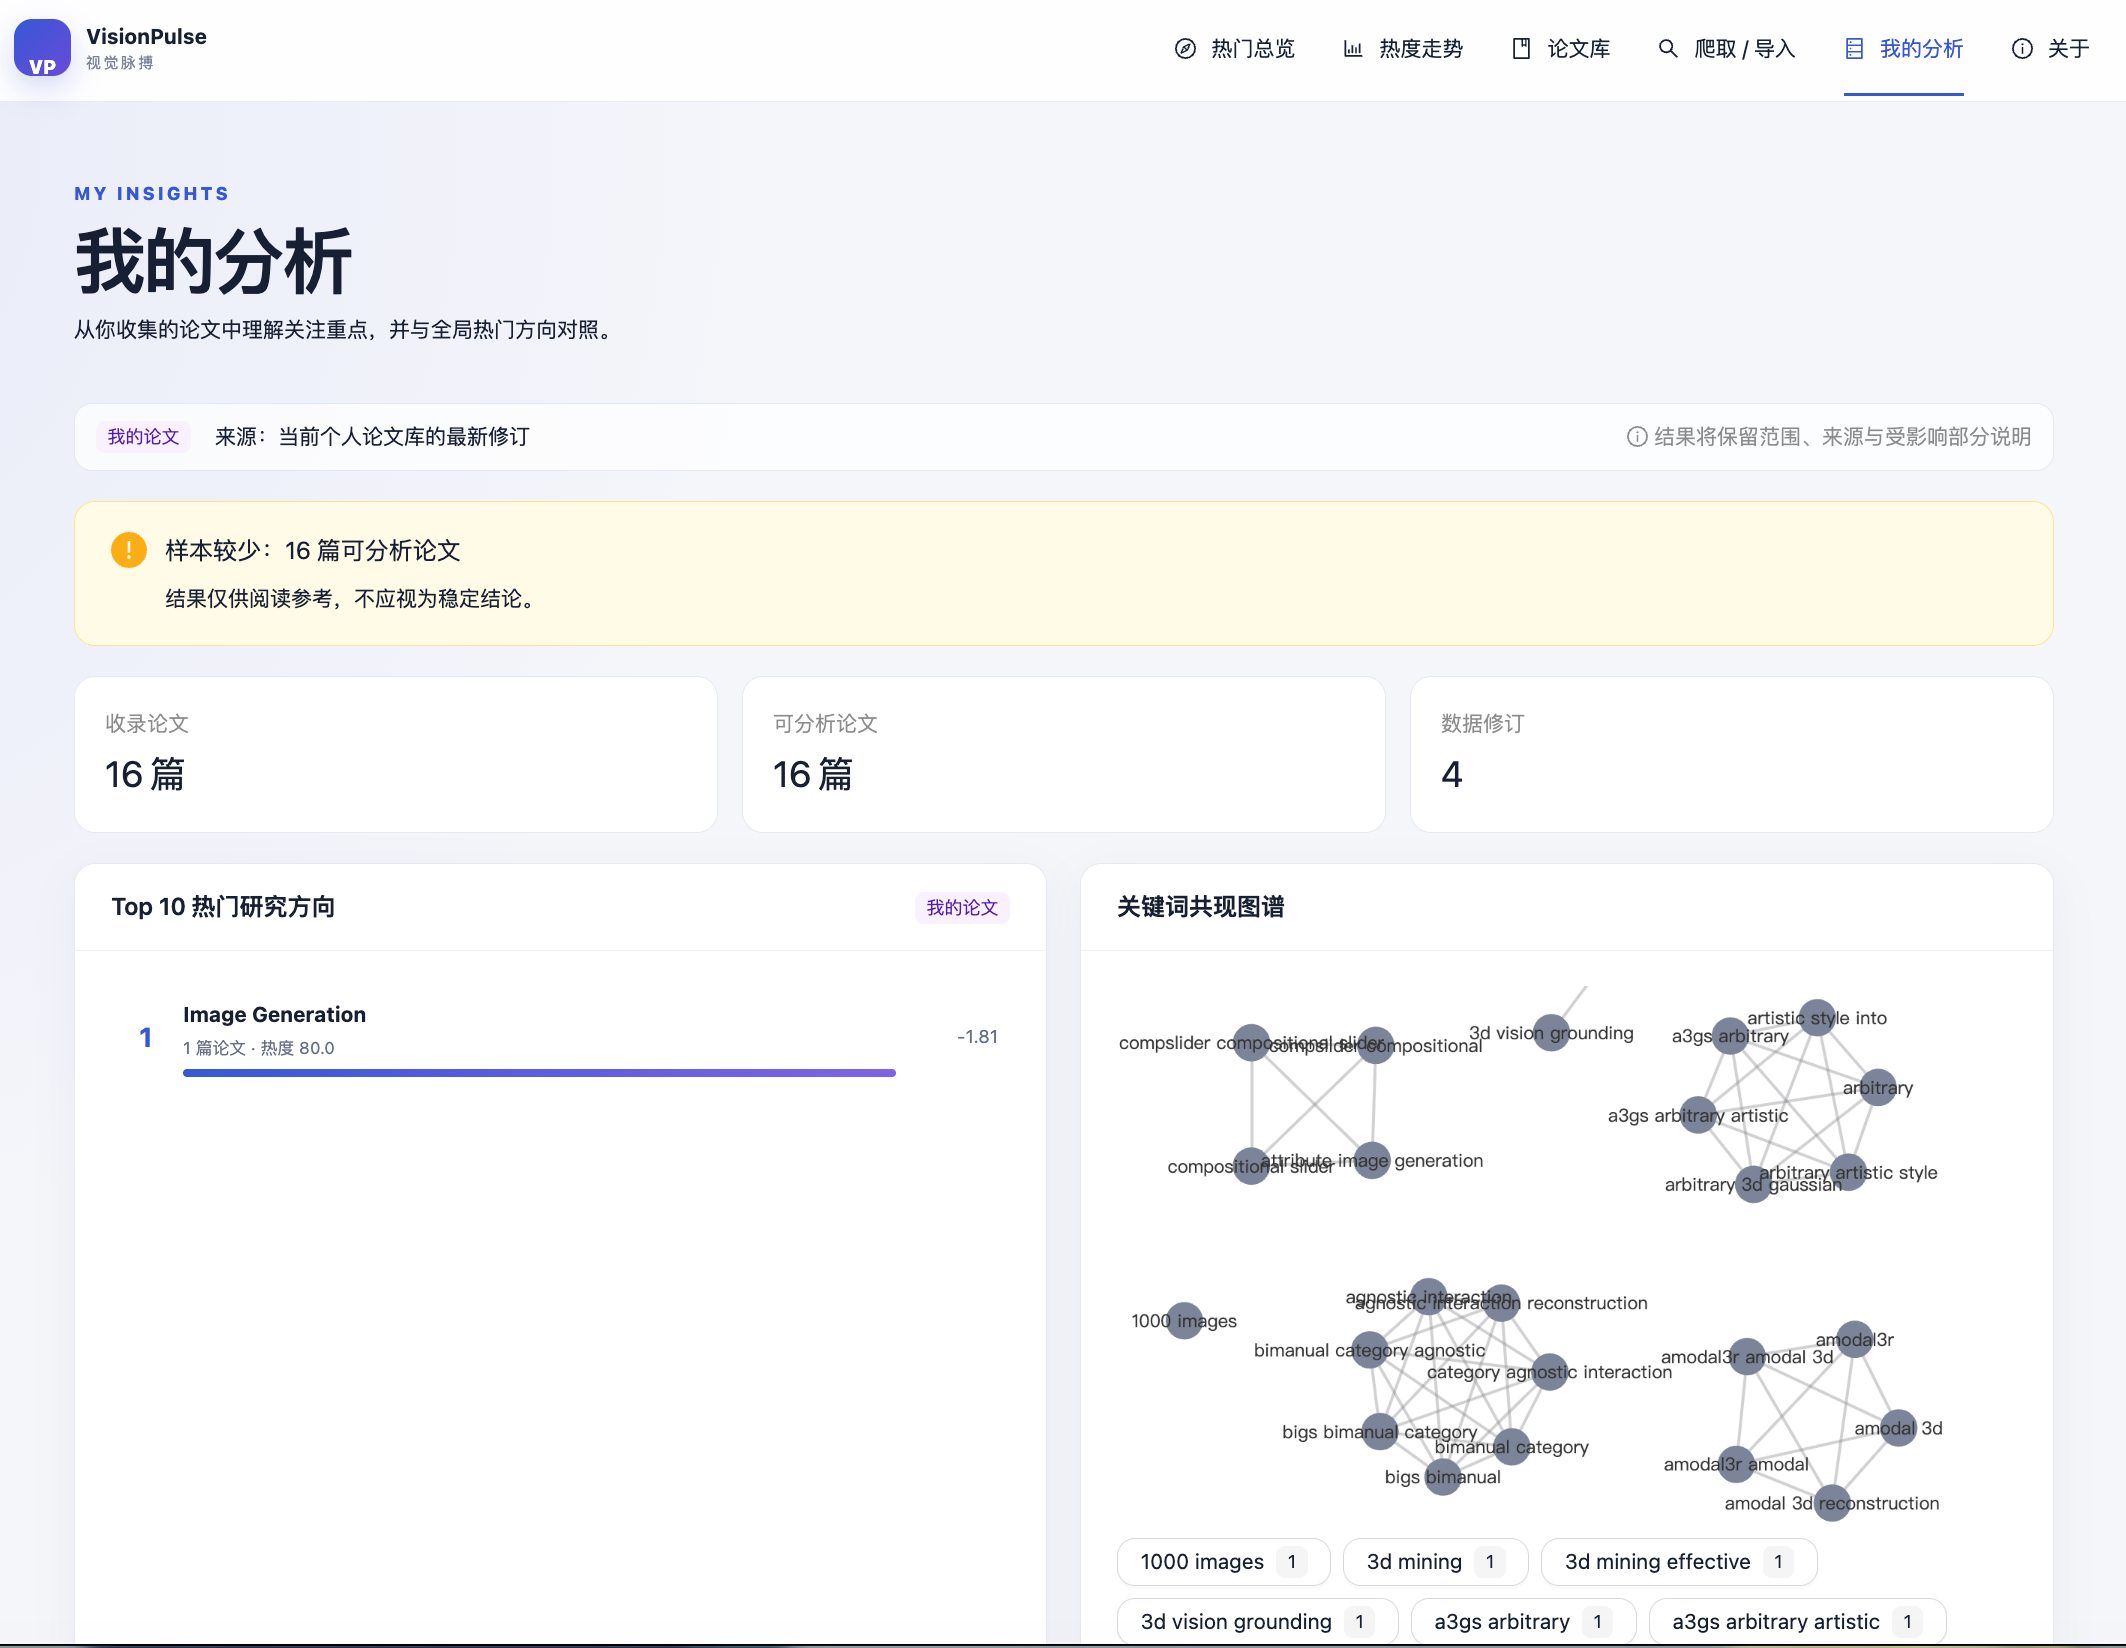
“我的分析”是基础作业要求之外进一步实现的个性化分析功能。它以个人论文库而不是全局论文集作为数据范围,统计收录论文数量、可分析论文数量和当前数据修订,并生成个人 Top 10 热门方向、关键词共现图谱和趋势结果。
该页面帮助用户回答“我收集的论文主要关注哪些研究方向”。用户能够将个人结果与全局热点进行对照,发现自己的关注重点以及尚未充分覆盖的方向。当个人可分析论文少于 20 篇时,系统会明确显示样本较少的提示,说明分析结果仅供阅读参考,不应被视为稳定结论。
VisionPulse 将全局热门方向、趋势对比、论文获取、个人论文管理和个性化分析连接成一条完整流程:
查看全局热点
→ 选择感兴趣的研究方向
→ 检索并确认候选论文
→ 管理个人论文库
→ 生成个人研究方向分析
系统不仅完成了论文爬取、论文列表管理、Top 10、关键词图谱和多年多会议热度对比五项基础功能,还通过个人分析、研究覆盖差距、结果追溯和数据来源标记增强了分析的个性化与可信度。
本项目主要使用 Codex 作为 AI 编程助手。在合作过程中,我没有采用“一次输入需求,让 AI 直接生成整个项目”的方式,而是将工作拆分为需求讨论、方案设计、任务规划、编码实现、测试验证和问题排查等阶段。AI 负责提供候选方案、代码初稿和排查思路,我负责确定需求、选择技术方案、检查代码、运行测试,并对最终结果负责。
| 工作内容 | AI 主要负责 | 我主要负责 |
|---|---|---|
| 需求分析 | 提问、补充用户场景、整理候选方案 | 判断产品定位,决定功能边界和优先级 |
| 原型设计 | 梳理信息架构、用户路径和异常状态 | 在 Figma 中完成页面、视觉和交互设计 |
| 开发规划 | 将目标拆解为 roadmap 和可验收 ticket | 调整先后顺序,确认范围和验收标准 |
| 编码实现 | 生成代码初稿、补充测试、执行重复性修改 | 阅读代码、修改实现、运行检查并决定是否提交 |
| 调试修复 | 分析日志,提出原因假设和修复方向 | 复现问题、验证假设、选择最终方案 |
| 部署运维 | 整理部署步骤,分析构建和网络错误 | 操作服务器,检查数据和线上功能 |
整个协作过程遵循“提出问题—AI 给出方案—人工判断—实际验证—继续迭代”的循环。以下选择三个较有代表性的案例说明具体过程。
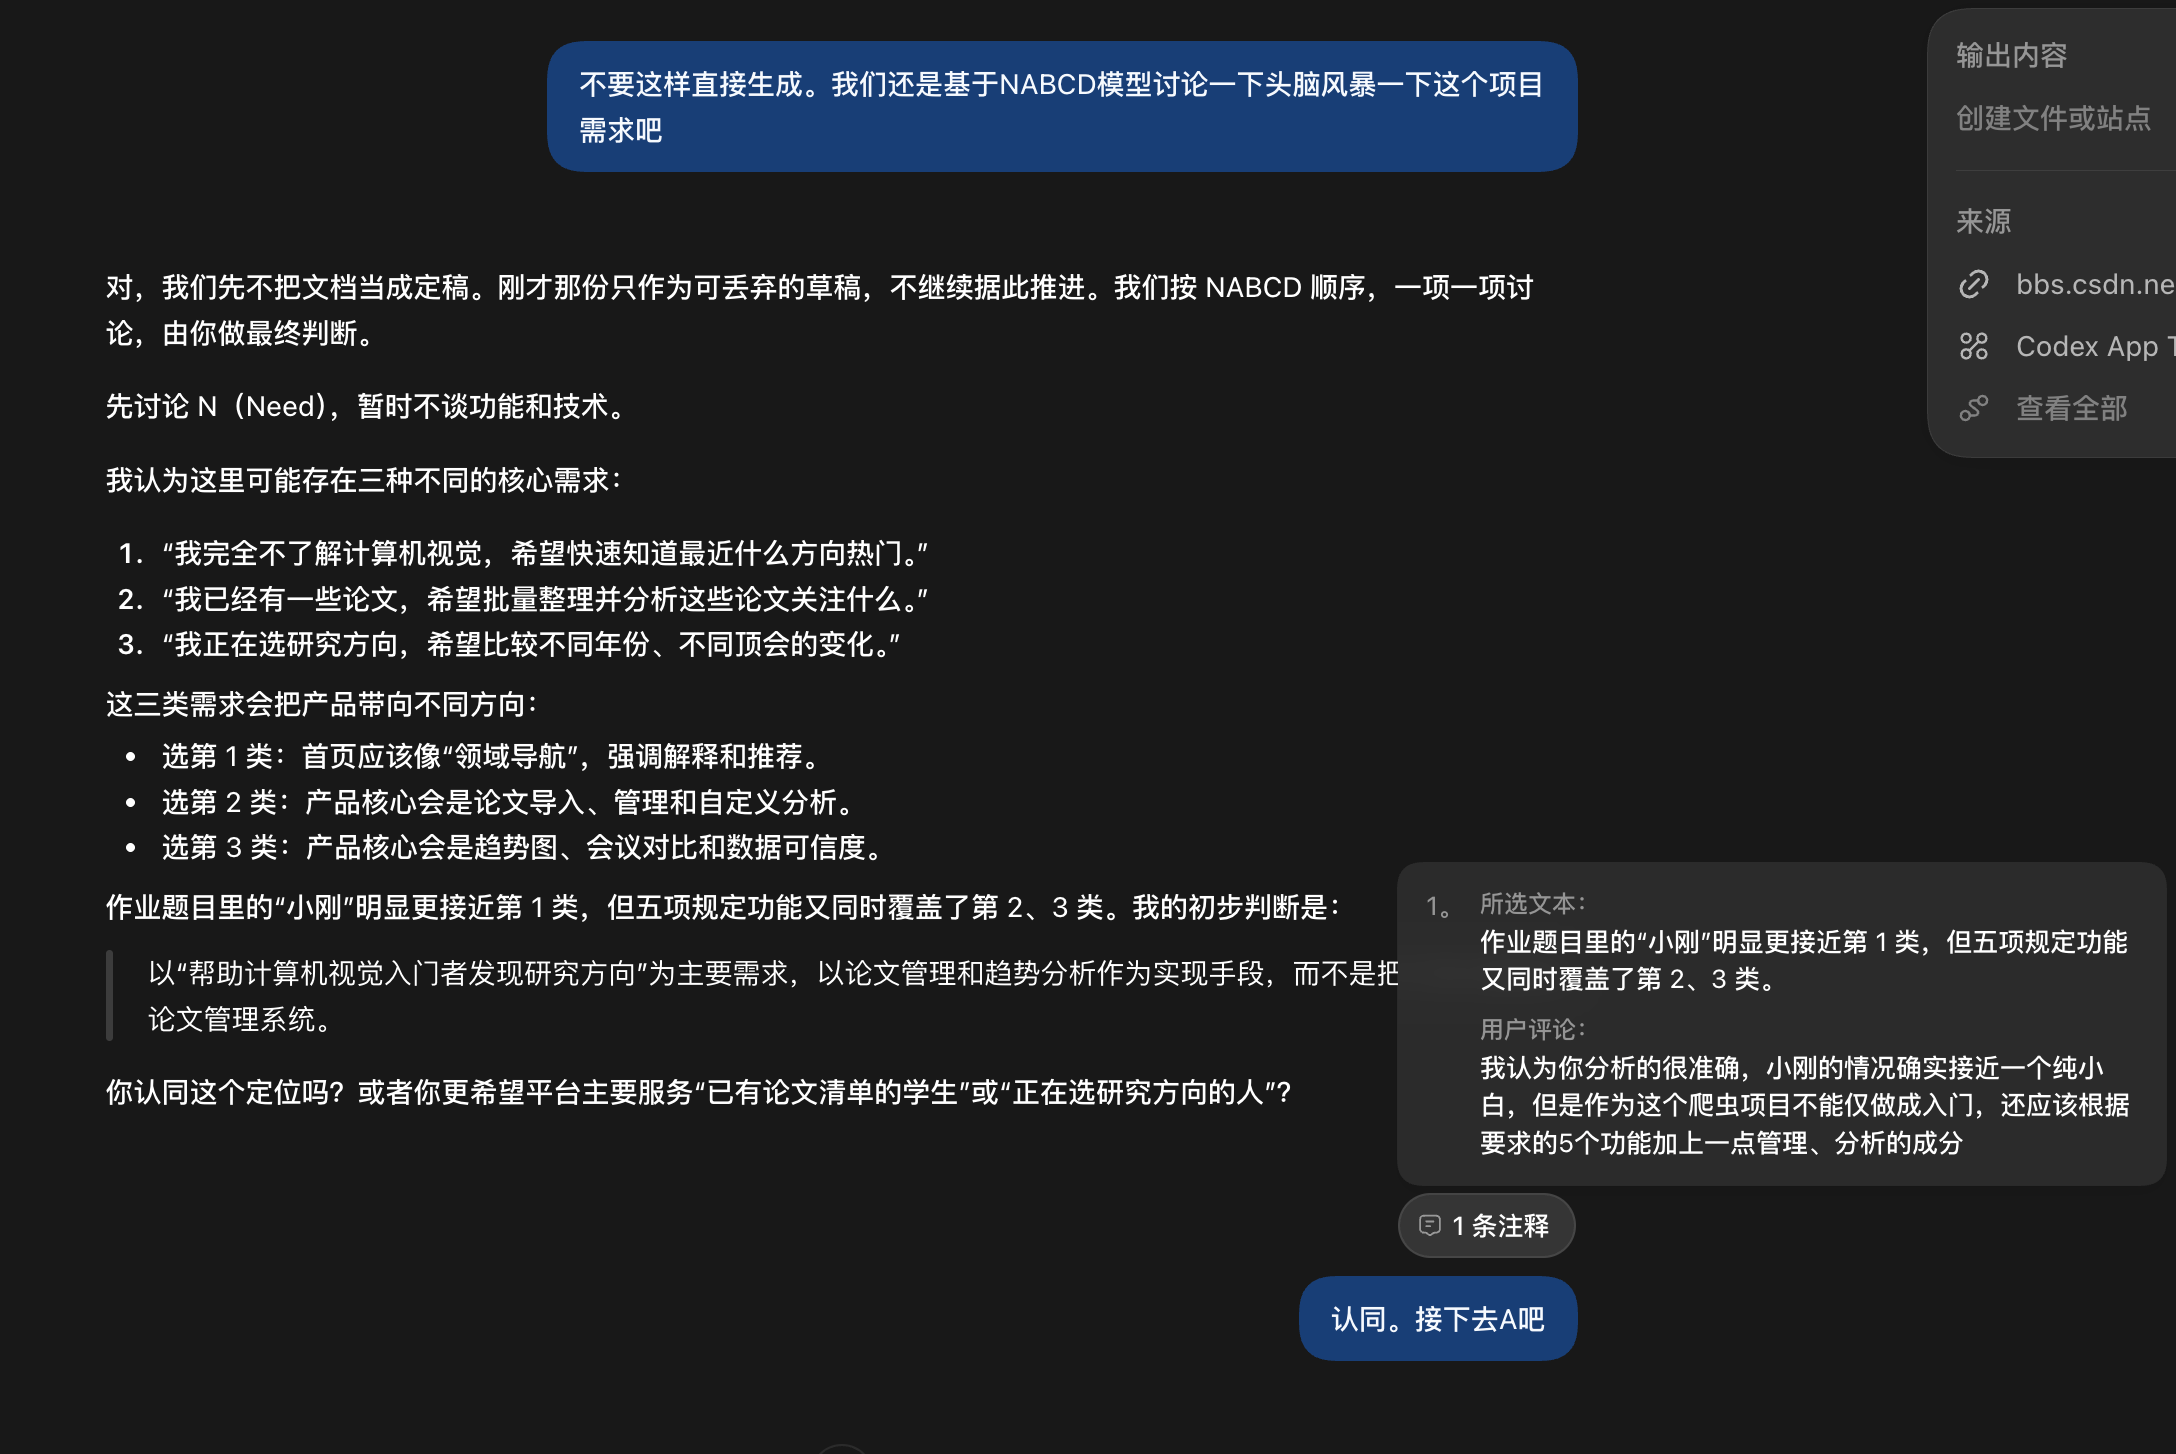
作业给出了论文爬取、论文管理、Top 10、关键词图谱和趋势对比五项功能,但如果只是把这五项功能平铺在导航栏中,产品会缺少一条连贯的使用路径。因此,在开始制作原型前,我先与 AI 按照 NABCD 模型逐项讨论需求,而不是让 AI 直接生成一份看似完整的需求文档。
我的关键提示词是:
不要这样直接生成。我们还是基于 NABCD 模型讨论一下,
头脑风暴一下这个项目需求吧。
AI 没有继续输出定稿,而是先从 Need 开始,将用户概括为三类:不了解计算机视觉热点的初学者、已经有论文清单并希望整理分析的用户,以及需要比较不同年份和会议的研究者。AI 随后提出,本项目应以“帮助计算机视觉初学者发现研究方向”为主要需求,同时利用论文管理和趋势分析支撑进一步研究。
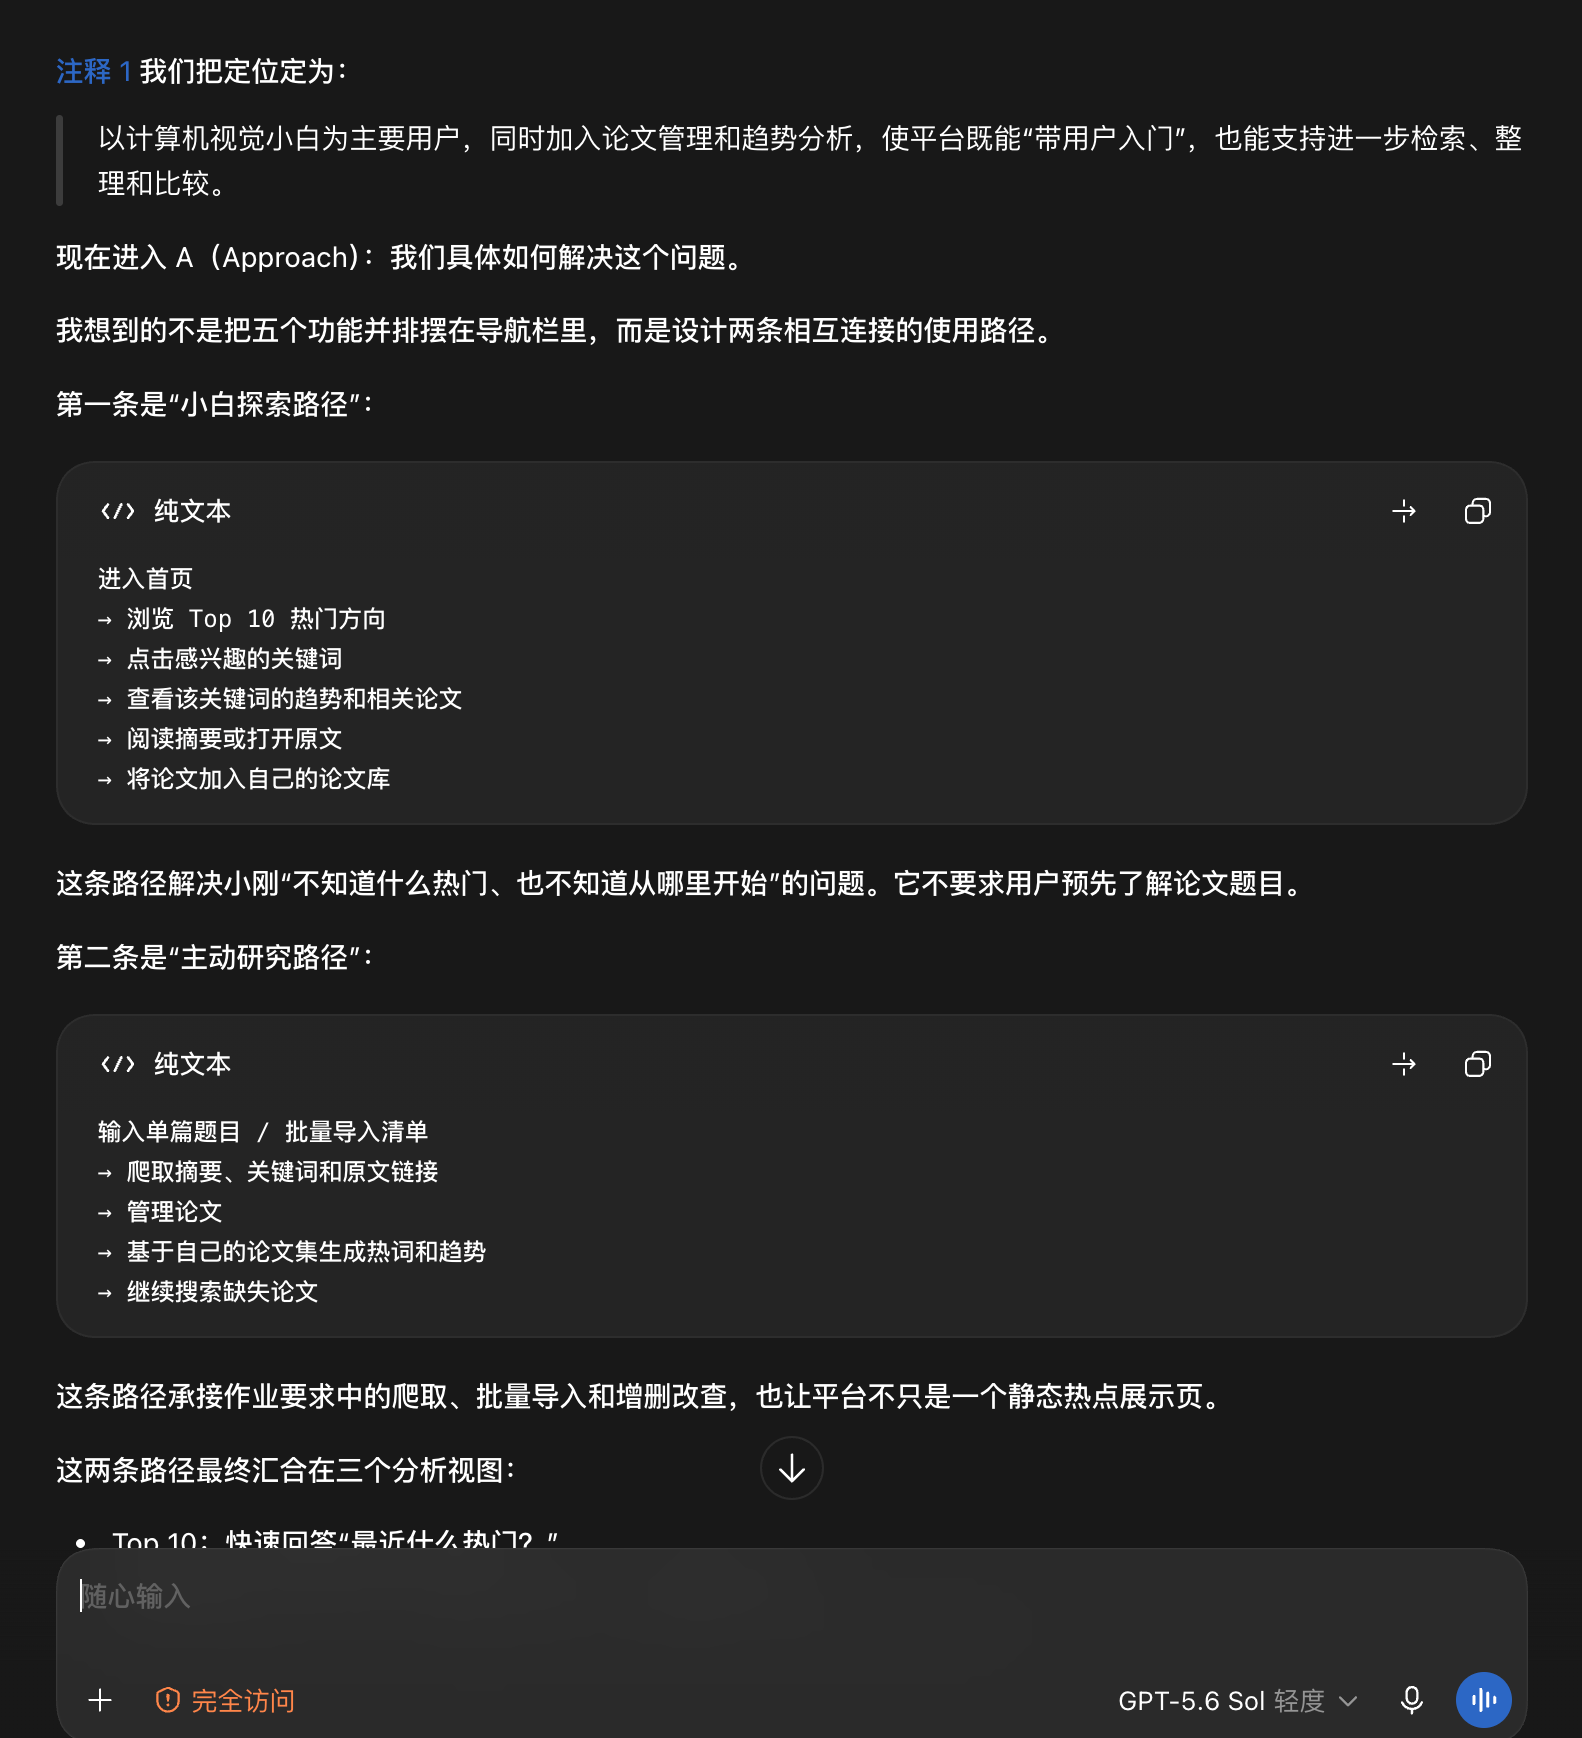
在确认用户定位后,AI 继续讨论 Approach,并提出两条互相连接的用户路径:
小白探索路径:
首页 Top 10 → 选择研究方向 → 查看趋势与论文 → 加入个人论文库

主动研究路径:
输入标题或批量清单 → 获取论文信息 → 管理论文 → 生成个人分析
我进一步提出“全局分析和个人分析都支持,但应以用户自己爬取的论文为主要分析对象”。AI 据此将方案调整为:全局分析负责给初学者提供入口,个人论文分析负责完成真正的研究管理,并建议增加标题检索、方向探索和批量导入三种数据获取方式。
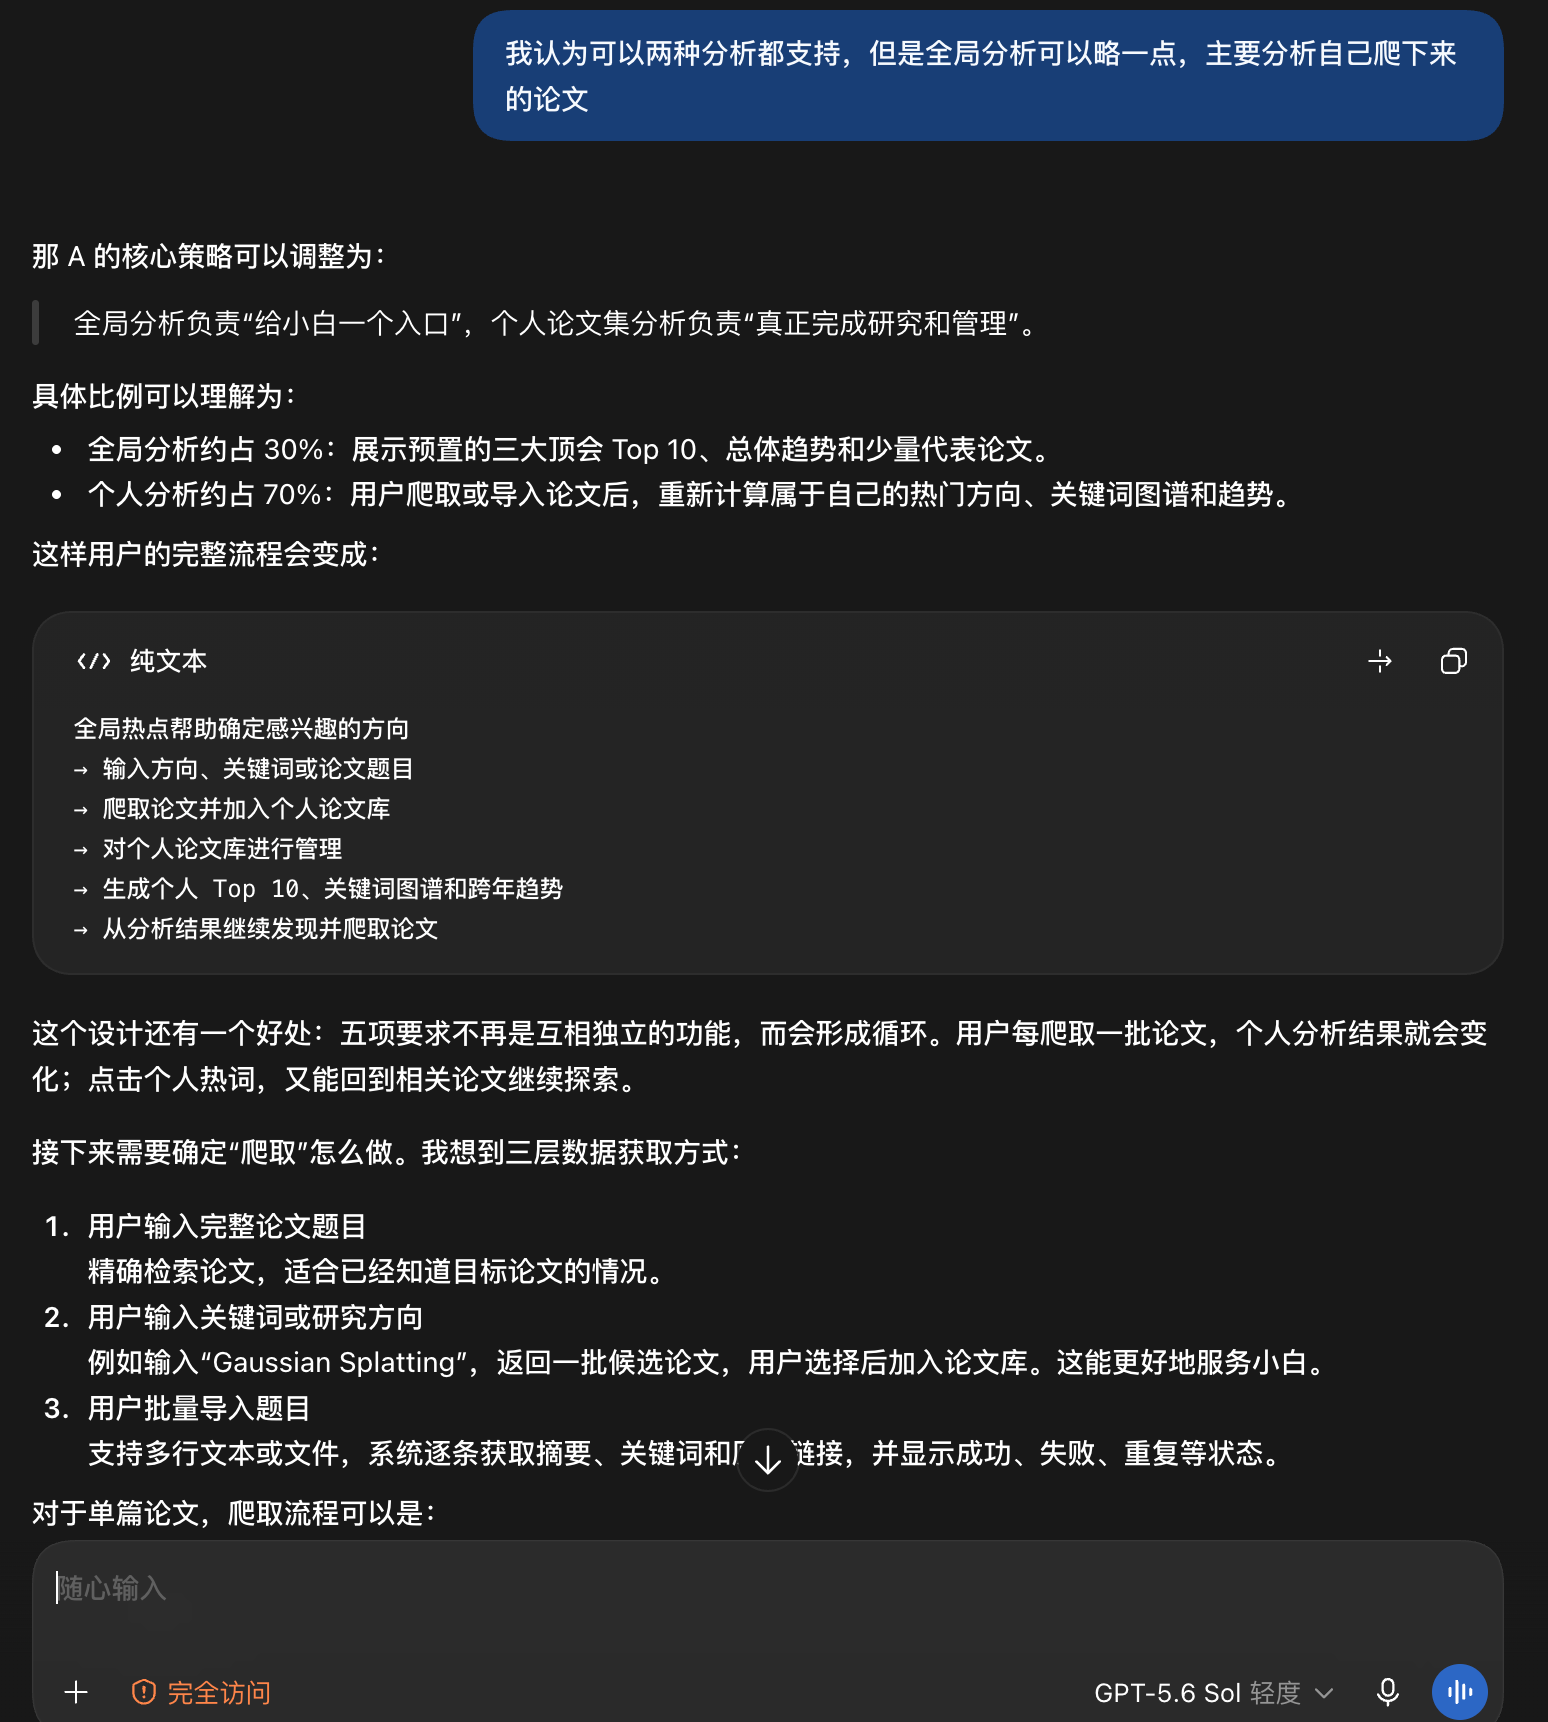
这次讨论最终影响了 Figma 原型的信息架构:首页默认展示全局数据,爬取/导入页负责获取候选论文,论文库负责维护个人数据,“我的分析”则根据最新论文库生成结果。
需求与原型确定后,我使用 Codex 中的 Wayfinder skill 规划编码阶段。Wayfinder 是一种面向交付的任务规划流程:先根据目标、约束和验收标准生成 roadmap,再把 roadmap 拆成范围明确的 ticket。每张 ticket 都对应一组可以实现和验证的改动,完成后更新状态,再继续下一张,避免让 AI 在一次任务中无边界地修改整个项目。
我向 Wayfinder 提交了作业的编码、数据获取、部署和扩展功能要求,要求其为项目形成实施路线。AI 输出了前端、后端、数据库、可视化、数据获取和部署等方面的候选技术栈,并据此拆分后续 ticket。
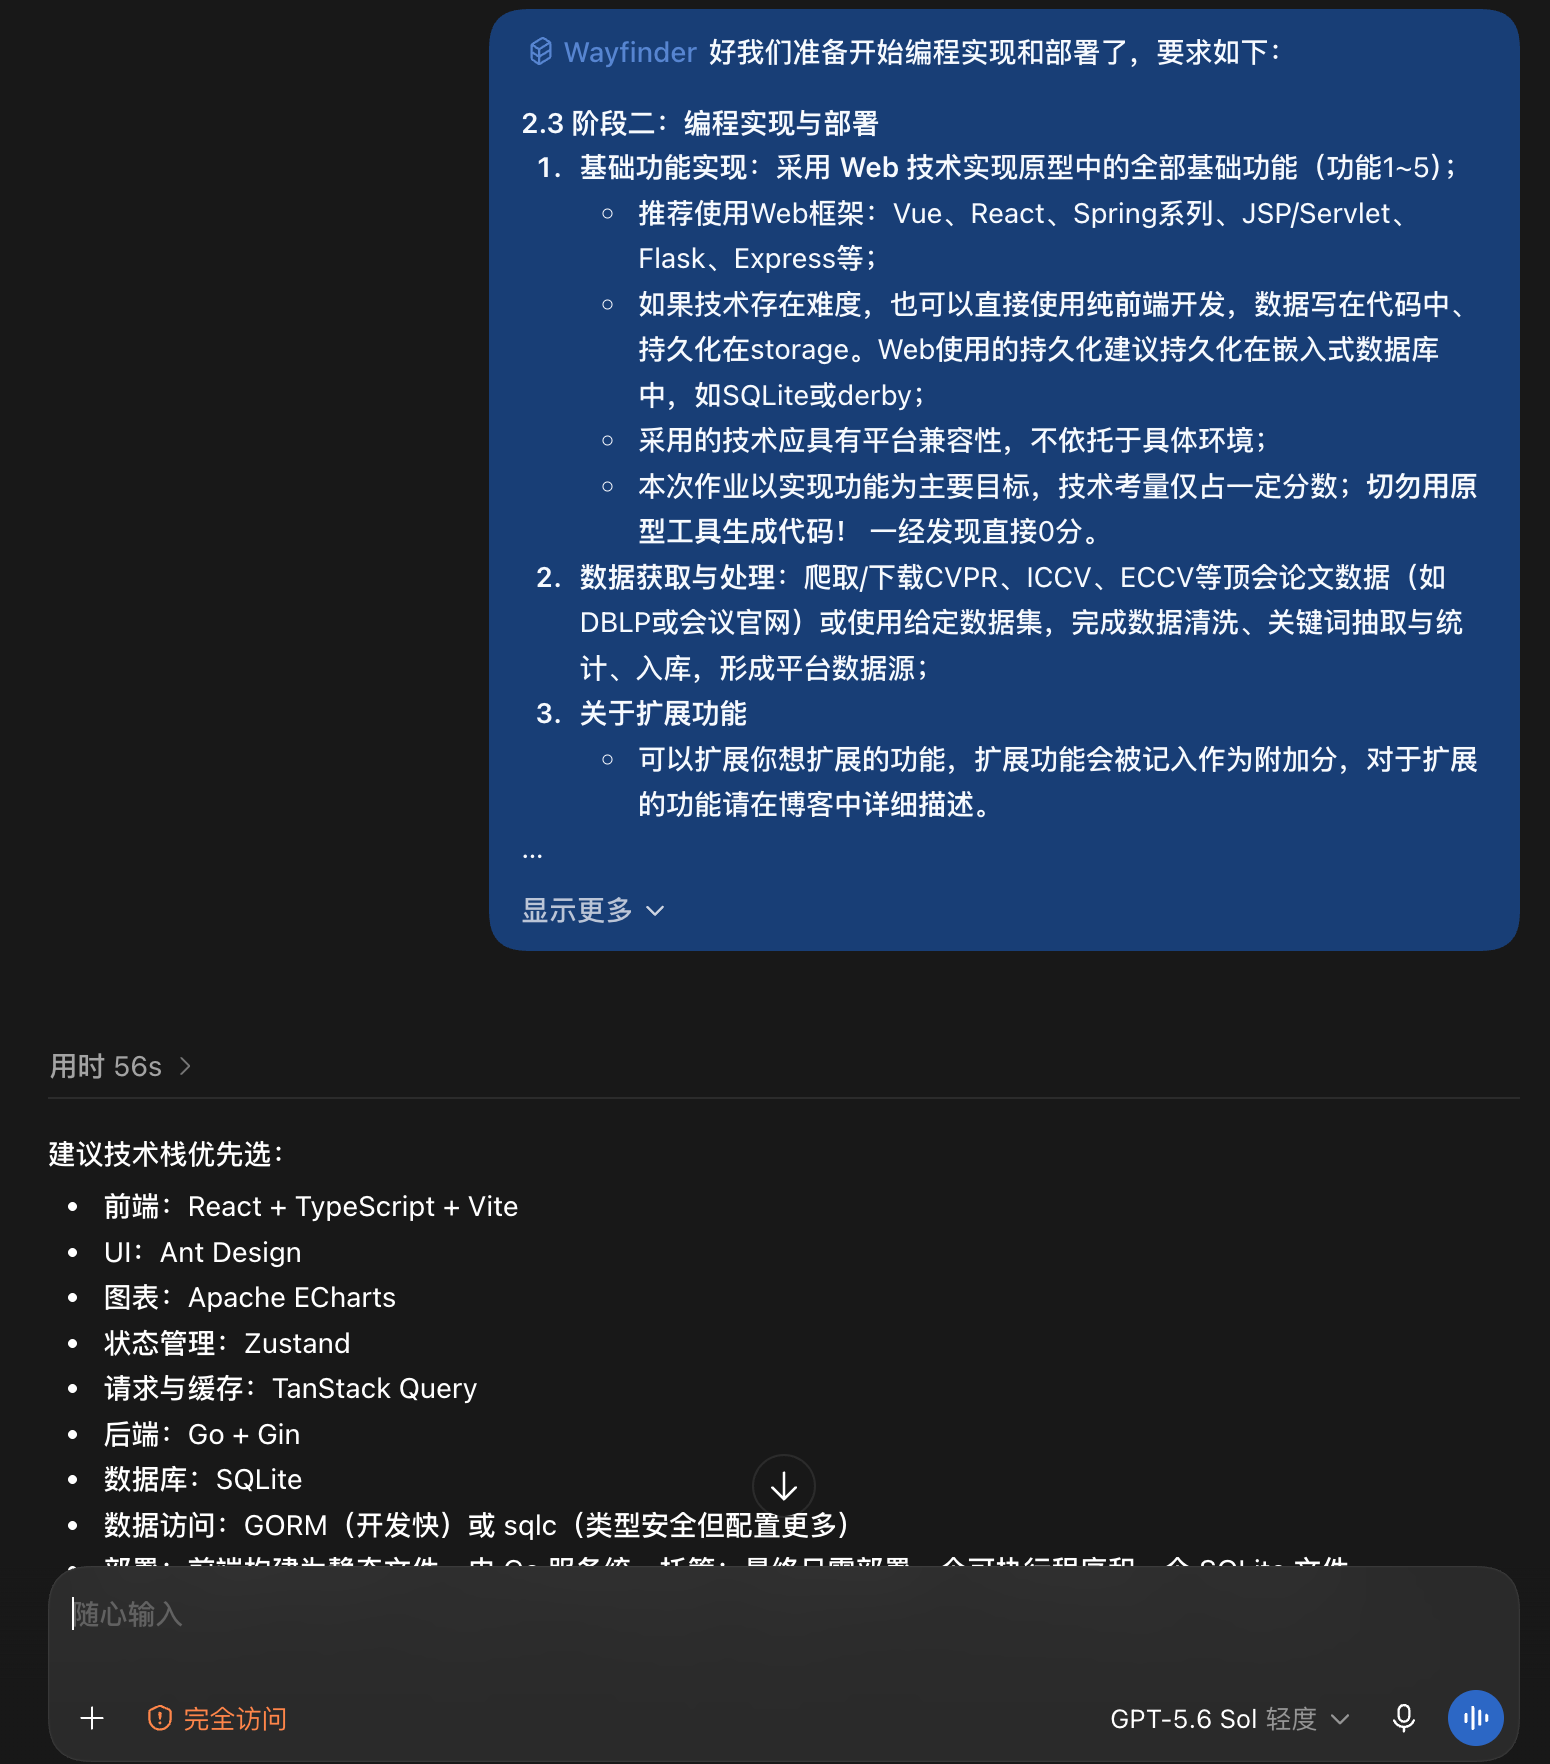
AI 最初建议的技术组合中包括 React、TypeScript、Vite、Ant Design、ECharts、Go、Gin 和 SQLite,同时还建议使用 Zustand、TanStack Query、GORM 或 sqlc。
我没有完全采用 AI 推荐的技术栈:
这一步说明 AI 输出只是候选方案。技术是否进入项目,需要结合实际复杂度、交付时间和维护成本判断。
roadmap 被拆解后,我按照 ticket 逐项推进。第七张 ticket 负责建立项目基础骨架:创建 React + TypeScript + Vite 前端,建立 Go + Gin 后端和 /api/v1/health 健康检查接口,统一 make dev、make check 和 make build 命令,并配置 ESLint、Prettier、gofmt、go vet、Vitest 和 Go Test。
我的关键提示词是:
开始第七项 ticket 吧。
AI 完成改动后汇报了修改文件、验证命令和提交信息。我随后检查页面是否能够启动、健康接口是否返回 {"status":"ok"},并确认 make check 通过后才接受此次改动。
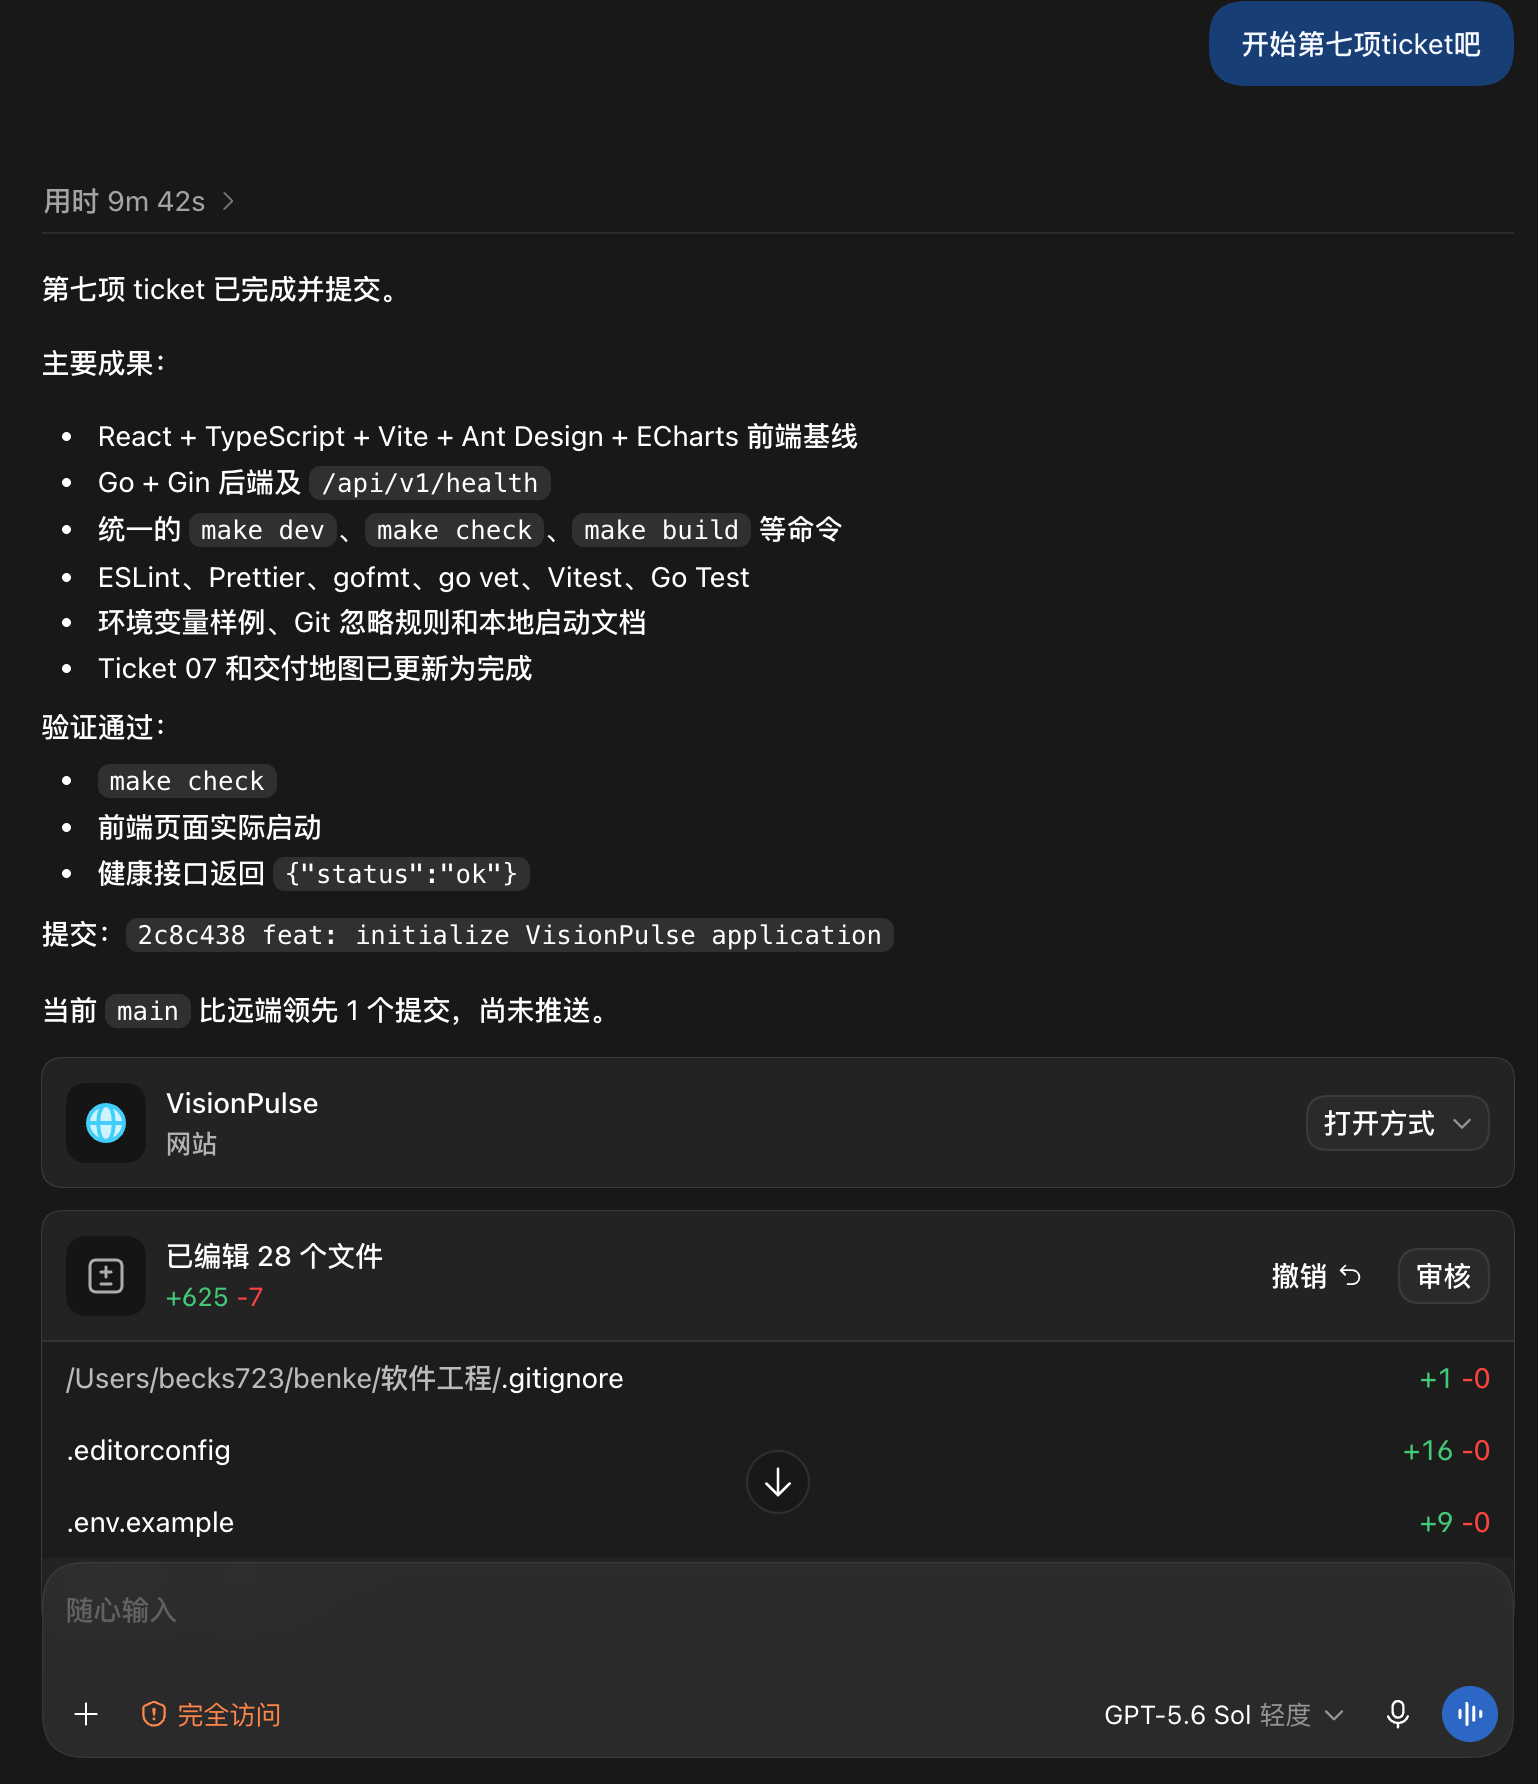
后续论文 API、检索导入、个人论文库、分析引擎、分析页面、端到端测试和部署配置也采用相同方式推进:每张 ticket 先规定范围和验收标准,AI 实现后必须运行检查,确认通过才进入下一项。这样做使 AI 编码从“一次生成大量代码”变成可以逐步检查和回退的小批量开发过程。
在云服务器初始化全局数据时,采集程序请求 DBLP 的 CVPR 2018 XML 数据发生 connection reset by peer。采集任务因此无法继续。由于本地环境能够使用相关功能,我需要先判断问题来自代码、服务器网络、代理还是 DBLP 的连接策略。
我向 AI 提供了实际执行命令和完整错误信息:
sudo sh ops/init-global-dataset.sh
Collecting DBLP conference records...
collect CVPR:2018: Get "https://dblp.org/db/conf/cvpr/cvpr2018.xml":
read tcp ...:443: read: connection reset by peer

判断这是服务器的问题还是我的代理问题?
AI 首先根据错误位置判断:连接是在腾讯云容器内部访问 DBLP 时被重置,更可能是云服务器到 DBLP 的网络链路或 DBLP 对该公网 IP 的访问策略,而不像本地电脑代理配置导致的问题。AI 同时检查了已有逻辑,指出程序虽然支持断点续传和有限重试,但对持续的连接重置仍无法保证完成全量采集。
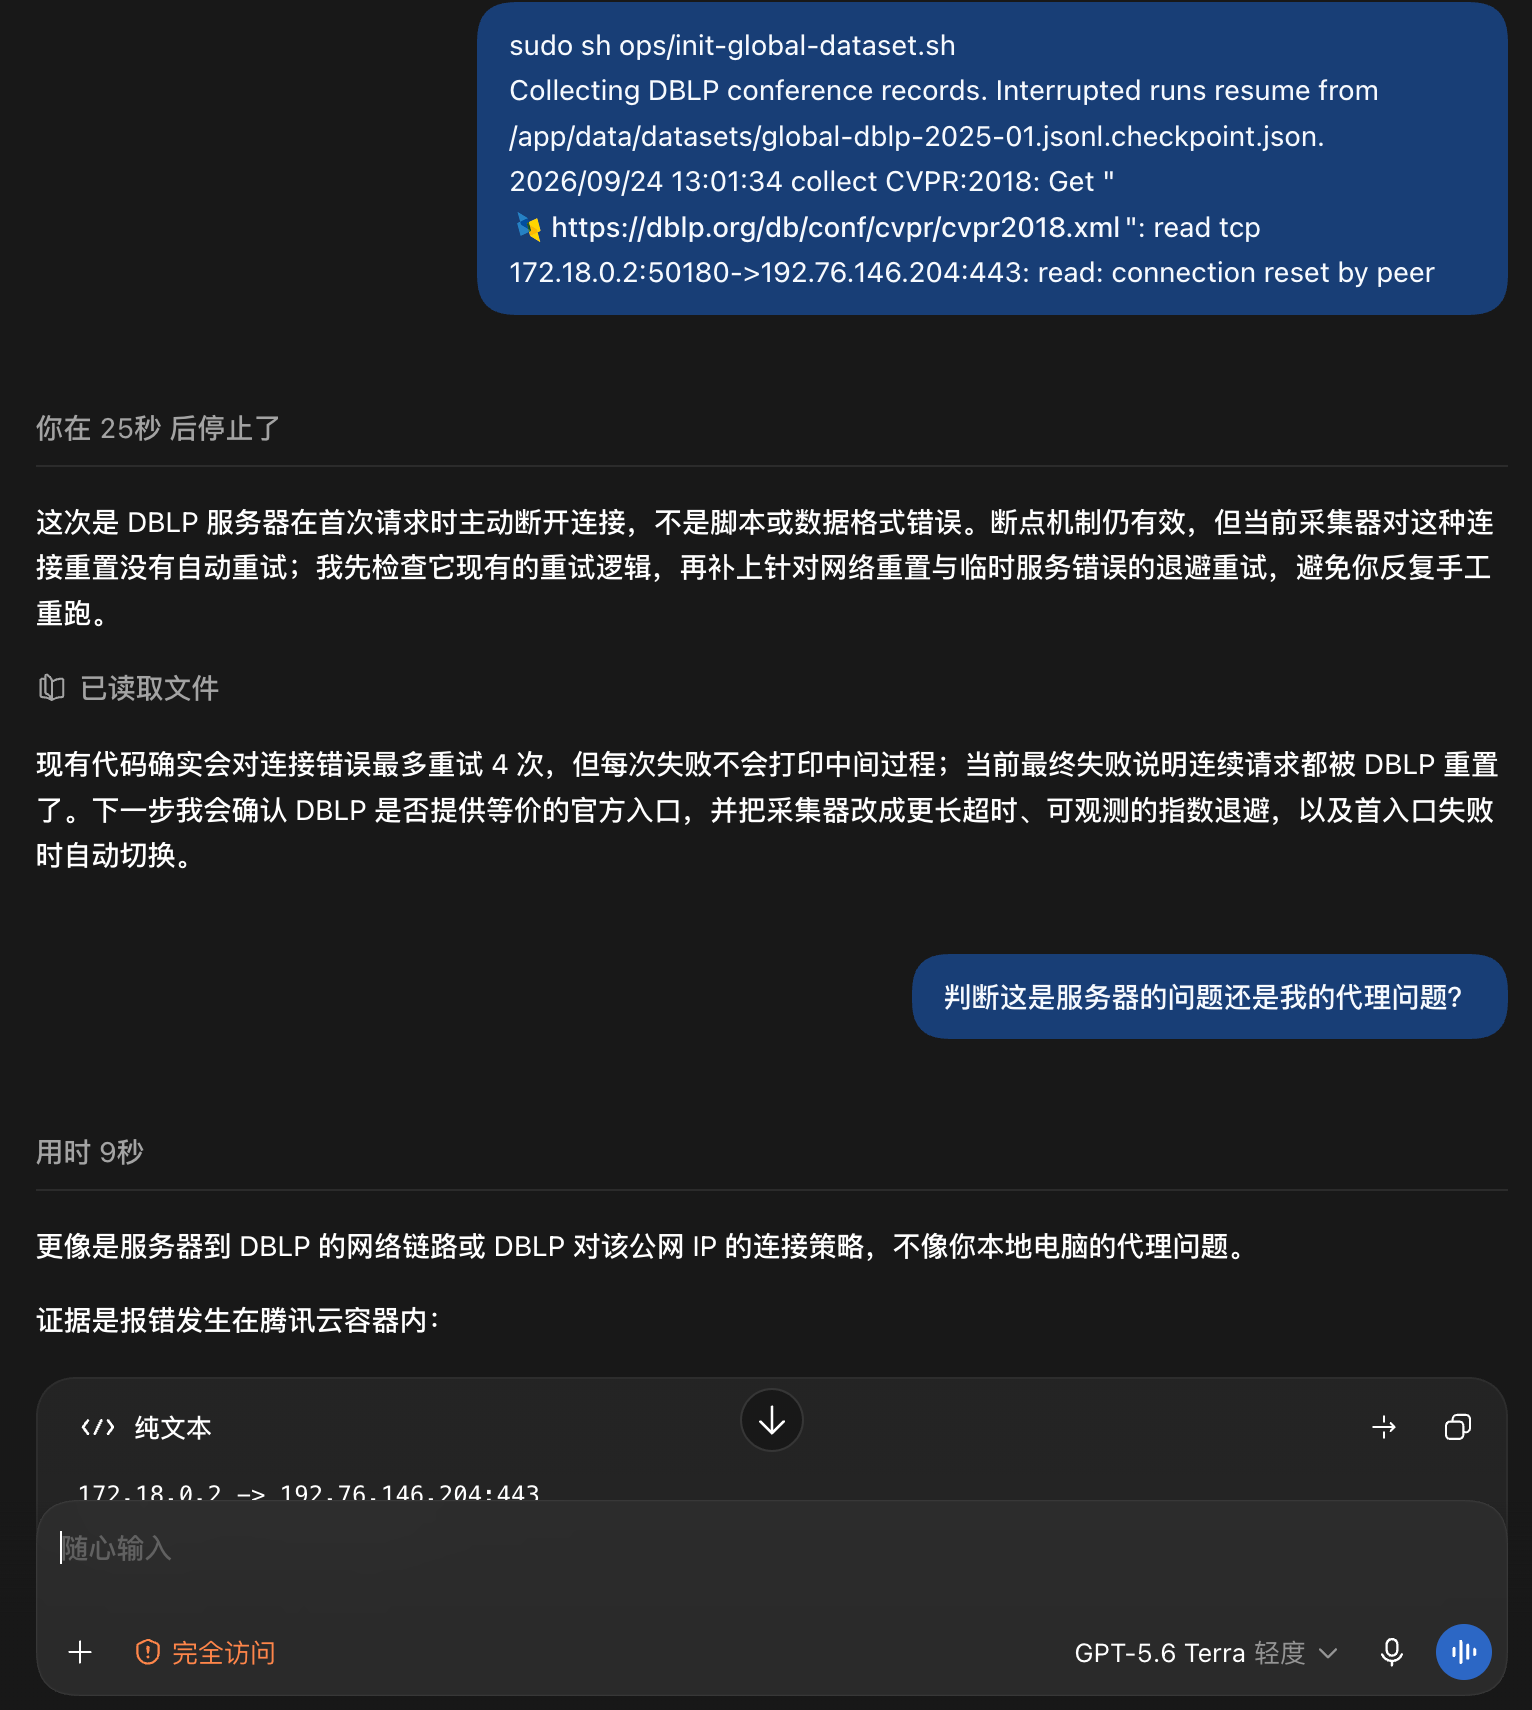
AI 最初建议延长超时、增加指数退避,并在入口失败时尝试替代数据来源。这些建议能够提高临时网络故障下的成功率,但不能解决云服务器持续无法访问 DBLP 的问题。如果不断增加重试次数,只会让初始化任务长时间阻塞。
因此,我最终没有把“无限重试”作为主要解决方案,而是采用以下处理:
preset 降级数据,不将其伪装成在线查询结果。这个方案牺牲了一部分实时性,但保证了网站在外部服务不可用时仍然能够完成查询和分析,也使系统对第三方服务故障具有更稳定的处理方式。
本项目中的需求讨论、技术方案、部分实现代码、测试代码、部署脚本和问题排查由 Codex 协助完成。AI 主要生成代码初稿和修改建议,我负责提供需求和约束、审查差异、运行测试、修改不合理实现并决定是否提交。原型页面的布局与交互、技术选型的最终取舍、线上部署操作和数据方案决策由我完成。
对于 AI 生成或修改的代码,我通过以下方式进行检查:
我能够说明最终保留代码的设计目的及主要执行流程。AI 的输出不会在未经理解和测试的情况下直接进入最终项目。
人机结对与传统人人结对都需要任务拆分、持续沟通、代码复审和共同的质量标准。区别在于 AI 能够快速生成候选方案和执行重复性工作,但它不了解所有隐含背景,也不会主动为最终结果承担责任。例如,Wayfinder 推荐的依赖并不都适合本项目;面对 DBLP 故障时,AI 最初提出的加强重试也只能解决部分情况。
因此,人机结对中人的主要价值不是向 AI 描述一句需求后等待结果,而是确定目标、补充约束、识别错误、做出取舍并验证结果。AI 提高了实现和排查速度,但需求是否合理、数据是否可信、代码是否安全以及项目是否真正完成,仍需要由开发者判断。第十四章将进一步评价 AI 在本项目中的贡献和局限。
本节选择论文检索与降级、批量导入、数据集采集和分析算法中的关键代码进行说明。完整实现可以在 CodeArts 仓库中查看,正文只保留能够体现主要设计思路的部分。
论文检索并不会直接把结果写入个人论文库,而是先生成一个 24 小时有效的候选批次。标题检索时先查询个人论文库;本地没有结果时请求 DBLP;DBLP 不可用时再查询预置数据,并通过 Origin 和 FallbackReason 把降级情况传递给前端。
func (s *Service) Search(
    ctx context.Context,
    mode, query string,
) (domain.ImportBatch, error) {
    query = strings.TrimSpace(query)
    if query == "" {
        return domain.ImportBatch{}, ErrEmptyInput
    }
    if mode != "title" && mode != "direction" {
        return domain.ImportBatch{}, ErrEmptyInput
    }

    var candidates []domain.Candidate
    var err error
    origin := "online"
    fallbackReason := ""

    // 标题检索优先检查个人论文库,避免重复联网查询。
    if mode == "title" {
        candidates, err = s.store.FindPersonalCandidates(ctx, query, 20)
        if err != nil {
            return domain.ImportBatch{}, err
        }
        if len(candidates) > 0 {
            origin = "personal"
        }
    }

    // 本地无结果时访问 DBLP;失败后使用预置数据。
    if len(candidates) == 0 {
        candidates, err = s.online.Search(ctx, query, 20)
        if err != nil {
            fallbackReason = "DBLP 暂时不可用,已改用本地预置数据"
            candidates, err = s.store.FindPresetCandidates(ctx, query, 20)
            if err != nil {
                return domain.ImportBatch{}, err
            }
            origin = "preset_fallback"
        }
    }

    return s.save(
        ctx,
        mode,
        origin,
        fallbackReason,
        []string{query},
        candidates,
    )
}

func (s *Service) save(
    ctx context.Context,
    mode, origin, fallback string,
    inputs []string,
    candidates []domain.Candidate,
) (domain.ImportBatch, error) {
    batch := domain.ImportBatch{
        ID:             uuid.NewString(),
        Mode:           mode,
        Status:         "preview",
        Origin:         origin,
        FallbackReason: fallback,
        ExpiresAt:      s.now().UTC().Add(24 * time.Hour),
        Items:          []domain.ImportItem{},
    }
    if mode != "batch" {
        batch.SearchID = batch.ID
    }
    for index := range candidates {
        candidate := candidates[index]
        candidate.ID = uuid.NewString()
        candidate.InputIndex = 0
        candidate.RawInput = inputs[0]
        batch.Items = append(batch.Items, domain.ImportItem{
            CandidateID: candidate.ID,
            InputIndex:  0,
            RawInput:    inputs[0],
            Candidate:   &candidate,
            Status:      "candidate",
        })
    }
    return s.store.SaveImportBatch(ctx, batch)
}
这段代码体现了系统的两个设计原则:第一,查询结果必须由用户确认后才能保存;第二,第三方数据源失败时可以降级,但必须如实标记来源。
批量导入先把每一行解析为单独输入,然后逐项查询候选论文。某一项没有结果时不会使整个批次失败,而是记录该项的错误状态。候选批次确认时必须携带幂等键,并对导入编号和选择结果计算摘要,避免用户重复点击造成重复写入。
func (s *Service) Preview(
ctx context.Context,
raw string,
) (domain.ImportBatch, error) {
lines := parseLines(raw)
if len(lines) == 0 {
return domain.ImportBatch{}, ErrEmptyInput
}
if len(lines) > 100 {
return domain.ImportBatch{}, ErrTooManyInputs
}
batch := domain.ImportBatch{
ID: uuid.NewString(),
Mode: "batch",
Status: "preview",
Origin: "online",
ExpiresAt: s.now().UTC().Add(24 * time.Hour),
Items: []domain.ImportItem{},
}
usedFallback := false
for index, line := range lines {
candidates, err := s.online.Search(ctx, line, 5)
if err != nil {
candidates, err = s.store.FindPresetCandidates(ctx, line, 5)
usedFallback = true
}
if err != nil {
return domain.ImportBatch{}, err
}
if len(candidates) == 0 {
batch.Items = append(batch.Items, domain.ImportItem{
CandidateID: uuid.NewString(),
InputIndex: index,
RawInput: line,
Status: "failed",
ErrorCode: "SEARCH_NO_RESULTS",
Message: "未找到候选论文",
})
continue
}
for _, candidate := range candidates {
candidate.ID = uuid.NewString()
candidate.InputIndex = index
candidate.RawInput = line
copy := candidate
batch.Items = append(batch.Items, domain.ImportItem{
CandidateID: candidate.ID,
InputIndex: index,
RawInput: line,
Candidate: ©,
Status: "candidate",
})
}
}
if usedFallback {
batch.Origin = "preset_fallback"
batch.FallbackReason =
"DBLP 部分或全部查询失败,已对失败项使用预置数据"
}
return s.store.SaveImportBatch(ctx, batch)
}
func (s *Service) Confirm(
ctx context.Context,
importID string,
selected []string,
key, requestID string,
) (domain.ImportSummary, error) {
if len(selected) == 0 {
return domain.ImportSummary{}, ErrNothingSelected
}
if strings.TrimSpace(key) == "" {
return domain.ImportSummary{}, ErrIdempotencyRequired
}
digestBytes := sha256.Sum256([]byte(
importID + "\x00" + strings.Join(selected, "\x00"),
))
digest := hex.EncodeToString(digestBytes[:])
return s.store.ConfirmImport(
ctx,
importID,
selected,
key,
digest,
requestID,
)
}
这种“预览—确认”两阶段流程比查询后自动入库多一步操作,但能够让用户核对论文,并清楚看到成功、失败和重复状态。
用于全局数据集的采集器会限制连续请求间隔,并对 429 和服务器错误进行有限次数的指数退避。如果服务端提供 Retry-After,程序优先按照该值等待。等待过程响应上下文取消,因此任务停止时不会卡在不可中断的休眠中。
func (c *DBLPClient) get(
    ctx context.Context,
    endpoint string,
) (io.ReadCloser, time.Time, error) {
    if c.HTTP == nil {
        c.HTTP = &http.Client{Timeout: 30 * time.Second}
    }
    if c.now == nil {
        c.now = time.Now
    }
    if c.sleep == nil {
        c.sleep = sleepContext
    }

    for attempt := 0; ; attempt++ {
        // 主动限制请求速度,避免给 DBLP 造成压力。
        if wait := c.MinInterval - c.now().Sub(c.lastRequest); wait > 0 {
            if err := c.sleep(ctx, wait); err != nil {
                return nil, time.Time{}, err
            }
        }

        req, err := http.NewRequestWithContext(
            ctx,
            http.MethodGet,
            endpoint,
            nil,
        )
        if err != nil {
            return nil, time.Time{}, err
        }
        req.Header.Set(
            "User-Agent",
            "VisionPulse/0.1 (course dataset builder)",
        )

        c.lastRequest = c.now()
        resp, err := c.HTTP.Do(req)
        if err == nil &&
            resp.StatusCode >= 200 &&
            resp.StatusCode < 300 {
            return resp.Body, c.now().UTC(), nil
        }
        if err == nil && resp.Body != nil {
            resp.Body.Close()
        }

        shouldStop := attempt >= c.MaxRetries ||
            (err == nil &&
                resp.StatusCode != http.StatusTooManyRequests &&
                resp.StatusCode < 500)
        if shouldStop {
            if err != nil {
                return nil, time.Time{}, err
            }
            return nil, time.Time{}, fmt.Errorf(
                "DBLP returned %s",
                resp.Status,
            )
        }

        wait := time.Second << attempt
        if err == nil {
            seconds, parseErr := strconv.Atoi(
                resp.Header.Get("Retry-After"),
            )
            if parseErr == nil && seconds > 0 {
                wait = time.Duration(seconds) * time.Second
            }
        }
        if err := c.sleep(ctx, wait); err != nil {
            return nil, time.Time{}, err
        }
    }
}

func sleepContext(ctx context.Context, duration time.Duration) error {
    timer := time.NewTimer(duration)
    defer timer.Stop()
    select {
    case <-ctx.Done():
        return ctx.Err()
    case <-timer.C:
        return nil
    }
}
重试只能处理临时错误,无法保证解决服务器到 DBLP 的持续连接重置。因此线上部署还提供预置数据导入方案,不能用无限重试掩盖外部服务不可用的问题。
分析模块先统一大小写和标点,再从标题生成一至三元短语,并与论文已有的来源关键词、人工关键词共同参与分析。候选词使用 IDF 降低通用词权重,最后保留得分最高的八个候选。术语表还会把缩写、同义词和相近表达映射到统一研究方向。
var stopwords = map[string]bool{
    "a": true, "an": true, "the": true,
    "and": true, "or": true, "of": true,
    "to": true, "in": true, "on": true,
    "for": true, "with": true, "from": true,
    "by": true, "via": true, "using": true,
    "towards": true, "paper": true,
    "method": true, "approach": true,
    "result": true, "results": true, "new": true,
}

func normalizeText(value string) string {
    value = strings.ToLower(strings.TrimSpace(value))
    var builder strings.Builder
    for _, char := range value {
        if unicode.IsLetter(char) || unicode.IsDigit(char) {
            builder.WriteRune(char)
        } else {
            builder.WriteByte(' ')
        }
    }
    return strings.Join(strings.Fields(builder.String()), " ")
}

func candidates(value string) map[string]int {
    words := tokens(value)
    const maxCandidateTokens = 80
    if len(words) > maxCandidateTokens {
        words = words[:maxCandidateTokens]
    }
    result := map[string]int{}
    for size := 1; size <= 3; size++ {
        for index := 0; index+size <= len(words); index++ {
            if stopwords[words[index]] ||
                stopwords[words[index+size-1]] {
                continue
            }
            term := strings.Join(words[index:index+size], " ")
            result[term]++
        }
    }
    return result
}

func buildIDF(papers []CorpusPaper) map[string]float64 {
    documentFrequency := map[string]int{}
    for _, paper := range papers {
        seen := map[string]bool{}
        for term := range candidates(paper.Title) {
            seen[term] = true
        }
        for term := range seen {
            documentFrequency[term]++
        }
    }
    result := map[string]float64{}
    for term, count := range documentFrequency {
        result[term] = math.Log(
            float64(len(papers)+1)/float64(count+1),
        ) + 1
    }
    return result
}

func extract(
    paper CorpusPaper,
    idf map[string]float64,
    unseen float64,
) []scoredTerm {
    title := candidates(paper.Title)
    all := map[string]scoredTerm{}

    for term, count := range title {
        weight := idf[term]
        if weight == 0 {
            weight = unseen
        }
        all[term] = scoredTerm{
            term: term,
            score: float64(2*count) * weight,
            words: len(strings.Fields(term)),
        }
    }

    list := make([]scoredTerm, 0, len(all))
    for _, item := range all {
        list = append(list, item)
    }
    sort.Slice(list, func(i, j int) bool {
        if list[i].score != list[j].score {
            return list[i].score > list[j].score
        }
        if list[i].words != list[j].words {
            return list[i].words > list[j].words
        }
        return list[i].term < list[j].term
    })
    if len(list) > 8 {
        list = list[:8]
    }
    return list
}
算法使用固定规则和版本号,保证相同数据得到可重复的结果。热度表示当前数据范围和算法下的研究关注程度,不代表论文质量或未来价值。
Top 10、图谱和趋势中的结果都会生成一个追溯令牌。令牌包含数据范围、数据集版本、个人论文库修订号和筛选条件,并使用 HMAC 签名。后端收到令牌后先检查签名和算法版本,再返回完全相同统计口径下的贡献论文。
func (s *Service) trace(filter traceFilter) string {
    filter.AlgorithmVersion = AlgorithmVersion
    raw, _ := json.Marshal(filter)
    mac := hmac.New(sha256.New, s.secret)
    mac.Write(raw)
    return base64.RawURLEncoding.EncodeToString(raw) + "." +
        base64.RawURLEncoding.EncodeToString(mac.Sum(nil))
}

func (s *Service) parseTrace(token string) (traceFilter, error) {
    parts := strings.Split(token, ".")
    if len(parts) != 2 {
        return traceFilter{}, ErrInvalidTrace
    }
    raw, err := base64.RawURLEncoding.DecodeString(parts[0])
    if err != nil {
        return traceFilter{}, ErrInvalidTrace
    }
    signature, err := base64.RawURLEncoding.DecodeString(parts[1])
    if err != nil {
        return traceFilter{}, ErrInvalidTrace
    }

    mac := hmac.New(sha256.New, s.secret)
    mac.Write(raw)
    if !hmac.Equal(signature, mac.Sum(nil)) {
        return traceFilter{}, ErrInvalidTrace
    }

    var filter traceFilter
    if json.Unmarshal(raw, &filter) != nil ||
        filter.AlgorithmVersion != AlgorithmVersion {
        return traceFilter{}, ErrInvalidTrace
    }
    return filter, nil
}
个人论文库发生修改后,旧修订号的追溯请求会被判定为过期,避免页面继续使用修改前的统计结论。
项目部署在腾讯云轻量应用服务器上,对外访问地址为 http://101.43.121.125/。生产环境使用一个 Go 容器同时提供 React 静态页面和 REST API,宿主机只向公网映射 80 端口。SQLite 数据保存在 /srv/visionpulse/data,因此重新构建或替换容器不会丢失论文数据。
浏览器
  ↓ HTTP 80
腾讯云 Ubuntu 22.04
  ↓ Docker Compose
VisionPulse 容器
  ├── React 静态页面
  ├── Go / Gin REST API
  └── /app/data → /srv/visionpulse/data
服务器安装 Docker Engine 和 Compose 插件。由于国内服务器访问 Docker Hub、Alpine 软件源和 Go Module 服务可能超时,构建时分别配置腾讯云 Docker 镜像源、国内 Alpine 镜像和 goproxy.cn。
首次部署时创建持久化目录并设置容器非 root 用户所需的权限,然后从 CodeArts 克隆代码、构建镜像并启动服务:
sudo mkdir -p /srv/visionpulse/data /srv/visionpulse/backups
sudo chown -R 10001:10001 /srv/visionpulse/data /srv/visionpulse/backups
cd /srv/visionpulse/app
export VISIONPULSE_IMAGE_TAG=$(git rev-parse --short HEAD)
docker compose config --quiet
docker compose build --pull
docker compose up -d
curl --fail http://127.0.0.1/api/v1/health
镜像标签使用当前 Git 提交的短 SHA,便于确认线上版本和执行回退。服务启动后,通过 /api/v1/health 检查后端状态,并从公网逐页验证热门总览、热度走势、论文库、爬取/导入、我的分析和关于页面。
项目提供演示数据和正式数据两种初始化方式。演示数据用于快速检查流程,并通过 is_example 明确标记;正式数据则从 CVPR、ICCV、ECCV 的 DBLP 记录采集、校验并发布。由于云服务器访问 DBLP 时出现持续连接重置,最终采用在可访问环境中生成并校验预置数据,再上传服务器幂等导入的方案。
更新应用前先执行 ops/backup.sh 创建 SQLite 一致性备份,再执行 git pull --ff-only、重新构建并启动。若新版本验收失败,可以将镜像标签切换回上一提交;只有数据库迁移与旧版本不兼容时,才使用 ops/restore.sh 恢复备份。
Compose 还配置了健康检查、restart: unless-stopped 自动恢复和日志轮转。部署后验证过首页及健康接口可以正常访问,当前公网健康检查返回:
{"status":"ok"}
项目使用 CodeArts 托管远程仓库,开发工作集中在 main 分支完成。仓库中还保留了平台初始化时的 master 分支,远程实际开发内容以 origin/main 为准。
mainorigin/main开发主体共形成 26 次提交,之后又补充了 fix: allow multiple import candidates 修复,因此当前 main 和 origin/main 实际共有 27 次提交。提交内容按照项目进展逐步形成,包括需求与架构文档、基础工程、论文 API、数据管道、前端页面、检索导入、个人论文库、分析引擎、自动化测试、部署配置和数据初始化。
提交信息采用 Conventional Commits,例如:
docs: define analysis methodology
feat: initialize VisionPulse application
feat: implement core paper API
feat: build paper data pipeline
feat: implement search and import workflow
feat: implement personal library management
feat: implement analysis engine
test: complete application acceptance suite
feat: add production deployment baseline
fix: scale global analysis for preset data
每次提交对应一个相对独立、能够检查的任务,而不是在项目完成后一次性上传全部代码。AI 根据 roadmap 和 ticket 完成阶段性实现后,我会检查改动并运行测试,再决定是否提交。
本项目由我独立开发,没有同时修改同一代码库的其他成员。为了减少个人课程项目中频繁创建功能分支、发起 PR、自己审核并合并所带来的流程开销,本次选择将通过验证的小批量改动直接提交到 main。这一选择适合当前单人、短周期、提交范围明确的场景,但不是一般团队协作的推荐范式。
在多人合作项目中,更合适的方式仍然是:
从 main 创建 feat/fix 分支
→ 在独立分支完成开发和测试
→ 发起 Pull Request / Merge Request
→ 由其他成员进行代码审查
→ 自动化检查通过后合并到 main
功能分支和 PR 能够隔离未完成的修改、保留讨论与审查记录,并降低多人同时开发时直接破坏主分支的风险。如果后续项目转为多人维护,我会恢复这一标准协作方式,并对 main 开启保护规则。
在本次项目中,AI 实际承担了大部分编码实现任务,包括前后端基础工程、接口、数据处理、分析模块、自动化测试和部署脚本。借助 roadmap 和 ticket,我可以把需求逐步交给 AI 实现,再通过代码审查和测试决定是否保留。对于重复性较高、范围明确并且有验收标准的工作,AI 的实现速度明显快于我从头编写。
不过,这并不意味着人在项目中的作用可以被替代。最重要的需求分析仍然需要由人完成:作业虽然列出了五项功能,但“产品面向谁”“全局分析和个人分析的关系是什么”“搜索结果是否应该自动保存”等问题没有唯一答案。AI 可以列出方案,却无法替我决定哪个方案更符合课程目标和实际使用场景。
技术选型同样需要人工判断。Wayfinder 曾建议增加 Zustand、TanStack Query、GORM 或 sqlc,但当前项目规模并不需要这些依赖。直接接受所有建议会让系统复杂度上升。因此,我最终只保留真正需要的 React、TypeScript、ECharts、Go、Gin 和 SQLite,并选择更直接的数据访问方式。
部署和运维也无法完全交给 AI。AI 可以阅读日志、生成命令并推测 DBLP 连接失败的原因,但服务器权限、网络状态、持久化目录、数据备份和公网验收仍然需要我实际操作。尤其当“增加重试”无法解决 DBLP 持续断开连接时,最终采用预置数据上传和降级查询,是结合服务器实际情况作出的人工决策。
本次合作中,严重的事实幻觉并不多,大多数建议都可以通过查看代码和运行测试验证。最明显的问题反而是 Token 消耗很快:项目上下文、需求文档和代码量逐渐增加后,一次任务需要读取大量内容,较长会话很容易消耗较多额度。
另一个问题是新会话不会天然记住此前所有项目约定。本项目明确选择直接在 main 上进行单人开发,但每次新开 session 后,AI 仍可能按照常见团队规范建议创建 feat 分支并走 PR。这不是代码层面的幻觉,而是项目局部约束没有被持久化。
更好的做法是把这种长期有效、每次任务都必须遵守的信息写入项目根目录的 AGENTS.md,例如:
## Git workflow

- This is a solo course project.
- Commit verified changes directly to `main`.
- Do not create feature branches or pull requests unless explicitly requested.
代码格式、命名和目录等规范继续写在 codestyle.md;而面向 AI 的工作流、验证命令和项目特殊约束更适合放在 AGENTS.md。这次项目为了赶进度没有及时补上这份说明,导致相同的分支约定需要重复强调,是我在协作流程上偷懒的地方。
总体来看,AI 是一名执行能力很强的结对伙伴,能够承担大量有清晰输入和验收标准的实现工作;人则需要负责定义问题、控制范围、选择方案、验证结果和承担最终责任。下一次合作中,我会更早建立 AGENTS.md,把长期约束写进项目,让 AI 在不同 session 之间保持更稳定的工作方式。
