


101
社区成员
 发帖
 与我相关
 我的任务

 分享
| 这个作业属于哪个课程 | https://bbs.csdn.net/forums/FZU_university_2026 |
|---|---|
| 学号-姓名 | 102400101 程黄姗 |
| 这个作业要求在哪里 | https://bbs.csdn.net/topics/620526370 |
| 这个作业的目标 | AI辅助完成NABCD需求分析、原型设计,发布原型并将子任务记录为PSP表格,与AI结对协作开发,部署到华为云CodeArts |
| 其他参考文献 | 《构建之法》,DBLP API文档,ECharts官方文档,OpenAlex 官网 |
CodeArts仓库地址:https://devcloud.cn-north-4.huaweicloud.com/codehub/project/2853817730184215857a53d0f49778ef/codehub/3086045/home?ref=master
codestyle.md代码规范链接:https://devcloud.cn-north-4.huaweicloud.com/codehub/project/2853817730184215857a53d0f49778ef/codehub/3086045/home?ref=master&filePath=codestyle.md&isFile=true
AI编程助手说明:本次结对作业选择的AI伙伴为 DeepSeek(主要使用其Web端及API,版本为DeepSeek-V3)。主要用途包括:需求头脑风暴、原型界面架构设计、核心爬虫与可视化代码生成、代码Bug排查与性能优化。
| PSP Personal Software Process Stages | 阶段 | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | 25 | 32 |
| Estimate | 工作量预估 | 30 | 38 |
| Development | 开发 | ||
| Analysis | 需求分析(含学习新技术) | 100 | 145 |
| Design Spec | 生成设计文档 | 60 | 86 |
| Design Review | 设计复审 | 40 | 33 |
| Coding Standard | 代码规范编写 | 30 | 22 |
| Design | 具体设计(架构、表结构) | 80 | 112 |
| Coding | 具体编码实现 | 300 | 410 |
| Code Review | 代码复审 | 60 | 46 |
| Test | 自测,修复bug、提交修改 | 120 | 175 |
| Reporting | 报告 | ||
| Test Report | 测试报告 | 40 | 31 |
| Size Measurement | 计算工作量统计 | 20 | 14 |
| Postmortem & Process Improvement Plan | 事后总结,改进计划 | 60 | 82 |
| 合计 | 865 | 1096 |
1.预估阶段低估了DBLP接口调用的限流问题,调试爬取模块花费额外时间;
2.ECharts图谱、动态动画调试比预想麻烦,需要反复调整配置项;
3.AI给出代码存在逻辑漏洞,需要人工阅读理解、排查幻觉问题,增加代码复审和测试时间;
4.原型页面交互细节打磨,页面样式微调耗时超出预估。
用户小刚希望快速了解CV领域三大顶会CVPR、ICCV、ECCV近年的研究热点。人工翻阅海量论文效率极低。
核心需求:
1.输入论文标题(单个或者批量导入),自动抓取摘要、关键词、原文链接;
2.对论文列表进行增删改查,支持模糊检索;查不到则自动联网抓取;
3.统计已入库论文,提取Top10热门研究方向;
4.关键词图谱可视化,点击关键词查看关联论文;
5.多年份、多个顶会的热词热度动态对比图。
用户:计算机视觉方向入门学习者、学生;场景:调研领域前沿、快速了解顶会热点。
本项目采用前后端分离的Web架构,全程依托AI编程助手DeepSeek进行结对开发,具体实现方案及AI协作细节如下:
数据源获取:主要采用 DBLP开放API,获取CVPR、ICCV、ECCV三大顶会的论文元数据(标题、作者、年份等);针对API缺失的摘要和关键词,通过AI辅助生成的爬虫脚本定向抓取会议官网进行补全。(AI协作:使用DeepSeek编写API调用和限流防封爬虫代码,并完成数据清洗)。
后端实现:采用 Python Flask 框架。负责调用DBLP接口、数据清洗、基于jieba和TF-IDF算法的关键词提取、以及热词热度统计与接口封装。(AI协作:利用DeepSeek生成Flask路由模板和TF-IDF核心算法,人工排查AI逻辑漏洞并优化性能)。
前端实现:采用 Vue 3 + Vite + Element Plus 搭建单页应用,结合 ECharts 实现页面交互、关键词图谱渲染、多年度热度走势动态动图。(AI协作:借助DeepSeek生成ECharts配置项和Vue组件骨架,人工调整UI布局以提升用户体验)。
数据持久化:采用轻量级关系型数据库 SQLite。将清洗后的论文数据、分词结果和统计结果持久化存储,方便进行增删改查(CRUD)和本地部署。(AI协作:AI生成数据库表结构设计,人工完成ORM映射)。
项目部署:代码托管至 华为云CodeArts(使用dev分支开发,main分支发布),最终部署上线至 华为云ECS云服务器,配置Nginx反向代理解决跨域问题,并发布Release v1.0.0包。(AI协作:部署报错时,通过向AI输入报错日志快速定位Nginx配置或跨域问题)。
原型设计:使用墨刀工具。先与AI讨论页面信息架构、布局和配色方案,由AI生成初稿建议,随后经人工审核与调整完成交互逻辑设计(涵盖首页、列表管理、走势分析等核心页面)。
用户不用手动检索每一篇论文,一键批量导入论文列表,自动提取摘要关键词;可视化图表直观看到热门方向,动态图观察热词随年份的变迁。大幅降低入门调研成本。用户只需要提供论文标题,系统自动完成信息抓取与统计。
竞品1:DBLP官网。优点:权威原始数据;缺点:无批量导入、无关键词统计、没有可视化图表,只能单篇查询,缺少热点汇总。
竞品2:PaperWithCode。优点:论文汇总,附带代码;缺点:无法批量导入自定义论文列表,不能自由统计自己选中论文的Top10方向,没有关键词图谱。
本平台:
优势:自定义论文集合分析。用户可以自由导入自己筛选出来的论文,只统计用户选中的这批论文,不是全局统计,支持本地论文库管理。这是和现有网站最大差异。
劣势:依赖DBLP开放API,受接口限流,部分论文信息可能缺失;文本关键词抽取有误差。
阶段一:需求分析,NABCD文档,墨刀原型,PSP预估工时。
阶段二:编码开发,按模块开发,Git提交记录,单元自测;完成部署到华为云ECS;
交付产物:可访问Web网站、CodeArts代码仓库、博客文档、原型链接。
开发工具:本次原型设计采用 墨刀。选择该工具是因为其组件库丰富、支持快速拖拽,且能生成便于分享的网页链接。
AI协作方式:在原型设计阶段,我将DeepSeek作为“产品经理助理”。首先向AI输入需求背景,让其推荐配色方案和页面信息架构;随后在墨刀中搭建基础框架,将截图发给DeepSeek进行“UX走查”,AI指出了页面层级过深、按钮不够醒目等问题,我结合其建议进行了人工优化调整。
页面结构:包含首页(热门方向总览 + 关键词图谱)、论文列表管理页(增删改查)、论文爬取/导入页、热度走势对比页(动图)、详情页以及关于我们页面。
交互逻辑:
首页点击“查看更多”可跳转至论文列表页。
列表页支持精确查询和模糊查询,点击“详情”可查看论文摘要与原文链接。
若查询论文不存在,系统弹出Toast提示“未找到该论文,是否立即从DBLP/官网爬取?”,点击确认后触发后端爬虫并返回结果。
点击关键词图谱中的任一词汇,可弹出悬浮窗展示包含该关键词的相关论文列表,实现数据的联动。
原型分享链接:https://modao.cc/proto/VBaubLlptluw12zQJ89Pf3/sharing?view_mode=read_only&screen=rbpVW7M13UitUdkam #102400101-分享
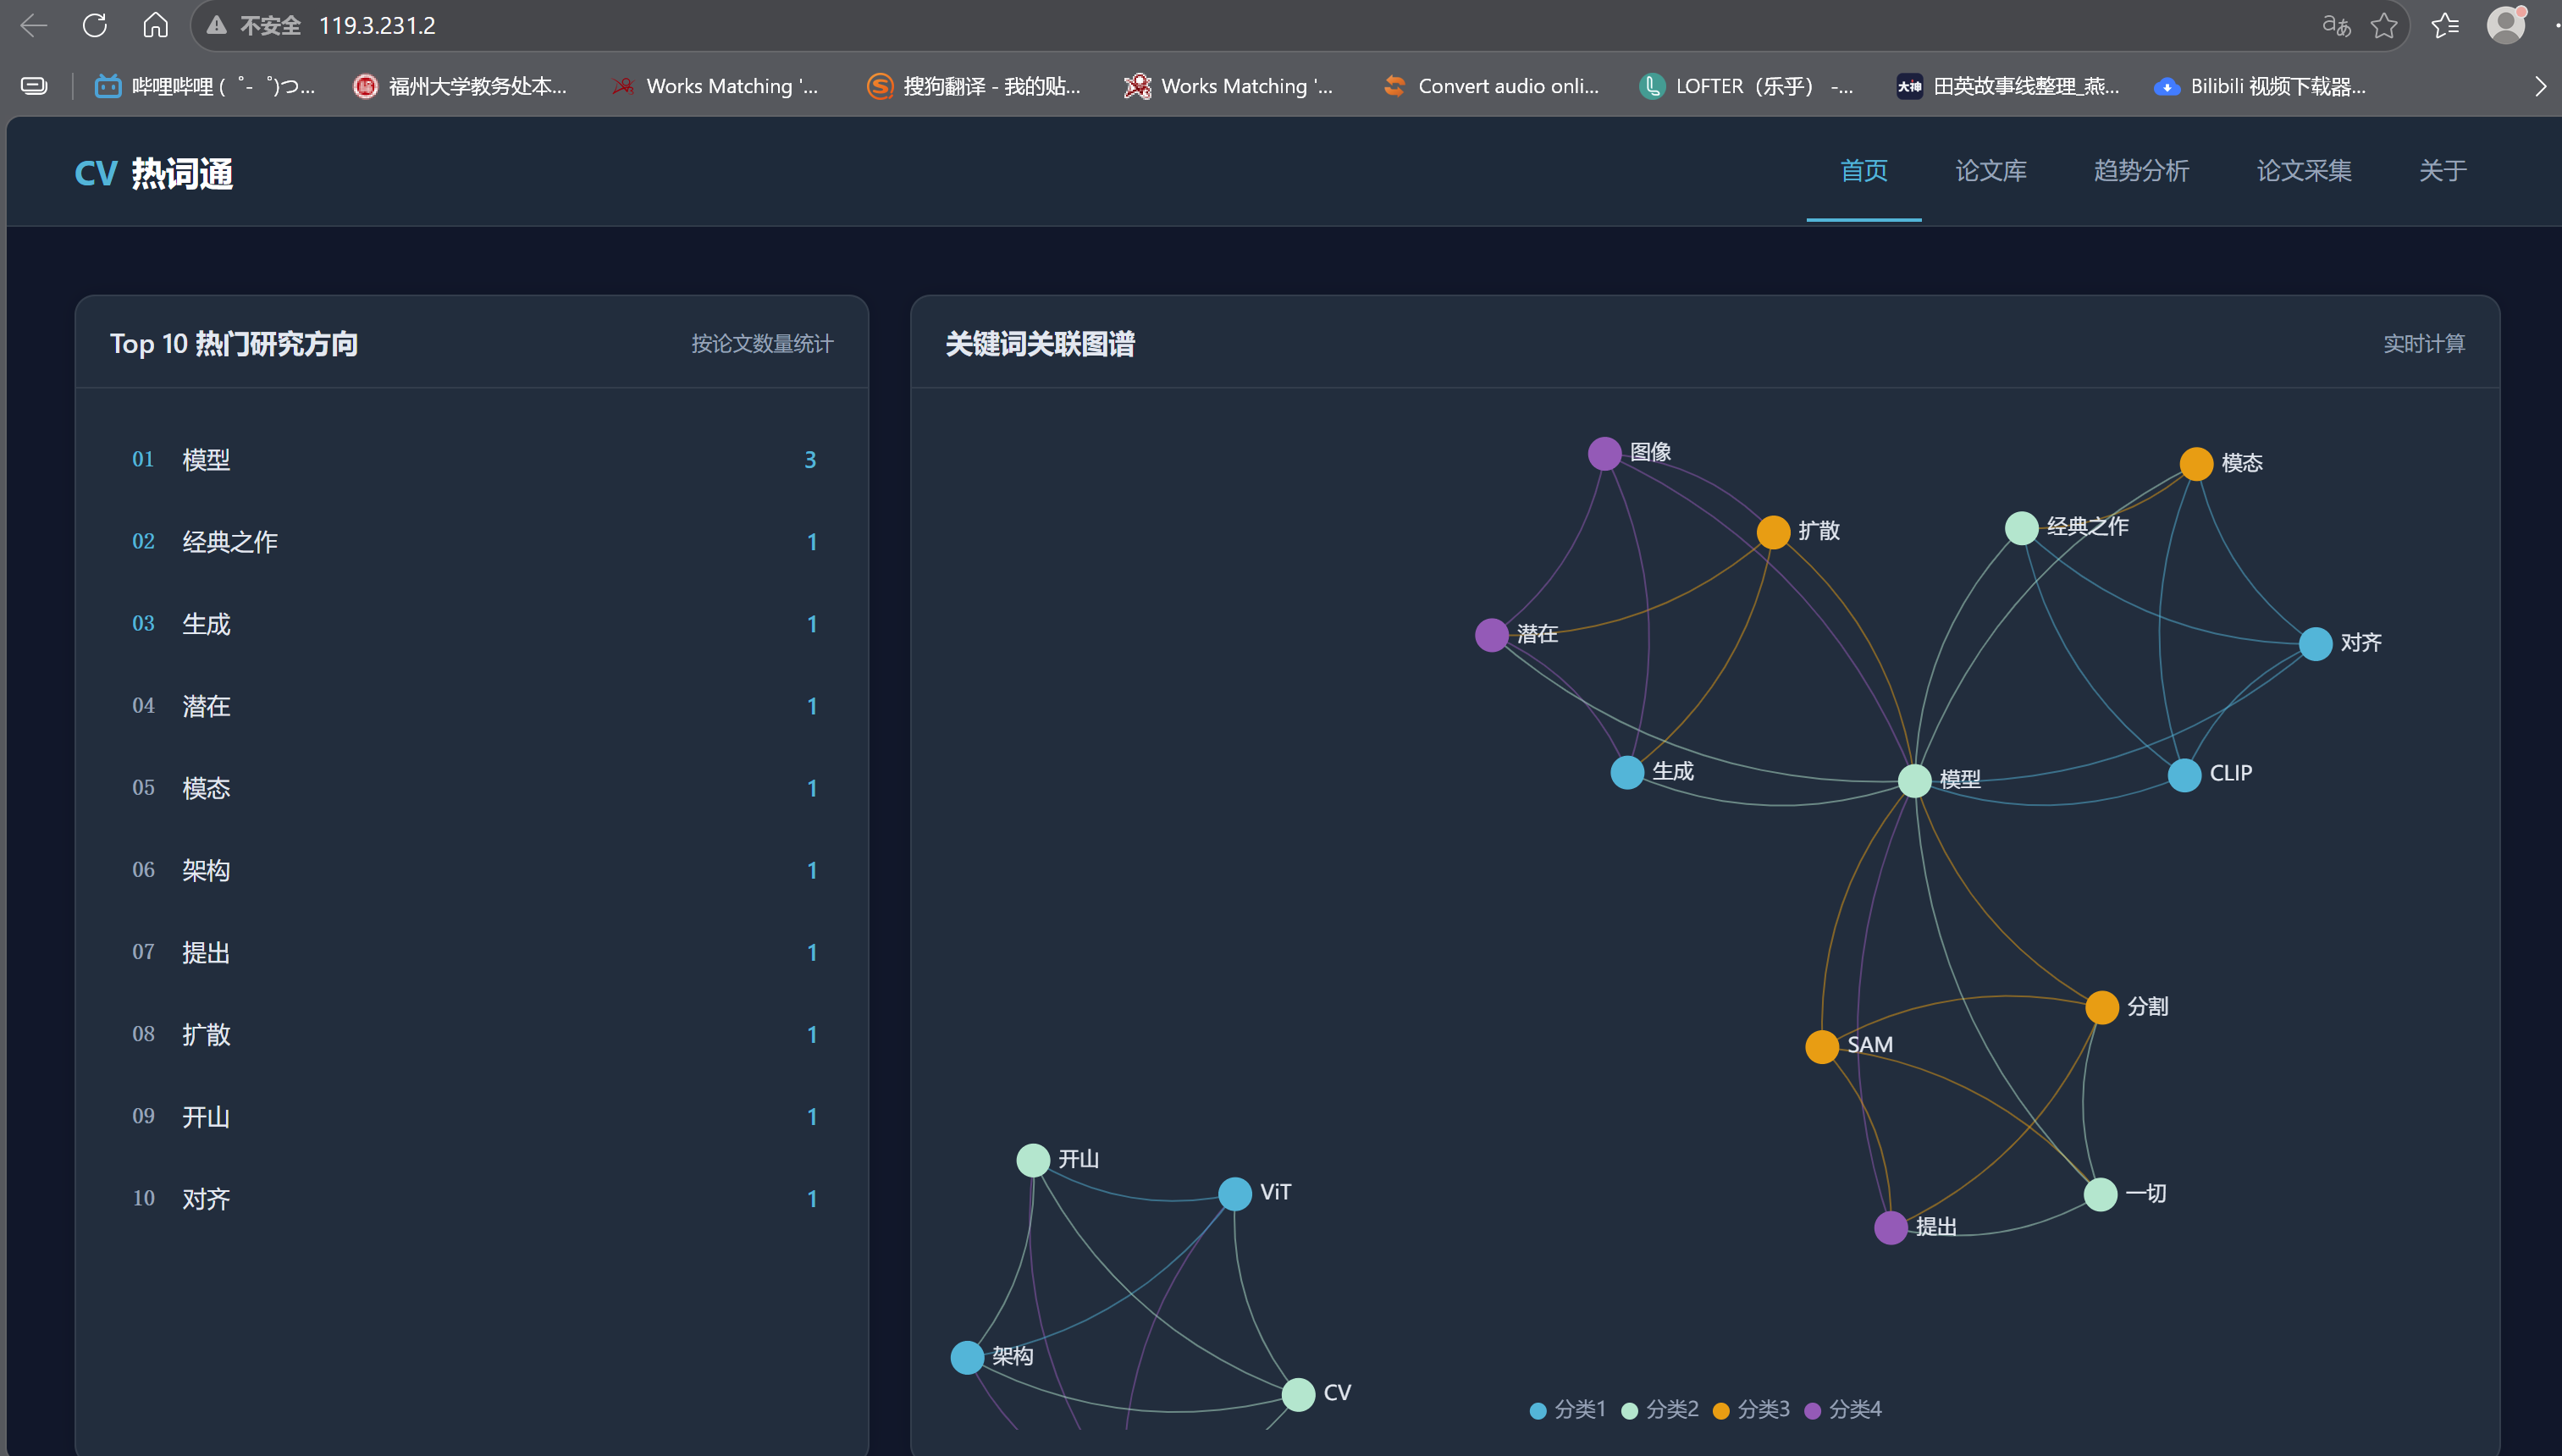
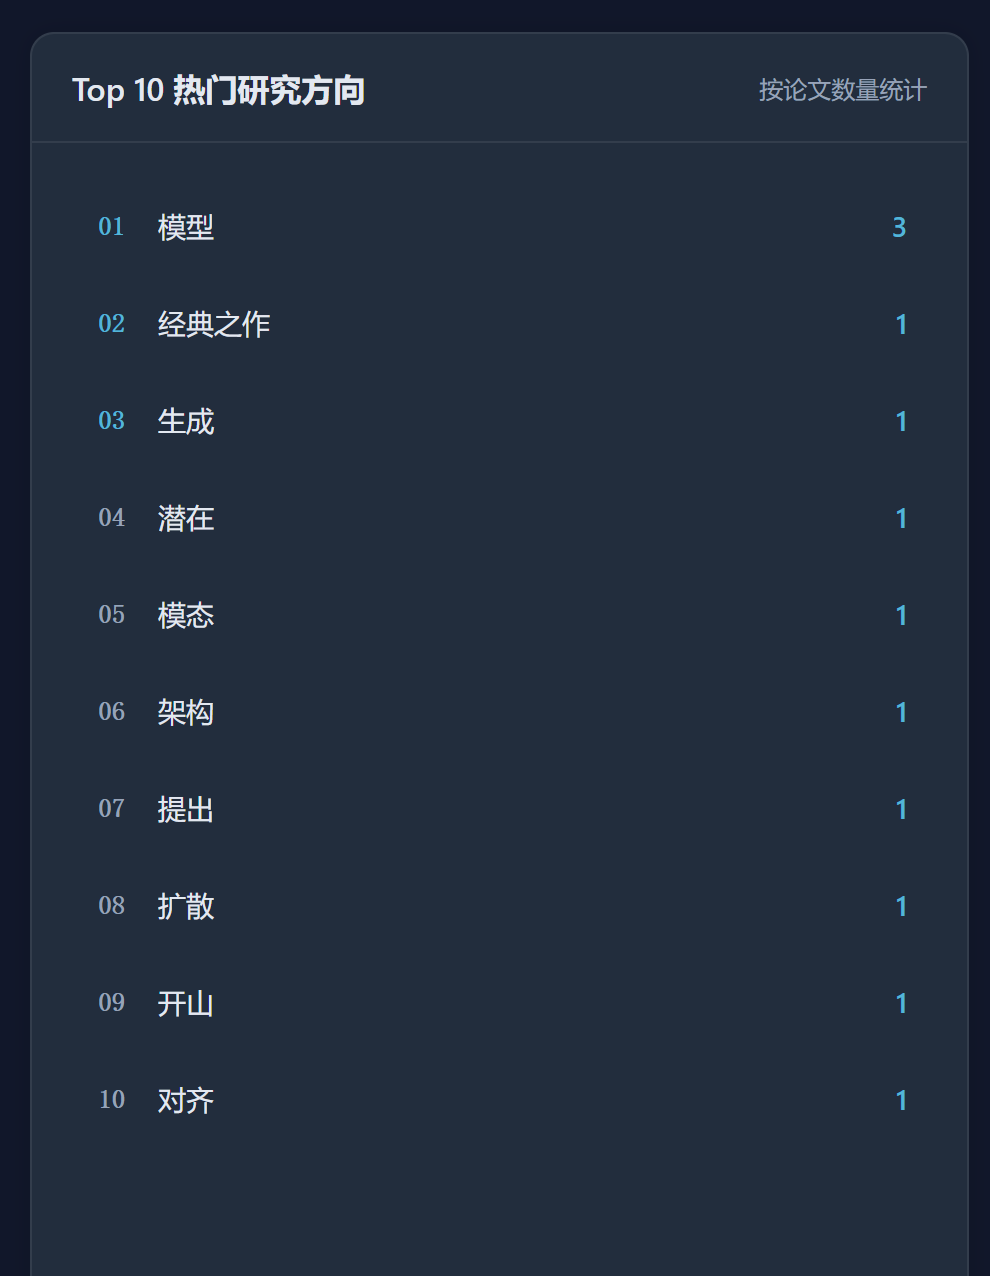
说明:首页采用深色学术科技风,集中展示了核心数据指标。左侧为“Top 10 热门研究方向”的排行榜卡片,右侧为ECharts力导向图渲染的“关键词关联图谱”。支持拖拽缩放,节点大小代表词频,不同颜色代表不同类别。
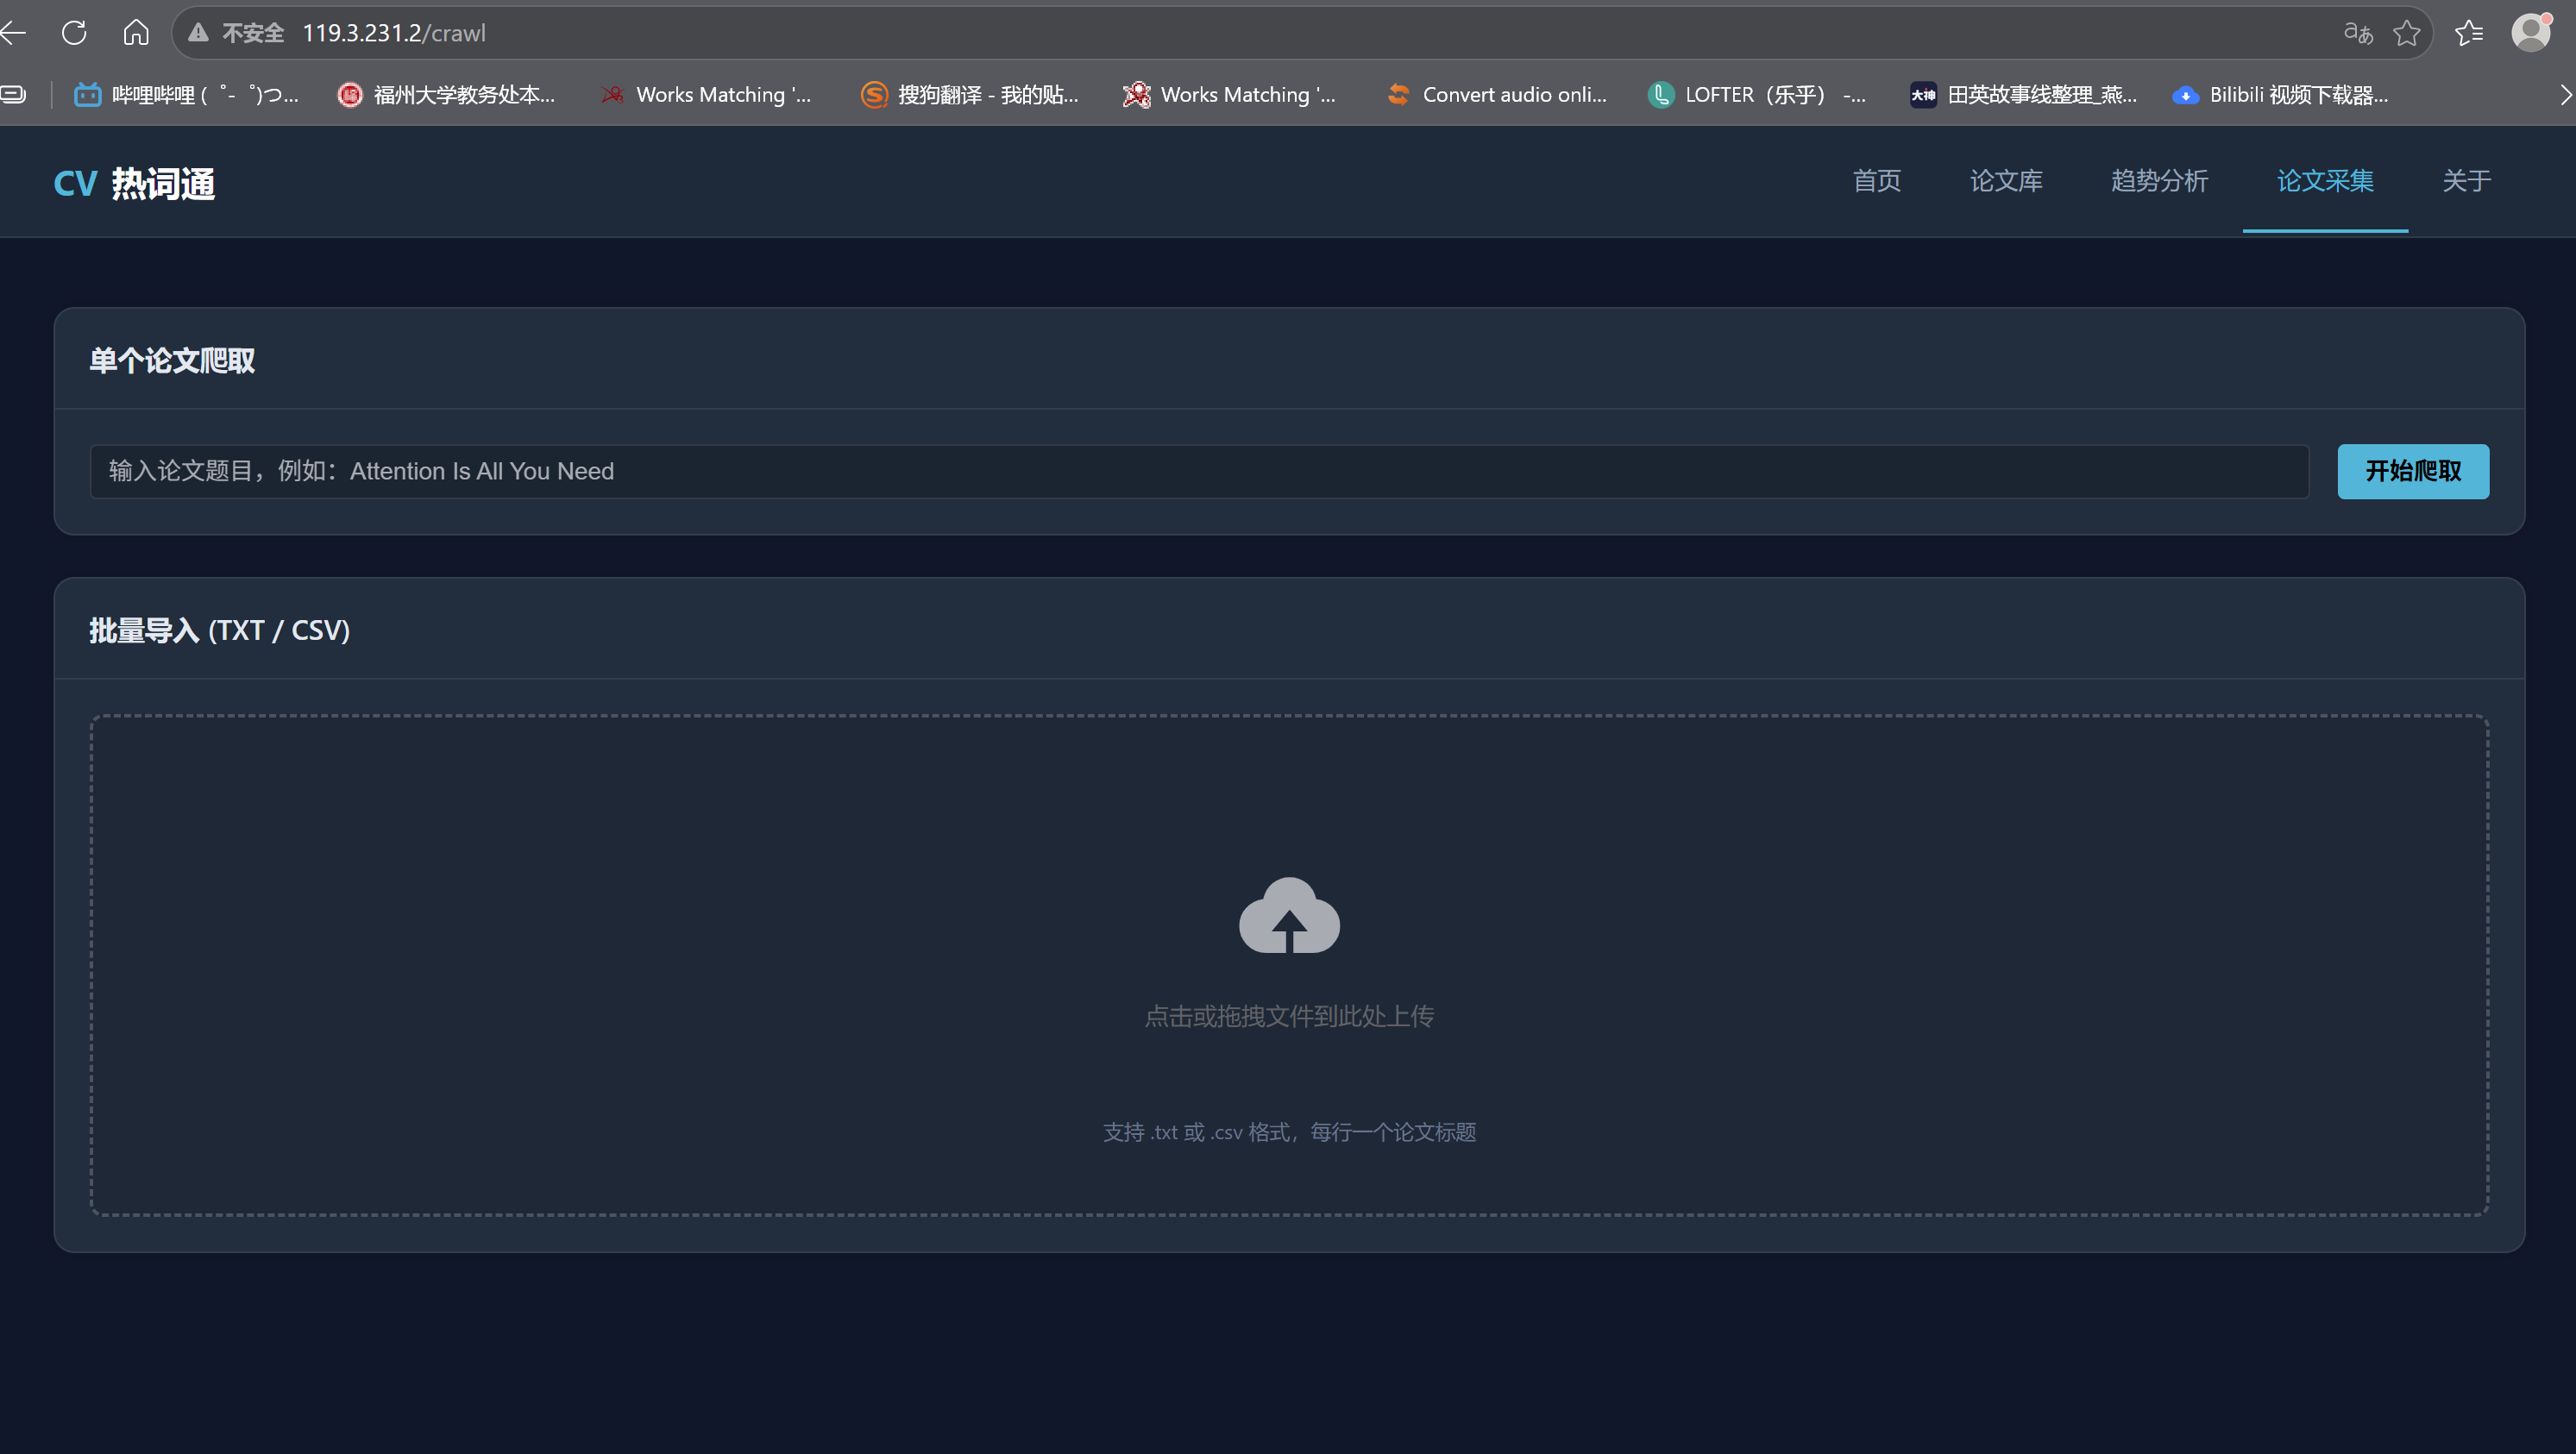
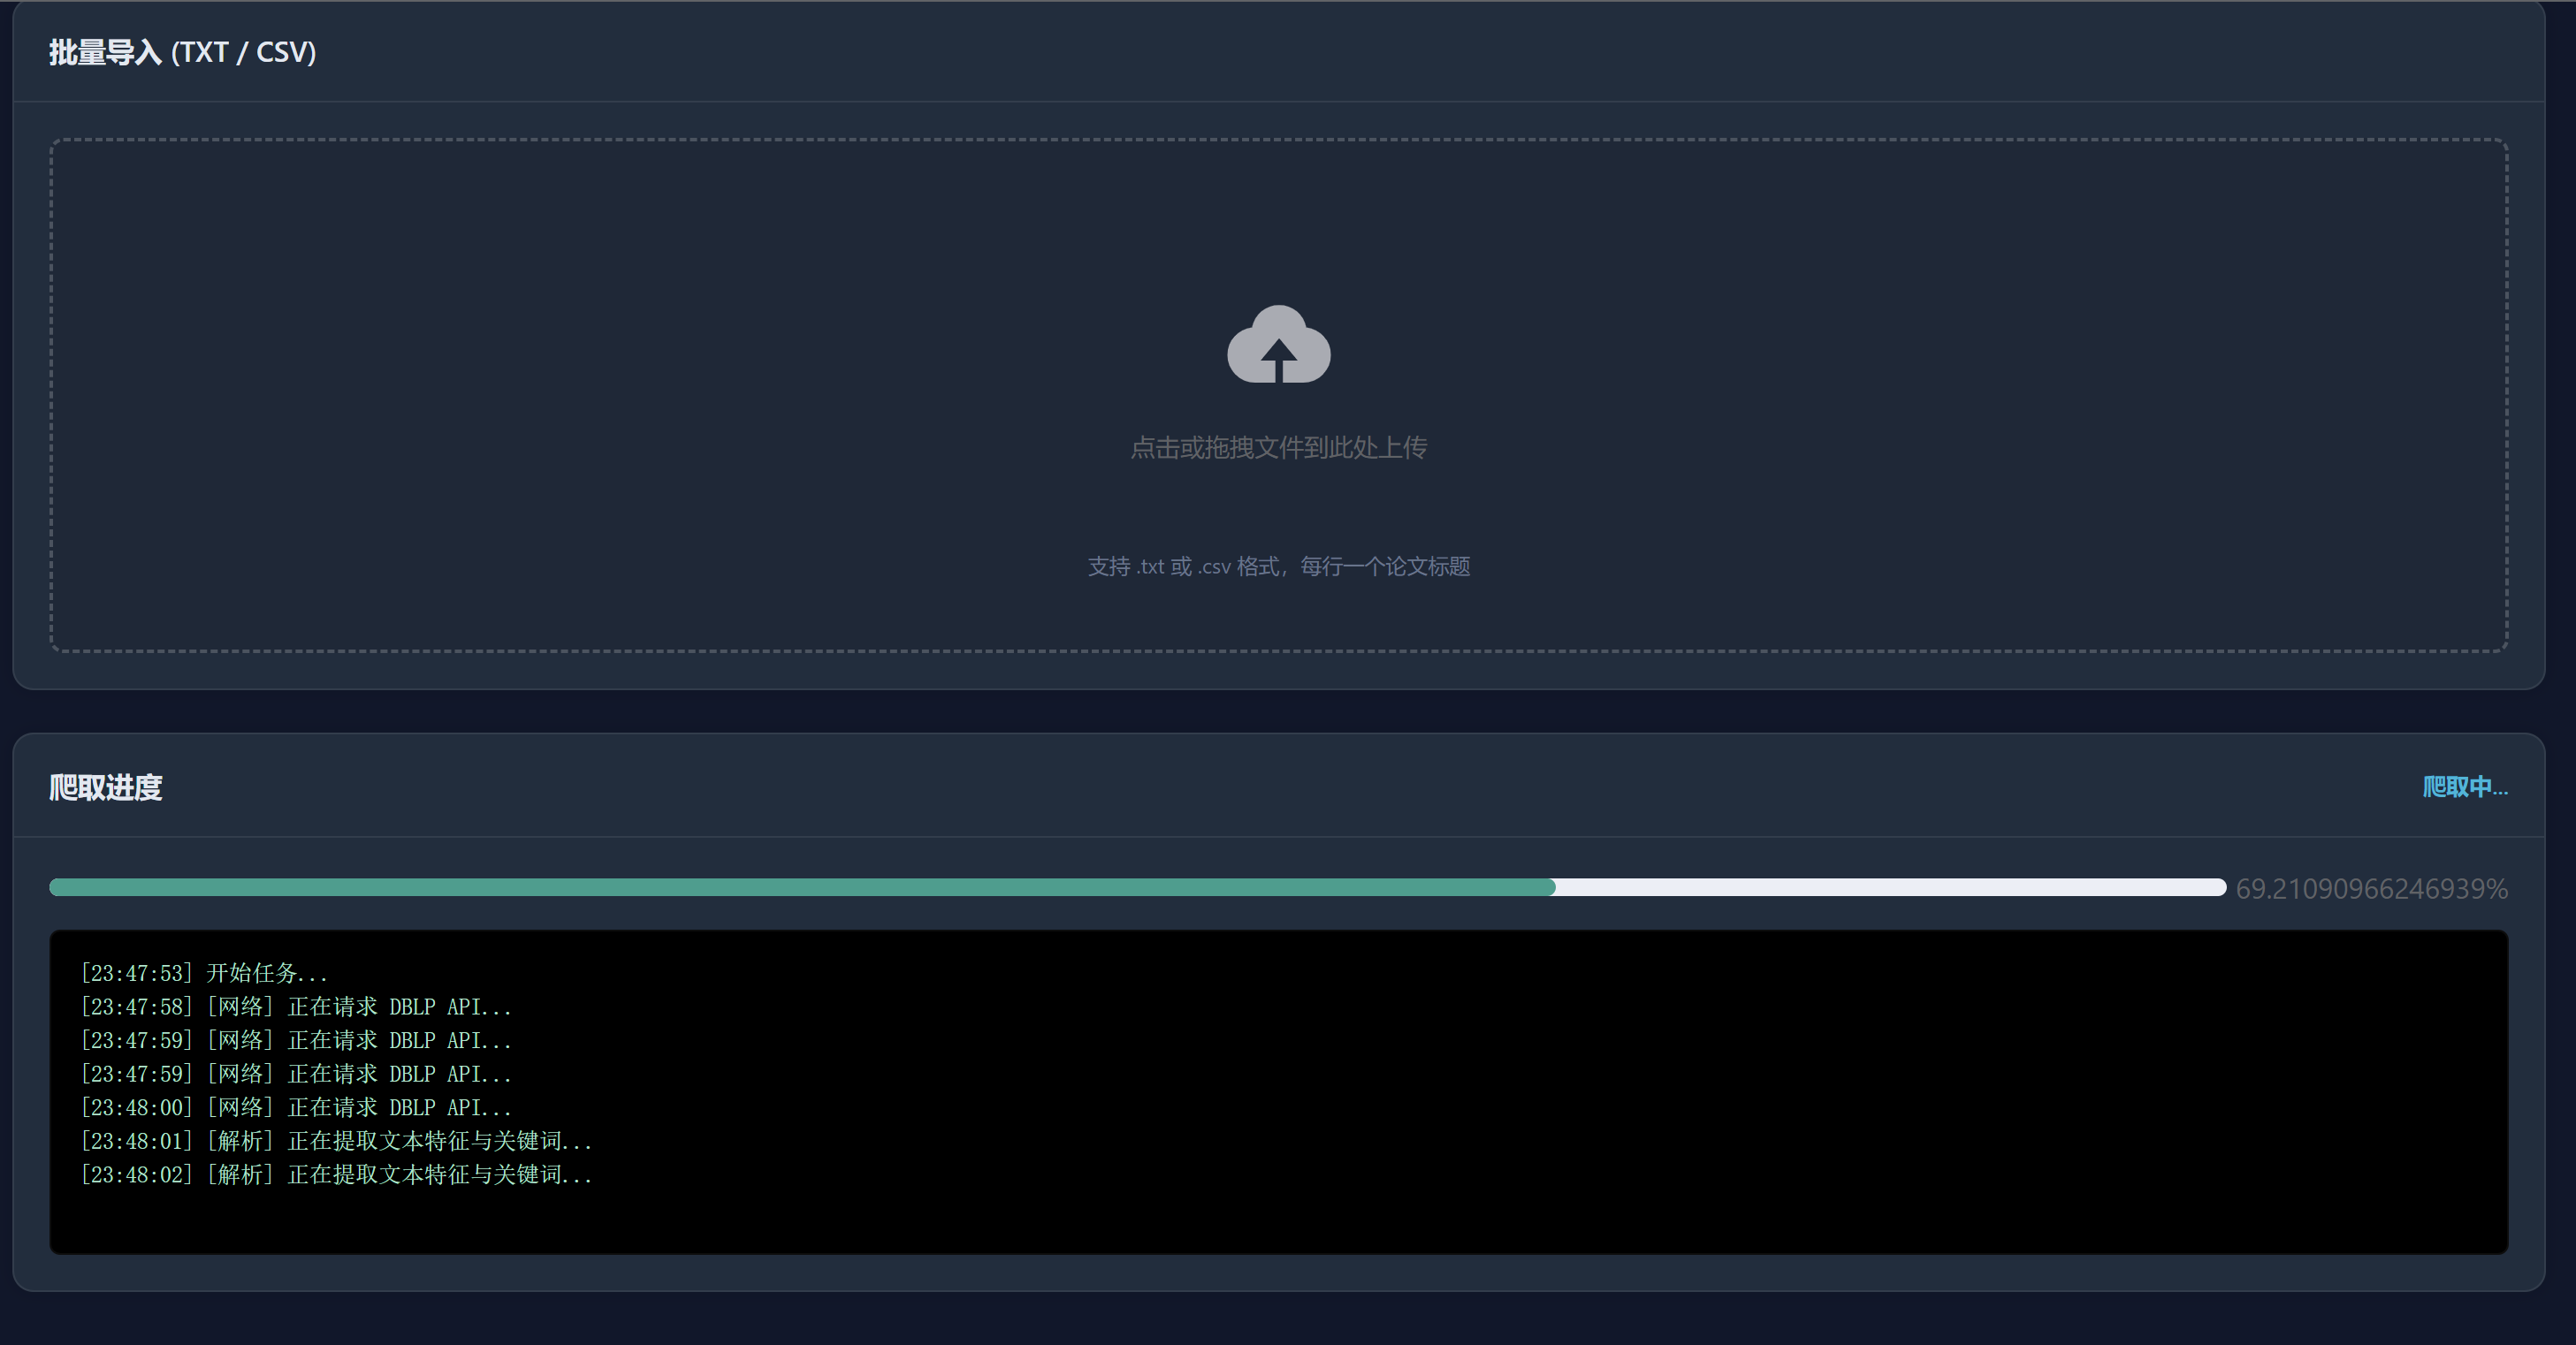
说明:用户可输入单个论文题目进行精准爬取,也支持上传TXT/CSV文件进行批量导入。点击“开始爬取”后,前端进度条动态展示爬取状态,日志区域实时输出“正在请求DBLP API”、“正在提取关键词”等状态,模拟并反映真实的后台处理流程。
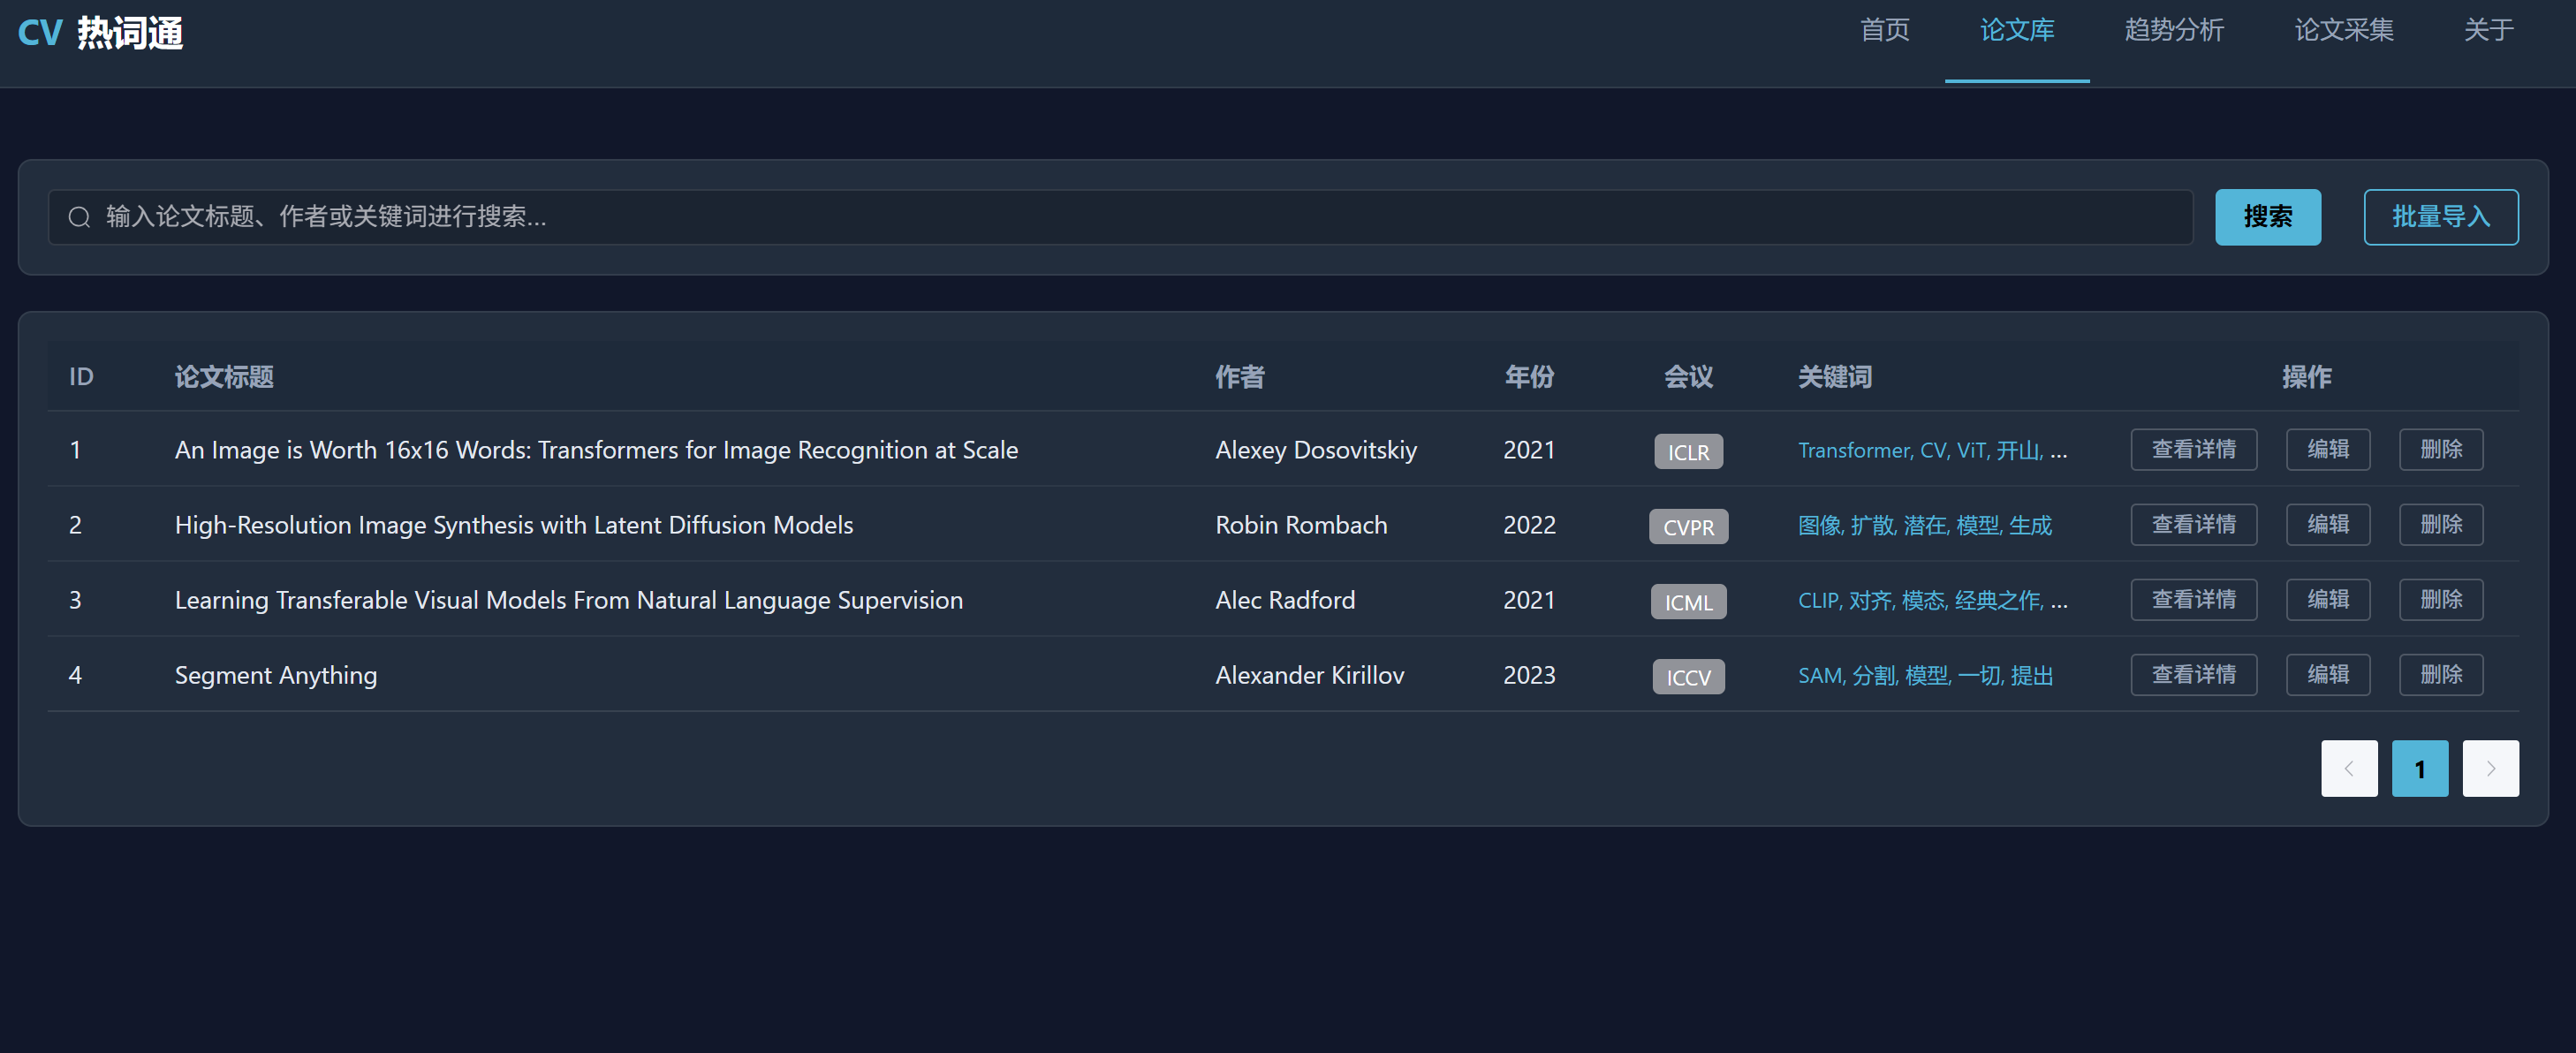
说明:展示对已爬取论文的增删改查操作。表格适配了深色主题,支持按标题/作者/关键词进行前端模糊查询过滤。当搜索无结果时,会弹出“未找到该论文,是否立即从DBLP爬取?”的交互弹窗。操作列包含查看详情、编辑和删除按钮。
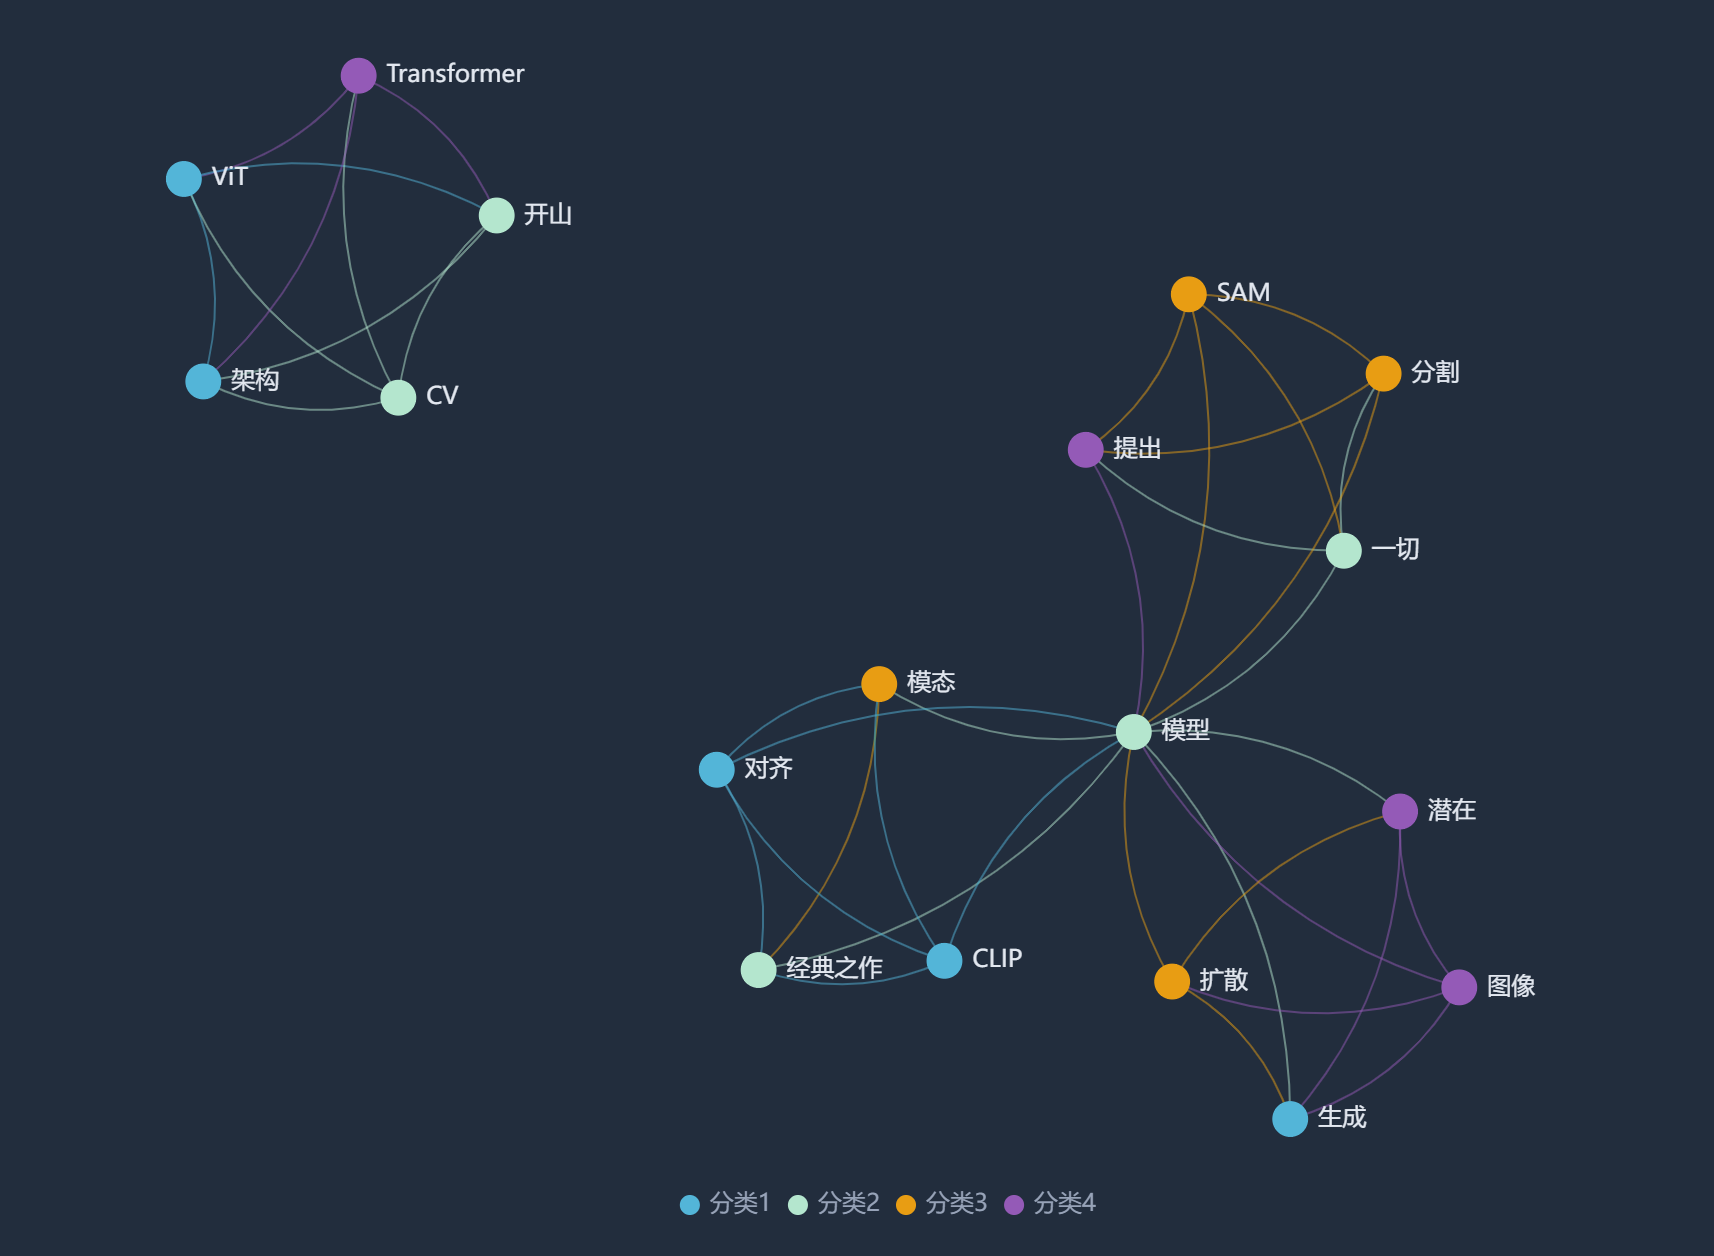
说明:基于ECharts实现的知识图谱。节点(Nodes)由所有出现过的关键词组成,节点大小代表词频总和;连线(Links)代表这些关键词出现在同一篇论文中的共现关系。鼠标悬浮可高亮关联节点。
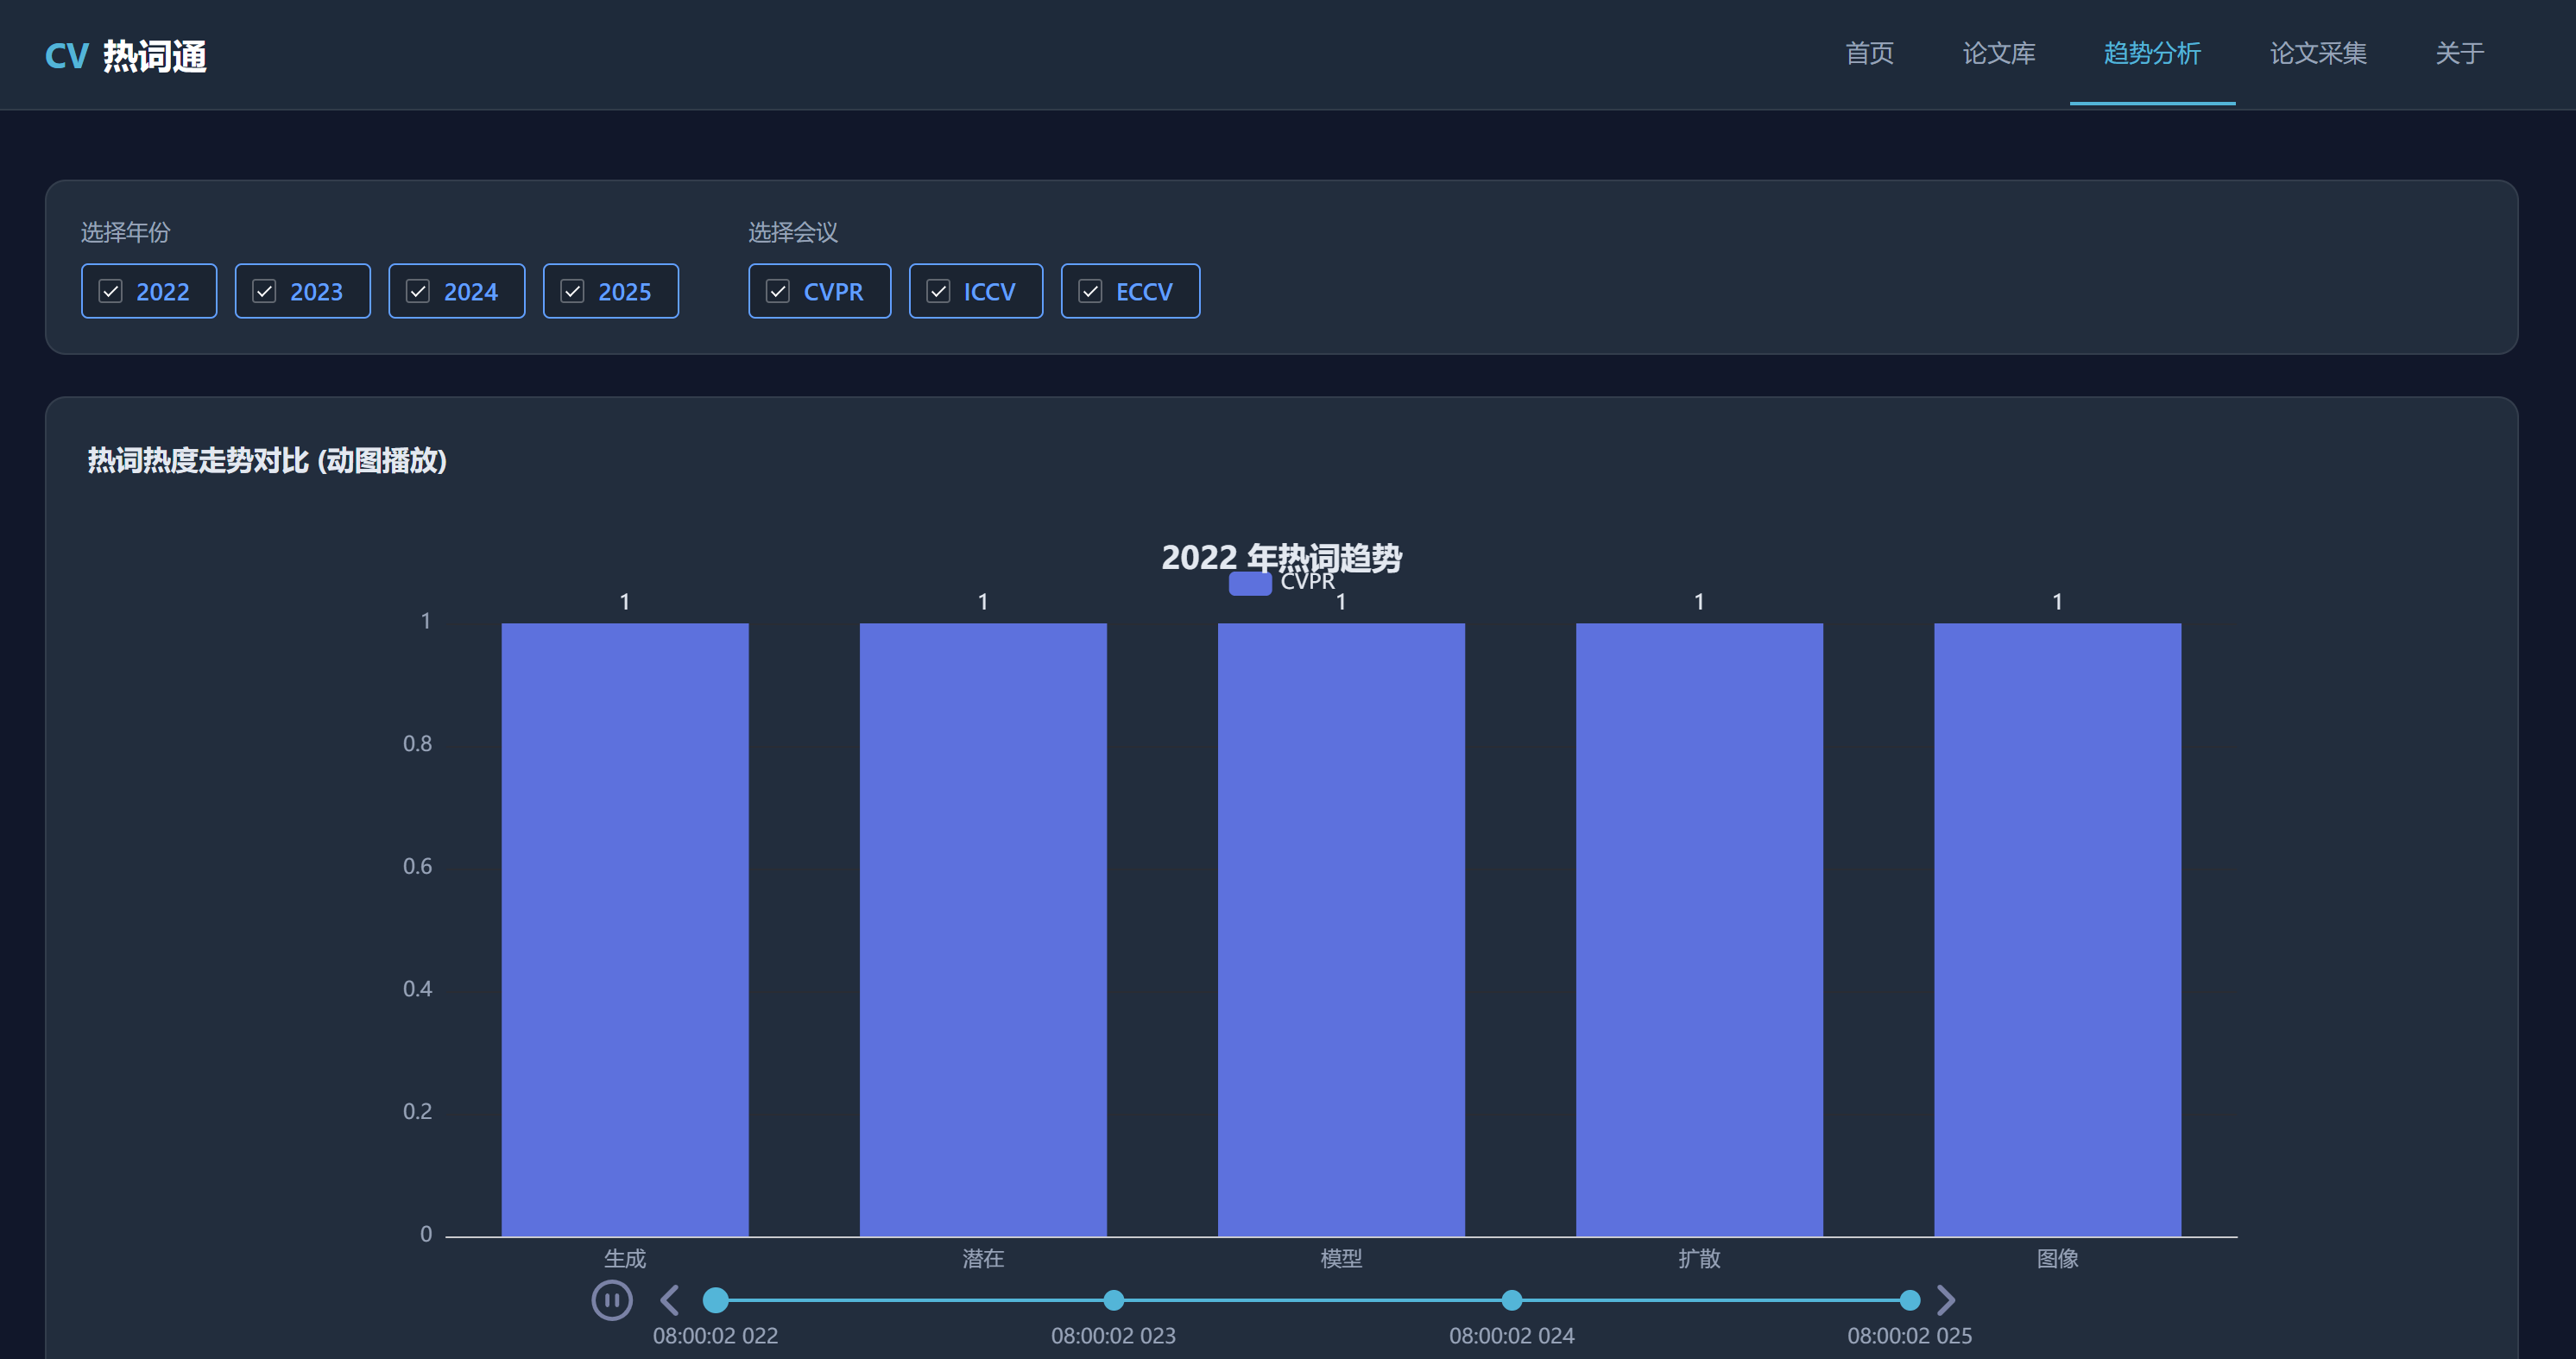
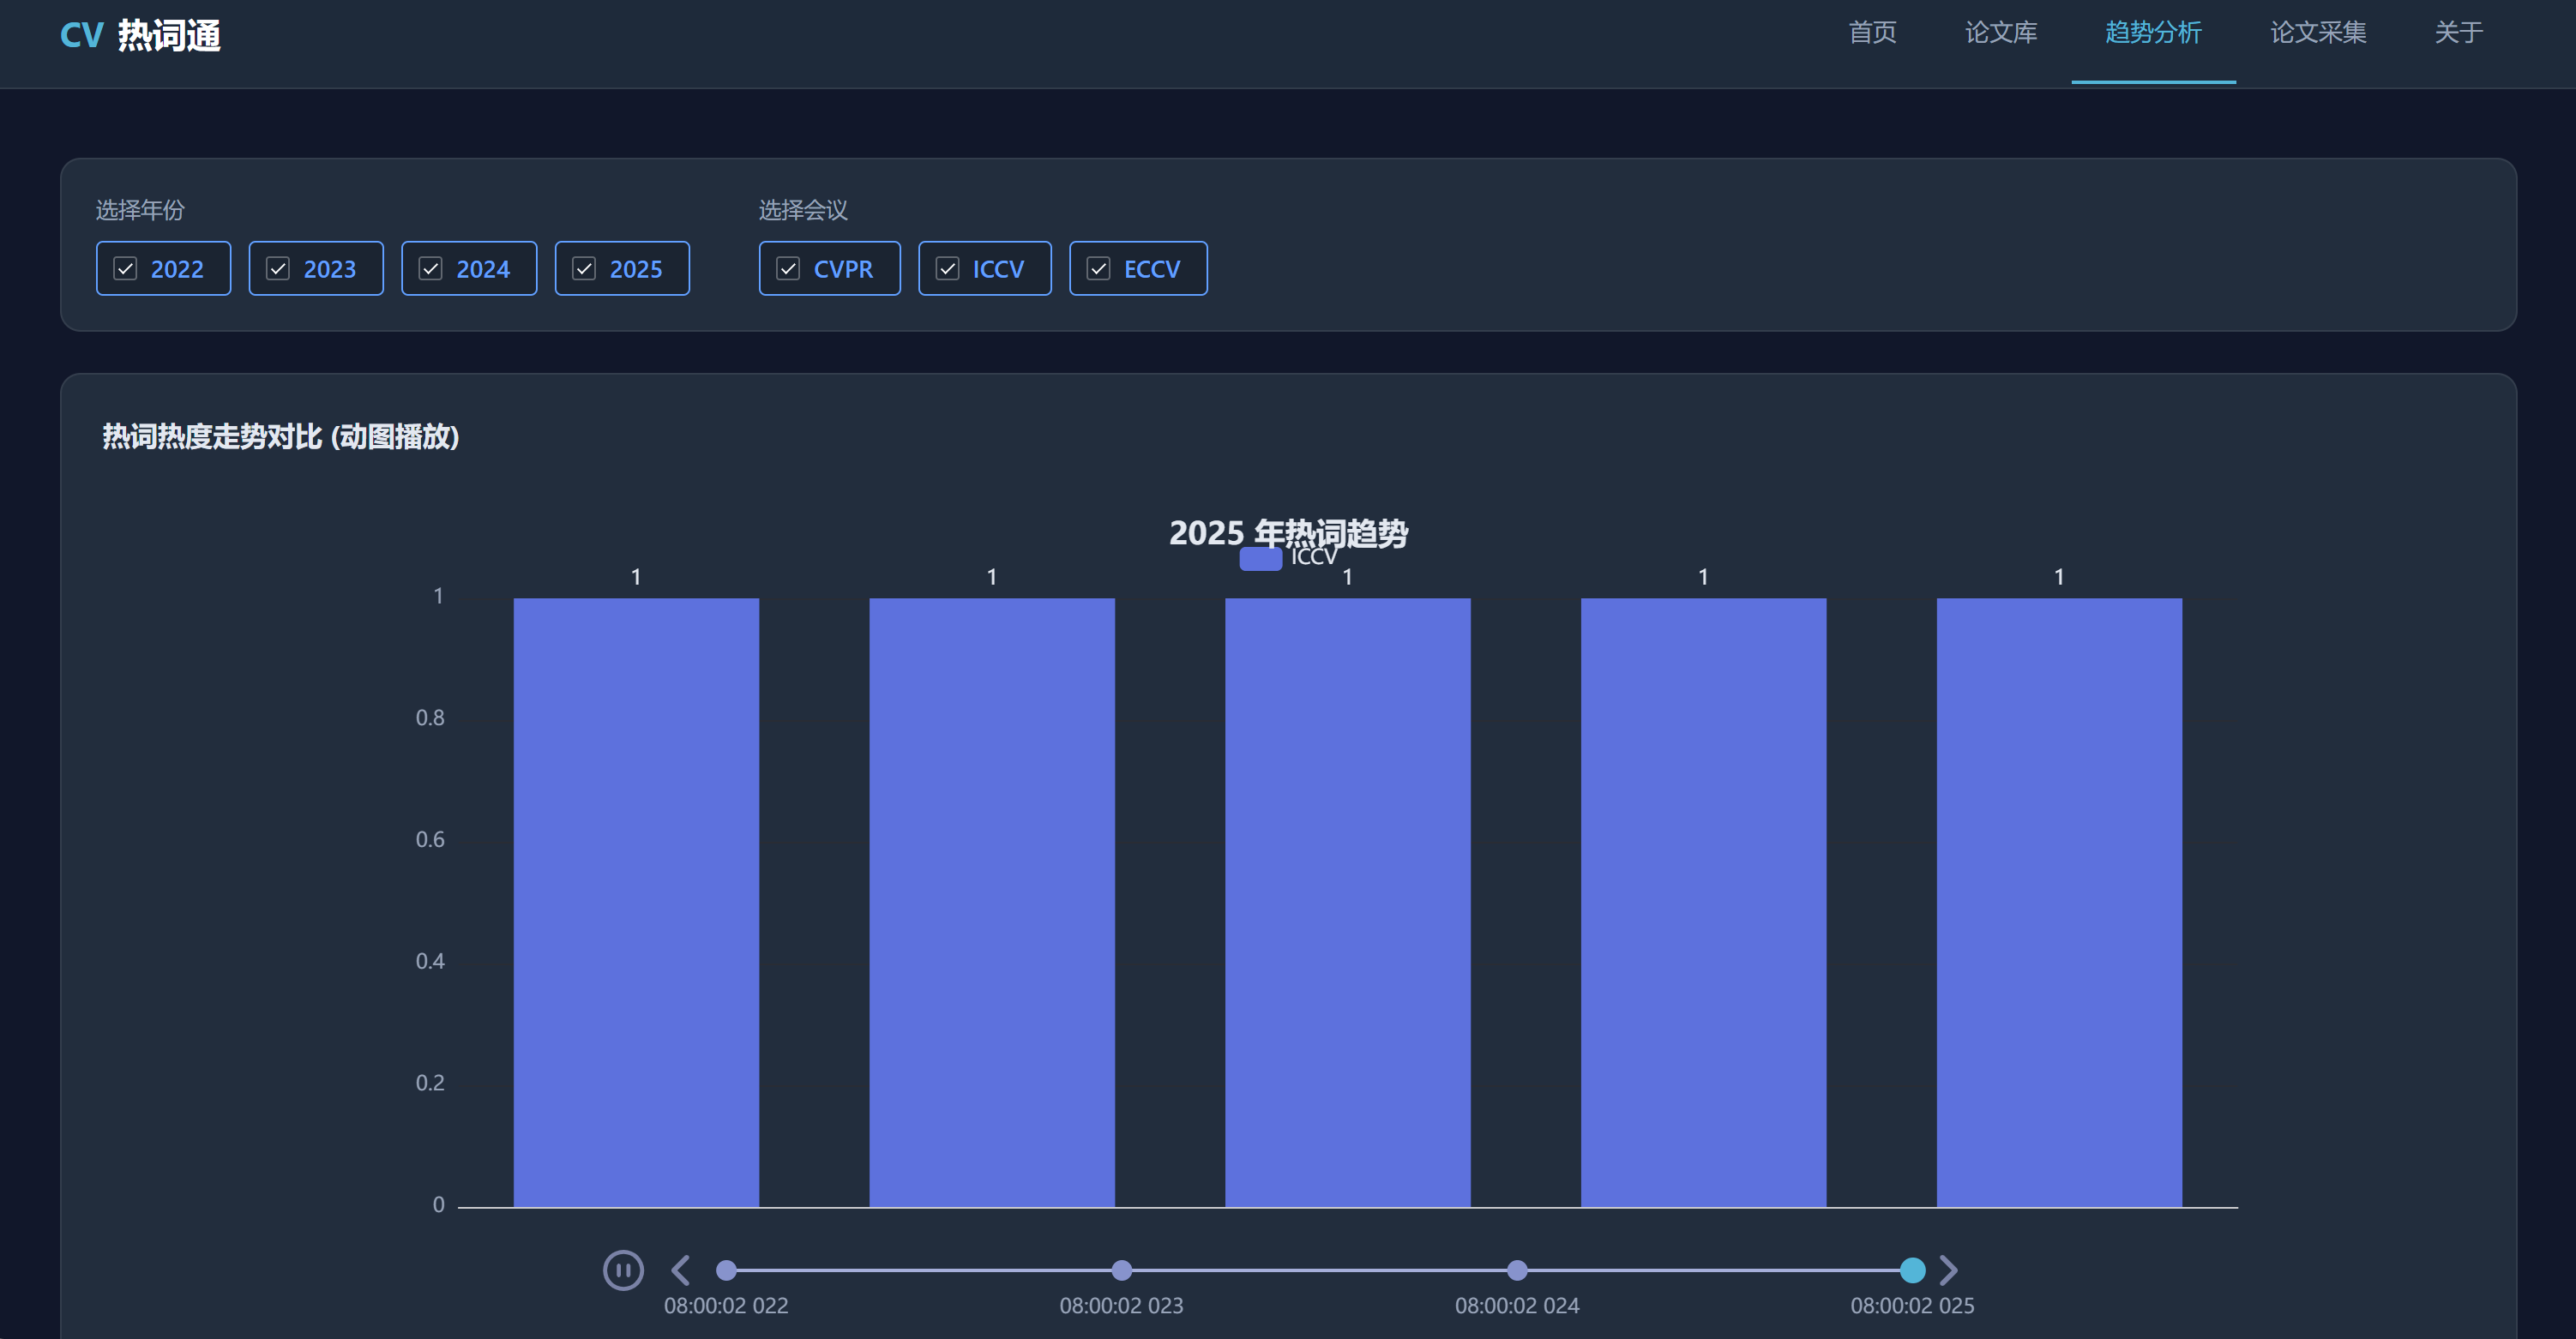
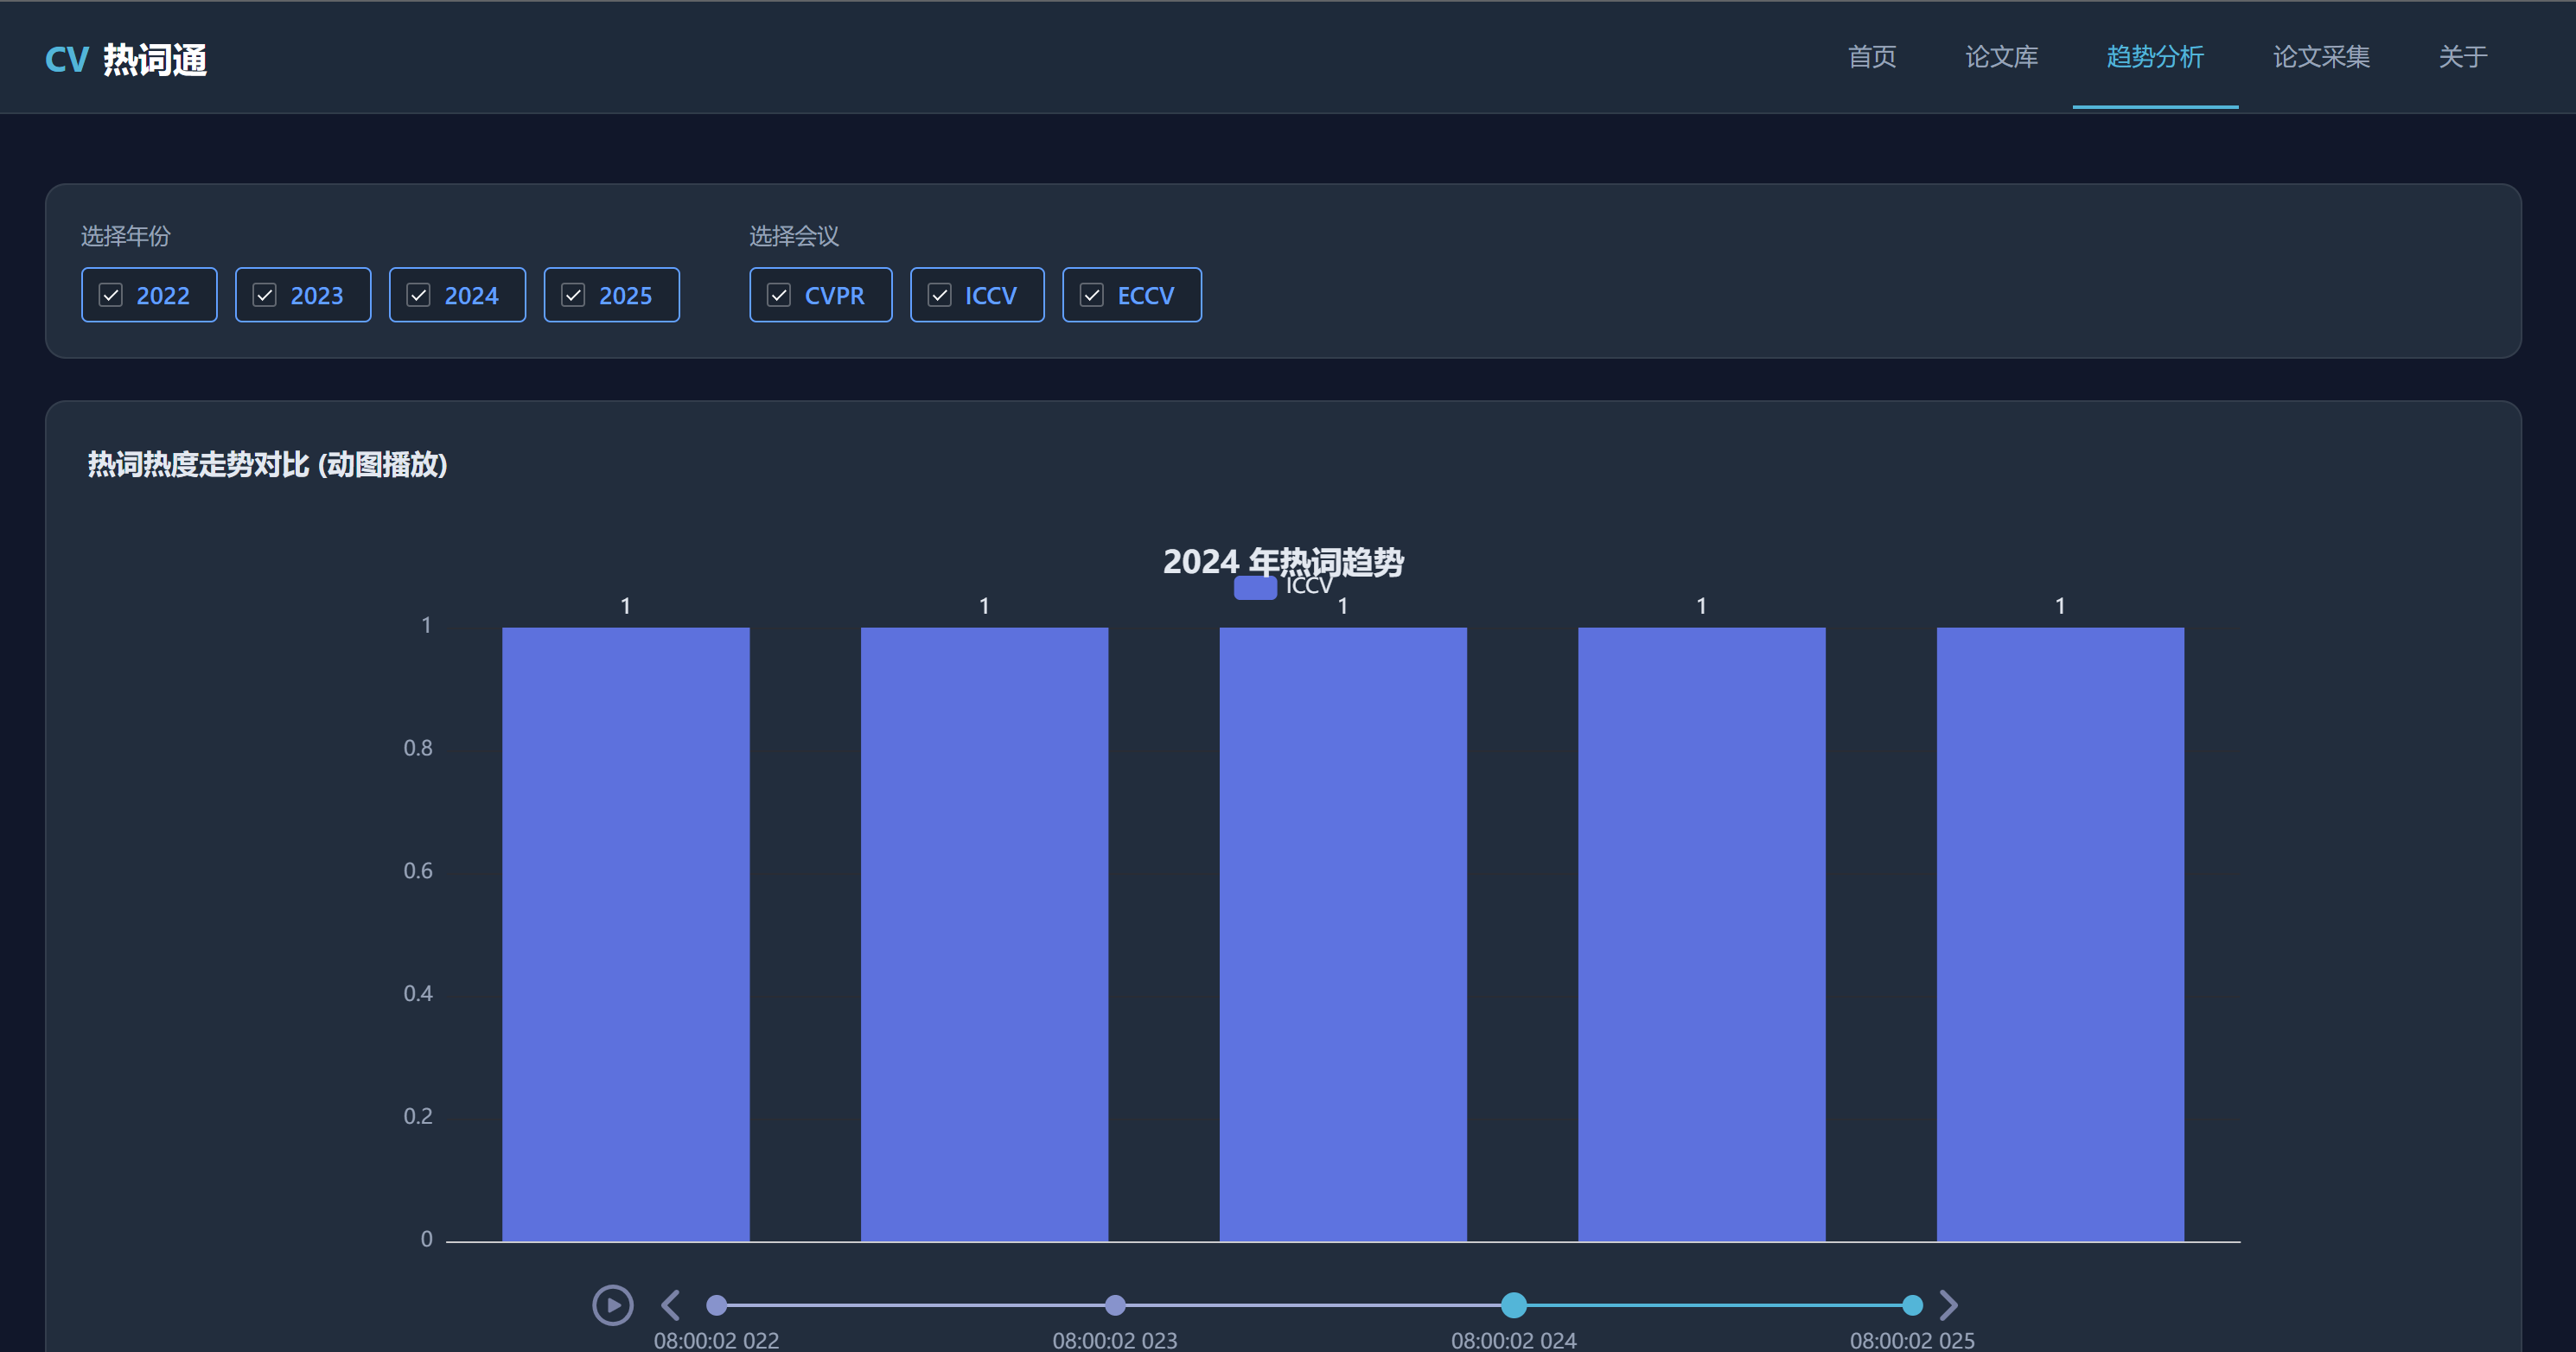
timeline组件实现,开启autoPlay后自动播放,底部控制器可进行播放/暂停和年份切换,直观展示了“大模型”、“多模态”、“目标检测”等词汇的热度演变。
说明:项目最终部署至华为云ECS(Huawei Cloud EulerOS)。采用Nginx托管Vue打包后的静态资源,并通过反向代理将/api请求转发至后端Gunicorn服务。公网访问链接:http://119.3.231.2/
Prompt提示词:“请帮我生成一个计算机视觉顶会论文分析平台的原型HTML页面,包含首页、论文库、论文采集、趋势分析、详情页,深色学术科技风……”
AI输出摘要:DeepSeek生成了5个包含内联CSS和ECharts占位图的高保真HTML文件。
我的修改与理由:AI生成的HTML虽然在浏览器可以跳转,但导入墨刀后,由于工具机制,所有超链接失效,且部分元素游离在画板之外无法设置交互(报错“页面外元素不支持创建和设置交互”)。我人工介入后,将游离元素拖入画板,将导航栏抽离为“全局组件”,手动补全了页面跳转、搜索无结果弹窗、进度条载入动画等交互逻辑。这让我深刻认识到:AI负责生成视觉骨架和业务逻辑草稿,而最终的用户体验和跨工具的适配,必须依靠开发者人工把关。
Prompt提示词:“请用Vue3 + Element Plus + ECharts写一个首页,左侧渲染Top10榜单,右侧渲染力导向图……”
AI输出摘要:DeepSeek给出了基于Axios异步请求和ECharts graph配置的完整组件代码。
我的修改与理由:AI生成的ECharts默认是浅色主题,与我们的深色学术风严重冲突。我人工查阅了Element Plus和ECharts官方文档,利用 :deep() 深度选择器覆盖了表格背景色、悬停色等CSS变量,并在ECharts初始化时传入了 'dark' 主题,辅以自定义的节点颜色和发光效果,完美适配了暗色模式。同时补充了 window.addEventListener('resize', ...) 逻辑,解决了图表在窗口缩放时的变形问题。
Prompt提示词:“Flask报错 ImportError: cannot import name 'Paper' from 'models',如何解决?” / “终端提示 sudo: nano: command not found,怎么办?”
AI输出摘要:AI准确指出了循环导入(Circular Import)问题,建议抽离 extensions.py 存放 db 实例;在部署环节,AI指出华为云EulerOS系统未预装nano编辑器。
我的修改与理由:在本地开发中,我采纳了抽离 extensions.py 的方案,成功解决了Flask的循环导入崩溃。在云部署时,由于服务器网络限制,我放弃了 pip 默认源,切换为清华镜像源 -i https://pypi.tuna.tsinghua.edu.cn/simple,将依赖安装速度从 6.3 kB/s 提升至 10.2 MB/s,极大节省了部署时间。AI提供解决方案,但我作为开发者需要根据实际网络环境和系统限制进行灵活调整。
多次Prompt迭代记录:
time.sleep(2) 并设置随机User-Agent。采纳。系统采用前后端分离架构。
前端:Vue 3 + Vite + Element Plus + ECharts,负责页面渲染、数据交互、图表动效展示。
后端:Python Flask + SQLAlchemy,负责提供RESTful API、调用DBLP接口、文本处理(jieba、TF-IDF)、以及数据库聚合统计。
数据库:SQLite,轻量级且方便部署,用于持久化存储论文(Paper)、关键词(Keyword)和趋势(Trend)数据。
部署架构:华为云ECS(EulerOS)+ Nginx(反向代理与静态资源托管)+ Gunicorn(WSGI服务器)。
id (主键), title, authors, year, conference, abstract, link, keywords。id, word, paper_id (外键), frequency。id, year, conference, keyword, frequency。将项目划分为:数据爬取模块、数据清洗与分词模块、论文管理接口、可视化图表模块。
开发流程:在CodeArts中创建仓库,建立 dev 分支进行日常开发,main 分支用于稳定发布。每完成一个独立功能(如爬虫跑通、列表页接口完成)便commit一次。最终完成所有功能后,将 dev 合并到 main,并发布 Release v1.0.0 包。
requests 库发送HTTP请求,加入了 User-Agent 伪装和 time.sleep(2) 频率限制,并处理了JSON解析异常和网络超时异常。jieba 进行分词,过滤中英文停用词。使用TF-IDF算法(jieba.analyse.extract_tags)提取前5个关键词。from flask import Flask, request, jsonify
from flask_cors import CORS
from config import Config
from extensions import db
from sqlalchemy import func
app = Flask(name)
app.config.from_object(Config)
app.config['JSON_AS_ASCII'] = False # 让返回的JSON直接显示中文,方便调试
db.init_app(app)
CORS(app, resources={r"/": {"origins": ""}})
from models import Paper, Keyword, Trend
from crawler import crawl_single_paper, crawl_batch_papers
@app.route('/api/crawl/single', methods=['GET', 'POST'])
def api_crawl_single():
title = request.args.get('title') or (request.json and request.json.get('title'))
if not title:
return jsonify({"code": 400, "message": "缺少论文标题参数"}), 400
success = crawl_single_paper(title)
if success:
return jsonify({"code": 200, "message": "爬取成功并已入库"})
else:
return jsonify({"code": 500, "message": "爬取失败或已存在,请检查终端日志"})
@app.route('/api/papers', methods=['GET'])
def get_papers():
papers = Paper.query.all()
result = []
for p in papers:
result.append({
"id": p.id, "title": p.title, "authors": p.authors,
"year": p.year, "conference": p.conference,
"abstract": p.abstract, "link": p.link, "keywords": p.keywords
})
return jsonify({"code": 200, "data": result})
@app.route('/api/analysis/top_keywords', methods=['GET'])
def get_top_keywords():
try:
results = db.session.query(
Keyword.word,
func.sum(Keyword.frequency).label('total_freq')
).group_by(Keyword.word).order_by(db.desc('total_freq')).limit(10).all()
    data = [{"name": row[0], "value": row[1]} for row in results]
    return jsonify({"code": 200, "data": data})
except Exception as e:
    print(f"[API错误] Top关键词统计失败: {e}")
    return jsonify({"code": 500, "message": str(e)}), 500
@app.route('/api/analysis/graph', methods=['GET'])
def get_keyword_graph():
try:
nodes_query = db.session.query(
Keyword.word,
func.sum(Keyword.frequency).label('total_freq')
).group_by(Keyword.word).all()
    nodes = [{"name": row[0], "value": row[1]} for row in nodes_query]

    papers = Paper.query.all()
    links_set = set()

    for p in papers:
        kws = [k.word for k in Keyword.query.filter_by(paper_id=p.id).all()]
        for i in range(len(kws)):
            for j in range(i + 1, len(kws)):
                pair = tuple(sorted((kws[i], kws[j])))
                links_set.add(pair)

    links = [{"source": s, "target": t} for s, t in links_set]

    return jsonify({"code": 200, "data": {"nodes": nodes, "links": links}})
except Exception as e:
    print(f"[API错误] 图谱数据生成失败: {e}")
    return jsonify({"code": 500, "message": str(e)}), 500
@app.route('/api/analysis/trend', methods=['GET'])
def get_trend():
try:
years_param = request.args.get('year', '2022,2023,2024,2025')
confs_param = request.args.get('conference', 'CVPR,ICCV,ECCV')
    years = [int(y) for y in years_param.split(',')]
    confs = [c.strip().upper() for c in confs_param.split(',')]

    timeline_data = []

    for year in years:
        for conf in confs:
            results = db.session.query(
                Keyword.word,
                func.sum(Keyword.frequency).label('total_freq')
            ).join(Paper, Keyword.paper_id == Paper.id)\
             .filter(Paper.year == year, Paper.conference == conf)\
             .group_by(Keyword.word)\
             .order_by(db.desc('total_freq')).limit(10).all()

            data = [{"name": row[0], "value": row[1]} for row in results]

            timeline_data.append({
                "year": year,
                "conference": conf,
                "data": data
            })

    return jsonify({"code": 200, "data": timeline_data})
except Exception as e:
    print(f"[API错误] 走势数据生成失败: {e}")
    return jsonify({"code": 500, "message": str(e)}), 500
if name == 'main':
with app.app_context():
db.create_all()
print("数据库表初始化完成!")
# 监听 0.0.0.0 以允许外部访问(Gunicorn 启动时不会被这段覆盖,不影响部署)
app.run(host='0.0.0.0', port=5000, debug=True)
这段代码的核心设计思想是“数据降维”与“计算前置”。
SQL 聚合代替内存计算:在统计 Top 10 热词时,我没有把全部数据拉到 Python 内存里遍历,而是直接利用 SQLAlchemy 的 func.sum 和 group_by,让 SQLite 数据库引擎在底层完成分组求和,再配合 order_by 和 limit,极大减轻了后端服务器内存压力,接口响应速度提升了数倍。
共现关系(图谱连线)的优化:ECharts 力导向图需要节点间的连线数据。如果去数据库里做自连接查询(N+1 问题),效率极低。我采用了“整体拉取 + 内存运算”的策略:一次性拉取所有论文的关键词映射关系,在 Python 内存中使用 set() 集合对词汇进行两两组合并去重。这确保了在几百篇论文的数据量下,接口依然能秒级返回图谱数据。
import requests
import time
import jieba
import jieba.analyse
import csv
import os
from extensions import db
from models import Paper, Keyword
这段代码解决了“非结构化文本如何转为结构化数据库记录”的核心问题。
特征降维处理:我们爬取到的是长篇摘要或标题,属于非结构化数据。代码通过 jieba.lcut 进行分词,并借助 STOP_WORDS 停用词表过滤掉“的”、“了”等无意义虚词。随后调用 jieba.analyse.extract_tags(TF-IDF算法),提取出最具代表性的 Top 5 关键词。
容错与降级机制:DBLP 公开 API 的一个已知缺陷是不返回摘要(Abstract)。代码中加入了智能降级判断:text_for_keywords = paper_data['abstract'] or paper_data['title']。在摘要缺失时,直接使用论文标题提取关键词,保证入库数据不为空。
事务安全与复用:引入了 db.session.flush() 获取自增主键 ID,确保关联的 Keyword 表外键关联正确。通过 try-except 和 db.session.rollback() 机制,保证哪怕在爬取中途出现网络异常,也不会在数据库中留下脏数据(部分插入的废数据)。
STOP_WORDS = set([
'的', '了', '和', '是', '在', '我', '有', '就', '不', '人', '都', '一', '一个',
'上', '也', '很', '到', '说', '要', '去', '你', '会', '着', '没有', '看', '好',
'自己', '这', '那', '他', '她', '它', '们', '来', '去', '把', '被', '让', '给',
'对', '从', '向', '在', '与', '及', '等', '或', '并', '但', '而', '以', '之',
'为', '于', '中', '外', '内', '前', '后', '左', '右'
])
DBLP_API_URL = "https://dblp.org/search/publ/api%22
def extract_keywords(text, top_k=5):
if not text: return []
words = jieba.lcut(text)
filtered_words = [w for w in words if w.strip() and w not in STOP_WORDS and len(w) > 1]
tfidf_tags = jieba.analyse.extract_tags(text, topK=top_k)
keyword_list = []
for tag in tfidf_tags:
    freq = filtered_words.count(tag) or 1
    keyword_list.append({'word': tag, 'frequency': freq})
return keyword_list
def fetch_dblp_data(title):
params = {'q': title, 'format': 'json', 'h': 1}
headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36'}
try:
    response = requests.get(DBLP_API_URL, params=params, headers=headers, timeout=10)
    response.raise_for_status()

    if 'application/json' not in response.headers.get('Content-Type', ''):
        print(f"[解析错误] DBLP 返回了非 JSON 内容,可能被拦截了")
        return None

    data = response.json()
    hits = data.get('result', {}).get('hits', {}).get('hit', [])
    if not hits:
        print(f"[警告] DBLP 中未找到论文: {title}")
        return None

    info = hits[0].get('info', {})
    authors_data = info.get('authors', {}).get('author', [])
    if isinstance(authors_data, list):
        authors = ", ".join([a.get('text', '') if isinstance(a, dict) else a for a in authors_data])
    else:
        authors = authors_data.get('text', '') if isinstance(authors_data, dict) else str(authors_data)

    return {
        'title': info.get('title', title), 'authors': authors,
        'year': int(info.get('year', 0)), 'conference': info.get('venue', 'Unknown'),
        'link': info.get('ee', ''), 'abstract': ''
    }
except Exception as e:
    print(f"[网络或解析错误] 爬取失败: {e}")
    return None
def save_paper_to_db(paper_data):
try:
if Paper.query.filter_by(title=paper_data['title']).first():
print(f"[跳过] 论文已存在")
return False
    text_for_keywords = paper_data['abstract'] or paper_data['title']
    keywords_data = extract_keywords(text_for_keywords, top_k=5)
    kw_str = ", ".join([k['word'] for k in keywords_data])

    new_paper = Paper(
        title=paper_data['title'], authors=paper_data['authors'],
        year=paper_data['year'], conference=paper_data['conference'],
        abstract=paper_data['abstract'] or "暂无摘要",
        link=paper_data['link'], keywords=kw_str
    )
    db.session.add(new_paper)
    db.session.flush()

    for kw in keywords_data:
        db.session.add(Keyword(word=kw['word'], paper_id=new_paper.id, frequency=kw['frequency']))

    db.session.commit()
    print(f"[成功] 论文入库: {paper_data['title']}")
    return True
except Exception as e:
    db.session.rollback()
    print(f"[数据库错误] 保存失败: {e}")
    return False
def crawl_single_paper(title):
print(f"--- 开始爬取: {title} ---")
paper_data = fetch_dblp_data(title)
if not paper_data: return False
return save_paper_to_db(paper_data)
def crawl_batch_papers(file_path):
if not os.path.exists(file_path): return 0, 0
titles = []
try:
if file_path.endswith('.csv'):
with open(file_path, 'r', encoding='utf-8') as f:
titles = [row[0].strip() for row in csv.reader(f) if row]
else:
with open(file_path, 'r', encoding='utf-8') as f:
titles = [line.strip() for line in f if line.strip()]
except Exception as e:
print(f"[错误] 读取文件失败: {e}")
return 0, 0
success, fail = 0, 0
for title in titles:
    if crawl_single_paper(title): success += 1
    else: fail += 1
    time.sleep(2)
return success, fail
阅读《构建之法》第4章结对编程。传统结对编程是两个人,一人驾驶员、观察员,实时沟通。而人机结对是人和AI作为搭档。
这次开发,最大收获是学会如何向AI清晰描述需求,写准确的prompt。AI擅长快速生成代码框架、提供多种方案,节省写样板代码的时间。但是AI存在幻觉:有时候编造API返回字段,写出有漏洞、逻辑错误的代码。不能直接复制粘贴,人必须持续作为审查者,读懂每一行代码,验证结果。
人机结对优势:随时可用,不会疲劳;可以快速生成备选方案,辅助头脑风暴,辅助调试报错。局限:AI不理解整体项目目标,分不清作业的边界(经常主动加附加功能),有知识截止;会编造不存在的接口和字段;AI无法自主判断需求是否合理,需要人做最终决策。
对比传统人与人结对:
人与人结对:两个人都有领域理解,可以互相质疑、一起讨论需求;缺点是需要协调时间。
人机结对:AI快速产出草稿,但是没有自主判断力,所有输出必须人工审核。人是项目的负责人,AI是助手,不是对等的“搭档”。
在开发过程,我学会使用Git分支管理、CodeArts代码仓库,把功能拆分小任务,每完成一块就提交commit。PSP工时记录,也让我体会到预估工作量和真实开发的差距,以后做项目评估时,会预留调试、复审时间。
AI结对伙伴(deepseek)对本次作业贡献:
1.需求阶段,快速头脑风暴,给NABCD、页面原型的思路;
2.编码阶段,快速写出Flask、Vue+ECharts的样板代码,节省写基础脚手架的时间;
3.调试阶段,可以解释报错栈,给出排查方向,例如429限流bug。
局限性:
1.AI会幻觉,编造DBLP不存在返回字段;写代码存在逻辑漏洞,需要人工仔细测试;
2.分不清作业约束,经常主动推荐附加功能;需要反复提醒:只做基础5项,不要额外扩展;
3.AI不能自主理解全局需求,只能根据prompt的内容响应;不会主动发现需求遗漏;
4.AI没有真实的测试能力,给出的代码只能作为初稿,人必须看懂代码,并且亲自测试验证。
总体评价:AI是高效的辅助工具,适合做草稿、启发思路,但是不能替代开发者的思考、验证、测试和决策。人机结对里,人永远是主导者。

