


88
社区成员
 发帖
 与我相关
 我的任务
 分享
| 这个作业属于哪个课程 | <班级的链接> |
|---|---|
| 这个作业要求在哪里 | https://bbs.csdn.net/topics/620526318 |
| 这个作业的目标 | 与AI人机结对,与AI协作设计,再与AI协作编程,部署到云服务器 |
| 其他参考文献 | 顶会论文下载合集 |
https://codehub.devcloud.cn-north-4.huaweicloud.com/05d6f10739194a53930f915362344414/cv_top_conf.git
- 需求分析阶段:AI 辅助完成
借助豆包完成需求拆解、NABCD 模型梳理、系统功能梳理;针对课程作业的 5 项基础功能做头脑风暴,输出页面信息架构、墨刀原型的设计方案;由本人人工校验、筛选、修正 AI 输出内容,调整原型布局、交互逻辑,保证原型贴合课程作业需求。
2.原型设计阶段:AI 辅助产出原型 HTML
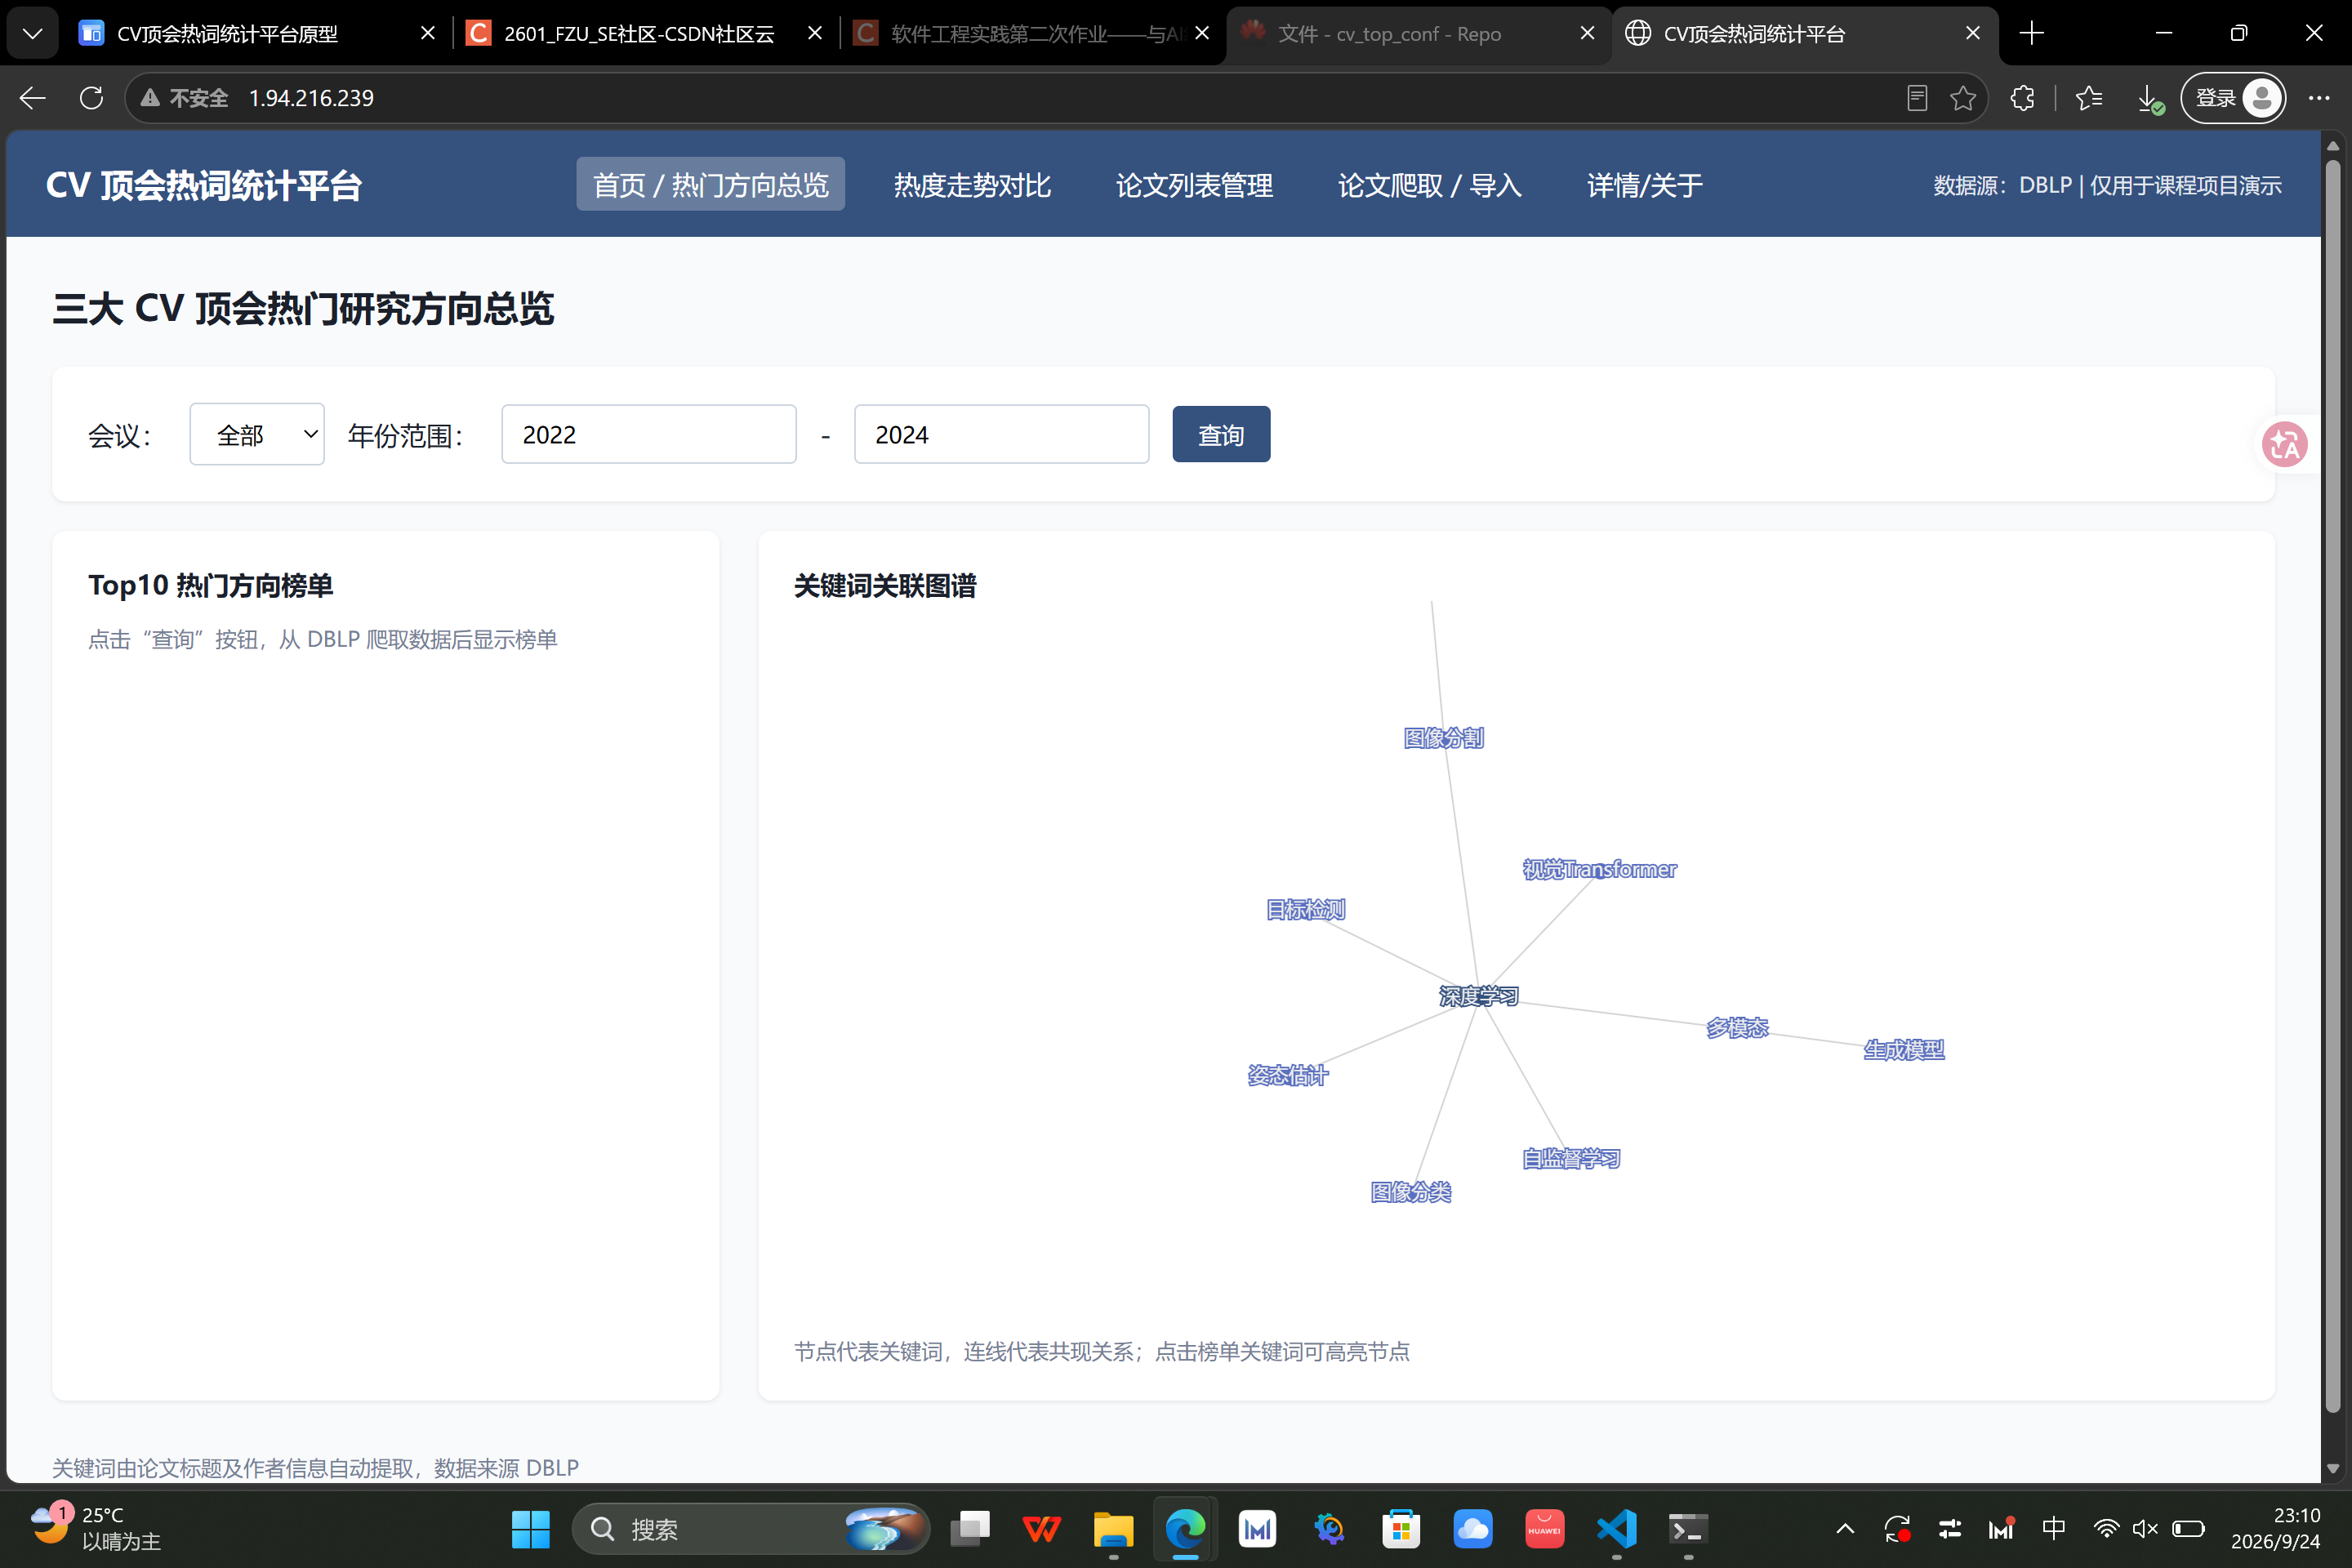
由我提出原型页面规格、配色、页面交互规则,AI 输出可直接用于墨刀评审的 HTML 原型代码;我对布局、导航菜单、交互事件(榜单关键词点击高亮图谱)进行人工修改调优,确定最终原型效果。
- 前端代码:由 AI 编写,本人审核修改
Vue+ECharts 前端页面整体代码由豆包生成。本人负责审查代码逻辑,修正页面跳转、图表渲染逻辑,调整样式布局,校验交互功能(趋势图渲染、弹窗、多选筛选),修复部分细节 bug,确认前端可以和后端接口正常对接。
- 后端代码:人与 AI 共同完成
AI 负责输出整体架构框架、数据库表设计、爬虫基础代码、TextRank 关键词提取算法、REST 接口初稿;本人主导业务逻辑设计:校验 SQL 防注入、完善参数处理、完善 CSV 批量导入逻辑、修正爬虫限流逻辑、调整接口入参出参格式;对 AI 生成的后端代码逐段阅读理解,完成测试,修复逻辑漏洞,保证论文增删改查、热词统计全部功能符合作业要求。
- 文档类内容:AI 辅助生成初稿,本人人工改写定稿
codestyle.md 代码规范、数据来源说明、代码模块分析、PSP 辅助梳理均由 AI 输出初稿;本人对照官方规范(PEP8、Vue 官方规范)以及作业要求进行修改、删减、校验,保证文档符合课程作业评分标准。
所有 AI 产出的原型、代码、文档,均经过本人人工阅读、校验、调试与修改;能够完整解释全部代码的设计思路、业务逻辑;没有直接复制未经理解的 AI 生成内容。
| PSP | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | ||
| • Estimate | • 估计这个任务需要多少时间 | 20 | 25 |
| Development | 开发 | ||
| • Analysis | • 需求分析 (包括学习新技术) | 40 | 55 |
| • Design Spec | • 生成设计文档 | 30 | 40 |
| • Design Review | • 设计复审 | 20 | 25 |
| • Coding Standard | • 代码规范 (为目前的开发制定合适的规范) | 20 | 20 |
| • Design | • 具体设计 | 30 | 35 |
| • Coding | • 具体编码 | 60 | 75 |
| • Code Review | • 代码复审 | 30 | 45 |
| • Test | • 测试(自我测试,修改代码,提交修改) | 30 | 45 |
| Reporting | 报告 | ||
| • Test Report | • 测试报告 | 20 | 25 |
| • Size Measurement | • 计算工作量 | 10 | 15 |
| • Postmortem & Process Improvement Plan | • 事后总结, 并提出过程改进计划 | 30 | 35 |
| 合计 | 340 | 440 |
一开始认为 AI 可以快速产出可用代码,节省大量编码时间。但实际开发中 AI 生成代码存在隐性逻辑 Bug,例如数据库一对多更新未清理旧数据、前端 ECharts 异步渲染时序问题。我需要逐行阅读、校验、修改代码,代码复审与调试花费的时间远超最初预估。
项目需要实现 ECharts 动态趋势动画、TextRank 关键词提取、DBLP 爬虫限流。预估阶段只考虑编码时间,忽略原理学习、方案对比的时间,需求分析阶段耗时增加。
本次遇到的 Bug 大多不是简单语法错误,而是前后端数据对齐、异步渲染、爬虫风控这类逻辑问题。这类 Bug 往往没有明显报错,需要反复打印数据、定位问题,自测修改阶段耗时增加。
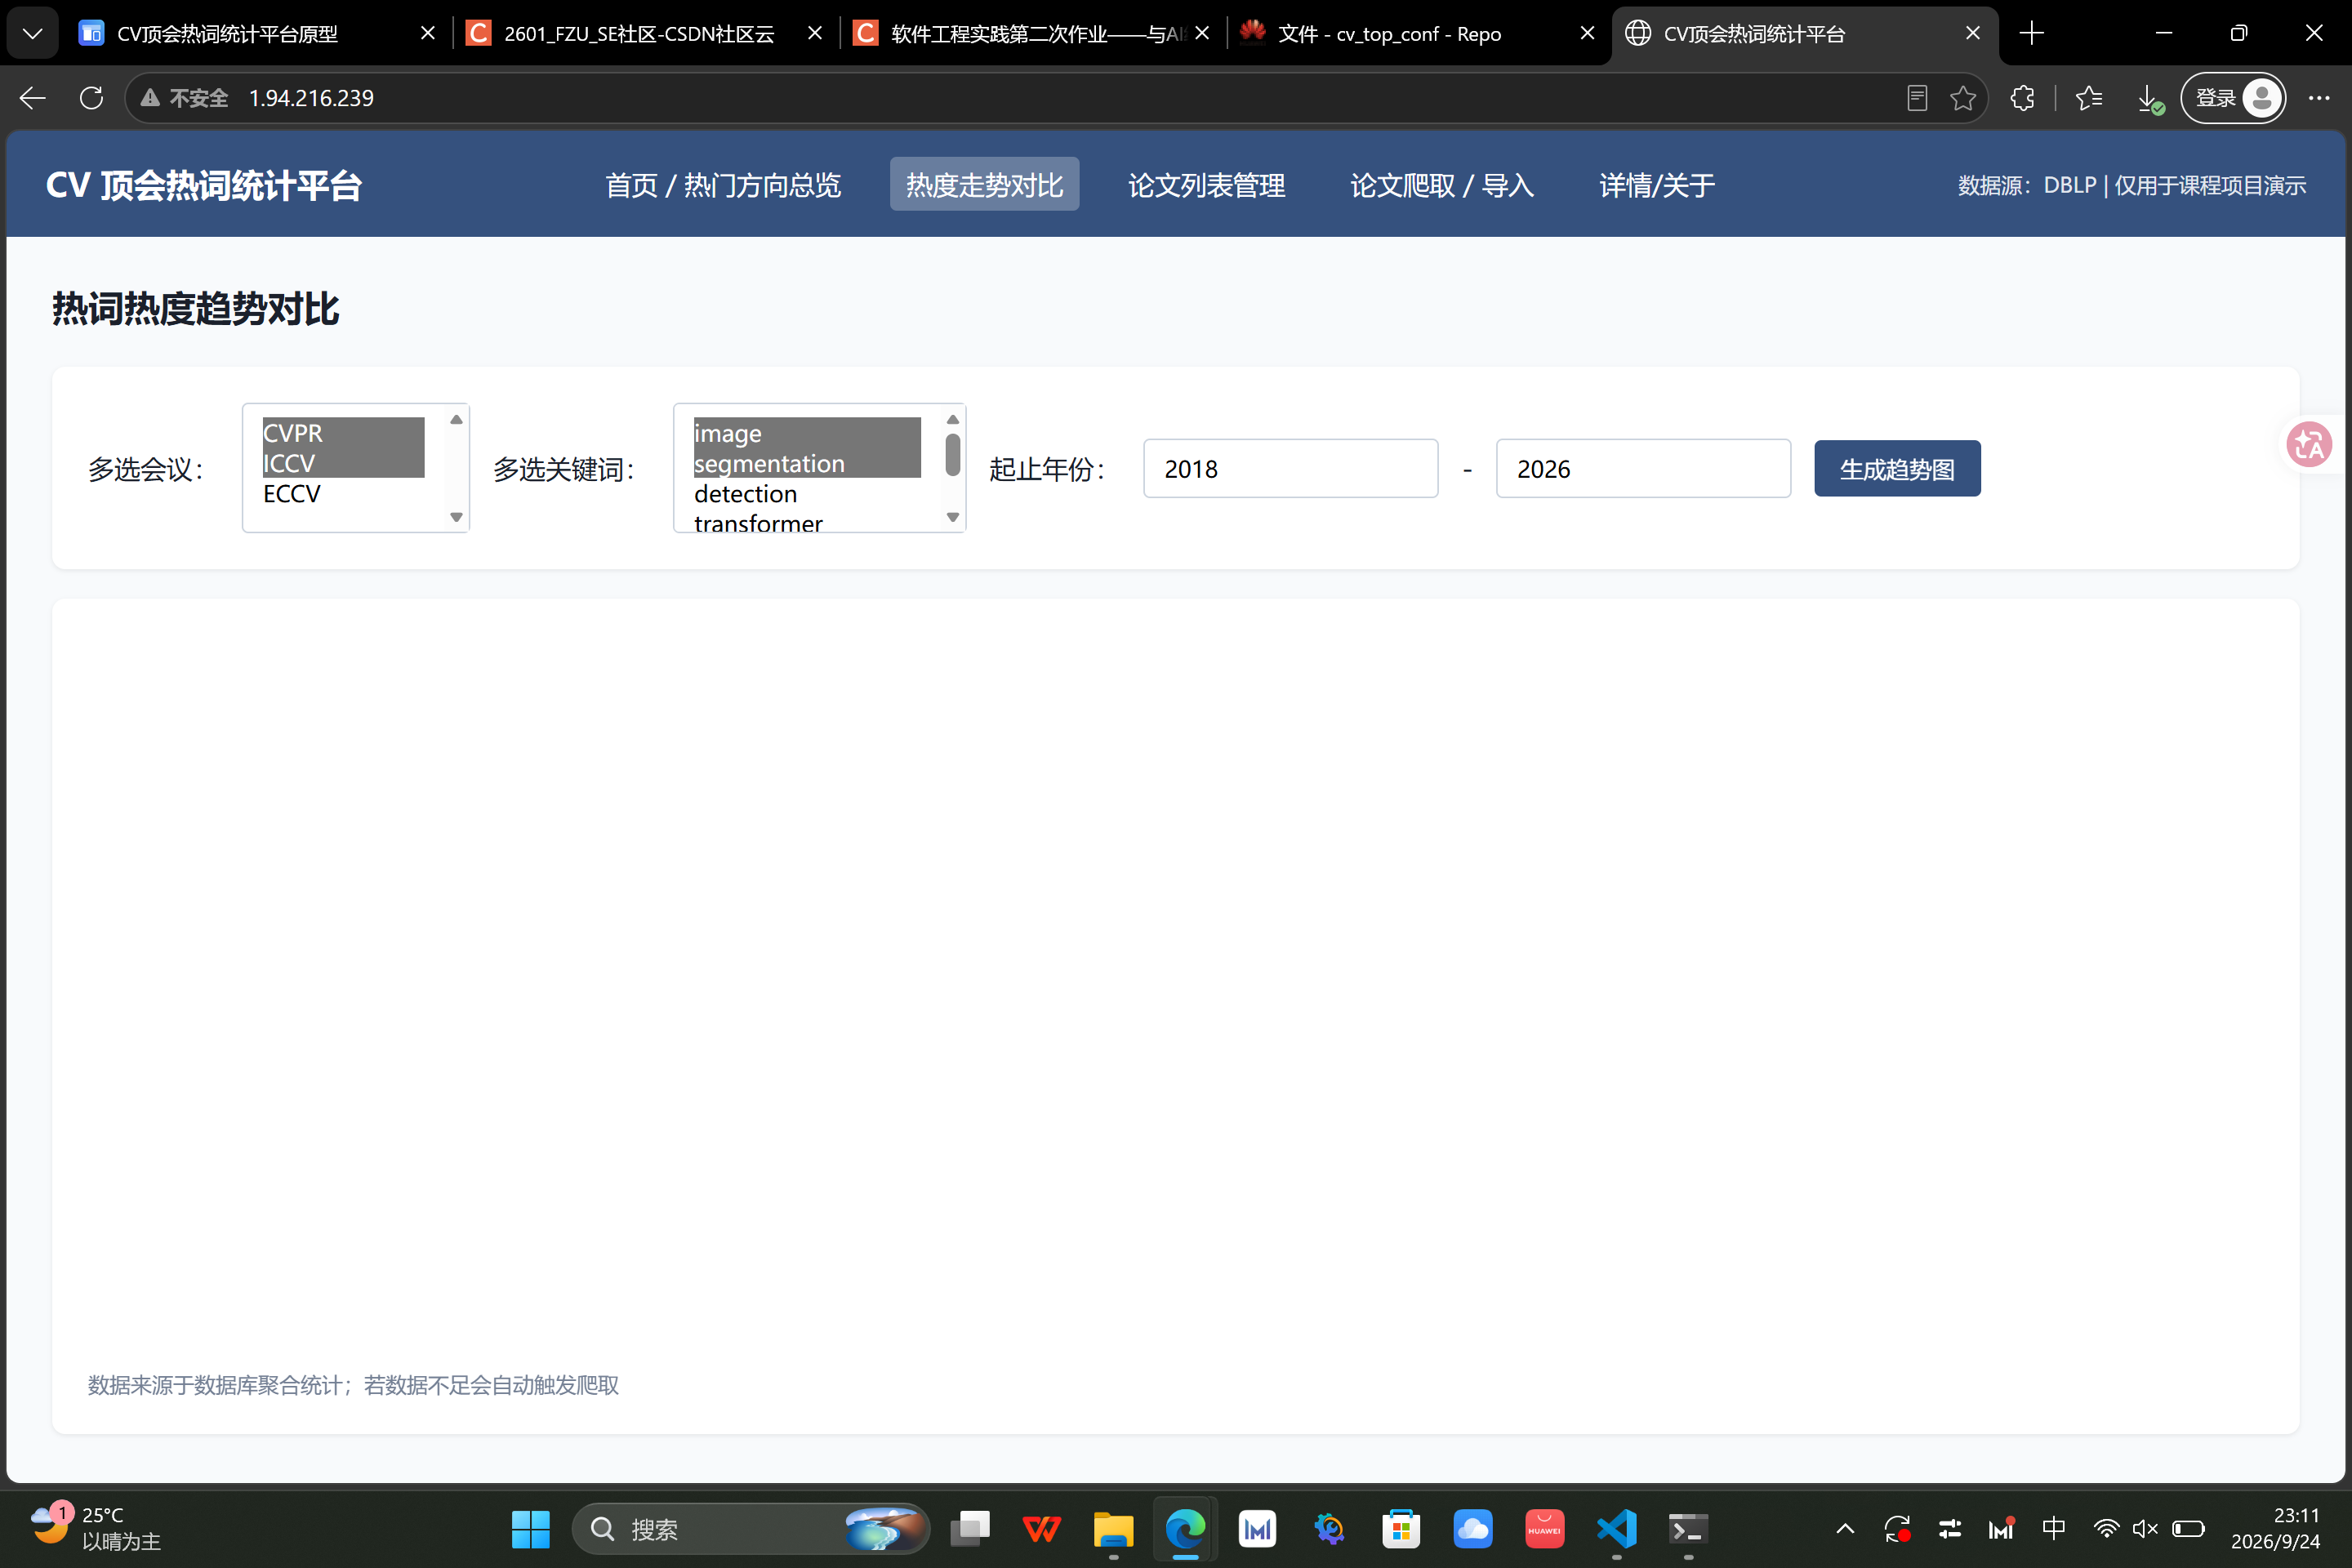
开发过程中迭代调整页面 2 的原型,移除静态图,仅保留筛选与生成趋势图按钮,新增动态折线动画需求,增加了设计与编码工作量。
除代码外,还需要编写 codestyle.md、AI 使用说明、Bug 记录、博客总结等材料,报告总结阶段的工作量大于预期。
本项目面向计算机视觉科研学习者、AI 研发人员、高校科研从业者核心群体,聚焦 CVPR、ICCV、ECCV 三大计算机视觉顶会,解决行业通用痛点与刚需。
针对上述用户需求,本项目采用前后端分离轻量化 Web 架构,结合数据爬虫、NLP 文本分析、数据可视化技术,搭建完整的顶会热词统计分析平台,整体方案成熟、高效、适配课程开发场景,具体实现方案如下:
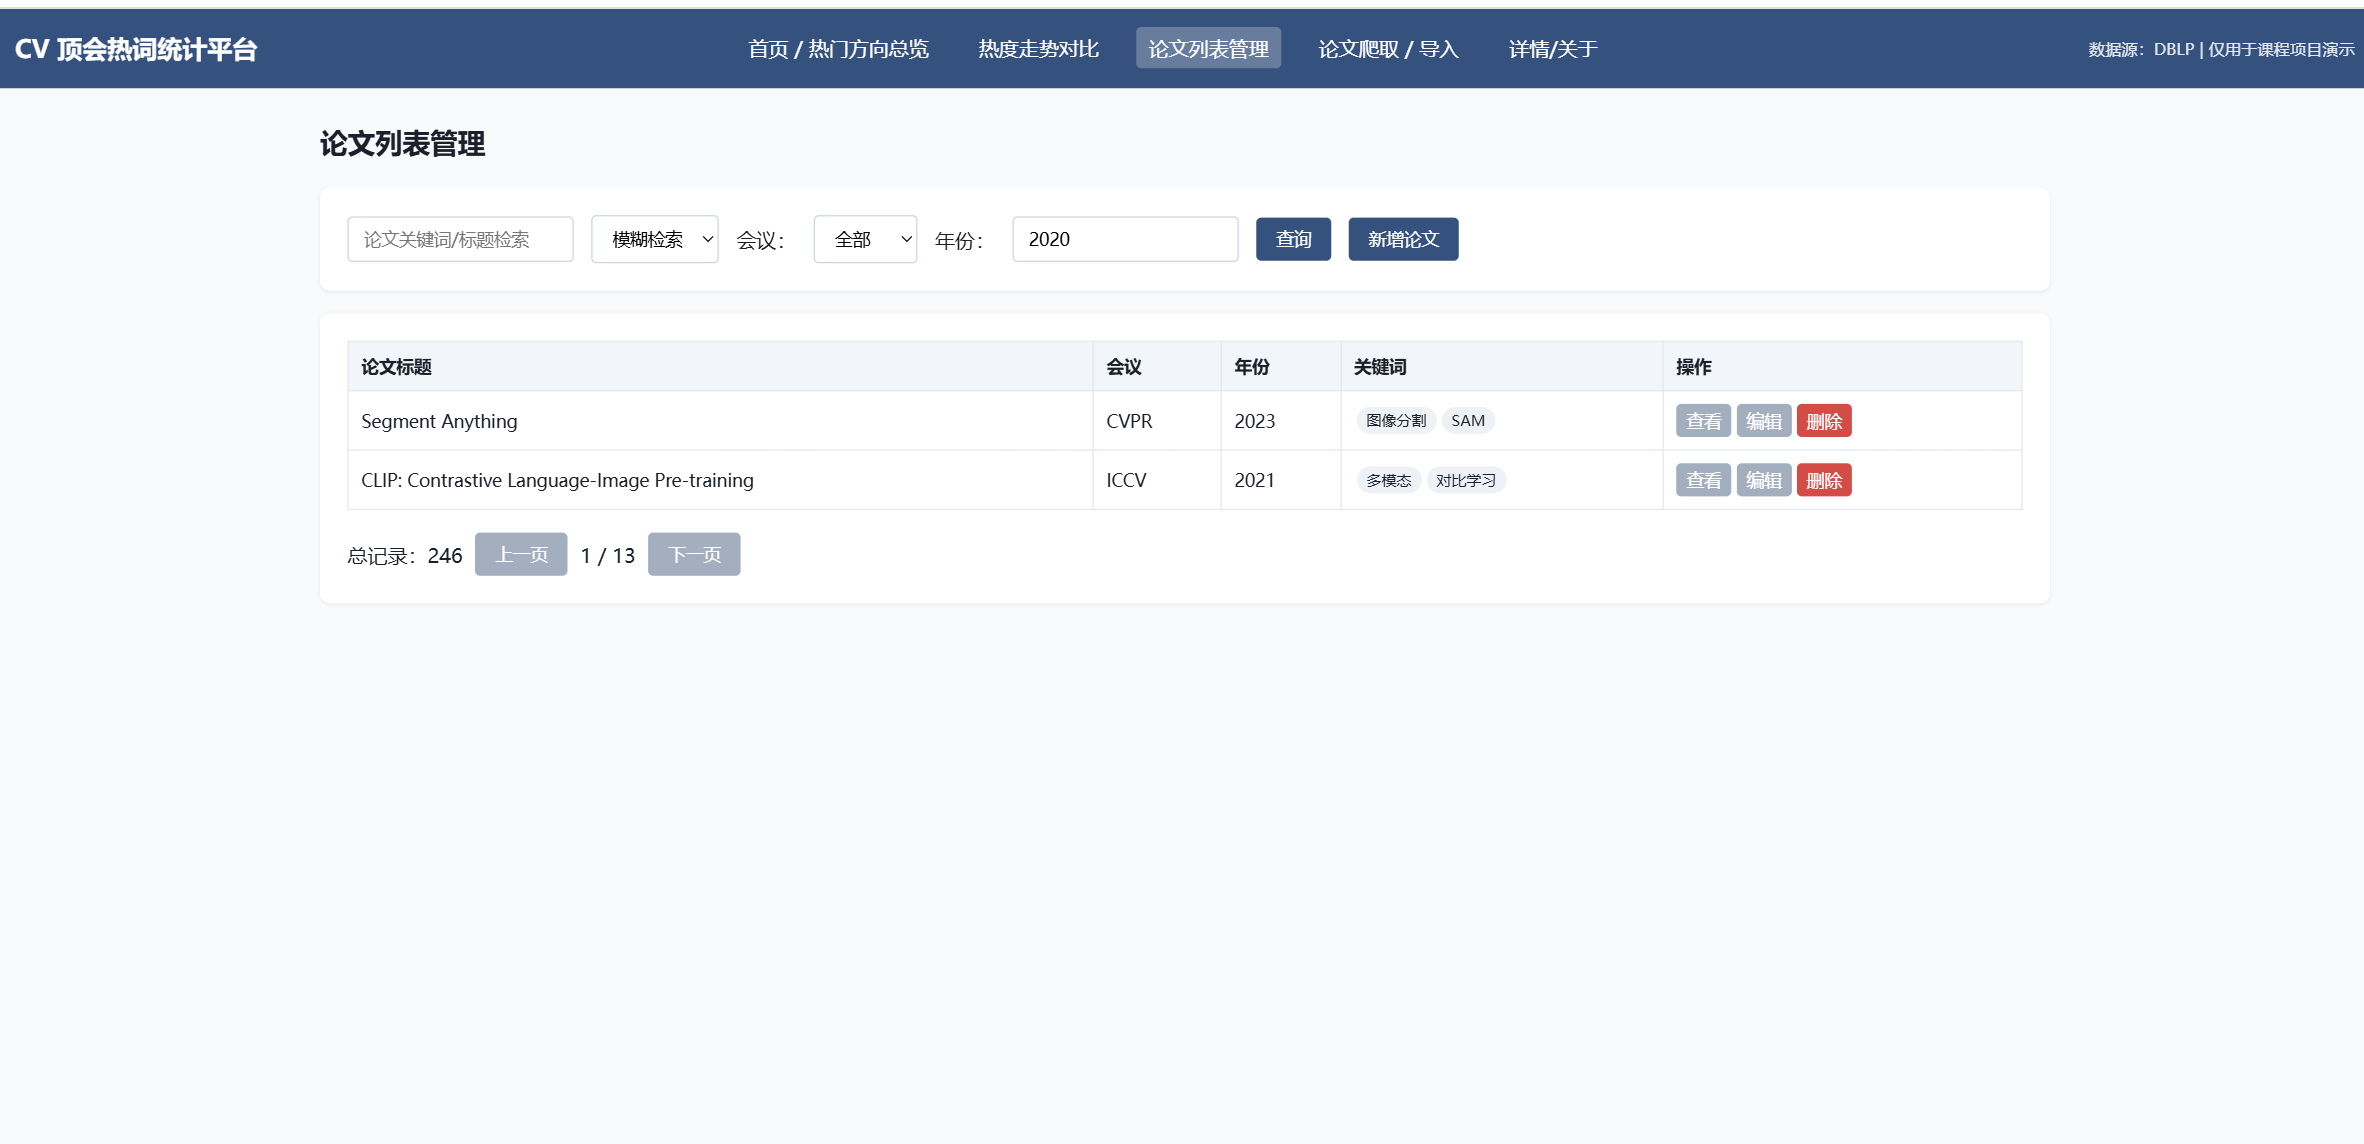
论文管理模块:搭建完整数据库接口,实现论文新增、删除、修改、查询功能,支持精确检索与模糊检索,本地无匹配数据时自动触发联网爬取,完善数据闭环。
热词统计模块:基于历年顶会论文关键词数据,统计关键词出现频次,生成年度 Top10 热门研究方向榜单。
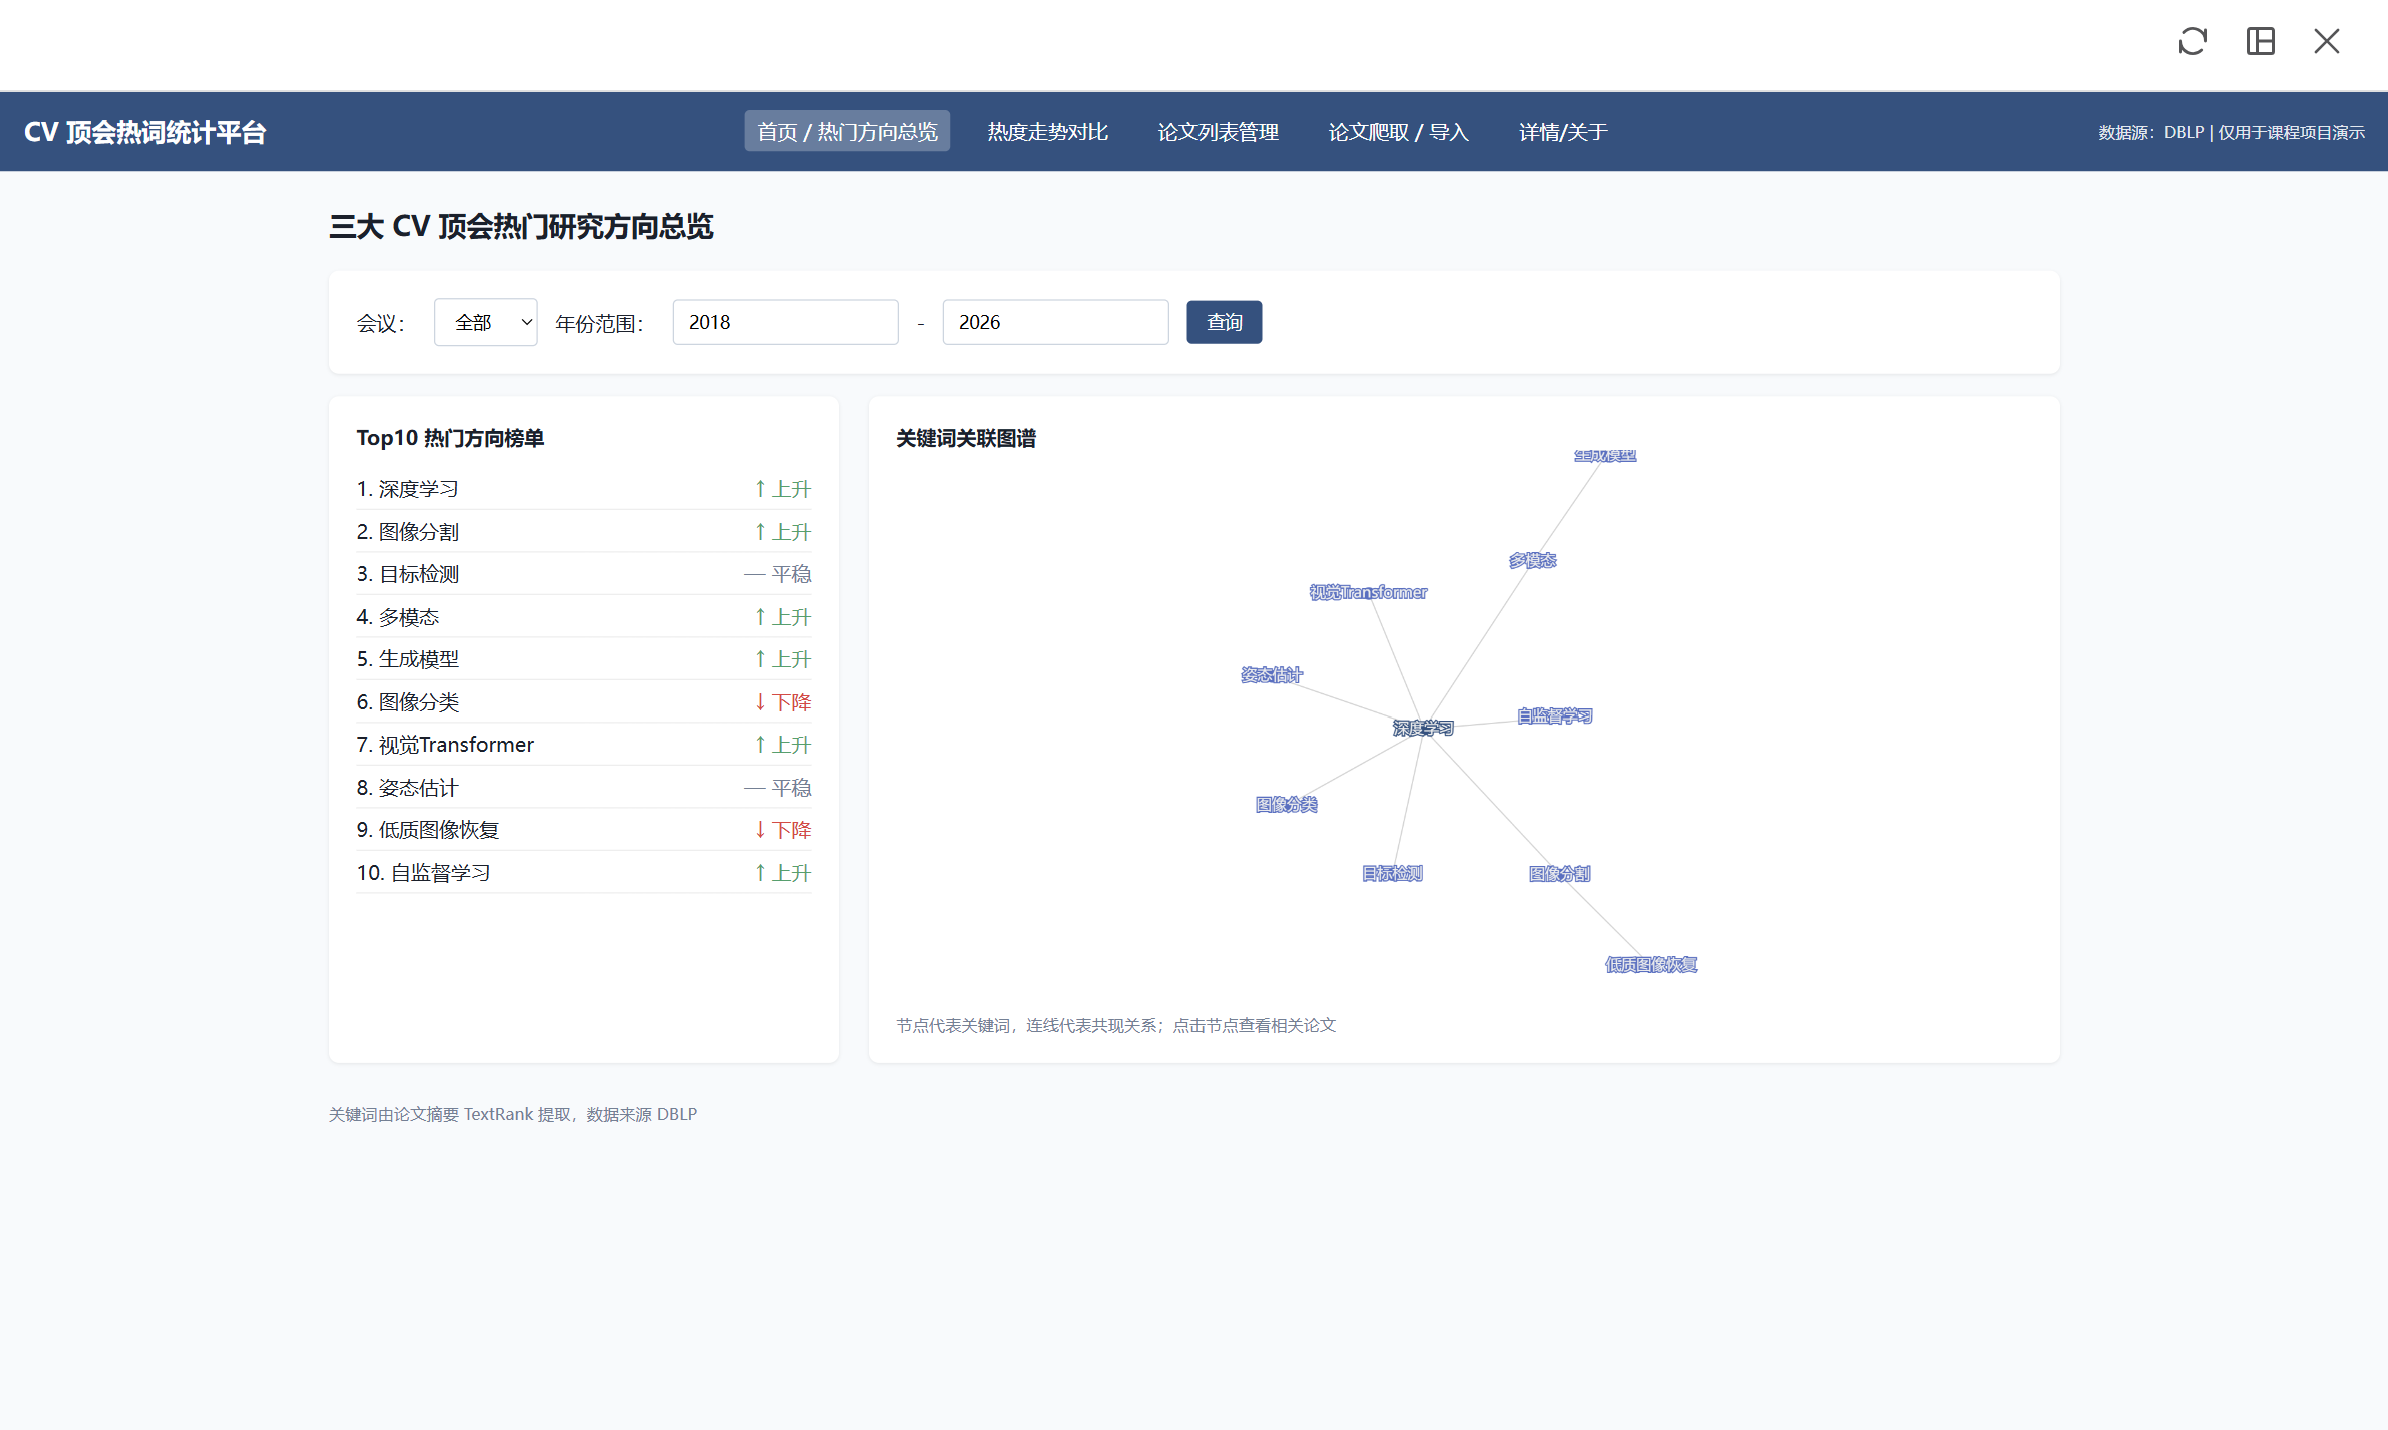
可视化分析模块:通过 ECharts 实现两大核心可视化功能,一是关键词关联图谱,直观展示关键词关联关系,支持点击跳转查看对应论文;二是多会议、多年份热度趋势图表,可视化展示热词热度演变规律,同时实现热度走势动图生成功能。
当前市面上无专门针对 CVPR、ICCV、ECCV 三大视觉顶会的一体化热词统计平台,现有工具各有明显短板,本项目差异化优势显著,具体竞品对比分析如下:
竞品短板:仅提供论文基础元数据检索,功能单一;无关键词提取、热词统计、热度趋势分析功能;无任何数据可视化能力;仅支持单篇查询,无法批量分析、宏观统计领域趋势。
本项目优势:基于 DBLP 权威数据二次加工,在原始论文数据基础上,新增 NLP 关键词挖掘、热词排行、趋势可视化核心功能,实现从 “数据查询” 到 “趋势分析” 的功能升级。
竞品短板:关键词提取精度不稳定、噪声较多;无三大 CV 顶会专属筛选统计模块,数据分散;不支持多年份、多会议横向热度对比;国内访问卡顿、稳定性差。
本项目优势:垂直聚焦计算机视觉三大顶会,数据维度精准专属;自定义 TextRank 算法优化关键词提取精度;适配国内网络环境,云端部署访问稳定,专属可视化功能针对性更强。
竞品短板:核心仅展示论文引用关联关系,无关键词热度统计、年度趋势演变功能;核心可视化能力单一,且高级功能收费,无法批量导出、分析热词数据。
本项目优势:主打关键词热度分析核心场景,而非论文引用关系;免费开源、功能轻量化,同时兼具关联图谱 + 热度趋势双可视化,适配学生免费使用需求。
竞品短板:多为单机 Python 脚本,无 Web 交互界面、无数据库持久化存储;缺少论文管理、检索功能;可视化简陋单一,无交互式图谱;未云端部署,无法在线演示使用。
本项目优势:完整成型的 Web 应用系统,具备完善的前后端交互、数据库管理、多功能可视化;遵循工程化开发规范,版本管理规范、云端可访问,是标准化、完整化的工程项目。
核心竞争优势总结:本项目填补了垂直聚焦 CV 三大顶会、集数据爬取、智能分析、多维可视化、在线服务于一体的轻量化学术工具空白,兼顾专业性、针对性、易用性,完美适配 CV 方向学生的科研调研刚需,相较于各类竞品功能更聚焦、场景更贴合、使用门槛更低。
- 线上可访问 Web 平台:华为云部署完成,支持外网直接访问,可完整演示全部核心功能。
- 标准化代码仓库:华为云 CodeArts 完整代码托管,包含规范的 Git 提交记录、分支管理、README 文档、代码规范文件。
- 完整项目博客文档:包含需求分析、原型设计、开发过程、AI 结对记录、功能演示、PSP 分析、项目反思等全套课程作业内容。
- 可演示可视化成果:热词榜单、关联图谱、年度热度趋势图、热度走势动图等成品素材,可直接用于成果展示。
原型链接
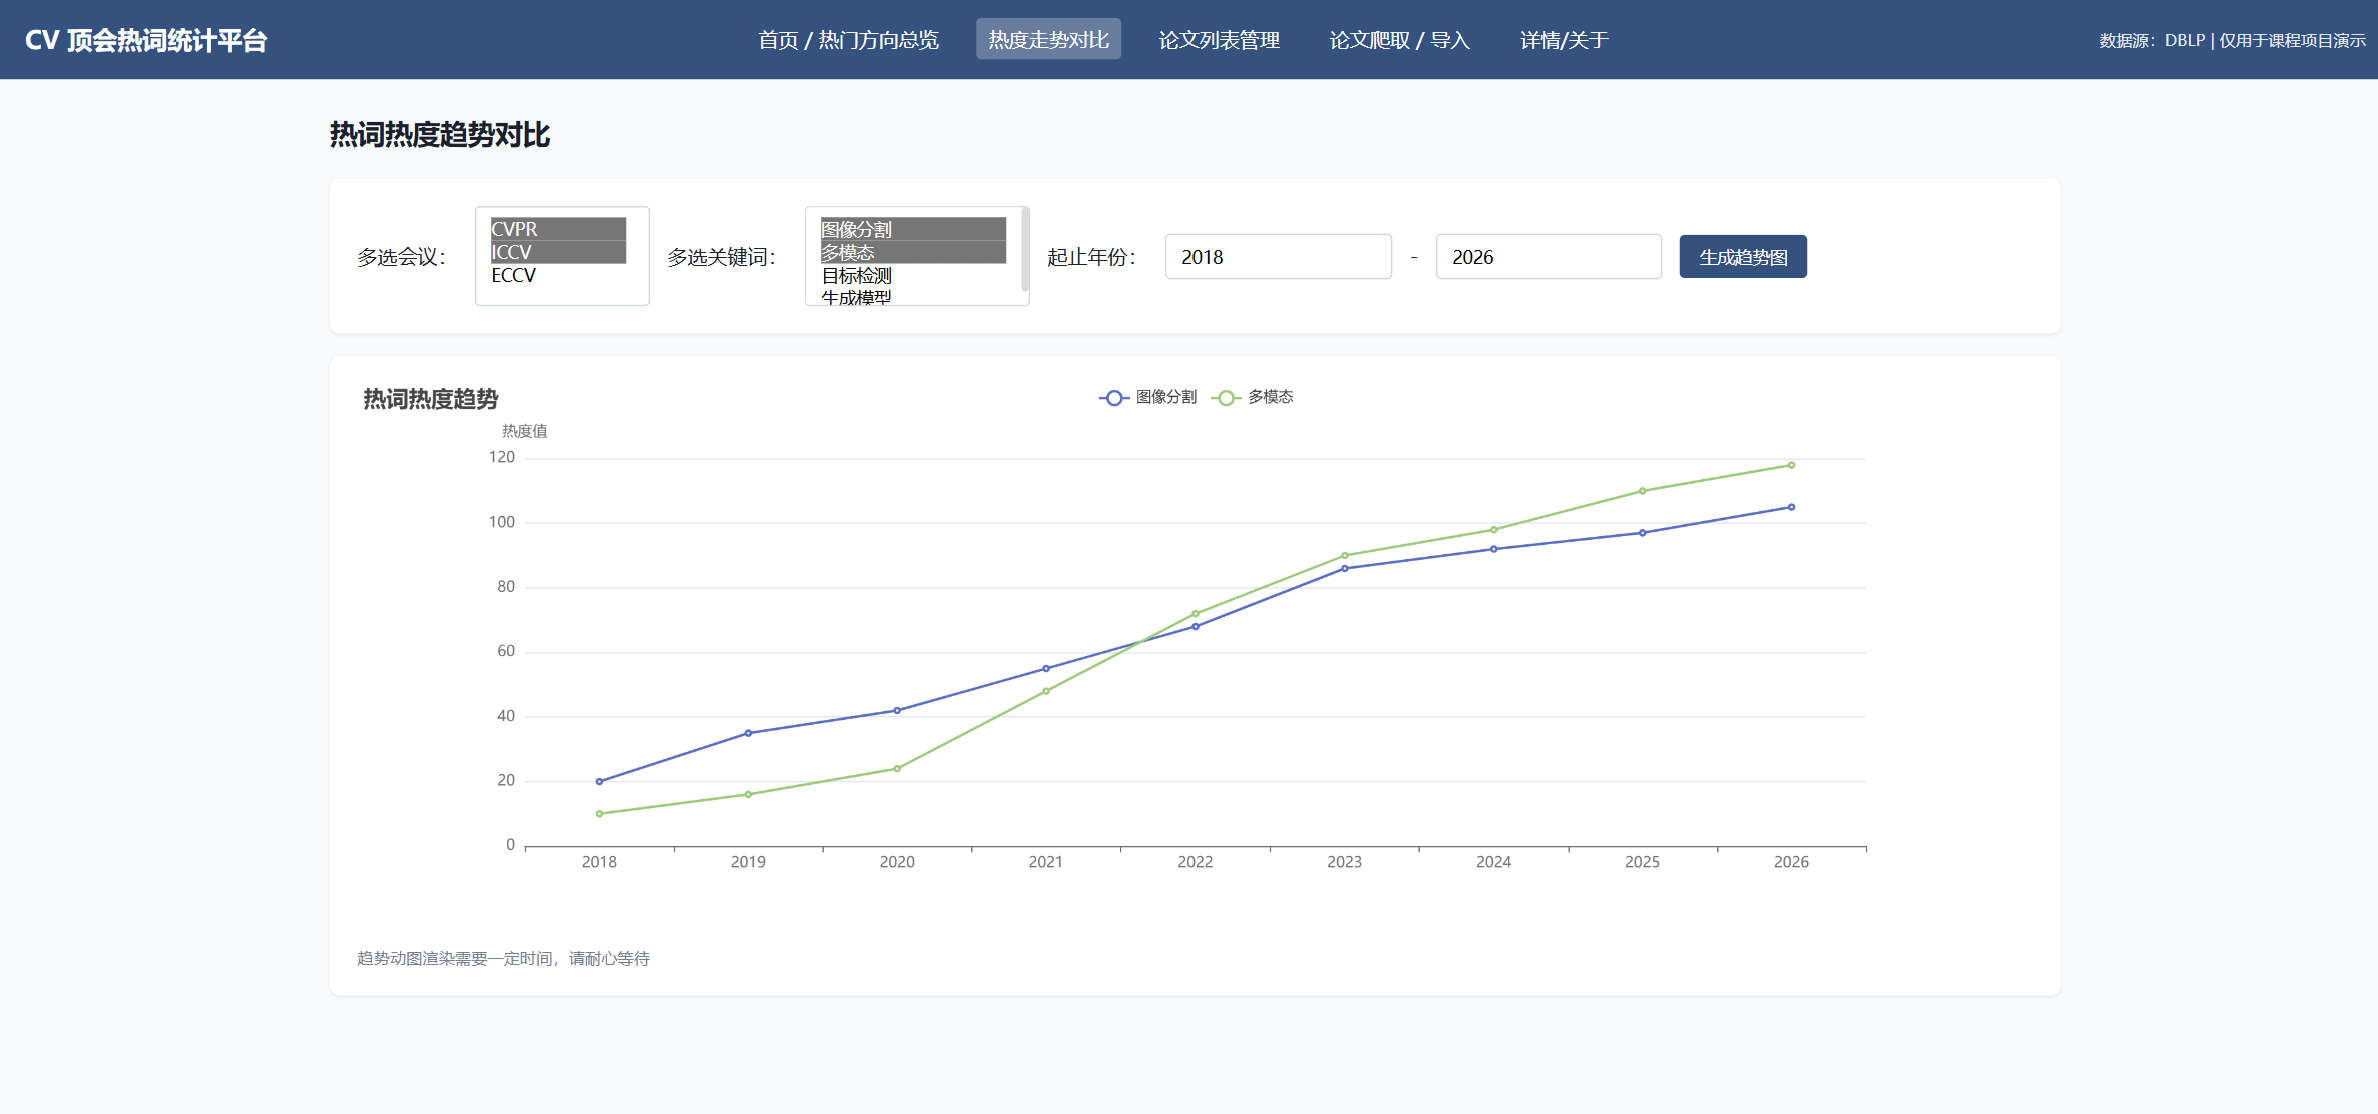
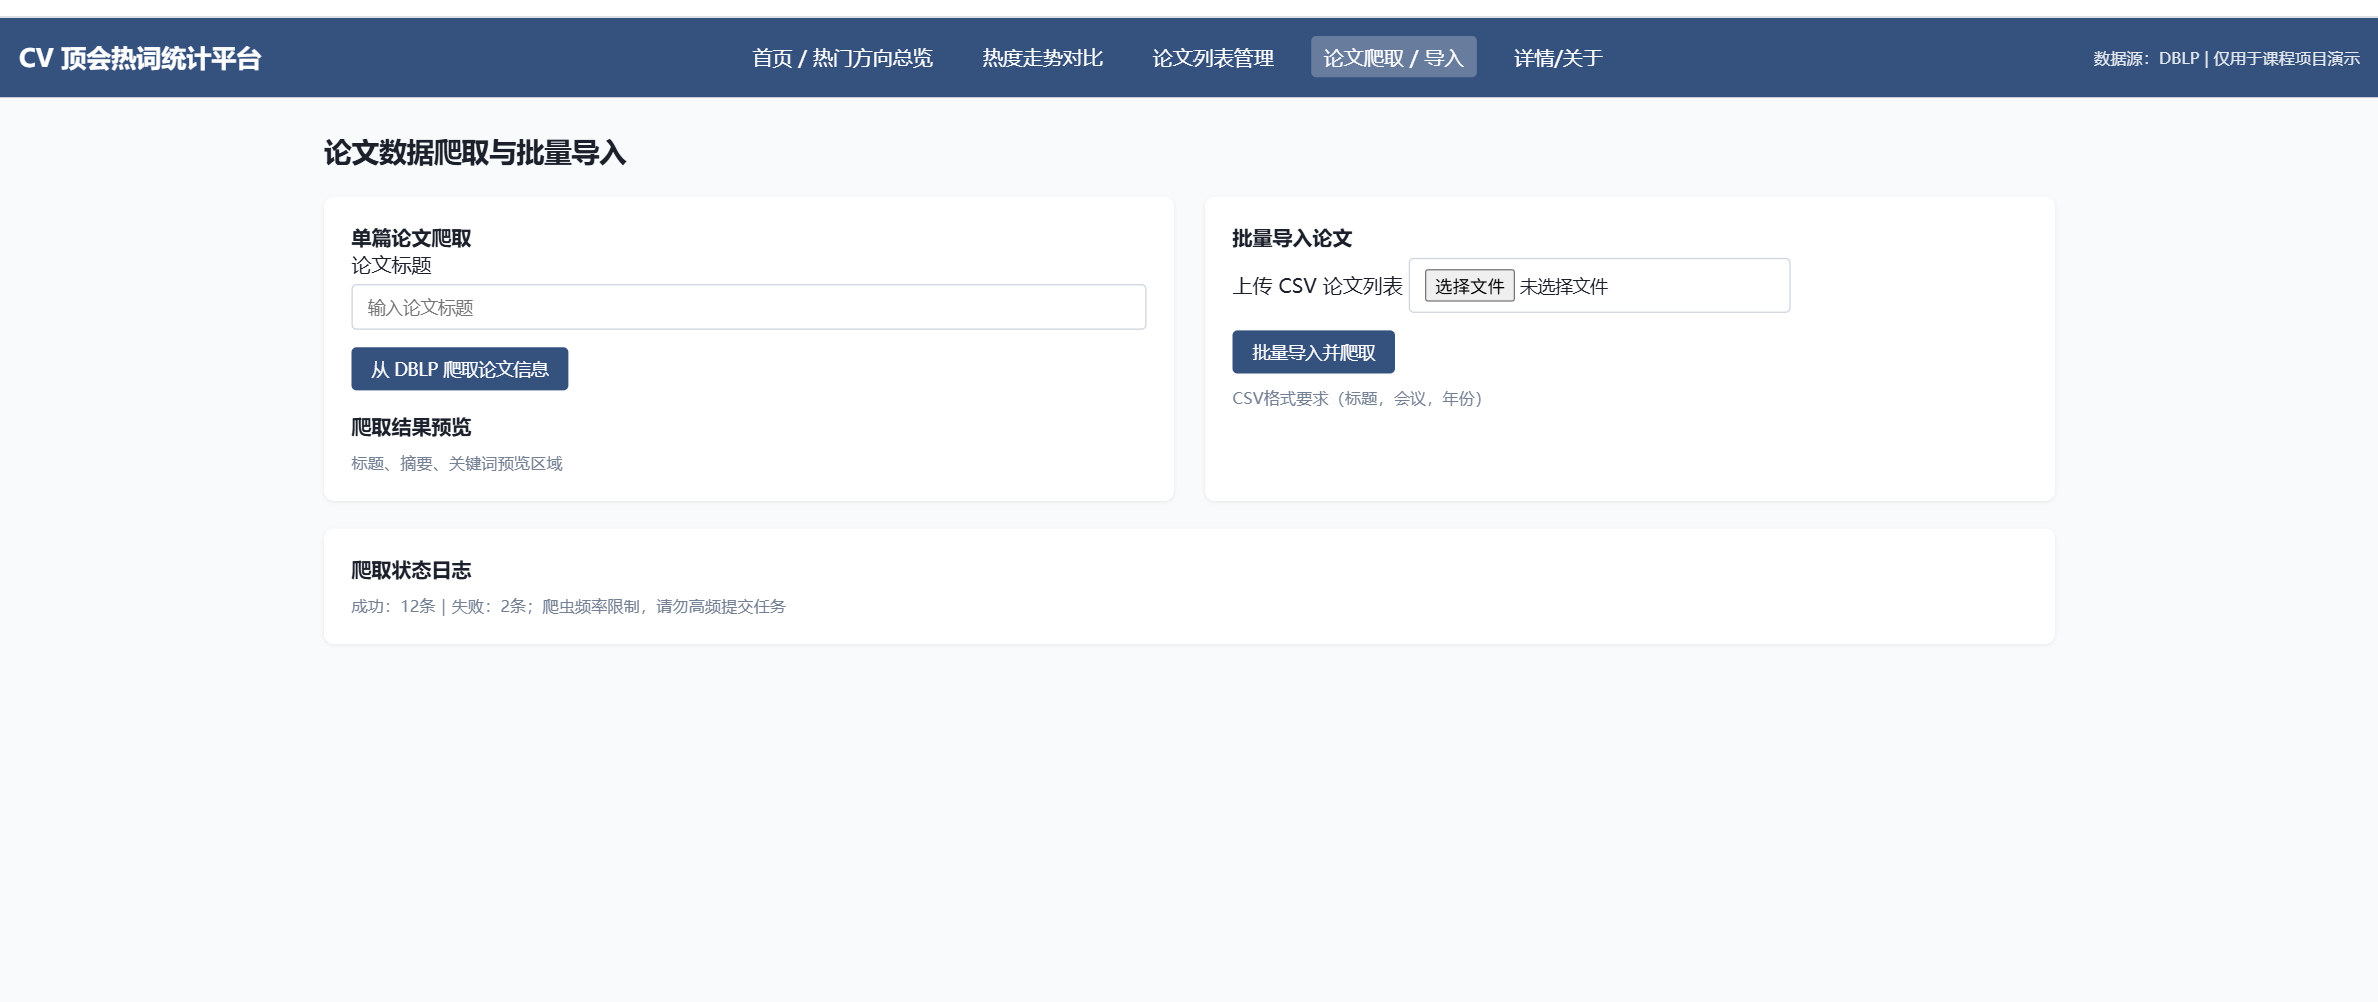
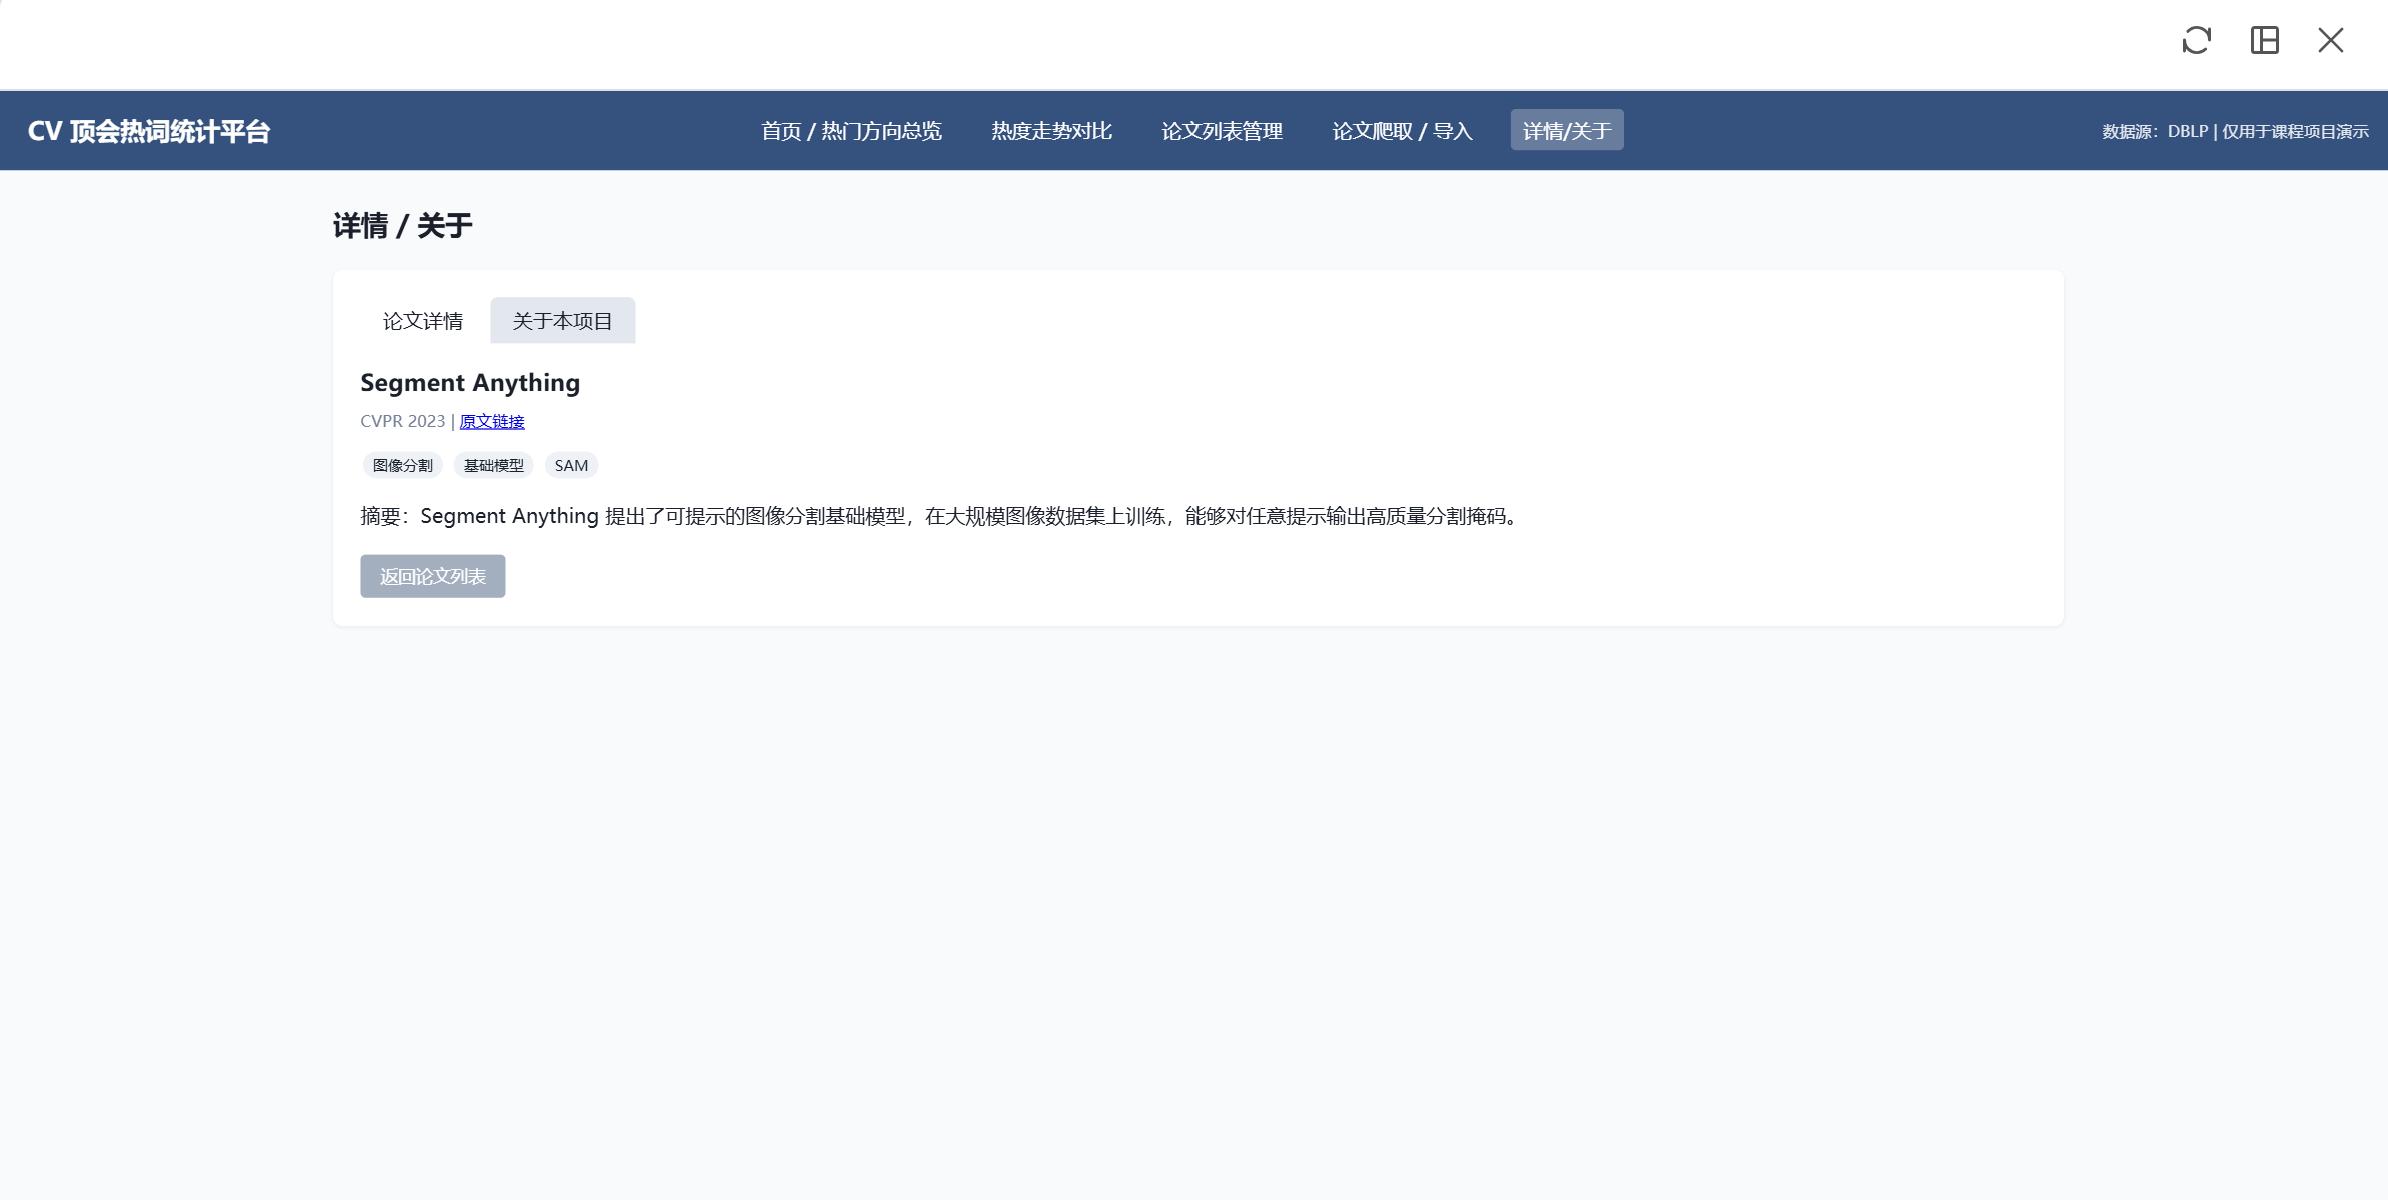
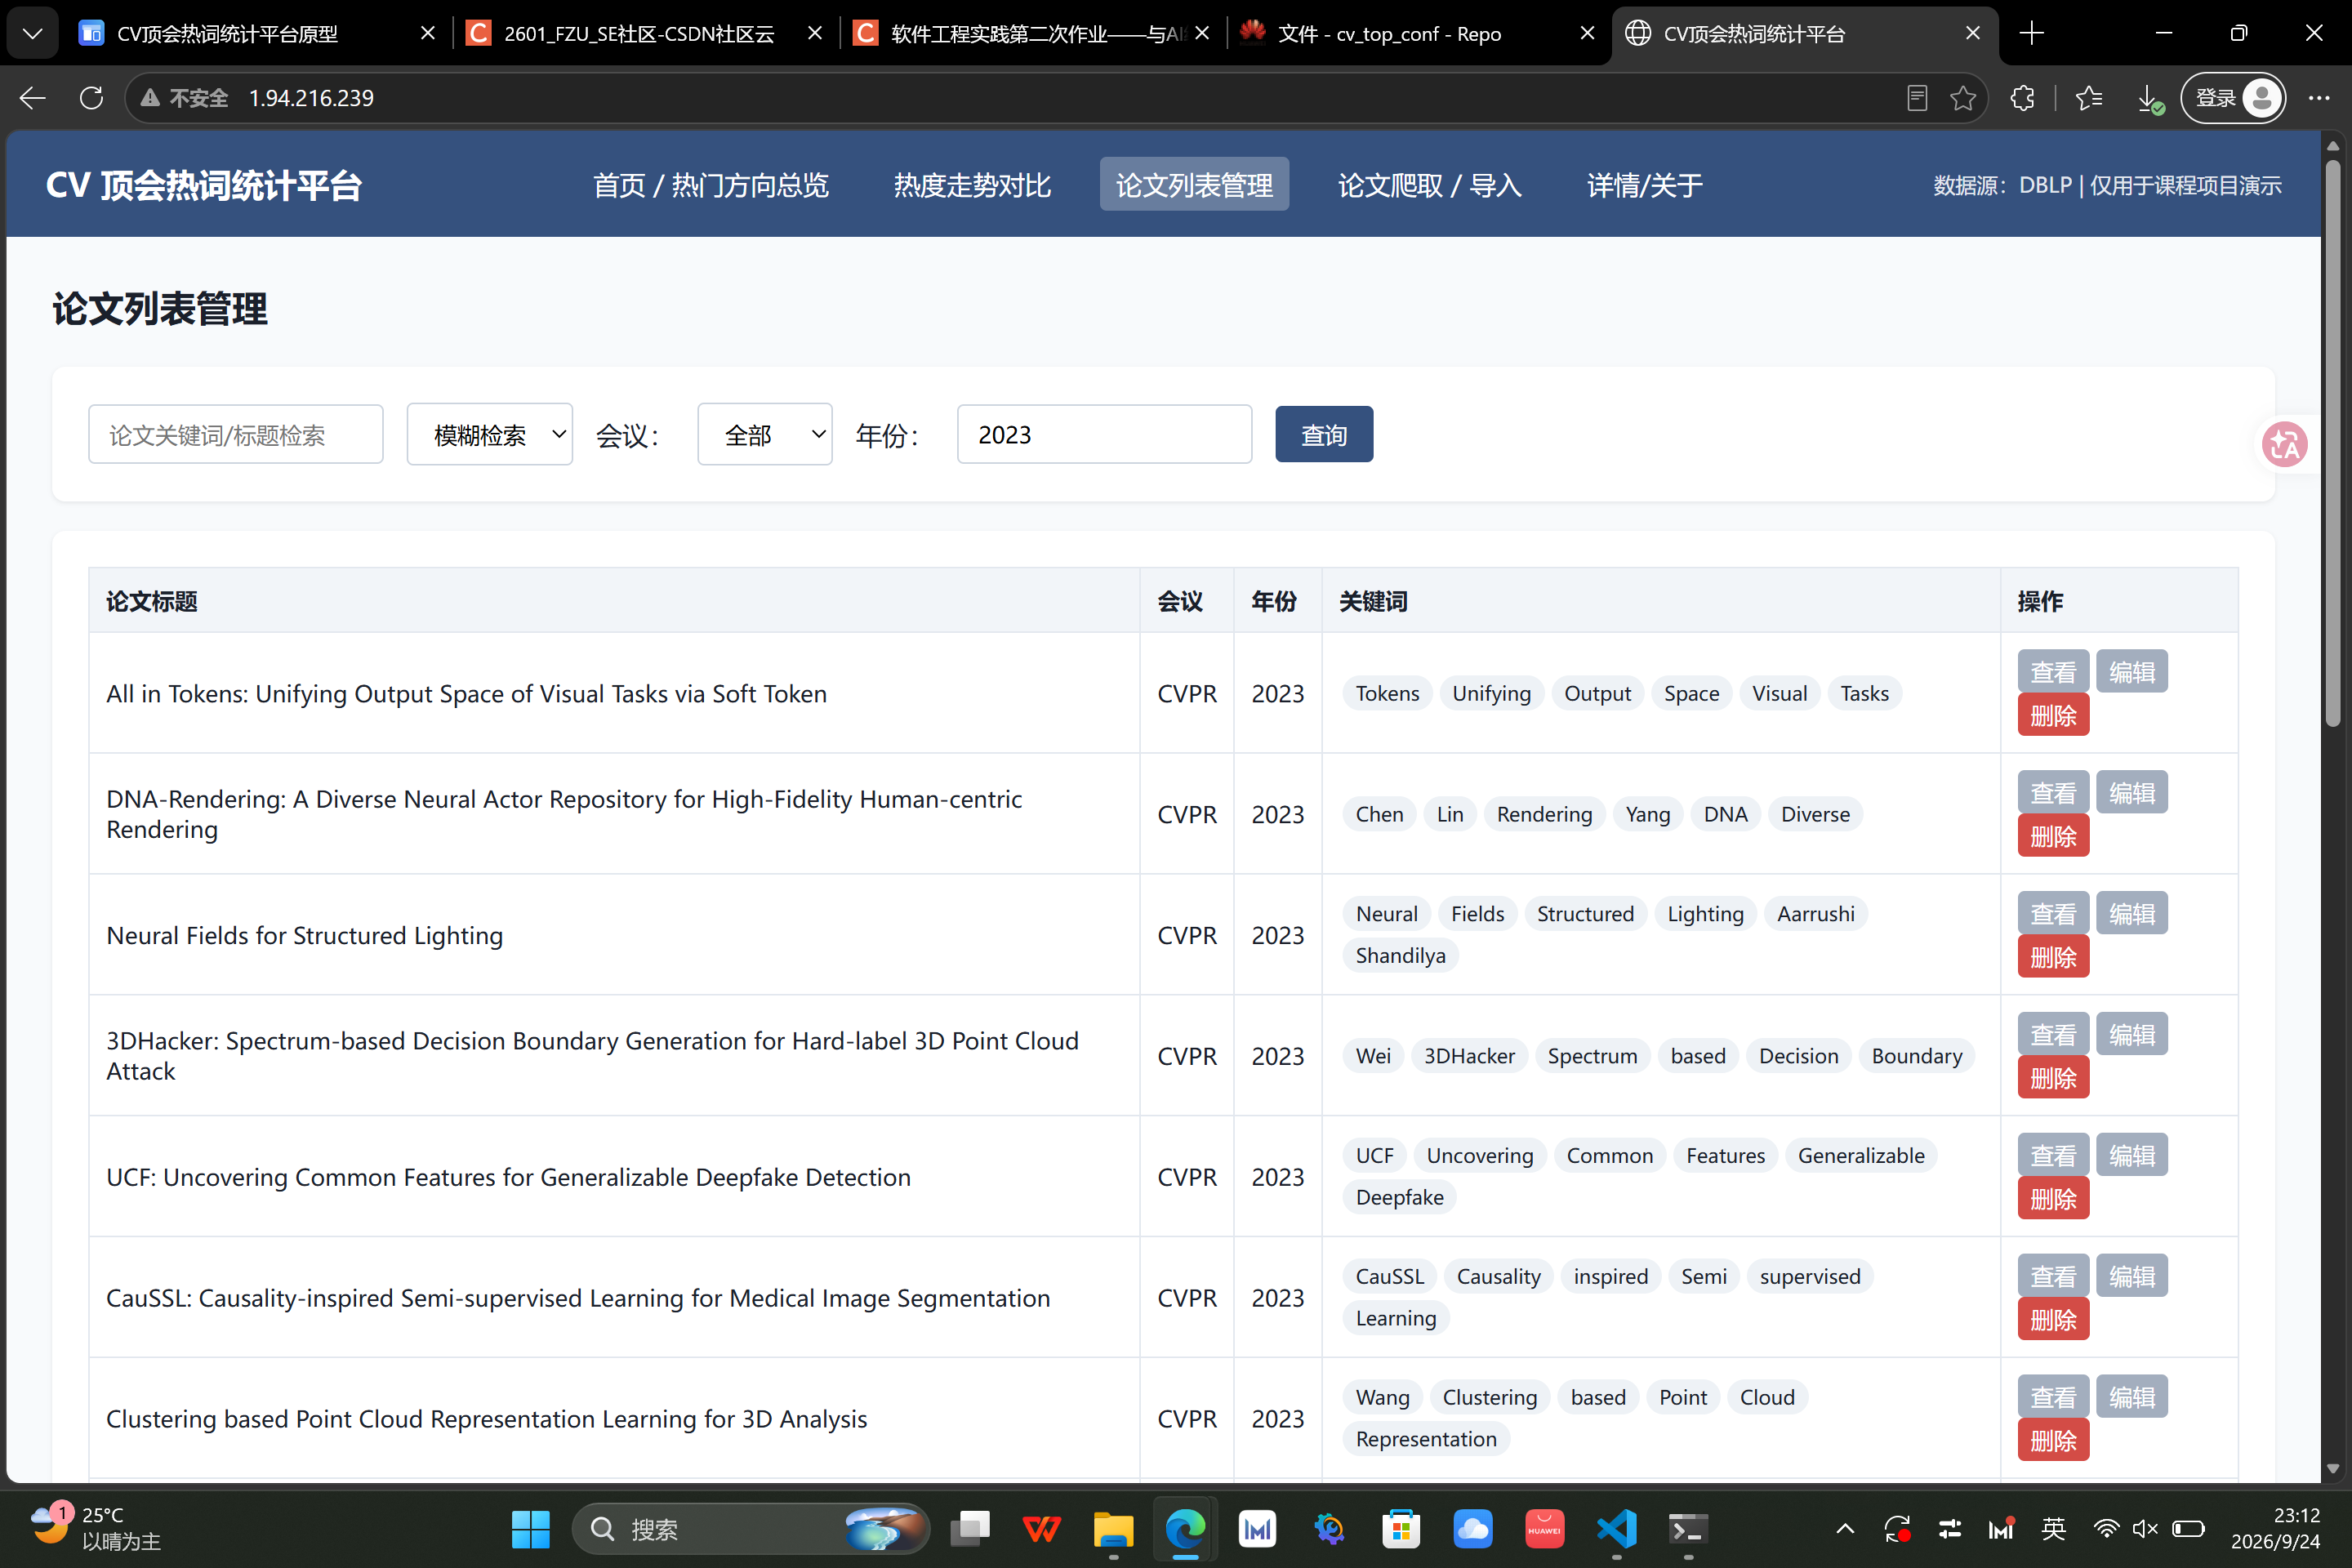
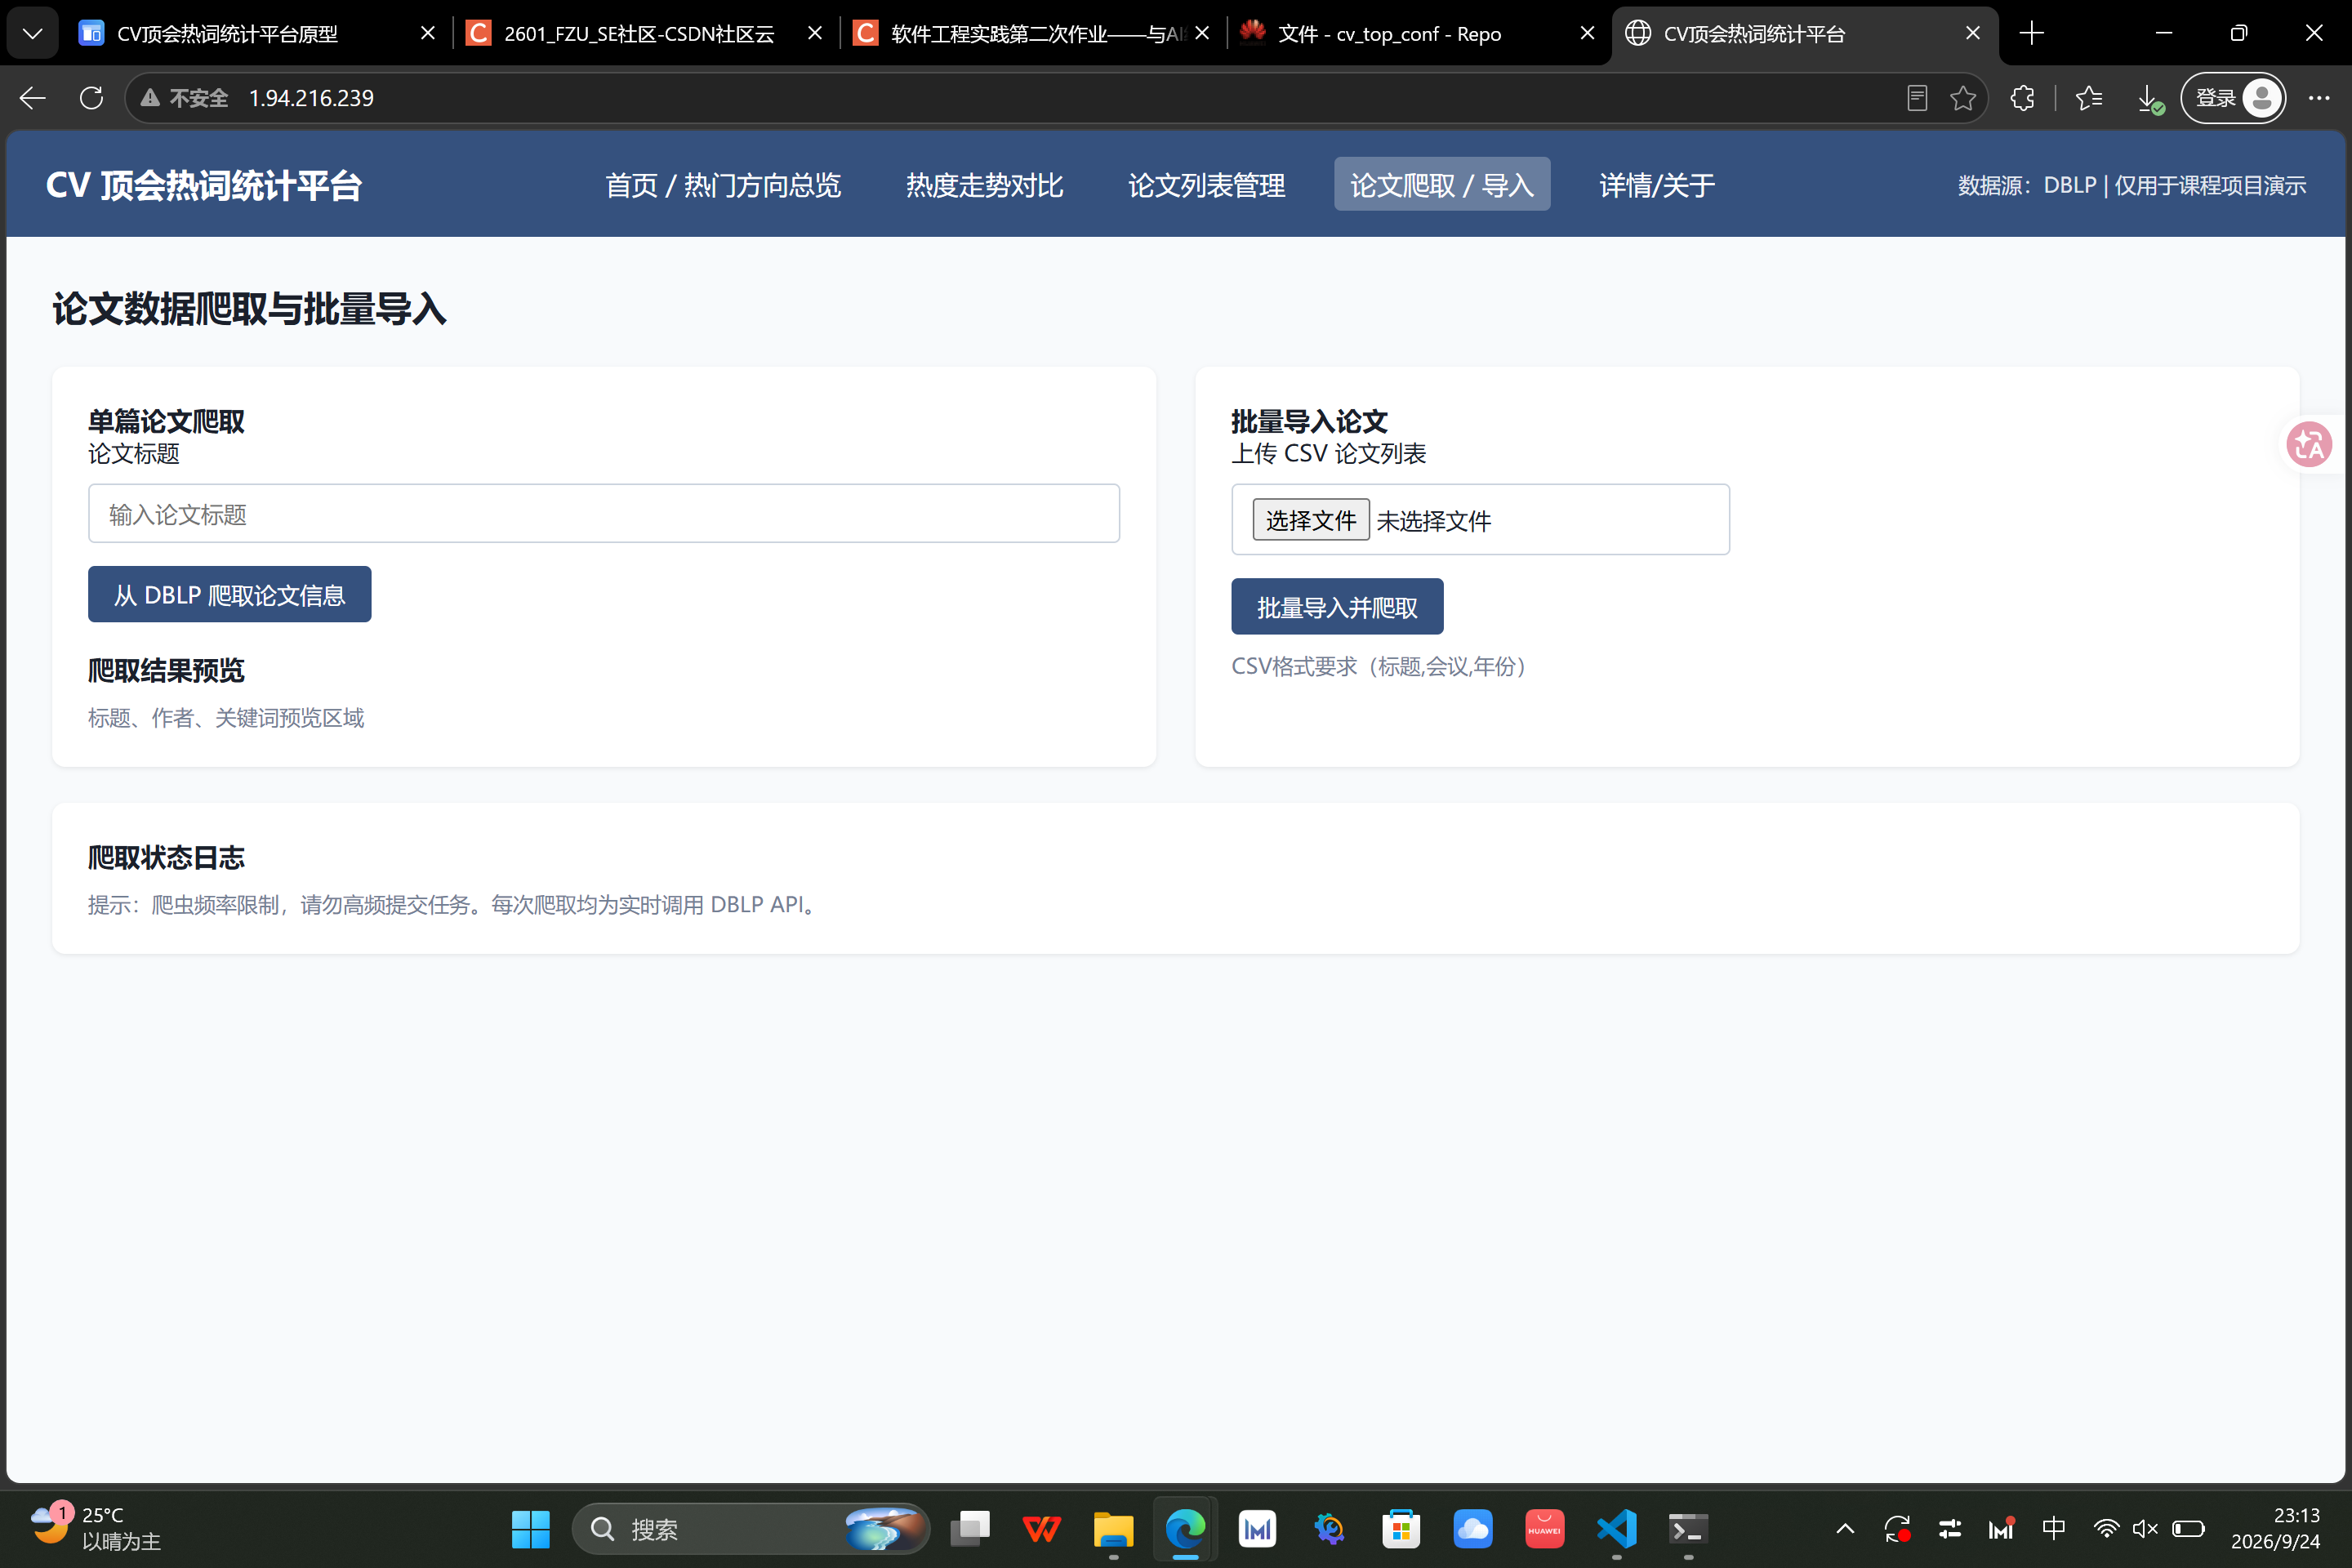
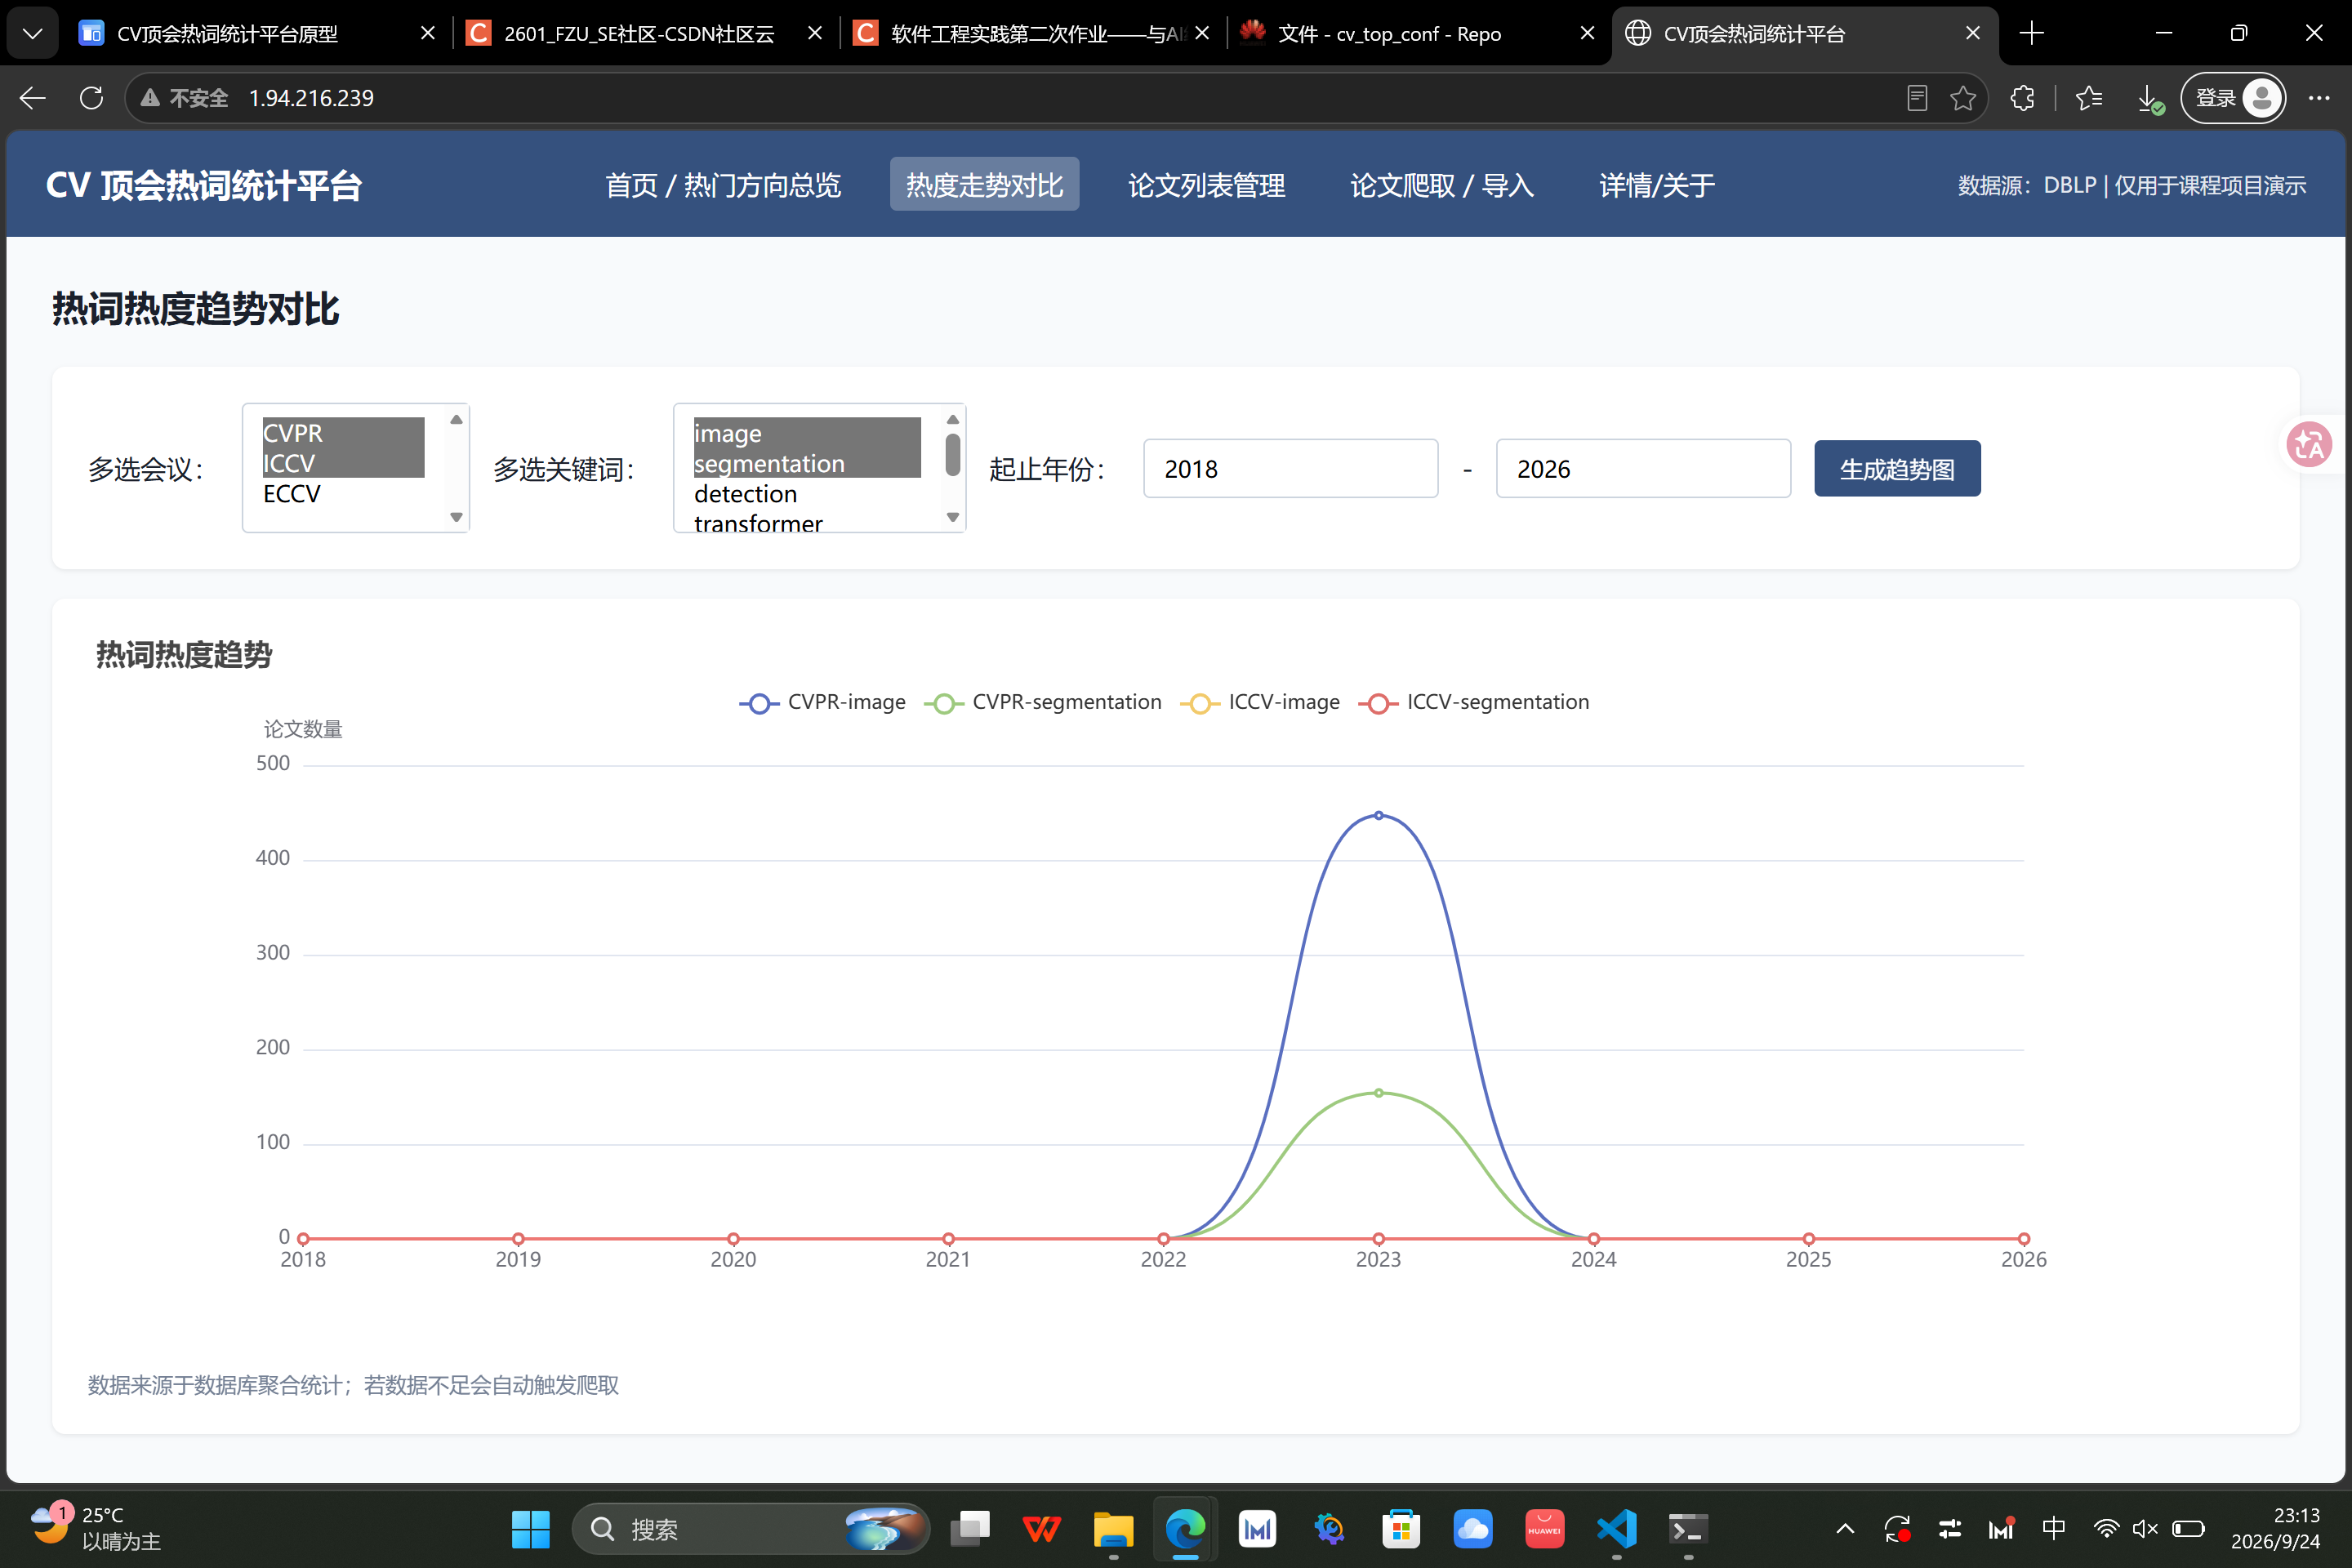
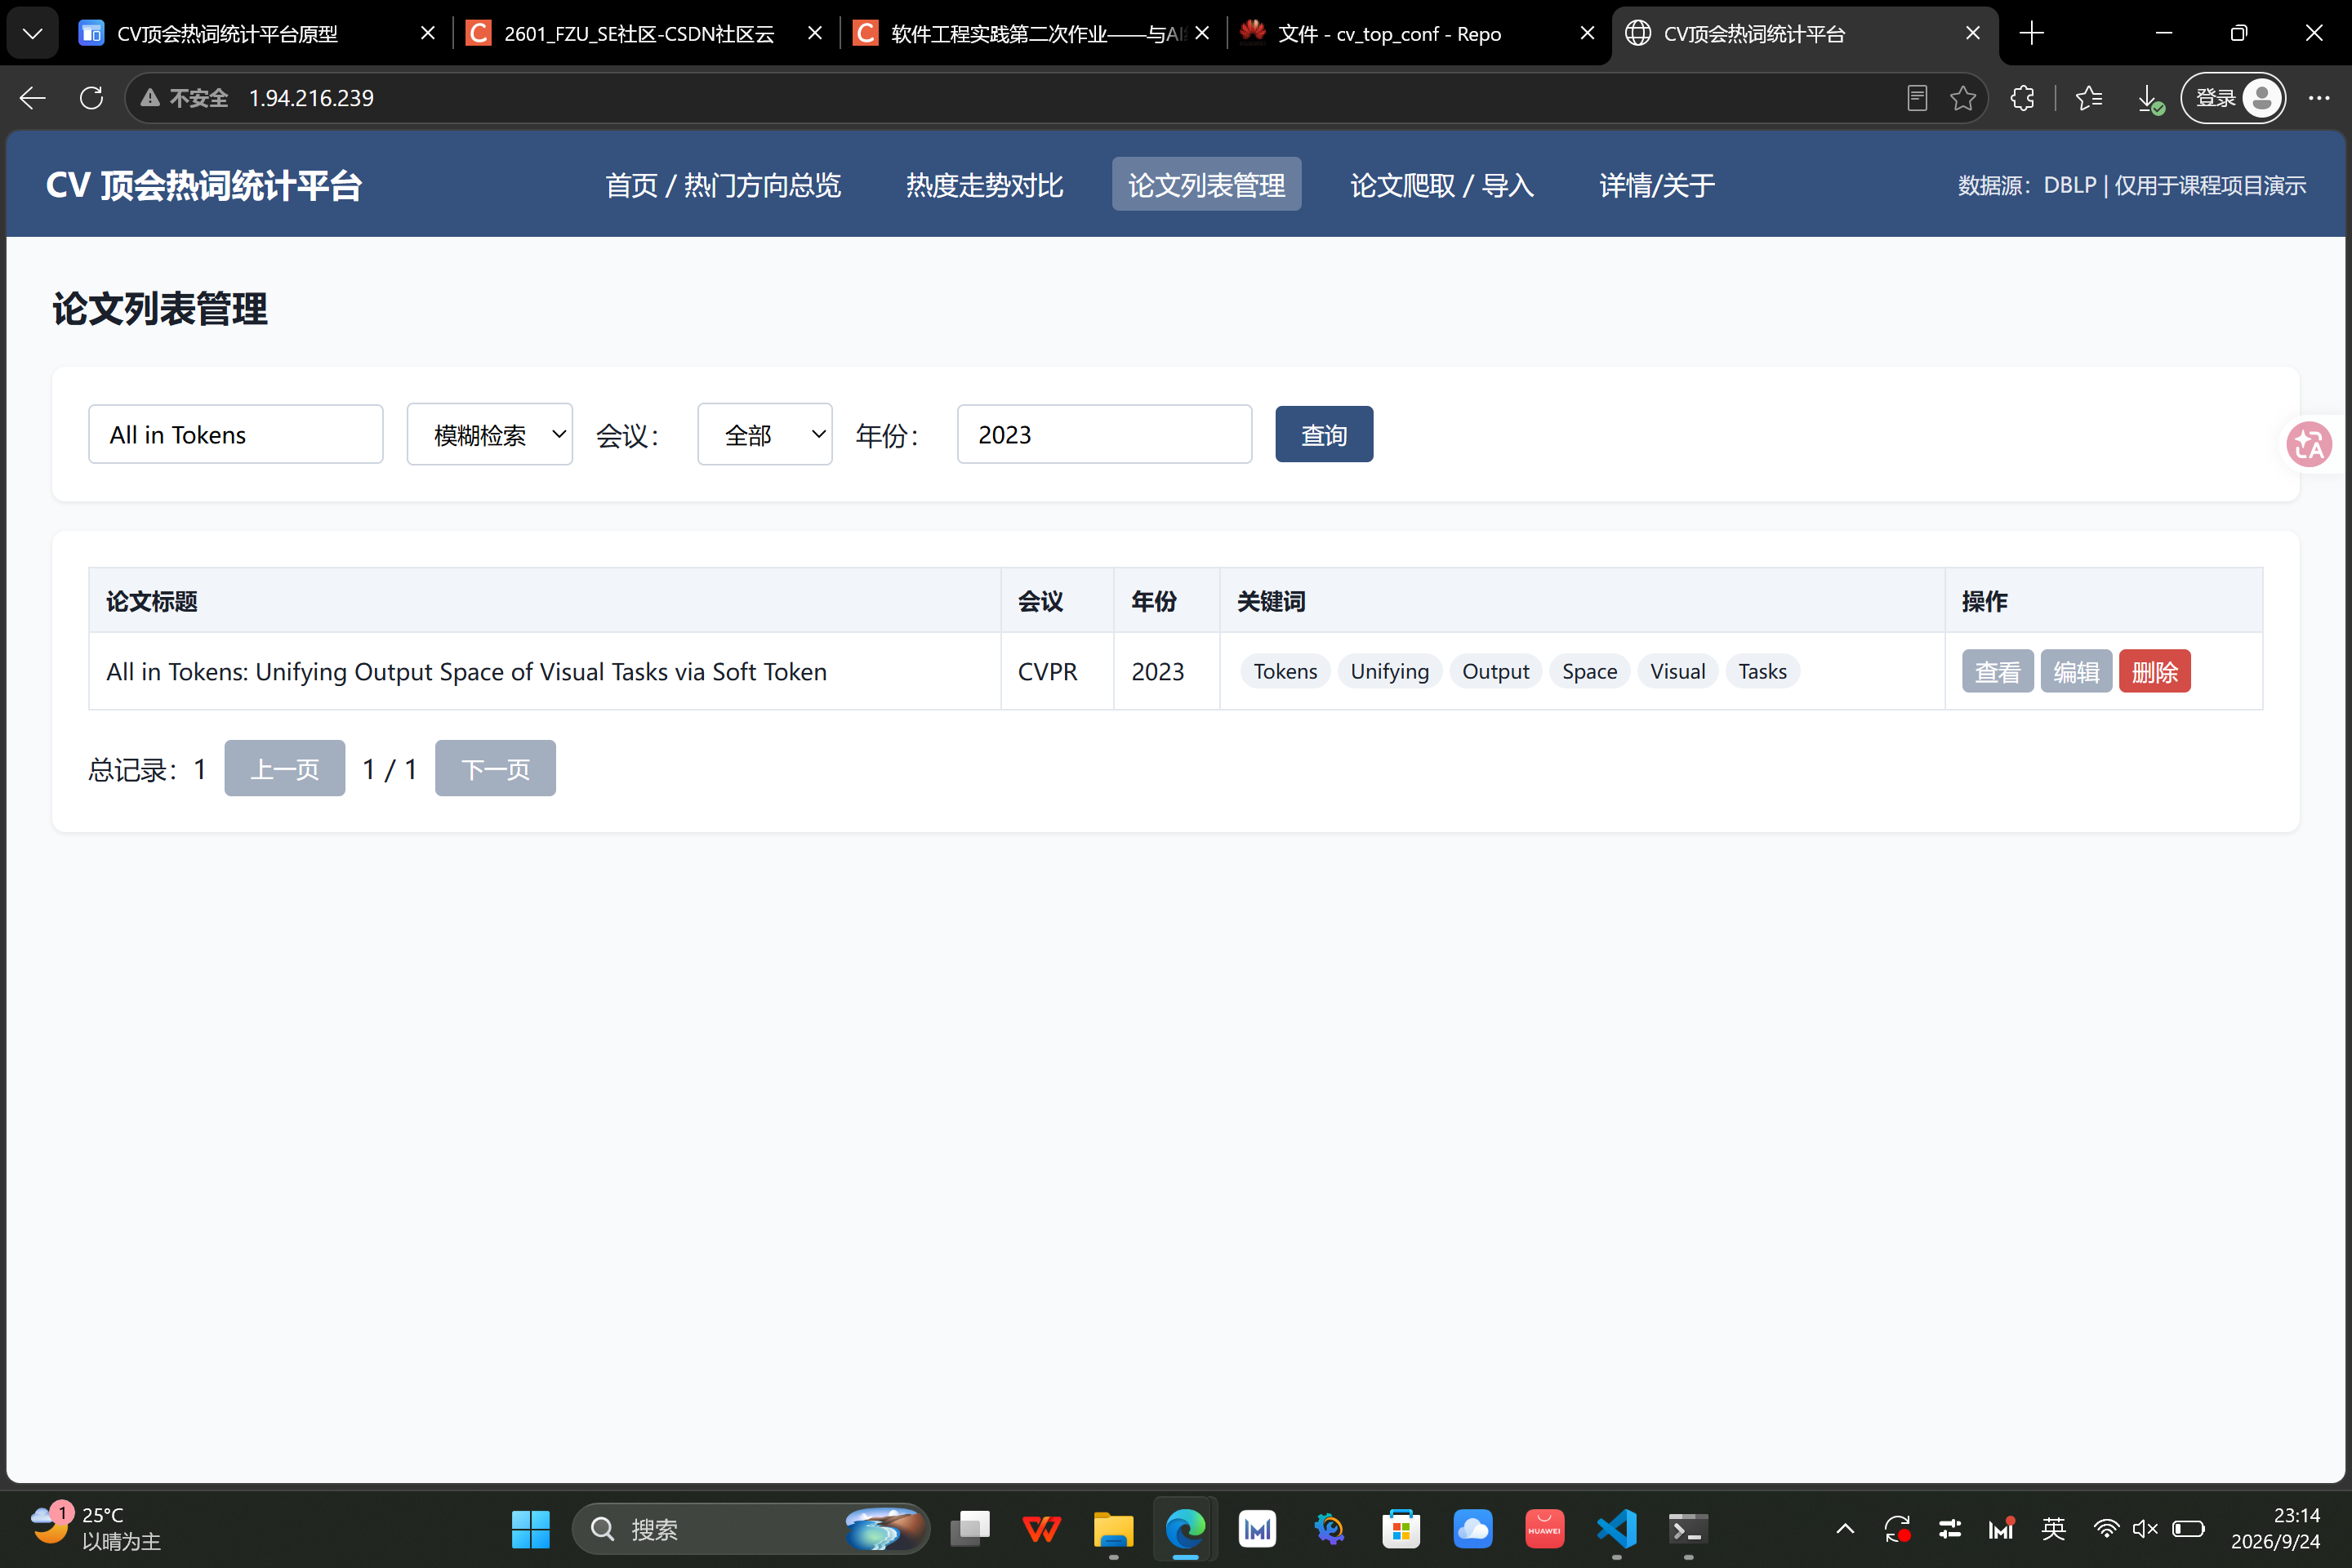
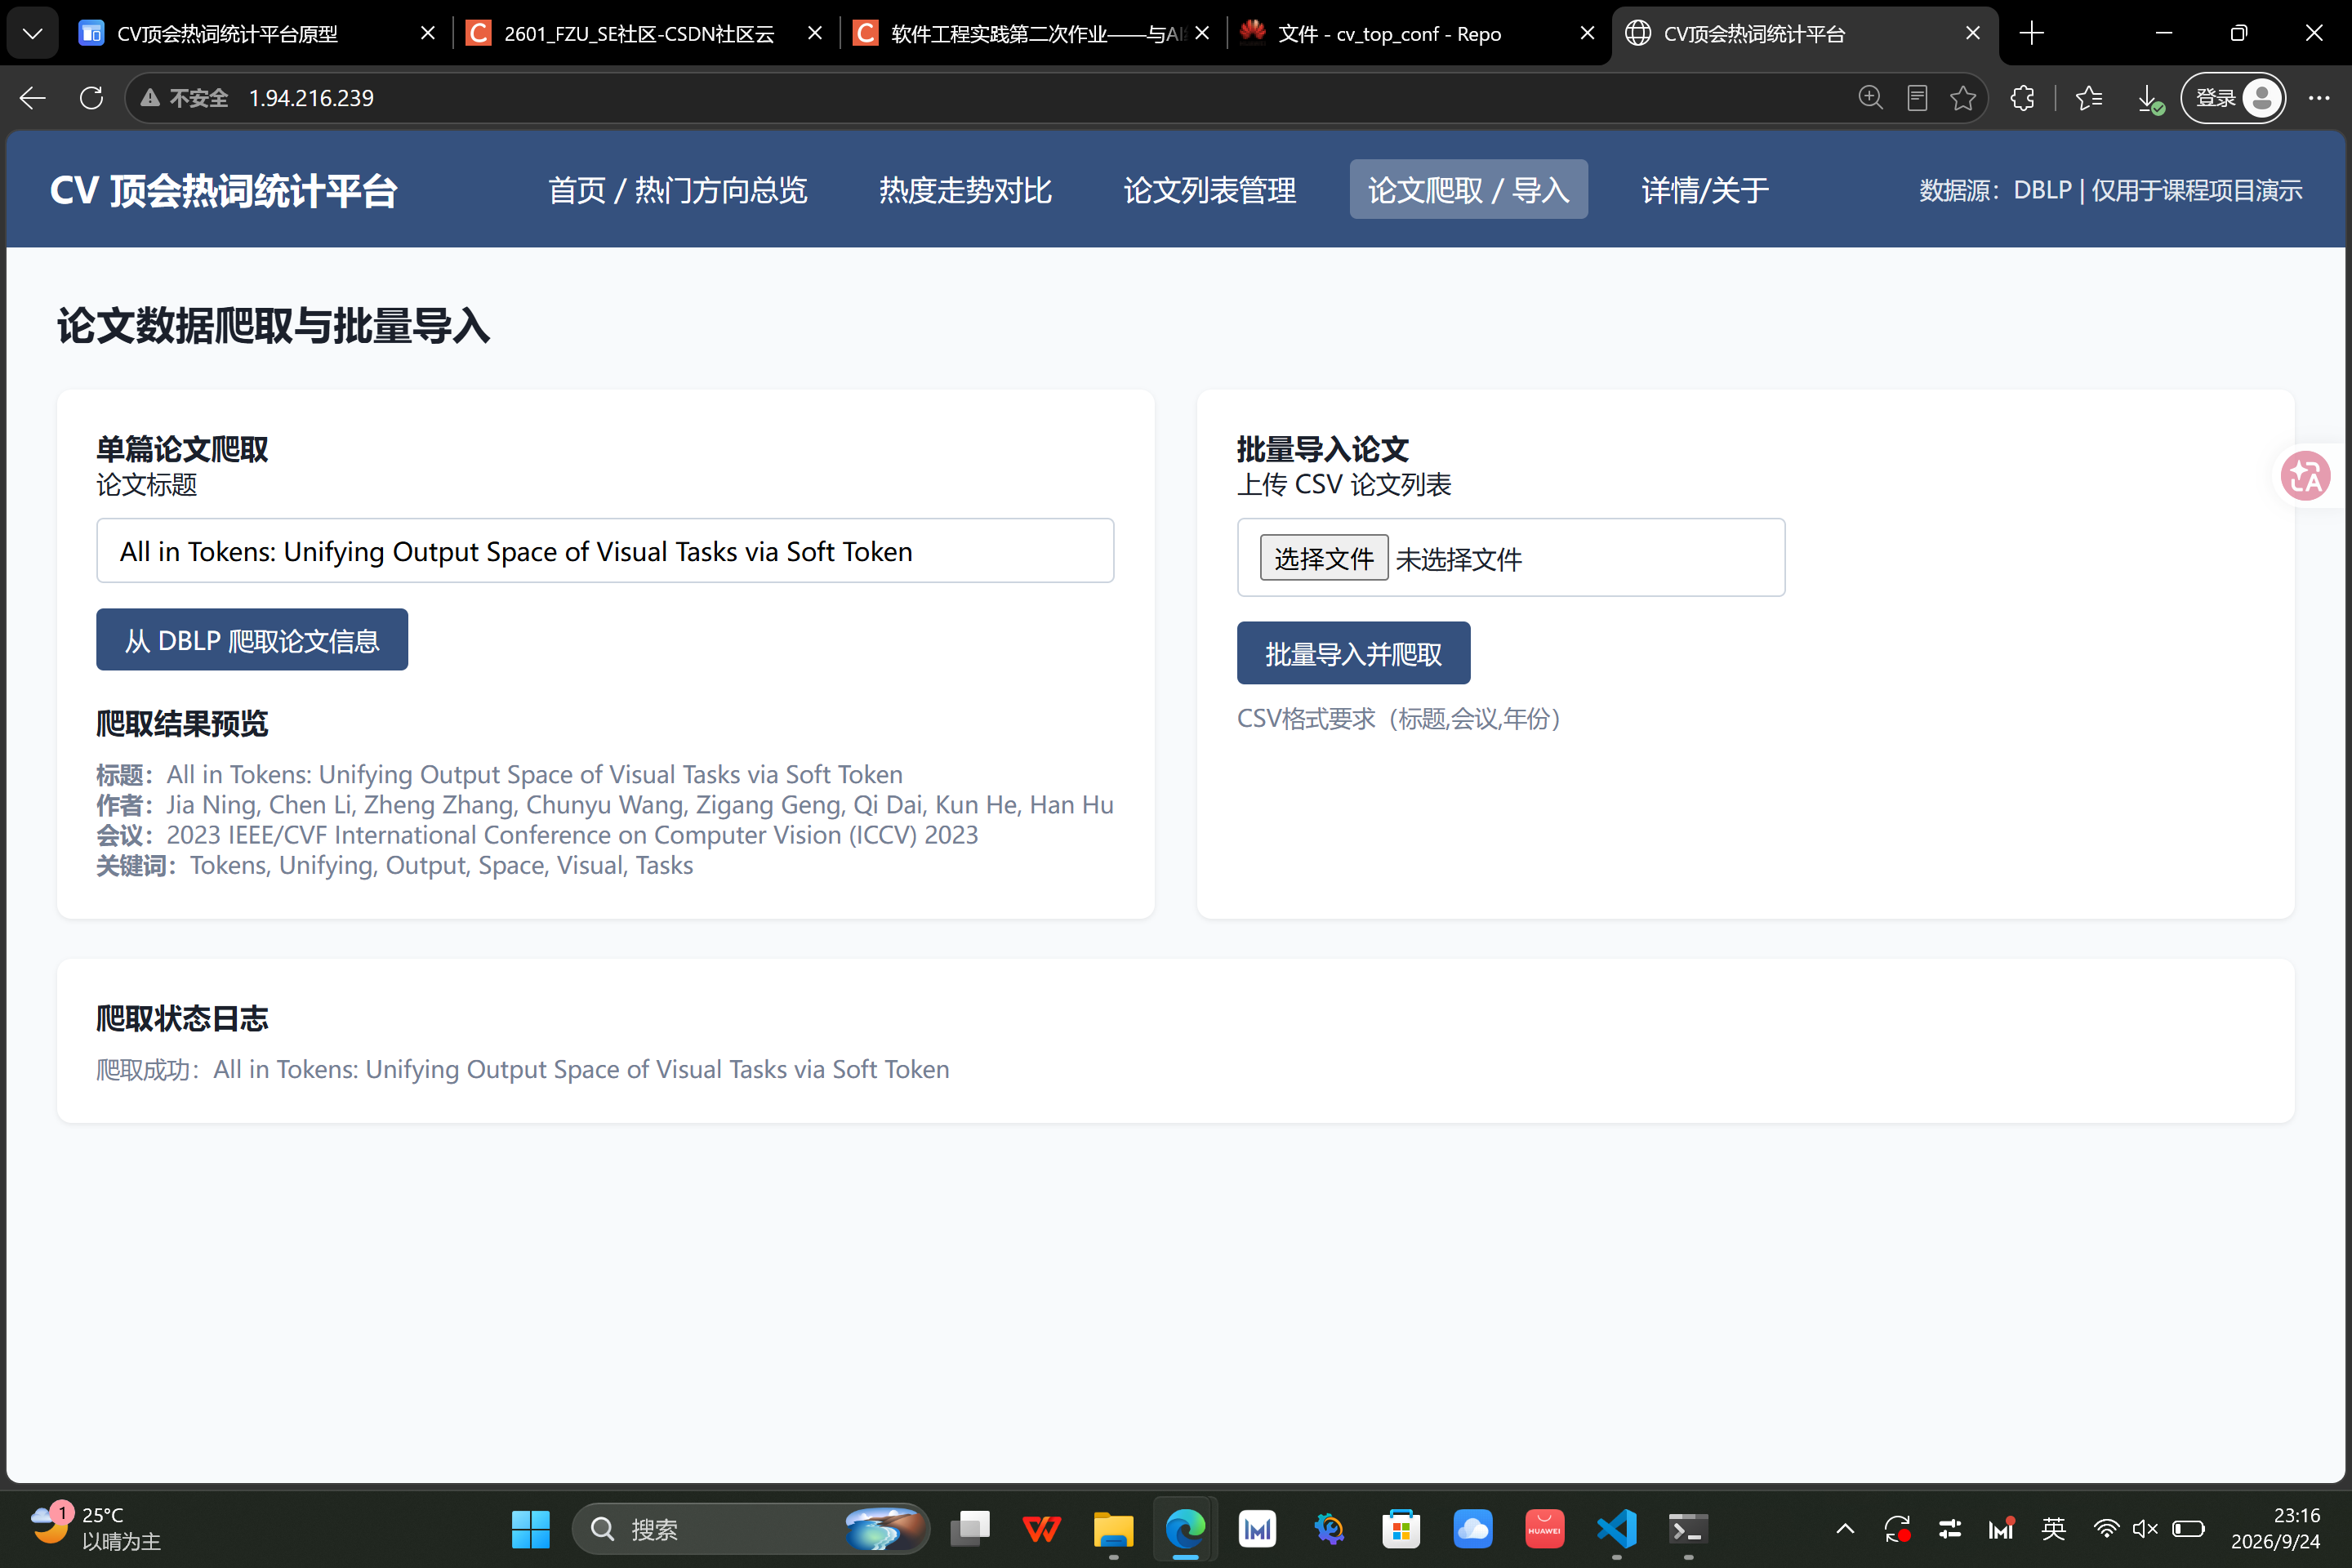
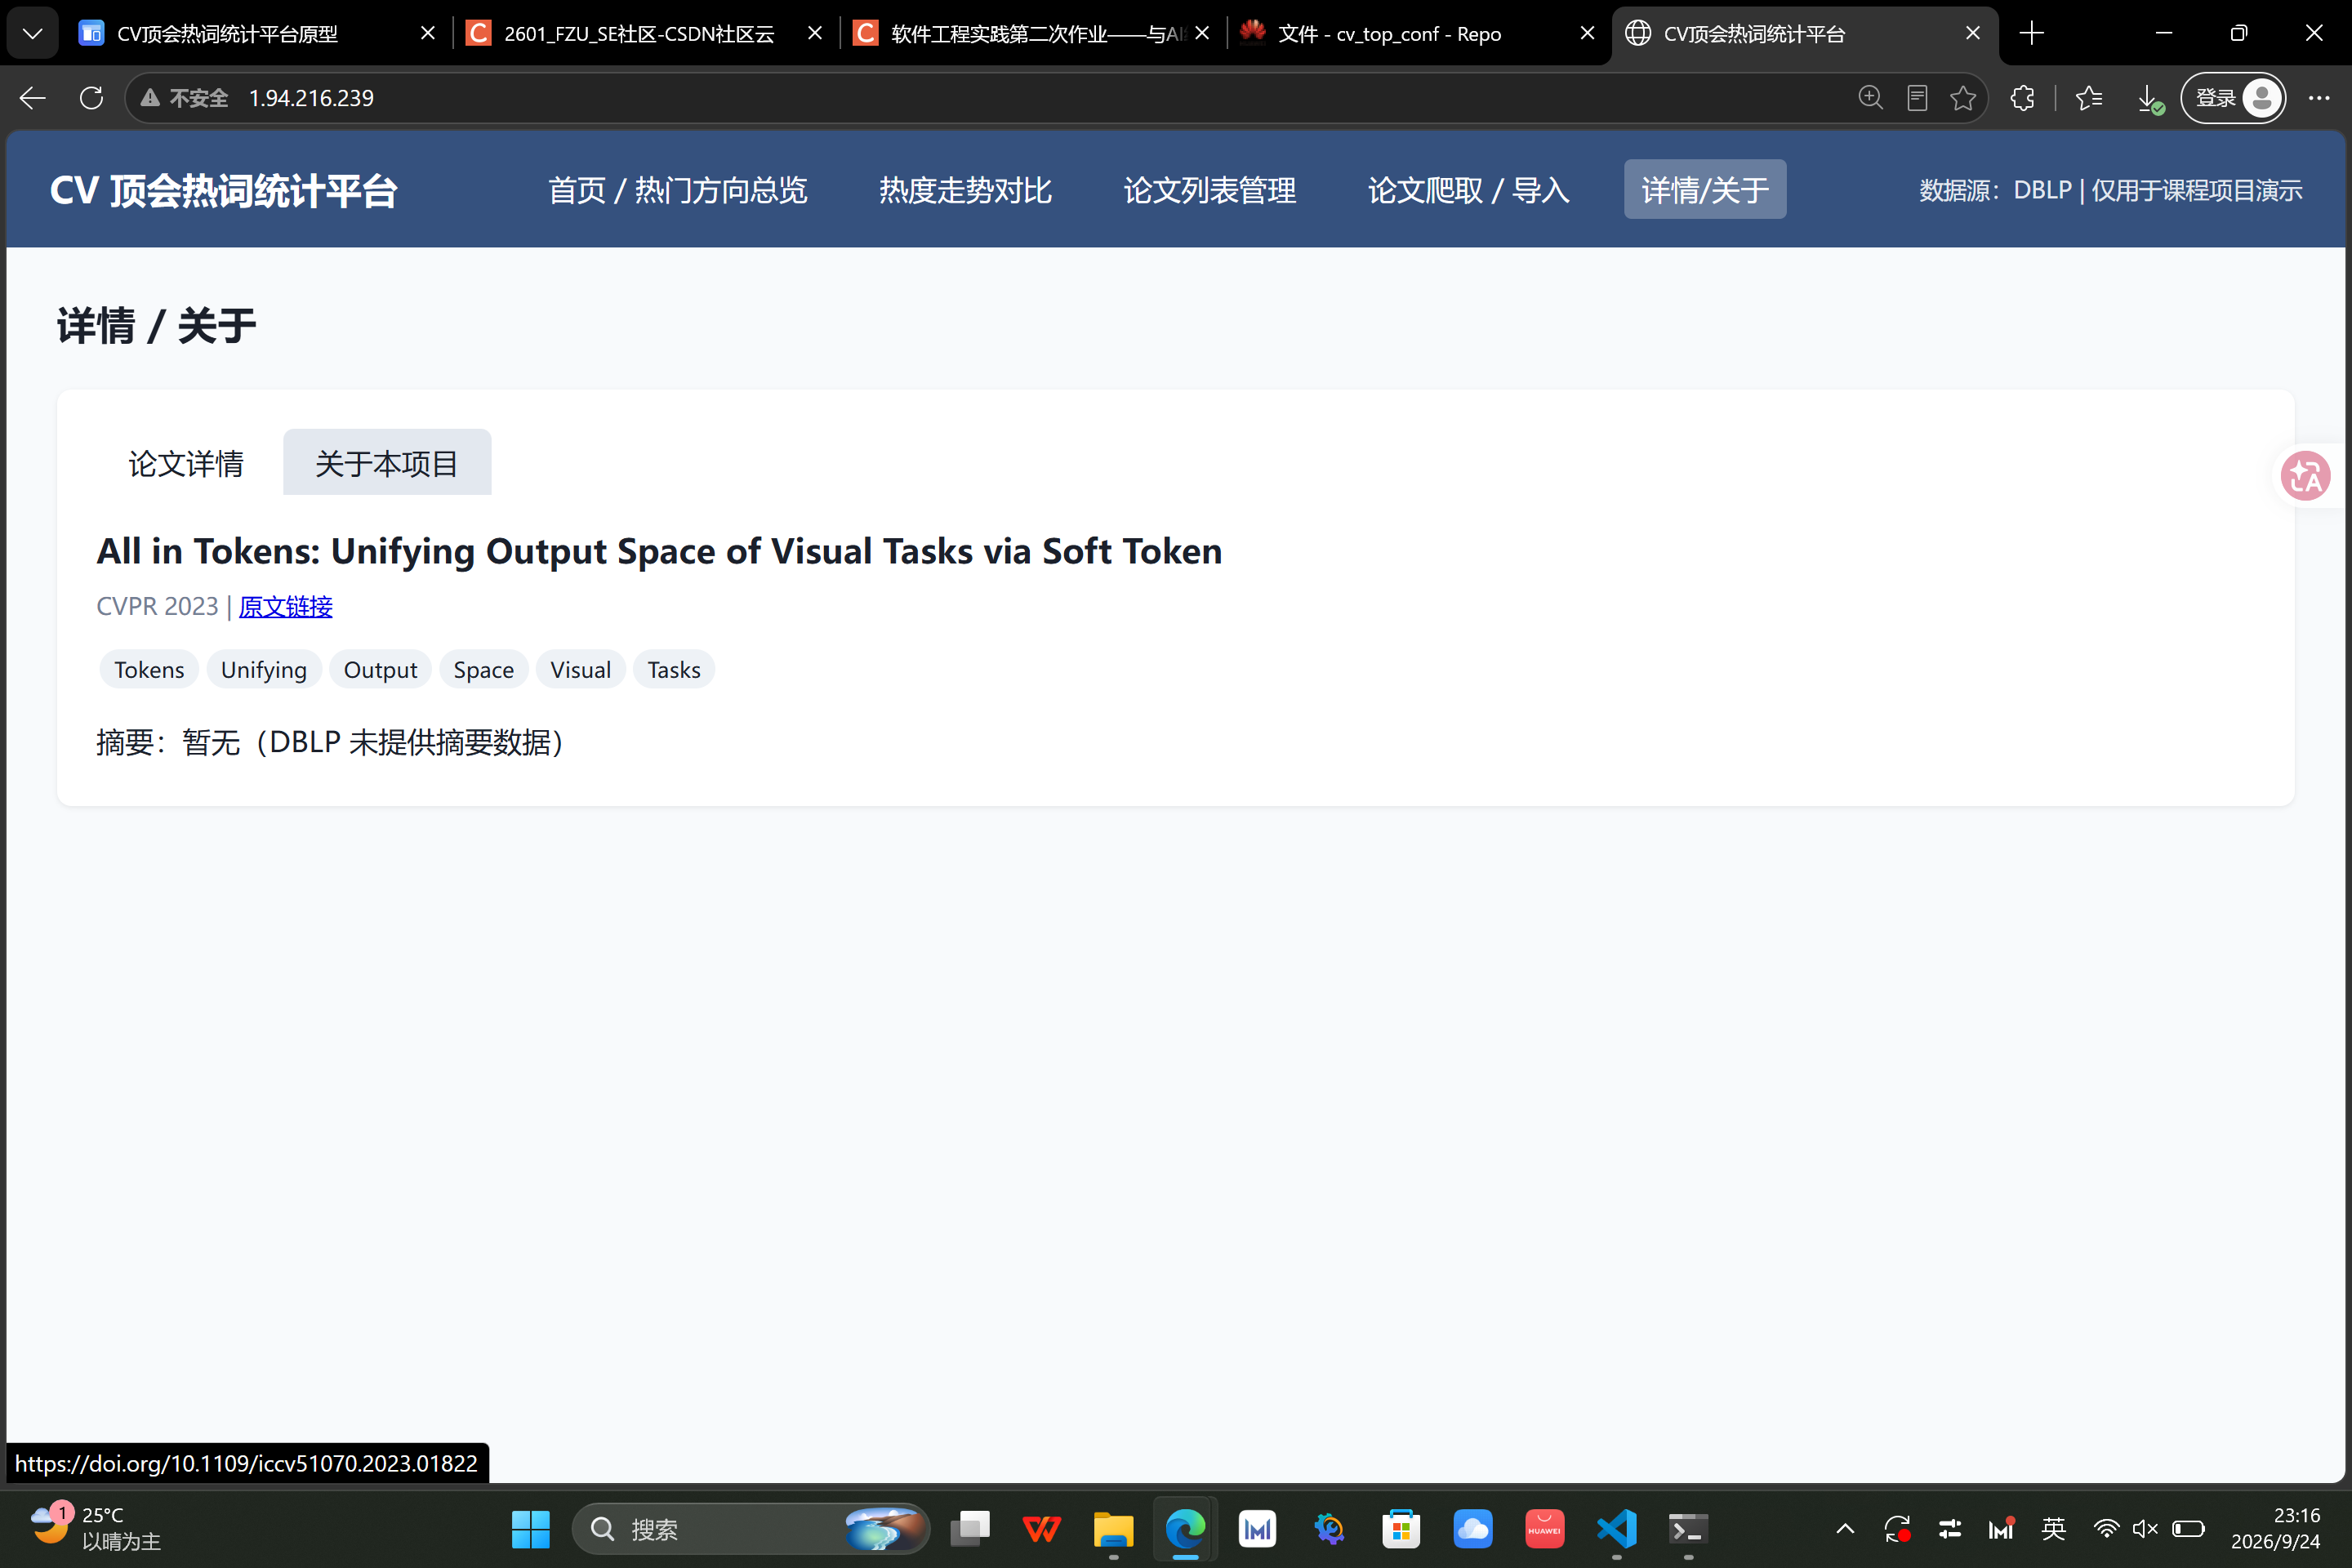
原型采用简洁学术风格,统一深蓝主色;一共 5 个页面,采用分层信息架构。首页左右布局展示 Top10 热词与关键词图谱;热度对比页上下布局放置筛选器与趋势图表、GIF 占位;论文管理页采用表格实现论文增删改查;导入页双卡片区分单篇爬取与批量导入;详情 / 关于页使用标签切换。原型只做页面结构与跳转示意,图表模块占位,满足本次作业原型交付要求。
###代表性案例
回答摘要
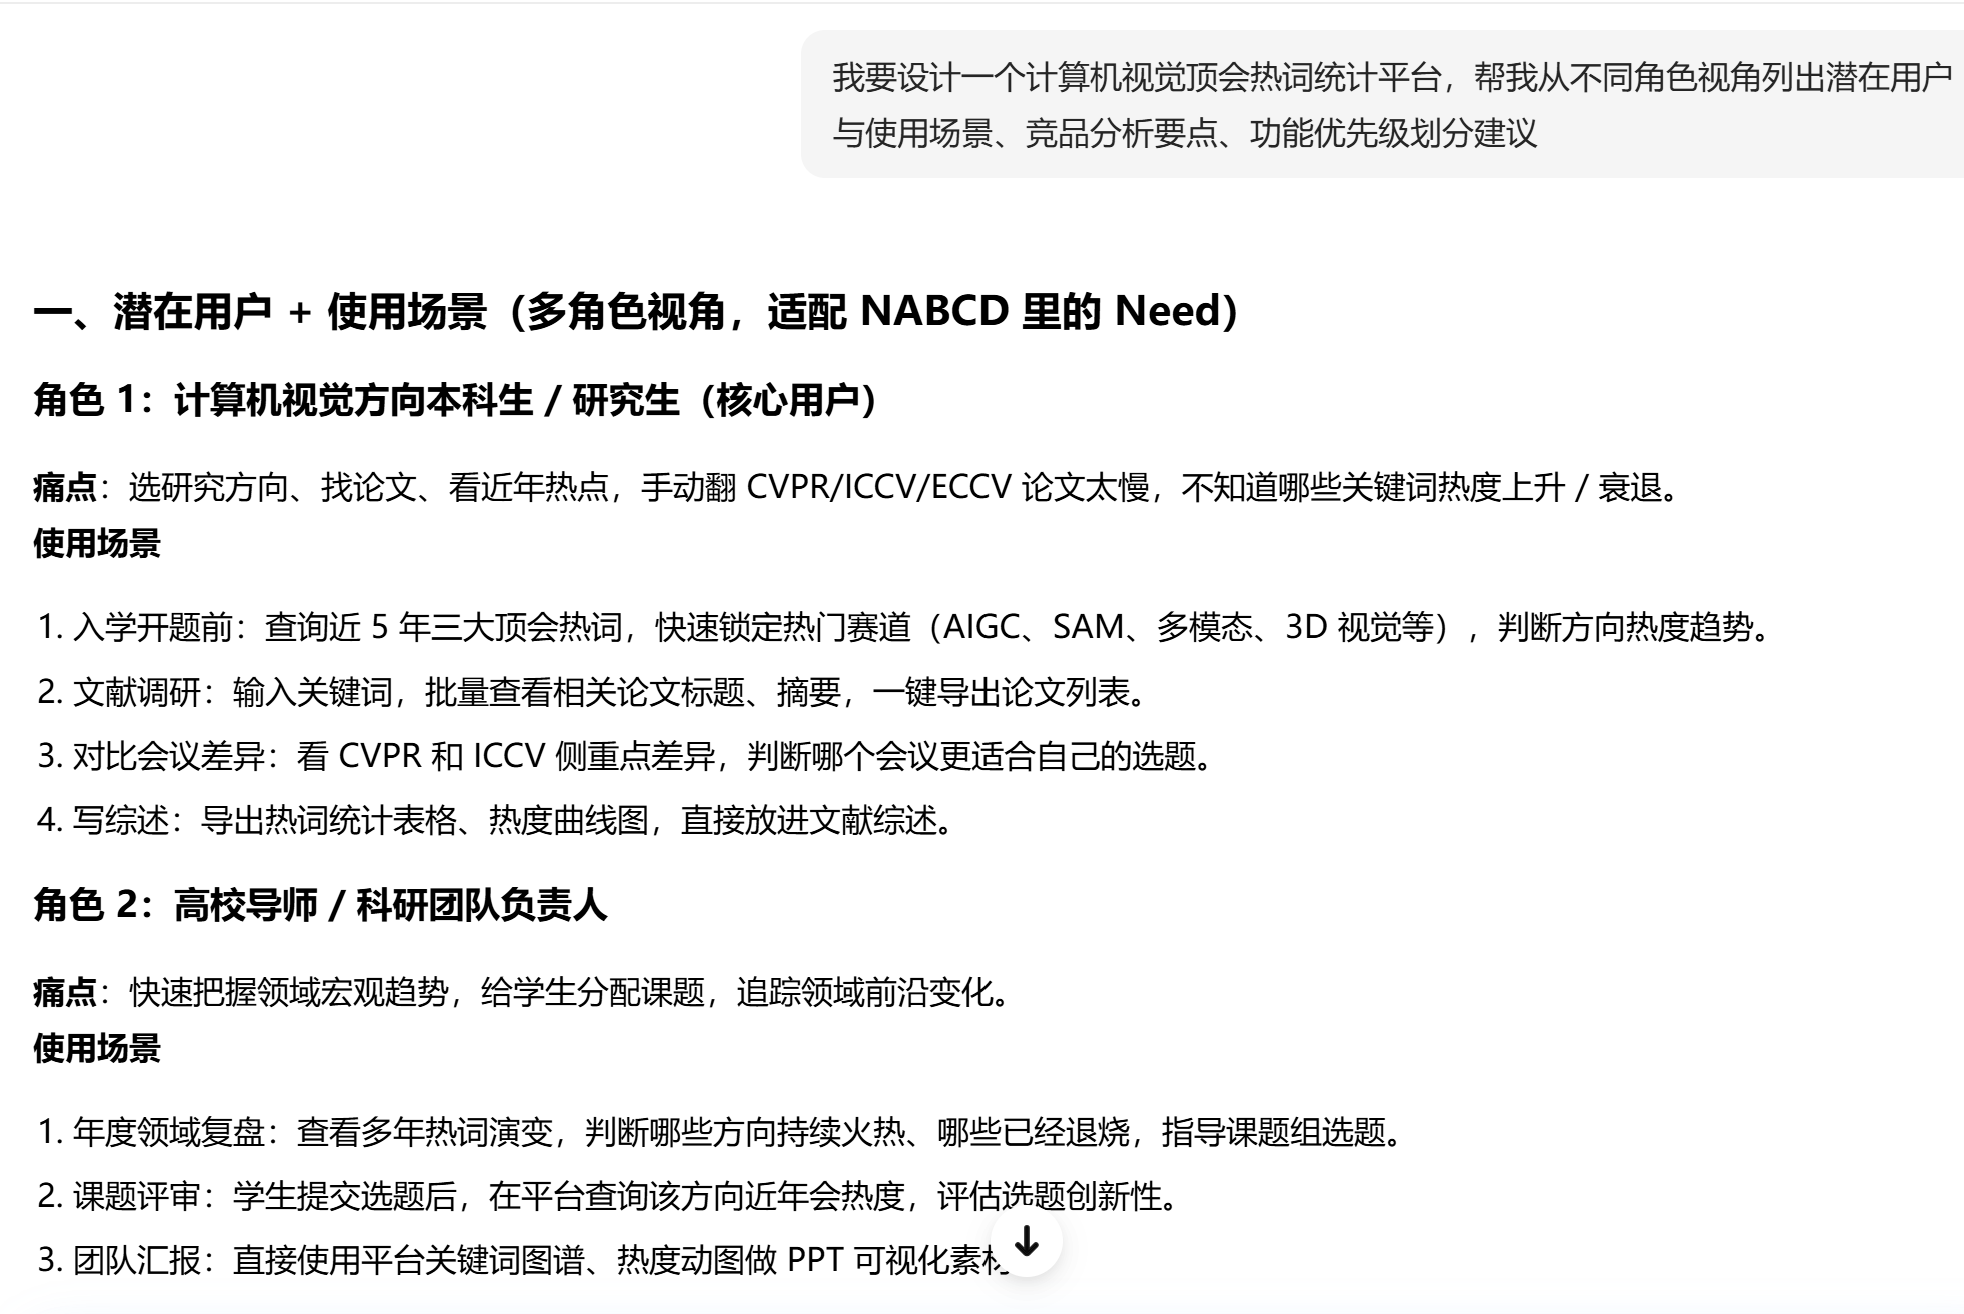
- 用户与场景:面向研究生、高校导师、行业工程师、课程学习者、普通爱好者,覆盖开题调研、课题指导、技术预研、项目演示等使用场景。
- 竞品分析:对比 DBLP、Semantic Scholar、Connected Papers 及开源脚本,指出现有工具缺少聚焦三大视觉顶会的一体化 Web 热词分析能力,为>本项目的差异化切入点。
- 功能优先级:Must‑have 完成论文爬取管理、关键词提取、热词排行等基础;Should‑have 实现关键词图谱、多维度热度对比;Could‑have 做动图导出、筛选等附加功能;Won’t‑have 舍弃登录、PDF 解析等非必要模块。
我的意见
采纳大部分;拒绝课程助教 / 软件工程课程学生,作为项目特有用户
理由:平台本身是面向科研人员的热词分析工具,该角色并不是平台产品意义上的真实用户,只是本次课程作业的评审者,混入用户画像会混淆产品需求边界,不纳入 NABCD 用户分析。
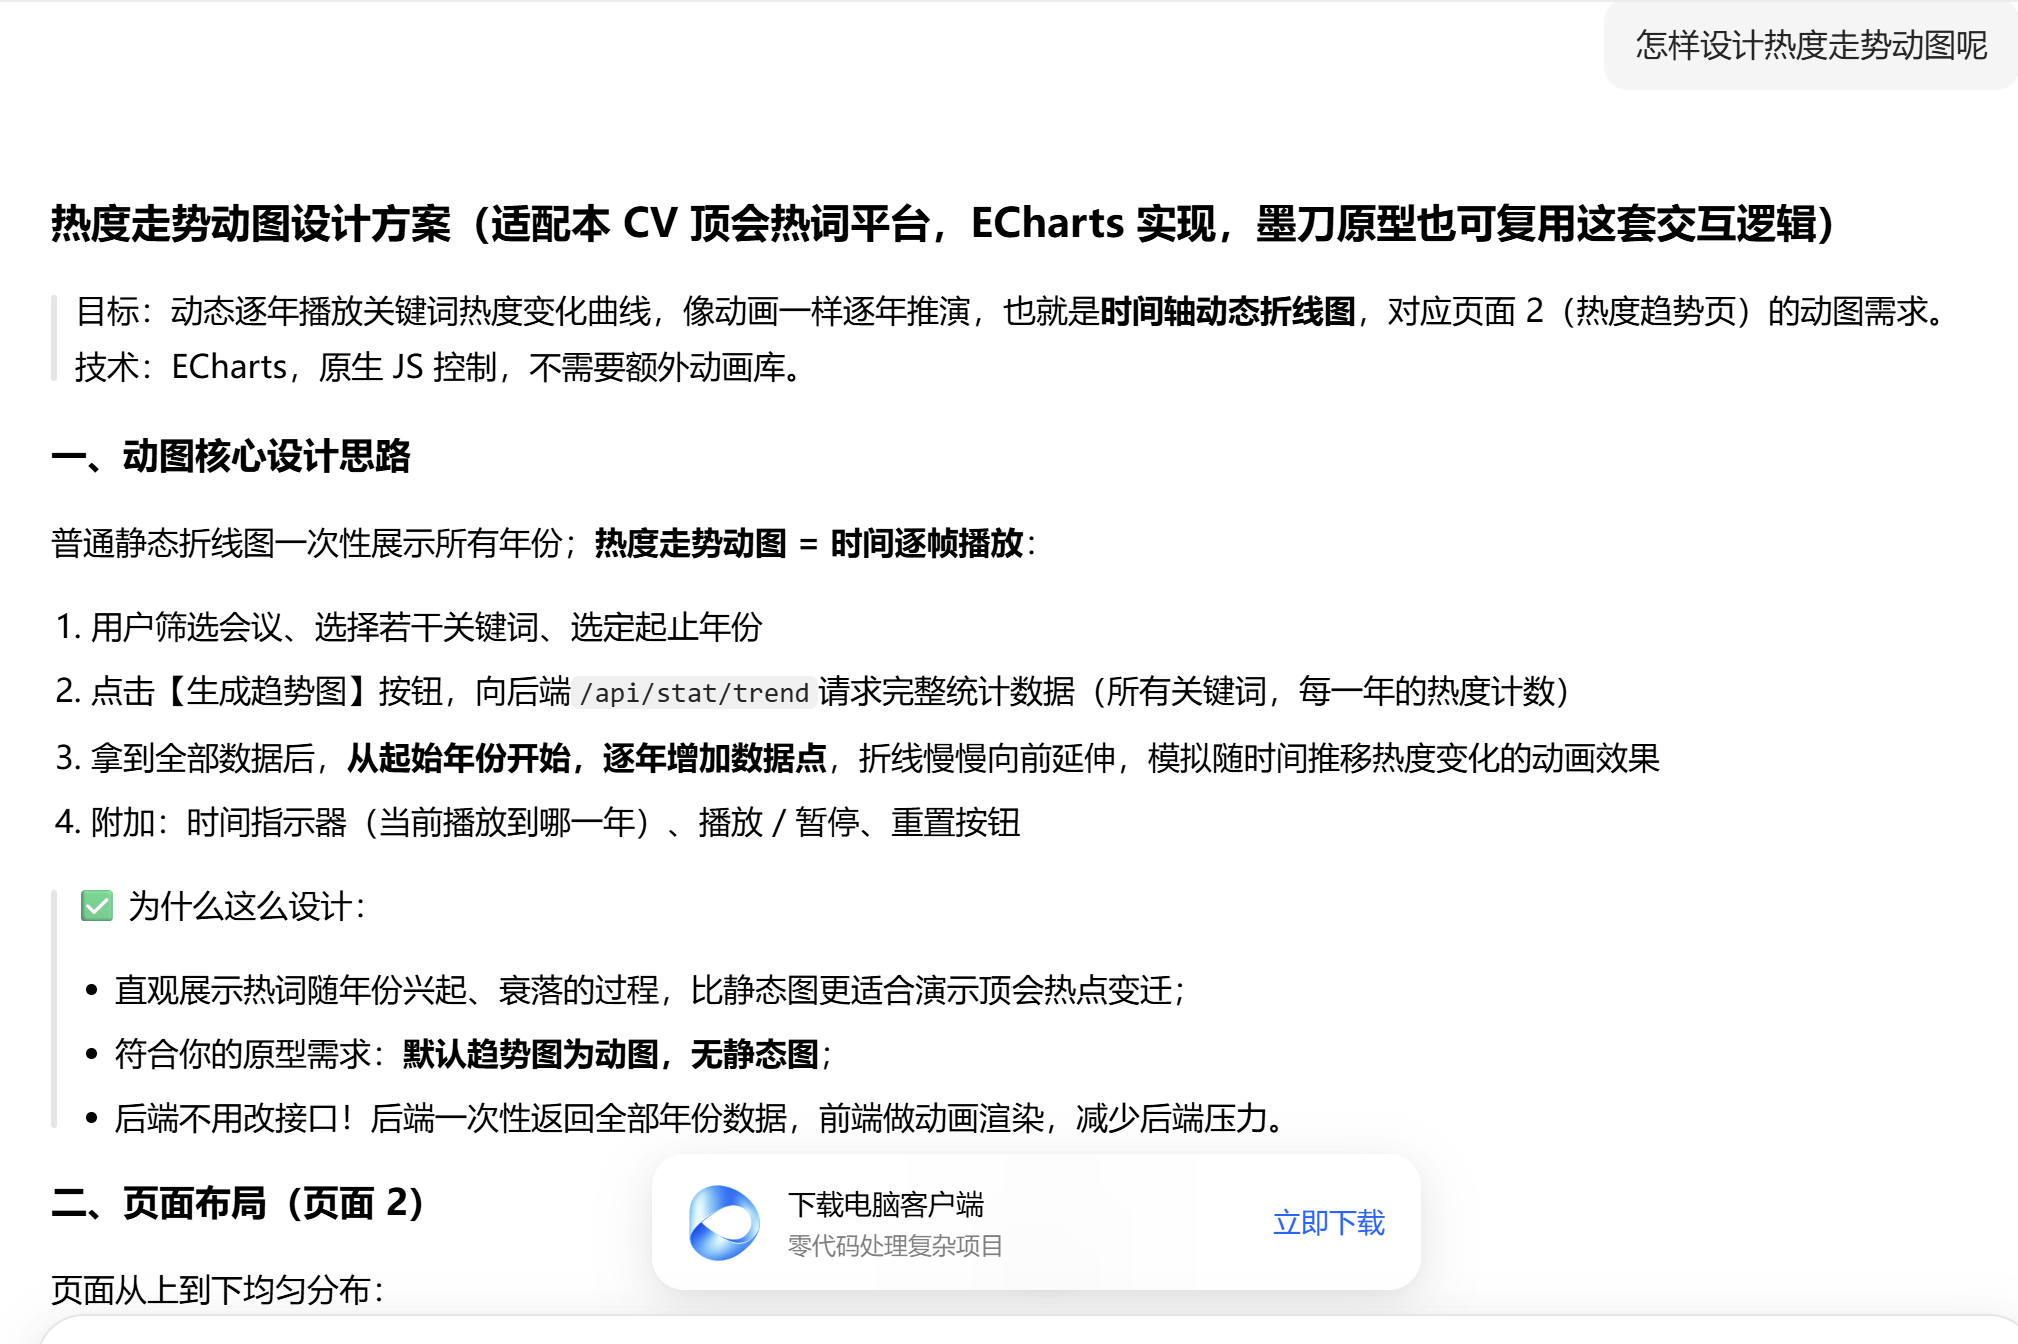
设计思路
普通静态折线图一次性展示所有年份;热度走势动图 = 时间逐帧播放:
- 用户筛选会议、选择若干关键词、选定起止年份
- 点击【生成趋势图】按钮,向后端
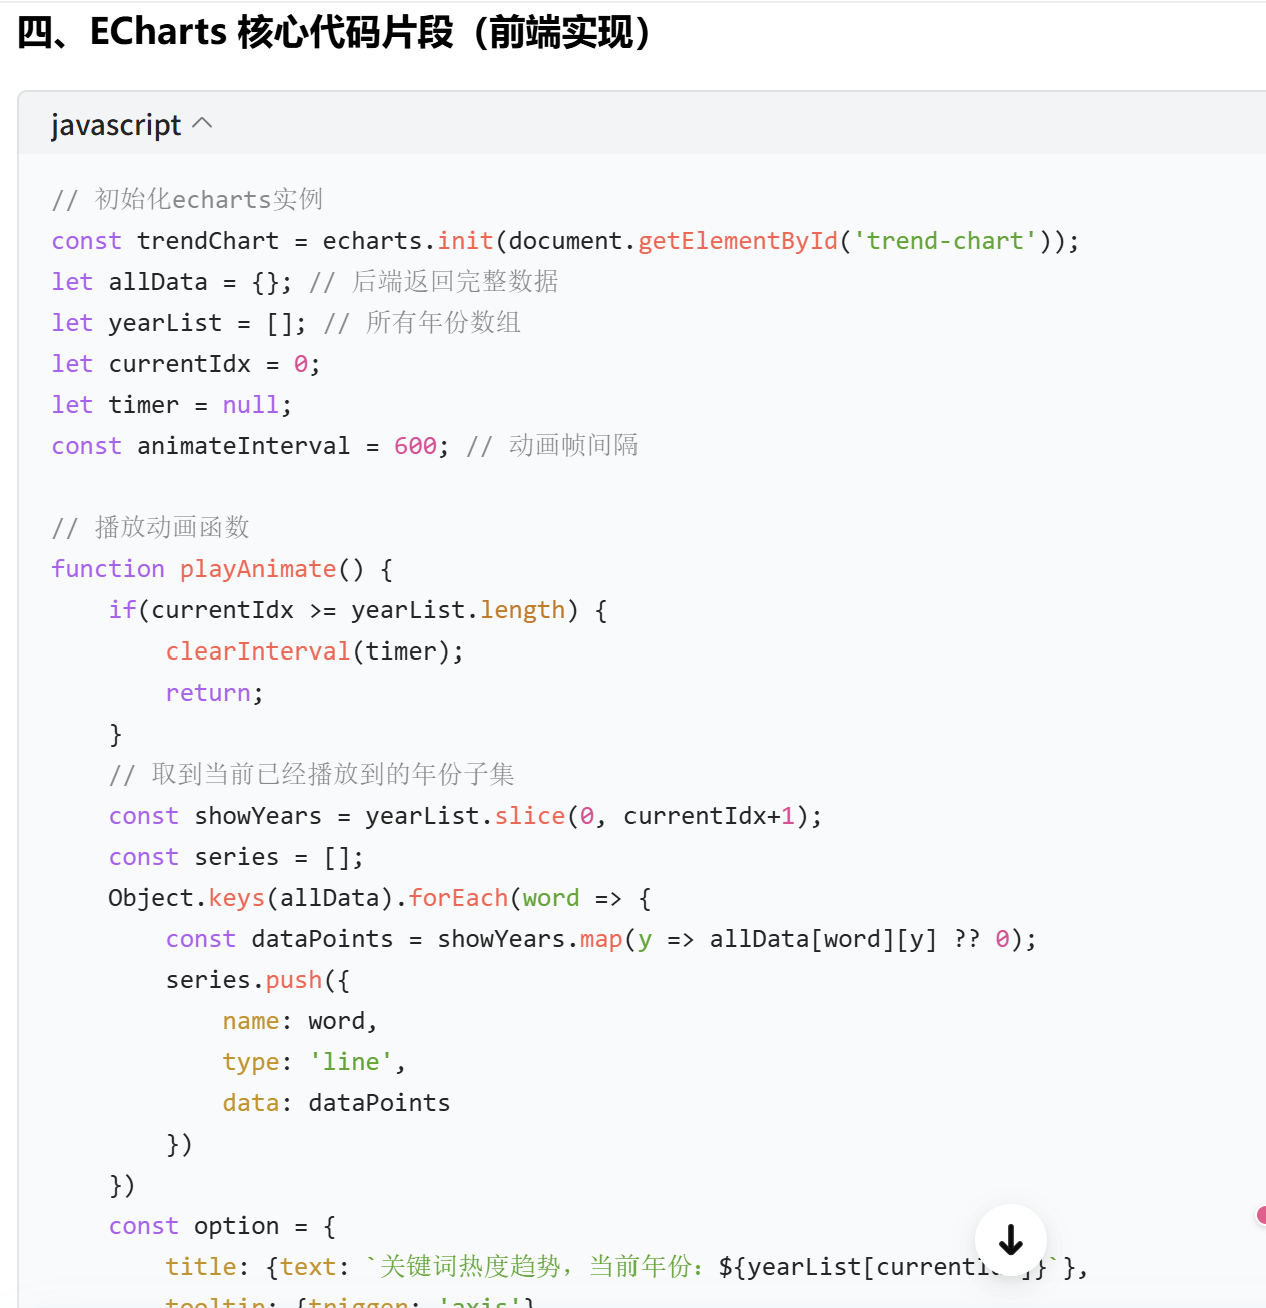
/api/stat/trend请求完整统计数据(所有关键词,每一年的热度计数)- 拿到全部数据后,从起始年份开始,逐年增加数据点,折线慢慢向前延伸,模拟随时间推移热度变化的动画效果
部分代码展示
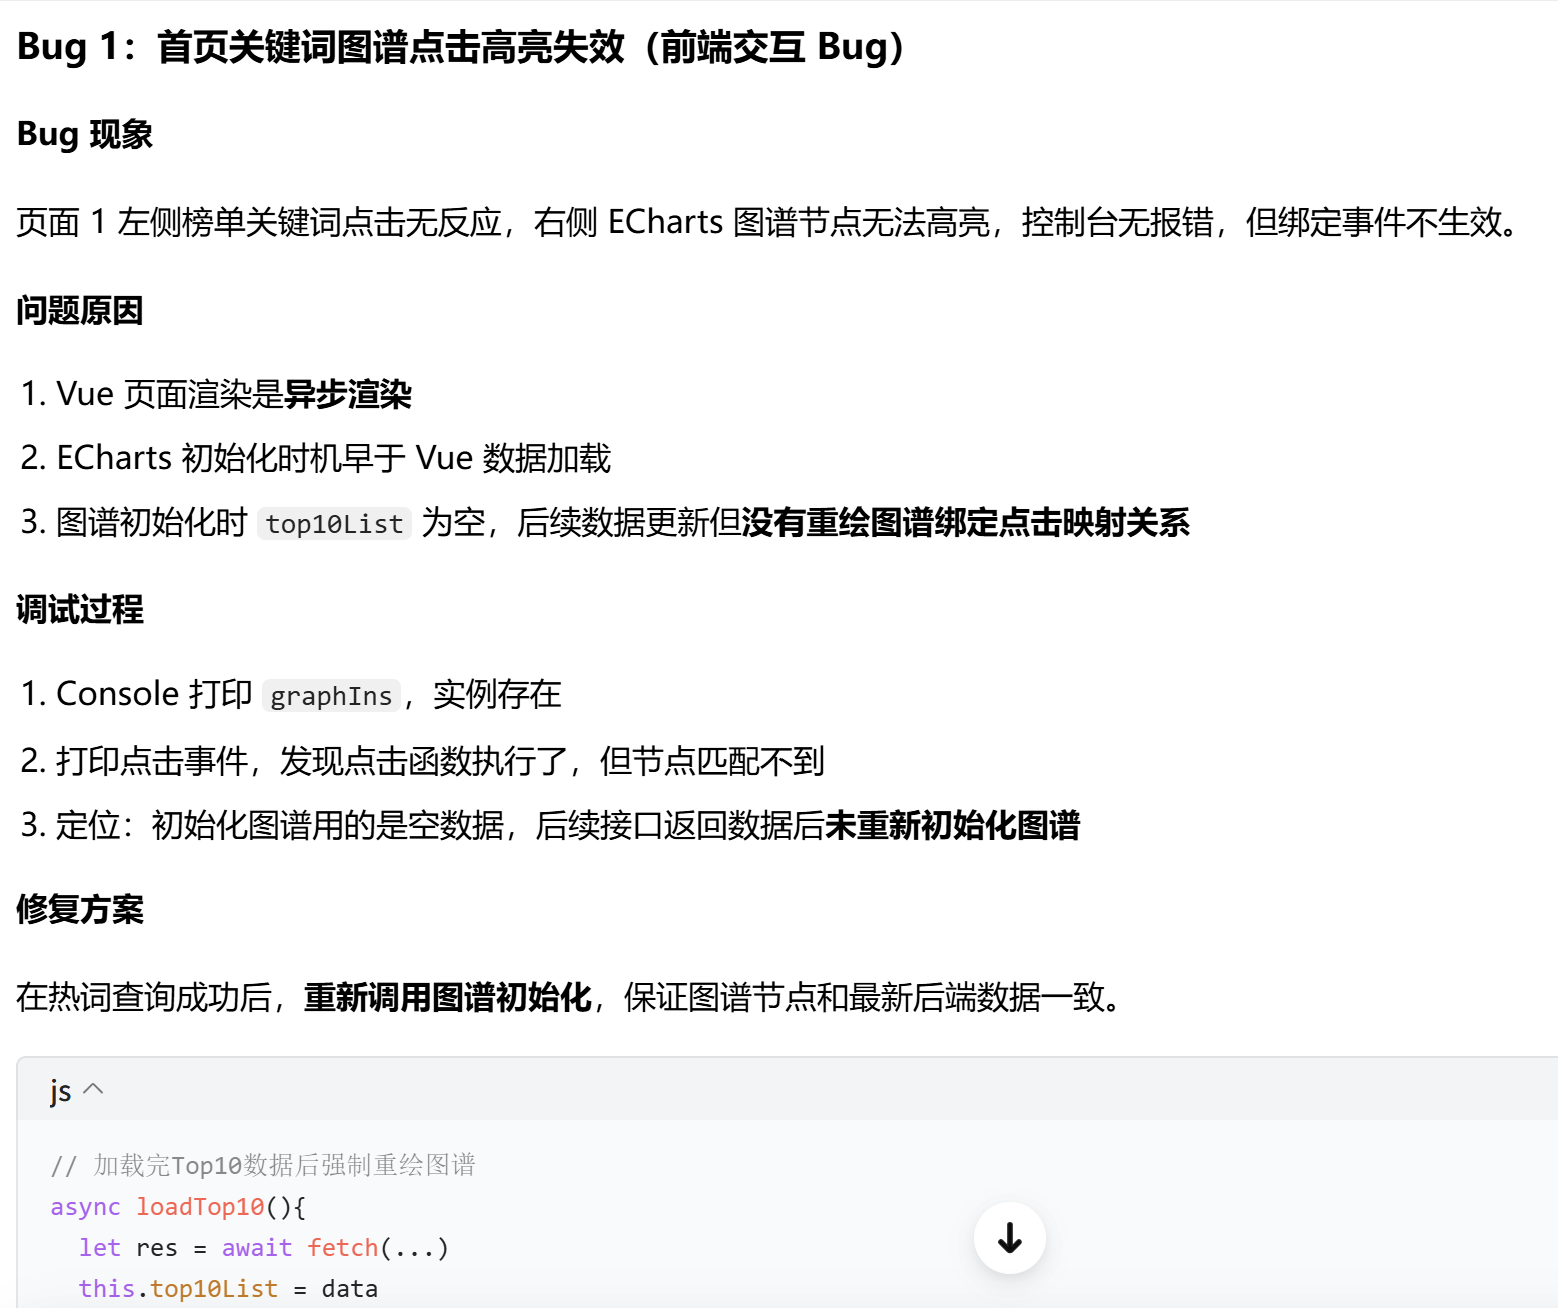
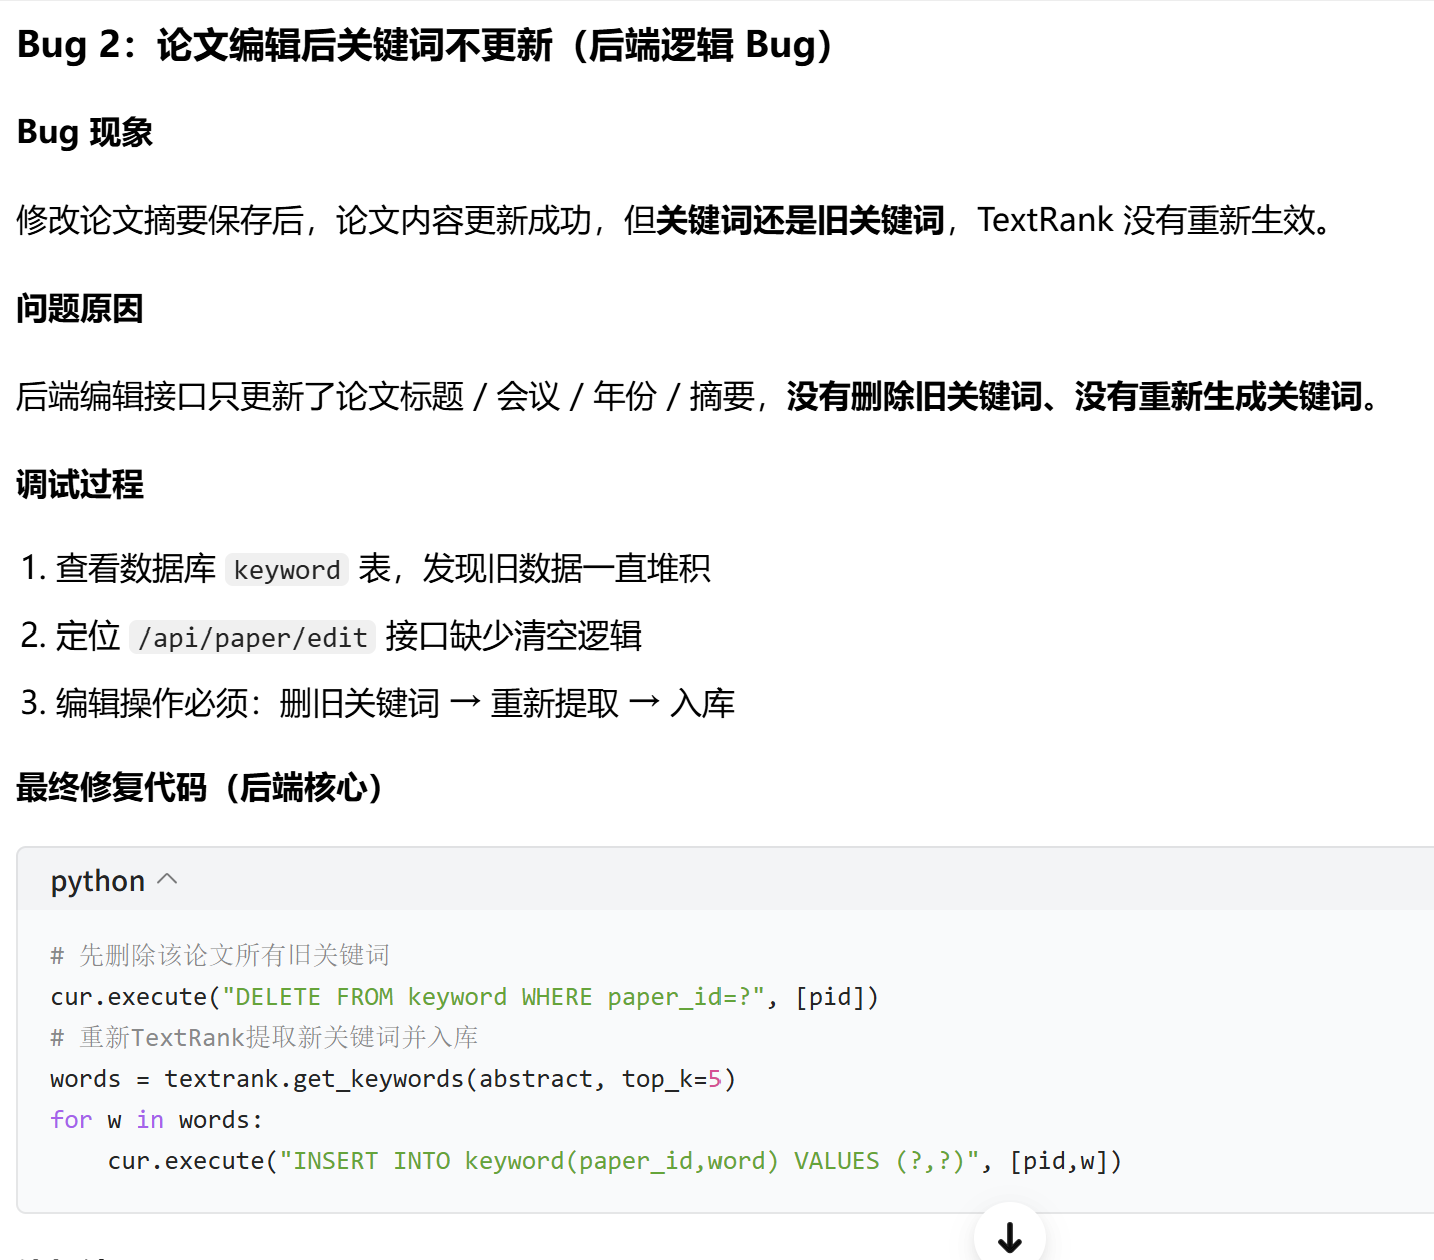
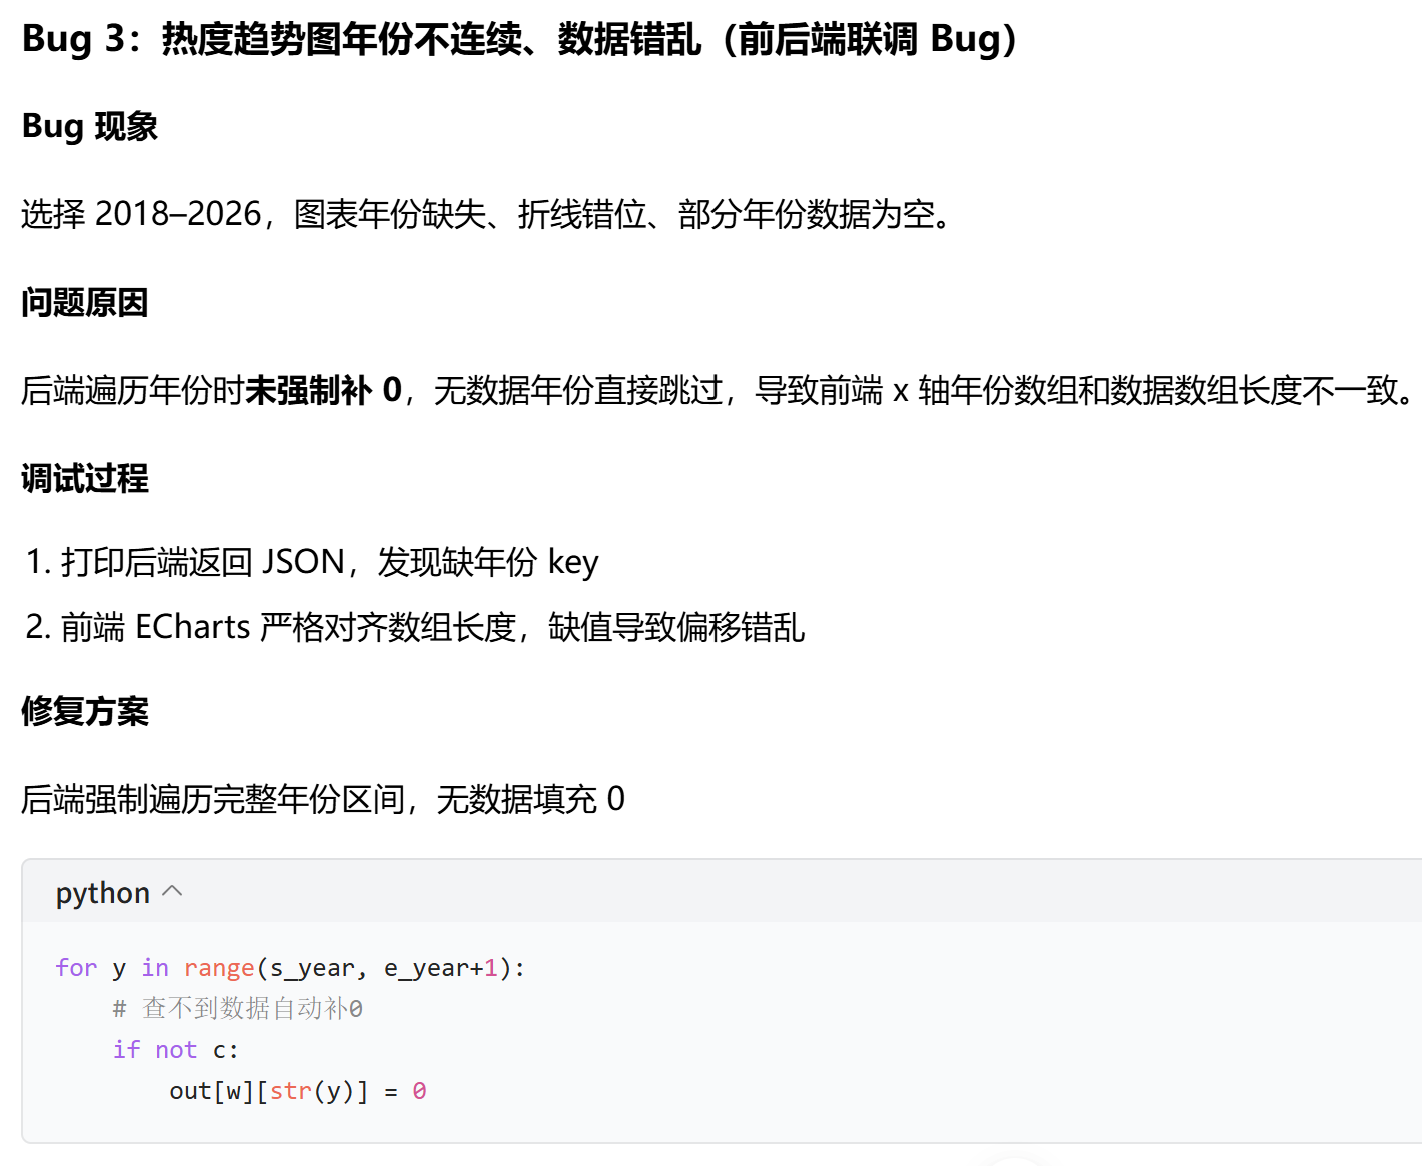
快速拓宽排查思路,打破思维盲区
快速复现、简化问题,提供可验证的最小修复样例
解释底层原理,不只给代码,帮助理解 Bug 根源
本项目采用人机结对编程模式完成设计与实现。首先进行需求分析,由我确定项目目标与业务边界,AI 辅助完成需求拆解。随后开展原型设计,我定义页面布局、交互约束,AI 生成墨刀可用 HTML 原型。系统设计阶段共同完成架构、数据库与代码规范设计。编码阶段,AI 负责前端代码编写,后端由我和 AI 协同开发,实现论文管理、爬虫采集、TextRank 关键词提取、热词统计与动态趋势可视化功能。在调试阶段,AI 辅助排查 Bug,我负责验证修复方案并完成测试;最后共同完成项目文档整理。整个过程由人把控项目决策与代码质量,AI 作为结对编程助手完成辅助性工作。
CV顶会热词统计分析平台(人机结对开发)
├─ 需求分析【人机协作】
│  ├─ 人工:确定项目目标、数据源、业务边界
│  └─ AI辅助:需求拆解、NABCD分析、功能头脑风暴
├─ 原型设计【人机协作】
│  ├─ 人工:定义页面规范、交互规则、配色、页面2动图约束
│  └─ AI辅助:生成墨刀HTML原型,迭代布局
├─ 系统设计【人机协作】
│  ├─ 人工:选定技术栈、数据库结构、接口规范
│  └─ AI辅助:编写codestyle.md、设计ECharts动态趋势图方案
├─ 编码实现【人机协作】
│  ├─ 前端模块(AI编写,人工审核修改)
│  │  ├─ 首页:Top10榜单、关键词力导向图谱
│  │  ├─ 热度趋势页:筛选控件、动态逐年播放趋势动图
│  │  ├─ 论文管理页:论文增删改查、检索
│  │  ├─ 爬取导入页:单篇爬虫、CSV批量导入
│  │  └─ 详情与关于页
│  └─ 后端模块【人与AI共同完成】
│     ├─ 数据采集模块:DBLP爬虫(带限流)
│     ├─ NLP模块:TextRank关键词提取
│     ├─ 数据库模块:SQLite论文/关键词CRUD
│     └─ REST接口模块:论文接口、热词统计接口
├─ 调试测试【人机协作】
│  ├─ 人工:复现Bug、验证修复、回归测试
│  └─ AI辅助:Bug定位、提供修复代码、分析问题根源
└─ 文档编写【人机协作】
   ├─ 人工:审核定稿,校验内容
   └─ AI辅助:生成文档初稿、博客素材、AI使用说明
代码与AI协作完成,提升了效率,同时我也发现了一些问题,并且进行修改。
路由编排
@app.route("/api/crawl", methods=["POST"])
def api_crawl():
 data = request.get_json() or {}
 venue = data.get("venue")
 ...
 venues = ["CVPR", "ICCV", "ECCV"]
 ...
 papers = crawler.fetch_venue_year(v, y, max_results=100)
 for p in papers:
     text = f"{p['title']} {p.get('authors', '')}"
     kws = kw_module.extract_keywords(text, top_k=6)
     p["keywords"] = ", ".join(kws)
     database.insert_paper(p)
     total_inserted += 1
这里把“爬取 → 关键词提取 → 入库”串起来。但 total_inserted 统计的是处理条数,不是实际插入条数。因为 database.insert_paper 内部是 INSERT OR IGNORE,重复数据会被忽略,这里仍会加 1。
查询与更新
@app.route("/api/papers", methods=["GET"])
def api_papers():
 if venue == "全部":
     venue = None
 papers, total = database.query_papers(
     venue=venue, year_start=year_start, year_end=year_end,
     keyword=keyword, page=page, page_size=page_size
 )
venue=全部 转为 None,交给数据库动态拼接条件。查询层和存储层通过 database.query_papers 解耦。
@app.route("/api/papers/<int:paper_id>", methods=["PUT"])
def api_update_paper(paper_id):
    database.update_paper(
        paper_id,
        data.get("title", ""),
        data.get("venue", ""),
        data.get("year"),
        data.get("abstract", "")
    )
这是整体覆盖式更新。如果前端只传 abstract,title/venue 会被空字符串覆盖,且不会重新提取关键词。
趋势接口
@app.route("/api/trend", methods=["POST"])
def api_trend():
 ...
 papers, total = database.query_papers(
     venue=venues[0] if venues else None,
     year_start=year_start, year_end=year_end,
     page=1, page_size=1
 )
 if total == 0:
     for v in venues:
         for y in range(year_start, year_end + 1):
             fetched = crawler.fetch_venue_year(v, y, max_results=50)
             ...
补爬判断只查了 venues[0]。如果第一个会议有数据,其他会议没数据,不会补爬。趋势数据随后由 database.get_trend_data 按关键词和会议生成。
CSV 导入
try:
 content = f.read().decode("utf-8-sig")
except Exception:
 content = f.read().decode("gbk", errors="ignore")
这里有 bug。如果第一次 f.read() 成功,但 .decode("utf-8-sig") 失败,文件流已经读到末尾,第二次 f.read() 会返回空字节。正确写法应先 raw = f.read(),再尝试不同编码解码,已修正。
初始化
```
database.init_db()
if name == "main":
app.run(host="127.0.0.1", port=8000, debug=False)
导入 app.py 时就会建表;本地监听 8000 端口,仅本机访问。

### 爬虫模块
1. DBLP 请求
DBLP_API = "https://dblp.org/search/publ/api%22
params = {
"q": query,
"format": "json",
"h": min(max_results, 1000),
"f": 0,
}
if venue:
params["q"] = f"{query} venue:{venue}"
if year:
params["q"] += f" year:{year}"
f=0 表示只取第一页,没有翻页逻辑;h 最大 1000,超过也不会继续取。因此 max_results 再大也只能拿到一页数据。

2. 结果解析
hits = data.get("result", {}).get("hits", {}).get("hit", [])
if isinstance(hits, dict):
hits = [hits]
for hit in hits:
info = hit.get("info", {})
authors_data = info.get("authors", {}).get("author", [])
...
paper = {
"dblp_key": info.get("key", ""),
"title": info.get("title", "").rstrip("."),
"authors": authors,
"venue": info.get("venue", ""),
"year": int(info["year"]) if info.get("year") else None,
...
}
统一了论文结构,供数据库层直接使用。DBLP 通常不返回摘要,所以 abstract 一般缺失。

3. 按会议年份抓取
def fetch_venue_year(venue, year, max_results=200):
query = f"venue:{venue} year:{year}"
papers = search_dblp(query, max_results=max_results)
filtered = []
for p in papers:
pv = p.get("venue", "").upper().replace(" ", "")
if venue.upper() in pv or pv in venue.upper():
filtered.append(p)
return filtered if filtered else papers
二次过滤存在空字符串问题。如果 pv 为空,pv in venue.upper() 永远为 True,可能把无关论文放进来。过滤后为空时又回退到原始 papers,等于放弃过滤。

### 数据库模块
1. 表结构
CREATE TABLE IF NOT EXISTS papers (
id INTEGER PRIMARY KEY AUTOINCREMENT,
dblp_key TEXT UNIQUE,
title TEXT NOT NULL,
authors TEXT,
venue TEXT,
year INTEGER,
doi TEXT,
url TEXT,
ee TEXT,
abstract TEXT,
keywords TEXT,
created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
CREATE INDEX IF NOT EXISTS idx_venue_year ON papers(venue, year);
CREATE INDEX IF NOT EXISTS idx_title ON papers(title);
dblp_key UNIQUE 用于去重;venue+year 联合索引适合按会议年份查询;keywords 用逗号字符串存储,不利于精确统计。

2. 插入
INSERT OR IGNORE INTO papers
(dblp_key, title, authors, venue, year, doi, url, ee, abstract, keywords)
VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?)
靠 dblp_key 唯一约束去重,重复插入静默忽略,不返回是否真正插入。

3. 查询
if keyword:
conditions.append("(title LIKE ? OR keywords LIKE ?)")
params.extend([f'%{keyword}%', f'%{keyword}%'])
sql = f"SELECT * FROM papers {where} ORDER BY year DESC, id DESC LIMIT ? OFFSET ?"
···参数化查询防注入;关键词用 LIKE %keyword% 模糊匹配,可能误命中,例如“图像分割”会命中“图像分割网络”。

4. 趋势统计
rows = conn.execute('''
SELECT year, COUNT(*) as cnt FROM papers
WHERE venue = ? AND year >= ? AND year <= ?
AND keywords LIKE ?
GROUP BY year ORDER BY year
''', (venue, year_start, year_end, f'%{kw}%')).fetchall()
venue 精确匹配,keywords 模糊匹配。如果爬虫存的 venue 是 IEEE CVPR,这里查 CVPR 就查不到。

5. Top 关键词
for r in rows:
if r['keywords']:
for kw in r['keywords'].split(','):
kw = kw.strip()
if kw:
counter[kw] += 1
return counter.most_common(limit)
```
全表读取后在 Python 中切分统计。数据量大时性能差;关键词本身含逗号会拆分错误。
本次课程大作业采用人机结对编程的模式完成整套顶会热词统计平台的开发。从最开始拿到题目时,我对爬虫、TextRank 算法、ECharts 动态可视化、前后端联调的整体实现思路比较模糊,不知道如何把数据采集、文本分析、数据统计、可视化展示串联成完整系统。
在需求分析阶段,我先自主确定项目定位、功能边界、数据源规则,再借助 AI 辅助拆解模块、梳理业务流程,让原本零散的功能点变得结构化、系统化。
进入编码阶段,我深刻体会到前后端分离项目的开发难度,不仅需要独立完成后端业务逻辑、数据库设计、爬虫限流、关键词算法处理,还要兼顾前端交互、图表渲染、异步时序问题。开发过程中遇到了图谱高亮失效、数据更新不同步、趋势图数据错位、批量爬取失败等多个真实 Bug。
一开始调试时经常无从下手,后来在 AI 辅助调试下,慢慢建立起先查数据、再查逻辑、最后看视图的排错思维。我不再依赖盲目改代码,而是能够冷静分析问题根源、定位 Bug 层级、逐步修复问题。
整个开发过程从迷茫、卡顿,到逐步熟练、架构清晰、功能完整,最终独立完成整套系统的设计、编码、调试、文档整理,让我完整经历了一次小型软件工程从 0 到 1 的完整开发流程。
我熟练掌握了 Flask 后端接口开发、SQLite 数据库设计、Vue 前端开发、ECharts 可视化实现,理解了后端提供数据、前端负责渲染的分层思想,不再只会写单一脚本代码,具备了完整 Web 项目开发能力。
本次项目严格遵循 PEP8、Vue 官方规范,编写了独立codestyle.md规范文档,学会了模块化开发、分层设计、数据一致性维护、接口标准化,摆脱了以往随手写代码的陋习,代码可读性、规范性、可维护性大幅提升。
我学会了人主导、AI 辅助的高效开发模式:人负责需求决策、架构设计、逻辑把控、代码审核,AI 负责初稿生成、代码优化、调试辅助、文档整理。
明白了 AI 不是替代开发,而是提升开发效率、拓宽思维、辅助学习的工具,真正掌握了新时代程序员的人机协作开发方式。
从需求分析、功能设计、架构设计、编码实现、调试测试到最终博客总结,我完整走完软件工程全流程,提升了项目设计能力、总结复盘能力和工程文档撰写能力。
豆包作为本次项目的 AI 结对编程伙伴,在项目全周期内提供了有效支持,但存在一定局限性,整体评价如下:
- 高效产出初稿,节省重复性工作
在需求拆解、原型 HTML、前端 ECharts 代码、文档初稿编写等工作中,可以快速生成可用的基础版本。遇到代码报错时,能够多角度给出排查思路,快速提供修复代码片段,打破个人思维盲区,缩短调试试错时间。- 知识面广,可快速提供多方案参考
当我在设计动态趋势图、数据库一对多维护、爬虫限流逻辑时,能够同时给出多种实现思路,并解释不同方案的优缺点,帮助我对比选型,拓宽设计思路。同时可以协助整理代码规范、Bug 记录,帮助沉淀项目经验。- 响应稳定,持续迭代修改
可以根据我不断细化的约束条件反复迭代原型与代码,例如反复调整页面 2,移除静态图,只保留筛选与生成趋势图按钮,持续按照需求修改代码与文档,适配项目持续变更的需求。
- 无法自主把控业务全局逻辑
AI 只能基于我给出的需求进行实现,不会主动发现业务层面的隐患。例如最开始编写论文编辑接口时,AI 没有主动意识到需要删除旧关键词,造成数据不一致问题,需要我人工审查业务逻辑,发现这类漏洞。- 生成代码存在隐性 Bug,必须人工核验
AI 产出的代码看似可以运行,但经常存在时序、数据对齐这类隐性缺陷。所有 AI 生成的代码都必须由我逐行阅读、测试、修改,不能直接投入使用。- 缺少真实运行环境感知
AI 无法直接看到程序运行时控制台、数据库里的真实数据。定位复杂 Bug 时,依然需要我主动提供报错信息、打印的数据,才能进一步分析。

