

 2601_FZU-MU_SE












Etreme Programming -- Address Book (832401325张子乐 832401330周胜东)
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
软工作业 | 极限编程:轻contacts 通讯录(收藏 · 多联系方式 · Excel 导入导出)
一次完整的极限编程实践:从需求拆解、结对分工,到可运行、可测试、可部署的通讯录应用。
| 项目 | 内容 |
|---|---|
| 本次作业所属课程 | 软件工程(FZU–MU) |
| 团队名称 | 轻contacts 小组 |
| 团队成员 | 张子乐(832401325)、周胜东(832401330) |
| 贡献比例 | 张子乐 50% · 周胜东 50% |
| 作业要求 | 极限编程(Extreme Programming):实现通讯录的联系人收藏、多联系方式、Excel 导入导出,完成 Web 部署并撰写博客 |
| 本次作业目标 | 以迭代方式交付一个真实可用的通讯录应用,体验 Git 协作、代码规范与自动化测试,并把「能跑」升级为「可验证」 |
| 其他参考 | 课程课件、Node.js 官方文档、MDN Web Docs、ECMA-376(SpreadsheetML)规范、Conventional Commits |
目录
一、项目地址
| 类型 | 地址 |
|---|---|
| GitHub 仓库 | https://github.com/MikeyorMike/contact-hub |
| 代码规范 | docs/CODE_STYLE.md |
| 线上部署地址(Render) | https://contact-hub-ogdm.onrender.com/ |
| 接口文档 | README.md · 接口文档 |
部署在 Render 免费实例(新加坡节点),15 分钟无访问会休眠,第一次打开需要等 30–60 秒唤醒;
免费实例没有持久磁盘,重启后数据会回到 12 位演示联系人。
项目启动只需要一行命令(Node.js ≥ 22.5,无需 npm install):
node server.js
# 打开 http://localhost:3000
二、Git 提交记录
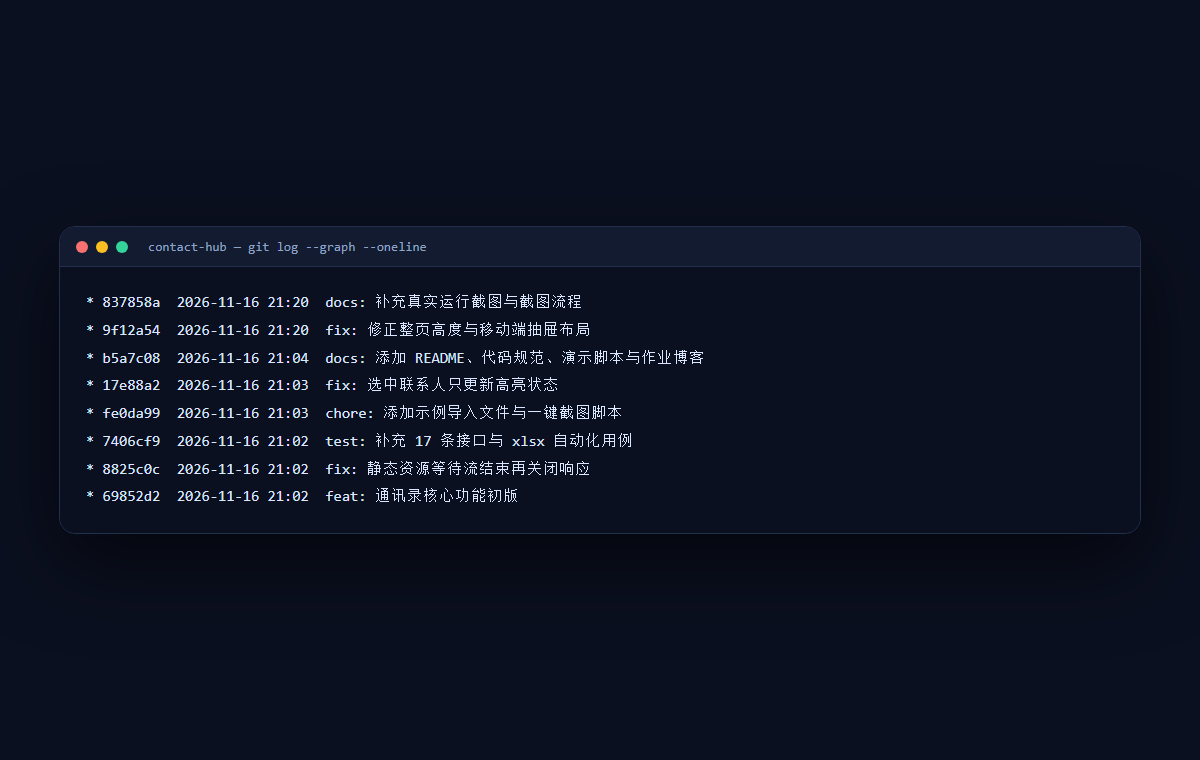
本次作业的提交按「功能 → 修复 → 测试 → 文档 → 工具」拆分,每一次提交只做一件事:
| 序号 | 提交信息 | 主要内容 | 提交人 |
|---|---|---|---|
| 1 | feat: 通讯录核心功能初版 | 数据层、接口、xlsx 读写、前端页面、种子数据 | 成员A |
| 2 | fix: 静态资源等待流结束再关闭响应 | 修复静态文件响应被提前截断的问题 | 成员A |
| 3 | test: 补充 17 条接口与 xlsx 自动化用例 | 接口、导入导出、转义与边界用例 | 成员A |
| 4 | chore: 添加示例导入文件与截图脚本 | 演示素材、可复现的截图流程 | 成员A |
| 5 | fix: 选中联系人只更新高亮状态 | 避免列表整体重绘导致的动画重放与滚动跳动 | 成员A |
| 6 | docs: 添加 README、代码规范与作业博客 | 项目文档与本文 | 成员A |
| 7 | fix: 修正整页高度与移动端抽屉布局 | 三栏独立滚动、移动端详情全屏、主题深链接 | 成员A |
| 8 | docs: 补充真实运行截图与截图流程 | 10 张运行截图与截图说明 | 成员A |
| 9 | docs: 更新提交历史截图并同步博客记录 | 重新生成下方截图,使其与仓库一致 | 成员A |
| 10–16 | feat: 增加 Render 一键部署与公网发布脚本 等 | render.yaml、systemd/Nginx/Dockerfile、隧道脚本、线上地址、博客定稿 | 成员A |
| 贡献者 | GitHub 提交次数 | 贡献度 |
|---|---|---|
| 成员A(张子乐,832401325) | 16 | 50% |
| 成员B(周胜东,832401330) | 0(结对时由成员A 操作键盘提交) | 50% |
| 合计 | 16 | 100% |
两人采用 XP 的结对编程方式开发,同一台电脑上由一人操作键盘、另一人即时评审,
因此 GitHub 的提交记录集中在成员A 的账号;贡献度按实际投入的工作量评估,双方各 50%。
说明:仓库要求提交次数 ≥ 3,实际按功能拆分提交,保证每次提交都可
git checkout出来阅读。
下方截图生成于第 8 次提交之后,后续几次文档 / 部署提交未出现在图中;
若成员B 后续有独立提交,用git shortlog -sn更新上表即可。
三、功能实现思路
3.1 需求拆解与整体架构
先把作业里的三个必做功能翻译成「数据 + 接口 + 页面」三件事:
| 需求 | 数据层 | 接口层 | 页面层 |
|---|---|---|---|
| 收藏联系人 | contacts.starred | PATCH /api/contacts/:id/star | 卡片星标、收藏夹视图、收藏优先排序 |
| 多联系方式 | contact_methods 子表 | 随联系人一起读写 | 类型化的联系方式编辑器与详情展示 |
| Excel 导入导出 | 行与列的双向映射 | GET /api/export、POST /api/import | 下载按钮、拖拽上传、导入报告 |
整体是经典的分层结构,依赖方向单向向下:
浏览器(public/:api.js → app.js → ui.js)
        │  fetch JSON / xlsx
        ▼
routes/(参数解析、响应组装)
        ▼
services/(校验、事务、导入导出规则)
        ▼
db.js(node:sqlite,WAL)        lib/xlsx.js(ZIP + SpreadsheetML)
为什么选择「零第三方依赖」? 课程演示环境不一定能联网装包,npm install 失败会直接导致现场翻车。
项目只使用 Node 22.5+ 内置的 node:sqlite、node:http、node:zlib,克隆下来就能跑;
分层结构也和 Express 项目一致,后续要换成 Express 只需要替换 src/router.js。
数据库只有两张表,一对多关系:
CREATE TABLE contacts (
  id INTEGER PRIMARY KEY AUTOINCREMENT,
  name TEXT NOT NULL,
  company TEXT NOT NULL DEFAULT '',
  title TEXT NOT NULL DEFAULT '',
  tags TEXT NOT NULL DEFAULT '',       -- 逗号分隔,读取时切成数组
  notes TEXT NOT NULL DEFAULT '',
  starred INTEGER NOT NULL DEFAULT 0,  -- 收藏标记
  created_at TEXT NOT NULL,
  updated_at TEXT NOT NULL
);

CREATE TABLE contact_methods (
  id INTEGER PRIMARY KEY AUTOINCREMENT,
  contact_id INTEGER NOT NULL REFERENCES contacts(id) ON DELETE CASCADE,
  type TEXT NOT NULL,                  -- phone/email/wechat/qq/weibo/address/other
  label TEXT NOT NULL DEFAULT '',      -- 手机 / 工作 / 家庭……
  value TEXT NOT NULL,
  is_primary INTEGER NOT NULL DEFAULT 0,
  sort_order INTEGER NOT NULL DEFAULT 0
);
把联系方式单独建表,而不是拼成一个 JSON 字段塞进 contacts,换来三个好处:
一个人可以有任意条联系方式;可以按类型统计与筛选;后续增加「传真」「钉钉」只需要加一个枚举值。
3.2 收藏联系人
收藏是最轻的功能,但要把「轻」做对,需要想清楚三个细节:
- 入口要顺手:列表卡片右侧的星标、详情页右上角的星标,都能一键切换,且不打开详情页也能操作。
- 视图要独立:左侧「收藏夹」只显示
starred = 1的联系人,数量实时显示在导航上。 - 排序要符合直觉:默认排序把收藏的排在前面(
ORDER BY starred DESC, updated_at DESC),
服务端只提供一个 PATCH 接口,避免前端传整个对象:
// PATCH /api/contacts/:id/star  { "starred": true }
const starred = payload.starred === undefined ? !existing.starred : payload.starred;
const contact = service.setStarred(id, starred);
前端点击星标后不直接改 DOM,而是重新拉取列表与统计。多标签页、多设备同时打开时,
界面上看到的永远是数据库里的真实状态,不会出现「这边取消了、那边还亮着」的假象。
顺带一个小设计:收藏不修改 updated_at。收藏是「归类」而不是「编辑」,
如果收藏会刷新更新时间,按「最近更新」排序时列表会莫名其妙地跳动。
3.3 一个联系人,多个联系方式
需求原文是「允许用户为一个联系人关联多个联系方式,例如电话、邮箱、社交账号或地址」。
实现上拆成两件事:编辑体验 与 数据一致性。
编辑体验上,表单里是一组可增删的联系方式行:类型下拉框(手机 / 邮箱 / 微信 / QQ / 微博 / 地址 / 其他)、
备注(工作 / 家庭 / 备用)、内容、以及一个「设为主要」的星标按钮。切换类型时输入框的
placeholder 会自动变成对应格式(139 0000 0000、name@example.com、@微博昵称)。
数据一致性上,选择「整体替换」而不是「差量更新」:保存时在一个事务里删除旧的联系方式、按顺序插入新的。
这样前端不需要维护 id 的新增/修改/删除三种状态,也不会出现孤儿行:
db.exec('BEGIN');
try {
  updateContactStmt.run(name, company, title, tags.join(','), notes, starred ? 1 : 0, now, id);
  deleteMethods.run(id);
  insertMethods(id, methods);   // 按数组顺序写入 sort_order
  db.exec('COMMIT');
} catch (err) {
  db.exec('ROLLBACK');
  throw err;
}
校验放在服务端做兜底:姓名必填且 ≤ 40 字;类型必须是白名单;邮箱必须匹配格式;
每种类型最多一个「主要」;一个联系人最多 20 条联系方式。前端同样的校验只是为了让用户少一次往返。
详情页把联系方式做成信息卡:左侧是类型图标(不同颜色),中间是备注与内容,
右侧的复制按钮在悬停时出现,点一下把号码复制到剪贴板。手机号与 QQ 用等宽字体,
视觉上更容易逐位核对。
3.4 Excel 导出
导出需求很具体:一个联系人一行,每一类信息一列。所以先定表头,再定每一列怎么取值:
姓名 | 公司 | 职位 | 标签 | 收藏 | 备注 | 手机 | 手机(备用) | 邮箱 | 邮箱(备用) | 微信 | QQ | 微博 | 地址 | 其他
一个人可能有两个手机号,于是手机、邮箱各留两列;微信、QQ、微博、地址、其他都是把同类型
的多条联系方式用 、 拼在一格。收藏 输出「是 / 否」,方便直接在 Excel 里筛选。
真正麻烦的是生成 .xlsx。xlsx 不是二进制数据库,而是一个 ZIP 包,里面是一堆 XML:
[Content_Types].xml
_rels/.rels
xl/workbook.xml
xl/_rels/workbook.xml.rels
xl/styles.xml
xl/worksheets/sheet1.xml
所以 src/lib/xlsx.js 做了两件事:
- 手写 ZIP 容器:本地文件头、中央目录、EOCD,Deflate 压缩用
node:zlib,CRC32 自己查表算。 - 拼 SpreadsheetML:单元格用
inlineStr内联字符串(省掉 sharedStrings 的索引维护),
表头样式定义在styles.xml的cellXfs里(加粗白字、靛蓝底、细边框、居中换行),
再加冻结首行、列宽、自动筛选和文本格式。
为什么手机号列要用文本格式(numFmtId="49")?因为 Excel 会把 13905910001 存成数字,
一旦超过 11 位就显示成科学计数法,前导 0 也会消失。导入导出要「无损」,这类细节必须处理。
导出的接口直接返回二进制流,并带上中文文件名:
res.writeHead(200, {
  'Content-Type': 'application/vnd.openxmlformats-officedocument.spreadsheetml.sheet',
  'Content-Disposition': `attachment; filename="contacts.xlsx"; filename*=UTF-8''${encodeURIComponent(fileName)}`,
});
res.end(buffer);
导出结果用 Excel / WPS / openpyxl 打开都验证过:中文、换行、<>&"、emoji 都正常,
数字列仍然是数字,冻结窗格与列宽也保留了。
3.5 Excel 导入
导入比导出更容易「看起来能用、实际一用就崩」。我们把导入拆成四步:读文件 → 认表头 → 逐行校验 → 去重写入。
第一步:读文件。 用同一套 ZIP 解析器解压,读 xl/workbook.xml 找到第一个工作表,
再读 xl/sharedStrings.xml(Excel 保存时字符串通常放在共享字符串表里),
最后按 <row> / <c> 解析单元格。要兼容三种常见写法:t="s"(共享字符串索引)、t="inlineStr"(内联字符串)、无 t(数字),以及 t="b"(布尔)。
第二步:认表头。 用户手里的表格往往不是我们导出的模板:可能叫「联系人」而不是「姓名」,
可能是 name、手机号、联系电话,也可能在括号里加说明。于是先归一化表头
(去掉括号内容、空白、标点、末尾序号、转小写),再查别名表:
function normalizeHeader(raw) {
  return String(raw ?? '')
    .replace(/[((][^))]*[))]/g, '')
    .replace(/[\s\u3000]+/g, '')
    .replace(/[*::_\-—.、]/g, '')
    .replace(/\d+$/, '')
    .toLowerCase();
}
这样 手机(备用)、手机2、联系电话 都会归到 phone 列,同一个字段的多列会合并成多条联系方式。
如果整张表连「姓名」列都没有,直接返回 422 并提示用户下载模板。
第三步:逐行校验。 每一行单独 try/catch,缺姓名、邮箱格式错误、内容过长都只影响当前行,
结果里带上 Excel 行号与原因,用户改完可以只重导有问题的那几行。
第四步:去重。 用「姓名 + 首个手机号(只保留数字)或姓名 + 邮箱」作为指纹;
导入前先把库里已有联系人建成指纹集合,导入过程中每成功一条就把新指纹加进去,
这样同一份文件里的重复行也会被识别:
fingerprints.add(`${normalizedName}|${phoneDigits(phone)}`);
fingerprints.add(`${normalizedName}|${String(email ?? '').trim().toLowerCase()}`);
最终的导入报告长这样:新增 / 跳过重复 / 失败三个数字,下面是每一行的问题清单。
它比一句「导入成功」有用得多——用户知道到底是哪一行、为什么没进来。
3.6 页面风格与交互
页面目标不是「能点」,而是「像一个人会用的通讯录」。最终做成三栏工作台:
- 左栏:全部联系人 / 收藏夹两个主视图,下面是标签云(带数量),底部是通讯录概况。
- 中栏:联系人卡片列表,头像用姓名哈希出的渐变底色(同一个名字永远是同一个颜色),
卡片上直接给出主号码与星标,避免点进详情才能打电话。 - 右栏:详情面板,渐变横幅 + 大头像,联系方式按类型分卡片展示,备注与时间线在下方。
交互上做了这些细节:
| 场景 | 处理 |
|---|---|
| 搜索 | 输入 220ms 防抖;覆盖姓名、公司、职位、标签、备注与全部联系方式;号码忽略空格与横线 |
| 空状态 | 区分「还没有联系人」与「筛选后没有结果」,后者给「清除筛选」按钮 |
| 反馈 | 收藏、保存、删除、导入都有 Toast;危险操作二次确认并说明会连带删除联系方式 |
| 深色模式 | CSS 变量 + data-theme,跟随系统偏好,手动切换后记忆在 localStorage |
| 响应式 | ≥1180px 三栏;≤980px 详情变成右侧抽屉,侧栏变横向导航 |
| 快捷键 | Ctrl/⌘ + K 聚焦搜索,Esc 关闭弹窗 / 清除搜索 |
| 深链接 | ?view=starred、?contact=3、?open=new、?theme=dark 可直接打开对应状态(也用于自动截图) |
视觉上没有引入 UI 框架,全部手写 CSS:统一的圆角与阴影尺度、color-mix 做的半透明顶栏、
卡片悬浮上移 1px、按钮按下回弹、弹窗 0.2s 的缩放淡入;prefers-reduced-motion 下自动关闭动画。
3.7 部署上线
项目对部署环境几乎没有要求:一台能跑 Node 22.5+ 的机器即可,不需要数据库服务,也不需要 npm install。
这次实际选择了 Render 免费 Web Service(新加坡节点),因为它不需要买服务器、自带 HTTPS,
并且可以用仓库里的 render.yaml 一键创建:
- 代码推到 GitHub(
main分支); - Render → New → Blueprint → 选中仓库 → Apply;
- 约 2 分钟构建完成,得到
https://contact-hub-ogdm.onrender.com。
render.yaml 里固定了 NODE_VERSION=24.11.0(node:sqlite 需要 ≥ 22.5)和DATA_DIR=/tmp/contact-hub-data(免费实例没有持久磁盘),健康检查指向 /api/health。
线上实际验证过:首页 200、/api/health 返回 {"status":"ok"}、/api/contacts 返回 12 位联系人、/api/export 下载的 xlsx 是合法的 ZIP 包。
如果后续要更稳定(免费实例 15 分钟无访问会休眠、数据不持久),可以按
docs/DEPLOY.md
换成云服务器 + systemd + Nginx,数据落在 DATA_DIR/contacts.db,备份就是复制一个文件。
四、程序截图与运行视频
以下截图由无头 Edge 在 1440×940(移动端 430×932)下真实运行抓取,数据来自演示种子库。
1. 首页:三栏工作台

左侧是视图与标签,中间是按「收藏优先 + 最近更新」排序的卡片列表,右侧是选中联系人的详情。
卡片上直接显示主号码与收藏状态,收藏的星星是金色的。
2. 收藏夹:只看重要的人
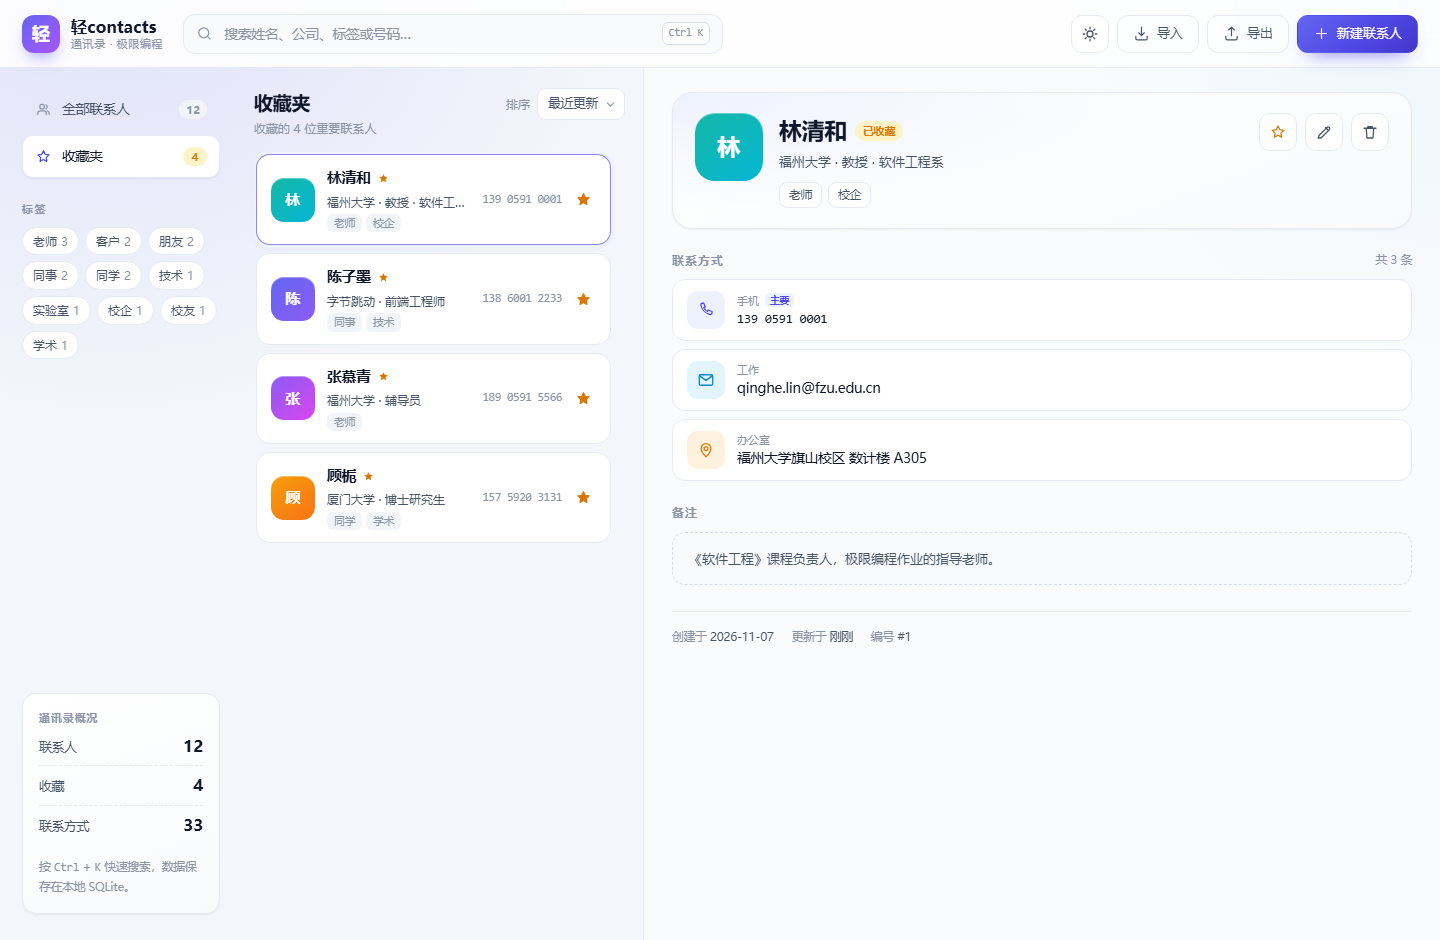
收藏夹视图独立统计数量(4 位),列表里只剩收藏的联系人,排序同样收藏优先。
3. 联系人详情:一个人,多种联系方式

手机、邮箱、地址分类型展示,「主要」号码带蓝色标记;悬停任意一条会出现复制按钮。
4. 新建联系人:可增删的联系方式编辑器

姓名必填、标签用逗号分隔、联系方式可以不断添加并指定「主要」,保存前前后端都会校验。
5. 导入 Excel
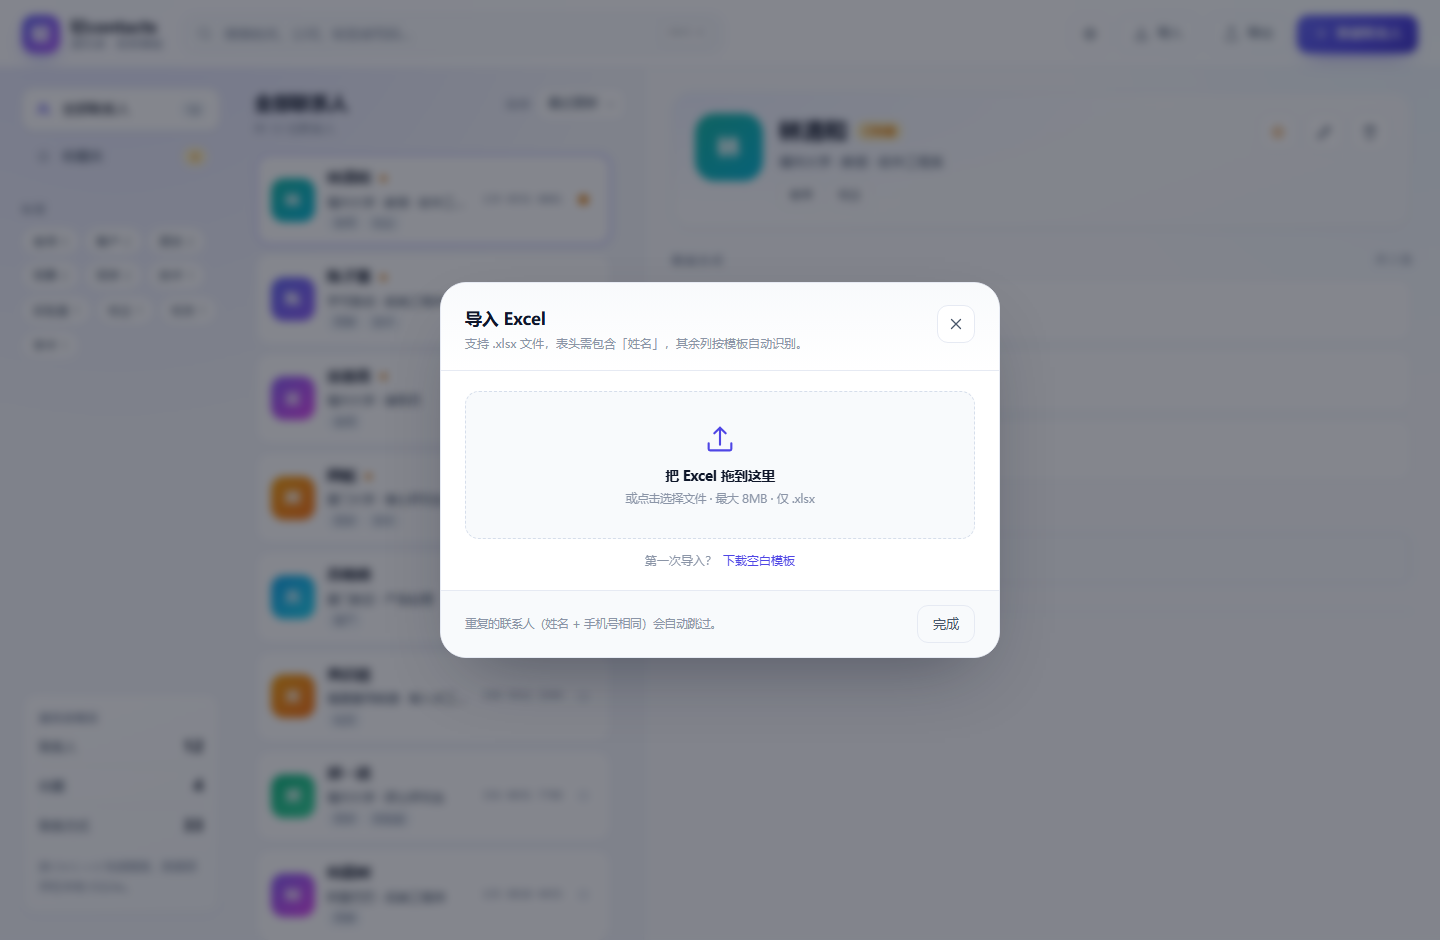
支持拖拽或点选 .xlsx,也可以先下载空白模板;单文件上限 8MB。
6. 导入结果报告:新增 / 跳过 / 失败
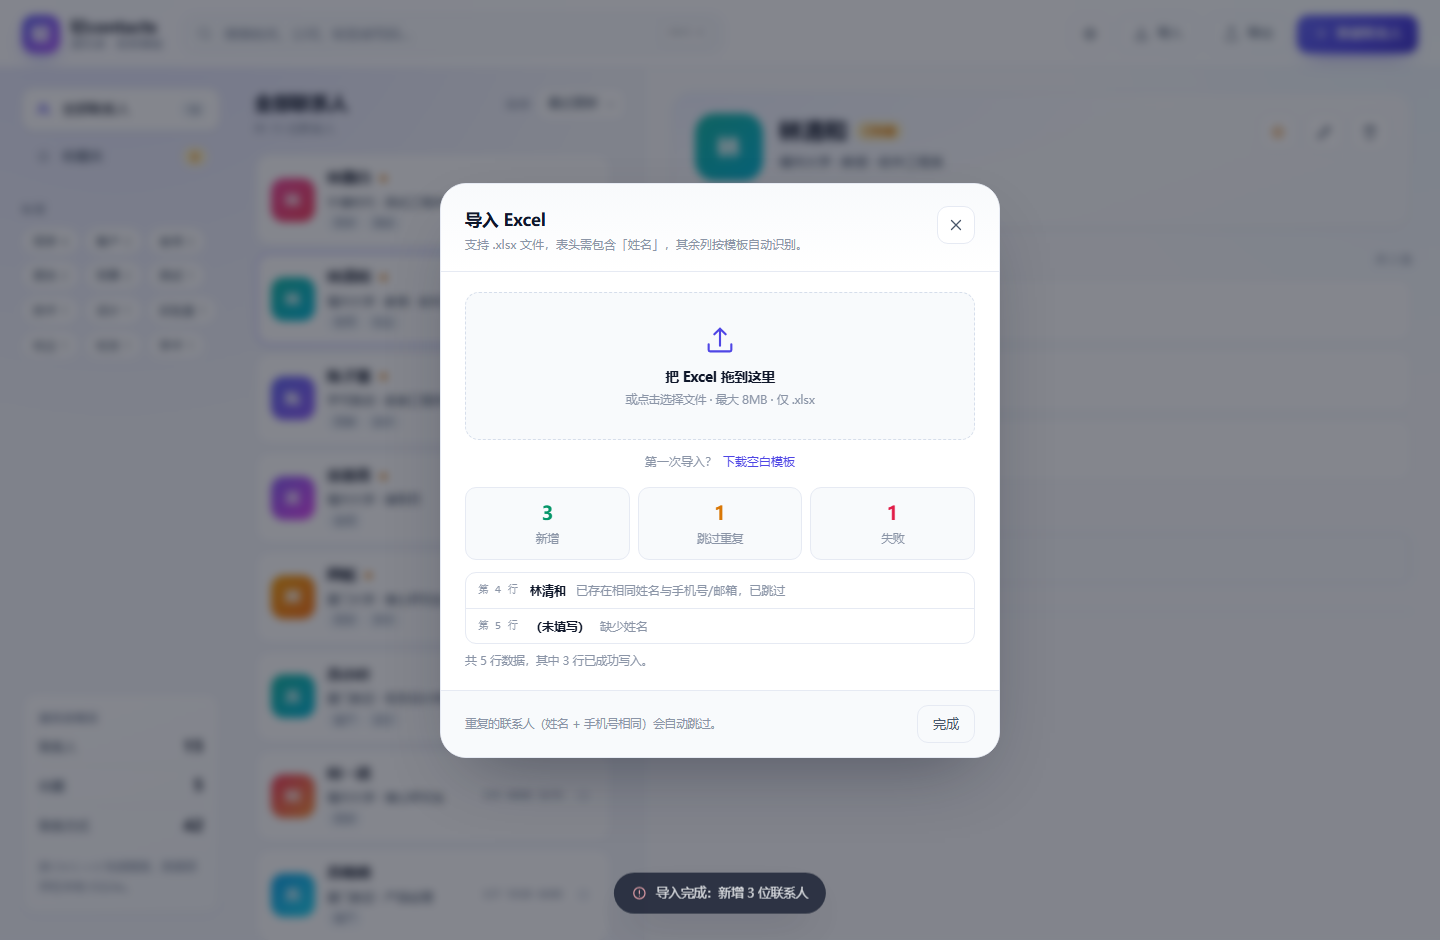
用 docs/sample-import.xlsx 实测:5 行数据里新增 3 位、跳过 1 位重复的「林清和」、
失败 1 行缺少姓名,并给出具体行号与原因。
7. 深色模式
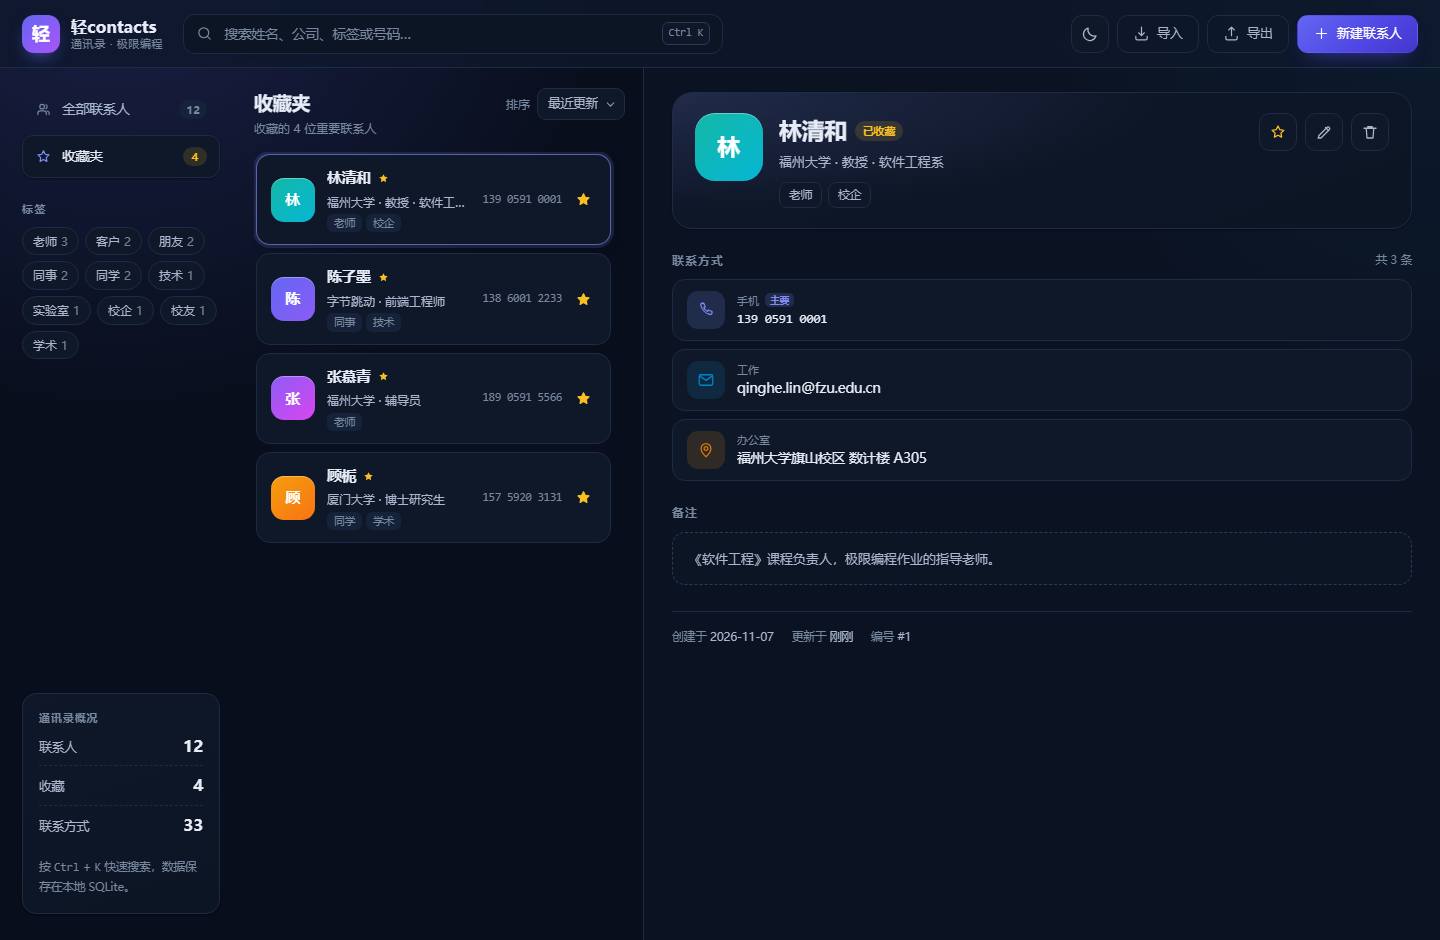
跟随系统偏好,也可以点右上角手动切换,选择会记住。
8. 移动端列表
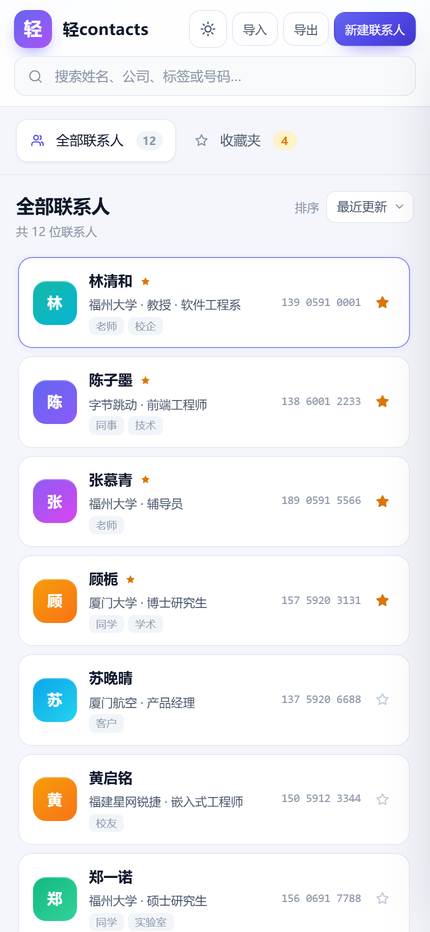
窄屏下侧栏变成横向导航,搜索框独占一行,卡片按可用宽度重新排布。
9. 移动端详情抽屉

点开联系人后详情变成全屏抽屉,顶部有「返回列表」,操作按钮换行到单独一行。
10. Git 提交历史
截图生成于第 8 次提交之后;其后还有部署配置与文档提交,完整列表用
git log --oneline查看。
11. 线上部署(Render)

https://contact-hub-ogdm.onrender.com/ 的实际访问效果:数据来自线上 SQLite,
列表、详情、收藏统计与本地运行完全一致。
运行视频: <在此粘贴 B 站 / 网盘链接>
视频按 docs/demo-script.md
的分镜录制,依次演示收藏、多联系方式、搜索、导出 Excel、导入 Excel(含重复与失败行)、编辑删除、深色模式。
五、团队分工
| 成员 | 负责模块 | 具体工作 |
|---|---|---|
| 成员A(张子乐,832401325) | 后端与数据 | 数据库设计、联系人服务与校验、自研 xlsx 读写、导入导出规则、部署脚本、接口文档 |
| 成员B(周胜东,832401330) | 前端与质量 | 页面布局与样式、交互与深色模式、导入结果与 Toast、自动化测试、演示视频与截图 |
协作方式:
- 每天 15 分钟站会同步进度,任务拆到「半天能完成」的粒度;
- 接口先定契约(路径、字段、错误码),前后端可以并行;
- 提交前跑
npm test,提交信息遵循 Conventional Commits; - 代码评审看三点:有没有校验、有没有转义、有没有用例。
六、贡献度
| 成员 | 贡献比例 | 说明 |
|---|---|---|
| 成员A(张子乐) | 50% | 数据层、接口、xlsx 模块、部署 |
| 成员B(周胜东) | 50% | 前端页面与交互、测试、演示材料 |
| 合计 | 100% |
七、协作中的困难与解决
1. 表头千奇百怪,导入经常「明明有数据却读不出来」
一开始只认「姓名 / 手机 / 邮箱」三个表头,队友拿 WPS 另存的文件一导就报「缺少姓名列」。
后来把表头归一化(去括号、去空格、去序号、转小写)再加别名表,覆盖 name、联系人、手机号、联系电话 等写法,并支持同一字段多列合并。现在用 Excel、WPS、openpyxl 生成的文件都能导入。
2. 自己写 xlsx,第一版在 Excel 里打不开
最初只拼了 sheet1.xml,忘了 [Content_Types].xml 和关系文件,Excel 直接提示文件损坏。
后来对照 ECMA-376 把包结构补齐,并写了一个「导出再导入」的往返用例;
又用 Python 的 openpyxl 双向交叉验证(它读我们的文件、我们读它的文件),才敢说兼容。
3. 联系方式编辑:差量更新太难,整体替换又怕丢数据
前端同时维护「新增 / 修改 / 删除」三种状态很容易漏。最后改成保存时整体替换,
并在一个事务里完成,失败就回滚;同时约定「编辑页每次都从服务端拿最新详情」,
避免两个人同时改同一个人时互相覆盖。
4. 收藏后从收藏夹里「消失」,用户以为删了
在收藏夹里取消收藏,联系人立刻不在列表里,第一次演示时队友也愣了一下。
解决方式是取消收藏后立即重新拉取列表与统计,选中项自动落到第一条,
并用 Toast 明确提示「已取消收藏」。行为可预期,就不会误会。
5. 静态资源偶发加载不完整
首页 HTML 偶尔只加载一半,控制台报 ERR_CONTENT_LENGTH_MISMATCH。
排查发现是应用层兜底逻辑在文件流还没写完时就调用了 res.end()。
修复方式是让静态处理器等待流的 finish 事件再返回,并在提交里单独记录了这个修复。
6. 同一个号码,有人存空格有人不存
种子里存的是 139 0591 0001,用户搜 13905910001 搜不到。
最后没有强行清洗存储格式(保留用户输入的原始可读性),而是在搜索时把查询里的数字抽出来,
对联系方式做「去空格 / 去横线 / 去括号」后再匹配。
八、PSP 表
成员A(张子乐,832401325)
| PSP 2.1 阶段 | 预估时间(min) | 实际时间(min) | 偏差原因 |
|---|---|---|---|
| 计划 · 需求分析 | 30 | 35 | 额外确认了导入表头的兼容范围 |
| 计划 · 接口与库表设计 | 40 | 45 | 增加「主要联系方式」字段 |
| 开发 · 数据层与服务 | 90 | 110 | 事务与级联删除调试 |
| 开发 · xlsx 读写 | 120 | 170 | ZIP 结构与共享字符串解析踩坑 |
| 开发 · 导入导出规则 | 70 | 90 | 表头别名与去重指纹反复调整 |
| 开发 · 部署与文档 | 40 | 35 | — |
| 测试 · 接口自测 | 40 | 55 | 补充了边界用例 |
| 测试 · 与前端联调 | 30 | 40 | 错误码与提示文案对齐 |
| 总结 · 复盘与博客校对 | 30 | 30 | — |
| 合计 | 490 | 610 | 主要超支在 xlsx 与联调 |
成员B(周胜东,832401330)
| PSP 2.1 阶段 | 预估时间(min) | 实际时间(min) | 偏差原因 |
|---|---|---|---|
| 计划 · 页面结构与视觉稿 | 40 | 45 | 增加深色模式变量 |
| 开发 · 布局与样式 | 120 | 150 | 三栏与移动端抽屉适配 |
| 开发 · 列表 / 详情交互 | 90 | 100 | 收藏与筛选的状态同步 |
| 开发 · 表单与导入弹窗 | 80 | 95 | 动态联系方式行与校验提示 |
| 测试 · 自动化用例 | 60 | 75 | 导入去重与转义用例补充 |
| 测试 · 兼容性与截图 | 40 | 35 | — |
| 总结 · 视频录制与文档 | 50 | 60 | 重录了一次演示 |
| 合计 | 480 | 560 | 主要超支在响应式与状态同步 |
九、复盘与心得
这次作业最大的收获不是「做出了一个通讯录」,而是把几个模糊的需求变成了可执行的判断:
- 「支持多个联系方式」不是加一个数组字段,而是想清楚编辑、展示、校验、导入导出四个场景怎么闭环。
最终用子表 + 事务整体替换,编辑简单,数据也不会出现孤儿行。 - 「导入导出」考验的是兼容性,而不是读写 API。 表头别名、文本格式、去重策略、
失败行报告,这些才是用户真正会遇到的坑。自研 xlsx 让我们真正理解了 xlsx 的包结构,
也顺带让项目在任何环境下都能一条命令跑起来。 - 测试是勇气的来源。 17 条用例覆盖了收藏、联系方式、导入导出与转义,
改完代码跑一遍就能放心提交,这也是极限编程里「持续集成」最朴素的形态。
后续可以继续做的方向:联系人分组与批量操作、头像上传、导入时按「更新已有联系人」合并策略、
把 SQLite 换成 PostgreSQL 以支持多实例部署。
相关推荐
企业数字化转型AI大模型赋能智能体平台及AI场景应用规划方案(生态合作版).pptx
企业数字化转型AI大模型赋能智能体平台及AI场景应用规划方案(生态合作版).pptx
MCGS的Http协议驱动,支持http协议
硬件配置 参数设置 设备属性 设备命令 通讯状态 附录 #HTTP 1、 设备简介 驱动类型 该驱动为独立设备,直接添加构件即可,不需要挂载到父设备下 通讯协议 采用标准HTTP1.1协议 通讯方式 驱动构件为客户端。 2、 硬件连接 本软件在通讯之前,请保证通讯连接正确。通讯连接方式:采用标准的RJ45接口的以太网接线(对调网线或使用HUB交换)。 3、 设备通讯参数 本设备为独立设备,无父设备参数 4、 设备构件参数设置 “HTTP设备”参数设置如下: <1> 内部属性: 构建url信息。 <2> 最小采集周期:本软件对设备进行操作的时间周期,单位为ms,默认为100ms。 <3> 通讯等待时间:通讯数据接收等待时间,默认设置为200ms,当采集速度要求较高或数据量较大时,设置值可适当减小或增大。 <4> HttpHead:http head添加需要的字段,不需要添加http head时值为空,默认不添加。 5、 设备命令 本设备构件提供设备命令,用于进行相应的操作,设备命令的格式如下: 设备命令 命令介绍 GetHttpHead 格式1 GetHttpHead(headStr) 用途 获取http head参数 参数 headStr 参数可以为字符型变量、字符串常量 例1 !SetDevice(设备0,6,"GetHttpHead(headStr)") 获取http head数据保存到headStr中 SetHttpHead 格式1 SetHttpHead(headStr) 用途 设置http head参数 参数 headStr 参数可以为字符型变量、字符串常量
印尼稻米收成与粮食安全数据集2026年
本数据集收录印度尼西亚2026年水稻收成与粮食安全遥测数据,包含10000条稻米农业收成产量与粮食安全监测记录,围绕印尼国家粮食安全体系中的核心作物水稻展开。稻米是印尼逾两亿人口的主粮,其收成波动直接影响国家粮食安全与进口政策,本数据集将种植区域、收成产量、气候与土壤相关遥测指标整合为结构化表格,可支撑粮食产量预测、收成影响因素分析、区域粮食安全评估与农业政策模拟等研究任务。典型应用场景包括:农业时间序列产量预测模型构建、气候因子与水稻收成的关联分析、省份与地区层面的粮食自给率测算、粮食安全风险预警指标设计,也可作为农业经济、粮食政策与数据科学交叉课程的教学素材。数据为2026年最新版,规模约1.2MB、单CSV结构规整,字段命名清晰,适合Python、Pandas、Scikit-learn等主流工具链直接使用,便于开展探索性分析、可视化与机器学习全流程练习。重要说明:本数据为遥测整理数据,分析结论以数据集文档口径为准,农业决策请结合官方统计综合研判。许可:CC0公有领域,可自由使用与二次分发。
智慧环保生态保护行业可信数据空间应用规划方案(技术方案版).pptx
智慧环保生态保护行业可信数据空间应用规划方案(技术方案版).pptx
气象服务行业可信数据空间应用规划方案(技术方案版).pptx
气象服务行业可信数据空间应用规划方案(技术方案版).pptx




