

 CUDA

CUDA Malloc时间以及较大静态矩阵声明
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
1. CUDA Malloc的时间较长。
我在程序中声明了一个256*256的一维数组,然后在GPU上对其进行简单的计算。结果发现Malloc的时间大约是98M cycles,数据拷贝时间大约是0.8M cycles。为什么Malloc时间这么长?不考虑计算,Malloc的时间比数据拷贝时间长100多倍,感觉不合理,请问为什么会出现这种情况?
2. 较大静态数据声明。
由于Malloc时间较长,所以我想把数据量扩大,以减少Malloc所占有的时间,以及测试Malloc时间是否与数据量相关。但是当我将静态数组修改为1024*1024时,运行直接退出。请问这种问题怎么解决?
希望有人能帮助我,谢谢!
程序代码如下:
#include <stdio.h>

#include "time.h"

#include <windows.h>

#include <cuda_runtime.h>


#define SIZE_Y 256

#define SIZE_X 256

#define BLOCK_NUM 2

#define THREAD_NUM 512

#define SIZE_Y_T 8

#define SIZE_X_T 8


bool InitCUDA()

{

	int count;

	cudaGetDeviceCount(&count);

	if(count == 0) {

		fprintf(stderr, "There is no device.\n");

		return false;

	}


	int i;

	for(i=0; i< count; i++) {

		cudaDeviceProp prop;

		if(cudaGetDeviceProperties(&prop, i) == cudaSuccess) {

			fprintf(stderr, "Device prop major:%d\n", prop.major);

			if(prop.major >= 1) {

				break;

			}

		}

	}


	if(i == count) {

		fprintf(stderr, "There is no device supporting CUDA.\n");

		return false;

	}


	cudaSetDevice(i);

	return true;

}


inline unsigned __int64 GetCycleCount()

{

	__asm _emit 0x0F

	__asm _emit 0x31

}


__global__ static void stencil(int *num, int* result)

{

	int sum = 0;

	const int tid = threadIdx.x;

	const int bid = blockIdx.x;


	for(int j=1; j< SIZE_Y_T-1; j++) {

		for(int i=1; i< SIZE_X_T-1; i++) {

			//result[(j+tid/32*32)*1024+i+tid%32*32] = 0.5*num[(j+tid/32*32)*1024+i+tid%32*32]+0.125*(num[(j+tid/32*32)*1024+i+tid%32*32-1]+num[(j+tid/32*32)*1024+i+tid%32*32+1]+num[(j+tid/32*32-1)*1024+i+tid%32*32]+num[(j+tid/32*32+1)*1024+i+tid%32*32]);

			result[(j+(bid*512+tid)/(SIZE_Y/SIZE_Y_T)*SIZE_Y_T)*SIZE_X+(i+(bid*256+tid)%(SIZE_Y/SIZE_Y_T)*SIZE_X_T)] = 2*num[(j+(bid*512+tid)/(SIZE_Y/SIZE_Y_T)*SIZE_Y_T)*SIZE_X+(i+(bid*256+tid)%(SIZE_Y/SIZE_Y_T)*SIZE_X_T)]+3*(num[(j+(bid*512+tid)/(SIZE_Y/SIZE_Y_T)*SIZE_Y_T+1)*SIZE_X+(i+(bid*256+tid)%(SIZE_Y/SIZE_Y_T)*SIZE_X_T)]+num[(j+(bid*512+tid)/(SIZE_Y/SIZE_Y_T)*SIZE_Y_T-1)*SIZE_X+(i+(bid*256+tid)%(SIZE_Y/SIZE_Y_T)*SIZE_X_T)]+num[(j+(bid*512+tid)/(SIZE_Y/SIZE_Y_T)*SIZE_Y_T)*SIZE_X+(i+(bid*256+tid)%(SIZE_Y/SIZE_Y_T)*SIZE_X_T+1)]+num[(j+(bid*512+tid)/(SIZE_Y/SIZE_Y_T)*SIZE_Y_T)*SIZE_X+(i+(bid*256+tid)%(SIZE_Y/SIZE_Y_T)*SIZE_X_T-1)]);

		}

	}

}


int main()

{

	int data[SIZE_Y*SIZE_X];


	unsigned long long start;

	unsigned long long end;


	if(!InitCUDA()) {

		printf("CUDA initializing Error!\n");

		return 0;

	}

	printf("CUDA initialized.\n");


	for(int j=0; j< SIZE_Y; j++) {

		for(int i=0; i< SIZE_X; i++) {

			data[j*SIZE_X+i] = rand()%10;

		}

	}


	start = GetCycleCount();

	int* gpudata, *result;

	cudaMalloc((void**) &gpudata, sizeof(int) * SIZE_X*SIZE_Y);

	cudaMalloc((void**) &result, sizeof(int) * SIZE_X*SIZE_Y);

	end = GetCycleCount();

	printf("Malloc time:%lu cycles\n", end-start);

	cudaMemcpy(gpudata, data, sizeof(int) * SIZE_X*SIZE_Y, cudaMemcpyHostToDevice);

	end = GetCycleCount();

	printf("Data copy time:%lu cycles\n", end-start);


	stencil<<<BLOCK_NUM, THREAD_NUM, 0>>>(gpudata, result);


	end = GetCycleCount();

	printf("Computing time:%lu cycles\n", end-start);


	int data_t[SIZE_Y*SIZE_X];

	cudaMemcpy(data_t, result, sizeof(int) * SIZE_X*SIZE_Y, cudaMemcpyDeviceToHost);

	end = GetCycleCount();

	printf("Result copy time:%lu cycles\n", end-start);

	cudaFree(gpudata);

	cudaFree(result);


	//Sleep(1000);


    end = GetCycleCount();

	printf("Stencil(GPU):%lu cycles\n", end-start);


    /*

	int sum = 0;

	for(int j = 1; j < SIZE_Y-1; j++) {

		for(int i = 1; i < SIZE_X-1; i++) {

			if(i%64 != 0 && i%64 != 63 && j%64 != 0 && j%64 != 63) {

				//sum = 0.5*data[j*SIZE_X+i]+0.125*(data[j*SIZE_X+i-1]+data[j*SIZE_X+i+1]+data[(j-1)*SIZE_X+i]+data[(j+1)*SIZE_X+i]);

				sum = 2*data[j*SIZE_X+i]+3*(data[j*SIZE_X+i+1]+data[j*SIZE_X+i-1]+data[(j+1)*SIZE_X+i]+data[(j-1)*SIZE_X+i]);

				if(sum != data_t[j*SIZE_X+i]) {

					printf("Result Error:%d %d s:%d d:%d\n", j, i, sum, data_t[j*SIZE_X+i]);

				}

				else {

					printf("Result Correct:%d %d s:%d d:%d\n", j, i, sum, data_t[j*SIZE_X+i]);

				}

			}

		}


	}

	*/


	return 0;

}
程序的运行结果如下:
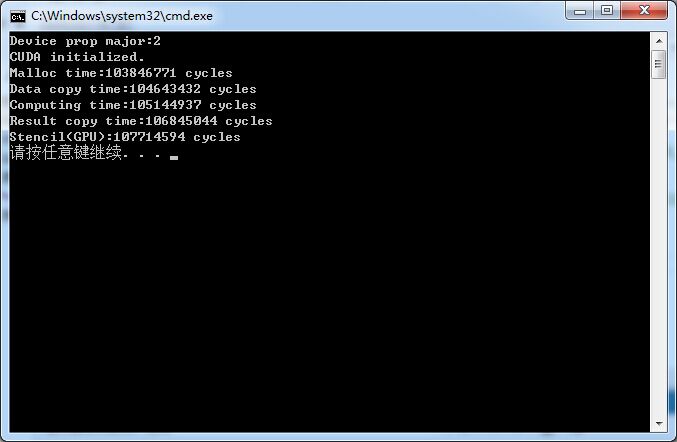
统计时间所用的函数是从网上找的,经过用Sleep函数测试是正确的。
相关推荐
win10+VS2017+Cuda10.0环境配置详解
一、安装 1.1硬件支持 首先确定你的电脑显卡是支持Cuda安装的。 右键“我的电脑”,然后点击“设备管理器”。在显示适配器里可以查看显卡型号。 如果包含在官网列表 中,则可以点击对应的型号到下载界面下载Cuda安装包。 1.2 安装VS2017 官网下载VS2017,并安装。 1.3 安装Cuda 在安装过程中,会自动检测本机是否已经安装了配套的VS版本其中之一,如果VS版本和Cuda版本不匹配的话,安装无法进行。 ( 另外,如果电脑安装了360杀毒的话,安装过程中会不断有疑似病毒修改的提示,要全部允许操作,否则无法安装。) 以上步骤无报错通过之后,基本环境已经搭建完成。 二、测试环
CUDA编程本质:从GPU物理约束理解内存与并行
GPU并非更快的CPU,而是一种受物理定律严格约束的并行协处理器——其性能瓶颈不在算力,而在显存带宽与线程调度效率。理解CUDA,首先要掌握SIMT架构、warp执行模型和多级内存层次(global/shared/constant)的协同机制;其次要意识到‘显式内存管理’和‘线程拓扑设计’是性能关键,而非自动并行化。在AI推理延迟压至微秒级、KV Cache与tiling策略直接影响L2命中率的今天,掌握CUDA意味着能从Nsight profiling数据中反推硬件行为,用shared memory ba
文档CUDA-7.5-安装及配置(WIN7-64-英伟达G卡-VS2012)
文档CUDA-7.5-安装及配置(WIN7-64-英伟达G卡-VS2012)
llama.cpp 基于 C/C++ 的 LLM 推理
Facebook的LLaMA模型在C/C++语言中的移植版本
llama.cpp-LLM inference in C/C++
Facebook的LLaMA模型在C/C++语言中的移植版本




