

 Spark

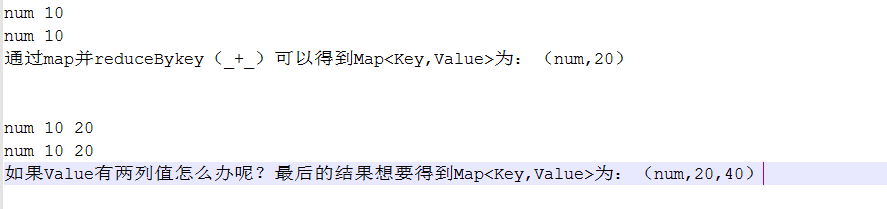
spark reducebykey计算多个value的值?如图
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
相关推荐
spark期末复习题总结
Spark中的reduceByKey操作是一个action操作,例如val key = Array(1, 2); val value = Array("one","two"); val m = key.zip
新手向,从用Spark求平均值到reduceByKey详解
1.前因后果 在网上看到了一种用Spark求平均值的算法,自己写了下,修改了一些错误,我这是能直接run起来的版本。我会在本文中对这段代码进行详细的讲解,以加强对reduceByKey用法的印象。耐心看完,保证你对reduceByKey算子理解且不会忘了。 首先把这位老哥测试的原始数据给大家: FFF 578 GGG 839 EEE 566 AAA 815 AAA 334 FFF 268...
【spark】三 python 用RDD.reduceByKey 方法实现 count(value),count(distinct value) [待验证]
需求 zeppelin的pyspark中 DataFrame.groupBy(*cols).agg()操作大数据量会爆内存。 推荐用RDD.reduceByKey()但是这个只能对两列,以第一列为key,第二列为value。 而且在同一个task上,同partition的数据先是同key的valfue进行合并操作,以此大大减少后面shuff的数据量。 本来想实现select groupkey,co...
Spark的TopN示例
```scalaval topN = data.mapValues(_ + 1).reduceByKey(_ + _) .map{ case (key, value) => (value, key) }
java-spark中各种常用算子的写法示例
3. reduceByKey 算子reduceByKey 算子是 Spark 中的一个高级算子,它可以将 Key-Value 对的数据聚合起来。




