

 Spark

spark 如何解决pv,uv实时数据
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
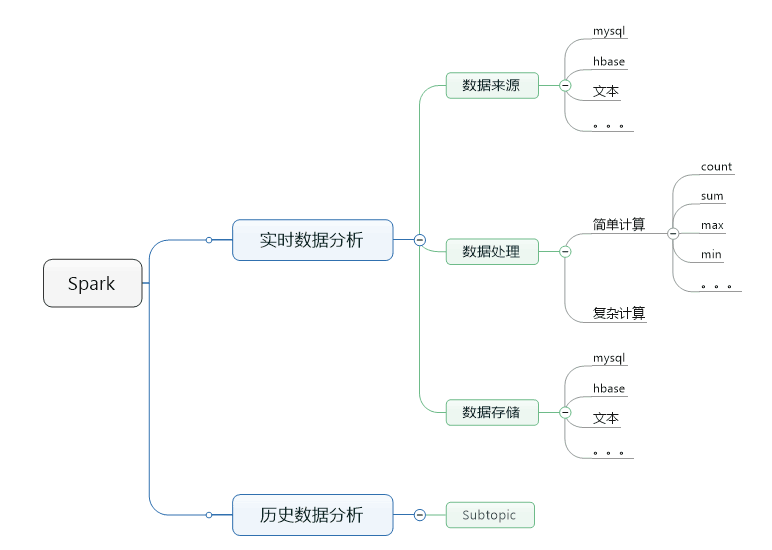
我自己也搭建了standalone的虚拟机集群,spark 连接mysql 读数据和wordcount例子我都做过,以及用sbt构建jar提交集群。
然而还不是很懂怎么处理多个数据源获取处理数据再返回数据库。(好像要用到kafka 等操作)
相关推荐
阿里大数据笔试
java, scala, python 相关代码实现。算法思想。分享答案
Spark企业级应用案例:电商用户行为分析实战
某电商平台日均产生5TB用户行为数据批处理慢:用Hive分析全量数据需4小时,无法支撑“上午出报表、下午做运营”的需求;实时性差:用Flink做流处理但批处理能力弱,无法统一批流逻辑,维护成本高;无法落地:仅做“PV/UV统计”等表层分析,未形成用户画像等可直接用于精准运营的输出。本文从电商用户行为分析的痛点用Structured Streaming解决实时分析问题(分钟级PV/UV);用Spark SQL解决批处理清洗问题(处理历史数据);用MLlib解决机器学习问题(用户分层)。
Doris在数仓中的实践.pdf
Doris在数仓中的实践.pdf
大数据离线分析项目(Hadoop).pdf
大数据离线分析项目(Hadoop).pdf大数据离线分析项目(Hadoop).pdf大数据离线分析项目(Hadoop).pdf大数据离线分析项目(Hadoop).pdf大数据离线分析项目(Hadoop).pdf大数据离线分析项目(Hadoop).pdf大数据离线分析项目(Hadoop).pdf大数据离线分析项目(Hadoop).pdf大数据离线分析项目(Hadoop).pdf
基于Spark Streaming的实时数据处理系统:从Lambda架构到新闻热榜实战
实时数据处理是应对海量数据即时分析需求的核心技术,其原理在于将连续产生的数据流进行微批次或逐事件处理,而非传统批处理的离线计算模式。这项技术的价值在于能够实现业务指标的秒级监控与决策支持,广泛应用于实时监控、风险控制、个性化推荐等场景。本文聚焦于构建一个新闻网实时分析系统,通过整合Spark Streaming、Kafka、Flume和Redis等组件,详细阐述了如何实现实时热门新闻排行、用户地域分布统计等关键功能。文中深入探讨了状态管理、偏移量处理等工程实践要点,并提供了针对数据倾斜、状态恢复等典型问题的




