

 Gauss松鼠会

我也能写数据库 —— Streaming(上)
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
概述
在前面两篇中介绍了 存储 和 UDF,然后就开始着手准备streaming了,开始走了些弯路,本以为需要构建起一个简单的流系统,才能写streaming sql呢,所以跑去看来几天的flink,然后再仔细研究了calcite的源码后发现,其实并不用那么麻烦,所以这个系列又能继续了。
现在,我打算用2-3章来说说streaming。
首先streaming是对表的一种补充,因为他代表着当前和未来的情况,而表则代表着过去。流是连续,流动的记录的集合,与表不同,流通常不存储再磁盘上,而是再网络上流动,在内存中保留的时间也很短。
但是与表类似,业务上也通常希望以基于关系代数的高级语言查询流,根据模式进行验证,并优化以利用可用的资源和算法。
Calcite的Streaming SQL是标准SQL的扩展,而不是另一种SQL like的语言。主要原因如下(翻译自calcite官方文档:
-
对于任何了解标准SQL的人来说,流式SQL都很容易学习。
-
语义清晰,无论使用表或是流,都可以返回相同的数据。
-
可以编写结合流和表的查询(或者流的历史记录,它基本上是内存中的表)。
-
许多现有的工具可以生成标准SQL。
-
如果不使用stream关键字,则返回常规标准SQL。
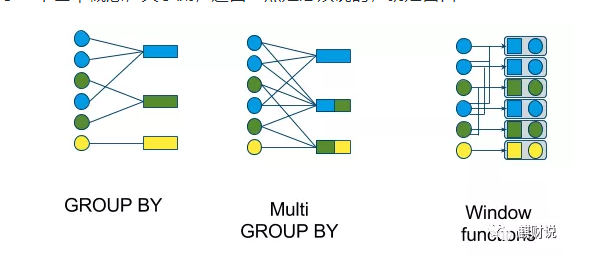
介绍了一下基本概念,关于流,还由一点是必须说的,就是窗口
-
tumbling window (GROUP BY)
-
hopping window (multi GROUP BY)
-
sliding window (window functions)
-
cascading window (window functions)
对于窗口和时间的一些理解,也可以看看,我的另外一篇文章《再谈Flink》
案例
好了,基础先说到这,下面来看看代码吧,这次其实非常简单,就可以完成streaming了,再一次强调,calcite的streaming sql和flink及spark的支持不同,不是api级别上的,而是支持stream关键字来支持流
我们已经有了前面工程的积累,这样代码量非常小的改动就可以完成了。
bookshopStream.json
首先,我们重新定义一个模型文件,取名bookshopStream.json
{
  "version": "1.0",
  "defaultSchema": "bookshopstream",
  "schemas": [
    {
      "name": "bookshopstream",
      "tables": [
        {
          "name": "BOOK",
          "type": "custom",
          "factory": "com.dafei1288.calcite.stream.InMemoryStreamTableFactory",
          "stream": {
            "stream": true
          },
          "operand": {
            "p1": "hello",
            "p2": "world"
          }
        }
      ]
    }
  ]
}
这里我们对schema并没有过多的设置,而是直接对tables属性进行了设置,将factory指定为com.dafei1288.calcite.stream.InMemoryStreamTableFactory,这类后续在细讲。这里我们将表名定义为BOOK,意在后续使用之前案例的Storage。
InMemoryStreamTableFactory
public class InMemoryStreamTableFactory implements TableFactory {
    @Override
    public Table create(SchemaPlus schema, String name, Map operand, RelDataType rowType) {
        System.out.println(operand);
        System.out.println(name);
        return new InMemoryStreamTable(name, Storage.getTable(name));
    }
}
因为在模型里,直接指定了TableFactory,这个类的职责就是构建Table表对象,其职责,有点类似之前案例里的InMemorySchema类的public Map<String, Table> getTableMap()方法。前文描述了过,指定了"name": "BOOK",所以,在这里代码执行的结果就是加载了BOOK表。
InMemoryStreamTable
public class InMemoryStreamTable extends InMemoryTable implements StreamableTable {
    public InMemoryStreamTable(String name, Storage.DummyTable it) {
        super(name, it);
    }

    @Override
    public Table stream() {
        System.out.println("streaming .....");
        return this;
    }
}
这里,为了能复用之前的存储逻辑,所以直接继承了InMemoryTable,所以,这个实现,其实底层并不是一个彻底的streaming实现,而是和之前案例一直的内存实现,但是这样就可以通过stream关键字,来进行sql查询了。
测试
public class TestStreamJDBC {
    public static void main(String[] args) {
        try {
            Class.forName("org.apache.calcite.jdbc.Driver");
        } catch (ClassNotFoundException e1) {
            e1.printStackTrace();
        }
        System.setProperty("saffron.default.charset", ConversionUtil.NATIVE_UTF16_CHARSET_NAME);
        System.setProperty("saffron.default.nationalcharset",ConversionUtil.NATIVE_UTF16_CHARSET_NAME);
        System.setProperty("saffron.default.collation.name",ConversionUtil.NATIVE_UTF16_CHARSET_NAME + "$en_US");

        Properties info = new Properties();
        String jsonmodle = "E:\\working\\others\\写作\\calcitetutorial\\src\\main\\resources\\bookshopStream.json";
        try {
            Connection connection =
                    DriverManager.getConnection("jdbc:calcite:model=" + jsonmodle, info);
            CalciteConnection calciteConn = connection.unwrap(CalciteConnection.class);

            ResultSet result = null;

            Statement st = connection.createStatement();

            st = connection.createStatement();
            //where b.name = '数据山'
            result = st.executeQuery("select stream * from BOOK as b ");
            while(result.next()) {
                System.out.println(result.getString(1)+" \t "+result.getString(2)+" \t "+result.getString(3)+" \t "+result.getString(4));
            }
            result.close();
        }catch(Exception e){
            e.printStackTrace();
        }

        }
}
select stream * from BOOK as b 这里撰写了一个简单的SQL,并使用了stream关键字,结果如下。
{p1=hello, p2=world, modelUri=E:\working\others\写作\calcitetutorial\src\main\resources\bookshopStream.json, baseDirectory=E:\working\others\写作\calcitetutorial\src\main\resources}
BOOK
streaming .....
scan ......
1 	 1 	 数据山 	 java
2 	 2 	 大关 	 sql
3 	 1 	 lili 	 sql
4 	 3 	 ten 	 c#
那么对于一个非stream表,使用stream关键字,会怎么样呢?那么我们会得到一个异常
ERROR: Cannot convert table 'xxx' to a stream
结尾
目前只是完成了最基础的查询,代码已提交到demo仓库
TBD
相关推荐
彻底理解 ABAP SQL 中的 Streaming 与 Locator:大对象访问、性能取舍与实战思路
本文介绍了SAP ABAP中处理大对象数据(LOB)的两种高效机制:Streaming和Locator。常规方法将整个LOB数据一次性读取到内存,在处理大体积数据时存在内存占用高、传输效率低等问题。Streaming机制通过流式处理实现分块读写,而Locator则通过定位器实现精确访问和数据库内部操作,避免不必要的数据传输。文章详细阐述了这两种机制的工作原理、适用场景及性能优化价值,同时也指出了使用时的注意事项和资源限制。这些技术特别适用于处理大文本、二进制附件等场景,能显著提升SAP系统处理大对象数据的效
【Structured Streaming】简单介绍
一、Spark Streaming曲折发展史 Spark Streaming针对实时数据流,提供了一套可扩展、高吞吐、可容错的流式计算模型。Spark Streaming接收实时数据源的数据,切分成很多小的batches,然后被Spark Engine执行,产出同样由很多小的batchs组成的结果流。本质上,这是一种micro-batch(微批处理)的方式处理 不足在于处理延时较高(无法优...
高校及科研院所如何利用外部数据完善技术转移转化机制.docx
科易网基于40亿+科创知识图谱数据库,深度探索AI技术在技术转移、成果转化、技术经纪、知识产权、产业创新、科技招商等垂直领域的多样化应用场景,研究科技创新领域的AI+数智化解决方案,推动科技创新与产业创新智能化发展。
完全复现虚拟同步发电机VSG自适应惯量阻尼控制仿真、根轨迹、调节系数对比(Simulink仿真、Matlab代码实现)
内容概要:本文档围绕“【完全复现】虚拟同步发电机VSG自适应惯量阻尼控制仿真、根轨迹、调节系数对比”这一主题,利用Simulink和Matlab平台,系统性地实现了虚拟同步发电机(VSG)的自适应惯量与阻尼控制策略的建模与仿真。内容涵盖VSG的核心控制原理、系统动态响应特性分析、根轨迹绘制以及在不同调节系数下的性能对比研究,旨在深入剖析关键控制参数对系统稳定性与动态性能的影响机制,为新能源并网系统中提升频率支撑能力和暂态稳定性的控制策略设计提供理论依据和技术支持。; 适合人群:具备扎实的电力系统分析与自动控制理论基础,熟练掌握Matlab/Simulink仿真工具,主要从事新能源发电、微电网运行、电力电子变换器控制或电力系统稳定研究的研究生、科研人员及工程技术人员。; 使用场景及目标:①开展虚拟同步发电机(VSG)的建模与先进控制策略的深入研究;②探究自适应惯量与阻尼控制对改善电网频率响应速度和平抑功率波动的作用机理;③运用根轨迹法进行系统稳定性分析,并指导控制器参数的优化整定;④完成高水平学术论文撰写或科研项目申报所需的仿真复现实验。; 阅读建议:本资源以“完全复现”为核心目标,提供了完整的仿真模型与配套代码。使用者应在深入理解同步发电机转子运动方程、虚拟惯量及阻尼物理意义的基础上,结合电力系统暂态稳定理论,逐步操作并调试仿真模型,尤其需关注不同调节系数变化对系统动态性能指标(如超调量、调节时间)的影响,从而深化对VSG内在控制机制与稳定边界的认知。
前端开发基于history.js的HTML5与HTML4浏览器兼容方案:单页应用无刷新历史状态管理技术实现-dQ4ehf7C1792158475
内容概要:本文系统介绍了如何利用history.js实现单页应用(SPA)在HTML5c与HTML4浏览器间s草错发的无缝历史状态管理。通过封装原生History API并在不支持的浏览器中自动降级为哈希路由,history.js解决了因浏览器兼容性导致的后退按钮失效、URL混乱等问题。文章详细讲解了其核心机制,包括状态对象管理、自动模式切换(HTML5 pushState vs HTML4 哈希)、状态数据持久化以及针,对Safari、IE等浏\览器的兼容性修复方案,并提供了从入门到实战的完整示例,涵盖初始化、事,件监听、页面加载及性能优化技巧。;DtPXB1792158476





