

 Gauss松鼠会

MySQL千万级数据的表如何优化
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
MySQL为了提升性能,会将表的索引装载到内存中。但是当表的数据到达一定的量的时候,会导致内存无法存储这些索引,无法存储索引,就只能进行磁盘IO,从而导致性能下降。
实战调优
我这里有张表,数据有1000w,目前只有一个主键索引
复制
CREATE TABLE `user` (
  `id` int(10) NOT NULL AUTO_INCREMENT,
  `uname` varchar(20) DEFAULT NULL COMMENT '账号',
  `pwd` varchar(20) DEFAULT NULL COMMENT '密码',
  `addr` varchar(80) DEFAULT NULL COMMENT '地址',
  `tel` varchar(20) DEFAULT NULL COMMENT '电话',
  `regtime` char(30) DEFAULT NULL COMMENT '注册时间',
  `age` int(11) DEFAULT NULL COMMENT '年龄',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=10000003 DEFAULT CHARSET=utf8;
查询所有大概16s。可谓是相当慢了。通常我们一个后台系统,比如这个是一个电商平台,这个是用户表。后台管理系统,一般会查询这些用户信息,做一些操作,比如后台直接新增用户啊,或者删除用户啊这些操作。
所以这里就诞生了两个需求,一个是查询count,一个是分页查询
我们分别来测试一下count用的时间和分页查询所用的时间
复制
select * from user limit 1, 10   //几乎不用时
select * from user limit 1000000, 10  //0.35s
select * from user limit 5000000, 10  //1.7s
select * from user limit 9000000, 10  //2.8s
select count(1) from user  //1.7s
从上面查询所用时间可以看出来,如果是分页查询的话,查询的数据越往后用时是越长的,查询count也需要1.7s。这显然是不符合我们的要求的。所以,这里我们就需要优化。首先我们在这里进行索引优化试试
首先看一下这是只有主键索引的执行计划:
复制
alter table `user` add INDEX `sindex` (`uname`,`pwd`,`addr`,`tel`,`regtime`,`age`)
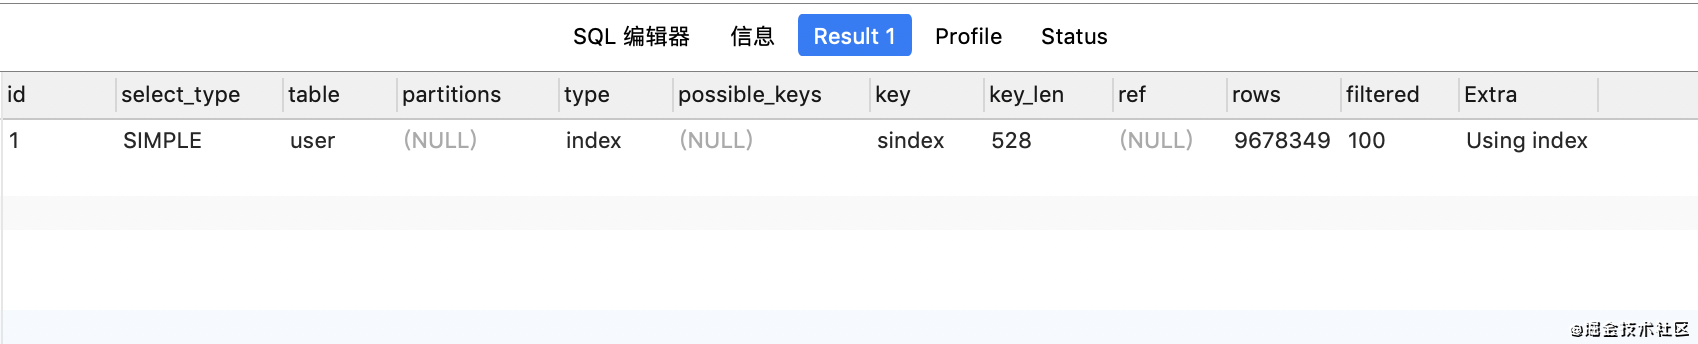
看上面的执行计划,虽然type是从all->index,走了sindex索引,但是实际上查询速度并没有发生改变。
其实,创建联合索引,是为了有条件查询的时候速度更快,而不是全表查询
复制
select * from user where uname='6.445329111484186' //3.5s(无联合索引)
select * from user where uname='6.445329111484186' //0.003s(有联合索引)
所以这就是有联合索引和无索引的差距
这里基本上可以证明,加了索引和不加索引,进行全表查询的时候,效率就是会很慢
既然索引这个结果已经不好使了,那就只能找其他方案了。根据我之前mysql面试里面讲的,count我们可以单独存储到一个表里面
复制
CREATE TABLE `attribute` (
  `id` int(11) NOT NULL,
  `formname` varchar(50) COLLATE utf8_bin NOT NULL COMMENT '表名',
  `formcount` int(11) NOT NULL COMMENT '表总数据',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin;
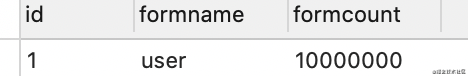
这里说一下,这种表一般不会查所有,只会查询一条,所以建表的时候,可以建成hash
复制
select formcount from attribute where formname='user' //几乎不用时
count就进行优化完了。如果上面有选择条件的话,就可以建立索引,通过走索引筛选的形式来查询,这样就可以不用读这个count了。
那么,count是没问题了,分页查询优化要如何优化呢?这里可以使用子查询来优化
复制
select * from user where
id>=(select id from user limit 9000000,1) limit 10 //1.7s
其实子查询这种写法,判断id,其实就是通过覆盖索引来查询。效率会大大增加。不过我这里测试是1.7s,以前在公司优化这方面的时候,比这个查询时间要低,大家也可以自己生成数据自己测试
但是如果说数据量太大了,我还是建议走es或者进行一些默认选择,count可以单独列出来
至此,一个千万级的数据分页查询的优化就完成了。
相关推荐
mysql千万级数据大表该如何优化?
1.数据的容量:1-3年内会大概多少条数据,每条数据大概多少字节; 2.数据项:是否有大字段,那些字段的值是否经常被更新; 3.数据查询SQL条件:哪些数据项的列名称经常出现在WHERE、GROUP BY、ORDER BY子句中等; 4.数据更新类SQL条件:有多少列经常出现UPDATE或DELETE 的WHERE子句中; 5.SQL量的统计比,如:SELECT:UPDATE+DELETE:INSERT=多少? 6.预计大表及相关联的SQL,每天总的执行量在何数量级? 7.表中的数据:更新为主的业务 还是 查询为主的业务 8.打算采用什么数据库物理服务器,以及数据库服务器架构? 9.并发如何?
如何优化MySQL千万级大表
千万级大表如何优化,这是一个很有技术含量的问题,通常我们的直觉思维都会跳转到拆分或者数据分区,在此我想做一些补充和梳理,想和大家做一些这方面的经验总结,也欢迎大家提出建议。从一开始脑海里开始也是火光四现,到不断的自我批评,后来也参考了一些团队的经验,我整理了下面的大纲内容。既然要吃透这个问题,我们势必要回到本源,我把这个问题分为三部分:“千万级”,“大表”,“优化”,也分别对应我们在图中标识的“数据量”,“对象”和“目标”。我来逐步展开说明一下,从而给出一系列的解决方案。千万级其实只是一个感官的数字,就是我们印象中的数据量大。?这里我们需要把这个概念细化,因为随着业务和时间的变化,数据量也会有
MySQL大表优化方案探讨
当MySQL单表记录数过大时,增删改查性能都会急剧下降,可以参考以下步骤来优化:除非单表数据未来会一直不断上涨,否则不要一开始就考虑拆分,拆分会带来逻辑、部署、运维的各种复杂度,一般以整型值为主的表在千万级以下,字符串为主的表在五百万以下是没有太大问题的。而事实上很多时候MySQL单表的性能依然有不少优化空间,甚至能正常支撑千万级以上的数据量:尽量使用TINYINT、SMALLINT、MEDIUM_INT作为整数类型而非INT,如果非负则加上UNSIGNEDVARCHAR的长度只分配真正需要的空间使用枚举或整数代替字符串类型尽量使用TIMESTAMP而非DATETIME,单表不要有太多字段
MySQL 千万级数据大表的优化策略及源代码示例
在处理千万级数据的大表时,MySQL 数据库的性能优化至关重要。优化数据库的设计和查询操作可以显著提高系统的响应速度和数据处理能力。以下是一些优化策略和相应的源代码示例,帮助您优化千万级数据大表的性能。通过以上优化策略和示例代码,您可以提高处理千万级数据大表的性能。请根据实际情况选择适合的优化方法,并根据具体需求进行调整和测试,以获得最佳性能。
mysql 千万级数据优化
介绍一下海量数据库sql 优化,及书写sql 应该注意的事项。




