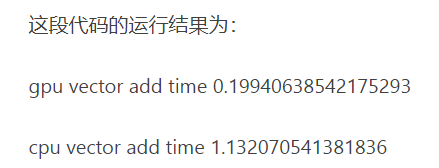
初次尝试GUP运行python,测试代码时发现结果不好

EarAST。 2022-09-30 09:59:40

使用的时pycharm,显卡为nvidia 2060

运行网上别人写的测试代码,据他所说gpu运行速度应当比cpu快很多


结果我自己运行时刚好相反,我是gpu设置出错了,还是代码有问题?请大佬指点!!! 

from numba import cuda
import numpy as np
import math
from time import time


@cuda.jit
def gpu_add(a, b, result, n):
    idx = cuda.threadIdx.x + cuda.blockDim.x * cuda.blockIdx.x
    if idx < n:
        result[idx] = a[idx] + b[idx]


def main():
    n = 20000000
    x = np.arange(n).astype(np.int32)
    y = 2 * x
    # 拷贝数据到设备端
    x_device = cuda.to_device(x)
    y_device = cuda.to_device(y)
    # 在显卡设备上初始化一块用于存放GPU计算结果的空间
    gpu_result = cuda.device_array(n)
    cpu_result = np.empty(n)
    threads_per_block = 1024
    blocks_per_grid = math.ceil(n / threads_per_block)
    start = time()
    gpu_add[blocks_per_grid, threads_per_block](x_device, y_device, gpu_result, n)
    cuda.synchronize()
    print("gpu vector add time " + str(time() - start))
    start = time()
    cpu_result = np.add(x, y)
    print("cpu vector add time " + str(time() - start))
    if np.array_equal(cpu_result, gpu_result.copy_to_host()):
        print("result correct!")


if __name__ == "__main__":
    main()


...全文
1183 1 打赏 收藏 举报
写回复
用AI写文章
1 条回复
切换为时间正序
请发表友善的回复…
发表回复
CSDN-Ada助手 2023-01-09
  • 打赏
  • 举报
回复
您可以前往 CSDN问答-Python 发布问题, 以便更快地解决您的疑问
文末附数据集可视化效果图。 【数据集概况】 · 检测类别(中文):[矿石0(0), 矿石1(1), 矿石10(10), 矿石11(11), 矿石2(2), 矿石3(3), 矿石4(4), 矿石7(7), 矿石8(8), 矿石9(9), 模组矿石(modore), 普通矿石(ore)] · 训练集:1383 张 · 验证集:130 张 · 测试集:66 张 · 总计:1579 张 该数据集聚焦于典型游戏内资源采集场景,以俯视角呈现冰雪覆盖的虚拟地形环境,包含多种类型矿石与特殊资源点。数据集中各类矿石分布密集且形态多样,标注清晰,能够有效支持对复杂背景下的小目标识别与分类任务,具备较高的训练价值和实际应用潜力。... 【训练曲线与评估图】 【模型训练配置】 参数 | 值 模型 | yolo26n 训练轮数 | 100 epochs 输入尺寸 | 640x640 批次大小 | 24 优化器 | auto 初始学习率 | 0.01 训练设备 【关键指标汇总】 训练了 100 个 epoch,最终轮指标: 指标 | 数值 mAP50 | **0.9185** mAP50-95 | 0.5810 Precision | 0.9468 Recall | 0.8648 train/box_loss | 1.2381 train/cls_loss | 0.4081 val/box_loss | 1.5489 val/cls_loss | 0.5361 【训练过程分析】 100 轮训练后 mAP50 达到 0.9185,模型收敛良好。Loss 曲线前段快速下降,后段趋于平稳,val_loss 无反弹,没有明显过拟合。但 mAP50-95 为 0.5810,和 mAP50 差距 0.34,定位精度仍有优化空间。 【模型性能评估】 Precision 0.9468、Recall 0.8648...

591

社区成员

发帖
与我相关
我的任务
社区描述
CUDA™是一种由NVIDIA推出的通用并行计算架构,该架构使GPU能够解决复杂的计算问题。 它包含了CUDA指令集架构(ISA)以及GPU内部的并行计算引擎。
社区管理员
  • CUDA编程社区
加入社区
  • 近7日
  • 近30日
  • 至今
社区公告
暂无公告

试试用AI创作助手写篇文章吧