

 CUDA

洗牌束指令归约与使用共享内存归约谁更快?
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
我做了一个测试,分别用洗牌束指令与共享内存进行归约计算,一个block内,循环做100000次,结果如下:
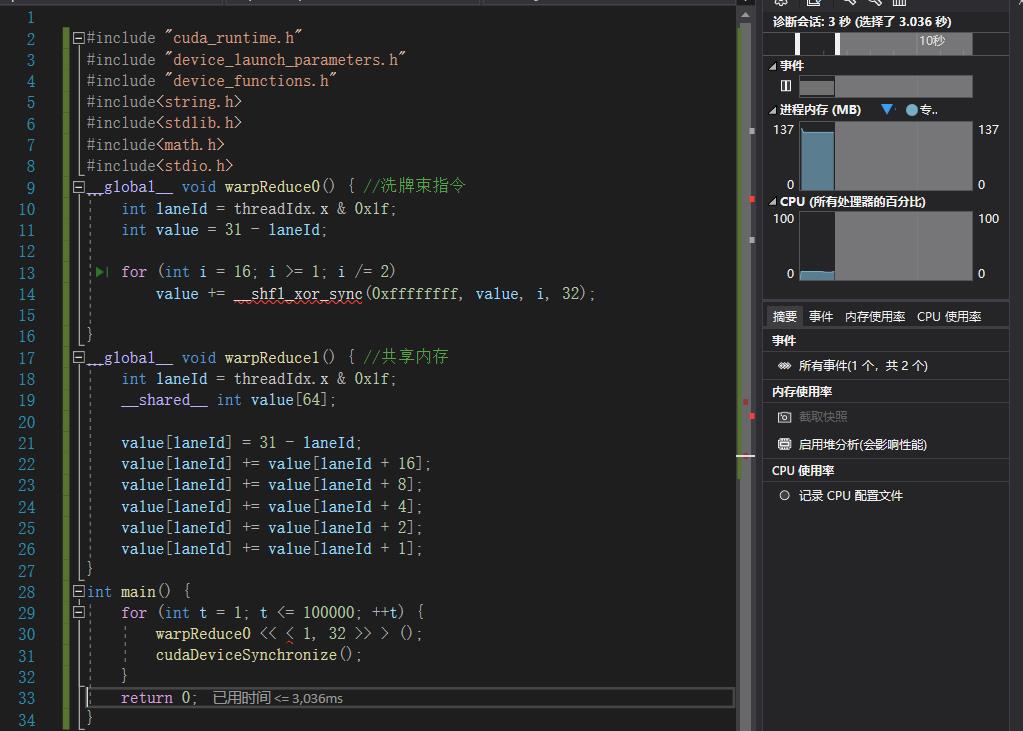
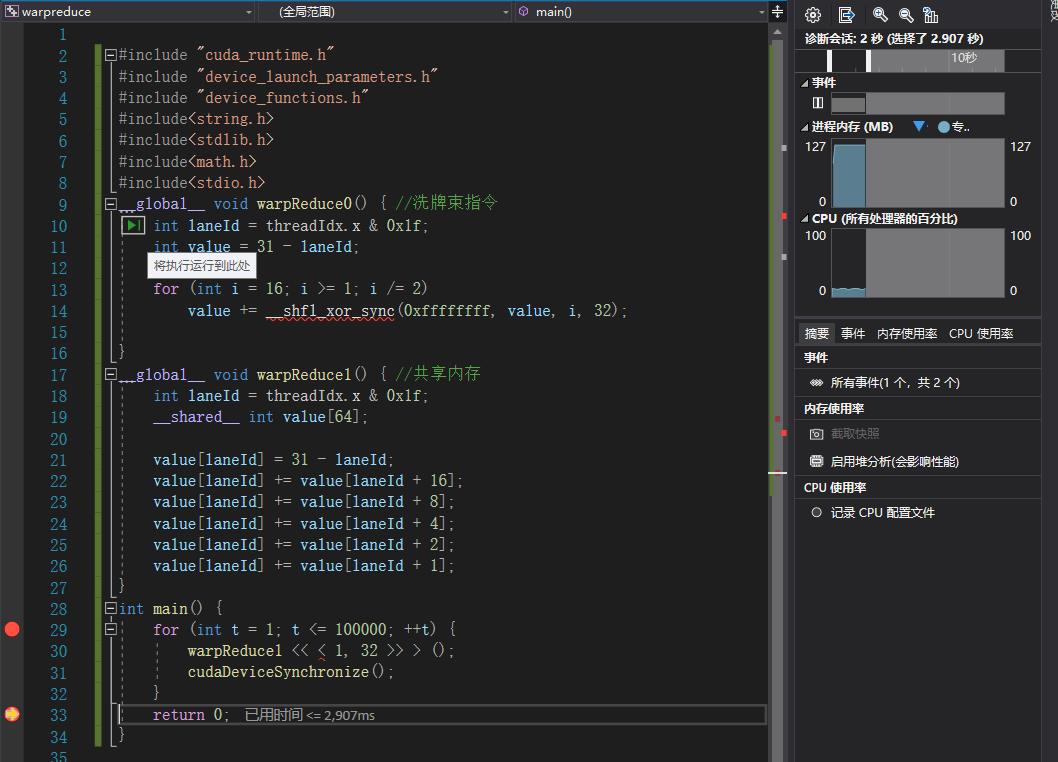
为什么洗牌束指令的速度不如shared memory?按照cuda操作指南的描述,洗牌束指令应该更快的,是程序有问题么?
相关推荐
大数据中的流处理与批处理.pdf
大数据中的流处理与批处理.pdf
进阶篇第10节:线程束洗牌指令(Shuffle)——线程间高效通信,替代共享内存的场景
本文介绍了CUDA中的Shuffle指令,它是一种比共享内存更高效的warp内线程通信方式。Shuffle指令允许warp内的32个线程直接读取其他线程的寄存器值,无需通过共享内存,具有极低延迟(1-2周期)且无bank冲突风险。文章详细解析了四种Shuffle变体的语法和使用场景,包括直接读取、向上/向下读取和异或读取,并提供了warp内归约求和和前缀和两个实战案例。性能测试表明,Shuffle指令比优化后的共享内存实现快60%,代码更简洁。建议在warp级数据交换场景中优先使用Shuffle指令替代共享
61、MapReduce在并行外部内存中的效率
本文研究了MapReduce在并行外部内存(PEM)模型中的效率,分析了洗牌步骤的I/O复杂度上界与下界。通过引入PEM模型并与BSP*模型进行比较,建立了两种模型间的可比性。针对不同映射和归约场景,提出了直接洗牌、依赖映射的洗牌策略以及完全合并等方法,并给出了相应的算法复杂度。基于稀疏矩阵向量乘法的下界分析,得出了在多种数据布局下的I/O复杂度下界,证明了算法的渐近最优性。研究成果为大规模数据处理中MapReduce的性能优化提供了理论支持和实践指导。
【信息科学与工程学】计算机科学与自动化——第一百八十九篇 计算机硬件 系列一 微处理器01
在金融行业CDN流推送场景中,结合WebRTC over SD-RTN与SD-WAN Branch方案,需兼顾要求。
Hadoop技术MapReduce简介共8页.pdf.zi
Hadoop技术MapReduce简介共8页.pdf.zip




