

 2023年北航面向对象设计与构造

OOP_U1_表达式展开
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
作业内容
题目描述
读入一系列自定义函数的定义以及一个包含幂函数、三角函数、自定义函数调用、求导算子的表达式,输出恒等变形展开所有括号后的表达式。
设定的形式化表述
- 表达式 →→ 空白项 [加减 空白项] 项 空白项 | 表达式 加减 空白项 项 空白项
- 项 →→ [加减 空白项] 因子 | 项 空白项 '*' 空白项 因子
- 因子 →→ 变量因子 | 常数因子 | 表达式因子|求导因子
- 变量因子 →→ 幂函数 | 三角函数 | 自定义函数调用
- 常数因子 →→ 带符号的整数
- 表达式因子 →→ '(' 表达式 ')' [空白项 指数]
- 幂函数 →→ 自变量 [空白项 指数]
- 自变量 →→ 'x' | 'y' | 'z'
- 三角函数 →→ 'sin' 空白项 '(' 空白项 因子 空白项 ')' [空白项 指数] | 'cos' 空白项 '(' 空白项 因子 空白项 ')' [空白项 指数]
- 指数 →→ '**' 空白项 ['+'] 允许前导零的整数 (注:指数一定不是负数)
- 带符号的整数 →→ [加减] 允许前导零的整数
- 允许前导零的整数 →→ ('0'|'1'|'2'|…|'9'){'0'|'1'|'2'|…|'9'}
- 空白项 →→ {空白字符}
- 空白字符 →→ (空格) |
\t - 加减 →→ '+' | '-'
自定义函数相关(相关限制见“公测数据限制”)
- 自定义函数定义 →→ 自定义函数名 空白项 '(' 空白项 自变量 空白项 [',' 空白项 自变量 空白项 [',' 空白项 自变量 空白项]] ')' 空白项 '=' 空白项 函数表达式
- 自定义函数调用 →→ 自定义函数名 空白项 '(' 空白项 因子 空白项 [',' 空白项 因子 空白项 [',' 空白项 因子 空白项]] ')'
- 自定义函数名 →→ 'f' | 'g' | 'h'
- 函数表达式 →→ 表达式 (注:本次作业函数表达式中可以调用其他自定义函数,但保证不会出现递归调用的情况)
求导算子相关(相关限制见“公测数据限制”)
- 求导因子 →→ 求导算子 空白项 '(' 空白项 表达式 空白项 ')'
- 求导算子 →→ 'dx' |'dy' |'dz'
其中
{}表示允许存在 0 个、1 个或多个。[]表示允许存在 0 个或 1 个。()内的运算拥有更高优先级,类似数学中的括号。|表示在多个之中选择一个。- 上述表述中使用单引号包裹的串表示字符串字面量,如 '(' 表示字符
(。
式子的具体含义参照其数学含义。
若输入字符串能够由“表达式”推导得出,则输入字符串合法。
附描述的不完善之处:未在任何地方说明函数定义与调用的参数数量需一致。
第一次作业
第一次作业需要完成的任务为:读入一个包含加、减、乘、乘方以及括号(其中括号的深度至多为 1 层)的多变量表达式,输出恒等变形展开所有括号后的表达式。
架构
以形式化表述与表达式的数学含义为依据,直接对表达式进行解析并储存于表达式树中,并引入多项式类完成表达式的计算。
- 表达式树:利用栈进行解析,赋予操作数(operand)与运算符(operator)优先级并进行建树,将优先级低的节点置于上层而优先级高的节点置于下层。计算基于多项式类递归完成,节点为运算符则递归运算,为操作数则返回对应多项式。
- 多元多项式类:主体为以单项式类为键,
BigInteger系数为值的HashMap,重写单项式类的hashCode与equals方法实现单项式等价的判断,完成新项的直接插入。单项式类使用String而非三个数以分别保存x、y、z的指数,增强可拓展性。重写父类与子类的toString方法以实现自定义的输出化简。
bug 分析
测试过程中发现优先级设置上的一些问题,主要原因是正负号的优先级与加减号不同,与幂的优先级产生了冲突,于是我根据前一个符号为操作数还是运算符来判定 +- 是正负号还是加减号,顺利解决了问题。而在与同学交流后发现大部分的同学都是使用正则替换来加入 $1$ 或 $0$ 以消除判断,这也值得借鉴,但感觉不够优雅(x)助教们也强调了正则替换的危险性,于是我仍沿用本身的思路。
修完后,在强测与互测中并未查出 bug。
在互测中 hack 到了房友的三个 bug,原因分别是未处理尾随空格、乘法后续项的解析长度有误、计算过程未合并导致超时。
总结
第一次作业作为三次作业的基础,其重要性是不言而喻的。一个优秀的架构不仅能减少重构的风险,还具有更强的可拓展性,也更容易修复 bug,因此我在思考架构上花费的时间较长,但这也是值得的,为我后续增量开发的轻松奠定了基础。
- 总体耗时:约 10h
- 强测得分:100
- 互测得分:4.5
第二次作业
第二次作业中需要完成的任务为:读入一系列自定义函数的定义以及一个包含幂函数、三角函数、自定义函数调用的表达式,输出恒等变形展开所有括号后的表达式。
架构
- 自定义函数方面,引入
Function类存储函数args和expr,使用functions HashMap实现从函数名到Function的映射,加入继承第一次作业节点Node类的FuncNode在每次函数调用时解析Function以规避树的拷贝问题,并实现了参数的替换方法。 - 三角函数方面,基于三角函数内部一般没有变化的原理与第一次作业使用
String存储未知量,便直接将三角函数括号内部分进行解析并与其组成字符串,将其当作未知量处理,轻松解决。
bug 分析
在强测与互测中并未查出 bug。
在互测中 hack 到了房友的多个 bug,原因包含未处理尾随空格、未考虑函数定义中等号左侧可能出现 \t 的问题、三角函数的指数为 $0$ 时无法正确处理、函数调用参数为幂函数时无法正确处理。
总结
主要难度在于自定义函数的参数代入,在这方面表达式树有很大优势,可以直接将解析好的函数表达式中对应参数替换为实参解析得到的根节点。由于周末感染甲流没有精力完成三角函数优化,仅做了一些设想。
- 总体耗时:不到 4h
- 强测得分:94.7
- 互测得分:8.5
第三次作业
第三次作业中需要完成的任务为:读入一系列自定义函数的定义以及一个包含幂函数、三角函数、自定义函数调用、求导算子的表达式,输出恒等变形展开所有括号后的表达式。
架构
- 自定义函数的互相调用:递归解析,已解决。
- 求导算子:直接根据规则对表达式树进行求导。
bug 分析
在强测与互测中并未查出 bug。
在互测中 hack 到了房友的一个 bug 和指导书的一个 bug:
- 房友的 bug 是因为三角函数优化为手动判断,未考虑周全导致错误
- 指导书的 bug 为,未规定自定义函数的 cost 上限,仅规定了调用时的 cost 相关内容;而在第三次作业中包含求导与自定义函数的互相调用,使同学们更倾向于在预处理中完成对函数的解析。这样,若输入一个极为复杂的自定义函数与简单的输入表达式,则可在满足互测要求的情况下使绝大部分同学的代码
TLE或MLE。在此感谢 zyt 于 OO 群指出相关可能性与和我的数据交流。
总结
由于表达式树的优越性和优化摆烂了,非常轻松地完成了本次作业,并未感受到老师一直在说的”第三次作业最难“。
- 总体耗时:约 1h
- 强测得分:92.4
- 互测得分:过于先进,不便展示
度量分析
因第三次作业提交的代码并未达到理想情况,且存在未完成的三角函数优化,在提交截止后我又进行了一些修整,以下分析对象为修整后代码。
代码规模
| Source file | Total Lines | Source Code Lines |
|---|---|---|
| ExpressionTree.java | 289 | 260 |
| MainClass.java | 14 | 13 |
| MultivariatePolynomial.java | 159 | 142 |
| Tools.java | 29 | 26 |
| Total | 491 | 441 |
可以看到,利用栈与表达式树的方法代码量较小。
UML类图
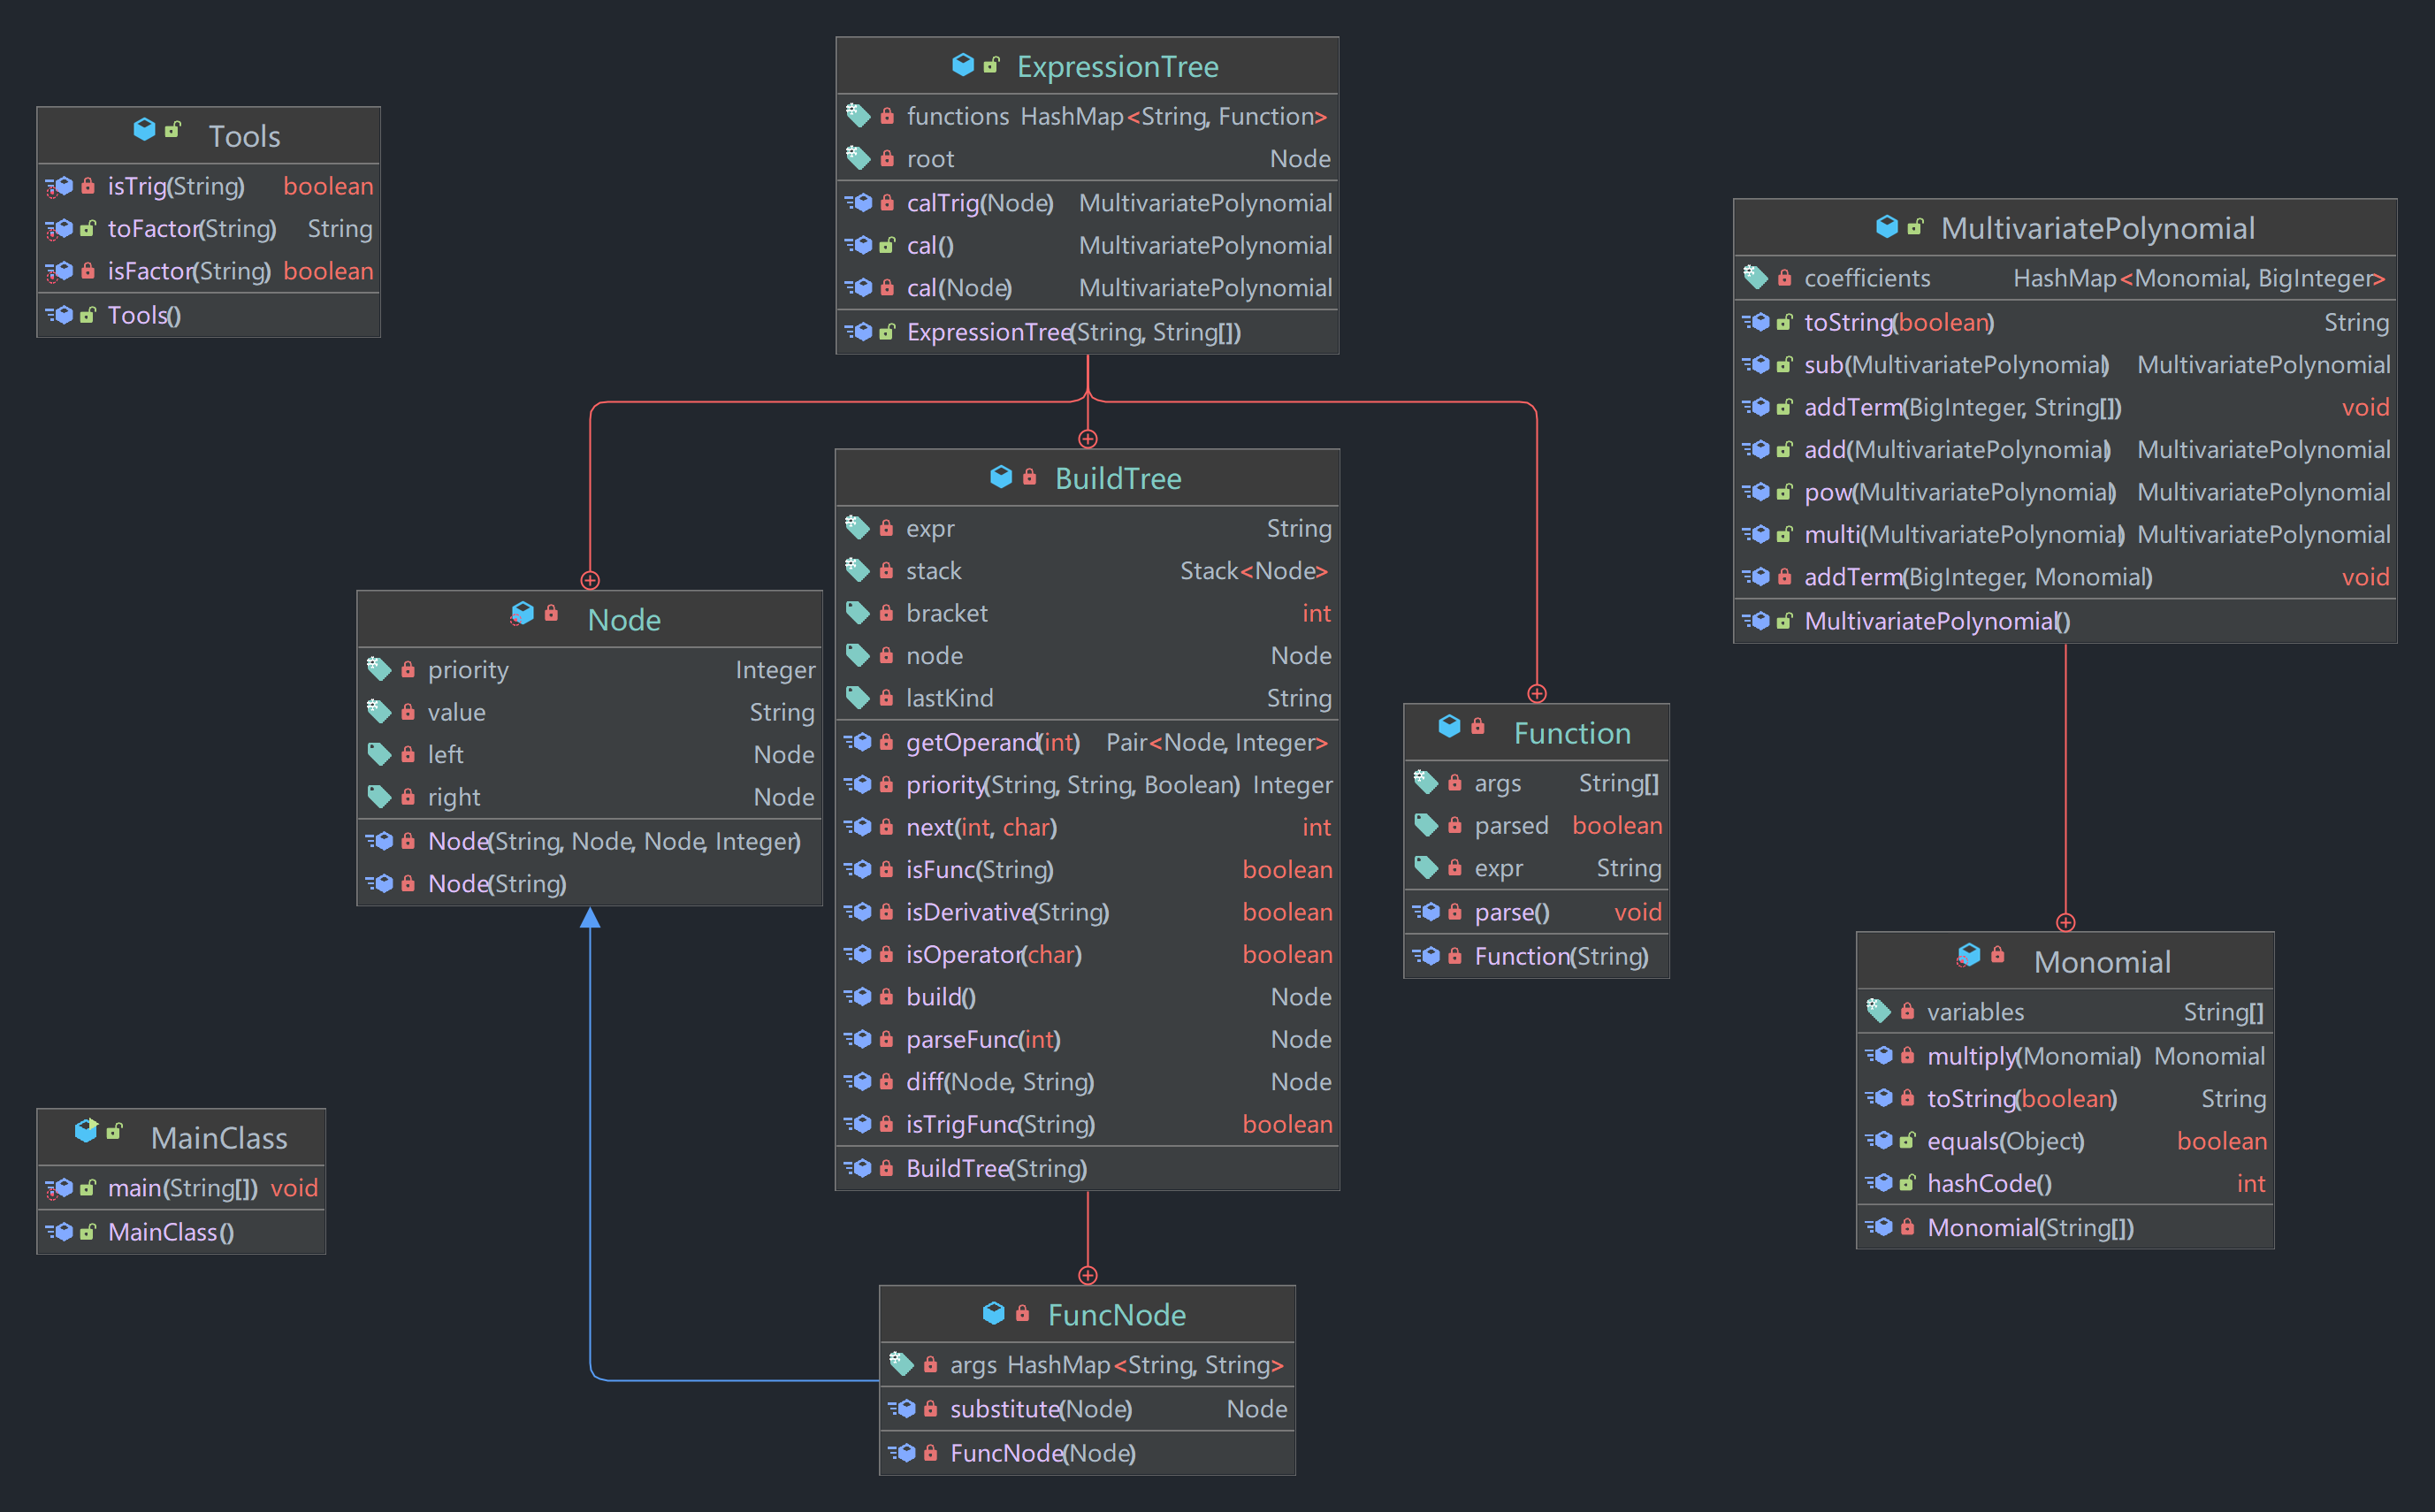
主要架构已在前文介绍。
复杂度分析
| Method | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| ExpressionTree.BuildTree.build() | 23.0 | 7.0 | 13.0 | 15.0 |
| ExpressionTree.BuildTree.BuildTree(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpressionTree.BuildTree.diff(Node, String) | 10.0 | 1.0 | 1.0 | 7.0 |
| ExpressionTree.BuildTree.FuncNode.FuncNode(Node) | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpressionTree.BuildTree.FuncNode.substitute(Node) | 4.0 | 3.0 | 2.0 | 3.0 |
| ExpressionTree.BuildTree.getOperand(int) | 7.0 | 1.0 | 6.0 | 7.0 |
| ExpressionTree.BuildTree.isDerivative(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpressionTree.BuildTree.isFunc(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpressionTree.BuildTree.isOperator(char) | 1.0 | 1.0 | 1.0 | 3.0 |
| ExpressionTree.BuildTree.isTrigFunc(String) | 1.0 | 1.0 | 2.0 | 2.0 |
| ExpressionTree.BuildTree.next(int, char) | 7.0 | 1.0 | 4.0 | 6.0 |
| ExpressionTree.BuildTree.parseFunc(int) | 2.0 | 1.0 | 3.0 | 3.0 |
| ExpressionTree.BuildTree.priority(String, String, Boolean) | 8.0 | 7.0 | 4.0 | 11.0 |
| ExpressionTree.cal() | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpressionTree.cal(Node) | 13.0 | 1.0 | 3.0 | 8.0 |
| ExpressionTree.calTrig(Node) | 12.0 | 1.0 | 5.0 | 7.0 |
| ExpressionTree.ExpressionTree(String, String[]) | 1.0 | 1.0 | 2.0 | 2.0 |
| ExpressionTree.Function.Function(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpressionTree.Function.parse() | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpressionTree.Node.Node(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpressionTree.Node.Node(String, Node, Node, Integer) | 0.0 | 1.0 | 1.0 | 1.0 |
| MainClass.main(String[]) | 1.0 | 1.0 | 2.0 | 2.0 |
| MultivariatePolynomial.add(MultivariatePolynomial) | 1.0 | 1.0 | 2.0 | 2.0 |
| MultivariatePolynomial.addTerm(BigInteger, Monomial) | 3.0 | 1.0 | 3.0 | 3.0 |
| MultivariatePolynomial.addTerm(BigInteger, String...) | 0.0 | 1.0 | 1.0 | 1.0 |
| MultivariatePolynomial.Monomial.equals(Object) | 6.0 | 6.0 | 2.0 | 6.0 |
| MultivariatePolynomial.Monomial.hashCode() | 1.0 | 1.0 | 2.0 | 2.0 |
| MultivariatePolynomial.Monomial.Monomial(String...) | 0.0 | 1.0 | 1.0 | 1.0 |
| MultivariatePolynomial.Monomial.multiply(Monomial) | 0.0 | 1.0 | 1.0 | 1.0 |
| MultivariatePolynomial.Monomial.toString(boolean) | 12.0 | 1.0 | 9.0 | 10.0 |
| MultivariatePolynomial.multi(MultivariatePolynomial) | 3.0 | 1.0 | 3.0 | 3.0 |
| MultivariatePolynomial.MultivariatePolynomial() | 0.0 | 1.0 | 1.0 | 1.0 |
| MultivariatePolynomial.pow(MultivariatePolynomial) | 5.0 | 3.0 | 4.0 | 5.0 |
| MultivariatePolynomial.sub(MultivariatePolynomial) | 1.0 | 1.0 | 2.0 | 2.0 |
| MultivariatePolynomial.toString(boolean) | 16.0 | 5.0 | 11.0 | 13.0 |
| Tools.isFactor(String) | 1.0 | 1.0 | 2.0 | 2.0 |
| Tools.isTrig(String) | 7.0 | 1.0 | 4.0 | 6.0 |
| Tools.toFactor(String) | 1.0 | 1.0 | 1.0 | 2.0 |
| Total | 147.0 | 63.0 | 106.0 | 145.0 |
| Average | 3.868 | 1.658 | 2.789 | 3.816 |
CogC = Cognitive complexity(认知复杂度)
ev(G) = Essential cyclomatic complexity(基本圈复杂度)
iv(G) = Design complexity(设计复杂度)
v(G) = cyclonmatic complexity(圈复杂度)
复杂度超标主要在于表达式树类的建树方法及多项式类的 toString 方法。建树方法包含多种不同符号的处理,为表达式解析的核心方法;toString 方法包含输出时的各类小优化,特判较多。
测试与 Hack 策略
自测为使用评测机对大量随机生成数据和针对性构造数据进行测试。
评测机
感谢[睿睿](TobyShiの博客 (toby-shi-cloud.github.io))提供的自动化测试工具与(我不知道blog链接)的 xc 哥哥的数据生成,我对其进行了些许魔改并持之以恒地push睿睿,使其更符合需求,能够自动完成多 java 文件的打包、投喂,包含自定义数据与随机数据多种模式。
评测机在 OO,至少在第一单元十分重要。即使无法完成正确性判断(虽然利用 sympy 包实现并不困难),也至少要实现自动多数据多文件投喂并输出,这能极大地增加你的自测与 Hack 效率。而数据生成器于第一单元反而是次要的,因为形式化表述较为严谨的特征,特殊及不同形式的数据往往很容易根据其来构造,只需要每种类型构造一些简单的例子就足够使用(根据 Hack 经验,多数成功 Hack 的样例都可以缩短到十几个到几个字符)
Hack 策略
如前文所述,Hack 的数据主要在于对形式化表述与 cost 机制的理解和其特殊点的使用,比如 0**0、---1 等,将这些基本的特殊内容与新增要求组合便能顺利找到绝大部分 bug;同样,从相反的方向出发,攻击代码对输出表达式的优化也是另一种优秀的方法。灵活使用以上两种方法与评测机的随机测试,我找到了所有房友在互测中被发现的所有 bug,甚至发现了指导书的不完善之处。
你说得对,但是
优化技巧
/*TODO*/
心得体会
根据我的不完全统计,我可能是极少数没有使用标准的递归下降方法的有效作业。除去和同学讨论的不便外,却也为我带来了不一样的体验。
在三次迭代中,我深深体会了优秀的架构的重要性,也体会到了面向对象程序设计强大的可维护性、可重用性与可拓展性。
附录
课程组的助教与老师们好,注意到老师们一直在强调 OO 先导课的重要性,希望在下一届能将该课程开放给所有希望选课的人,而不是限定了名额后在下一学期质问选不到课的同学为什么不选课,并在第四周的课上放上一页PPT简单地写上几个大字:不能忽视先导课的价值
相关推荐
为什么RingMo能成为遥感领域的首个生成式自监督基础模型?
RingMo作为遥感领域首个生成式自监督基础模型,通过创新的图像掩码建模技术解决了传统方法在遥感图像处理中的挑战。该模型利用两百万张多元数据集进行预训练,在小目标检测、场景分类等任务上表现卓越,显著提升了性能指标。RingMo的技术突破为遥感图像解译提供了高效解决方案,降低了标注成本并增强了模型泛化能力。
Rapid SCADA MQTT
一、配置RapidSCADA 1、准备KpMqtt.dll、Jint.dll库文件,从网盘下载。 2、将以上两个文件拷贝到SCADA安装目录的Comm/KP目录下,如下: C:\SCADA\ScadaComm\KP 3、新建SCADA项目 4、新建Line 5、新建Device 6、拷贝Config目录下的KpMqtt_001.xml文件、KpMqtt_Job.js文件到项目Comm\Config下,如下示例链接 C:\SCADA\Projects\MQTTProject\Instances\Defau
车载测试工程师必备:5分钟搞定CANoe台架搭建(附DBC导入技巧)
本文为车载测试工程师提供快速搭建CANoe测试台架的实用指南,涵盖硬件连接、DBC文件导入及常见报错解决方案。通过详细步骤和高效技巧,帮助工程师在5分钟内完成台架搭建,提升车载测试效率,特别适合紧急功能验证场景。
【GAN】pytorch-CycleGAN-and-pix2pix开源项目训练自定义数据集
Github:https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix 一、概念简介 图像转换:将一张图片转换为不同风格的图片,如将一张灰度图变成彩色图,素描图换成实物图。 pix2pix:需要成对的数据集,两个不同域的图像一一对应。 CycleGAN:不需要成对的数据集,只用两个不同域(domain)的图像集合X和Y,两个集合中的图像不是一一对应的。 二、训练pix2pix模型 2.1 combine_A_and_B datasets/combin
1014. 福尔摩斯的约会 (20)-PAT乙级真题
1014. 福尔摩斯的约会 (20) 大侦探福尔摩斯接到一张奇怪的字条:“我们约会吧!3485djDkxh4hhGE 2984akDfkkkkggEdsb s&hgsfdk d&Hyscvnm”。大侦探很快就明白了,字条上奇怪的乱码实际上就是约会的时间“星期四 14:04”,因为前面两字符串中第1对相同的大写英文字母(大小写有区分)是第4个字母’D’,代表星期四;第2对相同的字符是’




