

 BSV区块链

深度学习新手必学:使用Pytorch搭建一个N-Gram模型
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
本文由集智小仙女发表在集智AI学园公众号上,欢迎关注集智AI学园微信公众号:swarmAI。
前言
在使用语音搜索时,用户的输入语音常常含糊其词。比如 “daiyugang” 到底是 “戴玉刚” 还是 “带浴缸” ,仅凭声学根本无法判断。这时候就需要使用以往的大量历史搜索数据训练一个 N-gram 模型,依靠模型来估计出用户更可能的输入。
N-gram 的基本原理
N-gram 是计算机语言学和概率论范畴内的概念,是指给定的一段文本或语音中N个项目(item)的序列。项目(item)可以是音节、字母、单词。
N=1 时 N-gram 又称为 unigram,N=2 称为 bigram,N=3 称为 trigram,以此类推。实际应用通常采用 bigram 和 trigram 进行计算。
举例来说:“你今天休假了吗”
它的 bigram 依次为:
你今,今天,天休,休假,假了,了吗
制造这种语言模型的原因是基于这么一种思想:在整个语言环境中,句子T的出现概率是由组成T的N个item的出现概率组成的,如下公式所示:
P(T)=P(W1W2W3Wn)=P(W1)P(W2|W1)P(W3|W1W2)…P(Wn|W1W2…Wn-1)
以上公式难以实际应用。
此时出现马尔科夫模型,该模型认为,一个词的出现仅仅依赖于它前面出现的几个词。这就大大简化了上述公式:
P(T)≈P(W1)P(W2|W1)P(W3|W2)…P(Wn|Wn-1)
N-gram 的用途
输入法
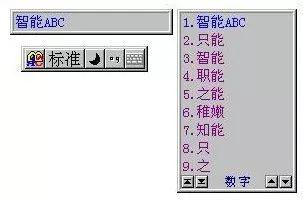
用前几个字预测后几个字,这个功能在我们每天都在用的输入法里及其重要。比如,我们曾经最爱用的“智能ABC”,据说就使用了 N-gram 技术。
语音识别
同样的用途,N-gram 模型也被应用在语音识别领域。比如用户在使用语音搜索的时候,输入的语音常常含糊其词。比如语音“daiyugang”到底是“戴玉刚”还是“带浴缸”,仅凭声学模型根本无法判断用户到底说的是什么词。这时候厂商就需要通过以往的大量历史搜索数据训练一个 N-gram 模型,依靠模型来估计出用户更可能的输入。
词嵌入
你可能会疑惑,哎之前不是讲了用 Word2Vec 和 GloVe 做词嵌入吗?怎么 N-gram 模型也来插一腿?
是这样子滴,通常在使用 N-gram 模型时,模型的输入是每个词的独热编码向量,而每个向量的长度正是“词典”的大小。这么一来,在 N-gram 模型得到良好的训练后,可以使用模型输入层的每个神经元(代表每个词)所对应的权重参数,作为这个词的词向量。经过 N-gram 模型嵌入得到的词向量不同于 Word2Vec 和 GloVe,在自然语言处理领域有其独特的价值。
使用 PyTorch 实现简单 N-gram 语言模型
在前面的资料中,有讲到马尔科夫模型,即认为一个词的出现仅仅依赖于它前面出现的几个词。
我们今天就打造一个用前两个词预测第三个词的 N-gram 模型。我们准备了一篇莎士比亚的14行诗作为文本,并按顺序将整首诗拆成一个一个的单词。将前两个词作为训练数据,将第三个词作为目标数据,以此类推整个文本,生成训练数据集。
然后我们把训练数据(前两个词)传入到我们的 N-gram 模型(也就是我们的神经网络)中,让 N-gram 模型学习去预测第三个词。
相关推荐
CBOW_Word2Vec:用PyTorch实现连续词袋(CBOW)模型。 CBOW和Skip-gram一起是使用深度学习在NLP中最常用的词嵌入方法之一
连续词袋(CBOW) NLP中使用深度学习经常使用连续词袋(CBOW)和Skip-gram模型。 给定目标词之前和之后的上下文词范围N,它会尝试预测当前(目标)词。 此代码是PyTorch教程在以下链接的Word Embeddings的“获取密集的词嵌入”中给出的练习的实现: https://pytorch.org/tutorials/beginner/nlp/word_embeddings_tutorial.html#getting-dense-word-embeddings 参考 有关单词嵌入的进一步研究,请阅读以下文章: 向量空间中单词表示的有效估计 word2vec解释:推导Mikolov等人的负采样词嵌入方法 单词和短语的分布式表示形式及其组成
Pytorch深度学习(5) — 词向量及Glove预训练模型使用
Pytorch深度学习(5) — 词向量及Glove预训练模型使用1.word2vec的原理和实现2.Glove预训练模型使用2.1 求近义词和类比词2.1.1 使用预训练的词向量2.2.2 应用预训练词向量2.2.2.1 求近义词2.2.2.2 求类比词小结 1.word2vec的原理和实现 具体参考: [CSDN]:https://blog.csdn.net/Daycym/article/details/88949343 2.Glove预训练模型使用 2.1 求近义词和类比词 在(word2vec的实现)中,我们在小规模数据集上训练了一个word2vec词嵌入模型,并通过词向量的余弦相似度
spearman的matlab代码-skip-gram-pytorch:skip-gram的完整pytorch实现
spearman的matlab代码skipgram 模型的完整 pytorch 实现(带有子采样和负采样)。 嵌入结果用 Spearman 秩相关检验。
基于PyTorch实现的词向量模型
资源名称:基于PyTorch实现的词向量模型 资源内容: 1. 英文文本数据集(1803个单词) 2. 其余代码
词嵌入与Skip-Gram模型[可运行源码]
本文详细介绍了词嵌入(word embedding)的概念及其在自然语言处理中的应用,通过对比one-hot编码,阐述了词嵌入如何通过高维向量表示单词的语义属性。文章以PyTorch为例,展示了词嵌入的实现代码,并深入讲解了Skip-Gram模型的原理,包括如何通过上下文单词预测目标单词,以及模型的训练细节。此外,还介绍了N Gram模型及其在语言预测中的应用,包括代码实现和训练过程。全文内容丰富,涵盖了词嵌入的基础知识、模型实现及实际应用,适合对自然语言处理感兴趣的读者学习参考。




