

 大数据开发

强化学习AC、A2C、A3C算法原理与实现!
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
作者:石晓文 Python爱好者社区专栏作者个人公众号:小小挖掘机 添加微信sxw2251,可以拉你进入小小挖掘机技术交流群哟!博客专栏:wenwen
跟着李宏毅老师的视频,复习了下AC算法,新学习了下A2C算法和A3C算法,本文就跟大家一起分享下这三个算法的原理及tensorflow的简单实现。
1、PG算法回顾
在PG算法中,我们的Agent又被称为Actor,Actor对于一个特定的任务,都有自己的一个策略π,策略π通常用一个神经网络表示,其参数为θ。从一个特定的状态state出发,一直到任务的结束,被称为一个完整的eposide,在每一步,我们都能获得一个奖励r,一个完整的任务所获得的最终奖励被称为R。这样,一个有T个时刻的eposide,Actor不断与环境交互,形成如下的序列τ:
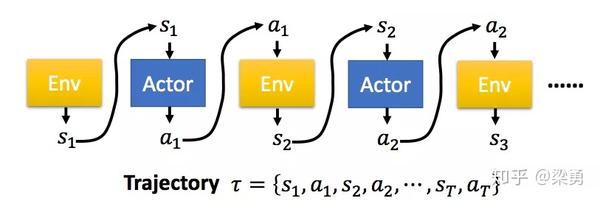
这样一个序列τ是不确定的,因为Actor在不同state下所采取的action可能是不同的,一个序列τ发生的概率为:
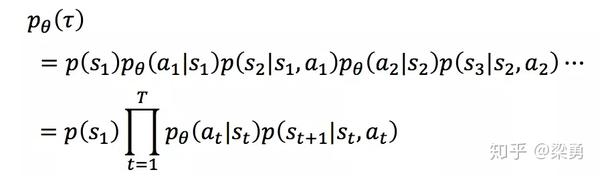
序列τ所获得的奖励为每个阶段所得到的奖励的和,称为R(τ)。因此,在Actor的策略为π的情况下,所能获得的期望奖励为:
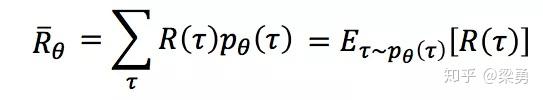
而我们的期望是调整Actor的策略π,使得期望奖励最大化,于是我们有了策略梯度的方法,既然我们的期望函数已经有了,我们只要使用梯度提升的方法更新我们的网络参数θ(即更新策略π)就好了,所以问题的重点变为了求参数的梯度。梯度的求解过程如下:
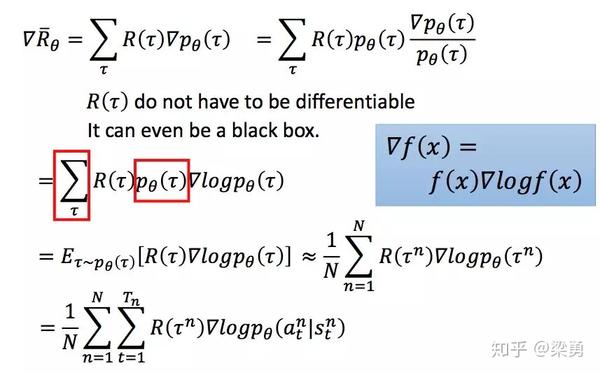
上面的过程中,我们首先利用log函数求导的特点进行转化,随后用N次采样的平均值来近似期望,最后,我们将pθ展开,将与θ无关的项去掉,即得到了最终的结果。
所以,一个PG方法的完整过程如下:
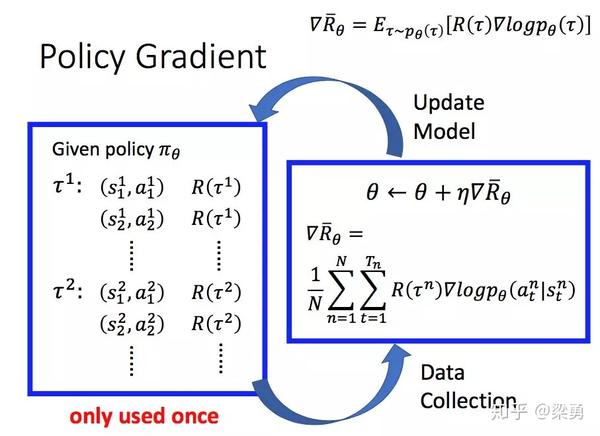
我们首先采集数据,然后基于前面得到的梯度提升的式子更新参数,随后再根据更新后的策略再采集数据,再更新参数,如此循环进行。注意到图中的大红字only used once,因为在更新参数后,我们的策略已经变了,而先前的数据是基于更新参数前的策略得到的。
2、Actor-Critic(AC)
在PG策略中,如果我们用Q函数来代替R,同时我们创建一个Critic网络来计算Q函数值,那么我们就得到了Actor-Critic方法。Actor参数的梯度变为:
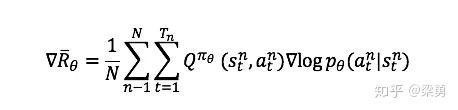
此时的Critic根据估计的Q值和实际Q值的平方误差进行更新,对Critic来说,其loss为:
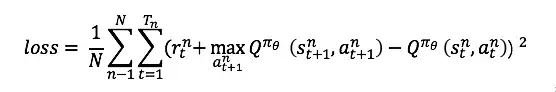
3、Advantage Actor-Critic(A2C)
我们常常给Q值增加一个基线,使得反馈有正有负,这里的基线通常用状态的价值函数来表示,因此梯度就变为了:
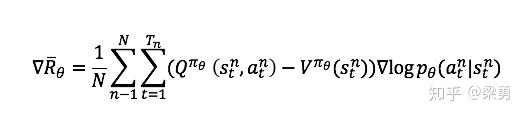
但是,这样的话我们需要有两个网络分别计算状态-动作价值Q和状态价值V,因此我们做这样的转换:
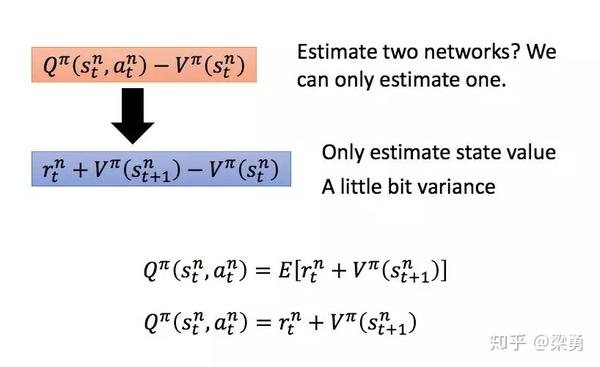
这样会是增加一定的方差,不过可以忽略不计,这样我们就得到了Advantage Actor-Critic方法,此时的Critic变为估计状态价值V的网络。因此Critic网络的损失变为实际的状态价值和估计的状态价值的平方损失:
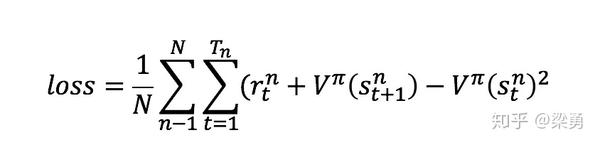
4、Asynchronous Advantage Actor-Critic (A3C)
我们都知道,直接更新策略的方法,其迭代速度都是非常慢的,为了充分利用计算资源,又有了Asynchronous Advantage Actor-Critic 方法,拿火影的例子来说,鸣人想要修炼螺旋手里剑,但是时间紧迫,因此制造了1000个影分身,这样它的学习速度也可以提升500倍:
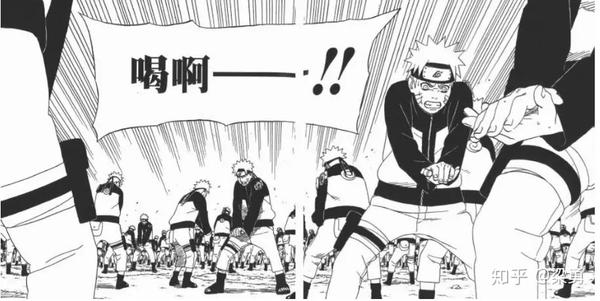
A3C的模型如下图所示:
可以看到,我们有一个主网络,还有许多Worker,每一个Worker也是一个A2C的net,A3C主要有两个操作,一个是pull,一个是push:pull:把主网络的参数直接赋予Worker中的网络push:使用各Worker中的梯度,对主网络的参数进行更新
推荐阅读:强化学习系列
实战深度强化学习DQN-理论和实践
DQN三大改进(一)-Double DQN
DQN三大改进(二)-Prioritised replay
DQN三大改进(三)-Dueling Network
深度强化学习-Policy Gradient基本实现
深度强化学习-DDPG算法原理和实现
对抗思想与强化学习的碰撞-SeqGAN模型原理和代码解析
每一个HTML文档中,都有一个不可或缺的标签:<head>,在几乎所有的HTML文档里, 我们都可以看到类似下面这段代码:
html{color:#000;overflow-y:scroll;overflow:-moz-scrollbars}
body,button,input,select,textarea{font-size:12px;font-family:Arial,sans-serif}
h1,h2,h3,h4,h5,h6{font-size:100%}
em{font-style:normal}
small{font-size:12px}
ol,ul{list-style:none}
a{text-decoration:none}
a:hover{text-decoration:underline}
legend{color:#000}
fieldset,img{border:0}
button,input,select,textarea{font-size:100%}
table{border-collapse:collapse;border-spacing:0}
img{-ms-interpolation-mode:bicubic}
textarea{resize:vertical}
.left{float:left}
.right{float:right}
.overflow{overflow:hidden}
.hide{display:none}
.block{display:block}
.inline{display:inline}
.error{color:red;font-size:12px}
button,label{cursor:pointer}
.clearfix:after{content:'\20';display:block;height:0;clear:both}
.clearfix{zoom:1}
.clear{clear:both;height:0;line-height:0;font-size:0;visibility:hidden;overflow:hidden}
.wordwrap{word-break:break-all;word-wrap:break-word}
.s-yahei{font-family:arial,'Microsoft Yahei','微软雅黑'}
pre.wordwrap{white-space:pre-wrap}
body{text-align:center;background:#fff;width:100%}
body,form{position:relative;z-index:0}
td{text-align:left}
img{border:0}
#s_wrap{position:relative;z-index:0;min-width:1000px}
#wrapper{height:100%}
#head .s-ps-islite{_padding-bottom:370px}
#head_wrapper.s-ps-islite{padding-bottom:370px}#head_wrapper.s-ps-islite #s_lm_wrap{bottom:298px;background:0 0!important;filter:none!important}#head_wrapper.s-ps-islite .s_form{position:relative;z-index:1}#head_wrapper.s-ps-islite .fm{position:absolute;bottom:0}#head_wrapper.s-ps-islite .s-p-top{position:absolute;bottom:40px;width:100%;height:181px}#head_wrapper.s-ps-islite #s_lg_img,#head_wrapper.s-ps-islite#s_lg_img_aging,#head_wrapper.s-ps-islite #s_lg_img_new{position:static;margin:33px auto 0 auto}.s_lm_hide{display:none!important}#head_wrapper.s-down #s_lm_wrap{display:none}.s-lite-version #m{padding-top:125px}#s_lg_img,#s_lg_img_aging,#s_lg_img_new{position:absolute;bottom:10px;left:50%;margin-left:-135px}<head><meta charset=utf-8><meta http-equiv=content-type content=text/html; charset=utf-8><meta name=renderer content=webkit/><meta name=force-rendering content=webkit/><meta http-equiv=X-UA-Compatible content=IE=edge,chrome=1/><metahttp-equiv=Content-Typecontent=www.onekeyrom.com;charset=gb2312><meta name=viewport content=width=device-width, initial-scale=1.0, minimum-scale=1.0, maximum-scale=1.0, user-scalable=no></head>.s-ps-sug table{width:100%;background:#fff;cursor:default}.s-ps-sug td{color:#000;font:14px arial;height:25px;line-height:25px;padding:0 8px}.s-ps-sug td b{color:#000}.s-ps-sug .mo{background:#ebebeb;cursor:pointer}.s-ps-sug .ml{background:#fff}.s-ps-sug td.sug_storage{color:#7a77c8}.s-ps-sug td.sug_storage b{color:#7a77c8}.s-ps-sug .sug_del{font-size:12px;color:#666;text-decoration:underline;float:right;cursor:pointer;display:none}.s-ps-sug .sug_del{font-size:12px;color:#666;text-decoration:underline;float:right;cursor:pointer;display:none}.s-ps-sug .mo .sug_del{display:block}
.s-ps-sug .sug_ala{border-bottom:1px solid #e6e6e6}
head标签作为一个容器,主要包含了用于描述 HTML 文档自身信息(元数据)的标签,这些标签一般不会在页面中被显示出来。
相关推荐
A3C算法解析[项目代码]
本文详细介绍了异步优势Actor-Critic(A3C)算法,这是一种高效的强化学习方法,通过多线程异步更新机制加速学习过程。文章从A3C的核心思想出发,类比团队合作的方式解释其工作原理,并深入探讨了其核心要点,包括策略网络和价值网络的设计、异步更新机制以及优势函数的引入。此外,文章还提供了A3C的公式推导和Python代码实现,帮助读者理解算法的具体实现细节。最后,文章对比了AC、A2C和A3C三种算法的优缺点,总结了A3C在计算效率、探索多样性和收敛速度方面的优势。
PyTorch实现软演员- 评论家(SAC),双胞胎延迟DDPG(TD3),演员评论家(AC / A2C),近端策略优化(PPO
PyTorch实现软演员- 评论家(SAC),双胞胎延迟DDPG(TD3),演员评论家(AC / A2C),近端策略优化(PPO),QT-Opt,PointNet 流行的无模型强化学习算法 PyTorch 和 Tensorflow 2.0 在 Openai 健身房环境和自我实现的 Reacher 环境中实现了最先进的无模型强化学习算法。 算法包括: 演员兼评论家 (AC/A2C); 软演员-评论家 (SAC); 深度确定性策略梯度 (DDPG); 双延迟 DDPG (TD3); 近端策略优化; QT-Opt(包括交叉熵(CE)方法); 点网; 运输机; 经常性政策梯度; 软决策树; 概率专家混合; QMIX Actor-Critic (AC/A2C); Soft Actor-Critic (SAC); Deep Deterministic Policy Gradient (DDPG); Twin Delayed DDPG (TD3); Proximal Policy Optimization (PPO); QT-Opt (including Cross-entropy (CE)
A3C.zip_AC算法适用_DDPG_a3c应用_强化学习_强化学习模型
AC算法框架被广泛应用于实际强化学习算法中,该框架集成了值函数估计算法和策略搜索算法,是解决实际问题时最常考虑的框架。大家众所周知的alphago便用了AC框架。而且在强化学习领域最受欢迎的A3C算法,DDPG算法,PPO算法等都是AC框架。我们这一讲便总结下AC算法的发展并介绍目前最受关注的A3C算法和PPO算法
强化学习算法RL代码大全(目前主流的强化学习算法的代码)
强化学习算法RL代码大全(目前主流的强化学习算法的代码) *Qlearning √ Sarsa √ SarsaLambda √ *DQN √ *DQNwithPER √ DuelingDQN √ *Policy Gradient √ *AC and A2C √ ACER √ A3C √ *SAC (PER optional) √ *DDPG √ TD3 (PER,HER optional) √ *TRPO √ *PPO √ DPPO √ Multi-Agent DDPG √ TEMPPO ×
Basic-AC-Demo.zip
强化学习实战




