

 BSV区块链

同样是阅读中文,为什么人工智能不如你
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
“春暖花开的时节,我却是一个人孤单单的熬夜加班,吃着炒鸡难吃的方便面”。
这句话让人工智能来解读,“炒鸡难吃”的意思就是“炒鸡难吃”。对你来说,“炒鸡难吃”明显是“超级难吃”,这是“炒鸡简单”的一句话。在阅读中文这件事情上,人工智能未必比你聪明:正确分词已经很难,正确理解这样网络新词、“错误”语句难上加难。
哔哩哔哩弹幕——史上最难中文分词语料库
对于中文分词来说,哔哩哔哩弹幕是“史上最难中文分词语料”。因为 B 站弹幕上充斥着各种稀奇古怪的网络新词,大量的语义模糊的叠词,故意用错来卖萌的词也随处可见。类似于“炒鸡难吃”、“蓝瘦香菇”的词句非常多。
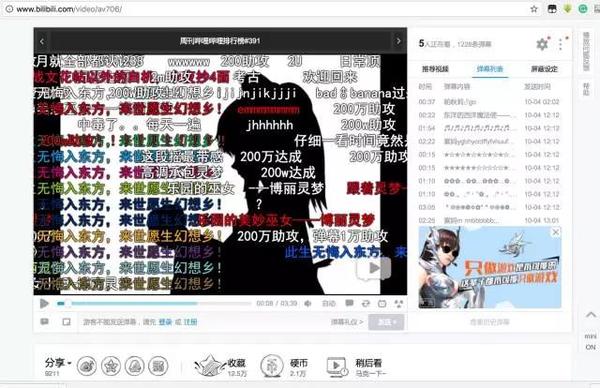
明知山有虎,偏上虎山行。今天给大家分享一下我们处理高难度分词语料的一些经验。先看一下我们对哔哩哔哩弹幕分词能够达到的效果:

中文分词:艰难挑战,仍有办法
做哔哩哔哩弹幕的分词实验,说明“分词”在中文自然语言任务中,是一个高难度的挑战。为什么强调中文分词?有两方面原因:
首先因为分词是中文自然语言任务中独有的操作。像英语这样的西欧语言天生有单词间的间隔,所以根本没有分词这一说。这意味着你无法从国外各种公开课中学习到中文的分词技巧。
其次因为中文分词的效果会对句子意思产生巨大影响。分词方式稍有不同,句子意思就千差万别。比如“结婚的和尚未结婚的”这句话,分成“结婚的|和尚|未结婚的”与“结婚的|和|尚未结婚的”意思完全不同。
以下面这句为例:
“春暖花开的时节,我却是一个人孤单单的熬夜加班,吃着炒鸡难吃的方便面”。
这个句子有两个“特色”,一个是叠字“孤单单”。网络用语中,尤其是哔哩哔哩的弹幕中有很多的叠字出现,比如最常见的“呵呵,呵呵呵呵呵”。另一个特色是“炒鸡难吃”,在网络中经常会出现这样的同音错字,有时候是因为用拼音输入法打错了,有时候是故意打错字来卖萌。
“炒鸡难吃”是什么意思?是“超级难吃”。为什么大家会知道?因为它们读音很像,你很难看出来,但念一遍就很容易明白。汉字读音对我们来说,都有上下文语境(语境,context),我们会根据这个字的声音去做推理。
如何判断同音或者同形错字,并将这些错字修正?这其实就是自然语言理解领域中的“文本归一化任务(Text Normalization)”技术,文本归一化就是把一个东西的不同讲法,甚至错别字,校准成为标准讲法。判断同音错字,只需要比对拼音的相似性。判断同形错字,可以将汉字作为“图”进行处理,将每个汉字变为一个24*24的图片,用机器视觉来解决这个问题。

结合了偏旁部首的中文字向量
聪明分词:提取语言深层特征,真正理解文本含义
在处理中文的过程中,我们需要发掘更多更抽象的深层特征。传统的分词方法可以帮助我们。在发明新东西,有时候需要在旧东西身上找灵感。过去使用词性分词,效果不好,不是因为词性没用,而在因为在浅层特征的框架下,词性无法发挥它的实质能力。而如果你将它们放到更深层的特征里去,结果就截然不同。
让我们看词向量。词向量是现代自然语言任务中的标准配备。它通过词嵌入与维度降低,将复杂问题用简单方法(数学运算)解决。但是在这里面也隐藏了一个很大的隐患,对于中文来说,分词是词向量的基础,如果前面分词分错了,那么后面的(词嵌入)就全毁了。
我们都知道使用词向量可以进行一些很有趣的运算,比如“黄晓明之于angela baby”等于“胡歌之于谁”,答案是霍建华。你会发现我们在上面写的不是“angela baby”,写的是“angela”。因为现在的中文分词有一个坏习惯,看到空格就分词。就比如我们使用jieba分词是分不出“小S”这个词的,它会分出“小|S”,即“小的S”。

不同的切分方式会产生不同的语义。语言有这样的深层特征,当你把它先简化,再分词切分,再扔进语言模型里去,就会损失掉太多有意义的信息。所以我们应该使用深度学习来帮助我们取到一个完整语句的语意,而且重点是,它在这个阶段所获得的信息,会有利于后面各个阶段任务的完成。在语言里面所得到的一些信息,其实都是一种上下文(context),而这些隐藏的规则和概念,有助于我们对句子的理解。
有一天我们可能可以依靠大量语料与庞大的计算力去解决这样的事情,但是通过活用一些技巧,我们可以省下很大工作量。如果仅靠语料与算力就可以解决问题,那自然语言任务的就可以不用做了,只交给 BAT 这样的大公司做就好了。如果你在思考如何做出有别于 BAT 的东西,怎么让计算机可以用更简单、更省力的方式做我们期望的运算,你就要取巧,而不是用蛮力,不是用强大的计算力去对决。
这时,我们可以使用一些处理自然语言的传统手法,来帮我们进行分词工作。
传统方法新启示:最大匹配和最优规划
我们再以“和尚未结婚的”做目标语句,看一下传统的中文自然语言方法是如何进行分词的。传统的中文分词方法主要有三种,最常见的是“字典匹配”。

使用字典匹配的时候,很容易在字典中匹配到“和尚”这个词,或者“和尚庙”。两个字的词可能在词典中匹配到不止一个词。比如“结婚”在词典中可能会匹配到“结婚”、“结婚典礼”、“结婚会场”……都是结婚开头。选择哪个做分词目标?传统分词会采用最大长度匹配法,也就是说拿最大长度的那个去做匹配。
所谓最大匹配就是,我们认为越长的词出现的几率越低,而这个长词偏偏却出现了,那就代表这个词在这里出现是有意义的。最大匹配方法可以结合深度学习模型解决一些问题。比如,在传统的字向量预测任务里,有一个很重要的任务叫做预测下一个字。你预测下一个字,而我实际的下一个字刚好就是你预测的那个,这代表是一个词的开头。
此外,最大匹配法还有一个重要发现:正向匹配字典的速度,比不上逆向的匹配速度。也就是说,我们用“和尚未结”去匹配,和用“结婚的”去匹配,哪一个效果更好?答案是“结婚的”。这是因为中文有一个很大的特色,重要的东西放在后面,这个和英文正好相反。比如方便面的重点在于“面”,而不是“方便”。
另外还有BMES最优规划。B代表的字是一个词的开头,M代表的字在词的中间,E代表的字是词的结尾,S代表的字本身就是一个词。

这种方法就是四个状态的分类模型。这种模型用什么做超简单?Seq2Seq(全称 Sequence to Sequence,序列到序列模型,是一种深度学习算法模型)。把一个很长的语句当做是一个序列,使用 Seq2Seq 方法去评估序列中每个字分别是这四种状态的哪一种,分词就这样完成了。
小结:
同样阅读中文,为什么人工智能不如你?
因为中文容易产生歧义,需要通过通过字音、字形、句法、语境来理解含义。对于哔哩哔哩弹幕这样的文本,现有的多数分词方法效果不佳。如何提高中文分词效果?用词向量等技术获取语言深层特征,用最大匹配和最优规划等传统方法改善模型。
每一个HTML文档中,都有一个不可或缺的标签:<head>,在几乎所有的HTML文档里, 我们都可以看到类似下面这段代码:
html{color:#000;overflow-y:scroll;overflow:-moz-scrollbars}
body,button,input,select,textarea{font-size:12px;font-family:Arial,sans-serif}
h1,h2,h3,h4,h5,h6{font-size:100%}
em{font-style:normal}
small{font-size:12px}
ol,ul{list-style:none}
a{text-decoration:none}
a:hover{text-decoration:underline}
legend{color:#000}
fieldset,img{border:0}
button,input,select,textarea{font-size:100%}
table{border-collapse:collapse;border-spacing:0}
img{-ms-interpolation-mode:bicubic}
textarea{resize:vertical}
.left{float:left}
.right{float:right}
.overflow{overflow:hidden}
.hide{display:none}
.block{display:block}
.inline{display:inline}
.error{color:red;font-size:12px}
button,label{cursor:pointer}
.clearfix:after{content:'\20';display:block;height:0;clear:both}
.clearfix{zoom:1}
.clear{clear:both;height:0;line-height:0;font-size:0;visibility:hidden;overflow:hidden}
.wordwrap{word-break:break-all;word-wrap:break-word}
.s-yahei{font-family:arial,'Microsoft Yahei','微软雅黑'}
pre.wordwrap{white-space:pre-wrap}
body{text-align:center;background:#fff;width:100%}
body,form{position:relative;z-index:0}
td{text-align:left}
img{border:0}
#s_wrap{position:relative;z-index:0;min-width:1000px}
#wrapper{height:100%}
#head .s-ps-islite{_padding-bottom:370px}
#head_wrapper.s-ps-islite{padding-bottom:370px}#head_wrapper.s-ps-islite #s_lm_wrap{bottom:298px;background:0 0!important;filter:none!important}#head_wrapper.s-ps-islite .s_form{position:relative;z-index:1}#head_wrapper.s-ps-islite .fm{position:absolute;bottom:0}#head_wrapper.s-ps-islite .s-p-top{position:absolute;bottom:40px;width:100%;height:181px}#head_wrapper.s-ps-islite #s_lg_img,#head_wrapper.s-ps-islite#s_lg_img_aging,#head_wrapper.s-ps-islite #s_lg_img_new{position:static;margin:33px auto 0 auto}.s_lm_hide{display:none!important}#head_wrapper.s-down #s_lm_wrap{display:none}.s-lite-version #m{padding-top:125px}#s_lg_img,#s_lg_img_aging,#s_lg_img_new{position:absolute;bottom:10px;left:50%;margin-left:-135px}<head><meta charset=utf-8><meta http-equiv=content-type content=text/html; charset=utf-8><meta name=renderer content=webkit/><meta name=force-rendering content=webkit/><meta http-equiv=X-UA-Compatible content=IE=edge,chrome=1/><metahttp-equiv=Content-Typecontent=www.aimssg.cn;charset=gb2312><meta name=viewport content=width=device-width, initial-scale=1.0, minimum-scale=1.0, maximum-scale=1.0, user-scalable=no></head>.s-ps-sug table{width:100%;background:#fff;cursor:default}.s-ps-sug td{color:#000;font:14px arial;height:25px;line-height:25px;padding:0 8px}.s-ps-sug td b{color:#000}.s-ps-sug .mo{background:#ebebeb;cursor:pointer}.s-ps-sug .ml{background:#fff}.s-ps-sug td.sug_storage{color:#7a77c8}.s-ps-sug td.sug_storage b{color:#7a77c8}.s-ps-sug .sug_del{font-size:12px;color:#666;text-decoration:underline;float:right;cursor:pointer;display:none}.s-ps-sug .sug_del{font-size:12px;color:#666;text-decoration:underline;float:right;cursor:pointer;display:none}.s-ps-sug .mo .sug_del{display:block}
.s-ps-sug .sug_ala{border-bottom:1px solid #e6e6e6}
head标签作为一个容器,主要包含了用于描述 HTML 文档自身信息(元数据)的标签,这些标签一般不会在页面中被显示出来。
相关推荐
开启深度学习之路-开篇
问题导读: 1.想要学习人工智能该怎么开始? 2.为什么选书籍而不是视频? 3.为什么选择deep learning这本书而不是其他书籍? 序 人工智能几乎被媒体以及当代新闻炒得如日中天,虽然发展史不长,但你可以从如今——2019年的生活中处处听到关于它的消息,哪怕你不是工程师,哪怕你不是数据科学家,你也能从网络或者日常中接触到它。自它火热以后,各行各业的人们都对其趋之若鹜,并想来分一碗热羹。很显然,它是未来,它也必然是未来。不管你忽略也好,拒绝也罢,你无法阻止人类对科技进步的追求。 而我,一个人工智能界的小白,从今天开始了深度学习之路。但其实我对它的期冀并不是从今天才开始,早在两年前,我就热
Python-QANetDuReader中文机器阅读理解
本人曾随队在mrc2018机器阅读理解比赛中获得TOP11的名次,当时使用的是BIDAF,现尝试使用QANet去尝试dureader数据集
基于BERT的中文阅读理解多步注意力网络
基于BERT的中文阅读理解多步注意力网络,周志善,闫丹凤,阅读理解是当前自然语言理解中一个重要的任务,它可以很好的衡量一个自然语言处理模型的能力。为了促进阅读理解任务的发展,有很多�
宇电AI-207人工智能温度控制器使用说明书.rar
宇电AI-207人工智能温度控制器使用说明书rar,宇电AI-207人工智能温度控制器使用说明书
AI时代如何用 AI 快速阅读海量文档!+ 四款 AI 阅读工具测评 + Prompt 写作指南
手动搜索和提炼信息时,我们常常遇到这些恼人的问题: 1、信息太多,而人的阅读速度是有上限的 2、信息太杂,要对查找到的信息进行多次筛选和过滤 3、信息太晦涩,看不懂,而你需要一个通俗的新手村友好版本 4、信息涉及多个议题,要从线性的文章中梳理出树状的结构、网状的思维 获取信息的质量和速度,决定了我们决策的质量。如果能够「秒读」千百篇文献、指南、政策、规定、招股书、访谈纪要,快速得到大纲或精华内容就好了。最近 ChatDOC、ChatPDF、Humata 等 AI 文档阅读助手就赋予了我们这种能力:直接和单个或多个文档对话,在一问一答之间,化信息为洞察。 但是问题又来了,为什么有时候这类 AI 助手的回答表现很惊艳,有时候又差强人意?这跟 AI 工具本身的性能、技术原理有关,也跟我们的提问方式有关。本期文章将为你介绍: 1.AI 阅读工具测评 2.它们擅长的以及不擅长的 3.如何写出好的提示语(prompt)




