

 Linux社区

如何获取百度百科的搜索推荐列表
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
对于某一词条在百度百科上的搜索结果,可以通过https://baike.baidu.com/item/+{关键字}来获取该词条的网页地址,但是对于某些有多个义项或关键字不能完全对应百度百科词条时,跳转到的页面不是我本意要搜索的词条。
为此,我想获取在百度百科搜索框内输入一个词条后的出现的所有相关结果,并对所有相关结果的页面进行访问,请问如何实现呢?
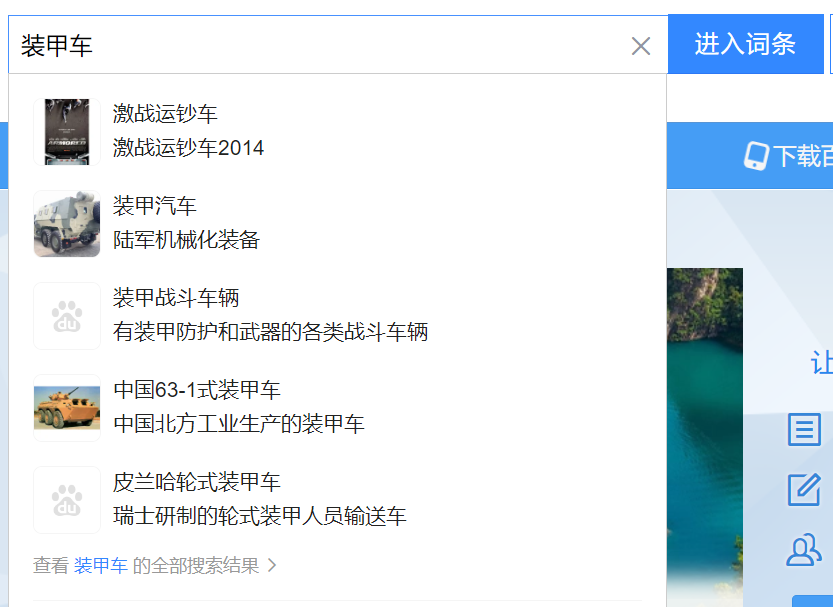
如图,我想获取所有五个推荐结果的跳转网页地址,应该如何编写爬虫代码。
ps:楼主使用的是scrapy爬虫框架,如果有别的实现框架也可以。
相关推荐
免费发链接的十大免费网站整理.pdf
免费发链接的十大免费网站整理.pdf
Python 爬虫实战:爬取百度百科词条内容(知识图谱数据提取与结构化存储)
在当今信息爆炸的时代,知识图谱作为一种结构化的知识表示方式,被广泛应用于搜索引擎、推荐系统、智能问答等领域。百度百科作为中文互联网上最大的百科全书,包含了丰富的知识信息。通过爬取百度百科词条内容,可以构建一个知识图谱,为后续的数据分析和应用提供基础。
python爬虫︱百度百科的requests请求、百度URL格式、网页保存、爬虫模块
1 、 百科网页请求 1.1 网站解析requests与urllib.request对比: py3中主要用requests以及urllib.request两款库用来做网页内容的解析,两者的使用较多以requests为优,解析的内容会做较多的优化。 两款内容的对比: from bs4 import BeautifulSoup url="http://finance.qq.com/gdyw...
「seo十万个为什么之增加反向链接的35个技巧」.pdf
「seo十万个为什么之增加反向链接的35个技巧」.pdf「seo十万个为什么之增加反向链接的35个技巧」.pdf「seo十万个为什么之增加反向链接的35个技巧」.pdf「seo十万个为什么之增加反向链接的35个技巧」.pdf「seo十万个为什么之增加反向链接的35个技巧」.pdf「seo十万个为什么之增加反向链接的35个技巧」.pdf「seo十万个为什么之增加反向链接的35个技巧」.pdf「seo十万个为什么之增加反向链接的35个技巧」.pdf
百度百科语料库
语料库分为人物、景区、动物




