


301
社区成员
 发帖
 与我相关
 我的任务

 分享
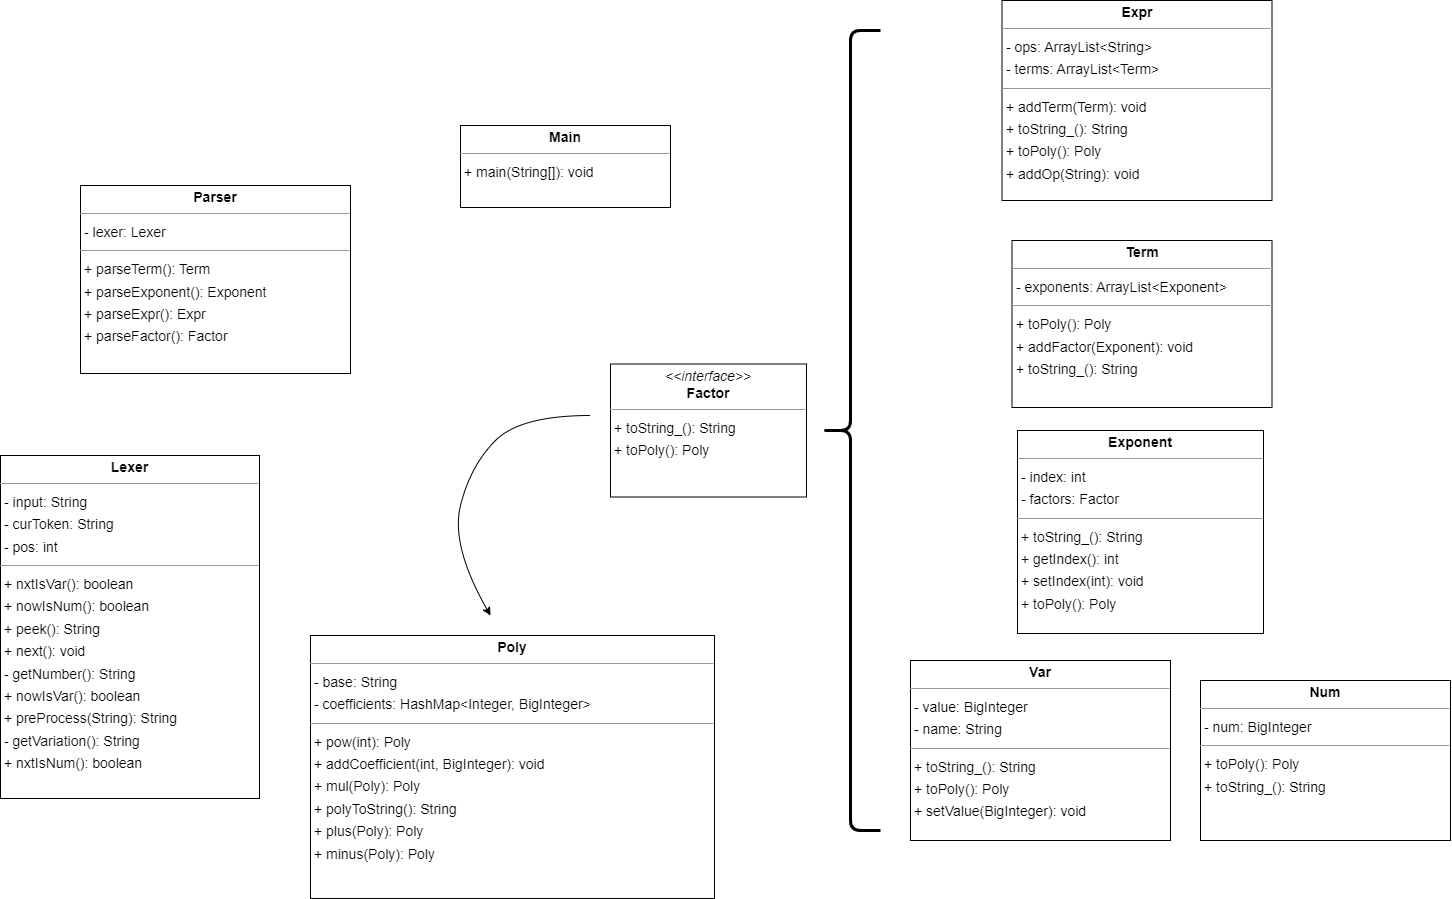
采用递归下降解析
Factor的层级划分为:表达式因子 $\Rightarrow$ 项因子 $\Rightarrow$ 幂因子 $\Rightarrow$ 数字/字母因子
预处理
Lexer lexer = new Lexer(input.replaceAll("[ \t]", ""));
在将字符串传入Lexer前就处理掉空格与Tab
归一化为多项式
新建多项式类Poly,其中包含toString方法用于输出
Factor中包含toPoly方法用于转为多项式
在转为多项式的同时,使用Poly中的计算方法进行化简合并
本次作业并无bug
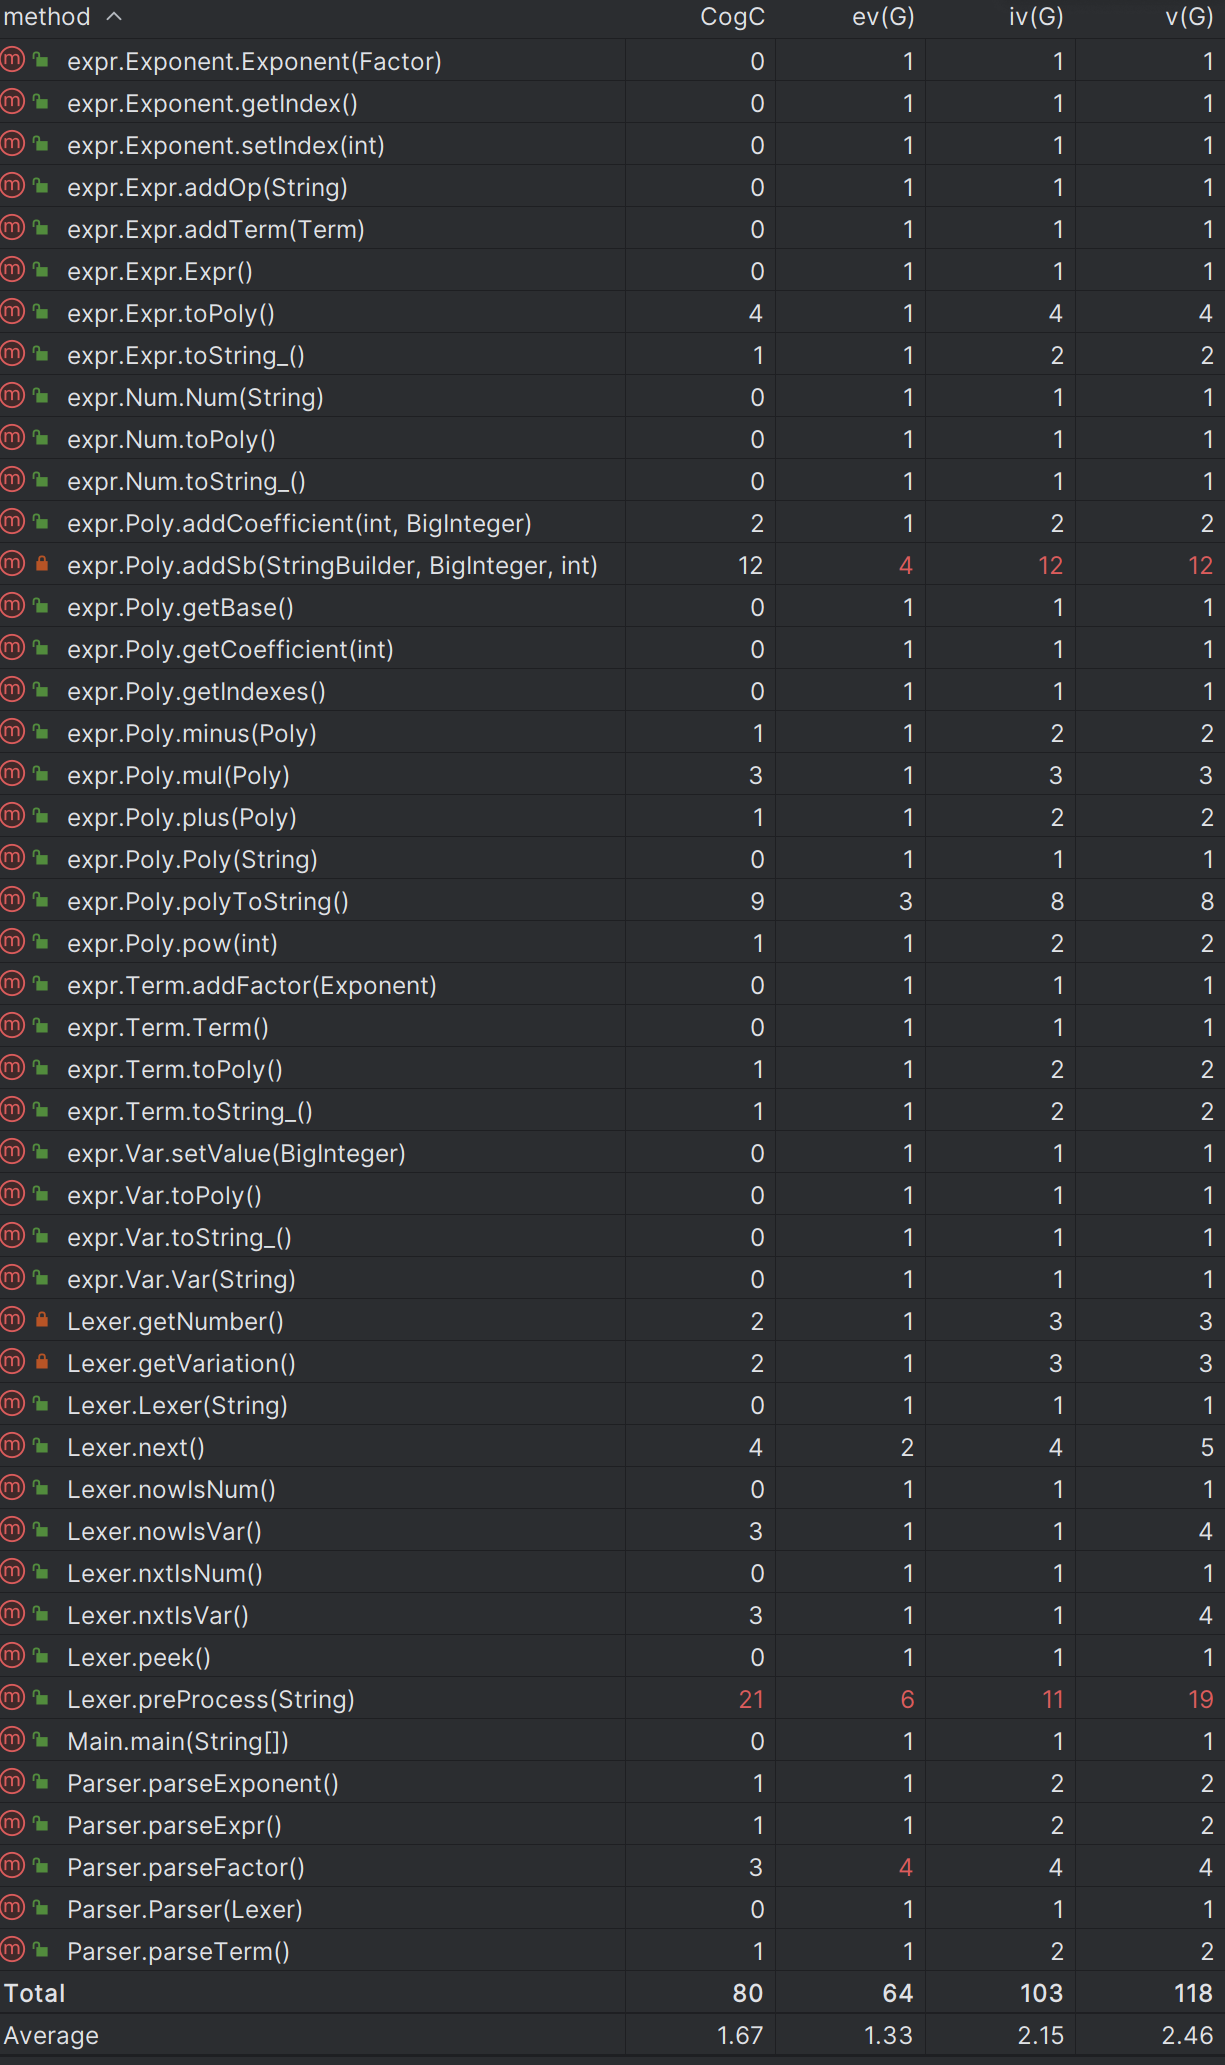
复杂度如下图
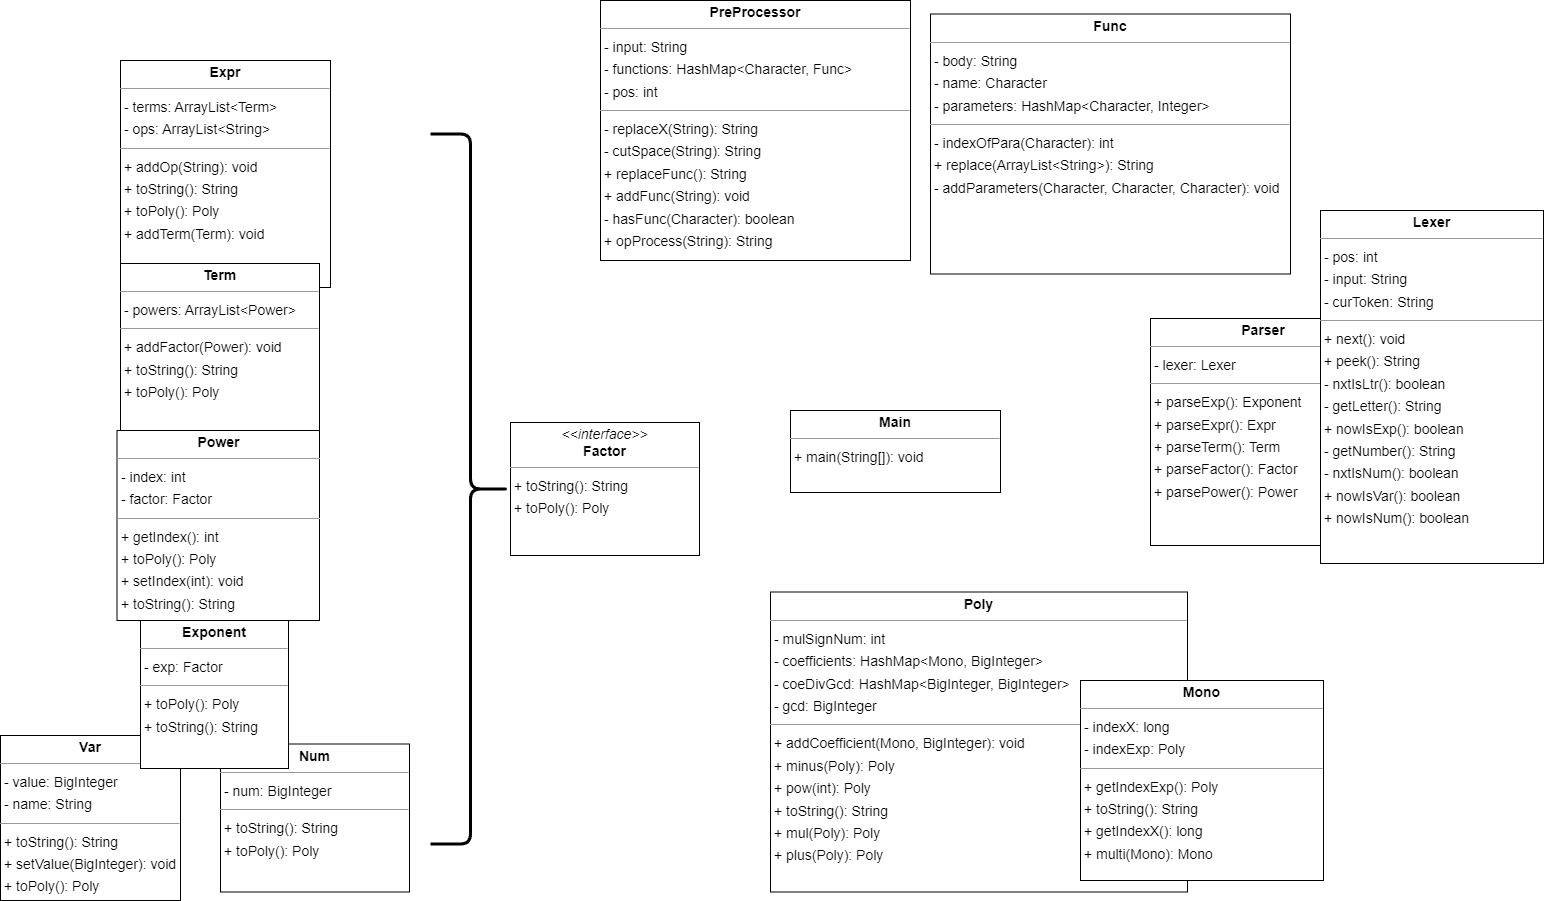
递归下降解析层次更新
表达式因子 $\Rightarrow$ 项因子 $\Rightarrow$ 幂因子 $\Rightarrow$ e指数因子 $\Rightarrow$ 数字/字母因子
单独提出一个预处理类PreProcessor
该类用于存储自定义函数、迭代替换自定义函数、去除空白符、去除连续正负号,经过其处理的字符串可直接用于递归下降解析
新增单项式类(指数类)Mono
用于存储多项式中x与exp的指数,也可看作指数类
本次作业强测中,由于用int存指数,导致化简后的指数超过int范围
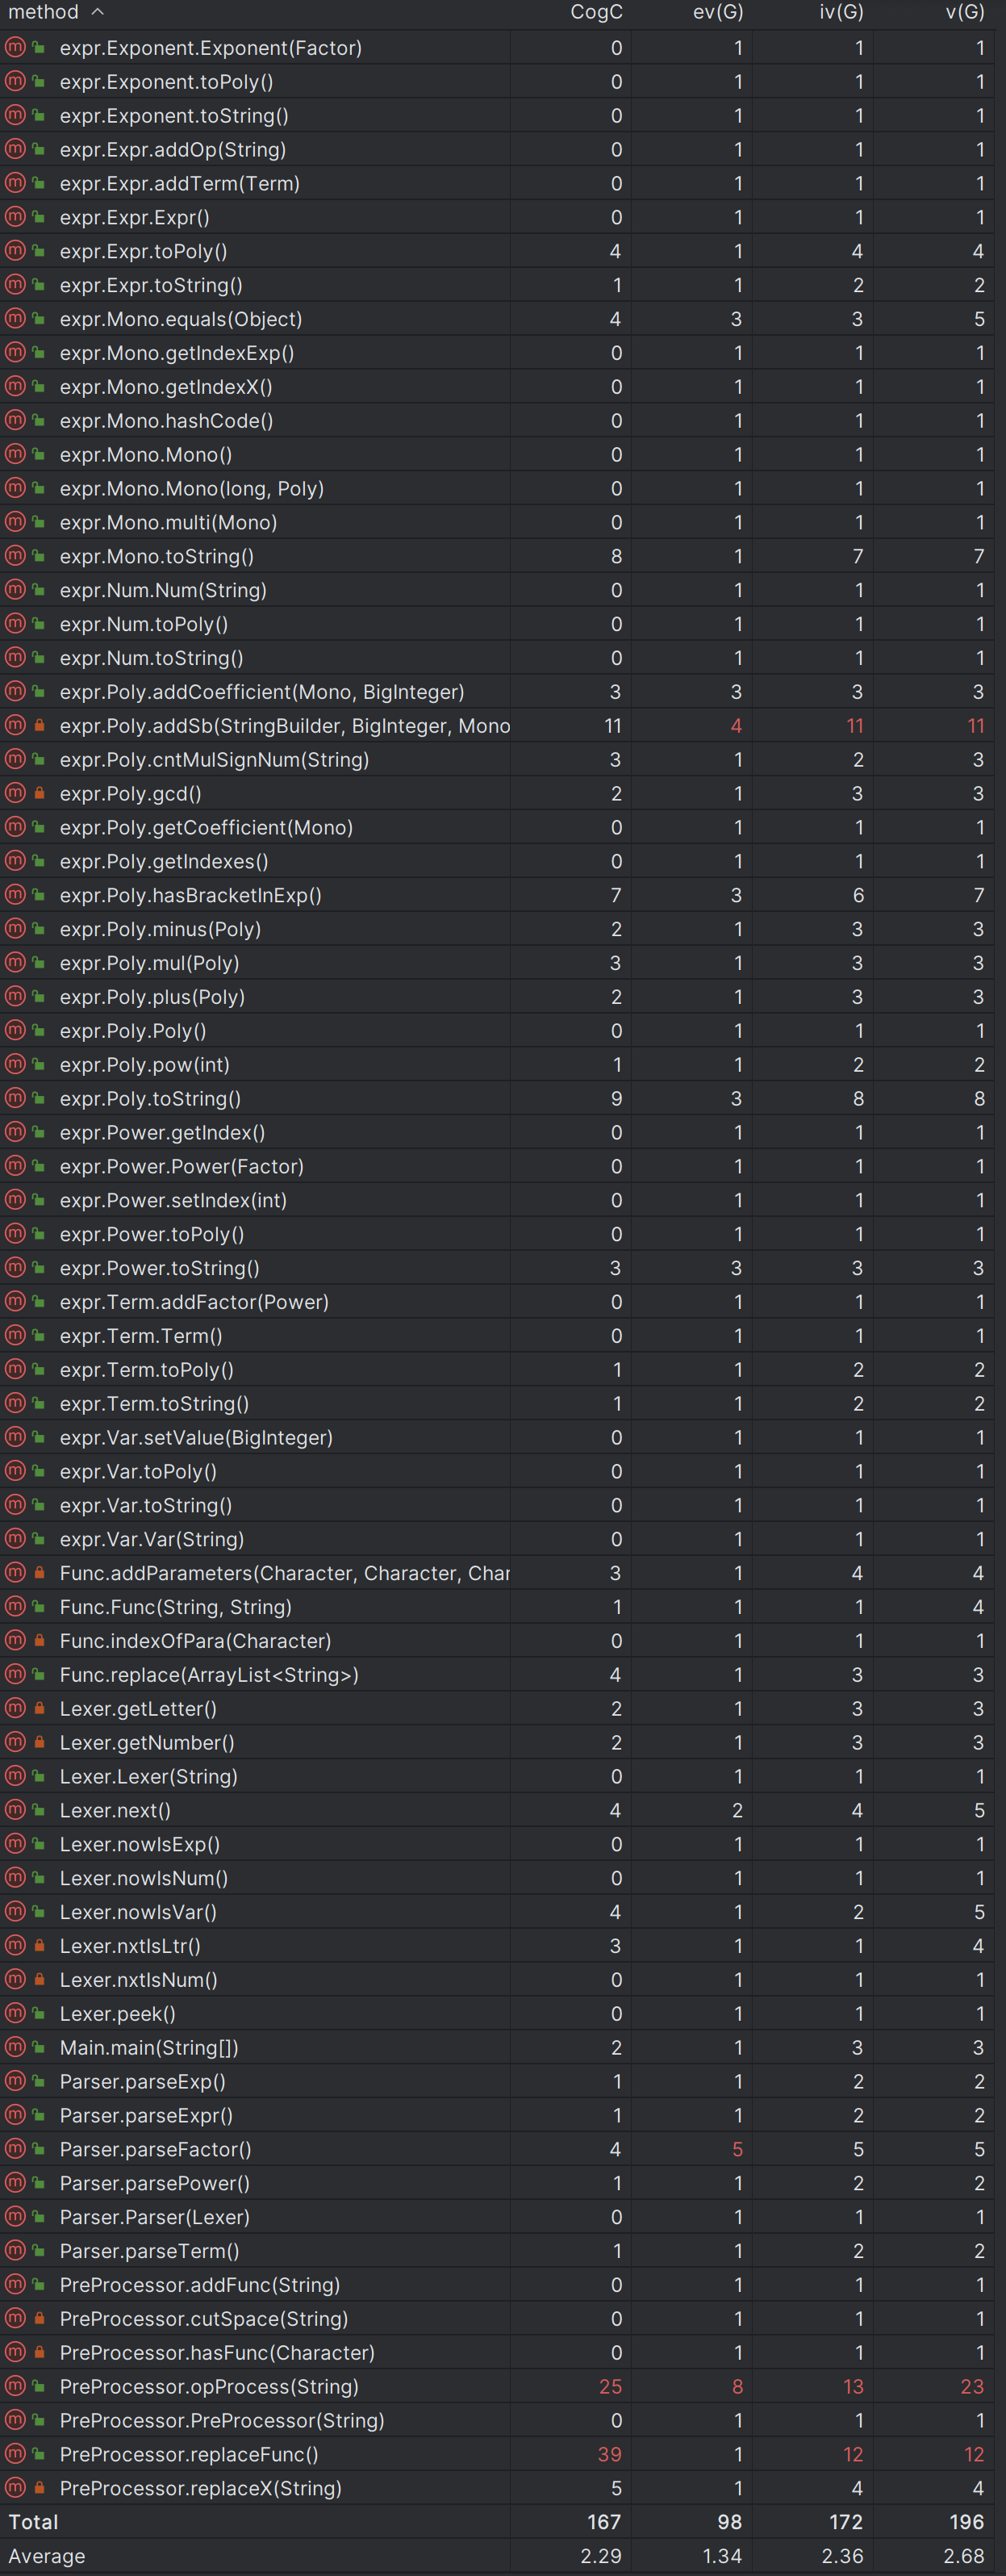
复杂度如下图
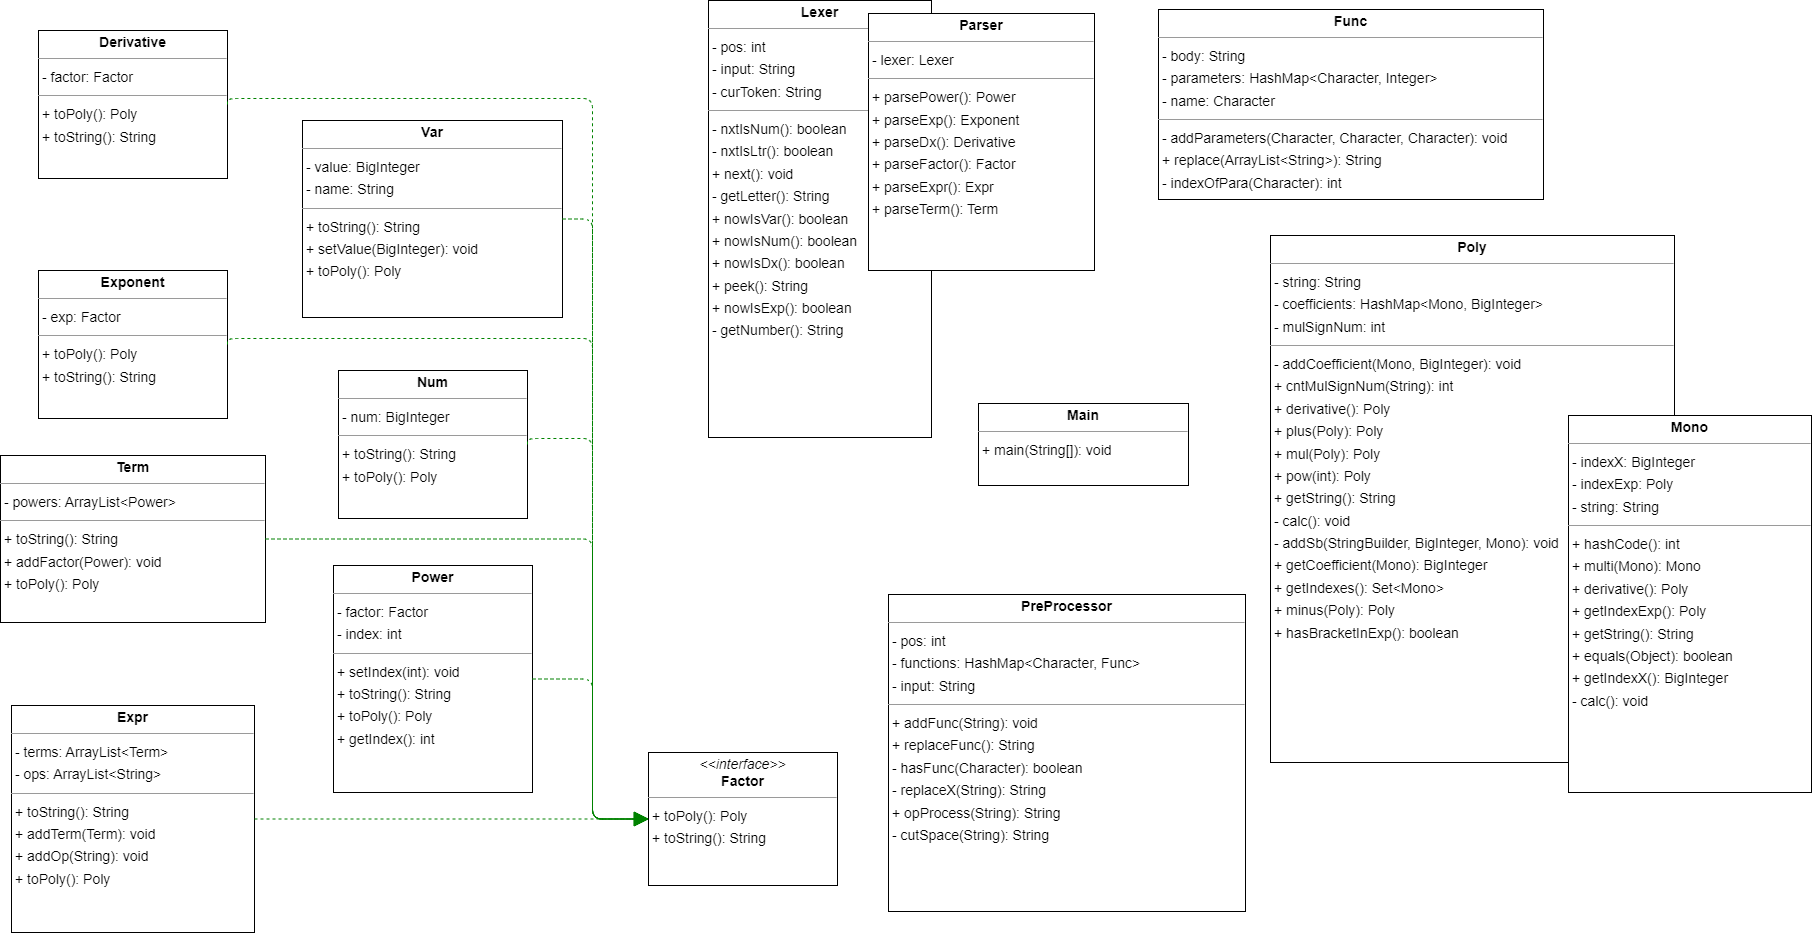
本次作业被hack了
原因是由于提速导致的多层括号的bug,特判一下就能修复
复杂度如下图
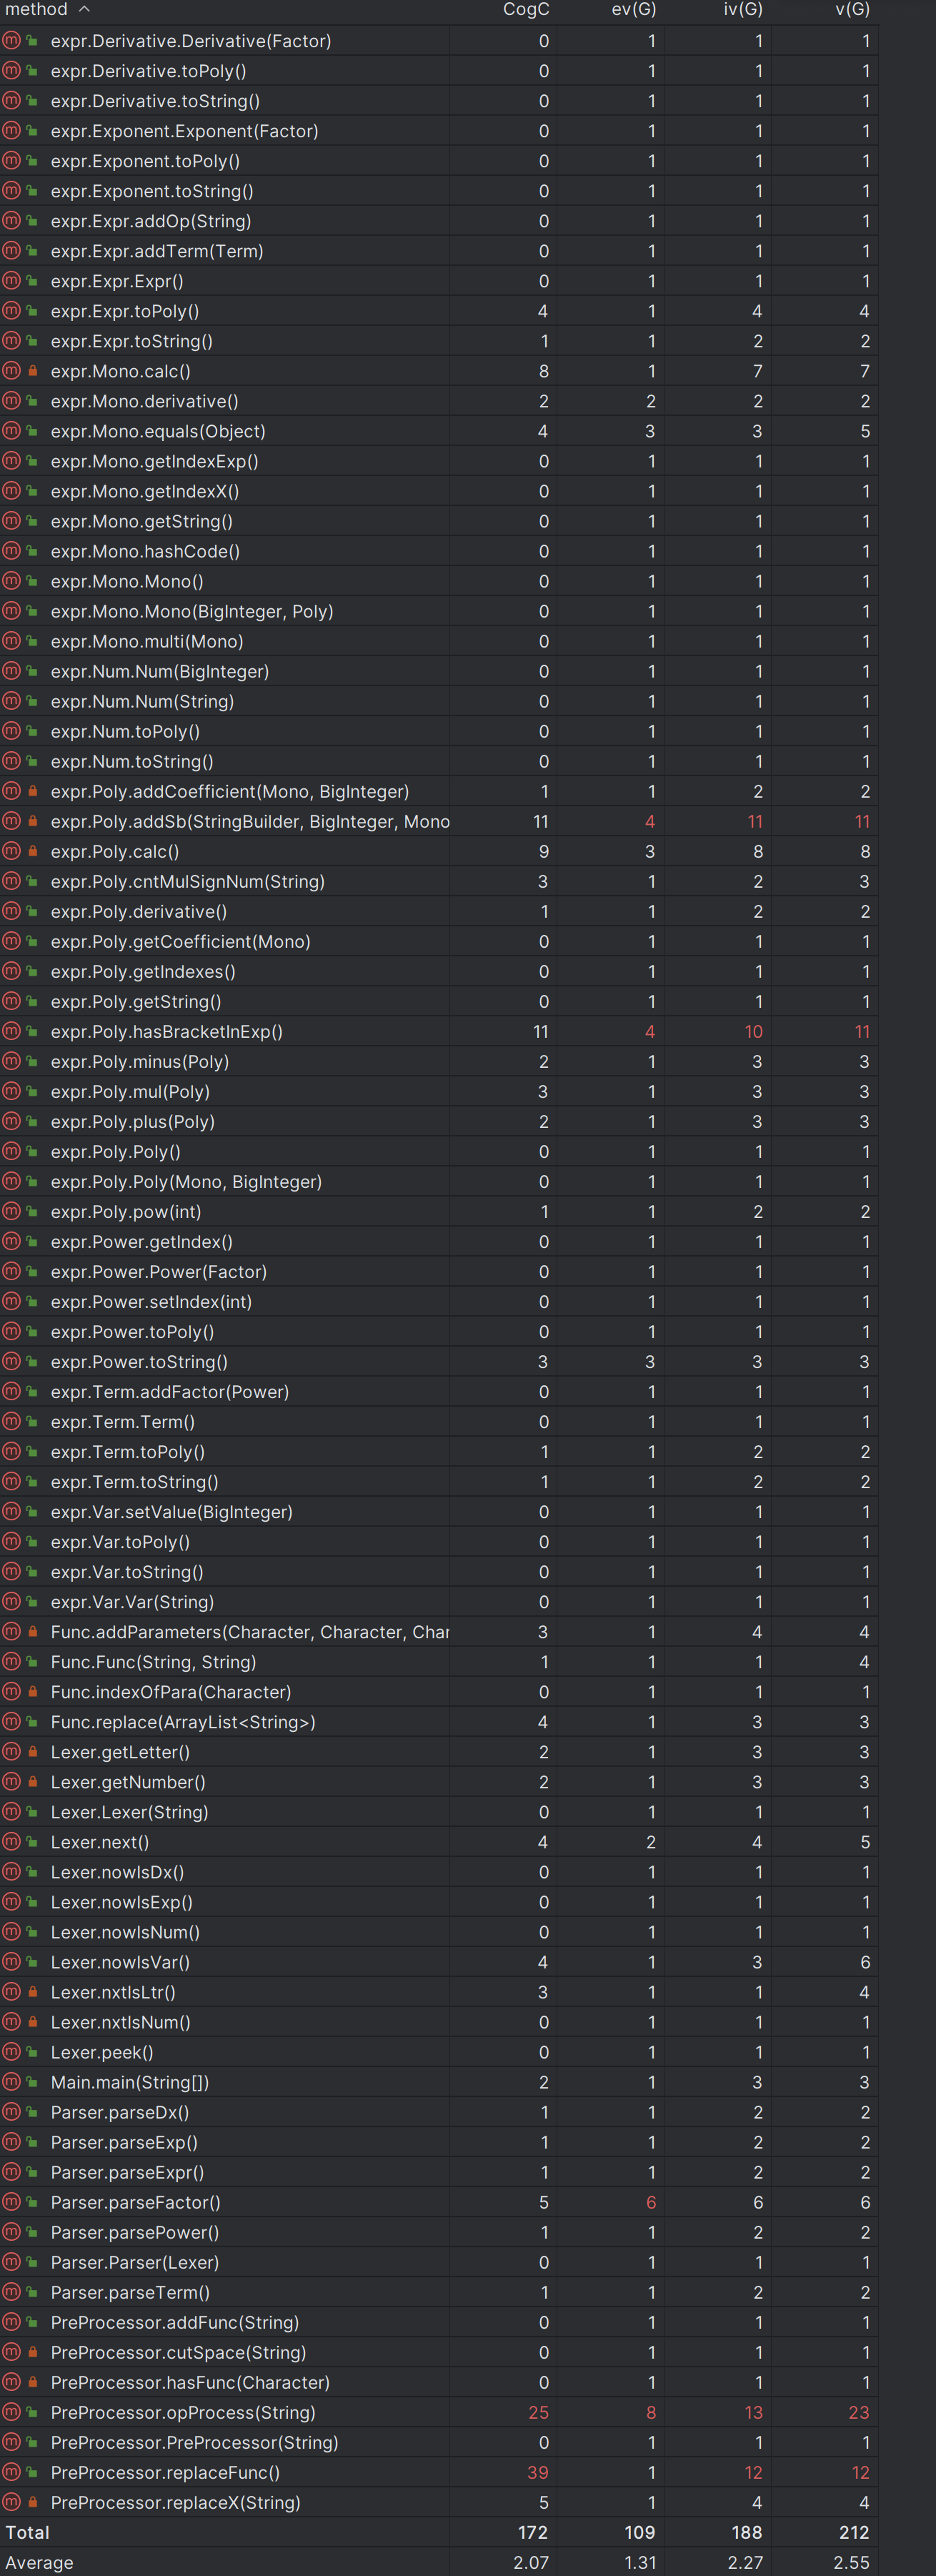
本次依旧没提公因数
害怕速度变慢
大佬帮忙提速
将原先的统一toString转为合并的时候就进行的分布toString并将结果存储,要使用的时候方便直接调用
将多项式中系数为0的单项式删除(也导致我出现了bug并被hack)
感谢大佬的测评机🥹,不仅让我改正了自己的许多bug,也在互测的时候发挥着重要作用
递归下降的解析方法让我也重新认识到了面向对象的精妙之处,将整体拆分为不同部分,各个部分各司其职,完成相对应的功能,教会了我从各自的功能出发进行思考
架构中的单项式与多项式具有分离、相互包含的关系,浑然一体、各司其职
在第一次作业中我尝试着对以后的作业留出可扩展的空间,然而在第二次作业中就完全废除掉了,可见我对于可扩展性的理解还是不够深入
假如还有第四次作业的话,要求表达式中的字母可以不光是x,那么我可能就会小小地重构以下了
在第三次作业大佬指导我提速之后,虽然我发现并修改了一些小bug,但还是漏掉了一个exp多层括号的bug,导致被hack(但是强测居然没测出来这个小bug),这提醒我以后要尽量全面地、基础性地测试


