


301
社区成员
 发帖
 与我相关
 我的任务
 分享
读入一个包含加、减、乘、乘方以及括号(其中括号的深度至多为 1 层)的单变量表达式,输出恒等变形展开所有括号后的表达式。
语法解析
针对输入的解析,我使用的是递归下降法,解析完成后再进行计算。涉及到的类有:
Lexer:将输入的表达式分解为一个个token
token类型有:数(包含一个或多个数字)、运算符(+,-,*,^)、括号和变量(x)
在获取token的时候会自动跳过所有的空白字符(空格和\t)
Parser:按照形式化表述的要求解析token流
形式化表述如下:
- 表达式 →→ 空白项 [加减 空白项] 项 空白项 | 表达式 加减 空白项 项 空白项
- 项 →→ [加减 空白项] 因子 | 项 空白项 '*' 空白项 因子
- 因子 →→ 变量因子 | 常数因子 | 表达式因子
- 变量因子 →→ 幂函数
- 常数因子 →→ 带符号的整数
- 表达式因子 →→ '(' 表达式 ')' [空白项 指数]
- 幂函数 →→ 'x' [空白项 指数]
- 指数 →→ '^' 空白项 ['+'] 允许前导零的整数 (注:指数一定不是负数)
- 带符号的整数 →→ [加减] 允许前导零的整数
- 允许前导零的整数 →→ ('0'|'1'|'2'|…|'9'){'0'|'1'|'2'|…|'9'}
- 空白项 →→ {空白字符}
- 空白字符 →→ (空格) |
\t- 加减 →→ '+' | '-'
类结构
Constant:常数
属性:
BigInteger constant // 存储常数的数值
PowerFunction:幂函数
x^index
属性:
String variable // 存储变量的名称(虽然这次作业只有x)
BigInteger index // 存储幂函数的指数
Term:(不含表达式因子的)项
任何不含表达式因子的项都可以化简为
coefficient * x^index,因此只需要存储系数和指数即可,本次作业因为对后续可能加入的不同变量名作出了预留,所以采用了Arraylist存储,实际上只需要存一个指数即可。属性:
BigInteger coefficient // 系数
ArrayList<PowerFunction> powerFunctions // 幂函数数组
Expression:表达式
任何的表达式都可以表达为
Term + Term + ... + Term,因此只需要存储Term数组属性:
ArrayList<Term> terms // 项数组
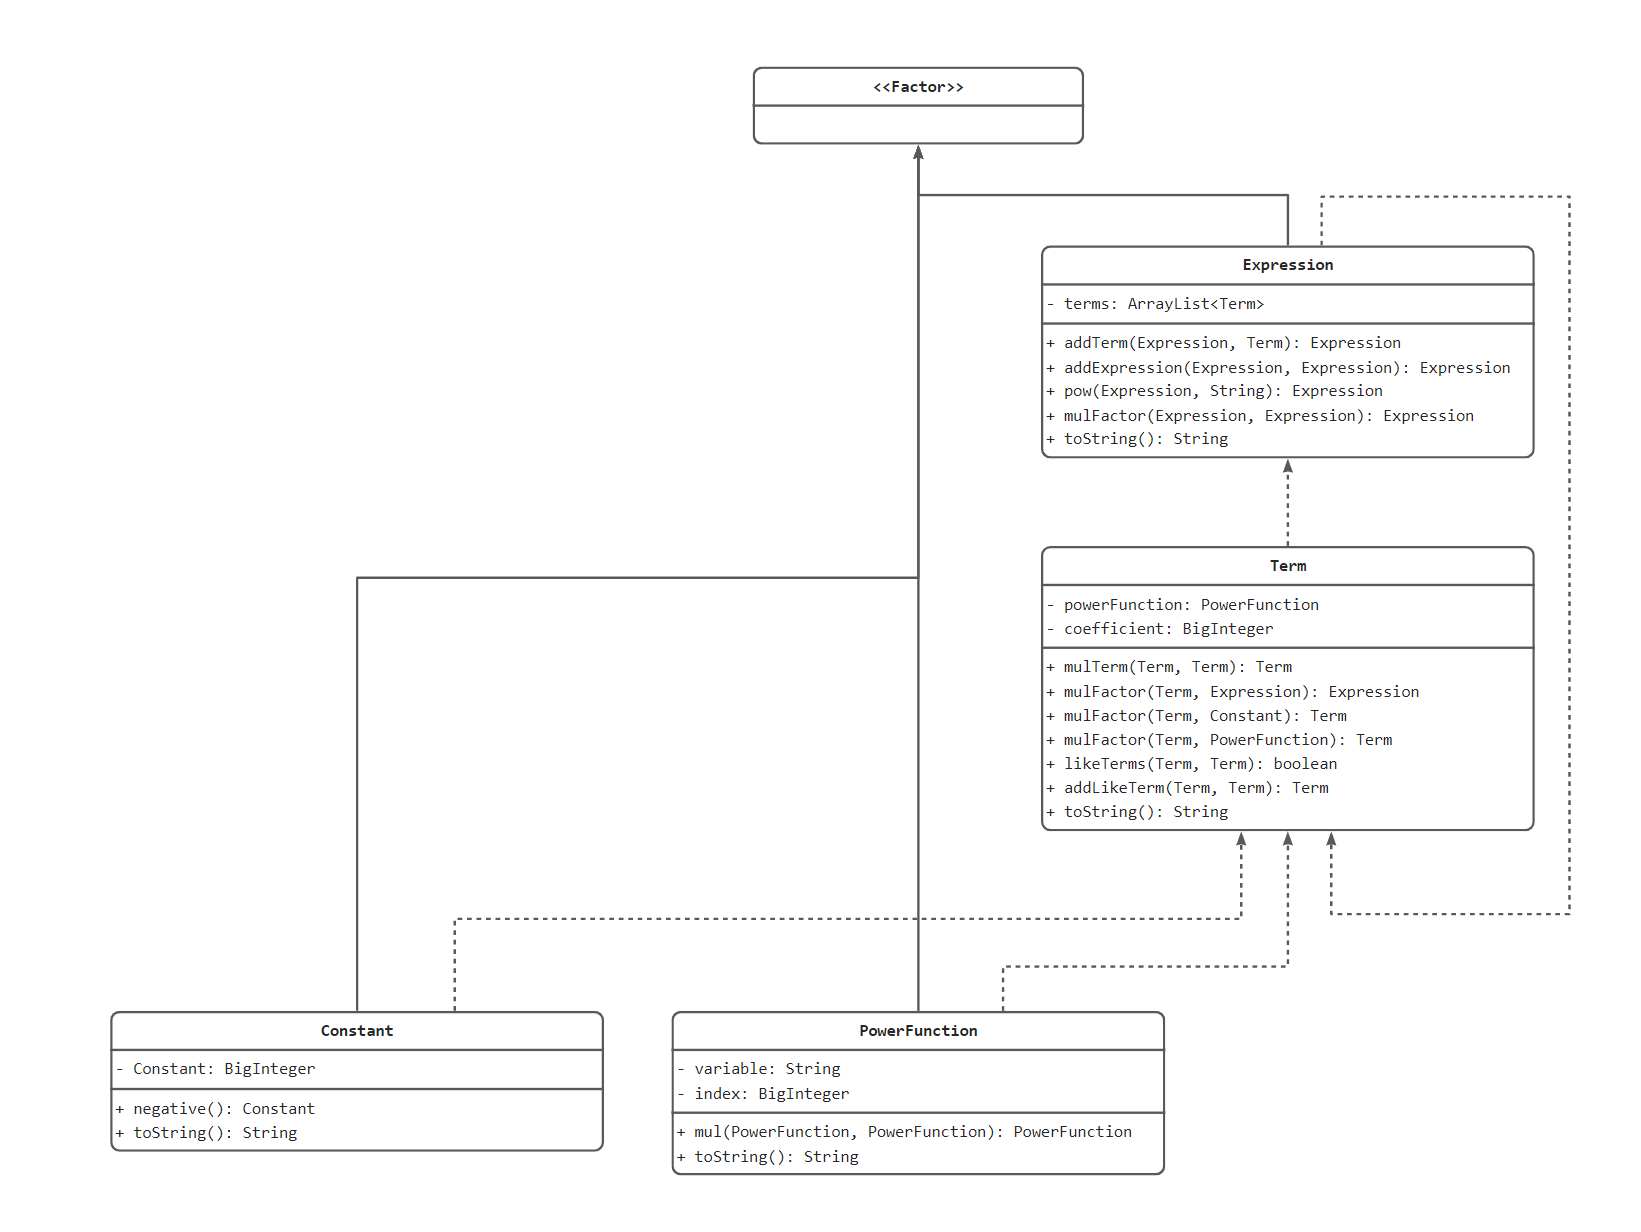
Factor:因子接口,常数、幂函数和表达式均实现Factor接口
类图如下:
计算过程:
初始化:
new Expression()初始化为0,即空数组
new Term()初始化为1*x^0,即1
计算
Term * Constant
直接将Constant和Term.coefficient相乘,并返回新的Term
Term * PowerFunction
将PowerFunction.index + Term.powerFuncion.index相加,作为新的Term.powerFunction.index
Term1 * Term2
对系数和幂函数分别执行1、2即可
Expression + Term
如果Expression中有Term的同类项,则在原有Term的基础上系数相加
反之Expression.terms.add(Term)直接加入Expression的Term数组
Expression * Term
对Expression中每一个Term进行上文的乘法操作即可
Expression1 * Expression2
对Expression1和Expression2中的所有项,分别一一执行3即可
Expression^index
重复调用index次6即可(如果index == 0则直接返回1)
Expression1 + Expression2
对Expression2中的每一项与Expression1执行4即可
注:计算方法均为静态方法,返回
Expression的均为Expression类的静态方法,返回Term的均为Term类的静态方法,这些方法在计算的时候返回的结果均为深拷贝的new对象,避免了可能出现错误修改引用问题。
输出过程:
输出的时候对每一个类均重写了toString方法,在输出的时候使用StringBuilder将个项连接
Constant
直接返回数字对应字符串
PowerFunction
如果指数为0,返回1
如果指数为1,返回x
反之返回x^index
Term
如果系数为0,返回0
如果系数为1,返回PowerFunction.toString()
如果幂函数指数为0,返回coefficient
反之,返回coefficient*x^index
Expression
如果没有项,返回0
反之返回带符号的项的拼接,(-) Term +/- Term +/- ... +/- Term
优化
优化主要在计算过程中的合并同类项,和输出过程中对..*1这种类型的化简
还可以做的优化是在输出的时候让第一项为正项,这样可以少一个负号
复杂度分析
下面是一些复杂度比较高的方法
| Method | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| Parser.termParser() | 16 | 2 | 11 | 11 |
| Term.likeTerms(Term, Term) | 16 | 9 | 5 | 9 |
| ... | ... | ... | ... | ... |
| Total | 121 | 83 | 113 | 139 |
| Average | 2.47 | 1.69 | 2.31 | 2.84 |
| Class | OCavg | OCmax | WMC |
|---|---|---|---|
| Constant | 1 | 1 | 5 |
| Expression | 2.5 | 6 | 25 |
| Lexer | 2.25 | 5 | 9 |
| Main | 1 | 1 | 1 |
| Parser | 3.88 | 11 | 31 |
| PowerFunction | 2.3 | 10 | 23 |
| Term | 3.27 | 9 | 36 |
复杂度比较高的方法分别为Parser.termParser()(解析Term)和Term.likeTerms(Term, Term)判断两个项是否为同类项。在第一次作业的时候,由于常数因子、幂函数因子和表达式因子都只是继承了因子接口,但是没有共同的方法,所以在Parser.termParser()中,针对不同的因子种类手动调用了不同的计算方法,导致复杂度很高。
Factor factor = factorParser();
if (factor instanceof Constant) {
    term = Term.mulFactor(term, (Constant) factor);
} else if (factor instanceof PowerFunction) {
    term = Term.mulFactor(term, (PowerFunction) factor);
} else {
    expr = new Expression((Expression) factor);
}
判断同类项的过程由于为了支持多变量写了很多多余的操作,所以复杂度也很高,但是其实可以不加。
发现bug策略
有的同学并没有在处理表达式的时候进行同类项合并,这样就会导致形如(x-x+x-x+x...+x-x+1)^8这样的数据由于长度过长导致爆栈或者超时。也有项或者表达式不输出0的情况。
在上次作业的基础上,读入一系列自定义函数的定义以及一个包含幂函数、指数函数、自定义函数调用的表达式,输出恒等变形展开所有括号后的表达式。
语法解析
和第一次作业一样,使用递归下降法,稍作修改,并且加入了用于解析函数的FunctionParser:
Lexer:加入对exp的检测
Parser:加入对exp的检测
指数函数 →→ 'exp' 空白项 '(' 空白项 因子 空白项 ')' [空白项 指数]
FunctionParser:对函数的翻译,与Parser不同的是他的每一步返回均为字符串,只用于函数形参的带入
在带入的时候,把函数表达式中的x,y,z替换为对应的实参
注:为了防止把exp中的x也替换,在处理的时候先把exp换成eee了
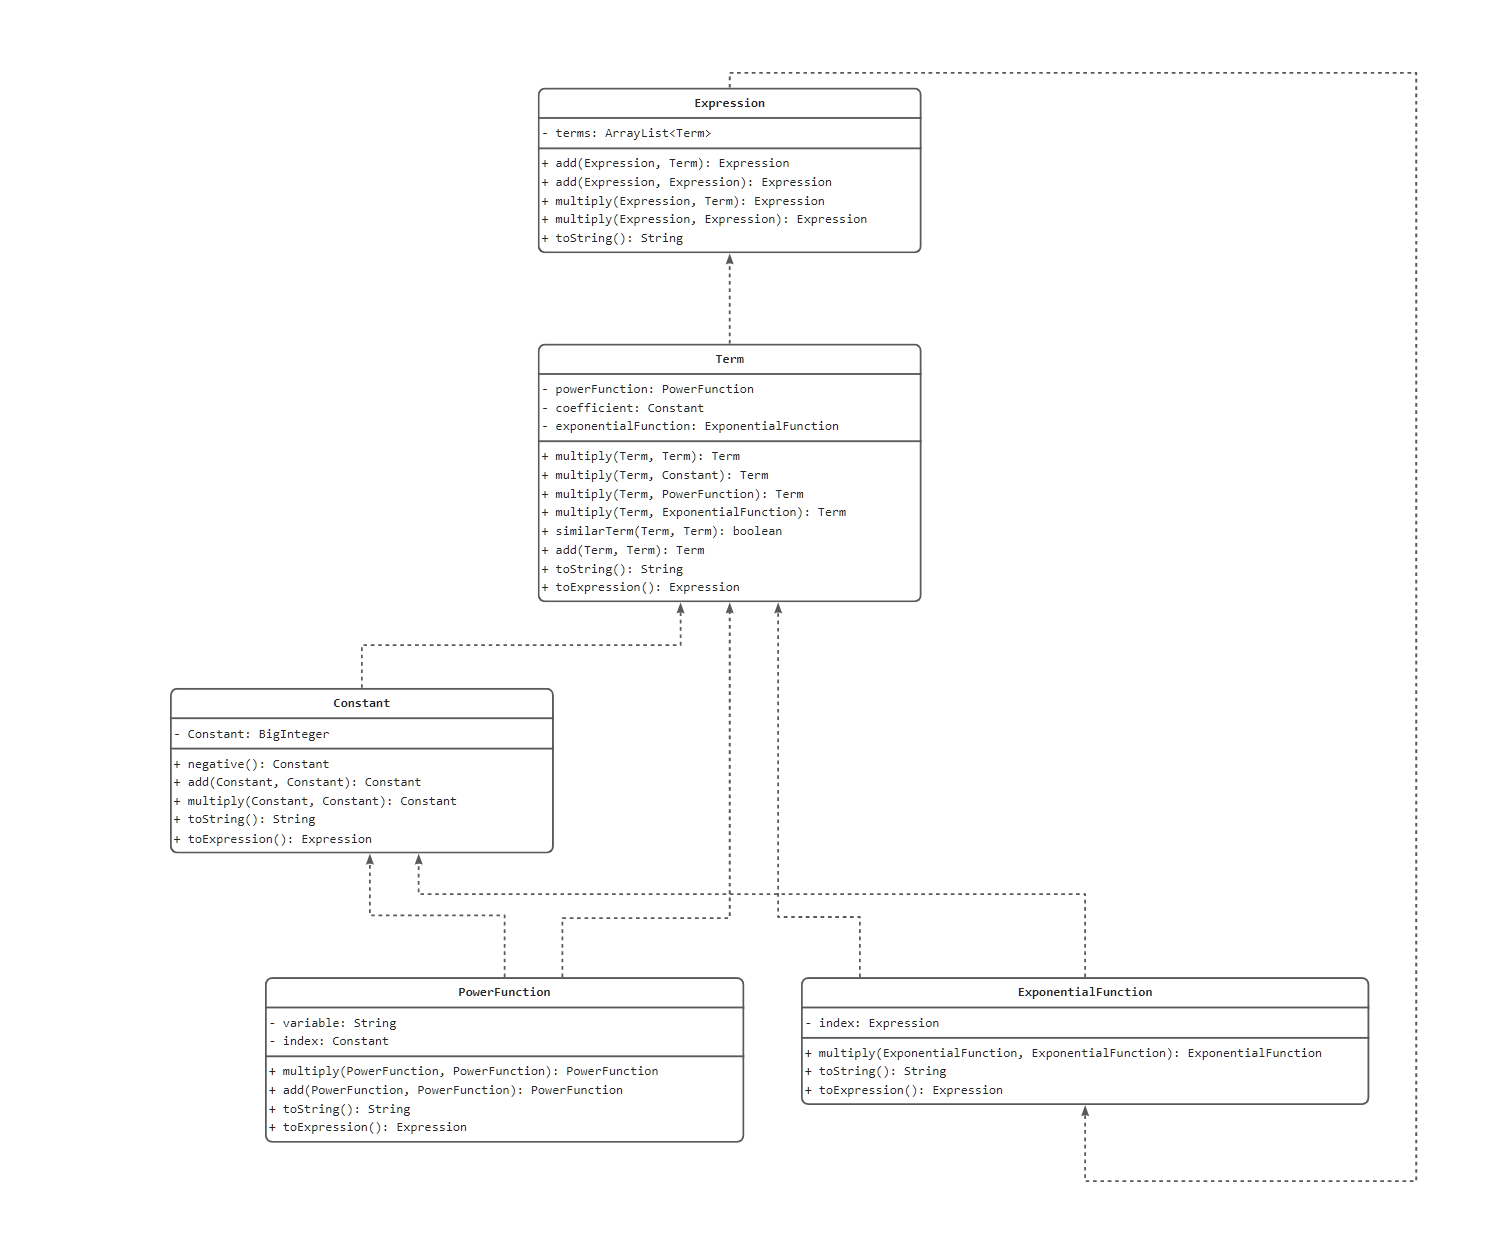
整体结构没有太大变化,在上次的基础上增加了:
ExponentialFunction
幂函数,
exp(index),其中index为一个Expression类的表达式
Term
由于加入了幂函数,因此任何不含表达式因子的项可以写成
coefficient * powerFunction * exponentialFunction,因此只在上次的基础上加入了幂函数。
计算
本次作业针对计算做了比较大的修改,核心目的是为了将计算方法分隔开,更好的封装
所有的计算方法均为静态方法,并且返回新的结果对象
// Constant
Constant multiply(Constant c1, Constant c2);
Constang add(Constant c1, Constant c2);
// PowerFunction
PowerFunction multiply(PowerFunction p1, PowerFunction p2);
// ExponentialFunction
ExponentialFunction multiply(ExponentialFunction e1, ExponentialFunction e2);
// Term
Term multiply(Term t1, Term t2);
Term multiply(Term t, Constant c);
Term multiply(Term t, PowerFunction p);
Term multiply(Term t, ExponentialFunction e);
Term add(Term t1, Term t2); // 同类项才能相加
// Expression
Expression add(Expression e, Term t);
Expression add(Expression e1, Expression e2); // 依次调用表达式+项即可
Expression multiply(Expression e, Term t);
Expression multiply(Expression e1, Expression e2); // 依次调用表达式*项即可
为了方便计算,所有的类都有一个方法将其转化为表达式,即toExpression()方法。
输出过程
与上次基本相同,添加了指数函数的输出,格式为:exp(index),其中index为表达式类型
类图
优化
本次可以优化的地方在上一次的基础上,加入了exp(index)的优化,主要就是提取指数内的公因数。
exp(999999+999999*x)可以优化为exp(1+x)^999999
复杂度分析(只列举较高的几个方法)
| Method | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| Expression.add(Expression, Term) | 10 | 1 | 6 | 6 |
| Parser.factorParser() | 12 | 6 | 7 | 7 |
| ... | ... | ... | ... | ... |
| Total | 138 | 135 | 193 | 218 |
| Average | 1.35 | 1.32 | 1.89 | 2.14 |
| Class | OCavg | OCmax | WMC |
|---|---|---|---|
| Constant | 1 | 1 | 10 |
| CustomFunction | 1.8 | 3 | 9 |
| ExponentialFunction | 1.12 | 2 | 9 |
| Expression | 2.5 | 6 | 30 |
| FunctionParser | 2.6 | 6 | 26 |
| Lexer | 2.4 | 7 | 12 |
| Main | 3 | 3 | 3 |
| Parser | 3.56 | 7 | 32 |
| PowerFunction | 1.12 | 2 | 9 |
| Term | 2 | 7 | 32 |
可以看到,这次的作业复杂度相对上一次有了显著降低,因为大部分的计算方法都被封装成了单独的方法,并且不同类之间的交互也减少到了最低。
发现bug策略
由于本次指数函数的形式化表述为:
exp(因子)[指数]
因子中幂函数的形式化表达是:
x[指数]
导致exp(-x)这样的表达式不符合形式化表达,因为-x不是因子,这点许多出错的。
读入一系列自定义函数的定义以及一个包含幂函数、指数函数、自定义函数调用、求导算子的表达式,输出恒等变形展开所有括号后的表达式。
语法解析
和之前的做法没有任何区别:
Lexer:加入dx的解析
Parser:加入dx的解析
形式化表述如下:
- 求导因子 →→ 求导算子 空白项 '(' 空白项 求导因子 空白项 ')' | 求导算子 空白项 '(' 空白项 表达式 空白项 ')'
- 求导算子 →→ 'dx'
FunctionParser:加入对dx的解析,并且由于本次函数定义支持递归声明,因此在处理的时候采用了执行3次FunctionParser,这样无论三个函数的递归顺序如何,均能完成带入。
在带入的时候,把函数表达式中的x,y,z替换为对应的实参
注:为了防止把dx中的x也替换,在处理的时候先把dx换成dd了
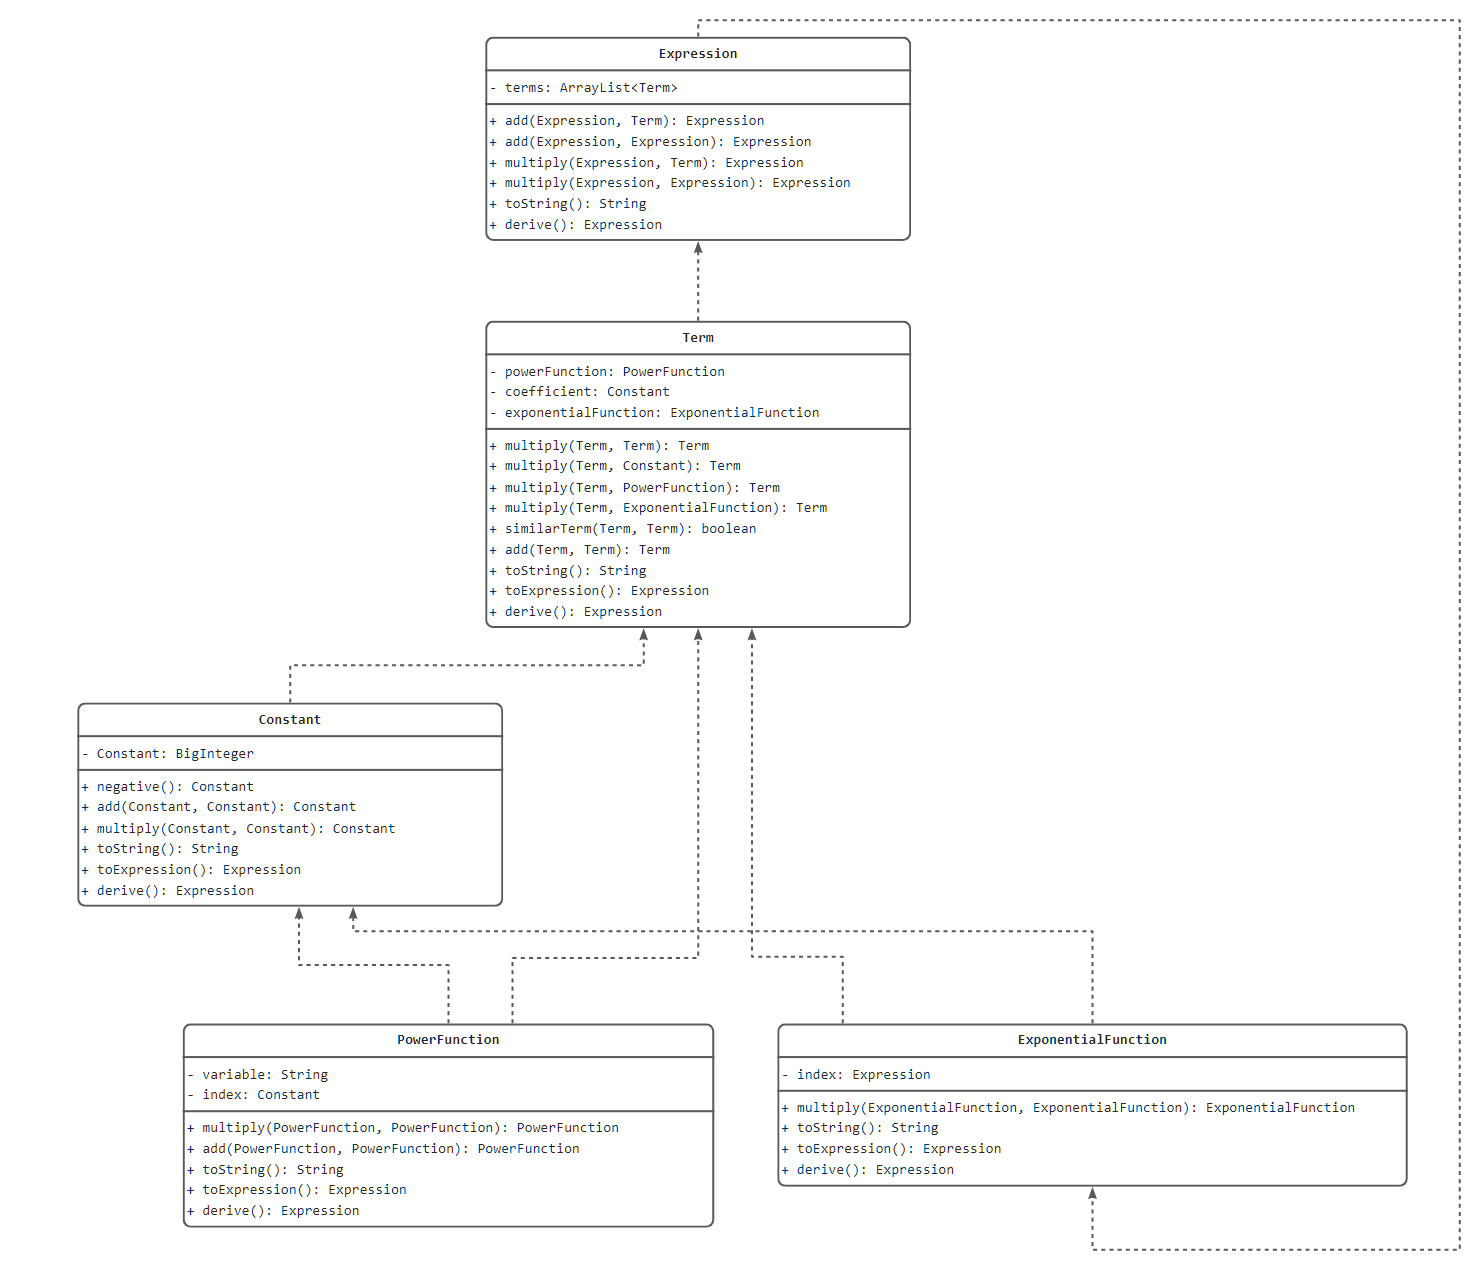
整体类结构和上次作业没有任何变化,只有每一个基础类加入了一个方法derive(),该方法返回统一为表达式。
// Constant
public Expression derive() {
    return Expression.ZERO;
}
// PowerFunction
public Expression derive() {
    PowerFunction p = new PowerFunction(variable, index.subtract(BigInteger.ONE));
    Constant c = new Constant(index);
    return Expression.multiply(c.toExpression(), p.toExpression());
}
// ExponentialFunction 使用链式法则
public Expression derive() {
    return Expression.multiply(this.toExpression(), index.derive());
}
// Term 使用乘法原理
public Expression derive() {
    return Expression.multiply(coefficient.toExpression(),
        Expression.add(
            Expression.multiply(powerFunction.toExpression(), exponentialFunction.derive()),
            Expression.multiply(powerFunction.derive(), exponentialFunction.toExpression())
        )
    );
}
// Expression
public Expression derive() {
    Expression res = new Expression();
    for (Term term: terms) {
        res = Expression.add(res, term.derive());
    }
    return res;
}
优化
本次作业没有什么可以在上次作业的基础上新加入的优化,针对长度的优化和表达式计算速度的优化都和上次的一样。
复杂度分析(只列举较高的几个方法)
| Method | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| Expression.add(Expression, Term) | 10 | 1 | 6 | 6 |
| Parser.factorParser() | 13 | 7 | 8 | 8 |
| FunctionParser.parseFactor() | 9 | 1 | 9 | 9 |
| ... | ... | ... | ... | ... |
| Total | 145 | 132 | 194 | 219 |
| Average | 1.48 | 1.35 | 1.98 | 2.23 |
| Class | OCavg | OCmax | WMC |
|---|---|---|---|
| Constant | 1 | 1 | 11 |
| CustomFunction | 1.8 | 3 | 9 |
| ExponentialFunction | 1.11 | 2 | 10 |
| Expression | 2.46 | 6 | 32 |
| FunctionParser | 2.64 | 7 | 29 |
| Lexer | 2.6 | 8 | 13 |
| Main | 4 | 4 | 4 |
| Parser | 3.5 | 8 | 35 |
| PowerFunction | 1.11 | 2 | 10 |
| Term | 1.94 | 7 | 33 |
可以看到,基本上复杂度和上次作业没有太大区别,大部分方法复杂度都比较低,高复杂度的方法由于<因子>的形式化表达本就很复杂,种类繁多,因此复杂度无法再做优化。
发现bug策略
基本上大部分的bug都在上次的强测中被检测出,因此这次主要还是在测试求导算子上,比如dx(dx(exp(0)))这种。
在完成第一次作业的时候,由于考虑了太多的扩展性,导致完成了很多不必要的工作,并且后续并没有在对应方向上拓展的需求,导致在第二次作业的时候为了简化结构把许多内容都删掉了,浪费了很多时间。以后在留扩展性的时候可以不先加入数据结构,而是改为加入新的类,然后重写判断方法,这样可以避免一开始就用HashMap导致代码复杂。
在设计类的时候,要最大限度的减少类之间的耦合,计算方法要返回新对象,不然可能会出现不可预料的奇怪错误。这点在调试的时候花费了许多时间,因此后几次代码都是采用了不可变类,即各因子在生成的时候即确定,之后内容不再改变,计算的时候均在复制的因子对象中进行修改。
我认为这几次作业的主要结构都是递归关系,但是对继承、接口相关并没有太多涉及,各因子继承自<<因子>>接口这个方法其实可有可无,以至于后两次作业采用toExpression()方法反而更简单。本次作业最适合用接口的应该是“可导”这个性质,只要实现了求导方法的因子都可导。
可以加入除法运算,输出的时候输出分子分母即可。

顶


