


301
社区成员
 发帖
 与我相关
 我的任务

 分享
写了依托答辩,简直惨不忍睹不忍直视
最终有几个在cost边缘大鹏展翅的互测数据没能修复,归根结底还是因为架构问题。Hashmap固然有其优点,例如可以很好地利用其键值对相等自动合并的特性进行合并同类项,但是理想的做法是和建树相结合而非直接进行暴力嵌套。
主要结构如下:
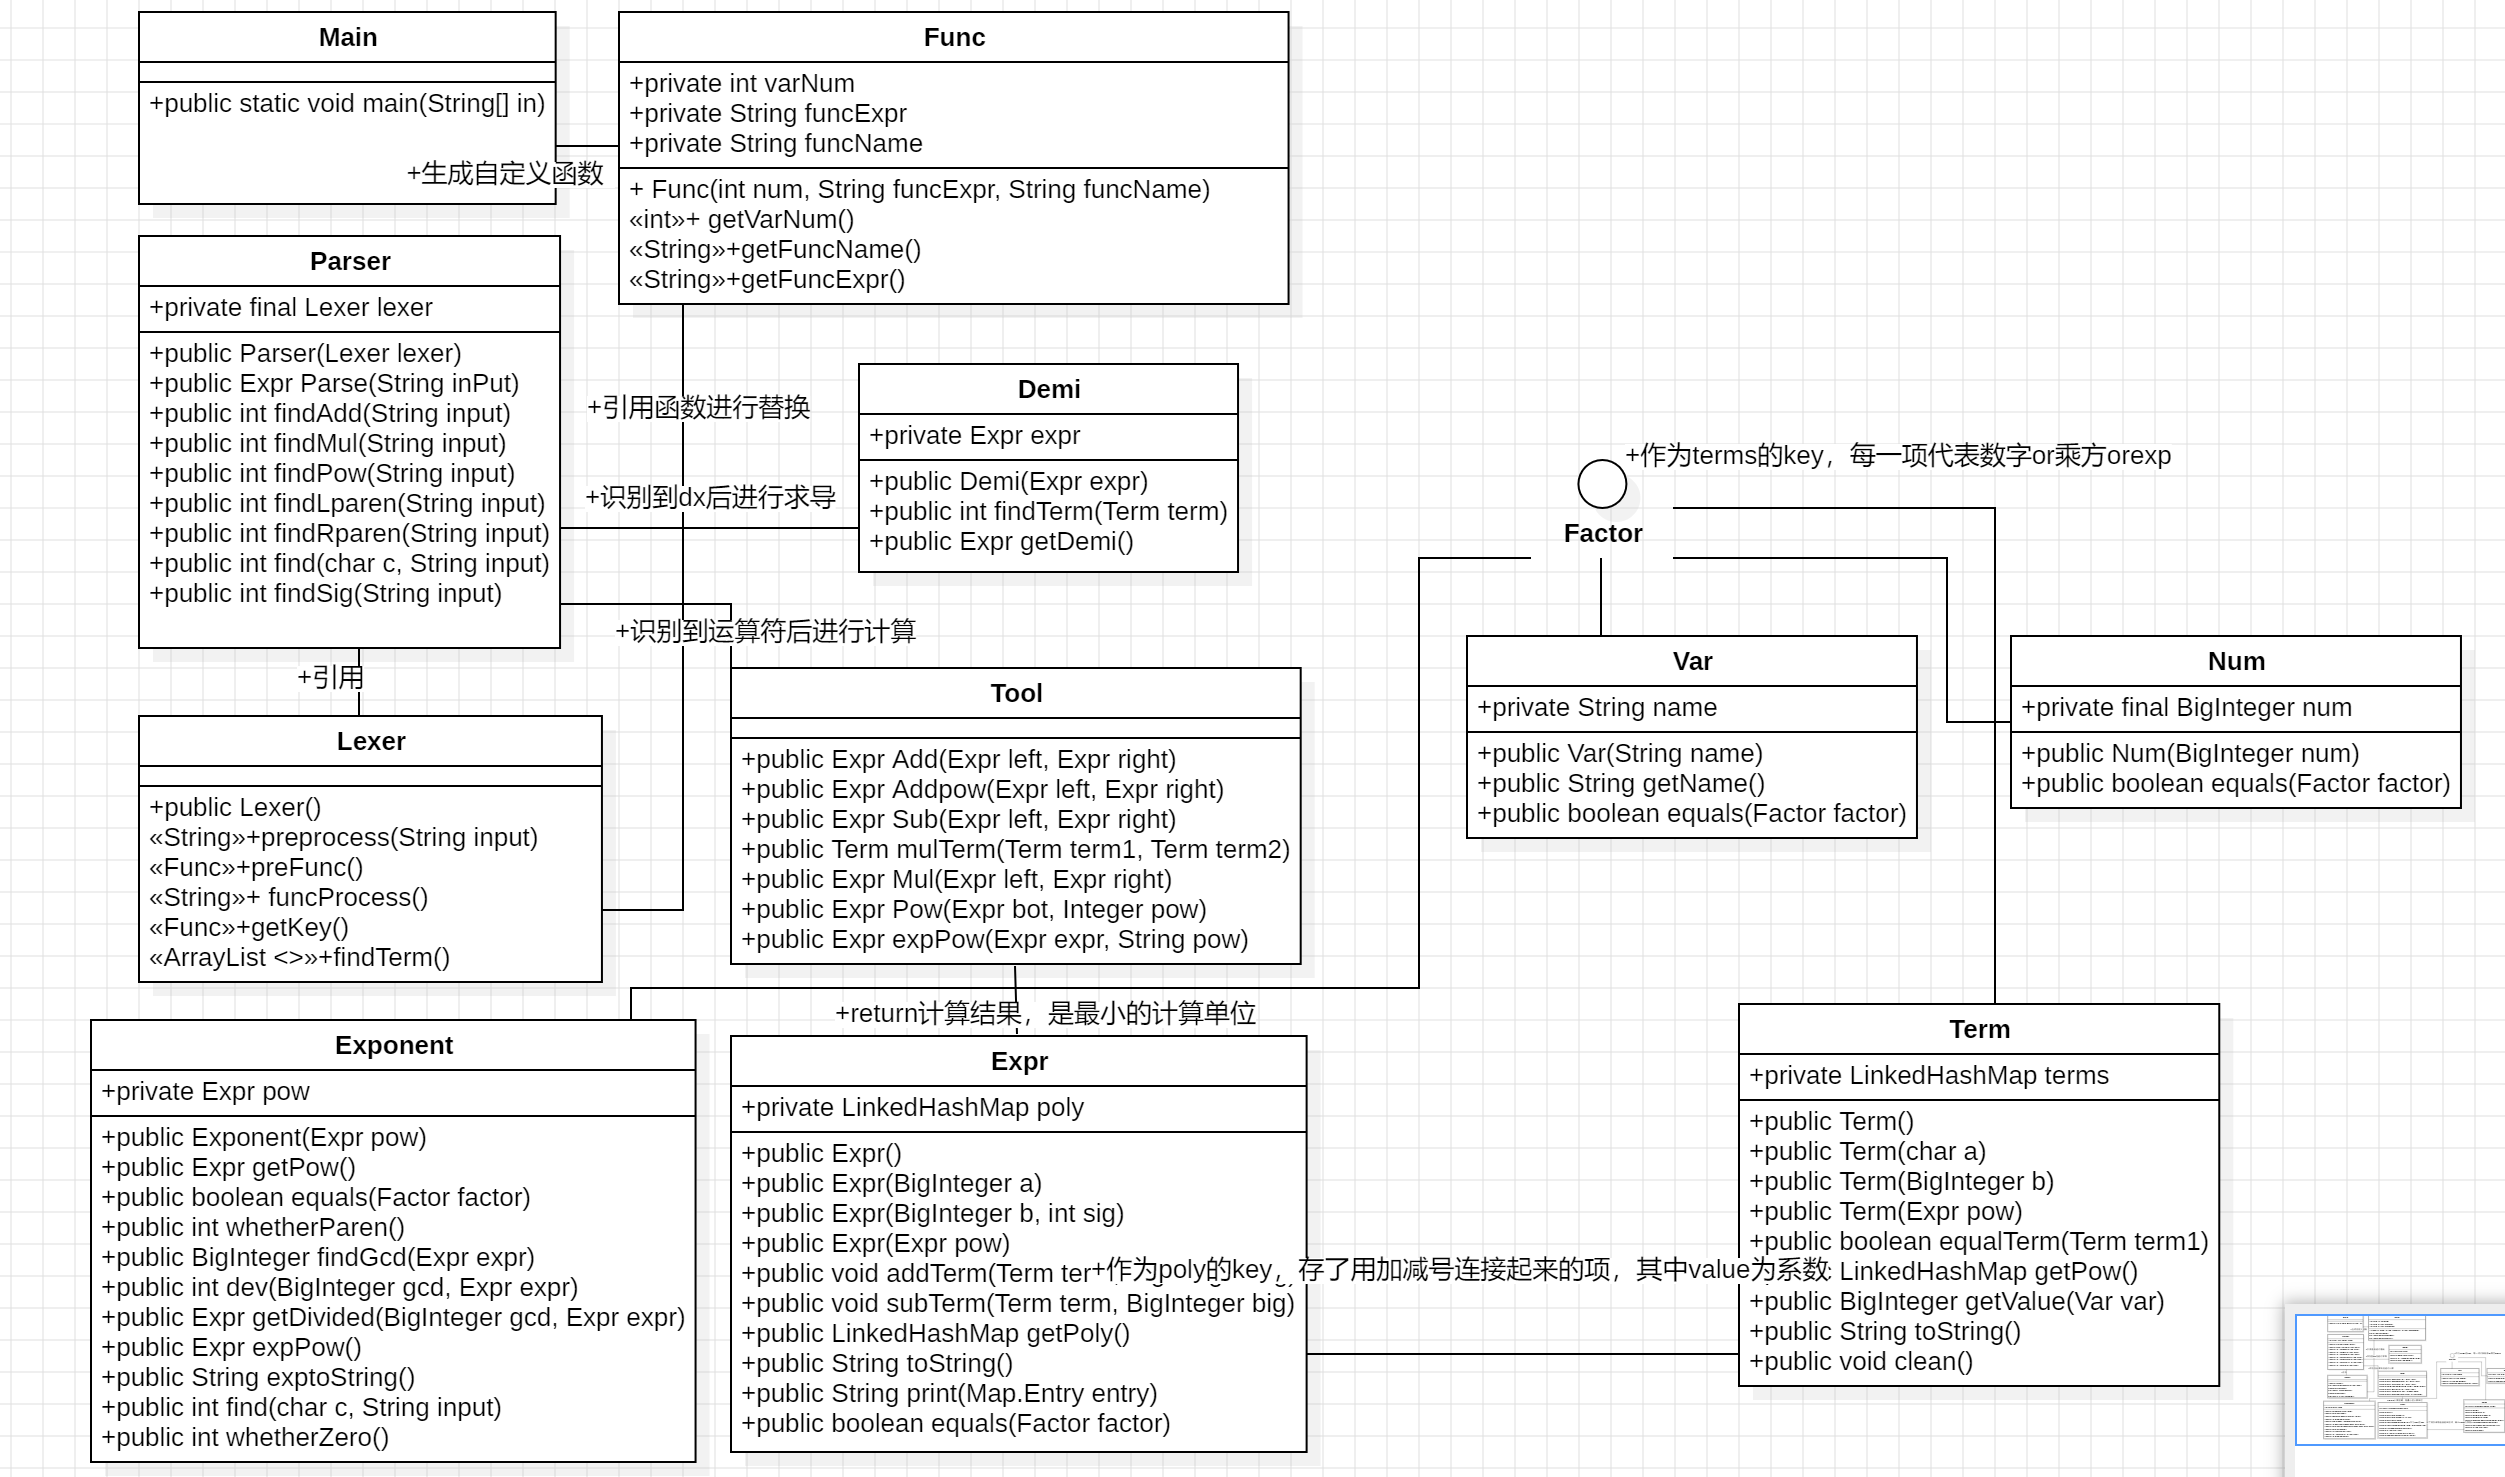
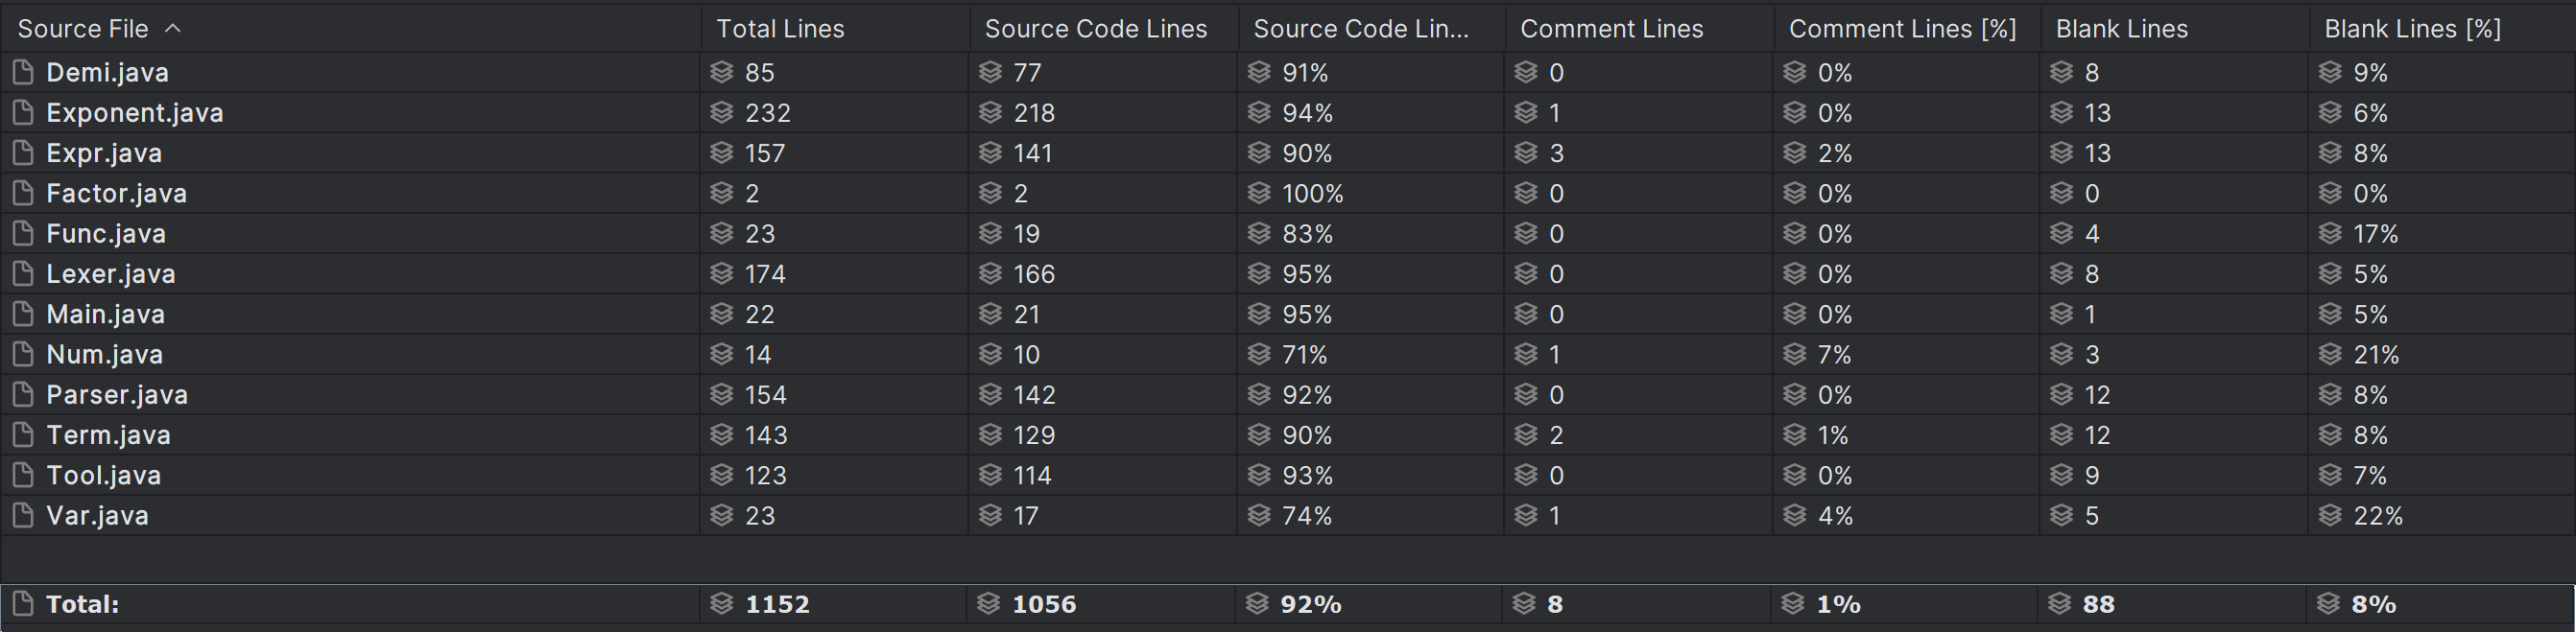
其中,第二次作业加入了Exponent和Func类,第三次作业加入了Demi类。
对于Main读入自定义函数导入Parser类进行解析,最后加入func容器进行管理。对于读入的需要解析的表达式,首先进行Lexer当中对前导0、多个连续+-、自定义函数的预处理,再放入Parser类当中进行解析。
对于解析,首先从末尾开始,根据+/-、*、^、()、exp/dx/x的优先级进行判断,并进行解析。
对于结果,依次存入Term当中,按照数字、x、exp的顺序进行存储,最终返回一个Expr。在后续的运算当中,通过比较Term是否相等来判断是否合并同类项。
最后返回toString,递归打印。
真是一堆酣畅淋漓的屎(言简意赅)
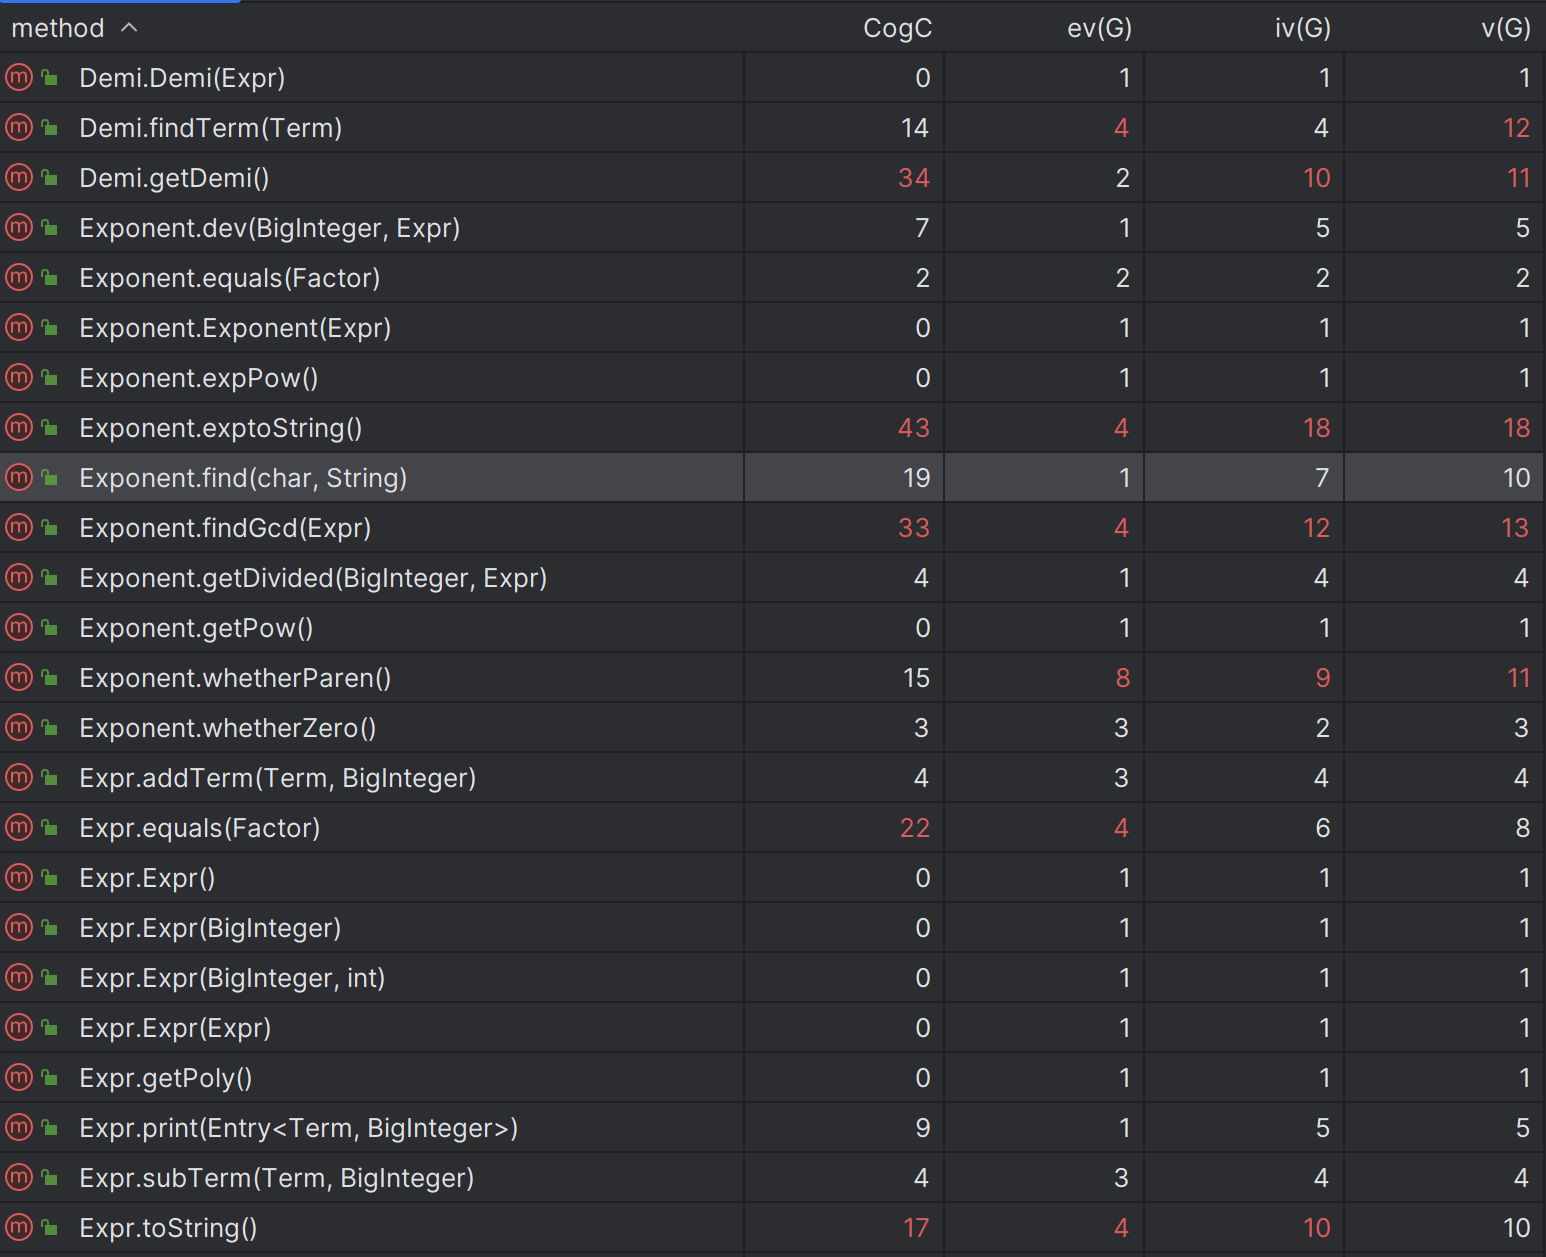

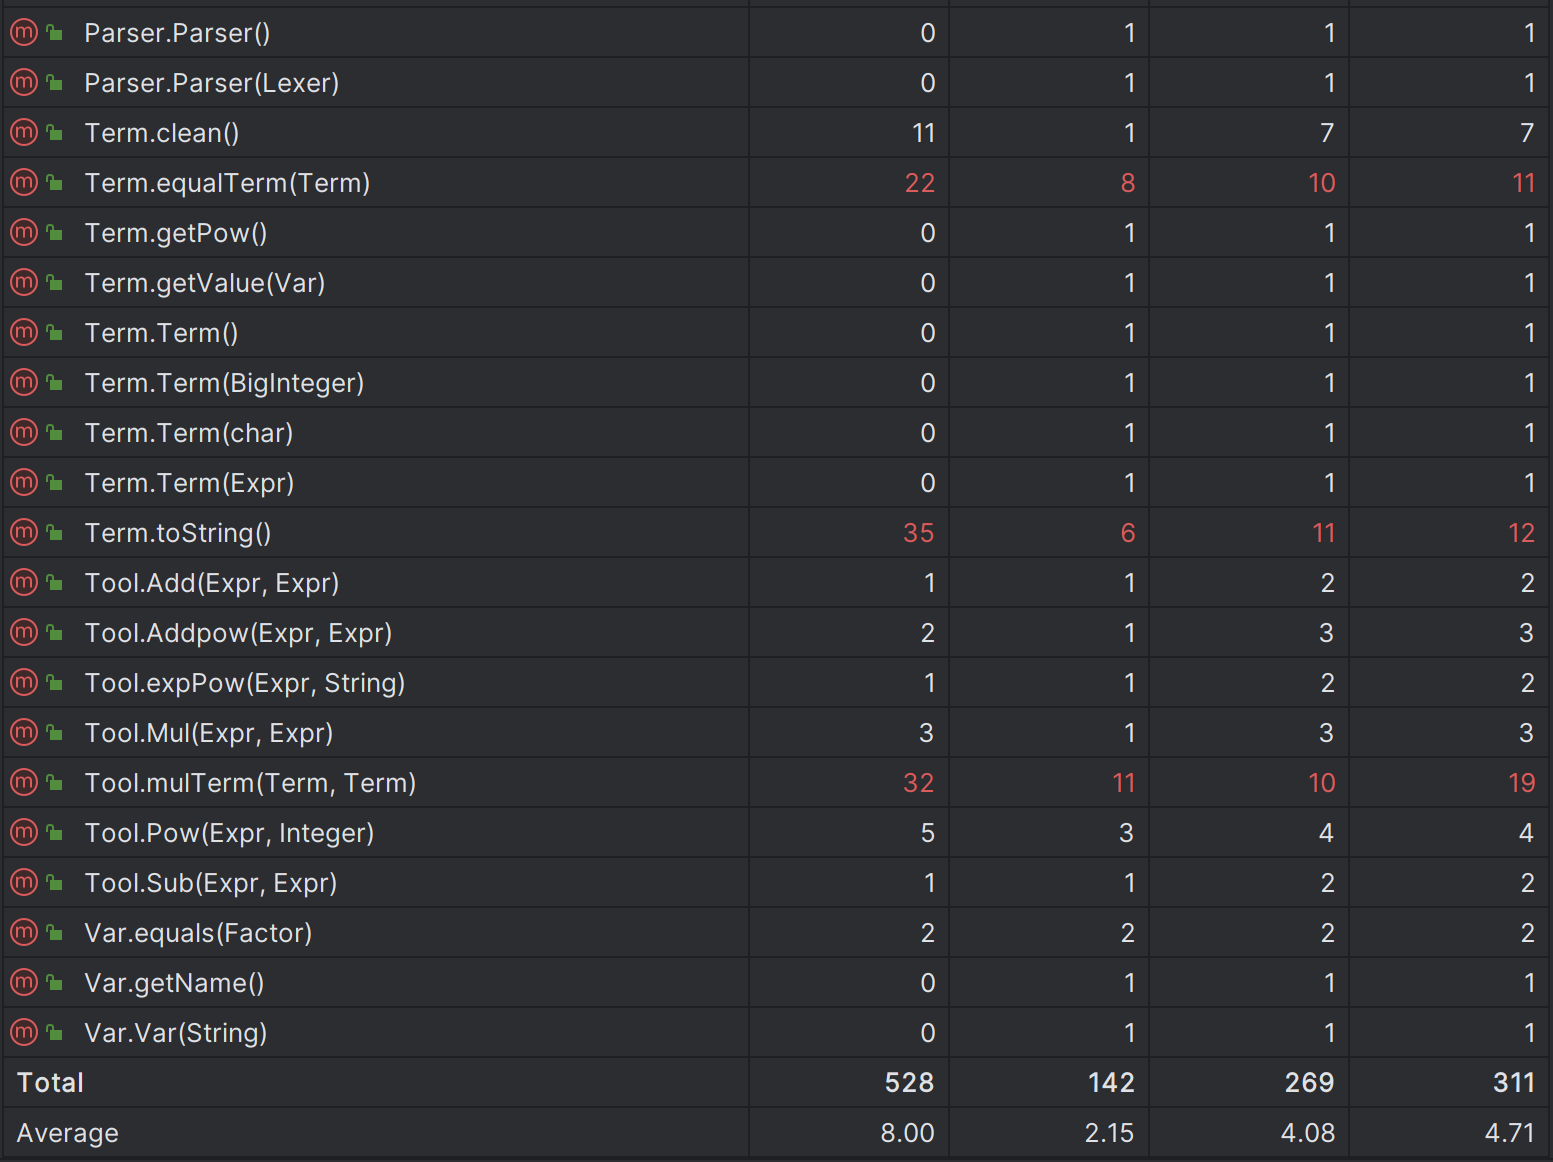
可以看到,存在不少方法有复杂度高,非结构化程度高,模块耦合度高,架构不清晰,很多方法堆在一个类中但没有很明确的聚类关系,意即我无法回答为什么这个方法应该放在这里而不是其他地方(真是奇怪hw1的时候感觉明显比oopre的代码架构有进步来着)
在以后的学习当中仍然需要注意这一点。
第一次作业奠定了基本架构。
第二次作业加入了Exponent类和Func类,将Term的属性从单纯的数字or x改变成为了Hashmap,与此同时加入了判断两个Term是否相等的一系列方法(涉及到深浅拷贝问题)。为了优化长度,我选择对Exponent的指数进行提公因数的化简,让第一次作业简单的toString方法变得复杂起来。
第三次作业加入了Demi类,并对Fun自定义函数的处理进行了改变,加入了对引用函数的展开。
在Term的生成当中,将“x”变为对应的变量名,并在判断是否相等时在Factor接口的类是否相等时加上判断变量名称是否相等。
以下是几组tle的互测数据:
0
dx(exp(exp(exp(exp(exp(exp(exp(exp(x^2)))))))))
输出:2*exp((exp(exp(exp(exp(exp(exp(exp(x^2)))))))+exp(exp(exp(exp(exp(exp(x^2))))))+exp(exp(exp(exp(exp(x^2)))))+exp(exp(exp(exp(x^2))))+exp(exp(exp(x^2)))+exp(exp(x^2))+exp(x^2)+x^2))*x
0
exp(exp(exp(exp(exp((x+1+exp(exp(x))))))))
输出:exp(exp(exp(exp(exp((x+1+exp(exp(x))))))))
2
g(z)=exp(exp(exp(exp(z))))
f(y)=exp(exp(exp(exp(g(y)))))
f(exp(exp(exp(exp(x^8)))))
输出:exp(exp(exp(exp(exp(exp(exp(exp(exp(exp(exp(exp(x^8))))))))))))
这几组数据的共同特点是exp嵌套层数极多。对于建树的架构而言,其复杂度是相加,但是对于HashMap嵌套的架构而言,遍历的复杂度不高,但是在toString方法输出时,其每一层的递归遍历复杂度是相乘的。因此最后的复杂度会相当恐怖,也就导致了这几组看起来平平无奇特别简单的数据的运行时间很恐怖。
闹鬼啦
以下是一些可能原因:
(1)HashMap的顺序不一定,但是如果某一部分的运行结果依赖HasnMap的遍历顺序就会出现因为运行和调试时的遍历顺序不同导致的结果不同。其奇怪之处就在于HashMap顺序不定因此程序没有依赖遍历顺序。
(2)toString方法在调用时改变了对象,导致toString函数最后的结果在不同快慢的调试和直接运行当中都不同。
(3)特别倒霉遇上了Oracle当中的一些Undefined Behavior,加上BigInteger产生了奇怪的化学反应(……)
(血泪教训是不要在发烧的时候写代码,会变得不幸QAQ
其实本身的判断很简单,但是之前在发烧的时候写了一堆乱七八糟,在此基础上再改,始终会囿于原本代码框架的影响,最后造出来一个不伦不类的东西。
输出格式的问题在于,对于exp的指数,x与exp(x)被视为因子,只需要打一层括号,而其余所有形式都需要两层。在将exp((n*x))(n为系数)提出变成exp(x)^n的形式时需要特判。
老生常谈的问题,此处需要记住的是,对于自定义的类(即非String、int等基础类)clone也是浅拷贝。
为了优化长度,我选择对Exponent的指数进行提公因数的化简,让第一次作业简单的toString方法变得复杂起来。
一个好的架构真的会让整个迭代都易如反掌,令人拥有完全不一样的迭代体验。Unit2开始,还是应该先考虑好整体的布局架构再进行代码写作,不可以到处乱塞了!!!
虽然评测机不一定能够完全覆盖掉每一个数据使之没有bug,但是绝大部分数据集评测机都能够覆盖。一个好的评测机会解决大部分的问题,希望Unit2我能够学着写一个属于自己的评测机。
起码没有将所有东西塞到一个类里,使之完成了CheckStyle的五百行限制(比上学期有进步)。不过每个方法最多不超过60行的限制有一些方法没有做到,下次需要注意。
在接下来的Unit2当中,希望我能够在完成必要任务的情况下能够做到:
(1)做好解耦
(2)做好聚类
(3)行有余力地话能够写一个自己的测评机


