


301
社区成员
 发帖
 与我相关
 我的任务

 分享
PS C:\some\random\path\to\src> tree /F .
.
│  Program.java
│
├─ast
│      AstVisitor.java
│      BinaryOperationNode.java
│      BinaryOperationType.java
│      ExpFunctionNode.java
│      ExpressionNode.java
│      IAstOperations.java
│      NumberNode.java
│      UnaryOperationNode.java
│      UnaryOperationType.java
│      UserFunctionCallNode.java
│      UserFunctionDefinition.java
│      VariableNode.java
│
├─expressions
│      ExpFunction.java
│      Expression.java
│      Term.java
│
├─frontend
│      Lexer.java
│      Parser.java
│      Token.java
│      Type.java
│
└─global
        Global.java
还有类图
因为建了树,所以类的数量多得要命......
我努力让这些类看起来规整些
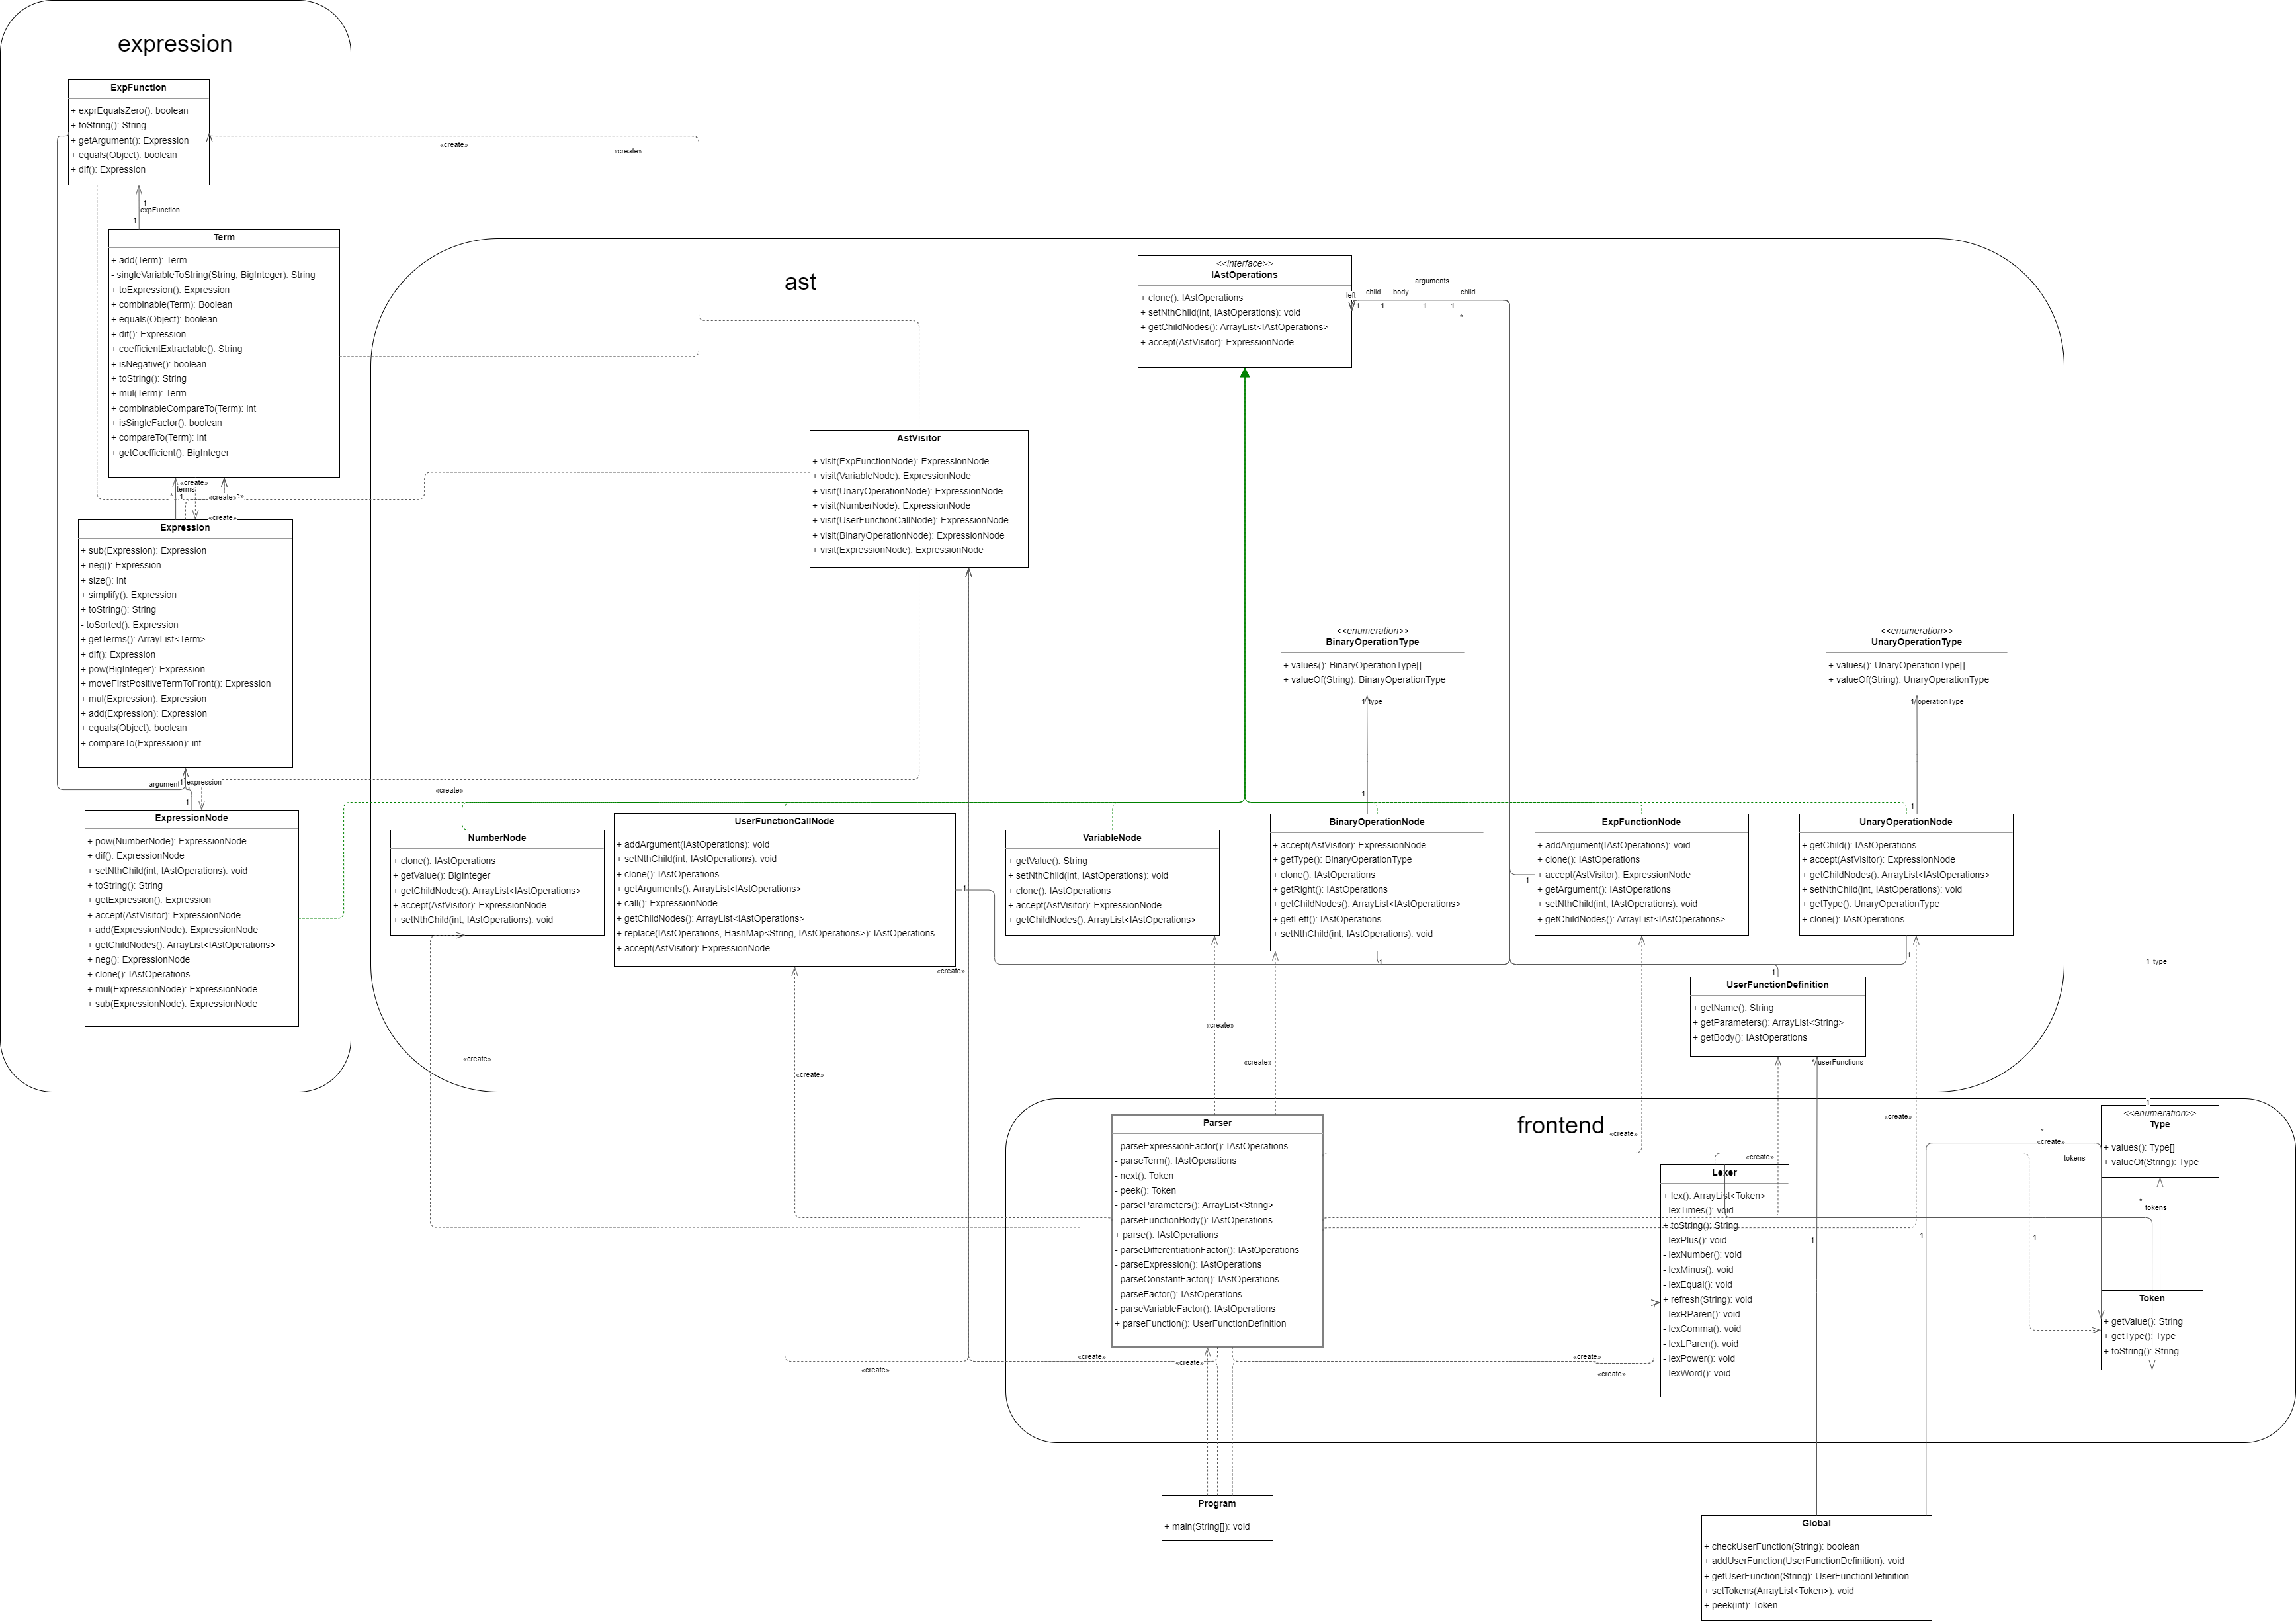
这坨1300行的东西主要由三个部分组成
frontend包,包含Lexer,Parser,负责解析用户输入ast包,包含抽象语法树的节点和Visitorexpression包,负责多项式的存储,计算和输出至于global/Global.java,我需要一个静态类来保存一些全局的设置,因为其他包里的类没法访问顶层的类,所以我只能单独开一个新的包。
这应该算一种设计失误,但我还没想到怎么解决这个问题。
frontend包我选择先将字符串由Lexer转换为Tokens,再由Parser解析的方式处理用户输入,我认为这样至少能让Lexer的代码看起来清晰一点儿。
// Filename: Type.java
public enum Type {
    NUMBER,
    VARIABLE,
    EXP,
    //...
}

// Filename: Lexer.java
public ArrayList<Token> lex() {
    tokens = new ArrayList<Token>();
    while (strIndex < input.length()) {
        char c = input.charAt(strIndex);
        if (Character.isDigit(c)) {
            lexNumber();
        }
        // ...
    }
    tokens.add(new Token(Type.EOF, ""));
    return tokens;
}

private void lexNumber() {
    StringBuilder value = new StringBuilder();
    while (strIndex < input.length() && Character.isDigit(input.charAt(strIndex))) {
        value.append(input.charAt(strIndex));
        strIndex++;
    }
    tokens.add(new Token(Type.NUMBER, value.toString()));
}
然后Parser会分析Tokens,并建立AST,用的是大家都在用的递归下降法。
ast包包含AstVisitor:实现了将任何一种节点转换为ExpressionNode的方法
包含以下节点:
BinaryOperationNode:表示加,减,乘,乘方这四种需要两个操作数的运算之一NumberNode:表示一个常数UnaryOperationNode:表示取相反数,求导这两种需要一个操作数的运算之一UserFunctionCallNode:表示调用用户自行定义的函数VariableNode:表示自变量或者形参自变量ExpFunctionNode:表示指数函数ExpressionNode:表示表达式。这个节点在Parser遍历时不会出现,而只作为visit()的返回值出现。包含IAstOperations接口,定义了所有节点要实现的方法:
ExpressionNode accept(AstVisitor visitor);
ArrayList<IAstOperations> getChildNodes();
void setNthChild(int n, IAstOperations child);
IAstOperations clone();
后面三个方法都是为了实现UserFunctionCallNode的实参替换才定义的,相当麻烦()
包含UserFunctionDefinition:
存储用户定义函数的名称,形参和函数表达式。因为函数表达式和通常的表达式遵循同样的形式化表述,所以可以存为另一棵AST。
这里做了一个优化:存储前将函数表达式展开到最简形式,再存储最简形式的AST,能提升处理复杂函数时的性能。
// Filename: ../frontend/Parser.java
private IAstOperations parseFunctionBody() {
    IAstOperations body = parseExpression();
    index = 0;
    String simplified = body.accept(new AstVisitor()).toString();
    Lexer lexer = new Lexer();
    lexer.refresh(simplified);
    Global.setTokens(lexer.lex());
    body = parseExpression();
    return body;
}
也许将表达式转换成树比重新解析一遍字符串更好,但那样我要多写几个方法,还是算了()
Parser建树完毕后,AstVisitor会以前序遍历方式访问AST,返回一个包含化简后的Expression的ExpressionNode。
我是这样处理UserFunctionCallNode的实参替换的:
// Filename: UserFunctionCallNode.java
public IAstOperations replace(
        IAstOperations root,
        HashMap<String, IAstOperations> replacements
) {
    ArrayList<IAstOperations> nodes = root.getChildNodes();
    for (IAstOperations node: nodes) {
        if (node instanceof VariableNode) {
            VariableNode variable = (VariableNode) node;
            if (replacements.containsKey(variable.getValue())) {
                root.setNthChild(nodes.indexOf(node), replacements.get(variable.getValue()));
            } else {
                throw new RuntimeException("Function call error: " + name);
            }
        } else {
            replace(node, replacements);
        }
    }
    return root;
}
expression包一大半是从hw1祖传下来的,一小半是从hw2祖传下来的。
简单来讲就是 ArrayList<Term>
实现了加,减,乘,乘方和求导
实现了排序,合并,和基于前两者的化简
项的排序函数写得正确的话可以做到可以合并的项一定相邻,O(n log n)是好文明。
互测房内有同学采用了基于两重循环的合并,TA们的运行效率使我不得不降低本地测试的强度,避免Hack的好策略。
Expression套了个壳在实现hw1时,我并没有建立AST,而是选择由Parser直接返回Expression。实现hw2时,我重构了代码,于是就产生了这一坨十多个类的ast包。
事实证明这次重构至少从代码量的角度来说是个大坑,但是增进了我对AST和访问者模式的理解,实现个乐呵也不错(笑)
因为我在hw2的实现能处理函数嵌套,hw3相对于hw2增加的内容只有求导一项,所以重构
在hw1时,我开了一个支持多变量表达式的分支,这一设计在hw3的函数形参自变量投入使用,预测大成功。
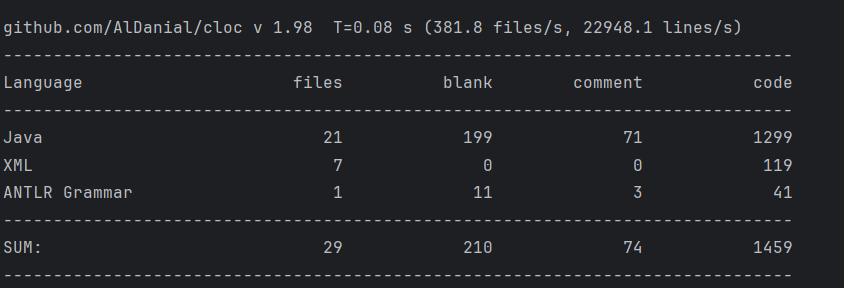
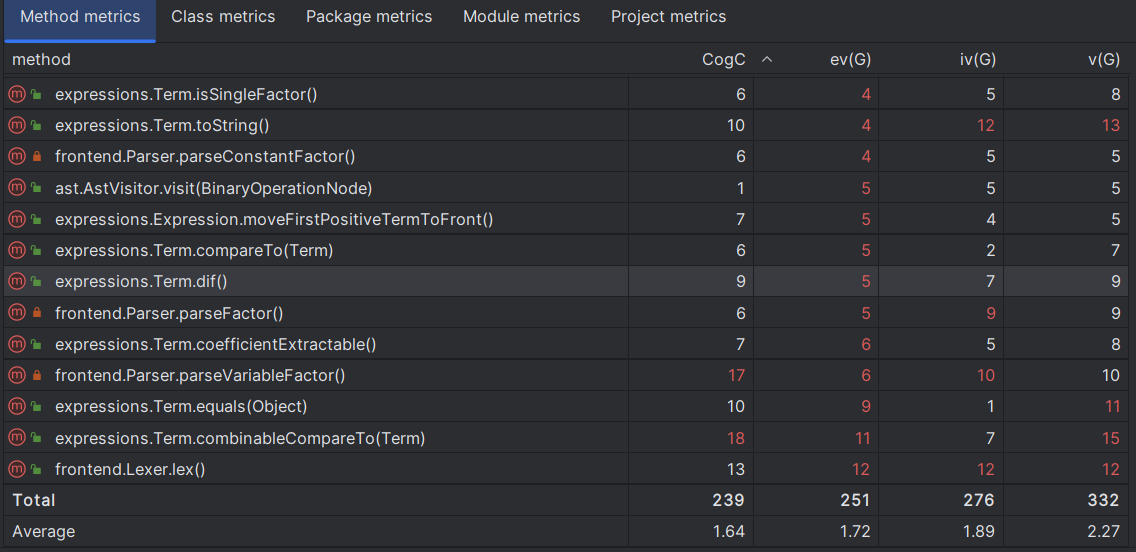
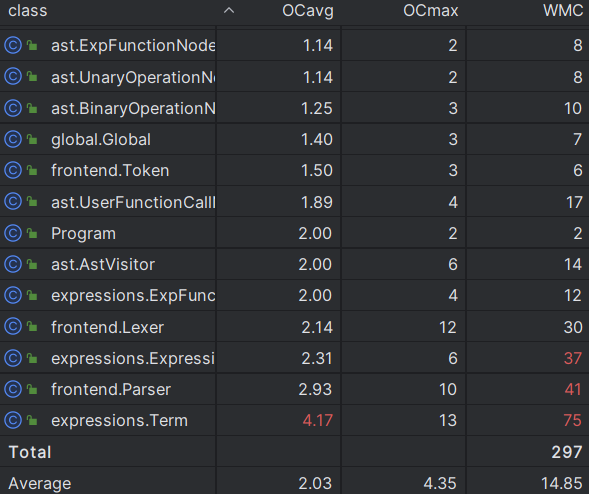
可见平均复杂度还行,高复杂度的方法主要集中在Term类中,鉴于Term管理的东西太多,高复杂度在一定程度上无法避免,但是可以通过拆分方法的方式缓解。
速度优化有时候很重要,来一条喜闻乐见的数据(注:不符合互测要求)测试看看:
2
h(x, z) = -x^2*8*(-exp(8)+exp(z^+8)*z^+0)^+4+--5*z^+8*8
f(y) = +-9*+7*(+h((++1*y^6+-9+y^+7*1), (+y*y^1*y-2)^8)*2++(+-(+0*2--0*y*y^+3+-y)+-(++y^+8*y)*exp(-6)*(y)^6)^4+(+-(++-7*y)^+8*y^5+-y)^7)---6*0
++h(-0, dx(dx(dx(-+x*x^4))))*f(2)*(--(5--5)^1*7*6++(++h(7, dx(++1))*f(dx(-3))*(-(x*0++7*+0*+6)^+6*(1*-4*+3--x^3*8*x^3++x*+2*x)^5*9++1*0*+3-f(x)*(+9*6*6)^6)++2*x-+x*+8))
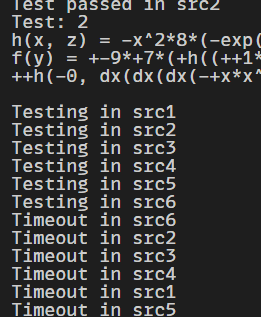
在本地测试中产生了10s Timeout所有房友的佳绩
Profiler运行结果:
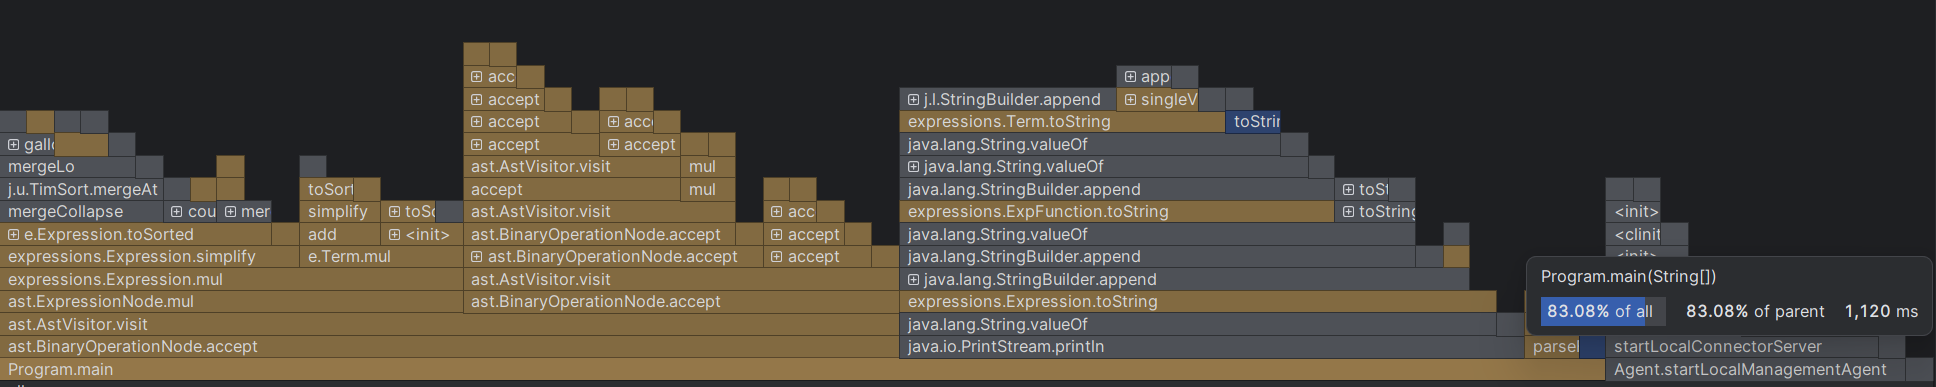
再看一位可以在合理时间内运行完毕的房友:
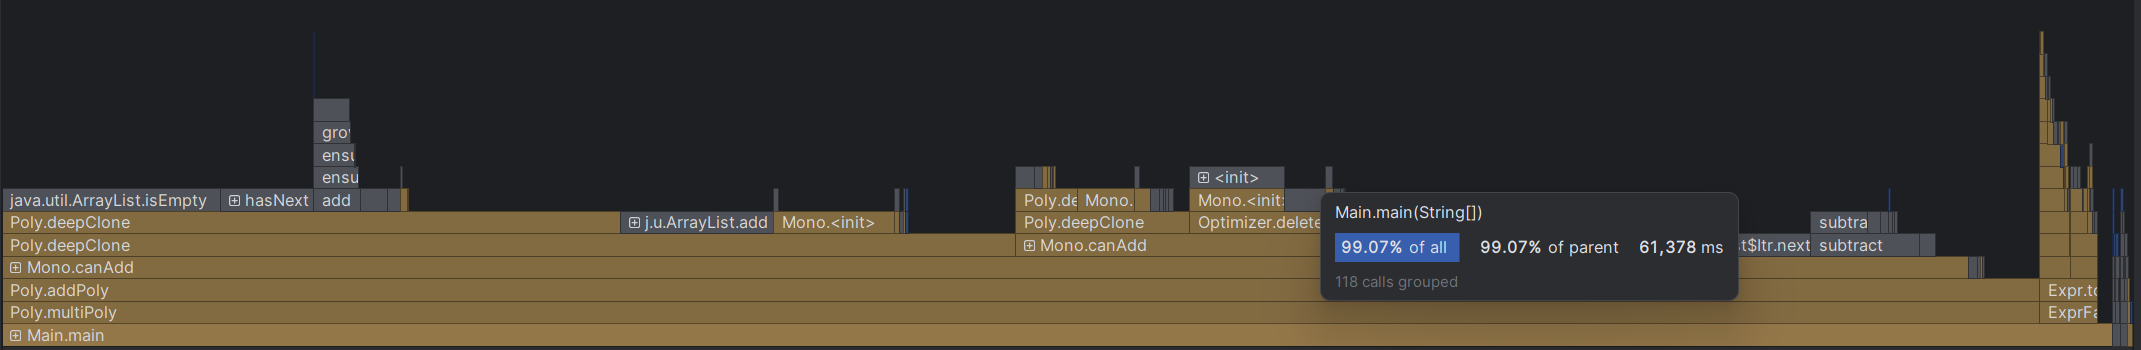
于是我们便可以根据图示耗时较长的方法进行针对性优化。
这个相信大家都会做,不然不仅长,而且乘方会TLE
如-1*x,x^0之类的情况
如exp((x)),exp(x)^0,exp(0)之类的情况
hw1做了,后续移除了,因为不太优雅
没做
我应该想到这点吗?也许我应该去了解一下他们说的“启发式算法”。
惭愧,在这点上我没什么发言权。在三次作业中我既没被别人找到bug,也没找到别人的bug。
并特别指出是否结合被测程序的代码设计结构来设计测试用例
并没有,也许看看会更好,但是大家的代码都耦合成一坨,分析其结构在不到两天的时间内是相当消耗精力的。
编写了了建议的基于Python的自动测试(对拍)脚本和基于C#的数据生成器。
一点心得是,互测环节要人工构造和自动测试相结合。自动测试是生成不了这样的数据的:
2
g(z)=exp(exp(exp(exp(z))))
f(y)=exp(exp(exp(exp(g(y)))))
f(exp(exp(exp(exp(x^8)))))
我认为本单元的内容比较合理,通过有实际意义的案例让同学们理解递归下降的方法。三次迭代的设计强调了好的代码架构的重要性。总之,我学了之后非常开心,有一种丰收的喜悦。


