


301
社区成员
 发帖
 与我相关
 我的任务

 分享
wj老师镇楼
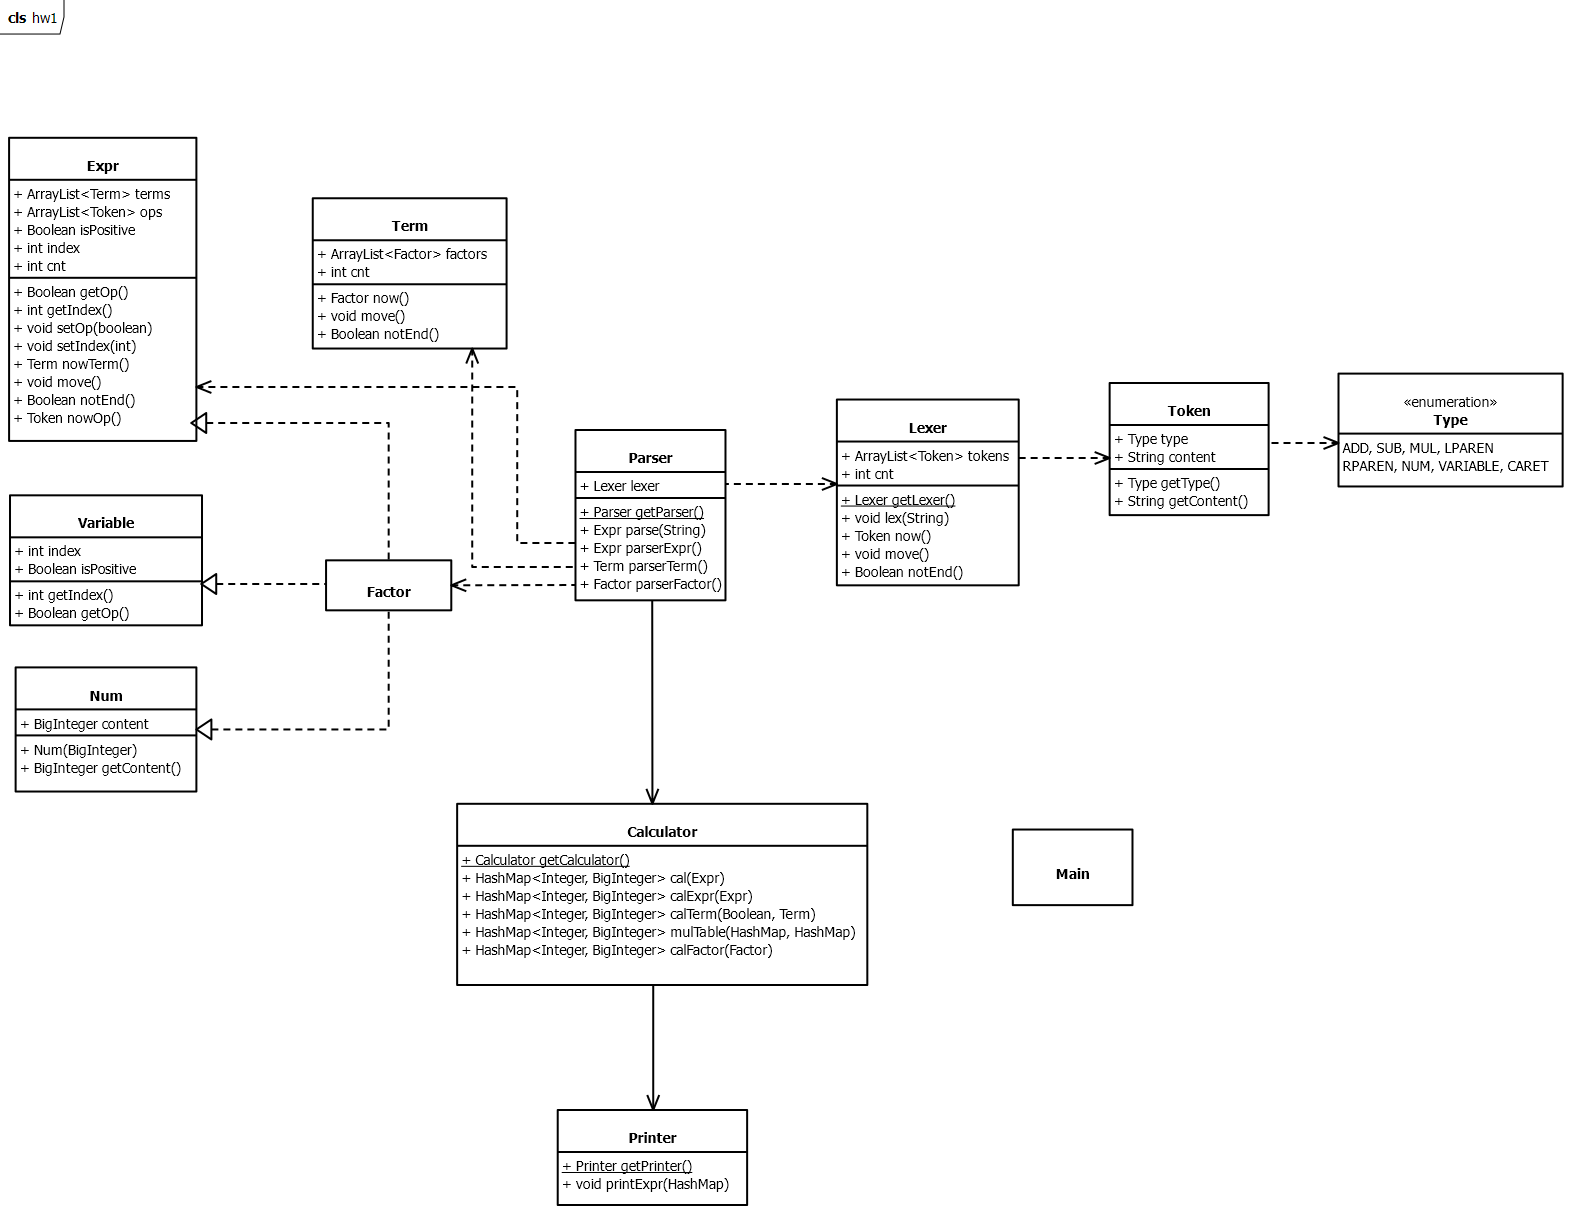
预处理
String.replaceAll方法去除字符串中所有空白符
分析词元
将表达式字符串拆解成+ - * ^ 常数 x ( )等词元
构造语法树
遍历词元,以+/-为分隔分析表达式中的项,以*为分隔分析项中的因子
分析因子时,先把前置的所有+/-读完确定正负号,再以第一个词元是常数,x或者左括号来确定因子类型
最终构建一颗树:其根结点是表达式,第二层结点是项,第三层是因子(若含表达式因子可继续向下展开)伪代码如下: Expr parserExpr() { 数组terms存放项term,数组ops存放项间加减符号op 用parseTerm方法分析第一个项并加入terms数组 while (表达式未结束且本词元是加减号) { 将本词元加入ops数组 用parseTerm方法分析下一个项并加入terms数组 } 返回一个以terms和ops数组为属性的Expr型对象 } Term parseTerm { 数组factors存放因子factors 用parseFactor方法分析第一个因子并加入factors数组 while(项未结束且本词元是乘号){ 用parseFactor方法分析下一个因子并加入factors数组 } 返回一个以factors数组为属性的Term型对象 } Factor parseFactor { 如果该词元是常数,则返回一个继承Factor的Num型对象 如果该词元是变量,则返回一个继承Factor的Variable型对象 否则返回一个继承Factor的Expr型对象 }计算语法树
将因子表示成一个hashmap<指数, 系数>,其中:
常数因子a添加键值对<0, a>,变量因子x^a添加键值对<a, 1>
将因子的hashmap做指数相加,系数相乘的运算,得到项的hashmap
将项的hashmap做指数不变,系数相加的运算,得到表达式的hashmap
同理,表达式因子递归可得,最终将整个表达式转化为一个hashmap
输出多项式
将计算语法树根节点表达式得到的hashmap按照格式输出成多项式
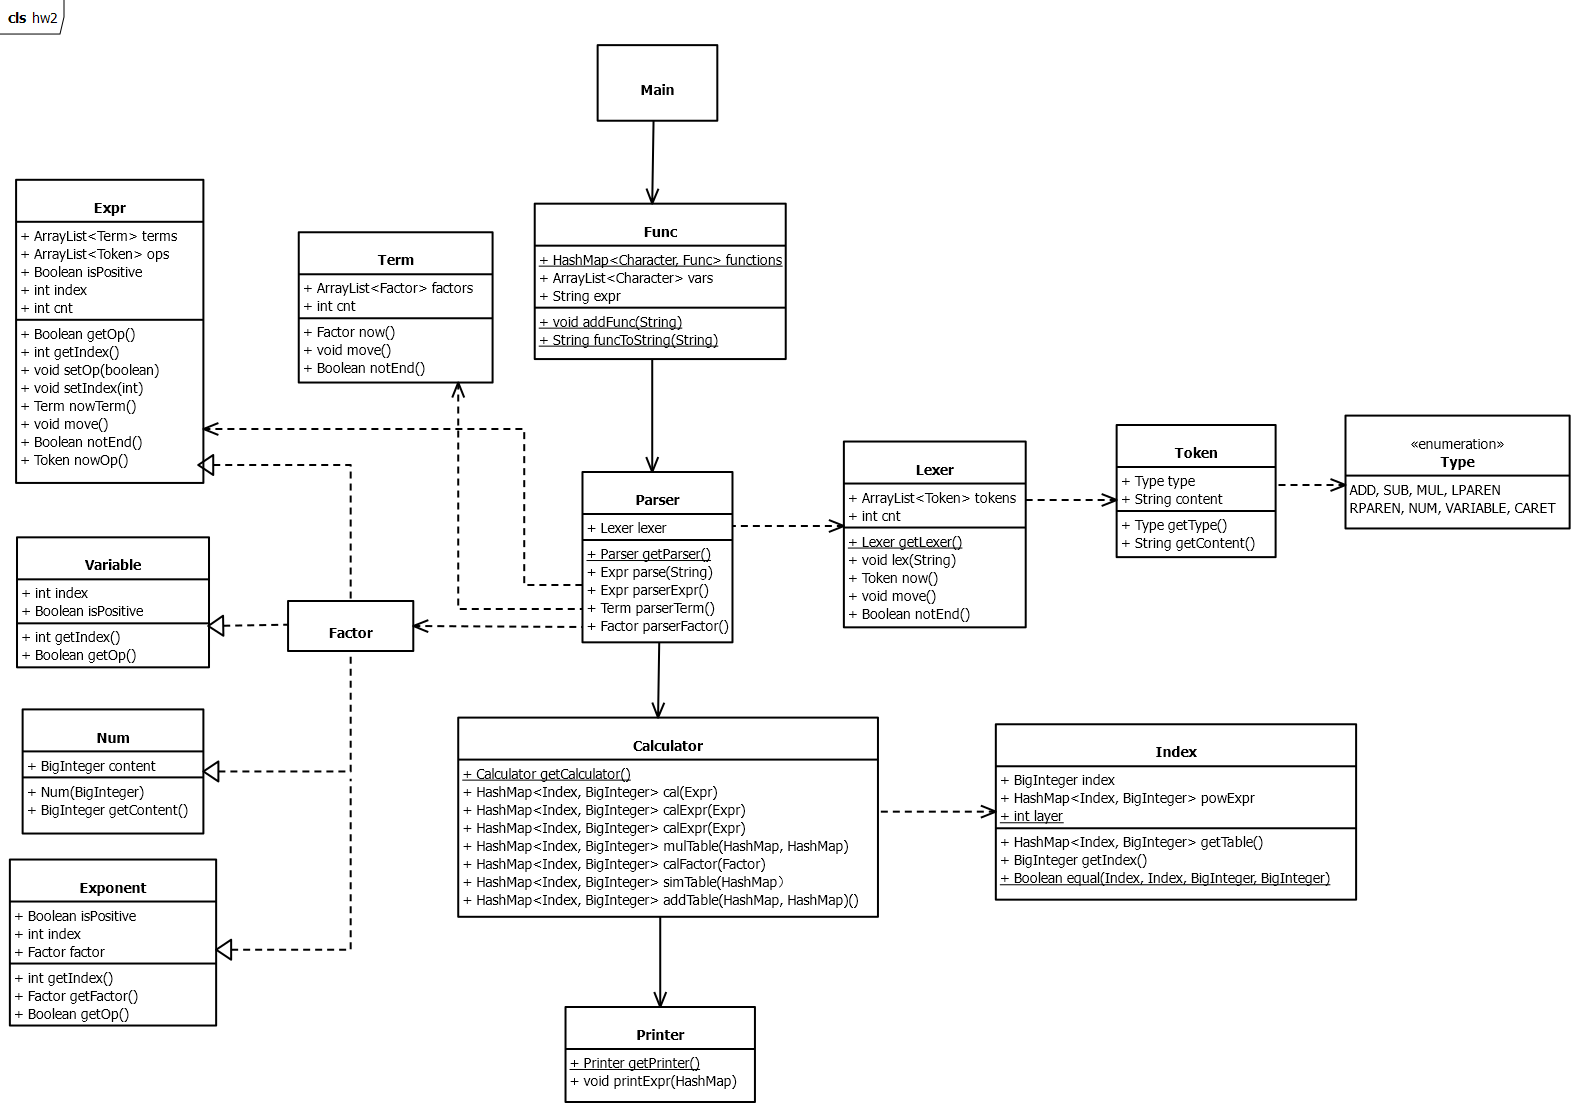
预处理
在预处理时将函数代入表达式,具体做法是:先读入函数,用hashmap记录<函数名,函数>的键值对,其中函数Func类有两个属性,第一个是用Arraylist保存的形参列vars,第二个是函数表达式。在每一条自定义函数输入后:
- 记录函数名
- 按照顺序读入形参,存入vars中
- 把'='后的字符串记录为函数表达式
- 把函数func和函数名的键值对加入hashmap
再将原表达式中的函数替代,具体做法是:
- 在原表达式中遍历到'f','g','h'
- 根据hashmap查询对应的函数func
- 将原表达式中函数名后括号中的实参按顺序读入实参数组params
- 将func的函数表达式中的x,y,z按照对应关系替换为实参(注意exp中的x也会被替换所以要先处理)
- 将替换后的函数表达式取代原表达式中的函数部分(注意将替换后的函数表达式两边加括号)
分析词元
只在type中添加了一种新枚举元素EXP
分析语法树
只在分析因子parseFactor时拓展了对指数函数Exp类的解析
计算语法树
在加入指数函数后,表达式最终每一项都会化简为形如a*x^b*exp(expr)的形式,因此,引入一种新的包装类Index,同时包含幂函数的指数index和指数函数的指数表达式powExpr,其中powExpr用hashmap<包装类Index, 系数>递归表示,对Index类设计两种构造器:
- 构造时只给出幂函数指数index,则powExpr部分设为null,形如计算变量因子或常数因子时调用
- 构造时给出幂函数的指数index和指数函数的指数表达式powExpr,形如计算指数函数因子时调用
因此,需要重写Calculator中对hashmap的加法addTable和乘法mulTable,以及需要对两个Index对象是否相等进行判定,除此之外,为了减少重复代码,还在Calculator类中抽象了去除hashmap系数为0的项的方法simTable,判等大致思路如下:
- 1和2的幂函数指数index是否相等,不相等返回false,相等进入下一步
- 1和2的指数函数指数表达式powExpr是否都为null(相当于exp(0)或者1),是则返回true,否则进入下一步
- 1和2的指数函数指数表达式powExpr是否其中一个为null,是则返回false,否则进入下一步
- 1和2的指数函数指数表达式powExpr是否键值对数目相等,否则返回false,是则进入下一步
- 用一个Arraylist保存在2的指数函数指数表达式powExpr中匹配过的键值Index,取1的指数函数指数表达式powExpr中的一个键值对3,再遍历2的指数函数指数表达式powExpr中的每一个键值对4,如果键值对4没有遍历过(即Arraylist中没有4的键值)且递归判别3和4相等,则将4的键值加入到Arraylist且break,遍历1中的下一个键值对。如果直到2中遍历完,都没有找到能匹配3的键值对,则返回false。如果将1完全遍历,则返回true
第5步伪代码如下:
ArrayList<Index> traversal = new ArrayList<>(); // 在该数组中即为遍历过
for (遍历1的键值3) {
  boolean everEqual = false; // 是否曾匹配过
  for (遍历2的键值4) {
      if (traversal不包含4 且 递归得到3和4的键值对相等)) {
          将4加入traversal
          everEqual = true;
          break;
      }
  }
  if (!everEqual) {
      return false;
  }
}
return true;
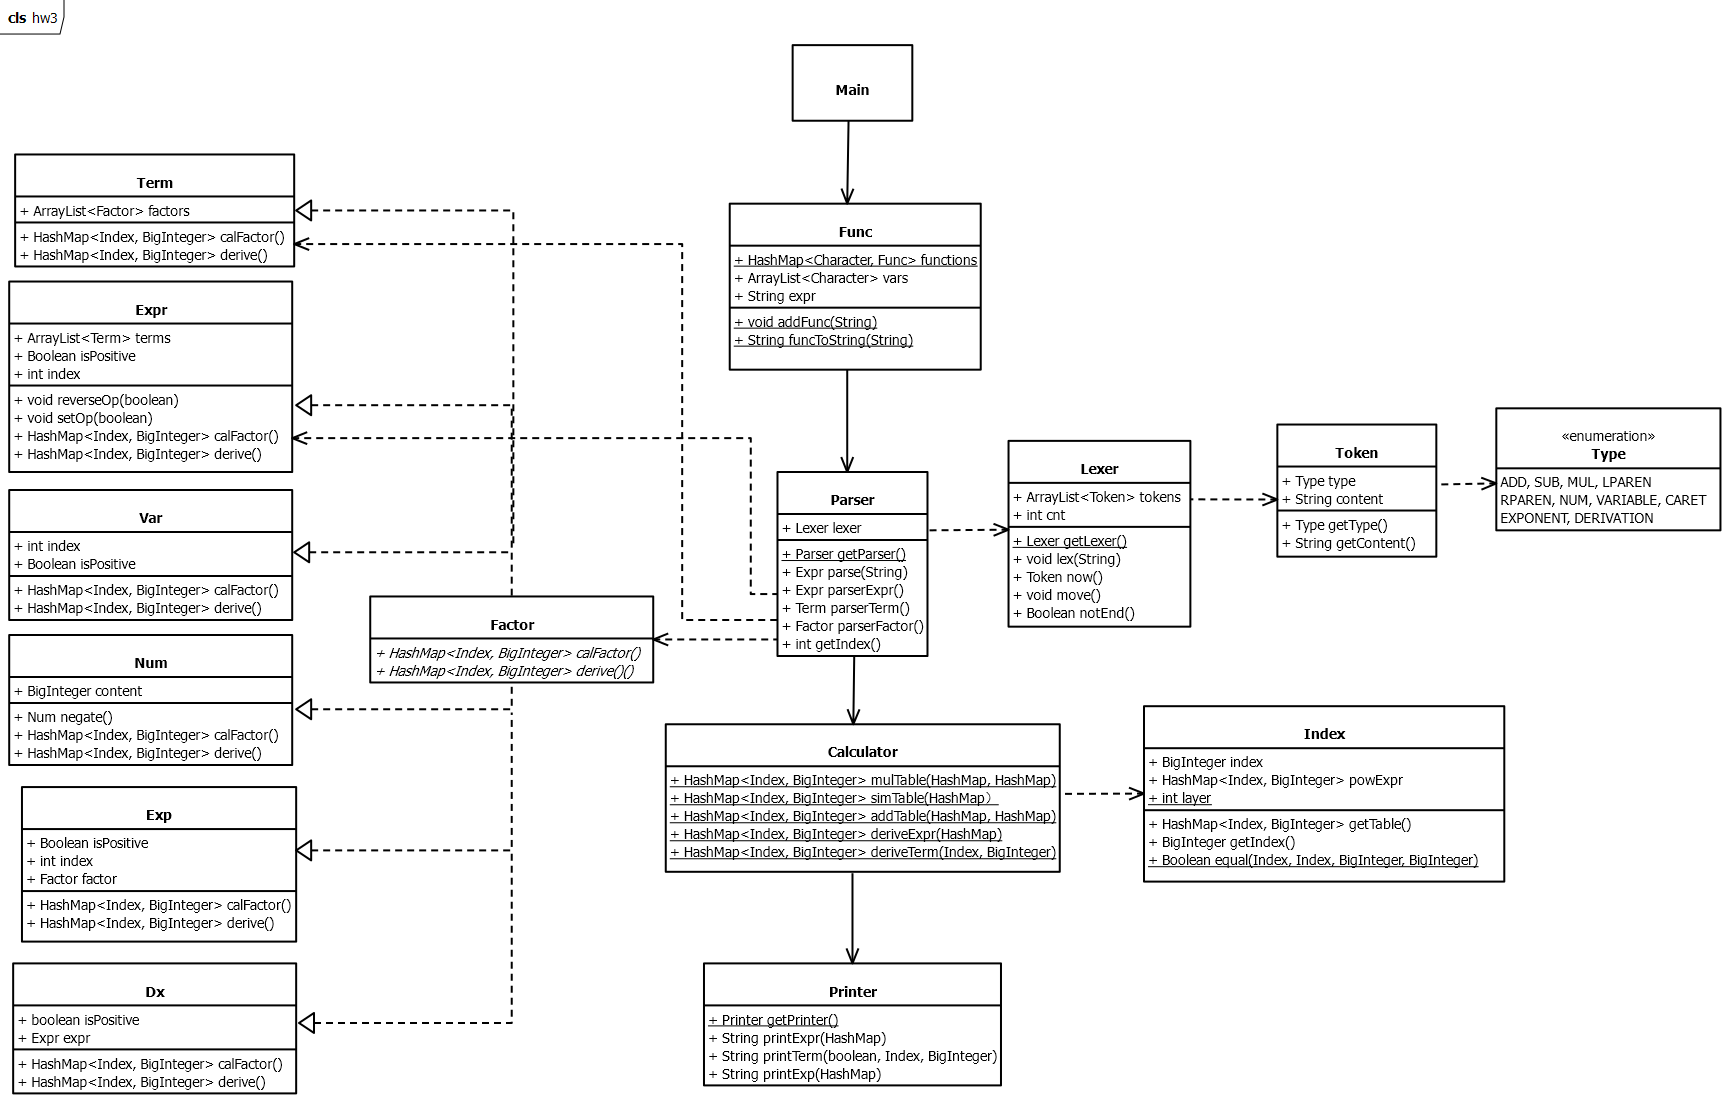
输出表达式
优化思路:
- 第一项尽量放系数为正的项,可以省一个'+'
- 1/-1在非第一项且非常数项中数字可省略
- 1次项即x^1 的^1可省略
| 源文件 | 总行数 | 源代码行数 | 源代码占比 |
|---|---|---|---|
| Printer.java | 122 | 113 | 0.92 |
| Calculator.java | 113 | 105 | 0.92 |
| Parser.java | 108 | 88 | 0.81 |
| Lexer.java | 79 | 71 | 0.89 |
| Func.java | 75 | 64 | 0.85 |
| Index.java | 73 | 64 | 0.87 |
| Expr.java | 65 | 56 | 0.86 |
| Term.java | 44 | 38 | 0.86 |
| Exp.java | 37 | 31 | 0.83 |
| Dx.java | 34 | 27 | 0.79 |
| Var.java | 34 | 28 | 0.82 |
| Num.java | 29 | 22 | 0.75 |
| Main.java | 26 | 20 | 0.76 |
| Token.java | 19 | 14 | 0.73 |
| Factor.java | 14 | 9 | 0.64 |
| 总计 | 872 | 750 | 0.86 |
| 方法 | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| factor.Dx.calFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Dx.derive() | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Dx.Dx(boolean, Expr) | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Exp.calFactor() | 1.0 | 1.0 | 2.0 | 2.0 |
| factor.Exp.derive() | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Exp.Exp(boolean, int, Factor) | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Expr.calFactor() | 10.0 | 1.0 | 6.0 | 7.0 |
| factor.Expr.derive() | 2.0 | 2.0 | 2.0 | 3.0 |
| factor.Expr.Expr(boolean, ArrayList, int) | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Expr.reverseOp(boolean) | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Expr.setIndex(int) | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Factor.Factor() | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Num.calFactor() | 1.0 | 2.0 | 2.0 | 2.0 |
| factor.Num.derive() | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Num.negate() | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Num.Num(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Term.calFactor() | 1.0 | 1.0 | 2.0 | 2.0 |
| factor.Term.derive() | 6.0 | 1.0 | 4.0 | 4.0 |
| factor.Term.Term(ArrayList) | 0.0 | 1.0 | 1.0 | 1.0 |
| factor.Var.calFactor() | 1.0 | 1.0 | 2.0 | 2.0 |
| factor.Var.derive() | 2.0 | 2.0 | 2.0 | 3.0 |
| factor.Var.Var(boolean, int) | 0.0 | 1.0 | 1.0 | 1.0 |
| Main.main(String[]) | 1.0 | 1.0 | 2.0 | 2.0 |
| output.Calculator.addTable(HashMap<Index, BigInteger>, HashMap<Index, BigInteger>) | 18.0 | 6.0 | 8.0 | 13.0 |
| output.Calculator.Calculator() | 0.0 | 1.0 | 1.0 | 1.0 |
| output.Calculator.deriveExpr(HashMap<Index, BigInteger>) | 3.0 | 1.0 | 3.0 | 3.0 |
| output.Calculator.deriveTerm(Index, BigInteger) | 3.0 | 2.0 | 3.0 | 4.0 |
| output.Calculator.mulTable(HashMap<Index, BigInteger>, HashMap<Index, BigInteger>) | 15.0 | 6.0 | 6.0 | 8.0 |
| output.Calculator.simTable(HashMap<Index, BigInteger>) | 5.0 | 3.0 | 3.0 | 5.0 |
| output.Index.equal(Index, Index, BigInteger, BigInteger) | 30.0 | 11.0 | 9.0 | 16.0 |
| output.Index.getIndex() | 0.0 | 1.0 | 1.0 | 1.0 |
| output.Index.getTable() | 0.0 | 1.0 | 1.0 | 1.0 |
| output.Index.Index(BigInteger) | 0.0 | 1.0 | 1.0 | 1.0 |
| output.Index.Index(BigInteger, HashMap<Index, BigInteger>) | 0.0 | 1.0 | 1.0 | 1.0 |
| output.Printer.getPrinter() | 1.0 | 1.0 | 1.0 | 2.0 |
| output.Printer.Printer() | 0.0 | 1.0 | 1.0 | 1.0 |
| output.Printer.printExp(HashMap<Index, BigInteger>) | 43.0 | 9.0 | 15.0 | 18.0 |
| output.Printer.printExpr(HashMap<Index, BigInteger>) | 7.0 | 4.0 | 6.0 | 7.0 |
| output.Printer.printTerm(boolean, Index, BigInteger) | 13.0 | 1.0 | 10.0 | 10.0 |
| parser.Func.addFunc(String) | 1.0 | 1.0 | 2.0 | 2.0 |
| parser.Func.Func(ArrayList, String) | 0.0 | 1.0 | 1.0 | 1.0 |
| parser.Func.funcToString(String) | 27.0 | 1.0 | 10.0 | 12.0 |
| parser.Lexer.getLexer() | 1.0 | 1.0 | 1.0 | 2.0 |
| parser.Lexer.lex(String) | 20.0 | 13.0 | 12.0 | 14.0 |
| parser.Lexer.Lexer() | 0.0 | 1.0 | 1.0 | 1.0 |
| parser.Lexer.move() | 0.0 | 1.0 | 1.0 | 1.0 |
| parser.Lexer.notEnd() | 0.0 | 1.0 | 1.0 | 1.0 |
| parser.Lexer.now() | 0.0 | 1.0 | 1.0 | 1.0 |
| parser.Parser.getIndex() | 4.0 | 1.0 | 4.0 | 4.0 |
| parser.Parser.getParser(Lexer) | 1.0 | 1.0 | 1.0 | 2.0 |
| parser.Parser.parse(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| parser.Parser.parseExpr() | 3.0 | 1.0 | 4.0 | 4.0 |
| parser.Parser.parseFactor() | 10.0 | 5.0 | 8.0 | 8.0 |
| parser.Parser.Parser(Lexer) | 0.0 | 1.0 | 1.0 | 1.0 |
| parser.Parser.parseTerm() | 2.0 | 1.0 | 3.0 | 3.0 |
| parser.Token.getContent() | 0.0 | 1.0 | 1.0 | 1.0 |
| parser.Token.getType() | 0.0 | 1.0 | 1.0 | 1.0 |
| parser.Token.Token(Type, String) | 0.0 | 1.0 | 1.0 | 1.0 |
| Total | 232.0 | 111.0 | 163.0 | 194.0 |
| Average | 4.0 | 1.9 | 2.8 | 3.3 |
exp((1)) -> exp(1)
exp((x)) -> exp(x)
exp((5*x^3)) -> exp(x^3)^5
exp((3*exp(3))) -> exp(exp(3))^3
exp((2*x^2+2*x^5+8*x^7)) -> exp((x^2+x^5+4*x^7))^2
出错样例:
0
dx(-dx(x^3+x^2)*x)
分析:
dx(expr)没有问题
dx(dx(expr))没有问题
dx(dx(expr)*x)没有问题
dx(-dx(expr)*x)有问题
原因:
dx(expr)会对expr求导,如果expr是-dx(expr1)*(expr2)的形式,会对dx对象先后使用derive和calfactor方法
在dx对象的derive和calFactor方法中,会通过改变dx对象的表达式的正负号来把dx对象的正负号代入到计算中
若dx对象的isPositive属性为false,则expr1的符号会被改变两次,则第二次改变后expr1的符号和原式相比没有变化,导致结果正负号发生错误
解决办法:
在使用derive后将expr1的符号修改回来
经验教训:
命令-查询分离原则——设计接口时,修改对象字段的方法无返回值,有返回值的方法不修改对象的字段
在预处理时将函数代入表达式时有没有加括号,如:
f(x,y) = x+y
f(1,2)*x
如果代入函数时没有加括号,就会变成1+2*x,结果错误
谢谢助教支持以及课程组的精心设计,受益匪浅😸


