


301
社区成员
 发帖
 与我相关
 我的任务

 分享
第一单元的作业围绕着表达式展开这一主题,通过三次迭代逐步实现了单变量表达式的括号展开与化简、支持自定义函数和指数函数的加入、支持求导等内容。
作为OO第一单元的作业,从中我们能进一步学习到面向对象的设计思想。同时初步了解接口、继承等设计方法,体会层次化设计思想的应用和工程实现。
在正文开始前,我想强调在本单元作业中最重要的体会——“架构”。即使是刚开始的第一单元,这三次作业也并不简单。而一个好的架构可以让自己在逐次作业中丝滑迭代,减少bug的产生。
第一次作业的主要内容是只含一层括号的单变量表达式的展开化简。表达式中所含3种因子:常数因子、幂函数因子与表达式因子。第一次作业的主要难点是在于从0到1的架构设计以及递归下降法解析表达式方法的理解。
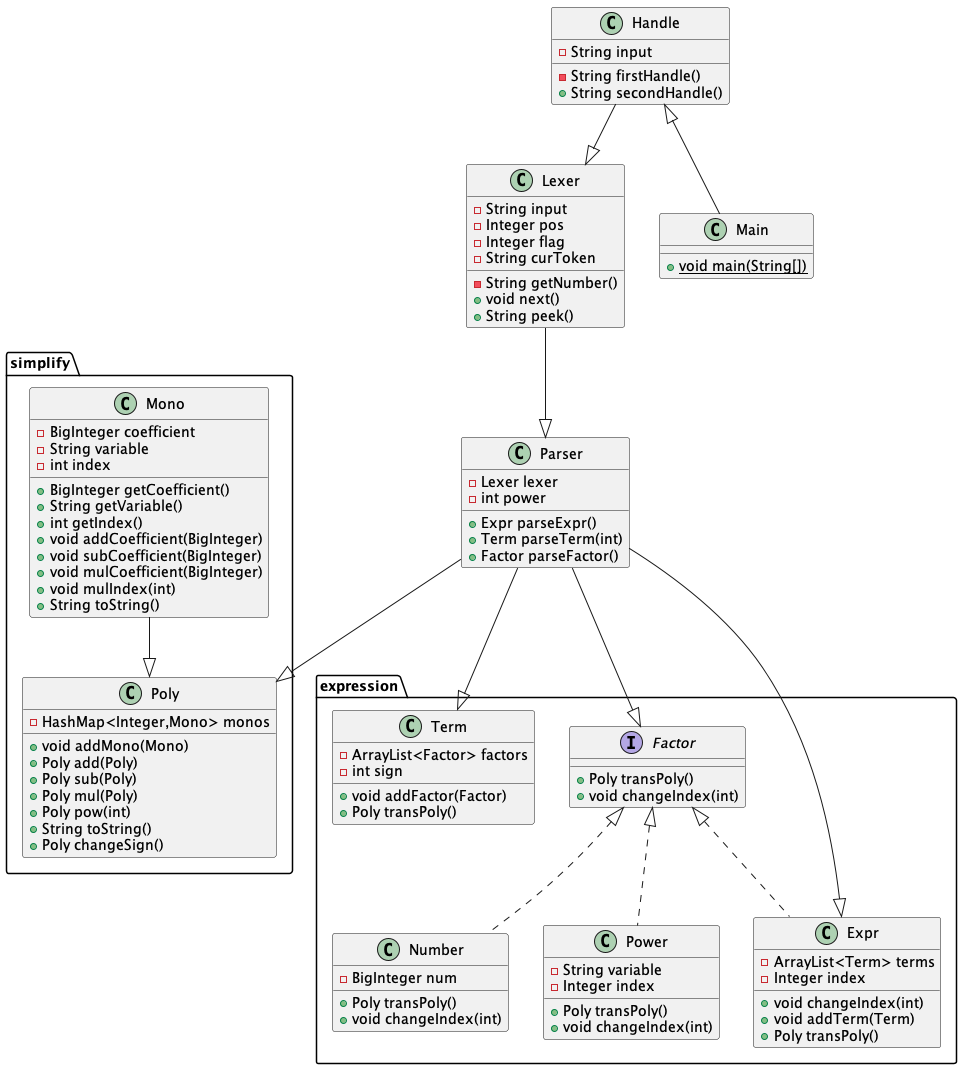
第一次作业聚焦于单变量不含嵌套括号的表达式展开化简。通过对表达式进行层次化分析,不难知可将表达式拆分为3个层次——Expr,Term,Factor,由因子形成项,项又组成表达式。其中因子Factor由含有3种——常数因子Number、幂函数Power,表达式因子Expr。有趣的是,表达式与表达式因子看似是不同的层次,实际上其内部结构是完全相同的。因此我们完全可以用一个类Expr即可实现这两种层次。
完成对表达式的初步分析并建类后,进入了本次作业最大的一个难题——即如何解析输入进来的表达式?这里,请无脑选用课程组推荐的解析方法——递归下降法。选用该种方法的原因不仅仅是因为课程组提供了该方法的代码模版,更因为选用这种方法对后续迭代深有裨益。只要架构得当,该方法能天然处理后续的各种嵌套情况(例如嵌套括号,嵌套自定义函数等等……)
完成上面两步后,便可以着手开始进行代码的前半部分编写了!对于读入进来的表达式,为了方便我们后续的解析,需要进行一些预处理。这些预处理包括不限于:删去多余的空白字符、对连续的加减符号只保留1个。当然,根据自己的解析方法,还可以做进一步的优化处理,例如针对第一项出现-x,(-x)这种情况,可以选择添前0的方法,变为0-x,(0-x)。还有很多处理的细节,都可以根据自己的需求酌情实现。总之,一切预处理都是为了方便自己后续的处理。
对于解析部分Lexer(词法分析器)与Parser(语法分析器),完全可使用课程组提供的递归下降模版,加以稍微修改便可为己所用。这里就不再赘述。
解析完表达式后,我们已经获得了一个由因子、项、表达式构成的语法树。接下来,如何化简并输出结果变成了我们的核心问题。这里我采用了广受好评的Poly-Mono架构。对于我们的计算化简输出都非常友好。稍微分析我们本次要化简输出的形式,可抽象化为基本单项式(Mono)与多个Mono组成的多项式(Poly)两个结构。对本次作业而言,Mono的基本结构如下式:
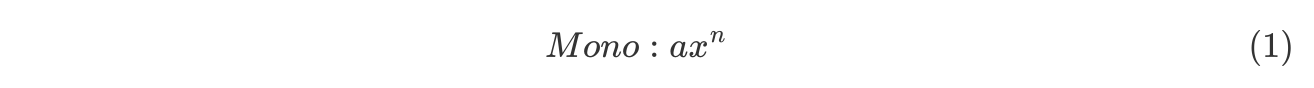
在Poly中,我们利用HashMap来组织Mono,使用指数index作为索引。并在所有的表达式层次类中实现transPoly()方法。将表达式转化为Poly多项式。在Poly类中,实现加法、乘法、合并同类项。
最后,我们重写Poly与Mono类中的toString()方法,即可对最终化简的表达式进行输出。
至此,本次作业便可圆满完成。
由于方法较多,我们截取部分代表性的复杂度方法进行分析:
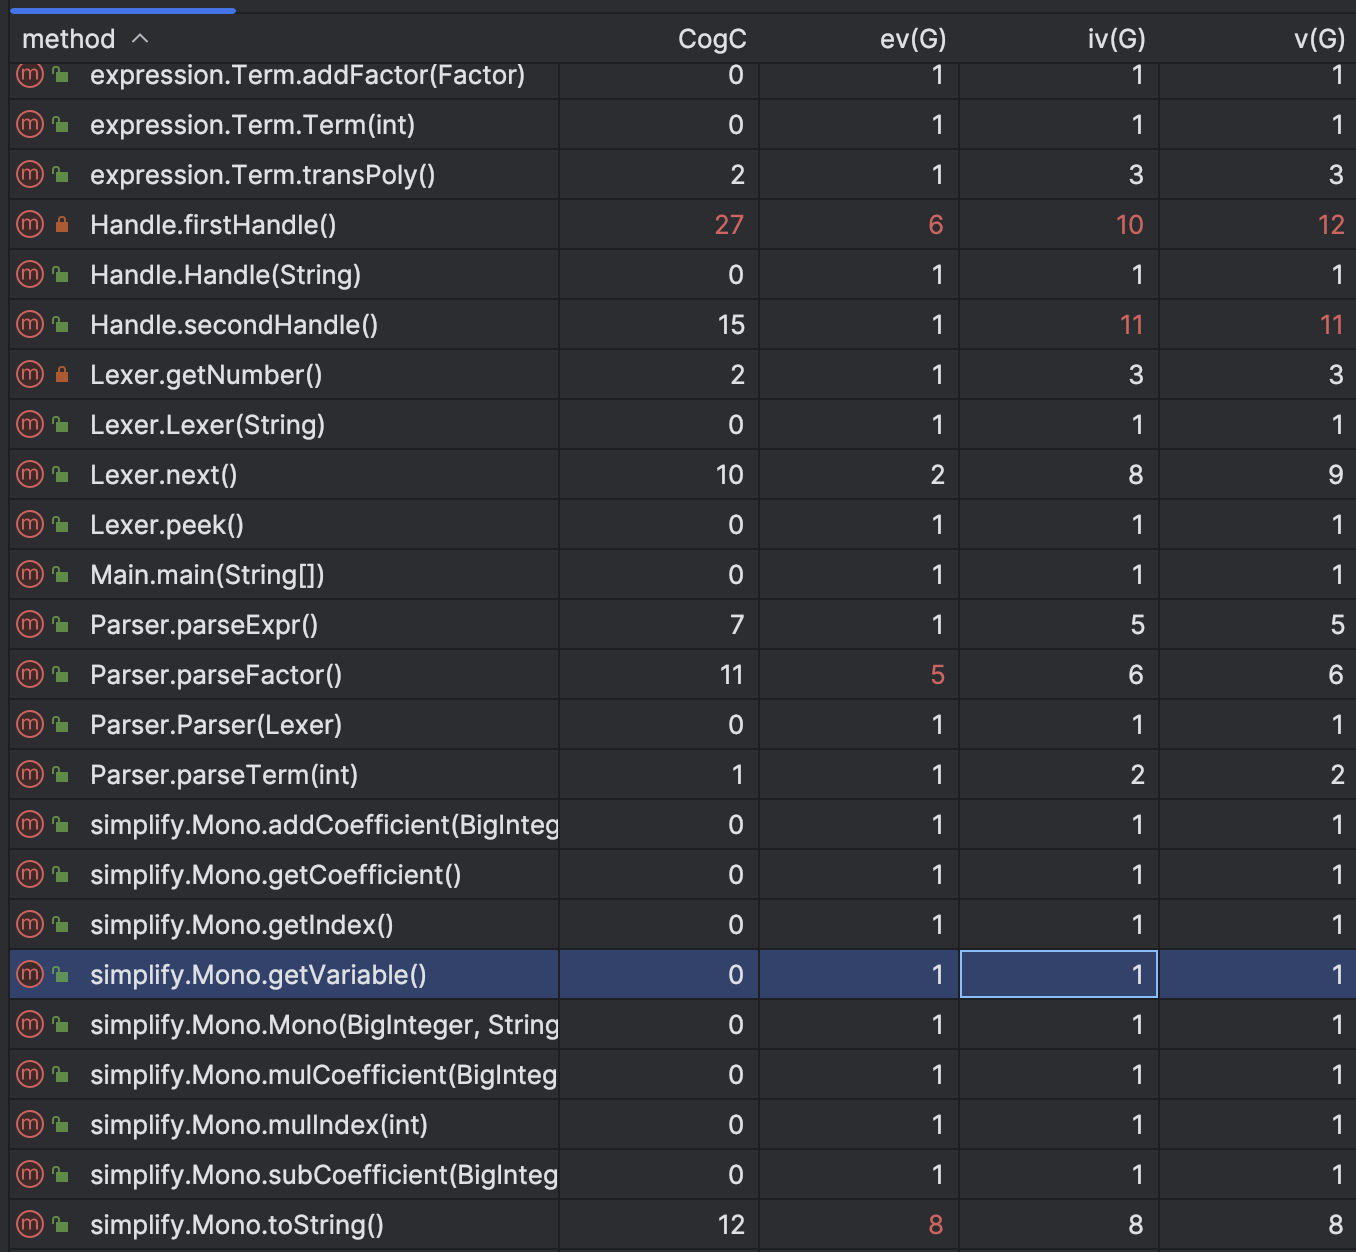
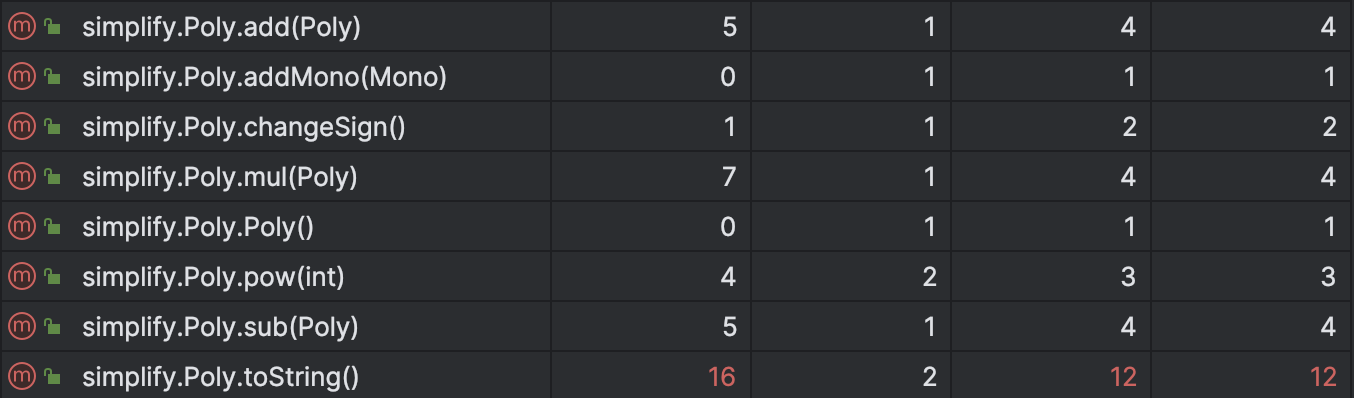
绝大部分方法的复杂度均在可控范围之内。
Handle类中两个方法的复杂度均较高,这是因为在预处理表达式时使用了很多if-else语句判断特殊情况,且处理较多。因此复杂度难以控制。
Poly和Mono类中的toString()方法复杂度较高,同样是使用了较多if-else语句判断情况,同时有长度优化的部分。行数较大导致复杂度较高
本次作业强测与互测均未出现bug。
第二次作业是本人认为三次作业中最难的一次。在架构设计、Bug修复等方面对我而言都是非常大的挑战。
本次作业较上一次作业新增下面几个需求:支持自定义函数、支持指数函数exp()、支持嵌套括号。难点在于自定义函数的解析、重构Mono最小单元,计算化简等。
为了更好地体现出各类的性质和相互依赖关系,本次作业特地为不同的类进行了分包处理。代码UML类图如下:
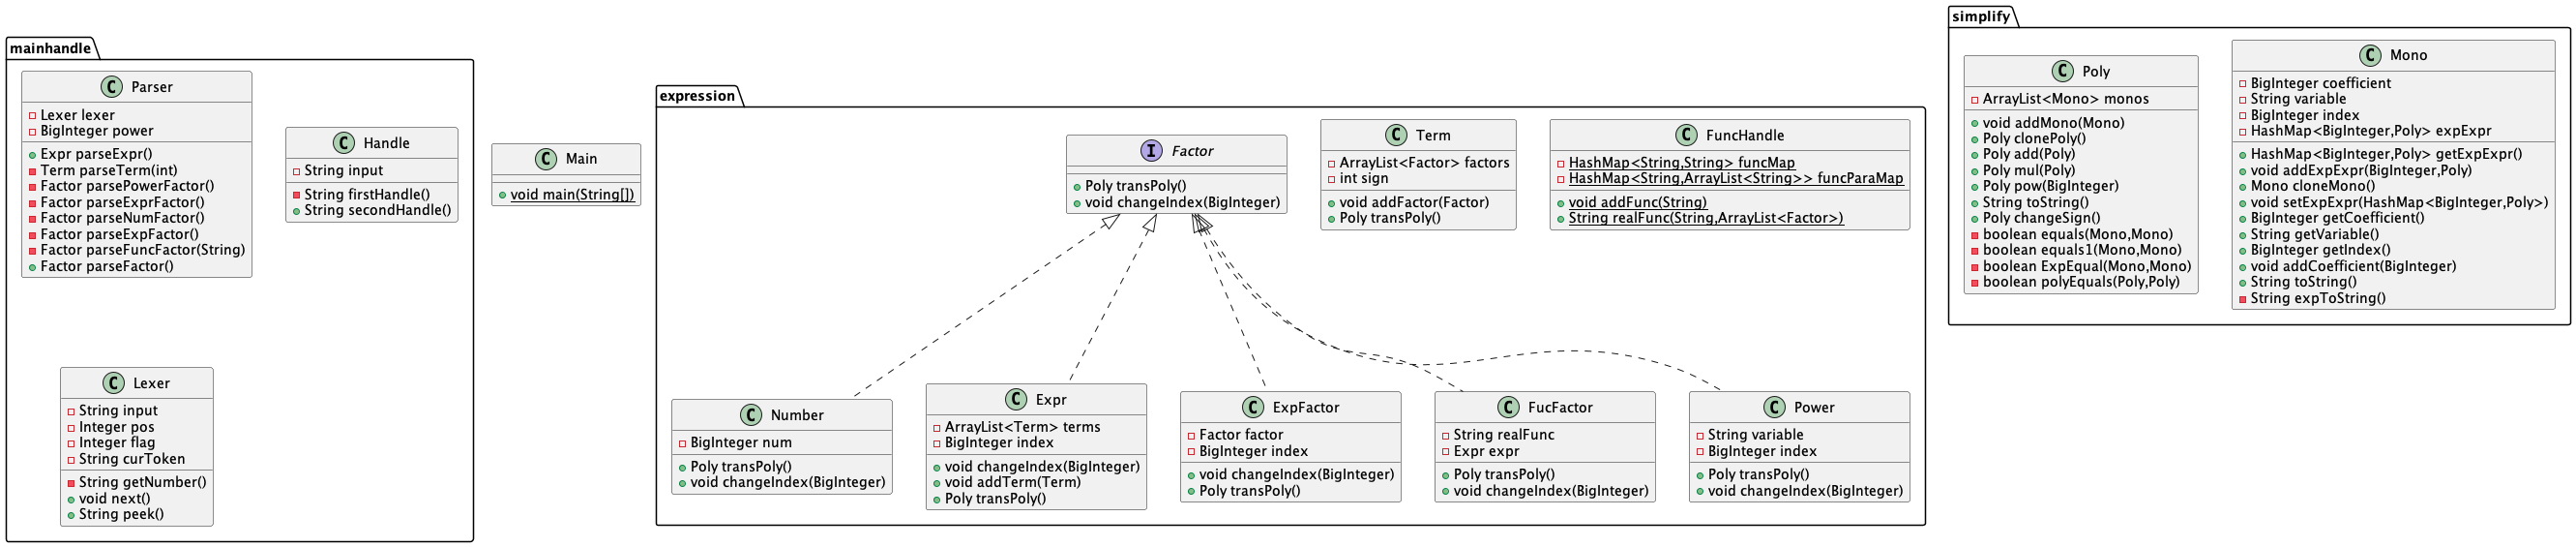
前文已经提到,我们使用的递归下降法能完美解决各种嵌套问题。因此我们的代码在第一次作业中实际上就已经能够实现嵌套括号的要求。
关于自定义函数,我们新建了FucFactor类,同时单独建立一个对读入的自定义函数表达式进行预处理的FuncHandle类。
关于指数函数,我们新建了ExpFactor类。
同样得益于递归下降法的使用,对于新增的两类因子,和其他因子的解析方法并无不同。只需要语法解析器解析到特定的字符,调用相应的因子生成方法即可。
由于加入了指数函数因子,hw1中使用的Mono基本单元就无法满足要求了。因此,我们修改基本单元如下:
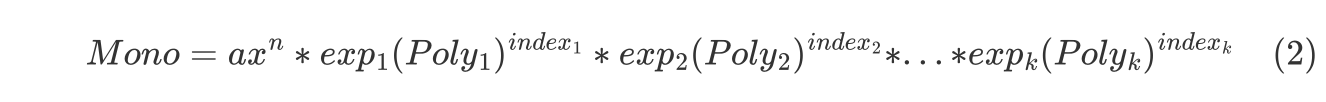
从Mono表达式中可看出,在hw1的基础上其后跟了一系列exp表达式,其index应各不相同。
因为方法较多,同样截取部分具有代表性的进行阐述
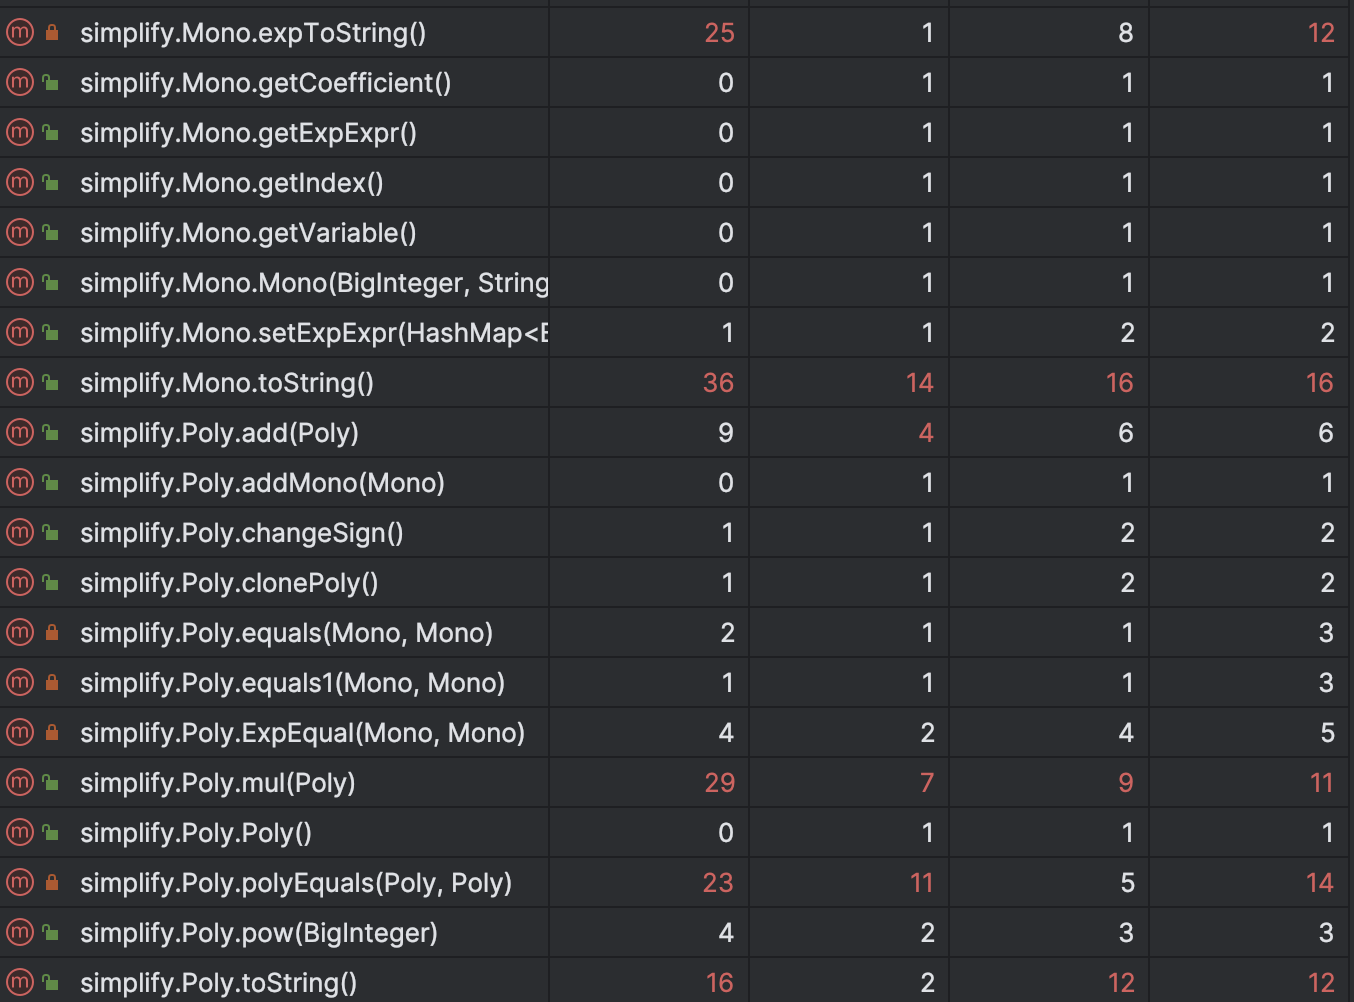
toString()方法的复杂度依然较高mul()方法复杂度陡增,此外判断两个Poly是否相等的方法也因指数函数的引入复杂度提高本次作业Bug频出,下面就几个非常重要的点进行阐述
x^8的嵌套这个数据点出现运行不出结果的问题。经过检查,是在乘法方法中没有进行去0项,导致计算了非常多次0项的内容,大幅度提高了CPU运行时间。去除后即可通过。第三次作业可以说是最良心的一次迭代作业了orz,只要前两次作业的架构合理。本次作业仅需百行内代码即可完成迭代。
本次作业有两个新需求:自定义函数表达式里可以有已经定义的自定义函数因子、支持求导因子。
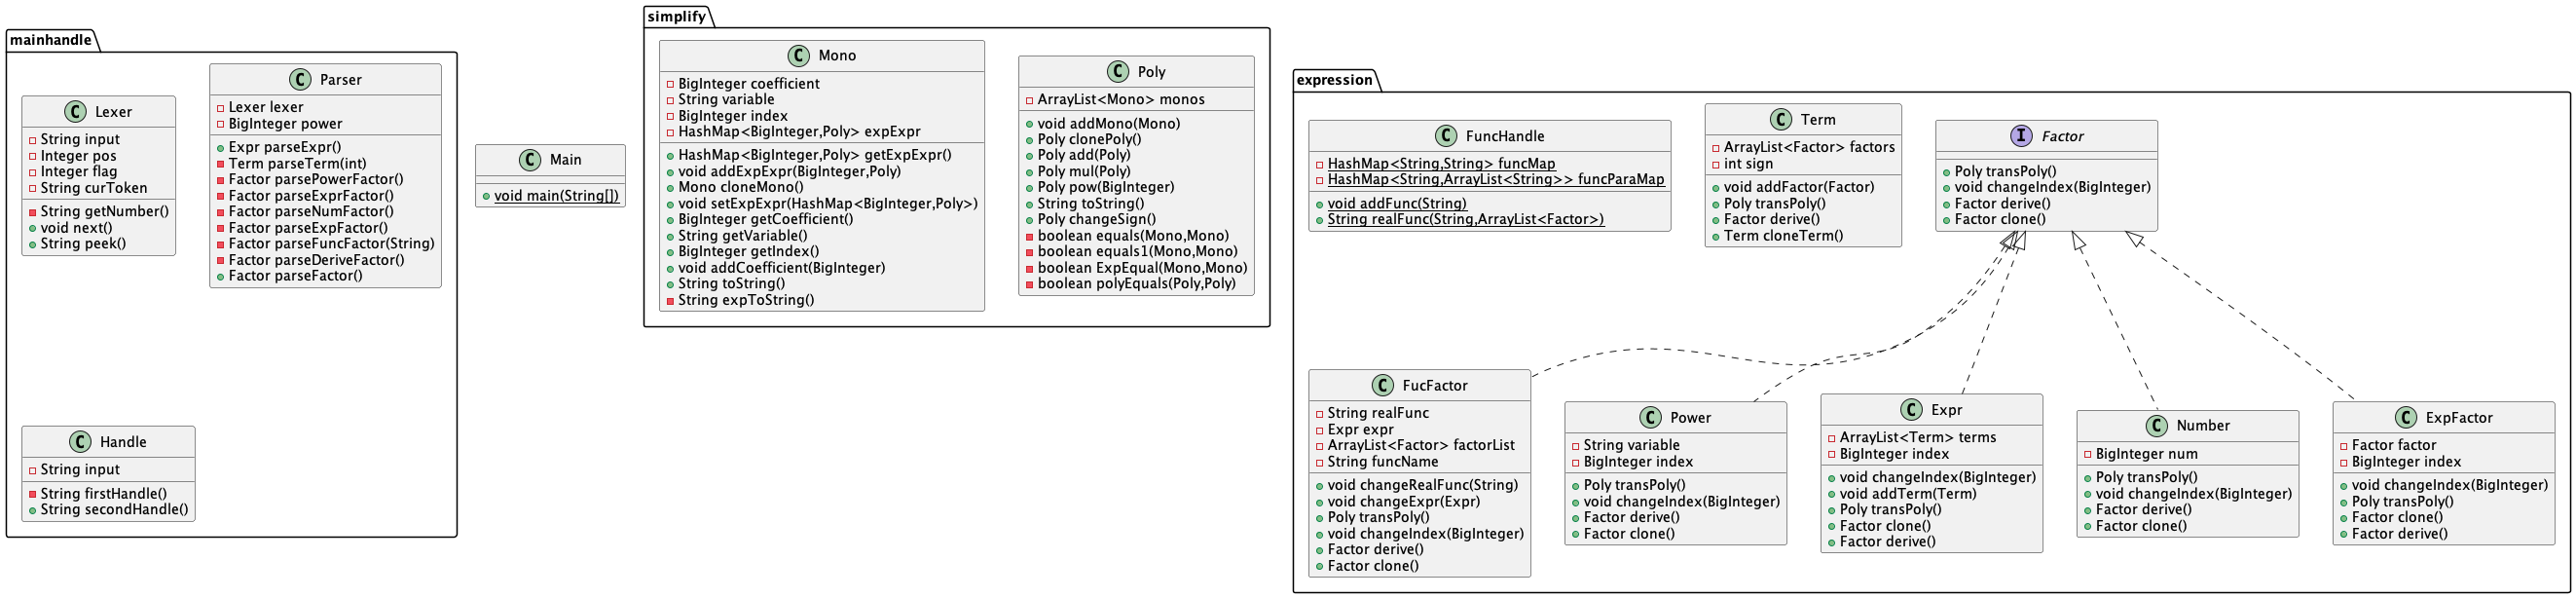
依然得益于递归下降的使用和我们的架构,我们的代码天然能支持自定义函数表达式定义中能有已经定义好的自定义函数因子。
关于求导因子,仅仅需要对表达式中的各个层次类中实现求导derive()方法,识别到求导算符时调用derive()方法即可。
部分复杂度表如下所示:
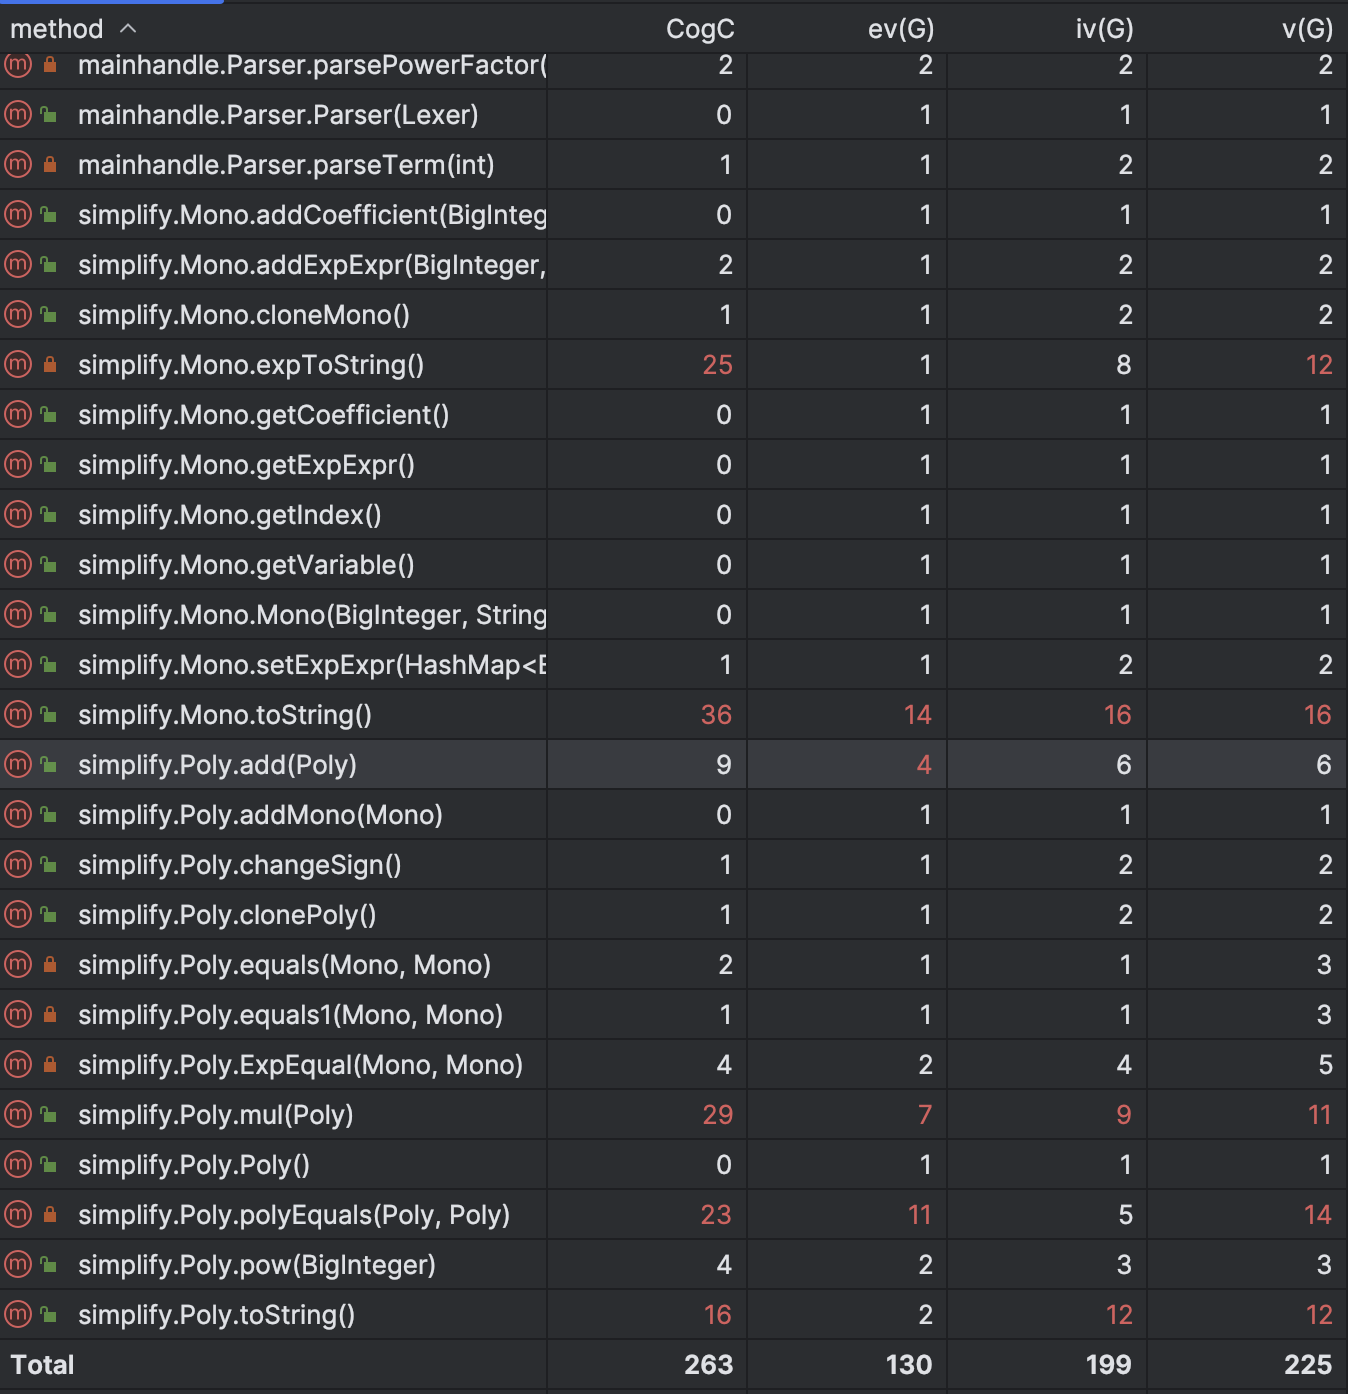
复杂度表现和hw2中基本一样,因此此处不再做阐述。
本次作业在互测中出现了bug,在多层exp(x^8)的嵌套下无法跑出结果。对代码进行运行时间分析,发现是调用了很多次多余的toString()方法,导致运行时间较长。调整后即可。
3次作业的代码测试策略均是:大量随机数据点的生成加上手动构造特殊或极端样例。
OO第一单元在这里基本就落下帷幕。回顾这一个月与OO的奋战,感叹的确学习到了非常多面向对象编程的思想。同时对层次化设计的工程实现有了更深层次的理解。希望在下一个单元能收获更多!


