


301
社区成员
 发帖
 与我相关
 我的任务
 分享
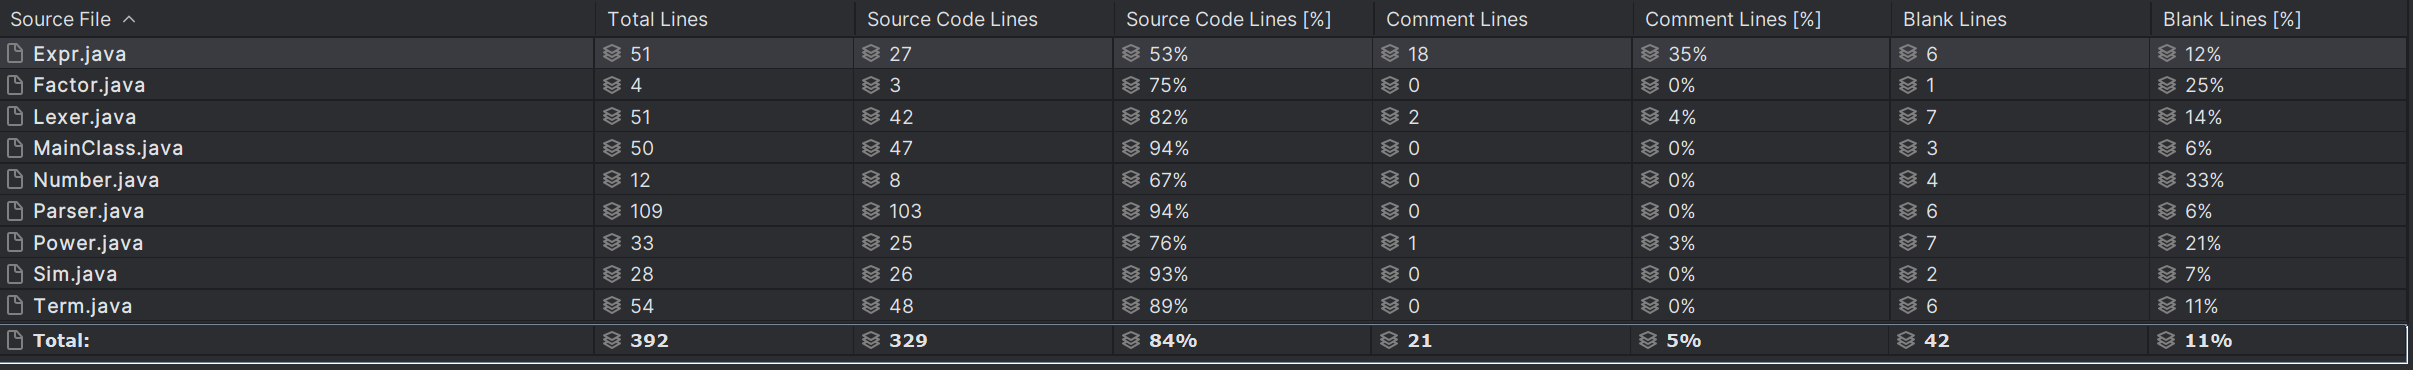
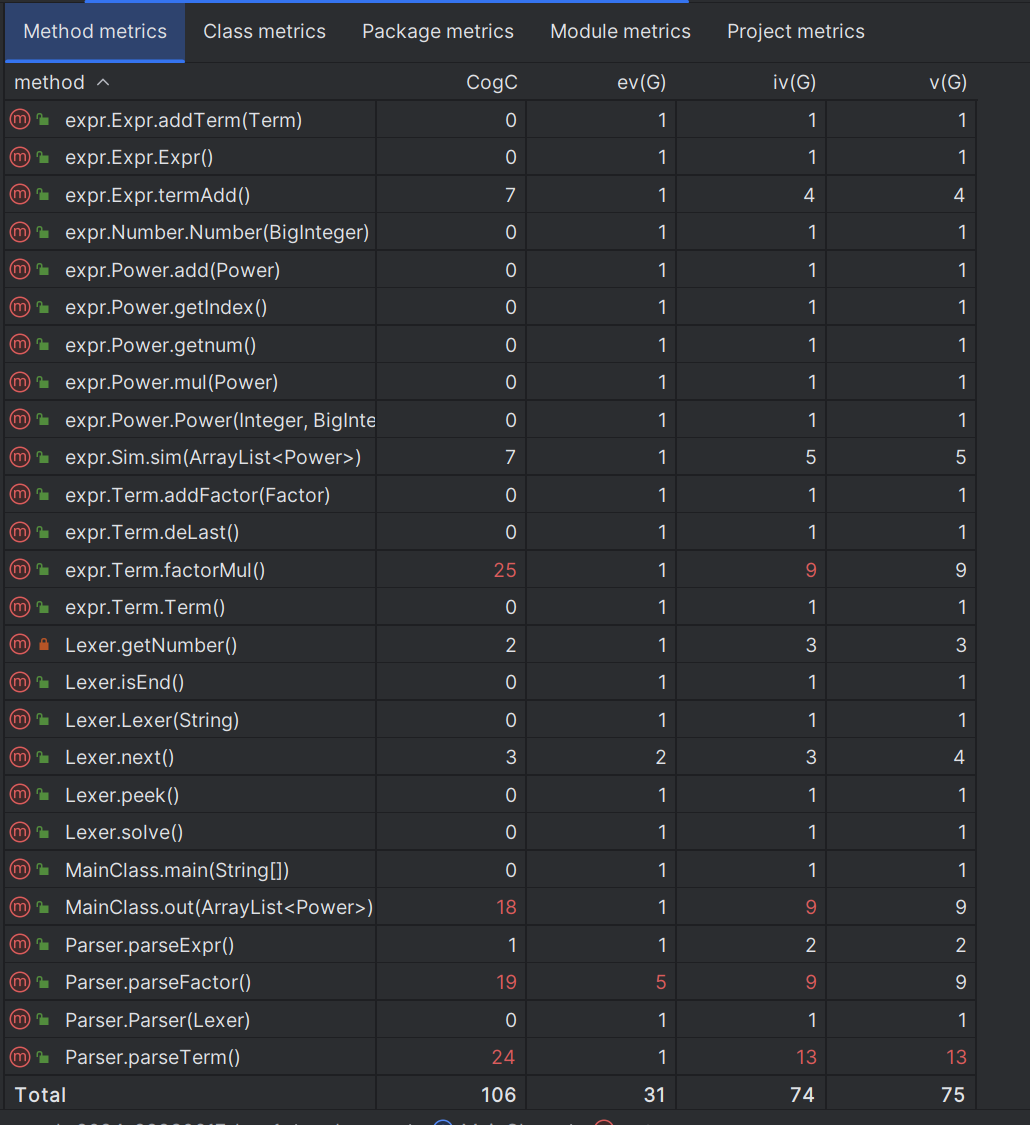

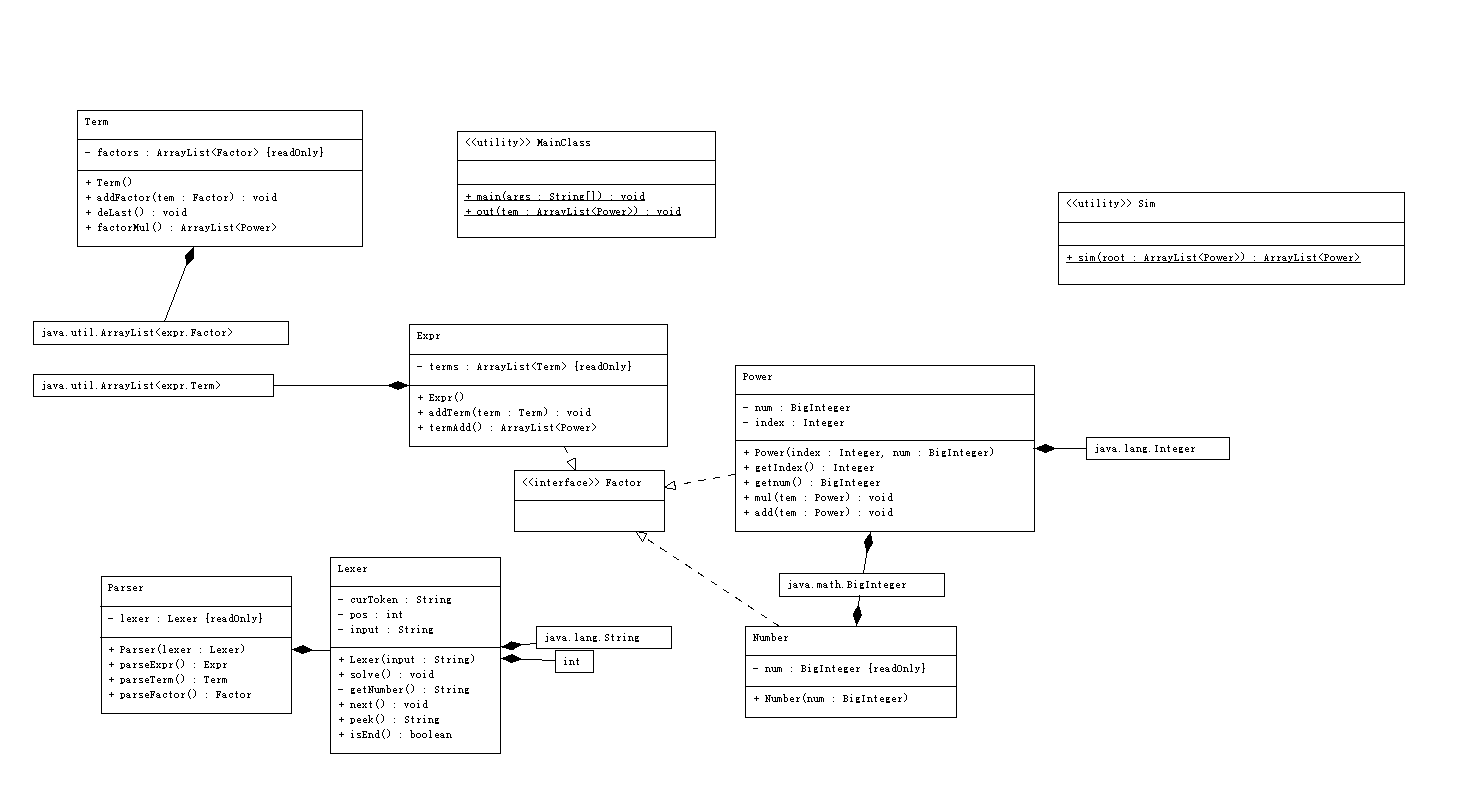
在第一次作业中,主要的架构参考了Training中给出的代码,其中有Lexer词法分析器,用于逐个读取字符,在我的处理中,把负号 - 前面都加上了一个正号 + ,将 - 号当做 -1 来处理,而Parser则对整体进行分析,有三个层次,分别是ParserExpr,ParserTerm 和 ParserFactor,用 + 号分割每一个Expr,用 * 号分割每一个Term,然后在最底层处理每一个Factor;
对于类的处理,其中式子总共有三个层次,表达式Expr,项Term,和因子Factor,其中由于括号,可以把 Expr 也变为因子,于是 表达式Expr 和 单项式Power 都以 Factor 为接口;
在Parser总体分析完成后,会返回一个Expr,我在Expr里面写了一个方法 termAdd 分析Expr的内容,同时也在 Term 里面写了 addFactor 方法,互相调用完成化简,返回一个Arraylist,然后进行合并同列项;
在我这样的处理方法下,第一次强测就全军覆没,在修改的时候发现主要的问题是因为把-号当做-1处理之后,再读到-号之后的字符时,不能再处理,于是在第一次的bug修复过程中,我无脑地把-号之后会遇到的情况加入了ParserTerm里面进行分析是否进行下一步,这样可以勉强度过第一次作业,但会在第二次作业时得到报复。
只简单合并同类项,未进行优化
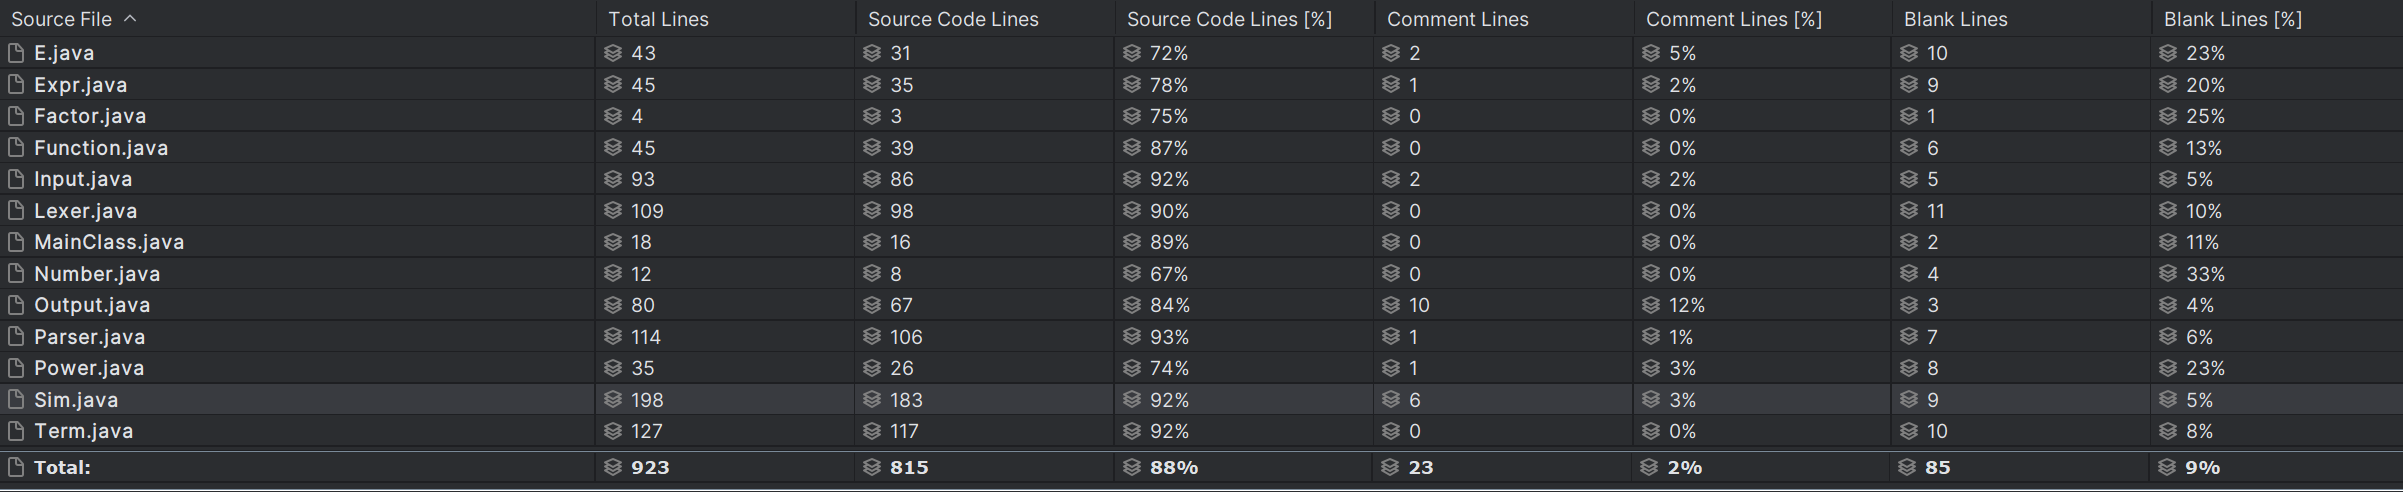
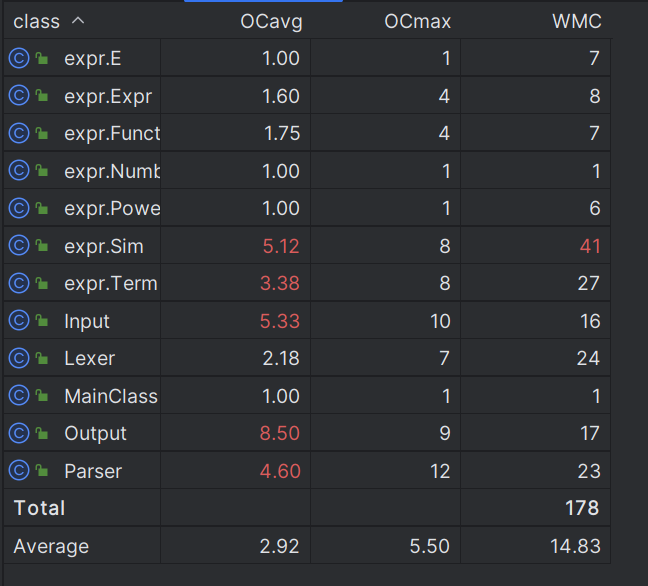
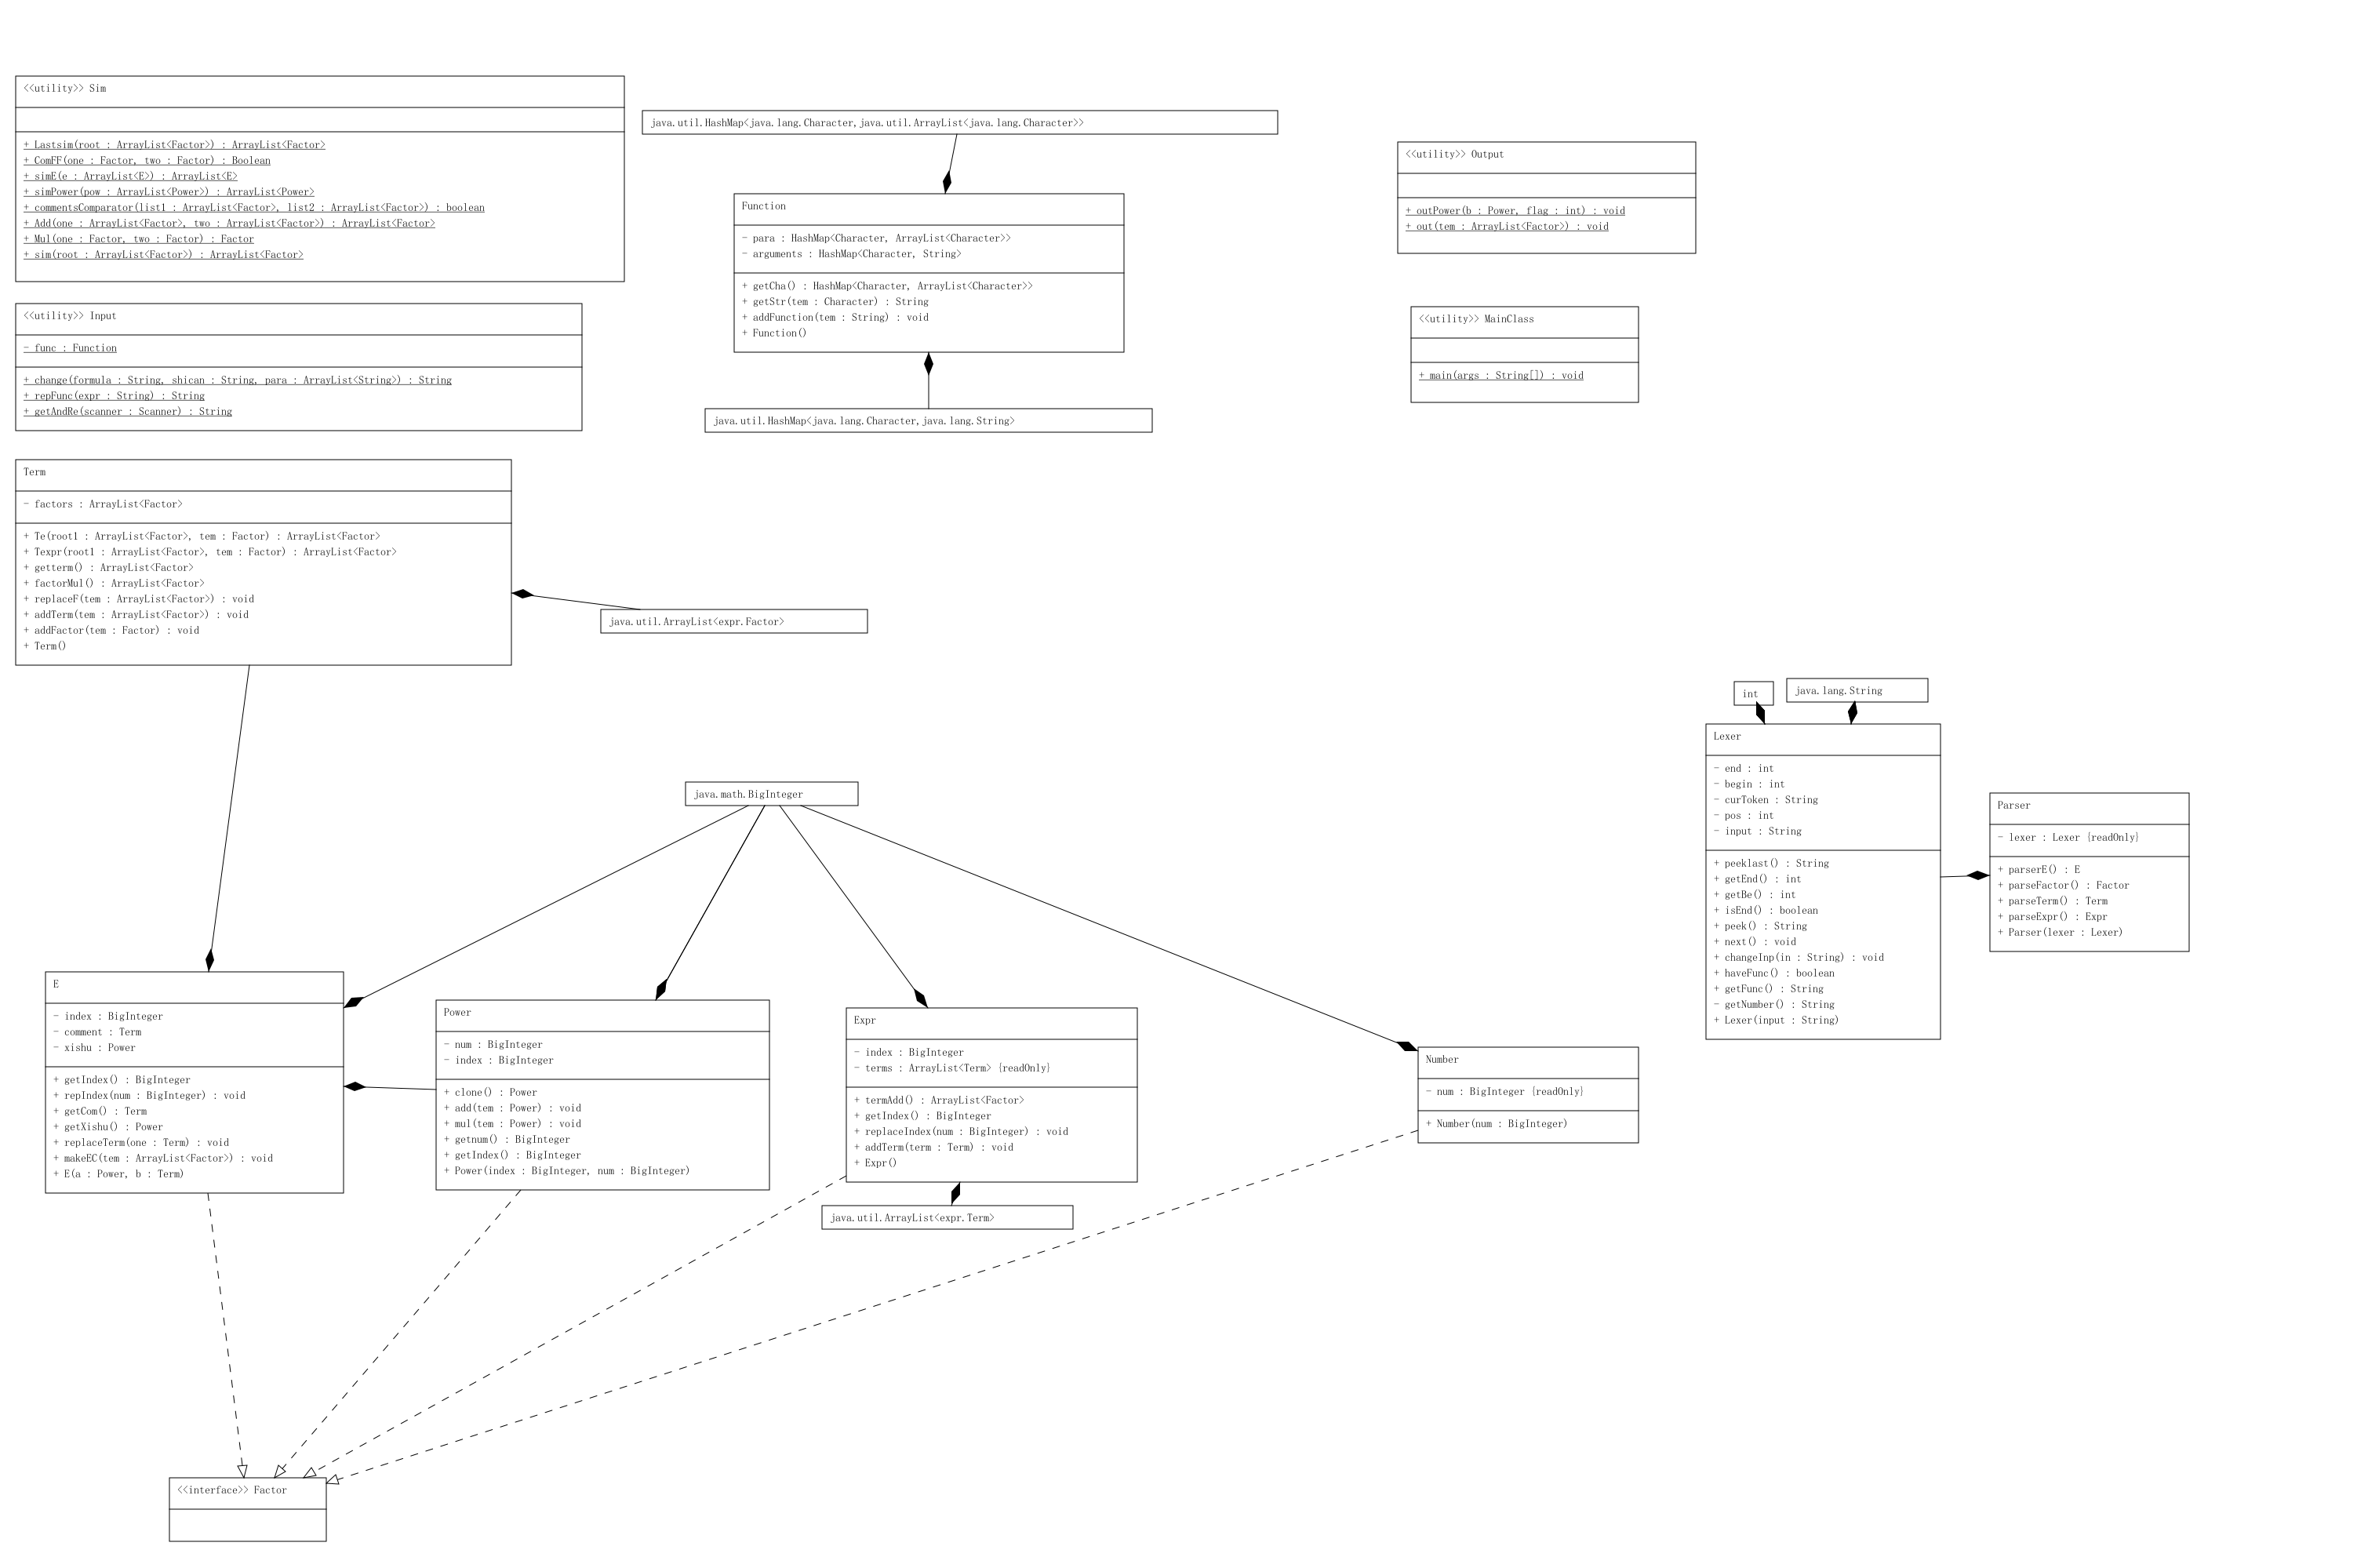
在第二次作业咯面,新加了自定义函数和指数函数,所以我在第一次作业的基础上添加了一个新的Input类处理传入的自定义函数,把表达式里面的自定义函数全部替换;然后新添加了指数函数 E 类,属性包含系数Power,内容Term;
因为新加了一个指数函数E类,其完全不同于用系数和指数就可以完全概括的Power类,于是在化简的时候需要新的方法,我采用HashMap<E系数的指数,Arraylist< E >>,其中由系数的指数找到可以相加的指数函数,然后在Arraylist里面遍历,用比较相等的方法比较每个E的内容comment,相同就可以系数相加了;
在Input类完成输入的分析,再传入Parser类中完成解析,再在Expr中完成计算和化简,因为化简的方法被多次调用,所以在这次作业中,我新建了一个专门储存化简方法的类 Sim,这样可以直接调用,看得更明白清楚
在强测中出现的第一个问题就是CTL了,在我处理指数 ^ 的时候,将其放到Term里面处理,在Term里面重复放入相同的指数个Factor,这样导致了在之后的解析过程中,多次遍历相加相乘,使得CPU运行时间过长,于是我把指数放入各个因子Factor中,都加入了BigInteger的指数属性,处理 ^ 直接放入Index指数里面,最后分析时可以更加简便;
还有就是因为许多条件都在Term里面判断是否要走下一步,导致了在处理最后一个字符的时候无法保证是否处理到;
无优化;
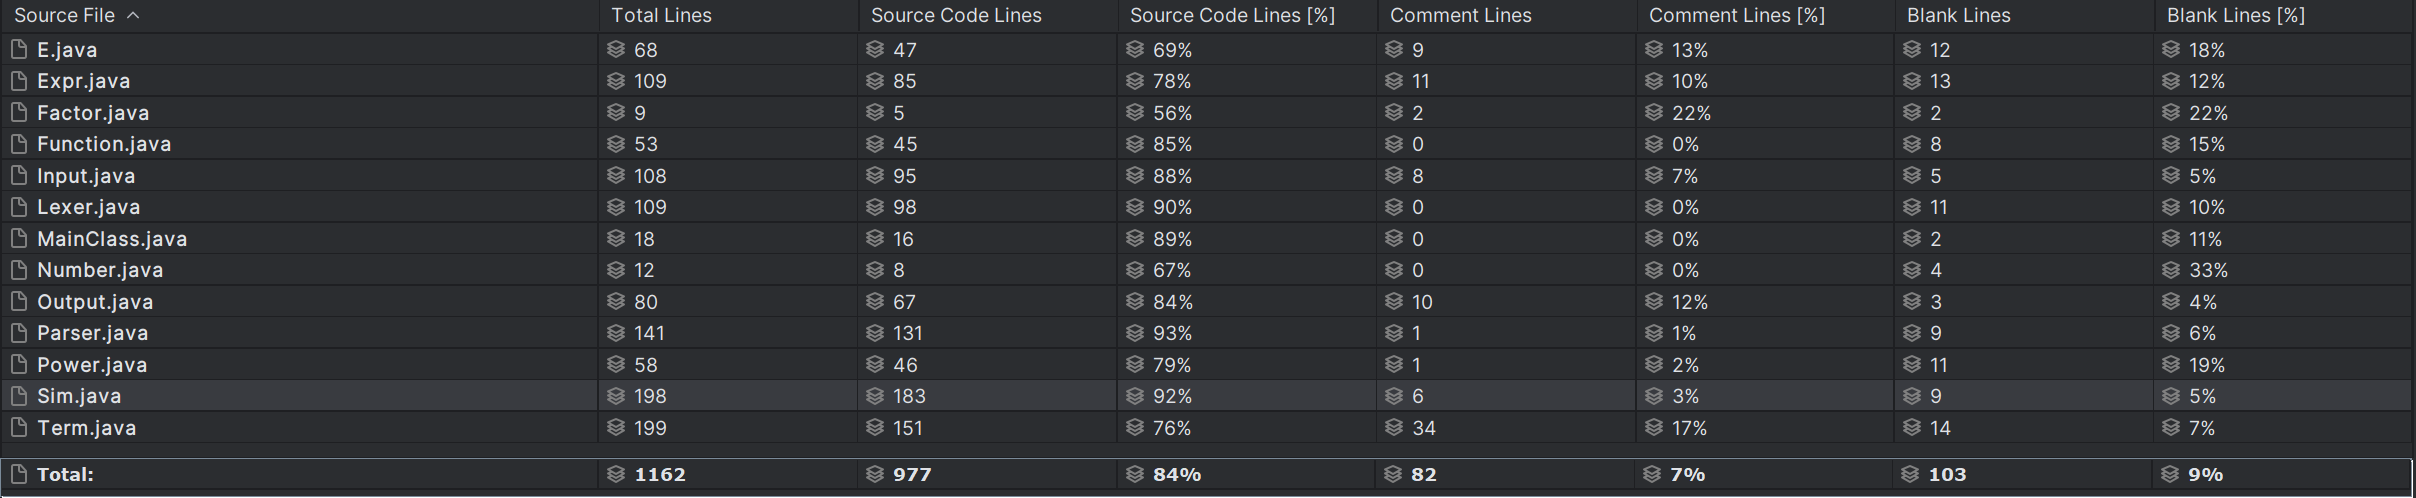
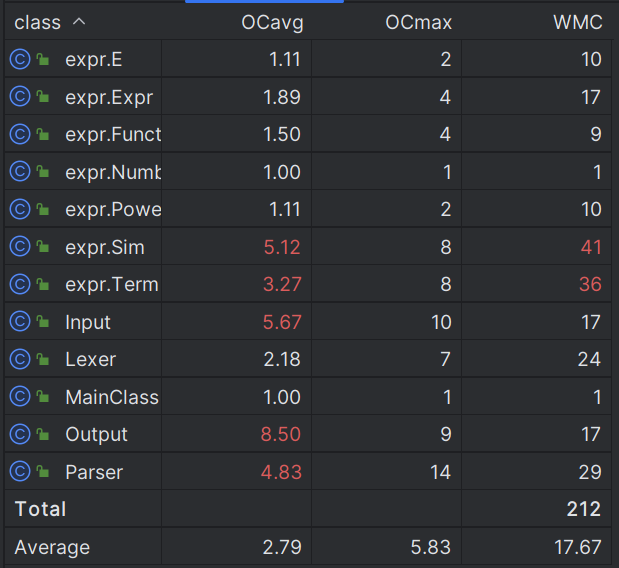
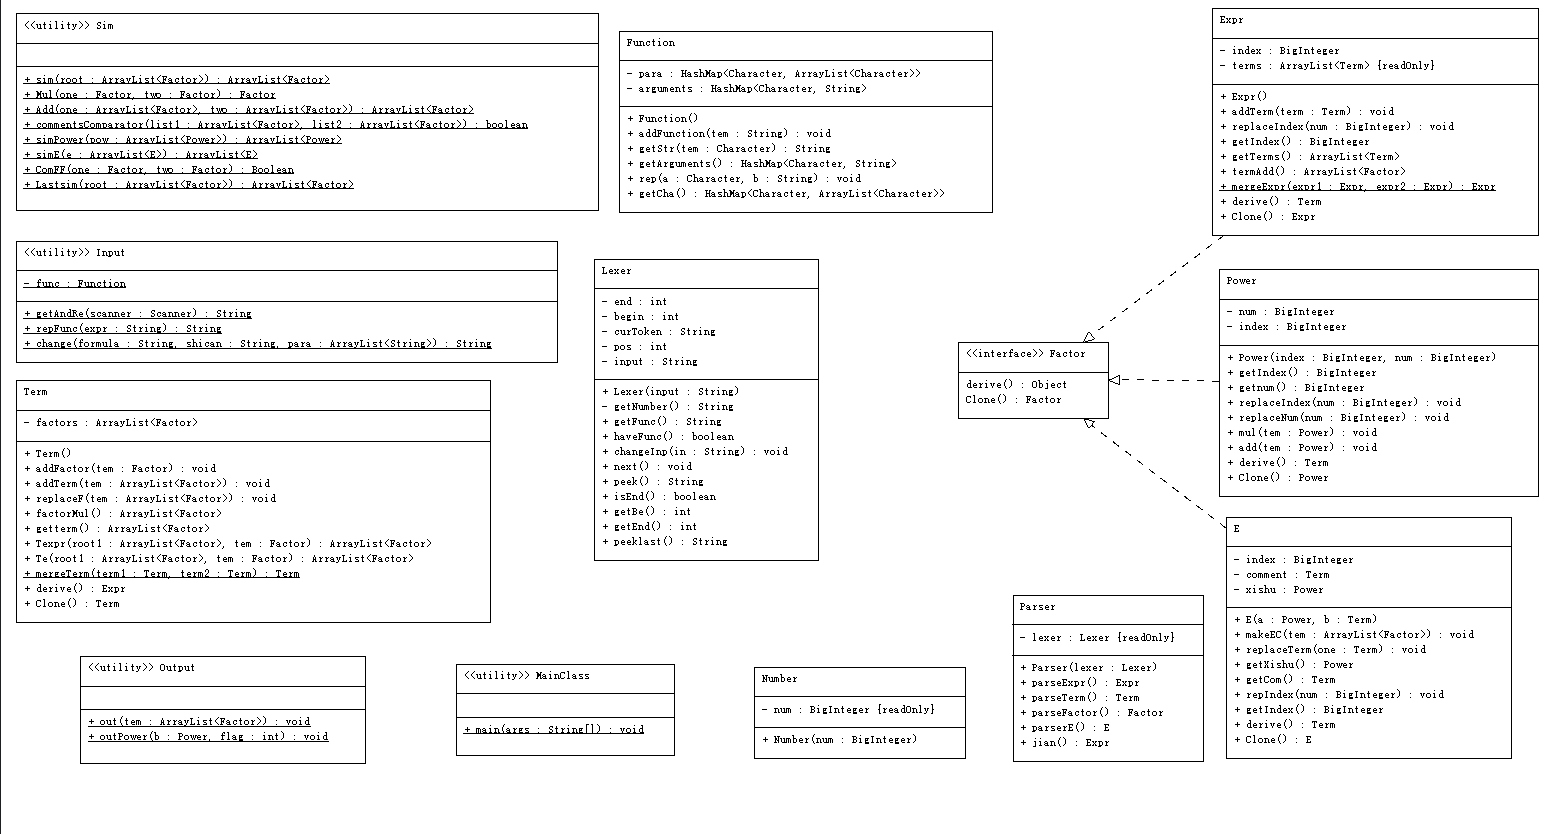
第三次作业中新加了求导函数dx,以及自定义函数在声明中可以调用已经声明了的自定义函数,于是在添加自定义函数的时候就每一次都调用替换的函数,实现自定义函数也被化简;
处理求导函数大多借鉴了第二次实验的代码,在每一个因子Factor下面添加了求导函数derive,然后在处理到dx的时候就和分析表达式一样就可以了;
在第三次作业强测中遇到了许多的Bug,首先有函数替换中重复替换导致了自定义函数出错是结果也出错,每一次都替换然后再放入即可解决;
还有就是深浅克隆导致的求导的过程中由于链式法则,在求导后一个因子的时候,同时改变了在前边的自己,从而导致了结果出错,解决方法是在求导时输入深克隆之后的因子即可;
同时在指数函数E的求导过程中也重写了方法,在有指数存在的情况下,原本是将其看做(t)^ n来处理,其中 t=exp();但是会很复杂,可以考虑到exp的特性,将指数乘到他的内容comment里面去,然后只需要保留Clone,加入comment求导就好了;
无优化;
在学习面向对象的过程中,架构是十分重要的,一个好的架构可以在后面迭代添加实现新功能的时候更加的简单快捷,同时将功能不同的各类分开,可以很好的编写和修改代码,将特定功能的类分离出去是一个很好的选择;


