


301
社区成员
 发帖
 与我相关
 我的任务

 分享
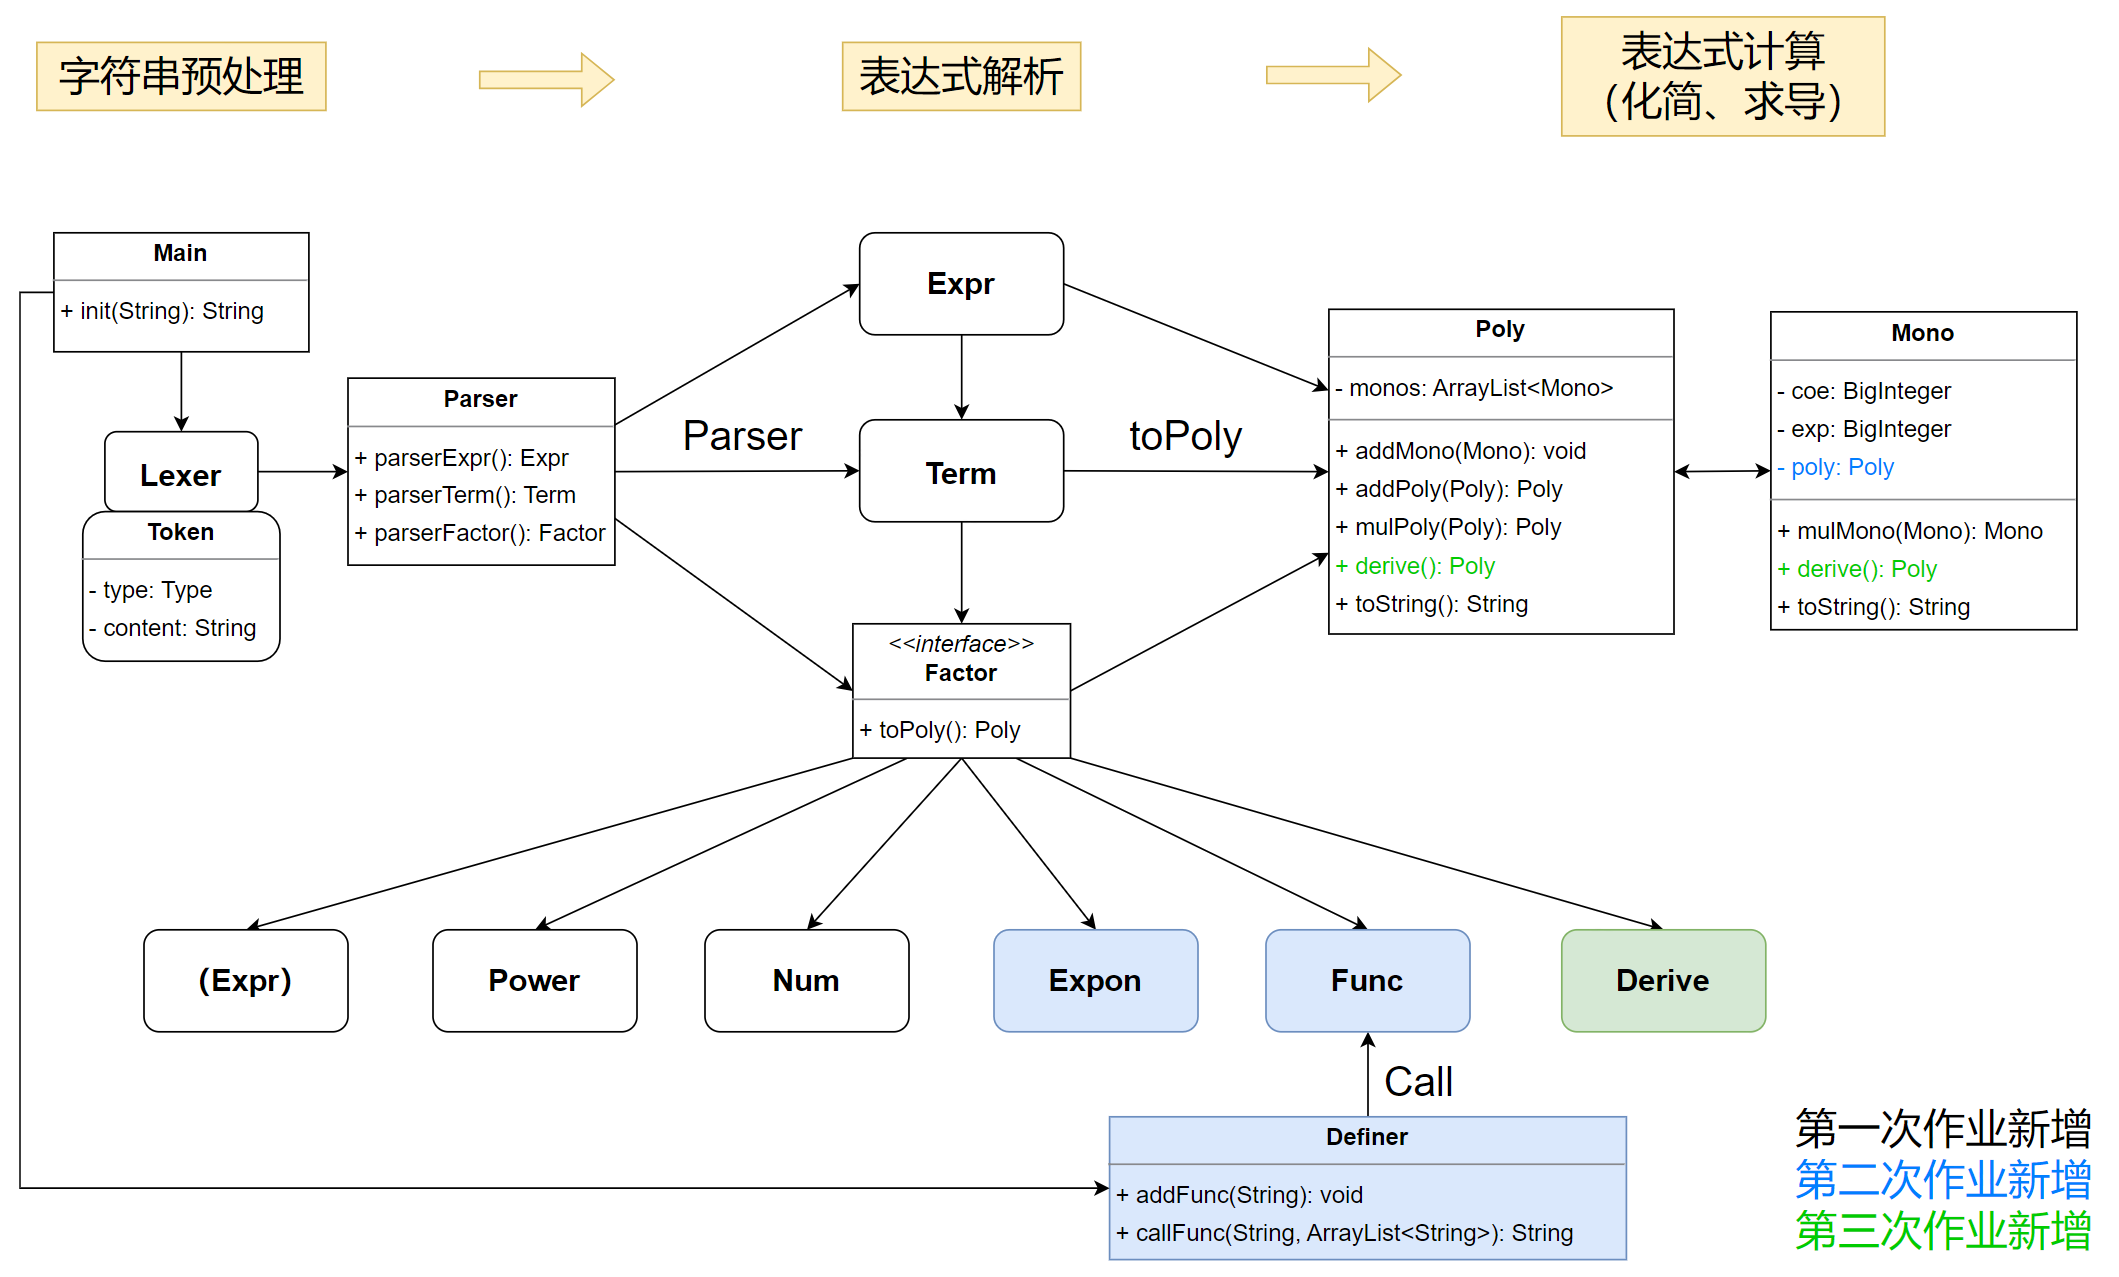
从宏观上看,本单元的架构设计如上图所示,从功能上主要分为三个层次:表达式的预处理、解析和计算。
Lexer 和 Token 类:负责对输入字符串进行预处理,解析 Token 流。
Parser 类:负责通过递归下降法解析表达式的逻辑结构。
Expr、Term 和 Factor 类:负责维护和存储表达式的逻辑结构。
Poly 和 Mono 类:负责对解析后的表达式进行化简、求导等操作。
根据单一职责原则和开闭原则,各层次中类的功能互不干扰,各司其职,高内聚、低耦合,数据按层次间进行传递,对于每个类具体的设计考虑请见下一部分。
读入一个包含加、减、乘、乘方以及括号(其中括号的深度至多为 1 层)的单变量表达式,输出恒等变形展开所有括号后的表达式。
第一次作业是“从无到有”的过程,一个好的架构能够为后面的迭代打下良好的基础,降低重构的可能性。对此我将表达式解析与计算分离,设计相关类各司其职,降低耦合度。
解析表达式主要有两种方法:正则表达式、递归下降法。通过学习 oolens 的推送和学长的博客,结合训练和实验课的体会,我选择使用递归下降法进行解析。
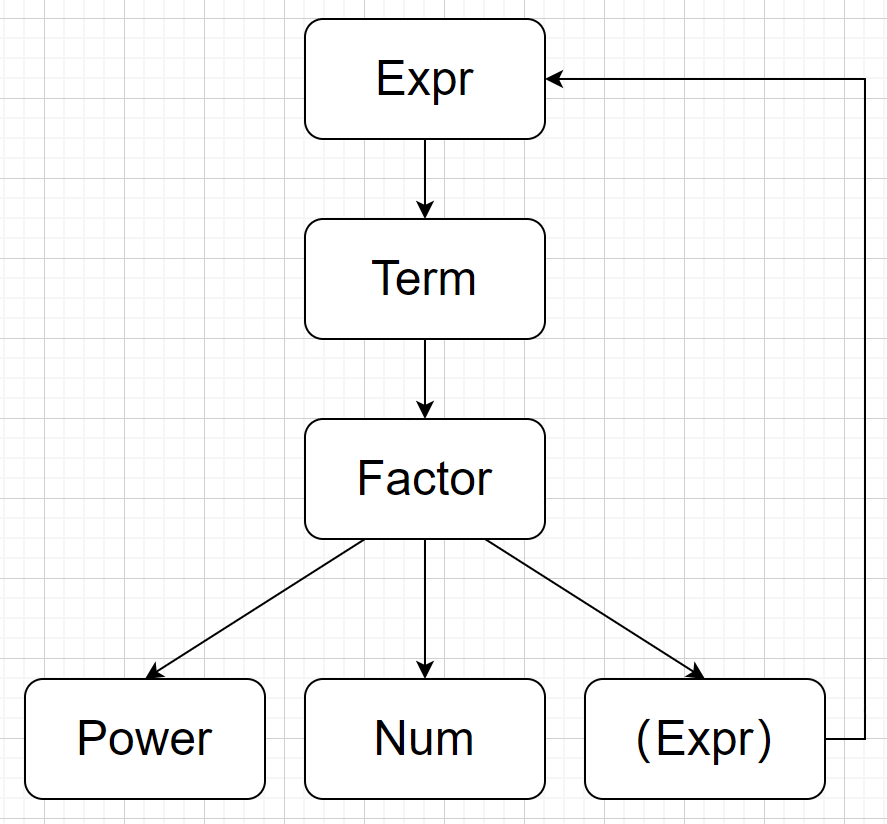
结合 BNF 描述的形式化表述,我设计了表达式类、项类、因子类来存储解析后的表达式,层层下降,符合递归下降的思想。
选择合适的局部视角,合理的屏蔽细节,将具体的实现封装,是让代码高效且清晰的重要手段。
首先使用 init() 方法对输入的表达式进行预处理,利用 replaceAll() 去除空白项、 连续的 +-、--、++、(+ 、^+、 *+,BigInteger会自动处理前导0。
接着由 Lexer 类解析 Token 流,提取其中的符号和数字。
最后 Parser 类对表达式进行解析,嵌套调用 parserExpr()、parserTerm()、parserFactor() 方法,这里要注意一个细节,就是 lexer.move() 的使用,要明确每次使用后 lexer 的指针所处位置,以免解析时出现bug。
为了简化计算,当 parser 遇到项之间的 - 时,会将 -1 作为因子存入项中,从而保证表达式中只有项之间相加,项中只有因子的相乘。
为简化合并同类项的过程,我设计了多项式 Poly 类和单项式 Mono 类,使展开之后的表达式中每一项的表示形式得到统一,可表示为:
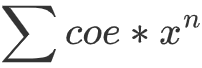
为方便快速检索,我使用 HashMap<Integer, Mono> 进行存储,这样就可以按照变量的幂来搜索同类项,合并系数。我在表达式类、项类、每个因子类中都实现了 toPoly 方法,最后在 Poly 类中进行多项式的相乘和相加:
public Poly mulPoly(Poly poly) {
    Poly res = new Poly();
    for (Mono mono1 : monos) {
        for (Mono mono2 : poly.monos) {
            res.addMono(mono1.mulMono(mono2));
            //为避免深浅克隆数据共享的问题,每次调用 mulMono()都会返回一个新的 Mono 对象,即使用不可变对象
        }
    }
    res.simplify();
    //防止tle和爆堆空间,每次调用 mulPoly()都会进行化简消除冗余项
    //细节:防止结果为 0时无输出,simplify()会自动添加一项 0
    return res;
}
指数为 0,1 :主要通过 if-else 特判实现
系数为 -1,0,1(注意结果为0时不能没有输出)
优先输出正项:x-1 会比 -1+x 少一个字符
表达式为 0 时,可以直接化简为 0,无需处理内部的化简(注意 0^0 = 1)
自己程序的 bug:在强测和互测中未出现bug
别人程序的 bug:
lexer 指针越界数据点:x[空白项]
// 出现 bug的代码
while (input.charAt(pos) == ' ' || input.charAt(pos) == '\t')
pos++;
// 没有判断 pos是否越界,导致当字符串末尾有空白符时出现 bug
数据点:x*0+0
数据点:(1+x+x^2+x^3+x^4+x^5+x^6+x^7+x^8)^8
当表达式较复杂时,部分程序会出现 Exception in thread "main" java.lang.OutOfMemoryError: Java heap space,但因为代价函数限制并没有hack成功。
hack 策略:采用测评机为主,阅读代码为辅的方式。对于测评机测出的数据往往不符合代价函数要求,需要删掉与 bug 无关的部分,我会结合被测程序的代码设计结构和多次排除的方法进行精简测试用例。
读入一系列自定义函数的定义以及一个包含幂函数、指数函数、自定义函数调用的表达式,输出恒等变形展开所有括号后的表达式。
递归下降法的优势在本次迭代中才真正显现出来,本身就支持嵌套多层括号,因此对第一次作业的代码不需要进行修改。但由于嵌套括号的出现,指数可能超出 int 的范围,需要改为 BigInteger。
根据指导书要求,自定义函数属于因子,所以我设计了 Func 类,并实现了 Factor 的接口,建立行为抽象层次。
将调用实参后的表达式以字符串的形式交给 parser 解析,和其他因子一样,调用 toPoly() 后直接返回内部表达式的 poly 形式,并没有替换到原表达式进行解析,实现了解耦合。
public class Func implements Factor {
    private Expr expr;

    public Func(String name, ArrayList<String> args) {
        Lexer lexer = new Lexer(Definer.callFunc(name, args));
        Parser parser = new Parser(lexer);
        expr = parser.parserExpr();
    }

    @Override
    public Poly toPoly() {
        return expr.toPoly();
    }
}
关键点在于如何实现实参的调用,进行字符串层次的替换还是对象层次的替换?
一是如果开始对函数定义式进行解析,需要支持 y, z 变量,在第一次作业中我没有实现,可能需要重构。
二是在对象层次的替换可能会增加表达式计算的复杂度:
f(x)=(x+1)^8 //定义
f((x-1)) //调用
//字符串层次的替换
((x-1)+1)^8
//对象层次的替换,对表达式展开会更复杂
1+8*x+28*x^2+56*x^3+70*x^4+56*x^5+28*x^6+8*x^7+x^8
所以基于以上两点的考虑我选择进行较为直接的字符串层次的替换,对此我设计了 Definer 类进行处理,涉及到一些细节问题:
h(y,x)=x+y^2 //定义
h(x,1) //调用
//错误结果
x+(x)^2 //先替换y
1+(1)^2 //再替换x
//正确结果
1+x^2
为解决这两个问题,我选择了非常 “朴素” 的替换方式,将 exp 替换为 #,xyz 分别替换为 abc
func = func.replaceAll("exp", "#");
func = func.replace('x', 'a').replace('y', 'b').replace('z', 'c');
func = func.replaceAll("#", "exp"); // 别忘还要替换回来
多层函数调用时不能使用 split(",") 来分割实参,比如 f(h(x,2),x^2),因此我选择使用括号栈的方式,通过左括号的数量来判断是不是一个实参。
注意在传参时只需替换最外层的实参(需要加一层括号保证运算优先级),不需要对 h(x,2) 替换成表达式,因为在我的实现中,会交给下一层的 parser 来实现,所以是一个递归的过程。
其实这样设计还有一个优势,在于已经支持了第三次作业中 “函数表达式中支持调用其他已定义的函数” 的要求。
设计 Expon 类来表示指数函数因子,在预处理时将指数函数外的指数放进因子中,即 exp(x)^2 转换为 exp(2*x)
由于指数函数的特殊性,需要修改基本项的形式:
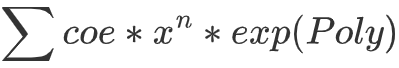
对同类项的判断和合并方式也需要修改,我使用 HashMap<BigInteger, HashMap<Poly, Mono>>,分别以 x的指数、exp 的指数作为 key 进行判等,而对 poly 的判等需要我们重写 equals() 和 hashCode() 方法。
在理论课上老师提醒我们 重新实现equals需确保层次结构下对象等同判断行为的一致性:
(toString 同理,且不应该有 side-effect)
public boolean equals(Object o); //right
public boolean equals(Poly o); //wrong
主要针对指数函数进行化简:
指数为0
指数只有一项时,可能可以去掉一层括号(exp(-x^2) 错误!)
当每项系数的绝对值相等时,可以将其提出(不能提出负数)
本次作业出现一个 bug,由于新增指数函数,其指数深克隆不彻底造成数据共享,在优化时修改了系数。
数据点:(1+x)*exp(exp((2+2*x)))
exp(exp((1+x))^2)+x*exp(exp((1+x))) //wrong
exp(exp((1+x))^2)+x*exp(exp((1+x))^2) //right
res.addMono(new Mono(mono.getCoe(),mono.getExp(),mono.getPoly())); //浅克隆!
虽然此前经过测评机的大量测试,依然没有测出这个 bug,需要深入研究如何提高测评数据覆盖的全面性。
修复策略:分别为 Poly 类和 Mono 类增加了 deepClone() 方法。
处理自定义函数时未考虑嵌套括号的情况
数据点:h((x),0)
// parser遇到右括号直接停止解析实参,出现bug
读入一系列自定义函数的定义以及一个包含幂函数、指数函数、自定义函数调用、求导算子的表达式,输出恒等变形展开所有括号后的表达式。
通过字符串层面的替换来调用实参,优势在于第二次作业已默认支持调用其他“已定义的”函数。
根据指导书的形式化表述,和自定义函数的思想类似,我设计了 Derive 类,并实现了 Factor 的接口。
public class Derive implements Factor {
    private Expr expr;

    public Derive(Expr expr) {
        this.expr = expr;
    }

    @Override
    public Poly toPoly() {
        return expr.toPoly().derive();
    }
}
可见 Derive 类中的代码并没有具体的求导方法,实验课上的代码指导我们对求导进行层次化实现,即把求导方法分布在每个类中;为了维护求导结构的统一性,减少代码修改量,我选择把求导方法放在了 Poly 类和 Mono 类中,但这样可能会使一些表达式的计算量增大,需要 trade-off 一下:
dx((1+x)^8)
//层次化实现,复合函数求导
8*(1+x)^7*dx(1+x)
//基本项形式求导,先全部展开再求导
dx(1+8*x+28*x^2+56*x^3+70*x^4+56*x^5+28*x^6+8*x^7+x^8)
若对基本项形式求导,可统一表示为:
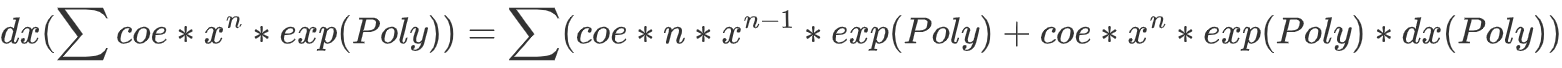
为防止出现深浅克隆的问题,我在每次求导时都会 new 一个对象。
优化方向与第二次作业相同:
这次实现了提取最大公因数,与原始表达式长度进行比较,输出较短者
exp 拆分(我没有实现)
在强测和互测中未发现 bug(可能大部分bug已经在 hw2 测出来了)
迭代变化可归结为两个维度:数据维度和处理维度,两个维度迭代都会带来属性和方法的变化,我们的目标是尽可能少改动设计结构,这就要求架构在设计时要遵循开闭原则,即对扩展开放,对修改关闭。
以2021级的作业为例,如果加入三角函数:
数据维度:需要增加 sin、cos 的因子类,在 Mono 类中修改基本项的表示形式,但依然可以保证形式统一:
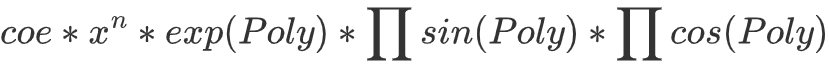
处理维度:为展开和合并带来新的规则,只需要修改 mulMono 方法和 equals 方法。如果要追求性能分,则需要根据三角函数的数学性质,对化简优化提出了更高的要求,也势必会增加代码的复杂度。
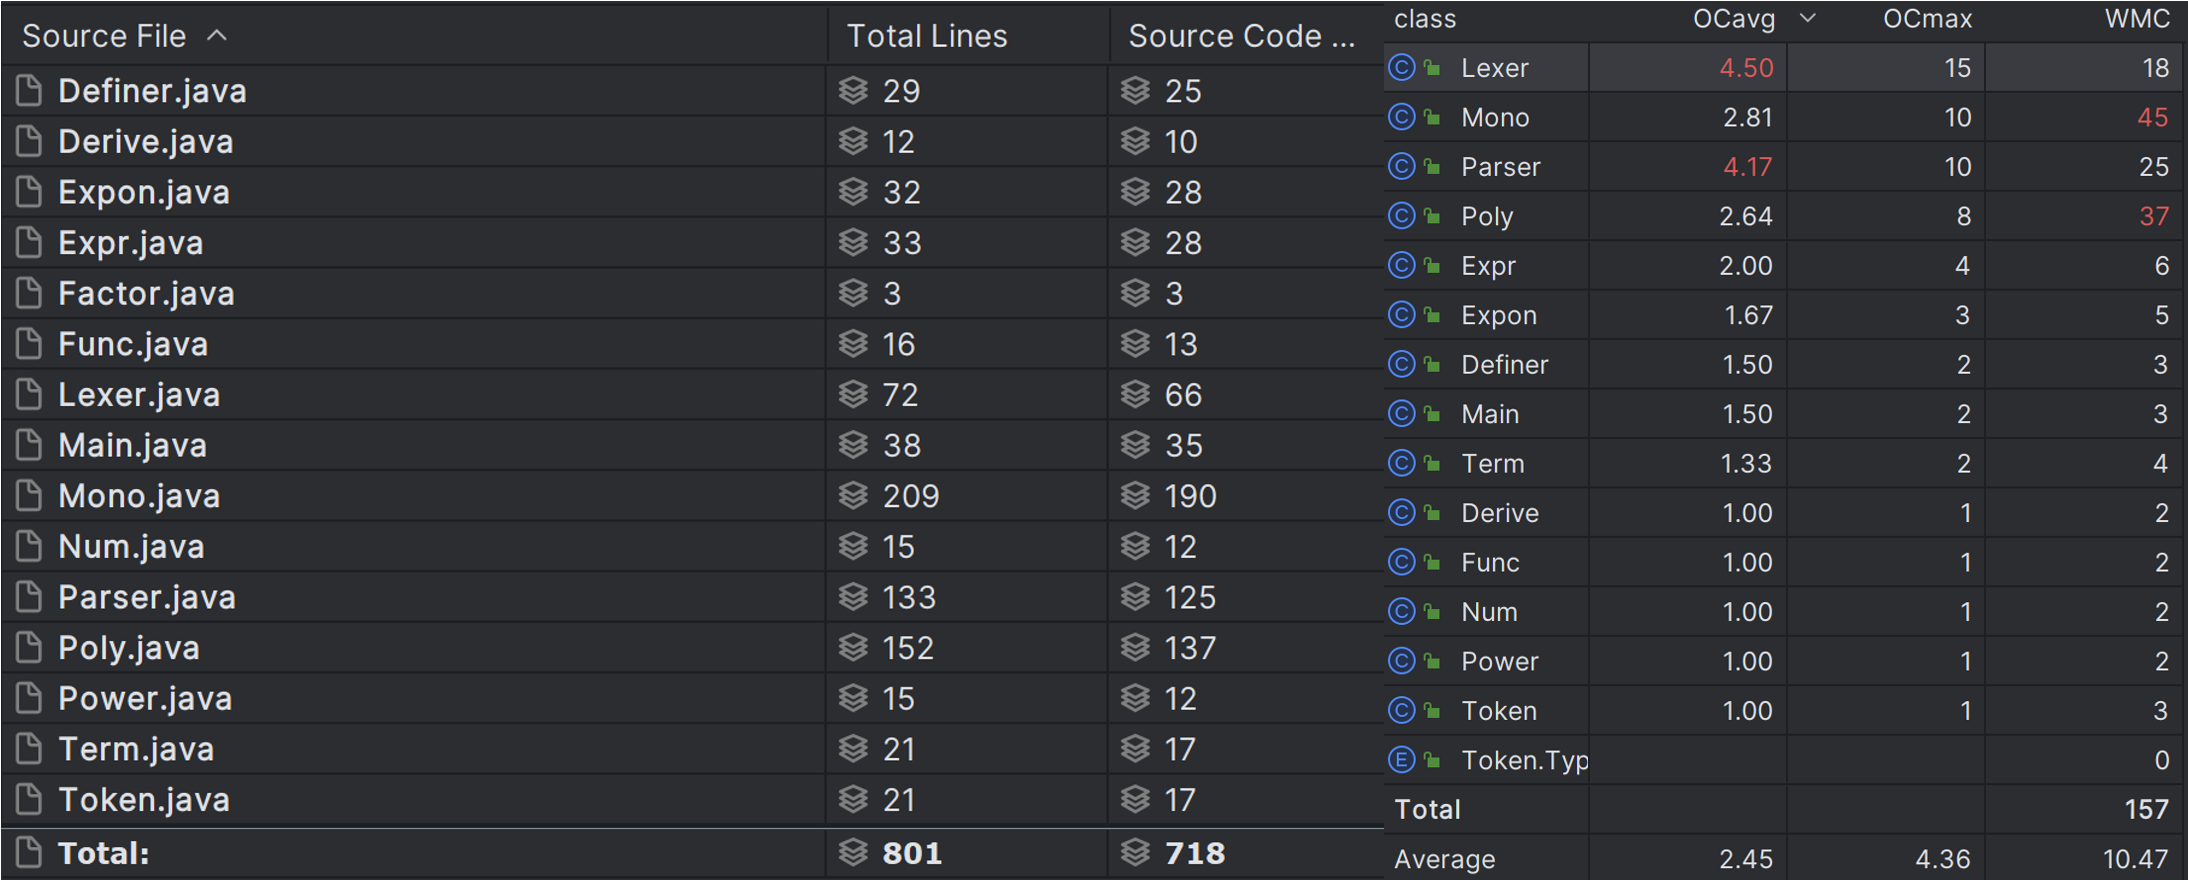
结合代码行数和类复杂度可以很明显的看出,可见大部分方法集中在 Poly 类和 Mono 类中,虽然在写作业时减少了工作量,但使结构不够合理,降低了可维护性和可读性,可以考虑按功能进行拆分。
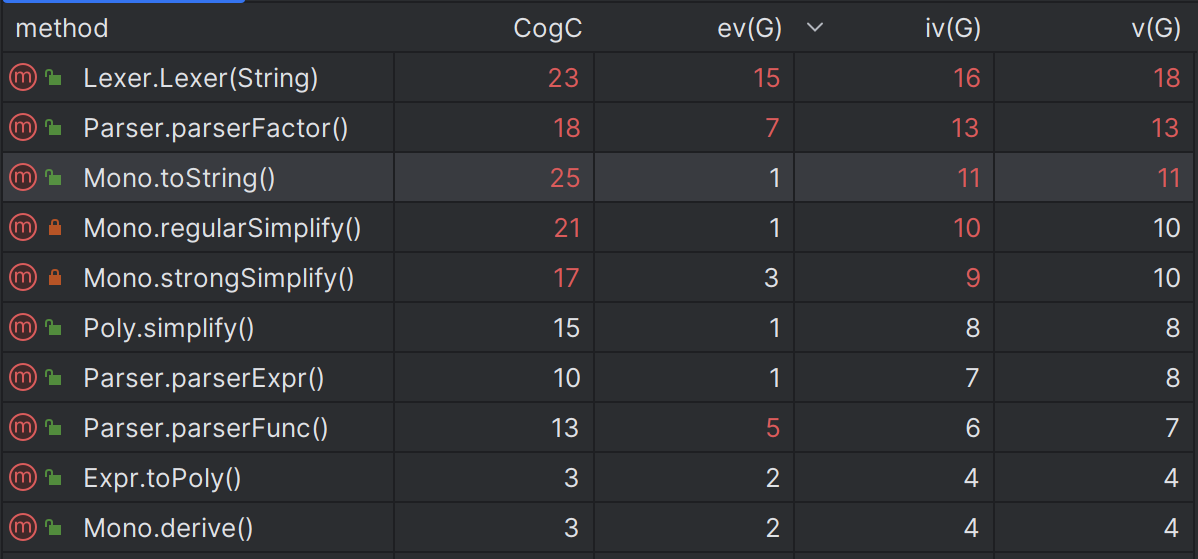
这里截取了复杂度较高的几个方法,Lexer 复杂度最高,是因为在解析表达式前,Lexer 需要整体将字符串扫描一遍,对于不同的 Token 类型都要建立一个新的 if 分支进行处理。由于在设计时我将自定义函数,求导算子均看作因子,所以随着作业迭代,parserFactor 类需要解析的因子类型也不断增加,复杂度上升。
Mono.toString() 方法调用了 regularSimplify() 和 strongSimplify() 方法,为实现优化我使用了大量的 if-else 进行特判,嵌套层数较深,导致这两个方法的代码结构不够清晰,牺牲了可读性,可见过度的优化难免会造成复杂度的增加,需要进行合理的取舍。
我也学习了一些降低圈复杂度的方法,如简化、合并条件表达式;将条件判定提炼出独立函数;将大函数拆成小函数;以明确函数取代参数等,可以在以后的作业中按需使用。
本单元要求我们通过对数学意义上的表达式结构进行建模,完成多项式的括号展开与函数调用、化简,我深刻体会到了层次化设计的思想的应用和具体的工程实现。通过迭代对架构的可扩展性提出要求,我对什么是一个好的架构有了更深入的理解。
得益于 OOPre 的训练,我对 Java 基础语法与基本容器的使用比较熟悉,所以在完成本单元作业的过程中更加关注于架构和功能本身的考量,而非基本的语法知识点。此外 Junit 的训练也使我在完成作业时养成了随时编写测试代码的习惯,通过结合分支覆盖率、行覆盖率和方法覆盖率进行全面测试,大大降低了出现低级 bug 的概率。
通过互测学习其他同学的代码,我学习到了不同的架构设计思路,同时也意识到自己程序的不足:当输入数据不合法时会直接导致程序崩溃,而有的同学的代码会返回对应不合法的提示,因此在以后的作业中要注意提高程序的鲁棒性和容错性。
第三次作业相较于第二次迭代内容较少,在互测时可能还是主要针对第二次作业中可能出现的 bug
在讨论课上通过交流我发现大部分同学都实现了接口,并没有使用继承,以后可以在实验课上或作业中增加对继承的训练~


