


301
社区成员
 发帖
 与我相关
 我的任务

 分享

反思:PowFactor、NumFactor、ExprFactor的父类是一个只有指数的Factor,感觉怪怪的,更应该把他们继承自同一个接口来实现统一的toPoly方法。
第一次作业需要实现从0到1的构建,我们需要对数学意义上的表达式结构进行建模并完成单变量多项式的括号展开,故主要任务有:
指导书清晰地指出了三个层次的概念:因子(变量因子、常数因子、表达式因子)、项、表达式,我们只需要为他们分别建类(Factor、Term、Expr),并把Factor作为PowFactor、NumFactor、ExprFactor的父类。同时注意表达式->项->因子这样的层次关系,依此完善这三个关键类的属性和方法。
学长博客里给项一个sign的属性好聪明
递归下降的内容在oolens推送的基础上修改完善
词法分析LexerLexer在遍历预处理之后的字符串时,识别其中的语法单元加入tokens中。(Token这一枚举类型用于记录表达式的基本语法单元)。在获得到的tokens基础上进行接下来的语法分析。
语法分析Parser
对表达式按照规则进行拆分,识别出构成表达式的一个一个项;对项按照规则进行拆分,识别出构成表达式的一个一个因子;构建自顶向下的语法树。
将a*x^b作为运算的最小单元用Moon存储;Poly由Moon组成,且拥有多项式相加、多项式相乘、多项式求幂的方法用于计算;为所有的关键类都增加将其转换为Poly的方法。
PreTreat用于预处理,对输入的字符串删除空白字符、合并+-、去除指数前的+号。至此,UML图中所有类的功能都已介绍完毕,之后的作业在此基础上迭代。
输出优化:在转化为字符串的过程中,处理了指数为0、1,系数为+1、-1、0,正项前移的情况。
大多数方法的复杂度在合理范围之内,仅给出复杂度超标的几个方法:
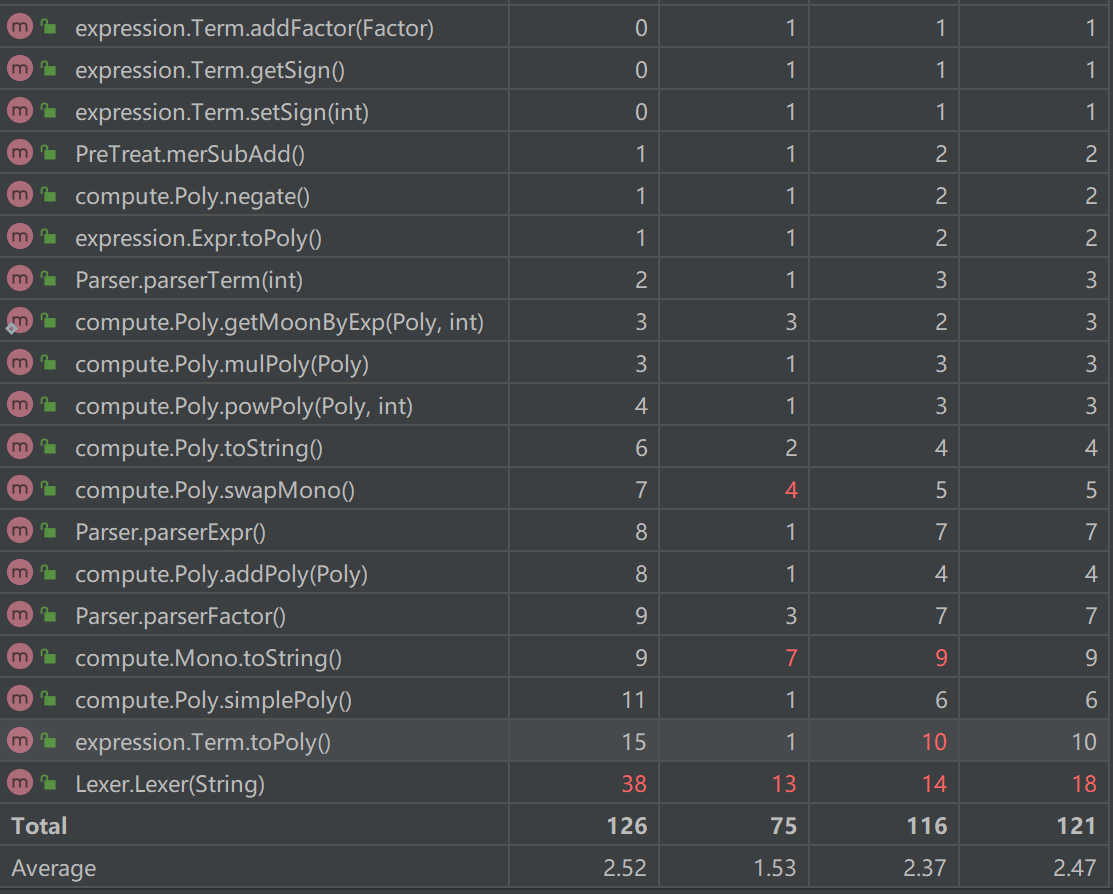
Mono类中toString()方法生成单项式的字符串形式时,需要使用大量的if-else语句判断优化。
Term类中toPoly()方法由于第一次作业将Factor设置为父类而非接口,需要判断语句进行强制类型转换。
Lexer类中使用if-else对表达式的语法单元进行解析,因此结构非常冗杂,导致代码量暴增。
课下在评测机上运行时,发现程序很容易超时(长久地陷入运行中且不输出结果),定位问题后发现是由于Poly类中addPoly、mulPoly、powPoly等与Poly相关的计算方法没有及时合并/化简,而化简这一环节放在了最后调用simplePoly。故当时的解决方案是在每次Poly相关的计算后都调用一次simplePoly。
为什么我没有在addPoly的过程中就实现合并呢?嗯因为第一次作业写的时候呆得很,没有意识到可以在实现加法的时候边遍历边合并,最终就能够得到最简式;而是在simplePoly中根据x的幂次对monoList排序之后再次遍历进行的合并。
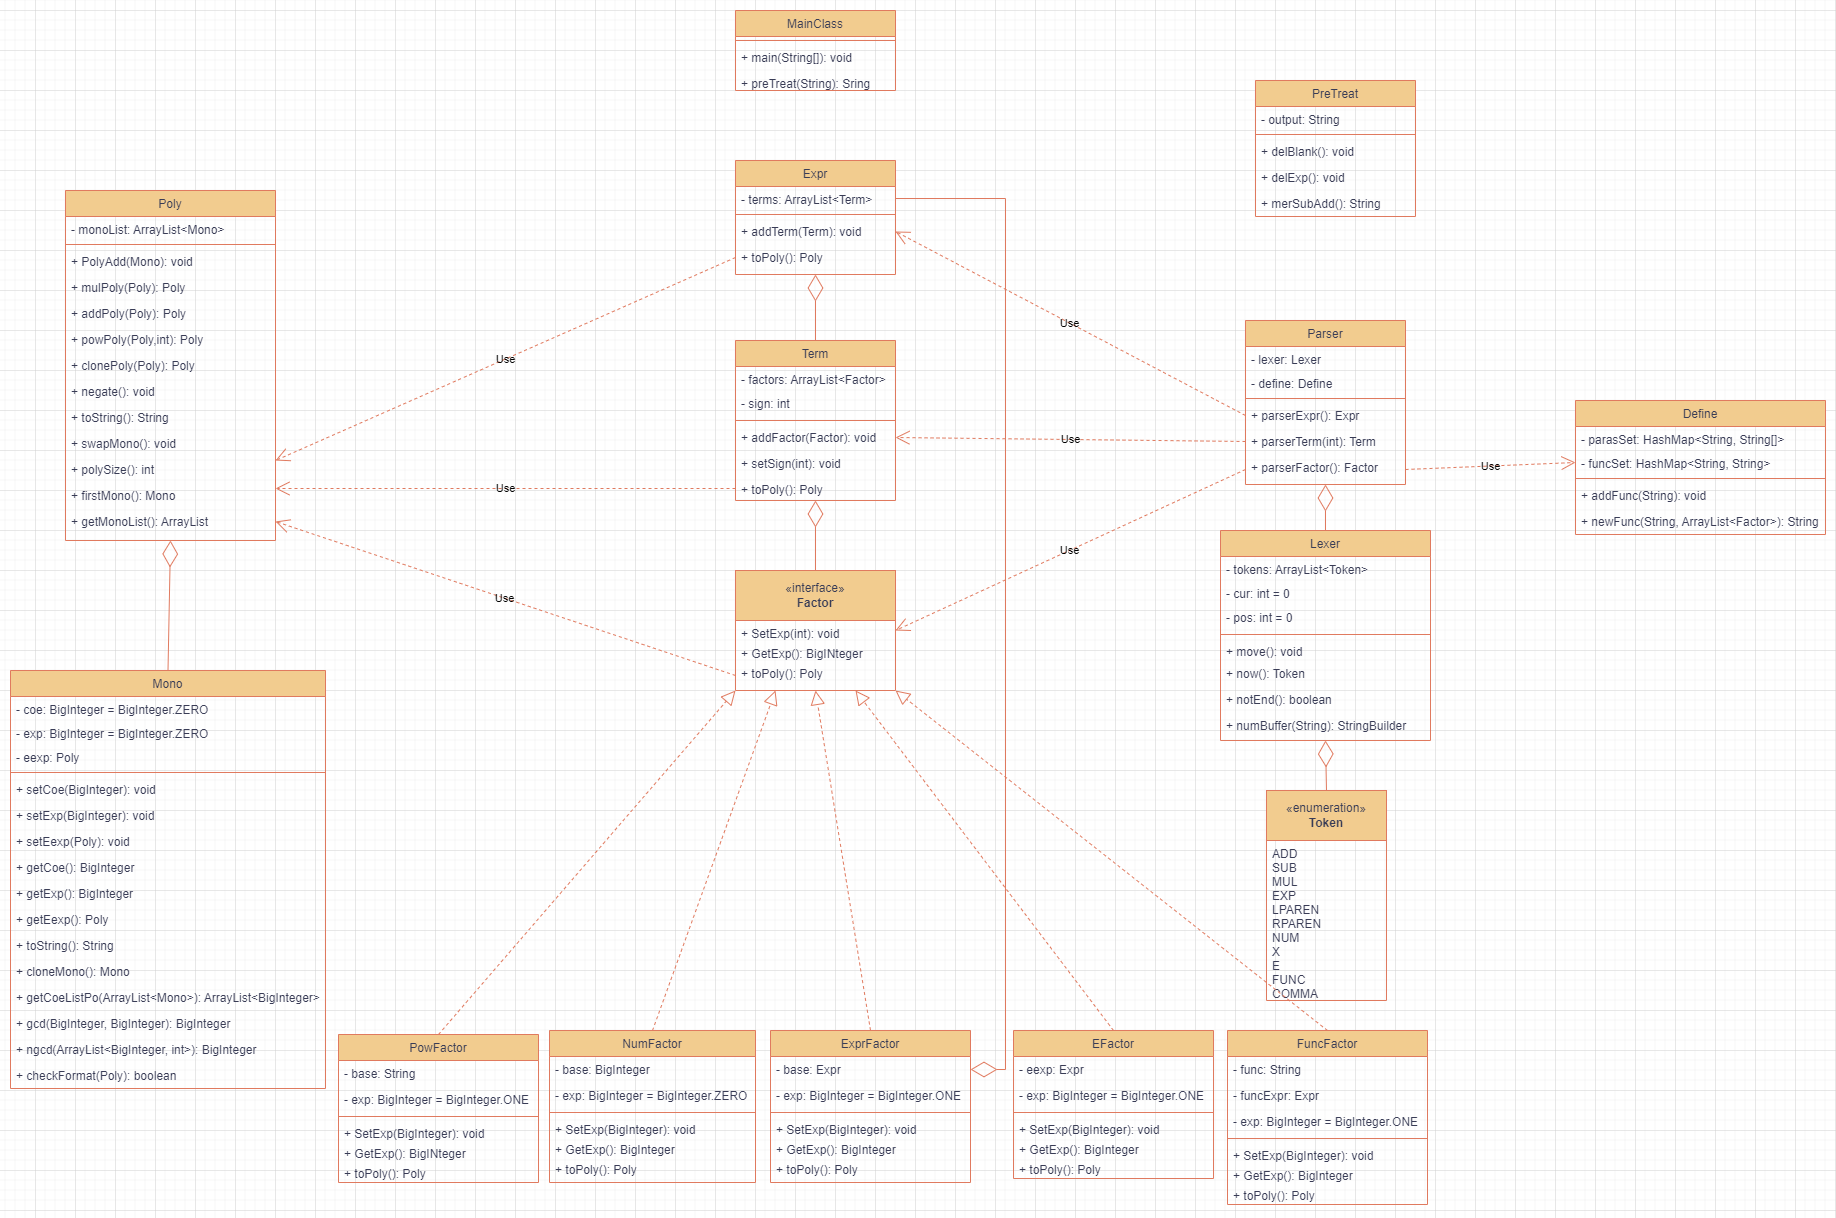
第二次作业的主要任务为:
为指数函数建类EFactor,实现Factor接口(将原先作为父类的Factor修改为接口)。语法分析增加对指数函数因子的分析。
改用a*x^b*exp作为运算的最小单元,指数从int类型改用BigInteger存储。修改Poly中的计算方法使之能够实现指数相关的运算。
hw2最终的框架对
Poly进行了较大的修改。之前的计算在每一次计算完成返回结果时都需要调用simplePoly,每一次的调用实际上要遍历两次monoList(排序一次合并一次),笨笨的而且肯定会超时。在bug修复阶段,废弃simplePoly,修改addPoly在计算的同时合并使结果最简。
为自定义函数因子建类FuncFactor,属性包括实参替换后函数的字符串形式、实参替换后的Expr形式、自定义函数因子的指数,实现Factor接口。
新增Define类,由HashMap<String, String[]>parasSet存储函数名称和形参,HashMap<String, String>funcSet存储函数名称和函数字符串形式;由方法addFunc向前述HashMap加入原函数,方法newFunc实现形参的替换。
语法分析增加对自定义函数因子的分析,借用Define类的方法分析FuncFactor相关属性。
输出优化:在转化为字符串的过程中,在第一次作业的基础上,求出了exp指数部分的最大公因数(由Mono中getCoeListPo、gcd、ngcd方法实现);对exp指数部分只有一个变量因子/常数因子的情况少输出一层括号(由Mono中checkFormat判断)。
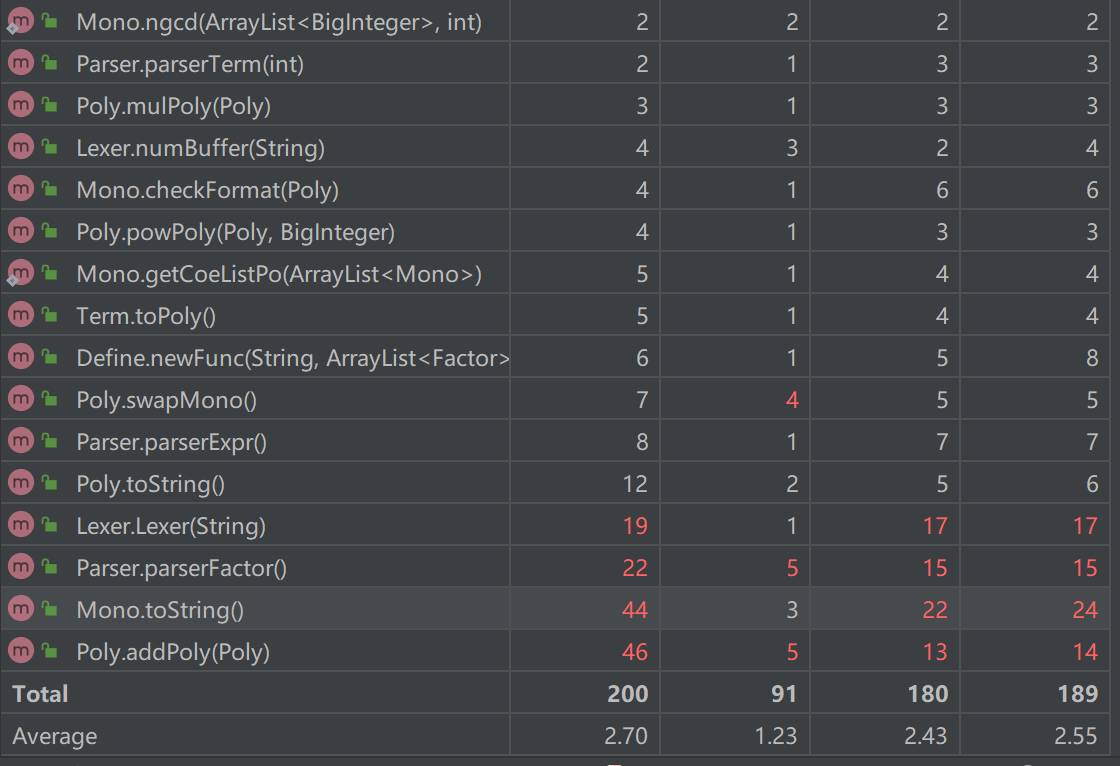
Poly中addPoly的复杂度明显增加,addPoly需要实现带指数函数的合并化简,处理逻辑复杂,复杂度高也在情理之中。公测和互测环节出现的bug如下:
对exp指数部分只有一个变量因子/常数因子的情况判断过于混乱,逻辑发生了很大的错误。修复时重写了Mono中checkFormat的判断。
0
(((((((((((x^8)^8)^8)^8)^8)^8)^8)^8)^8)^8)^8)^8
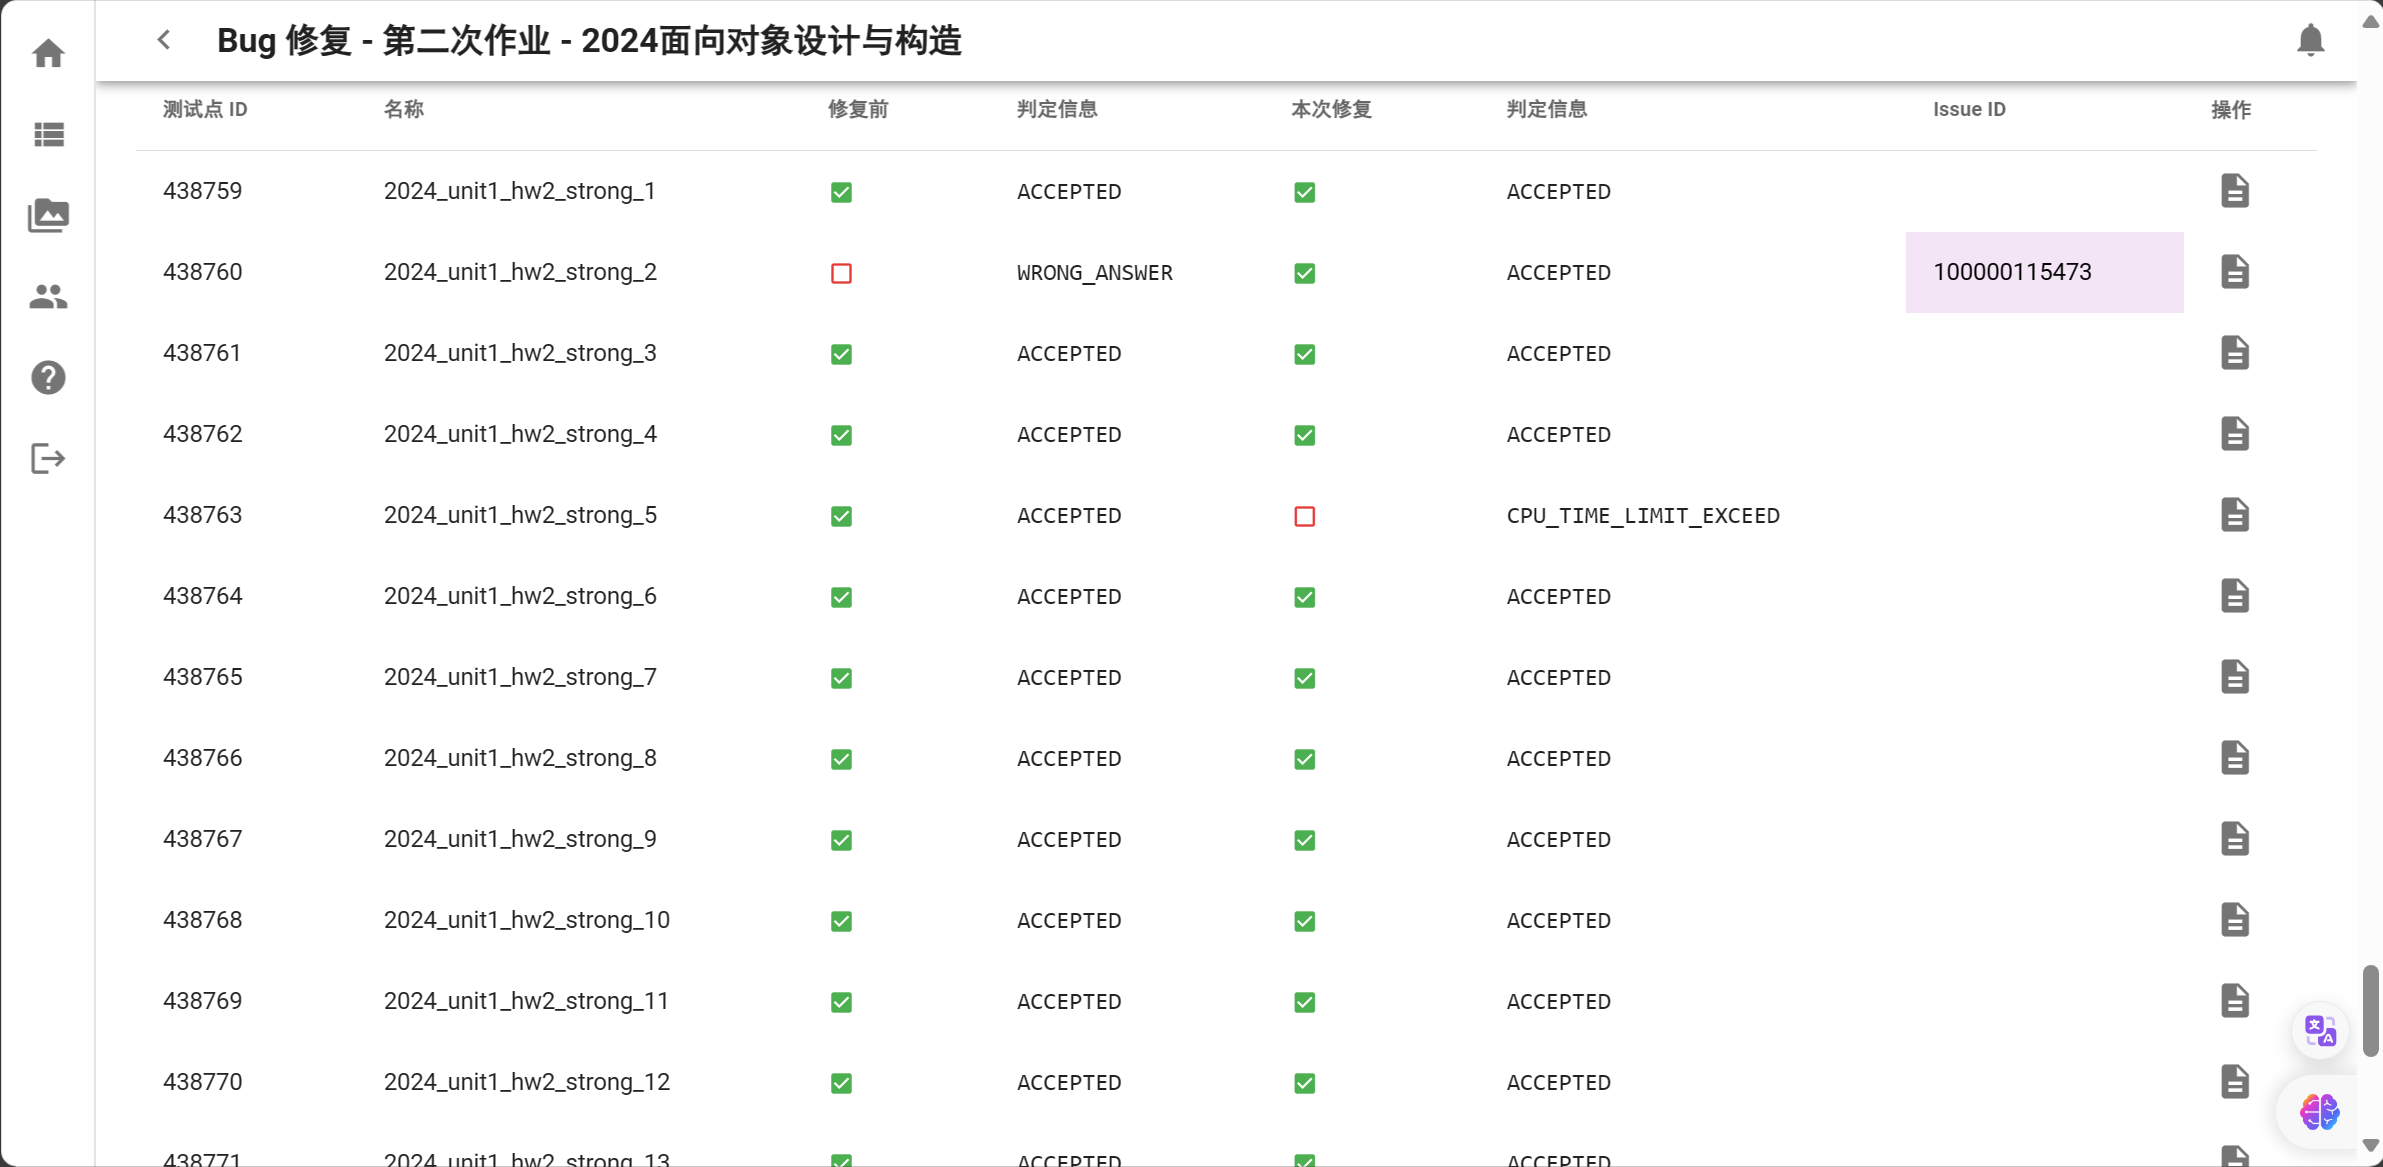
修复时起初认为可能是我在计算时频频调用simplePoly耗费较长时间,但在修改为边遍历边合并后运行时间并没有明显提升;后来sq老师告诉我在判断是否可以合并时不用每次都直接对两个Mono的exp做差,可以特判一下没有exp的情况。
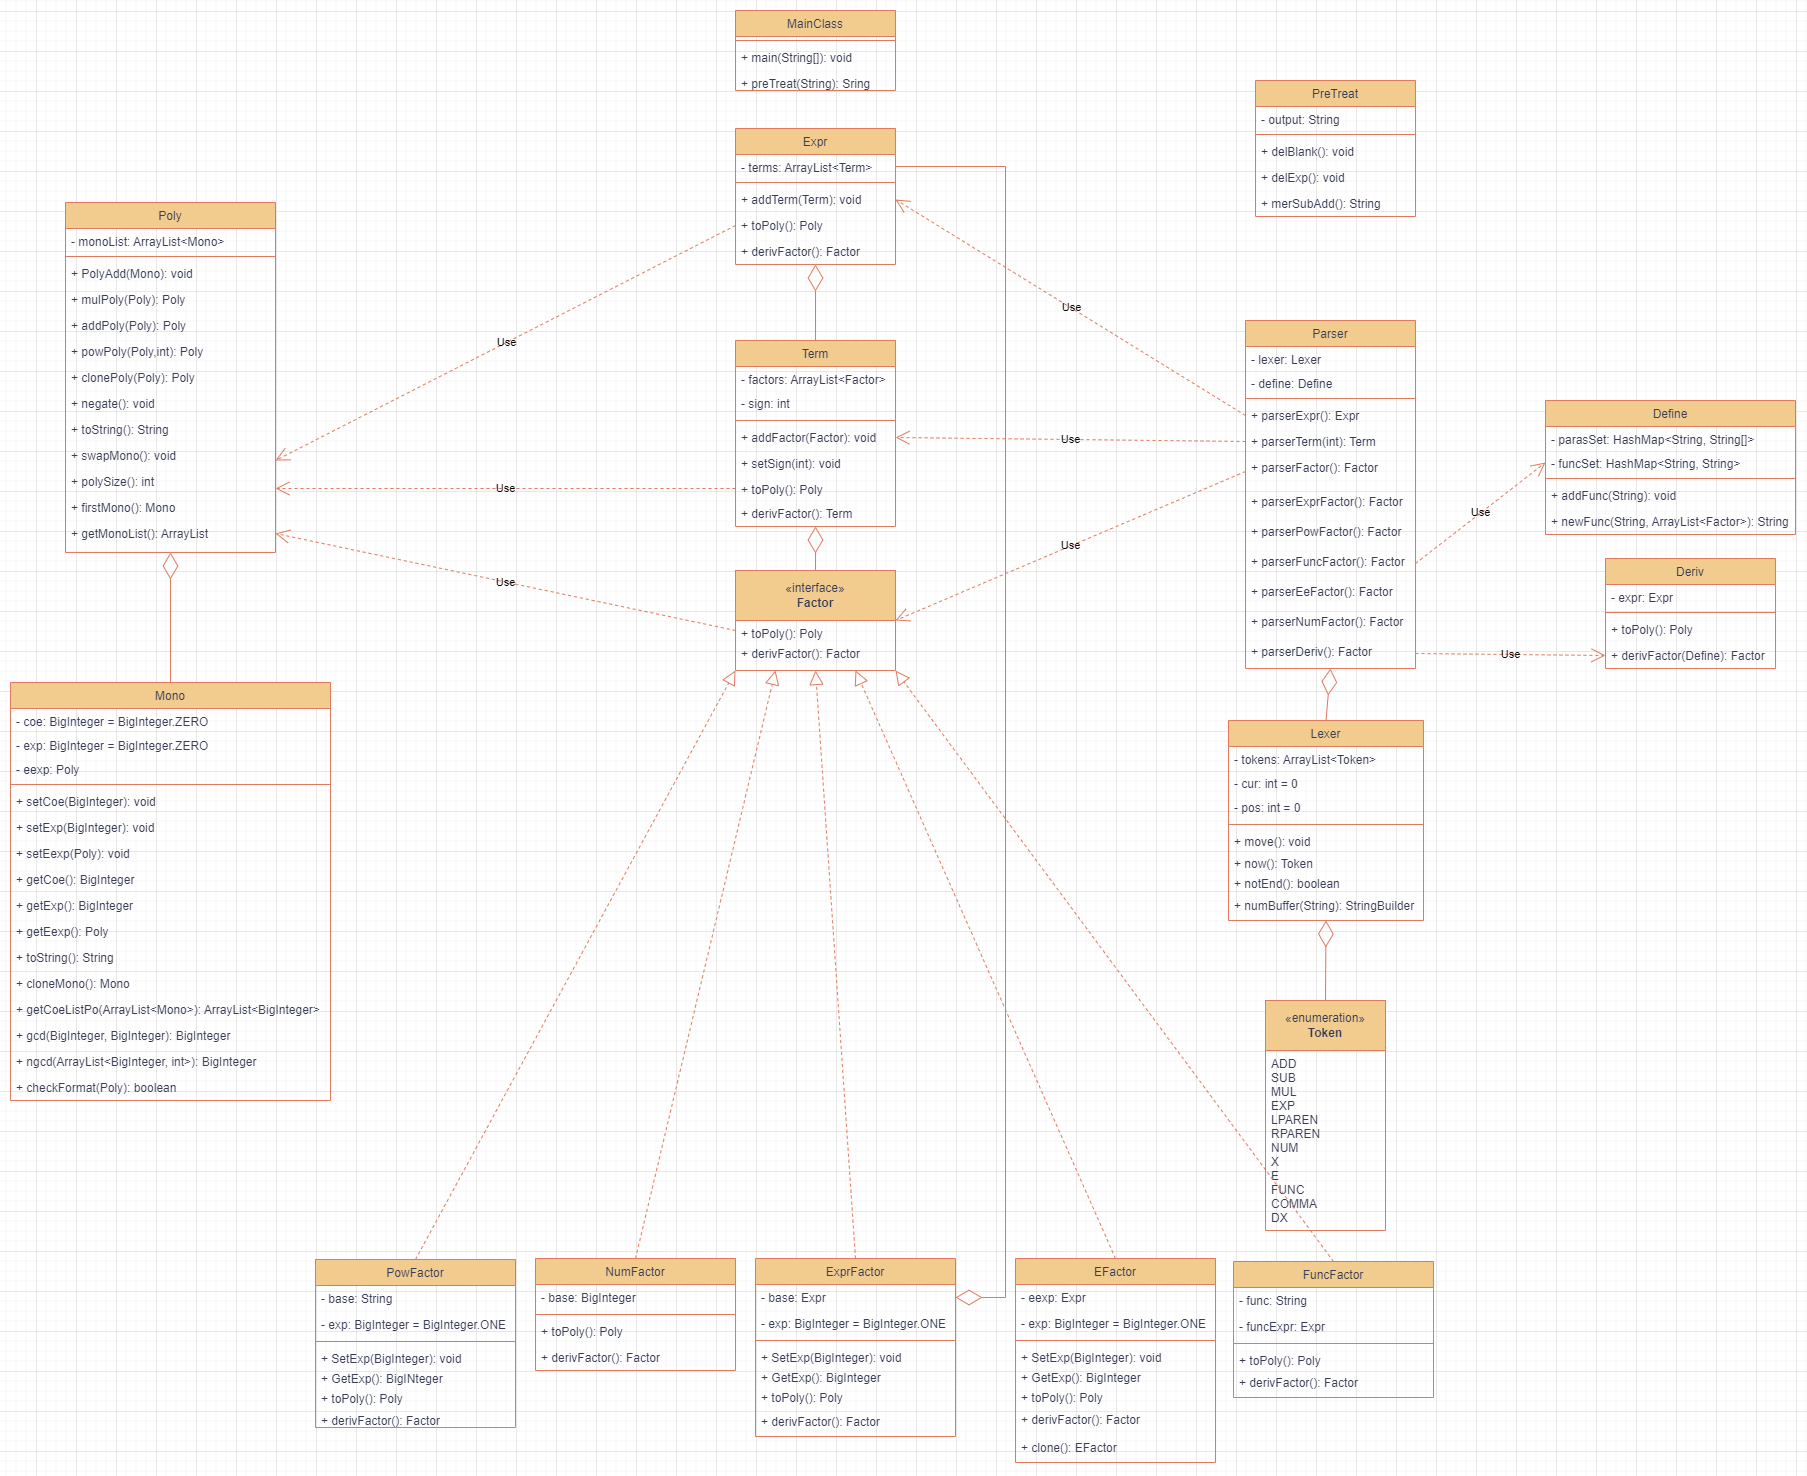
反思:Deriv没有实现Factor的接口是因为求导时需要传入define这个参数;但是Deriv应该实现Factor的接口,所以Define类中的成员和方法应该都设静态的,这样就可以通过类名直接调用,架构更加统一。
第三次作业的主要任务为:
首先,为每一个关键类添加了求导的方法。之后,为了不影响Poly中的计算,在语法分析部分识别求导算子并返回求导后的结果(返回的结果为Factor类型),之后正常参与运算即可。
第二次作业能够完成这项任务。
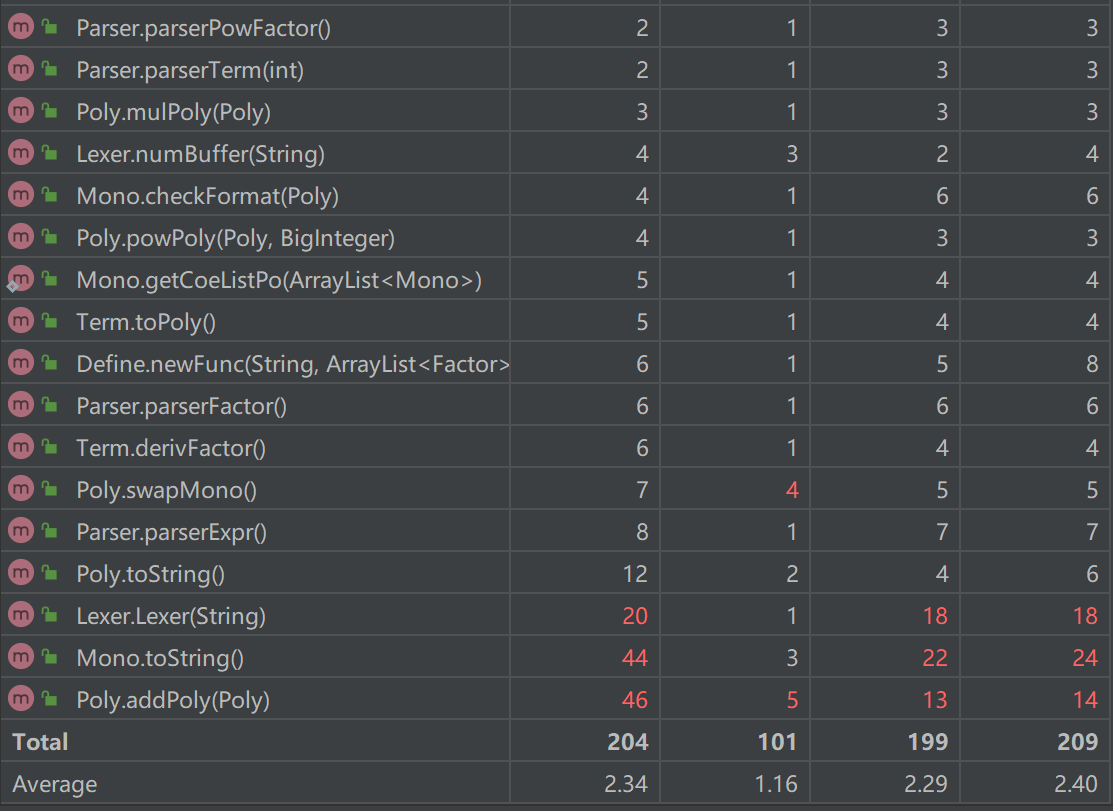
Parser中的parserFactor中的内部细节拆分为了parserPowFactor、parserNumFactor等方法,使得parserFactor的复杂度下降。互测时被hack到的样例如下:
0
dx(exp(exp(exp(exp(exp(exp(exp(exp(x^2)))))))))
再次出现了超时的问题,主要是因为在从表达式向Poly转化的过程中,频繁调用powPoly方法(powPoly方法又需要调用mulPoly方法和addPoly方法),故修复时将指数为1的表达式因子直接返回底数而不再调用powPoly。(但是感觉每次对于超时问题的修改都不是长久之计)
可能的迭代场景:多变量
词法分析阶段设置
PowFactor的底数;更改Mono的属性,用HashMap存储变量的指数、系数;实现多变量Poly的计算;求导时求偏导的实现。
要求的测试数据对dx的限制好严格,不论是对dx数目的限制还是dx的cost的计算方式,可以再宽松一点点。


