


301
社区成员
 发帖
 与我相关
 我的任务

 分享
在三次作业当中,我经历了一次重构
在第一次作业中,拿到题目,我根据题目给定的对于表达式的形式化描述,设计了以下的存储与解析结构
从题目的形式化表述出发,很自然地会第一想法是设计成以下的三层结构
根据题目的形式化表述,
表达式 → 空白项 [加减 空白项] 项 空白项 | 表达式 加减 空白项 项 空白项
可以看出,Expression要么是Term,要么是Expression加上Term
所以很自然地,
一方面,
根据Expression加上Term是一种Expression,可以设计出Expression的存储为:
public class Expression {
    private Expression left;
    private Term right;
}
另一方面,
根据Term是一种Expression,
这也就是一种is a的关系,自然而然会设计成Term继承自Expression这样一种结构
同理,根据对项的形式化表述:
项 → [加减 空白项] 因子 | 项 空白项 '*' 空白项 因子
把Term设计成:
public class Term extends Expression {
    private Term left;
    private Factor right;
}
在上面说的原因下,我采用了如下的继承关系
Term类继承自Expression类,Factor继承自Term类,Factor的三种类型继承自Factor类
关于解析的方法,一开始想的是写成一个构造函数,即
public Expression(String string);
再在这个构造方法中调用
public Term(String string);
但是后来发现这样的主要缺点在于,如果一个Expression是只有一个Term的,这样如果要存储,就只能存储成:
left = null;
right = new Term(string);
left是一个空指针,会造成不少麻烦,比如运算过程中
而如果能针对这种情况,直接把它存储为一个Term对象,这样就能避免这个问题,还能充分利用这个继承关系
在这样的想法下,我就把Expression构造方法改写成了createExpression的静态方法
public static Expression createExpression(String string);
在这个方法中根据是否只有一项,来决定是
return Term.createTerm(string);
还是
new Expression(Expression.createExpression(string.substring(0, index)), Term.createTerm(string.substring(index + 1)), isAdd);
其中此时Expression已经有了一个新的简单的构造方法
以multiply方法为例,
Expression有参数为Expression对象的multiply方法和参数为Term对象的multiply方法
Term有参数为Term对象的方法和参数为Factor对象的方法
除此之外,还有Term类下的以Expression对象为参数的方法,直接调用反过来的方法:
@Override
public Expression multiply(Expression expression) {
    return expression.multiply(this);
}
即,上对下的方法直接实现,下对上的方法采用反调
Factor有参数为Factor对象的方法和以Term对象为参数的方法
使用一个Polynomial类和Monomial类,把最大的expression的内容一一递归读出,按照
private final TreeMap<BigInteger, BigInteger> monomials = new TreeMap<>();
的方式存储,最后输出
我自己对于这个架构的评价是,在存储上,直接来源于形式化表述,在数学很自然;在解析上,充分利用了这些类之间的继承关系,把解析出来的对象设为它真实的最底层的对象(比如3*x^2这样一个只有一项的表达式,经过parseExpression之后,并不是生成一个表达式对象,而是生成一个项对象,而且表达式指针还能直接指向它);运算上,给每两种对象的运算都提供了合适的add等方法,使得在对两个表达式进行add的过程中可以充分地实现不需要管具体是什么对象,都可以自由的使用add,充分体现了里氏替换原则。
但是有几个致命的问题,导致我不得不抛弃这种方法重构:
但是由于这种存储方式,很容易在运算过程中递归层数过多,导致StackOverFlow
在第一次作业周六晚上6点的时候,有一位同学给了我这样一个数据,
37*+7*x^ +7 *x^0*-47 ++-06- +x^7-+x^1*3*-41*x^+1*+6+ x^+0*(--x^+0- +x^8++-3420035449*x^8 *-18+ -41*x^7*100)^7*(--76 *x^+6* -9*+14*42- 0*55++ +09 *x^+1* x^+3*61*x^6* x^7+-81*1-++ 60)^8*(+x^5*+38*3970090881+-74* x^ +6* -94+x^ 0*x^ +4*64*+ 32*x^3 * -014++23*+27*11*x^+0*+40*x^5- ++3881905692*x^+ 7*x^+7 *x^0*41*x^+7+ x^0*+48*x^1 *+15*56)^8* (-- 3* -2147483647* x^+8*x^ +8 *2+1*x^+5 - 13*x^+1)^8++x^+1
在我的代码上跑完之后就会StackOverFlow,一开始以为是死循环导致的,后面仔细找了发现还真没死循环,而是就是递归层数过多了,时间也比较紧,只能下次作业重构了
因此,在下一次的架构中,就要采取多叉树的架构,来解决递归层数过多
这样存储,把每个因子都当成一个独立的对象,就导致它们之间无法产生关联,不同的因子之间的数学上该有的关联,在内存中完全无法得到体现,就导致整个后面看起来很不自然,有面向对象的美感而没有数学的美感。
除此之外,还有实践上的问题在于,这样没法实现在边解析、存储的时候边化简,包括我运算也是在化简之前完成,就会出现,化简之前有很多数学上很冗余,但是又很难比较漂亮地解决的,诸如1*1*1*1*1*1*1*1*1*1*x*x*x*x*1等等这样的现象出现,也容易导致时间过长
因此,在下一次架构中,就要采取一种能够边解析边化简的架构,实现始终维护一个最简形式的存储
除此之外,我在这次的代码中,有一个问题在于,所有的类、属性、方法、变量的名字全部采用英文单词/短语的全名,就导致名字很长。一开始觉得这样是可以增加代码的可读性,但是后来发现,这样对于刚看这个代码的人友好,可以快速知道代码的含义,但是对于要花很多时间看这个代码的时候,已知盯着这样长的命名看,就会很容易导致视觉疲劳,不能一眼看出它的在做什么,而是要去理解长长的短语。包括计组P7的时候也有这个问题。
所以下次代码,打算把所有命名都改成能明确含义的情况下的最简称,比如Expression改成Expr,Polynomial改成Poly等
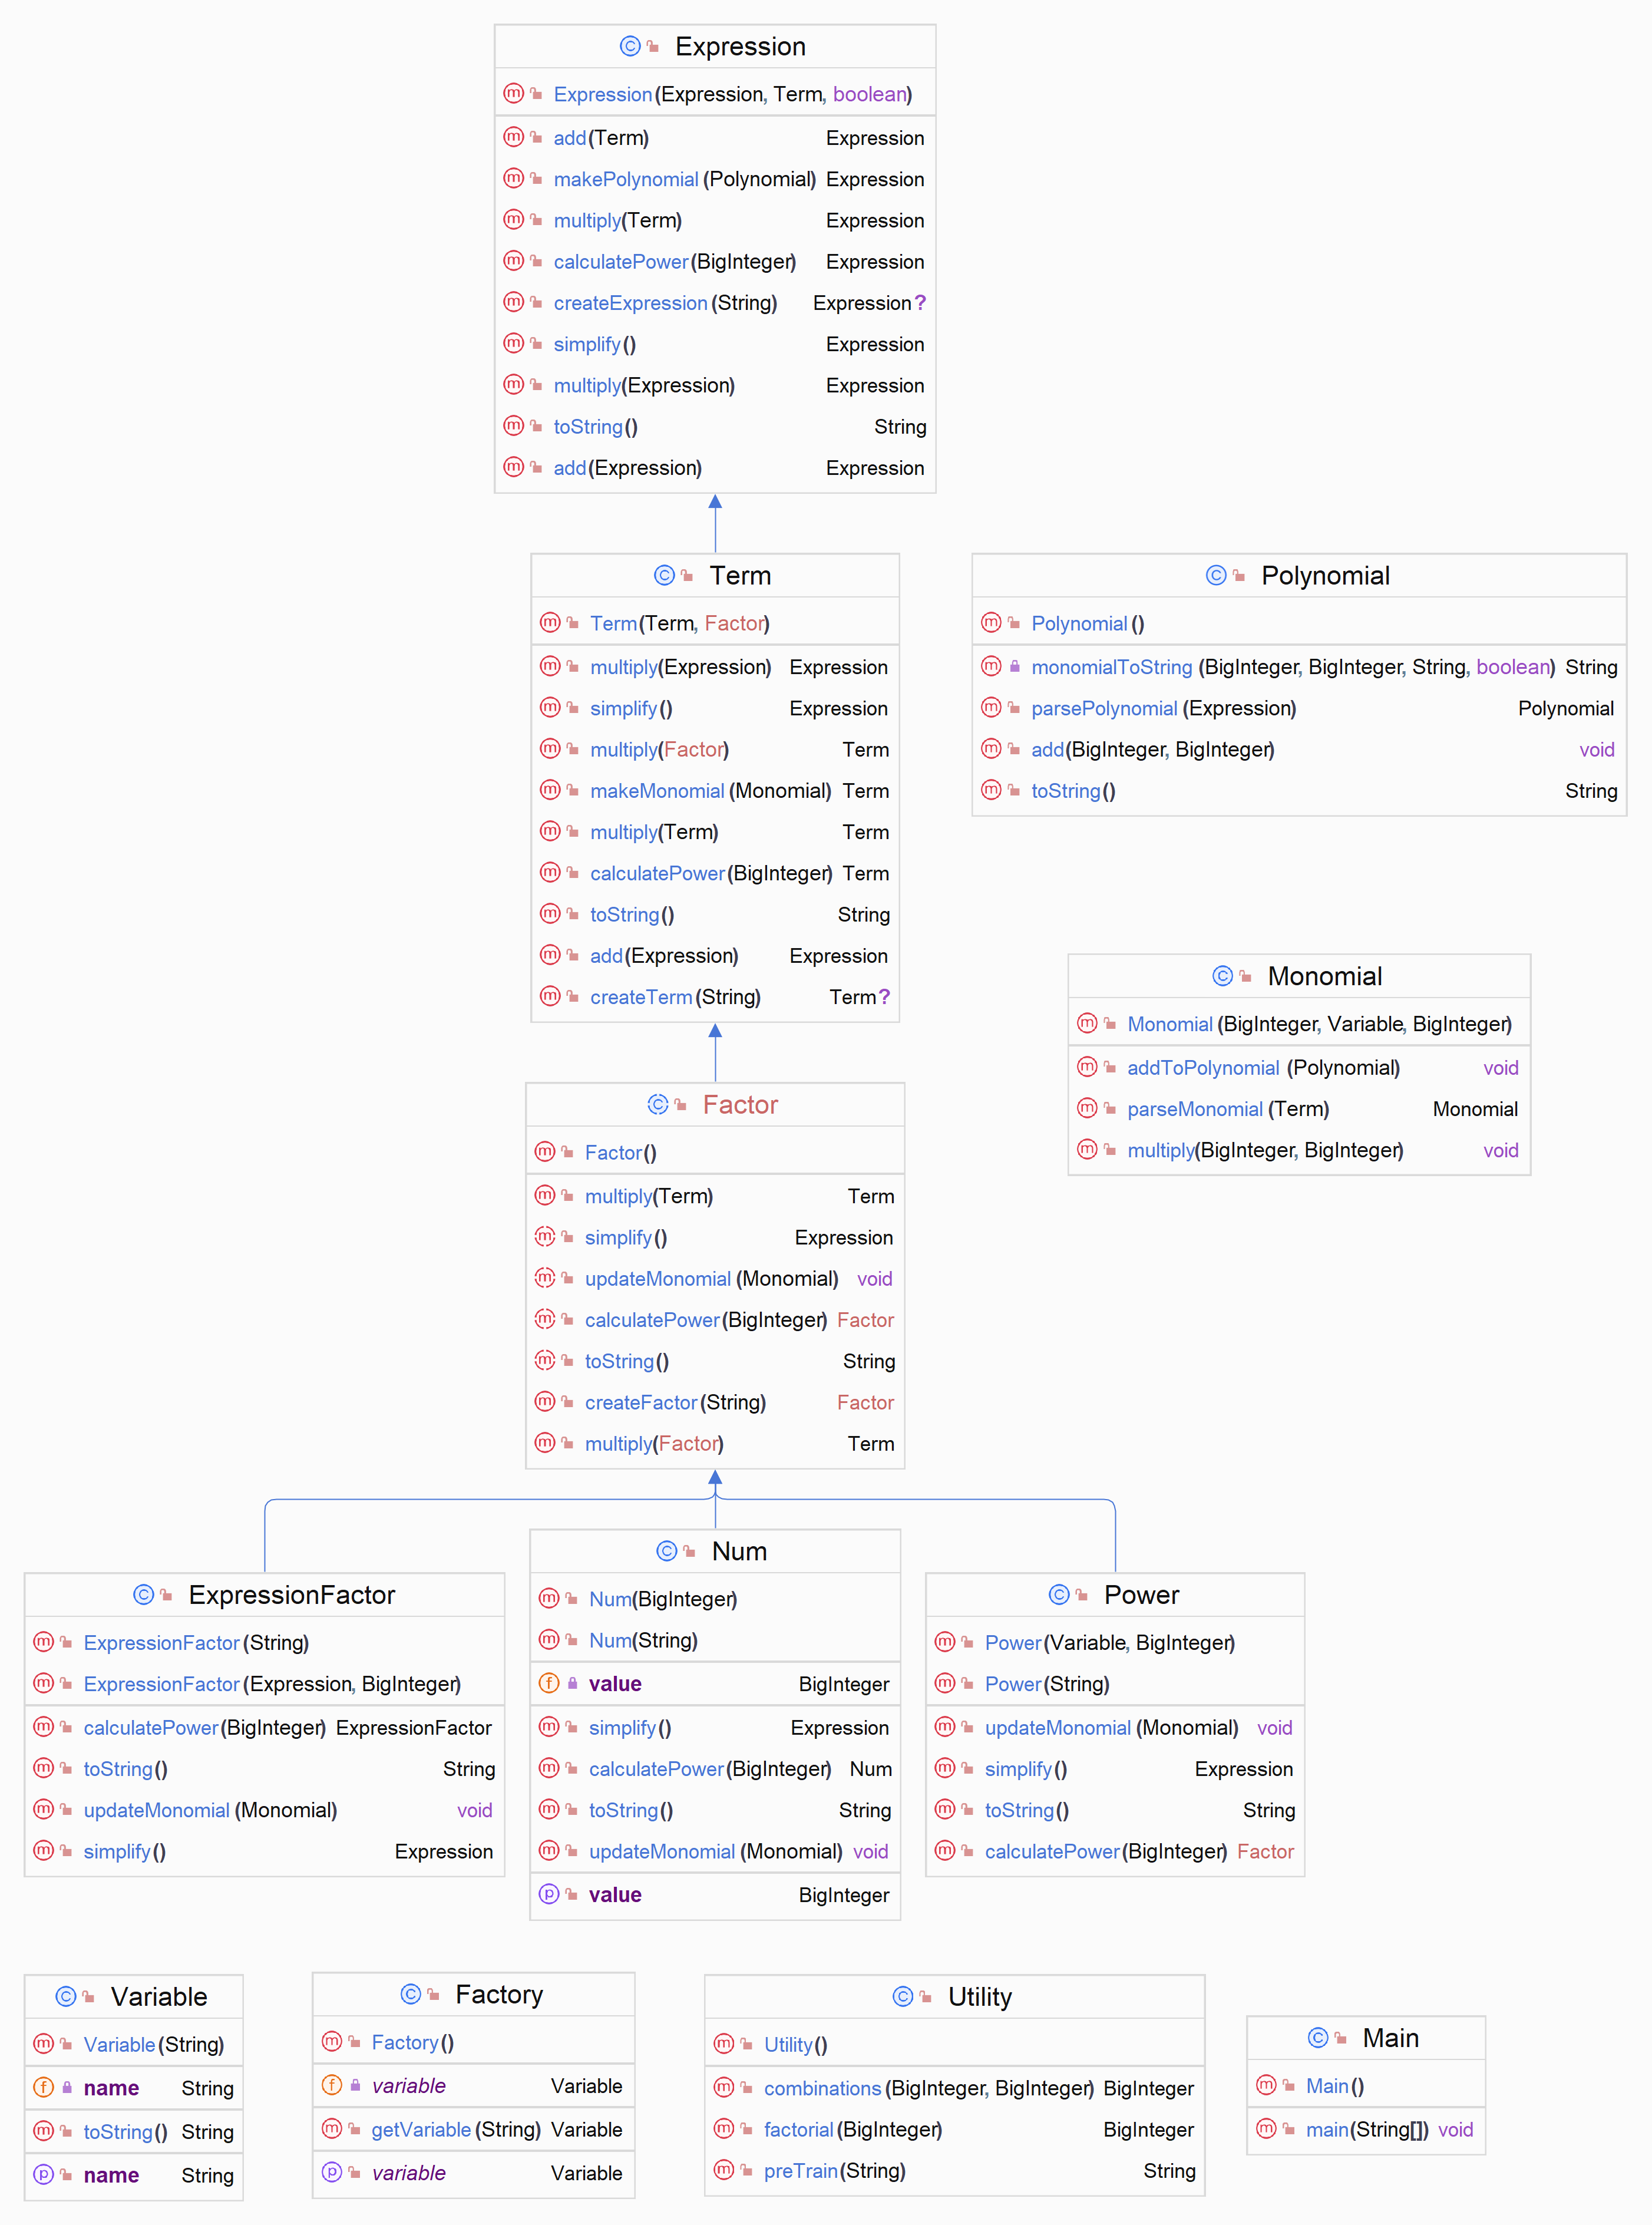
| Source File | Total Lines | Source Code Lines |
|---|---|---|
| Expression.java | 110 | 98 |
| ExpressionFactor.java | 58 | 51 |
| Factor.java | 42 | 34 |
| Factory.java | 20 | 17 |
| Main.java | 13 | 12 |
| Monomial.java | 33 | 28 |
| Num.java | 39 | 31 |
| Polynomial.java | 92 | 87 |
| Power.java | 50 | 43 |
| Term.java | 81 | 70 |
| Utility.java | 34 | 31 |
| Variable.java | 16 | 13 |
在上次的架构的两个教训下,采取了以下的架构
主要特点是,项、因子这些概念只在解析的时候有区分,在存储中统一使用Expr来存储,并且边解析边化简,每次解析得到的Expr都是化简成最简形式的
只有一种存储,Expr,所有的项和因子都用Expr来存储,同时也没有Poly类,因为Expr本身就是Poly
public class Expr {
    private HashMap<BigInteger, HashMap<Expr, BigInteger>> storage = new HashMap<>();
Expr存储时,就按照
$$
a\times x^b \times \exp(C)
$$
为一项,外层的key BigInteger即为自变量x的指数b,外层的value的key Expr即为exp的指数C,value的value的BigInteger即为系数a,这样可以便于合并同类项
为了实现以上的存储,必须要对Expr重写hashCode和equals
这里一个Expr只有一个属性storage,而storage是一个HashMap,经过测试,它自身的hashCode和equals经过了重写,所以Expr的equals和hashCode就可以很方便的实现为
@Override
public boolean equals(Object object) {
    if (object instanceof Expr) {
        return storage.equals(((Expr) object).storage);
    } else {
        return false;
    }
}

@Override
public int hashCode() {
    return storage.hashCode();
}
对于自定义函数,采用纯宏替换式的方法来实现,这样可以不必处理多变量问题,把未解决的问题直接地转换为了已解决的问题
这次的架构实现了边化简边优化,在时间和存储空间上都实现了比较高的效率
缺点在于,存储的时候直接用的一个不加任何修饰的双层HashMap,HashMap<BigInteger, HashMap<Expr, BigInteger>>,导致可读性比较差
另外,没有实现一个类似于迭代每个$a\times x^b \times \exp(C)$的迭代器,导致进行各种运算、求导、输出等过程中都要进行繁琐的二层遍历,代码的重复度比较高,而且这个双层遍历过程往往可读性很差,很容易混乱,导致错误
总体架构效率比较高,但是还需要加一些可读性方面的修饰
有以下类
其中Function、FunctionSet、Preprocess、Stringprocess在一个Utility包里,其中Function存储一个函数的信息,FunctionSet存储全部函数并提供函数替换方法,Utility包里的方法共同完成包括函数替换在内的预处理的过程
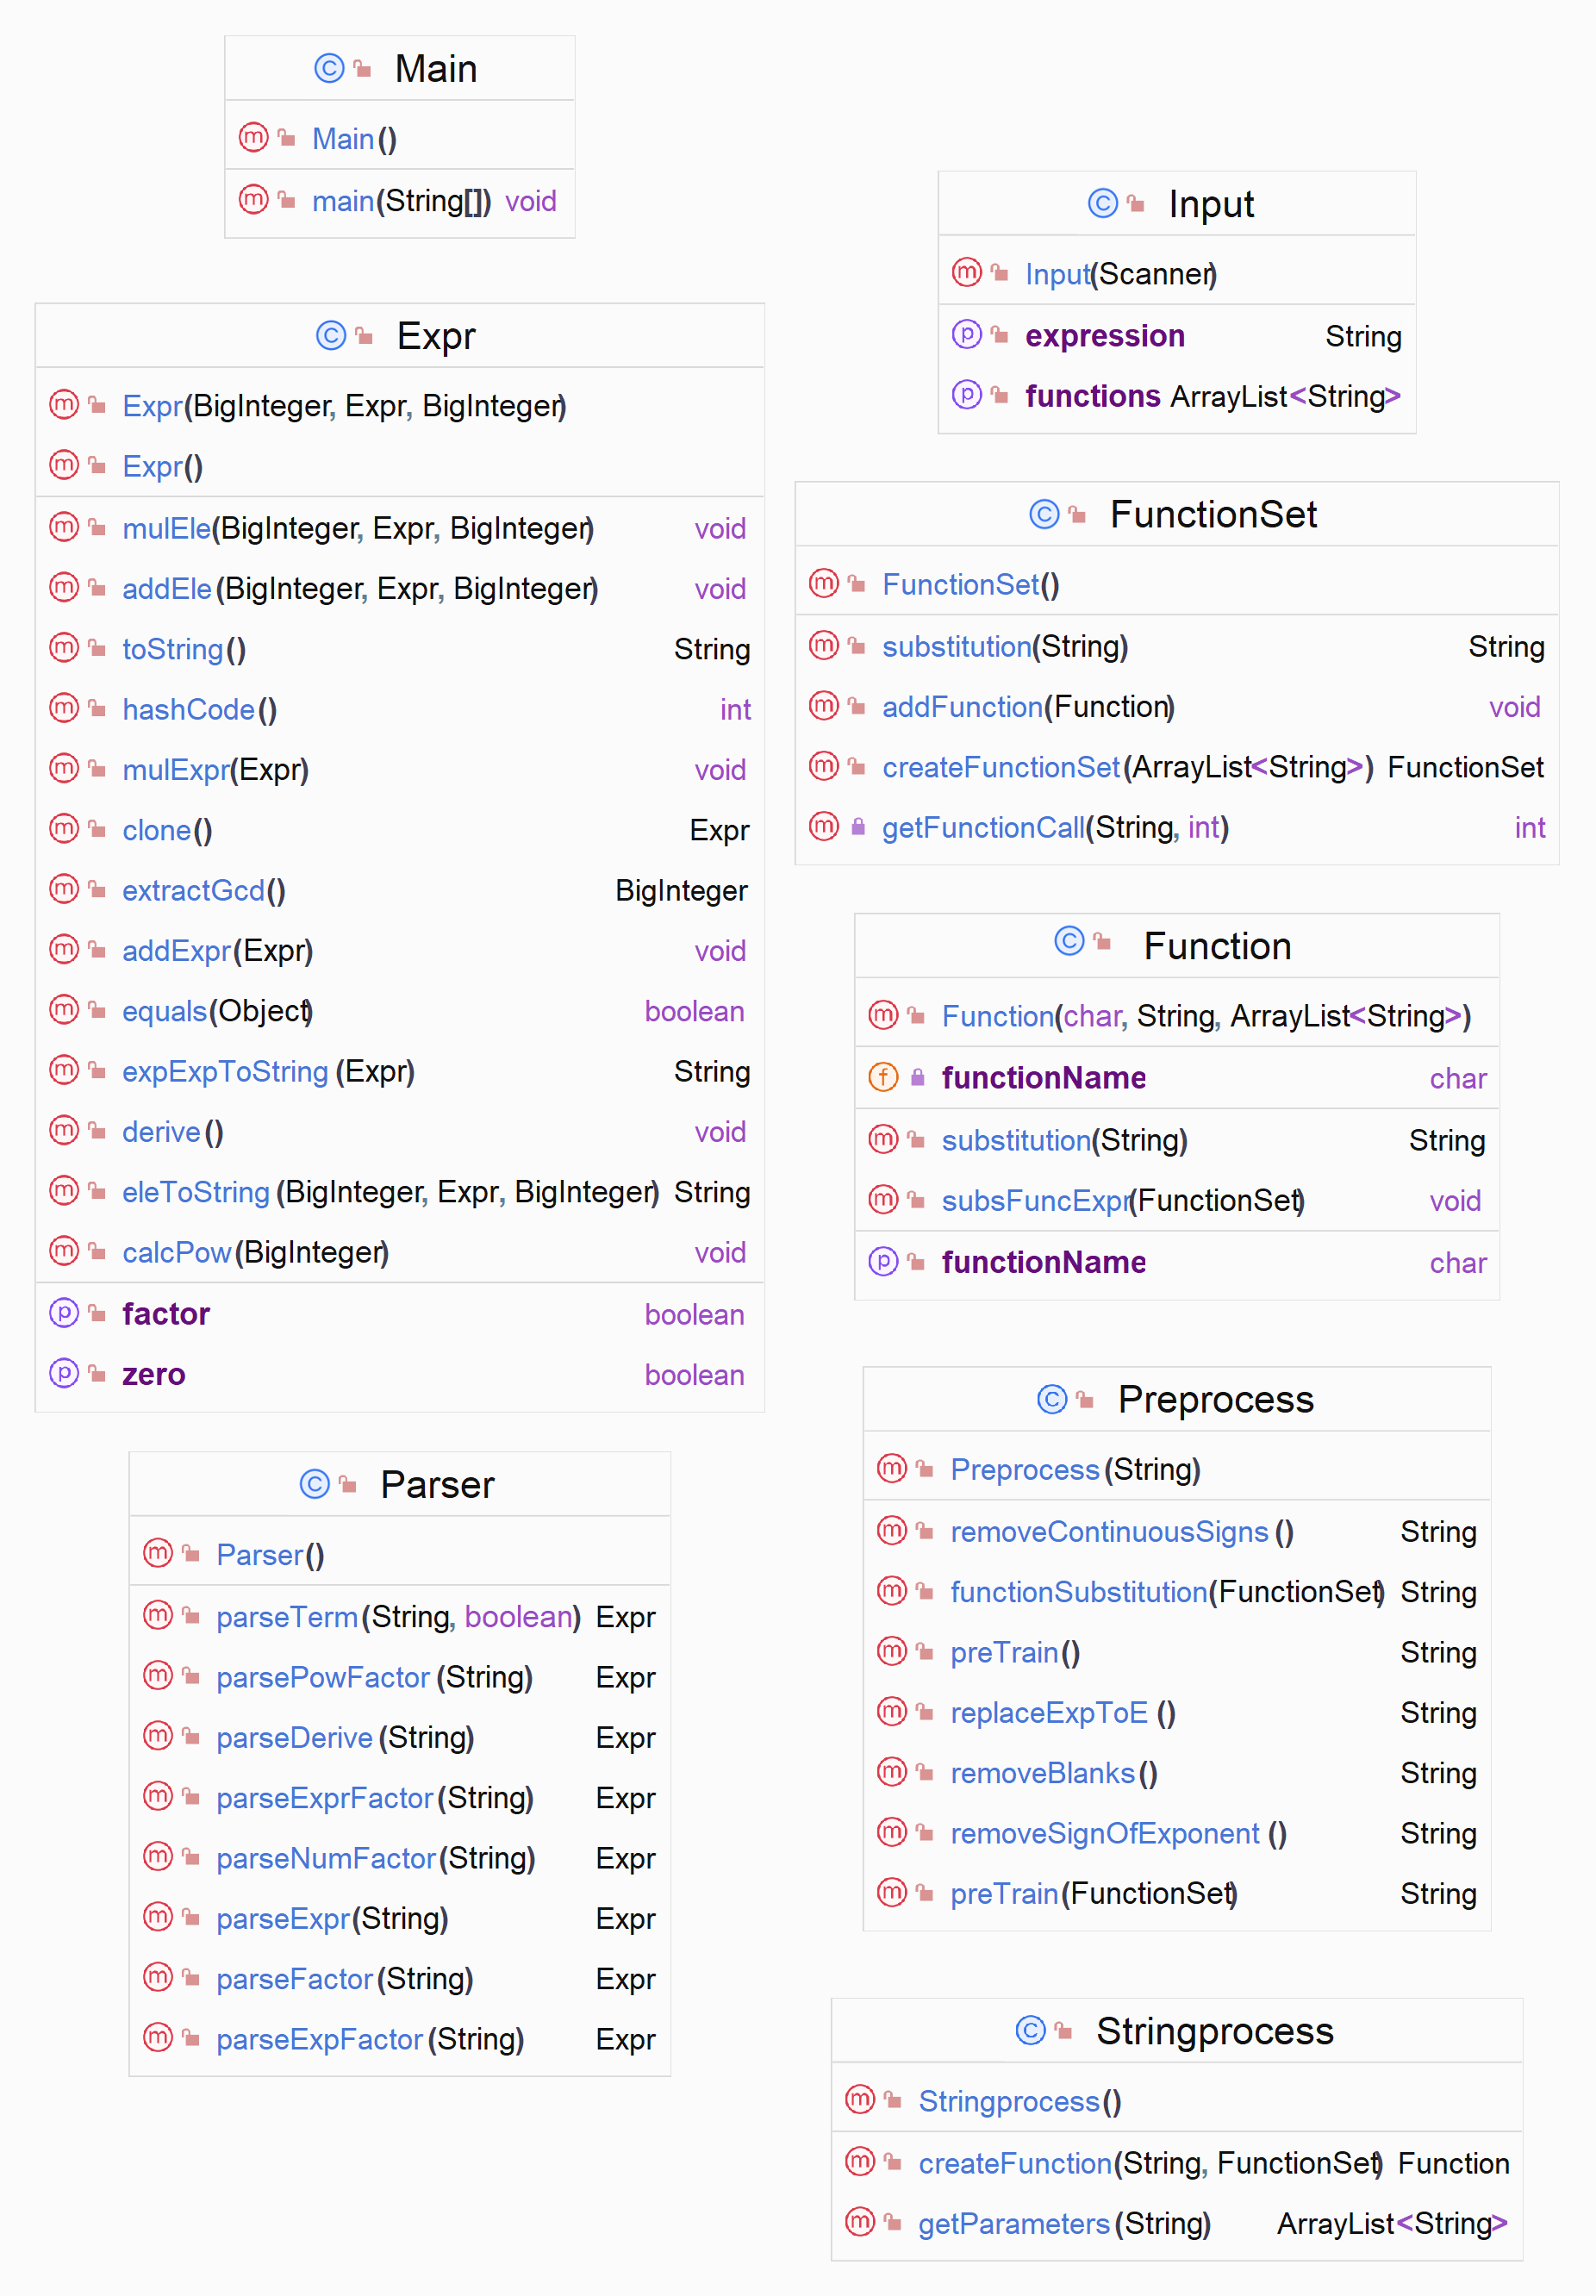
| Source File | Total Lines | Source Code Lines |
|---|---|---|
| Expr.java | 317 | 298 |
| Function.java | 36 | 30 |
| FunctionSet.java | 59 | 52 |
| Input.java | 24 | 20 |
| Main.java | 21 | 16 |
| Parser.java | 154 | 143 |
| Preprocess.java | 55 | 46 |
| Stringprocess.java | 53 | 50 |
在三次作业中,我的第二次作业出现了2个bug
在第二次和第三次作业中,我只采用了针对exp的提取公因数的优化,把exp内的公因数提出,并判断提取后是否isFactor()来判断是否要减少一个括号


