

 存算一体开发者

DeepSeek Coder V2开源发布,首超GPT4-Turbo的代码能力
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
去年11月,最强开源代码模型 DeepSeek-Coder 亮相,大力推动开源代码模型发展。
今年5月,最强开源 MoE 模型 DeepSeek-V2 发布,悄然引领模型结构创新潮流。
今天,全球首个在代码、数学能力上与GPT-4-Turbo争锋的模型,DeepSeek-Coder-V2,正式上线和开源。
全球顶尖的代码、数学能力
DeepSeek-Coder-V2 沿用 DeepSeek-V2 的模型结构,总参数 236B,激活 21B,在代码、数学的多个榜单上位居全球第二,介于最强闭源模型 GPT-4o 和 GPT-4-Turbo 之间。
新模型在Aider代码编辑基准测试上的正确率为73%,位居第二,与第一名Claude-3.5-Sonnect仅差4个百分点,但成本却低了20-50倍!最新发布的Llama-3.1-405B-Instruct得分只有66%,比DeepSeek Coder低了7个百分点!
-
77% claude-3.5-sonnet
-
73% DeepSeek Coder V2 0724
-
66% llama-3.1-405b-instruct
-
60% Mistral Large 2 (2407)
-
59% llama-3.1-70b-instruct
-
58% gpt-3.5-turbo-0301
-
38% llama-3.1-8b-instruct
Aider的代码编辑基准测试要求LLM编辑Python源文件,以完成来自Exercism的133个小编码练习。这个基准测试不仅衡量 LLM 的编码能力,还衡量它是否能够一致地按照系统提示中指定的格式编辑代码。
国内第一梯队的通用能力
在拥有世界前列的代码、数学能力的同时,DeepSeek-Coder-V2 还具有良好的通用性能,在中英通用能力上位列国内第一梯队。
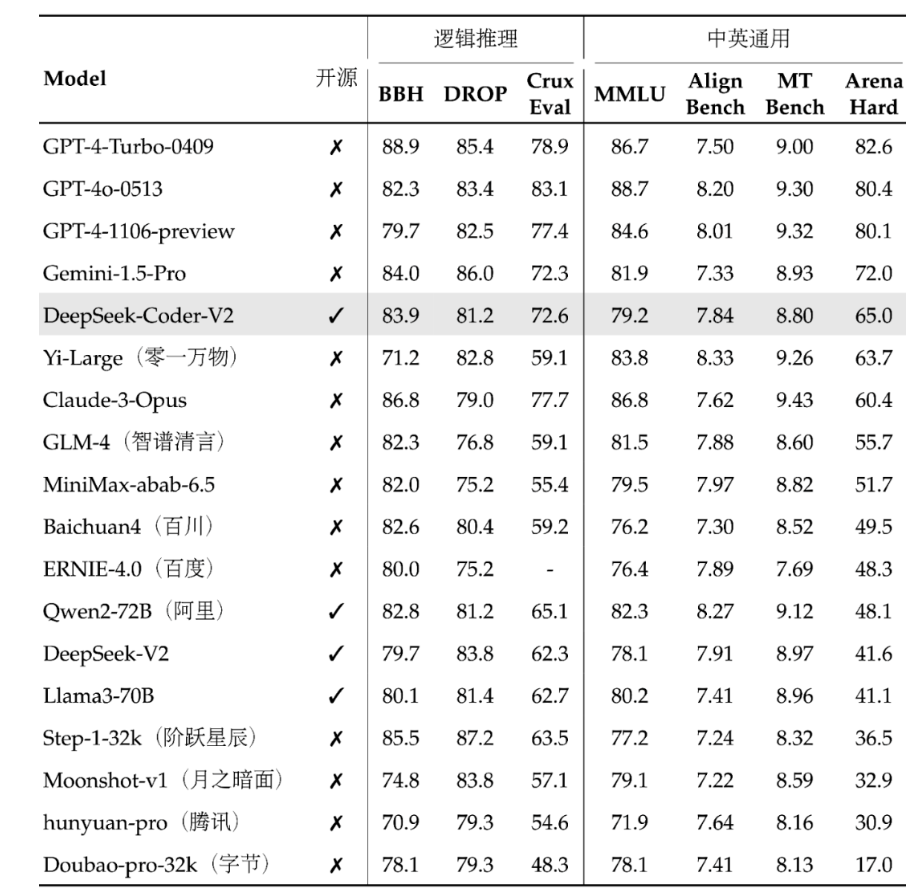
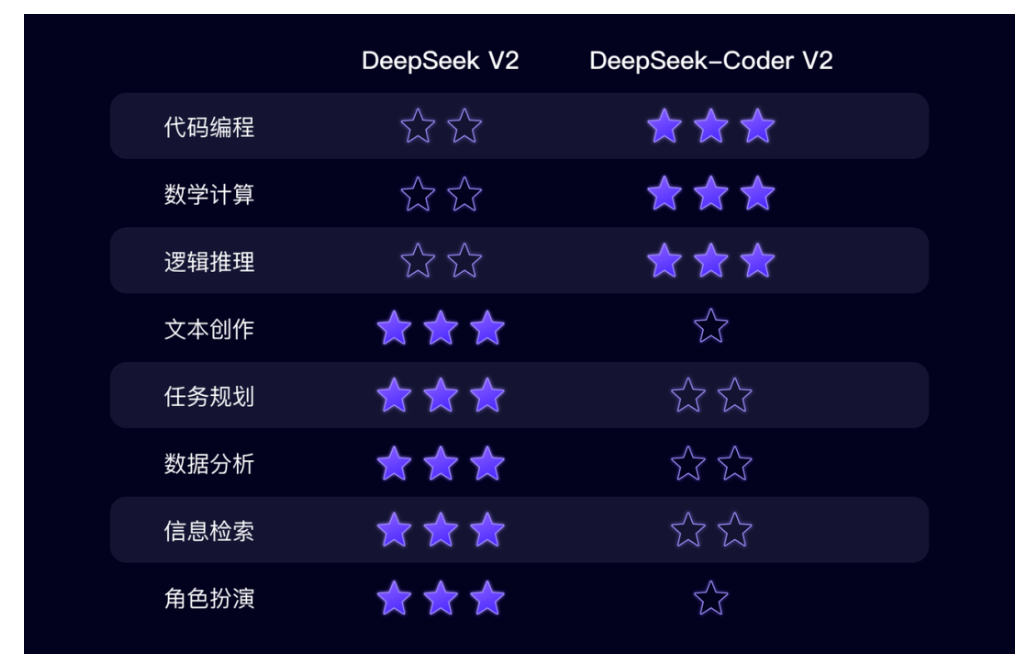
DeepSeek-Coder-V2 和 DeepSeek-V2 的差异
虽然 DeepSeek-Coder-V2 在评测中综合得分更高,但在实际应用中,两个模型各有所长。DeepSeek-V2 是文科生,DeepSeek-Coder-V2 是理科生,精通的技能点不同:
全面开源,两种规模
一如既往,DeepSeek-Coder-V2 模型、代码、论文均开源,免费商用,无需申请。
模型下载:
https://huggingface.co/deepseek-ai
代码仓库:
https://github.com/deepseek-ai/DeepSeek-Coder-V2
技术报告:
https://github.com/deepseek-ai/DeepSeek-Coder-V2/blob/main/paper.pdf
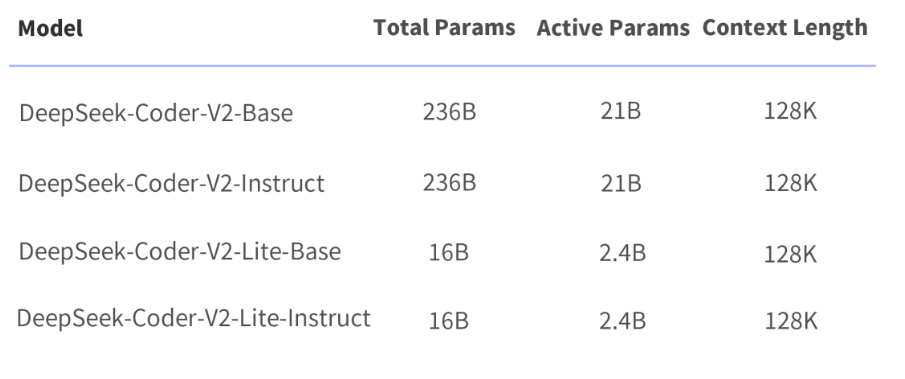
开源模型包含236B和16B两种参数规模
-
DeepSeek-Coder-V2:总参 236B(即官网和 API 版模型),单机 8*80G 可部署,单机 8*80G 可微调(需要技巧)
-
DeepSeek-Coder-V2-Lite:总参 16B,激活 2.4B,支持 FIM,代码能力接近 DeepSeek-Coder-33B(V1),单卡 40G 可部署,单机 8*80G 可训练。
API服务
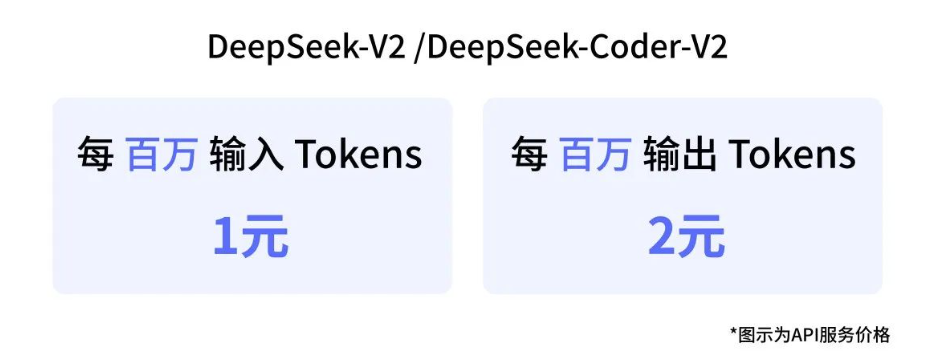
DeepSeek-Coder-V2 API 支持 32K 上下文,价格和 DeepSeek-V2 一致,还是大家熟悉的低价:
本地私有化部署
DeepSeek 提供本地私有化部署服务,标准化成品交付,开箱即用,轻松升级。
价格 45 万/套/年,支持灵活的商务方案(登录官网,联系客服)。
价格包含:
-
一台推理训练一体化的高性能服务器(Nvidia H20、Huawei 910B 或其它同级别显卡,8 显卡互联)。
-
模型:DeepSeek-V2-236B、Coder-V2-236B、后续其它模型。
-
一站式软件套件:推理、微调、运维等。
-
对每个客户,DeepSeek 均会针对应用场景,使用公开数据、脱敏数据进行训练和调优。客户可以使用私有数据进一步微调。
-
不低于 5 人日/年的技术支持。
预期性能:
-
输入:20000 tokens/s
-
输出:5000~10000 tokens/s
官网已上线 DeepSeek-Coder-V2
访问对话官网:coder.deepseek.com,与 DeepSeek-Coder-V2 永久免费畅聊。
访问开放平台:platform.deepseek.com,使用最新 DeepSeek-Coder-V2 API。
相关推荐
DeepSeek-Coder-V2指南[源码]
本文详细介绍了DeepSeek-Coder-V2,一款开源的混合专家(MoE)代码语言模型,其在代码相关任务中表现优异,性能与GPT4-Turbo相当。文章提供了从安装到使用的完整指南,包括系统和硬件要求、必备软件和依赖项的安装步骤,以及如何下载和验证模型。此外,还展示了模型的基本使用方法,如代码补全、代码插入和对话补全,并解释了相关参数设置。DeepSeek-Coder-V2为软件开发提供了强大的支持,帮助开发者提升效率。
DeepSeek Coder 2开源编码模型.pdf
deepseek最新资讯、配置方法、使用技巧,持续更新中
DeepSeek-Coder-v2 开源 AI 编程助手.pdf
deepseek最新资讯、配置方法、使用技巧,持续更新中
深度学习代码智能模型DeepSeek-Coder-V2:打破闭源模型屏障的技术突破与性能提升
内容概要:本文介绍了开源大型代码语言模型DeepSeek-Coder-V2,旨在推进代码智能化的发展,通过从高质量的多元语料中持续预训练超过6万亿词汇来改进其编码和数学推理能力,并将通用自然语言处理性能保持在高水平上。DeepSeek-Coder-V2不仅扩展了对多种编程语言的支持(由原来的86种增加到338种),还将最大上下文长度由16K扩大到了128K标记。实验结果表明,DeepSeek-Coder-V2的各项性能指标能够媲美当前最顶尖的闭源代码模型,如GPT4-Turbo,在编程任务上的表现尤为出色。 适用人群:主要面向软件开发者、人工智能研究人员以及需要高效代码生成工具的专业人士。 使用场景及目标:该模型适用于自动完成代码、错误修复、竞争编程等问题解决,尤其适用于处理复杂的长文本代码片段,有助于提高程序开发效率并减少人工成本;同时也可用于研究开放源代码的大规模语言模型及其应用潜力。 其他说明:作者团队通过对多个基准数据集进行全面评估,验证了DeepSeek-Coder-V2在各种实际应用场景中的优越性和竞争力。此外,该项目已向社区公开所有成果及代码,允许商业应用。
DeepSeek-Coder-V2 震撼发布:打破闭源模型在代码智能领域的坚固壁垒,引领开源新风向
资源下载链接为: https://pan.xunlei.com/s/VOYle0RdoxYaqSf-4pitI68NA1?pwd=2wvu DeepSeek-Coder-V2 是一款开源混合专家(MoE)代码语言模型,在特定代码任务中性能可与 GPT-4 Turbo 比肩。它基于 DeepSeek-V2 中间检查点进一步预训练,额外融入 6 万亿个令牌,大幅提升了编码与数学推理能力,同时在一般语言任务上保持相近性能。相较于 DeepSeek-Coder-33B,其在代码相关任务各维度、推理及通用功能上均有显著进步,还将支持的编程语言从 86 种扩展至 338 种,上下文长度从 16K 提升至 128K。在标准基准测试中,它在编码和数学基准测试上的表现优于 GPT-4 Turbo、Claude 3 Opus、Gemini 1.5 Pro 等闭源模型,支持的编程语言列表可通过相关渠道查询。 基于 DeepSeekMoE 框架,发布了 16B 和 236B 参数版本的 DeepSeek-Coder-V2,仅向公众开放 2.4B 和 21B 活动参数,包含基础模型与指令模型。 评估涵盖代码生成、代码完成、代码修复、数学推理、通用自然语言、上下文窗口等维度,具体结果可查看 Hugging Face 模型存储库中的 tokenizer_config.json。 聊天模板示例中,可添加可选系统消息,且最后一轮对话 “助理:” 冒号后无空格。16B-Lite 模型若此处加空格,可能出现英语问题获中文回复、响应含乱码文本、回答重复过多等情况;Ollama 旧版本存在该问题(详见相关 issue),最新版本已修复。 代码库遵循 MIT 许可证,DeepSeek-Coder-V2 基础 / 指令模型的使用受模型许可证约束,该系列(含 Base 和 Instruct 版本)支持商业使用。 相关引文




