

 存算一体开发者

AI时代前瞻系列—从文本到图像:DALL-E与MidJourney的技术解读
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
在人工智能的广阔领域中,从文本生成图像(Text-to-Image Generation)的技术取得了显著的进展。DALL-E和MidJourney作为这一领域的代表性模型,展示了强大的生成能力和广泛的应用前景。本文将深入解读这两种技术的原理、架构和实现,并通过代码实例展示其具体应用。
一、DALL-E的技术解析
DALL-E是OpenAI开发的一种基于Transformer架构的生成模型,能够根据文本描述生成高质量的图像。DALL-E的名字源于艺术家Salvador Dalí和动画角色Wall-E,体现了其在创造性和技术方面的融合。
1.1 DALL-E的架构
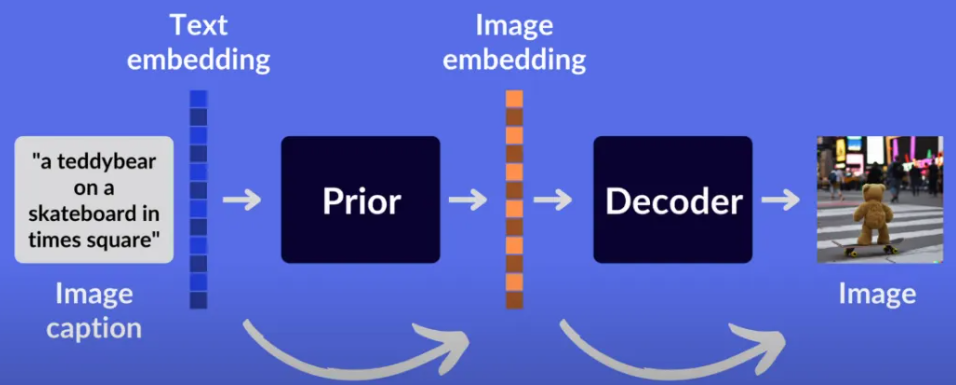
DALL-E的核心技术是Transformer,它是一种序列到序列的神经网络模型,最早用于自然语言处理任务。DALL-E通过对大规模文本和图像数据进行训练,学会了将文本描述映射到图像空间。
架构要点:
- 文本编码:DALL-E首先将输入的文本描述编码为一系列向量表示。
- 图像生成:然后,使用这些文本编码向量作为条件,生成图像的像素值。
- 自回归模型:DALL-E采用自回归的方式逐步生成图像,即每一步生成一个像素或一块像素区域,直到完成整个图像。
1.2 DALL-E的实现
以下是一个简单的代码示例,演示如何使用OpenAI的DALL-E模型生成图像:
import openai

# 设置API密钥
openai.api_key = 'your-api-key'

# 定义文本描述
text_description = "A two-story pink house shaped like a shoe."

# 生成图像
response = openai.Image.create(
    prompt=text_description,
    n=1,
    size="1024x1024"
)

# 获取图像URL
image_url = response['data'][0]['url']
print("Generated Image URL:", image_url)
二、MidJourney的技术解析
MidJourney是一个基于生成对抗网络(GANs)的文本生成图像模型,其目标是实现更高的图像逼真度和多样性。MidJourney通过对抗训练(adversarial training),使生成器(Generator)和判别器(Discriminator)相互竞争,从而提升生成图像的质量。
2.1 MidJourney的架构
MidJourney的架构由两个主要部分组成:生成器和判别器。
架构要点:
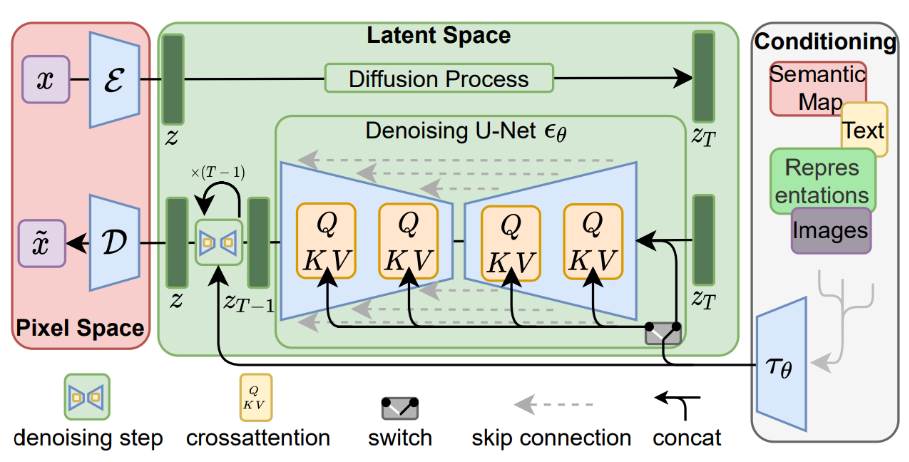
- 生成器:接受文本描述并生成相应的图像。
- 判别器:判断生成的图像是否真实(即来自训练数据集)或虚假(即生成器生成)。
- 对抗训练:生成器和判别器通过对抗训练共同进步,使生成器生成的图像越来越逼真,判别器越来越难以分辨。
2.2 MidJourney的实现
以下是一个简单的代码示例,演示如何使用MidJourney模型生成图像(假设我们有一个预训练的MidJourney模型):
import torch
from torchvision.utils import save_image
from midjourney import MidJourneyModel

# 加载预训练模型
model = MidJourneyModel()
model.load_state_dict(torch.load('midjourney_model.pth'))

# 定义文本描述
text_description = "A futuristic cityscape with flying cars."

# 生成图像
generated_image = model.generate_image(text_description)

# 保存生成的图像
save_image(generated_image, 'generated_image.png')
print("Generated Image saved as 'generated_image.png'")
三、DALL-E与MidJourney的比较
3.1 模型架构比较
- DALL-E:基于Transformer的自回归模型,更擅长捕捉文本与图像之间的复杂关系。
- MidJourney:基于GANs的对抗模型,生成的图像在逼真度和多样性方面具有优势。
3.2 应用场景比较
- DALL-E:适用于需要高质量文本到图像生成的场景,如艺术创作、广告设计等。
- MidJourney:适用于生成高逼真度图像的场景,如虚拟现实、电影特效等。
四、实现细节与性能优化
4.1 DALL-E的实现细节
DALL-E的实现涉及许多细节,包括数据预处理、模型训练和优化技术。以下是一些关键点:
数据预处理
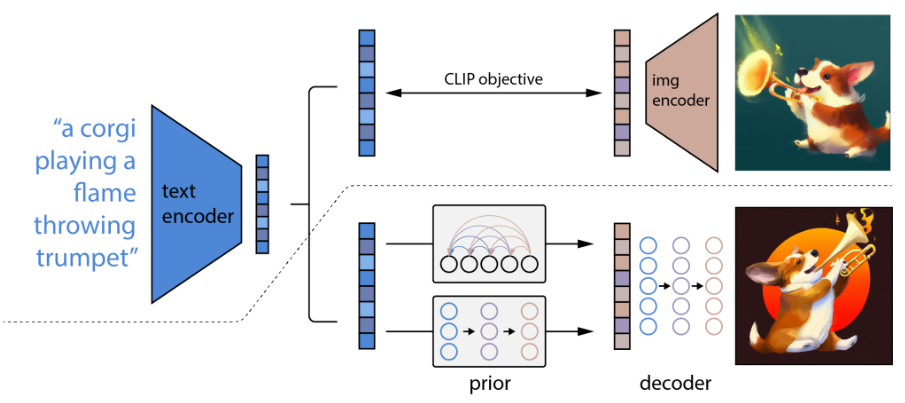
DALL-E需要大规模的图像-文本对数据集进行训练。在数据预处理中,首先将图像进行标准化处理,并将文本描述编码为一系列嵌入向量。
模型训练
DALL-E采用自回归方式生成图像,这需要大量的计算资源。训练过程中的关键是找到合适的超参数,如学习率、批量大小等,以确保模型的稳定训练。
import torch
from transformers import DALL_E

# 加载预训练的DALL-E模型
model = DALL_E.from_pretrained('dall-e')

# 定义文本描述
text_description = "A futuristic robot with neon lights."

# 文本编码
text_encoded = model.encode_text(text_description)

# 图像生成
generated_image = model.generate_image(text_encoded)

# 显示生成的图像
import matplotlib.pyplot as plt
plt.imshow(generated_image)
plt.show()
性能优化
为了提高DALL-E的生成速度和质量,可以采用以下优化技术:
- 混合精度训练:使用半精度浮点数(FP16)来加速训练过程,同时减少显存使用。
- 分布式训练:利用多台GPU进行分布式训练,加速模型的收敛。
- 知识蒸馏:将大型模型的知识转移到较小的模型中,以提升推理速度。
4.2 MidJourney的实现细节
MidJourney的实现基于生成对抗网络(GANs),其训练过程涉及生成器和判别器的对抗训练。以下是一些关键点:
数据预处理
与DALL-E类似,MidJourney需要大规模的图像-文本对数据集进行训练。预处理步骤包括图像的标准化和文本描述的编码。
模型训练
MidJourney采用GANs架构,需要同时训练生成器和判别器。训练过程中,生成器试图欺骗判别器,使其认为生成的图像是真实的,而判别器则不断提升自身的判别能力。
import torch
from torch import nn
from torchvision import transforms

# 定义生成器
class Generator(nn.Module):
    def __init__(self):
        super(Generator, self).__init__()
        # 定义生成器的网络结构
        self.model = nn.Sequential(
            # 网络层定义...
        )

    def forward(self, x):
        return self.model(x)

# 定义判别器
class Discriminator(nn.Module):
    def __init__(self):
        super(Discriminator, self).__init__()
        # 定义判别器的网络结构
        self.model = nn.Sequential(
            # 网络层定义...
        )

    def forward(self, x):
        return self.model(x)

# 加载预训练模型
generator = Generator()
generator.load_state_dict(torch.load('generator.pth'))

# 文本编码
text_description = "A serene mountain landscape with a river."
text_encoded = encode_text(text_description)

# 生成图像
generated_image = generator(text_encoded)

# 显示生成的图像
import matplotlib.pyplot as plt
plt.imshow(generated_image)
plt.show()
性能优化
为了提高MidJourney的生成质量和速度,可以采用以下优化技术:
- 谱归一化:在判别器中使用谱归一化,以稳定训练过程并提升生成图像的质量。
- 逐步增长:逐步增加生成器和判别器的网络深度,使模型能够生成更高分辨率的图像。
- 技巧训练:使用技巧训练(Tricks of the trade)如一阶平滑、标签平滑等,提升GANs的稳定性和性能。
4.3 实验与评估
在实验和评估方面,需要使用各种指标来衡量生成模型的性能。常用的评估指标包括:
- 感知质量:通过人类评估员对生成图像的主观评分来衡量图像质量。
- FID(Fréchet Inception Distance):通过计算生成图像与真实图像在Inception网络中的特征分布差异来评估图像质量。
- IS(Inception Score):通过Inception网络对生成图像的分类置信度来评估图像多样性和质量。
from torchvision.models import inception_v3
from torchmetrics.image.fid import FrechetInceptionDistance
from torchmetrics.image.inception import InceptionScore

# 加载Inception模型
inception_model = inception_v3(pretrained=True)

# 计算FID
fid = FrechetInceptionDistance()
fid_score = fid(real_images, generated_images)

# 计算IS
is = InceptionScore(inception_model)
is_score = is(generated_images)

print("FID Score:", fid_score)
print("Inception Score:", is_score)
五、应用与前景
5.1 现实应用
文本生成图像技术已经在多个领域展现出广泛的应用前景:
- 创意设计:艺术家和设计师可以利用DALL-E和MidJourney快速生成创意图像,提升创作效率。
- 广告与营销:营销人员可以根据文案生成相关图像,用于广告设计和社交媒体营销。
- 游戏与娱乐:游戏开发者可以使用这些技术生成游戏场景和角色,提高游戏的多样性和沉浸感。
5.2 未来发展
随着技术的不断进步,文本生成图像的质量和速度将进一步提升。未来可能的发展方向包括:
- 更高分辨率:生成更高分辨率和细节丰富的图像。
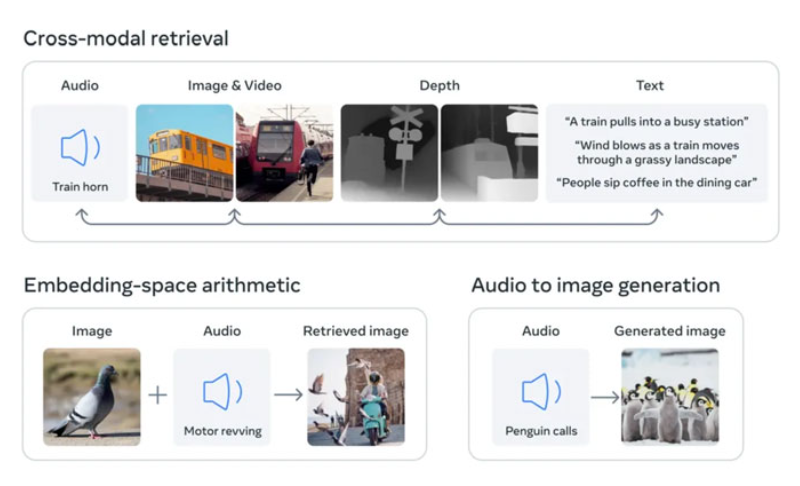
- 多模态融合:结合其他模态的数据(如声音、视频),生成更加丰富的多媒体内容。
- 自适应生成:根据用户的反馈和偏好,动态调整生成图像的风格和内容。
六、结语
从文本到图像的生成技术是人工智能领域的一大突破,DALL-E和MidJourney作为这一技术的代表,展示了各自的独特优势和广泛的应用前景。DALL-E基于Transformer架构,擅长捕捉文本与图像之间的复杂关系,生成高质量和富有创意的图像;MidJourney基于生成对抗网络(GANs),通过对抗训练提升图像的逼真度和多样性。
通过详细的技术解析,我们了解了DALL-E和MidJourney在数据预处理、模型训练和性能优化等方面的实现细节。此外,通过代码实例展示了如何使用这些模型生成图像,进一步增强了对其实际应用的理解。
在实验与评估方面,常用的感知质量、FID和IS等指标有助于衡量生成模型的性能,为模型优化提供了重要参考。
现实应用中,文本生成图像技术已经在创意设计、广告与营销、游戏与娱乐等领域展现出广泛的应用前景。未来,随着技术的不断进步,文本生成图像的质量和速度将进一步提升,发展方向包括更高分辨率、多模态融合和自适应生成等。
总之,DALL-E和MidJourney作为文本生成图像技术的先锋,展示了人工智能在创造性和技术领域的巨大潜力。未来,这一技术将继续发展,并在更多领域中发挥重要作用,为我们的生活和工作带来更多创新和便利。
相关推荐
AI绘画软件(Stable Diffusion、Midjourney、DALL-E 2)部署与开发指南
项目总结 本文详细介绍了Stable Diffusion、Midjourney和DALL-E 2等AI绘画软件的部署、训练模型、安装、原理、提示词合集、API开发和插件开发。通过这些步骤和示例代码,读者可以快速上手并开始使用这些强大的AI绘画工具进行创作和开发。 - **Stable Diffusion**:开源的扩散模型,可以本地部署和训练,适合需要自定义模型的用户。 - **Midjourney**:基于云服务,使用方便,但细节未公开。 - **DALL-E 2**:基于OpenAI API,提供强大的文本到图像生成能力,适合需要快速生成高质量图像的应用。 这些AI绘画软件为创作者和开发者提供了强大的工具,能够极大地提升工作效率和创作灵感。希望本文能为读者提供有价值的参考,帮助其更好地利用AI绘画技术。
从被动审核到主动风控:构建下一代视频内容安全体系
内容安全是数字平台运营的基石,其核心原理在于通过技术手段对用户生成内容进行风险识别与管控。随着AIGC技术的爆发式增长和短视频、直播等富媒体形态的普及,传统基于关键词过滤和人工复审的被动式审核模式已难以应对指数级增长的内容量和日益隐蔽的违规形式,如深度伪造和对抗性样本。这推动了技术价值从单纯的内容合规判断,向覆盖内容生产、上传、分发全链路的主动风险评估与拦截演进。其核心应用场景已扩展至实时直播风控、AIGC生成内容识别以及满足全球日益收紧的合规要求。本文探讨的主动风控范式,正是通过融合多模态内容理解、动态策
AI绘画新纪元:Stable Diffusion、Midjourney与DALL-E 2的深度解析与实战指南.pdf
Stable Diffusion、Midjourney、DALL-E 2等AI绘画软件的兴起,不仅为艺术家和设计师提供了全新的创作工具,也为科学研究、教育娱乐等领域带来了无限可能。随着技术的不断进步和开源社区的蓬勃发展,我们有理由相信,AI绘画的未来将更加光明,创意与技术的融合将开启一个全新的艺术时代。 对于开发者而言,掌握这些AI绘画软件的部署、训练、安装及API开发技能,将极大地提升个人竞争力和创新能力。同时,积极参与社区建设,分享经验、贡献插件,也是推动AI绘画技术发展的重要途径。让我们携手共进,探索AI绘画的无限可能!
了解Stable Diffusion、Midjourney和DALL-E 2等AI绘画软件的部署
了解Stable Diffusion、Midjourney和DALL-E 2等AI绘画软件的部署、训练模型、安装、原理、提示词合集、API开发和插件等方面的信息,可以帮助您更好地使用这些工具。以下是详细的介绍,这些AI绘画软件在不同场景下各有优势,用户可以根据具体需求选择合适的工具。如果需要更多的技术细节或实际操作步骤,可以参考官方文档或相关技术博客。
AI绘画Stable Diffusion、Midjourney、DALL2等AI绘画基础知识
AI绘画Stable Diffusion、Midjourney、DALL2等AI绘画基础知识





