- 1. 回首过去
- 1.1 我为什么选软件工程
- 1.2 我的入门路径
- 1.3 一些“长记性”的小事故
- 1.4 第一次“工程化”的转折
- 1.5 我理解的“好后端”
- 2. 立足当下
- 2.1 我已经能独立完成的事情
- 2.2 我打算系统补齐的短板
- 2.3 我在用的工作方式
- 2.4 我觉得还不够的地方
- 3. 展望未来
- 3.1 这学期的目标
- 3.2 里程碑与验收标准
- 3.3 输出与复盘的形式
- 4. 思维导图和学习路线
- 4.1 思维导图
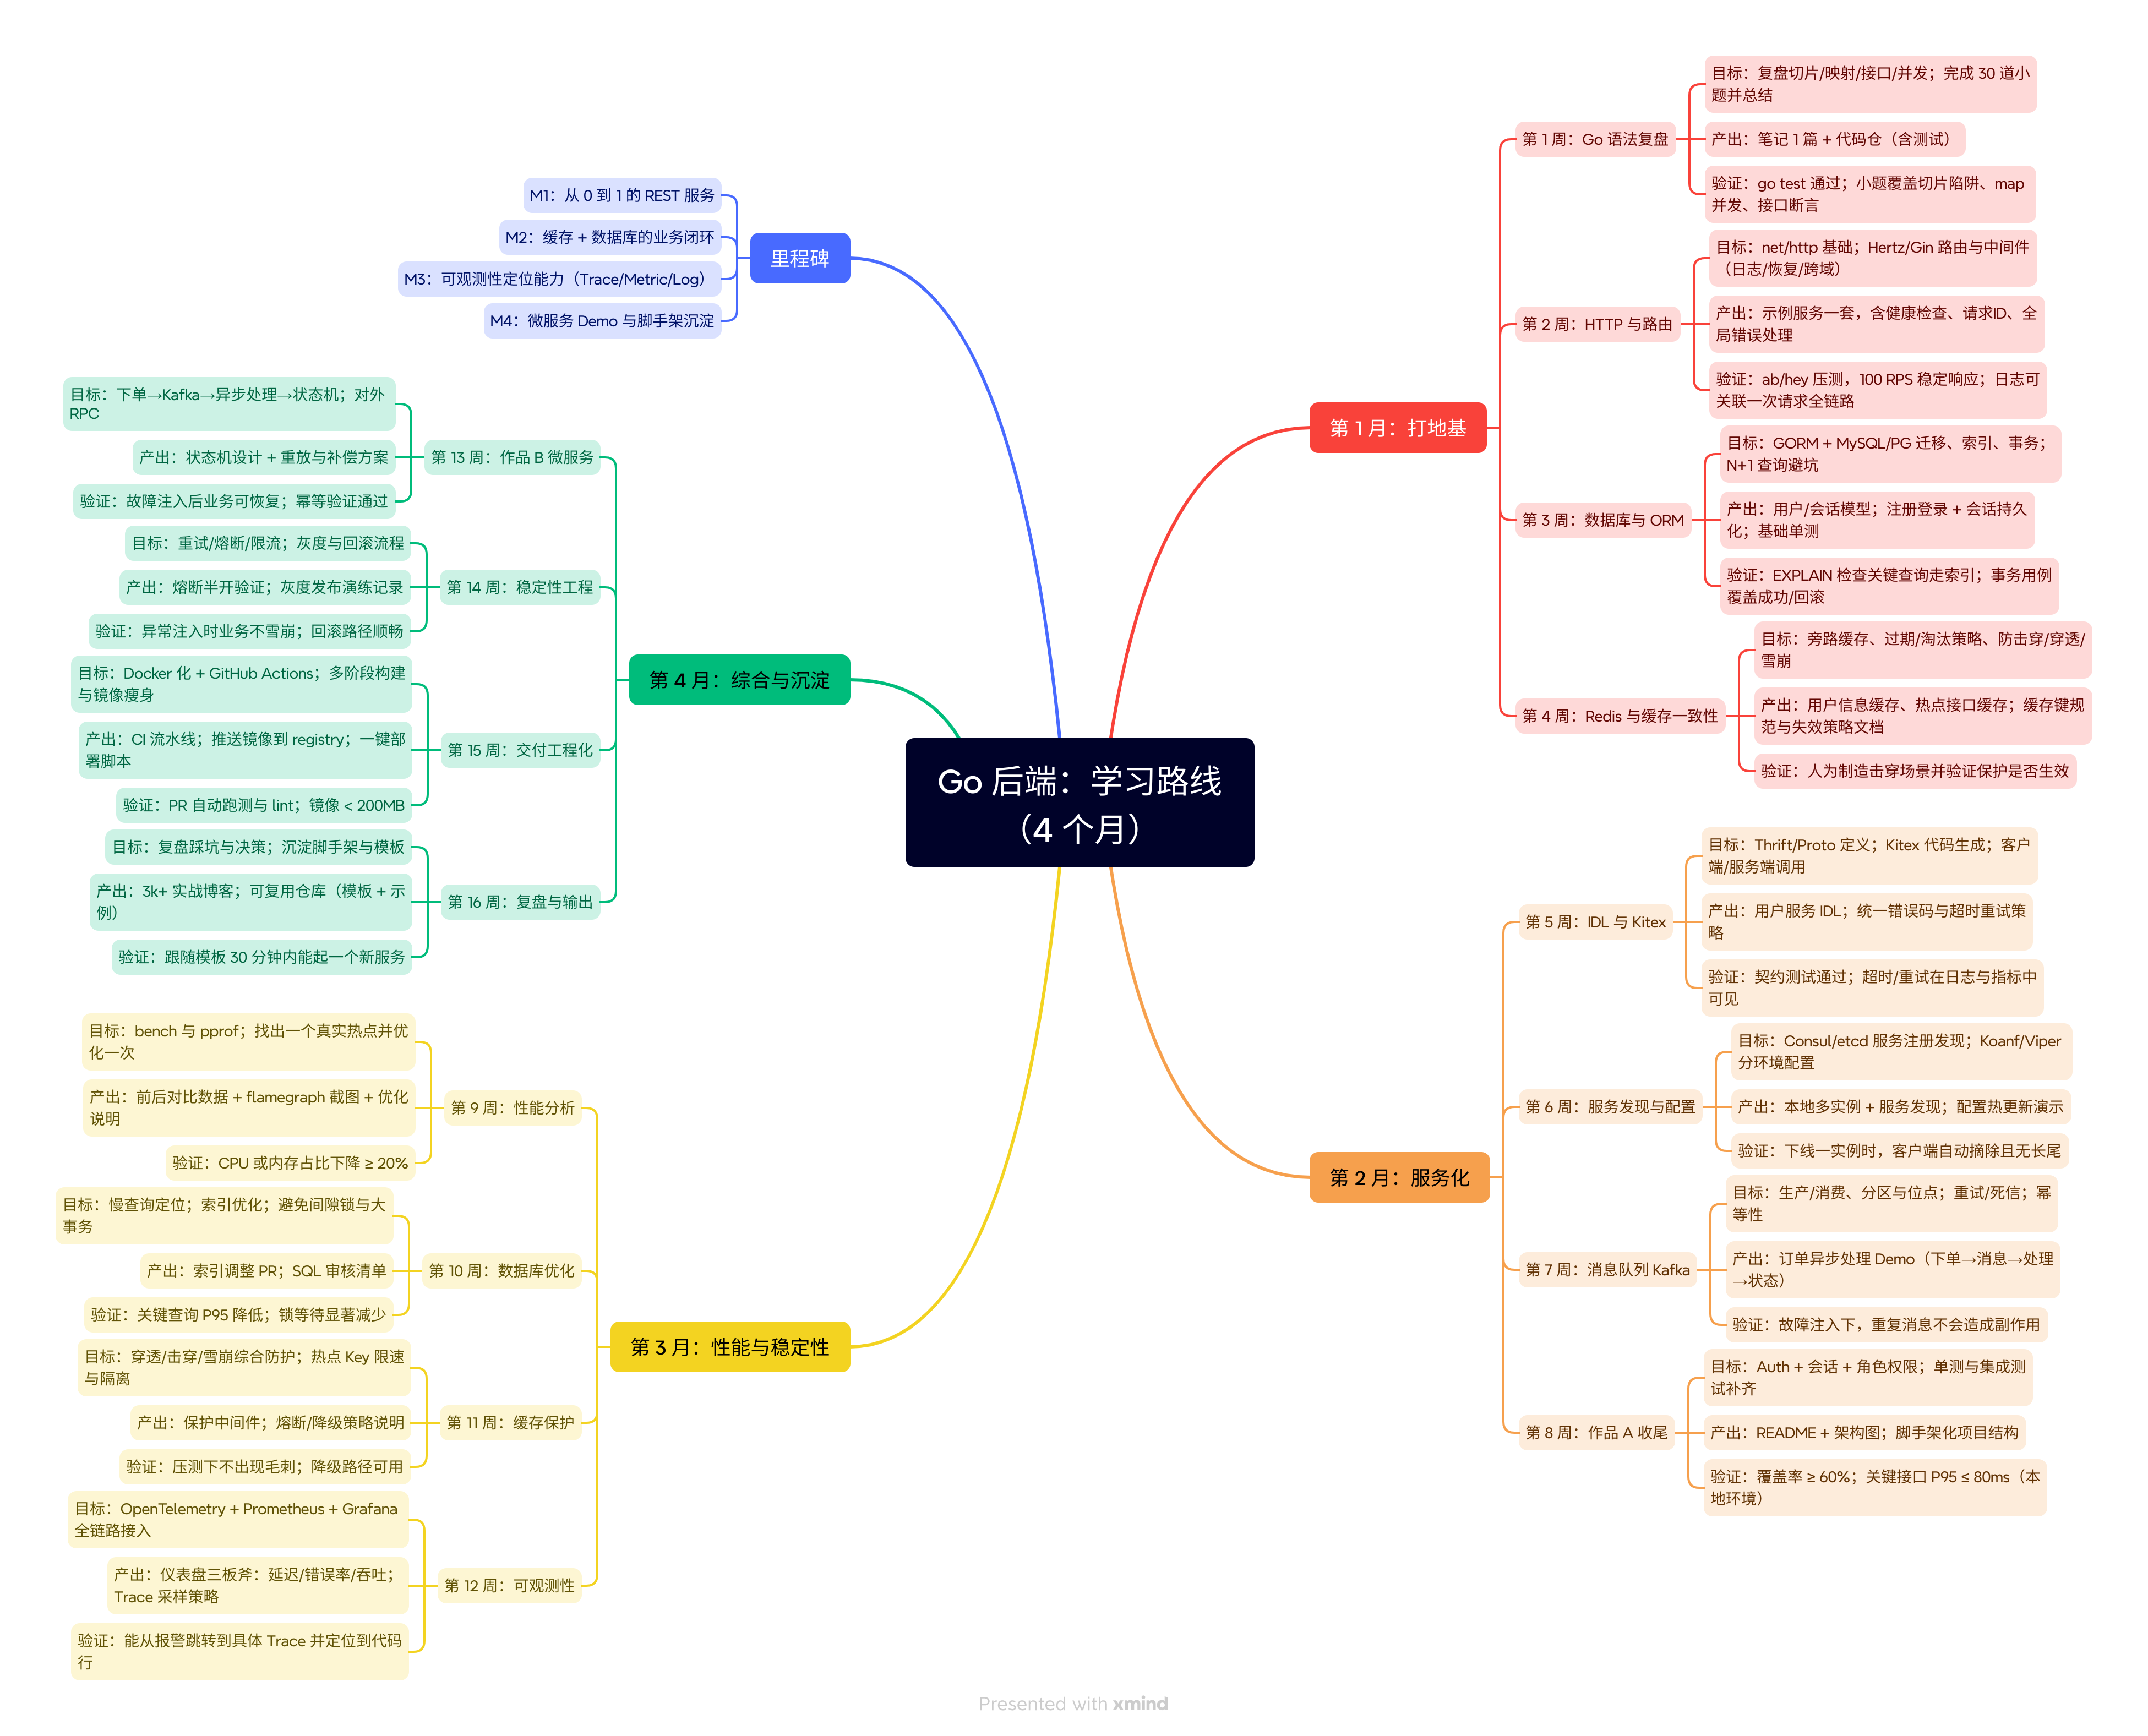
- 4.2 学习路径
1. 回首过去
1.1 我为什么选软件工程
高中时只凭直觉觉得写程序很酷,真正接触后发现“酷”背后是大量细节:从一个请求怎么走到数据库、到一次错误怎么被定位、再到一次发布怎么确保能回滚。越了解越觉得有意思——它像做实验,证据链齐了,问题就能被复现和修复。
1.2 我的入门路径
一开始先把 Go 基础语法打牢:切片、map、结构体、接口、指针这些该踩的坑基本都踩了。随后写过小爬虫练习 I/O 与并发;再往前是 net/http + Gin/Hertz 做基本 Web 服务,配上登录、会话、简单的权限。接着摸到 RPC(Kitex + Thrift / gRPC),再加入数据库 MySQL/PostgreSQL + GORM 和 Redis 缓存,最后尝试 Kafka 做异步处理。
1.3 一些“长记性”的小事故
在学习过程中,我遇到过许多印象深刻的事故:
- 切片扩容与“共享底层数组”导致的数据被意外篡改;
- 对 map 进行并发写,直接 panic;
- GORM 里一次不小心触发了 N+1 查询,接口延迟肉眼可见;
- 缓存键没设计好,热点接口被打穿;
- 事务里夹了外部网络调用,锁时间拉长。
这些小事故让我意识到:工程经验不是背来的,而是被坑出来的。
1.4 第一次“工程化”的转折
把项目整理成 domain / repo / usecase / infra 的分层后,很多事变得清晰:哪里该放业务、哪里该放 IO;再加上统一的配置(env),Makefile 做任务编排,日志收敛成结构化输出,出问题的时候心里就不慌了——至少知道从哪几步查起。
1.5 我理解的“好后端”
不是把接口写出来就算交差,而是能解释清楚“为什么这样设计”,出了问题拿得出证据(日志、指标、Trace),做了优化讲得出收益(对比数据)。这也是我给自己设的方向。
2. 立足当下
2.1 我已经能独立完成的事情
目前,我已经能够 Go 实现这些基本的事务:
- 用 Hertz/Gin 写 REST 接口:分组路由、参数校验、统一错误、简单鉴权、健康检查;
- GORM 基本 CRUD/迁移/关联,能读懂生成的 SQL;
- 在 MySQL/PG 里做表结构设计与索引落地,能用 EXPLAIN 看执行计划;
- 把 Redis 用起来:字符串/哈希/ZSet 基本模型,做简单缓存与过期策略;
- 写 Kitex + Thrift 的服务定义与客户端调用,配置超时与重试;
2.2 我打算系统补齐的短板
我仍有许多需要加强的地方:
- 缓存一致性与热点保护:穿透/击穿/雪崩的综合防护;
- 事务与锁:对隔离级别、行锁/间隙锁、慢查询定位与索引设计再系统化一遍;
- 可观测性与稳定性工程:OpenTelemetry/Jaeger、Prometheus/Grafana,以及熔断/限流/降级这些“保命线”;
- 交付工程:把 Docker 化与 GitHub Actions 常规化,做到一键构建与回滚。
2.3 我在用的工作方式
合理的工作方式是节约时间,更延长生命:
- 项目结构尽量遵循整洁架构,减少互相引用;
- 提交信息用 Conventional Commits,回看历史清楚;
- 常见命令都收进 Makefile(比如
make lint/test/run),减少“口头约定”; - 日志尽量结构化,重要操作打上 request-id,便于串联。
2.4 我觉得还不够的地方
学无止境,路漫漫其修远兮:
- Kafka 消费位点与幂等等价证明还需要更多实践;
- OpenTelemetry 的采样率与成本控制需要经验值;
- 复杂 SQL 的索引策略(多列、覆盖索引、回表代价)需要更多真实案例。
3. 展望未来
3.1 这学期的目标
把一条“能上线的后端服务链路”走通:入口(HTTP/RPC)→ 服务(Hertz/Gin/Kitex)→ 数据(GORM + MySQL/PG)→ 缓存(Redis)→ 异步(Kafka)→ 观测(OTel + Prom + Grafana),并沉淀成可复用的脚手架。
3.2 里程碑与验收标准
- M1:从 0 到 1 的 REST 服务(统一错误、请求 ID、基础中间件齐活);
- M2:一个“缓存 + 数据库”的业务闭环(能说明一致性策略与失效设计);
- M3:一次完整的定位与优化闭环(前后对比数据 + flamegraph 截图);
- M4:一个微服务 Demo(含状态机与补偿)+ 可复用模板仓库。
3.3 输出与复盘的形式
每周固定输出 3 件事:
- 一段可运行的代码;
- 一张“说得清”的图(架构/时序/指标面板截屏);
- 一段简短复盘(问题—过程—验证—反思)。
这样到期末自然会有一份完整的实践报告。
4. 思维导图和学习路线
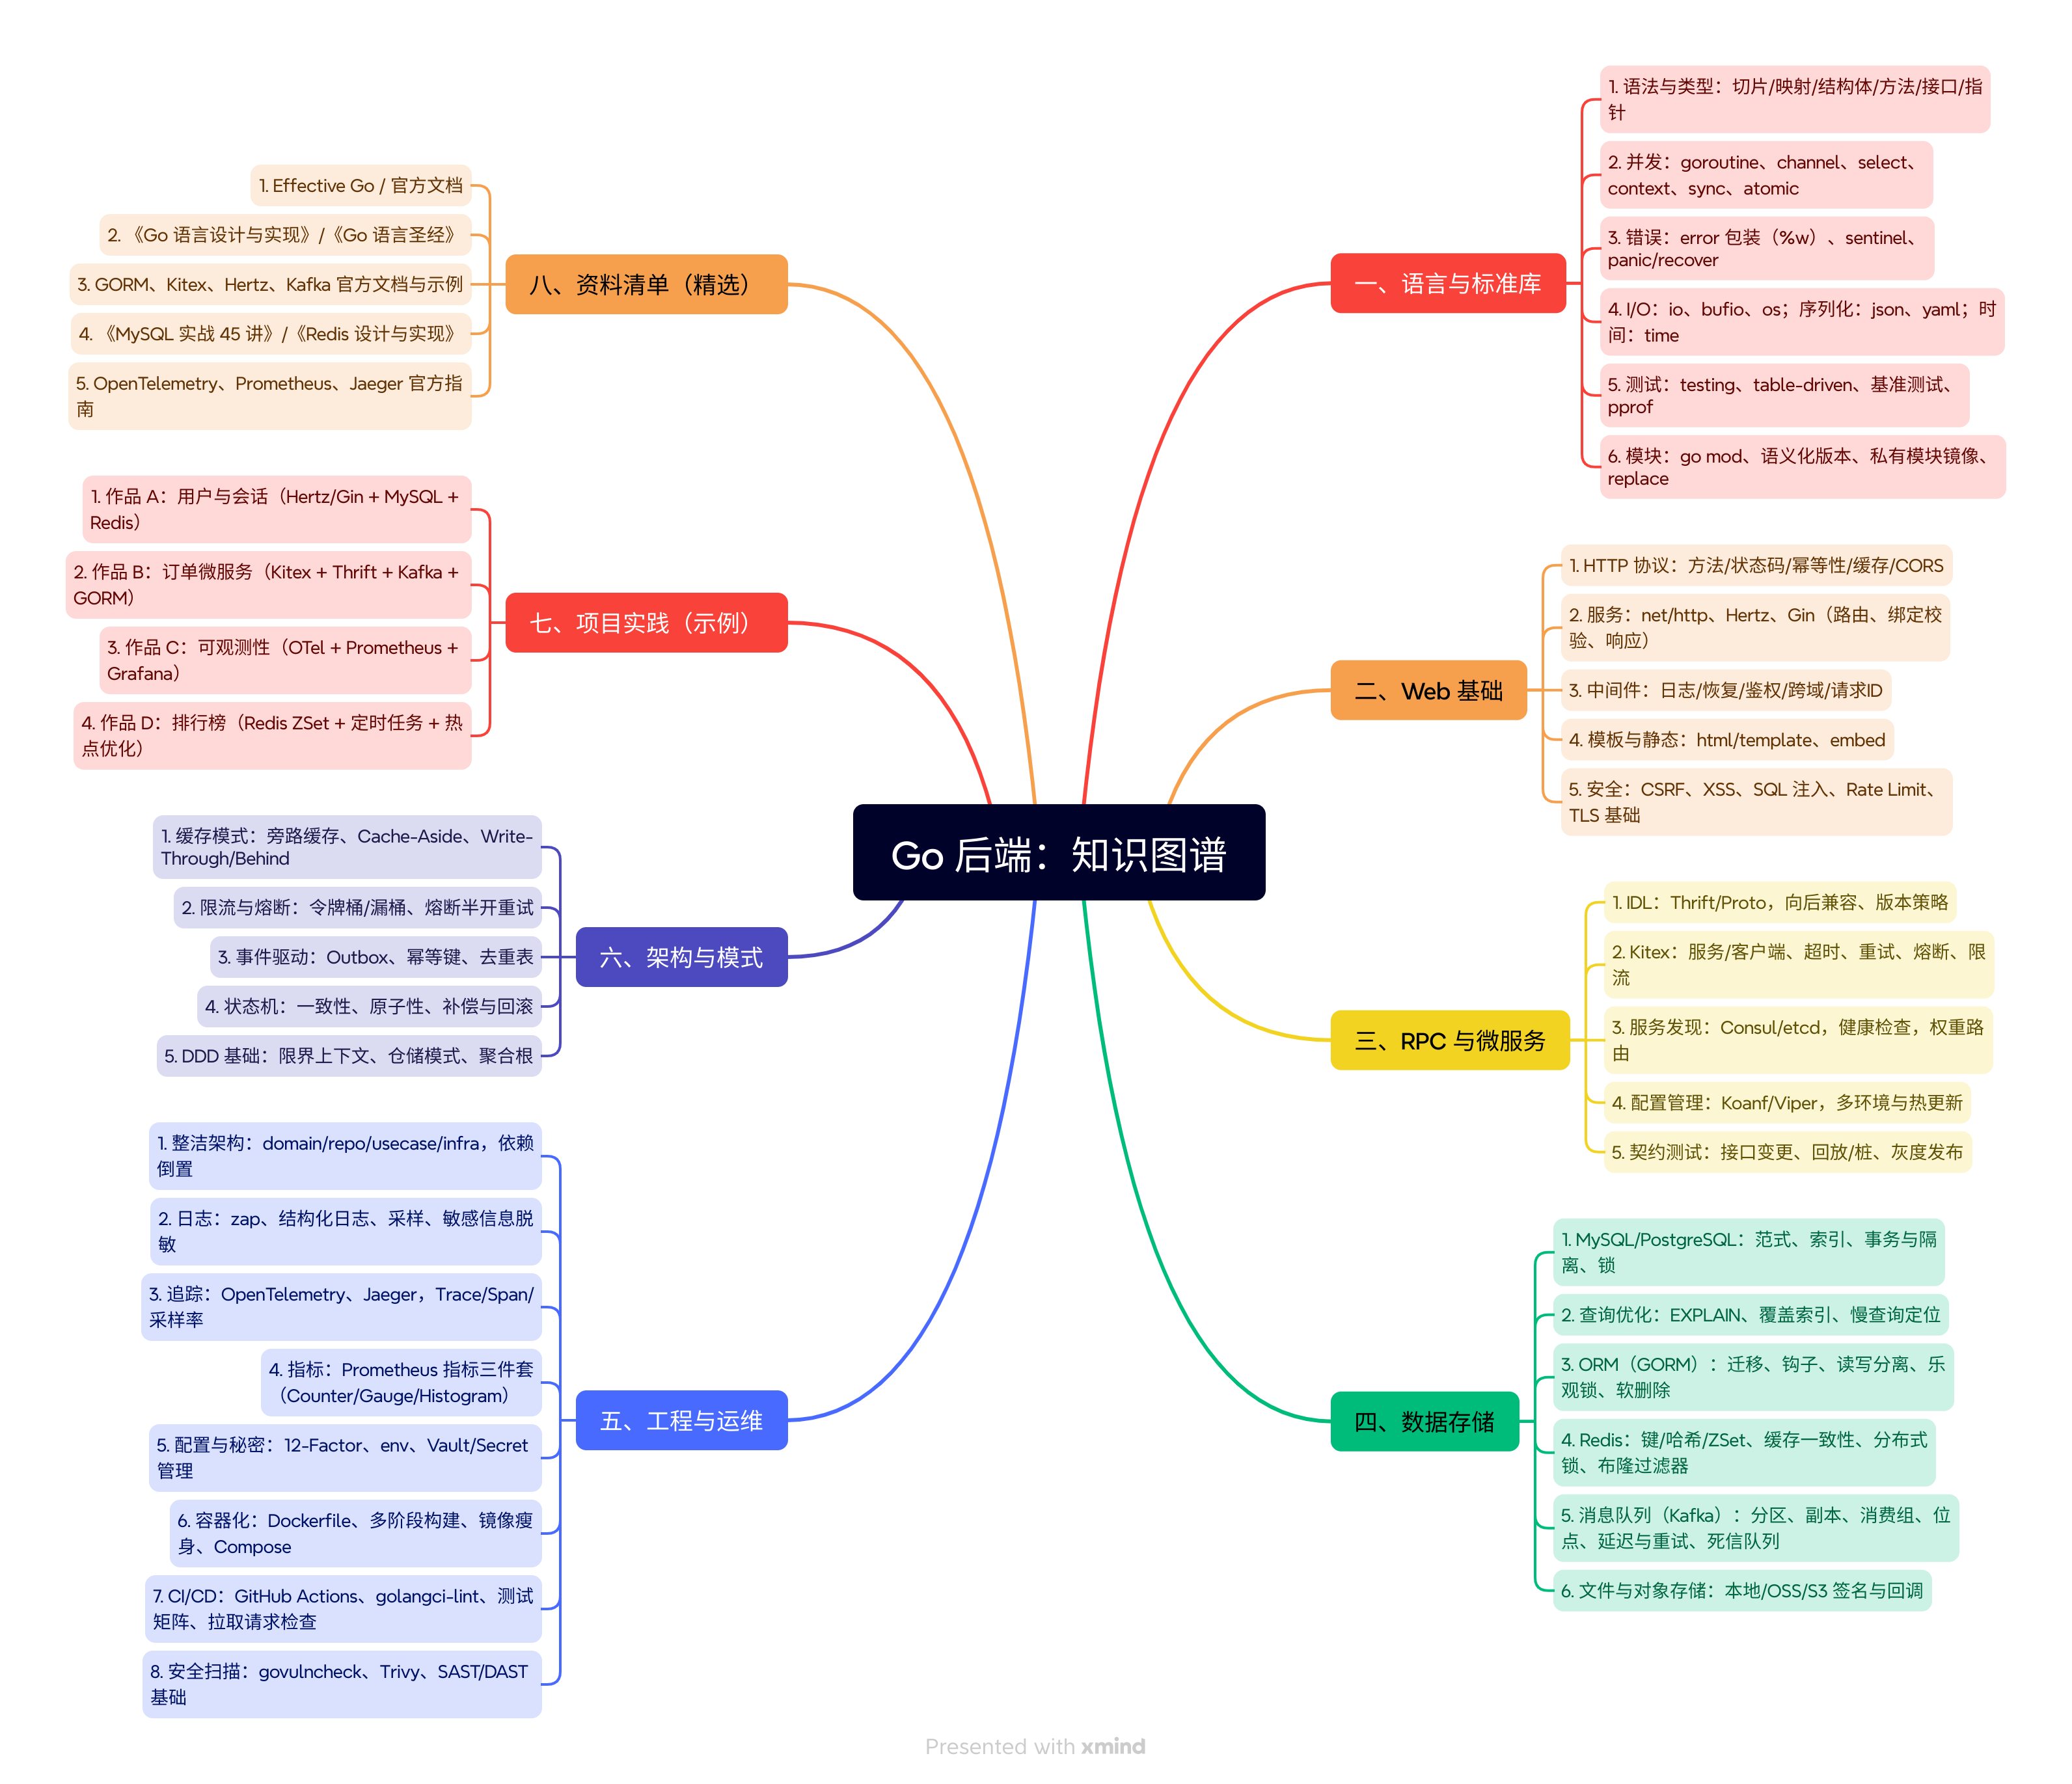
4.1 思维导图
4.2 学习路径


 发帖
 与我相关
 我的任务

 分享


