


309
社区成员
 发帖
 与我相关
 我的任务

 分享
2026 面向对象设计与构造第一单元总结博客(HW1~HW3)
一、前言
第一单元三次作业的核心任务,都是把“形式化文法下的表达式”转换为“可计算、可化简、可输出”的对象结构。
从 HW1 的单变量括号展开,到 HW2 的 exp、选择式、自定义函数,再到 HW3 的双变量、求导算子、递推函数,功能在持续增加,但我始终坚持同一条主线:
输入预处理 → 词法分析 → 语法解析(Expr/Term/Factor)→ 统一转 Poly 语义对象 → 化简/优化输出
回头看这三次迭代,最大的收获不是功能提高,而是逐步建立了可迭代架构的意识:新增需求尽量通过新增因子类和局部扩展实现,而不是大规模推翻重写。
二、基于度量分析程序结构
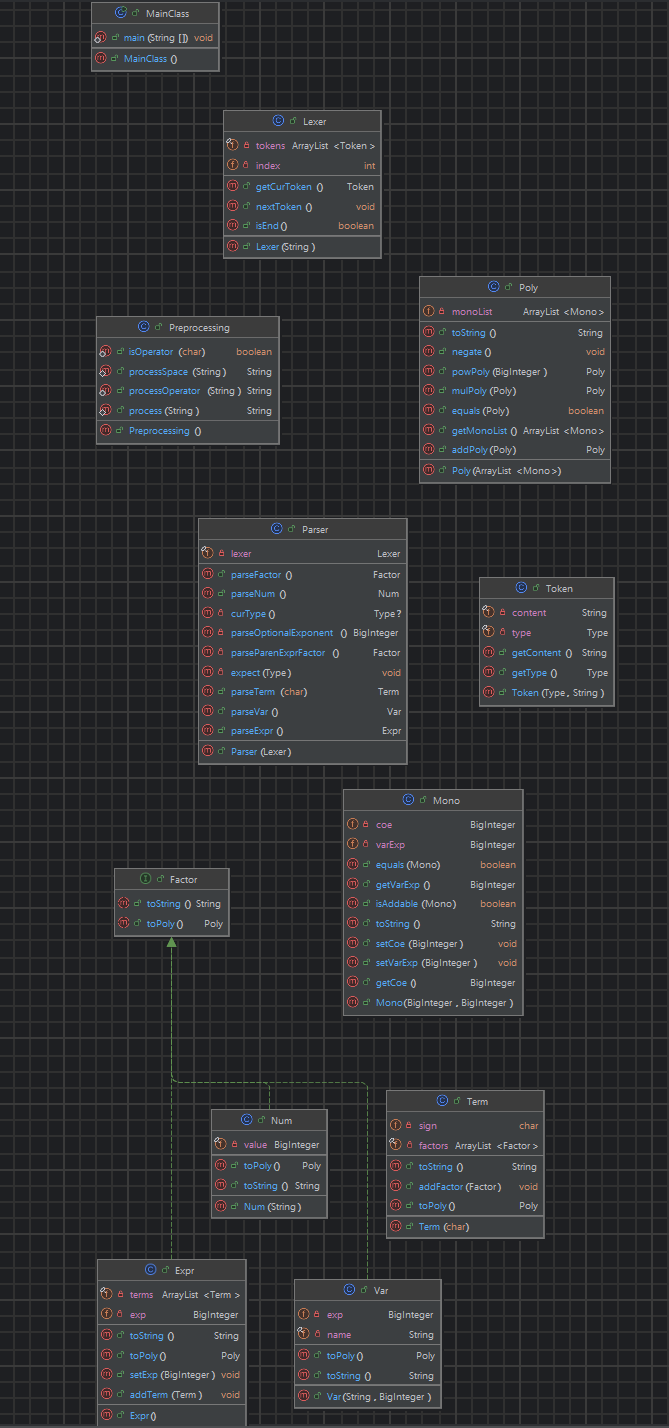
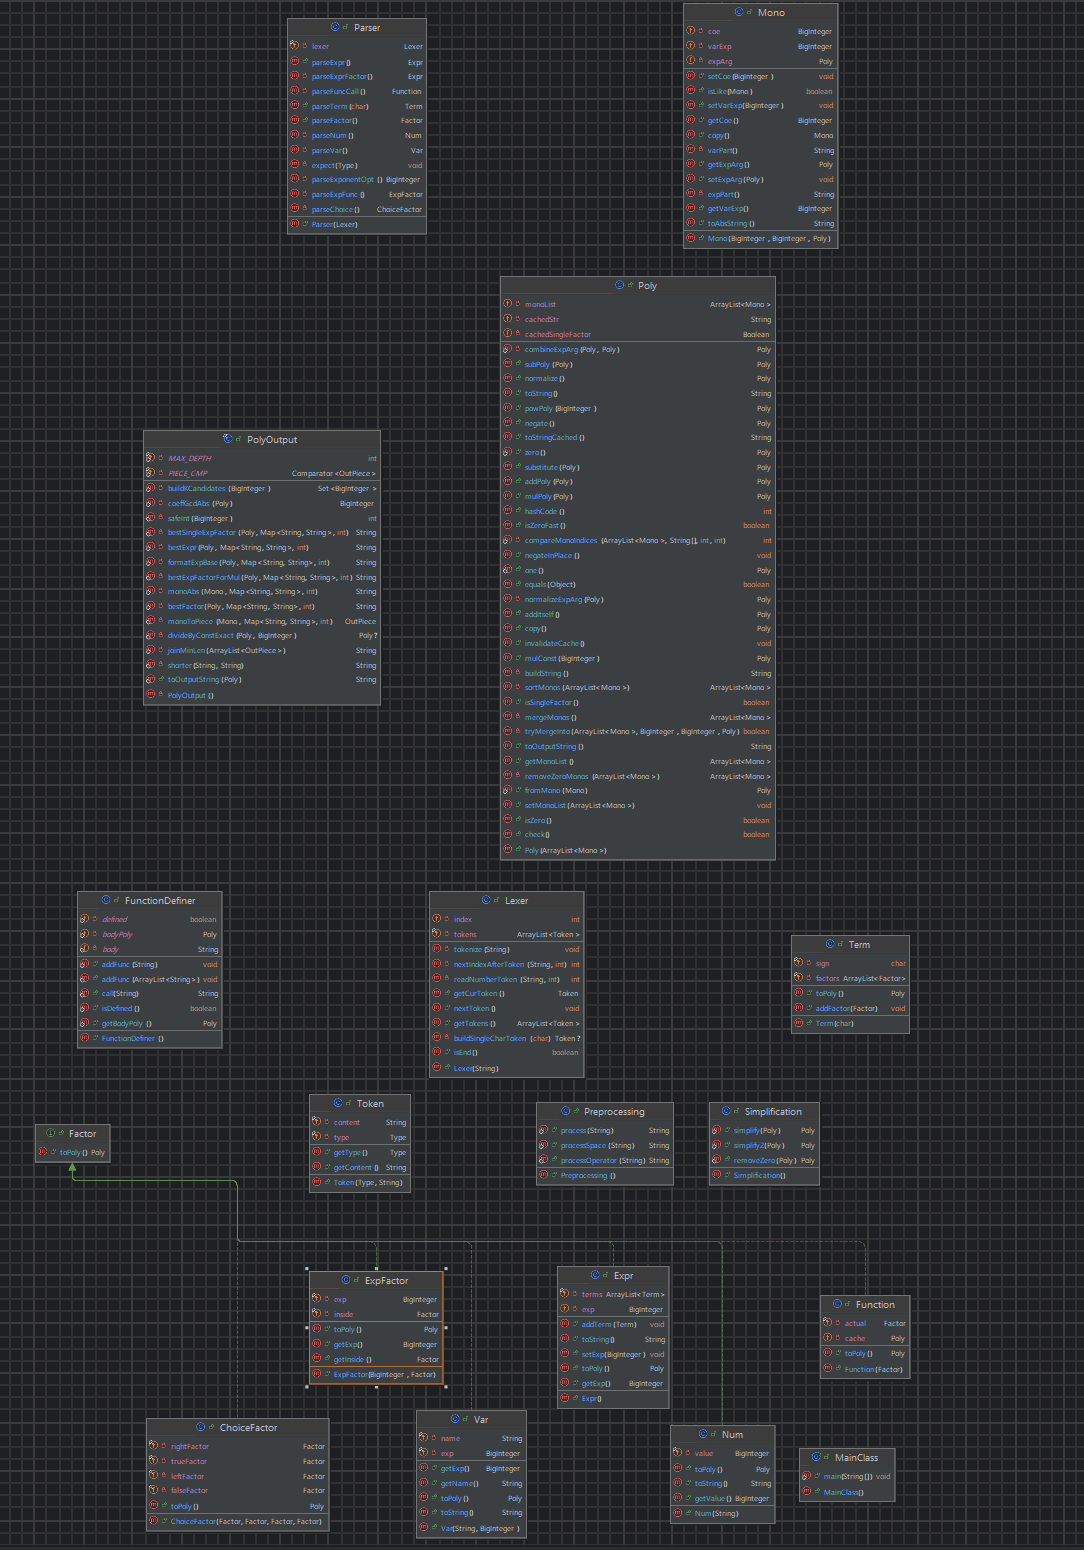
2.1 整体类图
第一次作业:
第二次作业:
第三次作业:
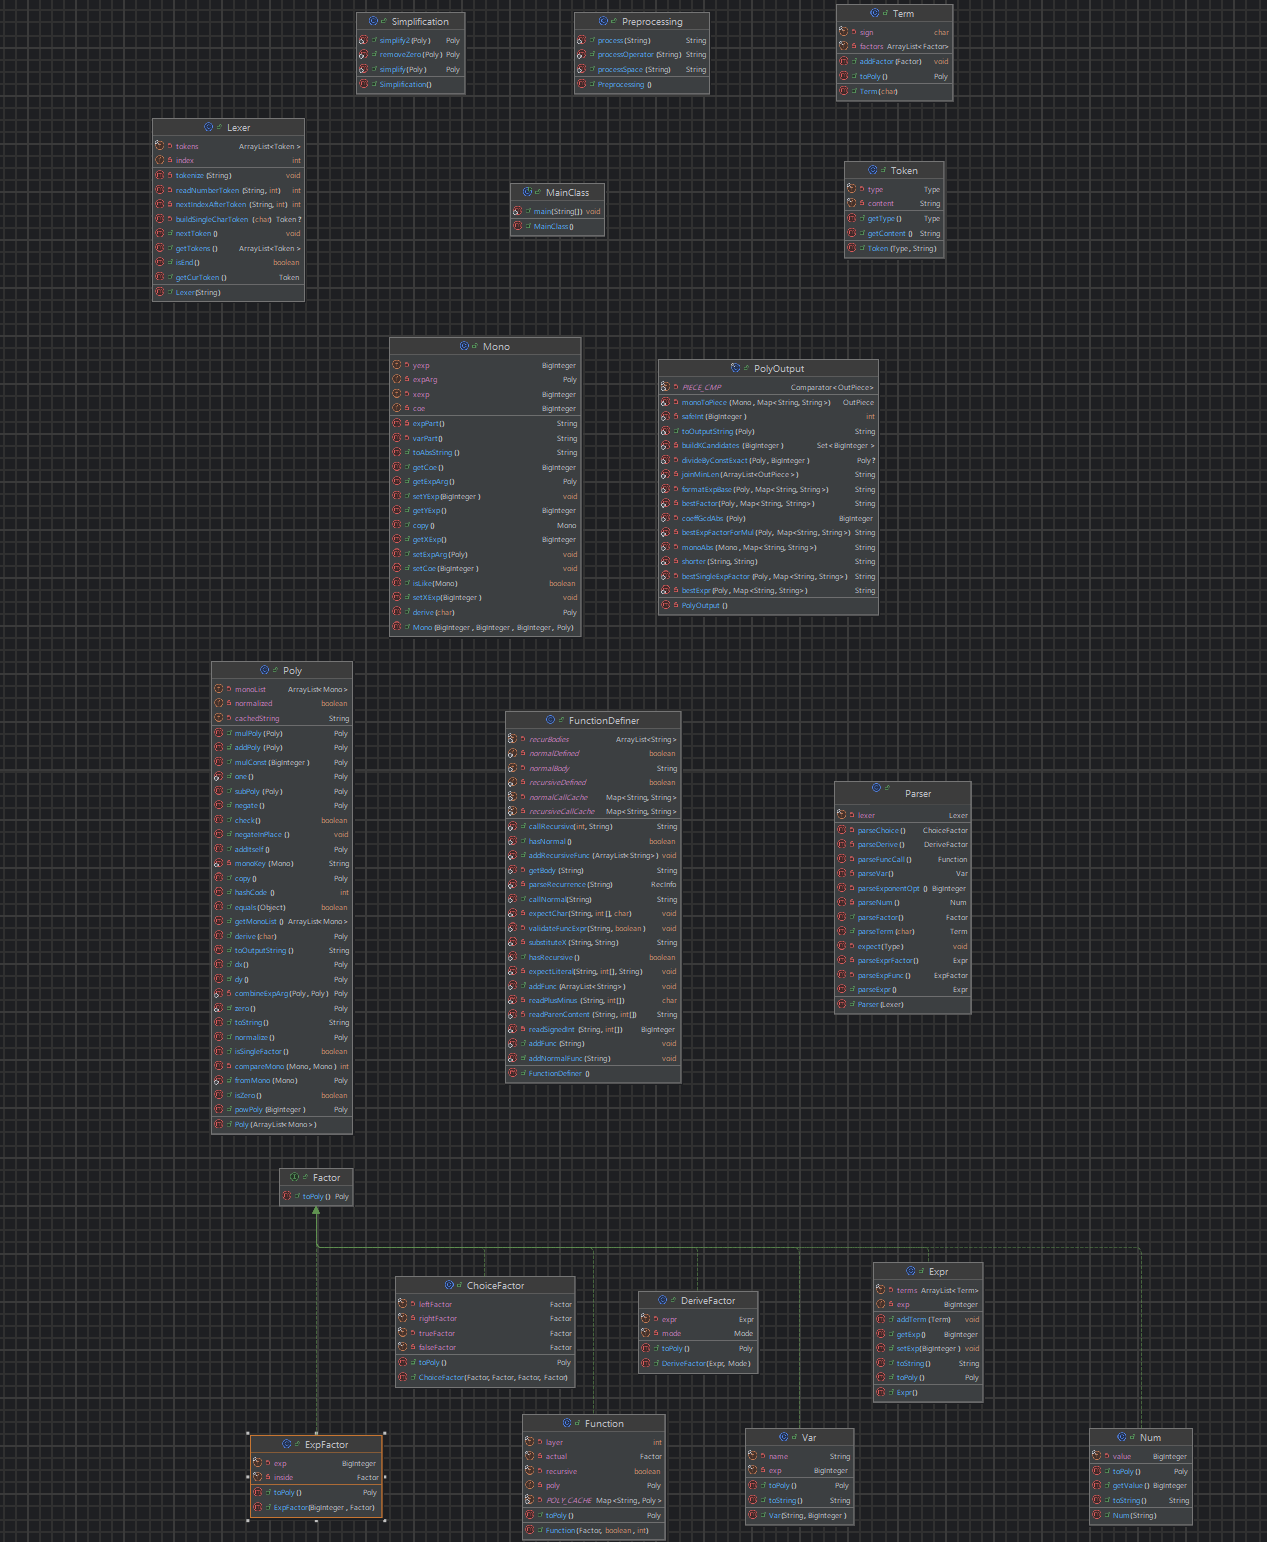
1)输入与预处理层
- MainClass:总流程驱动
- Preprocessing:去空白、规约连续 +/-
2)词法与语法层
- Lexer:把字符串切成 Token 流
- Token:词法单元定义
- Parser:递归下降,构造表达式结构
3)表达式对象层
- Expr:由多个Term构成,支持指数
- Term:由多个Factor相乘构成,带正负号
- Factor(接口)及其实现:
- Num、Var
- ExpFactor
- ChoiceFactor
- Function
- DeriveFactor(HW3)
4)代数核心层
- Mono:单项式
- HW1: (coe, varExp)
- HW2: (coe, varExp, expArg)
- HW3: (coe, xExp, yExp, expArg)
- Poly:多项式容器与运算内核(加减乘幂、代入、求导、归一化)
5)辅助与优化层
- FunctionDefiner:函数定义解析、缓存与替换
- PolyOutput:等价变换下的输出长度优化
- Simplification:封装归一化入口
2.2 规模与方法复杂度统计
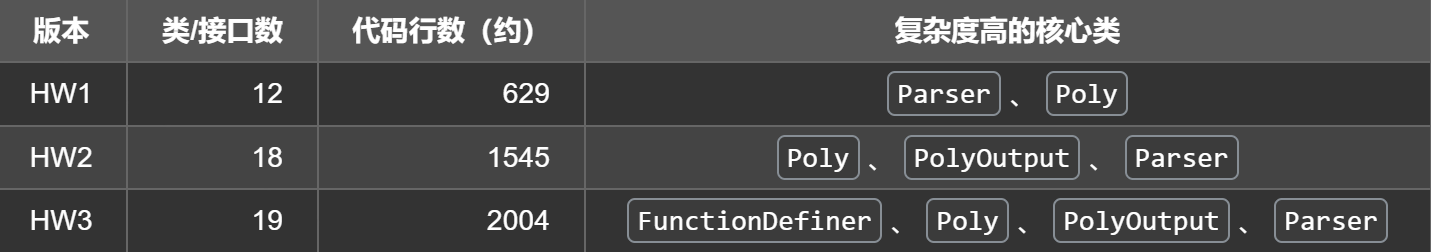
从规模上看,增长最明显的是 HW2/HW3 的“语义层 + 输出层”。
从复杂度上看,复杂方法高度集中在少数类中,呈现典型“长尾”分布:
- 低复杂方法:Num.toPoly、Var.toPoly、Term.toPoly
- 高复杂方法:FunctionDefiner.addRecursiveFunc、PolyOutput、Poly.normalize/addPoly/mulPoly
我的结构总体是“多数简单 + 少数重核”,这个分布本身是合理的,但风险在于:重核类一旦继续膨胀,维护成本会迅速上升。
2.3 OO 度量视角:内聚与耦合
内聚较好的类
- Num、Var、ChoiceFactor、Term:职责单一、行为短小,变更影响面小。
内聚中等类
- Parser、Poly:职责明确但分支多,属于“必要复杂”。
内聚不足的类(技术债)
- FunctionDefiner:同时承担定义解析、合法性校验、递推展开、替换、缓存,职责偏多。
耦合观察
- 主要耦合链路为:Parser → Factor实现 → Poly
- 这种语义耦合在本题中不可避免,但我通过 Factor.toPoly() 接口把耦合“收束”到统一转换点,避免了上层散落的类型判断。
三、三次作业的架构演进体验
3.1 HW1:先搭骨架,不做过度优化
HW1 的关键决策是把问题拆成两段:
1. 解析段:递归下降构建 `Expr/Term/Factor`
2. 计算段:统一转 `Poly`,再做加减乘幂与输出
这个决策的价值在后续迭代中被证明是正确的:功能再变,主流程没变。
当时我也有一些不足:
-Poly 合并项采用线性扫描,复杂度不够理想;
- Term.toPoly() 早期有状态副作用(后续已调整)。
3.2 HW2:第一次真正重构(exp/选择式/函数)
HW2 不只是“加三个语法点”,而是对数据模型提出了新要求。
我做的核心重构是:
(1)Mono结构升级
从 coe + x指数 升级为 coe + x指数 + exp参数,使 exp 能在代数层表示并参与运算。
(2)新增因子按接口接入
- ExpFactor.toPoly():实现 exp(A)^n = exp(n*A)、exp(0)=1
- ChoiceFactor.toPoly():通过 (A-B).normalize().isZero() 判定恒等
- Function.toPoly():实参代入函数体后再解析计算,并做缓存
(3)输出优化层独立
把“正确计算”和“更短输出”分开:
Poly 保证语义正确,PolyOutput 负责长度优化(记忆化 + 多候选比较)。
这次迭代后,我的代码进入可优化。
3.3 HW3:复杂语义接入(双变量/求导/递推)
HW3 的挑战主要是语义层:
(1)双变量扩展
Mono 改为 (coe, xExp, yExp, expArg)。
这个改动看似大,但由于上层接口稳定,迁移成本可控。
(2)求导算子
新增 DeriveFactor,统一处理 dx/dy/grad,最后都转成 Poly 上的求导:
- dx(E) → E.toPoly().dx()
- dy(E) → E.toPoly().dy()
- grad(E) → dx(E)+dy(E)
求导规则下沉到 Mono.derive(var),再由 Poly.derive 聚合,层次清晰。
(3)递推函数
FunctionDefiner 中预处理 f{0},f{1},f{n},并预展开到 f{2}...f{5},调用时做代换解析。
配合 Function 的 POLY_CACHE,明显减少重复解析开销。
3.4 重构前后对比
重构前,语义散在不同类,局部改动容易牵一发而动全身。
重构后,新增语义优先封装为新 Factor + 局部 Parser 分支,核心链路稳定。
这让我意识到:面向对象里,扩展点”比代码量更重要,扩展点设计得对,迭代就不会每次推倒重来。
3.5 新迭代场景:若增加 ln(...) / sin(...) / cos(...)
如果继续加通用函数及链式求导,我当前架构仍可继续迭代,但需做两件事:
1. 把 Mono 中对 expArg 的特化表示,升级为函数因子列表/映射
2. 将 FunctionDefiner 拆分为 DefParser + Validator + Expander + Cache 四个模块,提高内聚
也就是说,框架方向是对的,但要避免重核类继续变胖。
四、程序 bug 分析
4.1 我遇到/定位过的典型问题
问题1:函数代换的字符串污染风险(已修复) 早期如果直接字符级替换 x,可能误伤关键字片段。 后续我改成了按 Token 替换 VAR(x)(substituteX),只替换变量 token,不碰其他词法单元,问题解决。
问题2:缓存与可变对象的边界问题 在做缓存后,如果对象仍被原地修改,容易出现缓存失效或语义不一致。 我的修正策略是: 关键路径多返回新对象, normalize 后尽量只读, 对需要修改的地方显式新建对象,降低别名副作用。
问题3:输出优化递归过深导致性能不稳定 PolyOutput 的候选搜索在深嵌套表达式下会放大递归开销。 对应处理: 增加记忆化 key,控制拆分策略,防止爆炸式组合, 极端情况下允许退化到 canonical 输出,优先保证稳定。
问题4(互测中发现的bug):
对于样例:
1
f(x)=x+2*x^2+3*x^3+4*x^4+5*x^5*exp(x)
[(x==1)?f(f(f(f(f(f(f(f(f(x))))))))):f((x+1))]
程序无输出,运行超时。
正常来说,选择式因子中,条件为 x==1,x 与 1 不恒等(x-1 化简后不为零),因此应选择 false 分支 f((x+1))。true 分支共九层嵌套函数调用,不应被求值。程序应仅计算 f((x+1)) 并输出展开结果。
分析可知,导致错误原因有:函数调用采用字符串替换导致指数级膨胀,原始Function 类在构造时立即将实参转为字符串,通过文本替换将函数体中的 x 替换为实参字符串,再对替换后的字符串重新进行词法分析和语法解析。当函数体本身含有复杂结构(如多项式加 exp 项)时,每一层函数嵌套调用都会使字符串长度大幅增长。九层嵌套的 f(f(f(...f(x)...))) 会导致字符串呈指数级膨胀,词法分析和语法解析的时间开销随之爆炸式增长。即使选择式因子的条件判断结果为 false,原始代码在解析阶段就已经对 true 分支中的所有 Function 节点执行了构造,而构造过程中已经触发了完整的字符串替换和重新解析流程。所以九层嵌套的函数调用在条件判断之前就已经被完整展开,直接导致超时。同时,Poly 和 Mono 的深拷贝在嵌套结构中代价极高
原始 Mono 类在构造函数、copy 方法和 setExpArg 方法中均对 expArg 执行深拷贝。Poly 的 copy 方法递归调用每个 Mono 的 copy,形成递归深拷贝链。当 Poly 结构存在多层嵌套的 exp 参数时,单次深拷贝的时间复杂度与嵌套深度成正比。而 normalize 方法被 addPoly、mulPoly、mulConst 等方法频繁调用,其中每次都涉及对 Mono 的拷贝操作。
此外,原始 toString 方法每次调用都执行 copy 加 normalize,且 normalize 内部排序比较器中又调用 expArg 的 toString,形成递归调用链,在深层嵌套结构中进一步放大了开销。
接下来是修复的方法:函数调用改为 Poly 层面直接代入,将 Function 类的实现从字符串替换方式改为在内部数据结构 Poly 层面直接做变量代入。具体做法为:Function 构造时仅保存实参 Factor 的引用,不做任何计算。在 toPoly 方法被调用时,先将实参转为 Poly,再获取函数体的 Poly 结构,调用新增的 substitute 方法将函数体中所有的 x 替换为实参 Poly。这样完全绕开了字符串的生成、替换和重新解析过程。同时在 FunctionDefiner 中新增 getBodyPoly 方法,将函数体的解析结果缓存为 Poly 对象,避免每次函数调用都重新解析函数定义。由于 Function 的 toPoly 采用懒计算并配合缓存机制,选择式因子在条件判断为 false 时不会调用 true 分支的 toPoly,因此九层嵌套的函数调用根本不会被触发,从根本上避免了不必要的计算。同时消除 Mono 的深拷贝,将 Mono 中对 expArg 的所有深拷贝改为直接引用共享。此修改将 Mono 拷贝的时间复杂度从与嵌套深度成正比降为常数级别。同时将 isLike 方法中 expArg 的比较方式从递归 equals 改为基于缓存字符串的比较,避免深层递归。另外为 Poly 添加 toString 缓存,在 Poly 中新增字符串缓存字段,toString 方法首次调用时计算结果并缓存,后续调用直接返回缓存值。normalize 方法在执行时清除缓存以保证一致性。此修改使得深层嵌套 Poly 的 toString 从每次递归重算变为仅计算一次,后续均为常数时间访问。同理为 isSingleFactor 也添加了缓存。对 addPoly、isZero、negate、mulConst、powPoly 等方法进行优化,去除方法开头不必要的 copy 加 normalize 操作。新增 isZeroFast 方法直接遍历检查系数是否全为零,避免 isZero 中的拷贝开销。mulConst 在系数为一时直接返回自身。Function 的 toPoly 返回缓存对象时不再执行额外拷贝。将 normalize 中排序比较器内对 expArg 调用 toString 的逻辑改为预计算排序键。在排序前遍历所有项,将每个项的 expArg 的缓存字符串提取为排序键数组,排序时直接比较预计算的字符串,避免排序过程中反复触发 toString 的递归计算。最后,在 PolyOutput 的所有递归优化方法中新增深度参数,当递归深度超过阈值时退化为直接调用 toString 输出,防止深层嵌套的 exp 结构在输出优化阶段引发超时。
问题5(互测中发现的bug):
1
f(x)=exp(exp(exp(exp(exp(exp(exp(exp(x))))))))
f(f(f(f(x))))
现象
程序无输出,运行超时。
函数体为八层嵌套的 exp,f(f(f(f(x)))) 即四次函数复合,最终结果应为三十二层嵌套的 exp(exp(exp(...exp(x)...)))。程序应在合理时间内输出该结果。函数调用采用字符串替换导致中间表示膨胀原始 Function 类在构造时立即将实参 Factor 转为 Poly,再调用 toString 将 Poly 转为字符串,然后通过文本替换将函数体中的形参 x 替换为该字符串,最后对替换后的整个字符串重新进行词法分析和语法解析。函数体为八层嵌套 exp,其 toString 输出形如 exp(exp(exp(exp(exp(exp(exp(exp(x))))))))。计算 f(f(x)) 时,需先计算 f(x) 得到八层 exp 的字符串,再将该字符串代入函数体的 x 位置,得到十六层 exp 的字符串,随后对这个更长的字符串重新进行完整的词法分析和语法解析。计算 f(f(f(x))) 时字符串增长到二十四层,f(f(f(f(x)))) 时增长到三十二层。虽然字符串长度本身是线性增长的,但 toString 方法本身是递归实现的,每层 exp 的参数也是一个 Poly,其 toString 需要递归展开所有内层。加之每一层函数调用都要重新执行完整的词法分析和语法解析流程,累积的开销远超线性,导致程序超时。
Mono 对 exp 参数的深拷贝在嵌套结构中代价极高原始 Mono 类在构造函数、copy 方法和 setExpArg 方法中均对 expArg 字段执行深拷贝,即调用 expArg.copy()。Poly 的 copy 方法又会对其包含的每个 Mono 执行 copy,而每个 Mono 的 copy 又会对其 expArg 执行 copy,形成递归深拷贝链。三十二层嵌套的 Poly 结构中,最外层 Mono 的 expArg 是一个 Poly,该 Poly 包含的 Mono 的 expArg 又是一个 Poly,依此类推共三十二层。对最外层执行一次深拷贝需要递归三十二层,复制整棵嵌套树。而 normalize 方法被 addPoly、mulPoly、mulConst 等操作频繁调用,每次 normalize 都会对列表中的每个 Mono 执行 copy,累积起来产生数以万计的深拷贝操作,每次深拷贝又递归三十二层,最终导致超时。toString 无缓存且被排序比较器反复调用原始 Poly 的 toString 方法每次调用时先执行 this.copy().normalize(),生成一份全新的深拷贝并重新规范化,然后递归拼接字符串。normalize 方法内部的排序比较器在比较两个 Mono 时,会调用各自 expArg 的 toString 来确定排列顺序。排序比较器在一次排序中被调用多次,每次调用都触发 expArg 的 toString,而 expArg 的 toString 又要对其内部的 expArg 递归调用 toString,形成深层递归。由于没有任何缓存机制,相同的 toString 结果被反复计算,在三十二层嵌套的结构中造成了极大的冗余开销。
函数调用改为在 Poly 数据结构层面直接代入,将 Function 类的实现从字符串替换方式改为在内部数据结构 Poly 层面直接做变量代入。Function 构造时仅保存实参 Factor 的引用,不执行任何计算。在 toPoly 方法被实际调用时,先将实参转为 Poly,再从 FunctionDefiner 获取函数体的 Poly 结构,调用新增的 substitute 方法将函数体中所有的 x 替换为实参 Poly,返回一个全新的 Poly 作为结果。substitute 方法的逻辑为:遍历函数体 Poly 中的每个 Mono,对于 Mono 中 x 的幂次部分,将 x 替换为实参 Poly 的相应幂次;对于 Mono 中 exp 参数部分,递归调用 substitute 将 exp 参数内部的 x 也替换为实参 Poly。整个过程完全在 Poly 结构上操作,绕开了字符串生成、文本替换和重新解析的全部开销。同时在 FunctionDefiner 中新增 getBodyPoly 方法,将函数体的解析结果缓存为 Poly 对象,函数体只在首次调用时解析一次,后续直接复用缓存。采用这一方案后,f(f(f(f(x)))) 的计算过程为:第一次代入得到八层嵌套的 Poly,第二次代入得到十六层,第三次得到二十四层,第四次得到三十二层。每次代入操作在 Poly 结构上是线性时间的,不涉及任何字符串操作。
将 Mono 构造函数、copy 方法和 setExpArg 方法中对 expArg 的深拷贝改为直接引用赋值。这一修改的安全性前提是 Poly 的所有操作均为函数式风格,即 substitute、normalize、addPoly、mulPoly 等方法都返回新的 Poly 对象,不会修改已有的 Poly 实例。因此多个 Mono 共享同一个 expArg 引用不会引发数据不一致的问题。此修改将 Mono 拷贝操作的时间复杂度从与嵌套深度成正比降为常数级别,从根本上消除了深拷贝导致的性能瓶颈。同时将 isLike 方法中对两个 Mono 的 expArg 的比较方式从递归调用 equals 改为比较各自的缓存字符串表示,避免在深层嵌套结构中触发递归比较。为 Poly 的 toString 添加缓存机制,在 Poly 中新增私有字符串缓存字段。新增 toStringCached 方法,首次调用时计算字符串结果并存入缓存,后续调用直接返回缓存值。normalize 方法在执行时清除缓存,保证规范化操作之后缓存不会返回过期的旧值。toString 方法改为调用 toStringCached。此修改使得三十二层嵌套的 Poly 的字符串表示只需计算一次,后续无论被 isLike 比较还是被排序比较器引用,均为常数时间的缓存访问。同理为 isSingleFactor 判断也添加了缓存。减少 Poly 各方法中不必要的拷贝和规范化对 addPoly 方法,去除方法开头对 this 和参数分别执行 copy 加 normalize 的操作,改为直接将两个 Poly 的 Mono 列表拼接到一起,由最终的 normalize 统一完成合并同类项和排序。对 isZero 方法,新增 isZeroFast 方法直接遍历检查系数是否全为零,避免原来 isZero 中执行 copy 加 normalize 的开销。对 negate 和 mulConst 方法,去除返回结果前不必要的 normalize 调用,因为调用者会在需要时自行 normalize。mulConst 在系数为一时增加快速返回路径,直接返回自身。Function 的 toPoly 方法返回缓存对象时不再额外执行拷贝,FunctionDefiner 的 getBodyPoly 返回时也不再拷贝,因为 substitute 方法不会修改传入的 Poly。
优化 normalize 方法中的排序逻辑,将 normalize 中排序比较器内对 expArg 反复调用 toString 的逻辑改为预计算排序键。在排序前遍历所有待排序的 Mono,将每个 Mono 的 expArg 的缓存字符串提取出来存入一个排序键数组。排序过程中比较器直接比较预先提取的字符串,不再触发任何 toString 的递归计算。拆分 normalize 方法以满足代码风格要求,原始 normalize 方法共八十七行,超出代码风格检查工具要求的单方法六十行上限。将其拆分为多个职责单一的私有方法:mergeMonos 负责遍历并合并同类项,normalizeExpArg 负责规范化单个 exp 参数,tryMergeInto 负责尝试将一项合并到已有列表中,removeZeroMonos 负责清除系数为零的项,sortMonos 负责按规则排序,compareMonoIndices 封装排序比较逻辑。拆分后 normalize 方法本身仅包含七行调用代码。为输出优化模块添加递归深度限制
在 PolyOutput 的所有递归优化方法中新增深度参数,每次递归调用时深度加一。当深度超过设定的上限阈值时,方法直接退化为调用 toString 输出基础格式,不再尝试进一步的输出长度优化。此修改防止三十二层嵌套的 exp 结构在输出优化阶段引发过深的递归导致超时。
4.2 bug 方法与非 bug 方法复杂度对比
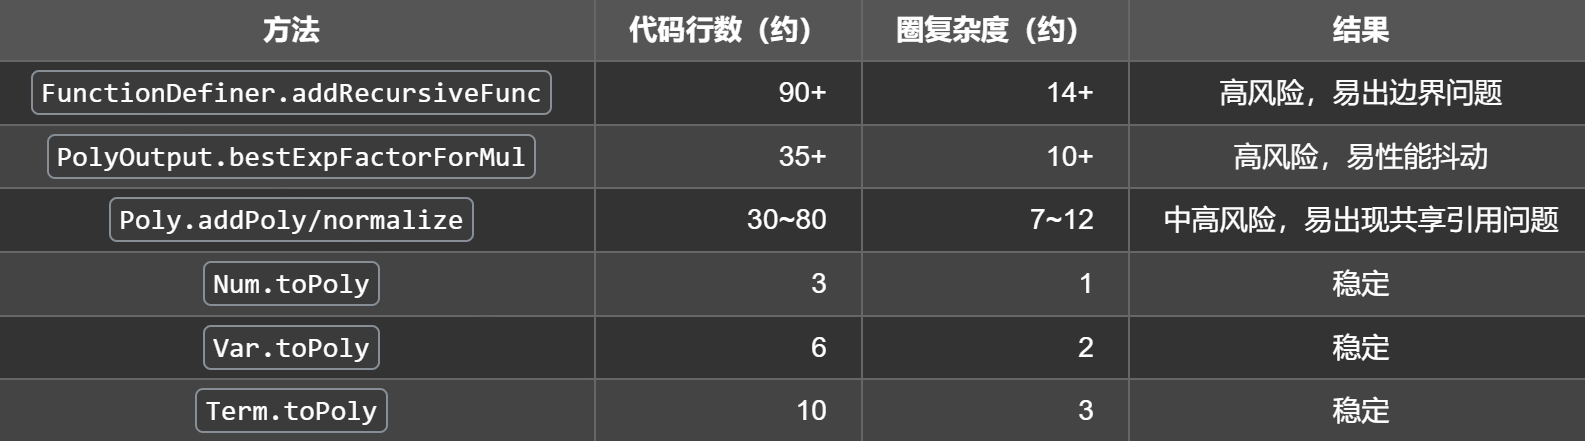
结论很明确:不是哪一层更容易出 bug,而是高分支 + 多职责 + 可变状态的方法更容易出 bug。
降低复杂度的可行方案:
五、发现别人程序 bug 的策略与有效性
我的互测策略不是纯随机,而是语法覆盖 + 结构定向 + 语义等价验证三层组合:
这种策略的有效性在于比纯随机更容易命中真实设计缺陷。
六、优化分析
6.1 已做优化
6.2 优化代码段
1.public Poly powPoly(BigInteger exp) {
if (exp.compareTo(BigInteger.ZERO) == 0) {
return Poly.one();
}
if (exp.compareTo(BigInteger.ONE) == 0) {
return this;
}
int e = exp.intValue();
Poly base = this.normalize();
Poly ans = Poly.one();
while (e > 0) {
if ((e & 1) == 1) {
ans = ans.mulPoly(base);
}
e >>= 1;
if (e > 0) {
base = base.mulPoly(base);
}
}
return ans.normalize();
}
优化前重复乘 e 次,复杂度近似 O(e) 次多项式乘法。优化后,二进制幂,乘法次数降为 O(log e)。对 (exp)^8 这类数据效果明显,HW2/HW3 性能更稳。
2.
private String cachedStr = null;
public String toStringCached() {
if (cachedStr != null) {
return cachedStr;
}
cachedStr = buildString();
return cachedStr;
}
@Override
public String toString() {
return toStringCached();
}
normalize、比较、输出优化会反复调用 toString()。引入缓存后,重复访问从“重复拼接字符串”变为“读取缓存”,显著减少StringBuilder 与对象创建开销。
3.
private boolean normalized = false;
public Poly normalize() {
if (normalized) {
return this;
}
// ... merge/sort/clean
this.normalized = true;
this.cachedString = null;
return this;
}
多处操作会“习惯性 normalize”,容易造成重复归并排序。使用标志位后,已归一化对象直接返回,减少重复计算,在求导、函数调用、输出优化链路中累计收益明显。
4.
private static final Map<String, Poly> POLY_CACHE = new HashMap<>();
@Override
public Poly toPoly() {
if (poly != null) { return poly; }
String actualStr = actual.toPoly().normalize().toString();
String callKey;
if (recursive) {
callKey = "R|" + layer + "|" + actualStr;
Poly cached = POLY_CACHE.get(callKey);
if (cached != null) { this.poly = cached; return poly; }
replaced = FunctionDefiner.callRecursive(layer, actualStr);
} else {
callKey = "N|" + actualStr;
Poly cached = POLY_CACHE.get(callKey);
if (cached != null) { this.poly = cached; return poly; }
replaced = FunctionDefiner.callNormal(actualStr);
}
// parse -> expr -> poly
POLY_CACHE.put(callKey, p);
this.poly = p;
return poly;
}
同一函数实参被多次调用时,避免重复“替换+解析+计算”,互测中高频重复子表达式场景下降耗明显。键值包含“函数类型/层数/实参规范串”,避免误命中。
5.
for (int i = 2; i <= 5; i++) {
String prev1 = recurBodies.get(i - 1);
String prev2 = recurBodies.get(i - 2);
String exp1 = substituteX(prev1, info.arg1);
String exp2 = substituteX(prev2, info.arg2);
String term1 = info.c1.toString() + "*(" + exp1 + ")";
String term2 = (info.c2.signum() >= 0)
? "+" + info.c2.toString() + "*(" + exp2 + ")"
: info.c2.toString() + "*(" + exp2 + ")";
String body = term1 + term2 + info.tail;
body = Preprocessing.process(body);
recurBodies.set(i, body);
}
把递推层展开前置到“读定义阶段”,调用阶段只做一次代换。把运行时重复递归展开成本转移到初始化,提升总体吞吐,对 f{n} 高频调用非常有效。
6.3优化与简洁性、正确性平衡
我的经验是:只要优化触碰共享状态与等价变换搜索,就必须优先保证正确性。对输出优化,不强求绝对最优,保证稳定 + 合法 + 较短更重要。对缓存,必须先设计清晰的对象生命周期与不可变边界,否则速度快了但结果不稳。
七、大模型使用情况
我在第一单元使用大模型主要是辅助而非替代:
体会:优点在于能快速给出思路和 checklist,局限是对题面细节(必要括号、合法输入边界)偶尔会看似合理但不完全正确,必须人工复核。关于房间内谁大量使用 AI 生成代码,我无法在证据不足时做确定判断,因此不作主观指认。
八、心得体会
第一单元最让我受益的不是某个具体算法,而是三个工程习惯:
从作业体验上看,三次迭代压力确实很大,但完成后回看,每次新增需求都在逼着我从写代码走向做设计。
九、未来方向建议
十、选做思考题
10.1 如何检查输入是否符合要求(空格、连续符号等)
我的做法是四步:
这样可同时覆盖词法合法性和语法合法性。
10.2 如何精确计算合法输入 cost
核心是按语法树递归计算:
常数、变量、单目正负、幂、exp、加减乘分别对应题面公式;选择式按题目定义用选择后的分支代价;函数调用先把实参作为表达式因子代入定义体,再计算代入后表达式 cost;递推函数需要保证每层 f {i} 的 cost 都满足阈值。
本质上是把 cost 当作语义属性,和 toPoly 一样自顶向下递归求值。
结语
第一单元三次作业让我真正体会到:面向对象不是类越多越好,而是抽象是否稳定、职责是否清晰、迭代是否可控。
我的代码还存在明显技术债(如 FunctionDefiner 过大、输出优化复杂度高),但总体上已经形成了较稳定的演进路径。后续我会继续朝高内聚、低耦合、可验证、可回归的方向优化自己的工程习惯。

