


309
社区成员
 发帖
 与我相关
 我的任务

 分享
| 方法名 (Method) | 基本复杂度 (ev(G)) | 设计复杂度 (iv(G)) | 圈复杂度 (v(G)) | 代码行数 (LOC) |
|---|---|---|---|---|
| expr.DeriveFactor.DeriveFactor(Expr, int) | 0 | 1 | 1 | 1 |
| expr.DeriveFactor.toPoly() | 3 | 3 | 3 | 3 |
| expr.ExpFactor.ExpFactor(Factor, int) | 0 | 1 | 1 | 1 |
| expr.ExpFactor.toPoly() | 0 | 1 | 1 | 1 |
| expr.Expr.addTerm(Term) | 0 | 1 | 1 | 1 |
| expr.Expr.Expr() | 0 | 1 | 1 | 1 |
| expr.Expr.toPoly() | 1 | 1 | 2 | 2 |
| expr.ExprFactor.ExprFactor(int, Expr) | 0 | 1 | 1 | 1 |
| expr.ExprFactor.toPoly() | 0 | 1 | 1 | 1 |
| expr.Num.Num(BigInteger) | 0 | 1 | 1 | 1 |
| expr.Num.toPoly() | 0 | 1 | 1 | 1 |
| expr.Poly.add(Poly) | 2 | 1 | 3 | 3 |
| expr.Poly.addTerm(TermKey, BigInteger) | 3 | 2 | 2 | 3 |
| expr.Poly.buildExp(Poly) | 34 | 10 | 10 | 20 |
| expr.Poly.buildGcdExp(Poly) | 26 | 9 | 6 | 10 |
| expr.Poly.buildResult(int, int[], String[]) | 3 | 2 | 1 | 2 |
| expr.Poly.deriveX() | 5 | 1 | 4 | 4 |
| expr.Poly.deriveY() | 5 | 1 | 4 | 4 |
| expr.Poly.equals(Object) | 3 | 3 | 2 | 4 |
| expr.Poly.getMap() | 0 | 1 | 1 | 1 |
| expr.Poly.greedyCompress(Poly) | 24 | 3 | 9 | 11 |
| expr.Poly.hashCode() | 0 | 1 | 1 | 1 |
| expr.Poly.mul(Poly) | 3 | 1 | 3 | 3 |
| expr.Poly.Poly() | 0 | 1 | 1 | 1 |
| expr.Poly.pow(int) | 6 | 2 | 5 | 5 |
| expr.Poly.simplify(StringBuilder, TermKey, BigInteger, boolean...) | 18 | 4 | 13 | 15 |
| expr.Poly.statusCompressDP(Poly) | 16 | 4 | 8 | 11 |
| expr.Poly.substitute(Poly) | 3 | 1 | 3 | 3 |
| expr.Poly.toString() | 9 | 7 | 5 | 8 |
| expr.SelectFactor.SelectFactor(...) | 0 | 1 | 1 | 1 |
| expr.SelectFactor.toPoly() | 2 | 2 | 2 | 2 |
| expr.Term.addFactor(Factor) | 0 | 1 | 1 | 1 |
| expr.Term.Term(int) | 0 | 1 | 1 | 1 |
| expr.Term.toPoly() | 3 | 3 | 2 | 3 |
| expr.TermKey.equals(Object) | 4 | 3 | 4 | 6 |
| expr.TermKey.getExpPoly() | 0 | 1 | 1 | 1 |
| expr.TermKey.getXvarExp() | 0 | 1 | 1 | 1 |
| expr.TermKey.getYvarExp() | 0 | 1 | 1 | 1 |
| expr.TermKey.hashCode() | 0 | 1 | 1 | 1 |
| expr.TermKey.mul(TermKey) | 0 | 1 | 1 | 1 |
| expr.TermKey.TermKey(BigInteger, BigInteger, Poly) | 0 | 1 | 1 | 1 |
| expr.Var.toPoly() | 2 | 1 | 1 | 2 |
| expr.Var.Var(BigInteger, String) | 0 | 1 | 1 | 1 |
| FuncFactor.FuncFactor(Expr, String) | 0 | 1 | 1 | 1 |
| FuncFactor.toPoly() | 0 | 1 | 1 | 1 |
| Lexer.getNum() | 8 | 1 | 5 | 6 |
| Lexer.getToken() | 0 | 1 | 1 | 1 |
| Lexer.handleSign() | 6 | 1 | 4 | 6 |
| Lexer.Lexer(String) | 0 | 1 | 1 | 1 |
| Lexer.next() | 15 | 2 | 9 | 13 |
| MainClass.getFuncPolys() | 0 | 1 | 1 | 1 |
| MainClass.handleFunction(String, String, String) | 11 | 6 | 3 | 6 |
| MainClass.main(String[]) | 18 | 4 | 10 | 11 |
| Parser.parseDeriveFactor(int) | 2 | 1 | 3 | 3 |
| Parser.parseExpFactor() | 5 | 1 | 5 | 5 |
| Parser.parseExpr() | 2 | 1 | 3 | 3 |
| Parser.parseExprFactor() | 5 | 2 | 4 | 4 |
| Parser.parseFactor() | 32 | 8 | 18 | 20 |
| Parser.Parser(Lexer) | 0 | 1 | 1 | 1 |
| Parser.parseSelectFactor() | 6 | 1 | 7 | 7 |
| Parser.parseTerm() | 4 | 1 | 4 | 5 |
| 总计 (Total) | 289 | 122 | 196 | 242 |
| 平均值 (Average) | 4.66 | 1.97 | 3.16 | 3.90 |
通过方法级别的复杂度分析,我们可以发现主要的复杂度集中在 Poly 类的 buildExp和simplify 方法中。这两个类的复杂度来源分别是复杂的字符串构建过程以及exp因子判断逻辑。这类复杂度是较难避免的,因为它们涉及到复杂的逻辑判断和字符串操作。除此之外,对于Lexer类中的next方法,其复杂度也较高,因为该方法需要处理多种情况,包括数字、符号、函数等。最应当注意的是MainClass的复杂度,其复杂度来源主要是handleFunction方法,以及递归函数的预求解,出于架构考虑,其实应当抽象出一个类专门处理递归函数。
| 源文件 (Source File) | 总行数 (Total Lines) | 源代码行数 (Source Code Lines) | 源代码占比 (%) | 注释行数 (Comment Lines) | 注释占比 (%) | 空白行数 (Blank Lines) | 空白占比 (%) |
|---|---|---|---|---|---|---|---|
| DeriveFactor.java | 22 | 19 | 86% | 0 | 0% | 3 | 14% |
| ExpFactor.java | 23 | 19 | 83% | 0 | 0% | 4 | 17% |
| Expr.java | 21 | 16 | 76% | 0 | 0% | 5 | 24% |
| ExprFactor.java | 17 | 14 | 82% | 0 | 0% | 3 | 18% |
| Factor.java | 5 | 4 | 80% | 0 | 0% | 1 | 20% |
| FuncFactor.java | 19 | 16 | 84% | 0 | 0% | 3 | 16% |
| Lexer.java | 74 | 66 | 89% | 0 | 0% | 8 | 11% |
| MainClass.java | 98 | 93 | 95% | 0 | 0% | 5 | 5% |
| Num.java | 15 | 11 | 73% | 0 | 0% | 4 | 27% |
| Parser.java | 144 | 133 | 92% | 0 | 0% | 11 | 8% |
| Poly.java | 361 | 337 | 93% | 0 | 0% | 24 | 7% |
| SelectFactor.java | 22 | 19 | 86% | 0 | 0% | 3 | 14% |
| Term.java | 28 | 23 | 82% | 0 | 0% | 5 | 18% |
| TermKey.java | 49 | 39 | 80% | 0 | 0% | 10 | 20% |
| Var.java | 26 | 22 | 85% | 0 | 0% | 4 | 15% |
| 总计 (Total) | 924 | 831 | 90% | 0 | 0% | 93 | 10% |
从代码规模量的度量结果可以看出,我的架构呈现出明显的中心化趋势.Poly和Parser代码规模远超其他类。这说明在迭代中,我为了快速实现功能,将多项式的加减乘、状压 DP、贪心压缩等逻辑全部揉进Poly类,使其出现了上帝类的倾向,内聚度有待提高。应当考虑将优化算法单独抽离为Optimizer类
| 类名 (Class) | 类间耦合度 (CBO) | 继承树深度 (DIT) | 方法缺乏内聚度 (LCOM) | 子类数量 (NOC) | 类的响应数量 (RFC) | 加权方法复杂度 (WMC) |
|---|---|---|---|---|---|---|
| expr.DeriveFactor | 4 | 1 | 1 | 0 | 6 | 4 |
| expr.ExpFactor | 5 | 1 | 1 | 0 | 10 | 2 |
| expr.Expr | 8 | 1 | 1 | 0 | 9 | 4 |
| expr.ExprFactor | 4 | 1 | 1 | 0 | 4 | 2 |
| expr.Factor | 1 | |||||
| expr.Num | 5 | 1 | 1 | 0 | 4 | 2 |
| expr.Poly | 12 | 1 | 1 | 0 | 64 | 98 |
| expr.SelectFactor | 3 | 1 | 1 | 0 | 4 | 3 |
| expr.Term | 5 | 1 | 1 | 0 | 12 | 5 |
| expr.TermKey | 6 | 1 | 1 | 0 | 14 | 9 |
| expr.Var | 4 | 1 | 1 | 0 | 6 | 3 |
| FuncFactor | 5 | 1 | 1 | 0 | 6 | 2 |
| Lexer | 2 | 1 | 1 | 0 | 14 | 23 |
| MainClass | 5 | 1 | 1 | 0 | 26 | 18 |
| Parser | 12 | 1 | 1 | 0 | 25 | 42 |
| 总计 (Total) | 217 | |||||
| 平均值 (Average) | 5.71 | 1.00 | 1.00 | 0.00 | 13.67 | 15.50 |
Poly和Parser的耦合度都达到了全局最高的12,且Poly的类相应数量高达64。这表明在架构演进中,多项式运算引擎和语法解析器承载了过多的外部依赖和调用链路。虽然我的 LCOM 指标保持在极佳的 1,说明类的内部属性维护是高度一致的,但过高的外部耦合提醒我,在后续开发中应当引入类似工厂模式或接口分离,以降低核心类的通讯成本。
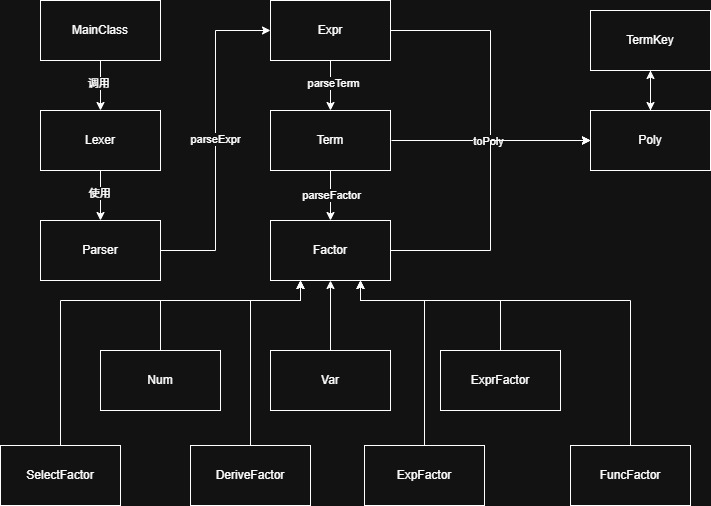
我的架构主要分为三层。左侧是基于Lexer和Parser的解析链路,中间是自顶向下的AST树状结构,并通过在AST的每层节点上都实现toPoly方法以达到从字符串到抽象数据的转换,这样做的好处是,后续的所有计算可以通过poly类内部的计算完成,耦合性较低,架构缺陷是过于依赖Poly类,该类的复杂度较高。TermKey是Poly类中的特征信息,通过该类结合HashMap可以实现O(1)级别的查找操作。
MainClass:主类,实现IO、空白字符替换和递归函数预求值,只完成最基本的操作与替换Lexer:词法分析器,将字符串拆分为一个个Token,并处理连续符号Parser:语法分析器,将Token序列利用递归下降法解析为ASTExpr:表达式,维护所有项,规定所有表达式实现toPoly方法Term:项,维护每一项的符号和因子,实现toPoly方法,之所以将符号全部交给Term,是因为这样做可以只实现add方法,减轻Poly工作量Factor:因子接口,规定所有因子实现toPoly方法Poly:多项式运算引擎,实现多项式的加减乘除、求导、求值等操作TermKey:多项式特征信息,用于在HashMap中查找多项式Num:常数因子。AST 的最底层叶子节点,内部封装一个BigInteger存放精确数值,toPoly时直接返回一个常数多项式。Var:变量因子。记录自变量名称及其指数,在toPoly阶段负责将其转化为底层运算引擎可识别的标准幂函数多项式。ExprFactor:表达式因子。其内部包裹着一个Expr类对象。在toPoly时直接调用Expr的转换方法,解决了任意深度的括号嵌套问题。ExpFactor:指数因子。内部维护底部的表达式或因子,toPoly阶段负责构建带自然底数exp的数学模型,同时也是触发中、小规模数据“贪心与状压DP乘开优化”的入口。DeriveFactor:求导算子因子。保存求导目标变量(如dx,dy)及内部表达式,在AST转换为多项式的阶段,直接调用底层Poly的deriveX()或deriveY(),将求导操作转化为代数运算。FuncFactor:自定义函数调用因子。保存函数标识与实参列表,在解析或转换阶段负责完成实参向形参的映射与代入,配合主类的预处理实现函数的等价替换。SelectFactor:选择式因子。用于处理指导书中规定的条件求值与选择逻辑,通过解析内部的分支条件,在toPoly计算时动态返回正确的代数结果多项式。
在三次作业的迭代过程中,我的架构并没有经历性重构。这极大程度上得益于我在第一次作业就确立的AST解析前端与底层代数引擎完全分离的核心思想。
在第一次作业中,我建立了标准的递归下降解析链路,通过Lexer和Parser将输入转化为由Expr、Term、Factor构成的抽象语法树(AST)。为了彻底剥离解析与计算的耦合,我设计了Poly类和TermKey类作为多项式的唯一代数运算载体,所有语法树节点最终都会通过调用自身的toPoly方法转化为底层数学模型。
第二次作业引入了括号嵌套,在不改变任何原有架构的基础上,仅新增了ExprFactor节点。它在实现Factor接口的同时内部包裹一个Expr对象,调用toPoly时直接透传给内部表达式,用少量代码量实现了括号解析。
第三次作业加入了求导算子和自定义函数。由于底层Poly引擎的代数封装较为合理,应对求导需求时,我只需在Poly内部扩展deriveX与deriveY方法,并在AST层面增加DeriveFactor节点即可,增加变量命则不得不修改Var类,使其维护一个变量名类,并对应修改TermKey。
全新的迭代需求:引入三角函数因子sin(Factor)与cos(Factor),内部允许嵌套任意因子,并要求支持基本的合并与化简。
只需要新建SinFactor与CosFactor两个类并实现Factor接口。在词法分析阶段,让Lexer增加对sin和cos字符串的识别;在语法分析阶段,仅需在Parser的parseFactor方法中增加两个对应分支即可。
至于数学引擎的数据结构扩充,目前的TermKey类负责维护项的特征(如维护了x和y的指数)。为了支持三角函数嵌套,需在TermKey内部新增两个容器,例如HashMap<Poly, BigInteger> sinMap和HashMap<Poly, BigInteger> cosMap。这里的键设为Poly正好完美契合了三角函数内部可能嵌套任意复杂多项式表达式的需求,而值则代表该三角函数整体的指数。
在扩充了TermKey的数据结构后,需要重写TermKey的equals、hashCode以及mul方法,使其在合并同类项和相乘时,额外比对并合并sinMap和cosMap中的内容即可。最外层的Poly类不需要大幅度改动。
在本次作业中,程序的架构设计、性能优化与Bug的产生有紧密的联系。以下结合未通过的公测用例与互测情况,将程序的缺陷、优化过程及测试策略进行综合分析。
在第二次作业迭代中,为了加快开发进度,我起初并未将自定义函数抽象为独立的因子类,而是直接在 MainClass 中利用正则表达式进行全局的字符串预替换。这一设计在遇到 SelectFactor(选择式因子)时TLE了。选择式逻辑本应具备短路求值的特性,但全局字符串预替换强制展开了所有可能的分支,导致在多层嵌套和复杂条件判断下,计算量呈指数级爆炸。为解决此问题,我重构并抽象出了 FuncFactor 节点,将其推迟到 AST 转换为多项式时再按需进行实参代入,恢复了短路特性。
此外,在处理深层嵌套表达式时,我还遇到了两处因缺失记忆化(缓存)导致的 TLE:
toString 缓存缺失:在多层嵌套的 AST 结构中,外层节点的 toString 频繁依赖内层节点的反复转化,产生大量冗余开销。后续我在各节点类中增加缓存字段,使重复转化降为 O(1) 复杂度。为了将底层 DP 的拆分结果向上层组合,同时避免重新生成 AST 带来的代码臃肿,我尝试直接截获底层返回的字符串进行判断。初版实现中,我未加入 !ans.contains("*e") 等判定条件,导致在触发乘开优化后,外层少加了必要的包裹括号,直接破坏了表达式的等价性。
修复该问题时,我采用了 !ans.contains("*e") 进行特征嗅探。但在互测中被发现,当测试数据合法包含乘法与自然底数时(例如 exp((exp((2*exp(x)+3))))),内层的 2*exp(x) 会导致嗅探器发生误判,错误地处理了外层括号。
对比分析代码复杂度,未出现 Bug 的基础方法(如 expr.Term.toPoly)圈复杂度仅为 2-3,而承载优化逻辑的 Poly.greedyCompress 与 Poly.buildExp 最大圈复杂度(OCmax)分别达到 11 和 14。单纯的字符串包含匹配将树状层级关系压缩为了线性匹配,丢失了AST的深度信息,导致方法在遇到exp嵌套可乘开exp单因子的时候括号层数变多,性能下降。
为降低复杂度并彻底解决问题,我引入了带有深度的单向扫描策略:
int index = 0;
for (int i = 0; i < ans.length() - 1; i++) {
    char c = ans.charAt(i);
    if (c == '(') { index++; }
    if (c == ')') { index--; }
    if (index == 0 && c == '*' && ans.charAt(i + 1) == 'e') {
        isFactor = false;
        break;
    }
}
在互测阶段,我主要通过自身的bug来构造测试用例:针对架构缺陷的定向测试:阅读他人代码时,重点关注其函数的解析方式与缓存机制,若发现对方采用全局字符串替换处理函数,便构造包含大量冗余分支的选择因子嵌套数据,测试其短路特性以诱发 TLE;若发现未见明显缓存,便构造深层级的exp(exp(...))嵌套数据测试其时间复杂度。
在三次迭代中,我会将自己的架构抛给AI,并询问其改进意见,比如第一次作业中,多项式因子类是应该单独抽象出一个类还是复用expr等。另外,针对一些特定的优化算法,我如果不会实现,也不会照搬AI源码,而是学习构建思路以后自己重新复现一遍,因此并非出现直接使用AI源码的情况。
除作业本身,在第一次和第二次作业的互测环节我均使用AI搭建了评测机,但是AI的数据构建效果并不好,不能有效地构造出bug。
经过本单元的学习,我深切体会到了递归方法的巧妙性和危险性,以后涉及递归使用的方法,我会注意其边界条件,并在必要时添加缓存以减少不必要的时间开销。另外,我意识到优化可能伴随一定的风险,每一步优化都要全面考虑其与本身架构的适配性。
希望辅导书能多给出一些架构提示和算法提示,鼓励同学进行合理的优化,并提醒同学一定要注意复杂度

