


309
社区成员
 发帖
 与我相关
 我的任务

 分享
完成第三次作业迭代后,我的程序总共有13个类、1个接口。其中,大部分类只有1~3个属性,而核心类Poly拥有6个属性。同时,大部分类的方法数量较少,只有2~8个方法,而Poly类有20个方法。这也使得Poly类在其他类只有几十行代码的情况下,拥有了200多行代码,显得较为臃肿。
| 类名 (Class) | 属性个数 | 方法个数 | 类总代码规模 |
|---|---|---|---|
| Factor (接口) | 0 | 2 | 5 |
| NumFactor | 1 | 2 | 19 |
| VarFactor | 1 | 2 | 28 |
| ExprFactor | 1 | 2 | 21 |
| ExpFactor | 1 | 2 | 25 |
| DerivFactor | 1 | 2 | 23 |
| FuncFactor | 1 | 4 | 47 |
| SelFactor | 1 | 3 | 55 |
| Preprocess | 1 | 4 | 34 |
| Lexer | 3 | 4 | 45 |
| MainClass | 0 | 2 | 47 |
| MonoKey | 3 | 8 | 51 |
| Parser | 4 | 4 | 78 |
| Poly (核心类) | 6 | 20 | 285 |
对于方法规模而言,最大的方法是Parser类中的parseFactor方法,拥有42行代码;而控制分支最多的是Poly类中的appendTerm方法,控制分支数为14。从这些数据来看,整体的方法规模控制较好,但有部分方法分支较多,同时Poly类的复杂度较高且过于庞大,需要进行职责分离。 通过IDEA自带的MetricsReloaded插件,我分析了程序的Complexity metrics。
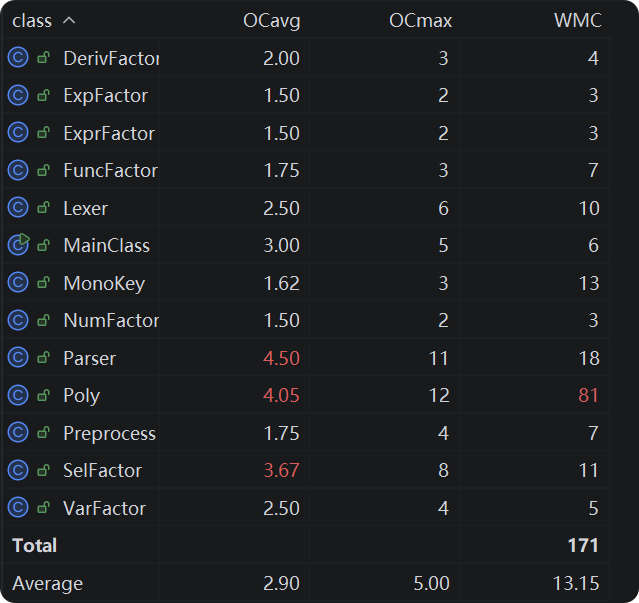
分析结果显示,程序的平均圈复杂度为3.39,圈复杂度最高和次高的方法均在Poly类中,分别是appendTerm方法(圈复杂度18)和needsParenForExp方法(圈复杂度16)。此外,从图中可以看出,Poly类的类权重方法总和(WMC)为81,远高于其他类的WMC,说明Poly类承担了太多的职责,是一个典型的大型类。这进一步说明了我的Poly类设计的不够合理,需要改进才能便于维护和扩展。 同时,根据分析数据,我的程序的数据内聚性较好,MonoKey(单项式的变量部分)和Poly(多项式对象)的数据结构设计较为合理,Poly内部使用HashMap<MonoKey, BigInteger>来存储多项式的项,能够高效地进行项的操作。但是部分类存在比较严重的循环依赖问题,例如Poly类依赖于MonoKey类,而MonoKey类又依赖于Poly类,这种循环依赖会增加代码的耦合度,降低代码的可维护性和可扩展性。下面是我的作业类图:
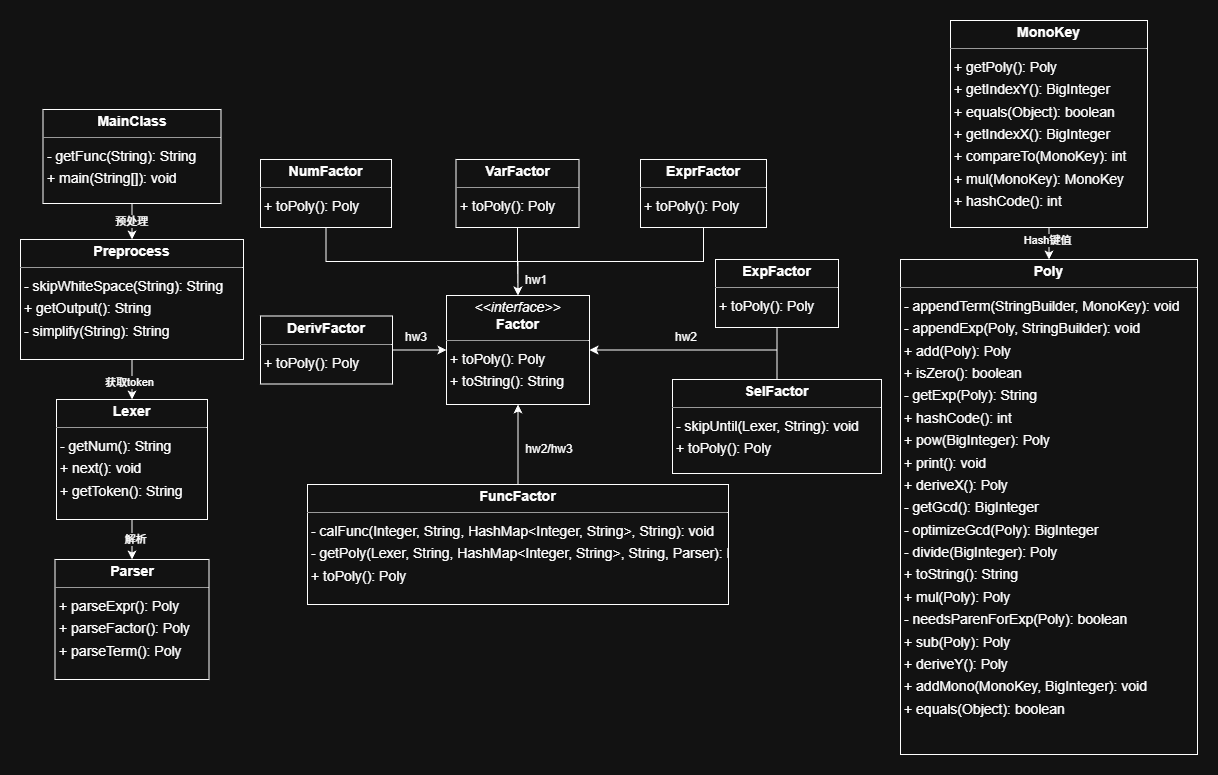
根据这张图,可以看出整体上,本程序先是由MainClass类进行启动和输入,对于输入的字符串,先经过Preprocess进行预处理,去掉空白符并简化部分符号,然后再交给Lexer类进行词法分析获取token,接着再将解析的token依次传给Parser类进行语法分析,利用递归下降的思维,按照Expr->Term->Factor的顺序依次下降,解析的得到的表达式使用Poly类进行存储和计算。在Poly类中,使用HashMap<MonoKey, BigInteger> monos进行存储,其中MonoKey用于存储x、y的指数和exp的内部因子,并作为键值来区分不同的单项式。不同的因子NumFactor、VarFactor、ExprFactor、ExpFactor、DerivFactor、FuncFactor、SelFactor等都实现了Factor接口,并各自实现解析对应因子的功能。 总的来说,所有的Factor接口的实现类都直接实现了Factor接口,系统采用了扁平的接口设计,没有滥用继承。并且各类的职责较为清晰,各自负责相关的功能,例如Lexer类负责词法分析,Parser类负责语法分析,Poly类负责多项式的表示和操作等。但是Poly类的职责过于庞大,包含了多项式的表示、计算、化简等多个方面的功能,导致了类的复杂度较高,难以维护和扩展。并且各种Factor的实现类虽然职责较为单一,但在某些情况下也存在一定的重复代码,且存在职责错位的问题,应考虑分离出解析的功能。
在第一次作业中,我的设计比较简单,主要是为了实现功能而设计的。因此,对于接口Factor我只实现了NumFactor、VarFactor、ExprFactor这三个类来分别表示数字、变量和表达式三种因子。并且在这次开发中,我便想到以Poly类为核心来表示所有的因子、项以及表达式,这是因为我认为无论是单项式还是多项式,最终都可以抽象为一个Poly对象来进行存储和计算,这样可以统一处理各种表达式的计算和化简等操作。所以我将存储、计算和化简等功能都放在了Poly类中来实现,使用HashMap<Integer, BigInteger> monos来存储单项式的变量部分(即x的指数)和系数,并且在Poly类中实现了各种操作多项式的方法,例如加法、乘法。但也是由于Poly类承担了过多的职责,导致了类的复杂度较高,在本次作业中埋下了隐患。这种以Poly类为核心的设计我也继续沿用到了后面的作业中。
在第二次作业中,我在第一次作业的基础上增加了对指数函数因子、选择式因子、自定义函数的支持,因此我增加了ExpFactor、SelFactor、FuncFactor三个类来分别表示这三种新的因子。同时,由于指数函数因子的导入,导致原来的多项式的单项的变量部分不再局限于x的指数,因此我设计了一个新的类MonoKey来专门表示单项式的变量部分,包含了x的指数以及exp的内部因子等信息,并且在Poly类中使用HashMap<MonoKey, BigInteger> monos来存储单项式的变量部分和系数。这次迭代我也在预处理阶段增加了将exp替换为E的功能,以便于后续的解析和计算,方便代入函数表达式时直接进行字符串替换然后解析。对于自定义函数的实现,我在输入阶段便提前处理并解析了自定义函数的定义,然后将其变成字符串存储在funcDef中,便于后续替换解析。而其他两种新增因子则与之前的因子的解析类似,并未调整太多。总的来说,第二次作业依旧时依赖第一次作业的主框架来迭代的,并未进行重构,依然以Poly类为核心来实现各种功能,导致了Poly类的复杂度进一步增加,且在某些情况下出现了职责错位的问题,例如FuncFactor类中既包含了自定义函数的解析功能,也包含了自定义函数的计算功能,这些功能虽然相关但也可以考虑分离出来以降低类的复杂度。
第三次作业在第二次作业的基础上增加了对导数因子的支持,并在自定义函数方面新增了递推函数的支持,在全局上,第三次作业还新增了第二个变量y。基于这些要求,我的迭代依然是保留了之前的代码和框架,在MonoKey类中增加了y的指数来支持第二个变量,并且增加了DerivFactor类来支持导数因子,同时在FuncFactor类中增加了对递推函数的支持。虽然这些功能的实现并不复杂,但由于依然沿用了之前以Poly类为核心的设计,导致了Poly类继续膨胀。
如果还有后续迭代,比如新增三角函数因子,我计划继续沿用之前的设计框架,在MonoKey类中增加三角函数的相关信息来支持三角函数的单项式表示,并且增加一个新的类TrigFactor来支持三角函数因子的解析和计算功能。同时,我也计划对Poly类进行重构,尝试将多项式的表示和计算等功能分离出来,降低Poly类的复杂度,提高代码的可维护性和可扩展性。
在第一次作业中,由于Poly类的复杂度较高,导致我在实现相关存储时没有做到统一性,存在部分情况下哈希表中存在全零的键值对而没有被删去,加之在toString方法中未考虑这种情况,导致输出为空字符串而不是0,这是一个比较严重的bug,导致了部分测试用例的失败,比如单独输入一个0时,输出却是空字符串。出现这种bug的根本原因是在设计时没有考虑到Poly类的复杂度过高,导致了代码的混乱和不够严谨,未能统一处理多项式的存储,并且没有充分考虑到各种边界情况的处理。与其他方法相比,出现bug的toString方法的复杂度较高,圈复杂度为16,是所有方法中最高的,其他复杂度也均为最高的,且代码有59行,远高于其他方法的代码行数,这也说明了toString方法设计的不够合理,过于复杂,未能很好地处理各种情况,导致了bug的出现。对于修复这个bug,我并未进行重构,而是为toString方法增加了一个判断,如果处理完得到的StringBuilder对象的长度为0,则直接返回字符串0,以此来修复这个bug。在后续的迭代中,我又加入了isZero方法来判断一个多项式是否为零,进一步增强了代码的健壮性,并将toString方法的各部分逻辑进行了调整,拆分成了多个小方法来处理不同的情况,降低了toString方法的复杂度,减少了代码行数,提高了代码的可读性和可维护性。 在第二次和第三次的作业中,我的程序均未在强测和互测中暴露出新的bug,这说明在第一次作业中暴露的bug已经得到了有效的修复,并且在后续的迭代中,我也对代码进行了相应的调整和优化,增强了代码的健壮性和可维护性。但是在第二次互测结束后,通过同学的测试用例,我发现了一个新的bug,当输入嵌套层数过多的exp时,程序会运行超时,出发TLE,这是由于在输出解析好的表达式时,toString方法会被多次调用,反复解析已经处理的表达式,导致了指数级的时间复杂度,最终在嵌套层数过多时触发了TLE。这个bug的根本原因是由于在设计时没有考虑到toString方法可能会被多次调用,且每次调用的复杂度较高,导致了性能问题的出现。对于修复这个bug,我在toString方法中增加了一个缓存机制,当一个多项式对象被解析成字符串后,将其结果缓存起来,如果下次再调用toString方法时,直接返回缓存的结果,而不需要再次进行解析,这样就大大降低了toString方法的时间复杂度,提高了程序的性能,成功修复了这个bug。
在寻找bug的过程中,我主要采用了以下几种策略:
代码审查:通过仔细阅读和检查源代码,尤其是复杂的方法和逻辑,来寻找可能存在的错误和不合理的设计。这种方法可以帮助我发现一些明显的错误,如在第二次作业中有同学使用Integer来存储指数,这存在潜在的溢出风险,利用合适的数据我成功hack了这个bug。
测试新增功能:在每次迭代中,我都会针对新增的功能进行测试,大部分同学的bug往往是在引入新功能时出现的,因此我会重点关注这些新增功能的实现和测试,在第二次作业中通过构造表达式因子相关的数据,我成功hack了一个关于表达式因子后的内容无法解析的bug。
边界测试:我会针对一些边界情况进行测试,例如输入为零、输入为负数、输入为大数等情况,同时还会构造嵌套层数较多的表达式来测试程序的性能和稳定性,在第二次作业中通过构造选择式因子相关的数据,我成功hack了一个关于选择式因子解析超时的bug。
输出格式测试:大部分同学将输出性能的优化放在了输出部分,但有时会由于部分优化而导致输出格式不正确,因此我会针对输出的格式进行测试,确保输出符合要求。在第三次作业中通过exp相关的数据,由于部分同学的优化策略的问题,导致其在输出时少了一层括号,最终导致输出格式不正确,我成功hack了这个bug。
在第一次作业中,在实现基本功能的基础上,想要让输出最短,实现性能的优化,便是合并所有的同类项,并且在输出时进行一些优化,例如当系数为1或-1时省略系数,当指数为0时省略变量部分等,同时通过排序优先将系数为正数的项放在前面,这样可以减少输出第一个负号。前半部分的优化在计算过程中使用HashMap来存储单项式的变量部分和系数,这样在进行加法、乘法等操作时,可以快速地合并同类项;而后半部分的优化则是在toString方法中进行的,通过一些条件判断来决定是否输出系数、变量部分以及符号等,并设计了一个排序规则来给哈希表的Value进行排序,让正系数的项优先输出。
在第二次作业中,在第一次作业的基础上增加了指数函数因子,而对于指数函数因子部分,便有很大的优化空间。出于稳健性的考虑,我只进行了提最大公因数这一个优化,通过比较提取前后多项式的输出长短来判断是否提取最大公因数,这样可以在某些情况下大幅度减少输出的长度,提高输出的性能。
在第三次作业中,受室友启发,我在第二次作业的基础上增加了一个新的优化策略,即对于一个多项式的最大公因数,我选择其因数中能够使得输出长度最短的那个来进行提取,这样可以在更多的情况下减少输出的长度,提高输出的性能。同时,鉴于第二次作业多名同学被TLE问题hack,我在代码中添加了一些缓存机制来优化时间性能,例如在toString方法中增加了一个缓存,当一个多项式对象被解析成字符串后,将其结果缓存起来,如果下次再调用toString方法时,直接返回缓存的结果,而不需要再次进行解析,这样就大大降低了toString方法的时间复杂度,能够有效规避许多TLE问题。
在第一次作业中,我的AI使用率较低,主要是由于第一次作业的功能较为简单,基础功能实现基本不需要AI来辅助,但在性能优化方面,我构想出了讲正项提前的策略,但对于相关的排序规则的设计和实现,我还是借助了AI来辅助完成的,让AI根据我的自然语言描述生成了相关的代码来实现这个功能。 在第二次作业中,我的AI使用率有所提升,大概有15%,主要是由于exp因子的引入,导致了相关的功能实现较为复杂,由于我将HashMap<Integer, BigInteger>改为了HashMap<MonoKey, BigInteger>,相关的方法如equals、hashCode等都需要进行相应的调整,这些调整都是我在完成所有框架后让AI检查代码时,AI提出的需要重写的地方;同时在性能优化方面,我也让AI帮我实现了一个功能,即提取最大公因数来优化输出性能,但主要是询问AI相关的实现细节。 在第三次作业中,我的AI使用率有所下降。因为第三次迭代所加的内容不多且相对简单,主要是增加了导数因子和递推函数的支持。 在代码生成之外,我有使用过大模型来找bug,在第二次作业中,大模型直接指出了我在处理选择式因子的时候出现的重大逻辑问题并帮我纠正了这个问题。 在三次作业中,我的互测房间均有疑似大量使用AI生成代码的同学,如第一次的某位同学仅使用一个Main类就实现了所有功能,非常不符合学生的编程习惯,在第二三次中,有部分同学的代码中保留了大量的注释和提示信息,且代码风格非常不统一,这些都可能是使用AI生成代码的迹象。
这一单元的学习主要以梯度下降为主题,通过这些作业的迭代,一方面我更加熟悉了Java的面向对象编程,另一方面我也体会到梯度下降这种解析方式的强大和灵活性,将一个复杂的表达式依次下降解析,最终得到相关的结果。 同时,我也体会到架构设计的重要性,由于我设计的不合理,我的代码最终产生了一个“上帝类”,即Poly类,导致了代码的复杂度较高,难以维护和扩展。这也让我思考在写代码之前,应该先进行合理的架构设计,明确各个类的职责,避免出现过于庞大的类。 这次的开发也更让我感觉到大模型的强大,它不仅能够帮助我实现一些复杂的功能,还能够帮我找出代码中的bug。除此之外,通过周围的其他同学的反馈,我感觉vibe coding已经能够很好的实现作业要求的功能,这让我有了一种危机感。
我认为第一单元的设计还是非常合理,貌似相较于往年,删去了三角函数因子这个令人一眼就头疼的元素,整体上功能的设计和迭代的节奏都非常好,无论是对有过先导课基础的同学还是没有过先导课基础的同学都非常友好。未来可能可以修改的地方就是规范对大模型的使用吧。

