


309
社区成员
 发帖
 与我相关
 我的任务

 分享
| 类名 | 属性名称(个数) | 方法个数 | 方法名称列表 | 大约的代码规模(行) |
|---|---|---|---|---|
| Lexer | input, pos, curToken (3) | 5 | Lexer, simplify, getNumber, next, peek | 80 |
| Parser | lexer (1) | 7 | Parser, parseExpr, parseTerm, parseFactor, parseFactor2, parseExpo, parseFn | 110 |
| Calculation | function, zero, one, num1, num2, argument1, argument2, expr (9) | 20 | change方法,get方法,add, multiply, multiplyOne, reverse, addOne, dx, dy, toString | 125 |
| Poly | ei, xi, yi, coe (4) | 14 | Poly, get方法, change方法, copy, dx, dy, eiEqual, needBra, toString | 115 |
| Factor | (0) | 1 | 以下皆为Factor的实现类,均包含重写的toString和returnPolys方法 | 3 |
| Expr | terms (1) | 4 | Expr, addTerm | 27 |
| Term | expos (1) | 4 | Term, addExpo | 23 |
| Exponential | coe, factor, index (3) | 3 | Exponential | 38 |
| Choice | one, two, three, four (4) | 3 | Choice | 20 |
| Exp | factor (1) | 3 | Exp | 13 |
| DVary | vary, argument (2) | 3 | DVary | 18 |
| F | argument (1) | 3 | F | 12 |
| Fn | num, argument (2) | 4 | Fn, returnFn | 28 |
| Number | num (1) | 3 | Number | 12 |
| Vary | vary (1) | 3 | Vary | 20 |
由于古法绘图实在是太麻烦了,又没找到合适的生成软件,所以此处采用文字解释。
Lexer(词法分析器)用于标准化表达式和解析完整的词。+计算,将-处理为某个因子的负号,例如x-+exp(x)->x+-exp(x)、(+1-2)^2->(1+-2)^2。此外,我新增了处理模式(mode)管理,如果mode==0,则处理自定义函数表达式,否则处理运算表达式。这样很大程度上重复利用了Lexer。exp(、[(、f{等,这样有助于我识别模式。Parser(语法分析器)用于构建语法树,我的识别逻辑是parseExpr->parseTerm->parseExpo->parseFactor,返回逻辑是Expr<-Term<-Exponential<-Choice/Exp/DVary/F/Fn/Number/Vary,这可能和指导书的解析逻辑不同,特别是必须经过parseExpo,但是基于我对负号的特殊识别,这样做是比较有效的。Calculation(计算类)用于存储静态变量及对HashMap<Poly> polys的运算,例如多项式的求导,多项式与多项式之间的加减乘等。静态变量用于存储自定义函数定义解析出来的Function。而其他方法都是对polys的处理,毕竟我不想再造一个类用于表示HashMap<Poly> polys。Poly(多项式的一项)其中包含系数coe、x的指数、y的指数、e的指数。我写的copy方法用于深拷贝,dx,dy用于对单项求导,eiEqual用于在不改变两个ei的情况下判断是否相等,needBra和toString共同决定了单项的字符串表示方式,needBra用于判断exp()里面是否需要括号。Factor的实现类,用于构建语法树,除了自己的独特的属性以外,均包括HashSet<Poly> returnPolys(HashSet<Poly> arguments)方法,其中arguments表示的是实参是什么,如果是null则认为就是x,否则把x替换成arguments。还包含toString方法,这个方法没有实际用处,只是方便我调试所做的,因为可以直接显示出这个类的所有属性和关系,方便观察。public HashSet<Poly> returnPolys(HashSet<Poly> arguments) { //vary的returnPolys
HashSet<Poly> polys = new HashSet<>();
if (vary.equals("y")) {
polys.add(new Poly(BigInteger.ONE, BigInteger.ZERO, BigInteger.ONE, new HashSet<>()));
return polys;
}
if (arguments == null) {
polys.add(new Poly(BigInteger.ONE, BigInteger.ONE, BigInteger.ZERO, new HashSet<>()));
return polys;
}
for (Poly p : arguments) {
polys.add(p.copy());
}
return polys;
}
我认为自己的代码内聚和相互间的耦合程度比较高,Factor实现类设计高内聚,实现类互不干扰。Poly处理poly相关操作,Calculation处理polys相关操作,统一用returnPolys返回结果。
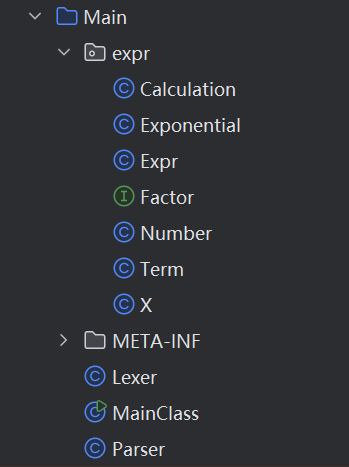
这是我第一次作业的架构,参考了训练栏目,使用了Lexer和Parser类解析表达式;但是使用TreeMap<BigInteger, BigInteger>来表示多项式,key为x的指数,value为系数。
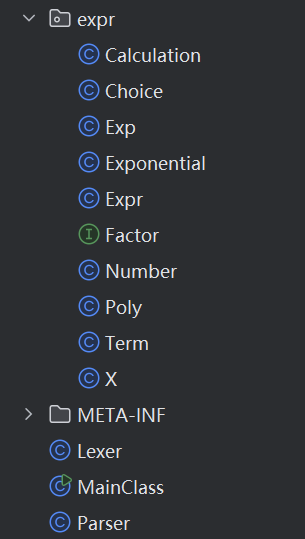
这次因为新增了exp,不仅增加了数据多样性,还有递归结构,所以新增了Poly类;为了解析选择式因子新增了选择式因子类;为了解析f(x)在Lexer中用字符串替换把f(x)换成表达式了。
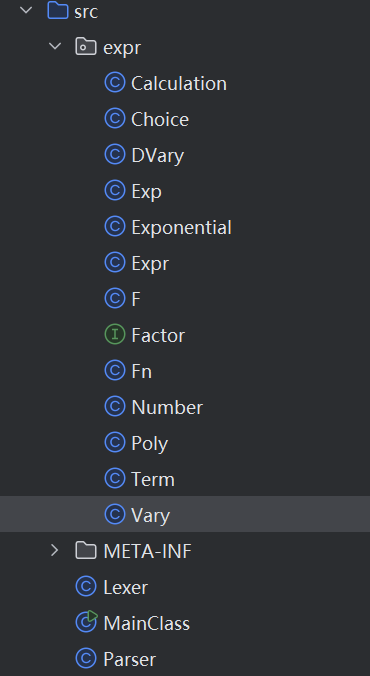
由于意识到选择式因子的cost陷阱,将f(x)改为用类解析,不提前替换;新增了求导和递推函数类;新增了y变量,改了Poly的属性个数,还把X类改成了Vary(自变量)类。
本次作业出现了两次bug,都是因为Exponential 中的运算造成的TLE,第一次是因为Exponential运算使用的是循环乘法,但是当指数函数的括号内的多项式只有一项时,仍然进行循环乘法所以超时了,改进方法为,当只有一项的时候,直接进行指数运算。第二次是因为Exponential中的运算从0开始循环乘法,所以即使指数为1,也会进行一次乘法,所以多个一次方叠加导致cost极低但是会TLE。
我的反思是,当明显有更低的时间复杂度的时候应该采取对应措施,我原本的写法过于追求规范化或者说图省事、代码量小,导致了时间上的代价。
我的bug不是因为逻辑问题,而是时间问题,我的个人体会是,如果想要减少逻辑bug,应该更加优美、标准的书写代码,而不是凌乱的条件判断;但是如果想要优化性能,难免要到处打补丁。
我所用的方法主要是,自己搭建评测机,直接测试别人的代码输出;留意自己写代码时出现的bug,再将其样例hack别人;学习别人hack自己的样例在下一次作业使用。我有结合被测程序的代码设计结构来设计测试用例但是不多,因为同房间七个人实在是太多了,根本做不到一个个自己看代码,丢给ai看都嫌多。
我只进行了正项提前优化,其他的并未进行,因为我觉得优化很有TLE或者出BUG的风险,不如专注改善架构。
我在正确性,性能优化上几乎不使用AI,我只会询问AI关于java的某个类有什么方法,该方法语法是什么之类的。
我搭建评测机使用的是gemini Pro,第一二次作业的评测机效果都不错,但是第三次的效果并不好。而且评测机只能找到正确性bug,不能设计出让其TLE的数据。
捡起了上学期的java知识,还在重构中体会到了优秀架构的魅力。
我希望改变研讨课的方式,这样的交流有些没有效率,并且交流范围很小。我更希望老师设置问题之后,让同学们在线回答分享自己最有感悟的地方或者觉得自己最有亮点的设计,大家都可以在全班范围内查看并且留言,而不是尴尬地坐成一长条,听不见别人说话,别人也不想说话。

